Share
Embed
Transcript
25 slides
-
・2014 Graduate@Keio Univ. ・2014-2021 Toshiba Research ・2017-2018 Stanford Visiting Scholar
@Mark Horwitz Group ・Keio Univ. Associate Professor Keio CSG PI https://sites.google.com/keio.jp/keio-csg/ 自己紹介 -
自己紹介 [ISSCC’24] (回路トップ学会) [ASP-DAC’24] ダイ写真(Single array) I/O Register CIM SAR
ADC [SSDM’24] [WIP:DAC’24] [ICCAD’24] [To appear?] DNNプロセッサ研究 ・CNN→LLM メモリ内演算技術の研究(Compute-in-Memory) ・世界初のCNN/Transformer動作 New-gen LiDAR Spoofing, [Sato, NDSS’24] 走行車両へのLiDARセンサ攻撃, [Sato, NDSS’25] -
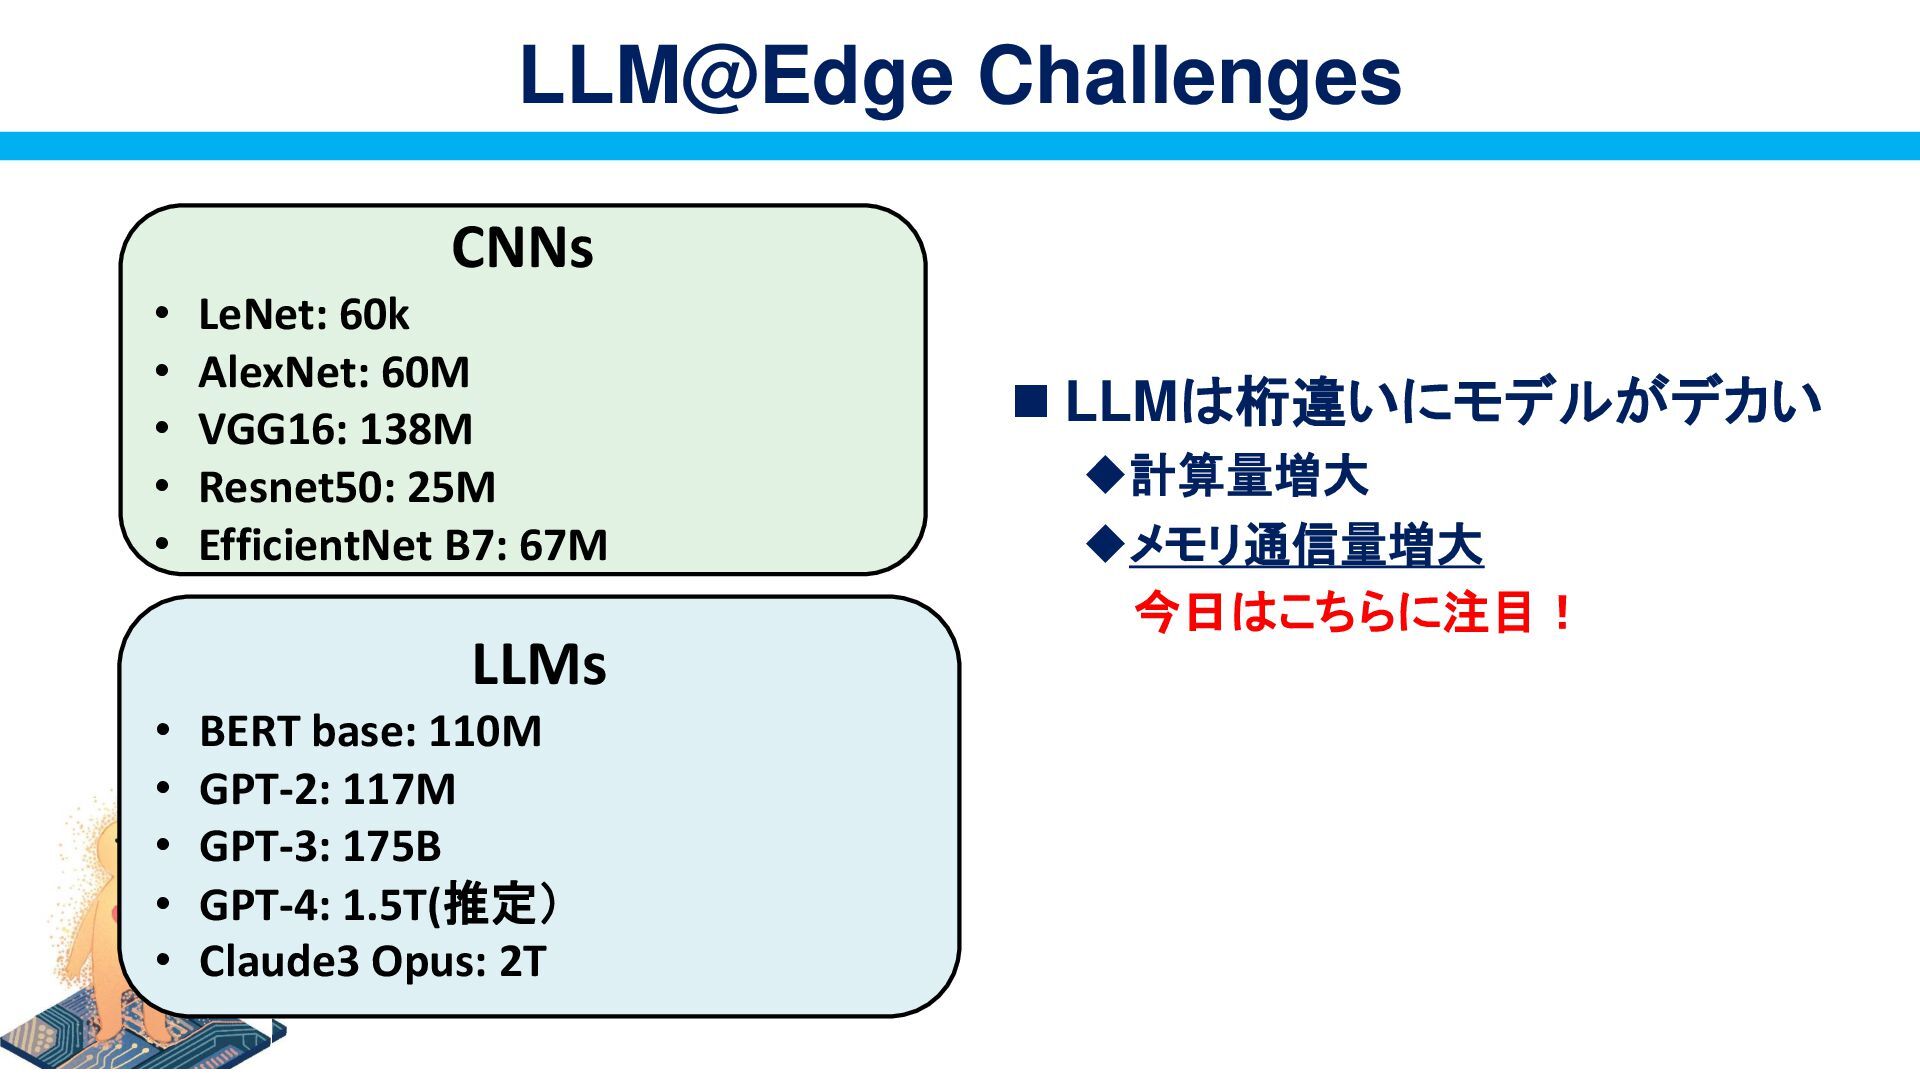
◼ LLMは桁違いにモデルがデカい ◆計算量増大 ◆メモリ通信量増大 LLM@Edge Challenges 今日はこちらに注目! CNNs • LeNet:
60k • AlexNet: 60M • VGG16: 138M • Resnet50: 25M • EfficientNet B7: 67M LLMs • BERT base: 110M • GPT-2: 117M • GPT-3: 175B • GPT-4: 1.5T(推定) • Claude3 Opus: 2T -
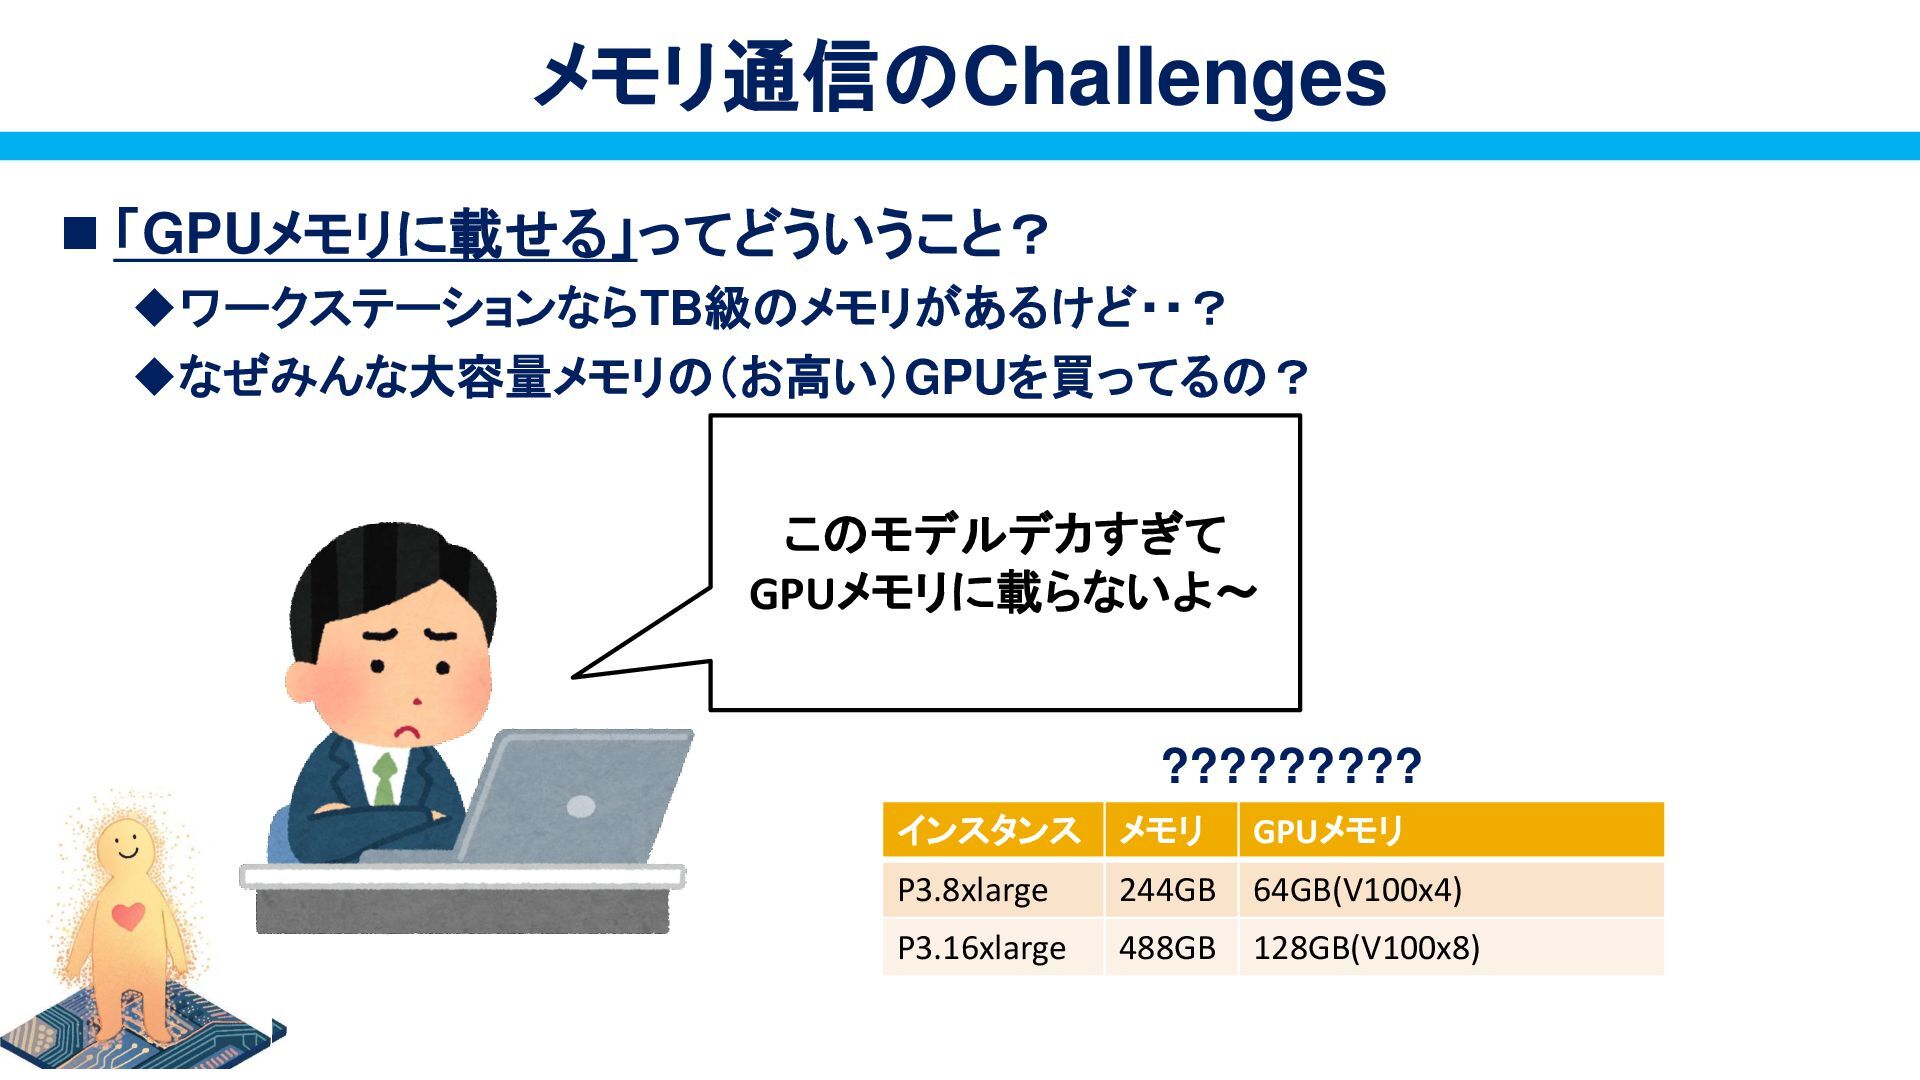
メモリ通信のChallenges ◼ 「GPUメモリに載せる」ってどういうこと? ◆ワークステーションならTB級のメモリがあるけど・・? ◆なぜみんな大容量メモリの(お高い)GPUを買ってるの? このモデルデカすぎて GPUメモリに載らないよ~ インスタンス メモリ GPUメモリ
P3.8xlarge 244GB 64GB(V100x4) P3.16xlarge 488GB 128GB(V100x8) ????????? -
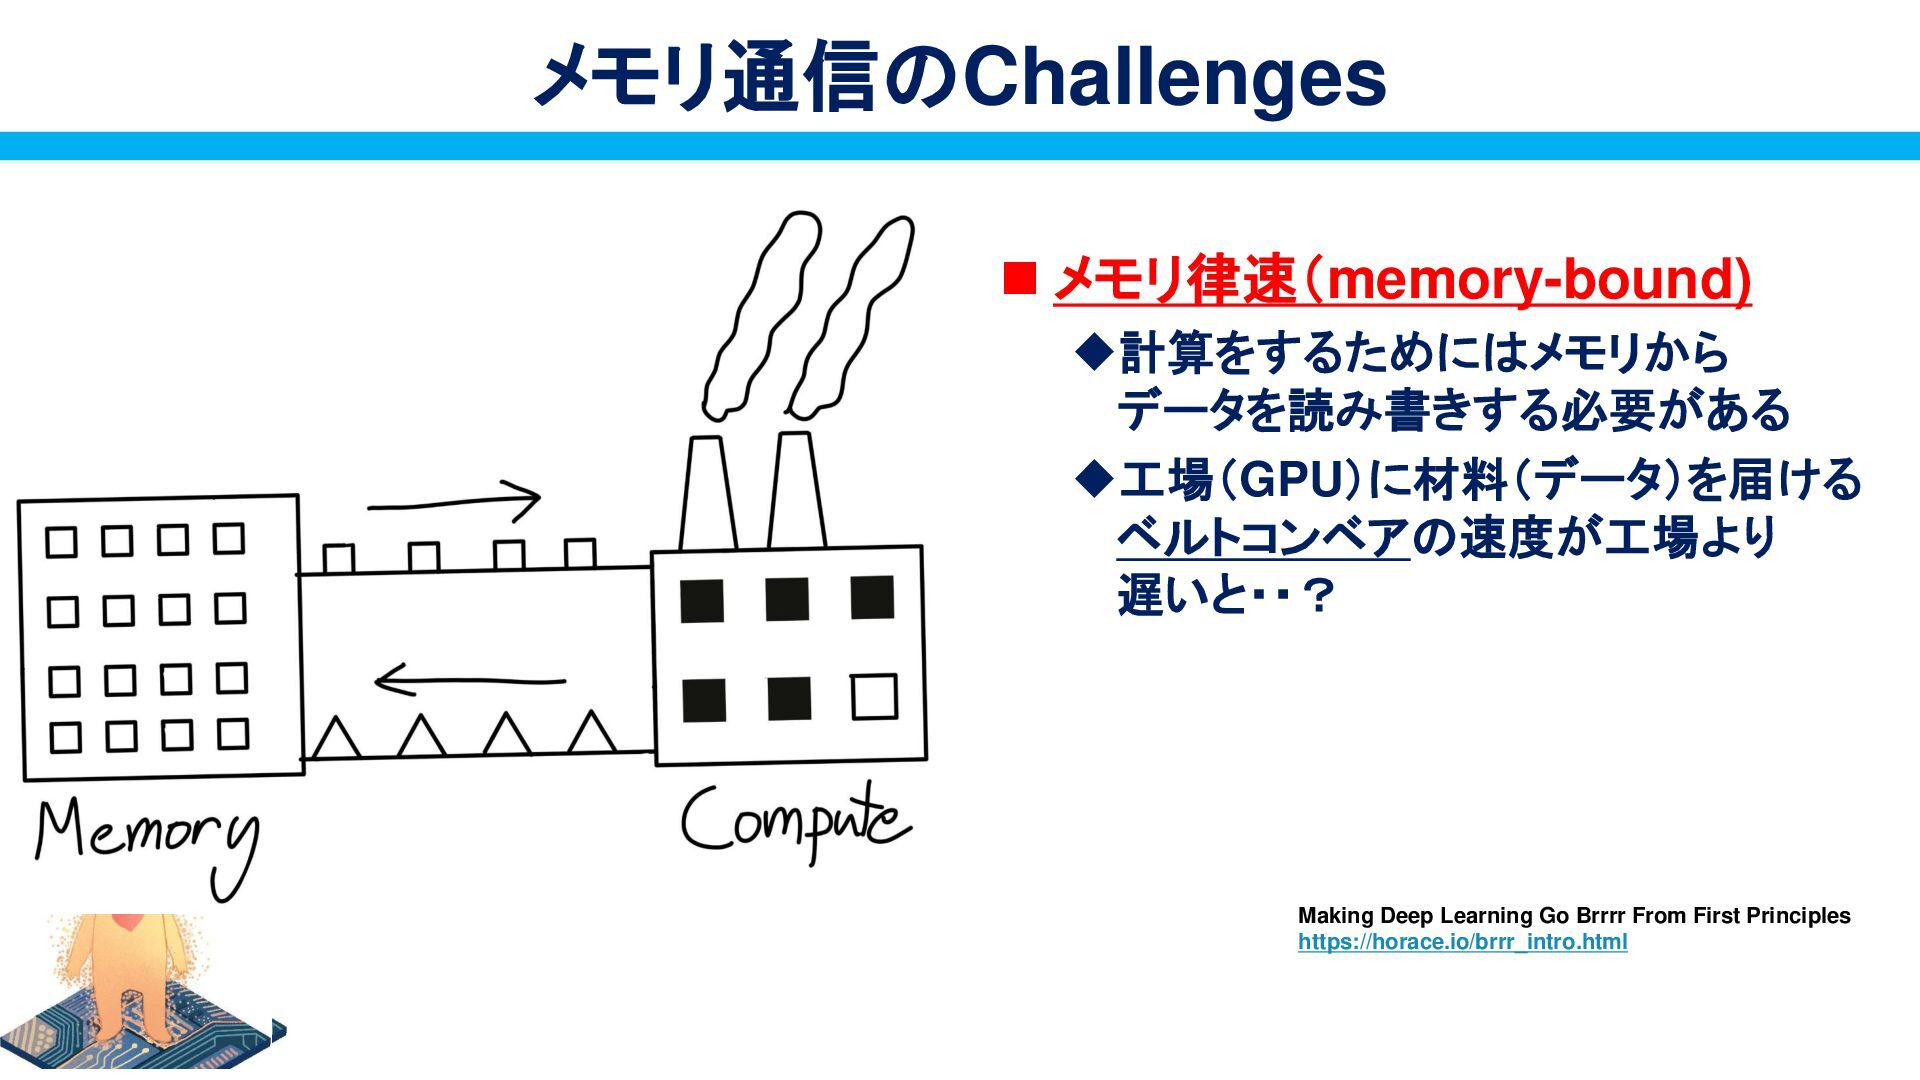
メモリ通信のChallenges ◼ メモリ律速(memory-bound) ◆計算をするためにはメモリから データを読み書きする必要がある ◆工場(GPU)に材料(データ)を届ける ベルトコンベアの速度が工場より 遅いと・・? Making Deep
Learning Go Brrrr From First Principles https://horace.io/brrr_intro.html -
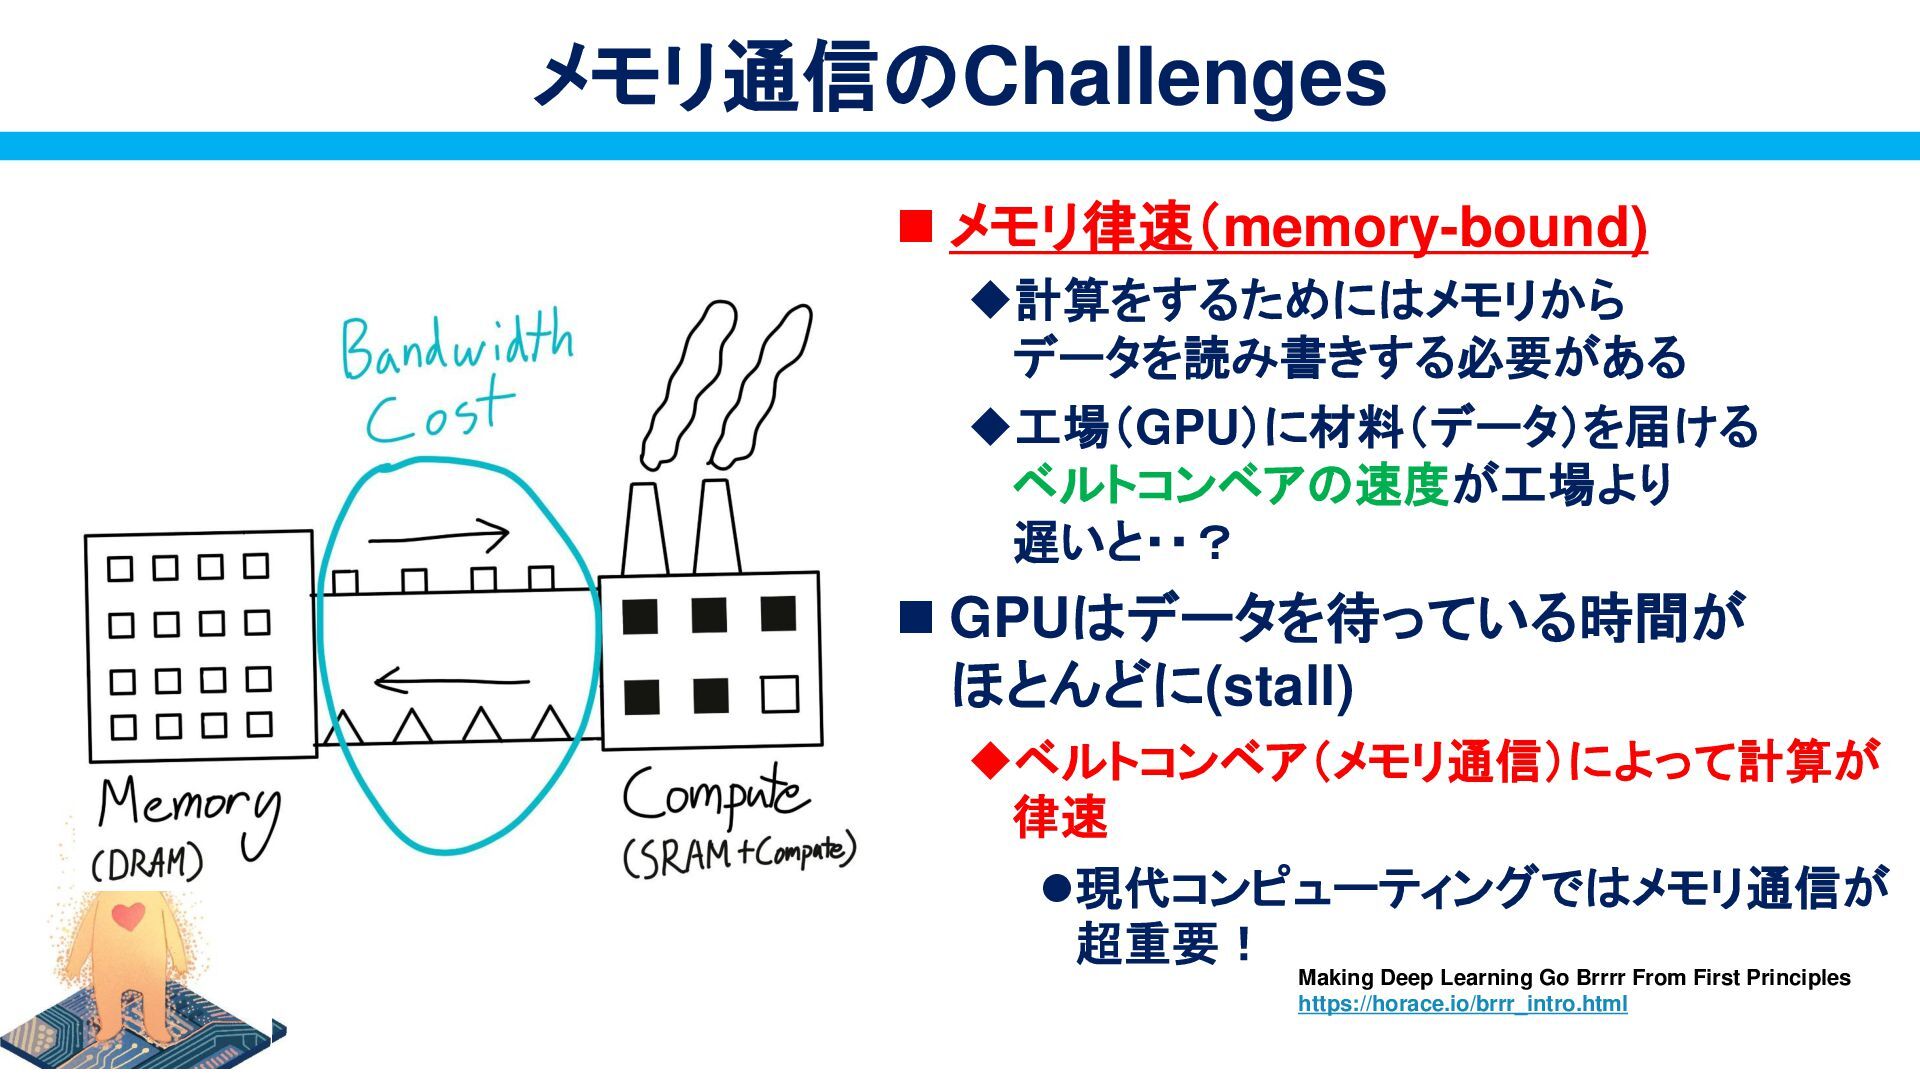
メモリ通信のChallenges ◼ メモリ律速(memory-bound) ◆計算をするためにはメモリから データを読み書きする必要がある ◆工場(GPU)に材料(データ)を届ける ベルトコンベアの速度が工場より 遅いと・・? ◼ GPUはデータを待っている時間が
ほとんどに(stall) ◆ベルトコンベア(メモリ通信)によって計算が 律速 ⚫現代コンピューティングではメモリ通信が 超重要! Making Deep Learning Go Brrrr From First Principles https://horace.io/brrr_intro.html -
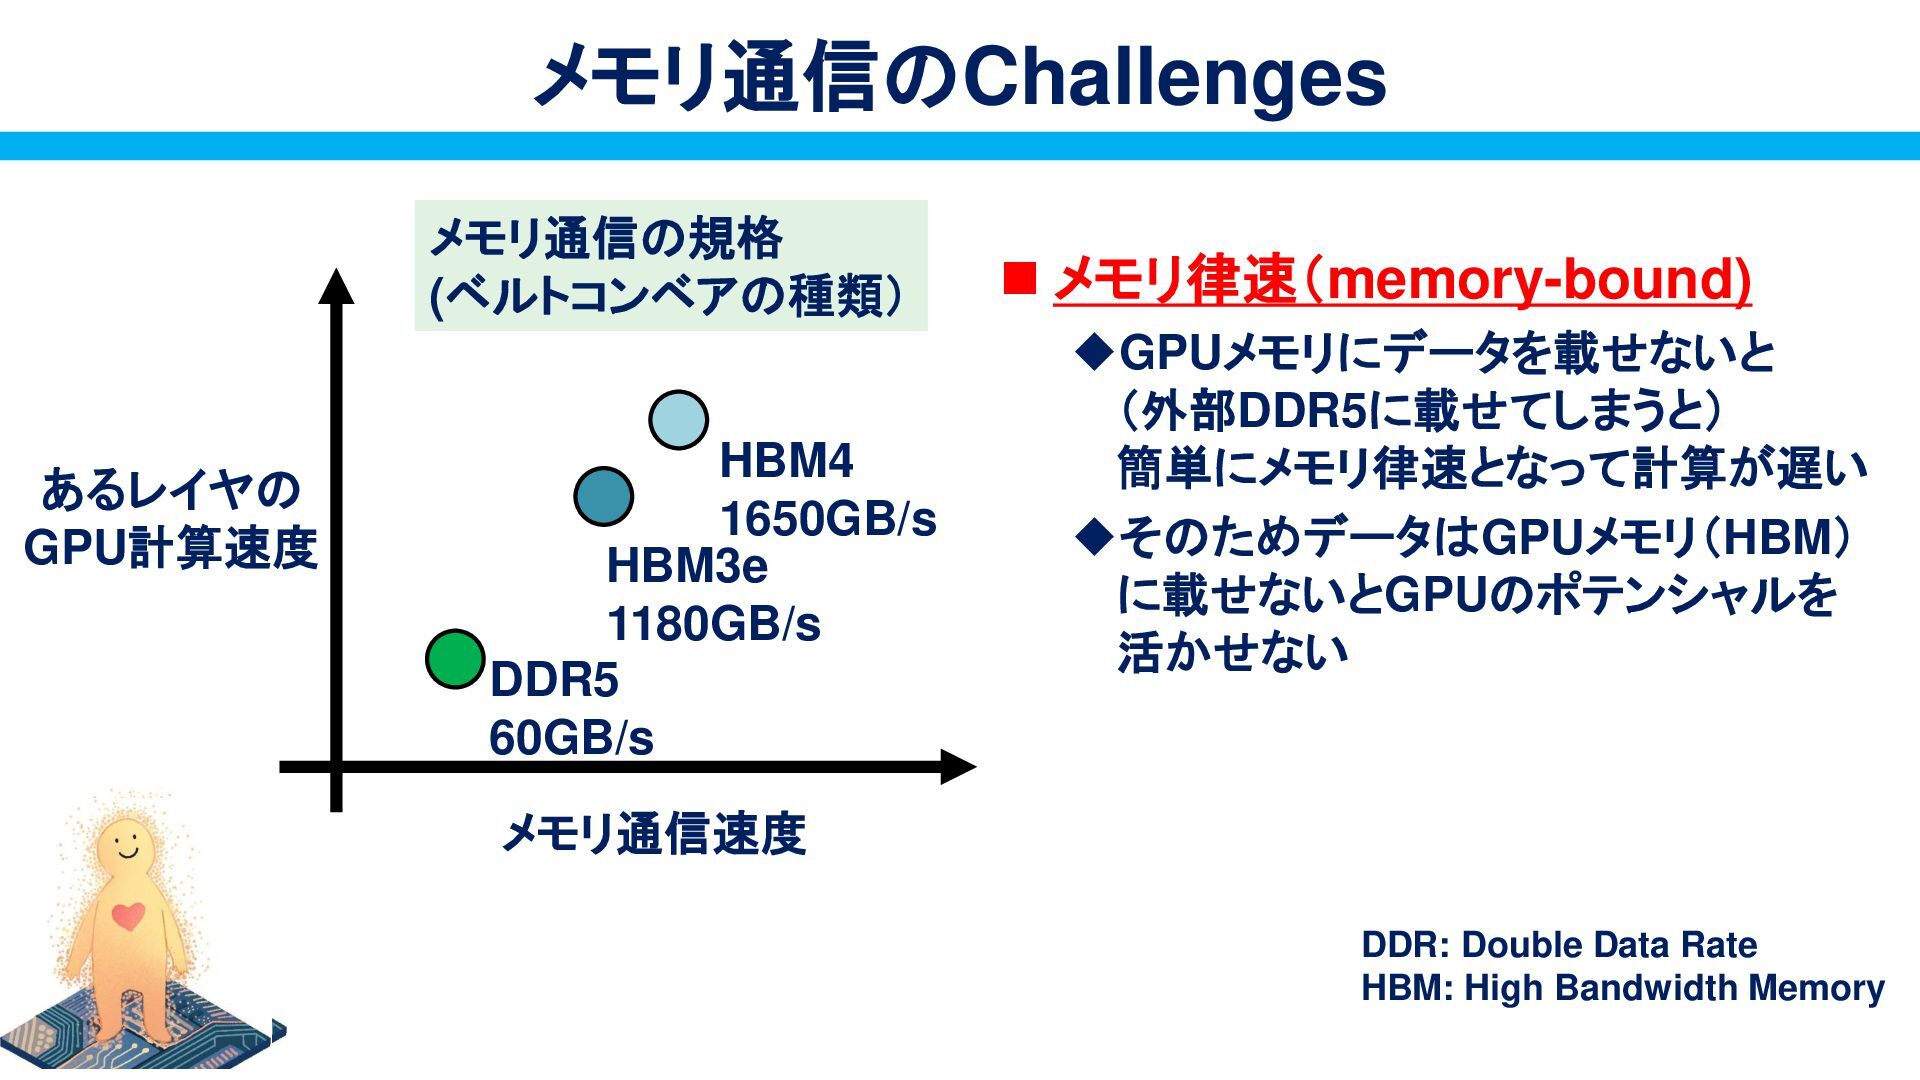
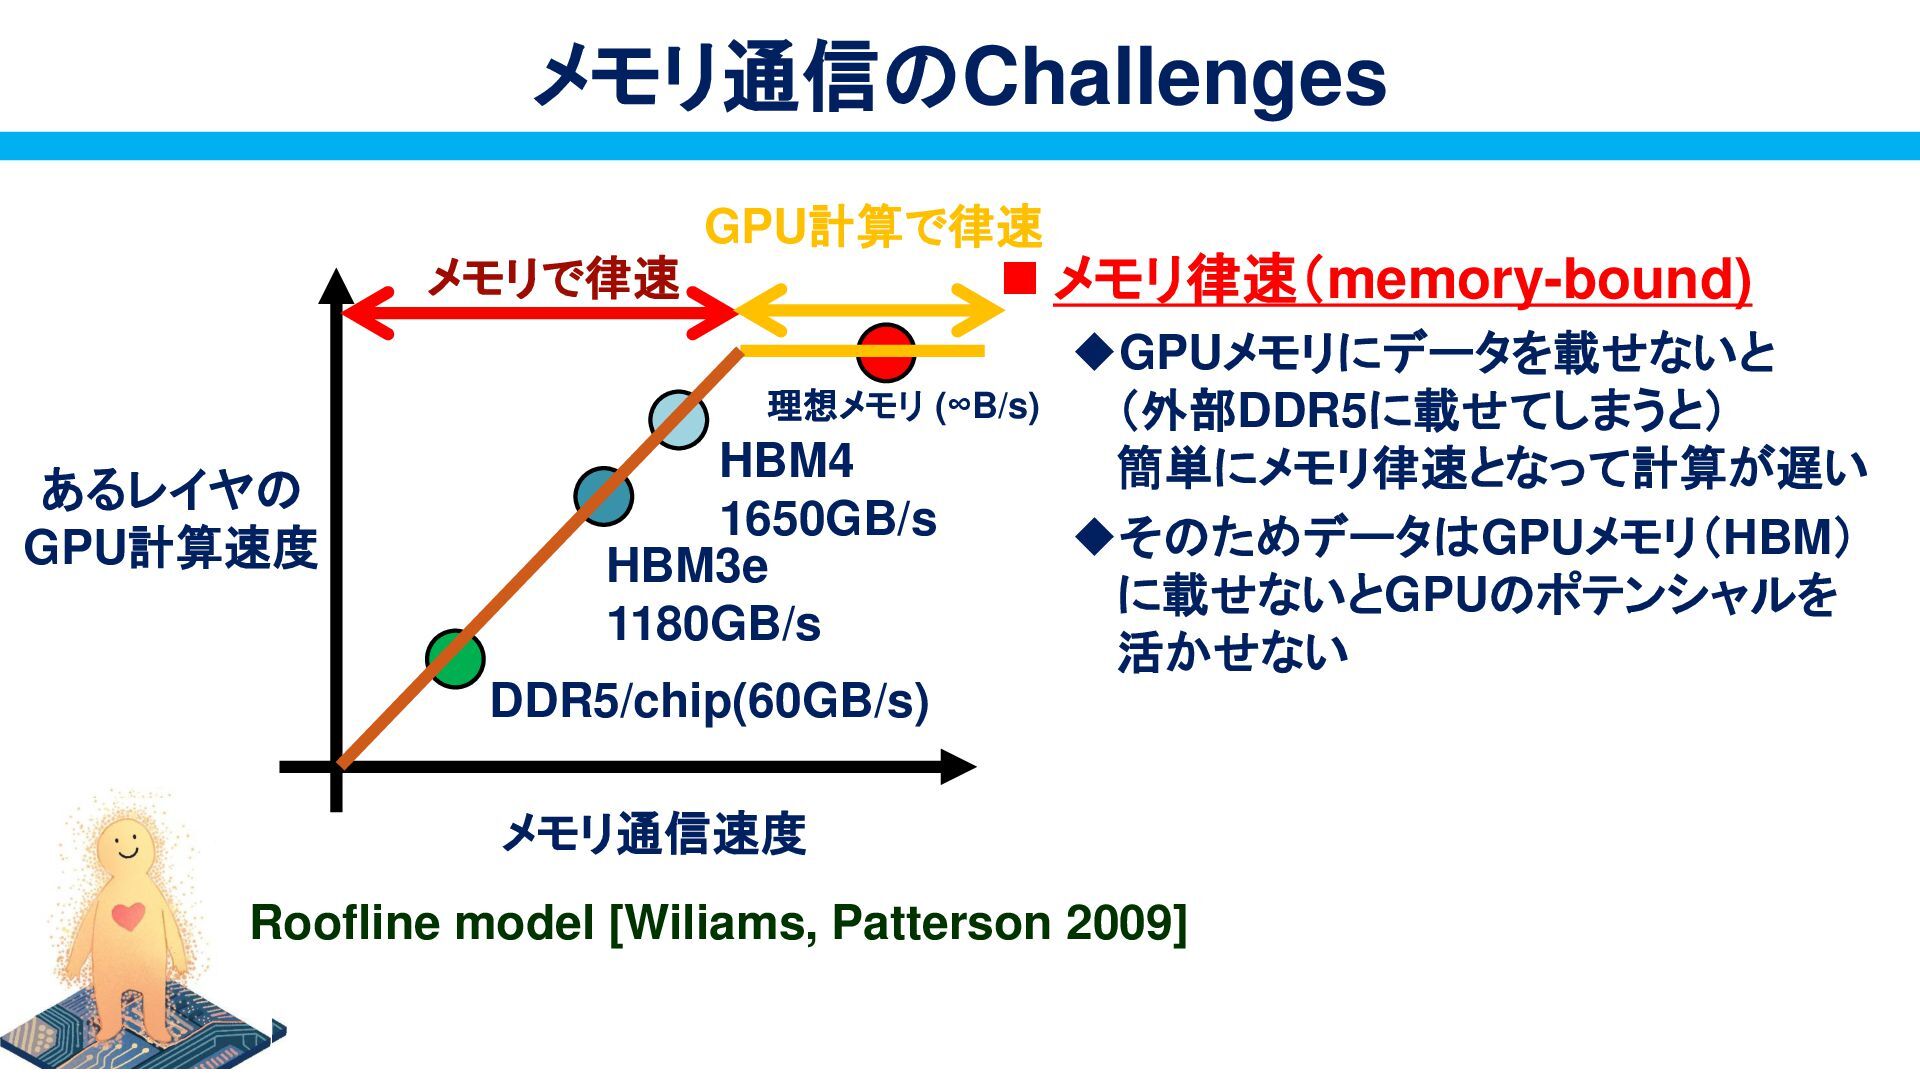
メモリ通信のChallenges ◼ メモリ律速(memory-bound) ◆GPUメモリにデータを載せないと (外部DDR5に載せてしまうと) 簡単にメモリ律速となって計算が遅い ◆そのためデータはGPUメモリ(HBM) に載せないとGPUのポテンシャルを 活かせない メモリ通信速度
あるレイヤの GPU計算速度 DDR5 60GB/s HBM3e 1180GB/s HBM4 1650GB/s DDR: Double Data Rate HBM: High Bandwidth Memory メモリ通信の規格 (ベルトコンベアの種類) -
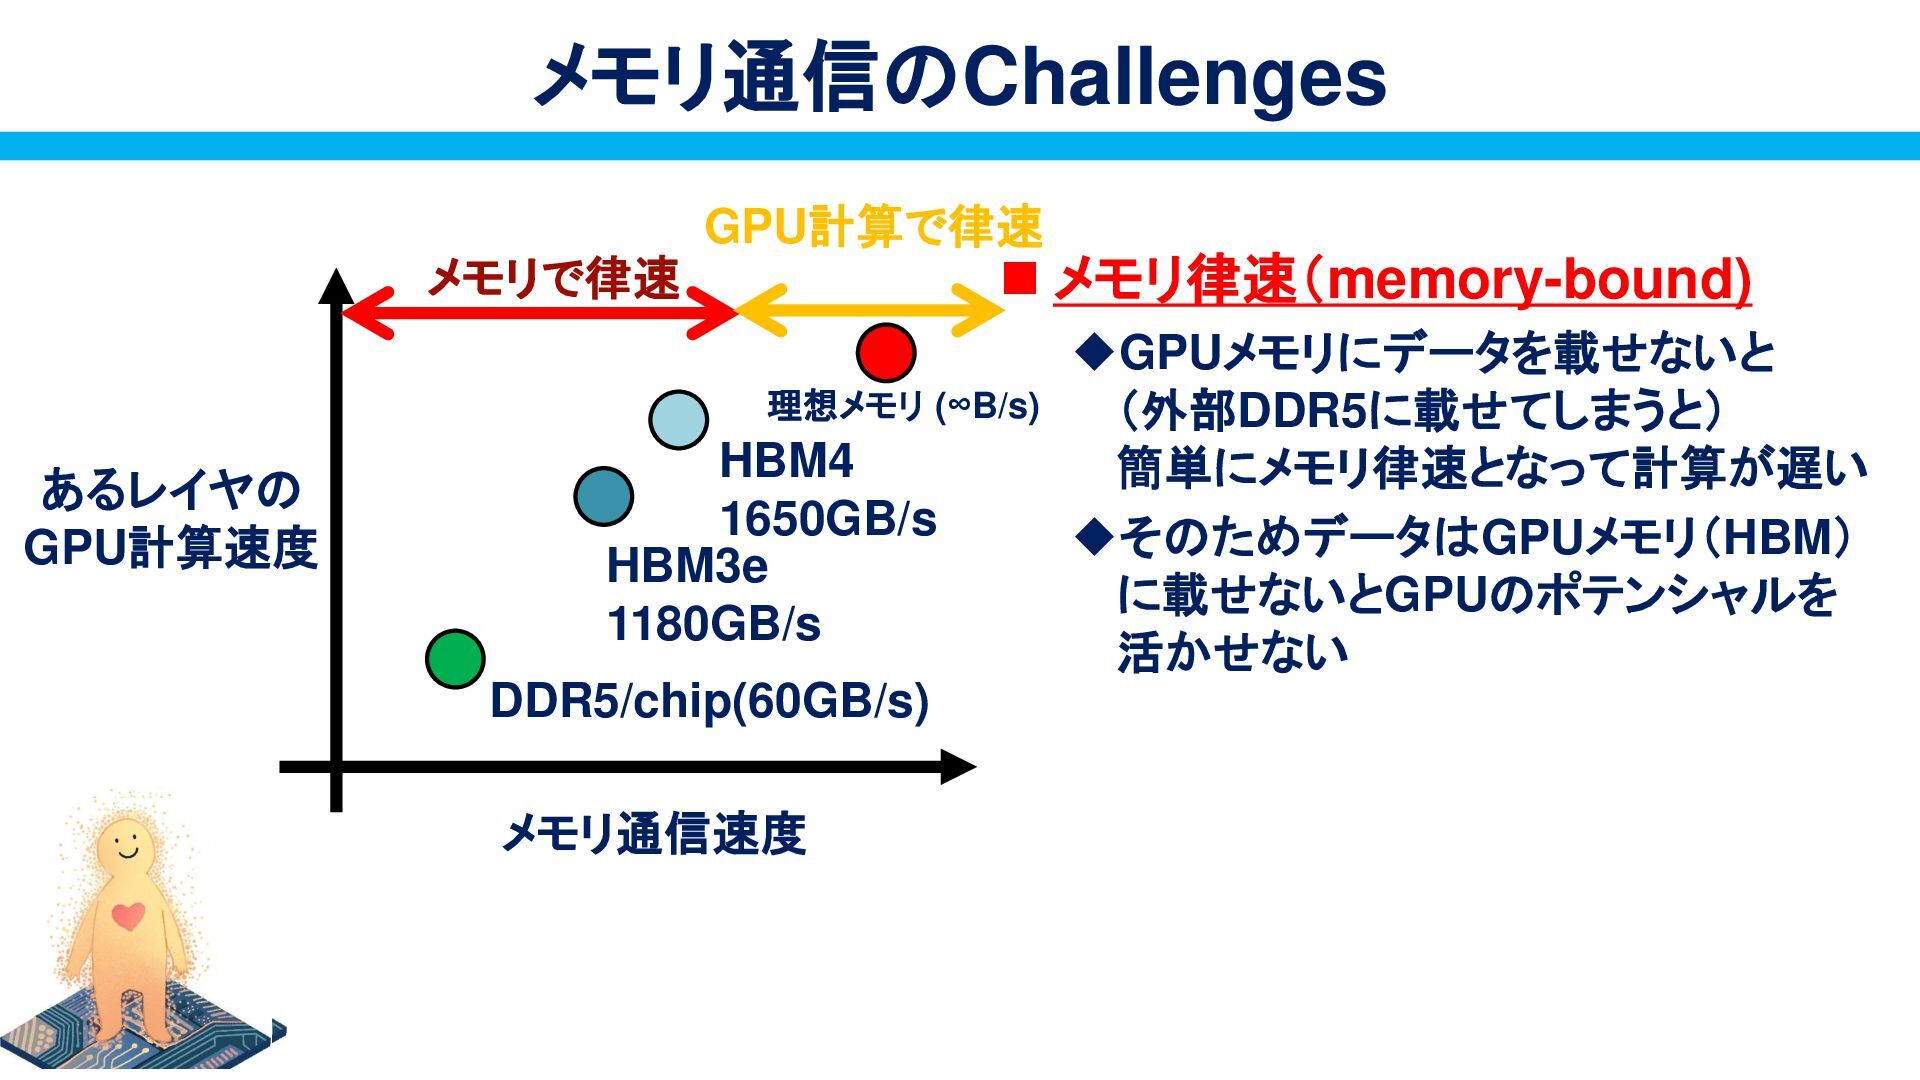
メモリ通信のChallenges ◼ メモリ律速(memory-bound) ◆GPUメモリにデータを載せないと (外部DDR5に載せてしまうと) 簡単にメモリ律速となって計算が遅い ◆そのためデータはGPUメモリ(HBM) に載せないとGPUのポテンシャルを 活かせない メモリ通信速度
あるレイヤの GPU計算速度 DDR5/chip(60GB/s) HBM3e 1180GB/s HBM4 1650GB/s GPU計算で律速 メモリで律速 理想メモリ (∞B/s) -
メモリ通信のChallenges ◼ メモリ律速(memory-bound) ◆GPUメモリにデータを載せないと (外部DDR5に載せてしまうと) 簡単にメモリ律速となって計算が遅い ◆そのためデータはGPUメモリ(HBM) に載せないとGPUのポテンシャルを 活かせない メモリ通信速度
あるレイヤの GPU計算速度 DDR5/chip(60GB/s) HBM3e 1180GB/s HBM4 1650GB/s GPU計算で律速 メモリで律速 Roofline model [Wiliams, Patterson 2009] 理想メモリ (∞B/s) -
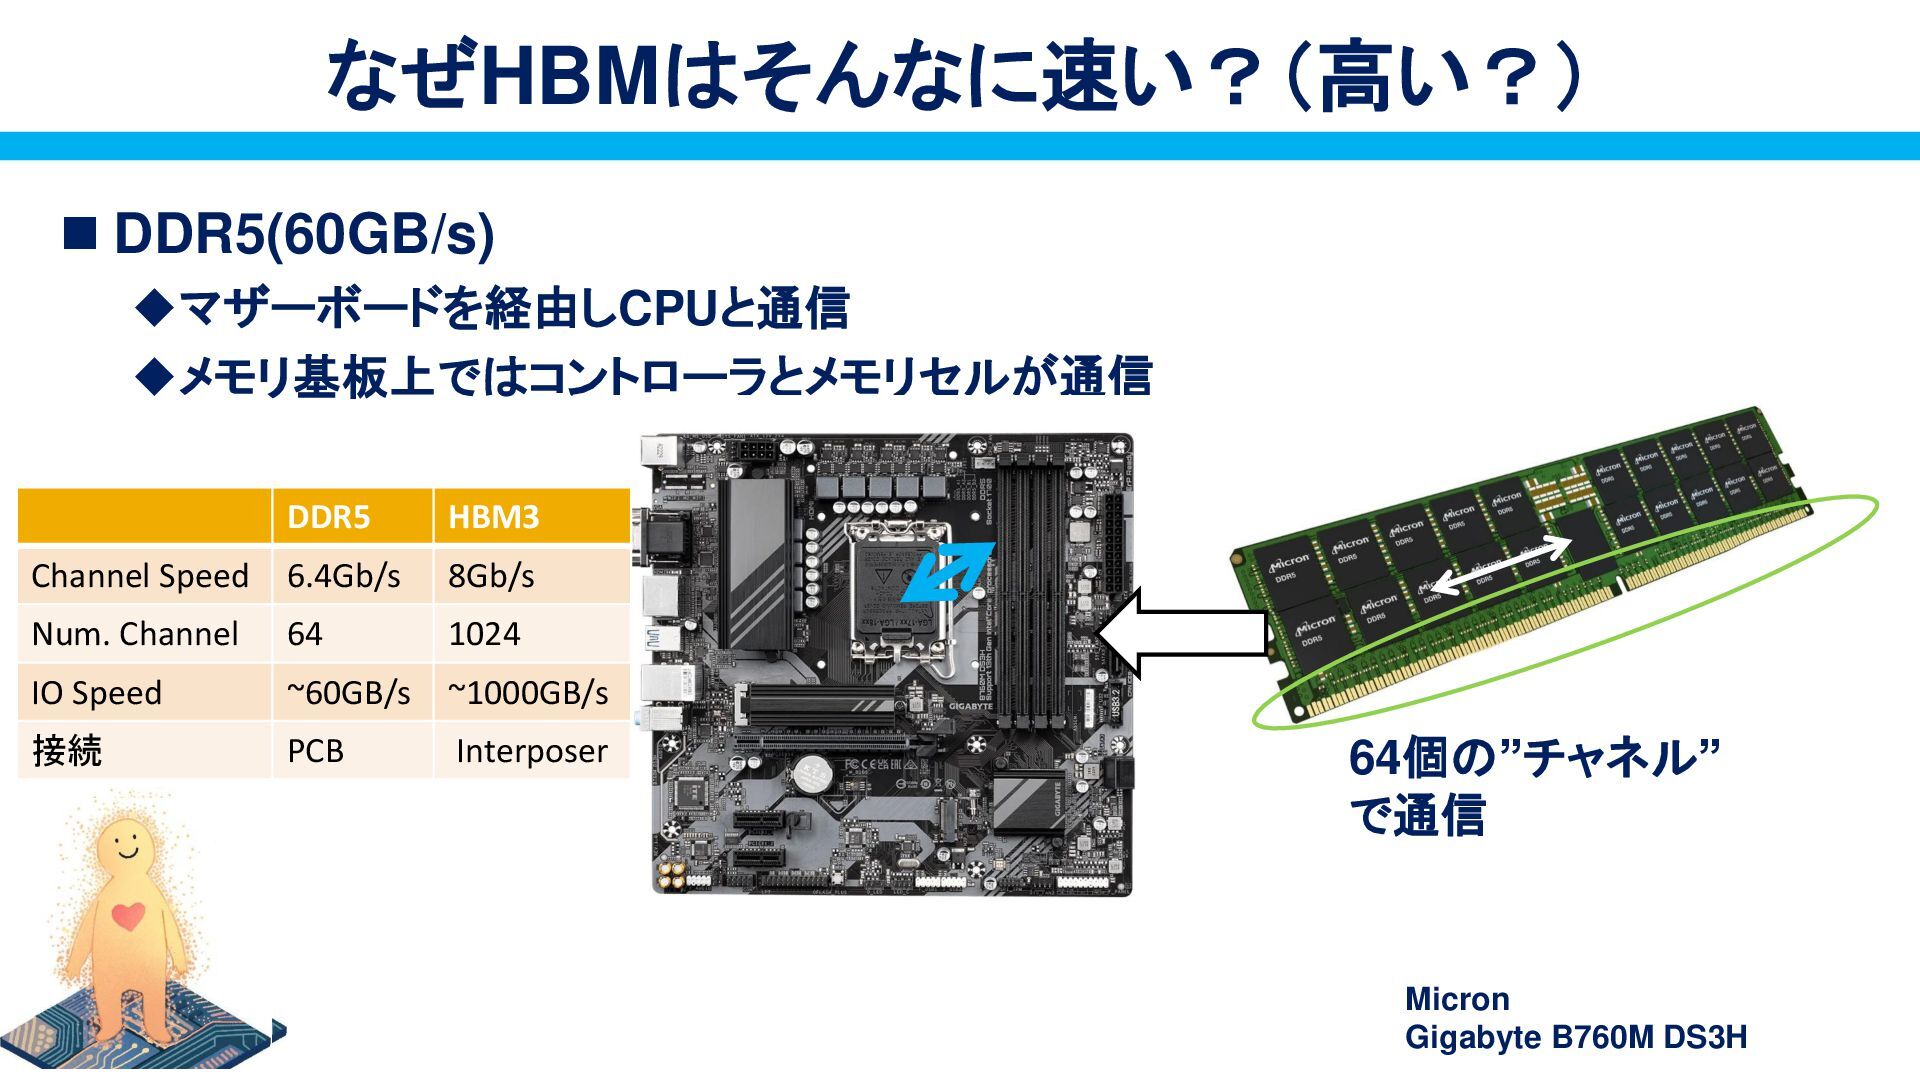
◼ DDR5(60GB/s) ◆マザーボードを経由しCPUと通信 ◆メモリ基板上ではコントローラとメモリセルが通信 なぜHBMはそんなに速い?(高い?) Micron Gigabyte B760M DS3H DDR5
HBM3 Channel Speed 6.4Gb/s 8Gb/s Num. Channel 64 1024 IO Speed ~60GB/s ~1000GB/s 接続 PCB Interposer 64個の”チャネル” で通信 -
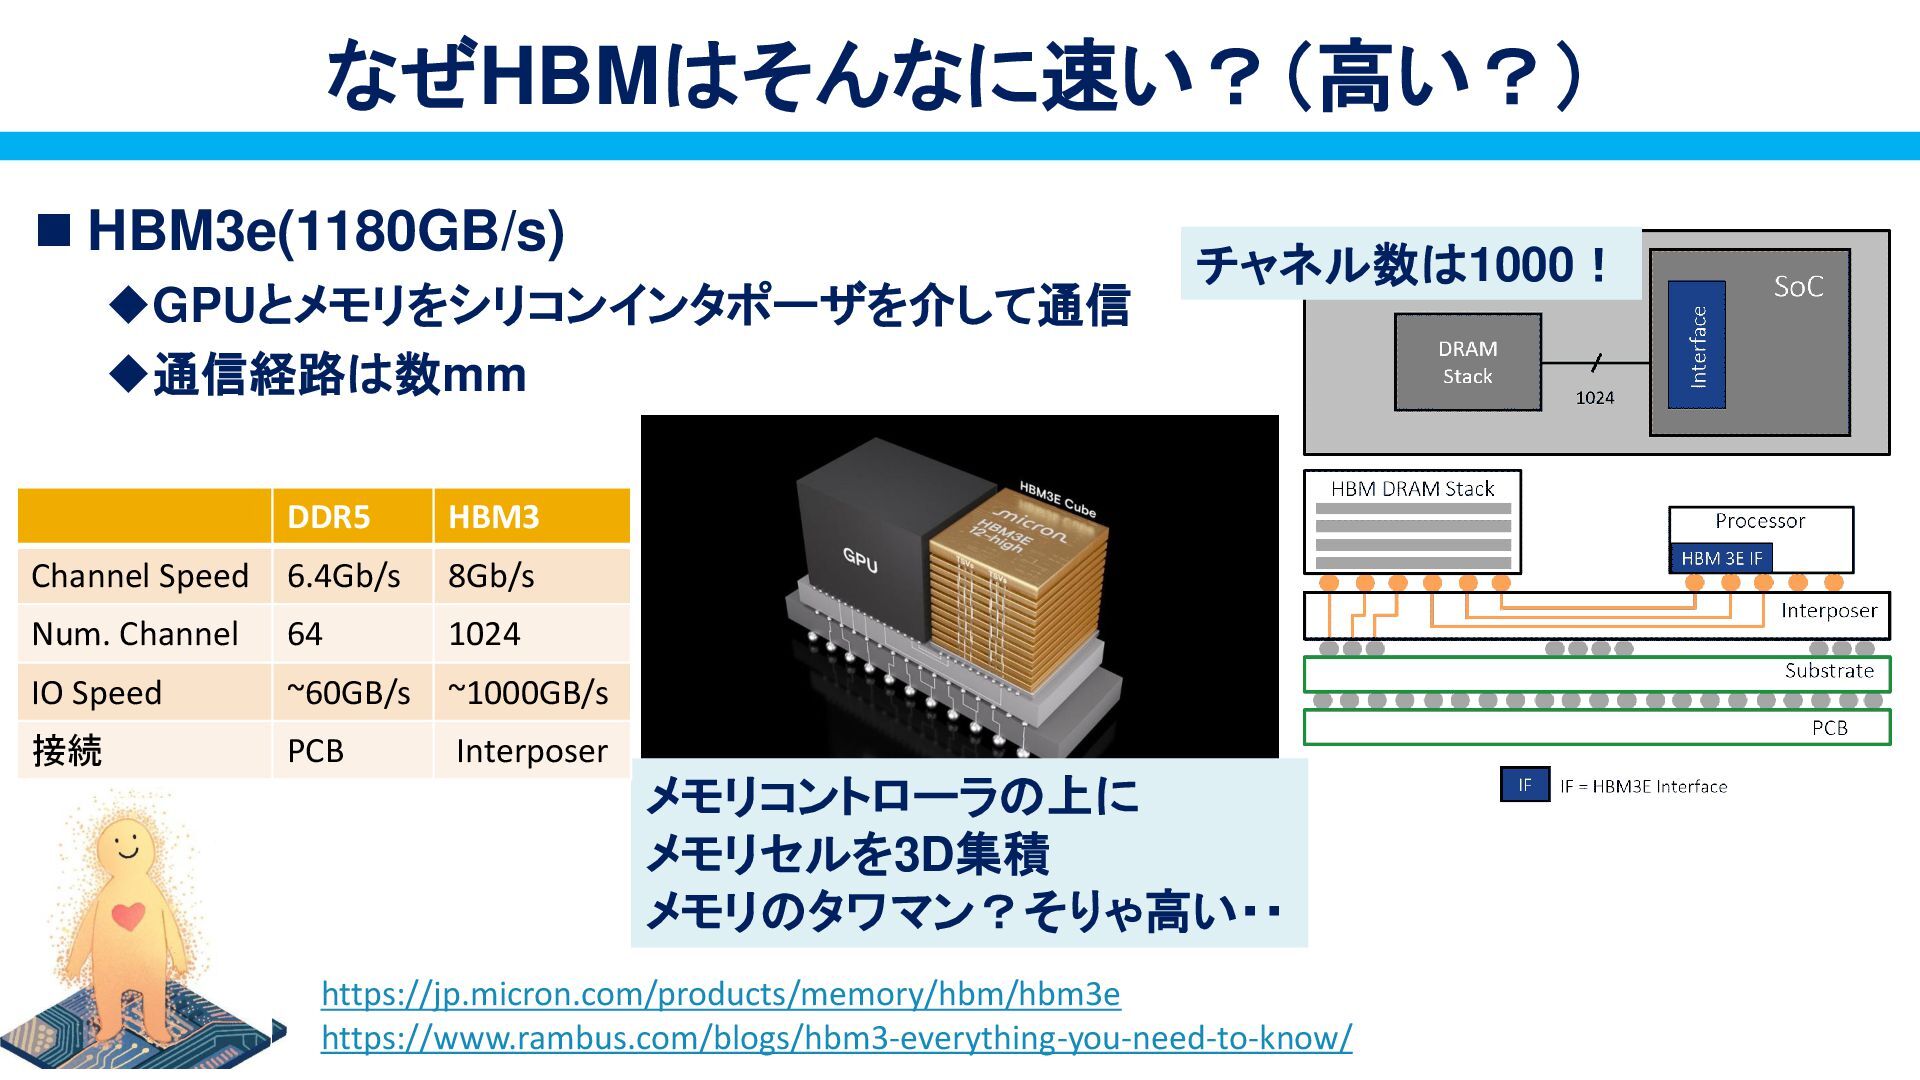
◼ HBM3e(1180GB/s) ◆GPUとメモリをシリコンインタポーザを介して通信 ◆通信経路は数mm なぜHBMはそんなに速い?(高い?) https://jp.micron.com/products/memory/hbm/hbm3e https://www.rambus.com/blogs/hbm3-everything-you-need-to-know/ メモリコントローラの上に メモリセルを3D集積 メモリのタワマン?そりゃ高い・・
DDR5 HBM3 Channel Speed 6.4Gb/s 8Gb/s Num. Channel 64 1024 IO Speed ~60GB/s ~1000GB/s 接続 PCB Interposer チャネル数は1000! -
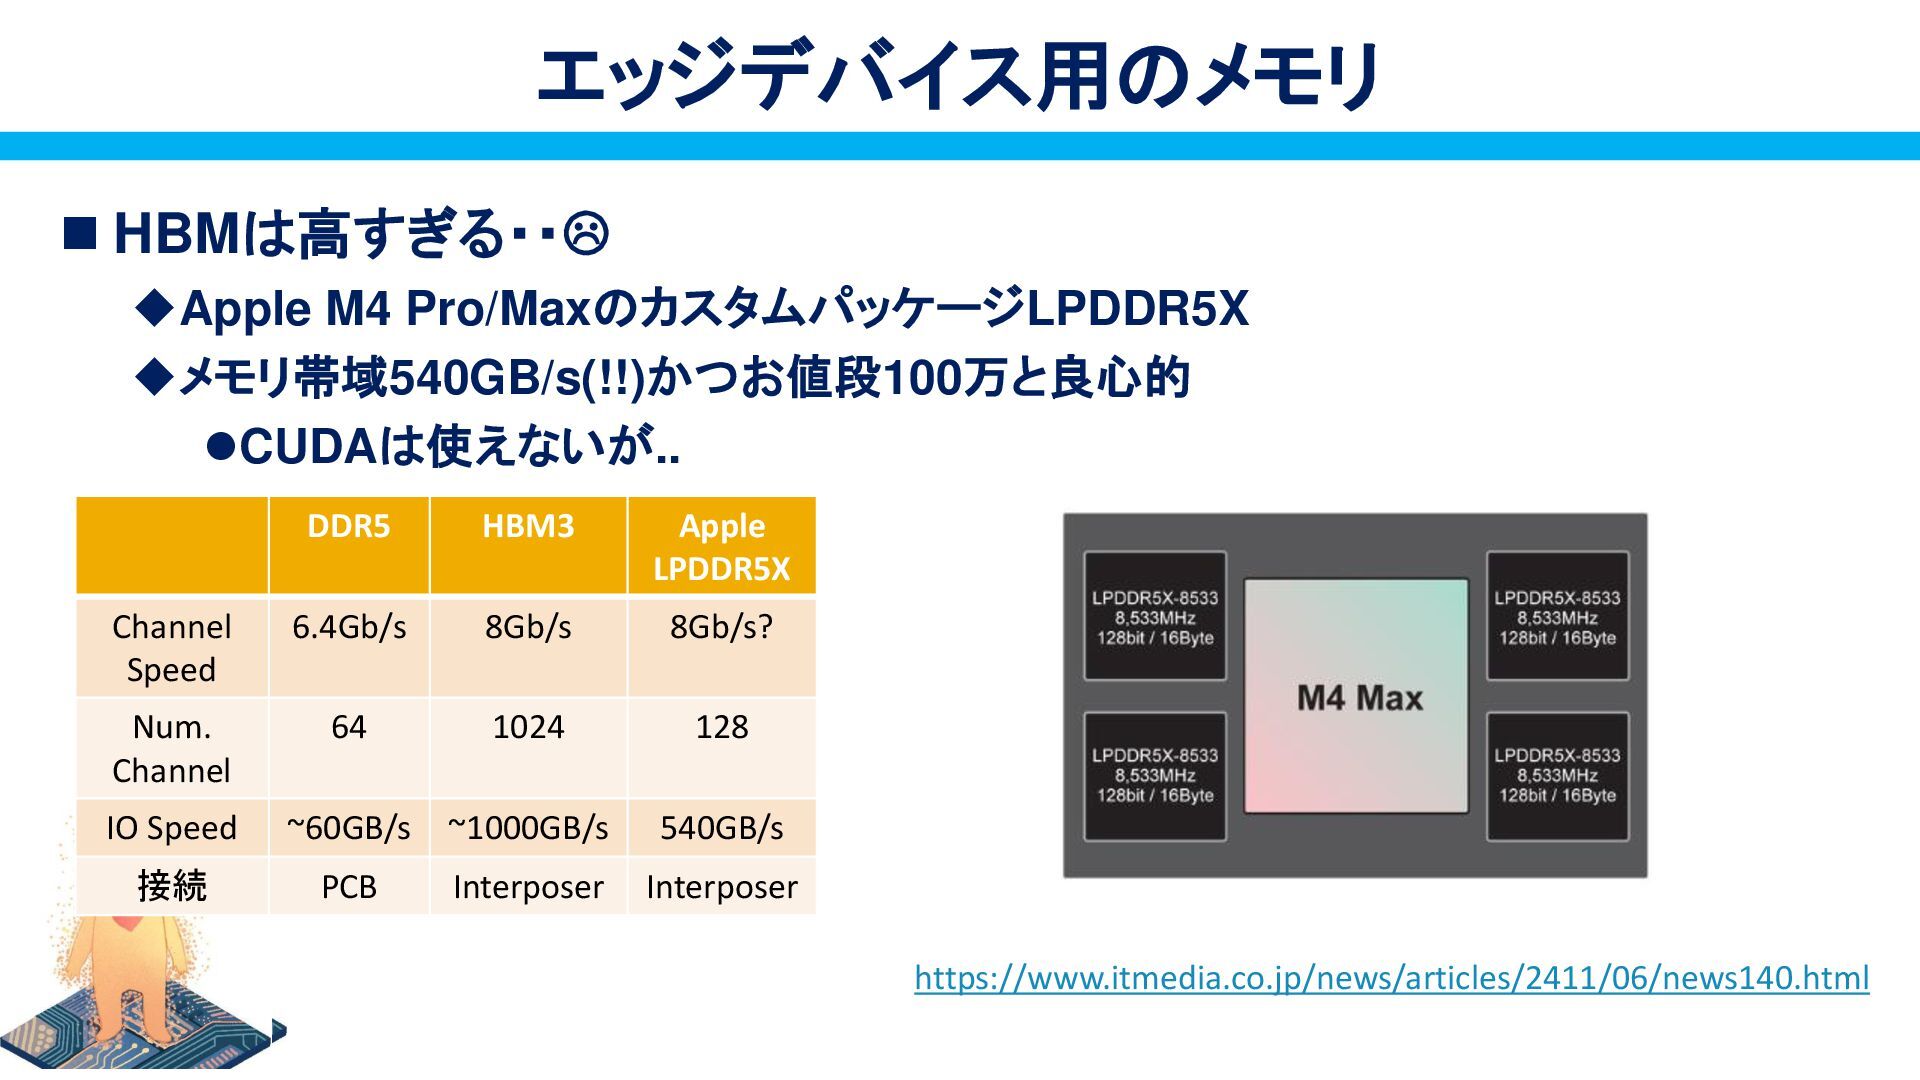
◼ HBMは高すぎる・・ ◆Apple M4 Pro/MaxのカスタムパッケージLPDDR5X ◆メモリ帯域540GB/s(!!)かつお値段100万と良心的 ⚫CUDAは使えないが.. エッジデバイス用のメモリ DDR5 HBM3
Apple LPDDR5X Channel Speed 6.4Gb/s 8Gb/s 8Gb/s? Num. Channel 64 1024 128 IO Speed ~60GB/s ~1000GB/s 540GB/s 接続 PCB Interposer Interposer https://www.itmedia.co.jp/news/articles/2411/06/news140.html -
◼ メモリ通信量を緩和 ◆モデル量子化 ◼ メモリ通信の最適化 ◆Flash Attention ◼ Tokenキャッシュの活用 ◆K-V
Cache LLM@Edgeのために何ができるか? この後の亀澤様の講演で詳しく! -
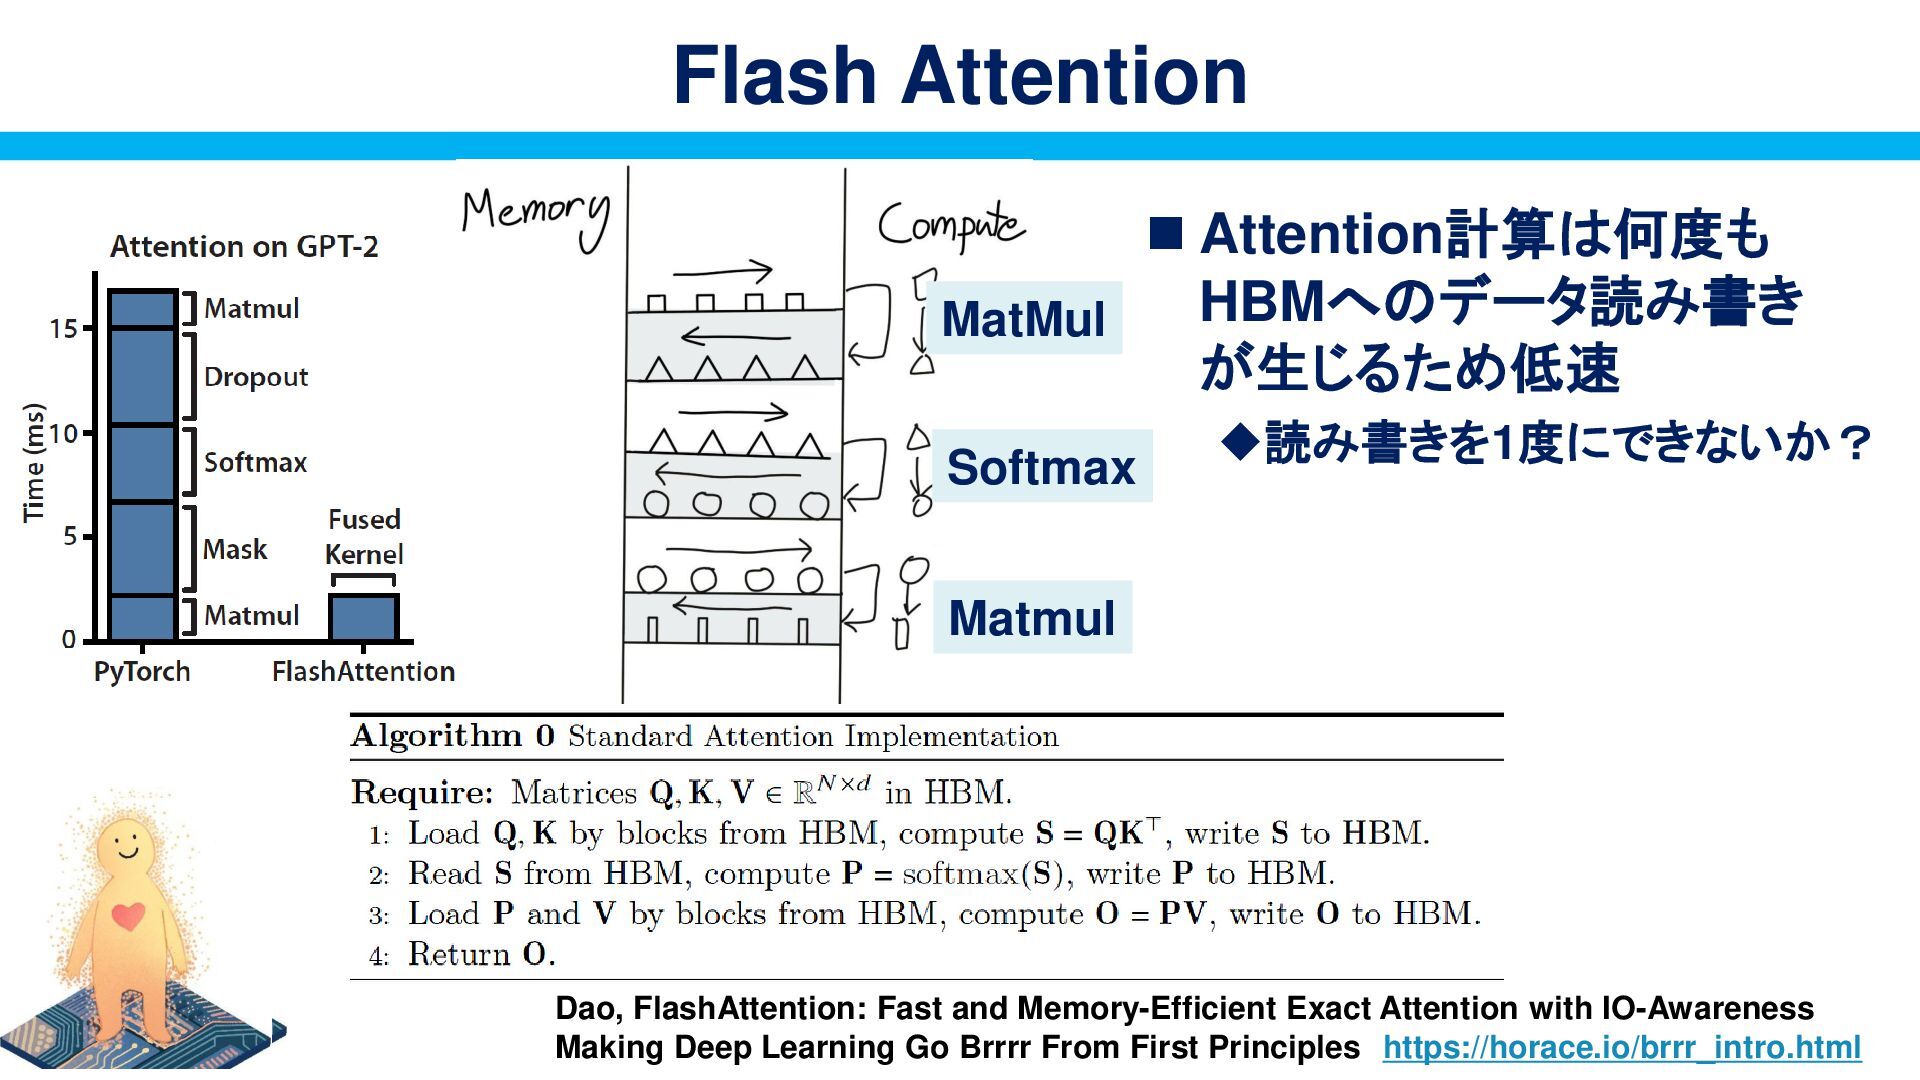
◼ Attention計算は何度も HBMへのデータ読み書き が生じるため低速 ◆読み書きを1度にできないか? Flash Attention Dao, FlashAttention: Fast
and Memory-Efficient Exact Attention with IO-Awareness Making Deep Learning Go Brrrr From First Principles https://horace.io/brrr_intro.html MatMul Softmax Matmul -
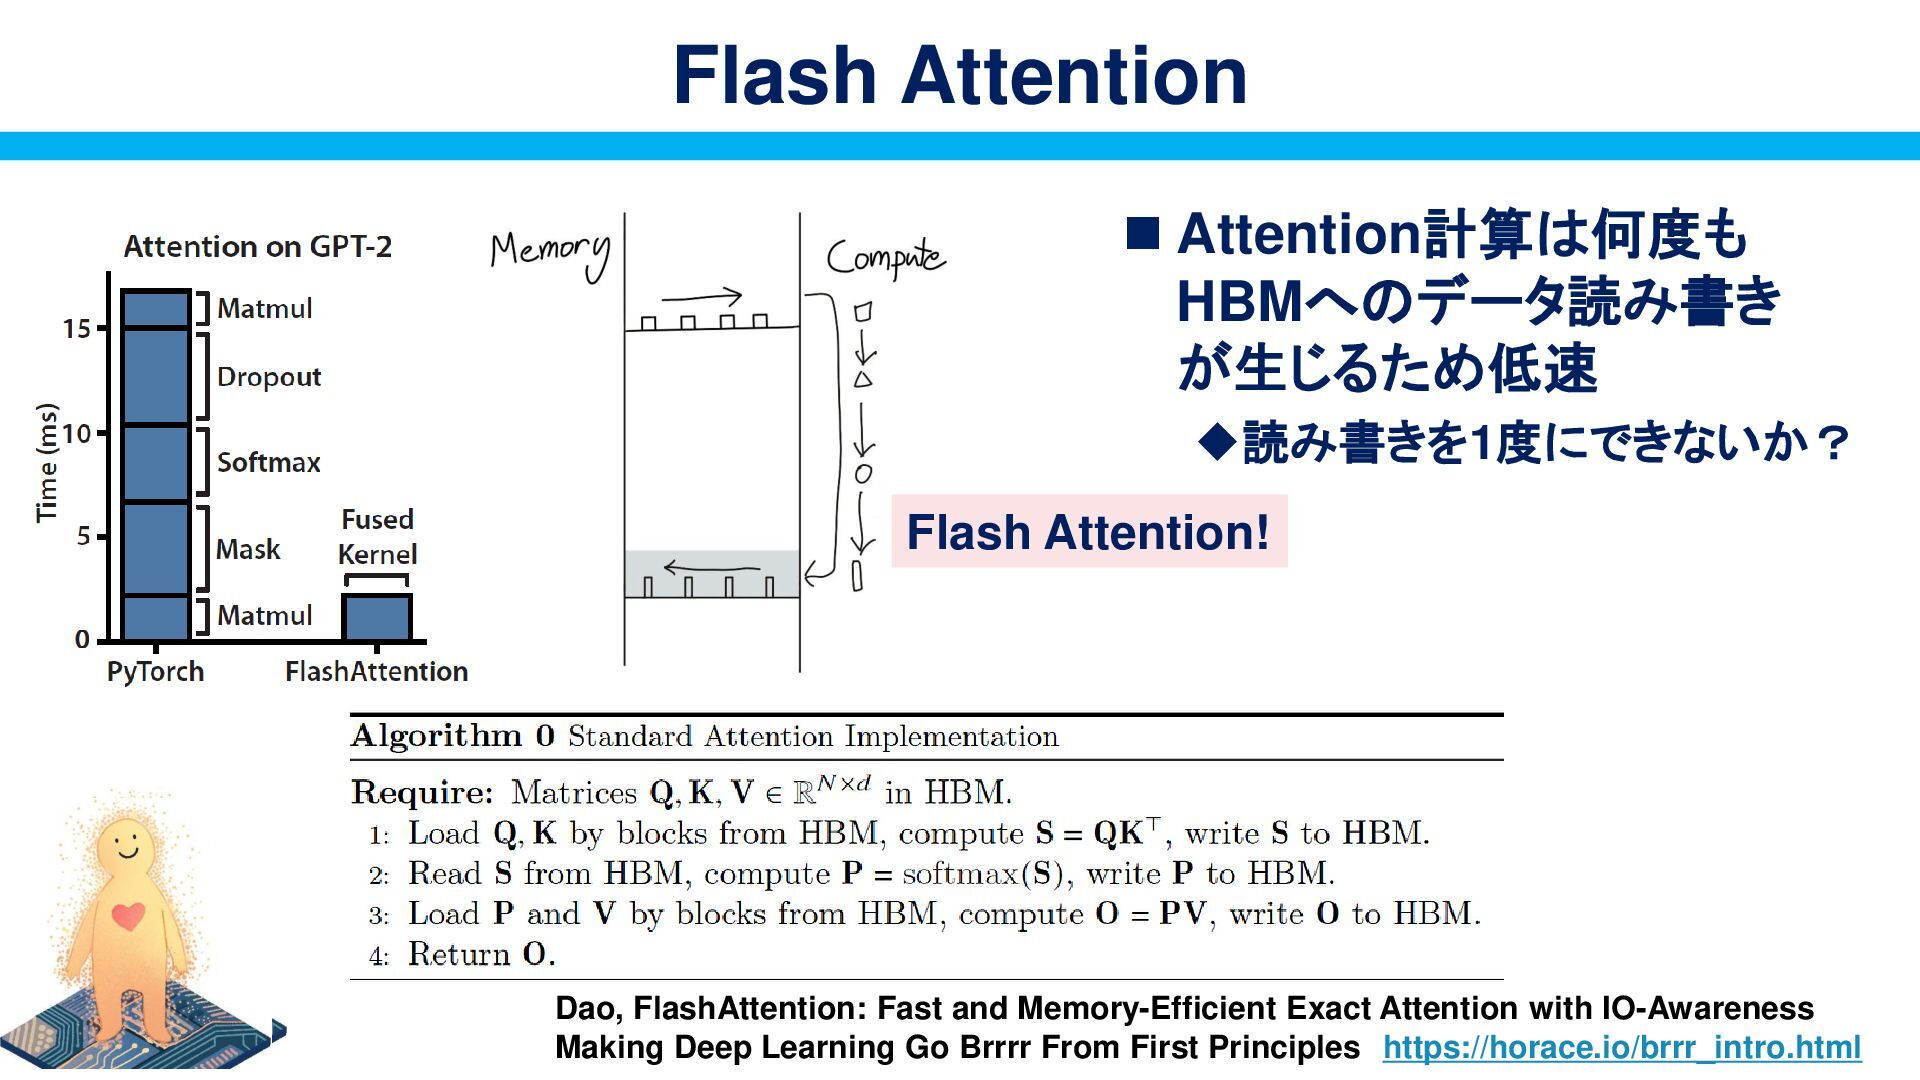
◼ Attention計算は何度も HBMへのデータ読み書き が生じるため低速 ◆読み書きを1度にできないか? Flash Attention Dao, FlashAttention: Fast
and Memory-Efficient Exact Attention with IO-Awareness Making Deep Learning Go Brrrr From First Principles https://horace.io/brrr_intro.html Flash Attention! -
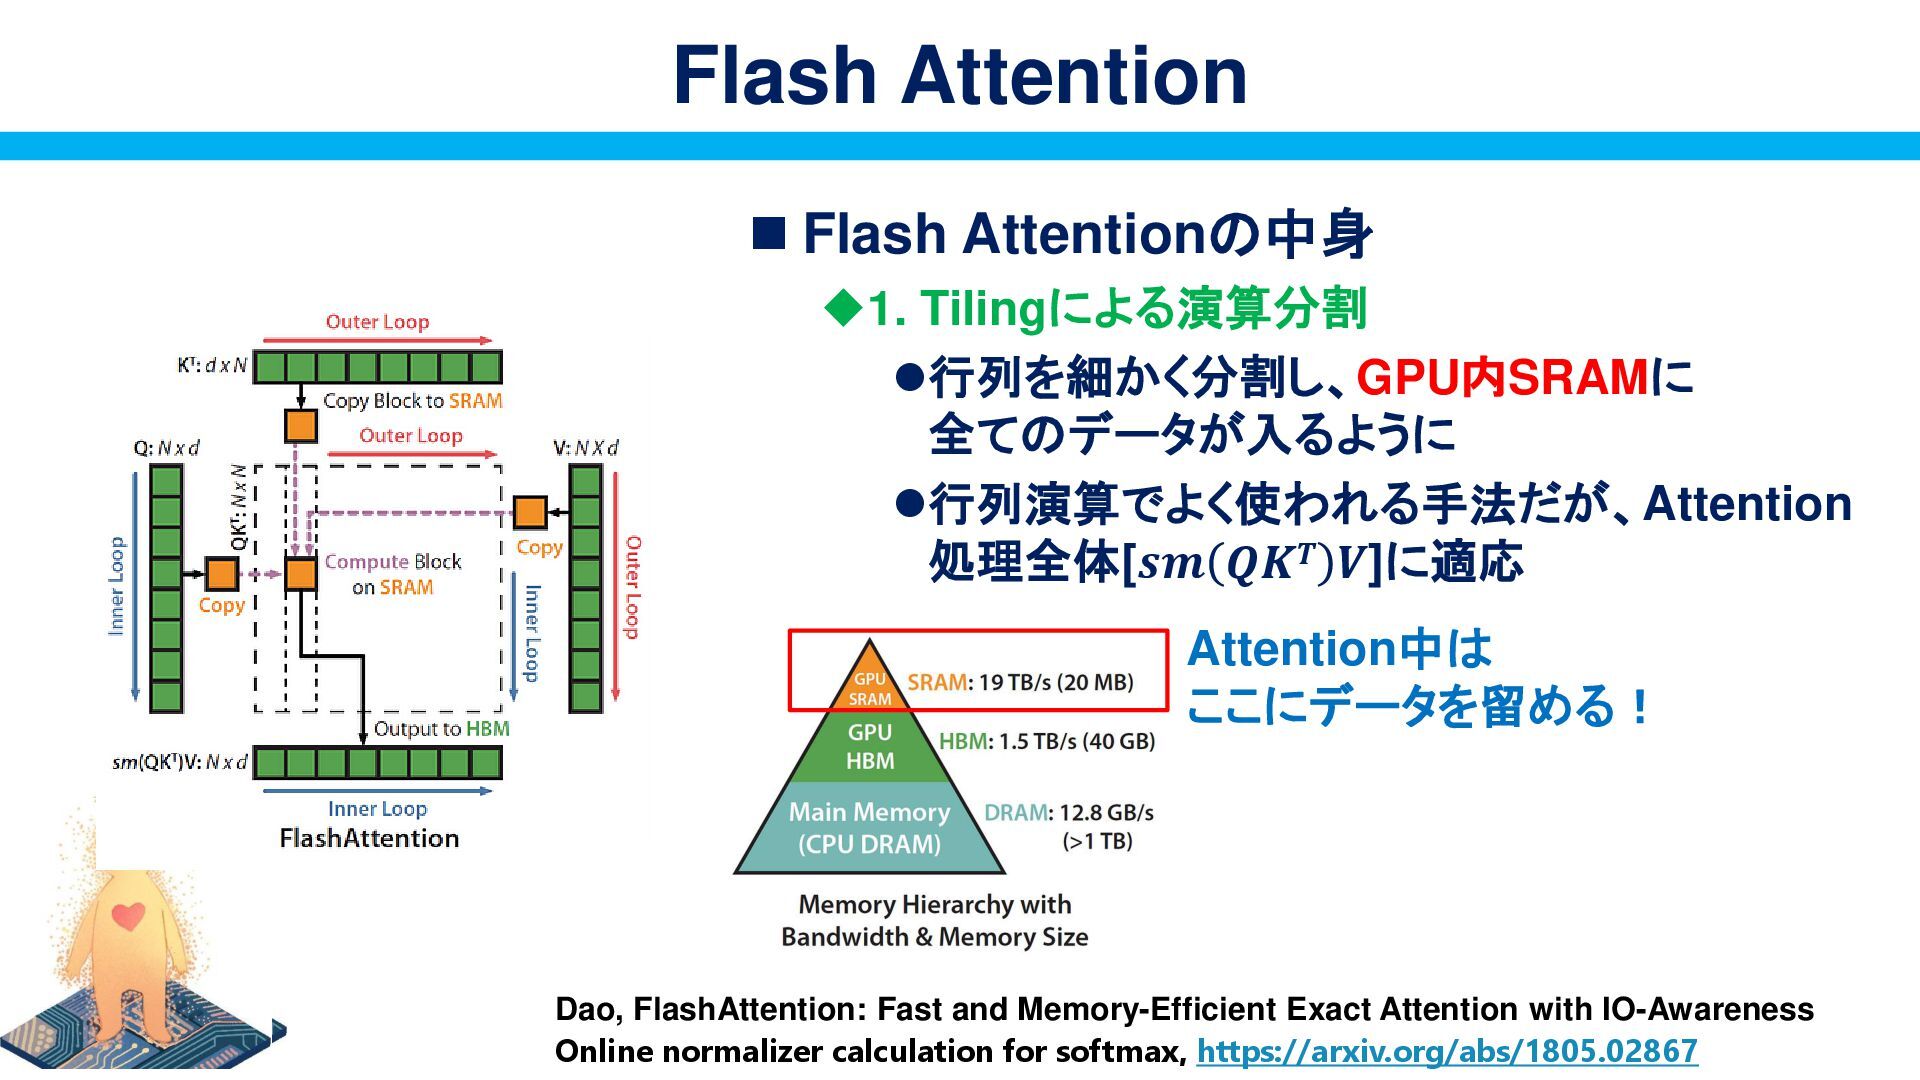
◼ Flash Attentionの中身 ◆1. Tilingによる演算分割 ⚫行列を細かく分割し、GPU内SRAMに 全てのデータが入るように ⚫行列演算でよく使われる手法だが、Attention 処理全体[𝒔𝒎 𝑸𝑲𝑻
𝑽]に適応 Flash Attention Dao, FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness Online normalizer calculation for softmax, https://arxiv.org/abs/1805.02867 Attention中は ここにデータを留める! -
◼ Flash Attentionの中身 ◆2. Online Softmax[ref]により 分割データからsoftmaxを計算可能に ⚫通常kernel fusionはForwardのみ最適化する が、Flash
AttentionはBackwardも対応。 Flash Attention Dao, FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness [ref] Online normalizer calculation for softmax, https://arxiv.org/abs/1805.02867 Softmax式 -
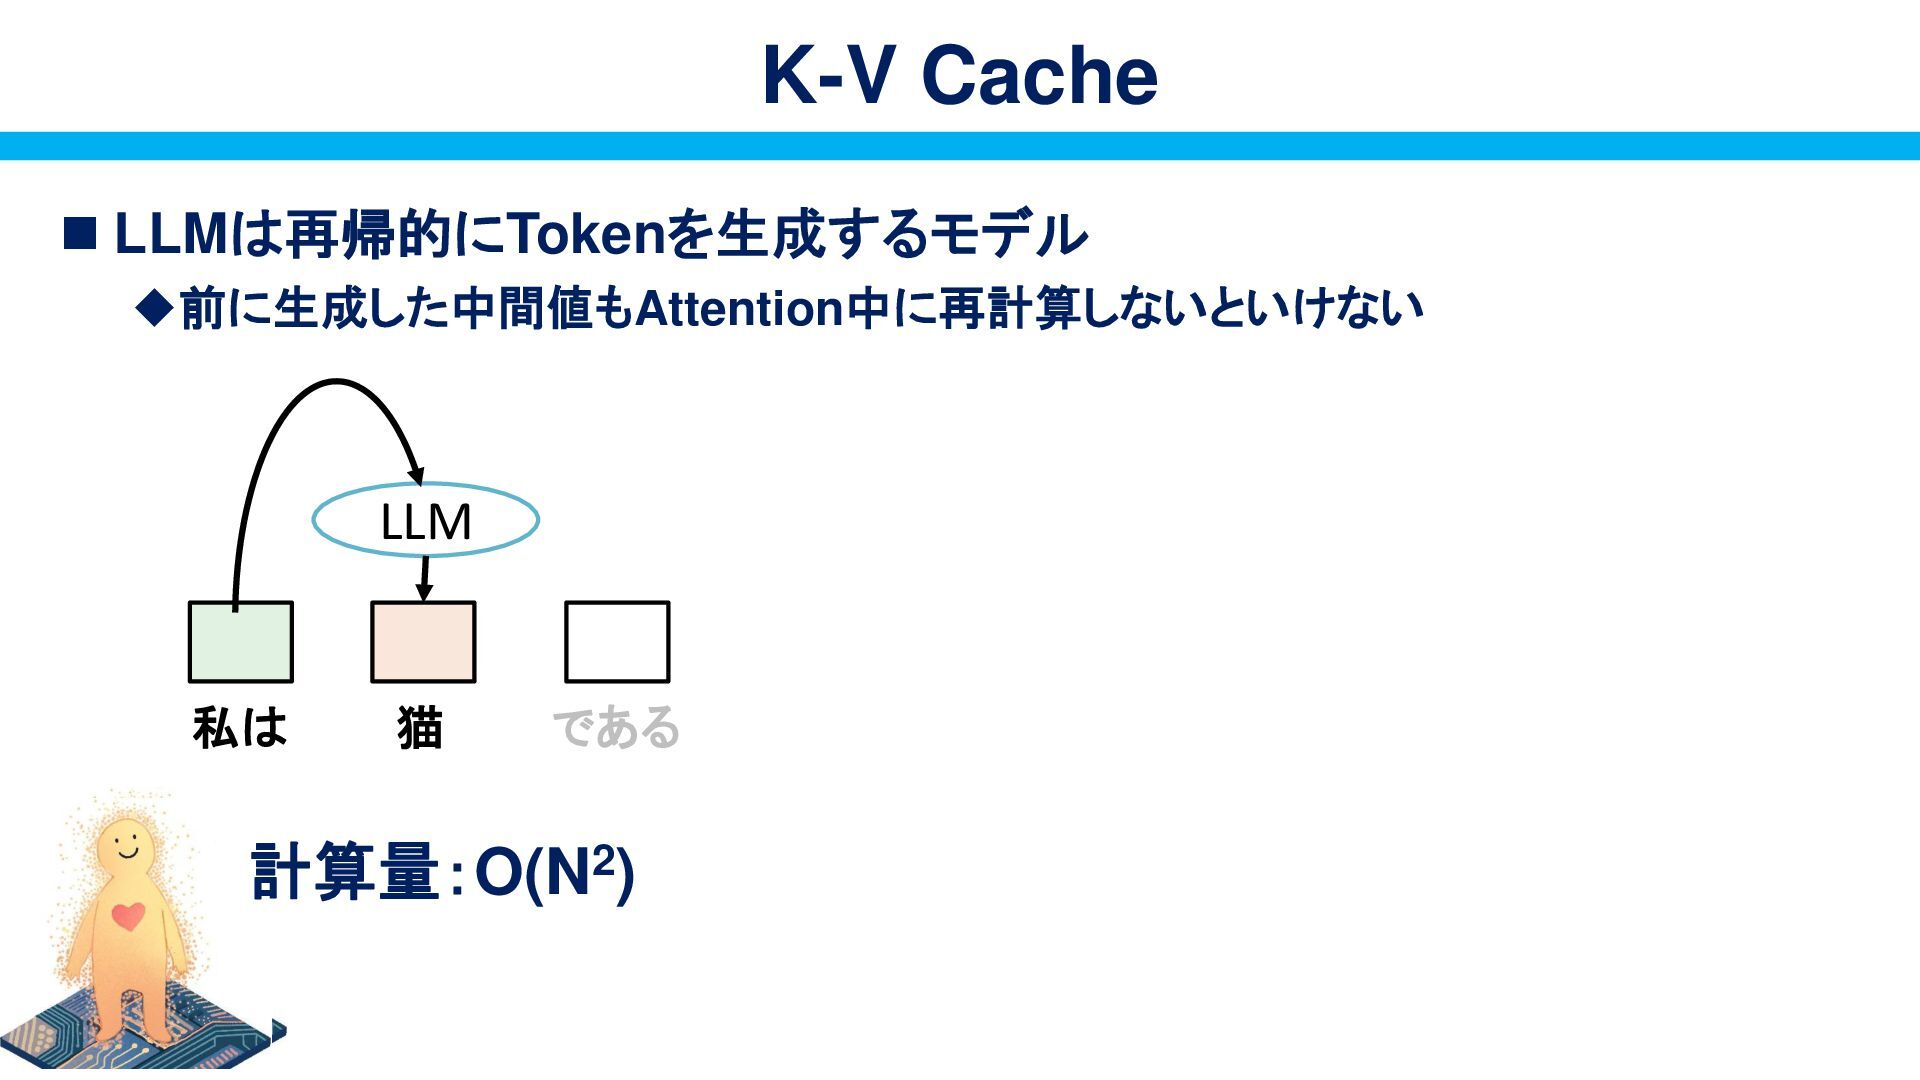
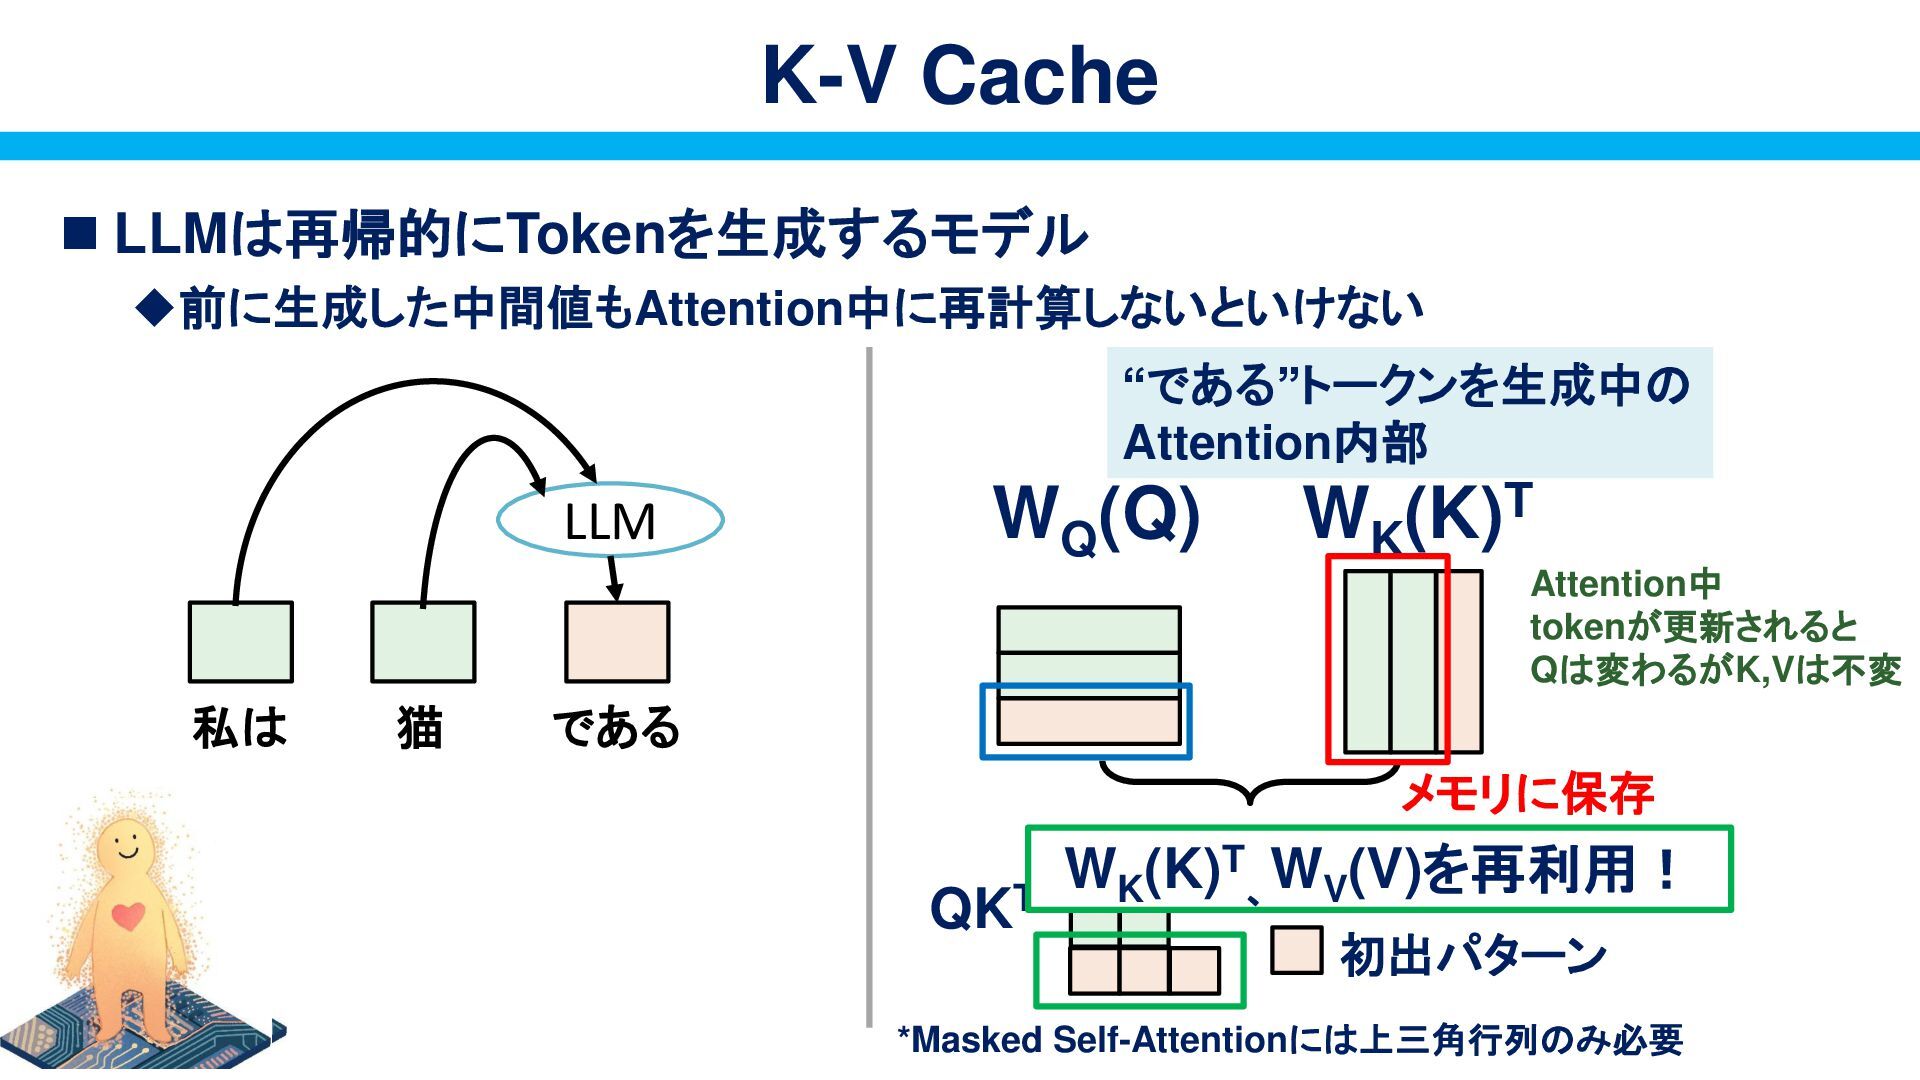
◼ LLMは再帰的にTokenを生成するモデル ◆前に生成した中間値もAttention中に再計算しないといけない K-V Cache 私は 猫 である LLM WQ
(Q) WK (K)T “である”トークンを生成中の Attention内部 QKT 初出パターン 既出パターン メモリに保存 *Masked Self-Attentionには上三角行列のみ必要 WK (K)T 、 WV (V)を再利用! Attention中 tokenが更新されると Qは変わるがK,Vは不変 -
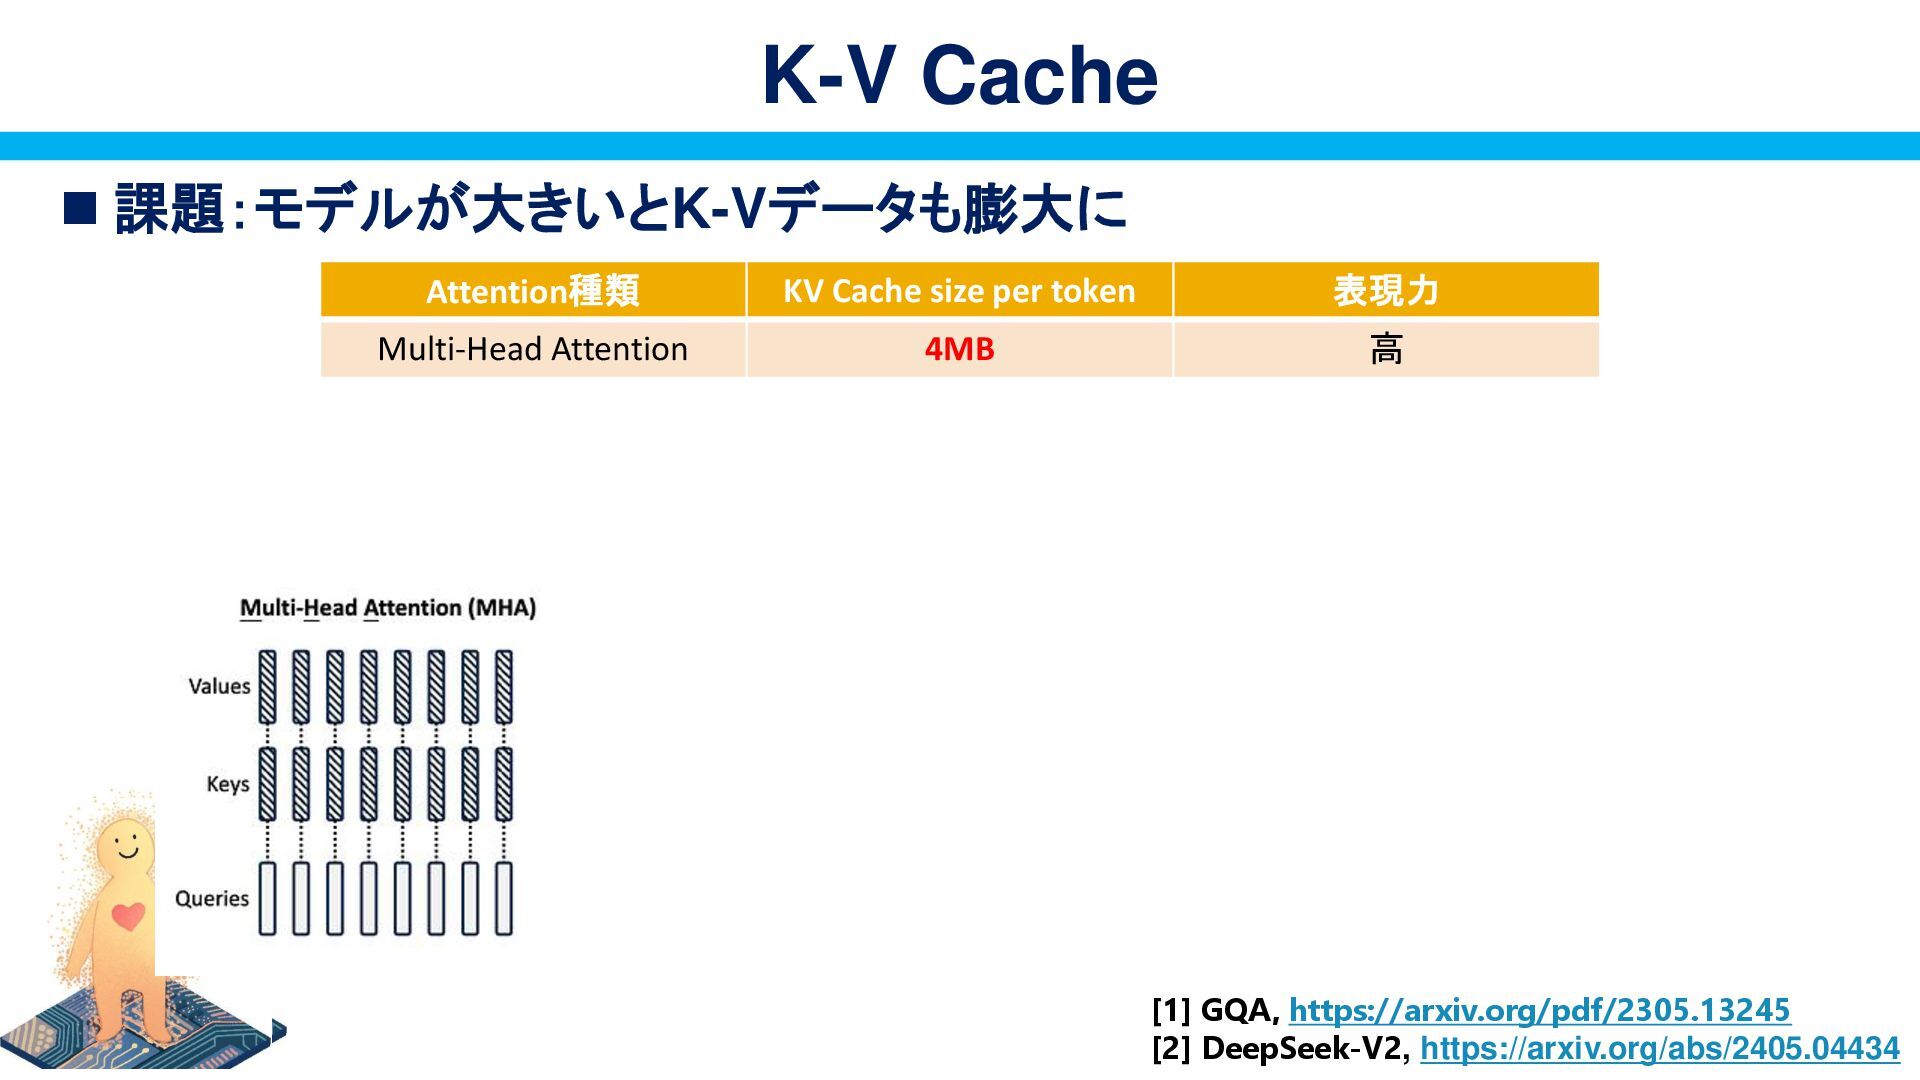
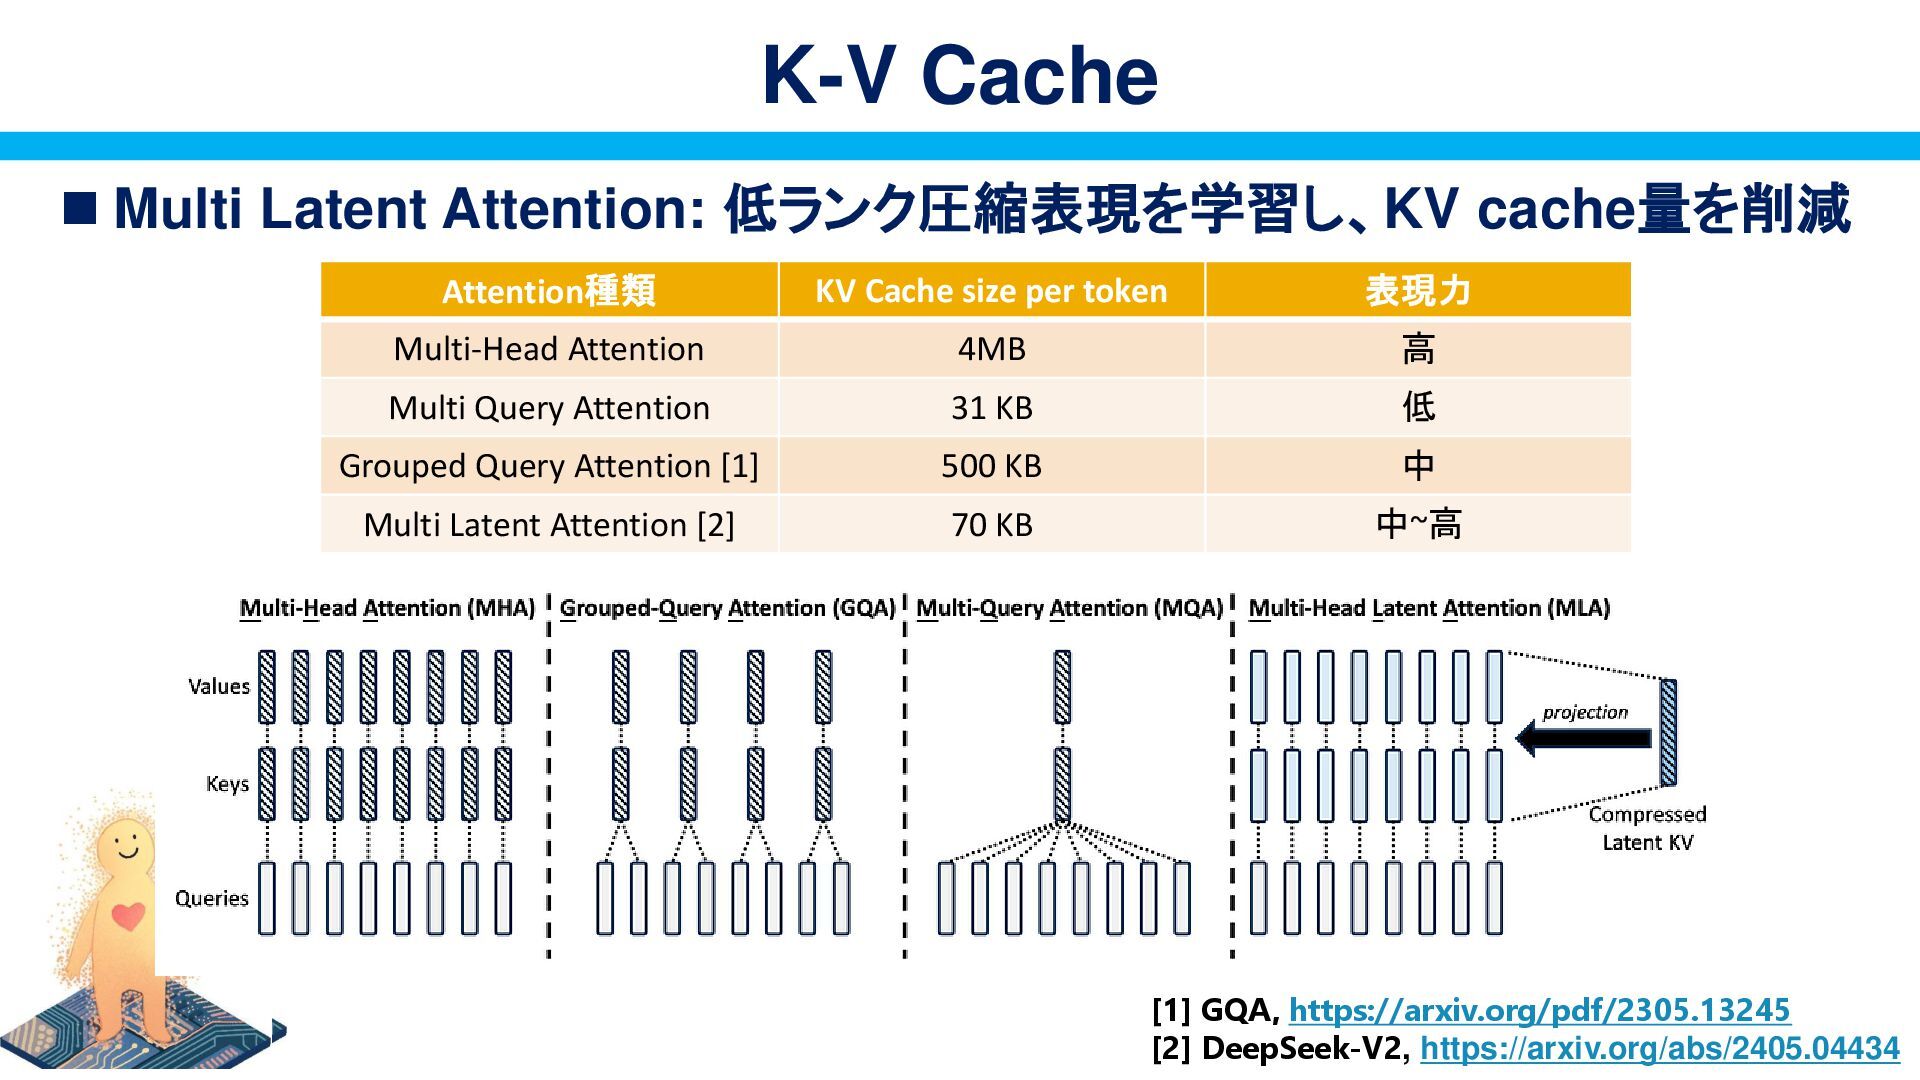
◼ 課題:モデルが大きいとK-Vデータも膨大に K-V Cache Attention種類 KV Cache size per token
表現力 Multi-Head Attention 4MB 高 [1] GQA, https://arxiv.org/pdf/2305.13245 [2] DeepSeek-V2, https://arxiv.org/abs/2405.04434 -
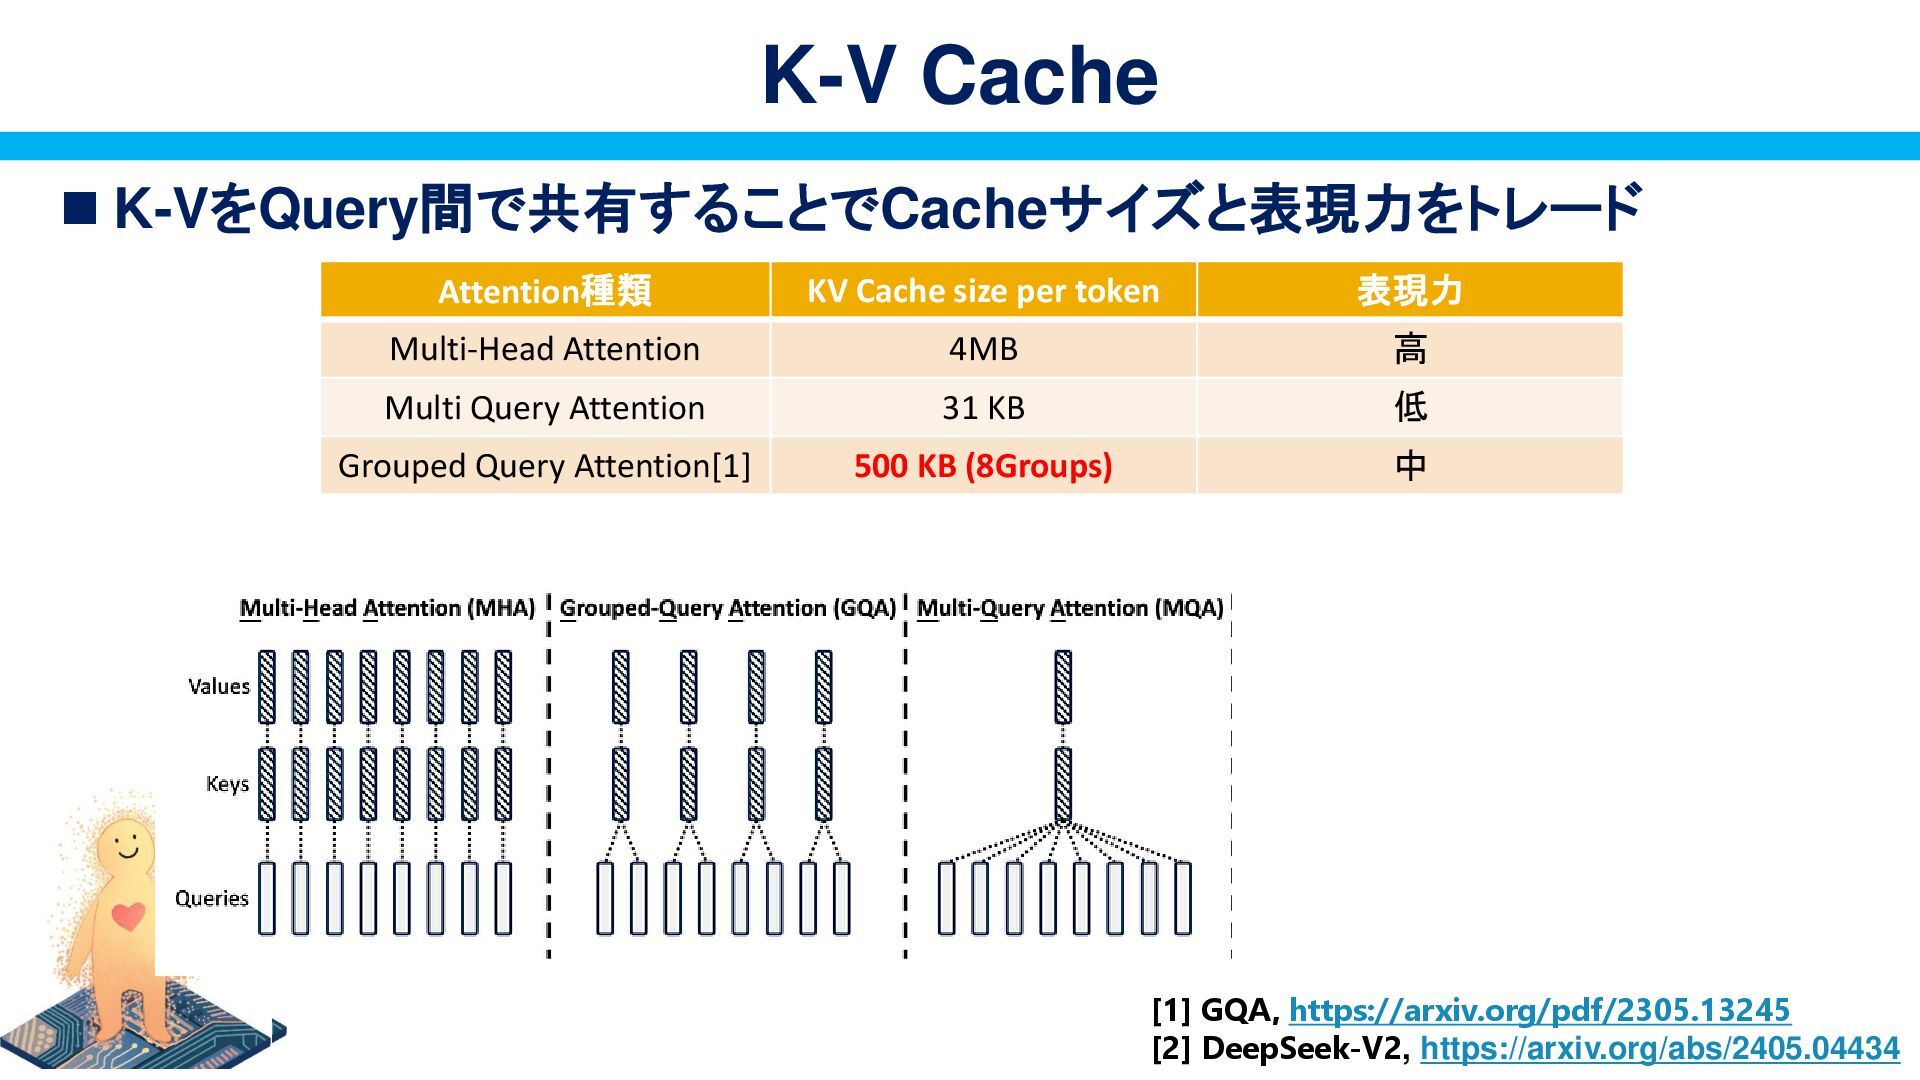
◼ K-VをQuery間で共有することでCacheサイズと表現力をトレード K-V Cache Attention種類 KV Cache size per token
表現力 Multi-Head Attention 4MB 高 Multi Query Attention 31 KB 低 Grouped Query Attention[1] 500 KB (8Groups) 中 [1] GQA, https://arxiv.org/pdf/2305.13245 [2] DeepSeek-V2, https://arxiv.org/abs/2405.04434 -
◼ Multi Latent Attention: 低ランク圧縮表現を学習し、KV cache量を削減 K-V Cache Attention種類 KV
Cache size per token 表現力 Multi-Head Attention 4MB 高 Multi Query Attention 31 KB 低 Grouped Query Attention [1] 500 KB 中 Multi Latent Attention [2] 70 KB 中~高 [1] GQA, https://arxiv.org/pdf/2305.13245 [2] DeepSeek-V2, https://arxiv.org/abs/2405.04434 -
◼ 現代コンピューティングではメモリ通信が重要 ◆通信速度が遅いとすぐにメモリ律速してしまう ◆そのためHBMが大きな注目を浴びている ◼ LLM@Edge用の重要技術として以下を紹介した ◆Flash Attention ◆K-V Cache,
Multihead Latent Attention まとめ