Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ロイター記事から日経平均騰落を予測
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
susia9610
March 08, 2020
82
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ロイター記事から日経平均騰落を予測
susia9610
March 08, 2020
Featured
See All Featured
Bioeconomy Workshop: Dr. Julius Ecuru, Opportunities for a Bioeconomy in West Africa
akademiya2063
PRO
1
410
Making Projects Easy
brettharned
120
6.8k
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
How to optimise 3,500 product descriptions for ecommerce in one day using ChatGPT
katarinadahlin
PRO
3
3.9k
Collaborative Software Design: How to facilitate domain modelling decisions
baasie
1
340
Speed Design
sergeychernyshev
33
2.2k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
300
The Cost Of JavaScript in 2023
addyosmani
55
10k
Leo the Paperboy
mayatellez
10
2.4k
Fireside Chat
paigeccino
43
4.1k
30 Presentation Tips
portentint
PRO
1
430
Transcript
ロイター記事から日経平均騰落を予測 金志炫
1. はじめに 1)背景 - 現在、金融業界のポートフォリオリスクマネジメント部門にて、時系列データのテクニカル分析や財務諸表などの ファンダメンタル分析業務に従事。 - 定量分析のみならず機械学習を通じて非財務指標による分析(SNS、インターネット、開示文書、新聞などのテキ スト類)が盛んであると、、、(自分が知らなかっただけかもしりませんが) 効率的市場仮設※から、定性的な情報もすでに市場に織り込み済みだとすると、「テキスト情報が出た直後株価に反映され、果
たしてテキストデータが株価騰落を予測する価値はあるのか?しかも株価に影響する要素はテキスト情報以外にもたくさんある ので、そもそも予測の価値がないのでは?」と疑問を持ちながら、「でも実際はどうなんだろう?一度データ分析を通じて検証し てみようではないか」という好奇心から本プロジェクトを進めることとなった。 ※効率的市場仮説 とは、金融経済学において市場は常に完全に情報的に効率的であるとする仮説。ここで言う情報的に効率 的であるとは、金融市場における金融商品の価格がその商品の価値を決定づける情報を反映しているという意味 1
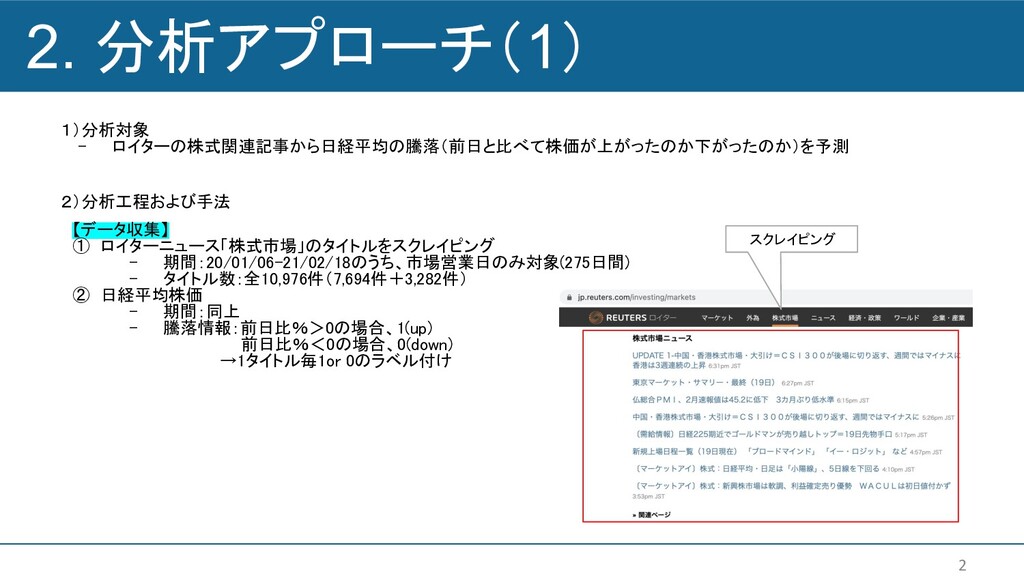
1)分析対象 - ロイターの株式関連記事から日経平均の騰落(前日と比べて株価が上がったのか下がったのか)を予測 2)分析工程および手法 【データ収集】 ① ロイターニュース「株式市場」のタイトルをスクレイピング - 期間:20/01/06-21/02/18のうち、市場営業日のみ対象(275日間) - タイトル数:全10,976件(7,694件+3,282件)
② 日経平均株価 - 期間:同上 - 騰落情報:前日比%>0の場合、1(up) 前日比%<0の場合、0(down) →1タイトル毎1or 0のラベル付け 2. 分析アプローチ(1) スクレイピング 2
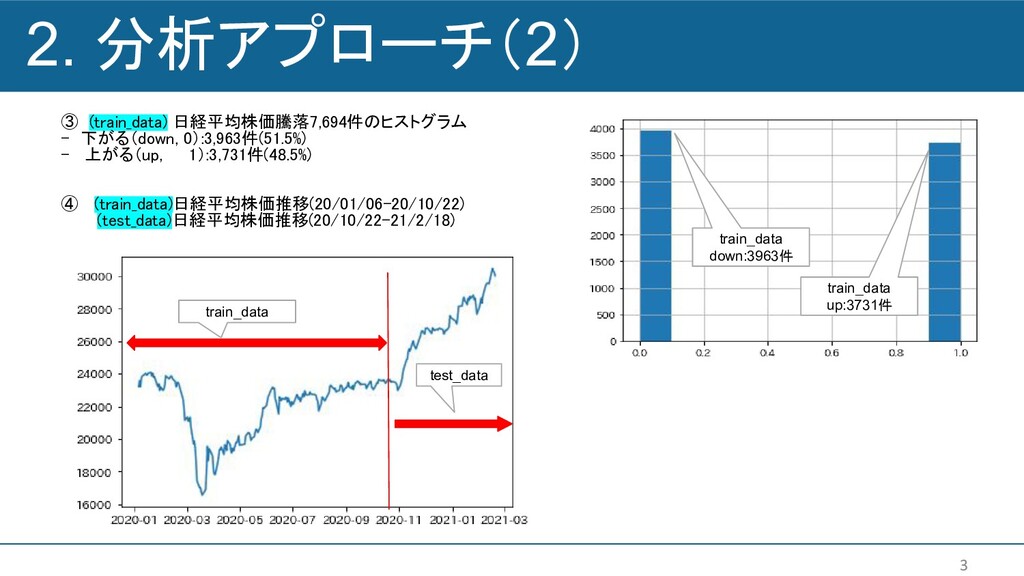
③ (train_data) 日経平均株価騰落7,694件のヒストグラム - 下がる(down, 0):3,963件(51.5%) - 上がる(up, 1):3,731件(48.5%) ④
(train_data)日経平均株価推移(20/01/06-20/10/22) (test_data)日経平均株価推移(20/10/22-21/2/18) 2. 分析アプローチ(2) train_data test_data train_data down:3963件 train_data up:3731件 3
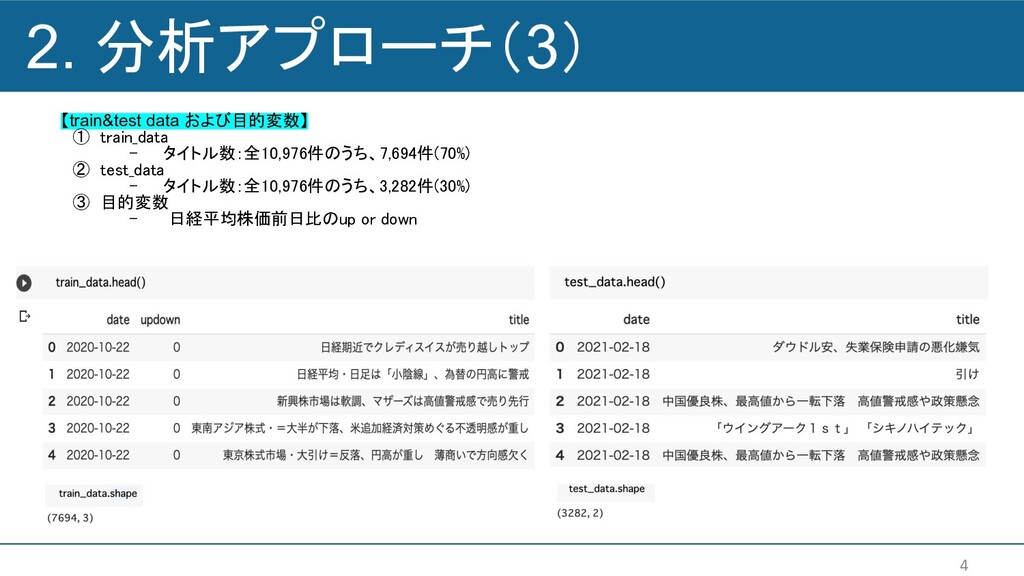
【train&test data および目的変数】 ① train_data - タイトル数:全10,976件のうち、7,694件(70%) ② test_data - タイトル数:全10,976件のうち、3,282件(30%) ③ 目的変数
- 日経平均株価前日比のup or down 2. 分析アプローチ(3) 4
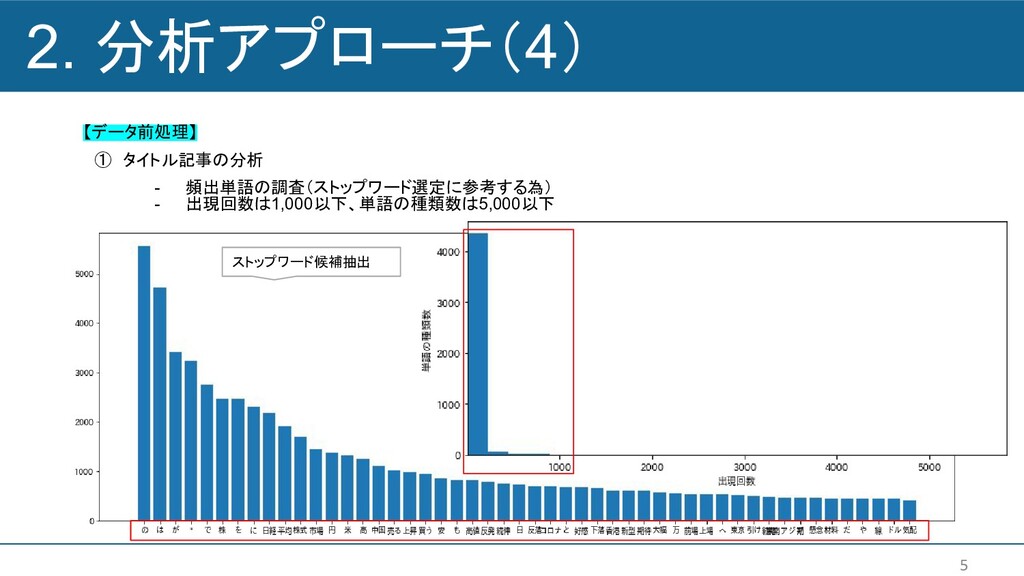
2. 分析アプローチ(4) 【データ前処理】 ① タイトル記事の分析 - 頻出単語の調査(ストップワード選定に参考する為) - 出現回数は1,000以下、単語の種類数は5,000以下 ストップワード候補抽出
5
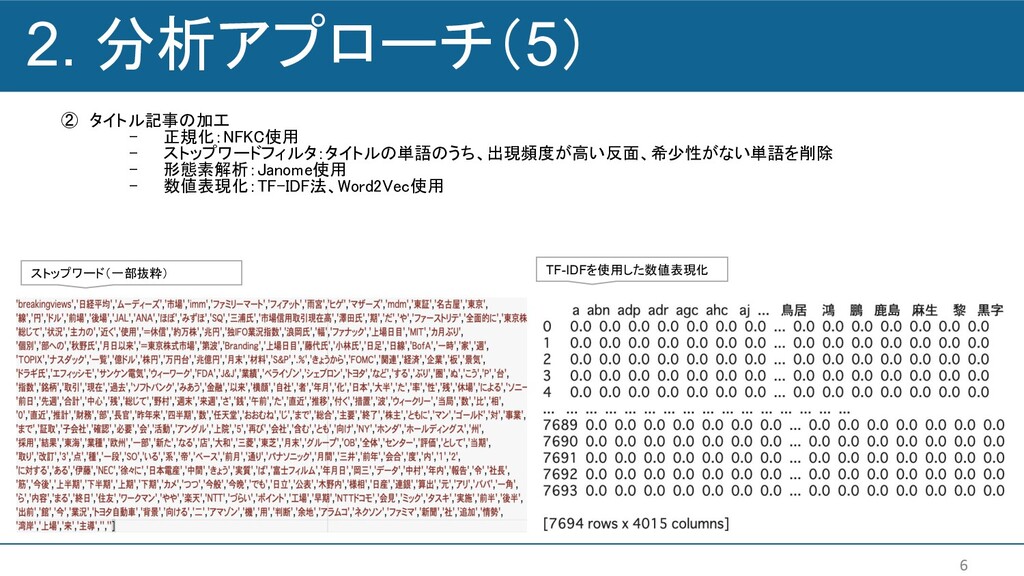
② タイトル記事の加工 - 正規化:NFKC使用 - ストップワードフィルタ:タイトルの単語のうち、出現頻度が高い反面、希少性がない単語を削除 - 形態素解析:Janome使用 - 数値表現化:TF-IDF法、Word2Vec使用
2. 分析アプローチ(5) ストップワード(一部抜粋) TF-IDFを使用した数値表現化 6
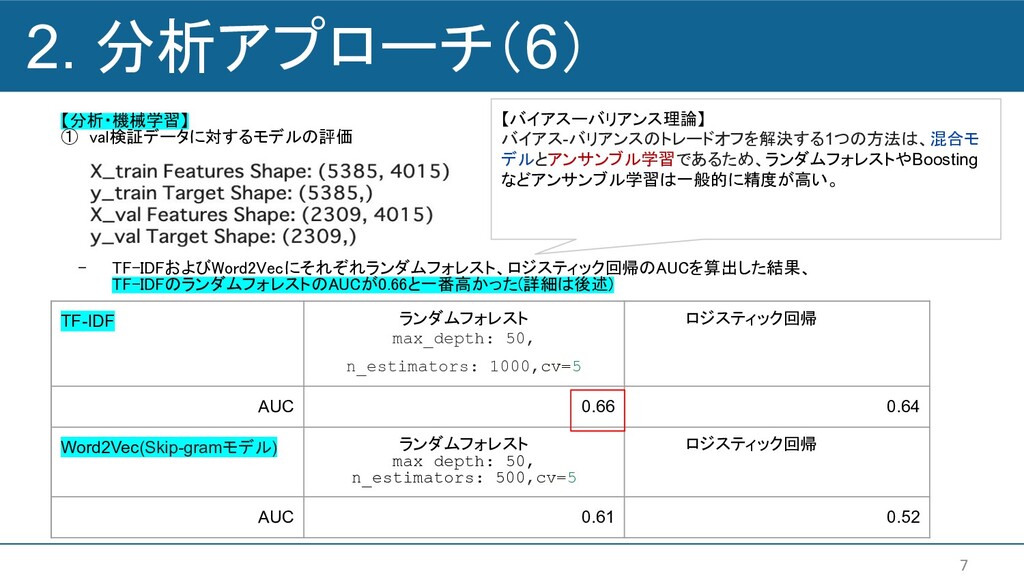
【分析・機械学習】 ① val検証データに対するモデルの評価 -
TF-IDFおよびWord2Vecにそれぞれランダムフォレスト、ロジスティック回帰のAUCを算出した結果、 TF-IDFのランダムフォレストのAUCが0.66と一番高かった(詳細は後述) 2. 分析アプローチ(6) TF-IDF ランダムフォレスト max_depth: 50, n_estimators: 1000,cv=5 ロジスティック回帰 AUC 0.66 0.64 Word2Vec(Skip-gramモデル) ランダムフォレスト max_depth: 50, n_estimators: 500,cv=5 ロジスティック回帰 AUC 0.61 0.52 【バイアスーバリアンス理論】 バイアス-バリアンスのトレードオフを解決する1つの方法は、混合モ デルとアンサンブル学習であるため、ランダムフォレストやBoosting などアンサンブル学習は一般的に精度が高い。 7
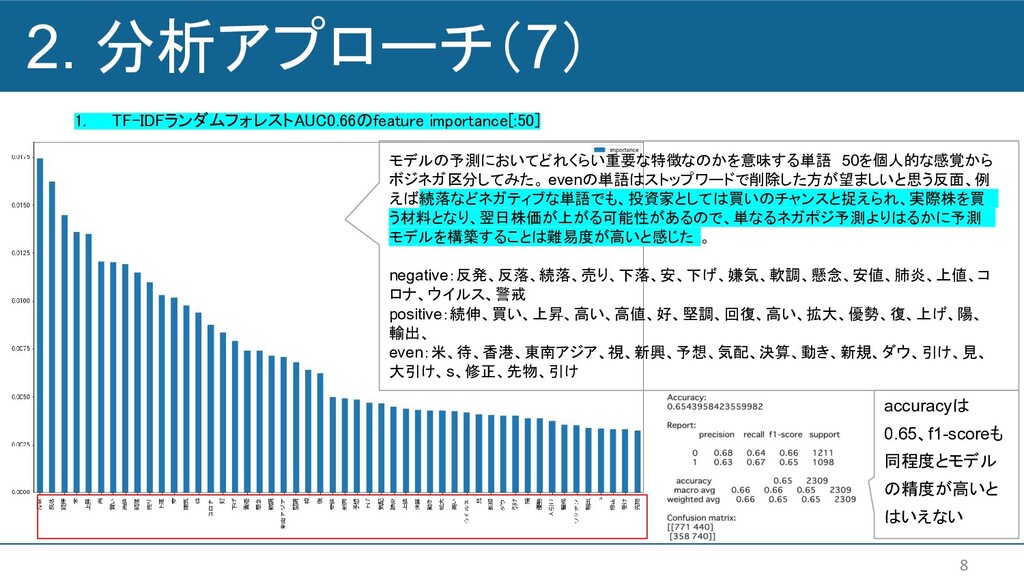
1. TF-IDFランダムフォレストAUC0.66のfeature importance[:50] 2. 分析アプローチ(7) モデルの予測においてどれくらい重要な特徴なのかを意味する単語 50を個人的な感覚から ボジネガ区分してみた。 evenの単語はストップワードで削除した方が望ましいと思う反面、例
えば続落などネガティブな単語でも、投資家としては買いのチャンスと捉えられ、実際株を買 う材料となり、翌日株価が上がる可能性があるので、単なるネガポジ予測よりはるかに予測 モデルを構築することは難易度が高いと感じた 。 negative:反発、反落、続落、売り、下落、安、下げ、嫌気、軟調、懸念、安値、肺炎、上値、コ ロナ、ウイルス、警戒 positive:続伸、買い、上昇、高い、高値、好、堅調、回復、高い、拡大、優勢、復、上げ、陽、 輸出、 even:米、待、香港、東南アジア、視、新興、予想、気配、決算、動き、新規、ダウ、引け、見、 大引け、s、修正、先物、引け 8 accuracyは 0.65、f1-scoreも 同程度とモデル の精度が高いと はいえない
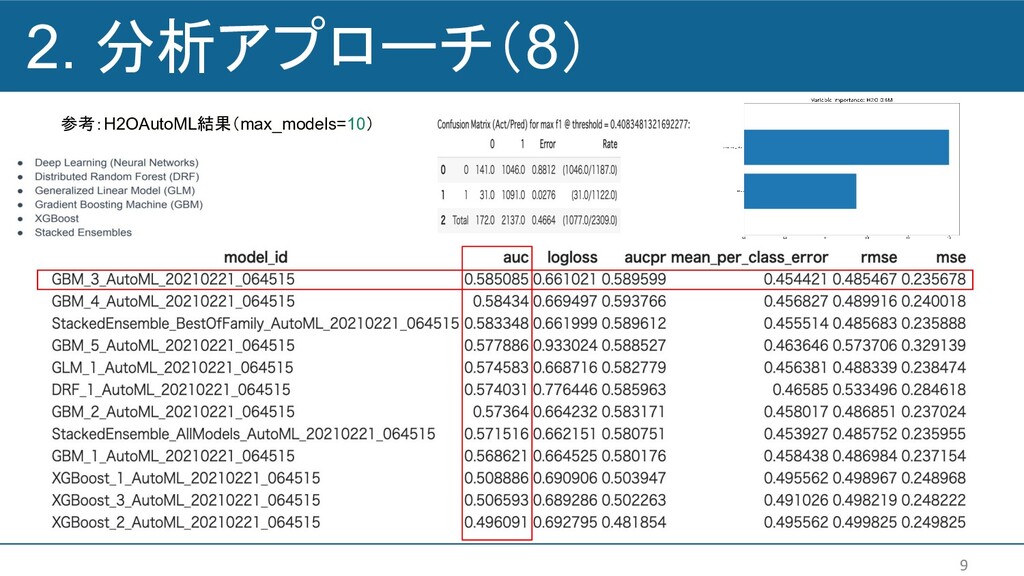
参考:H2OAutoML結果(max_models=10) 2. 分析アプローチ(8) 9
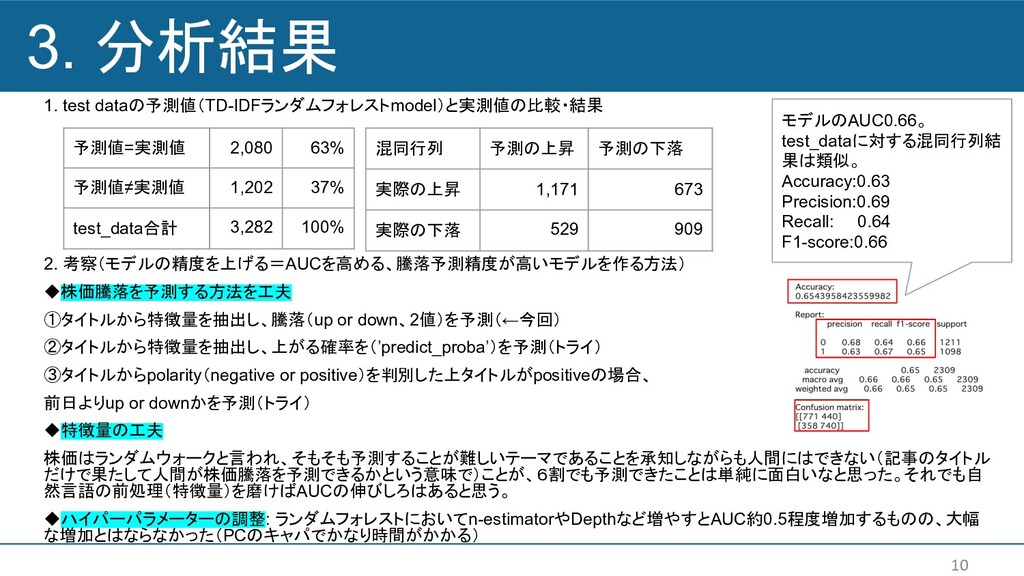
1. test dataの予測値(TD-IDFランダムフォレストmodel)と実測値の比較・結果 2. 考察(モデルの精度を上げる=AUCを高める、騰落予測精度が高いモデルを作る方法) ◆株価騰落を予測する方法を工夫 ①タイトルから特徴量を抽出し、騰落(up or down、2値)を予測(←今回) ②タイトルから特徴量を抽出し、上がる確率を(’predict_proba’)を予測(トライ)
③タイトルからpolarity(negative or positive)を判別した上タイトルがpositiveの場合、 前日よりup or downかを予測(トライ) ◆特徴量の工夫 株価はランダムウォークと言われ、そもそも予測することが難しいテーマであることを承知しながらも人間にはできない(記事のタイトル だけで果たして人間が株価騰落を予測できるかという意味で)ことが、6割でも予測できたことは単純に面白いなと思った。それでも自 然言語の前処理(特徴量)を磨けばAUCの伸びしろはあると思う。 ◆ハイパーパラメーターの調整: ランダムフォレストにおいてn-estimatorやDepthなど増やすとAUC約0.5程度増加するものの、大幅 な増加とはならなかった(PCのキャパでかなり時間がかかる) 3. 分析結果 予測値=実測値 2,080 63% 予測値≠実測値 1,202 37% test_data合計 3,282 100% 混同行列 予測の上昇 予測の下落 実際の上昇 1,171 673 実際の下落 529 909 モデルのAUC0.66。 test_dataに対する混同行列結 果は類似。 Accuracy:0.63 Precision:0.69 Recall: 0.64 F1-score:0.66 10
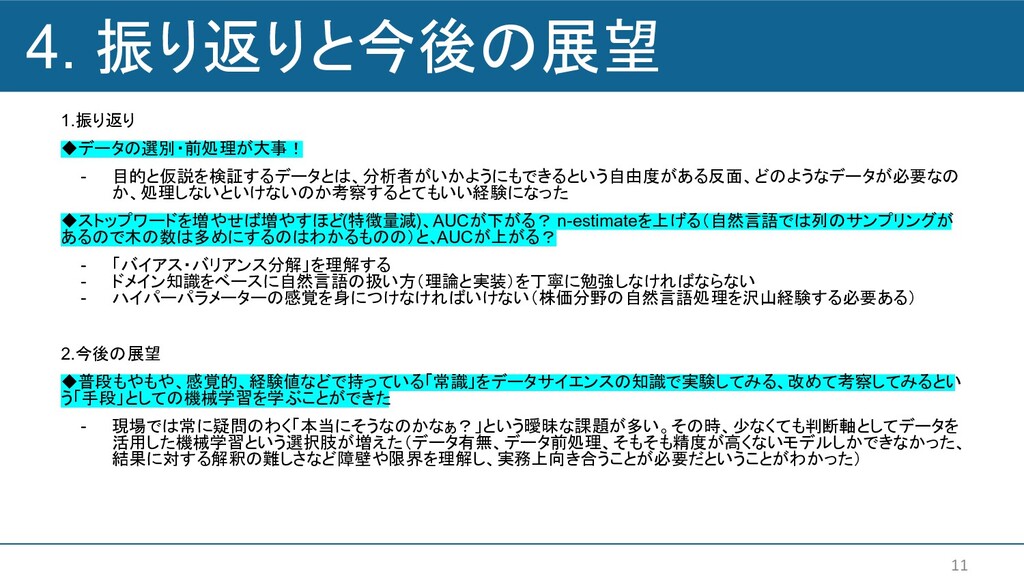
1.振り返り ◆データの選別・前処理が大事! - 目的と仮説を検証するデータとは、分析者がいかようにもできるという自由度がある反面、どのようなデータが必要なの か、処理しないといけないのか考察するとてもいい経験になった ◆ストップワードを増やせば増やすほど(特徴量減)、AUCが下がる? n-estimateを上げる(自然言語では列のサンプリングが あるので木の数は多めにするのはわかるものの)と、AUCが上がる? - 「バイアス・バリアンス分解」を理解する
- ドメイン知識をベースに自然言語の扱い方(理論と実装)を丁寧に勉強しなければならない - ハイパーパラメーターの感覚を身につけなければいけない(株価分野の自然言語処理を沢山経験する必要ある) 2.今後の展望 ◆普段もやもや、感覚的、経験値などで持っている「常識」をデータサイエンスの知識で実験してみる、改めて考察してみるとい う「手段」としての機械学習を学ぶことができた - 現場では常に疑問のわく「本当にそうなのかなぁ?」という曖昧な課題が多い。その時、少なくても判断軸としてデータを 活用した機械学習という選択肢が増えた(データ有無、データ前処理、そもそも精度が高くないモデルしかできなかった、 結果に対する解釈の難しさなど障壁や限界を理解し、実務上向き合うことが必要だということがわかった) 4. 振り返りと今後の展望 11


 akademiya2063
 brettharned
 chrisshort
 katarinadahlin
 baasie
 sergeychernyshev
 jeffersonlam
 sabderemane
 addyosmani
 mayatellez
 paigeccino
 portentint