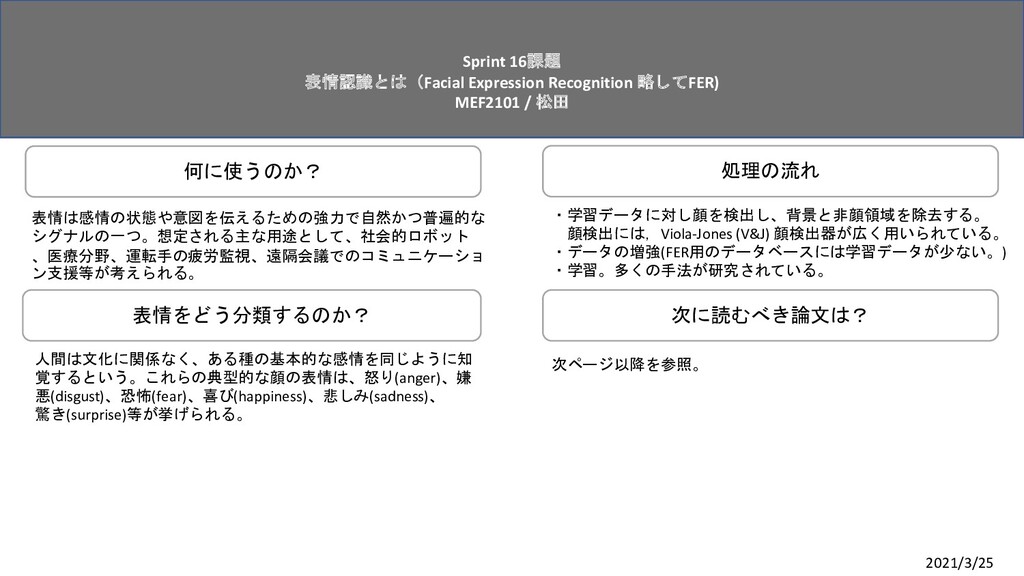
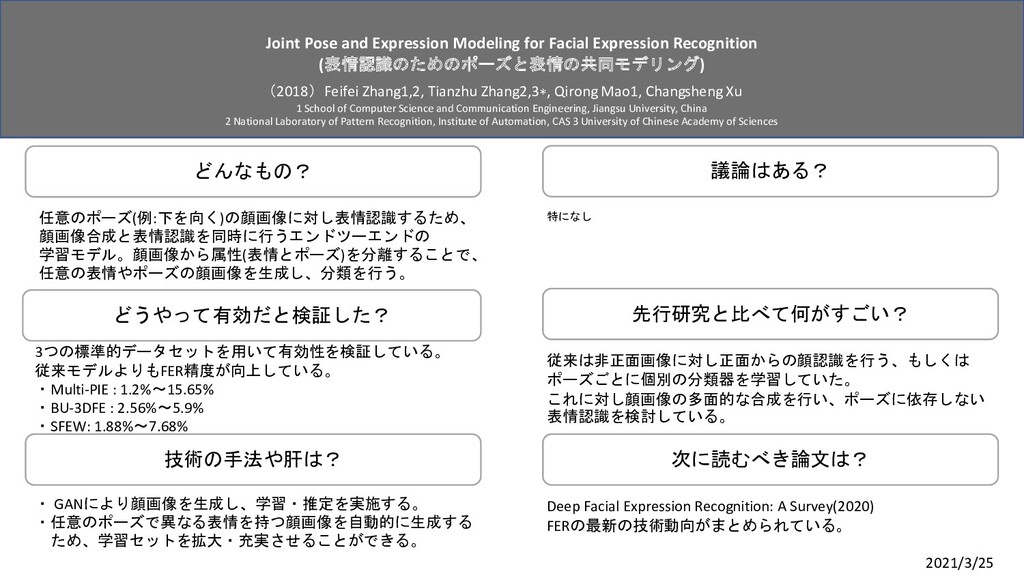
A Survey(2020) FERの最新の技術動向がまとめられている。 特になし 3つの標準的データセットを用いて有効性を検証している。 従来モデルよりもFER精度が向上している。 ・Multi-PIE : 1.2%〜15.65% ・BU-3DFE : 2.56%~5.9% ・SFEW: 1.88%〜7.68% ・ GANにより顔画像を生成し、学習・推定を実施する。 ・任意のポーズで異なる表情を持つ顔画像を自動的に生成する ため、学習セットを拡大・充実させることができる。 従来は非正面画像に対し正面からの顔認識を行う、もしくは ポーズごとに個別の分類器を学習していた。 これに対し顔画像の多面的な合成を行い、ポーズに依存しない 表情認識を検討している。 任意のポーズ(例:下を向く)の顔画像に対し表情認識するため、 顔画像合成と表情認識を同時に行うエンドツーエンドの 学習モデル。顔画像から属性(表情とポーズ)を分離することで、 任意の表情やポーズの顔画像を生成し、分類を行う。 Joint Pose and Expression Modeling for Facial Expression Recognition (表情認識のためのポーズと表情の共同モデリング) (2018)Feifei Zhang1,2, Tianzhu Zhang2,3∗, Qirong Mao1, Changsheng Xu 1 School of Computer Science and Communication Engineering, Jiangsu University, China 2 National Laboratory of Pattern Recognition, Institute of Automation, CAS 3 University of Chinese Academy of Sciences 2021/3/25
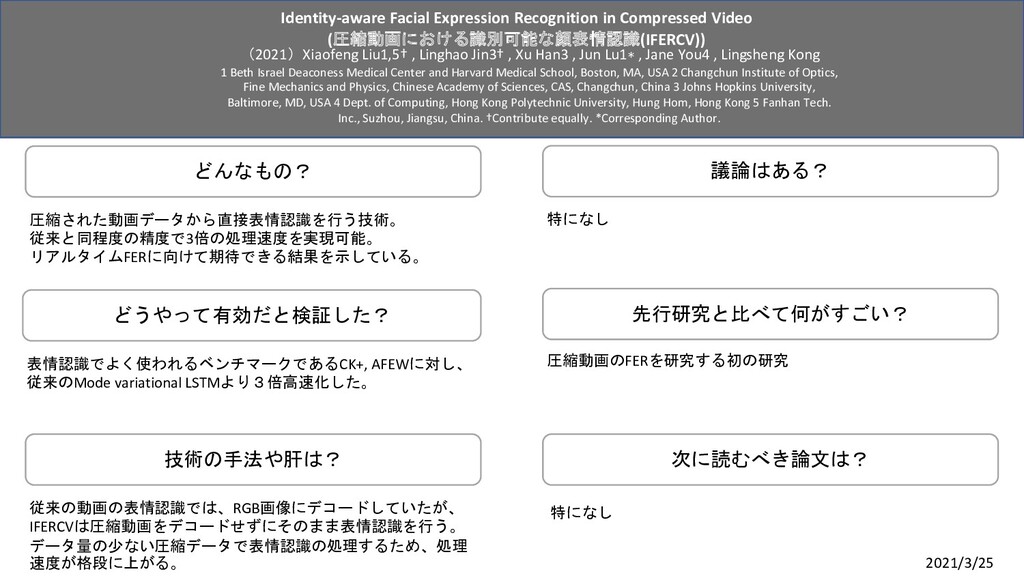
variational LSTMより3倍高速化した。 従来の動画の表情認識では、RGB画像にデコードしていたが、 IFERCVは圧縮動画をデコードせずにそのまま表情認識を行う。 データ量の少ない圧縮データで表情認識の処理するため、処理 速度が格段に上がる。 圧縮動画のFERを研究する初の研究 圧縮された動画データから直接表情認識を行う技術。 従来と同程度の精度で3倍の処理速度を実現可能。 リアルタイムFERに向けて期待できる結果を示している。 Identity-aware Facial Expression Recognition in Compressed Video (圧縮動画における識別可能な顔表情認識(IFERCV)) (2021)Xiaofeng Liu1,5† , Linghao Jin3† , Xu Han3 , Jun Lu1∗ , Jane You4 , Lingsheng Kong 1 Beth Israel Deaconess Medical Center and Harvard Medical School, Boston, MA, USA 2 Changchun Institute of Optics, Fine Mechanics and Physics, Chinese Academy of Sciences, CAS, Changchun, China 3 Johns Hopkins University, Baltimore, MD, USA 4 Dept. of Computing, Hong Kong Polytechnic University, Hung Hom, Hong Kong 5 Fanhan Tech. Inc., Suzhou, Jiangsu, China. †Contribute equally. *Corresponding Author. 2021/3/25 特になし


 masakiokuda
 minorun365
 odashi
 kentarofujii
 willnet
 sansantech
 satomasahiro2005
 onk
 yamanoku
 prog893
 puhitaku
 hiracky16
 lara
 livdayseo
 mfonobong
 coloredviolet
 twada
 inesmontani
 jonoalderson
 jdejongh
 vanstee
 cassininazir
 427marketing
 mza