Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Моделирование БД

Моделирование БД

Это было не обучение per se, а скорее организованная дискуссия.
Поэтому некоторые слайды сохранили черновые артефакты, а в некоторых случаях представлено несколько вариантов на выбор.

Достигнутый результат: К сожалению, из-за коронавируса и других ограничений по большинству поставленных вопросов прийти к консенсусам не удалось

More Decks by Vasilii Gorokhov-Apelsinov

Other Decks in Programming

Transcript

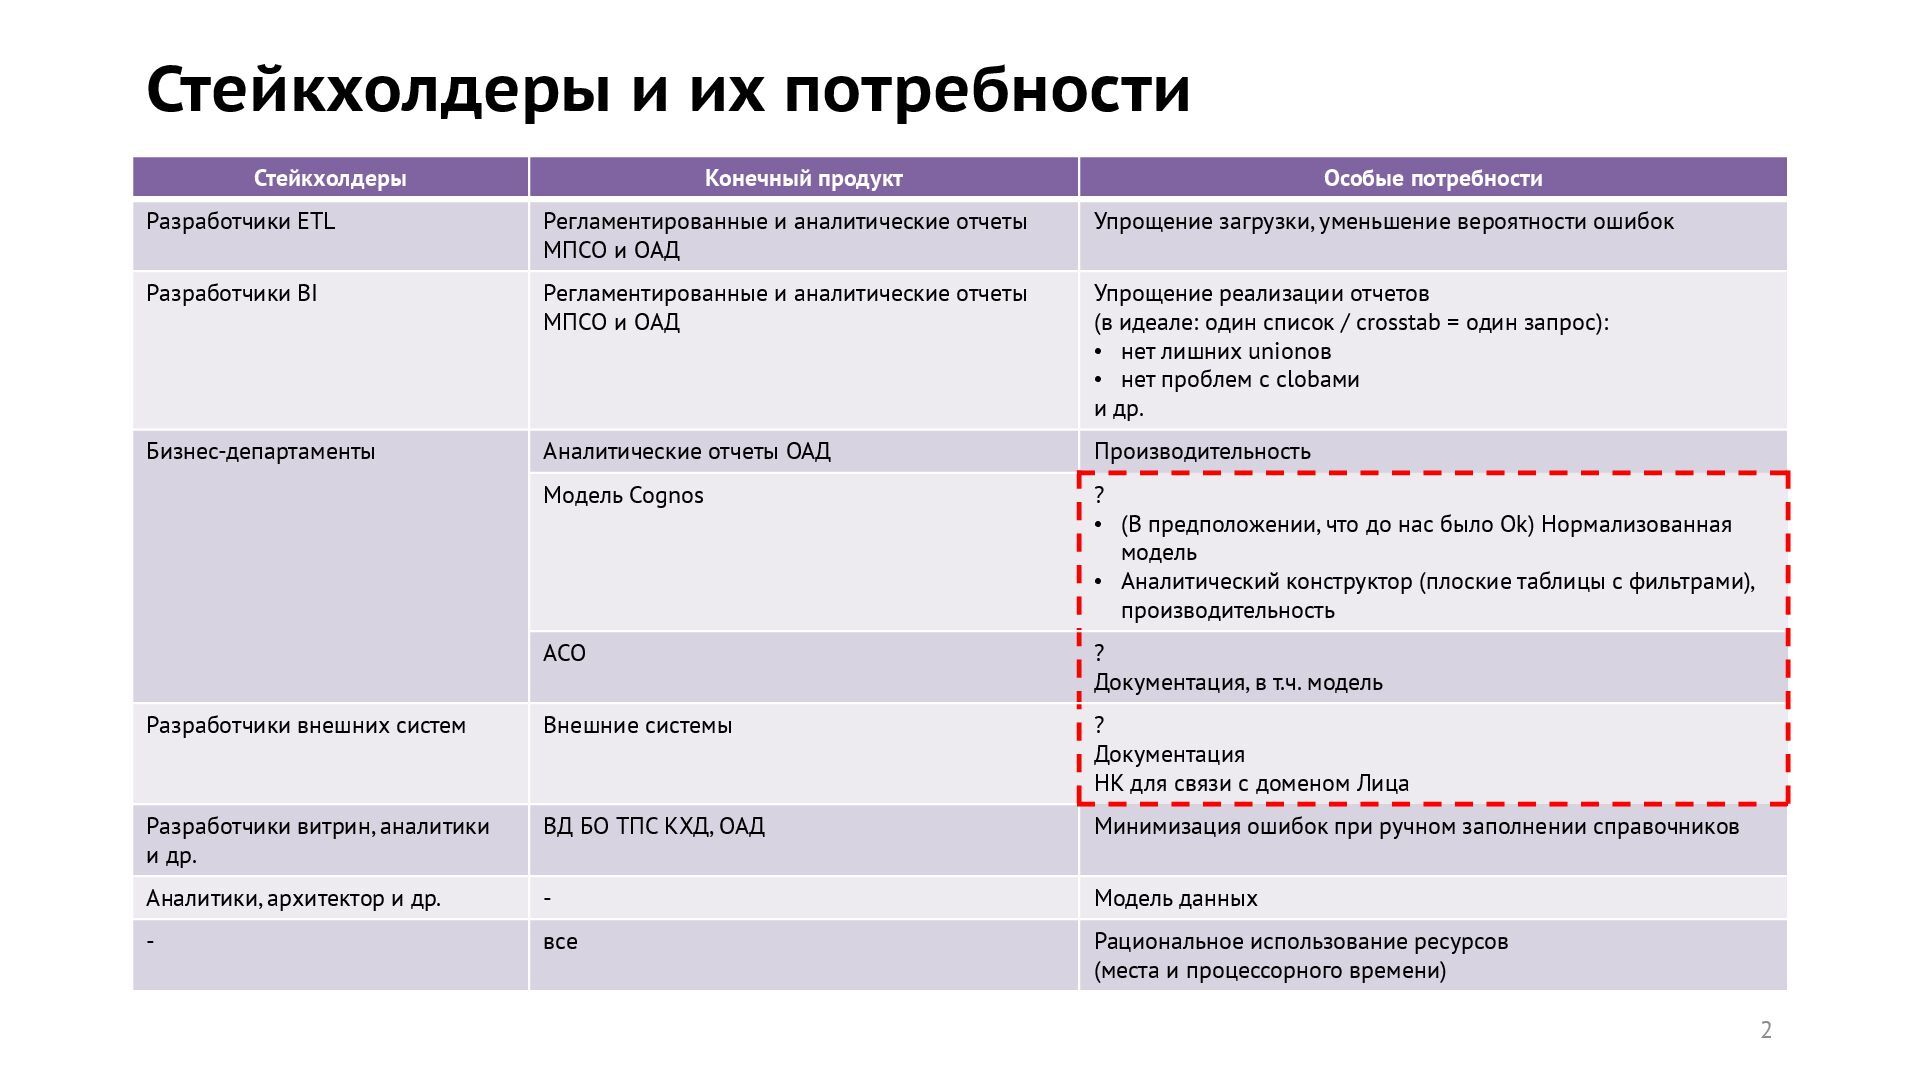
  1. Стейкхолдеры и их потребности Стейкхолдеры Конечный продукт Особые потребности Разработчики

    ETL Регламентированные и аналитические отчеты МПСО и ОАД Упрощение загрузки, уменьшение вероятности ошибок Разработчики BI Регламентированные и аналитические отчеты МПСО и ОАД Упрощение реализации отчетов (в идеале: один список / crosstab = один запрос): • нет лишних unionов • нет проблем с clobами и др. Бизнес-департаменты Аналитические отчеты ОАД Производительность Модель Cognos ? • (В предположении, что до нас было Ok) Нормализованная модель • Аналитический конструктор (плоские таблицы с фильтрами), производительность АСО ? Документация, в т.ч. модель Разработчики внешних систем Внешние системы ? Документация HK для связи с доменом Лица Разработчики витрин, аналитики и др. ВД БО ТПС КХД, ОАД Минимизация ошибок при ручном заполнении справочников Аналитики, архитектор и др. - Модель данных - все Рациональное использование ресурсов (места и процессорного времени) 2
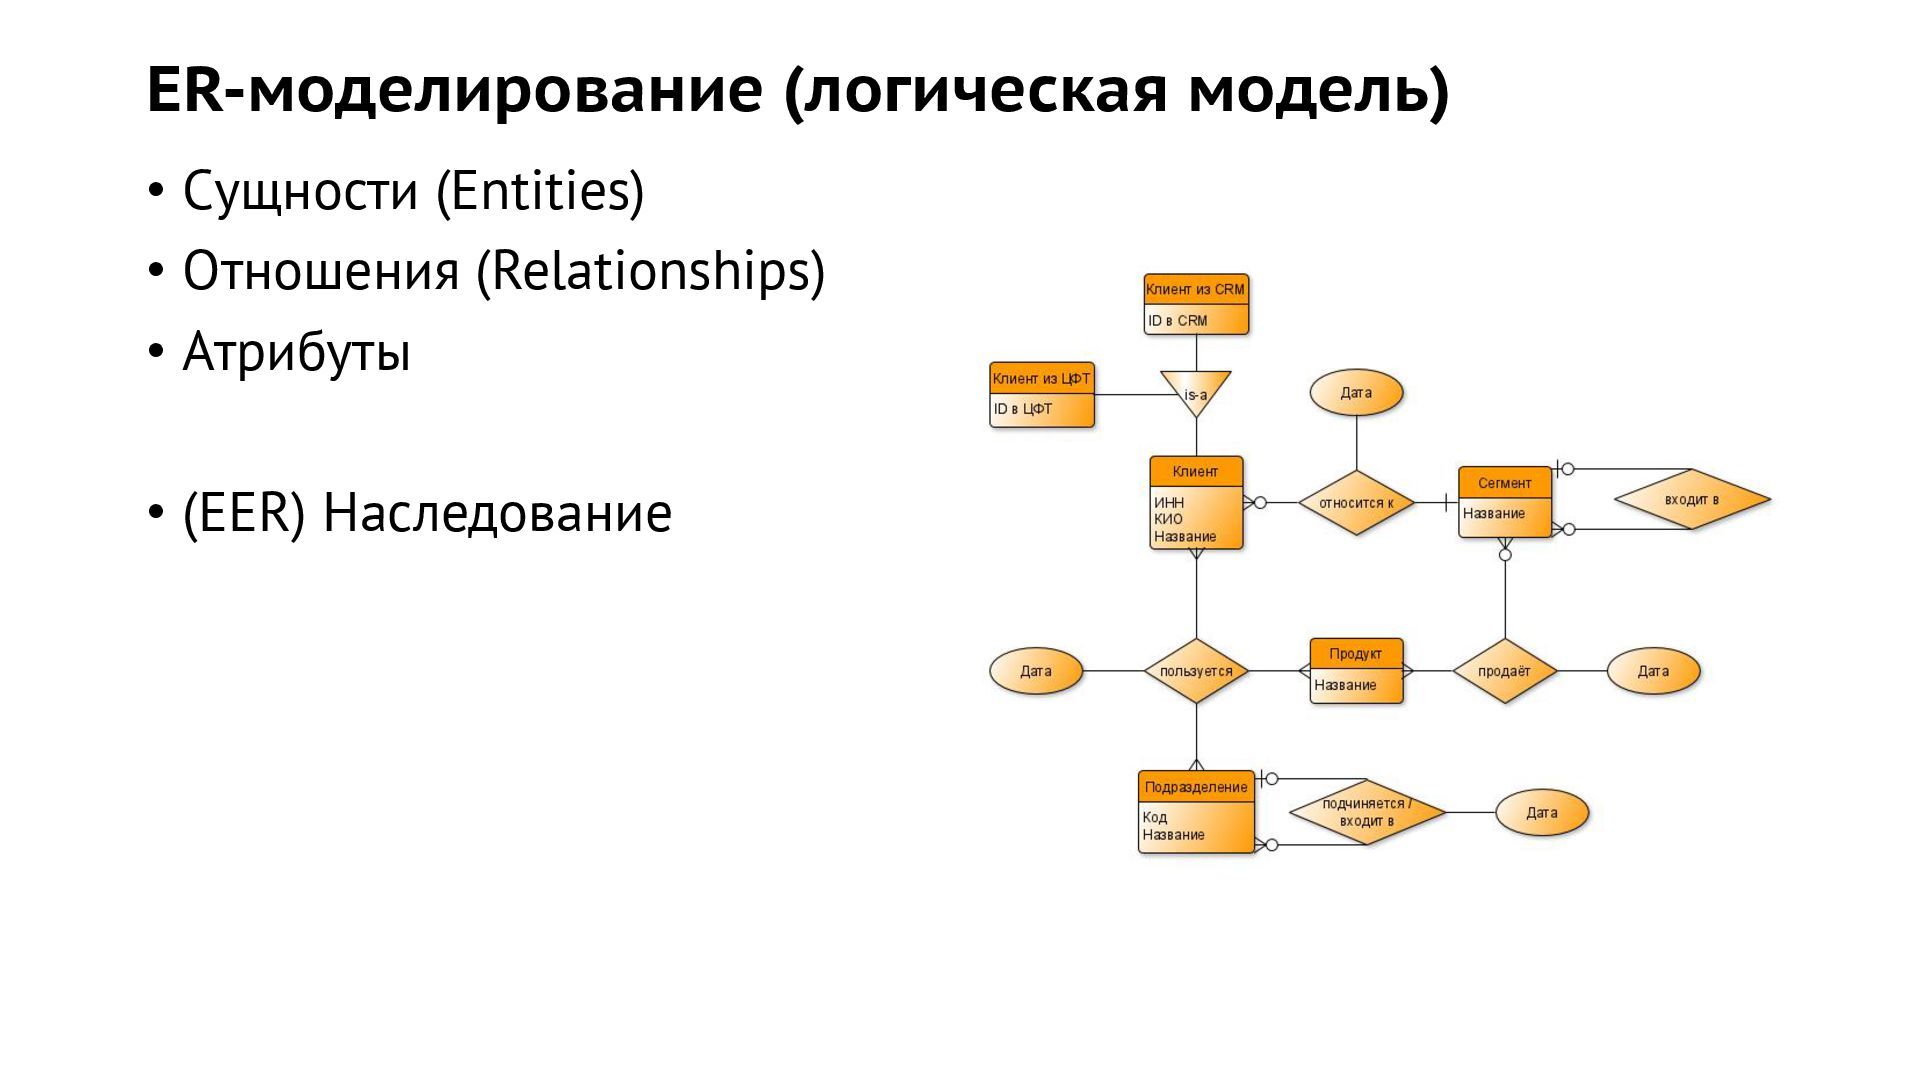
  2. Подходы к моделированию БД • ER Modeling • Нормализация •

    Data Vault • Anchor Modeling • Dimensional Modeling • "Универсальная таблица" 3
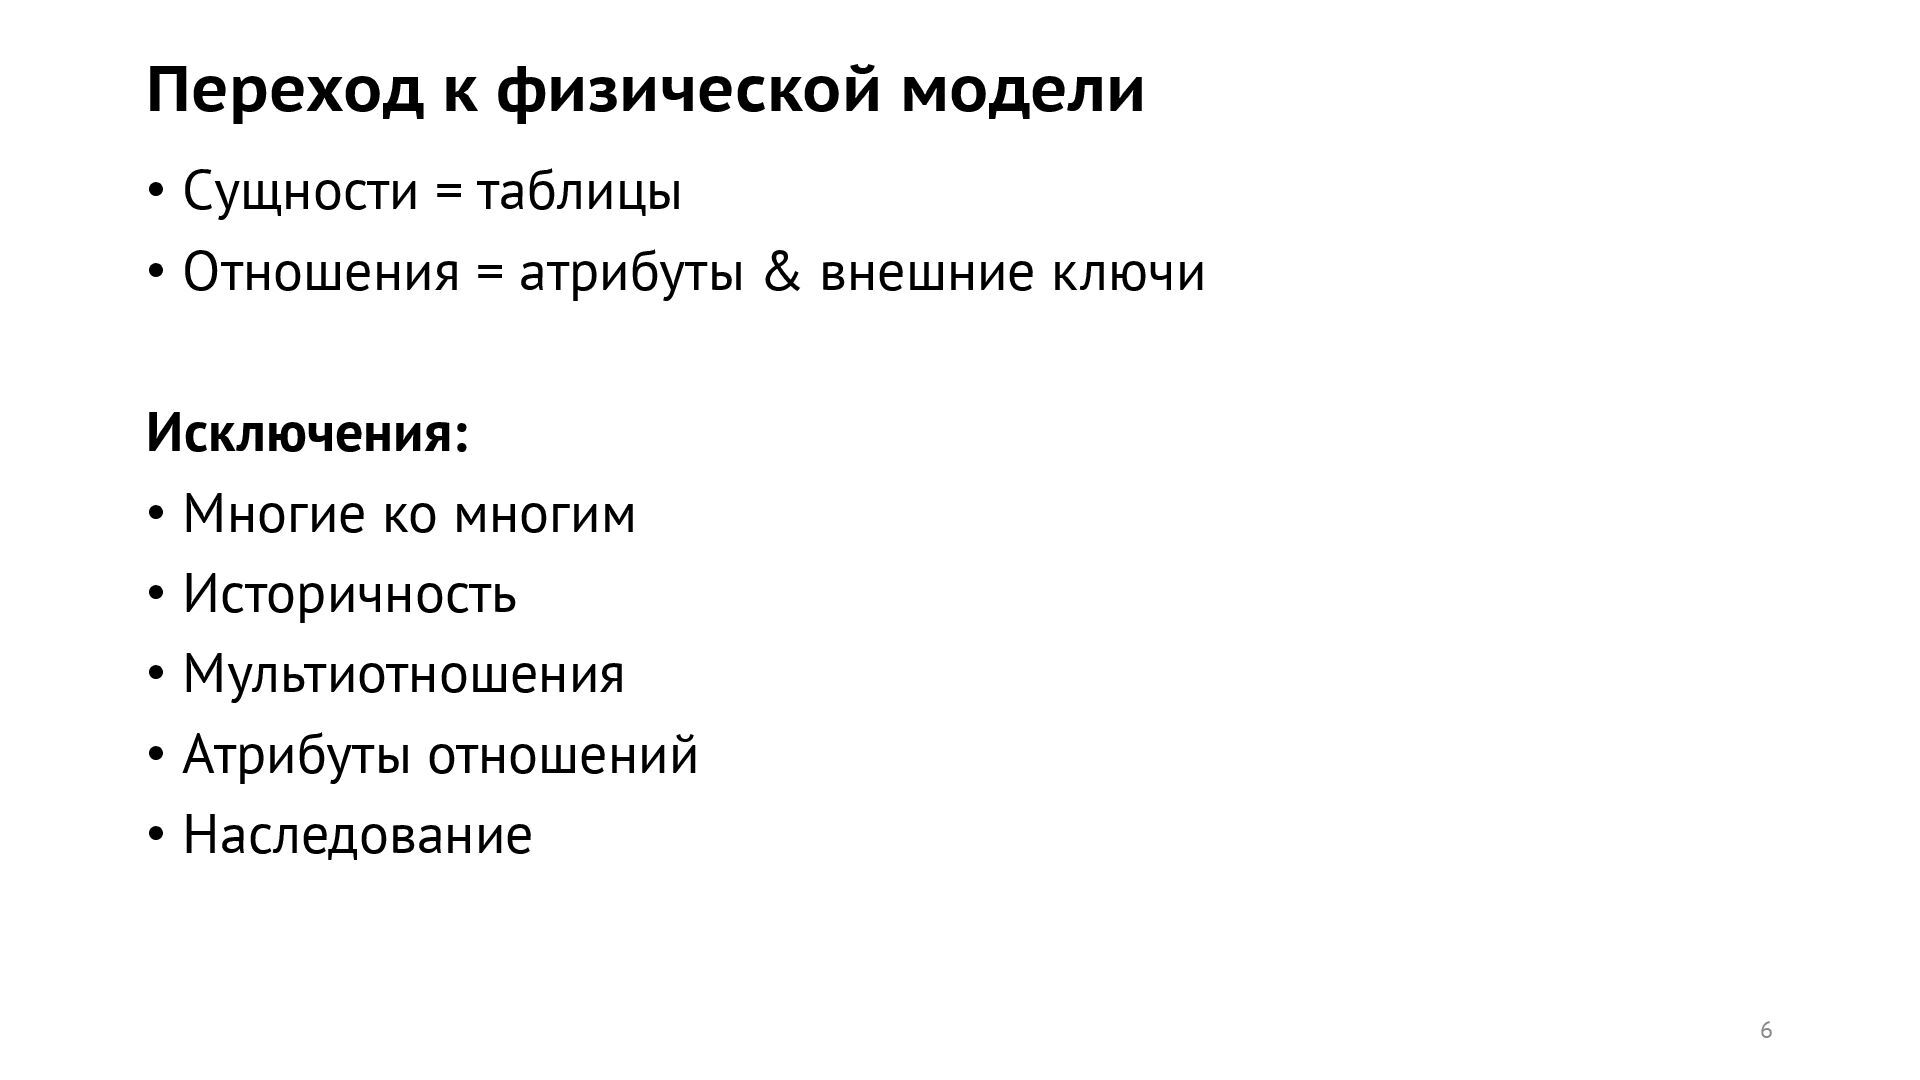
  3. Переход к физической модели • Сущности = таблицы • Отношения

    = атрибуты & внешние ключи Исключения: • Многие ко многим • Историчность • Мультиотношения • Атрибуты отношений • Наследование 6
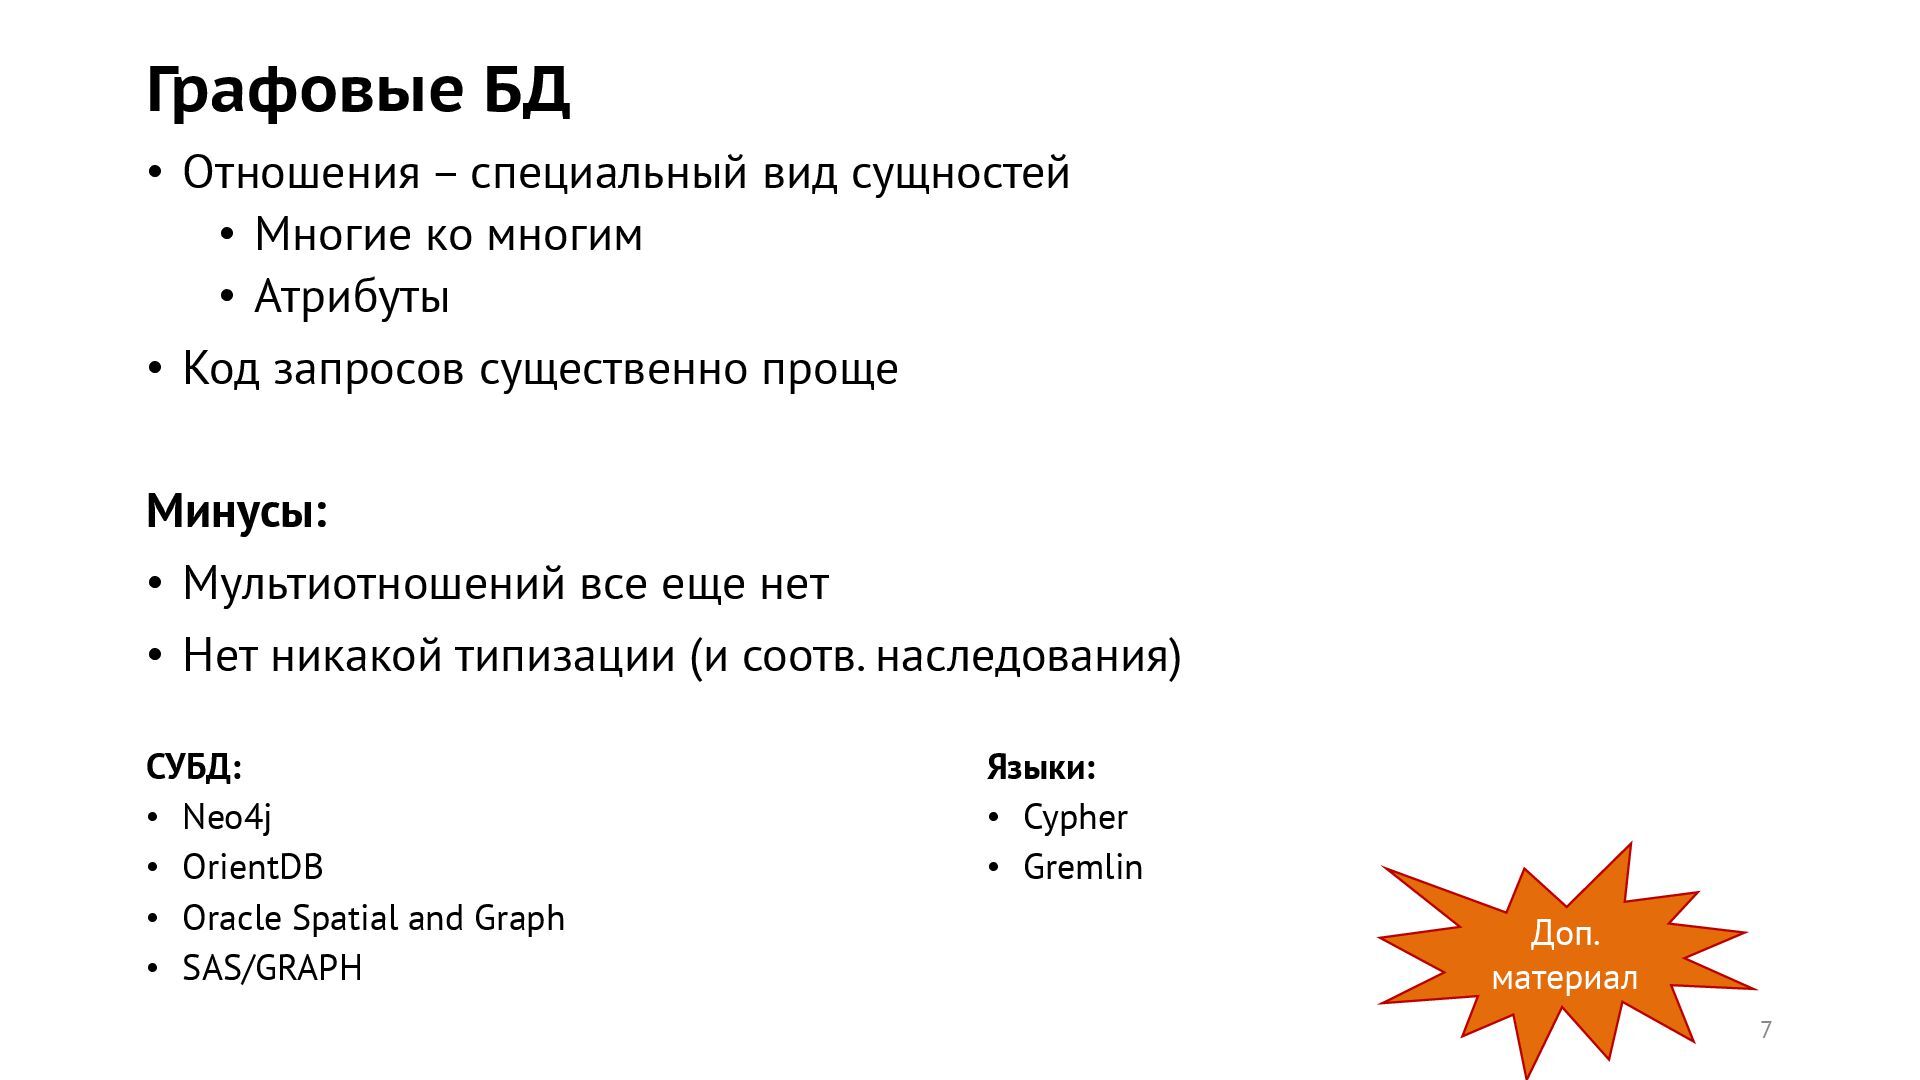
  4. Графовые БД СУБД: • Neo4j • OrientDB • Oracle Spatial

    and Graph • SAS/GRAPH Языки: • Cypher • Gremlin 7 • Отношения – специальный вид сущностей • Многие ко многим • Атрибуты • Код запросов существенно проще Минусы: • Мультиотношений все еще нет • Нет никакой типизации (и соотв. наследования) Доп. материал
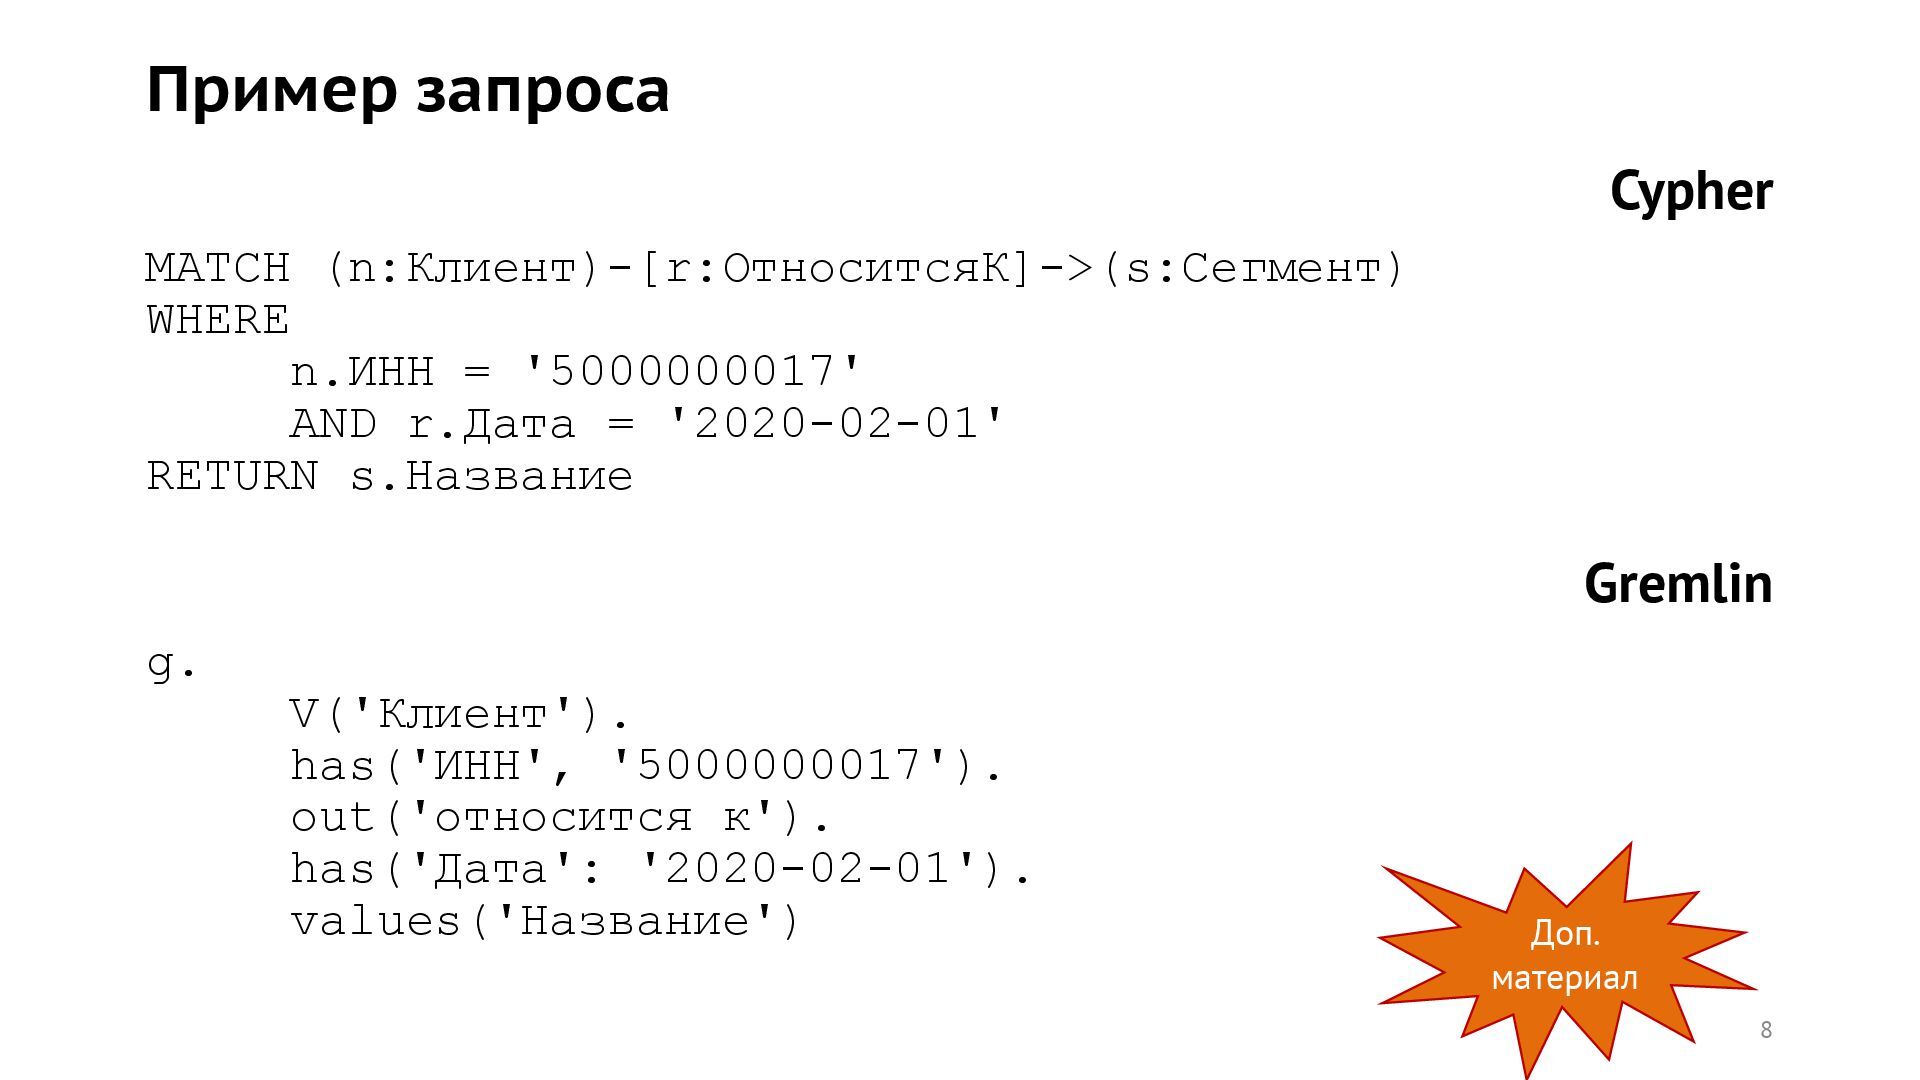
  5. Пример запроса Cypher MATCH (n:Клиент)-[r:ОтноситсяК]->(s:Сегмент) WHERE n.ИНН = '5000000017' AND

    r.Дата = '2020-02-01' RETURN s.Название Gremlin g. V('Клиент'). has('ИНН', '5000000017'). out('относится к'). has('Дата': '2020-02-01'). values('Название') 8 Доп. материал
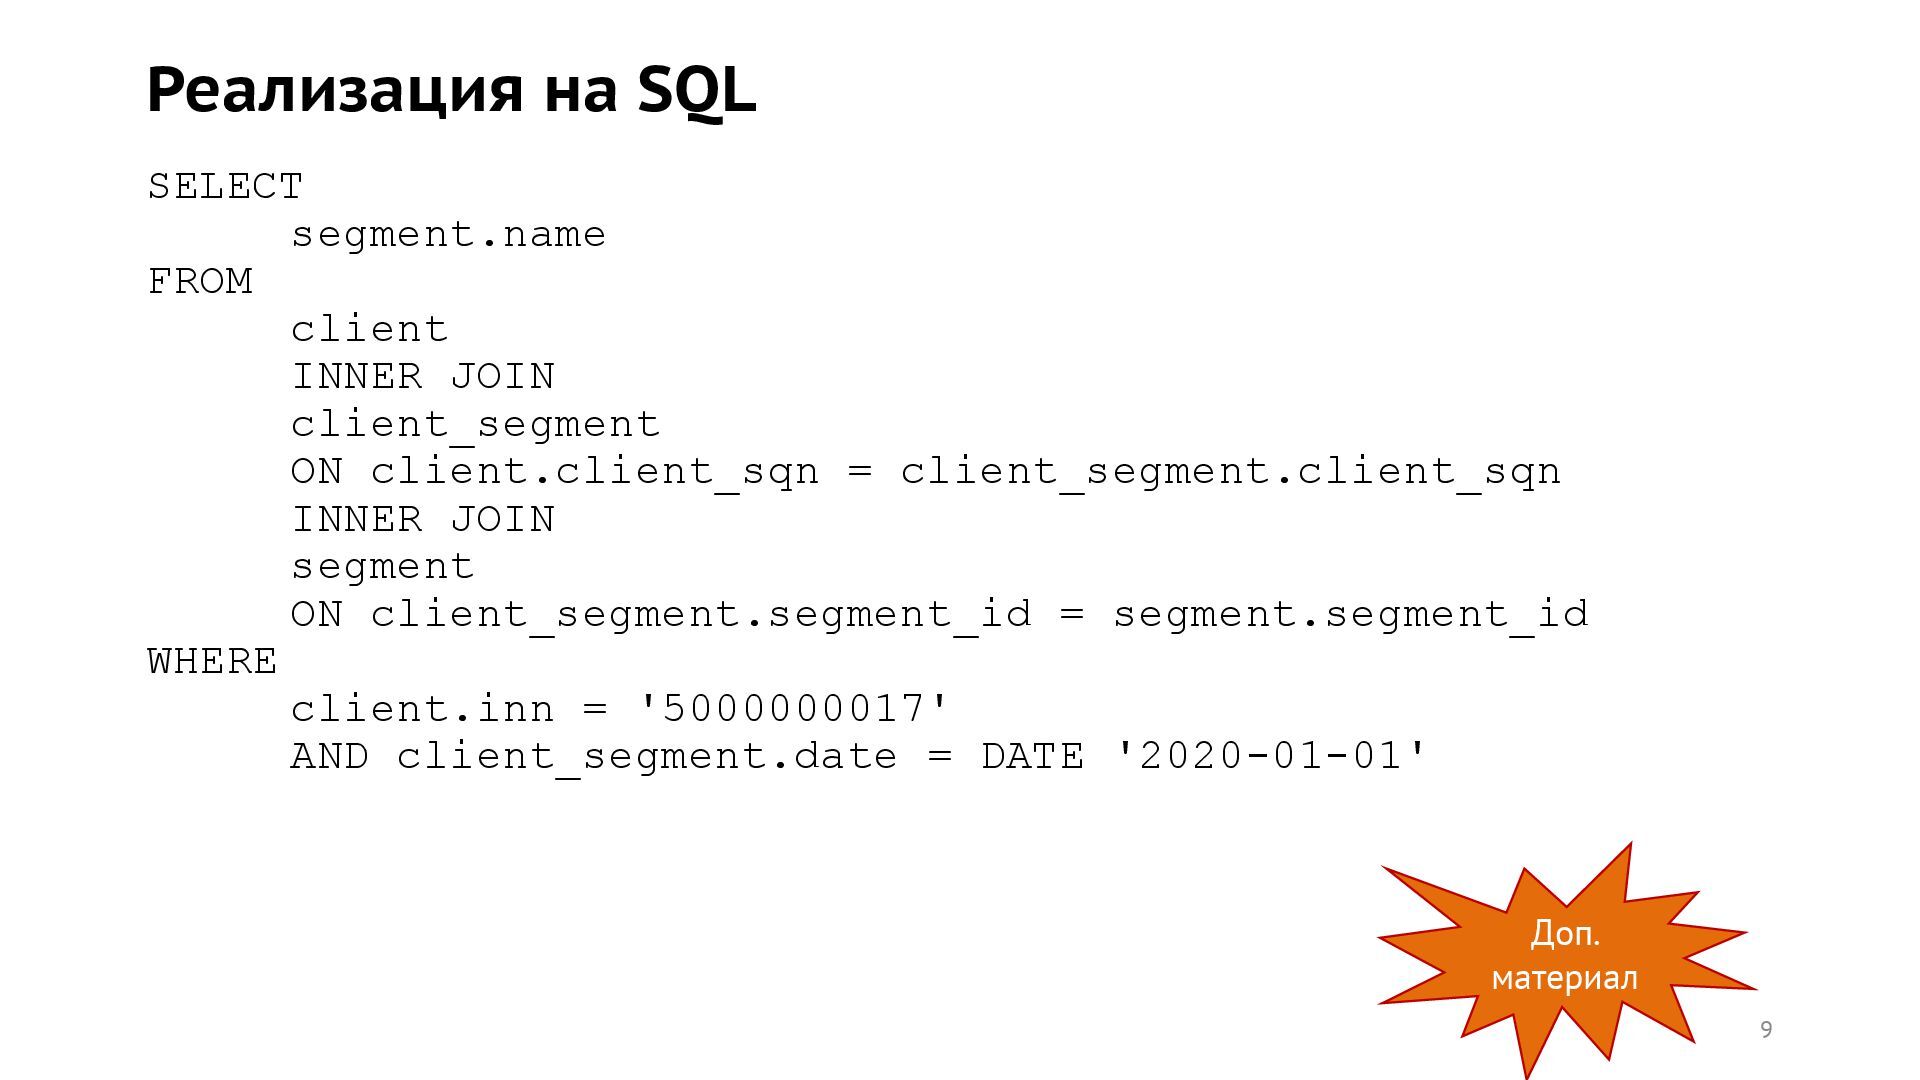
  6. Реализация на SQL SELECT segment.name FROM client INNER JOIN client_segment

    ON client.client_sqn = client_segment.client_sqn INNER JOIN segment ON client_segment.segment_id = segment.segment_id WHERE client.inn = '5000000017' AND client_segment.date = DATE '2020-01-01' 9 Доп. материал
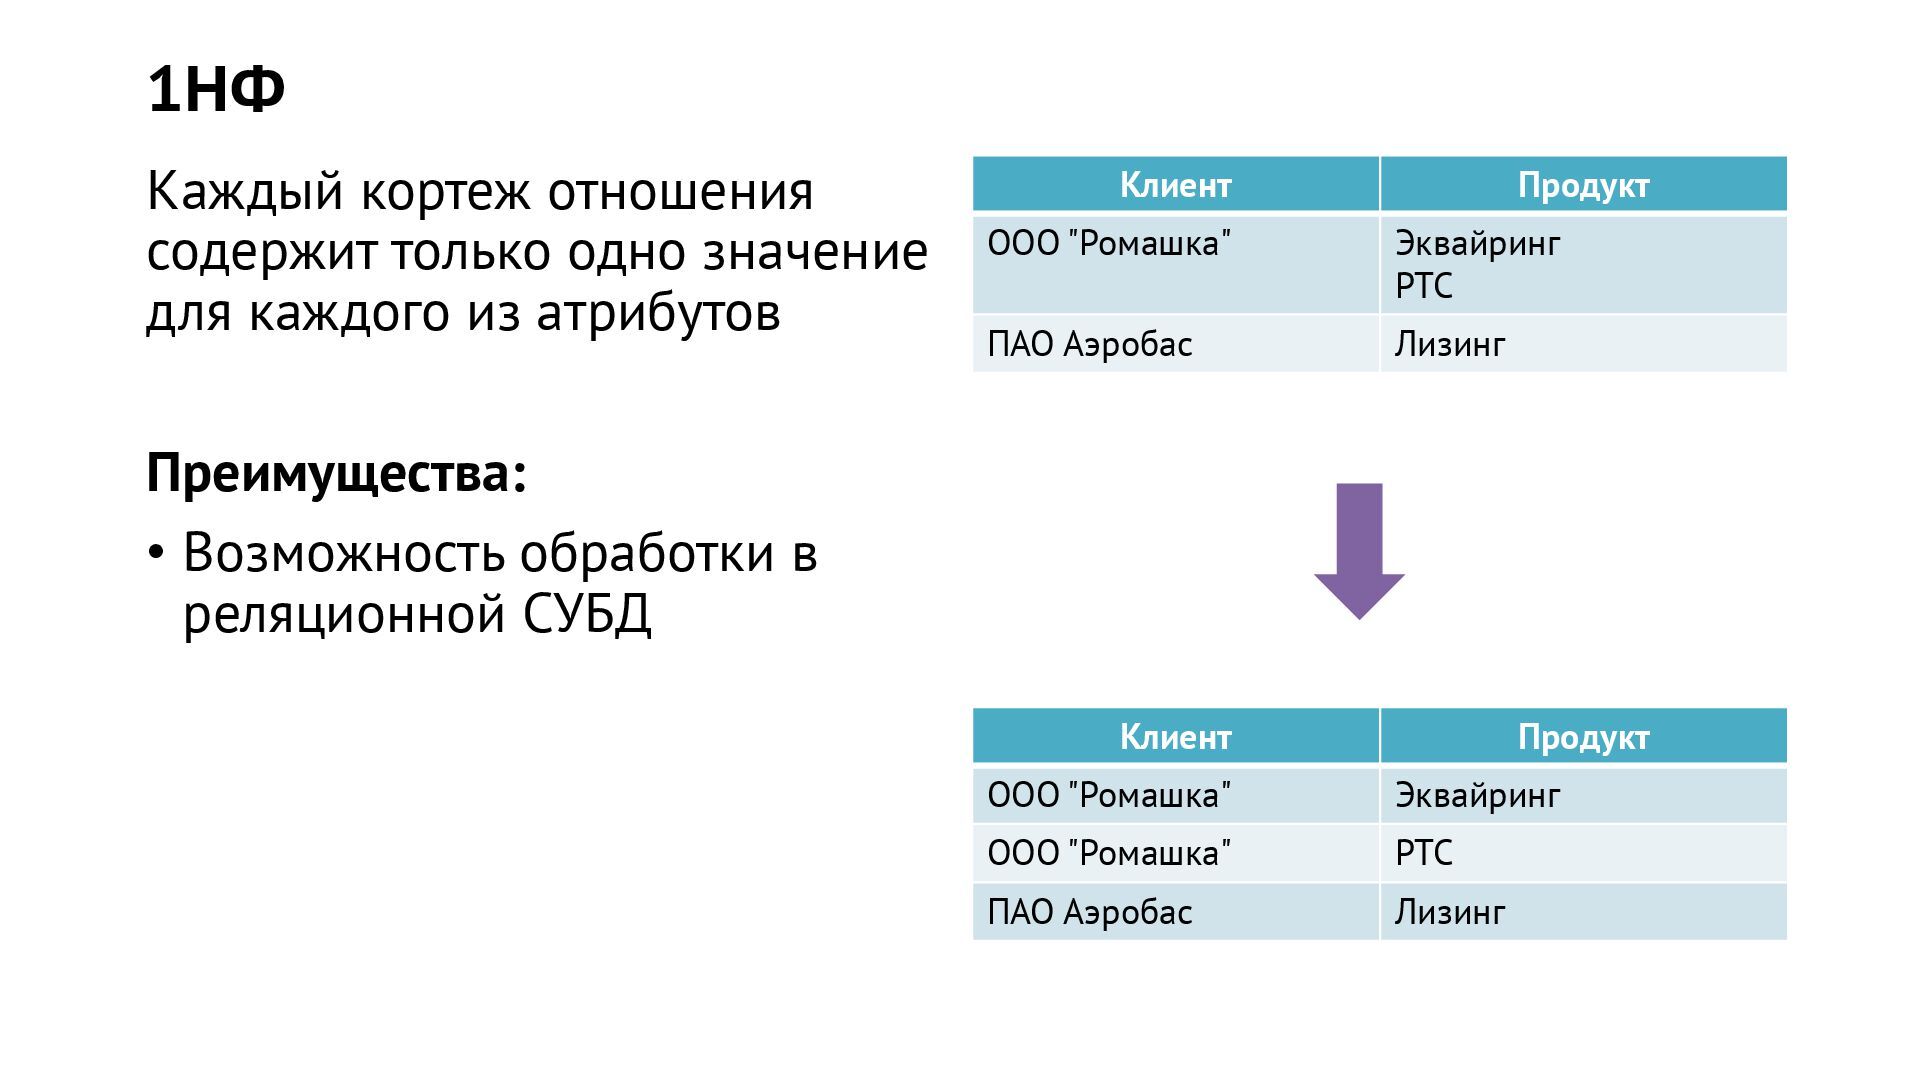
  7. 1НФ Каждый кортеж отношения содержит только одно значение для каждого

    из атрибутов Преимущества: • Возможность обработки в реляционной СУБД Клиент Продукт ООО "Ромашка" Эквайринг РТС ПАО Аэробас Лизинг Клиент Продукт ООО "Ромашка" Эквайринг ООО "Ромашка" РТС ПАО Аэробас Лизинг
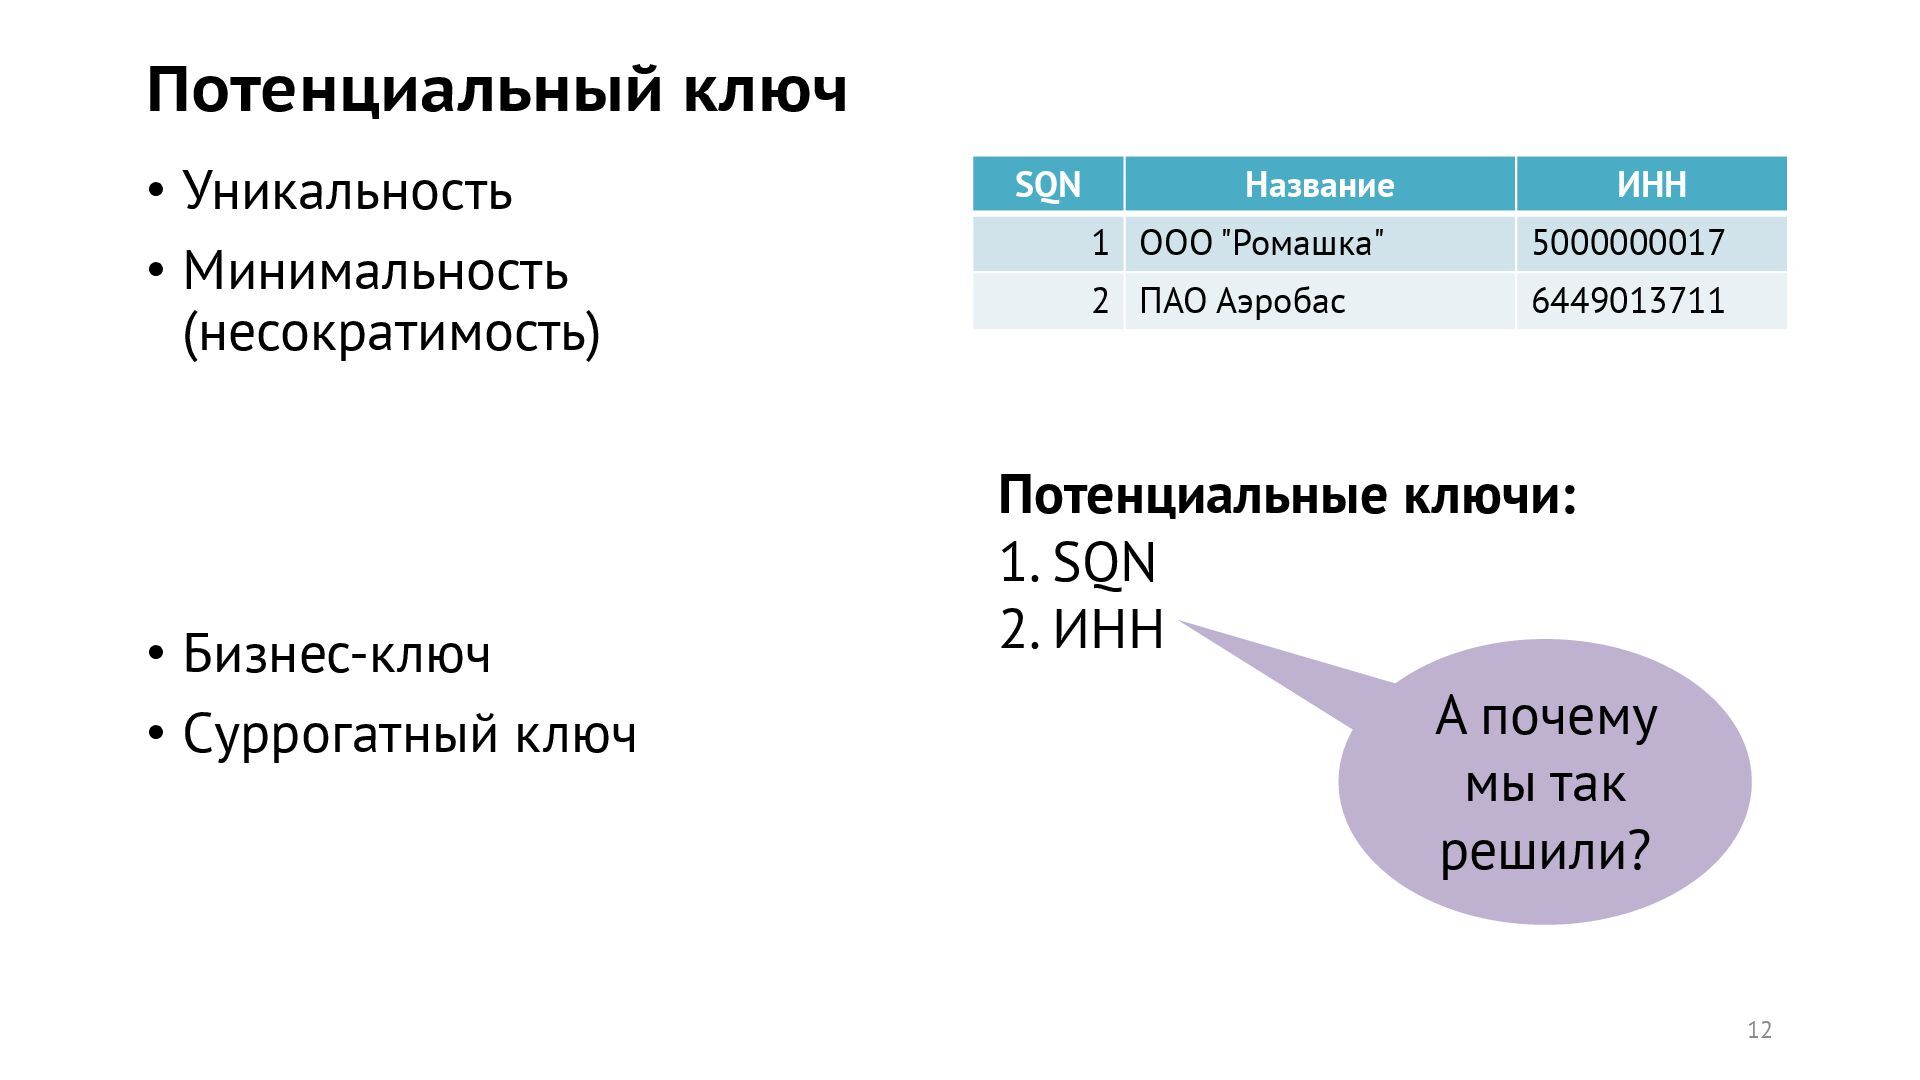
  8. Потенциальный ключ • Уникальность • Минимальность (несократимость) • Бизнес-ключ •

    Суррогатный ключ 12 SQN Название ИНН 1 ООО "Ромашка" 5000000017 2 ПАО Аэробас 6449013711 Потенциальные ключи: 1. SQN 2. ИНН А почему мы так решили?
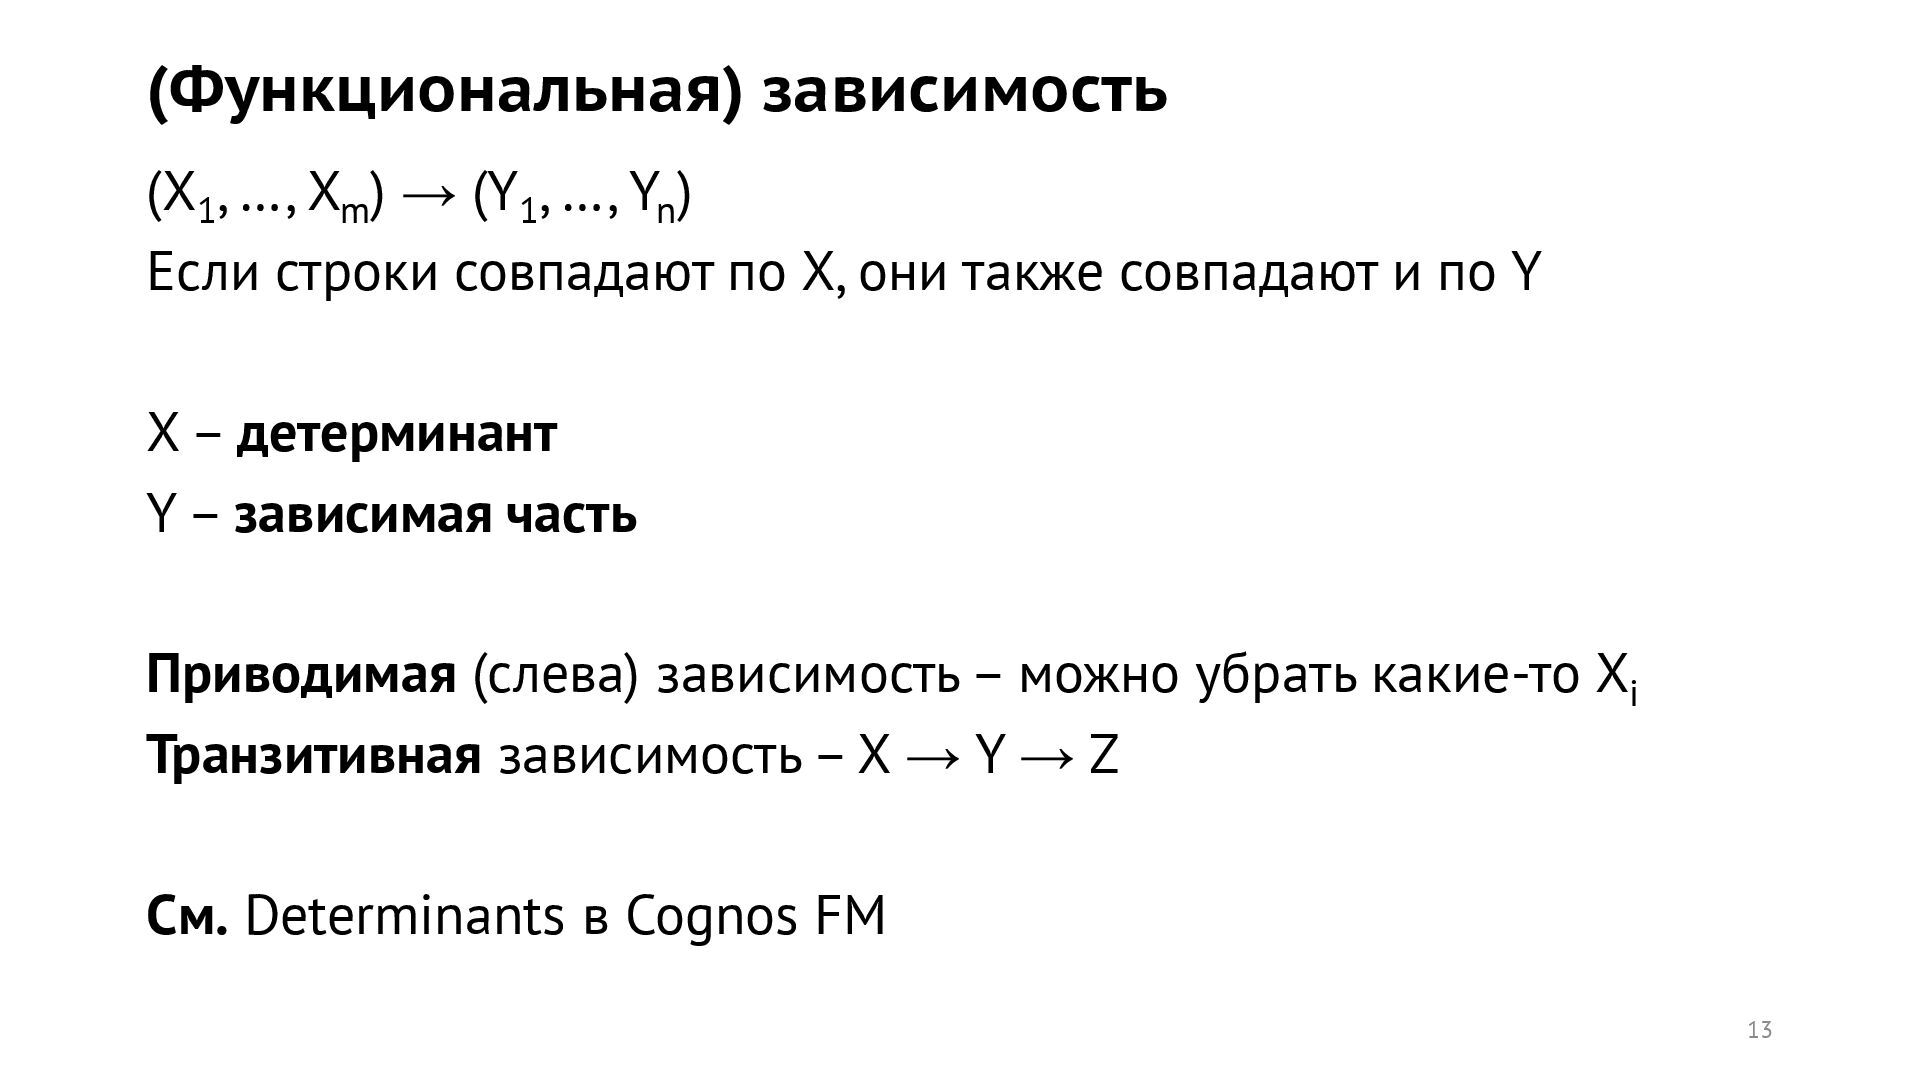
  9. (Функциональная) зависимость (X1 , …, Xm ) → (Y1 ,

    …, Yn ) Если строки совпадают по X, они также совпадают и по Y X – детерминант Y – зависимая часть Приводимая (слева) зависимость – можно убрать какие-то Xi Транзитивная зависимость – X → Y → Z См. Determinants в Cognos FM 13
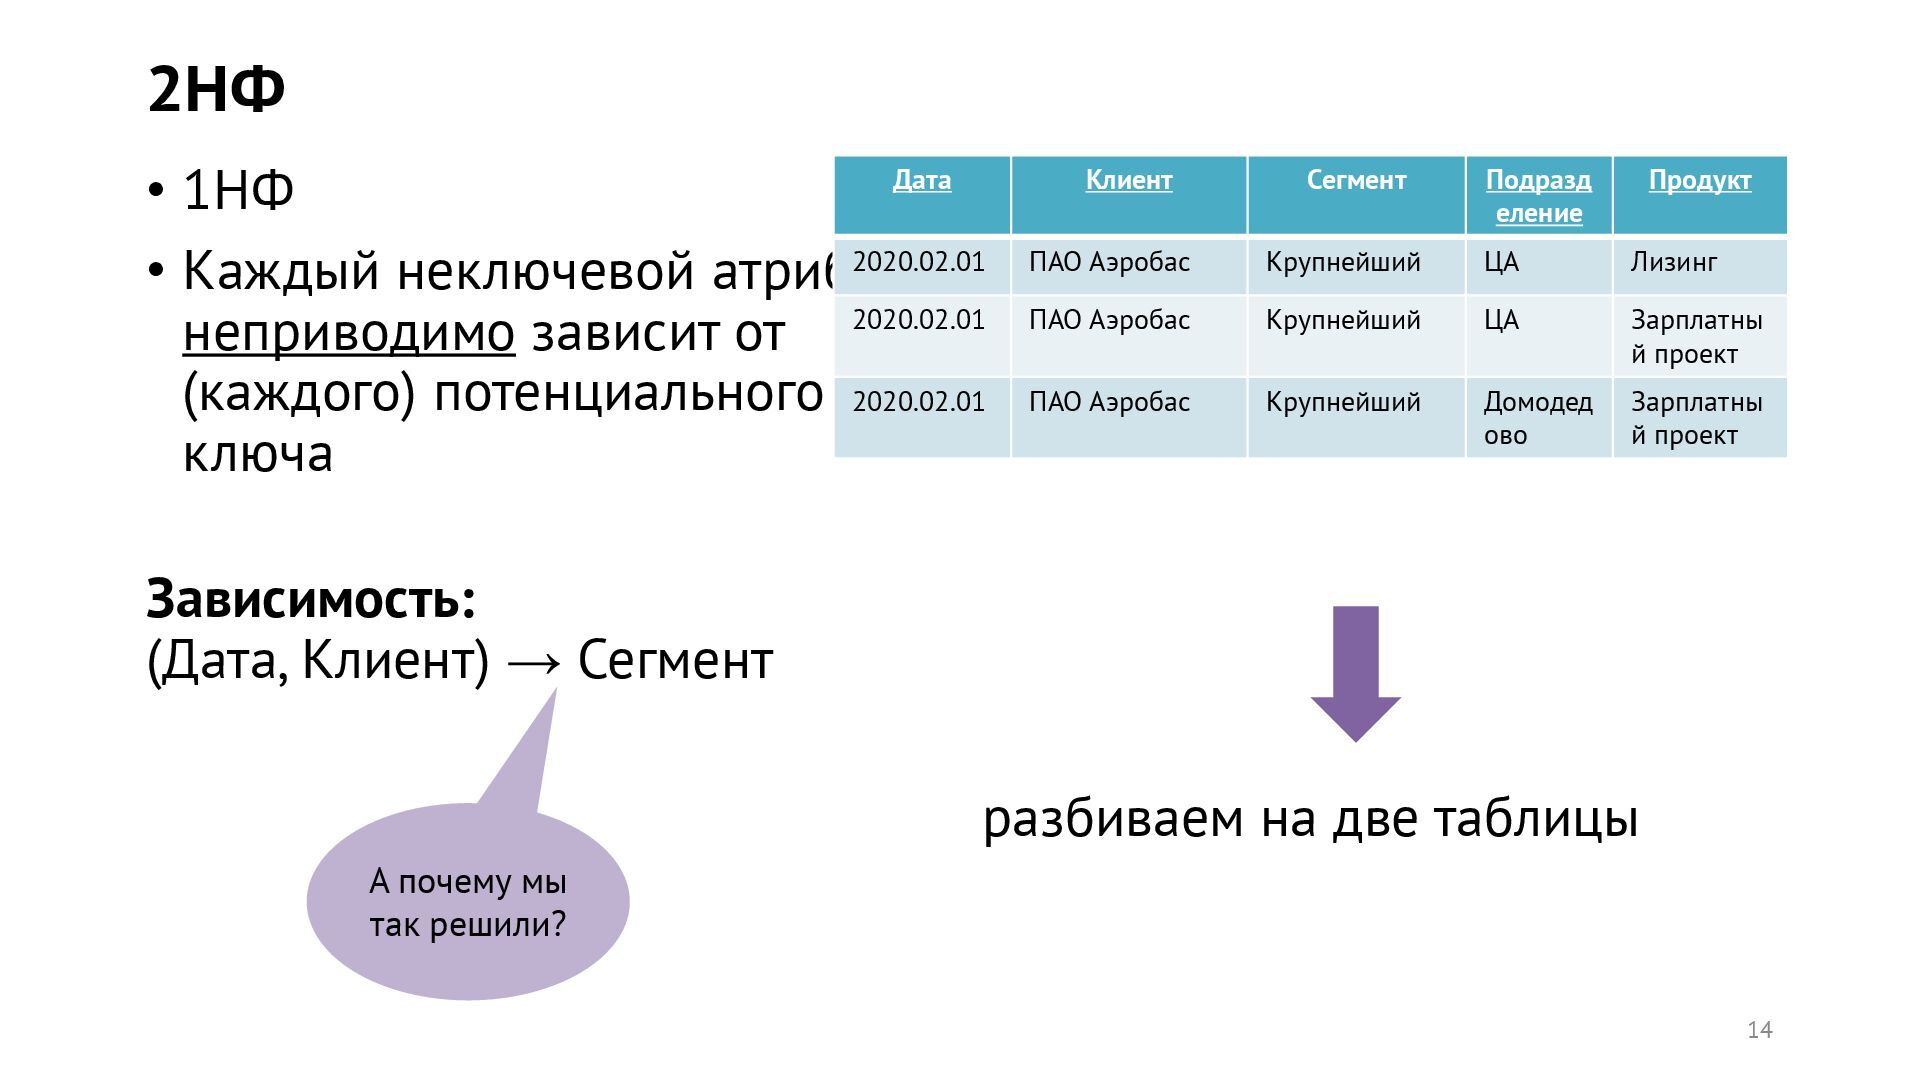
  10. 2НФ • 1НФ • Каждый неключевой атрибут неприводимо зависит от

    (каждого) потенциального ключа Дата Клиент Сегмент Подразд еление Продукт 2020.02.01 ПАО Аэробас Крупнейший ЦА Лизинг 2020.02.01 ПАО Аэробас Крупнейший ЦА Зарплатны й проект 2020.02.01 ПАО Аэробас Крупнейший Домодед ово Зарплатны й проект 14 Зависимость: (Дата, Клиент) → Сегмент разбиваем на две таблицы А почему мы так решили?
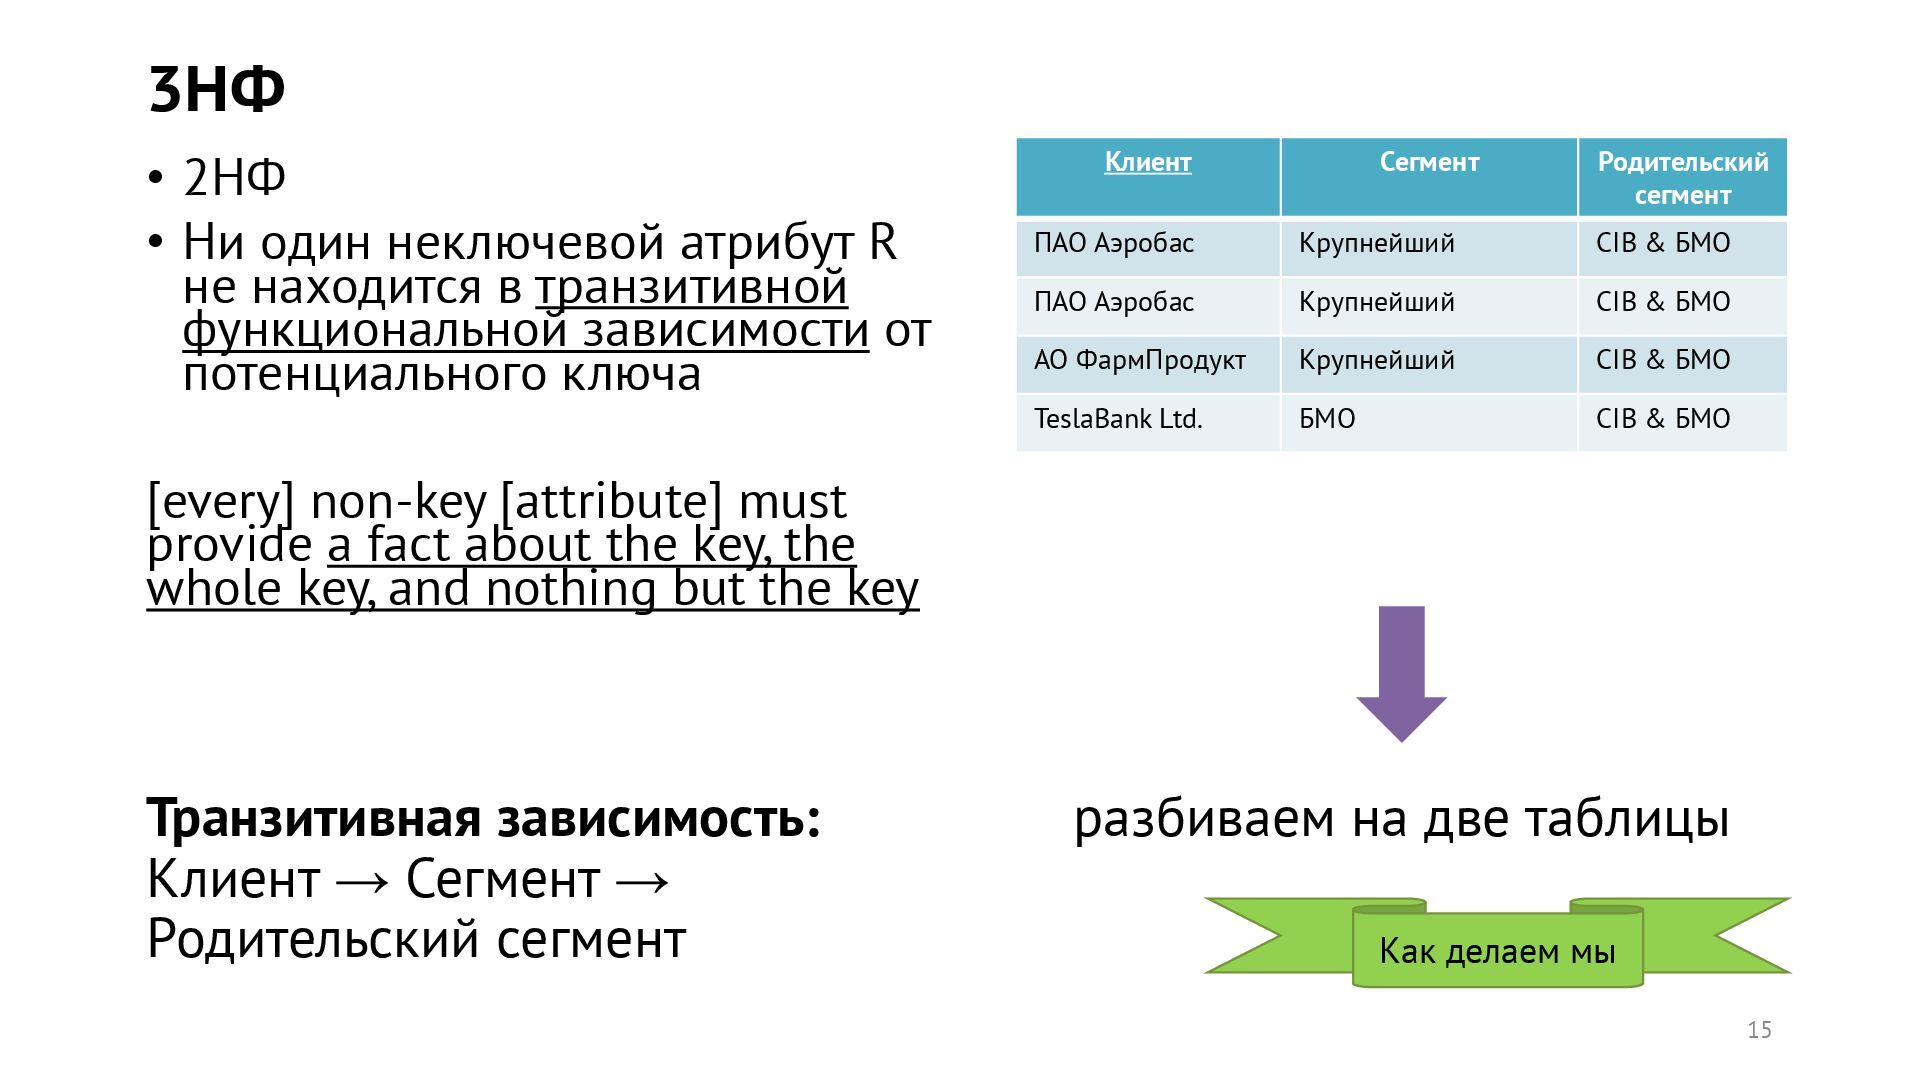
  11. 3НФ • 2НФ • Ни один неключевой атрибут R не

    находится в транзитивной функциональной зависимости от потенциального ключа [every] non-key [attribute] must provide a fact about the key, the whole key, and nothing but the key Клиент Сегмент Родительский сегмент ПАО Аэробас Крупнейший CIB & БМО ПАО Аэробас Крупнейший CIB & БМО АО ФармПродукт Крупнейший CIB & БМО TeslaBank Ltd. БМО CIB & БМО 15 Транзитивная зависимость: Клиент → Сегмент → Родительский сегмент разбиваем на две таблицы Как делаем мы
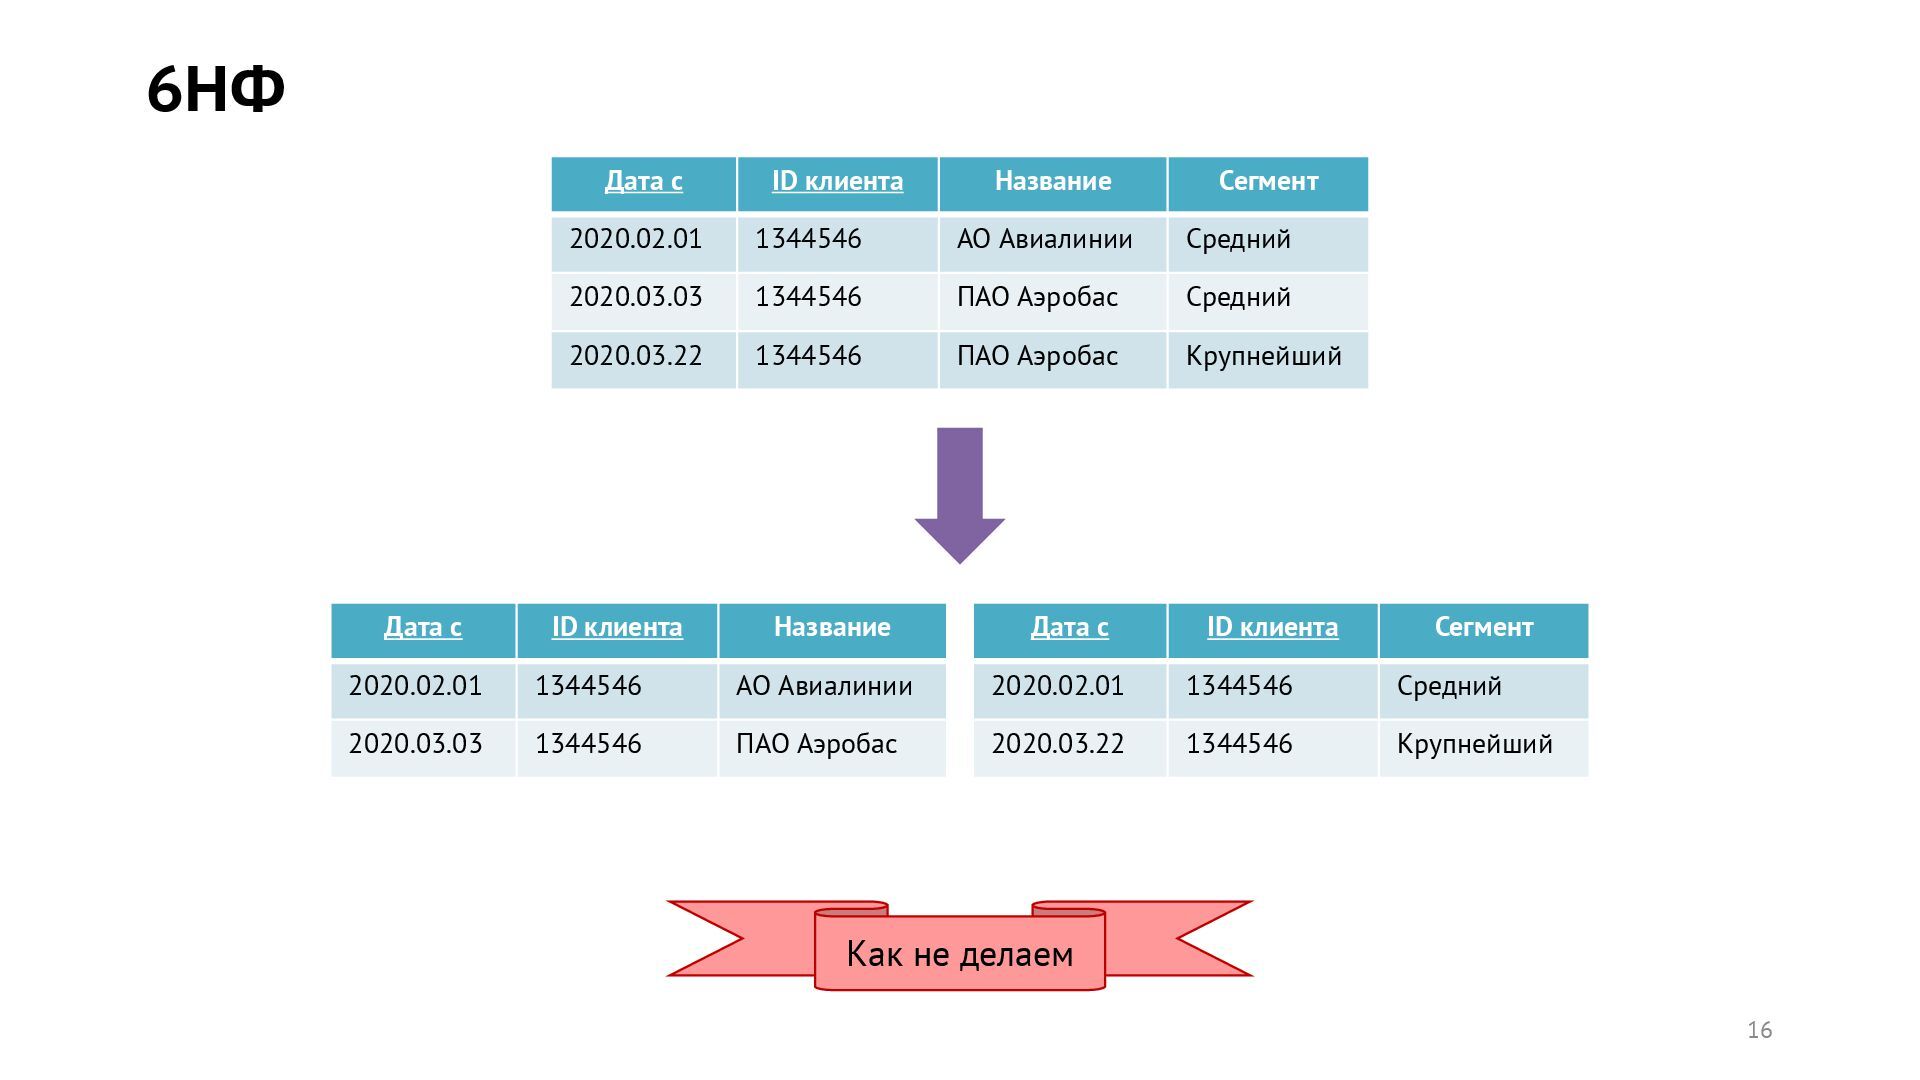
  12. 6НФ 16 Дата с ID клиента Название Сегмент 2020.02.01 1344546

    АО Авиалинии Средний 2020.03.03 1344546 ПАО Аэробас Средний 2020.03.22 1344546 ПАО Аэробас Крупнейший Дата с ID клиента Название 2020.02.01 1344546 АО Авиалинии 2020.03.03 1344546 ПАО Аэробас Дата с ID клиента Сегмент 2020.02.01 1344546 Средний 2020.03.22 1344546 Крупнейший Как не делаем
  13. Выводы о нормализации • Задача нетривиальная • Требуется хорошее знание

    предметной области (т.е. ER-модели). Иначе риск ошибок и переделок • Значительно сложнее (= дольше и дороже), чем денормализация 17
  14. Преимущества нормализованных структур: • Точно отражают отношения. Заменяют ER-модель •

    Качество данных: гарантия целостности и согласованности данных. Данные все еще могут быть некорректные, но одинаково во всех местах • Быстрее загрузка и обновление • (Обычно) Меньше размер, что может улучшить производительность чтения • Данные не задваиваются (не нужен distinct/group by) • Гибкость для пользователя Недостатки: • (Иногда) Хуже производительность • Больше кода 18
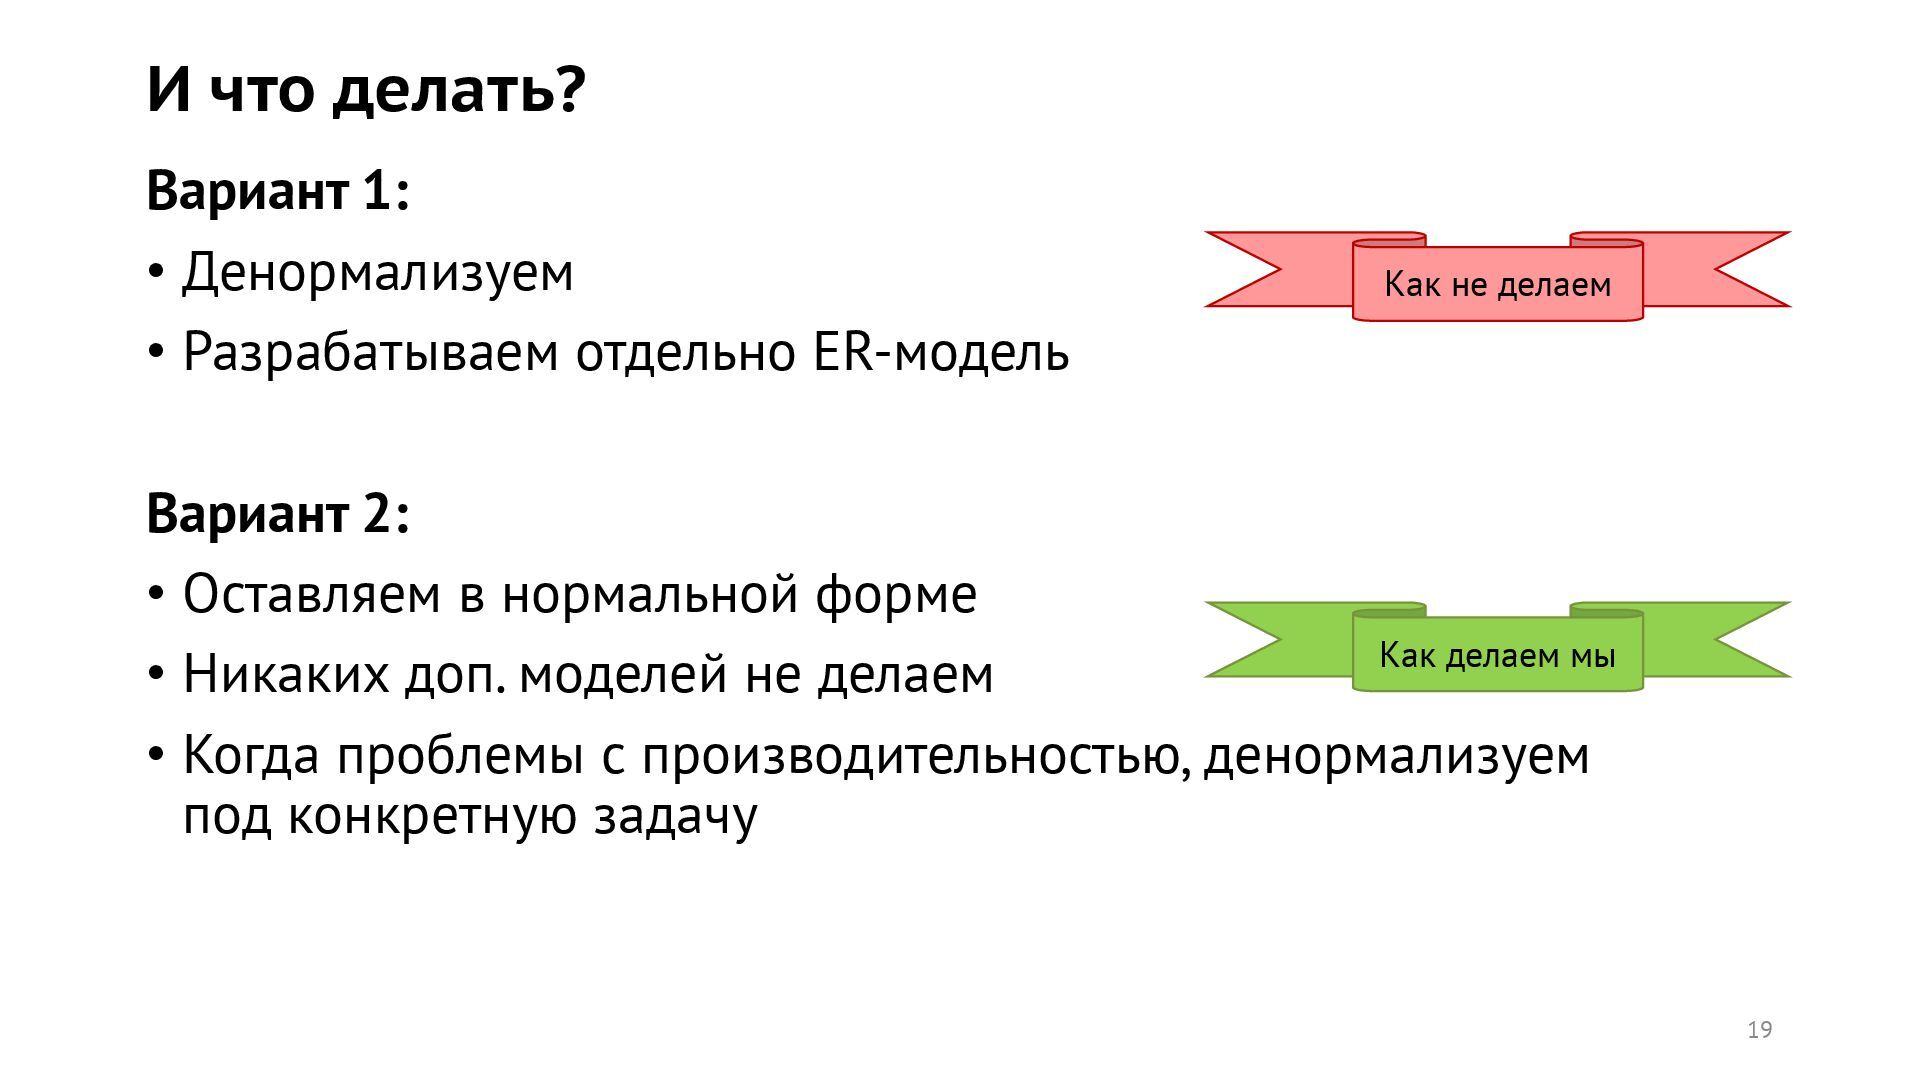
  15. И что делать? Вариант 1: • Денормализуем • Разрабатываем отдельно

    ER-модель Вариант 2: • Оставляем в нормальной форме • Никаких доп. моделей не делаем • Когда проблемы с производительностью, денормализуем под конкретную задачу 19 Как делаем мы Как не делаем
  16. Хорошие новости * В XSD: • Элементы → Таблицы •

    Атрибуты → Колонки • Вложенность → Внешний ключ В ABO_SOD уже все нормализовано. Копируем их структуру, добавляя наши технологические колонки и ссылки на справочники * для МПСО, но на каждую дату отдельно
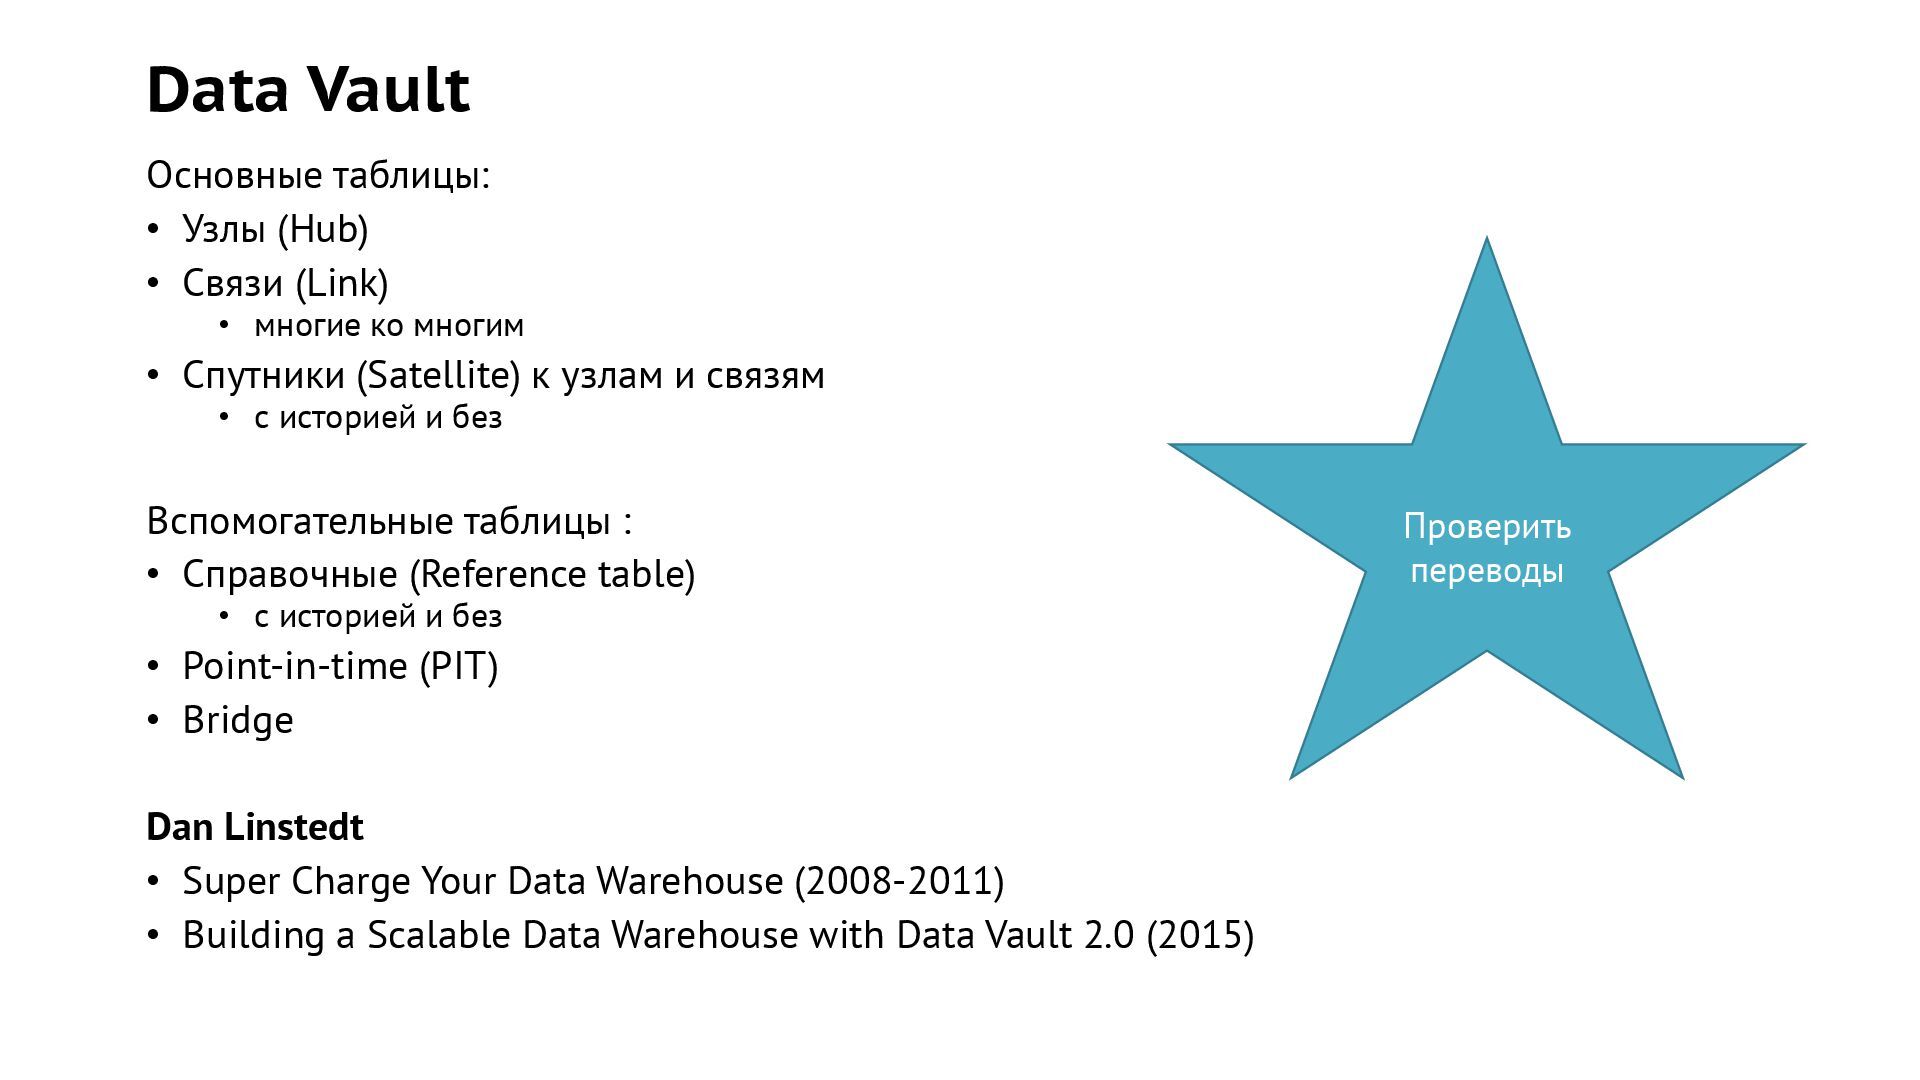
  17. Data Vault Основные таблицы: • Узлы (Hub) • Связи (Link)

    • многие ко многим • Спутники (Satellite) к узлам и связям • с историей и без Вспомогательные таблицы : • Справочные (Reference table) • с историей и без • Point-in-time (PIT) • Bridge Dan Linstedt • Super Charge Your Data Warehouse (2008-2011) • Building a Scalable Data Warehouse with Data Vault 2.0 (2015) Проверить переводы
  18. За и против DV Преимущество DV – Agile: • Интеграция

    гетерогенных исходных систем • Гибкость • Масштабируемость Недостатки: • (IMHO) Нет четкой границы между Reference table и Hub. Вероятно, разница, считаем ли мы это сущностью или нет. Но это всё ещё опровергает преимущество agile • (IMHO) В критичных бизнес-процессах нельзя использовать хэши 23
  19. Анкерное (якорное) моделирование (Anchor Modeling) • Якоря (Anchor) • Связи

    (Tie) • с историей и без • Атрибуты (Attribute) к якорям и связям • один атрибут – одна таблица (6 НФ) • с историей и без • Узлы (Knot) – справочники http://www.anchormodeling.com/ Преимущества: • Автогенерация кода
  20. Dimensional Modeling Два вида таблиц: • Измерения (разрезы) (Dimensions) •

    Факты (Facts): • Ссылки на измерения • Метрики (Measures) Ralph Kimball https://www.kimballgroup.com/data-warehouse-business- intelligence-resources/kimball-techniques/dimensional-modeling- techniques/ Microsoft SSAS – построен на его идеях
  21. Nulls (рекомендации Kimball) • Null в метриках – Ok: •

    Агрегатные функции (sum, count etc.) работают корректно • Надо заменить на 0 → на стороне BI • Null в ссылках на измерения – запрещены • Нарушается ссылостная целостность • Требуется left join • Вместо этого, измерение должно иметь строку «по умолчанию» («не определено», ID = -1 и т.п.) 28 Как делаем мы
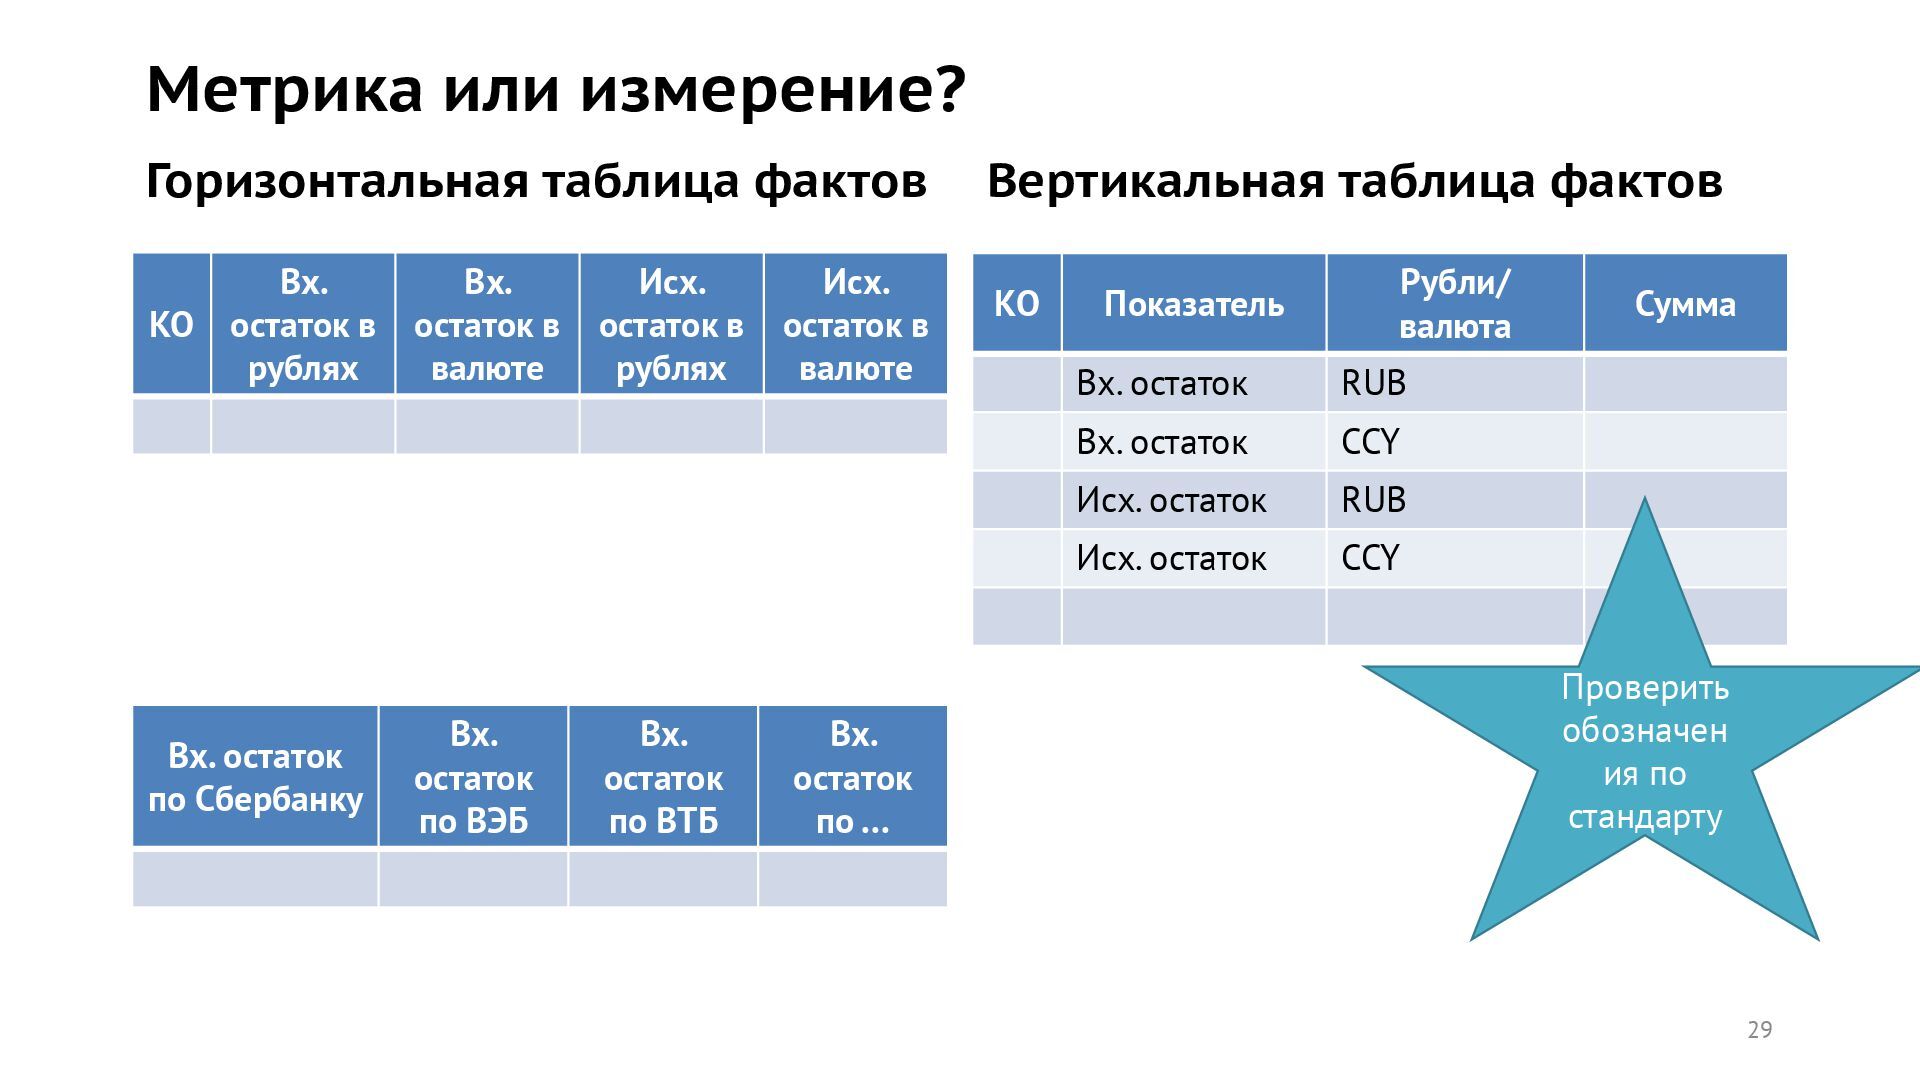
  22. Метрика или измерение? КО Вх. остаток в рублях Вх. остаток

    в валюте Исх. остаток в рублях Исх. остаток в валюте КО Показатель Рубли/ валюта Сумма Вх. остаток RUB Вх. остаток CCY Исх. остаток RUB Исх. остаток CCY 29 Вертикальная таблица фактов Горизонтальная таблица фактов Вх. остаток по Сбербанку Вх. остаток по ВЭБ Вх. остаток по ВТБ Вх. остаток по … Проверить обозначен ия по стандарту
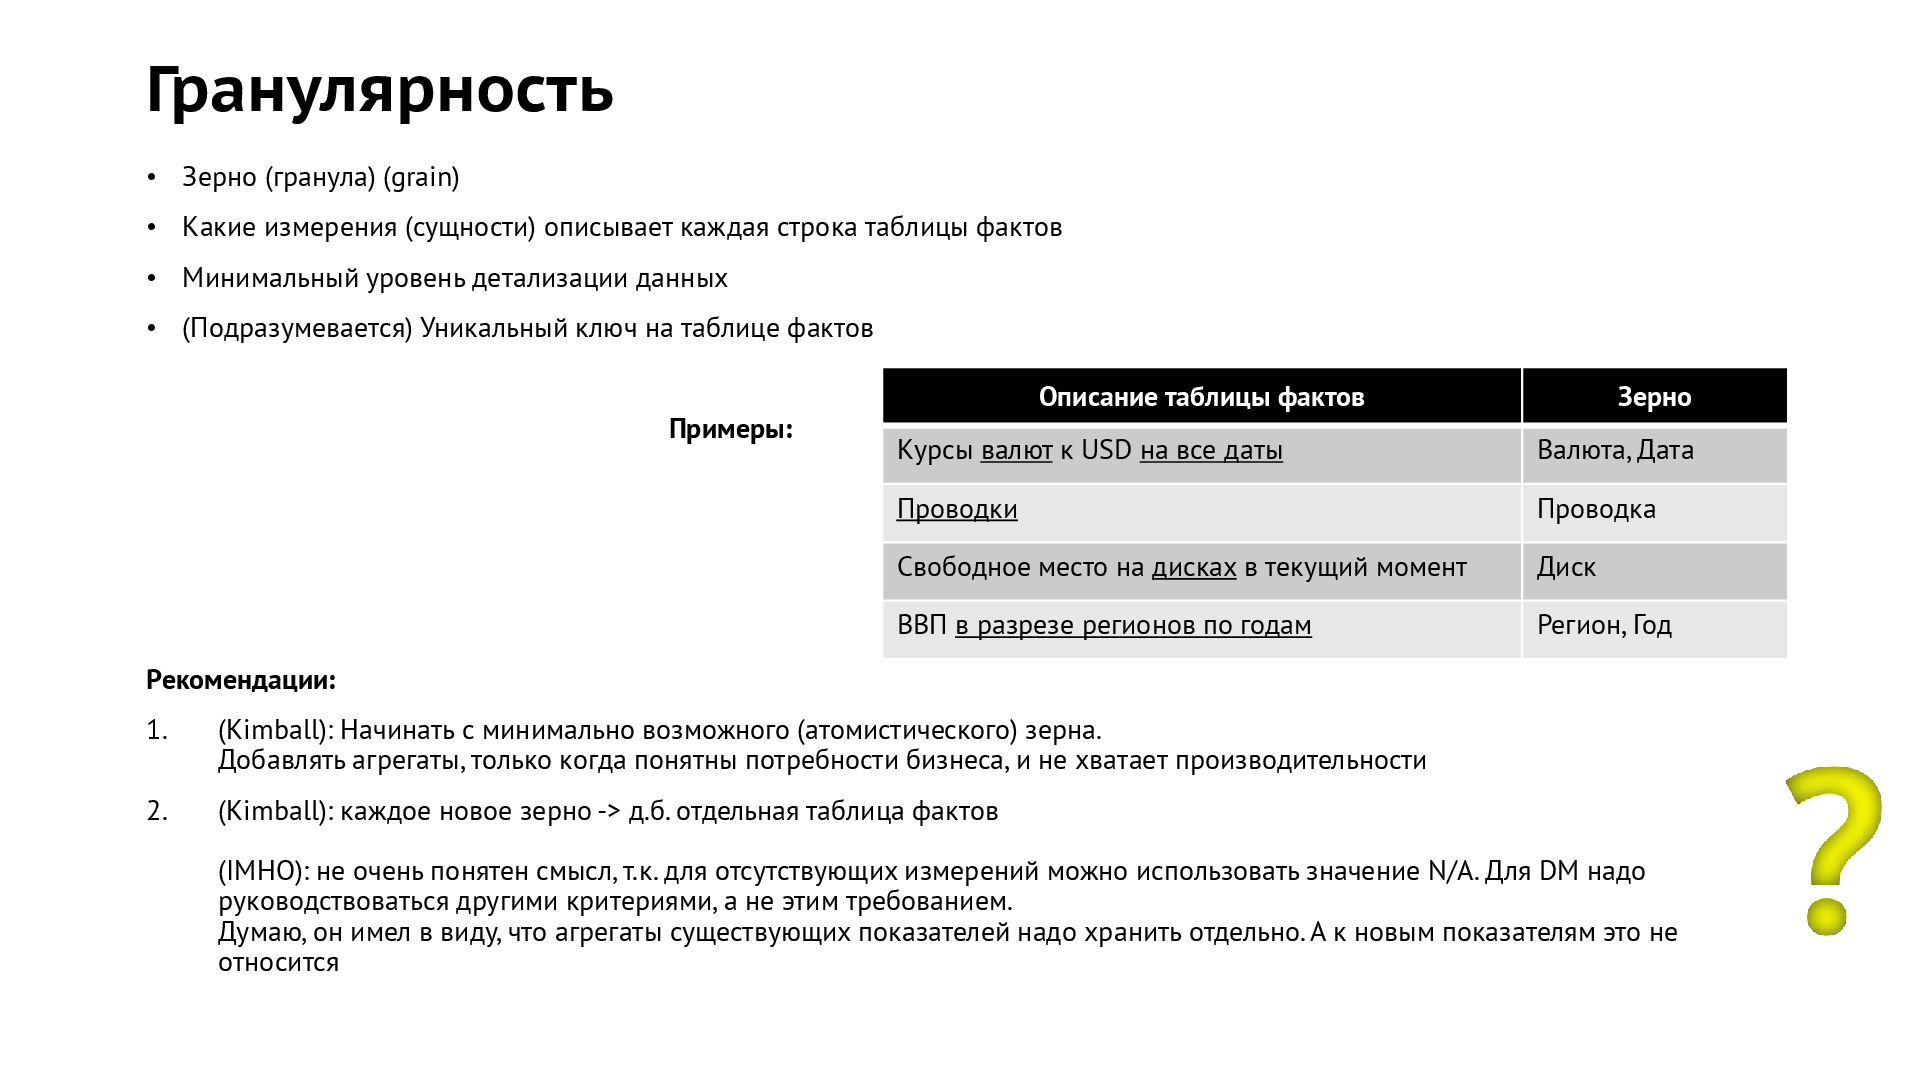
  23. Гранулярность • Зерно (гранула) (grain) • Какие измерения (сущности) описывает

    каждая строка таблицы фактов • Минимальный уровень детализации данных • (Подразумевается) Уникальный ключ на таблице фактов Примеры: Рекомендации: 1. (Kimball): Начинать с минимально возможного (атомистического) зерна. Добавлять агрегаты, только когда понятны потребности бизнеса, и не хватает производительности 2. (Kimball): каждое новое зерно -> д.б. отдельная таблица фактов (IMHO): не очень понятен смысл, т.к. для отсутствующих измерений можно использовать значение N/A. Для DM надо руководствоваться другими критериями, а не этим требованием. Думаю, он имел в виду, что агрегаты существующих показателей надо хранить отдельно. А к новым показателям это не относится Описание таблицы фактов Зерно Курсы валют к USD на все даты Валюта, Дата Проводки Проводка Свободное место на дисках в текущий момент Диск ВВП в разрезе регионов по годам Регион, Год ?
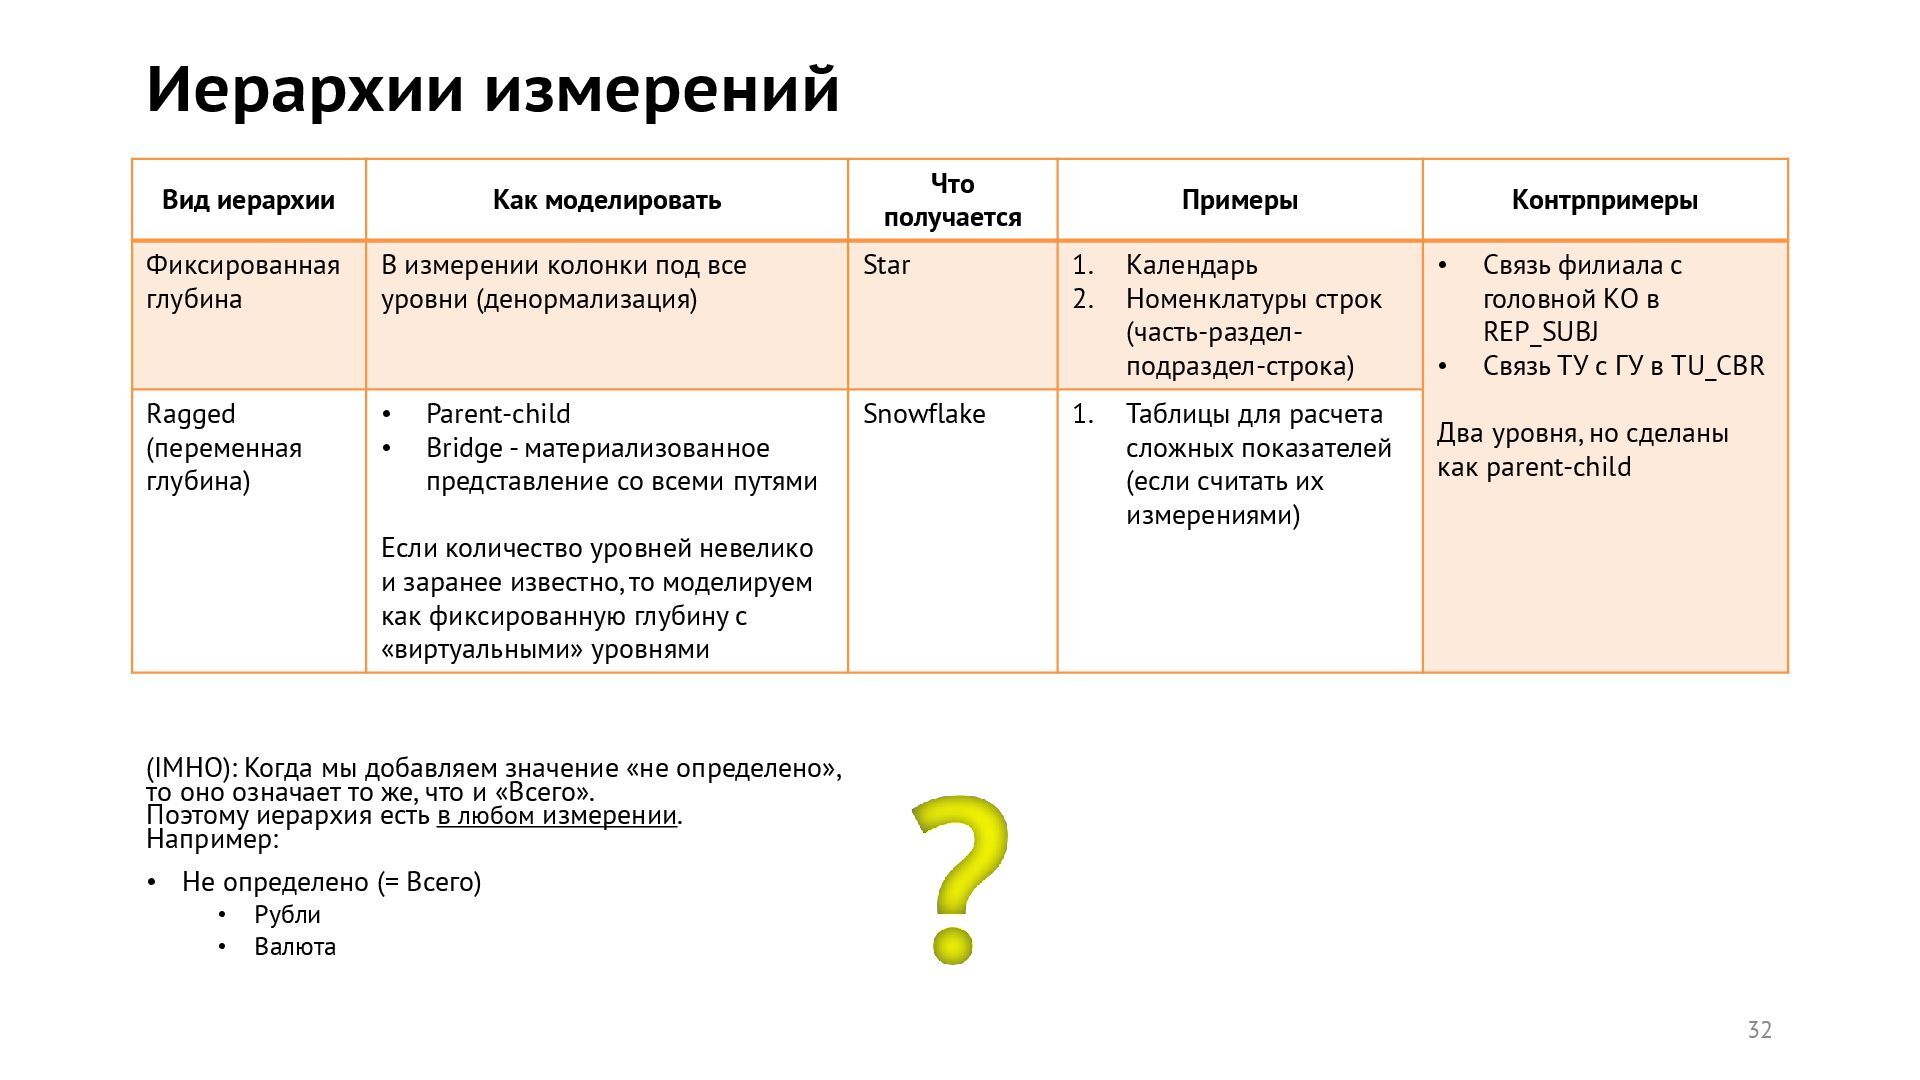
  24. Иерархии измерений (IMHO): Когда мы добавляем значение «не определено», то

    оно означает то же, что и «Всего». Поэтому иерархия есть в любом измерении. Например: • Не определено (= Всего) • Рубли • Валюта 32 Вид иерархии Как моделировать Что получается Примеры Контрпримеры Фиксированная глубина В измерении колонки под все уровни (денормализация) Star 1. Календарь 2. Номенклатуры строк (часть-раздел- подраздел-строка) • Связь филиала с головной КО в REP_SUBJ • Связь ТУ с ГУ в TU_CBR Два уровня, но сделаны как parent-child Ragged (переменная глубина) • Parent-child • Bridge - материализованное представление со всеми путями Если количество уровней невелико и заранее известно, то моделируем как фиксированную глубину с «виртуальными» уровнями Snowflake 1. Таблицы для расчета сложных показателей (если считать их измерениями) ?
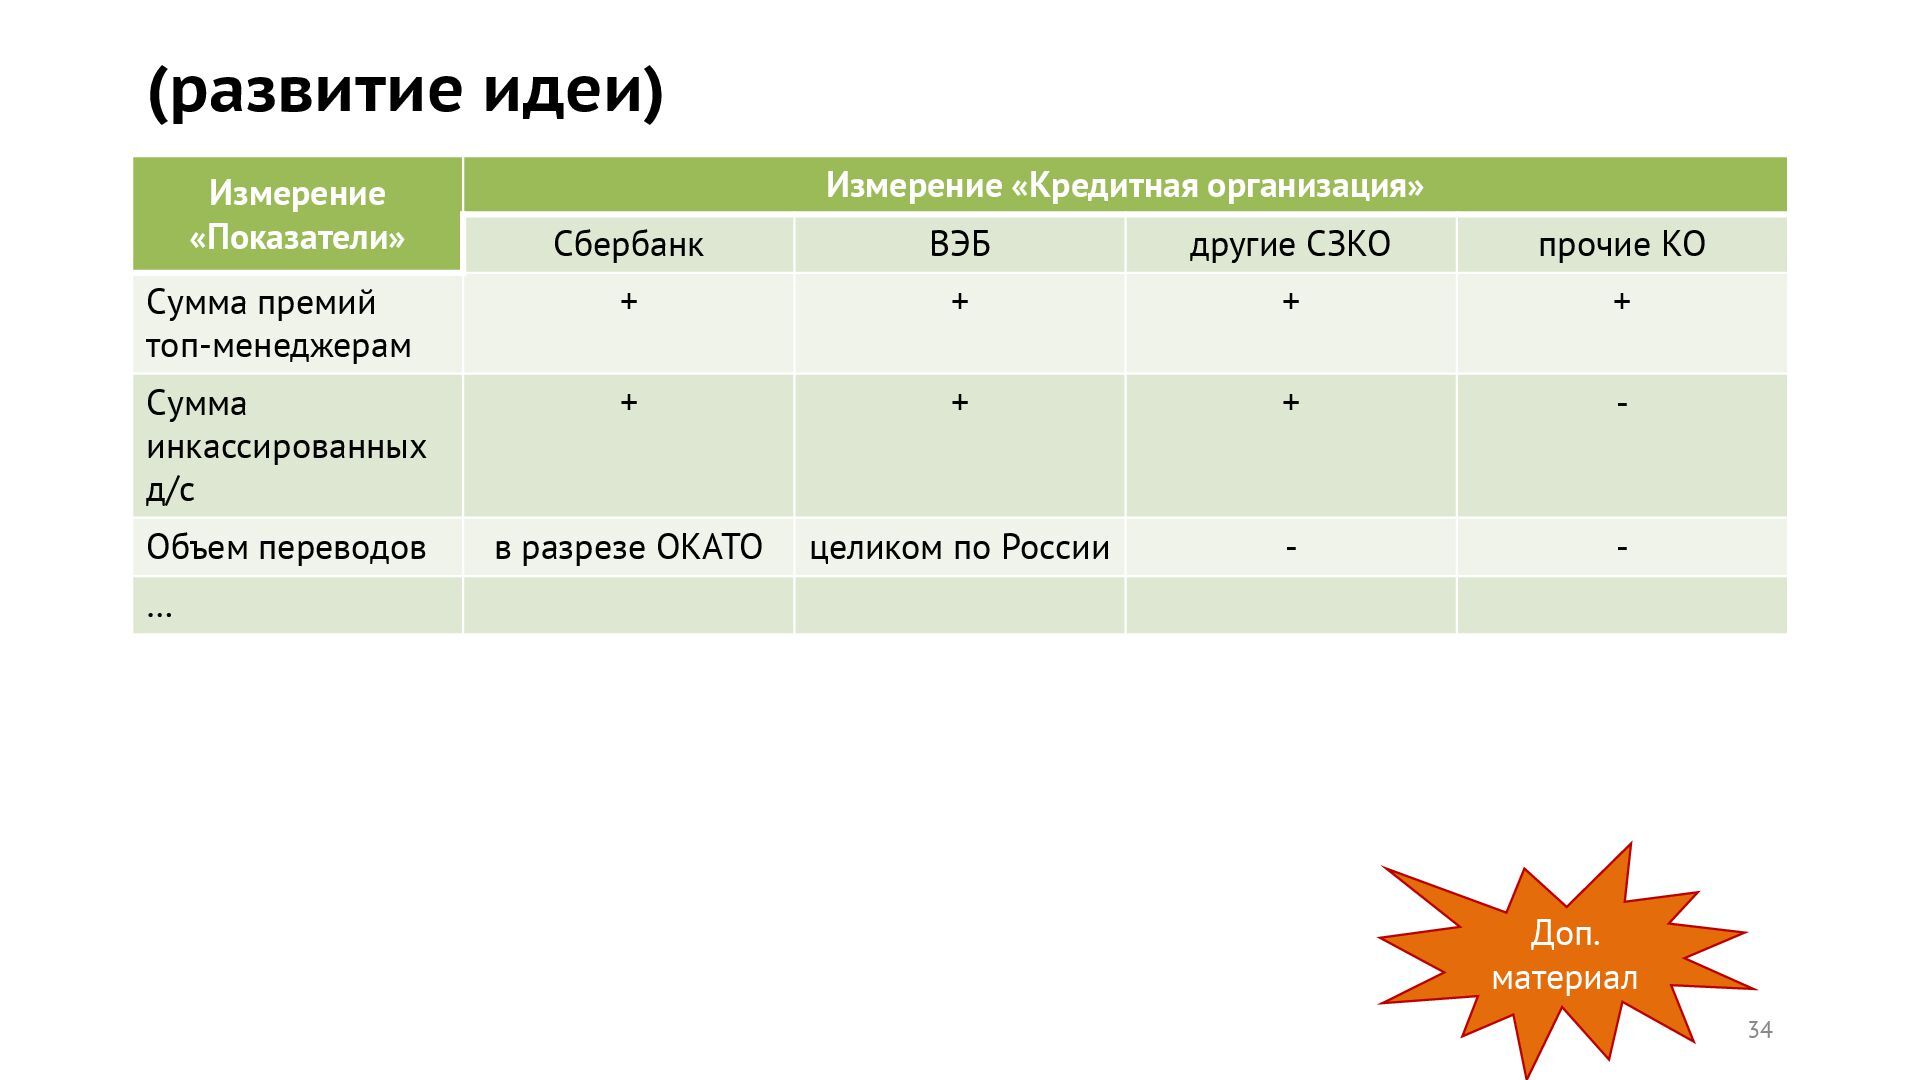
  25. (развитие идеи) Измерение «Показатели» Измерение «Кредитная организация» Сбербанк ВЭБ другие

    СЗКО прочие КО Сумма премий топ-менеджерам + + + + Сумма инкассированных д/с + + + - Объем переводов в разрезе ОКАТО целиком по России - - … 34 Доп. материал
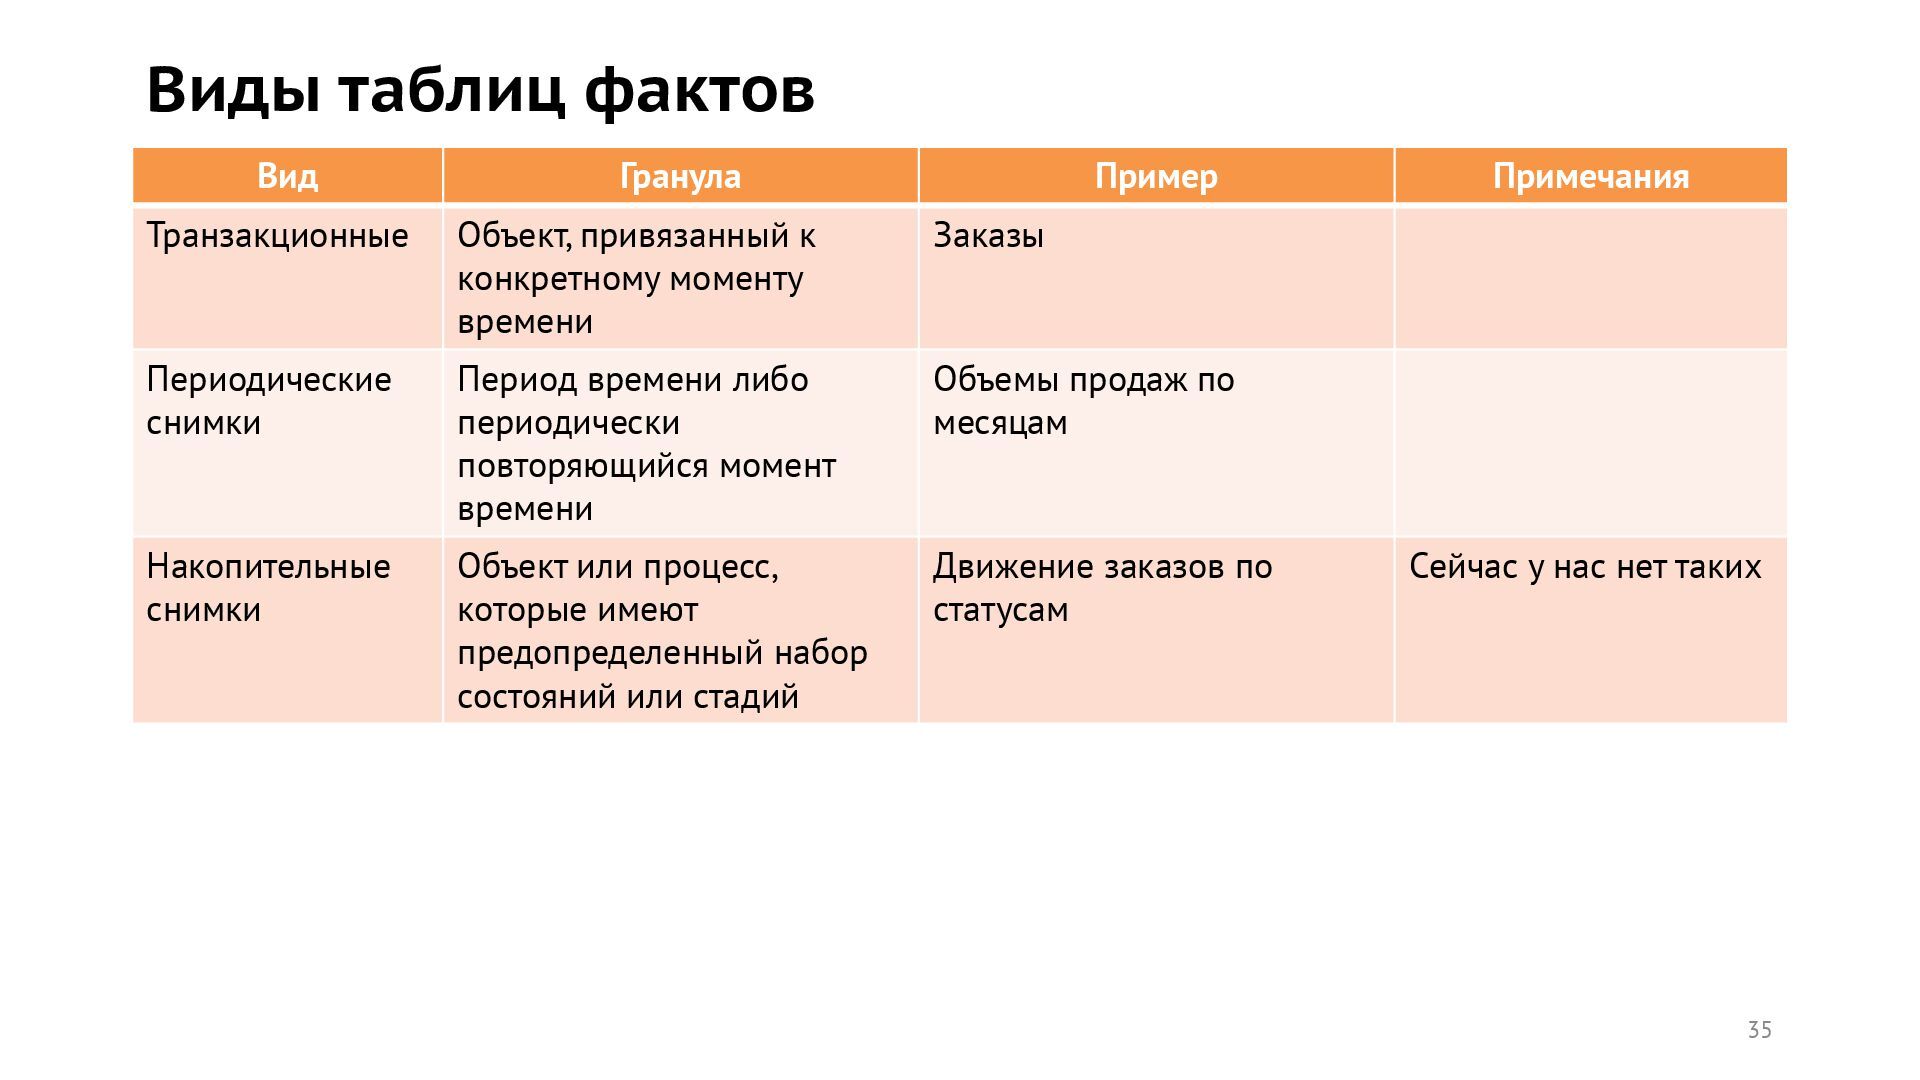
  26. Виды таблиц фактов Вид Гранула Пример Примечания Транзакционные Объект, привязанный

    к конкретному моменту времени Заказы Периодические снимки Период времени либо периодически повторяющийся момент времени Объемы продаж по месяцам Накопительные снимки Объект или процесс, которые имеют предопределенный набор состояний или стадий Движение заказов по статусам Сейчас у нас нет таких 35
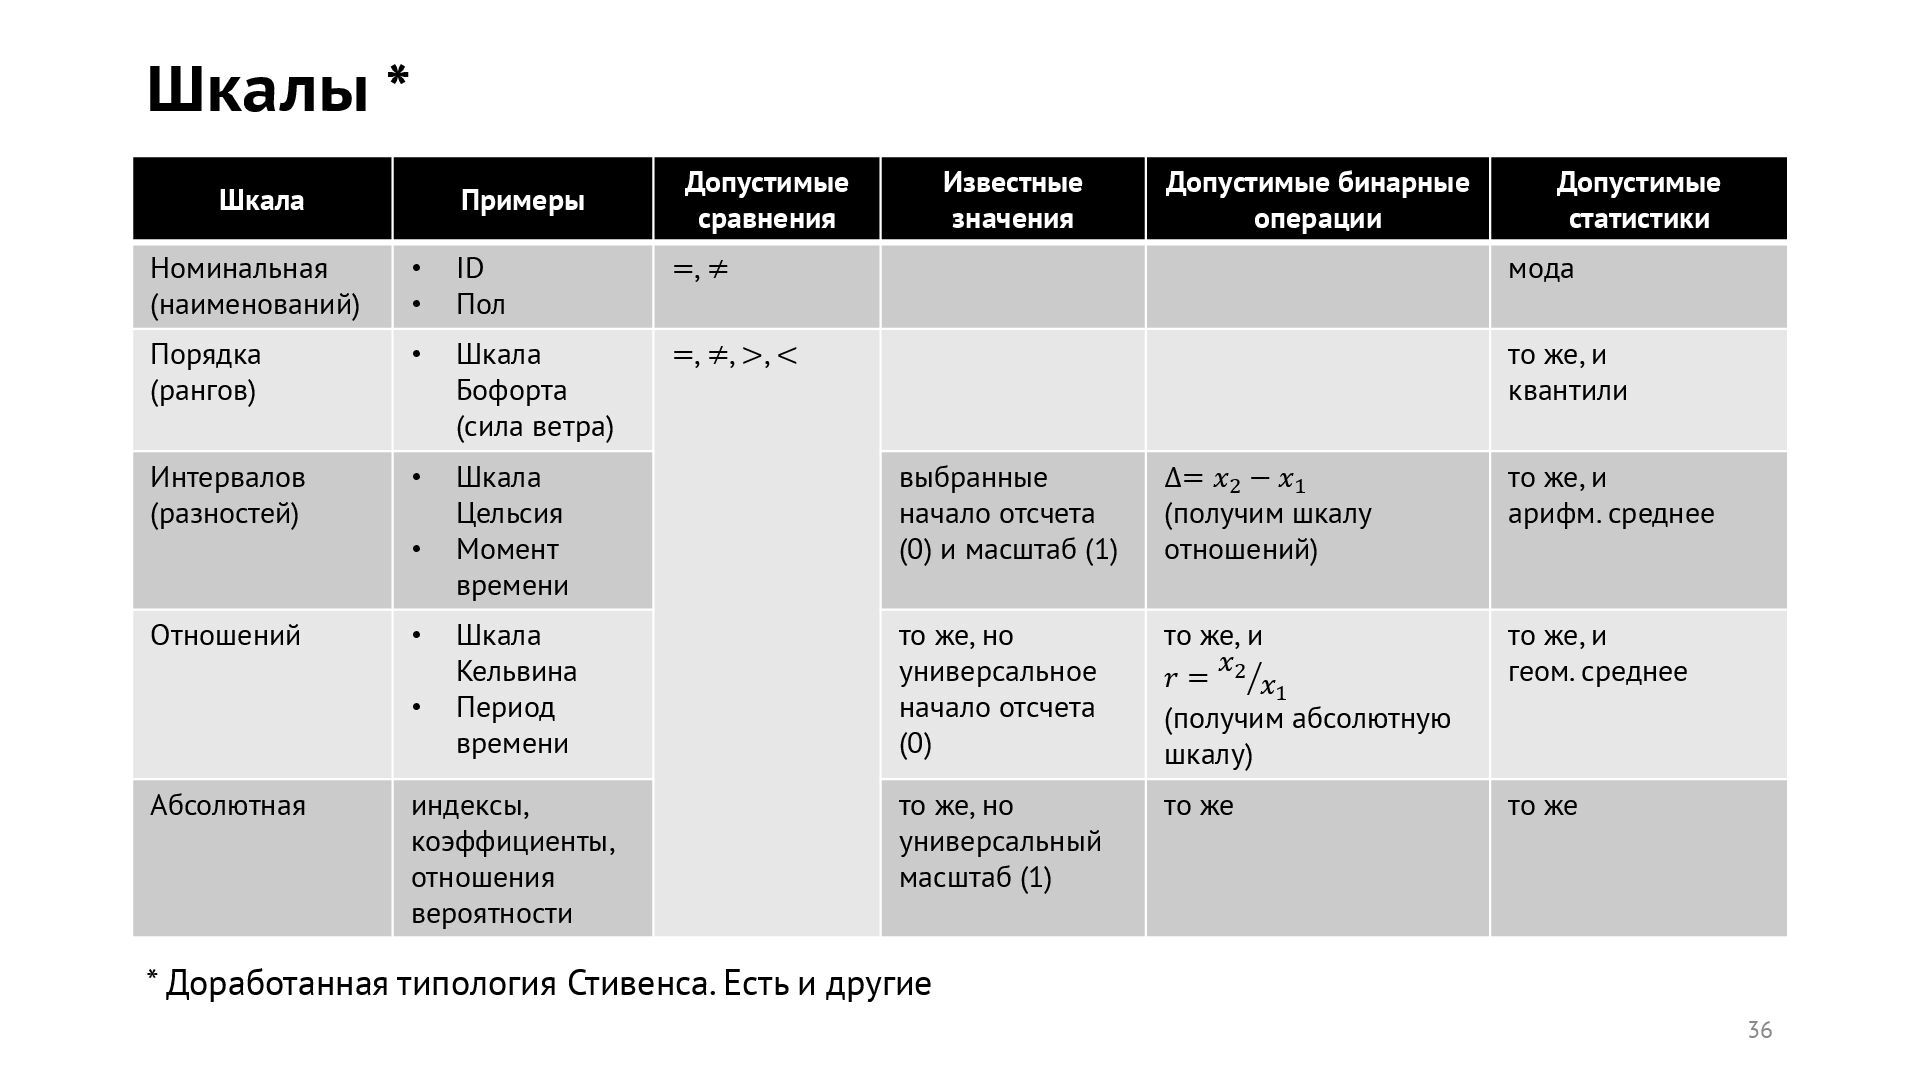
  27. Шкалы * Шкала Примеры Допустимые сравнения Известные значения Допустимые бинарные

    операции Допустимые статистики Номинальная (наименований) • ID • Пол =, ≠ мода Порядка (рангов) • Шкала Бофорта (сила ветра) =, ≠, >, < то же, и квантили Интервалов (разностей) • Шкала Цельсия • Момент времени выбранные начало отсчета (0) и масштаб (1) ∆= 𝑥2 − 𝑥1 (получим шкалу отношений) то же, и арифм. среднее Отношений • Шкала Кельвина • Период времени то же, но универсальное начало отсчета (0) то же, и 𝑟 = ൗ 𝑥2 𝑥1 (получим абсолютную шкалу) то же, и геом. среднее Абсолютная индексы, коэффициенты, отношения вероятности то же, но универсальный масштаб (1) то же то же 36 * Доработанная типология Стивенса. Есть и другие
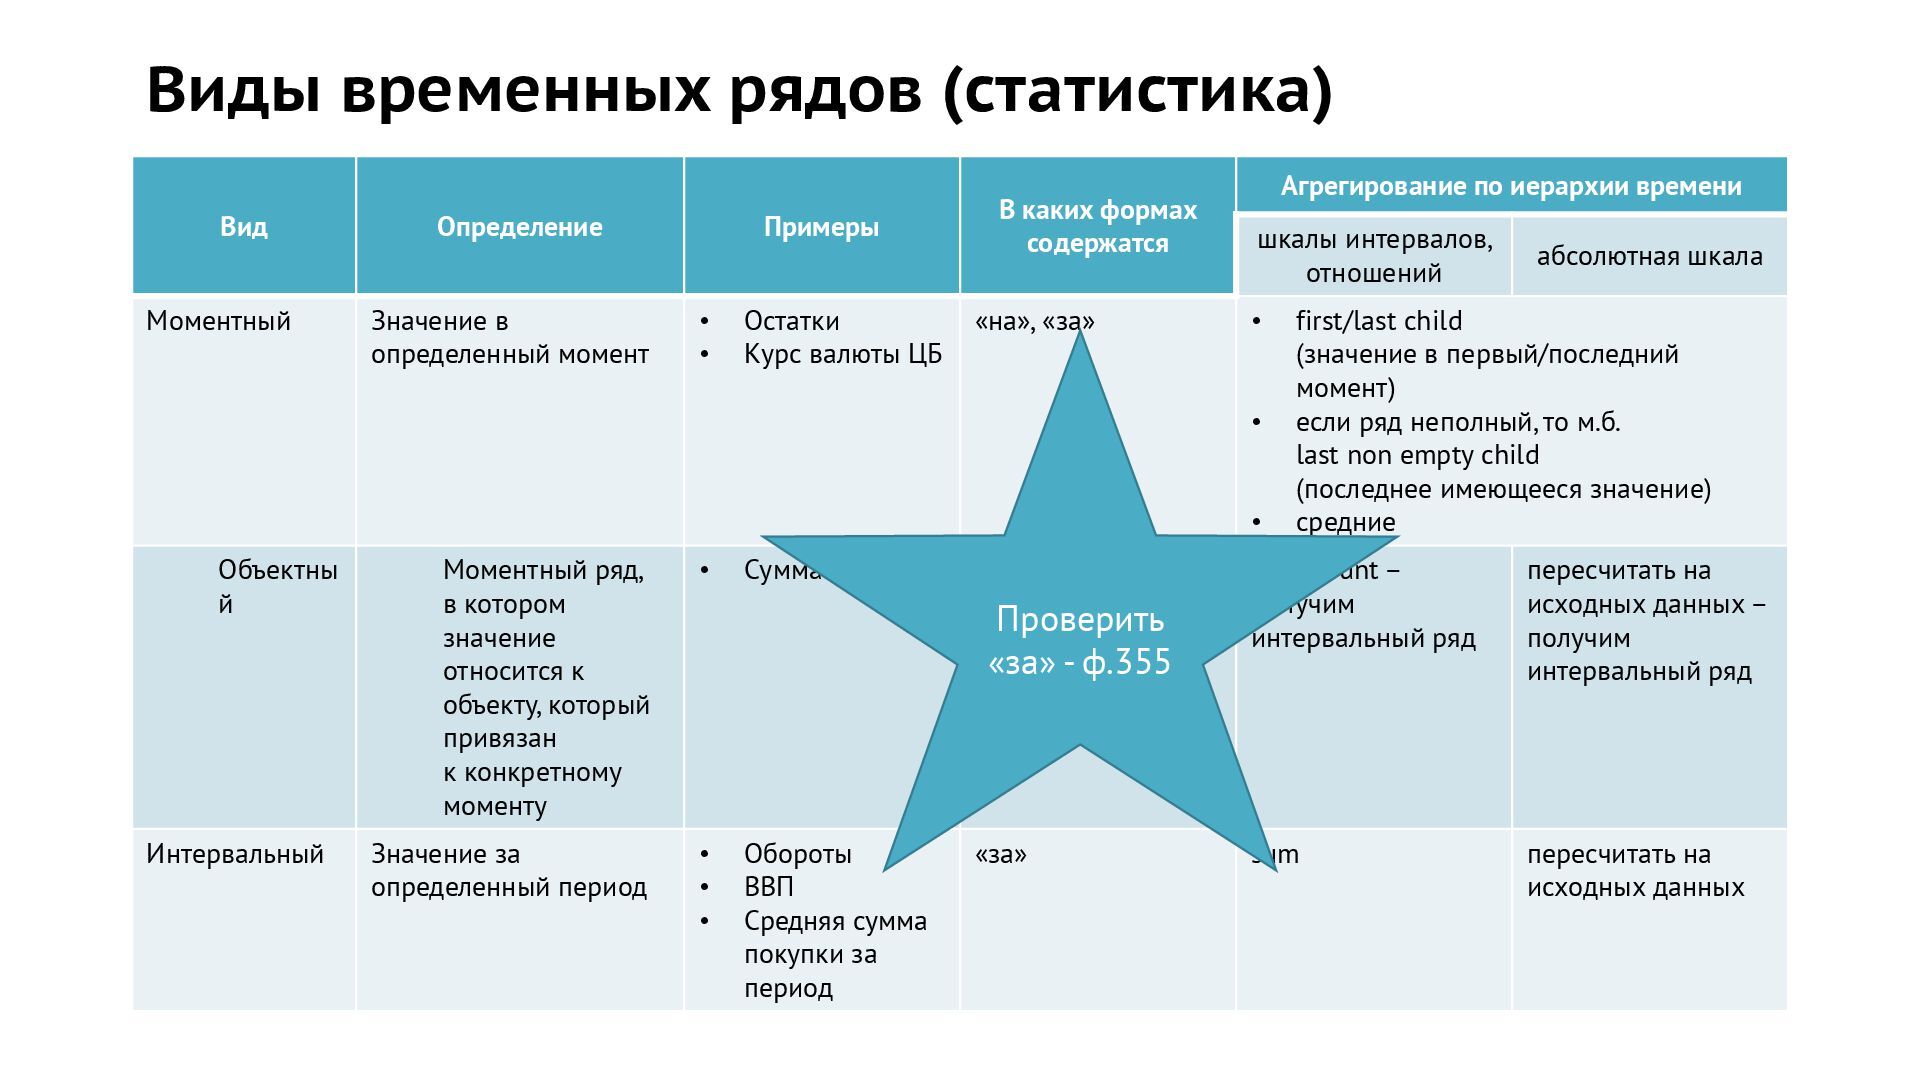
  28. Виды временных рядов (статистика) Вид Определение Примеры В каких формах

    содержатся Агрегирование по иерархии времени шкалы интервалов, отношений абсолютная шкала Моментный Значение в определенный момент • Остатки • Курс валюты ЦБ «на», «за» • first/last child (значение в первый/последний момент) • если ряд неполный, то м.б. last non empty child (последнее имеющееся значение) • средние Объектны й Моментный ряд, в котором значение относится к объекту, который привязан к конкретному моменту • Сумма покупки «за» ? sum, count – получим интервальный ряд пересчитать на исходных данных – получим интервальный ряд Интервальный Значение за определенный период • Обороты • ВВП • Средняя сумма покупки за период «за» sum пересчитать на исходных данных Проверить «за» - ф.355
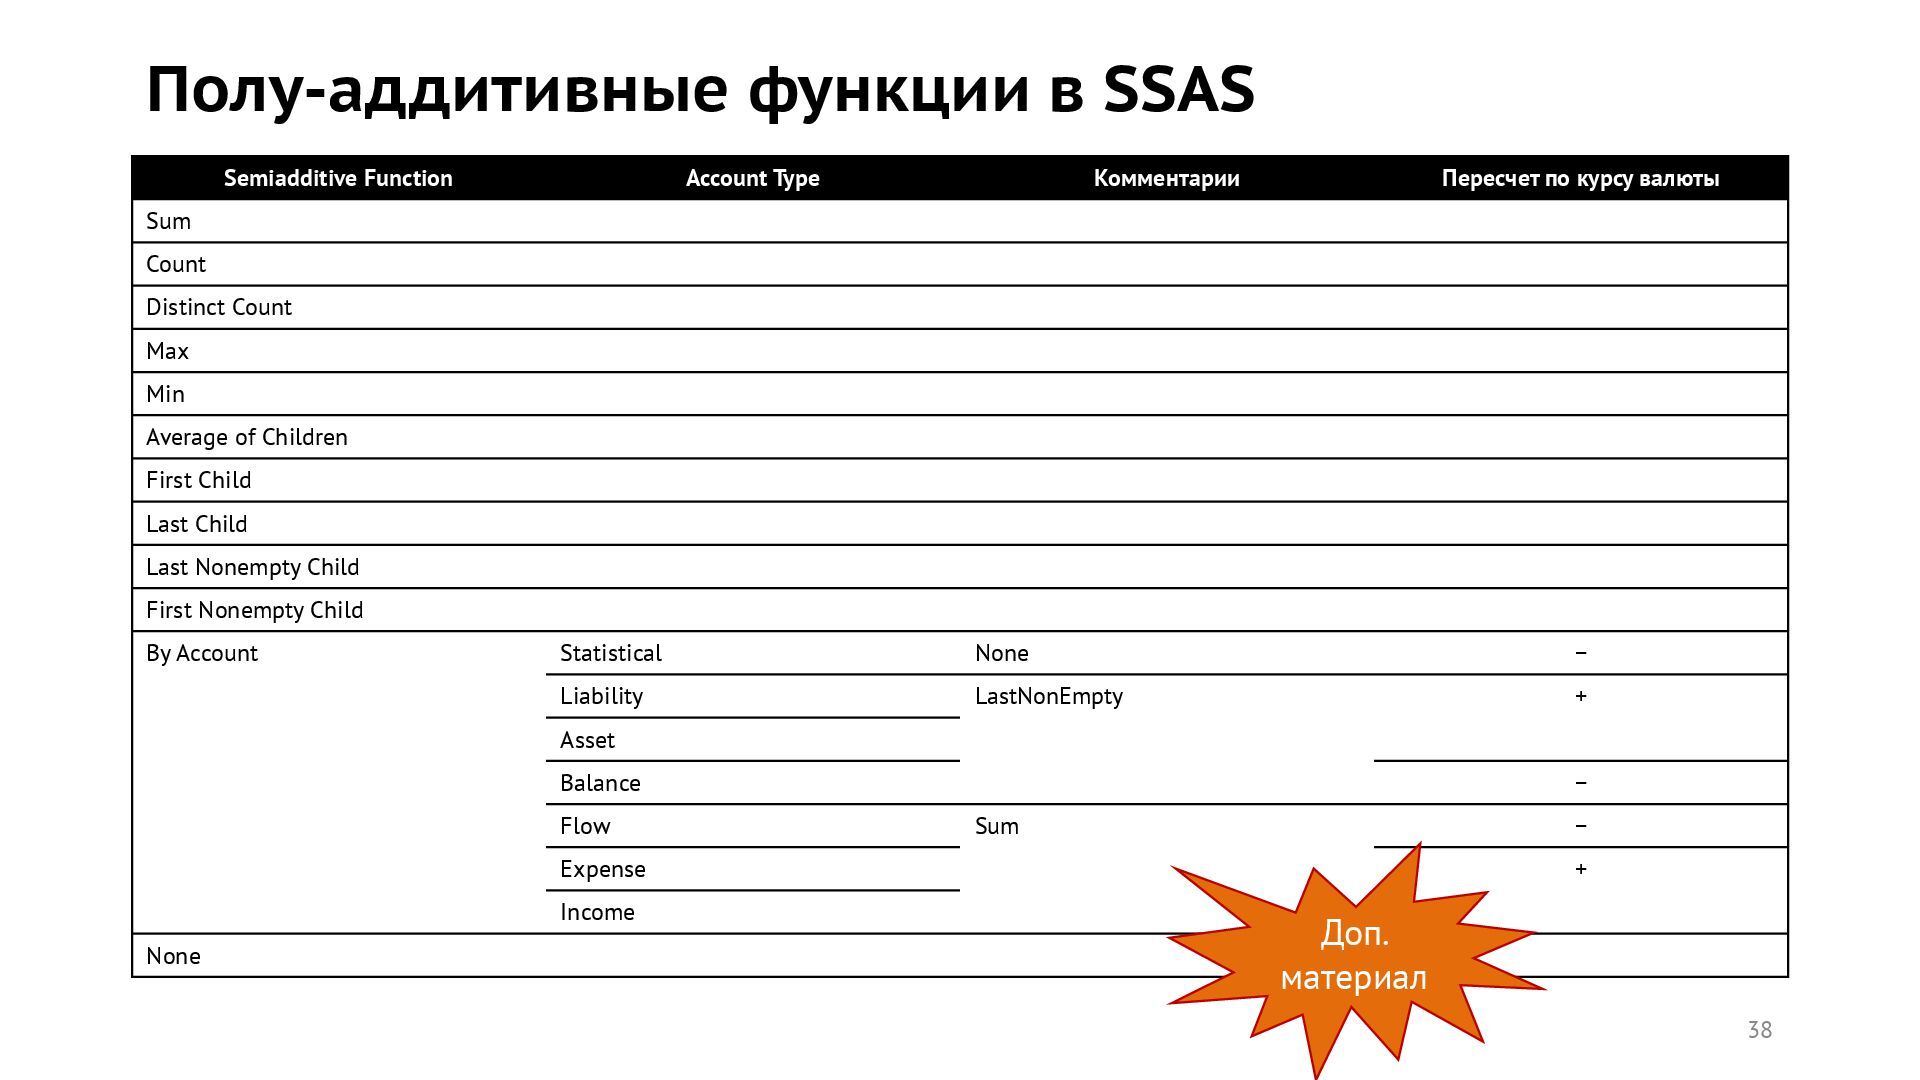
  29. Полу-аддитивные функции в SSAS Semiadditive Function Account Type Комментарии Пересчет
    по курсу валюты Sum Count Distinct Count Max Min Average of Children First Child Last Child Last Nonempty Child First Nonempty Child By Account Statistical None − Liability LastNonEmpty + Asset Balance − Flow Sum − Expense + Income None 38 Доп. материал
  30. Реализуется на клиенте (SQL, Cognos): • Sum, Count • First/Last

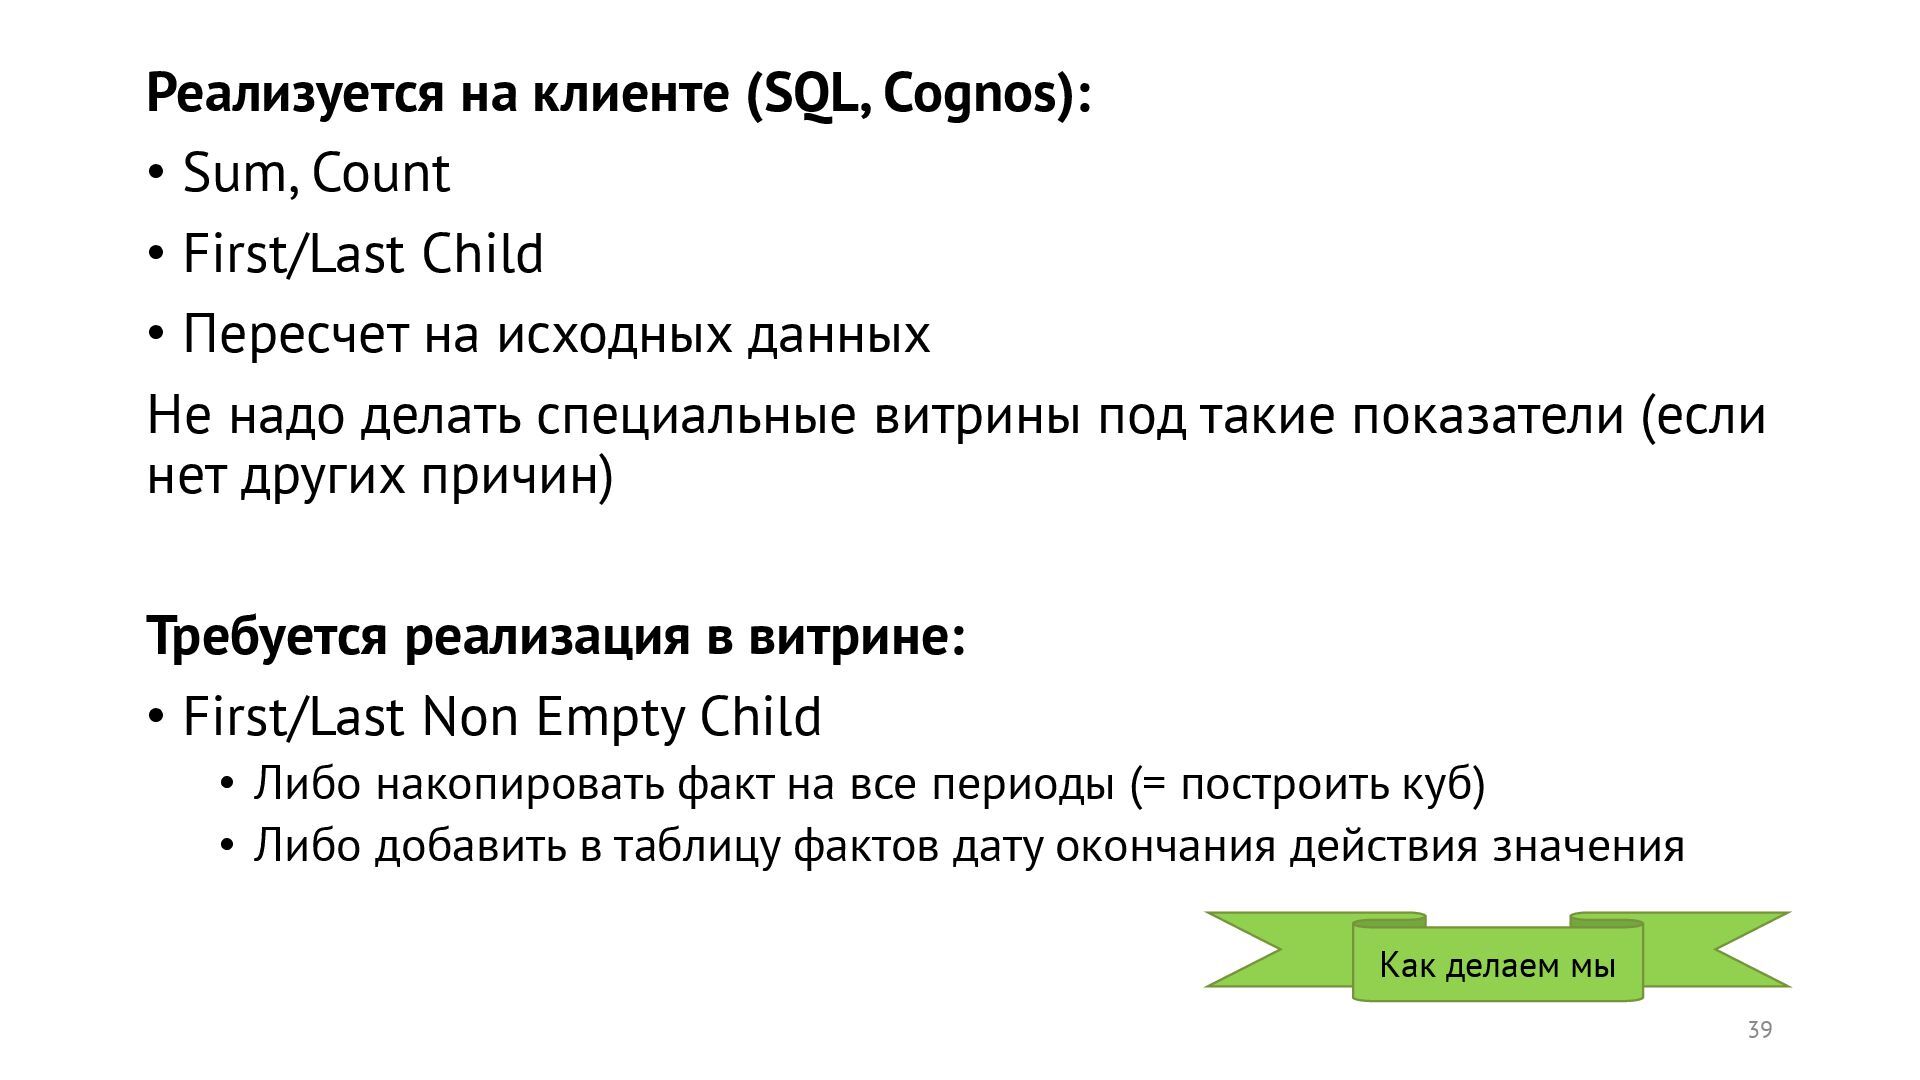
    Child • Пересчет на исходных данных Не надо делать специальные витрины под такие показатели (если нет других причин) Требуется реализация в витрине: • First/Last Non Empty Child • Либо накопировать факт на все периоды (= построить куб) • Либо добавить в таблицу фактов дату окончания действия значения 39 Как делаем мы
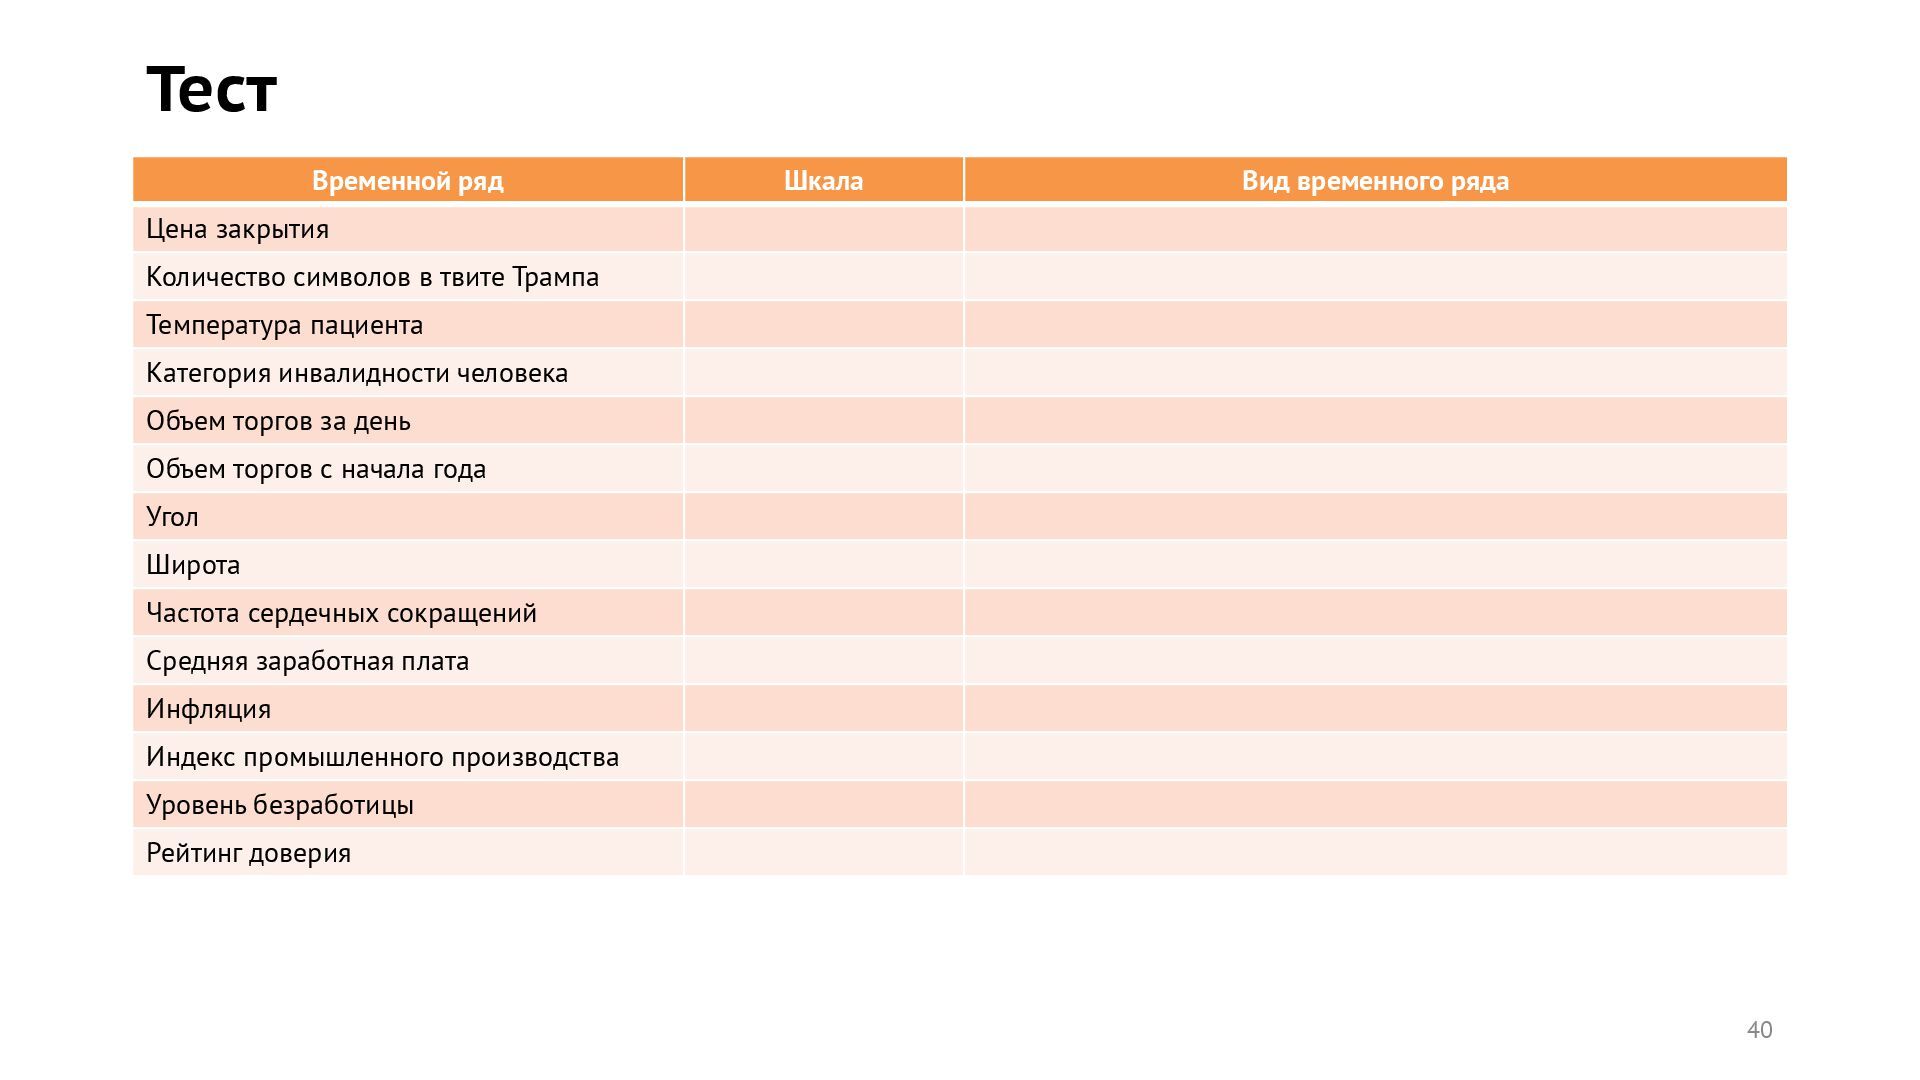
  31. Тест Временной ряд Шкала Вид временного ряда Цена закрытия Количество

    символов в твите Трампа Температура пациента Категория инвалидности человека Объем торгов за день Объем торгов с начала года Угол Широта Частота сердечных сокращений Средняя заработная плата Инфляция Индекс промышленного производства Уровень безработицы Рейтинг доверия 40
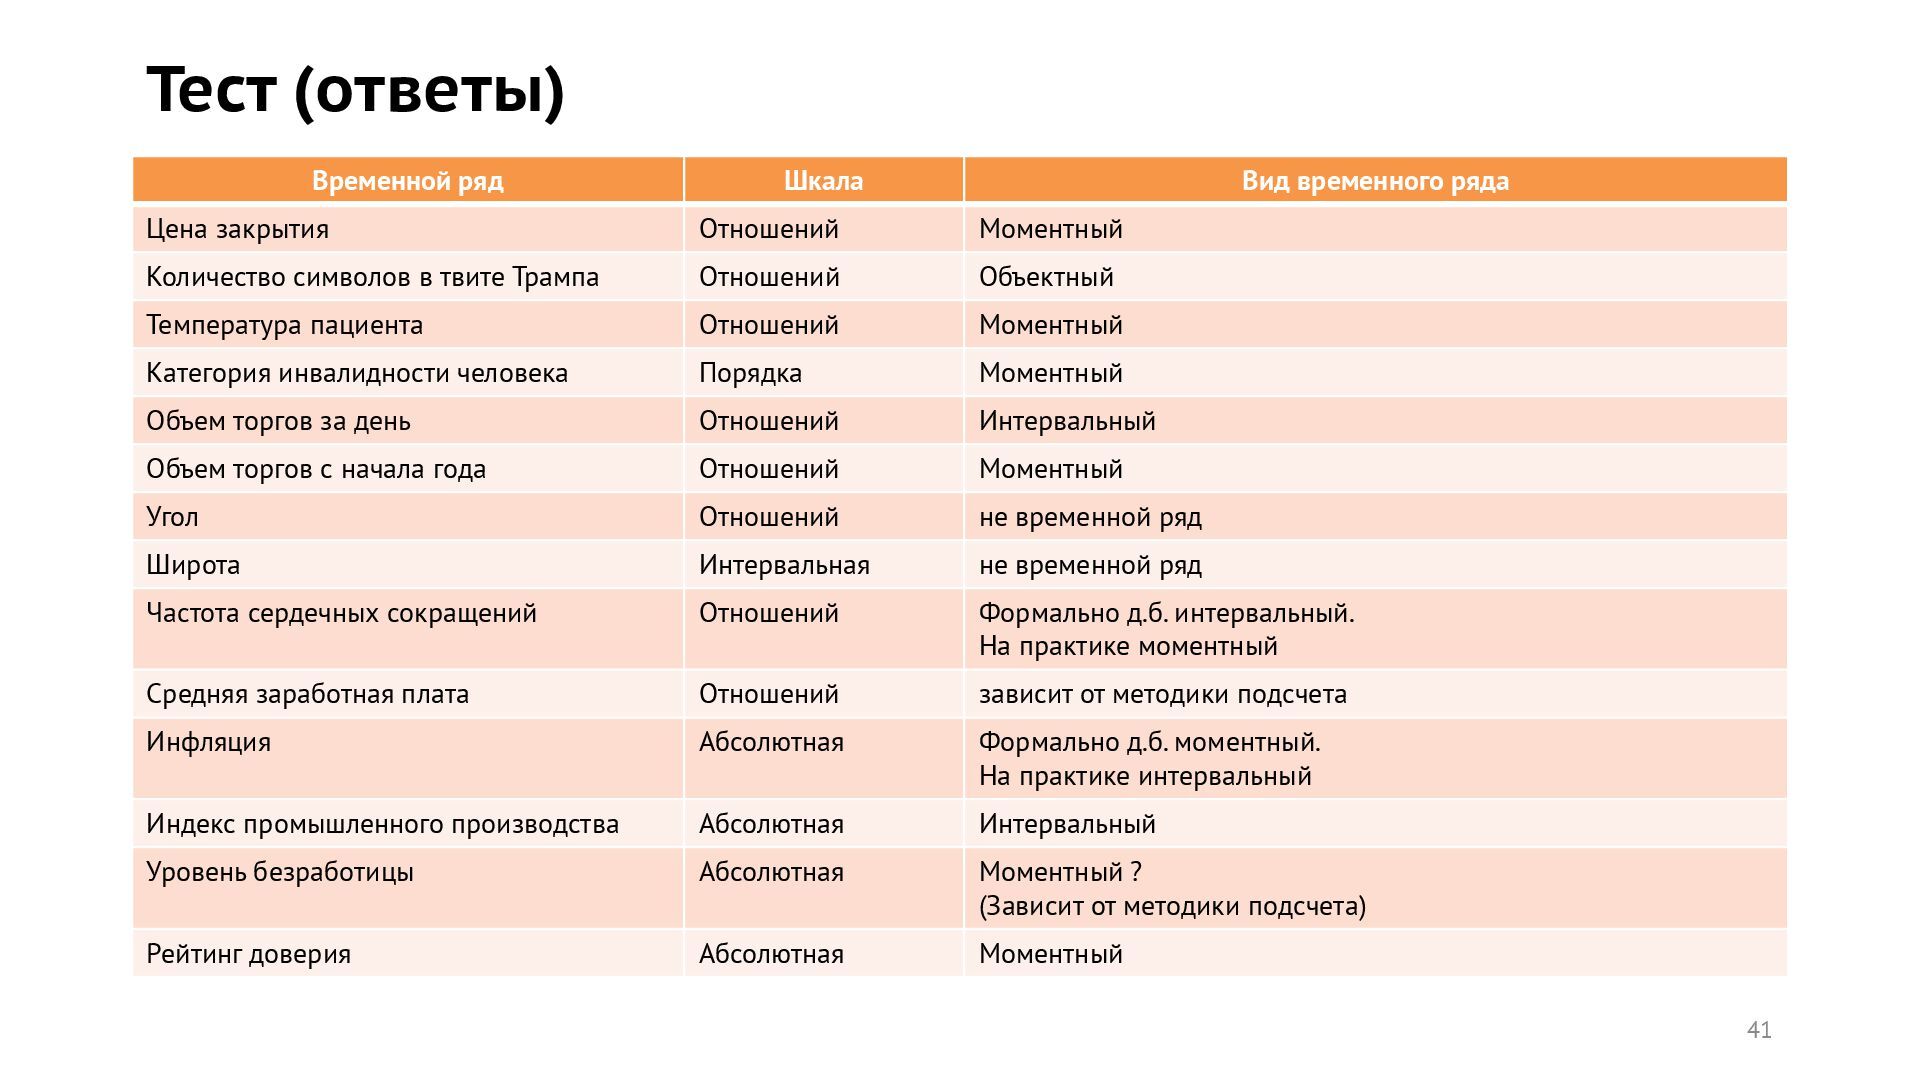
  32. Тест (ответы) Временной ряд Шкала Вид временного ряда Цена закрытия

    Отношений Моментный Количество символов в твите Трампа Отношений Объектный Температура пациента Отношений Моментный Категория инвалидности человека Порядка Моментный Объем торгов за день Отношений Интервальный Объем торгов с начала года Отношений Моментный Угол Отношений не временной ряд Широта Интервальная не временной ряд Частота сердечных сокращений Отношений Формально д.б. интервальный. На практике моментный Средняя заработная плата Отношений зависит от методики подсчета Инфляция Абсолютная Формально д.б. моментный. На практике интервальный Индекс промышленного производства Абсолютная Интервальный Уровень безработицы Абсолютная Моментный ? (Зависит от методики подсчета) Рейтинг доверия Абсолютная Моментный 41
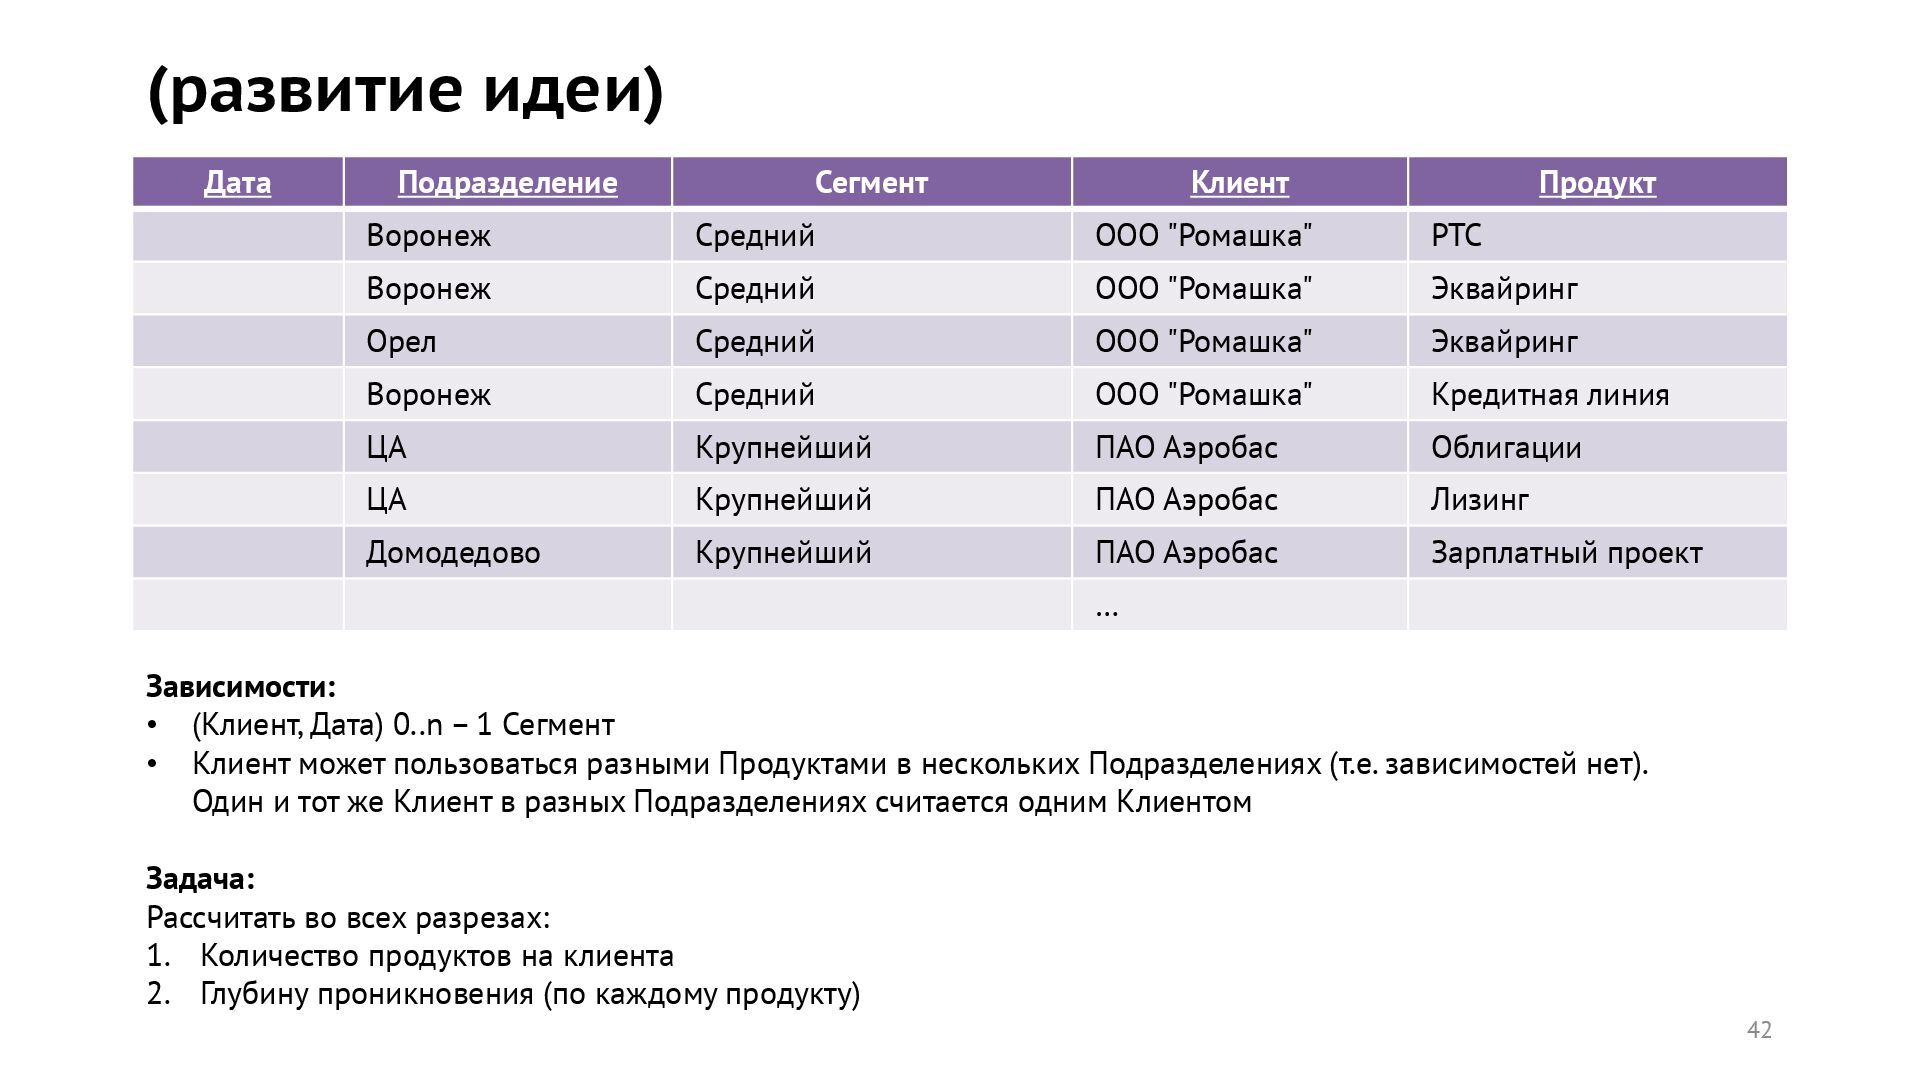
  33. (развитие идеи) Дата Подразделение Сегмент Клиент Продукт Воронеж Средний ООО

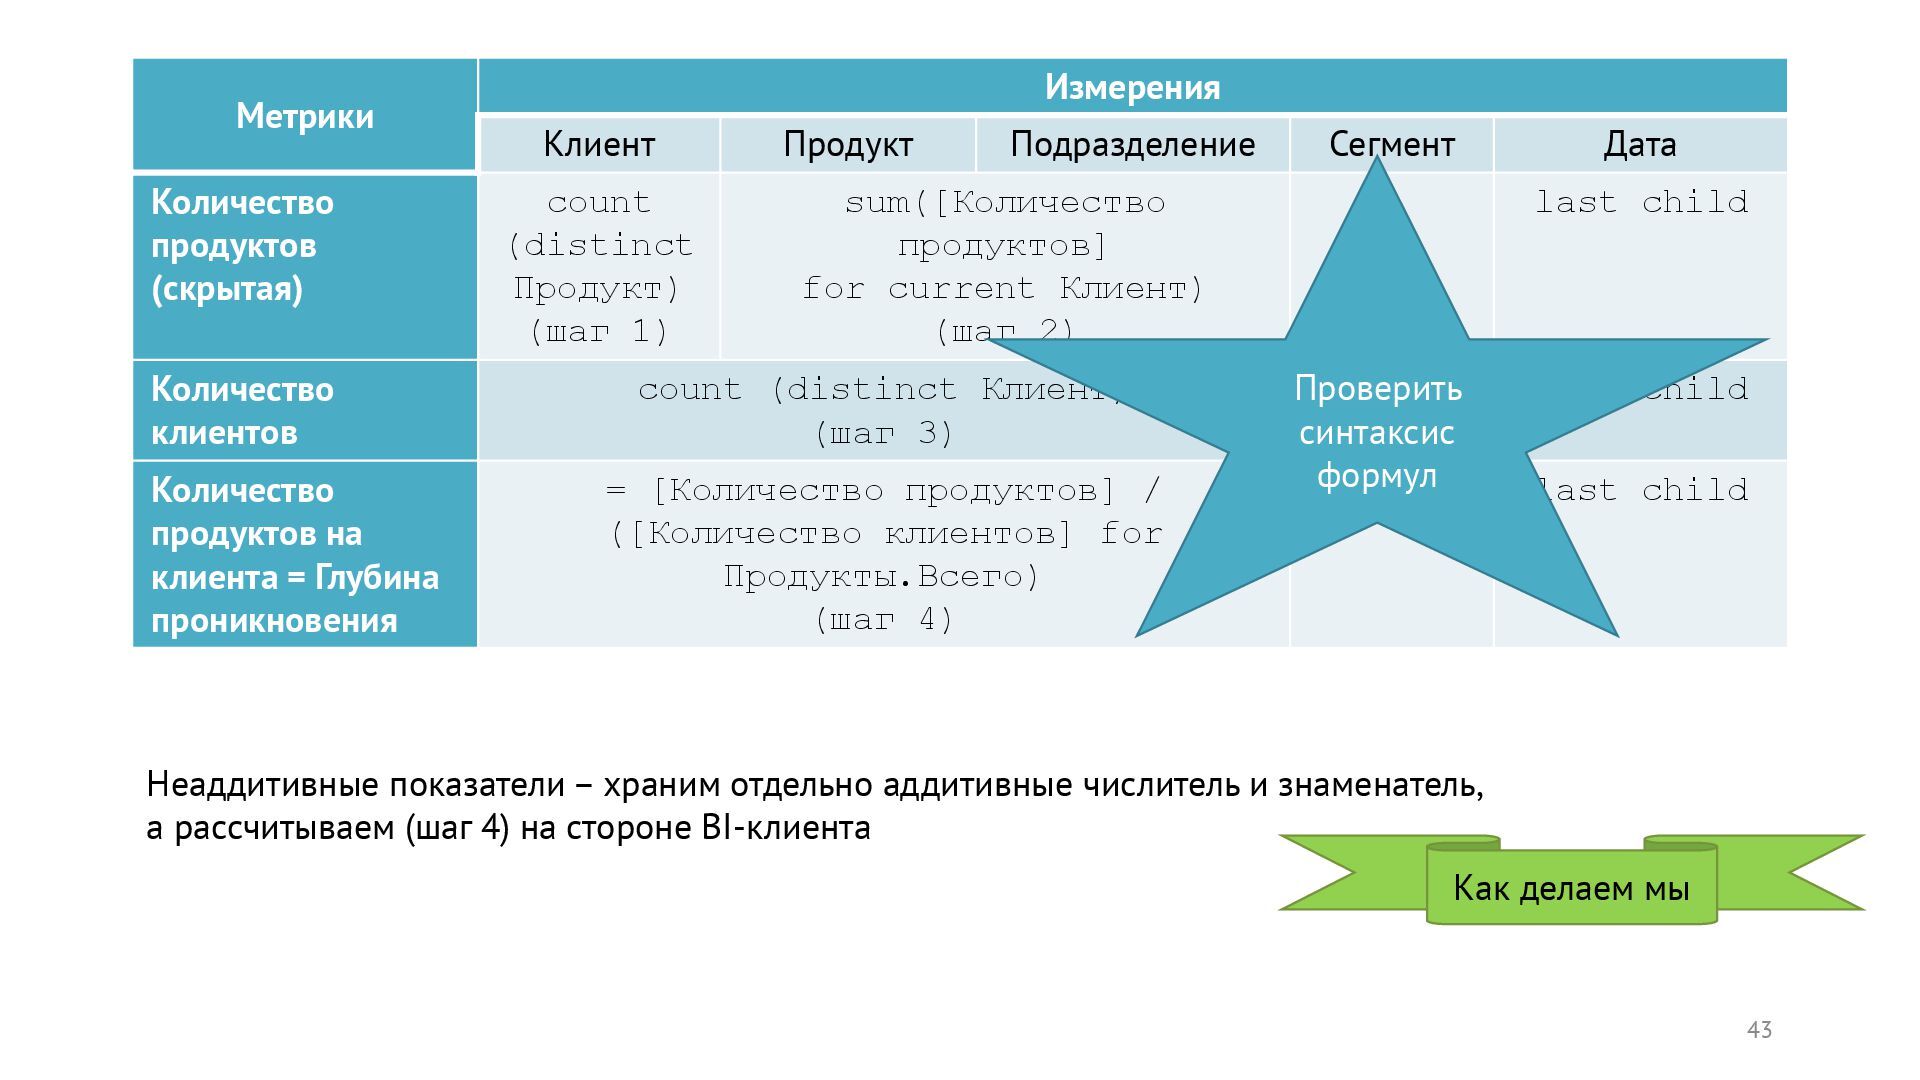
    "Ромашка" РТС Воронеж Средний ООО "Ромашка" Эквайринг Орел Средний ООО "Ромашка" Эквайринг Воронеж Средний ООО "Ромашка" Кредитная линия ЦА Крупнейший ПАО Аэробас Облигации ЦА Крупнейший ПАО Аэробас Лизинг Домодедово Крупнейший ПАО Аэробас Зарплатный проект … 42 Зависимости: • (Клиент, Дата) 0..n – 1 Сегмент • Клиент может пользоваться разными Продуктами в нескольких Подразделениях (т.е. зависимостей нет). Один и тот же Клиент в разных Подразделениях считается одним Клиентом Задача: Рассчитать во всех разрезах: 1. Количество продуктов на клиента 2. Глубину проникновения (по каждому продукту)
  34. Метрики Измерения Клиент Продукт Подразделение Сегмент Дата Количество продуктов (скрытая)

    count (distinct Продукт) (шаг 1) sum([Количество продуктов] for current Клиент) (шаг 2) - last child Количество клиентов count (distinct Клиент) (шаг 3) sum last child Количество продуктов на клиента = Глубина проникновения = [Количество продуктов] / ([Количество клиентов] for Продукты.Всего) (шаг 4) - last child 43 Неаддитивные показатели – храним отдельно аддитивные числитель и знаменатель, а рассчитываем (шаг 4) на стороне BI-клиента Как делаем мы Проверить синтаксис формул
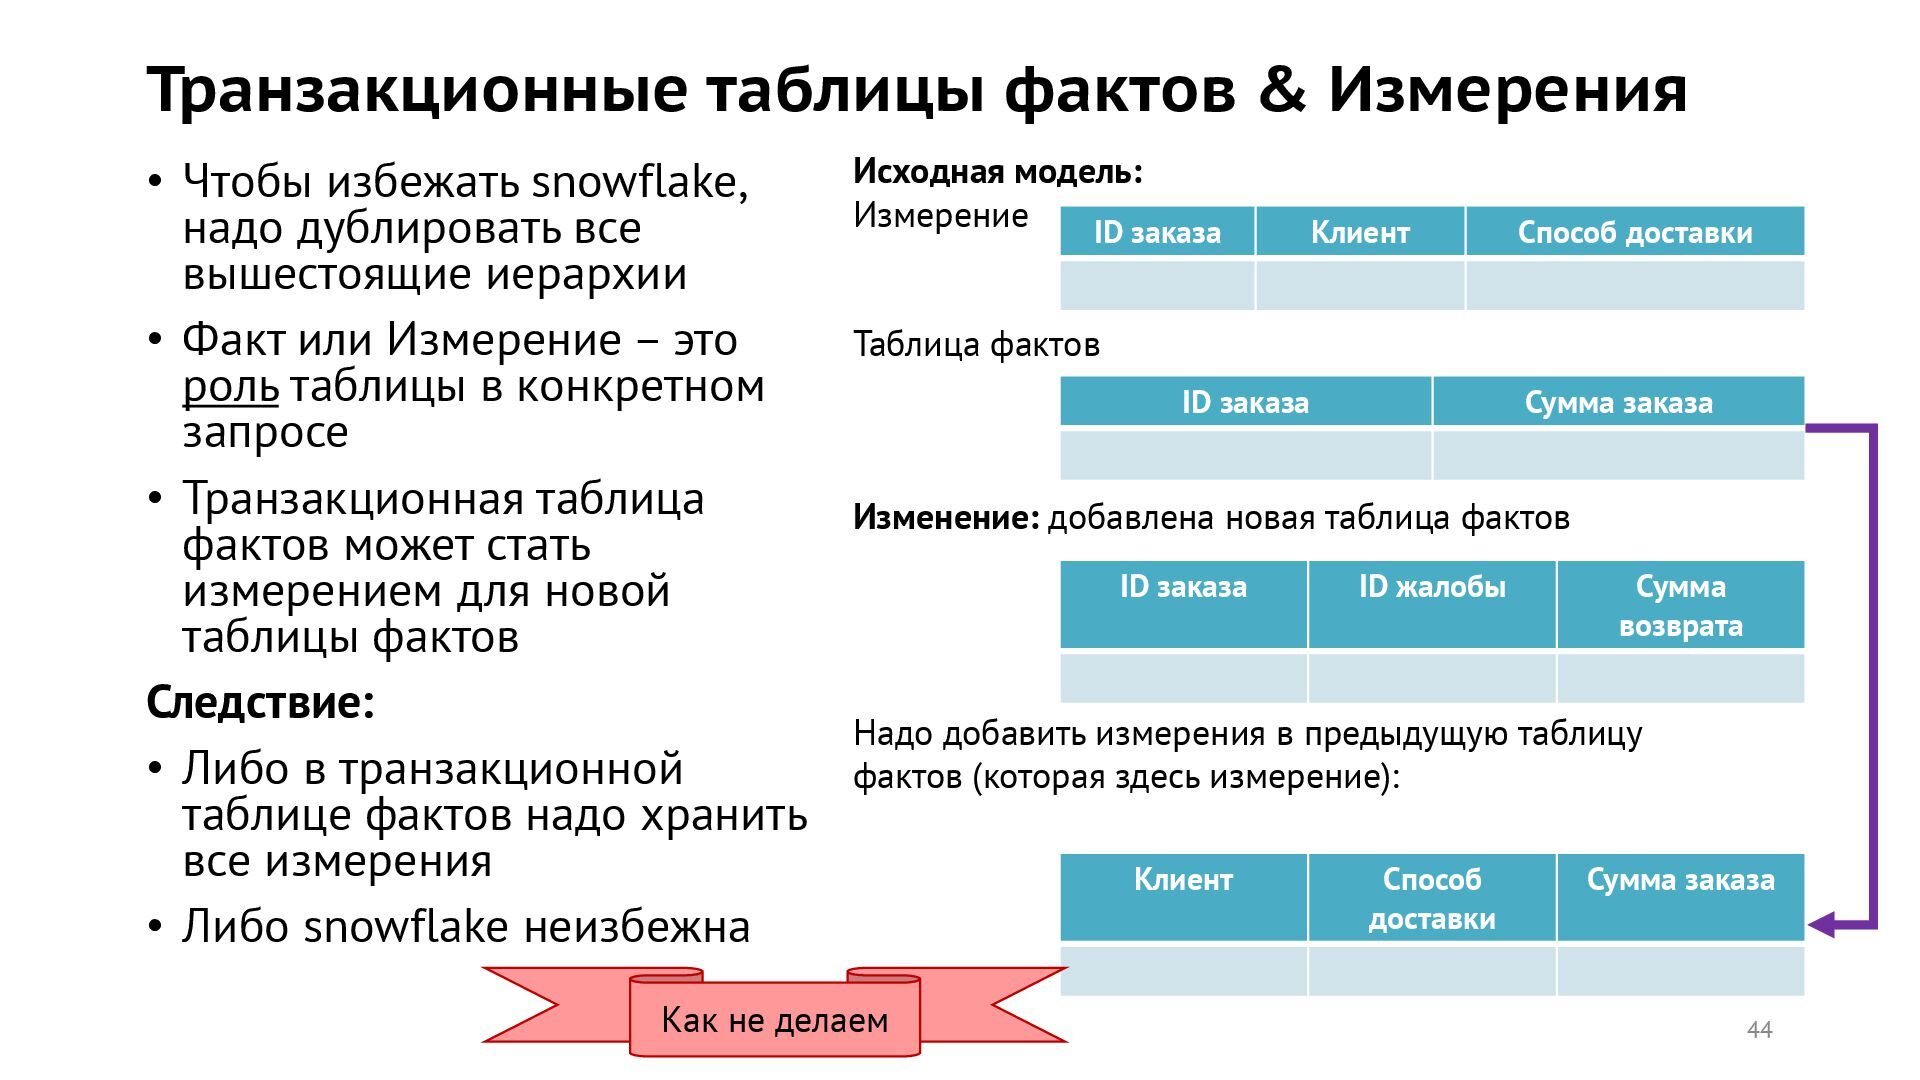
  35. Транзакционные таблицы фактов & Измерения • Чтобы избежать snowflake, надо

    дублировать все вышестоящие иерархии • Факт или Измерение – это роль таблицы в конкретном запросе • Транзакционная таблица фактов может стать измерением для новой таблицы фактов Следствие: • Либо в транзакционной таблице фактов надо хранить все измерения • Либо snowflake неизбежна 44 ID заказа Сумма заказа ID заказа Клиент Способ доставки ID заказа ID жалобы Сумма возврата Клиент Способ доставки Сумма заказа Исходная модель: Измерение Таблица фактов Изменение: добавлена новая таблица фактов Надо добавить измерения в предыдущую таблицу фактов (которая здесь измерение): Как не делаем
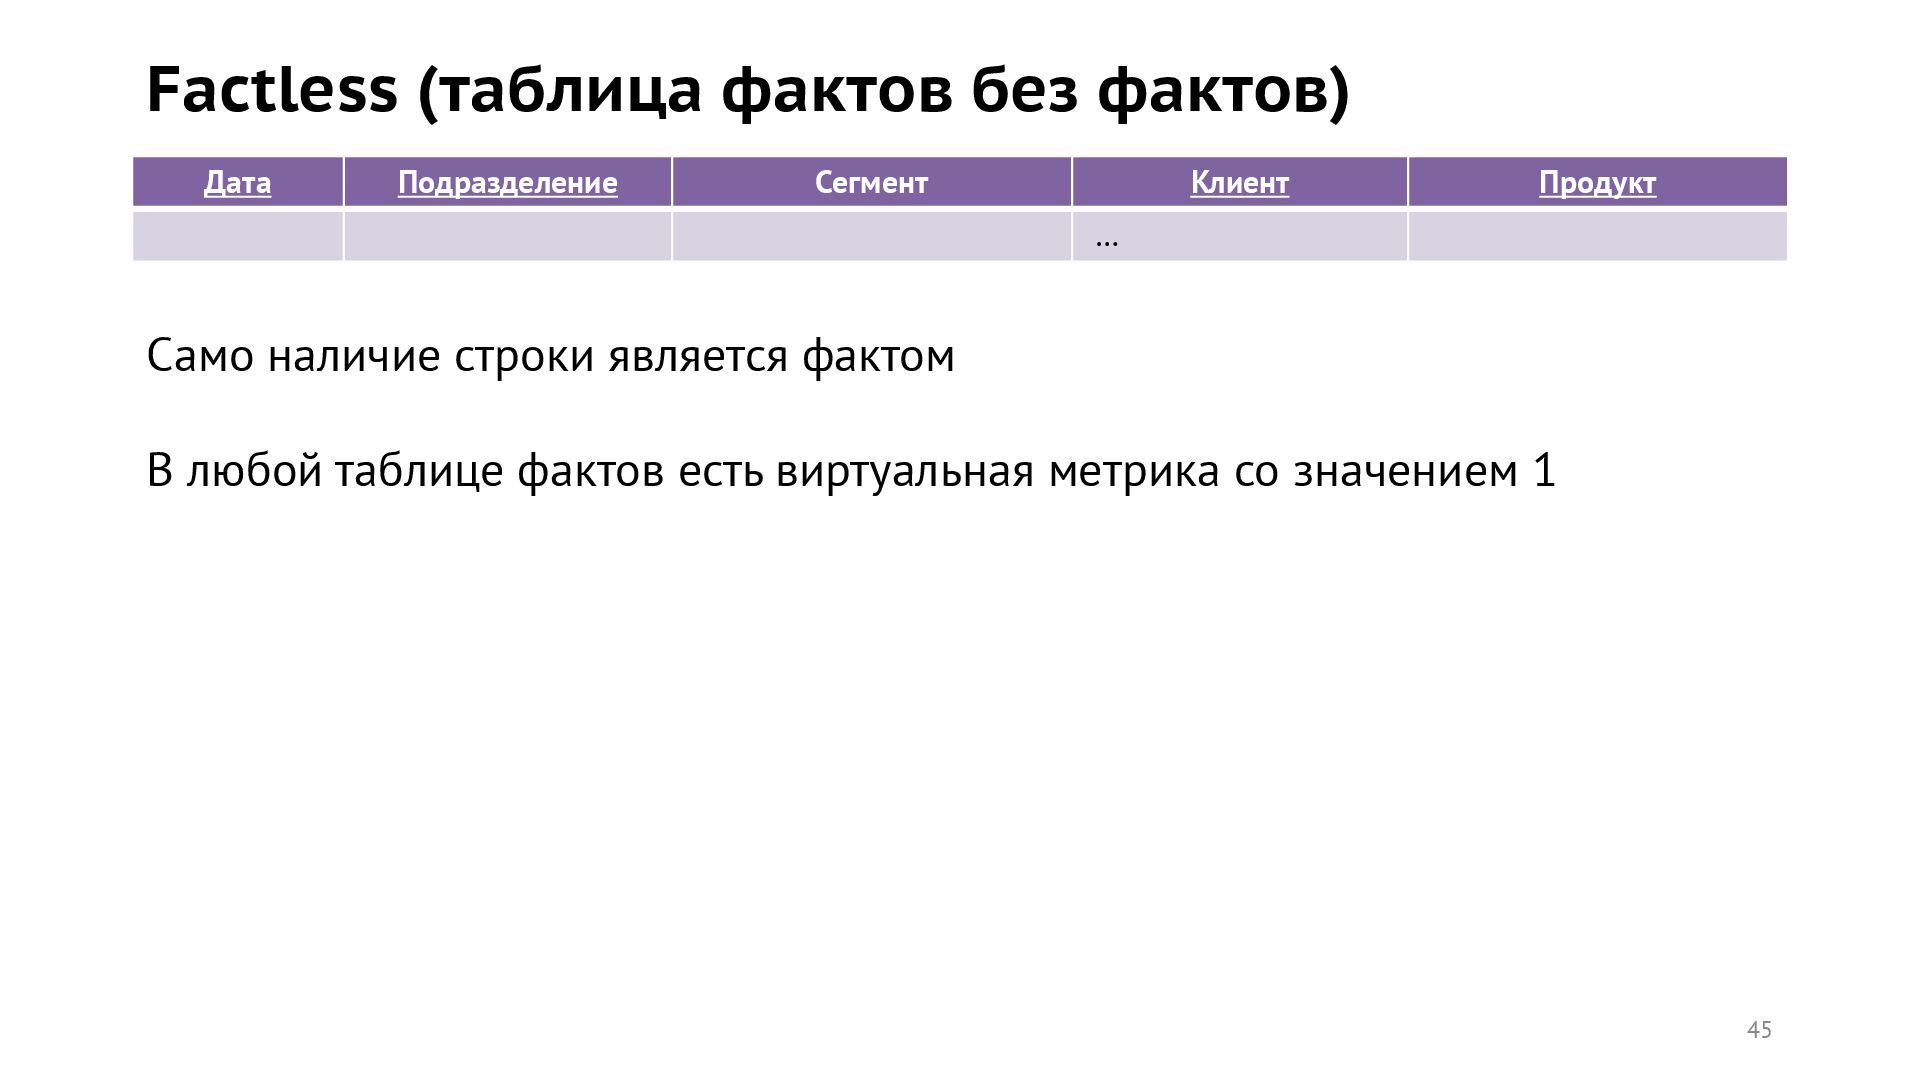
  36. Factless (таблица фактов без фактов) 45 Дата Подразделение Сегмент Клиент

    Продукт … Само наличие строки является фактом В любой таблице фактов есть виртуальная метрика со значением 1
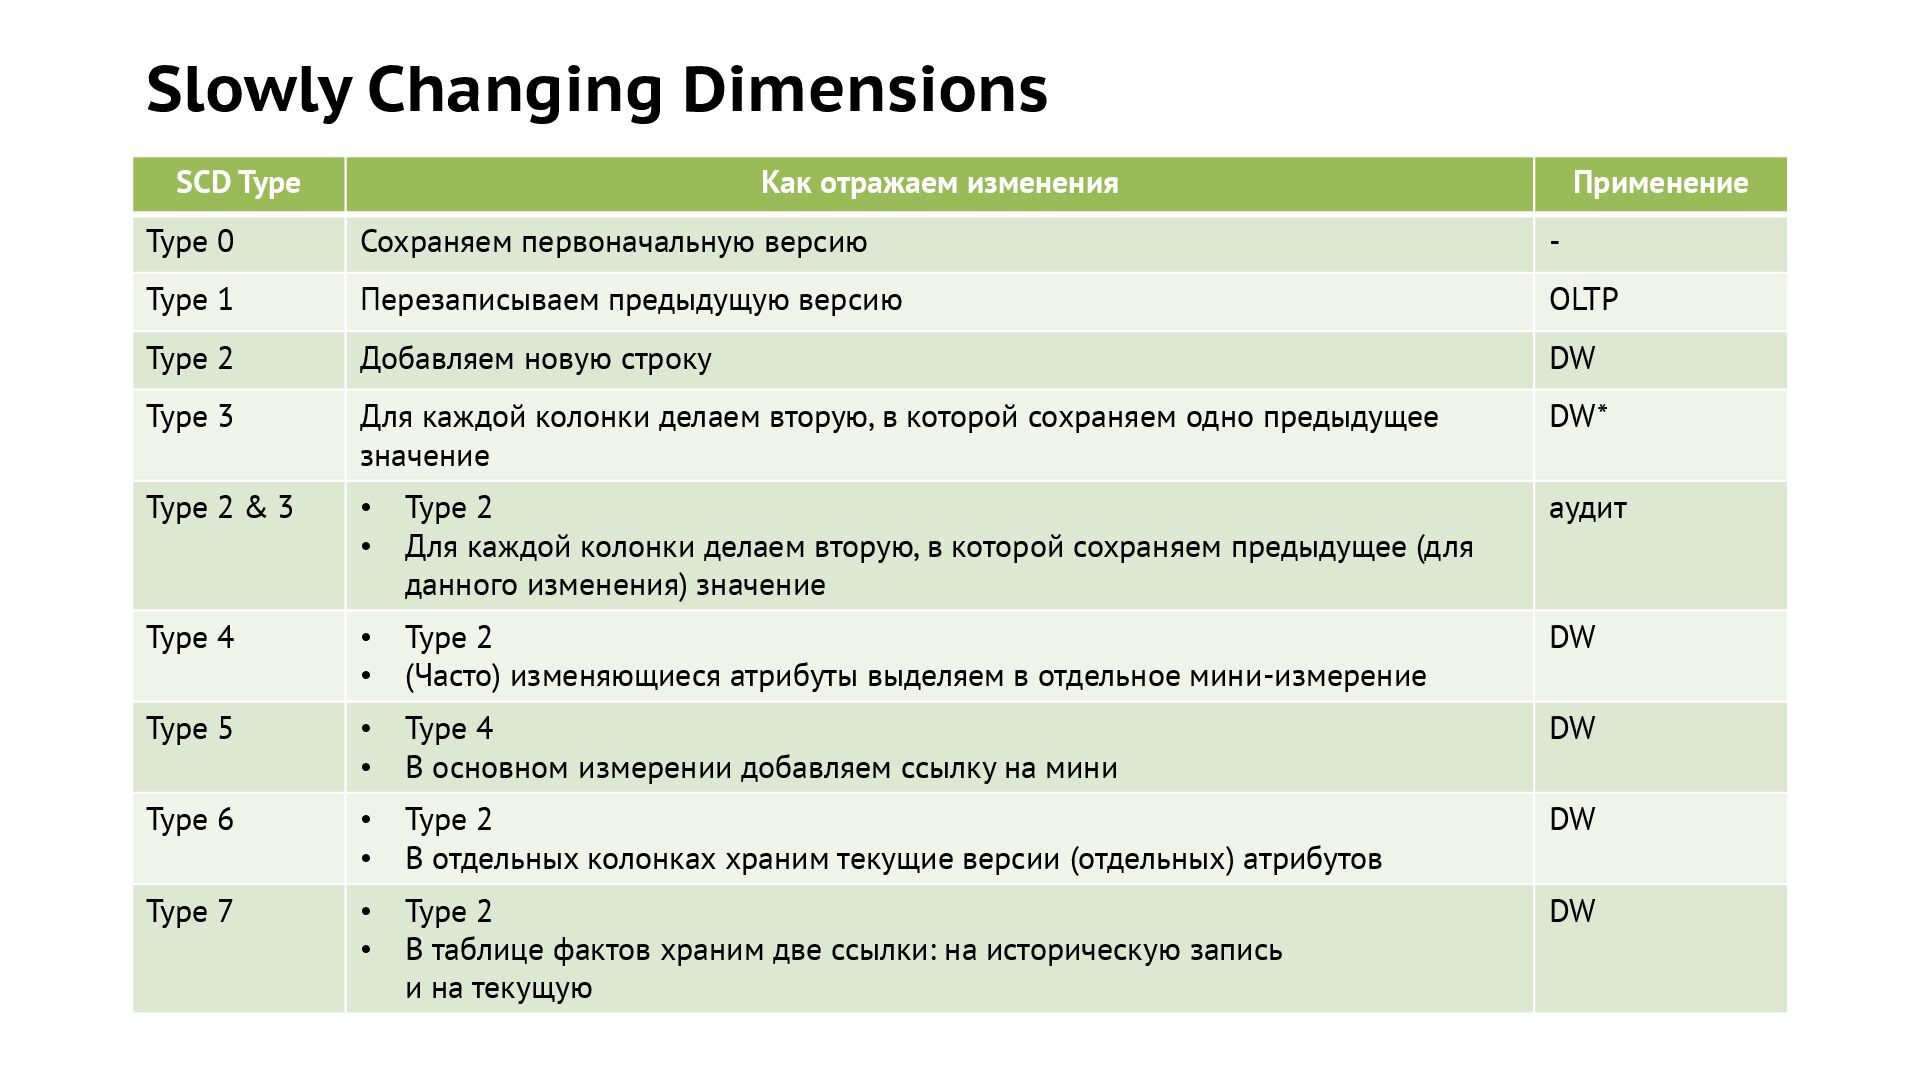
  37. Slowly Changing Dimensions SCD Type Как отражаем изменения Применение Type

    0 Сохраняем первоначальную версию - Type 1 Перезаписываем предыдущую версию OLTP Type 2 Добавляем новую строку DW Type 3 Для каждой колонки делаем вторую, в которой сохраняем одно предыдущее значение DW* Type 2 & 3 • Type 2 • Для каждой колонки делаем вторую, в которой сохраняем предыдущее (для данного изменения) значение аудит Type 4 • Type 2 • (Часто) изменяющиеся атрибуты выделяем в отдельное мини-измерение DW Type 5 • Type 4 • В основном измерении добавляем ссылку на мини DW Type 6 • Type 2 • В отдельных колонках храним текущие версии (отдельных) атрибутов DW Type 7 • Type 2 • В таблице фактов храним две ссылки: на историческую запись и на текущую DW
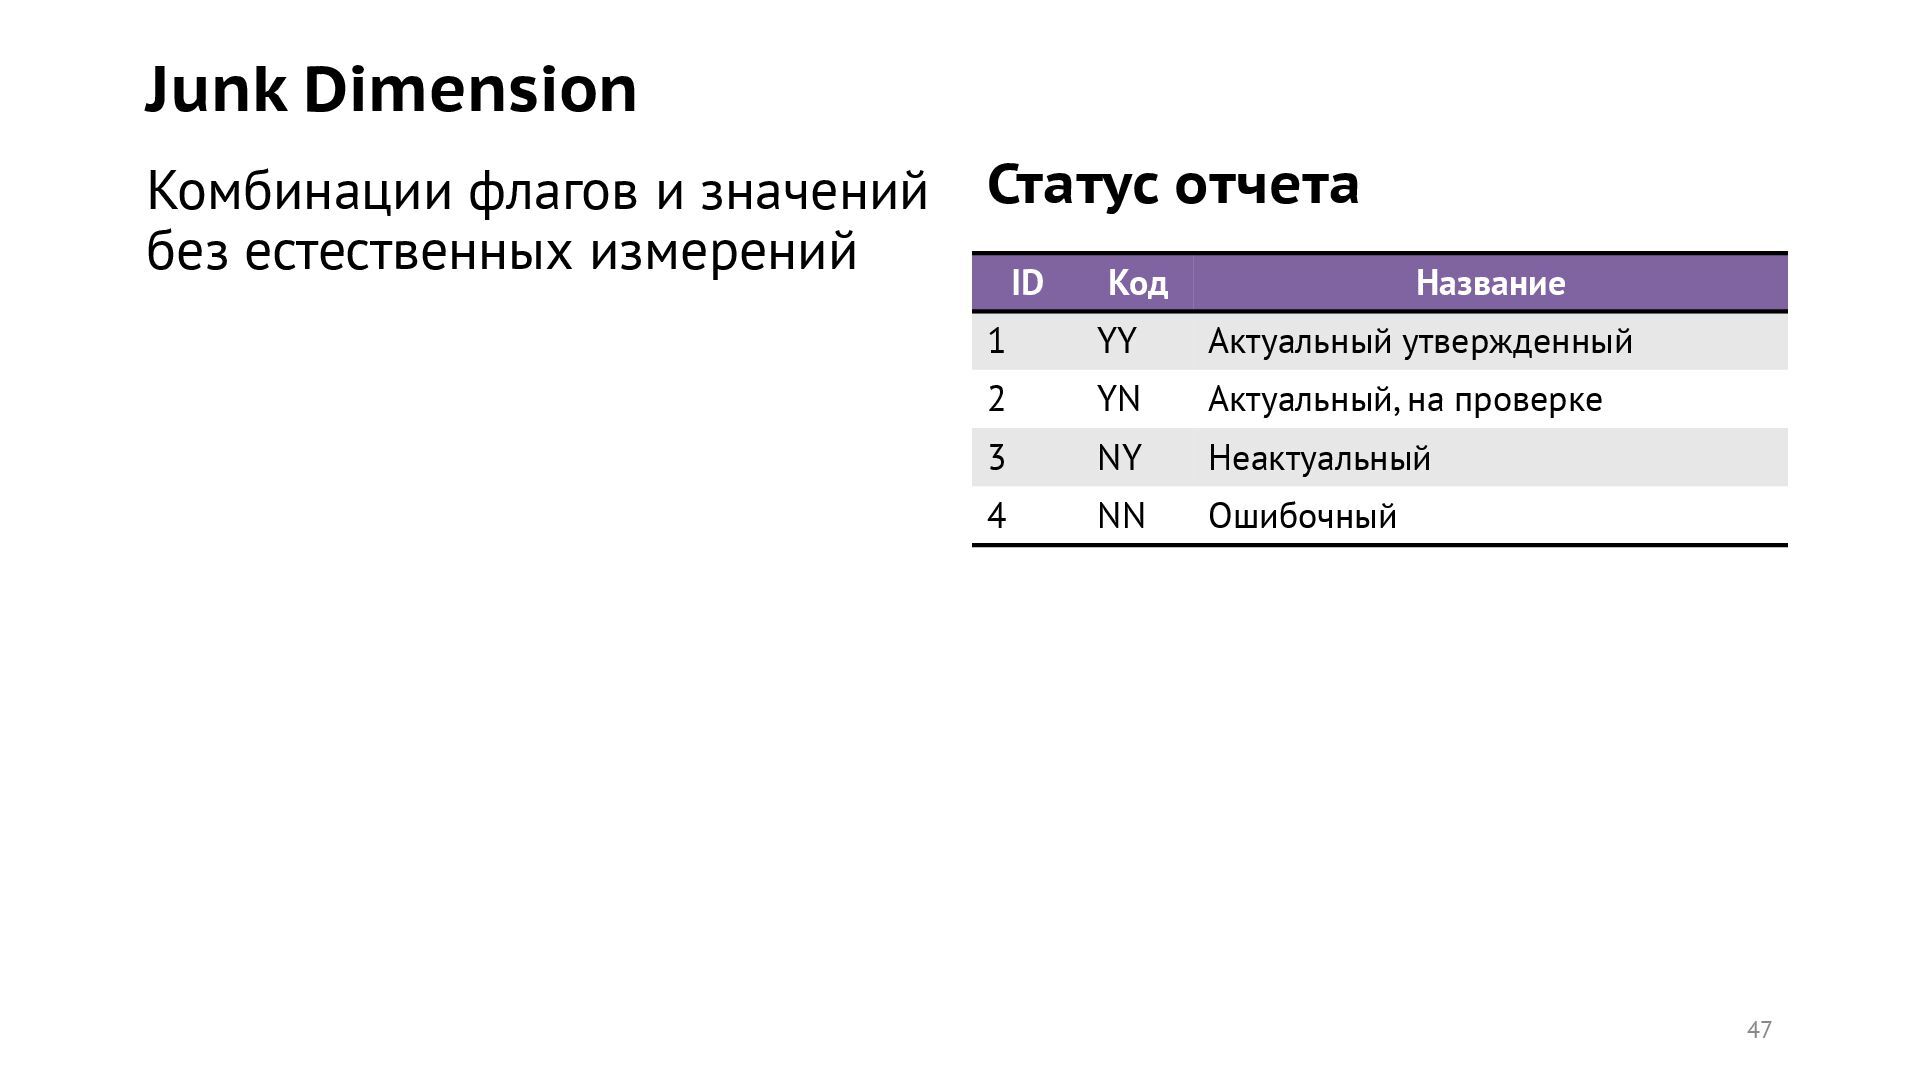
  38. Junk Dimension Комбинации флагов и значений без естественных измерений ID

    Код Название 1 YY Актуальный утвержденный 2 YN Актуальный, на проверке 3 NY Неактуальный 4 NN Ошибочный 47 Статус отчета
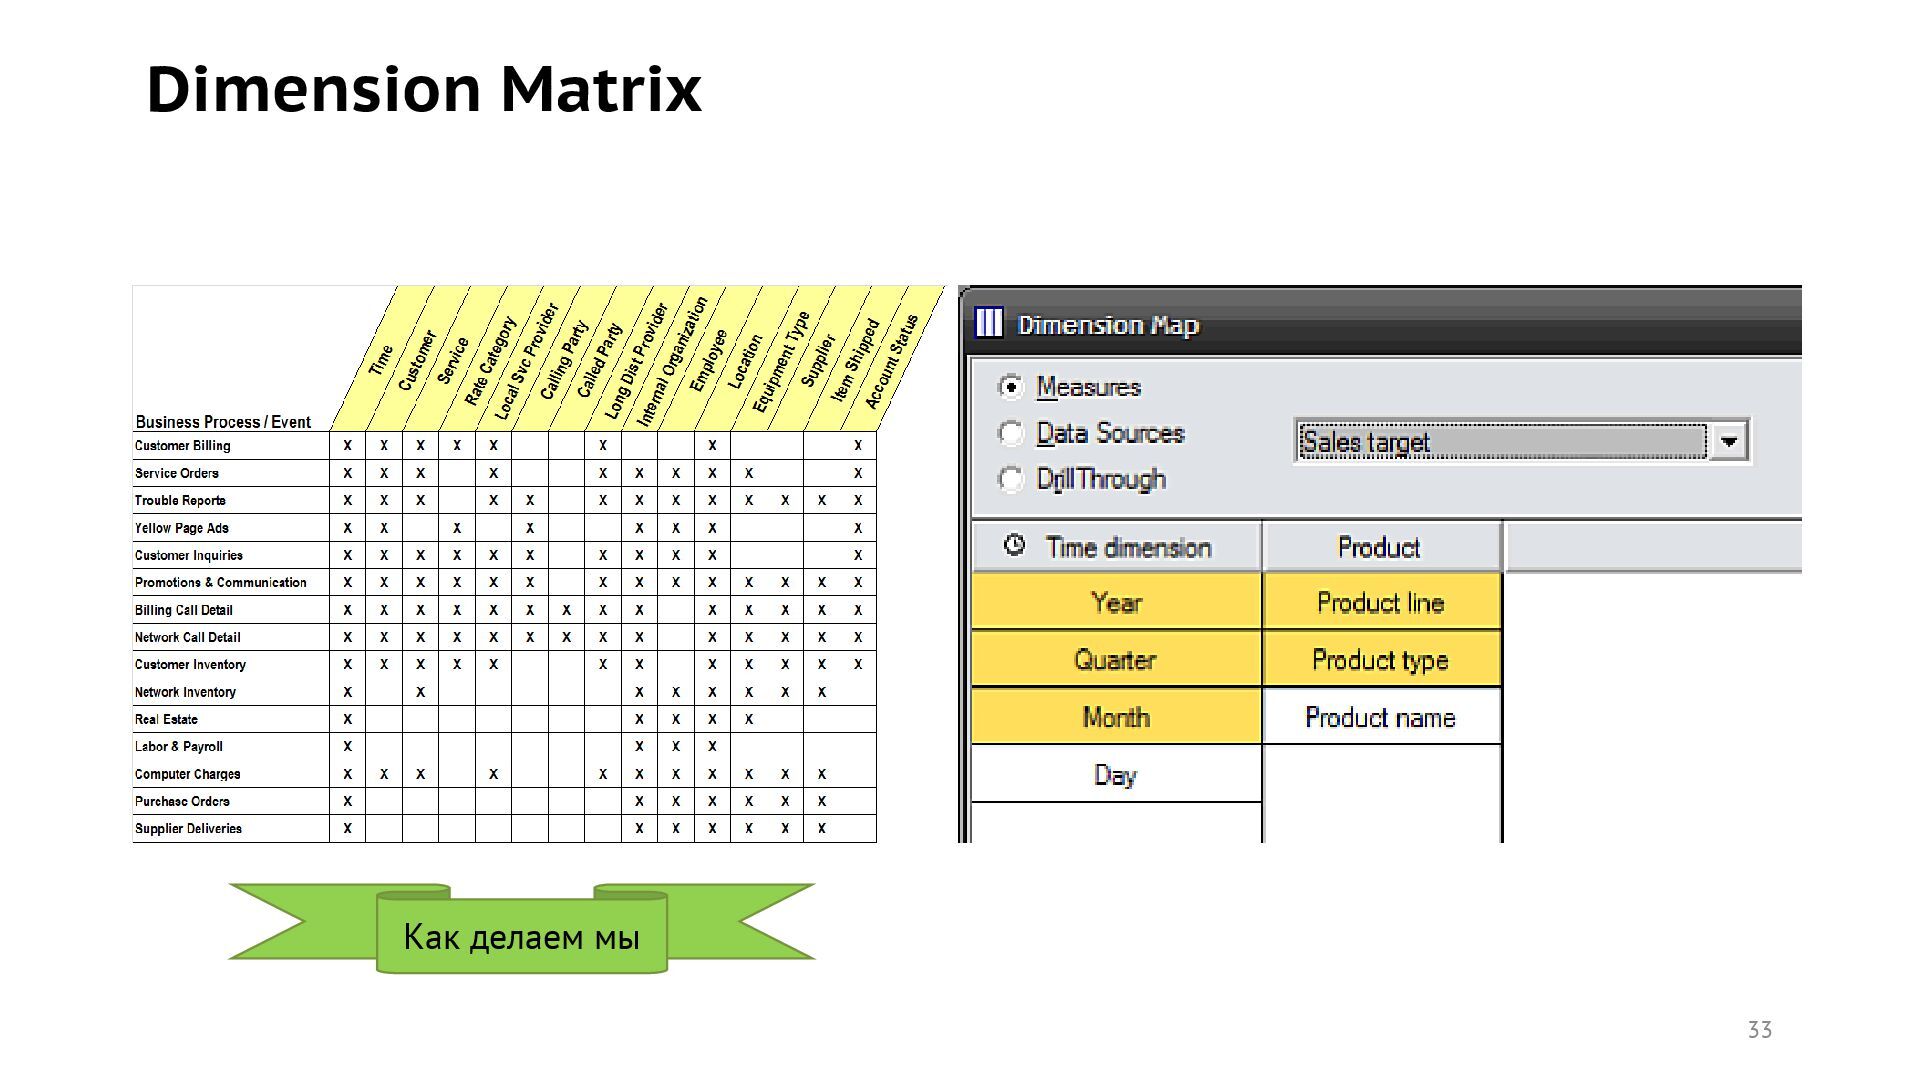
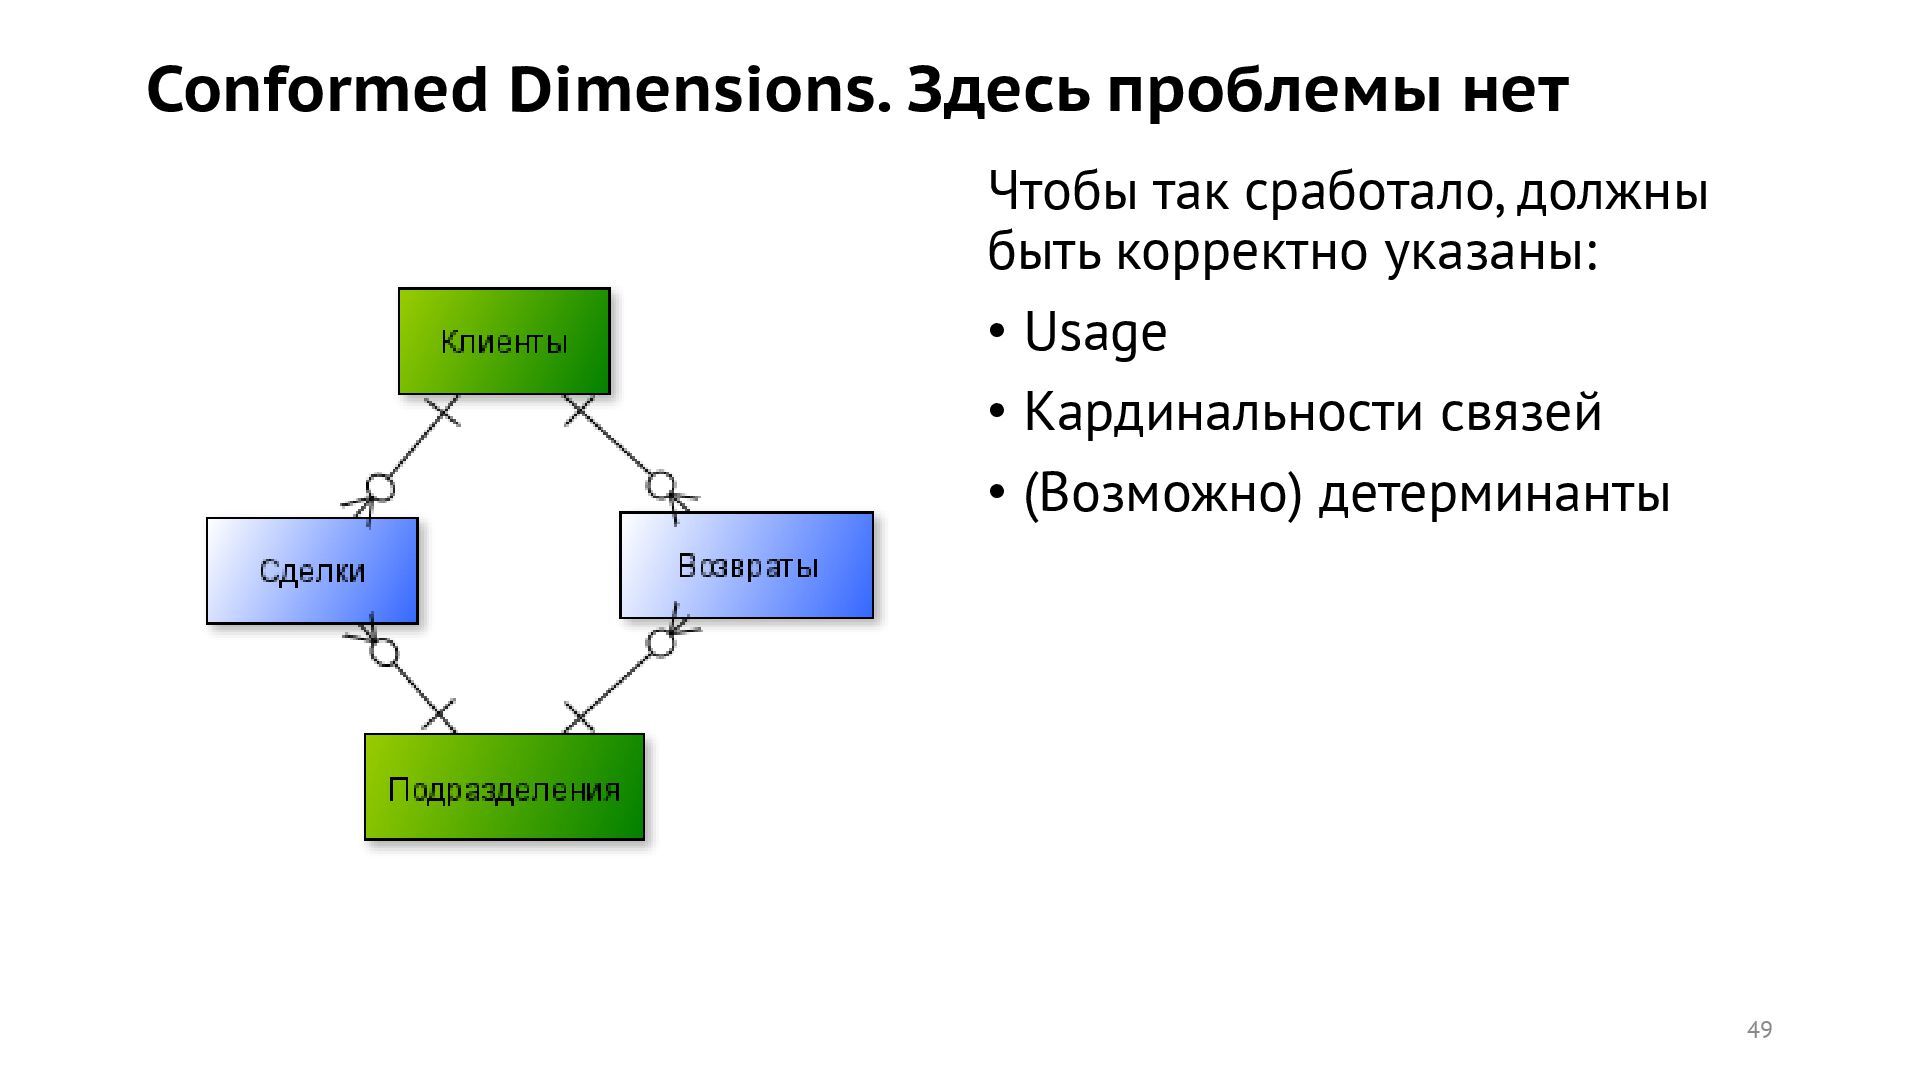
  39. Conformed Dimensions. Здесь проблемы нет Чтобы так сработало, должны быть

    корректно указаны: • Usage • Кардинальности связей • (Возможно) детерминанты 49
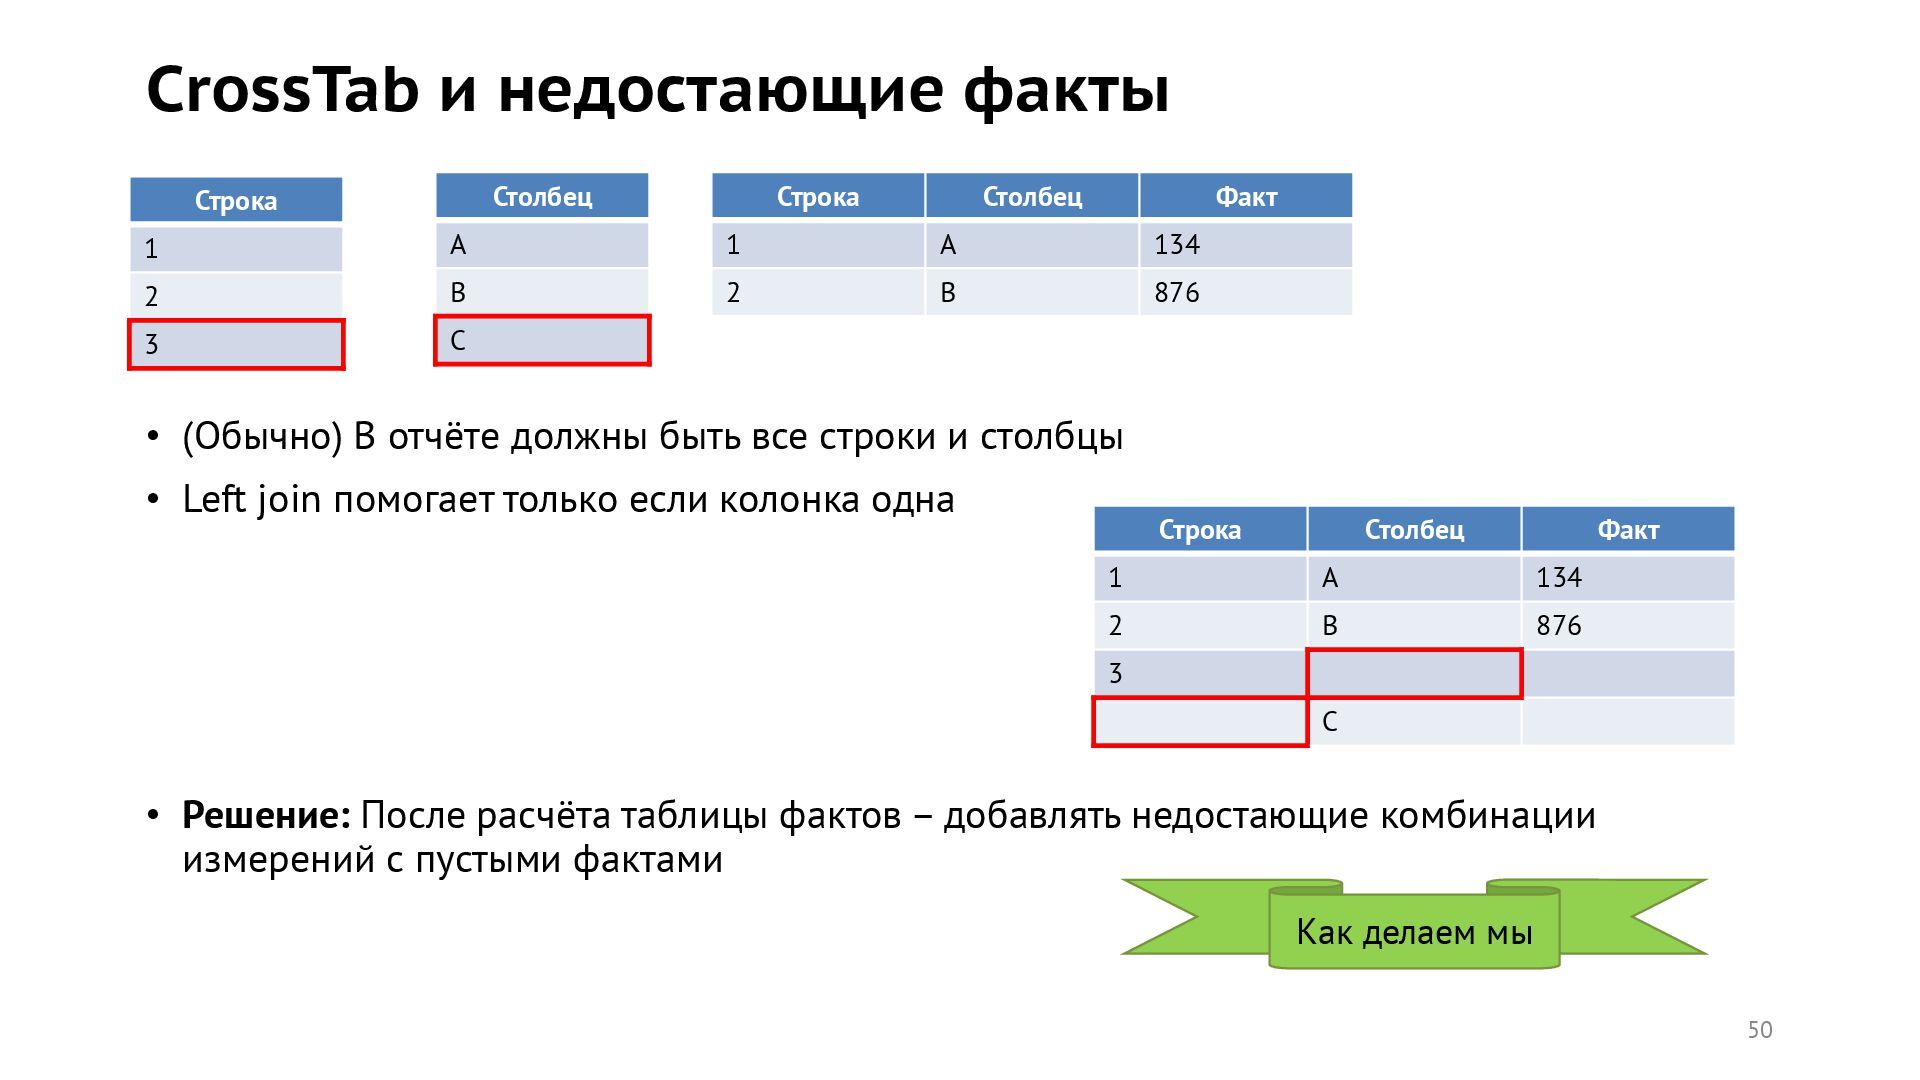
  40. CrossTab и недостающие факты • (Обычно) В отчёте должны быть

    все строки и столбцы • Left join помогает только если колонка одна • Решение: После расчёта таблицы фактов – добавлять недостающие комбинации измерений с пустыми фактами 50 Как делаем мы Строка Столбец Факт 1 A 134 2 B 876 Строка 1 2 3 Столбец A B С Строка Столбец Факт 1 A 134 2 B 876 3 C
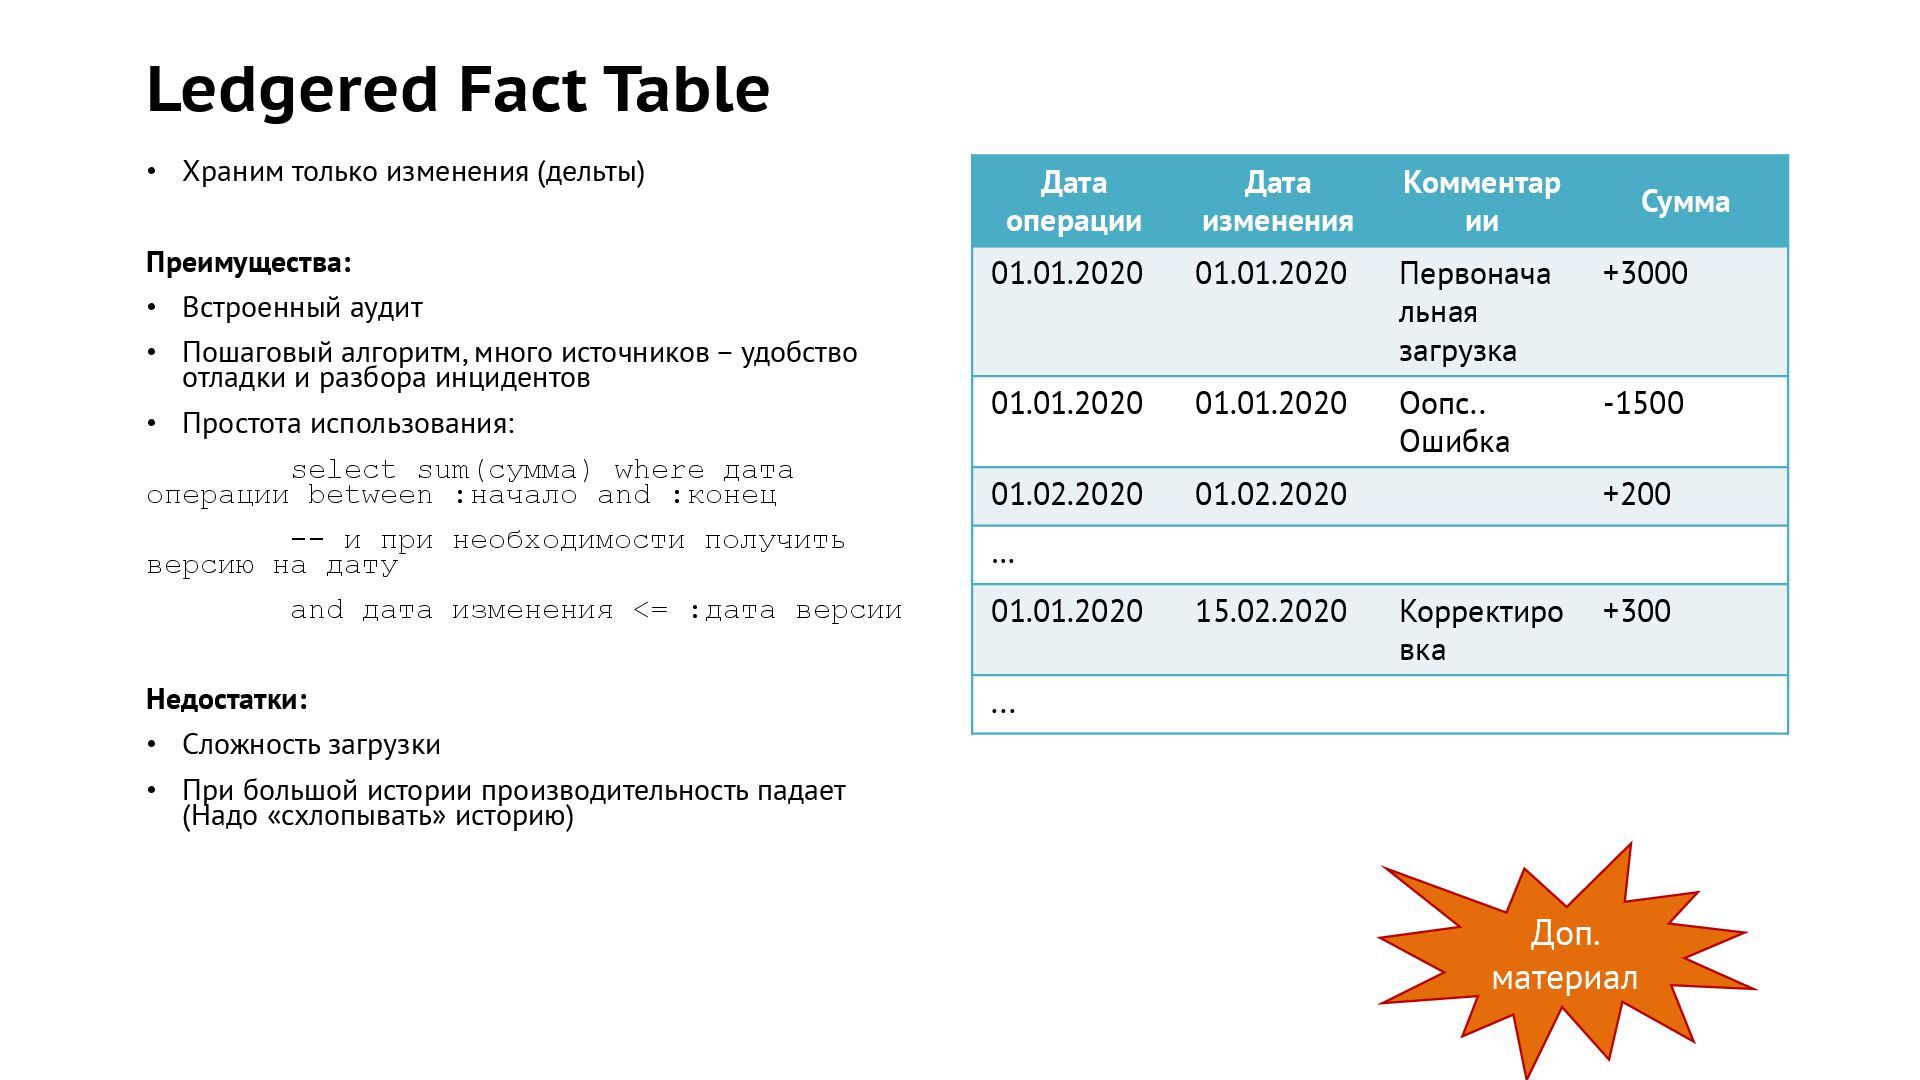
  41. Ledgered Fact Table • Храним только изменения (дельты) Преимущества: •

    Встроенный аудит • Пошаговый алгоритм, много источников – удобство отладки и разбора инцидентов • Простота использования: select sum(сумма) where дата операции between :начало and :конец -- и при необходимости получить версию на дату and дата изменения <= :дата версии Недостатки: • Сложность загрузки • При большой истории производительность падает (Надо «схлопывать» историю) Дата операции Дата изменения Комментар ии Сумма 01.01.2020 01.01.2020 Первонача льная загрузка +3000 01.01.2020 01.01.2020 Оопс.. Ошибка -1500 01.02.2020 01.02.2020 +200 … 01.01.2020 15.02.2020 Корректиро вка +300 ... Доп. материал
  42. Другие идеи • Если одна и та же метрика называется

    одинаково в нескольких таблицах фактов, то она должна и считаться одинаково. И наоборот 52 Как делаем мы
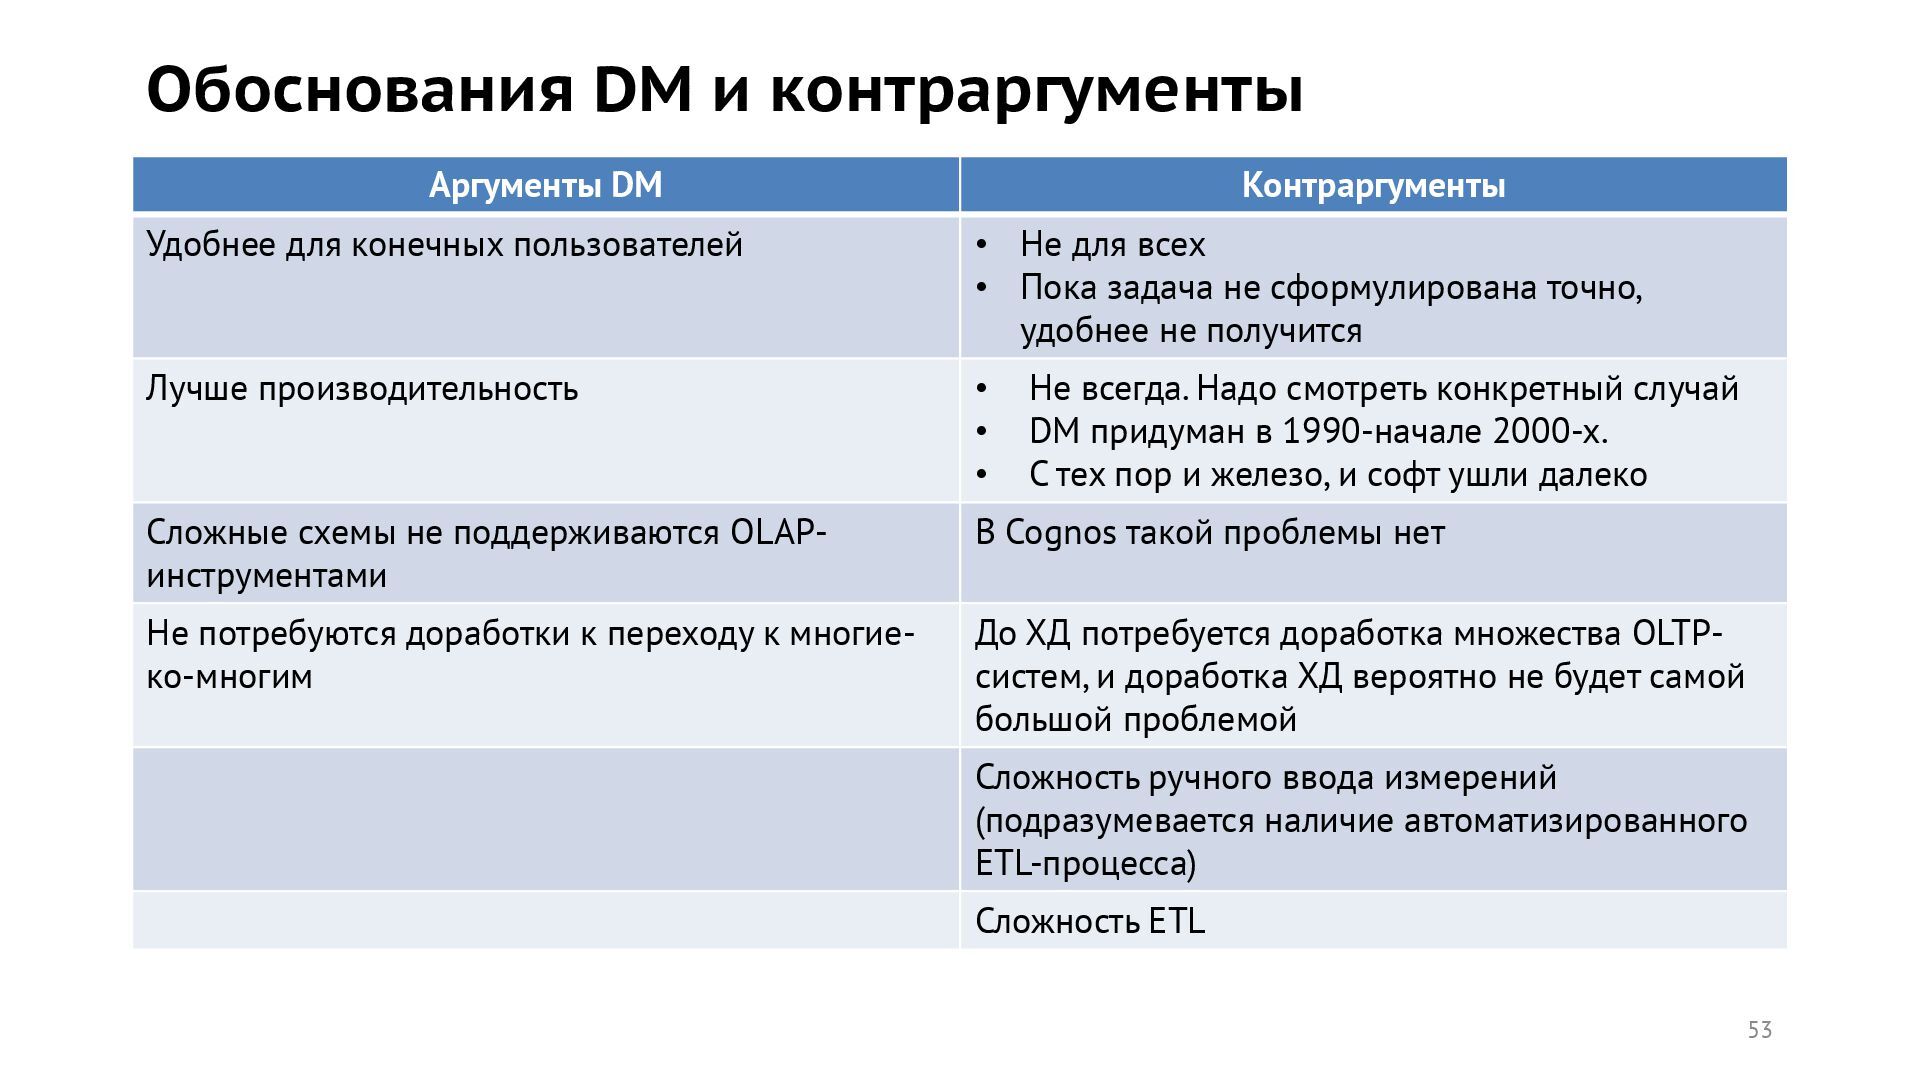
  43. Обоснования DM и контраргументы Аргументы DM Контраргументы Удобнее для конечных

    пользователей • Не для всех • Пока задача не сформулирована точно, удобнее не получится Лучше производительность • Не всегда. Надо смотреть конкретный случай • DM придуман в 1990-начале 2000-х. • С тех пор и железо, и софт ушли далеко Сложные схемы не поддерживаются OLAP- инструментами В Cognos такой проблемы нет Не потребуются доработки к переходу к многие- ко-многим До ХД потребуется доработка множества OLTP- систем, и доработка ХД вероятно не будет самой большой проблемой Сложность ручного ввода измерений (подразумевается наличие автоматизированного ETL-процесса) Сложность ETL 53
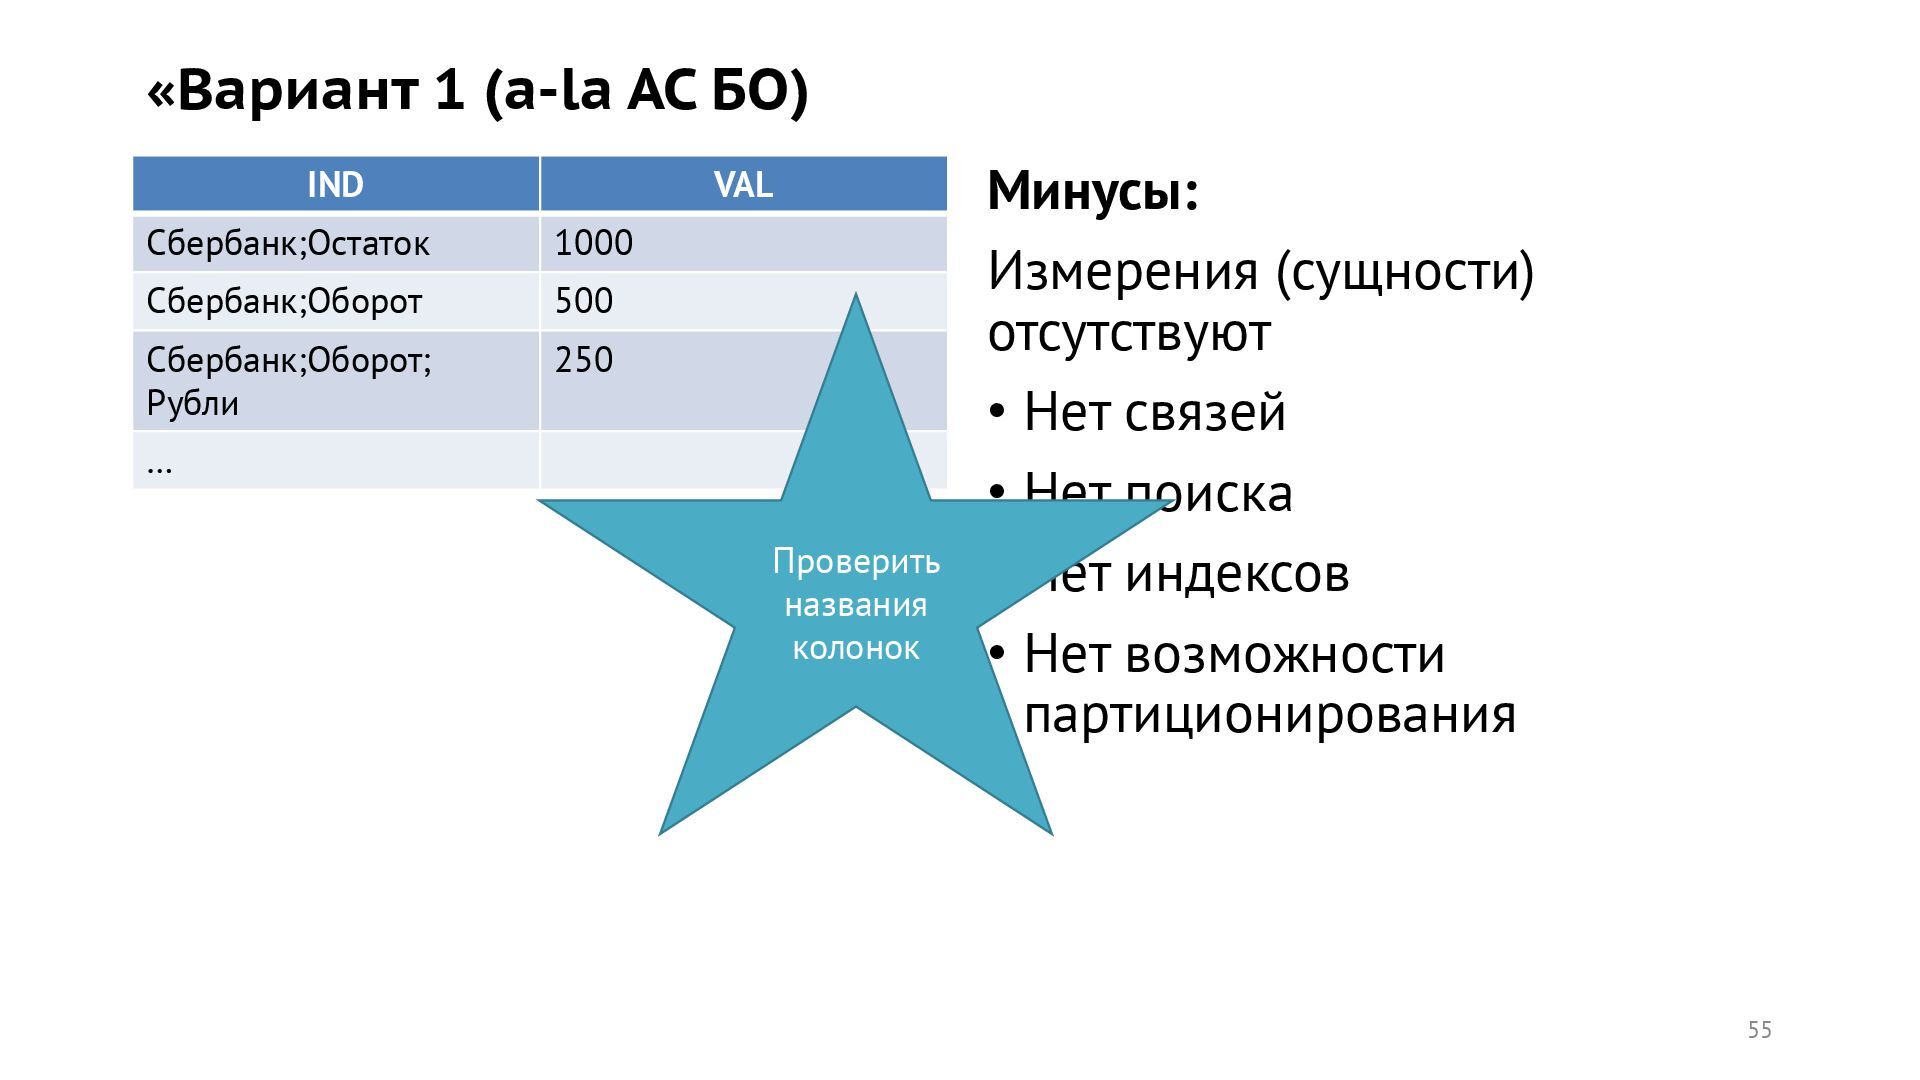
  44. «Вариант 1 (a-la АС БО) Минусы: Измерения (сущности) отсутствуют •

    Нет связей • Нет поиска • Нет индексов • Нет возможности партиционирования 55 IND VAL Сбербанк;Остаток 1000 Сбербанк;Оборот 500 Сбербанк;Оборот; Рубли 250 … Проверить названия колонок
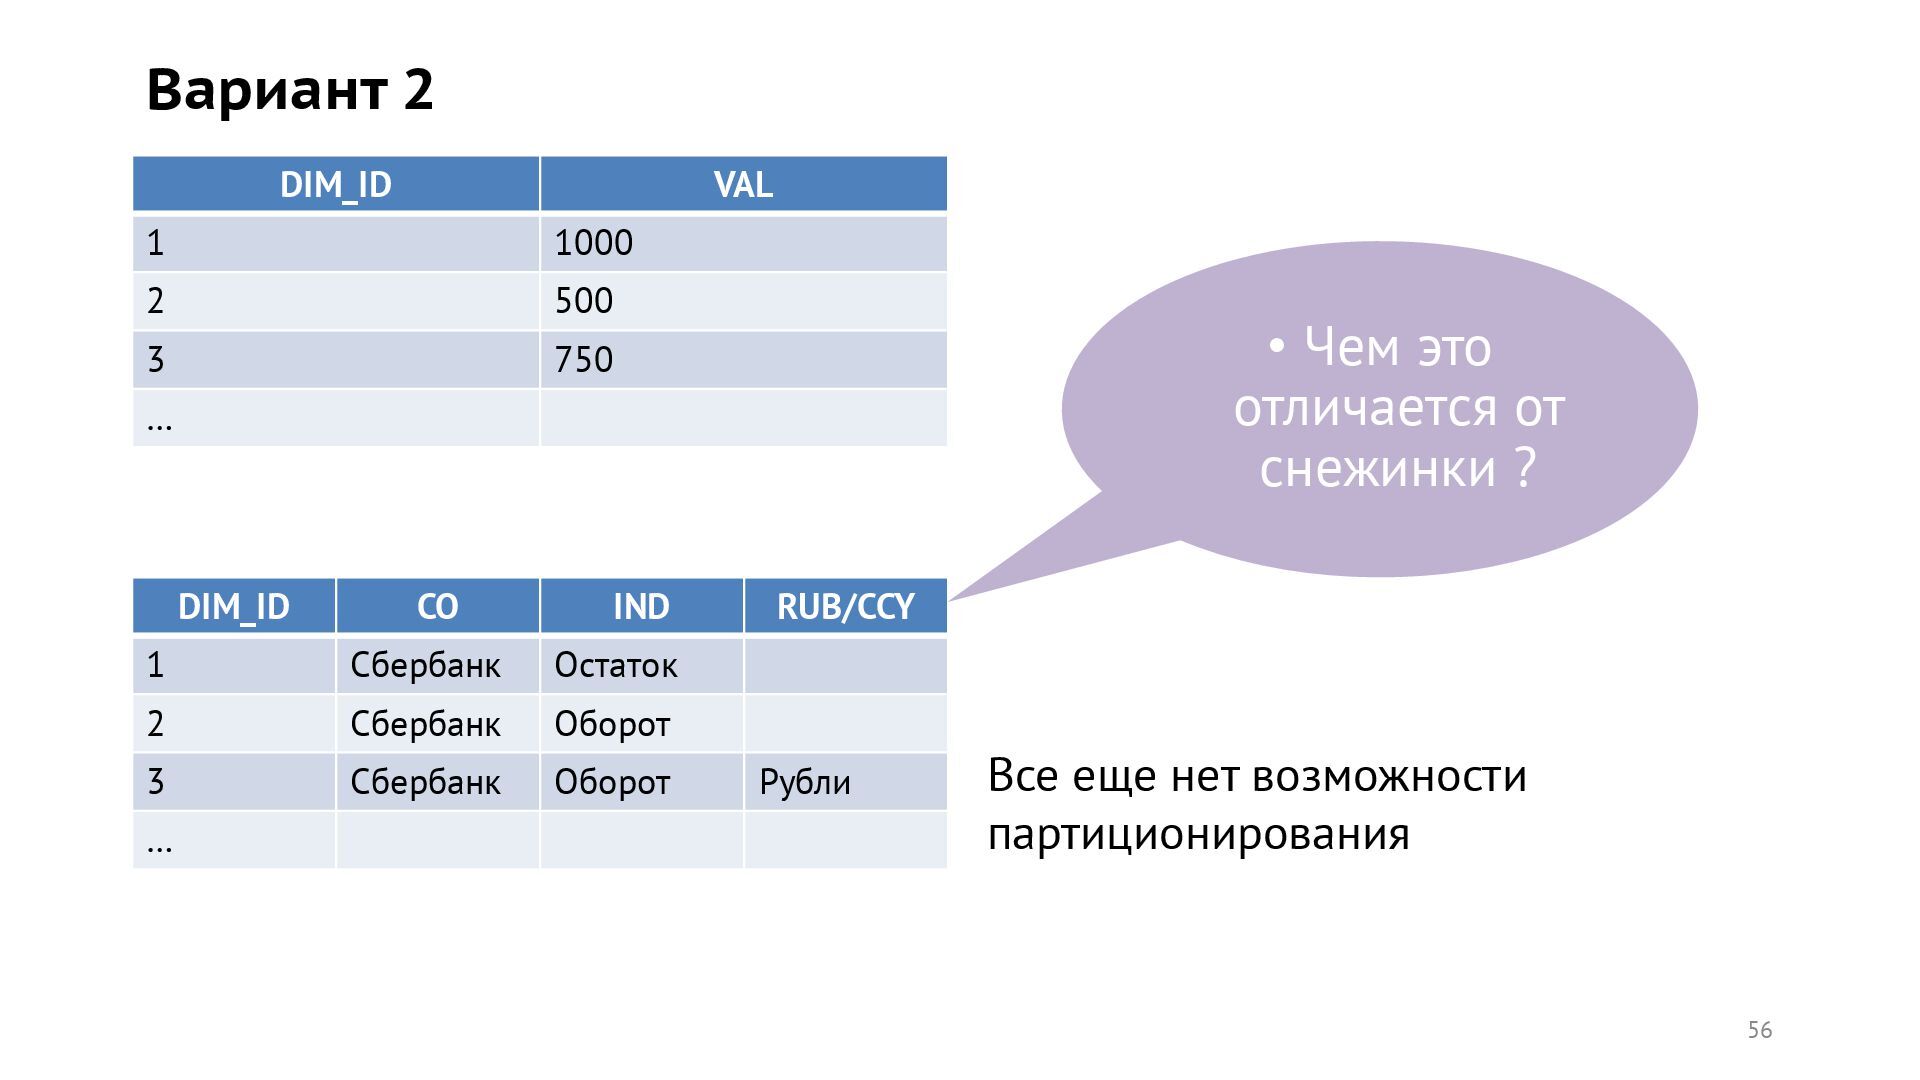
  45. Вариант 2 DIM_ID VAL 1 1000 2 500 3 750

    … 56 DIM_ID CO IND RUB/CCY 1 Сбербанк Остаток 2 Сбербанк Оборот 3 Сбербанк Оборот Рубли … • Чем это отличается от снежинки ? Все еще нет возможности партиционирования
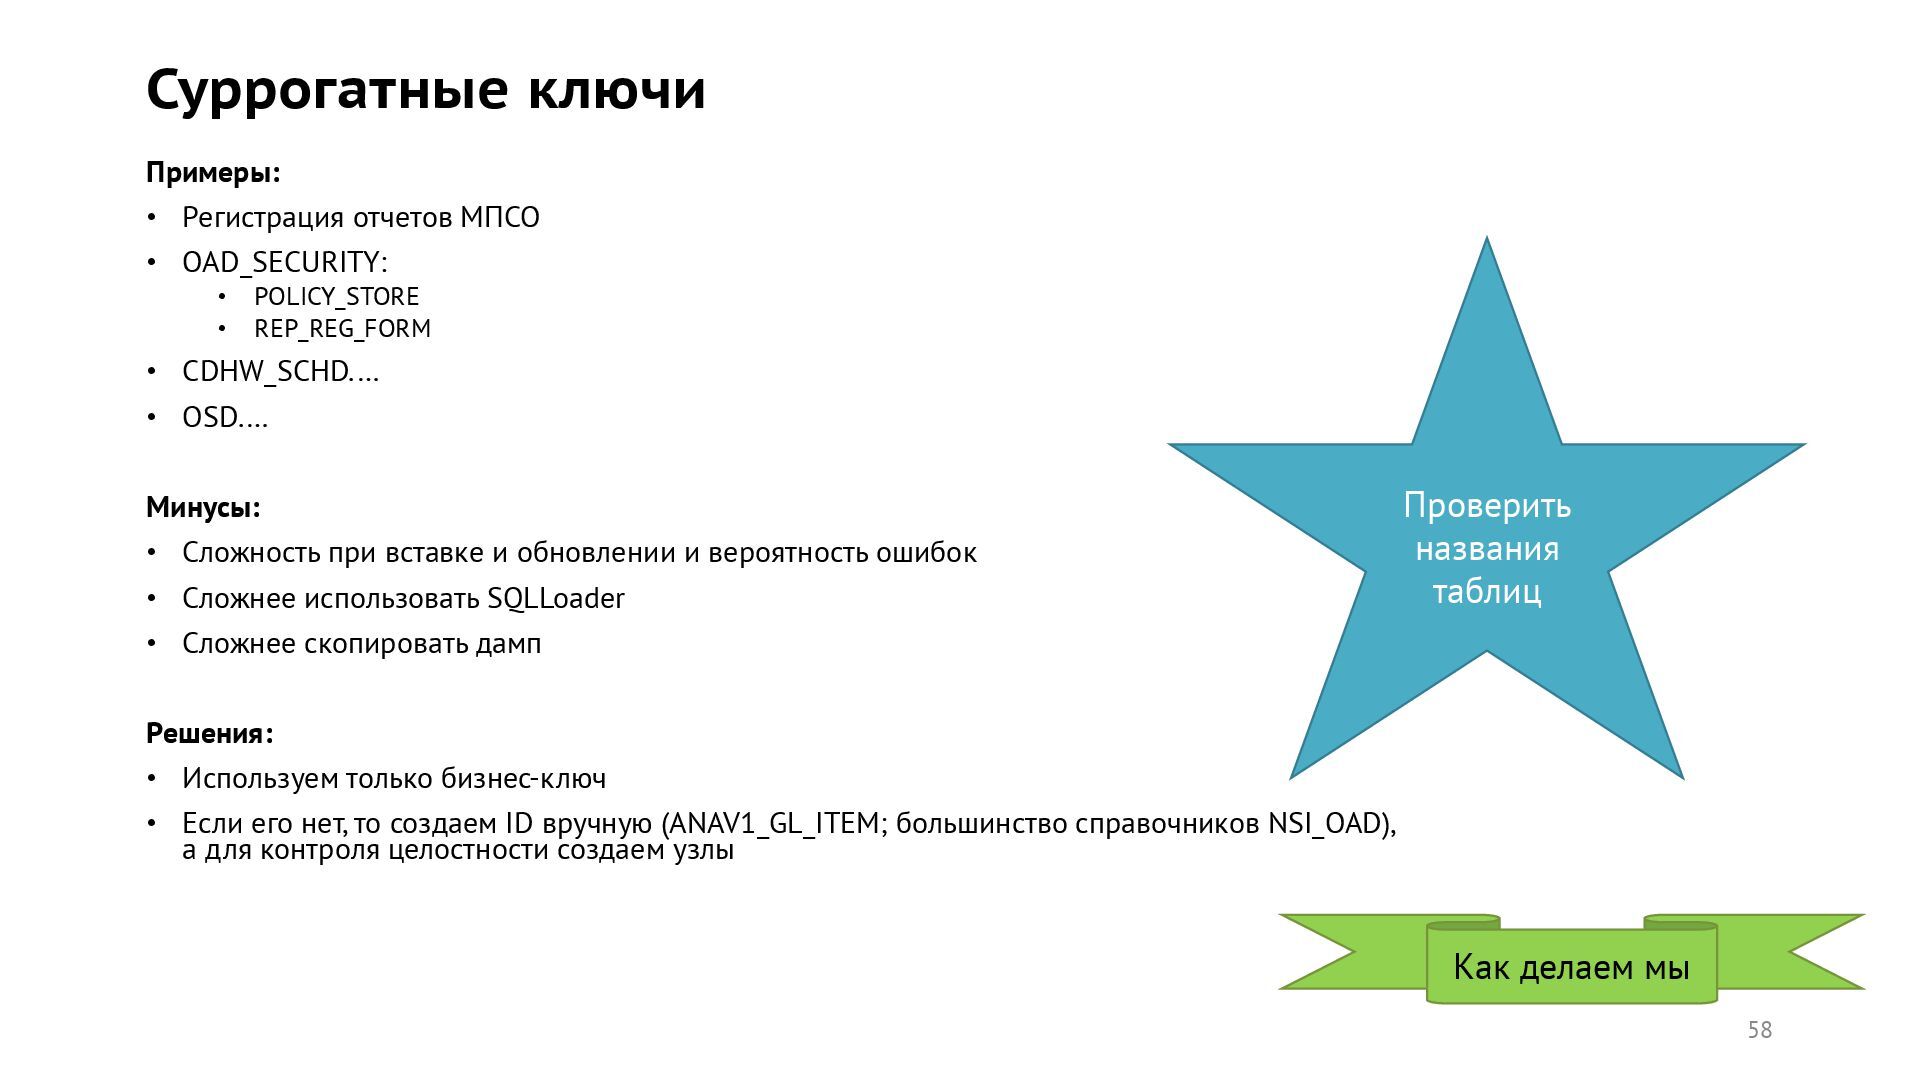
  46. Суррогатные ключи Примеры: • Регистрация отчетов МПСО • OAD_SECURITY: •

    POLICY_STORE • REP_REG_FORM • CDHW_SCHD.… • OSD.… Минусы: • Сложность при вставке и обновлении и вероятность ошибок • Сложнее использовать SQLLoader • Сложнее скопировать дамп Решения: • Используем только бизнес-ключ • Если его нет, то создаем ID вручную (ANAV1_GL_ITEM; большинство справочников NSI_OAD), а для контроля целостности создаем узлы 58 Как делаем мы Проверить названия таблиц
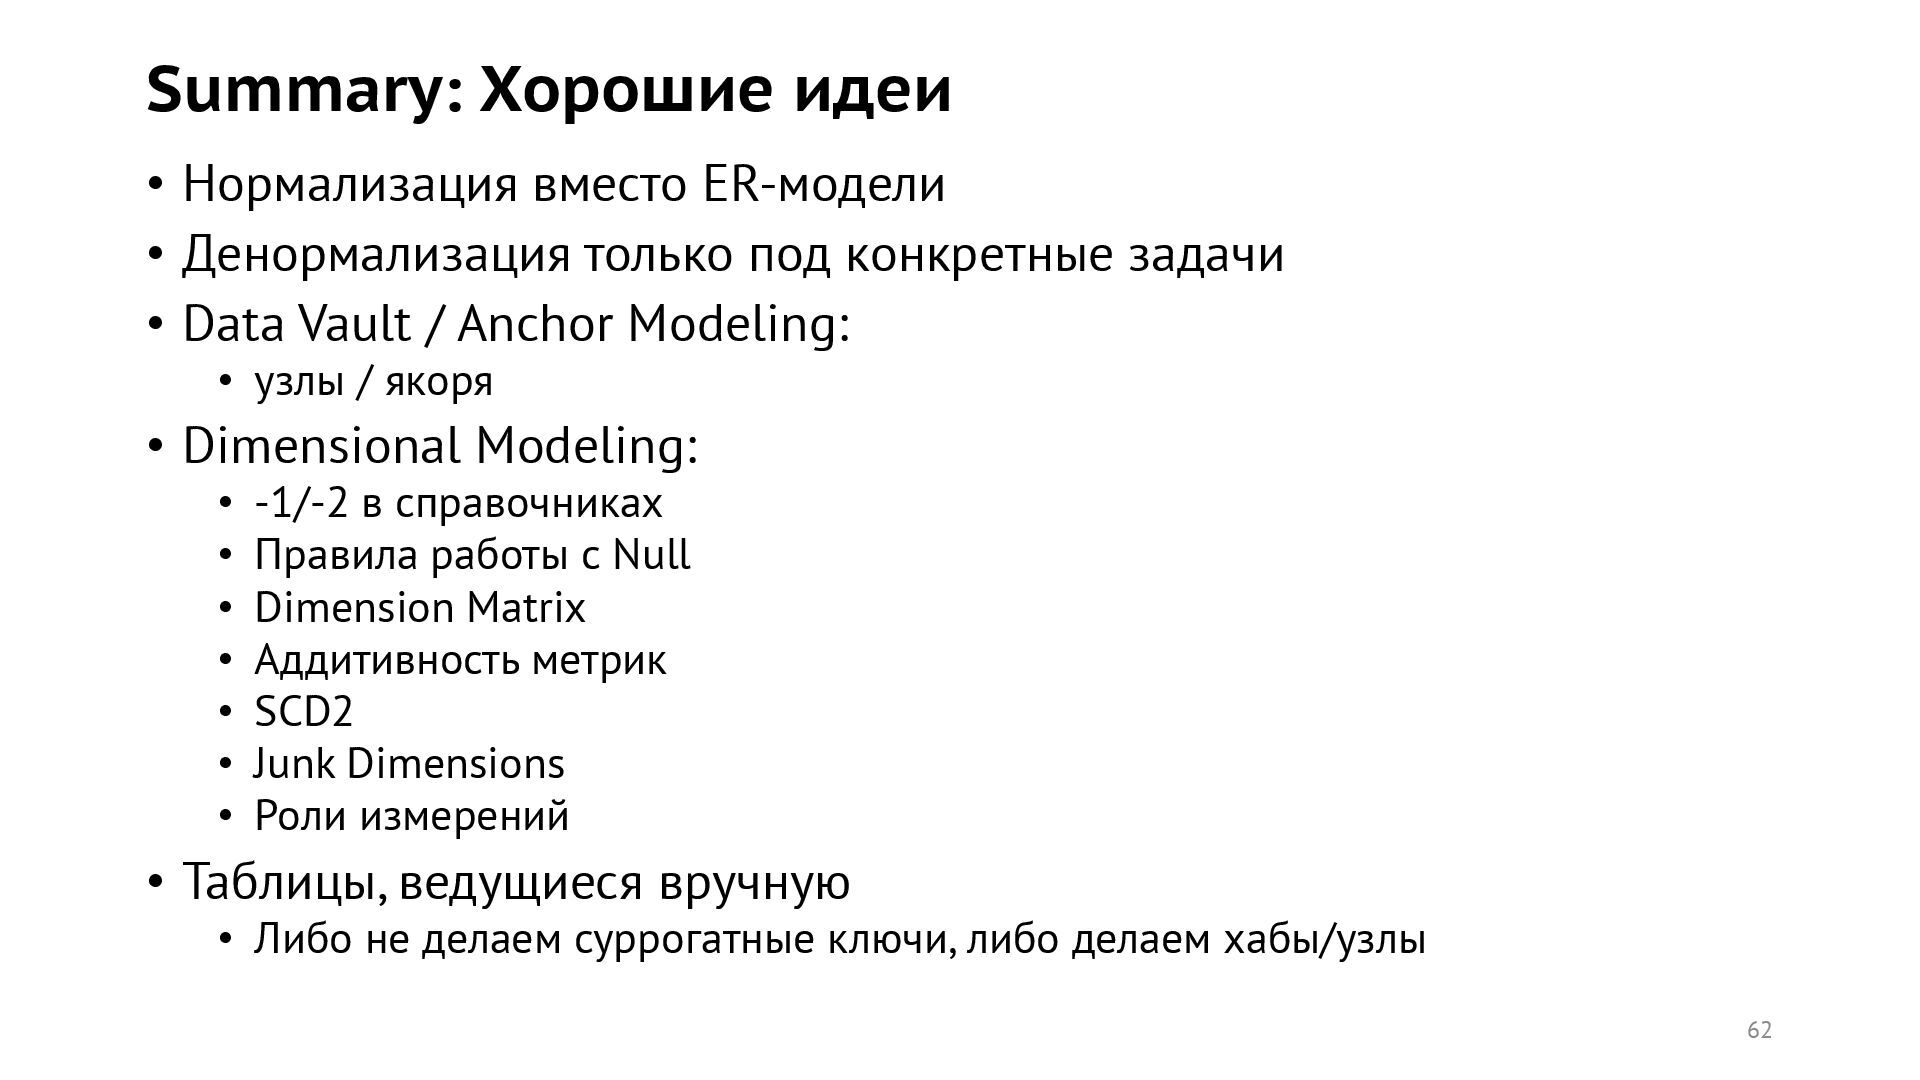
  47. Summary: Хорошие идеи • Нормализация вместо ER-модели • Денормализация только

    под конкретные задачи • Data Vault / Anchor Modeling: • узлы / якоря • Dimensional Modeling: • -1/-2 в справочниках • Правила работы с Null • Dimension Matrix • Аддитивность метрик • SCD2 • Junk Dimensions • Роли измерений • Таблицы, ведущиеся вручную • Либо не делаем суррогатные ключи, либо делаем хабы/узлы 62
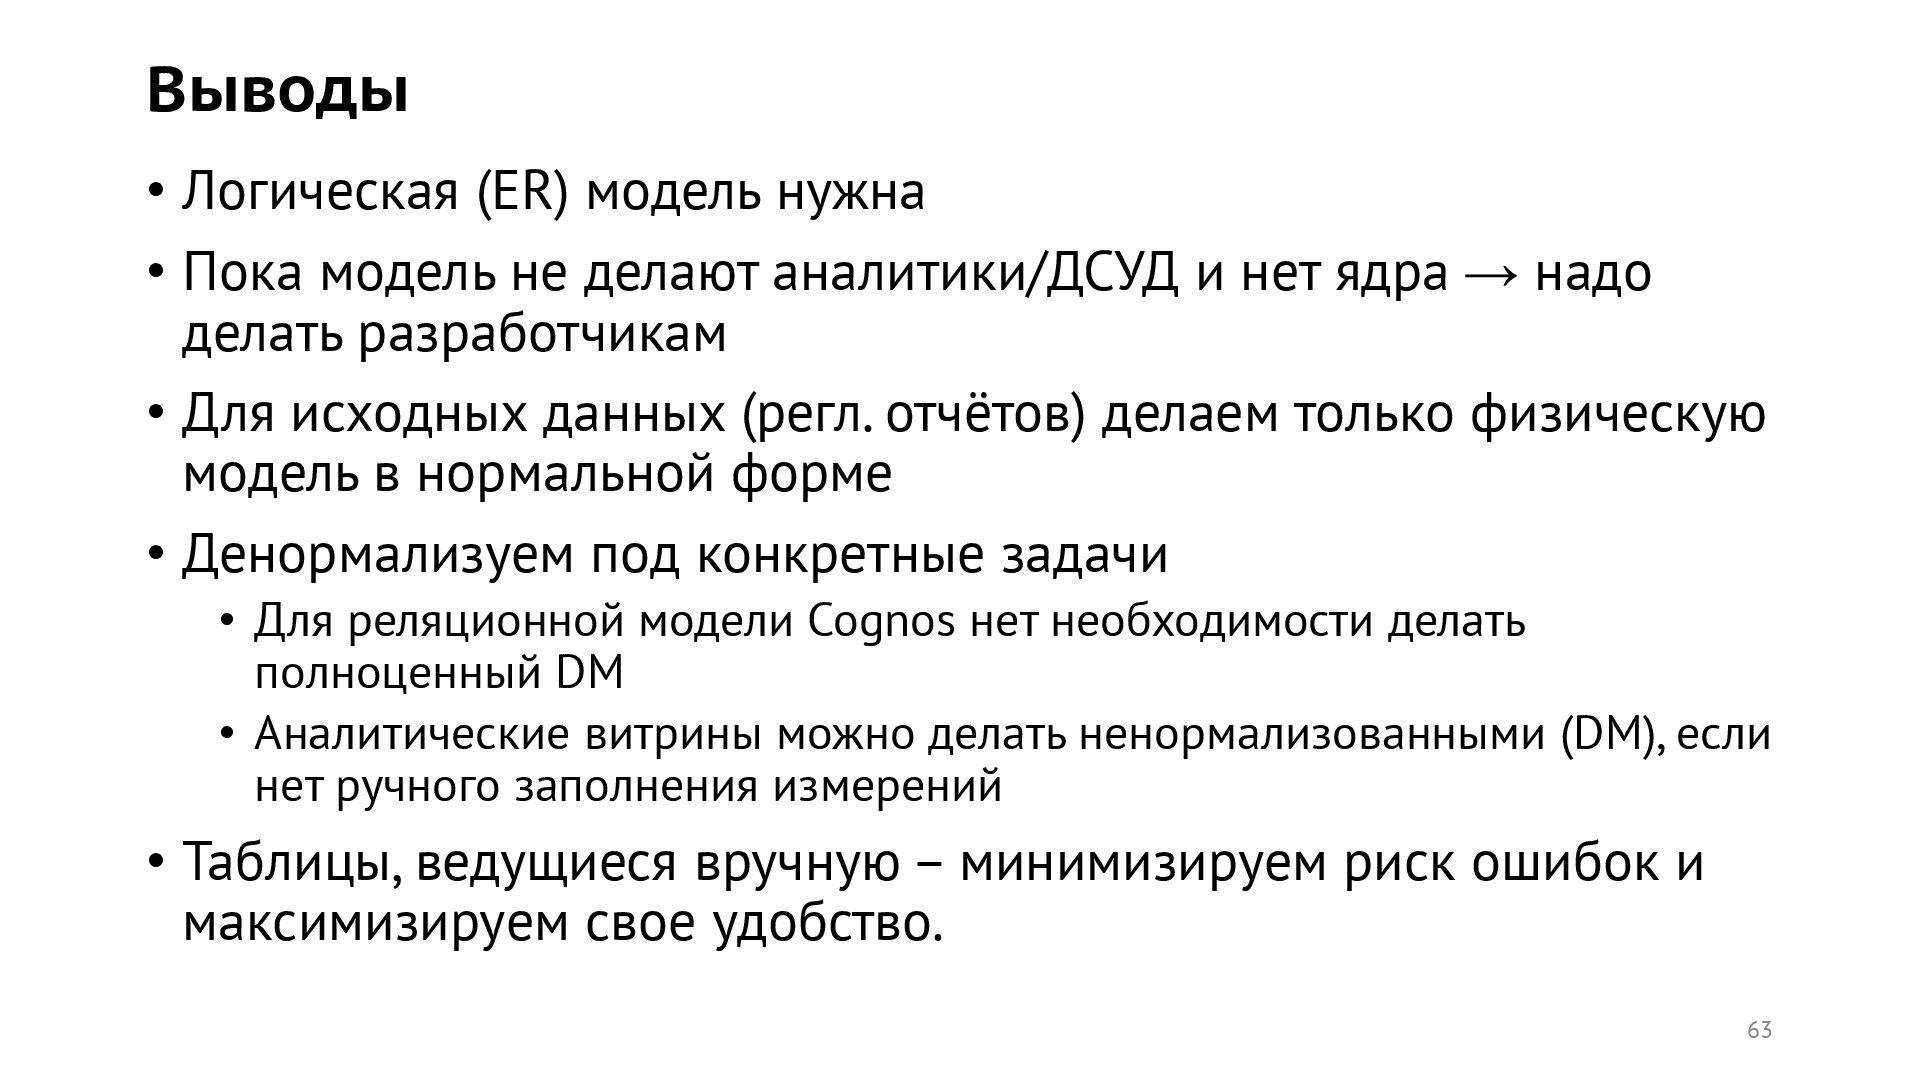
  48. Выводы • Логическая (ER) модель нужна • Пока модель не

    делают аналитики/ДСУД и нет ядра → надо делать разработчикам • Для исходных данных (регл. отчётов) делаем только физическую модель в нормальной форме • Денормализуем под конкретные задачи • Для реляционной модели Cognos нет необходимости делать полноценный DM • Аналитические витрины можно делать ненормализованными (DM), если нет ручного заполнения измерений • Таблицы, ведущиеся вручную – минимизируем риск ошибок и максимизируем свое удобство. 63
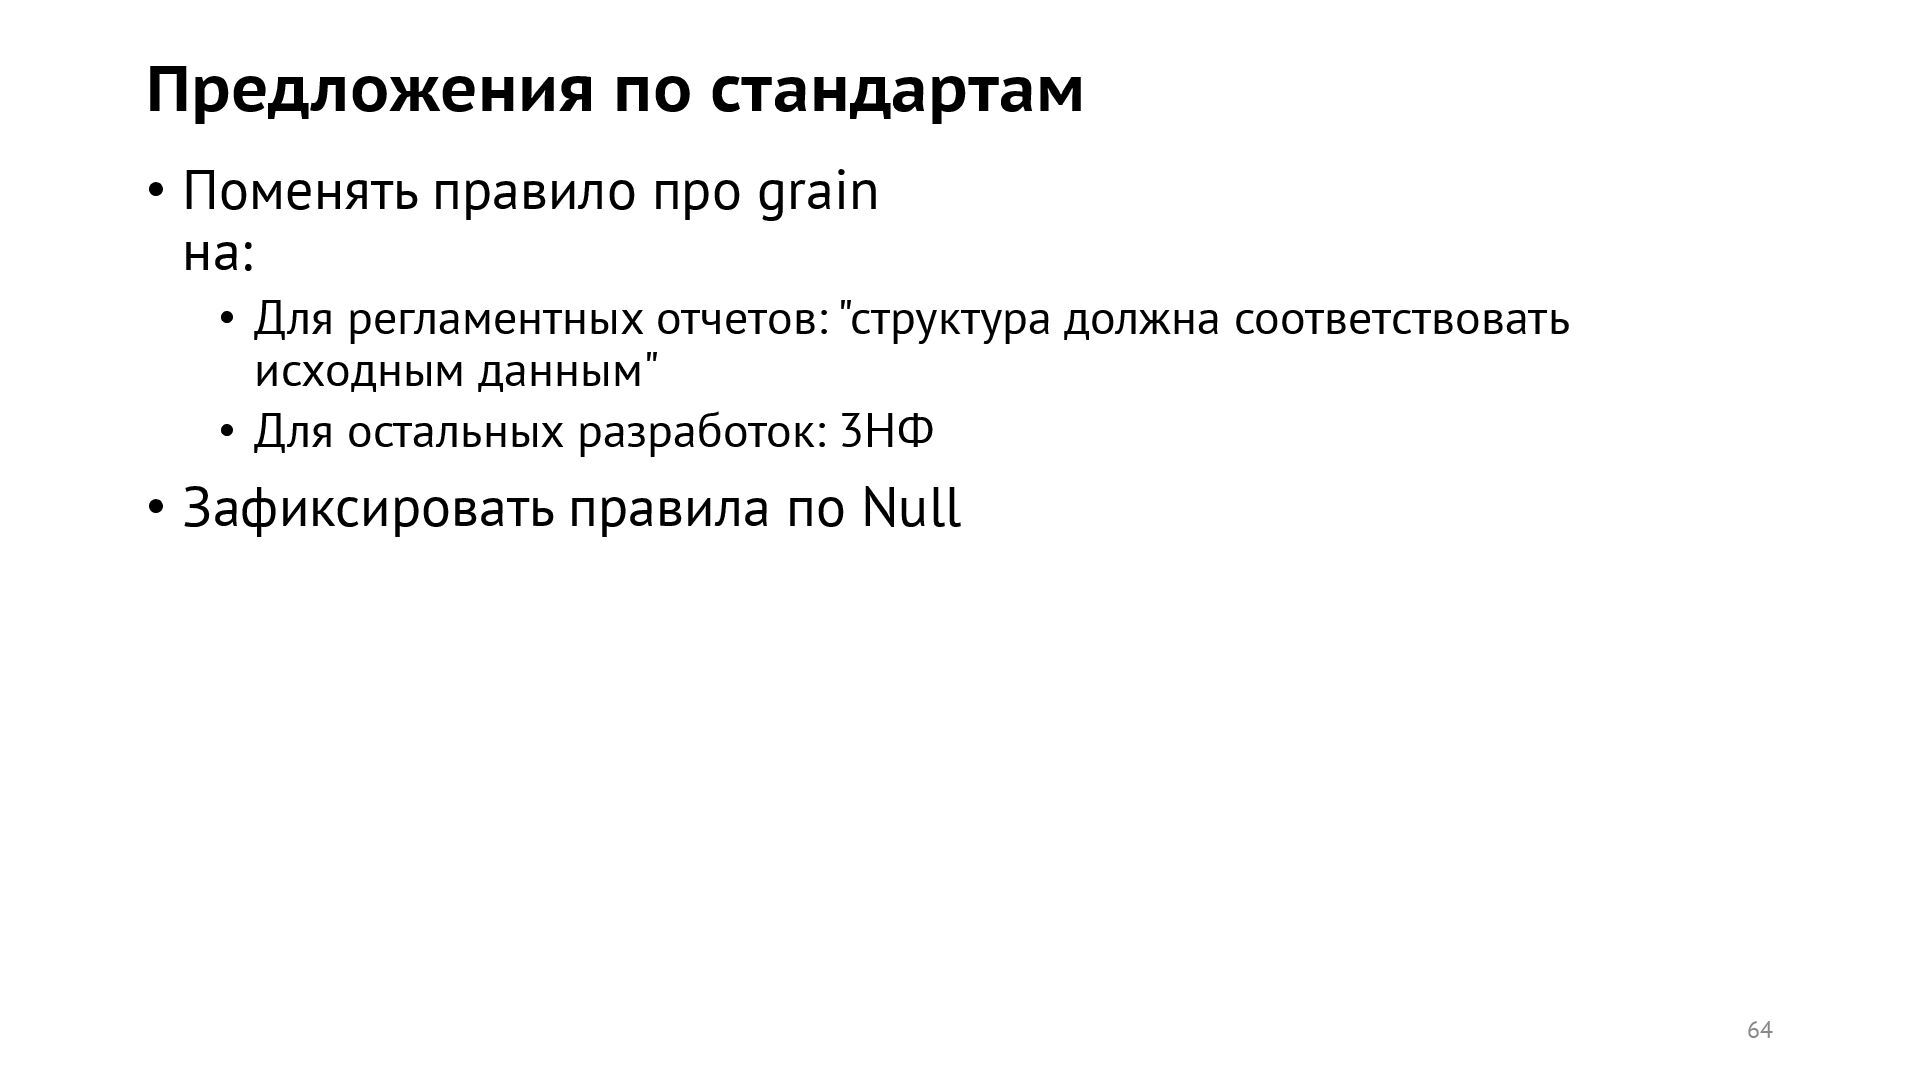
  49. Предложения по стандартам • Поменять правило про grain на: •

    Для регламентных отчетов: "структура должна соответствовать исходным данным" • Для остальных разработок: 3НФ • Зафиксировать правила по Null 64
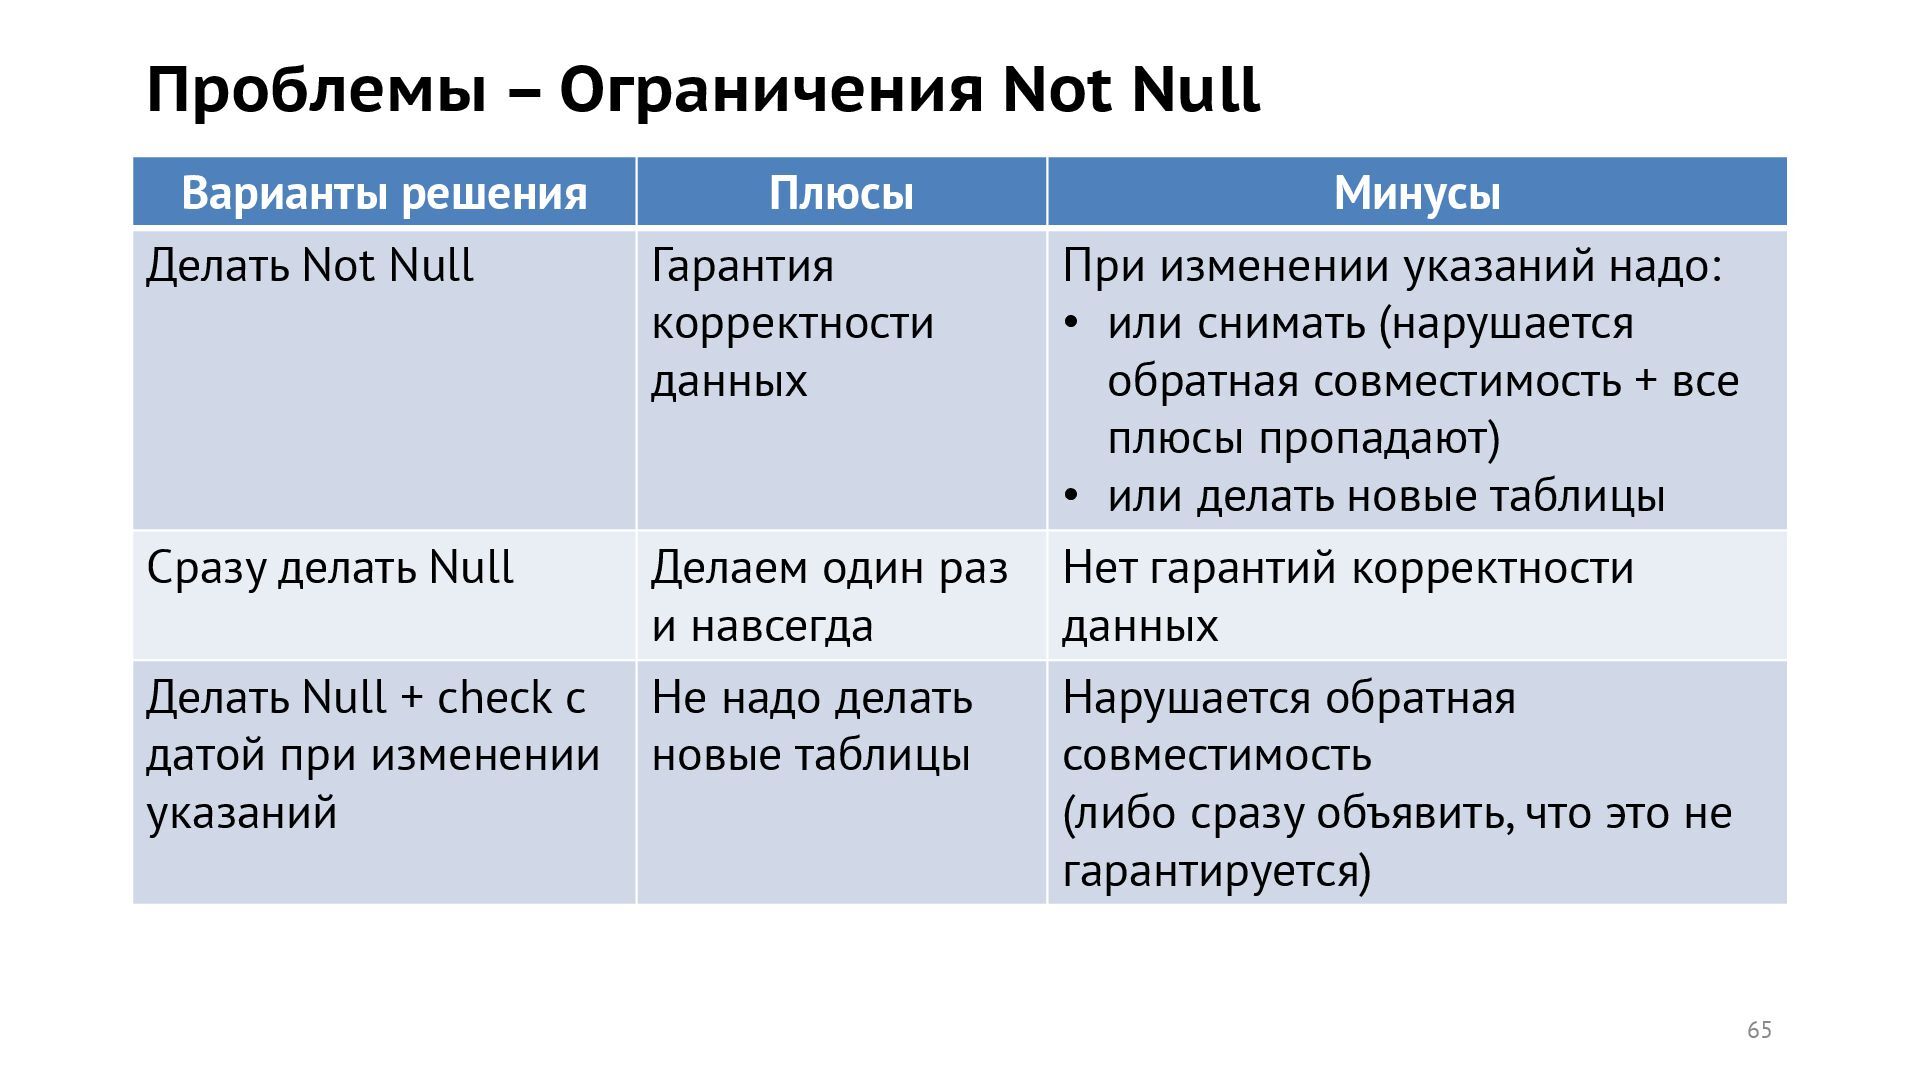
  50. Проблемы – Ограничения Not Null Варианты решения Плюсы Минусы Делать

    Not Null Гарантия корректности данных При изменении указаний надо: • или снимать (нарушается обратная совместимость + все плюсы пропадают) • или делать новые таблицы Сразу делать Null Делаем один раз и навсегда Нет гарантий корректности данных Делать Null + check с датой при изменении указаний Не надо делать новые таблицы Нарушается обратная совместимость (либо сразу объявить, что это не гарантируется) 65
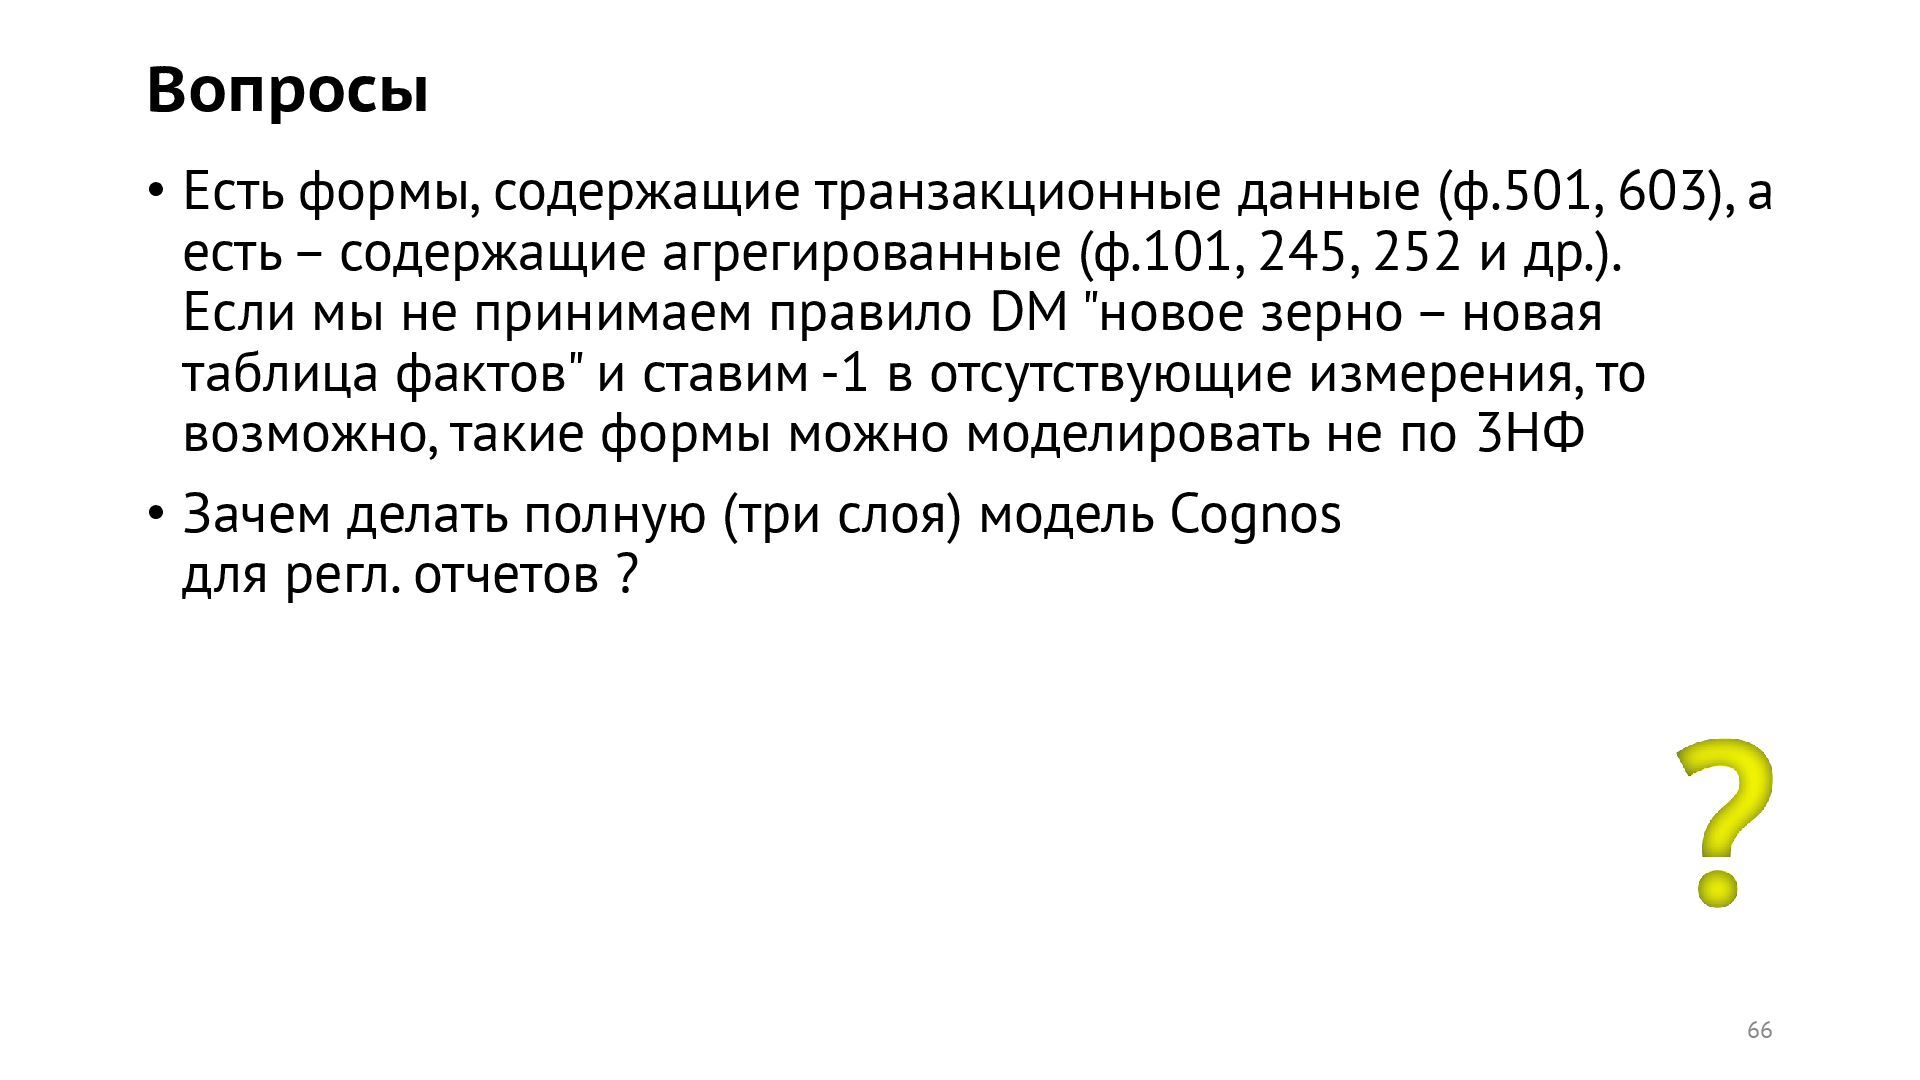
  51. Вопросы • Есть формы, содержащие транзакционные данные (ф.501, 603), а

    есть – содержащие агрегированные (ф.101, 245, 252 и др.). Если мы не принимаем правило DM "новое зерно – новая таблица фактов" и ставим -1 в отсутствующие измерения, то возможно, такие формы можно моделировать не по 3НФ • Зачем делать полную (три слоя) модель Cognos для регл. отчетов ? 66 ?
  52. Code Smells • ID или SQN не входит ни в

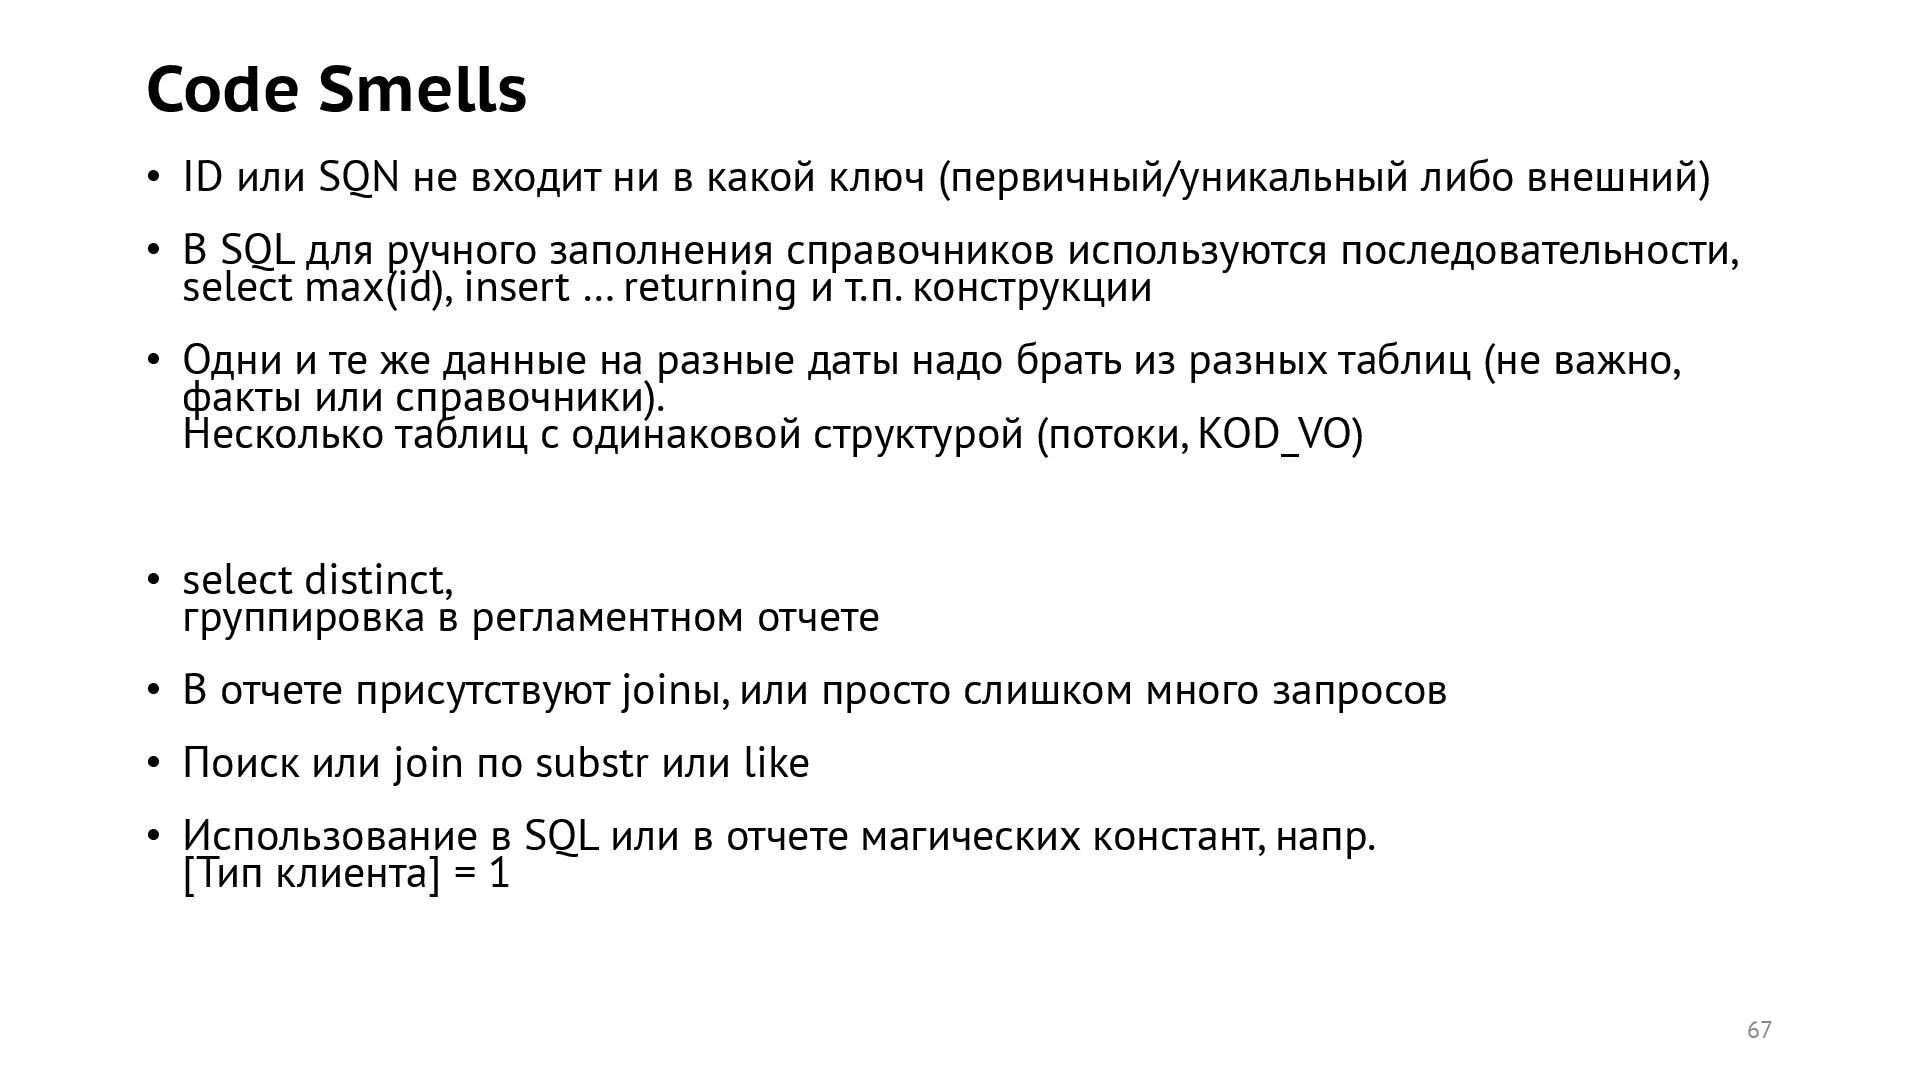
    какой ключ (первичный/уникальный либо внешний) • В SQL для ручного заполнения справочников используются последовательности, select max(id), insert … returning и т.п. конструкции • Одни и те же данные на разные даты надо брать из разных таблиц (не важно, факты или справочники). Несколько таблиц с одинаковой структурой (потоки, KOD_VO) • select distinct, группировка в регламентном отчете • В отчете присутствуют joinы, или просто слишком много запросов • Поиск или join по substr или like • Использование в SQL или в отчете магических констант, напр. [Тип клиента] = 1 67