Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Git & CI для БД и не только

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

Git & CI для БД и не только

Достигнутый результат: до моего ухода из ЦБ большинство идей так и не было реализовано и осталось только на бумаге

Оглядываясь назад: Попытка отслеживать версии enterprise-продукта как коробочного (и выбирать для разных сред разные версии) — всё ещё привлекательна. Однако, она требует нормального разделения на разработку и эксплуатацию. В ЦБ такое разделение было только формальное. С другой стороны, предельный вариант DevOps как раз и означает объединение команд и ответственности. Так что тут у меня не сформировалось готового мнения.

Проблема на самом деле более глубокая — в определении, какие именно услуги оказываются заказчику (ITSM), и что именно является АС (ГОСТ 34). В данном случае большое количество новых разработок — это не какие-то опциональные фичи, а регламентированная отчётность, которая должна быть разработана и установлена к определённой дате. А в таком случае сопровождение скорее входит в услугу, и АС возможно являются все среды вместе. Это конечно не исключает управления версиями модулей как отдельных продуктов, однако его полезность остаётся под вопросом.

Долгое время у меня существовало убеждение, что CI/CD и ITIL (управление изменениями) в принципе невозможно поженить. Но вроде бы вариант CD в варианте Continuous Delivery (в Prod только вручную по кнопке) рабочий.

More Decks by Vasilii Gorokhov-Apelsinov

Other Decks in Programming

Transcript

  1. Git & CI для БД и не только ППК ОАД

    Василий Горохов-Апельсинов июль 2019
  2. Задачи • Внедрить систему контроля версий для БД • Автоматизировать

    проверку и тестирование отдельных пакетов и патчей целиком • Проверку делать на актуальной копии ЗОЭ/ЗПЭ • Избежать дрифта зон • Автоматизировать сборку патчей • Автоматизировать остальные процессы: • Генерация документации • Оповещение внешних систем • Типовые операции: обновление представлений, создание синонимов, раздача грантов и т.п. – всё, что можно автоматизировать • SQL-скрипты в метаданных хранить как отдельные SQL-скрипты и так же проверять
  3. git • Массовая замена • Массовое переименование • Приведение к

    стандартам • Гипотетически более производительно
  4. Правка в БД • PL/SQL – сразу компиляция • Многим

    разработчикам привычнее поправить в БД, чем копаться в файлах
  5. Готовые инструменты управления версиями БД • liquibase • не выгружает

    гранты • бесплатная (open source) версия не выгружает PL/SQL • универсальный инструмент, поэтому достаточно сложный для доработки • не совместим с хранением объектов в отдельных файлах • не интегрируется с комбинированным подходом • Gitora • требует установки в БД под SYSом (поэтому я его пока не смог потестировать) • Flyway • предлагается как стандартный в ЕХД • работает только в одну сторону – из файлов (git) в БД Вывод: проще сделать свой инструмент, чем мучаться или дорабатывать существующий
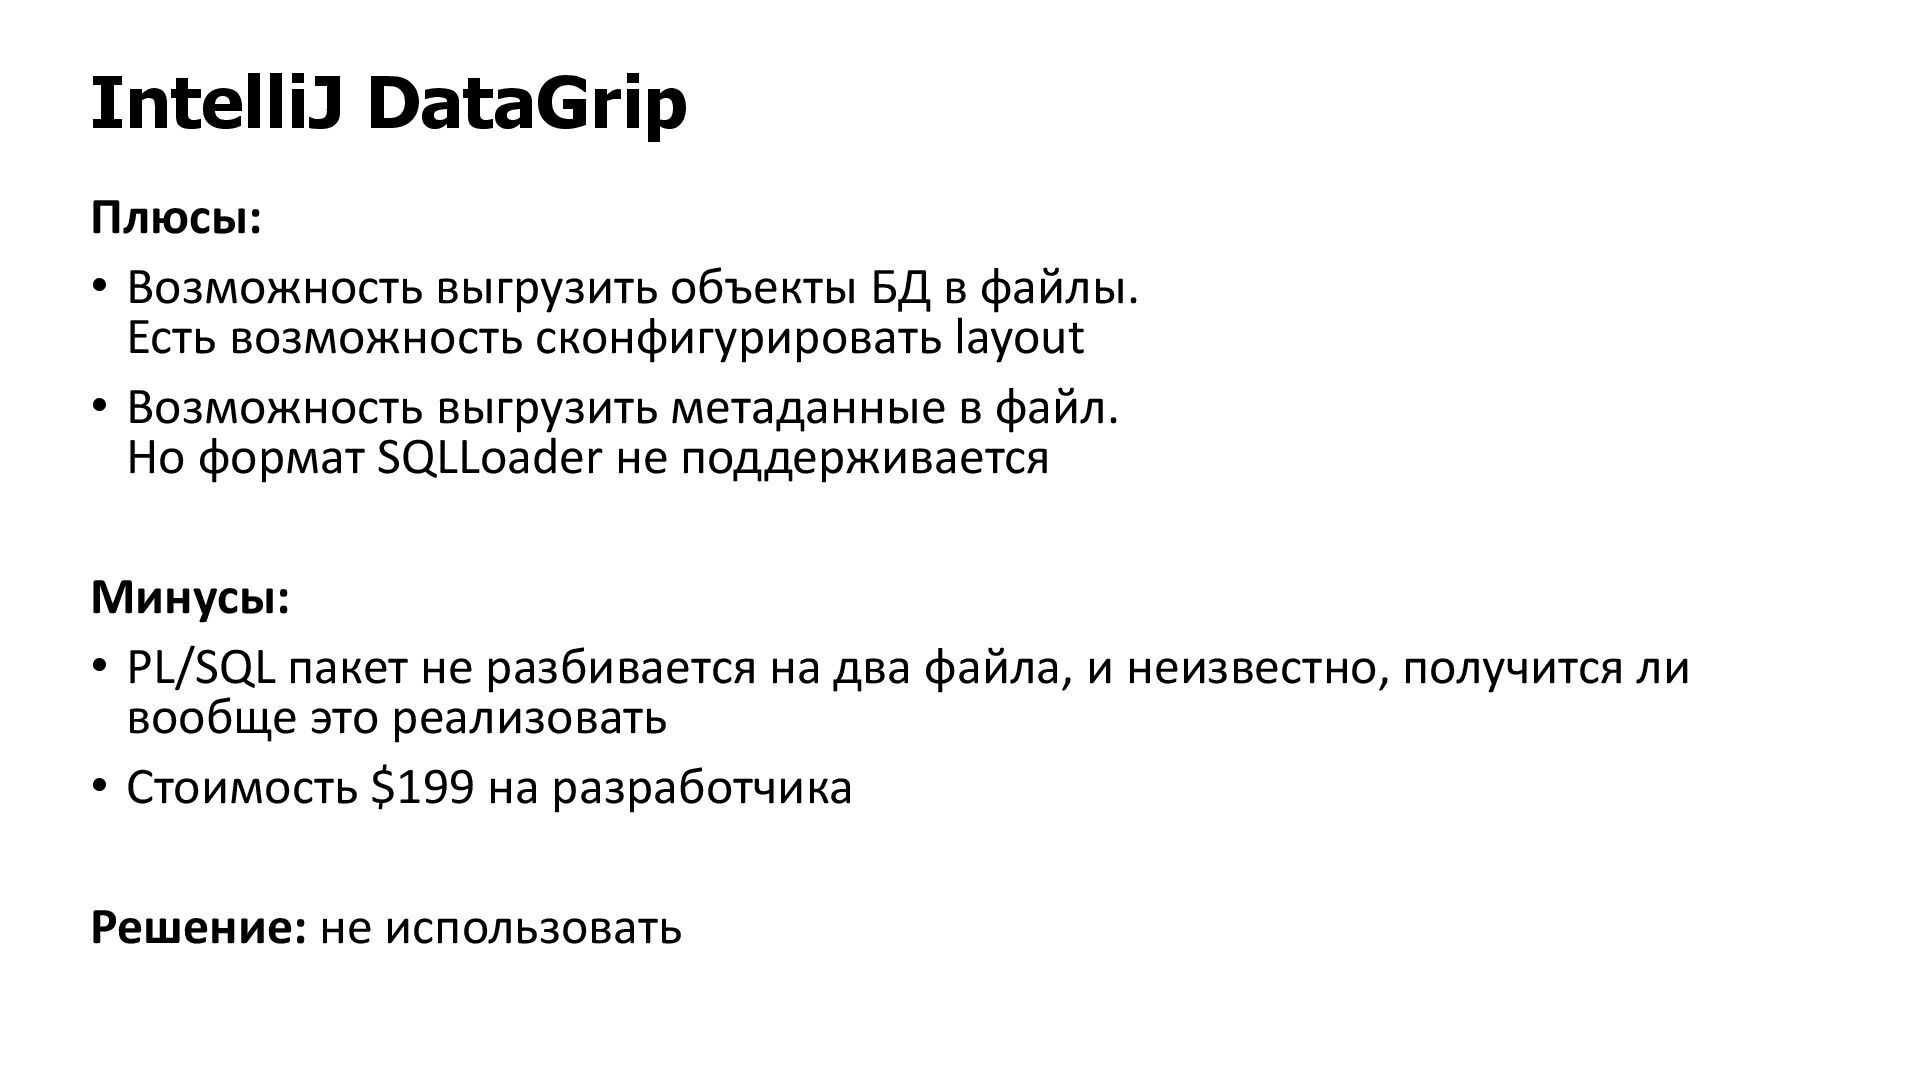
  6. IntelliJ DataGrip Плюсы: • Возможность выгрузить объекты БД в файлы.

    Есть возможность сконфигурировать layout • Возможность выгрузить метаданные в файл. Но формат SQLLoader не поддерживается Минусы: • PL/SQL пакет не разбивается на два файла, и неизвестно, получится ли вообще это реализовать • Стоимость $199 на разработчика Решение: не использовать
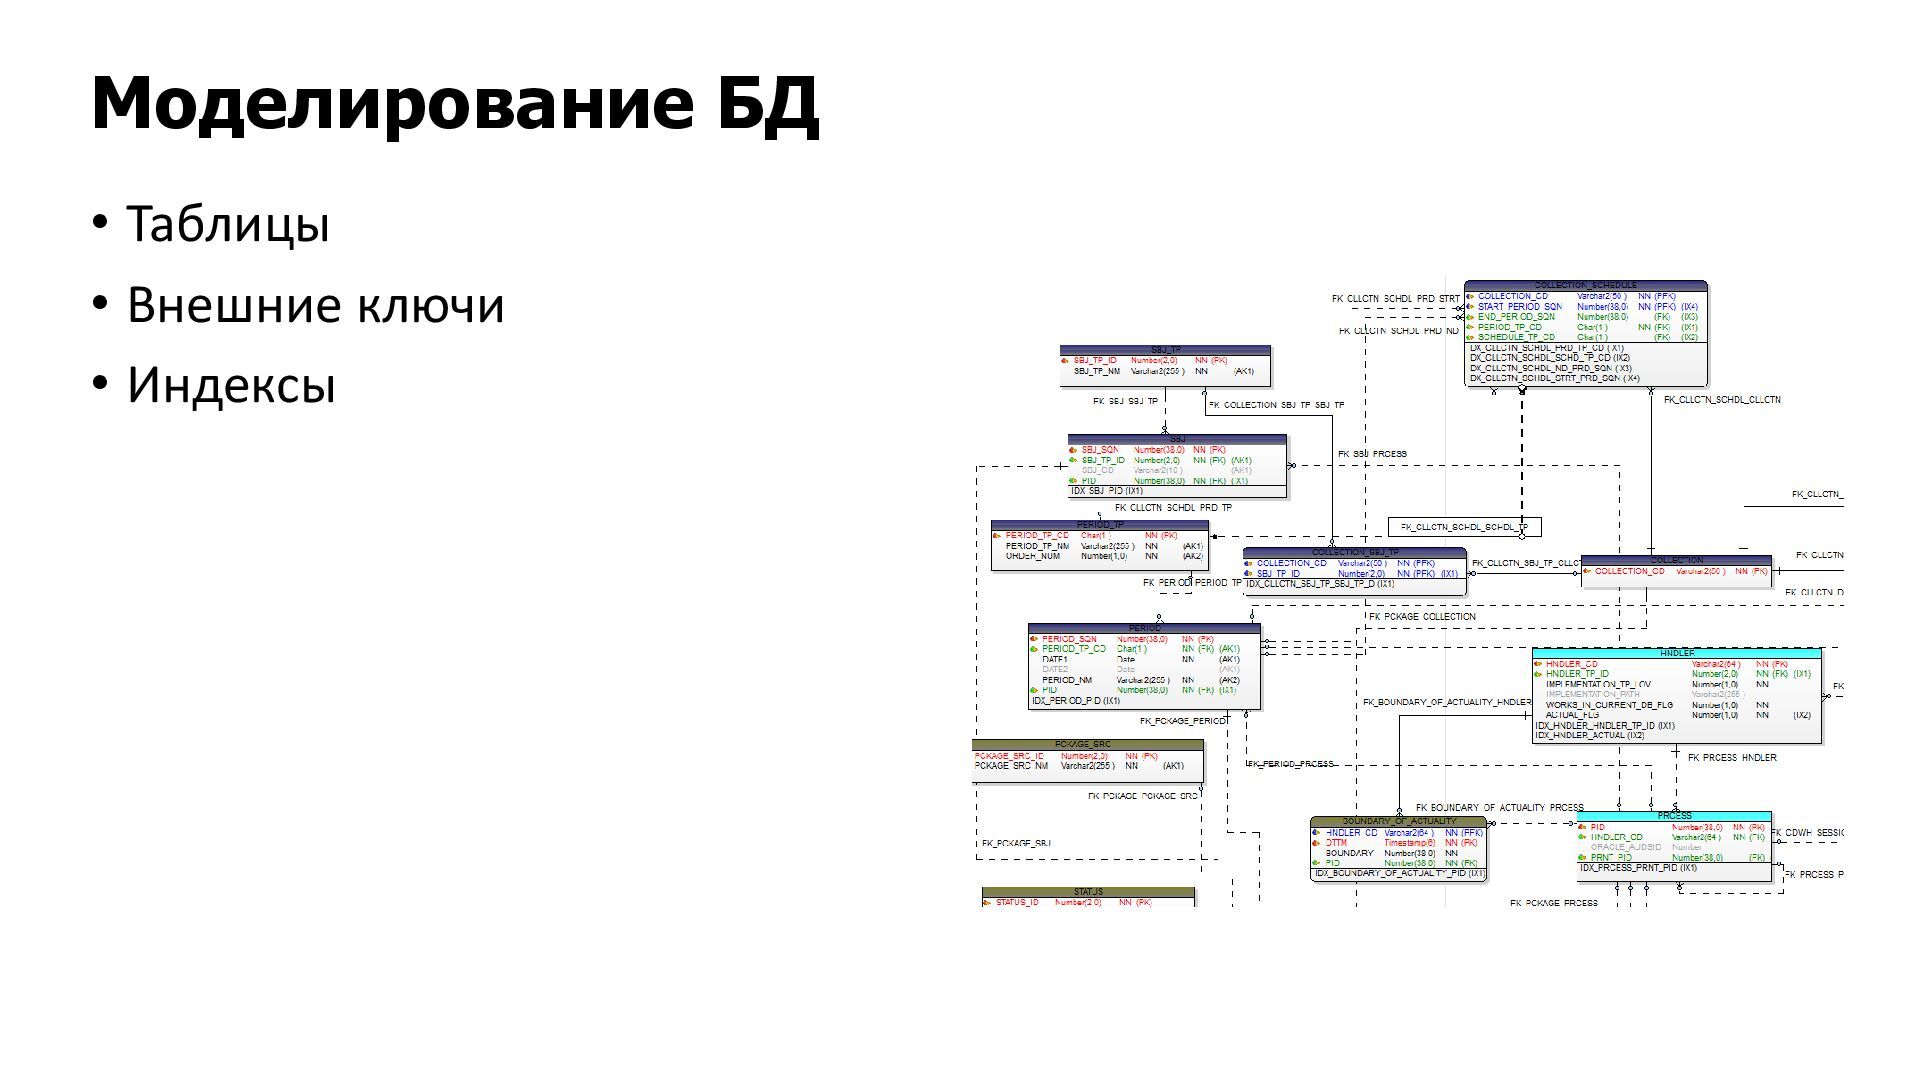
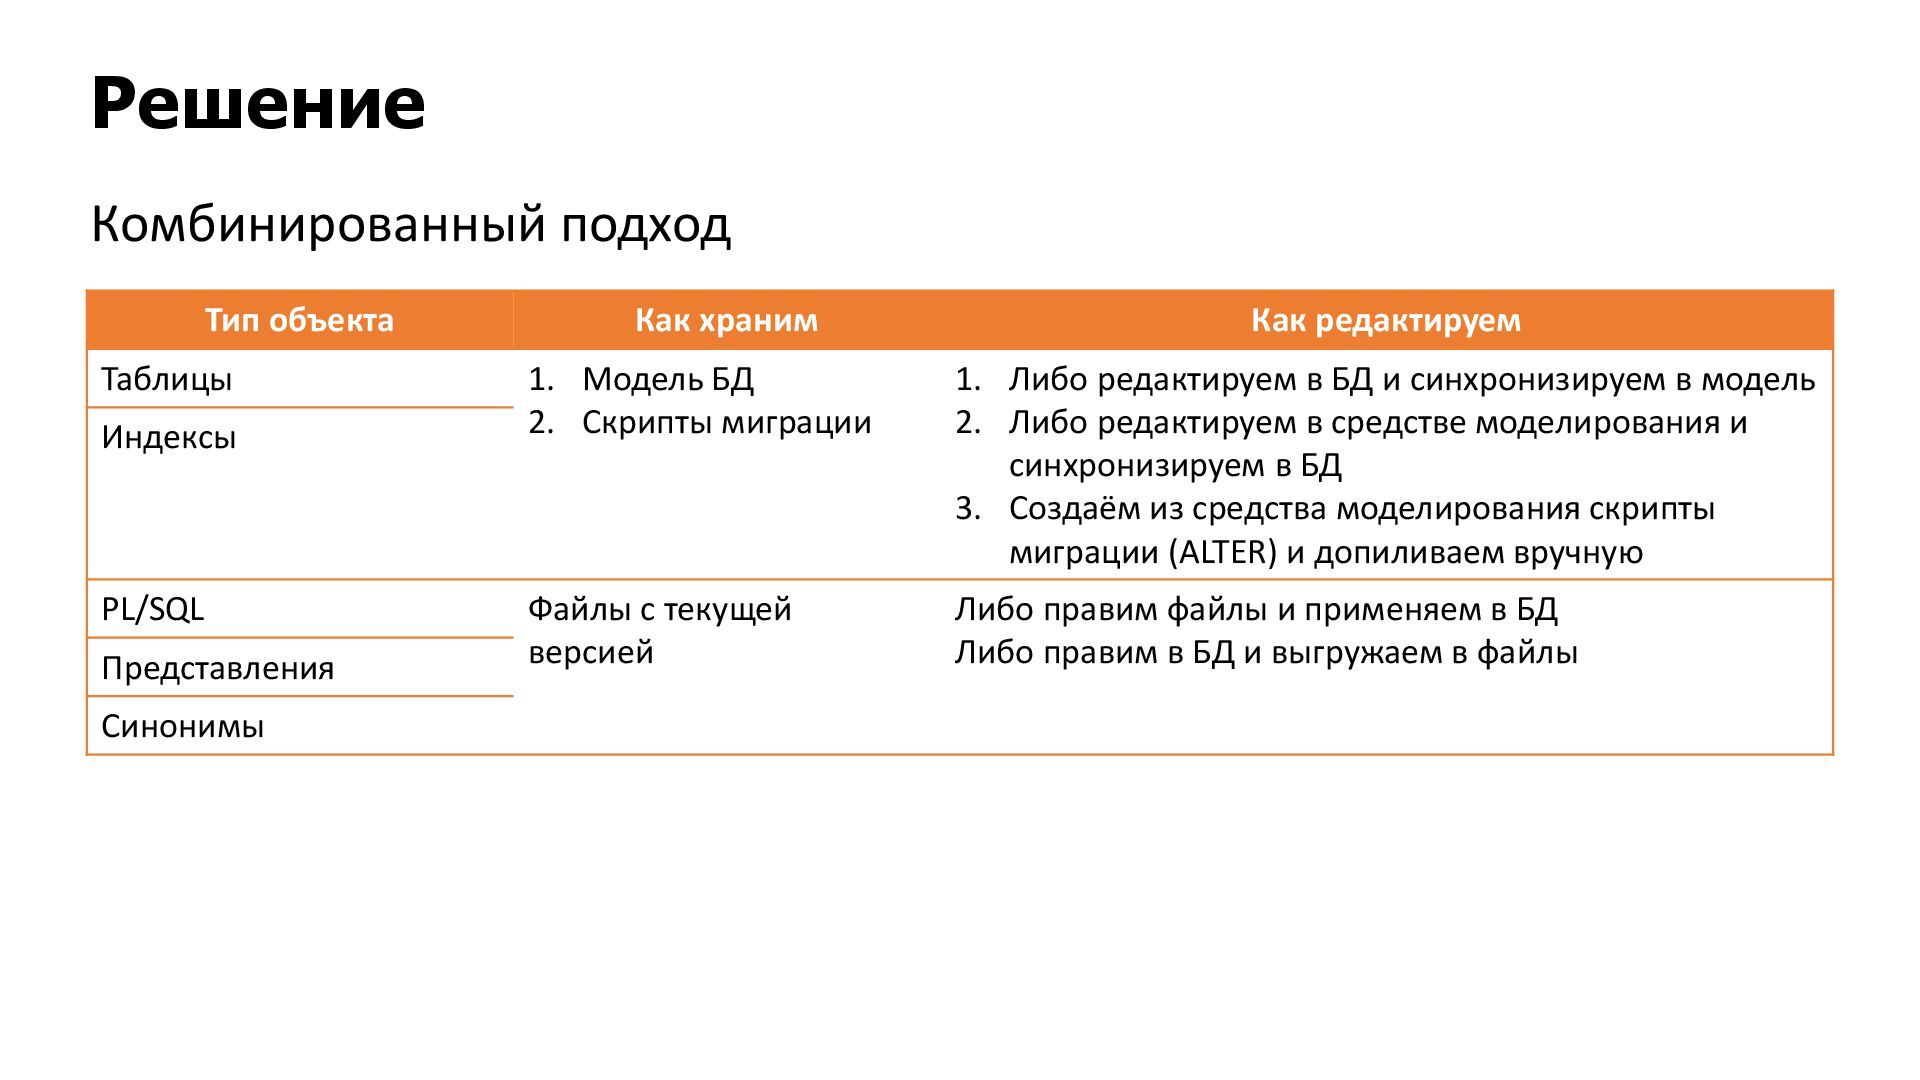
  7. Решение Комбинированный подход Тип объекта Как храним Как редактируем Таблицы

    1. Модель БД 2. Скрипты миграции 1. Либо редактируем в БД и синхронизируем в модель 2. Либо редактируем в средстве моделирования и синхронизируем в БД 3. Создаём из средства моделирования скрипты миграции (ALTER) и допиливаем вручную Индексы PL/SQL Файлы с текущей версией Либо правим файлы и применяем в БД Либо правим в БД и выгружаем в файлы Представления Синонимы
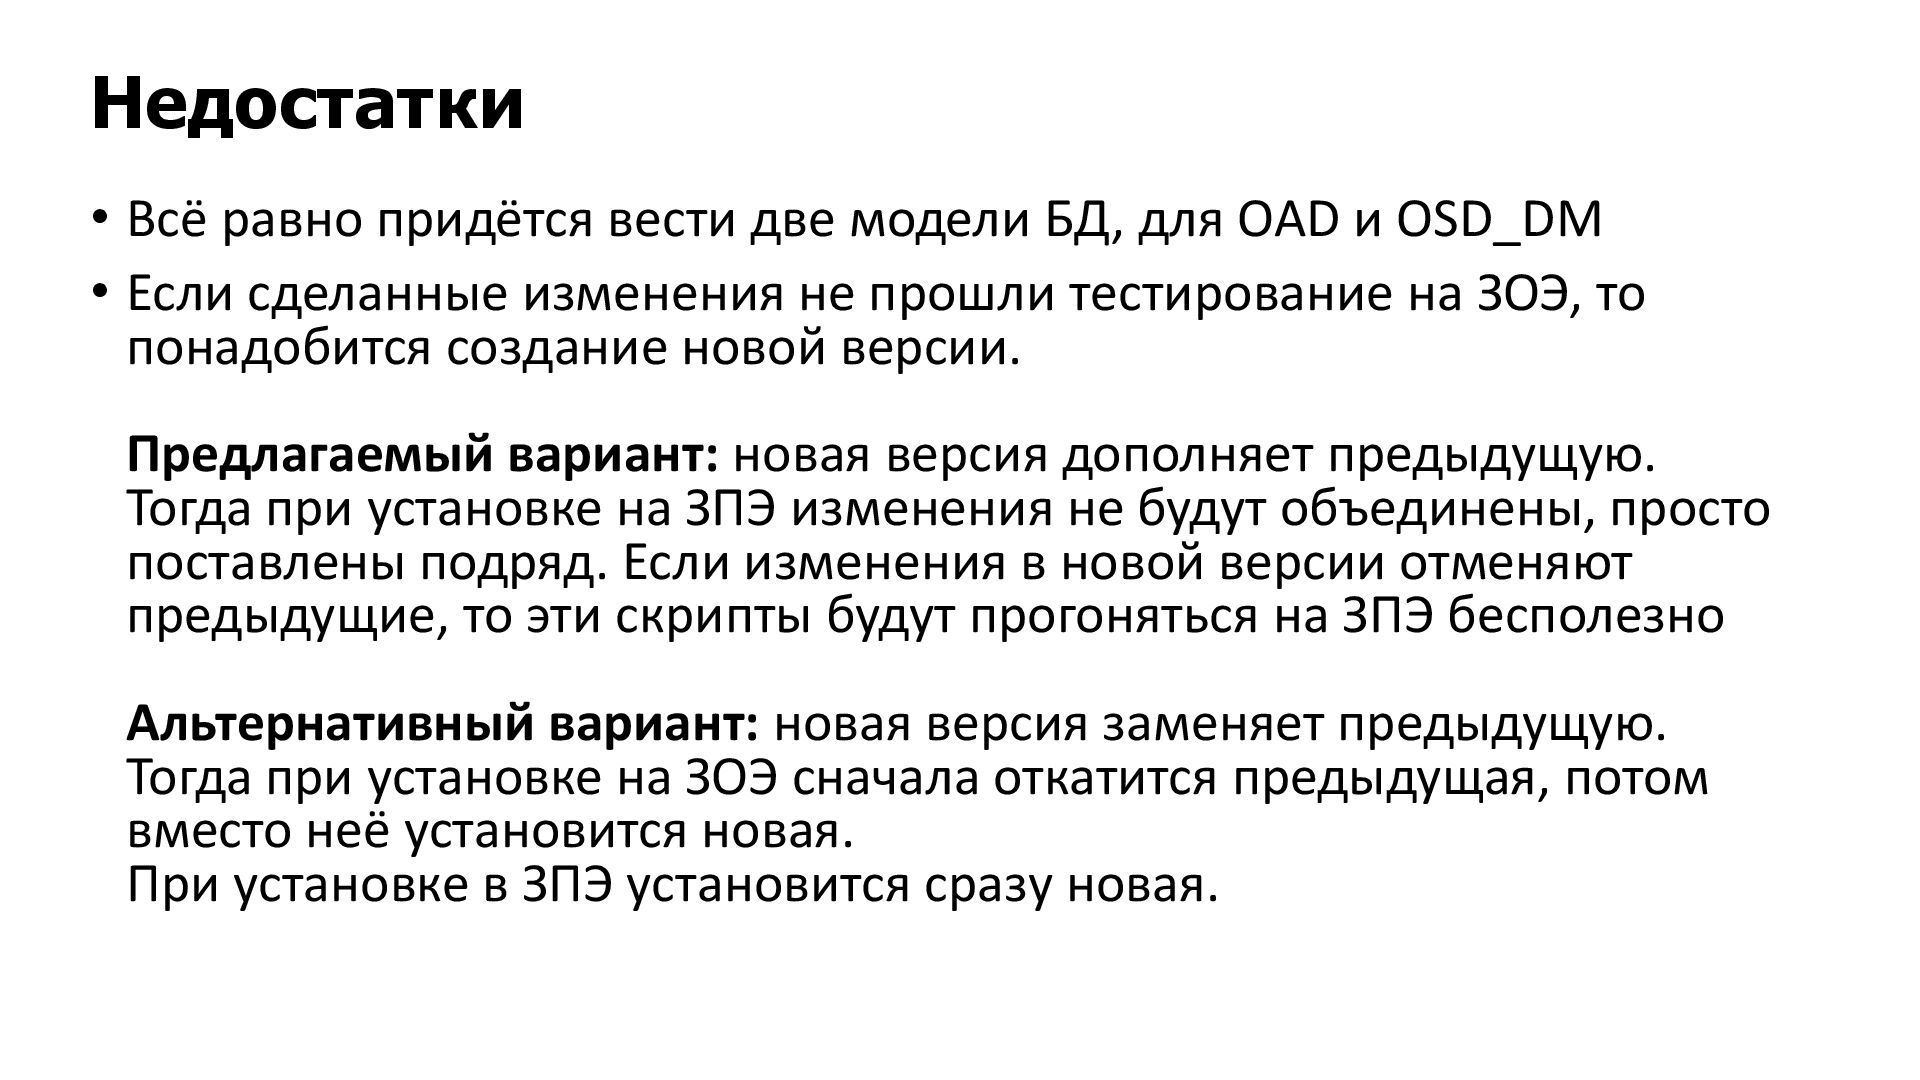
  8. Недостатки • Всё равно придётся вести две модели БД, для

    OAD и OSD_DM • Если сделанные изменения не прошли тестирование на ЗОЭ, то понадобится создание новой версии. Предлагаемый вариант: новая версия дополняет предыдущую. Тогда при установке на ЗПЭ изменения не будут объединены, просто поставлены подряд. Если изменения в новой версии отменяют предыдущие, то эти скрипты будут прогоняться на ЗПЭ бесполезно Альтернативный вариант: новая версия заменяет предыдущую. Тогда при установке на ЗОЭ сначала откатится предыдущая, потом вместо неё установится новая. При установке в ЗПЭ установится сразу новая.
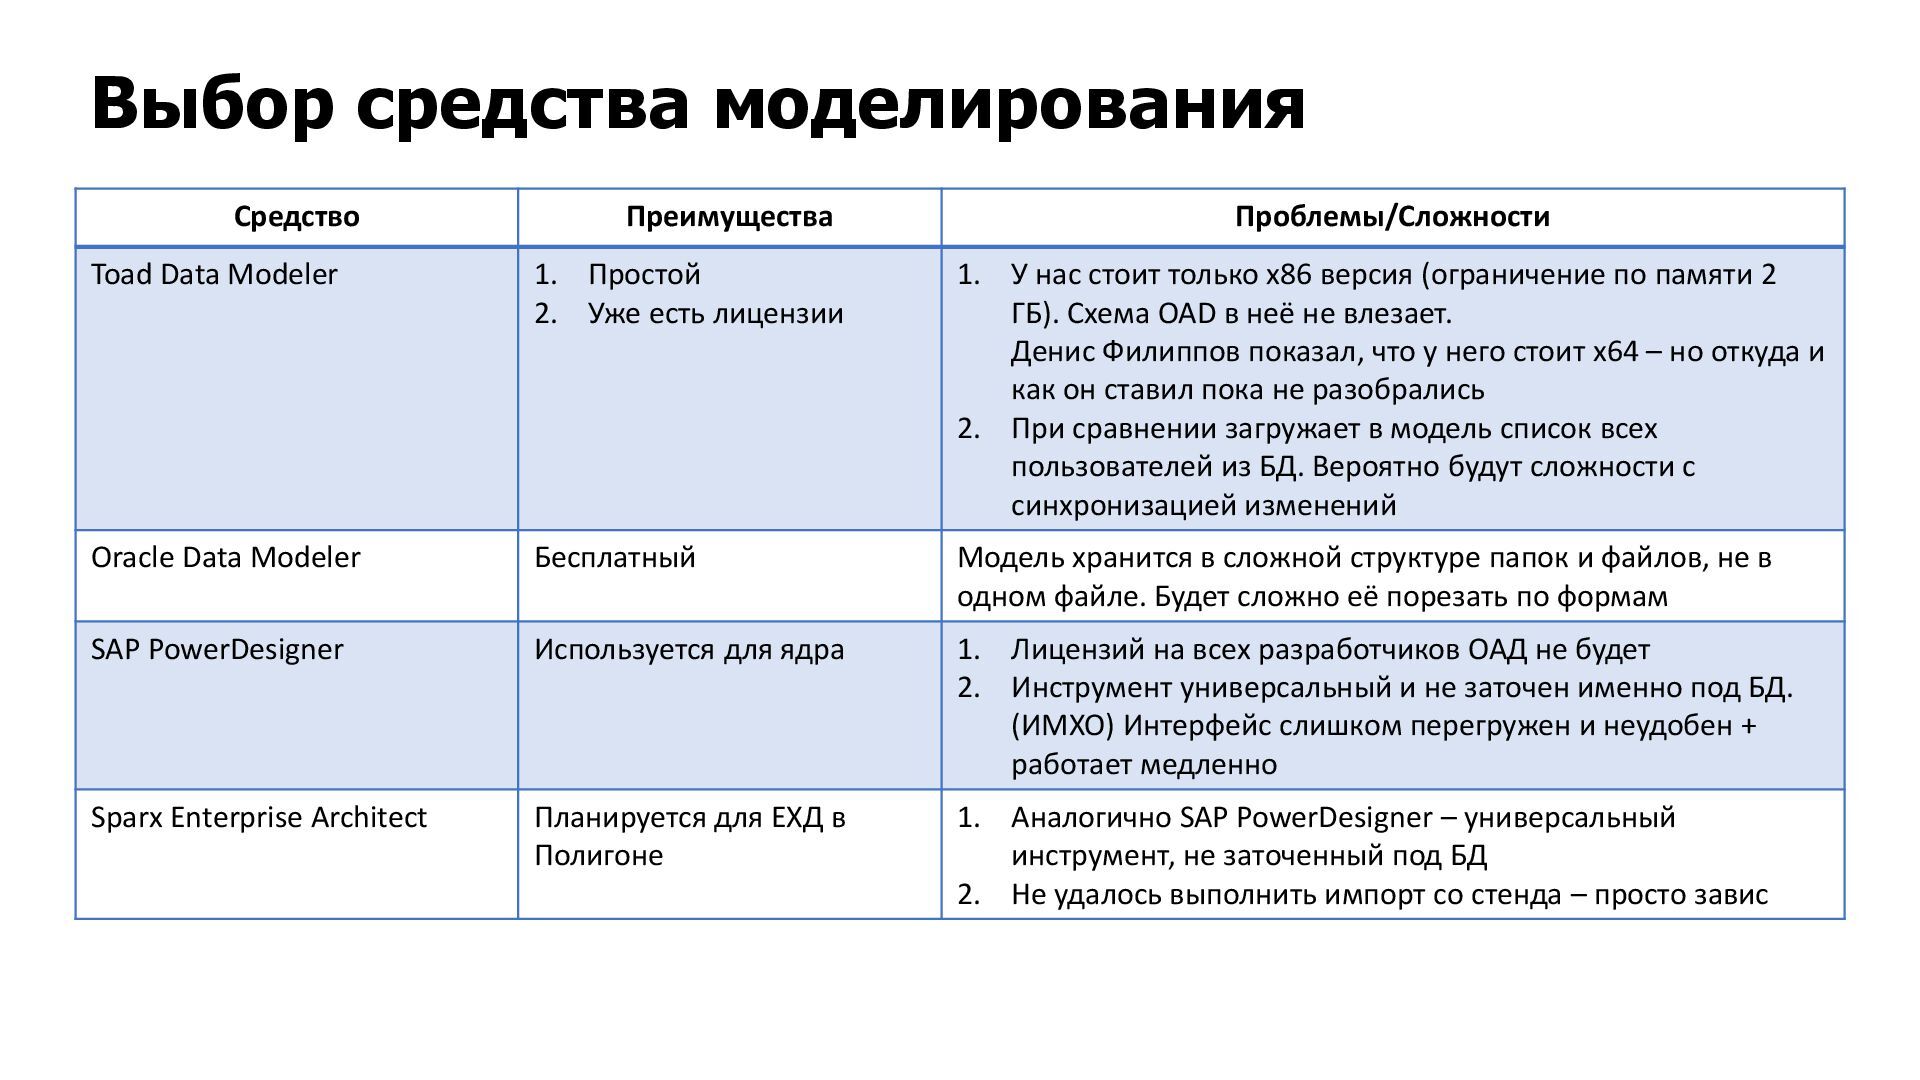
  9. Выбор средства моделирования Средство Преимущества Проблемы/Сложности Toad Data Modeler 1.

    Простой 2. Уже есть лицензии 1. У нас стоит только x86 версия (ограничение по памяти 2 ГБ). Схема OAD в неё не влезает. Денис Филиппов показал, что у него стоит x64 – но откуда и как он ставил пока не разобрались 2. При сравнении загружает в модель список всех пользователей из БД. Вероятно будут сложности с синхронизацией изменений Oracle Data Modeler Бесплатный Модель хранится в сложной структуре папок и файлов, не в одном файле. Будет сложно её порезать по формам SAP PowerDesigner Используется для ядра 1. Лицензий на всех разработчиков ОАД не будет 2. Инструмент универсальный и не заточен именно под БД. (ИМХО) Интерфейс слишком перегружен и неудобен + работает медленно Sparx Enterprise Architect Планируется для ЕХД в Полигоне 1. Аналогично SAP PowerDesigner – универсальный инструмент, не заточенный под БД 2. Не удалось выполнить импорт со стенда – просто завис
  10. Гранты • Для обычных объектов БД, один объект = один

    файл. Удаление файла = удаление объекта в БД • Если хранить каждый грант в отдельном файле – очень много файлов, неудобно • Для GRANT очень простой набор опций Решение: • Хранить гранты на один объект в одном файле в формате CSV • При синхронизации с БД/создании патча на основании изменений в файле генерировать скрипты GRANT/REVOKE
  11. Метаданные • Если формат будет совместим с Excel, то будет

    относительно удобно редактировать. Скрипты с INSERT неудобно • Есть желание использовать эти метаданные в разных процессах разработки и сборки • Проверки на корректность, которые можно сделать без вставки их в БД, - по файлу сделать быстрее и проще • Если таблица содержит длинное поле CLOB, стандартный INSERT (без трюков) сделать нельзя • SQL-скрипты, которые лежат в метаданных, надо проверять на соответствие стандартам и т.п. как обычный SQL • Готовых инструментов командной строки, которые умеют синхронизировать метаданные из файлов с БД - мне не известно (Google ничего не предложил) Решение: • Хранить метаданные в формате CSV/TBL • Поля CLOB (SQL-скрипты) хранить в отдельных файлах • Синхронизировать БД с файлами так же, как и DDL • Если метаданные содержат CLOB - использовать SQLLoader для загрузки Иначе при сборке патча генерировать из этих CSV/TBL INSERT-скрипты (для уменьшения количества шагов установки) TODO: • Пока нет договорённости с ЦЭС, что он выполнит SQLLoader • SQLLoader не умеет делать UPDATE и DELETE. Надо либо добавить какие-то доп. операции до установки. Либо грузить во временную таблицу и потом синхронизировать. Либо каждый раз удалять всё и грузить заново (несовместимо с FOREIGN KEY). Либо использовать какой-то другой инструмент
  12. Кастомные инструменты • ExportDDL • выгружает объекты БД в файлы

    • устанавливает файлы в БД (не патч, просто выполнение скриптов!) • makepatch-oad • формирует в папке distr файл CK5DITRXXX-YYYY.vN.yaml с порядком запуска скриптов • разработчик может вручную поправить порядок запуска • Jenkins • генерирует готовые патчи для ЗОЭ и ЗПЭ • генерирует суммарную документацию об изменениях в патче • генерирует документацию о текущей версии в ЗОЭ/ЗПЭ TODO: Предполагается, что порядок запуска придётся иногда менять. Если не придётся, то смысла генерировать и хранить distr/*.yaml нет
  13. TODO • Хранить ли версию в PL/SQL пакетах и как

    её обновлять/синхронизировать
  14. Git и работа с изменениями Как перенести изменения из одной

    ветки в другую? • Ветки & merge • Сливаются все коммиты • Сохраняется история и факт merge • Если известно, что какой-то кусок кода будет переноситься отдельно – надо сразу разрабатывать его в отдельной ветке • Cherry-pick • Один коммит • История теряется. Факт cherry-pick не сохраняется. Совершенно отдельный коммит, не имеющий никакого отношения к исходному
  15. Репозитории • Совершенно разный жизненный цикл аналитических витрин и отчётов

    • Отчёты СЭУ ГУ по ЦФО (ANA) – в ЗОЭ с 2017 года. До сих пор не доведена до рабочего состояния • Отчёты НПС – поступили в мае 2019, надо реализовать к 15.06.2019 Чтобы переносить что-то быстрее, что-то медленнее, надо иметь три ветки и вручную выбирать, что мёрджить. При ручном выборе есть риск ошибок и дрифта • Изменения в регламентных отчётах д.б. учтены в аналитических отчётах и делаться по возможности атомарно • Чем больше репозиторий, тем больше требуется времени на сборку и тестирование. Явно разделённые модули можно собирать и тестировать независимо друг от друга Выводы: 1. Аналитические отчёты надо хранить в одном репозитории с регламентными витринами 2. Если делать ветки под разработку каждого блока отчётов и витрин, их будет слишком много. Надо разделить разные формы и витрины на репозитории Главное правило деления: все изменения в репозитории переносятся в новую зону целиком Для начала делаем для каждой формы (без учёта букв) свой репозиторий В ЕХД используют один репозиторий, т.к. у них нет такого жизненного цикла разных возможностей. Всё всегда устанавливается целиком. Можно говорить, что они на самом деле следуют тому же критерию, что и мы.
  16. Дрифт зон Причина Решение Остающиеся проблемы Патч не установился полностью

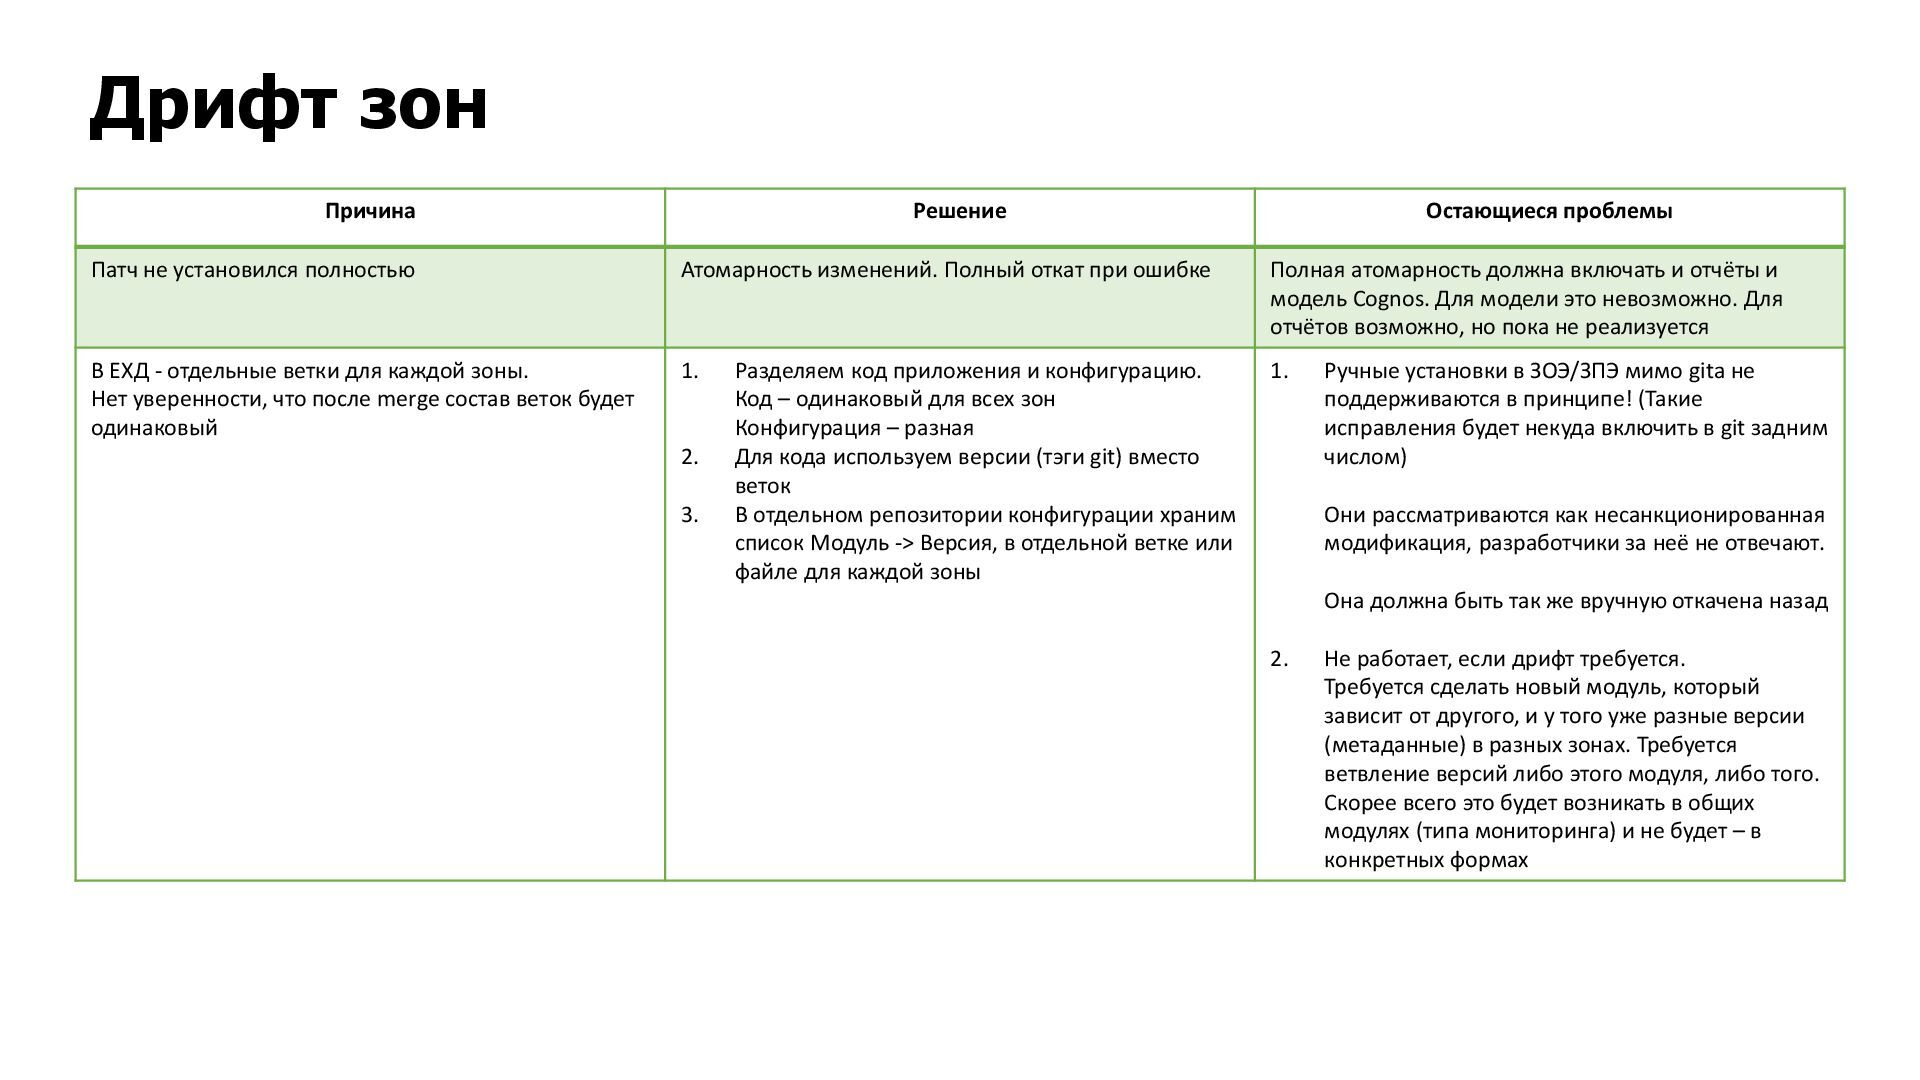
    Атомарность изменений. Полный откат при ошибке Полная атомарность должна включать и отчёты и модель Cognos. Для модели это невозможно. Для отчётов возможно, но пока не реализуется В ЕХД - отдельные ветки для каждой зоны. Нет уверенности, что после merge состав веток будет одинаковый 1. Разделяем код приложения и конфигурацию. Код – одинаковый для всех зон Конфигурация – разная 2. Для кода используем версии (тэги git) вместо веток 3. В отдельном репозитории конфигурации храним список Модуль -> Версия, в отдельной ветке или файле для каждой зоны 1. Ручные установки в ЗОЭ/ЗПЭ мимо gitа не поддерживаются в принципе! (Такие исправления будет некуда включить в git задним числом) Они рассматриваются как несанкционированная модификация, разработчики за неё не отвечают. Она должна быть так же вручную откачена назад 2. Не работает, если дрифт требуется. Требуется сделать новый модуль, который зависит от другого, и у того уже разные версии (метаданные) в разных зонах. Требуется ветвление версий либо этого модуля, либо того. Скорее всего это будет возникать в общих модулях (типа мониторинга) и не будет – в конкретных формах
  17. Rollback DDL Встроенные механизмы Oracle: • CREATE EDITION – работает

    для БД в целом • Не работает для TABLE • Для смены Edition надо делать • либо ALTER SESSION (можно попробовать, но рискованно. + Это не повлияет, например, на линки) • либо ALTER DATABASE DEFAULT EDITION (такой грант нам не дадут) • CREATE SCHEMA AUTHORIZATION • работает только для одного пользователя • только для TABLE, VIEW, GRANT Решение: • кастомные скрипты отката • включать отдельный пункт в план для ЦЭС • альтернатива: после всех скриптов запускать доп. скрипты, проверяющие (сохранённый где-то) результат и при ошибках возвращающие всё назад
  18. To Squash or Not To Squash Грязная история: Коммитов много,

    взаимосвязанные изменения не сгруппированы Чистая история: Изменения сгруппированы в один или несколько логически цельных коммитов Видны все попытки (WIP) Только то, что «взлетело». Без черновиков Видны реальные усилия разработчика Виден только результат. “Hide the sausage making” В истории сохранены косяки Косяки, которые были, но исправлены до merge и никуда не попали – не сохраняются Чтобы быстро находить все свои изменения, разработчики засоряют код комментариями со своими никами, номерами задач, датами. История версий файла на самом деле не используется Нет никакой потребности в доп. комментариях. Всё и так быстро получается из истории gitа Работает хорошо только при применении отдельных веток (никаких общих “develop”) TODO: Принять решение как мы работаем
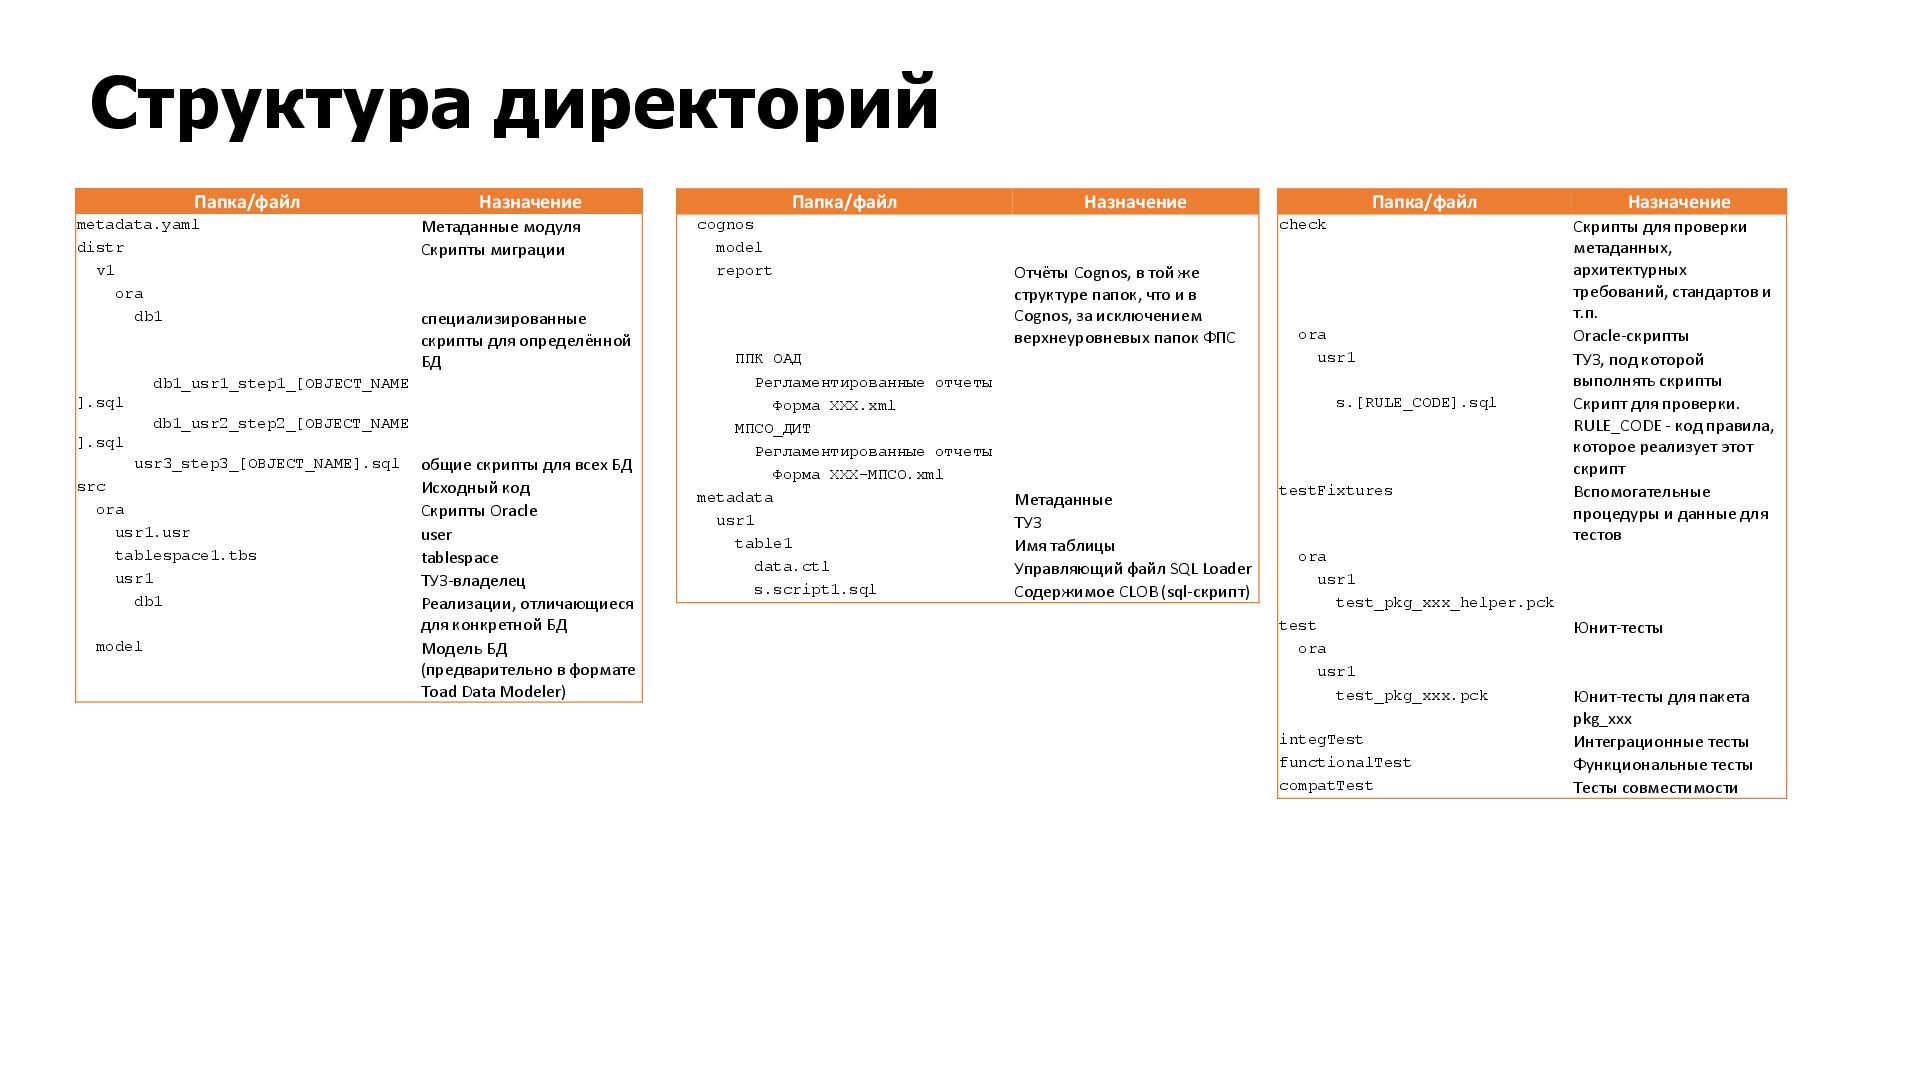
  19. Структура директорий Папка/файл Назначение metadata.yaml Метаданные модуля distr Скрипты миграции

    v1 ora db1 специализированные скрипты для определённой БД db1_usr1_step1_[OBJECT_NAME ].sql db1_usr2_step2_[OBJECT_NAME ].sql usr3_step3_[OBJECT_NAME].sql общие скрипты для всех БД src Исходный код ora Скрипты Oracle usr1.usr user tablespace1.tbs tablespace usr1 ТУЗ-владелец db1 Реализации, отличающиеся для конкретной БД model Модель БД (предварительно в формате Toad Data Modeler) Папка/файл Назначение cognos model report Отчёты Cognos, в той же структуре папок, что и в Cognos, за исключением верхнеуровневых папок ФПС ППК ОАД Регламентированные отчеты Форма XXX.xml МПСО_ДИТ Регламентированные отчеты Форма XXX-МПСО.xml metadata Метаданные usr1 ТУЗ table1 Имя таблицы data.ctl Управляющий файл SQL Loader s.script1.sql Содержимое CLOB (sql-скрипт) Папка/файл Назначение check Скрипты для проверки метаданных, архитектурных требований, стандартов и т.п. ora Oracle-скрипты usr1 ТУЗ, под которой выполнять скрипты s.[RULE_CODE].sql Скрипт для проверки. RULE_CODE - код правила, которое реализует этот скрипт testFixtures Вспомогательные процедуры и данные для тестов ora usr1 test_pkg_xxx_helper.pck test Юнит-тесты ora usr1 test_pkg_xxx.pck Юнит-тесты для пакета pkg_xxx integTest Интеграционные тесты functionalTest Функциональные тесты compatTest Тесты совместимости
  20. Тестирование PL/SQL - проблемы 1. Скрытие реализации vs Юнит-тестирование 2.

    Автономные транзакции 3. Test Doubles • Dummies • Fakes • Stubs • Spies • Mocks
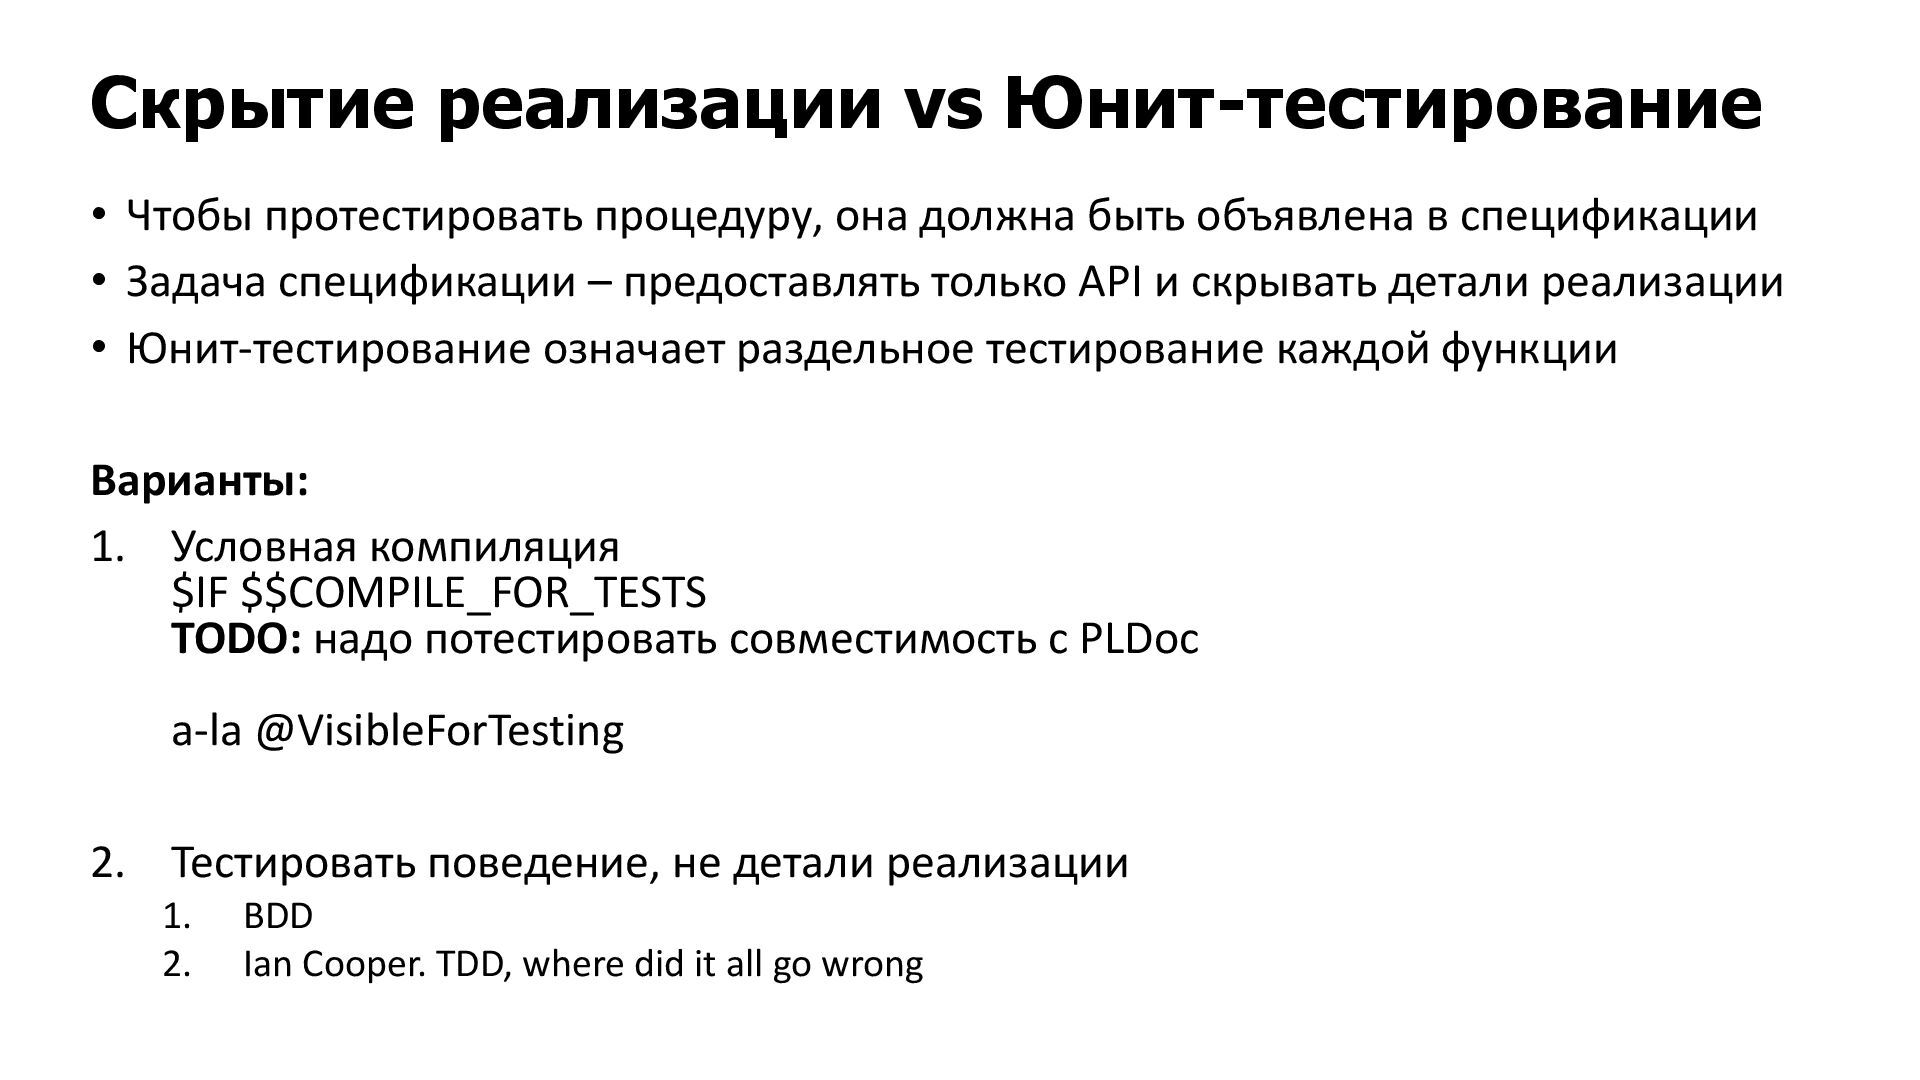
  21. Скрытие реализации vs Юнит-тестирование • Чтобы протестировать процедуру, она должна

    быть объявлена в спецификации • Задача спецификации – предоставлять только API и скрывать детали реализации • Юнит-тестирование означает раздельное тестирование каждой функции Варианты: 1. Условная компиляция $IF $$COMPILE_FOR_TESTS TODO: надо потестировать совместимость с PLDoc a-la @VisibleForTesting 2. Тестировать поведение, не детали реализации 1. BDD 2. Ian Cooper. TDD, where did it all go wrong
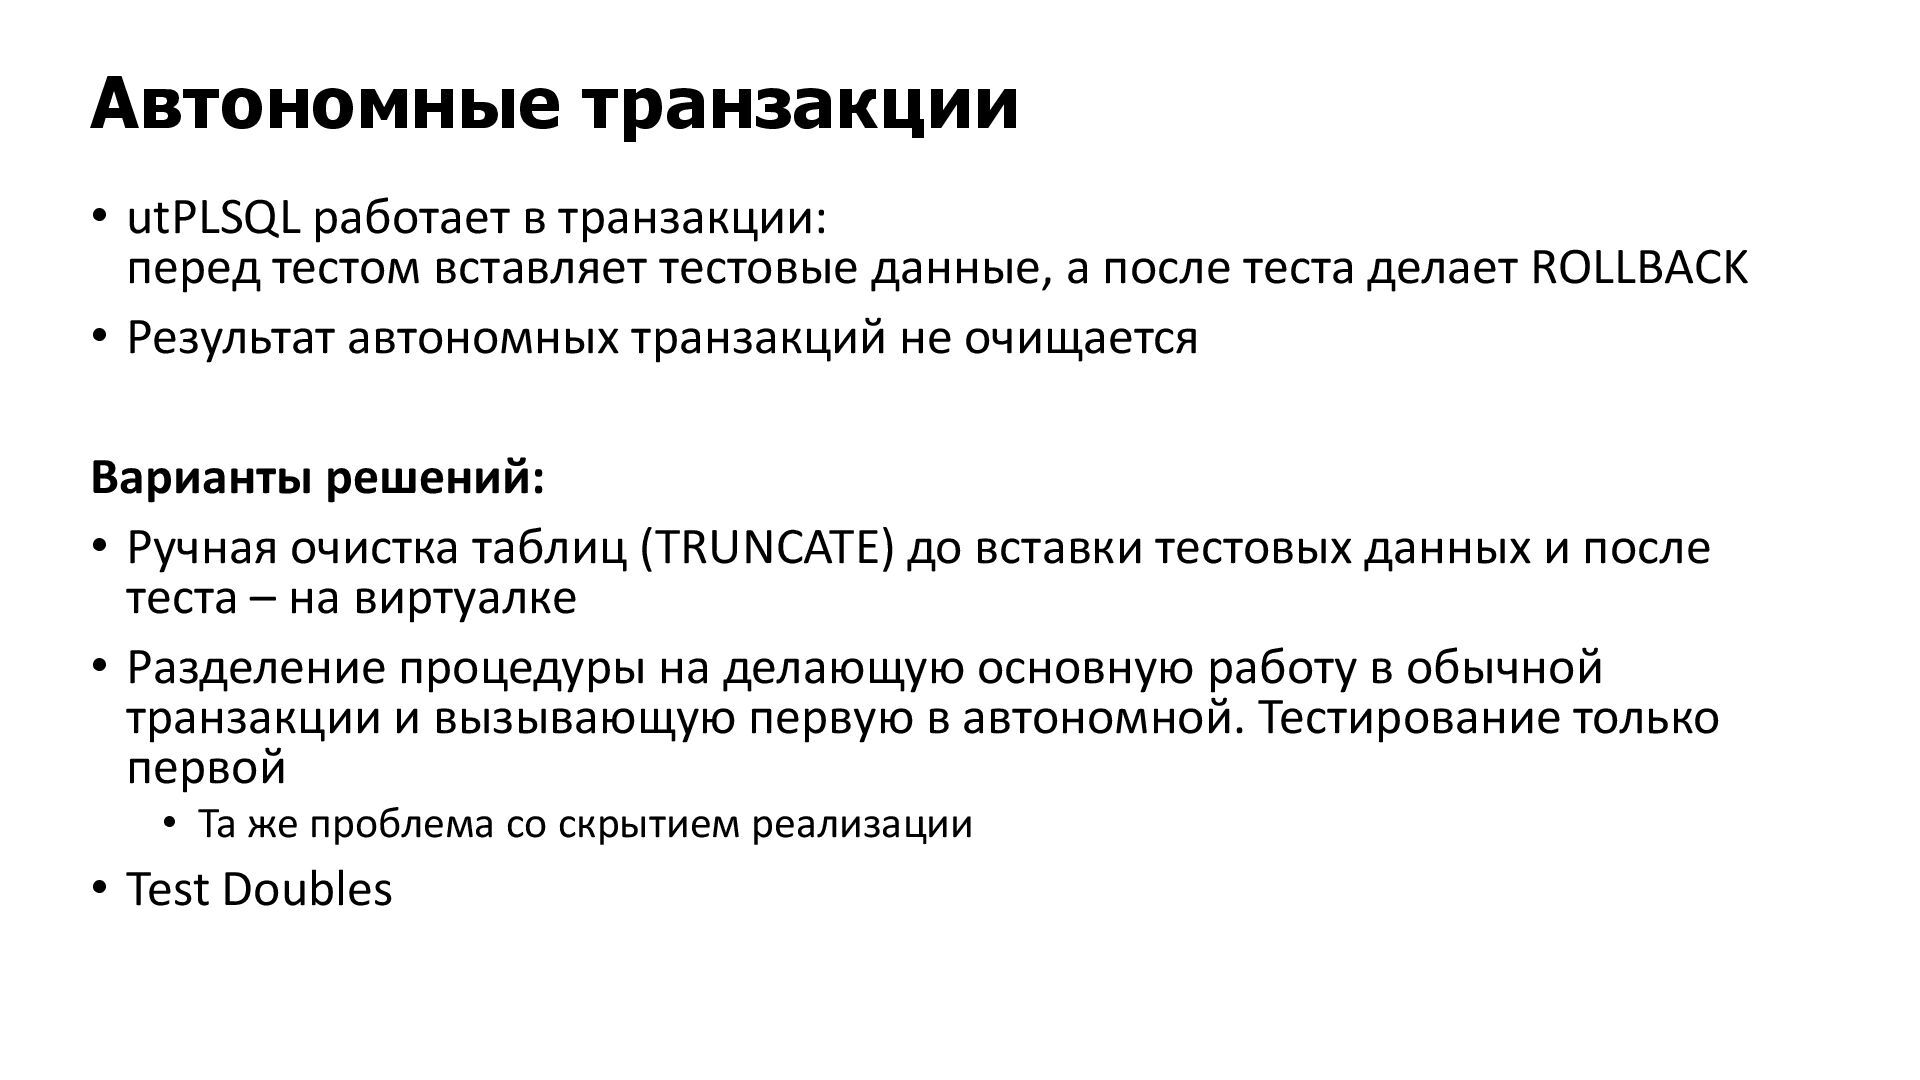
  22. Автономные транзакции • utPLSQL работает в транзакции: перед тестом вставляет

    тестовые данные, а после теста делает ROLLBACK • Результат автономных транзакций не очищается Варианты решений: • Ручная очистка таблиц (TRUNCATE) до вставки тестовых данных и после теста – на виртуалке • Разделение процедуры на делающую основную работу в обычной транзакции и вызывающую первую в автономной. Тестирование только первой • Та же проблема со скрытием реализации • Test Doubles
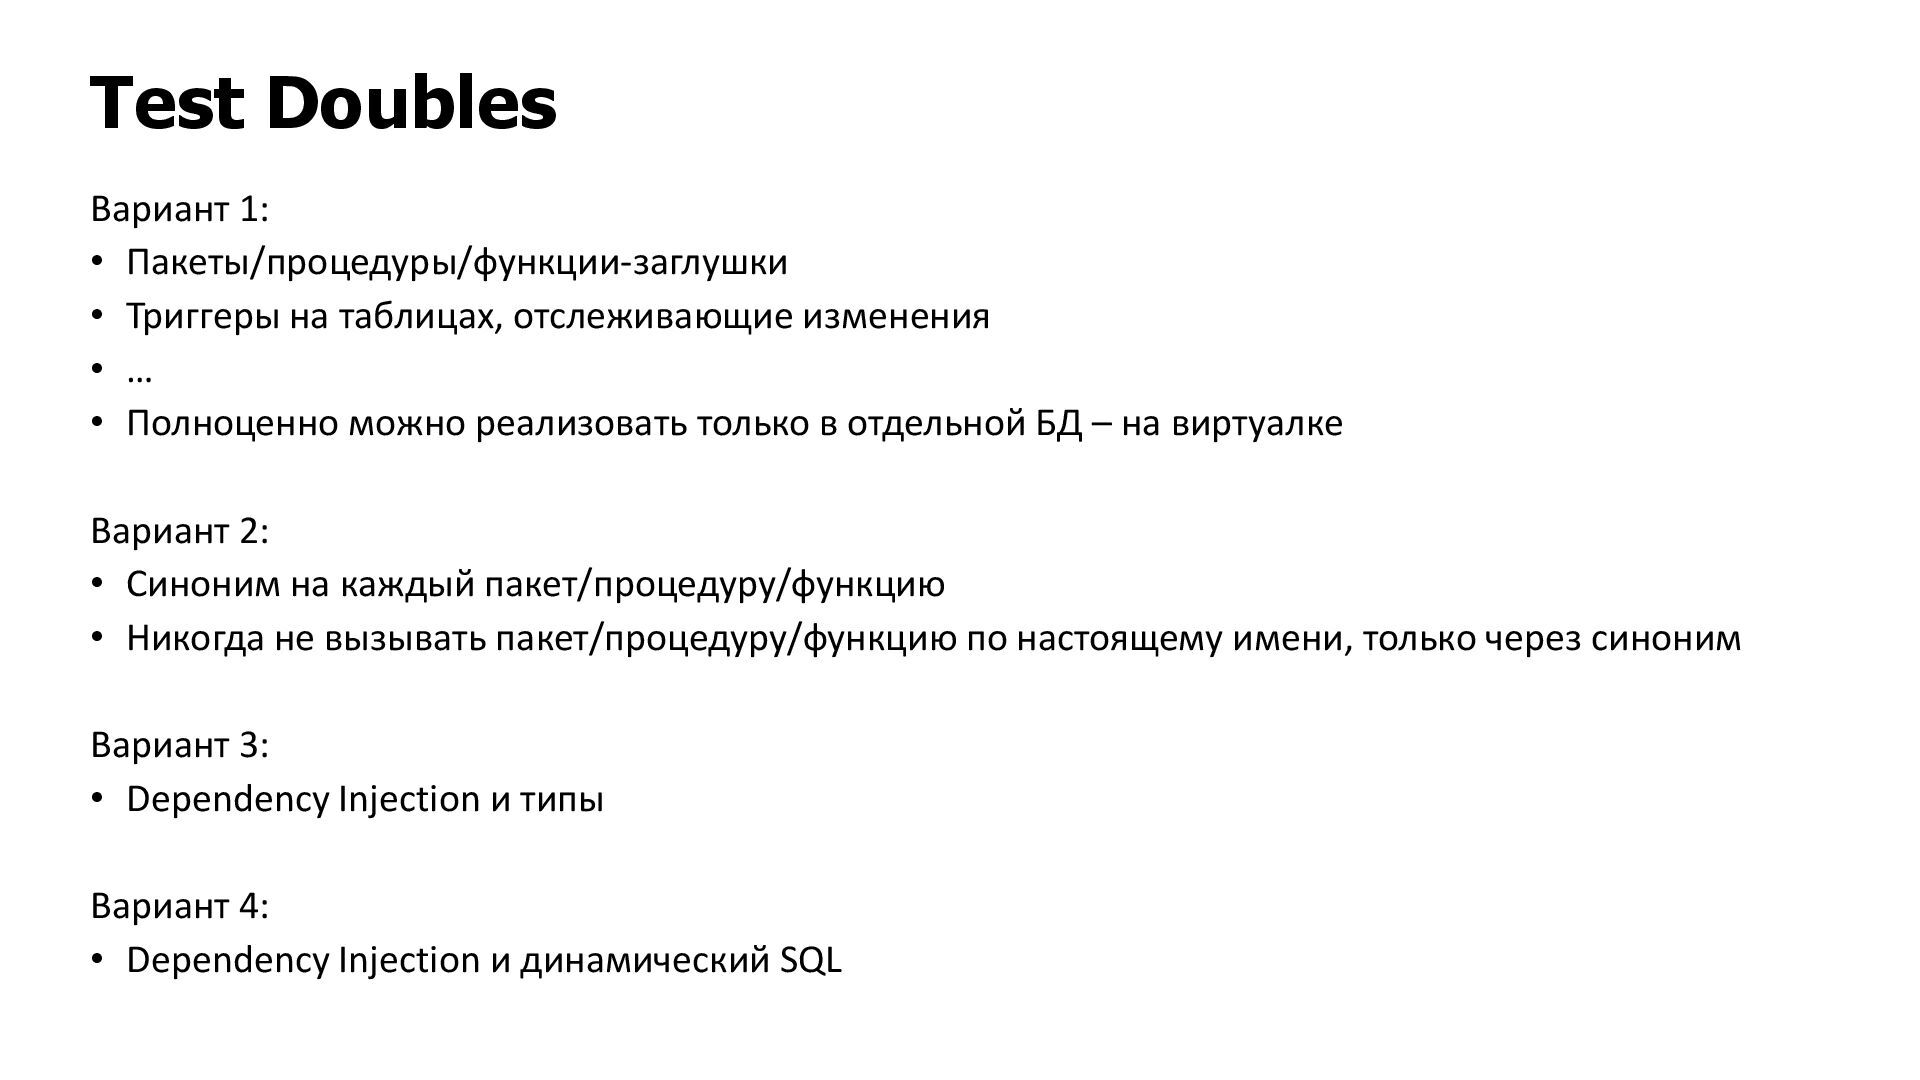
  23. Test Doubles Вариант 1: • Пакеты/процедуры/функции-заглушки • Триггеры на таблицах,

    отслеживающие изменения • … • Полноценно можно реализовать только в отдельной БД – на виртуалке Вариант 2: • Синоним на каждый пакет/процедуру/функцию • Никогда не вызывать пакет/процедуру/функцию по настоящему имени, только через синоним Вариант 3: • Dependency Injection и типы Вариант 4: • Dependency Injection и динамический SQL
  24. Тестирование – выводы • На виртуалках • Т.к. нет гарантий,

    что после ошибочного теста всё корректно вернётся в исходное состояние – надо убивать ВМ и поднимать новую из образа
  25. Подготовка тестовых VM TODO: Вариант 1: Устанавливать каждый раз заново

    Вариант 2: Устанавливать патч на существующую машину
  26. Установка БД с нуля Автоматически: • Генерируем полный скрипт из

    модели • Устанавливаем все объекты и метаданные из файлов
  27. Документация Варианты: • Для PL/SQL есть PLDoc Надо несколько комплектов

    документации: • Для разработчиков – API – те пакеты, которые запускаются из других пакетов • Для поддержки – параметры процедур, которые запускаются из АРМ оператора ТПС КХД • В средствах моделирования (Toad) есть генерация документации • В Oracle SQLDeveloper встроен DBDoc, который описывает все типы объектов в БД. Но пока непонятно, как его запускать программно (из-под Jenkins) • Для Java – javadoc TODO: • Пока непонятно, как генерировать документацию об изменениях. В Liquibase такая функциональность есть встроенная • Требуется выбрать инструменты или написать что-то своё • Нужен HTTP-сервер для размещения документации • Требуется либо полноценно заменить ООИБ в Confluence (в том числе оповещения). Либо автоматизированно обновлять его • Выбрать инструмент для документирования REST
  28. Cognos • Нет необходимости в отдельном пакете ЗОЭ/ЗПЭ • Хранить

    модели в Cognos • Форматировать XML + вырезать ненужные файлы и теги • Импорт всей истории с SharePoint – есть прототип инструмента • Выгружать отчёты из Cognos в git и обратно • TODO: Разработать инструмент • Так же форматировать XML • При сборке патча разворачивать всё во временную папку, публиковать пакет с правильными источниками и упаковывать в архив • Для публикации пакета из модели – есть прототип инструмента • Для развёртывания отчётов – тот же инструмент TODO: MotioCI – можно использовать только для ручного тестирования Надо либо просить доработку для автоматизированного запуска (и после этого покупать). Либо делать свой параллельный инструмент
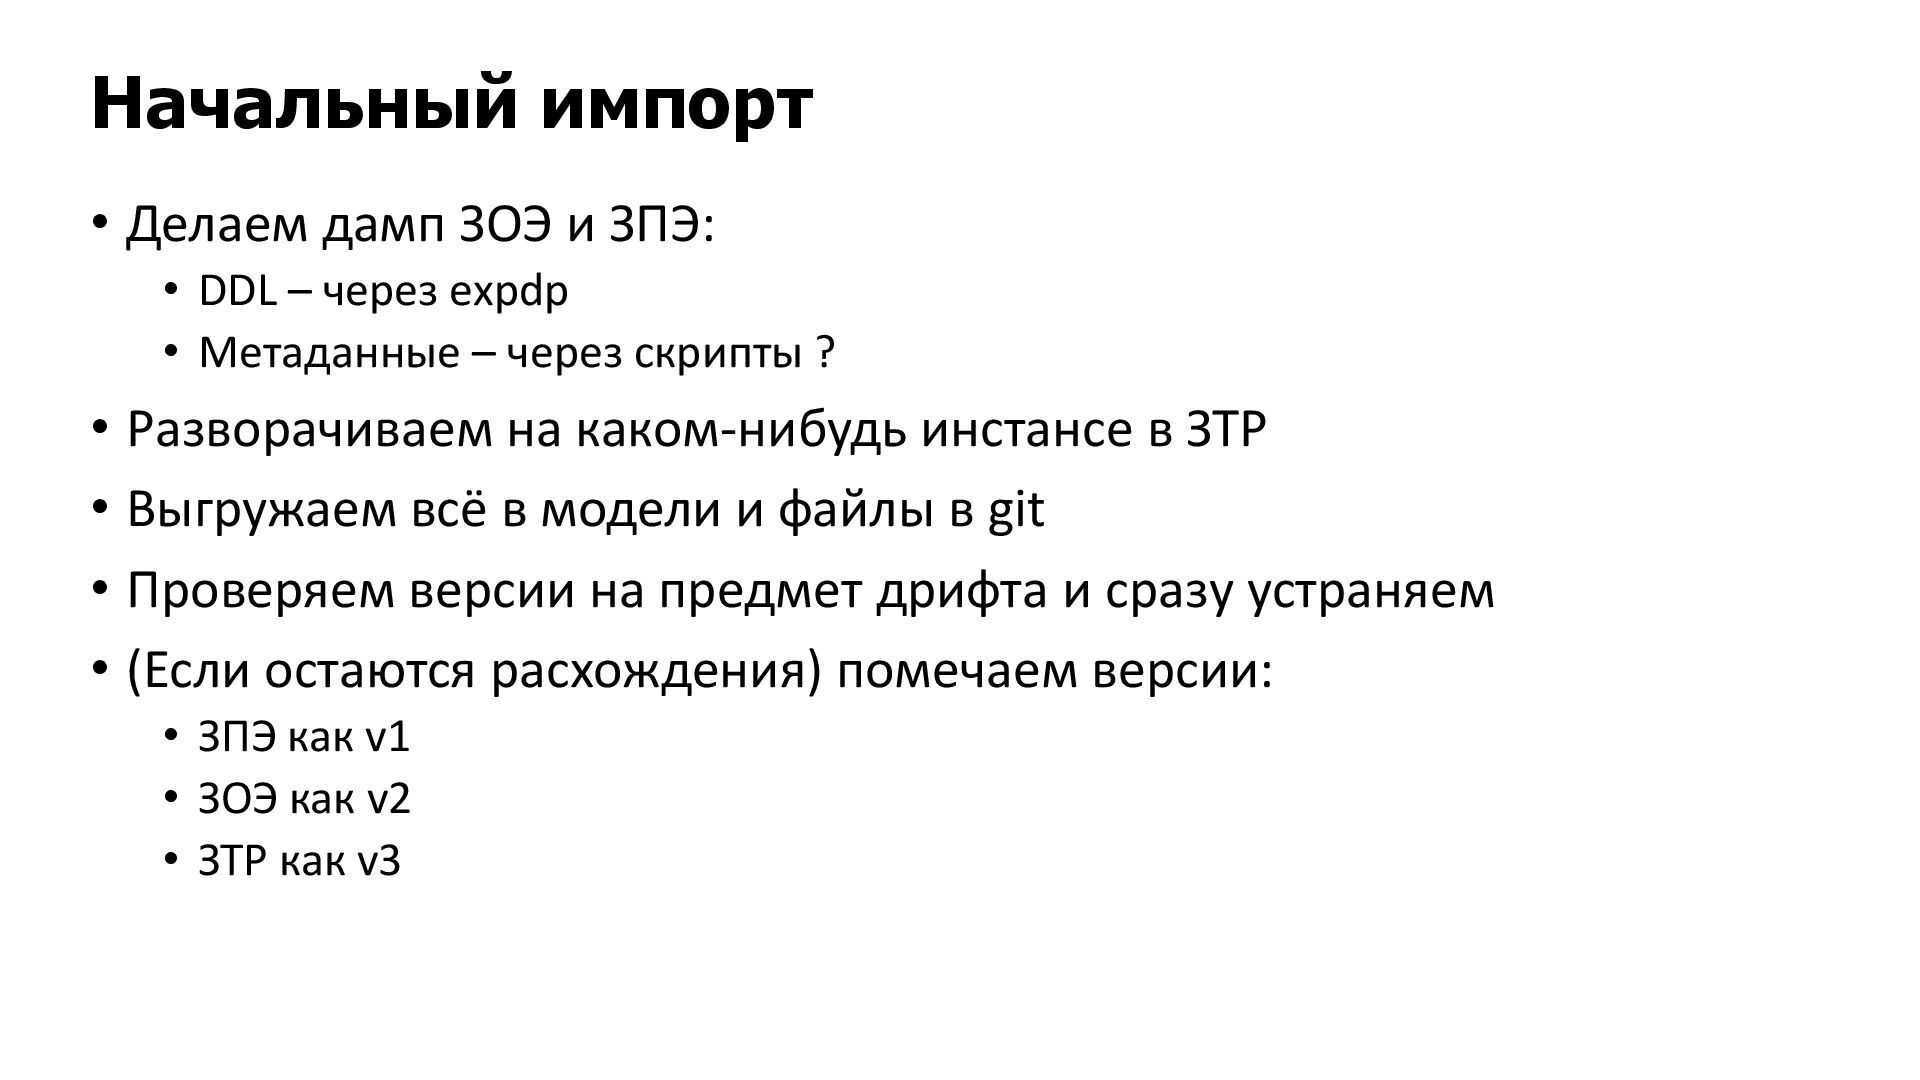
  29. Начальный импорт • Делаем дамп ЗОЭ и ЗПЭ: • DDL

    – через expdp • Метаданные – через скрипты ? • Разворачиваем на каком-нибудь инстансе в ЗТР • Выгружаем всё в модели и файлы в git • Проверяем версии на предмет дрифта и сразу устраняем • (Если остаются расхождения) помечаем версии: • ЗПЭ как v1 • ЗОЭ как v2 • ЗТР как v3
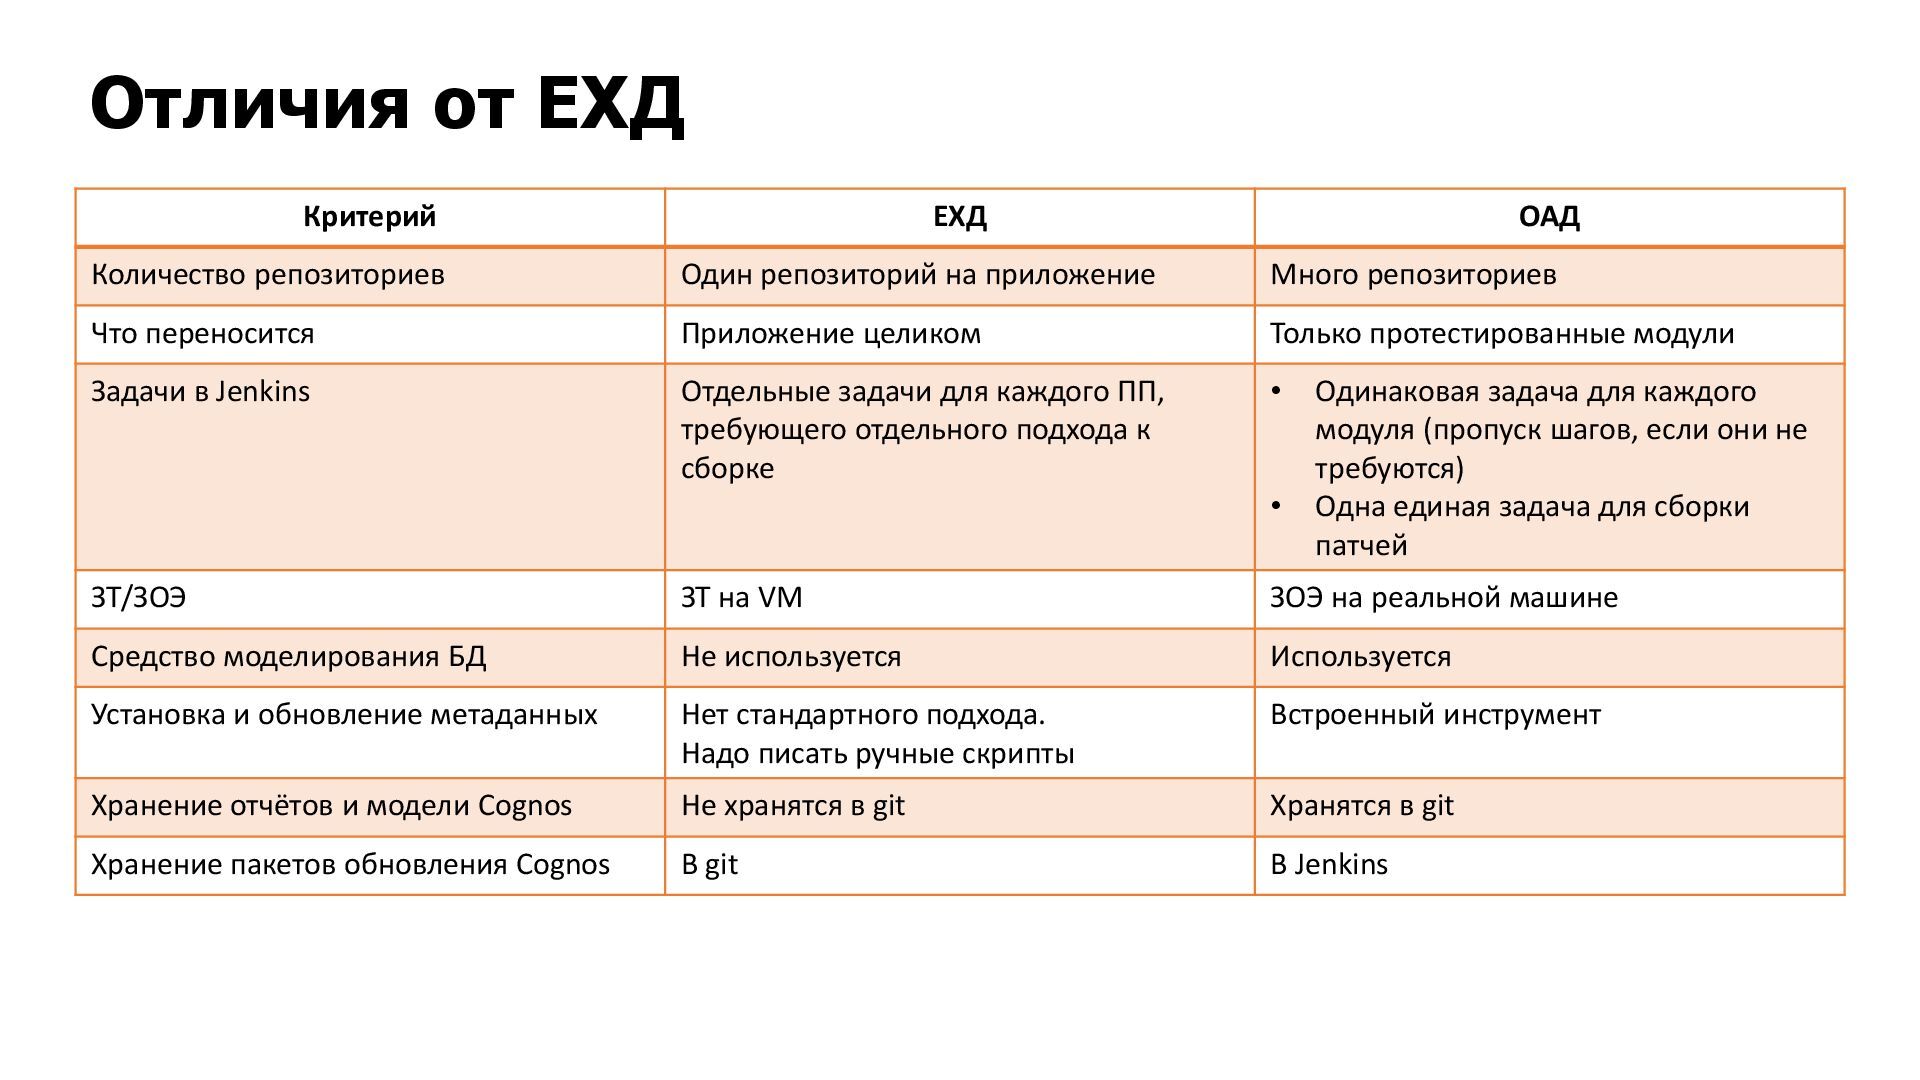
  30. Отличия от ЕХД Критерий ЕХД ОАД Количество репозиториев Один репозиторий

    на приложение Много репозиториев Что переносится Приложение целиком Только протестированные модули Задачи в Jenkins Отдельные задачи для каждого ПП, требующего отдельного подхода к сборке • Одинаковая задача для каждого модуля (пропуск шагов, если они не требуются) • Одна единая задача для сборки патчей ЗТ/ЗОЭ ЗТ на VM ЗОЭ на реальной машине Средство моделирования БД Не используется Используется Установка и обновление метаданных Нет стандартного подхода. Надо писать ручные скрипты Встроенный инструмент Хранение отчётов и модели Cognos Не хранятся в git Хранятся в git Хранение пакетов обновления Cognos В git В Jenkins
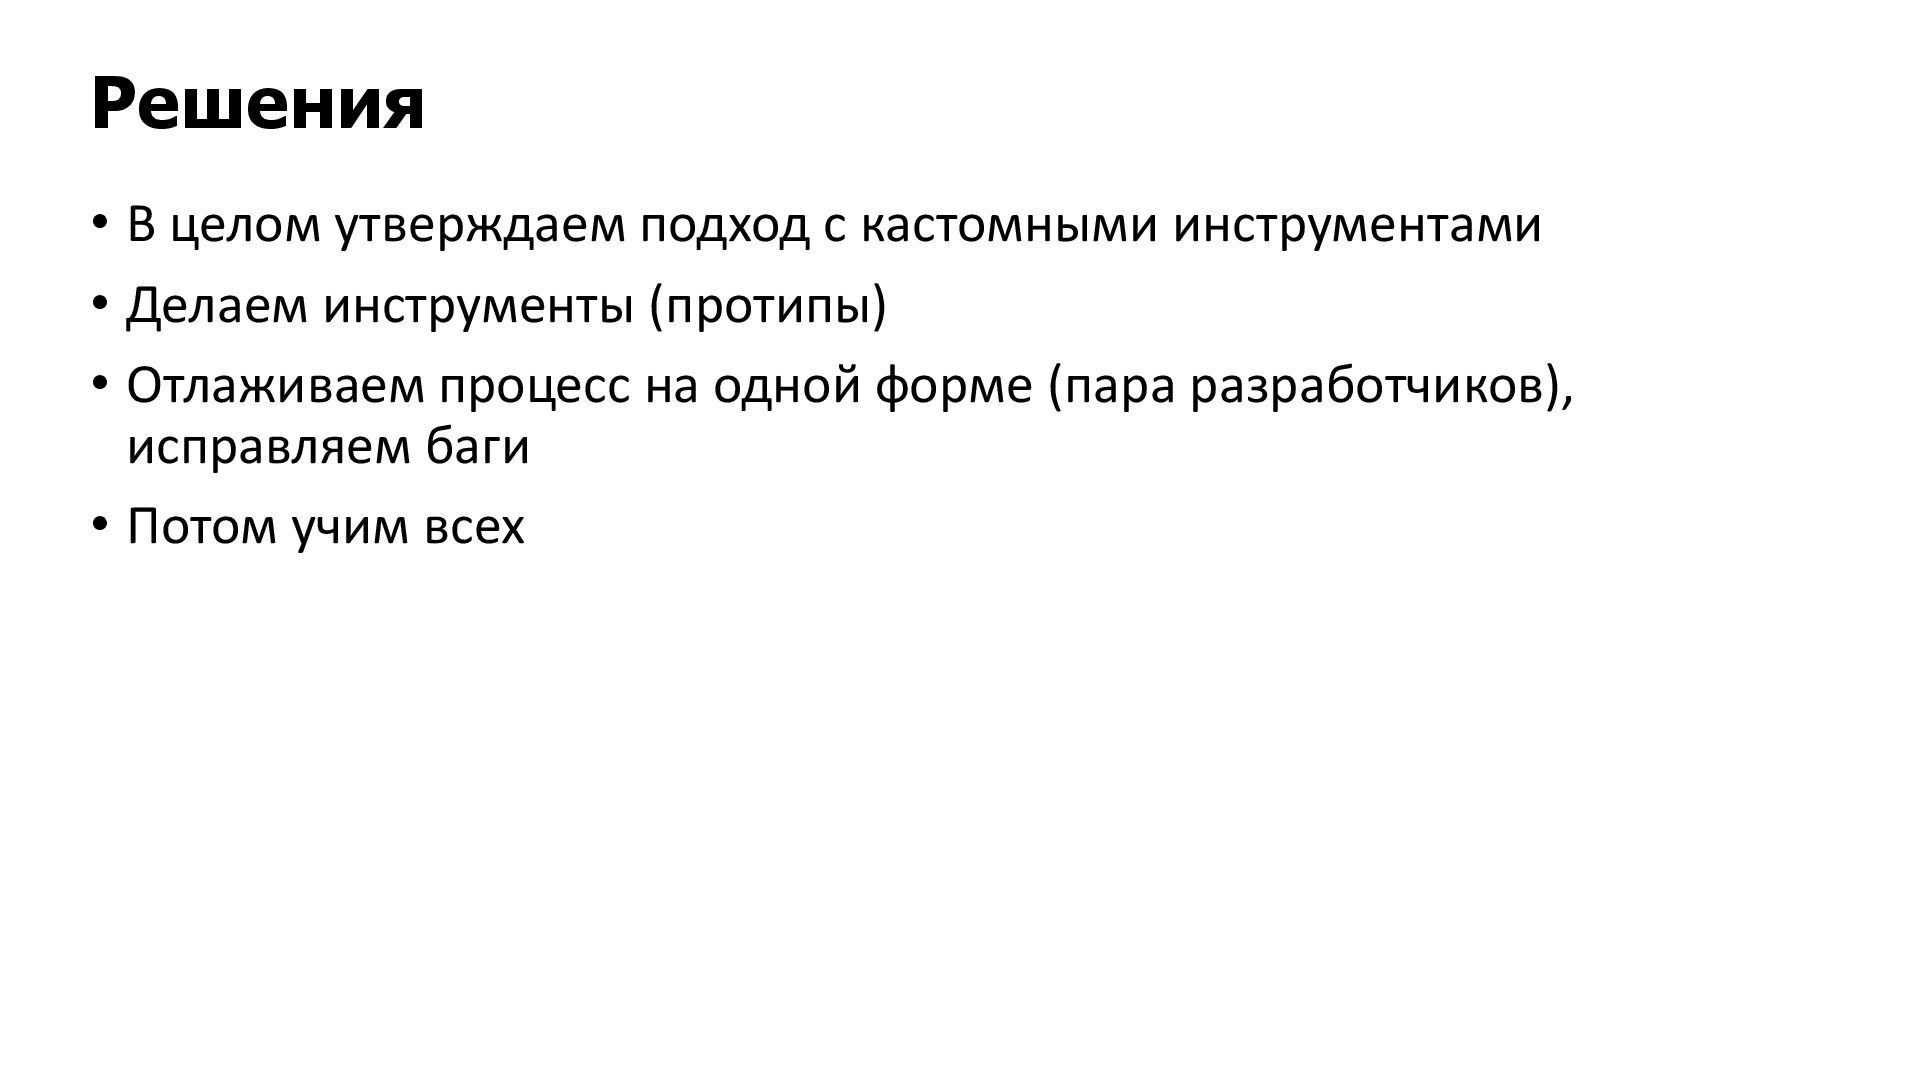
  31. Решения • В целом утверждаем подход с кастомными инструментами •

    Делаем инструменты (протипы) • Отлаживаем процесс на одной форме (пара разработчиков), исправляем баги • Потом учим всех