Upgrade to Pro — share decks privately, control downloads, hide ads and more …

PRML10章前半

Avatar for Ohamu Ohamu
November 10, 2023
200

 PRML10章前半

ゼミの輪講で使った資料
導出部分は他サイト様に委ねている部分が大きいです

Avatar for Ohamu

Ohamu

November 10, 2023

Transcript

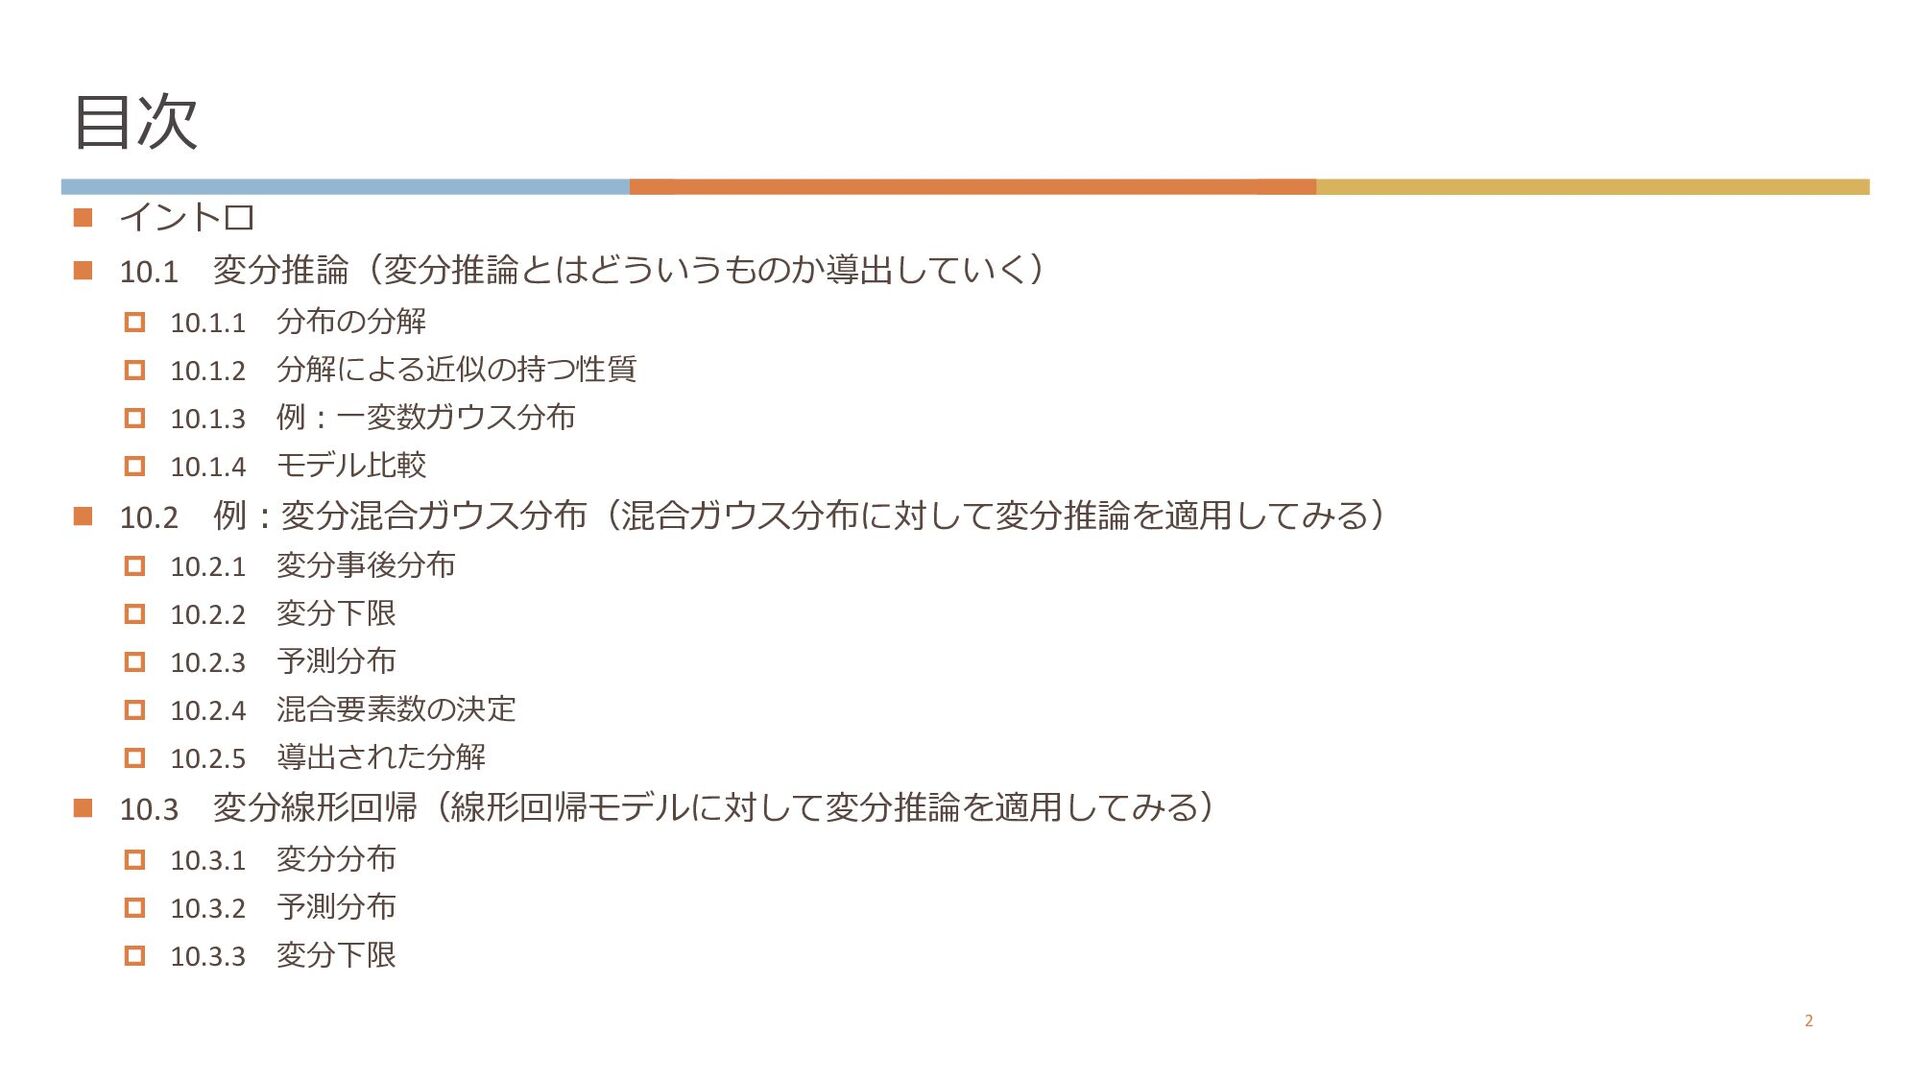
  1. ⽬次 n イントロ n 10.1 変分推論(変分推論とはどういうものか導出していく) p 10.1.1 分布の分解 p

    10.1.2 分解による近似の持つ性質 p 10.1.3 例︓⼀変数ガウス分布 p 10.1.4 モデル⽐較 n 10.2 例︓変分混合ガウス分布(混合ガウス分布に対して変分推論を適⽤してみる) p 10.2.1 変分事後分布 p 10.2.2 変分下限 p 10.2.3 予測分布 p 10.2.4 混合要素数の決定 p 10.2.5 導出された分解 n 10.3 変分線形回帰(線形回帰モデルに対して変分推論を適⽤してみる) p 10.3.1 変分分布 p 10.3.2 予測分布 p 10.3.3 変分下限 2
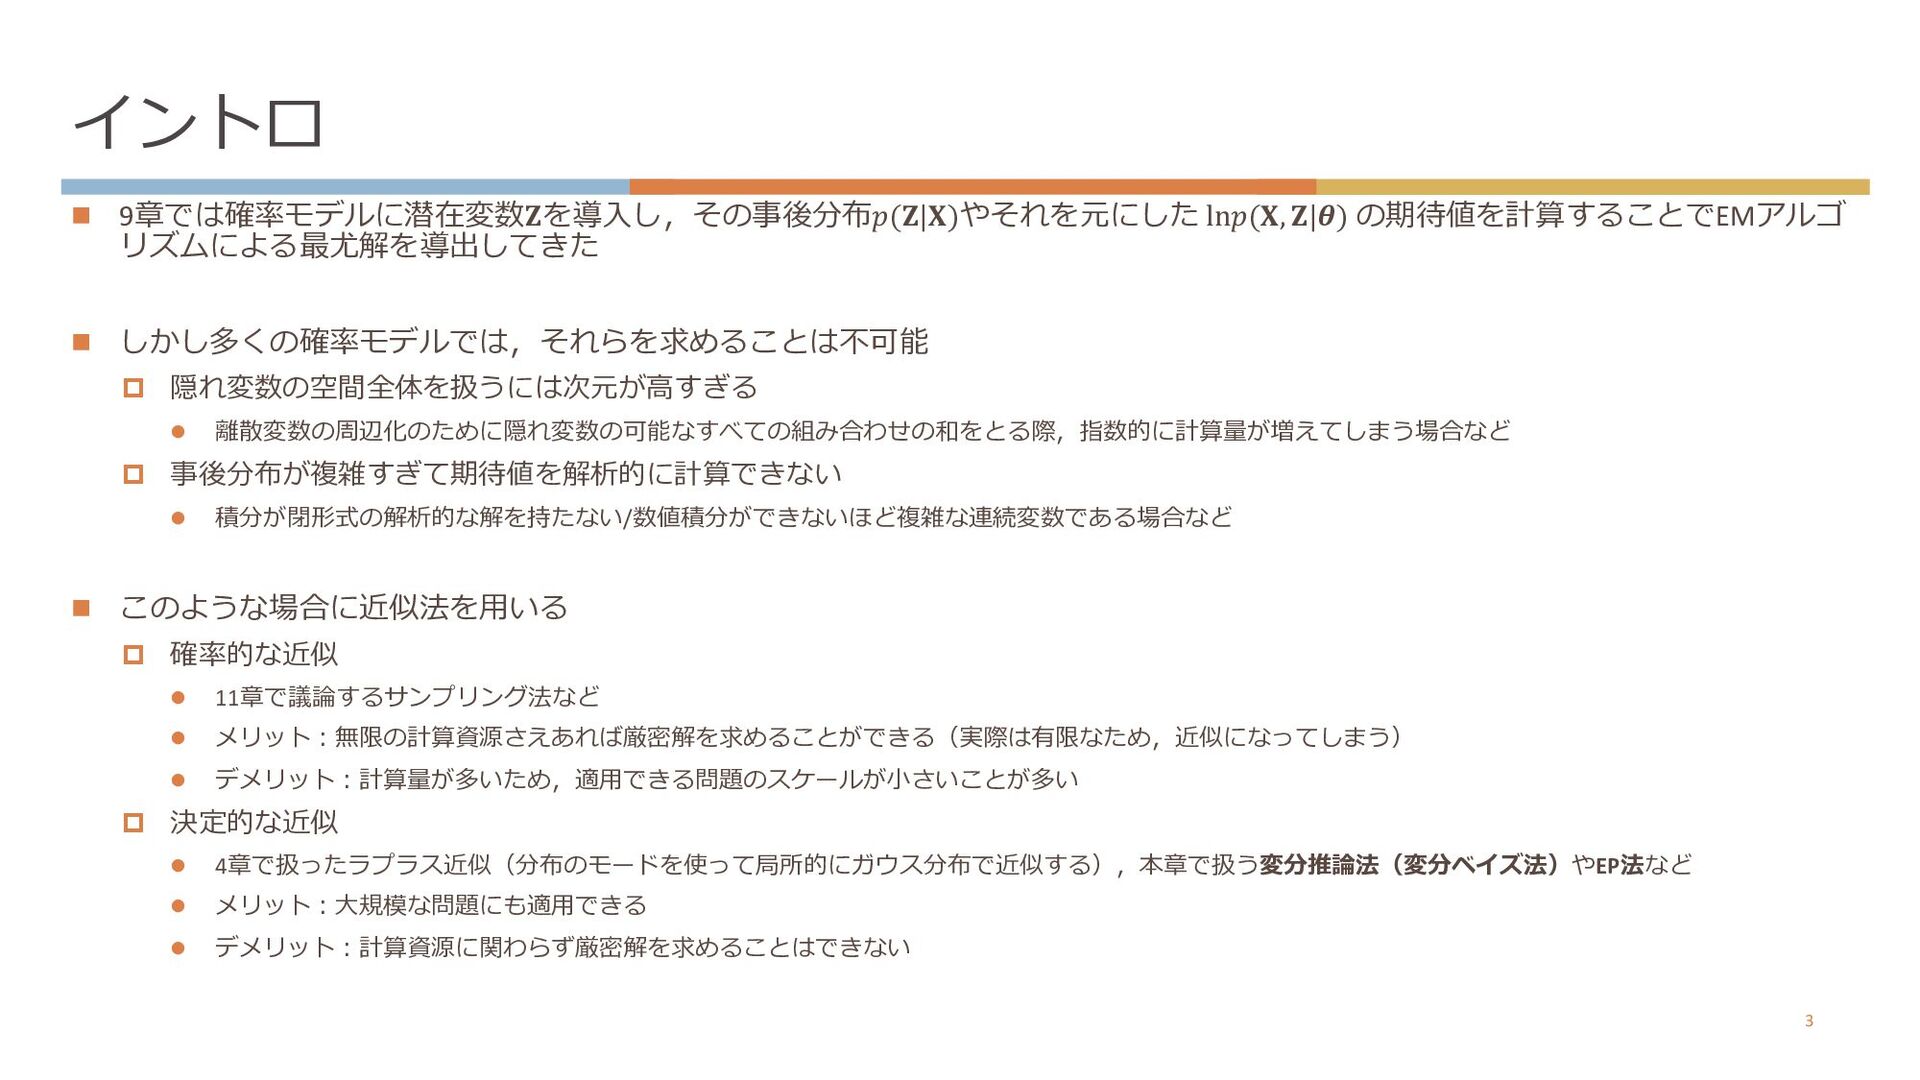
  2. イントロ n 9章では確率モデルに潜在変数𝐙を導⼊し,その事後分布𝑝(𝐙|𝐗)やそれを元にした ln𝑝(𝐗, 𝐙|𝜽) の期待値を計算することでEMアルゴ リズムによる最尤解を導出してきた n しかし多くの確率モデルでは,それらを求めることは不可能 p

    隠れ変数の空間全体を扱うには次元が⾼すぎる l 離散変数の周辺化のために隠れ変数の可能なすべての組み合わせの和をとる際,指数的に計算量が増えてしまう場合など p 事後分布が複雑すぎて期待値を解析的に計算できない l 積分が閉形式の解析的な解を持たない/数値積分ができないほど複雑な連続変数である場合など n このような場合に近似法を⽤いる p 確率的な近似 l 11章で議論するサンプリング法など l メリット︓無限の計算資源さえあれば厳密解を求めることができる(実際は有限なため,近似になってしまう) l デメリット︓計算量が多いため,適⽤できる問題のスケールが⼩さいことが多い p 決定的な近似 l 4章で扱ったラプラス近似(分布のモードを使って局所的にガウス分布で近似する),本章で扱う変分推論法(変分ベイズ法)やEP法など l メリット︓⼤規模な問題にも適⽤できる l デメリット︓計算資源に関わらず厳密解を求めることはできない 3
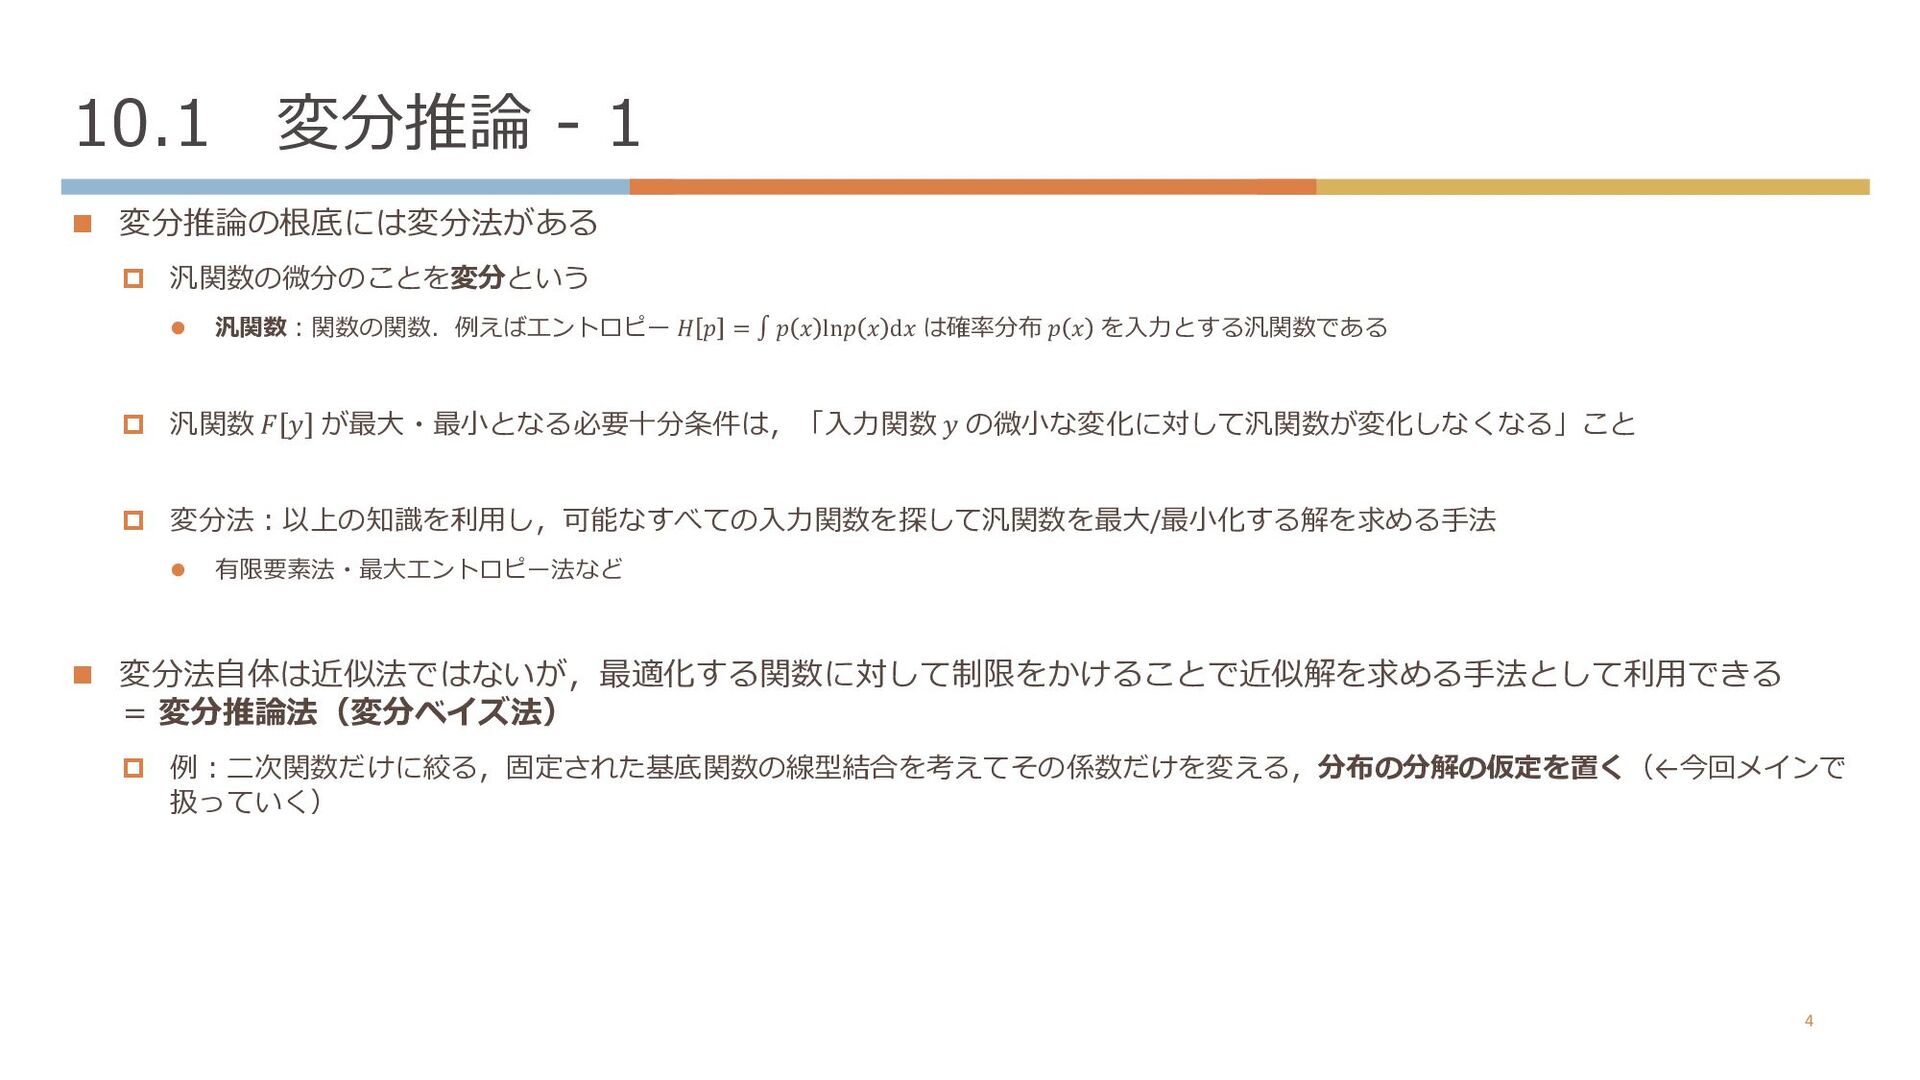
  3. 10.1 変分推論 - 1 n 変分推論の根底には変分法がある p 汎関数の微分のことを変分という l 汎関数︓関数の関数.例えばエントロピー

    𝐻 𝑝 = ∫ 𝑝 𝑥 ln𝑝 𝑥 d𝑥 は確率分布 𝑝 𝑥 を⼊⼒とする汎関数である p 汎関数 𝐹 𝑦 が最⼤・最⼩となる必要⼗分条件は,「⼊⼒関数 𝑦 の微⼩な変化に対して汎関数が変化しなくなる」こと p 変分法︓以上の知識を利⽤し,可能なすべての⼊⼒関数を探して汎関数を最⼤/最⼩化する解を求める⼿法 l 有限要素法・最⼤エントロピー法など n 変分法⾃体は近似法ではないが,最適化する関数に対して制限をかけることで近似解を求める⼿法として利⽤できる = 変分推論法(変分ベイズ法) p 例︓⼆次関数だけに絞る,固定された基底関数の線型結合を考えてその係数だけを変える,分布の分解の仮定を置く(←今回メインで 扱っていく) 4
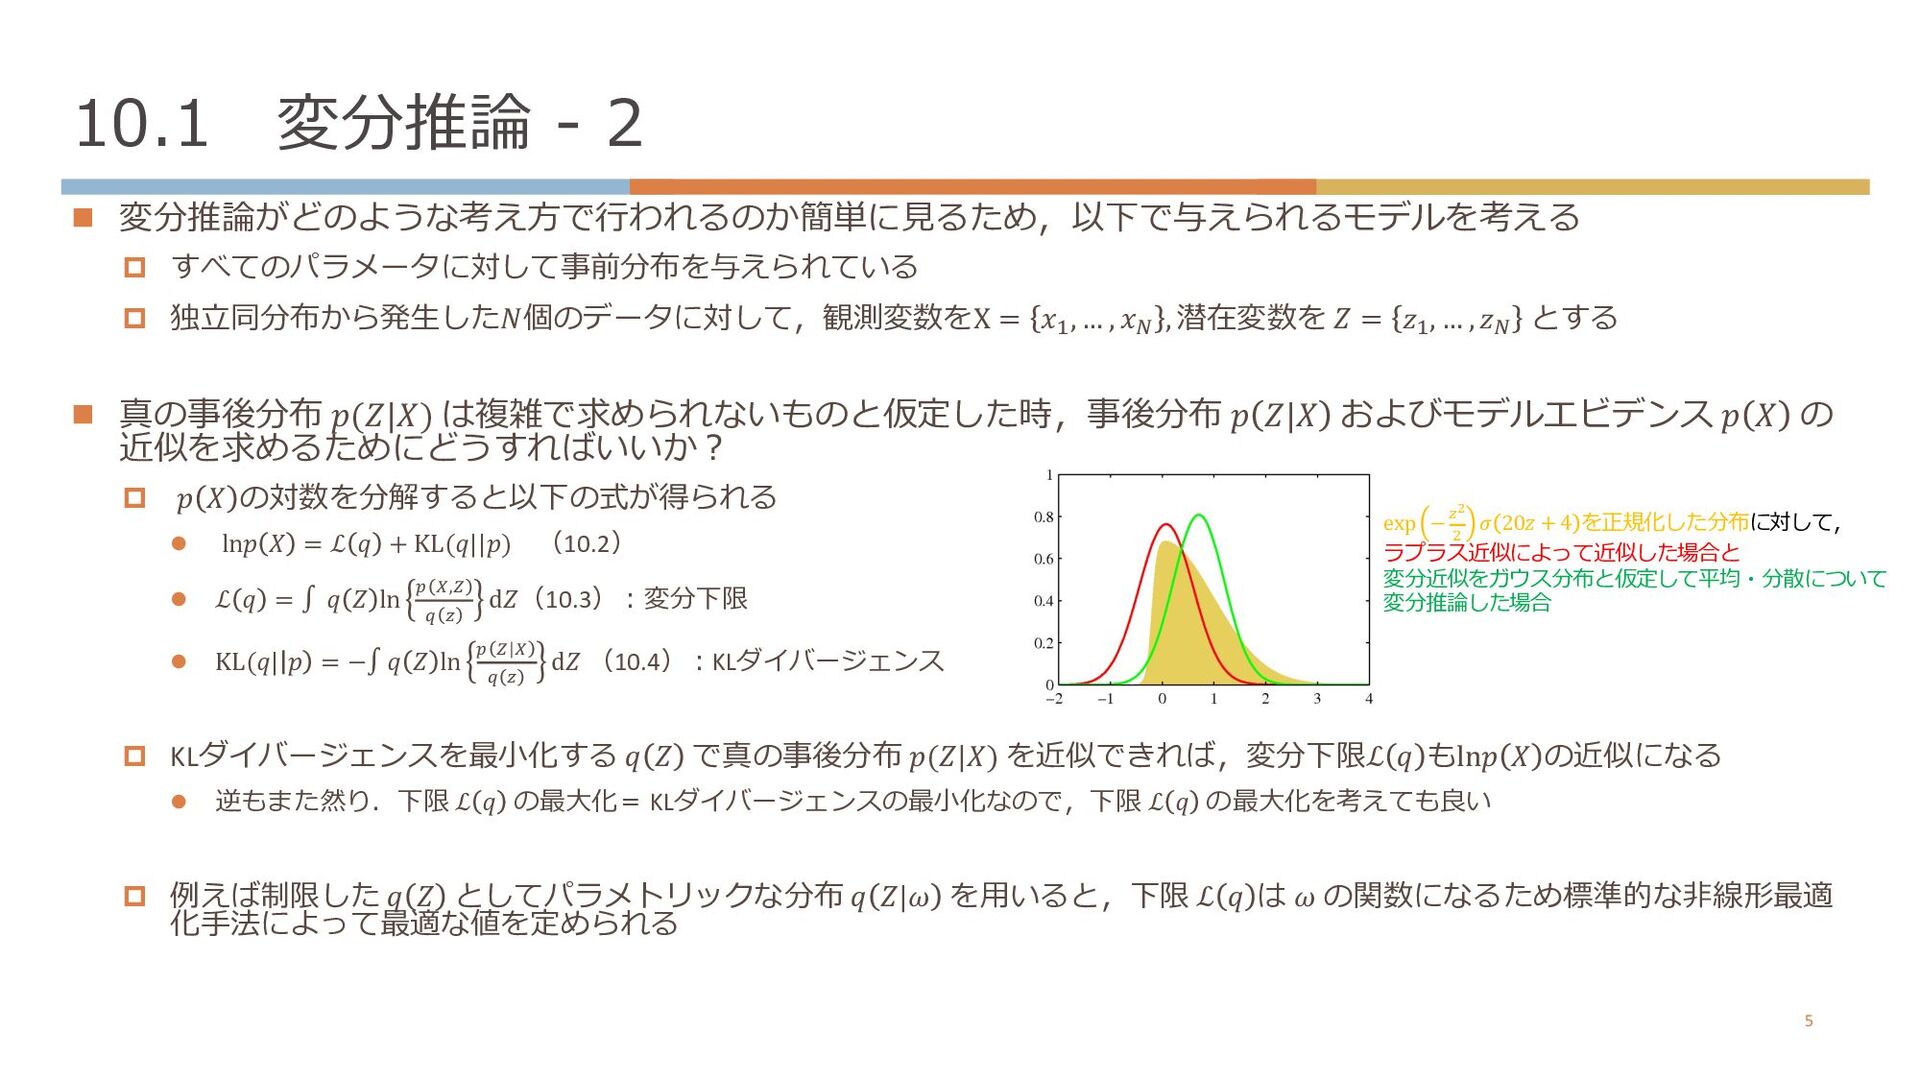
  4. 10.1 変分推論 - 2 n 変分推論がどのような考え⽅で⾏われるのか簡単に⾒るため,以下で与えられるモデルを考える p すべてのパラメータに対して事前分布を与えられている p 独⽴同分布から発⽣した𝑁個のデータに対して,観測変数をX

    = 𝑥! , … , 𝑥" , 潜在変数を 𝑍 = 𝑧! , … , 𝑧" とする n 真の事後分布 𝑝(𝑍|𝑋) は複雑で求められないものと仮定した時,事後分布 𝑝 𝑍|𝑋 およびモデルエビデンス 𝑝 𝑋 の 近似を求めるためにどうすればいいか︖ p 𝑝 𝑋 の対数を分解すると以下の式が得られる l ln𝑝 𝑋 = ℒ 𝑞 + KL(𝑞||𝑝) (10.2) l ℒ 𝑞 = ∫ 𝑞 𝑍 ln ! ",$ % & d𝑍(10.3)︓変分下限 l KL(𝑞| 𝑝 = −∫ 𝑞 𝑍 ln ! $|" % & d𝑍 (10.4)︓KLダイバージェンス p KLダイバージェンスを最⼩化する 𝑞 𝑍 で真の事後分布 𝑝(𝑍|𝑋) を近似できれば,変分下限ℒ 𝑞 もln𝑝 𝑋 の近似になる l 逆もまた然り.下限 ℒ 𝑞 の最⼤化= KLダイバージェンスの最⼩化なので,下限 ℒ 𝑞 の最⼤化を考えても良い p 例えば制限した 𝑞 𝑍 としてパラメトリックな分布 𝑞 𝑍|𝜔 を⽤いると,下限 ℒ 𝑞 は 𝜔 の関数になるため標準的な⾮線形最適 化⼿法によって最適な値を定められる 5 exp −!! " 𝜎 20𝑧 + 4 を正規化した分布に対して, ラプラス近似によって近似した場合と 変分近似をガウス分布と仮定して平均・分散について 変分推論した場合
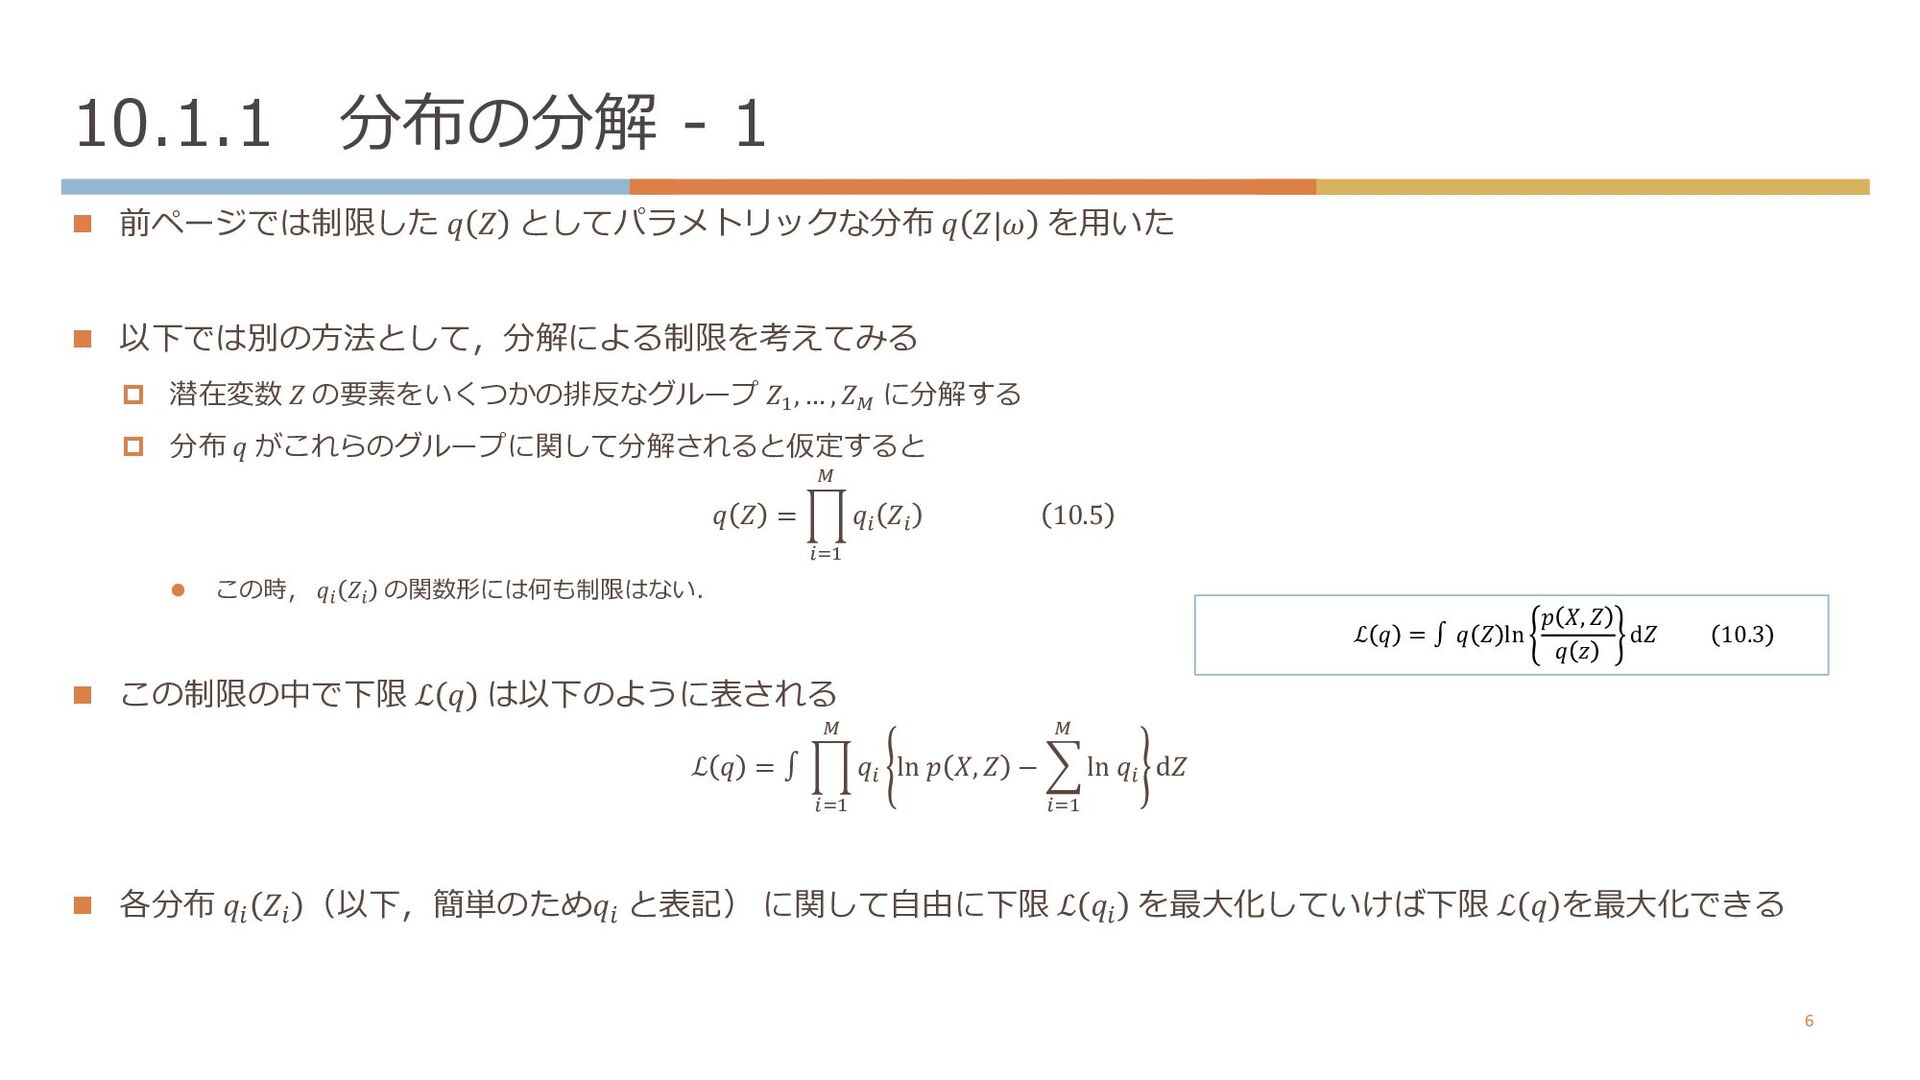
  5. 10.1.1 分布の分解 - 1 6 n 前ページでは制限した 𝑞 𝑍 としてパラメトリックな分布

    𝑞 𝑍|𝜔 を⽤いた n 以下では別の⽅法として,分解による制限を考えてみる p 潜在変数 𝑍 の要素をいくつかの排反なグループ 𝑍! , … , 𝑍" に分解する p 分布 𝑞 がこれらのグループに関して分解されると仮定すると 𝑞 𝑍 = ( #$! " 𝑞# 𝑍# 10.5 l この時, 𝑞( 𝑍( の関数形には何も制限はない. n この制限の中で下限 ℒ 𝑞 は以下のように表される ℒ 𝑞 = ∫ ( #$! " 𝑞# ln 𝑝 𝑋, 𝑍 − 4 #$! " ln 𝑞# d𝑍 n 各分布 𝑞+ 𝑍+ (以下,簡単のため𝑞+ と表記) に関して⾃由に下限 ℒ 𝑞+ を最⼤化していけば下限 ℒ 𝑞 を最⼤化できる ℒ 𝑞 = ∫ 𝑞 𝑍 ln 𝑝 𝑋, 𝑍 𝑞 𝑧 d𝑍 10.3
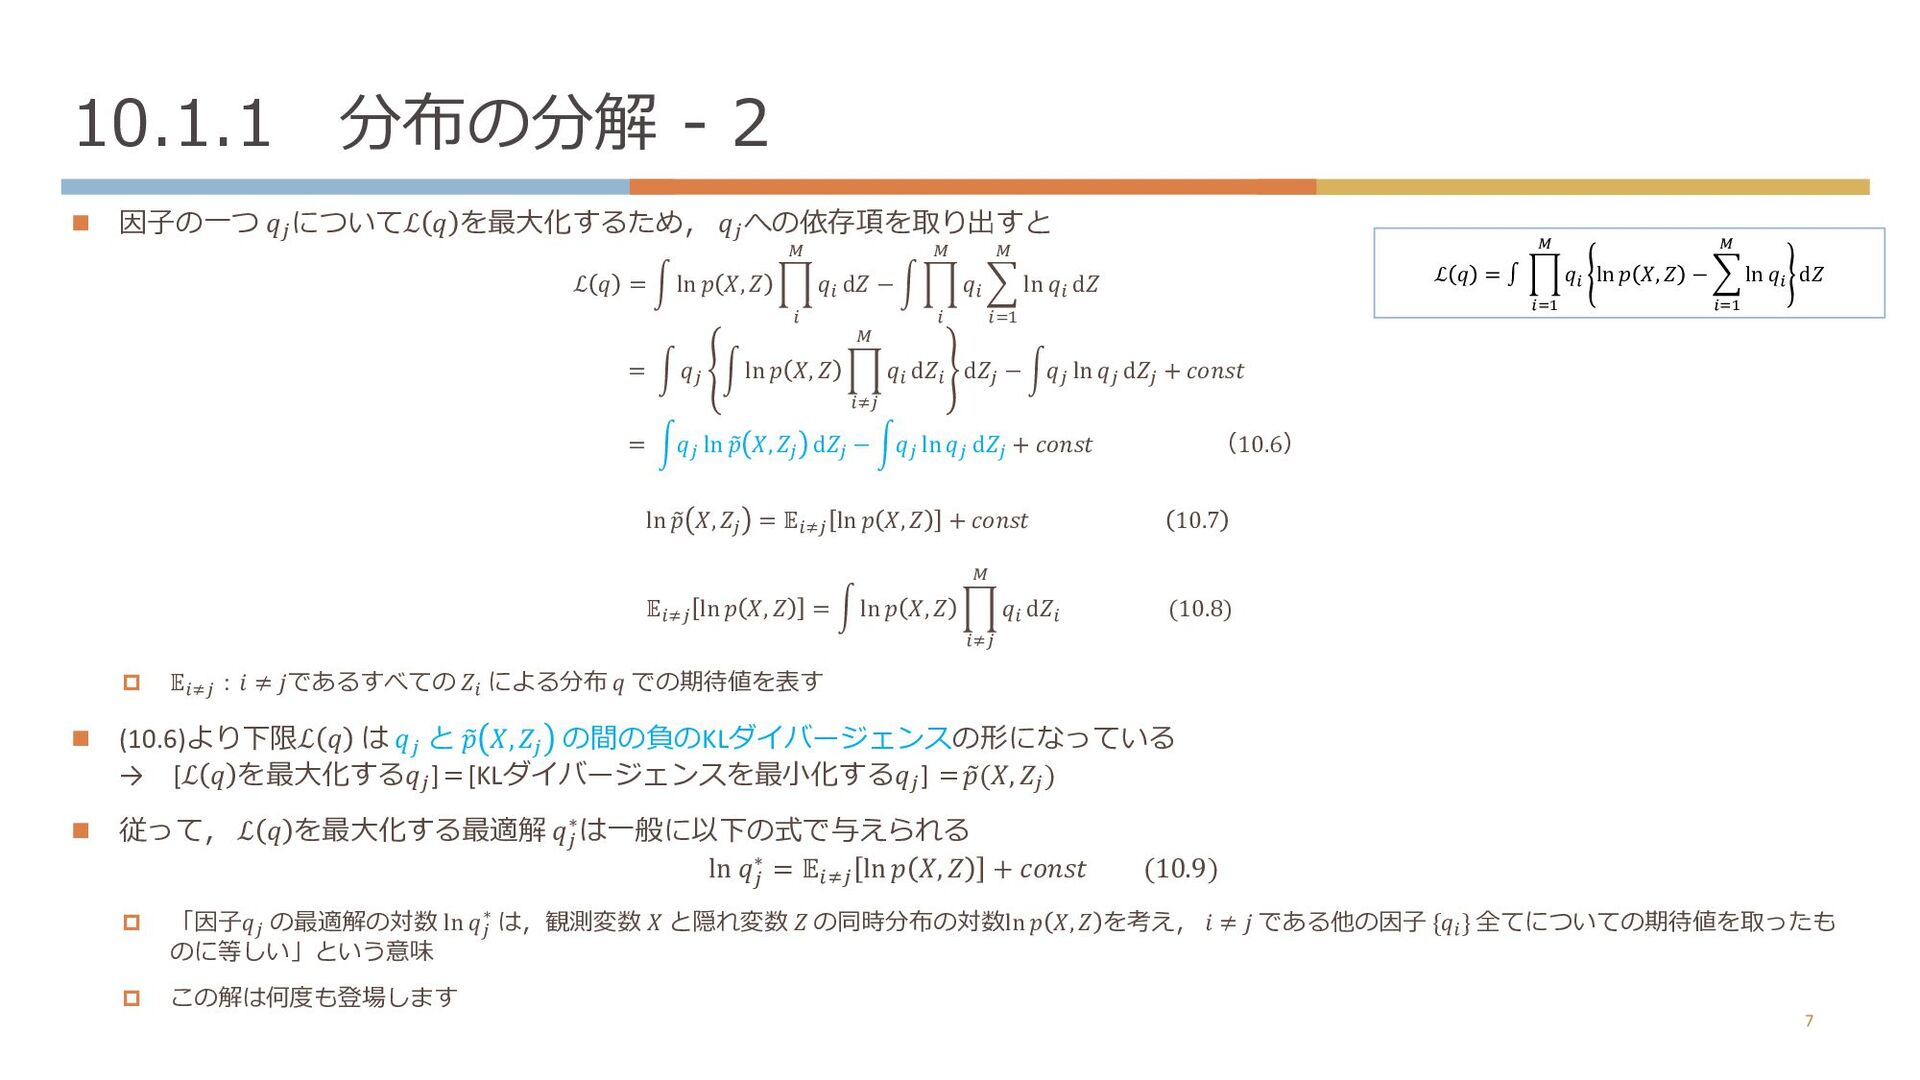
  6. 10.1.1 分布の分解 - 2 n 因⼦の⼀つ 𝑞% についてℒ 𝑞 を最⼤化するため,

    𝑞% への依存項を取り出すと ℒ 𝑞 = 4 ln 𝑝 𝑋, 𝑍 5 ( ) 𝑞( d𝑍 − 4 5 ( ) 𝑞( 7 (*+ ) ln 𝑞( d𝑍 = 4 𝑞, 4 ln 𝑝 𝑋, 𝑍 5 (-, ) 𝑞( d𝑍( d𝑍, − 4𝑞, ln 𝑞, d𝑍, + 𝑐𝑜𝑛𝑠𝑡 = 4𝑞, ln > 𝑝 𝑋, 𝑍, d𝑍, − 4𝑞, ln 𝑞, d𝑍, + 𝑐𝑜𝑛𝑠𝑡 (10.6) ln > 𝑝 𝑋, 𝑍, = 𝔼(-, ln 𝑝 𝑋, 𝑍 + 𝑐𝑜𝑛𝑠𝑡 10.7 𝔼(-, ln 𝑝 𝑋, 𝑍 = 4 ln 𝑝 𝑋, 𝑍 5 (-, ) 𝑞( d𝑍( (10.8) p 𝔼(-, :𝑖 ≠ 𝑗であるすべての 𝑍( による分布 𝑞 での期待値を表す n (10.6)より下限ℒ 𝑞 は 𝑞% と 6 𝑝 𝑋, 𝑍% の間の負のKLダイバージェンスの形になっている → [ℒ 𝑞 を最⼤化する𝑞%]=[KLダイバージェンスを最⼩化する𝑞%] = 6 𝑝(𝑋, 𝑍% ) n 従って, ℒ 𝑞 を最⼤化する最適解 𝑞% ∗は⼀般に以下の式で与えられる ln 𝑞% ∗ = 𝔼#'% ln 𝑝 𝑋, 𝑍 + 𝑐𝑜𝑛𝑠𝑡 (10.9) p 「因⼦𝑞, の最適解の対数 ln 𝑞, ∗ は,観測変数 𝑋 と隠れ変数 𝑍 の同時分布の対数ln 𝑝 𝑋, 𝑍 を考え, 𝑖 ≠ 𝑗 である他の因⼦ {𝑞(} 全てについての期待値を取ったも のに等しい」という意味 p この解は何度も登場します 7 ℒ 𝑞 = ∫ 1 #$% & 𝑞# ln 𝑝 𝑋, 𝑍 − 8 #$% & ln 𝑞# d𝑍
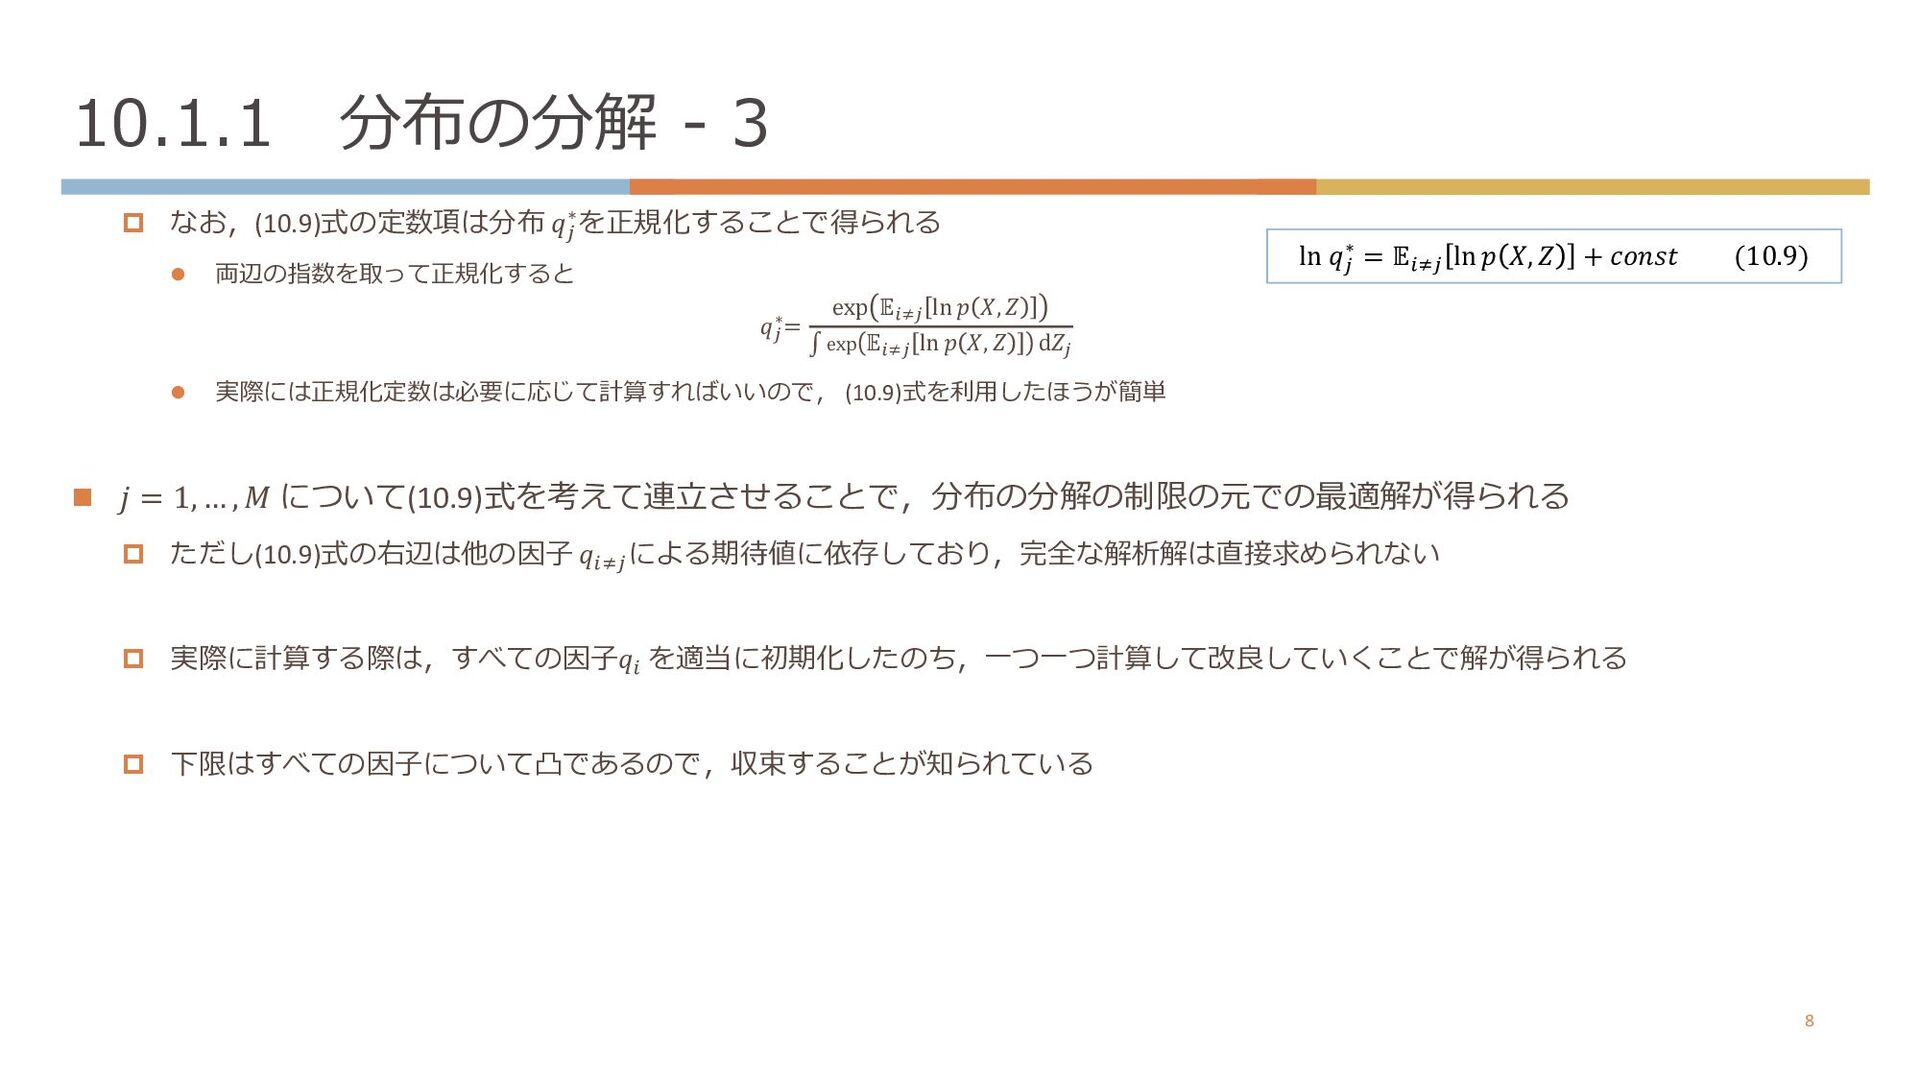
  7. 10.1.1 分布の分解 - 3 p なお,(10.9)式の定数項は分布 𝑞% ∗を正規化することで得られる l 両辺の指数を取って正規化すると

    𝑞, ∗= exp 𝔼(-, ln 𝑝 𝑋, 𝑍 ∫ exp 𝔼(-, ln 𝑝 𝑋, 𝑍 d𝑍, l 実際には正規化定数は必要に応じて計算すればいいので, (10.9)式を利⽤したほうが簡単 n 𝑗 = 1, … , 𝑀 について(10.9)式を考えて連⽴させることで,分布の分解の制限の元での最適解が得られる p ただし(10.9)式の右辺は他の因⼦ 𝑞#'% による期待値に依存しており,完全な解析解は直接求められない p 実際に計算する際は,すべての因⼦𝑞# を適当に初期化したのち,⼀つ⼀つ計算して改良していくことで解が得られる p 下限はすべての因⼦について凸であるので,収束することが知られている 8 ln 𝑞% ∗ = 𝔼#'% ln 𝑝 𝑋, 𝑍 + 𝑐𝑜𝑛𝑠𝑡 (10.9)
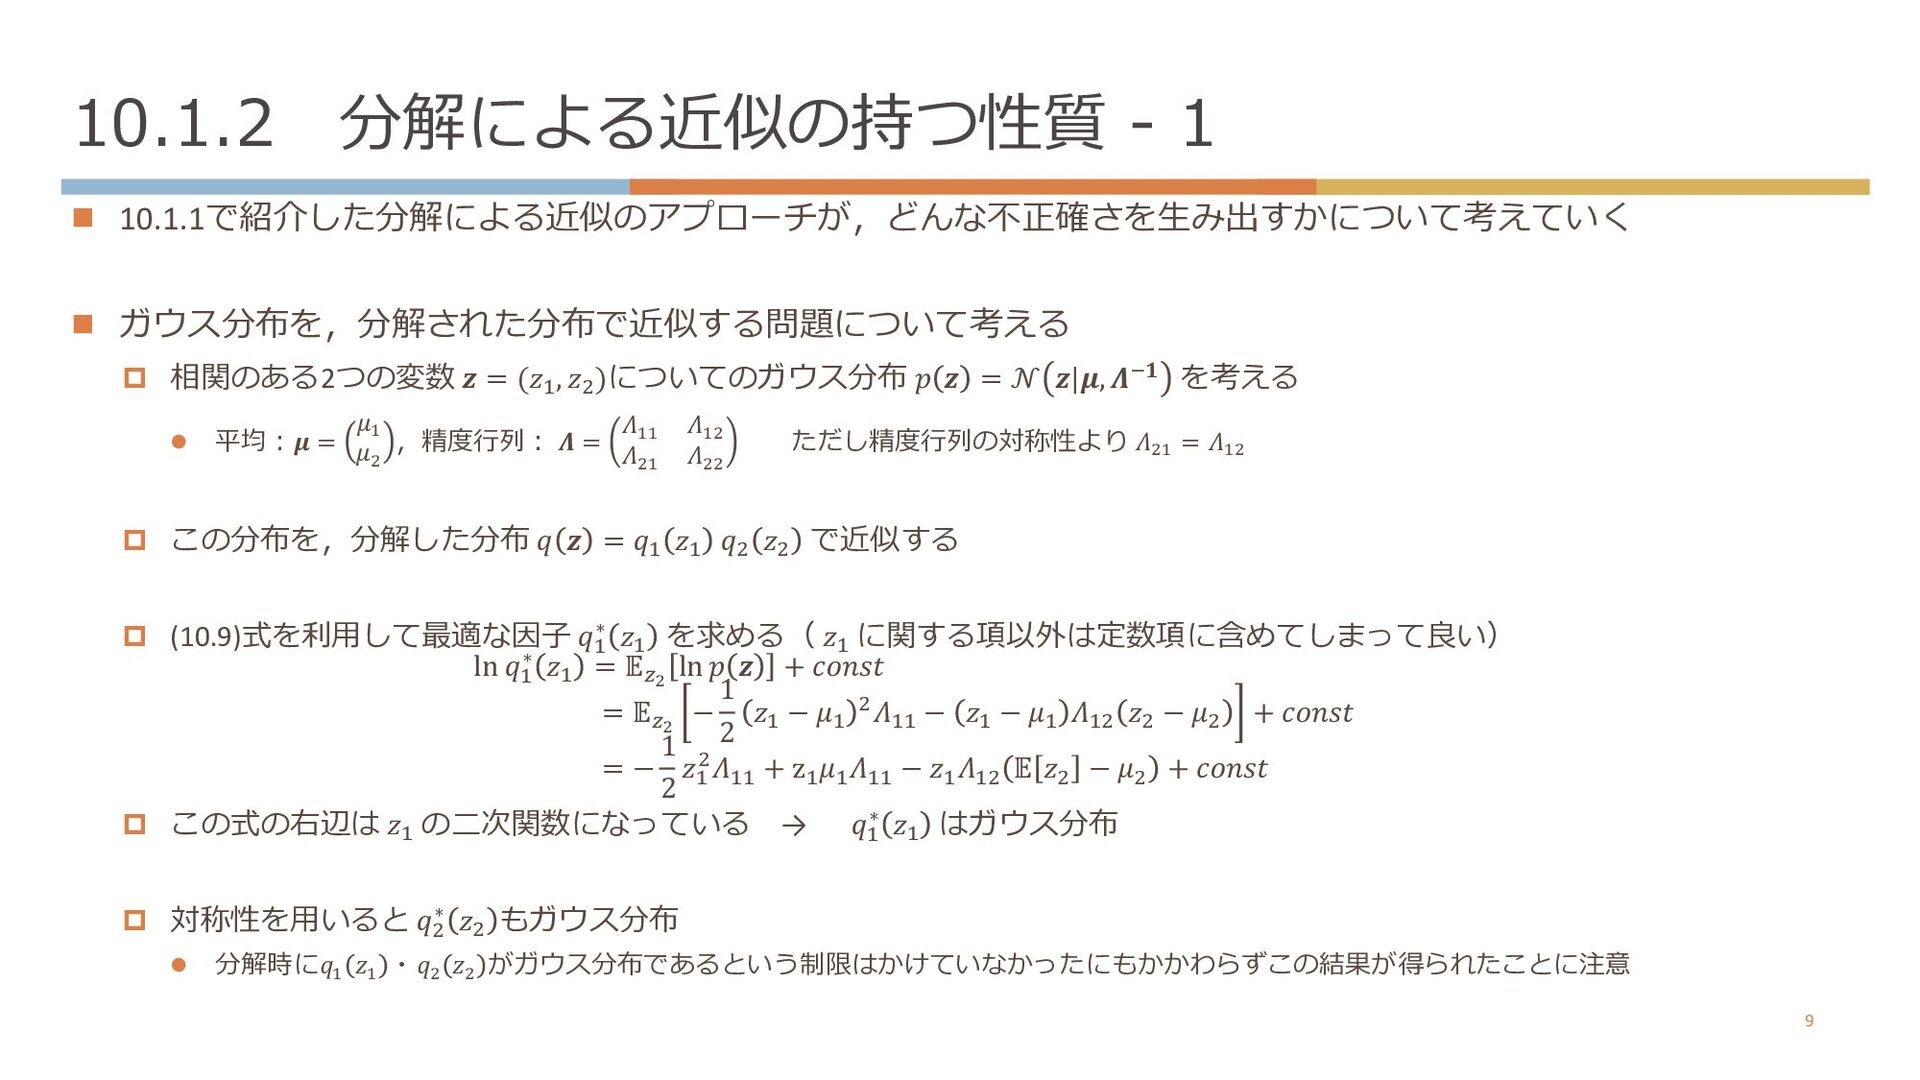
  8. 10.1.2 分解による近似の持つ性質 - 1 n 10.1.1で紹介した分解による近似のアプローチが,どんな不正確さを⽣み出すかについて考えていく n ガウス分布を,分解された分布で近似する問題について考える p 相関のある2つの変数

    𝒛 = (𝑧! , 𝑧: )についてのガウス分布 𝑝 𝒛 = 𝒩 𝒛|𝝁, 𝜦;𝟏 を考える l 平均︓𝝁 = 𝜇+ 𝜇/ ,精度⾏列︓ 𝜦 = 𝛬++ 𝛬+/ 𝛬/+ 𝛬// ただし精度⾏列の対称性より 𝛬/+ = 𝛬+/ p この分布を,分解した分布 𝑞 𝒛 = 𝑞! 𝑧! 𝑞: 𝑧: で近似する p (10.9)式を利⽤して最適な因⼦ 𝑞! ∗ 𝑧! を求める( 𝑧! に関する項以外は定数項に含めてしまって良い) ln 𝑞! ∗ 𝑧! = 𝔼>0 ln 𝑝 𝒛 + 𝑐𝑜𝑛𝑠𝑡 = 𝔼>0 − 1 2 𝑧! − 𝜇! :𝛬!! − 𝑧! − 𝜇! 𝛬!: 𝑧: − 𝜇: + 𝑐𝑜𝑛𝑠𝑡 = − 1 2 𝑧! :𝛬!! + z! 𝜇! 𝛬!! − 𝑧! 𝛬!: 𝔼 𝑧: − 𝜇: + 𝑐𝑜𝑛𝑠𝑡 p この式の右辺は 𝑧! の⼆次関数になっている → 𝑞! ∗ 𝑧! はガウス分布 p 対称性を⽤いると 𝑞: ∗ 𝑧: もガウス分布 l 分解時に𝑞+ 𝑧+ ・𝑞/ 𝑧/ がガウス分布であるという制限はかけていなかったにもかかわらずこの結果が得られたことに注意 9
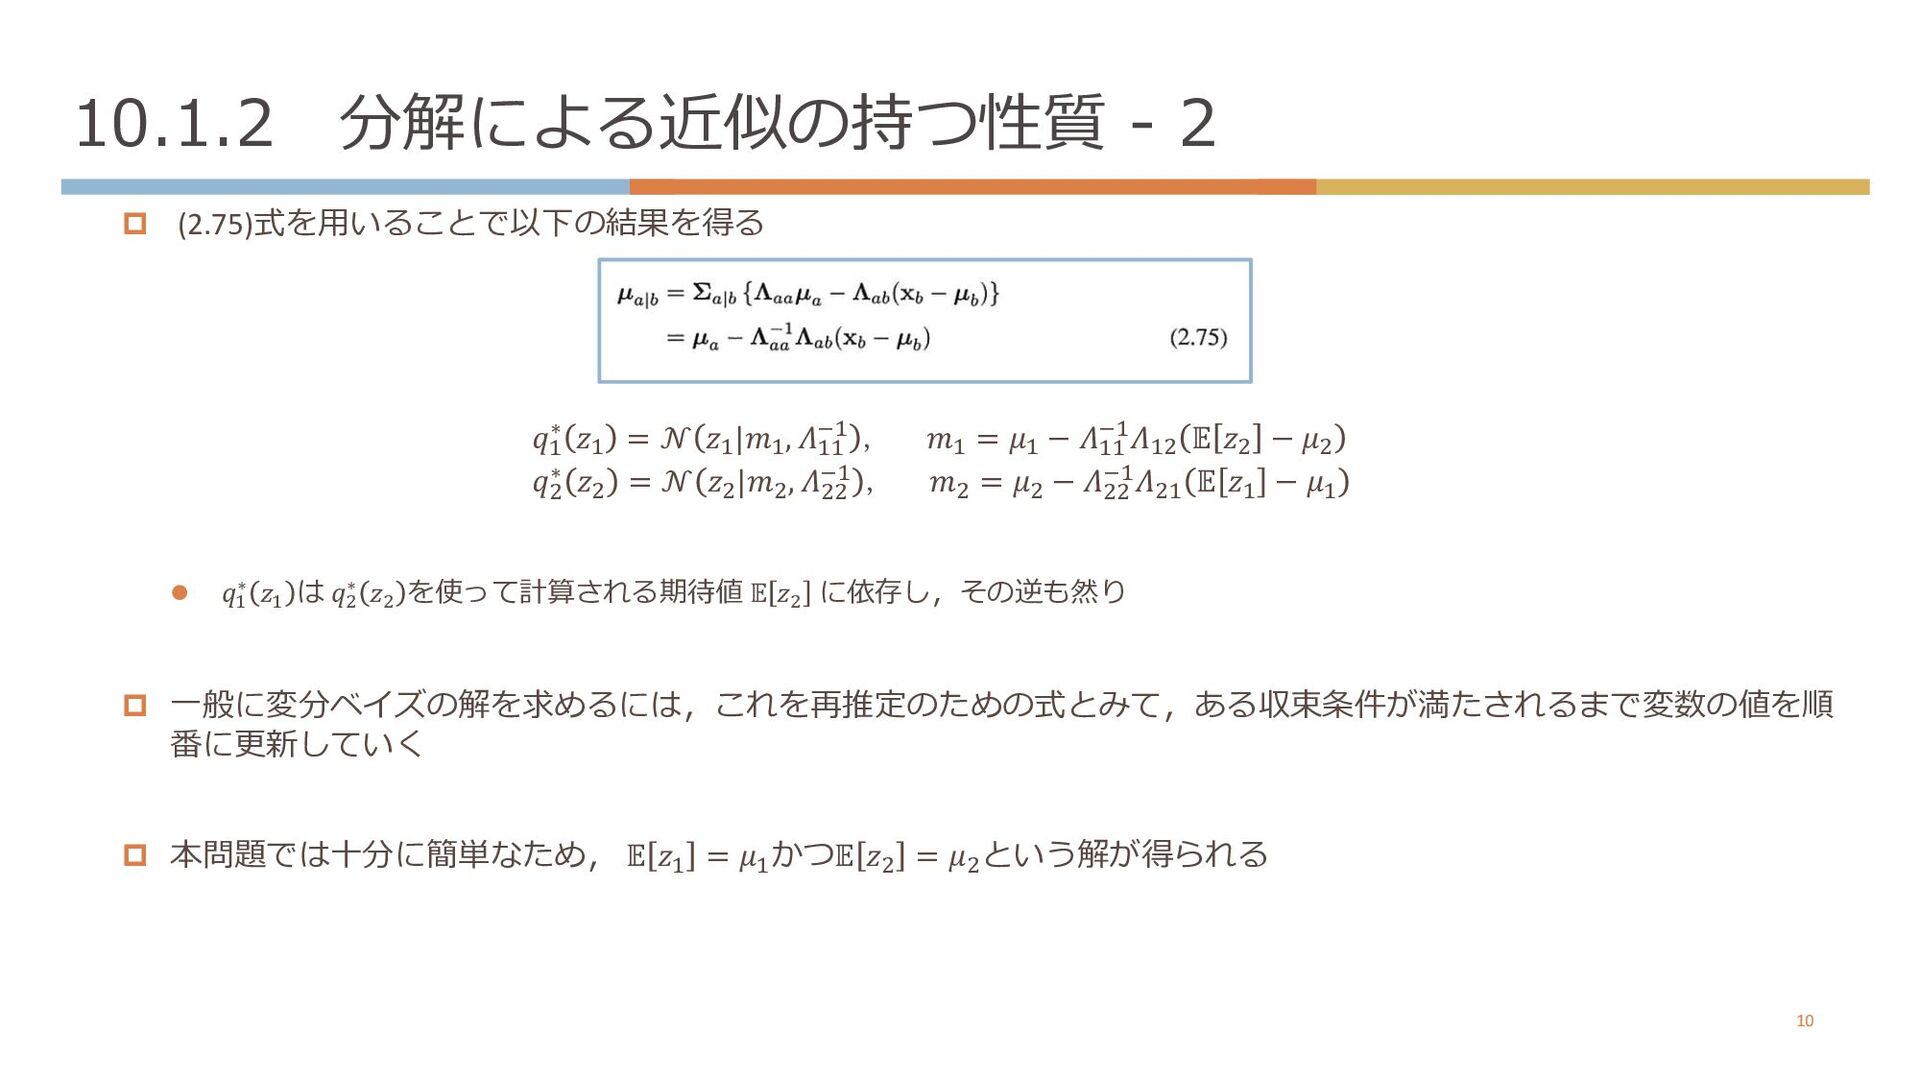
  9. 10.1.2 分解による近似の持つ性質 - 2 p (2.75)式を⽤いることで以下の結果を得る 𝑞M ∗ 𝑧M =

    𝒩 𝑧M|𝑚M, 𝛬MM OM , 𝑚M = 𝜇M − 𝛬MM OM𝛬MP 𝔼 𝑧P − 𝜇P 𝑞P ∗ 𝑧P = 𝒩 𝑧P |𝑚P , 𝛬PP OM , 𝑚P = 𝜇P − 𝛬PP OM𝛬PM 𝔼 𝑧M − 𝜇M l 𝑞! ∗ 𝑧! は 𝑞+ ∗ 𝑧+ を使って計算される期待値 𝔼 𝑧+ に依存し,その逆も然り p ⼀般に変分ベイズの解を求めるには,これを再推定のための式とみて,ある収束条件が満たされるまで変数の値を順 番に更新していく p 本問題では⼗分に簡単なため, 𝔼 𝑧M = 𝜇M かつ𝔼 𝑧P = 𝜇P という解が得られる 10
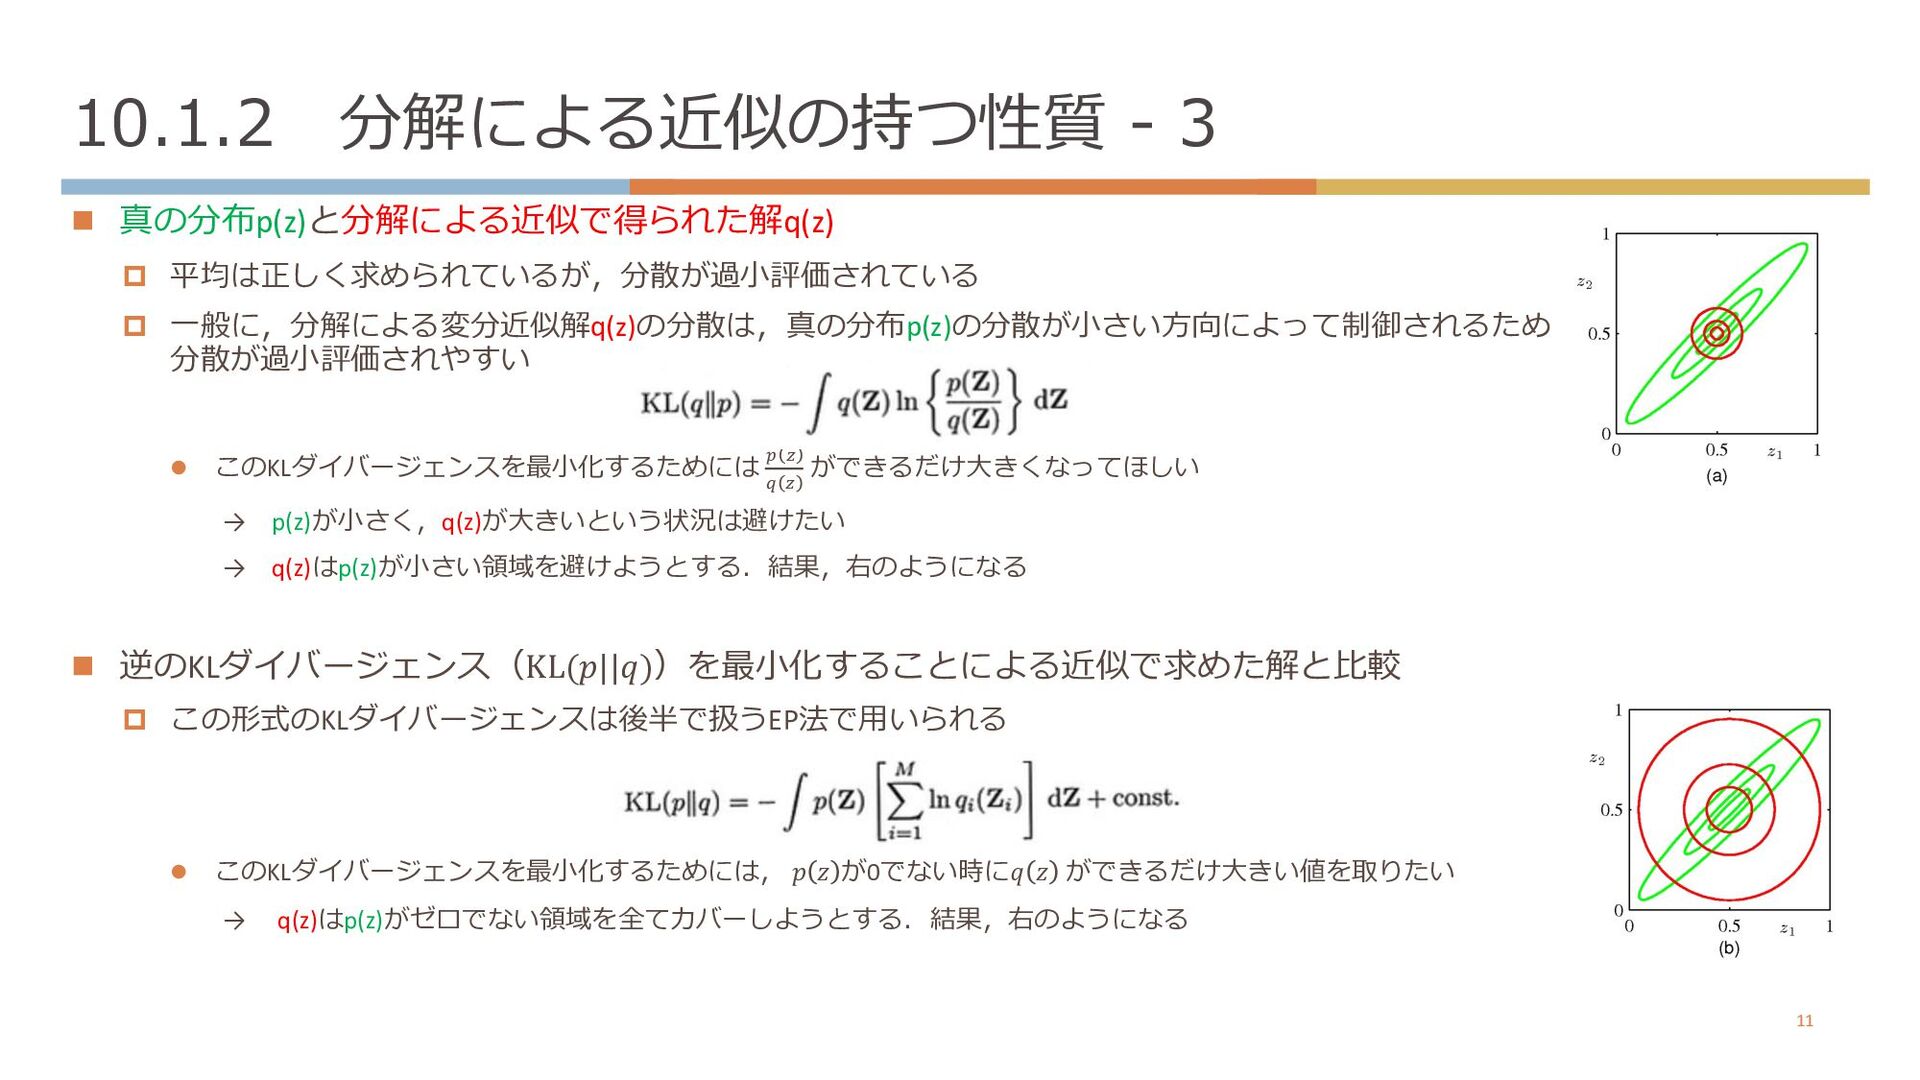
  10. 10.1.2 分解による近似の持つ性質 - 3 n 真の分布p(z)と分解による近似で得られた解q(z) p 平均は正しく求められているが,分散が過⼩評価されている p ⼀般に,分解による変分近似解q(z)の分散は,真の分布p(z)の分散が⼩さい⽅向によって制御されるため

    分散が過⼩評価されやすい l このKLダイバージェンスを最⼩化するためには ! & % & ができるだけ⼤きくなってほしい → p(z)が⼩さく,q(z)が⼤きいという状況は避けたい → q(z)はp(z)が⼩さい領域を避けようとする.結果,右のようになる n 逆のKLダイバージェンス(KL(𝑝||𝑞))を最⼩化することによる近似で求めた解と⽐較 p この形式のKLダイバージェンスは後半で扱うEP法で⽤いられる l このKLダイバージェンスを最⼩化するためには, 𝑝 𝑧 が0でない時に𝑞 𝑧 ができるだけ⼤きい値を取りたい → q(z)はp(z)がゼロでない領域を全てカバーしようとする.結果,右のようになる 11
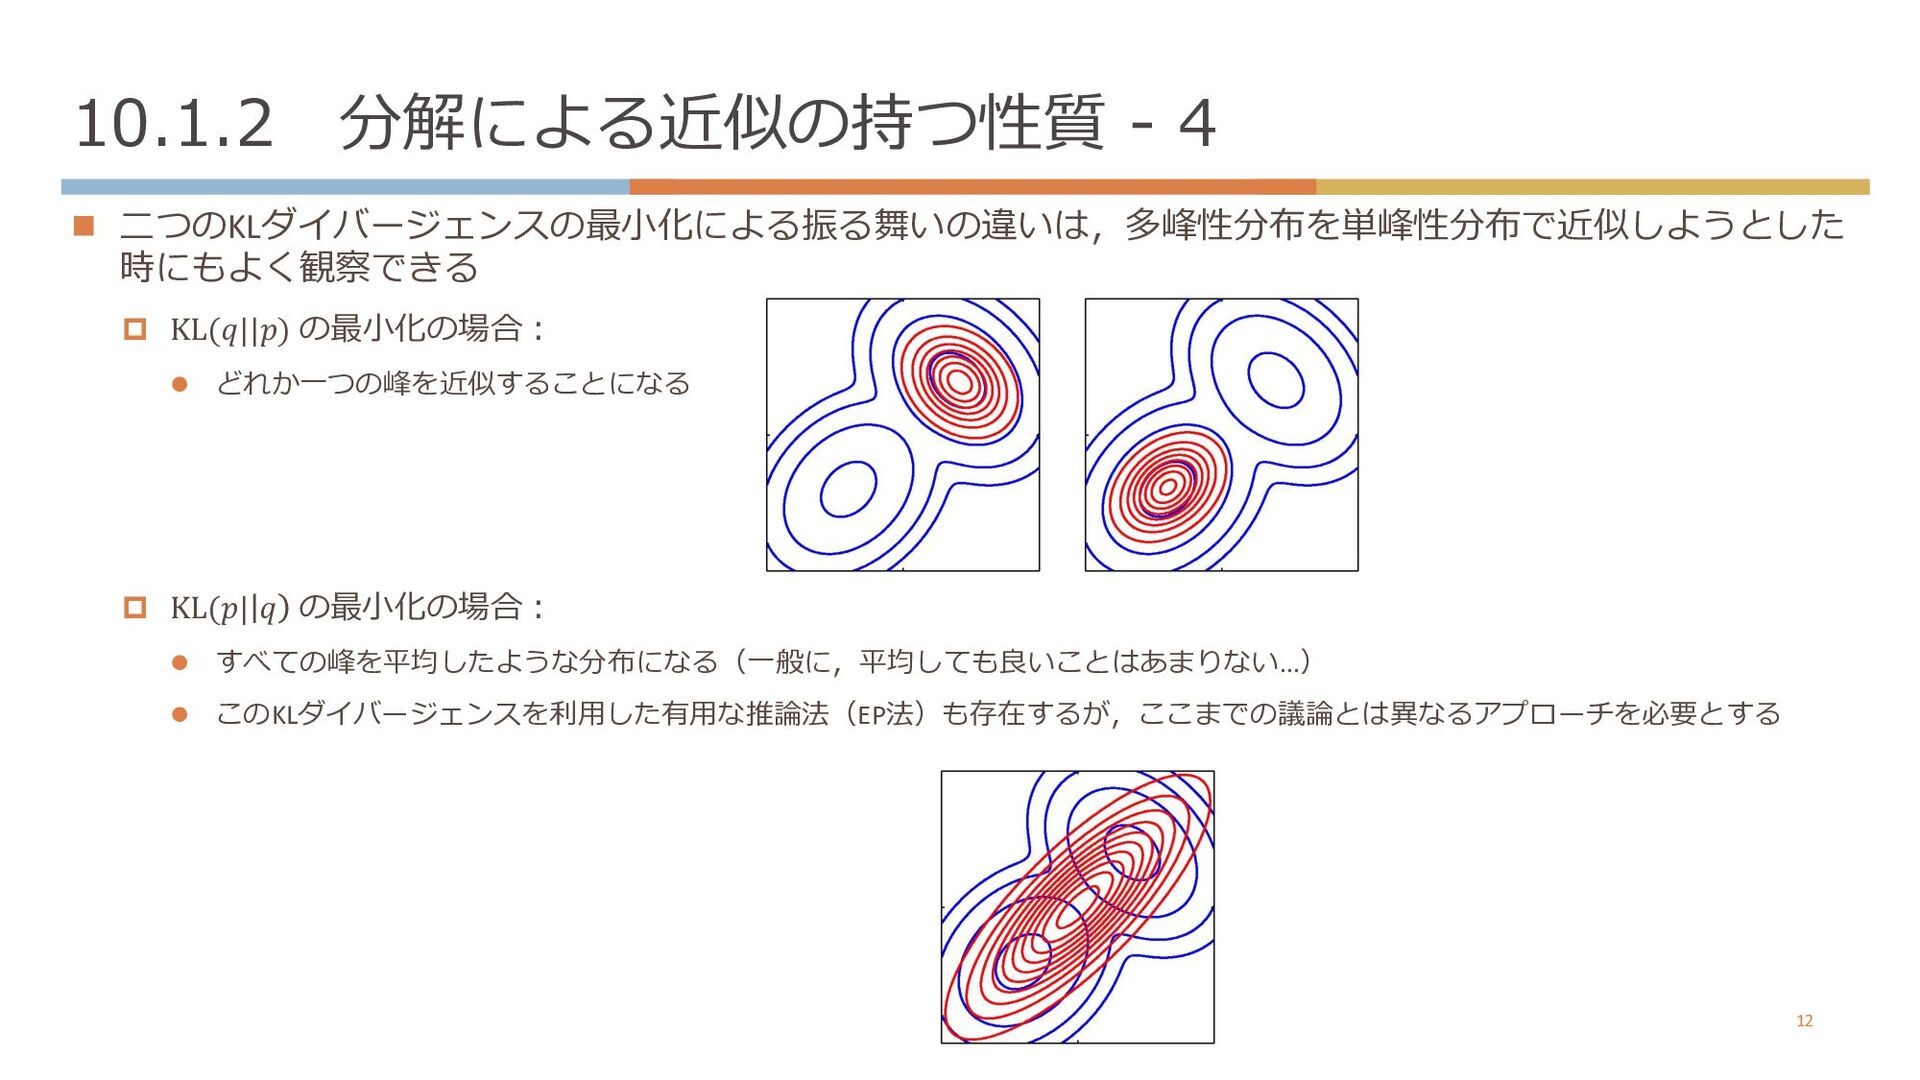
  11. 10.1.2 分解による近似の持つ性質 - 4 n ⼆つのKLダイバージェンスの最⼩化による振る舞いの違いは,多峰性分布を単峰性分布で近似しようとした 時にもよく観察できる p KL(𝑞||𝑝) の最⼩化の場合︓

    l どれか⼀つの峰を近似することになる p KL(𝑝| 𝑞 の最⼩化の場合︓ l すべての峰を平均したような分布になる(⼀般に,平均しても良いことはあまりない...) l このKLダイバージェンスを利⽤した有⽤な推論法(EP法)も存在するが,ここまでの議論とは異なるアプローチを必要とする 12
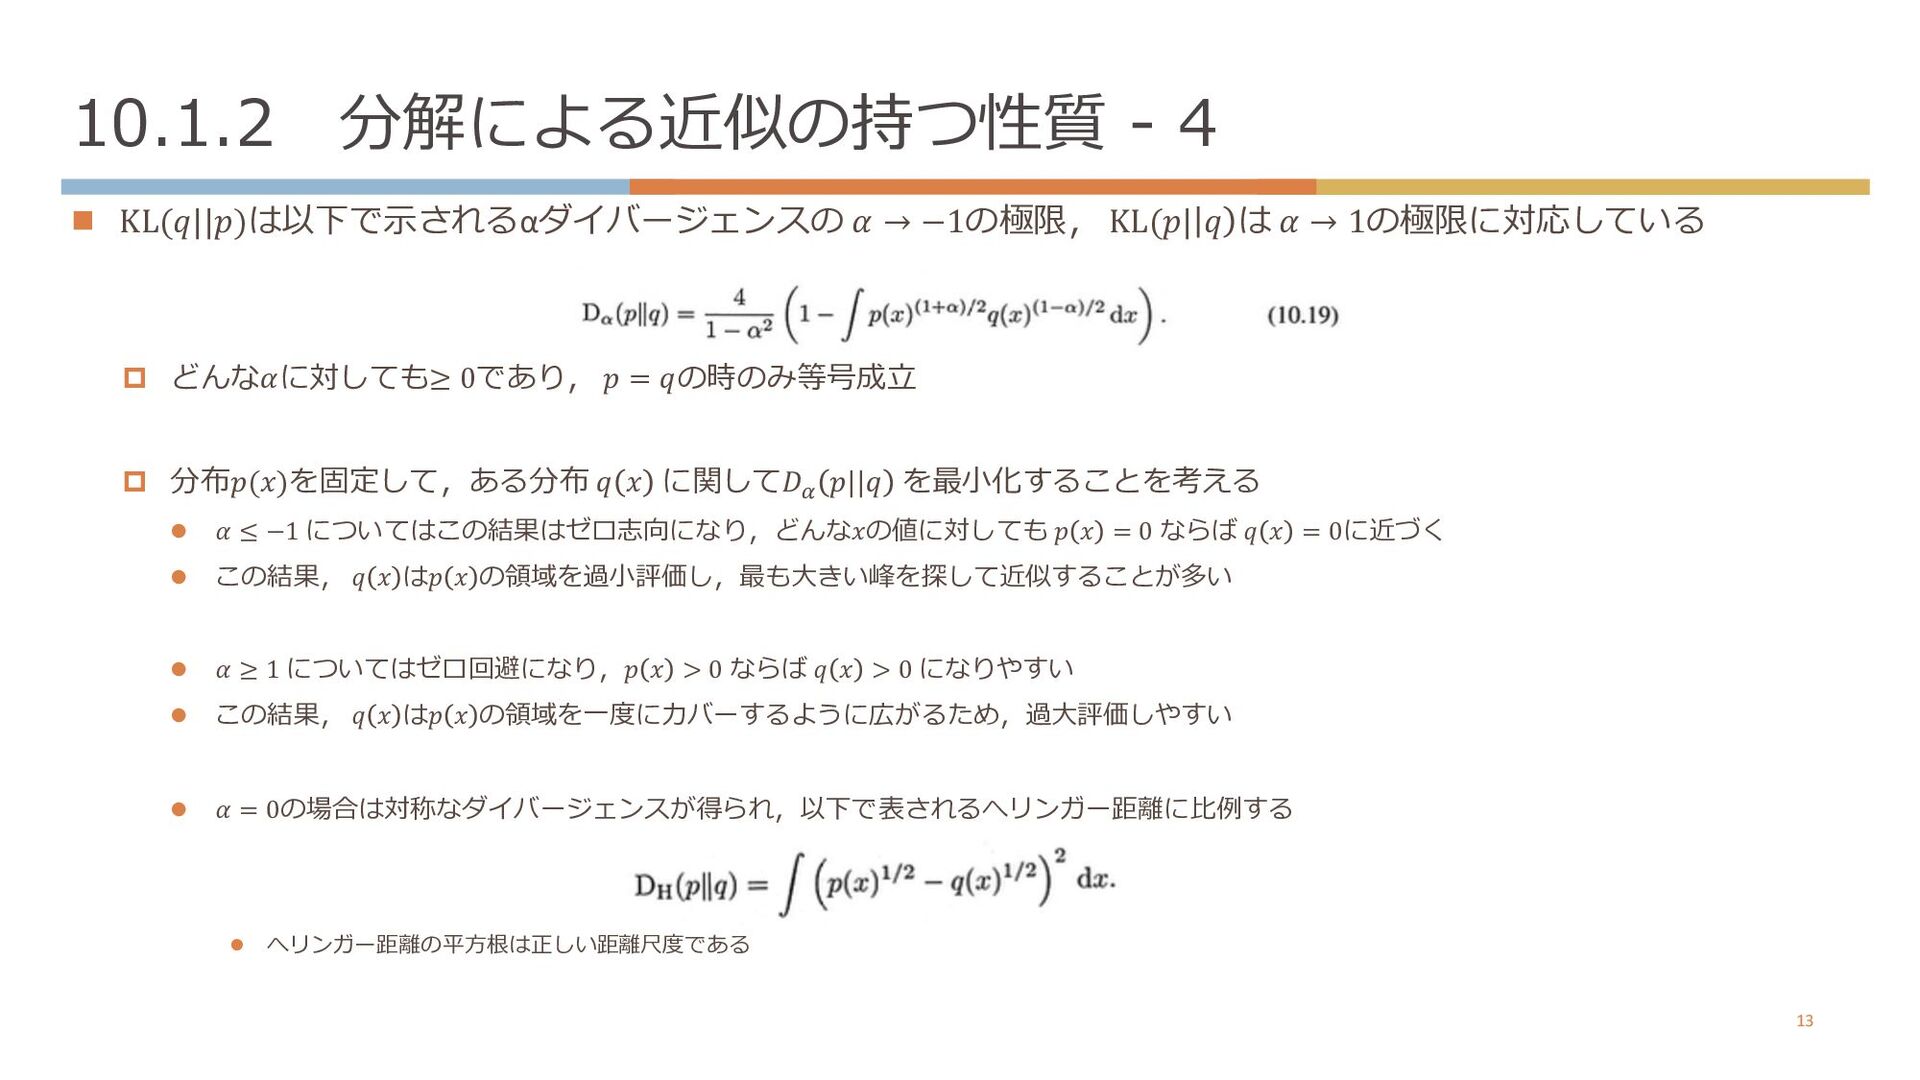
  12. 10.1.2 分解による近似の持つ性質 - 4 n KL(𝑞||𝑝)は以下で⽰されるαダイバージェンスの 𝛼 → −1の極限, KL(𝑝|

    𝑞 は 𝛼 → 1の極限に対応している p どんな𝛼に対しても≥ 0であり, 𝑝 = 𝑞の時のみ等号成⽴ p 分布𝑝(𝑥)を固定して,ある分布 𝑞 𝑥 に関して𝐷? 𝑝||𝑞 を最⼩化することを考える l 𝛼 ≤ −1 についてはこの結果はゼロ志向になり,どんな𝑥の値に対しても 𝑝 𝑥 = 0 ならば 𝑞 𝑥 = 0に近づく l この結果, 𝑞 𝑥 は𝑝 𝑥 の領域を過⼩評価し,最も⼤きい峰を探して近似することが多い l 𝛼 ≥ 1 についてはゼロ回避になり,𝑝 𝑥 > 0 ならば 𝑞 𝑥 > 0 になりやすい l この結果, 𝑞 𝑥 は𝑝 𝑥 の領域を⼀度にカバーするように広がるため,過⼤評価しやすい l 𝛼 = 0の場合は対称なダイバージェンスが得られ,以下で表されるへリンガー距離に⽐例する l へリンガー距離の平⽅根は正しい距離尺度である 13
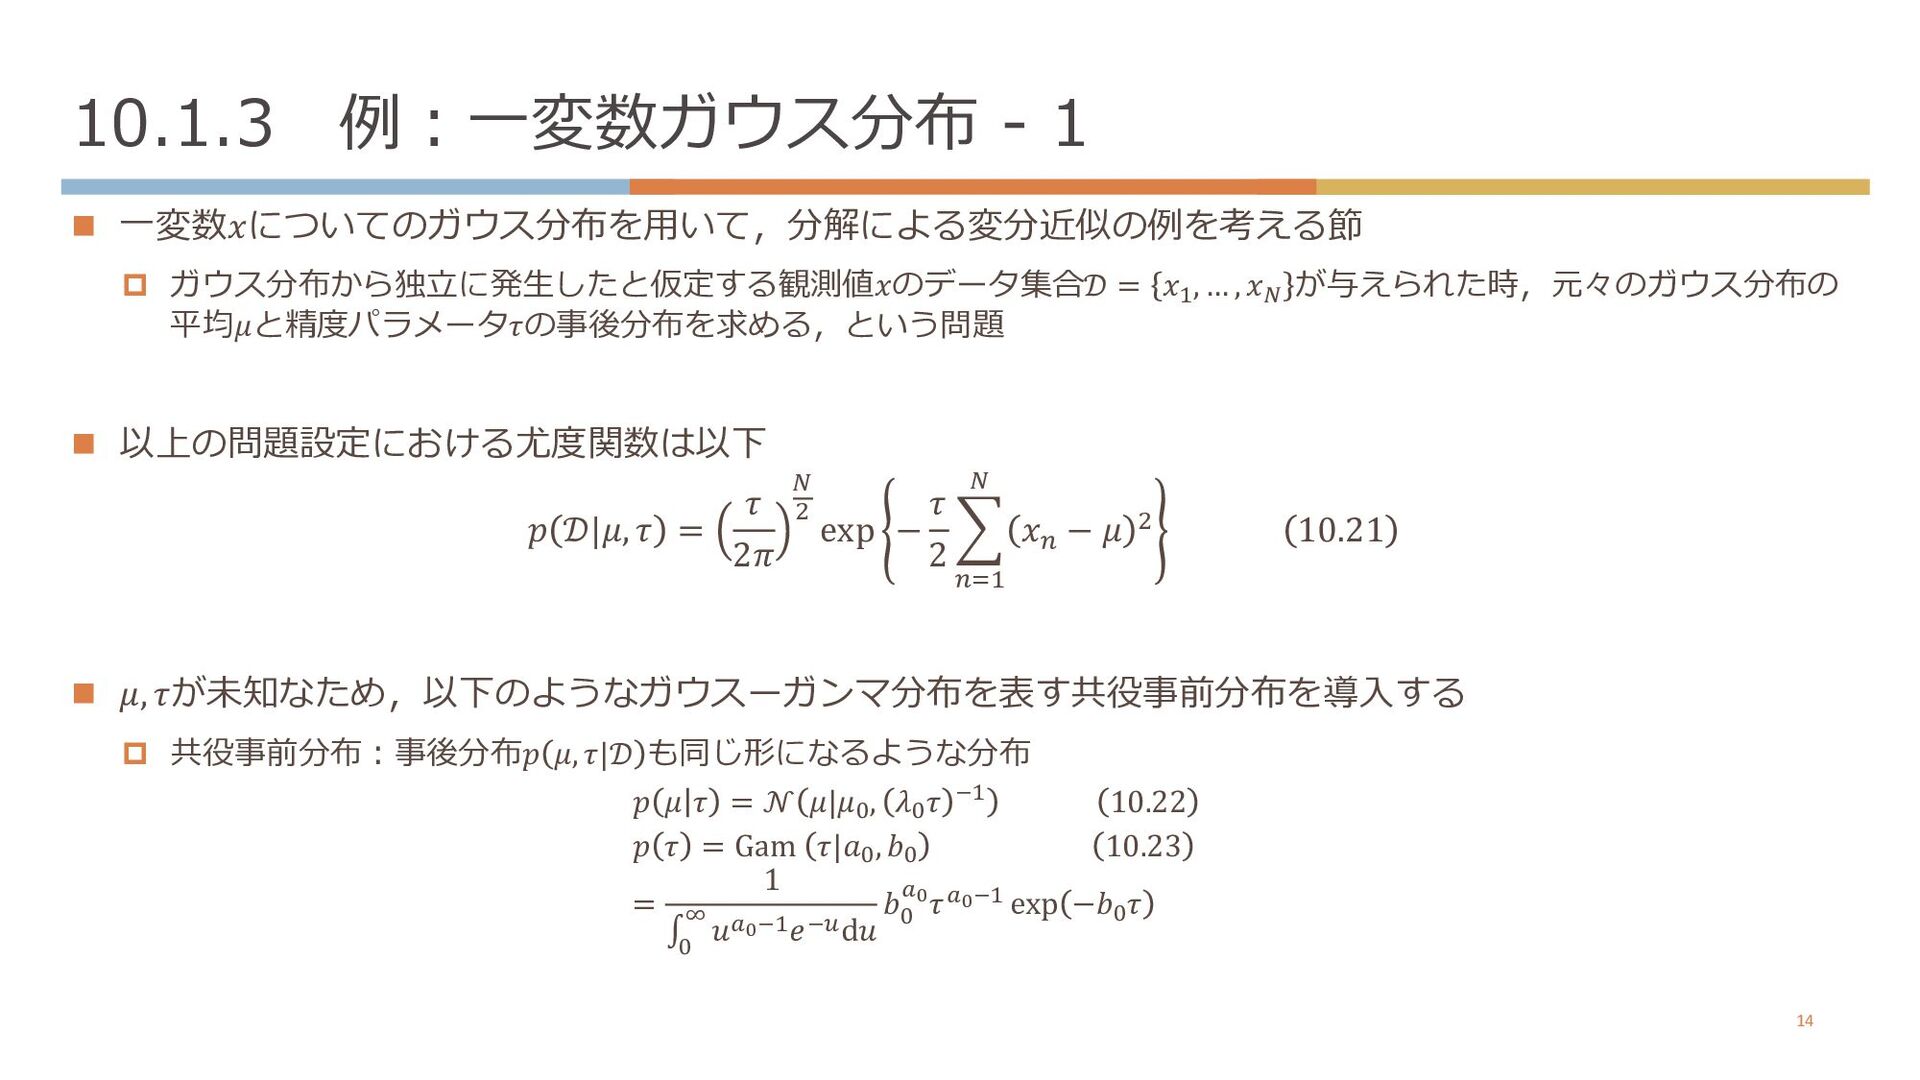
  13. 10.1.3 例︓⼀変数ガウス分布 - 1 n ⼀変数𝑥についてのガウス分布を⽤いて,分解による変分近似の例を考える節 p ガウス分布から独⽴に発⽣したと仮定する観測値𝑥のデータ集合𝒟 = 𝑥M,

    … , 𝑥Q が与えられた時,元々のガウス分布の 平均𝜇と精度パラメータ𝜏の事後分布を求める,という問題 n 以上の問題設定における尤度関数は以下 𝑝 𝒟|𝜇, 𝜏 = 𝜏 2𝜋 > ? exp − 𝜏 2 / @AB > 𝑥@ − 𝜇 ? 10.21 n 𝜇, 𝜏が未知なため,以下のようなガウスーガンマ分布を表す共役事前分布を導⼊する p 共役事前分布︓事後分布𝑝 𝜇, 𝜏|𝒟 も同じ形になるような分布 𝑝 𝜇 𝜏 = 𝒩 𝜇|𝜇R, 𝜆R𝜏 OM 10.22 𝑝 𝜏 = Gam 𝜏|𝑎R, 𝑏R 10.23 = 1 ∫ R S 𝑢T,OM𝑒OUd𝑢 𝑏R T,𝜏T,OM exp −𝑏R 𝜏 14
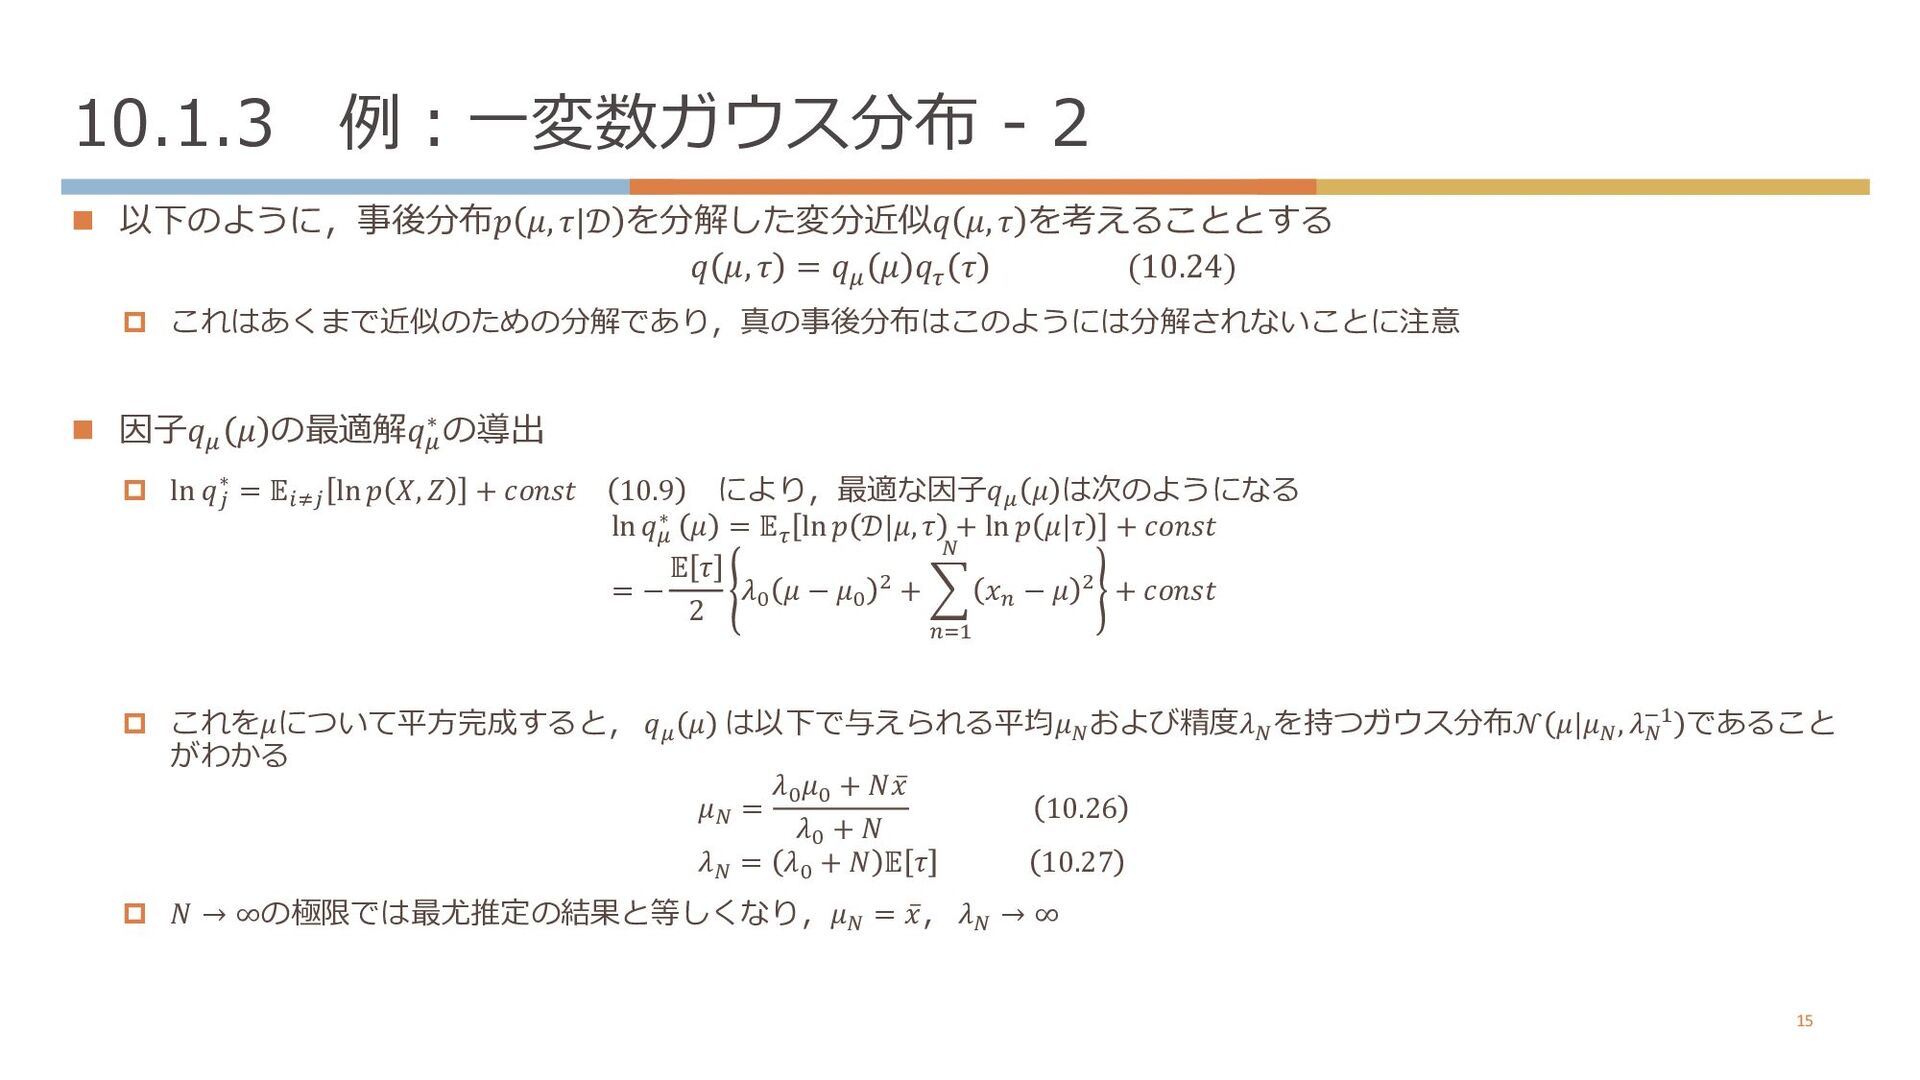
  14. 10.1.3 例︓⼀変数ガウス分布 - 2 n 以下のように,事後分布𝑝 𝜇, 𝜏|𝒟 を分解した変分近似𝑞 𝜇,

    𝜏 を考えることとする 𝑞 𝜇, 𝜏 = 𝑞V 𝜇 𝑞W 𝜏 (10.24) p これはあくまで近似のための分解であり,真の事後分布はこのようには分解されないことに注意 n 因⼦𝑞V 𝜇 の最適解𝑞V ∗ の導出 p ln 𝑞@ ∗ = 𝔼AB@ ln 𝑝 𝑋, 𝑍 + 𝑐𝑜𝑛𝑠𝑡 10.9 により,最適な因⼦𝑞C 𝜇 は次のようになる ln 𝑞C ∗ 𝜇 = 𝔼D ln 𝑝 𝒟|𝜇, 𝜏 + ln 𝑝 𝜇|𝜏 + 𝑐𝑜𝑛𝑠𝑡 = − 𝔼 𝜏 2 𝜆E 𝜇 − 𝜇E : + P FG! " 𝑥F − 𝜇 : + 𝑐𝑜𝑛𝑠𝑡 p これを𝜇について平⽅完成すると, 𝑞C 𝜇 は以下で与えられる平均𝜇" および精度𝜆" を持つガウス分布𝒩 𝜇|𝜇" , 𝜆" ;! であること がわかる 𝜇" = 𝜆E 𝜇E + 𝑁 ̅ 𝑥 𝜆E + 𝑁 10.26 𝜆" = 𝜆E + 𝑁 𝔼 𝜏 10.27 p 𝑁 → ∞の極限では最尤推定の結果と等しくなり,𝜇" = ̅ 𝑥, 𝜆" → ∞ 15
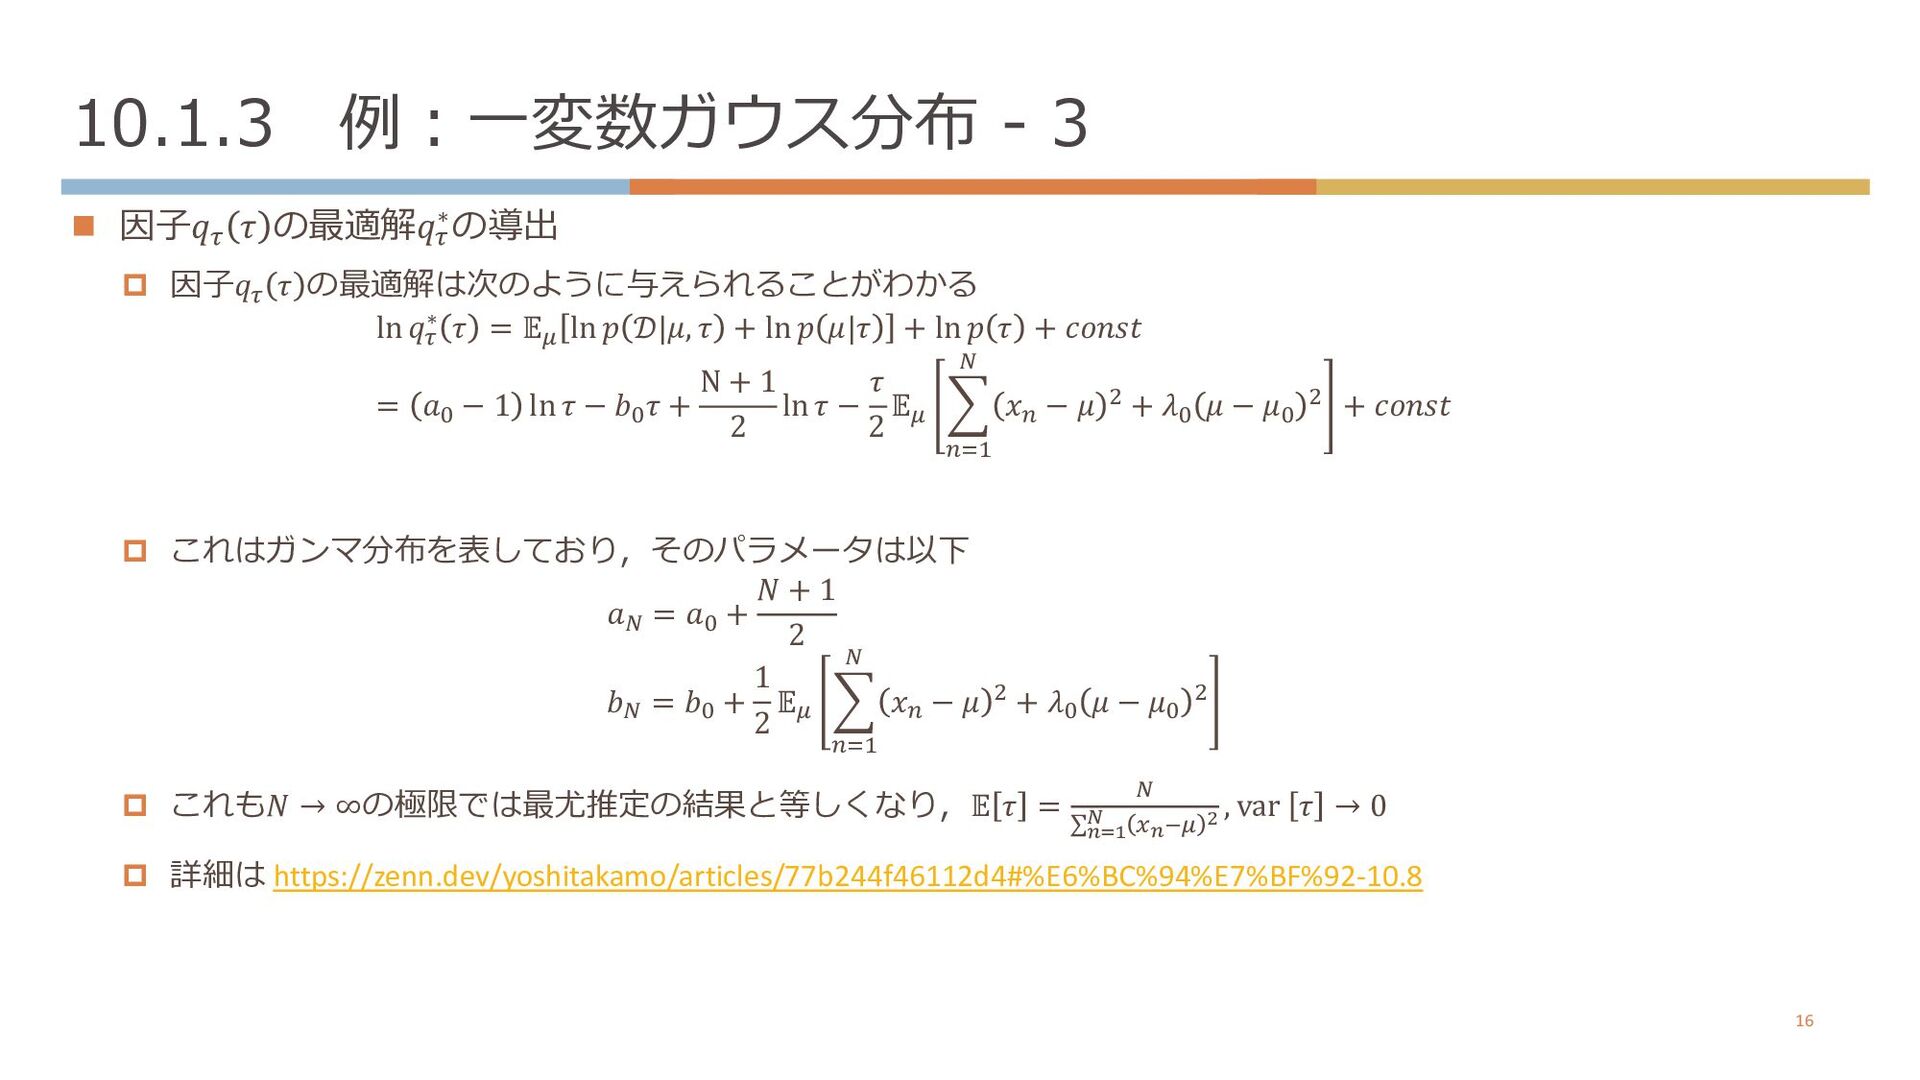
  15. 10.1.3 例︓⼀変数ガウス分布 - 3 n 因⼦𝑞C 𝜏 の最適解𝑞C ∗の導出 p

    因⼦𝑞W 𝜏 の最適解は次のように与えられることがわかる ln 𝑞W ∗ 𝜏 = 𝔼V ln 𝑝 𝒟|𝜇, 𝜏 + ln 𝑝 𝜇|𝜏 + ln 𝑝 𝜏 + 𝑐𝑜𝑛𝑠𝑡 = 𝑎R − 1 ln 𝜏 − 𝑏R𝜏 + N + 1 2 ln 𝜏 − 𝜏 2 𝔼V U XYM Q 𝑥X − 𝜇 P + 𝜆R 𝜇 − 𝜇R P + 𝑐𝑜𝑛𝑠𝑡 p これはガンマ分布を表しており,そのパラメータは以下 𝑎Q = 𝑎R + 𝑁 + 1 2 𝑏Q = 𝑏R + 1 2 𝔼V U XYM Q 𝑥X − 𝜇 P + 𝜆R 𝜇 − 𝜇R P p これも𝑁 → ∞の極限では最尤推定の結果と等しくなり,𝔼 𝜏 = Q ∑-./ 0 [-OV 1 , var 𝜏 → 0 p 詳細は https://zenn.dev/yoshitakamo/articles/77b244f46112d4#%E6%BC%94%E7%BF%92-10.8 16
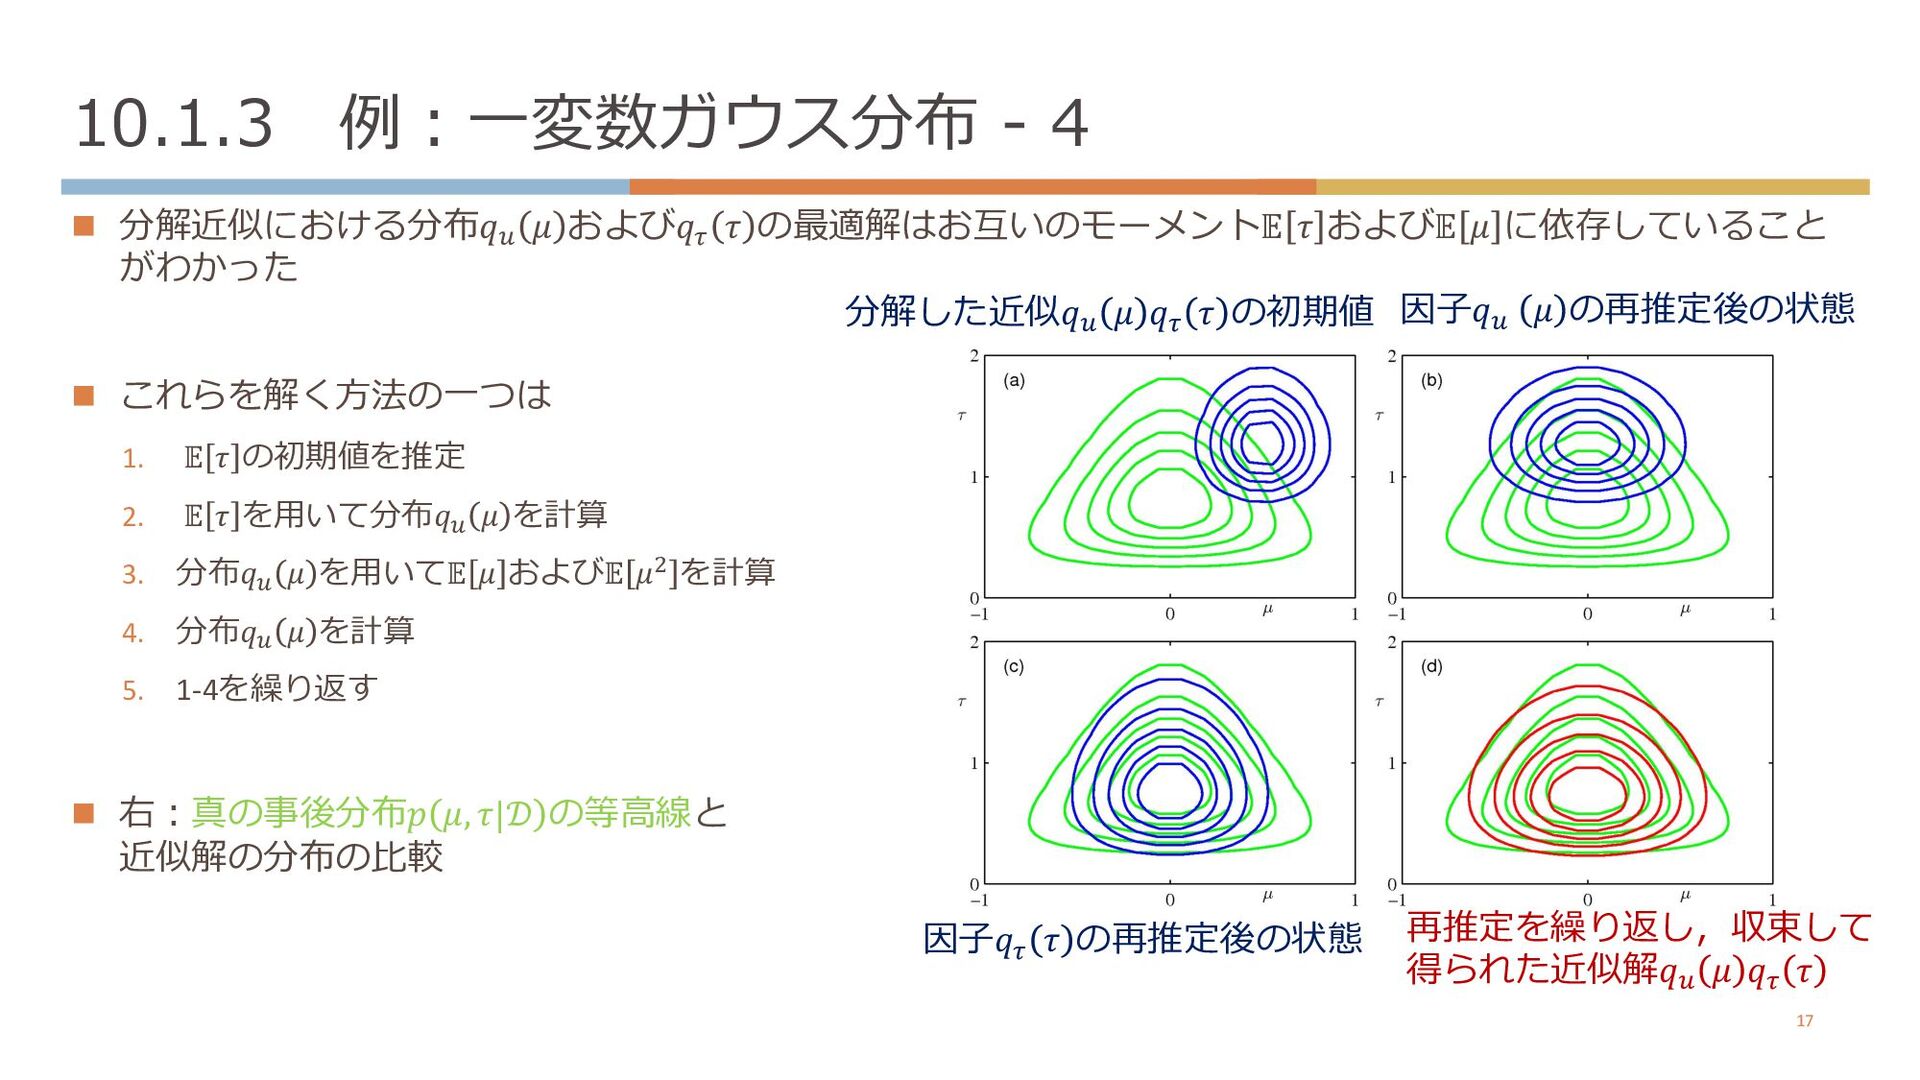
  16. 10.1.3 例︓⼀変数ガウス分布 - 4 n 分解近似における分布𝑞E 𝜇 および𝑞C 𝜏 の最適解はお互いのモーメント𝔼

    𝜏 および𝔼 𝜇 に依存していること がわかった n これらを解く⽅法の⼀つは 1. 𝔼 𝜏 の初期値を推定 2. 𝔼 𝜏 を⽤いて分布𝑞U 𝜇 を計算 3. 分布𝑞U 𝜇 を⽤いて𝔼 𝜇 および𝔼 𝜇P を計算 4. 分布𝑞U 𝜇 を計算 5. 1-4を繰り返す n 右︓真の事後分布𝑝 𝜇, 𝜏|𝒟 の等⾼線と 近似解の分布の⽐較 17 分解した近似𝑞E 𝜇 𝑞C 𝜏 の初期値 因⼦𝑞E 𝜇 の再推定後の状態 因⼦𝑞C 𝜏 の再推定後の状態 再推定を繰り返し,収束して 得られた近似解𝑞E 𝜇 𝑞C 𝜏
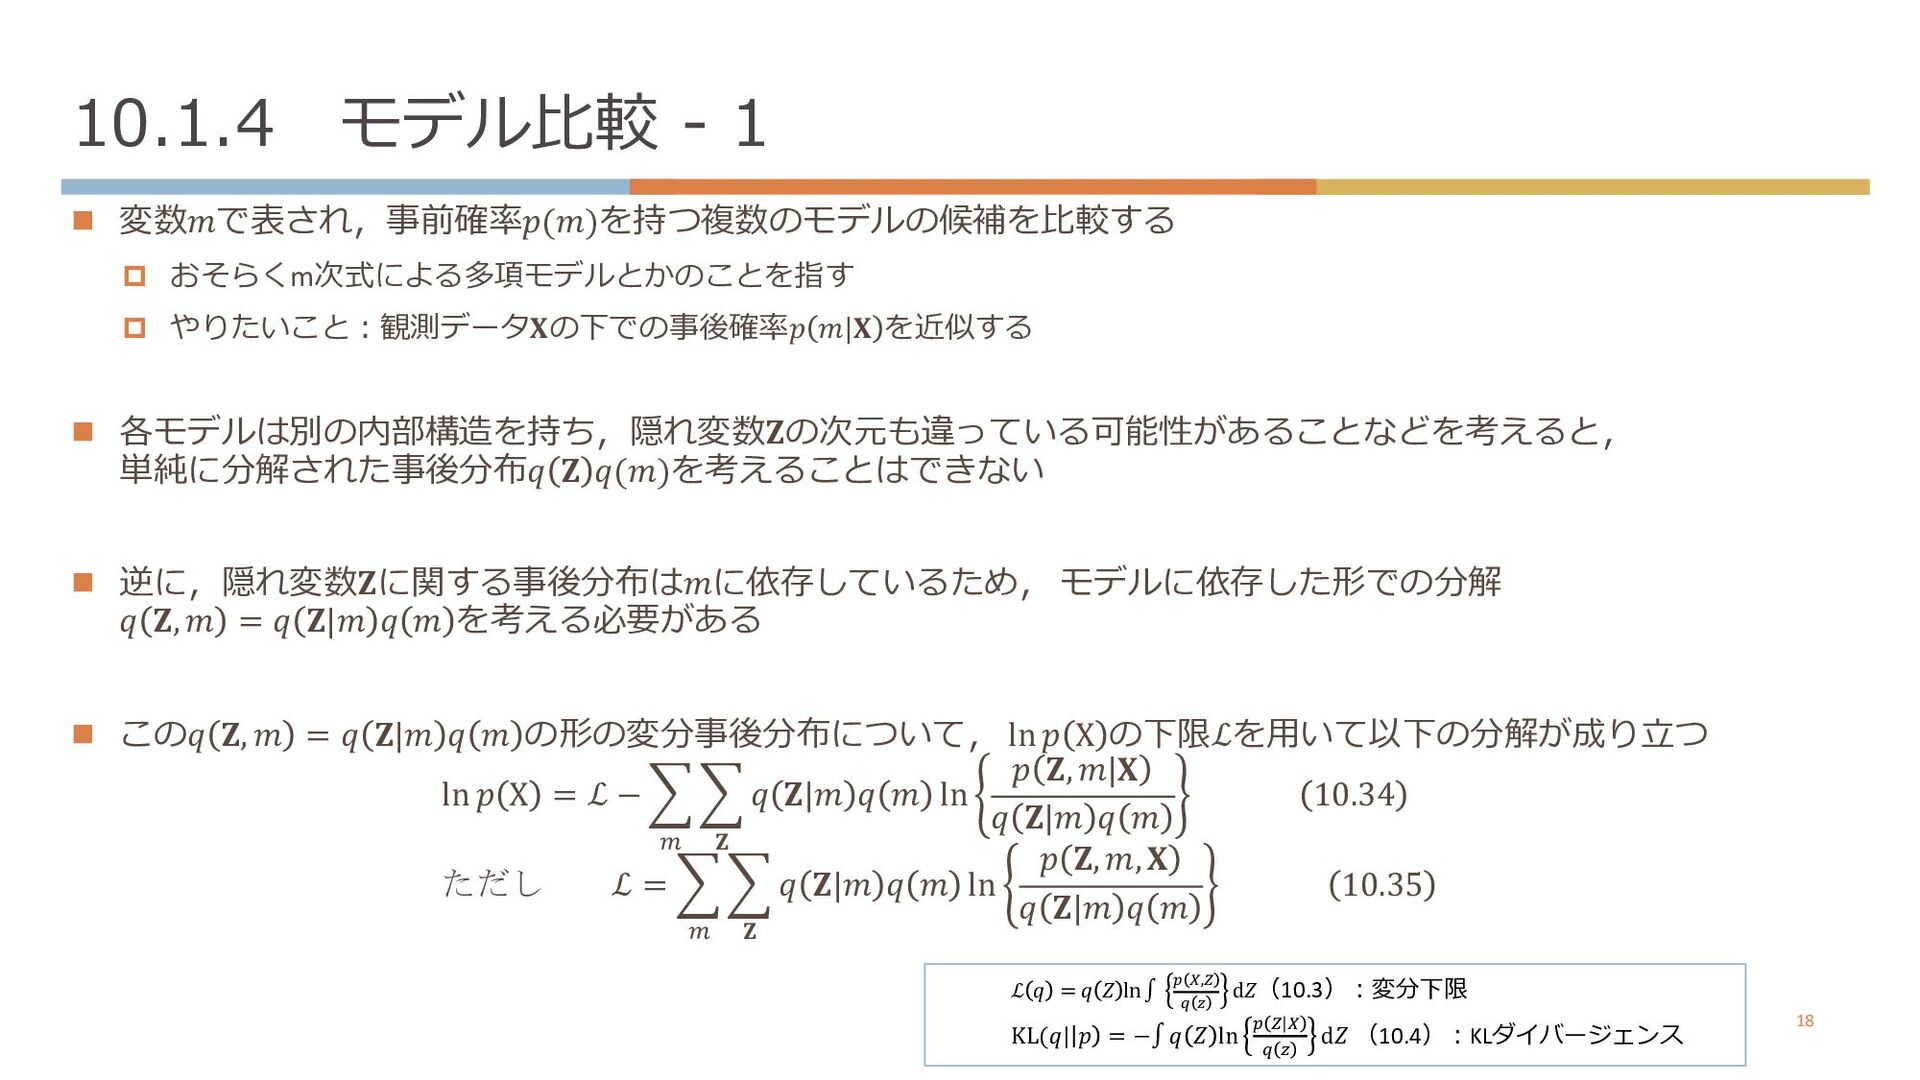
  17. n 変数𝑚で表され,事前確率𝑝(𝑚)を持つ複数のモデルの候補を⽐較する p おそらくm次式による多項モデルとかのことを指す p やりたいこと︓観測データ𝐗の下での事後確率𝑝 𝑚|𝐗 を近似する n 各モデルは別の内部構造を持ち,隠れ変数𝐙の次元も違っている可能性があることなどを考えると,

    単純に分解された事後分布𝑞 𝐙 𝑞(𝑚)を考えることはできない n 逆に,隠れ変数𝐙に関する事後分布は𝑚に依存しているため, モデルに依存した形での分解 𝑞 𝐙, 𝑚 = 𝑞 𝐙|𝑚 𝑞 𝑚 を考える必要がある n この𝑞 𝐙, 𝑚 = 𝑞 𝐙|𝑚 𝑞 𝑚 の形の変分事後分布について, ln 𝑝 X の下限ℒを⽤いて以下の分解が成り⽴つ ln 𝑝 X = ℒ − = \ = 𝐙 𝑞 𝐙|𝑚 𝑞 𝑚 ln 𝑝 𝐙, 𝑚|𝐗 𝑞 𝐙|𝑚 𝑞 𝑚 10.34 ただし ℒ = = \ = 𝐙 𝑞 𝐙|𝑚 𝑞 𝑚 ln 𝑝 𝐙, 𝑚, 𝐗 𝑞 𝐙|𝑚 𝑞 𝑚 10.35 10.1.4 モデル⽐較 - 1 18 ℒ 𝑞 = 𝑞 𝑍 ln∫ ' (,* + ! d𝑍(10.3)︓変分下限 KL(𝑞| 𝑝 = −∫ 𝑞 𝑍 ln ! $|" % & d𝑍 (10.4)︓KLダイバージェンス
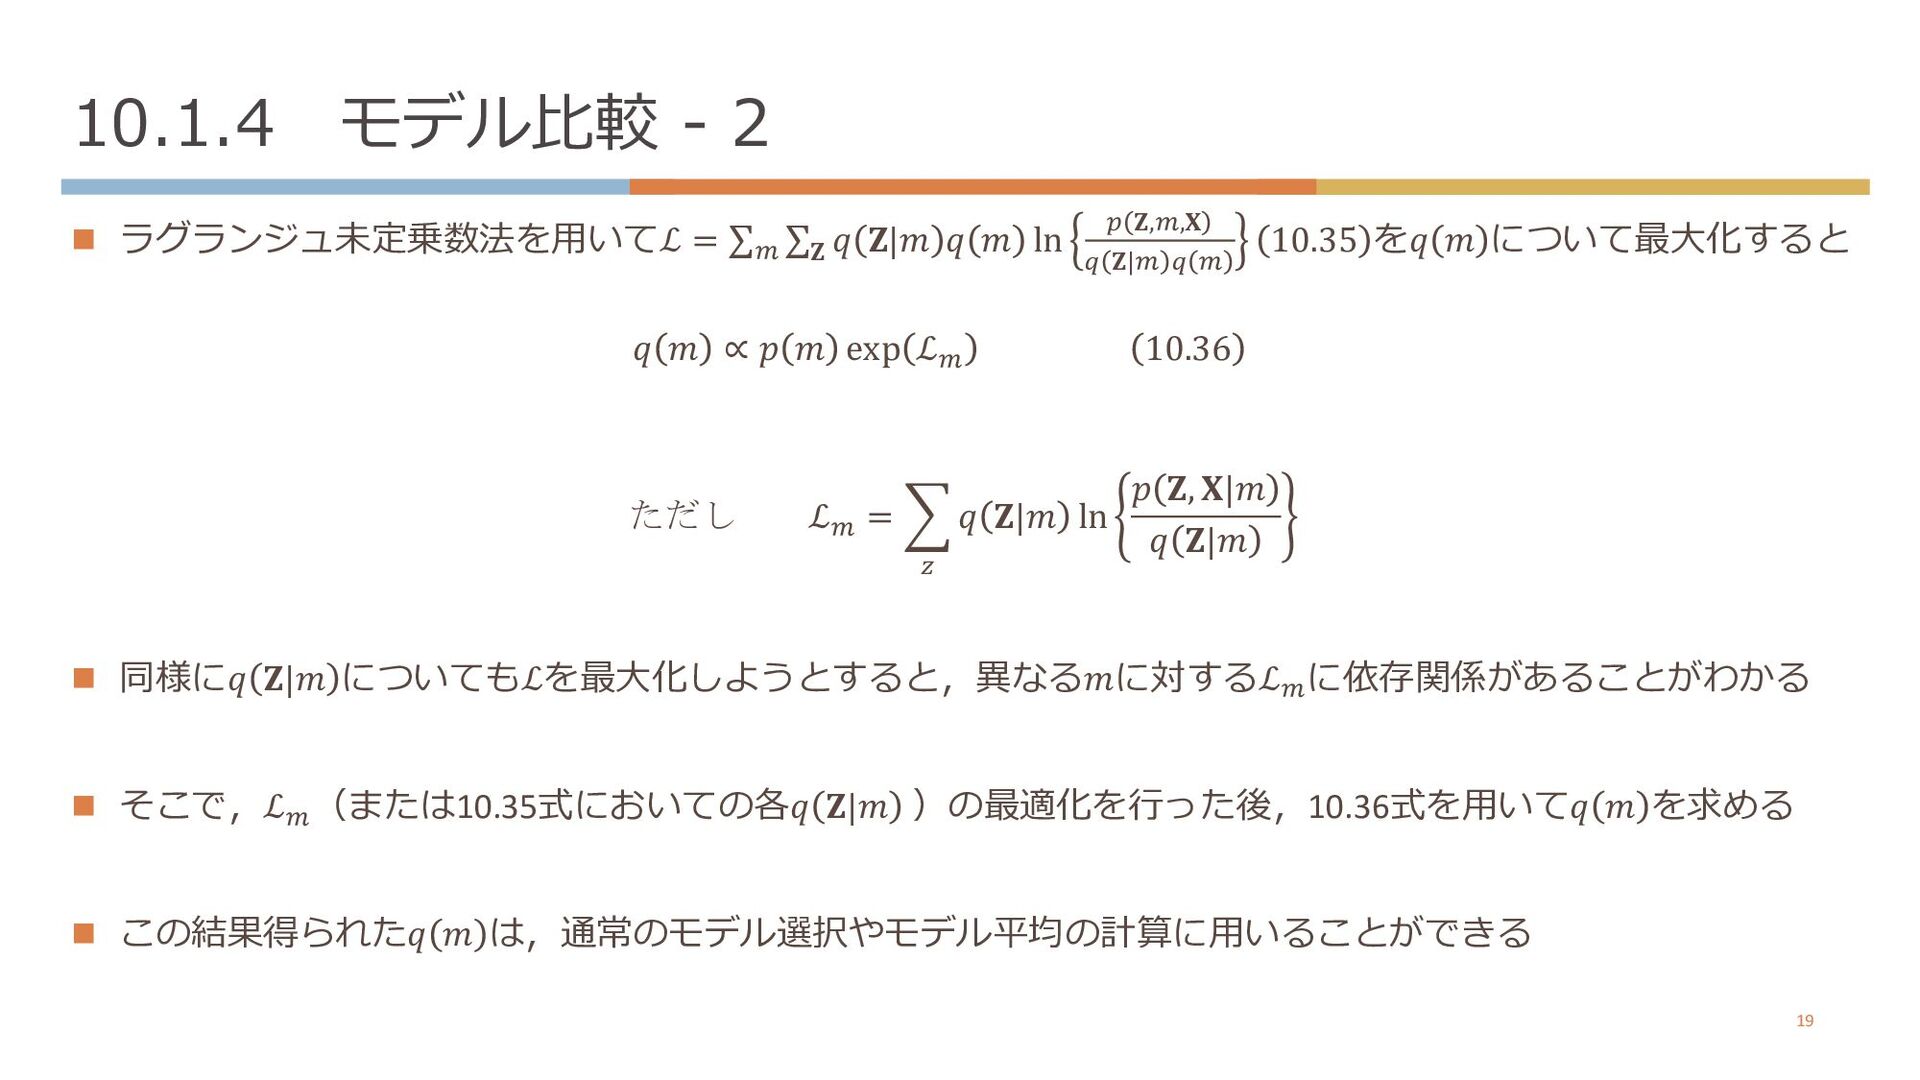
  18. 10.1.4 モデル⽐較 - 2 n ラグランジュ未定乗数法を⽤いてℒ = ∑F ∑𝐙 𝑞

    𝐙|𝑚 𝑞 𝑚 ln H 𝐙,F,𝐗 K 𝐙|F K F 10.35 を𝑞 𝑚 について最⼤化すると 𝑞 𝑚 ∝ 𝑝 𝑚 exp ℒF 10.36 ただし ℒF = / L 𝑞 𝐙|𝑚 ln 𝑝 𝐙, 𝐗|𝑚 𝑞 𝐙|𝑚 n 同様に𝑞 𝐙|𝑚 についてもℒを最⼤化しようとすると,異なる𝑚に対するℒF に依存関係があることがわかる n そこで,ℒF (または10.35式においての各𝑞 𝐙|𝑚 )の最適化を⾏った後,10.36式を⽤いて𝑞 𝑚 を求める n この結果得られた𝑞 𝑚 は,通常のモデル選択やモデル平均の計算に⽤いることができる 19
  19. 10.1 まとめ n 10.1 p 事後分布𝑝(𝐙|𝐗)やそれを元にした ln𝑝(𝐗, 𝐙|𝜽) の期待値を計算できない場合について,変分推論法を導⼊することで最適化することを考 えた

    n 10.1.1 p 変分推論において分布の分解という制限を考えたとき,分解された各分布の最適解が他の分布による期待値に依存することがわかった p すなわち最適解は再推定を繰り返すことで得られる n 10.1.2 p KLダイバージェンスの性質によっておこる,分布の分解による近似の持つ不正確さを確かめた n 10.1.3 p ガウス分布に対して分布の分解による変分推論を⾏い,やはり各分布の最適解が他の分布による期待値に依存することをみた p データ数N→∞の極限においては最尤推定と同じ解が得られることも⾒た n 10.1.4 p 事前確率𝑝(𝑚)を持つ複数のモデルに対して事後確率𝑝 𝑚|𝐗 を近似する場合には,単純な事後分布の分解𝑞 𝐙, 𝑚 = 𝑞 𝐙 𝑞(𝑚)ではなく 𝐙がモデルに依存した形での分解𝑞 𝐙, 𝑚 = 𝑞 𝐙|𝑚 𝑞 𝑚 を考える必要があることを確認した 20
  20. 10.2 例︓変分混合ガウス分布 - 1 n (9章で扱ったのと同じ)以下のガウス混合モデルについて変分推論法を適⽤してみる p 観測値集合︓𝐗 = 𝐱𝟏

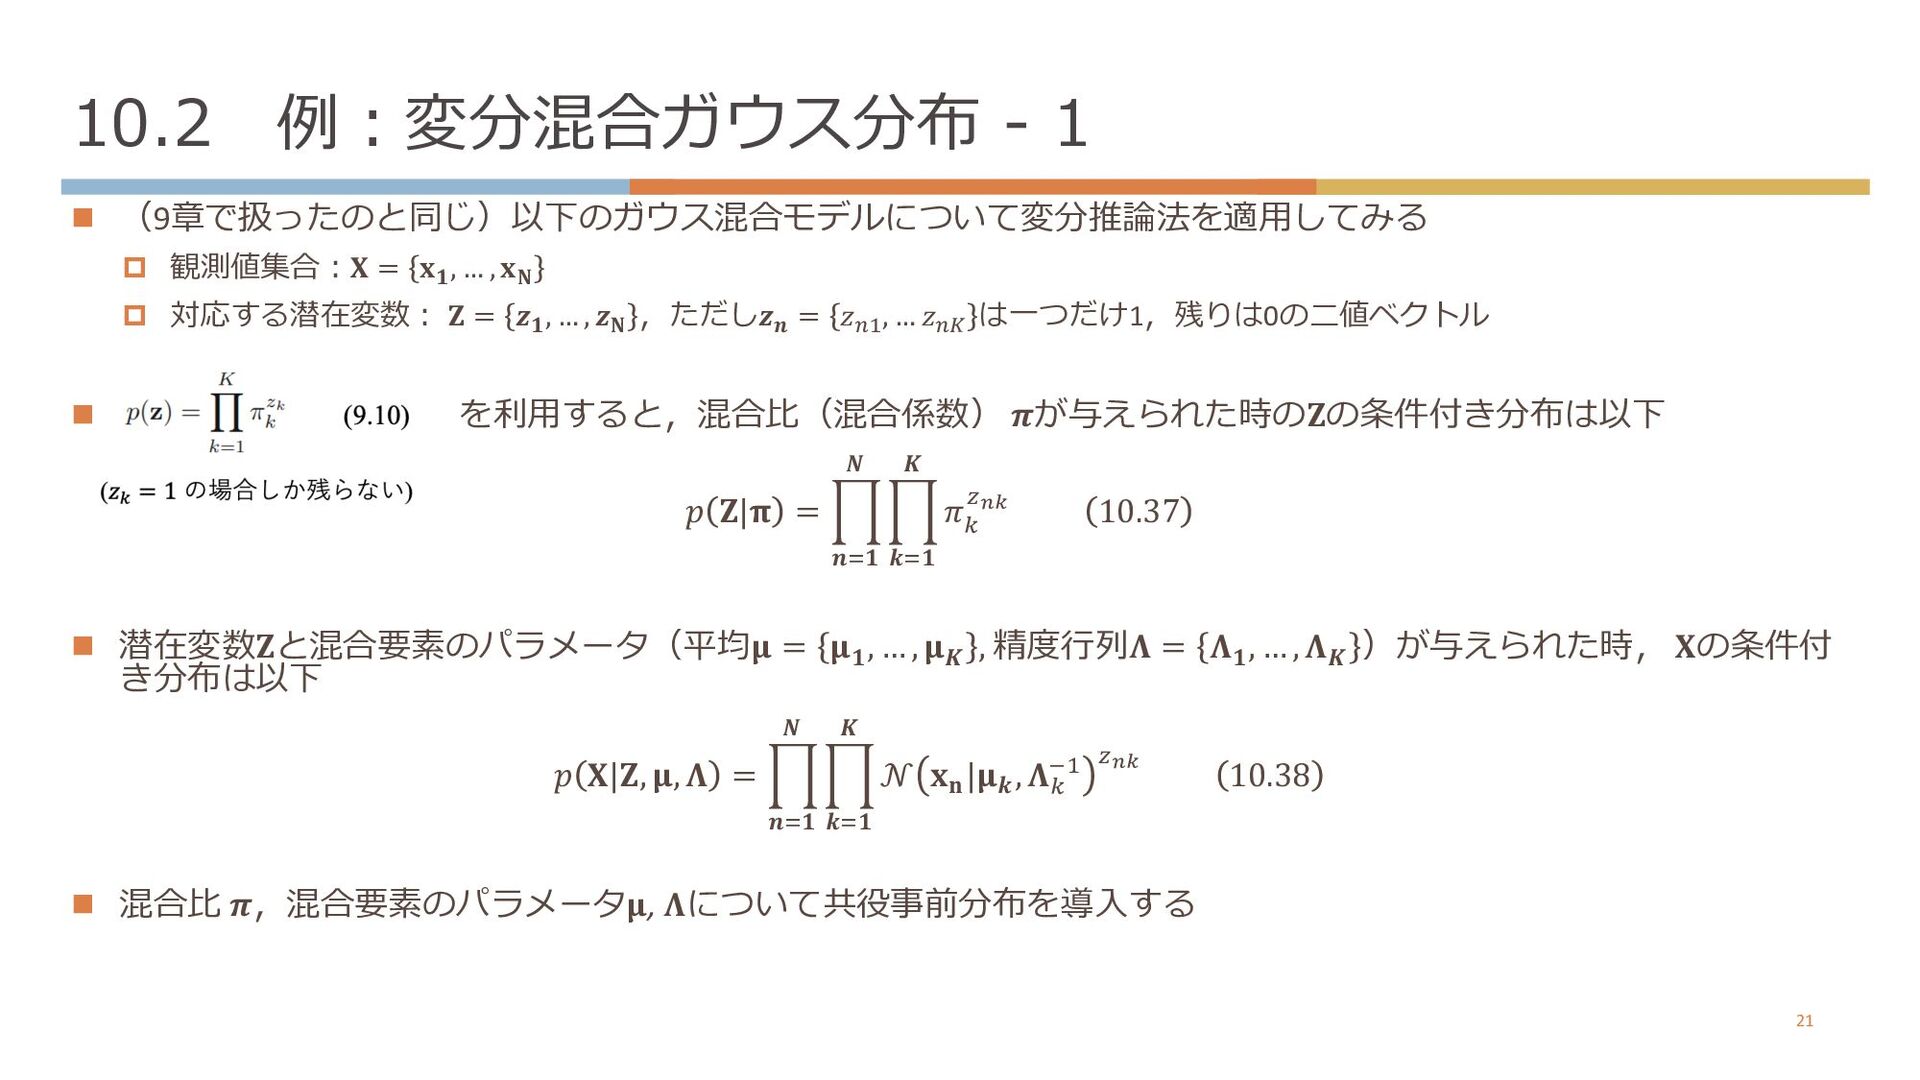
    , … , 𝐱𝐍 p 対応する潜在変数︓ 𝐙 = 𝒛𝟏 , … , 𝒛𝐍 ,ただし𝒛𝒏 = 𝑧F! , … 𝑧FJ は⼀つだけ1,残りは0の⼆値ベクトル n を利⽤すると,混合⽐(混合係数) 𝝅が与えられた時の𝐙の条件付き分布は以下 𝑝 𝐙|𝛑 = C 𝒏Y𝟏 𝑵 C 𝒌Y𝟏 𝑲 𝜋 f g-2 10.37 n 潜在変数𝐙と混合要素のパラメータ(平均𝛍 = 𝛍𝟏 , … , 𝛍𝑲 , 精度⾏列𝚲 = 𝚲𝟏 , … , 𝚲𝑲 )が与えられた時, 𝐗の条件付 き分布は以下 𝑝 𝐗|𝐙, 𝛍, 𝚲 = C 𝒏Y𝟏 𝑵 C 𝒌Y𝟏 𝑲 𝒩 𝐱𝐧 |𝛍𝒌 , 𝚲f OM g-2 10.38 n 混合⽐ 𝝅,混合要素のパラメータ𝛍, 𝚲について共役事前分布を導⼊する 21
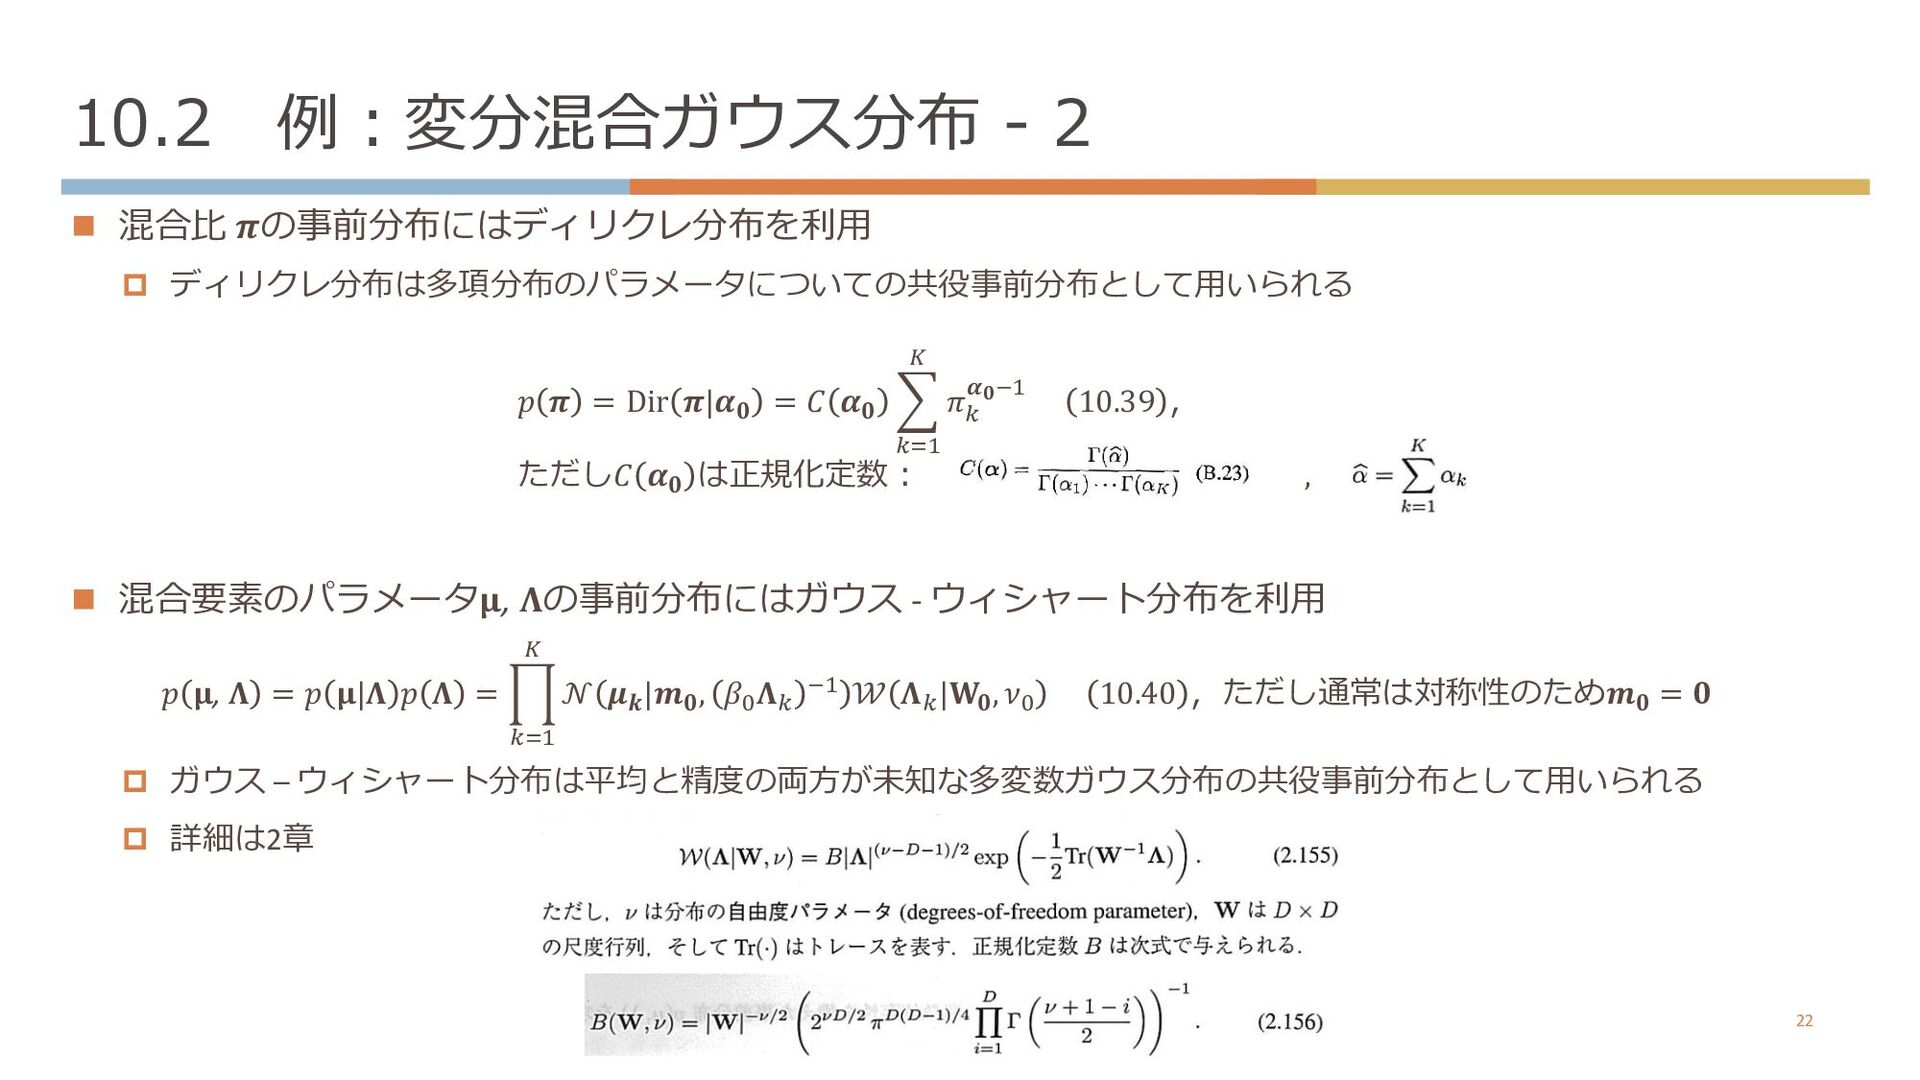
  21. 10.2 例︓変分混合ガウス分布 - 2 n 混合⽐ 𝝅の事前分布にはディリクレ分布を利⽤ p ディリクレ分布は多項分布のパラメータについての共役事前分布として⽤いられる 𝑝

    𝝅 = Dir 𝝅|𝜶𝟎 = 𝐶 𝜶𝟎 U fYM j 𝜋f 𝜶𝟎OM 10.39 , ただし𝐶 𝜶𝟎 は正規化定数︓ ,, n 混合要素のパラメータ𝛍, 𝚲の事前分布にはガウス - ウィシャート分布を利⽤ 𝑝 𝛍, 𝚲 = 𝑝 𝛍|𝚲 𝑝 𝚲 = d fYM j 𝒩 𝝁𝒌|𝒎𝟎, 𝛽R𝚲f OM 𝒲 𝚲f|𝐖𝟎, 𝜈R 10.40 ,ただし通常は対称性のため𝒎𝟎 = 𝟎 p ガウス – ウィシャート分布は平均と精度の両⽅が未知な多変数ガウス分布の共役事前分布として⽤いられる p 詳細は2章 22
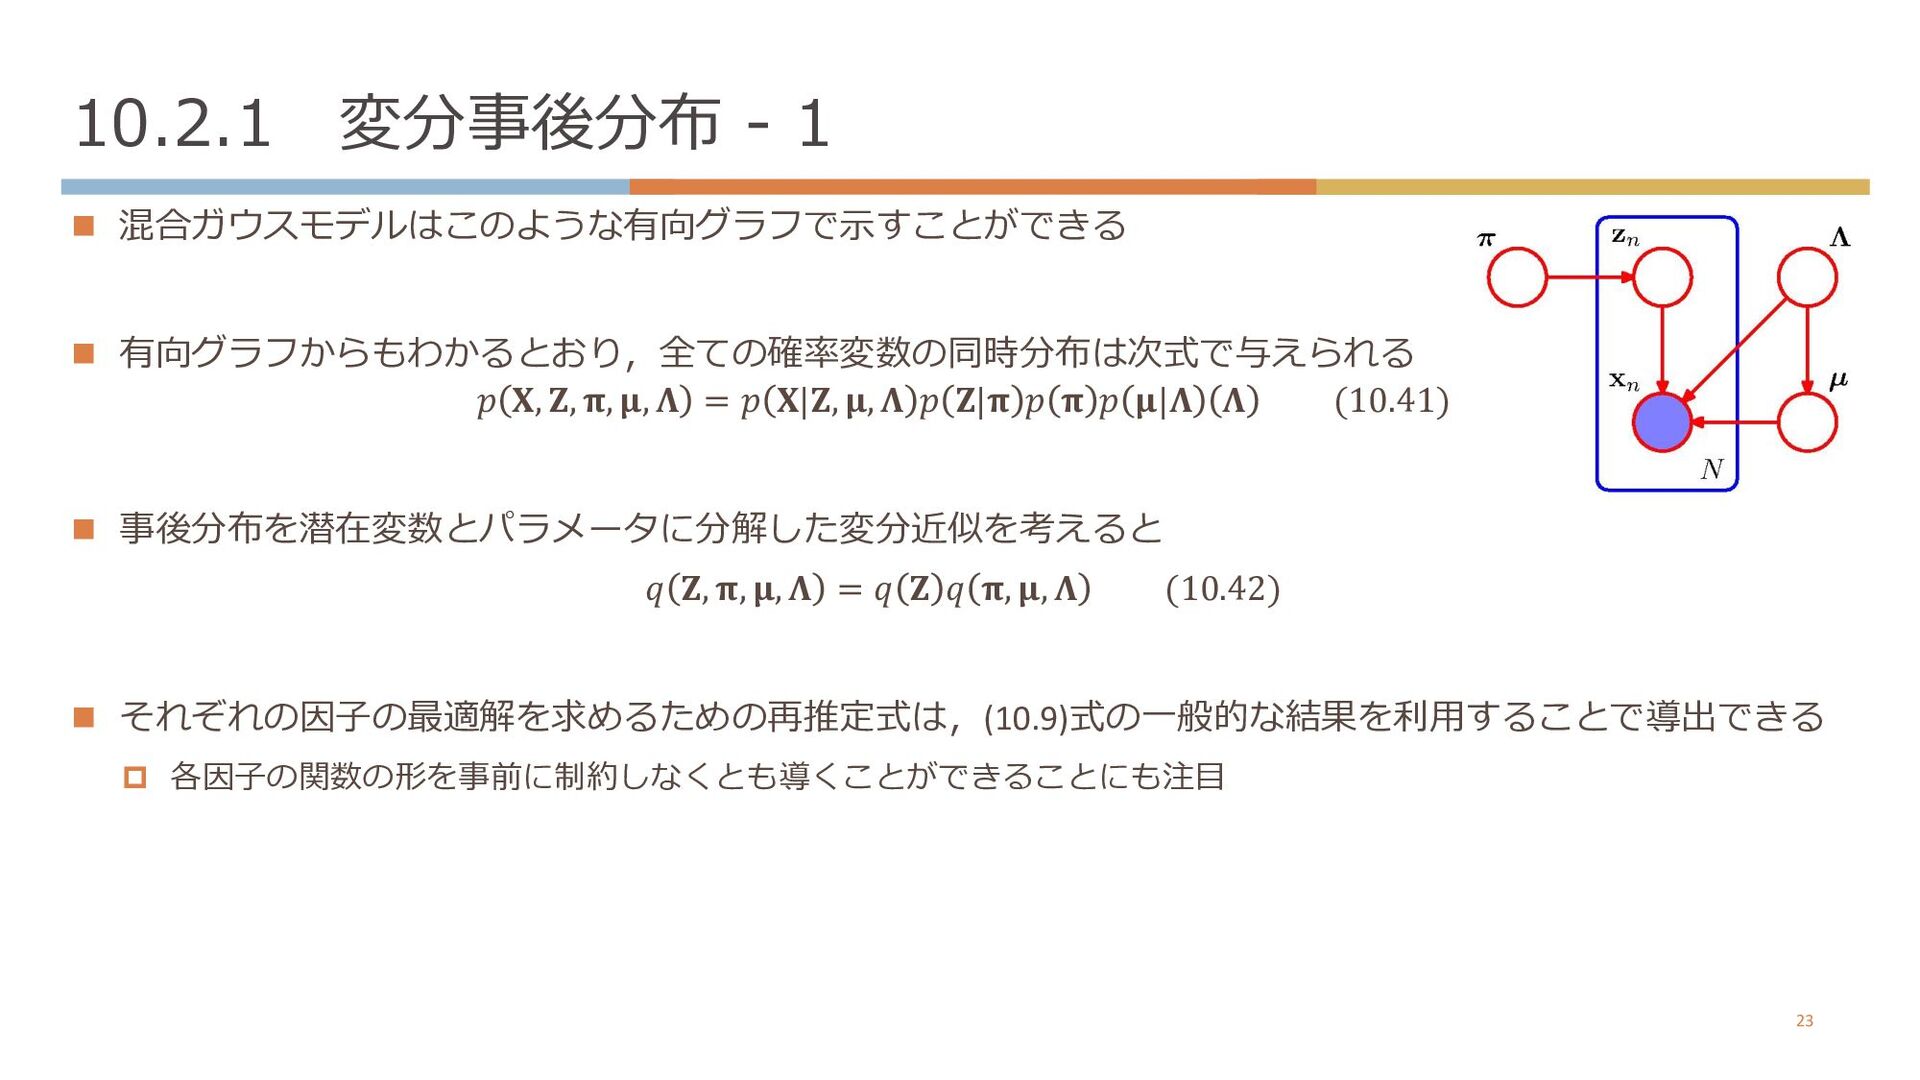
  22. 10.2.1 変分事後分布 - 1 n 混合ガウスモデルはこのような有向グラフで⽰すことができる n 有向グラフからもわかるとおり,全ての確率変数の同時分布は次式で与えられる 𝑝 𝐗,

    𝐙, 𝛑, 𝛍, 𝚲 = 𝑝 𝐗|𝐙, 𝛍, 𝚲 𝑝 𝐙|𝛑 𝑝 𝛑 𝑝 𝛍|𝚲 𝚲 (10.41) n 事後分布を潜在変数とパラメータに分解した変分近似を考えると 𝑞 𝐙, 𝛑, 𝛍, 𝚲 = 𝑞 𝐙 𝑞 𝛑, 𝛍, 𝚲 (10.42) n それぞれの因⼦の最適解を求めるための再推定式は,(10.9)式の⼀般的な結果を利⽤することで導出できる p 各因⼦の関数の形を事前に制約しなくとも導くことができることにも注⽬ 23
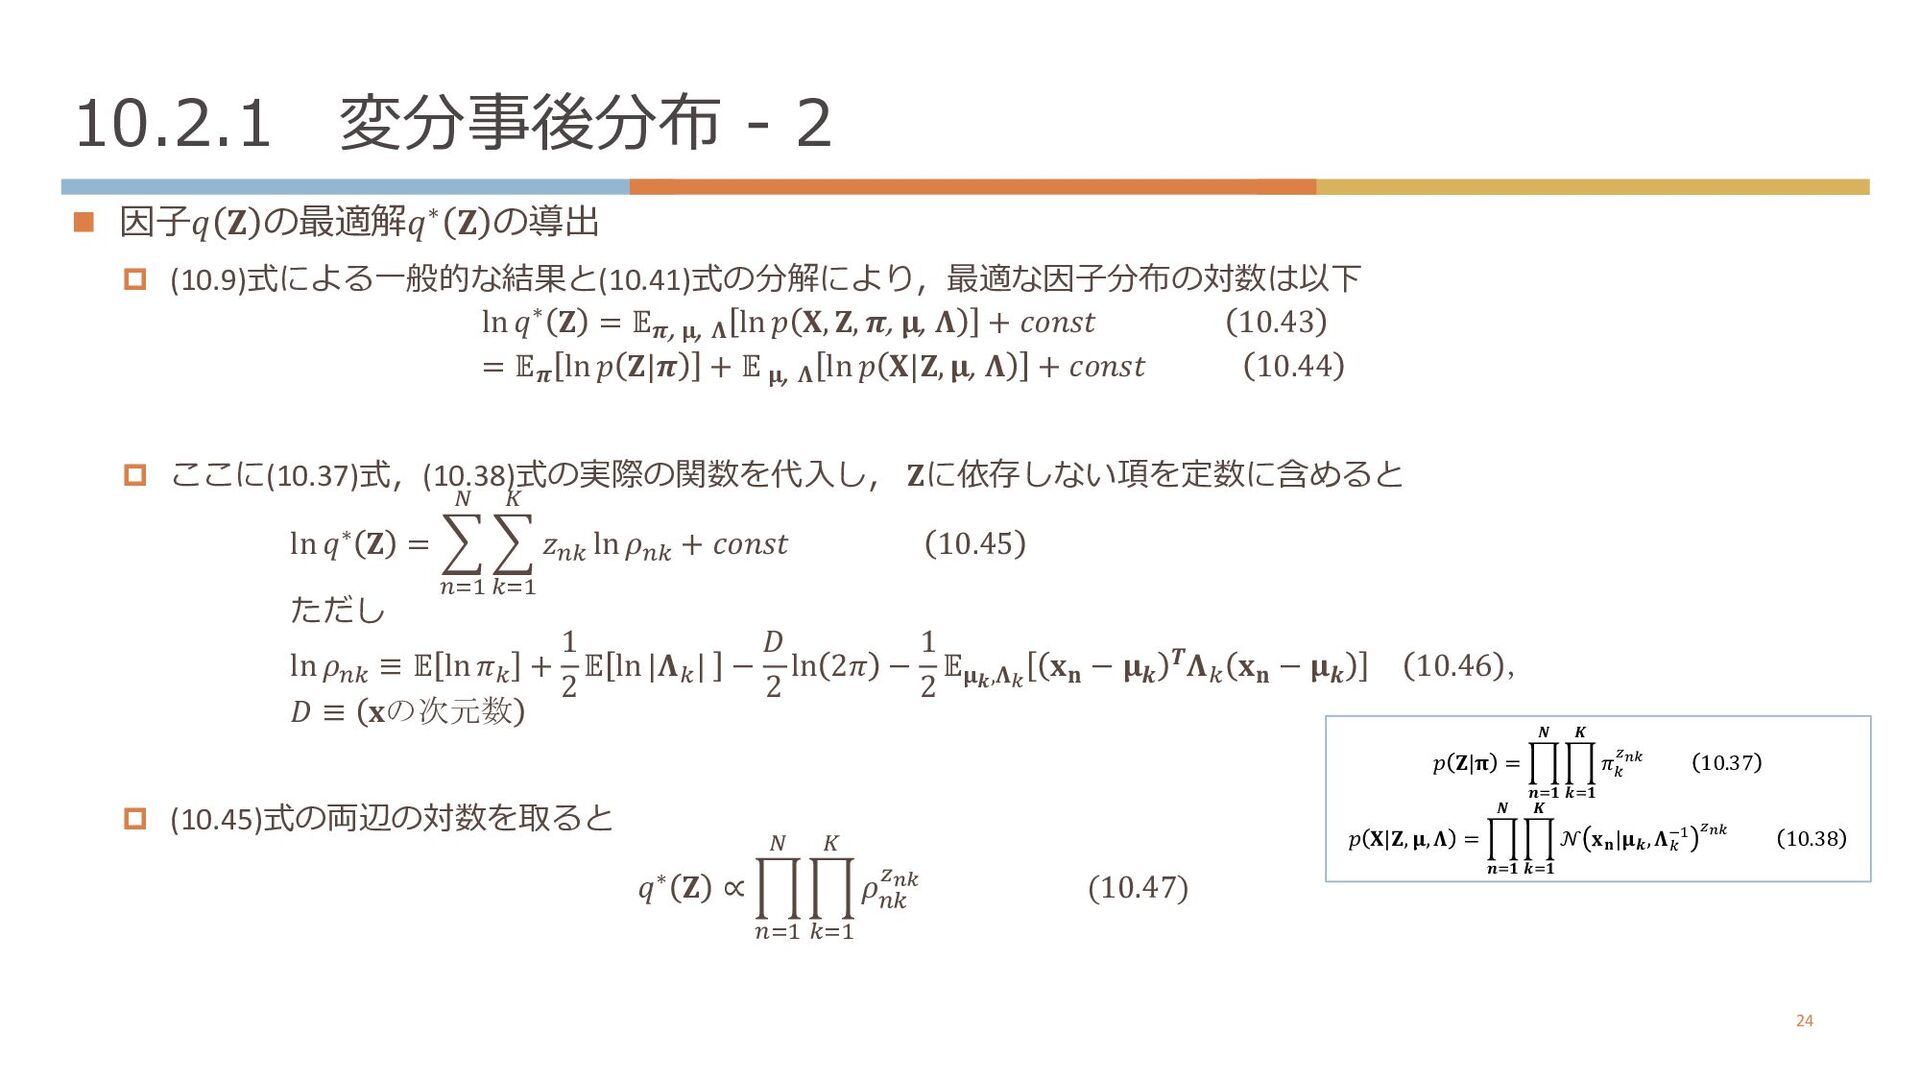
  23. 10.2.1 変分事後分布 - 2 n 因⼦𝑞 𝐙 の最適解𝑞∗ 𝐙 の導出

    p (10.9)式による⼀般的な結果と(10.41)式の分解により,最適な因⼦分布の対数は以下 ln 𝑞∗ 𝐙 = 𝔼𝝅, 𝛍, 𝚲 ln 𝑝 𝐗, 𝐙, 𝝅, 𝛍, 𝚲 + 𝑐𝑜𝑛𝑠𝑡 10.43 = 𝔼𝝅 ln 𝑝 𝐙|𝝅 + 𝔼 𝛍, 𝚲 ln 𝑝 𝐗|𝐙, 𝛍, 𝚲 + 𝑐𝑜𝑛𝑠𝑡 10.44 p ここに(10.37)式,(10.38)式の実際の関数を代⼊し, 𝐙に依存しない項を定数に含めると ln 𝑞∗ 𝐙 = U XYM Q U fYM j 𝑧Xf ln 𝜌Xf + 𝑐𝑜𝑛𝑠𝑡 10.45 ただし ln 𝜌Xf ≡ 𝔼 ln 𝜋f + 1 2 𝔼 ln |𝚲f| − 𝐷 2 ln 2𝜋 − 1 2 𝔼𝛍𝒌,𝚲2 𝐱𝐧 − 𝛍𝒌 𝑻𝚲f 𝐱𝐧 − 𝛍𝒌 10.46 , 𝐷 ≡ 𝐱の次元数 p (10.45)式の両辺の対数を取ると 𝑞∗ 𝐙 ∝ d XYM Q d fYM j 𝜌Xf g-2 (10.47) 24 𝑝 𝐙|𝛑 = 1 𝒏$𝟏 𝑵 1 𝒌$𝟏 𝑲 𝜋1 !"# 10.37 𝑝 𝐗|𝐙, 𝛍, 𝚲 = 1 𝒏$𝟏 𝑵 1 𝒌$𝟏 𝑲 𝒩 𝐱𝐧 |𝛍𝒌 , 𝚲1 3% !"# 10.38
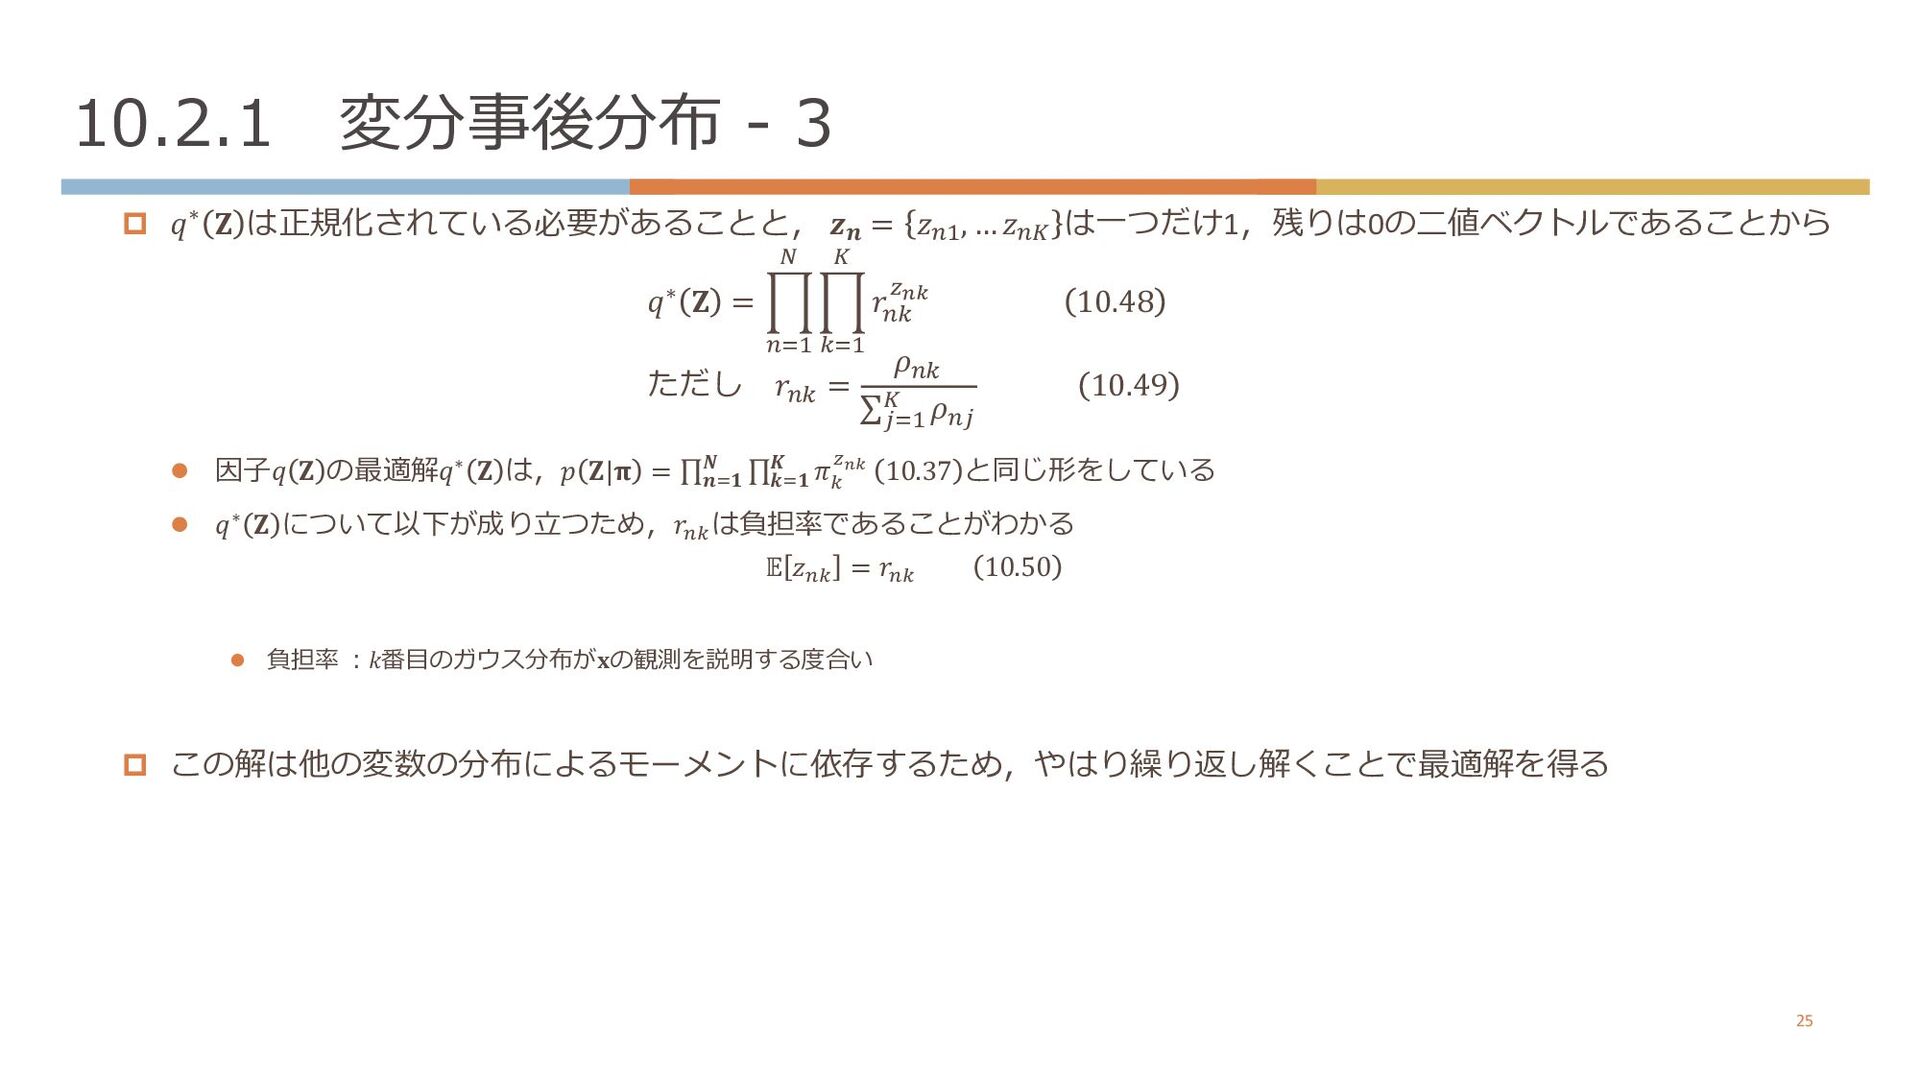
  24. 10.2.1 変分事後分布 - 3 p 𝑞∗ 𝐙 は正規化されている必要があることと, 𝒛𝒏 =

    𝑧XM, … 𝑧Xj は⼀つだけ1,残りは0の⼆値ベクトルであることから 𝑞∗ 𝐙 = d XYM Q d fYM j 𝑟Xf g-2 10.48 ただし 𝑟Xf = 𝜌Xf ∑pYM j 𝜌Xp 10.49 l 因⼦𝑞 𝐙 の最適解𝑞∗ 𝐙 は,𝑝 𝐙|𝛑 = ∏𝒏$𝟏 𝑵 ∏𝒌$𝟏 𝑲 𝜋 9 :45 10.37 と同じ形をしている l 𝑞∗ 𝐙 について以下が成り⽴つため,𝑟;9 は負担率であることがわかる 𝔼 𝑧;9 = 𝑟;9 10.50 l 負担率 ︓𝑘番⽬のガウス分布が𝐱の観測を説明する度合い p この解は他の変数の分布によるモーメントに依存するため,やはり繰り返し解くことで最適解を得る 25
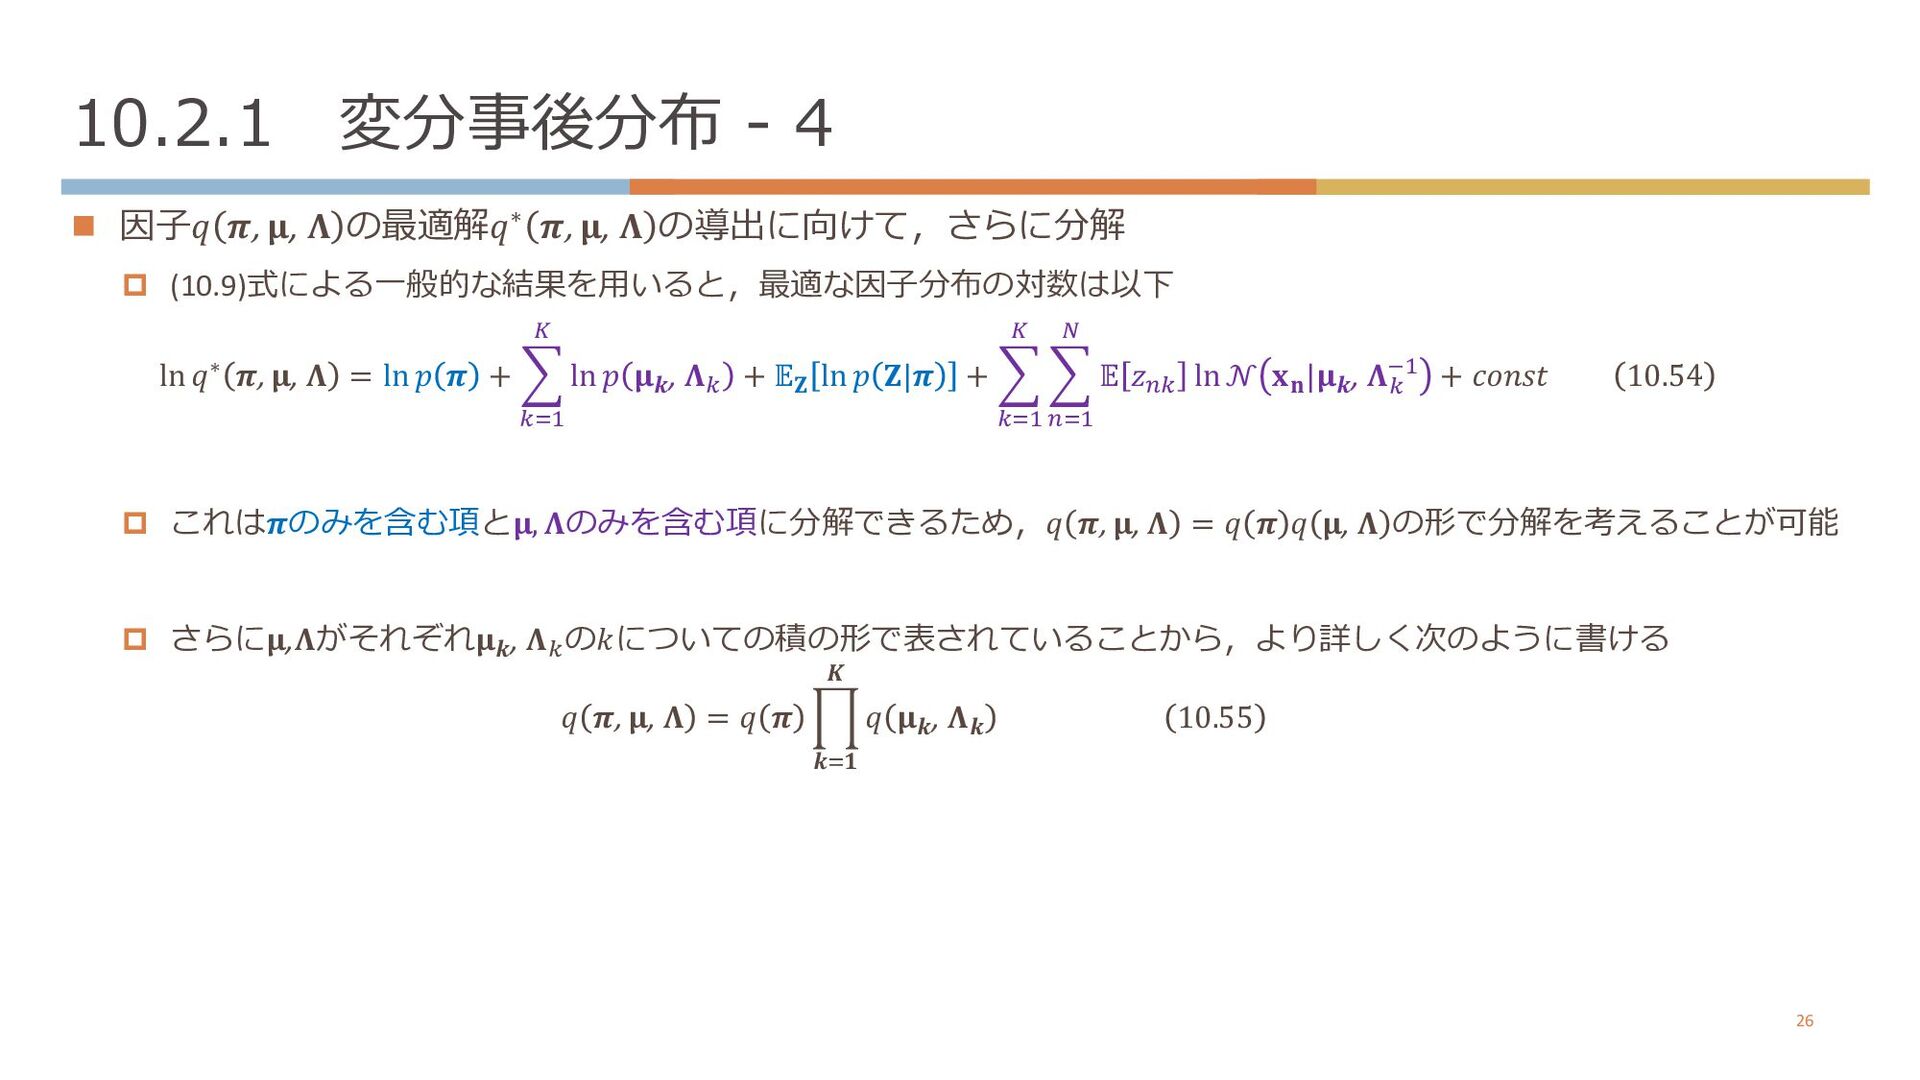
  25. 10.2.1 変分事後分布 - 4 n 因⼦𝑞 𝝅, 𝛍, 𝚲 の最適解𝑞∗

    𝝅, 𝛍, 𝚲 の導出に向けて,さらに分解 p (10.9)式による⼀般的な結果を⽤いると,最適な因⼦分布の対数は以下 ln 𝑞∗ 𝝅, 𝛍, 𝚲 = ln 𝑝 𝝅 + U fYM j ln 𝑝 𝛍𝒌, 𝚲f + 𝔼𝐙 ln 𝑝 𝐙|𝝅 + U fYM j U XYM Q 𝔼 𝑧Xf ln 𝒩 𝐱𝐧 |𝛍𝒌, 𝚲f OM + 𝑐𝑜𝑛𝑠𝑡 10.54 p これは𝝅のみを含む項と𝛍, 𝚲のみを含む項に分解できるため,𝑞 𝝅, 𝛍, 𝚲 = 𝑞 𝝅 𝑞 𝛍, 𝚲 の形で分解を考えることが可能 p さらに𝛍,𝚲がそれぞれ𝛍𝒌, 𝚲f の𝑘についての積の形で表されていることから,より詳しく次のように書ける 𝑞 𝝅, 𝛍, 𝚲 = 𝑞 𝝅 d 𝒌Y𝟏 𝑲 𝑞 𝛍𝒌, 𝚲𝒌 10.55 26
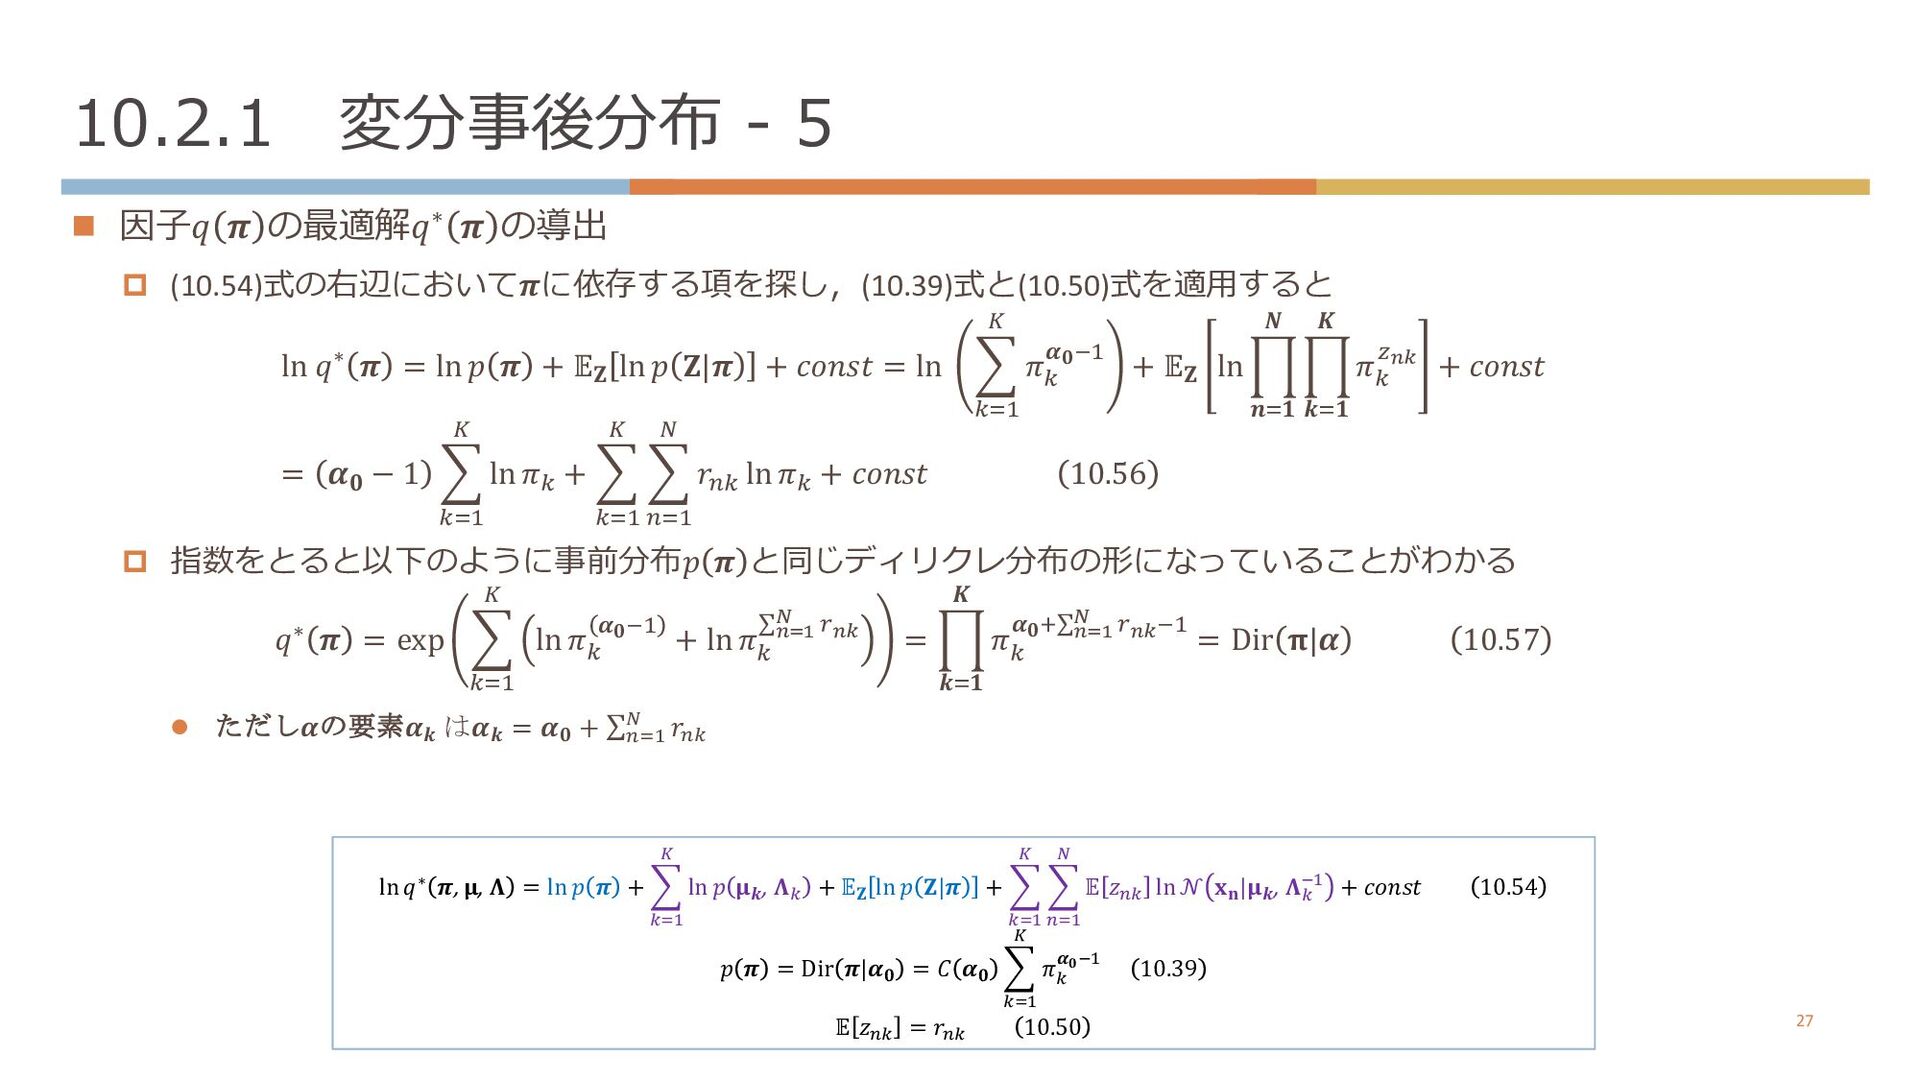
  26. 10.2.1 変分事後分布 - 5 n 因⼦𝑞 𝝅 の最適解𝑞∗ 𝝅 の導出

    p (10.54)式の右辺において𝝅に依存する項を探し,(10.39)式と(10.50)式を適⽤すると ln 𝑞∗ 𝝅 = ln 𝑝 𝝅 + 𝔼𝐙 ln 𝑝 𝐙|𝝅 + 𝑐𝑜𝑛𝑠𝑡 = ln U fYM j 𝜋f 𝜶𝟎OM + 𝔼𝐙 ln d 𝒏Y𝟏 𝑵 d 𝒌Y𝟏 𝑲 𝜋f g-2 + 𝑐𝑜𝑛𝑠𝑡 = 𝜶𝟎 − 1 U fYM j ln 𝜋f + U fYM j U XYM Q 𝑟Xf ln 𝜋f + 𝑐𝑜𝑛𝑠𝑡 10.56 p 指数をとると以下のように事前分布𝑝 𝝅 と同じディリクレ分布の形になっていることがわかる 𝑞∗ 𝝅 = exp U fYM j ln 𝜋f 𝜶𝟎OM + ln 𝜋f ∑-./ 0 s-2 = d 𝒌Y𝟏 𝑲 𝜋f 𝜶𝟎t∑-./ 0 s-2OM = Dir 𝛑|𝜶 10.57 l ただし𝜶の要素𝜶𝒌 は𝜶𝒌 = 𝜶𝟎 + ∑;$! < 𝑟;9 27 ln 𝑞∗ 𝝅, 𝛍, 𝚲 = ln 𝑝 𝝅 + 7 1*+ 2 ln 𝑝 𝛍𝒌, 𝚲1 + 𝔼𝐙 ln 𝑝 𝐙|𝝅 + 7 1*+ 2 7 5*+ 6 𝔼 𝑧51 ln 𝒩 𝐱𝐧|𝛍𝒌, 𝚲1 8+ + 𝑐𝑜𝑛𝑠𝑡 10.54 𝑝 𝝅 = Dir 𝝅|𝜶𝟎 = 𝐶 𝜶𝟎 7 1*+ 2 𝜋1 𝜶𝟎8+ 10.39 𝔼 𝑧51 = 𝑟51 10.50
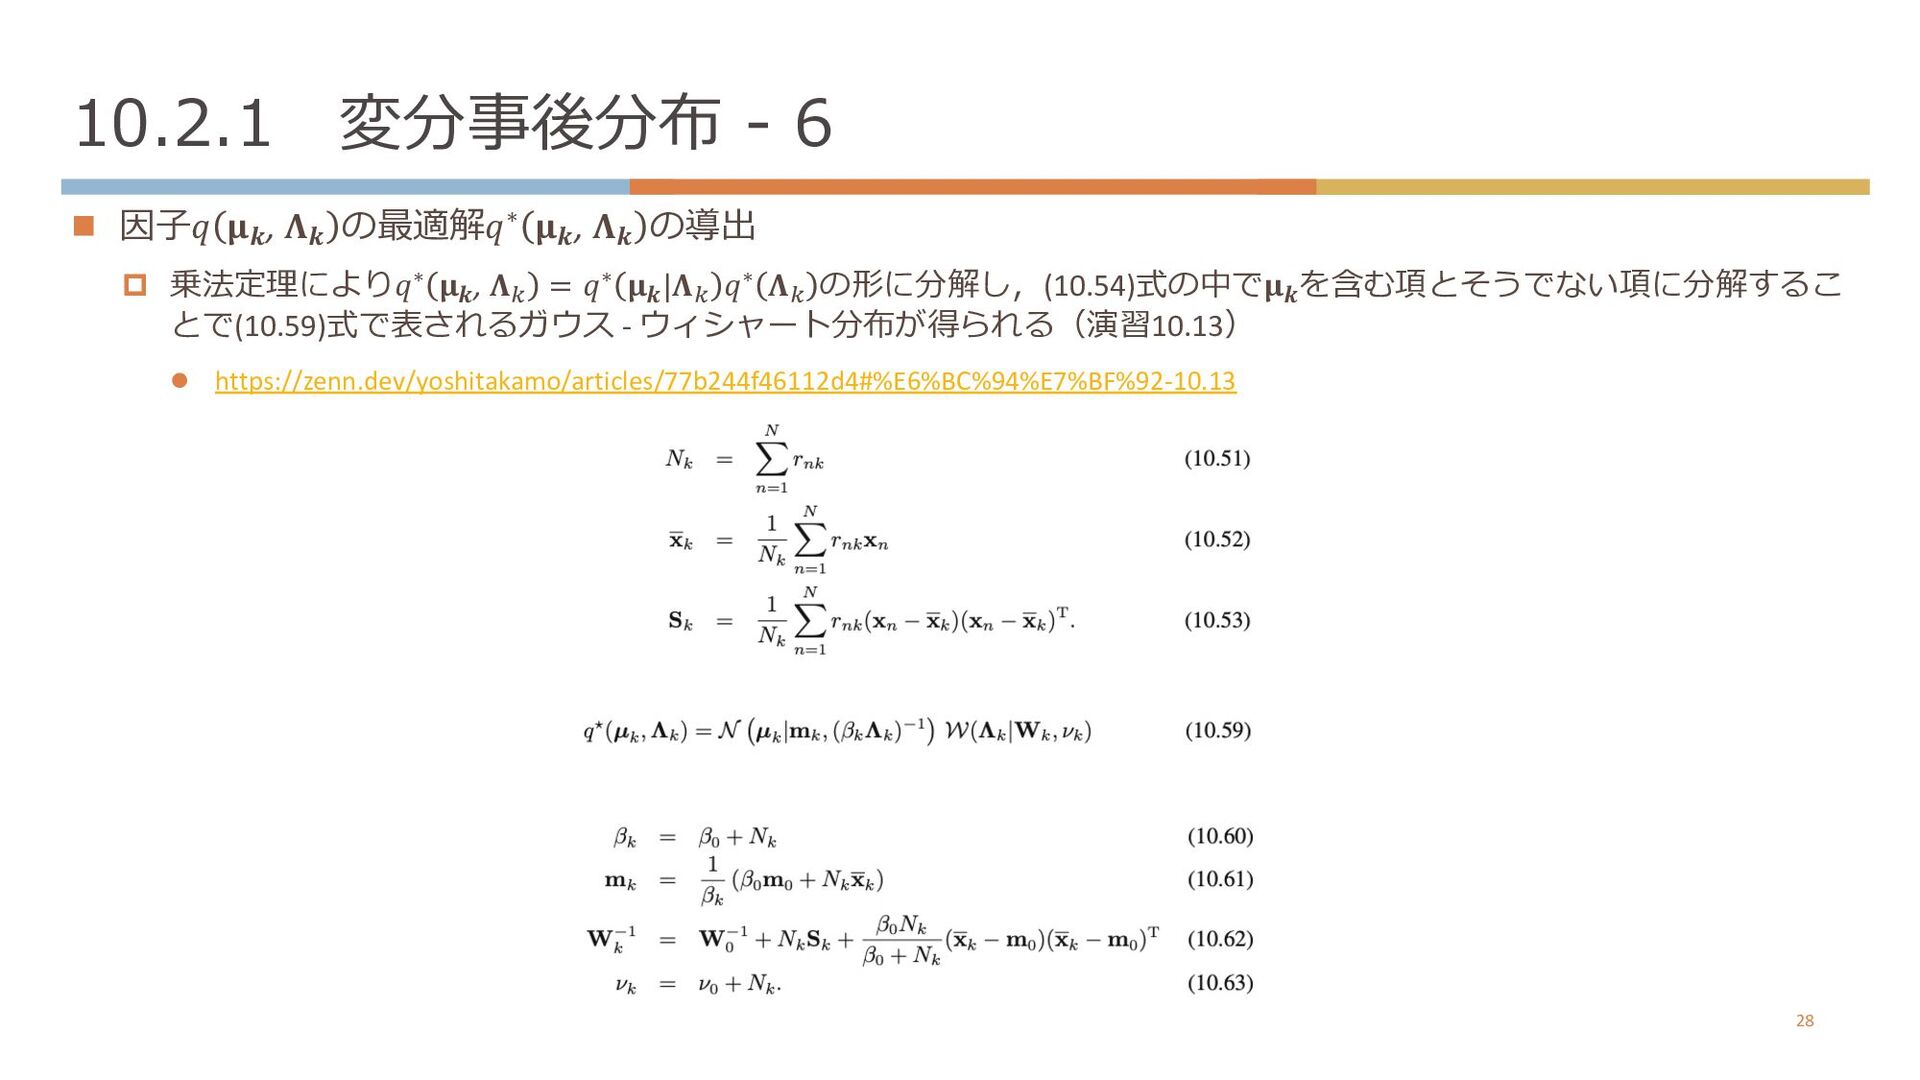
  27. 10.2.1 変分事後分布 - 6 n 因⼦𝑞 𝛍𝒌, 𝚲𝒌 の最適解𝑞∗ 𝛍𝒌,

    𝚲𝒌 の導出 p 乗法定理により𝑞∗ 𝛍𝒌, 𝚲f = 𝑞∗ 𝛍𝒌|𝚲f 𝑞∗ 𝚲f の形に分解し,(10.54)式の中で𝛍𝒌 を含む項とそうでない項に分解するこ とで(10.59)式で表されるガウス - ウィシャート分布が得られる(演習10.13) l https://zenn.dev/yoshitakamo/articles/77b244f46112d4#%E6%BC%94%E7%BF%92-10.13 28
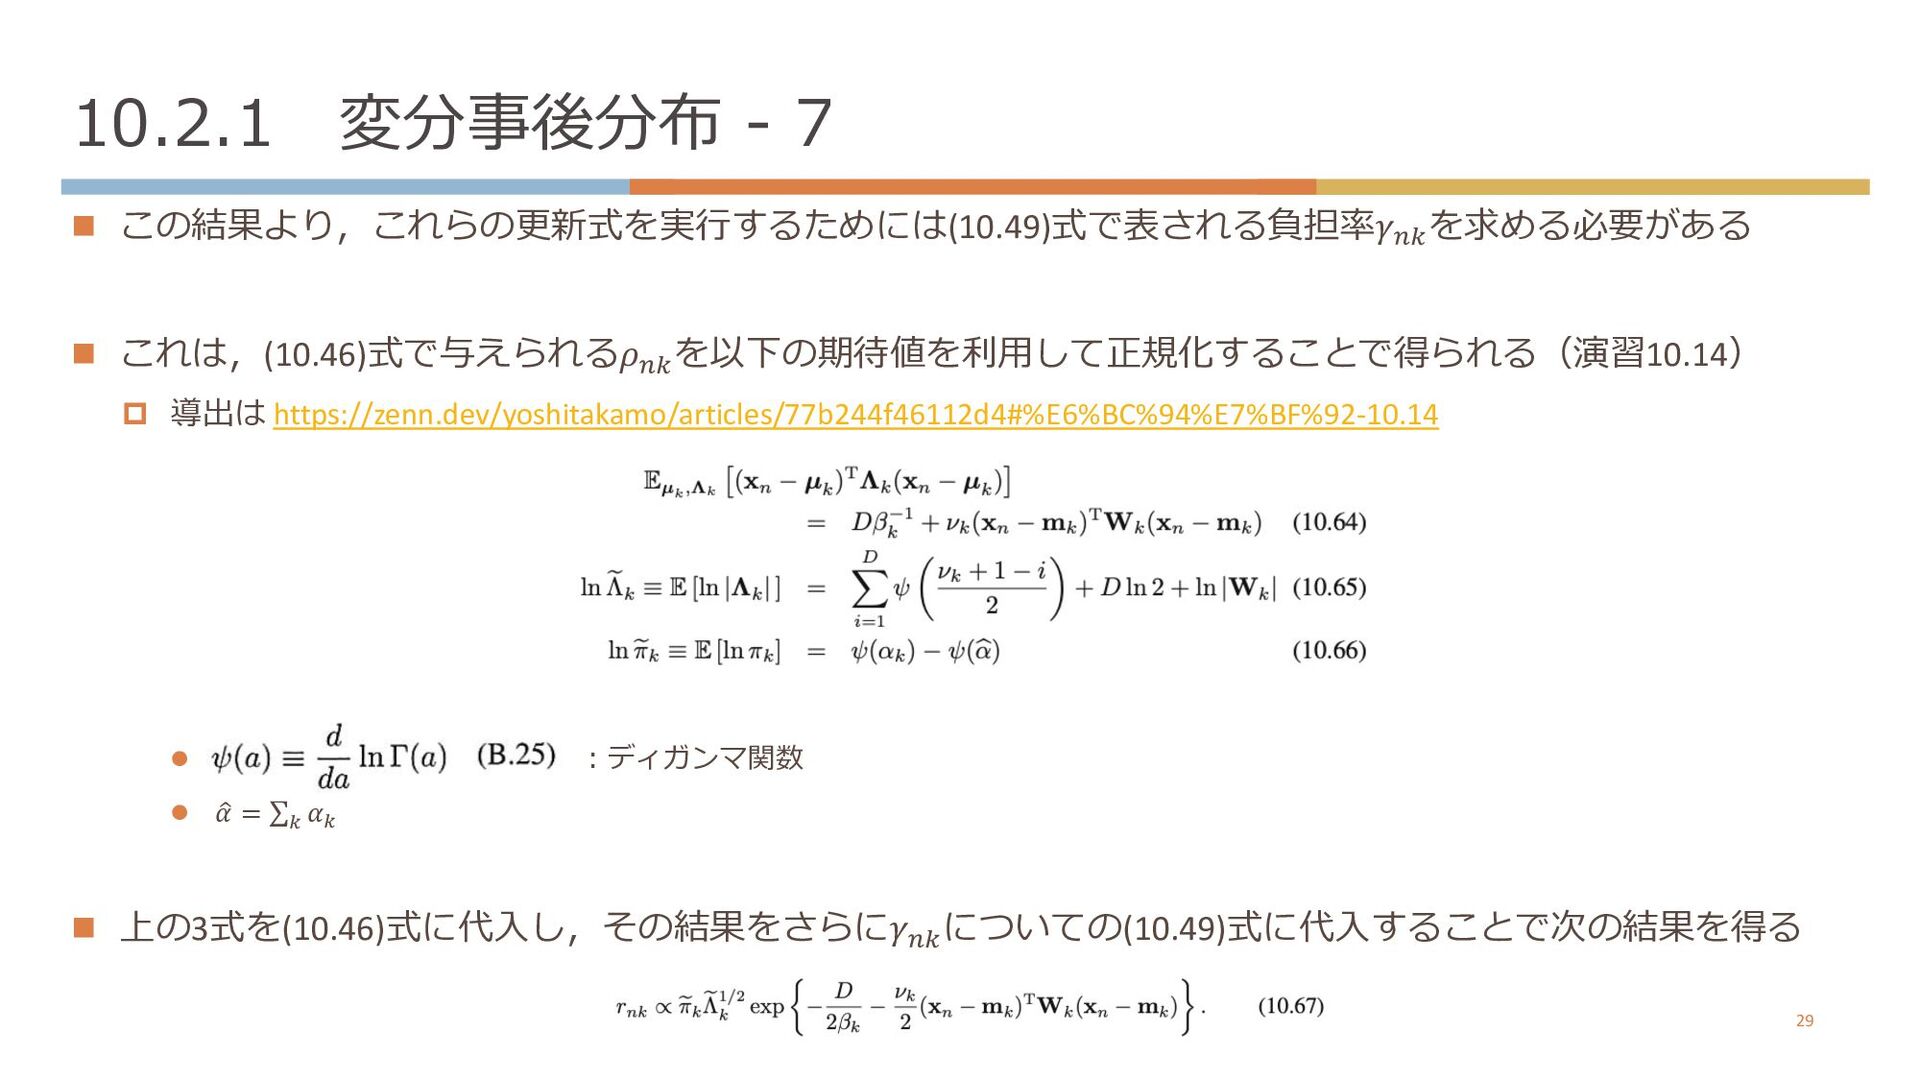
  28. 10.2.1 変分事後分布 - 7 n この結果より,これらの更新式を実⾏するためには(10.49)式で表される負担率𝛾@N を求める必要がある n これは,(10.46)式で与えられる𝜌@N を以下の期待値を利⽤して正規化することで得られる(演習10.14)

    p 導出は https://zenn.dev/yoshitakamo/articles/77b244f46112d4#%E6%BC%94%E7%BF%92-10.14 l ︓ディガンマ関数 l O 𝛼 = ∑9 𝛼9 n 上の3式を(10.46)式に代⼊し,その結果をさらに𝛾@N についての(10.49)式に代⼊することで次の結果を得る 29
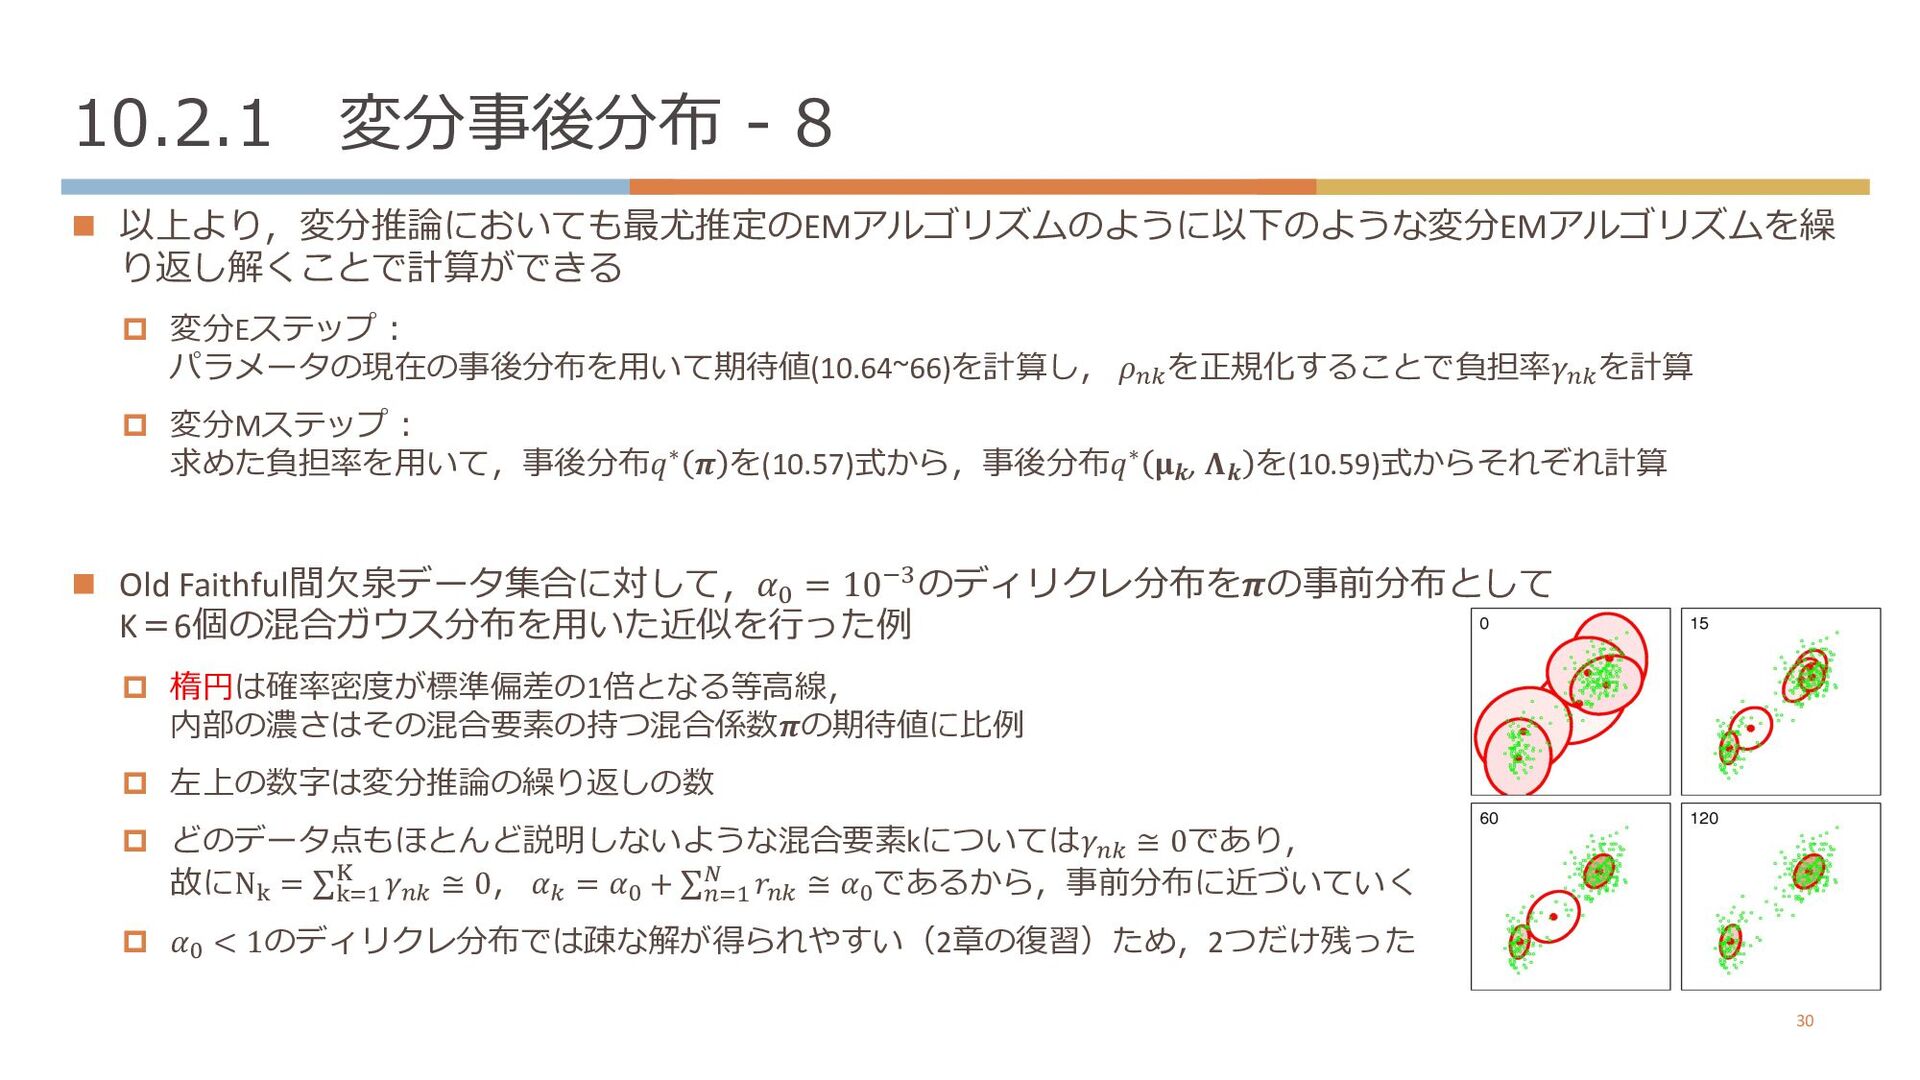
  29. 10.2.1 変分事後分布 - 8 n 以上より,変分推論においても最尤推定のEMアルゴリズムのように以下のような変分EMアルゴリズムを繰 り返し解くことで計算ができる p 変分Eステップ︓ パラメータの現在の事後分布を⽤いて期待値(10.64~66)を計算し,

    𝜌Xf を正規化することで負担率𝛾Xf を計算 p 変分Mステップ︓ 求めた負担率を⽤いて,事後分布𝑞∗ 𝝅 を(10.57)式から,事後分布𝑞∗ 𝛍𝒌, 𝚲𝒌 を(10.59)式からそれぞれ計算 n Old Faithful間⽋泉データ集合に対して,𝛼O = 10PQのディリクレ分布を𝝅の事前分布として K=6個の混合ガウス分布を⽤いた近似を⾏った例 p 楕円は確率密度が標準偏差の1倍となる等⾼線, 内部の濃さはその混合要素の持つ混合係数𝝅の期待値に⽐例 p 左上の数字は変分推論の繰り返しの数 p どのデータ点もほとんど説明しないような混合要素kについては𝛾Xf ≅ 0であり, 故にN• = ∑•YM € 𝛾Xf ≅ 0, 𝛼f = 𝛼R + ∑XYM Q 𝑟Xf ≅ 𝛼R であるから,事前分布に近づいていく p 𝛼R < 1のディリクレ分布では疎な解が得られやすい(2章の復習)ため,2つだけ残った 30
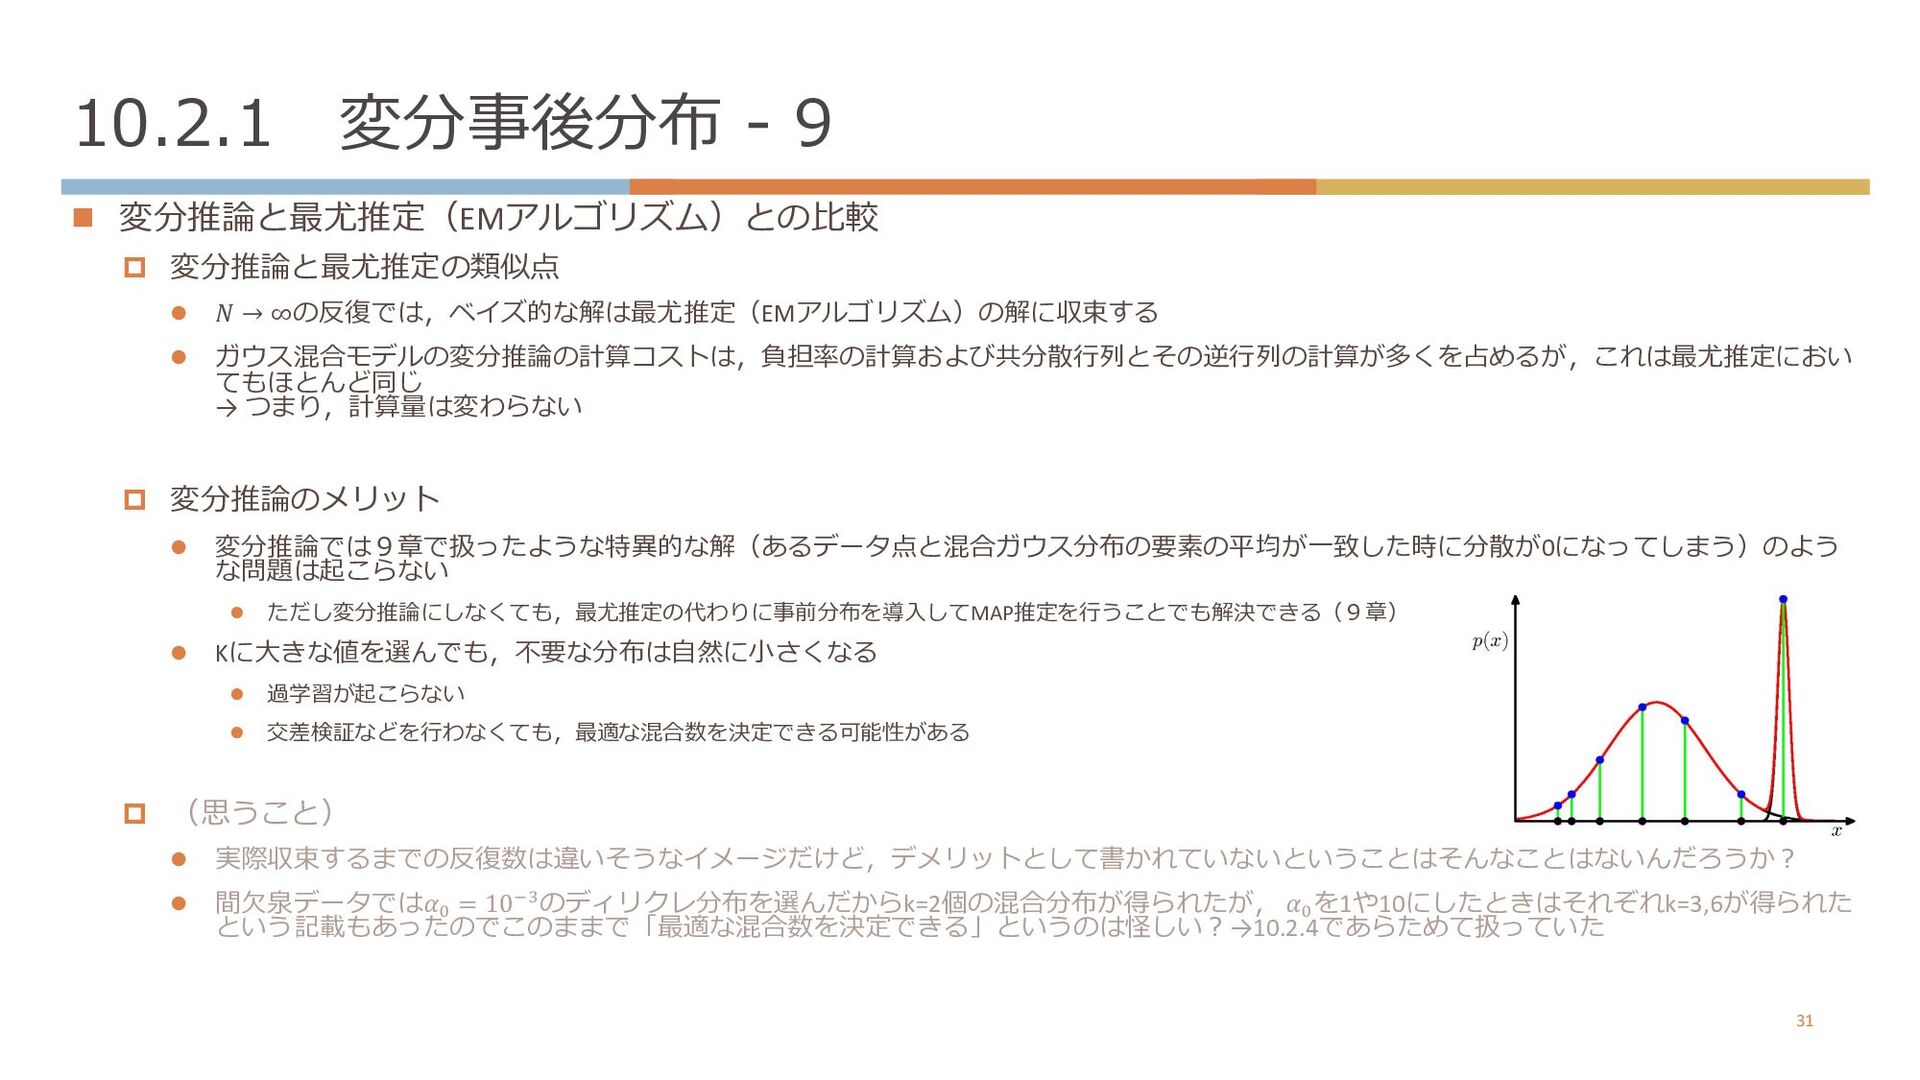
  30. 10.2.1 変分事後分布 - 9 n 変分推論と最尤推定(EMアルゴリズム)との⽐較 p 変分推論と最尤推定の類似点 l 𝑁

    → ∞の反復では,ベイズ的な解は最尤推定(EMアルゴリズム)の解に収束する l ガウス混合モデルの変分推論の計算コストは,負担率の計算および共分散⾏列とその逆⾏列の計算が多くを占めるが,これは最尤推定におい てもほとんど同じ → つまり,計算量は変わらない p 変分推論のメリット l 変分推論では9章で扱ったような特異的な解(あるデータ点と混合ガウス分布の要素の平均が⼀致した時に分散が0になってしまう)のよう な問題は起こらない l ただし変分推論にしなくても,最尤推定の代わりに事前分布を導⼊してMAP推定を⾏うことでも解決できる(9章) l Kに⼤きな値を選んでも,不要な分布は⾃然に⼩さくなる l 過学習が起こらない l 交差検証などを⾏わなくても,最適な混合数を決定できる可能性がある p (思うこと) l 実際収束するまでの反復数は違いそうなイメージだけど,デメリットとして書かれていないということはそんなことはないんだろうか︖ l 間⽋泉データでは𝛼; = 108<のディリクレ分布を選んだからk=2個の混合分布が得られたが, 𝛼; を1や10にしたときはそれぞれk=3,6が得られた という記載もあったのでこのままで「最適な混合数を決定できる」というのは怪しい︖→10.2.4であらためて扱っていた 31
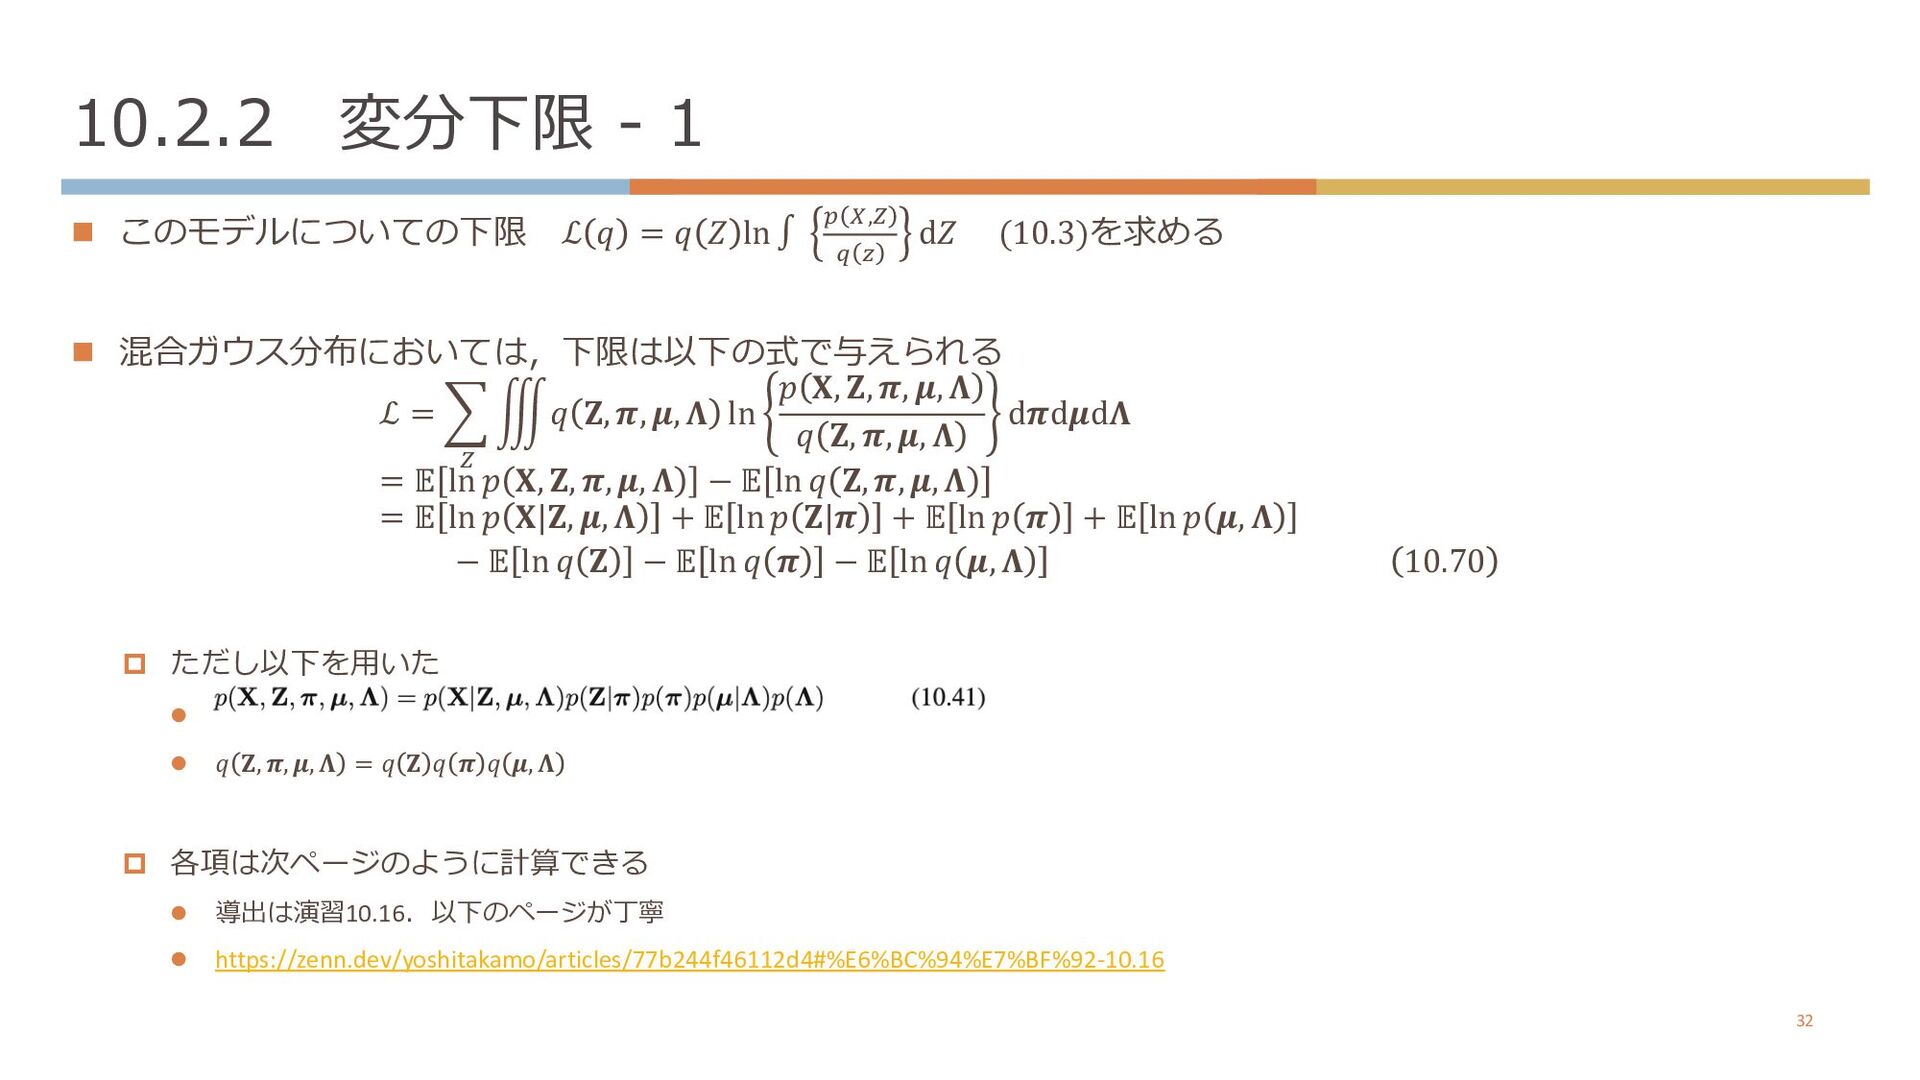
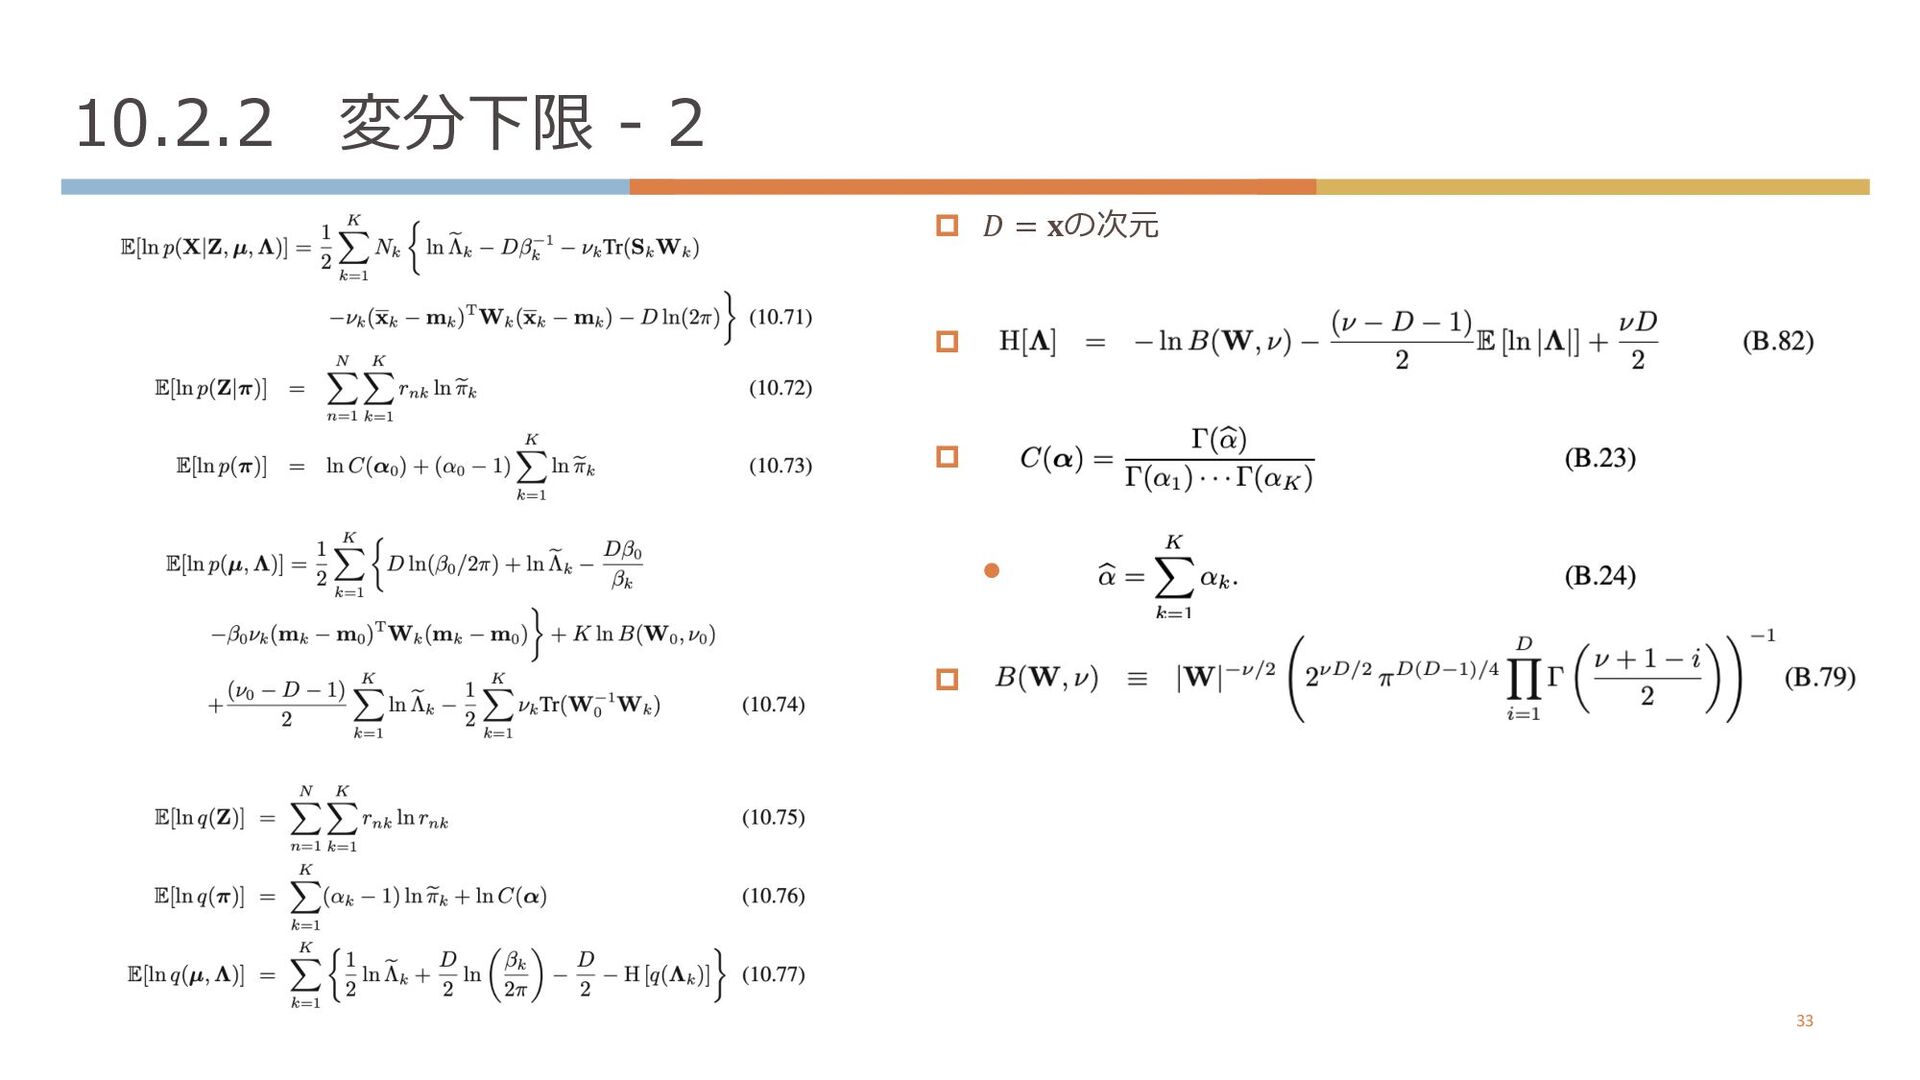
  31. 10.2.2 変分下限 - 1 n このモデルについての下限 ℒ 𝑞 = 𝑞

    𝑍 ln ∫ • ‚,ƒ „ g d𝑍 (10.3)を求める n 混合ガウス分布においては,下限は以下の式で与えられる ℒ = = ƒ N𝑞 𝐙, 𝝅, 𝝁, 𝚲 ln 𝑝 𝐗, 𝐙, 𝝅, 𝝁, 𝚲 𝑞 𝐙, 𝝅, 𝝁, 𝚲 d𝝅d𝝁d𝚲 = 𝔼 ln 𝑝 𝐗, 𝐙, 𝝅, 𝝁, 𝚲 − 𝔼 ln 𝑞 𝐙, 𝝅, 𝝁, 𝚲 = 𝔼 ln 𝑝 𝐗|𝐙, 𝝁, 𝚲 + 𝔼 ln 𝑝 𝐙|𝝅 + 𝔼 ln 𝑝 𝝅 + 𝔼 ln 𝑝 𝝁, 𝚲 − 𝔼 ln 𝑞 𝐙 − 𝔼 ln 𝑞 𝝅 − 𝔼 ln 𝑞 𝝁, 𝚲 10.70 p ただし以下を⽤いた l l 𝑞 𝐙, 𝝅, 𝝁, 𝚲 = 𝑞 𝐙 𝑞 𝝅 𝑞 𝝁, 𝚲 p 各項は次ページのように計算できる l 導出は演習10.16.以下のページが丁寧 l https://zenn.dev/yoshitakamo/articles/77b244f46112d4#%E6%BC%94%E7%BF%92-10.16 32
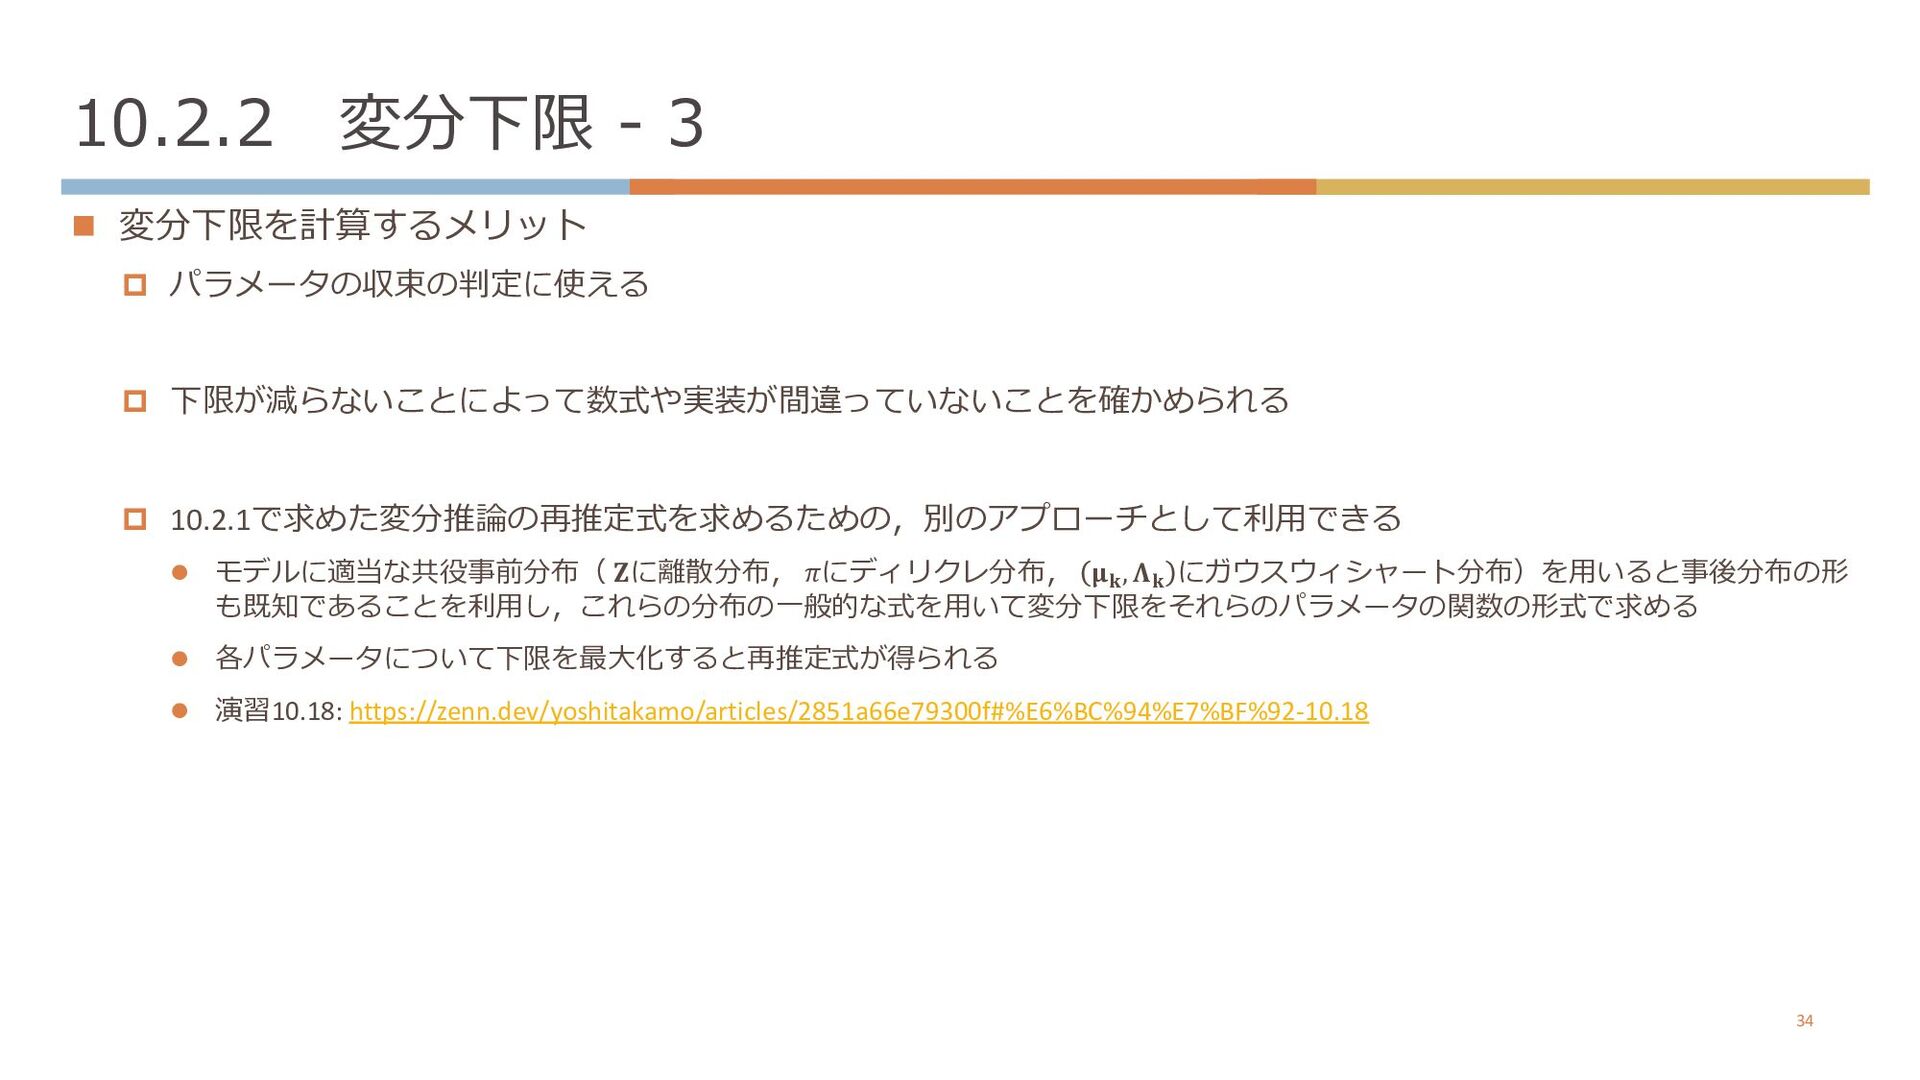
  32. n 変分下限を計算するメリット p パラメータの収束の判定に使える p 下限が減らないことによって数式や実装が間違っていないことを確かめられる p 10.2.1で求めた変分推論の再推定式を求めるための,別のアプローチとして利⽤できる l モデルに適当な共役事前分布(

    𝐙に離散分布, 𝜋にディリクレ分布, 𝛍𝐤 , 𝚲𝐤 にガウスウィシャート分布)を⽤いると事後分布の形 も既知であることを利⽤し,これらの分布の⼀般的な式を⽤いて変分下限をそれらのパラメータの関数の形式で求める l 各パラメータについて下限を最⼤化すると再推定式が得られる l 演習10.18: https://zenn.dev/yoshitakamo/articles/2851a66e79300f#%E6%BC%94%E7%BF%92-10.18 34 10.2.2 変分下限 - 3
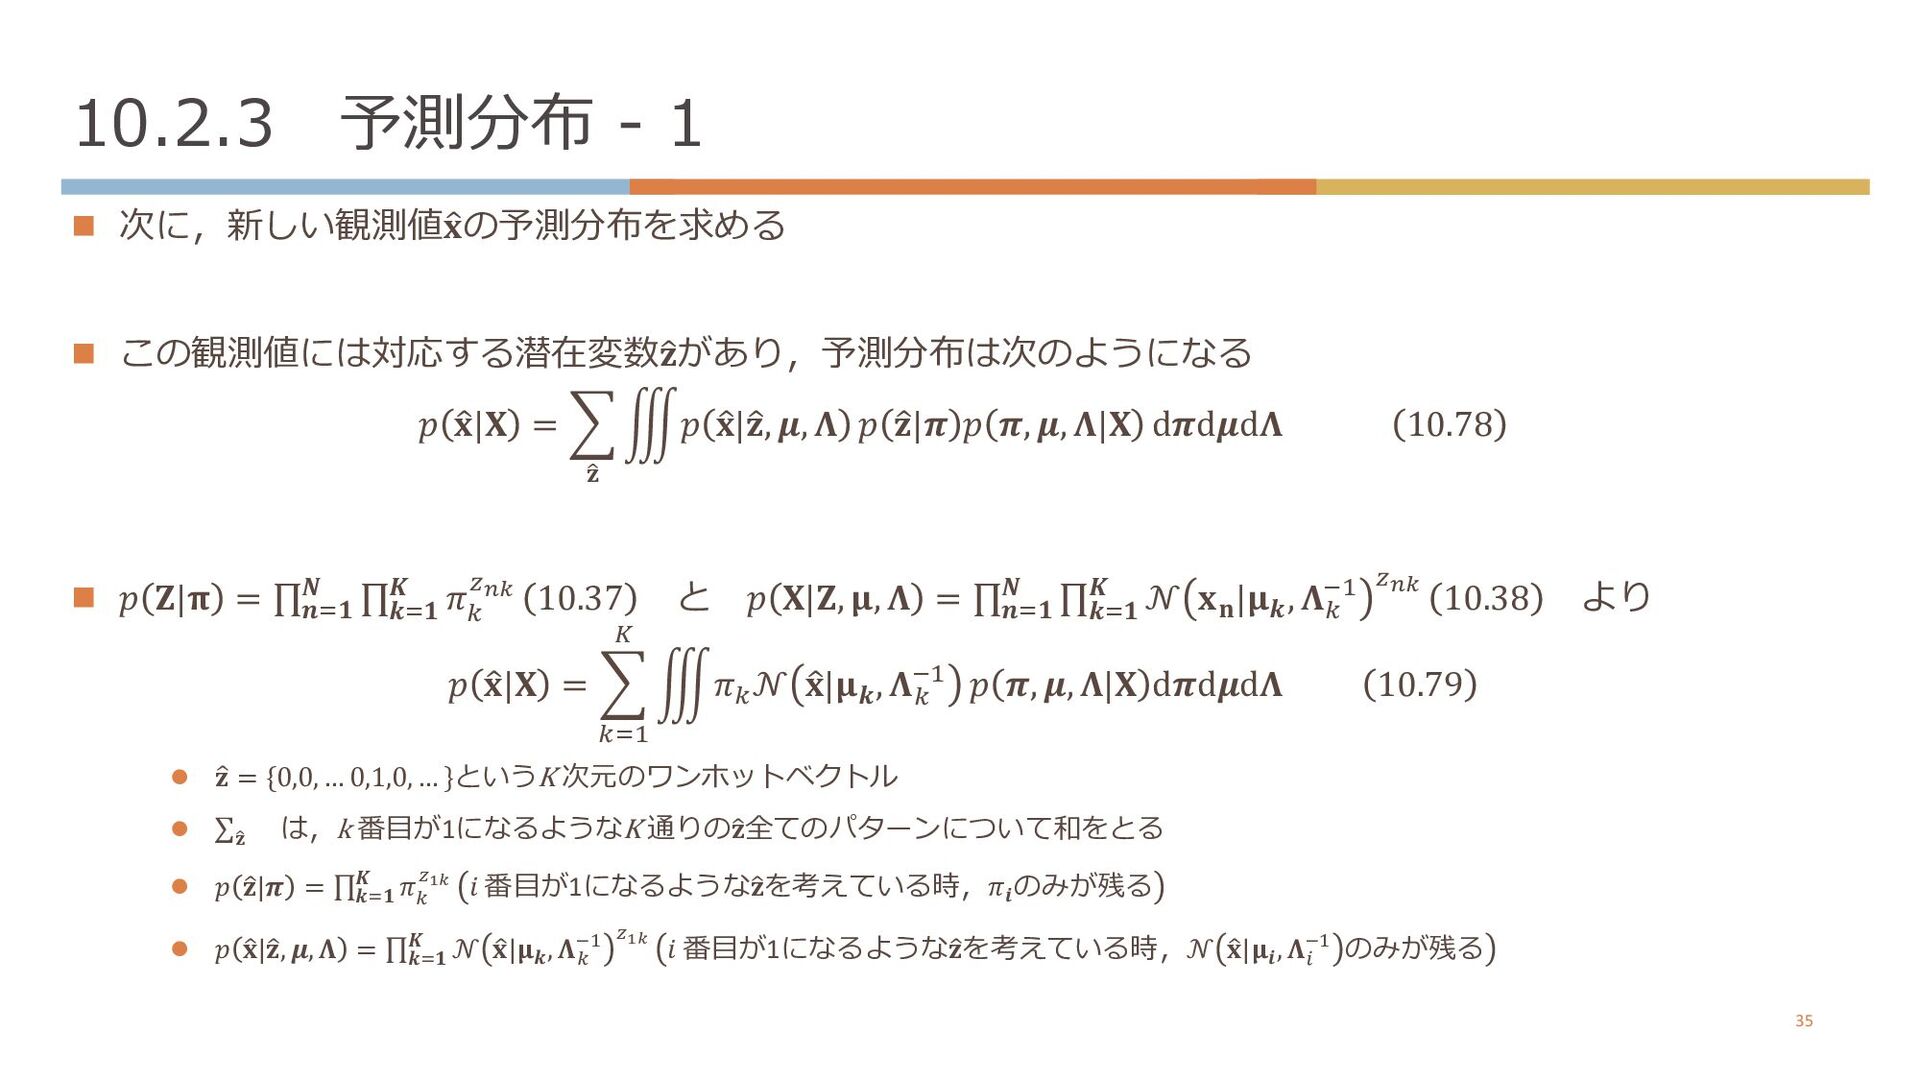
  33. 10.2.3 予測分布 - 1 n 次に,新しい観測値J 𝐱の予測分布を求める n この観測値には対応する潜在変数J 𝐳があり,予測分布は次のようになる

    𝑝 J 𝐱|𝐗 = / W 𝐳 M𝑝 J 𝐱|J 𝐳, 𝝁, 𝚲 𝑝 J 𝐳|𝝅 𝑝 𝝅, 𝝁, 𝚲|𝐗 d𝝅d𝝁d𝚲 10.78 n 𝑝 𝐙|𝛑 = ∏𝒏A𝟏 𝑵 ∏𝒌A𝟏 𝑲 𝜋 N LYZ 10.37 と 𝑝 𝐗|𝐙, 𝛍, 𝚲 = ∏𝒏A𝟏 𝑵 ∏𝒌A𝟏 𝑲 𝒩 𝐱𝐧 |𝛍𝒌 , 𝚲N PB LYZ 10.38 より 𝑝 J 𝐱|𝐗 = / NAB ^ M𝜋N 𝒩 J 𝐱|𝛍𝒌 , 𝚲N PB 𝑝 𝝅, 𝝁, 𝚲|𝐗 d𝝅d𝝁d𝚲 10.79 l O 𝐳 = {0,0, … 0,1,0, … }というK 次元のワンホットベクトル l ∑> 𝐳 は,k 番⽬が1になるようなK 通りのO 𝐳全てのパターンについて和をとる l 𝑝 O 𝐳|𝝅 = ∏𝒌$𝟏 𝑲 𝜋9 :65 𝑖 番⽬が1になるようなO 𝐳を考えている時,𝜋𝒊 のみが残る l 𝑝 O 𝐱|O 𝐳, 𝝁, 𝚲 = ∏𝒌$𝟏 𝑲 𝒩 O 𝐱|𝛍𝒌 , 𝚲9 A! :65 𝑖 番⽬が1になるようなO 𝐳を考えている時,𝒩 O 𝐱|𝛍𝒊 , 𝚲# A! のみが残る 35
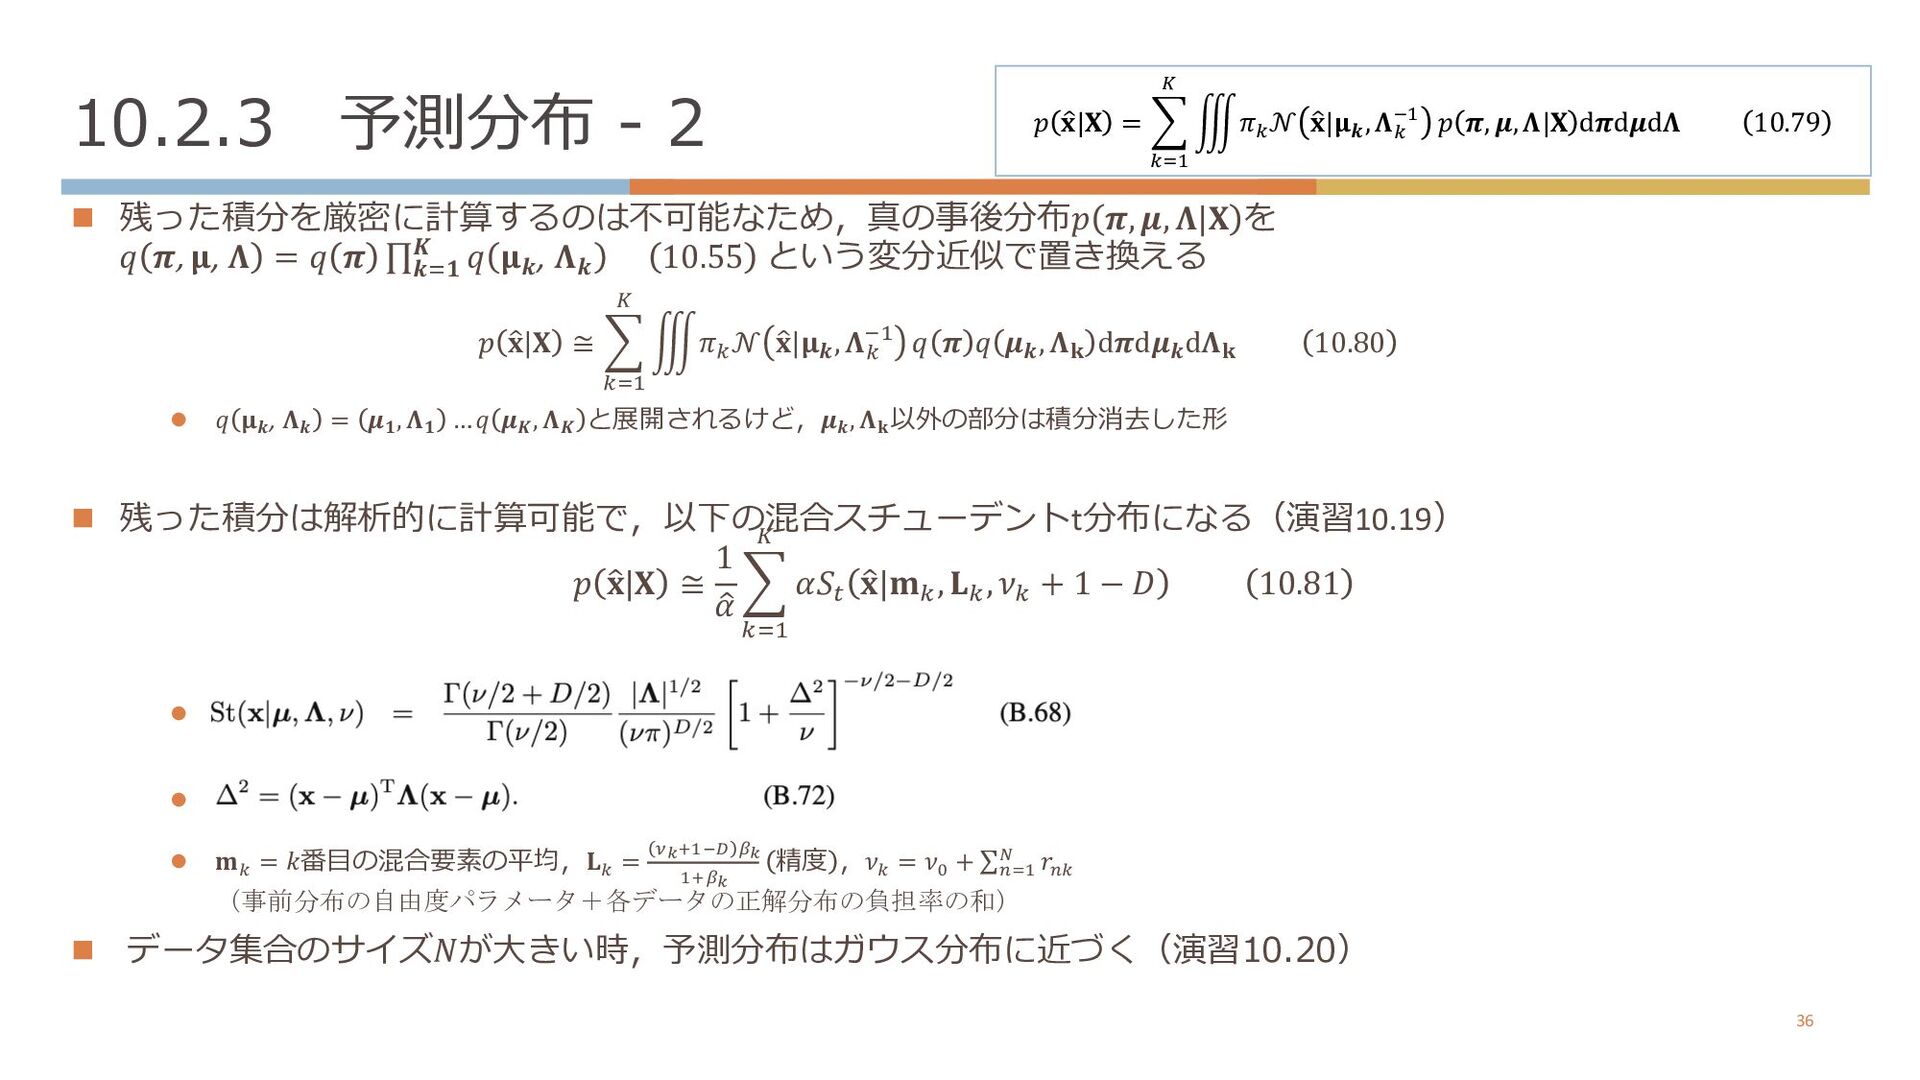
  34. n 残った積分を厳密に計算するのは不可能なため,真の事後分布𝑝 𝝅, 𝝁, 𝚲|𝐗 を 𝑞 𝝅, 𝛍, 𝚲

    = 𝑞 𝝅 ∏𝒌Y𝟏 𝑲 𝑞 𝛍𝒌 , 𝚲𝒌 10.55 という変分近似で置き換える 𝑝 X 𝐱|𝐗 ≅ P [G! J Z𝜋[ 𝒩 X 𝐱|𝛍𝒌 , 𝚲[ ;! 𝑞 𝝅 𝑞 𝝁𝒌 , 𝚲𝐤 d𝝅d𝝁𝒌 d𝚲𝐤 10.80 l 𝑞 𝛍𝒌 , 𝚲𝒌 = 𝝁𝟏 , 𝚲𝟏 … 𝑞 𝝁𝑲 , 𝚲𝑲 と展開されるけど,𝝁𝒌 , 𝚲𝐤 以外の部分は積分消去した形 n 残った積分は解析的に計算可能で,以下の混合スチューデントt分布になる(演習10.19) 𝑝 S 𝐱|𝐗 ≅ 1 S 𝛼 = fYM j 𝛼𝑆… S 𝐱|𝐦f , 𝐋f , 𝜈f + 1 − 𝐷 10.81 l l l 𝐦1 = 𝑘番⽬の混合要素の平均,𝐋1 = @5A+8B C5 +AC5 精度 ,𝜈1 = 𝜈; + ∑5*+ 6 𝑟51 (事前分布の自由度パラメータ+各データの正解分布の負担率の和) n データ集合のサイズ𝑁が⼤きい時,予測分布はガウス分布に近づく(演習10.20) 36 10.2.3 予測分布 - 2 𝑝 O 𝐱|𝐗 = 4 9$! B ^𝜋9 𝒩 O 𝐱|𝛍𝒌 , 𝚲9 A! 𝑝 𝝅, 𝝁, 𝚲|𝐗 d𝝅d𝝁d𝚲 10.79
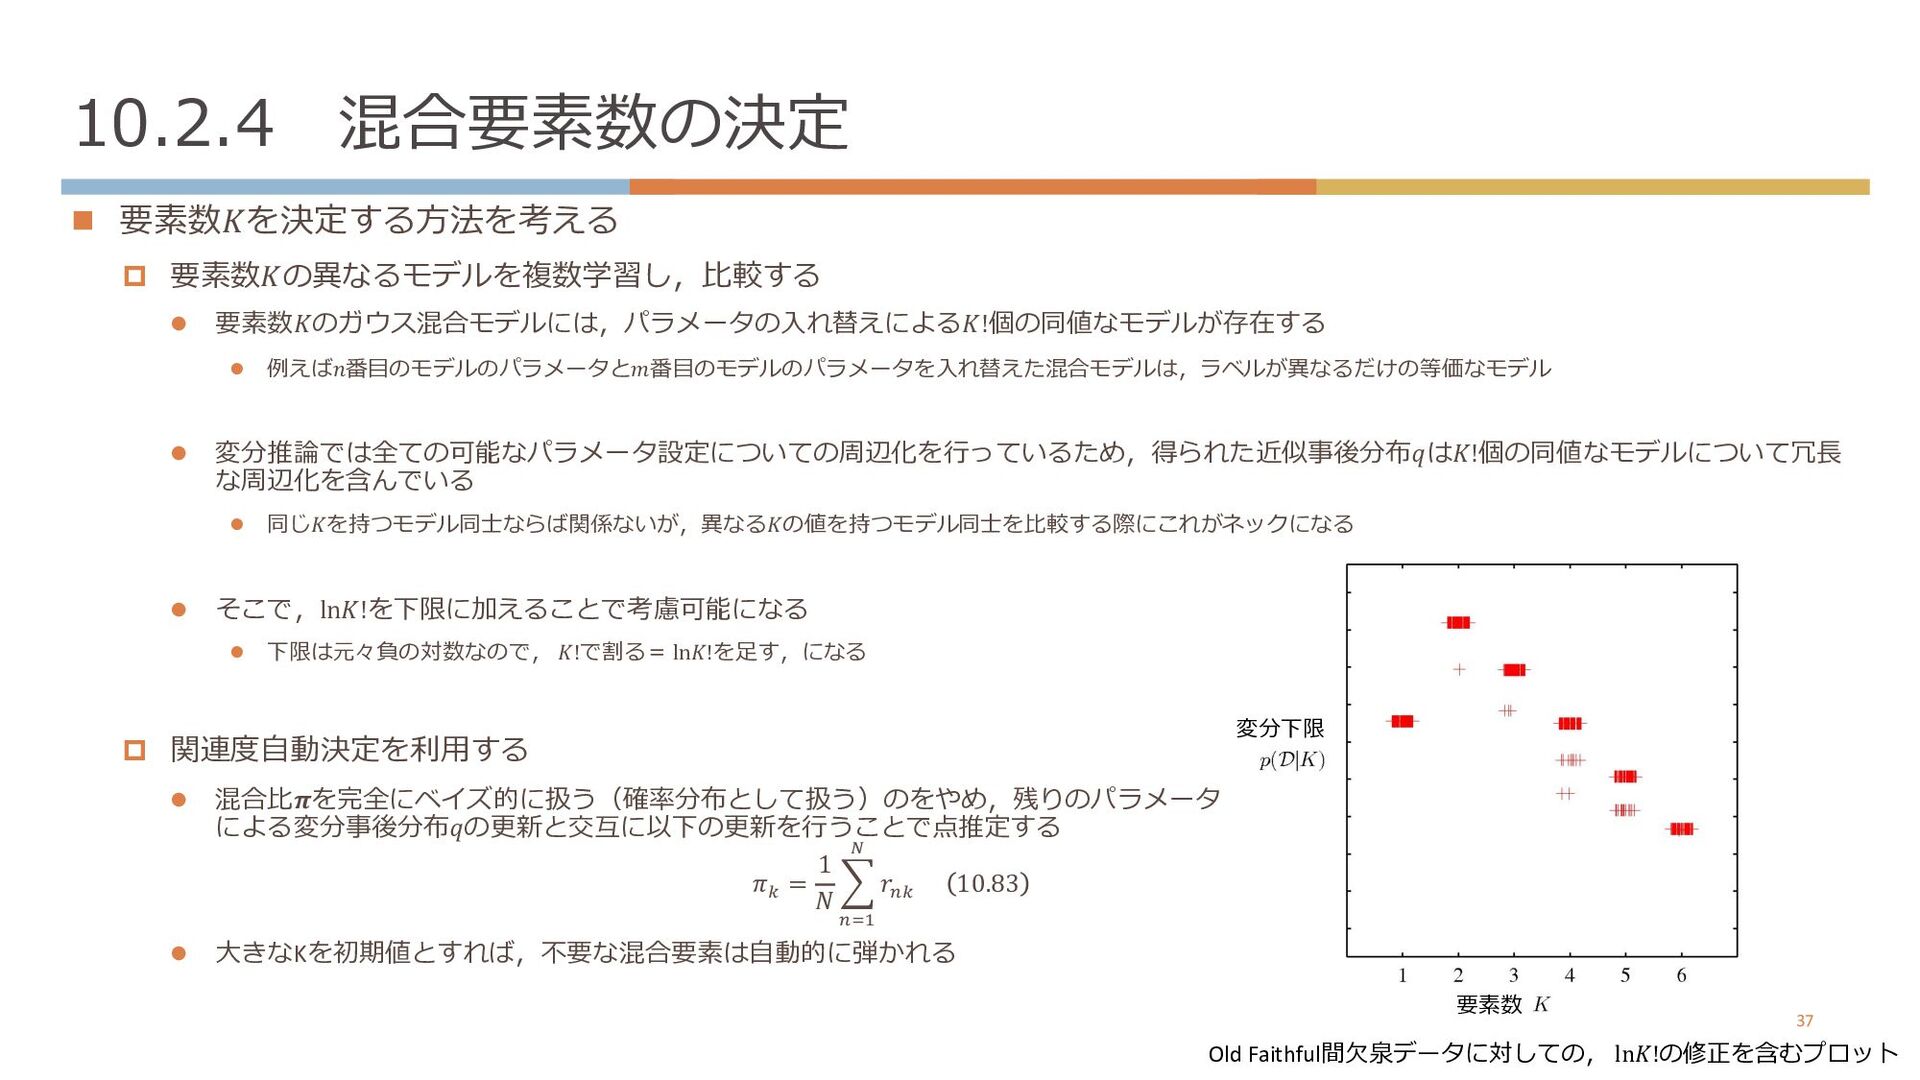
  35. 10.2.4 混合要素数の決定 n 要素数𝐾を決定する⽅法を考える p 要素数𝐾の異なるモデルを複数学習し,⽐較する l 要素数𝐾のガウス混合モデルには,パラメータの⼊れ替えによる𝐾!個の同値なモデルが存在する l 例えば𝑛番⽬のモデルのパラメータと𝑚番⽬のモデルのパラメータを⼊れ替えた混合モデルは,ラベルが異なるだけの等価なモデル

    l 変分推論では全ての可能なパラメータ設定についての周辺化を⾏っているため,得られた近似事後分布𝑞は𝐾!個の同値なモデルについて冗⻑ な周辺化を含んでいる l 同じ𝐾を持つモデル同⼠ならば関係ないが,異なる𝐾の値を持つモデル同⼠を⽐較する際にこれがネックになる l そこで,ln𝐾!を下限に加えることで考慮可能になる l 下限は元々負の対数なので, 𝐾!で割る= ln𝐾!を⾜す,になる p 関連度⾃動決定を利⽤する l 混合⽐𝝅を完全にベイズ的に扱う(確率分布として扱う)のをやめ,残りのパラメータ による変分事後分布𝑞の更新と交互に以下の更新を⾏うことで点推定する 𝜋1 = 1 𝑁 j 5*+ 6 𝑟51 10.83 l ⼤きなKを初期値とすれば,不要な混合要素は⾃動的に弾かれる 37 Old Faithful間⽋泉データに対しての, ln𝐾!の修正を含むプロット 変分下限 要素数
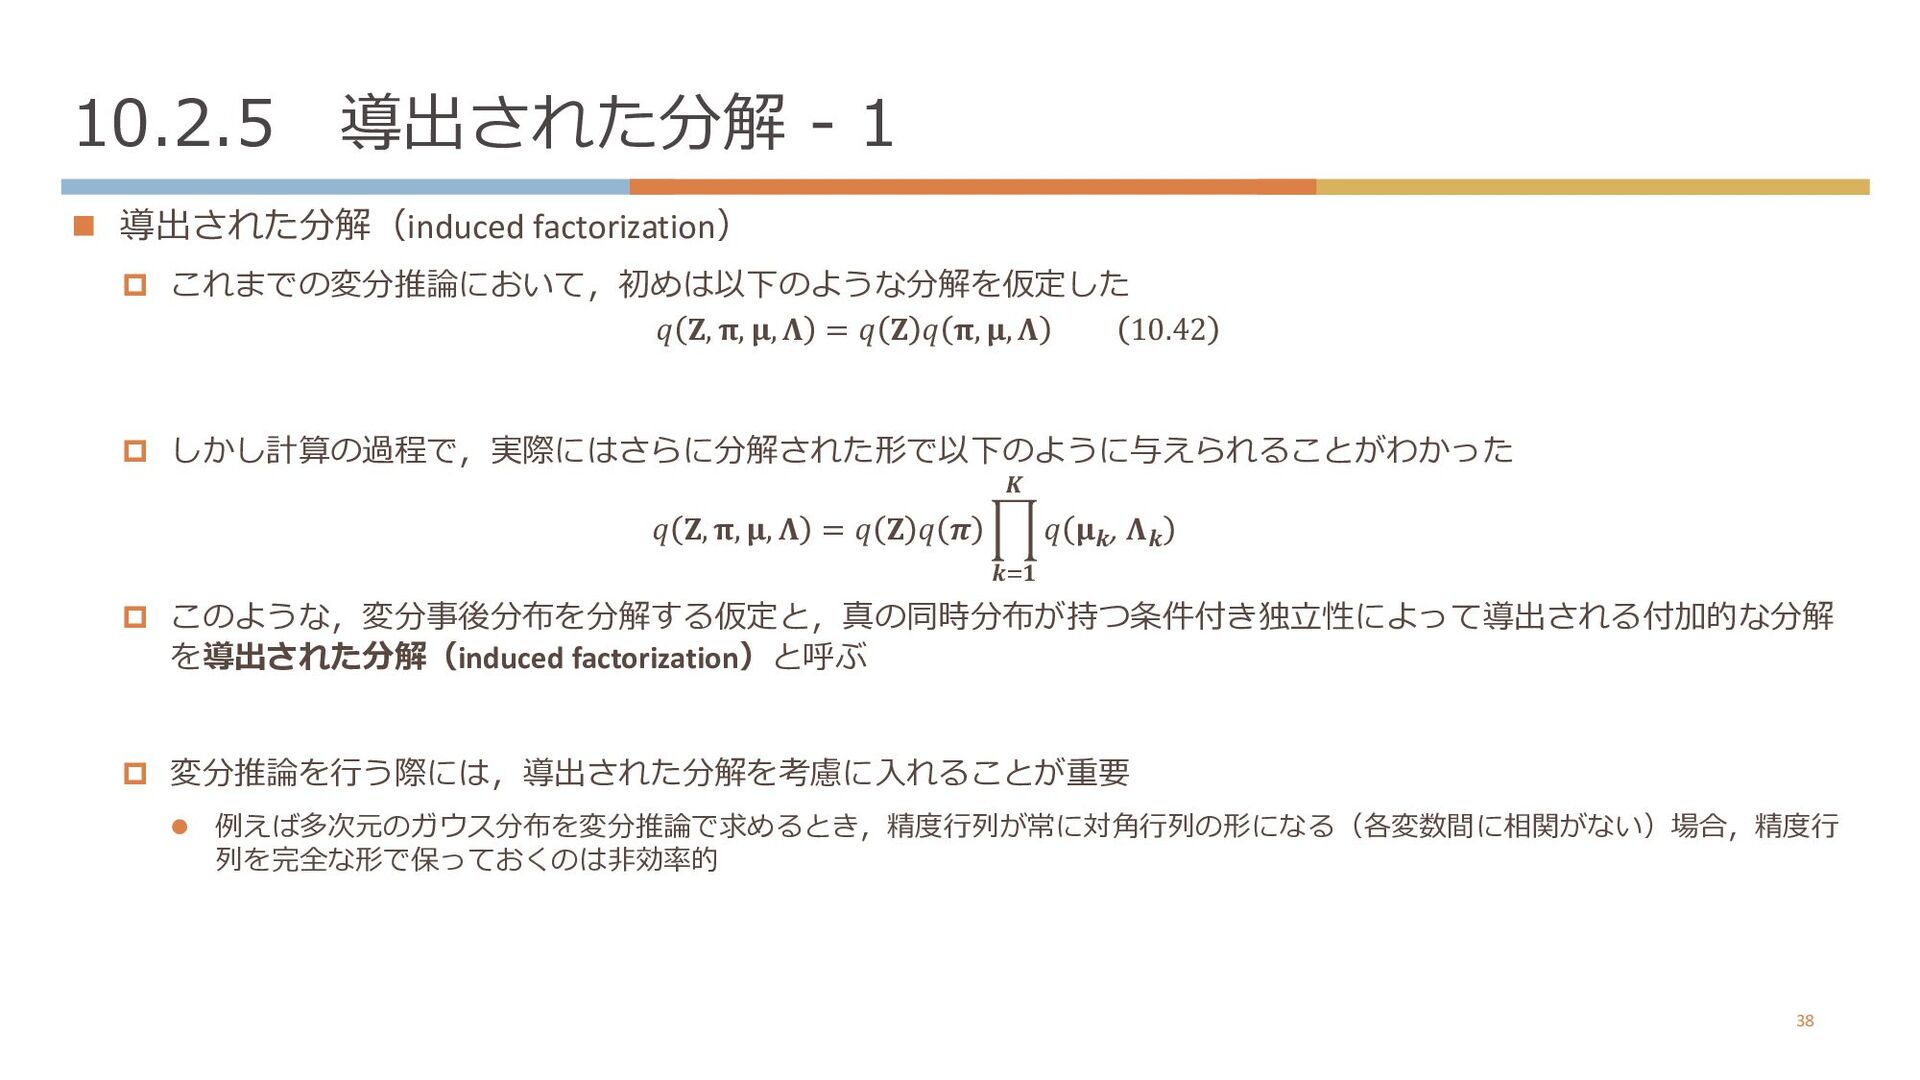
  36. 10.2.5 導出された分解 - 1 n 導出された分解(induced factorization) p これまでの変分推論において,初めは以下のような分解を仮定した 𝑞

    𝐙, 𝛑, 𝛍, 𝚲 = 𝑞 𝐙 𝑞 𝛑, 𝛍, 𝚲 10.42 p しかし計算の過程で,実際にはさらに分解された形で以下のように与えられることがわかった 𝑞 𝐙, 𝛑, 𝛍, 𝚲 = 𝑞 𝐙 𝑞 𝝅 d 𝒌Y𝟏 𝑲 𝑞 𝛍𝒌, 𝚲𝒌 p このような,変分事後分布を分解する仮定と,真の同時分布が持つ条件付き独⽴性によって導出される付加的な分解 を導出された分解(induced factorization)と呼ぶ p 変分推論を⾏う際には,導出された分解を考慮に⼊れることが重要 l 例えば多次元のガウス分布を変分推論で求めるとき,精度⾏列が常に対⾓⾏列の形になる(各変数間に相関がない)場合,精度⾏ 列を完全な形で保っておくのは⾮効率的 38
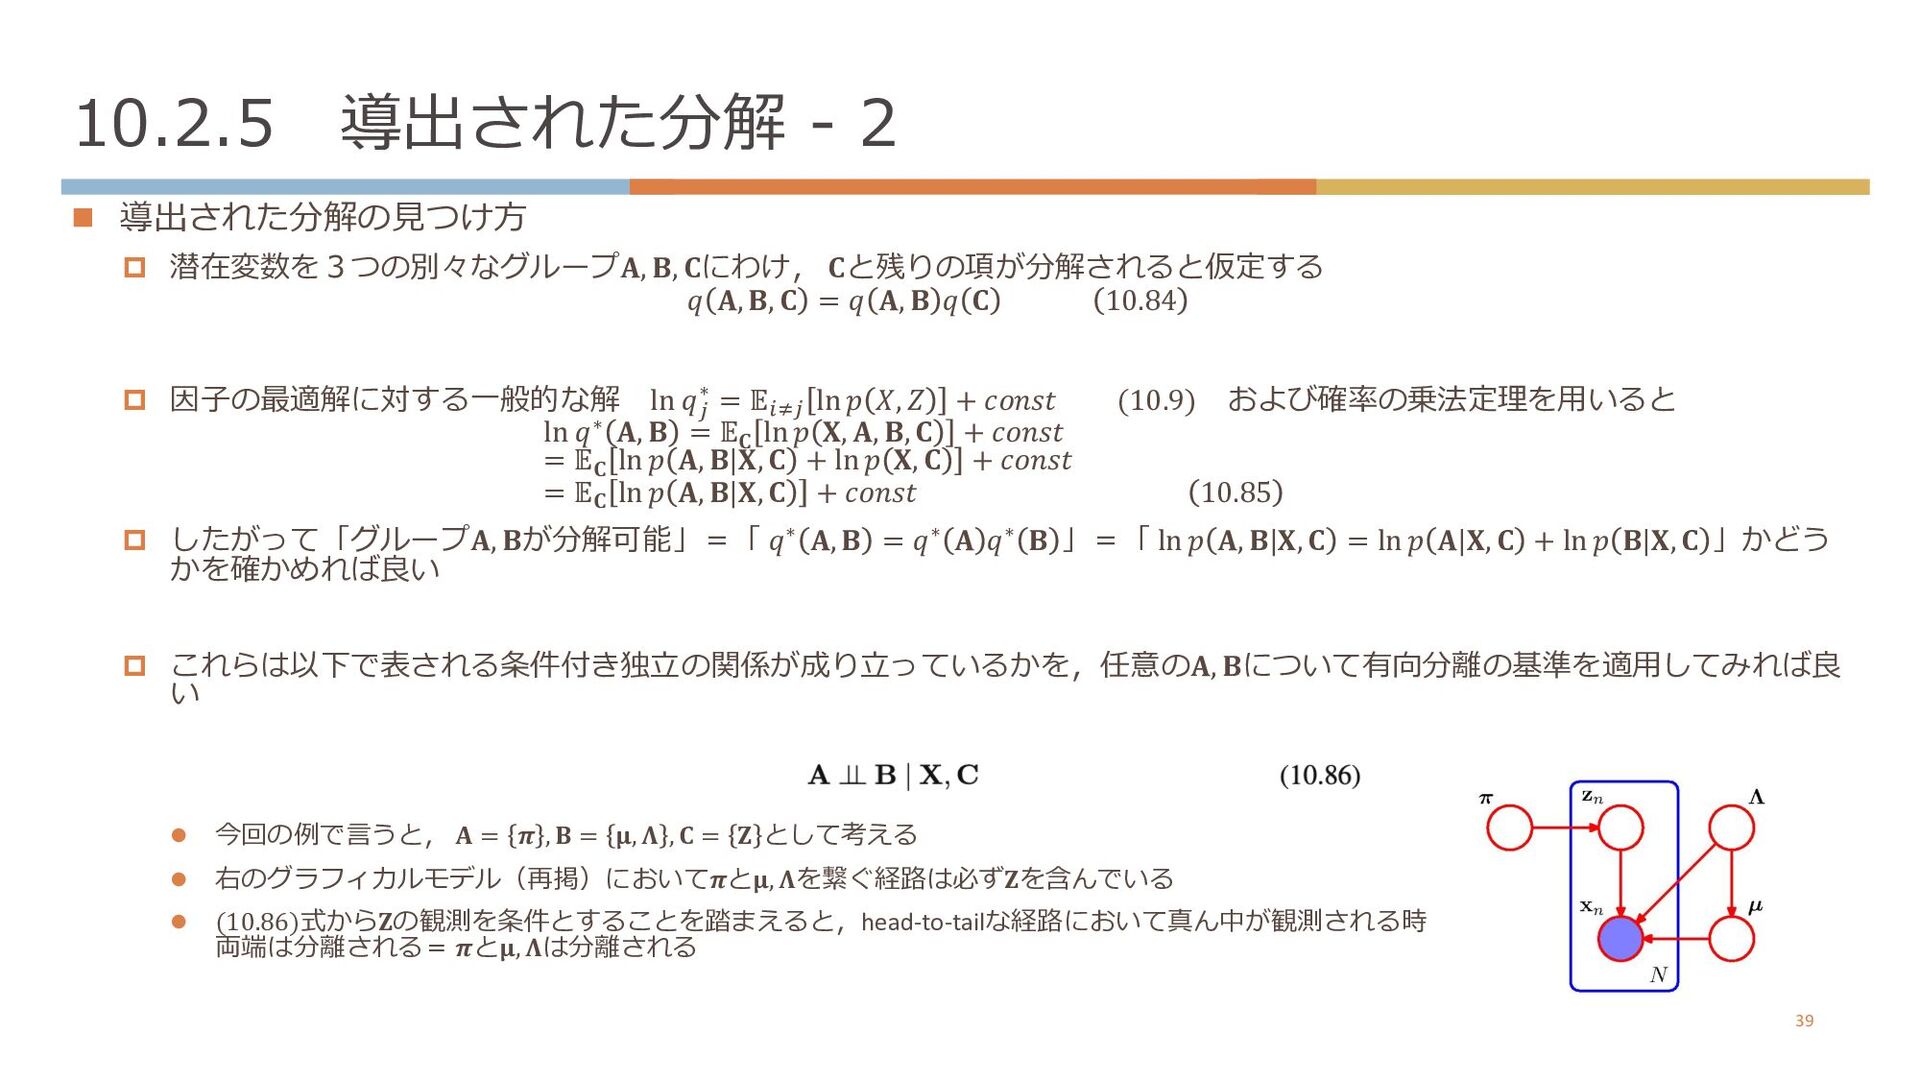
  37. 10.2.5 導出された分解 - 2 n 導出された分解の⾒つけ⽅ p 潜在変数を3つの別々なグループ𝐀, 𝐁, 𝐂にわけ,

    𝐂と残りの項が分解されると仮定する 𝑞 𝐀, 𝐁, 𝐂 = 𝑞 𝐀, 𝐁 𝑞 𝐂 10.84 p 因⼦の最適解に対する⼀般的な解 ln 𝑞@ ∗ = 𝔼AB@ ln 𝑝 𝑋, 𝑍 + 𝑐𝑜𝑛𝑠𝑡 (10.9) および確率の乗法定理を⽤いると ln 𝑞∗ 𝐀, 𝐁 = 𝔼𝐂 ln 𝑝 𝐗, 𝐀, 𝐁, 𝐂 + 𝑐𝑜𝑛𝑠𝑡 = 𝔼𝐂 ln 𝑝 𝐀, 𝐁|𝐗, 𝐂 + ln 𝑝 𝐗, 𝐂 + 𝑐𝑜𝑛𝑠𝑡 = 𝔼𝐂 ln 𝑝 𝐀, 𝐁|𝐗, 𝐂 + 𝑐𝑜𝑛𝑠𝑡 10.85 p したがって「グループ𝐀, 𝐁が分解可能」=「 𝑞∗ 𝐀, 𝐁 = 𝑞∗ 𝐀 𝑞∗ 𝐁 」=「 ln 𝑝 𝐀, 𝐁|𝐗, 𝐂 = ln 𝑝 𝐀|𝐗, 𝐂 + ln 𝑝 𝐁|𝐗, 𝐂 」かどう かを確かめれば良い p これらは以下で表される条件付き独⽴の関係が成り⽴っているかを,任意の𝐀, 𝐁について有向分離の基準を適⽤してみれば良 い l 今回の例で⾔うと, 𝐀 = 𝝅 , 𝐁 = 𝛍, 𝚲 , 𝐂 = 𝐙 として考える l 右のグラフィカルモデル(再掲)において𝝅と𝛍, 𝚲を繋ぐ経路は必ず𝐙を含んでいる l (10.86)式から𝐙の観測を条件とすることを踏まえると,head-to-tailな経路において真ん中が観測される時 両端は分離される= 𝝅と𝛍, 𝚲は分離される 39
  38. 10.2のまとめ n 10.2 p ガウス混合モデルについて変分推論法を適⽤してみた p 混合⽐ 𝝅にはディリクレ分布,混合要素のパラメータ𝛍, 𝚲にはガウス -

    ウィシャート分布を事前分布として⽤いた n 10.2.1 p 事後分布を潜在変数とパラメータに分解した変分近似を考え,それらについて10.1で求めた⼀般的な解を適⽤することで変分EMアルゴリズムが得られること を⾒た n 10.2.2 p 変分下限の計算をみた.計算するメリットは以下 l パラメータの収束の判定に使える l 下限が減らないことによって数式や実装が間違っていないことを確かめられる l 変分推論の再推定式を求めるための,別のアプローチとして利⽤できる n 10.2.3 p 新しい観測値ˆ 𝐱の予測分布を求め,それが混合スチューデントt分布になること,およびデータ数が無限⼤の極限では混合ガウス分布になることを学んだ n 10.2.4 p 混合要素数の決定⼿法を学んだ l 下限の式にln𝐾!を加えた要素数𝐾の異なるモデルを複数学習し⽐較 l 関連度⾃動決定 n 10.2.5 p 導出された分解を考慮することで計算が効率化できることと,その導き⽅を学んだ 40
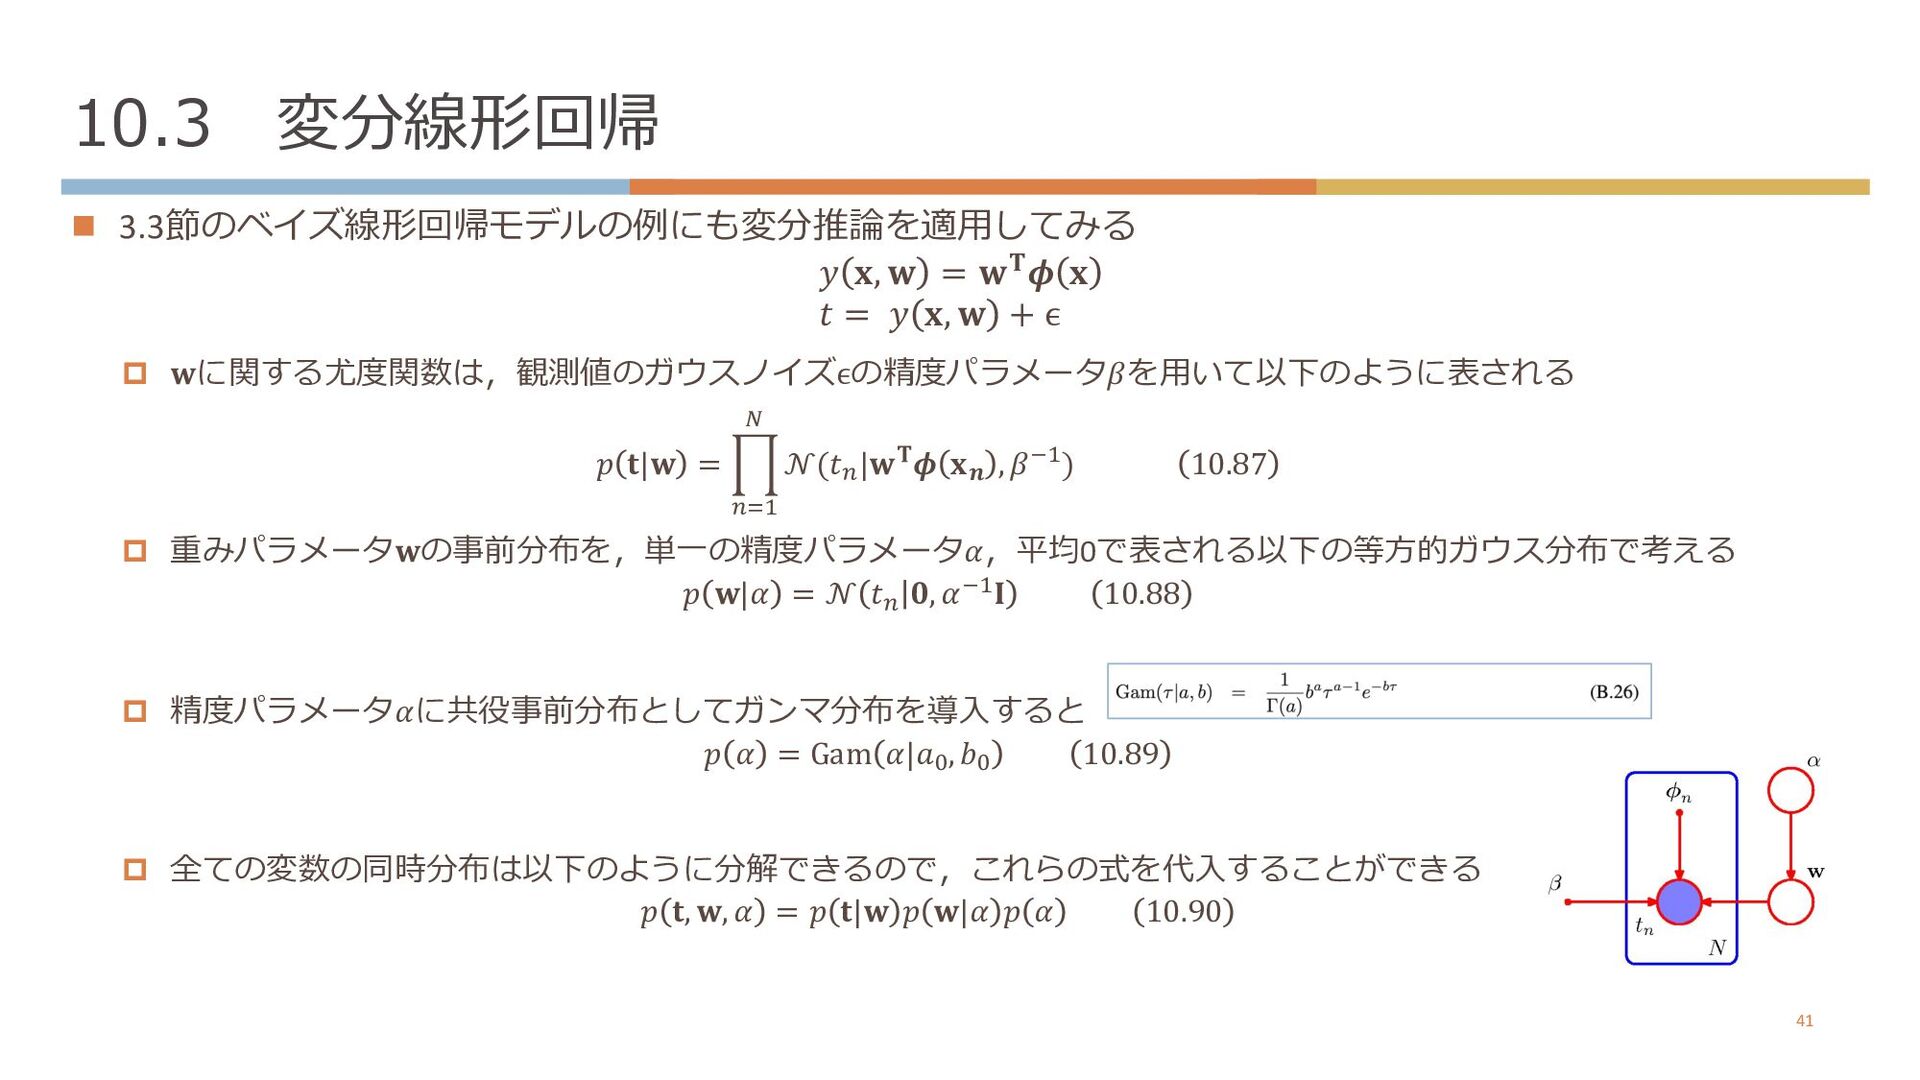
  39. 10.3 変分線形回帰 n 3.3節のベイズ線形回帰モデルの例にも変分推論を適⽤してみる 𝑦 𝐱, 𝐰 = 𝐰𝐓𝝓 𝐱

    𝑡 = 𝑦 𝐱, 𝐰 + ϵ p 𝐰に関する尤度関数は,観測値のガウスノイズϵの精度パラメータ𝛽を⽤いて以下のように表される 𝑝 𝐭|𝐰 = d XYM Q 𝒩(𝑡X|𝐰𝐓𝝓 𝐱𝒏 , 𝛽OM) 10.87 p 重みパラメータ𝐰の事前分布を,単⼀の精度パラメータ𝛼,平均0で表される以下の等⽅的ガウス分布で考える 𝑝 𝐰|𝛼 = 𝒩 𝑡X 𝟎, 𝛼OM𝐈 10.88 p 精度パラメータ𝛼に共役事前分布としてガンマ分布を導⼊すると 𝑝 𝛼 = Gam 𝛼|𝑎R, 𝑏R 10.89 p 全ての変数の同時分布は以下のように分解できるので,これらの式を代⼊することができる 𝑝 𝐭, 𝐰, 𝛼 = 𝑝 𝐭|𝐰 𝑝 𝐰|𝛼 𝑝 𝛼 10.90 41
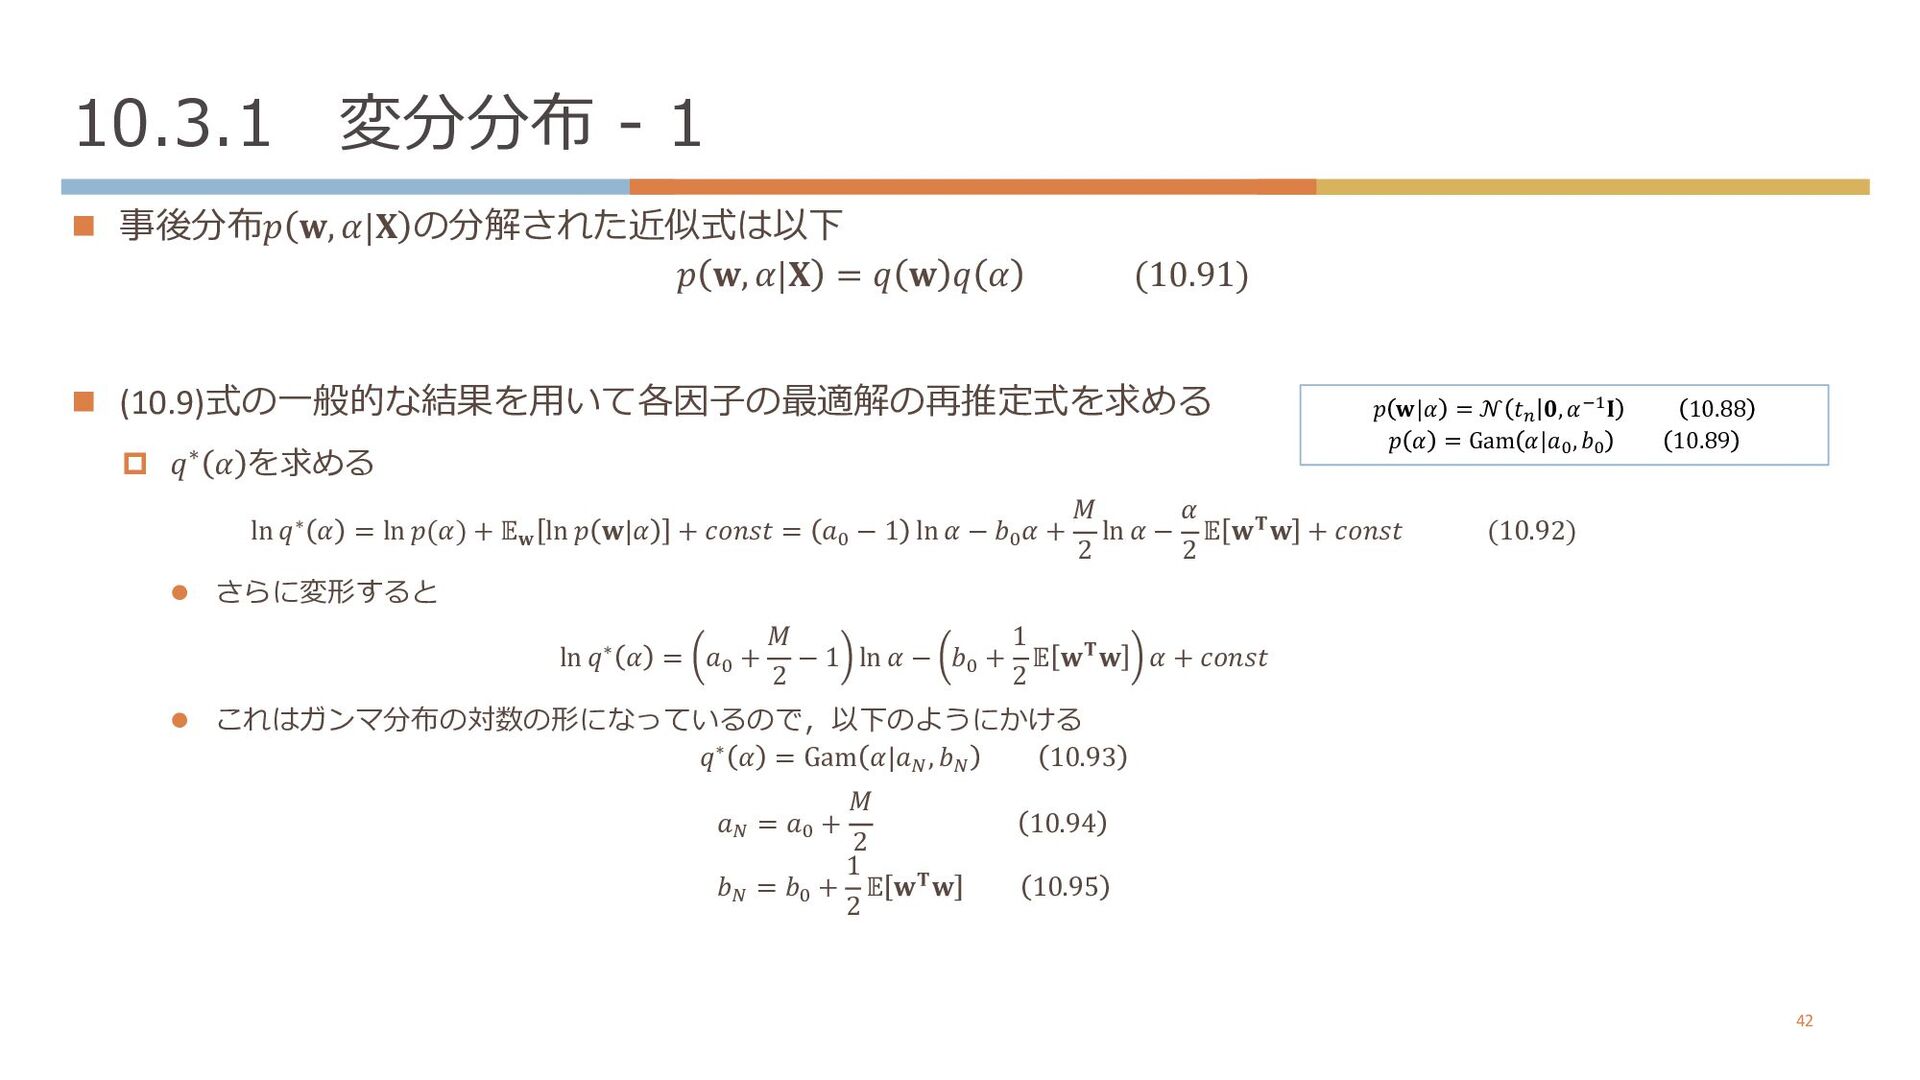
  40. 10.3.1 変分分布 - 1 n 事後分布𝑝 𝐰, 𝛼|𝐗 の分解された近似式は以下 𝑝

    𝐰, 𝛼|𝐗 = 𝑞 𝐰 𝑞 𝛼 (10.91) n (10.9)式の⼀般的な結果を⽤いて各因⼦の最適解の再推定式を求める p 𝑞∗ 𝛼 を求める ln 𝑞∗ 𝛼 = ln 𝑝(𝛼) + 𝔼𝐰 ln 𝑝 𝐰|𝛼 + 𝑐𝑜𝑛𝑠𝑡 = 𝑎D − 1 ln 𝛼 − 𝑏D 𝛼 + 𝑀 2 ln 𝛼 − 𝛼 2 𝔼 𝐰𝐓𝐰 + 𝑐𝑜𝑛𝑠𝑡 (10.92) l さらに変形すると ln 𝑞∗ 𝛼 = 𝑎D + 𝑀 2 − 1 ln 𝛼 − 𝑏D + 1 2 𝔼 𝐰𝐓𝐰 𝛼 + 𝑐𝑜𝑛𝑠𝑡 l これはガンマ分布の対数の形になっているので,以下のようにかける 𝑞∗ 𝛼 = Gam 𝛼|𝑎< , 𝑏< 10.93 𝑎< = 𝑎D + 𝑀 2 10.94 𝑏< = 𝑏D + 1 2 𝔼 𝐰𝐓𝐰 10.95 42 𝑝 𝐰|𝛼 = 𝒩 𝑡5 𝟎, 𝛼8+𝐈 10.88 𝑝 𝛼 = Gam 𝛼|𝑎;, 𝑏; 10.89
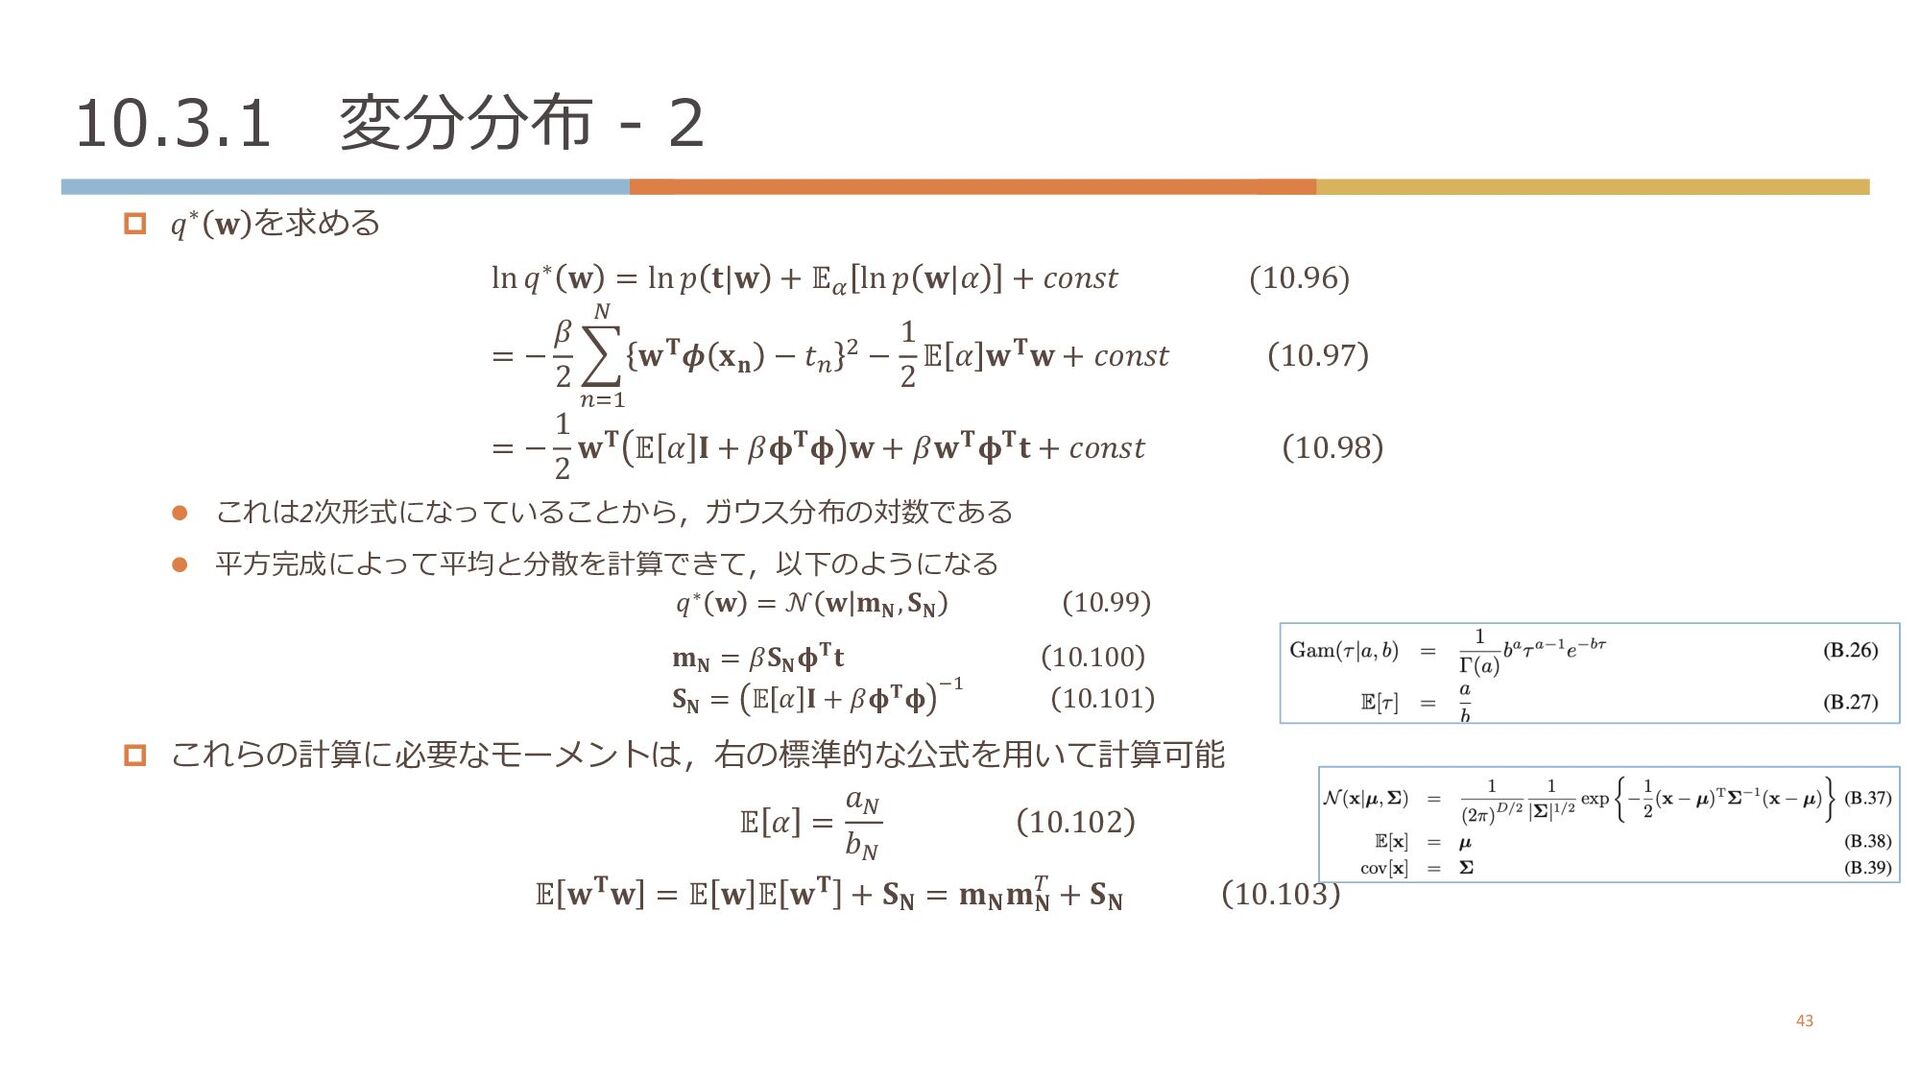
  41. 10.3.1 変分分布 - 2 p 𝑞∗ 𝐰 を求める ln 𝑞∗

    𝐰 = ln 𝑝 𝐭|𝐰 + 𝔼’ ln 𝑝 𝐰|𝛼 + 𝑐𝑜𝑛𝑠𝑡 (10.96) = − 𝛽 2 U XYM Q 𝐰𝐓𝝓 𝐱𝐧 − 𝑡X P − 1 2 𝔼 𝛼 𝐰𝐓𝐰 + 𝑐𝑜𝑛𝑠𝑡 10.97 = − 1 2 𝐰𝐓 𝔼 𝛼 𝐈 + 𝛽𝛟𝐓𝛟 𝐰 + 𝛽𝐰𝐓𝛟𝐓𝐭 + 𝑐𝑜𝑛𝑠𝑡 10.98 l これは2次形式になっていることから,ガウス分布の対数である l 平⽅完成によって平均と分散を計算できて,以下のようになる 𝑞∗ 𝐰 = 𝒩 𝐰 𝐦𝐍 , 𝐒𝐍 10.99 𝐦𝐍 = 𝛽𝐒𝐍 𝛟𝐓𝐭 10.100 𝐒𝐍 = 𝔼 𝛼 𝐈 + 𝛽𝛟𝐓𝛟 A! 10.101 p これらの計算に必要なモーメントは,右の標準的な公式を⽤いて計算可能 𝔼 𝛼 = 𝑎Q 𝑏Q 10.102 𝔼 𝐰𝐓𝐰 = 𝔼 𝐰 𝔼 𝐰𝐓 + 𝐒𝐍 = 𝐦𝐍𝐦𝐍 ” + 𝐒𝐍 10.103 43
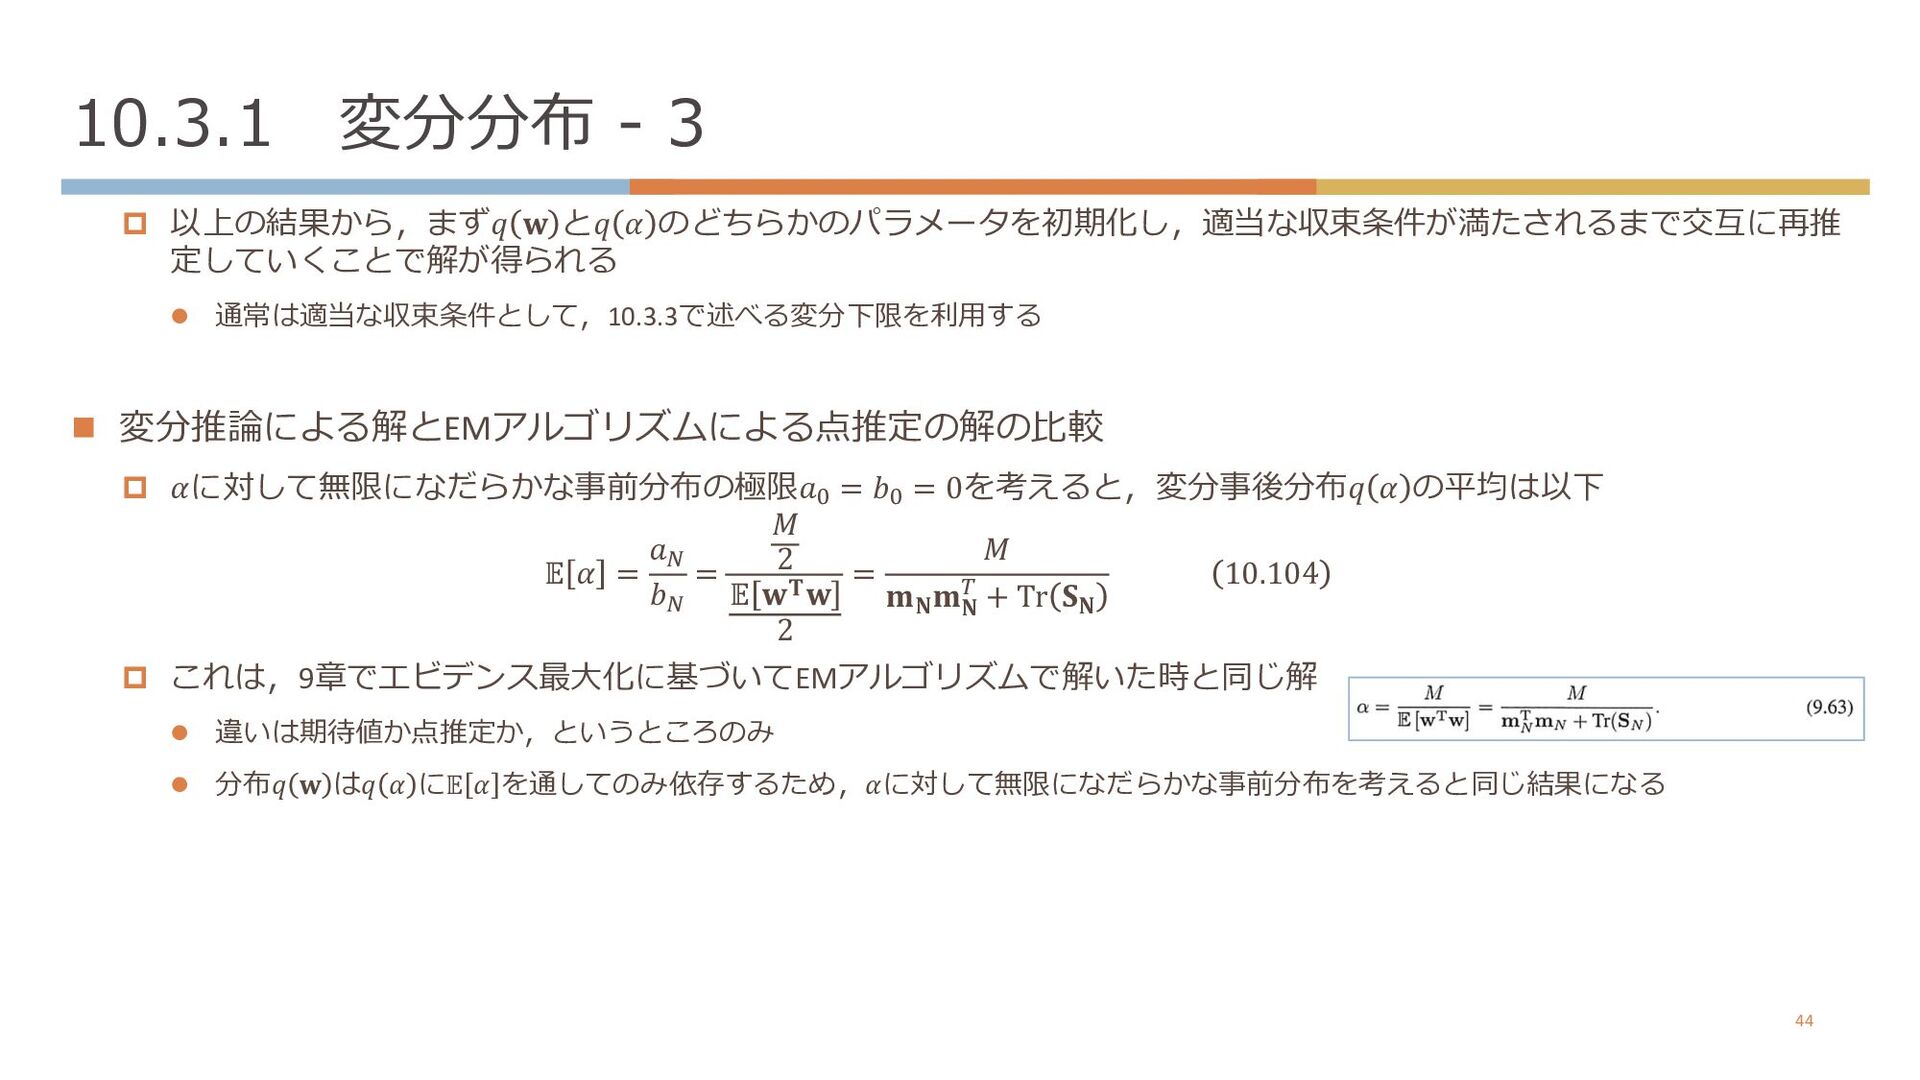
  42. 10.3.1 変分分布 - 3 p 以上の結果から,まず𝑞 𝐰 と𝑞 𝛼 のどちらかのパラメータを初期化し,適当な収束条件が満たされるまで交互に再推

    定していくことで解が得られる l 通常は適当な収束条件として,10.3.3で述べる変分下限を利⽤する n 変分推論による解とEMアルゴリズムによる点推定の解の⽐較 p 𝛼に対して無限になだらかな事前分布の極限𝑎R = 𝑏R = 0を考えると,変分事後分布𝑞 𝛼 の平均は以下 𝔼 𝛼 = 𝑎Q 𝑏Q = 𝑀 2 𝔼 𝐰𝐓𝐰 2 = 𝑀 𝐦𝐍 𝐦𝐍 ” + Tr 𝐒𝐍 10.104 p これは,9章でエビデンス最⼤化に基づいてEMアルゴリズムで解いた時と同じ解 l 違いは期待値か点推定か,というところのみ l 分布𝑞 𝐰 は𝑞 𝛼 に𝔼 𝛼 を通してのみ依存するため,𝛼に対して無限になだらかな事前分布を考えると同じ結果になる 44
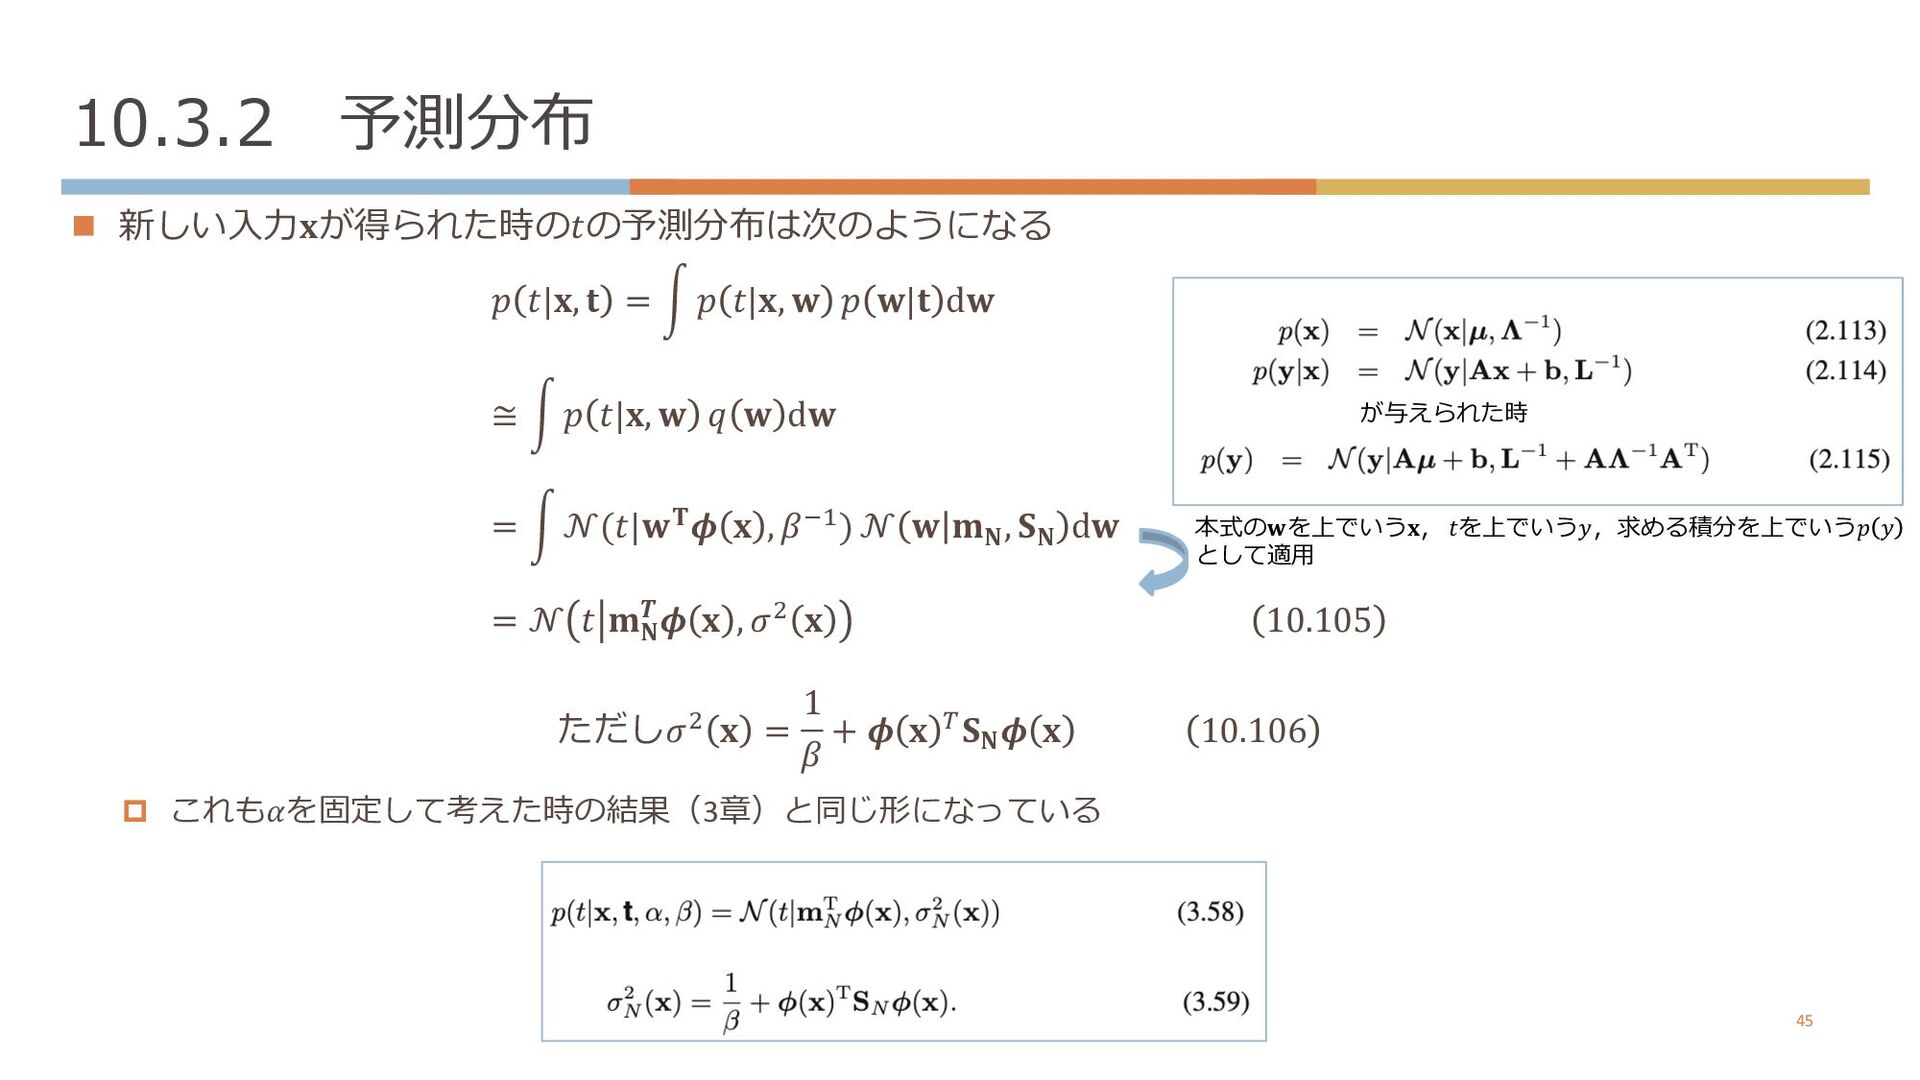
  43. 10.3.2 予測分布 n 新しい⼊⼒𝐱が得られた時の𝑡の予測分布は次のようになる 𝑝 𝑡|𝐱, 𝐭 = \ 𝑝

    𝑡|𝐱, 𝐰 𝑝 𝐰|𝐭 d𝐰 ≅ \ 𝑝 𝑡|𝐱, 𝐰 𝑞 𝐰 d𝐰 = \ 𝒩(𝑡|𝐰𝐓𝝓 𝐱 , 𝛽PB) 𝒩 𝐰 𝐦𝐍 , 𝐒𝐍 d𝐰 = 𝒩 𝑡 𝐦𝐍 𝑻𝝓 𝐱 , 𝜎? 𝐱 10.105 ただし𝜎? 𝐱 = 1 𝛽 + 𝝓 𝐱 u𝐒𝐍 𝝓 𝐱 10.106 p これも𝛼を固定して考えた時の結果(3章)と同じ形になっている 45 が与えられた時 本式の𝐰を上でいう𝐱, 𝑡を上でいう𝑦,求める積分を上でいう𝑝 𝑦 として適⽤
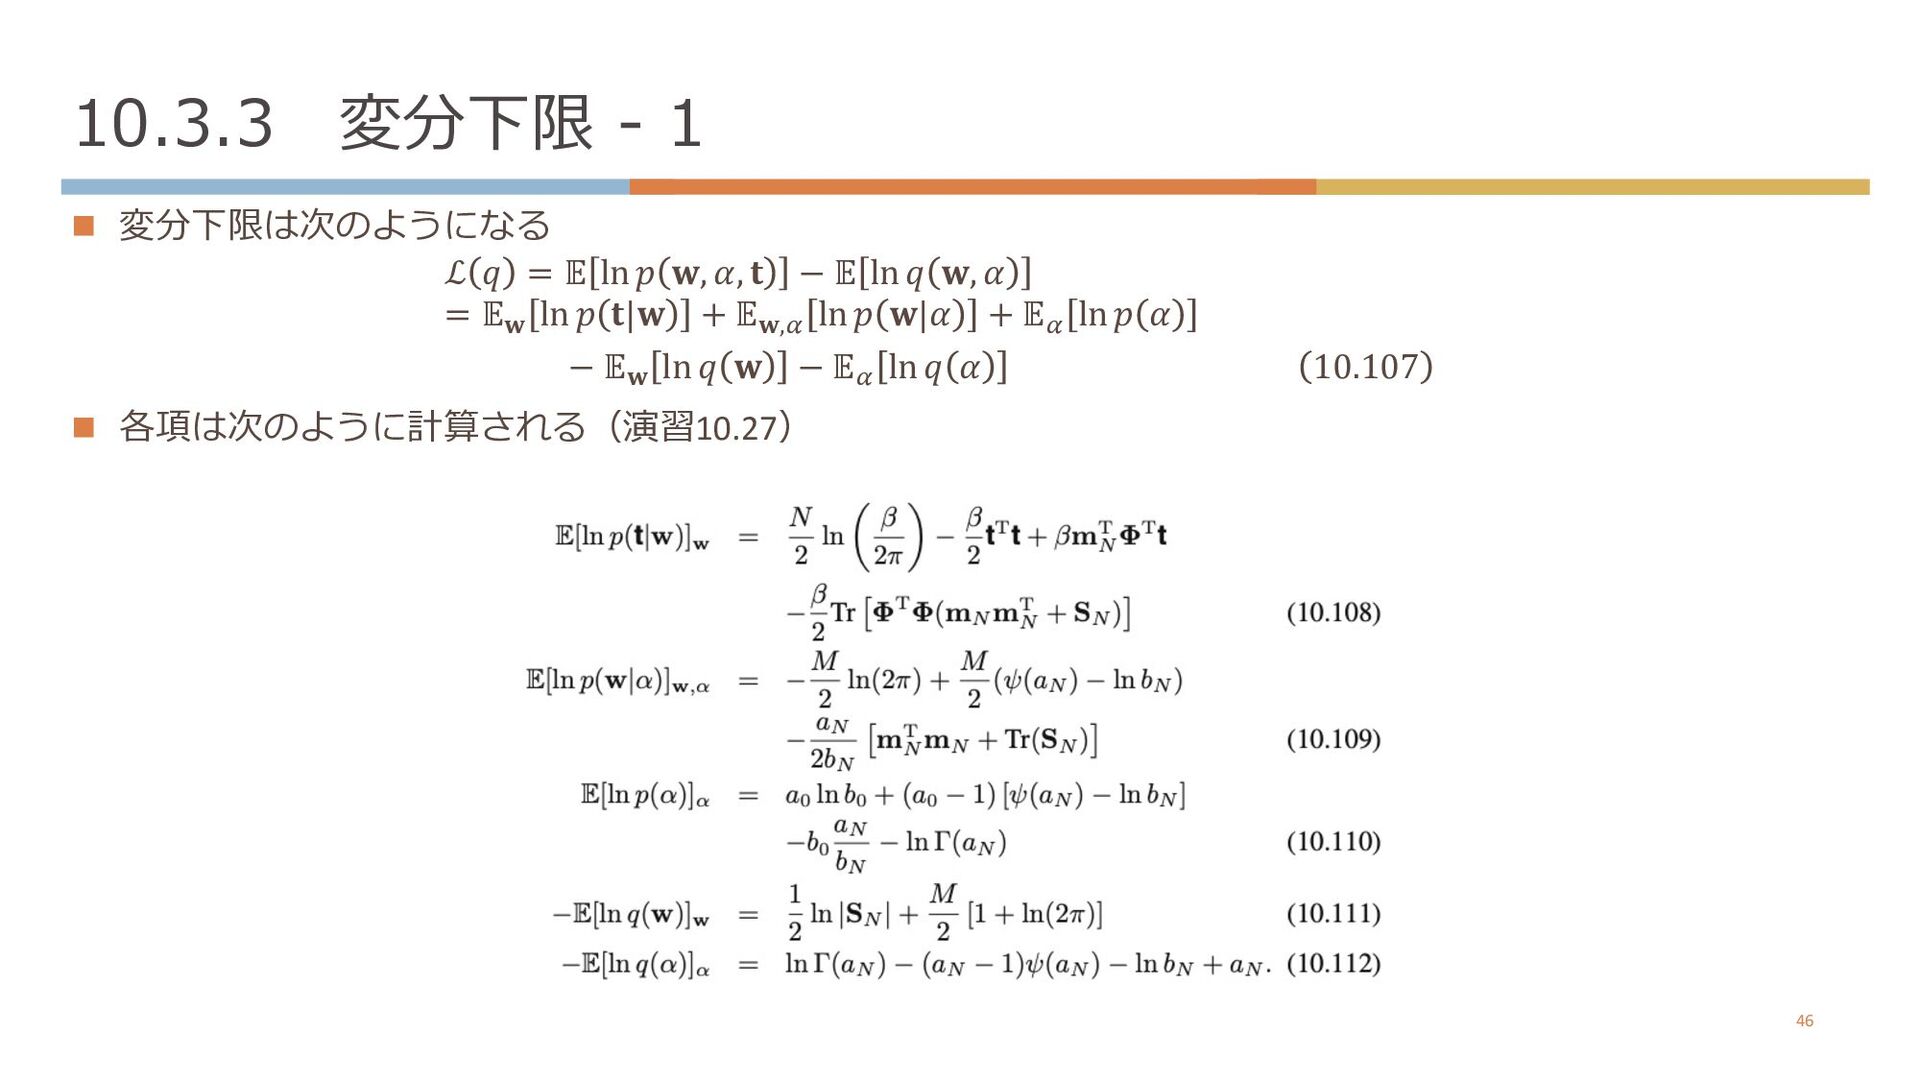
  44. 10.3.3 変分下限 - 1 n 変分下限は次のようになる ℒ 𝑞 = 𝔼

    ln 𝑝 𝐰, 𝛼, 𝐭 − 𝔼 ln 𝑞 𝐰, 𝛼 = 𝔼𝐰 ln 𝑝 𝐭|𝐰 + 𝔼𝐰,w ln 𝑝 𝐰|𝛼 + 𝔼w ln 𝑝 𝛼 − 𝔼𝐰 ln 𝑞 𝐰 − 𝔼w ln 𝑞 𝛼 10.107 n 各項は次のように計算される(演習10.27) 46
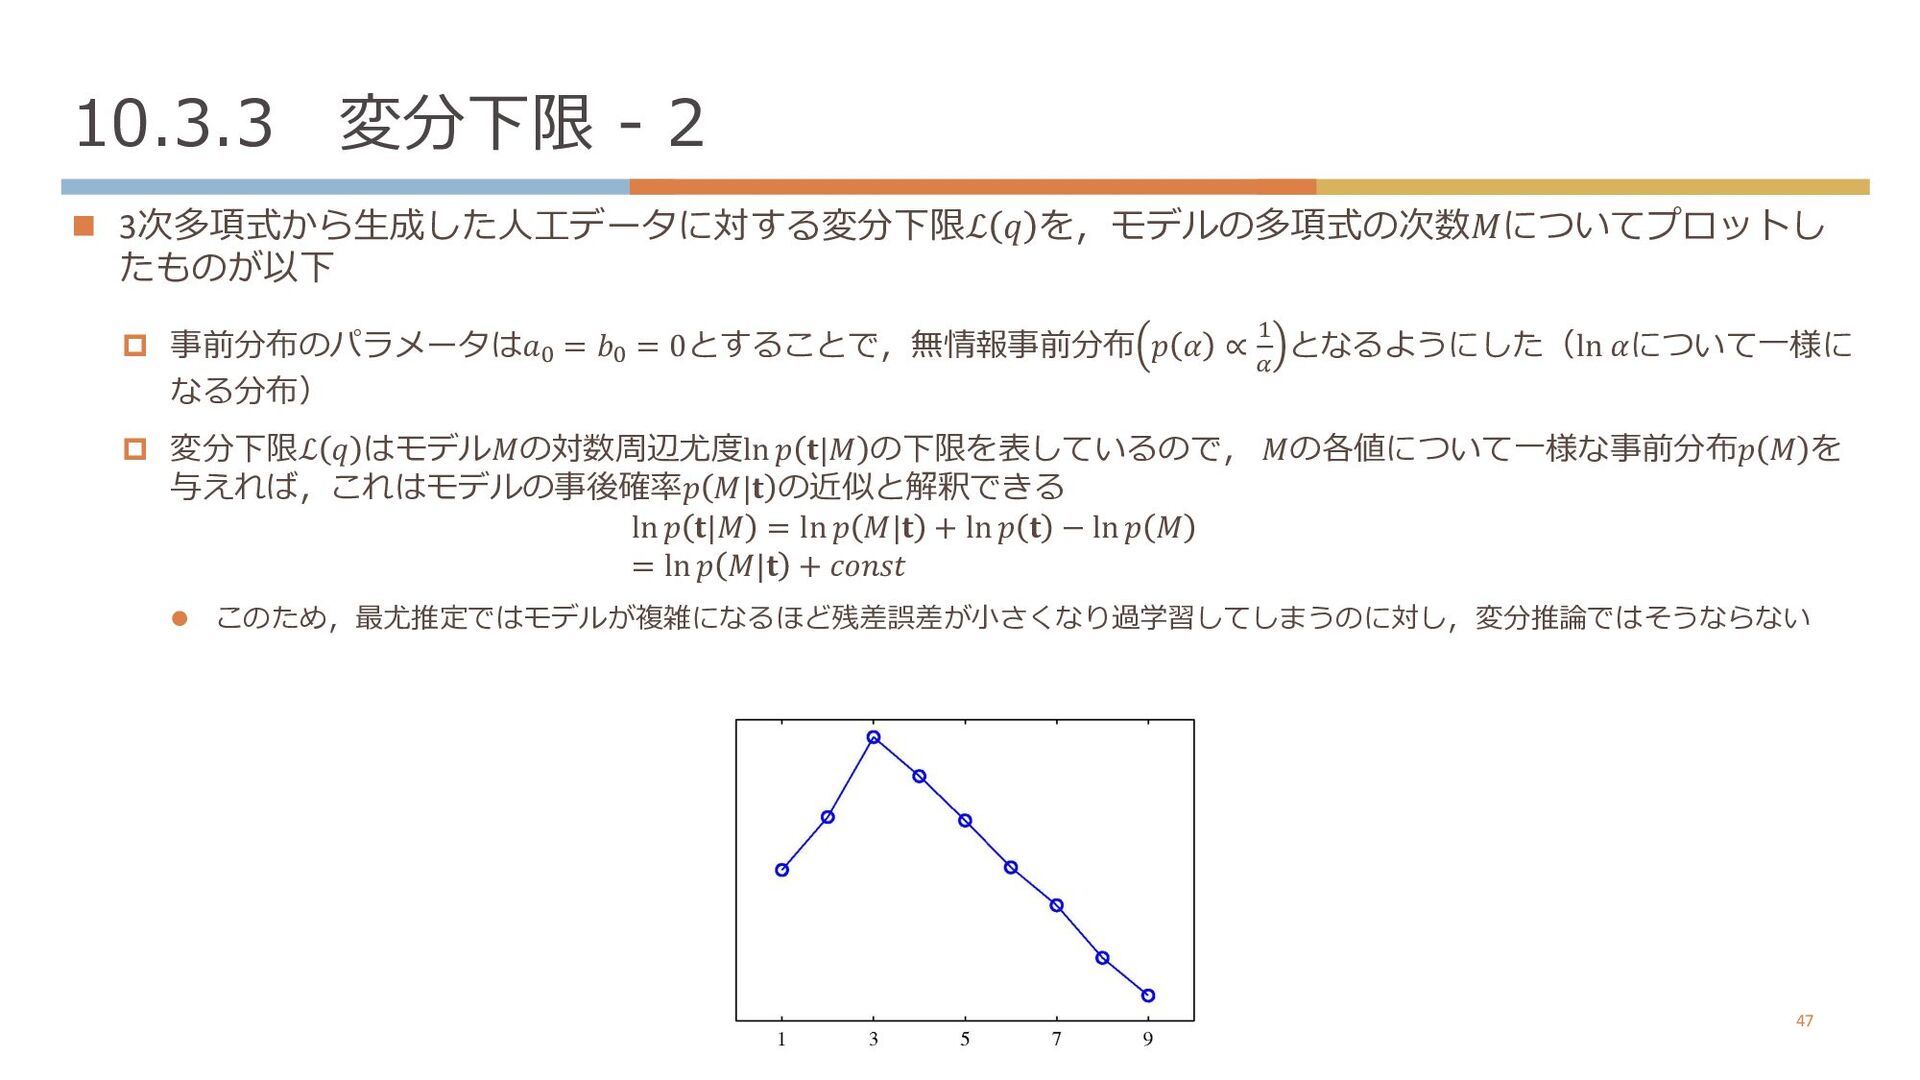
  45. 10.3.3 変分下限 - 2 n 3次多項式から⽣成した⼈⼯データに対する変分下限ℒ 𝑞 を,モデルの多項式の次数𝑀についてプロットし たものが以下 p

    事前分布のパラメータは𝑎R = 𝑏R = 0とすることで,無情報事前分布 𝑝 𝛼 ∝ M ’ となるようにした(ln 𝛼について⼀様に なる分布) p 変分下限ℒ 𝑞 はモデル𝑀の対数周辺尤度ln 𝑝 𝐭|𝑀 の下限を表しているので, 𝑀の各値について⼀様な事前分布𝑝 𝑀 を 与えれば,これはモデルの事後確率𝑝 𝑀|𝐭 の近似と解釈できる ln 𝑝 𝐭|𝑀 = ln 𝑝 𝑀|𝐭 + ln 𝑝 𝐭 − ln 𝑝 𝑀 = ln 𝑝 𝑀|𝐭 + 𝑐𝑜𝑛𝑠𝑡 l このため,最尤推定ではモデルが複雑になるほど残差誤差が⼩さくなり過学習してしまうのに対し,変分推論ではそうならない 47
  46. 10.3のまとめ n 10.3 p 線形回帰問題について変分推論を適⽤してみた n 10.3.1 p ⼀般的な結果を⽤いて各因⼦の最適解の再推定式を求めることができた l

    𝑞 𝐰 と𝑞 𝛼 のどちらかのパラメータを初期化し,適当な収束条件が満たされるまで交互に再推定していく p 𝛼に対して無限になだらかな事前分布の極限𝑎E = 𝑏E = 0 (無情報事前分布)を考えると,EMアルゴリズムで解いた時と同じ 解が得られることを⾒た n 10.3.2 p 新しい⼊⼒𝐱が得られた時の𝑡の予測分布を求めた p これも𝛼を固定して考えた時の結果と同じ形になっていることを⾒た n 10.3.3 p 変分下限を求めた p 複数のモデルを⽐較する際,その変分下限を⽐べることで⽐較可能なことを⾒た 48