Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Join Algorithm in Spark
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
yabooun
June 28, 2022
Technology
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Join Algorithm in Spark
Sparkを扱う上で最も重要な概念のひとつであるJoinについて、どういったアルゴリズムが使われているのかを解説します。
yabooun
June 28, 2022
More Decks by yabooun
See All by yabooun
データ分析基盤の要件分析の話(202201_JEDAI)
yabooun
1
1.1k
Other Decks in Technology
See All in Technology
PHPカンファレンス関西の招待状 / Invitation to PHP Conference Kansai
ykanoh
0
110
無理せず続ける、子育てエンジニアの学び
codmoninc
PRO
0
870
「事実」を「計測」して、「解釈」する 〜AWS Lambdaのメモリ最適解の見つけ方〜
maimyyym
0
170
Webの常識が通じないHTMLメールのダークモード
teamlab
PRO
0
120
10年後、Engineering 行為を剥奪されるとして、わたしたちは、どう、何を創ればいいだろうか。 / If Engineering Is Taken Away in 10 Years, How and What Should We Create?
bitkey
PRO
1
190
アウトプット初心者、半年間のふりかえり
4o1sobblue
0
430
日本語に強いオープンな大規模言語モデル「LLM-jp」
odashi
4
1.1k
Refining Active Record
shugo
0
150
実体験から学ぶ分析エージェントの開発と運⽤
recruitengineers
PRO
8
2.4k
20261017福岡devIO 「AIは"良いダッシュボード"を作れるか?
jtakeda
0
140
Rustuna: Rustによる高速なOptuna実装
pfn
PRO
0
190
DevelopersIO 2026 知識の地図を描く ─ オントロジーとは何か?
ishikawa_satoru
1
1.7k
Featured
See All Featured
<Decoding/> the Language of Devs - We Love SEO 2024
nikkihalliwell
1
360
SEO in 2025: How to Prepare for the Future of Search
ipullrank
3
3.9k
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
77k
Impact Scores and Hybrid Strategies: The future of link building
tamaranovitovic
0
460
Thoughts on Productivity
jonyablonski
76
5.4k
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
600
4 Signs Your Business is Dying
shpigford
187
23k
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
Distributed Sagas: A Protocol for Coordinating Microservices
caitiem20
333
23k
Chasing Engaging Ingredients in Design
codingconduct
0
360
Technical Leadership for Architectural Decision Making
baasie
3
600
Leading Effective Engineering Teams in the AI Era
addyosmani
9
2.7k
Transcript
Join Algorithm in Spark 2022/06/28 @yabooun
自己紹介 藪本 晃輔 @yabooun 株式会社ジオロジック CTO 趣味: 登山、ピアノ、日本酒 晴れてると、空ばかり眺めてしまうので、今週末山に行ってきます。
Joinとは • 複数のテーブルを一定のルールに基づいて結合する処理 • SQLの基本的な構文のひとつ • LEFT JOIN, RIGHT JOIN,
INNER JOIN, CROSS JOIN, LEFT LATERAL JOIN, ・・・ • サブクエリも全部JOINで書ける • ただし、同じJOINでも、データ量やクエリによって違うアルゴリズムが使われる ◦ 使われるアルゴリズムは基本的に処理系が決める ◦ アルゴリズムによって全然速さが違う • RDBMSやHadoop/Spark等のビッグデータ系のシステムでは別のアルゴリズム ◦ ビッグデータ系はRDBMSより多くのアルゴリズムがある • 意外と奥が深いJOIN
RDBMSにおけるJOIN 1. Hash Join 2. Sort Merge Join 3. Nested
Loop Join
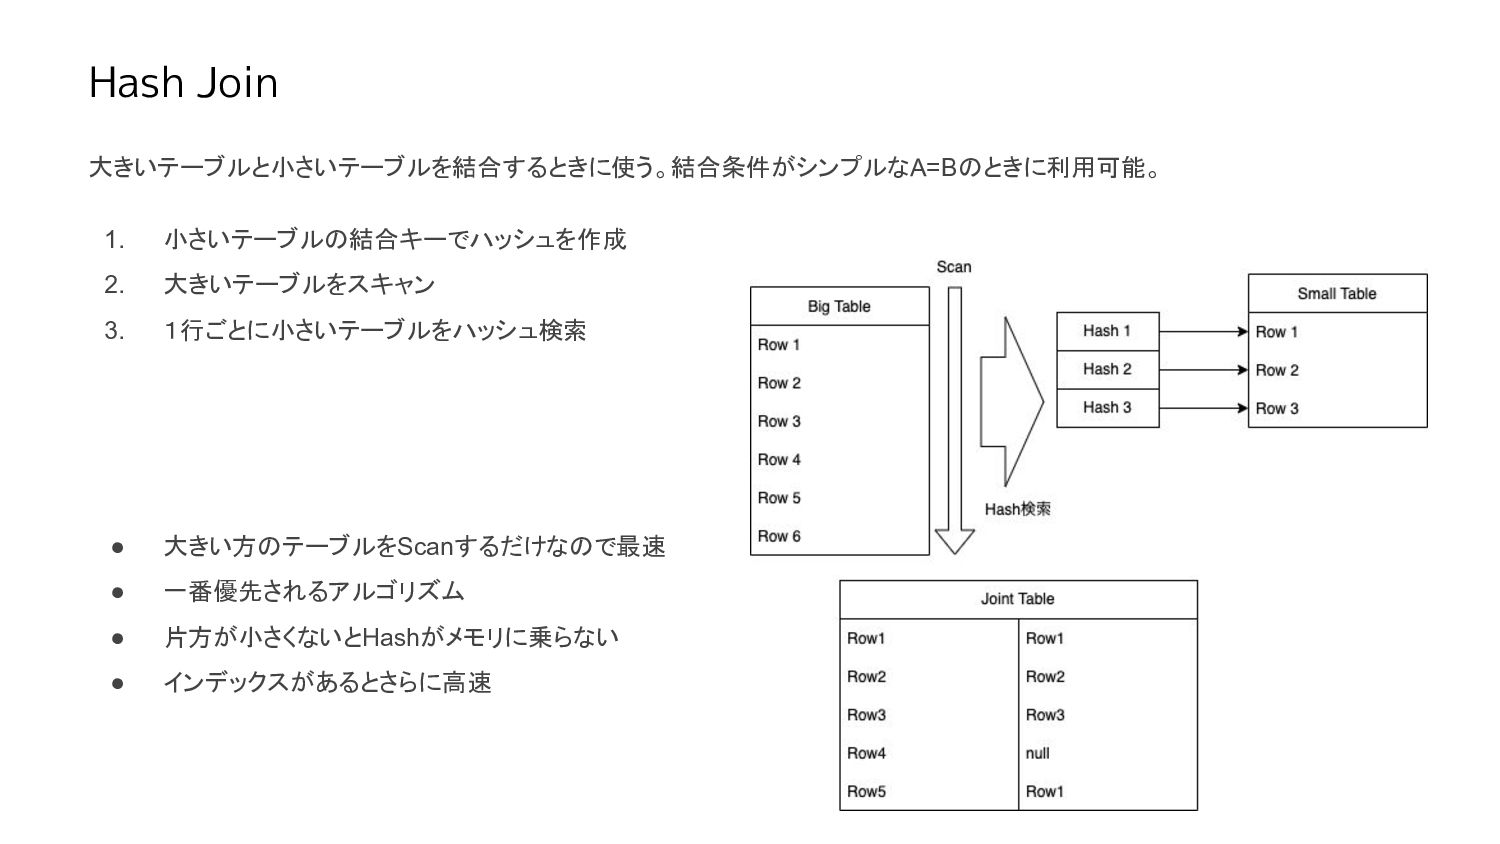
Hash Join 大きいテーブルと小さいテーブルを結合するときに使う。結合条件がシンプルなA=Bのときに利用可能。 1. 小さいテーブルの結合キーでハッシュを作成 2. 大きいテーブルをスキャン 3. 1行ごとに小さいテーブルをハッシュ検索 •
大きい方のテーブルをScanするだけなので最速 • 一番優先されるアルゴリズム • 片方が小さくないとHashがメモリに乗らない • インデックスがあるとさらに高速
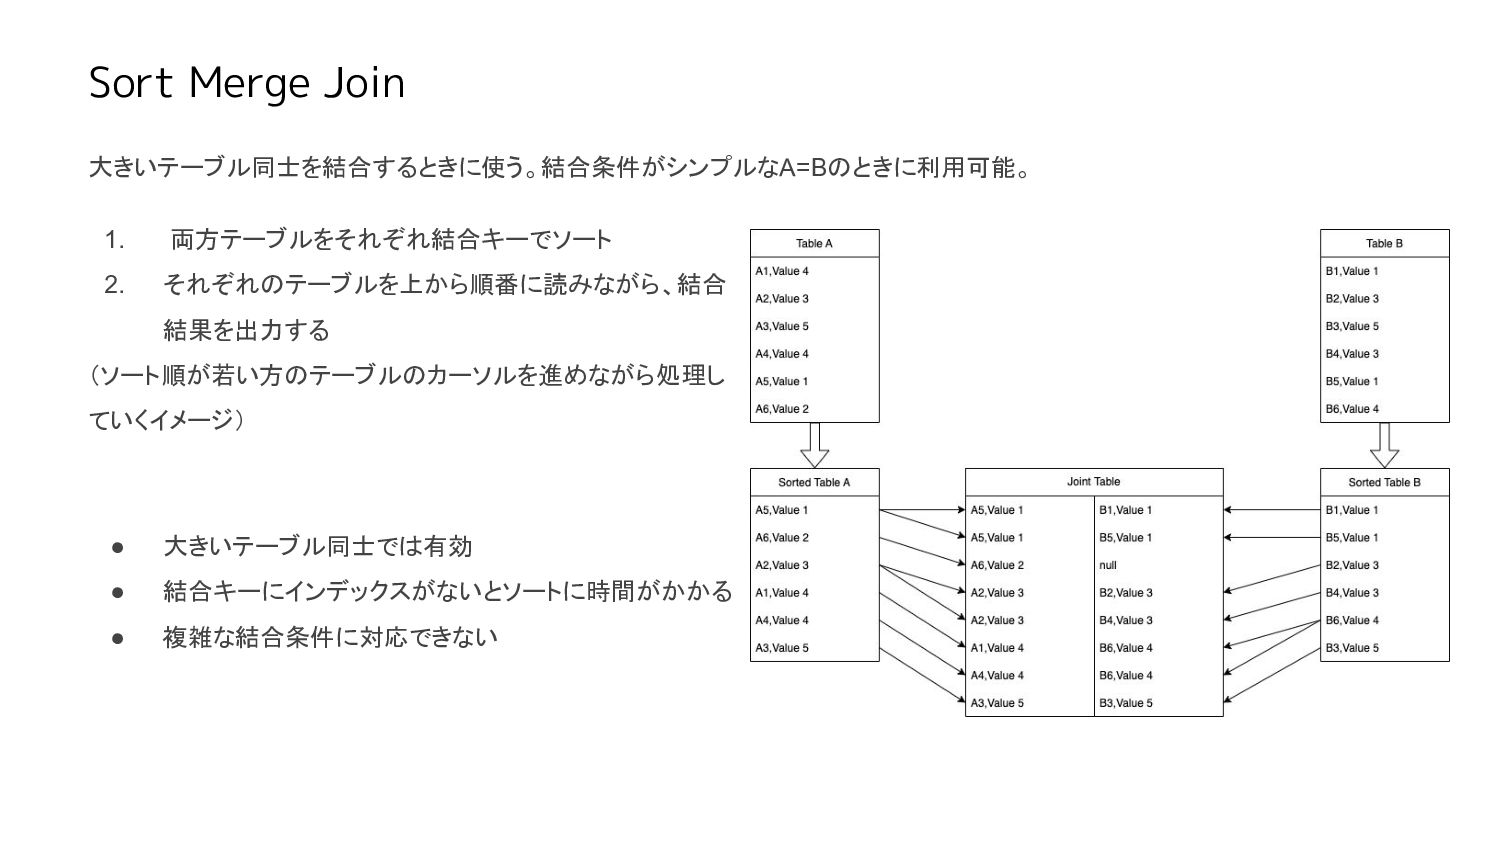
Sort Merge Join 大きいテーブル同士を結合するときに使う。結合条件がシンプルなA=Bのときに利用可能。 1. 両方テーブルをそれぞれ結合キーでソート 2. それぞれのテーブルを上から順番に読みながら、結合 結果を出力する (ソート順が若い方のテーブルのカーソルを進めながら処理し
ていくイメージ) • 大きいテーブル同士では有効 • 結合キーにインデックスがないとソートに時間がかかる • 複雑な結合条件に対応できない
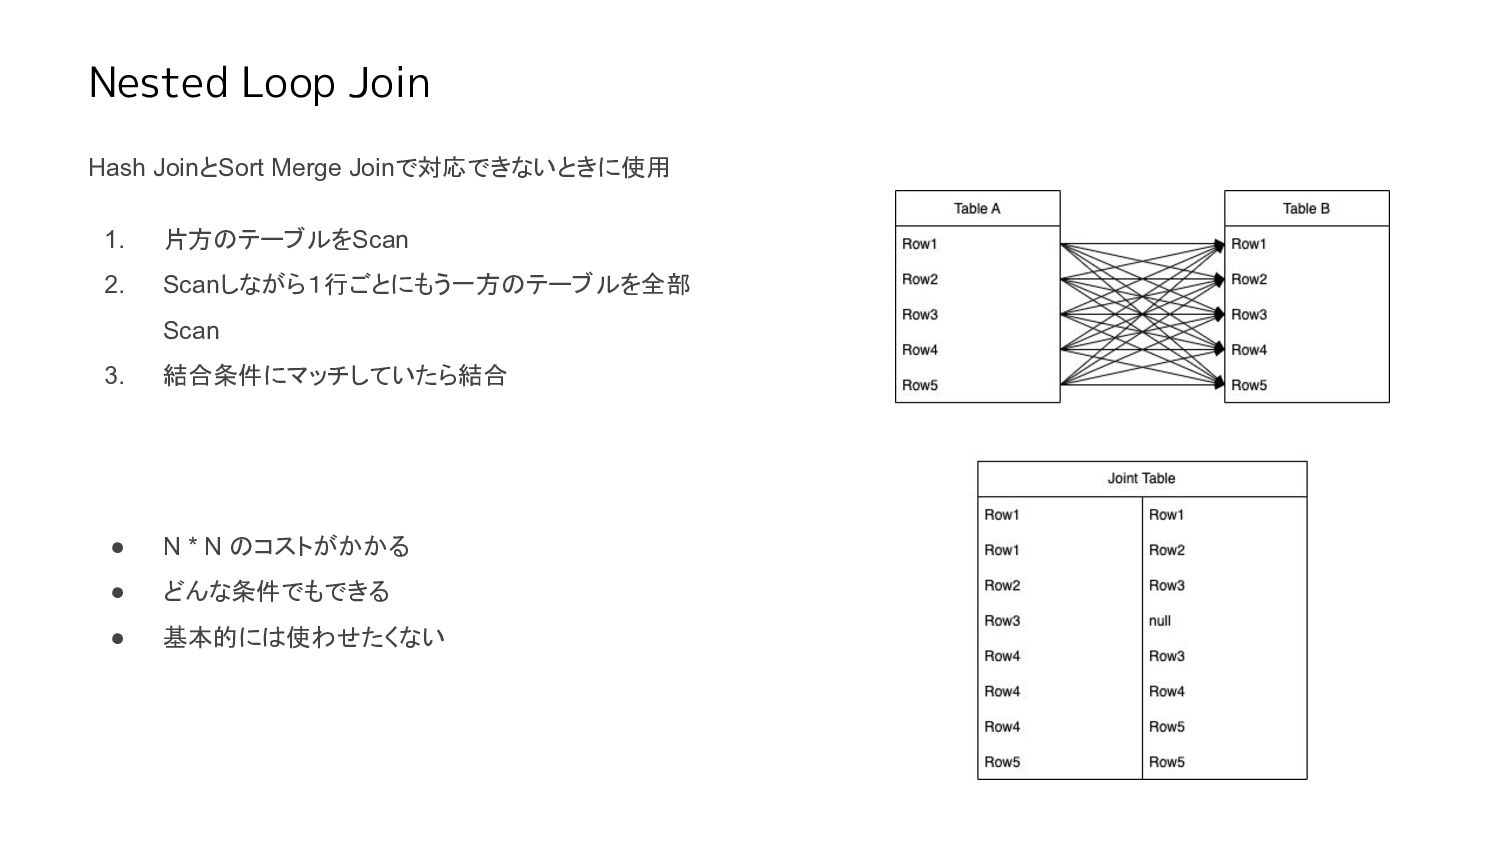
Nested Loop Join Hash JoinとSort Merge Joinで対応できないときに使用 1. 片方のテーブルをScan 2.
Scanしながら1行ごとにもう一方のテーブルを全部 Scan 3. 結合条件にマッチしていたら結合 • N * N のコストがかかる • どんな条件でもできる • 基本的には使わせたくない
RDBMSにおけるJOIN • 基本的にはHash Joinが使われるようにしよう • せめてSort Merge Joinが使われるようにしよう • Joinのキーはインデックス登録しておこう
• 文字列結合したり変な条件で Joinすると遅い
SparkにおけるJOIN • Sparkでもほとんど似た考え方の Joinが使われる • 複数のノードからなるクラスタで実行されるため、同じアルゴリズムでも複数パターン • アルゴリズムひとつ変わると、クエリの速度が 1,000倍くらい余裕で変わる
SparkにおけるJOIN 1. Broadcast Hash Join 2. Shuffle Hash Join 3.
Shuffle Sort Merge Join 4. Broadcast Nested Loop Join 5. Cartesian Join
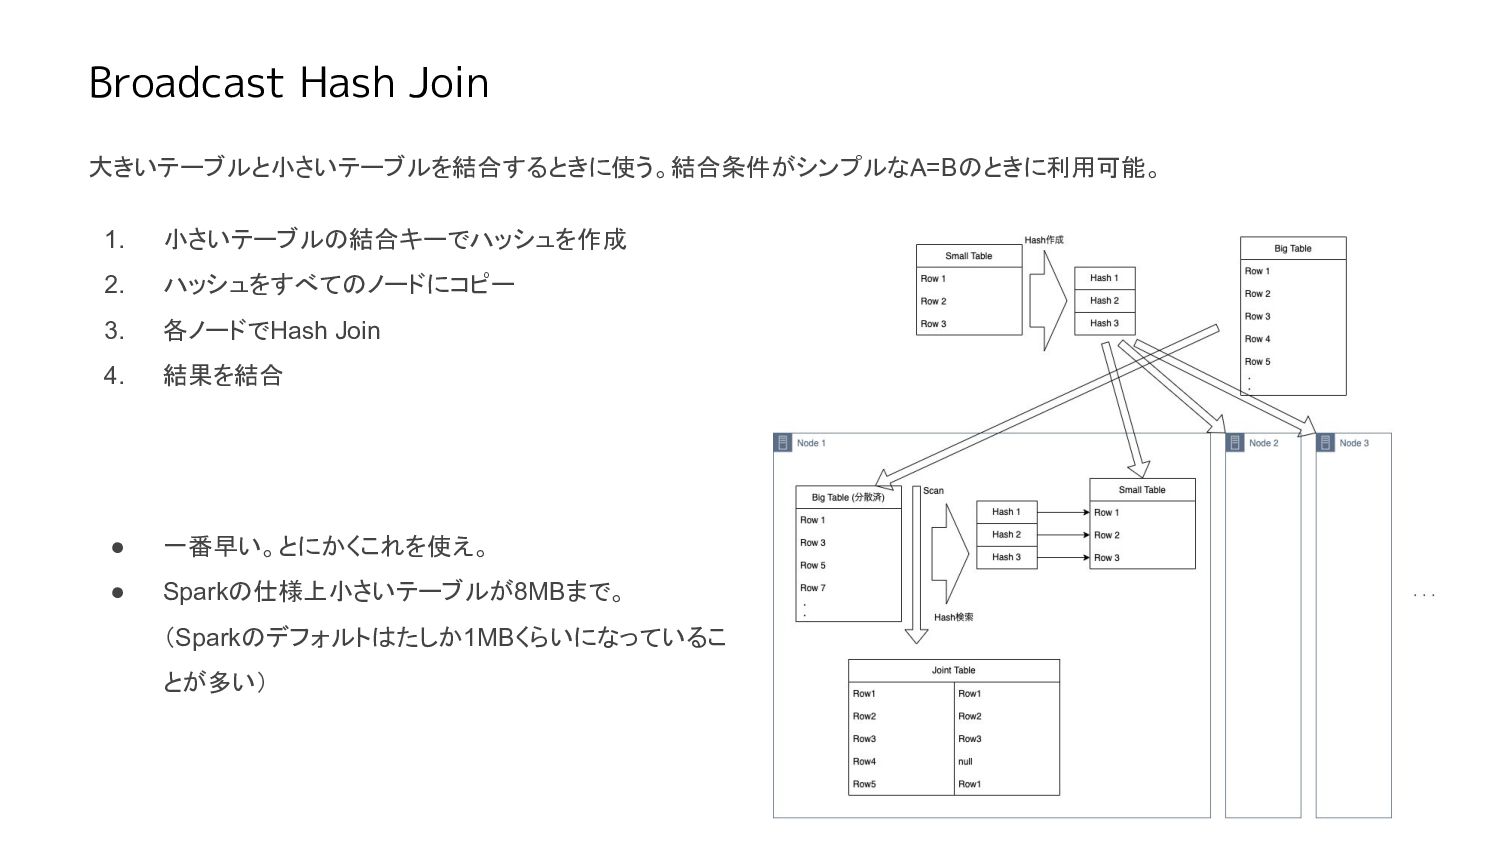
Broadcast Hash Join 大きいテーブルと小さいテーブルを結合するときに使う。結合条件がシンプルなA=Bのときに利用可能。 1. 小さいテーブルの結合キーでハッシュを作成 2. ハッシュをすべてのノードにコピー 3. 各ノードでHash
Join 4. 結果を結合 • 一番早い。とにかくこれを使え。 • Sparkの仕様上小さいテーブルが8MBまで。 (Sparkのデフォルトはたしか1MBくらいになっているこ とが多い)
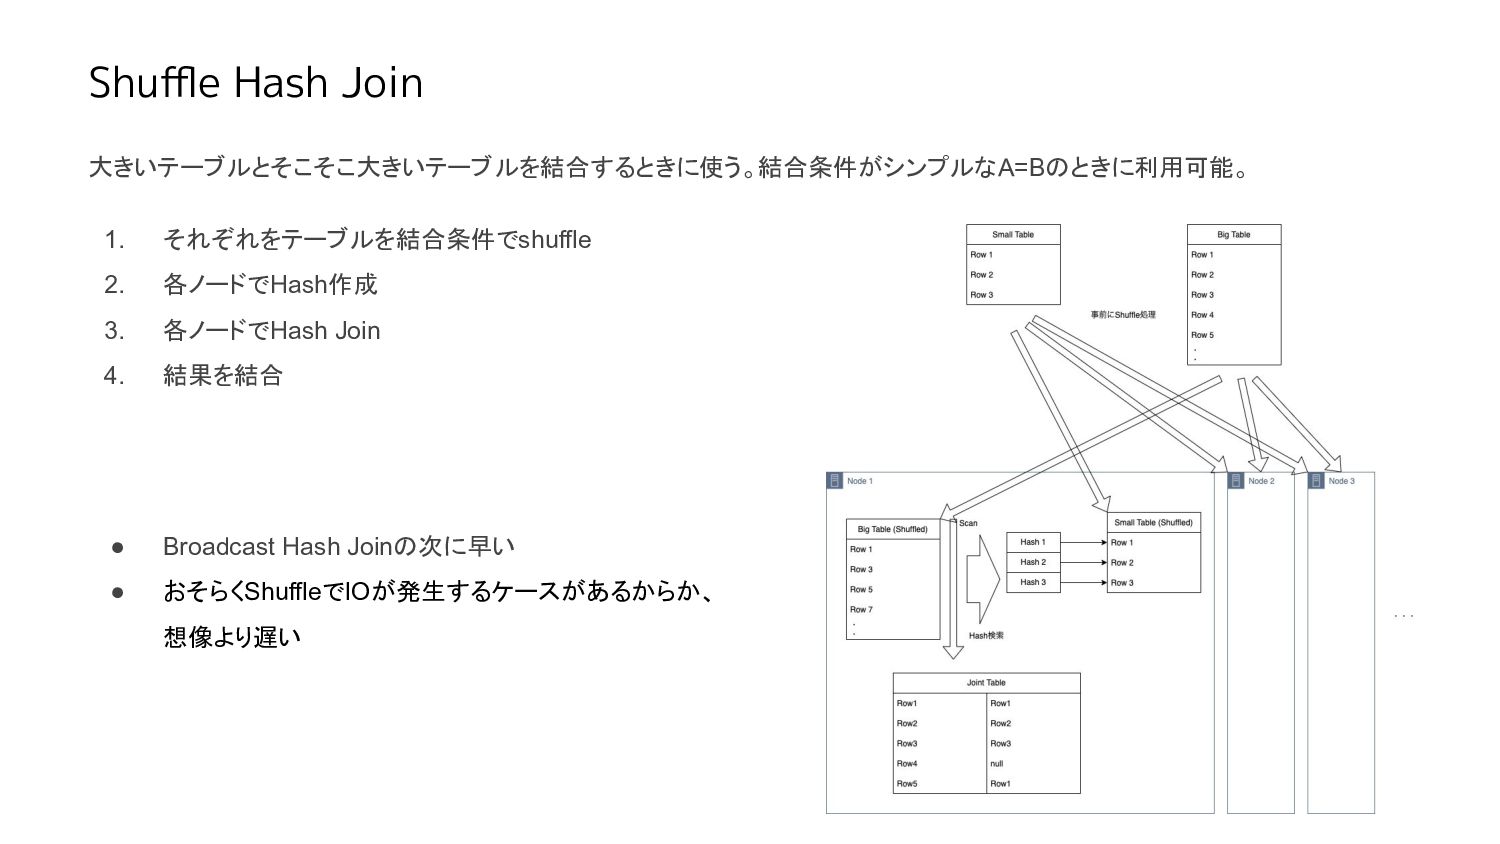
Shuffle Hash Join 大きいテーブルとそこそこ大きいテーブルを結合するときに使う。結合条件がシンプルなA=Bのときに利用可能。 1. それぞれをテーブルを結合条件でshuffle 2. 各ノードでHash作成 3. 各ノードでHash
Join 4. 結果を結合 • Broadcast Hash Joinの次に早い • おそらくShuffleでIOが発生するケースがあるからか、 想像より遅い
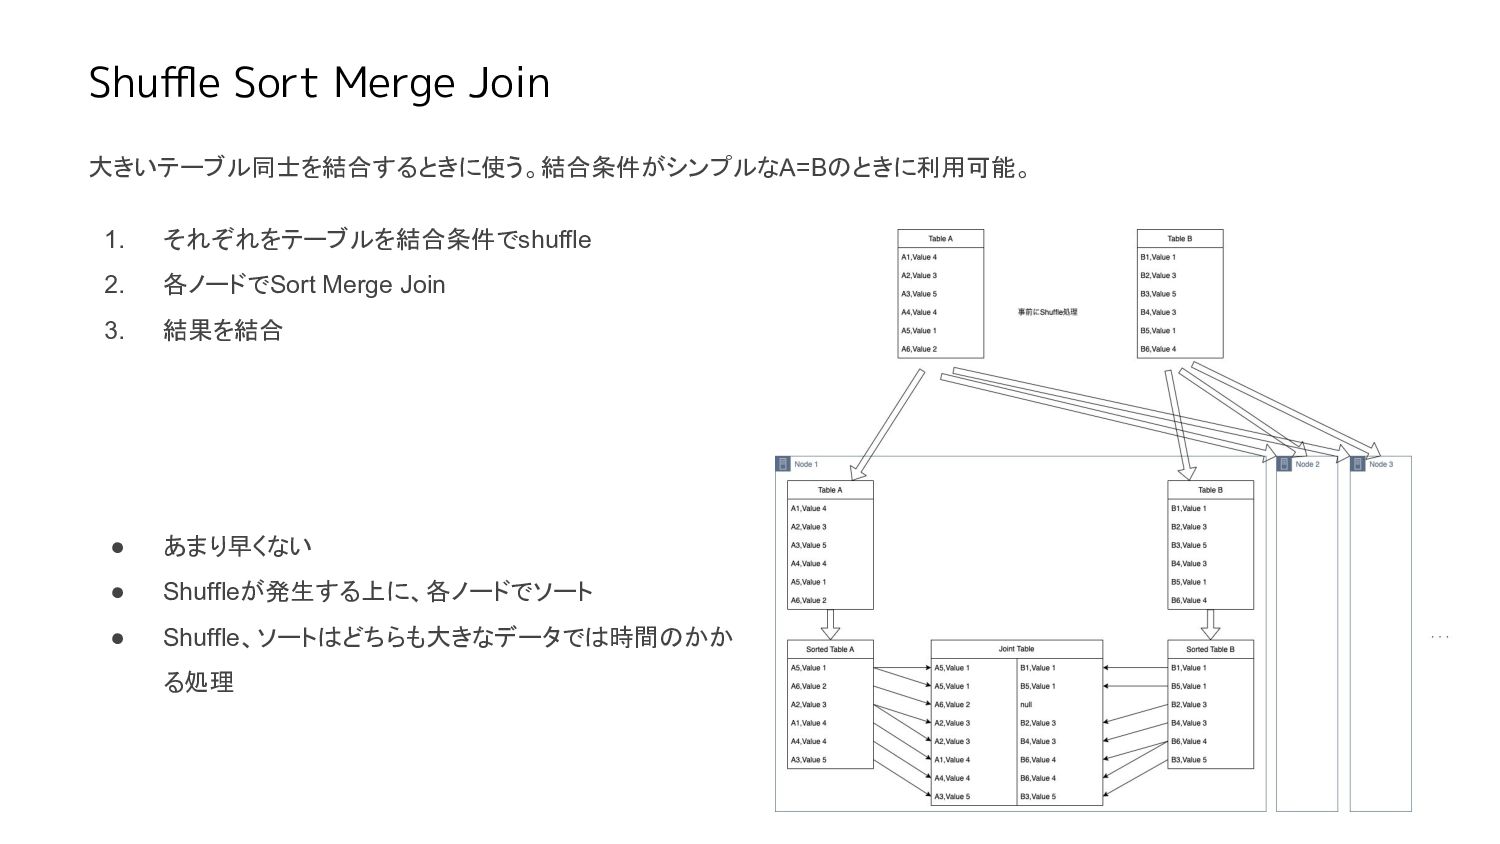
Shuffle Sort Merge Join 大きいテーブル同士を結合するときに使う。結合条件がシンプルなA=Bのときに利用可能。 1. それぞれをテーブルを結合条件でshuffle 2. 各ノードでSort Merge
Join 3. 結果を結合 • あまり早くない • Shuffleが発生する上に、各ノードでソート • Shuffle、ソートはどちらも大きなデータでは時間のかか る処理
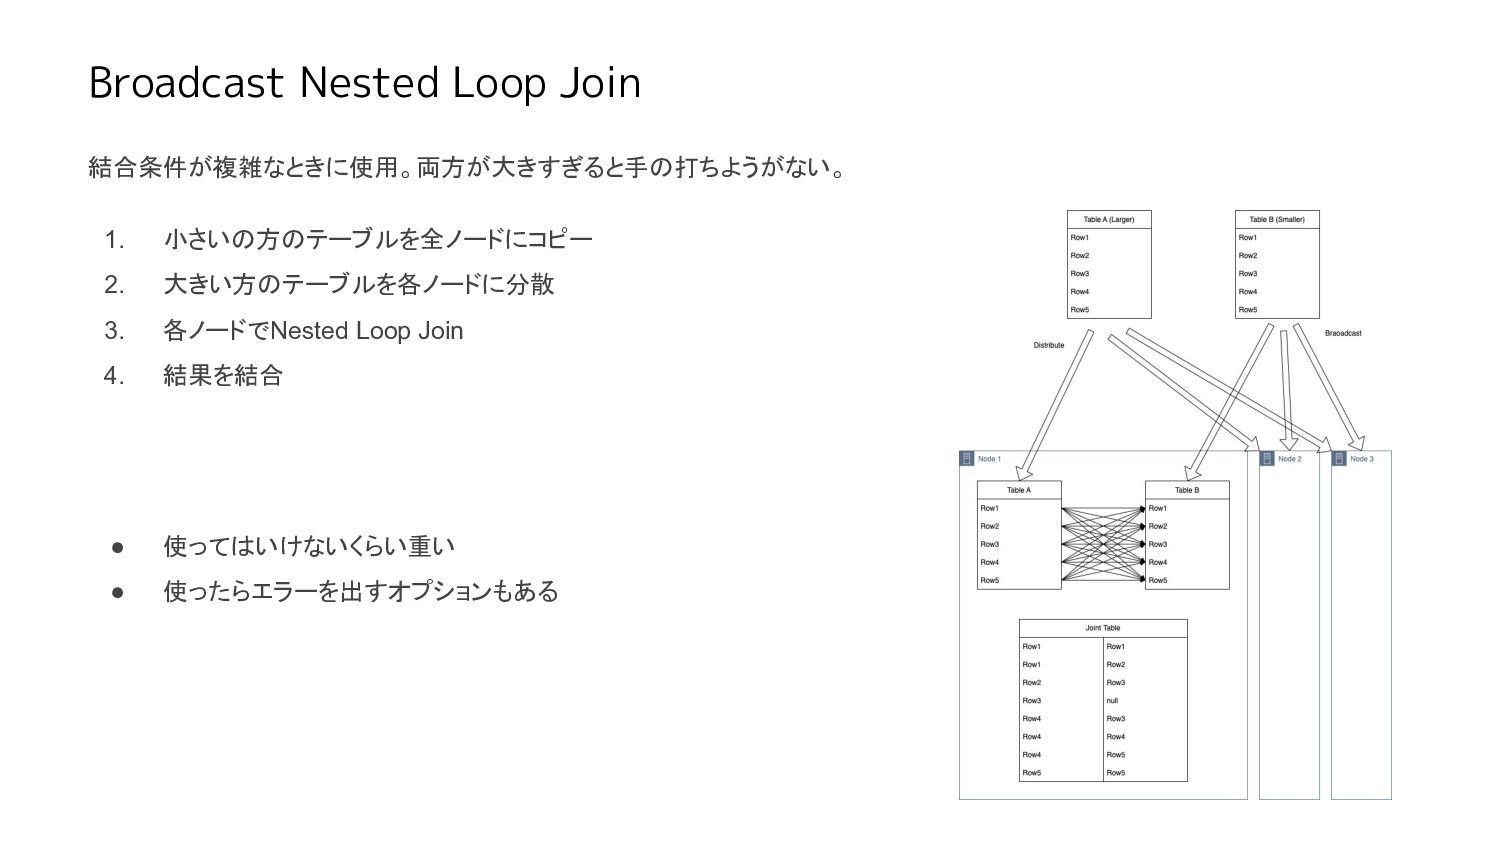
Broadcast Nested Loop Join 結合条件が複雑なときに使用。両方が大きすぎると手の打ちようがない。 1. 小さいの方のテーブルを全ノードにコピー 2. 大きい方のテーブルを各ノードに分散 3.
各ノードでNested Loop Join 4. 結果を結合 • 使ってはいけないくらい重い • 使ったらエラーを出すオプションもある
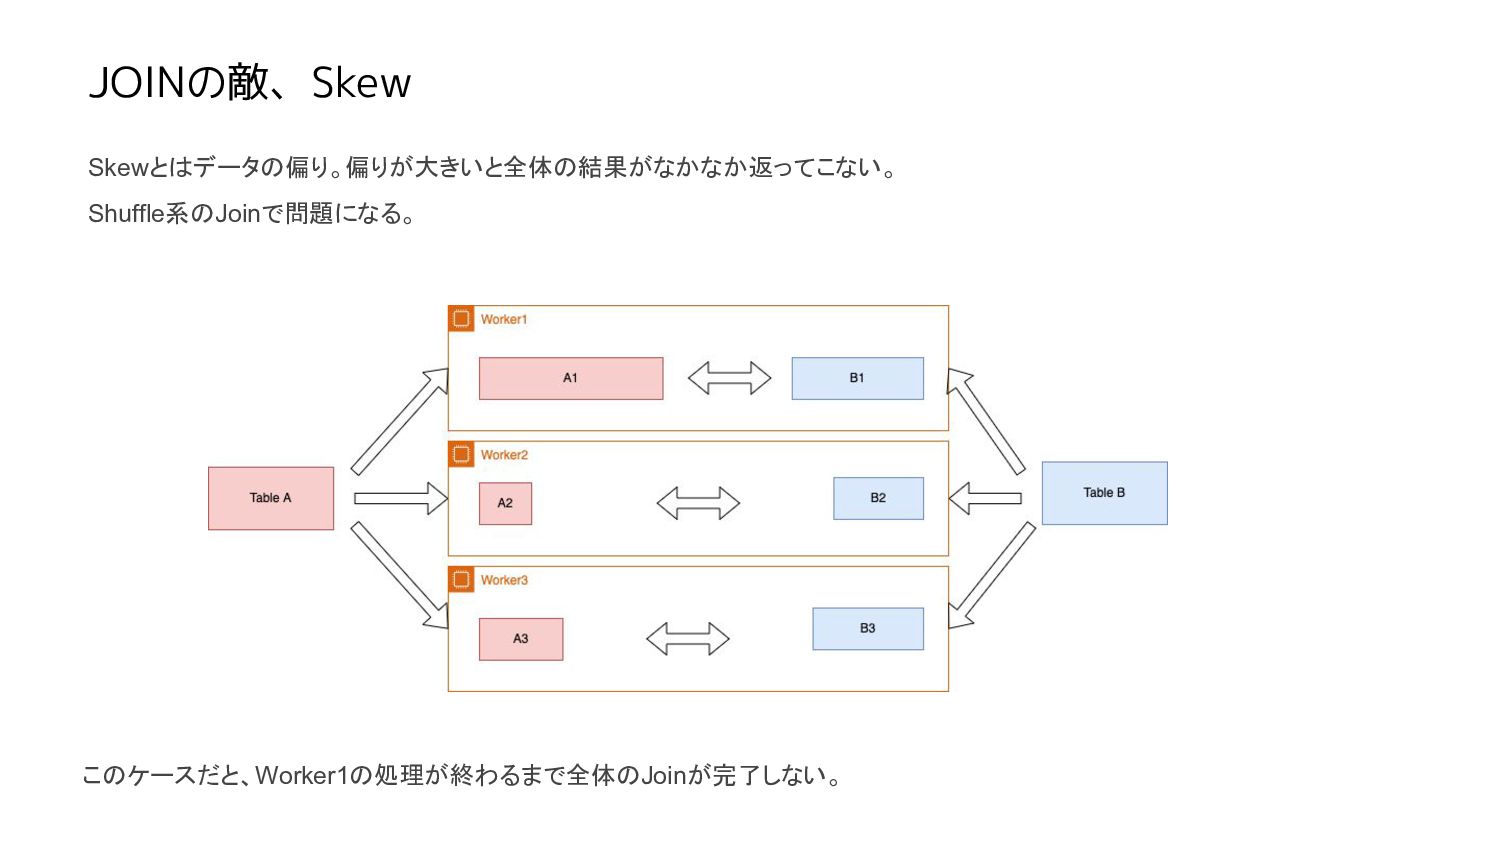
JOINの敵、Skew Skewとはデータの偏り。偏りが大きいと全体の結果がなかなか返ってこない。 Shuffle系のJoinで問題になる。 このケースだと、Worker1の処理が終わるまで全体のJoinが完了しない。
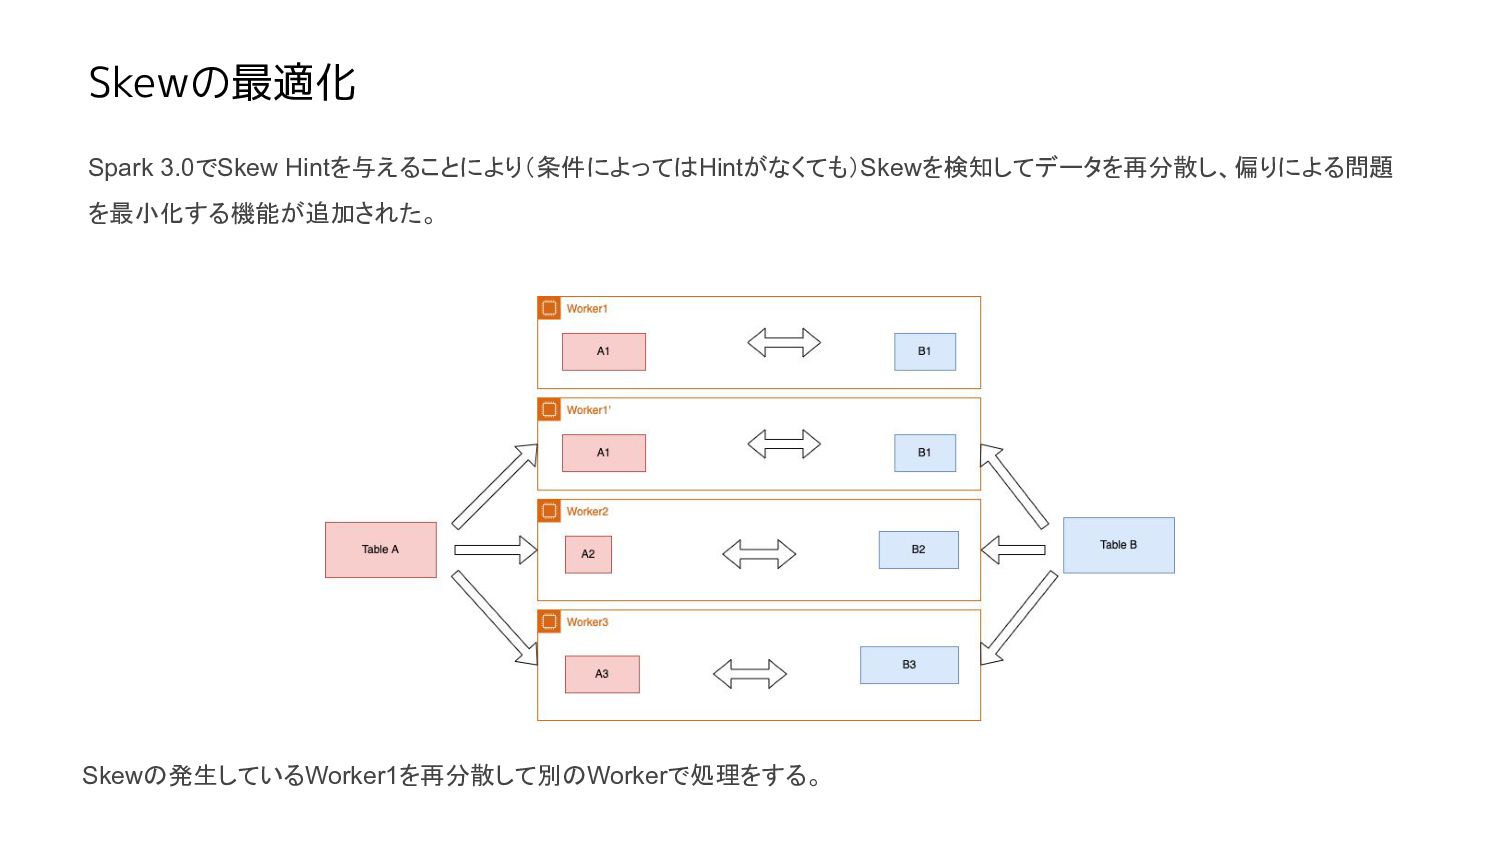
Skewの最適化 Spark 3.0でSkew Hintを与えることにより(条件によってはHintがなくても)Skewを検知してデータを再分散し、偏りによる問題 を最小化する機能が追加された。 Skewの発生しているWorker1を再分散して別のWorkerで処理をする。
結論 • できるだけBroadcast Joinを使おう ◦ マスタとの結合は明示的に Bradcast Hash Joinを使わせたりする •
どうしても出来ないときでも、複雑な条件では Joinしないようにしよう • Shuffle Joinが発生するカラムは均等に分散される設計にしよう ◦ IDFAやランダムな文字列などは基本的に偏りがない ◦ ステータスやtype系のものでJoinしようとするとSkewが発生しやすい • あとは実際どのJoinが使われているか、実行プランを確認しよう

 SiteGround - Reliable hosting with speed, security, and support you can count on.


 yabooun
 ykanoh
 codmoninc
 maimyyym
 teamlab
 bitkey
 4o1sobblue
 odashi
 shugo
 recruitengineers
 jtakeda
 pfn
 ishikawa_satoru
 nikkihalliwell
 ipullrank
 soudai
 tamaranovitovic
 jonyablonski
 reverentgeek
 shpigford
 caitiem20
 codingconduct
 baasie
 addyosmani