Share
Embed
Transcript
39 slides
-
0 手続き的知識源を用いた 方法を表すクエリからの目的抽出 兵庫県立大学 工家 昂之 兵庫県立大学 山本 岳洋 青山学院大学
莊司 慶行 3a-2-2 DEIM 2023 3月5日 -
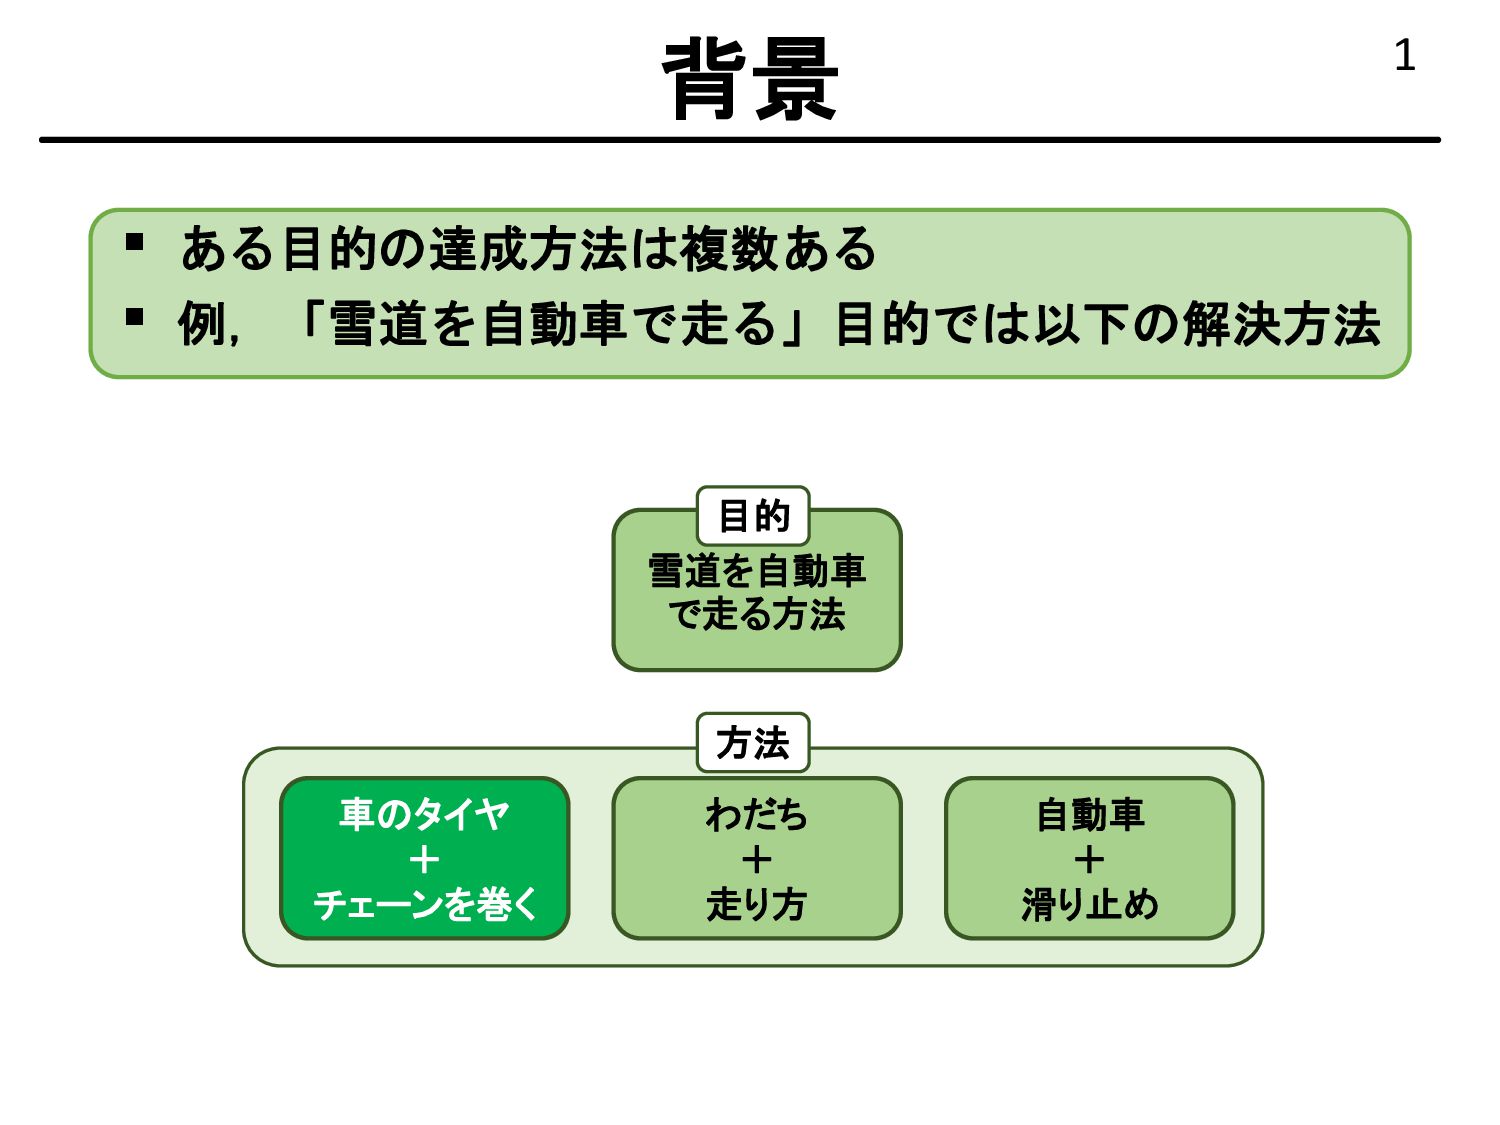
1 ▪ ある目的の達成方法は複数ある ▪ 例,「雪道を自動車で走る」目的では以下の解決方法 背景 自動車 + 滑り止め わだち
+ 走り方 車のタイヤ + チェーンを巻く 方法 雪道を自動車 で走る方法 目的 -
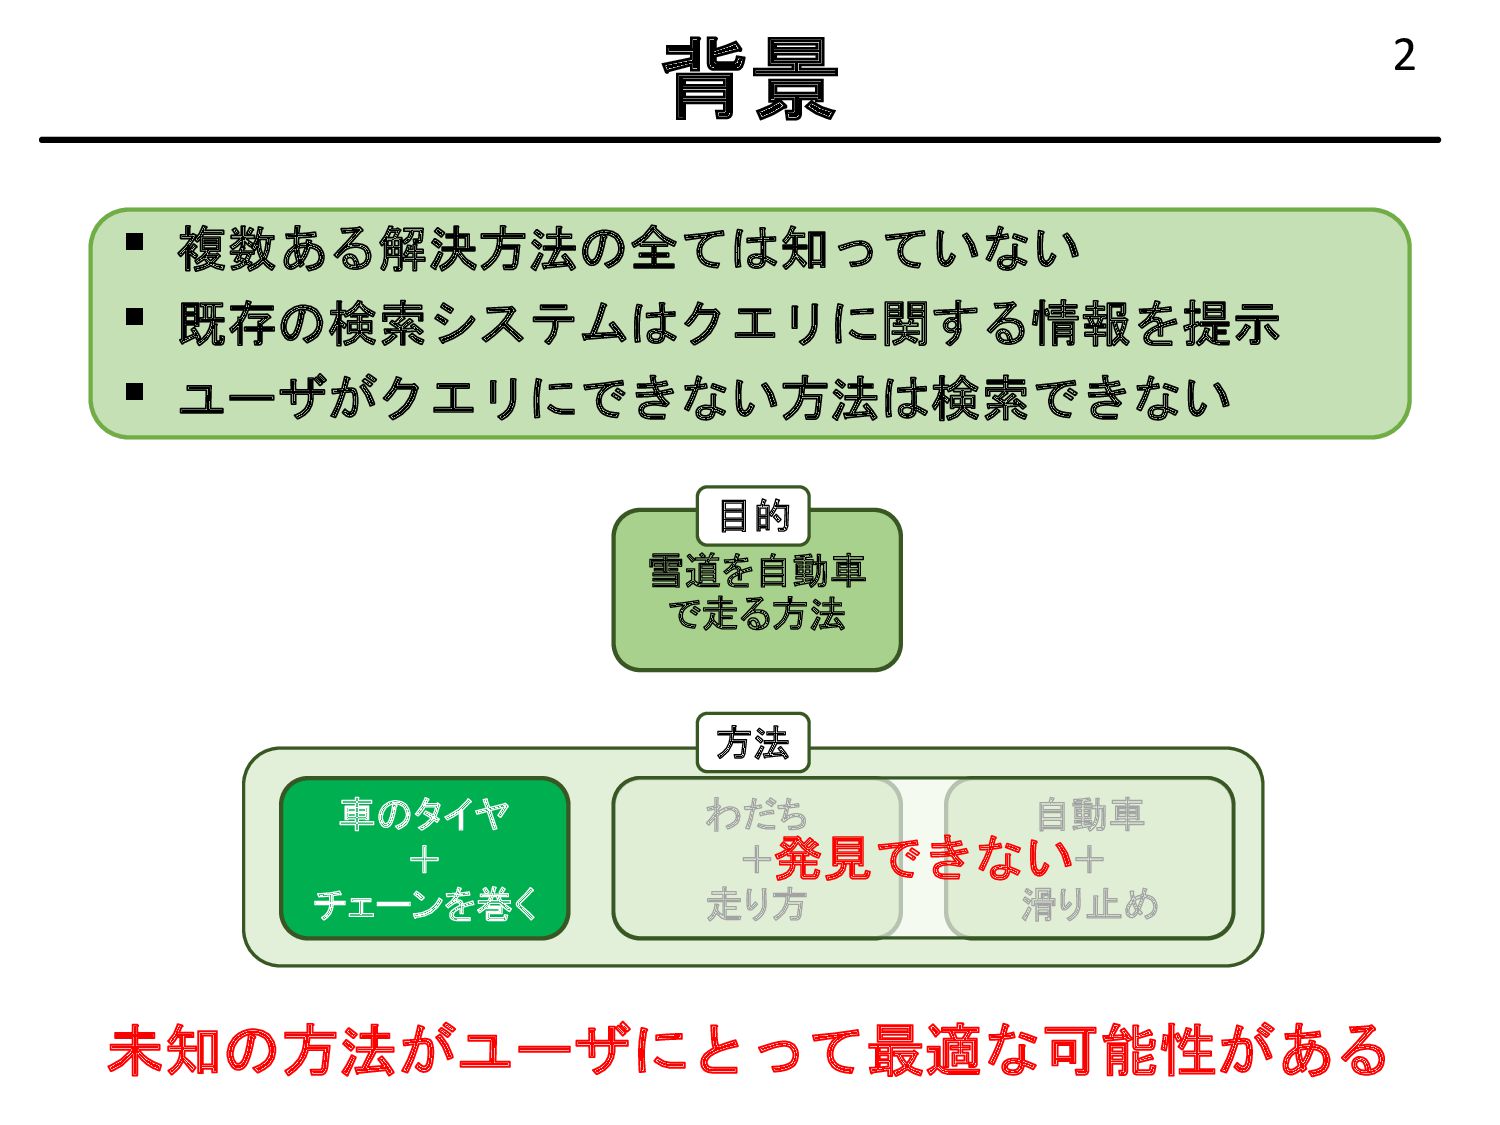
2 ▪ 複数ある解決方法の全ては知っていない ▪ 既存の検索システムはクエリに関する情報を提示 ▪ ユーザがクエリにできない方法は検索できない 背景 自動車 +
滑り止め わだち + 走り方 車のタイヤ + チェーンを巻く 方法 発見できない 雪道を自動車 で走る方法 目的 未知の方法がユーザにとって最適な可能性がある -
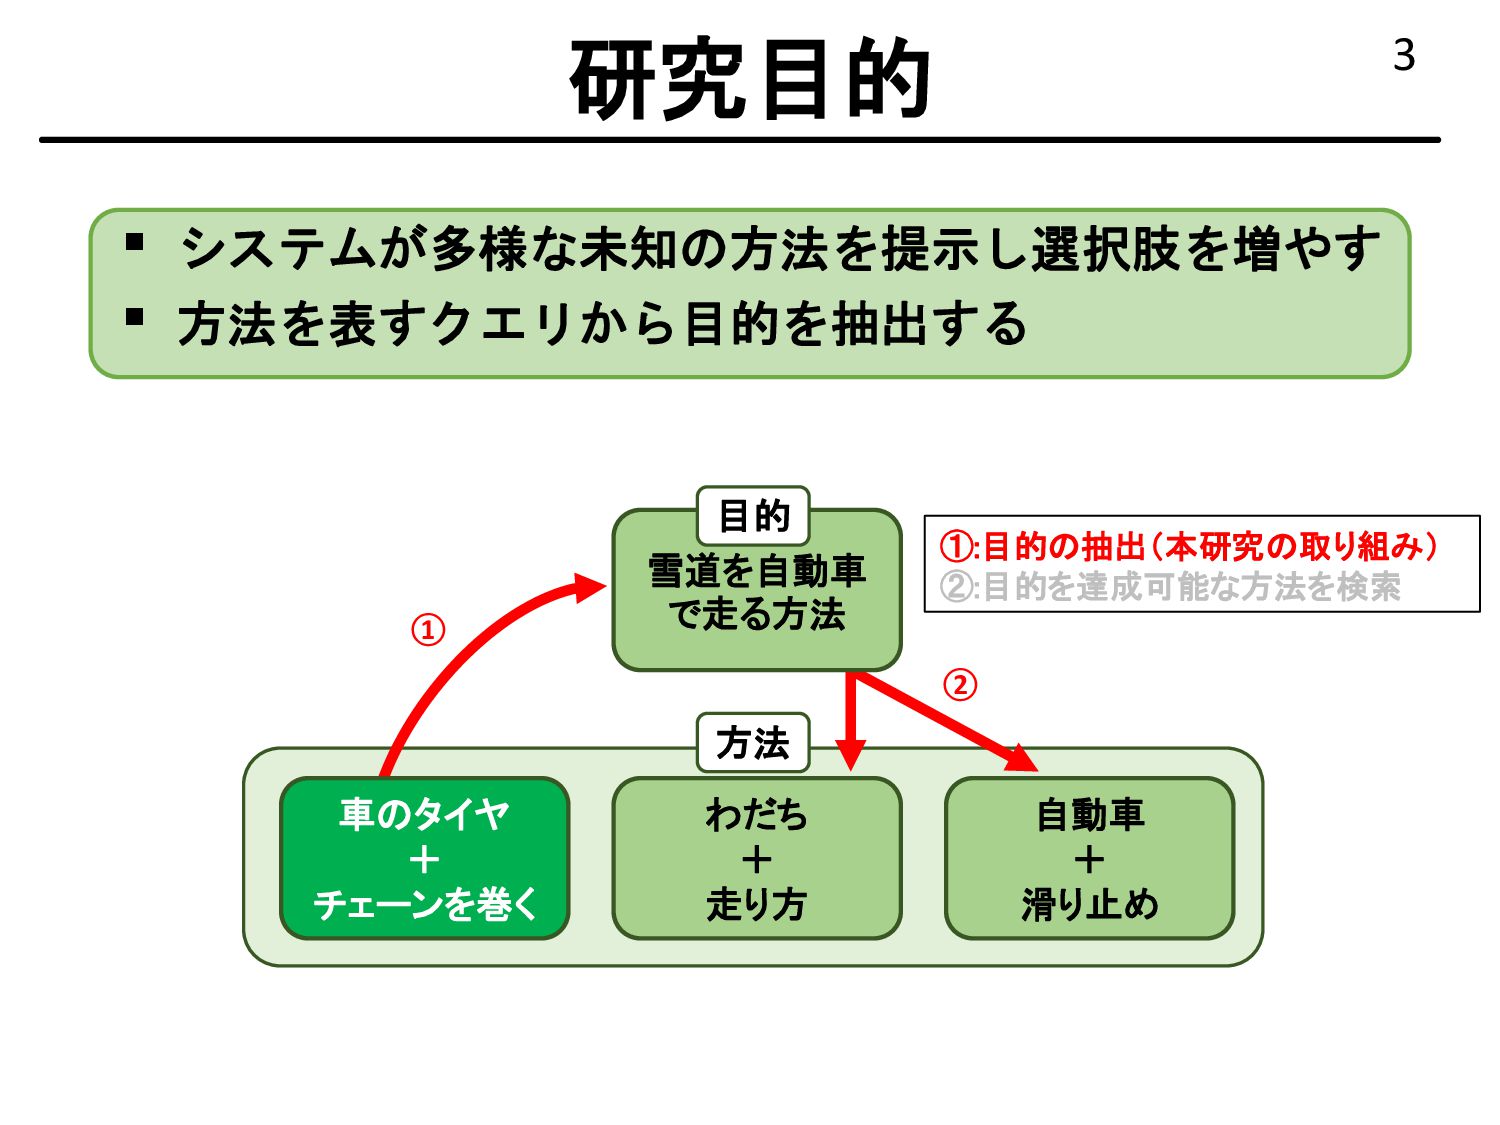
3 ▪ システムが多様な未知の方法を提示し選択肢を増やす ▪ 方法を表すクエリから目的を抽出する 研究目的 自動車 + 滑り止め ①
② わだち + 走り方 車のタイヤ + チェーンを巻く 方法 雪道を自動車 で走る方法 目的 ①:目的の抽出(本研究の取り組み) ②:目的を達成可能な方法を検索 -
4 ▪ クエリ修正前後のクエリの関係を分類した研究[1] 関連研究 [1] Paolo Boldi; Francesco Bonchi; Carlos
Castillo; Sebastiano Vigna, From “Dango” to “Japanese Cakes” :Query Reformulation Models and Patterns, 2009 IEEE/WIC/ACM International Joint Conference on Web Intelligence and Intelligent Agent Technology, pp. 183- 190, 2009 果物 リンゴ 特化 汎化 本研究が実現したいこと 車のタイヤに チェーンを巻く 雪道を自動車 で走る方法 上位語置き換えやキーワード削除で実現できない 特化 汎化 -
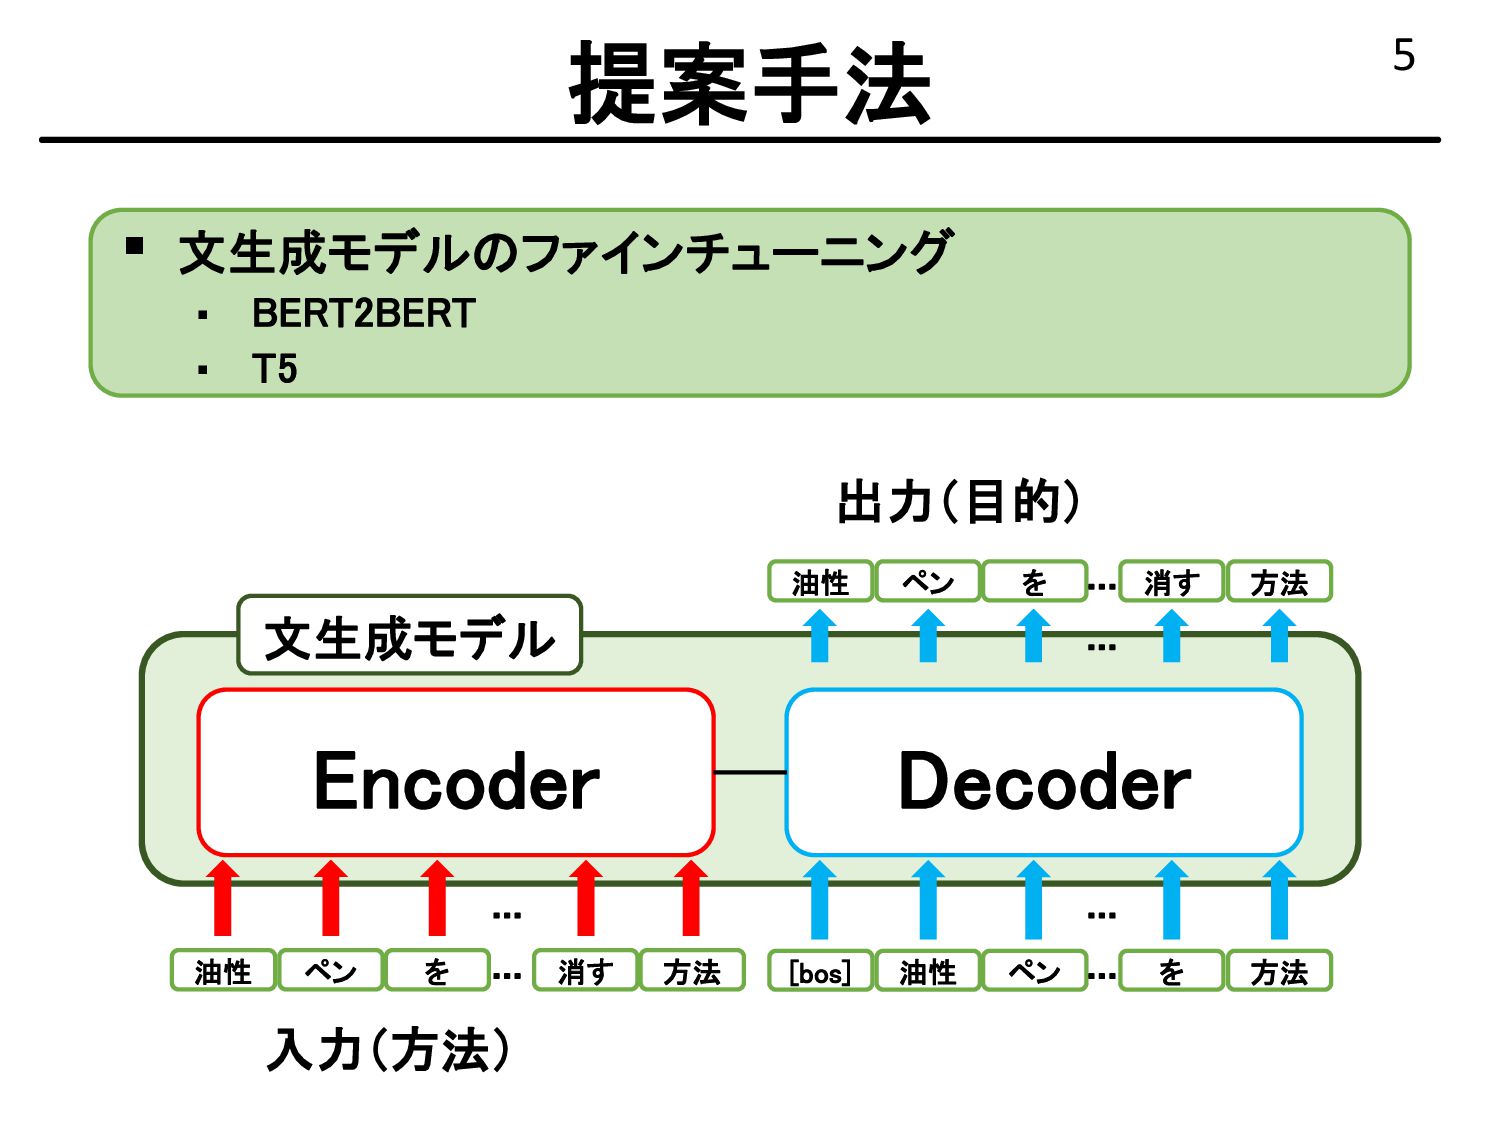
5 ▪ 文生成モデルのファインチューニング ▪ BERT2BERT ▪ T5 提案手法 Encoder Decoder
入力(方法) 出力(目的) 油性 を 消す 方法 ... ペン 油性 を 消す 方法 ペン ... 文生成モデル [bos] ペン を 方法 油性 ... ... ... ... -
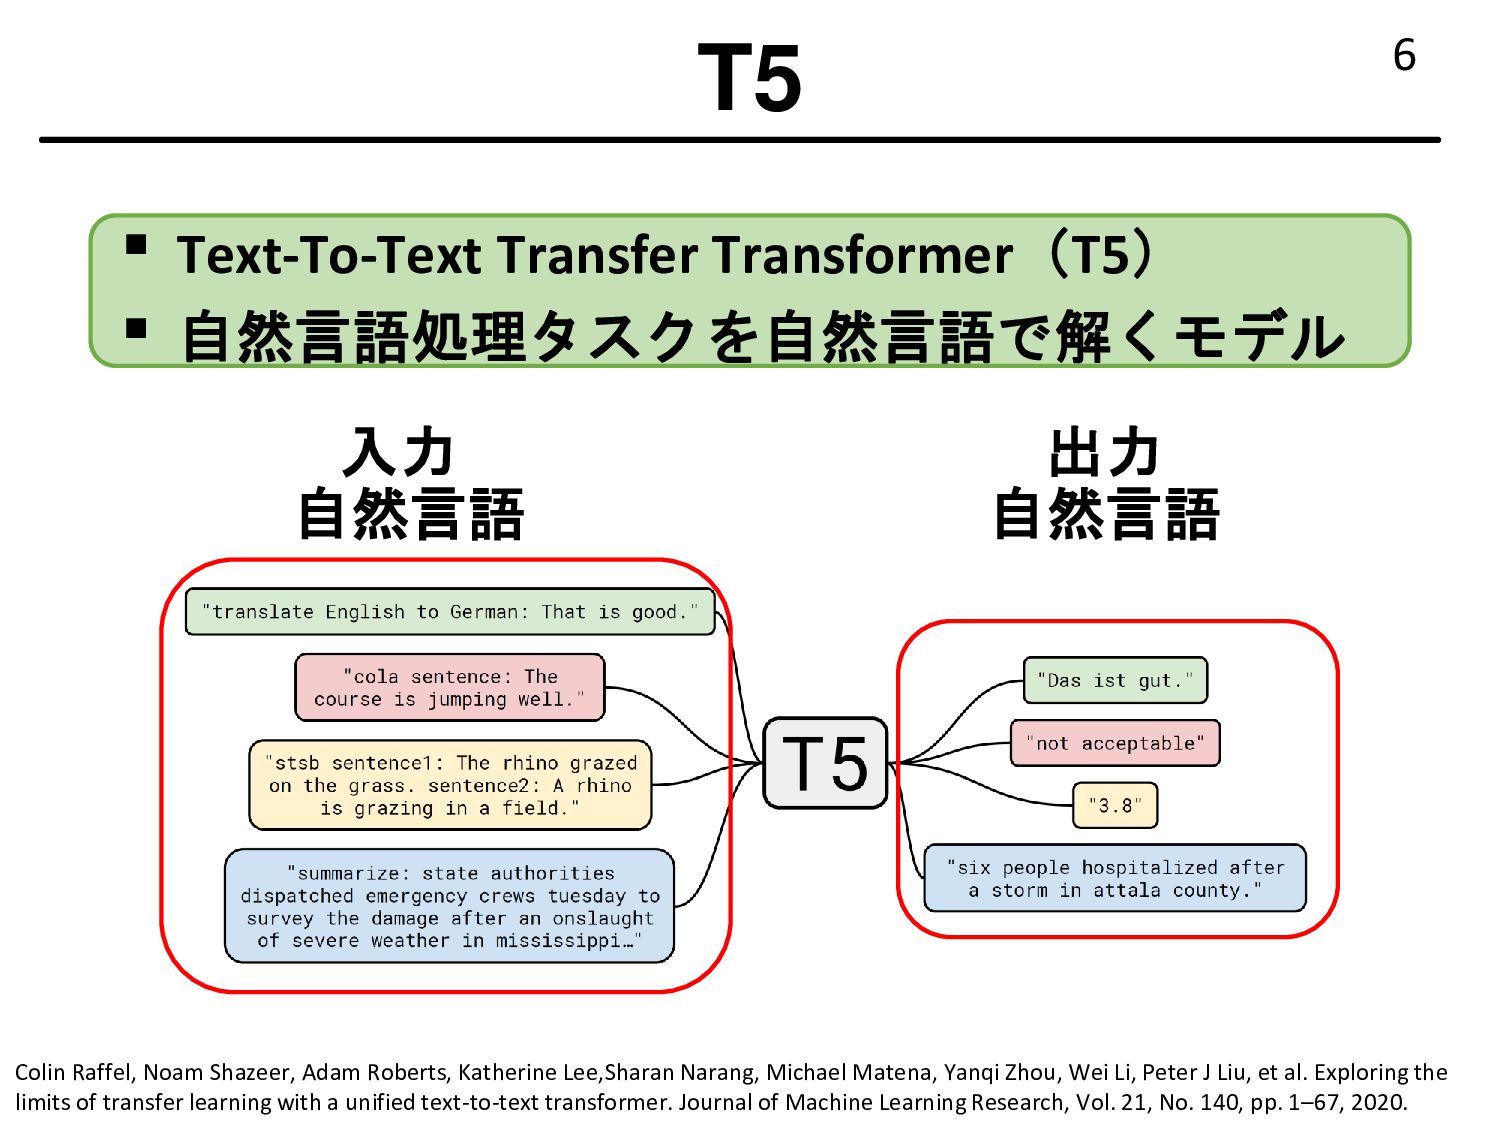
6 ▪ Text-To-Text Transfer Transformer(T5) ▪ 自然言語処理タスクを自然言語で解くモデル T5 Colin Raffel,
Noam Shazeer, Adam Roberts, Katherine Lee,Sharan Narang, Michael Matena, Yanqi Zhou, Wei Li, Peter J Liu, et al. Exploring the limits of transfer learning with a unified text-to-text transformer. Journal of Machine Learning Research, Vol. 21, No. 140, pp. 1–67, 2020. 自然言語 出力 入力 自然言語 -
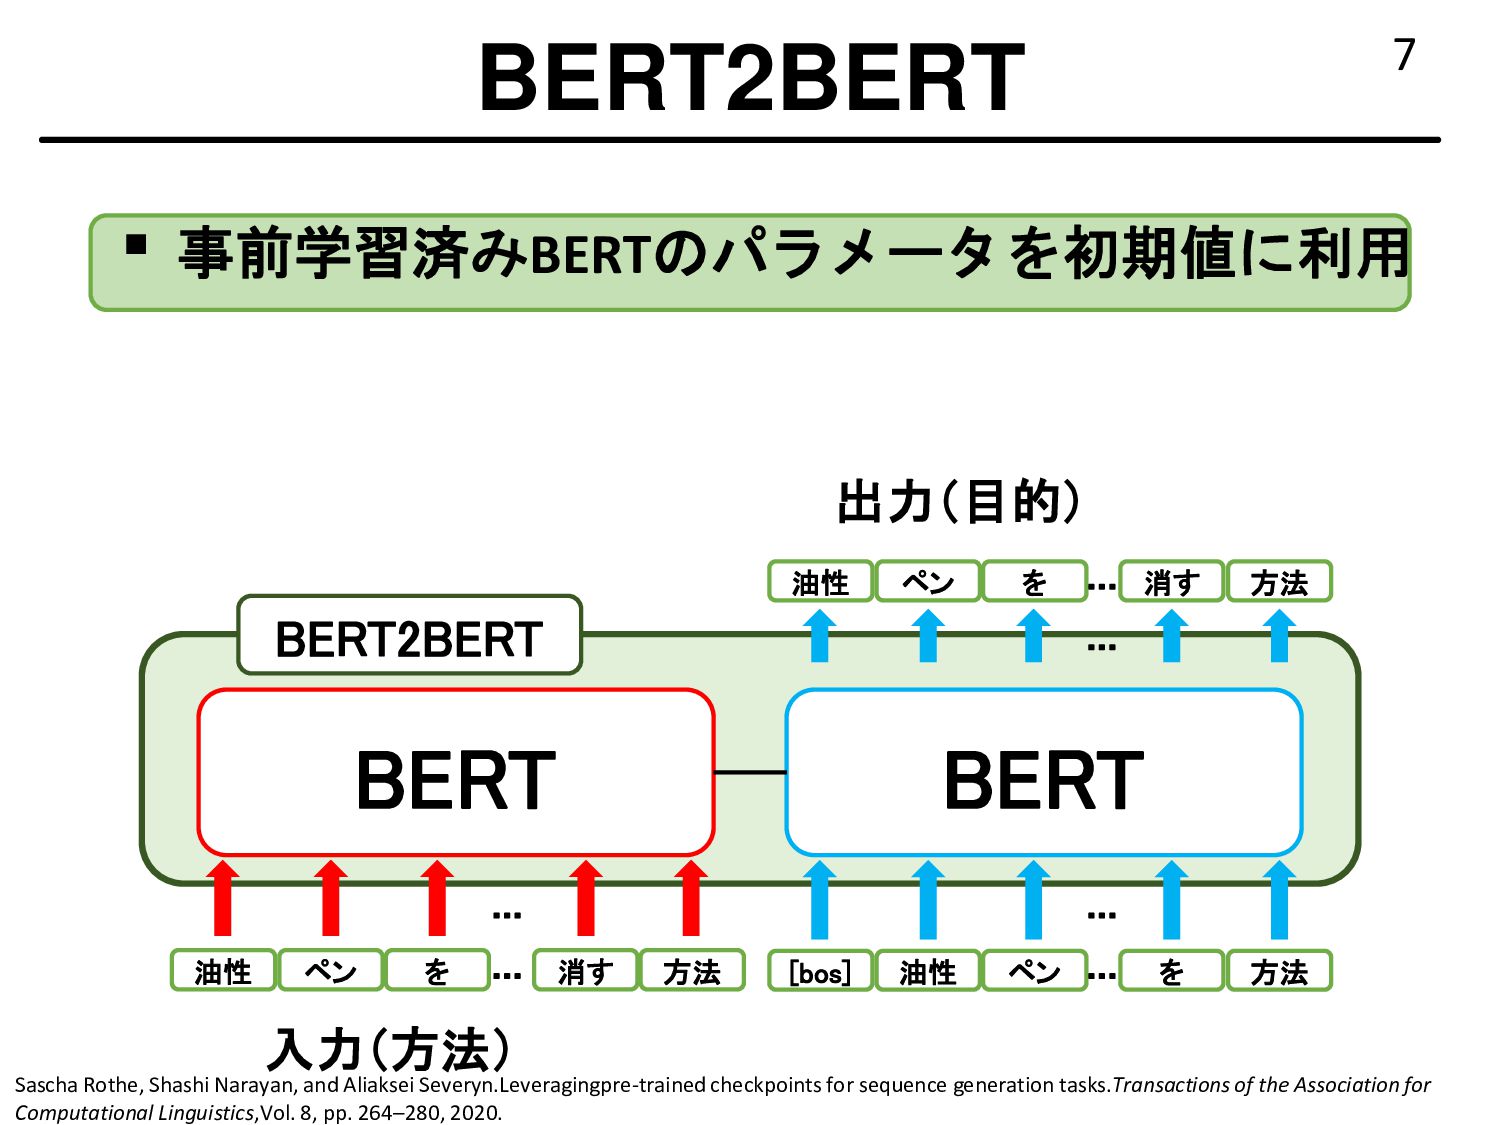
7 ▪ 事前学習済みBERTのパラメータを初期値に利用 BERT2BERT Sascha Rothe, Shashi Narayan, and Aliaksei
Severyn.Leveragingpre-trained checkpoints for sequence generation tasks.Transactions of the Association for Computational Linguistics,Vol. 8, pp. 264–280, 2020. BERT BERT 入力(方法) 出力(目的) 油性 を 消す 方法 ... ペン 油性 を 消す 方法 ペン ... BERT2BERT [bos] ペン を 方法 油性 ... ... ... ... -
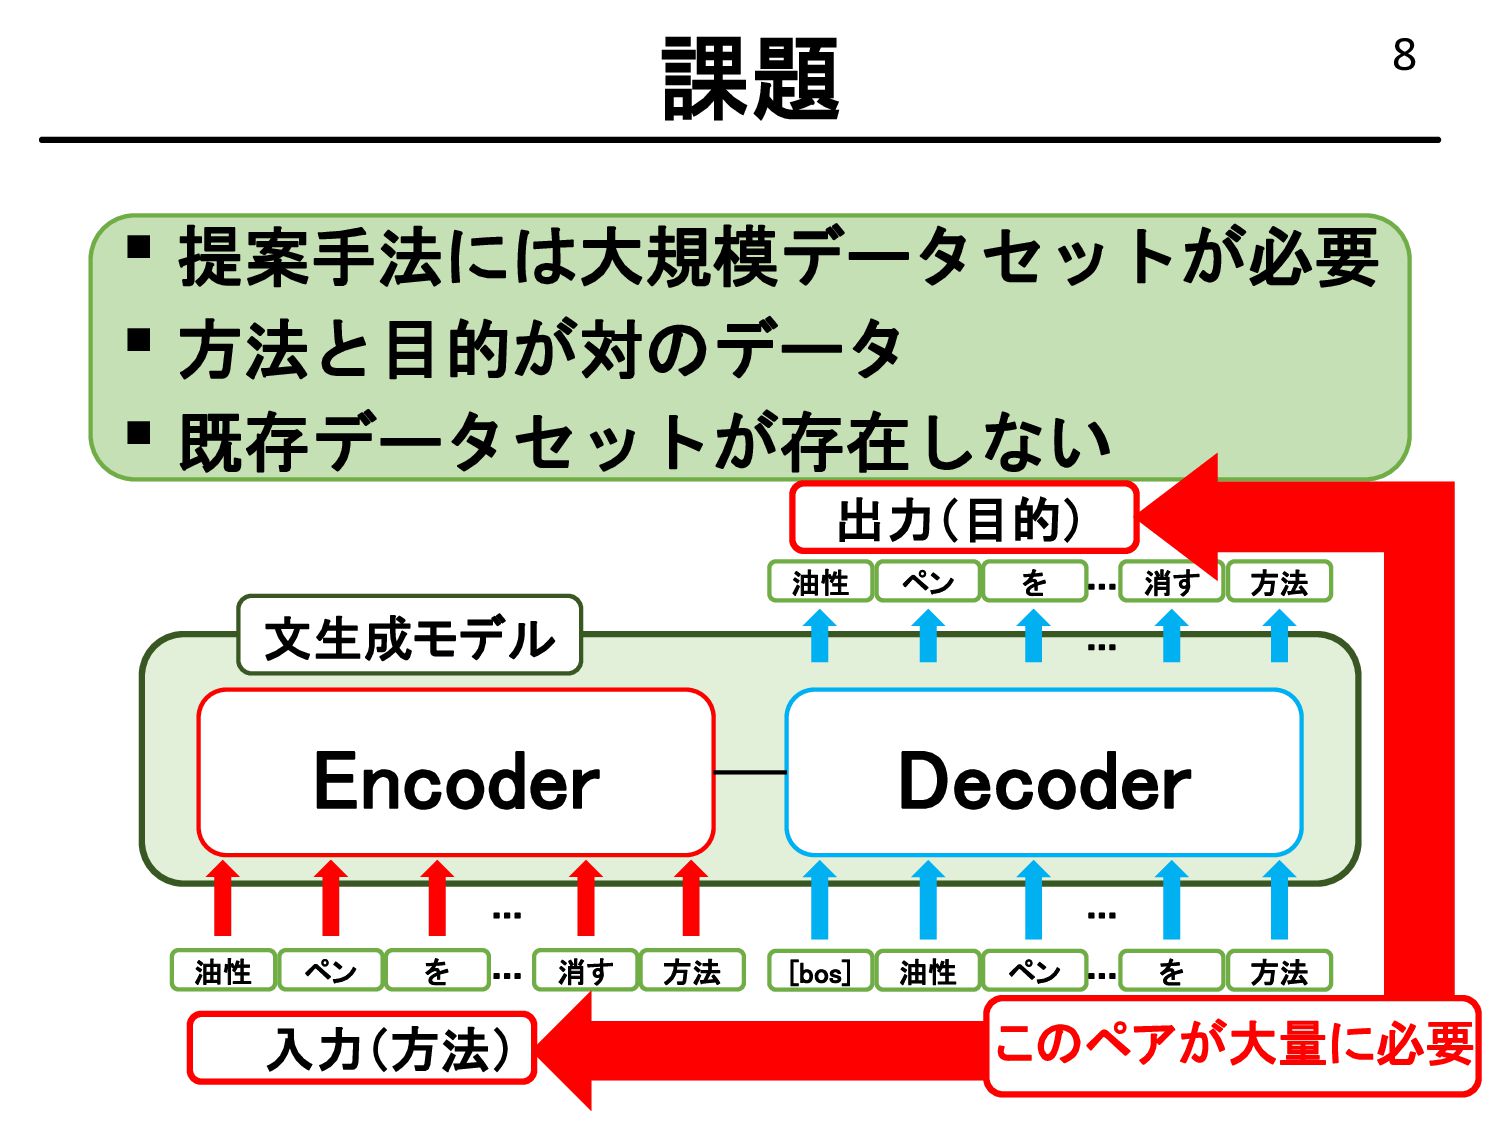
8 ▪ 提案手法には大規模データセットが必要 ▪ 方法と目的が対のデータ ▪ 既存データセットが存在しない 課題 Encoder Decoder
入力(方法) 出力(目的) 油性 を 消す 方法 ... ペン 油性 を 消す 方法 ペン ... 文生成モデル [bos] ペン を 方法 油性 ... ... ... ... このペアが大量に必要 -
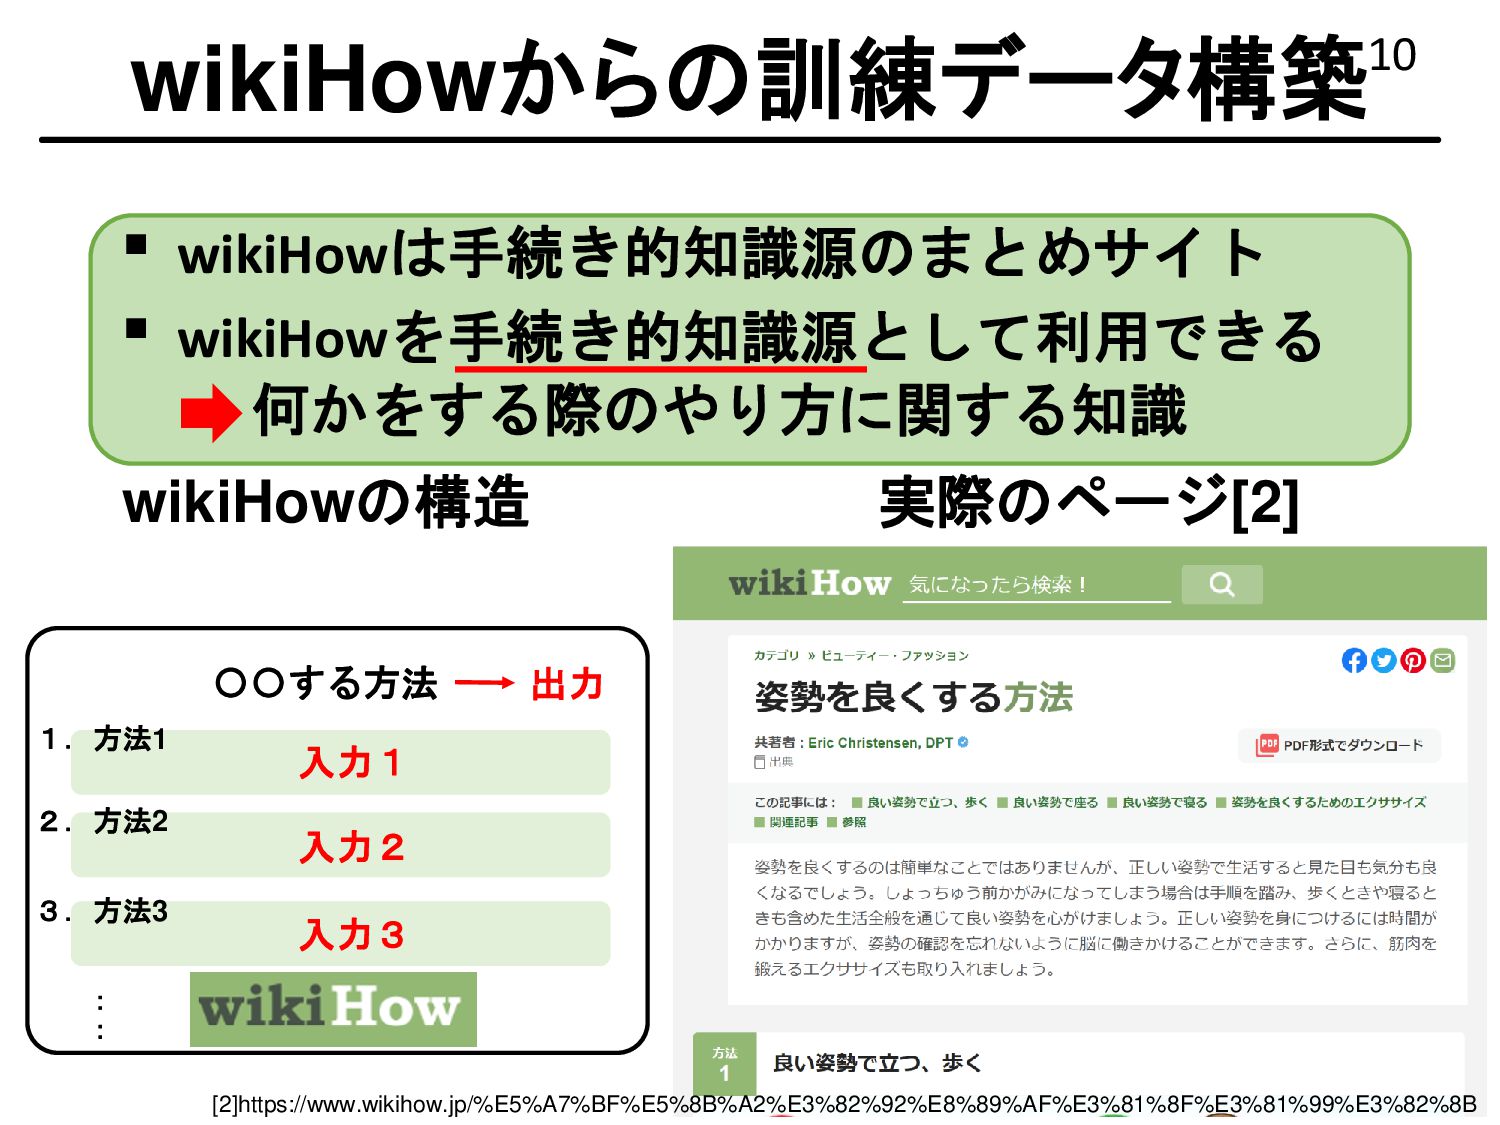
10 ▪ wikiHowは手続き的知識源のまとめサイト ▪ wikiHowを手続き的知識源として利用できる ▪ 何かをする際のやり方に関する知識 wikiHowからの訓練データ構築 〇〇する方法 1.方法1
2.方法2 3.方法3 : : 出力 入力1 入力2 入力3 wikiHowの構造 実際のページ[2] [2]https://www.wikihow.jp/%E5%A7%BF%E5%8B%A2%E3%82%92%E8%89%AF%E3%81%8F%E3%81%99%E3%82%8B -
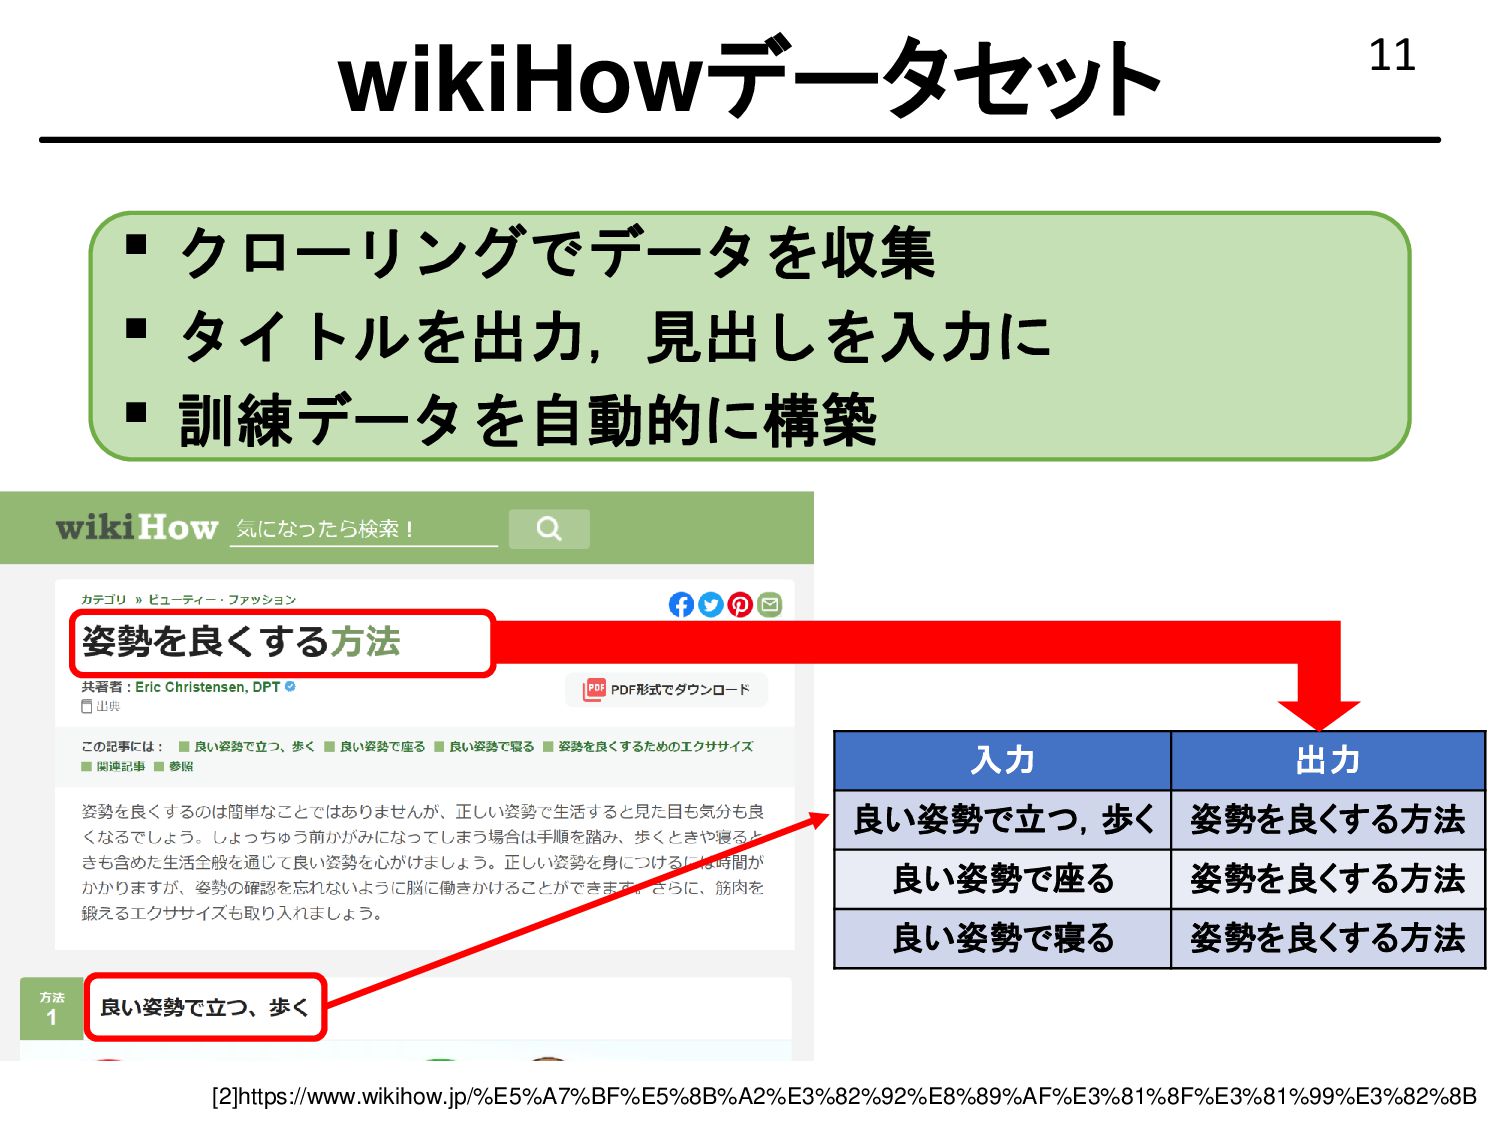
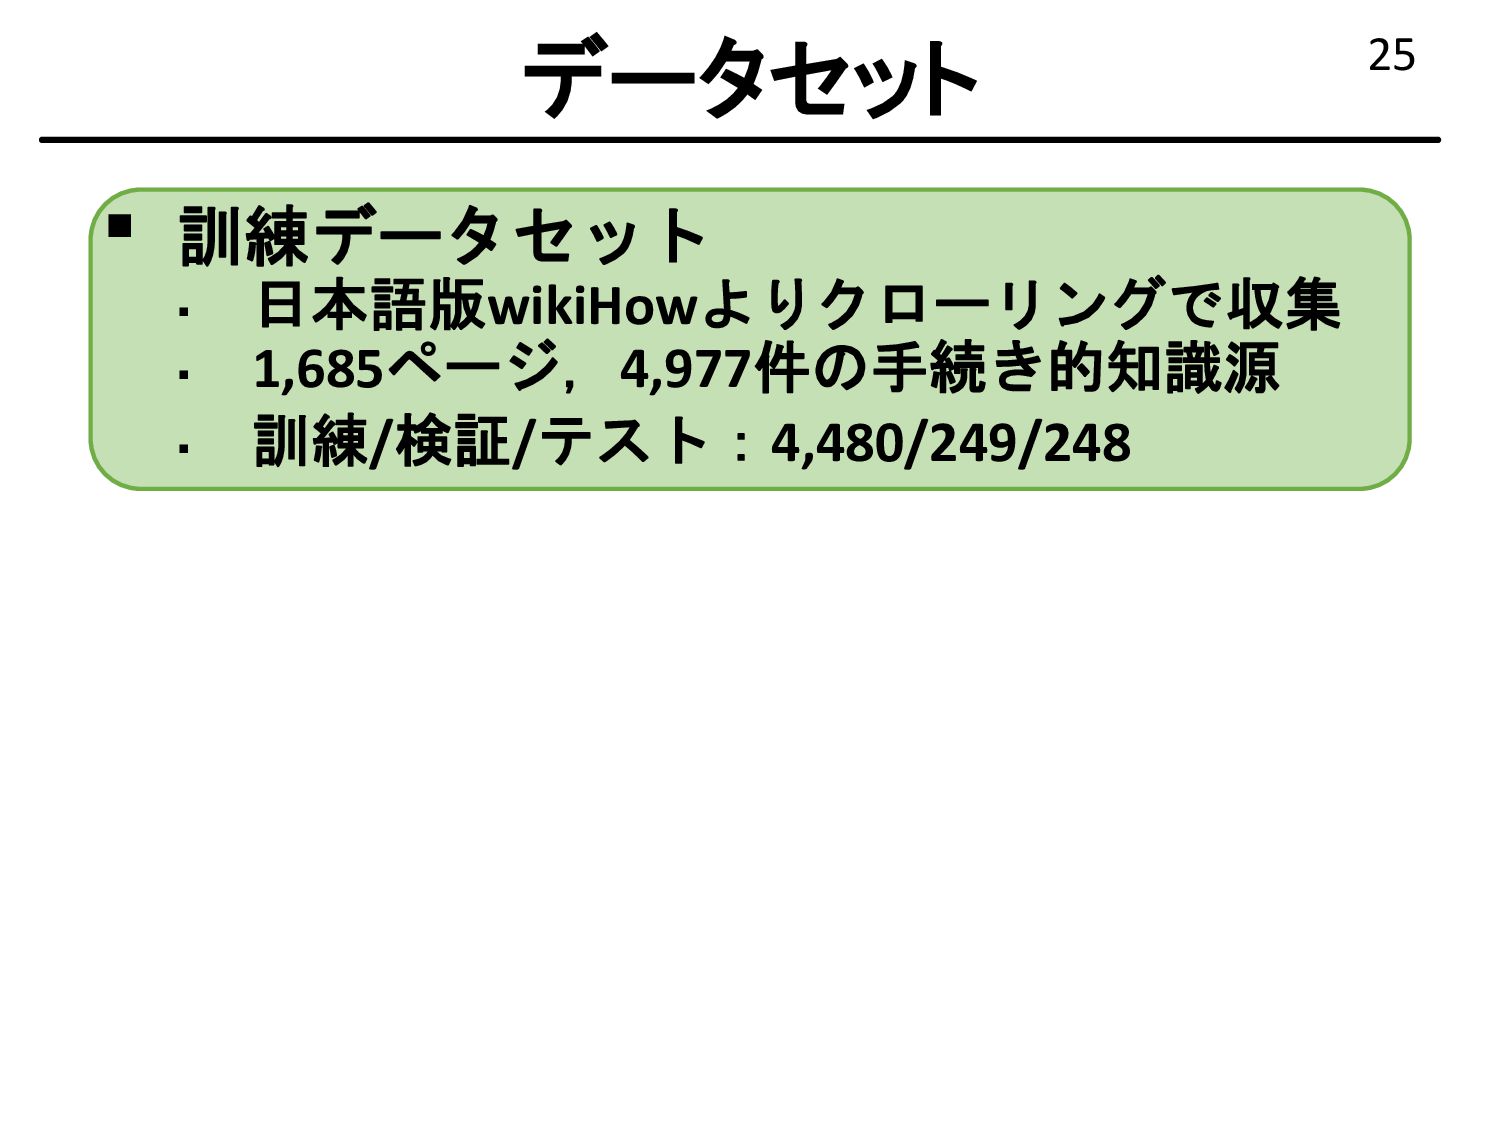
11 ▪ クローリングでデータを収集 ▪ タイトルを出力,見出しを入力に ▪ 訓練データを自動的に構築 wikiHowデータセット 入力 出力
良い姿勢で立つ,歩く 姿勢を良くする方法 良い姿勢で座る 姿勢を良くする方法 良い姿勢で寝る 姿勢を良くする方法 [2]https://www.wikihow.jp/%E5%A7%BF%E5%8B%A2%E3%82%92%E8%89%AF%E3%81%8F%E3%81%99%E3%82%8B -
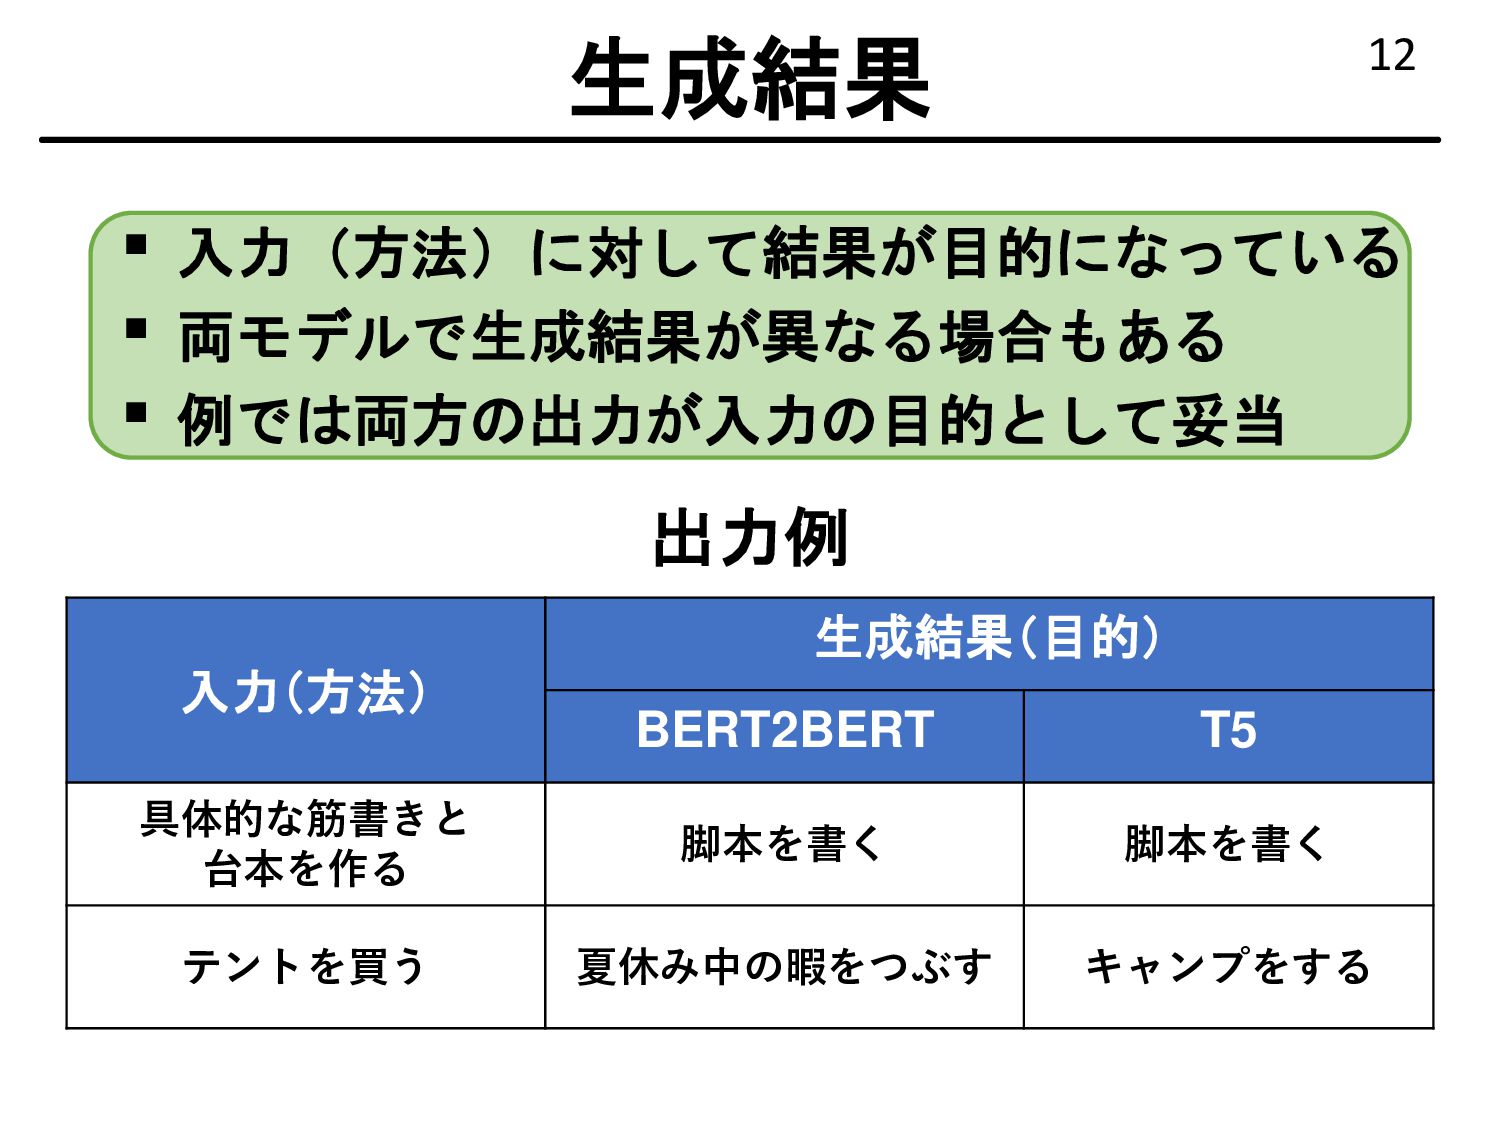
12 ▪ 入力(方法)に対して結果が目的になっている ▪ 両モデルで生成結果が異なる場合もある ▪ 例では両方の出力が入力の目的として妥当 生成結果 出力例 入力(方法)
生成結果(目的) BERT2BERT T5 具体的な筋書きと 台本を作る 脚本を書く 脚本を書く テントを買う 夏休み中の暇をつぶす キャンプをする -
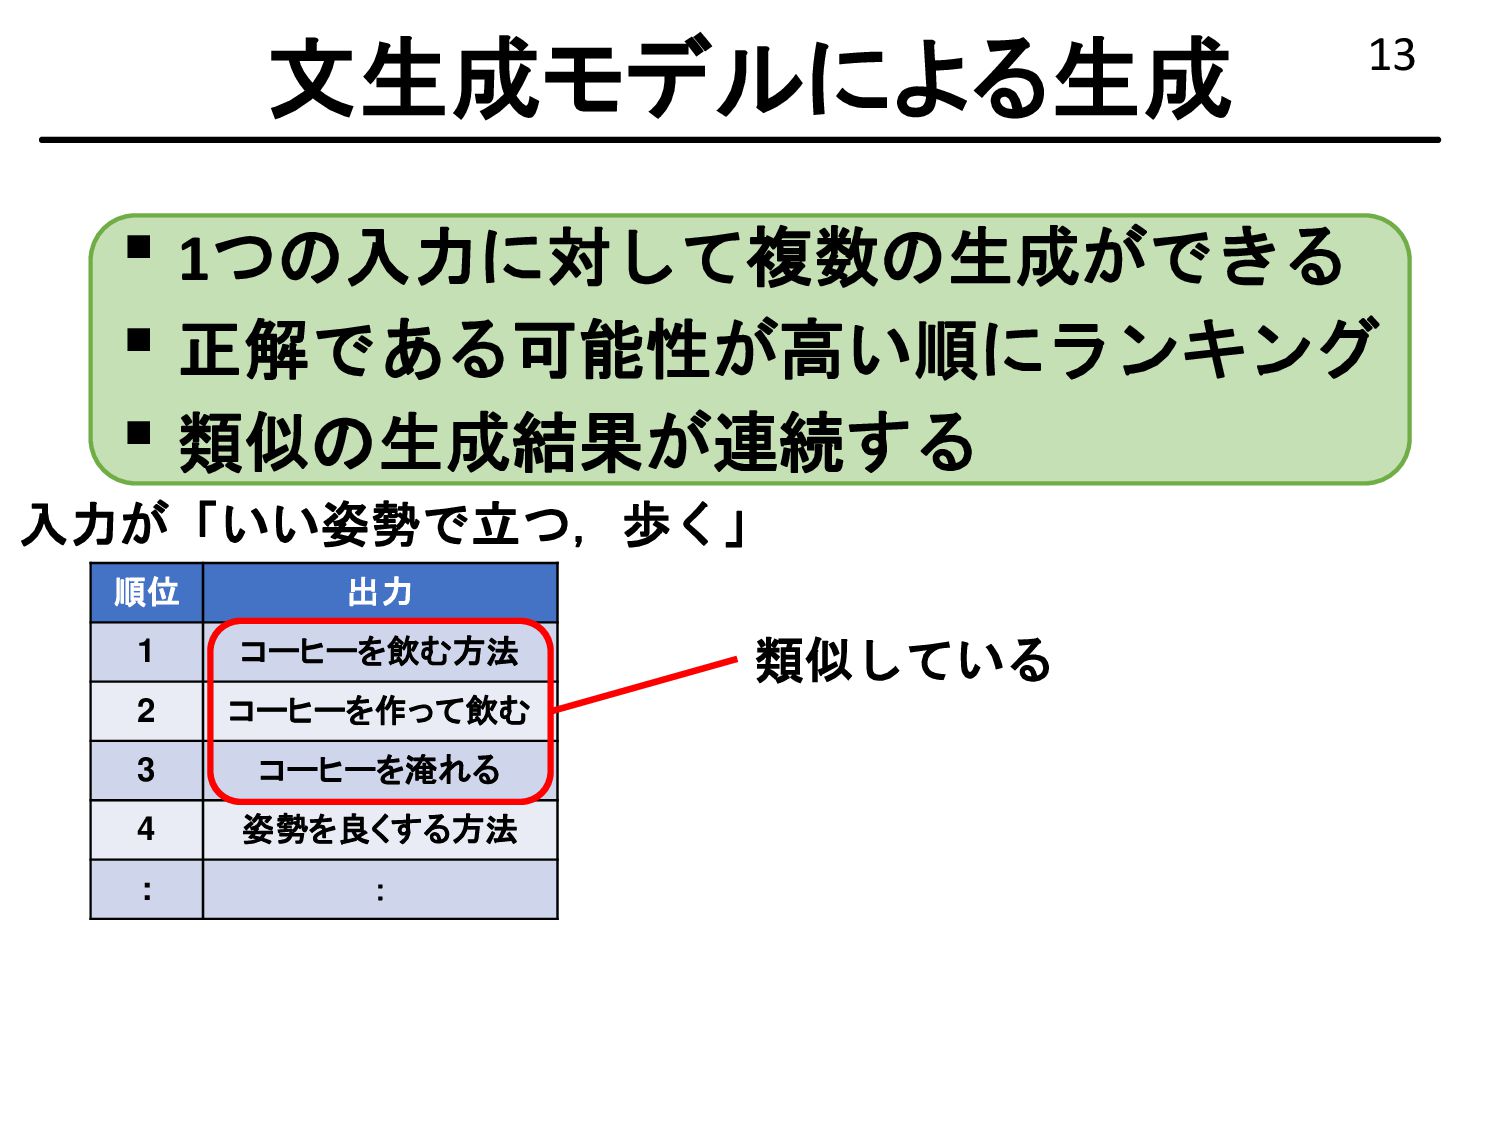
13 ▪ 1つの入力に対して複数の生成ができる ▪ 正解である可能性が高い順にランキング ▪ 類似の生成結果が連続する 文生成モデルによる生成 類似している 順位
出力 1 コーヒーを飲む方法 2 コーヒーを作って飲む 3 コーヒーを淹れる 4 姿勢を良くする方法 : : 入力が「いい姿勢で立つ,歩く」 -
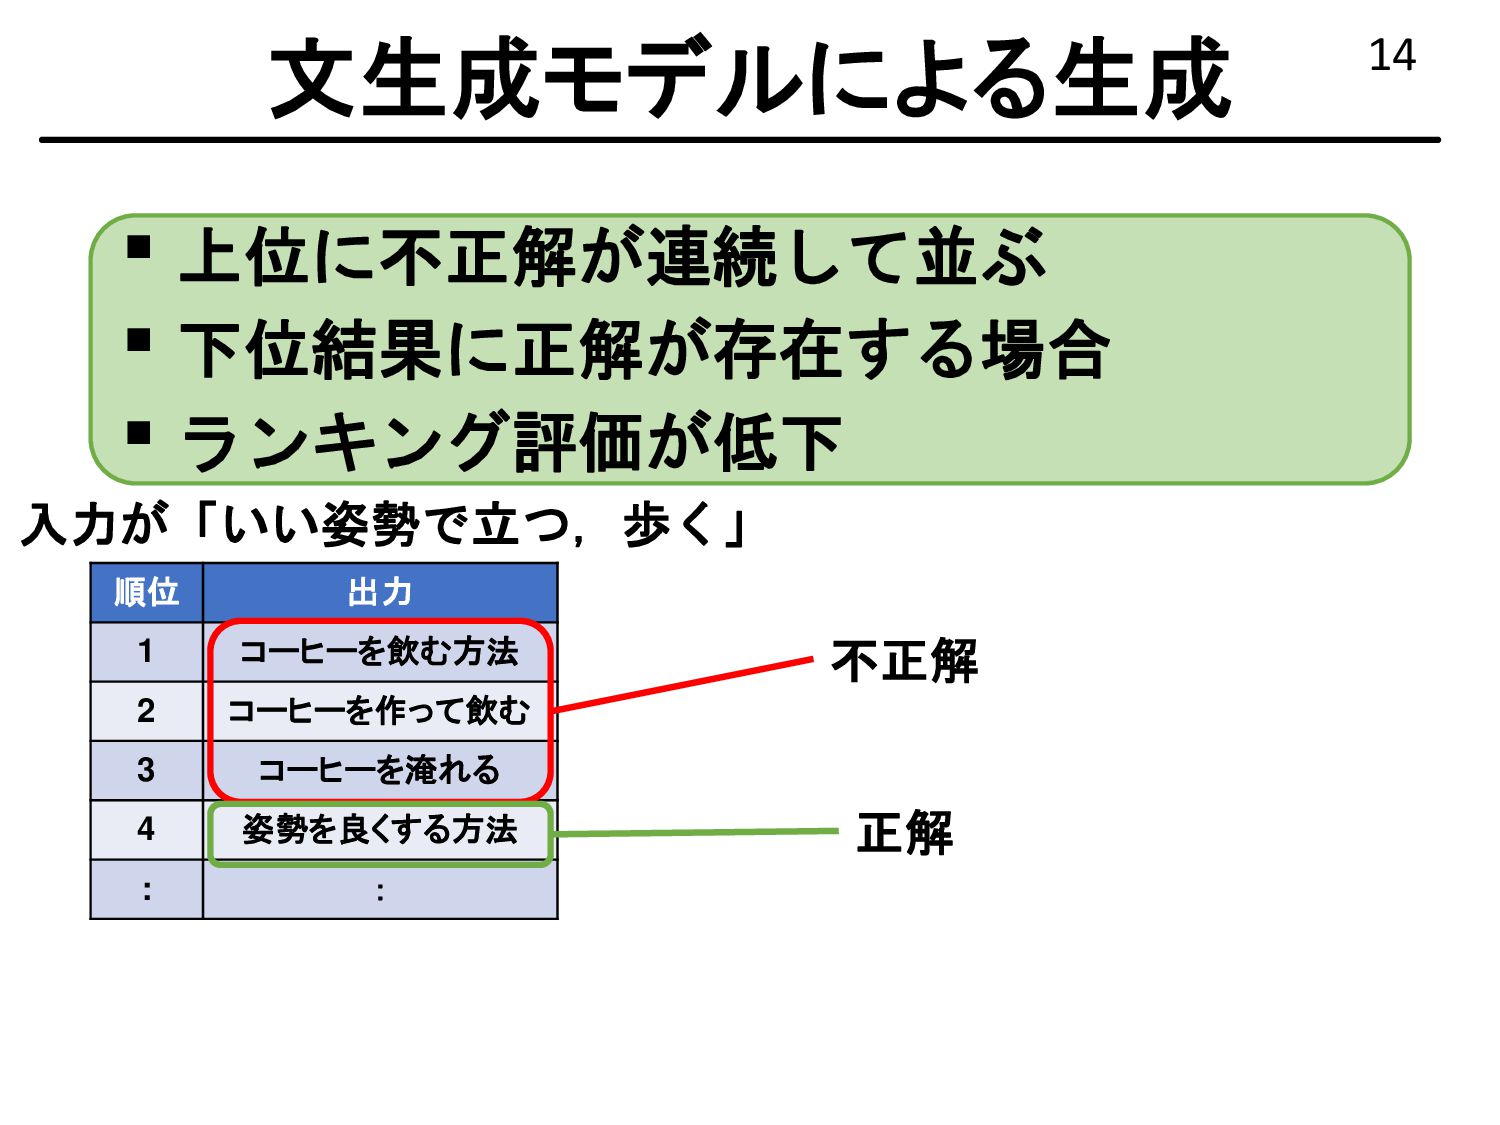
14 ▪ 上位に不正解が連続して並ぶ ▪ 下位結果に正解が存在する場合 ▪ ランキング評価が低下 文生成モデルによる生成 不正解 順位
出力 1 コーヒーを飲む方法 2 コーヒーを作って飲む 3 コーヒーを淹れる 4 姿勢を良くする方法 : : 入力が「いい姿勢で立つ,歩く」 正解 -
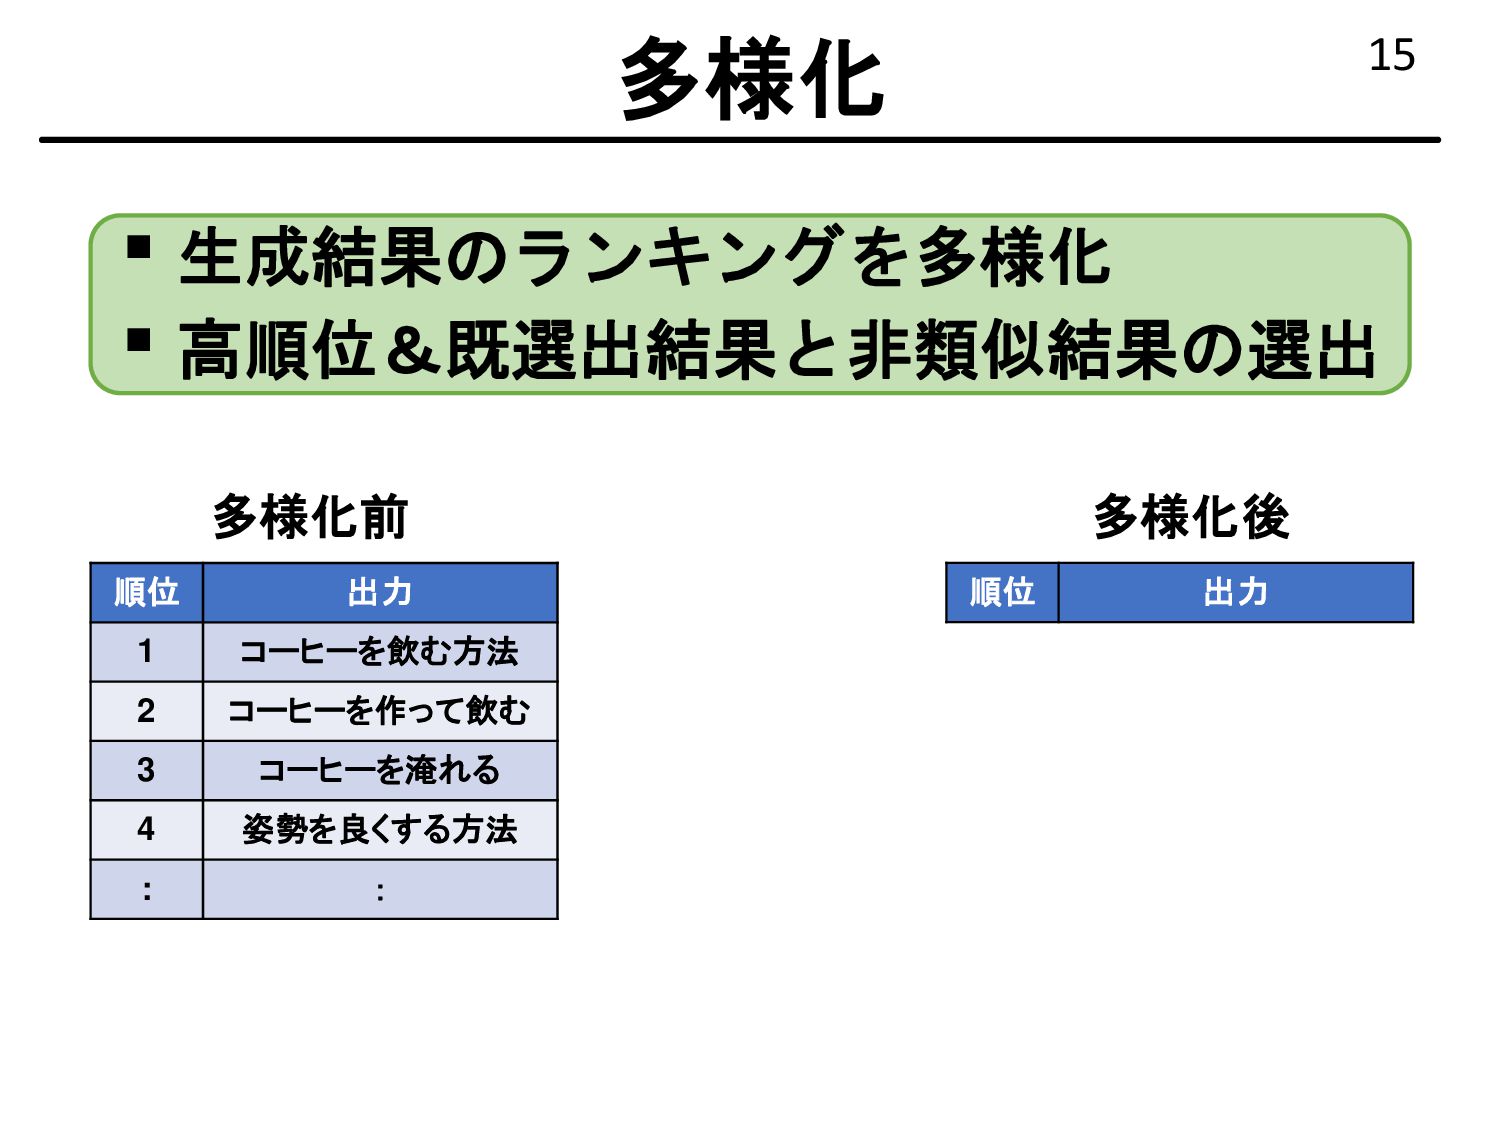
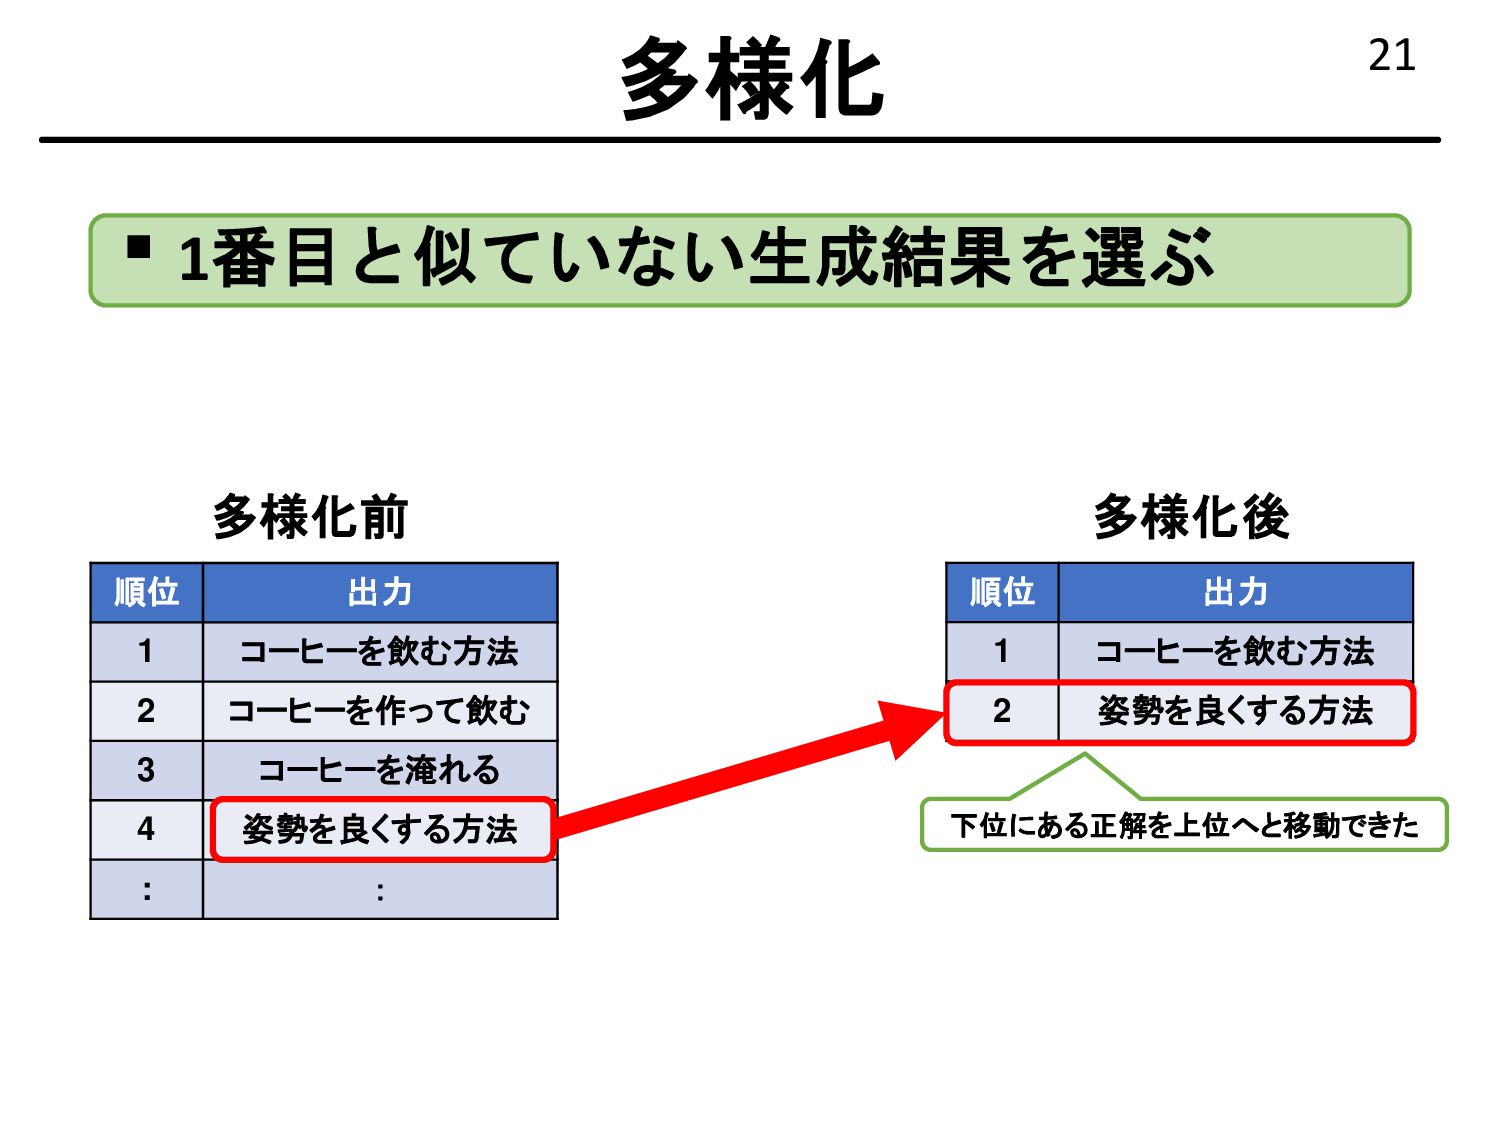
15 ▪ 生成結果のランキングを多様化 ▪ 高順位&既選出結果と非類似結果の選出 多様化 多様化前 多様化後 順位 出力
1 コーヒーを飲む方法 2 コーヒーを作って飲む 3 コーヒーを淹れる 4 姿勢を良くする方法 : : 順位 出力 -
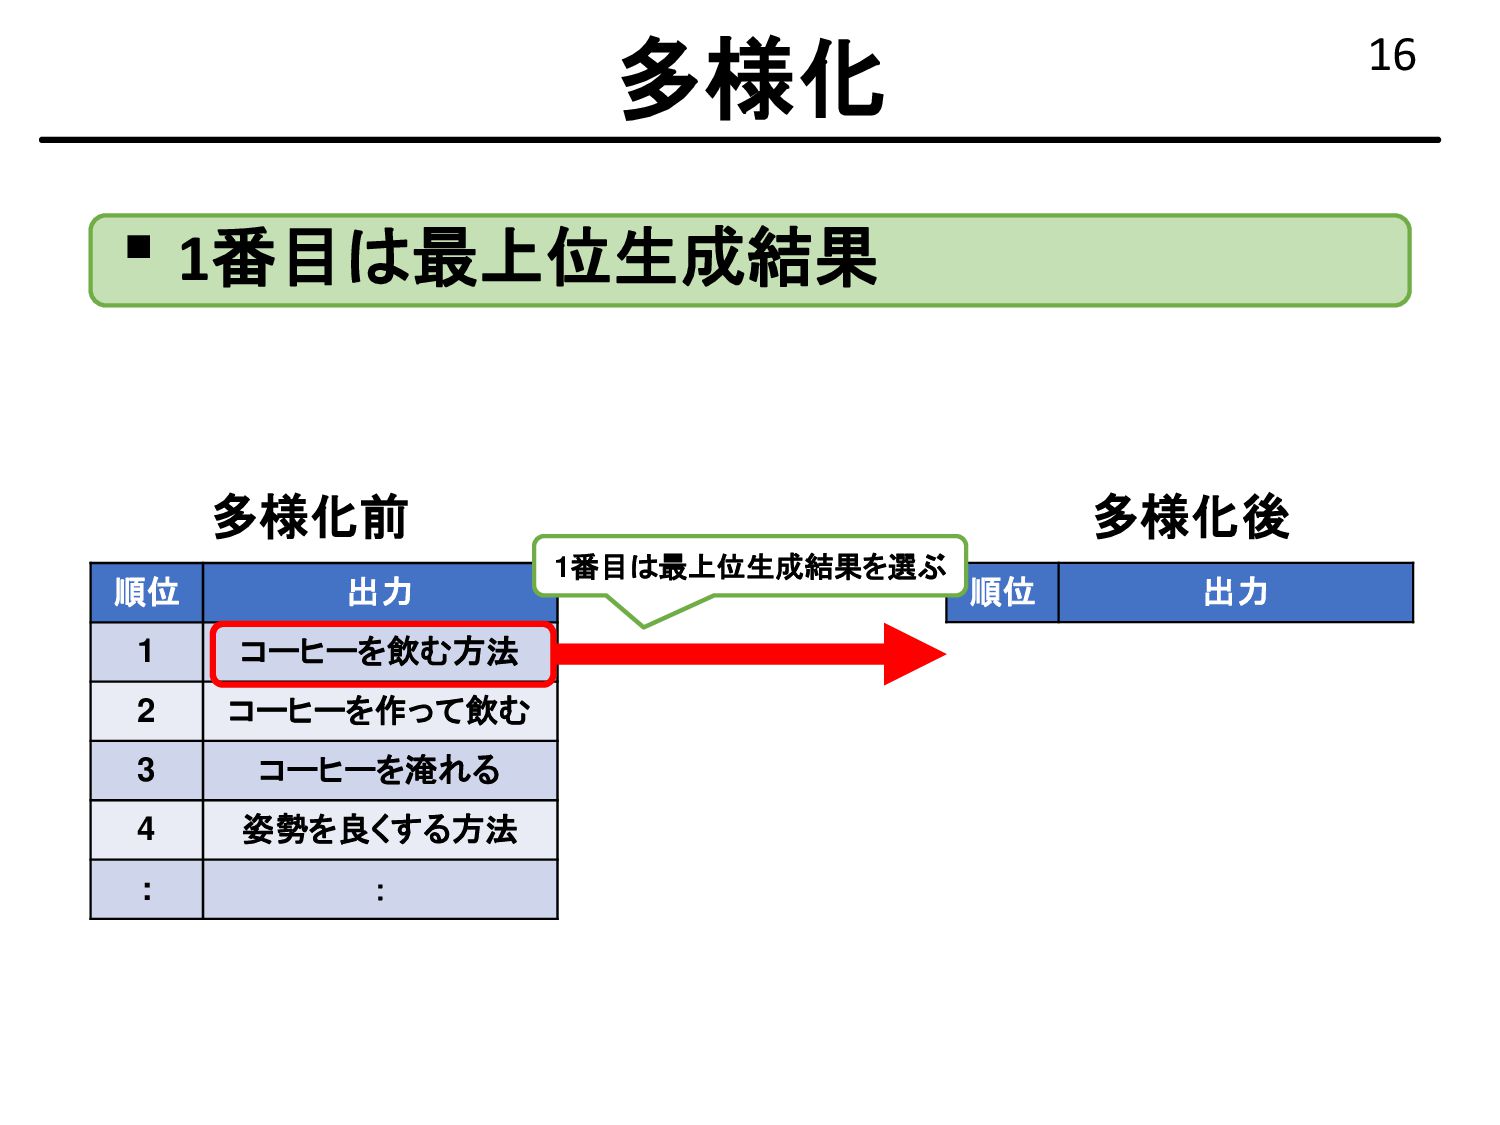
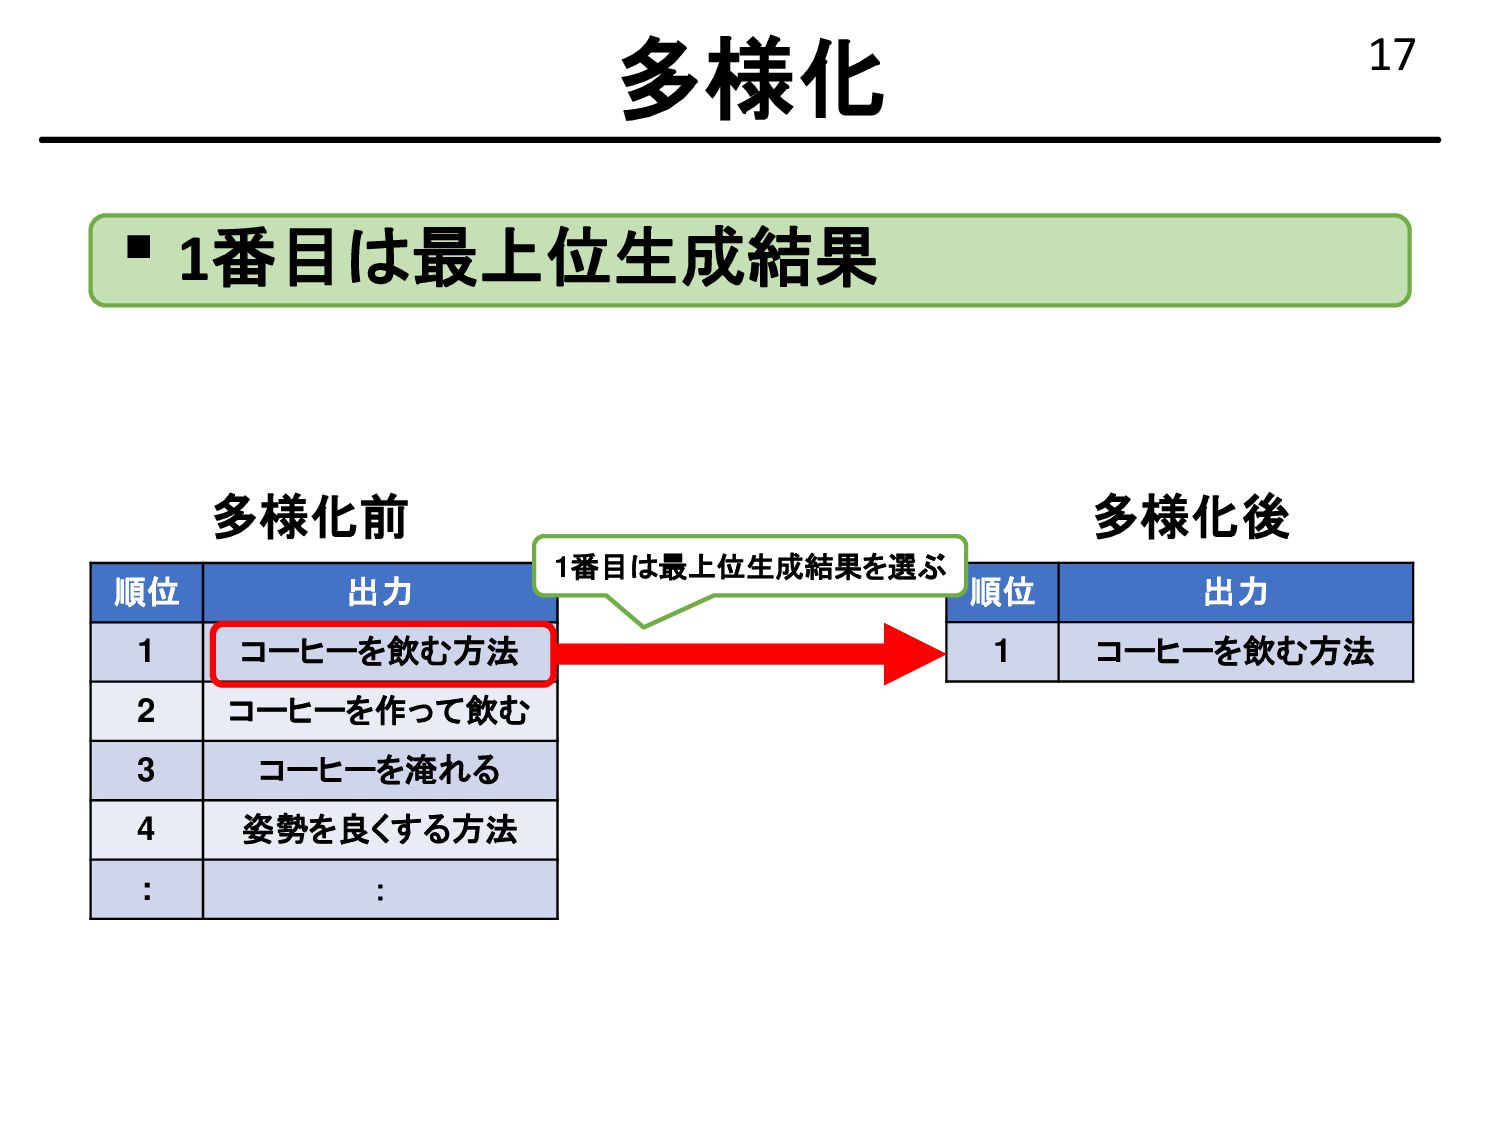
16 ▪ 1番目は最上位生成結果 多様化 多様化前 多様化後 順位 出力 1 コーヒーを飲む方法
2 コーヒーを作って飲む 3 コーヒーを淹れる 4 姿勢を良くする方法 : : 順位 出力 1番目は最上位生成結果を選ぶ -
17 ▪ 1番目は最上位生成結果 多様化 多様化前 多様化後 順位 出力 1 コーヒーを飲む方法
2 コーヒーを作って飲む 3 コーヒーを淹れる 4 姿勢を良くする方法 : : 順位 出力 1 コーヒーを飲む方法 1番目は最上位生成結果を選ぶ -
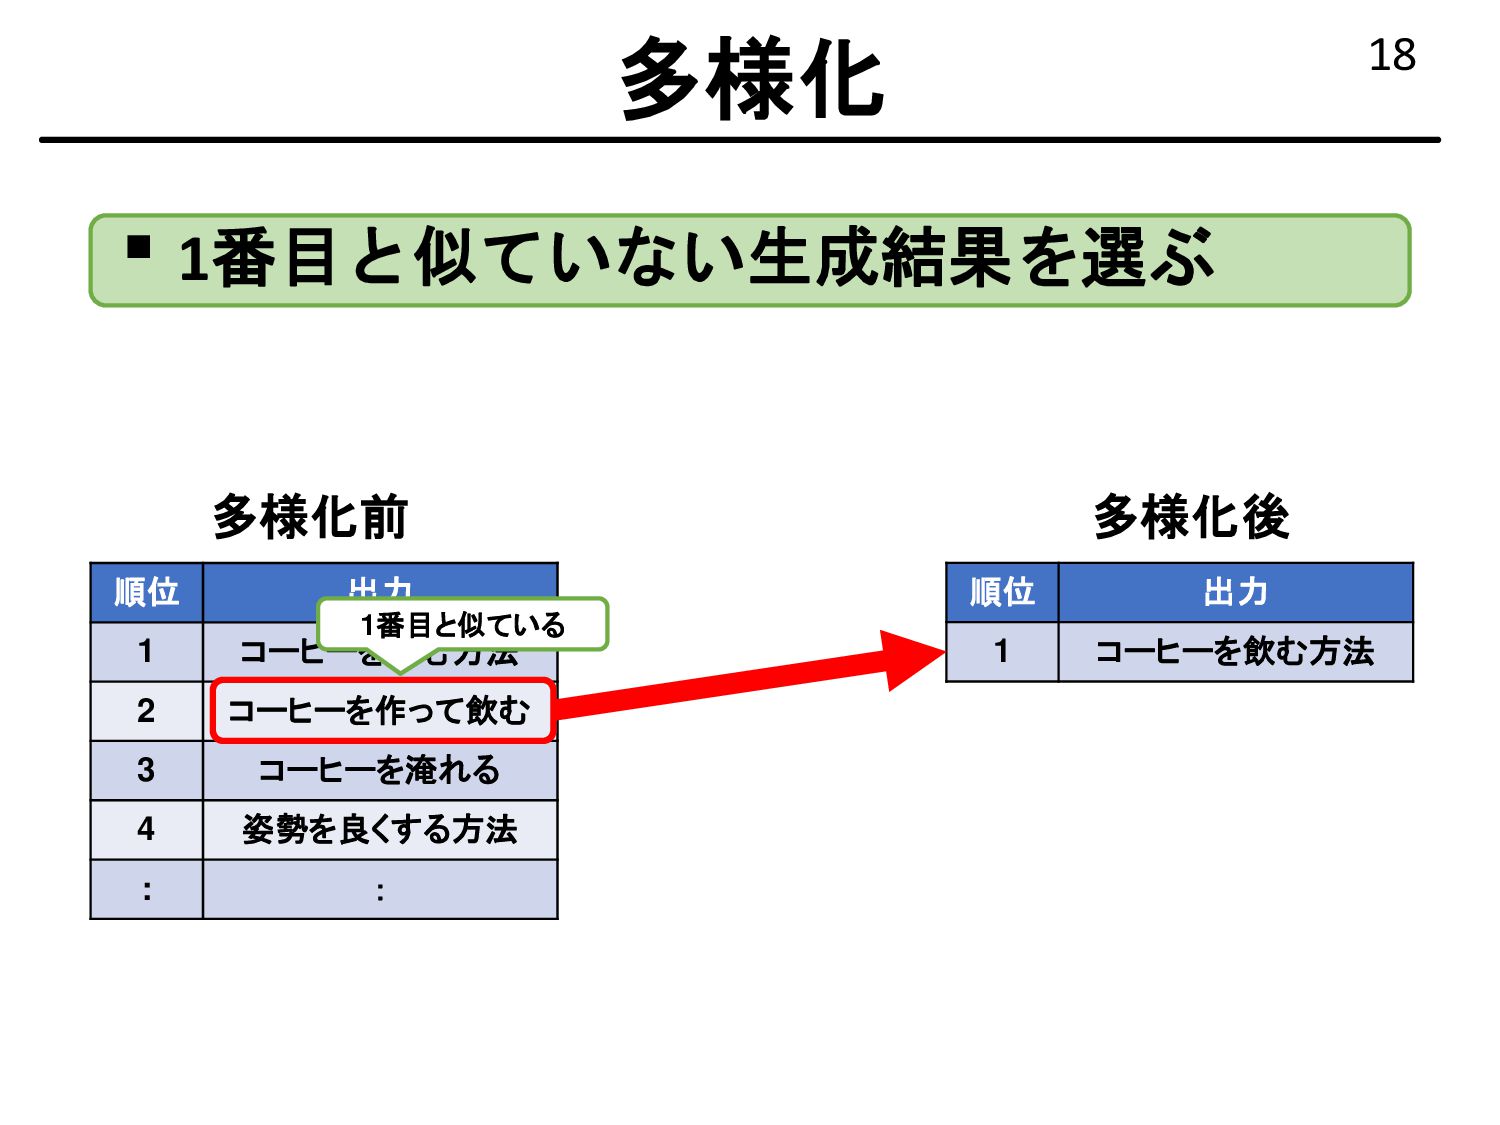
18 ▪ 1番目と似ていない生成結果を選ぶ 多様化 多様化前 多様化後 順位 出力 1 コーヒーを飲む方法
2 コーヒーを作って飲む 3 コーヒーを淹れる 4 姿勢を良くする方法 : : 順位 出力 1 コーヒーを飲む方法 1番目と似ている -
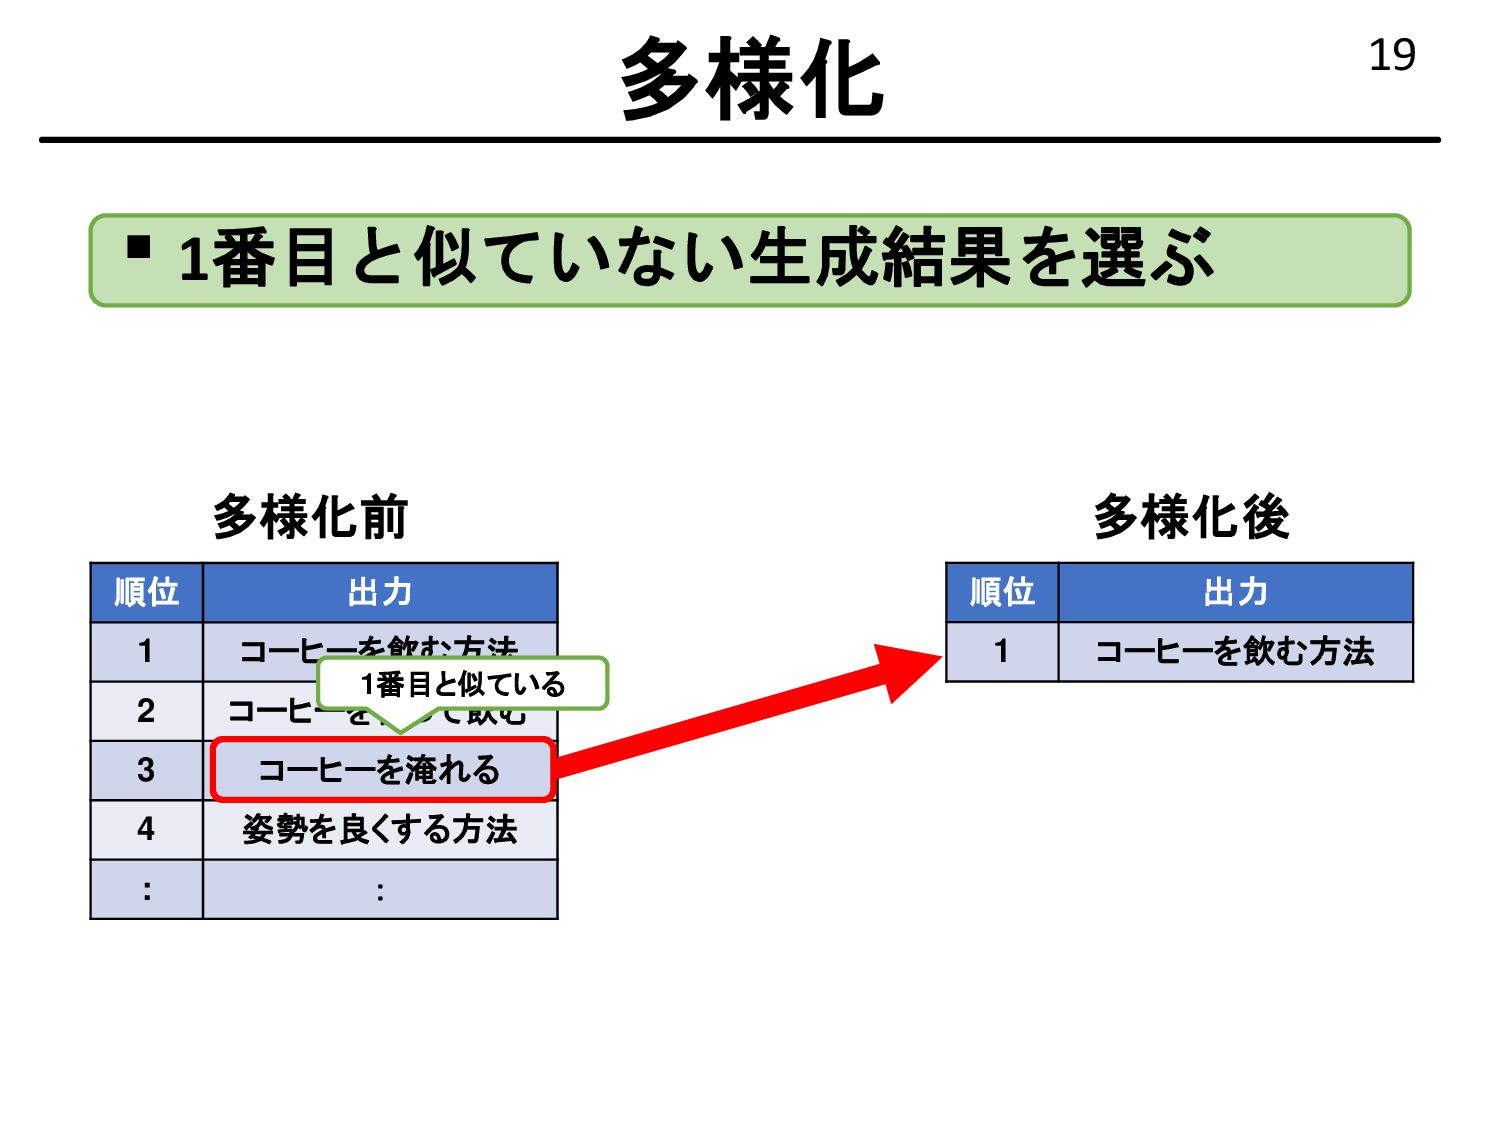
19 ▪ 1番目と似ていない生成結果を選ぶ 多様化 多様化前 多様化後 順位 出力 1 コーヒーを飲む方法
2 コーヒーを作って飲む 3 コーヒーを淹れる 4 姿勢を良くする方法 : : 順位 出力 1 コーヒーを飲む方法 1番目と似ている -
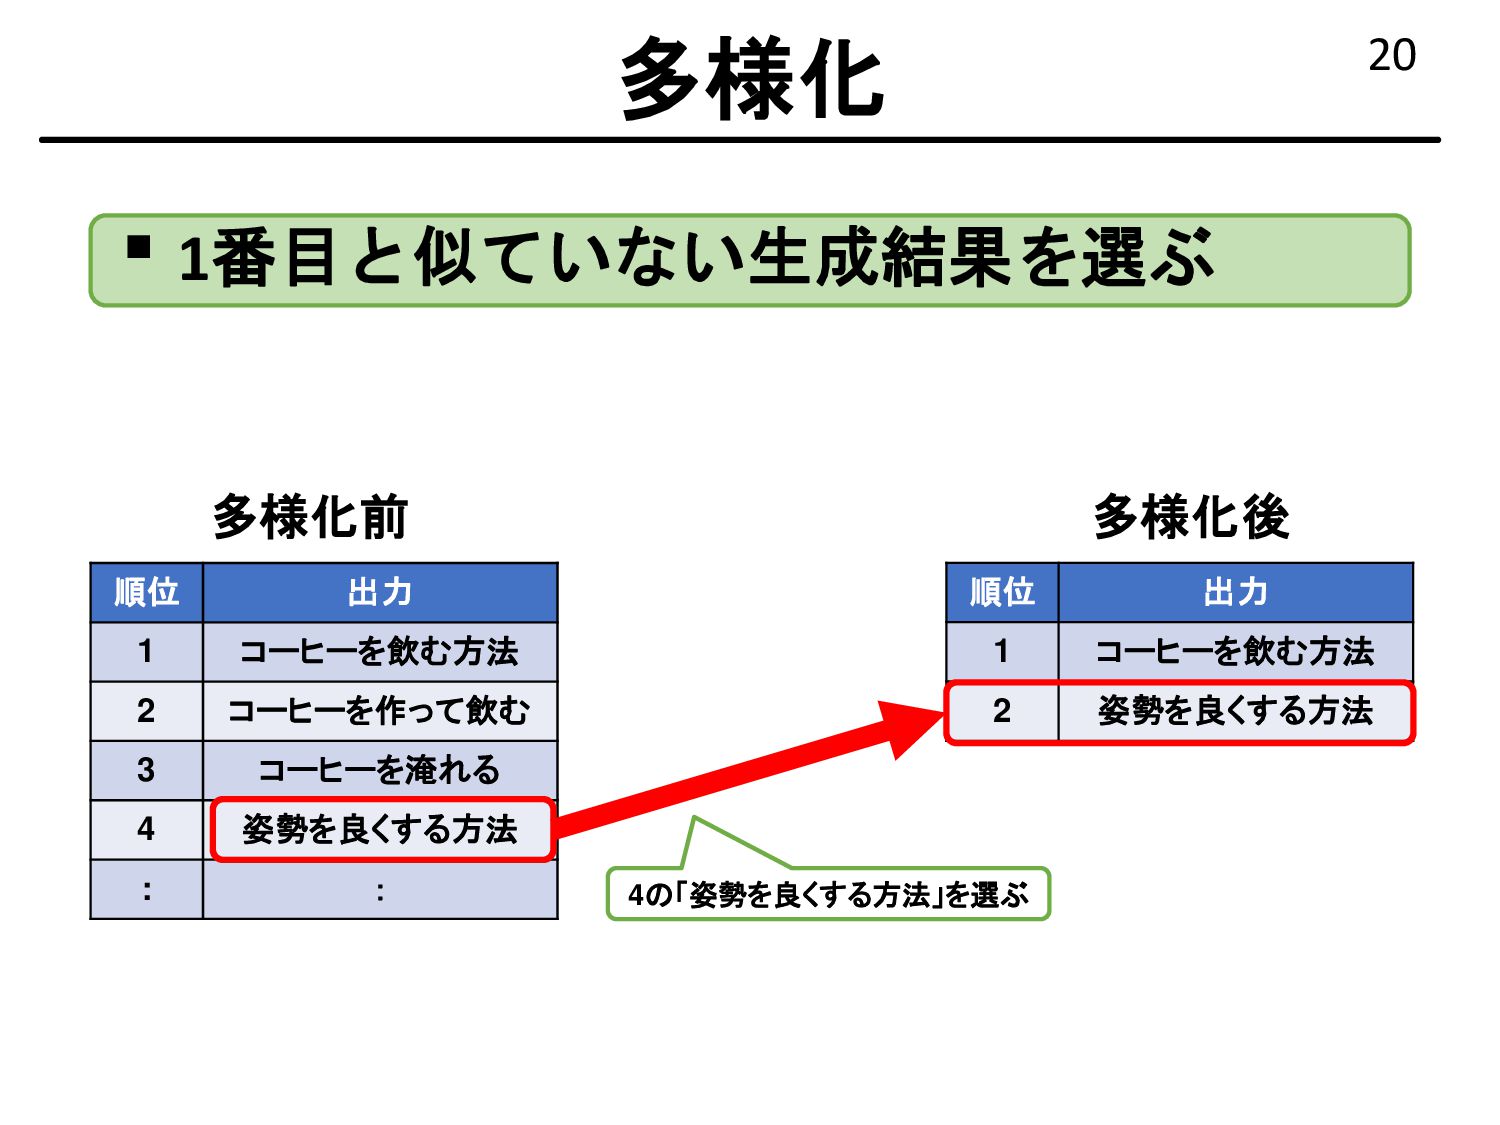
20 ▪ 1番目と似ていない生成結果を選ぶ 多様化 多様化前 多様化後 順位 出力 1 コーヒーを飲む方法
2 コーヒーを作って飲む 3 コーヒーを淹れる 4 姿勢を良くする方法 : : 順位 出力 1 コーヒーを飲む方法 2 姿勢を良くする方法 4の「姿勢を良くする方法」を選ぶ -
21 ▪ 1番目と似ていない生成結果を選ぶ 多様化 多様化前 多様化後 順位 出力 1 コーヒーを飲む方法
2 コーヒーを作って飲む 3 コーヒーを淹れる 4 姿勢を良くする方法 : : 順位 出力 1 コーヒーを飲む方法 2 姿勢を良くする方法 下位にある正解を上位へと移動できた -
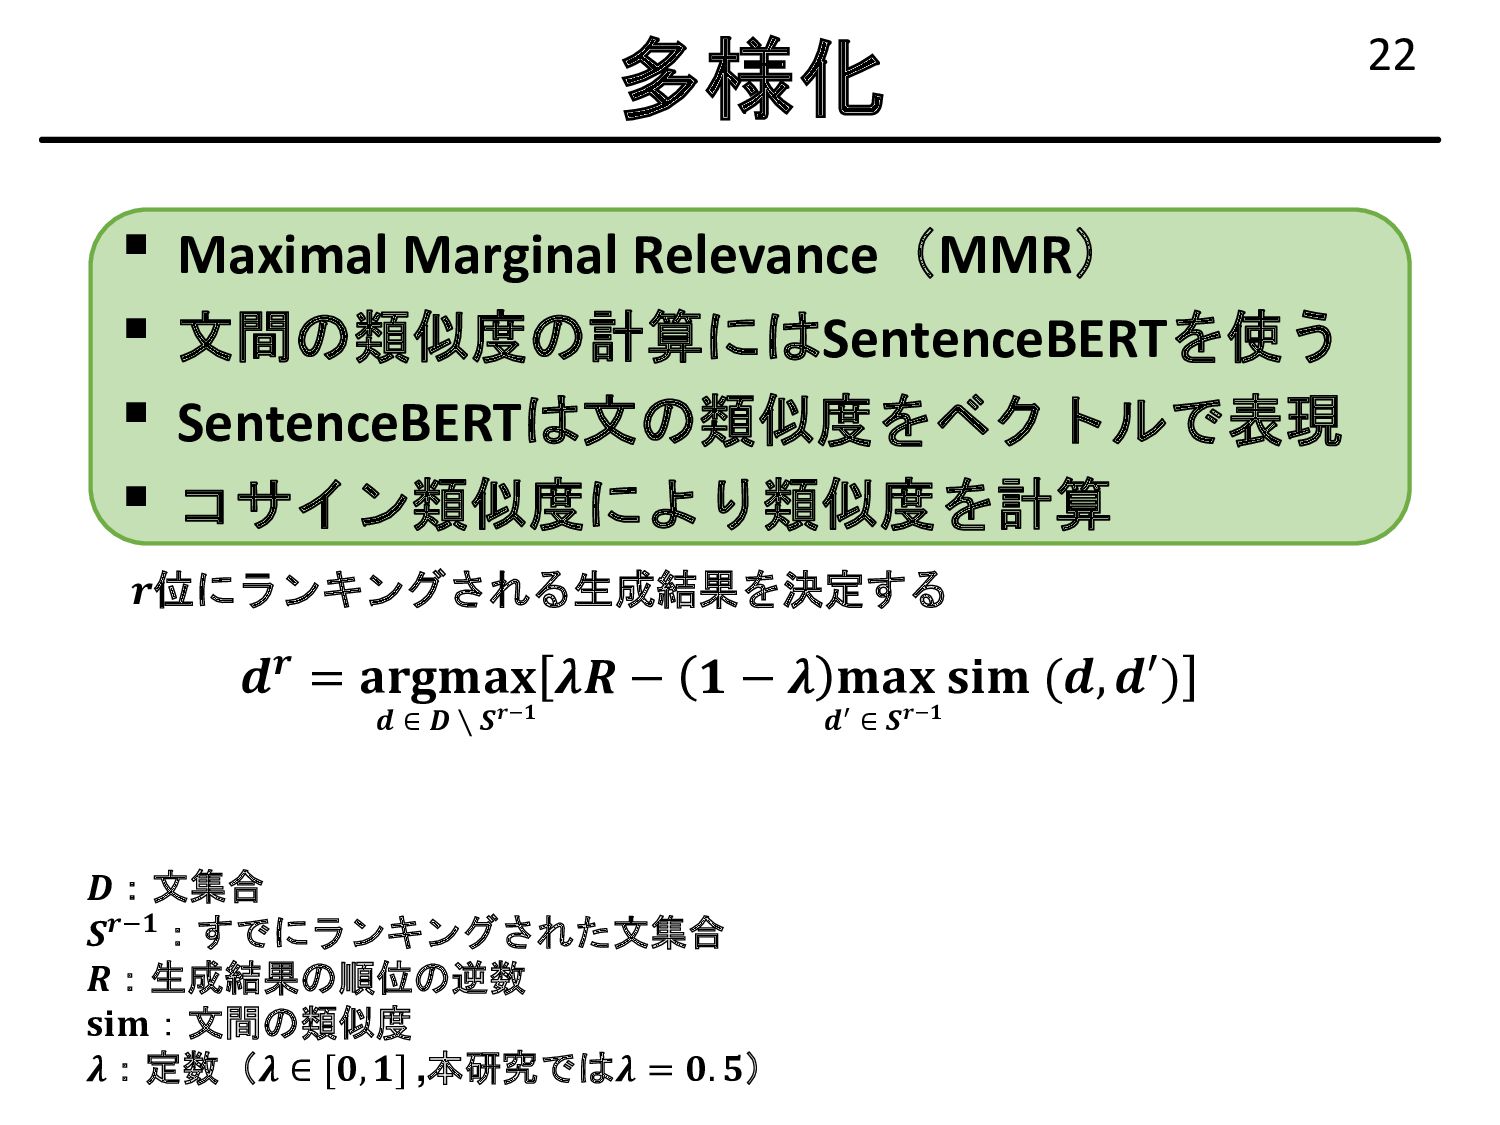
22 ▪ Maximal Marginal Relevance(MMR) ▪ 文間の類似度の計算にはSentenceBERTを使う ▪ SentenceBERTは文の類似度をベクトルで表現 ▪
コサイン類似度により類似度を計算 多様化 𝒅𝒓 = 𝐚𝐫𝐠𝐦𝐚𝐱 𝝀𝑹 − 𝟏 − 𝝀 𝐦𝐚𝐱 𝐬𝐢𝐦 (𝒅, 𝒅′) 𝒅 ∈ 𝑫 ∖ 𝑺𝒓−𝟏 𝒅′ ∈ 𝑺𝒓−𝟏 𝒓位にランキングされる生成結果を決定する 𝑫:文集合 𝑺𝒓−𝟏:すでにランキングされた文集合 𝑹:生成結果の順位の逆数 𝐬𝐢𝐦:文間の類似度 𝝀:定数(𝝀 ∈ [𝟎, 𝟏] ,本研究では𝝀 = 𝟎. 𝟓) -
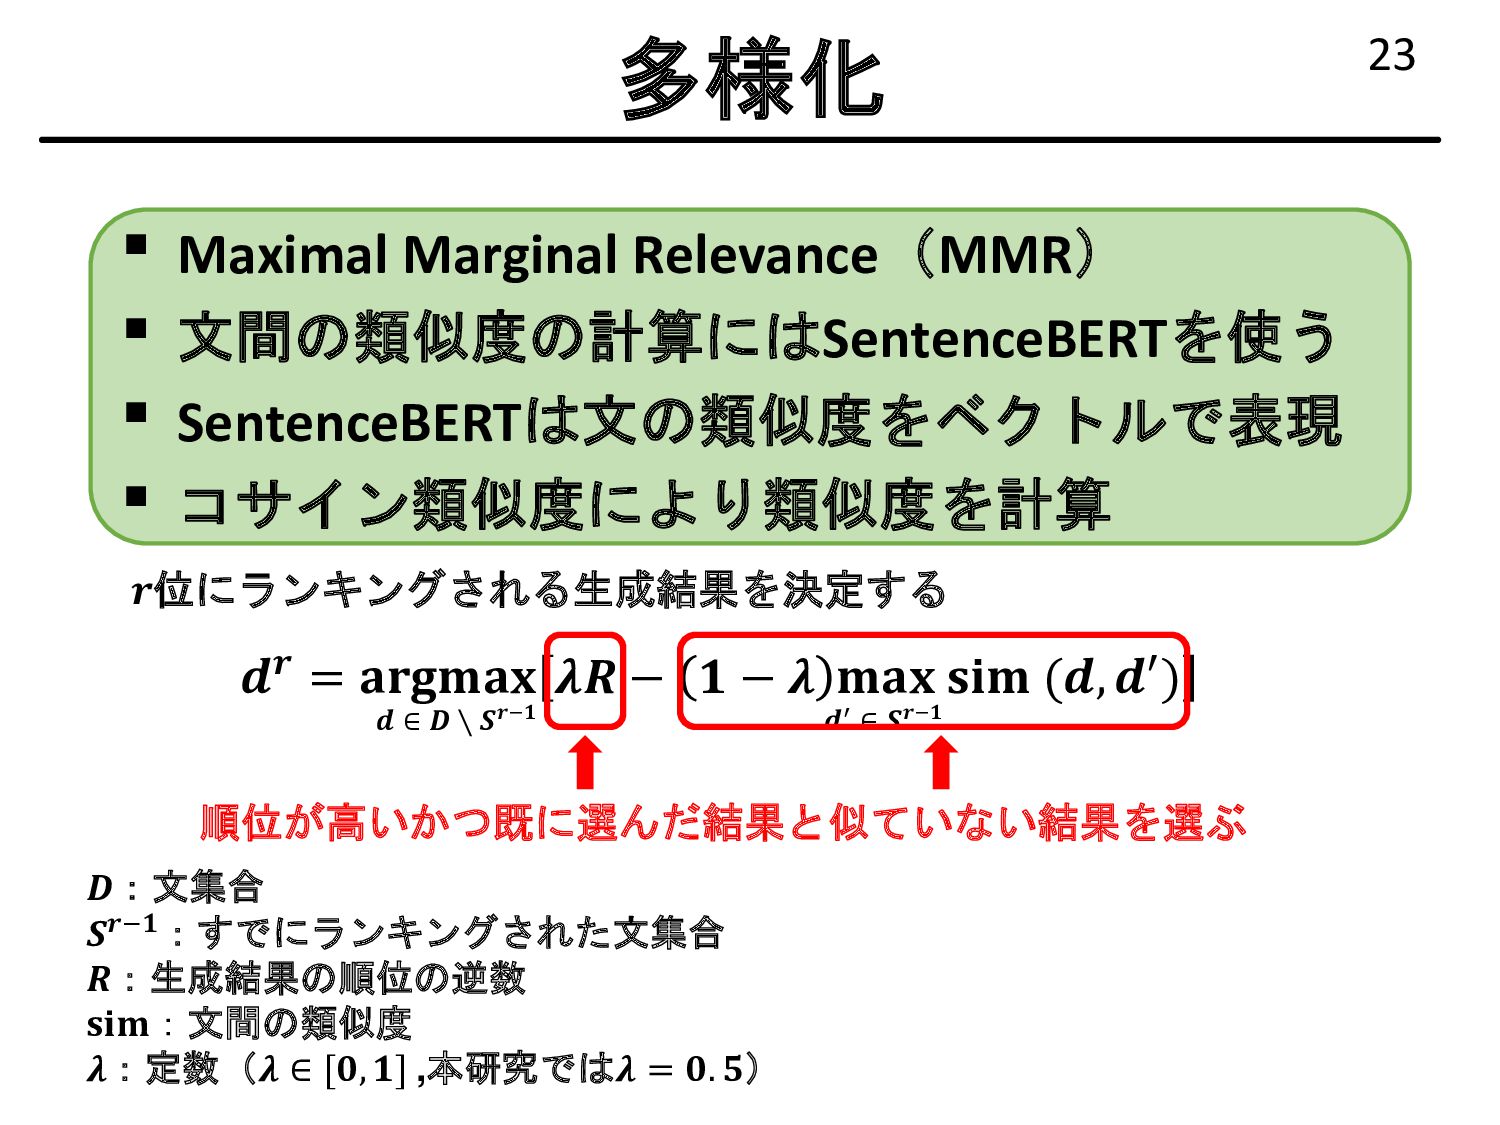
23 ▪ Maximal Marginal Relevance(MMR) ▪ 文間の類似度の計算にはSentenceBERTを使う ▪ SentenceBERTは文の類似度をベクトルで表現 ▪
コサイン類似度により類似度を計算 多様化 𝑫:文集合 𝑺𝒓−𝟏:すでにランキングされた文集合 𝑹:生成結果の順位の逆数 𝐬𝐢𝐦:文間の類似度 𝝀:定数(𝝀 ∈ [𝟎, 𝟏] ,本研究では𝝀 = 𝟎. 𝟓) 𝒅𝒓 = 𝐚𝐫𝐠𝐦𝐚𝐱 𝝀𝑹 − 𝟏 − 𝝀 𝐦𝐚𝐱 𝐬𝐢𝐦 (𝒅, 𝒅′) 𝒅 ∈ 𝑫 ∖ 𝑺𝒓−𝟏 𝒅′ ∈ 𝑺𝒓−𝟏 𝒓位にランキングされる生成結果を決定する 順位が高いかつ既に選んだ結果と似ていない結果を選ぶ -
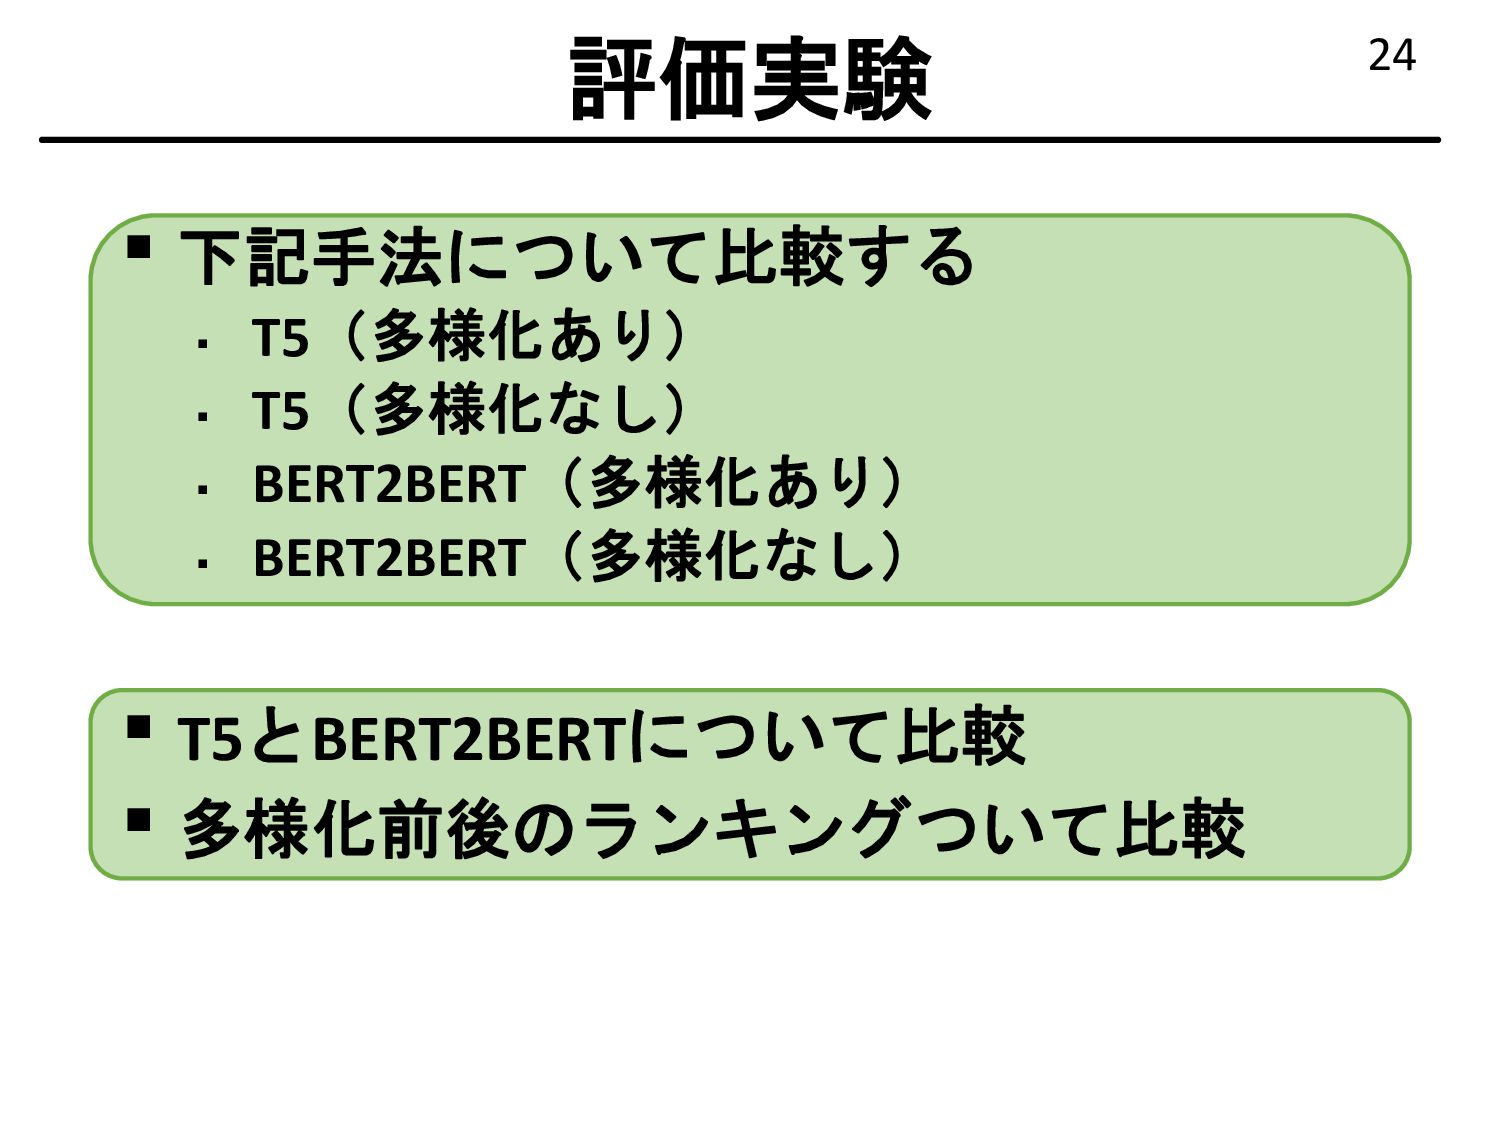
24 ▪ 下記手法について比較する ▪ T5(多様化あり) ▪ T5(多様化なし) ▪ BERT2BERT(多様化あり) ▪
BERT2BERT(多様化なし) ▪ T5とBERT2BERTについて比較 ▪ 多様化前後のランキングついて比較 評価実験 -
26 ▪ 事前学習済みモデル ▪ T5(sonoisa/t5-base-japanese) ▪ BERT2BERT(東北大学の事前学習済みモデル) ▪ 学習の設定 ▪
学習率 ▪ T5:3.0×10⁻⁴ ▪ BERT2BERT:2.0×10⁻⁶ ▪ 損失関数:交差エントロピー ▪ 最適化関数:Adam Weight Decay ▪ バッチサイズ:256 ▪ 最大トークン数:32 ▪ 早期終了によりエポック数を決定 学習条件 -
27 ▪ 自動評価 ▪ BERTScoreで正解との類似度を数値化 ▪ 人手評価 ▪ 生成結果が入力の目的かを0,1で評価 ▪
データセットから30件選び評価 評価尺度 -
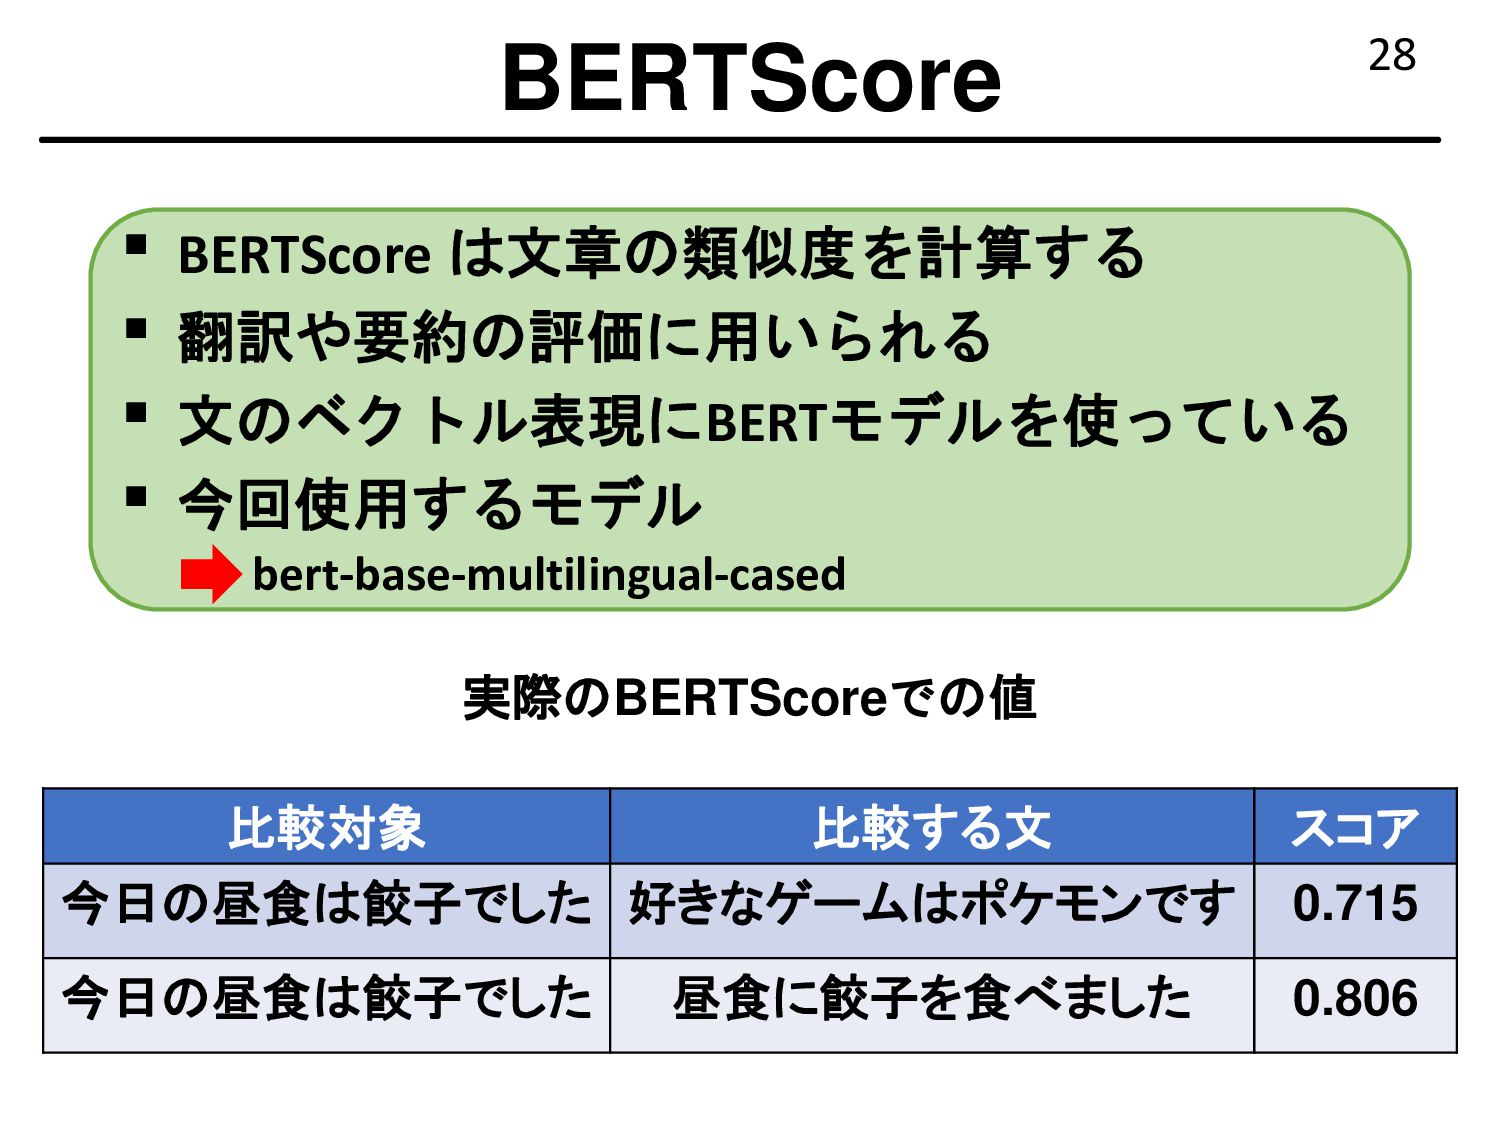
28 ▪ BERTScore は文章の類似度を計算する ▪ 翻訳や要約の評価に用いられる ▪ 文のベクトル表現にBERTモデルを使っている ▪ 今回使用するモデル
▪ bert-base-multilingual-cased BERTScore 比較対象 比較する文 スコア 今日の昼食は餃子でした 好きなゲームはポケモンです 0.715 今日の昼食は餃子でした 昼食に餃子を食べました 0.806 実際のBERTScoreでの値 -
30 ▪ 生成結果上位100件のBERTScoreを評価する ▪ しきい値以上のBERTScorを正解とみなす ▪ テストデータ248件の平均逆順位を計算(MRR) ランキングの自動評価 コーヒーを飲む方法 コーヒーを淹れる
炒飯の作り方 : : 0.769154 0.844105 0.618718 : : 姿勢を良くする方法 0.907411 BERTScore A:姿勢を良くする方法 0 0 1 0 : : RR:0.333 例,しきい値が0.9のとき -
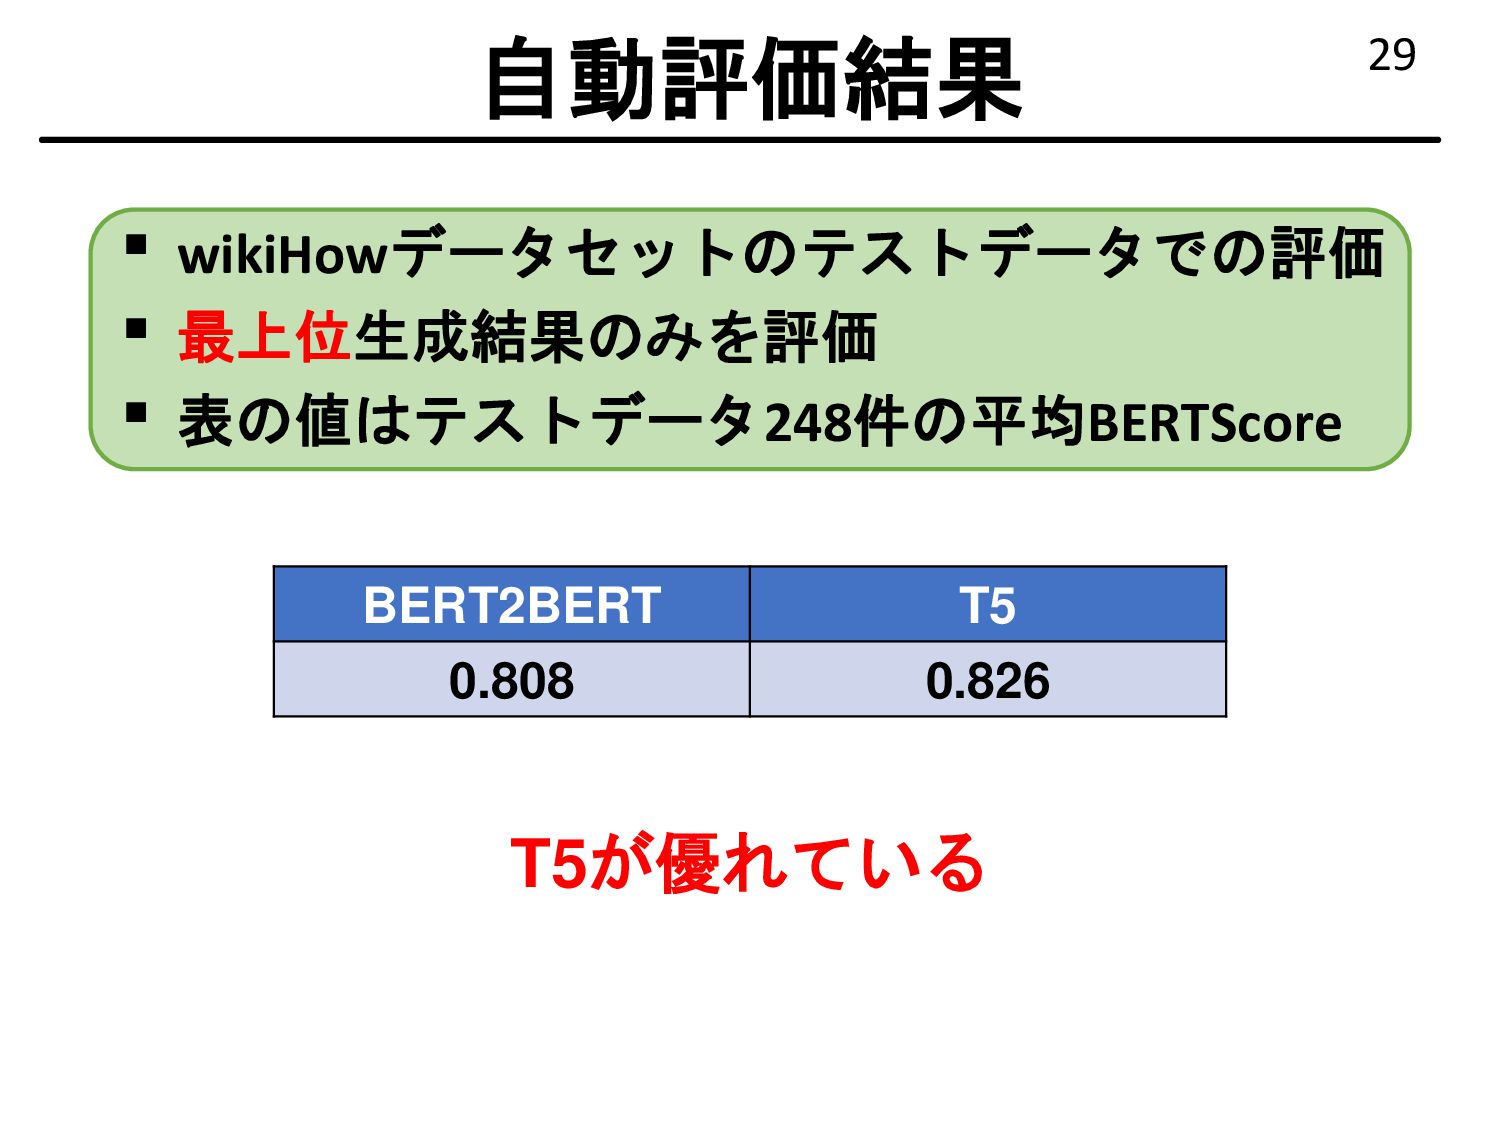
31 ▪ しきい値を超えるBERTScoreを正解とみなす ▪ テストデータ248件の平均逆順位(MRR) ▪ しきい値を0.7~1.0の間で変化 自動評価結果(ランキング) T5 BERT2BERT
BERT2BERT(多様化) T5(多様化なし)が優れている T5(多様化) -
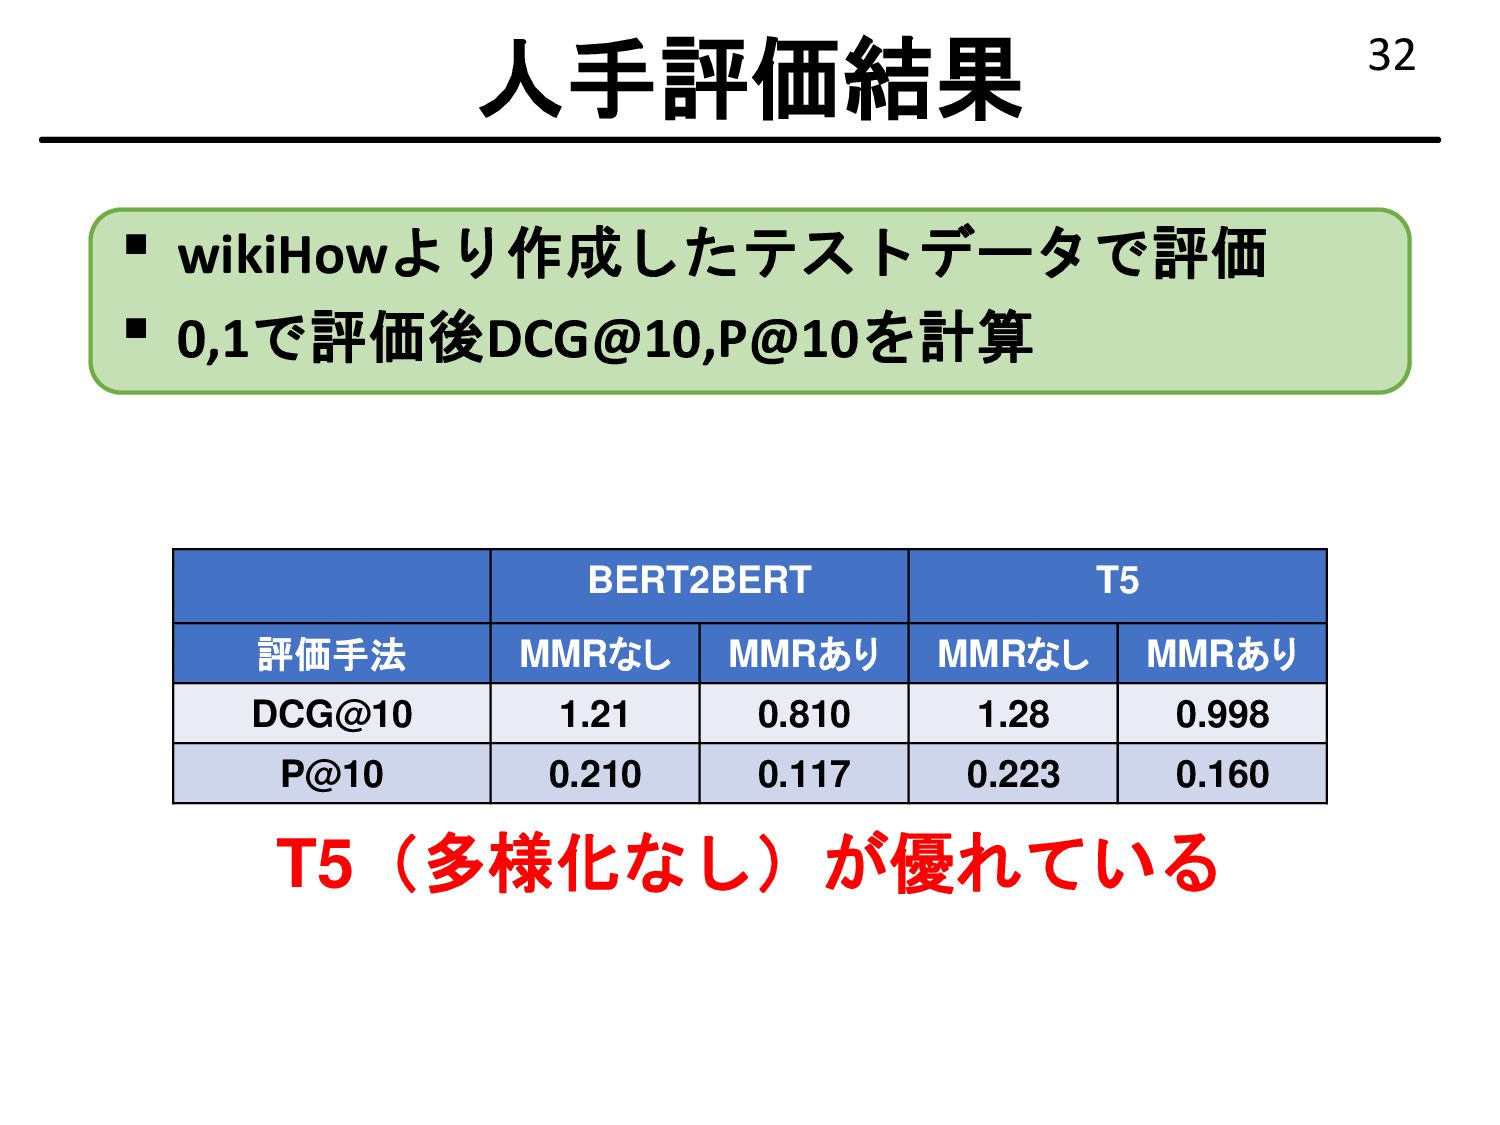
32 ▪ wikiHowより作成したテストデータで評価 ▪ 0,1で評価後DCG@10,P@10を計算 人手評価結果 BERT2BERT T5 評価手法 MMRなし
MMRあり MMRなし MMRあり DCG@10 1.21 0.810 1.28 0.998 P@10 0.210 0.117 0.223 0.160 T5(多様化なし)が優れている -
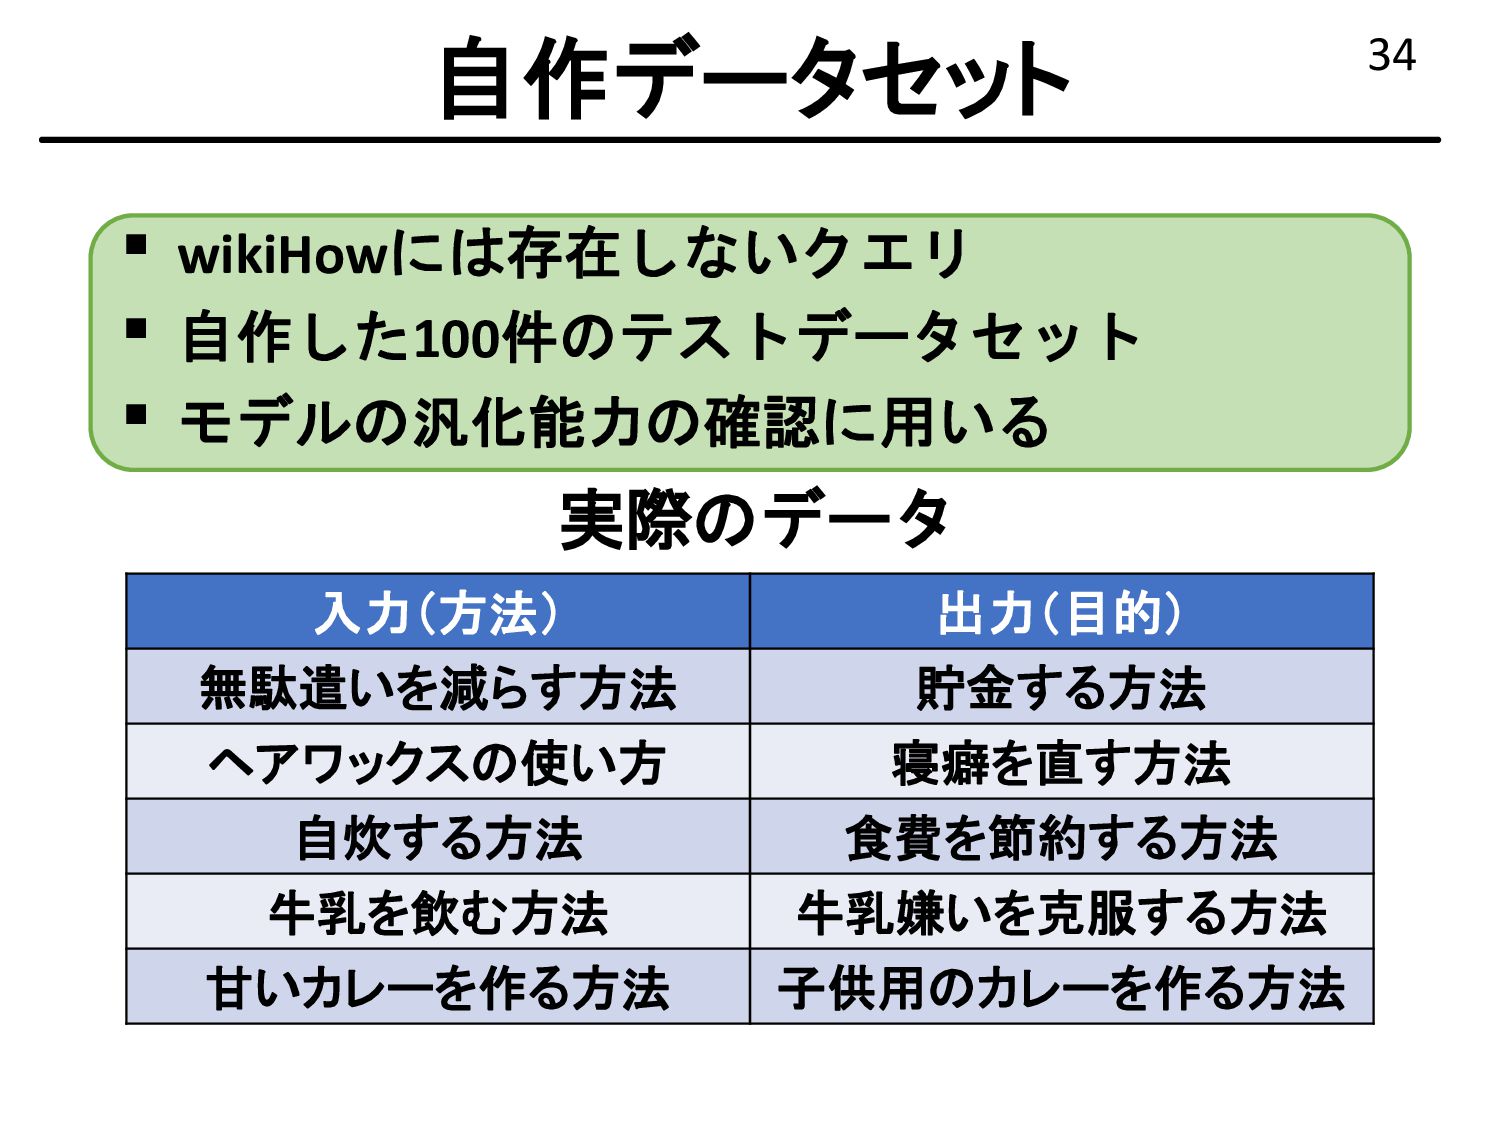
34 ▪ wikiHowには存在しないクエリ ▪ 自作した100件のテストデータセット ▪ モデルの汎化能力の確認に用いる 自作データセット 実際のデータ 入力(方法)
出力(目的) 無駄遣いを減らす方法 貯金する方法 ヘアワックスの使い方 寝癖を直す方法 自炊する方法 食費を節約する方法 牛乳を飲む方法 牛乳嫌いを克服する方法 甘いカレーを作る方法 子供用のカレーを作る方法 -
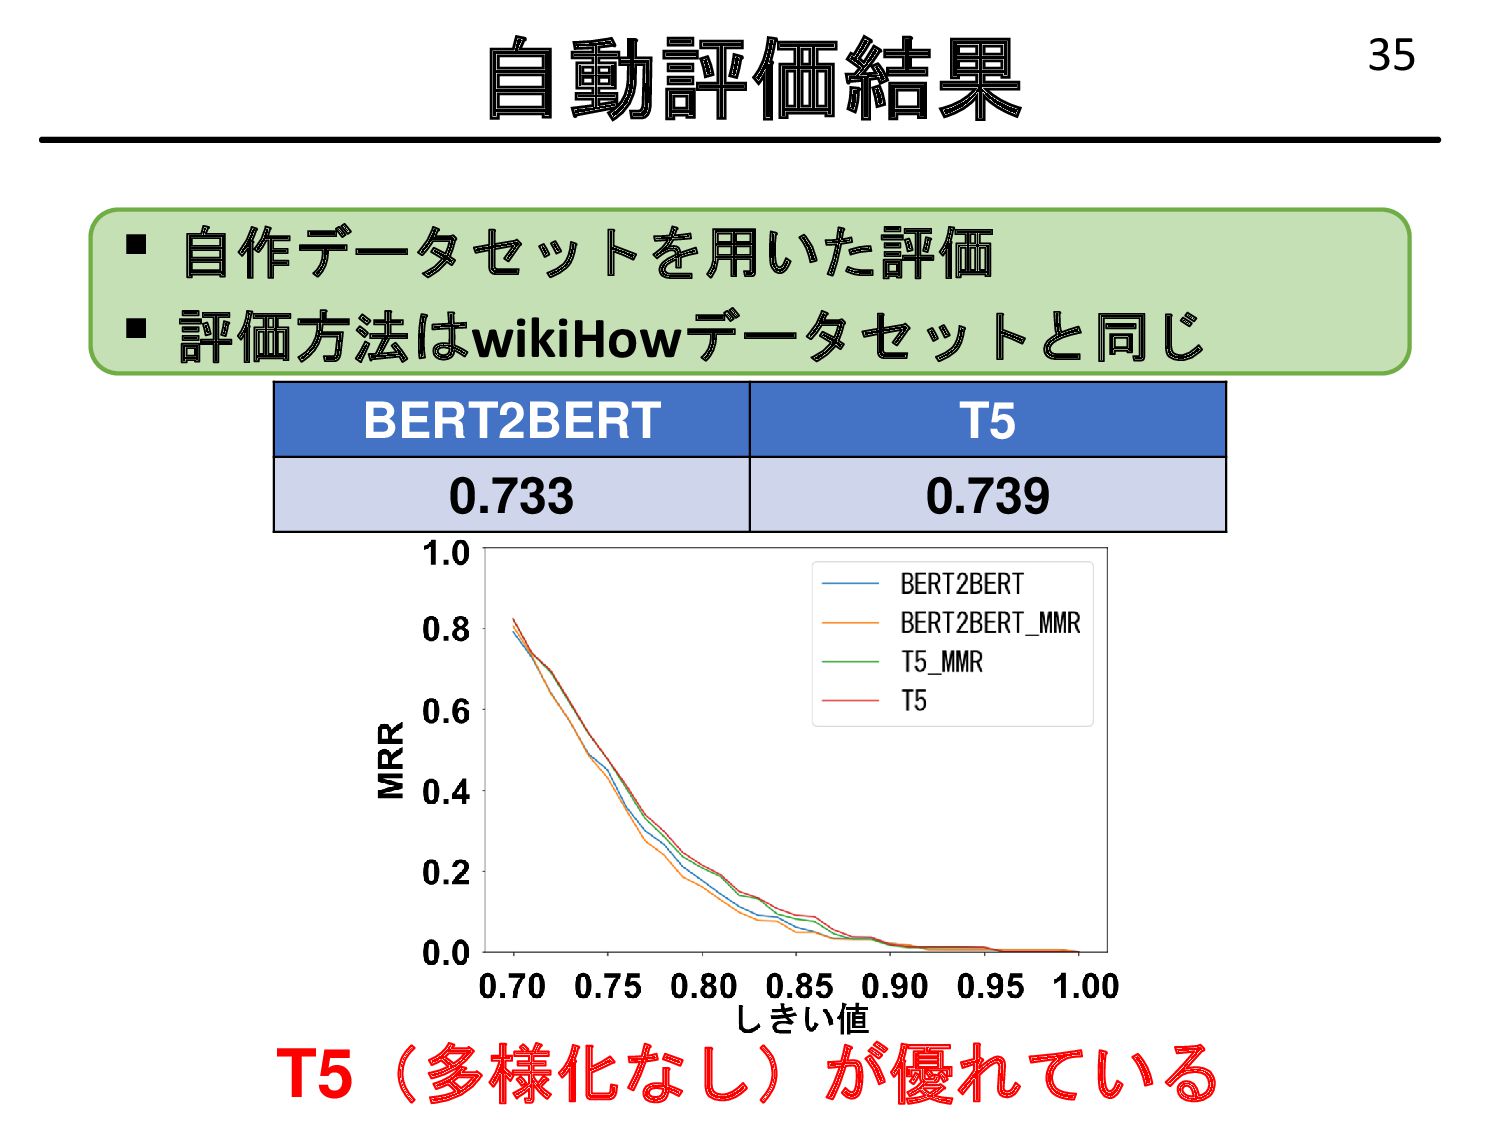
35 ▪ 自作データセットを用いた評価 ▪ 評価方法はwikiHowデータセットと同じ 自動評価結果 BERT2BERT T5 0.733 0.739
T5が優れている T5(多様化なし)が優れている -
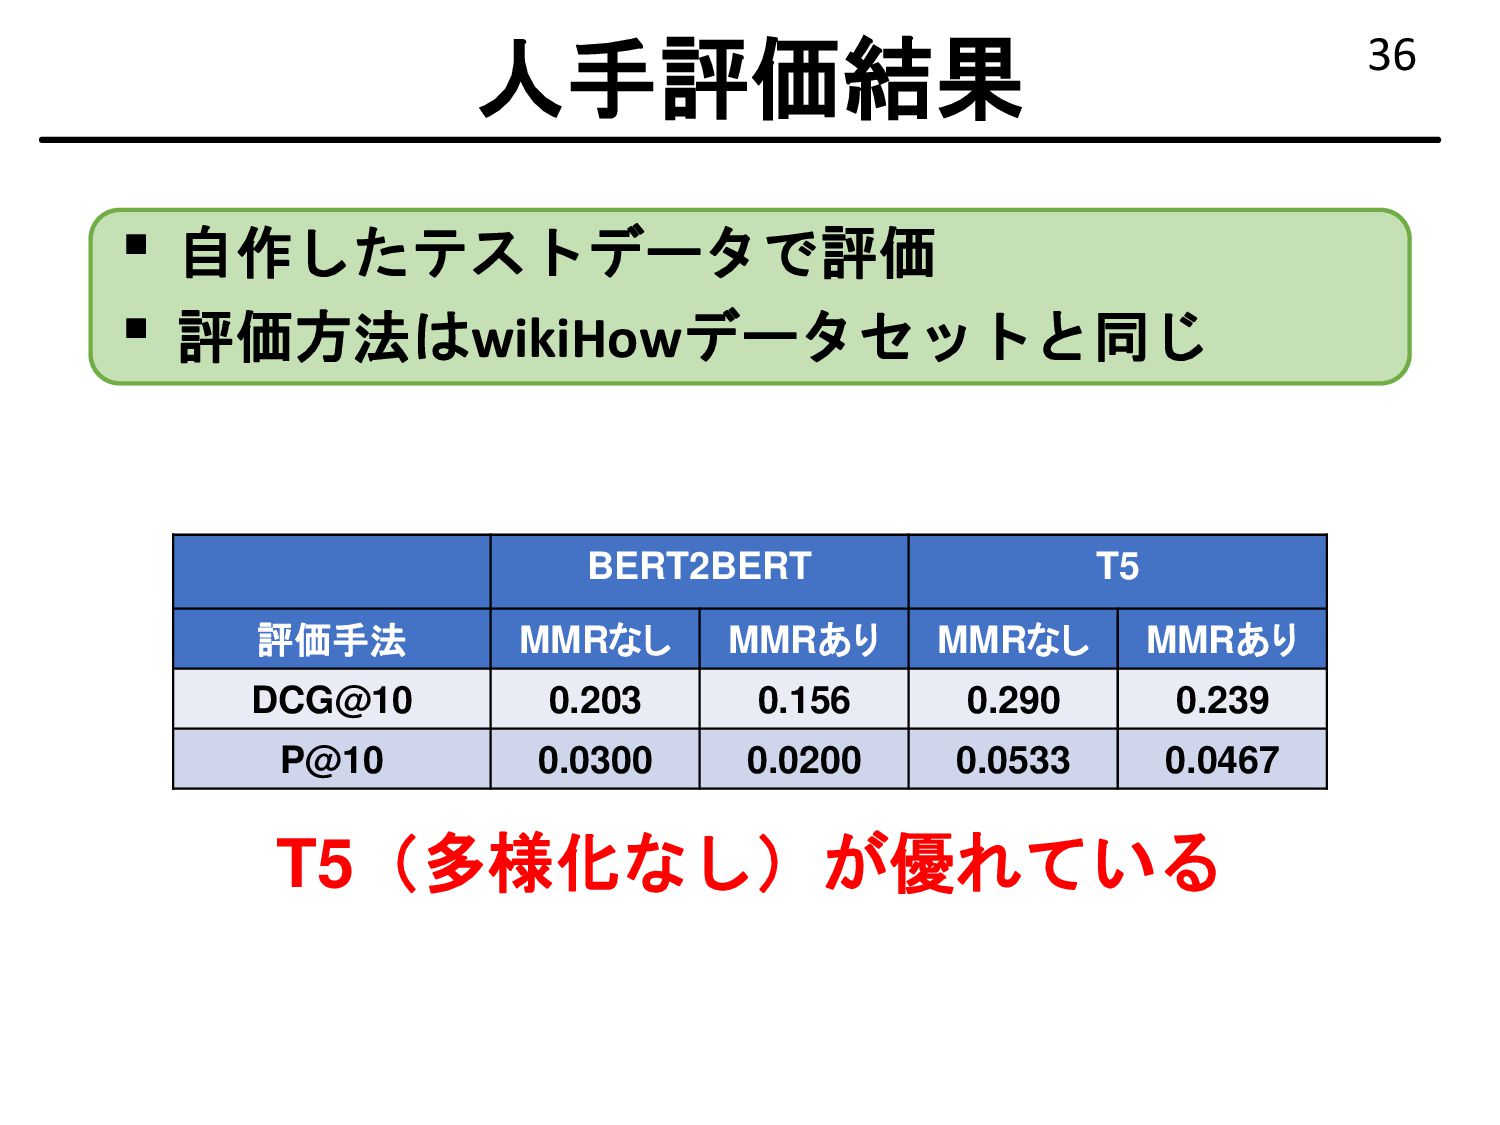
36 ▪ 自作したテストデータで評価 ▪ 評価方法はwikiHowデータセットと同じ 人手評価結果 BERT2BERT T5 評価手法 MMRなし
MMRあり MMRなし MMRあり DCG@10 0.203 0.156 0.290 0.239 P@10 0.0300 0.0200 0.0533 0.0467 T5(多様化なし)が優れている -
38 ▪ 手続き的知識源を用いた 方法を表すクエリからの目的抽出 ▪ まとめ ▪ 様々な方法について情報を得たい ▪ ユーザの入力から目的を抽出する
▪ 文生成モデルのファインチューニング ▪ 手続き的知識源利用した訓練データ自動構築 ▪ 結果について ▪ T5(多様化なし)が優れている ▪ 今後の課題 ▪ キーワードクエリ ▪ 実際にほかの方法を提案する まとめ