Upgrade to Pro — share decks privately, control downloads, hide ads and more …

ACL2026_hiramatsu

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →

 ACL2026_hiramatsu

Transcript

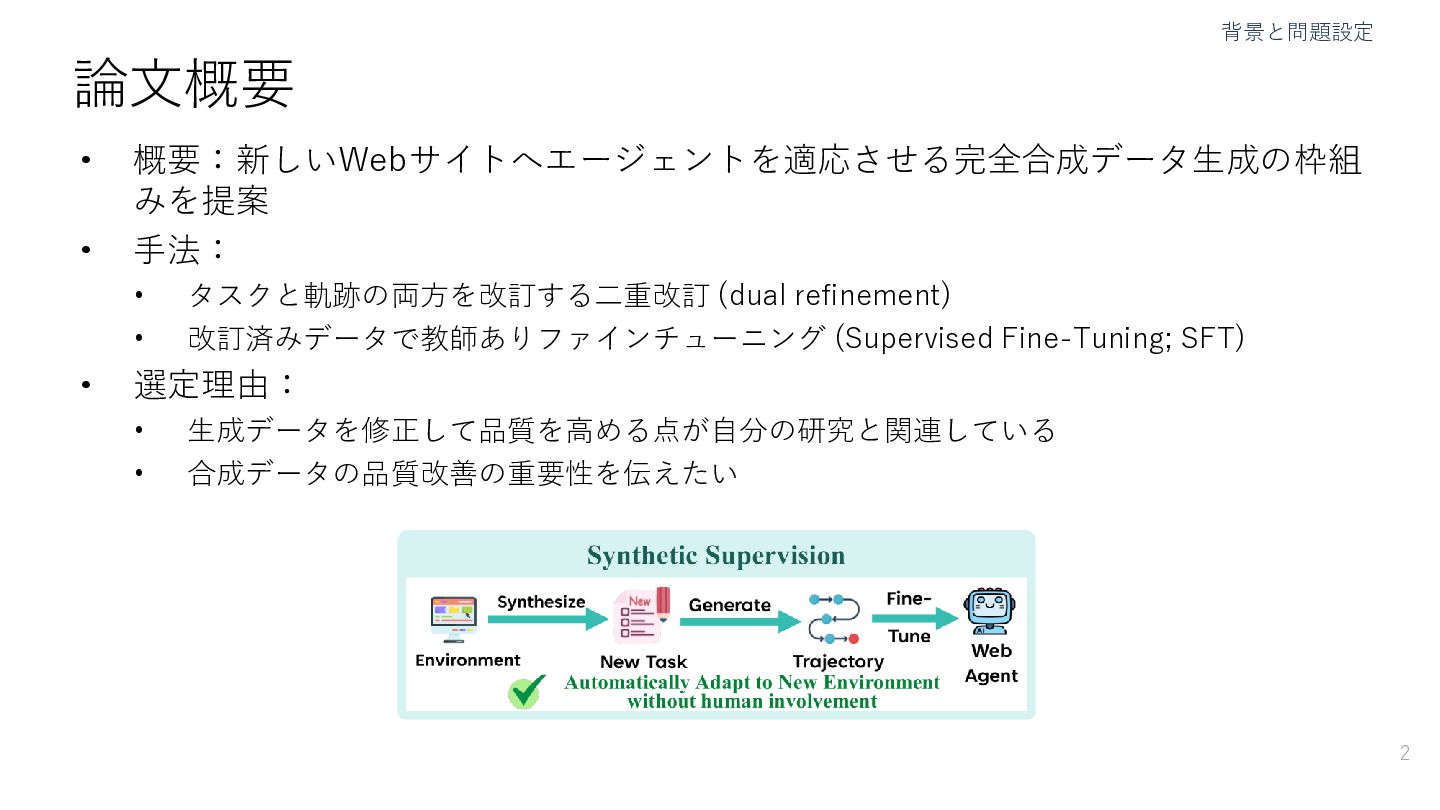
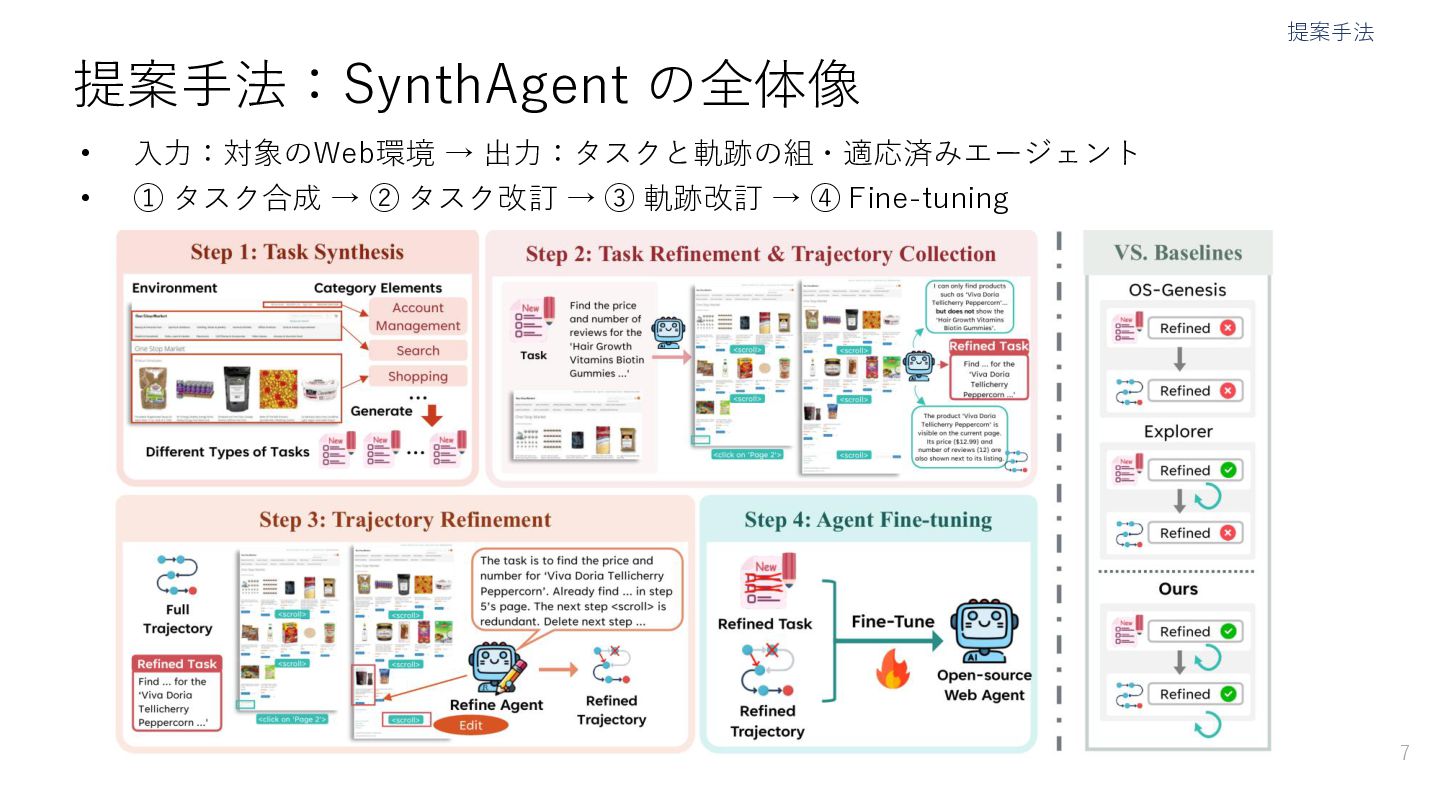
  1. 背景と問題設定 論文概要 • • 概要:新しいWebサイトへエージェントを適応させる完全合成データ生成の枠組 みを提案 手法: • • •

    タスクと軌跡の両方を改訂する二重改訂 (dual refinement) 改訂済みデータで教師ありファインチューニング (Supervised Fine-Tuning; SFT) 選定理由: • • 生成データを修正して品質を高める点が自分の研究と関連している 合成データの品質改善の重要性を伝えたい 2
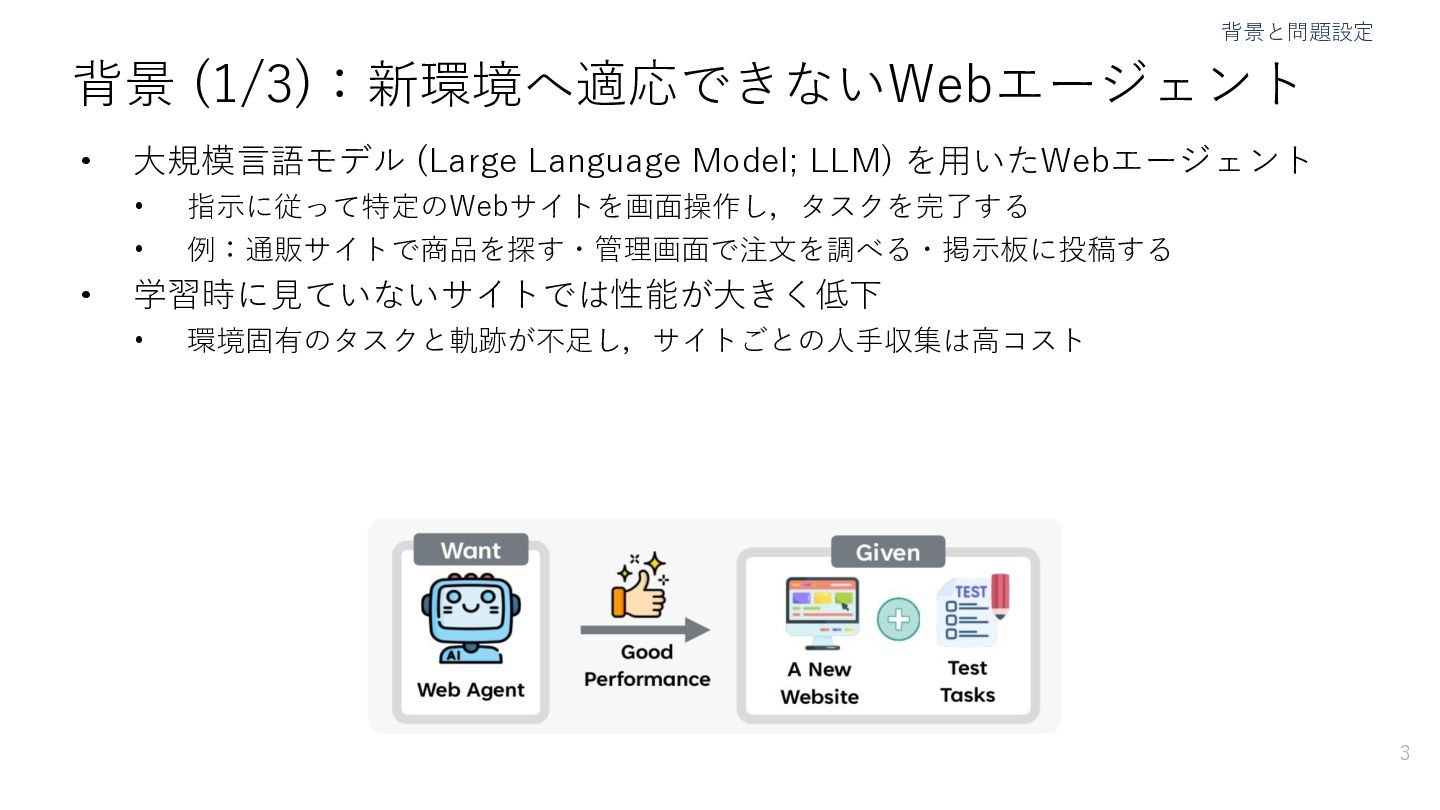
  2. 背景と問題設定 背景 (1/3):新環境へ適応できないWebエージェント • 大規模言語モデル (Large Language Model; LLM) を用いたWebエージェント

    • • • 指示に従って特定のWebサイトを画面操作し,タスクを完了する 例:通販サイトで商品を探す・管理画面で注文を調べる・掲示板に投稿する 学習時に見ていないサイトでは性能が大きく低下 • 環境固有のタスクと軌跡が不足し,サイトごとの人手収集は高コスト 3
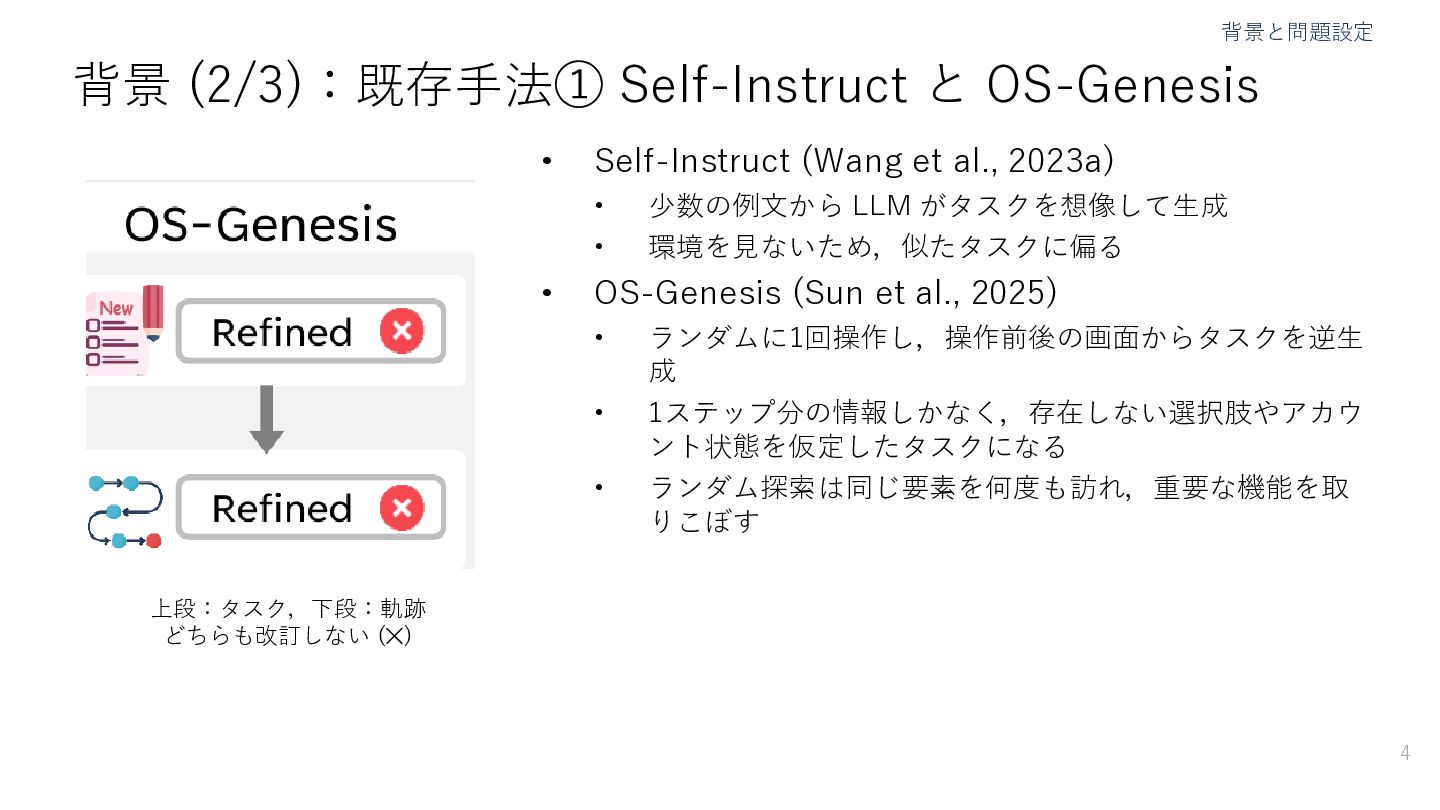
  3. 背景と問題設定 背景 (2/3):既存手法① Self-Instruct と OS-Genesis • Self-Instruct (Wang et

    al., 2023a) • • • 少数の例文から LLM がタスクを想像して生成 環境を見ないため,似たタスクに偏る OS-Genesis (Sun et al., 2025) • • • ランダムに1回操作し,操作前後の画面からタスクを逆生 成 1ステップ分の情報しかなく,存在しない選択肢やアカウ ント状態を仮定したタスクになる ランダム探索は同じ要素を何度も訪れ,重要な機能を取 りこぼす 上段:タスク,下段:軌跡 どちらも改訂しない (✕) 4
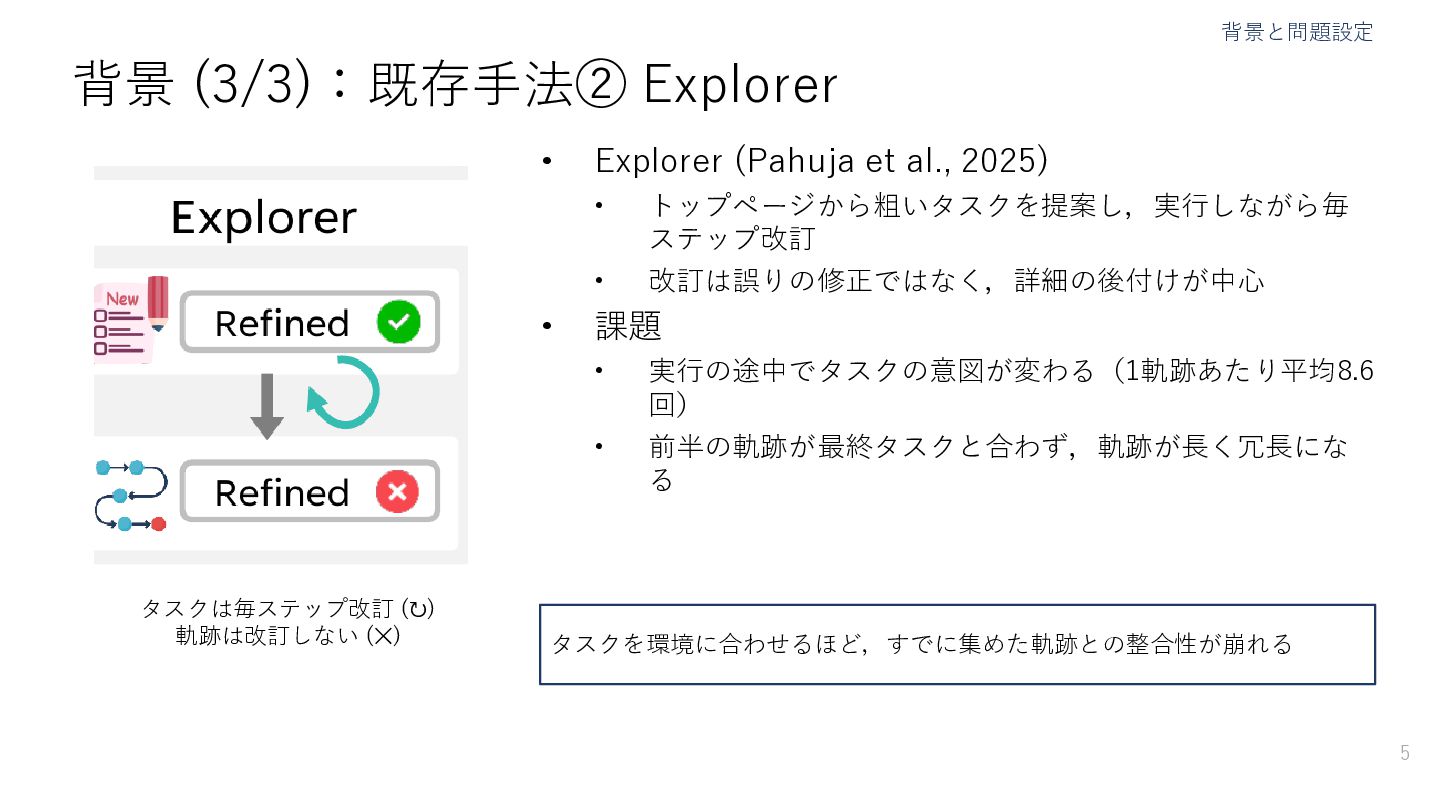
  4. 背景と問題設定 背景 (3/3):既存手法② Explorer • Explorer (Pahuja et al., 2025)

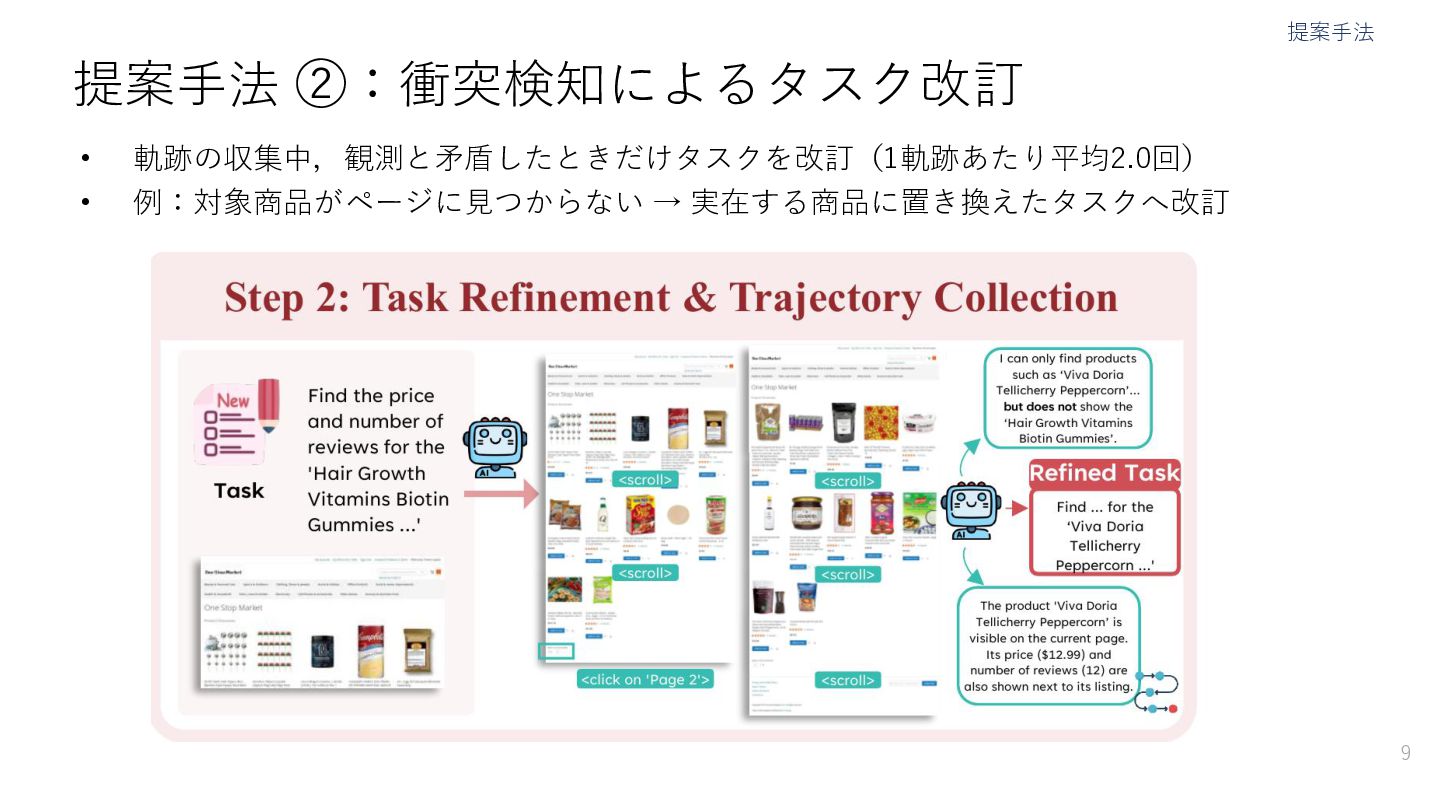
    • • • 課題 • • タスクは毎ステップ改訂 (↻) 軌跡は改訂しない (✕) トップページから粗いタスクを提案し,実行しながら毎 ステップ改訂 改訂は誤りの修正ではなく,詳細の後付けが中心 実行の途中でタスクの意図が変わる(1軌跡あたり平均8.6 回) 前半の軌跡が最終タスクと合わず,軌跡が長く冗長にな る タスクを環境に合わせるほど,すでに集めた軌跡との整合性が崩れる 5
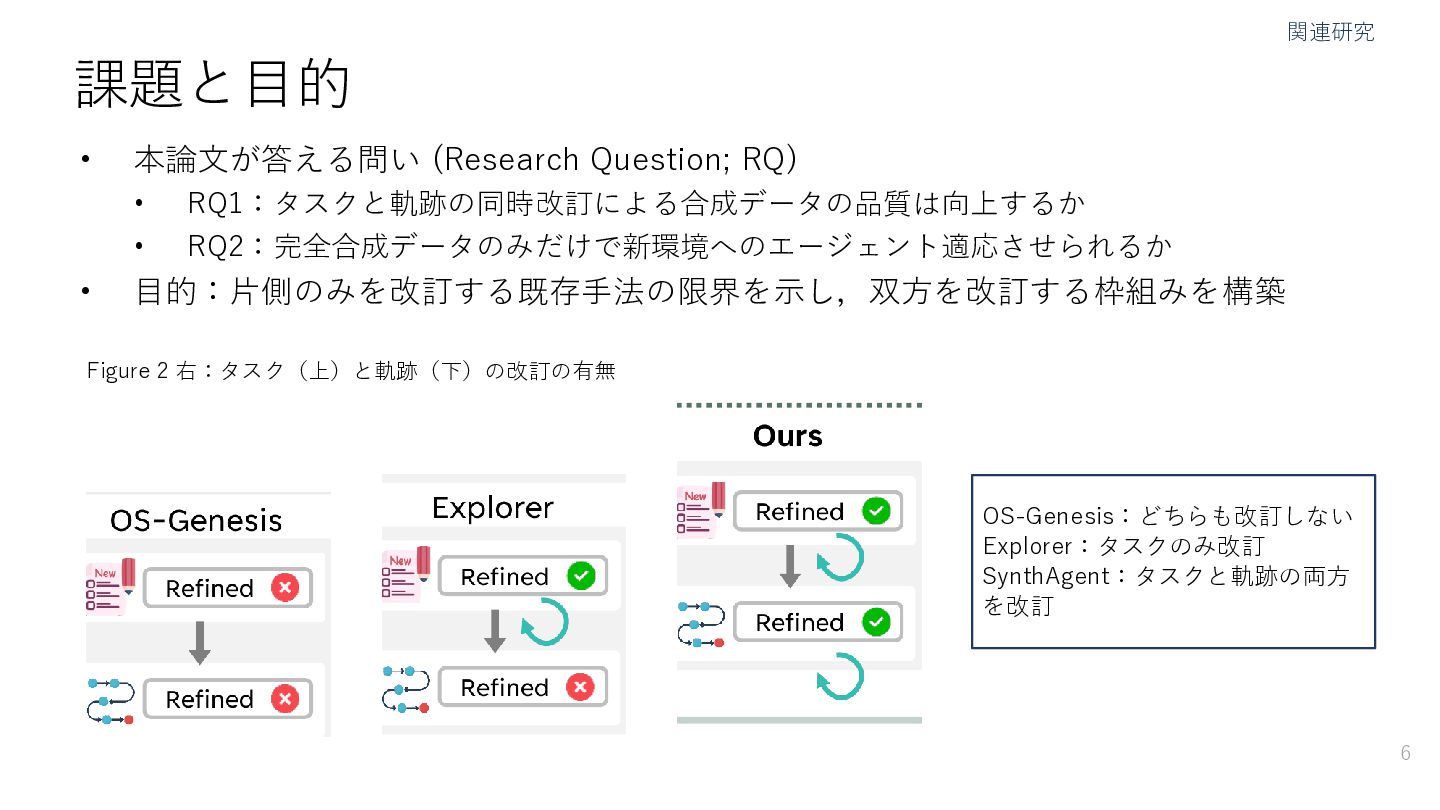
  5. 関連研究 課題と目的 • 本論文が答える問い (Research Question; RQ) • • •

    RQ1:タスクと軌跡の同時改訂による合成データの品質は向上するか RQ2:完全合成データのみだけで新環境へのエージェント適応させられるか 目的:片側のみを改訂する既存手法の限界を示し,双方を改訂する枠組みを構築 Figure 2 右:タスク(上)と軌跡(下)の改訂の有無 OS-Genesis:どちらも改訂しない Explorer:タスクのみ改訂 SynthAgent:タスクと軌跡の両方 を改訂 6
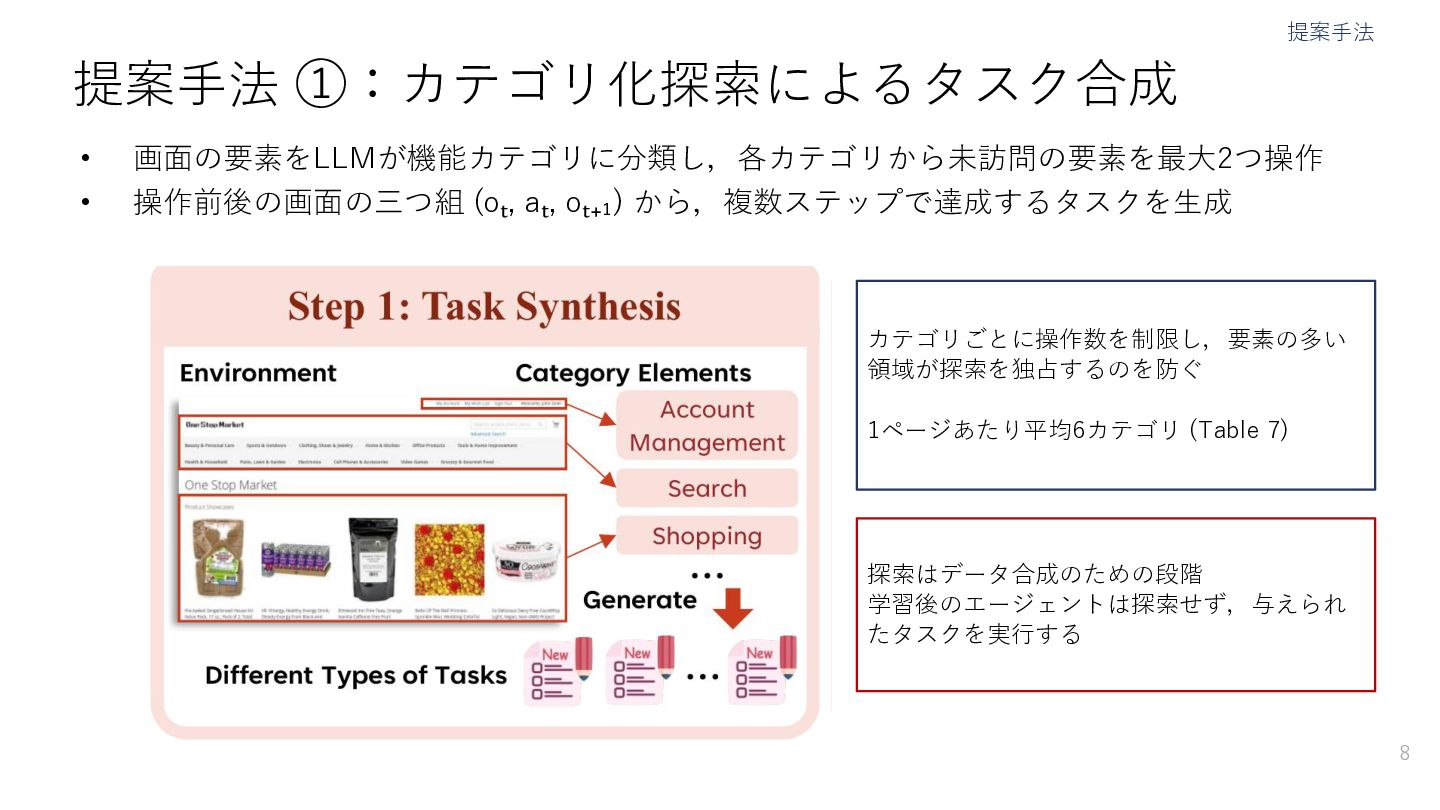
  6. 提案手法 提案手法 ①:カテゴリ化探索によるタスク合成 • • 画面の要素をLLMが機能カテゴリに分類し,各カテゴリから未訪問の要素を最大2つ操作 操作前後の画面の三つ組 (oₜ, aₜ, oₜ₊₁)

    から,複数ステップで達成するタスクを生成 カテゴリごとに操作数を制限し,要素の多い 領域が探索を独占するのを防ぐ 1ページあたり平均6カテゴリ (Table 7) 探索はデータ合成のための段階 学習後のエージェントは探索せず,与えられ たタスクを実行する 8
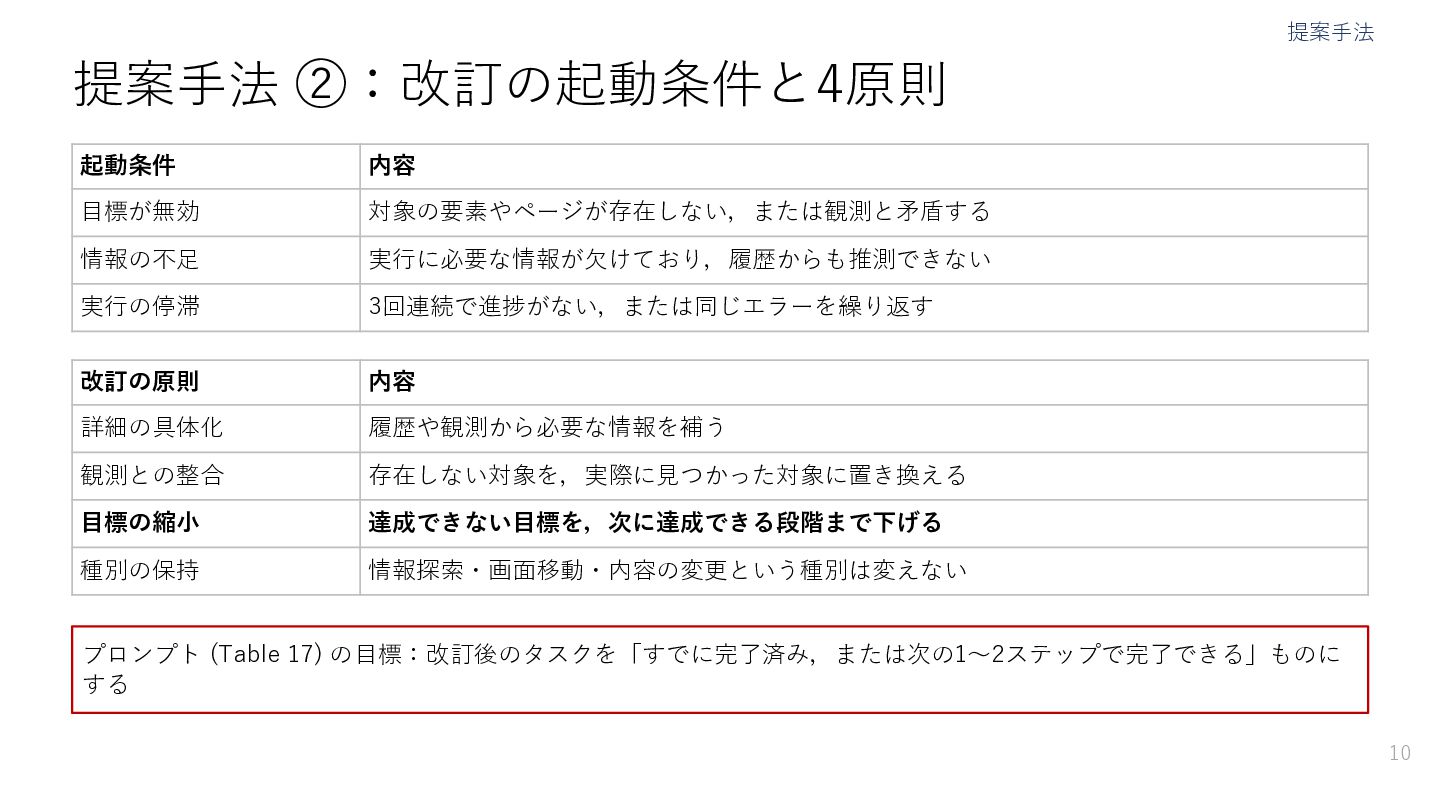
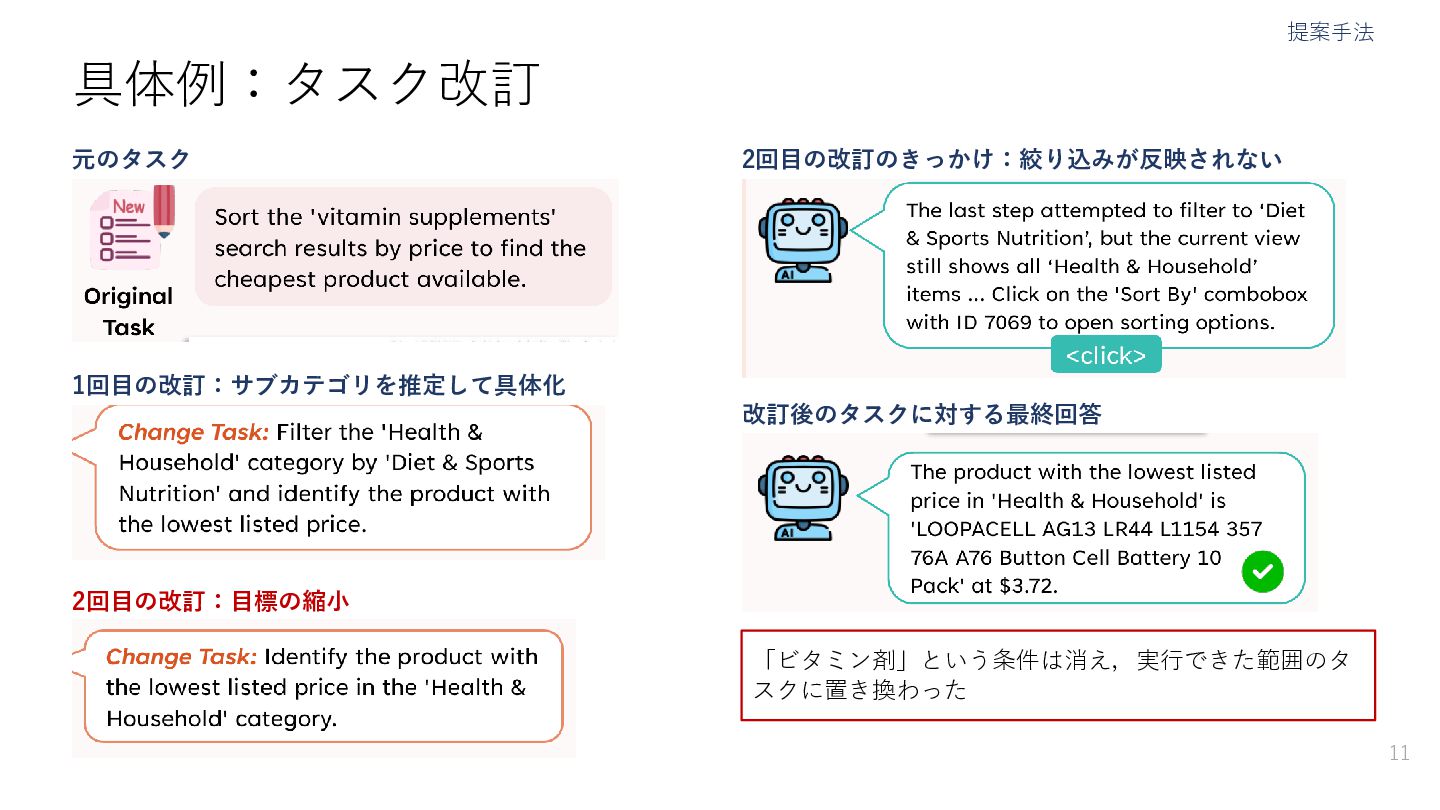
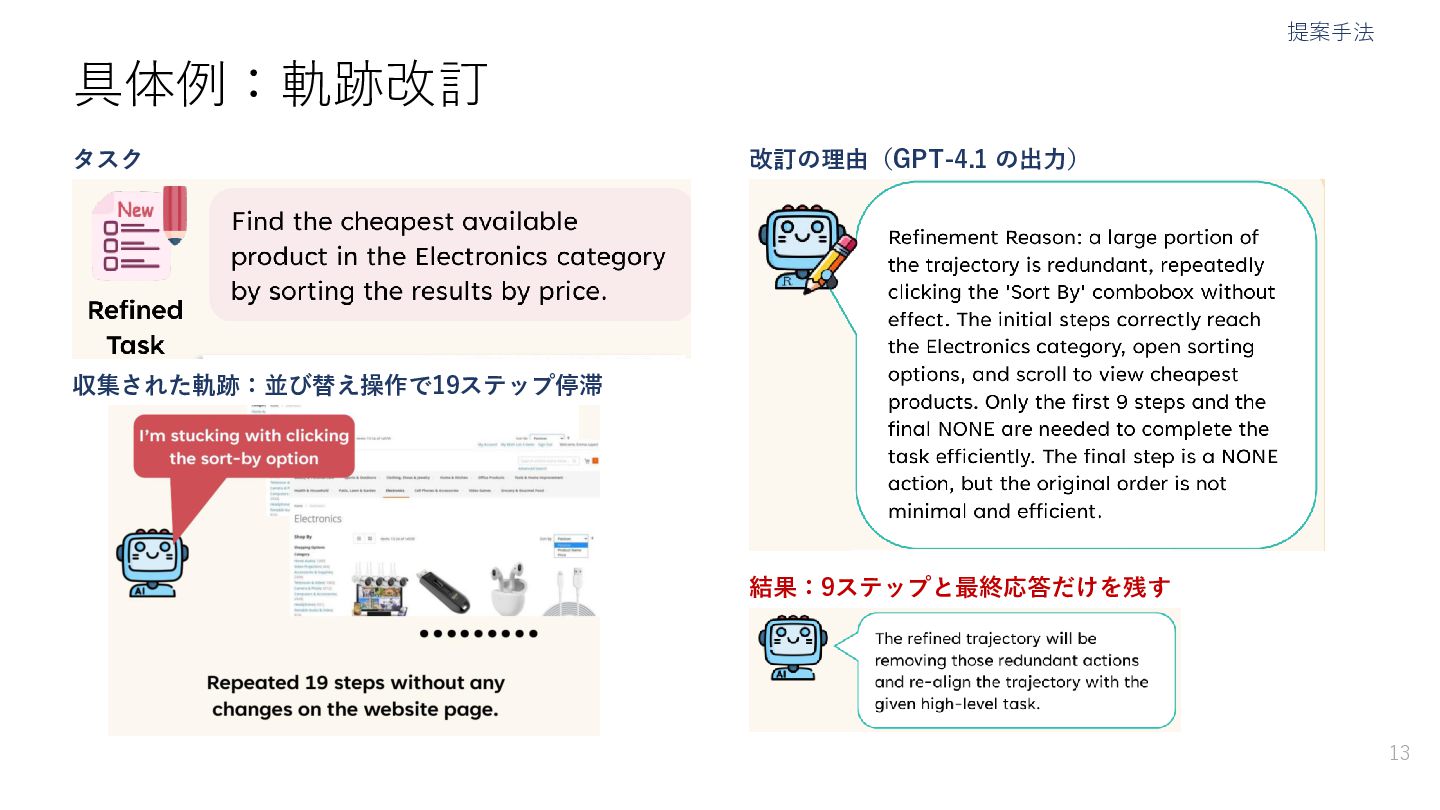
  7. 提案手法 提案手法 ②:改訂の起動条件と4原則 起動条件 内容 目標が無効 対象の要素やページが存在しない,または観測と矛盾する 情報の不足 実行に必要な情報が欠けており,履歴からも推測できない 実行の停滞

    3回連続で進捗がない,または同じエラーを繰り返す 改訂の原則 内容 詳細の具体化 履歴や観測から必要な情報を補う 観測との整合 存在しない対象を,実際に見つかった対象に置き換える 目標の縮小 達成できない目標を,次に達成できる段階まで下げる 種別の保持 情報探索・画面移動・内容の変更という種別は変えない プロンプト (Table 17) の目標:改訂後のタスクを「すでに完了済み,または次の1〜2ステップで完了できる」ものに する 10
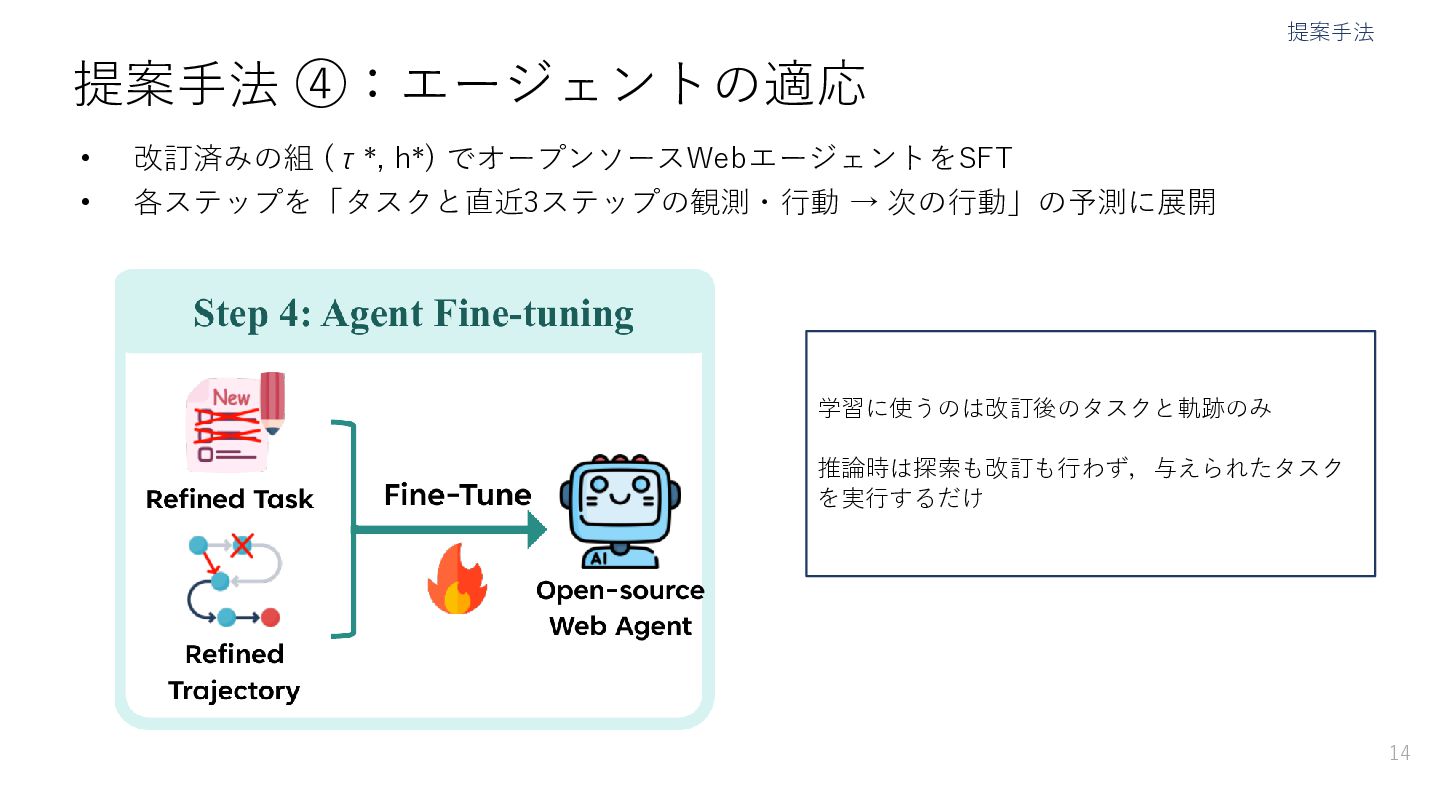
  8. 提案手法 提案手法 ④:エージェントの適応 • • 改訂済みの組 (τ*, h*) でオープンソースWebエージェントをSFT 各ステップを「タスクと直近3ステップの観測・行動

    → 次の行動」の予測に展開 学習に使うのは改訂後のタスクと軌跡のみ 推論時は探索も改訂も行わず,与えられたタスク を実行するだけ 14
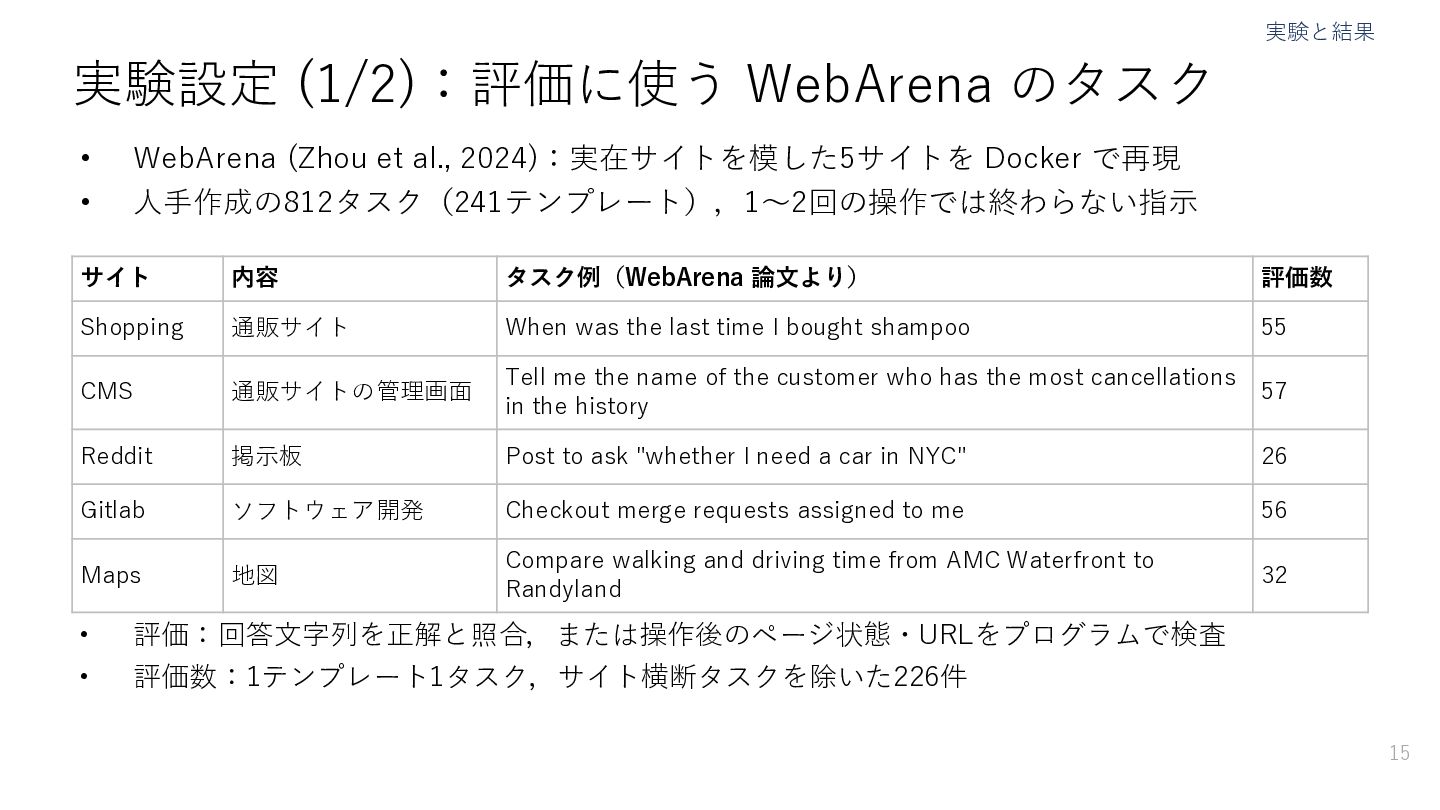
  9. 実験と結果 実験設定 (1/2):評価に使う WebArena のタスク • • WebArena (Zhou et

    al., 2024):実在サイトを模した5サイトを Docker で再現 人手作成の812タスク(241テンプレート),1〜2回の操作では終わらない指示 サイト 内容 タスク例(WebArena 論文より) 評価数 Shopping 通販サイト When was the last time I bought shampoo 55 CMS 通販サイトの管理画面 Tell me the name of the customer who has the most cancellations in the history 57 Reddit 掲示板 Post to ask "whether I need a car in NYC" 26 Gitlab ソフトウェア開発 Checkout merge requests assigned to me 56 Maps 地図 Compare walking and driving time from AMC Waterfront to Randyland 32 • • 評価:回答文字列を正解と照合,または操作後のページ状態・URLをプログラムで検査 評価数:1テンプレート1タスク,サイト横断タスクを除いた226件 15
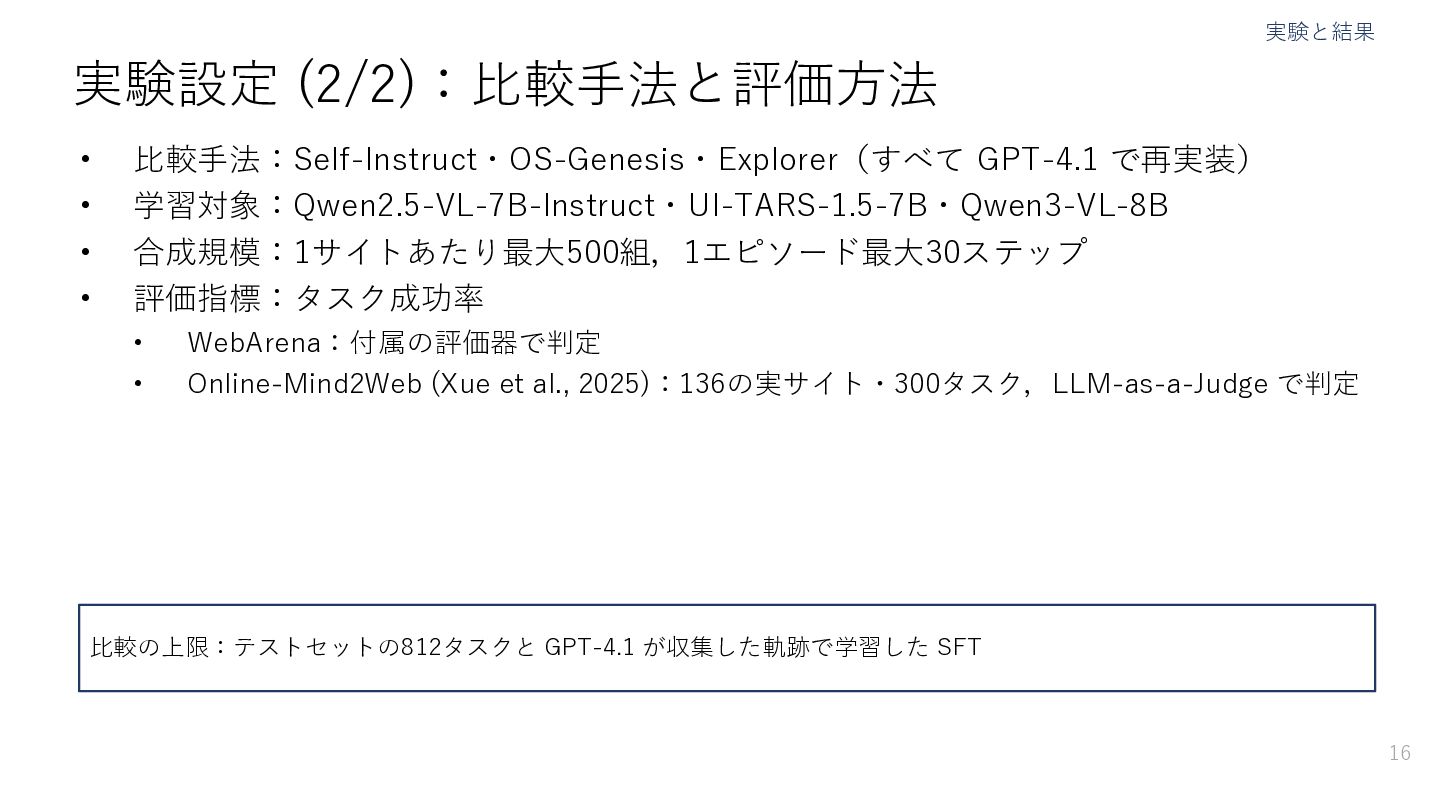
  10. 実験と結果 実験設定 (2/2):比較手法と評価方法 • • • • 比較手法:Self-Instruct・OS-Genesis・Explorer(すべて GPT-4.1 で再実装)

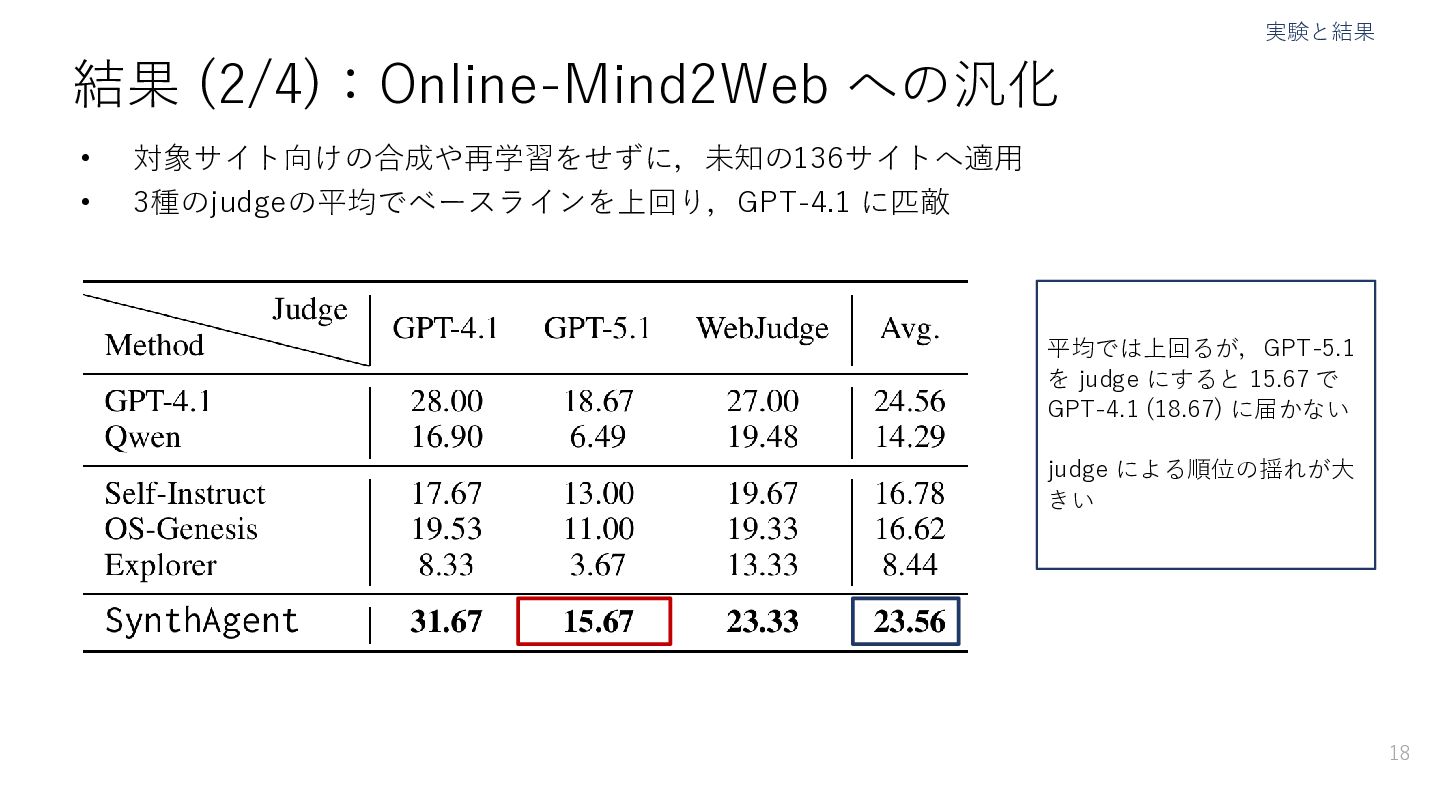
    学習対象:Qwen2.5-VL-7B-Instruct・UI-TARS-1.5-7B・Qwen3-VL-8B 合成規模:1サイトあたり最大500組,1エピソード最大30ステップ 評価指標:タスク成功率 • • WebArena:付属の評価器で判定 Online-Mind2Web (Xue et al., 2025):136の実サイト・300タスク,LLM-as-a-Judge で判定 比較の上限:テストセットの812タスクと GPT-4.1 が収集した軌跡で学習した SFT 16
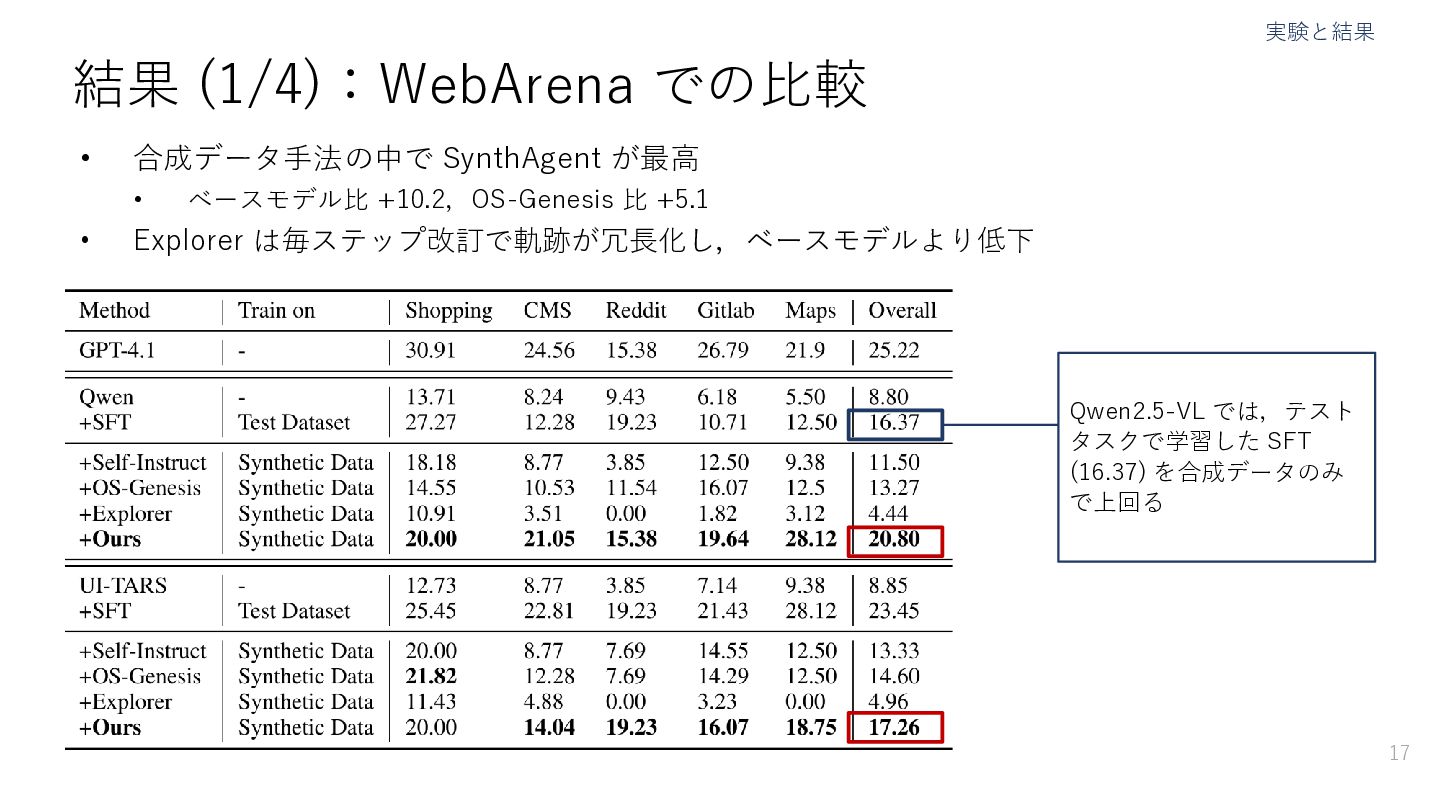
  11. 実験と結果 結果 (1/4):WebArena での比較 • 合成データ手法の中で SynthAgent が最高 • •

    ベースモデル比 +10.2,OS-Genesis 比 +5.1 Explorer は毎ステップ改訂で軌跡が冗長化し,ベースモデルより低下 Qwen2.5-VL では,テスト タスクで学習した SFT (16.37) を合成データのみ で上回る 17
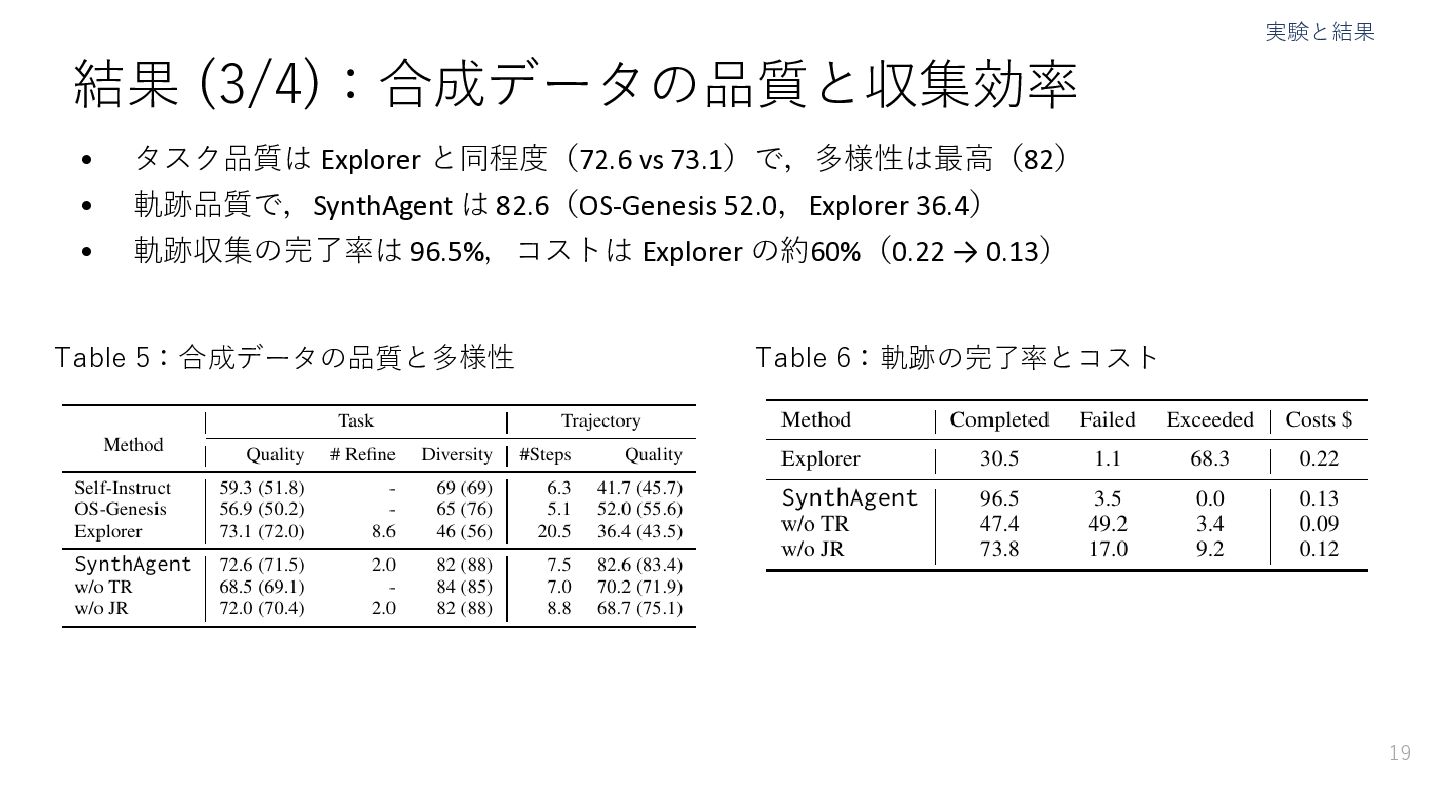
  12. 実験と結果 結果 (3/4):合成データの品質と収集効率 • タスク品質は Explorer と同程度(72.6 vs 73.1)で,多様性は最高(82) •

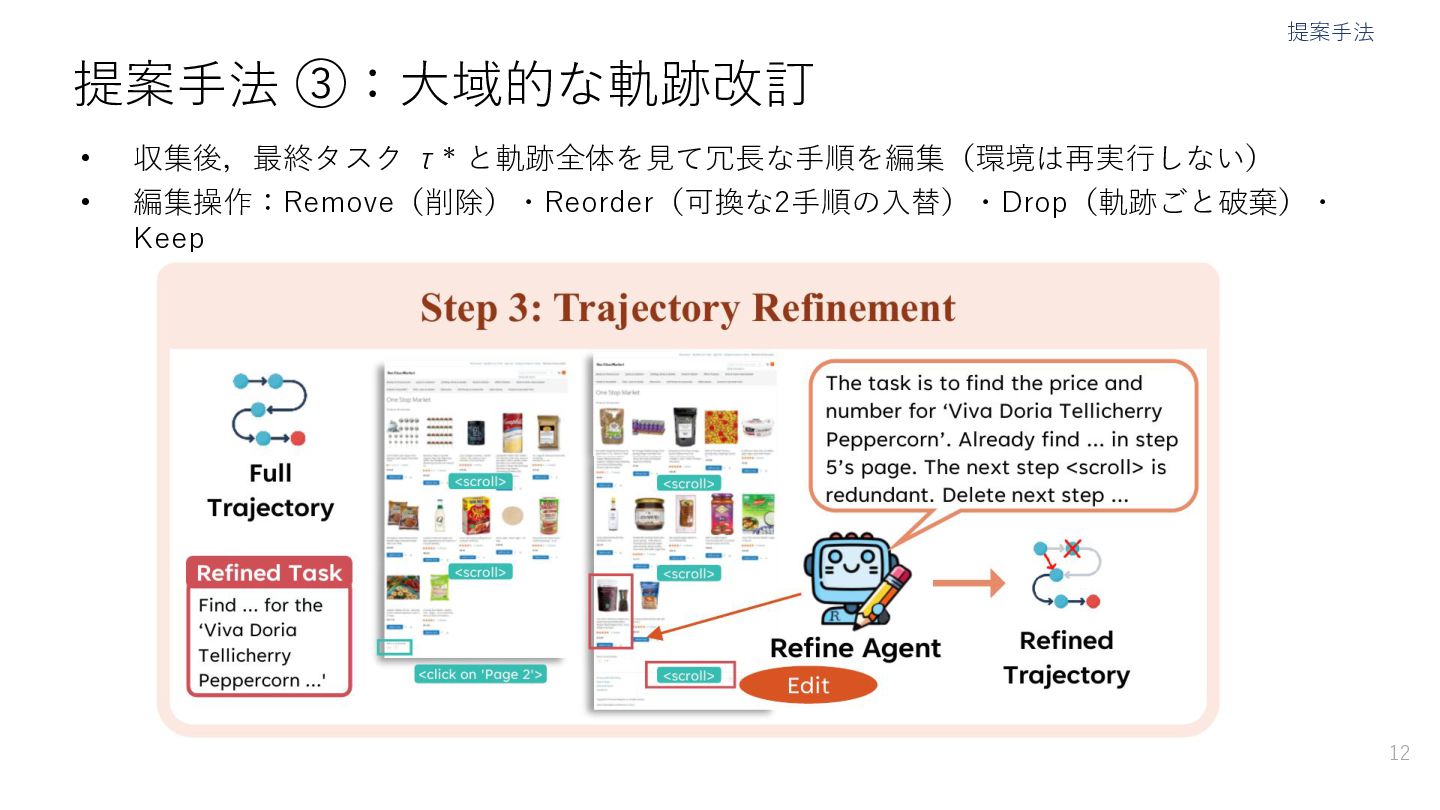
    軌跡品質で,SynthAgent は 82.6(OS-Genesis 52.0,Explorer 36.4) • 軌跡収集の完了率は 96.5%,コストは Explorer の約60%(0.22 → 0.13) Table 5:合成データの品質と多様性 Table 6:軌跡の完了率とコスト 19
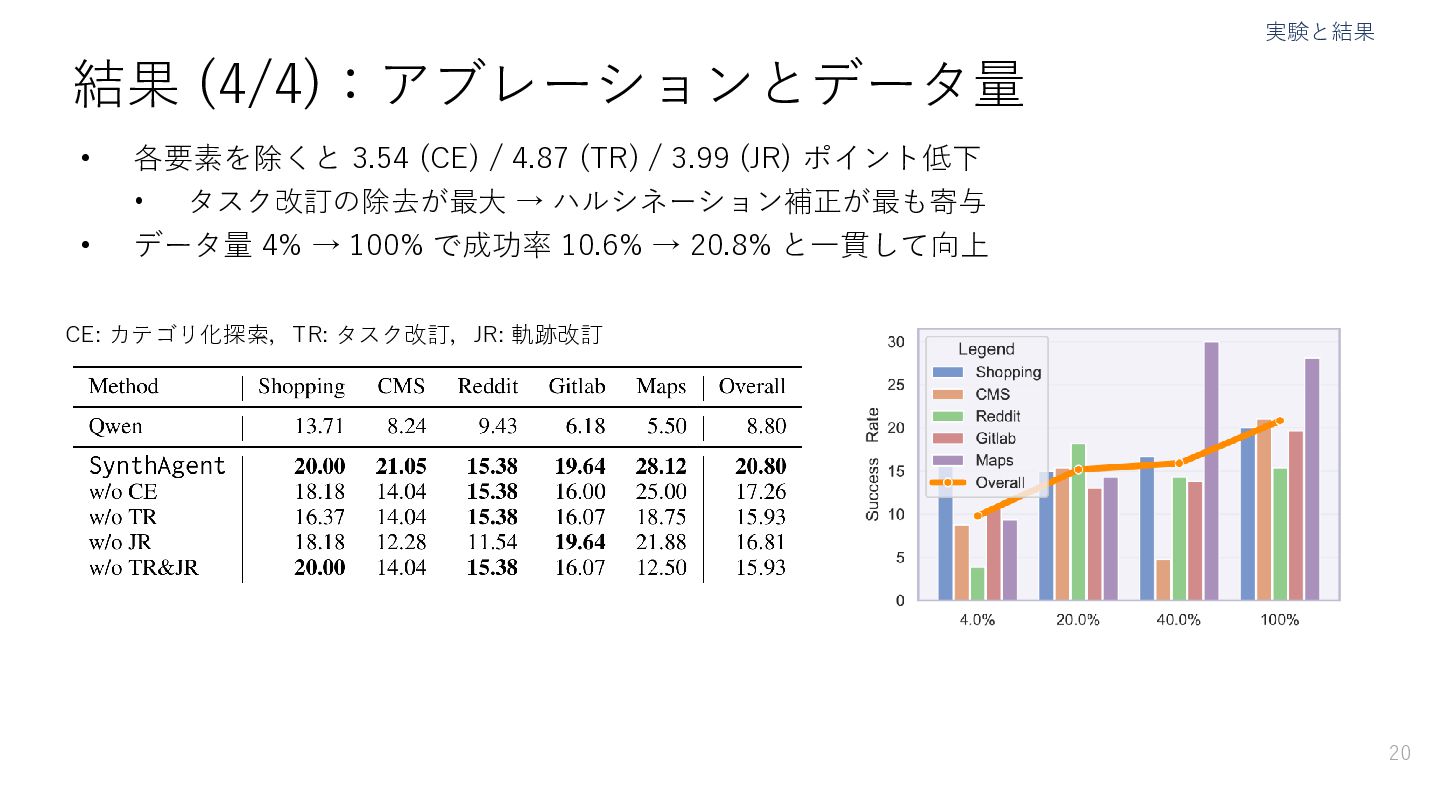
  13. 実験と結果 結果 (4/4):アブレーションとデータ量 • • 各要素を除くと 3.54 (CE) / 4.87

    (TR) / 3.99 (JR) ポイント低下 • タスク改訂の除去が最大 → ハルシネーション補正が最も寄与 データ量 4% → 100% で成功率 10.6% → 20.8% と一貫して向上 CE: カテゴリ化探索,TR: タスク改訂,JR: 軌跡改訂 20
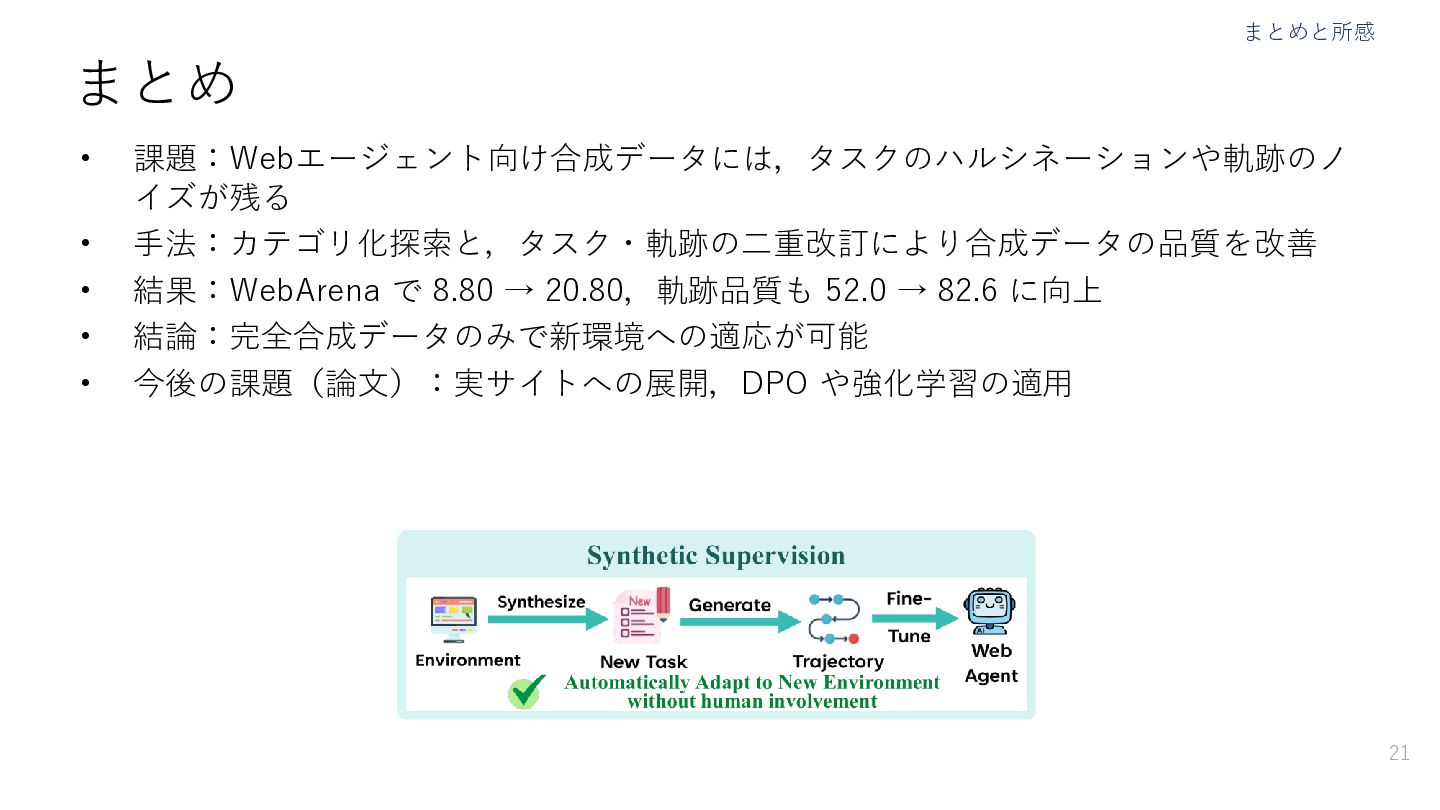
  14. まとめと所感 まとめ • • • • • 課題:Webエージェント向け合成データには,タスクのハルシネーションや軌跡のノ イズが残る 手法:カテゴリ化探索と,タスク・軌跡の二重改訂により合成データの品質を改善

    結果:WebArena で 8.80 → 20.80,軌跡品質も 52.0 → 82.6 に向上 結論:完全合成データのみで新環境への適応が可能 今後の課題(論文):実サイトへの展開,DPO や強化学習の適用 21
  15. まとめと所感 所感 • 良い点 • • • タスク改訂で生じる軌跡の不整合まで考慮した設計 品質改善が下流性能と収集効率の向上につながっている 気になる点

    • • 未知サイトへの評価が LLM-as-a-Judge に依存し,judge によって手法間の順位が変化 目標の縮小がどの程度起き,難易度にどう影響したかが未評価 22