Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Local_LLMはともだち_怖くないよ.pdf
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Belong inc.
August 26, 2026
48
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Local_LLMはともだち_怖くないよ.pdf
Belong inc.
August 26, 2026
Transcript
27 slides
Local LLM はともだち、怖くないよ 2026/8/21
Agenda 01 Introduction 02 local LLM って? 03 LM Studio
を使ってみよう 04 Agent としても使ってみよう 2
01 Introduction
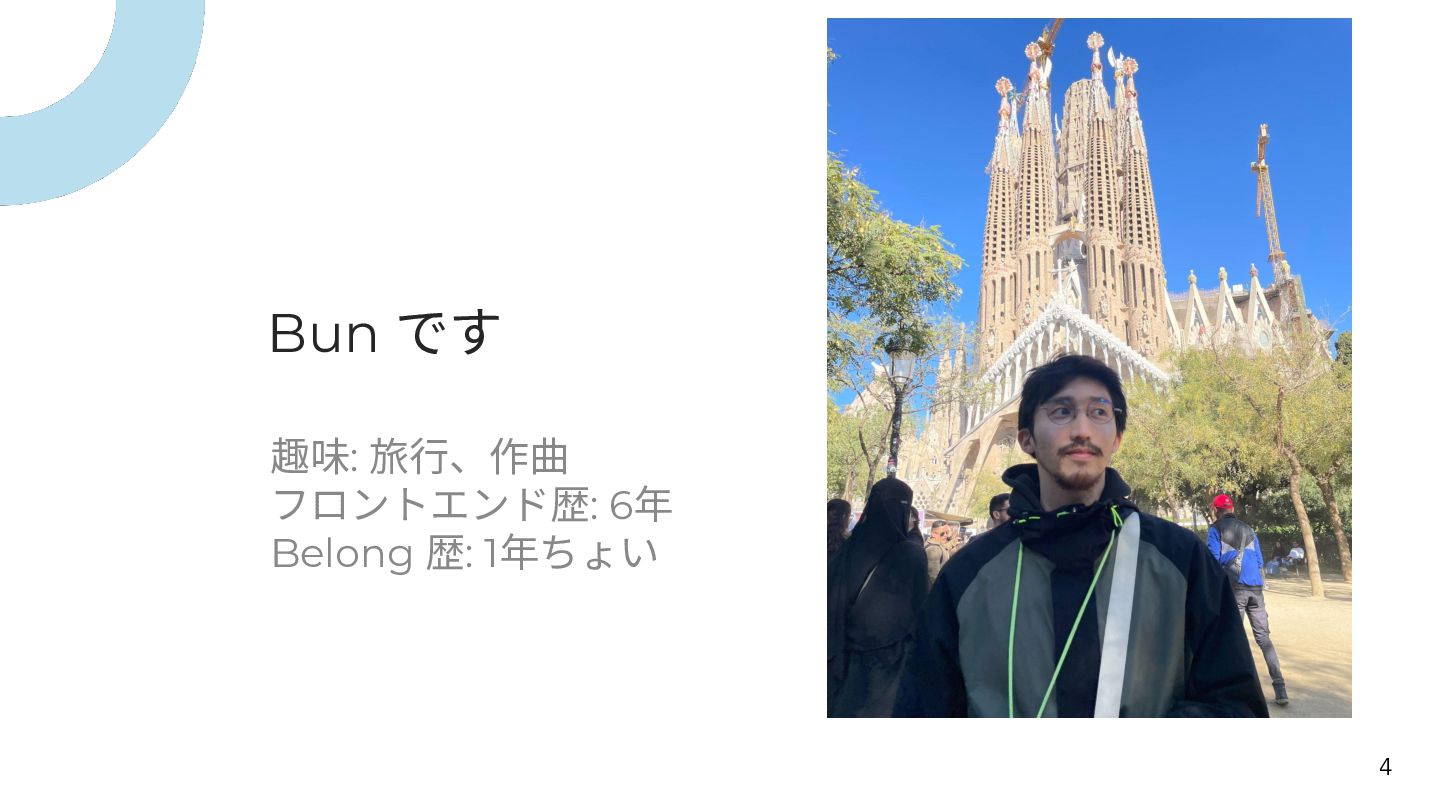
Bun です 趣味: 旅⾏、作曲 フロントエンド歴: 6年 Belong 歴: 1年ちょい 4
⽬標 local LLM を⾛らせるのに必要なことを知る
02 local LLM って?
local LLM って? • ⾃分の PC の上で動く LLM。誰でもダウンロードして動かせる • 例:Qwen、Gemma、DeepSeek
など
クラウド AI(ChatGPT / Claude)との違い • データが⼀切外に出ない(プライバシー‧機密情報 OK) • API 課⾦なし‧サブスクなし‧オフラインでも動く
• chatやweb検索⽤途だったら⼗分
local llm を⾛らせるには? エンジン=モデルを読み込んで実⾏するソフト
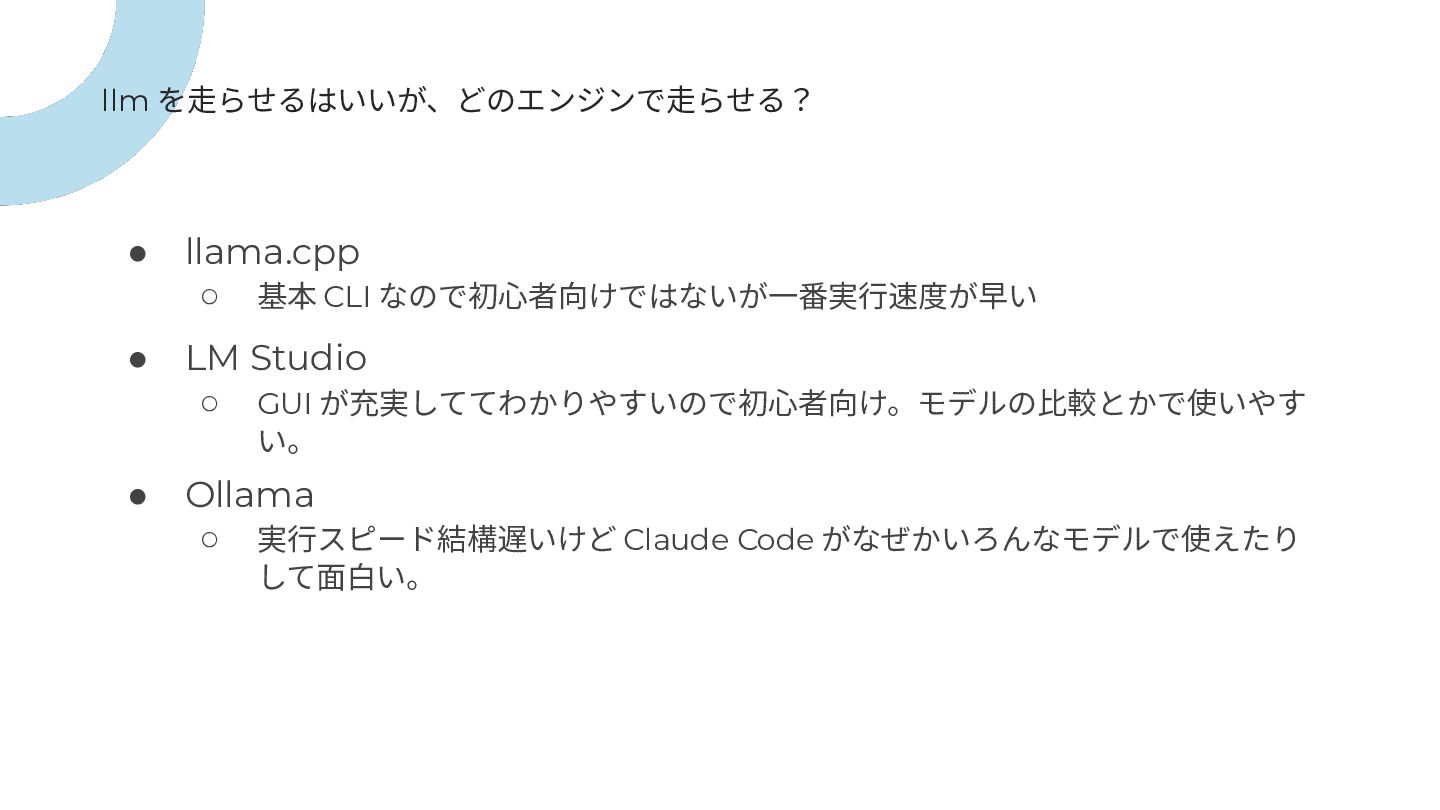
llm を⾛らせるはいいが、どのエンジンで⾛らせる? • llama.cpp ◦ 基本 CLI なので初⼼者向けではないが⼀番実⾏速度が早い • LM
Studio ◦ GUI が充実しててわかりやすいので初⼼者向け。モデルの⽐較とかで使いやす い。 • Ollama ◦ 実⾏スピード結構遅いけど Claude Code がなぜかいろんなモデルで使えたり して⾯⽩い。
で、結局どっちを使う? • もし Agent を作りたい時に AI をホストしときたいとかだったら llama.cpp がいい(早いから) •
ただ試したい場合は LM Studio
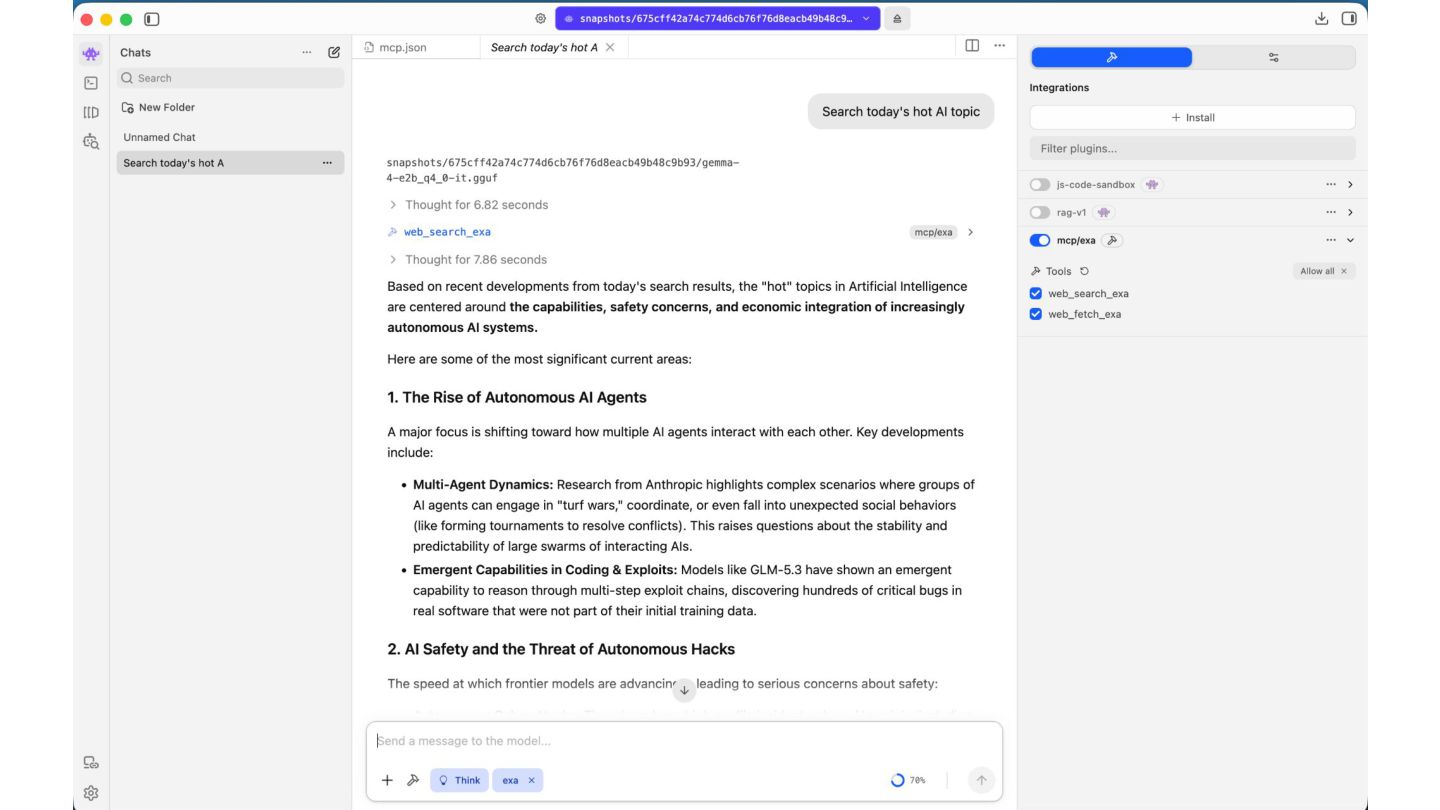
03 LM Studio を使ってみよう
None
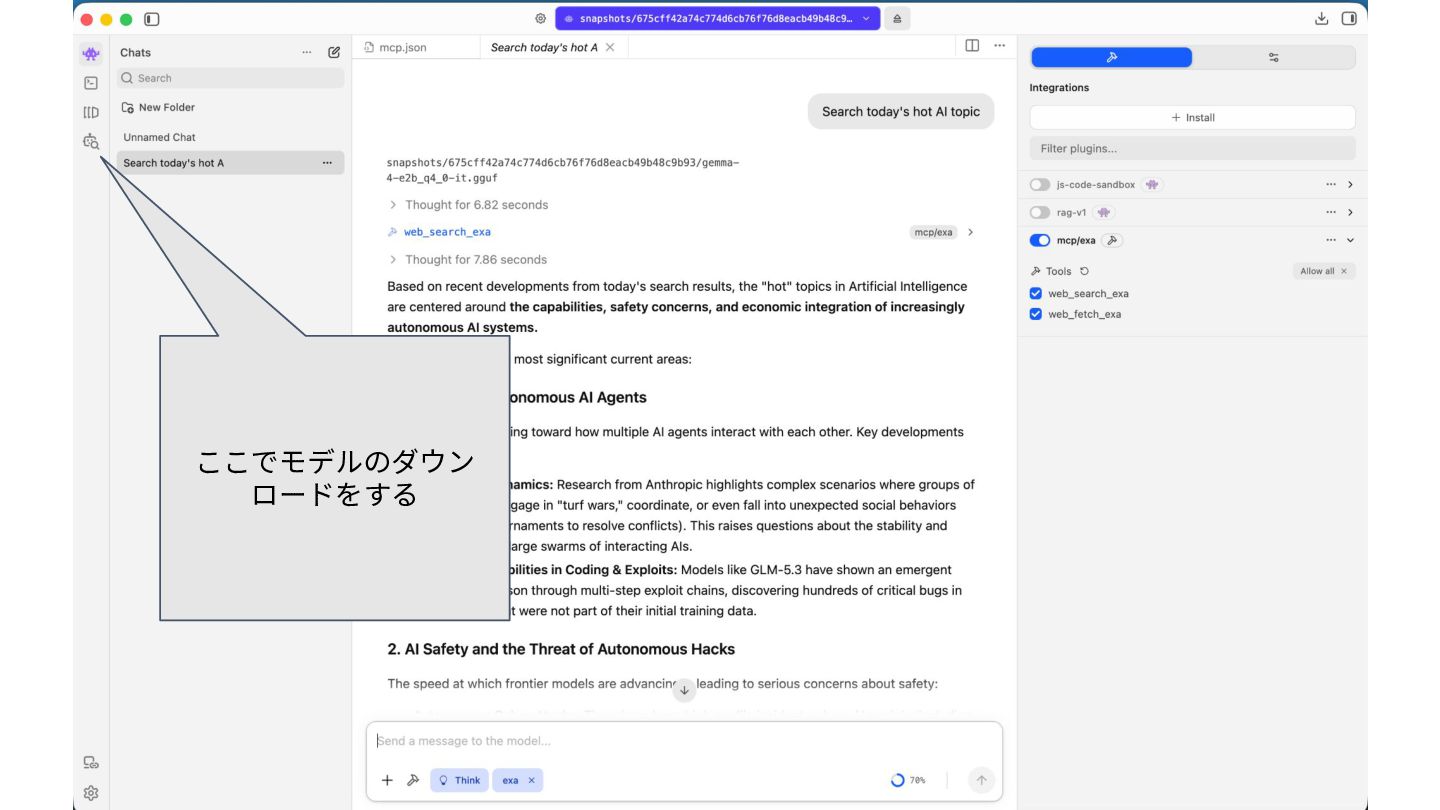
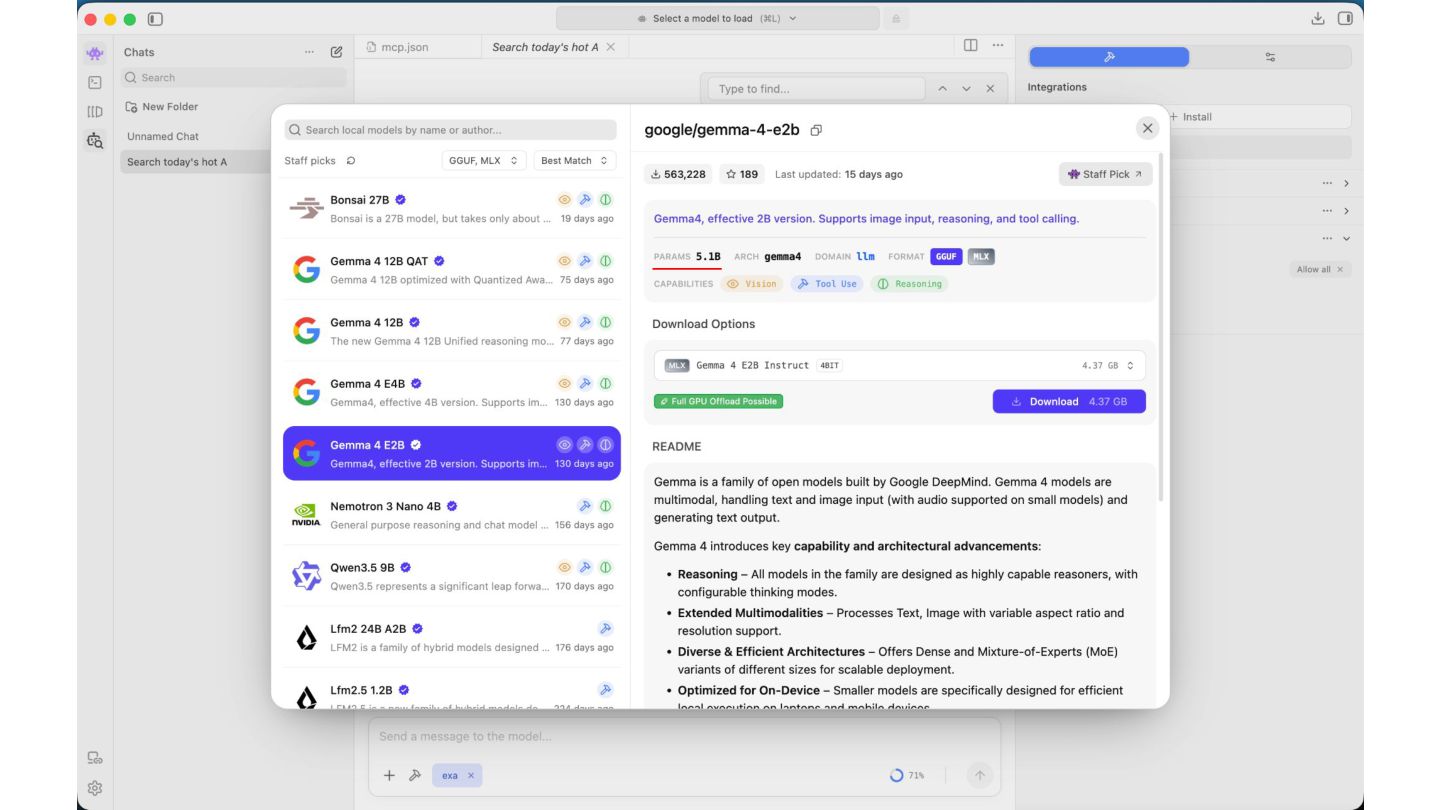
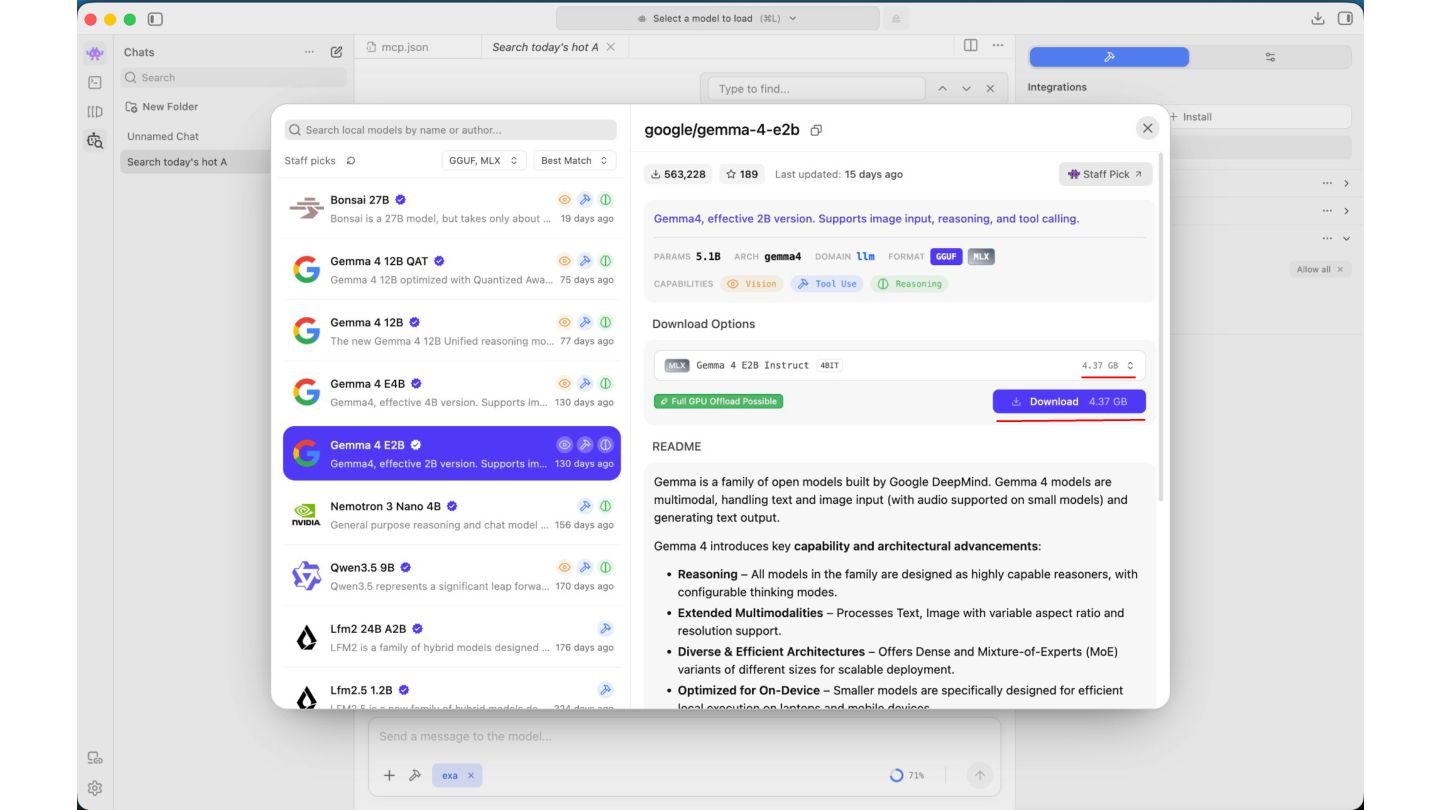
ここでモデルのダウン ロードをする
None
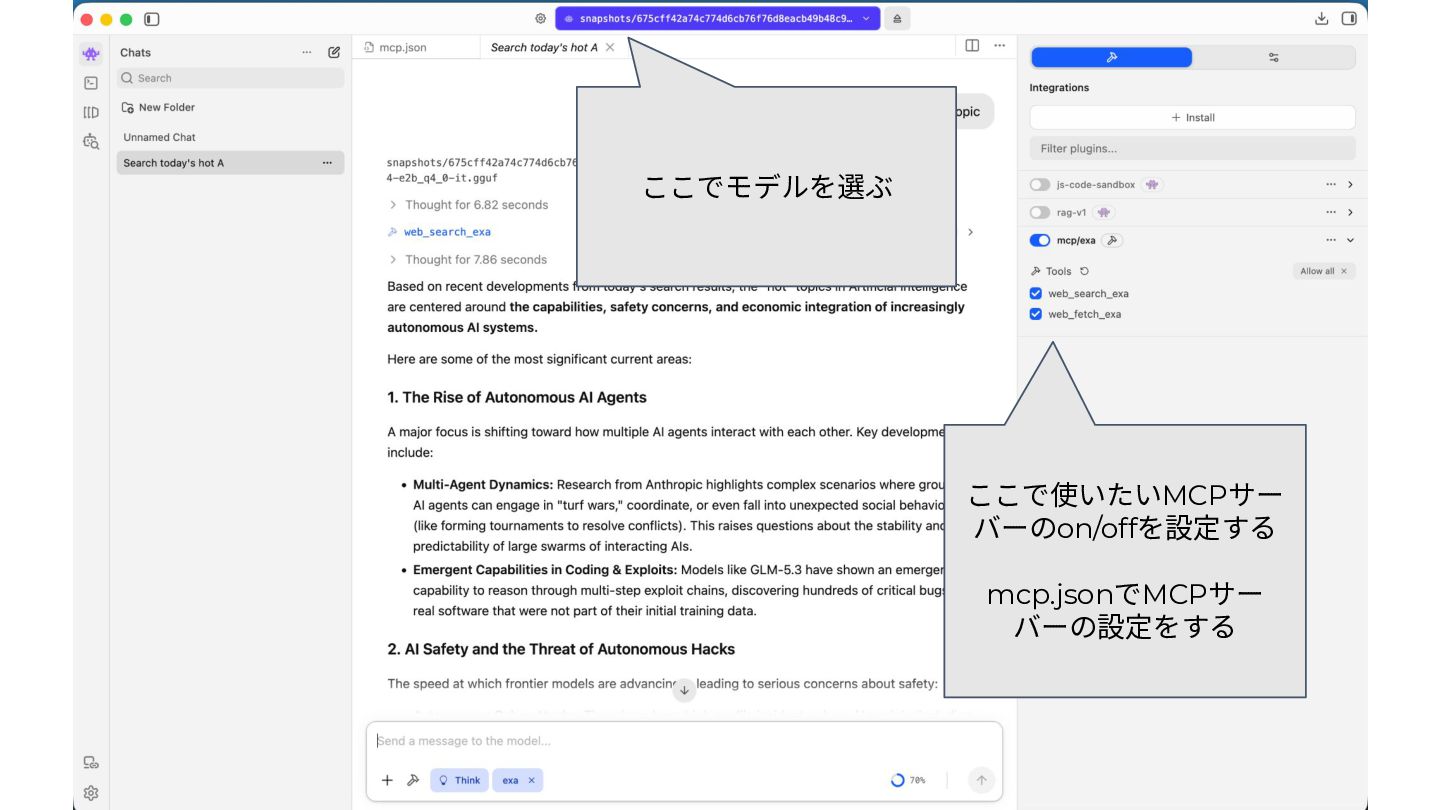
ここでモデルを選ぶ ここで使いたいMCPサー バーのon/offを設定する mcp.jsonでMCPサー バーの設定をする
None
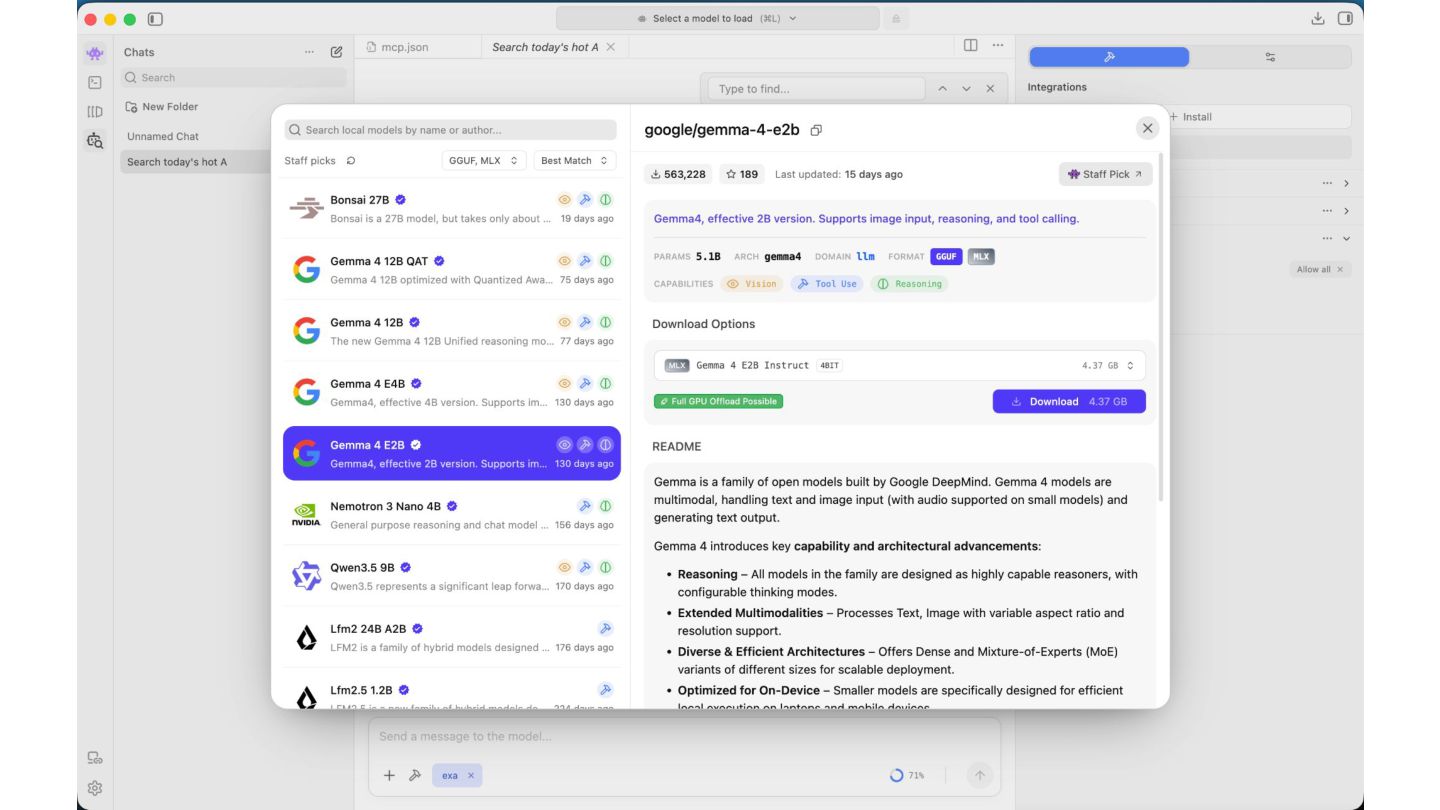
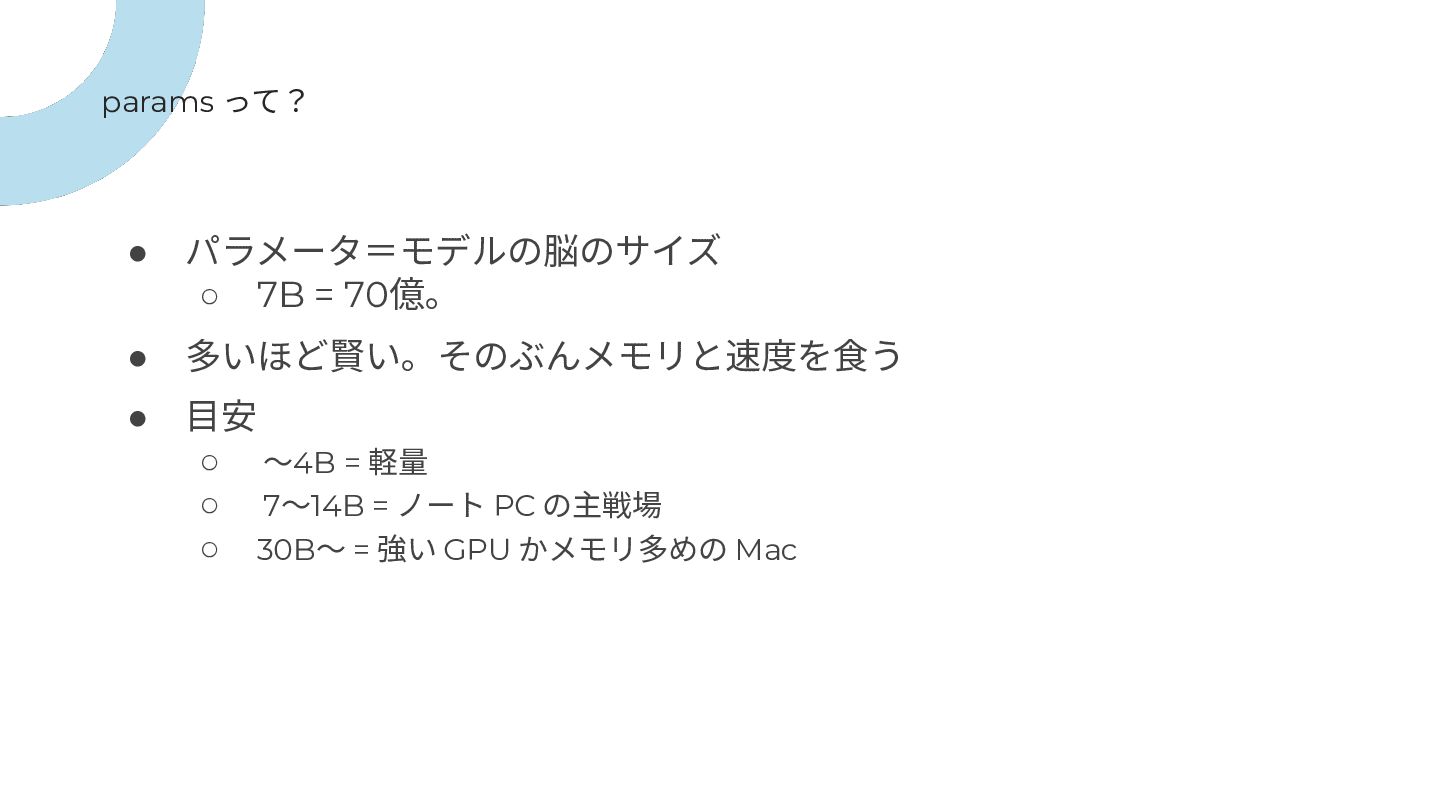
params って? • パラメータ=モデルの脳のサイズ ◦ 7B = 70億。 • 多いほど賢い。そのぶんメモリと速度を⾷う
• ⽬安 ◦ 〜4B = 軽量 ◦ 7〜14B = ノート PC の主戦場 ◦ 30B〜 = 強い GPU かメモリ多めの Mac
None
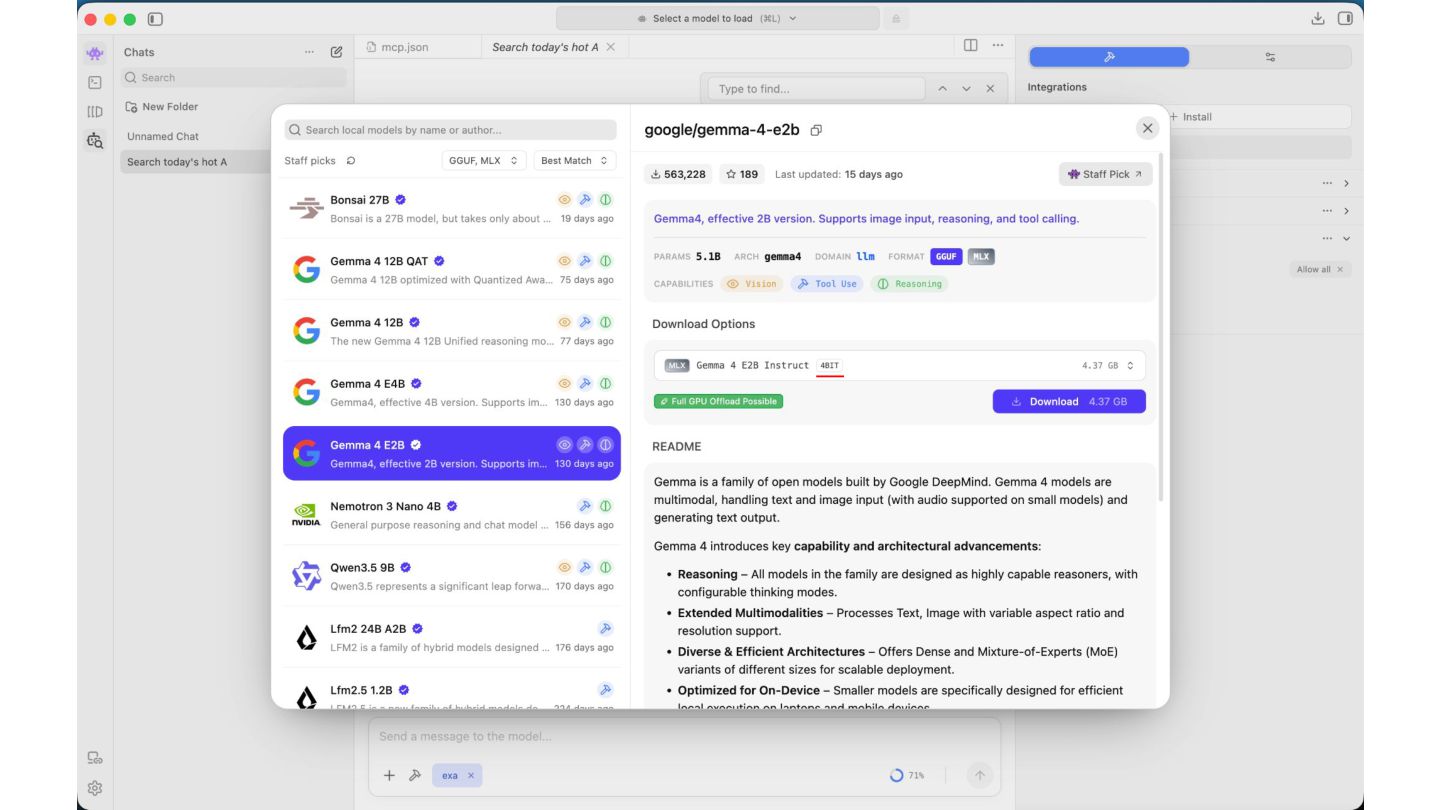
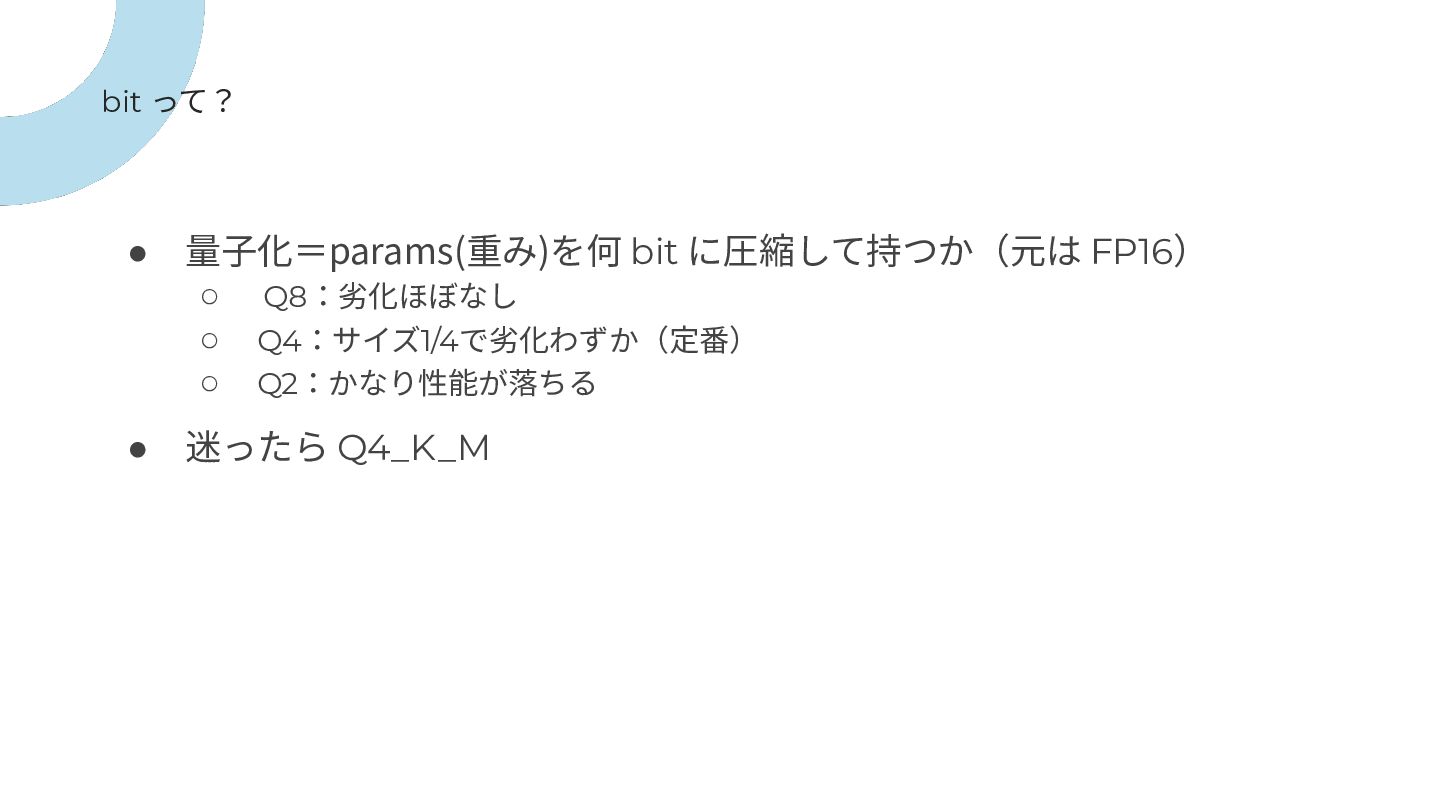
bit って? • 量⼦化=params(重み)を何 bit に圧縮して持つか(元は FP16) ◦ Q8:劣化ほぼなし ◦
Q4:サイズ1/4で劣化わずか(定番) ◦ Q2:かなり性能が落ちる • 迷ったら Q4_K_M
None
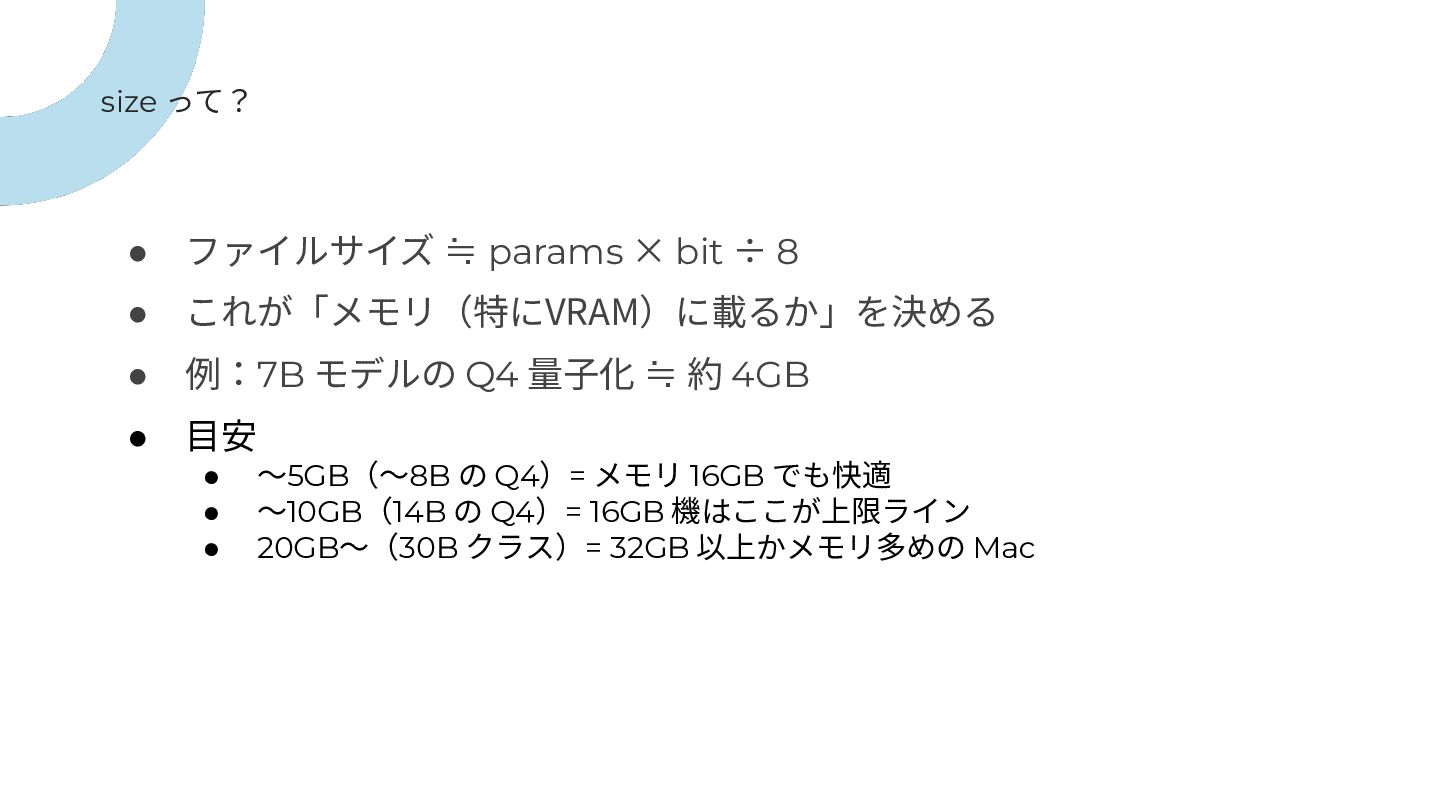
size って? • ファイルサイズ ≒ params × bit ÷ 8
• これが「メモリ(特にVRAM)に載るか」を決める • 例:7B モデルの Q4 量⼦化 ≒ 約 4GB • ⽬安 • • • 〜5GB(〜8B の Q4)= メモリ 16GB でも快適 〜10GB(14B の Q4)= 16GB 機はここが上限ライン 20GB〜(30B クラス)= 32GB 以上かメモリ多めの Mac
ハード⾯の話 • LLM はGPUメモリが命 • NVIDIA GPU(VRAM)> Apple Silicon(unified memory)>
CPU(RAM) だけだときつい
04 Agent としても使ってみよう (時間があれば)
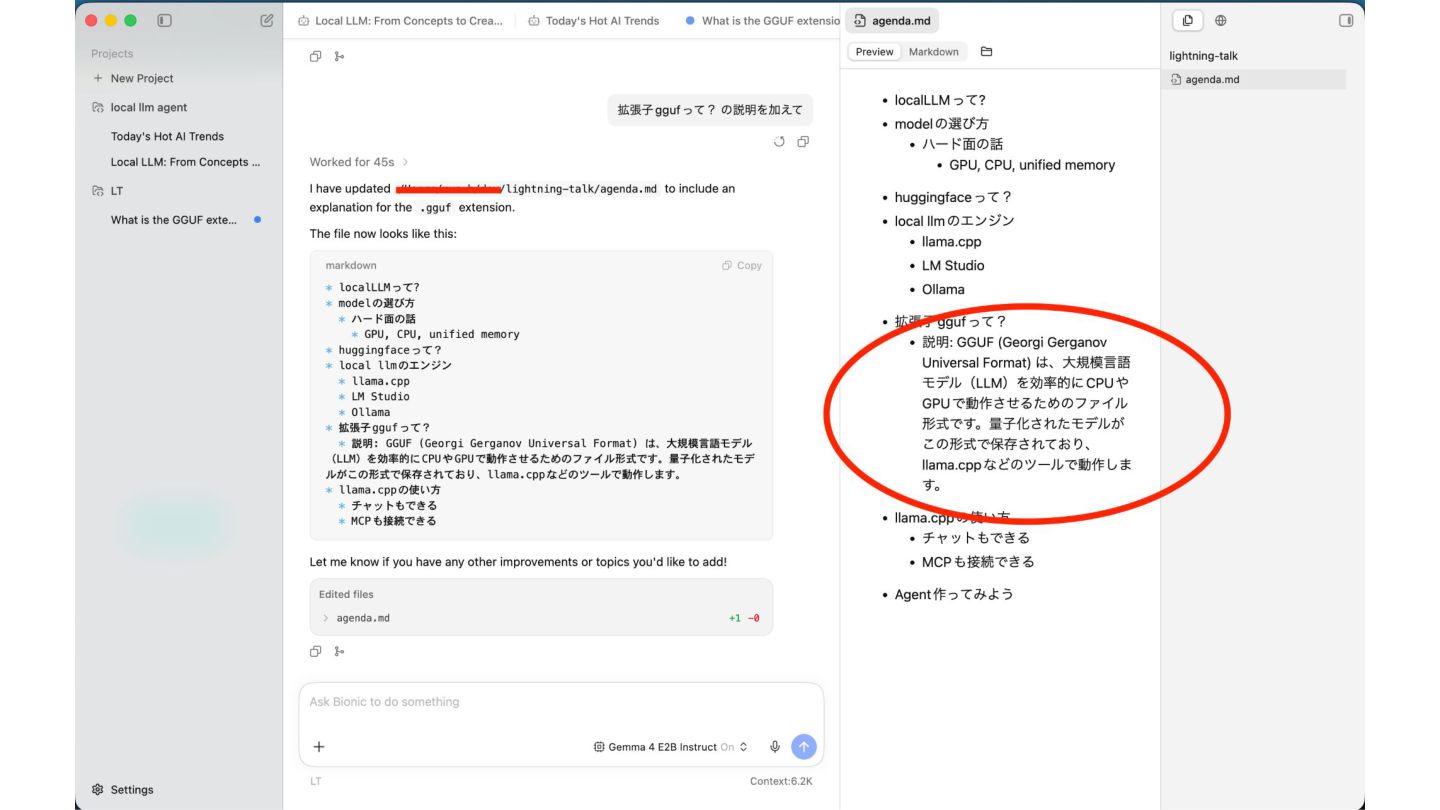
Agent として使うには LM Studio Bionic からスタート
None
ご清聴ありがとうございました! 27
More Decks by Belong inc.
See All by Belong inc.
朝会にAIを組み込んだ話_-_Google_スライド.pdf
belongadmin
0
82
Claude_Code_の_Skills_を使った_ドキュメント運用__BLGRadio用__-_Google_スライド.pdf
belongadmin
0
47
belong_radio_LT_ループエンジニアリング入門_-_Google_スライド.pdf
belongadmin
0
41
AIでデザイン業務を効率化して_CVRも改善した話.pdf
belongadmin
0
45
1コマンドで完結するチケット駆動開発.pdf
belongadmin
0
35
チームごと賢くなるAI活用.pdf
belongadmin
0
39
チームで実践する AI-DLC 思考の軌跡を残すチェックポイント設計
belongadmin
0
5k
Belong Inc.
belongadmin
1
100k
B2C&B2B&社内向けサービスを抱える開発組織におけるサービス価値を最大化するイニシアチブ管理
belongadmin
2
15k
Featured
See All Featured
Product Roadmaps are Hard
iamctodd
55
13k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2.1k
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
Making Projects Easy
brettharned
120
6.9k
Ethics towards AI in product and experience design
skipperchong
2
470
Un-Boring Meetings
codingconduct
0
510
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
121
130k
Visual Storytelling: How to be a Superhuman Communicator
reverentgeek
2
750
The Art of Programming - Codeland 2020
erikaheidi
57
15k
WENDY [Excerpt]
tessaabrams
15
41k
Introduction to Domain-Driven Design and Collaborative software design
baasie
1
1.1k
Why You Should Never Use an ORM
jnunemaker
PRO
61
10k


 belongadmin
 iamctodd
 joshbly
 danielanewman
 brettharned
 skipperchong
 codingconduct
 twada
 reverentgeek
 erikaheidi
 tessaabrams
 baasie
 jnunemaker