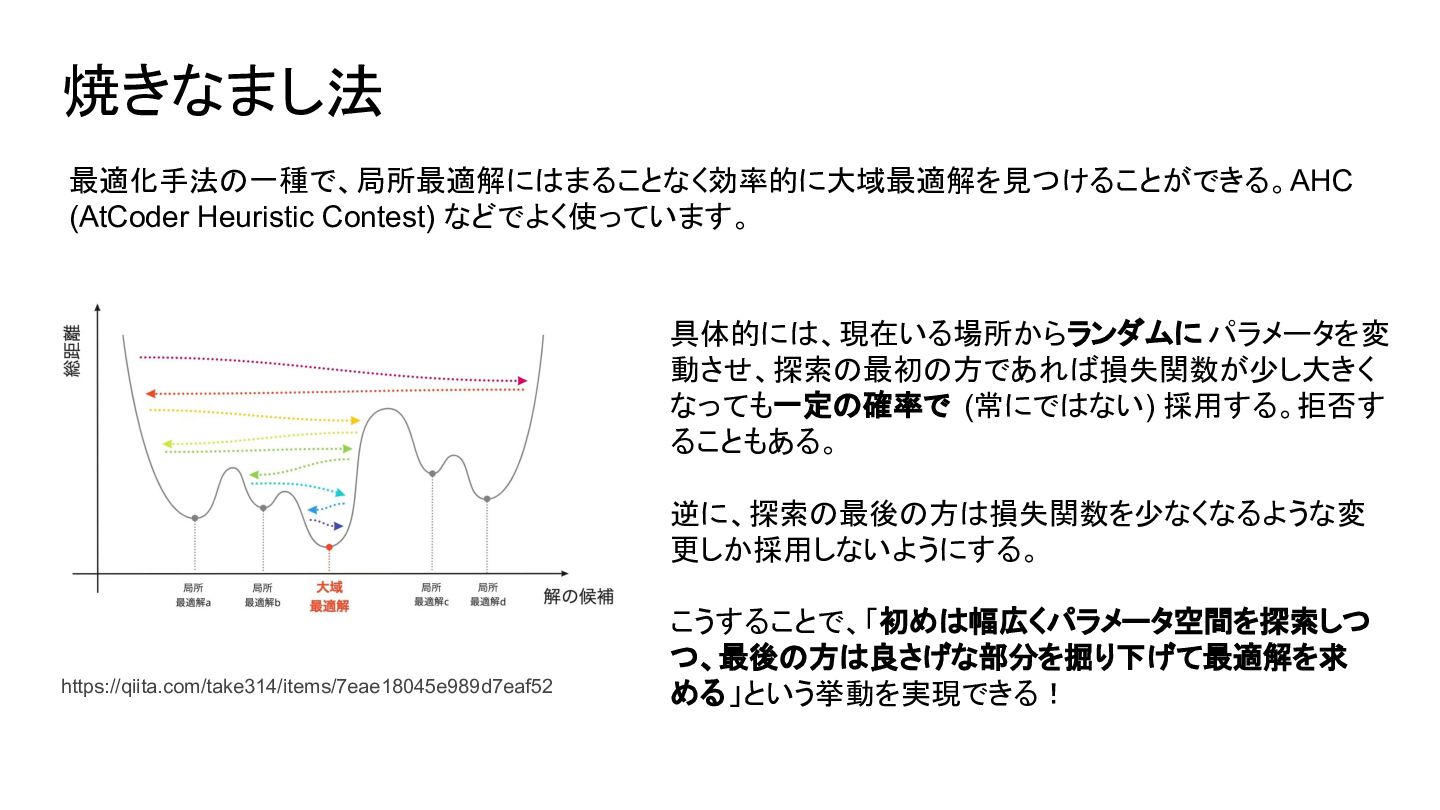
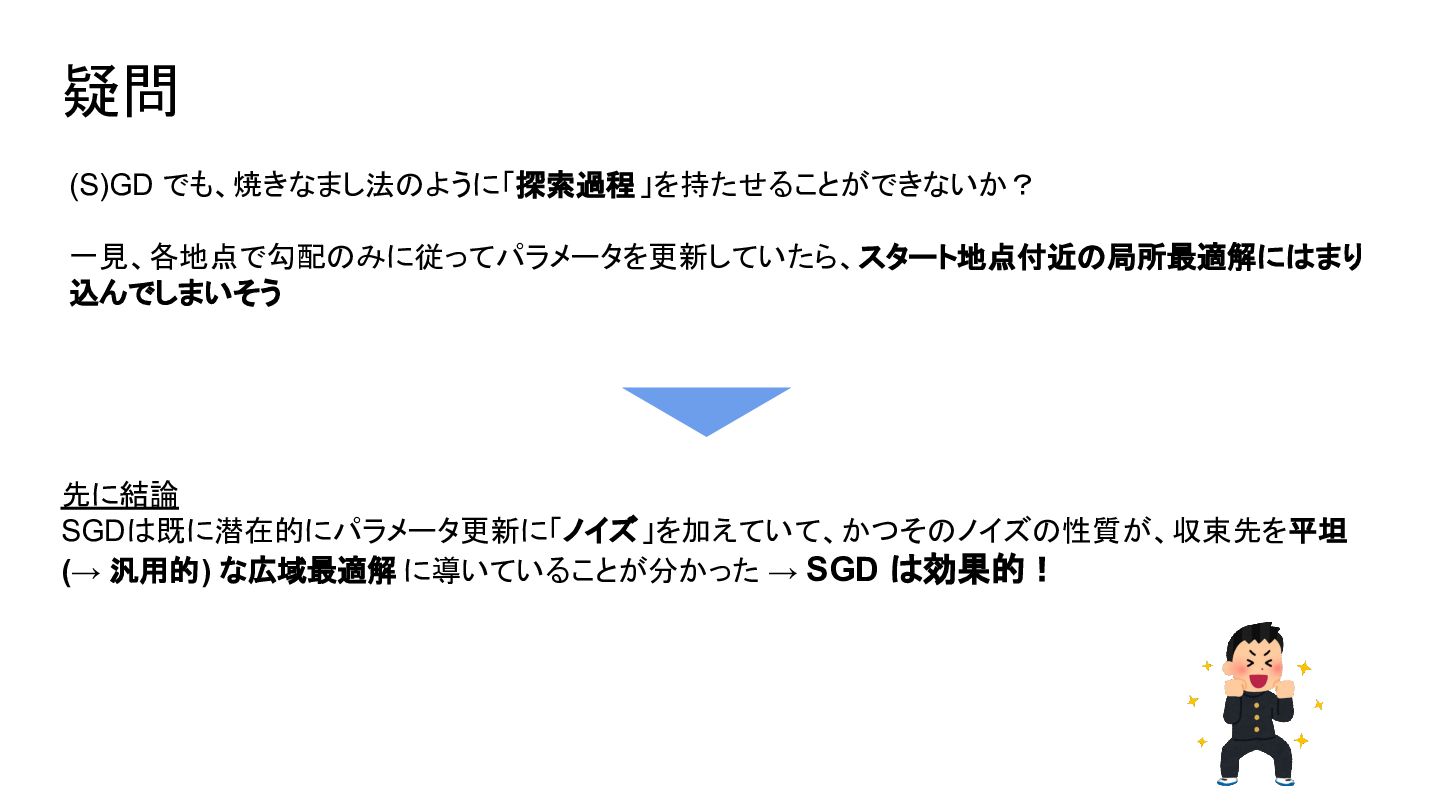
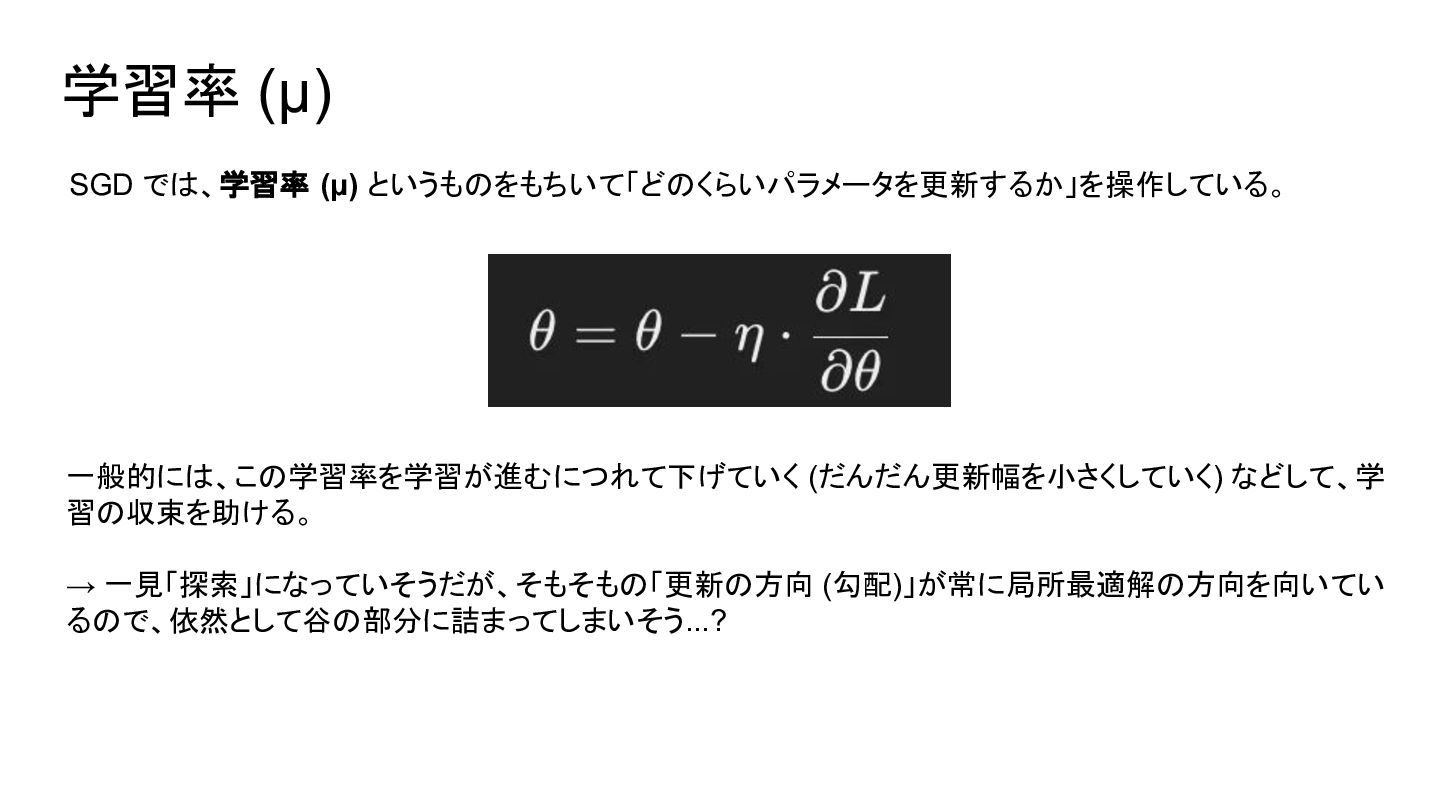
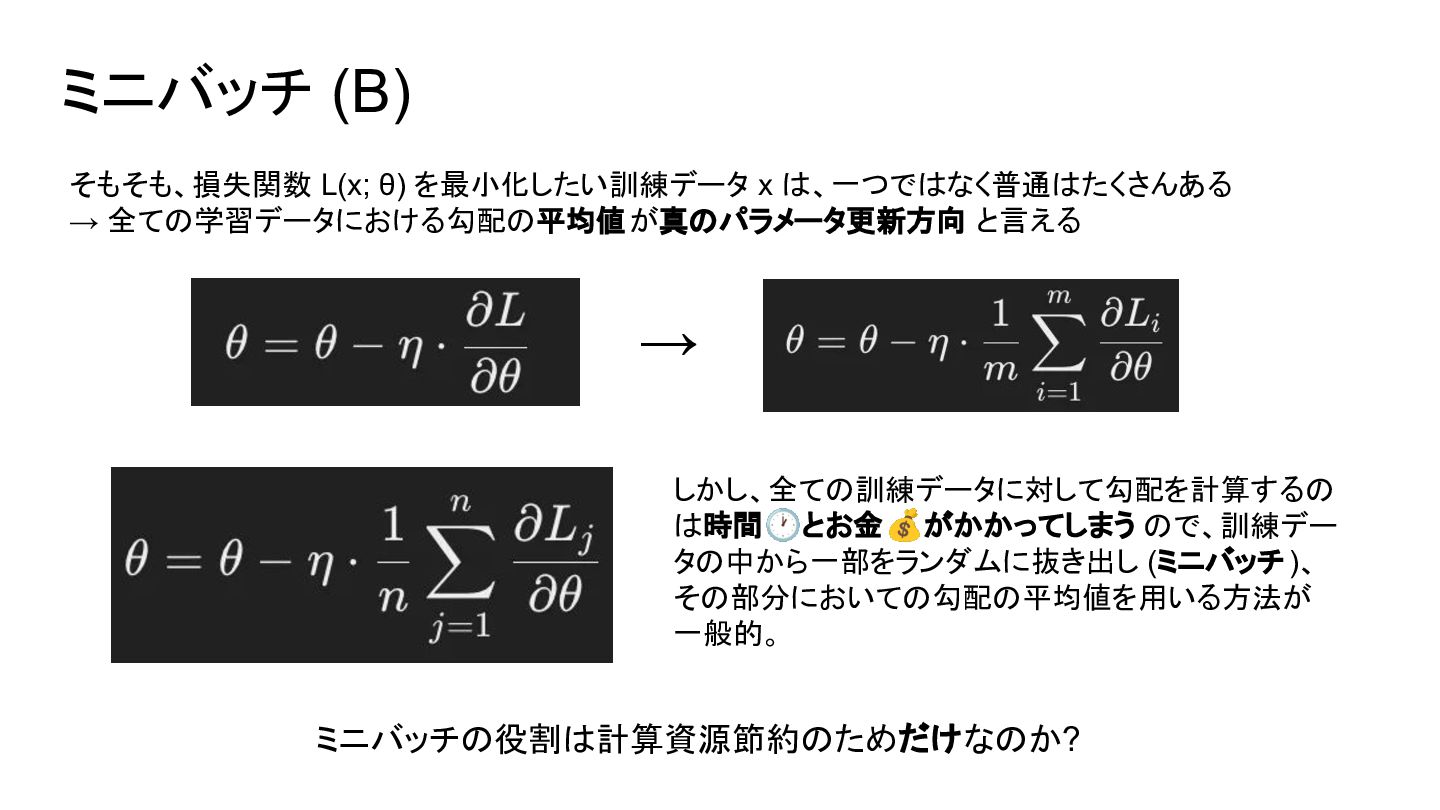
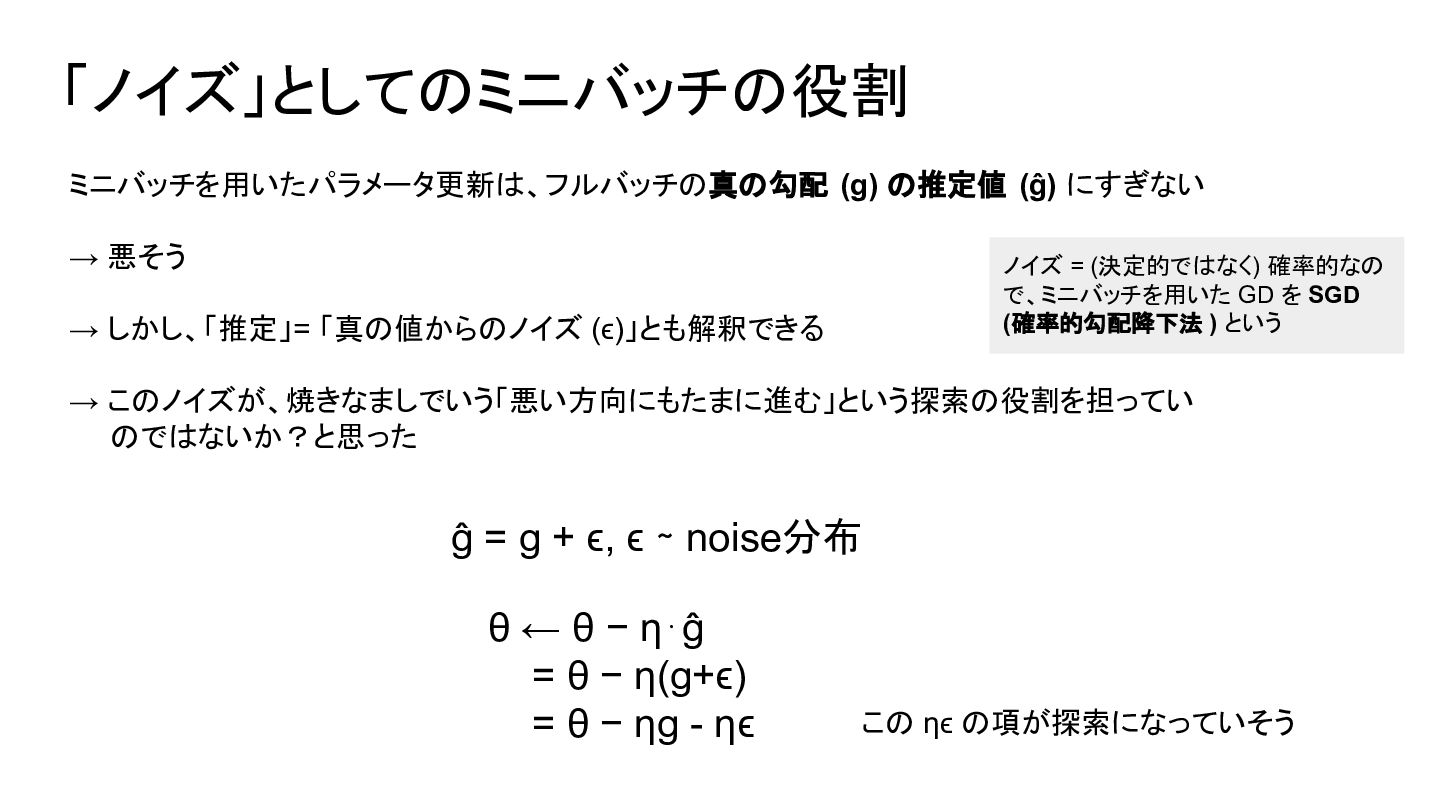
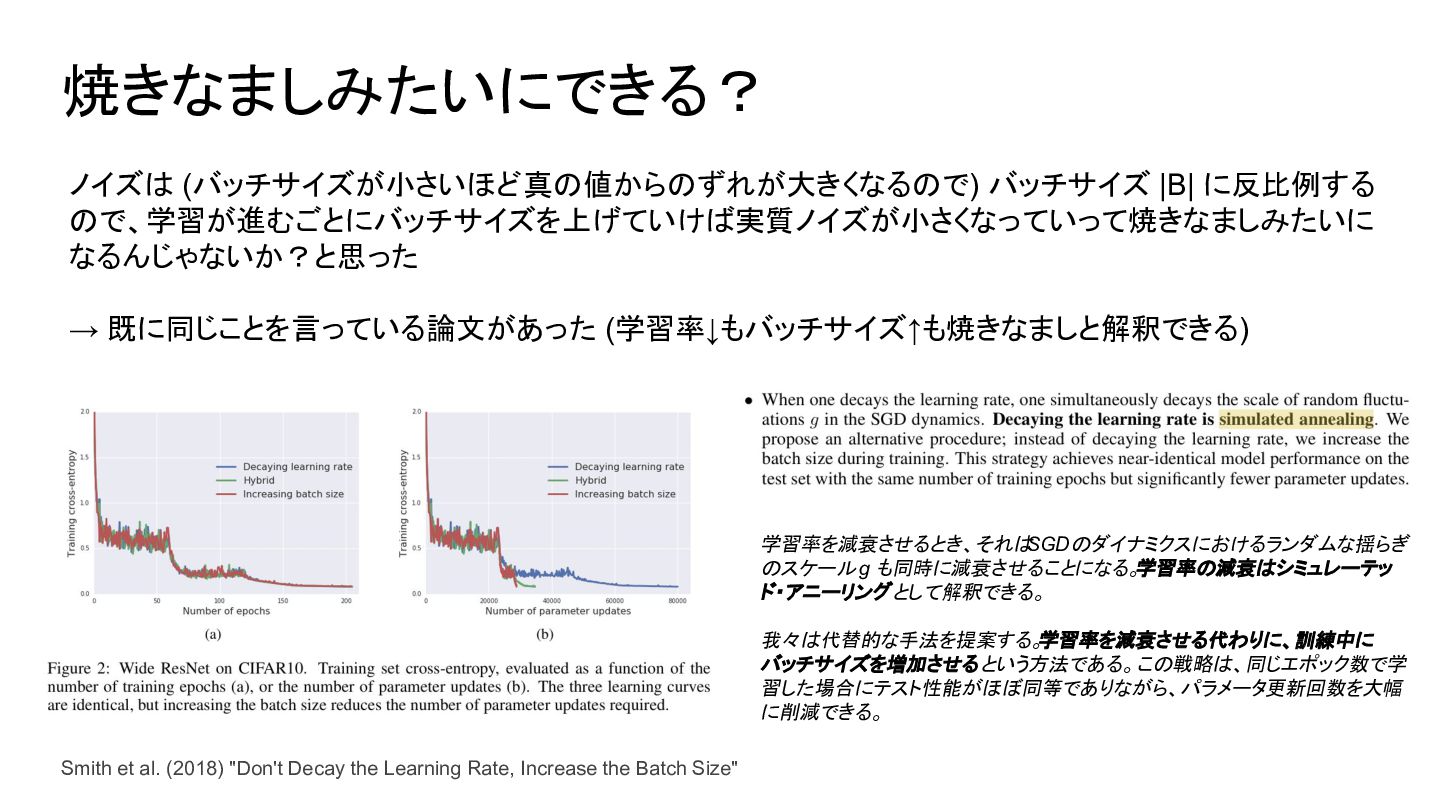
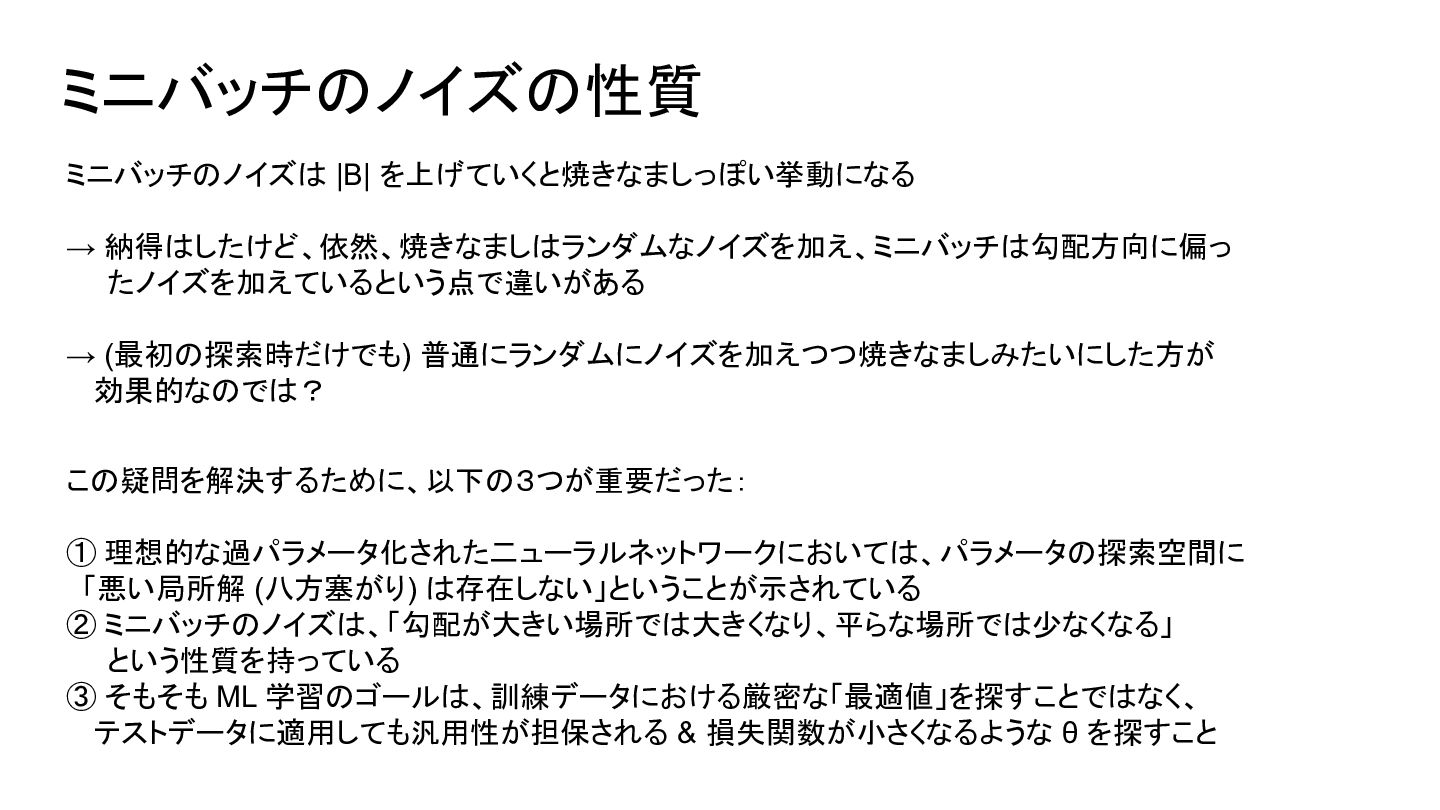
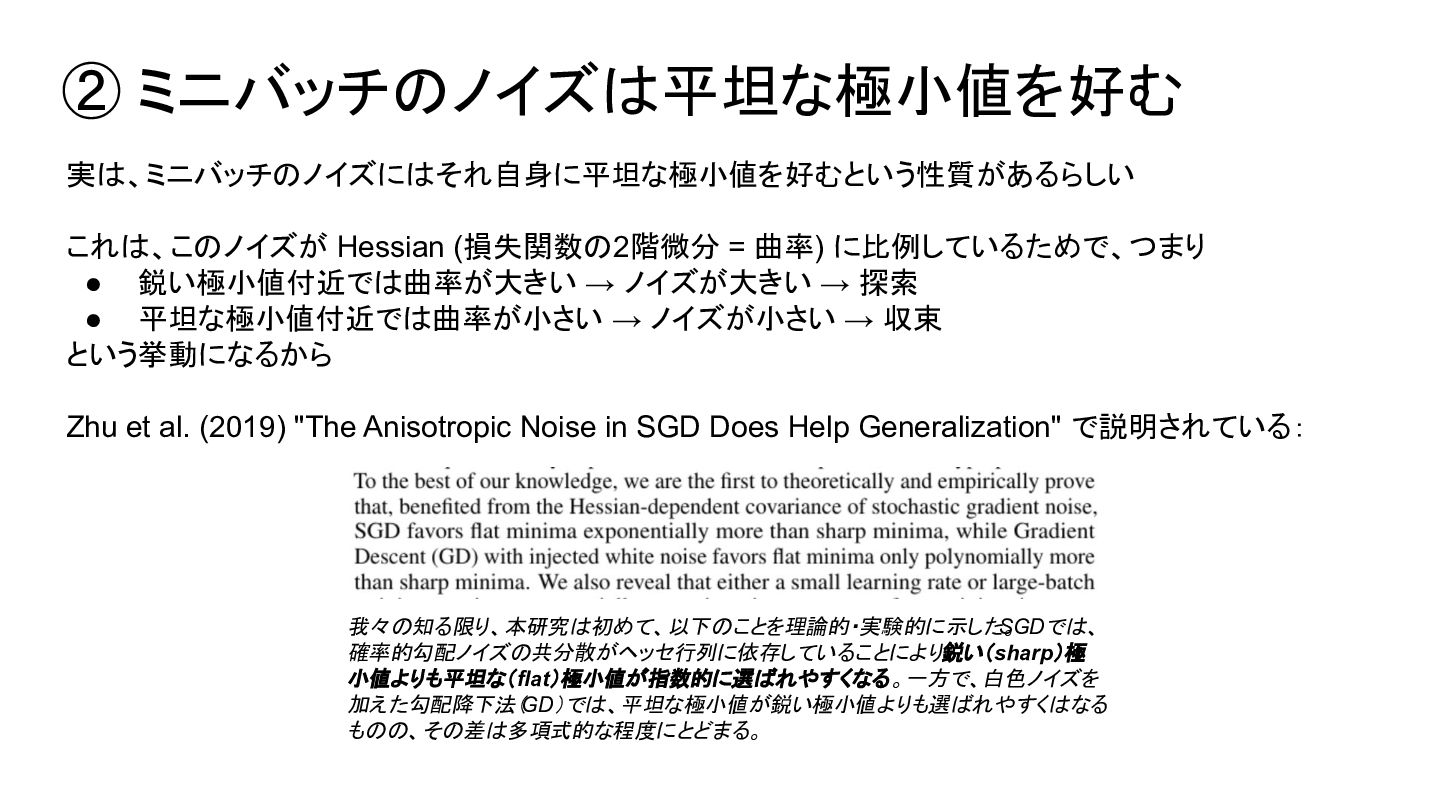
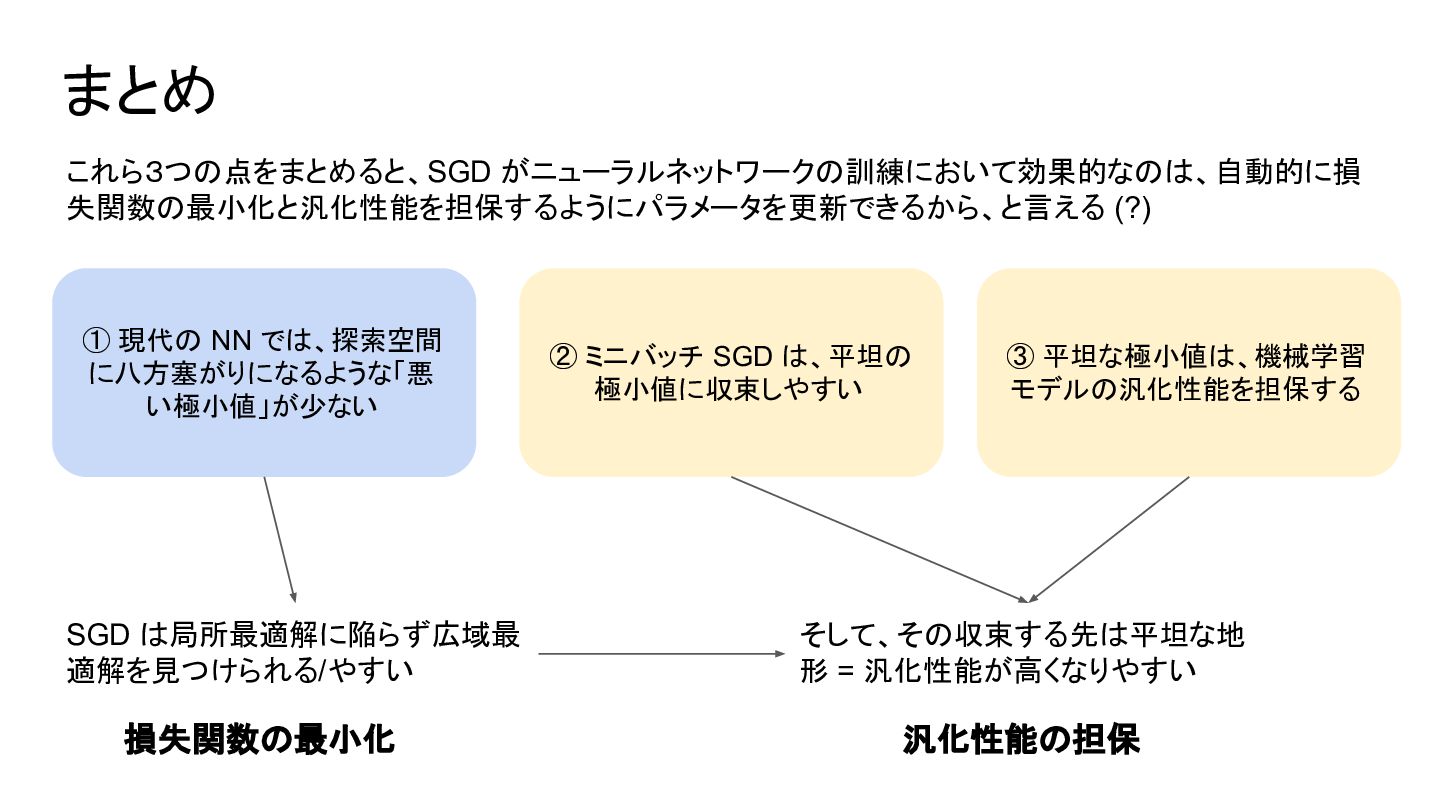
効果的なのでは? この疑問を解決するために、以下の3つが重要だった: ① 理想的な過パラメータ化された二ューラルネットワークにおいては、パラメータの探索空間に 「悪い局所解 (八方塞がり) は存在しない」ということが示されている ② ミニバッチのノイズは、「勾配が大きい場所では大きくなり、平らな場所では少なくなる」 という性質を持っている ③ そもそも ML 学習のゴールは、訓練データにおける厳密な「最適値」を探すことではなく、 テストデータに適用しても汎用性が担保される & 損失関数が小さくなるような θ を探すこと
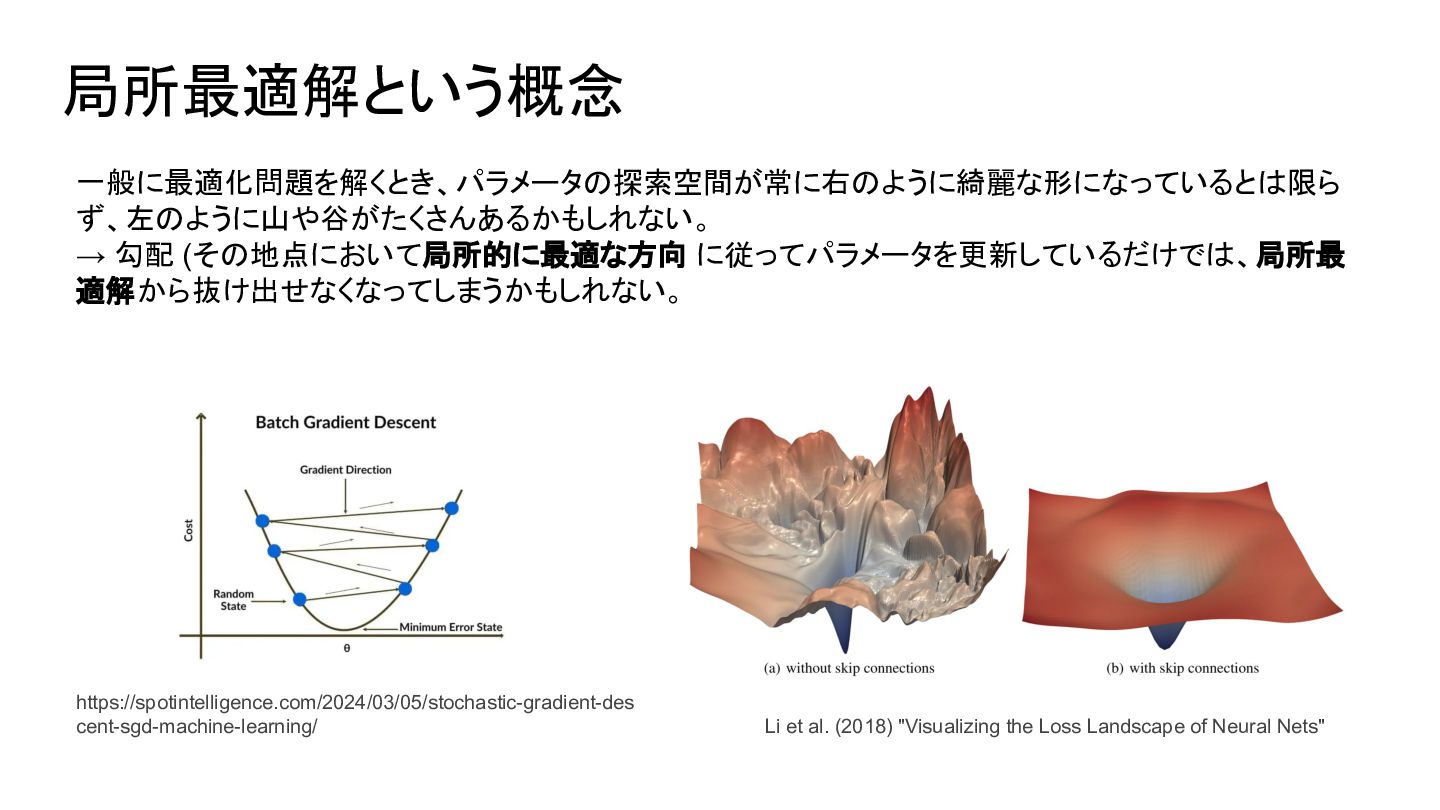
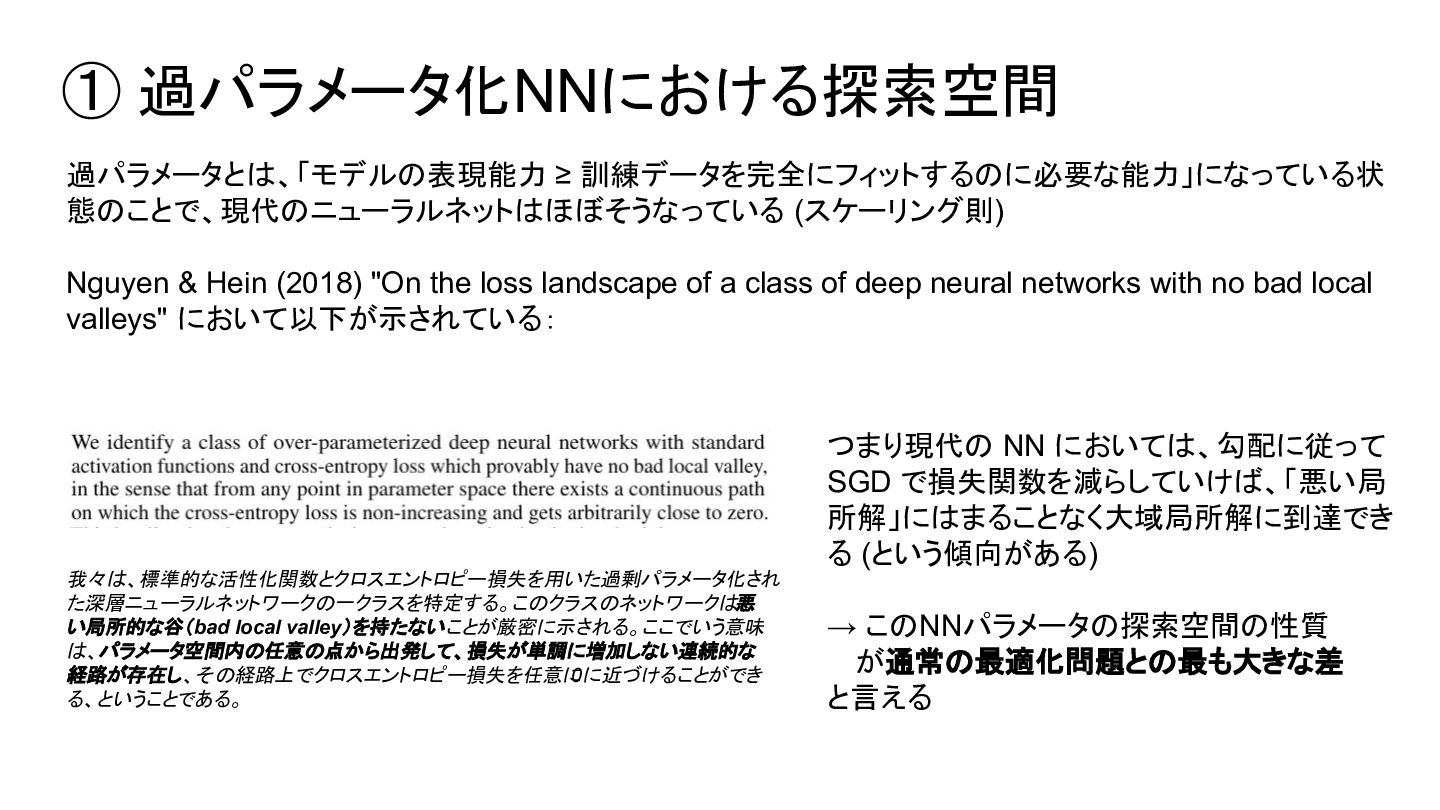
(2018) "On the loss landscape of a class of deep neural networks with no bad local valleys" において以下が示されている: 我々は、標準的な活性化関数とクロスエントロピー損失を用いた過剰パラメータ化され た深層ニューラルネットワークの一クラスを特定する。このクラスのネットワークは、 悪 い局所的な谷(bad local valley)を持たないことが厳密に示される。ここでいう意味 は、パラメータ空間内の任意の点から出発して、損失が単調に増加しない連続的な 経路が存在し、その経路上でクロスエントロピー損失を任意に 0に近づけることができ る、ということである。 つまり現代の NN においては、勾配に従って SGD で損失関数を減らしていけば、「悪い局 所解」にはまることなく大域局所解に到達でき る (という傾向がある) → このNNパラメータの探索空間の性質 が通常の最適化問題との最も大きな差 と言える
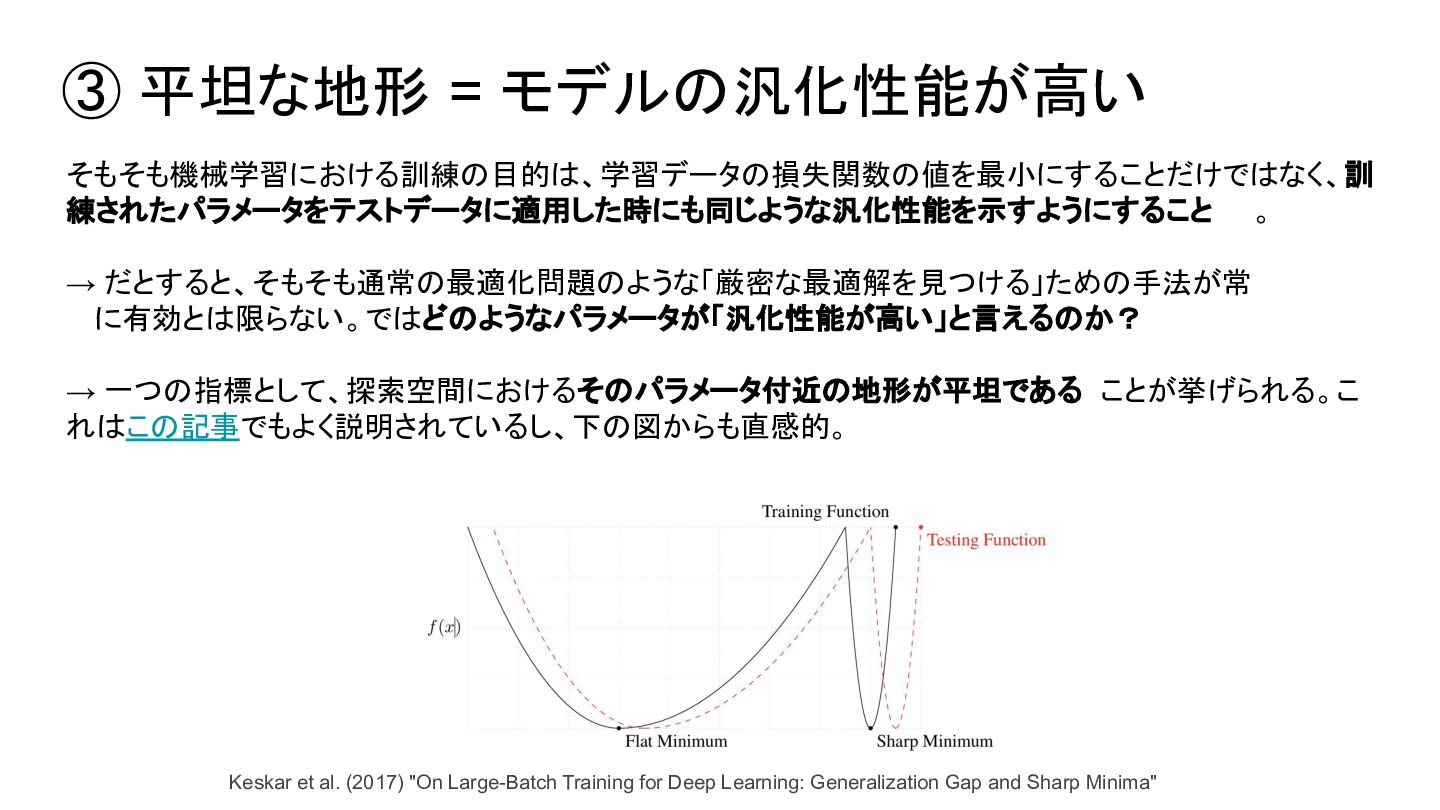
に有効とは限らない。ではどのようなパラメータが「汎化性能が高い」と言えるのか? → 一つの指標として、探索空間におけるそのパラメータ付近の地形が平坦である ことが挙げられる。こ れはこの記事でもよく説明されているし、下の図からも直感的。 Keskar et al. (2017) "On Large-Batch Training for Deep Learning: Generalization Gap and Sharp Minima"


 yasaichi
 texmeijin
 artoy
 takai
 xleitix
 y0hgi
 iwatsukayura
 deka_morita
 panda728
 har1101
 minodriven
 akit37
 baasie
 mkilby
 lara
 jacobian
 schroneko
 marktimemedia
 palkan
 addyosmani
 cargoodrich
 davidcarrasco
 leimatthew05
 pedronauck