train de la SNCF (filiale privée) 4,32 milliards d’euros de VA Présent sur 15 pays en Europe (90 Monde) 83 millions de billets vendus par an (60 % sur mobile) 39 billets vendus par seconde en pic de vente 12 millions de visiteurs uniques par mois Plus de 1000 collaborateurs 2 Data-centers (3500 serveurs, 120 applications en production) 99,997 % de disponibilité demandée, soit 15 minutes par an Esprit startup Monde du web
Debruyne ([email protected]) Responsable du pôle bigdata infrastructure au sein de la direction technique • Parcours DBA OLTP/DWH – ARCHITECTE BIGDATA (17 ans d’expérience dans l’IT) Equipe bimodale : ingénierie (BUILD) et administration (RUN) • Besoin clients : innovation, architecture, automatisation, .. • Accompagnent clients : build/run projets, QOS, SLAS Missions : • Construire un socle technique infra et technos bigdata • Proposer un ensemble de services autour du bigdata • Assurer au global le build/run/mco de ces services Orientation Agile: orientation services/produits Exemple Projets : • Connaissance client / personnalisation • Analyse predictive • Offloading BI • Ingestion IOT
une des sources d’informations majeures pour les équipes d’exploitation et de support. En cas d’incident ou d’analyse, il est nécessaire d’avoir un accès rapide à ces logs Sur quelques serveurs, cela est gérable manuellement et/ou de manière scriptée Dès que nous dépassons plusieurs dizaines de serveurs, cela devient plus compliqué et prend du temps Avec le SI actuel : la virtualisation multiple le nombre de serveurs et/ou d’instances, il convient d’avoir une solution de centralisation Les besoins initiaux Pouvoir accéder aux logs des serveurs à partir d’un point unique et pouvoir chercher dans ces logs sans les recopier en local
toutes les heures Problèmes : Chaque utilisateur copie les logs en totalité sur son poste pour analyse Scalabilité limitée : avec l’évolution du SI, nous n’arrivons plus à copier les logs en moins d’une heure Pas de recherche déportée PREHISTOIRE (200-) CENTRALISATION SUR UN PARTAGE WINDOWS
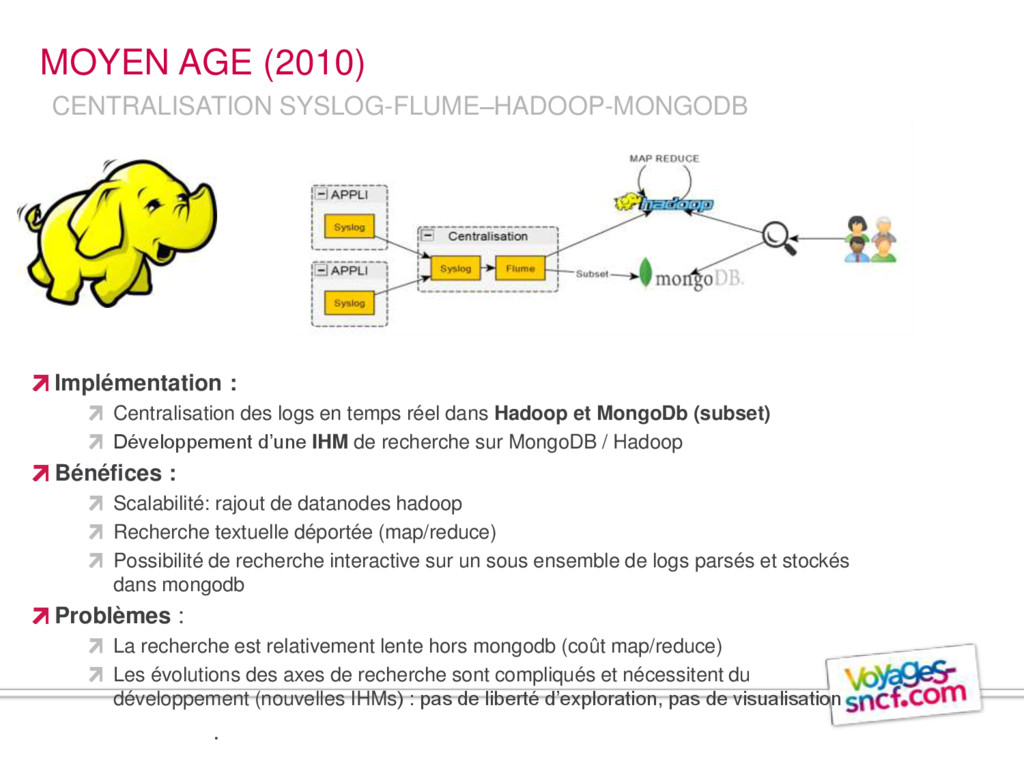
et MongoDb (subset) Développement d’une IHM de recherche sur MongoDB / Hadoop Bénéfices : Scalabilité: rajout de datanodes hadoop Recherche textuelle déportée (map/reduce) Possibilité de recherche interactive sur un sous ensemble de logs parsés et stockés dans mongodb Problèmes : La recherche est relativement lente hors mongodb (coût map/reduce) Les évolutions des axes de recherche sont compliqués et nécessitent du développement (nouvelles IHMs) : pas de liberté d’exploration, pas de visualisation MOYEN AGE (2010) CENTRALISATION SYSLOG-FLUME–HADOOP-MONGODB
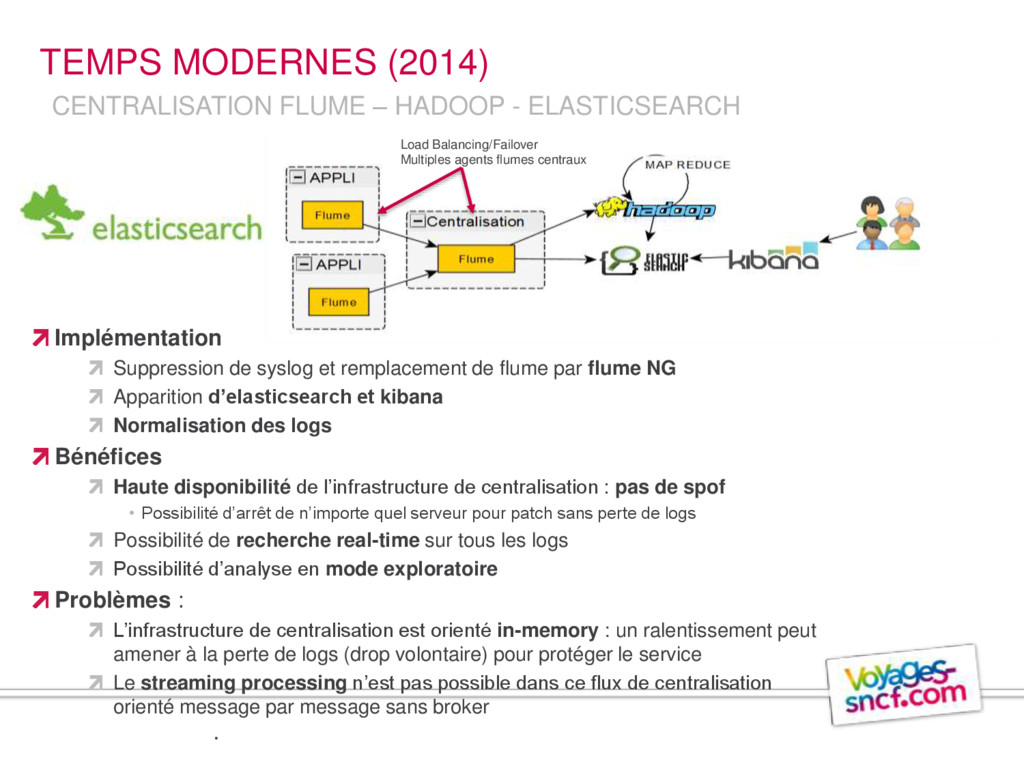
NG Apparition d’elasticsearch et kibana Normalisation des logs Bénéfices Haute disponibilité de l’infrastructure de centralisation : pas de spof • Possibilité d’arrêt de n’importe quel serveur pour patch sans perte de logs Possibilité de recherche real-time sur tous les logs Possibilité d’analyse en mode exploratoire Problèmes : L’infrastructure de centralisation est orienté in-memory : un ralentissement peut amener à la perte de logs (drop volontaire) pour protéger le service Le streaming processing n’est pas possible dans ce flux de centralisation orienté message par message sans broker TEMPS MODERNES (2014) CENTRALISATION FLUME – HADOOP - ELASTICSEARCH Load Balancing/Failover Multiples agents flumes centraux
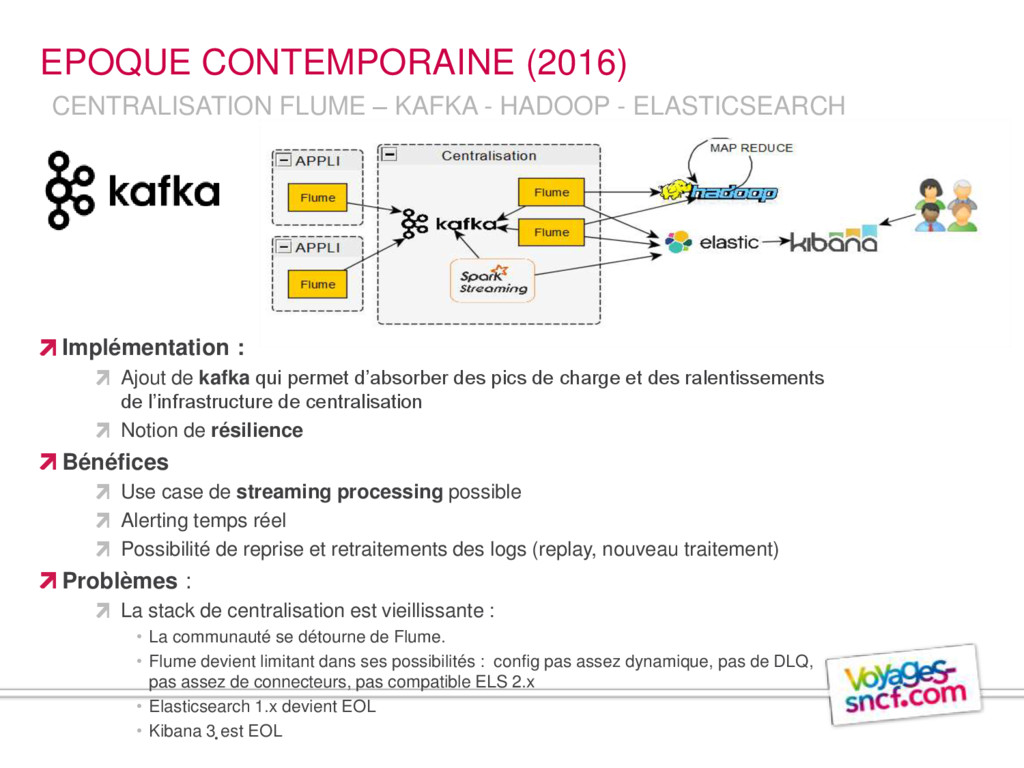
de charge et des ralentissements de l’infrastructure de centralisation Notion de résilience Bénéfices Use case de streaming processing possible Alerting temps réel Possibilité de reprise et retraitements des logs (replay, nouveau traitement) Problèmes : La stack de centralisation est vieillissante : • La communauté se détourne de Flume. • Flume devient limitant dans ses possibilités : config pas assez dynamique, pas de DLQ, pas assez de connecteurs, pas compatible ELS 2.x • Elasticsearch 1.x devient EOL • Kibana 3 est EOL EPOQUE CONTEMPORAINE (2016) CENTRALISATION FLUME – KAFKA - HADOOP - ELASTICSEARCH
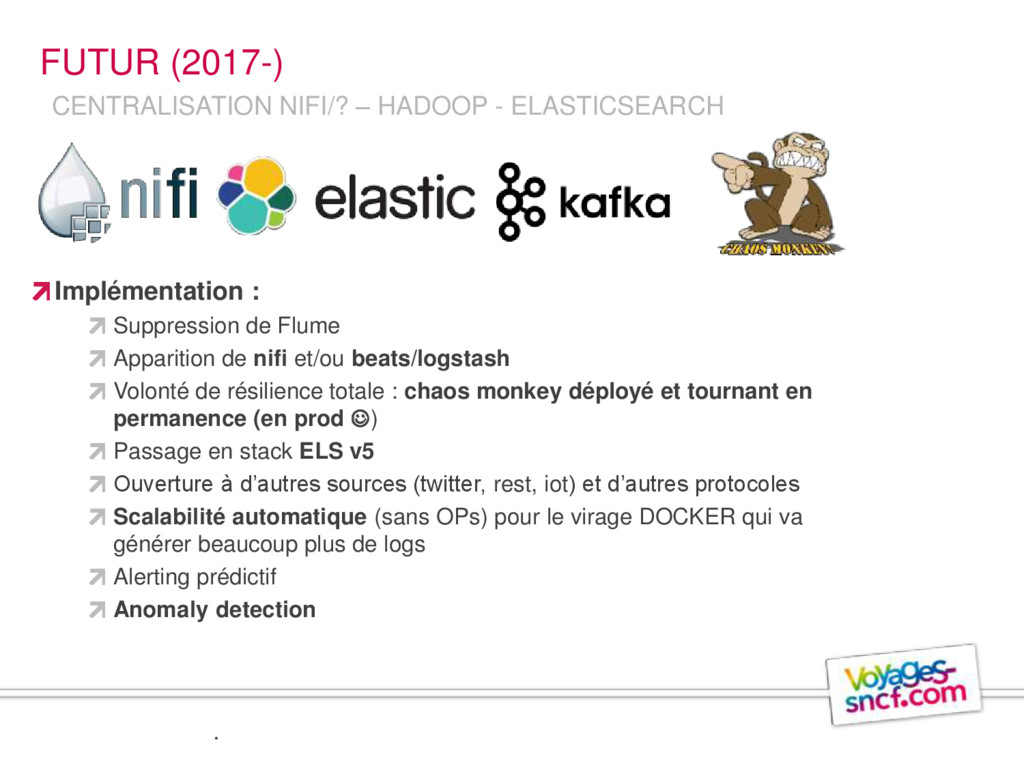
Volonté de résilience totale : chaos monkey déployé et tournant en permanence (en prod ) Passage en stack ELS v5 Ouverture à d’autres sources (twitter, rest, iot) et d’autres protocoles Scalabilité automatique (sans OPs) pour le virage DOCKER qui va générer beaucoup plus de logs Alerting prédictif Anomaly detection FUTUR (2017-) CENTRALISATION NIFI/? – HADOOP - ELASTICSEARCH
des logs applicatifs et techniques de différentes applications/techno implique des actions manuelles et de la config spécifique Différent type de sources : • tail • Syslog • Logger Parser ces logs afin de rendre possible la recherche sur des champs devient très compliqué à assurer : REGEX/GROK MAPPING Incohérence des champs entre applis croisement des logs entre multi-technos compliqués sans normalisation Maintenir ce code de parsing à chaque évolution applicative, chaque changement de version devient un cauchemar et un travail à plein temp
normalisation des logs est la réponse à ces problèmes Librairie interne LOGDORAK disponible pour les principales technos • JAVA , PYTHON , PHP, NODEJS Définition d’un format auto-descriptif (JSON like) pour les autres technos : • APACHE, NGINX, HAPROXY Ces formats sont extensibles par les projets de manière autonome Plus de parsing dans la chaine de centralisation, pas de regex/grok à maintenir Harmonisation du nommage des champs au global Référentiel disponible Possibilité pour les métiers d’étendre dynamiquement cette norme Utilisation de protocole binaire de sérialisation AVRO – THRIFT • Plus de performances • Pas de limitations de taille • Schéma évolutif
chaque message Pour les messages dédiés à ELS, nous avons des headers pour le nom d’index, la version du schéma/mapping, la rétention, … Les applications peuvent chacune avoir un index (timestampé) dédié: Fonction de la volumétrie, accès ou de spécificité de schéma Importance du log, priorité Rotation daily, weekly, monthly, none (performance) Les indexs ne sont jamais attaqués directement par kibana ou les appels RESTS Il n’y a que Flume qui alimente les indexs AUTOMATISATION AU MAXIMUM
les indexs Les Ops peuvent travailler de manière transparente (réindexation online possible) Masque les indexs utilisés (simplicité, sécurité) Optimize, Clôture et purge automatique des indexs (curator) en fonction des spécificités IHM disponible pour les projets afin de pouvoir réouvrir les indexs « closed » Tiering des indexs (hot,warm,cold) sur différents types de serveurs en fonction de leur ancienneté Snapshots automatique (backup) avec curator AUTOMATISATION AU MAXIMUM
chaque application Chaque équipe adapte en fonction de ses besoins Autonomie pour voir les logs de tous les environnements (si pas de problème de sécurité) Envoi de toutes les métriques techniques dans GRAPHITE (time series) avec alerting sur les métriques les plus pertinentes : Statut cluster, nb nodes, pool thread, cpu, heap, docs/s, indexing time, … AUTOMATISATION AU MAXIMUM
déploiement (module puppet) Ready out of the box (commence à changer avec la v5) Scalabilité linéaire : •On rajoute des serveurs et les données se répartissent automatiquement Haute disponibilité native Possibilité d’avoir des serveurs dédiés pour certains indexs (Très) performant si bien utilisé Evolutions rapides Grosse communauté active (>25K commits github) Documentation exhaustive et bien structurée
un peu jeune au niveau productivité : nécessité de plugins (kopf) ou de script shells Pas d’isolation réelle des ressources La gestion de la mémoire (heap) est délicate même avec les doc_values Des problèmes de stabilité : haute disponibilité toujours en cours d’amélioration Ne peut être un primary datastore : voir @aphyr (aka Kyle Kingsbury) Kibana 4 casse la compatibilité des dashboards créés en Kibana 3 • La migration vers ELS 2.x/5.x est bloquée à cause de cela
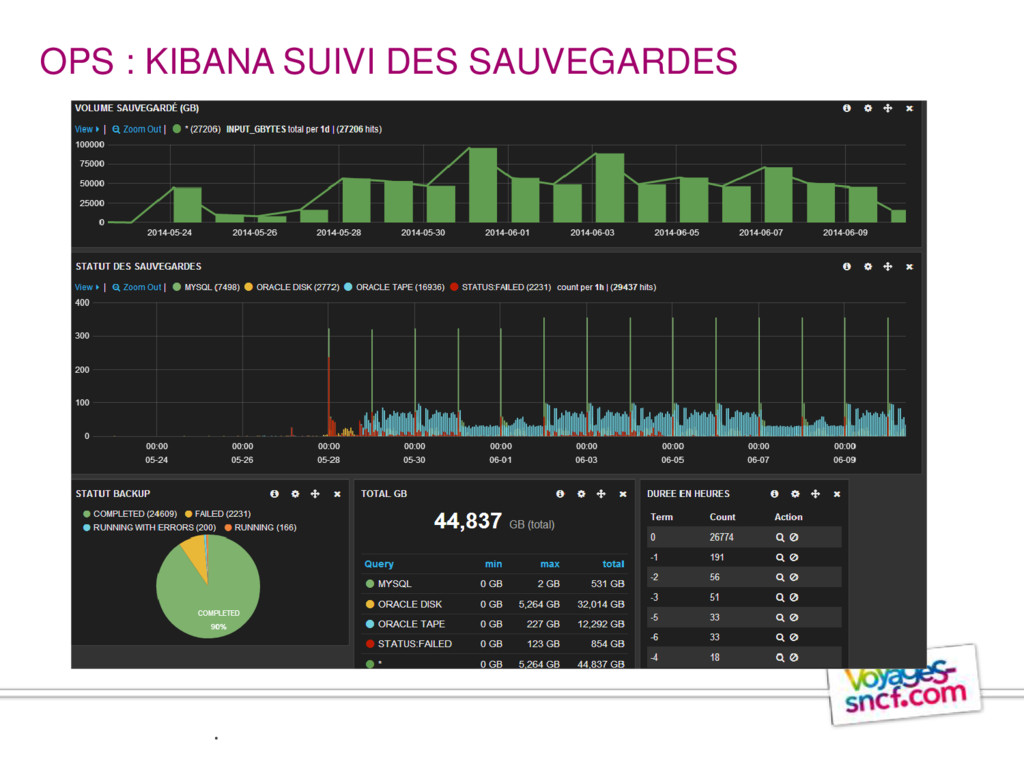
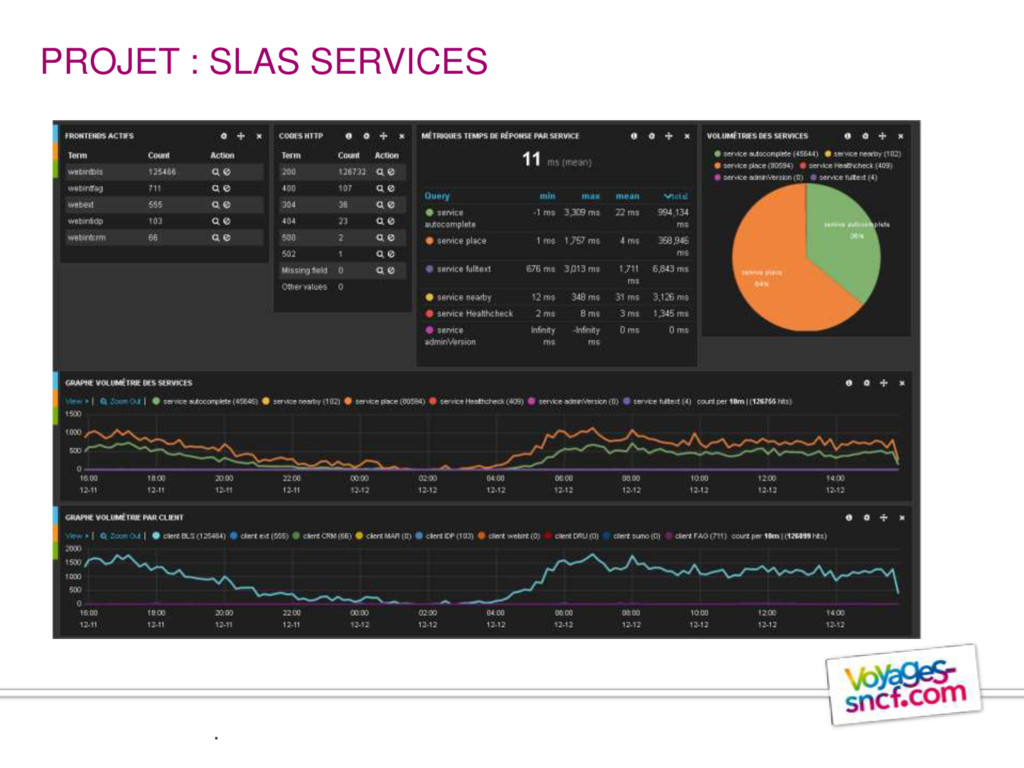
en temps réel et la recherche est instantanée / interactive KIBANA a libéré les usages sur la manipulation de ces logs : Formation de plus de 100 personnes à KIBANA en interne Différentes utilisations par utilisateurs : Développeurs: suivi bugs, comportements Intégrateurs : suivi de l’indus, des déploiements Exploitation (Ops, support 1-3) : suivi technique Chef de projets, MOA, MOE : suivi métier Direction : suivi global, pilotage
sous différents axes techniques et métiers : la centralisation des logs est devenue un asset indispensable. KIBANA est utilisé quotidiennement par plus d’une centaine de personnes et des télés affichent en permanence des dashboards
physiques Nombre de projets centralisés Plus de 50 projets en production utilisent ELS/KIBANA pour le suivi Volumétrie +2 milliards documents / jour 1,2 To / jour => 2,5 To avec réplication x2 Dashboards kibana 500 dashboards dont une centaine accédée quotidiennement
demand (Elastalert) Analytique premier niveau accessible à tout le monde Anti-scraping Autres usages Auto-complétion • Exemple : recherche de gares Geo IP • Exemple : affichage en fonction de la localisation mobile Search A venir As a Service : auto-provisioning


 odashi
 teamlab
 greenmidori
 occhi
 rfdnxbro
 minorun365
 finengine
 namiki64
 tetsuya28
 daidaidai
 puhitaku
 shuta13
 chrisshort
 lynnandtonic
 yeseniaperezcruz
 addyosmani
 mza
 coloredviolet
 danielanewman
 popppiees
 mfonobong
 retrage
 takai
 konakalab