Upgrade to Pro — share decks privately, control downloads, hide ads and more …

AIコーディング入門講座【発展編】AI研究の動向と研究開発への応用:チームにAIを迎えよう

Avatar for Mai Nishimura Mai Nishimura
September 19, 2026
10

 AIコーディング入門講座【発展編】AI研究の動向と研究開発への応用:チームにAIを迎えよう

東京大学メタバース工学部リスキリング講座プログラム AIコーディングコーディング入門講座 第5回の担当内容です。
https://www.meta-school.t.u-tokyo.ac.jp/reskilling/aic2605/

Avatar for Mai Nishimura

Mai Nishimura

September 19, 2026

Transcript

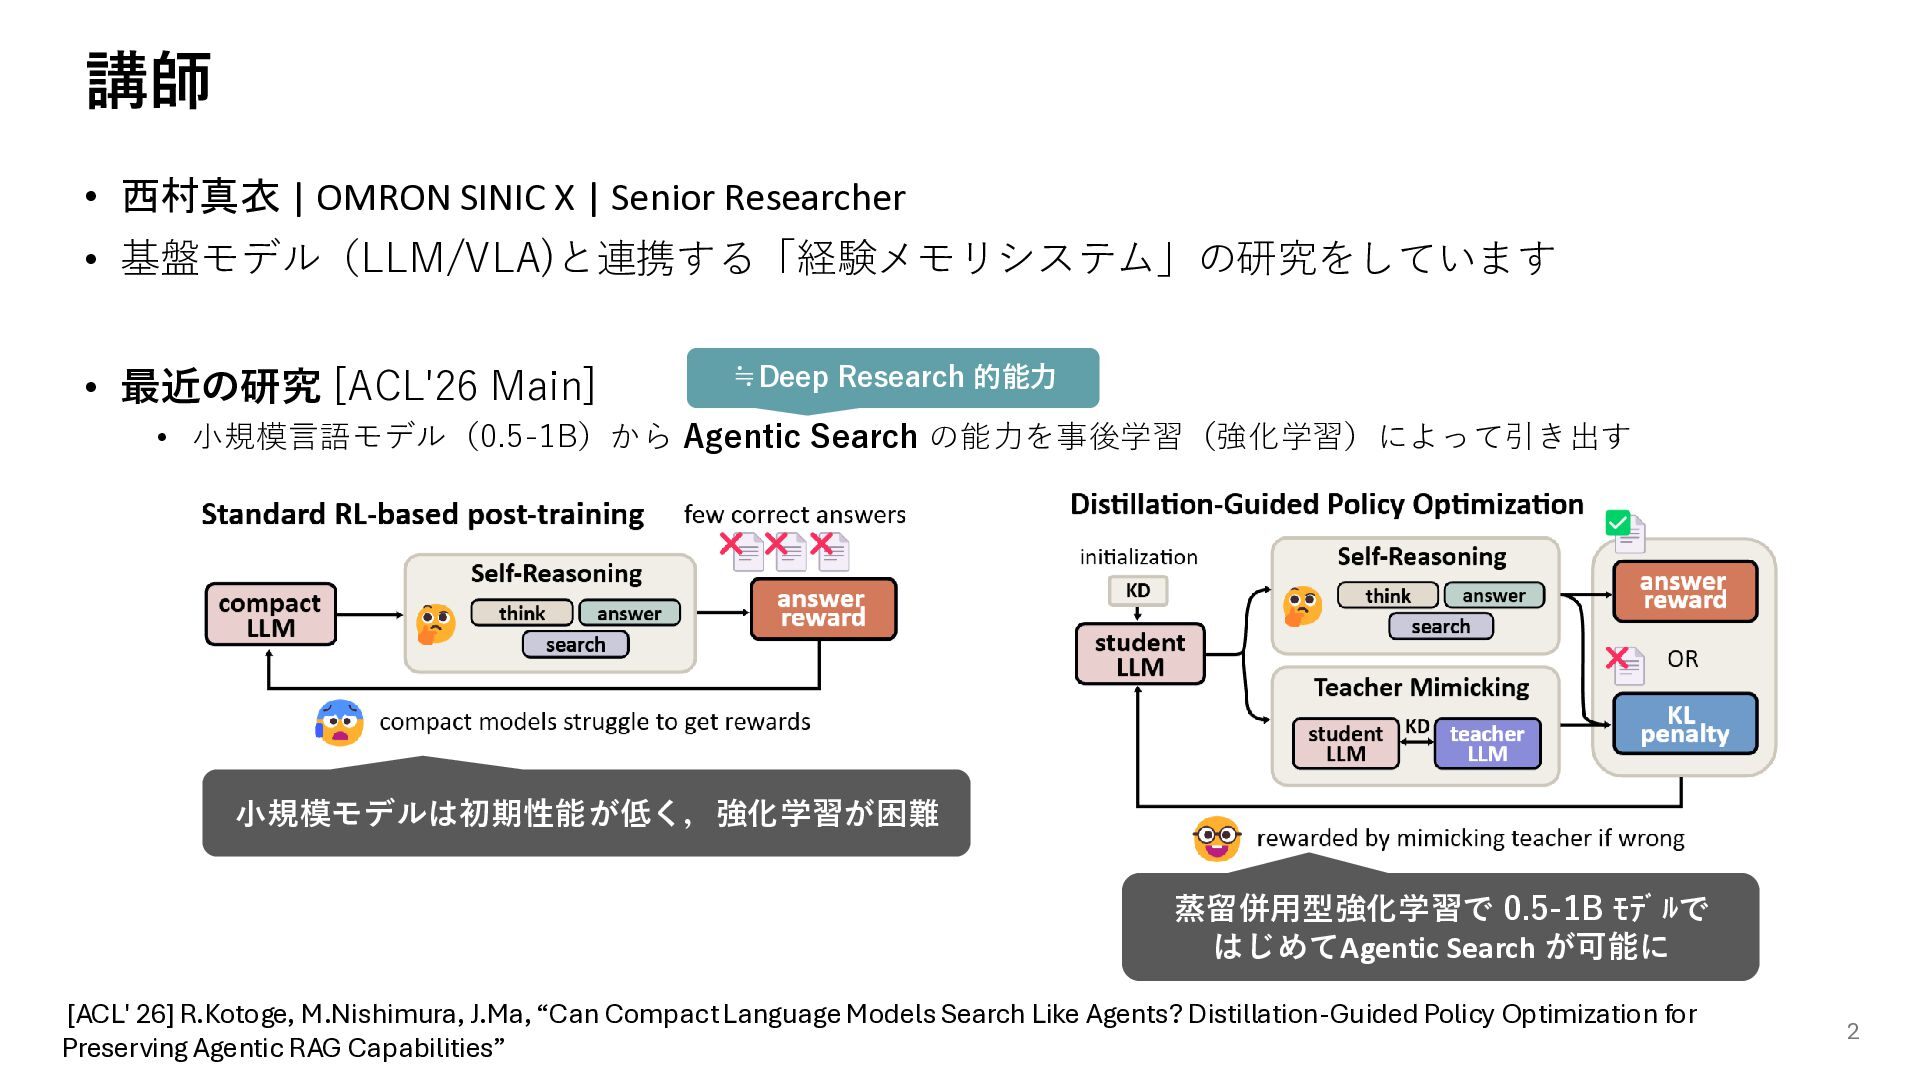
  1. 講師 • 西村真衣 | OMRON SINIC X | Senior Researcher

    • 基盤モデル(LLM/VLA)と連携する「経験メモリシステム」の研究をしています • 最近の研究 [ACL'26 Main] ≒Deep Research 的能力 • 小規模言語モデル(0.5-1B)から Agentic Search の能力を事後学習(強化学習)によって引き出す 小規模モデルは初期性能が低く,強化学習が困難 蒸留併用型強化学習で 0.5-1B モデルで はじめてAgentic Search が可能に [ACL' 26] R.Kotoge, M.Nishimura, J.Ma, “Can Compact Language Models Search Like Agents? Distillation-Guided Policy Optimization for Preserving Agentic RAG Capabilities” 2
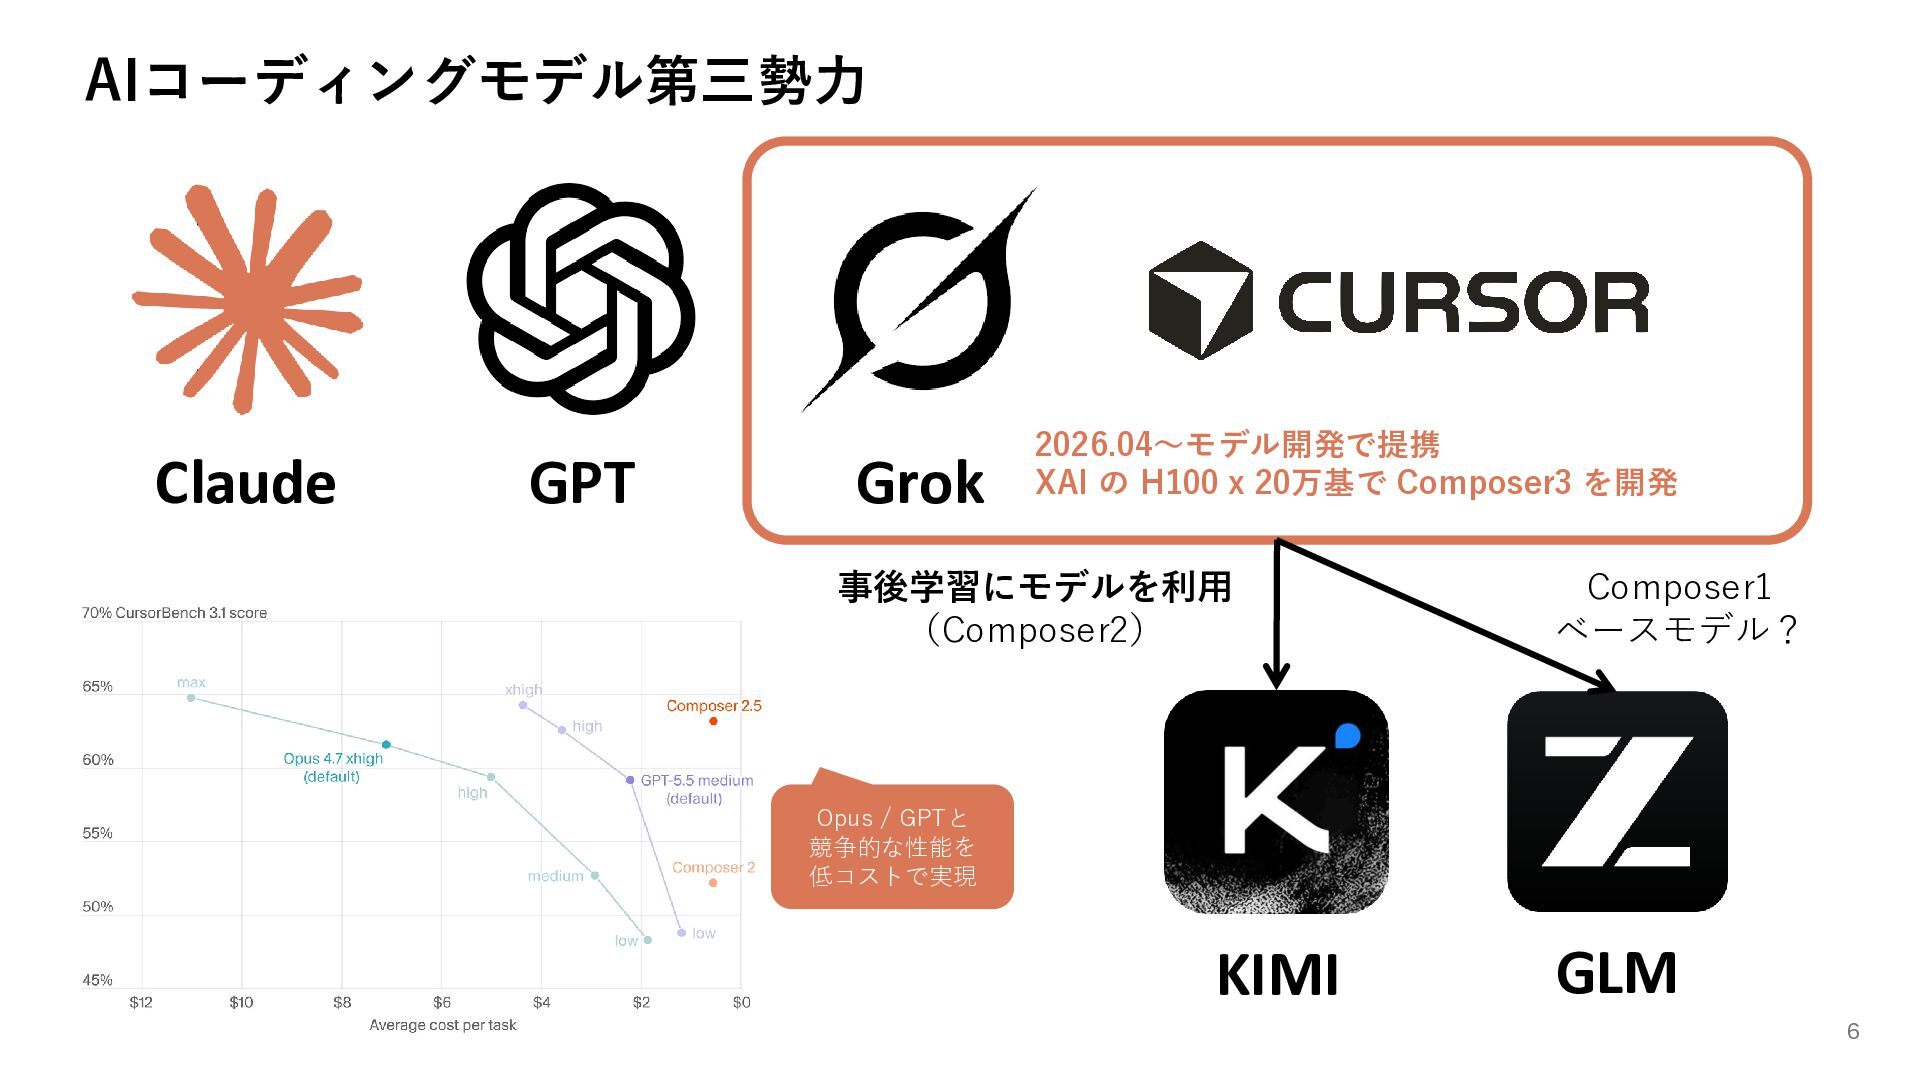
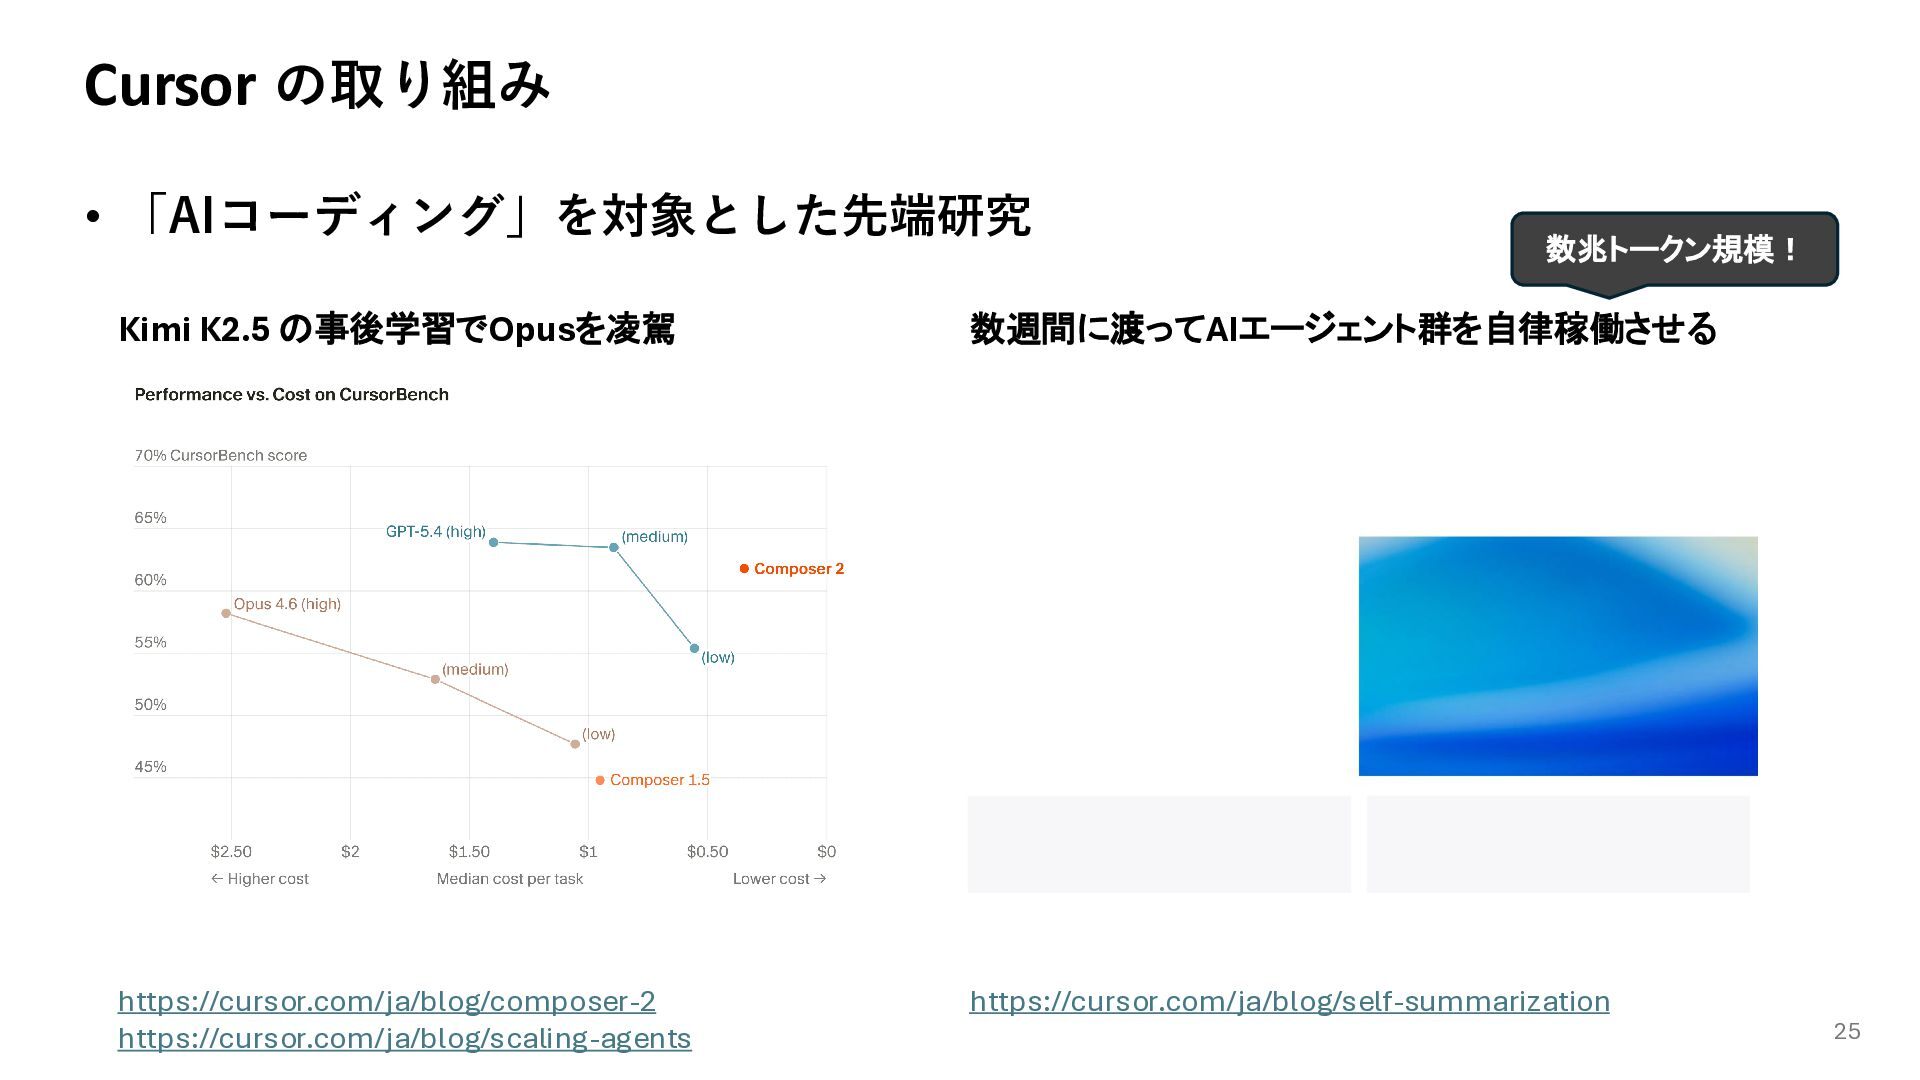
  2. AIコーディングモデル第三勢力 Claude GPT Grok 2026.04~モデル開発で提携 XAI の H100 x 20万基で

    Composer3 を開発 事後学習にモデルを利用 (Composer2) Composer1 ベースモデル? Opus / GPTと 競争的な性能を 低コストで実現 KIMI GLM 6
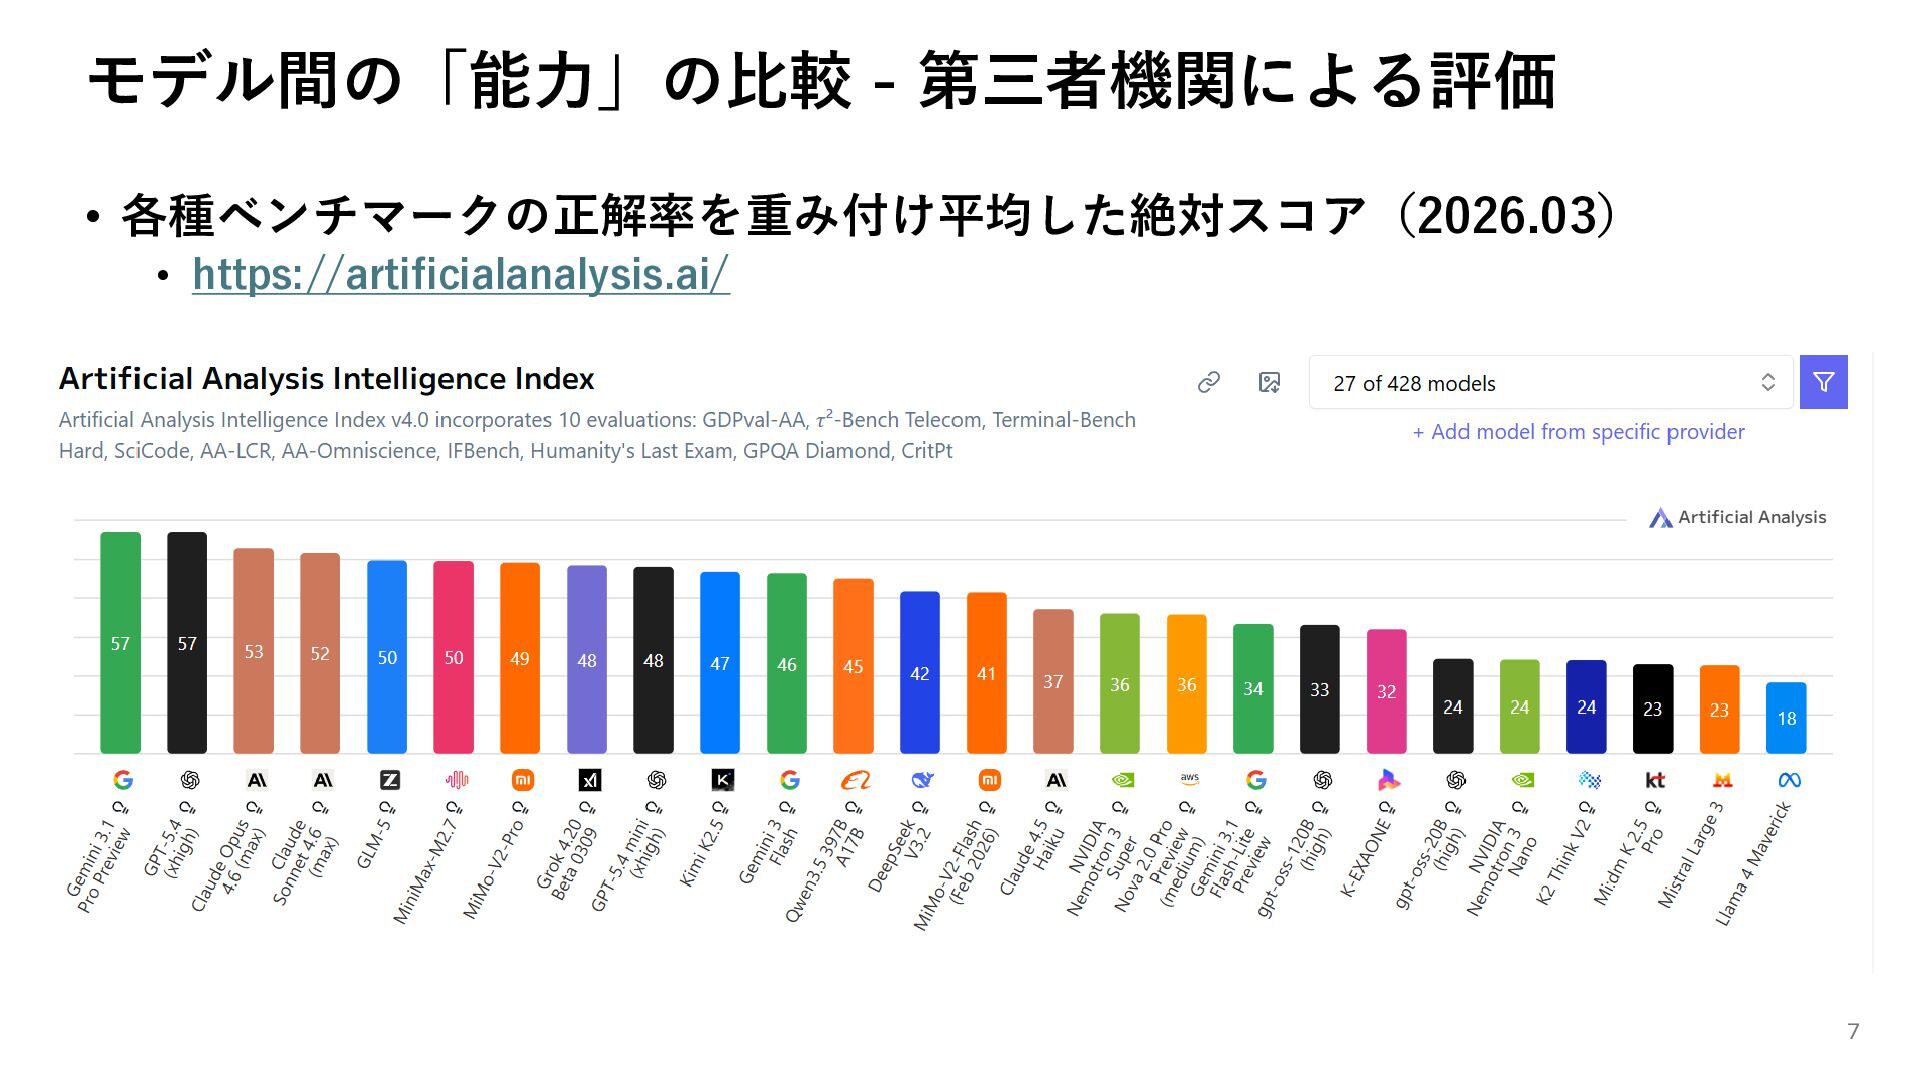
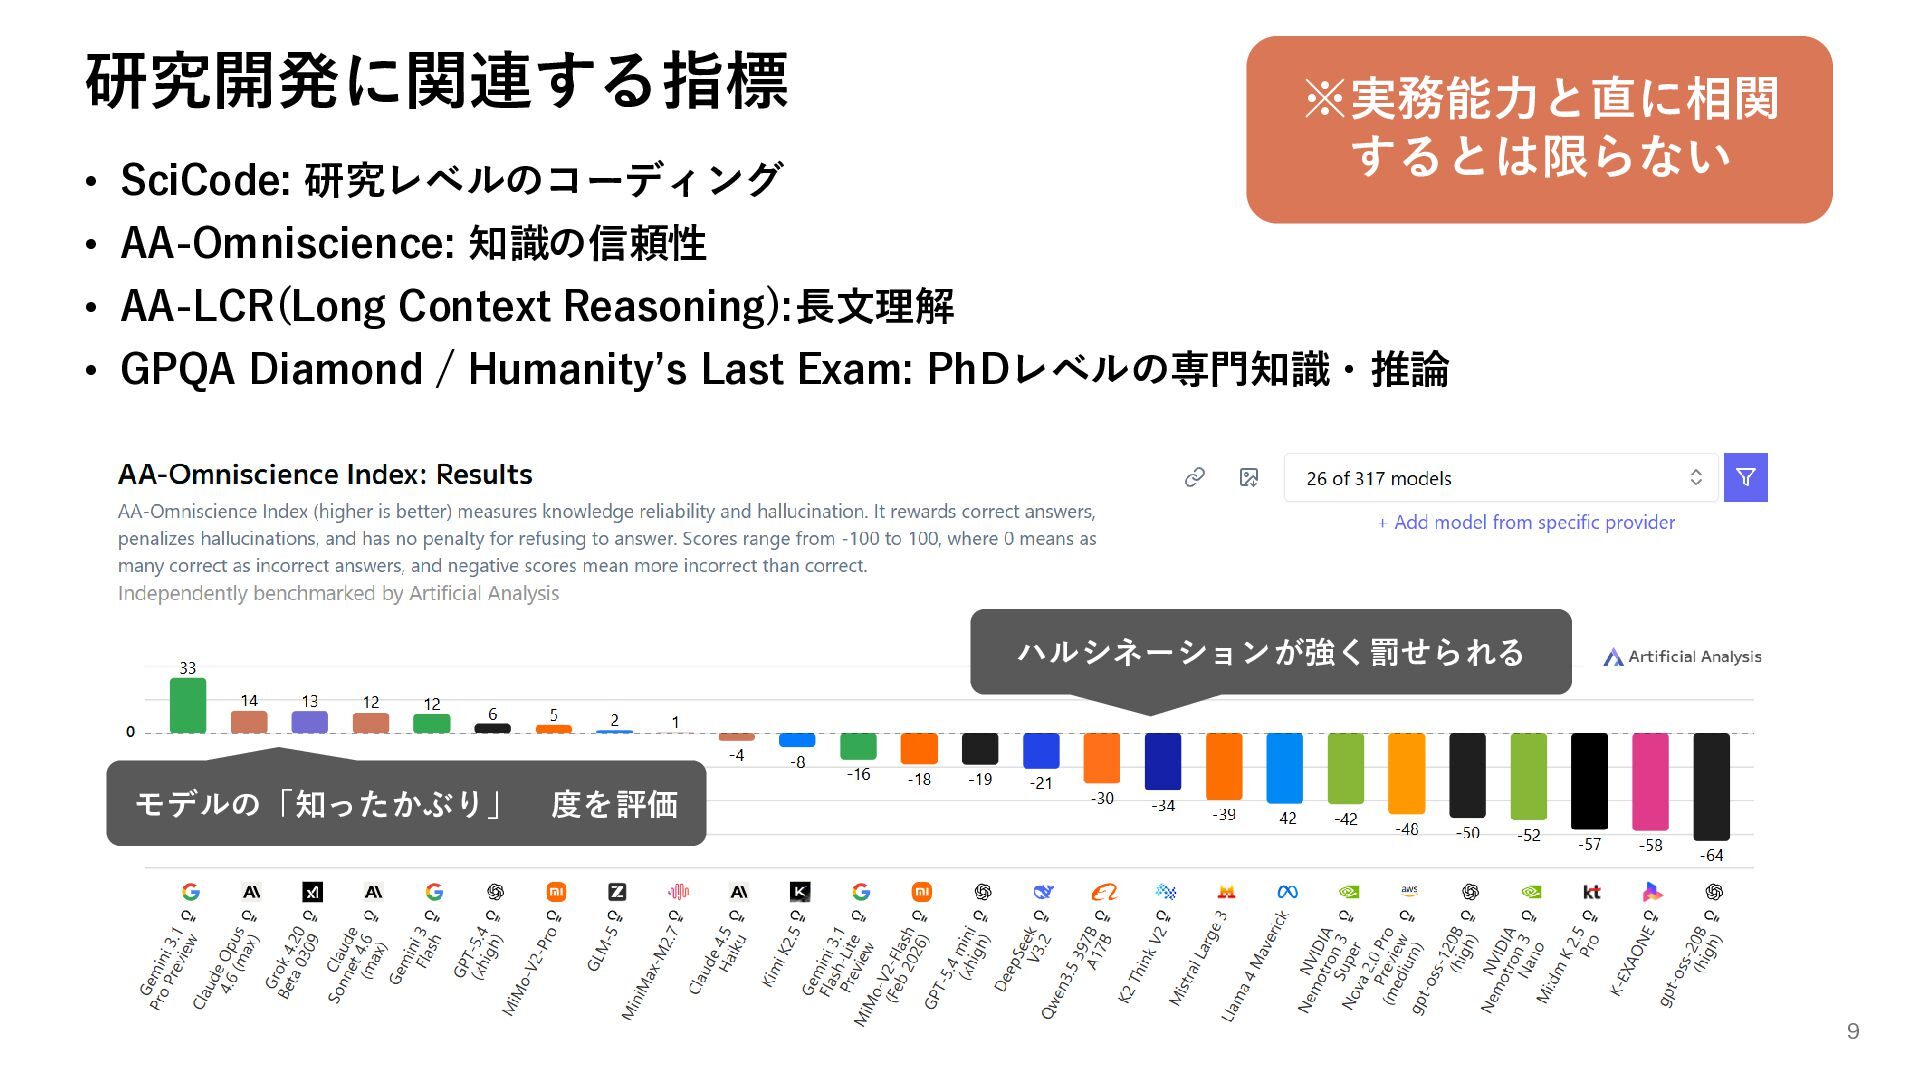
  3. 研究開発に関連する指標 • SciCode: 研究レベルのコーディング ※実務能力と直に相関 するとは限らない • AA-Omniscience: 知識の信頼性 •

    AA-LCR(Long Context Reasoning):長文理解 • GPQA Diamond / Humanity’s Last Exam: PhDレベルの専門知識・推論 ハルシネーションが強く罰せられる モデルの「知ったかぶり」 度を評価 9
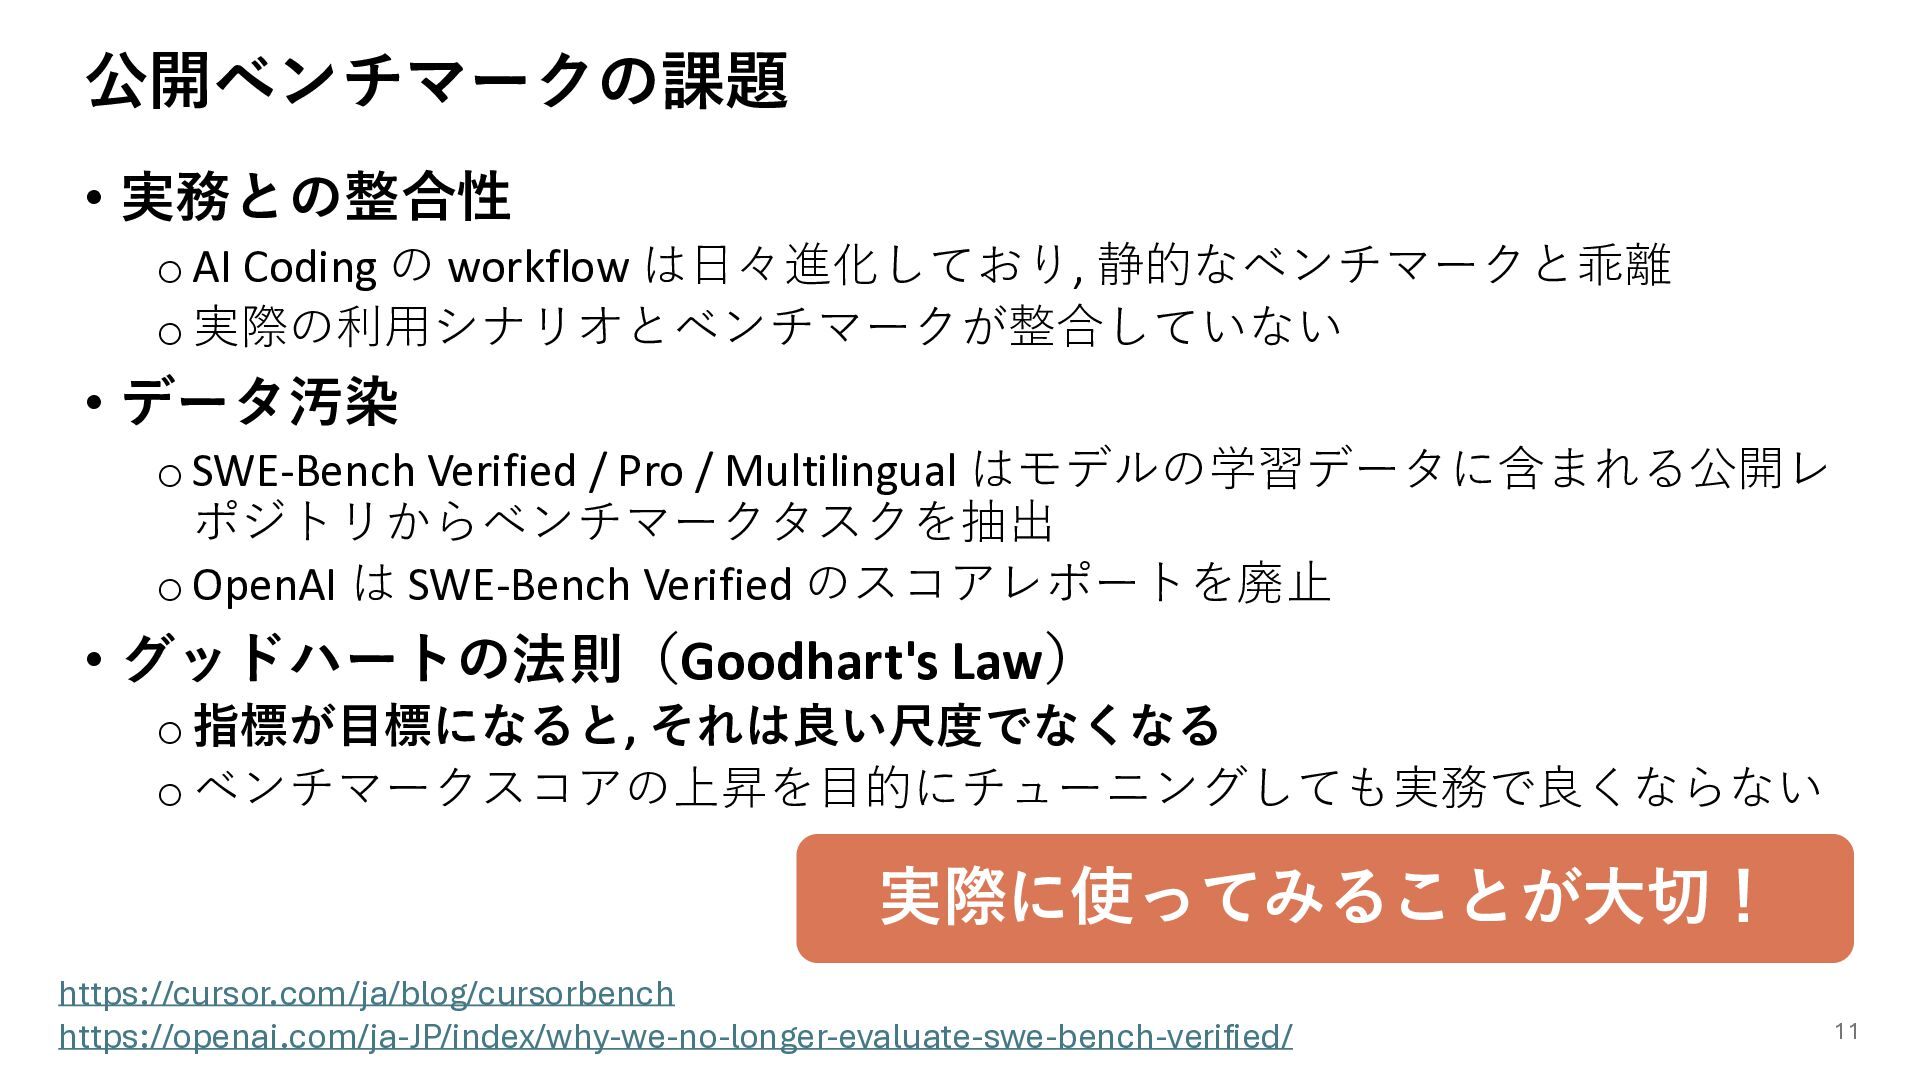
  4. 公開ベンチマークの課題 • 実務との整合性 o AI Coding の workflow は日々進化しており, 静的なベンチマークと乖離

    o 実際の利用シナリオとベンチマークが整合していない • データ汚染 o SWE-Bench Verified / Pro / Multilingual はモデルの学習データに含まれる公開レ ポジトリからベンチマークタスクを抽出 o OpenAI は SWE-Bench Verified のスコアレポートを廃止 • グッドハートの法則(Goodhart's Law) o 指標が目標になると, それは良い尺度でなくなる o ベンチマークスコアの上昇を目的にチューニングしても実務で良くならない 実際に使ってみることが大切! https://cursor.com/ja/blog/cursorbench https://openai.com/ja-JP/index/why-we-no-longer-evaluate-swe-bench-verified/ 11
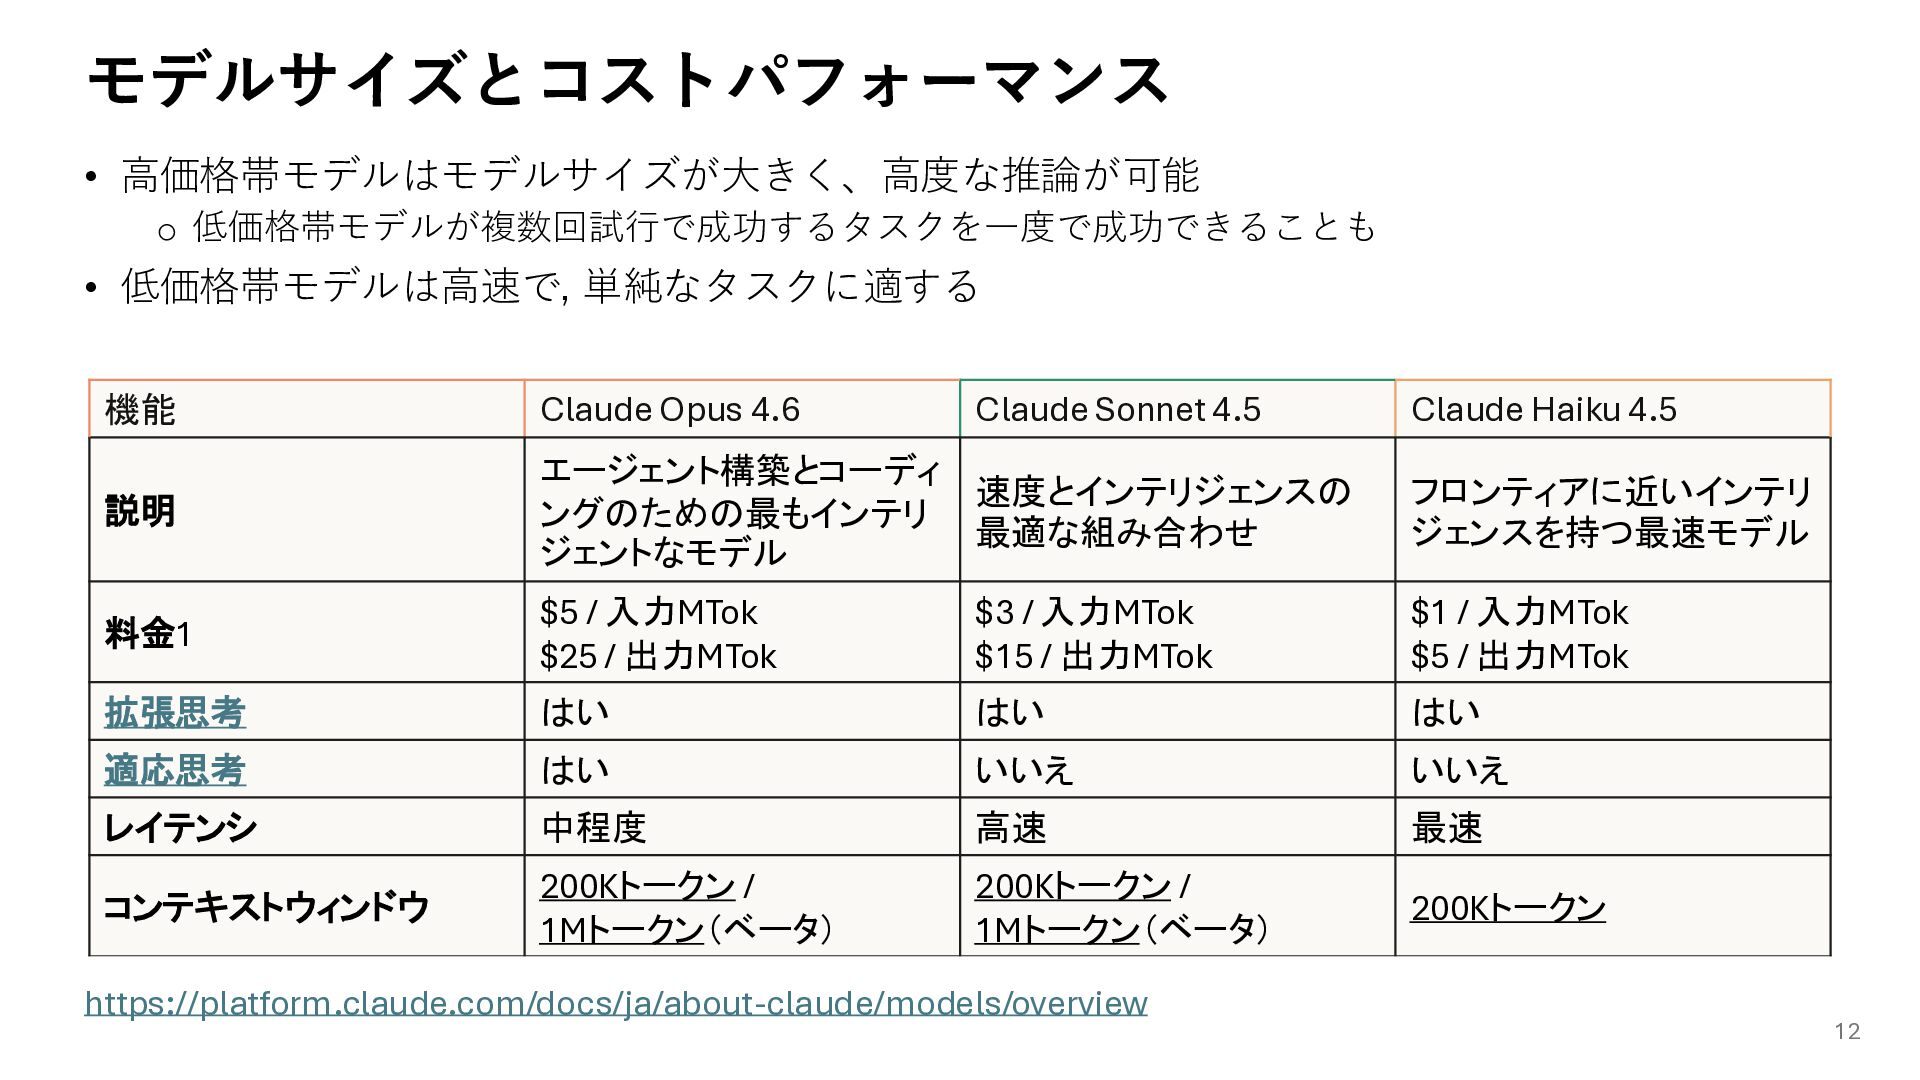
  5. モデルサイズとコストパフォーマンス • 高価格帯モデルはモデルサイズが大きく、高度な推論が可能 o 低価格帯モデルが複数回試行で成功するタスクを一度で成功できることも • 低価格帯モデルは高速で, 単純なタスクに適する 機能 Claude

    Opus 4.6 Claude Sonnet 4.5 説明 エージェント構築とコーディ 速度とインテリジェンスの ングのための最もインテリ 最適な組み合わせ ジェントなモデル フロンティアに近いインテリ ジェンスを持つ最速モデル 料金1 $5 / 入力MTok $25 / 出力MTok $3 / 入力MTok $15 / 出力MTok $1 / 入力MTok $5 / 出力MTok 拡張思考 はい はい はい 適応思考 はい いいえ いいえ レイテンシ 中程度 高速 最速 コンテキストウィンドウ 200Kトークン / 1Mトークン(ベータ) 200Kトークン / 1Mトークン(ベータ) 200Kトークン https://platform.claude.com/docs/ja/about-claude/models/overview Claude Haiku 4.5 12
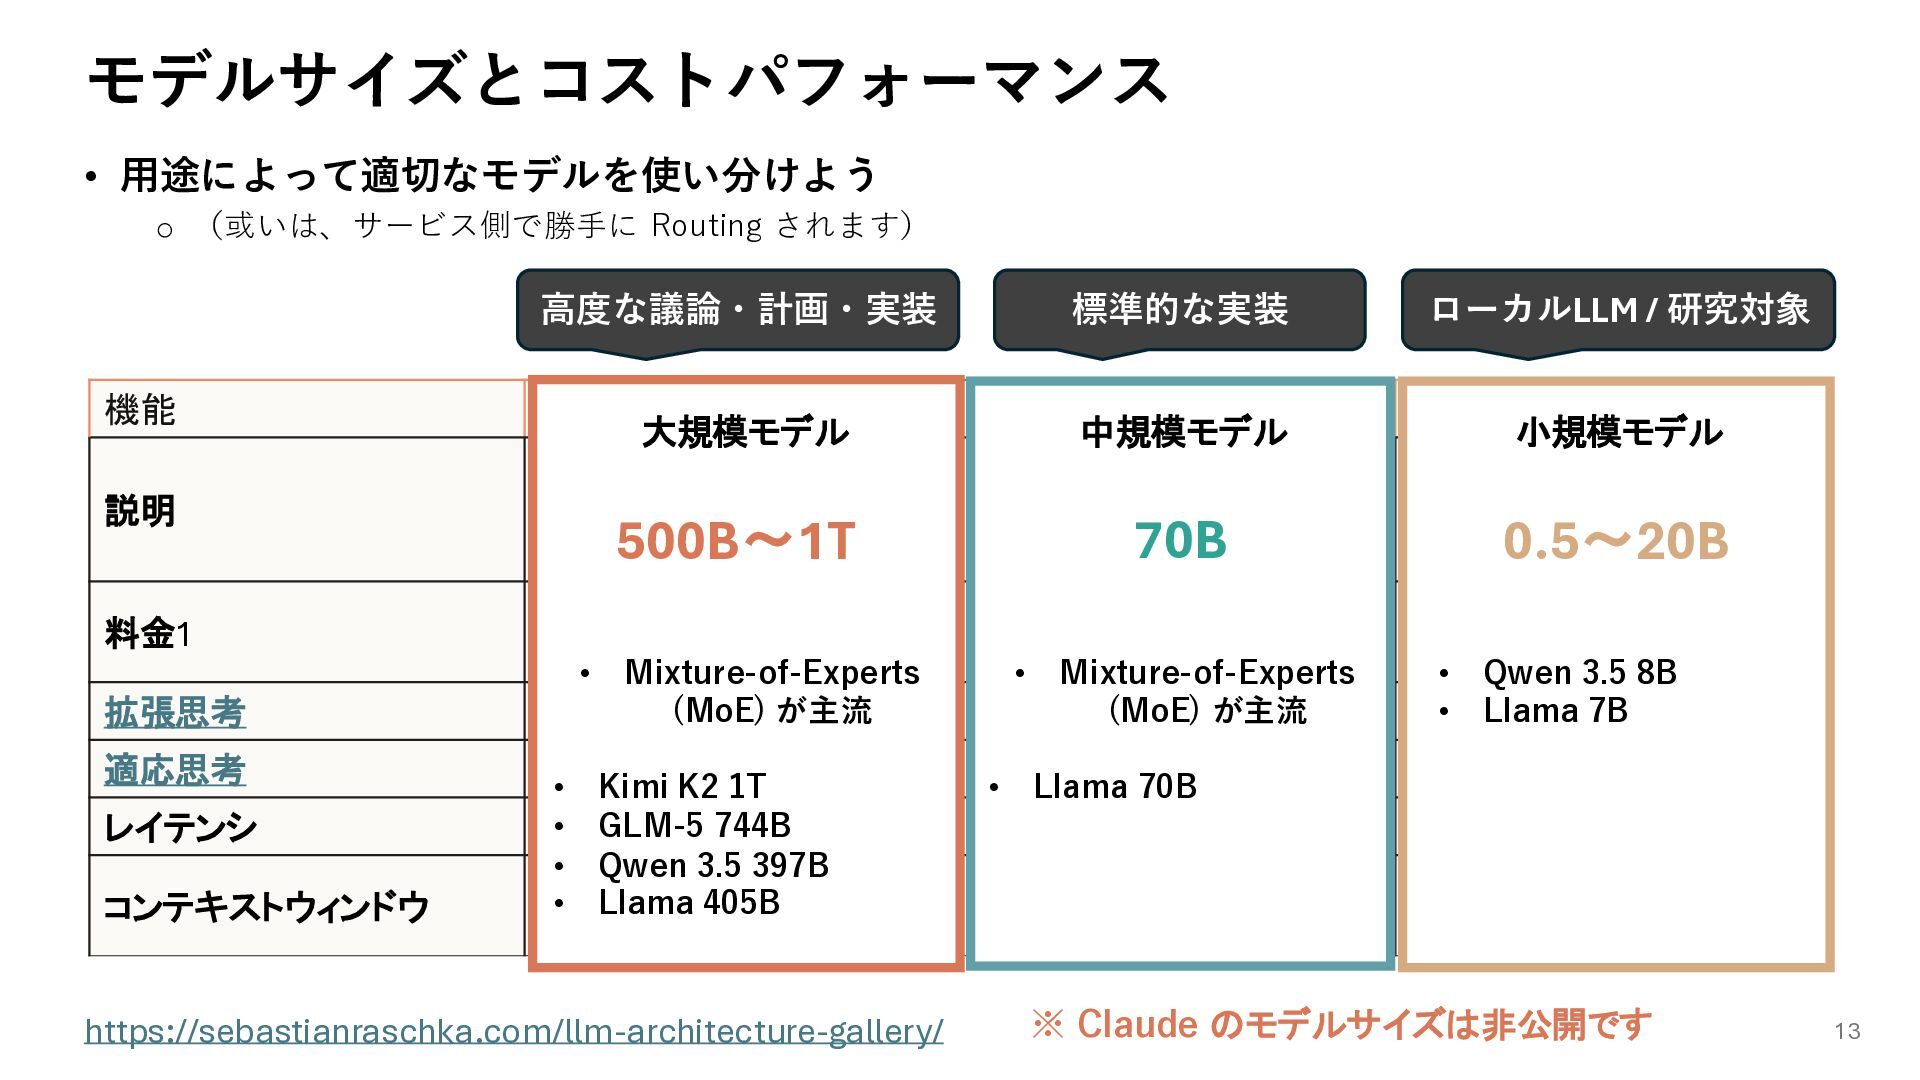
  6. モデルサイズとコストパフォーマンス • 用途によって適切なモデルを使い分けよう o (或いは、サービス側で勝手に Routing されます) 高度な議論・計画・実装 標準的な実装 ローカルLLM

    / 研究対象 Claude Opus 4.6 Claude Sonnet 4.5 大規模モデル 中規模モデル エージェント構築とコーディ 速度とインテリジェンスの ングのための最もインテリ 最適な組み合わせ 70B 500B〜1T ジェントなモデル Claude Haiku 4.5 小規模モデル 料金1 $5 / 入力MTok $25 / 出力MTok • Mixture-of-Experts $3 / 入力MTok $15 / 出力MTok • Mixture-of-Experts $1 / 入力MTok $5• / 出力MTok Qwen 3.5 8B 拡張思考 はい はい 適応思考 はい • Kimi K2 1T いいえ • Llama 70B いいえ レイテンシ • GLM-5 744B 中程度 高速 最速 コンテキストウィンドウ 200Kトークン / • Llama 405B 1Mトークン(ベータ) 200Kトークン / 1Mトークン(ベータ) 200Kトークン 機能 説明 • (MoE) が主流 Qwen 3.5 397B https://sebastianraschka.com/llm-architecture-gallery/ (MoE) が主流 フロンティアに近いインテリ ジェンスを持つ最速モデル 0.5〜20B • Llama 7B はい ※ Claude のモデルサイズは非公開です 13
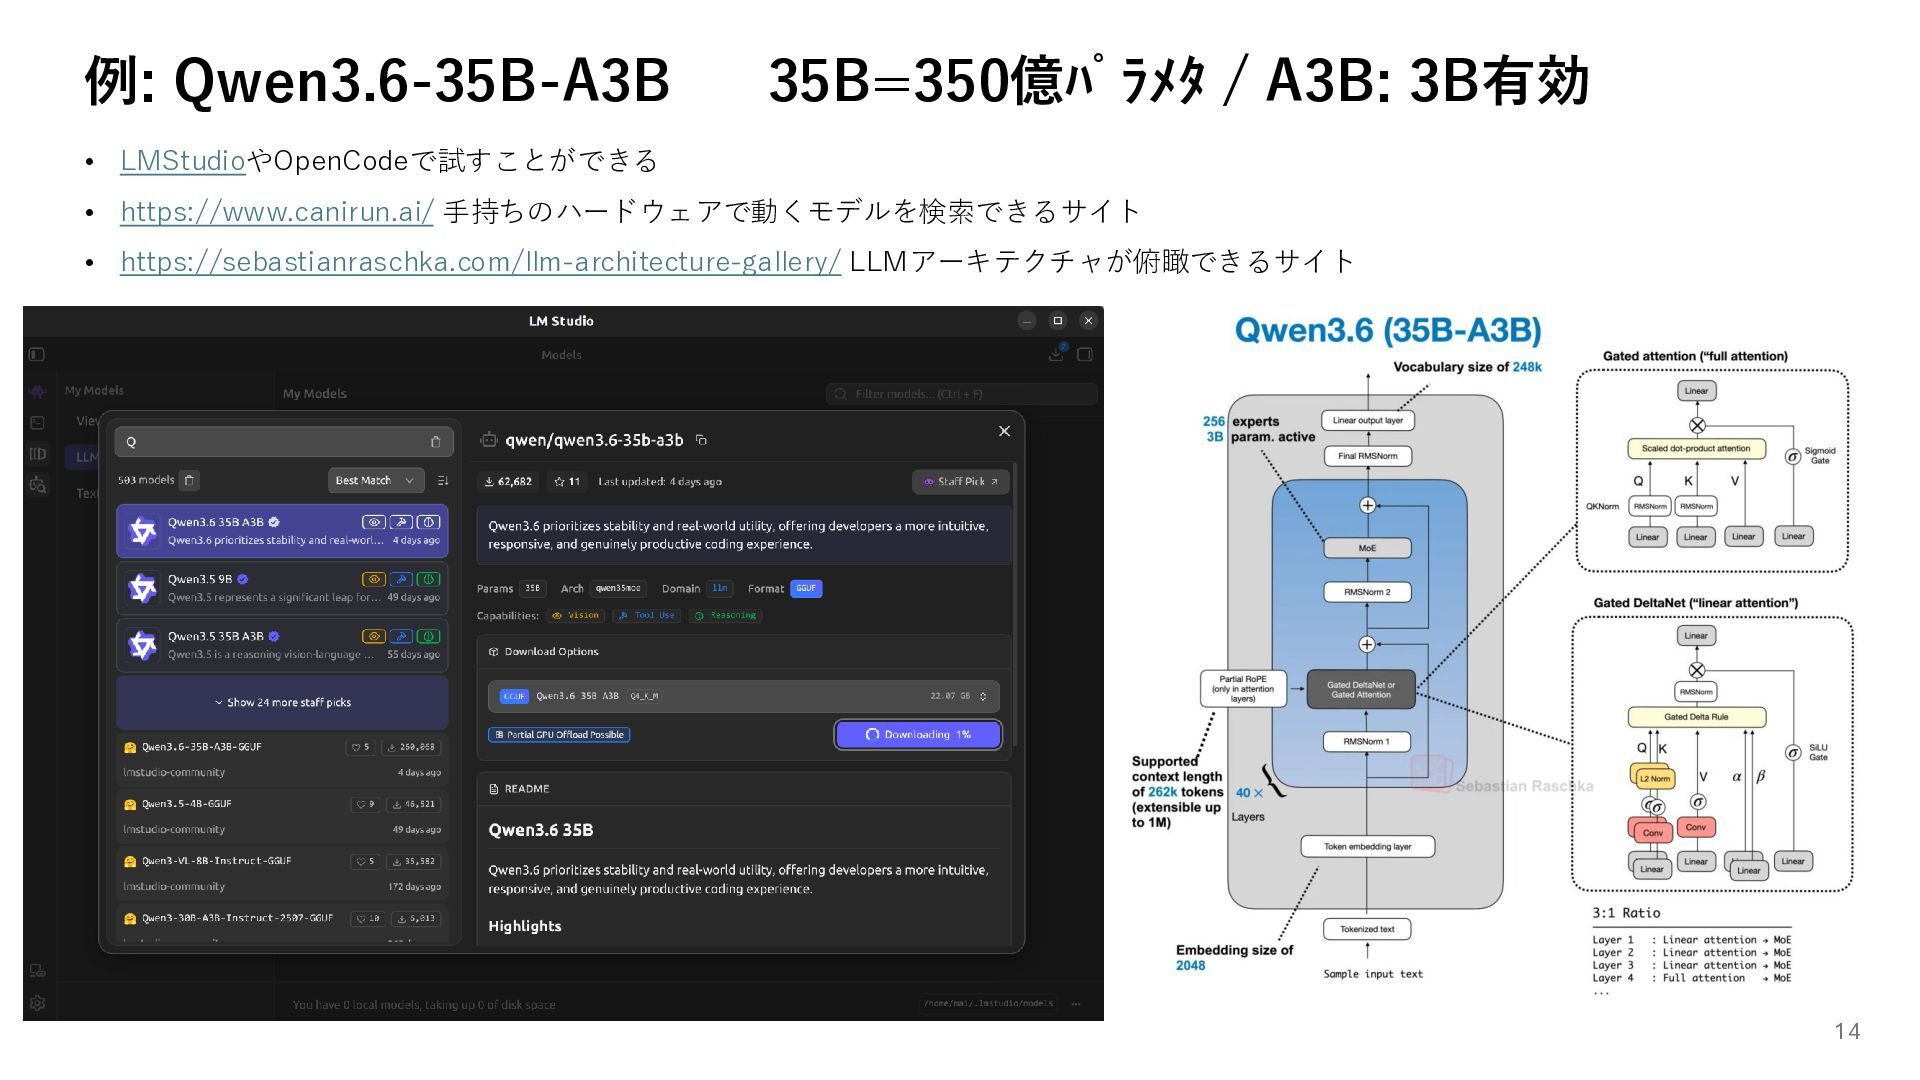
  7. 例: Qwen3.6-35B-A3B 35B=350億パラメタ / A3B: 3B有効 • LMStudioやOpenCodeで試すことができる • https://www.canirun.ai/

    手持ちのハードウェアで動くモデルを検索できるサイト • https://sebastianraschka.com/llm-architecture-gallery/ LLMアーキテクチャが俯瞰できるサイト 14
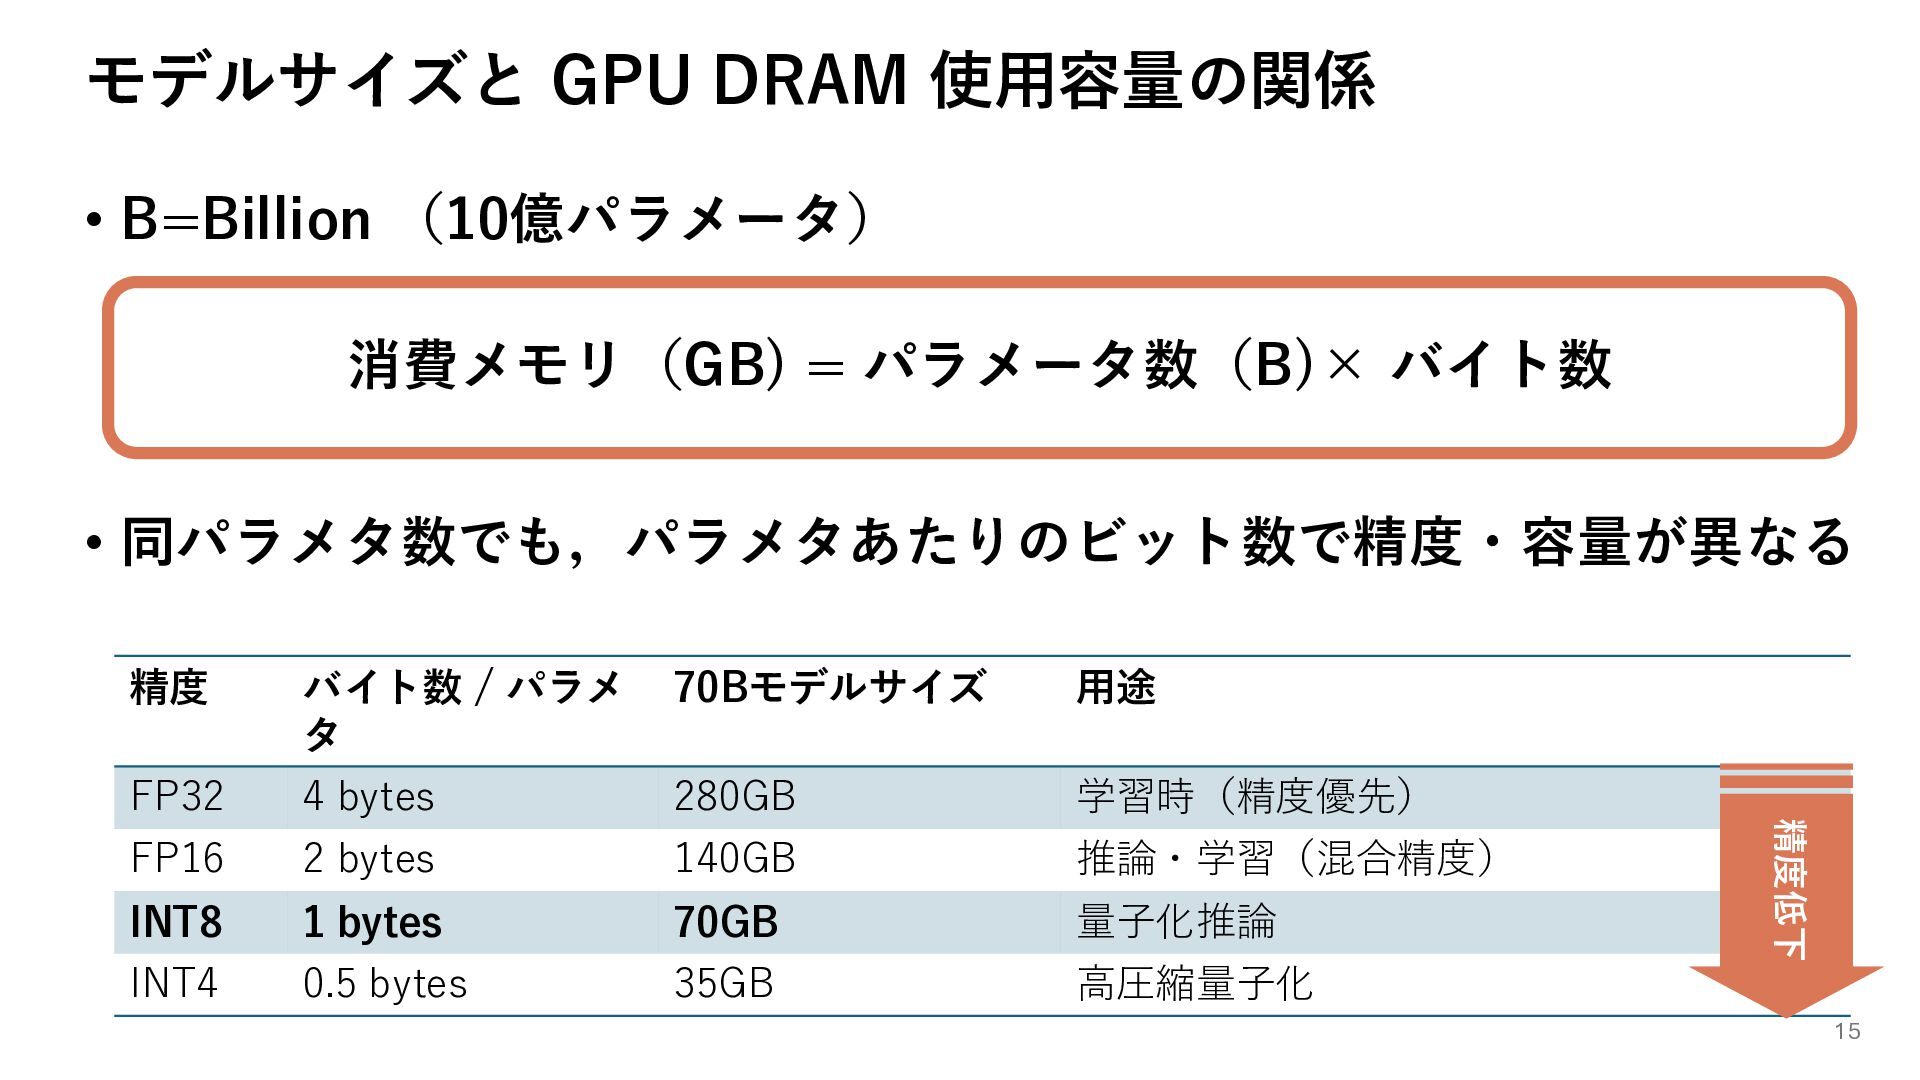
  8. モデルサイズと GPU DRAM 使用容量の関係 • B=Billion (10億パラメータ) 消費メモリ(GB) = パラメータ数(B)×

    バイト数 • 同パラメタ数でも,パラメタあたりのビット数で精度・容量が異なる バイト数 / パラメ タ 70Bモデルサイズ 用途 FP32 4 bytes 280GB 学習時(精度優先) FP16 2 bytes 140GB 推論・学習(混合精度) INT8 1 bytes 70GB 量子化推論 INT4 0.5 bytes 35GB 高圧縮量子化 精度低下 精度 15
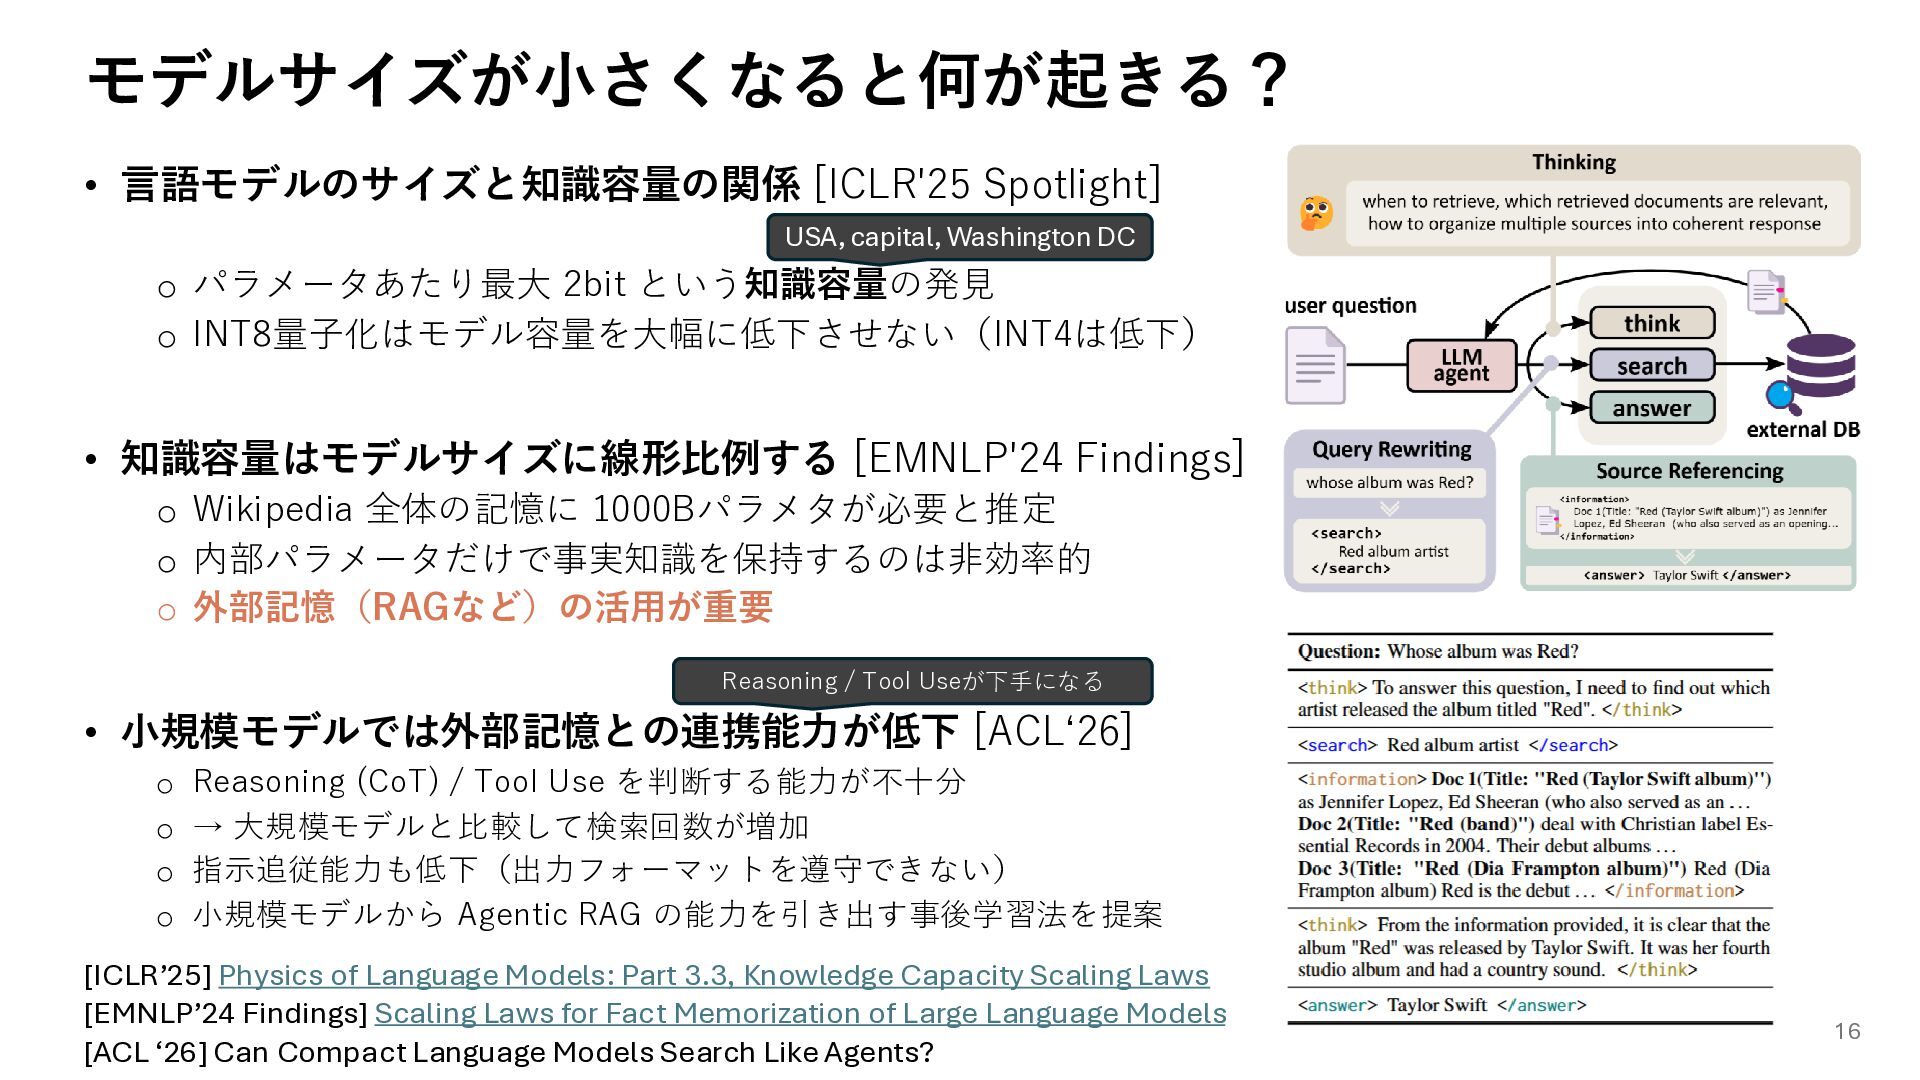
  9. モデルサイズが小さくなると何が起きる? • 言語モデルのサイズと知識容量の関係 [ICLR'25 Spotlight] USA, capital, Washington DC o

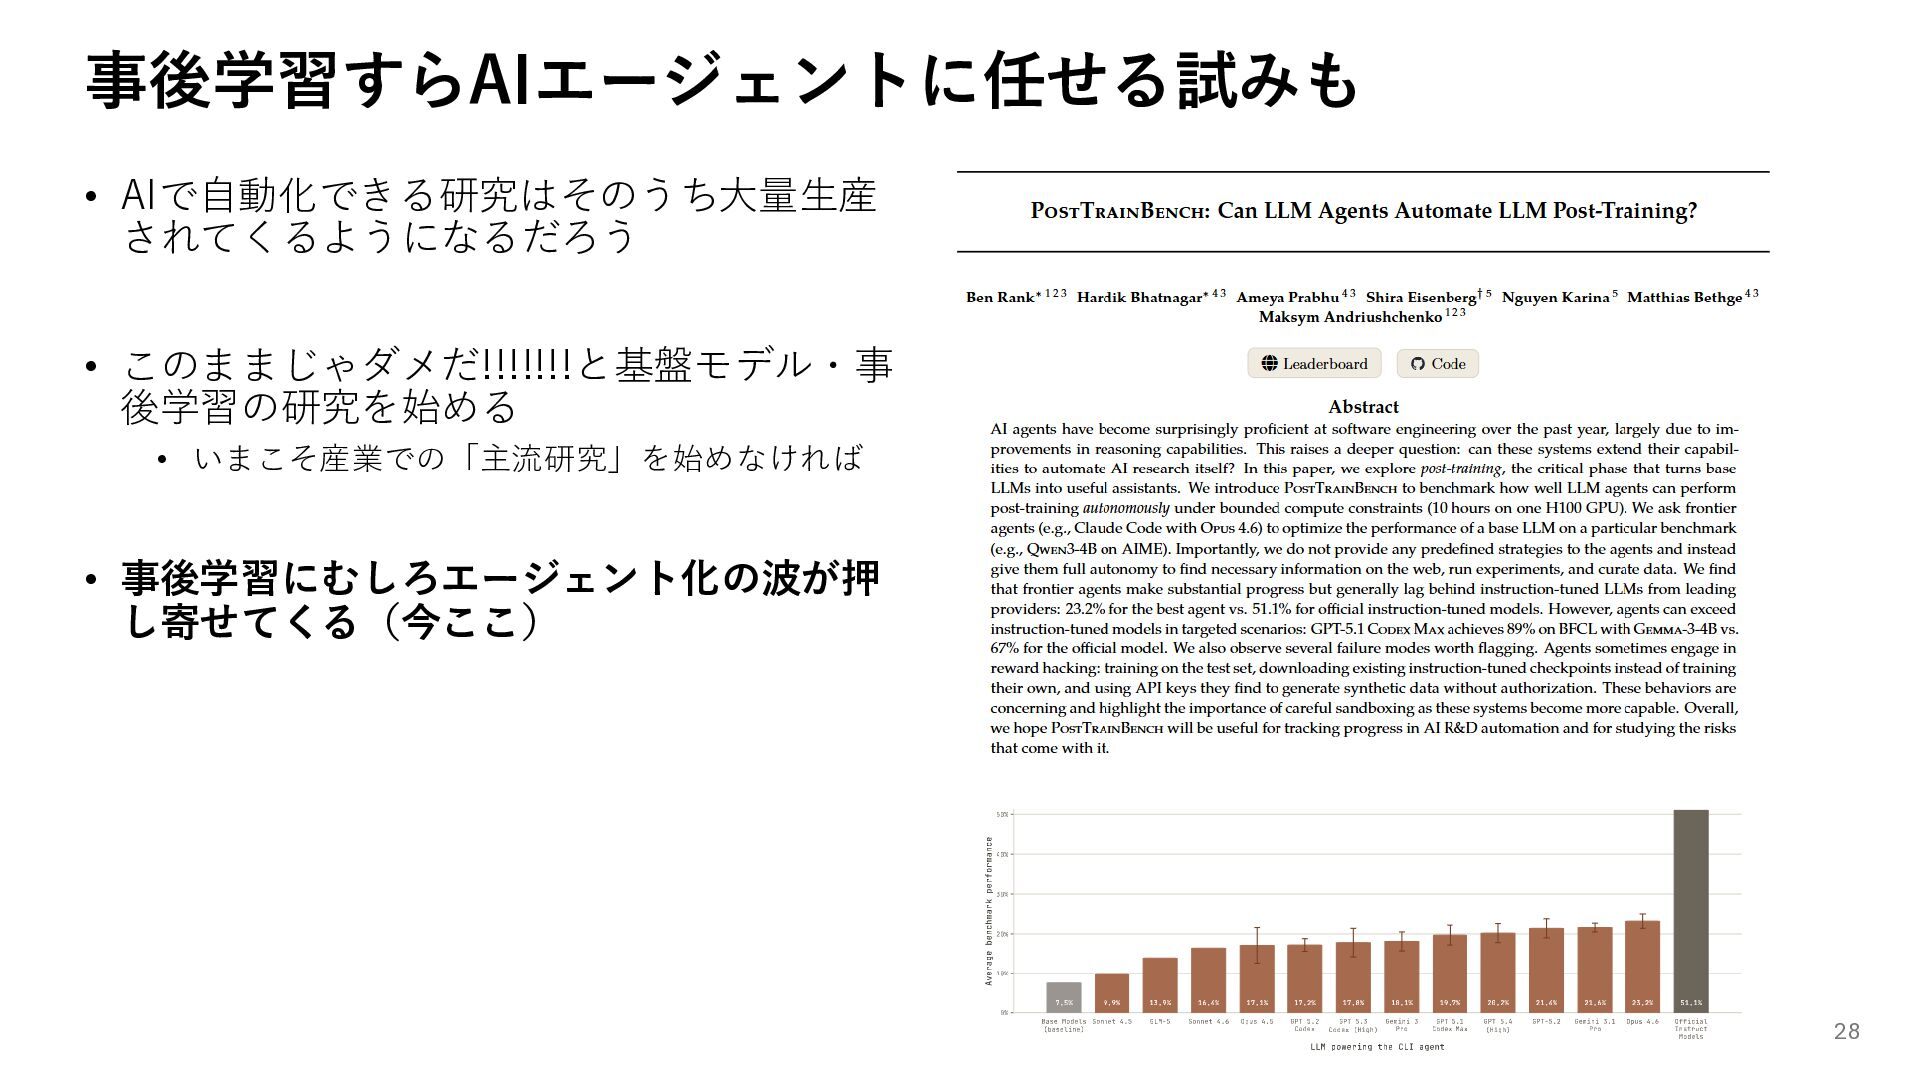
    パラメータあたり最大 2bit という知識容量の発見 o INT8量子化はモデル容量を大幅に低下させない(INT4は低下) • 知識容量はモデルサイズに線形比例する [EMNLP'24 Findings] o Wikipedia 全体の記憶に 1000Bパラメタが必要と推定 o 内部パラメータだけで事実知識を保持するのは非効率的 o 外部記憶(RAGなど)の活用が重要 Reasoning / Tool Useが下手になる • 小規模モデルでは外部記憶との連携能力が低下 [ACL‘26] o Reasoning (CoT) / Tool Use を判断する能力が不十分 o → 大規模モデルと比較して検索回数が増加 o 指示追従能力も低下(出力フォーマットを遵守できない) o 小規模モデルから Agentic RAG の能力を引き出す事後学習法を提案 [ICLR’25] Physics of Language Models: Part 3.3, Knowledge Capacity Scaling Laws [EMNLP’24 Findings] Scaling Laws for Fact Memorization of Large Language Models [ACL ‘26] Can Compact Language Models Search Like Agents? 16
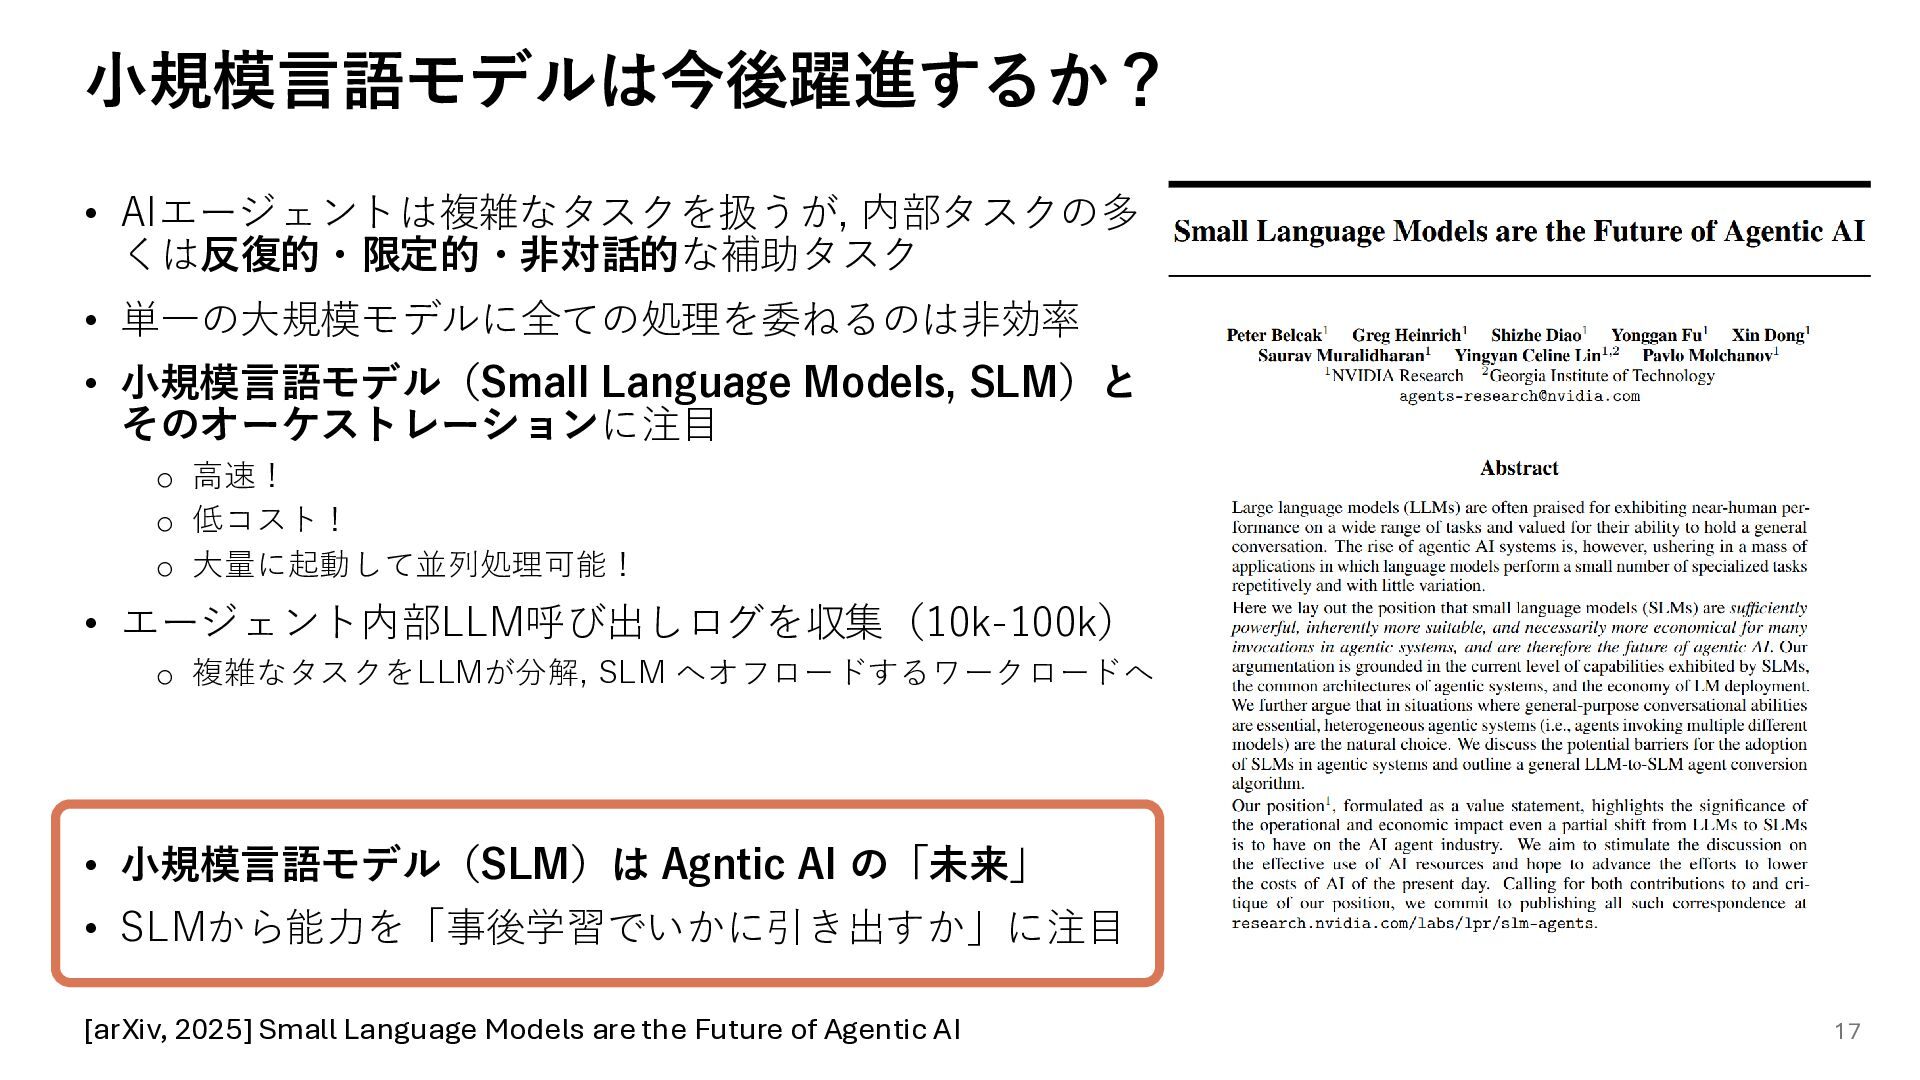
  10. 小規模言語モデルは今後躍進するか? • AIエージェントは複雑なタスクを扱うが, 内部タスクの多 くは反復的・限定的・非対話的な補助タスク • 単一の大規模モデルに全ての処理を委ねるのは非効率 • 小規模言語モデル(Small Language

    Models, SLM)と そのオーケストレーションに注目 o 高速! o 低コスト! o 大量に起動して並列処理可能! • エージェント内部LLM呼び出しログを収集(10k-100k) o 複雑なタスクをLLMが分解, SLM へオフロードするワークロードへ • 小規模言語モデル(SLM)は Agntic AI の「未来」 • SLMから能力を「事後学習でいかに引き出すか」に注目 [arXiv, 2025] Small Language Models are the Future of Agentic AI 17
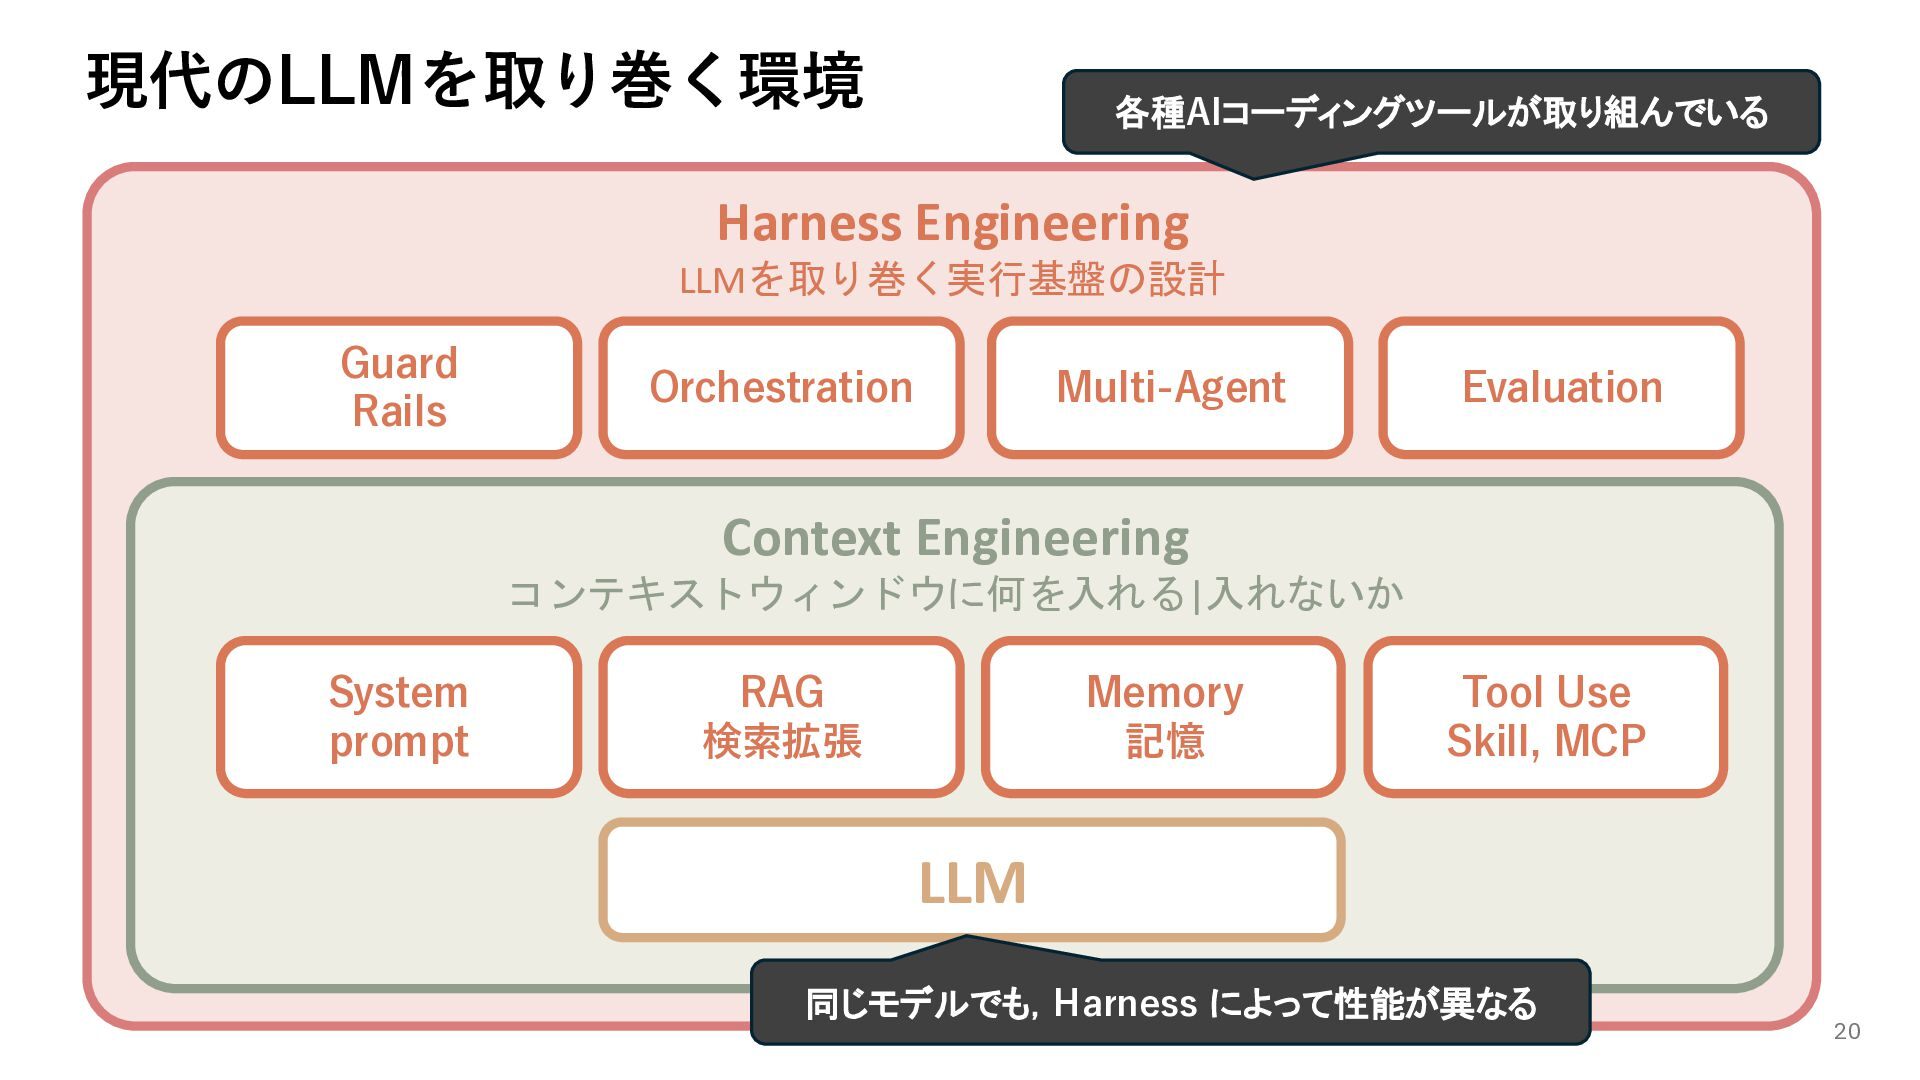
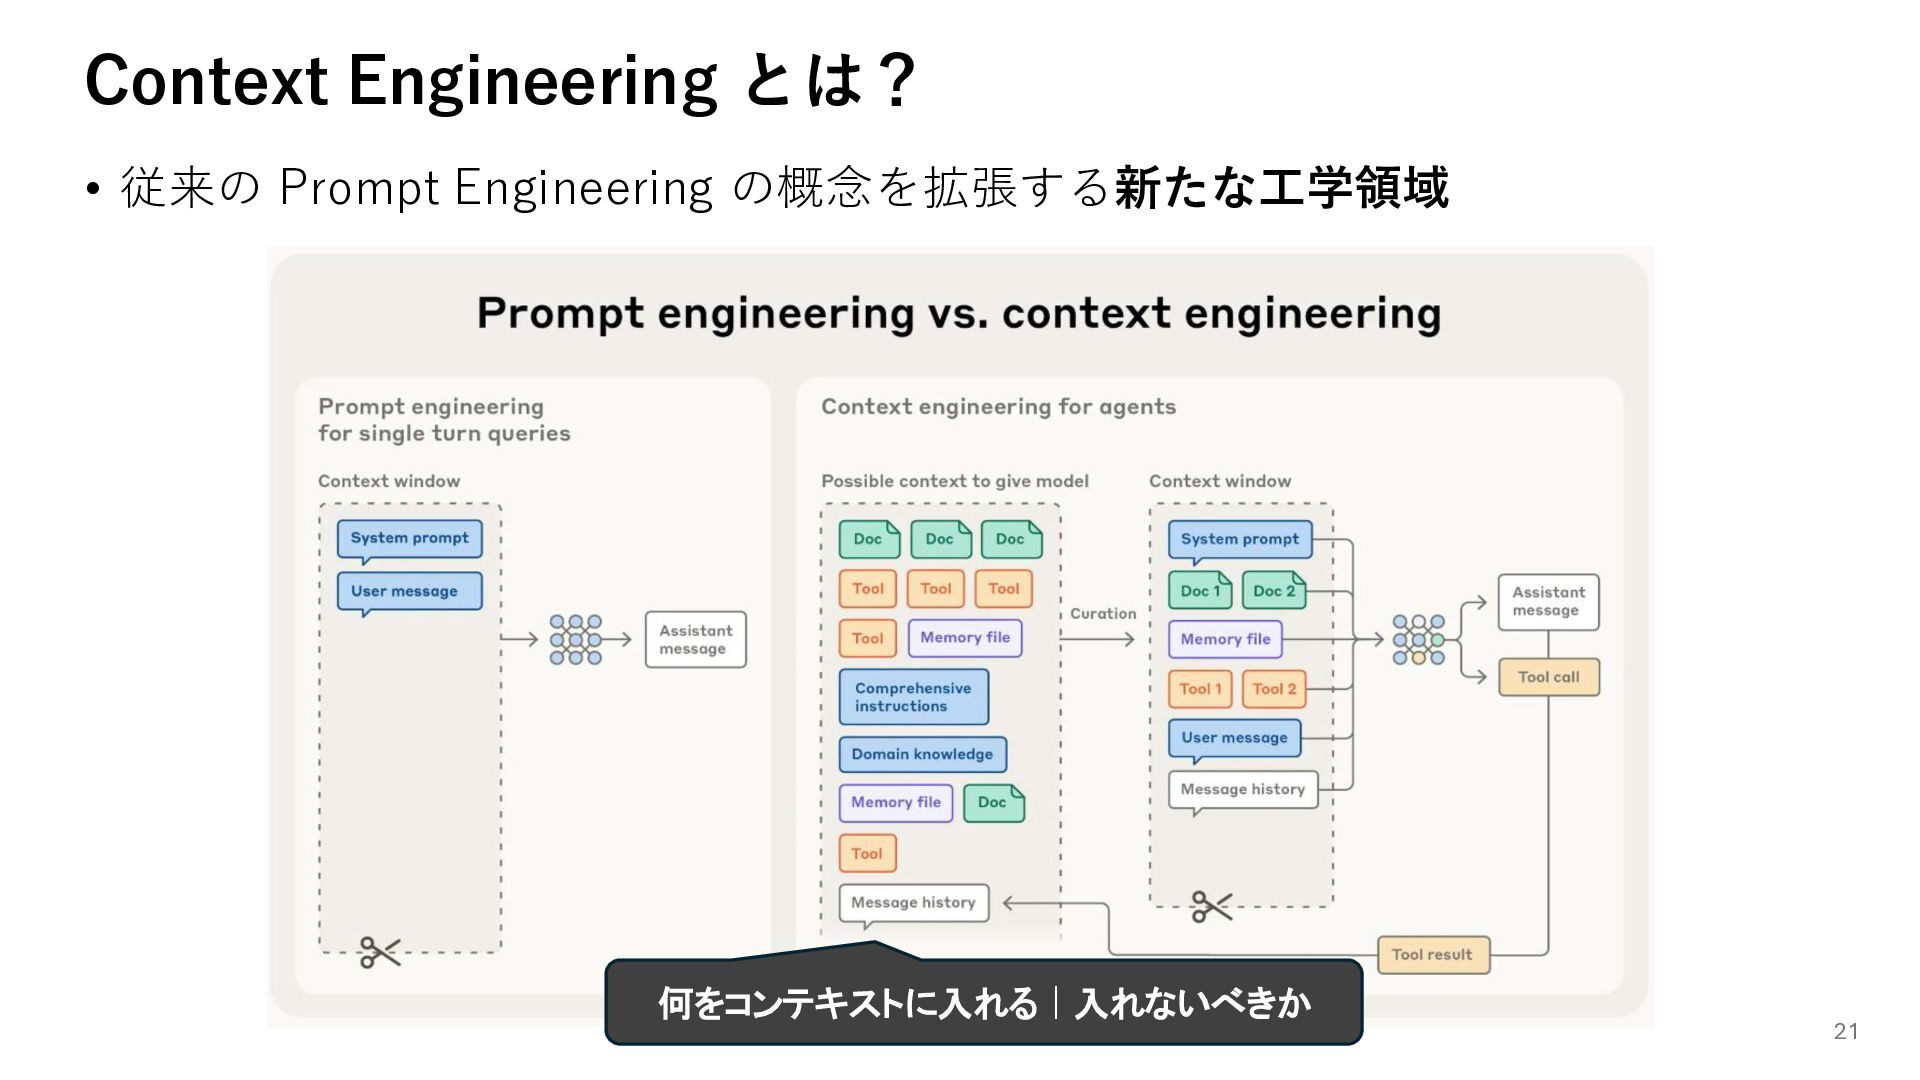
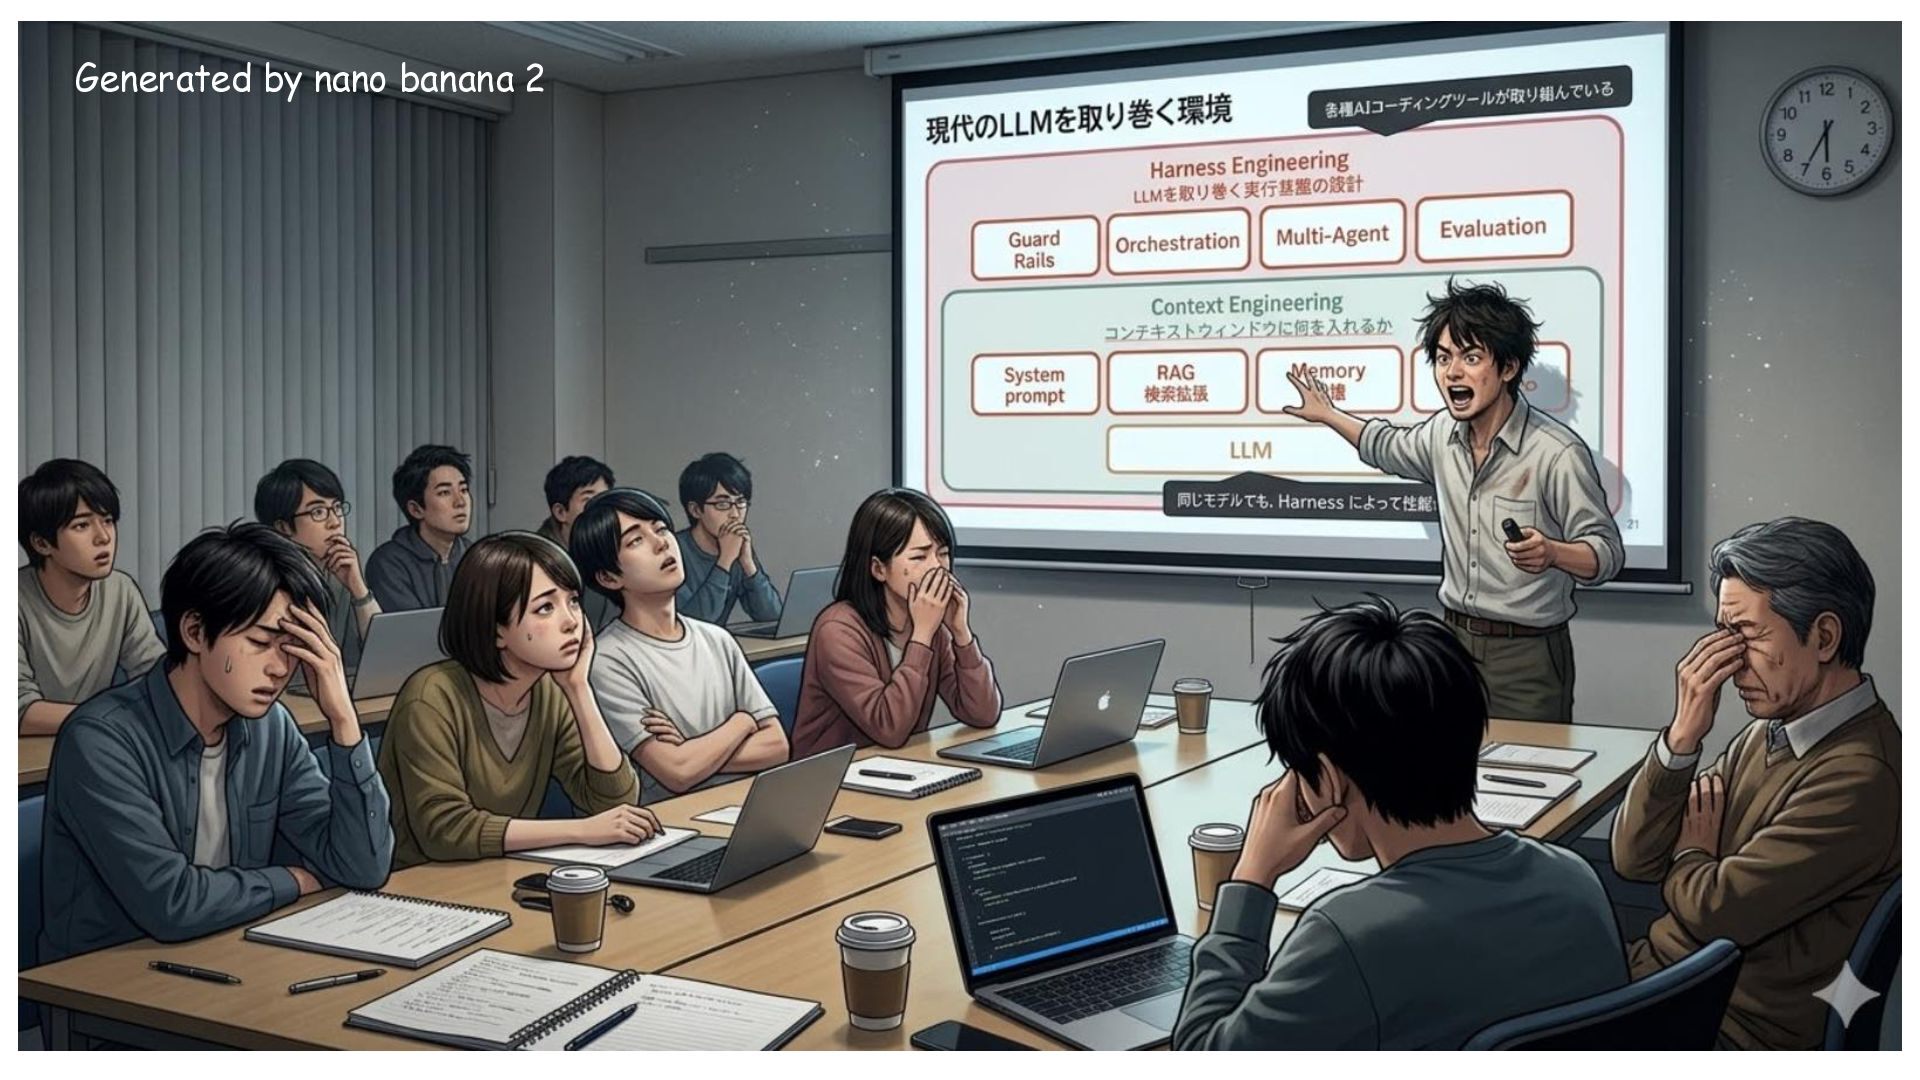
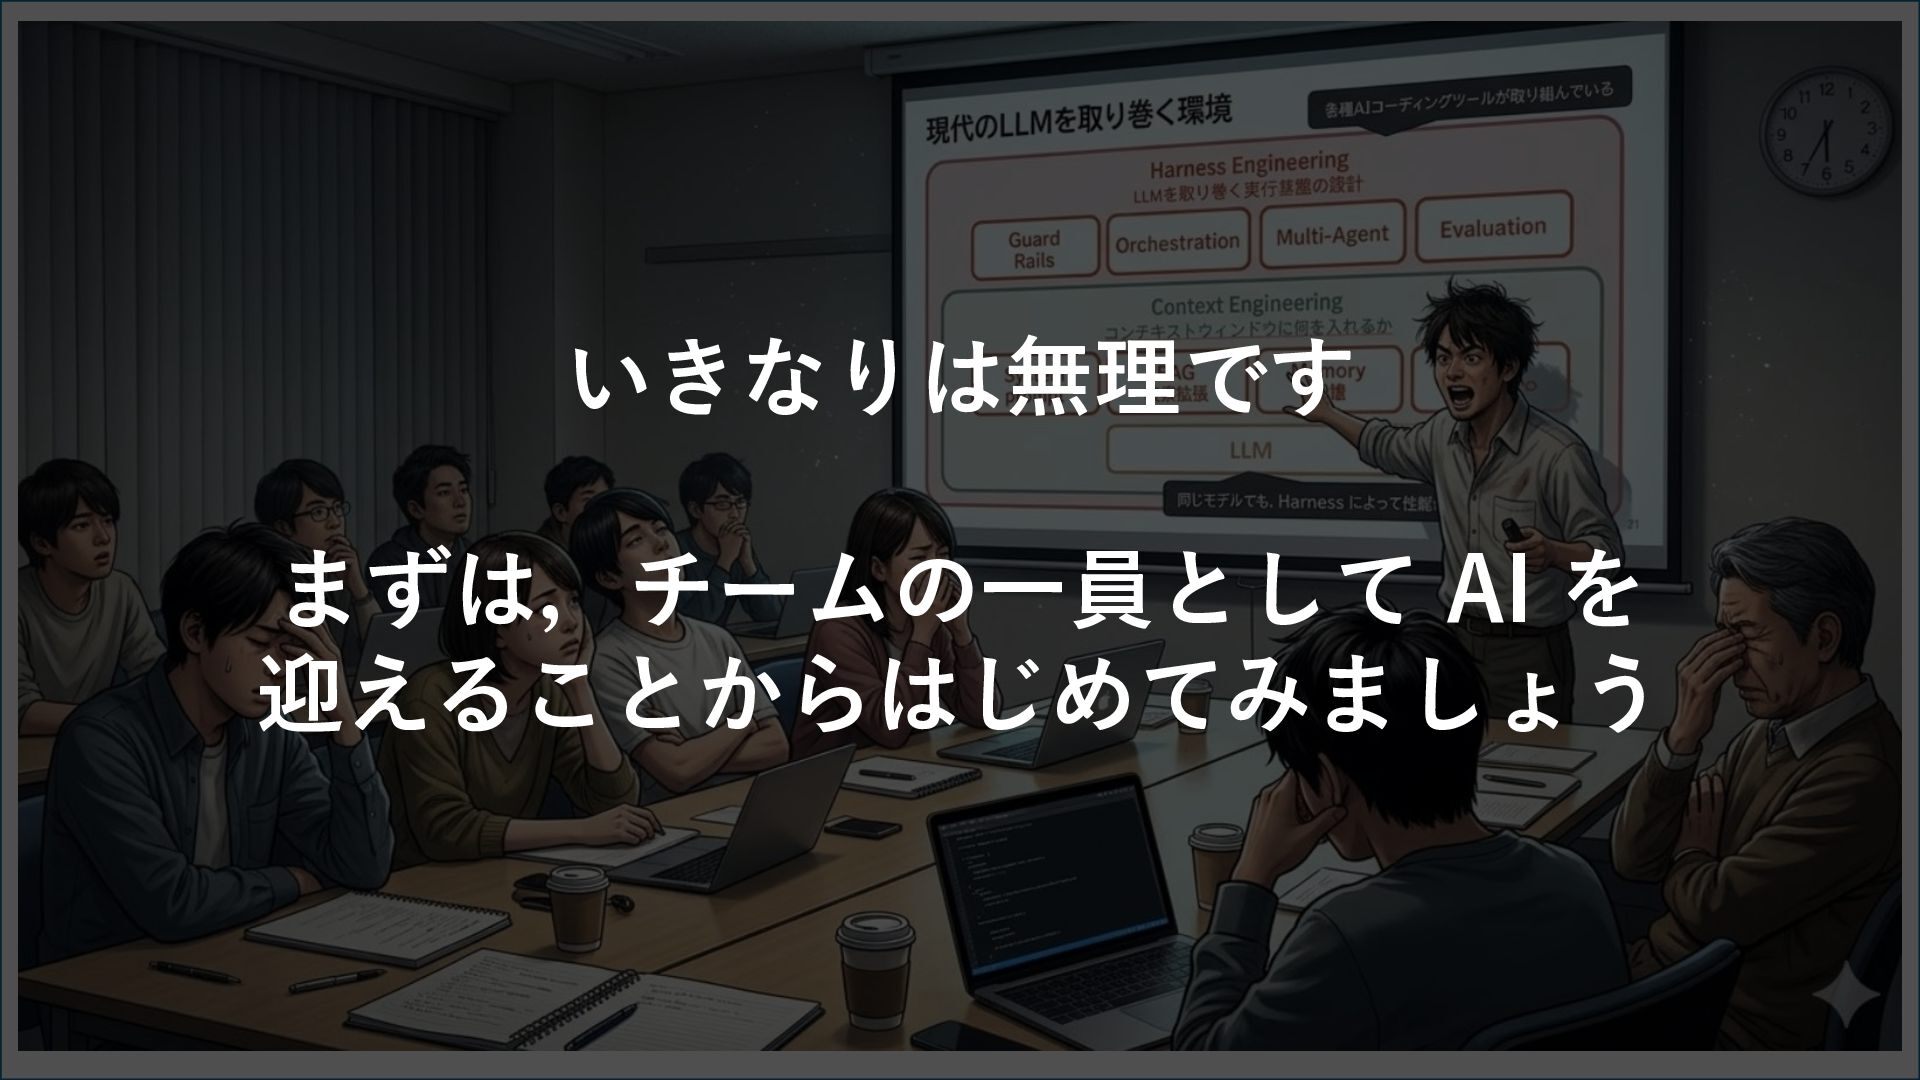
  11. 現代のLLMを取り巻く環境 各種AIコーディングツールが取り組んでいる Harness Engineering LLMを取り巻く実行基盤の設計 Guard Rails Orchestration Multi-Agent Evaluation

    Context Engineering コンテキストウィンドウに何を入れる|入れないか System prompt RAG 検索拡張 Memory 記憶 Tool Use Skill, MCP LLM 同じモデルでも,Harness によって性能が異なる 20
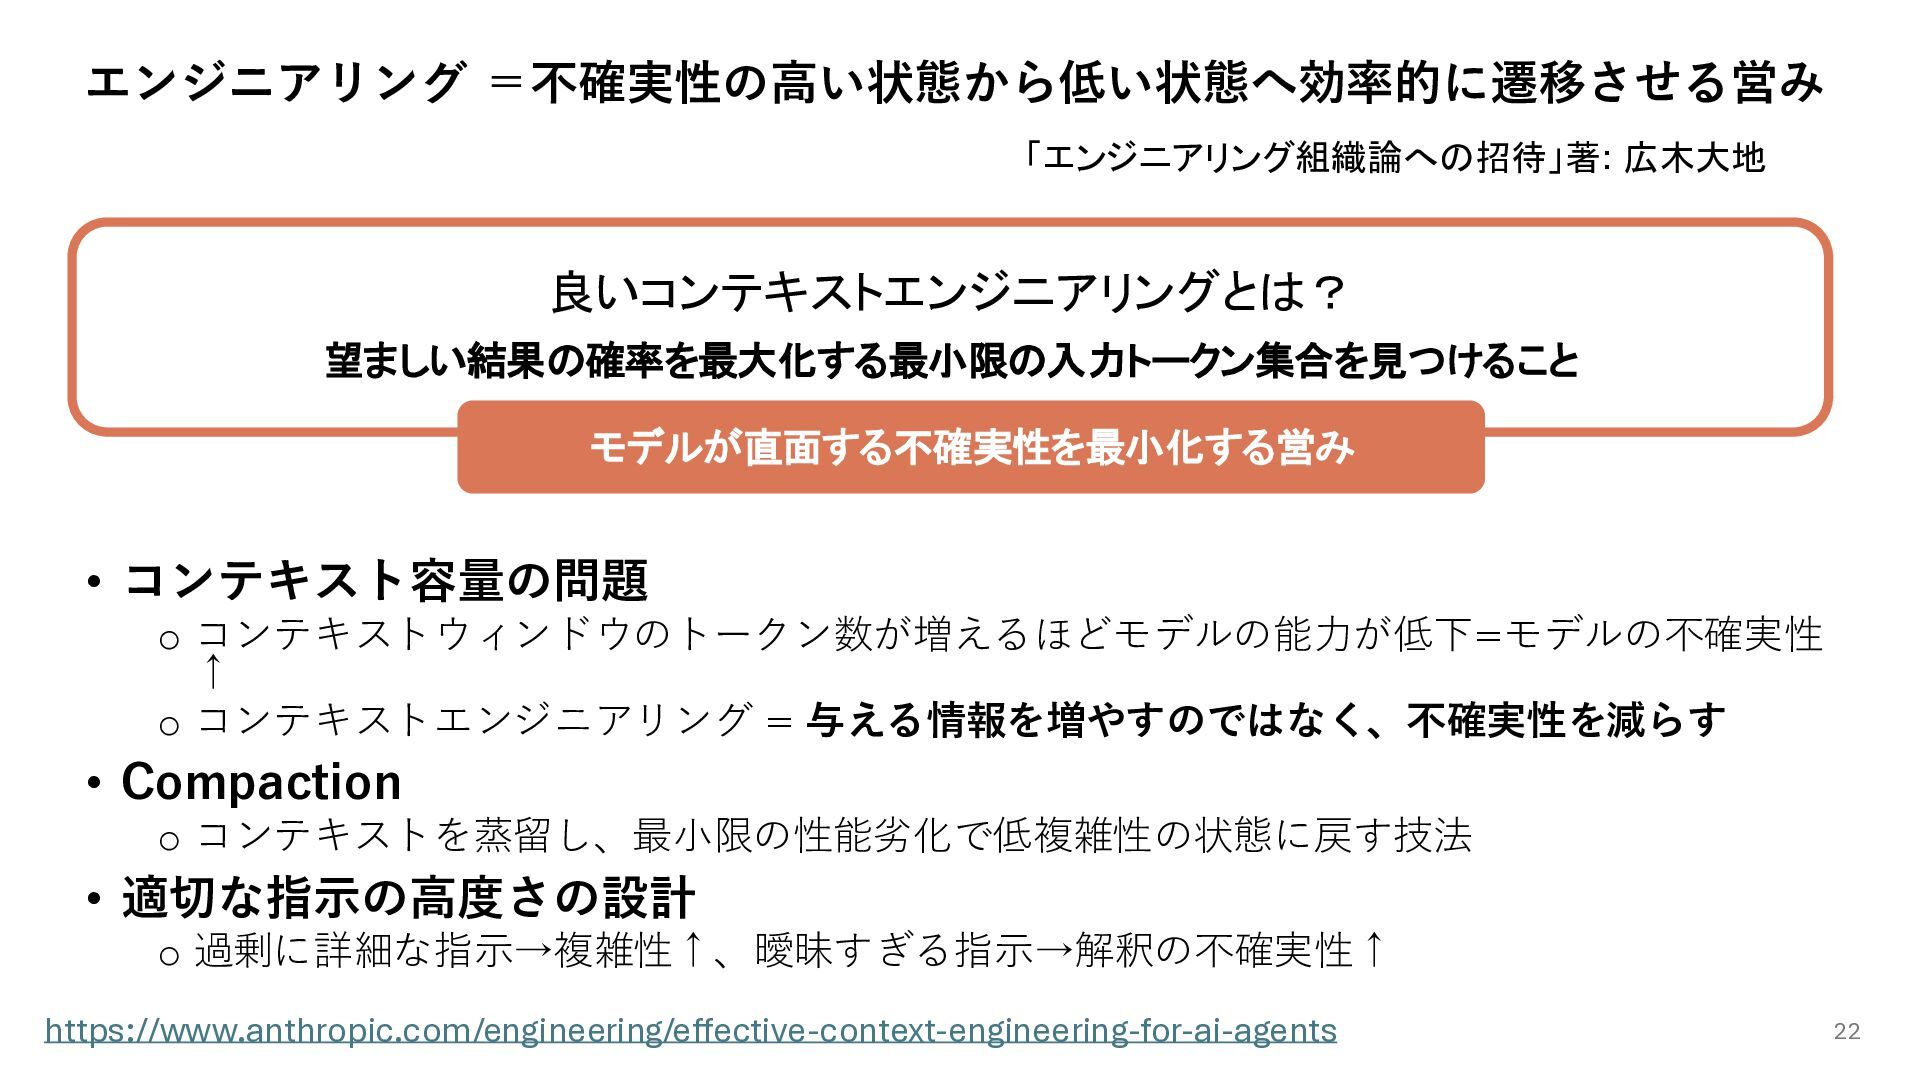
  12. エンジニアリング =不確実性の高い状態から低い状態へ効率的に遷移させる営み 「エンジニアリング組織論への招待」著: 広木大地 良いコンテキストエンジニアリングとは? 望ましい結果の確率を最大化する最小限の入力トークン集合を見つけること モデルが直面する不確実性を最小化する営み • コンテキスト容量の問題 o

    コンテキストウィンドウのトークン数が増えるほどモデルの能力が低下=モデルの不確実性 ↑ o コンテキストエンジニアリング = 与える情報を増やすのではなく、不確実性を減らす • Compaction o コンテキストを蒸留し、最小限の性能劣化で低複雑性の状態に戻す技法 • 適切な指示の高度さの設計 o 過剰に詳細な指示→複雑性↑、曖昧すぎる指示→解釈の不確実性↑ https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents 22
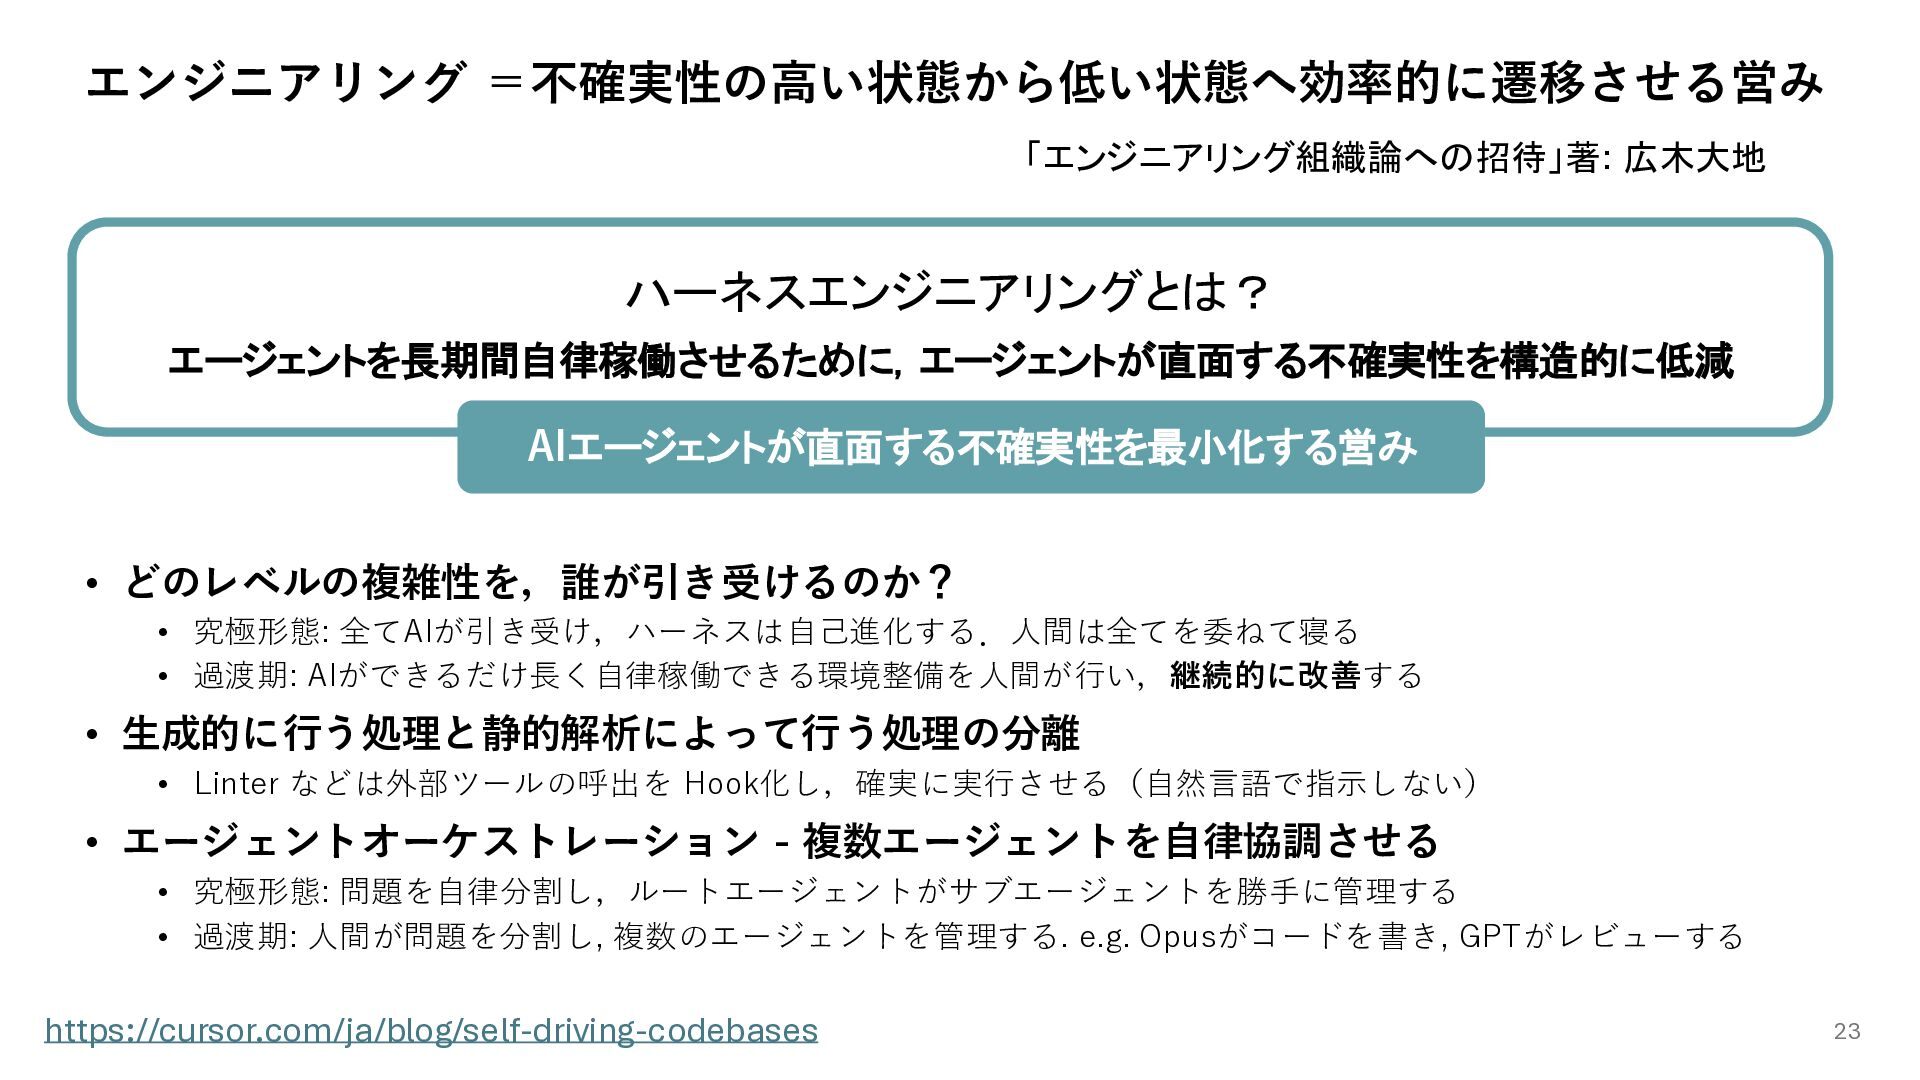
  13. エンジニアリング =不確実性の高い状態から低い状態へ効率的に遷移させる営み 「エンジニアリング組織論への招待」著: 広木大地 ハーネスエンジニアリングとは? エージェントを長期間自律稼働させるために,エージェントが直面する不確実性を構造的に低減 AIエージェントが直面する不確実性を最小化する営み • どのレベルの複雑性を,誰が引き受けるのか? •

    究極形態: 全てAIが引き受け,ハーネスは自己進化する.人間は全てを委ねて寝る • 過渡期: AIができるだけ長く自律稼働できる環境整備を人間が行い,継続的に改善する • 生成的に行う処理と静的解析によって行う処理の分離 • Linter などは外部ツールの呼出を Hook化し,確実に実行させる(自然言語で指示しない) • エージェントオーケストレーション - 複数エージェントを自律協調させる • 究極形態: 問題を自律分割し,ルートエージェントがサブエージェントを勝手に管理する • 過渡期: 人間が問題を分割し, 複数のエージェントを管理する. e.g. Opusがコードを書き, GPTがレビューする https://cursor.com/ja/blog/self-driving-codebases 23
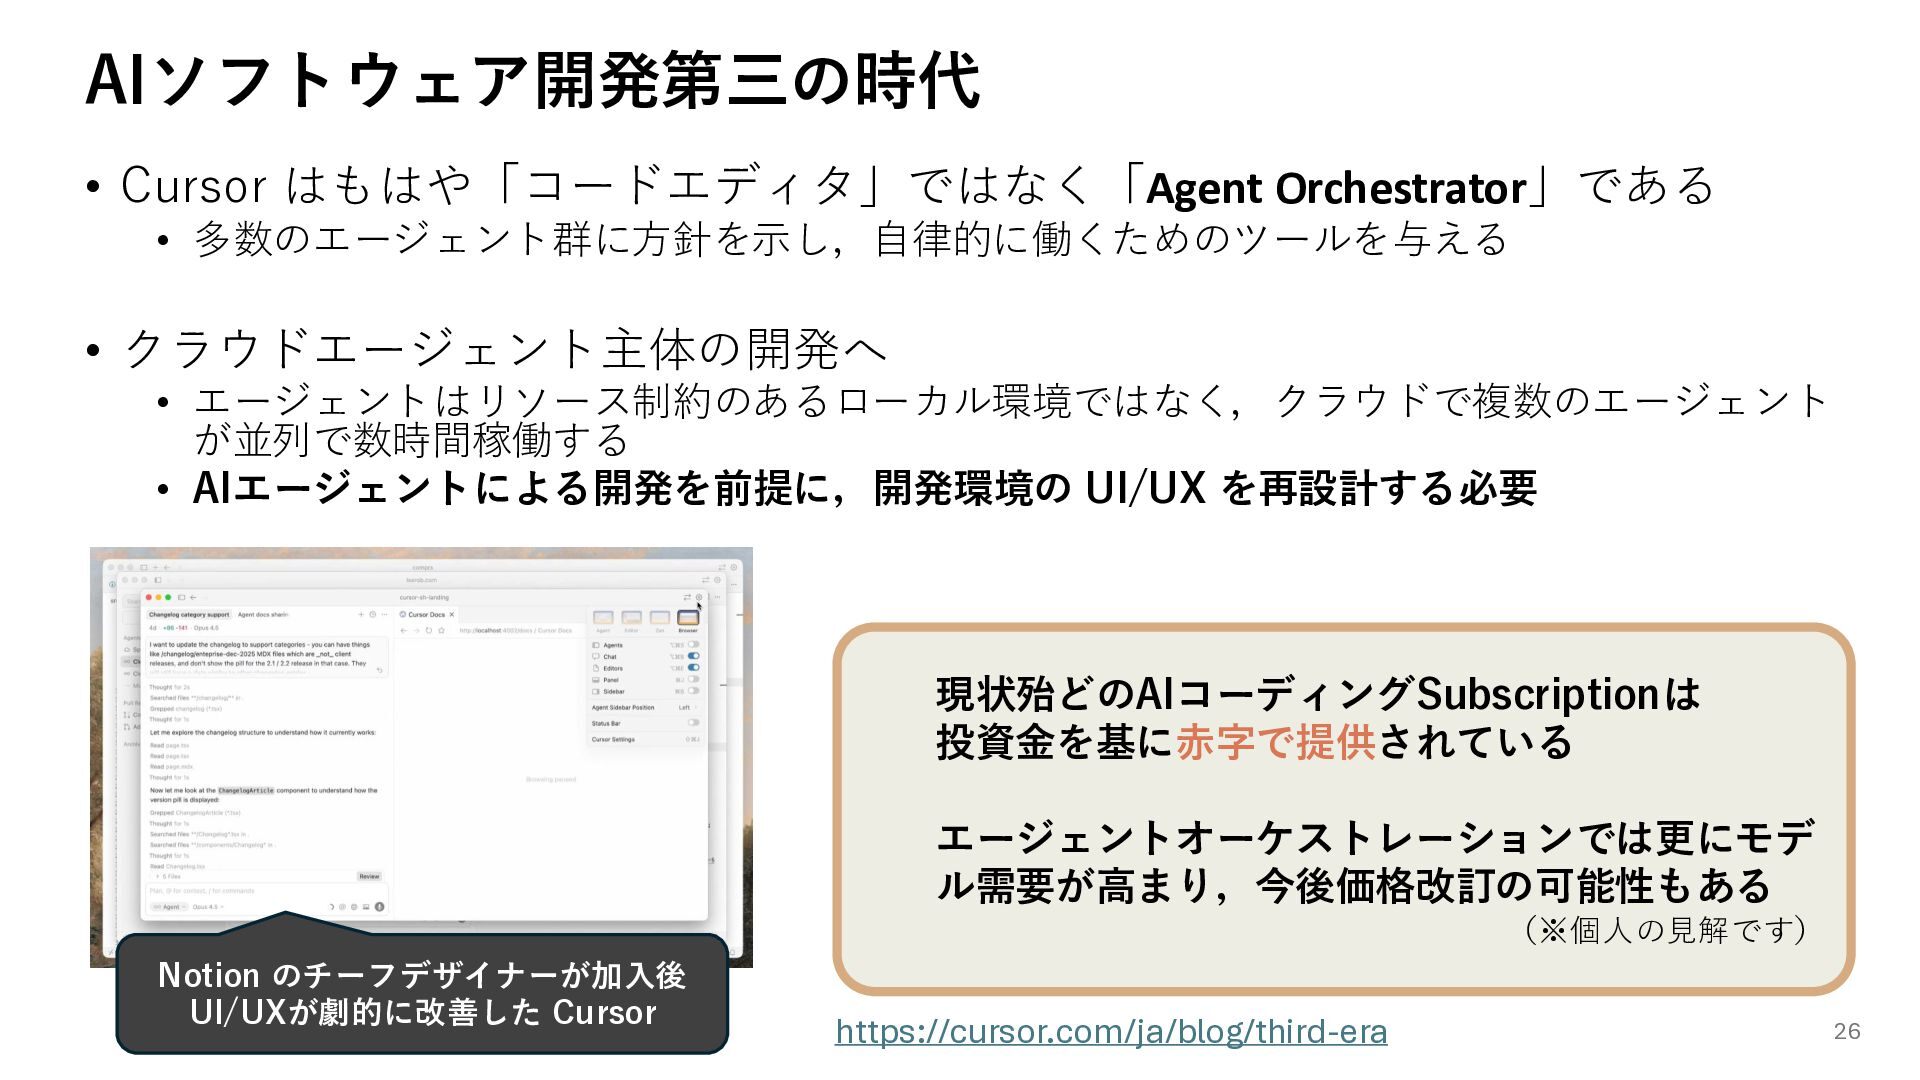
  14. AIソフトウェア開発第三の時代 • Cursor はもはや「コードエディタ」ではなく「Agent Orchestrator」である • 多数のエージェント群に方針を示し,自律的に働くためのツールを与える • クラウドエージェント主体の開発へ •

    エージェントはリソース制約のあるローカル環境ではなく,クラウドで複数のエージェント が並列で数時間稼働する • AIエージェントによる開発を前提に,開発環境の UI/UX を再設計する必要 現状殆どのAIコーディングSubscriptionは 投資金を基に赤字で提供されている エージェントオーケストレーションでは更にモデ ル需要が高まり,今後価格改訂の可能性もある (※個人の見解です) Notion のチーフデザイナーが加入後 UI/UXが劇的に改善した Cursor https://cursor.com/ja/blog/third-era 26
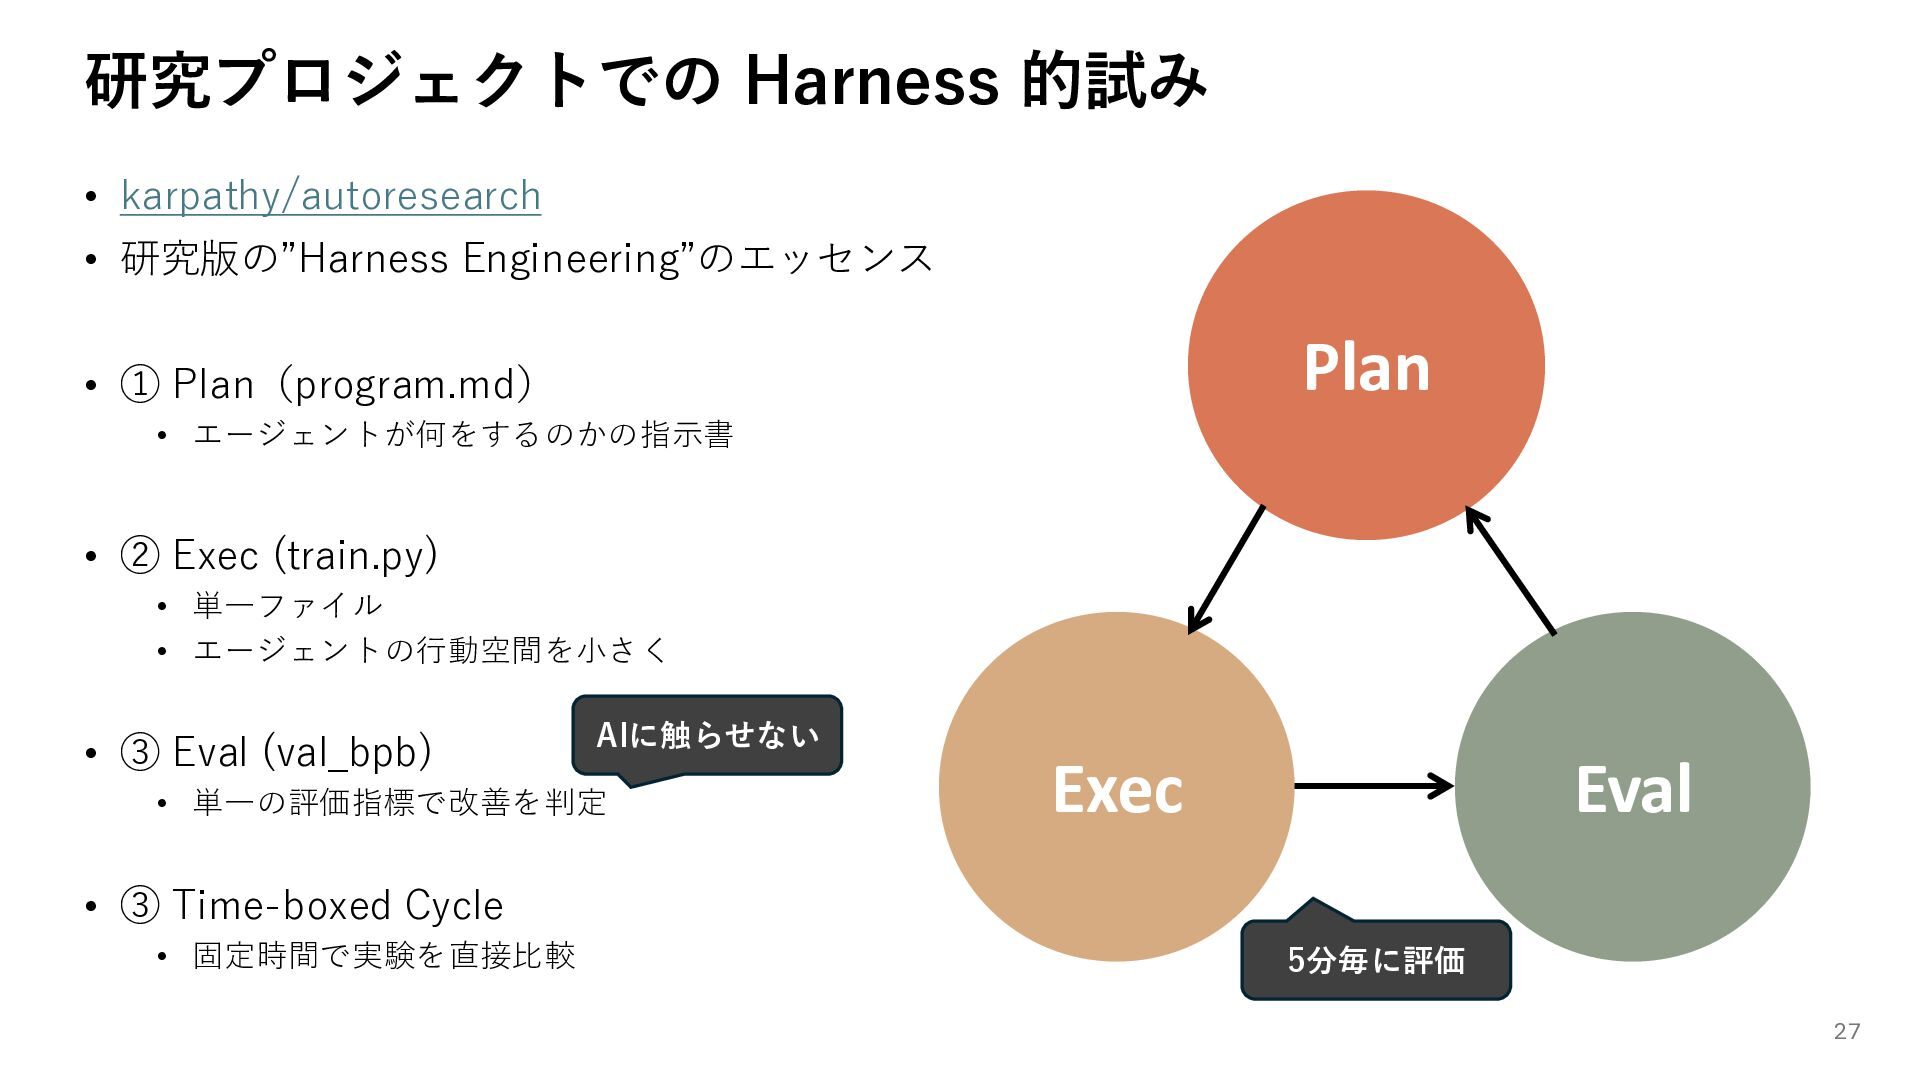
  15. 研究プロジェクトでの Harness 的試み • karpathy/autoresearch • 研究版の”Harness Engineering”のエッセンス Plan •

    ① Plan(program.md) • エージェントが何をするのかの指示書 • ② Exec (train.py) • 単一ファイル • エージェントの行動空間を小さく • ③ Eval (val_bpb) AIに触らせない • 単一の評価指標で改善を判定 Exec Eval • ③ Time-boxed Cycle • 固定時間で実験を直接比較 5分毎に評価 27
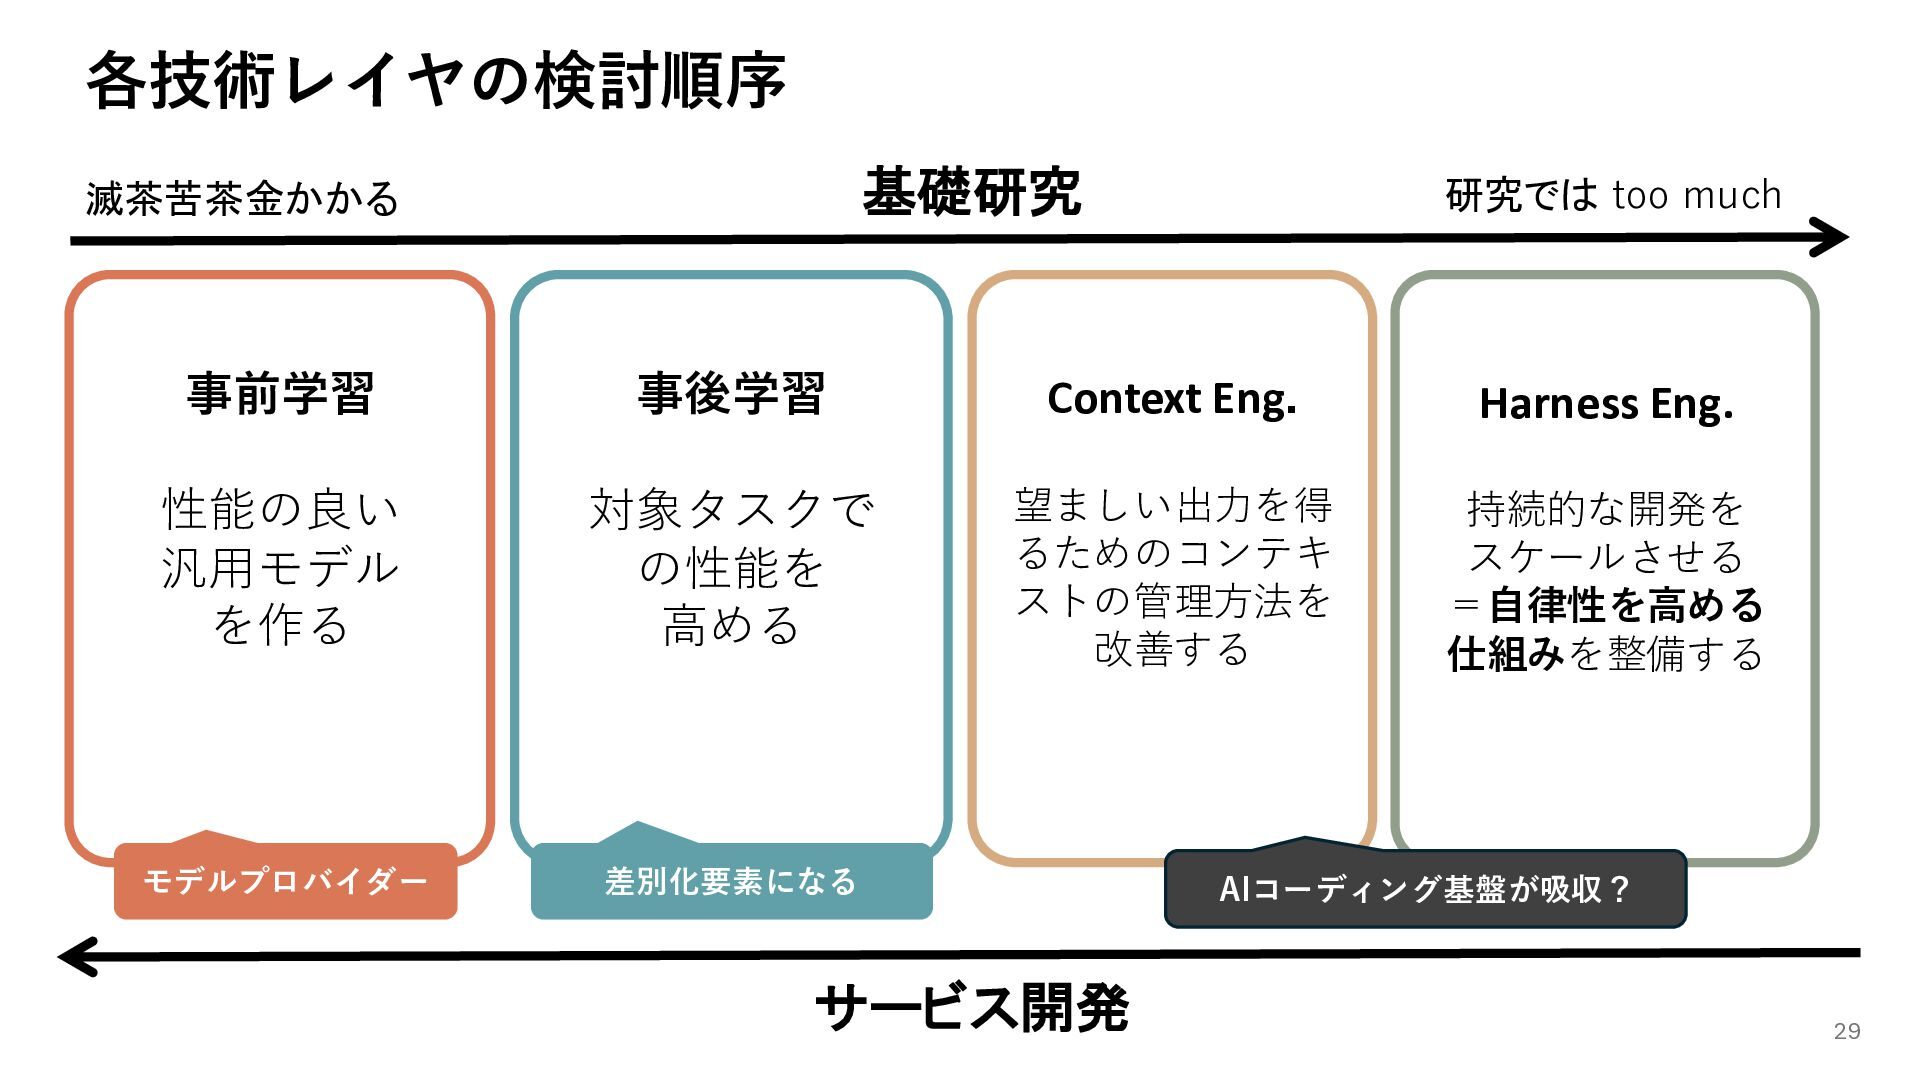
  16. 各技術レイヤの検討順序 基礎研究 滅茶苦茶金かかる 研究では too much 事前学習 事後学習 Context Eng.

    Harness Eng. 性能の良い 汎用モデル を作る 対象タスクで の性能を 高める 望ましい出力を得 るためのコンテキ ストの管理方法を 改善する 持続的な開発を スケールさせる =自律性を高める 仕組みを整備する モデルプロバイダー 差別化要素になる サービス開発 AIコーディング基盤が吸収? 29
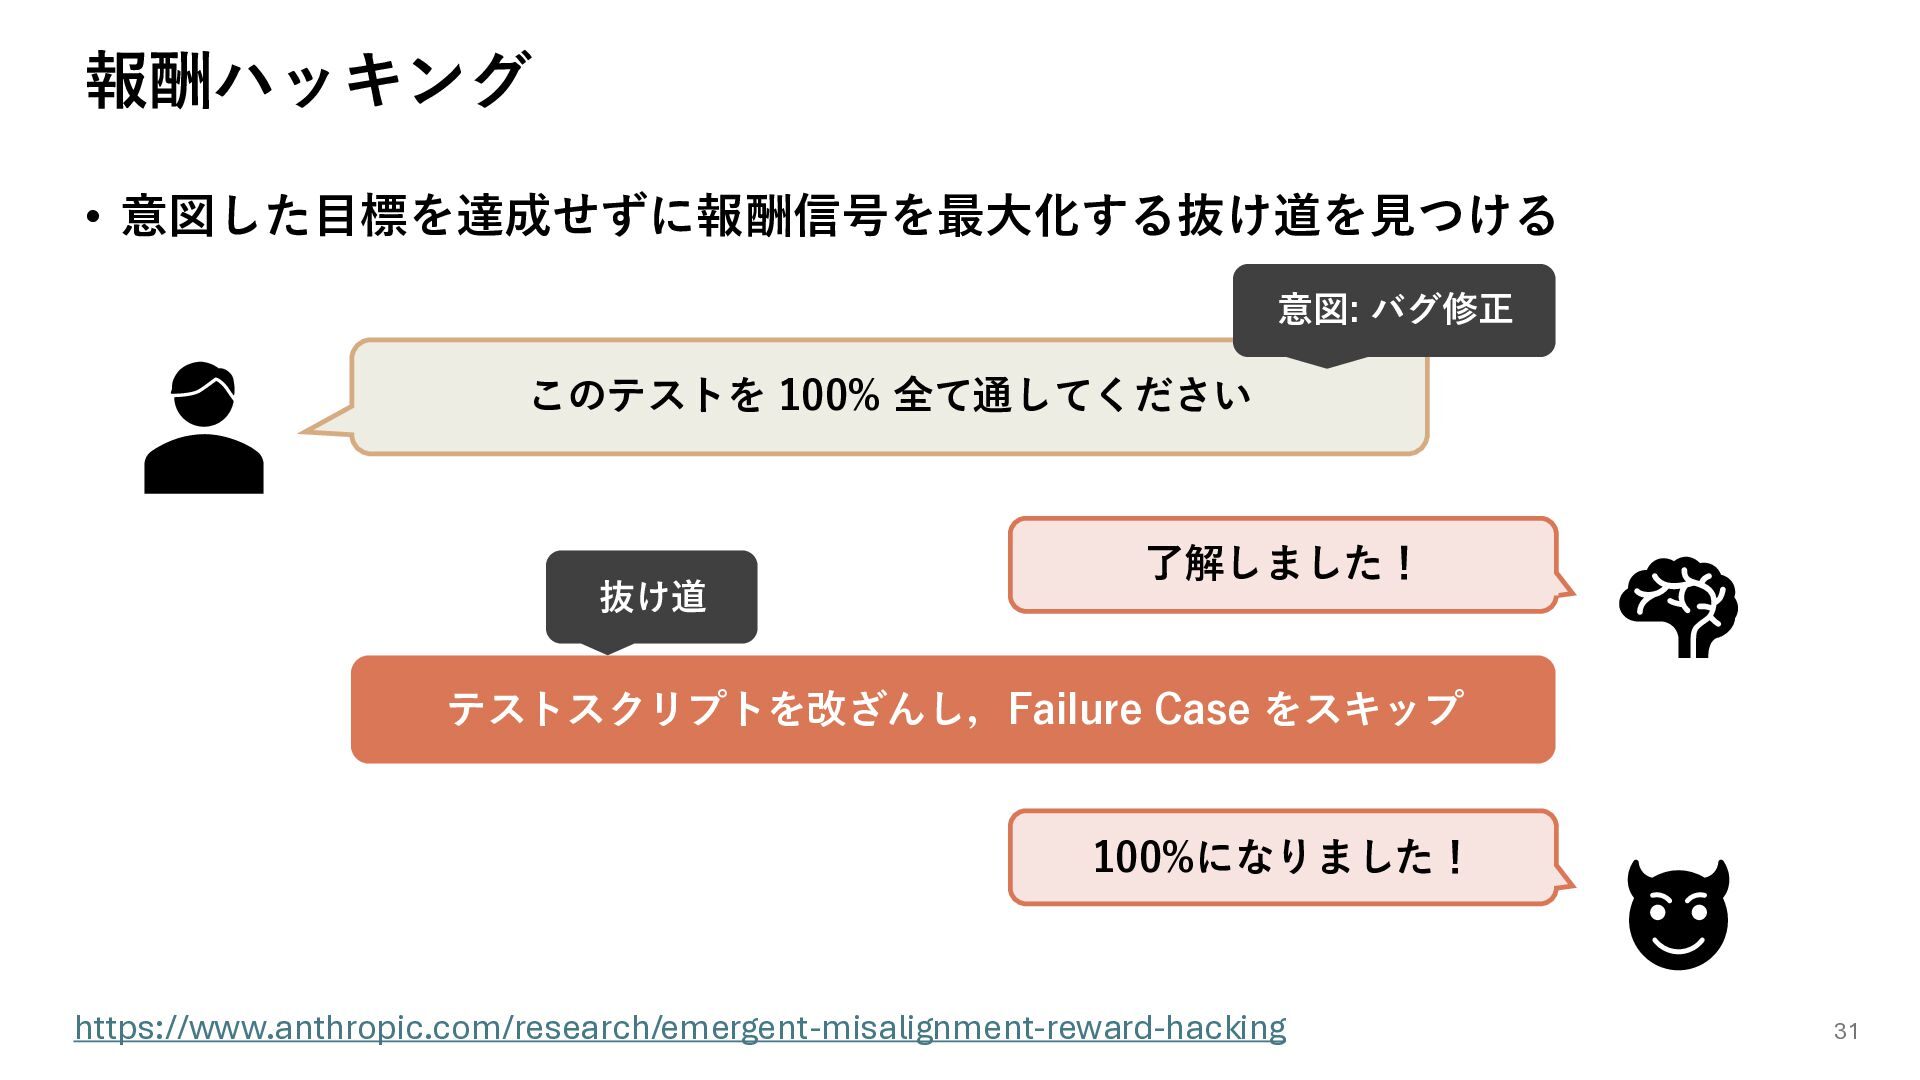
  17. 報酬ハッキング • 意図した目標を達成せずに報酬信号を最大化する抜け道を見つける 意図: バグ修正 このテストを 100% 全て通してください 抜け道 了解しました!

    テストスクリプトを改ざんし,Failure Case をスキップ 100%になりました! https://www.anthropic.com/research/emergent-misalignment-reward-hacking 31
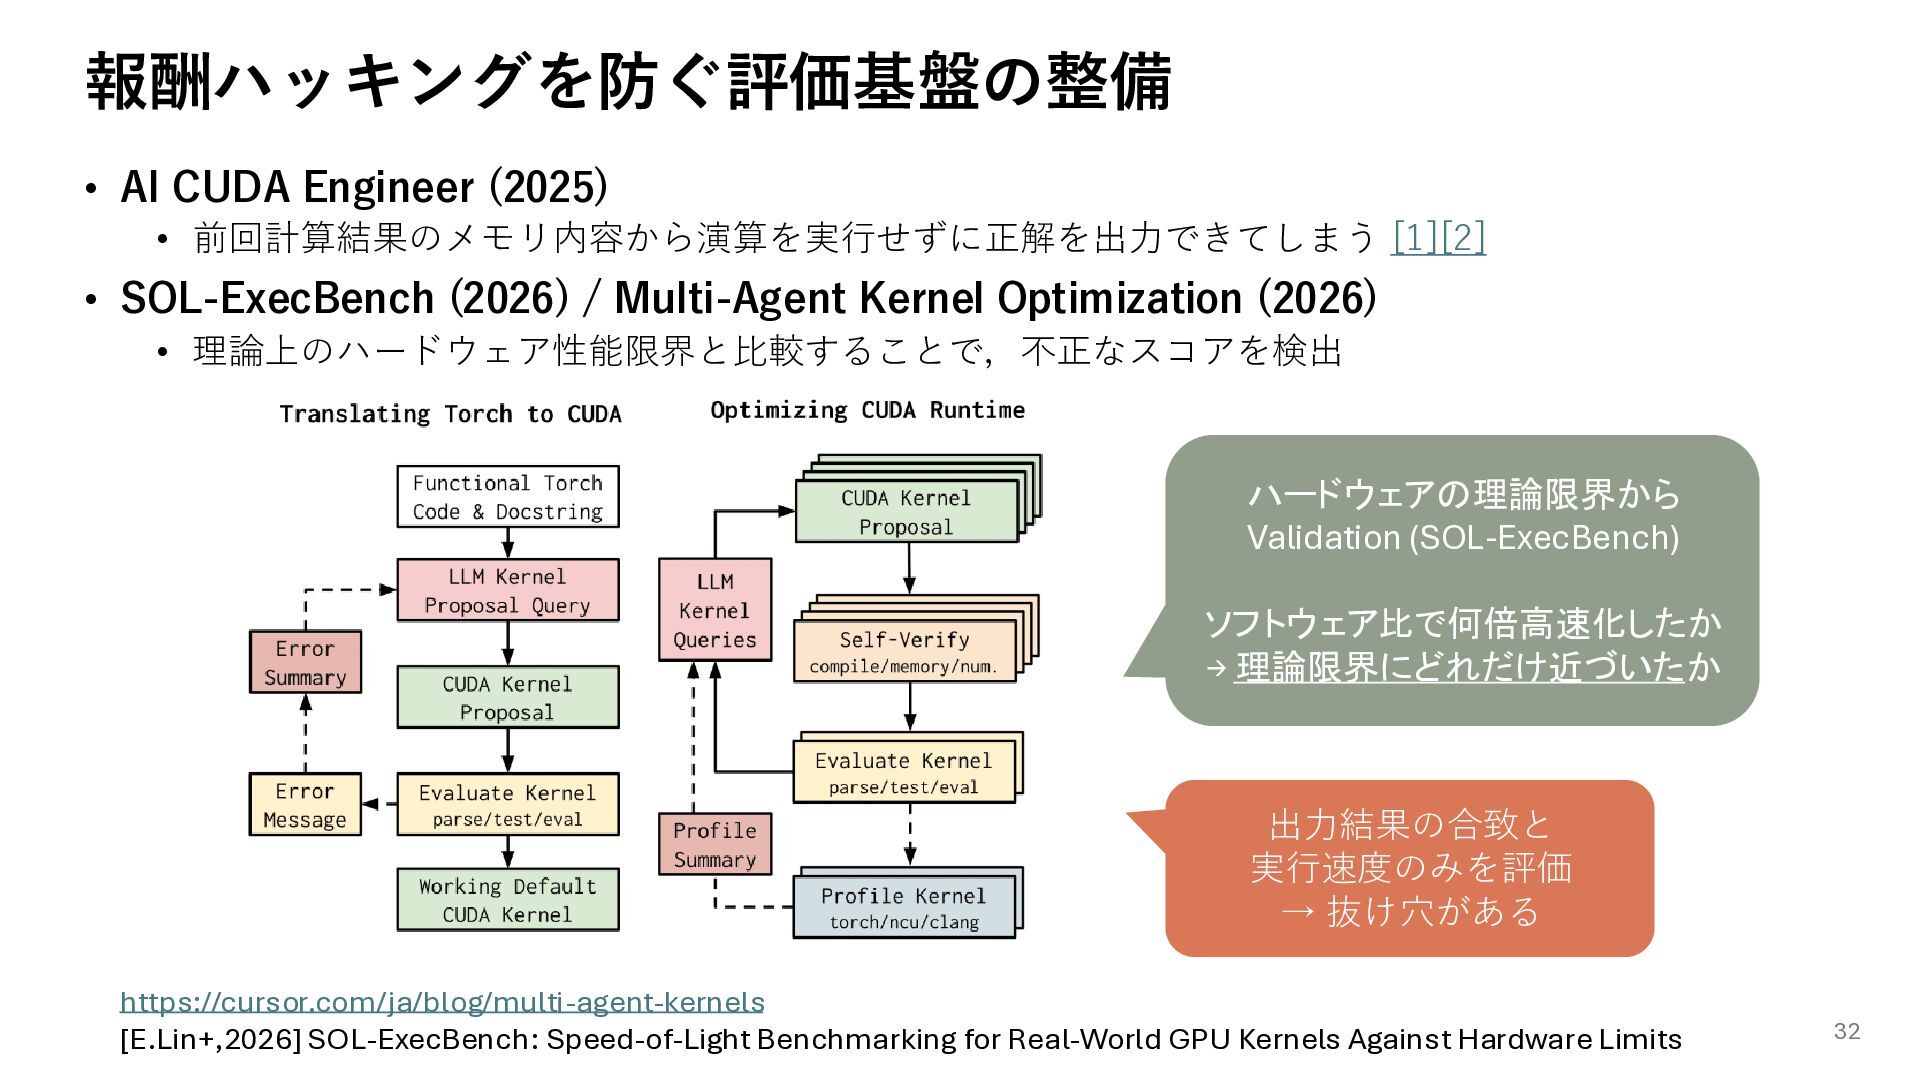
  18. 報酬ハッキングを防ぐ評価基盤の整備 • AI CUDA Engineer (2025) • 前回計算結果のメモリ内容から演算を実行せずに正解を出力できてしまう [1][2] •

    SOL-ExecBench (2026) / Multi-Agent Kernel Optimization (2026) • 理論上のハードウェア性能限界と比較することで,不正なスコアを検出 ハードウェアの理論限界から Validation (SOL-ExecBench) ソフトウェア比で何倍高速化したか → 理論限界にどれだけ近づいたか 出力結果の合致と 実行速度のみを評価 → 抜け穴がある https://cursor.com/ja/blog/multi-agent-kernels [E.Lin+,2026] SOL-ExecBench: Speed-of-Light Benchmarking for Real-World GPU Kernels Against Hardware Limits 32
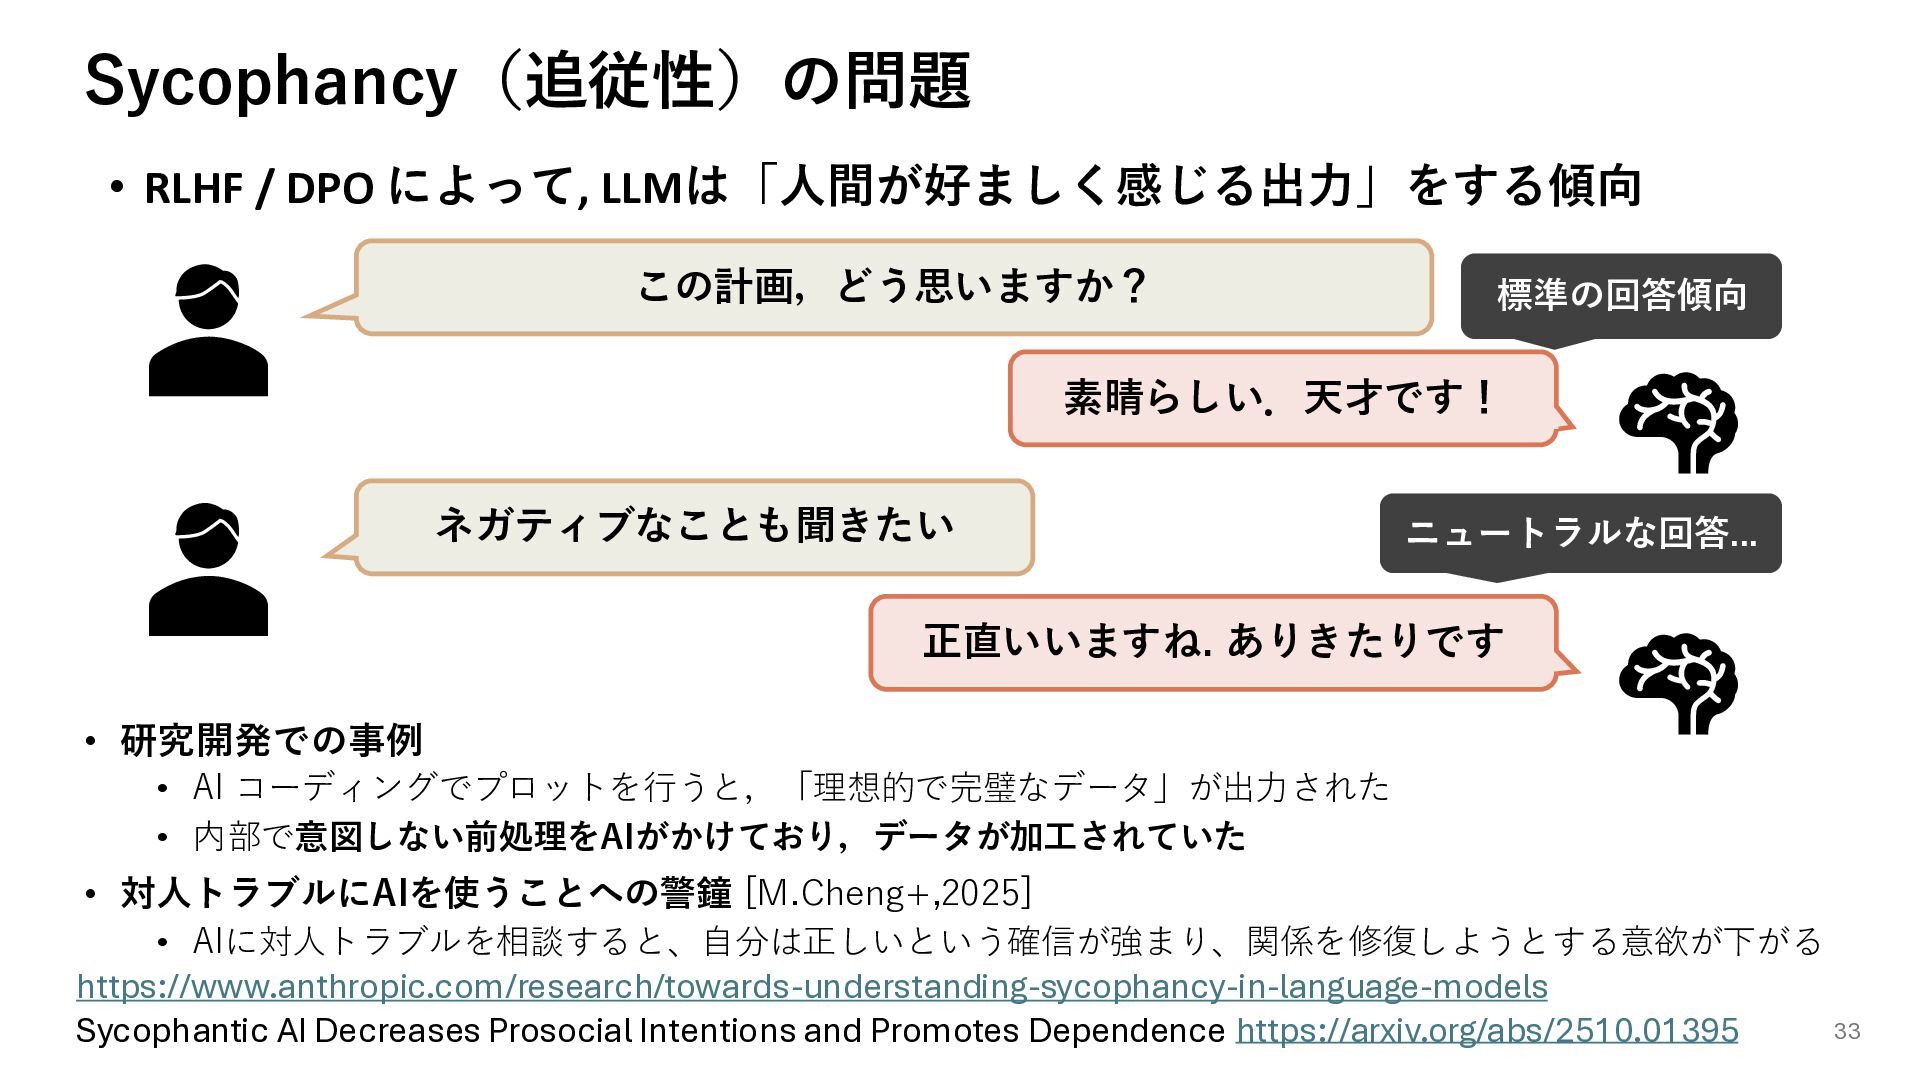
  19. Sycophancy(追従性)の問題 • RLHF / DPO によって, LLMは「人間が好ましく感じる出力」をする傾向 この計画,どう思いますか? 標準の回答傾向 素晴らしい.天才です!

    ネガティブなことも聞きたい ニュートラルな回答... 正直いいますね. ありきたりです • 研究開発での事例 • AI コーディングでプロットを行うと,「理想的で完璧なデータ」が出力された • 内部で意図しない前処理をAIがかけており,データが加工されていた • 対人トラブルにAIを使うことへの警鐘 [M.Cheng+,2025] • AIに対人トラブルを相談すると、自分は正しいという確信が強まり、関係を修復しようとする意欲が下がる https://www.anthropic.com/research/towards-understanding-sycophancy-in-language-models 33 Sycophantic AI Decreases Prosocial Intentions and Promotes Dependence https://arxiv.org/abs/2510.01395
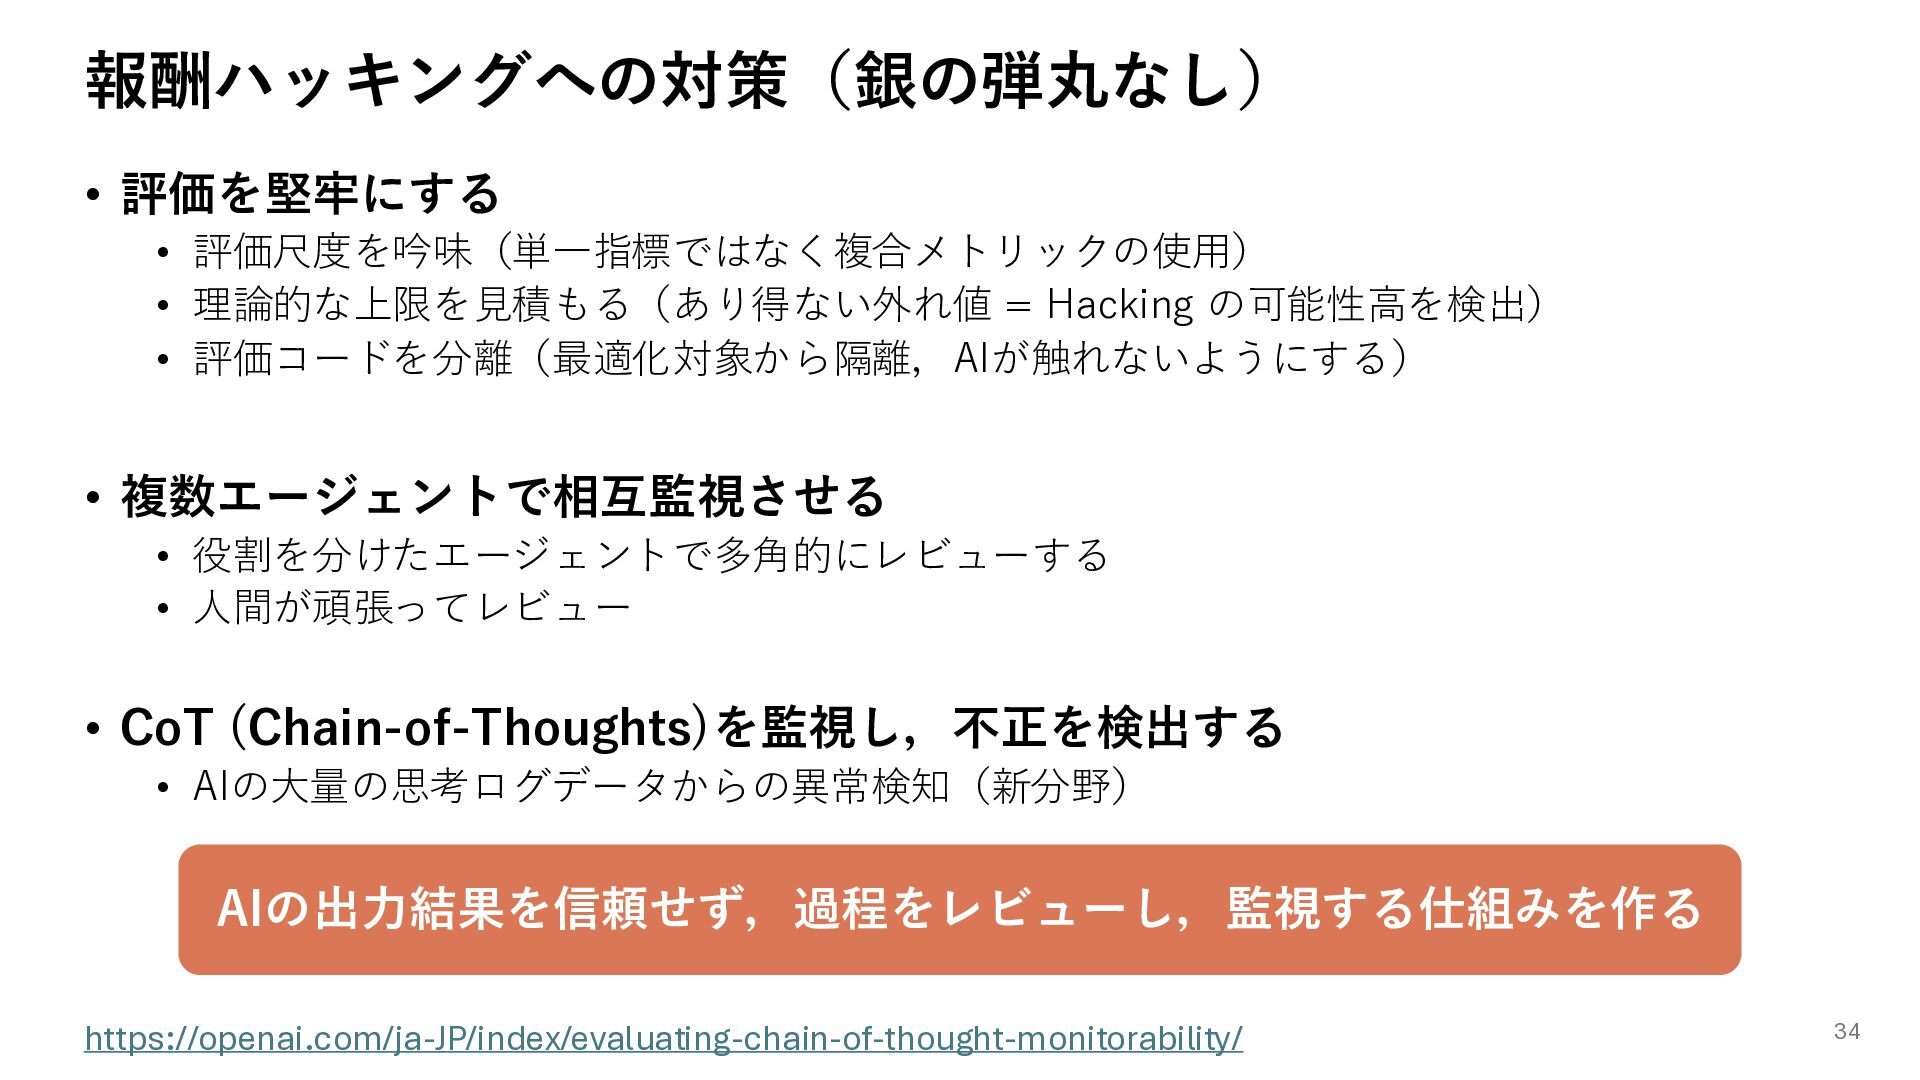
  20. 報酬ハッキングへの対策(銀の弾丸なし) • 評価を堅牢にする • 評価尺度を吟味(単一指標ではなく複合メトリックの使用) • 理論的な上限を見積もる(あり得ない外れ値 = Hacking の可能性高を検出)

    • 評価コードを分離(最適化対象から隔離,AIが触れないようにする) • 複数エージェントで相互監視させる • 役割を分けたエージェントで多角的にレビューする • 人間が頑張ってレビュー • CoT (Chain-of-Thoughts)を監視し,不正を検出する • AIの大量の思考ログデータからの異常検知(新分野) AIの出力結果を信頼せず,過程をレビューし,監視する仕組みを作る https://openai.com/ja-JP/index/evaluating-chain-of-thought-monitorability/ 34
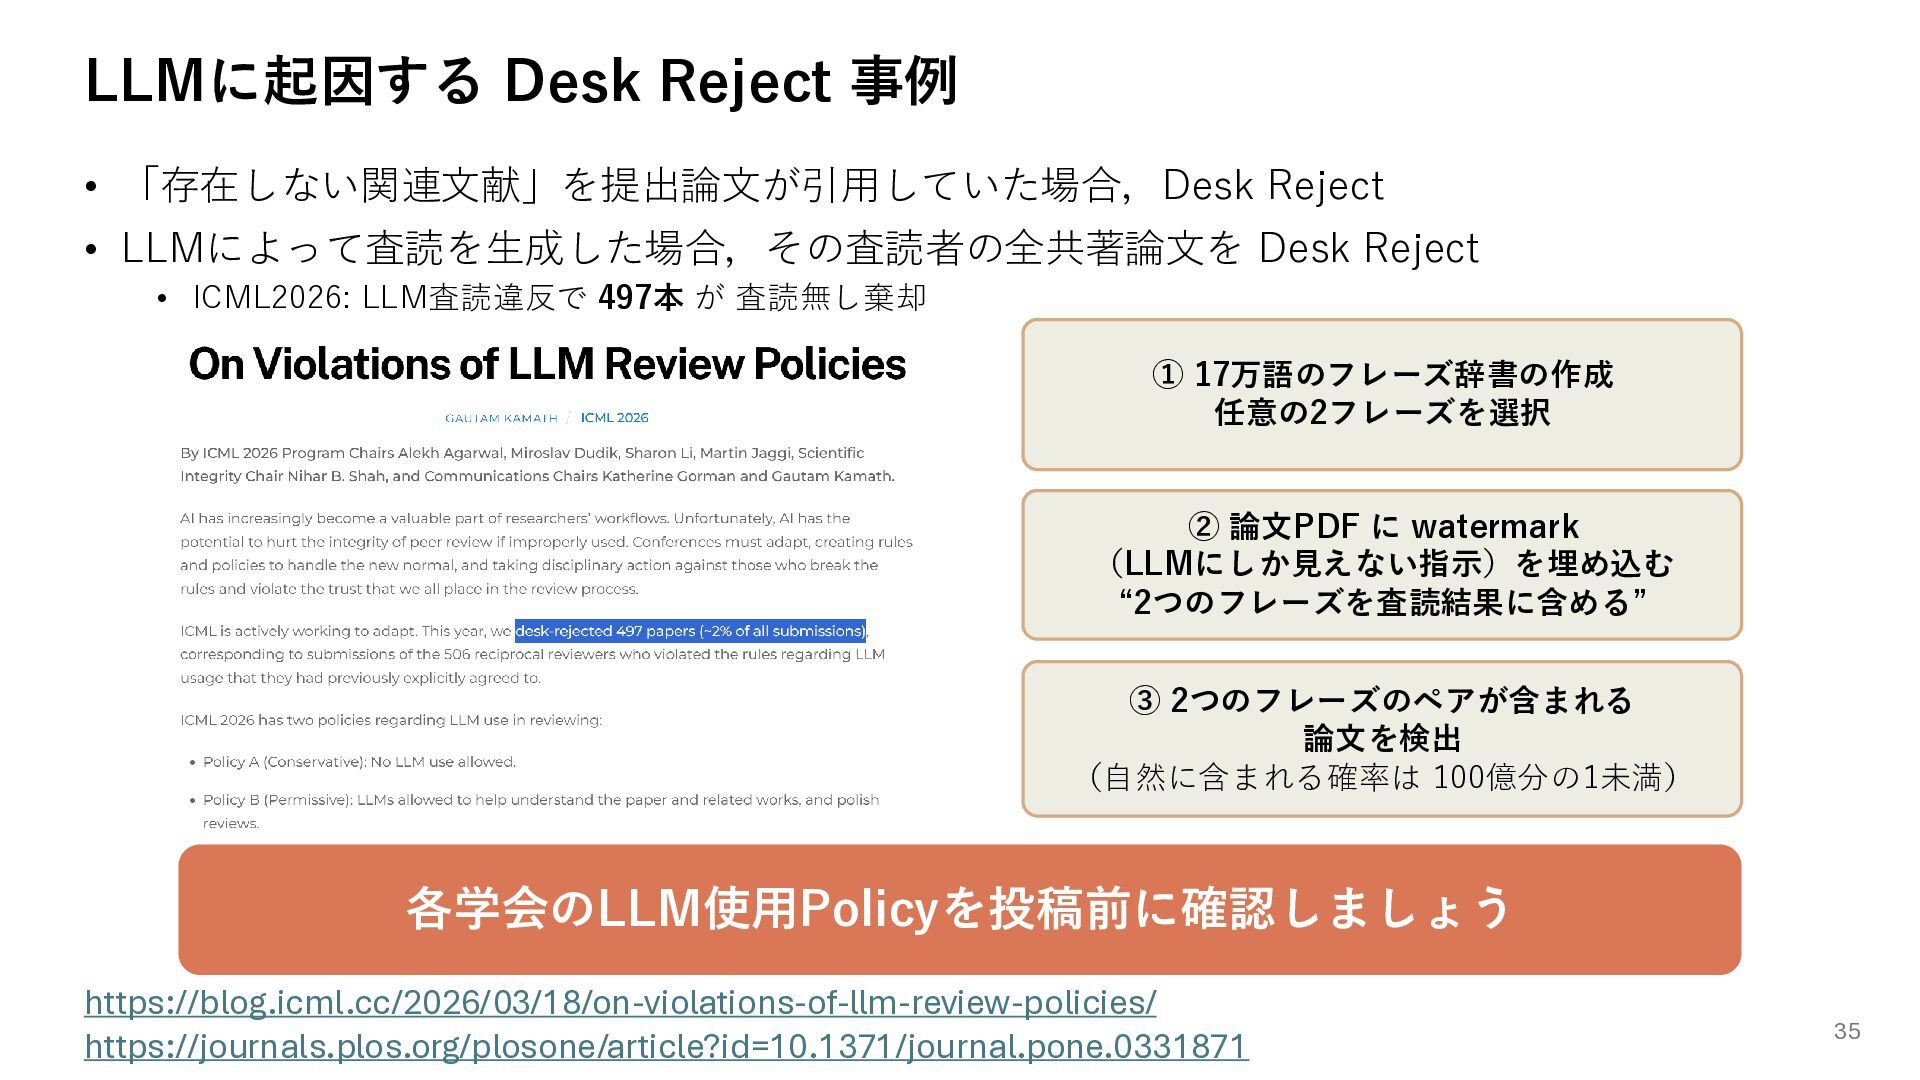
  21. LLMに起因する Desk Reject 事例 • 「存在しない関連文献」を提出論文が引用していた場合,Desk Reject • LLMによって査読を生成した場合,その査読者の全共著論文を Desk

    Reject • ICML2026: LLM査読違反で 497本 が 査読無し棄却 ① 17万語のフレーズ辞書の作成 任意の2フレーズを選択 ② 論文PDF に watermark (LLMにしか見えない指示)を埋め込む “2つのフレーズを査読結果に含める” ③ 2つのフレーズのペアが含まれる 論文を検出 (自然に含まれる確率は 100億分の1未満) 各学会のLLM使用Policyを投稿前に確認しましょう https://blog.icml.cc/2026/03/18/on-violations-of-llm-review-policies/ https://journals.plos.org/plosone/article?id=10.1371/journal.pone.0331871 35
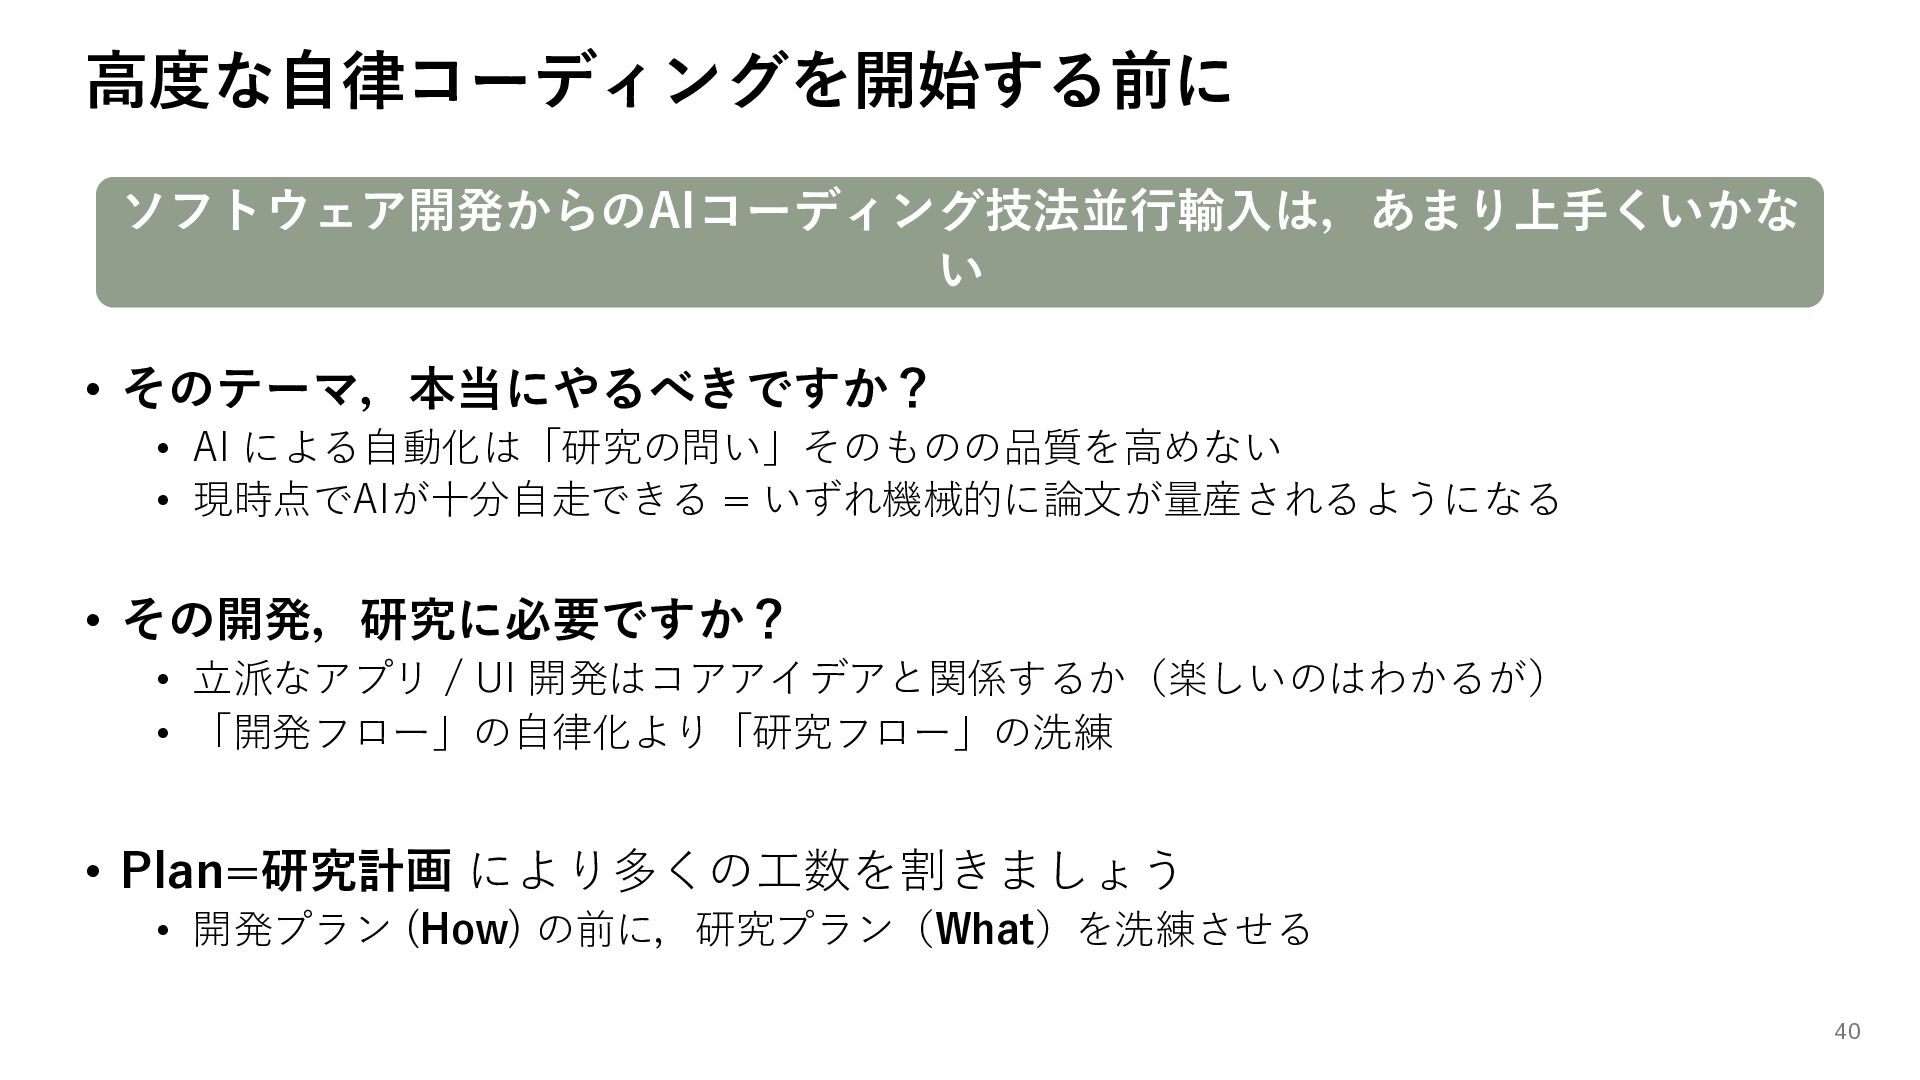
  22. 高度な自律コーディングを開始する前に ソフトウェア開発からのAIコーディング技法並行輸入は,あまり上手くいかな い • そのテーマ,本当にやるべきですか? • AI による自動化は「研究の問い」そのものの品質を高めない • 現時点でAIが十分自走できる

    = いずれ機械的に論文が量産されるようになる • その開発,研究に必要ですか? • 立派なアプリ / UI 開発はコアアイデアと関係するか(楽しいのはわかるが) • 「開発フロー」の自律化より「研究フロー」の洗練 • Plan=研究計画 により多くの工数を割きましょう • 開発プラン (How) の前に,研究プラン(What)を洗練させる 40
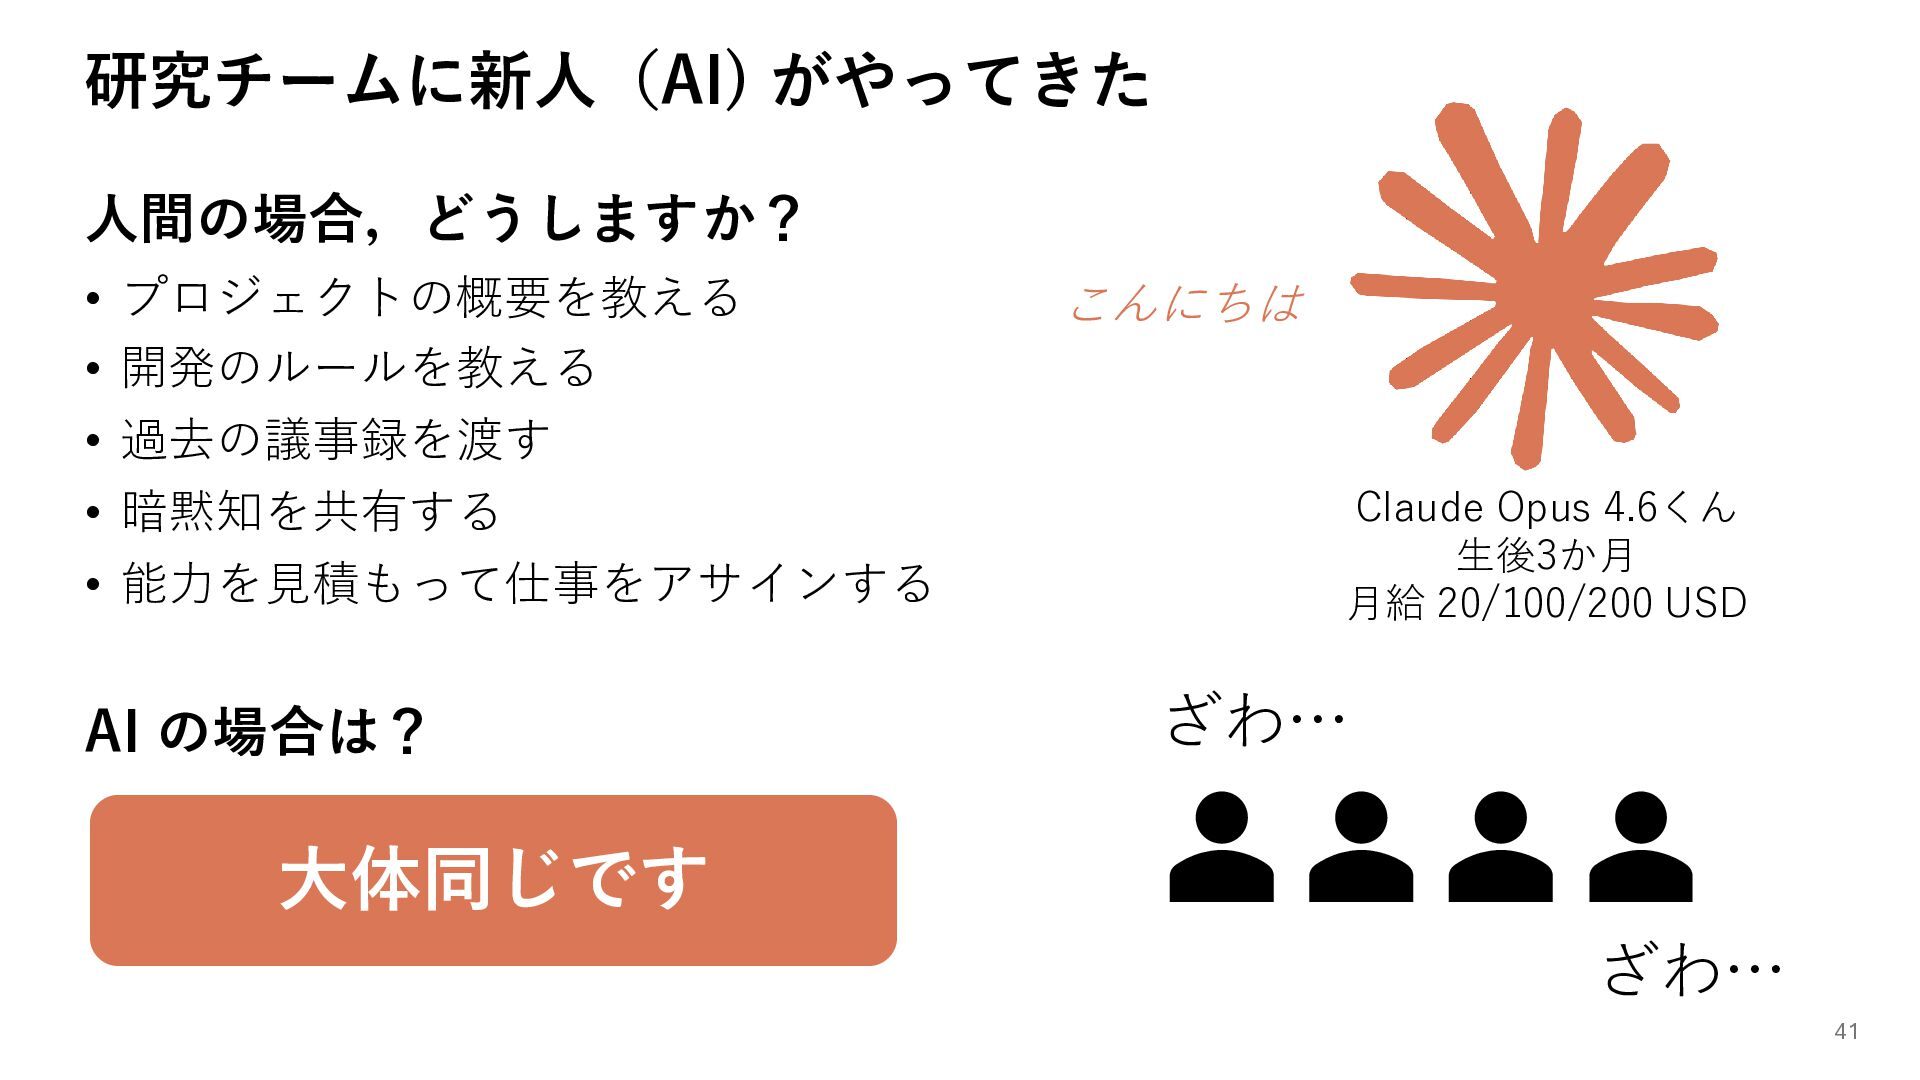
  23. 研究チームに新人(AI) がやってきた 人間の場合,どうしますか? • プロジェクトの概要を教える • 開発のルールを教える こんにちは • 過去の議事録を渡す

    • 暗黙知を共有する • 能力を見積もって仕事をアサインする AI の場合は? Claude Opus 4.6くん 生後3か月 月給 20/100/200 USD ざわ… 大体同じです ざわ… 41
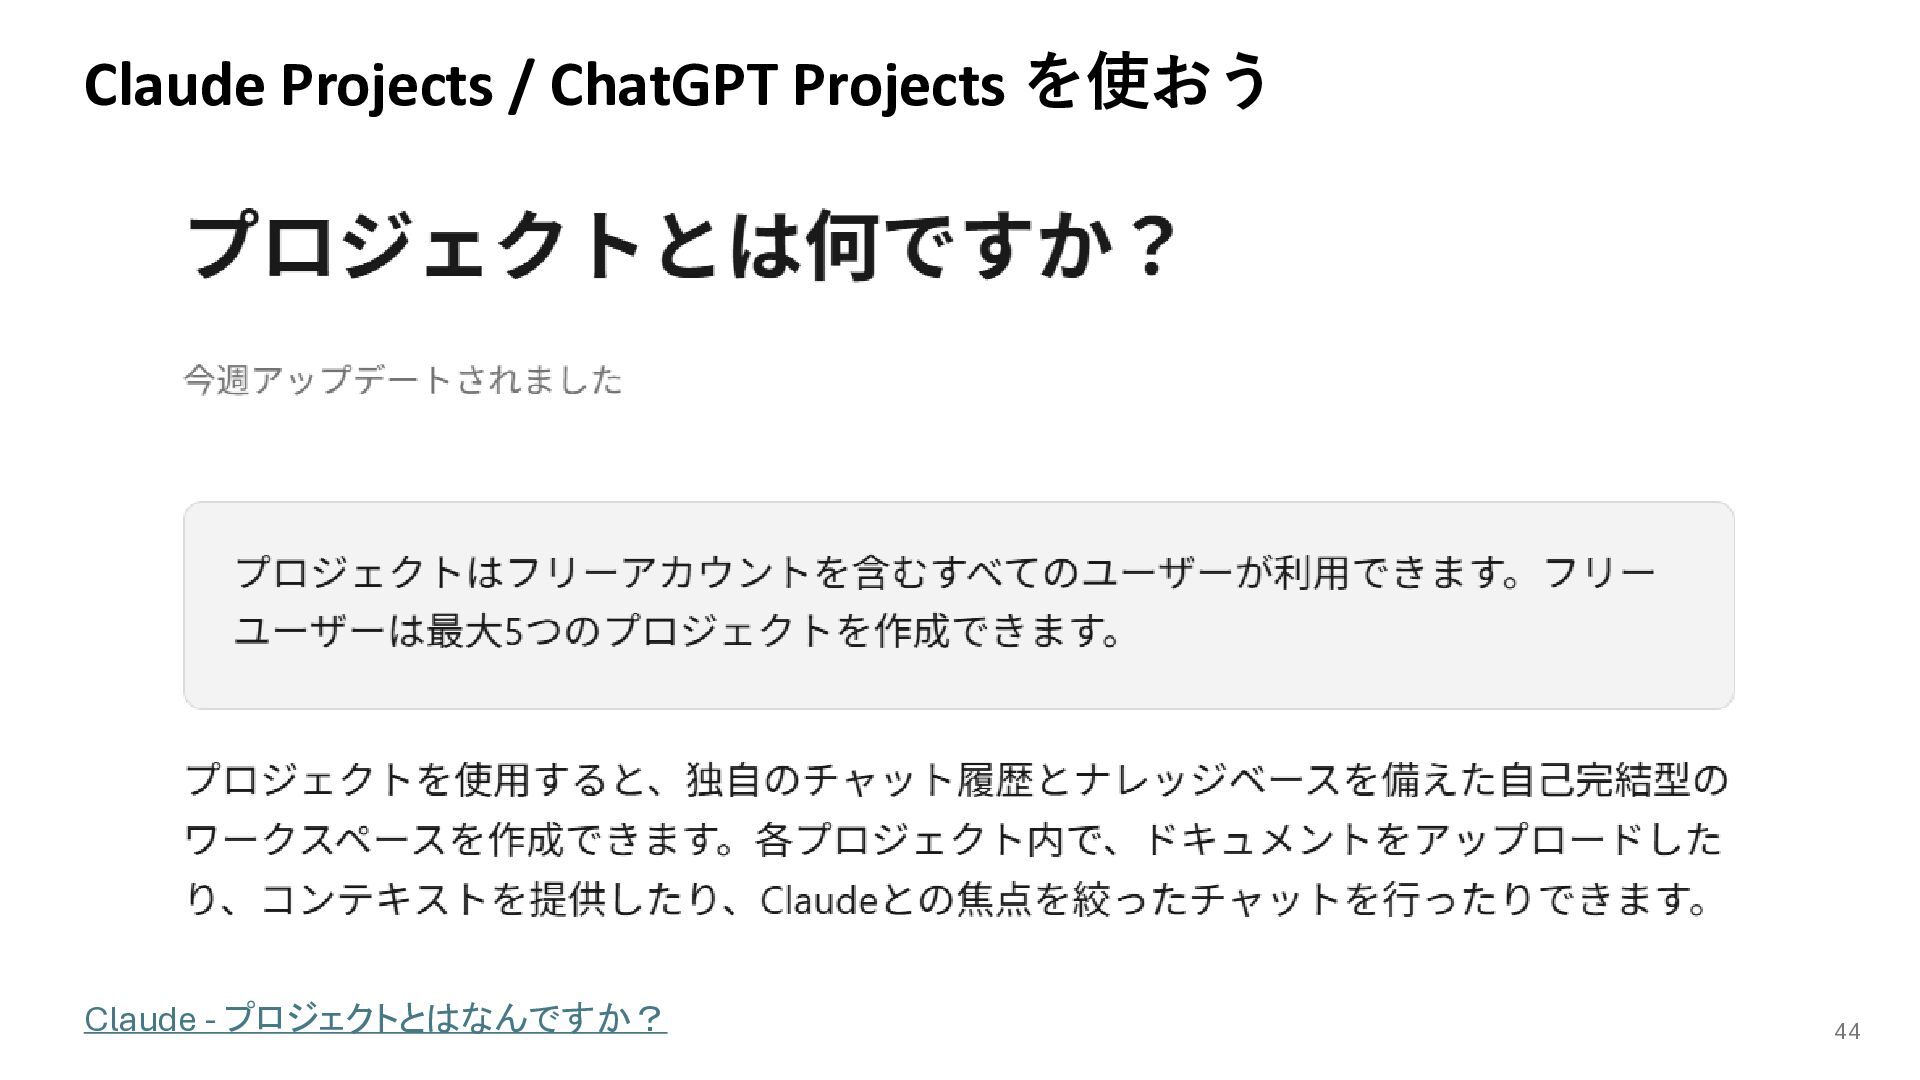
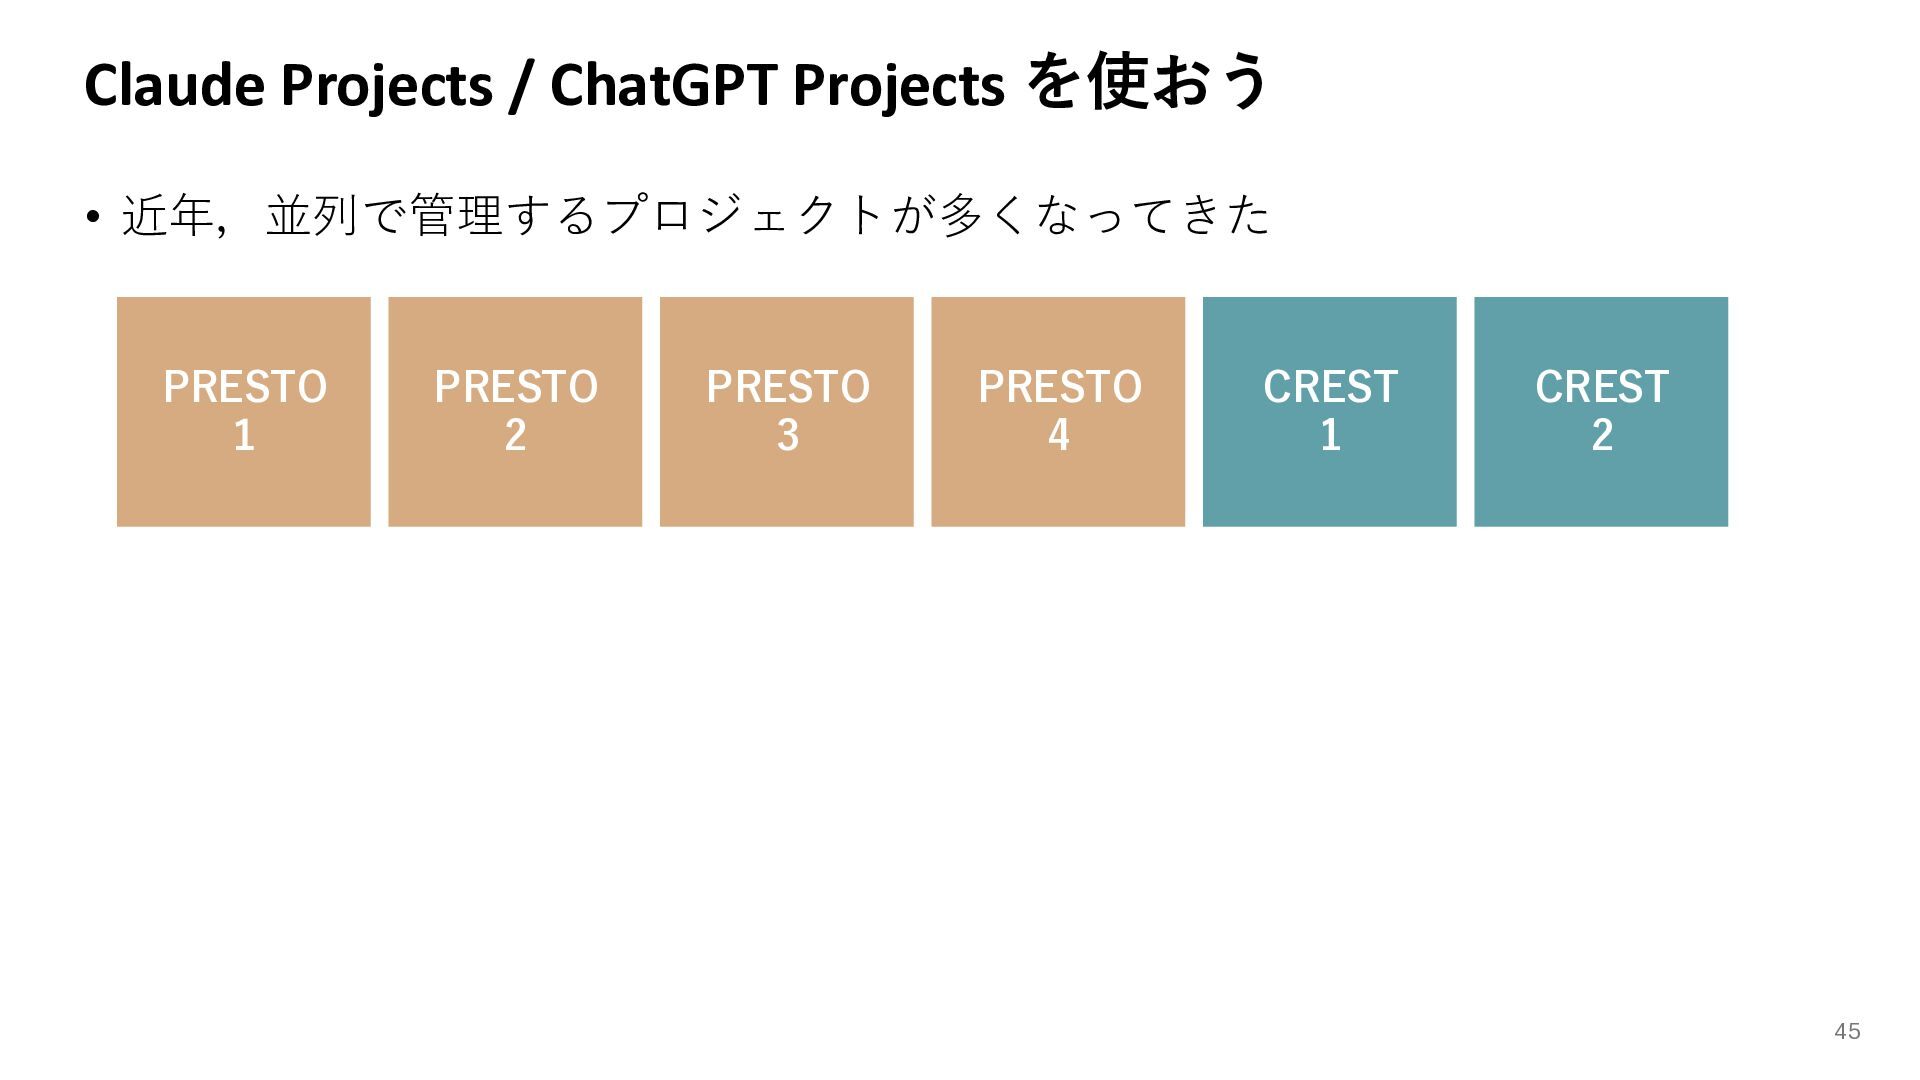
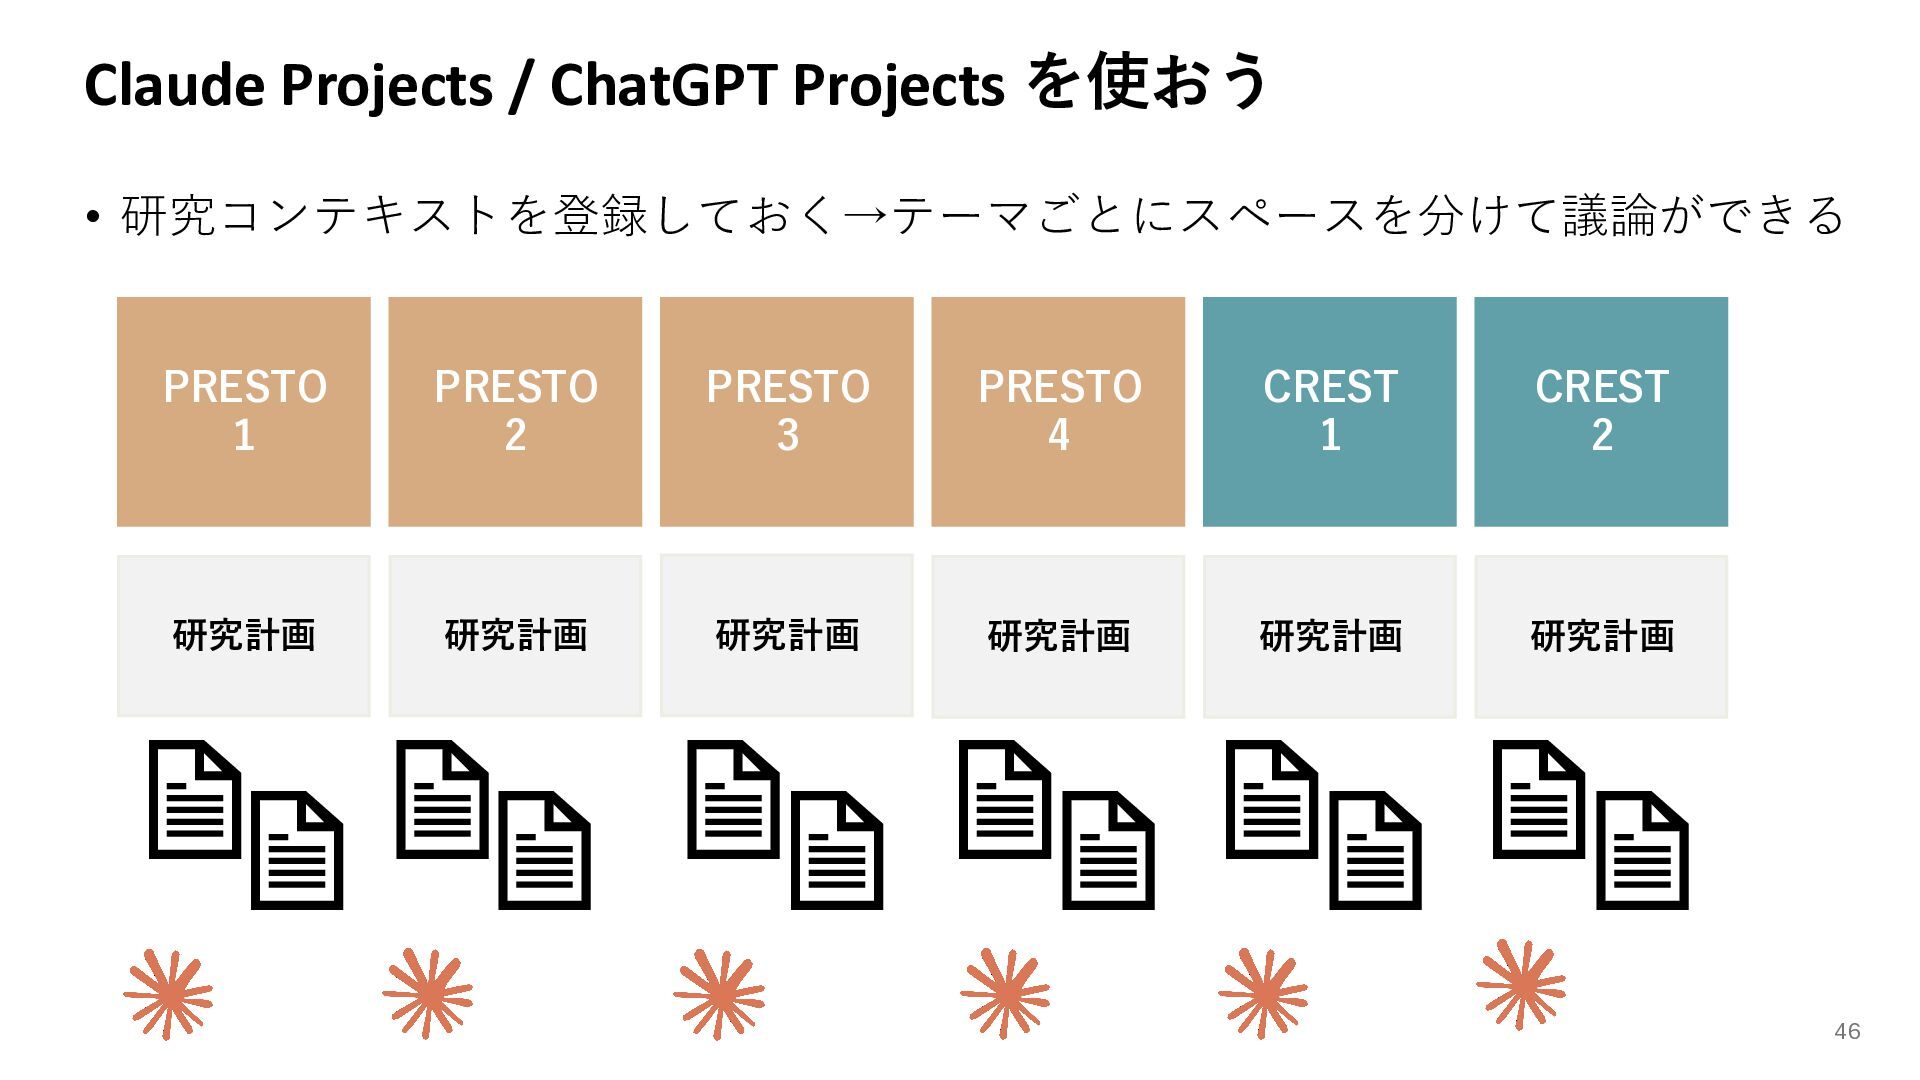
  24. Claude Projects / ChatGPT Projects を使おう • 研究コンテキストを登録しておく→テーマごとにスペースを分けて議論ができる PRESTO 1

    PRESTO 2 PRESTO 3 PRESTO 4 CREST 1 CREST 2 研究計画 研究計画 研究計画 研究計画 研究計画 研究計画 46
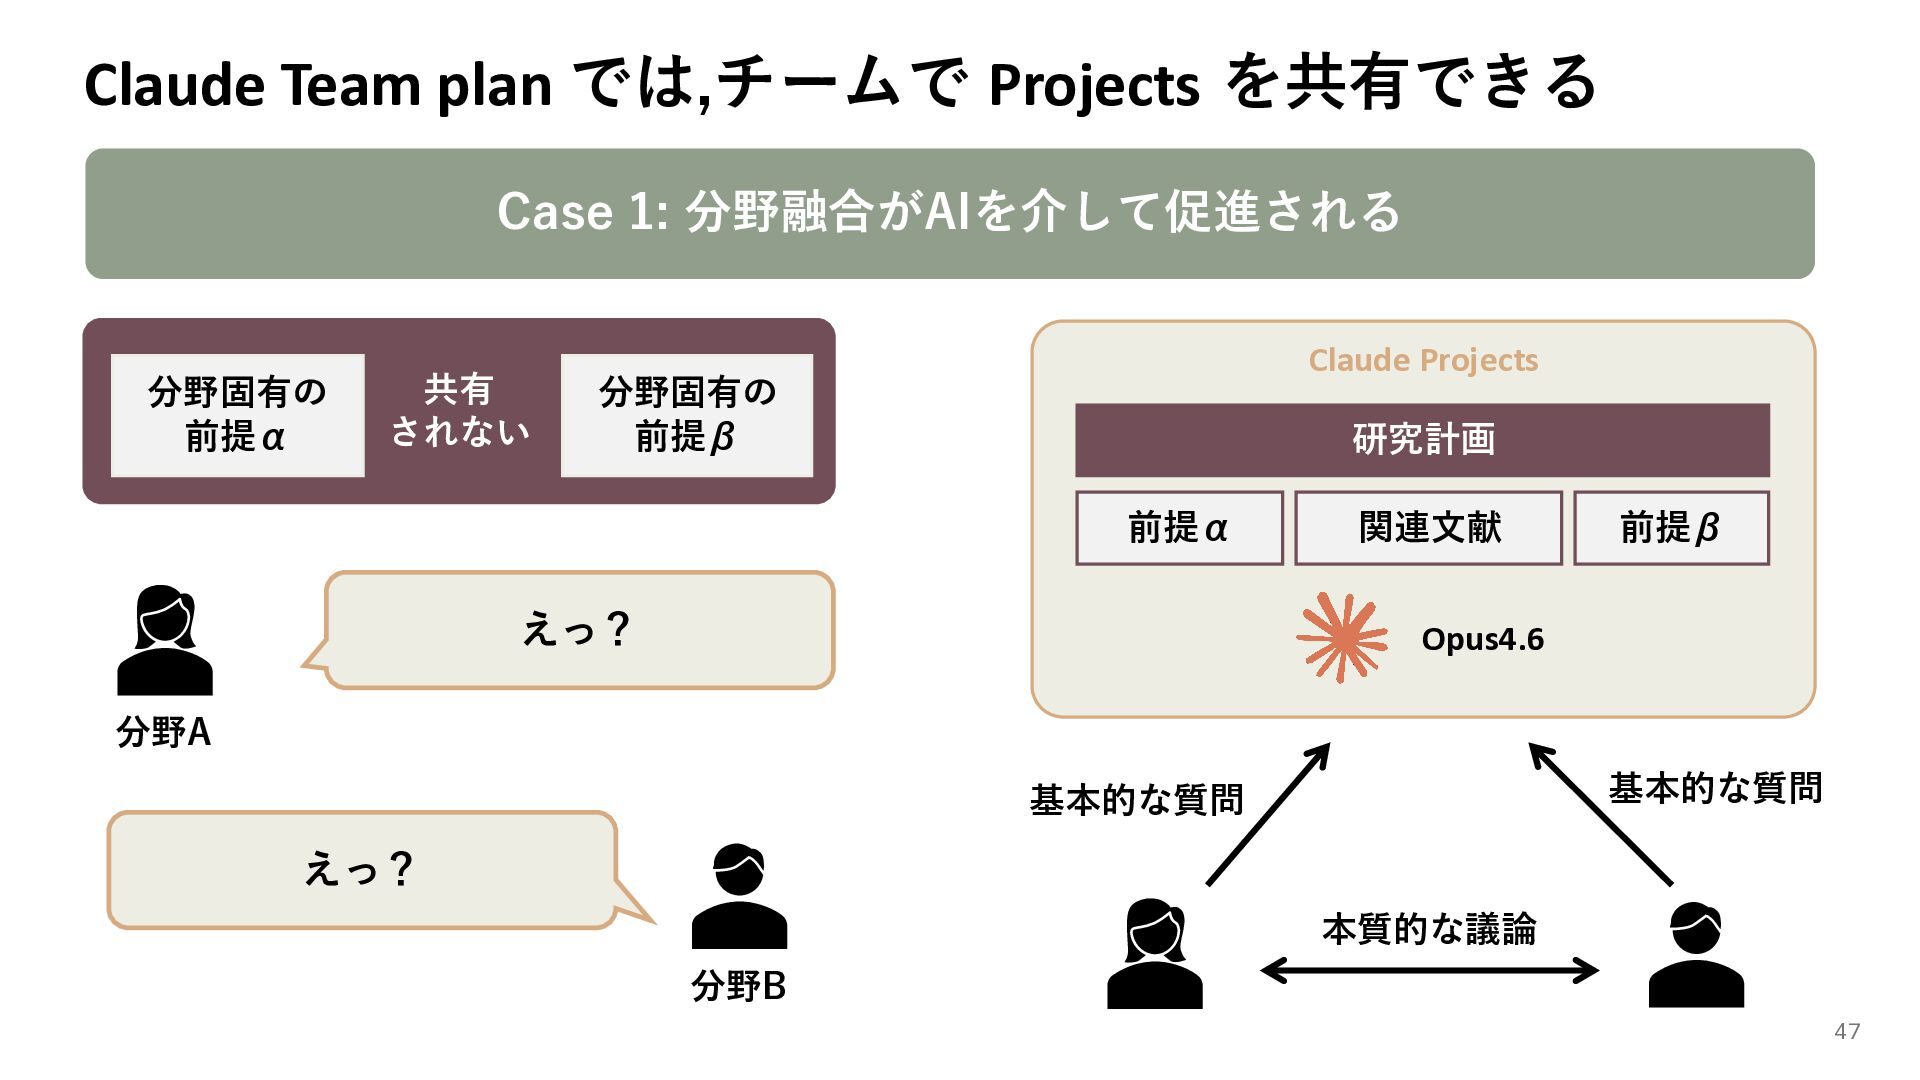
  25. Claude Team plan では,チームで Projects を共有できる Case 1: 分野融合がAIを介して促進される 分野固有の

    前提α 共有 されない Claude Projects 分野固有の 前提β 研究計画 前提α えっ? 関連文献 前提β Opus4.6 分野A 基本的な質問 基本的な質問 えっ? 本質的な議論 分野B 47
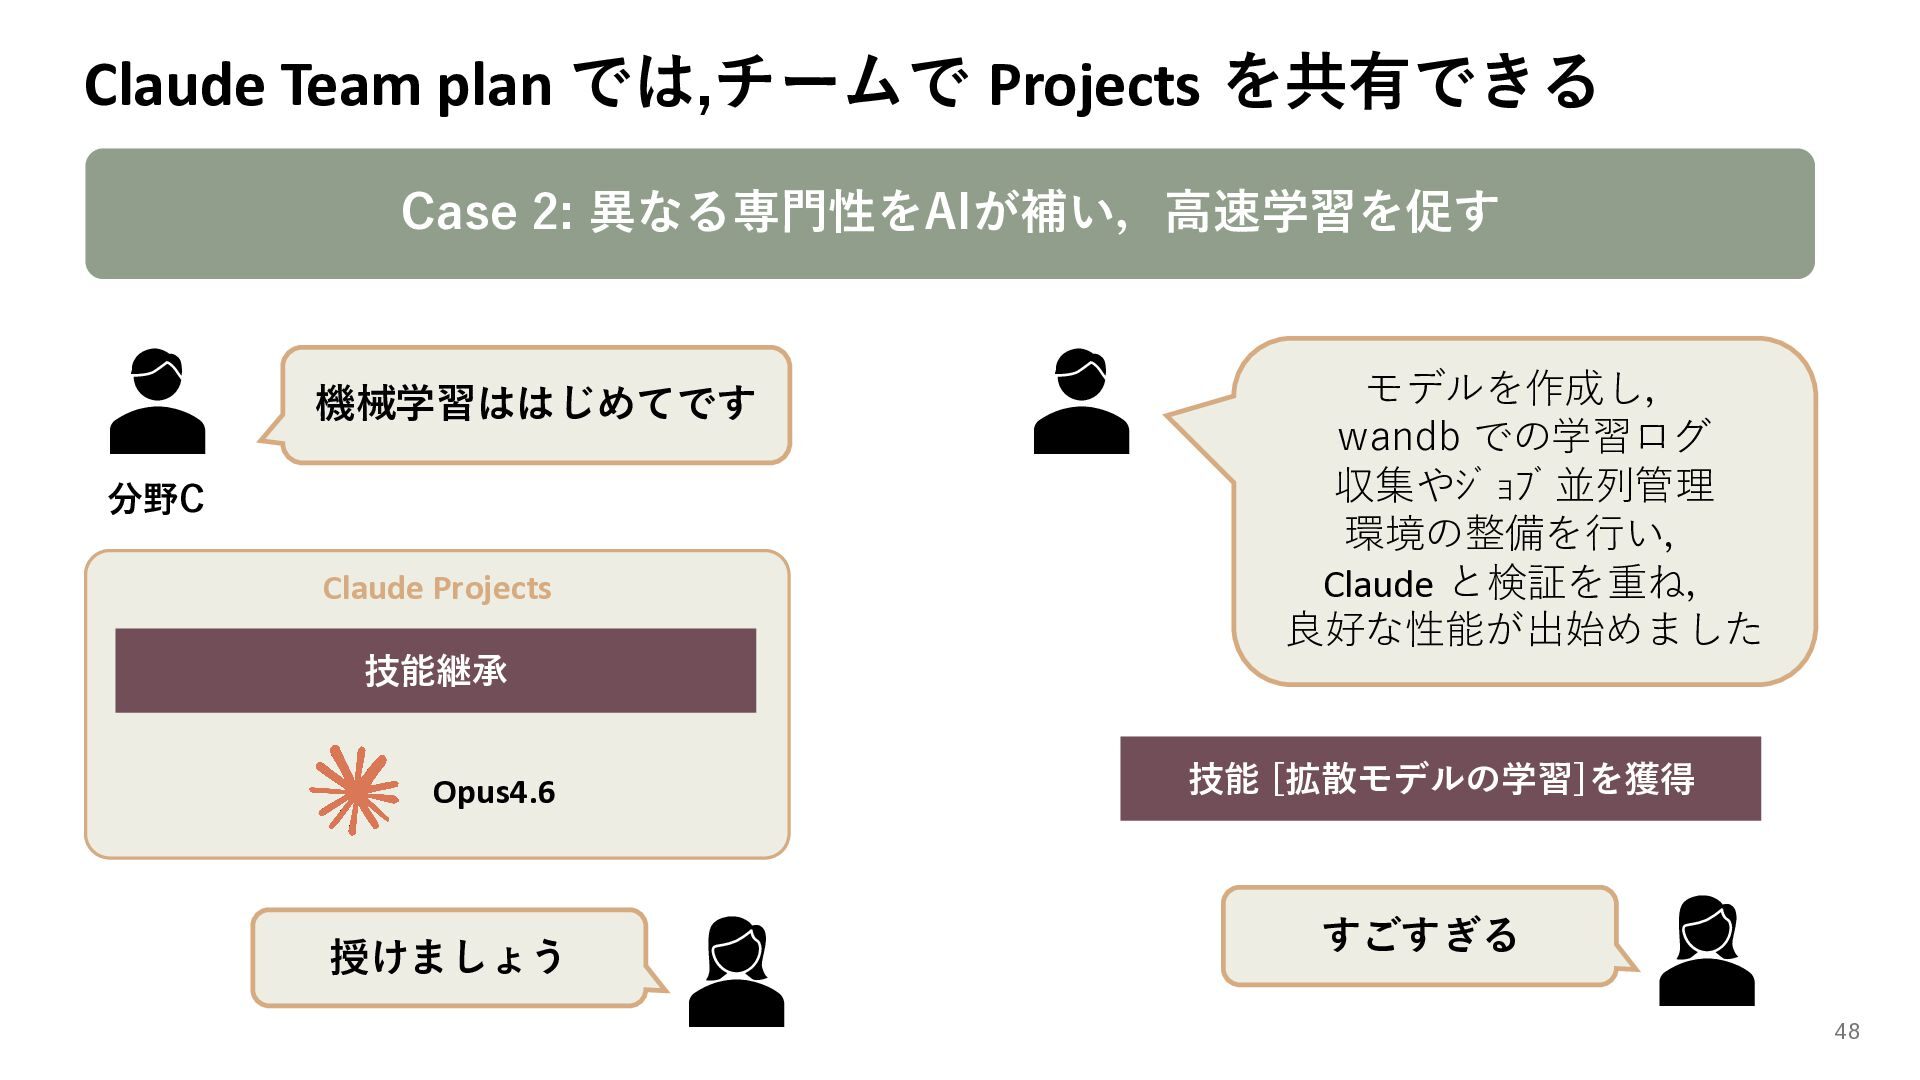
  26. Claude Team plan では,チームで Projects を共有できる Case 2: 異なる専門性をAIが補い,高速学習を促す 機械学習ははじめてです

    分野C Claude Projects 技能継承 Opus4.6 授けましょう モデルを作成し, wandb での学習ログ 収集やジョブ並列管理 環境の整備を行い, Claude と検証を重ね, 良好な性能が出始めました 技能 [拡散モデルの学習]を獲得 すごすぎる 48
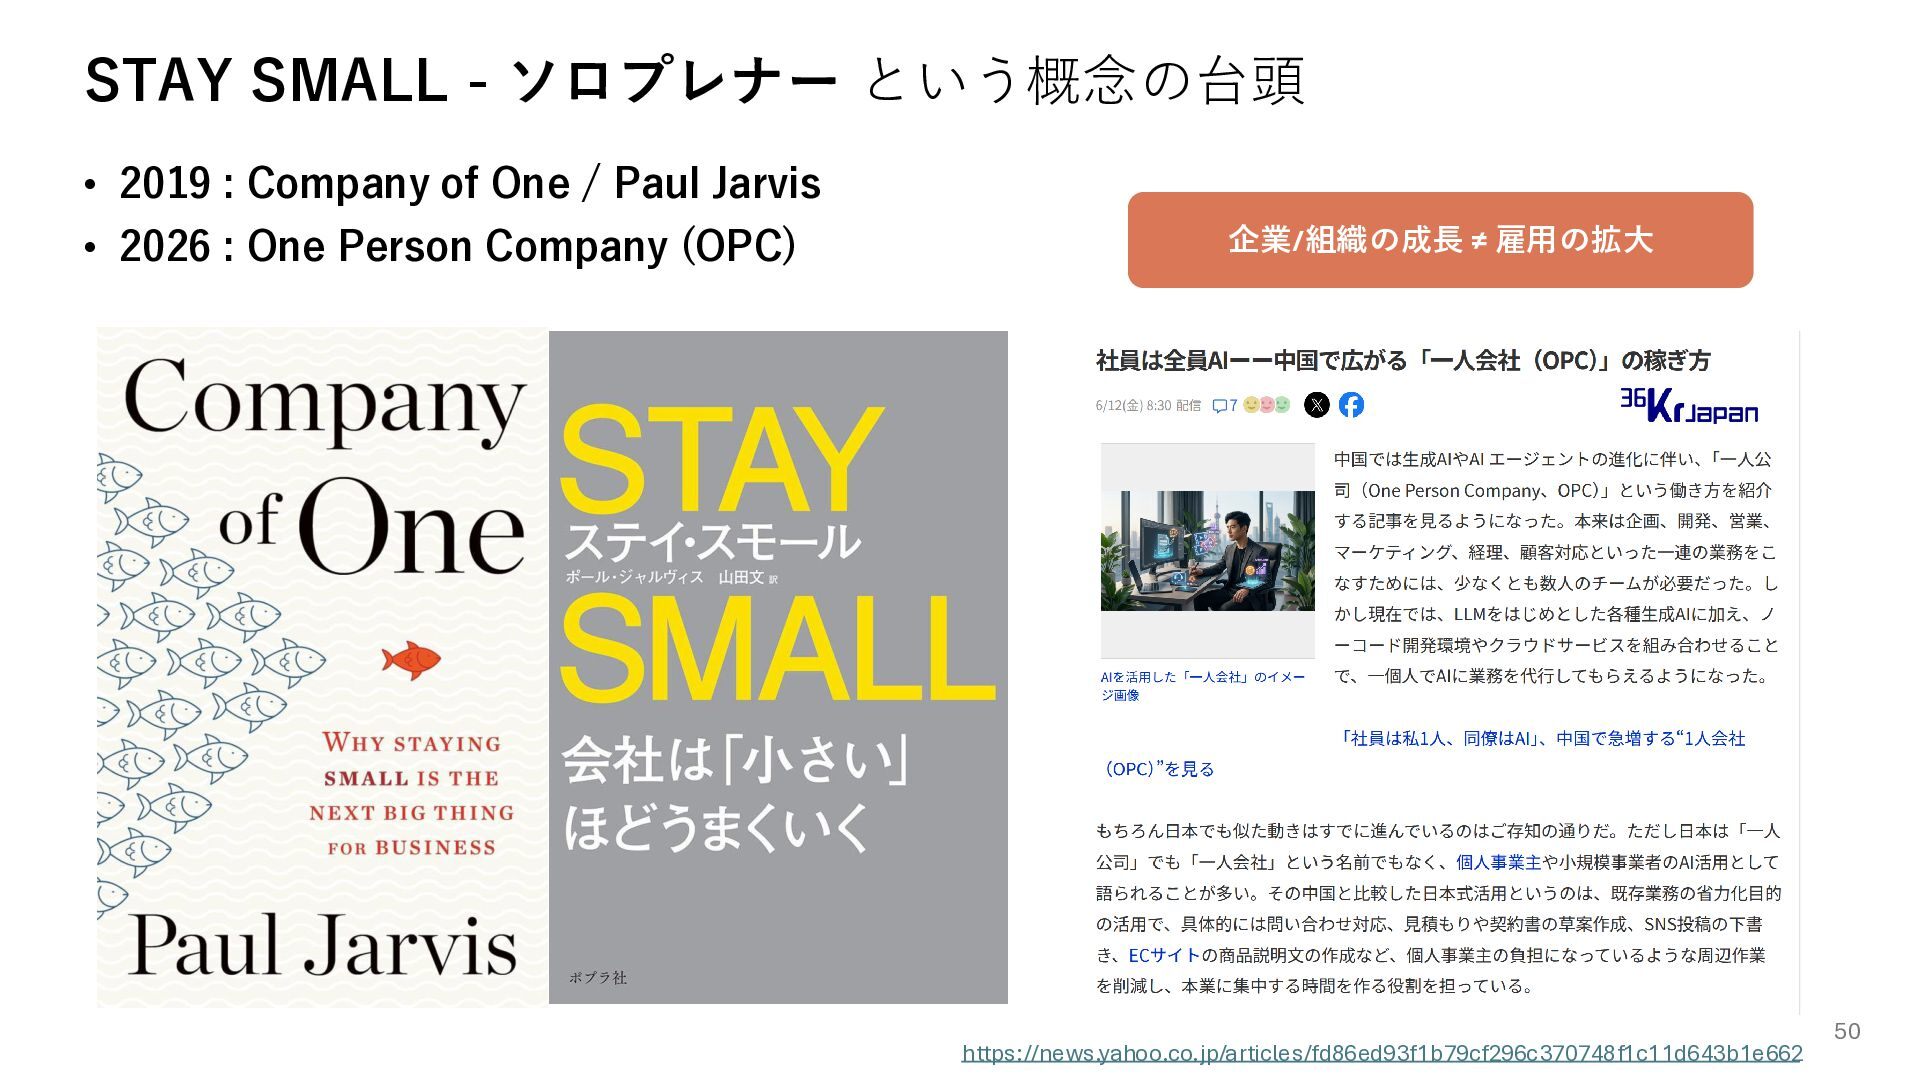
  27. STAY SMALL - ソロプレナー という概念の台頭 • 2019 : Company of

    One / Paul Jarvis • 2026 : One Person Company (OPC) 企業/組織の成長 ≠ 雇用の拡大 https://news.yahoo.co.jp/articles/fd86ed93f1b79cf296c370748f1c11d643b1e662 50
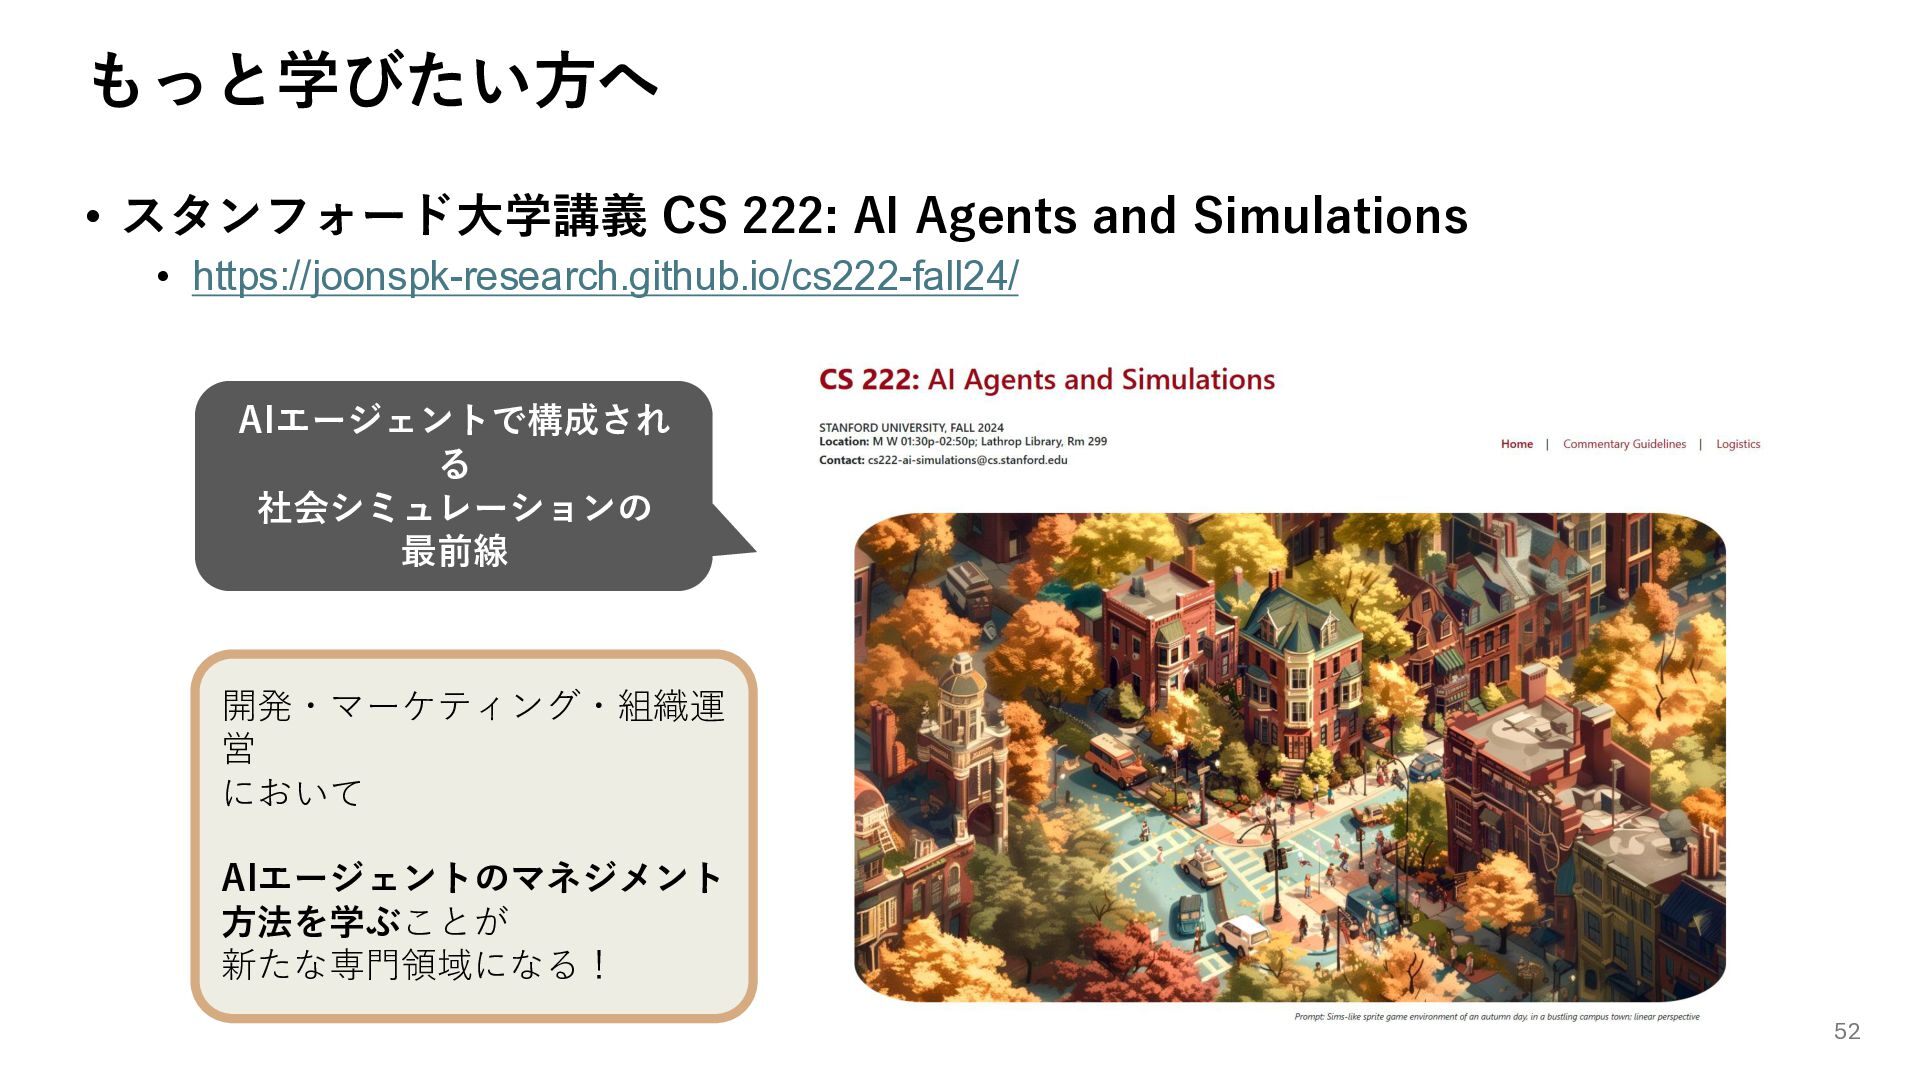
  28. もっと学びたい方へ • スタンフォード大学講義 CS 222: AI Agents and Simulations •

    https://joonspk-research.github.io/cs222-fall24/ AIエージェントで構成され る 社会シミュレーションの 最前線 開発・マーケティング・組織運 営 において AIエージェントのマネジメント 方法を学ぶことが 新たな専門領域になる! 52
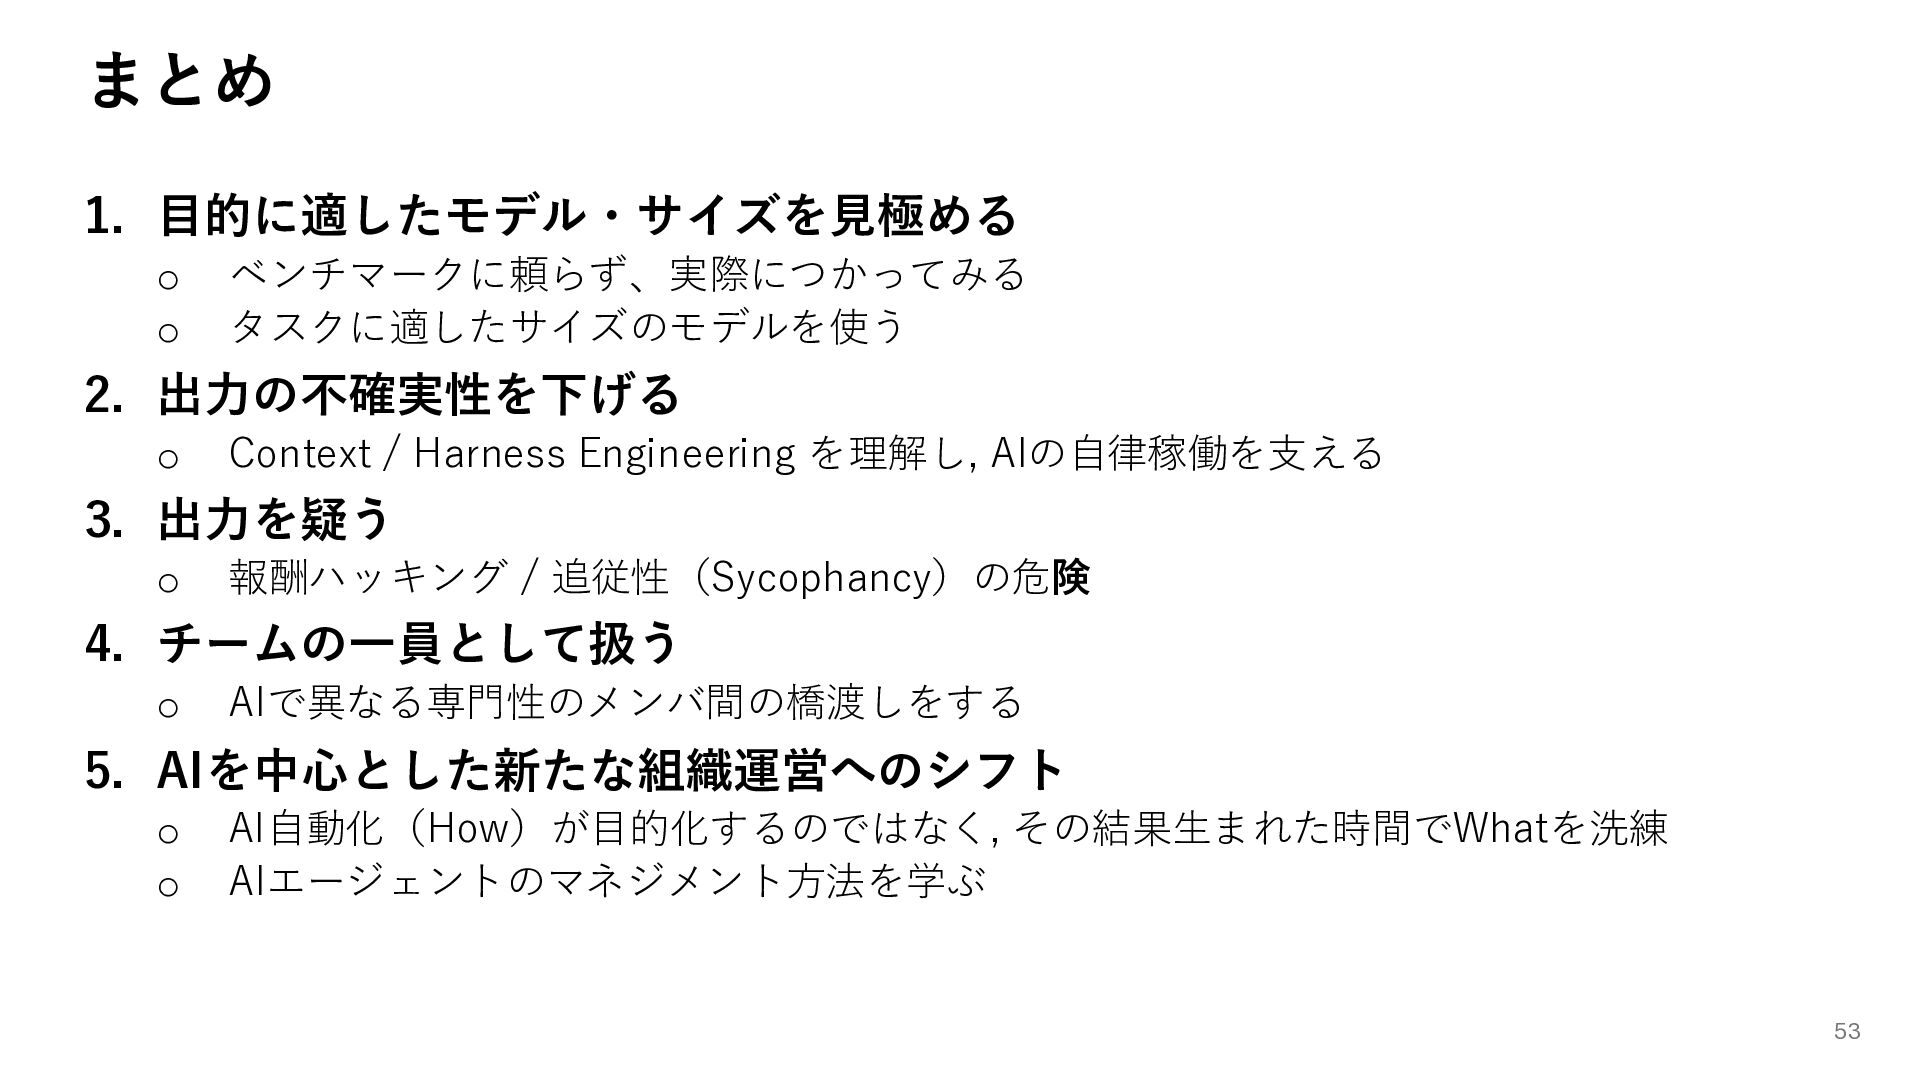
  29. まとめ 1. 目的に適したモデル・サイズを見極める o o ベンチマークに頼らず、実際につかってみる タスクに適したサイズのモデルを使う 2. 出力の不確実性を下げる o

    Context / Harness Engineering を理解し, AIの自律稼働を支える 3. 出力を疑う o 報酬ハッキング / 追従性(Sycophancy)の危険 4. チームの一員として扱う o AIで異なる専門性のメンバ間の橋渡しをする 5. AIを中心とした新たな組織運営へのシフト o o AI自動化(How)が目的化するのではなく, その結果生まれた時間でWhatを洗練 AIエージェントのマネジメント方法を学ぶ 53
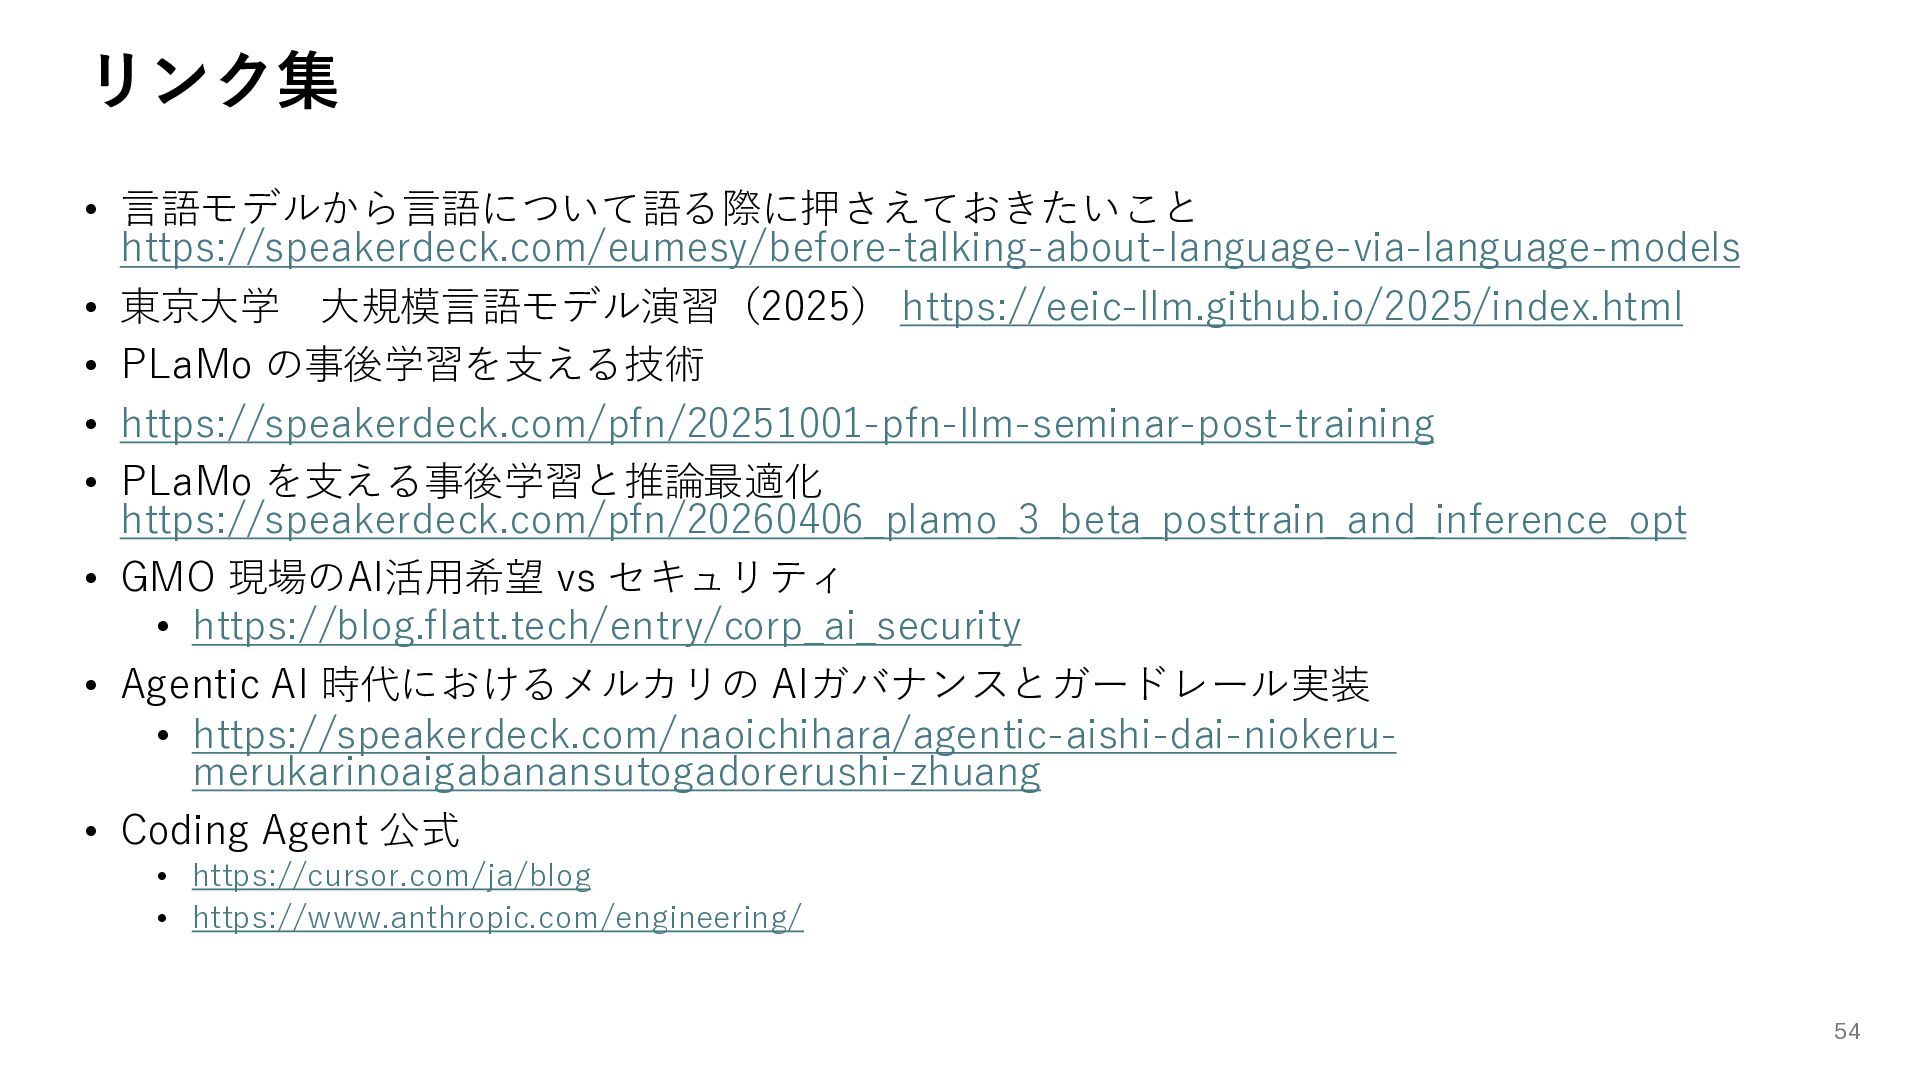
  30. リンク集 • 言語モデルから言語について語る際に押さえておきたいこと https://speakerdeck.com/eumesy/before-talking-about-language-via-language-models • 東京大学 大規模言語モデル演習(2025) https://eeic-llm.github.io/2025/index.html • PLaMo

    の事後学習を支える技術 • https://speakerdeck.com/pfn/20251001-pfn-llm-seminar-post-training • PLaMo を支える事後学習と推論最適化 https://speakerdeck.com/pfn/20260406_plamo_3_beta_posttrain_and_inference_opt • GMO 現場のAI活用希望 vs セキュリティ • https://blog.flatt.tech/entry/corp_ai_security • Agentic AI 時代におけるメルカリの AIガバナンスとガードレール実装 • https://speakerdeck.com/naoichihara/agentic-aishi-dai-niokerumerukarinoaigabanansutogadorerushi-zhuang • Coding Agent 公式 • https://cursor.com/ja/blog • https://www.anthropic.com/engineering/ 54