Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Nagoya NLP ACL reading seminar 2026 kinoshita

Nagoya NLP ACL reading seminar 2026 kinoshita

Presentation slides for the ACL Reading Seminar 2026 at Nagoya NLP. The paper I will present is “d-TreeRPO: Towards More Reliable Policy Optimization for Diffusion Language Models” by Pan et al.

Avatar for Takato Kinoshita

Takato Kinoshita

September 23, 2026

Other Decks in Research

Transcript

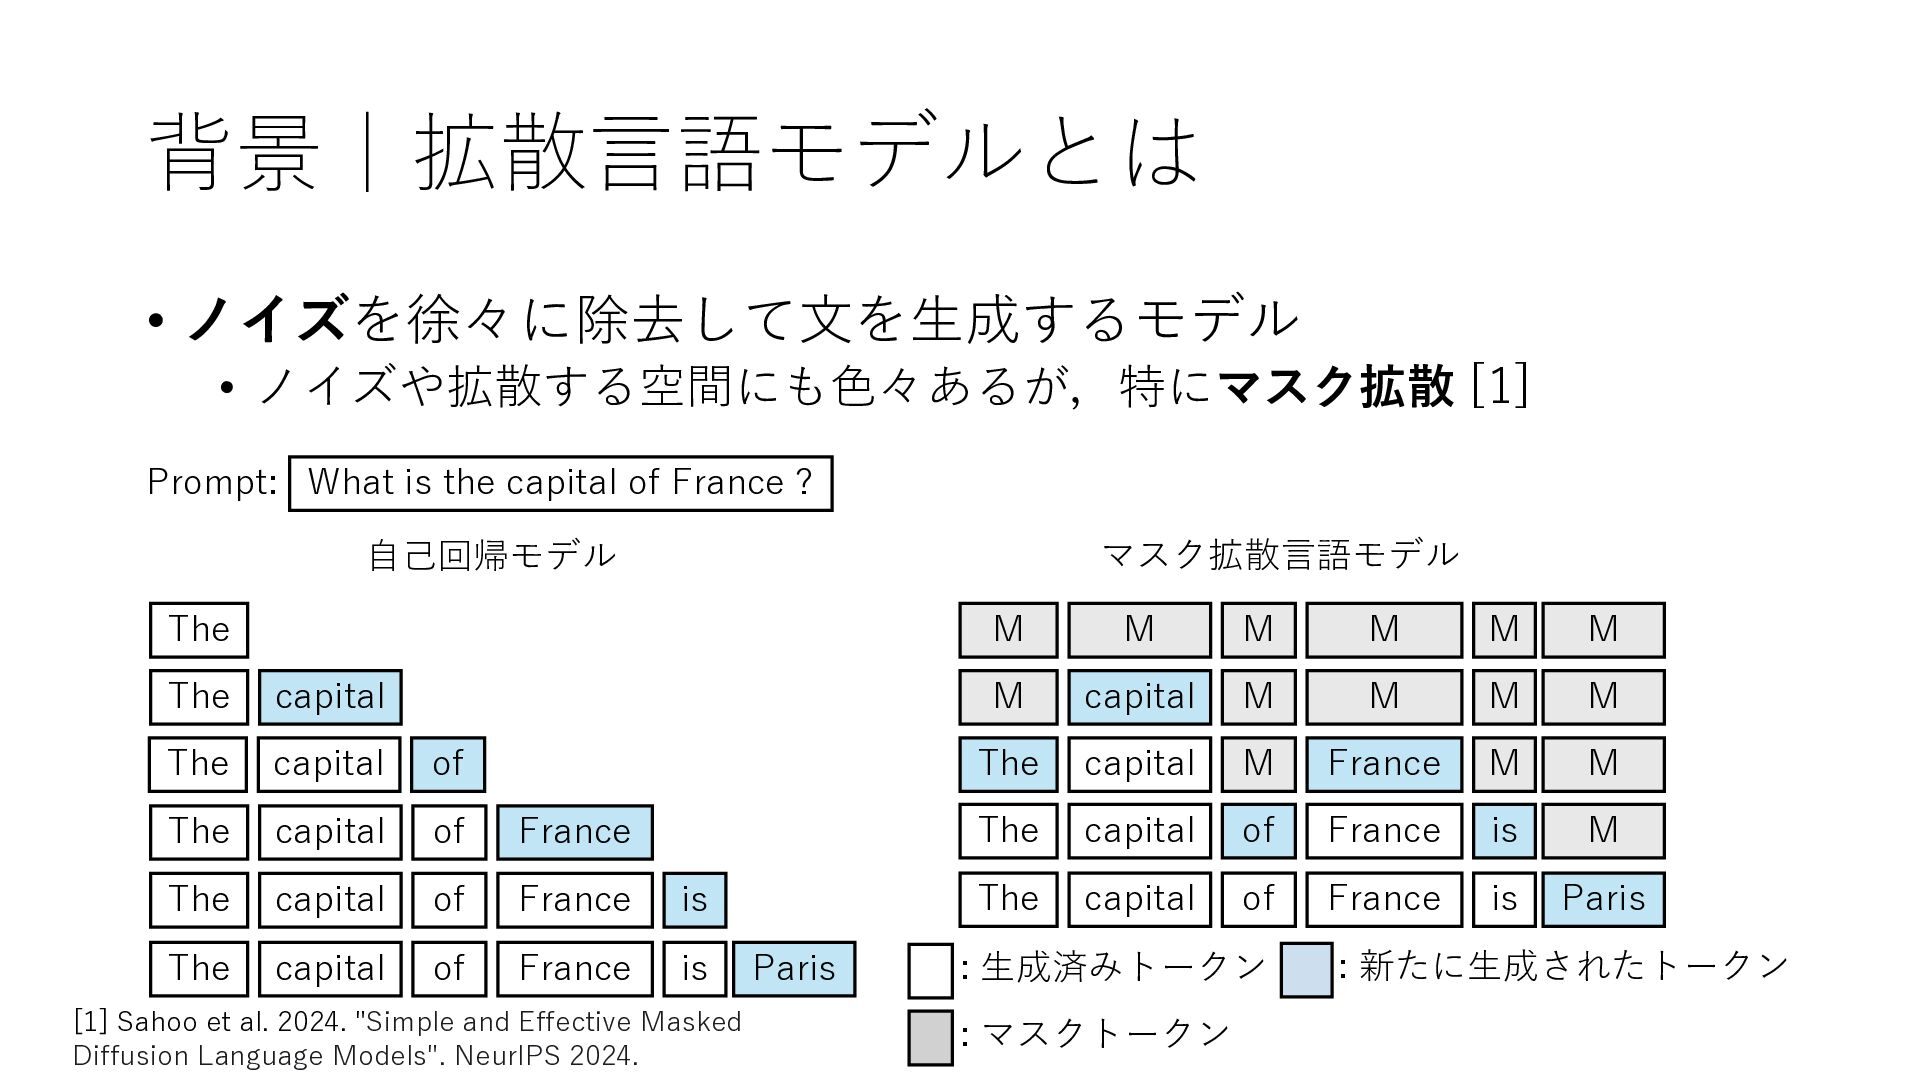
  1. 背景|拡散言語モデルとは • ノイズを徐々に除去して文を生成するモデル • ノイズや拡散する空間にも色々あるが,特にマスク拡散 [1] Prompt: What is the

    capital of France ? マスク拡散言語モデル 自己回帰モデル The The capital The capital of The capital of France The capital of France is The capital of France is [1] Sahoo et al. 2024. "Simple and Effective Masked Diffusion Language Models". NeurIPS 2024. Paris M M M M M M M capital M M M M The capital M France M M The capital of France is M The capital of France is Paris : 生成済みトークン : マスクトークン : 新たに生成されたトークン
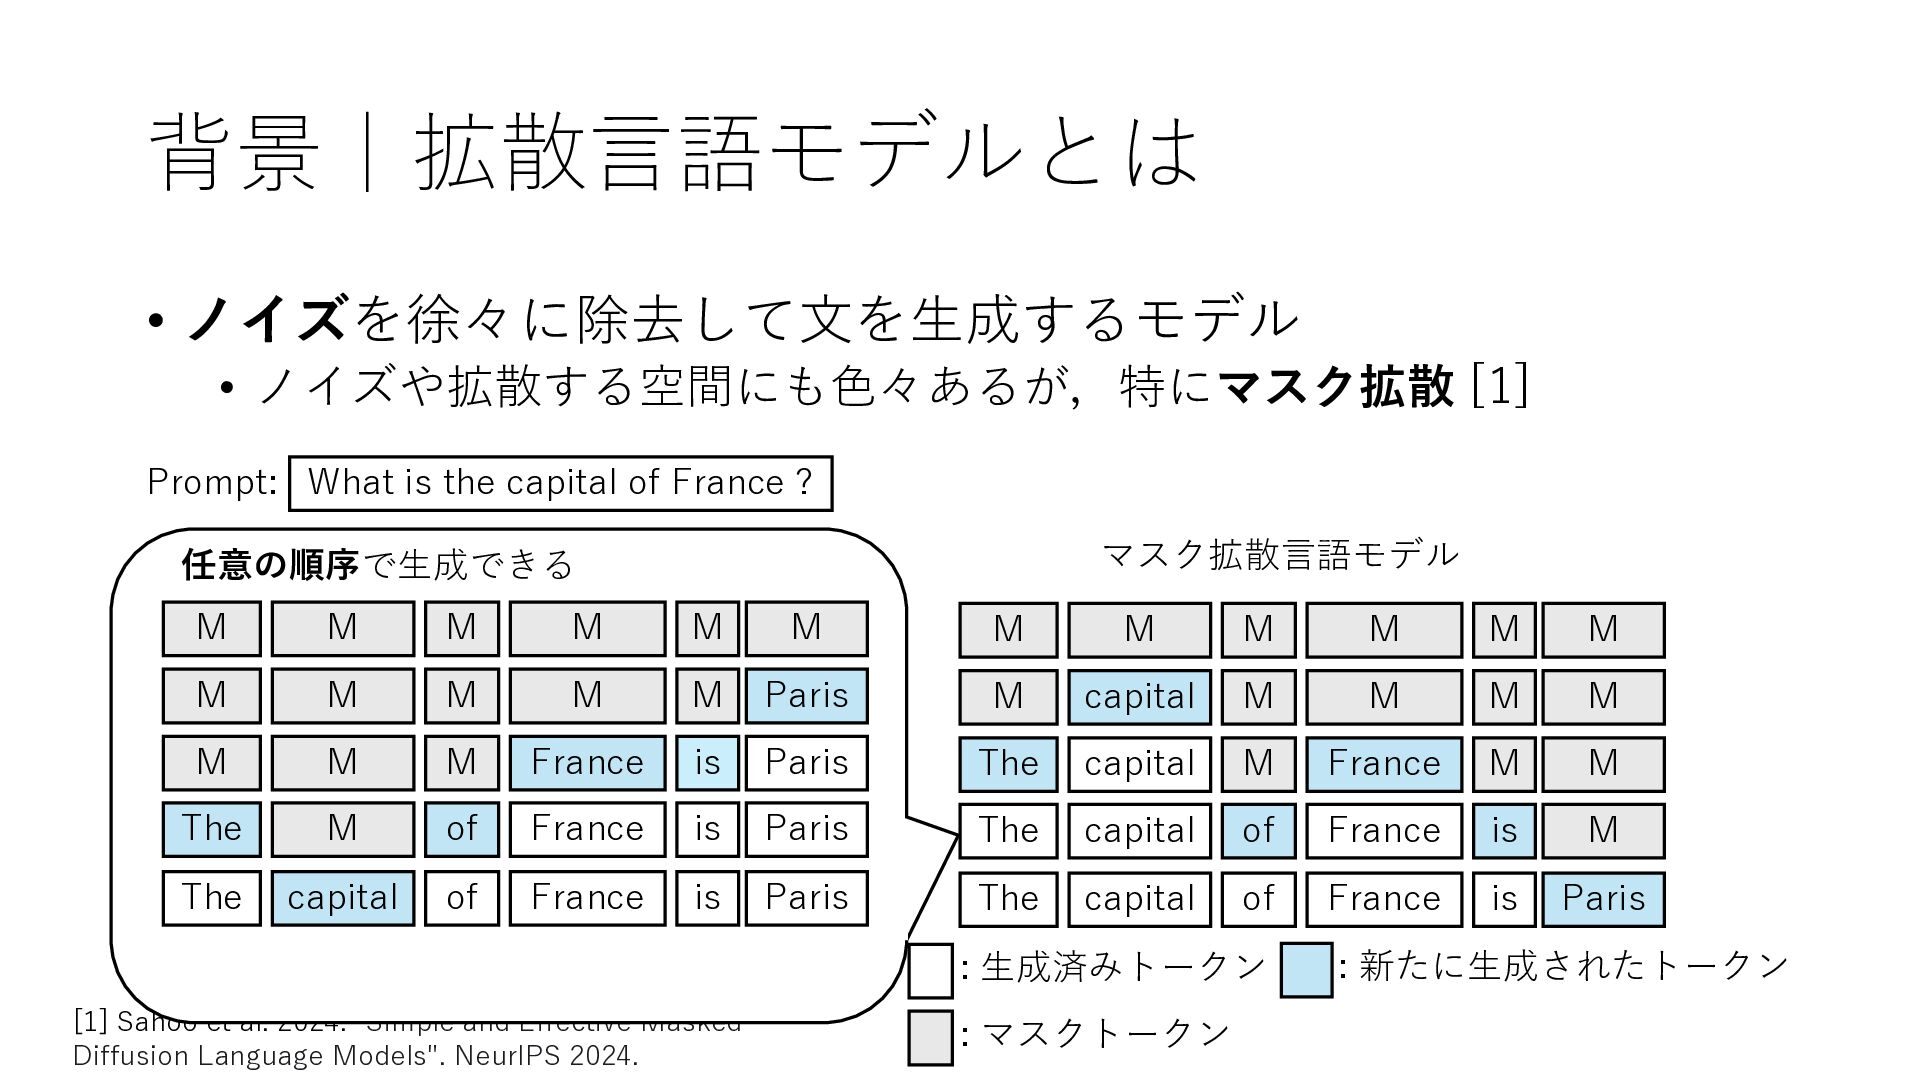
  2. 背景|拡散言語モデルとは • ノイズを徐々に除去して文を生成するモデル • ノイズや拡散する空間にも色々あるが,特にマスク拡散 [1] Prompt: What is the

    capital of France ? マスク拡散言語モデル 自己回帰モデル 任意の順序で生成できる M The M M M M M M M M M M M M The M capital M M M Paris M capital M M M M M The M capital M of France is Paris The capital M France M M The capital M The of of France France is Paris The capital of France is M The capital capital of of The France France isis Paris The capital of France is Paris The France is Paris : 生成済みトークン capital of [1] Sahoo et al. 2024. "Simple and Effective Masked Diffusion Language Models". NeurIPS 2024. : マスクトークン : 新たに生成されたトークン
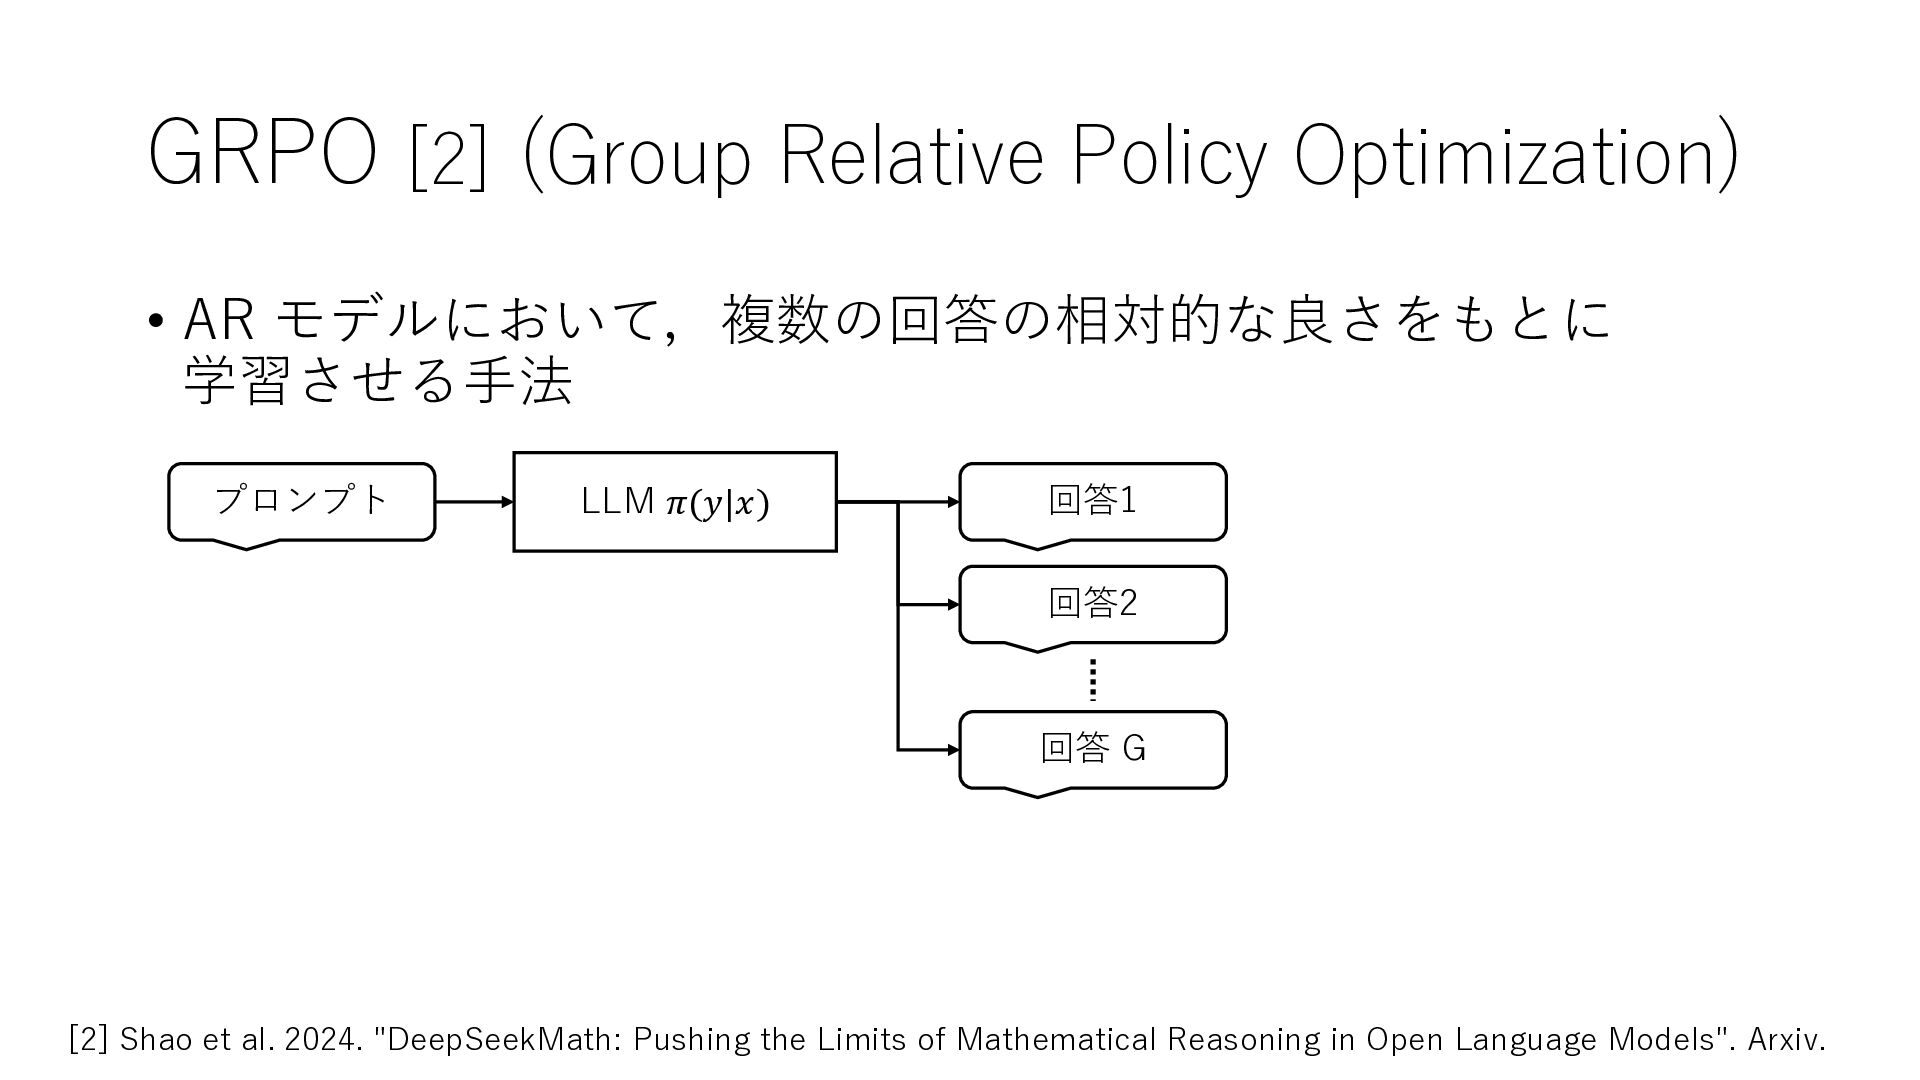
  3. GRPO [2] (Group Relative Policy Optimization) • AR モデルにおいて,複数の回答の相対的な良さをもとに 学習させる手法

    プロンプト LLM 𝜋(𝑦|𝑥) 回答1 回答2 回答 G [2] Shao et al. 2024. "DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models". Arxiv.
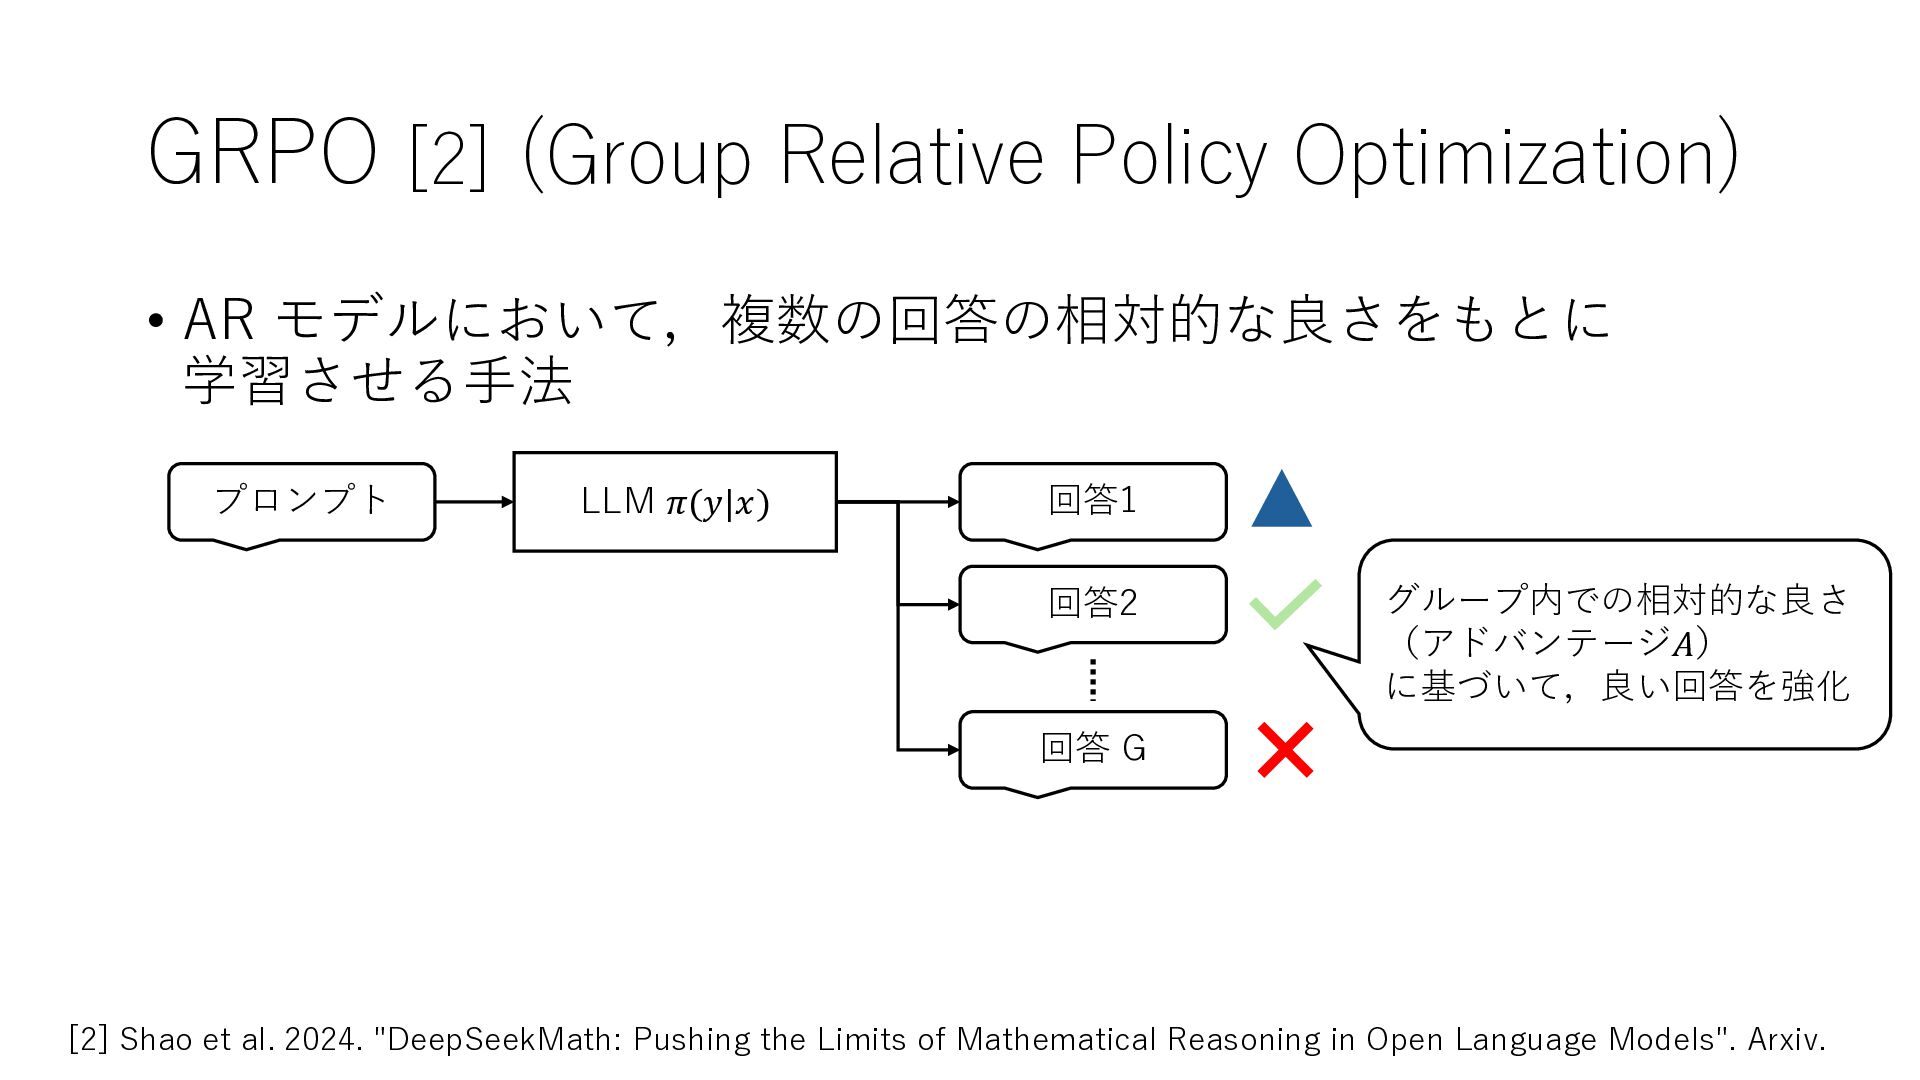
  4. GRPO [2] (Group Relative Policy Optimization) • AR モデルにおいて,複数の回答の相対的な良さをもとに 学習させる手法

    プロンプト LLM 𝜋(𝑦|𝑥) 回答1 回答2 グループ内での相対的な良さ (アドバンテージ𝐴) に基づいて,良い回答を強化 回答 G [2] Shao et al. 2024. "DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models". Arxiv.
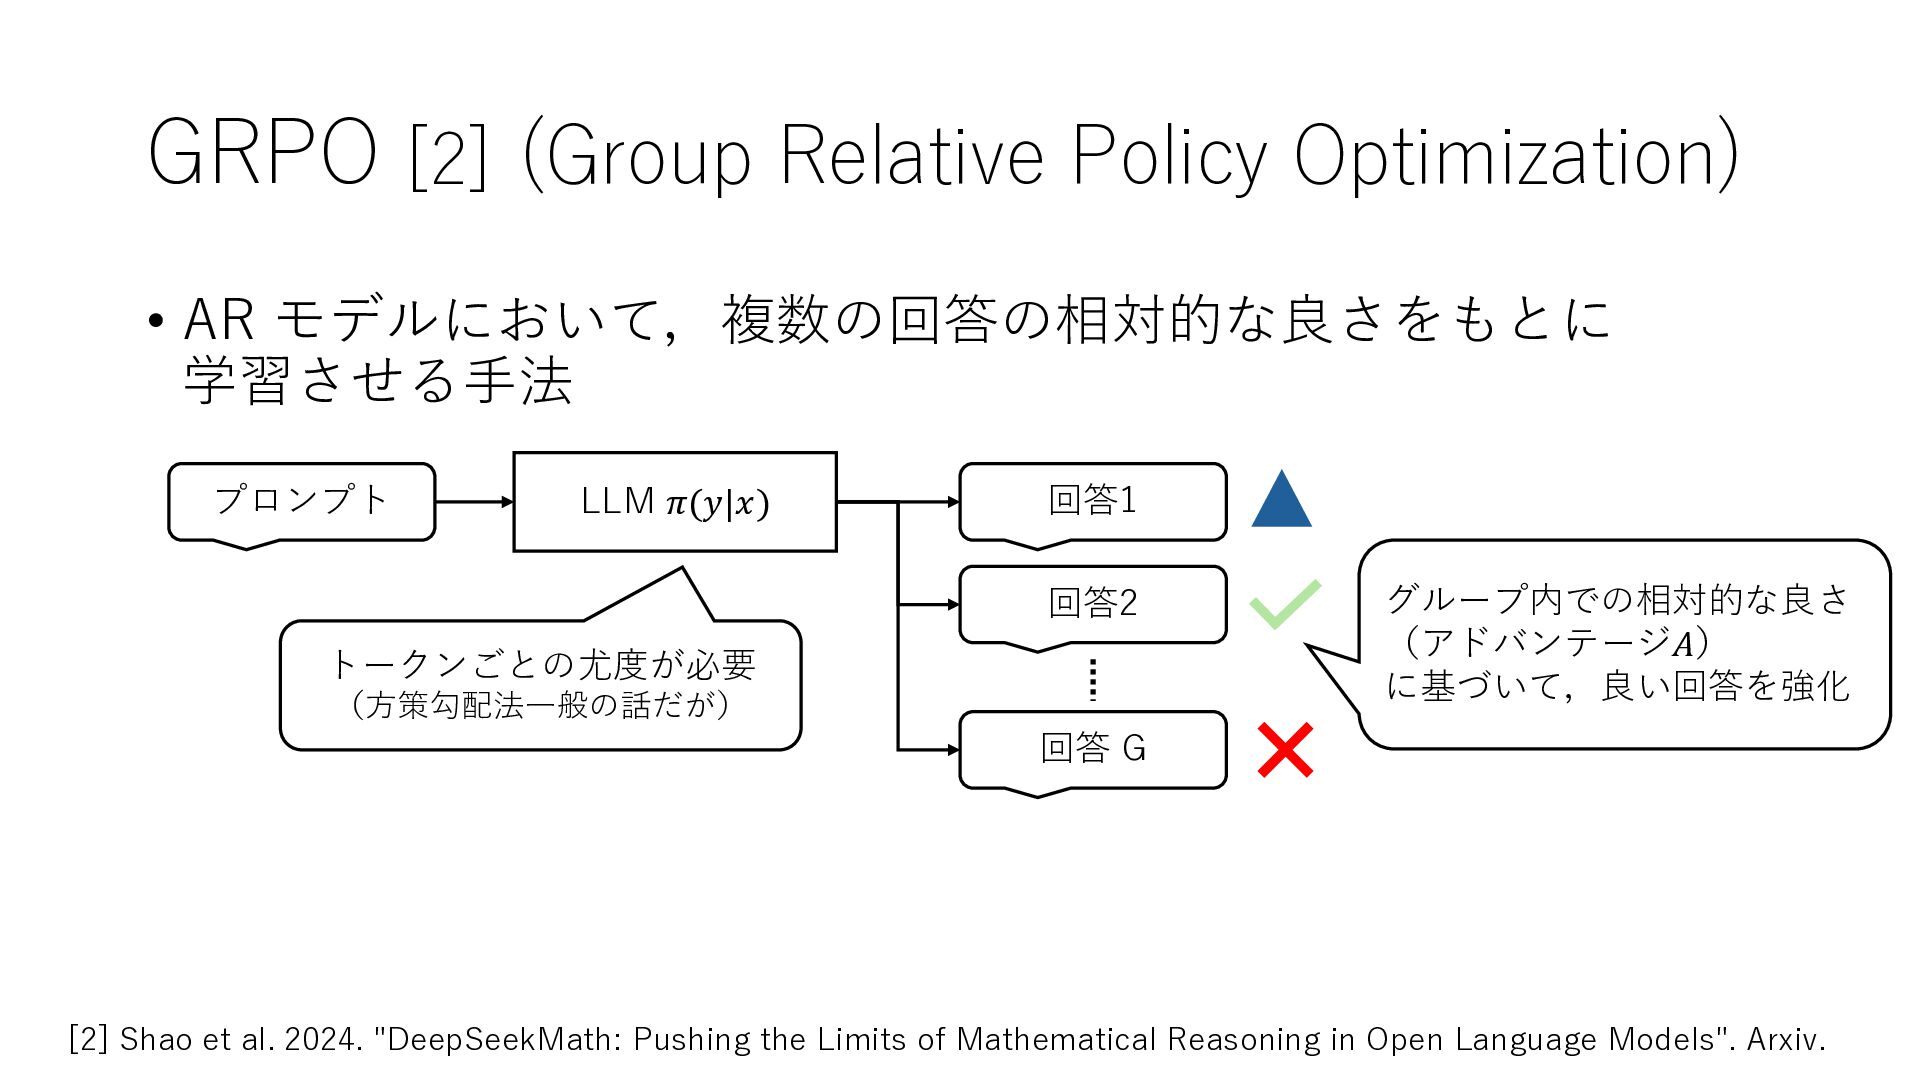
  5. GRPO [2] (Group Relative Policy Optimization) • AR モデルにおいて,複数の回答の相対的な良さをもとに 学習させる手法

    プロンプト LLM 𝜋(𝑦|𝑥) 回答1 回答2 トークンごとの尤度が必要 (方策勾配法一般の話だが) グループ内での相対的な良さ (アドバンテージ𝐴) に基づいて,良い回答を強化 回答 G [2] Shao et al. 2024. "DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models". Arxiv.
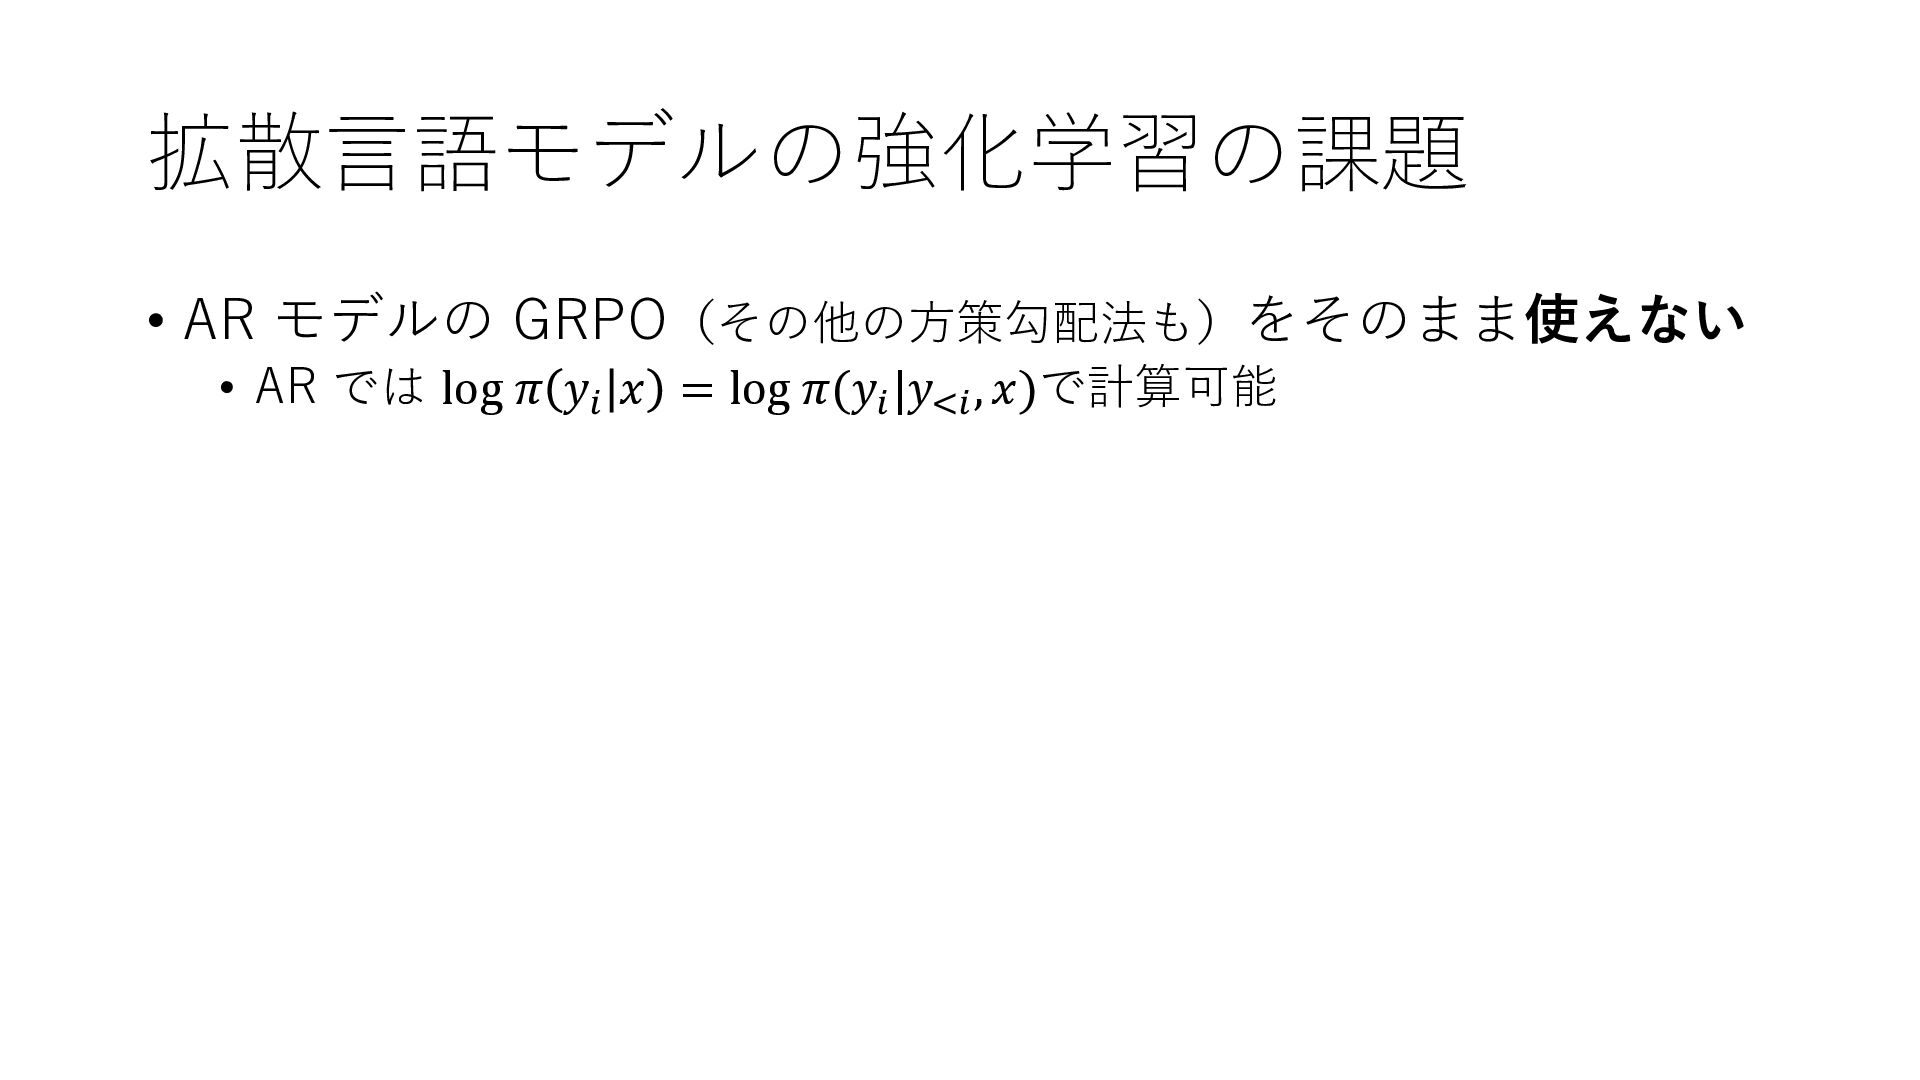
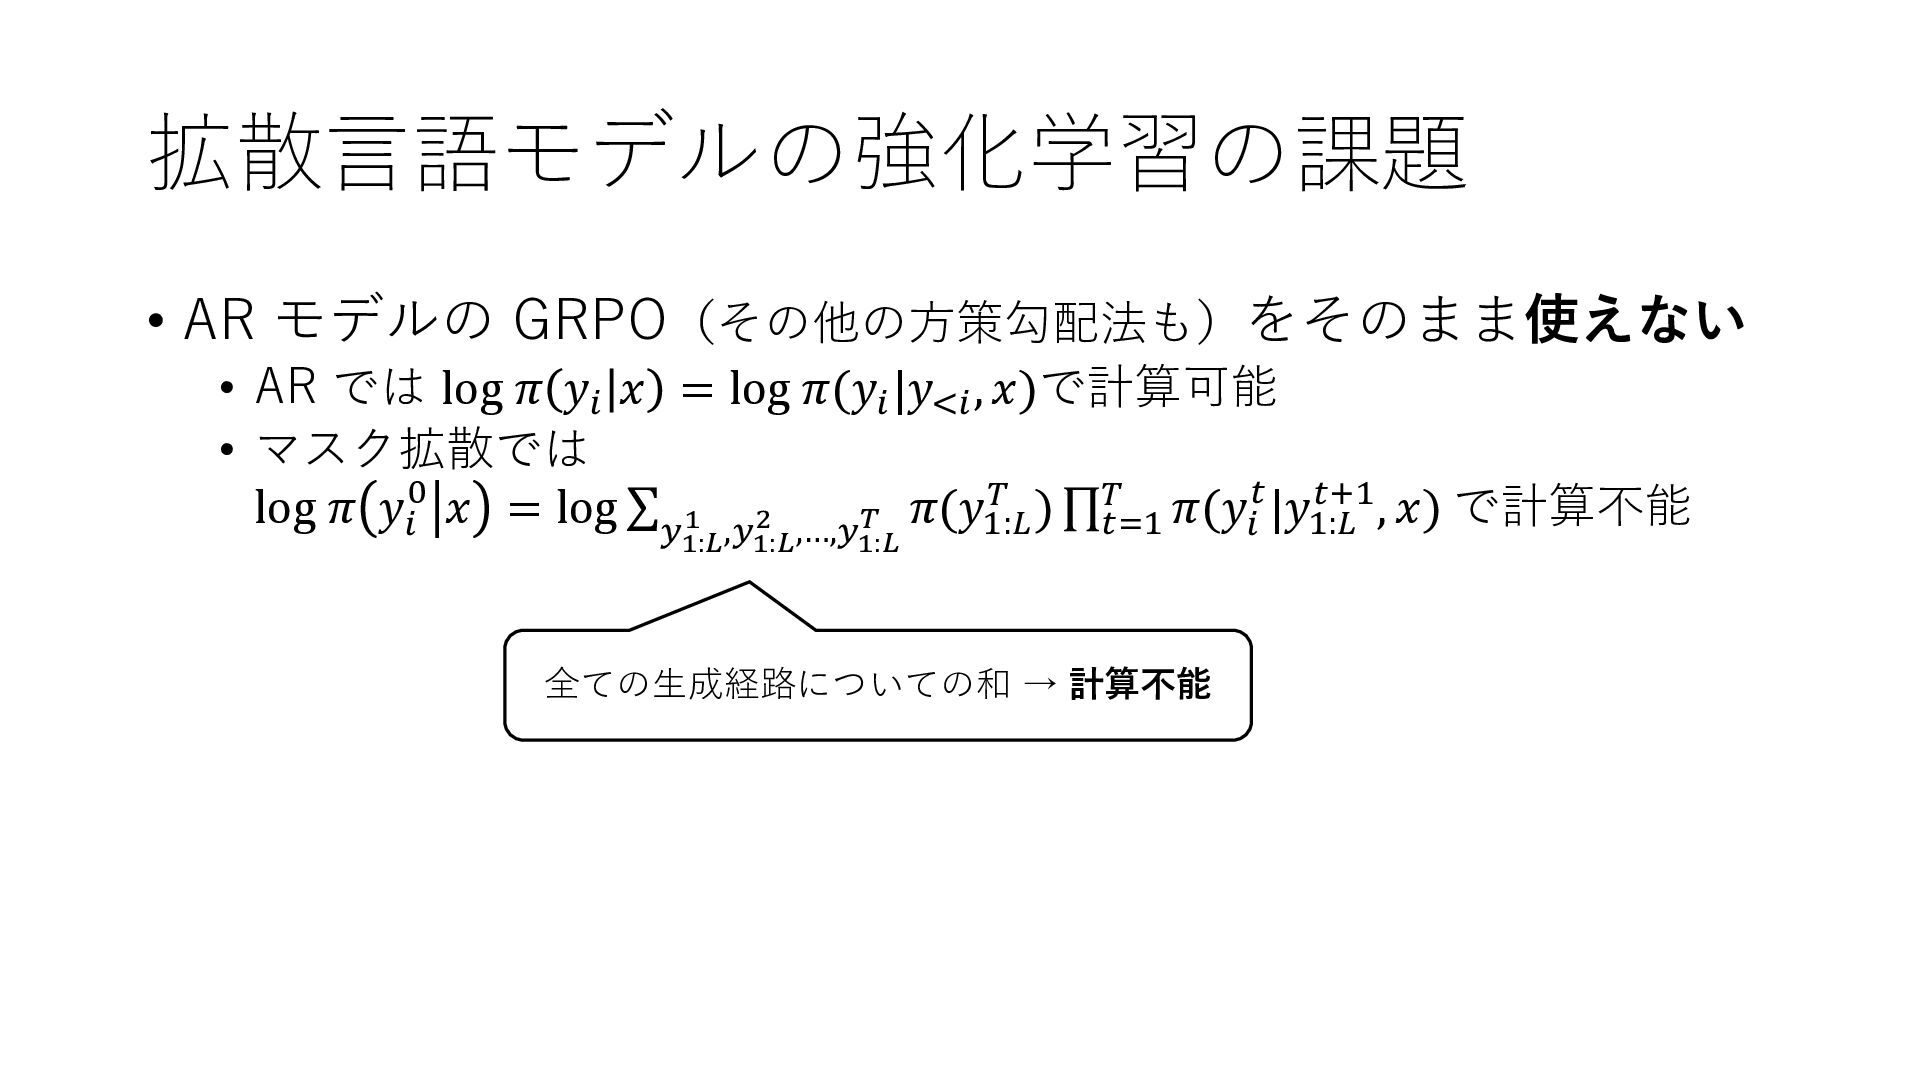
  6. 拡散言語モデルの強化学習の課題 • AR モデルの GRPO(その他の方策勾配法も)をそのまま使えない • AR では log 𝜋

    𝑦𝑖 𝑥 = log 𝜋(𝑦𝑖 |𝑦<𝑖 , 𝑥)で計算可能 • マスク拡散では 𝑡+1 𝑇 log 𝜋 𝑦𝑖0 𝑥 = log σ𝑦1 ,𝑦2 ,…,𝑦𝑇 𝜋(𝑦1:𝐿 ) ς𝑇𝑡=1 𝜋(𝑦𝑖𝑡 |𝑦1:𝐿 , 𝑥) で計算不能 1:𝐿 1:𝐿 1:𝐿 全ての生成経路についての和 → 計算不能
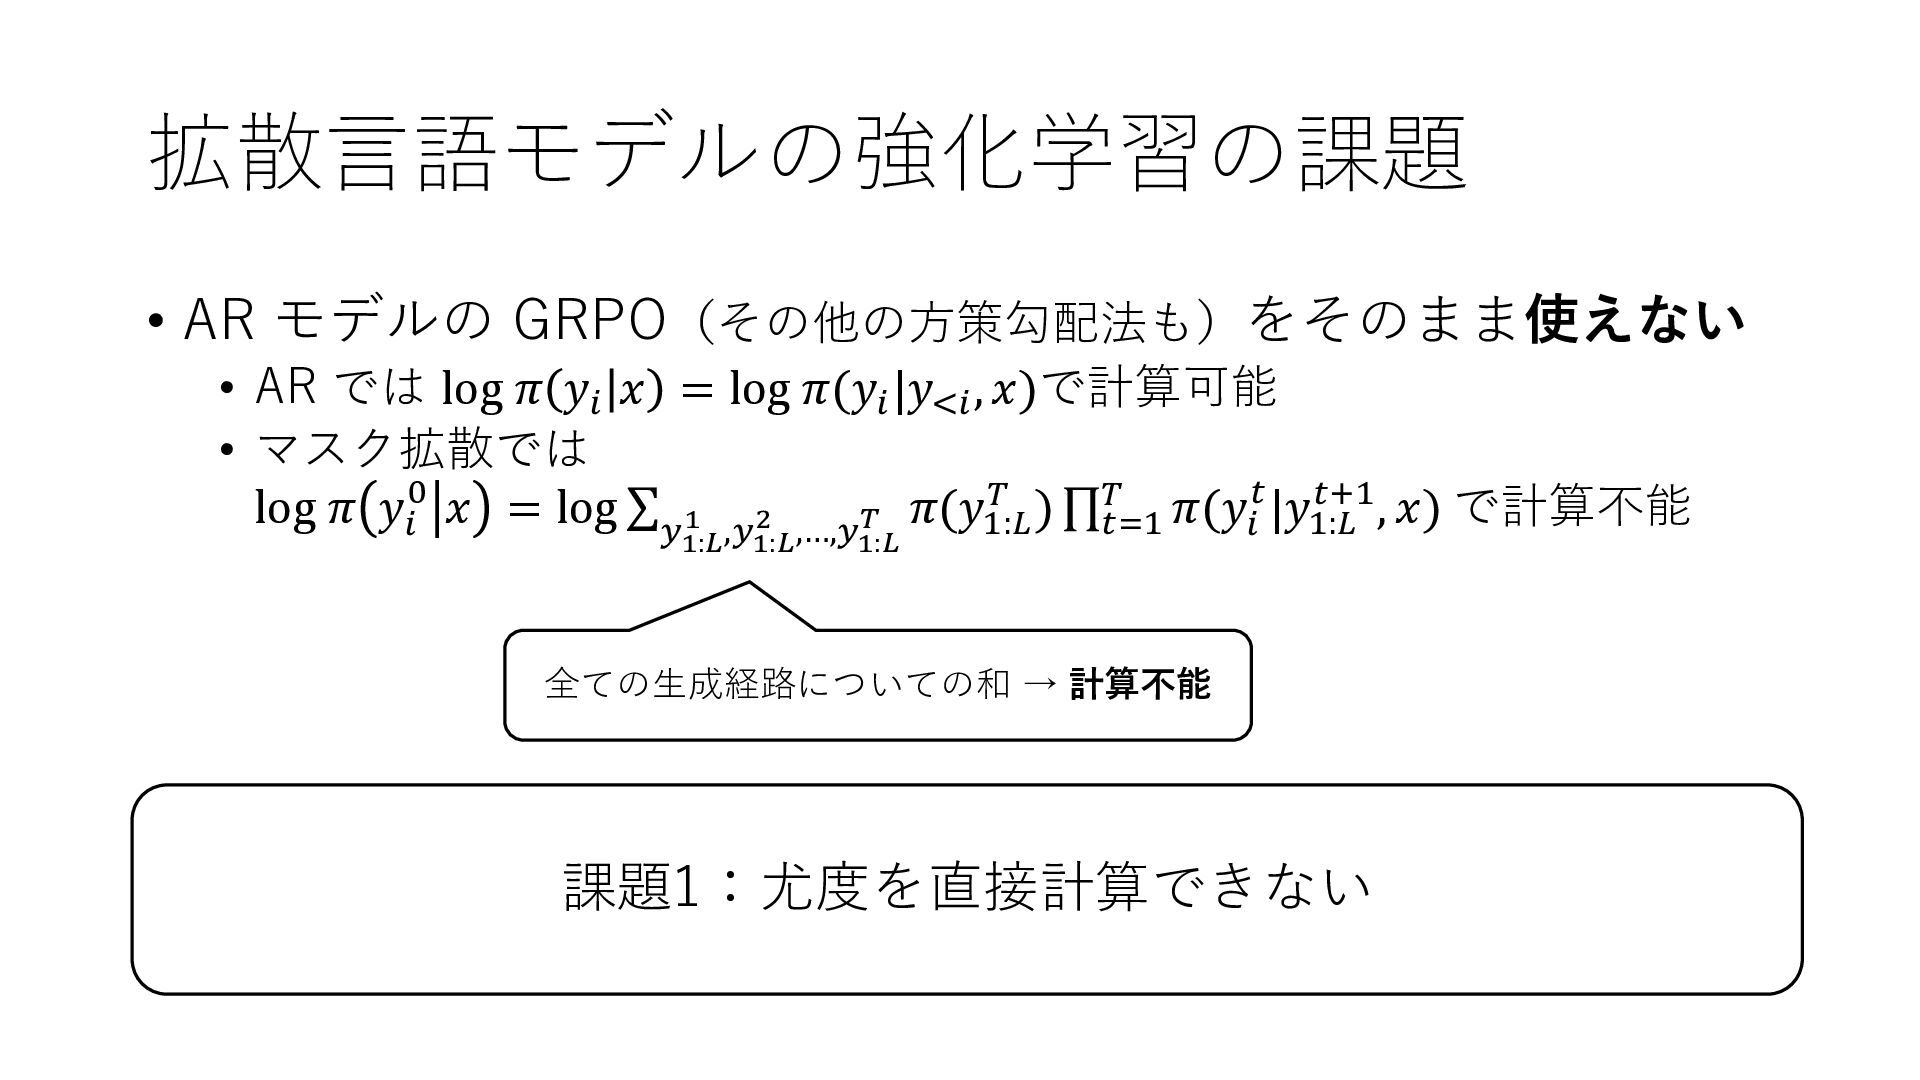
  7. 拡散言語モデルの強化学習の課題 • AR モデルの GRPO(その他の方策勾配法も)をそのまま使えない • AR では log 𝜋

    𝑦𝑖 𝑥 = log 𝜋(𝑦𝑖 |𝑦<𝑖 , 𝑥)で計算可能 • マスク拡散では 𝑡+1 𝑇 log 𝜋 𝑦𝑖0 𝑥 = log σ𝑦1 ,𝑦2 ,…,𝑦𝑇 𝜋(𝑦1:𝐿 ) ς𝑇𝑡=1 𝜋(𝑦𝑖𝑡 |𝑦1:𝐿 , 𝑥) で計算不能 1:𝐿 1:𝐿 1:𝐿 全ての生成経路についての和 → 計算不能 課題1:尤度を直接計算できない
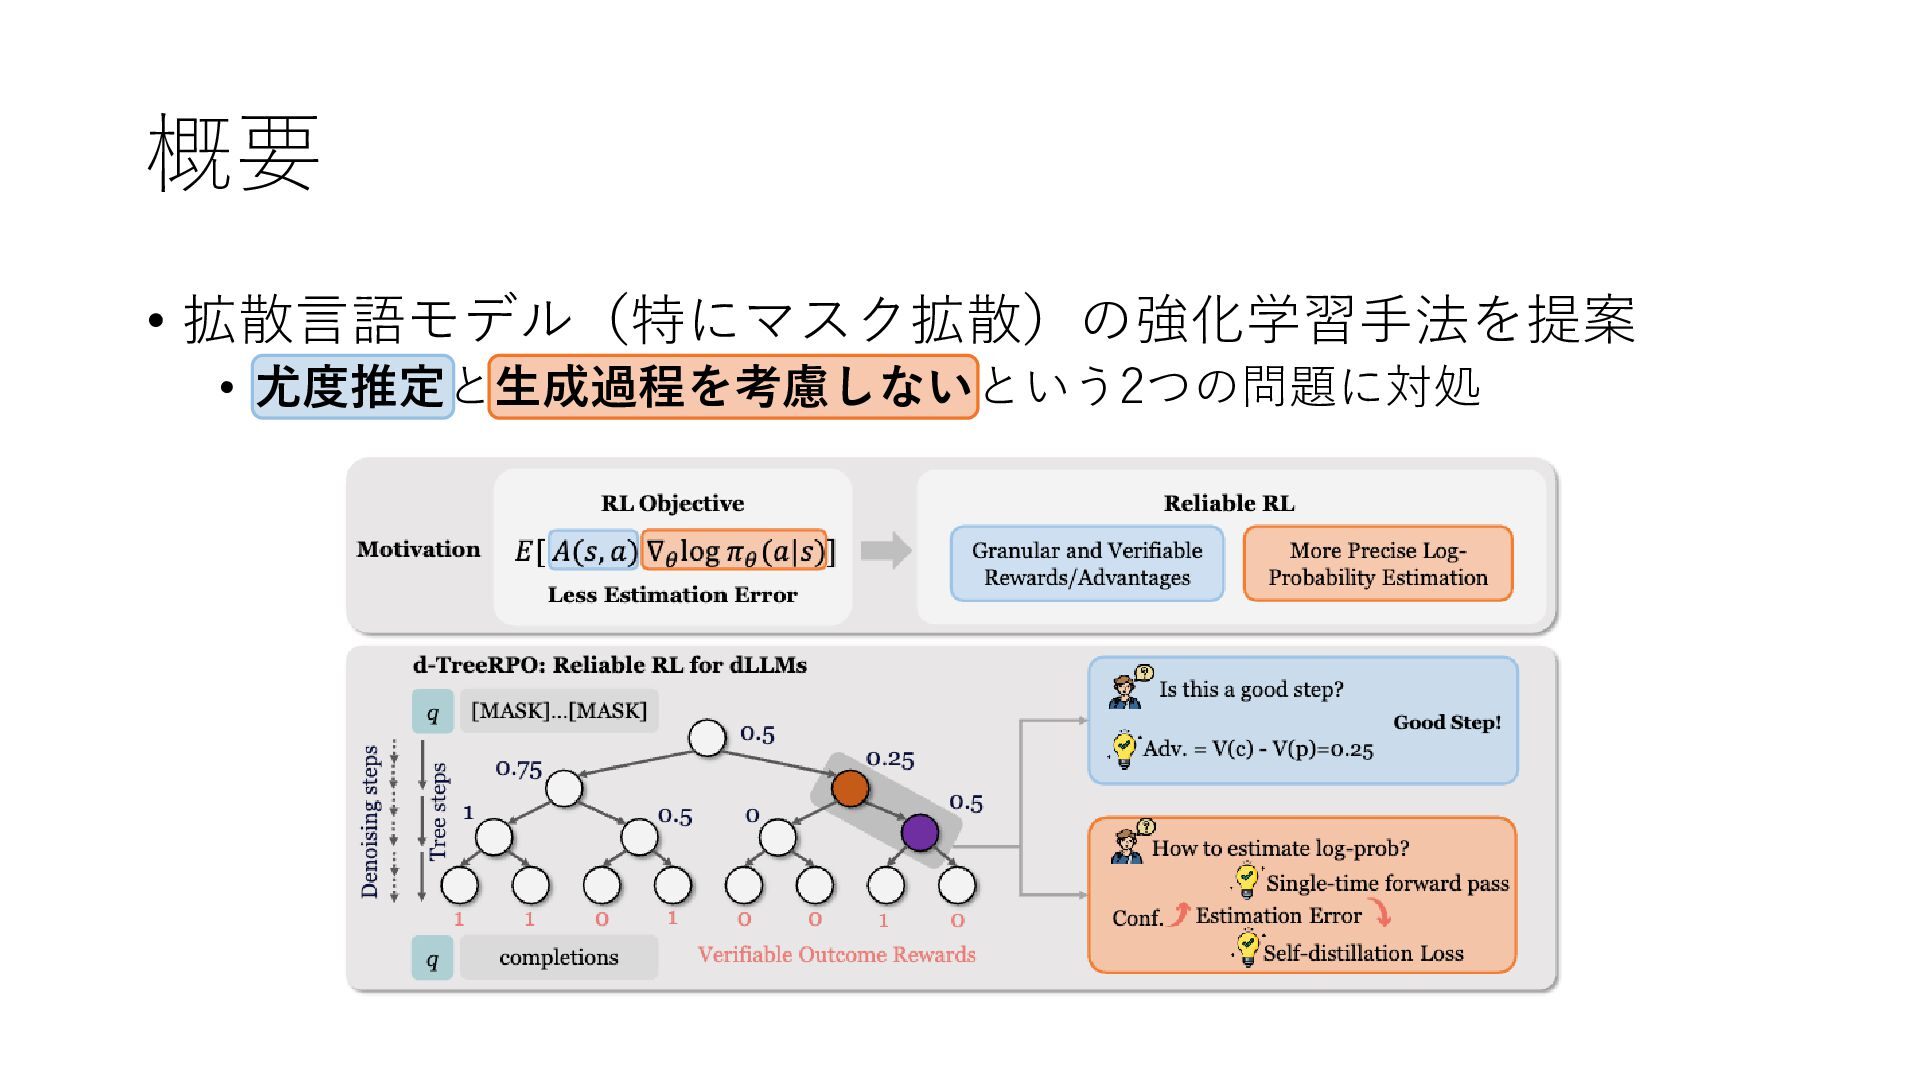
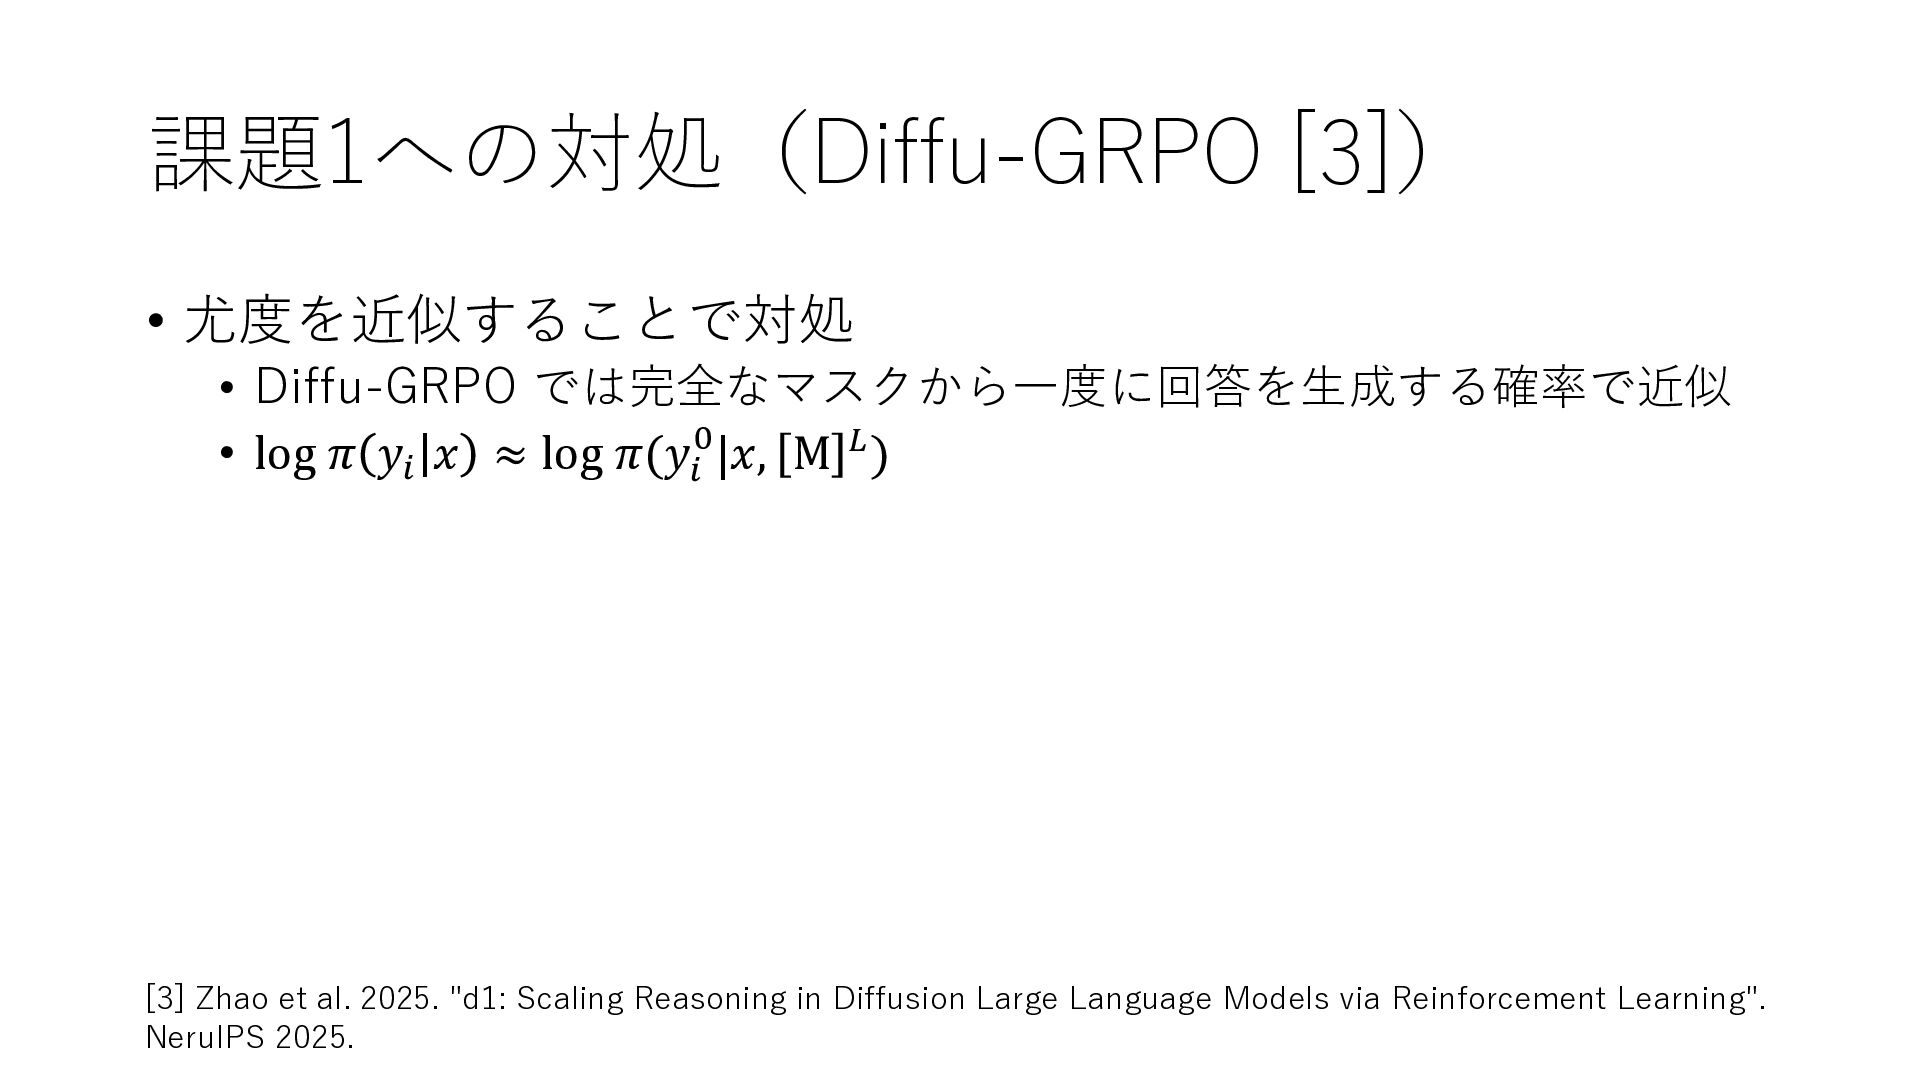
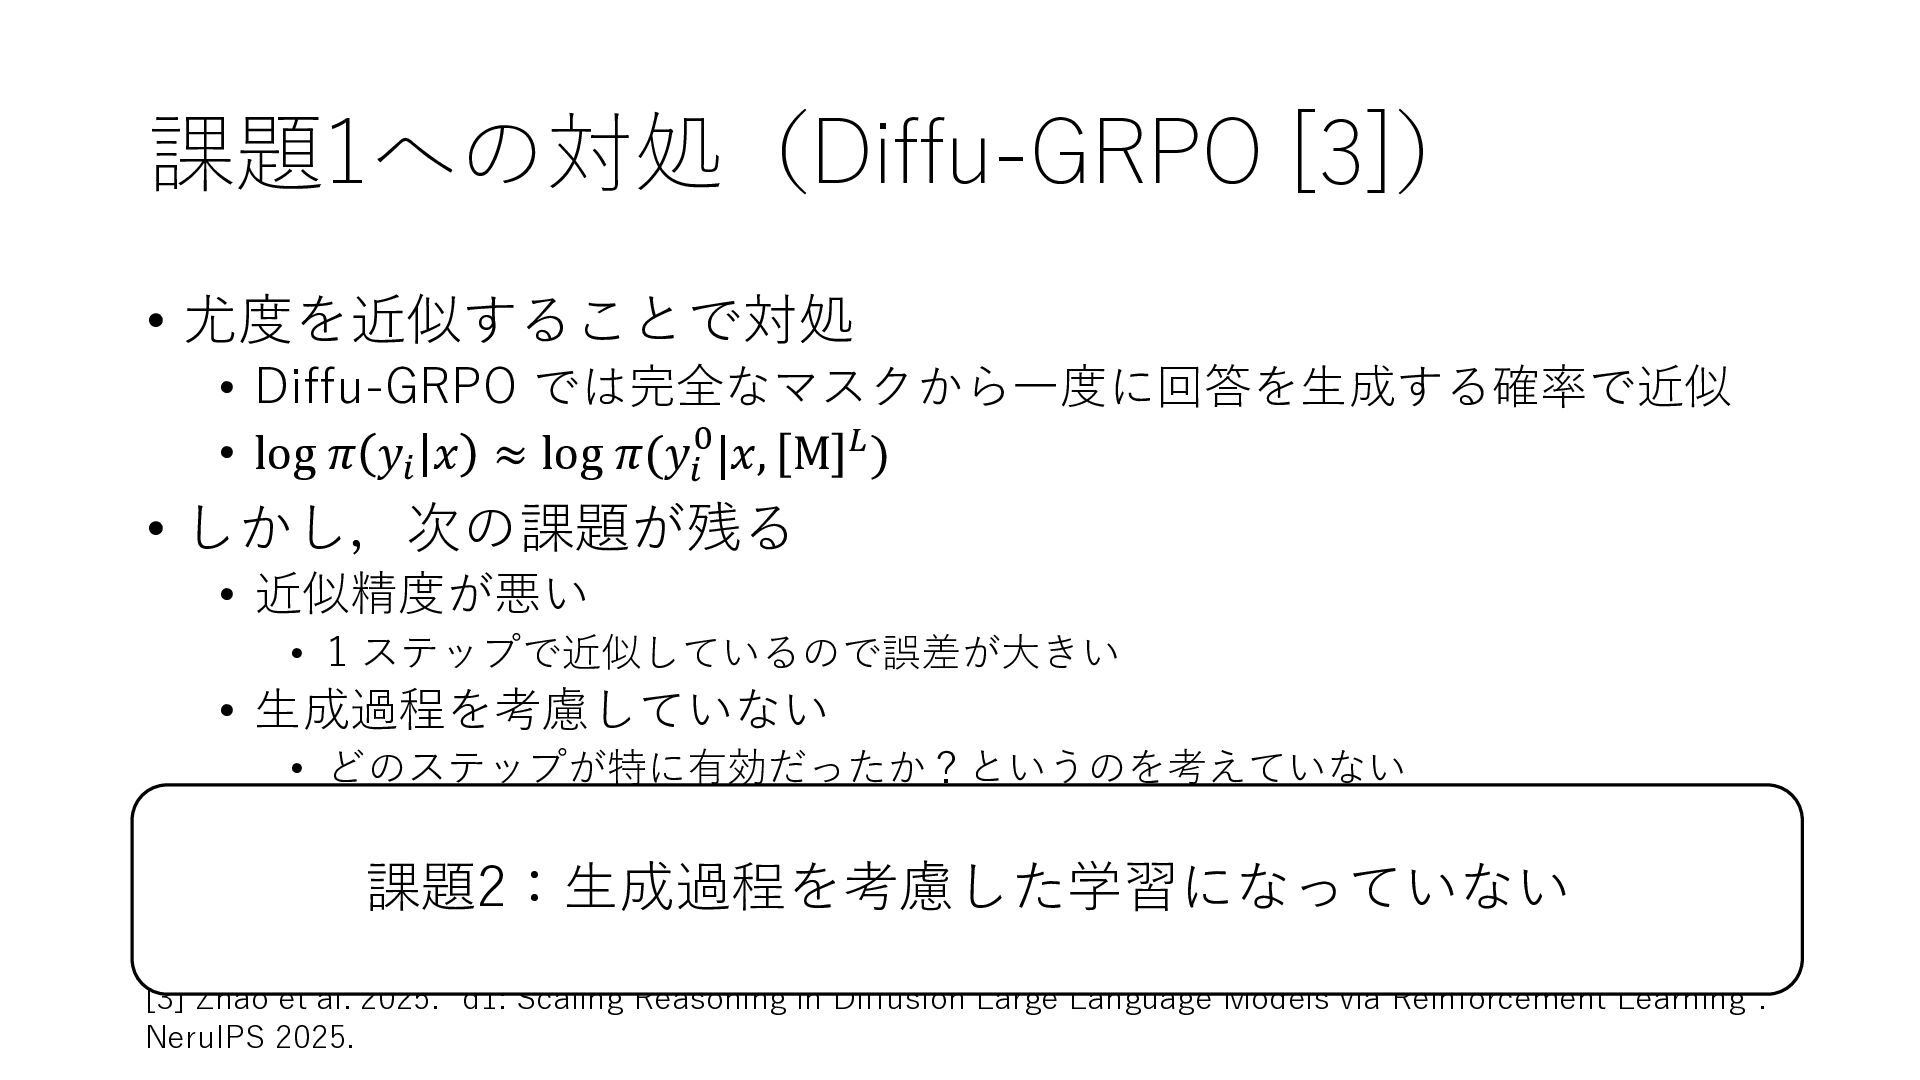
  8. 課題1への対処(Diffu-GRPO [3]) • 尤度を近似することで対処 • Diffu-GRPO では完全なマスクから一度に回答を生成する確率で近似 • log 𝜋

    𝑦𝑖 𝑥 ≈ log 𝜋(𝑦𝑖0 |𝑥, M 𝐿 ) [3] Zhao et al. 2025. "d1: Scaling Reasoning in Diffusion Large Language Models via Reinforcement Learning". NeruIPS 2025.
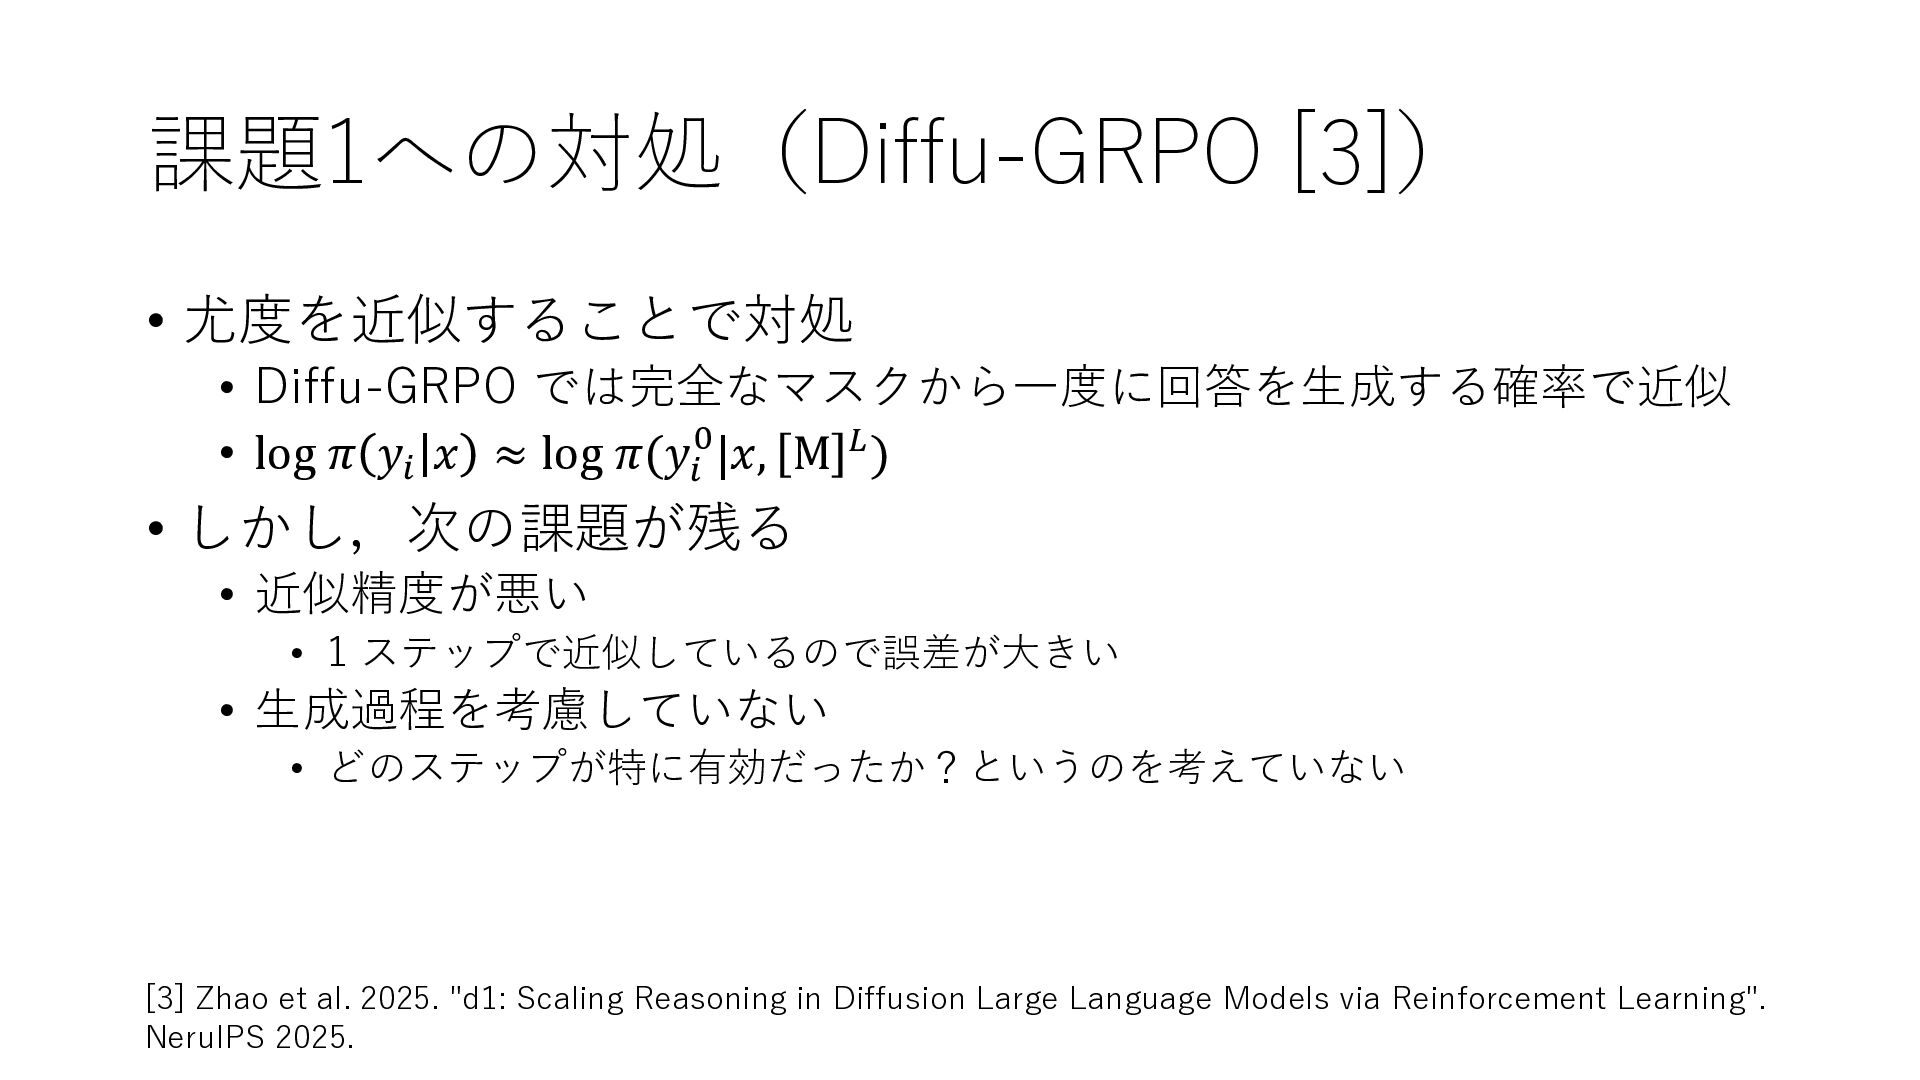
  9. 課題1への対処(Diffu-GRPO [3]) • 尤度を近似することで対処 • Diffu-GRPO では完全なマスクから一度に回答を生成する確率で近似 • log 𝜋

    𝑦𝑖 𝑥 ≈ log 𝜋(𝑦𝑖0 |𝑥, M 𝐿 ) • しかし,次の課題が残る • 近似精度が悪い • 1 ステップで近似しているので誤差が大きい • 生成過程を考慮していない • どのステップが特に有効だったか?というのを考えていない [3] Zhao et al. 2025. "d1: Scaling Reasoning in Diffusion Large Language Models via Reinforcement Learning". NeruIPS 2025.
  10. 課題1への対処(Diffu-GRPO [3]) • 尤度を近似することで対処 • Diffu-GRPO では完全なマスクから一度に回答を生成する確率で近似 • log 𝜋

    𝑦𝑖 𝑥 ≈ log 𝜋(𝑦𝑖0 |𝑥, M 𝐿 ) • しかし,次の課題が残る • 近似精度が悪い • 1 ステップで近似しているので誤差が大きい • 生成過程を考慮していない • どのステップが特に有効だったか?というのを考えていない 課題2:生成過程を考慮した学習になっていない [3] Zhao et al. 2025. "d1: Scaling Reasoning in Diffusion Large Language Models via Reinforcement Learning". NeruIPS 2025.
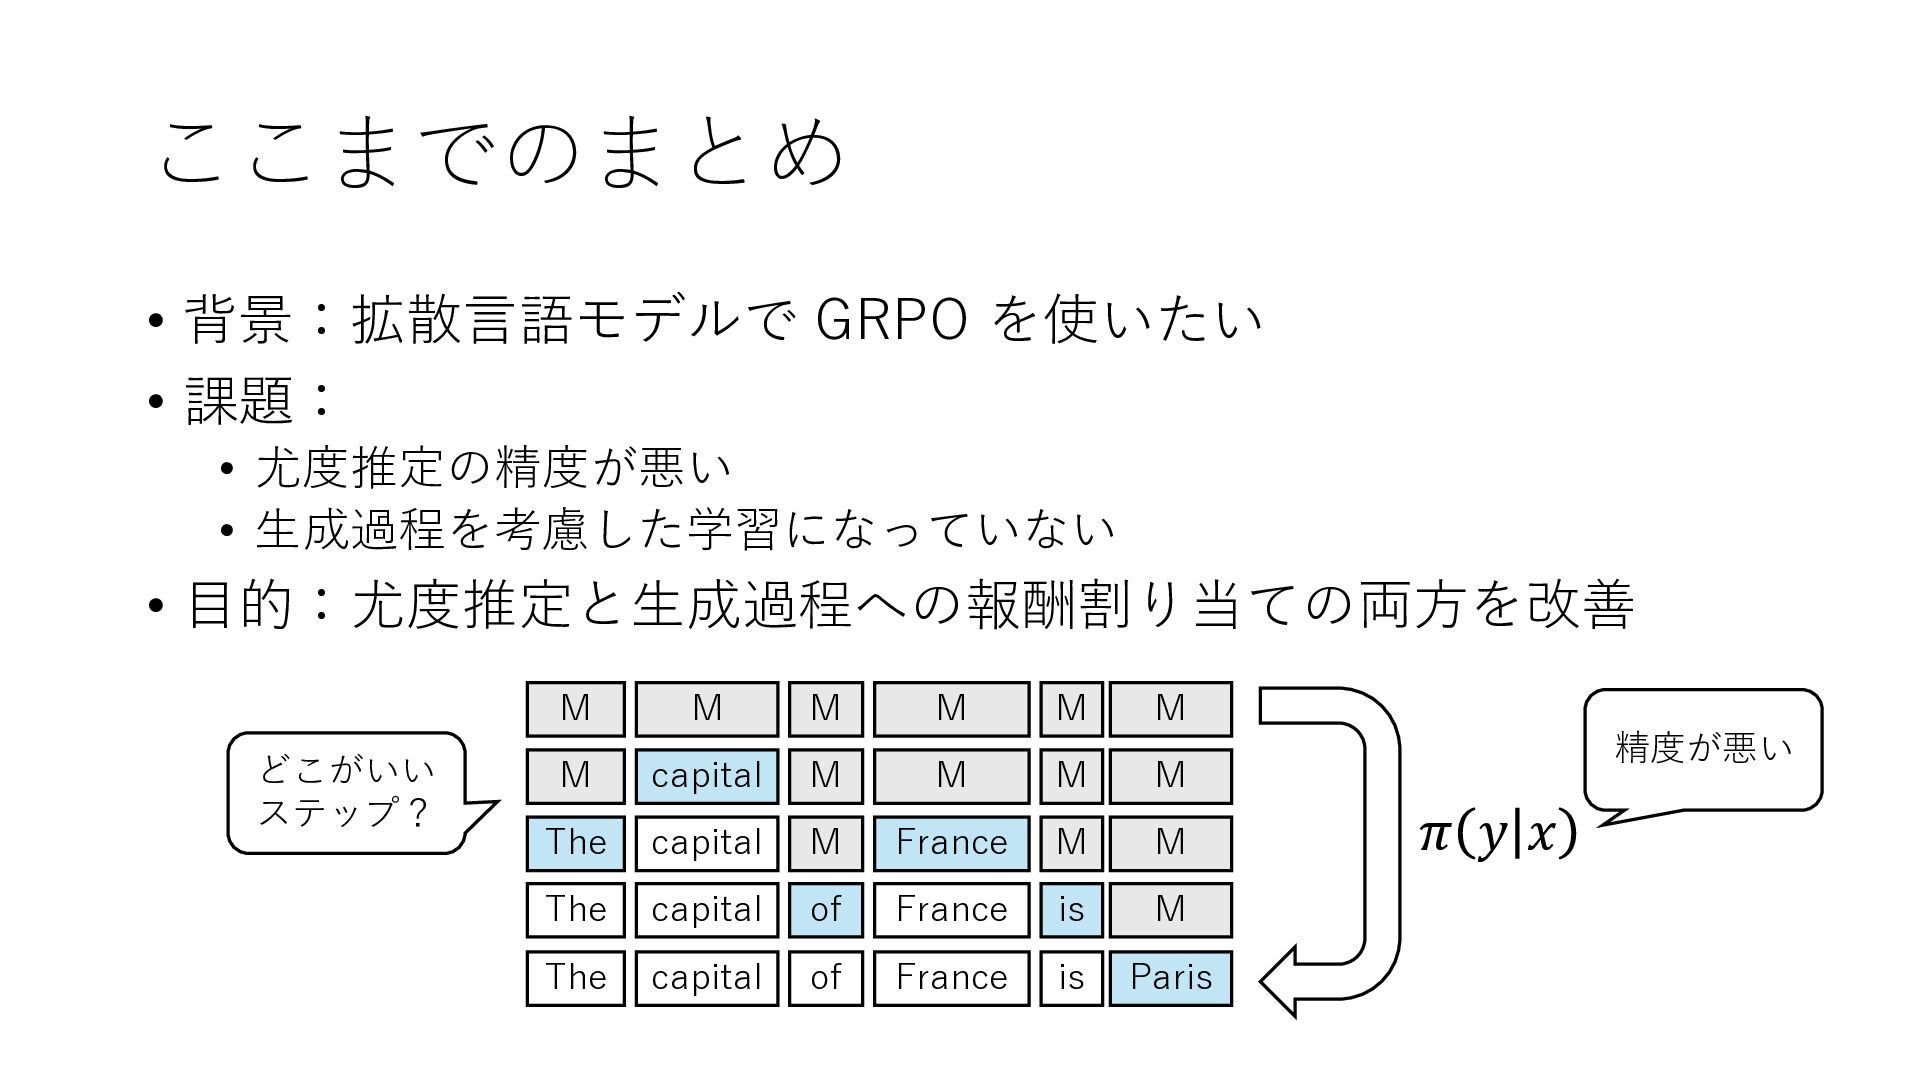
  11. ここまでのまとめ • 背景:拡散言語モデルで GRPO を使いたい • 課題: • 尤度推定の精度が悪い •

    生成過程を考慮した学習になっていない • 目的:尤度推定と生成過程への報酬割り当ての両方を改善 どこがいい ステップ? M M M M M M M capital M M M M The capital M France M M The capital of France is M The capital of France is Paris 精度が悪い 𝜋 𝑦𝑥
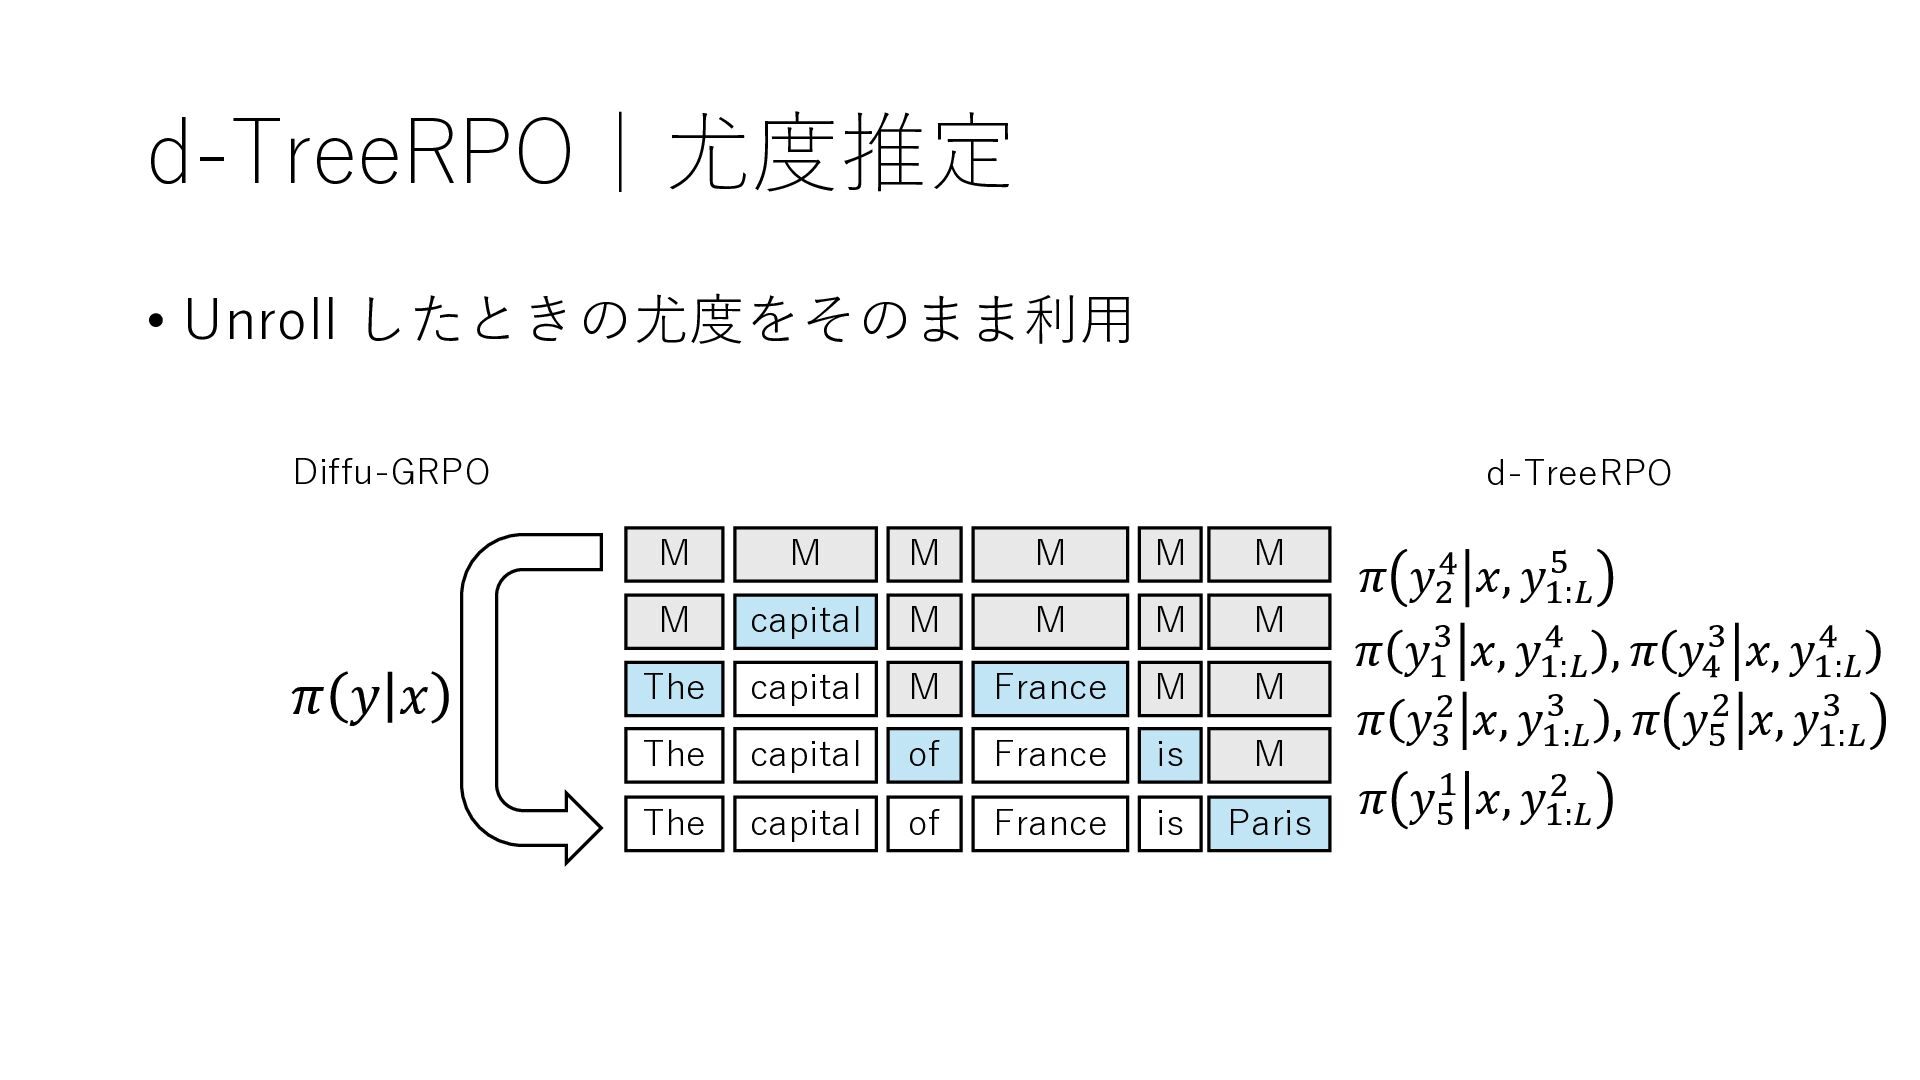
  12. d-TreeRPO|尤度推定 • Unroll したときの尤度をそのまま利用 Diffu-GRPO 𝜋 𝑦𝑥 d-TreeRPO M M

    M M M M M capital M M M M The capital M France M M The capital of France is M The capital of France is Paris 5 𝜋 𝑦24 𝑥, 𝑦1:𝐿 4 4 𝜋 𝑦13 𝑥, 𝑦1:𝐿 , 𝜋 𝑦43 𝑥, 𝑦1:𝐿 3 3 𝜋 𝑦32 𝑥, 𝑦1:𝐿 , 𝜋 𝑦52 𝑥, 𝑦1:𝐿 2 𝜋 𝑦51 𝑥, 𝑦1:𝐿
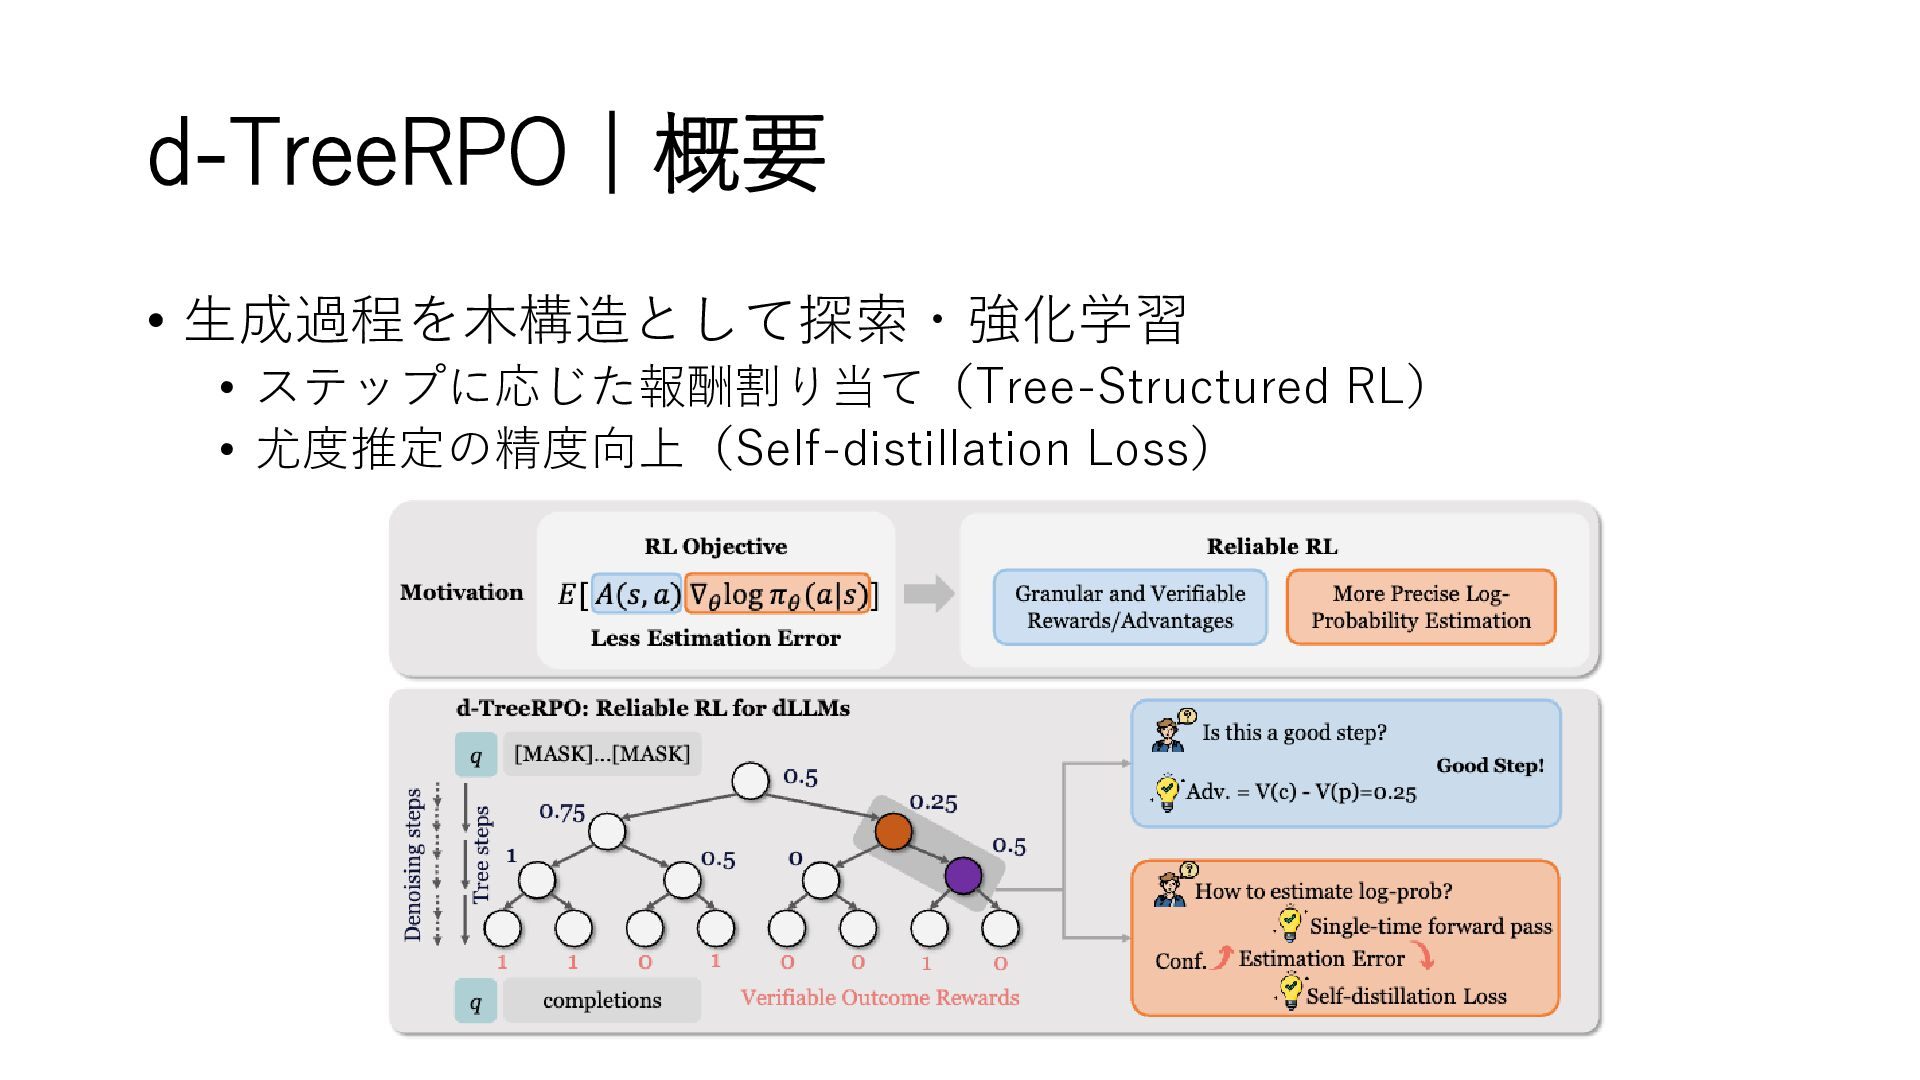
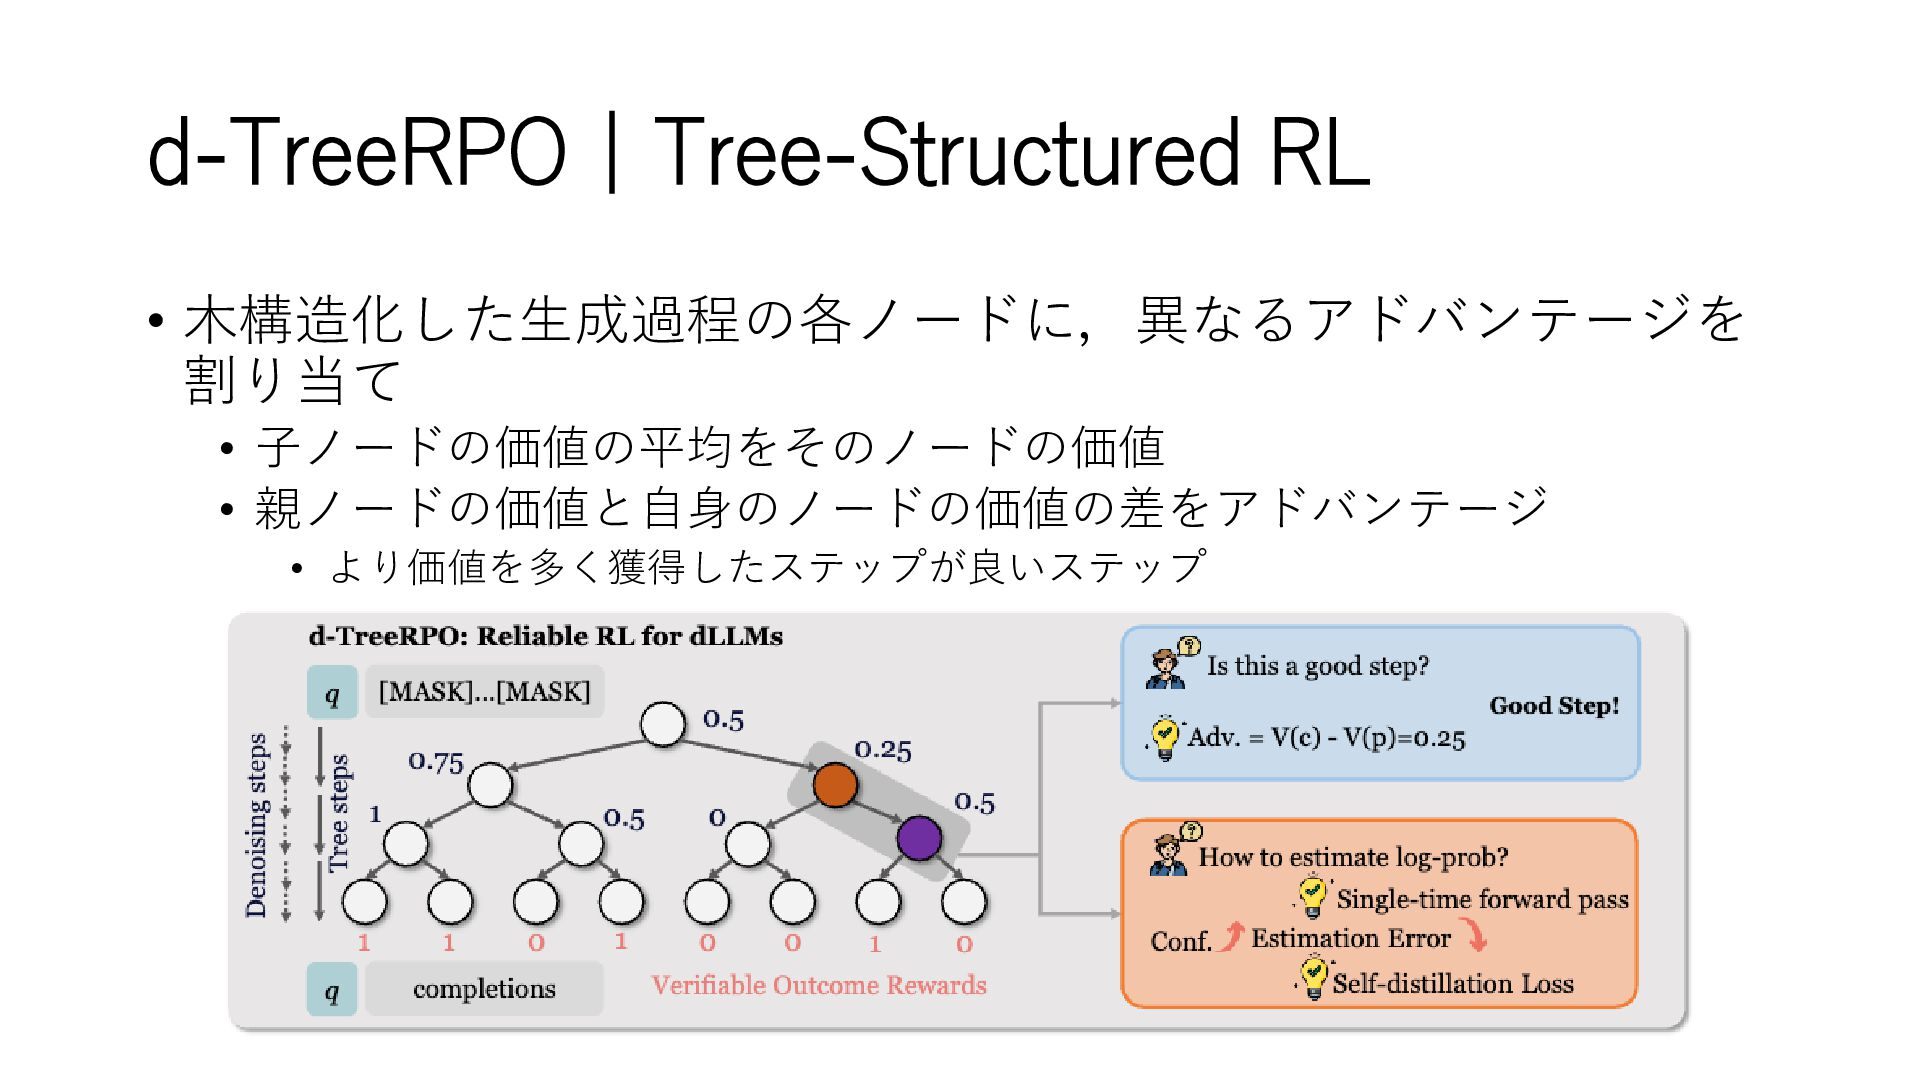
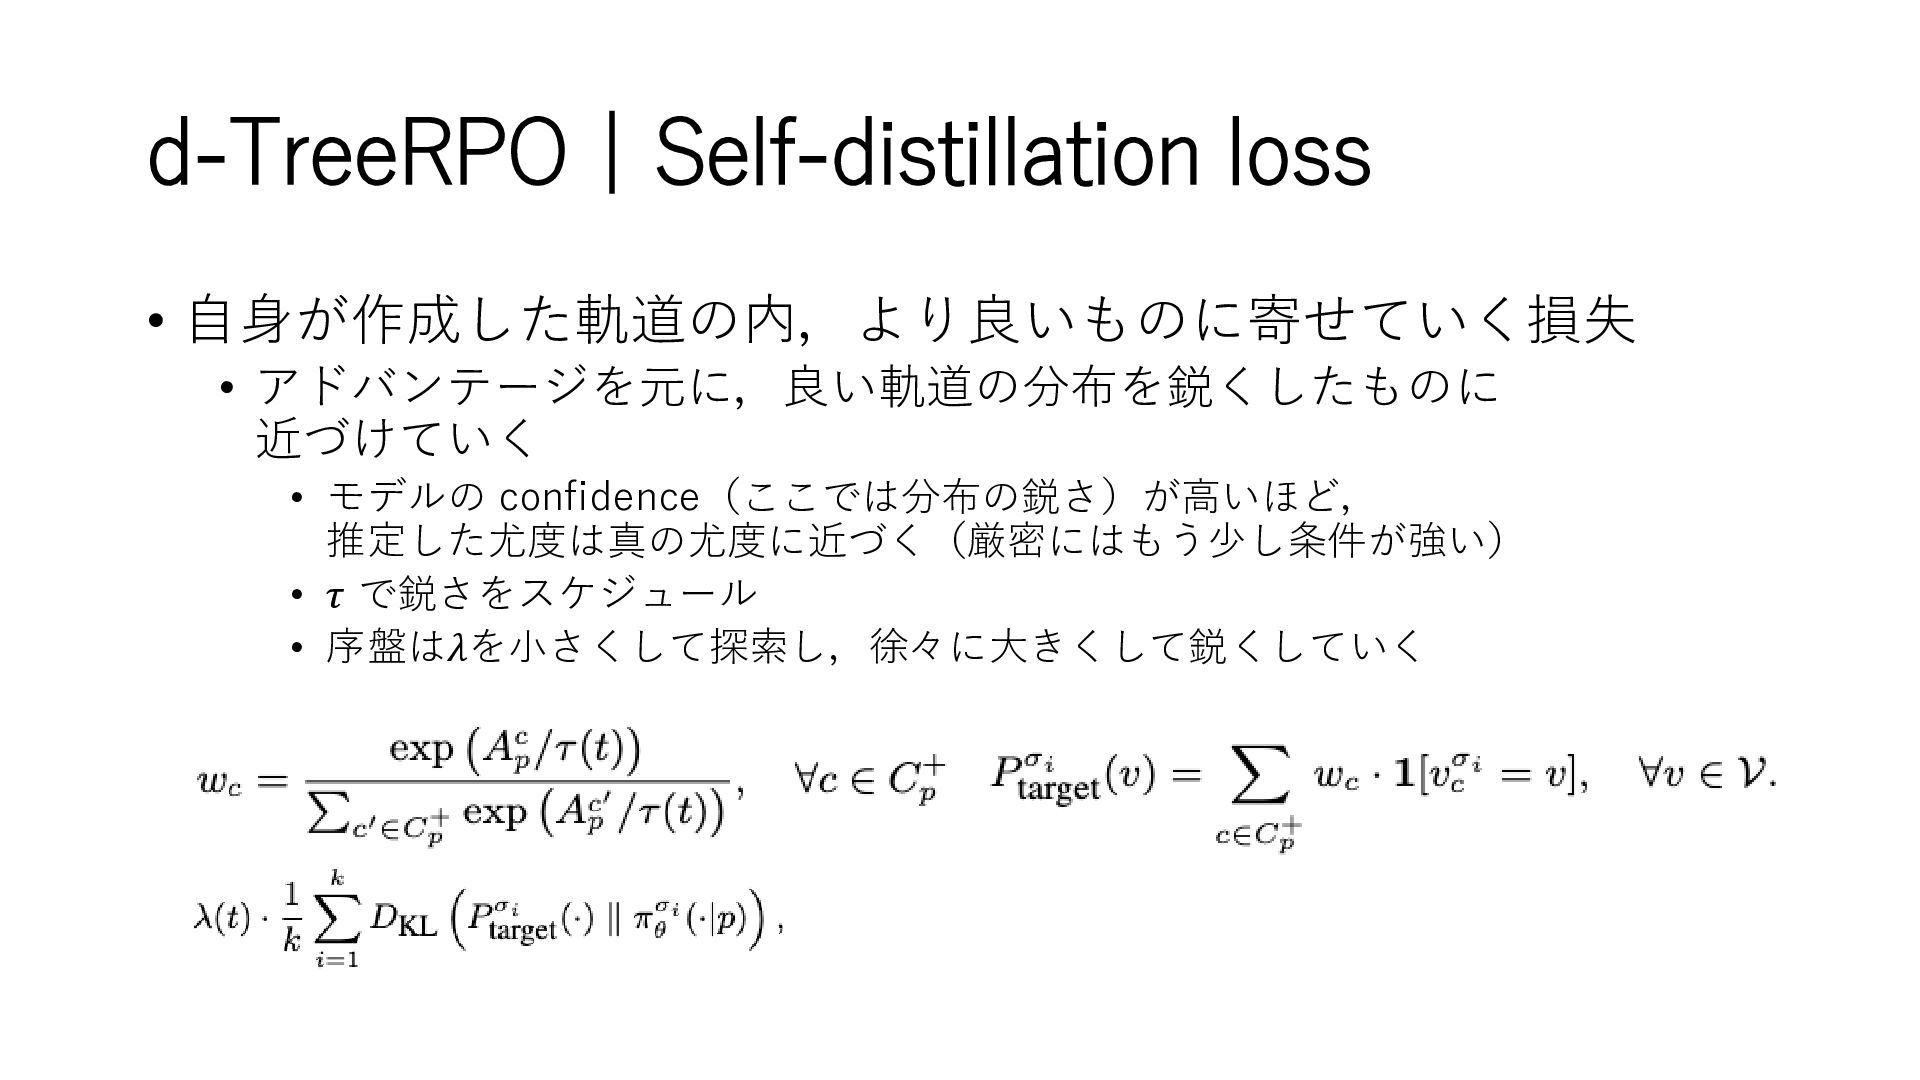
  13. d-TreeRPO|Self-distillation loss • 自身が作成した軌道の内,より良いものに寄せていく損失 • アドバンテージを元に,良い軌道の分布を鋭くしたものに 近づけていく • モデルの confidence(ここでは分布の鋭さ)が高いほど,

    推定した尤度は真の尤度に近づく(厳密にはもう少し条件が強い) • 𝜏 で鋭さをスケジュール • 序盤は𝜆を小さくして探索し,徐々に大きくして鋭くしていく
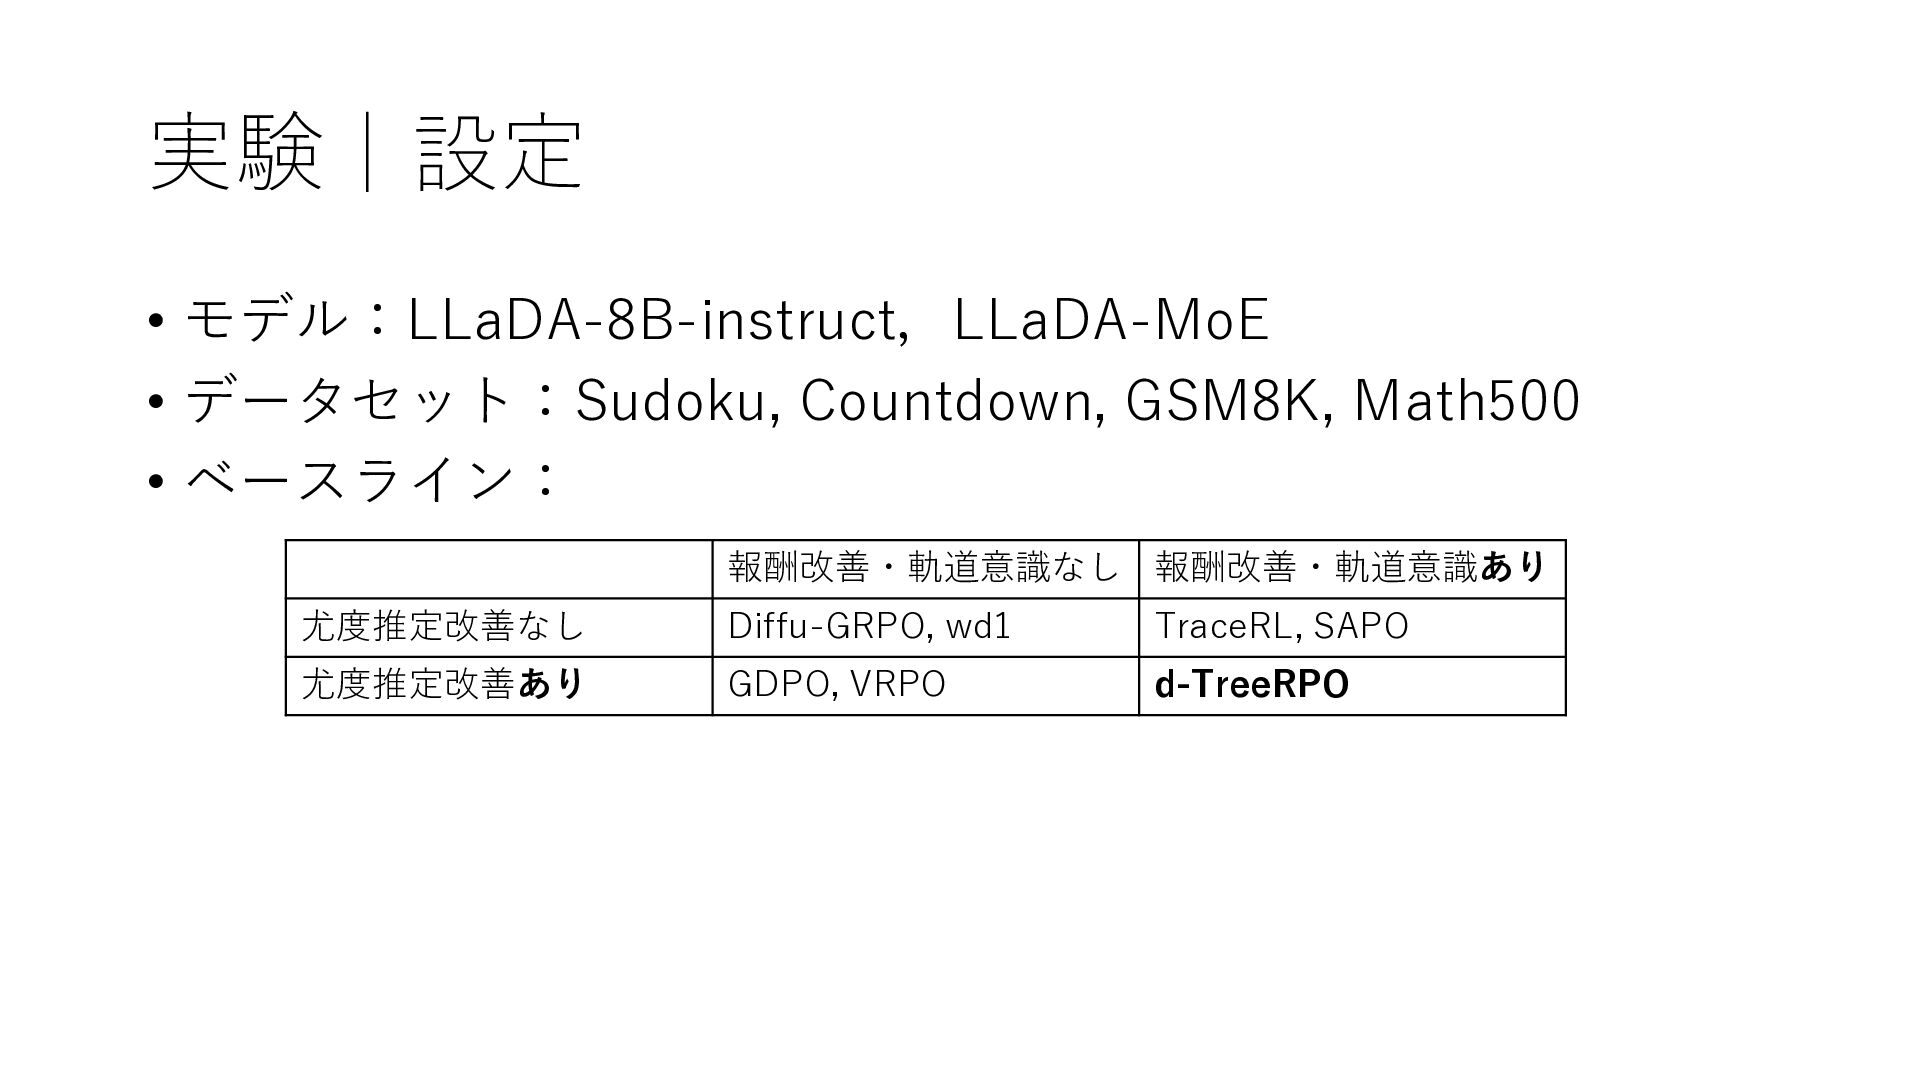
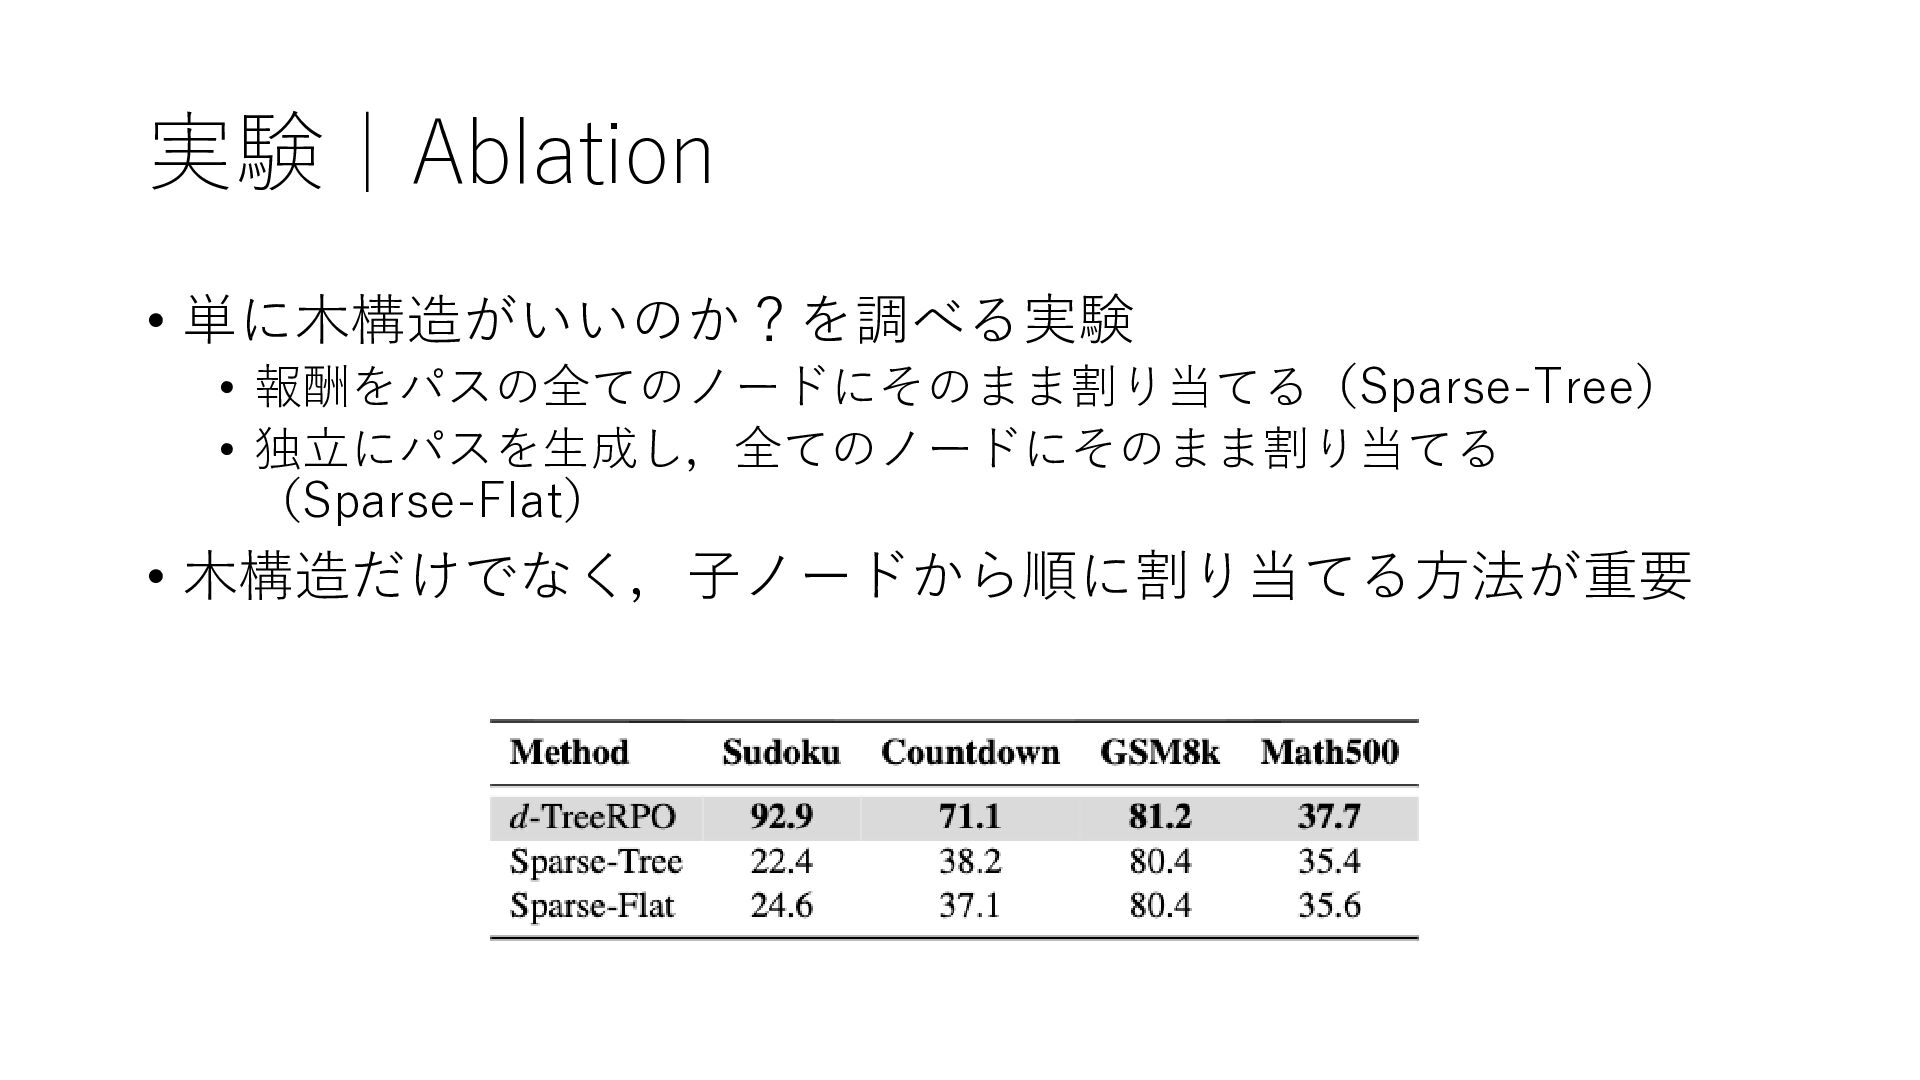
  14. 実験|設定 • モデル:LLaDA-8B-instruct,LLaDA-MoE • データセット:Sudoku, Countdown, GSM8K, Math500 • ベースライン:

    報酬改善・軌道意識なし 報酬改善・軌道意識あり 尤度推定改善なし Diffu-GRPO, wd1 TraceRL, SAPO 尤度推定改善あり GDPO, VRPO d-TreeRPO
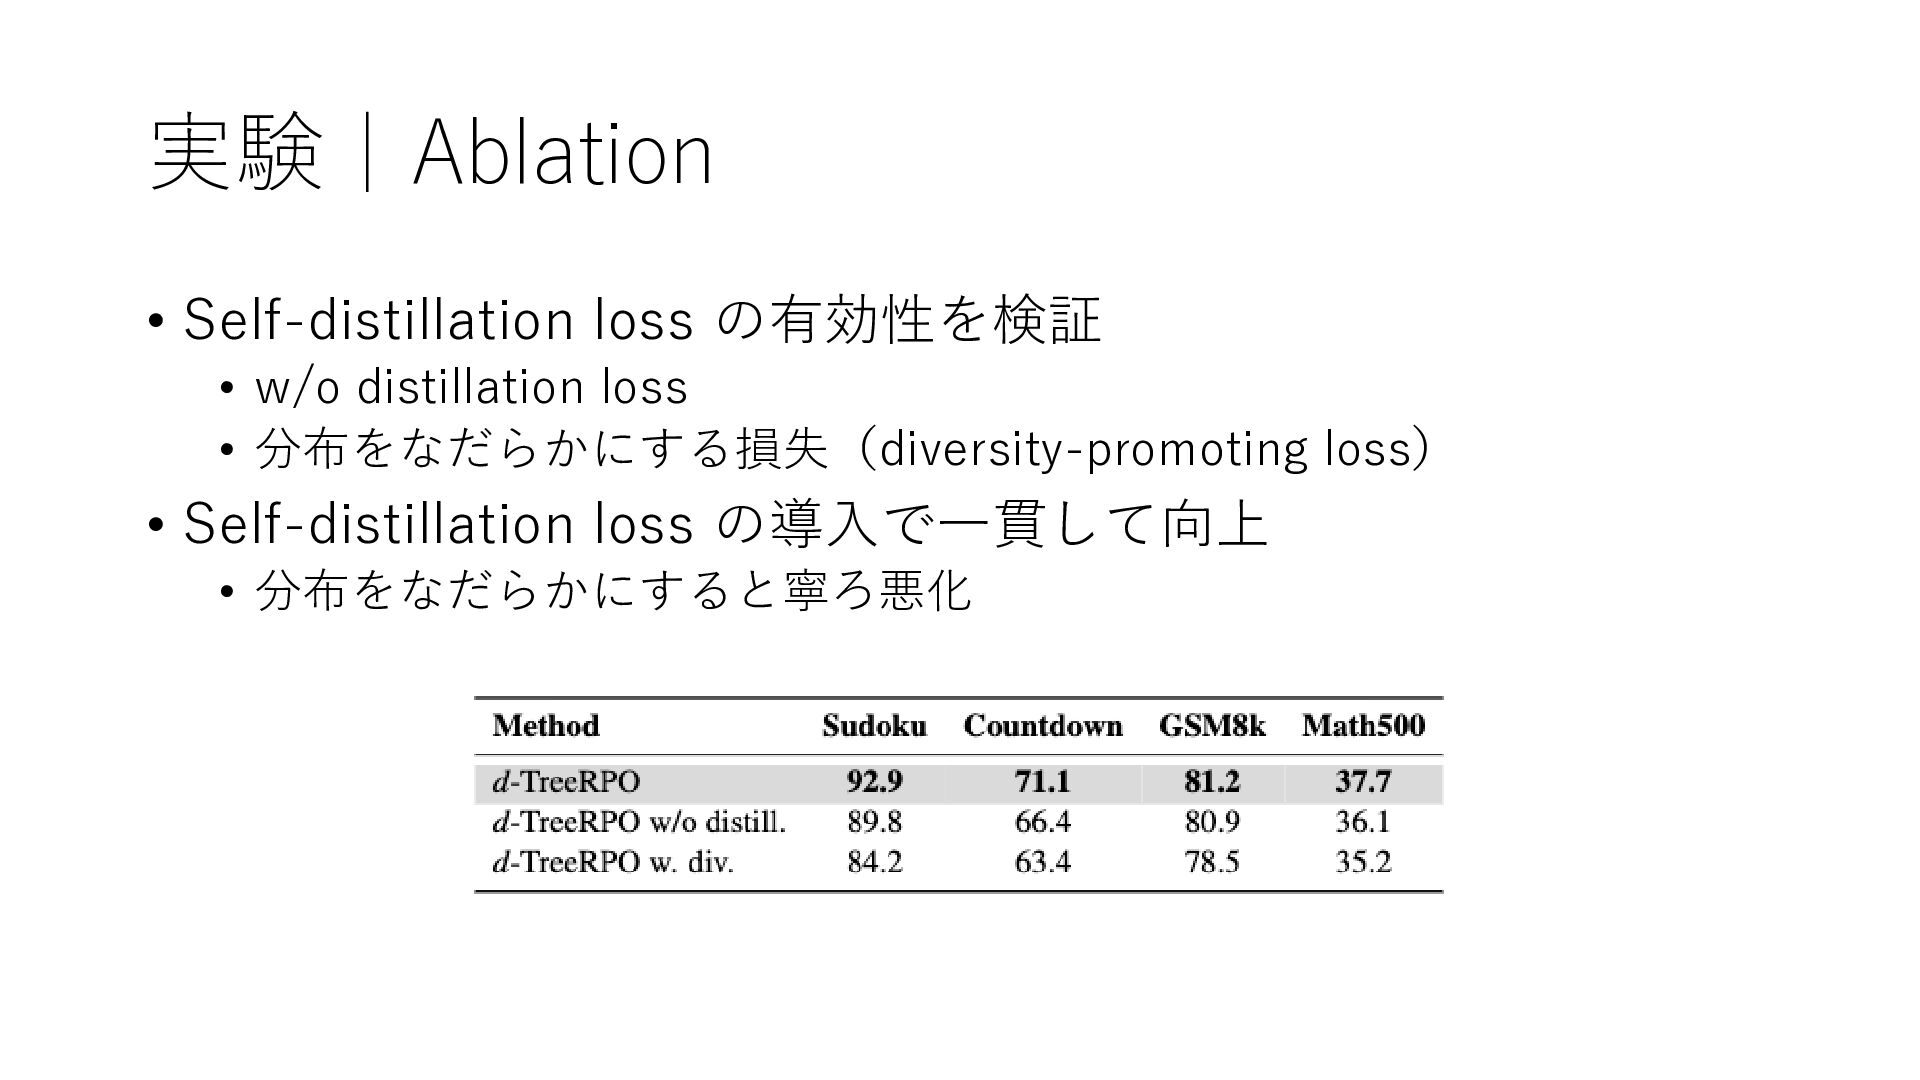
  15. 実験|Ablation • Self-distillation loss の有効性を検証 • w/o distillation loss •

    分布をなだらかにする損失(diversity-promoting loss) • Self-distillation loss の導入で一貫して向上 • 分布をなだらかにすると寧ろ悪化
  16. まとめ • 背景 • 拡散言語モデルで GRPO による学習をしたいが,次の課題がある • 尤度を直接計算できない •

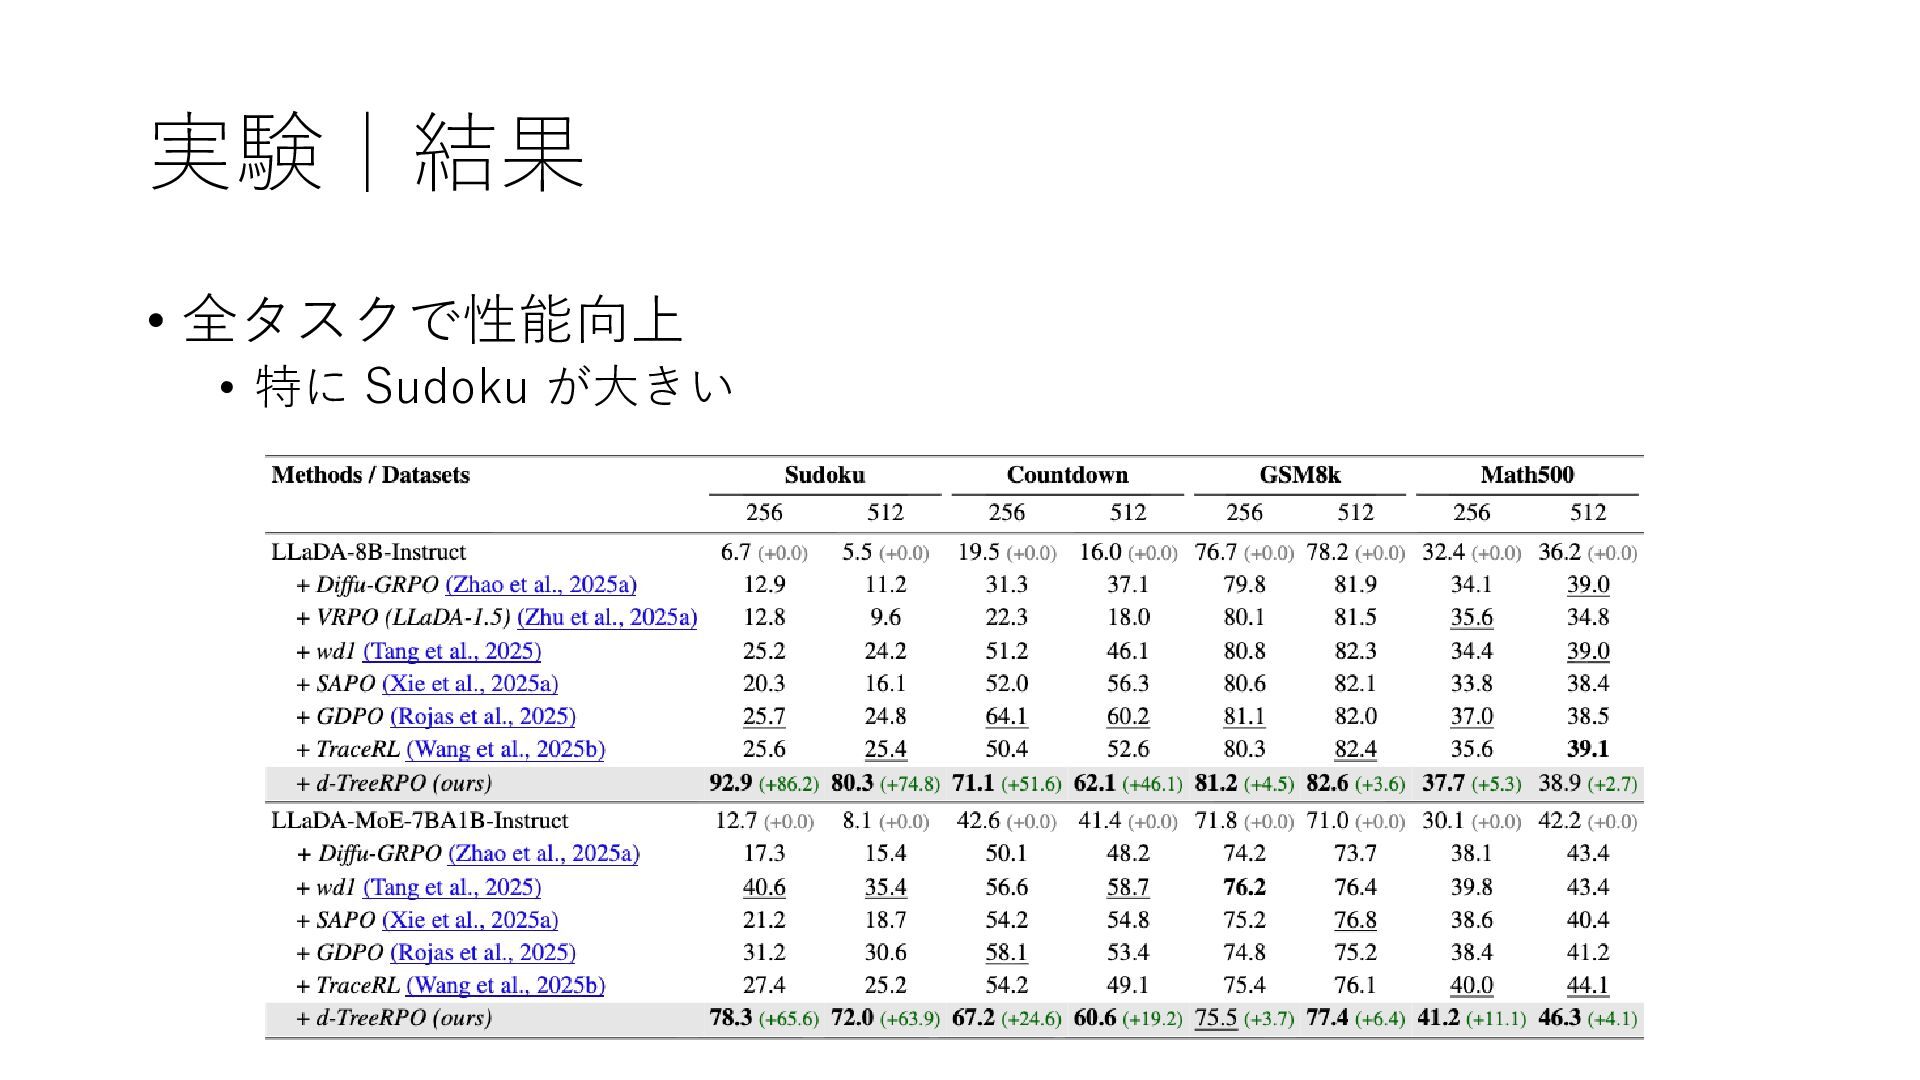
    生成過程が一意でないので,どれが良いのかを考慮しないといけない • 目的 • 尤度推定と生成過程への報酬割り当ての両方を改善 • 手法 • 生成過程を木構造とみなし,これを生かした報酬割り当て + 分布先鋭化 • 結果 • 数独,カウントダウン,数学で性能向上