de NoSQL? • Diferencias entre bases de datos SQL y NoSQL – ACID – BASE • Bases de datos NoSQL – Tipos de bases de datos NoSQL – Neo4J – ElasticSearch – Redis – MongoDB 2
de NoSQL? • Diferencias entre bases de datos SQL y NoSQL – ACID – BASE • Bases de datos NoSQL – Tipos de bases de datos NoSQL – Neo4J – ElasticSearch – Redis – MongoDB 3
de Gestión de Bases de Datos – Conjunto de Software – Permiten el almacenamiento, modificación y extracción de la información, así como la administración de una Base de Datos 7
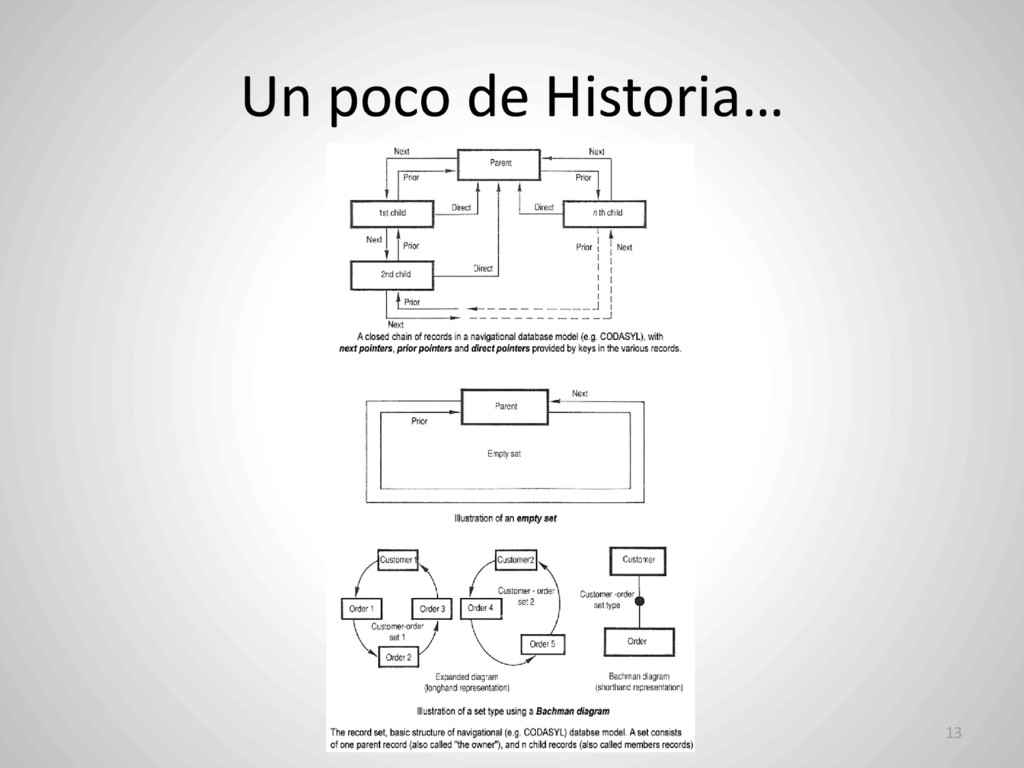
Navigational Database – Registros localizados principalmente siguiendo referencias desde otros registros – Las referencias permitían localizar el lugar donde debía leerse el siguiente registro en la cinta 12
a Objetos – Se empieza a tratar-interpretar los datos como objetos – Object-Relational Impedance Mismatch – Aparición de los ORMs (Object Relational Mappings) 30
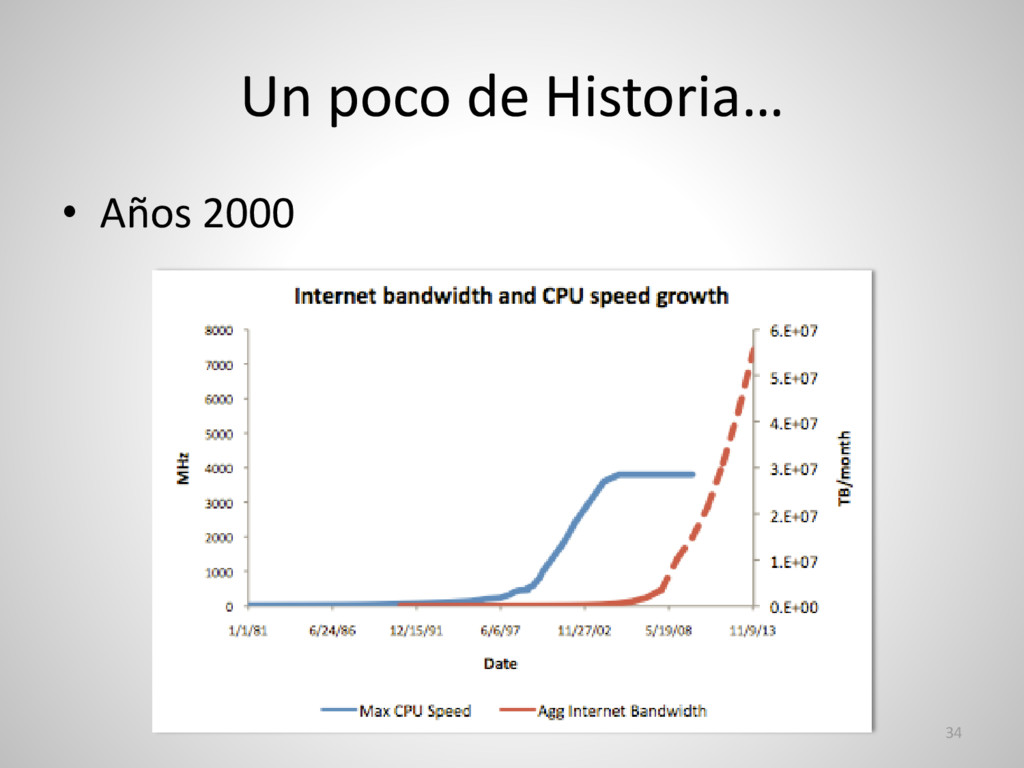
Social Media – Expansión del e-Commerce – Ley de Moore: mayor capacidad de almacenamiento y procesado de información – Incremento masivo de los datos coleccionados 33
tiempo aparecen y se popularizan las Metodologías de Desarrollo Ágil • Ciclos de desarrollo cortos • Constante evolución de requerimientos • Flexibilidad de diseño 36
Relacional • Difícil de Evolucionar • Migraciones Lentas y Difíciles • En sincronía con la aplicación – Los programadores suelen tratar directamente con el ORM, perdiendo visibilidad de la capa de BD 37
ORMs proporcionan una capa de abstracción que facilita y acelera el desarrollo, supone inherentemente una pérdida de rendimiento en la capa de datos, ya que las queries son autogeneradas y rara vez se manipulan para ser optimizadas 38
de NoSQL? • Diferencias entre bases de datos SQL y NoSQL – ACID – BASE • Bases de datos NoSQL – Tipos de bases de datos NoSQL – Neo4J – ElasticSearch – Redis – MongoDB 43
llevar a cabo una tarea comparada con los recursos utilizados – Si un sistema puede hacer más que otro usando la misma cantidad de recursos (misma capacidad) entonces tiene un mayor rendimiento 45
de un sistema de ofrecer cierto nivel de funcionalidad y servicio en sus operaciones de manera ininterrumpida – Generalmente esto require tener servidores redundantes, replicar la información y ofrecer tolerancia a fallos 46
un sistema de poder crecer en número de usuarios y operaciones realizadas de manera continua sin que la calidad de su servicio se vea afectada – Capacidad de un sistema para reaccionar y adaptarse a la demanda sin pérdida de calidad – También aplica a los costes 47
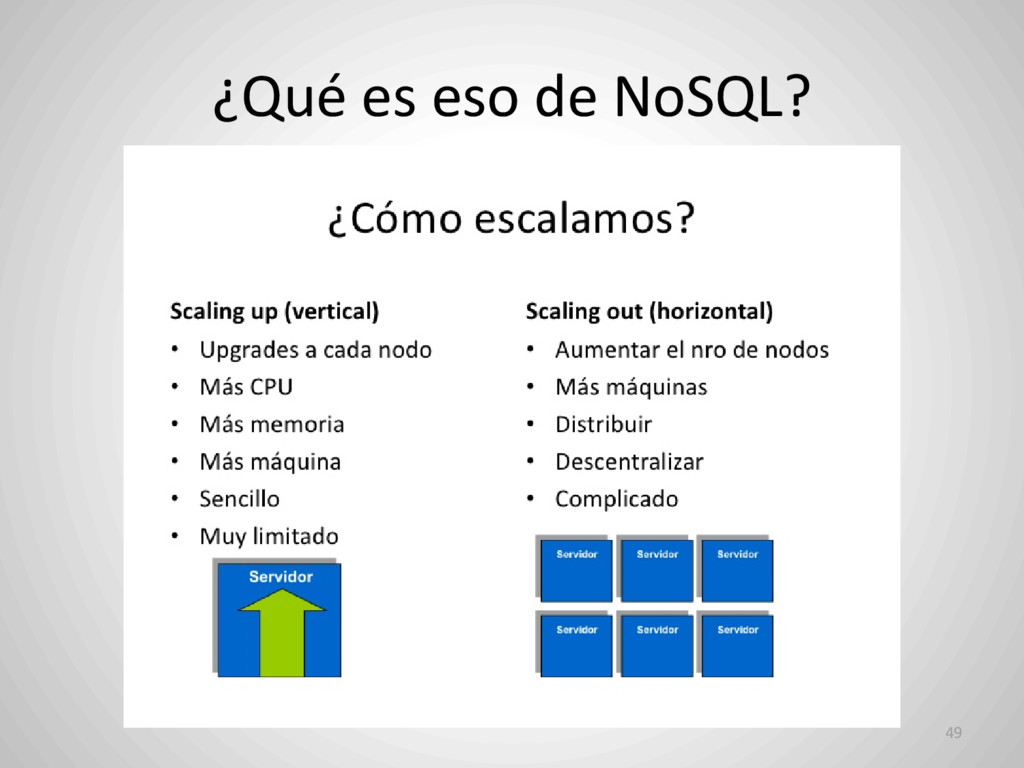
Vertical: el sistema aumenta su capacidad utilizando equipos más potentes y con más recursos – Horizontal: el sistema crece dividiendo su carga de trabajo entre más equipos de las mismas características 48
fue nombrado en 1998 por Carlo Strozzi para referirse a su base de datos no relacional • Subconjunto de bases de datos que difieren del modelo clásico de bases de datos típicamente por no usar SQL • Son usadas por Google, Amazon, Twitter, Facebook… para enfrentarse a problemas de rendimiento 51
datos relacionales (RBDMS) como las NoSQL son de Almacenamiento estructurado – En las bases de datos relacionales la estructura se define en las tablas – En las bases de datos no sql no es necesario definir una estructura, aunque si que es recomendable 52
de NoSQL? • Diferencias entre bases de datos SQL y NoSQL – ACID – BASE • Bases de datos NoSQL – Tipos de bases de datos NoSQL – Neo4J – ElasticSearch – Redis – MongoDB 53
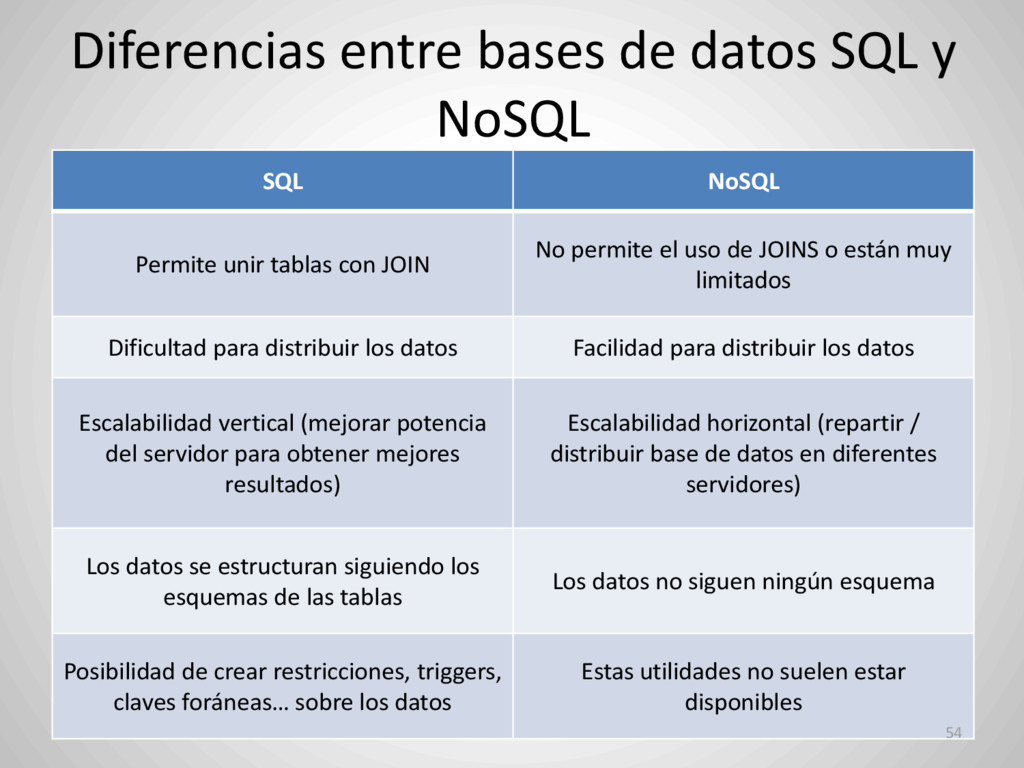
Permite unir tablas con JOIN No permite el uso de JOINS o están muy limitados Dificultad para distribuir los datos Facilidad para distribuir los datos Escalabilidad vertical (mejorar potencia del servidor para obtener mejores resultados) Escalabilidad horizontal (repartir / distribuir base de datos en diferentes servidores) Los datos se estructuran siguiendo los esquemas de las tablas Los datos no siguen ningún esquema Posibilidad de crear restricciones, triggers, claves foráneas… sobre los datos Estas utilidades no suelen estar disponibles 54
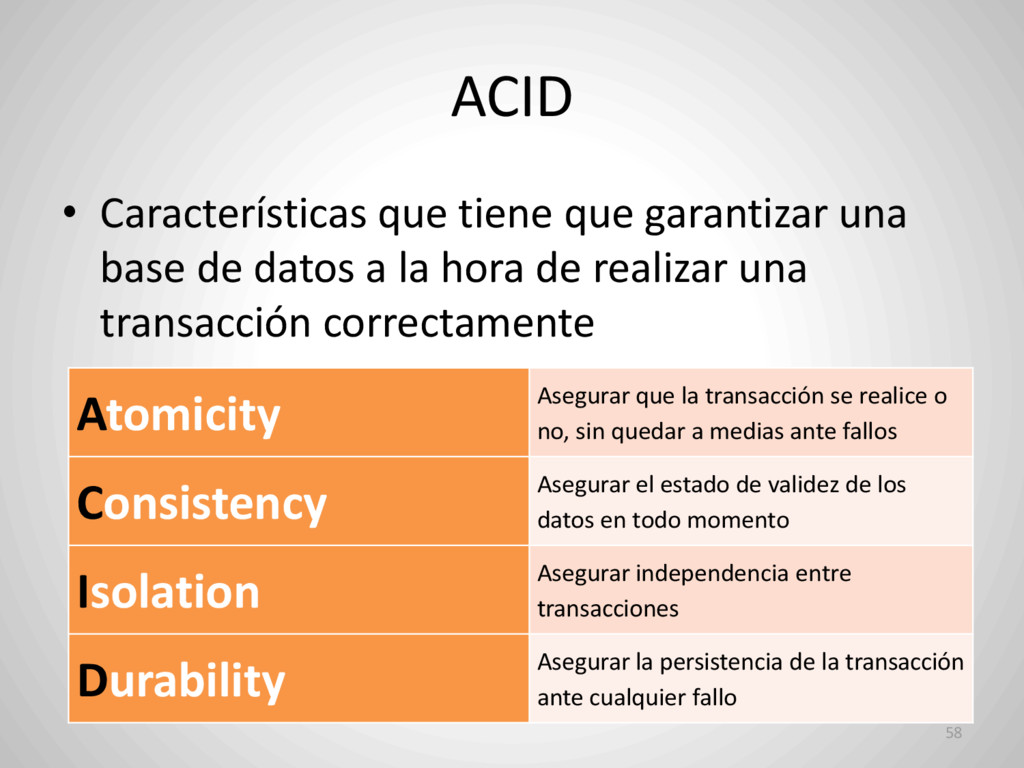
datos a la hora de realizar una transacción correctamente Atomicity Asegurar que la transacción se realice o no, sin quedar a medias ante fallos Consistency Asegurar el estado de validez de los datos en todo momento Isolation Asegurar independencia entre transacciones Durability Asegurar la persistencia de la transacción ante cualquier fallo 58
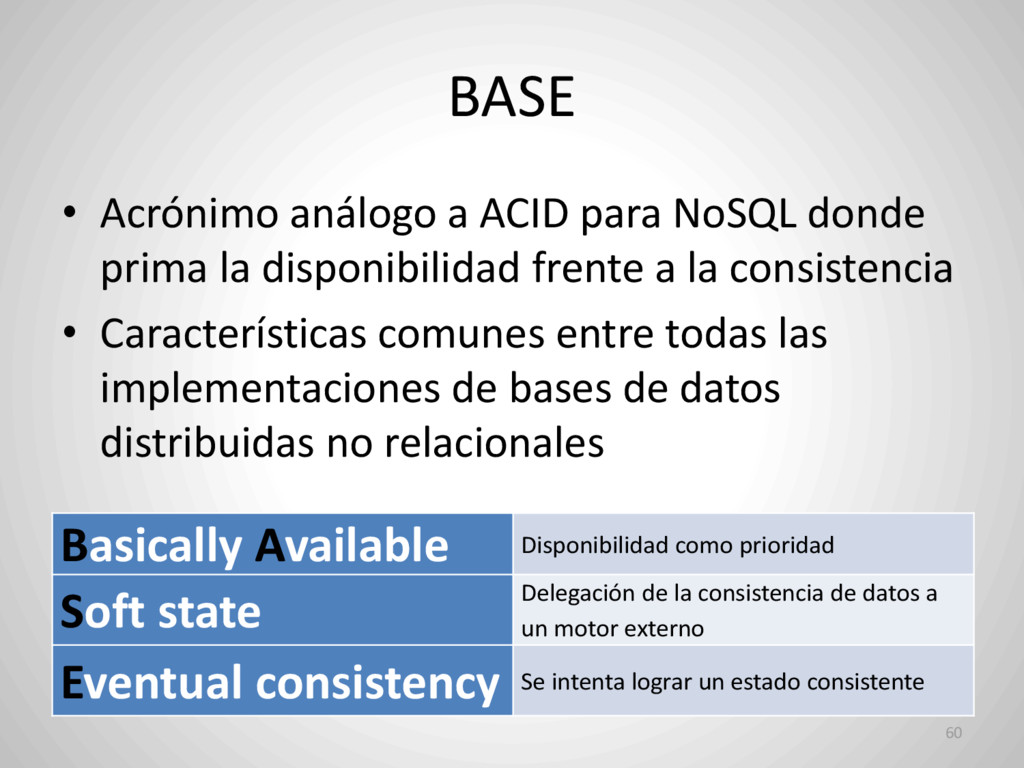
la disponibilidad frente a la consistencia • Características comunes entre todas las implementaciones de bases de datos distribuidas no relacionales Basically Available Disponibilidad como prioridad Soft state Delegación de la consistencia de datos a un motor externo Eventual consistency Se intenta lograr un estado consistente 60
de NoSQL? • Diferencias entre bases de datos SQL y NoSQL – ACID – BASE • Bases de datos NoSQL – Tipos de bases de datos NoSQL – Neo4J – ElasticSearch – Redis – MongoDB 62
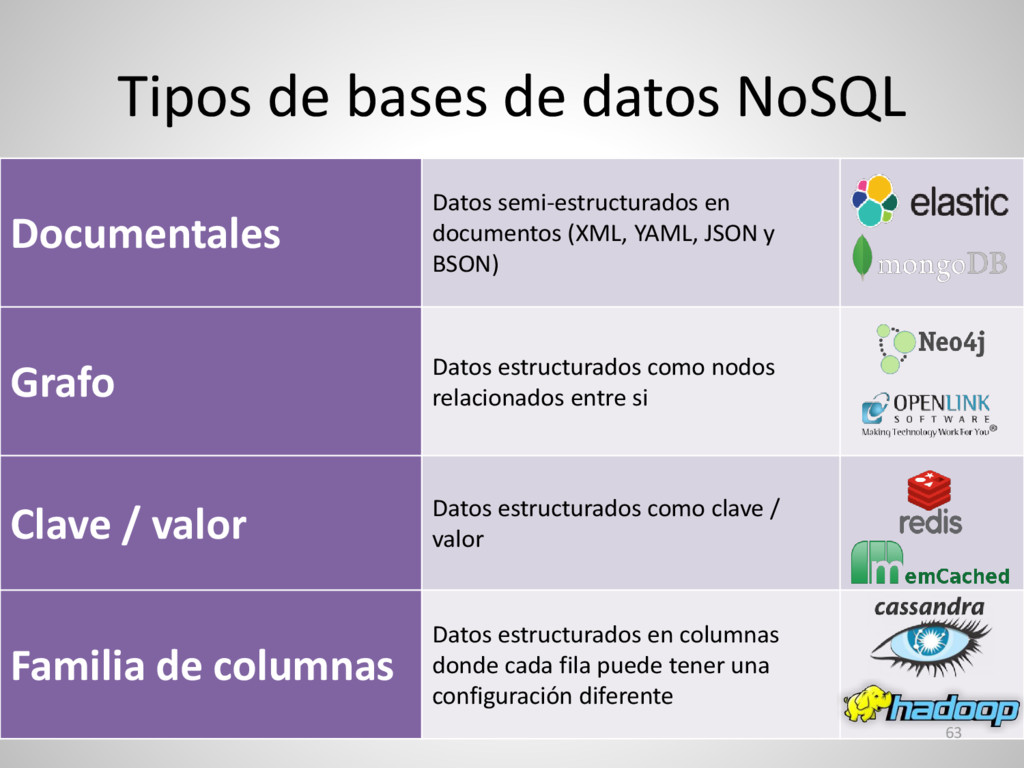
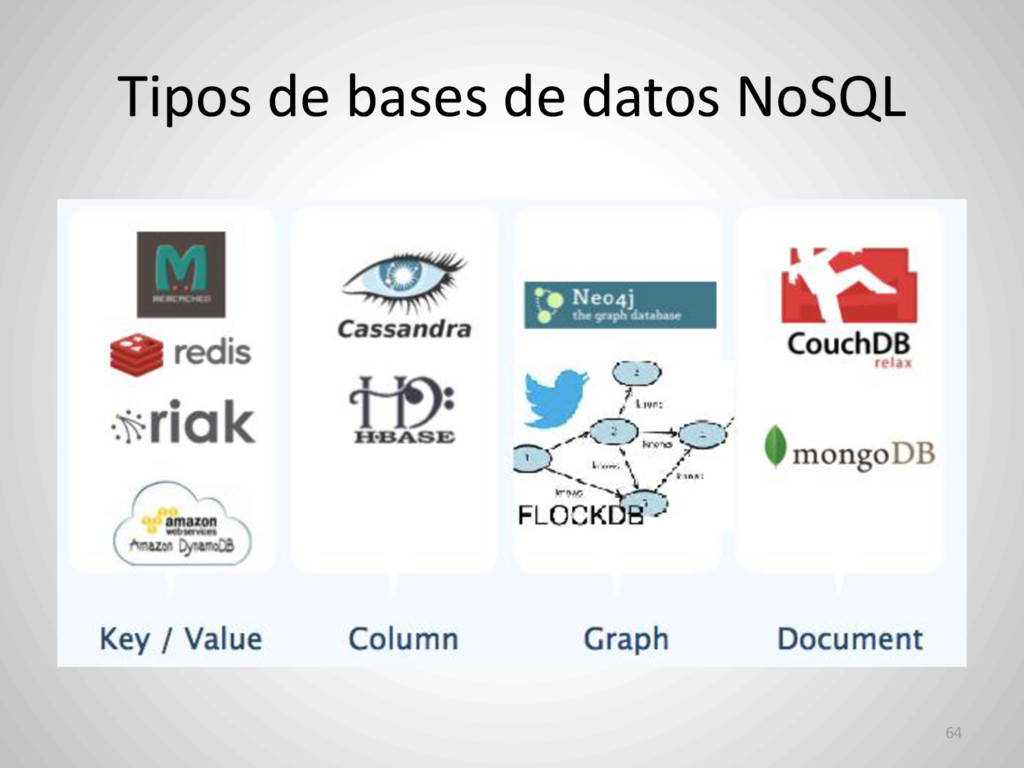
documentos (XML, YAML, JSON y BSON) Grafo Datos estructurados como nodos relacionados entre si Clave / valor Datos estructurados como clave / valor Familia de columnas Datos estructurados en columnas donde cada fila puede tener una configuración diferente 63
de gestionar millones de grafos/nodos/relaciones/propiedades en una sola máquina • Completamente transaccional • Máxima escalabilidad • Software libre 65
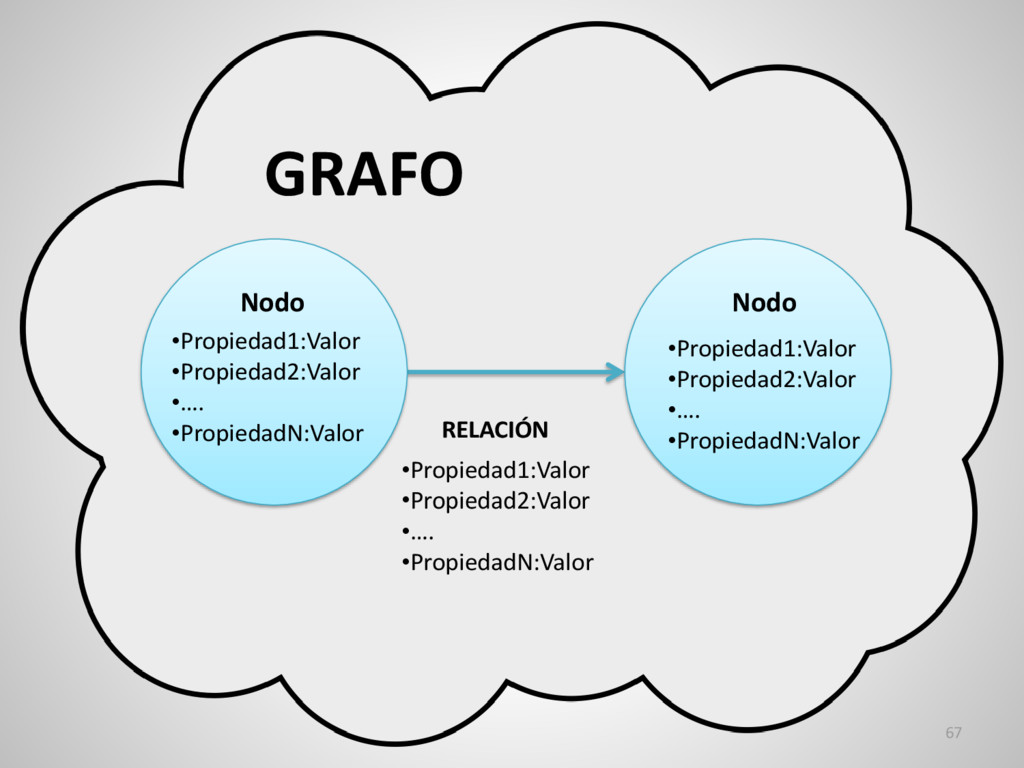
Propiedades – Una Propiedad es una relación clave / valor donde la clave es un identificador de tipo string • Los Nodos se organizan en Relaciones que también tienen Propiedades • Un Índice mapea Propiedades tanto de Nodos como de Relaciones para conseguir consultas de datos más eficientes 66
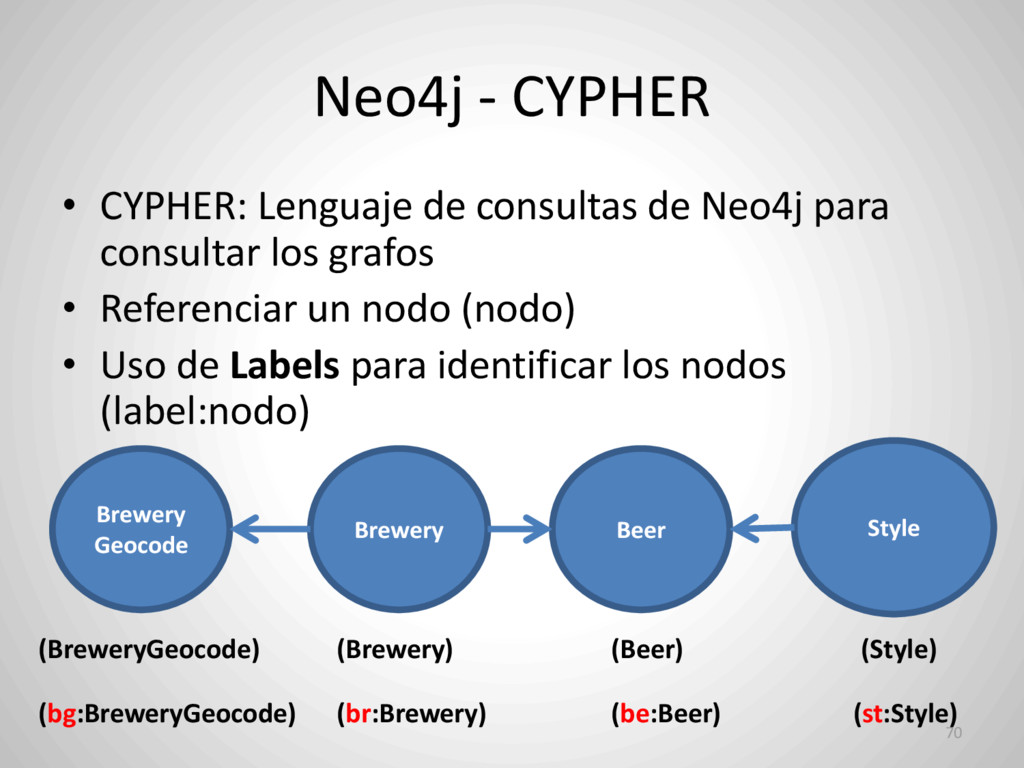
para consultar los grafos • Referenciar un nodo (nodo) • Uso de Labels para identificar los nodos (label:nodo) 70 Brewery Beer Style Brewery Geocode (BreweryGeocode) (Brewery) (Beer) (Style) (bg:BreweryGeocode) (br:Brewery) (be:Beer) (st:Style)
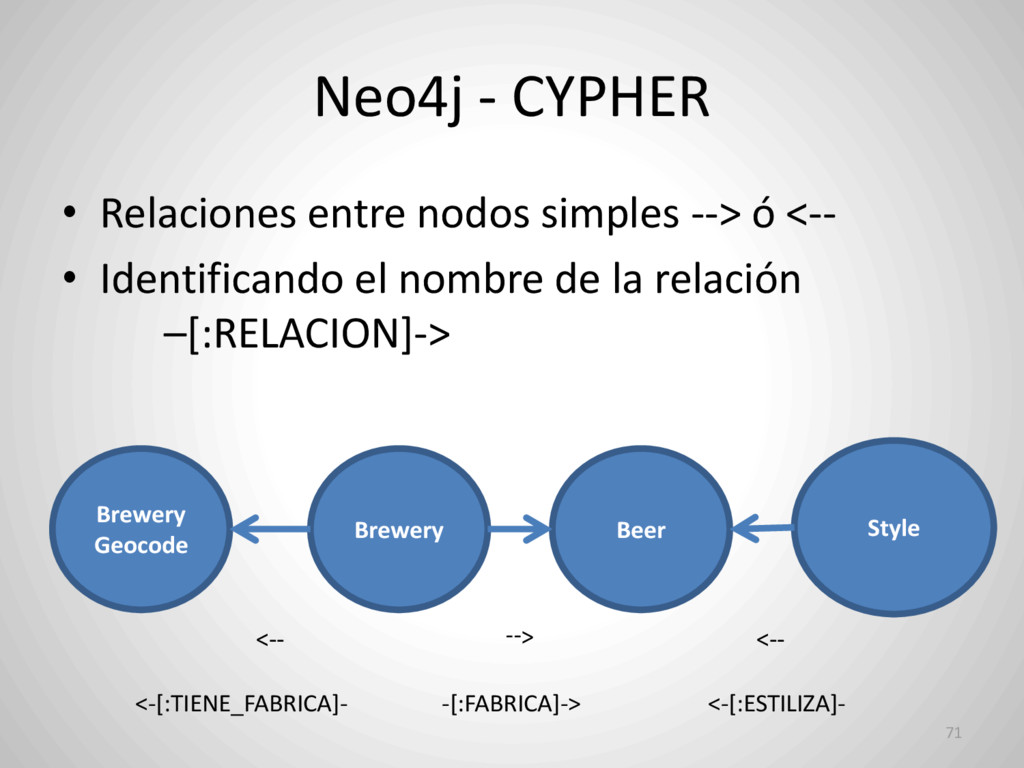
<-- • Identificando el nombre de la relación –[:RELACION]-> 71 Brewery Beer Style Brewery Geocode <-- <-- <-- <-[:TIENE_FABRICA]- <-[:ESTILIZA]- -[:FABRICA]->
datos de manera distribuida • Almacena documentos pudiendo estructurar su contenido con un schema / mapping • Indexa los datos en tiempo real • Utiliza JSON y un API web RESTFul • Permite agrupar / facetar el contenido de los documentos 74
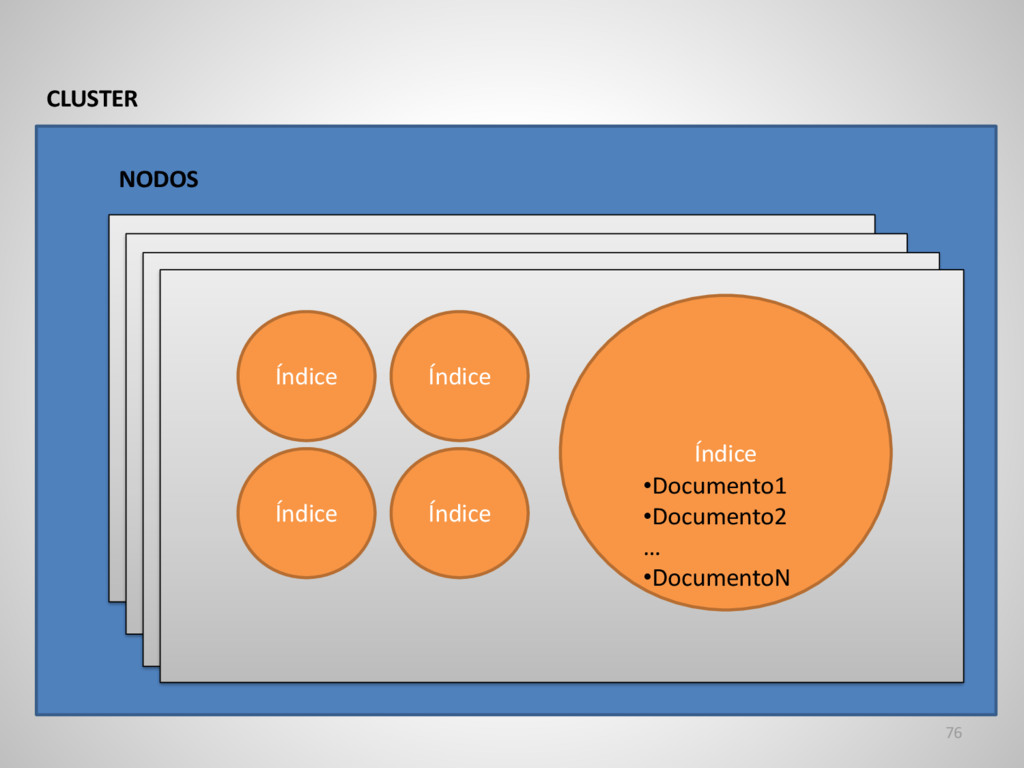
que mantienen la información distribuida • Un Nodo almacena la información y se encara de las tareas de indexación – No hay límite de Nodos • Un Índice es una colección de Documentos con características similares 75
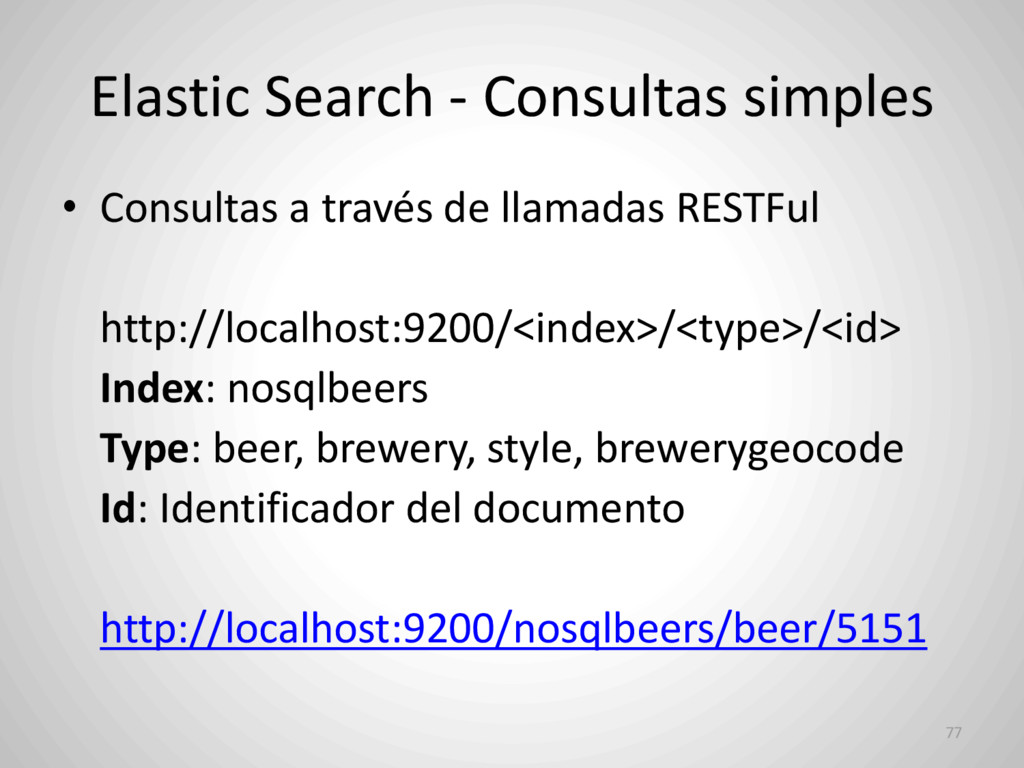
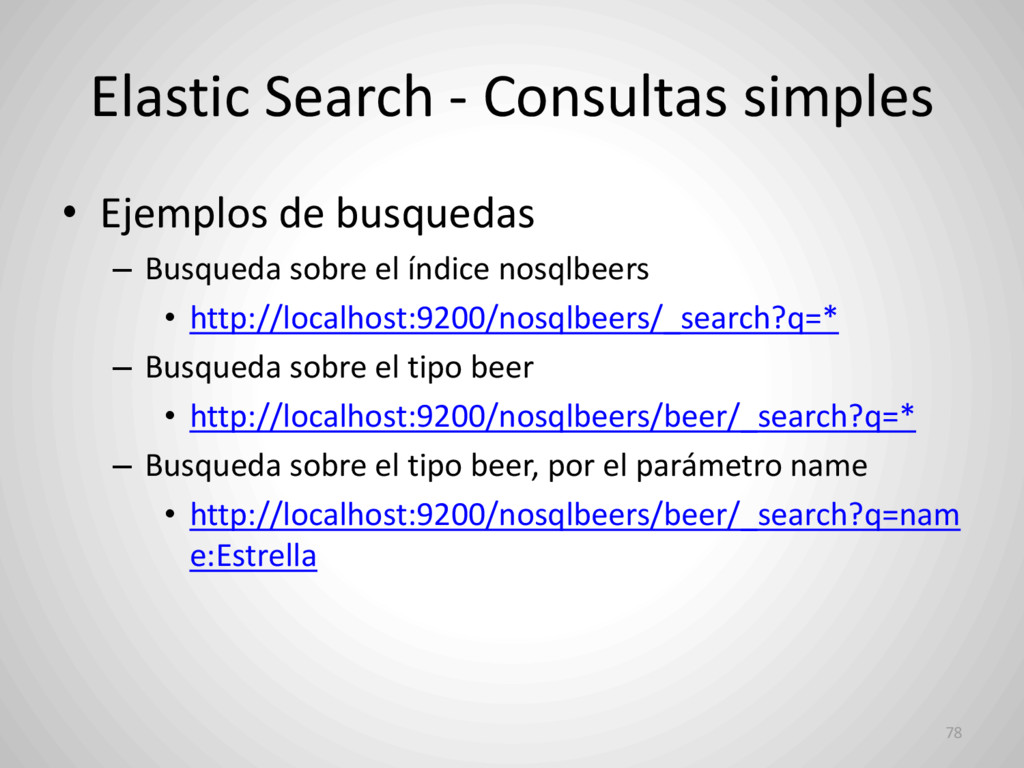
Busqueda sobre el índice nosqlbeers • http://localhost:9200/nosqlbeers/_search?q=* – Busqueda sobre el tipo beer • http://localhost:9200/nosqlbeers/beer/_search?q=* – Busqueda sobre el tipo beer, por el parámetro name • http://localhost:9200/nosqlbeers/beer/_search?q=nam e:Estrella 78
en formato JSON como rangos y agregaciones • Imposible pasar esos parámetros por URL – Uso de curl desde línea de comandos – Plugin Sense de Elastic Search para Chrome 79
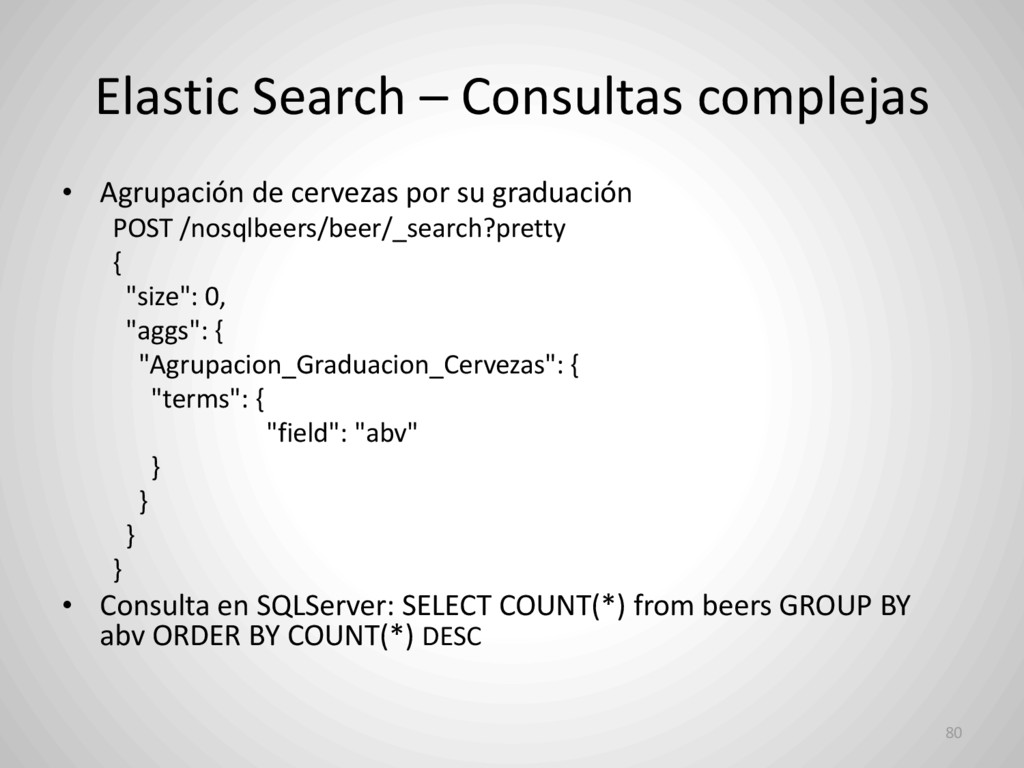
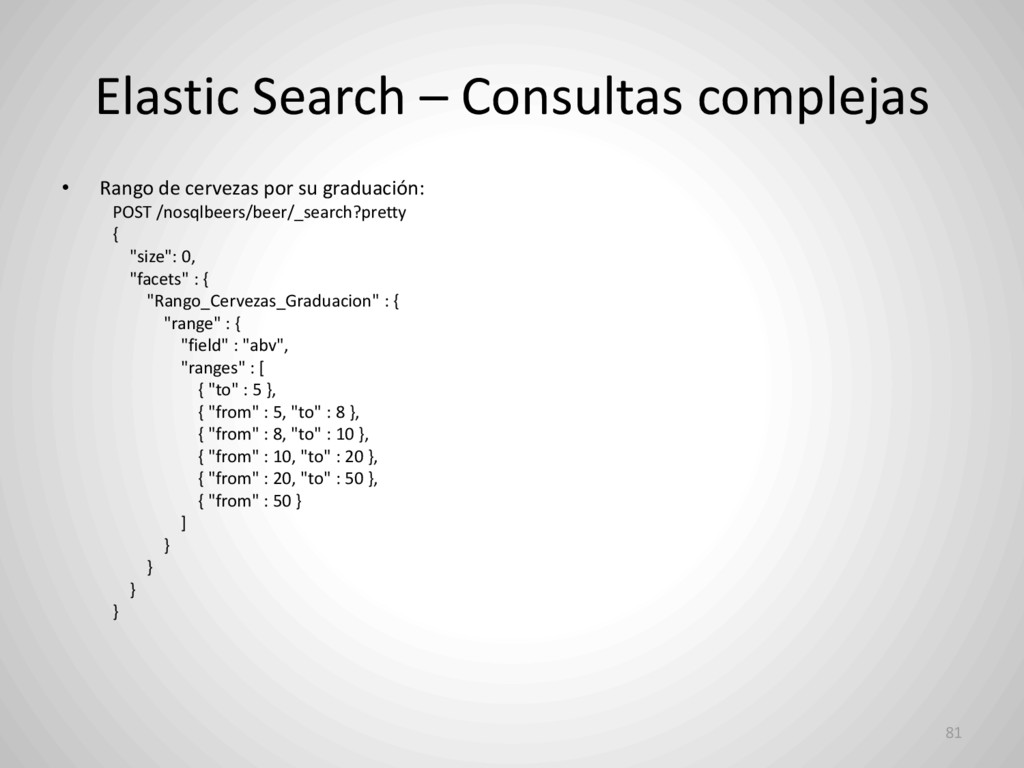
su graduación POST /nosqlbeers/beer/_search?pretty { "size": 0, "aggs": { "Agrupacion_Graduacion_Cervezas": { "terms": { "field": "abv" } } } } • Consulta en SQLServer: SELECT COUNT(*) from beers GROUP BY abv ORDER BY COUNT(*) DESC 80
• Almacena los datos en memoria RAM • Permite poner una fecha de expiración a los datos • Se usa como memoria caché para cargas pesadas por su velocidad 82
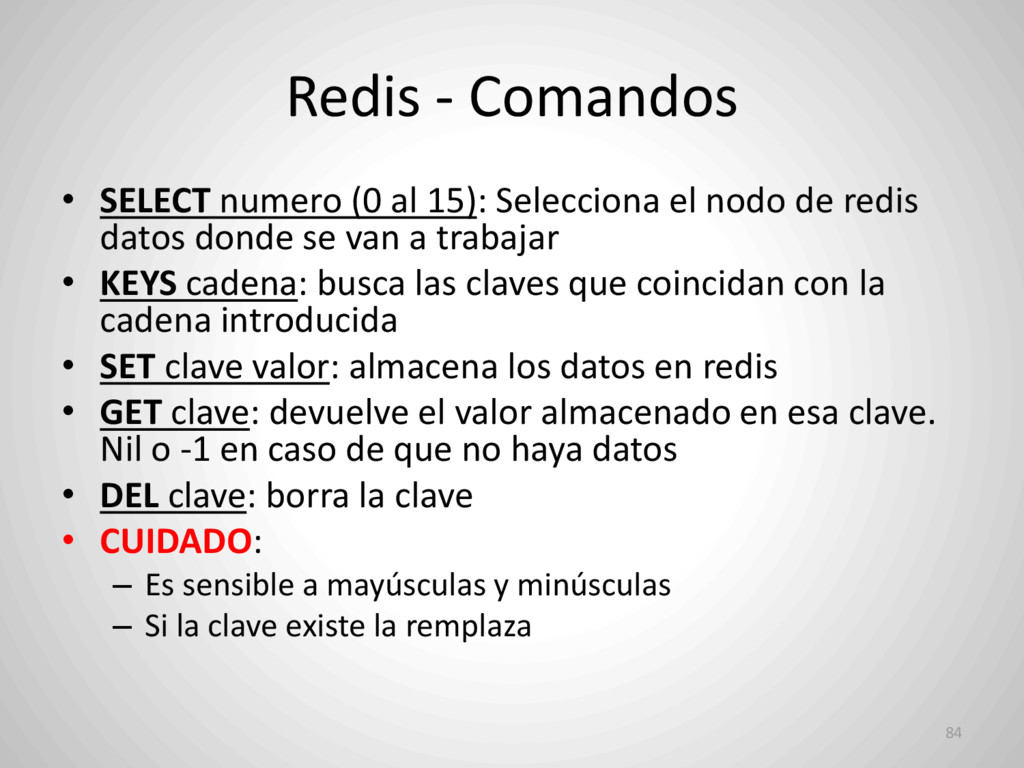
el nodo de redis datos donde se van a trabajar • KEYS cadena: busca las claves que coincidan con la cadena introducida • SET clave valor: almacena los datos en redis • GET clave: devuelve el valor almacenado en esa clave. Nil o -1 en caso de que no haya datos • DEL clave: borra la clave • CUIDADO: – Es sensible a mayúsculas y minúsculas – Si la clave existe la remplaza 84
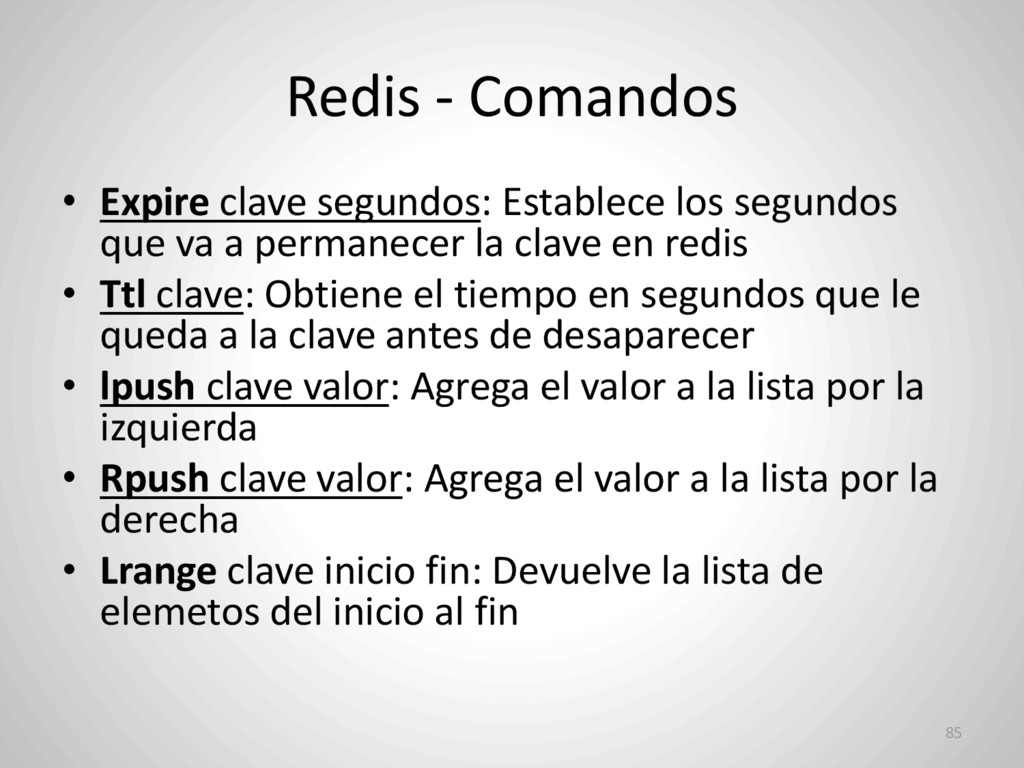
que va a permanecer la clave en redis • Ttl clave: Obtiene el tiempo en segundos que le queda a la clave antes de desaparecer • lpush clave valor: Agrega el valor a la lista por la izquierda • Rpush clave valor: Agrega el valor a la lista por la derecha • Lrange clave inicio fin: Devuelve la lista de elemetos del inicio al fin 85
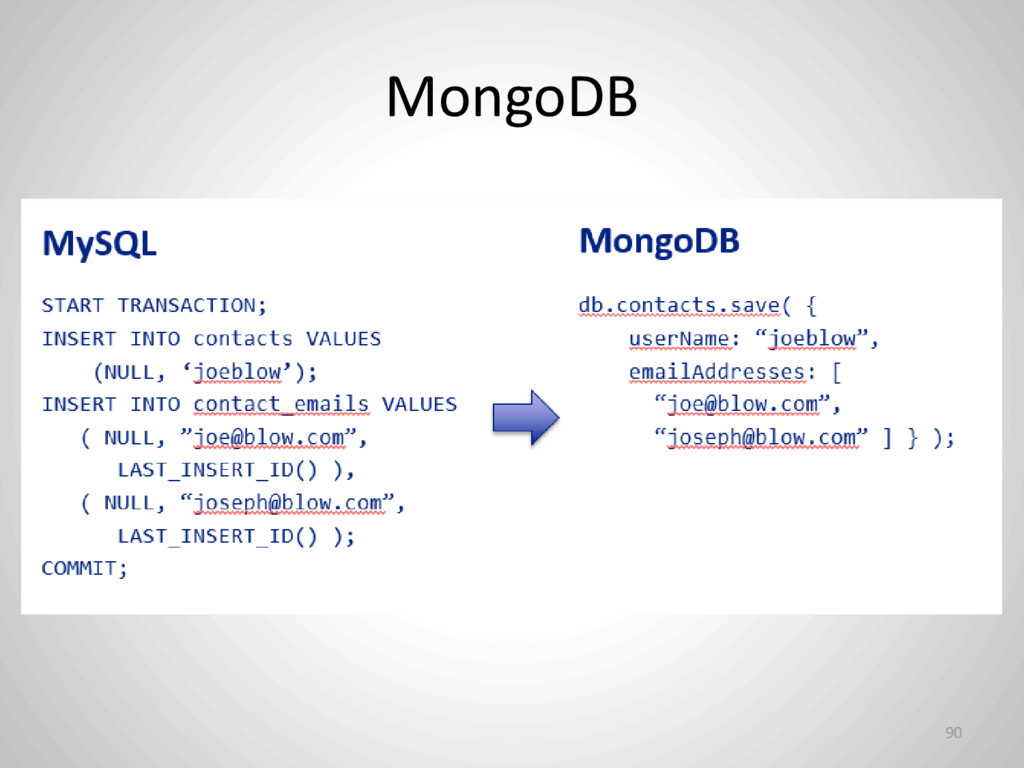
las necesidades modernas • Conversión transparente de objetos en la aplicación a documentos JSON • Flexiblidad para modelos de datos dinámicos • Mejor localidad de datos 87

 SiteGround - Reliable hosting with speed, security, and support you can count on.


 dordoka
 classmethod_kaz
 ykiyota
 civitaspo
 coco_se
 news_it_enj
 hponka
 codmoninc
 tkc66buzz
 go0517go
 visional_engineering_and_design
 bryan
 uxyall
 shlominoach
 palkan
 axbom
 schroneko
 davidcarrasco
 afnizarnur
 rmw
 aleyda
 mayatellez
 holman