Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
deep learning book 8.1
Search
E-musu
October 26, 2017
75
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
deep learning book 8.1
E-musu
October 26, 2017
Featured
See All Featured
The Mindset for Success: Future Career Progression
greggifford
PRO
0
540
GraphQLとの向き合い方2022年版
quramy
50
15k
What’s in a name? Adding method to the madness
productmarketing
PRO
24
4.2k
sira's awesome portfolio website redesign presentation
elsirapls
0
450
Product Roadmaps are Hard
iamctodd
55
13k
svc-hook: hooking system calls on ARM64 by binary rewriting
retrage
2
630
Navigating the moral maze — ethical principles for Al-driven product design
skipperchong
2
630
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
The untapped power of vector embeddings
frankvandijk
2
1.9k
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
1
3.4k
A designer walks into a library…
pauljervisheath
211
25k
Bash Introduction
62gerente
615
220k
Transcript
Deep learning book 8.1 2017/10/27 発表者:福⽥拓也 1
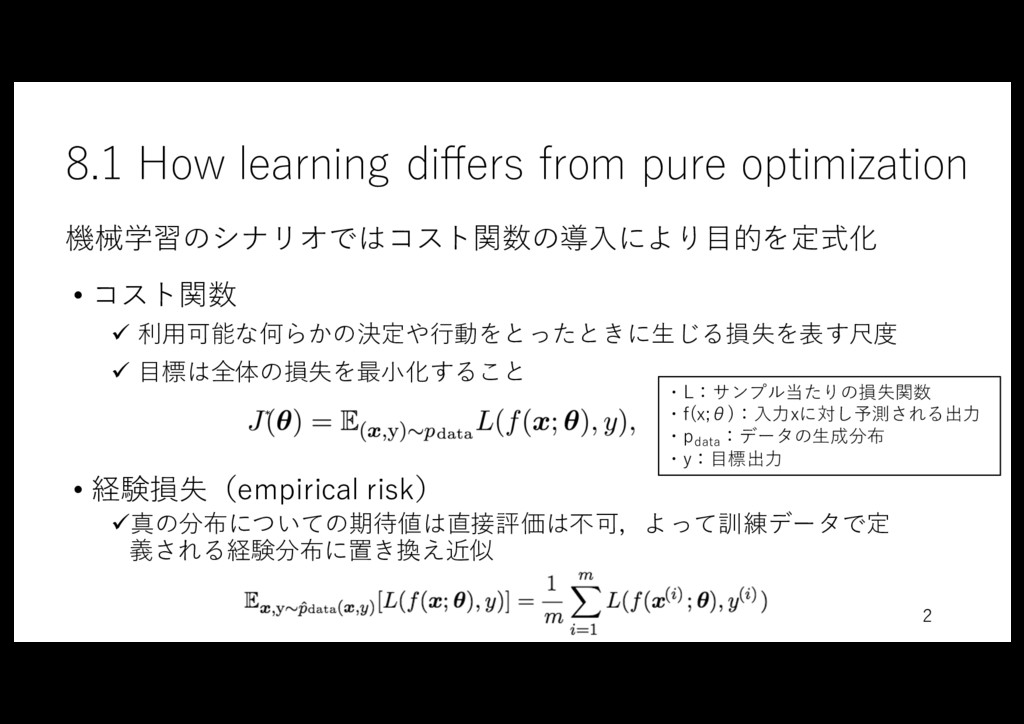
• コスト関数 ü 利⽤可能な何らかの決定や⾏動をとったときに⽣じる損失を表す尺度 ü ⽬標は全体の損失を最⼩化すること • 経験損失(empirical risk) ü真の分布についての期待値は直接評価は不可,よって訓練データで定
義される経験分布に置き換え近似 機械学習のシナリオではコスト関数の導⼊により⽬的を定式化 8.1 How learning differs from pure optimization 2 ・L:サンプル当たりの損失関数 ・f(x;θ):⼊⼒xに対し予測される出⼒ ・pdata :データの⽣成分布 ・y:⽬標出⼒
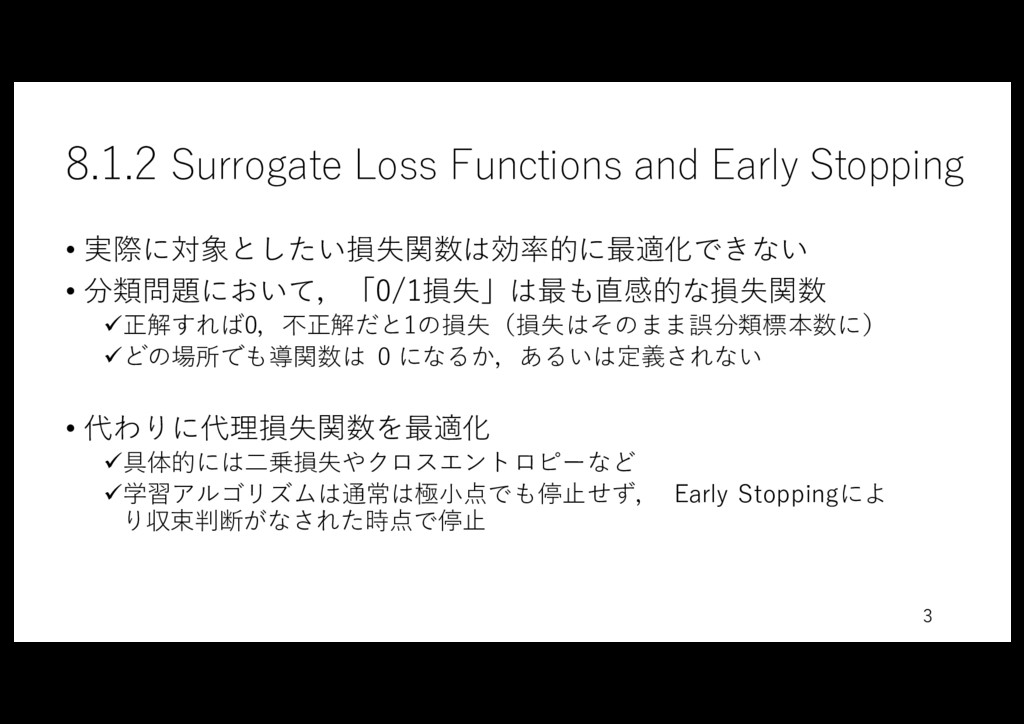
8.1.2 Surrogate Loss Functions and Early Stopping • 実際に対象としたい損失関数は効率的に最適化できない •
分類問題において,「0/1損失」は最も直感的な損失関数 ü正解すれば0,不正解だと1の損失(損失はそのまま誤分類標本数に) üどの場所でも導関数は 0 になるか,あるいは定義されない • 代わりに代理損失関数を最適化 ü具体的には⼆乗損失やクロスエントロピーなど ü学習アルゴリズムは通常は極⼩点でも停⽌せず, Early Stoppingによ り収束判断がなされた時点で停⽌ 3
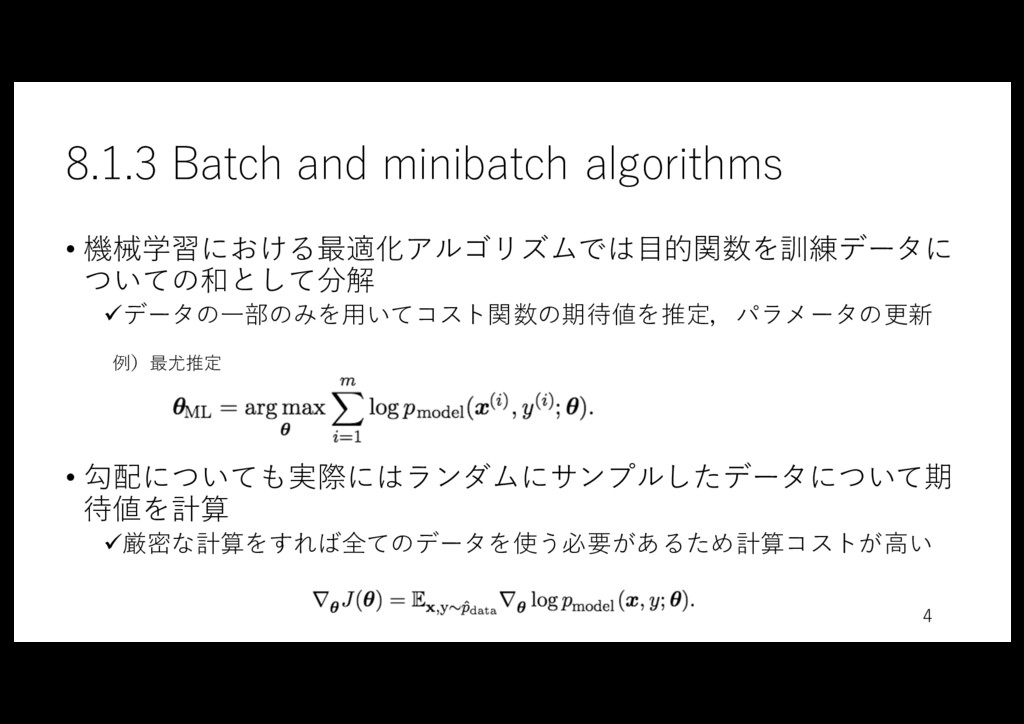
8.1.3 Batch and minibatch algorithms • 機械学習における最適化アルゴリズムでは⽬的関数を訓練データに ついての和として分解 üデータの⼀部のみを⽤いてコスト関数の期待値を推定,パラメータの更新 •
勾配についても実際にはランダムにサンプルしたデータについて期 待値を計算 ü厳密な計算をすれば全てのデータを使う必要があるため計算コストが⾼い 4 例)最尤推定
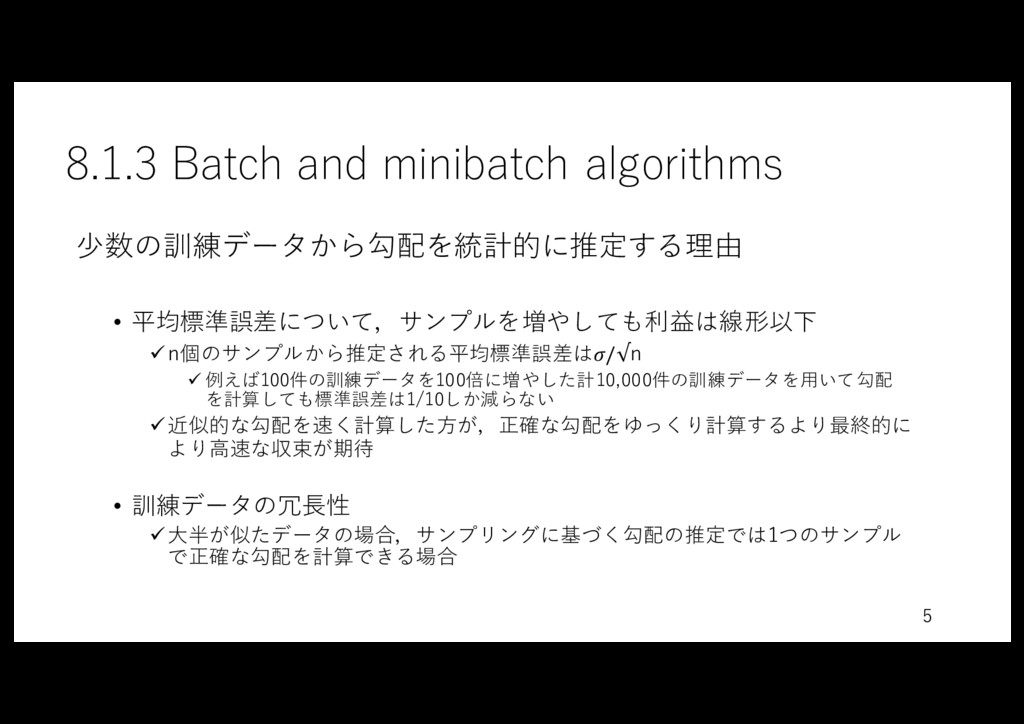
8.1.3 Batch and minibatch algorithms 少数の訓練データから勾配を統計的に推定する理由 • 平均標準誤差について,サンプルを増やしても利益は線形以下 ün個のサンプルから推定される平均標準誤差は/√n ü
例えば100件の訓練データを100倍に増やした計10,000件の訓練データを⽤いて勾配 を計算しても標準誤差は1/10しか減らない ü近似的な勾配を速く計算した⽅が,正確な勾配をゆっくり計算するより最終的に より⾼速な収束が期待 • 訓練データの冗⻑性 ü⼤半が似たデータの場合,サンプリングに基づく勾配の推定では1つのサンプル で正確な勾配を計算できる場合 5
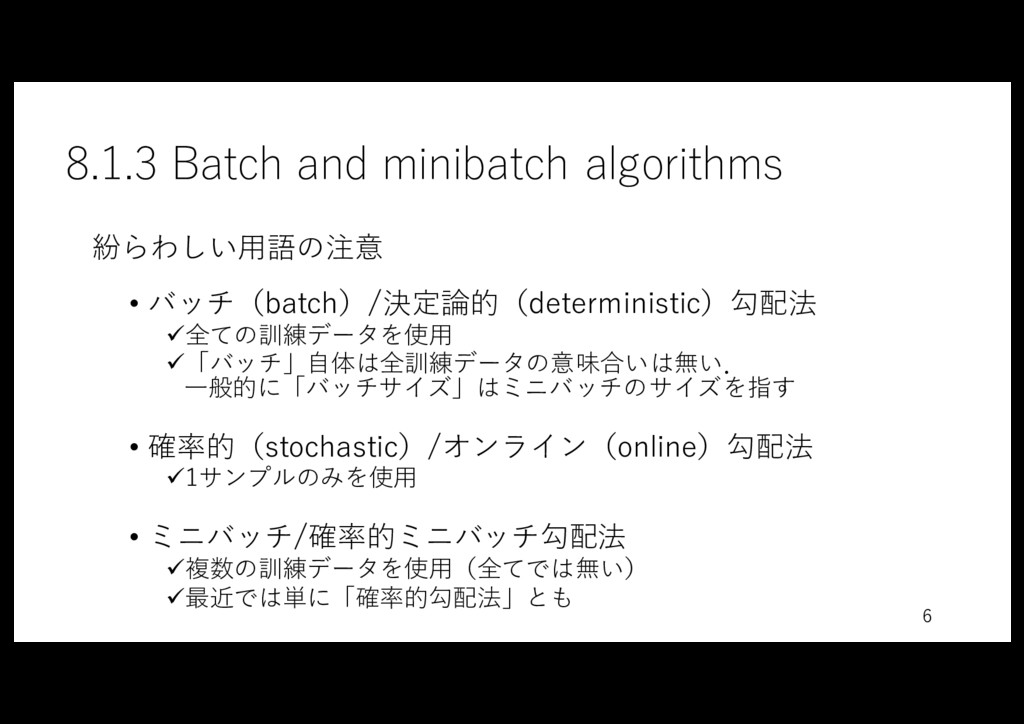
8.1.3 Batch and minibatch algorithms 紛らわしい⽤語の注意 • バッチ(batch)/決定論的(deterministic)勾配法 ü全ての訓練データを使⽤ ü「バッチ」⾃体は全訓練データの意味合いは無い.
⼀般的に「バッチサイズ」はミニバッチのサイズを指す • 確率的(stochastic)/オンライン(online)勾配法 ü1サンプルのみを使⽤ • ミニバッチ/確率的ミニバッチ勾配法 ü複数の訓練データを使⽤(全てでは無い) ü最近では単に「確率的勾配法」とも 6
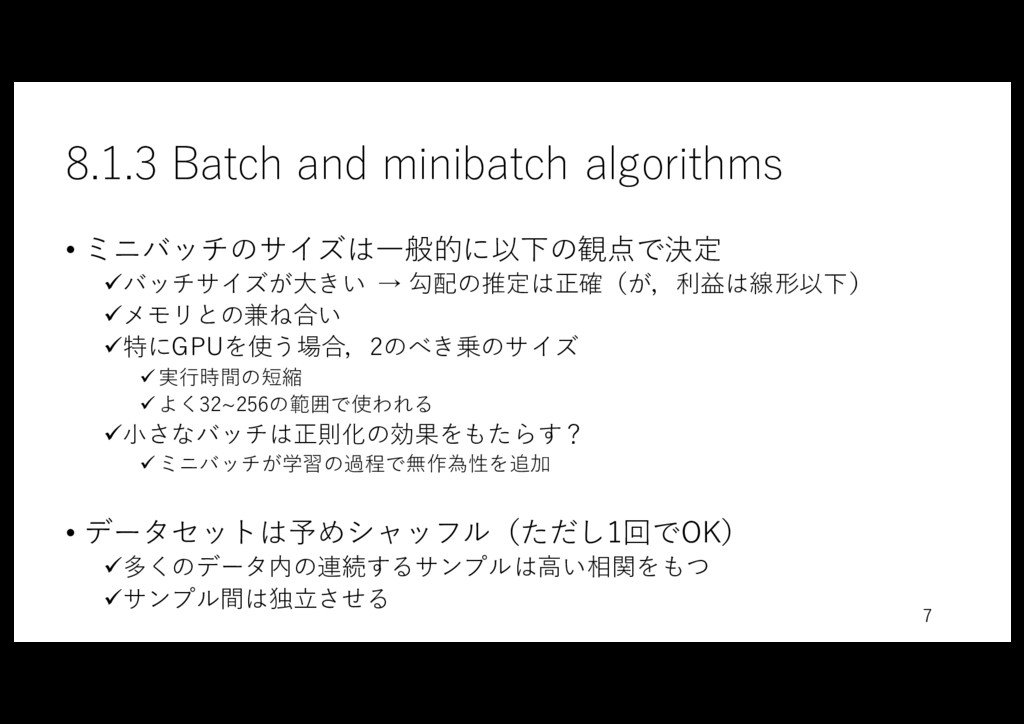
8.1.3 Batch and minibatch algorithms • ミニバッチのサイズは⼀般的に以下の観点で決定 üバッチサイズが⼤きい → 勾配の推定は正確(が,利益は線形以下)
üメモリとの兼ね合い ü特にGPUを使う場合,2のべき乗のサイズ ü実⾏時間の短縮 üよく32~256の範囲で使われる ü⼩さなバッチは正則化の効果をもたらす? üミニバッチが学習の過程で無作為性を追加 • データセットは予めシャッフル(ただし1回でOK) ü多くのデータ内の連続するサンプルは⾼い相関をもつ üサンプル間は独⽴させる 7


 greggifford
 quramy
 productmarketing
 elsirapls
 iamctodd
 retrage
 skipperchong
 danielanewman
 frankvandijk
 uxyall
 pauljervisheath
 62gerente