Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Apache Solr - A deeper look

Avatar for Stefan Stefan
March 19, 2013

Apache Solr - A deeper look

Avatar for Stefan

Stefan

March 19, 2013

Other Decks in Technology

Transcript

  1. Apache Solr - A deeper look Stefan Sprenger, Developer dkd

    Olivier Dobberkau, Geschäftsführer dkd
  2. Apache Solr basiert im Kern auf Apache Lucene REST-ähnliche HTTP-Schnittstelle

    verarbeitet XML, JSON, CSV und Binärdaten erweitert Lucene um diverse Features, z.B. Facetten Suchwort-Highlighting HTML-Admin-Interface Caching Stable-Versionen: 3.6.2 und 4.2
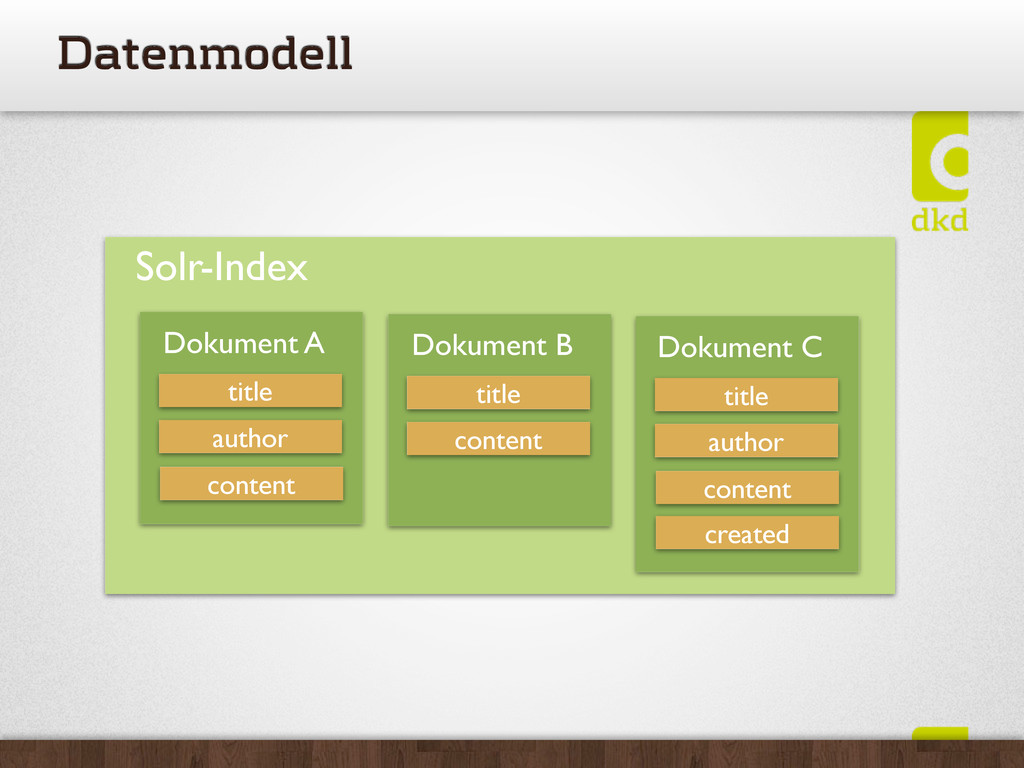
  3. Datenmodell Solr-Index Dokument A title author content Dokument B title

    content Dokument C title author content created
  4. Lucene Query Language (1) erlaubt das Durchsuchen von Dokumenten Keyword-Matching

    title:“TYPO3“ title:“TYPO3“ AND content:“Solr“ title:“TYPO3“ OR content:“Solr“ Wildcard-Matching title:“TYPO*“ *:“TYPO3“
  5. Dateiindexierung mit Apache Tika Tika ist in Solr integriert extrahiert

    Metadaten aus Dateien erkennt 1200+ Dateitypen liest davon 600+ z.B. Of ce-Formate, Audio, Bilder, Videos, E-Mails, ...
  6. Apache Nutch kann zur Indexierung von externen Webseiten verwendet werden

    EXT:solr bietet eine API an, die ein selbst entwickeltes Nutch-Plugin verwendet Integration in TYPO3
  7. Ziel Relevanz der Suchergebnisse beein ussen beschreibt die Qualität/Güte der

    Suchergebnisse Ergebnisse verbessern Standard-Sortierung: Relevanz Ergebnisse mit hoher Relevanz stehen am Anfang
  8. Case-Insensitive Matches Wenn nach „solr“ gesucht wird, sollen auch Dokumente,

    die „Solr“ enhalten, gefunden werden Verwenden eines lowercase-Filters
  9. Boosting von exakten Matches exakte Matches sollen eine höhere Relevanz

    in den Suchergebnissen erhalten z.B. Case-sensitive Schreibweise eigenes Feld mittels copyField erstellen, das das Wort in exakter Schreibweise enthält ohne lowercase-Filter dieses Feld erhält eine höhere Priorität
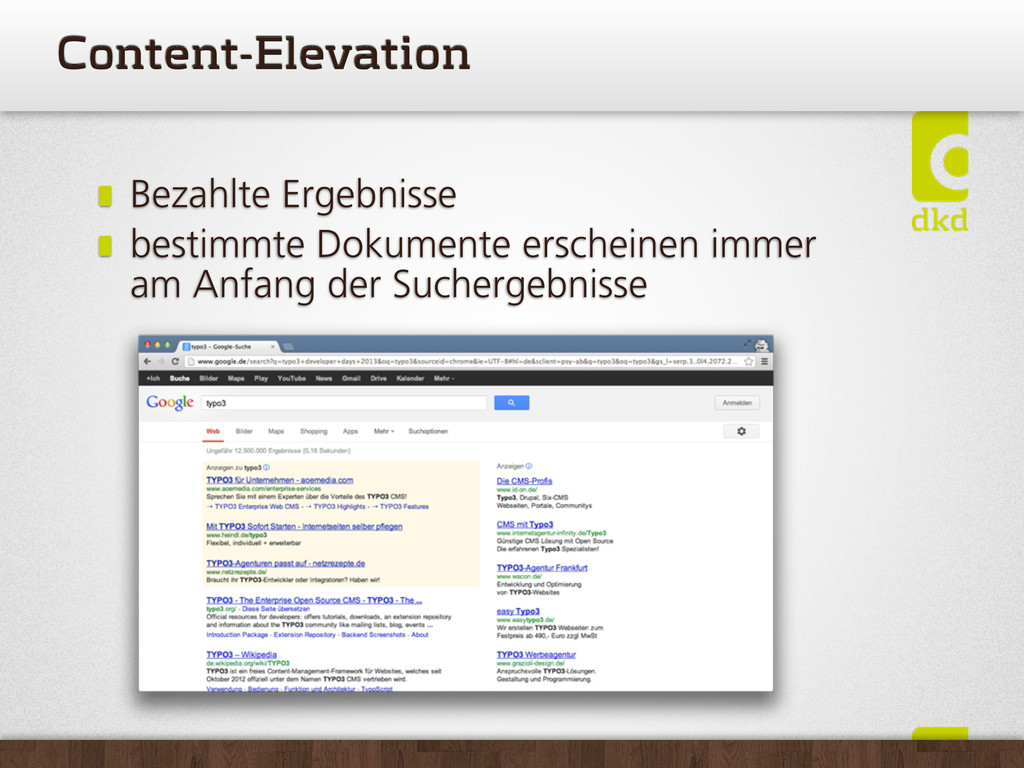
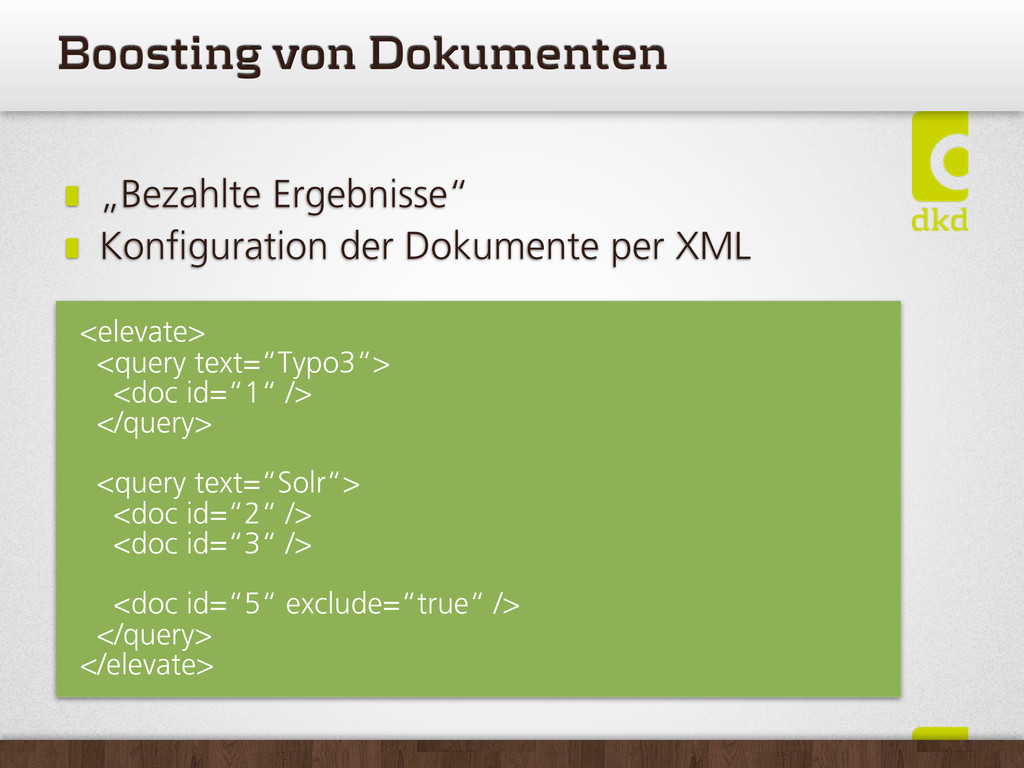
  10. Boosting von Dokumenten „Bezahlte Ergebnisse“ Kon guration der Dokumente per

    XML <elevate> <query text=“Typo3“> <doc id=“1“ /> </query> <query text=“Solr“> <doc id=“2“ /> <doc id=“3“ /> <doc id=“5“ exclude=“true“ /> </query> </elevate>
  11. Attributsbasierte Empfehlungen (1) http://de.slideshare.net/treygrainger/building-a-real-time-solrpowered-recommendation-engine Verwenden von Eigenschaften, die man vom

    Benutzer kennt, um einen Solr-Index abzufragen Beispiel: man weiß, dass ein Benutzer sich für den Studiengang „Informatik“ interessiert dann können Dokumente aus dem Fachbereich „Informatik“ vorgeschlagen werden fachbereich:Informatik
  12. More Like This eigenes Solr-Modul arbeitet basierend auf Begriffen („Terms“)

    in Attributen Solr berechnet die textliche Ähnlichkeit der Dokumente und schlägt die Top-Treffer vor
  13. Apache Stanbol Content Enhancement annotiert Texte mit Metadaten z.B. Personen,
    Orte nutzt Apache Solr zur Speicherung unterstützt Mehrsprachigkeit