Share
Embed
Apresentação Tópicos Avançados em Inteligência Artificial - CIn / UFPE
Apresentação do artigo "A Modularity Maximization Algorithm for Community Detection in Social Networks with Low Time Complexity " para o seminário da disciplina de Tópicos Avançados em Inteligência Artificial - CIn / UFPE.
Autores do artigo:
Mohsen Arab - Department of Computer Science IASBSZanjan, Iran
Mohsen Afsharchi - Department of Computer Engineering University of ZanjanZanjan, Iran
Gileno Filho
February 04, 2014
Transcript
37 slides
-
Aluno: Gileno Alves Santa Cruz Filho Professor: Ricardo Bastos
Cavalcante Prudêncio Disciplina: Tópicos Avançados em Inteligência ArDficial Universidade Federal de Pernambuco – UFPE Centro de InformáDca – Cin Graduação em Ciência da Computação UFPE Mohsen Arab -‐ Department of Computer Science IASBS Zanjan, Iran Mohsen Afsharchi -‐ Department of Computer Engineering University of Zanjan Zanjan, Iran -
! Introdução ! Trabalhos Relacionados ! A Proposta
– Introdução – Pesagem dos vérDces – Detecção Preliminar das Comunidades – Merge ! Análise de Complexidade e Experimentos ! Conclusão -
! A importância da detecção de comunidades – Mineração de
dados em Redes sociais – As redes mais complexas tendem a estruturar comunidades com interesses em comum – Elas servem não só para estruturar interesses em comum bem como para verificar com elas interagem com outros grupos -
! Grande volume de dados – Redes com milhões e
até bilhões de vérDces – Os algoritmos atuais não são saDsfatórios do ponto de vista da complexidade de tempo ! A ideia é mostrar um algoritmo com boa complexidade de tempo e espaço, e com uma qualidade aceitável comparado aos algoritmos atuais -
! Quando não mencionado, “n” é o número de
vérDces do grafo e “m” é o número de arestas ! Sub-‐comunidades são pequenas comunidades, normalmente geradas na fase inicial ! Vamos considerar grafos não-‐orientados -
! O mais bem conhecido algoritmo de detecção de
comunidades é o proposto por Girvan e Newman. – M. Girvan and M. E. Newman, Proc. Natl. Acad. Sci. USA 99, 7821 (2002). – Usa uma medida de similaridade chamada “edge betweenness.” – Tem complexidade O(n3) -
! No mesmo caminho de Girvan e Newman, sugiram
outros algoritmos que baixaram a complexidade e/ou oDmizaram algum aspecto do algoritmo original, alguns arDgos: – M. E. J. Newman and M. Girvan, Finding and evaluaDng community structure in networks, Phys. Rev. E 69, 026113 (2004). – M. E. J. Newman, DetecDng community structure in net-‐ works, Eur. Phys. J. B 38, 321-‐330 (2004). -
– A. Clauset, M. E. Newman, and C. Moore, Phys.
Rev. E 70, 066111 (2004). – G. Palla, I. Derenyi, I. Farkas, and T. Vicsek, Uncovering the overlapping community structure of complex networks in nature and society, Nature 435, 814 (2005). – M. Rosvall and C. T. Bergstrom, Maps of random walks on complex networks reveal community structure, Proc. Natl. Acad. Sci. USA 104, 7327 (2007). -
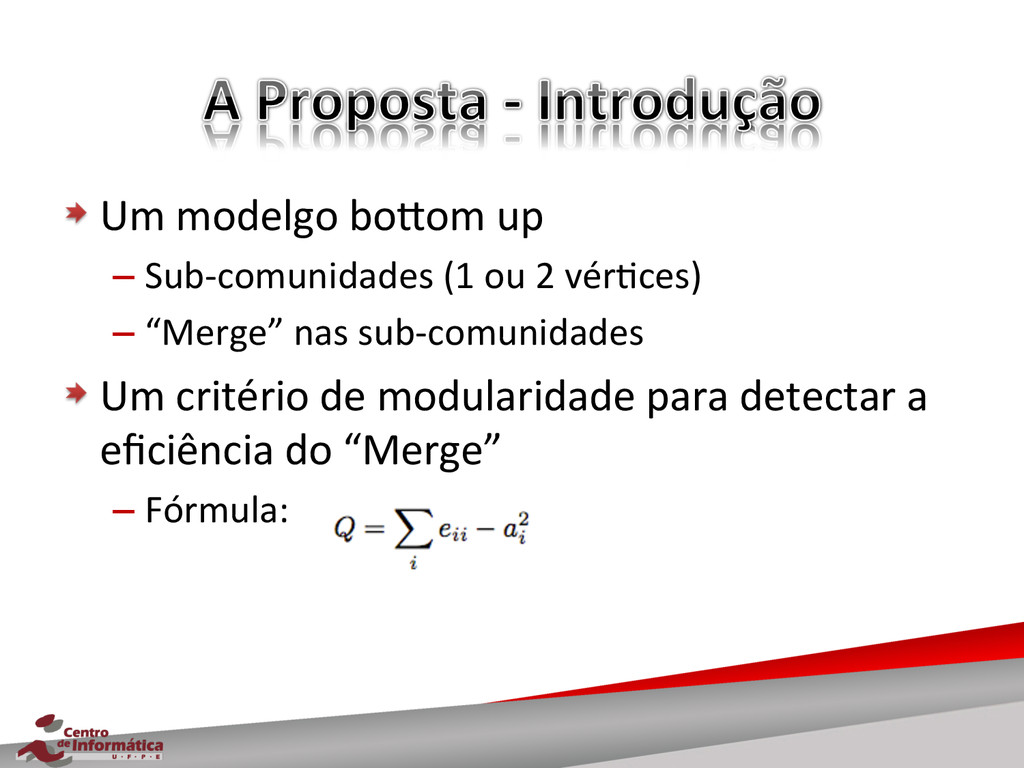
! Um modelgo booom up – Sub-‐comunidades (1 ou 2
vérDces) – “Merge” nas sub-‐comunidades ! Um critério de modularidade para detectar a eficiência do “Merge” – Fórmula: -
! eii é a fração das arestas que conectam 2
nós na comunidade i – A fração real de arestas internas na comunidade i ! ai é a fração das arestas que conectam 2 vérDces na comunidade, i.e. podendo ser 1 ou ambos os vérDces na comunidade – ai2 é a probabilidade de que uma aresta comece num vérDce da comunidade i, mulDplicado pela fração de arestas que terminam num vérDce da comunidade i -
! É possível pensar o ai como a soma dos
graus dos vérDces da comunidade i dividido pela soma dos graus de todos os vérDces do grafo ! A soma proposta é para todas as comunidades -
! É normal assumir que comunidades são grupos de
vérDces similares ! Baseando-‐se apenas na estrutura da rede, vérDces similares são aqueles que comparDlham vizinhos em comum -
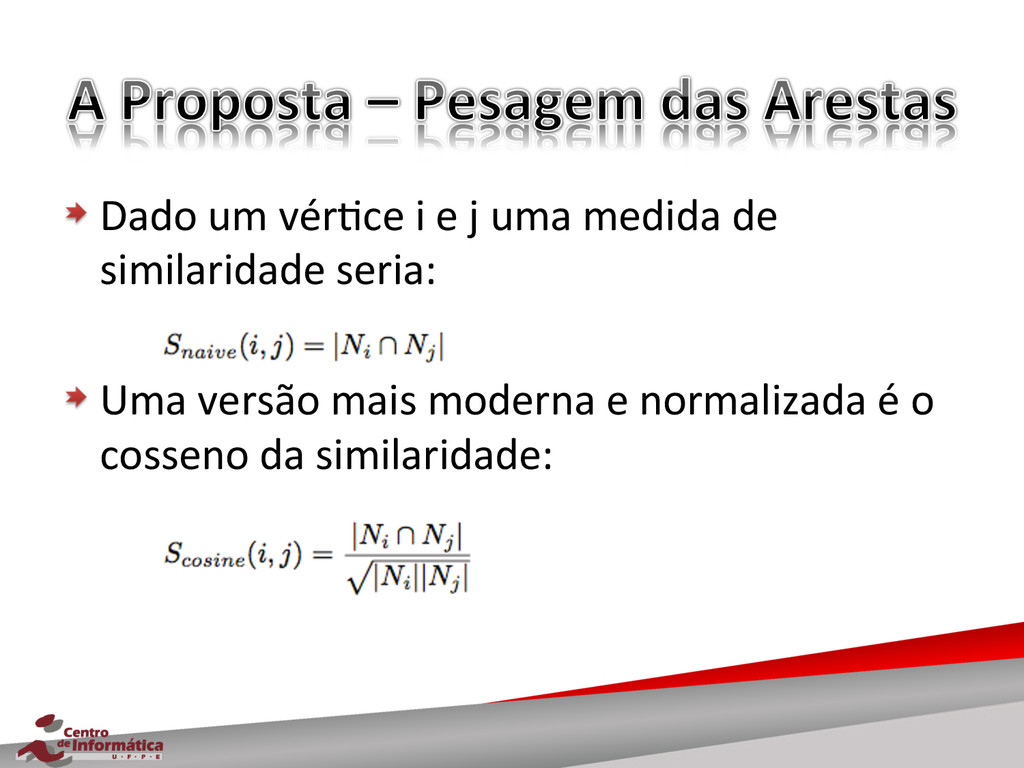
! Dado um vérDce i e j uma medida de
similaridade seria: ! Uma versão mais moderna e normalizada é o cosseno da similaridade: -
! Nós iremos usar essa medida de similaridade para
todas as arestas (ou quase todas) ! Com esse resultado iremos poder criar as primeiras sub-‐comunidades ! Assim, irei mostrar a evolução do algoritmo de pesagem dos vérDces -
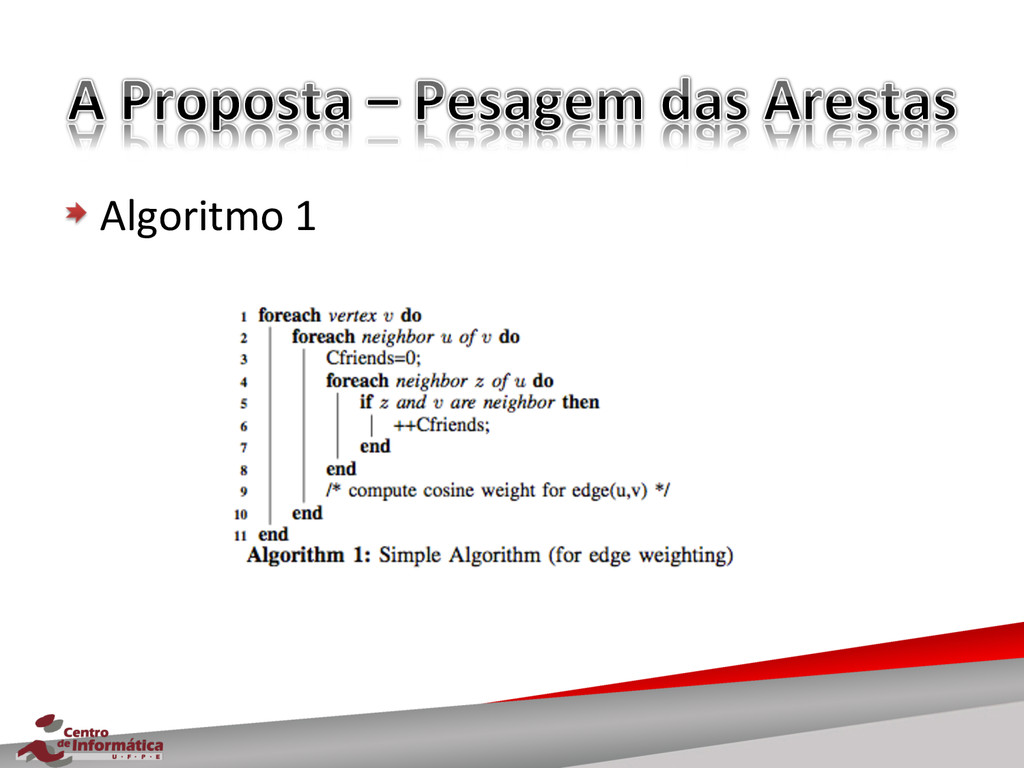
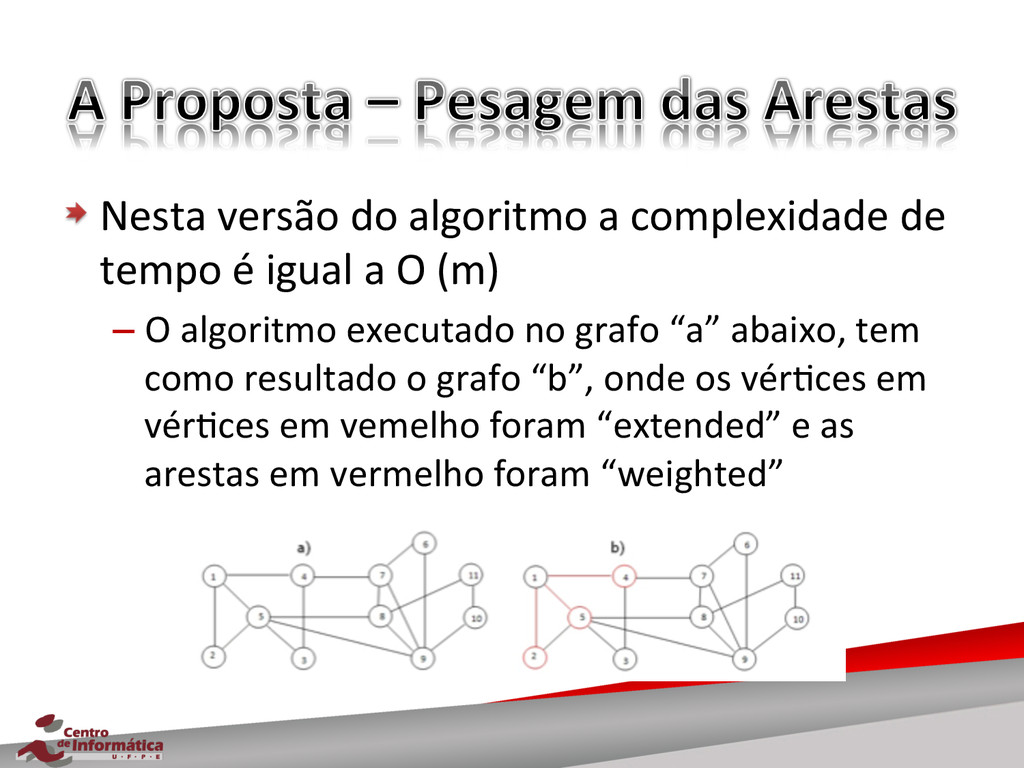
! Nesta versão do algoritmo a complexidade de tempo
é igual a O (m) – O algoritmo executado no grafo “a” abaixo, tem como resultado o grafo “b”, onde os vérDces em vérDces em vemelho foram “extended” e as arestas em vermelho foram “weighted” -
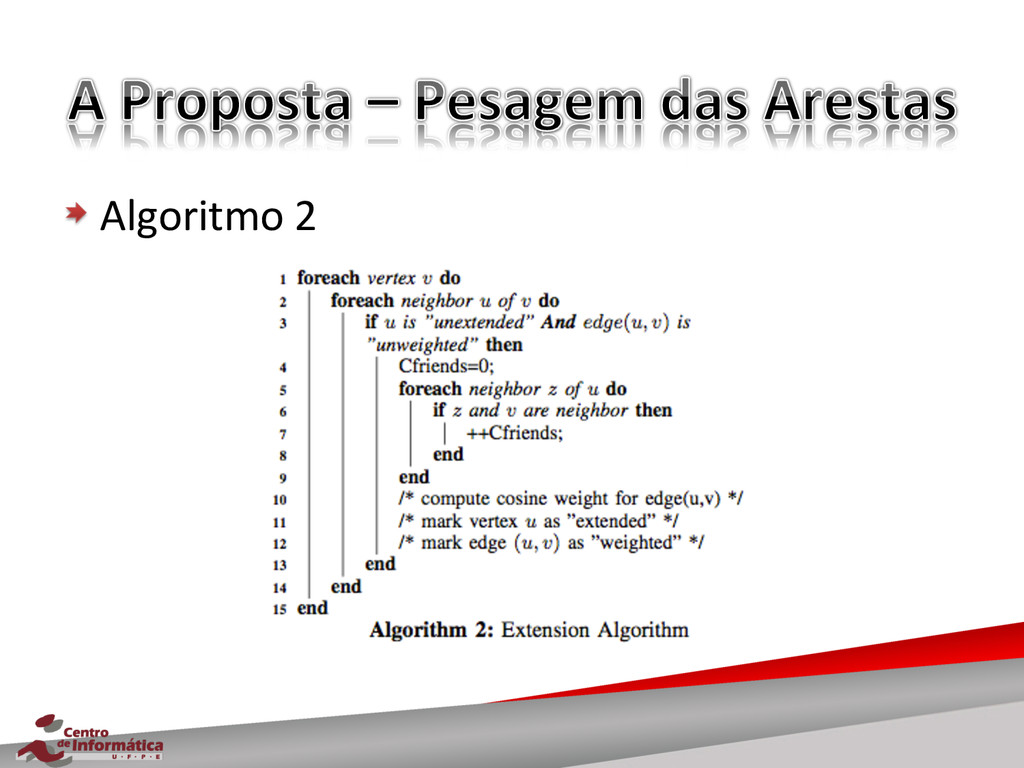
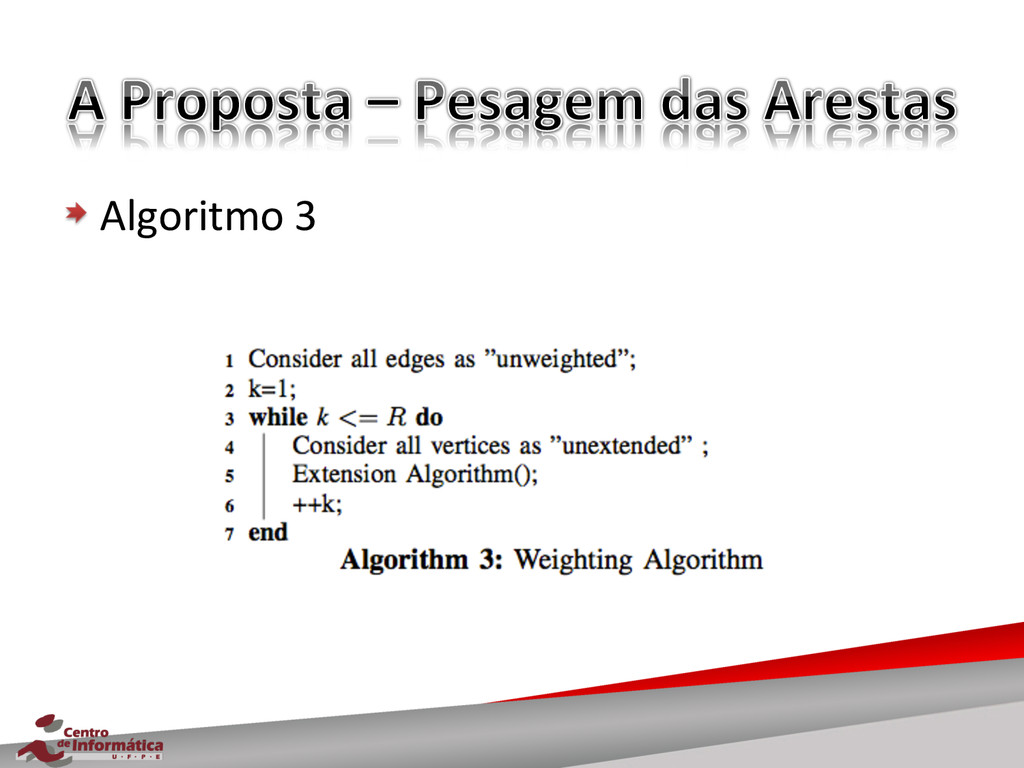
! Nessa versão 3, a complexidade de tempo fica
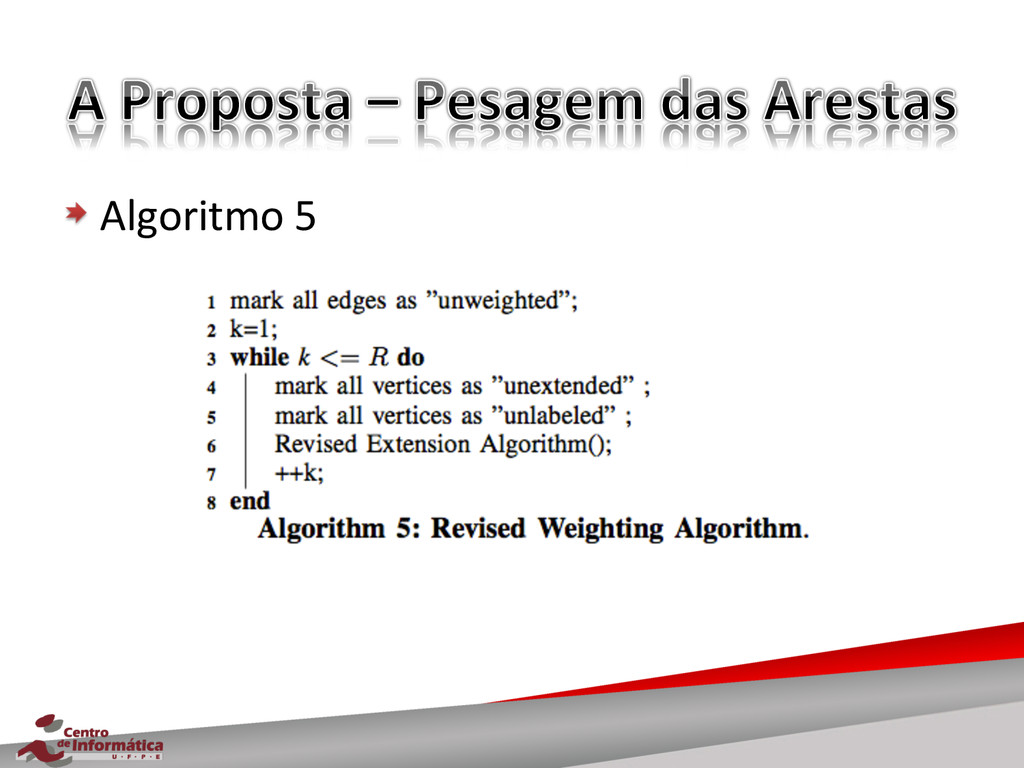
como O (R.m) ! É importante mencionar qual valor seria adequado para o R: – Considere “D” como sendo a média dos graus do grafo – Assim se os vérDces Dverem graus iguais, vamos precisar de no máximo “D” iterações para pesar as arestas vizinhas de cada vérDce -
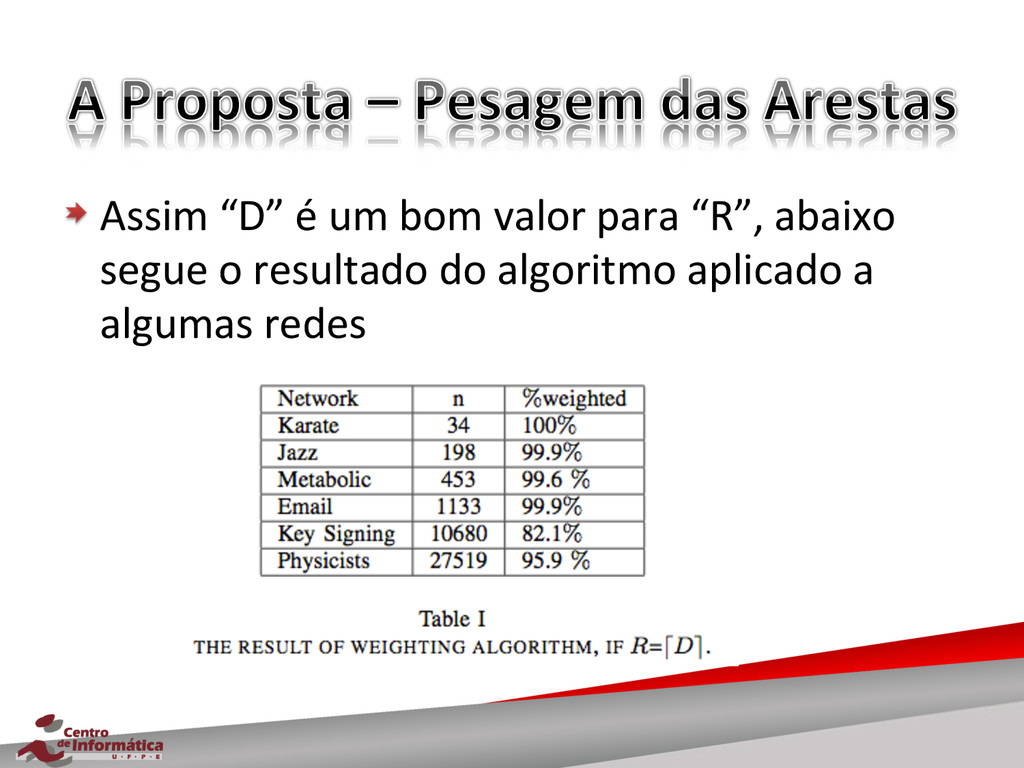
! Assim “D” é um bom valor para “R”, abaixo
segue o resultado do algoritmo aplicado a algumas redes -
! Entretanto, não é o objeDvo desse algoritmo pesar
todas as arestas, este é apenas o primeiro estágio para criar as sub-‐ comunidades ! Além disso, em grafos reais que são esparsos, “D” tende a ser muito pequeno, podendo ser até menor que log(n), assim iremos usar “R” igual a log(n) -
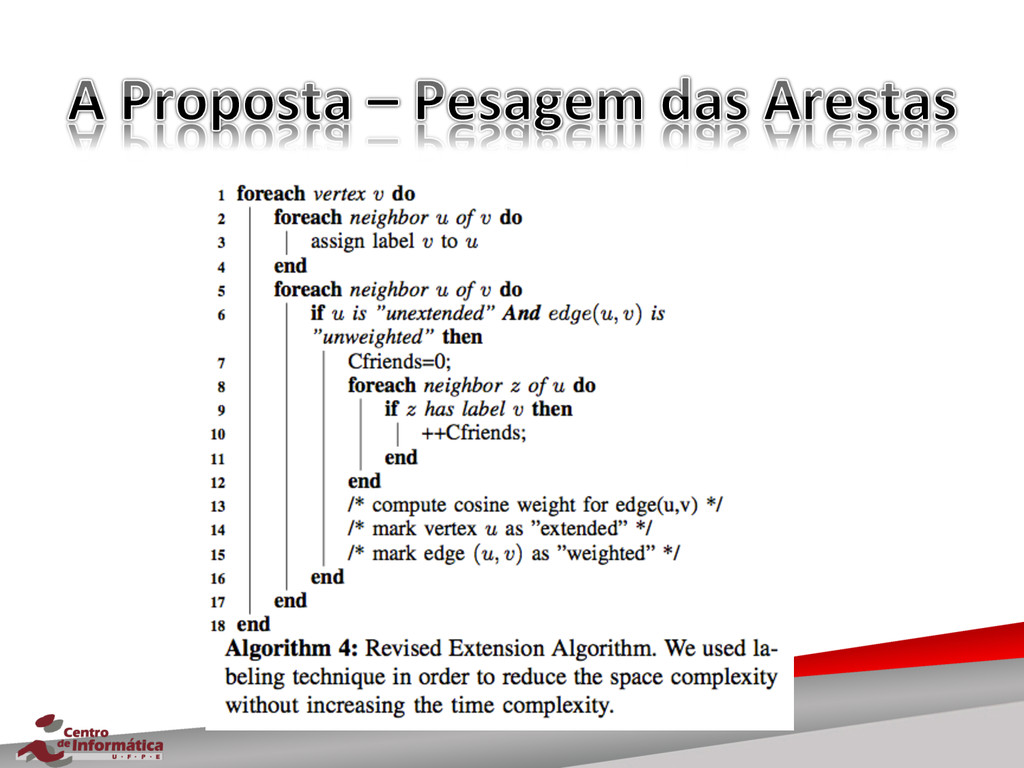
! Algoritmo 4 – A ideia agora é reduzir a
complexidade de espaço sem aumentar a complexidade de tempo – Para isso vamos rótular os vérDces, criando assim uma lista de adjacência -
! Após a pesagem as arestas são colocadas num
array e ordenadas pelo peso de forma descrescente ! Todos os vérDces são marcados como “unassigned” ! E para cada aresta os vérDces vão virar uma sub-‐comunidade se ambos não foram “assign”, se virarem uma sub-‐comunidade são marcados como “assign” -
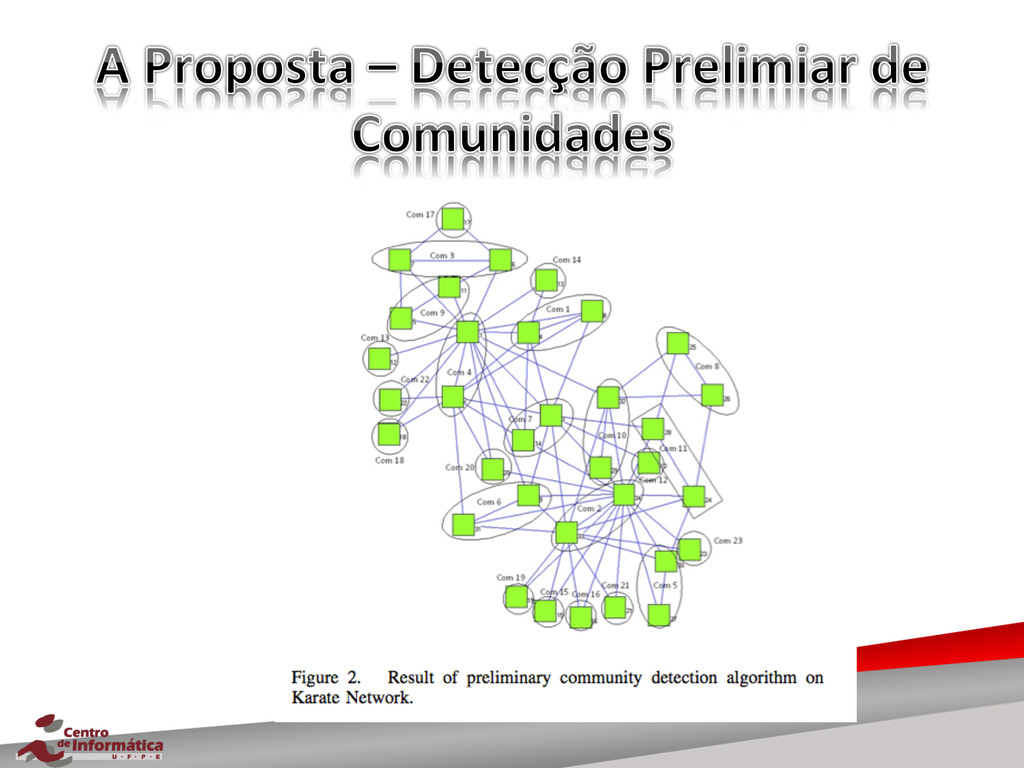
! Os vérDces que não formaram uma sub-‐ comunidade se
tornam uma sub-‐comunidade de apenas 1 vérDce ! Um exemplo do algoritmo na Karate Network -
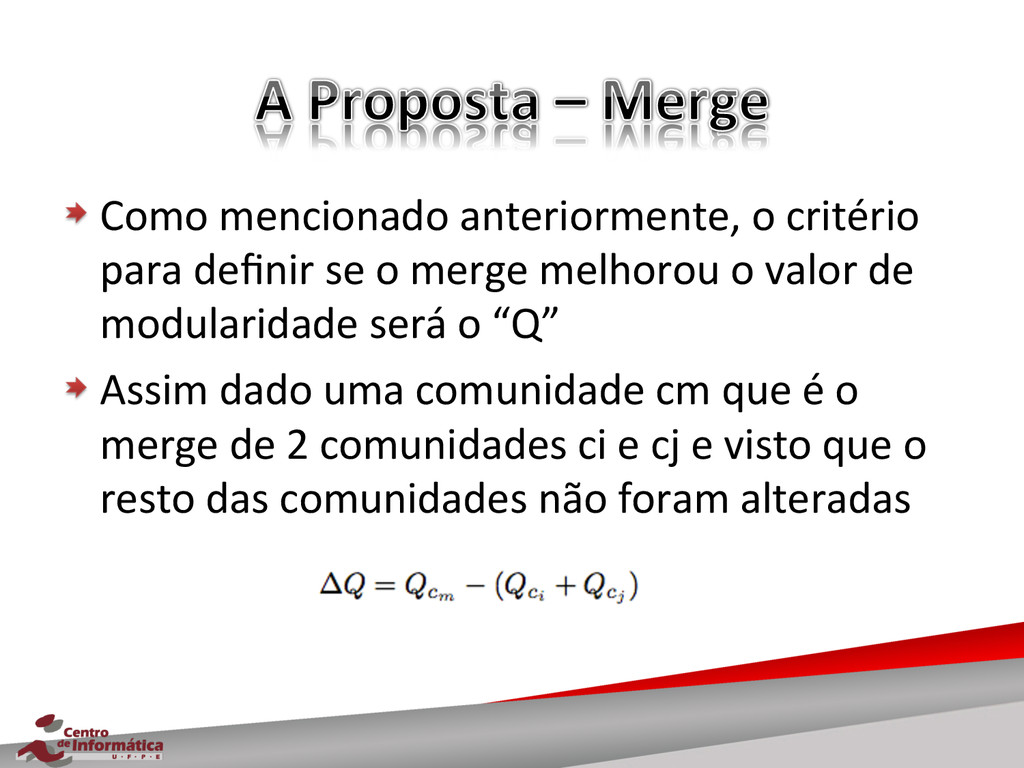
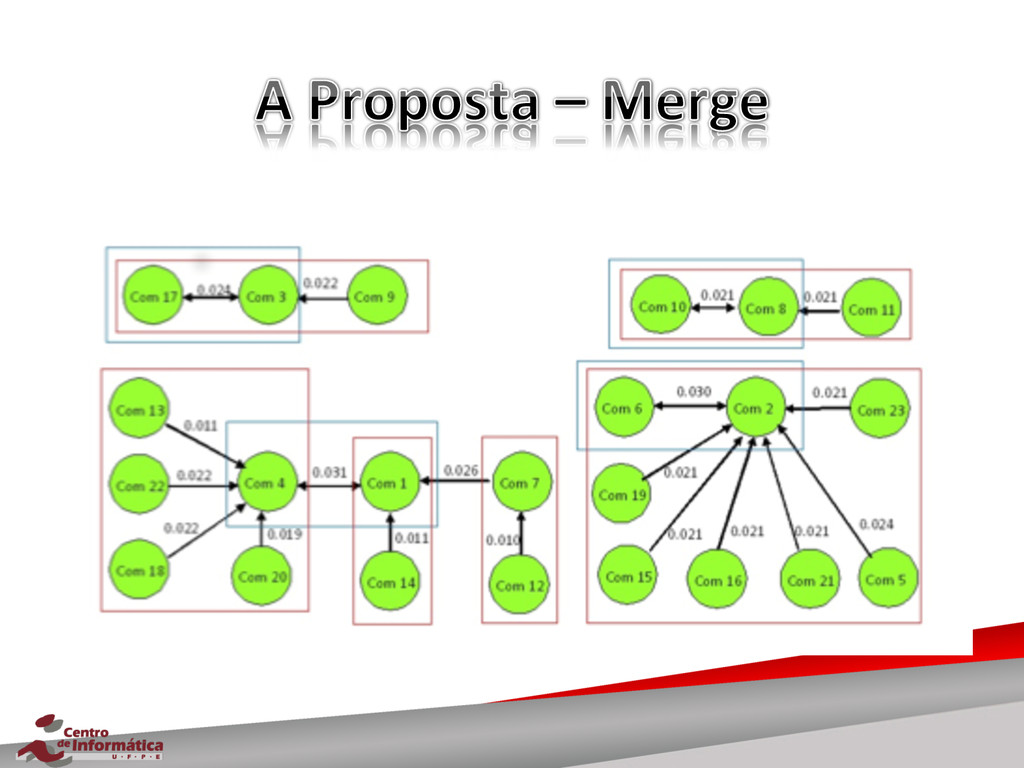
! Como mencionado anteriormente, o critério para definir se
o merge melhorou o valor de modularidade será o “Q” ! Assim dado uma comunidade cm que é o merge de 2 comunidades ci e cj e visto que o resto das comunidades não foram alteradas -
! Assim para uma dada comunidade ci é procurado
a comunidade vizinha cj que maximiza o ∆Q ! Se as comunidades sofrerem o “merge” uma seta direcionada é colocada da comunidade ci para cj ! Esse Dpo de merge é chamado de “pairwise”, que garante o aumento da modularidade mais é mais lento -
! Para tornar o processo mais rápido, foi usado
uma versão híbrida, onde em determinado número de iterações o “merge” do Dpo “pairwise” é usado e no restante o “single neighbors” é usado ! O “single neighbors” consiste em fazer o merge das comunidades que tem apenas 1 seta de ligação com a comunidade correspondente a essa seta -
! O número total de iterações foi definido como
Rm que de forma razoável pode ser declarado como log(n) ! Assim uma fração de Rm é de “merge” do Dpo “pairwise” e outra de “single neighbors”. ! Nos experimentos foi setado essa fração para 0.5 e conforme o valor de Rm e dessa fração (mais “pairwise”) aumentaram, melhores valores de modularidade foram encontrados -
! No final de cada iteração é calculado a
modularidade ! No final de todas as iterações é escolhido o valor máximo da modularidade -
! O algoritmo é divido em 3 partes: algoritmo
de pesagem, detecção de sub-‐comunidades e merge das sub-‐comunidades ! Considerando grafos esparsos a complexidade de tempo total é O(n.log(n)) -
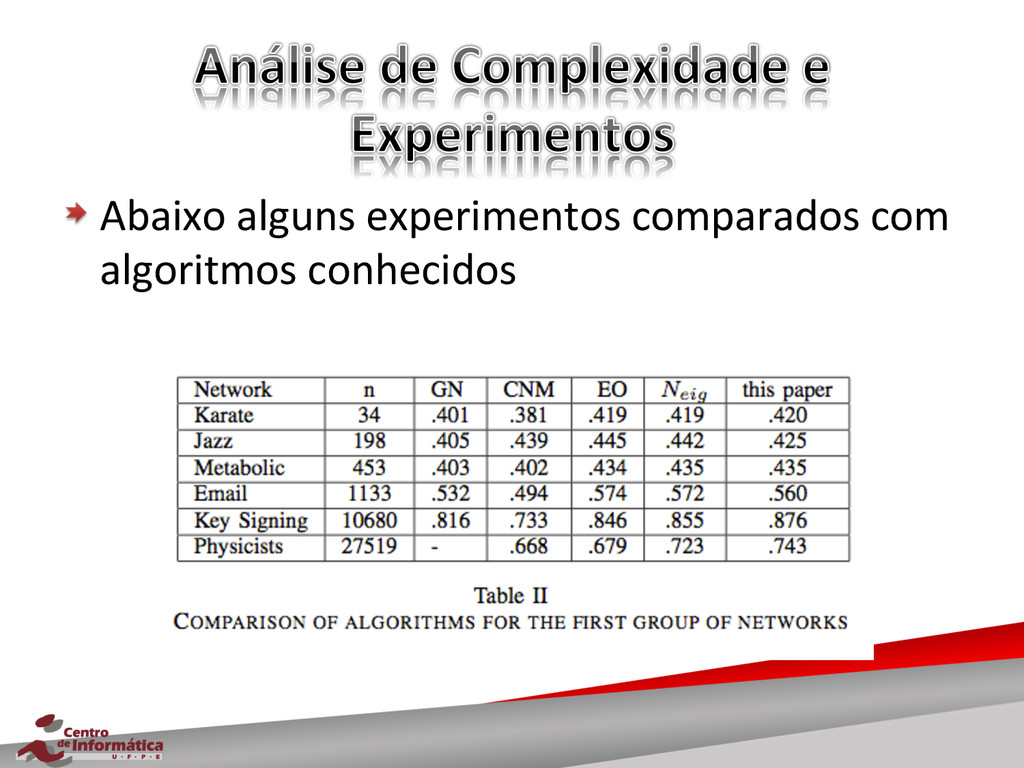
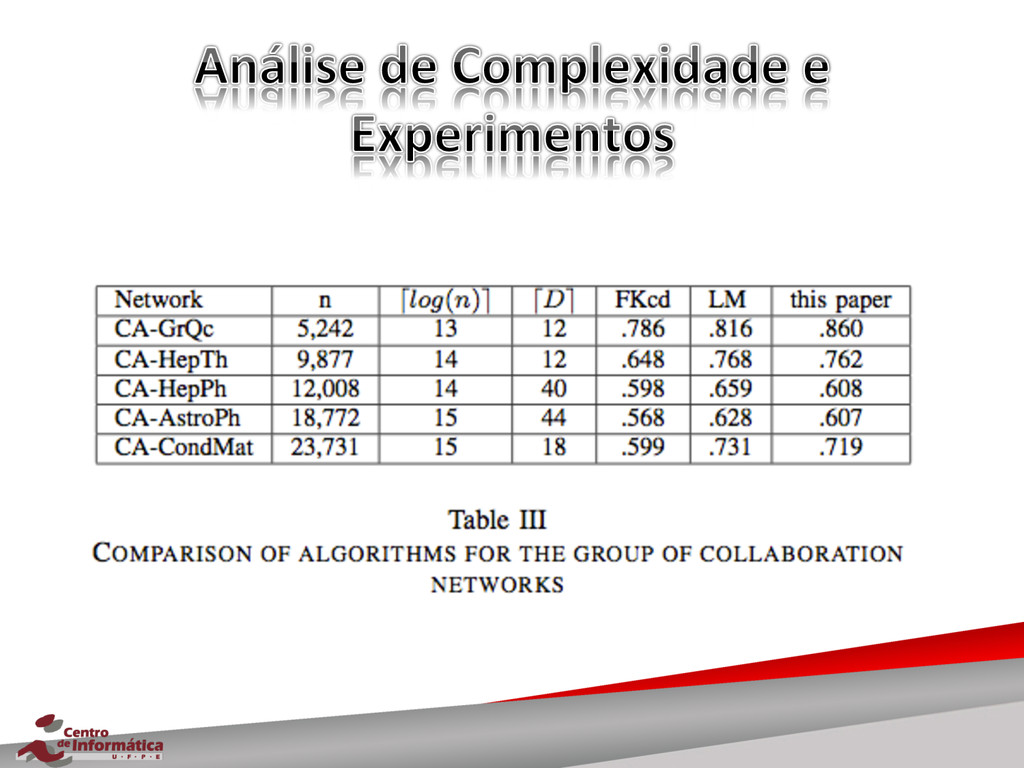
! O algoritmo proposto tenta maximizar o valor de
modularidade ! Com uma complexidade razoável comparado a outros algoritmos de detecção de comunidades ele mostrou bons resultados ! Para algumas redes o algoritmo tem um baixo custo, podendo ser aplicado a redes maiores