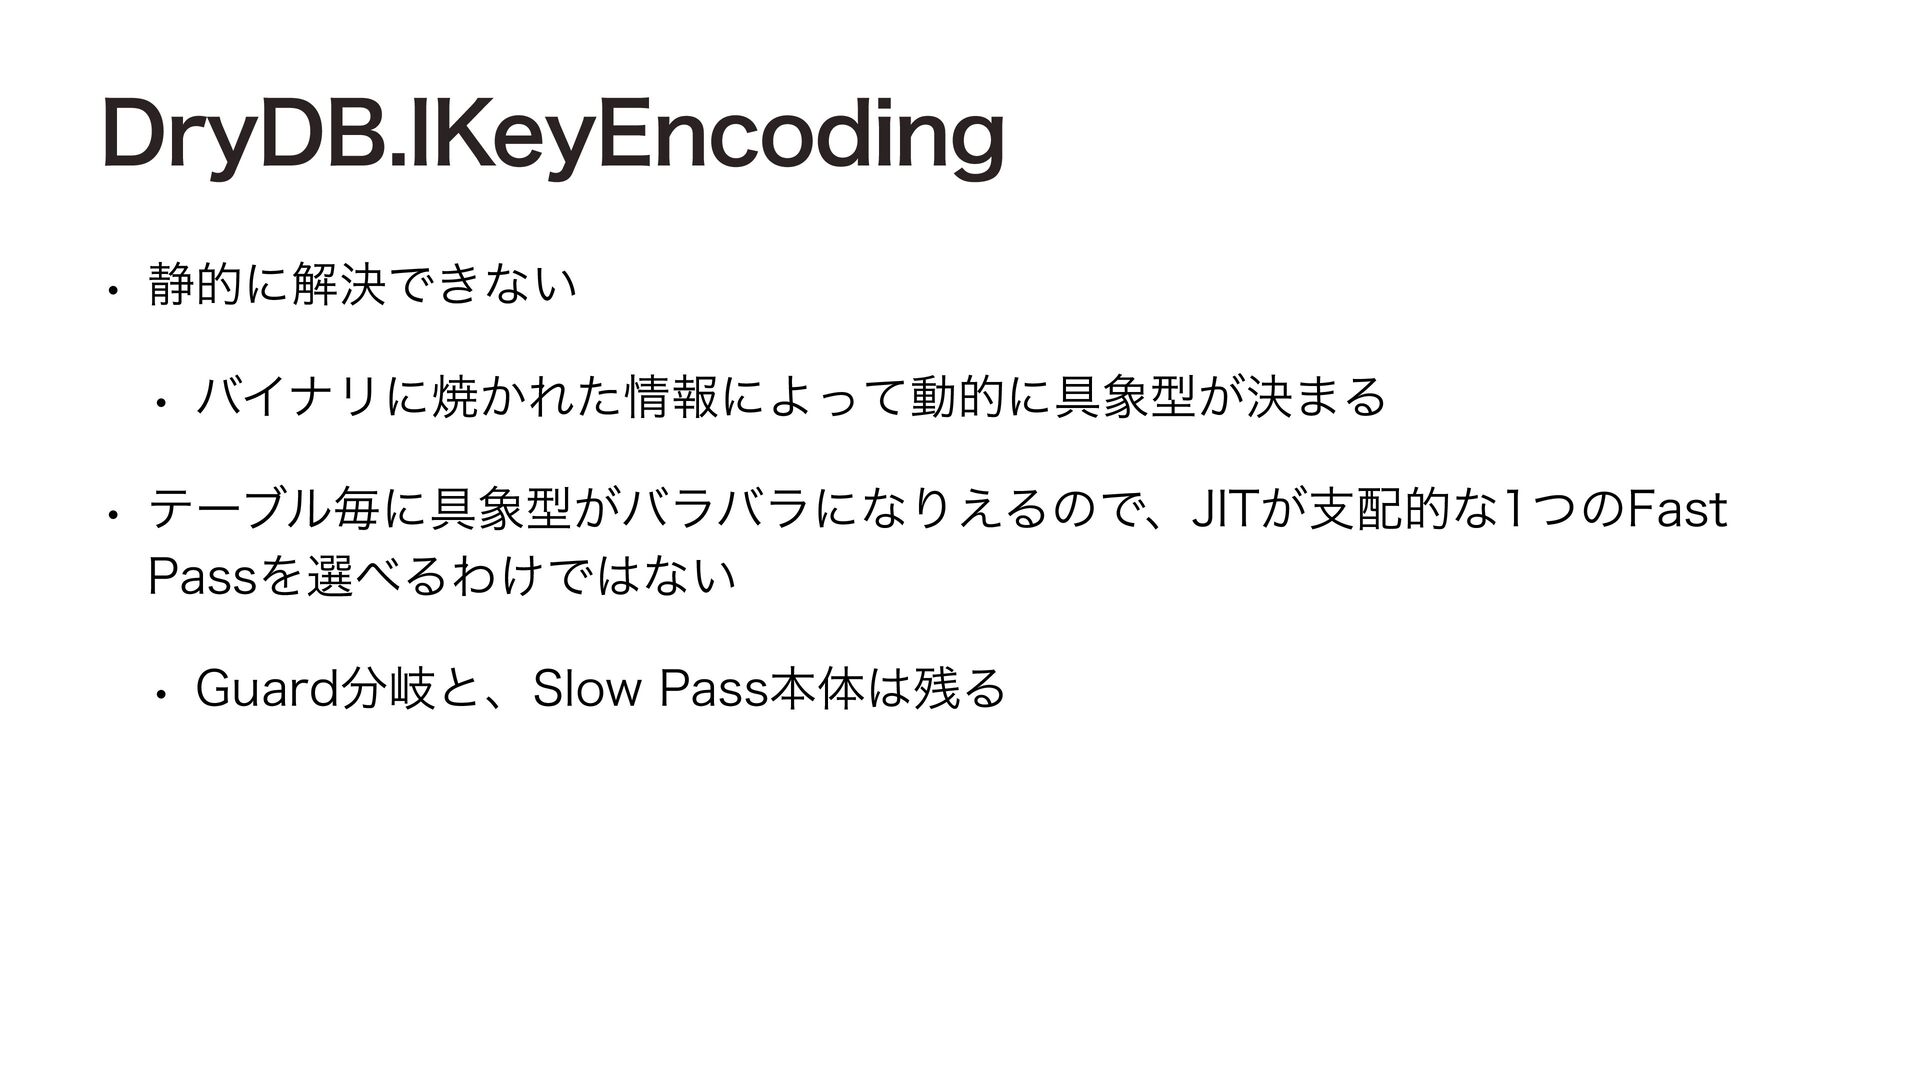
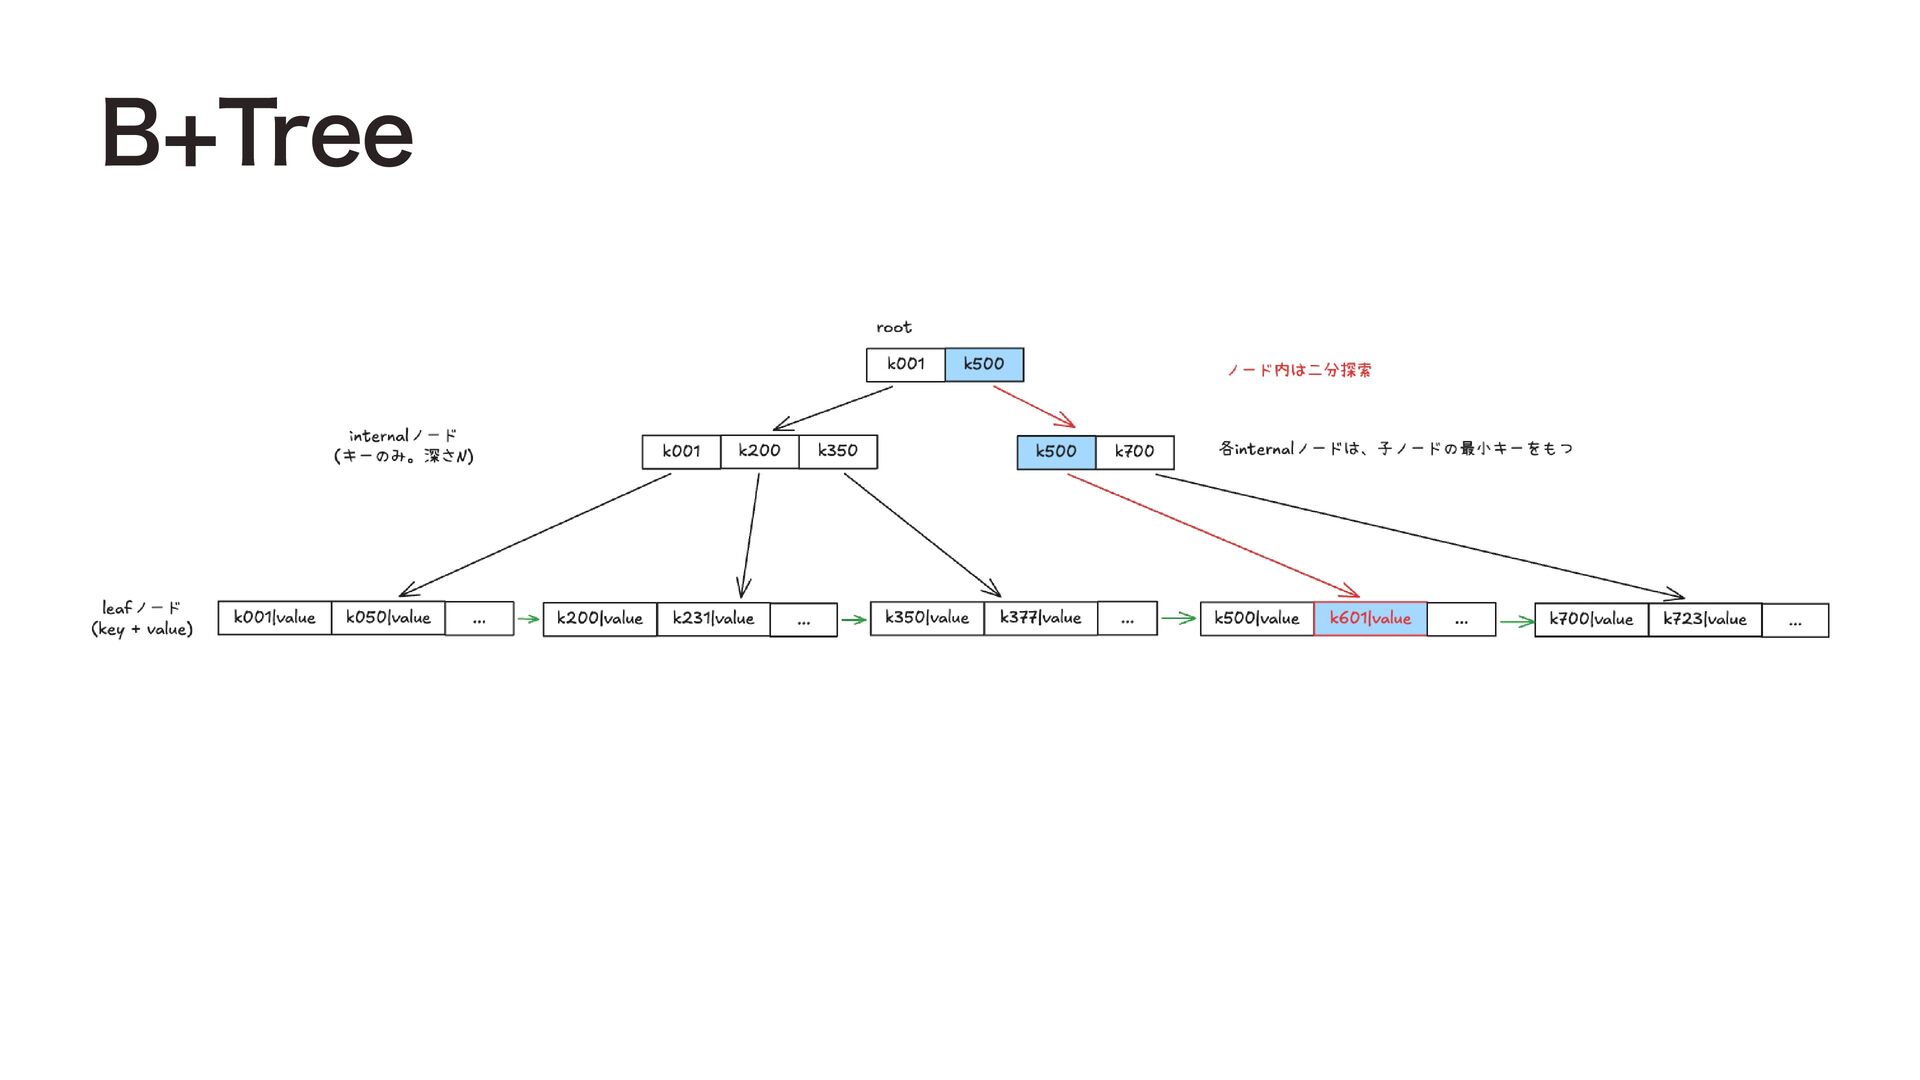
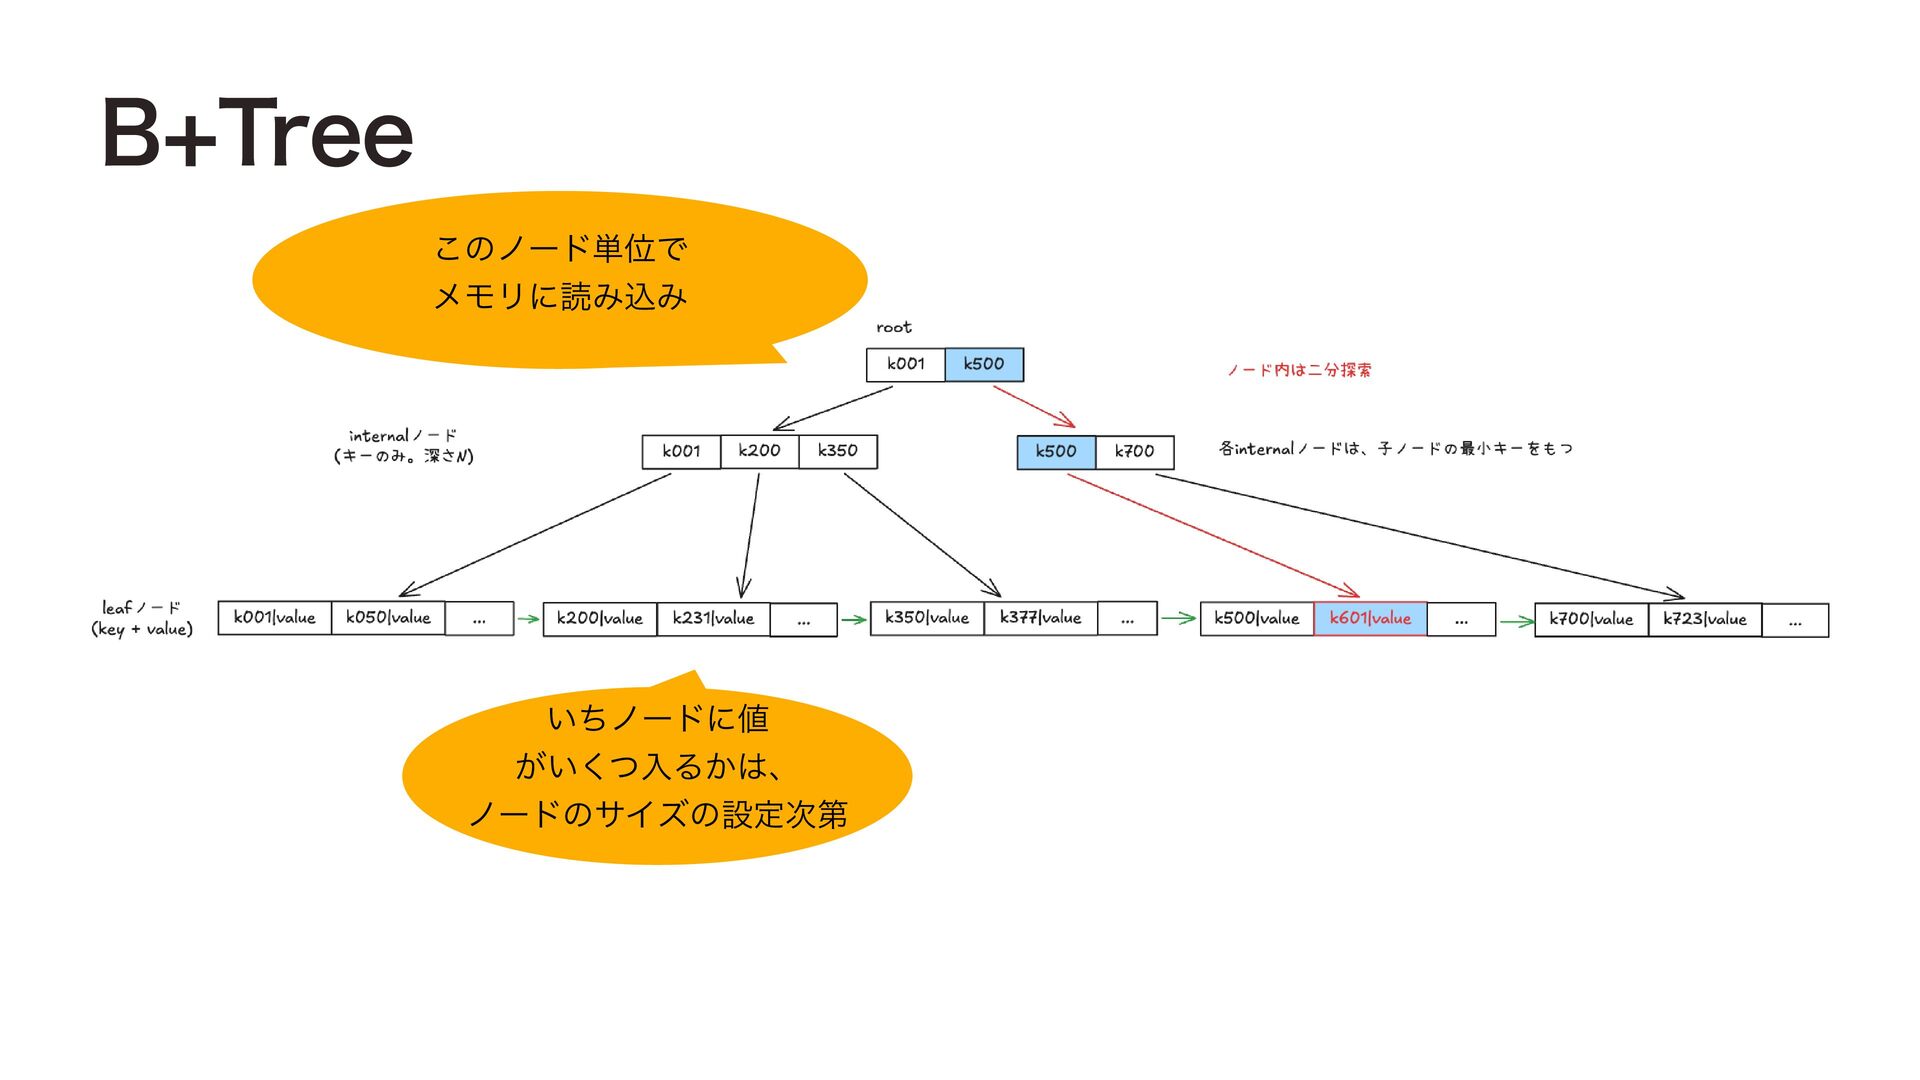
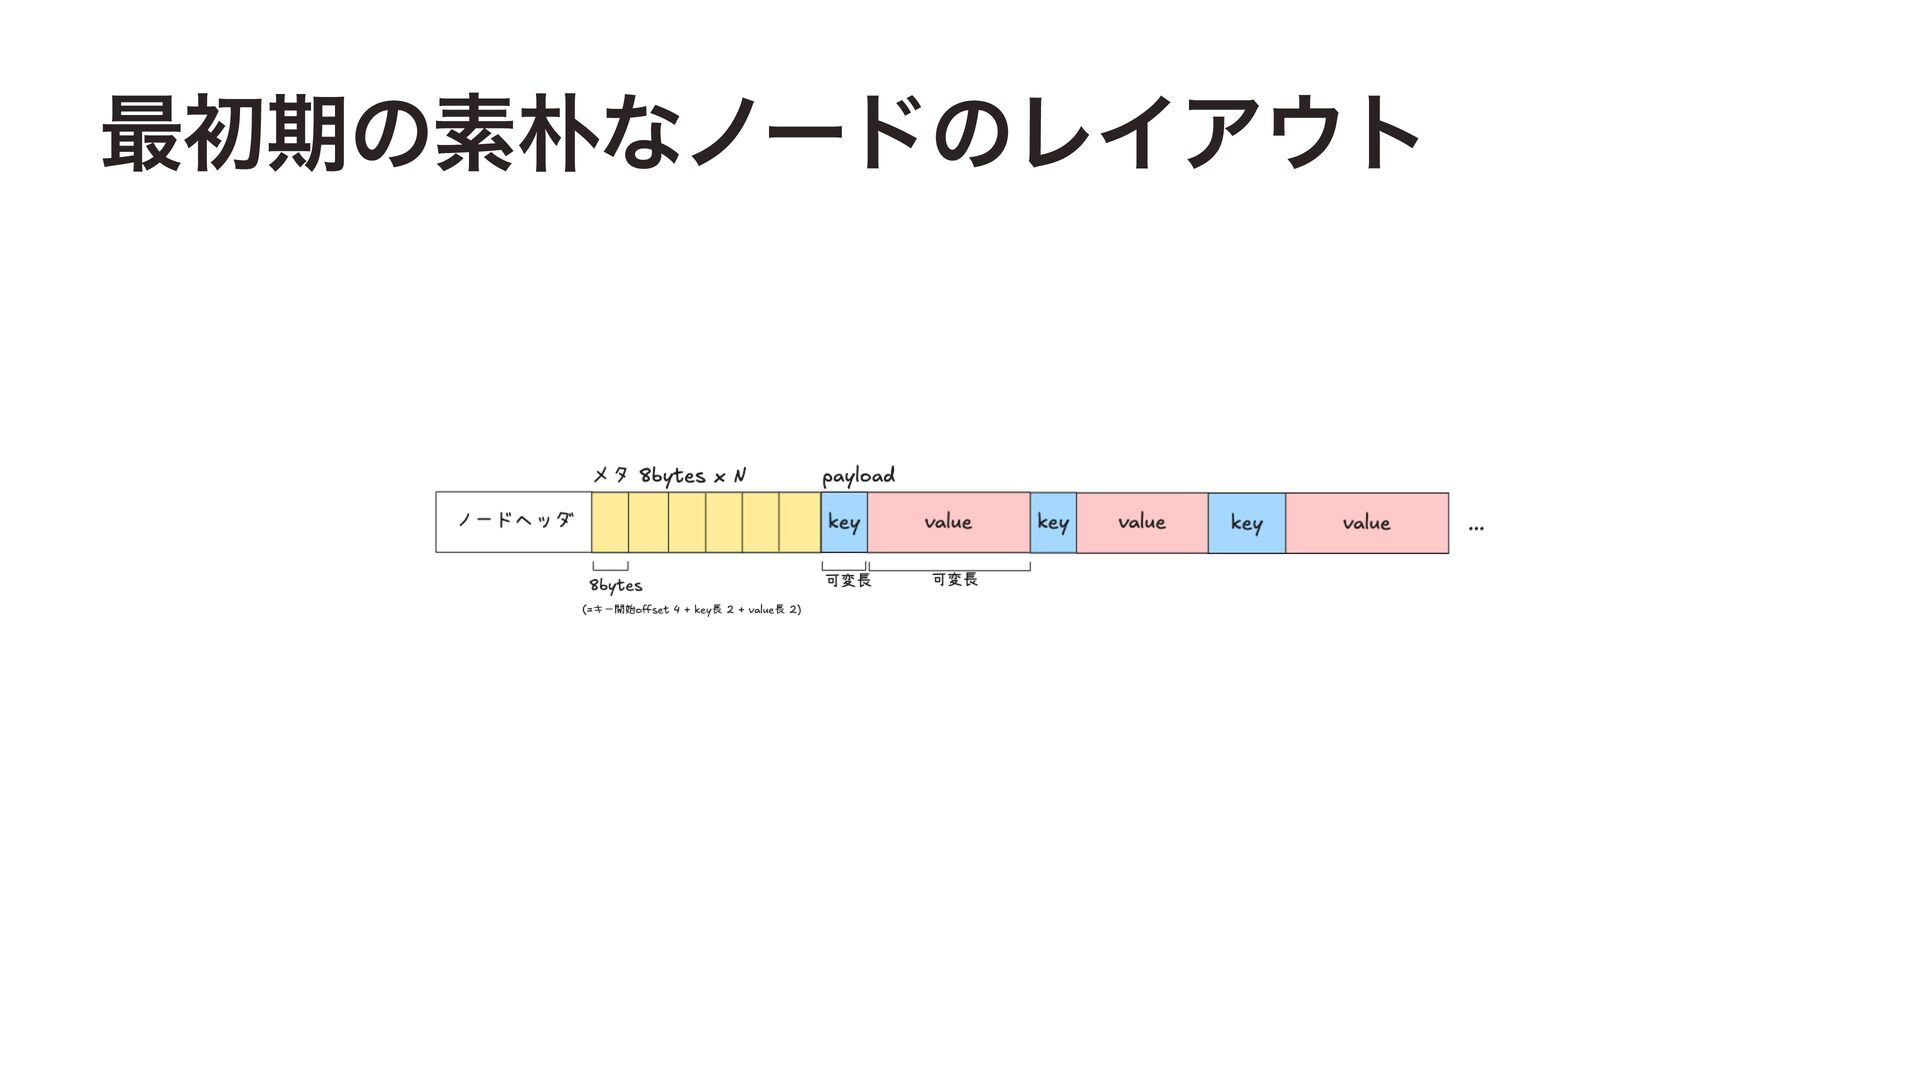
Upgrade to Pro — share decks privately, control downloads, hide ads and more …

最速のread性能を目指すピュアC#製組み込みDB実装 - C# Kaigi 2026

Avatar for hadashiA hadashiA
September 19, 2026
400

最速のread性能を目指すピュアC#製組み込みDB実装 - C# Kaigi 2026

Avatar for hadashiA

hadashiA

September 19, 2026

Transcript

  1. About Speaker ハダシA / @hadashiA • フリーランスでエンジニアしてます • Webサービス /

    オンラインゲームの仕事とか • C#/Unity用のOSS活動する勢 • RubyKaigi 2026 にも登壇したよ
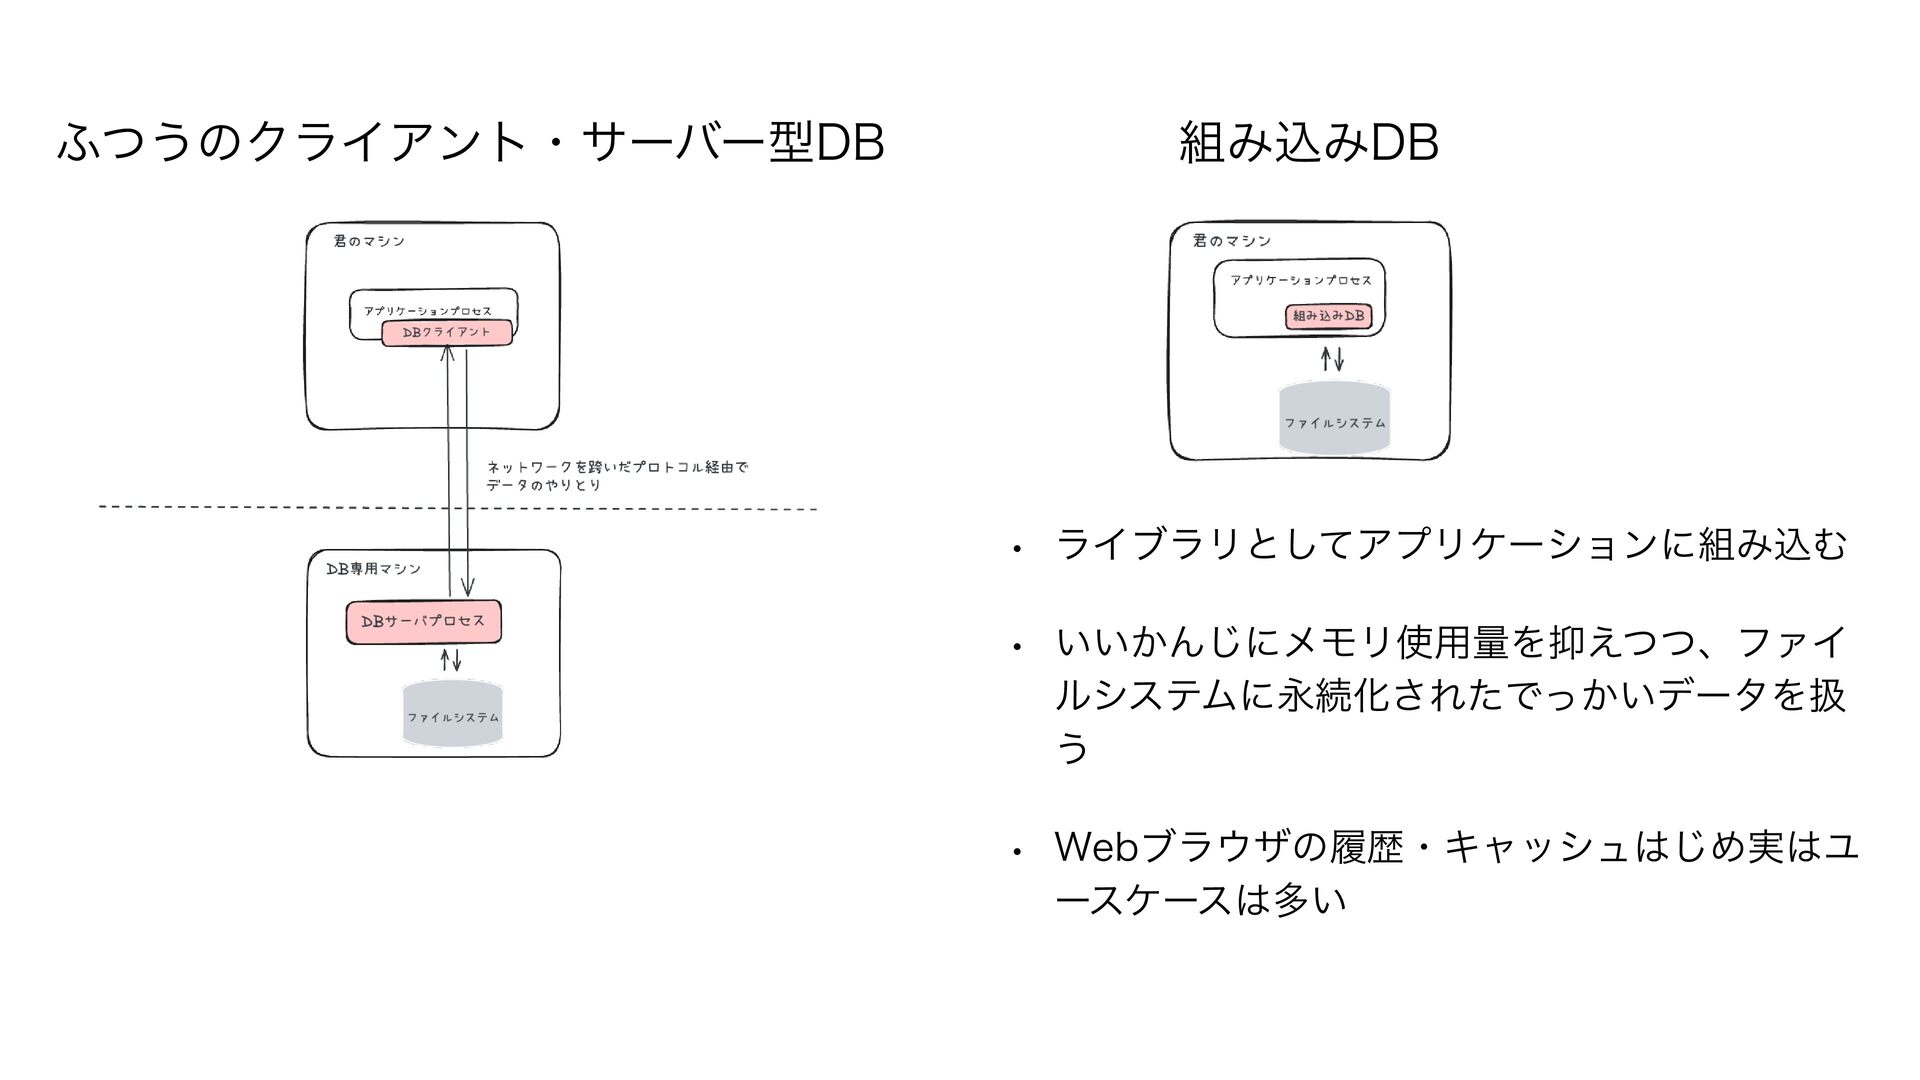
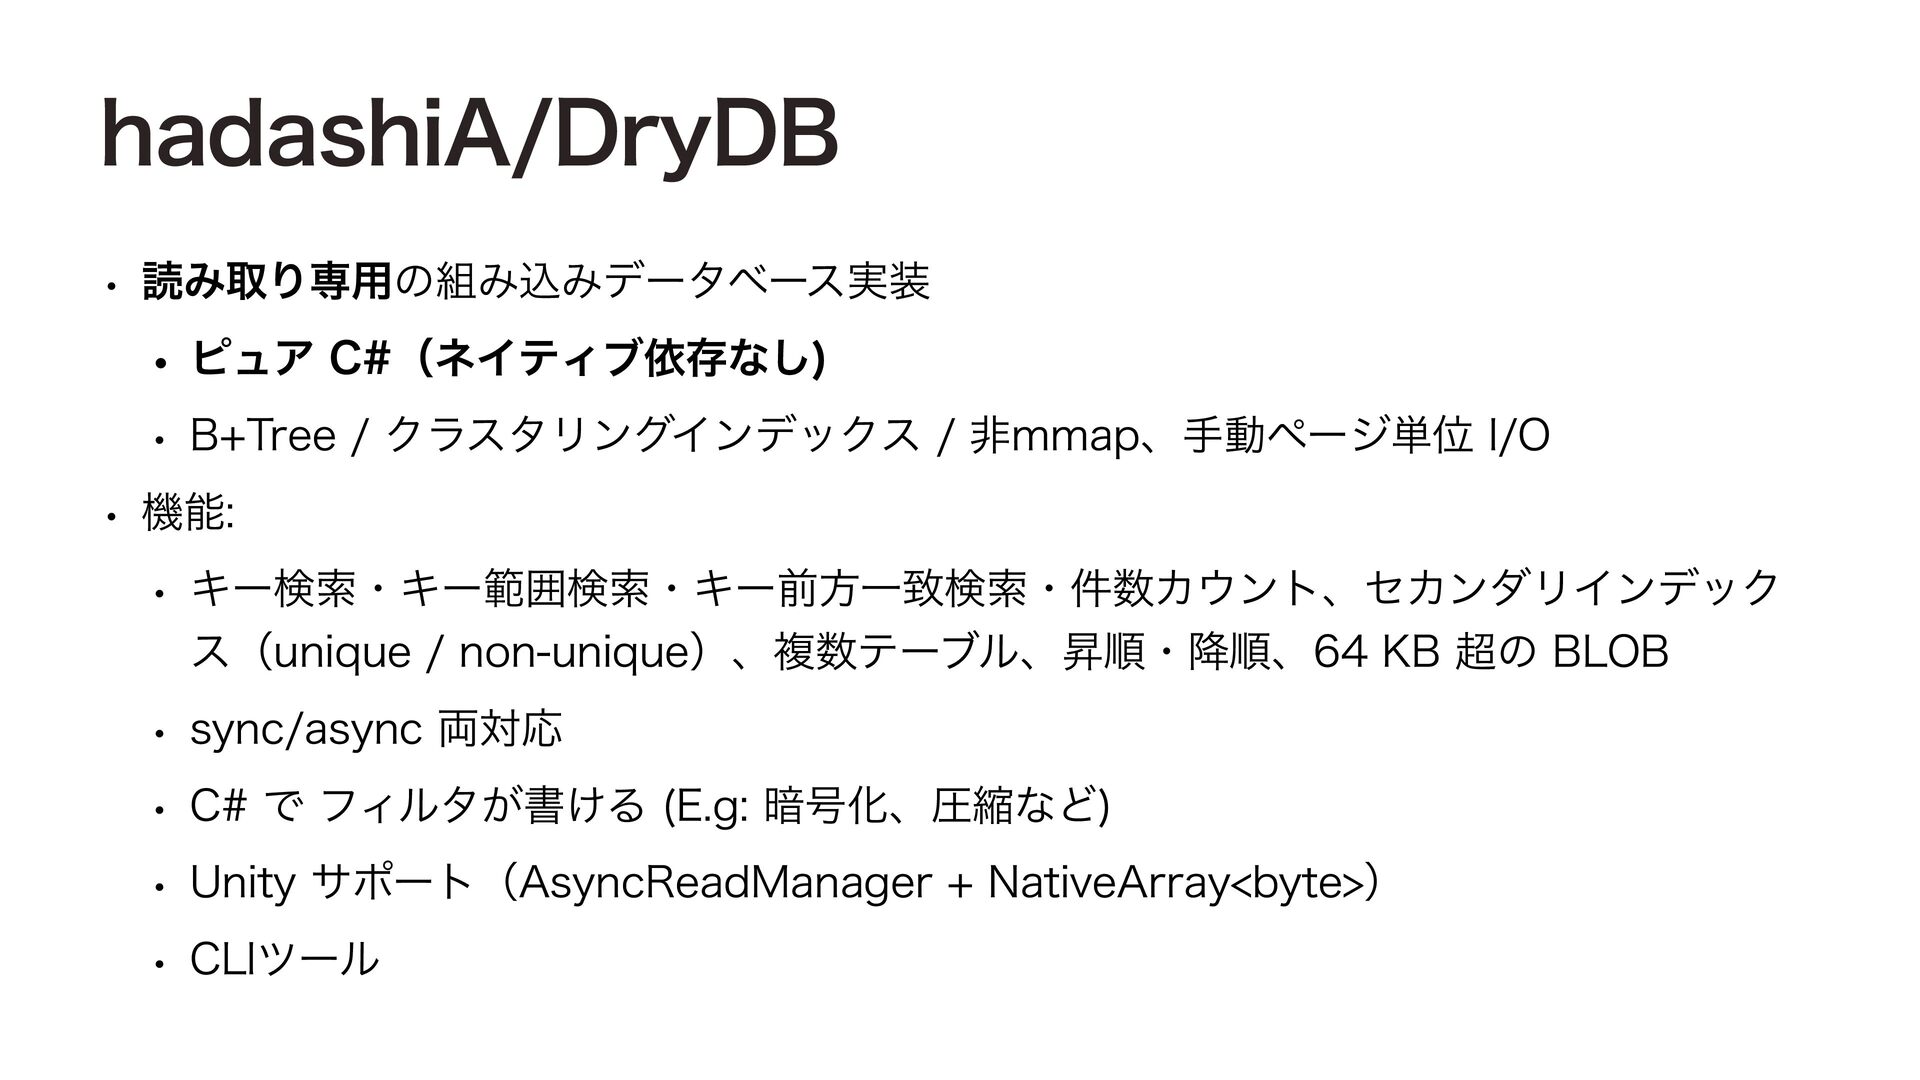
  2. hadashiA/DryDB • 読み取り専用の組み込みデータベース実装 • ピュア C#(ネイティブ依存なし) • B+Tree / クラスタリングインデックス

    / 非mmap、手動ページ単位 I/O • 機能: • キー検索・キー範囲検索・キー前方一致検索・件数カウント、セカンダリインデック ス(unique / non-unique)、複数テーブル、昇順・降順、64 KB 超の BLOB • sync/async 両対応 • C# で フィルタが書ける (E.g: 暗号化、圧縮など) • Unity サポート(AsyncReadManager + NativeArray<byte>) • CLIツール
  3. Why readonly? • ゲームとかだと、運営側が用意した大量のデータをアプリに組み込んで出荷したい • いわゆるマスターデータ • よくある手法の問題点 • Unityアセット

    • ポータビリティが無い(Unity 外・サーバから読めない) • 動的配布が面倒 • 動的ロード/アンロード管理が面倒 • メインスレッド以外から読めない • MessagePack/JSON/protobuf を丸ごとデシリアライズ(MasterMemory 等): • 取得は最速 • いつの間にか「メモリに載る量だけをマスターデータとみなす」制約がでてくる ハイパー省メモリかつ高速なreadonly組み込みDBをUnityにぶちこもう https://hadashikick.land/tech/vkv-preview
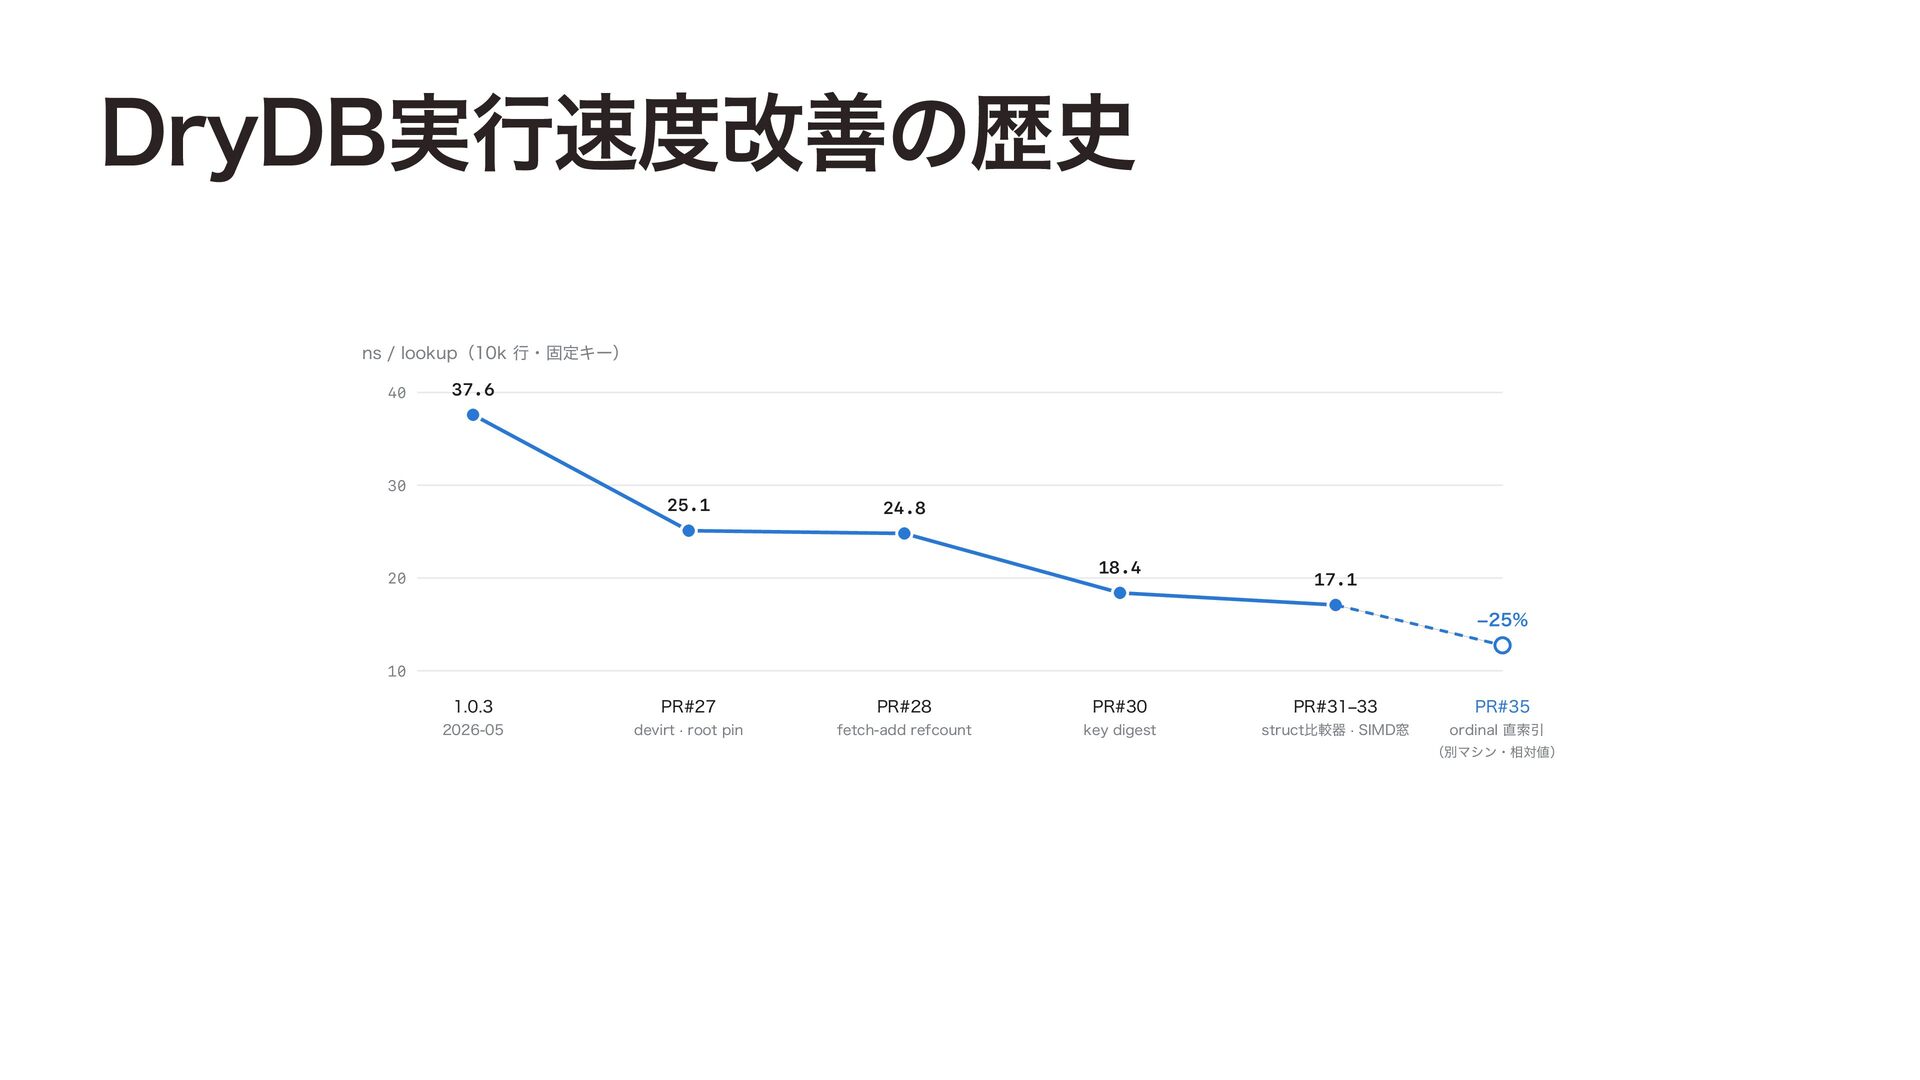
  4. DryDB実行速度改善の歴史 ns / lookup(10k 行・固定キー) 40 37.6 30 25.1 24.8

    18.4 20 17.1 ­25% 10 1.0.3 2026-05 PR#27 devirt · root pin PR#28 fetch-add refcount PR#30 key digest PR#31‒33 struct比較器 · SIMD窓 PR#35 ordinal 直索引 (別マシン・相対値)
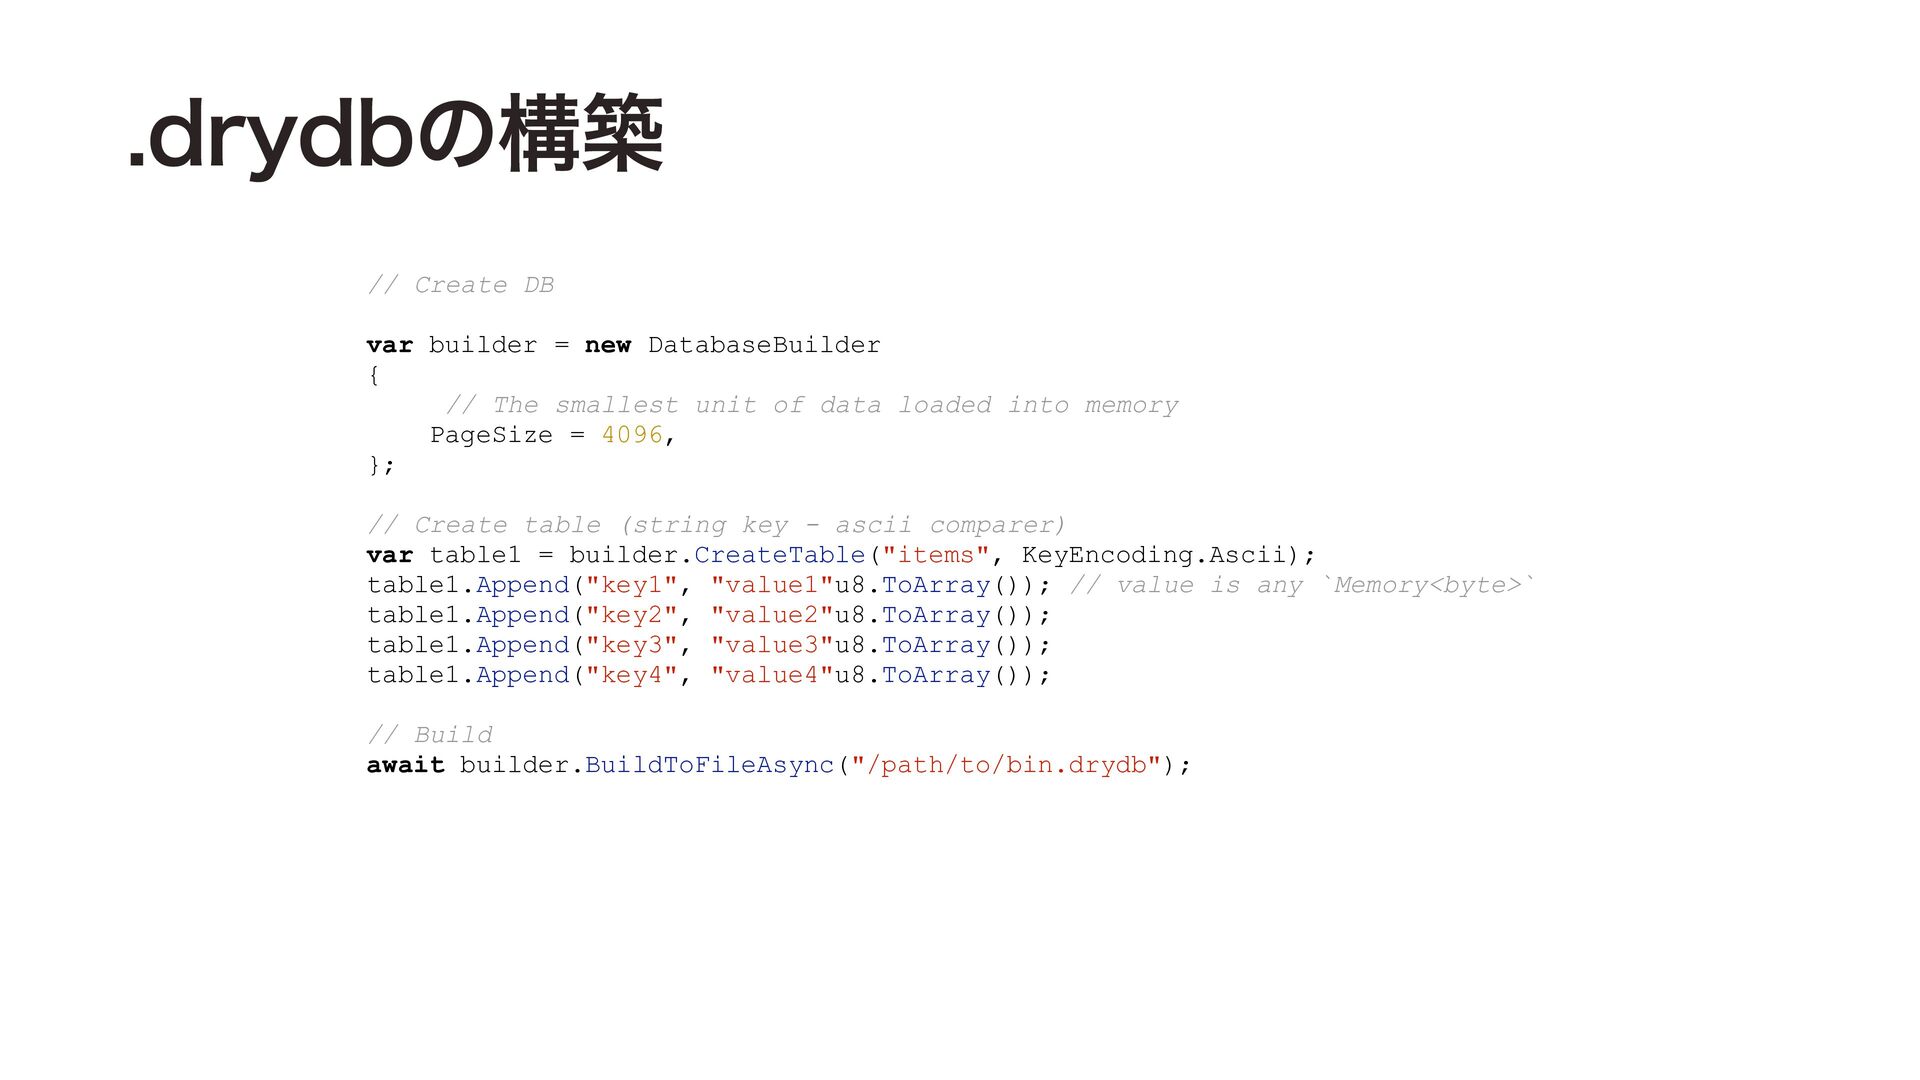
  5. .drydbの構築 // Create DB var builder = new DatabaseBuilder {

    // The smallest unit of data loaded into memory PageSize = 4096, }; // Create table (string key - ascii comparer) var table1 = builder.CreateTable("items", KeyEncoding.Ascii); table1.Append("key1", "value1"u8.ToArray()); // value is any `Memory<byte>` table1.Append("key2", "value2"u8.ToArray()); table1.Append("key3", "value3"u8.ToArray()); table1.Append("key4", "value4"u8.ToArray()); // Build await builder.BuildToFileAsync("/path/to/bin.drydb");
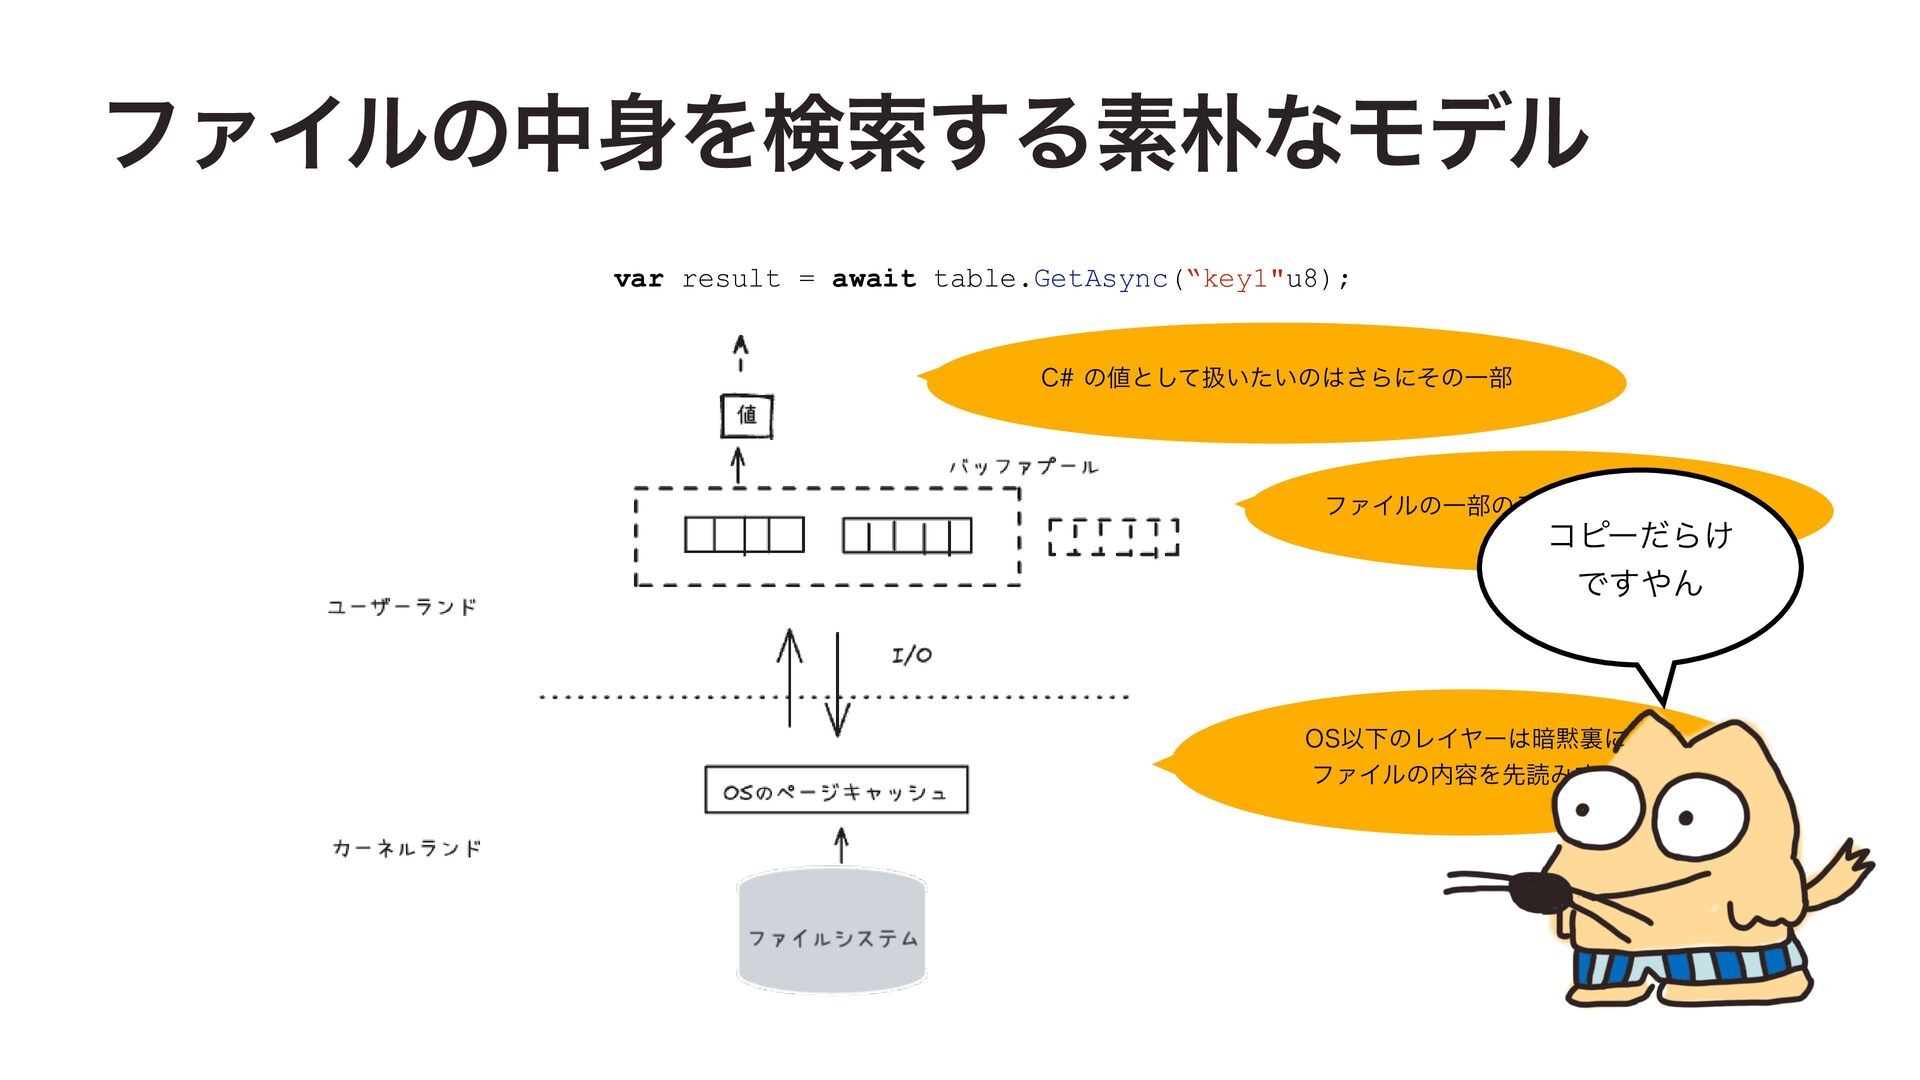
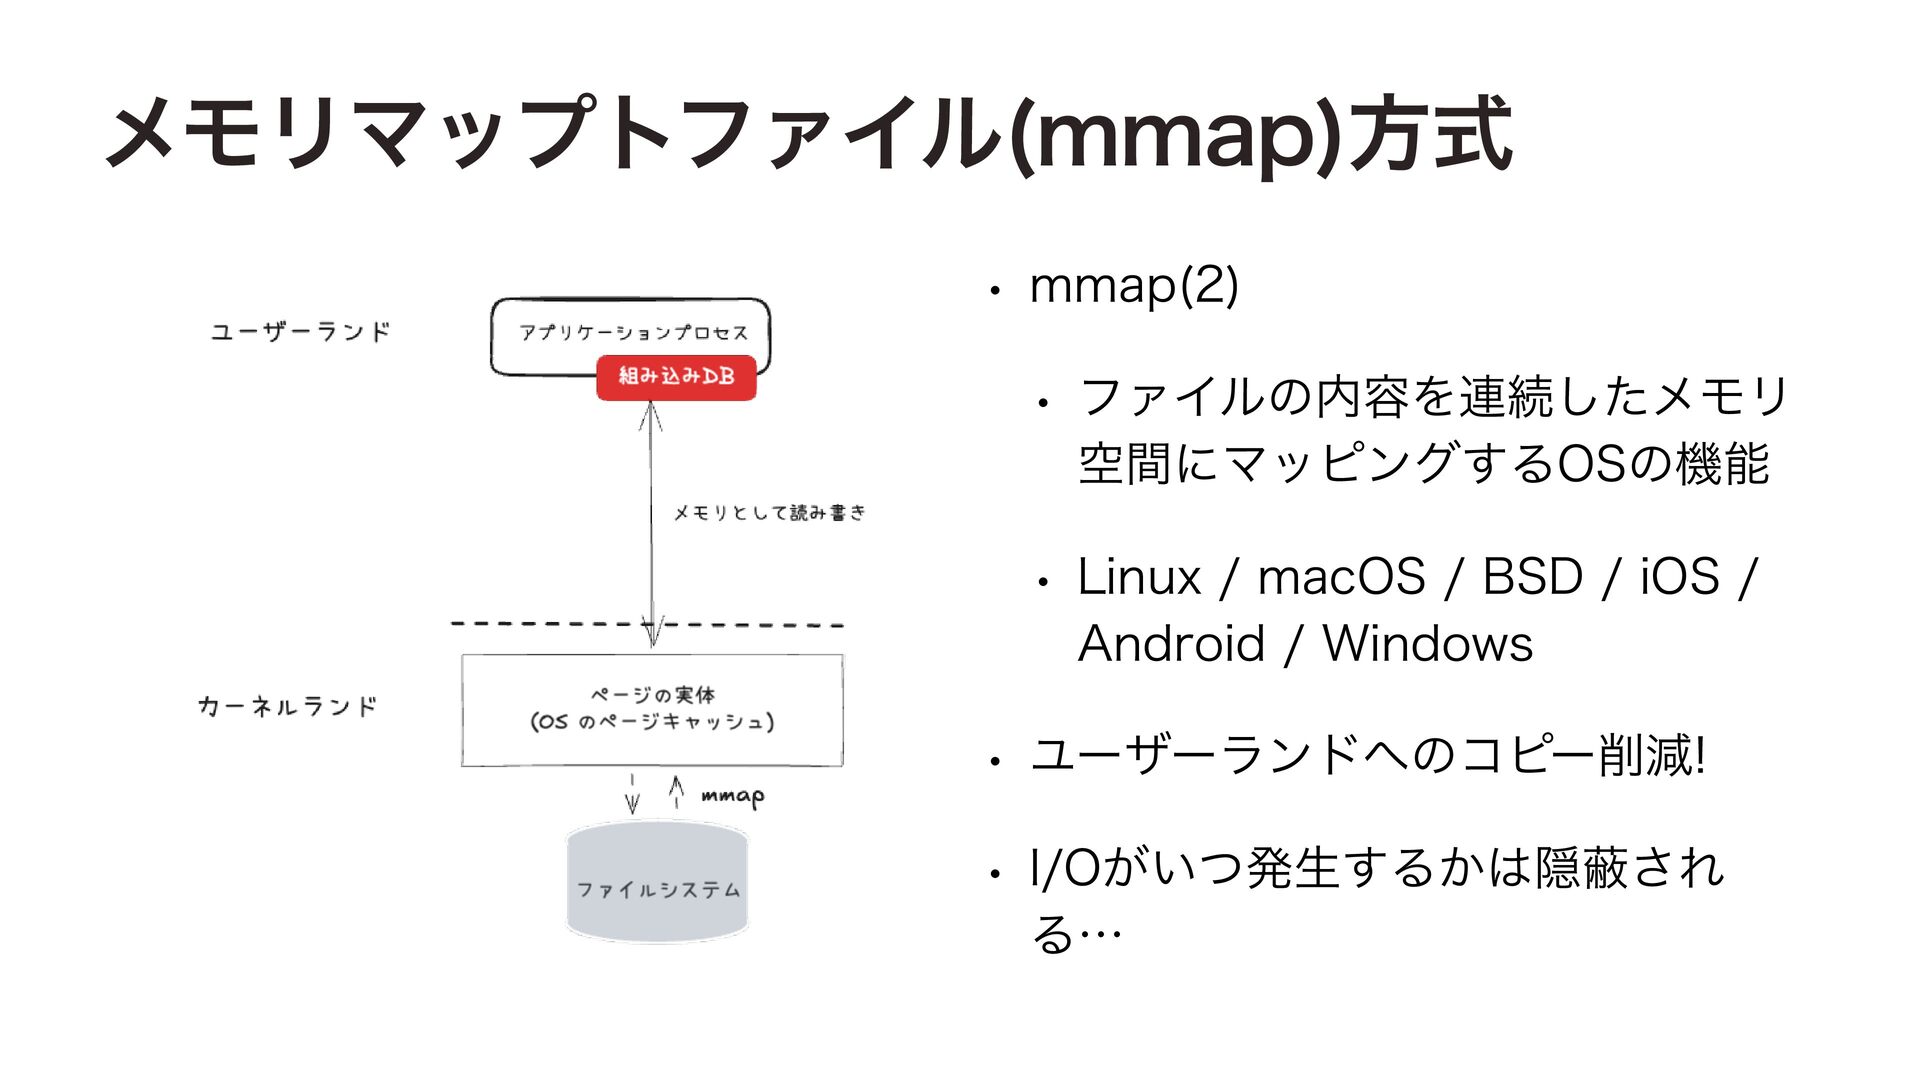
  6. メモリマップトファイル(mmap)方式 • mmap(2) • ファイルの内容を連続したメモリ 空間にマッピングするOSの機能 • Linux / macOS

    / BSD / iOS / Android / Windows • ユーザーランドへのコピー削減! • I/Oがいつ発生するかは隠蔽され る…
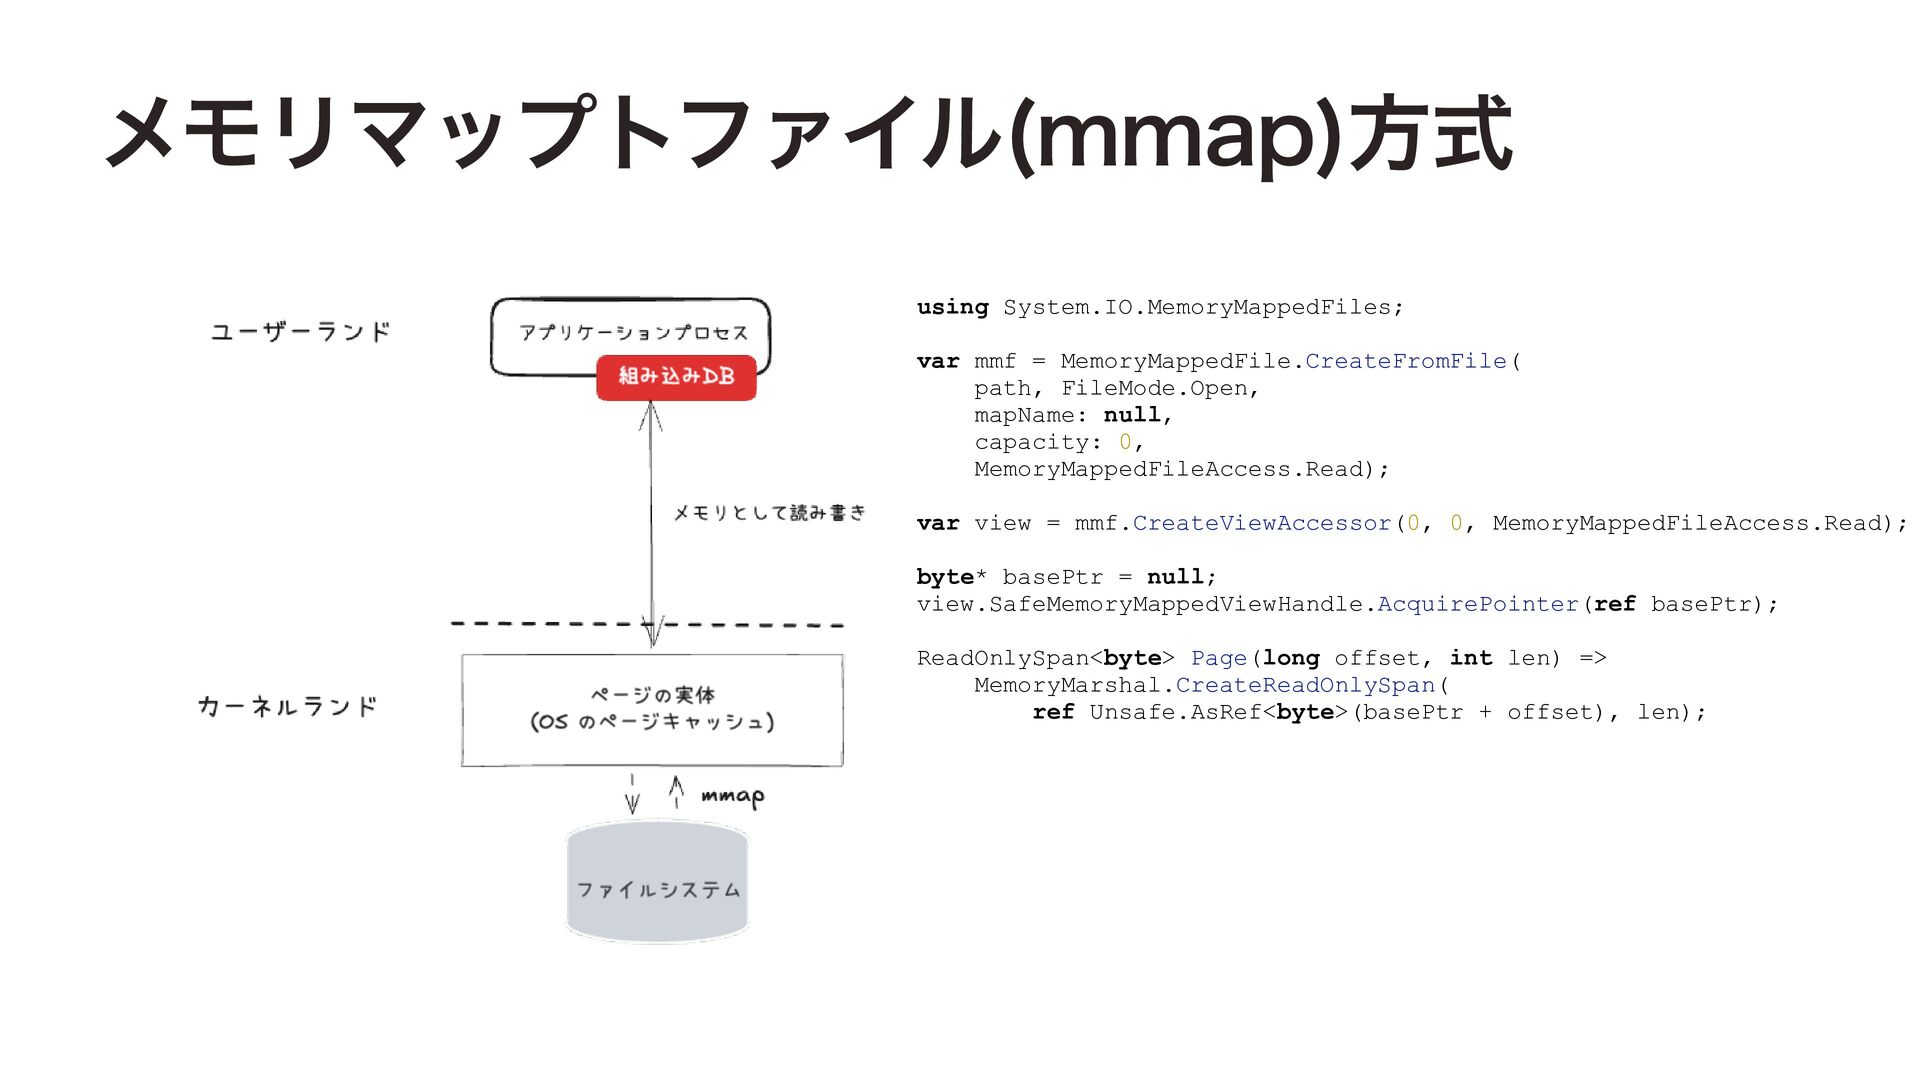
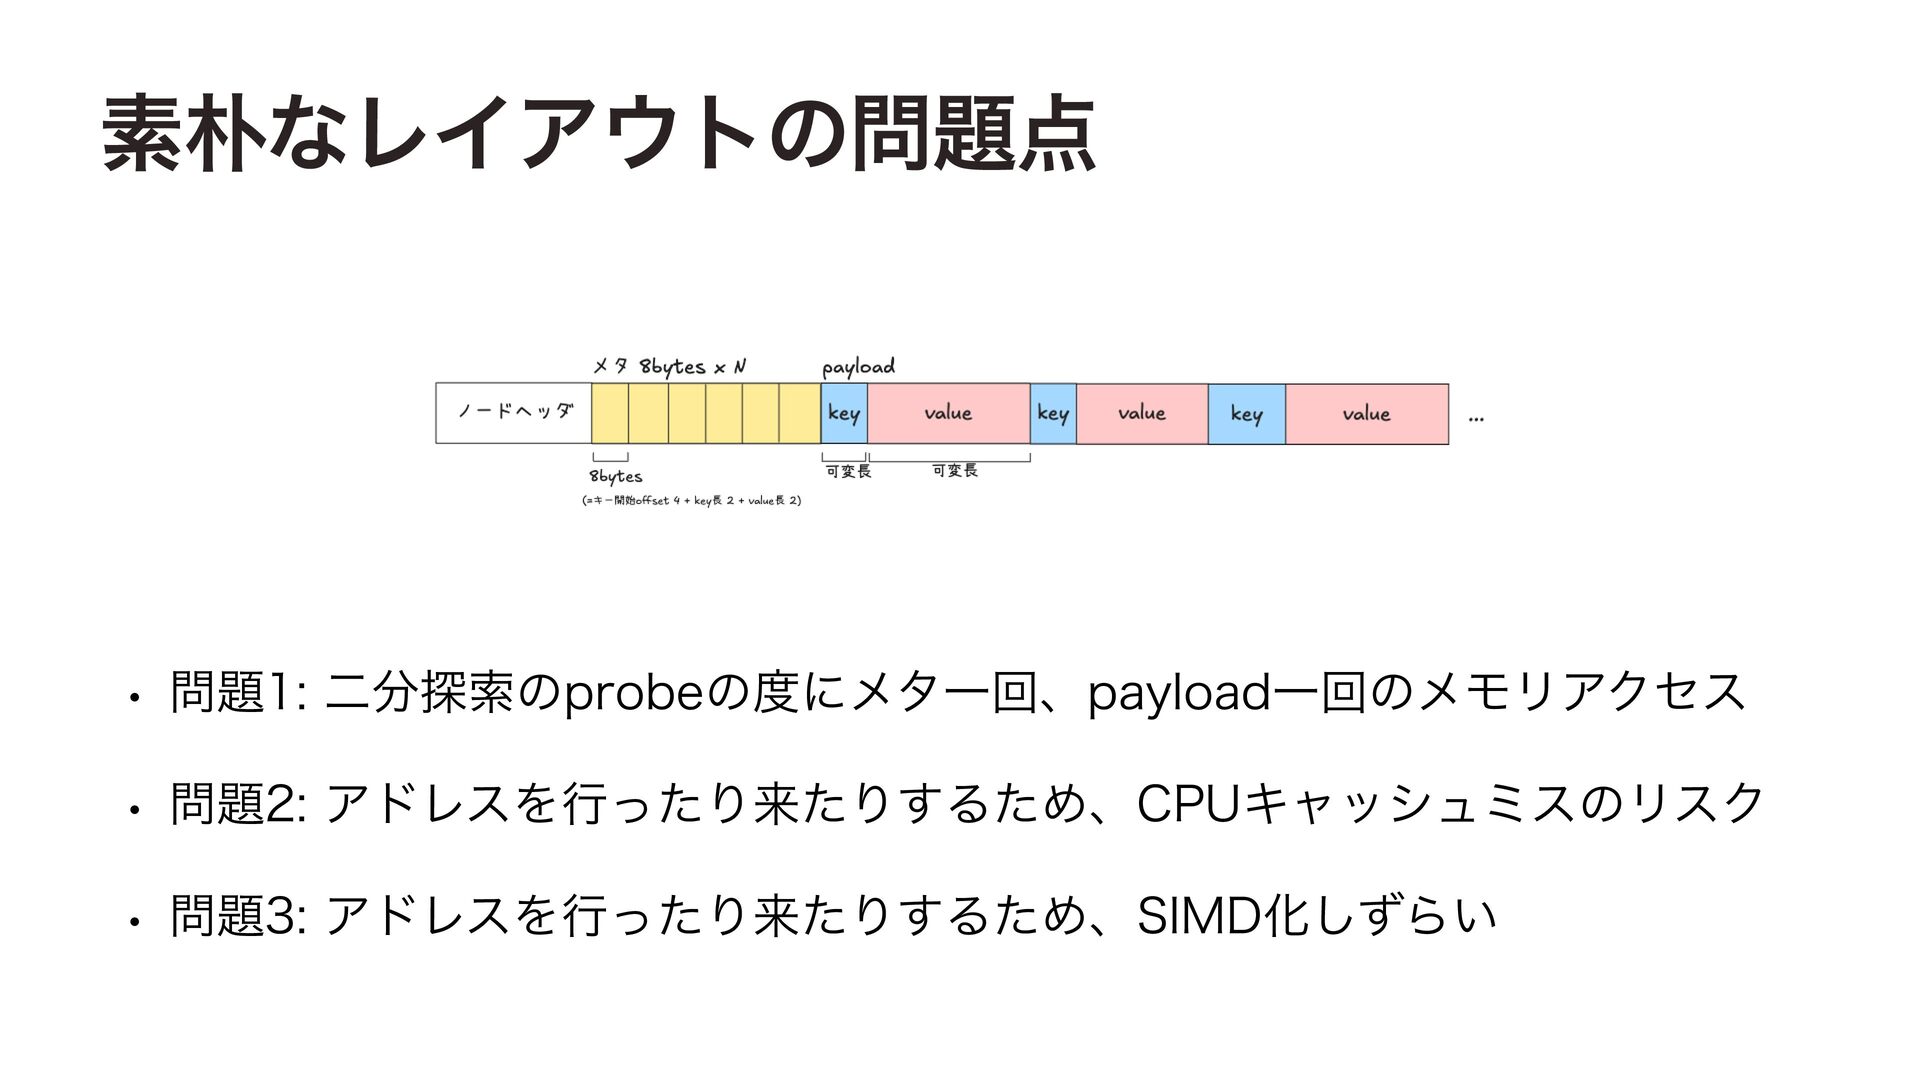
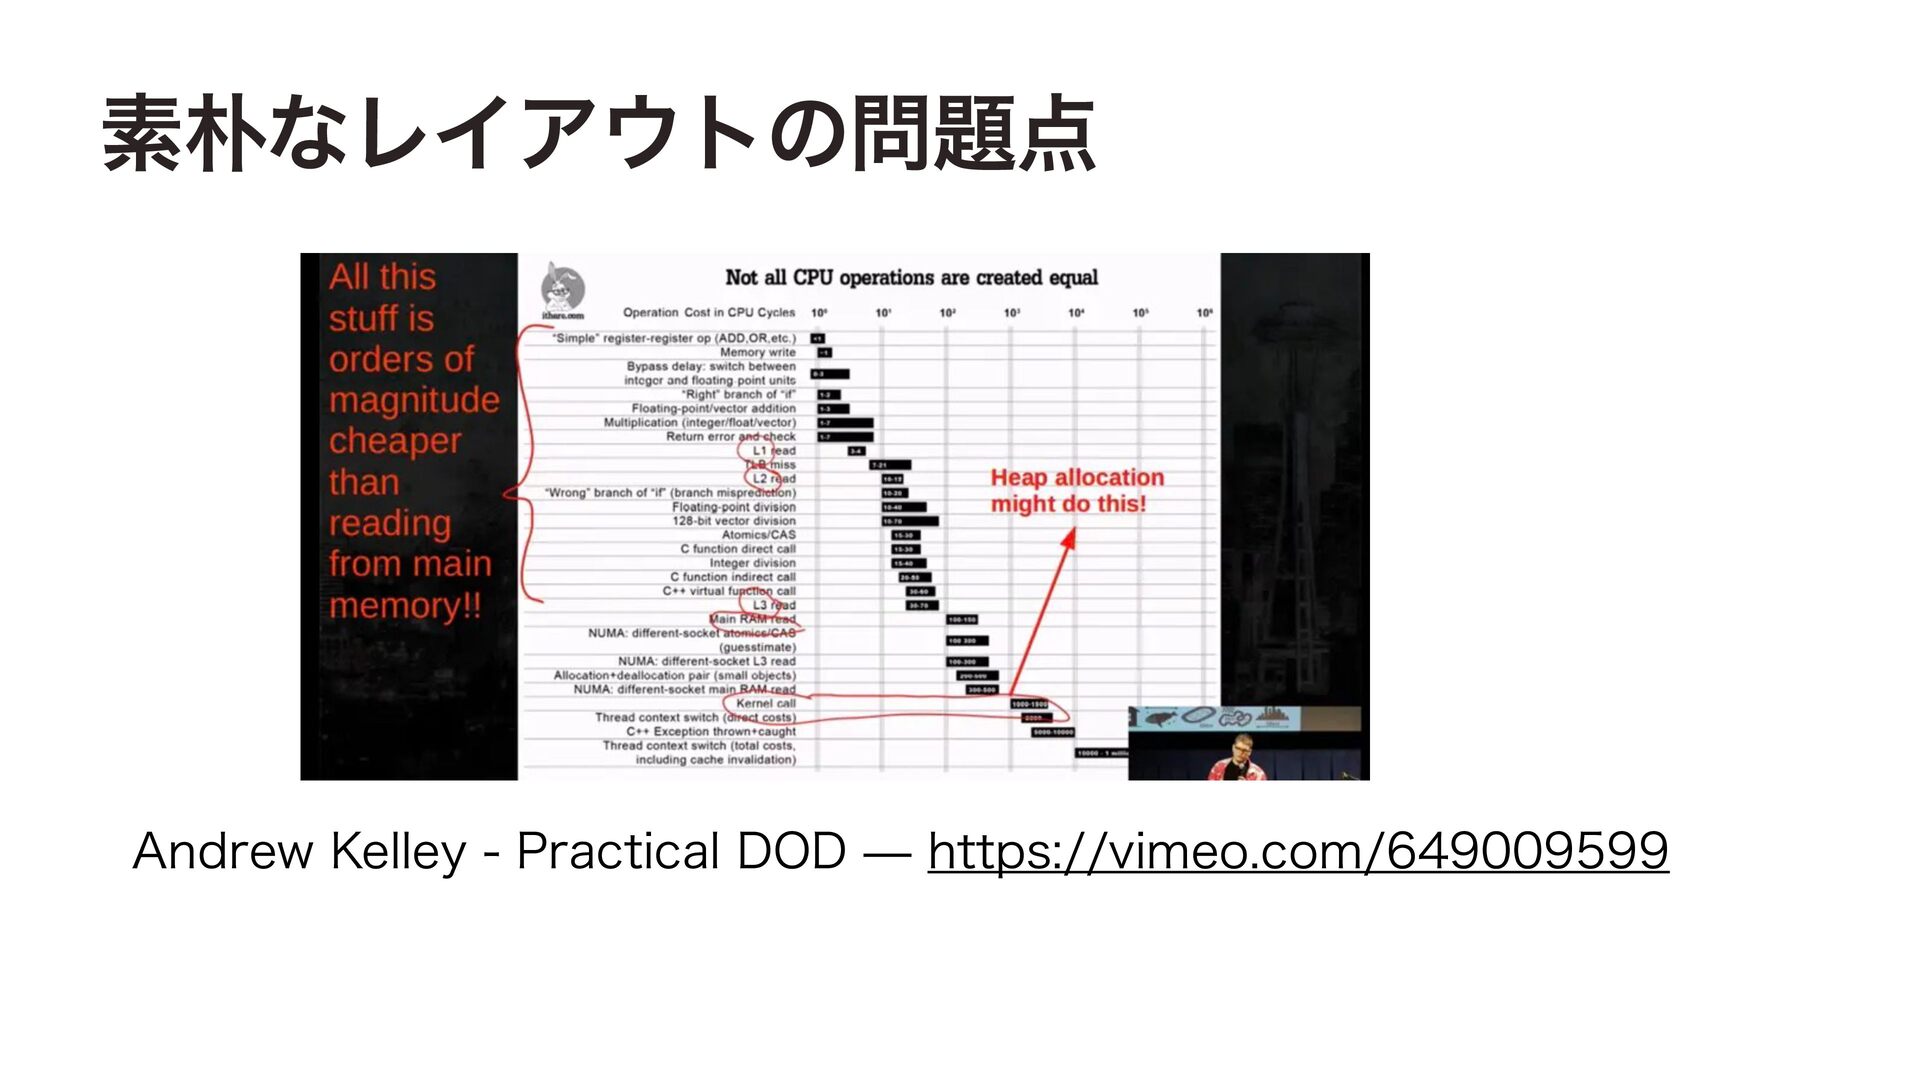
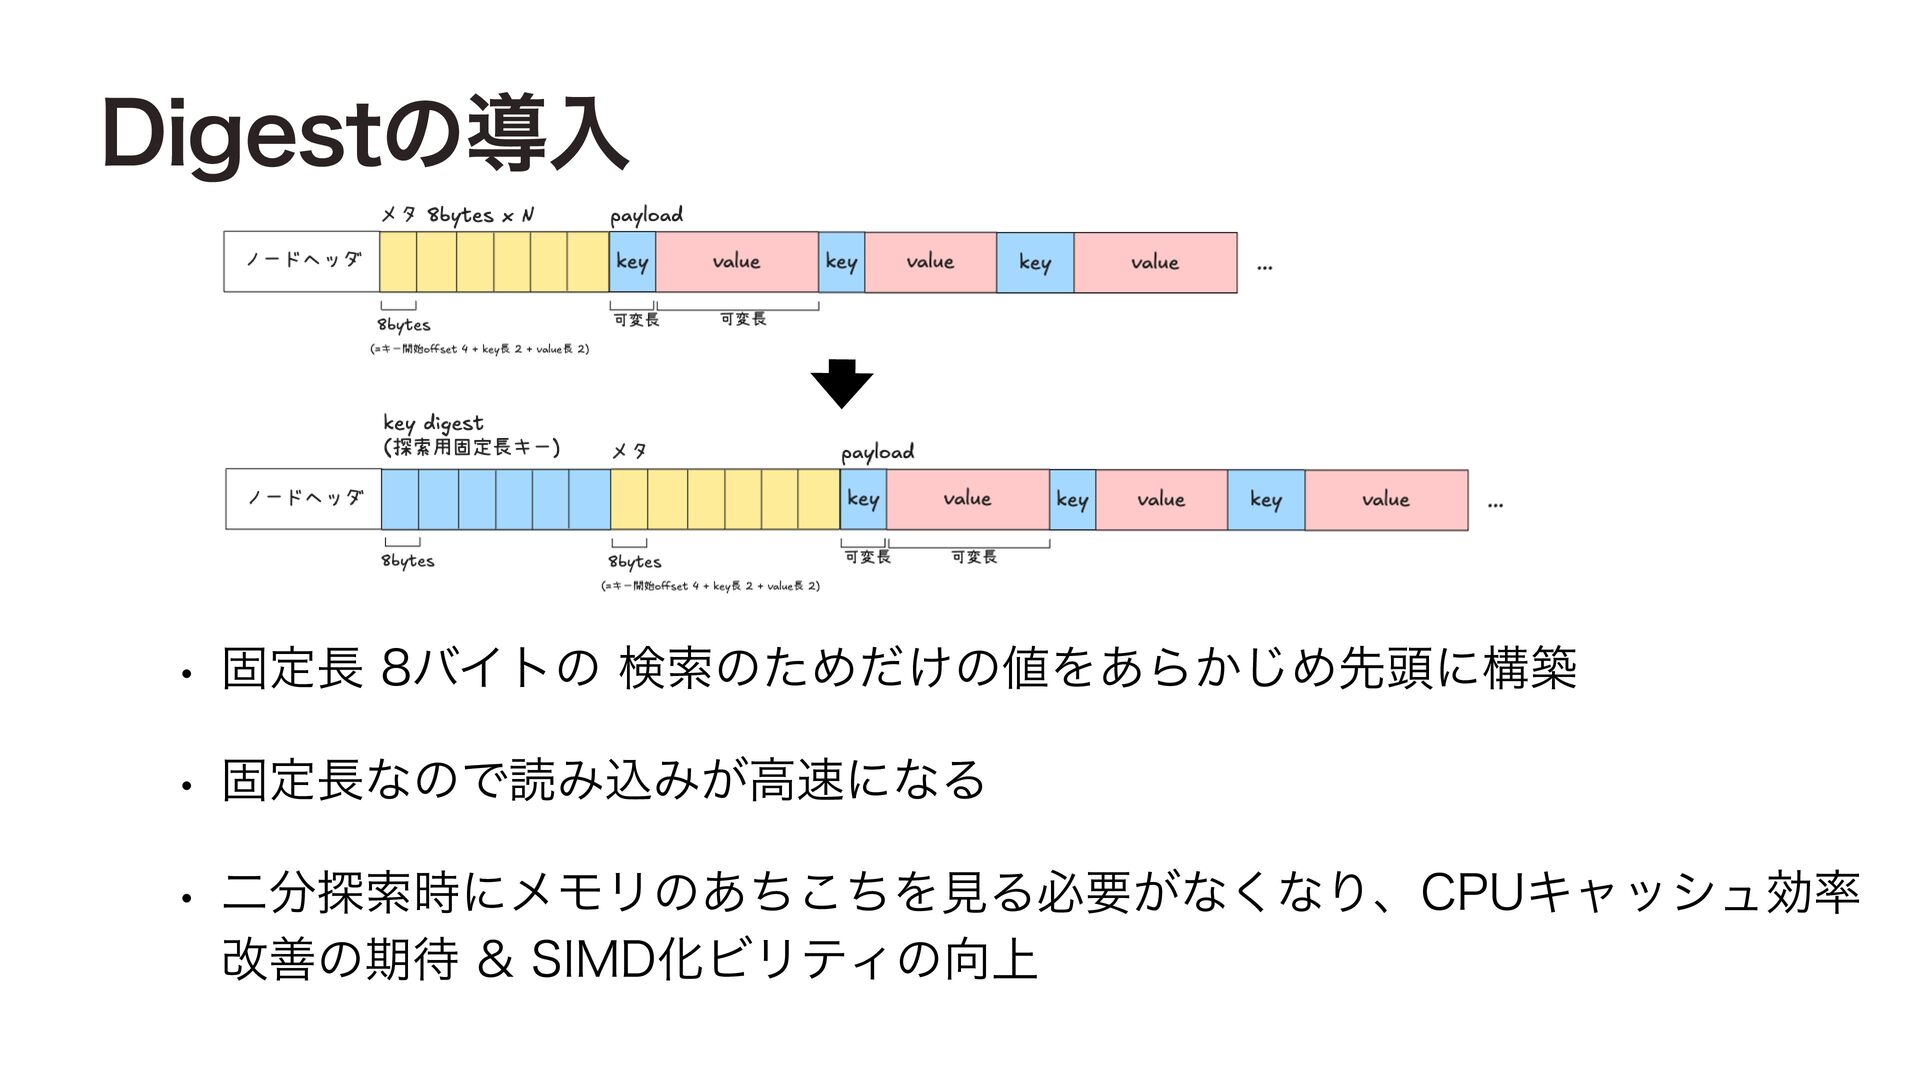
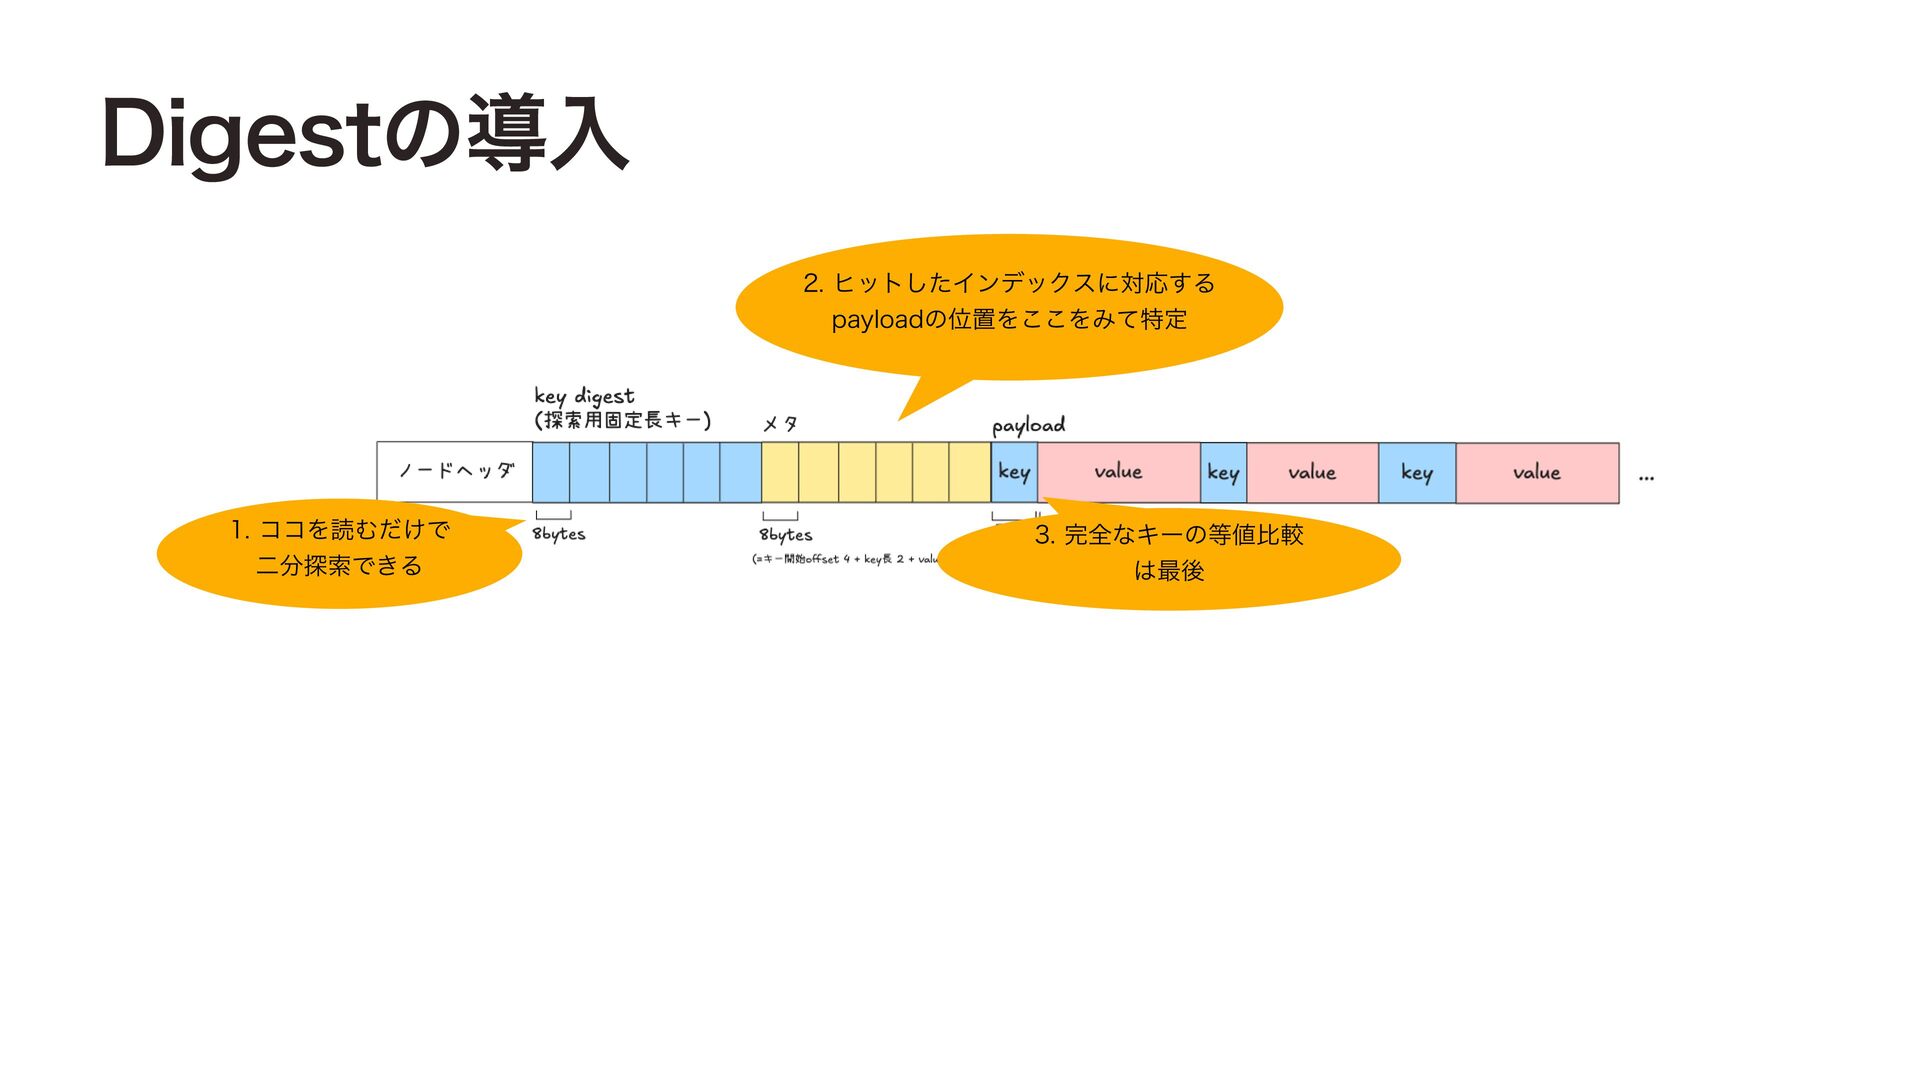
  7. メモリマップトファイル(mmap)方式 using System.IO.MemoryMappedFiles; var mmf = MemoryMappedFile.CreateFromFile( path, FileMode.Open, mapName:

    null, capacity: 0, MemoryMappedFileAccess.Read); var view = mmf.CreateViewAccessor(0, 0, MemoryMappedFileAccess.Read); byte* basePtr = null; view.SafeMemoryMappedViewHandle.AcquirePointer(ref basePtr); ReadOnlySpan<byte> Page(long offset, int len) => MemoryMarshal.CreateReadOnlySpan( ref Unsafe.AsRef<byte>(basePtr + offset), len);
  8. mmap方式の欠点 • I/O の発生点が見えない・止められない • C# だから async 化したいのに…… •

    キャッシュポリシーを選べない • OS の汎用 LRU はスキャン耐性が無く、索引ページの優先保持もできず、メモリ上限も不明 • 最大メモリ使用量をコントロールしずらい • 変換を挟めない • 圧縮・暗号化・チェックサムは「ディスク上とメモリ上でバイト列が違う」ことを要求するが、mmap は同一であることが前提 • TLB (Tlanslation Lookup Bu er) あふれ • 仮想メモリアドレス領域が大きくなると、仮想メモリアドレス → 物理アドレス 変換のためのテーブルがTLBにおさまらなくなり、 lookupコストが増大する ff Are You Sure You Want to Use MMAP in Your Database Management System? Andrew Crotty, Viktor Leis, Andy Pavlo ― CIDR 2022 https://db.cs.cmu.edu/mmap-cidr2022/
  9. Mmap方式は不採用がトレンド • RocksDB → LevelDBをforkし、mmapを廃止 • The History of RocksDB

    • LevelDB → 初期実装は mmap 。後に移行。 • MongoDB → MMAPv1 エンジンを廃止して WiredTiger へ。 ff • SQLite → mmap モードを持つがデフォルトでo 。
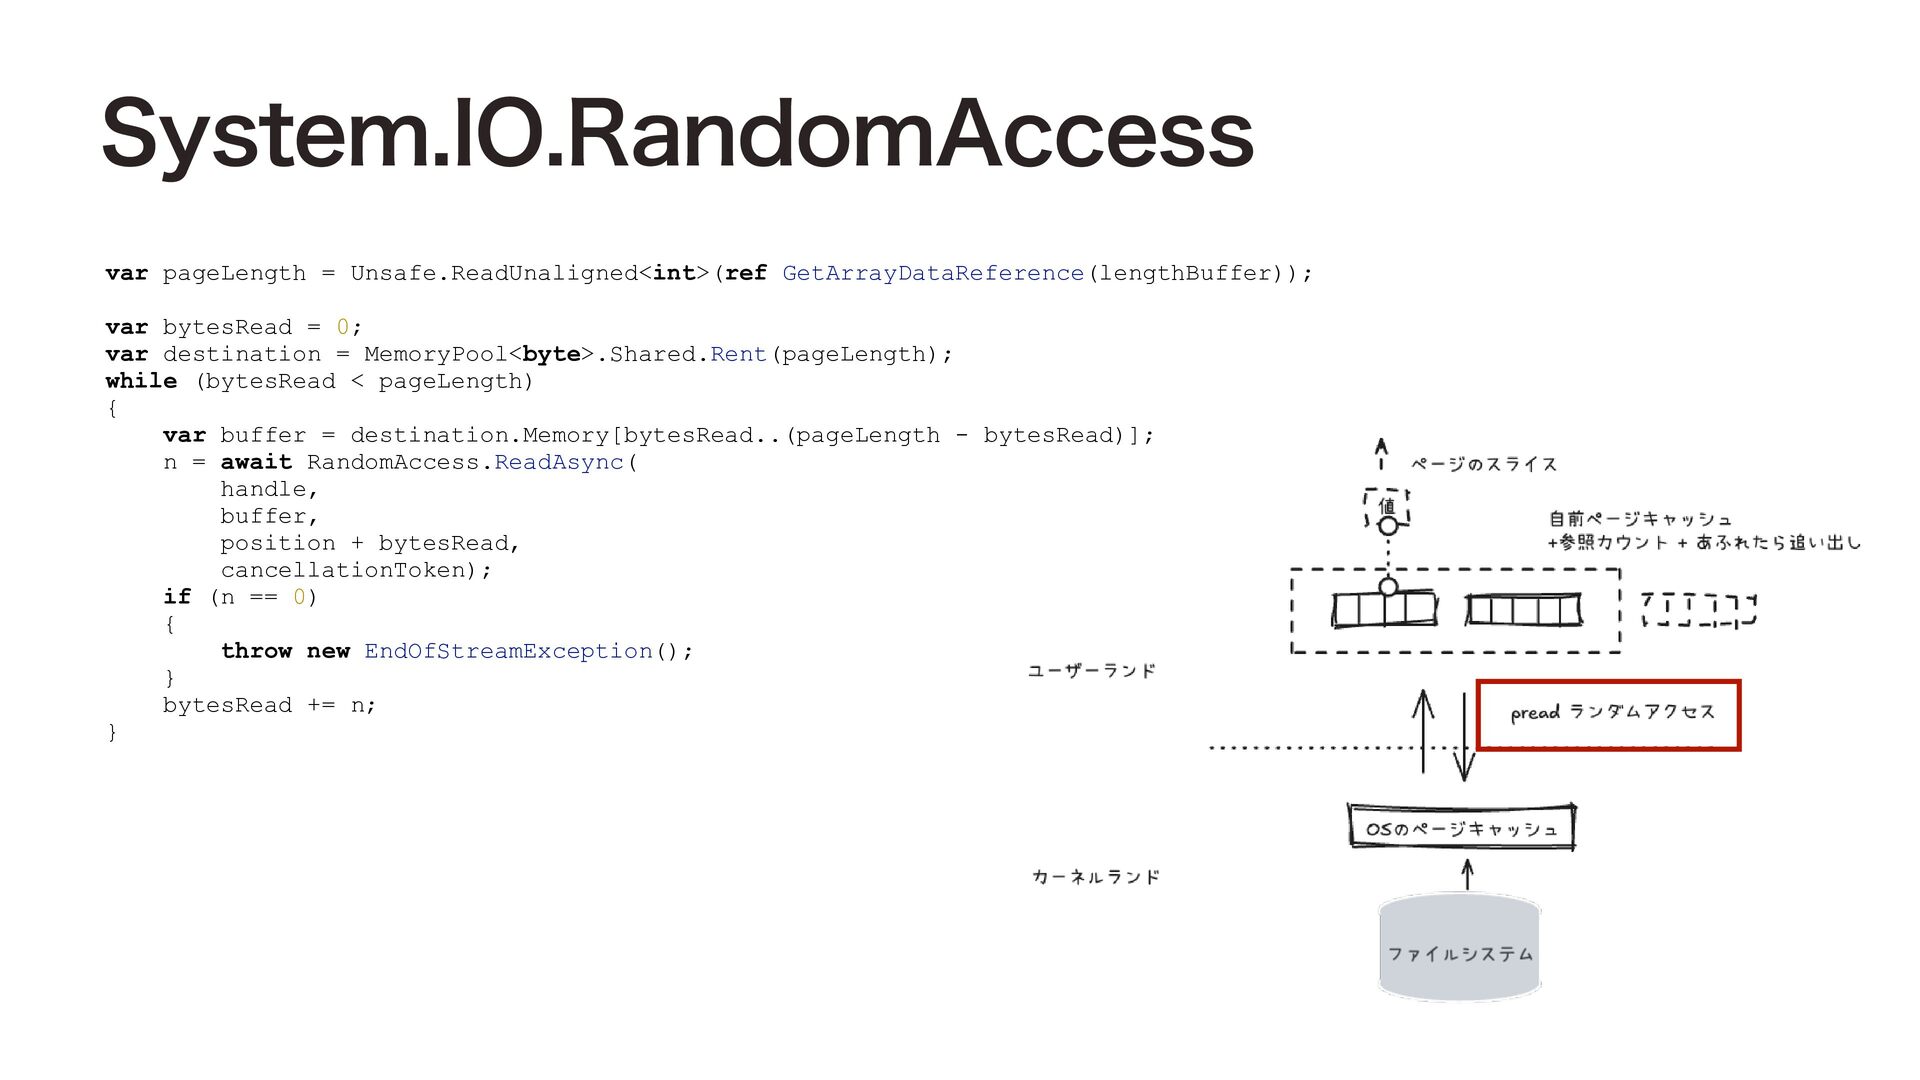
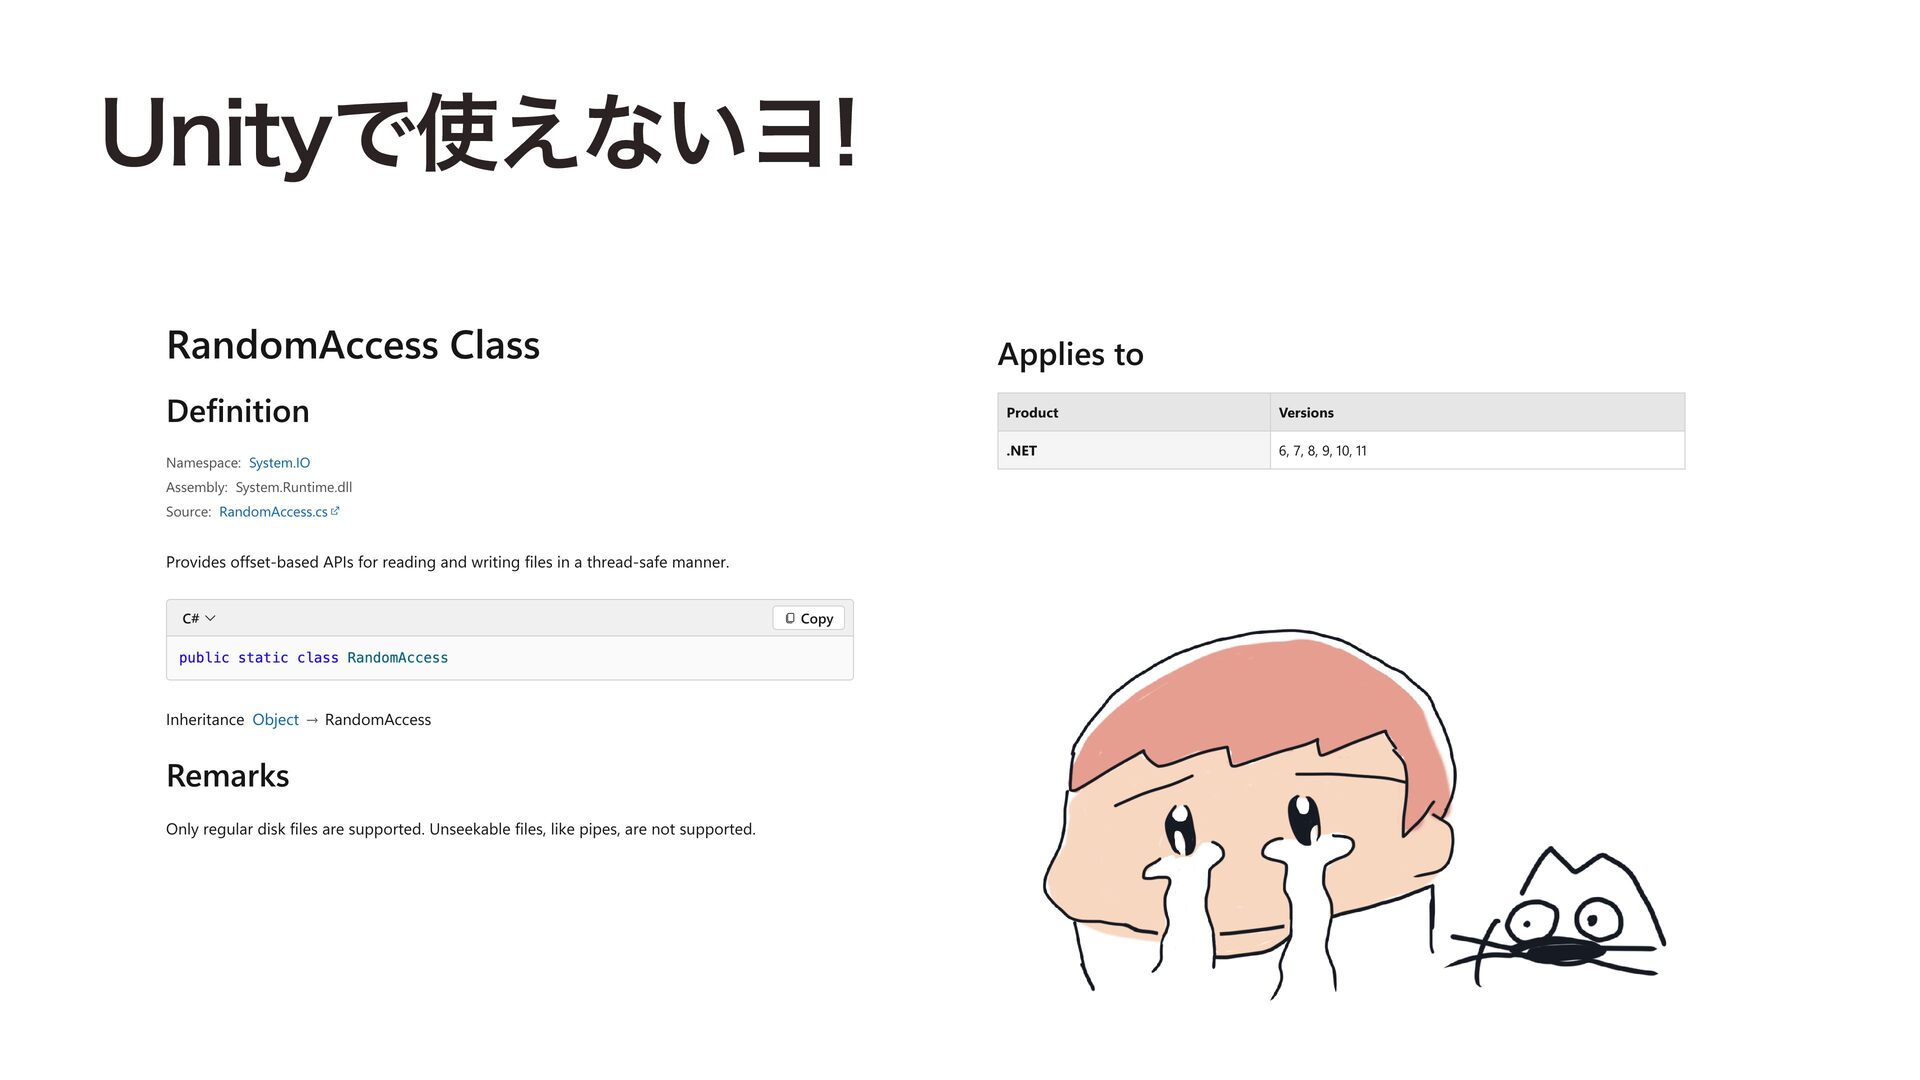
  10. System.IO.RandomAccess var pageLength = Unsafe.ReadUnaligned<int>(ref GetArrayDataReference(lengthBuffer)); var bytesRead = 0;

    var destination = MemoryPool<byte>.Shared.Rent(pageLength); while (bytesRead < pageLength) { var buffer = destination.Memory[bytesRead..(pageLength - bytesRead)]; n = await RandomAccess.ReadAsync( handle, buffer, position + bytesRead, cancellationToken); if (n == 0) { throw new EndOfStreamException(); } bytesRead += n; }
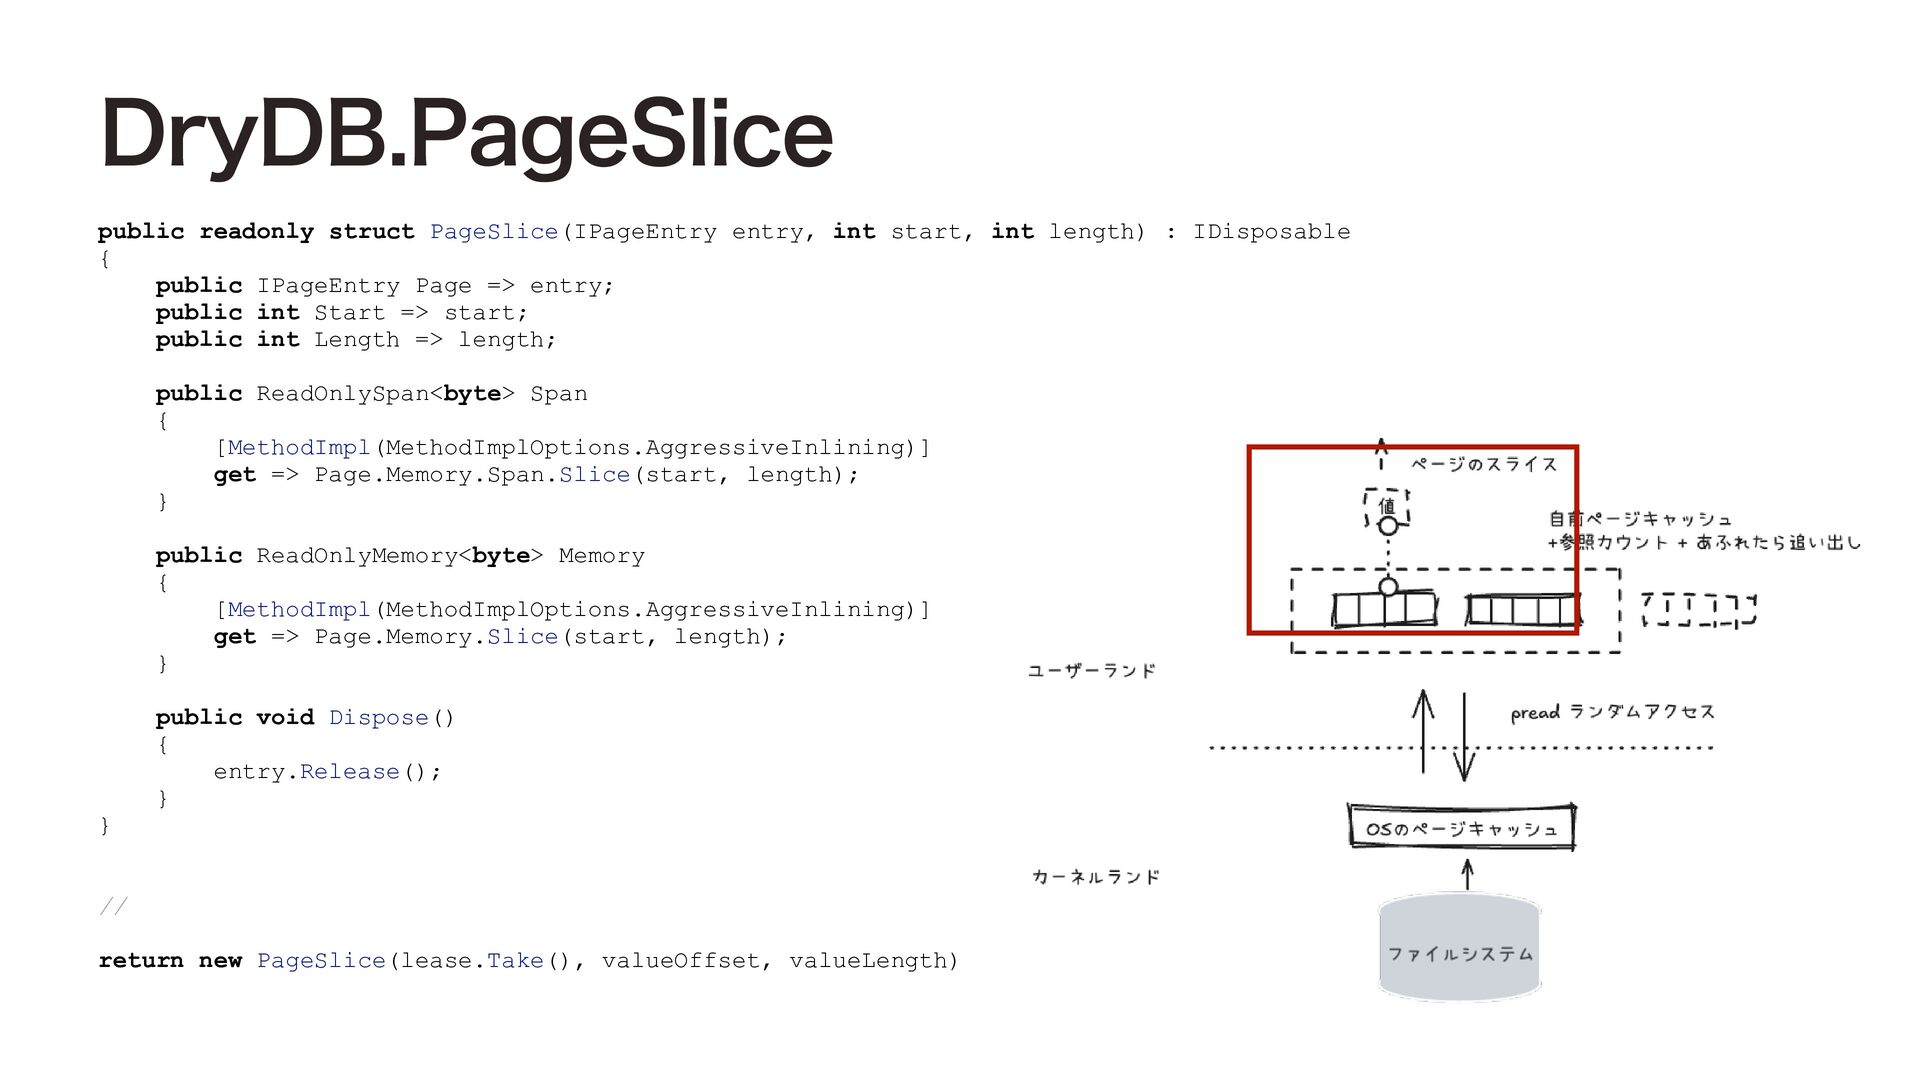
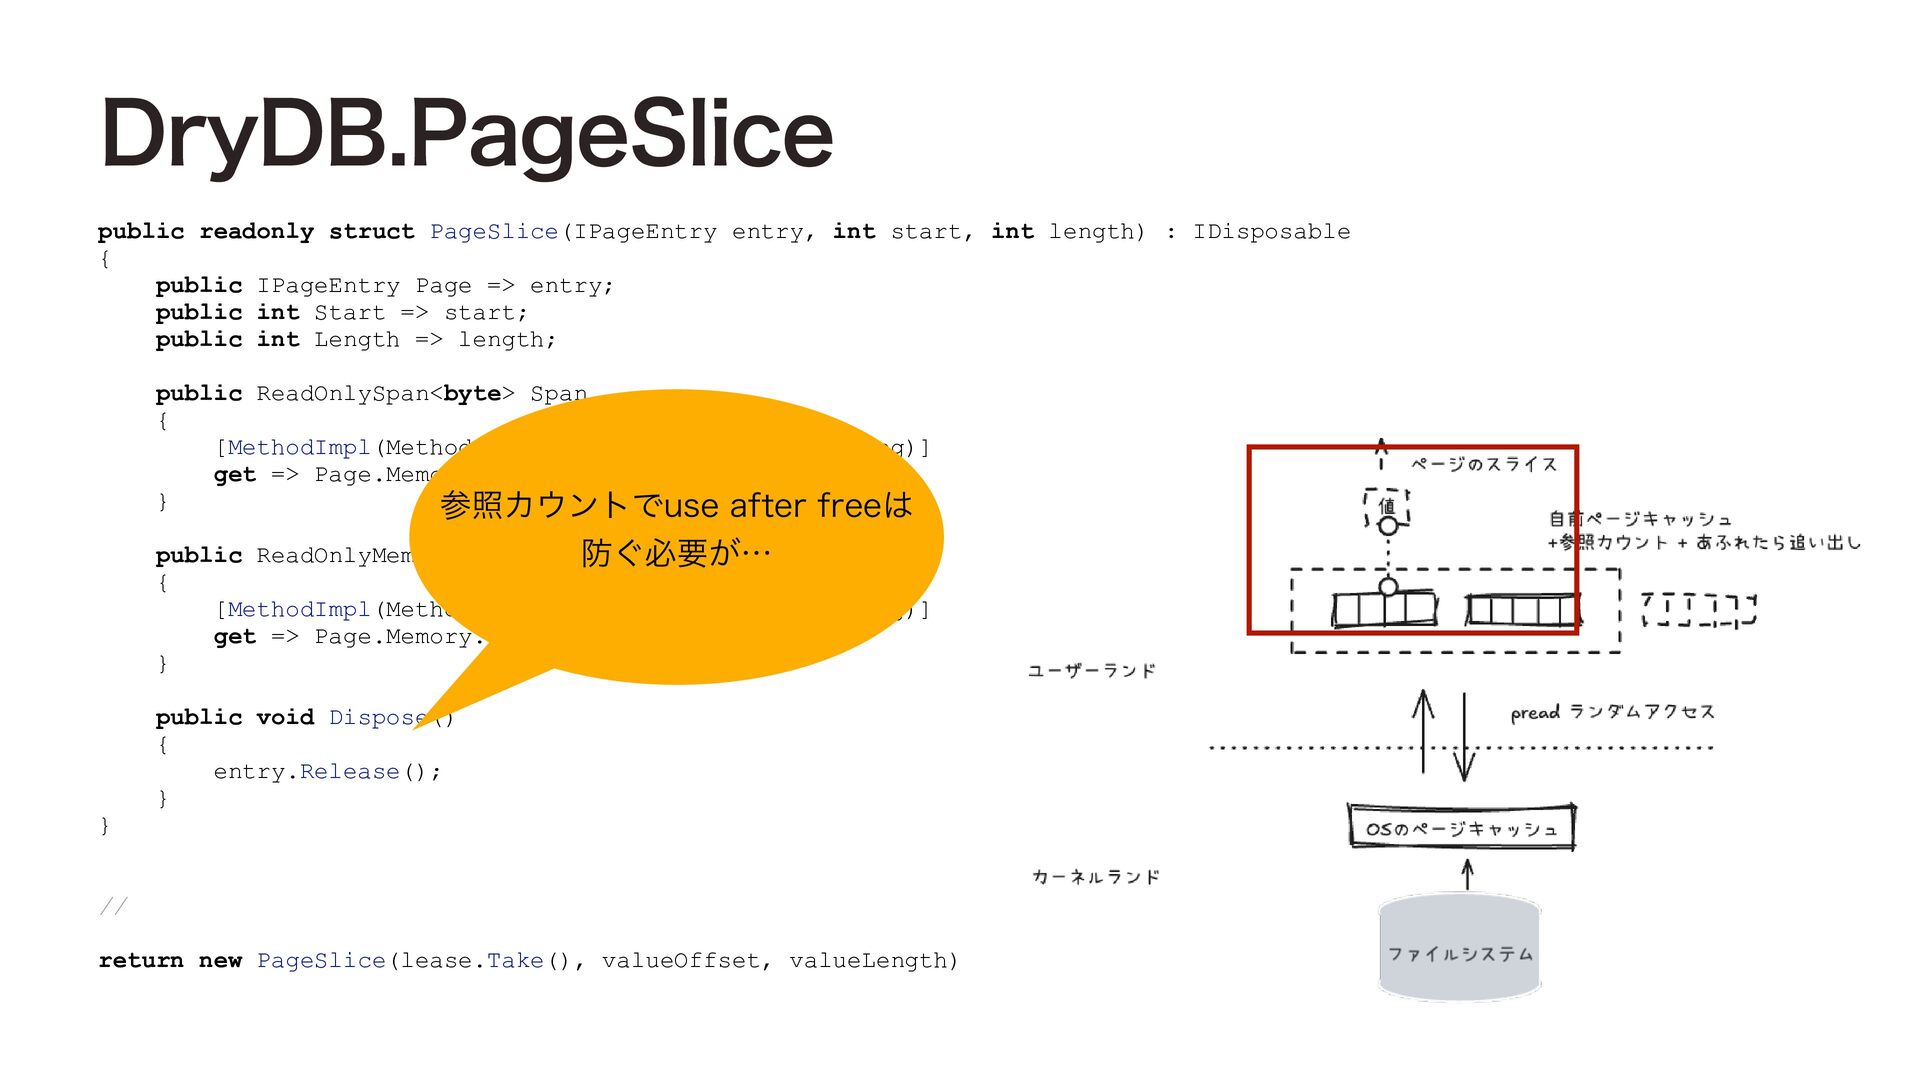
  11. DryDB.PageSlice public readonly struct PageSlice(IPageEntry entry, int start, int length)

    : IDisposable { public IPageEntry Page => entry; public int Start => start; public int Length => length; public ReadOnlySpan<byte> Span { [MethodImpl(MethodImplOptions.AggressiveInlining)] get => Page.Memory.Span.Slice(start, length); } public ReadOnlyMemory<byte> Memory { [MethodImpl(MethodImplOptions.AggressiveInlining)] get => Page.Memory.Slice(start, length); } } public void Dispose() { entry.Release(); } // return new PageSlice(lease.Take(), valueOffset, valueLength)
  12. DryDB.PageSlice public readonly struct PageSlice(IPageEntry entry, int start, int length)

    : IDisposable { public IPageEntry Page => entry; public int Start => start; public int Length => length; public ReadOnlySpan<byte> Span { [MethodImpl(MethodImplOptions.AggressiveInlining)] get => Page.Memory.Span.Slice(start, length); } 参照カウントでuse after freeは public ReadOnlyMemory<byte> Memory 防ぐ必要が… { [MethodImpl(MethodImplOptions.AggressiveInlining)] get => Page.Memory.Slice(start, length); } } public void Dispose() { entry.Release(); } // return new PageSlice(lease.Take(), valueOffset, valueLength)
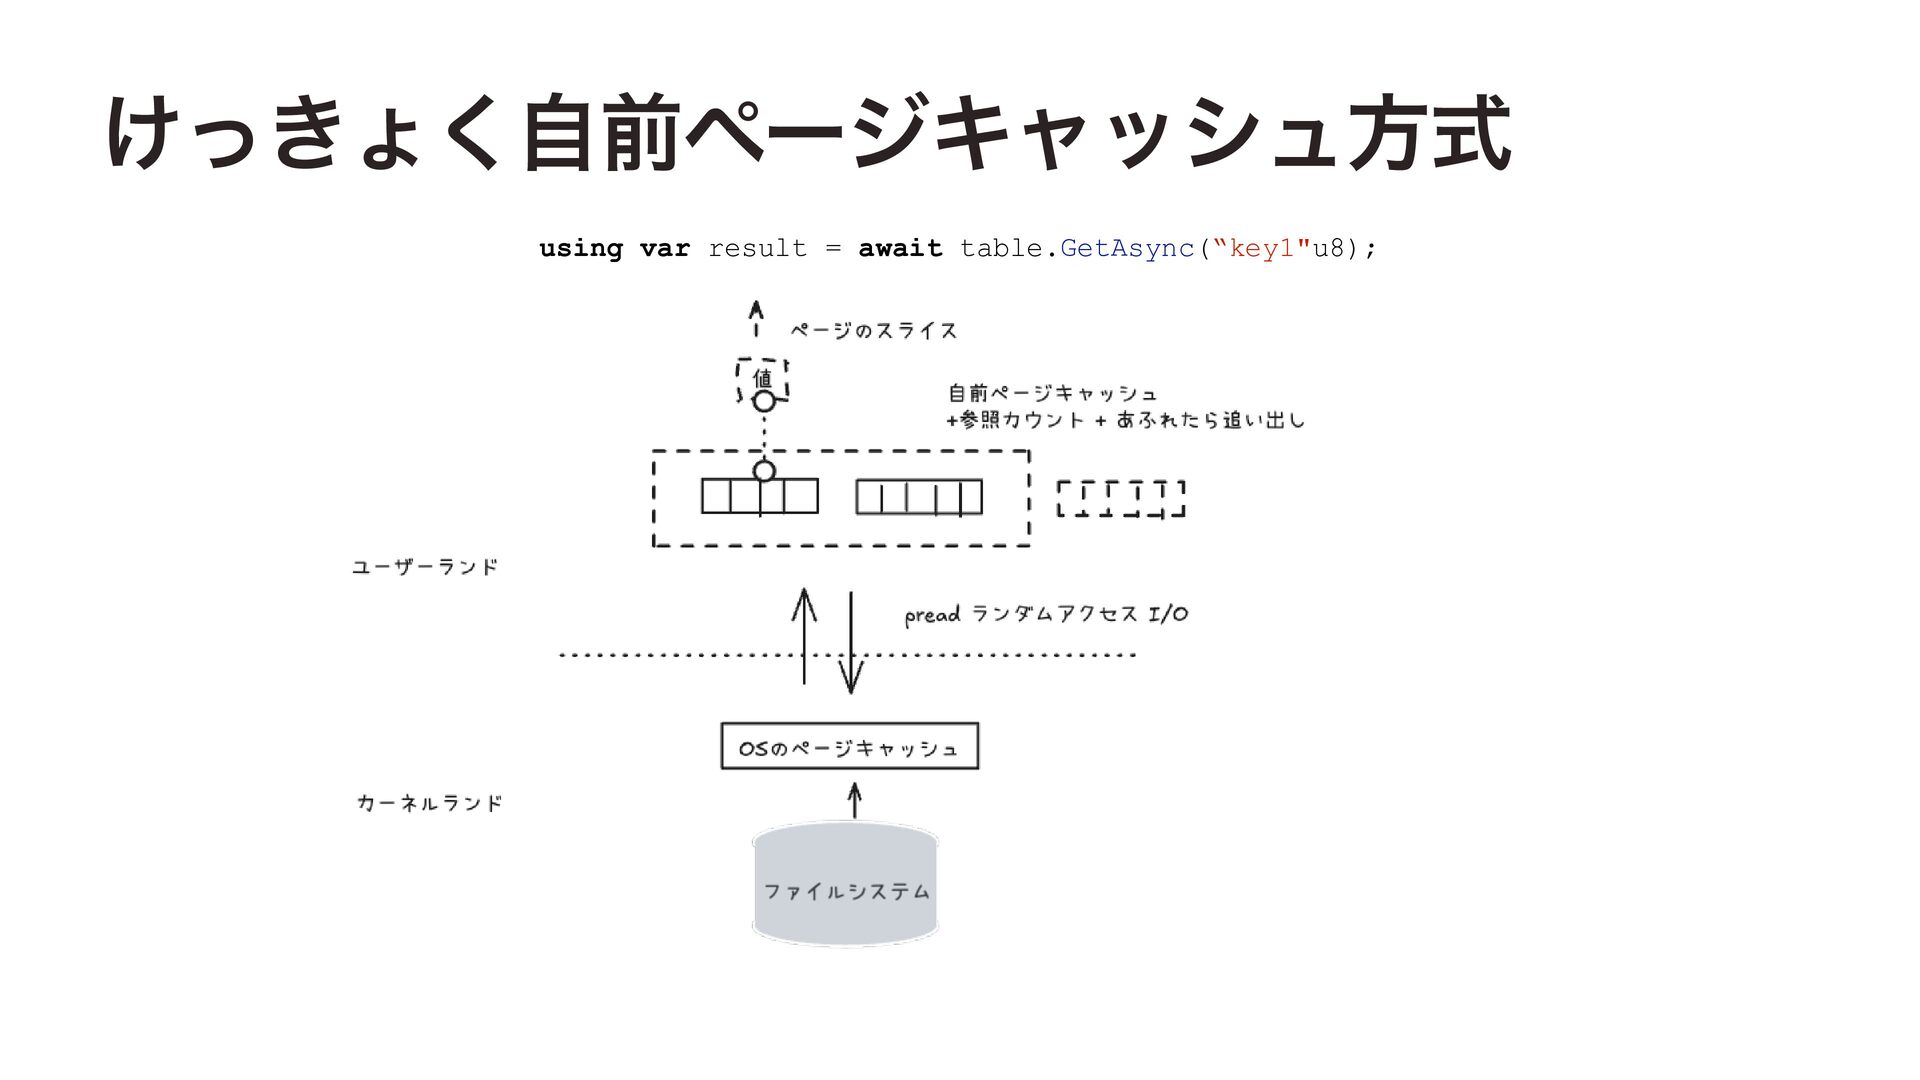
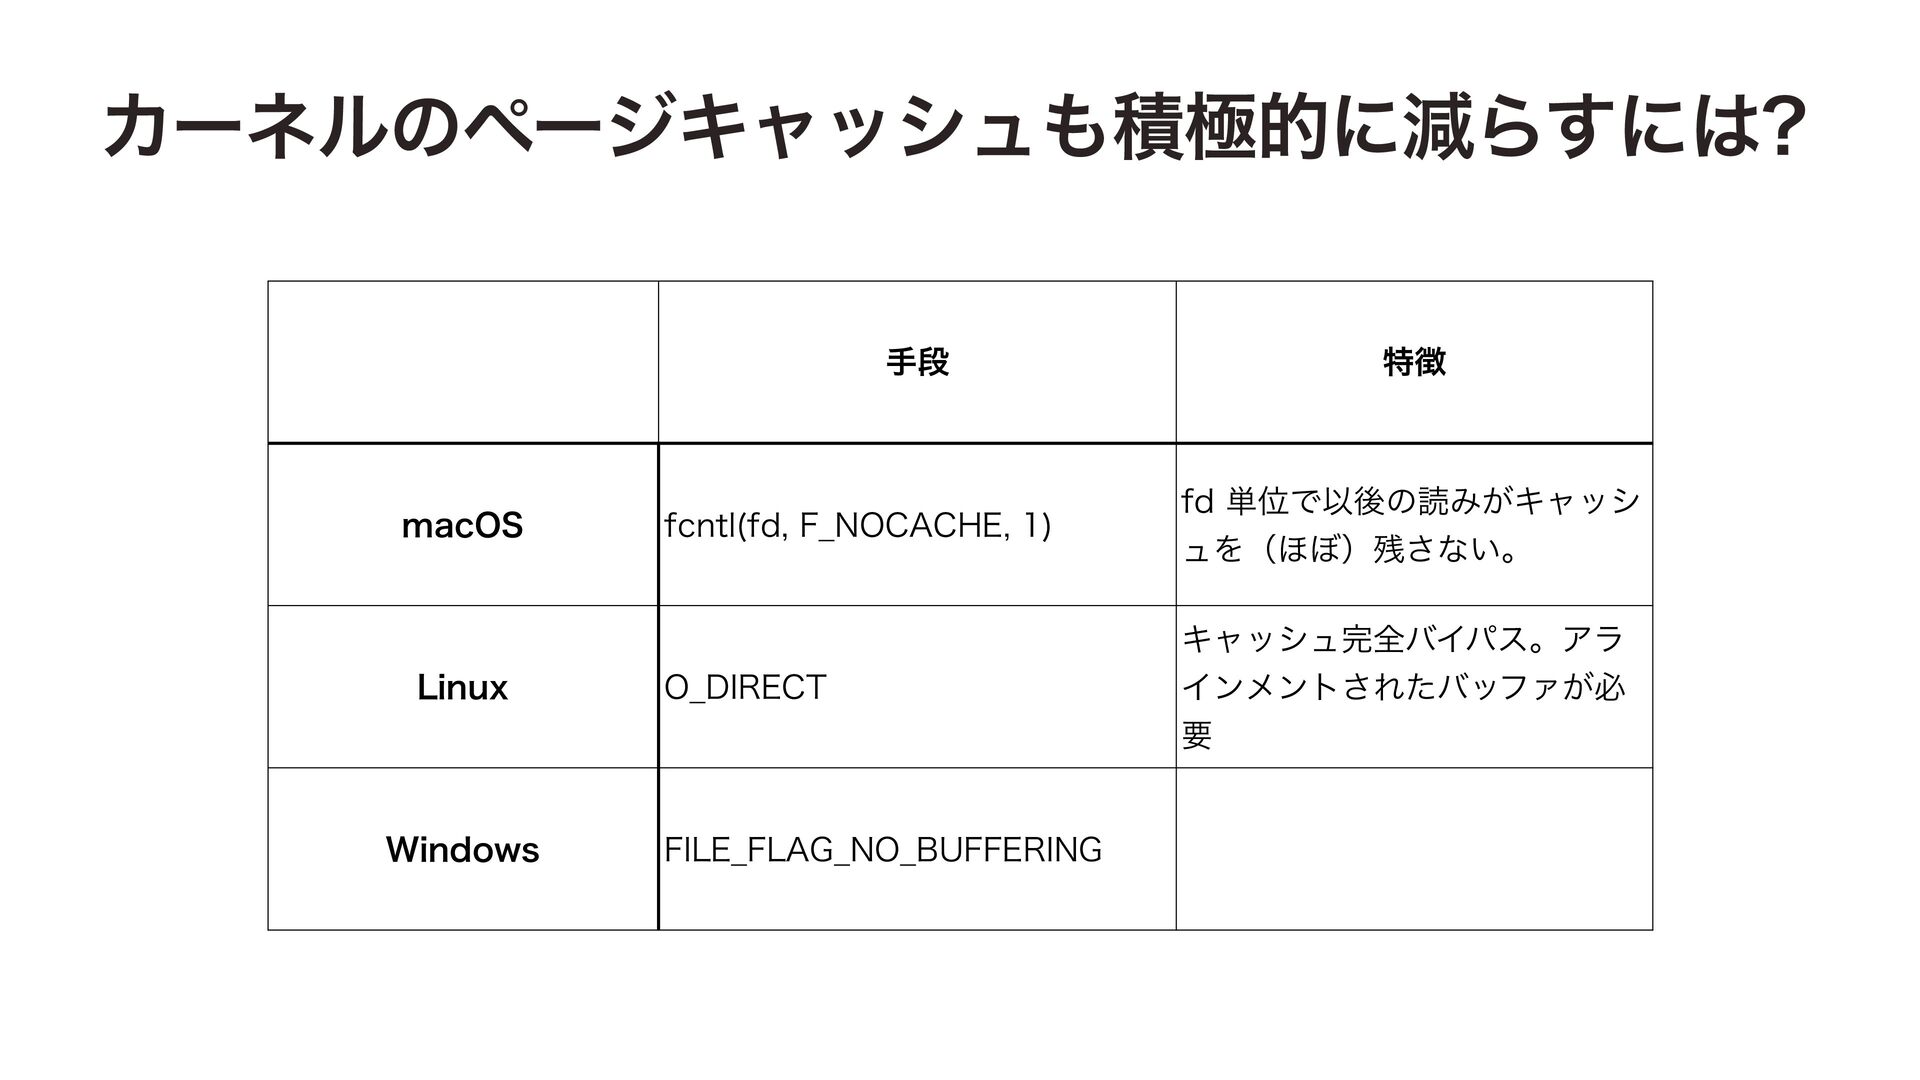
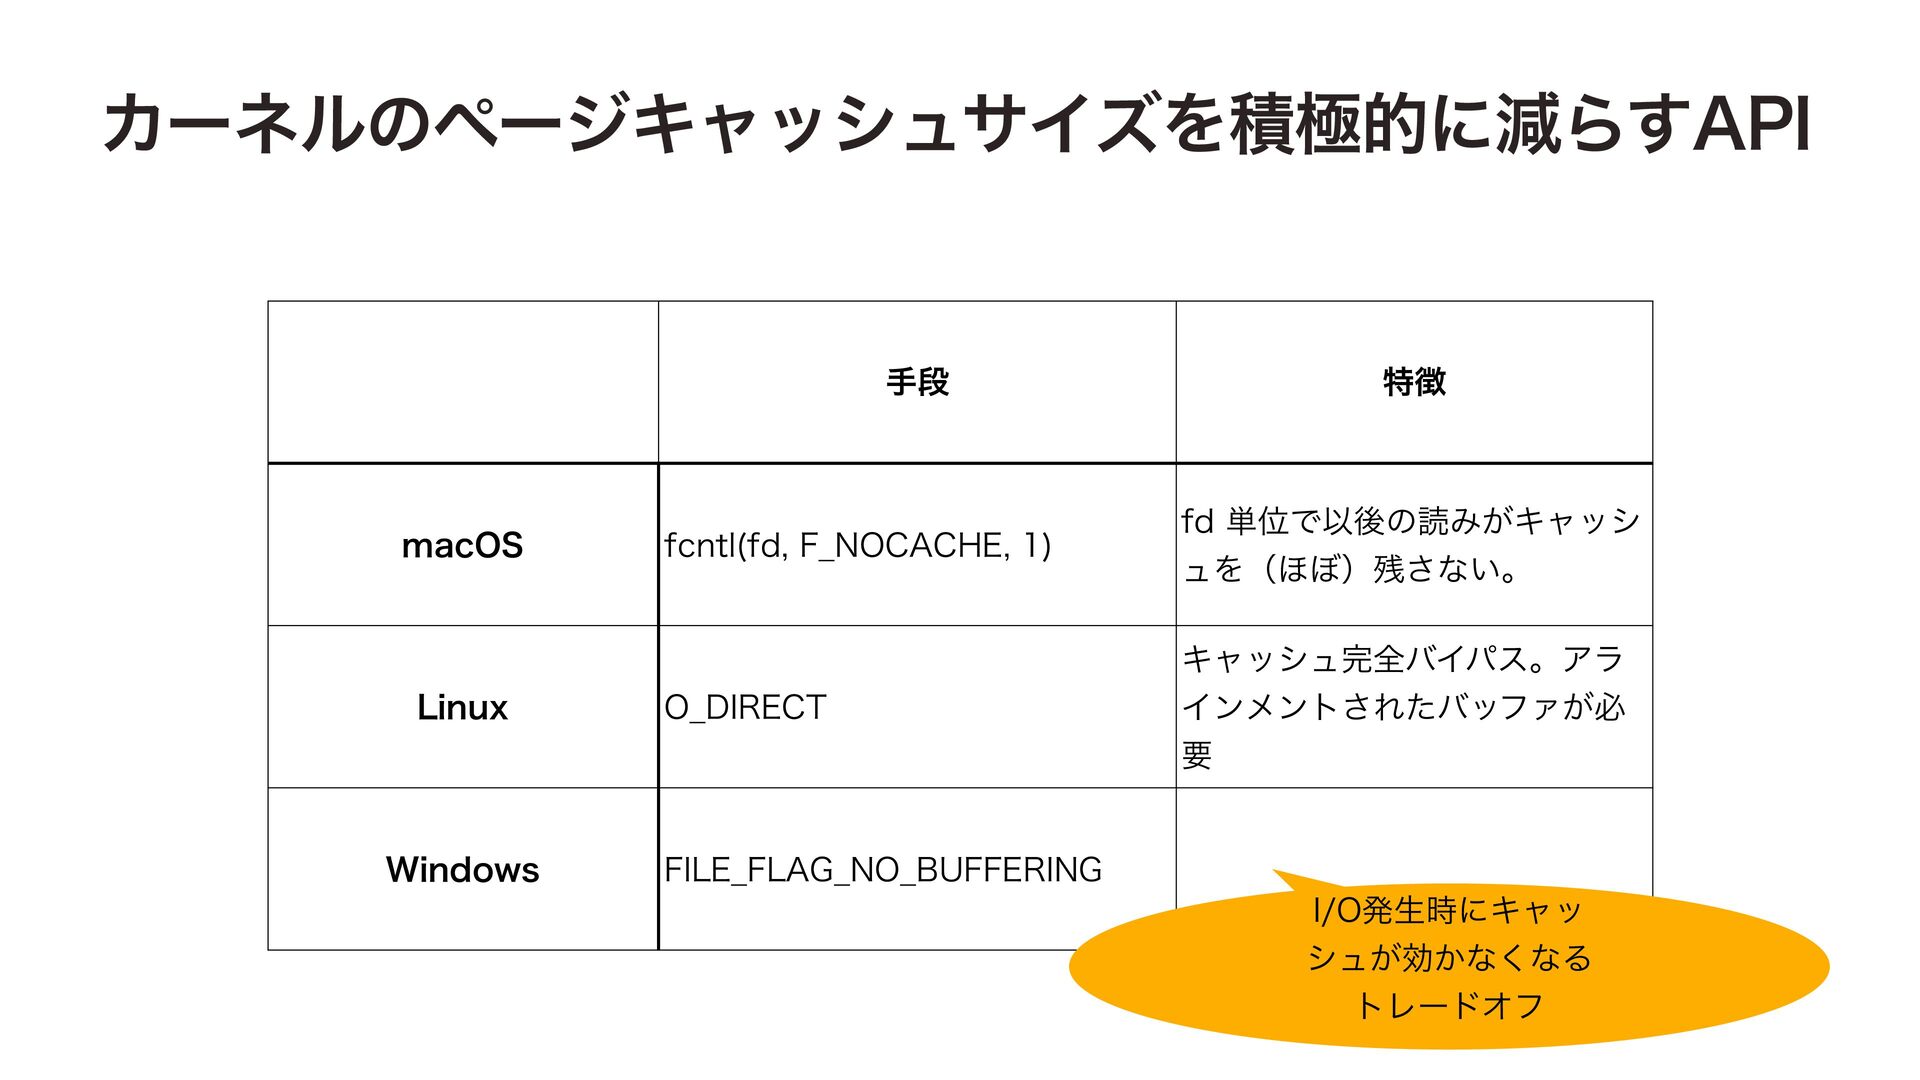
  13. カーネルのページキャッシュも積極的に減らすには? 手段 macOS Linux Windows 特徴 fcntl(fd, F̲NOCACHE, 1) fd

    単位で以後の読みがキャッシ ュを(ほぼ)残さない。 O̲DIRECT キャッシュ完全バイパス。アラ インメントされたバッファが必 要 FILE̲FLAG̲NO̲BUFFERING
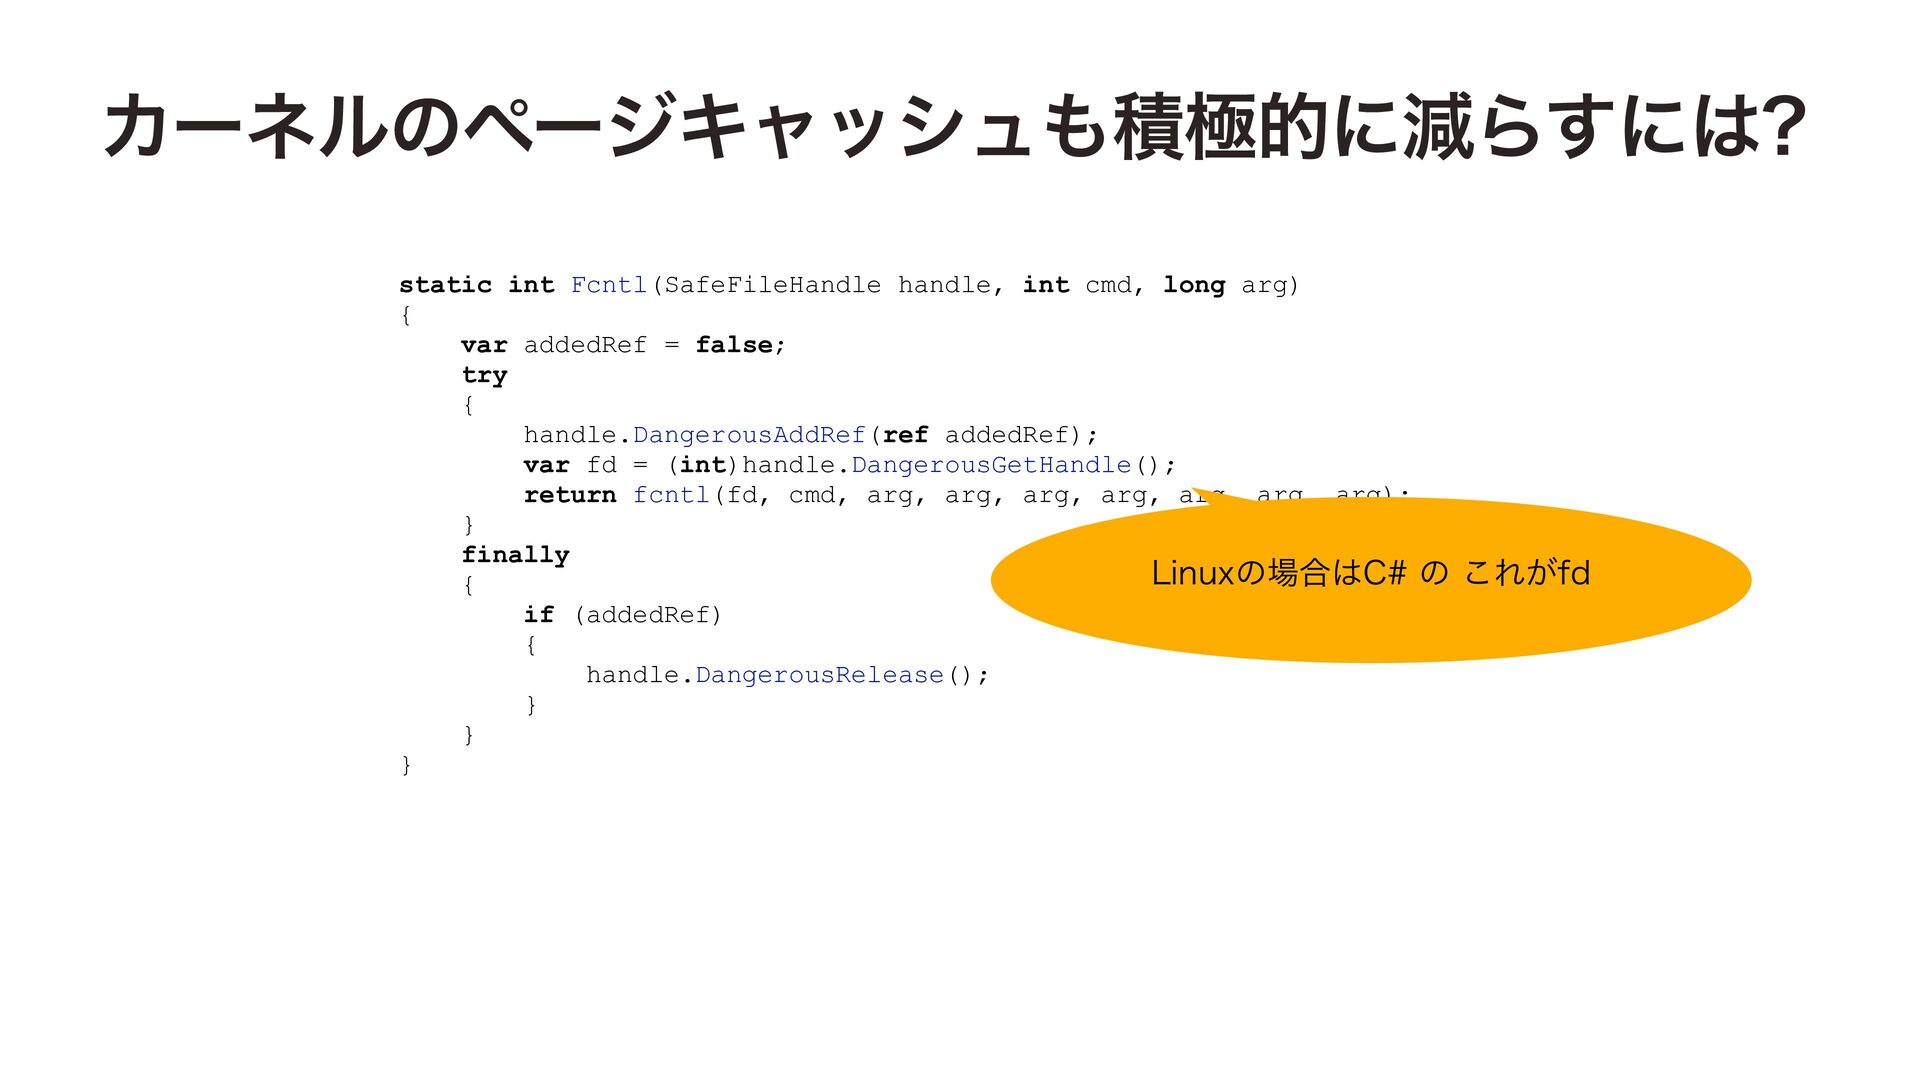
  14. カーネルのページキャッシュも積極的に減らすには? static int Fcntl(SafeFileHandle handle, int cmd, long arg) {

    var addedRef = false; try { handle.DangerousAddRef(ref addedRef); var fd = (int)handle.DangerousGetHandle(); return fcntl(fd, cmd, arg, arg, arg, arg, arg, arg, arg); } finally Linuxの場合はC# の これがfd { if (addedRef) { handle.DangerousRelease(); } } }
  15. カーネルのページキャッシュサイズを積極的に減らすAPI 手段 macOS Linux Windows fcntl(fd, F̲NOCACHE, 1) O̲DIRECT 特徴

    fd 単位で以後の読みがキャッシ ュを(ほぼ)残さない。 キャッシュ完全バイパス。アラ インメントされたバッファが必 要 FILE̲FLAG̲NO̲BUFFERING I/O発生時にキャッ シュが効かなくなる トレードオフ
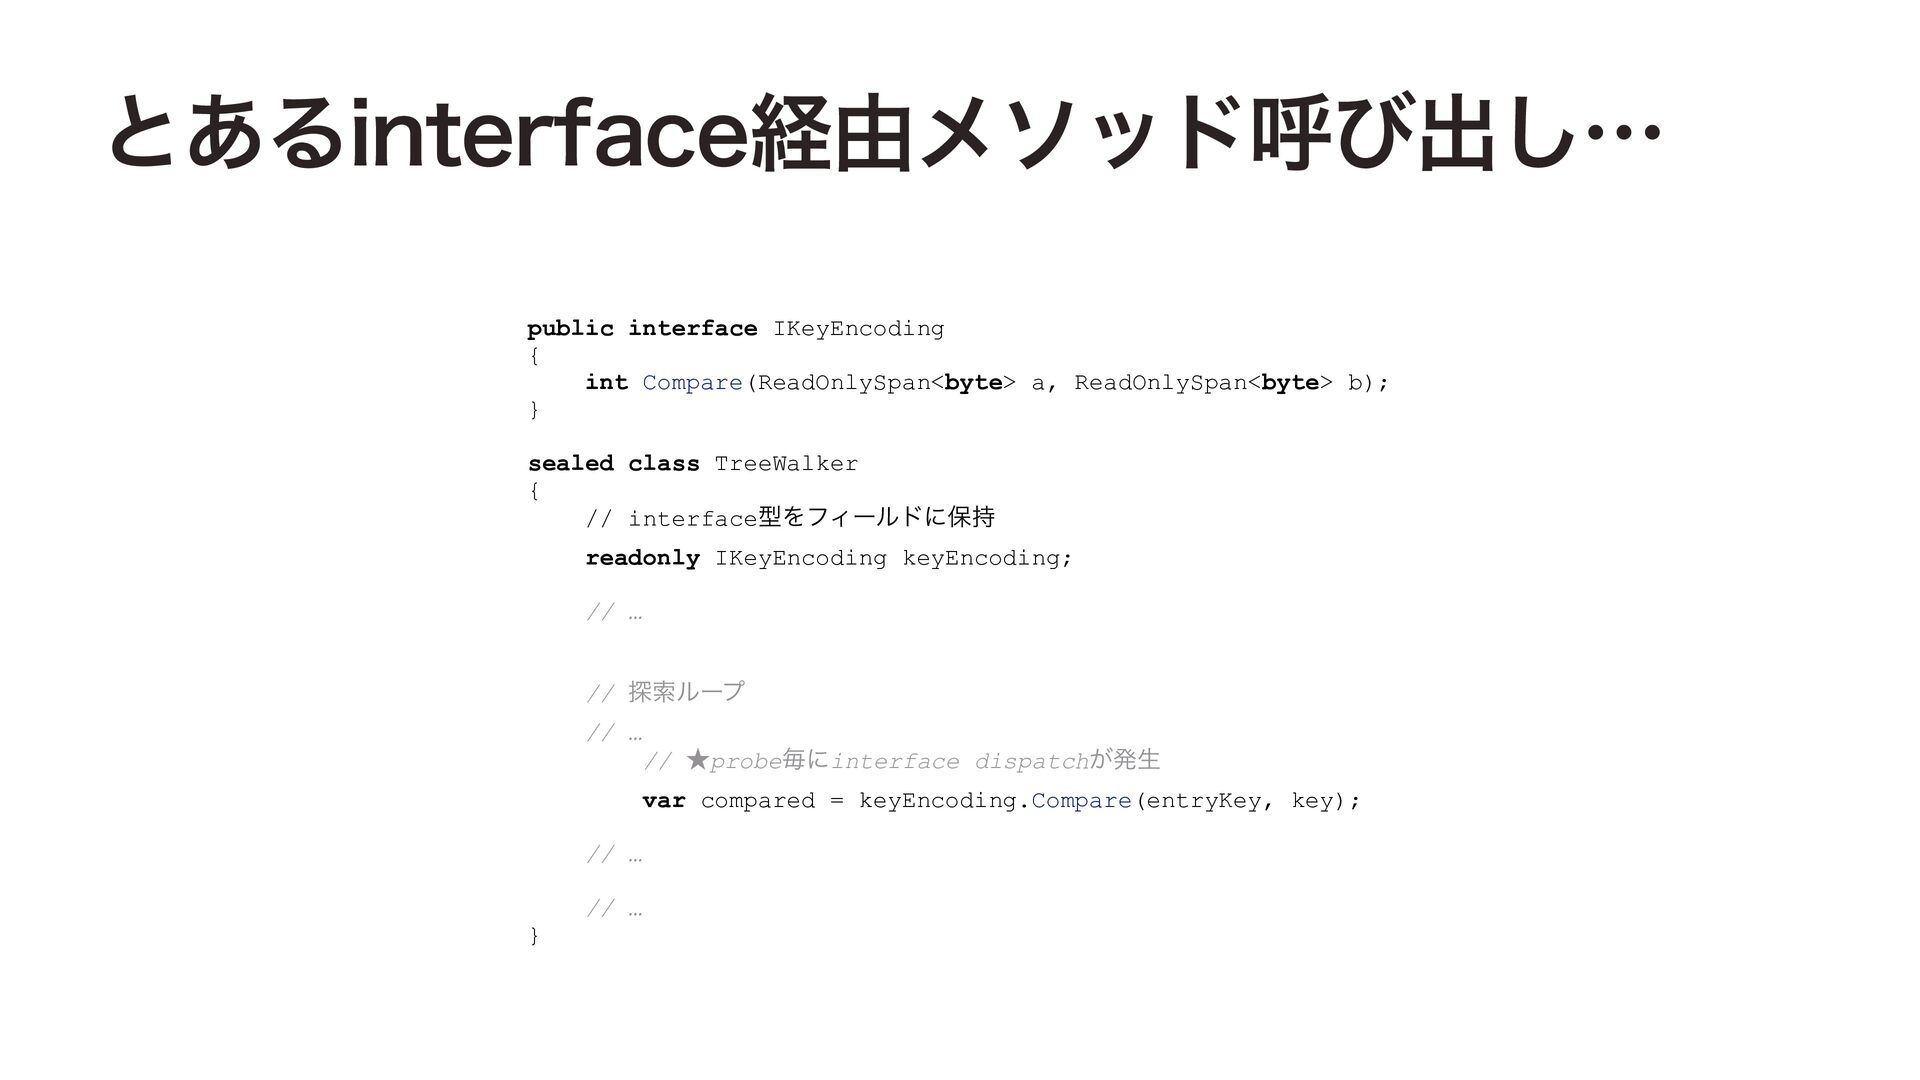
  16. とあるinterface経由メソッド呼び出し… public interface IKeyEncoding { int Compare(ReadOnlySpan<byte> a, ReadOnlySpan<byte> b);

    } sealed class TreeWalker { // interface型をフィールドに保持 readonly IKeyEncoding keyEncoding; // … // 探索ループ // … // ★probe毎にinterface dispatchが発生 var compared = keyEncoding.Compare(entryKey, key); // … } // …
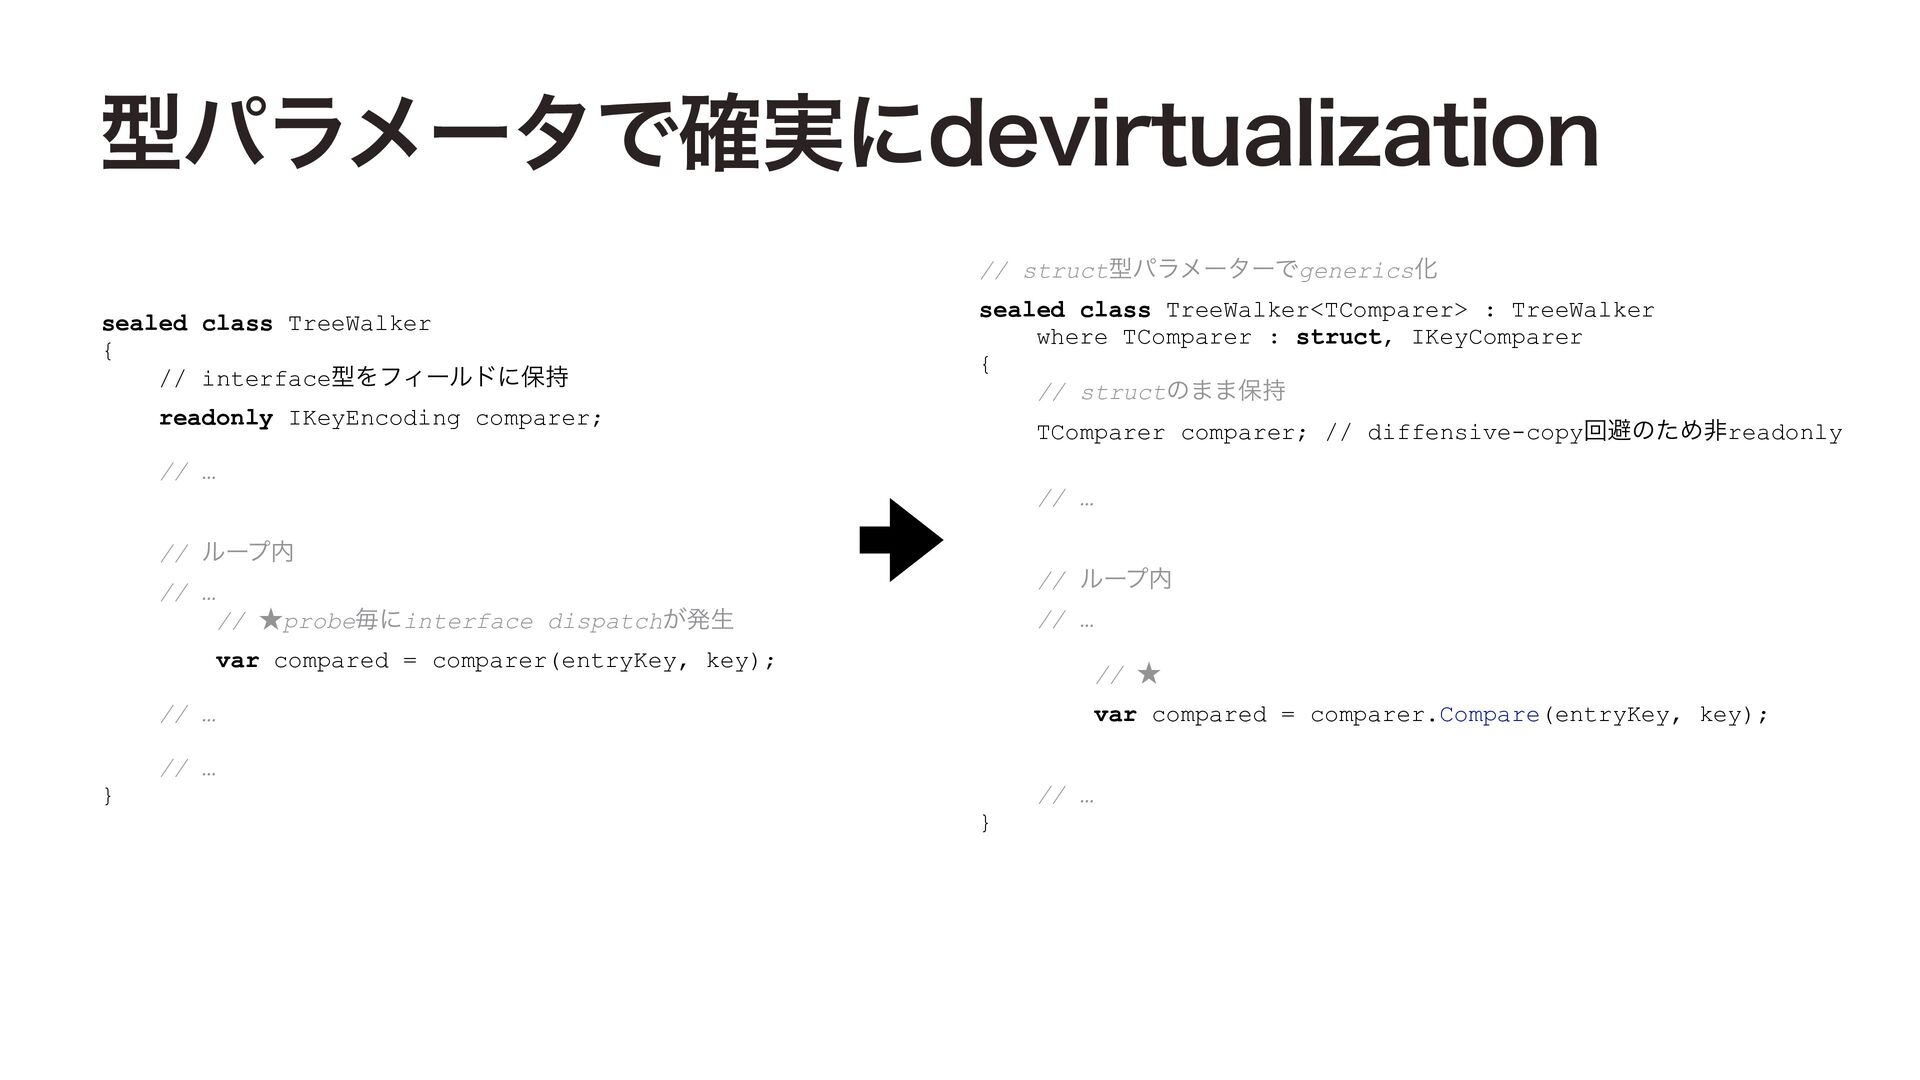
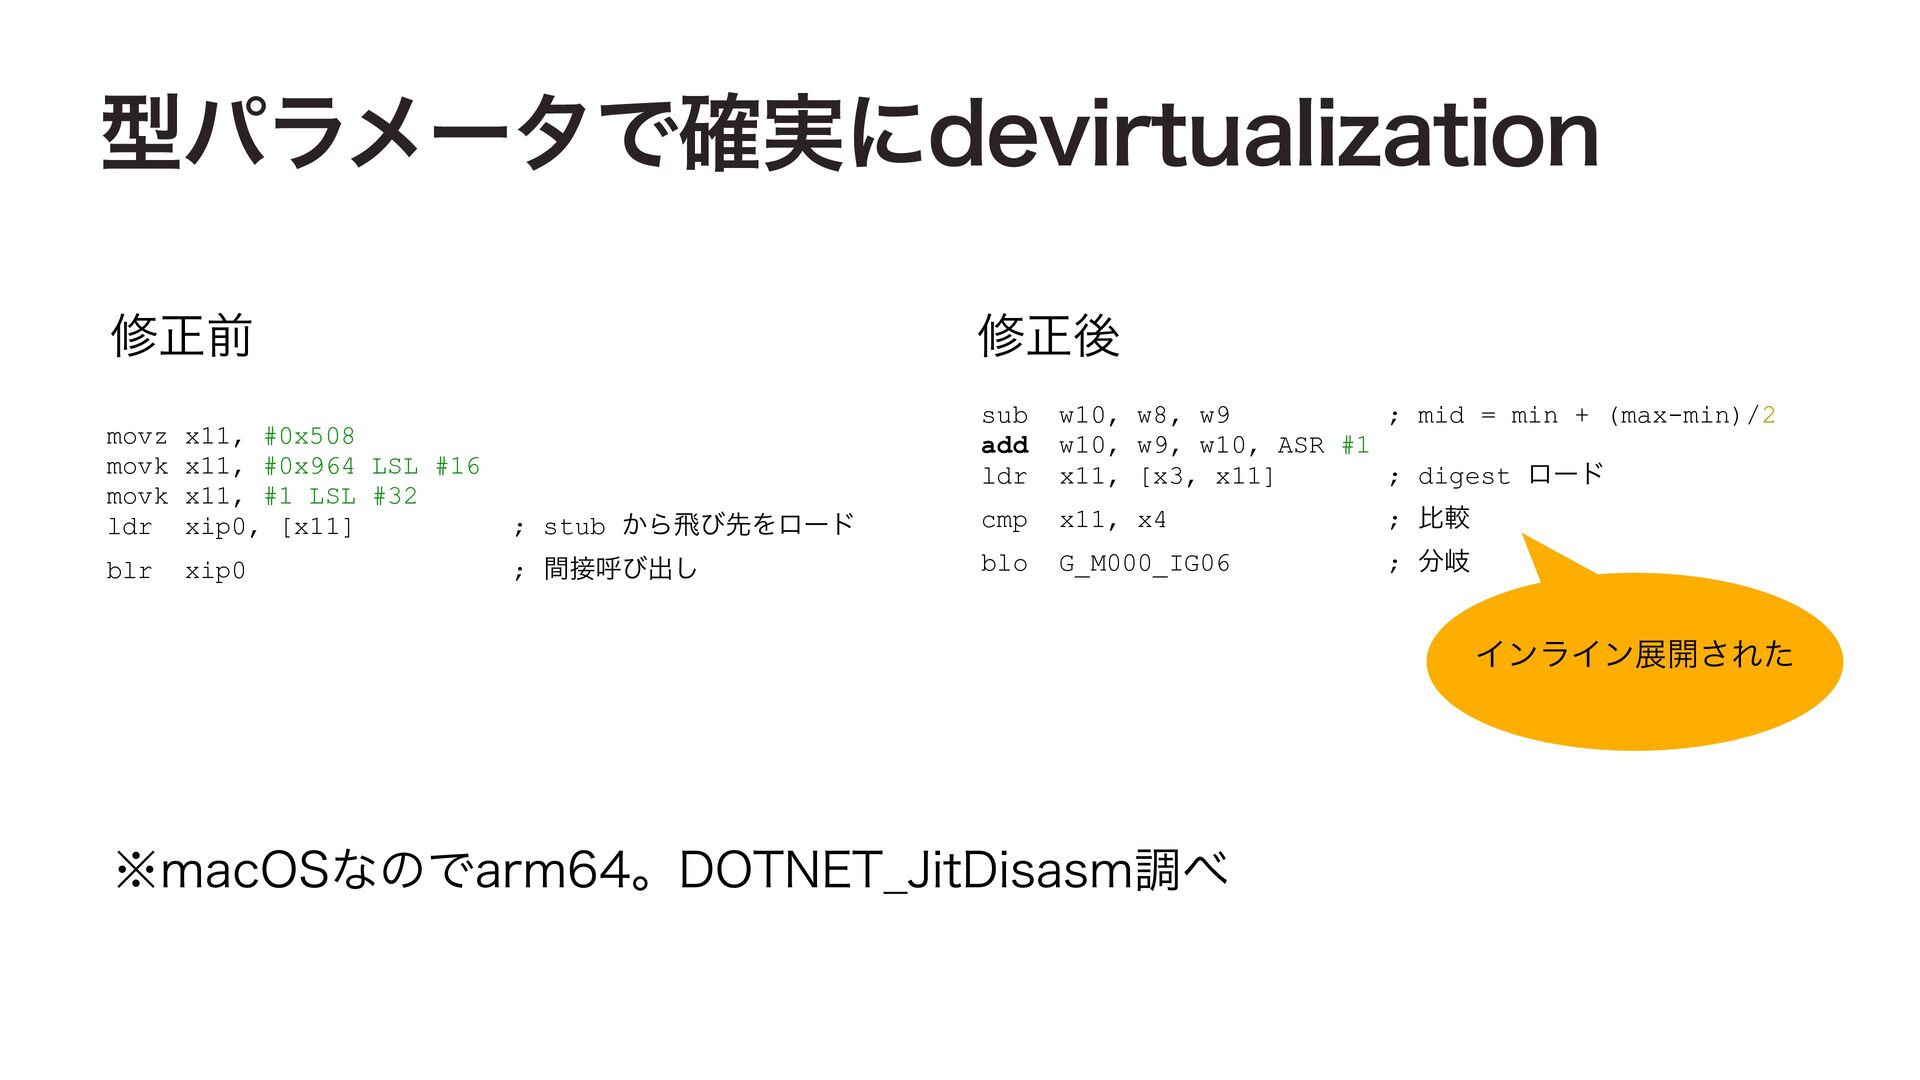
  17. 型パラメータで確実にdevirtualization // struct型パラメーターでgenerics化 sealed class TreeWalker { // interface型をフィールドに保持 readonly

    IKeyEncoding comparer; sealed class TreeWalker<TComparer> : TreeWalker where TComparer : struct, IKeyComparer { // structのまま保持 TComparer comparer; // diffensive-copy回避のため非readonly // … // … // ループ内 // ループ内 // … // … // ★probe毎にinterface dispatchが発生 var compared = comparer(entryKey, key); // ★ var compared = comparer.Compare(entryKey, key); // … } // … } // …
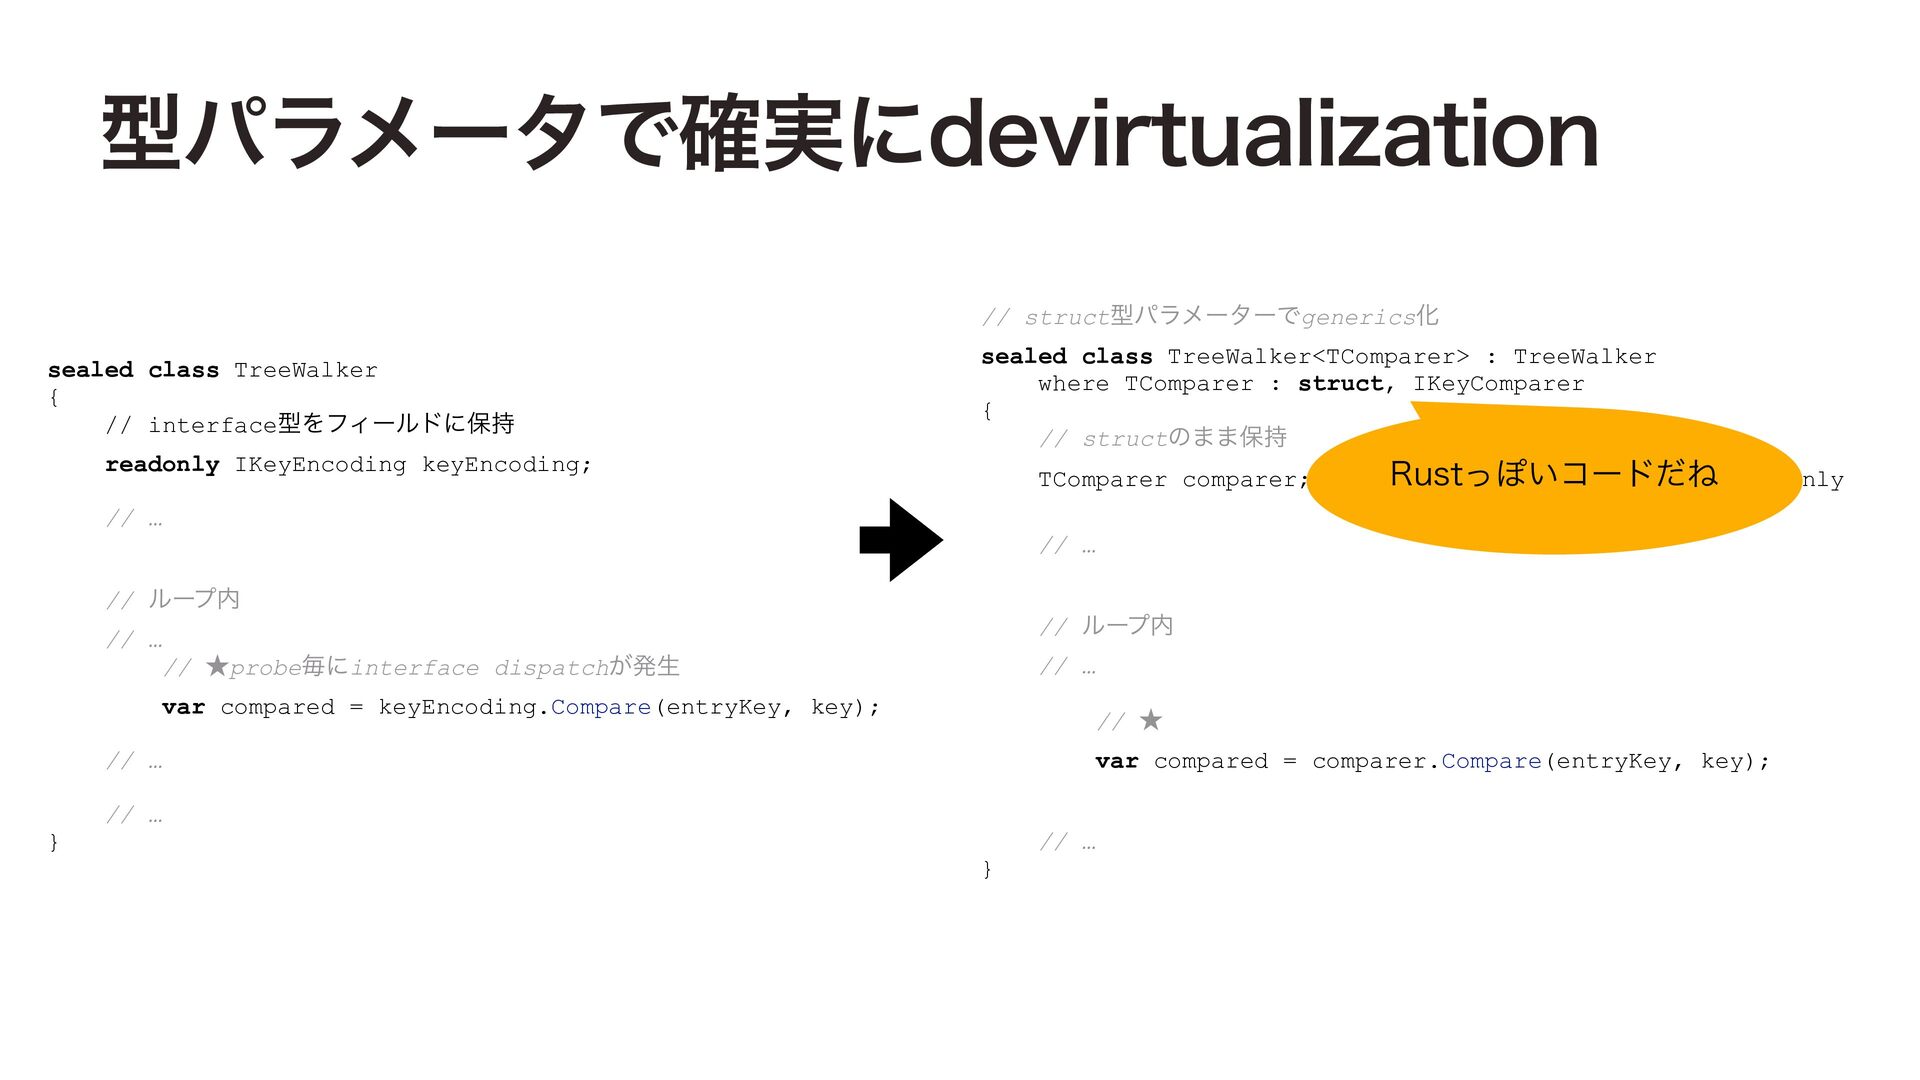
  18. 型パラメータで確実にdevirtualization // struct型パラメーターでgenerics化 sealed class TreeWalker { // interface型をフィールドに保持 readonly

    IKeyEncoding keyEncoding; sealed class TreeWalker<TComparer> : TreeWalker where TComparer : struct, IKeyComparer { // structのまま保持 Rustっぽいコードだね TComparer comparer; // diffensive-copy回避のため非readonly // … // … // ループ内 // ループ内 // … // … // ★probe毎にinterface dispatchが発生 var compared = keyEncoding.Compare(entryKey, key); // ★ var compared = comparer.Compare(entryKey, key); // … } // … } // …
  19. 型パラメータで確実にdevirtualization 修正前 修正後 sub add ldr w10, w8, w9 ;

    mid = min + (max-min)/2 w10, w9, w10, ASR #1 x11, [x3, x11] ; digest ロード movz x11, #0x508 movk x11, #0x964 LSL #16 movk x11, #1 LSL #32 ldr xip0, [x11] ; stub から飛び先をロード cmp x11, x4 ; 比較 blr ; 間接呼び出し blo G_M000_IG06 ; 分岐 xip0 インライン展開された ※macOSなのでarm64。DOTNET̲JitDisasm調べ
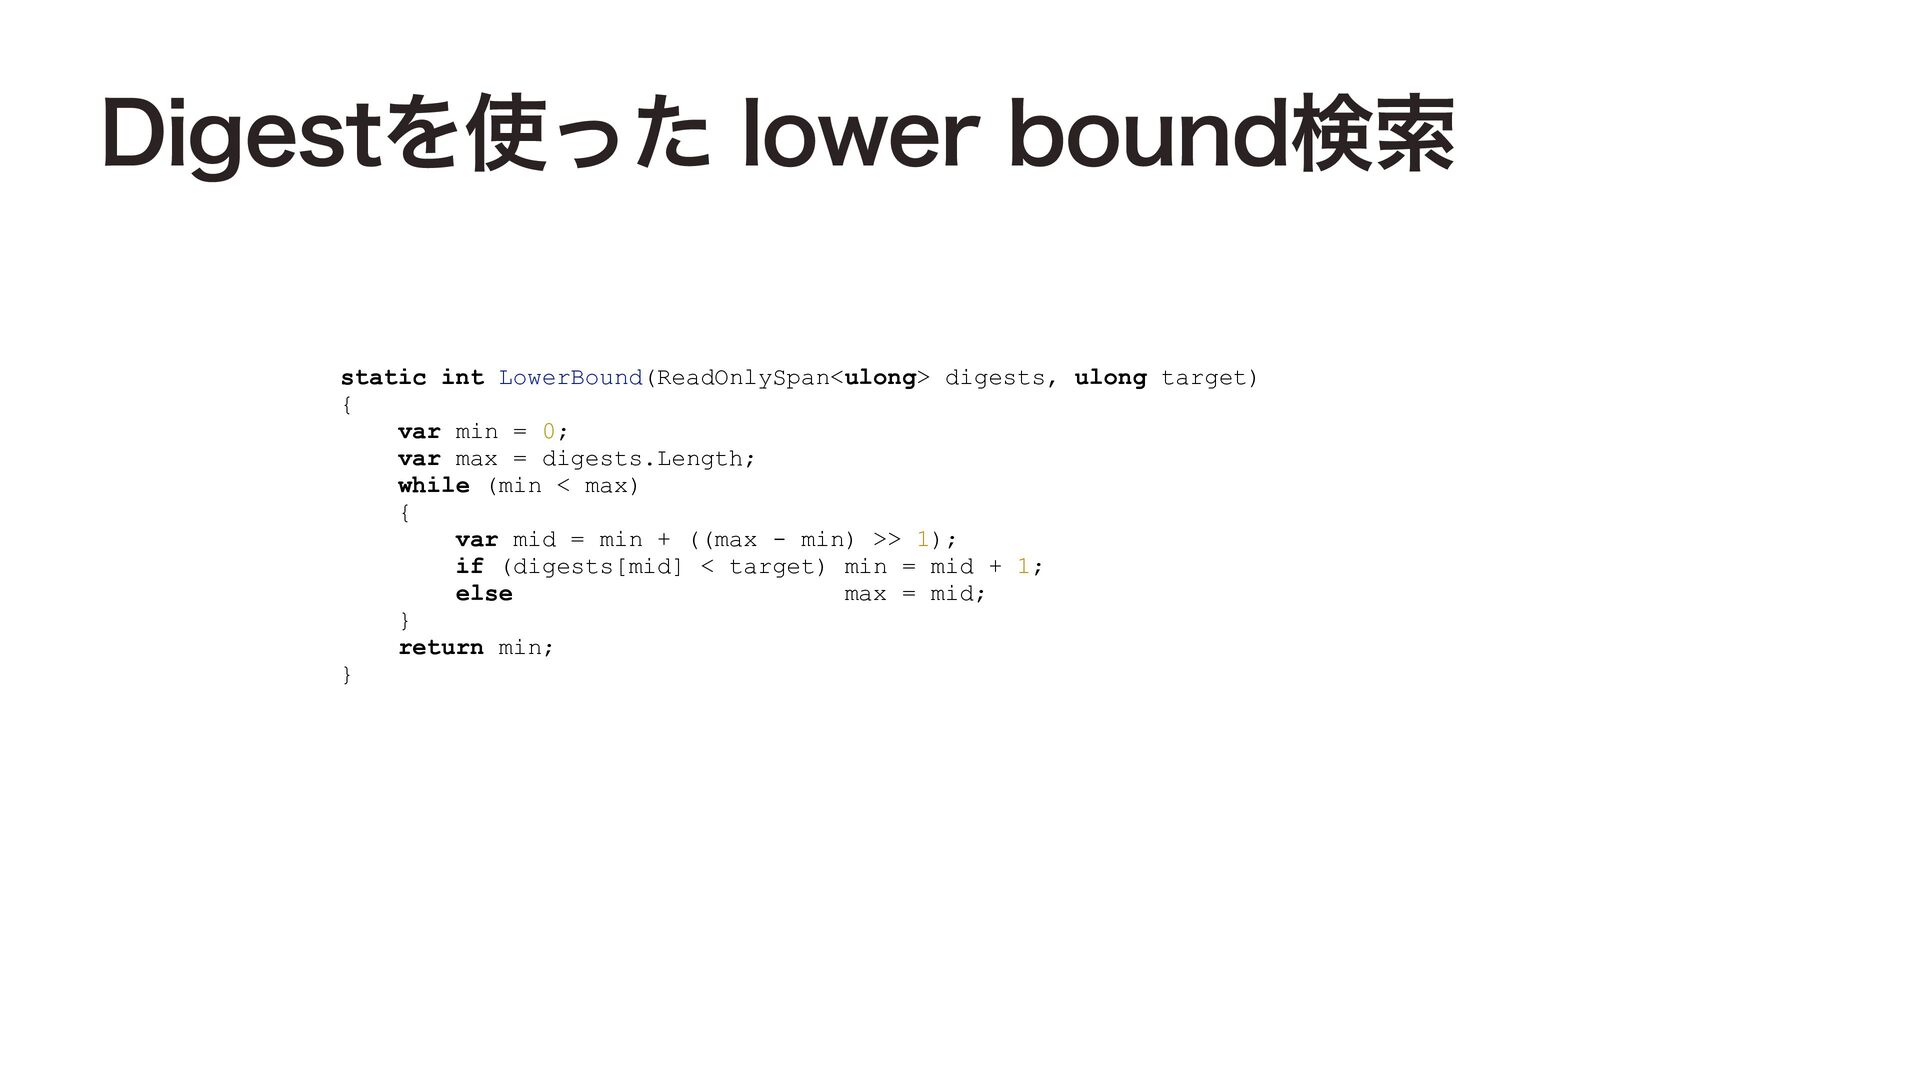
  20. Digestを使った lower bound検索 static int LowerBound(ReadOnlySpan<ulong> digests, ulong target) {

    var min = 0; var max = digests.Length; while (min < max) { var mid = min + ((max - min) >> 1); if (digests[mid] < target) min = mid + 1; else max = mid; } return min; }
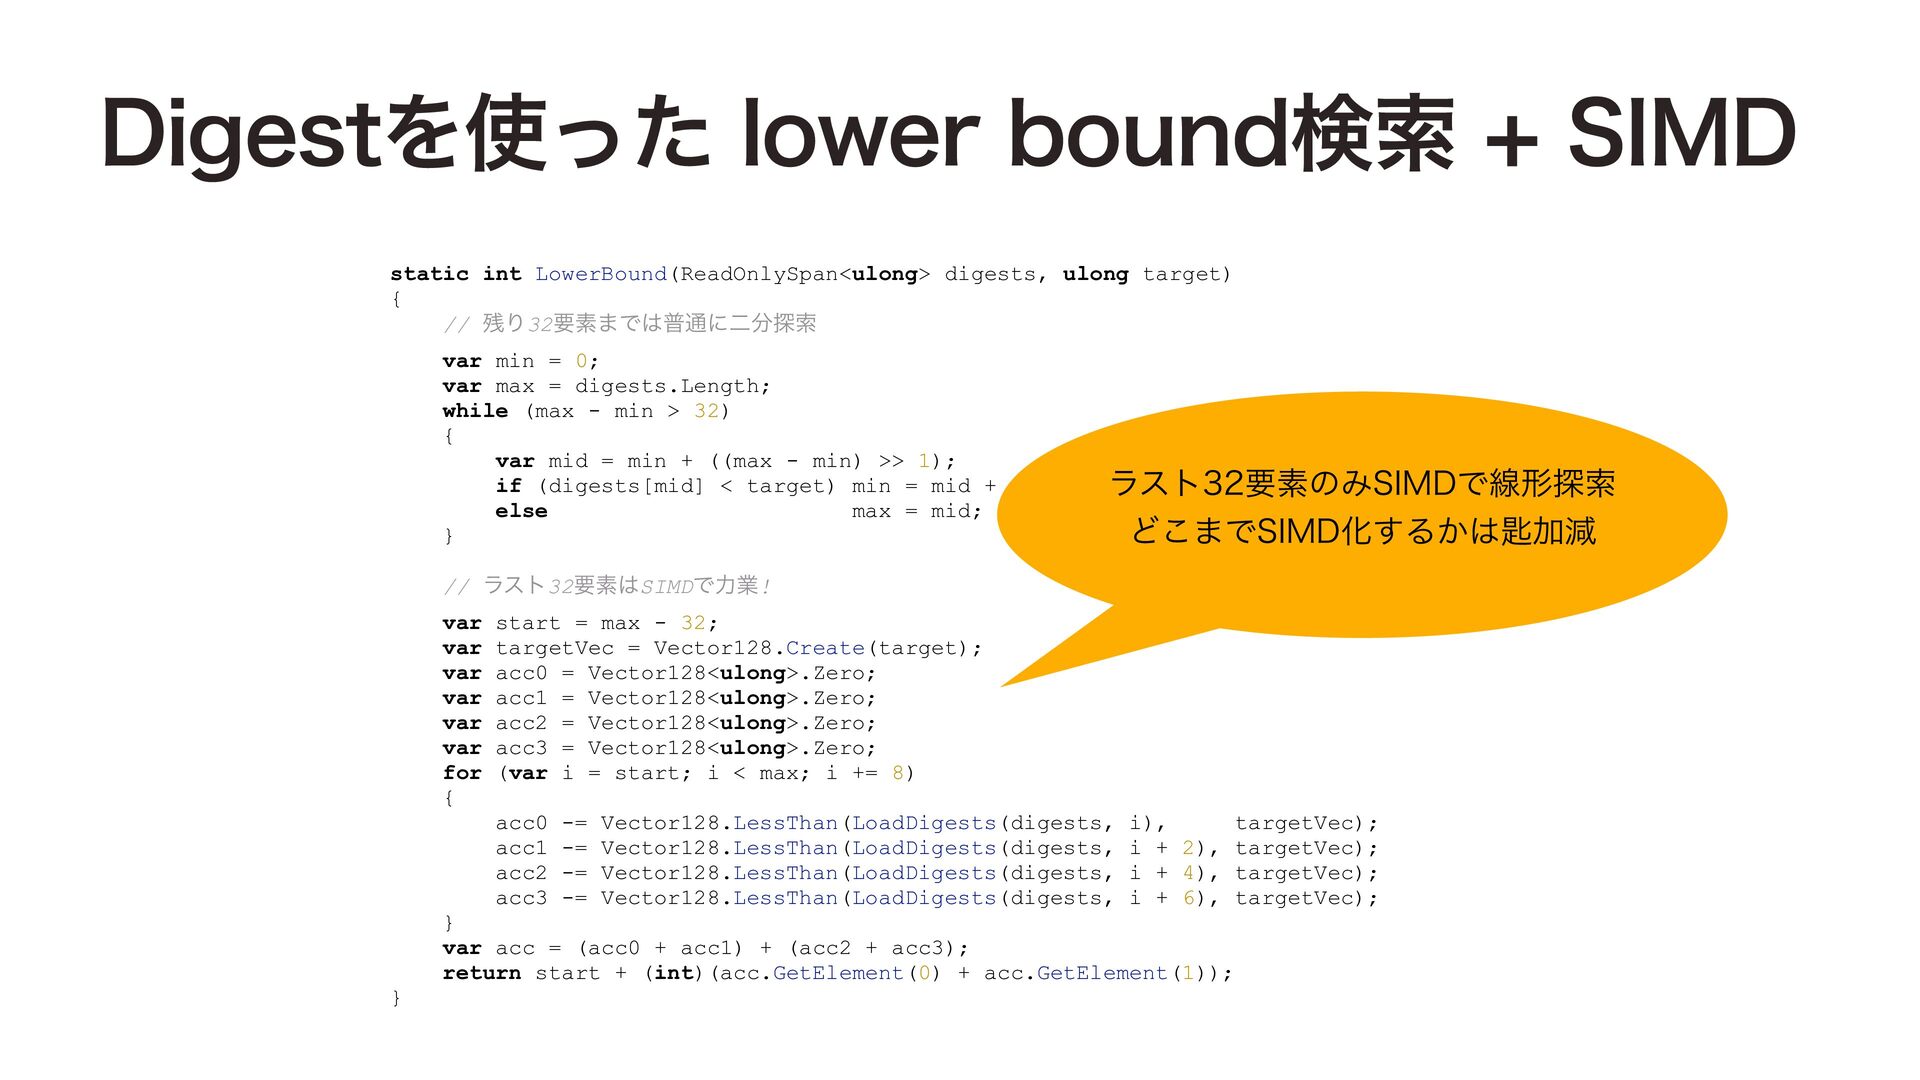
  21. Digestを使った lower bound検索 + SIMD static int LowerBound(ReadOnlySpan<ulong> digests, ulong

    target) { // 残り32要素までは普通に二分探索 var min = 0; var max = digests.Length; while (max - min > 32) { var mid = min + ((max - min) >> 1); if (digests[mid] < target) min = mid + 1; else max = mid; } ラスト32要素のみSIMDで線形探索 どこまでSIMD化するかは匙加減 // ラスト32要素はSIMDで力業! var start = max - 32; var targetVec = Vector128.Create(target); var acc0 = Vector128<ulong>.Zero; var acc1 = Vector128<ulong>.Zero; var acc2 = Vector128<ulong>.Zero; var acc3 = Vector128<ulong>.Zero; for (var i = start; i < max; i += 8) { acc0 -= Vector128.LessThan(LoadDigests(digests, i), targetVec); acc1 -= Vector128.LessThan(LoadDigests(digests, i + 2), targetVec); acc2 -= Vector128.LessThan(LoadDigests(digests, i + 4), targetVec); acc3 -= Vector128.LessThan(LoadDigests(digests, i + 6), targetVec); } var acc = (acc0 + acc1) + (acc2 + acc3); return start + (int)(acc.GetElement(0) + acc.GetElement(1)); }
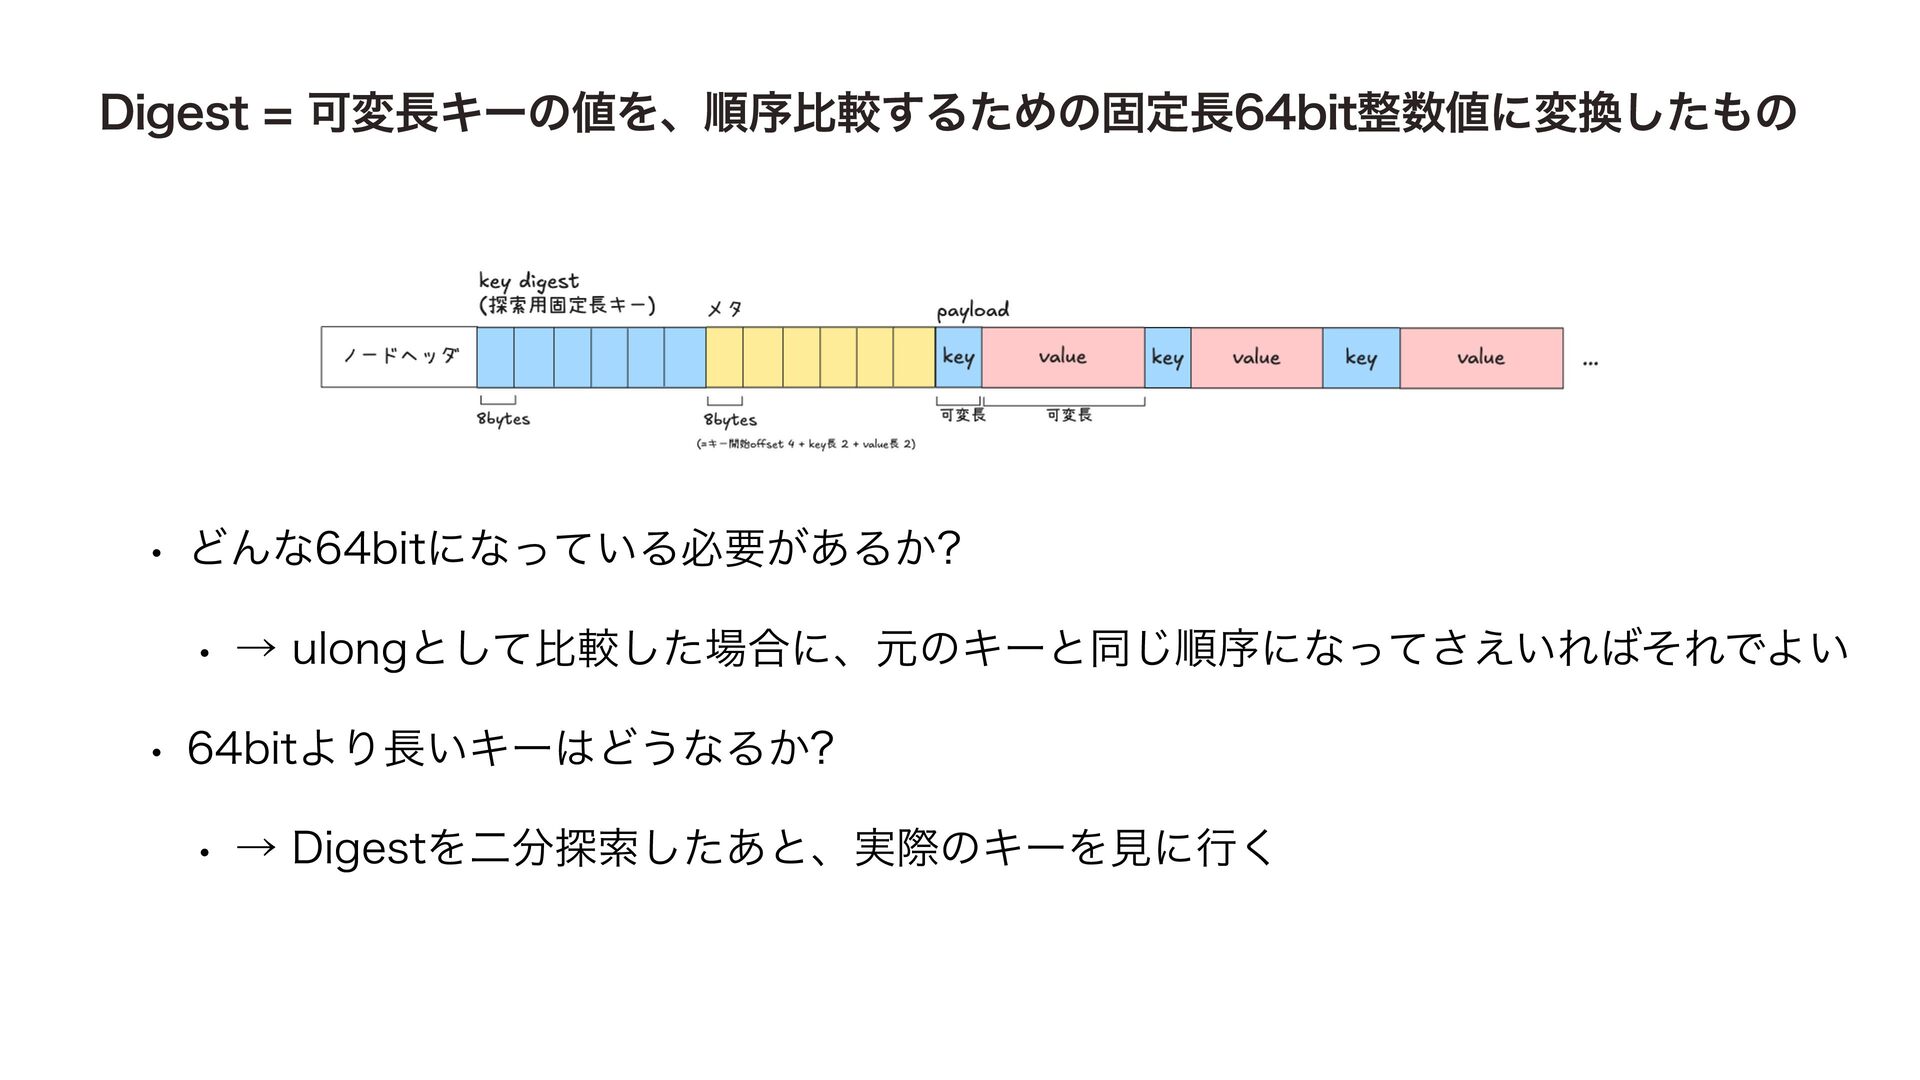
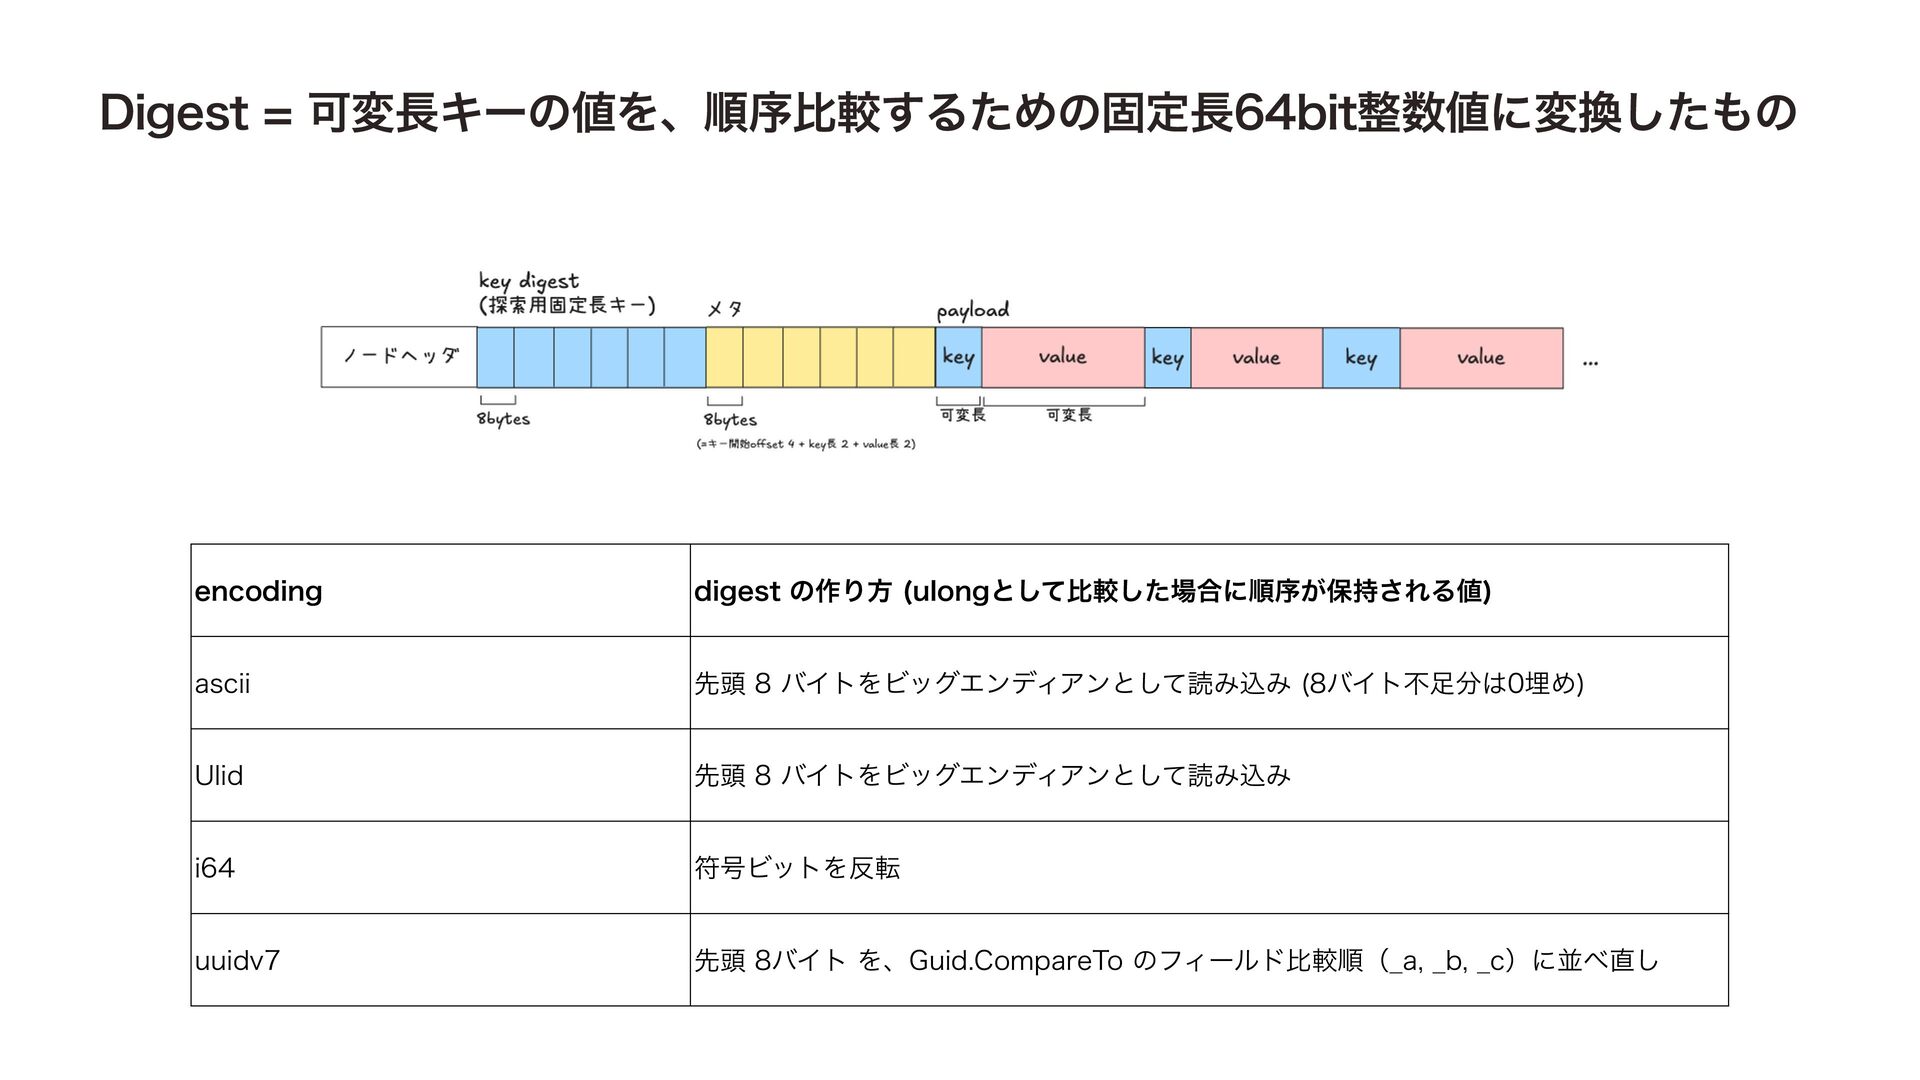
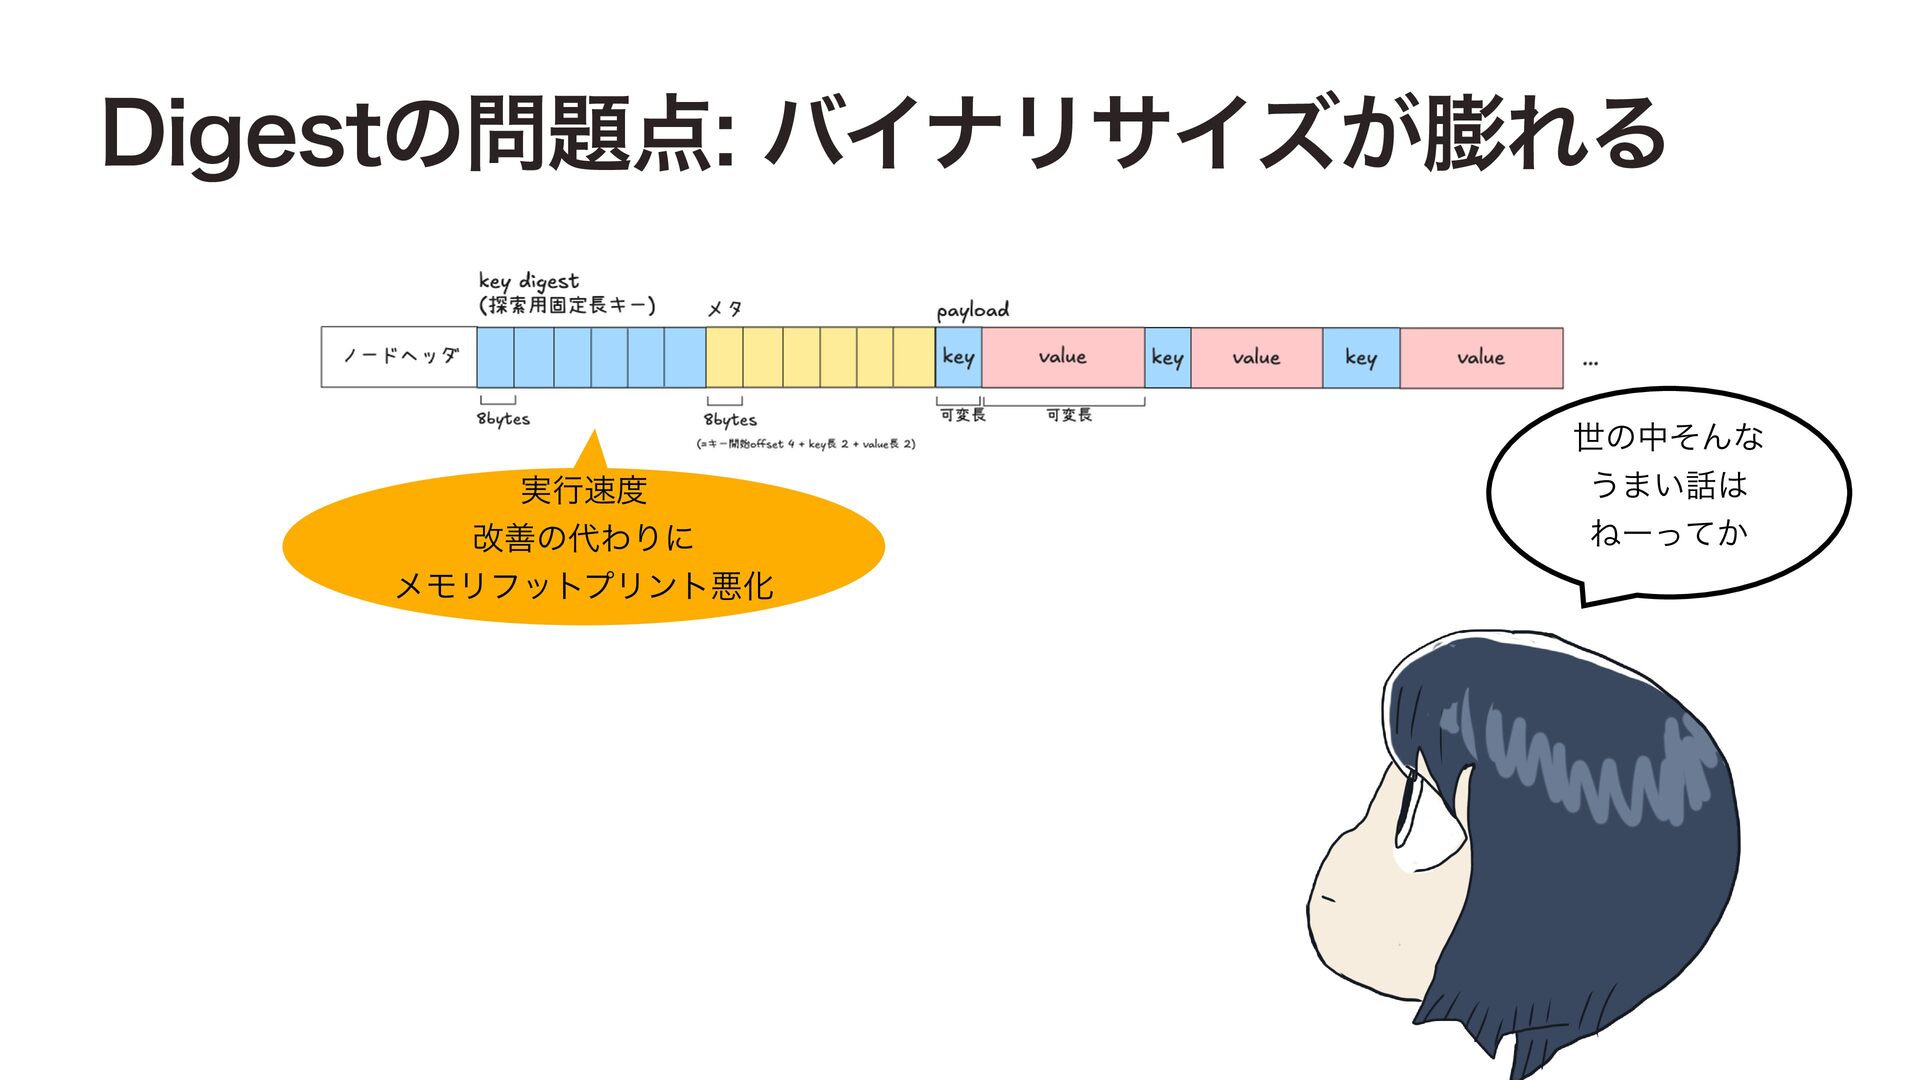
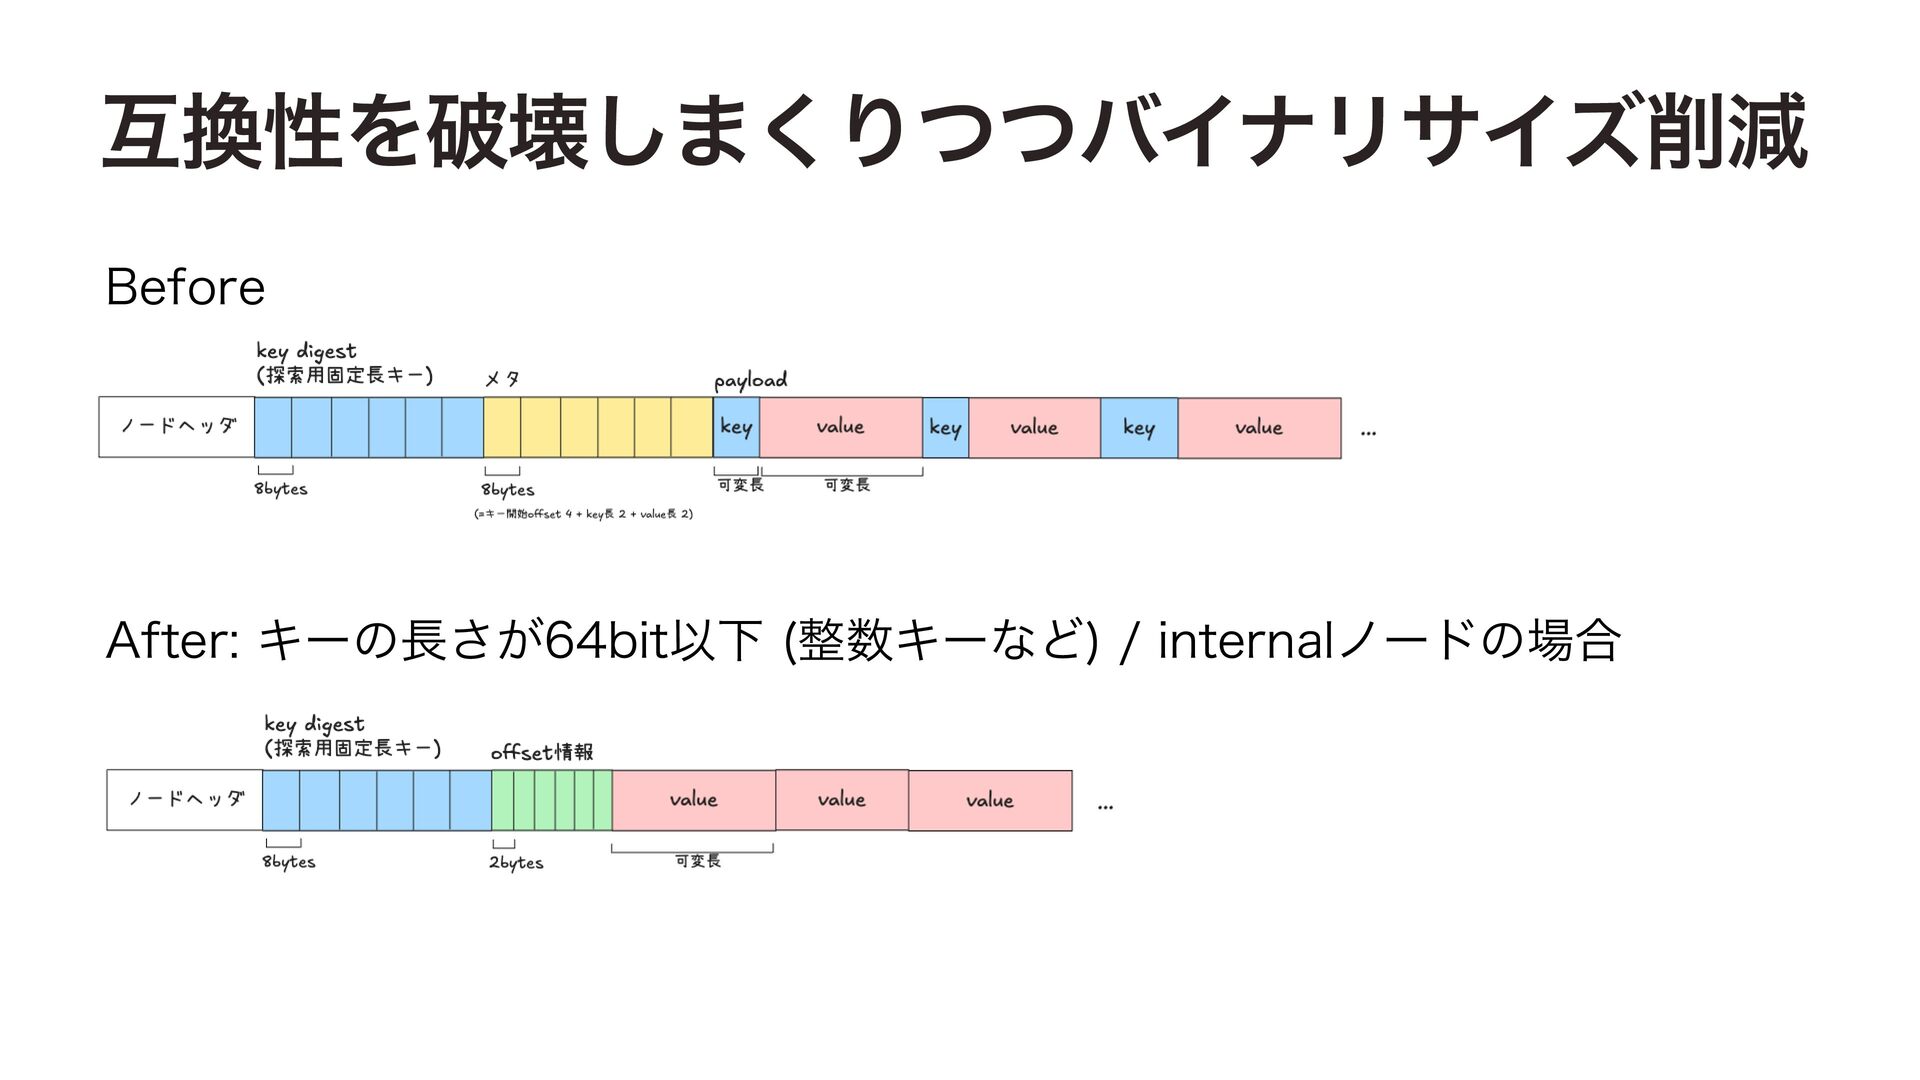
  22. Digest = 可変長キーの値を、順序比較するための固定長64bit整数値に変換したもの encoding digest の作り方 (ulongとして比較した場合に順序が保持される値) ascii 先頭 8

    バイトをビッグエンディアンとして読み込み (8バイト不足分は0埋め) Ulid 先頭 8 バイトをビッグエンディアンとして読み込み i64 符号ビットを反転 uuidv7 先頭 8バイト を、Guid.CompareTo のフィールド比較順(̲a, ̲b, ̲c)に並べ直し
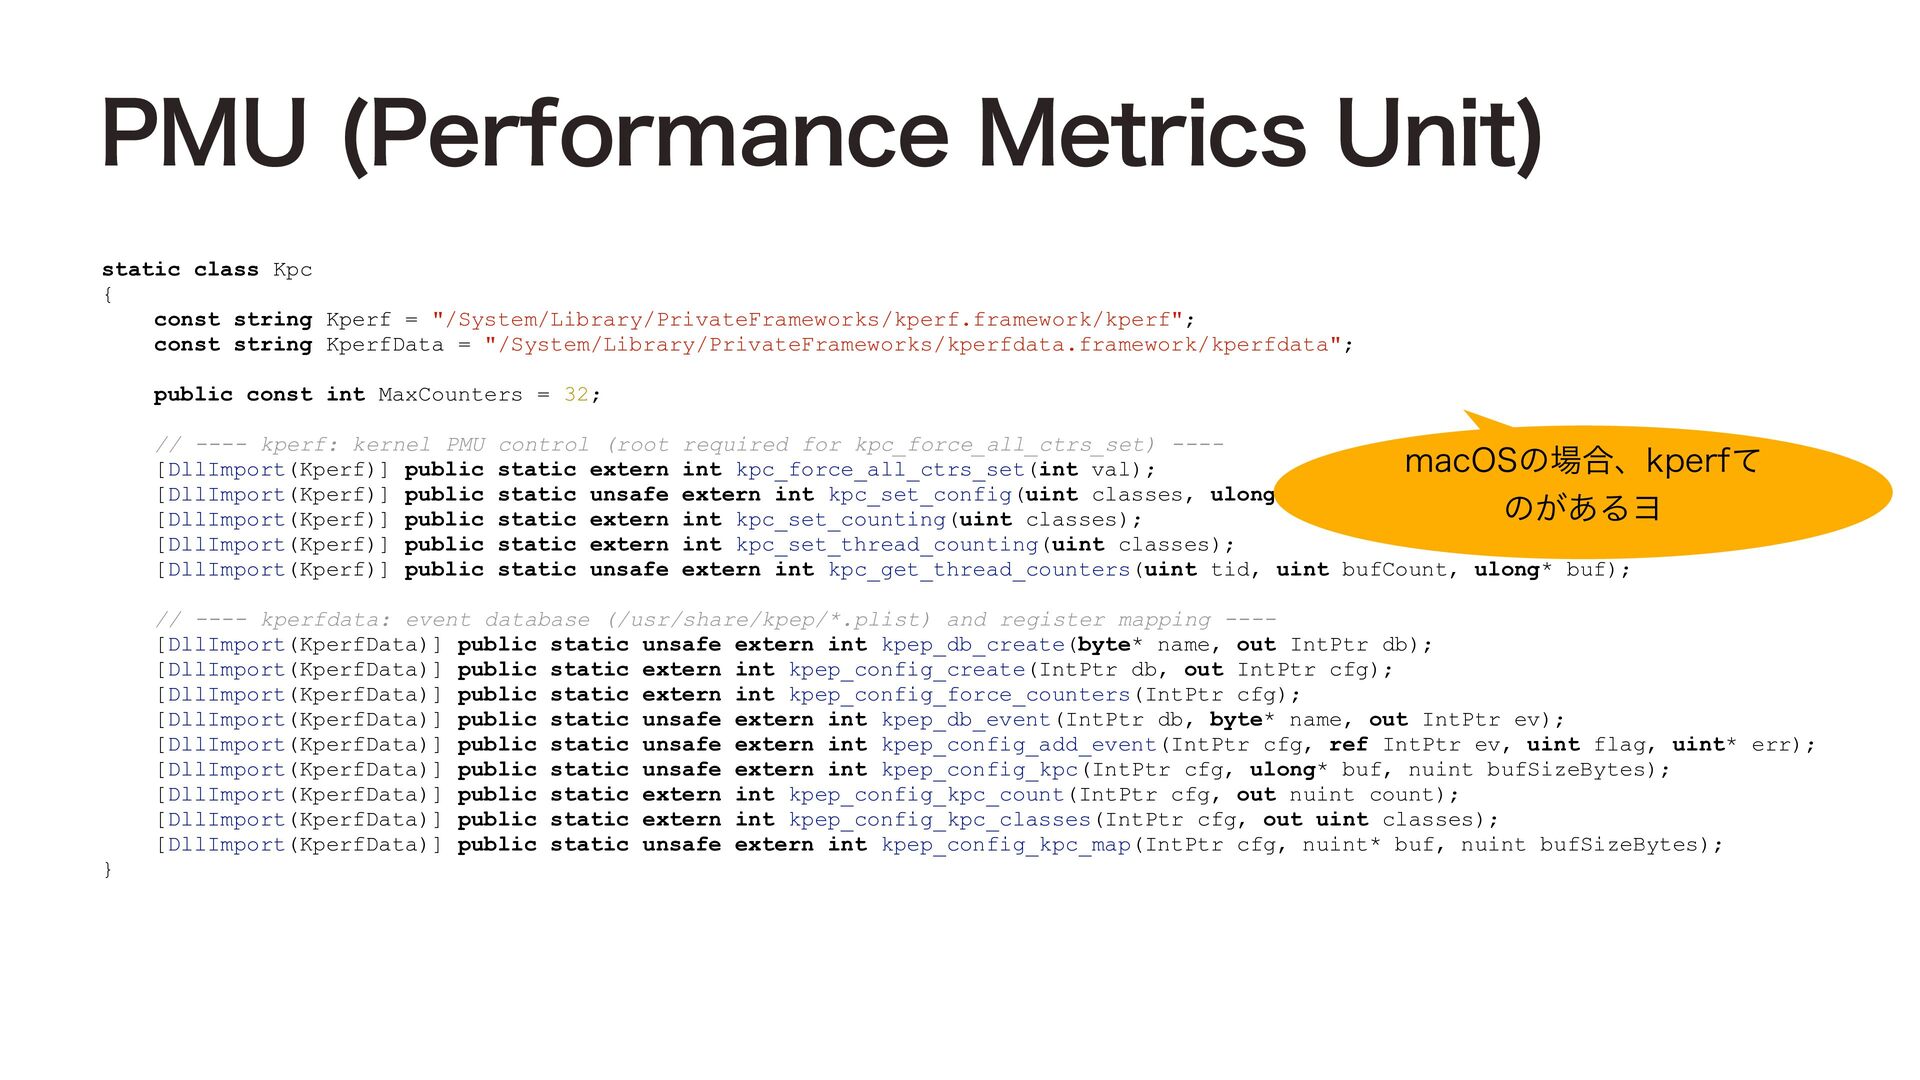
  23. PMU (Performance Metrics Unit) static class Kpc { const string

    Kperf = "/System/Library/PrivateFrameworks/kperf.framework/kperf"; const string KperfData = "/System/Library/PrivateFrameworks/kperfdata.framework/kperfdata"; public const int MaxCounters = 32; // ---- kperf: kernel PMU control (root required for kpc_force_all_ctrs_set) ---macOSの場合、kperfて [DllImport(Kperf)] public static extern int kpc_force_all_ctrs_set(int val); [DllImport(Kperf)] public static unsafe extern int kpc_set_config(uint classes, ulong* config); のがあるヨ [DllImport(Kperf)] public static extern int kpc_set_counting(uint classes); [DllImport(Kperf)] public static extern int kpc_set_thread_counting(uint classes); [DllImport(Kperf)] public static unsafe extern int kpc_get_thread_counters(uint tid, uint bufCount, ulong* buf); // ---- kperfdata: event database (/usr/share/kpep/*.plist) and register mapping ---[DllImport(KperfData)] public static unsafe extern int kpep_db_create(byte* name, out IntPtr db); [DllImport(KperfData)] public static extern int kpep_config_create(IntPtr db, out IntPtr cfg); [DllImport(KperfData)] public static extern int kpep_config_force_counters(IntPtr cfg); [DllImport(KperfData)] public static unsafe extern int kpep_db_event(IntPtr db, byte* name, out IntPtr ev); [DllImport(KperfData)] public static unsafe extern int kpep_config_add_event(IntPtr cfg, ref IntPtr ev, uint flag, uint* err); [DllImport(KperfData)] public static unsafe extern int kpep_config_kpc(IntPtr cfg, ulong* buf, nuint bufSizeBytes); [DllImport(KperfData)] public static extern int kpep_config_kpc_count(IntPtr cfg, out nuint count); [DllImport(KperfData)] public static extern int kpep_config_kpc_classes(IntPtr cfg, out uint classes); [DllImport(KperfData)] public static unsafe extern int kpep_config_kpc_map(IntPtr cfg, nuint* buf, nuint bufSizeBytes); }
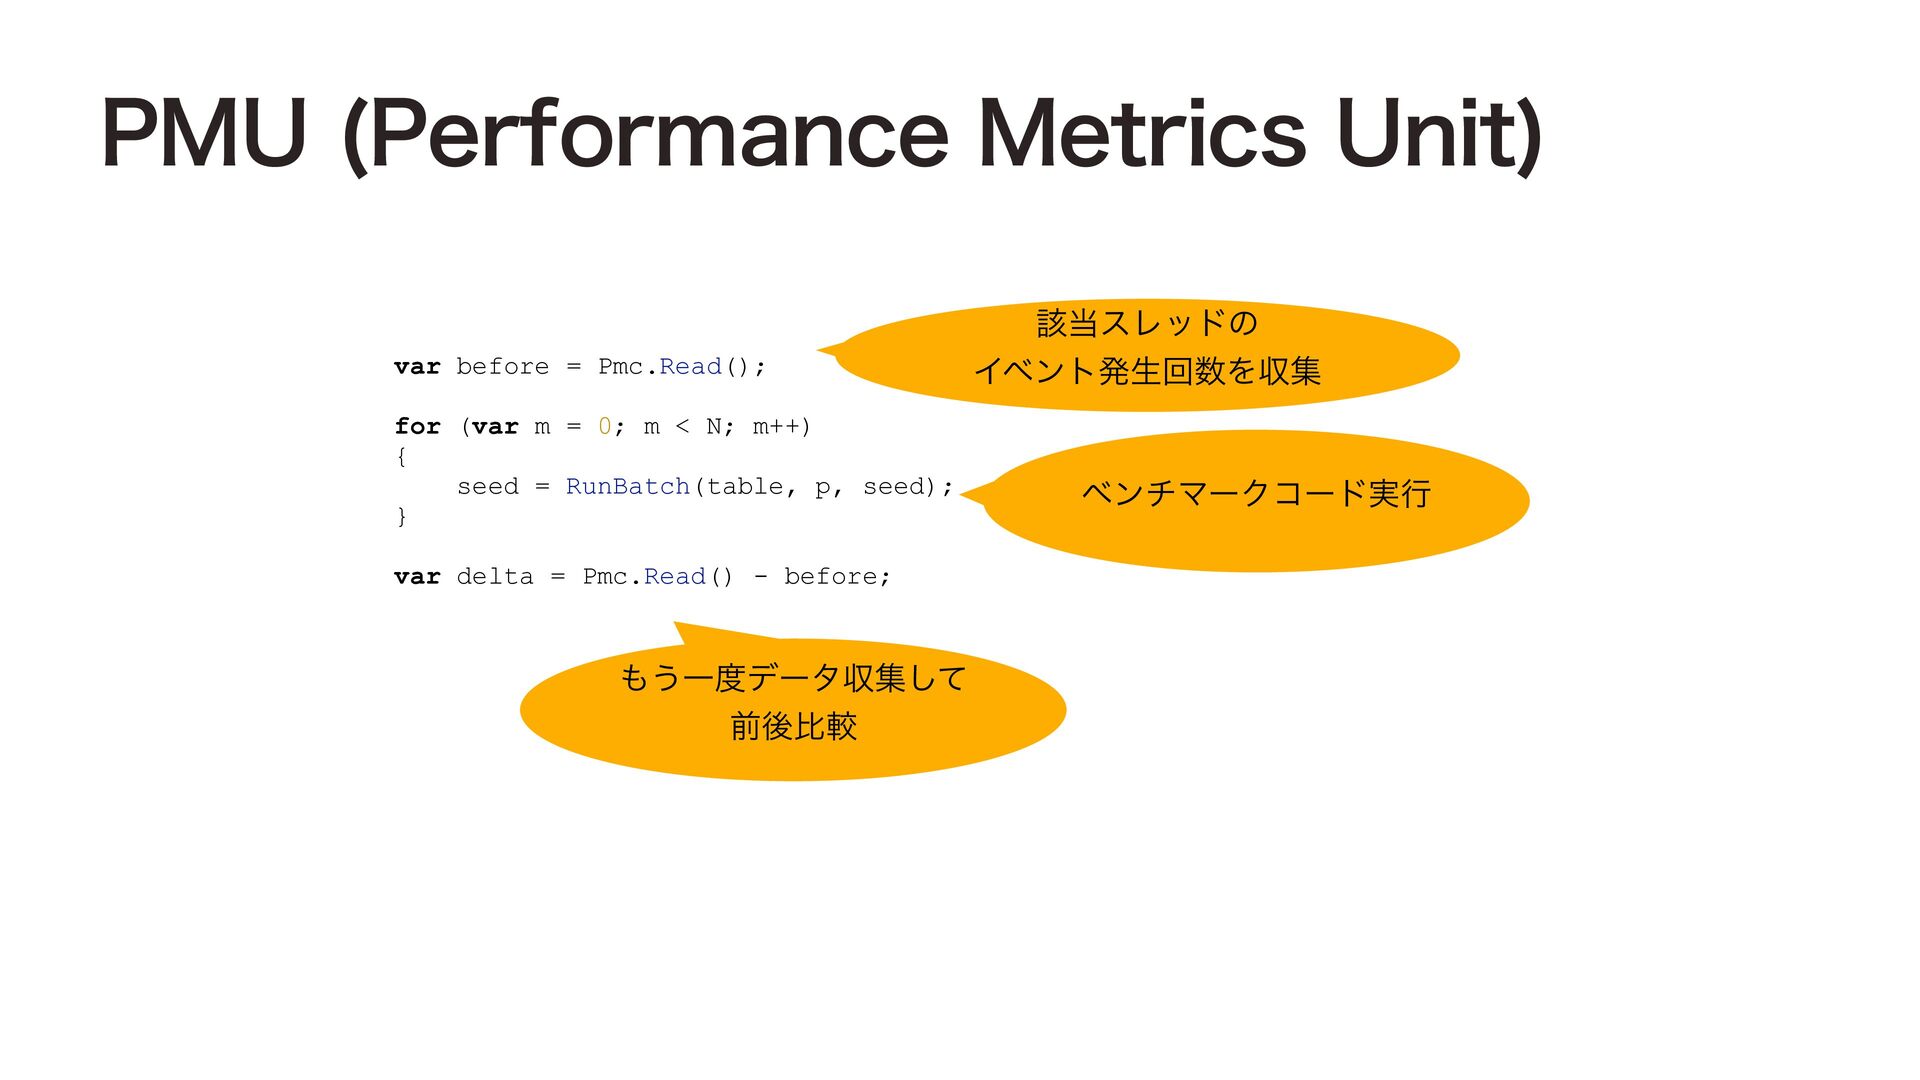
  24. PMU (Performance Metrics Unit) var before = Pmc.Read(); for (var

    m = 0; m < N; m++) { seed = RunBatch(table, p, seed); } var delta = Pmc.Read() - before; もう一度データ収集して 前後比較 該当スレッドの イベント発生回数を収集 ベンチマークコード実行
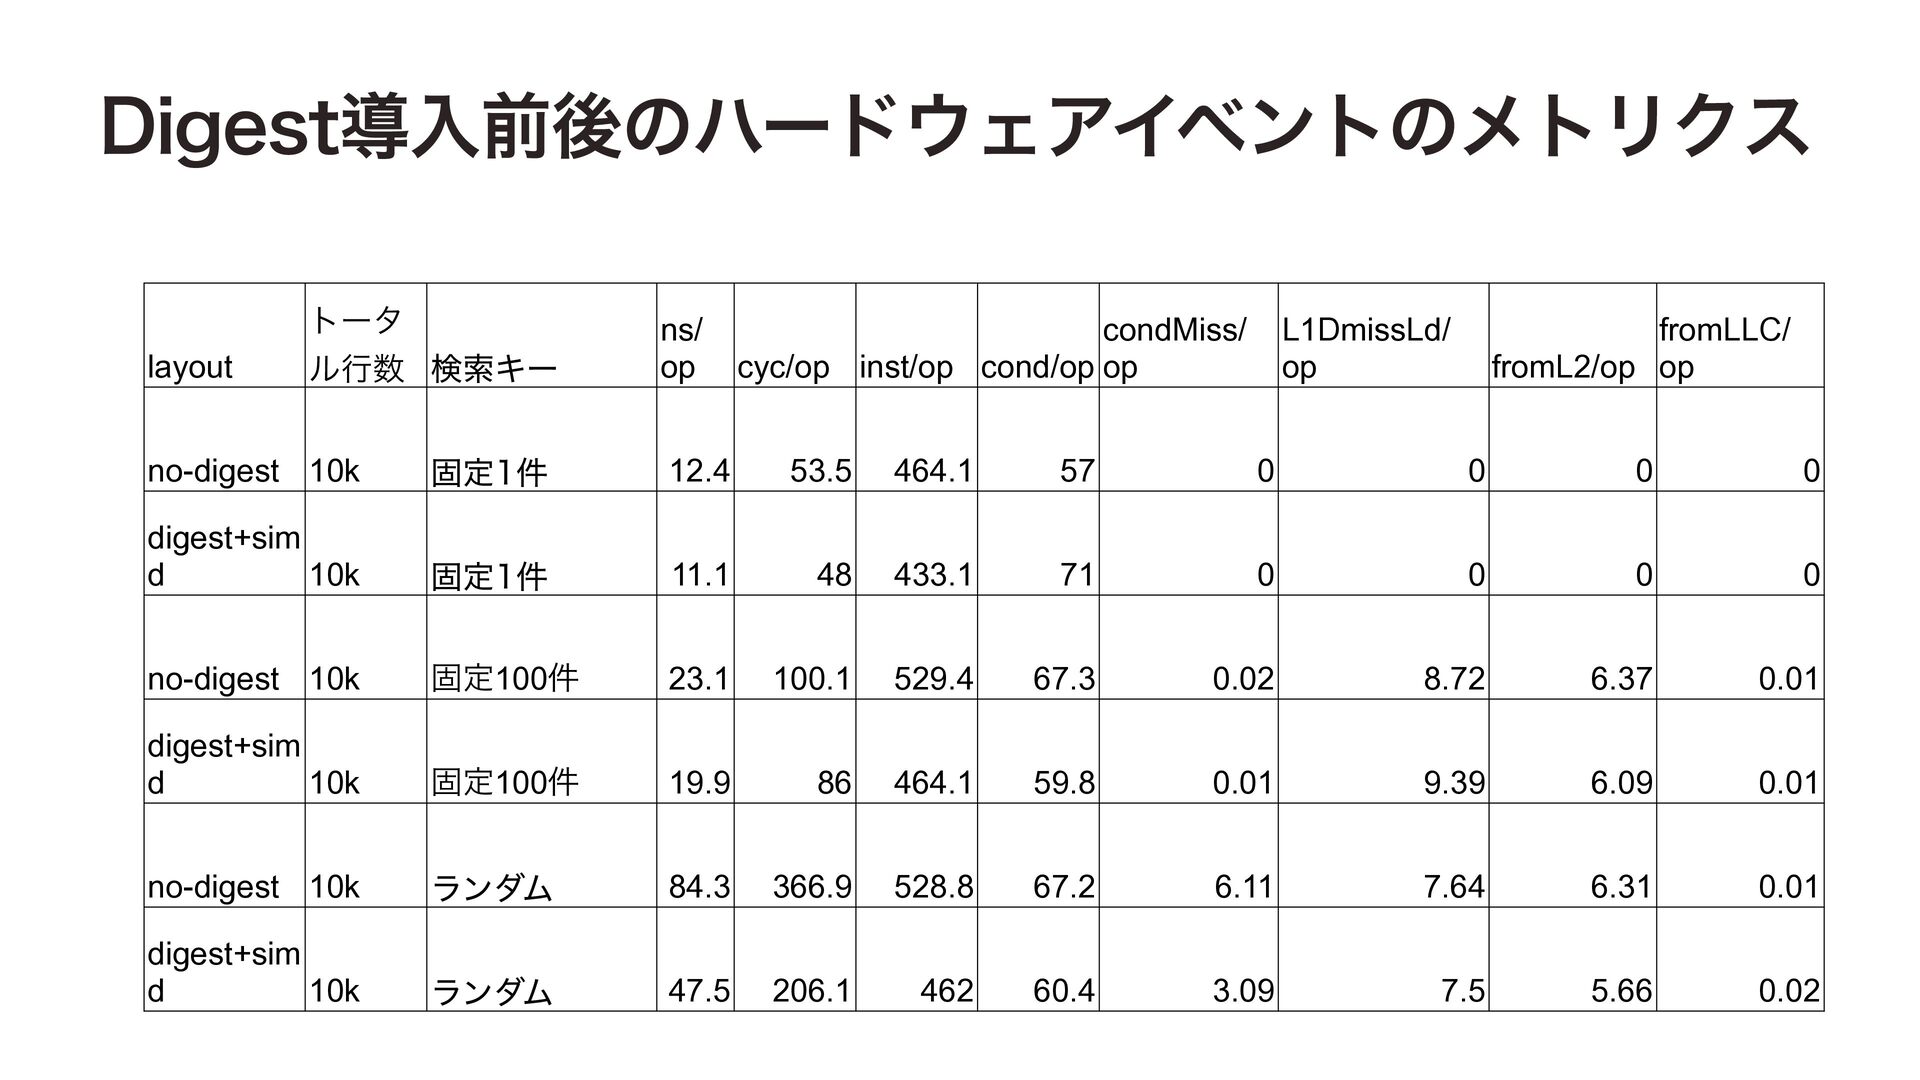
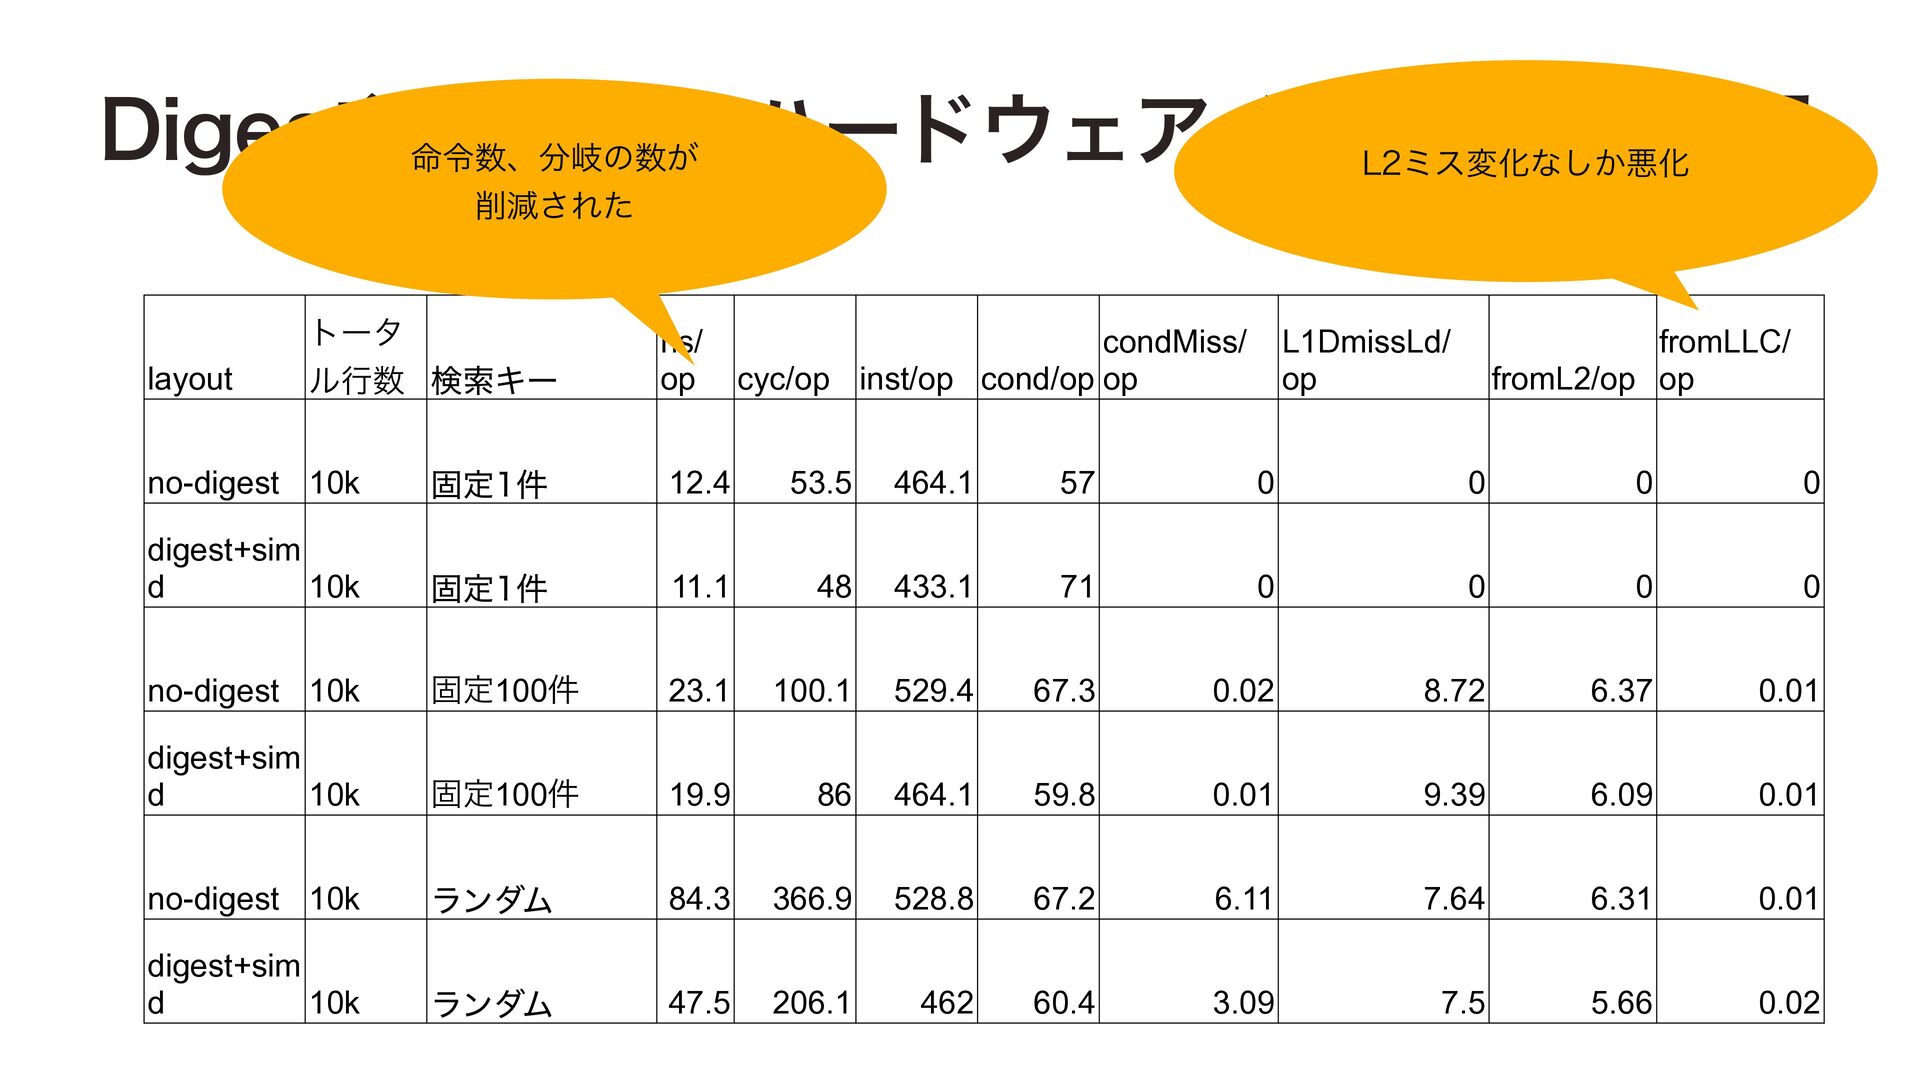
  25. Digest導入前後のハードウェアイベントのメトリクス layout トータ ル行数 検索キー ns/ op condMiss/ cyc/op inst/op

    cond/op op L1DmissLd/ op fromLLC/ fromL2/op op no-digest 10k 固定1件 12.4 53.5 464.1 57 0 0 0 0 digest+sim d 10k 固定1件 11.1 48 433.1 71 0 0 0 0 no-digest 10k 固定100件 23.1 100.1 529.4 67.3 0.02 8.72 6.37 0.01 digest+sim d 10k 固定100件 19.9 86 464.1 59.8 0.01 9.39 6.09 0.01 no-digest 10k ランダム 84.3 366.9 528.8 67.2 6.11 7.64 6.31 0.01 digest+sim d 10k ランダム 47.5 206.1 462 60.4 3.09 7.5 5.66 0.02
  26. Digest導入前後のハードウェアイベント計測結果 命令数、分岐の数が L2ミス変化なしか悪化 削減された layout トータ ル行数 検索キー ns/ op

    condMiss/ cyc/op inst/op cond/op op L1DmissLd/ op fromLLC/ fromL2/op op no-digest 10k 固定1件 12.4 53.5 464.1 57 0 0 0 0 digest+sim d 10k 固定1件 11.1 48 433.1 71 0 0 0 0 no-digest 10k 固定100件 23.1 100.1 529.4 67.3 0.02 8.72 6.37 0.01 digest+sim d 10k 固定100件 19.9 86 464.1 59.8 0.01 9.39 6.09 0.01 no-digest 10k ランダム 84.3 366.9 528.8 67.2 6.11 7.64 6.31 0.01 digest+sim d 10k ランダム 47.5 206.1 462 60.4 3.09 7.5 5.66 0.02
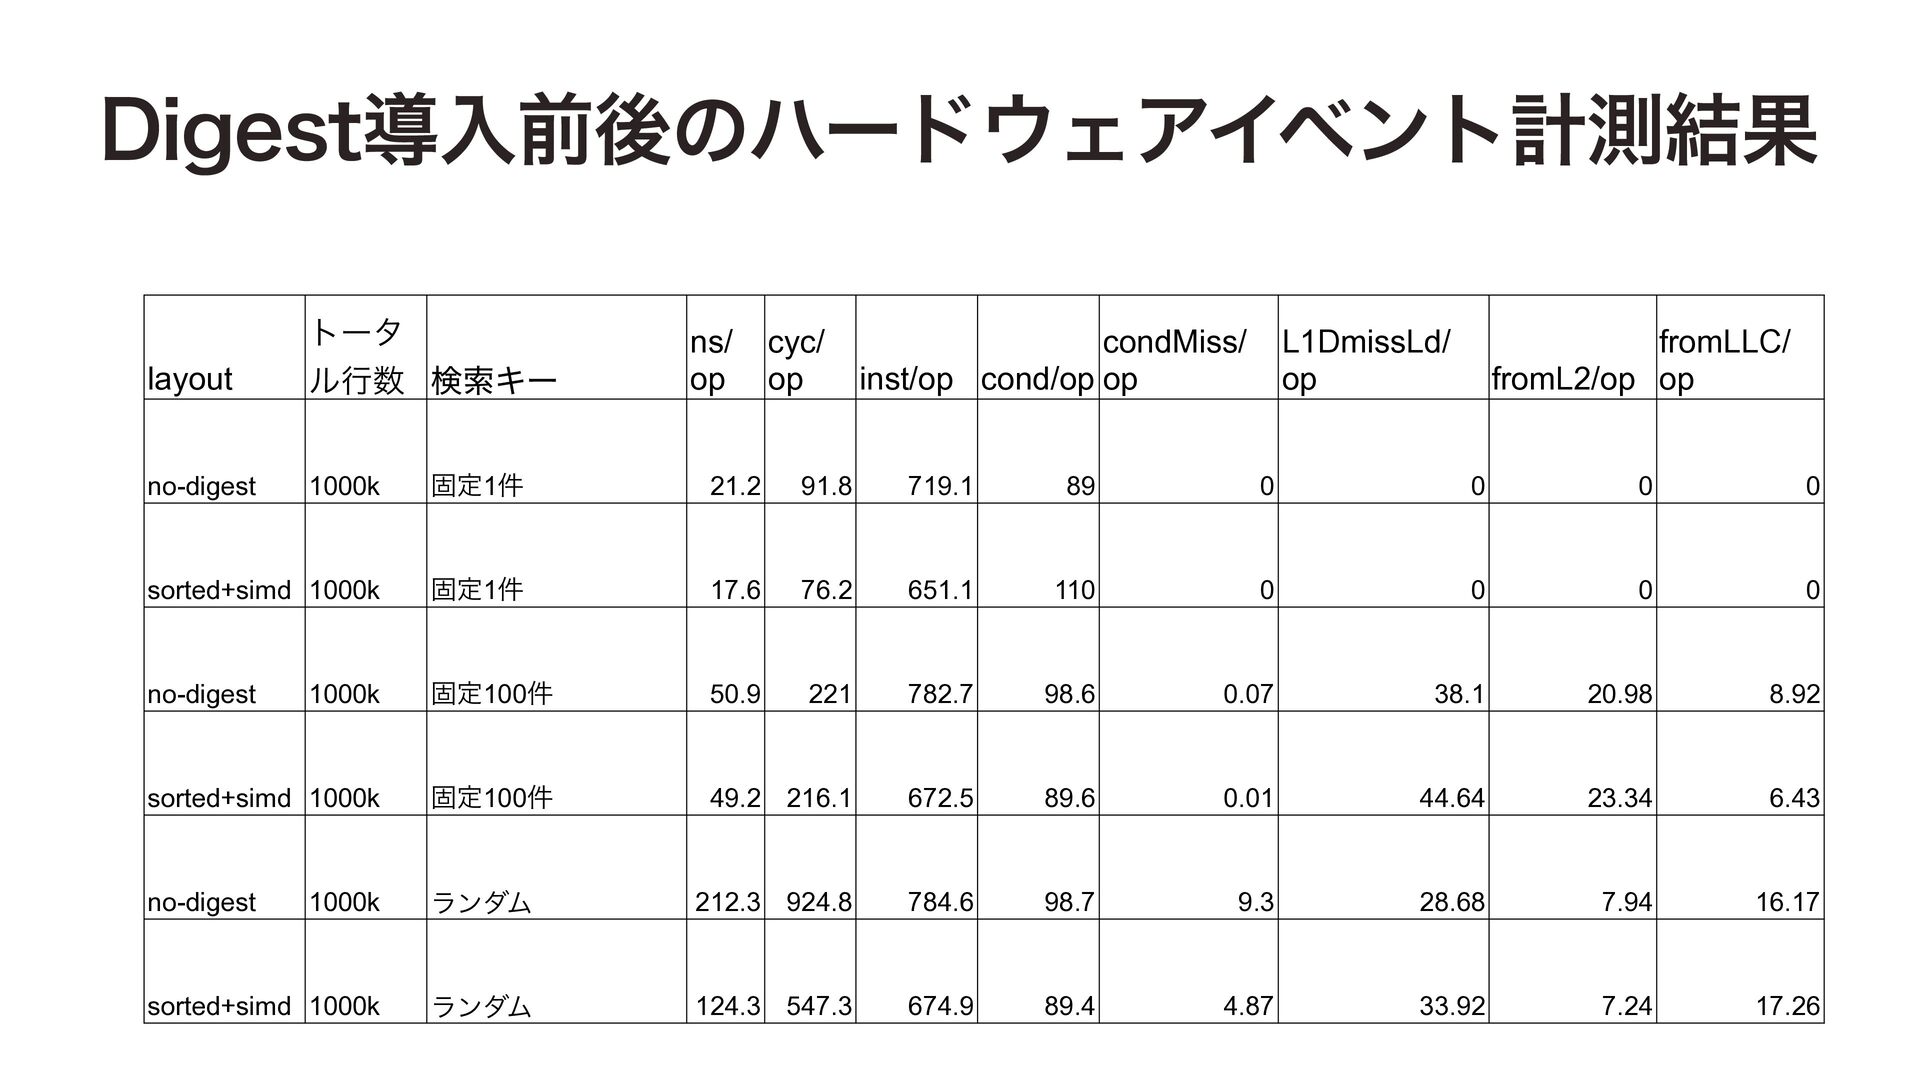
  27. Digest導入前後のハードウェアイベント計測結果 layout トータ ル行数 検索キー no-digest 1000k 固定1件 21.2 91.8

    719.1 89 0 0 0 0 sorted+simd 1000k 固定1件 17.6 76.2 651.1 110 0 0 0 0 no-digest 1000k 固定100件 50.9 221 782.7 98.6 0.07 38.1 20.98 8.92 sorted+simd 1000k 固定100件 49.2 216.1 672.5 89.6 0.01 44.64 23.34 6.43 no-digest 1000k ランダム 212.3 924.8 784.6 98.7 9.3 28.68 7.94 16.17 sorted+simd 1000k ランダム 124.3 547.3 674.9 89.4 4.87 33.92 7.24 17.26 ns/ op cyc/ op condMiss/ inst/op cond/op op L1DmissLd/ op fromLLC/ fromL2/op op
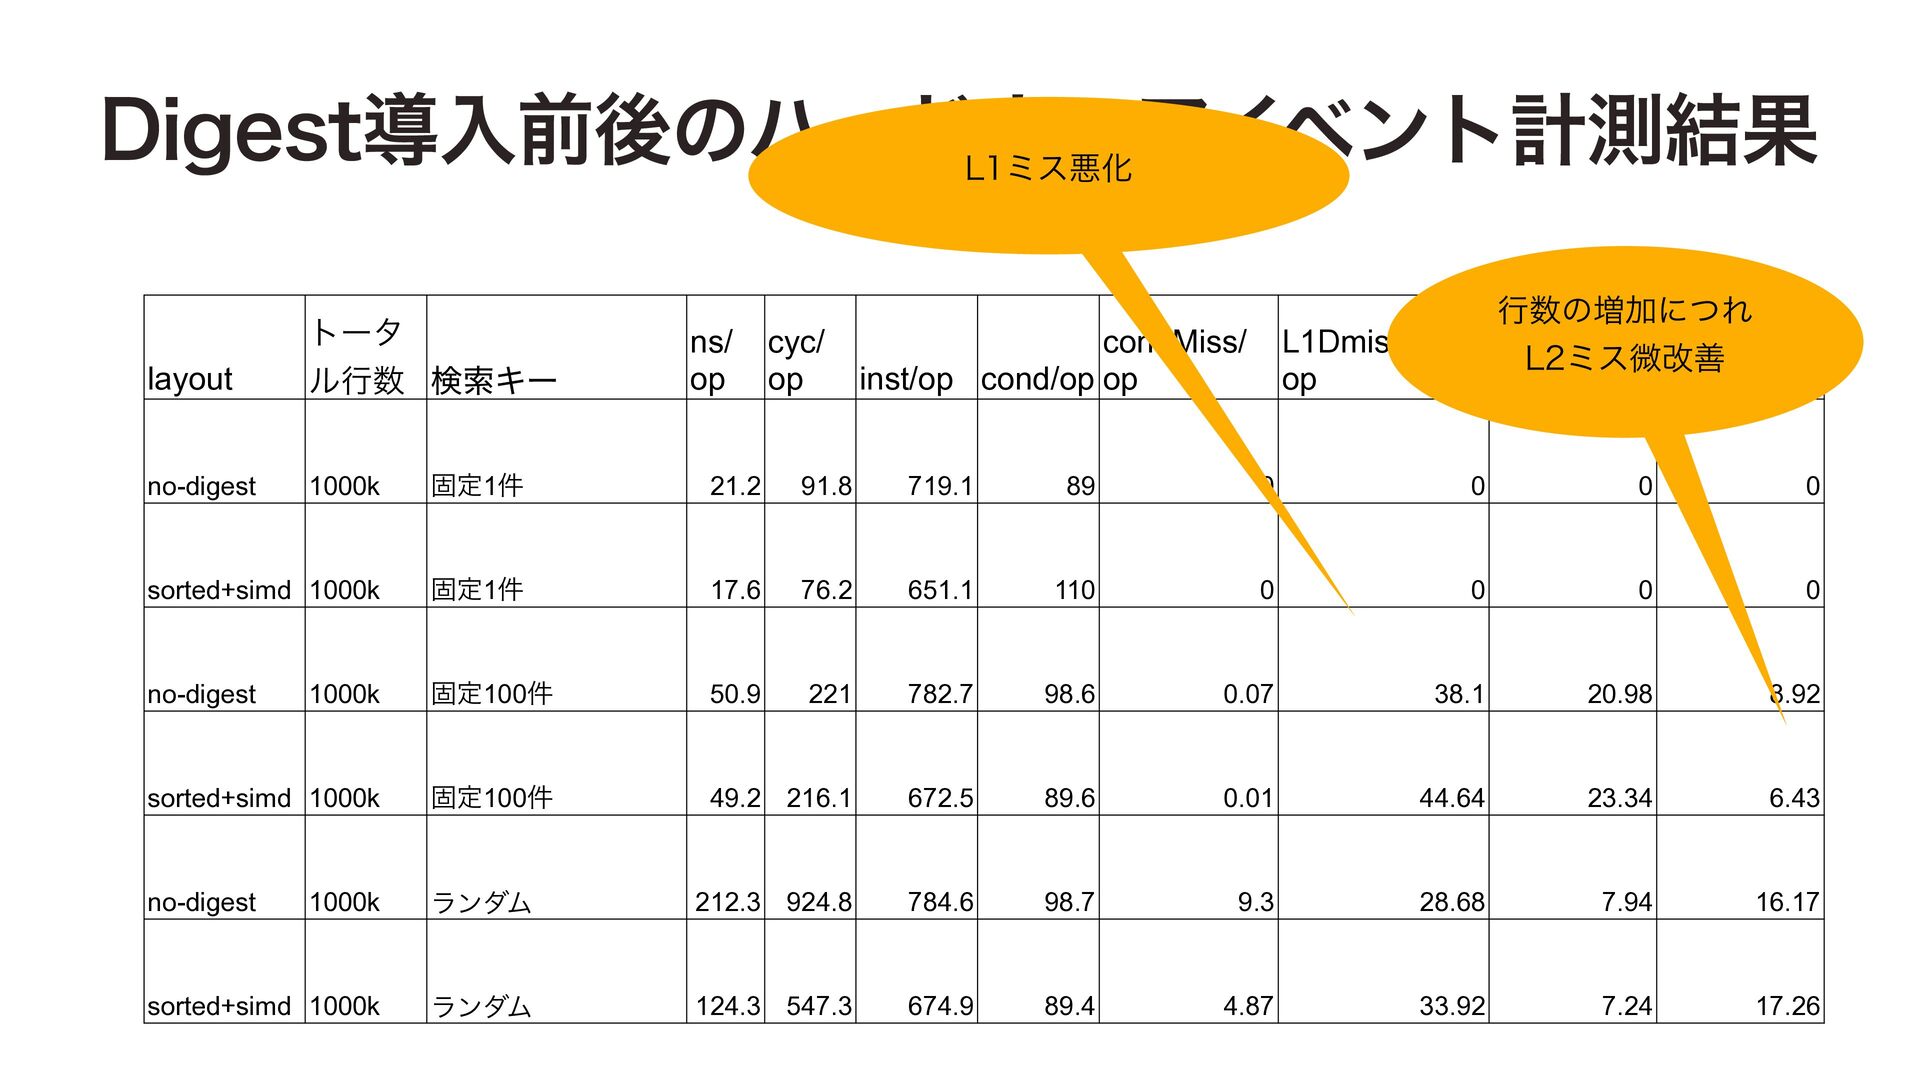
  28. Digest導入前後のハードウェアイベント計測結果 L1ミス悪化 行数の増加につれ fromLLC/ L2ミス微改善 fromL2/op op layout トータ ル行数

    検索キー no-digest 1000k 固定1件 21.2 91.8 719.1 89 0 0 0 0 sorted+simd 1000k 固定1件 17.6 76.2 651.1 110 0 0 0 0 no-digest 1000k 固定100件 50.9 221 782.7 98.6 0.07 38.1 20.98 8.92 sorted+simd 1000k 固定100件 49.2 216.1 672.5 89.6 0.01 44.64 23.34 6.43 no-digest 1000k ランダム 212.3 924.8 784.6 98.7 9.3 28.68 7.94 16.17 sorted+simd 1000k ランダム 124.3 547.3 674.9 89.4 4.87 33.92 7.24 17.26 ns/ op cyc/ op condMiss/ inst/op cond/op op L1DmissLd/ op
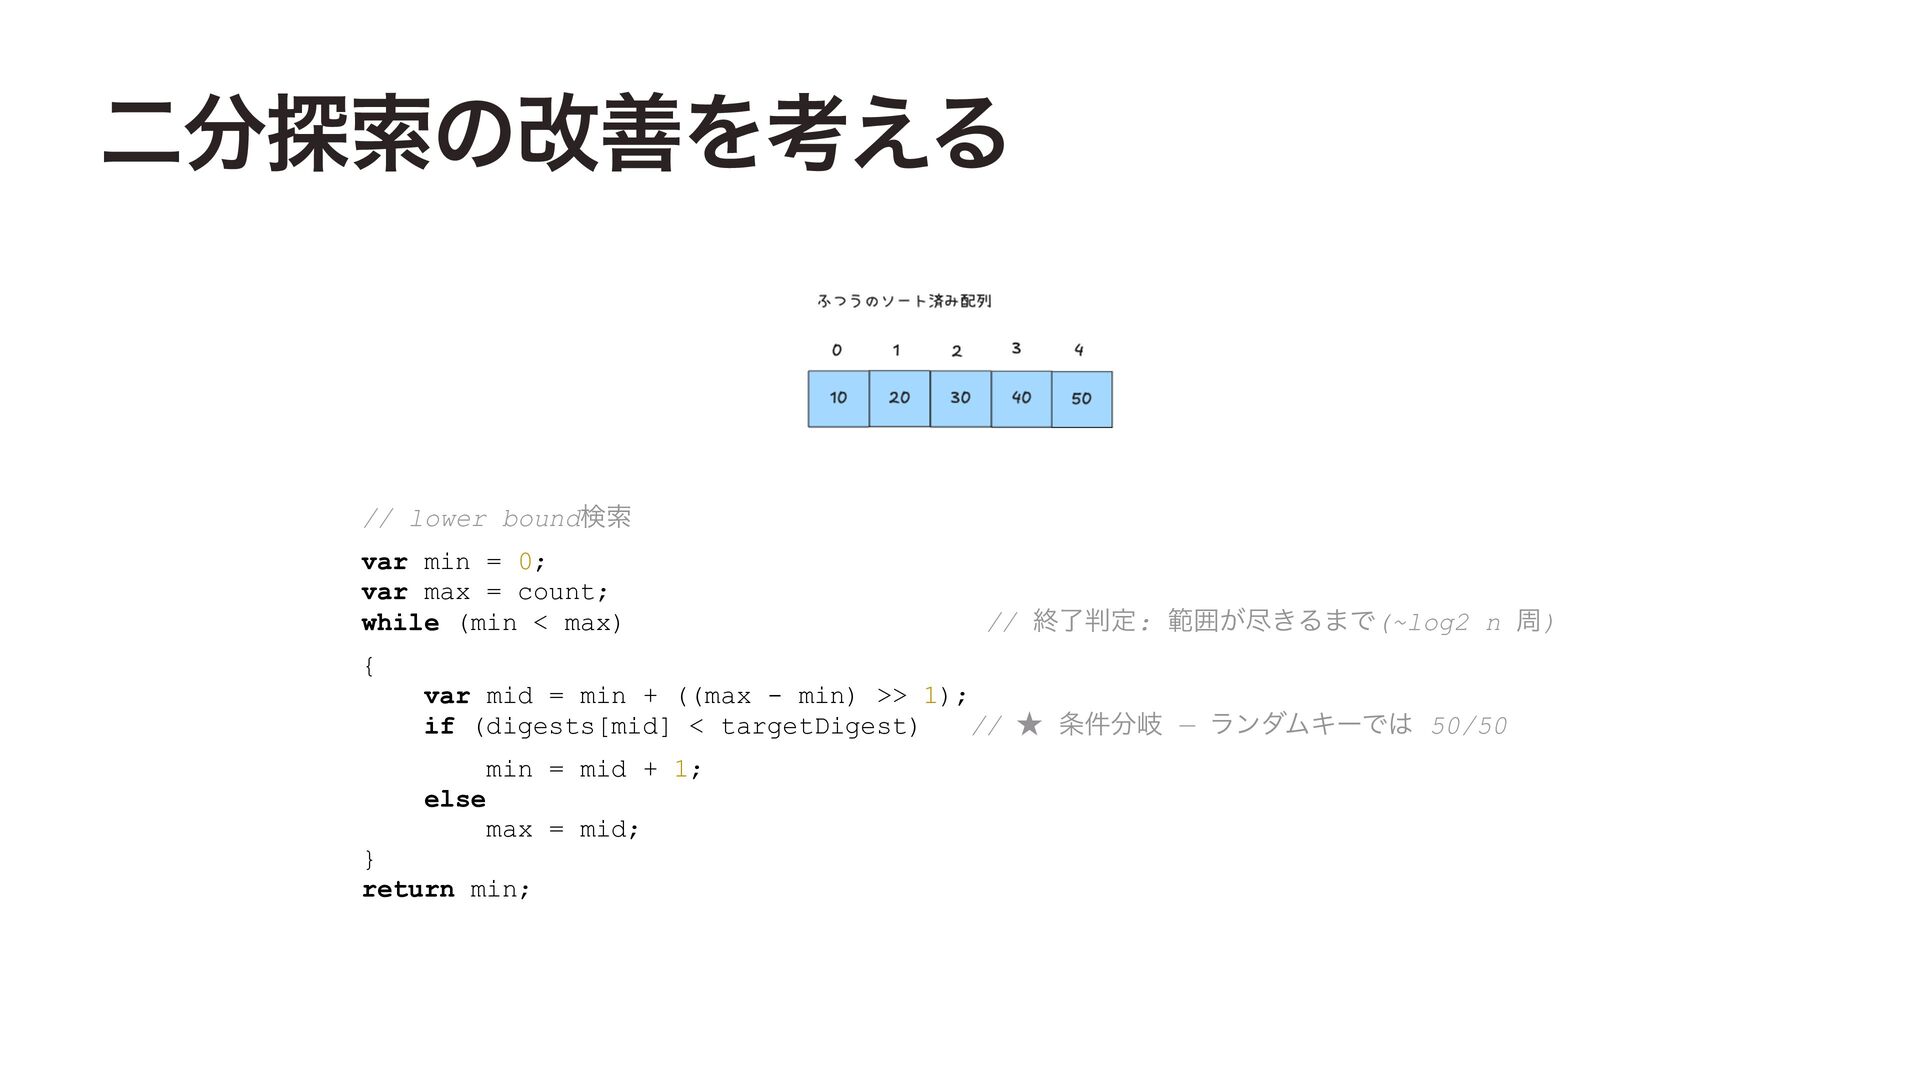
  29. 二分探索の改善を考える // lower bound検索 var min = 0; var max

    = count; while (min < max) // 終了判定: 範囲が尽きるまで(~log2 n 周) { var mid = min + ((max - min) >> 1); if (digests[mid] < targetDigest) // ★ 条件分岐 — ランダムキーでは 50/50 min = mid + 1; else max = mid; } return min;
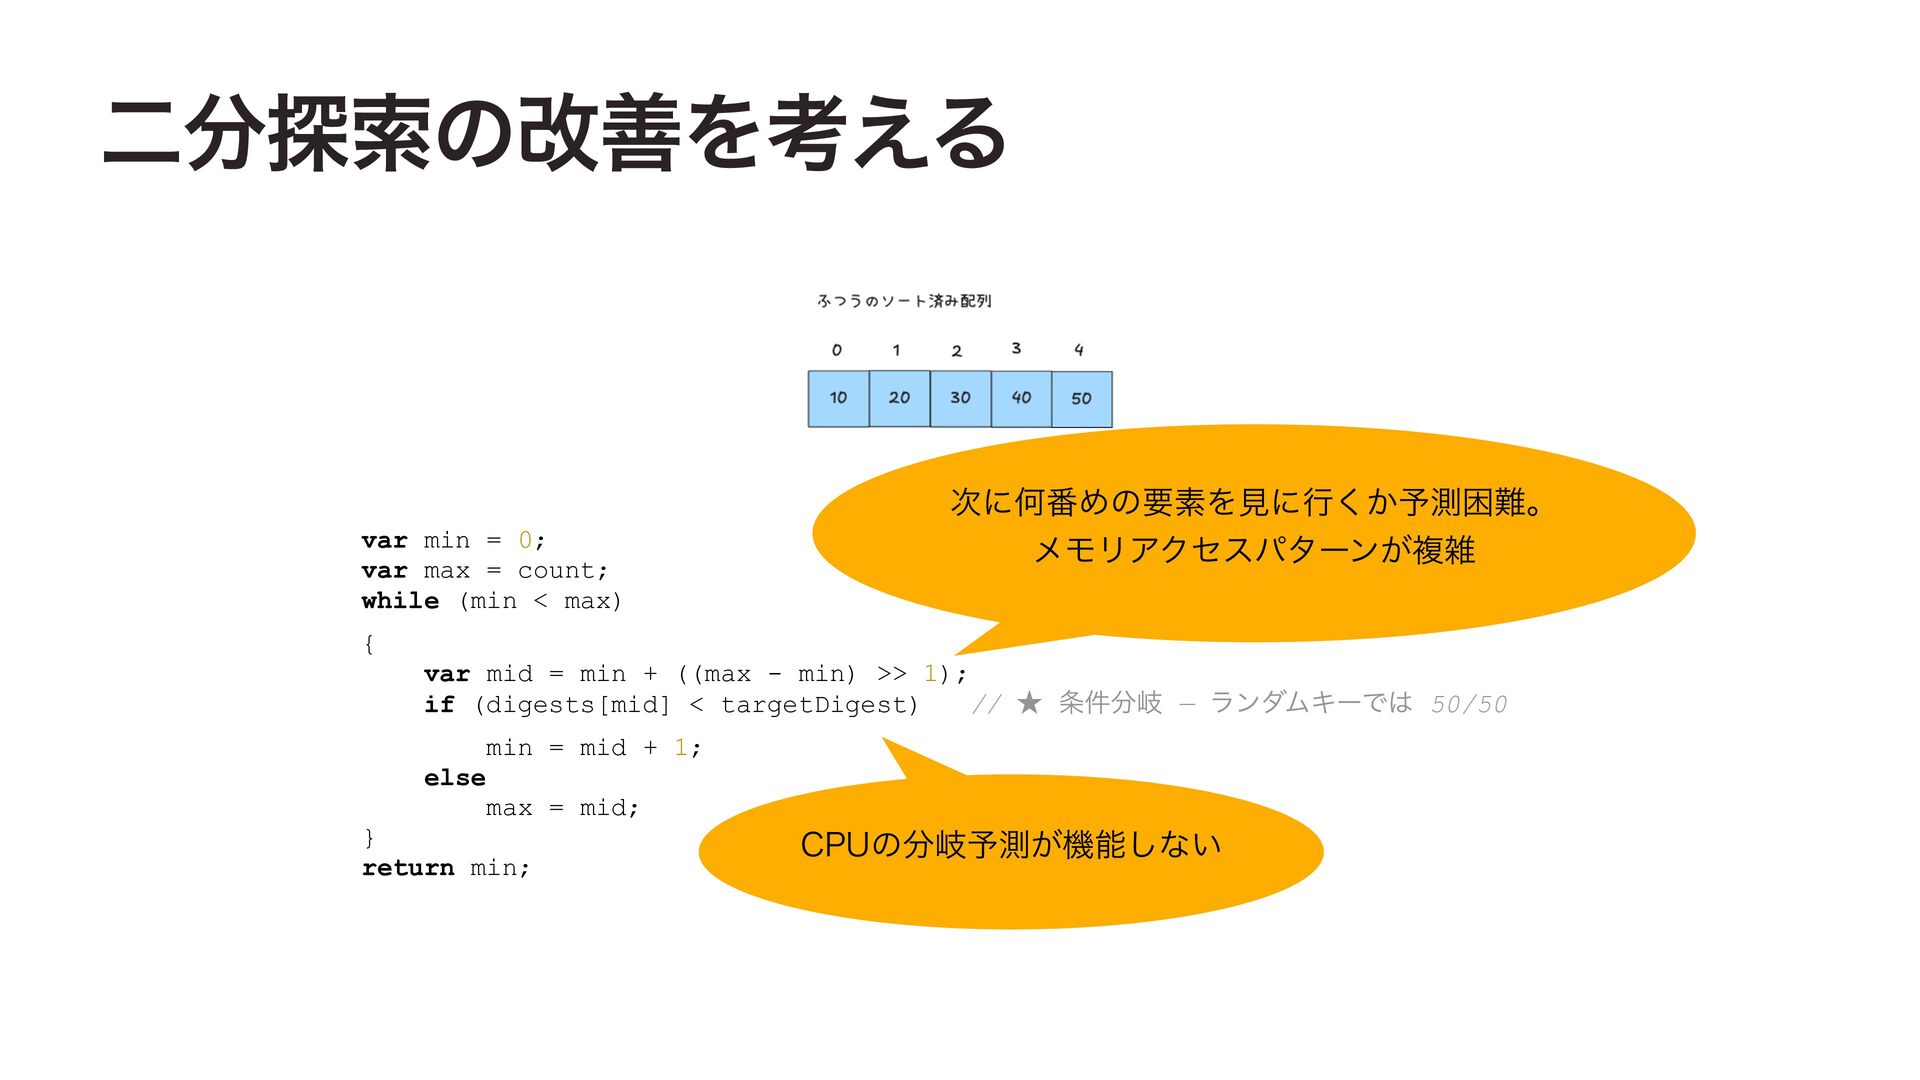
  30. 二分探索の改善を考える var min = 0; var max = count; while

    (min < max) 次に何番めの要素を見に行くか予測困難。 メモリアクセスパターンが複雑 // 終了判定: 範囲が尽きるまで(~log2 n 周) { var mid = min + ((max - min) >> 1); if (digests[mid] < targetDigest) // ★ 条件分岐 — ランダムキーでは 50/50 min = mid + 1; else max = mid; } return min; CPUの分岐予測が機能しない
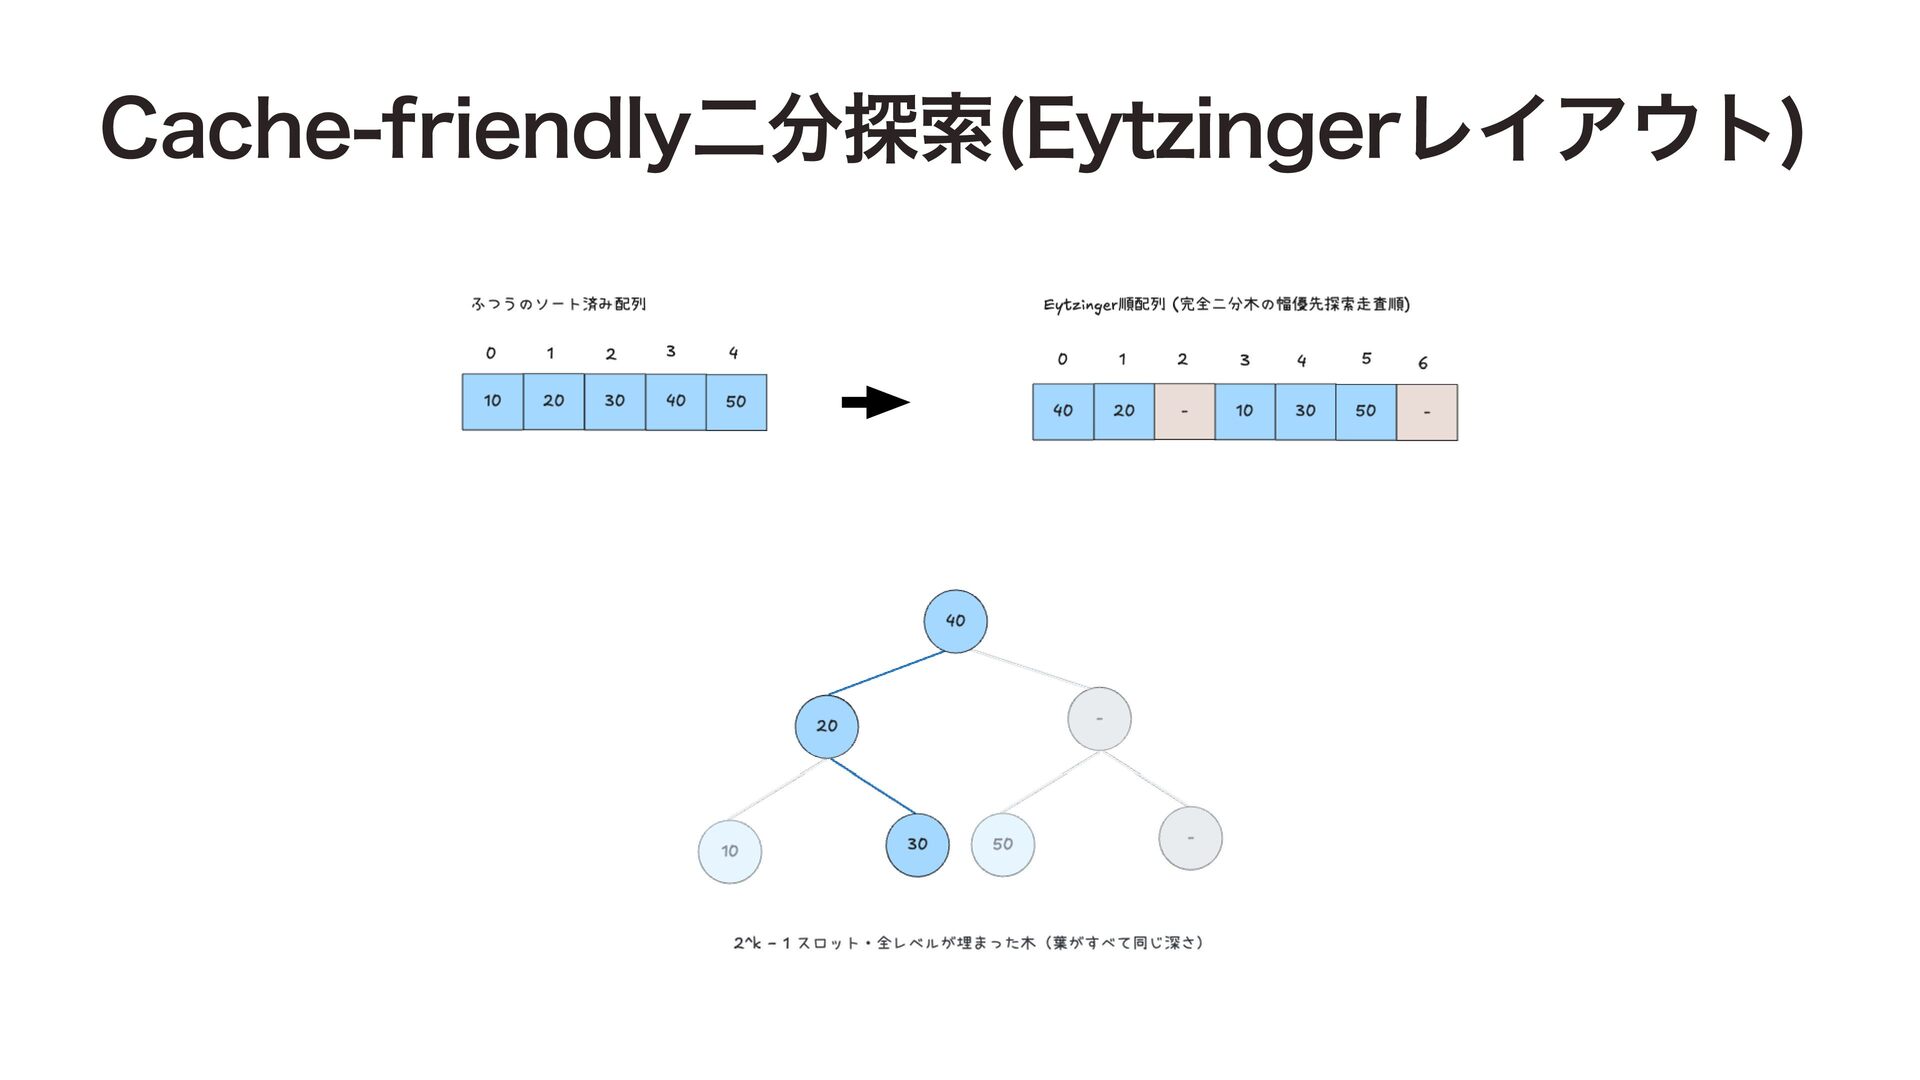
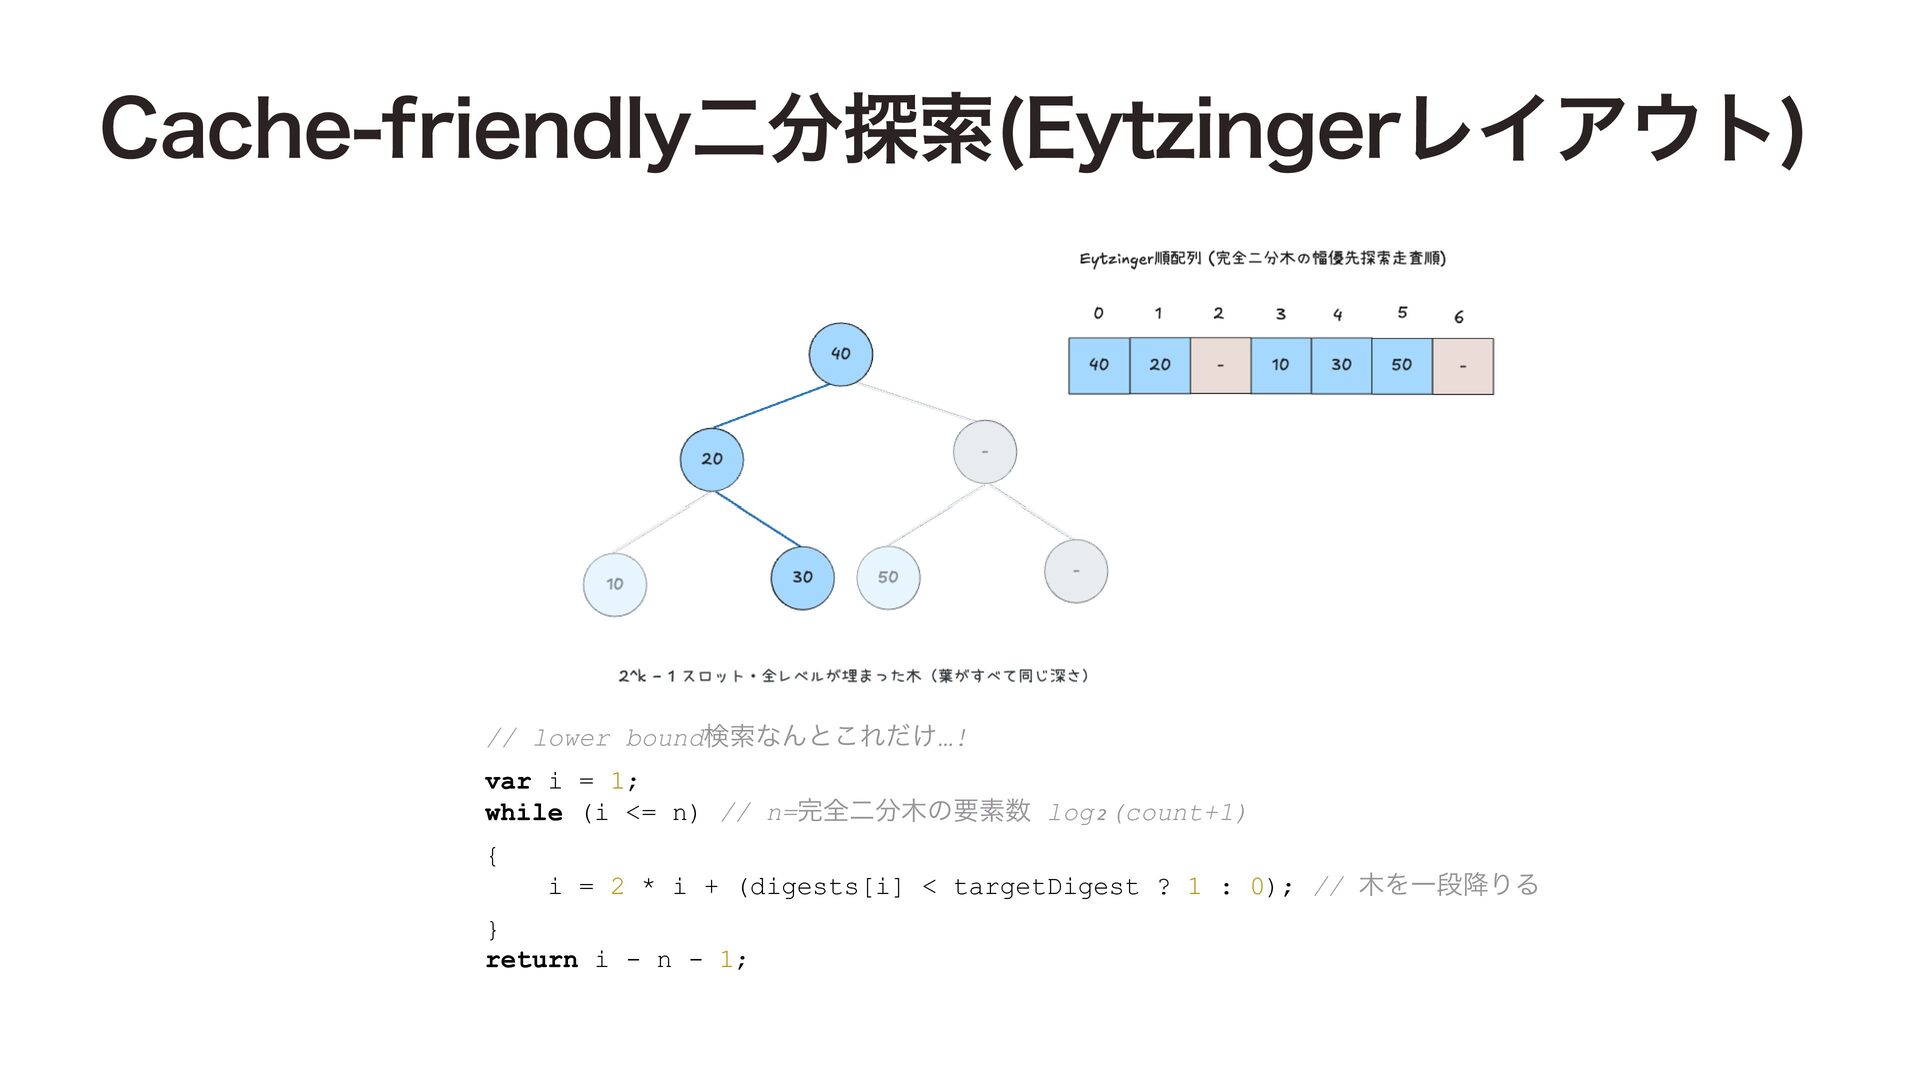
  31. Cache-friendly二分探索(Eytzingerレイアウト) // lower bound検索なんとこれだけ…! var i = 1; while (i

    <= n) // n=完全二分木の要素数 log₂(count+1) { i = 2 * i + (digests[i] < targetDigest ? 1 : 0); // 木を一段降りる } return i - n - 1;
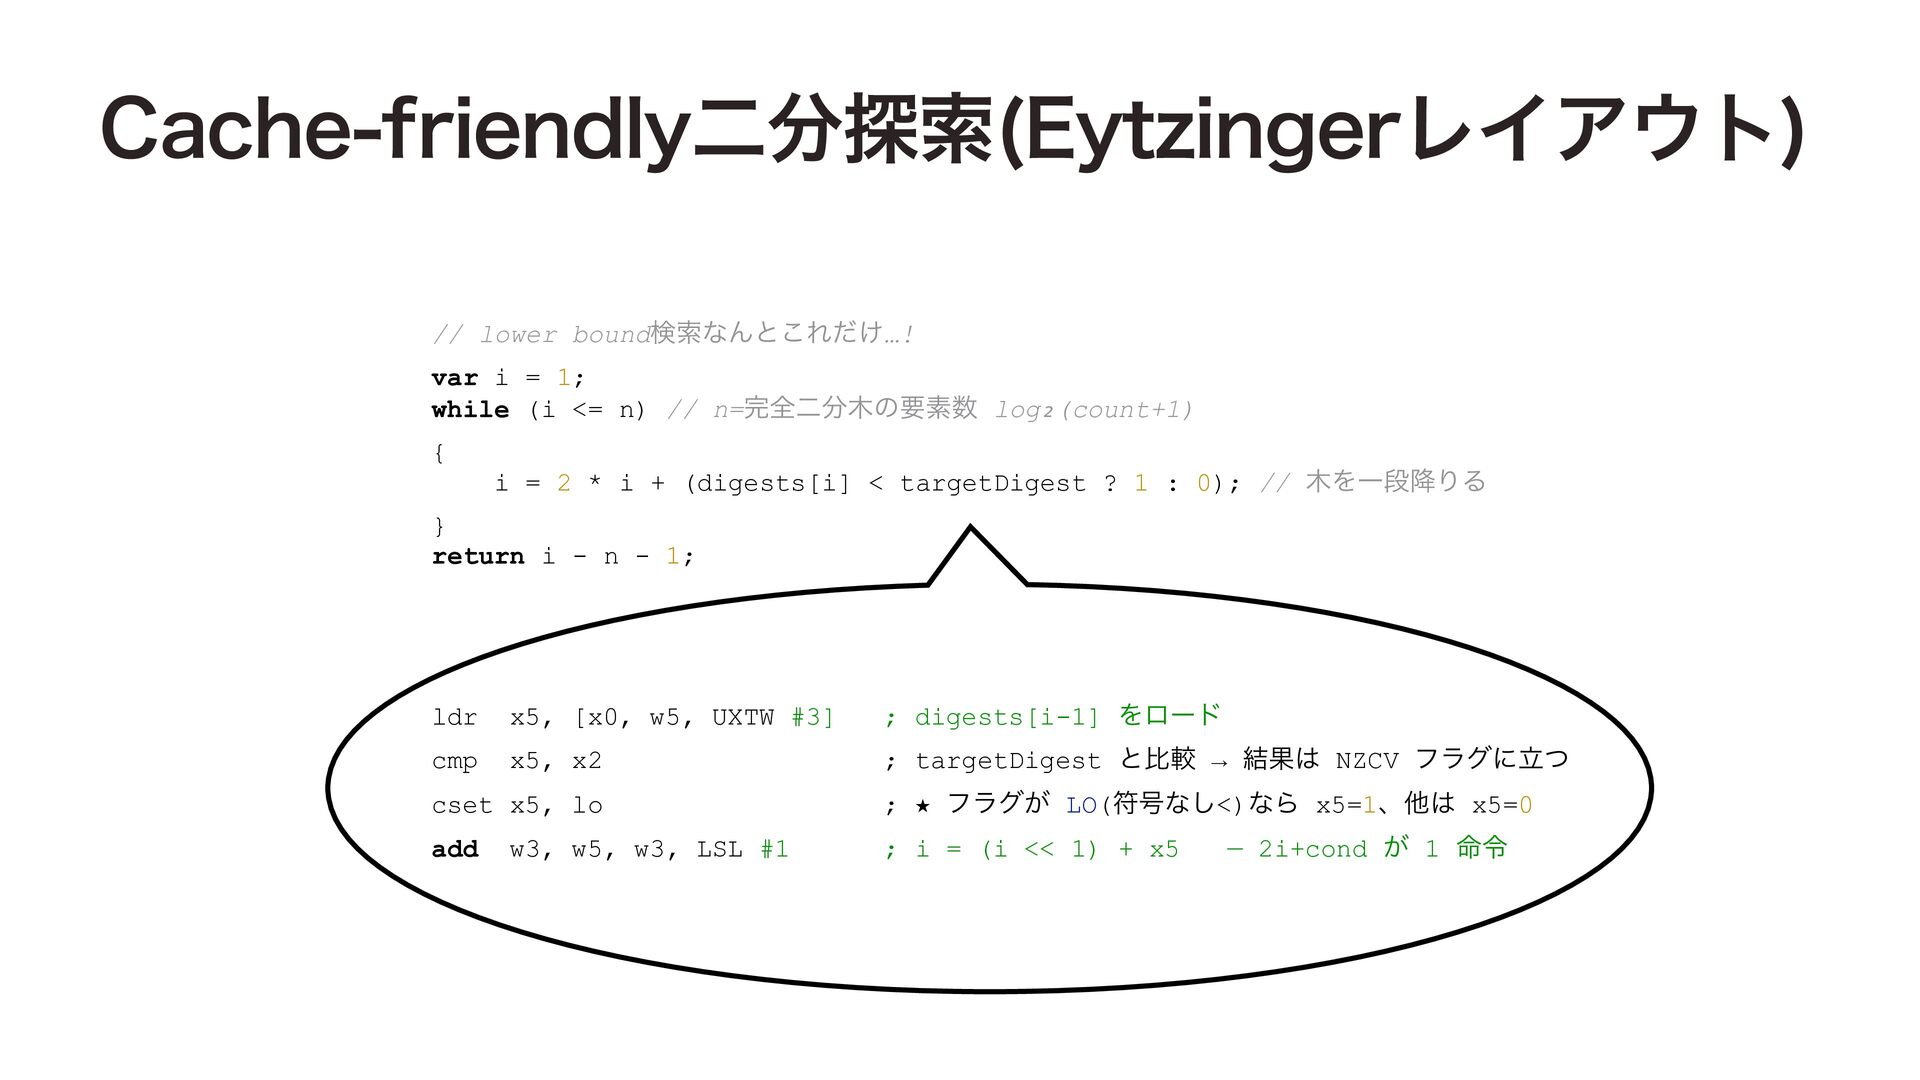
  32. Cache-friendly二分探索(Eytzingerレイアウト) // lower bound検索なんとこれだけ…! var i = 1; while (i

    <= n) // n=完全二分木の要素数 log₂(count+1) { i = 2 * i + (digests[i] < targetDigest ? 1 : 0); // 木を一段降りる } return i - n - 1; ldr x5, [x0, w5, UXTW #3] ; digests[i-1] をロード cmp x5, x2 ; targetDigest と比較 → 結果は NZCV フラグに立つ cset x5, lo ; ★ フラグが LO(符号なし<)なら x5=1、他は x5=0 add ; i = (i << 1) + x5 w3, w5, w3, LSL #1 — 2i+cond が 1 命令
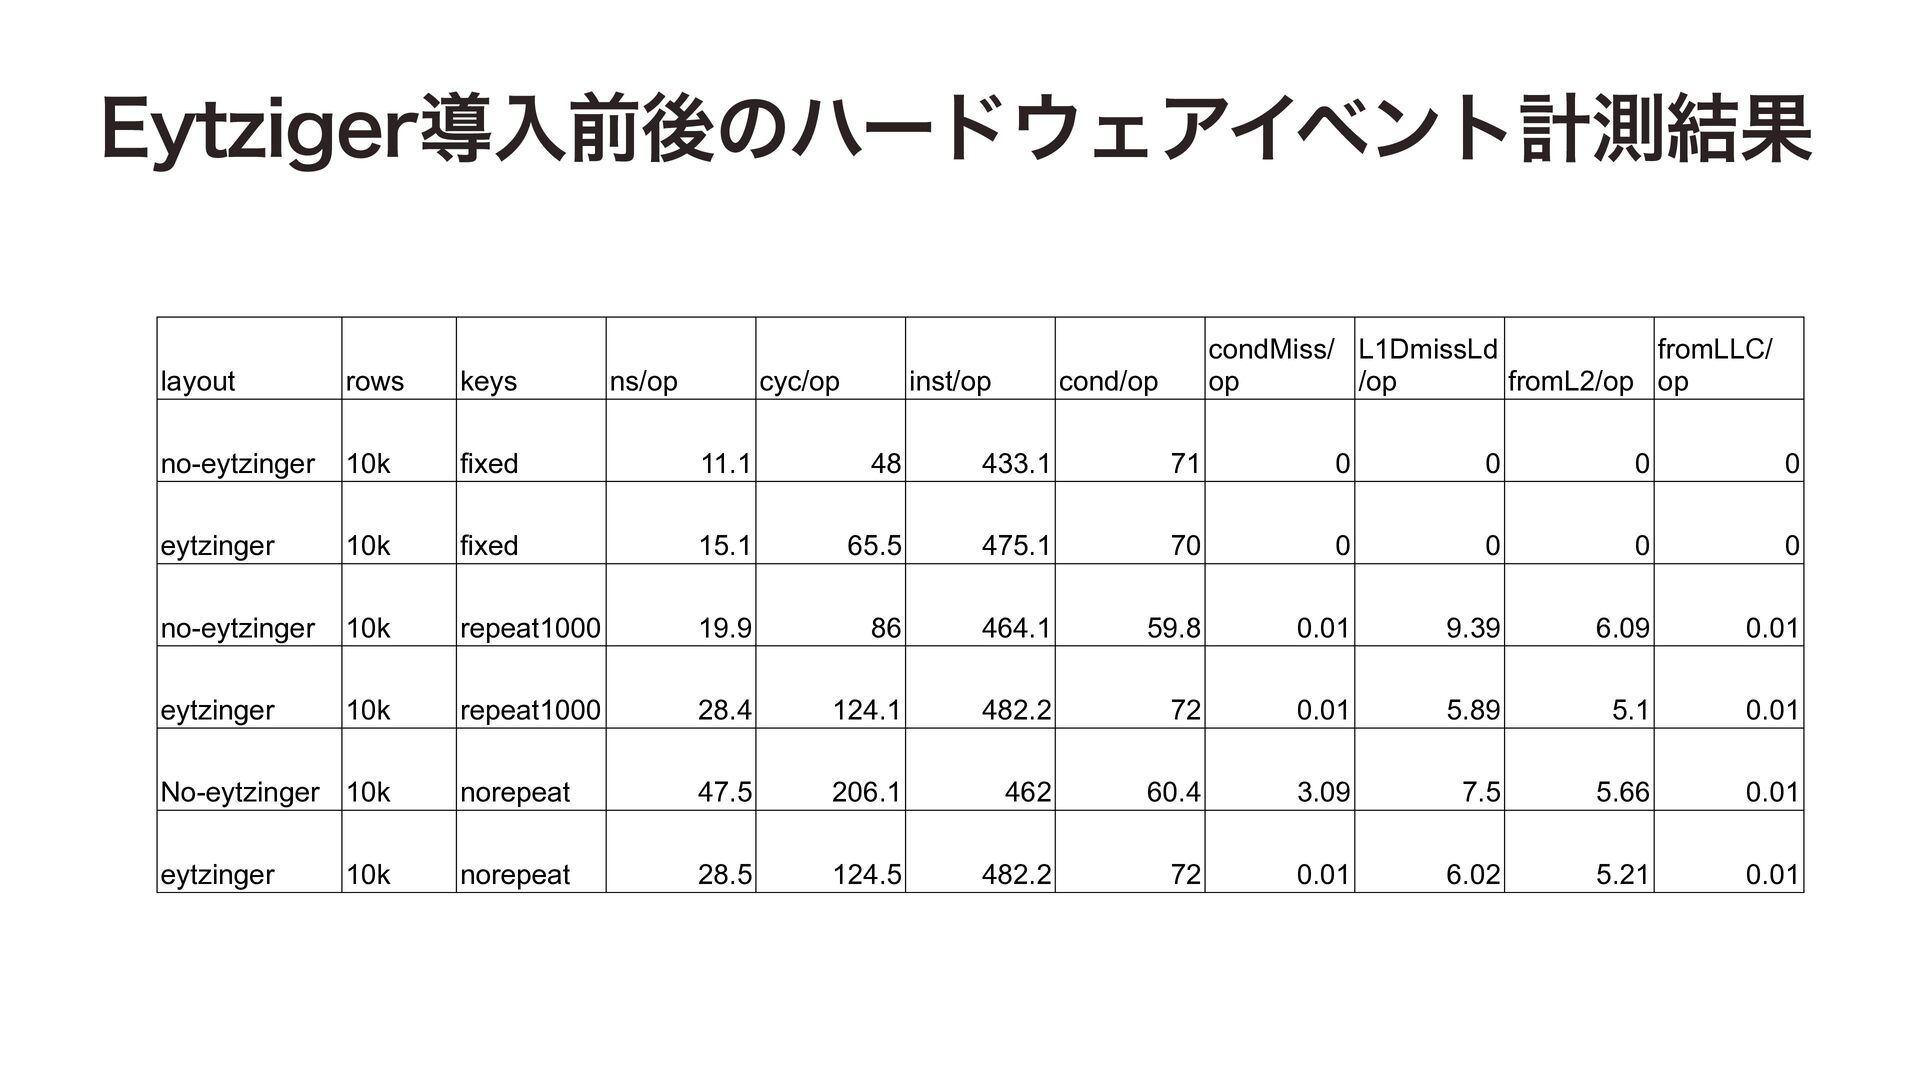
  33. Eytziger導入前後のハードウェアイベント計測結果 layout rows keys no-eytzinger 10k fixed 11.1 48 433.1

    71 0 0 0 0 eytzinger 10k fixed 15.1 65.5 475.1 70 0 0 0 0 no-eytzinger 10k repeat1000 19.9 86 464.1 59.8 0.01 9.39 6.09 0.01 eytzinger 10k repeat1000 28.4 124.1 482.2 72 0.01 5.89 5.1 0.01 No-eytzinger 10k norepeat 47.5 206.1 462 60.4 3.09 7.5 5.66 0.01 eytzinger norepeat 28.5 124.5 482.2 72 0.01 6.02 5.21 0.01 10k ns/op cyc/op inst/op condMiss/ L1DmissLd fromLLC/ op /op fromL2/op op cond/op
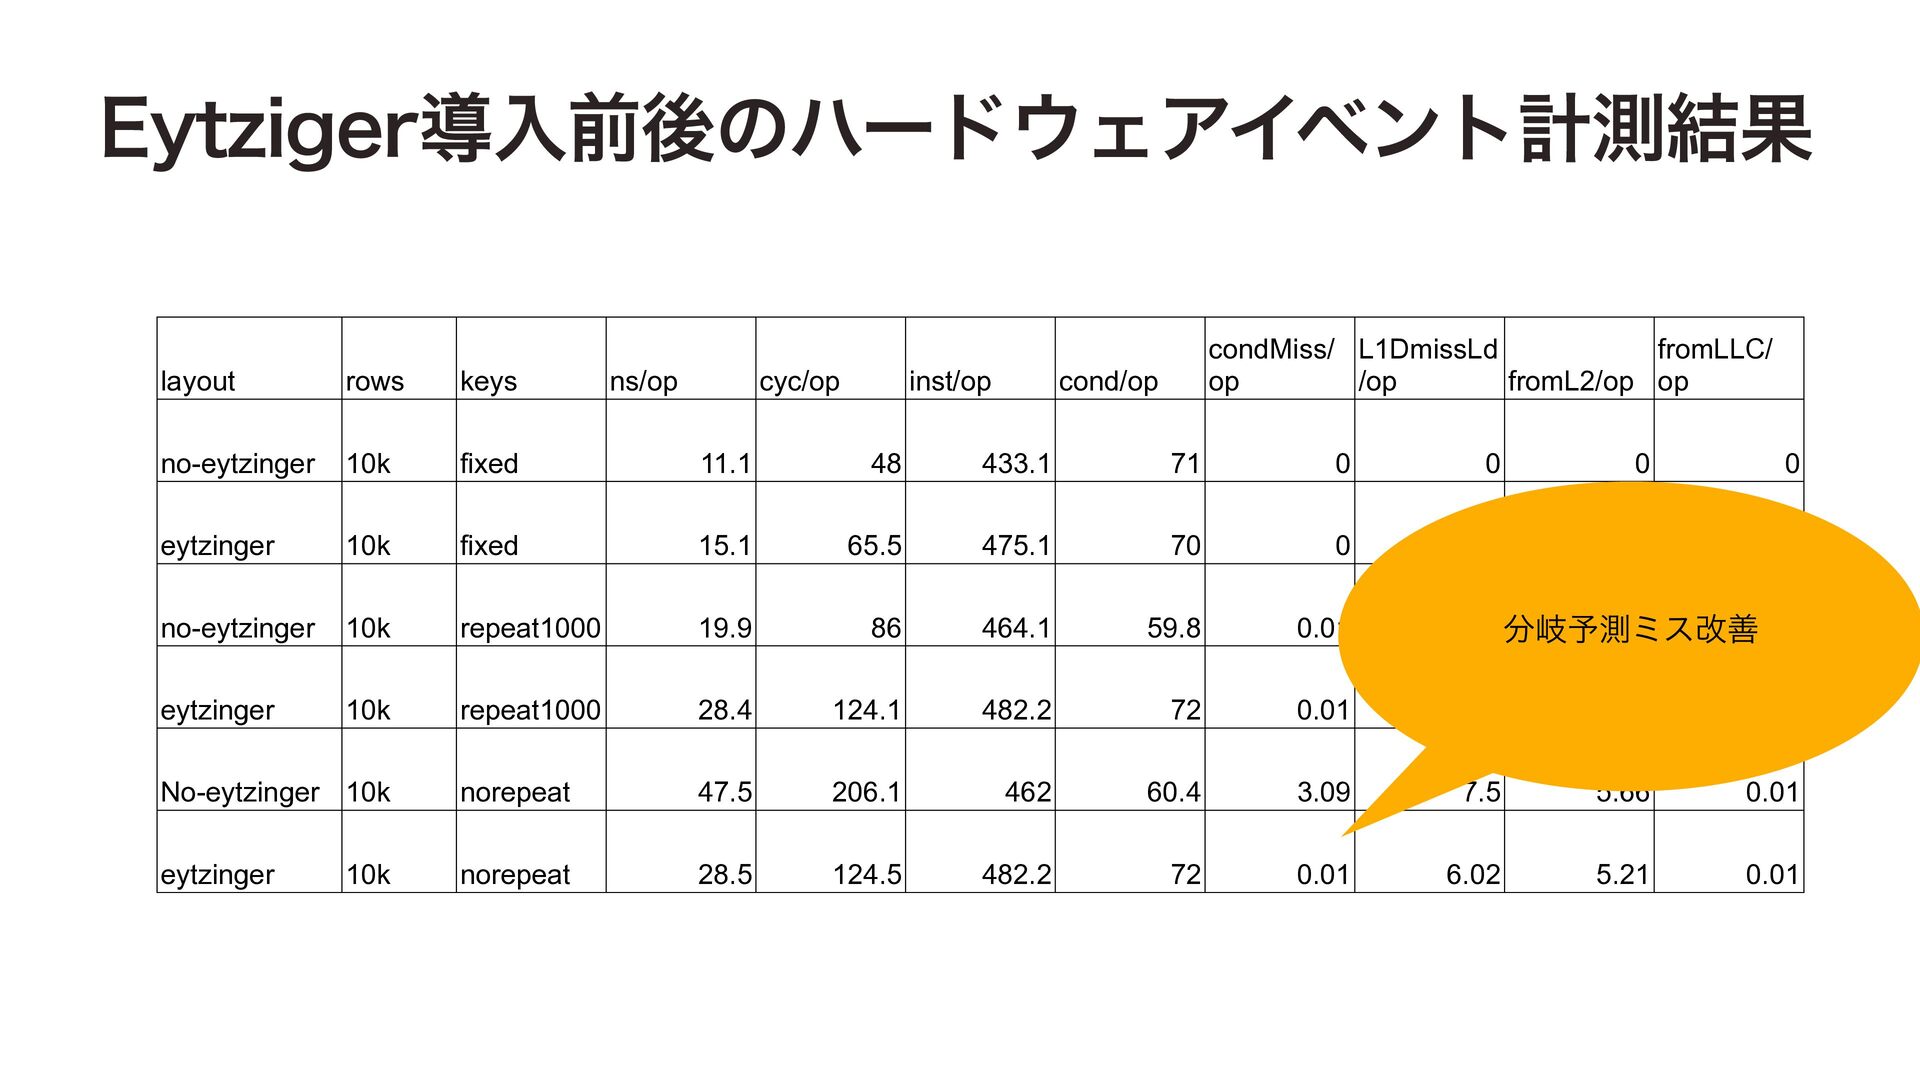
  34. Eytziger導入前後のハードウェアイベント計測結果 layout rows keys no-eytzinger 10k fixed 11.1 48 433.1

    71 0 0 0 0 eytzinger 10k fixed 15.1 65.5 475.1 70 0 0 0 0 no-eytzinger 10k repeat1000 19.9 86 464.1 59.8 0.01 9.39 分岐予測ミス改善 6.09 0.01 eytzinger 10k repeat1000 28.4 124.1 482.2 72 0.01 5.89 5.1 0.01 No-eytzinger 10k norepeat 47.5 206.1 462 60.4 3.09 7.5 5.66 0.01 eytzinger norepeat 28.5 124.5 482.2 72 0.01 6.02 5.21 0.01 10k ns/op cyc/op inst/op condMiss/ L1DmissLd fromLLC/ op /op fromL2/op op cond/op
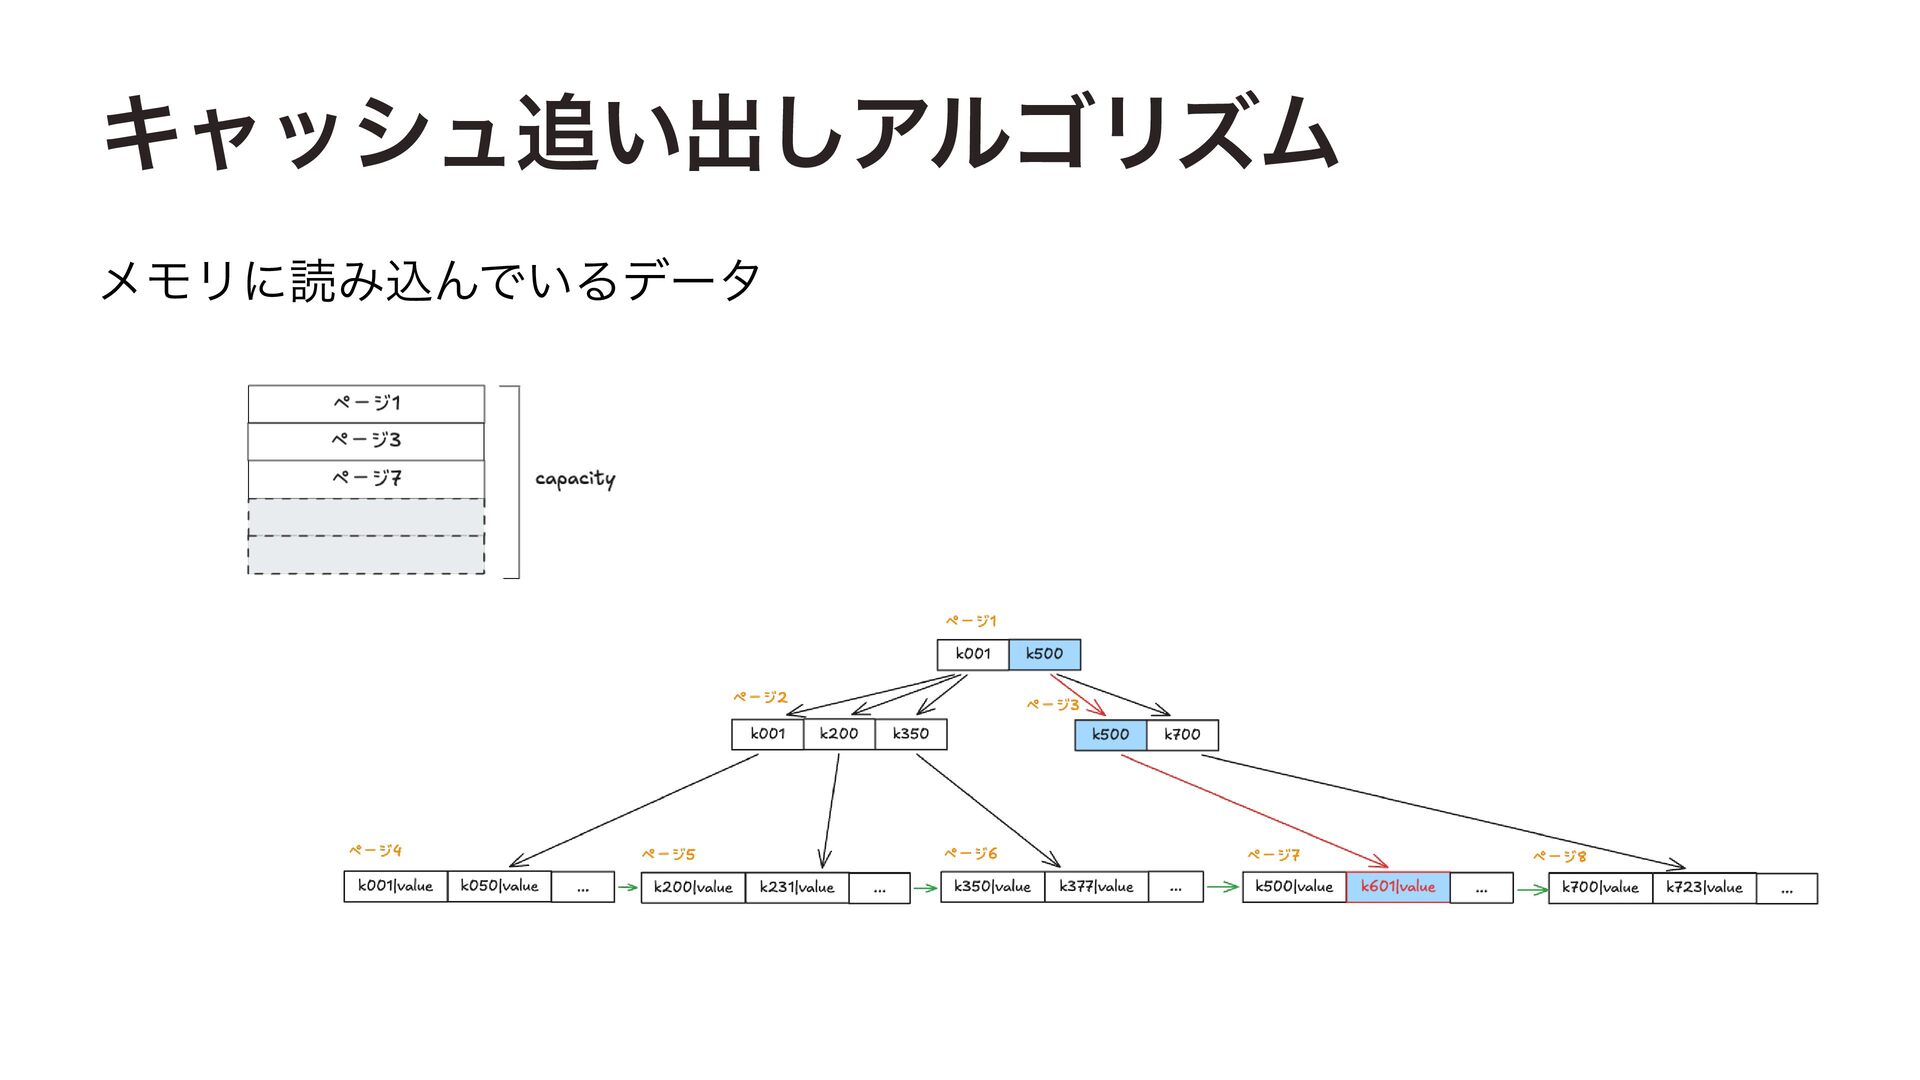
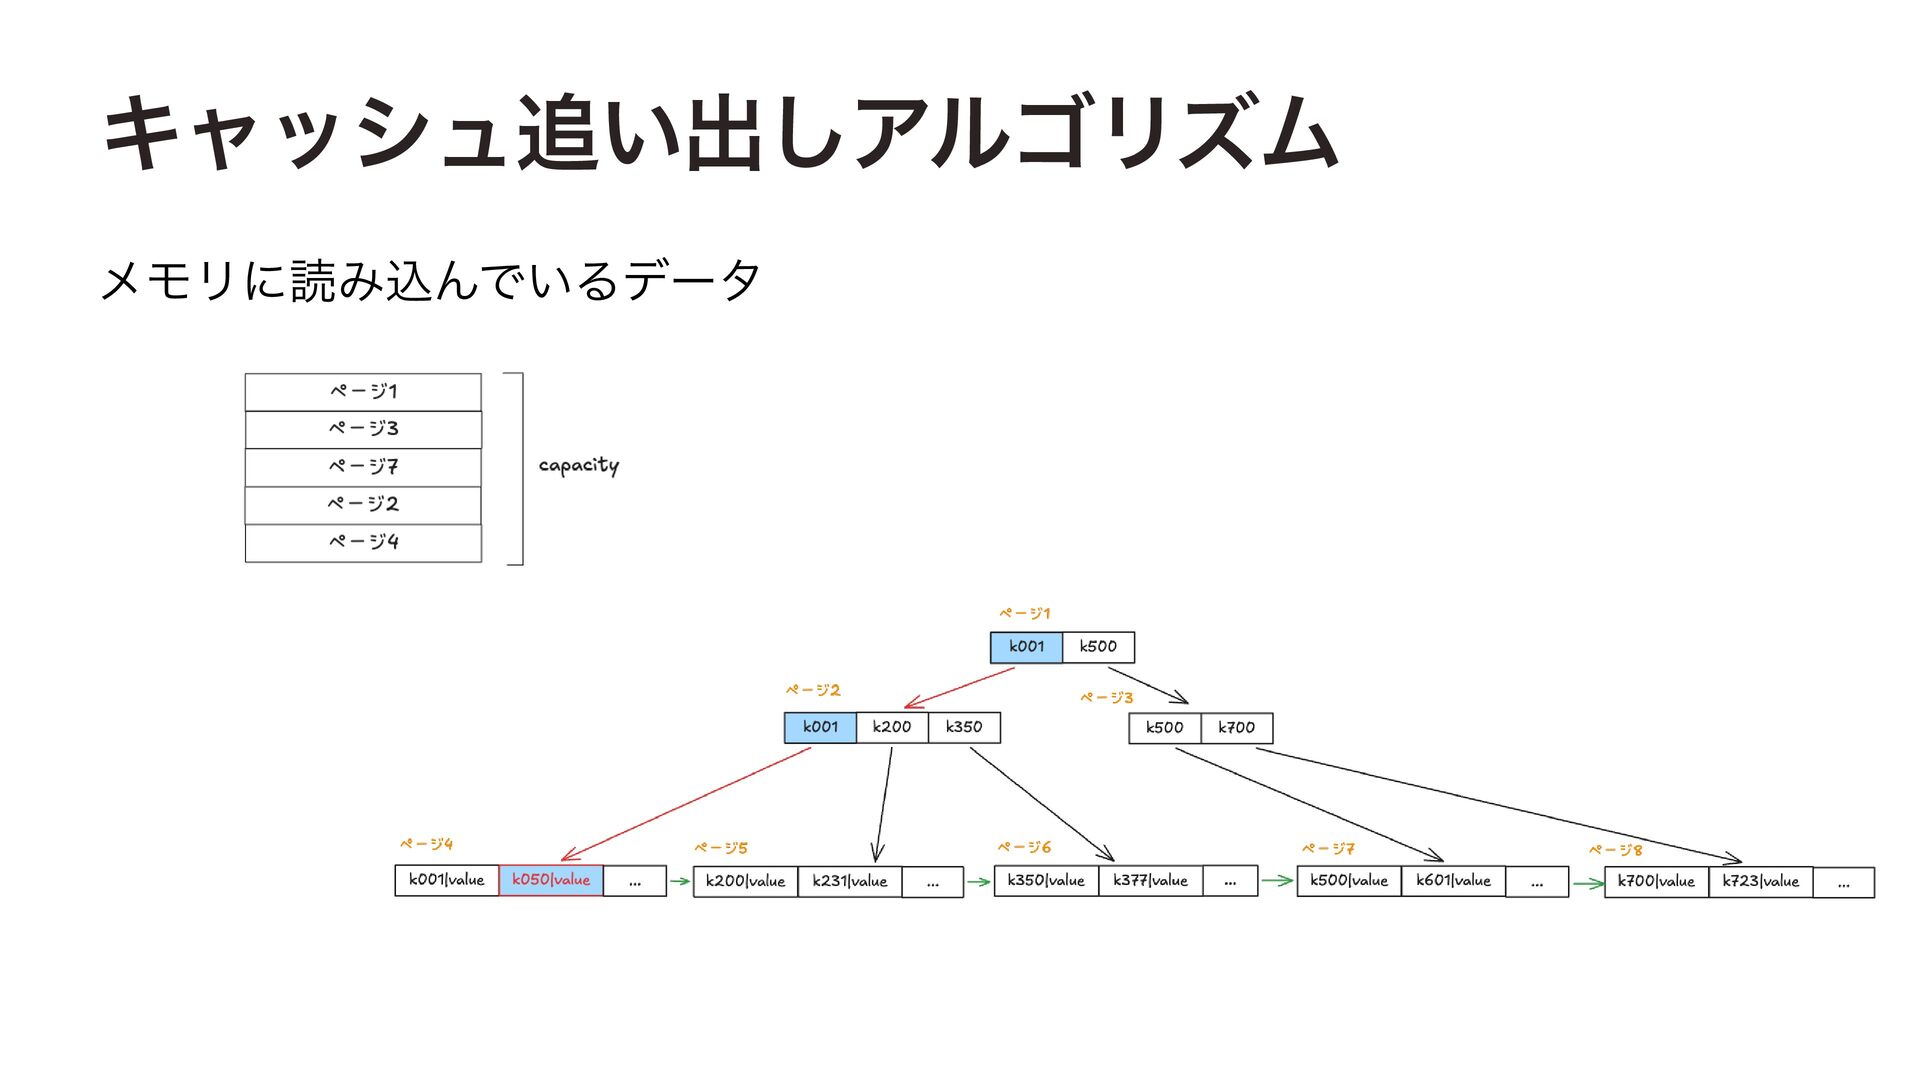
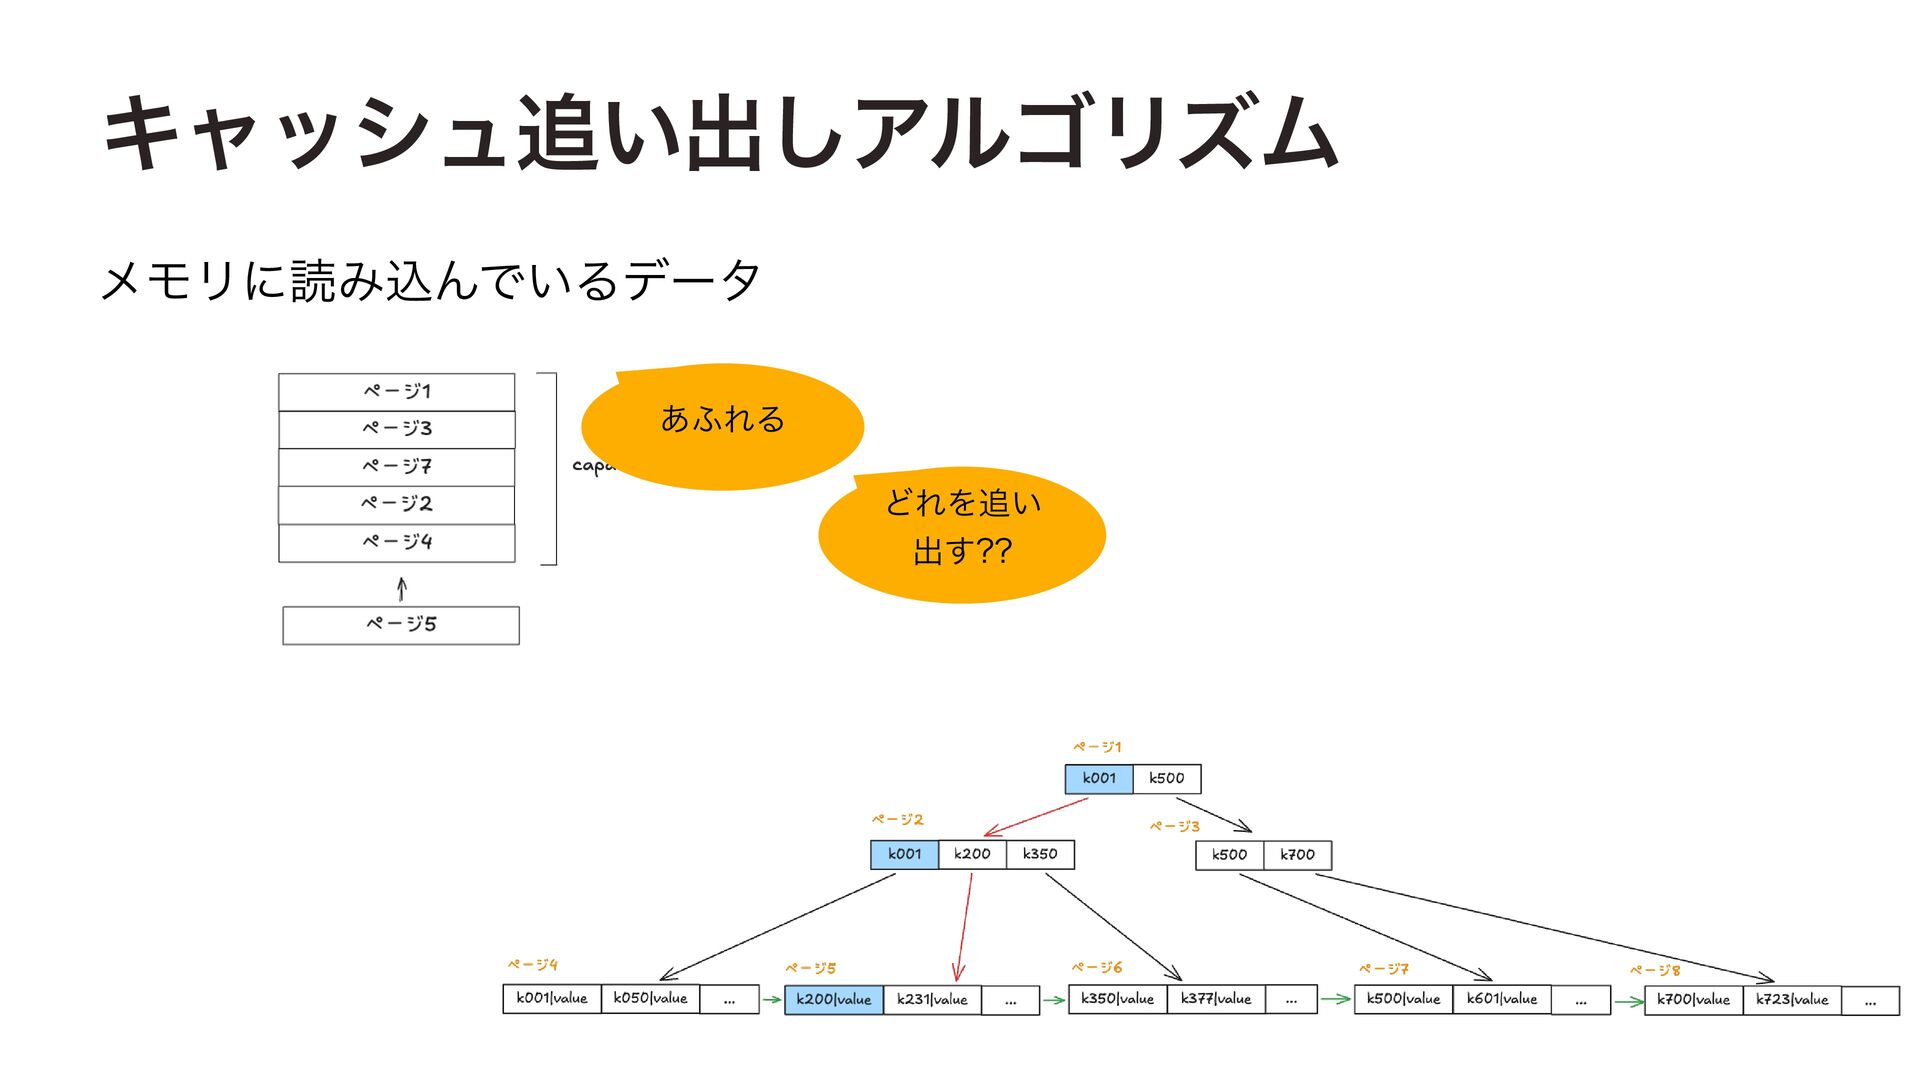
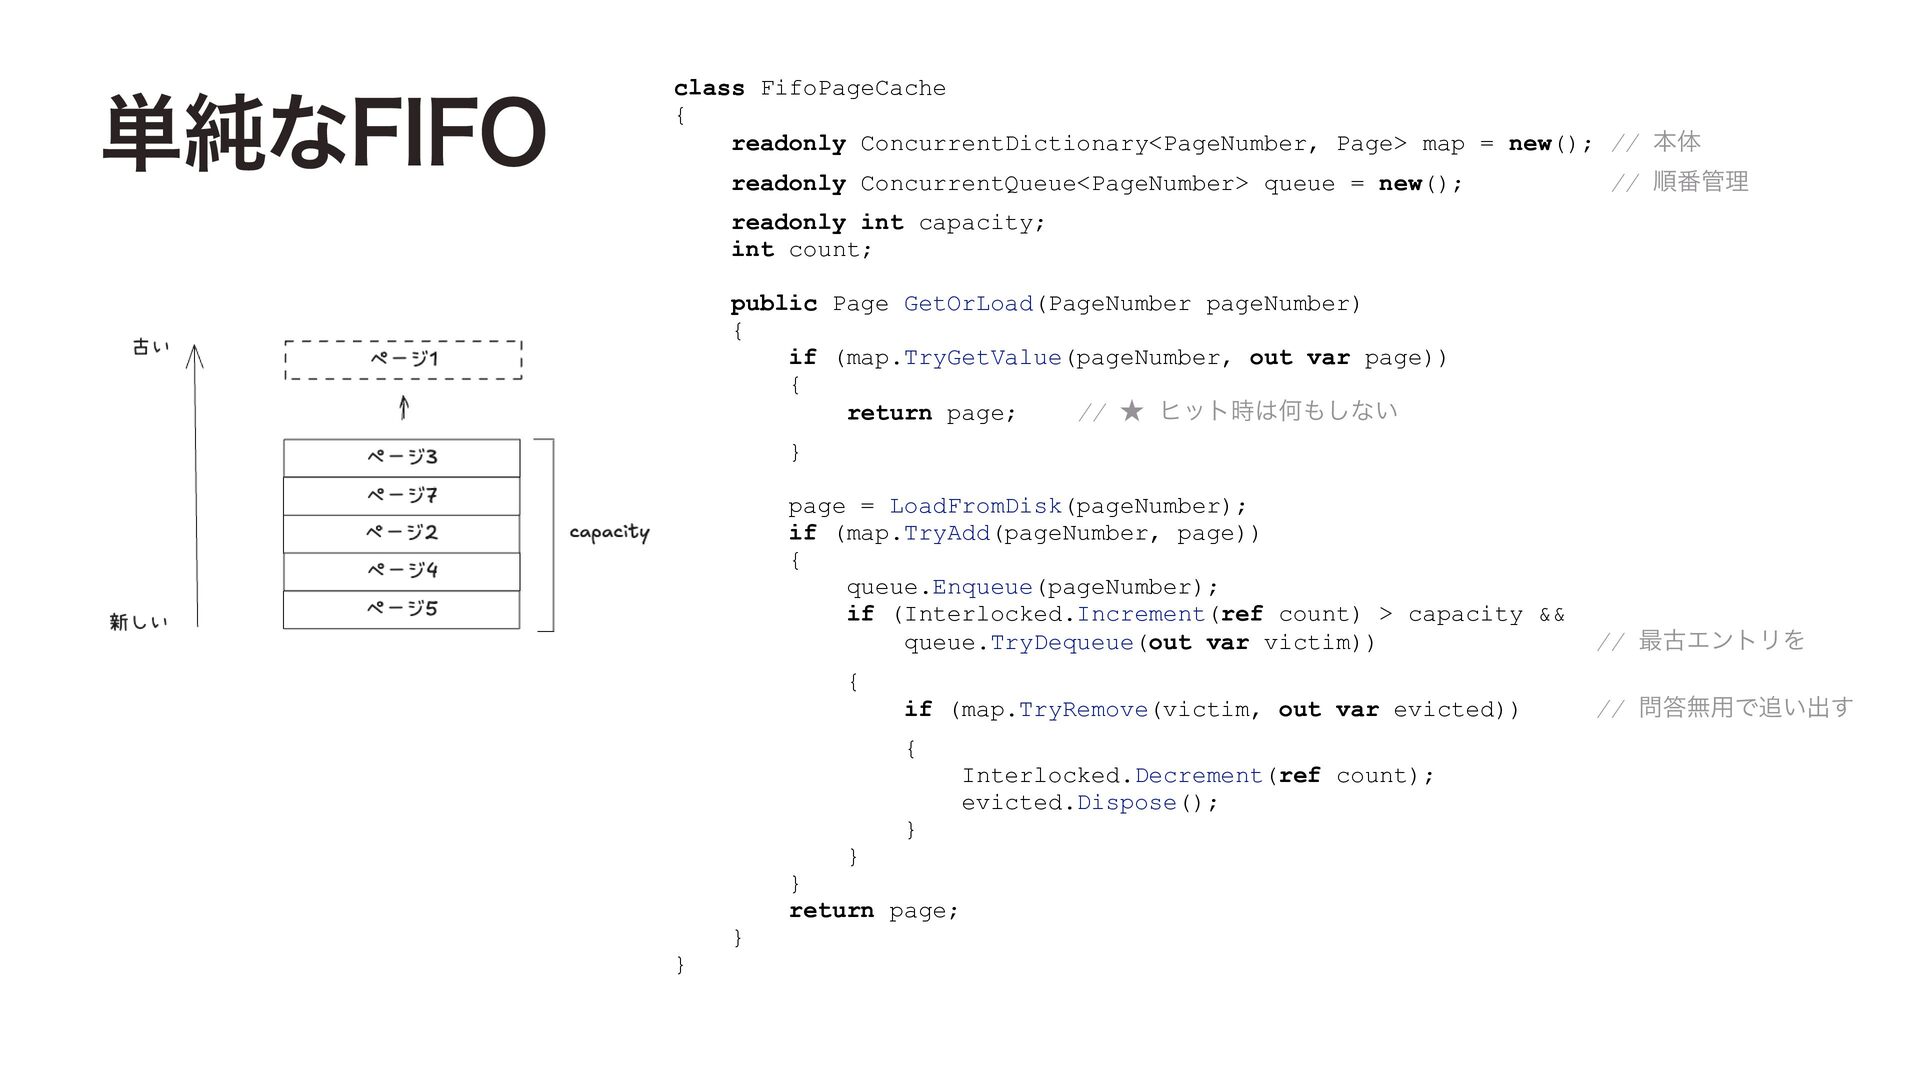
  35. 単純なFIFO class FifoPageCache { readonly ConcurrentDictionary<PageNumber, Page> map = new();

    // 本体 readonly ConcurrentQueue<PageNumber> queue = new(); // 順番管理 readonly int capacity; int count; public Page GetOrLoad(PageNumber pageNumber) { if (map.TryGetValue(pageNumber, out var page)) { return page; // ★ ヒット時は何もしない } page = LoadFromDisk(pageNumber); if (map.TryAdd(pageNumber, page)) { queue.Enqueue(pageNumber); if (Interlocked.Increment(ref count) > capacity && queue.TryDequeue(out var victim)) // 最古エントリを { if (map.TryRemove(victim, out var evicted)) { } } } } } return page; Interlocked.Decrement(ref count); evicted.Dispose(); // 問答無用で追い出す
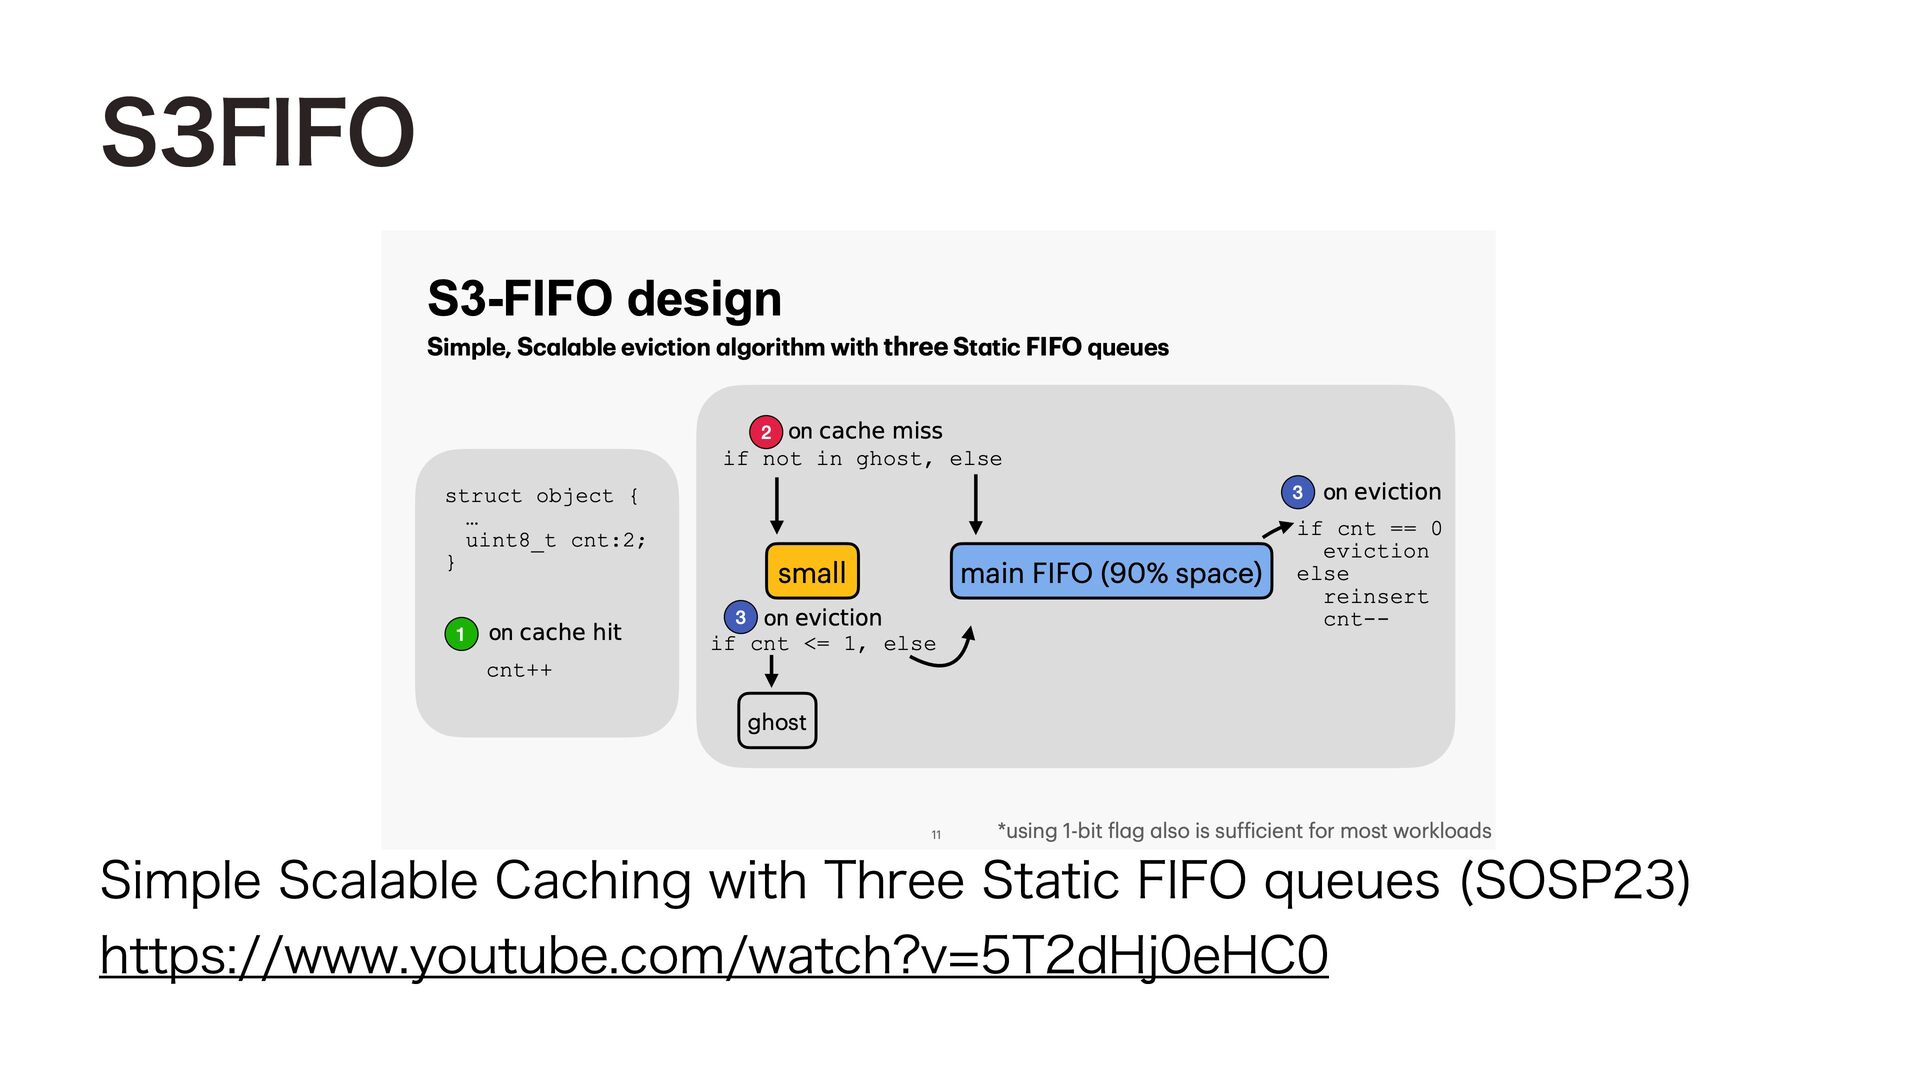
  36. S3FIFO Simple Scalable Caching with Three Static FIFO queues (SOSP23)

    https://www.youtube.com/watch?v=5T2dHj0eHC0
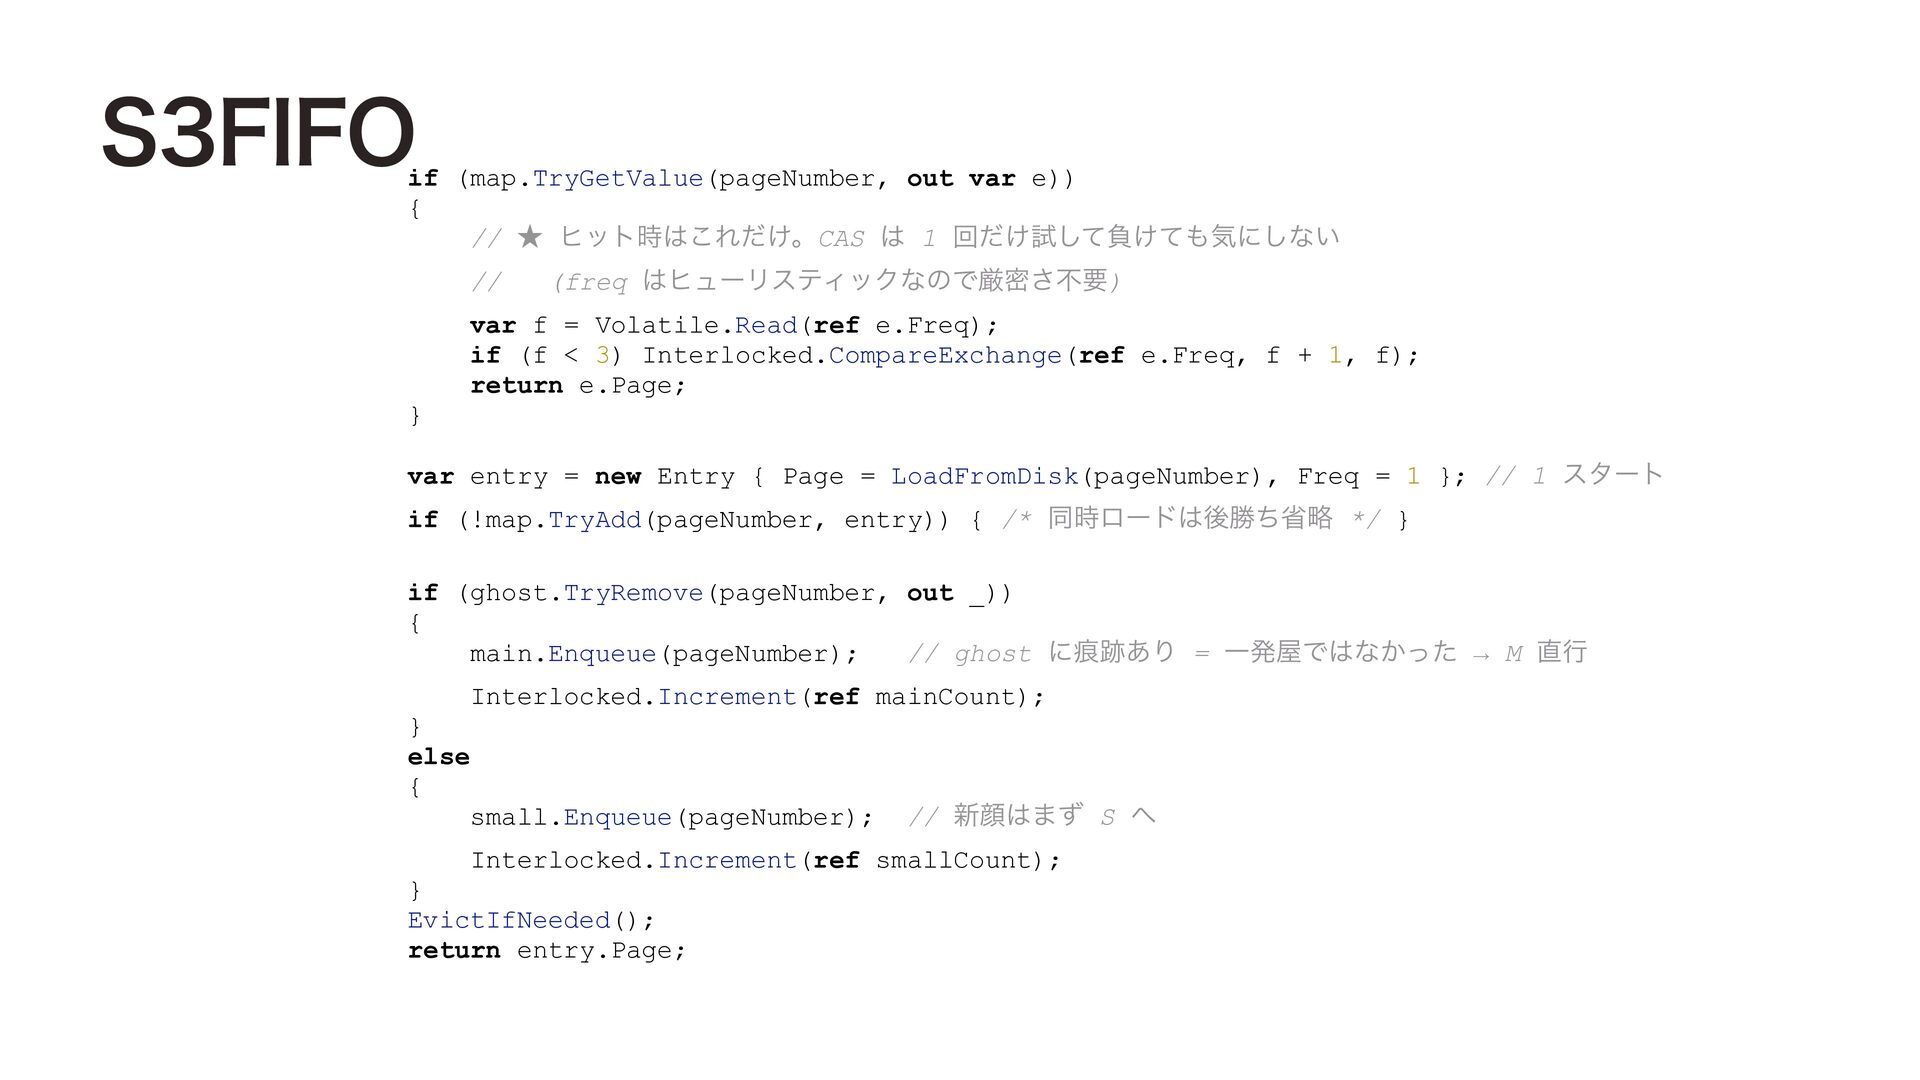
  37. S3FIFO if (map.TryGetValue(pageNumber, out var e)) { // ★ ヒット時はこれだけ。CAS

    は 1 回だけ試して負けても気にしない // (freq はヒューリスティックなので厳密さ不要) var f = Volatile.Read(ref e.Freq); if (f < 3) Interlocked.CompareExchange(ref e.Freq, f + 1, f); return e.Page; } var entry = new Entry { Page = LoadFromDisk(pageNumber), Freq = 1 }; // 1 スタート if (!map.TryAdd(pageNumber, entry)) { /* 同時ロードは後勝ち省略 */ } if (ghost.TryRemove(pageNumber, out _)) { main.Enqueue(pageNumber); // ghost に痕跡あり = 一発屋ではなかった → M 直行 Interlocked.Increment(ref mainCount); } else { small.Enqueue(pageNumber); // 新顔はまず S へ Interlocked.Increment(ref smallCount); } EvictIfNeeded(); return entry.Page;
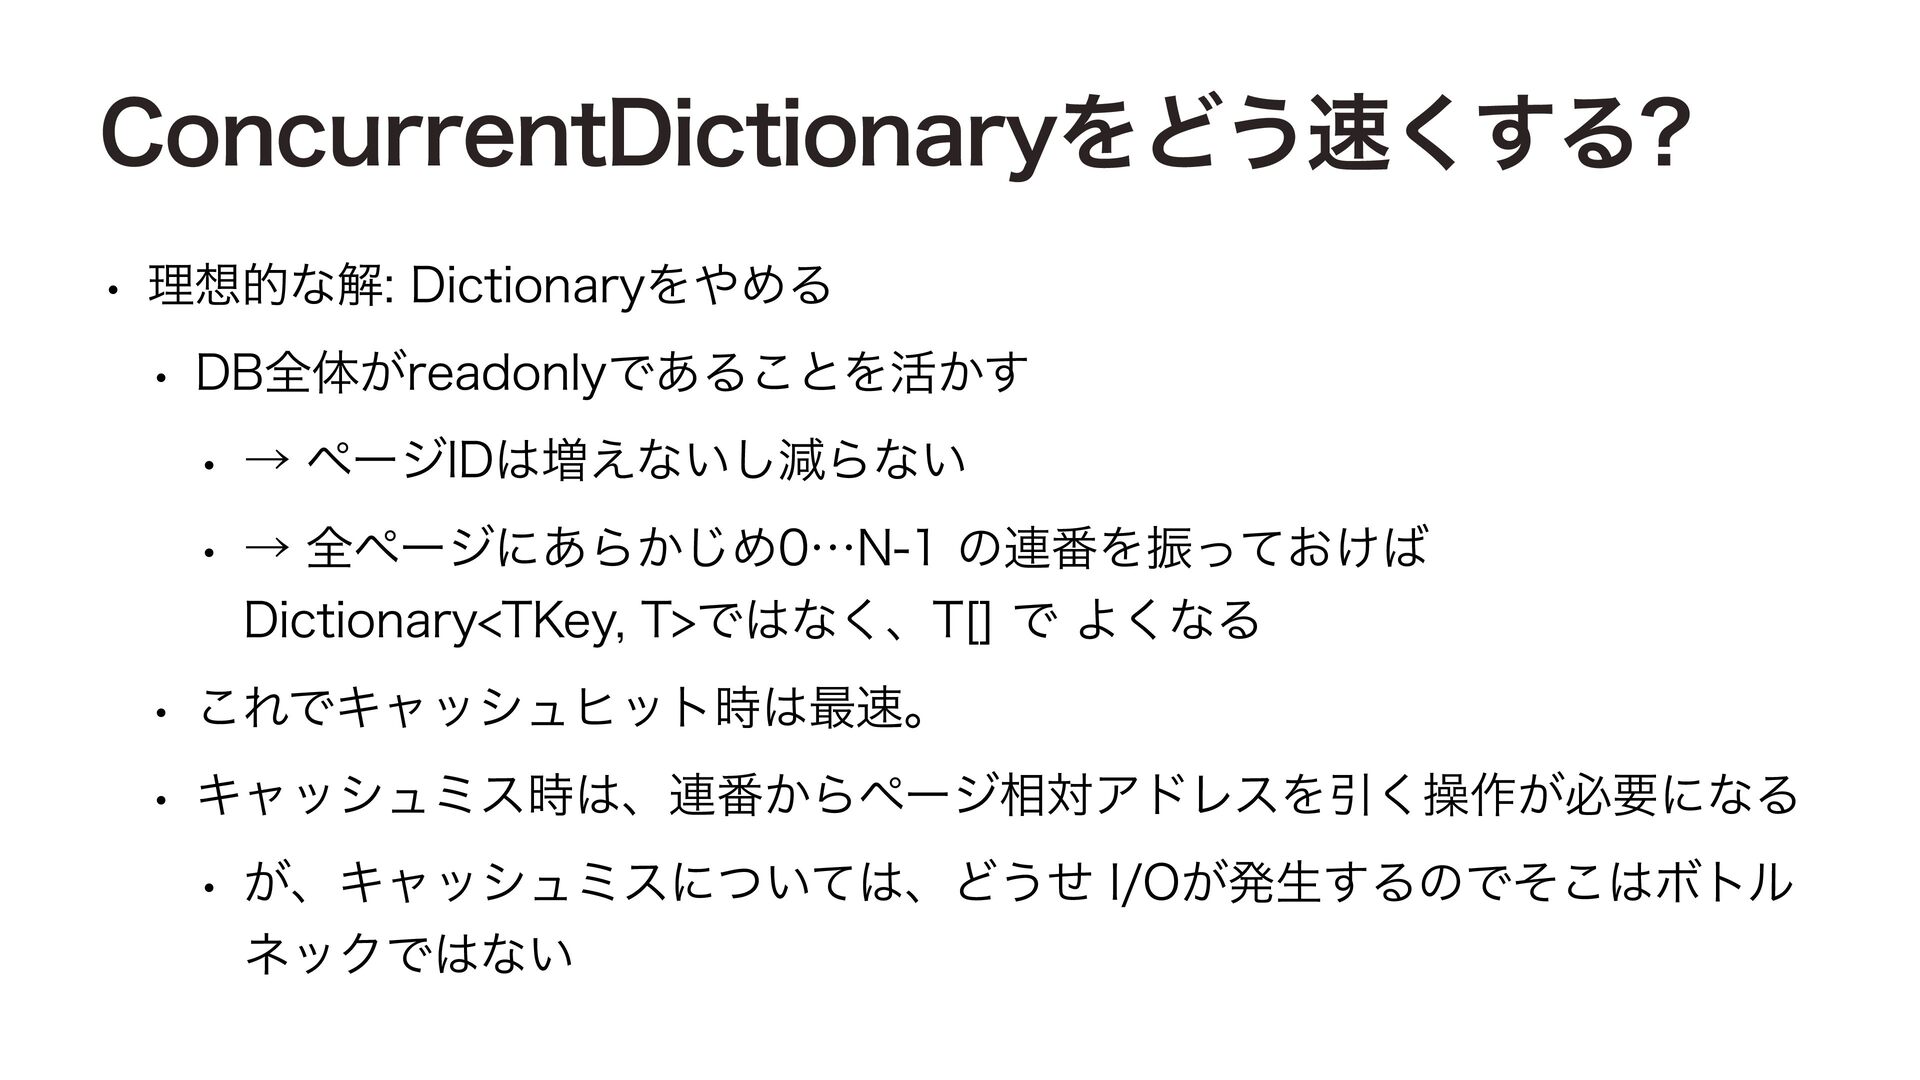
  38. ConcurrentDictionaryをどう速くする? • 理想的な解: Dictionaryをやめる • DB全体がreadonlyであることを活かす • → ページIDは増えないし減らない •

    → 全ページにあらかじめ0…N-1 の連番を振っておけば Dictionary<TKey, T>ではなく、T[] で よくなる • これでキャッシュヒット時は最速。 • キャッシュミス時は、連番からページ相対アドレスを引く操作が必要になる • が、キャッシュミスについては、どうせ I/Oが発生するのでそこはボトル ネックではない
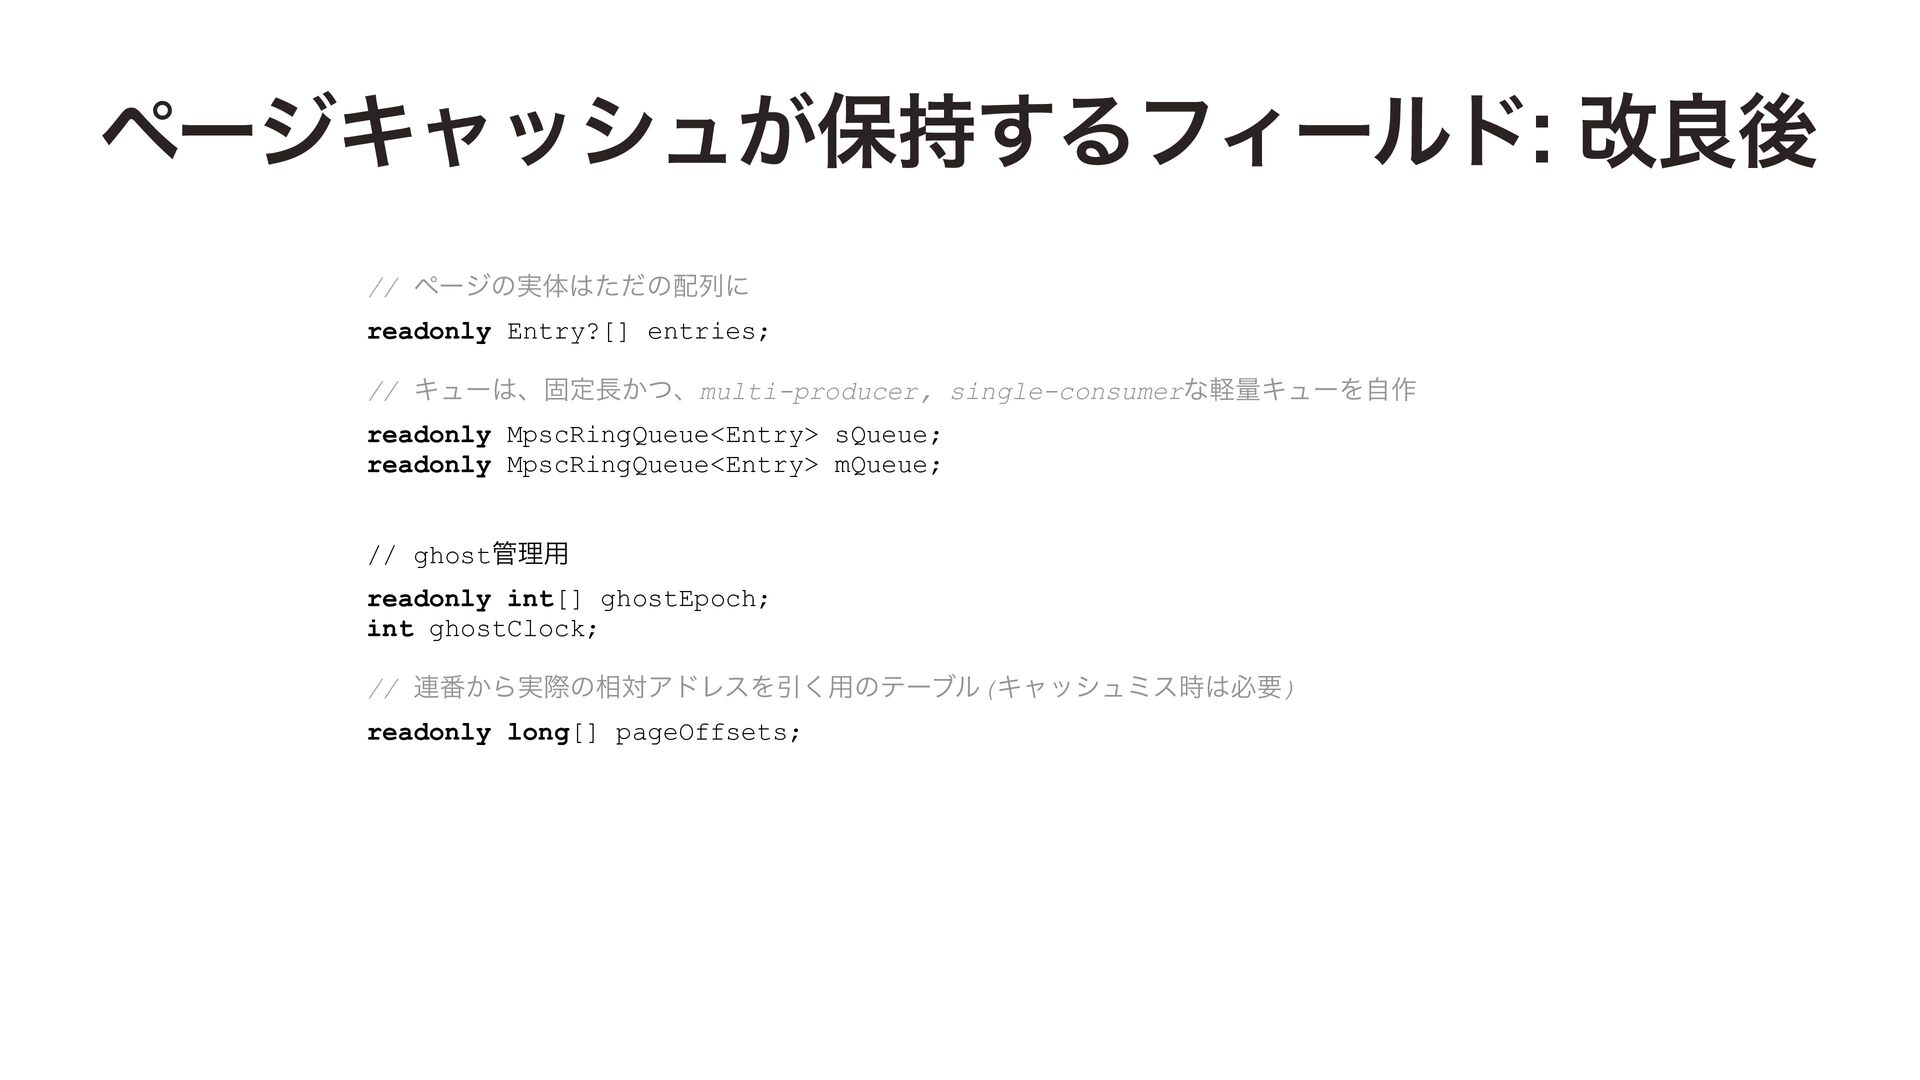
  39. ページキャッシュが保持するフィールド: 改良後 // ページの実体はただの配列に readonly Entry?[] entries; // キューは、固定長かつ、multi-producer, single-consumerな軽量キューを自作

    readonly MpscRingQueue<Entry> sQueue; readonly MpscRingQueue<Entry> mQueue; // ghost管理用 readonly int[] ghostEpoch; int ghostClock; // 連番から実際の相対アドレスを引く用のテーブル(キャッシュミス時は必要) readonly long[] pageOffsets;
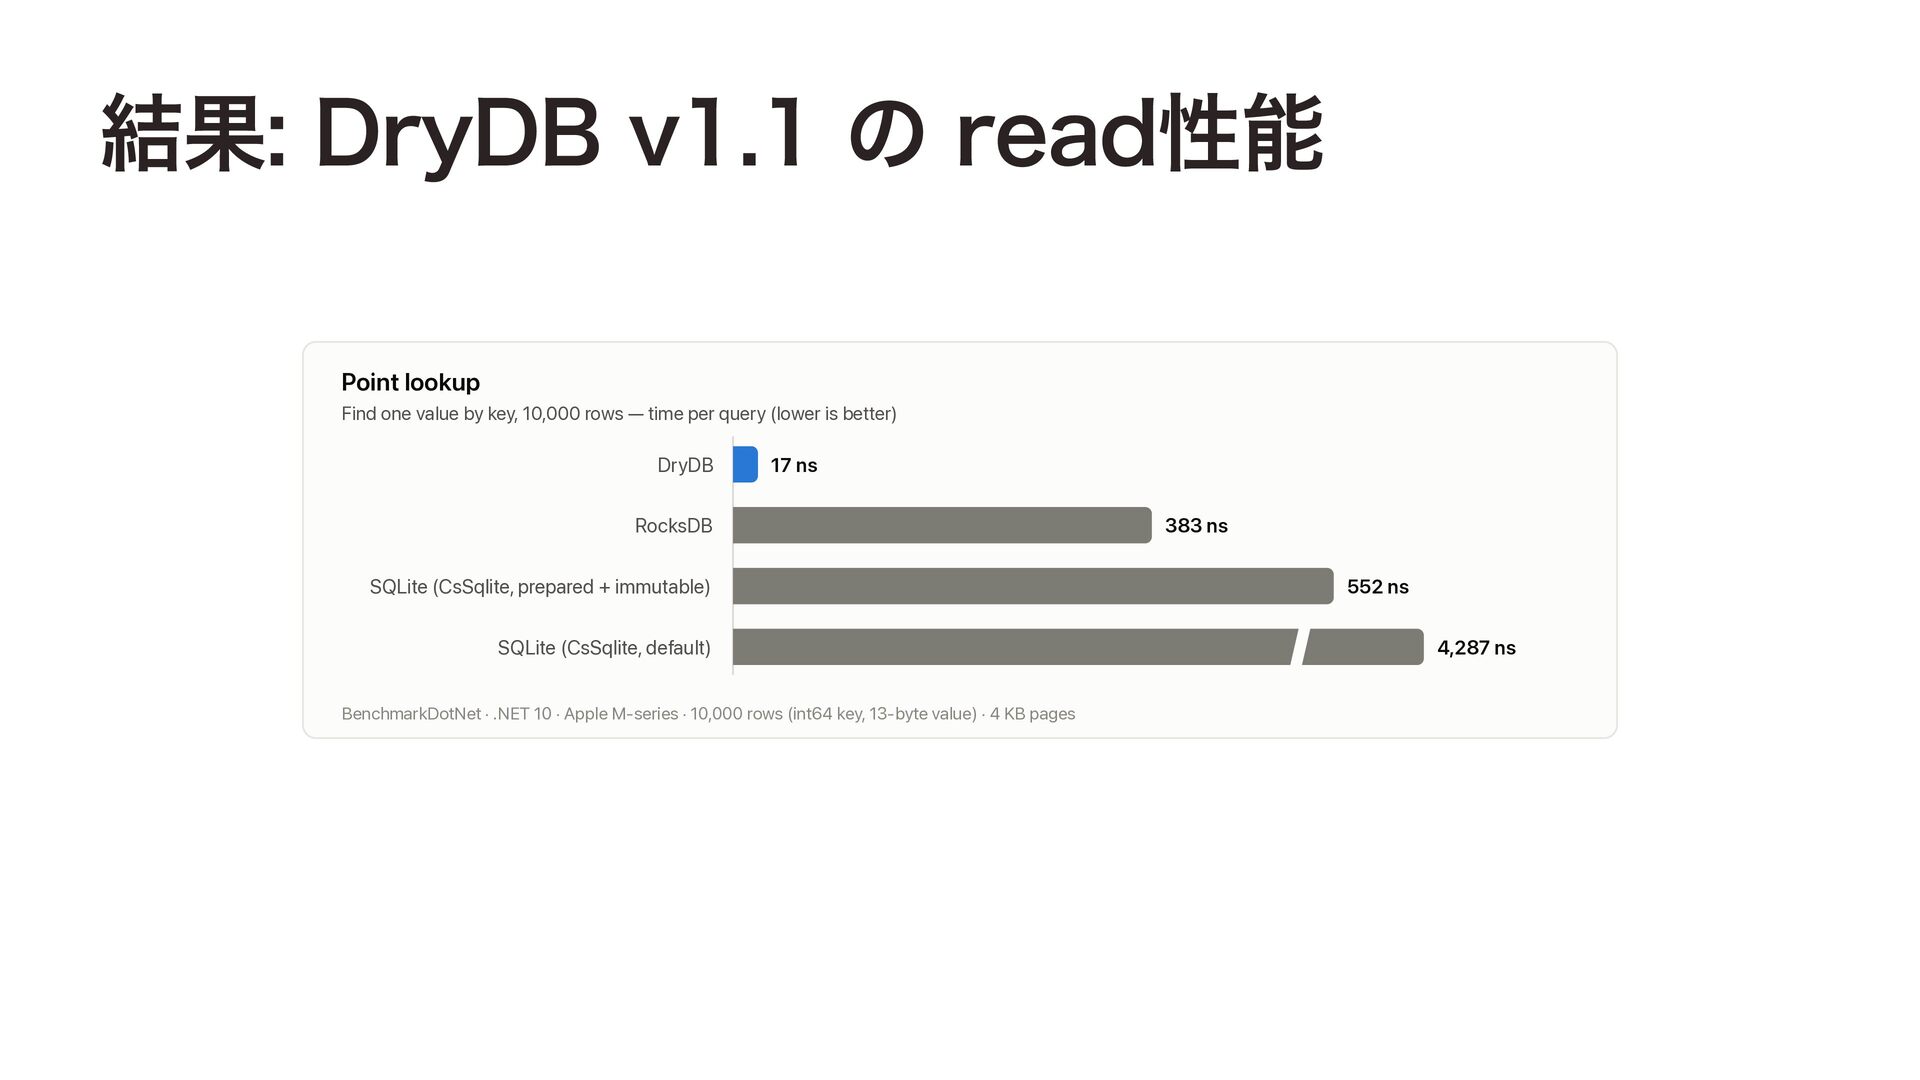
  40. 結果: DryDB v1.1 の read性能 Point lookup Find one value

    by key, 10,000 rows — time per query (lower is better) DryDB 17 ns RocksDB SQLite (CsSqlite, prepared + immutable) SQLite (CsSqlite, default) BenchmarkDotNet · .NET 10 · Apple M-series · 10,000 rows (int64 key, 13-byte value) · 4 KB pages 383 ns 552 ns 4,287 ns
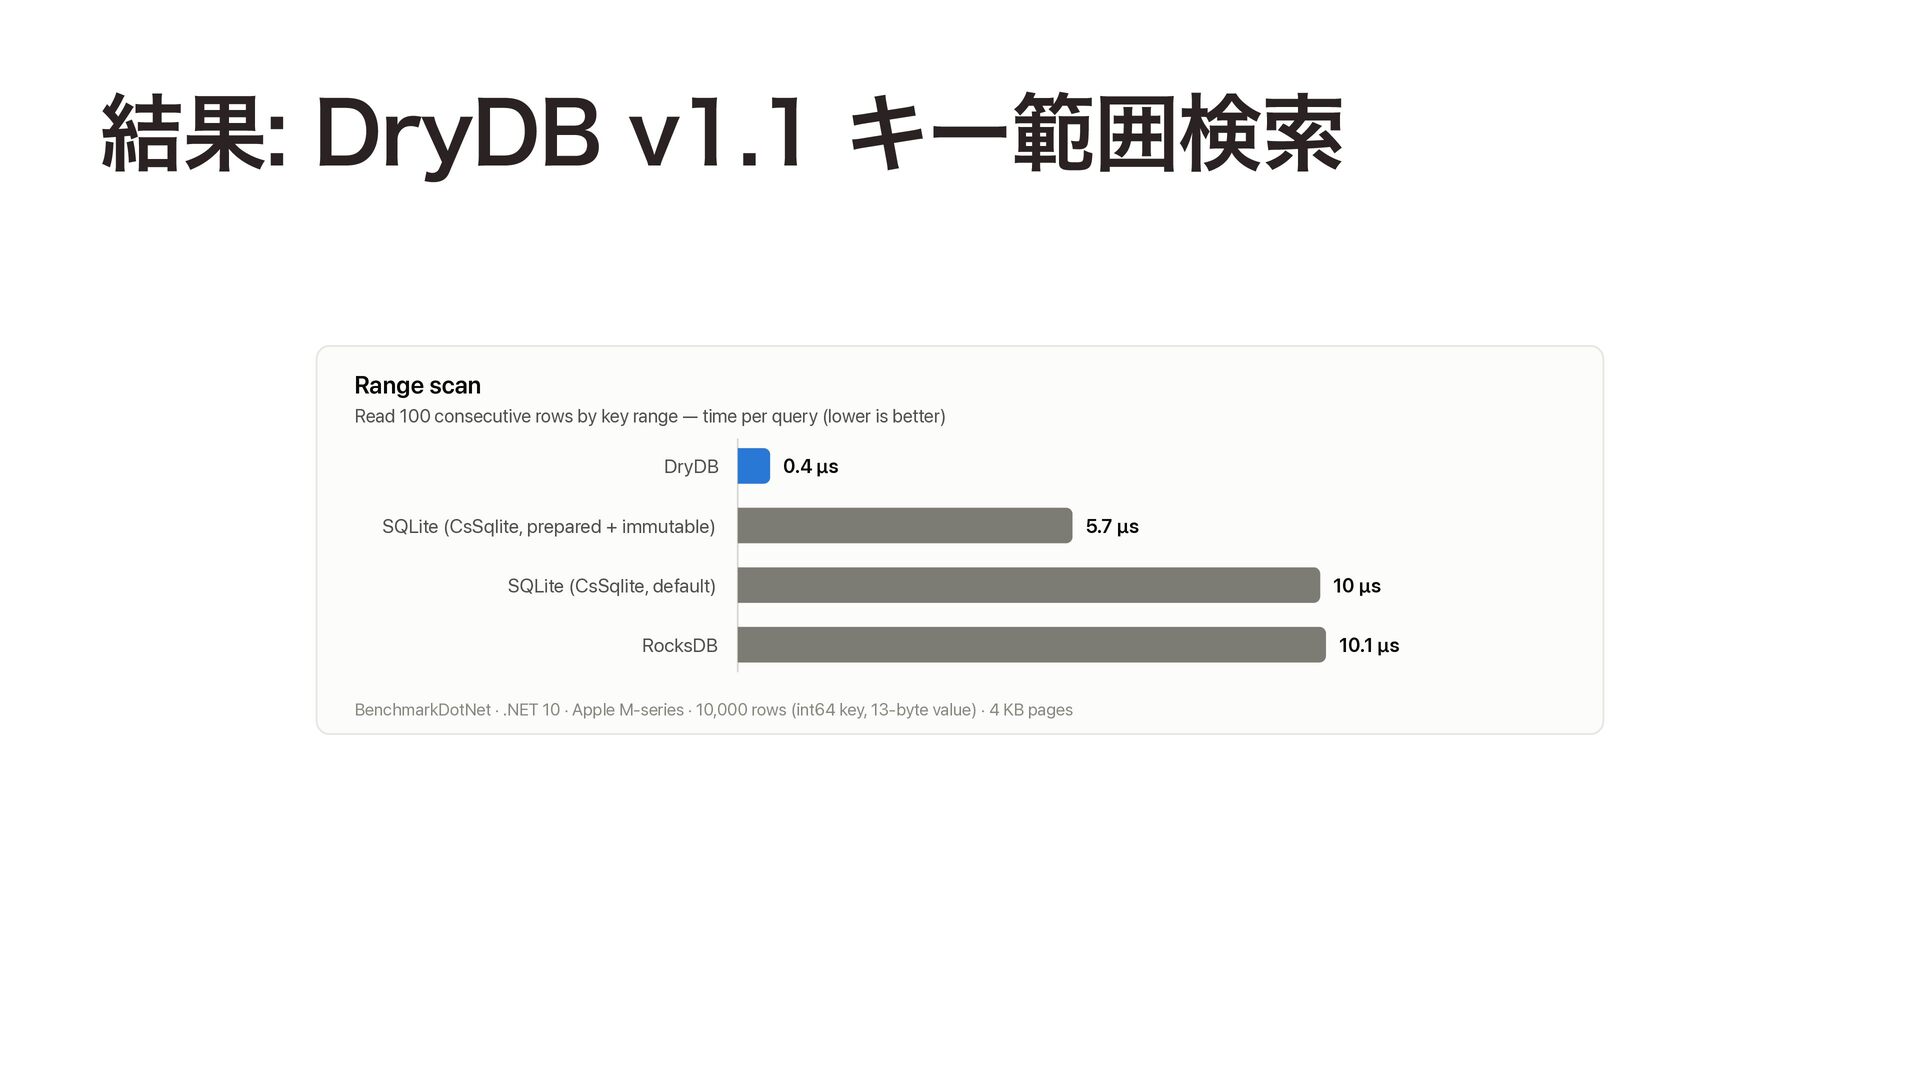
  41. 結果: DryDB v1.1 キー範囲検索 Range scan Read 100 consecutive rows

    by key range — time per query (lower is better) DryDB 0.4 µs SQLite (CsSqlite, prepared + immutable) SQLite (CsSqlite, default) RocksDB BenchmarkDotNet · .NET 10 · Apple M-series · 10,000 rows (int64 key, 13-byte value) · 4 KB pages 5.7 µs 10 µs 10.1 µs
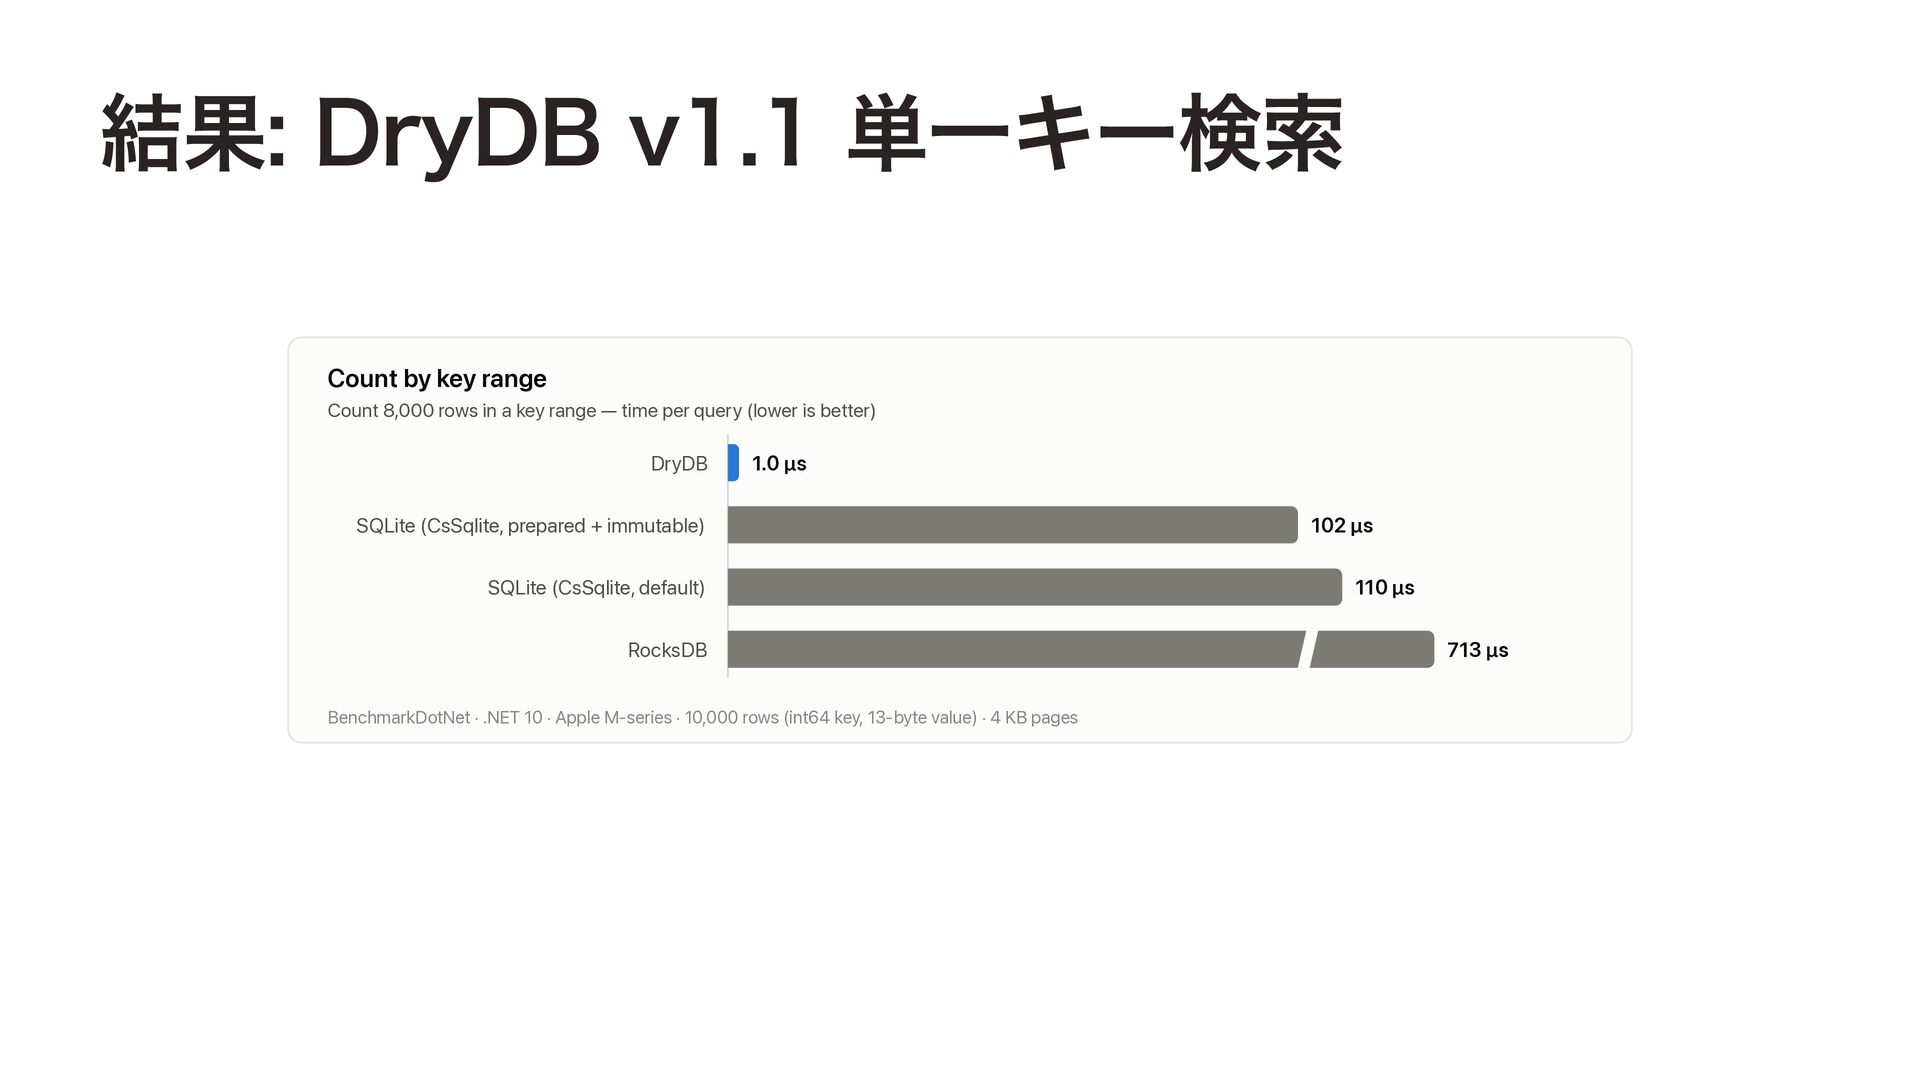
  42. 結果: DryDB v1.1 単一キー検索 Count by key range Count 8,000

    rows in a key range — time per query (lower is better) DryDB 1.0 µs SQLite (CsSqlite, prepared + immutable) SQLite (CsSqlite, default) RocksDB BenchmarkDotNet · .NET 10 · Apple M-series · 10,000 rows (int64 key, 13-byte value) · 4 KB pages 102 µs 110 µs 713 µs