Share
Embed
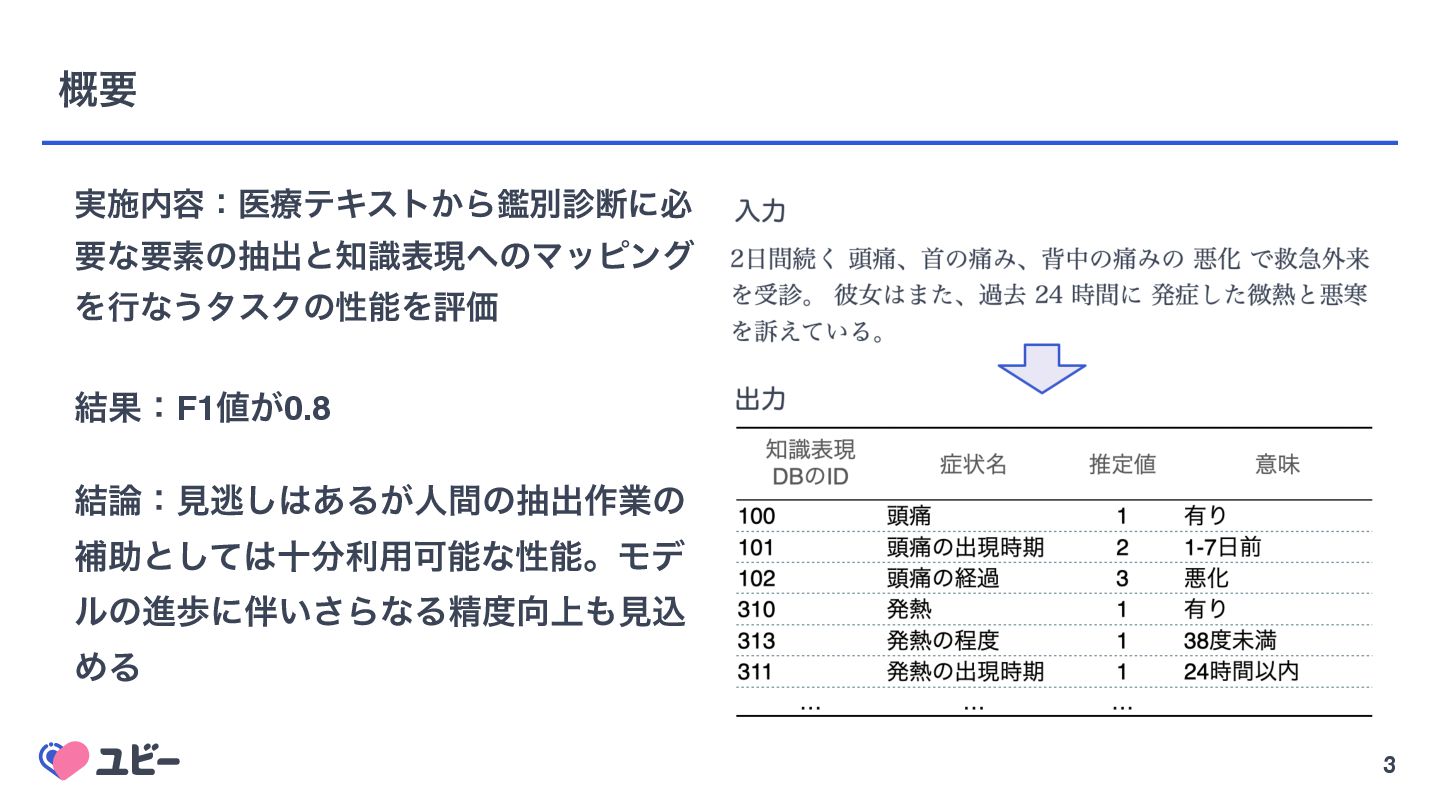
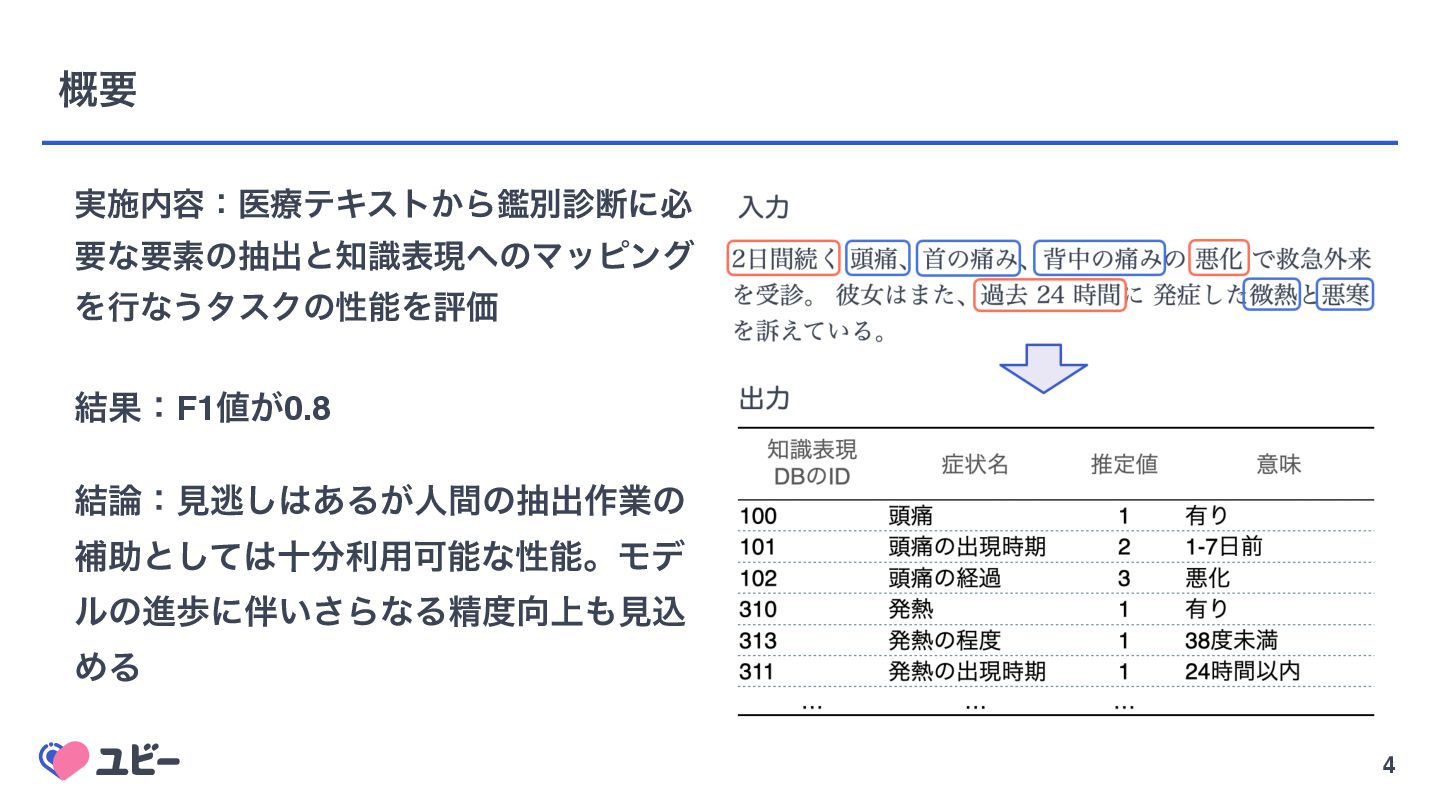
診断前の病歴テキストを対象としたLLMによるエンティティリンキング精度検証
2025年度人工知能学会全国大会(第39回)の口頭発表資料
キーワード:医療テキスト、LLM、NLP、固有表現抽出、Entity Linking
Evaluation of Entity Linking Accuracy Using LLMs on Pre-Diagnostic Medical History Texts
https://confit.atlas.jp/guide/event/jsai2025/subject/1O4-OS-18a-04/advanced?cryptoId=
Takashi Nishibayashi
May 29, 2025
Transcript
28 slides
-
2 ൃදͷ༰ • ݚڀ֓ཁ • എܠɾత • ࡐྉɾ࣮ݧઃఆ • ݁Ռ
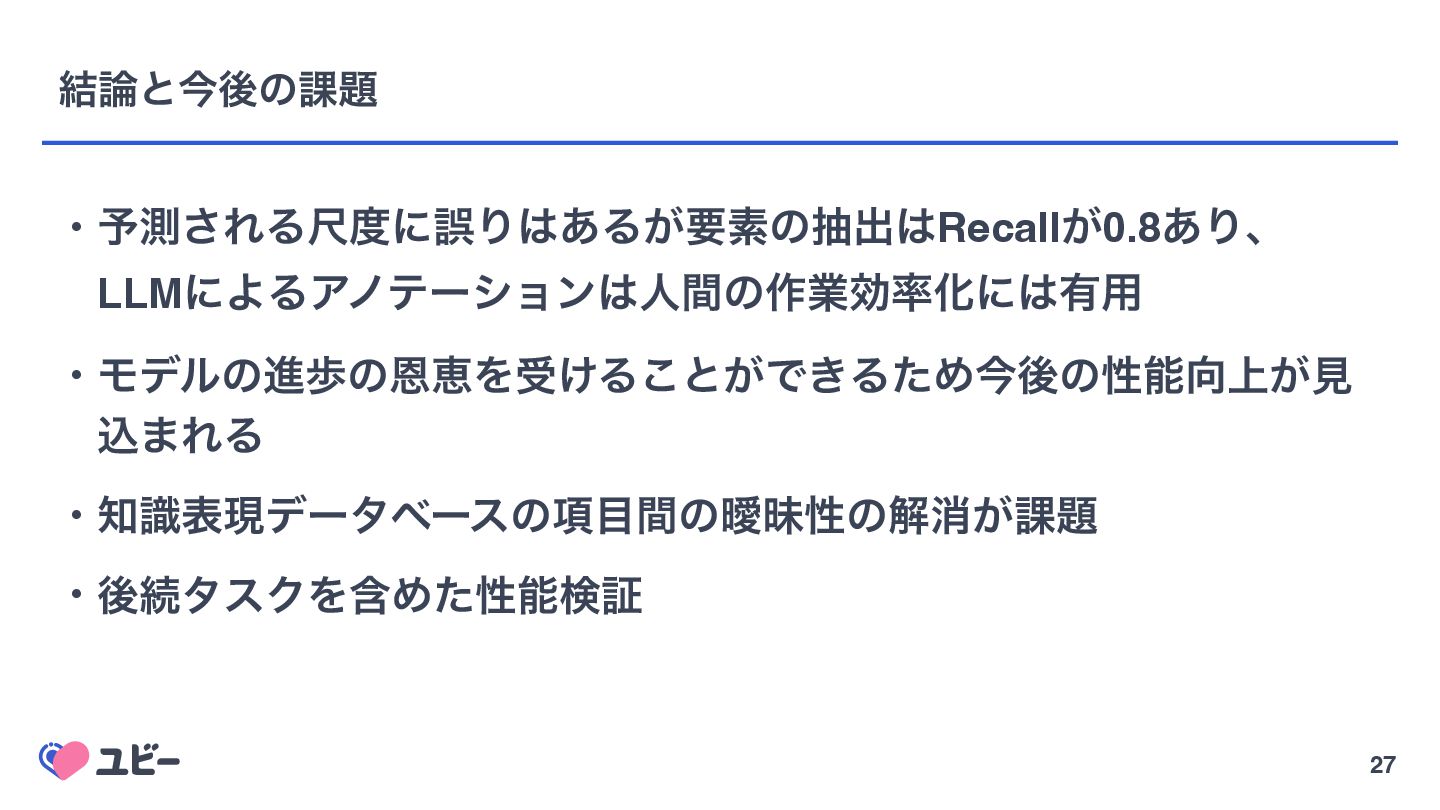
• LLMग़ྗͷޡΓੳ • ݁ͱࠓޙͷ՝ -
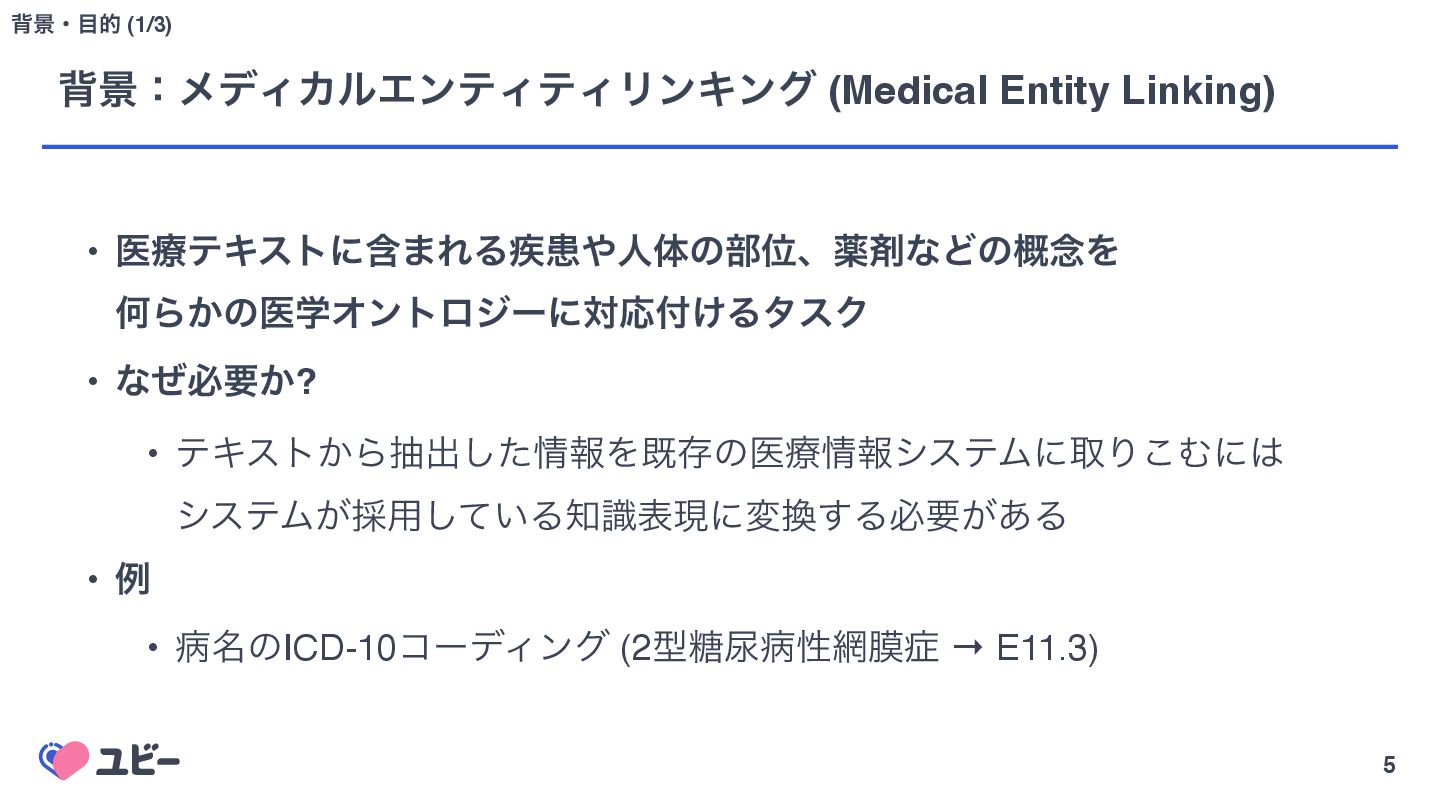
5 എܠɿϝσΟΧϧΤϯςΟςΟϦϯΩϯά (Medical Entity Linking) എܠɾత (1/3) • ҩྍςΩετʹؚ·ΕΔ࣬ױਓମͷ෦ҐɺༀࡎͳͲͷ֓೦Λ ԿΒ͔ͷҩֶΦϯτϩδʔʹରԠ͚ΔλεΫ
• ͳͥඞཁ͔? • ςΩετ͔Βநग़ͨ͠ใΛطଘͷҩྍใγεςϜʹऔΓ͜Ήʹ γεςϜ͕࠾༻͍ͯ͠Δࣝදݱʹม͢Δඞཁ͕͋Δ • ྫ • ප໊ͷICD-10ίʔσΟϯά (2ܕපੑບ → E11.3) -
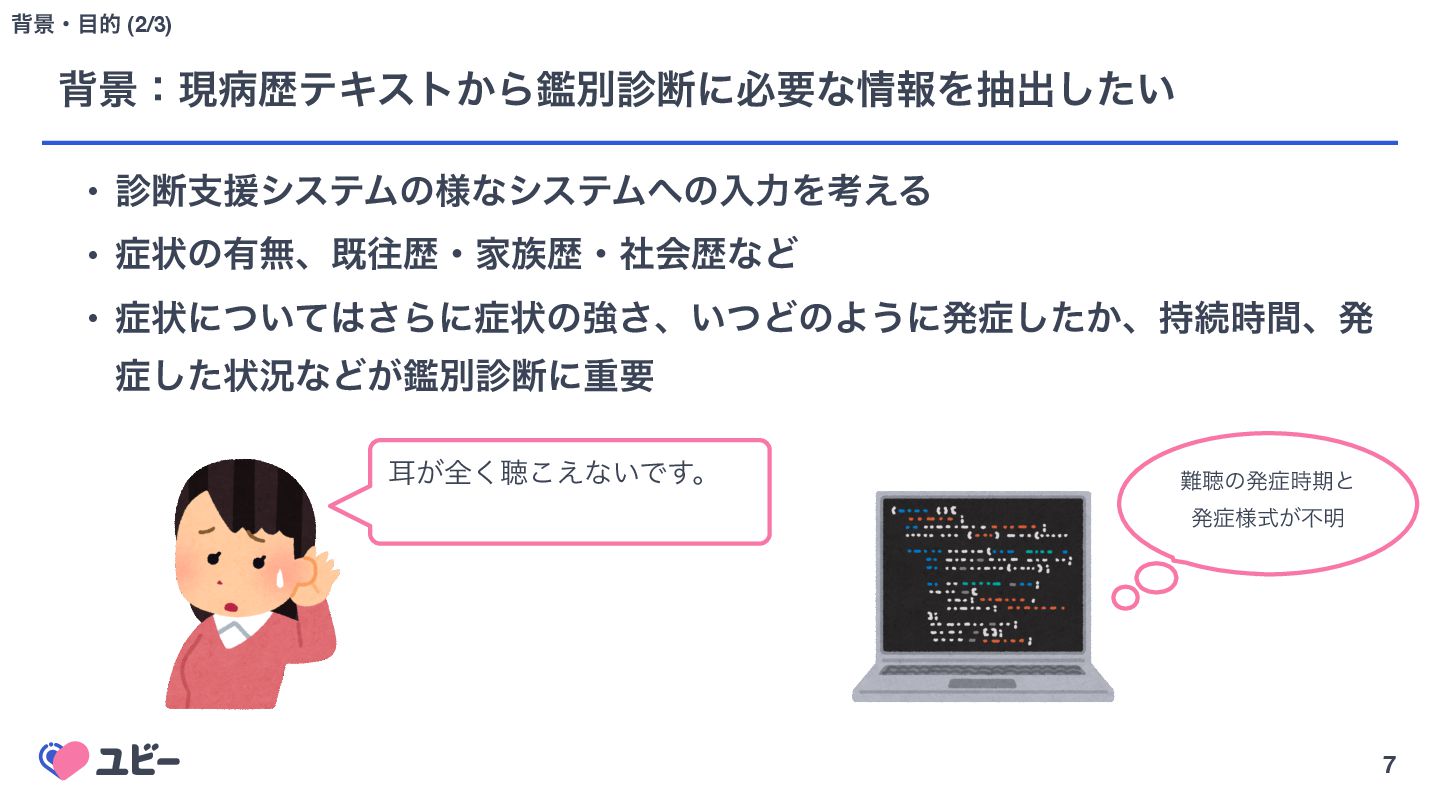
7 എܠɿݱපྺςΩετ͔ΒؑผஅʹඞཁͳใΛநग़͍ͨ͠ എܠɾత (2/3) ͕ࣖશ͘ௌ͑͜ͳ͍Ͱ͢ɻ ௌͷൃ࣌ظͱ ൃ༷͕ࣜෆ໌ • அࢧԉγεςϜͷ༷ͳγεςϜͷೖྗΛߟ͑Δ •
ঢ়ͷ༗ແɺطԟྺɾՈྺɾࣾձྺͳͲ • ঢ়ʹ͍ͭͯ͞Βʹঢ়ͷڧ͞ɺ͍ͭͲͷΑ͏ʹൃ͔ͨ͠ɺ࣋ଓ࣌ؒɺൃ ͨ͠ঢ়گͳͲ͕ؑผஅʹॏཁ -
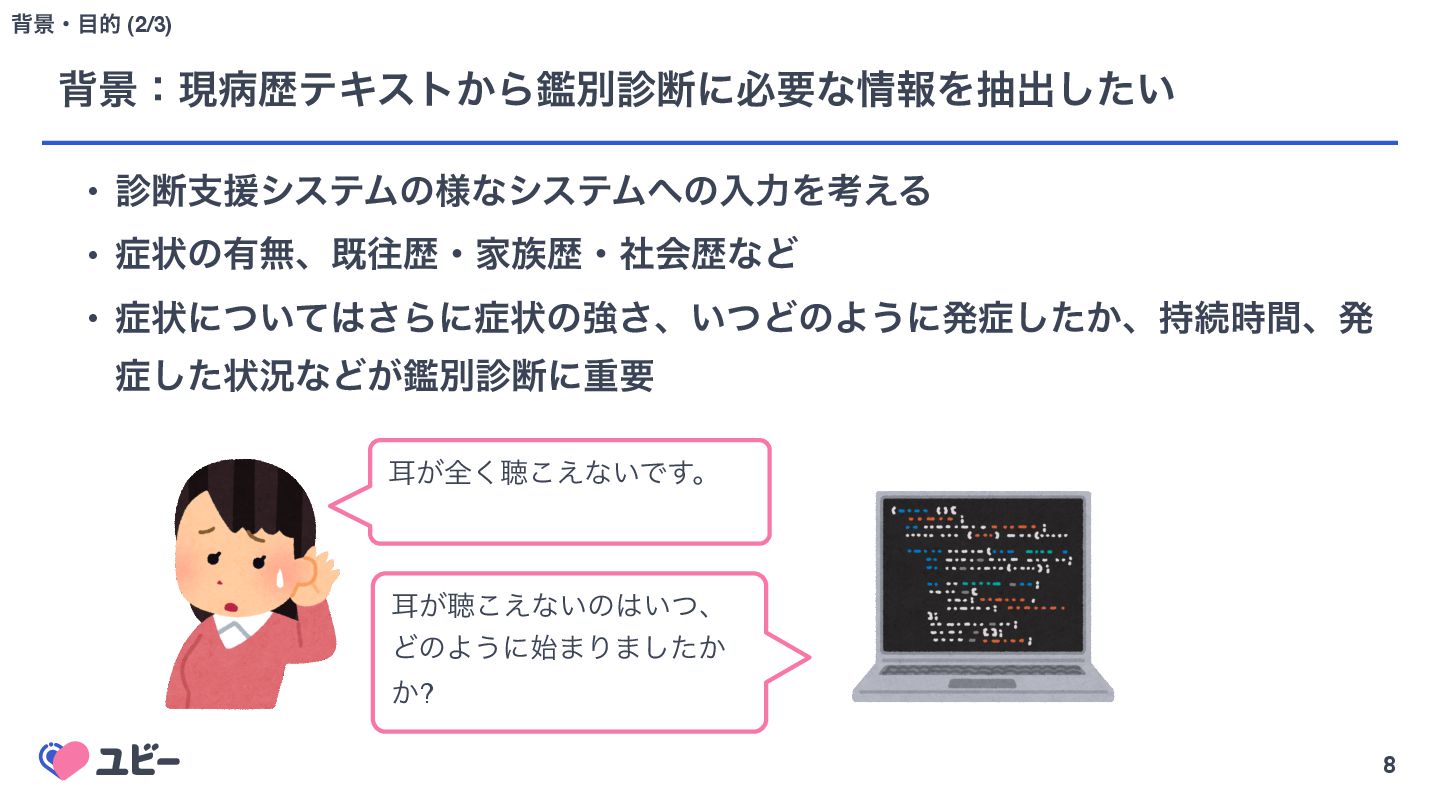
8 എܠɿݱපྺςΩετ͔ΒؑผஅʹඞཁͳใΛநग़͍ͨ͠ എܠɾత (2/3) ͕ࣖશ͘ௌ͑͜ͳ͍Ͱ͢ɻ ͕ࣖௌ͑͜ͳ͍ͷ͍ͭɺ ͲͷΑ͏ʹ࢝·Γ·͔ͨ͠ ͔? • அࢧԉγεςϜͷ༷ͳγεςϜͷೖྗΛߟ͑Δ
• ঢ়ͷ༗ແɺطԟྺɾՈྺɾࣾձྺͳͲ • ঢ়ʹ͍ͭͯ͞Βʹঢ়ͷڧ͞ɺ͍ͭͲͷΑ͏ʹൃ͔ͨ͠ɺ࣋ଓ࣌ؒɺൃ ͨ͠ঢ়گͳͲ͕ؑผஅʹॏཁ -
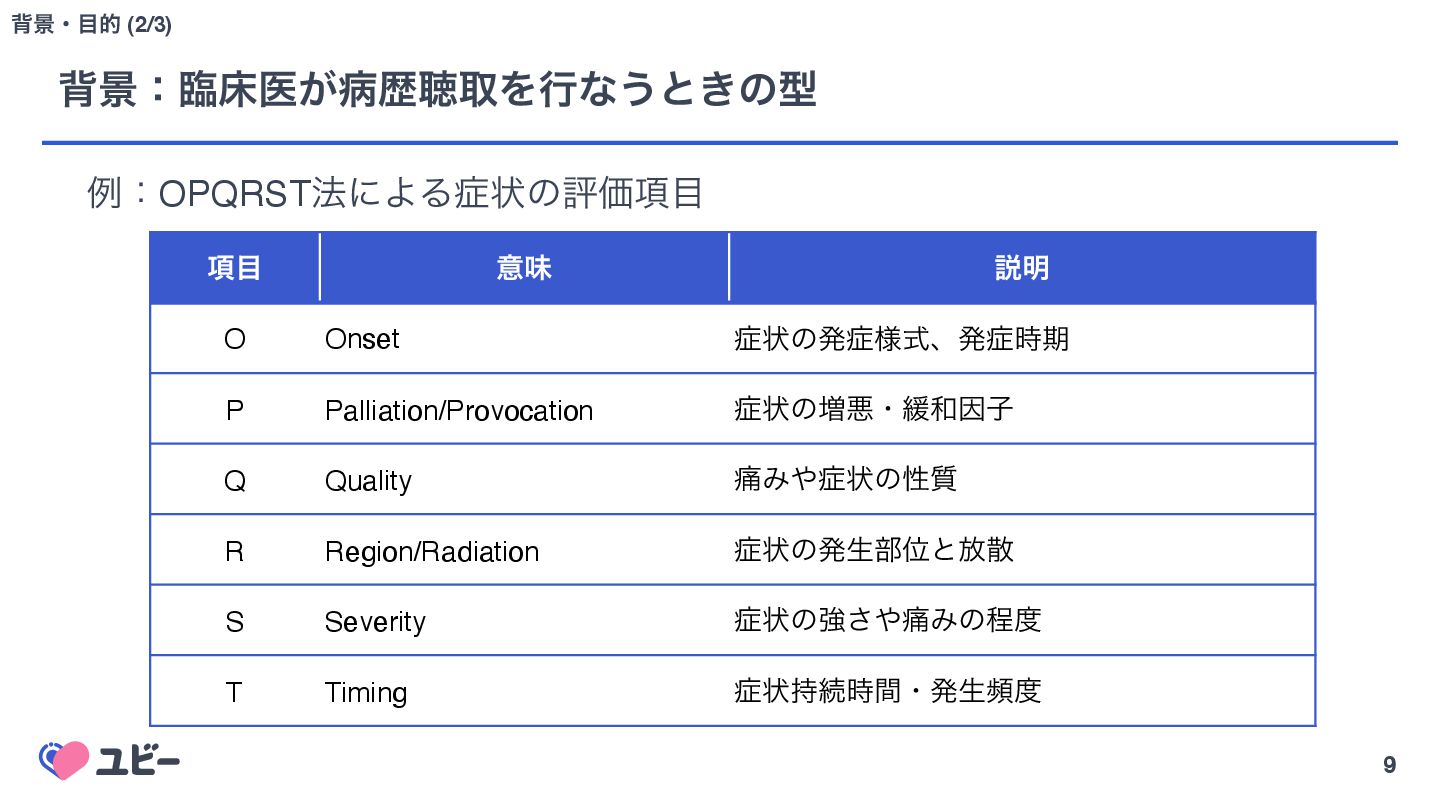
9 എܠɿྟচҩ͕පྺௌऔΛߦͳ͏ͱ͖ͷܕ എܠɾత (2/3) ྫɿOPQRST๏ʹΑΔঢ়ͷධՁ߲ ߲ ҙຯ આ໌ O Onset
ঢ়ͷൃ༷ࣜɺൃ࣌ظ P Palliation/Provocation ঢ়ͷ૿ѱɾ؇Ҽࢠ Q Quality ௧Έঢ়ͷੑ࣭ R Region/Radiation ঢ়ͷൃੜ෦Ґͱ์ࢄ S Severity ঢ়ͷڧ͞௧Έͷఔ T Timing ঢ়࣋ଓ࣌ؒɾൃੜස -
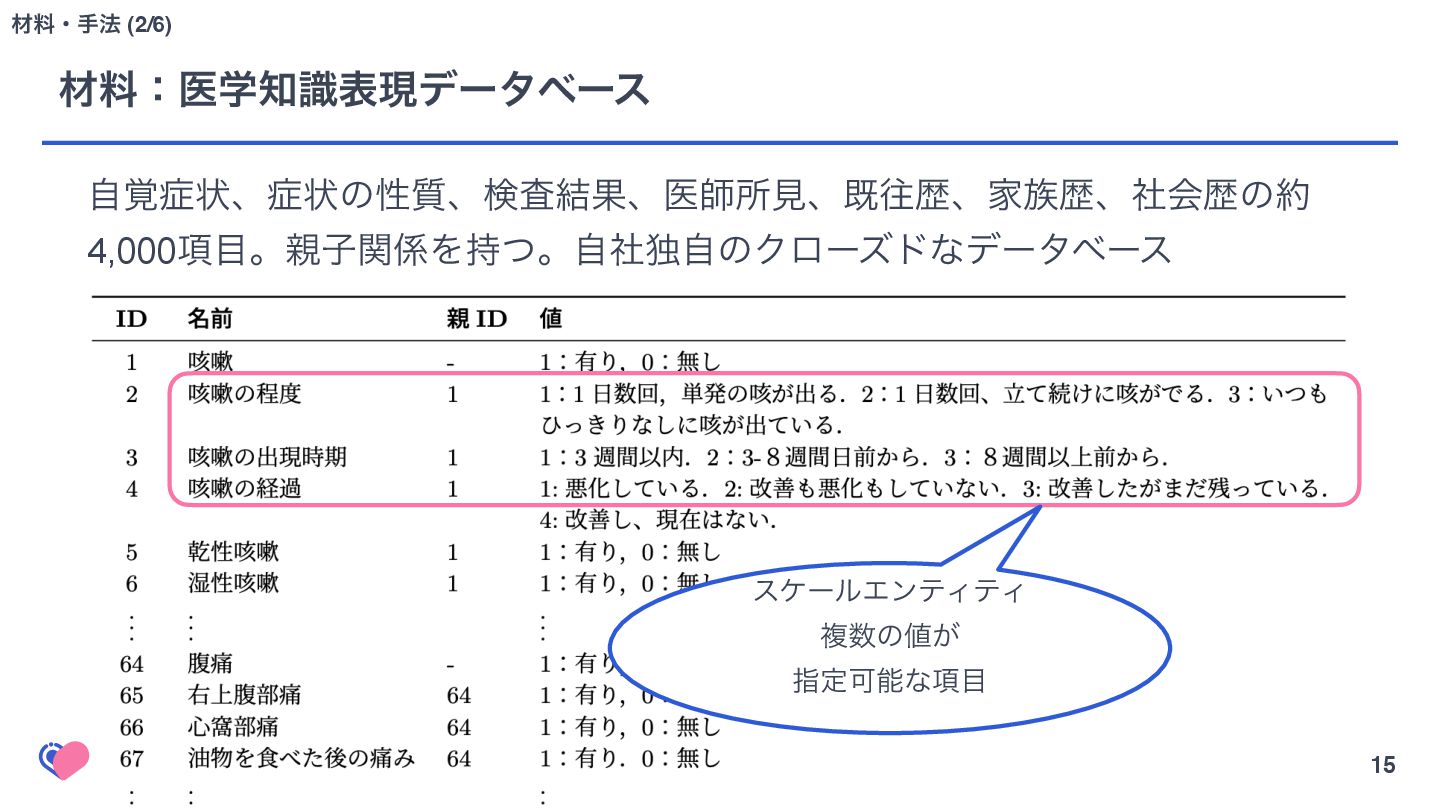
12 ࡐྉɿݱපྺςΩετ ࡐྉɾख๏ (1/6) Avey Benchmark Vignette suite [1] ঢ়νΣοΧʔͷੑೳධՁ༻ʹ࡞ΒΕͨྫςΩετσʔληοτ
ྸɾੑผɾओૌɾݱපྺΛຊޠʹ༁ͯ͠ར༻ [1] Hammoud, M., Douglas, S., Darmach, M., Alawneh, S., Sanyal, S., and Kanbour, Y.: Evaluating the Diagnostic Performance of Symptom Checkers: Clinical Vignette Study, JMIR AI, Vol. 3, p. e46875 (2024) جຊใɿ 40ࡀ ঁੑ ओૌɿ Ί·͍ ݱපྺɿ 1 ؒʹΘͨΓ܁Γฦ͞ΕΔΊ·͍ͷൃ࡞͕͋Γ·͢ɻΊ·͍ͷൃ࡞෦͕ճస͠ ͍ͯΔΑ͏ͳײ֮Ͱɺ20͔Β࣌ؒଓ͖ɺు͖ؾᅅుΛ͏͜ͱ͕͋Γ·͢ɻ ͜ΕΒͷൃ࡞ৗੜ׆ʹࢧোΛ͖ͨ͠ɺΊ·͍;Β͖͕ͭؒଓ͘͜ͱ͕͋ Γ·͢ɻҙࣝΛࣦͬͨ͜ͱ͋Γ·ͤΜɻ·ͨױऀࣖͷ٧·ͬͨײ͡ɺࣖ໐Γ… -
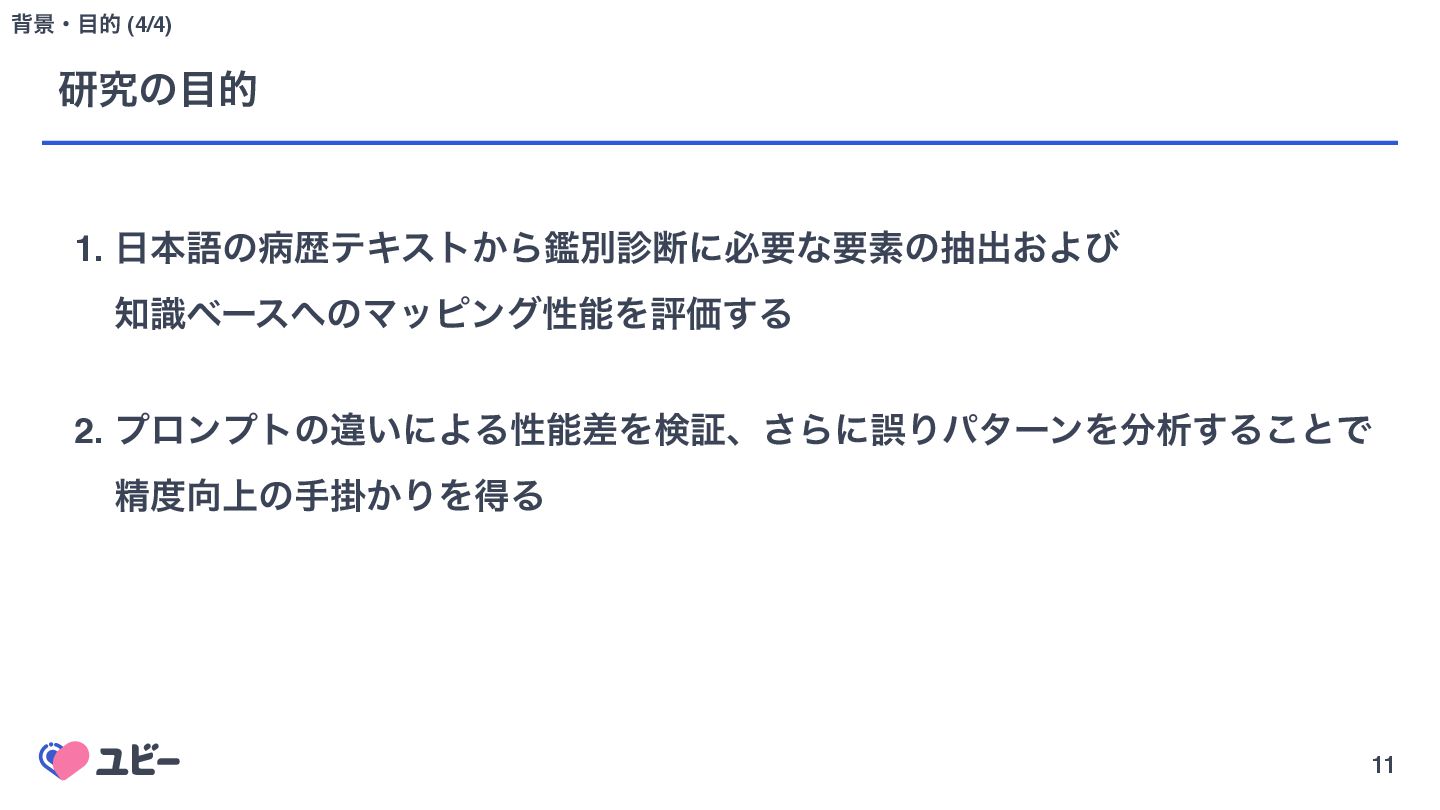
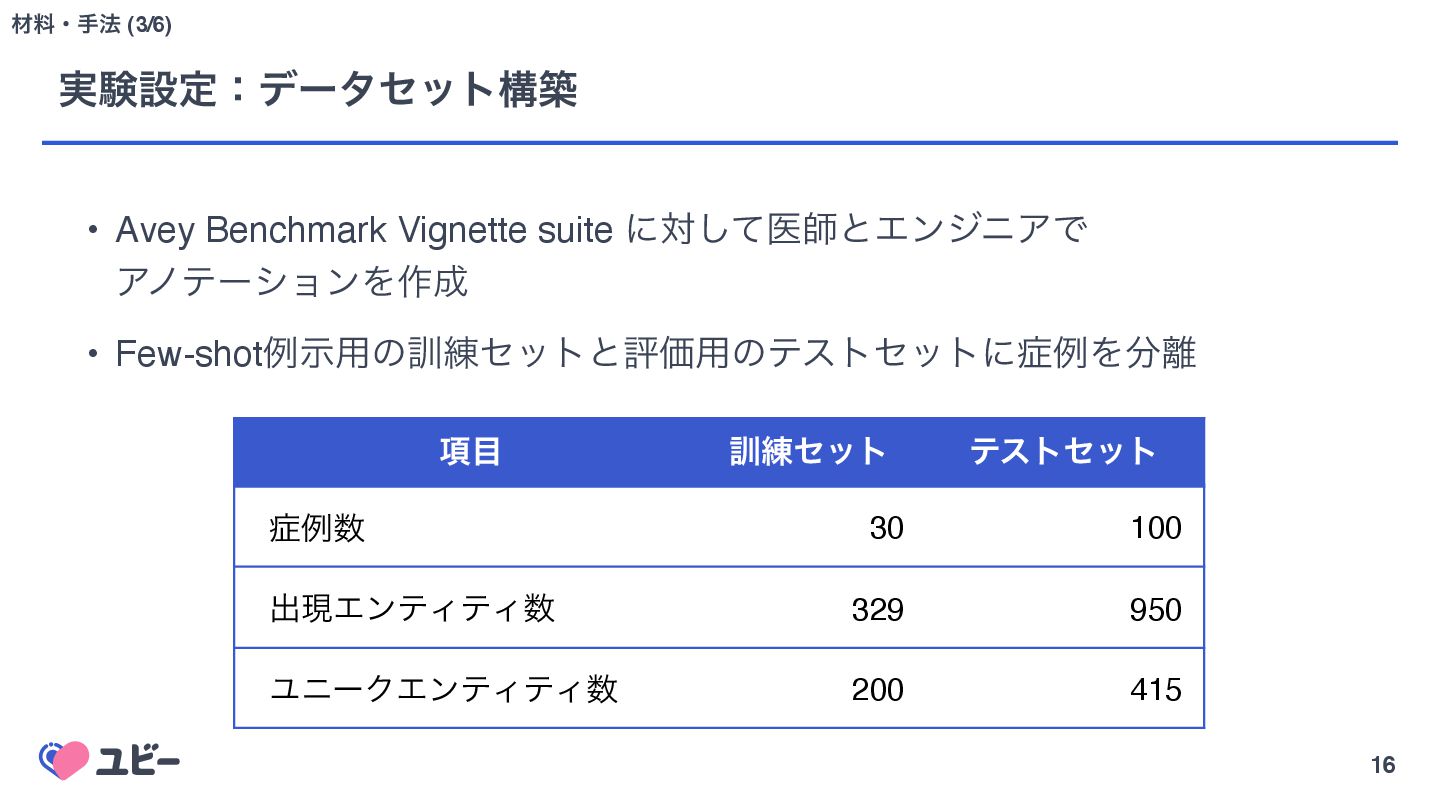
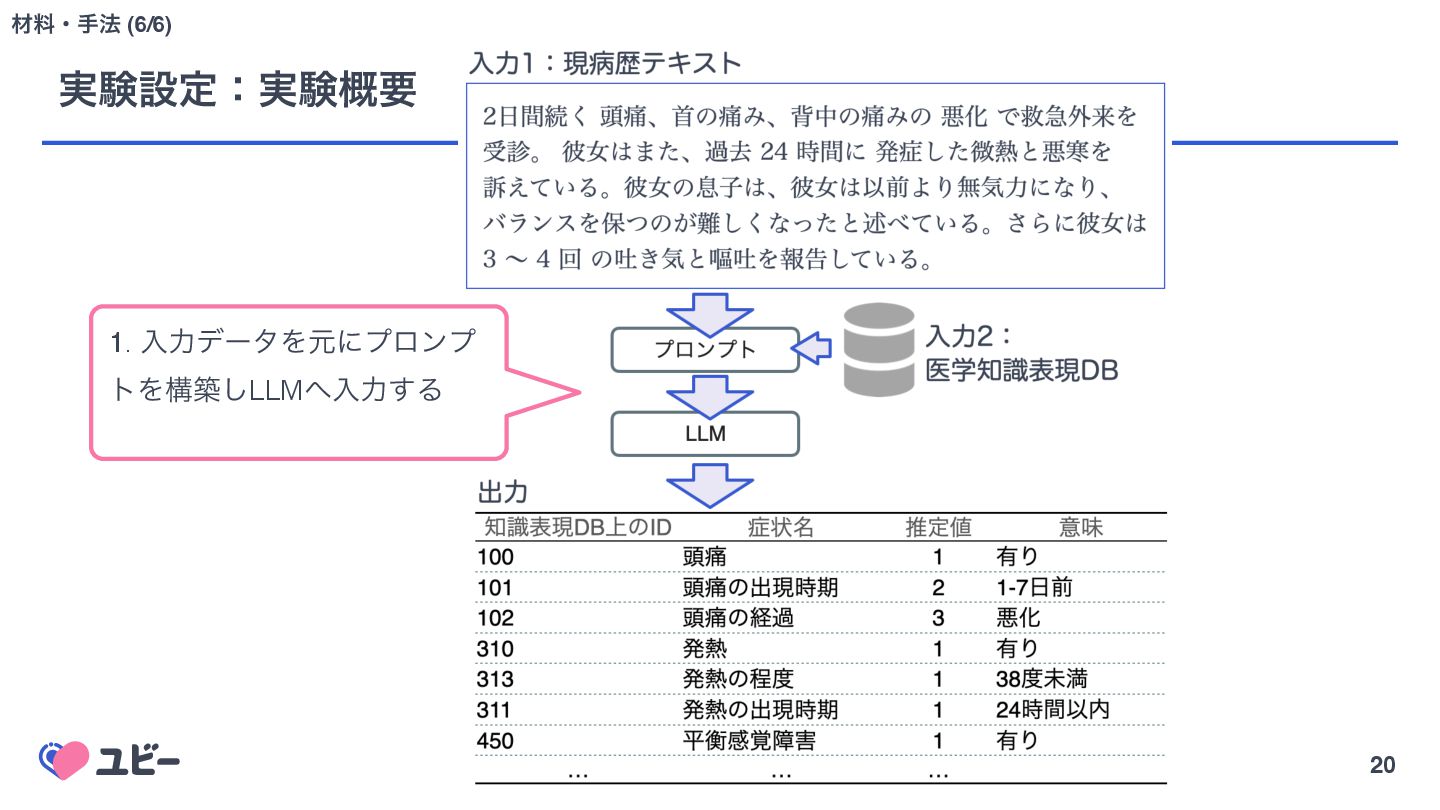
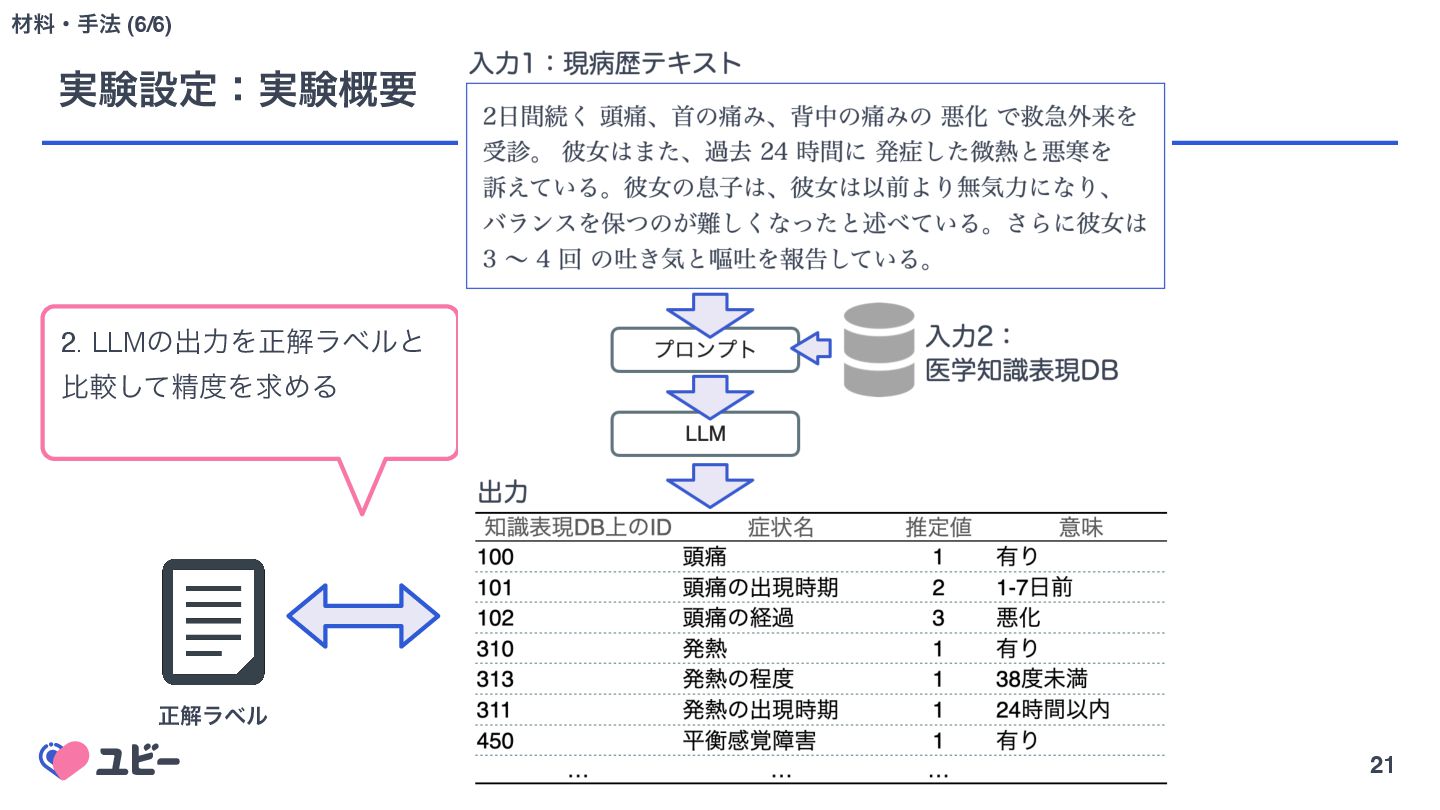
16 ࣮ݧઃఆɿσʔληοτߏங ࡐྉɾख๏ (3/6) • Avey Benchmark Vignette suite ʹରͯ͠ҩࢣͱΤϯδχΞͰ
ΞϊςʔγϣϯΛ࡞ • Few-shotྫࣔ༻ͷ܇࿅ηοτͱධՁ༻ͷςετηοτʹྫΛ ߲ ܇࿅ηοτ ςετηοτ ྫ 30 100 ग़ݱΤϯςΟςΟ 329 950 ϢχʔΫΤϯςΟςΟ 200 415 -
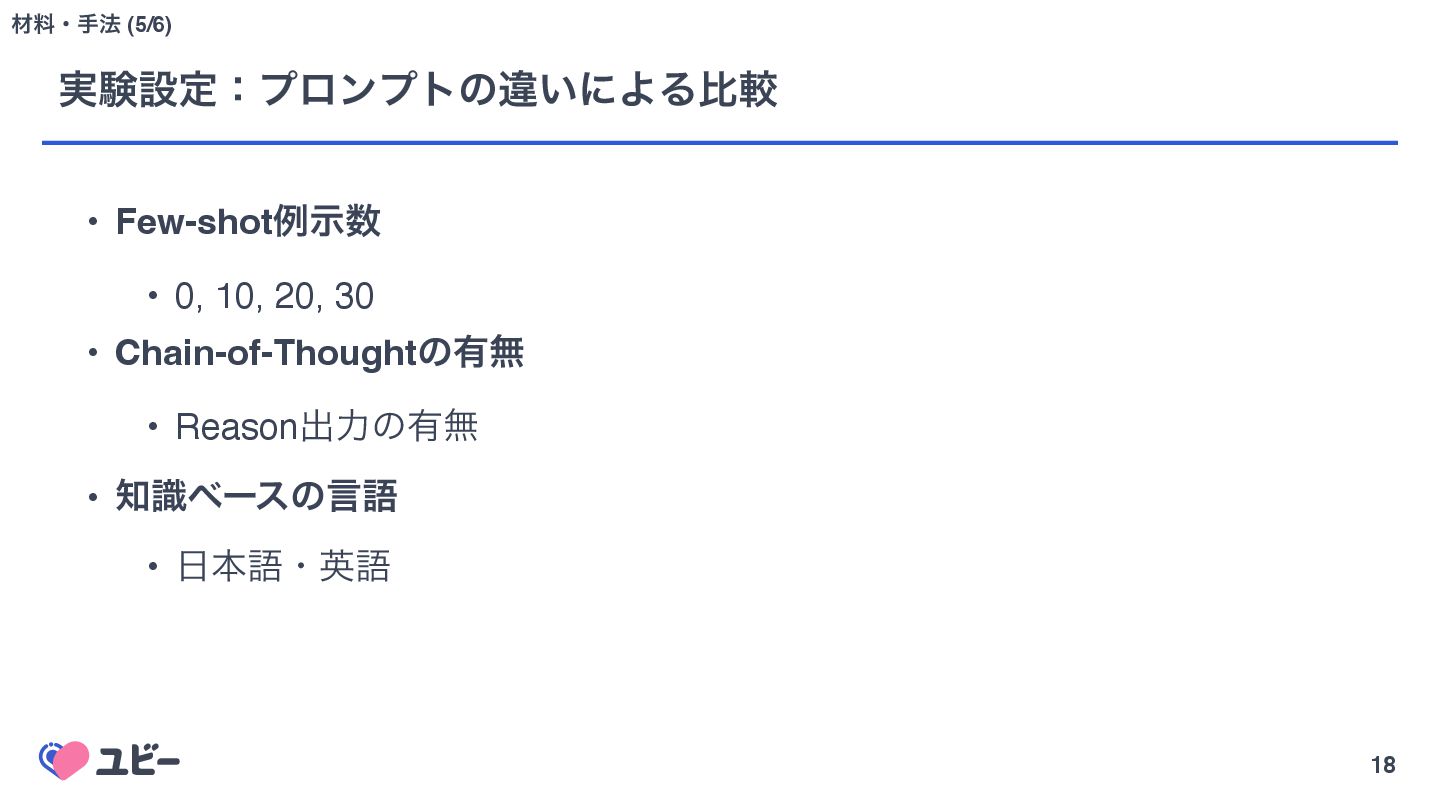
18 ࣮ݧઃఆɿϓϩϯϓτͷҧ͍ʹΑΔൺֱ ࡐྉɾख๏ (5/6) • Few-shotྫࣔ • 0, 10, 20,
30 • Chain-of-Thoughtͷ༗ແ • Reasonग़ྗͷ༗ແ • ࣝϕʔεͷݴޠ • ຊޠɾӳޠ -
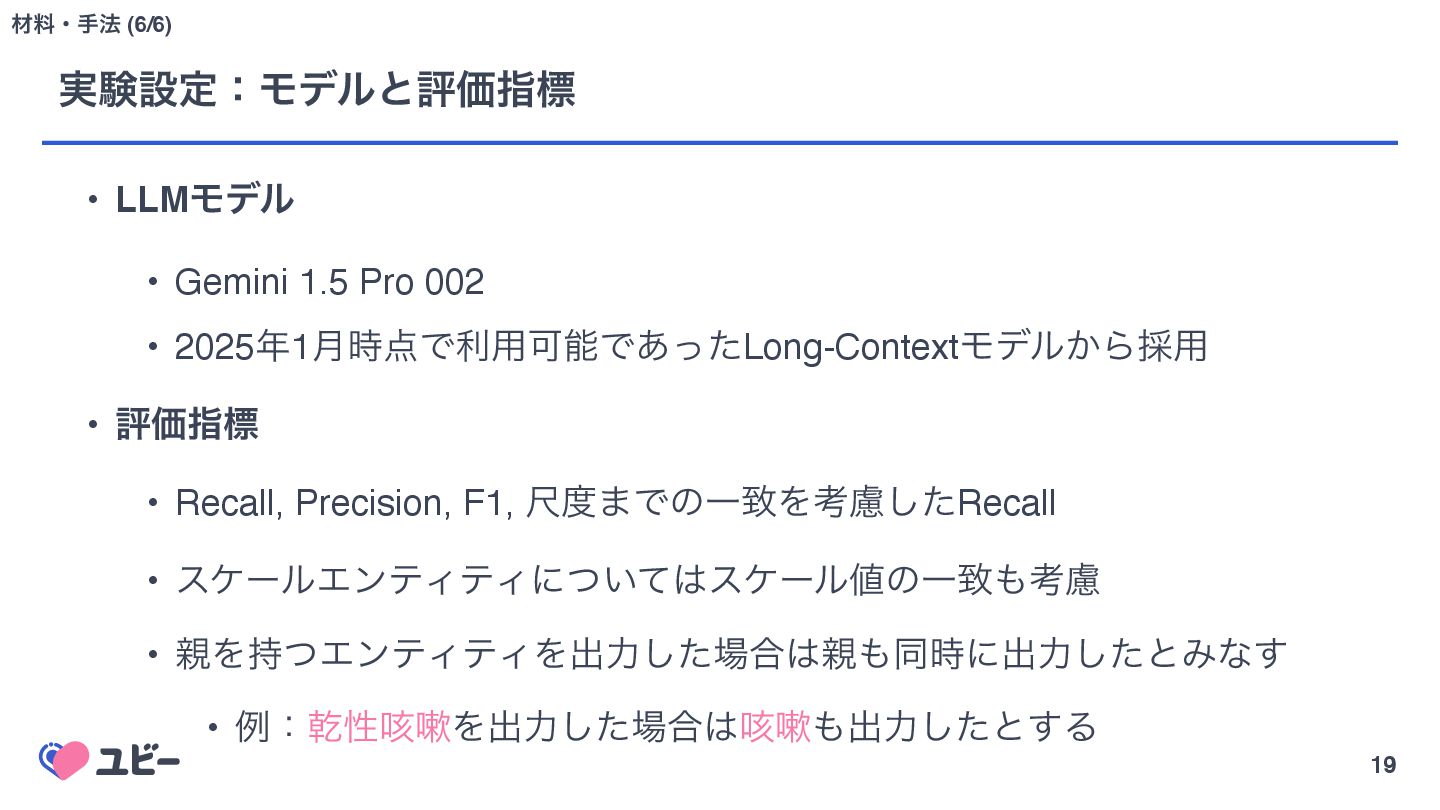
19 ࣮ݧઃఆɿϞσϧͱධՁࢦඪ ࡐྉɾख๏ (6/6) • LLMϞσϧ • Gemini 1.5 Pro
002 • 20251݄࣌Ͱར༻ՄೳͰ͋ͬͨLong-ContextϞσϧ͔Β࠾༻ • ධՁࢦඪ • Recall, Precision, F1, ई·ͰͷҰகΛߟྀͨ͠Recall • εέʔϧΤϯςΟςΟʹ͍ͭͯεέʔϧͷҰகߟྀ • Λ࣋ͭΤϯςΟςΟΛग़ྗͨ͠߹ಉ࣌ʹग़ྗͨ͠ͱΈͳ͢ • ྫɿסੑ֏ᅉΛग़ྗͨ͠߹֏ᅉग़ྗͨ͠ͱ͢Δ -
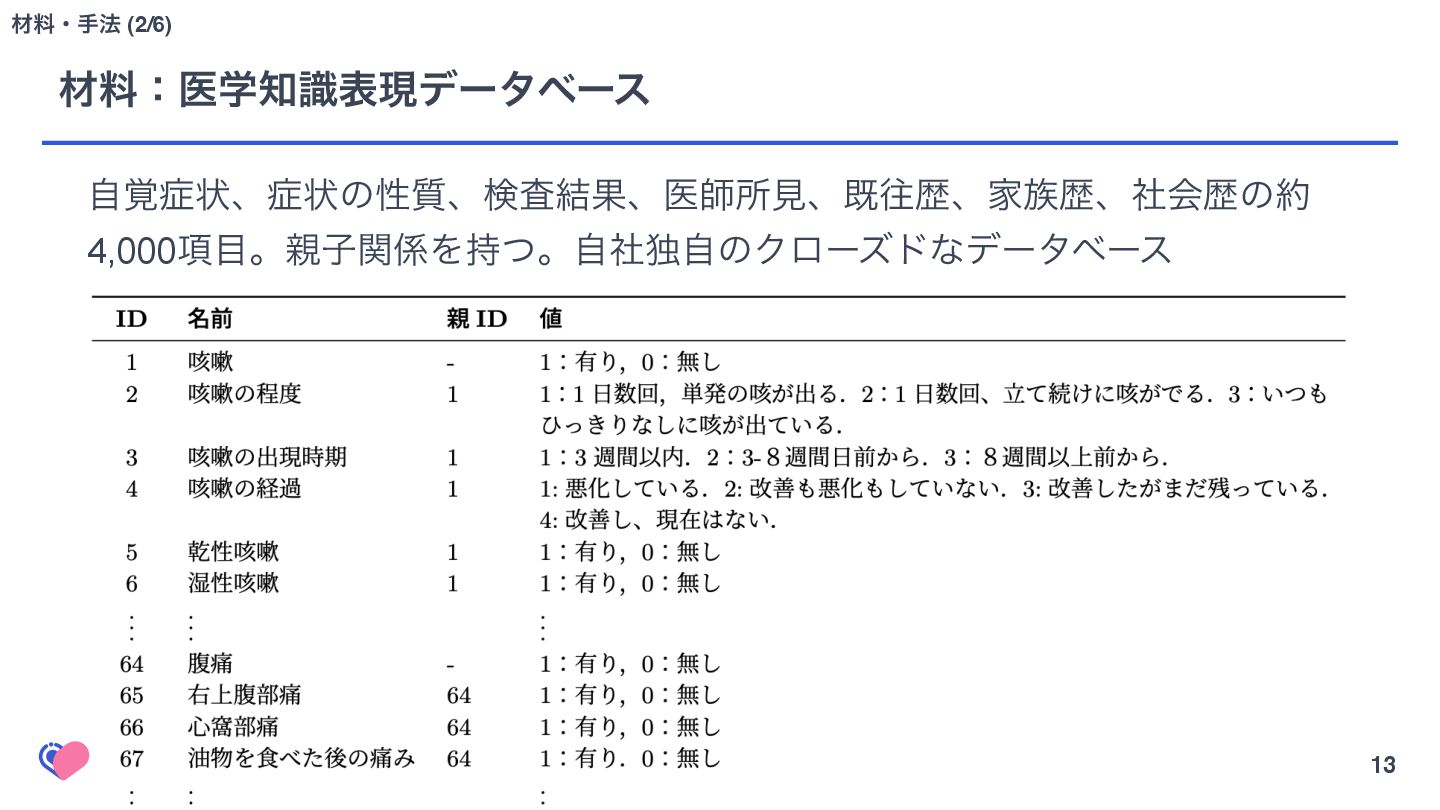
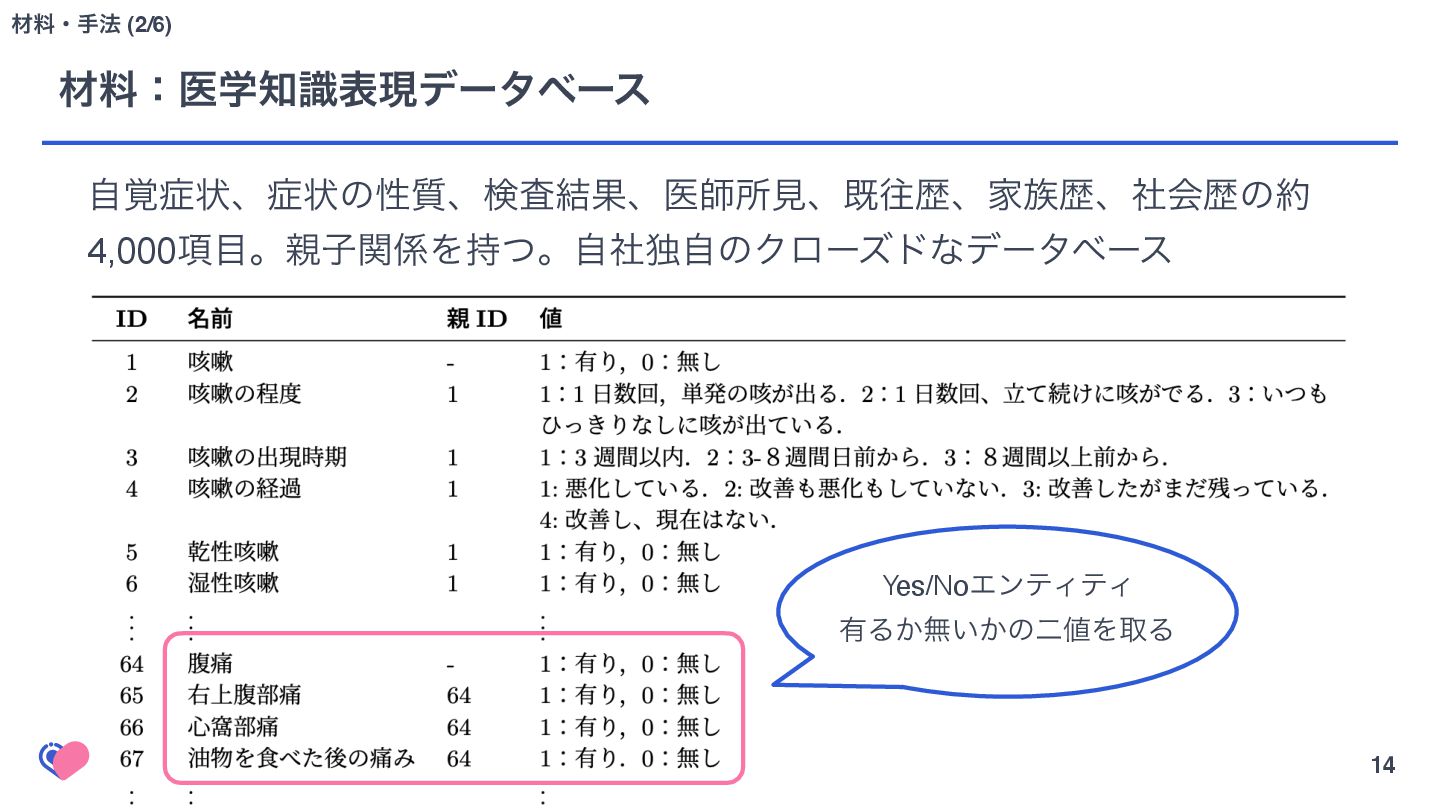
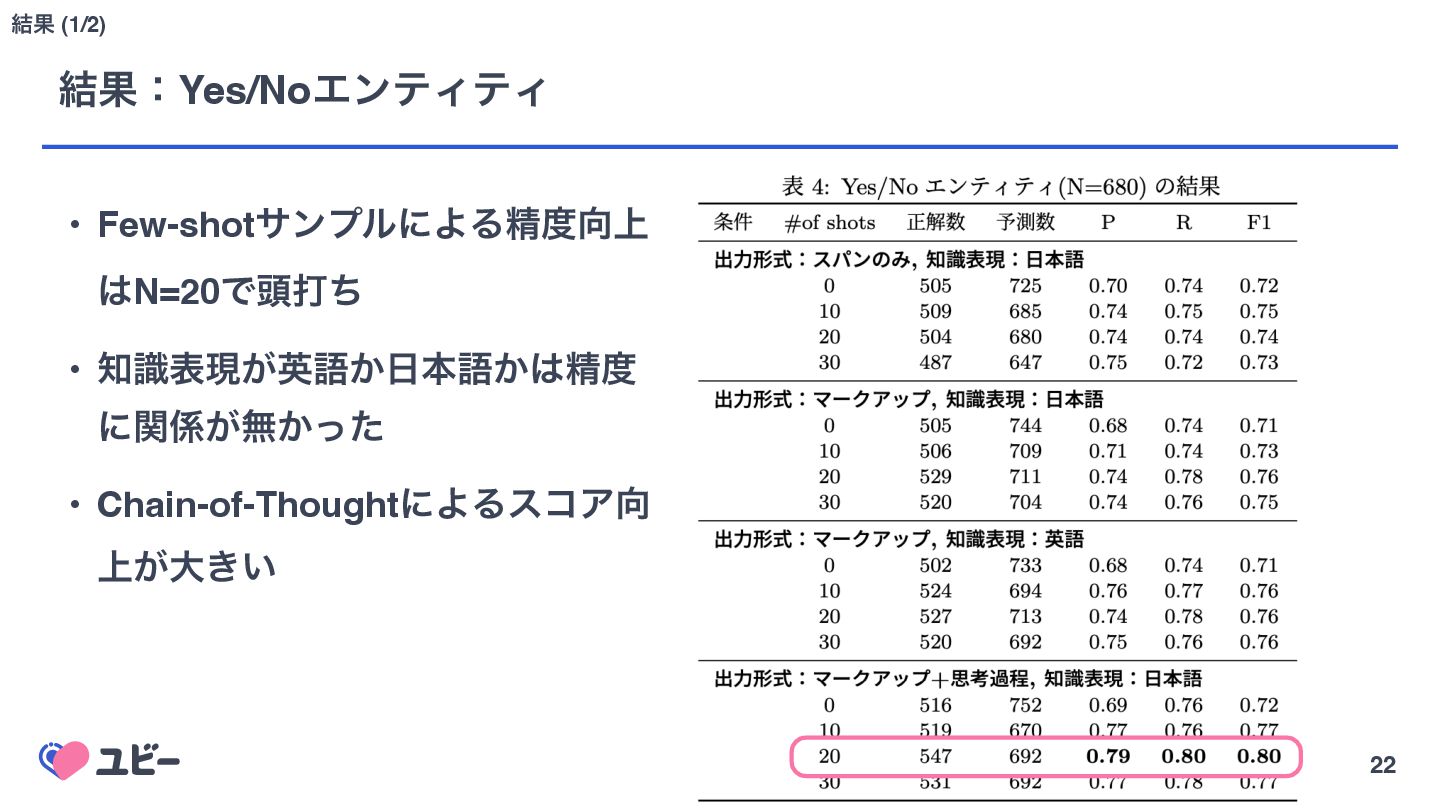
22 ݁ՌɿYes/NoΤϯςΟςΟ ݁Ռ (1/2) • Few-shotαϯϓϧʹΑΔਫ਼্ N=20Ͱ಄ଧͪ • ࣝදݱ͕ӳޠ͔ຊޠ͔ਫ਼ ʹ͕ؔແ͔ͬͨ
• Chain-of-ThoughtʹΑΔείΞ ্͕େ͖͍ -
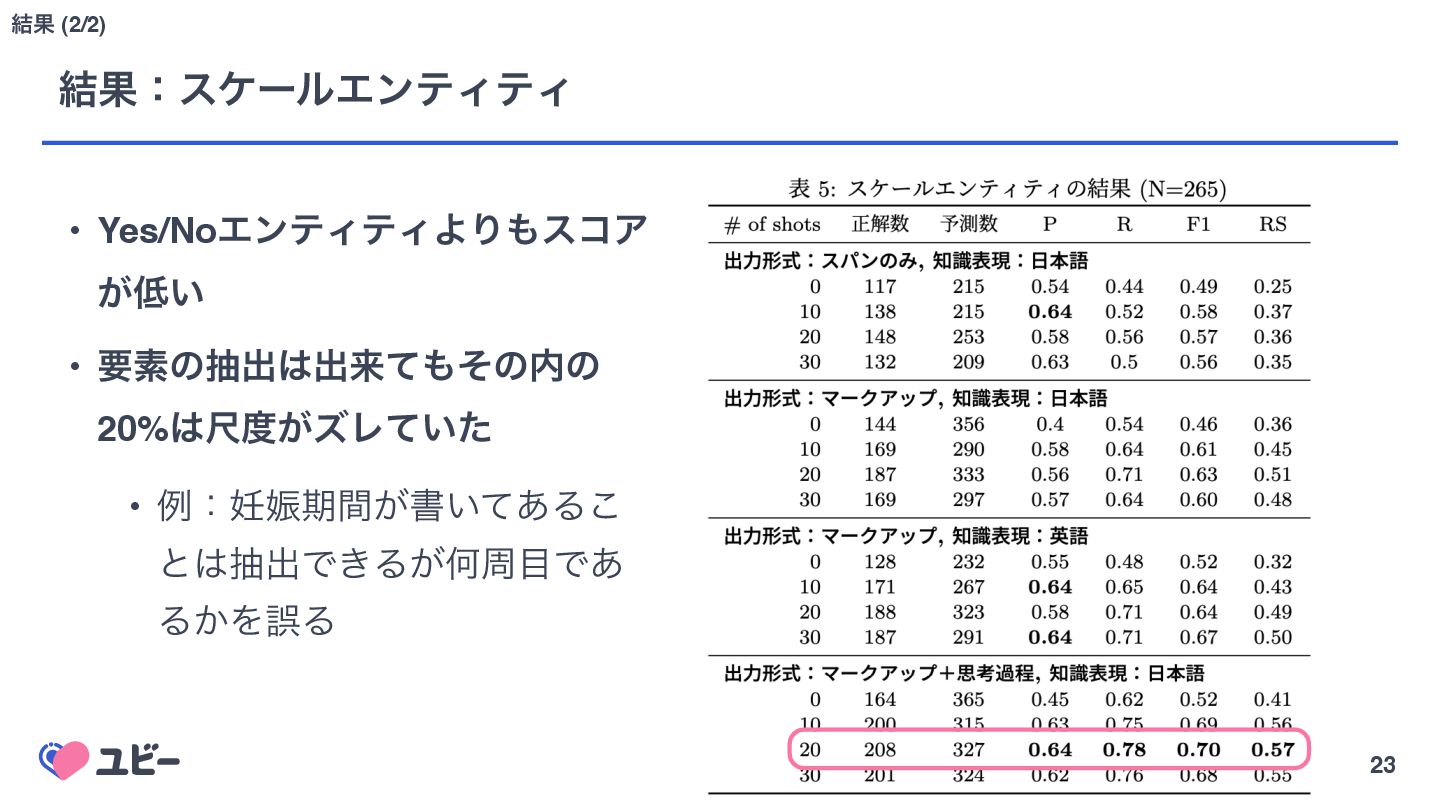
23 ݁ՌɿεέʔϧΤϯςΟςΟ ݁Ռ (2/2) • Yes/NoΤϯςΟςΟΑΓείΞ ͕͍ • ཁૉͷநग़ग़དྷͯͦͷͷ 20%ई͕ζϨ͍ͯͨ
• ྫɿ৷ظ͕ؒॻ͍ͯ͋Δ͜ ͱநग़Ͱ͖Δ͕ԿपͰ͋ Δ͔ΛޡΔ -
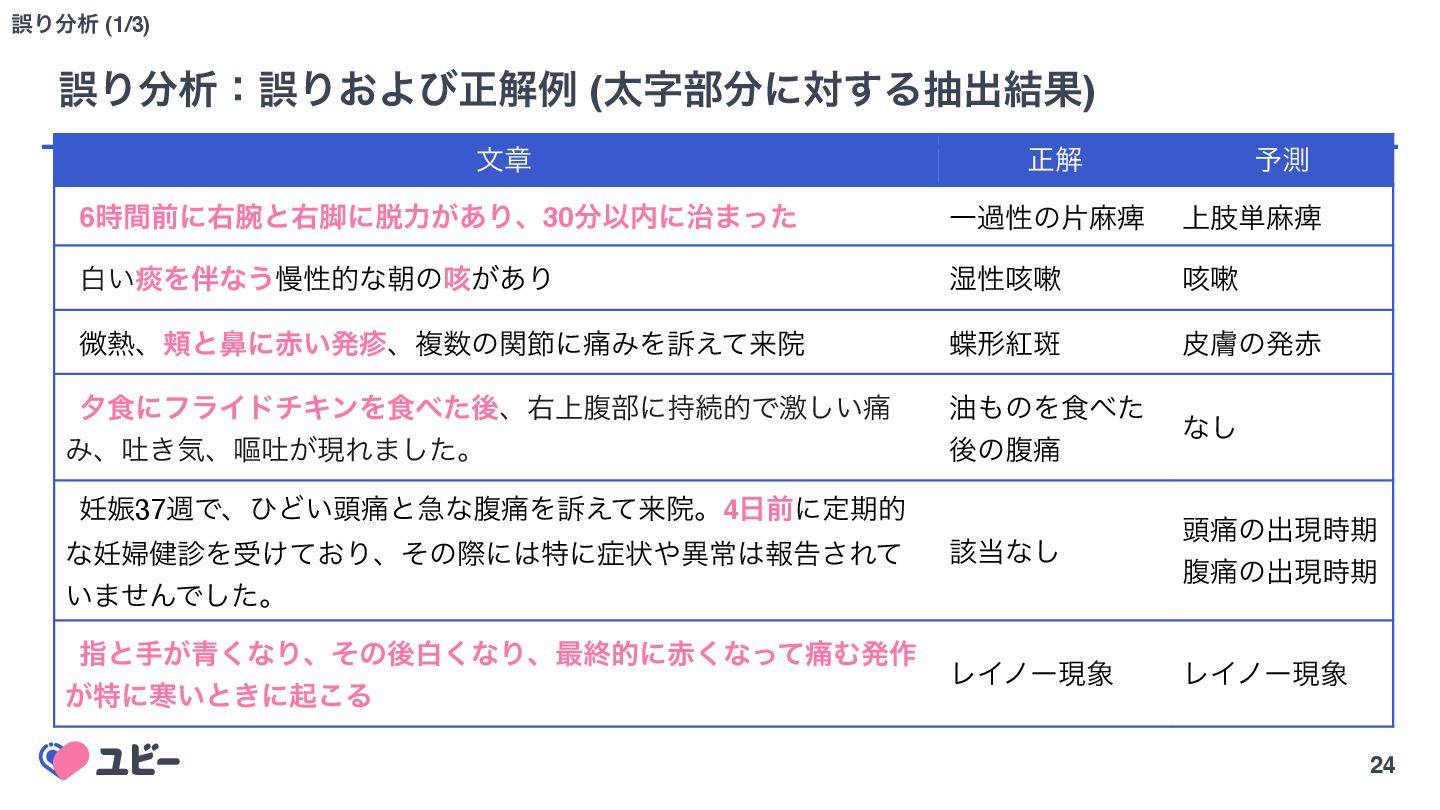
24 ޡΓੳɿޡΓ͓Αͼਖ਼ղྫ (ଠࣈ෦ʹର͢Δநग़݁Ռ) ޡΓੳ (1/3) จষ ਖ਼ղ ༧ଌ 6࣌ؒલʹӈͱӈ٭ʹྗ͕͋Γɺ30Ҏʹ࣏·ͬͨ Ұաੑͷยຑᙺ
্ࢶ୯ຑᙺ ന͍ᙹΛͳ͏ຫੑతͳேͷ֏͕͋Γ ࣪ੑ֏ᅉ ֏ᅉ ඍɺͱඓʹ͍ൃɺෳͷؔઅʹ௧ΈΛૌ͑ͯདྷӃ ܗߚൗ ൽෘͷൃ ༦৯ʹϑϥΠυνΩϯΛ৯ͨޙɺӈ্ෲ෦ʹ࣋ଓతͰܹ͍͠௧ Έɺు͖ؾɺᅅు͕ݱΕ·ͨ͠ɻ ༉ͷΛ৯ͨ ޙͷෲ௧ ͳ͠ ৷37िͰɺͻͲ͍಄௧ͱٸͳෲ௧Λૌ͑ͯདྷӃɻ4લʹఆظత ͳ්݈Λड͚͓ͯΓɺͦͷࡍʹಛʹঢ়ҟৗใࠂ͞Εͯ ͍·ͤΜͰͨ͠ɻ ֘ͳ͠ ಄௧ͷग़ݱ࣌ظ ෲ௧ͷग़ݱ࣌ظ ࢦͱख͕੨͘ͳΓɺͦͷޙന͘ͳΓɺ࠷ऴతʹ͘ͳͬͯ௧Ήൃ࡞ ͕ಛʹפ͍ͱ͖ʹى͜Δ ϨΠϊʔݱ ϨΠϊʔݱ -
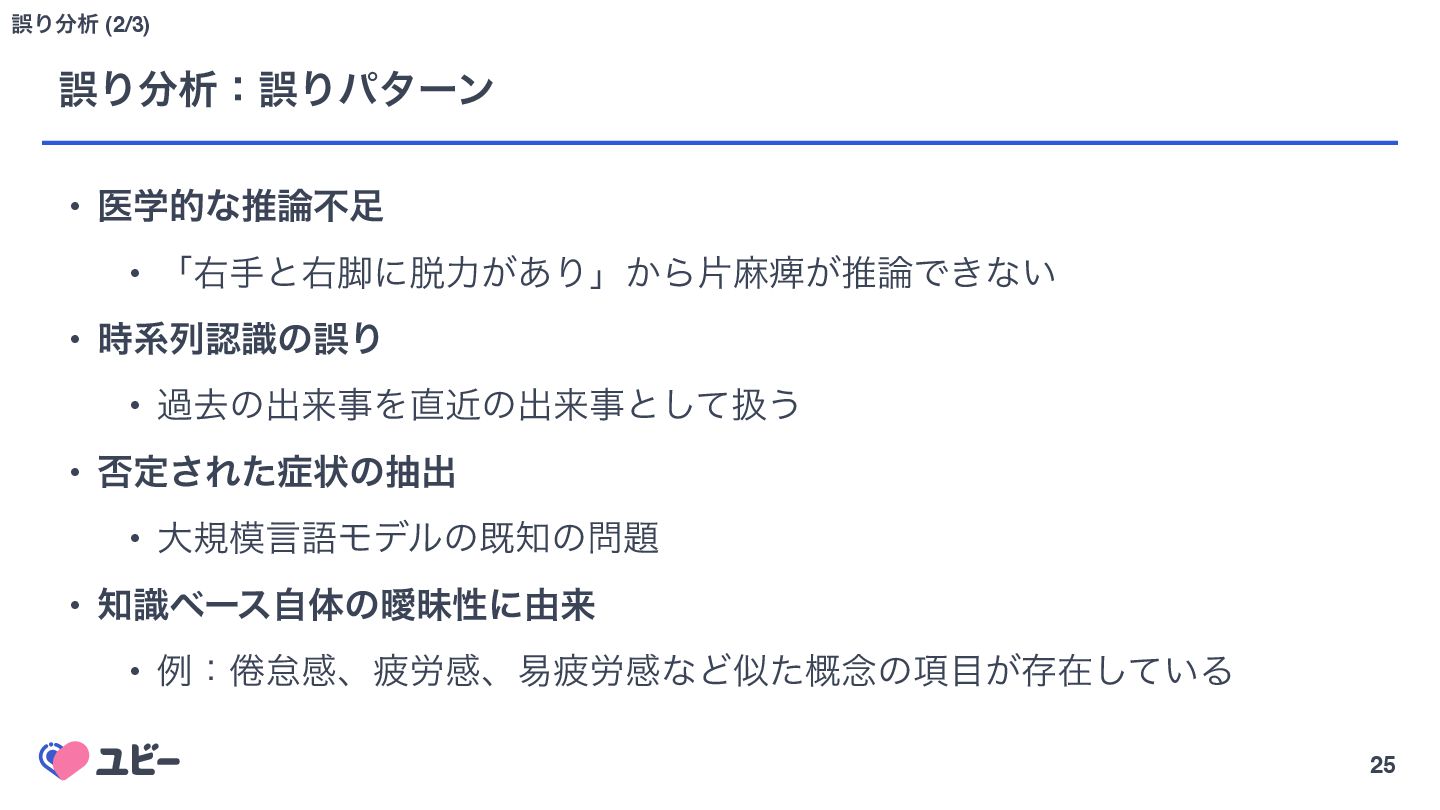
25 ޡΓੳɿޡΓύλʔϯ • ҩֶతͳਪෆ • ʮӈखͱӈ٭ʹྗ͕͋Γʯ͔Βยຑᙺ͕ਪͰ͖ͳ͍ • ࣌ܥྻೝࣝͷޡΓ • աڈͷग़དྷࣄΛۙͷग़དྷࣄͱͯ͠ѻ͏
• ൱ఆ͞Εͨঢ়ͷநग़ • େنݴޠϞσϧͷطͷ • ࣝϕʔεࣗମͷᐆດੑʹ༝དྷ • ྫɿ᷺ଵײɺർ࿑ײɺқർ࿑ײͳͲࣅͨ֓೦ͷ߲͕ଘࡏ͍ͯ͠Δ ޡΓੳ (2/3) -
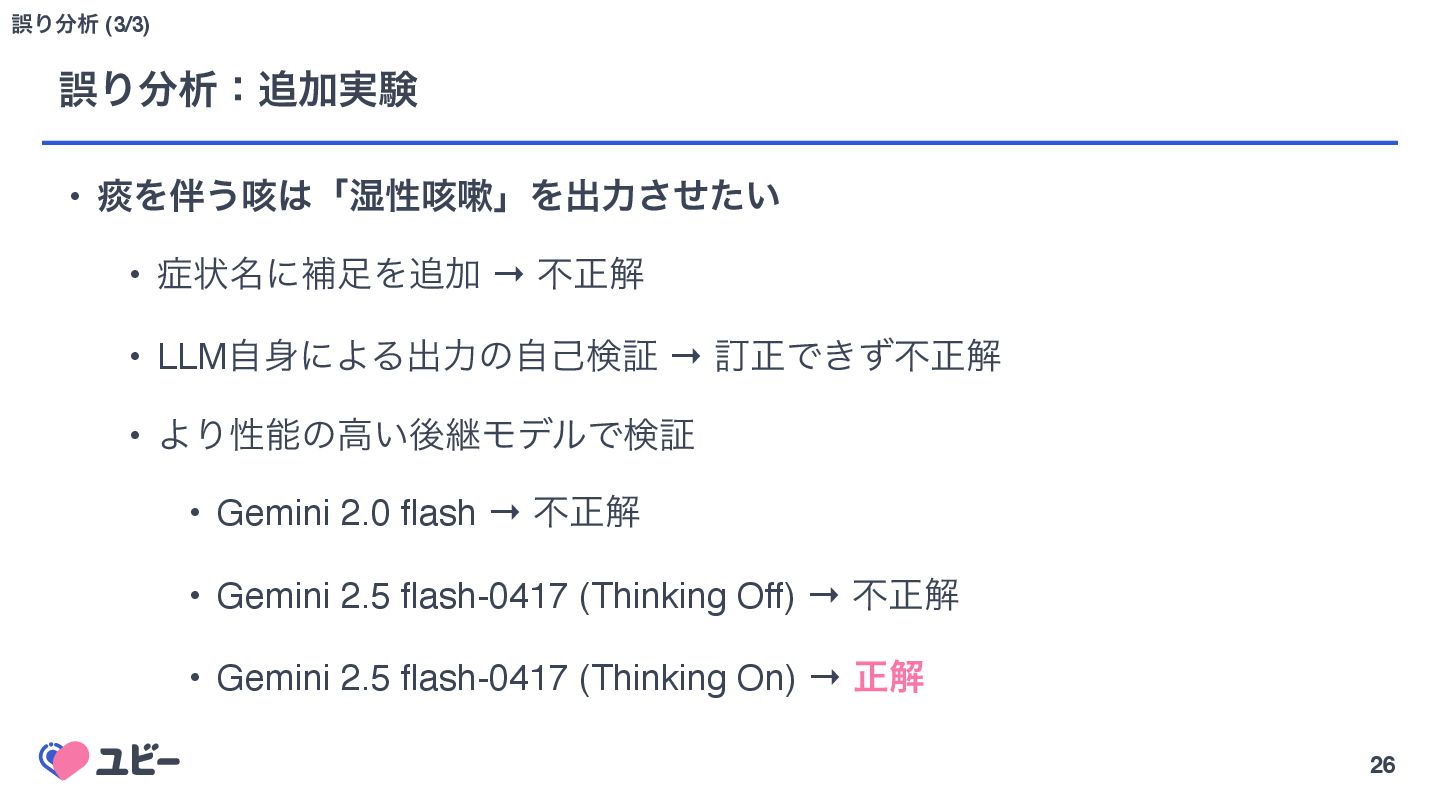
26 ޡΓੳɿՃ࣮ݧ • ᙹΛ͏֏ʮ࣪ੑ֏ᅉʯΛग़ྗ͍ͤͨ͞ • ঢ়໊ʹิΛՃ → ෆਖ਼ղ • LLMࣗʹΑΔग़ྗͷࣗݾݕূ
→ గਖ਼Ͱ͖ͣෆਖ਼ղ • ΑΓੑೳͷߴ͍ޙܧϞσϧͰݕূ • Gemini 2.0 flash → ෆਖ਼ղ • Gemini 2.5 flash-0417 (Thinking Off) → ෆਖ਼ղ • Gemini 2.5 flash-0417 (Thinking On) → ਖ਼ղ ޡΓੳ (3/3) -
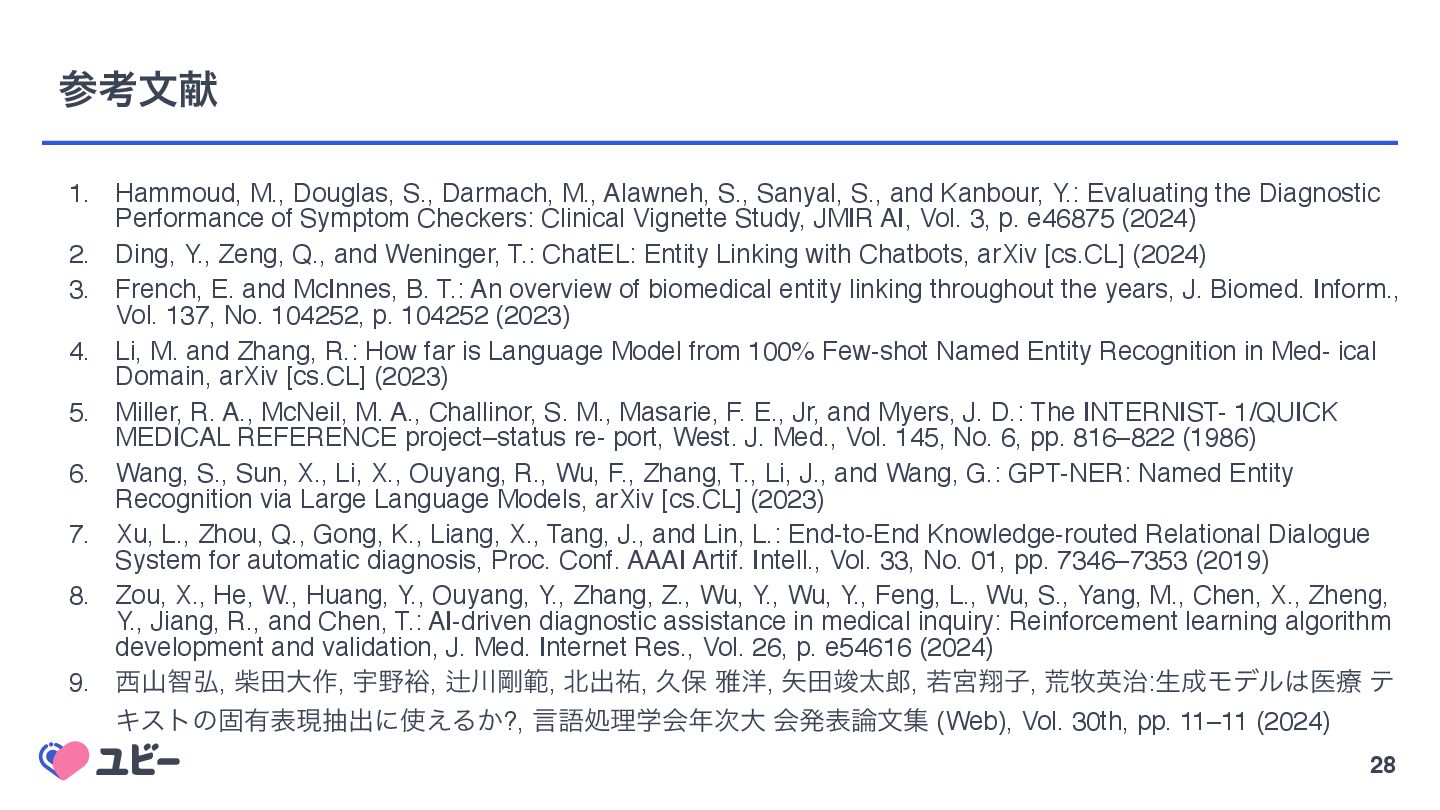
28 ࢀߟจݙ 1. Hammoud, M., Douglas, S., Darmach, M., Alawneh,
S., Sanyal, S., and Kanbour, Y.: Evaluating the Diagnostic Performance of Symptom Checkers: Clinical Vignette Study, JMIR AI, Vol. 3, p. e46875 (2024) 2. Ding, Y., Zeng, Q., and Weninger, T.: ChatEL: Entity Linking with Chatbots, arXiv [cs.CL] (2024) 3. French, E. and McInnes, B. T.: An overview of biomedical entity linking throughout the years, J. Biomed. Inform., Vol. 137, No. 104252, p. 104252 (2023) 4. Li, M. and Zhang, R.: How far is Language Model from 100% Few-shot Named Entity Recognition in Med- ical Domain, arXiv [cs.CL] (2023) 5. Miller, R. A., McNeil, M. A., Challinor, S. M., Masarie, F. E., Jr, and Myers, J. D.: The INTERNIST- 1/QUICK MEDICAL REFERENCE project–status re- port, West. J. Med., Vol. 145, No. 6, pp. 816–822 (1986) 6. Wang, S., Sun, X., Li, X., Ouyang, R., Wu, F., Zhang, T., Li, J., and Wang, G.: GPT-NER: Named Entity Recognition via Large Language Models, arXiv [cs.CL] (2023) 7. Xu, L., Zhou, Q., Gong, K., Liang, X., Tang, J., and Lin, L.: End-to-End Knowledge-routed Relational Dialogue System for automatic diagnosis, Proc. Conf. AAAI Artif. Intell., Vol. 33, No. 01, pp. 7346–7353 (2019) 8. Zou, X., He, W., Huang, Y., Ouyang, Y., Zhang, Z., Wu, Y., Wu, Y., Feng, L., Wu, S., Yang, M., Chen, X., Zheng, Y., Jiang, R., and Chen, T.: AI-driven diagnostic assistance in medical inquiry: Reinforcement learning algorithm development and validation, J. Med. Internet Res., Vol. 26, p. e54616 (2024) 9. ࢁஐ߂, ࣲాେ࡞, Ӊ༟, ⁋߶ൣ, ग़༞, ٱอ խ༸, ాॡଠ, एٶᠳࢠ, ߥӳ࣏:ੜϞσϧҩྍ ς Ωετͷݻ༗දݱநग़ʹ͑Δ͔?, ݴޠॲཧֶձ࣍େ ձൃදจू (Web), Vol. 30th, pp. 11–11 (2024)