Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
G検定_完全統合版.pdf
Search
primal_ EN
August 10, 2026
7
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
G検定_完全統合版.pdf
primal_ EN
August 10, 2026
Featured
See All Featured
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Making the Leap to Tech Lead
cromwellryan
135
10k
DevOps and Value Stream Thinking: Enabling flow, efficiency and business value
helenjbeal
2
410
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
590
BBQ
matthewcrist
90
10k
Heart Work Chapter 1 - Part 1
lfama
PRO
10
37k
ReactJS: Keep Simple. Everything can be a component!
pedronauck
666
130k
Evolution of real-time – Irina Nazarova, EuRuKo, 2024
irinanazarova
9
1.6k
The Psychology of Web Performance [Beyond Tellerrand 2023]
tammyeverts
49
3.6k
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
Bootstrapping a Software Product
garrettdimon
PRO
306
120k
Technical Leadership for Architectural Decision Making
baasie
3
600
Transcript
G 検定 学習スライド 第1章 人工知能( AI )とは 定義・分類・研究の歴史をわかりやすく整理
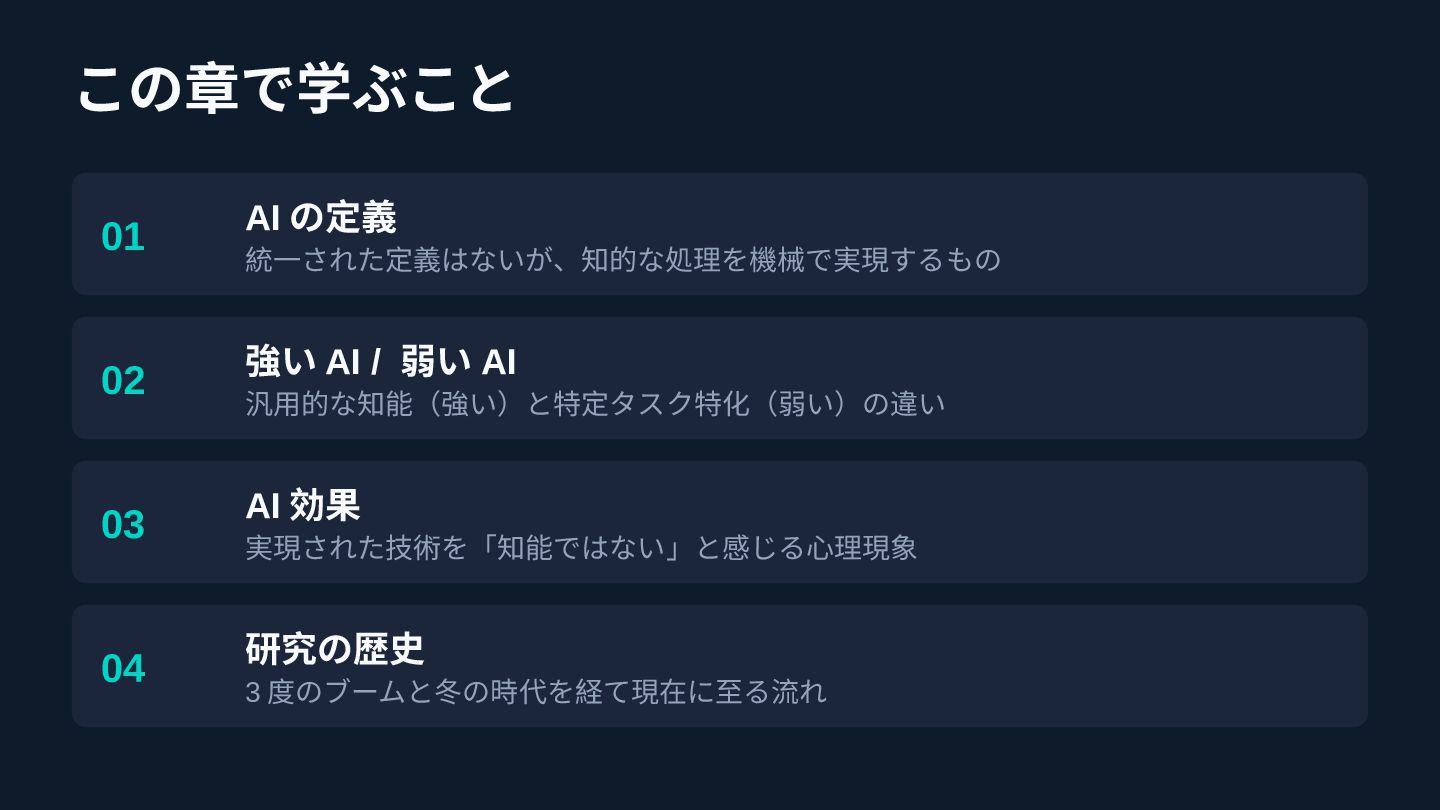
この章で学ぶこと 01 02 03 04 AI の定義 統一された定義はないが、知的な処理を機械で実現するもの 強い AI
/ 弱い AI 汎用的な知能(強い)と特定タスク特化(弱い)の違い AI 効果 実現された技術を「知能ではない」と感じる心理現象 研究の歴史 3 度のブームと冬の時代を経て現在に至る流れ
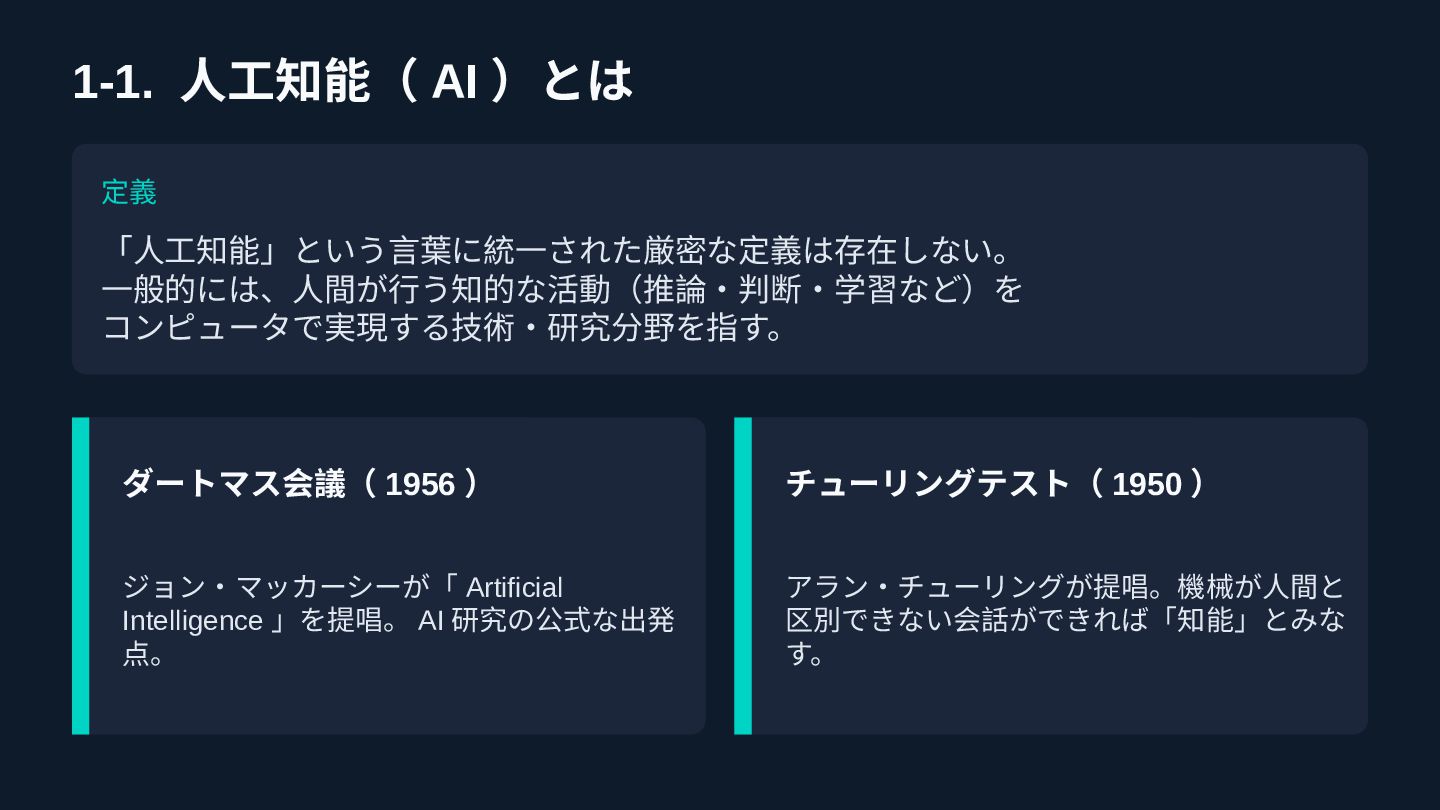
1-1. 人工知能( AI )とは 定義 「人工知能」という言葉に統一された厳密な定義は存在しない。 一般的には、人間が行う知的な活動(推論・判断・学習など)を コンピュータで実現する技術・研究分野を指す。 ダートマス会議( 1956
) チューリングテスト( 1950 ) ジョン・マッカーシーが「 Artificial Intelligence 」を提唱。 AI 研究の公式な出発 点。 アラン・チューリングが提唱。機械が人間と 区別できない会話ができれば「知能」とみな す。
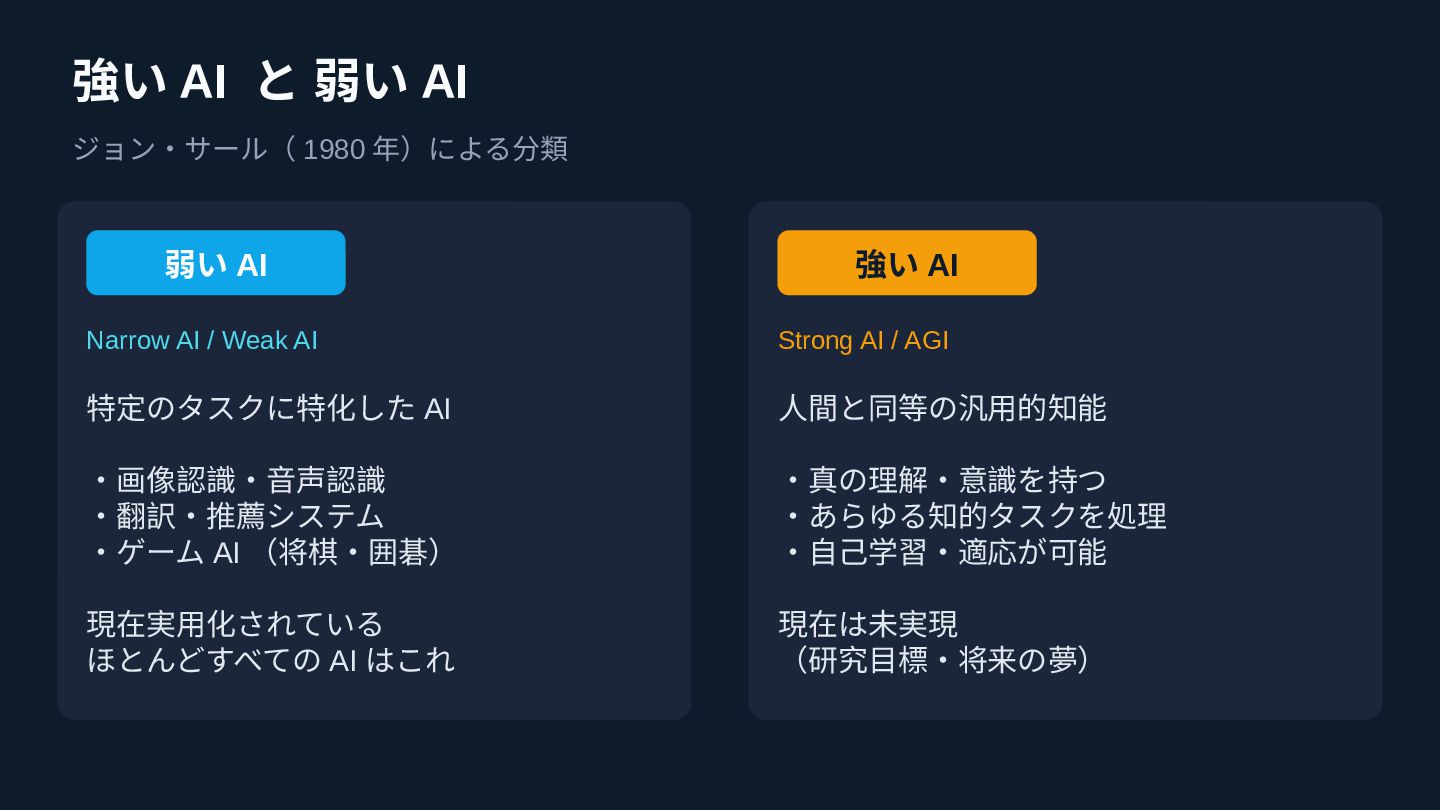
強い AI と 弱い AI ジョン・サール( 1980 年)による分類 弱い AI
強い AI Narrow AI / Weak AI Strong AI / AGI 特定のタスクに特化した AI 人間と同等の汎用的知能 ・画像認識・音声認識 ・翻訳・推薦システム ・ゲーム AI (将棋・囲碁) ・真の理解・意識を持つ ・あらゆる知的タスクを処理 ・自己学習・適応が可能 現在実用化されている ほとんどすべての AI はこれ 現在は未実現 (研究目標・将来の夢)
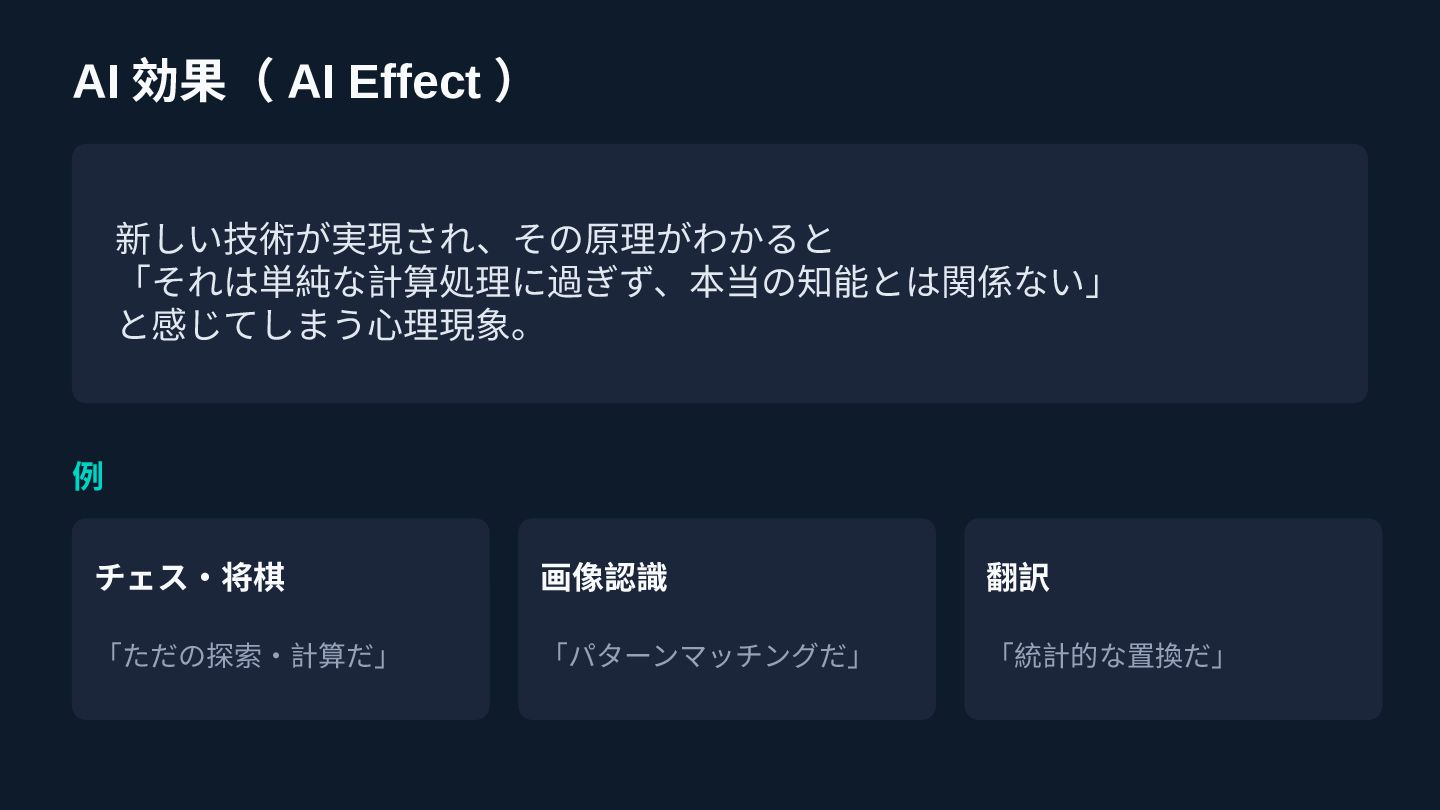
AI 効果( AI Effect ) 新しい技術が実現され、その原理がわかると 「それは単純な計算処理に過ぎず、本当の知能とは関係ない」 と感じてしまう心理現象。 例 チェス・将棋
画像認識 翻訳 「ただの探索・計算だ」 「パターンマッチングだ」 「統計的な置換だ」
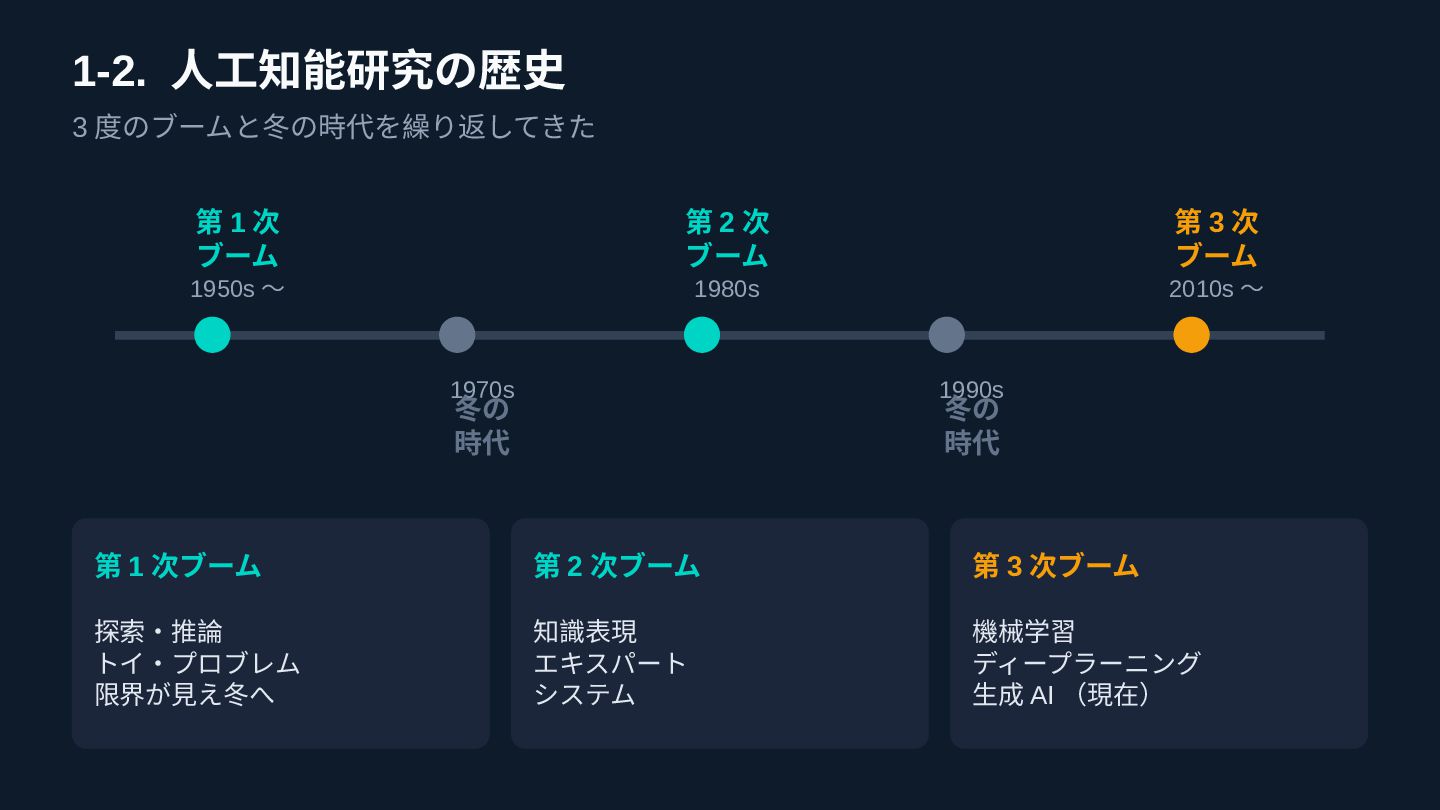
1-2. 人工知能研究の歴史 3 度のブームと冬の時代を繰り返してきた 第1次 ブーム 第2次 ブーム 1950s 〜
第3次 ブーム 2010s 〜 1980s 1970s 1990s 冬の 時代 冬の 時代 第 1 次ブーム 第 2 次ブーム 第 3 次ブーム 探索・推論 トイ・プロブレム 限界が見え冬へ 知識表現 エキスパート システム 機械学習 ディープラーニング 生成 AI (現在)
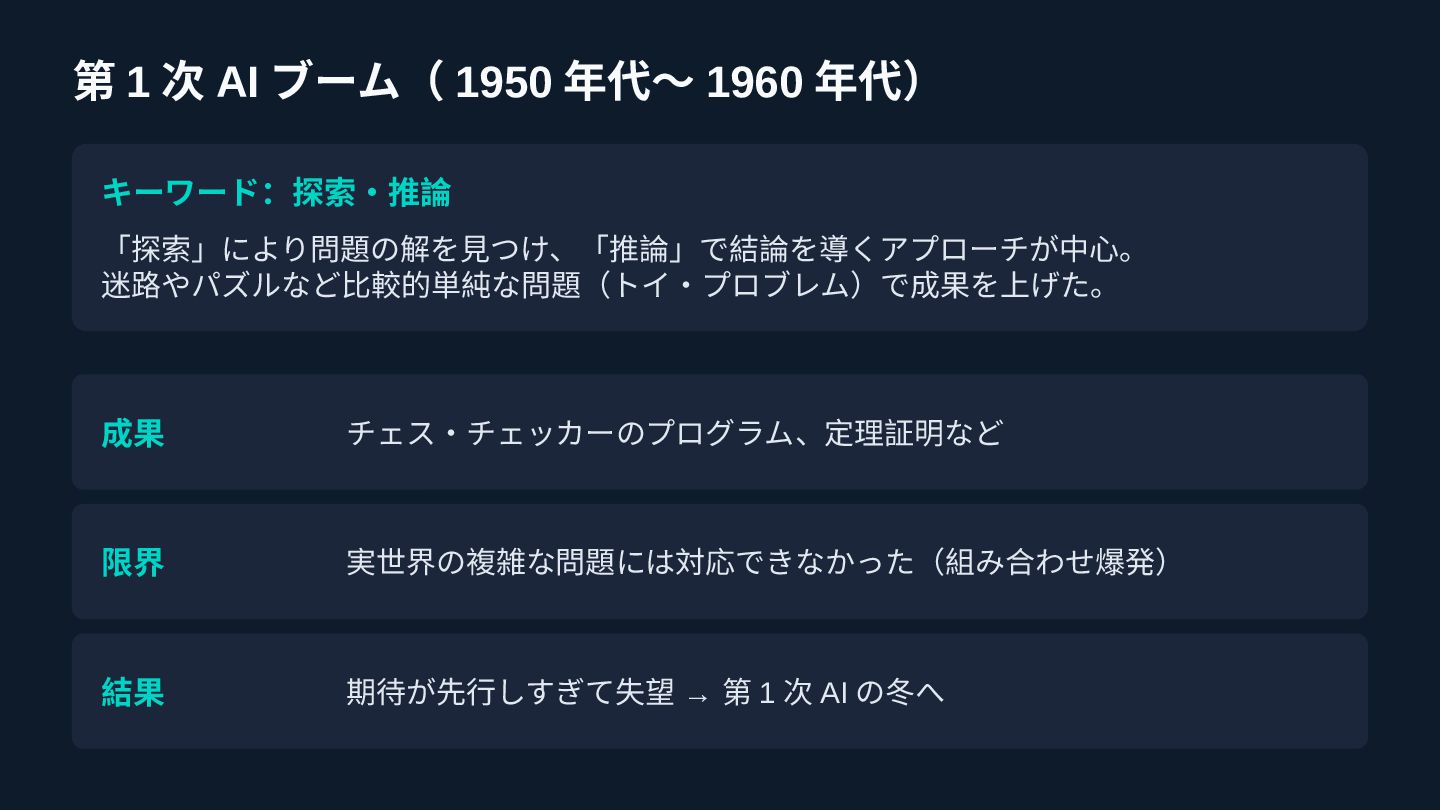
第 1 次 AI ブーム( 1950 年代〜 1960 年代) キーワード:探索・推論
「探索」により問題の解を見つけ、「推論」で結論を導くアプローチが中心。 迷路やパズルなど比較的単純な問題(トイ・プロブレム)で成果を上げた。 成果 チェス・チェッカーのプログラム、定理証明など 限界 実世界の複雑な問題には対応できなかった(組み合わせ爆発) 結果 期待が先行しすぎて失望 → 第 1 次 AI の冬へ
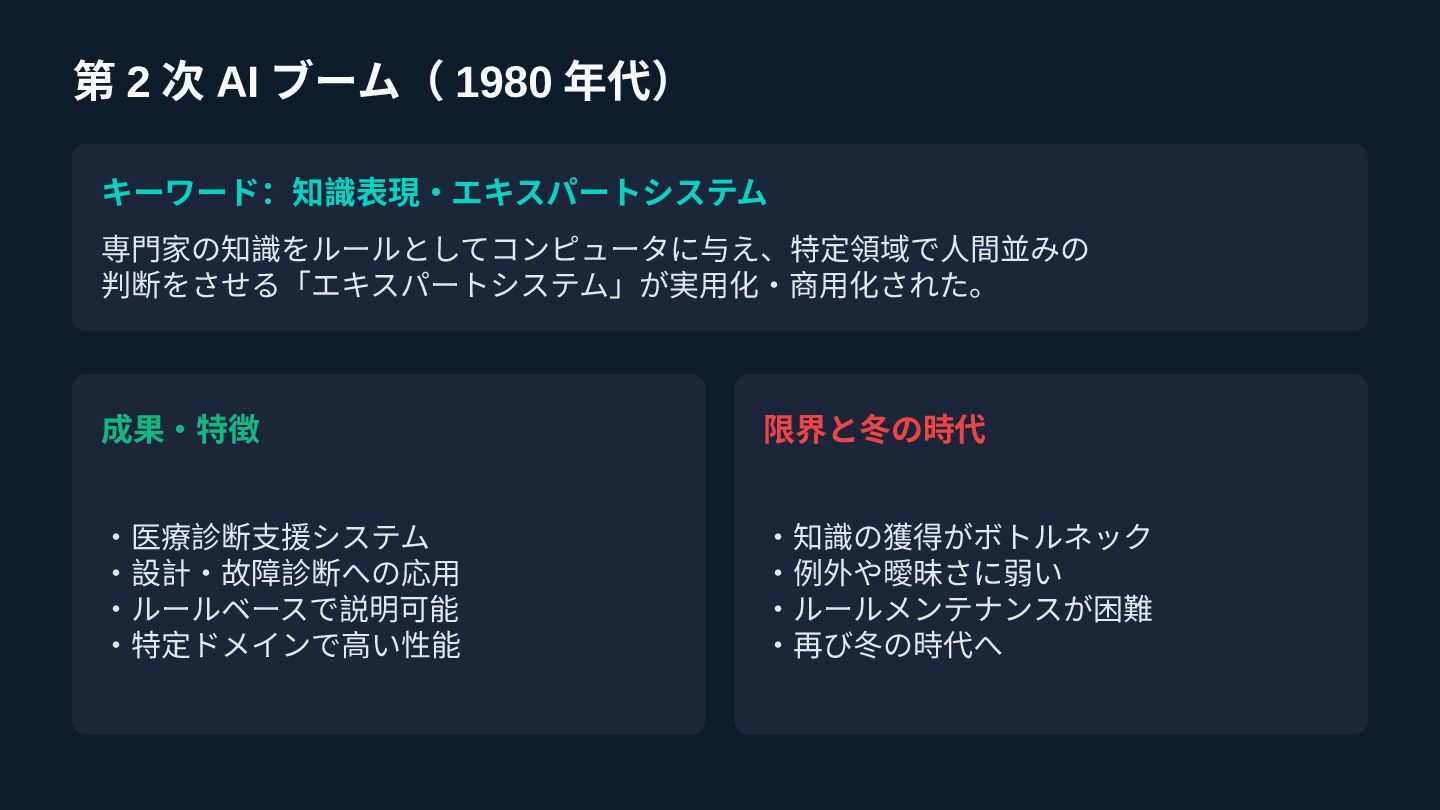
第 2 次 AI ブーム( 1980 年代) キーワード:知識表現・エキスパートシステム 専門家の知識をルールとしてコンピュータに与え、特定領域で人間並みの 判断をさせる「エキスパートシステム」が実用化・商用化された。
成果・特徴 限界と冬の時代 ・医療診断支援システム ・設計・故障診断への応用 ・ルールベースで説明可能 ・特定ドメインで高い性能 ・知識の獲得がボトルネック ・例外や曖昧さに弱い ・ルールメンテナンスが困難 ・再び冬の時代へ
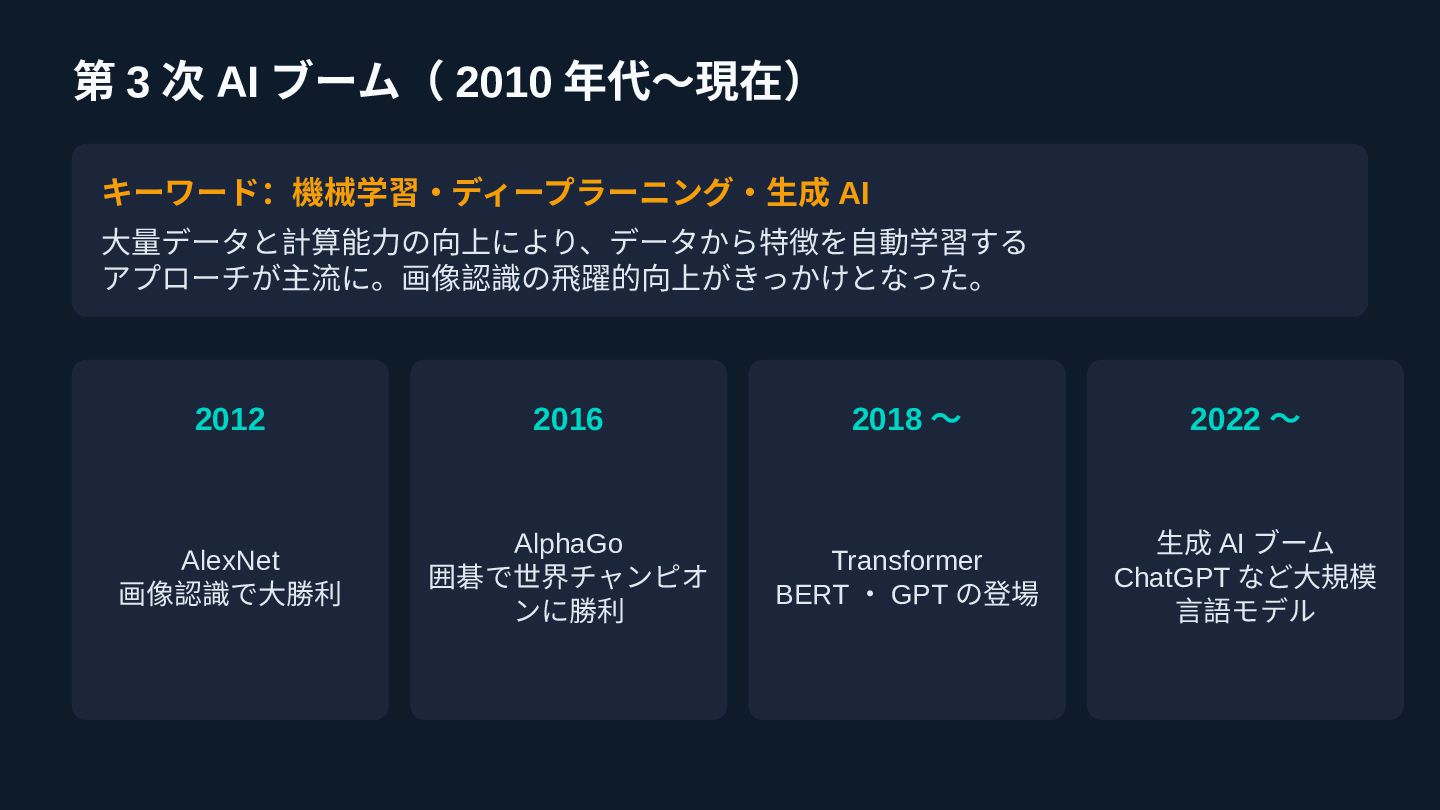
第 3 次 AI ブーム( 2010 年代〜現在) キーワード:機械学習・ディープラーニング・生成 AI 大量データと計算能力の向上により、データから特徴を自動学習する
アプローチが主流に。画像認識の飛躍的向上がきっかけとなった。 2012 2016 2018 〜 2022 〜 AlexNet 画像認識で大勝利 AlphaGo 囲碁で世界チャンピオ ンに勝利 Transformer BERT ・ GPT の登場 生成 AI ブーム ChatGPT など大規模 言語モデル
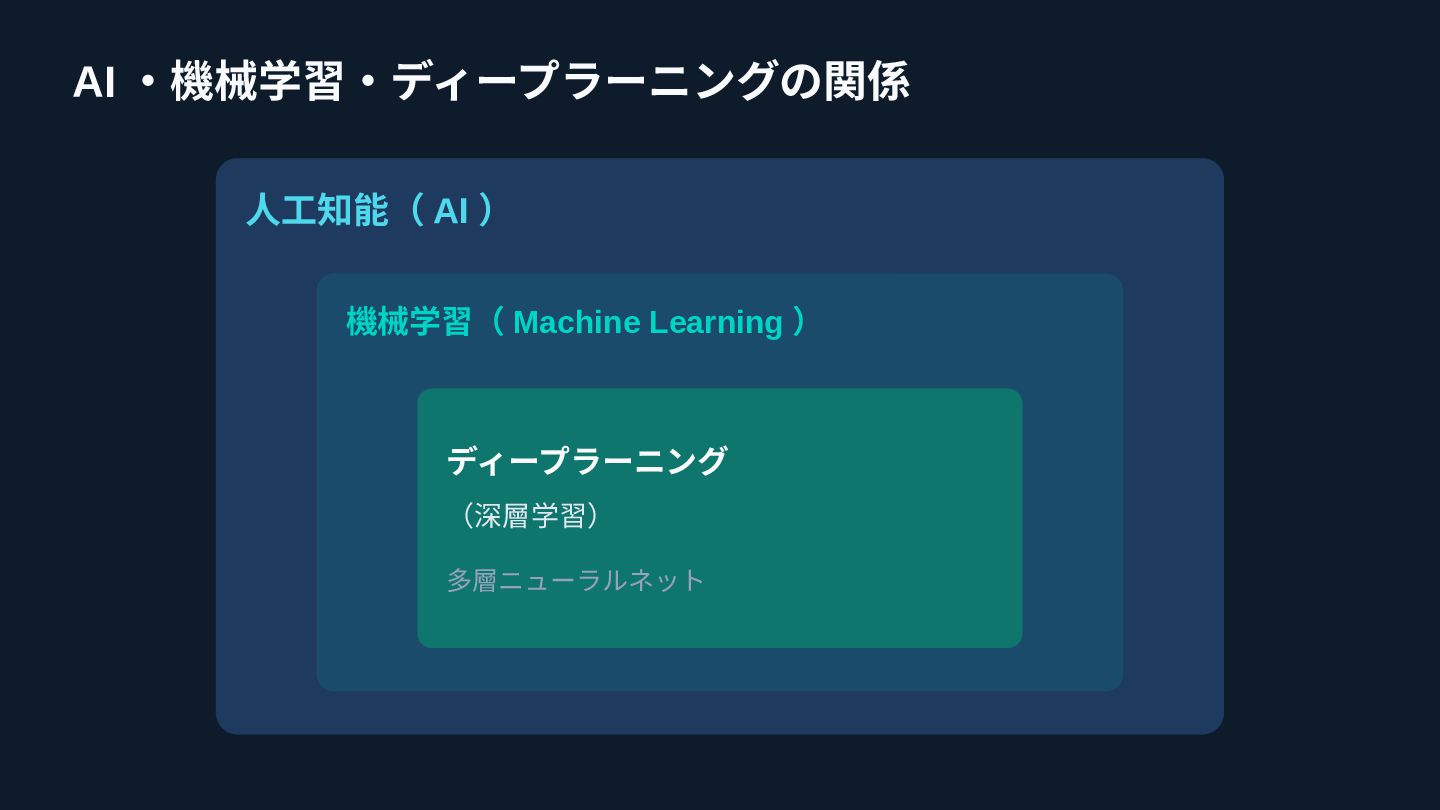
AI ・機械学習・ディープラーニングの関係 人工知能( AI ) 機械学習( Machine Learning ) ディープラーニング
(深層学習) 多層ニューラルネット
第 1 章 まとめ 1 AI に統一定義はないが、「人間の知的活動を機械で実現する技術」と捉える 2 弱い AI
(特定タスク)が現状の主流。強い AI (汎用知能)は未実現 3 AI 効果:実現されると「知能ではない」と感じる心理現象に注意 4 歴史は 3 度のブーム。現在は第 3 次ブーム( DL ・生成 AI )の只中 5 関係性: AI ⊃ 機械学習 ⊃ ディープラーニング
次の章へ 第2章 人工知能をめぐる動向 探索・推論 / 知識表現 / 機械学習・深層学習の流れを詳しく学びます
G 検定 学習スライド 第2章 人工知能をめぐる動向 探索・推論 / 知識表現・オントロジー / エキスパートシステム
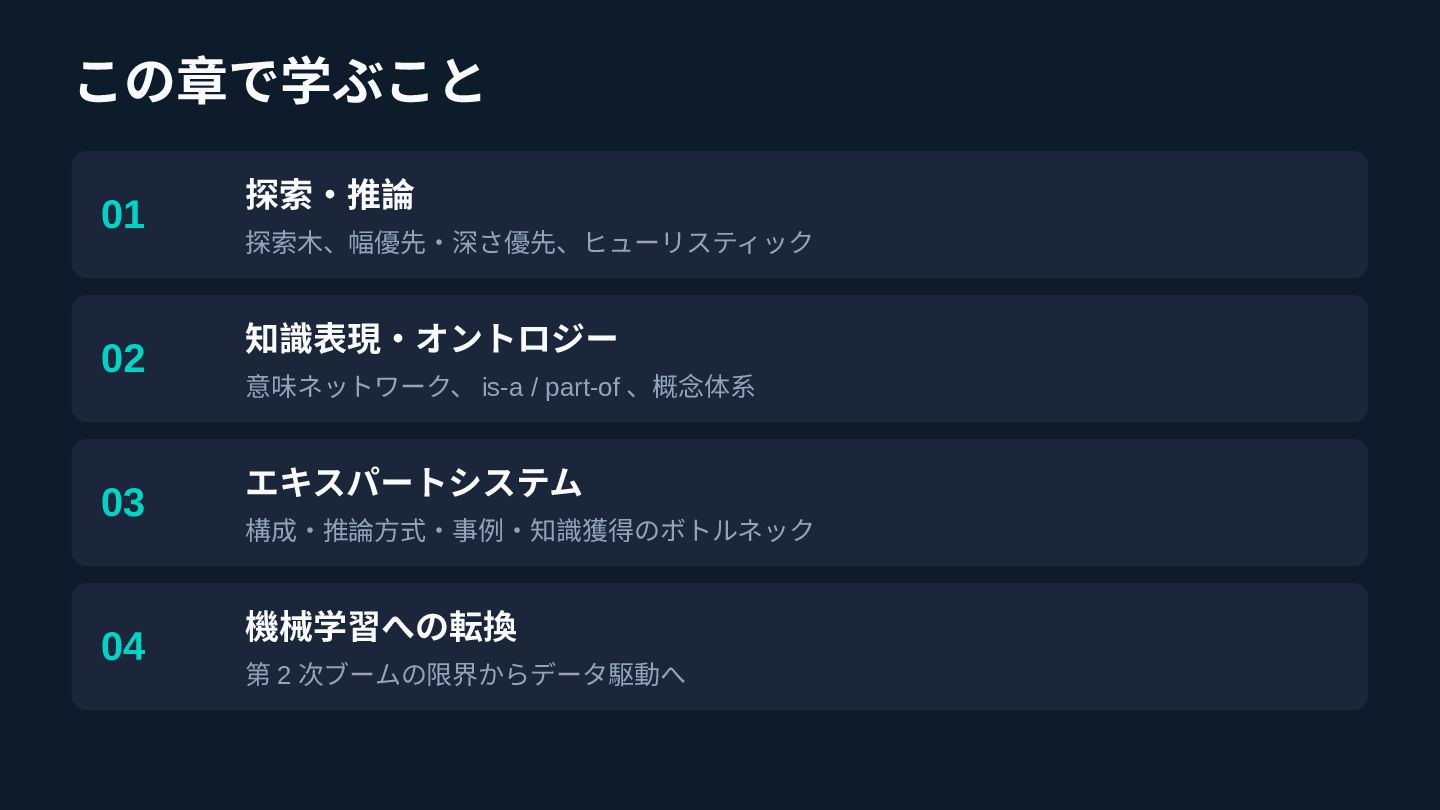
この章で学ぶこと 01 02 03 04 探索・推論 探索木、幅優先・深さ優先、ヒューリスティック 知識表現・オントロジー 意味ネットワーク、 is-a
/ part-of 、概念体系 エキスパートシステム 構成・推論方式・事例・知識獲得のボトルネック 機械学習への転換 第 2 次ブームの限界からデータ駆動へ
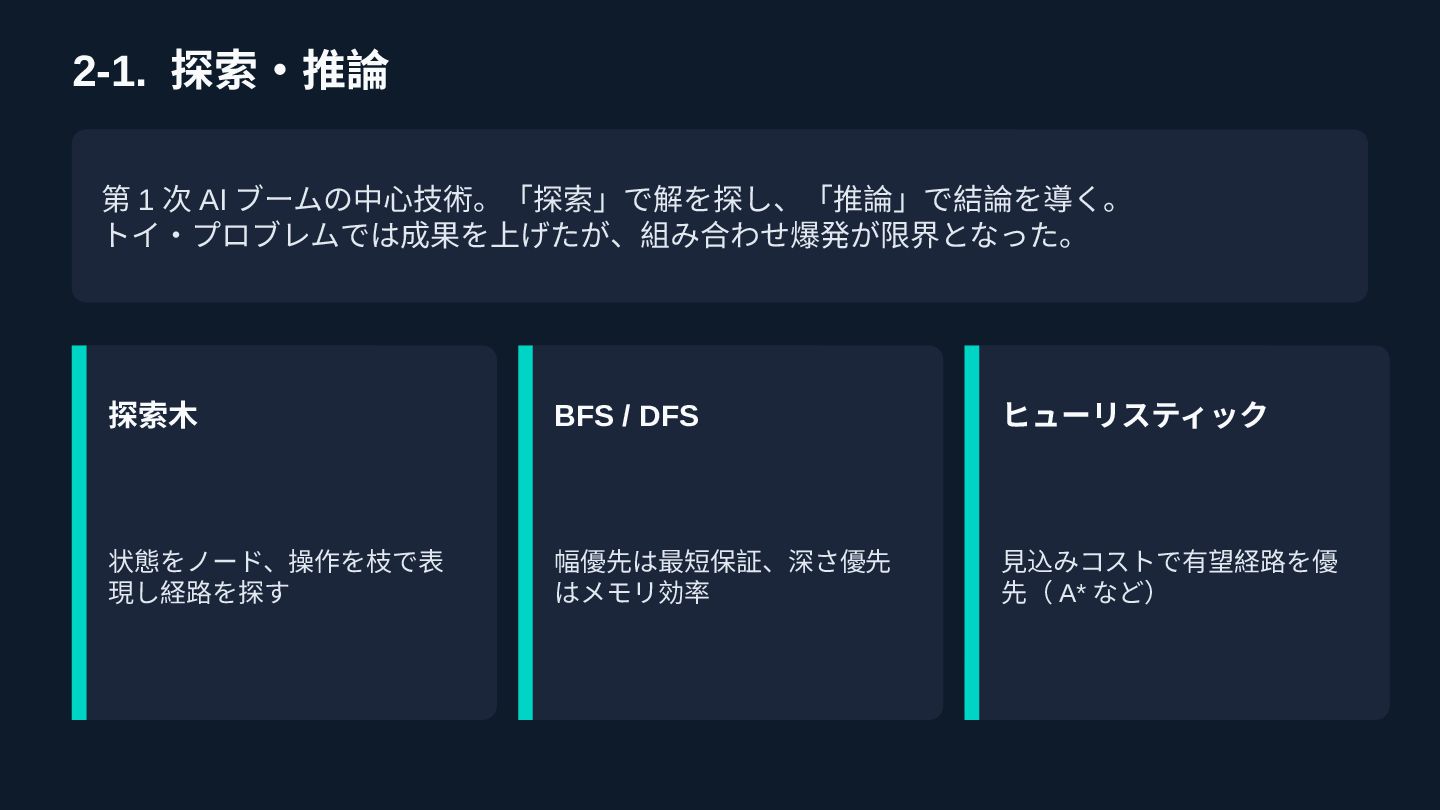
2-1. 探索・推論 第 1 次 AI ブームの中心技術。「探索」で解を探し、「推論」で結論を導く。 トイ・プロブレムでは成果を上げたが、組み合わせ爆発が限界となった。 探索木 BFS
/ DFS ヒューリスティック 状態をノード、操作を枝で表 現し経路を探す 幅優先は最短保証、深さ優先 はメモリ効率 見込みコストで有望経路を優 先( A* など)
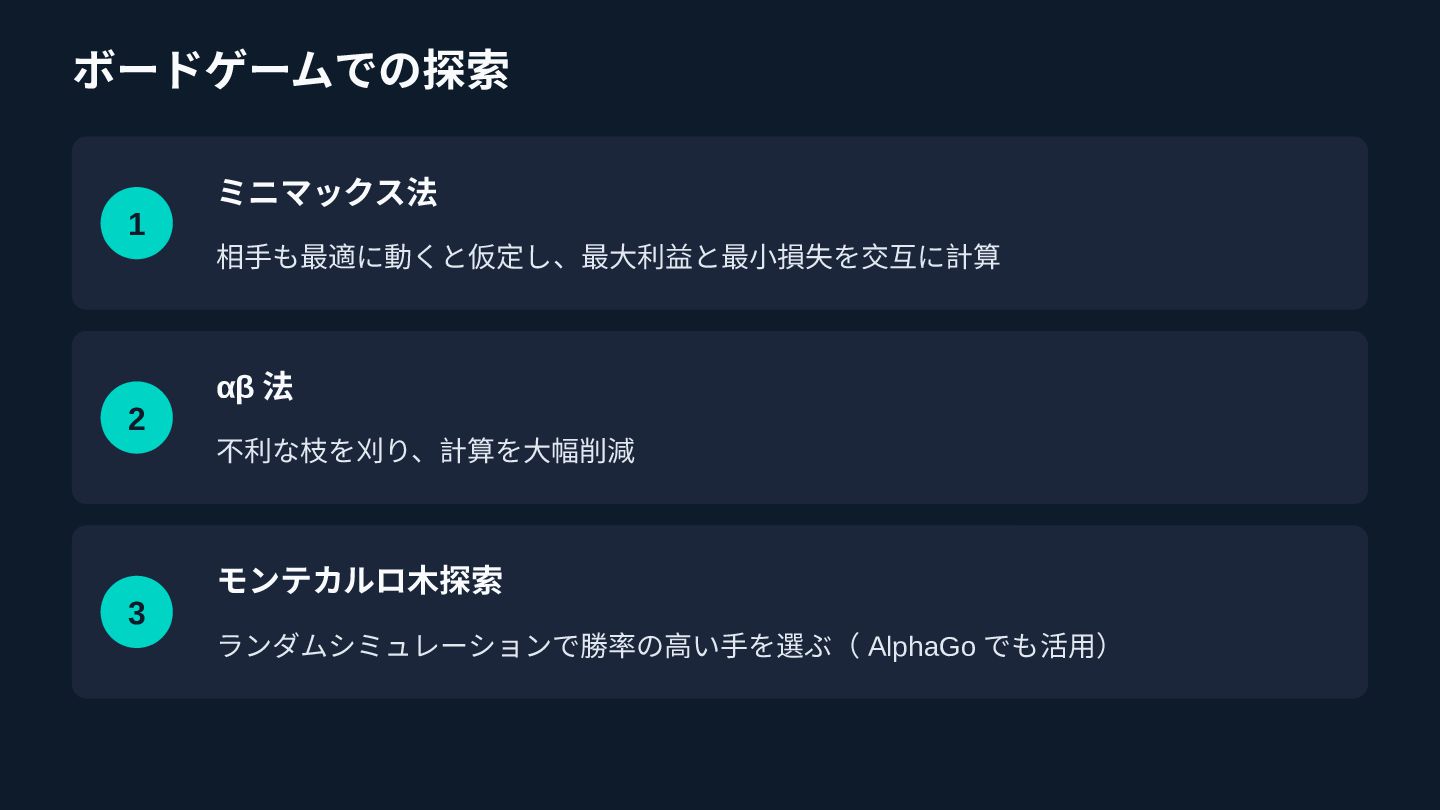
ボードゲームでの探索 1 2 3 ミニマックス法 相手も最適に動くと仮定し、最大利益と最小損失を交互に計算 αβ 法 不利な枝を刈り、計算を大幅削減 モンテカルロ木探索
ランダムシミュレーションで勝率の高い手を選ぶ( AlphaGo でも活用)
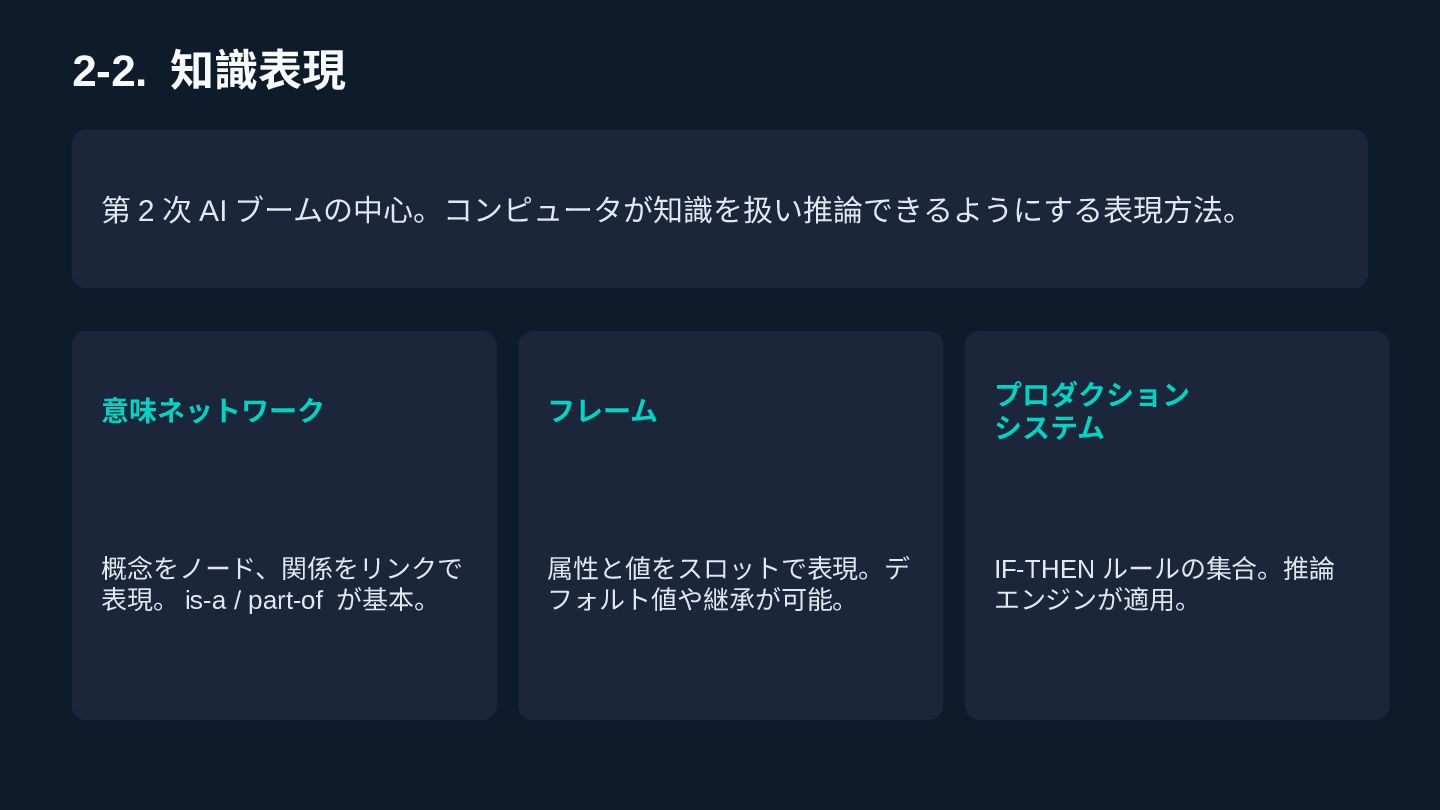
2-2. 知識表現 第 2 次 AI ブームの中心。コンピュータが知識を扱い推論できるようにする表現方法。 意味ネットワーク フレーム プロダクション
システム 概念をノード、関係をリンクで 表現。 is-a / part-of が基本。 属性と値をスロットで表現。デ フォルト値や継承が可能。 IF-THEN ルールの集合。推論 エンジンが適用。
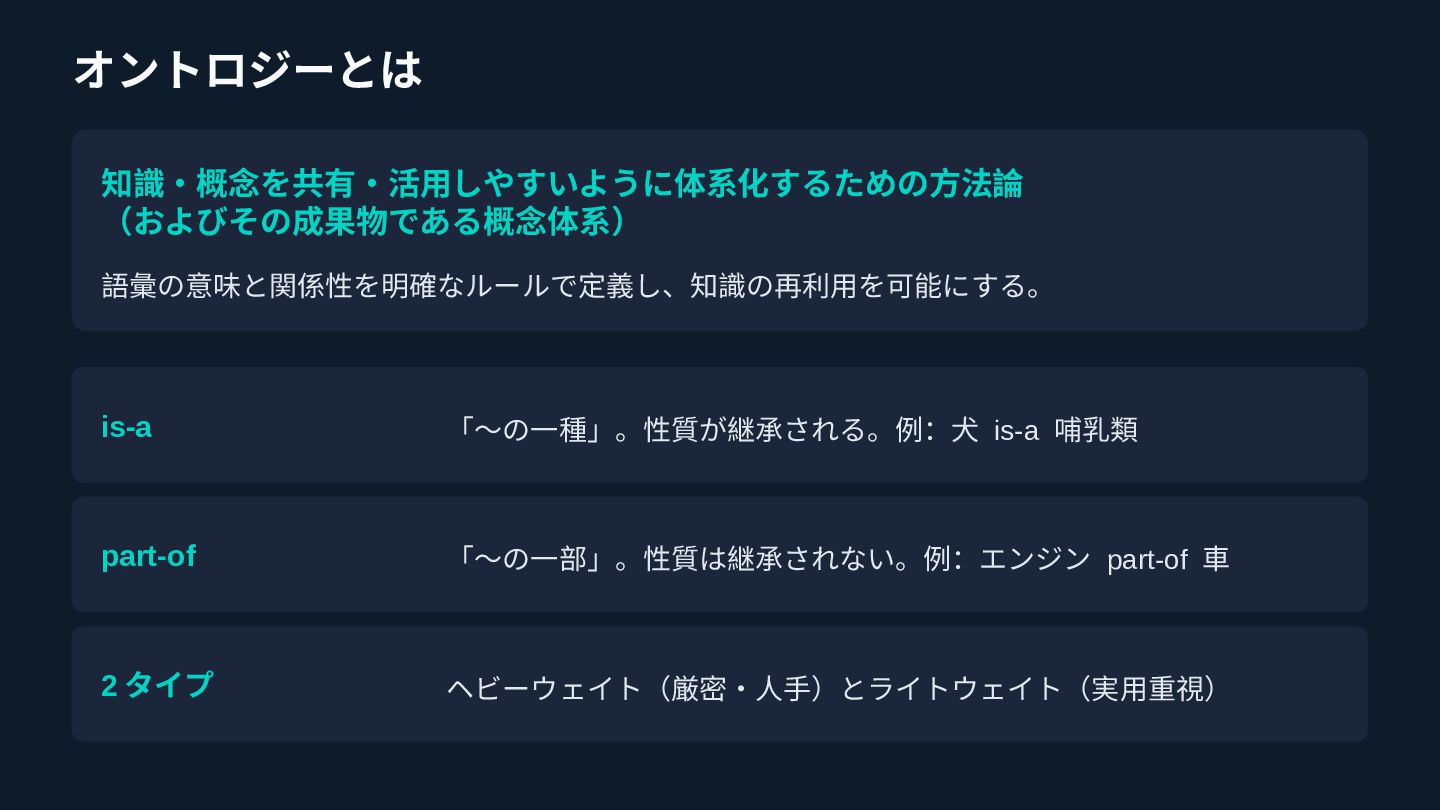
オントロジーとは 知識・概念を共有・活用しやすいように体系化するための方法論 (およびその成果物である概念体系) 語彙の意味と関係性を明確なルールで定義し、知識の再利用を可能にする。 is-a 「〜の一種」。性質が継承される。例:犬 is-a 哺乳類 part-of 「〜の一部」。性質は継承されない。例:エンジン
part-of 車 2 タイプ ヘビーウェイト(厳密・人手)とライトウェイト(実用重視)
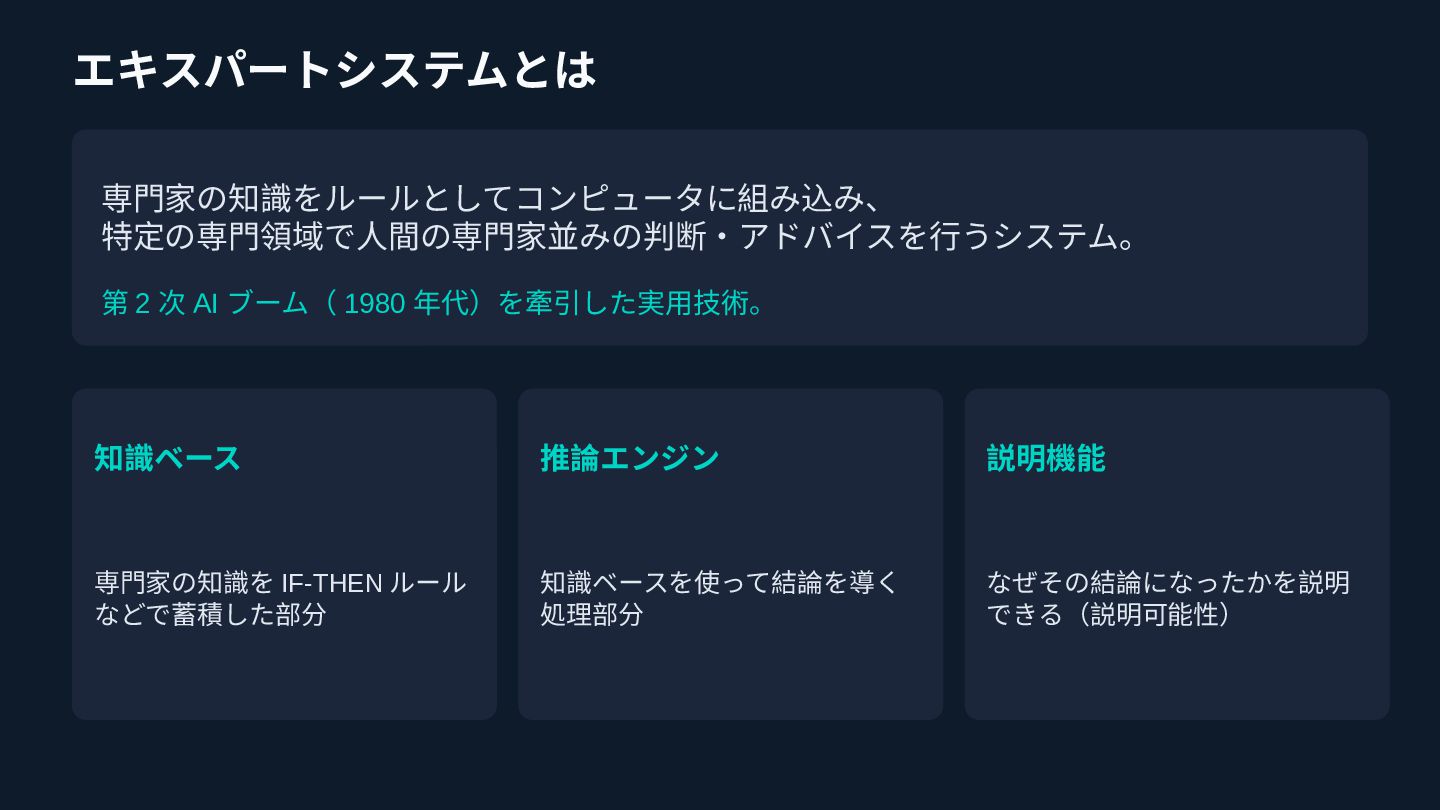
エキスパートシステムとは 専門家の知識をルールとしてコンピュータに組み込み、 特定の専門領域で人間の専門家並みの判断・アドバイスを行うシステム。 第 2 次 AI ブーム( 1980 年代)を牽引した実用技術。
知識ベース 推論エンジン 説明機能 専門家の知識を IF-THEN ルール などで蓄積した部分 知識ベースを使って結論を導く 処理部分 なぜその結論になったかを説明 できる(説明可能性)
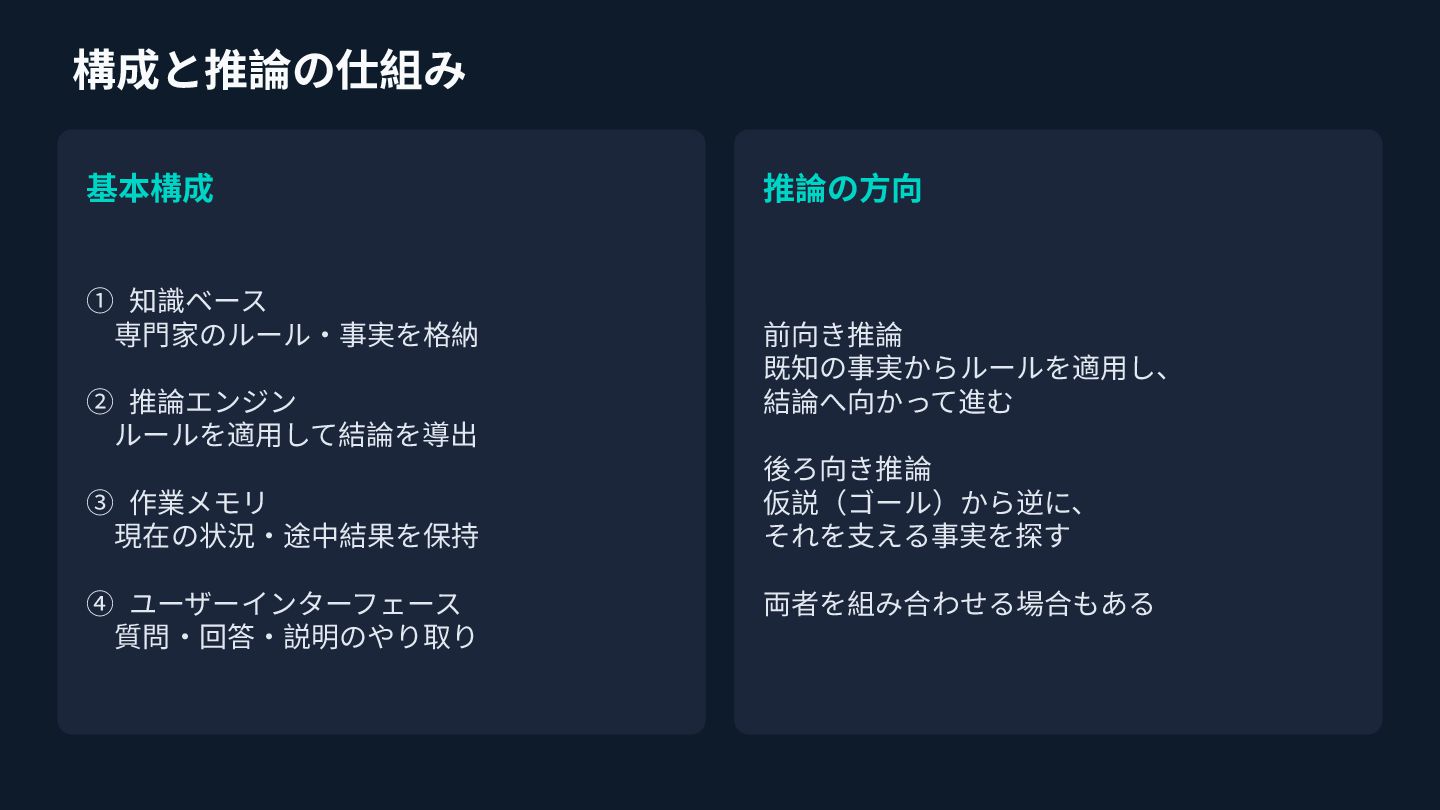
構成と推論の仕組み 基本構成 ① 知識ベース 専門家のルール・事実を格納 ② 推論エンジン ルールを適用して結論を導出 ③ 作業メモリ
現在の状況・途中結果を保持 ④ ユーザーインターフェース 質問・回答・説明のやり取り 推論の方向 前向き推論 既知の事実からルールを適用し、 結論へ向かって進む 後ろ向き推論 仮説(ゴール)から逆に、 それを支える事実を探す 両者を組み合わせる場合もある
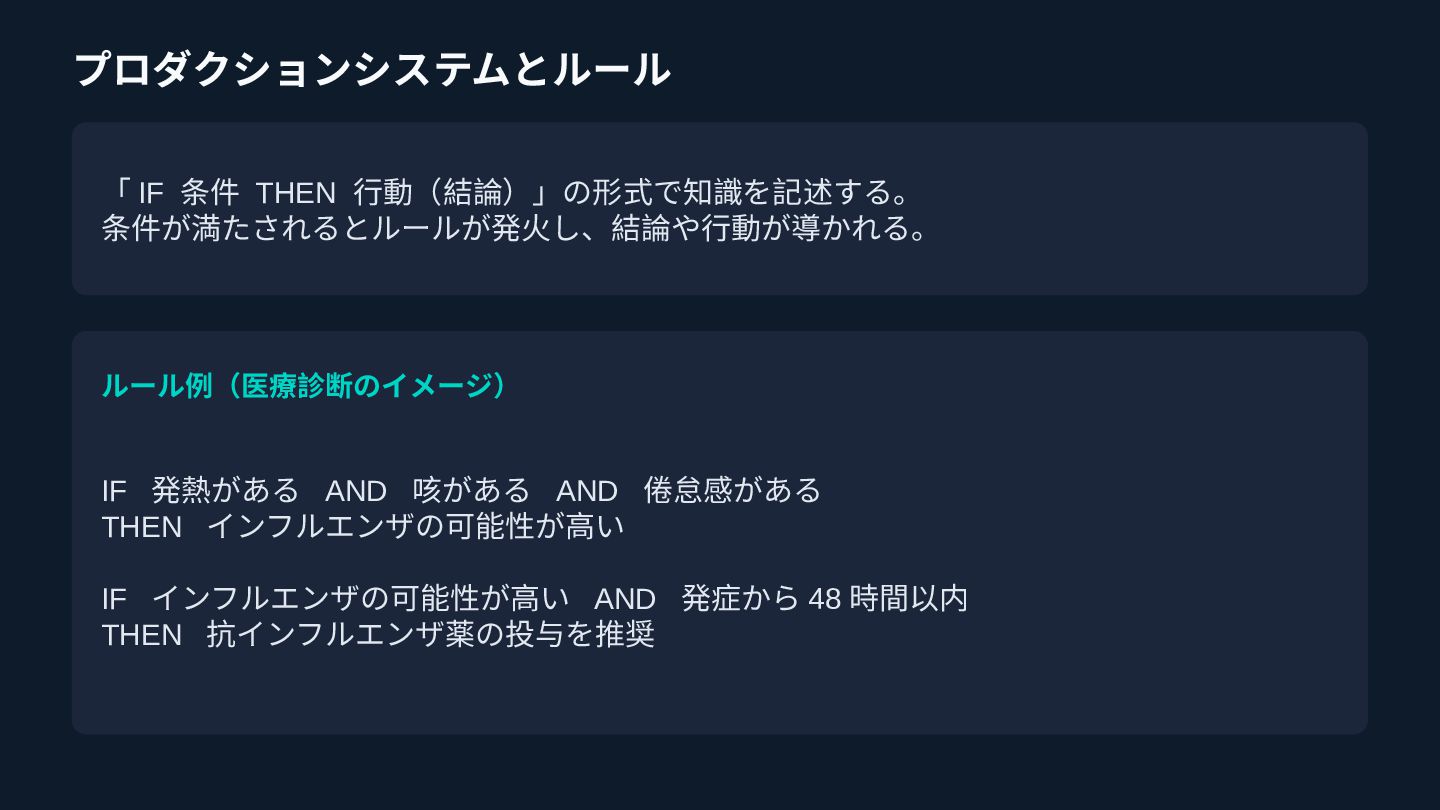
プロダクションシステムとルール 「 IF 条件 THEN 行動(結論)」の形式で知識を記述する。 条件が満たされるとルールが発火し、結論や行動が導かれる。 ルール例(医療診断のイメージ) IF 発熱がある
AND 咳がある AND 倦怠感がある THEN インフルエンザの可能性が高い IF インフルエンザの可能性が高い AND 発症から 48 時間以内 THEN 抗インフルエンザ薬の投与を推奨
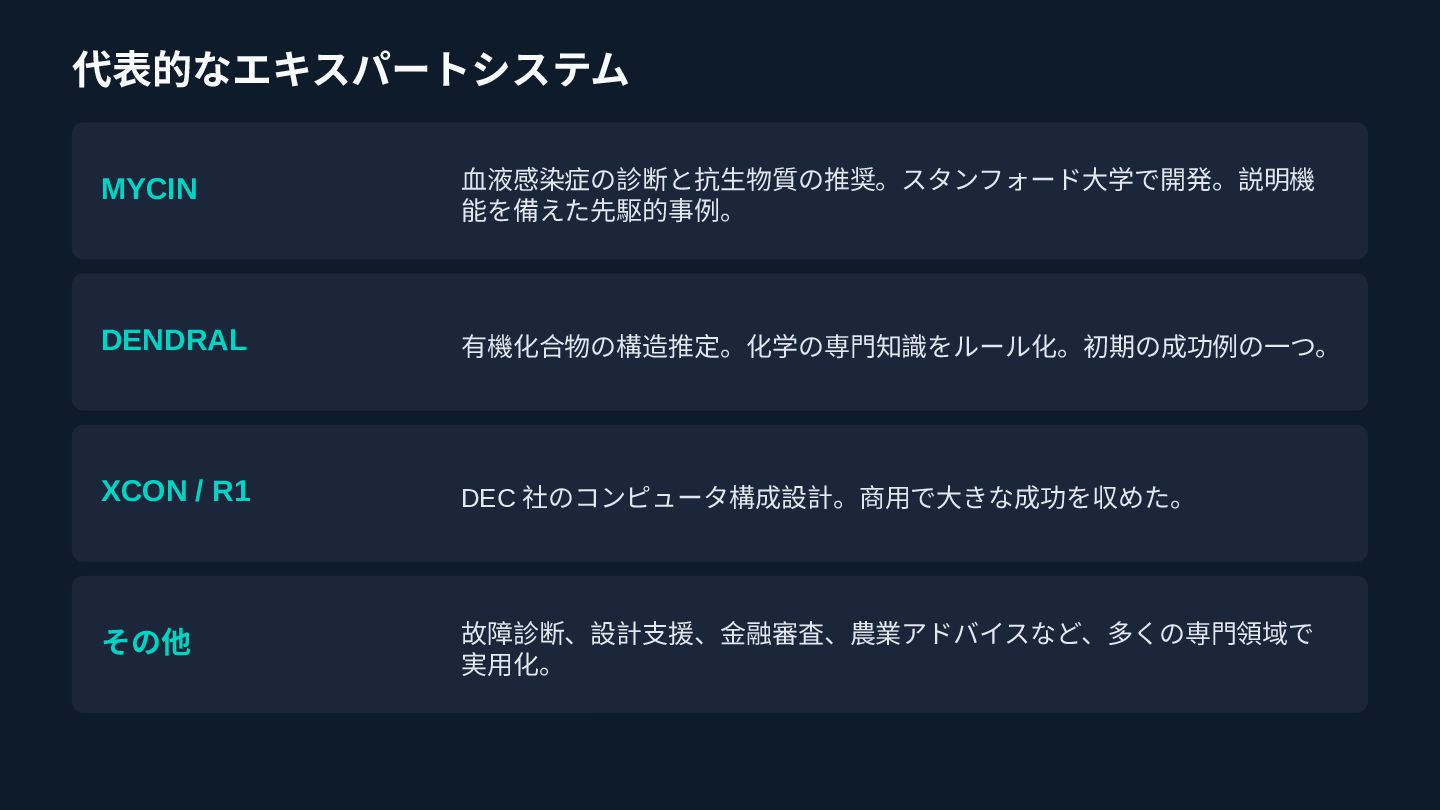
代表的なエキスパートシステム MYCIN 血液感染症の診断と抗生物質の推奨。スタンフォード大学で開発。説明機 能を備えた先駆的事例。 DENDRAL 有機化合物の構造推定。化学の専門知識をルール化。初期の成功例の一つ。 XCON / R1 DEC
社のコンピュータ構成設計。商用で大きな成功を収めた。 その他 故障診断、設計支援、金融審査、農業アドバイスなど、多くの専門領域で 実用化。
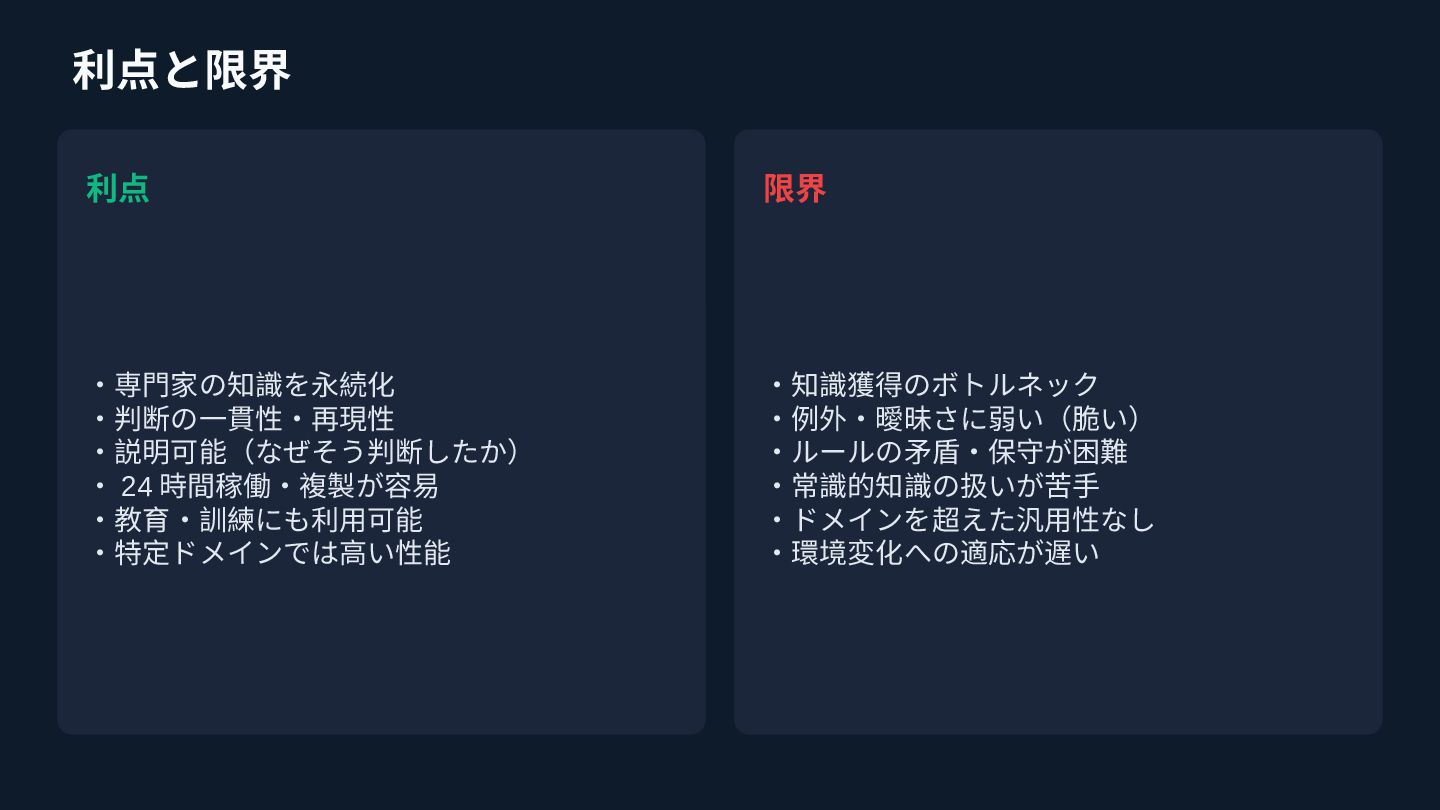
利点と限界 利点 限界 ・専門家の知識を永続化 ・判断の一貫性・再現性 ・説明可能(なぜそう判断したか) ・ 24 時間稼働・複製が容易 ・教育・訓練にも利用可能
・特定ドメインでは高い性能 ・知識獲得のボトルネック ・例外・曖昧さに弱い(脆い) ・ルールの矛盾・保守が困難 ・常識的知識の扱いが苦手 ・ドメインを超えた汎用性なし ・環境変化への適応が遅い
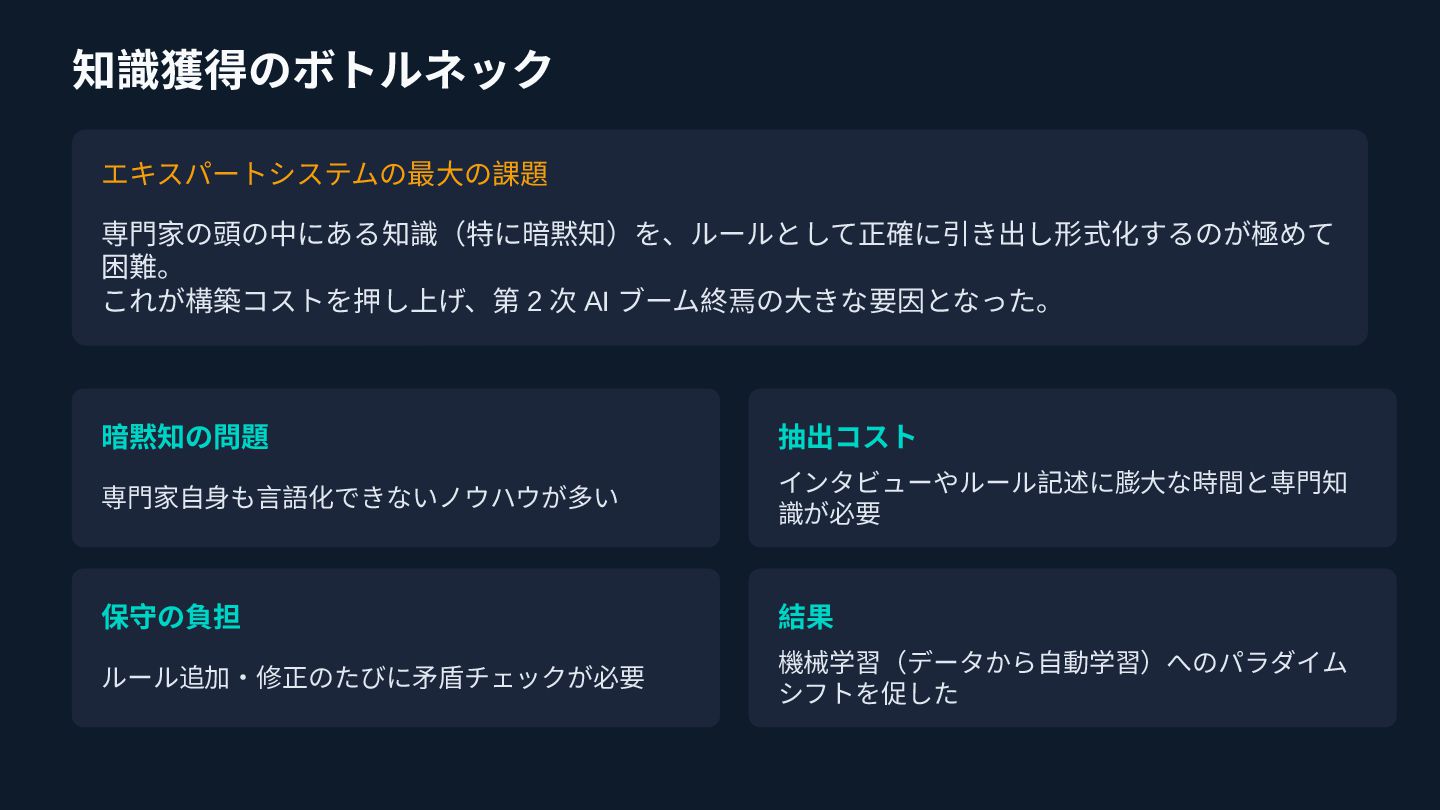
知識獲得のボトルネック エキスパートシステムの最大の課題 専門家の頭の中にある知識(特に暗黙知)を、ルールとして正確に引き出し形式化するのが極めて 困難。 これが構築コストを押し上げ、第 2 次 AI ブーム終焉の大きな要因となった。 暗黙知の問題
抽出コスト 専門家自身も言語化できないノウハウが多い インタビューやルール記述に膨大な時間と専門知 識が必要 保守の負担 結果 ルール追加・修正のたびに矛盾チェックが必要 機械学習(データから自動学習)へのパラダイム シフトを促した
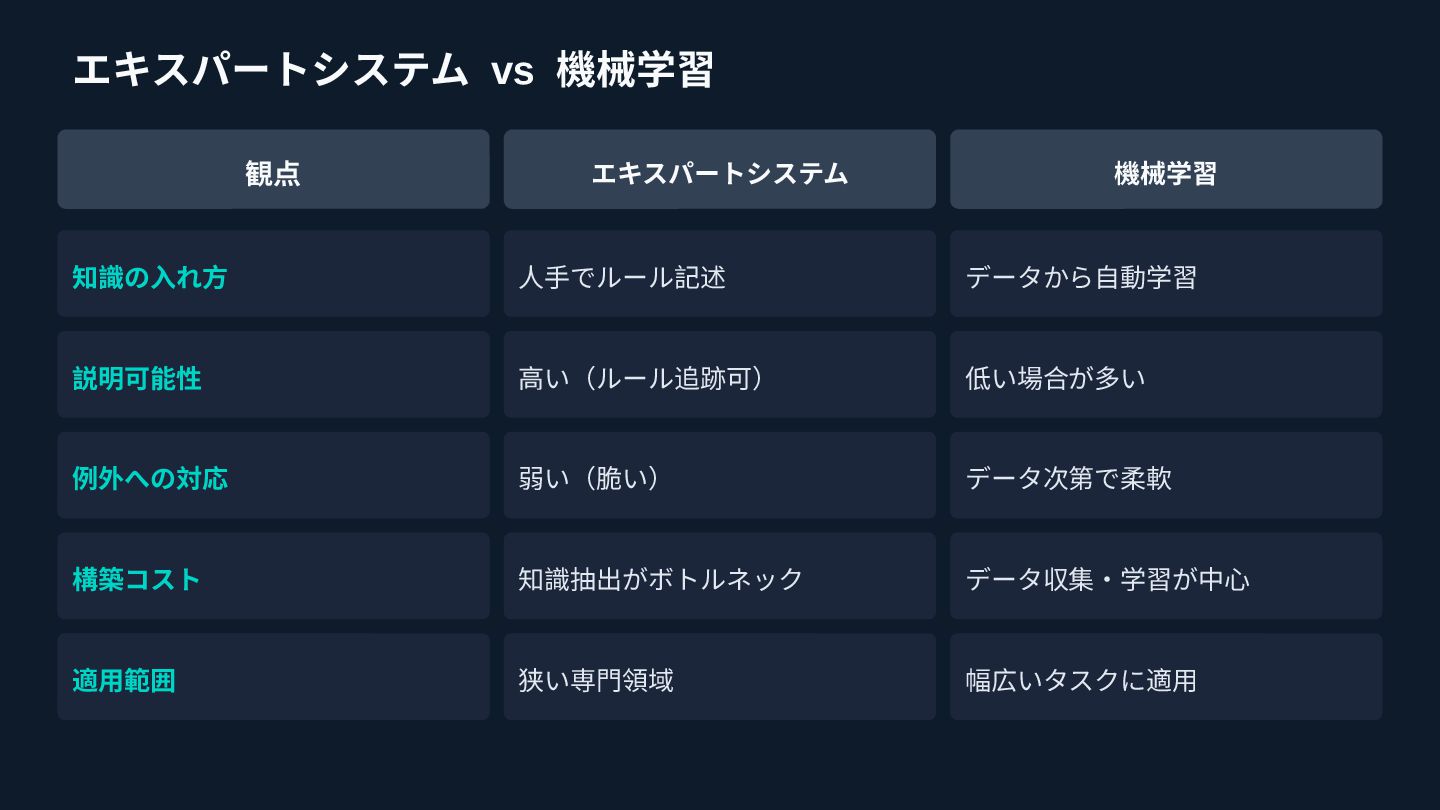
エキスパートシステム vs 機械学習 観点 エキスパートシステム 機械学習 知識の入れ方 人手でルール記述 データから自動学習 説明可能性
高い(ルール追跡可) 低い場合が多い 例外への対応 弱い(脆い) データ次第で柔軟 構築コスト 知識抽出がボトルネック データ収集・学習が中心 適用範囲 狭い専門領域 幅広いタスクに適用
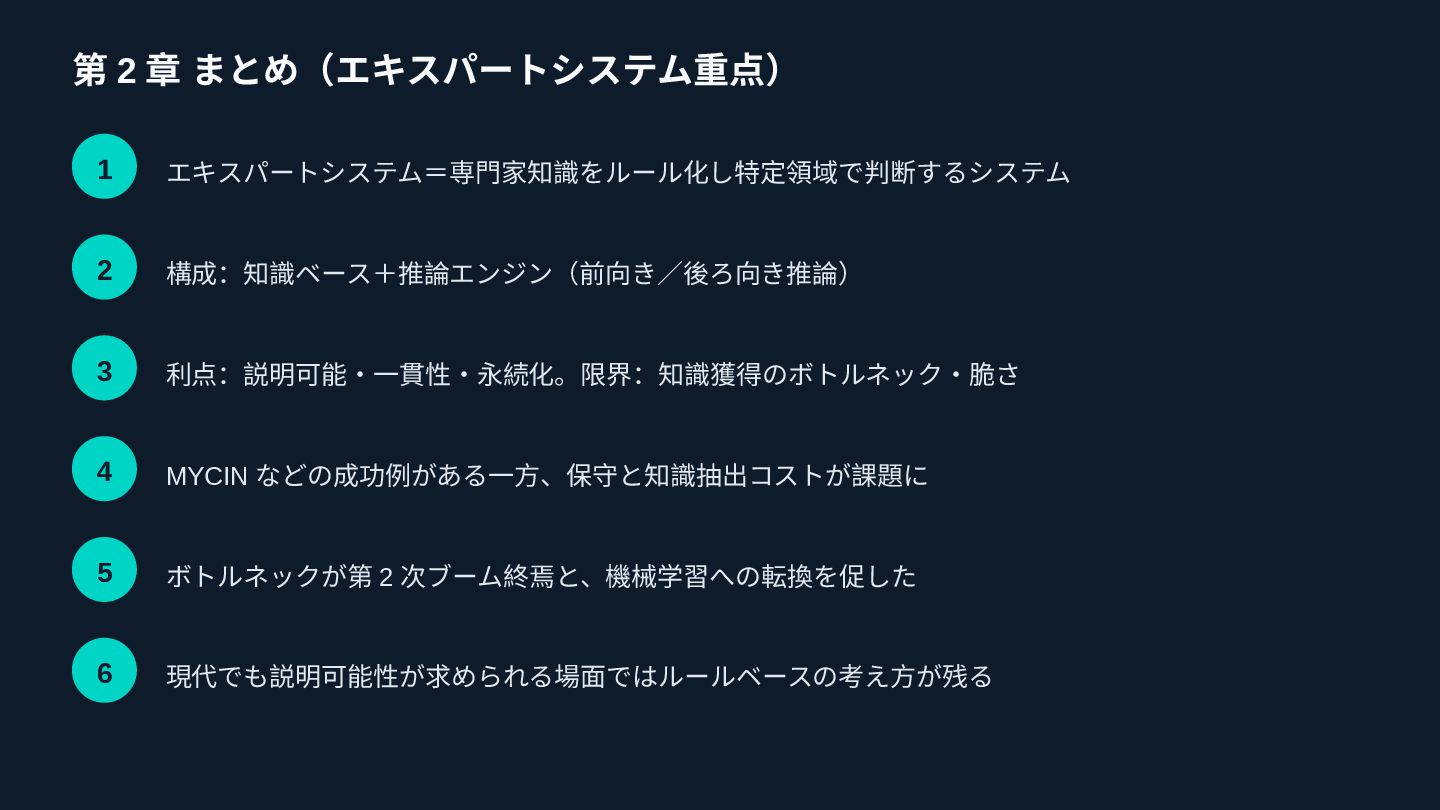
第 2 章 まとめ(エキスパートシステム重点) 1 エキスパートシステム=専門家知識をルール化し特定領域で判断するシステム 2 構成:知識ベース+推論エンジン(前向き/後ろ向き推論) 3 利点:説明可能・一貫性・永続化。限界:知識獲得のボトルネック・脆さ
4 MYCIN などの成功例がある一方、保守と知識抽出コストが課題に 5 ボトルネックが第 2 次ブーム終焉と、機械学習への転換を促した 6 現代でも説明可能性が求められる場面ではルールベースの考え方が残る
次の章へ 第3章 機械学習の具体的手法 教師あり・なし・強化学習、モデル評価などを学びます
G 検定 学習スライド 第3章 機械学習の具体的手法 機械学習モデル / 強化学習 / モデル評価(深掘り版)
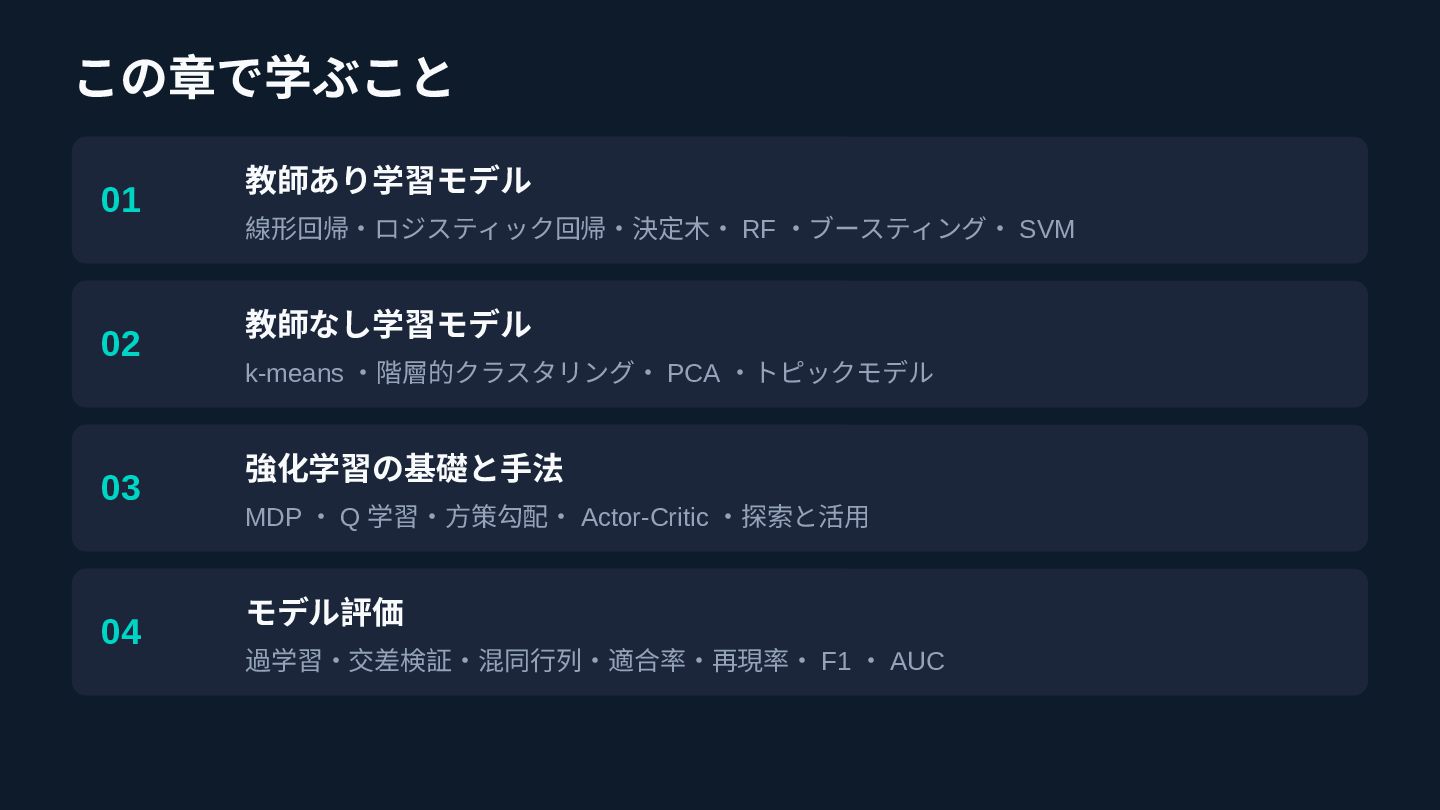
この章で学ぶこと 01 02 03 04 教師あり学習モデル 線形回帰・ロジスティック回帰・決定木・ RF ・ブースティング・ SVM
教師なし学習モデル k-means ・階層的クラスタリング・ PCA ・トピックモデル 強化学習の基礎と手法 MDP ・ Q 学習・方策勾配・ Actor-Critic ・探索と活用 モデル評価 過学習・交差検証・混同行列・適合率・再現率・ F1 ・ AUC
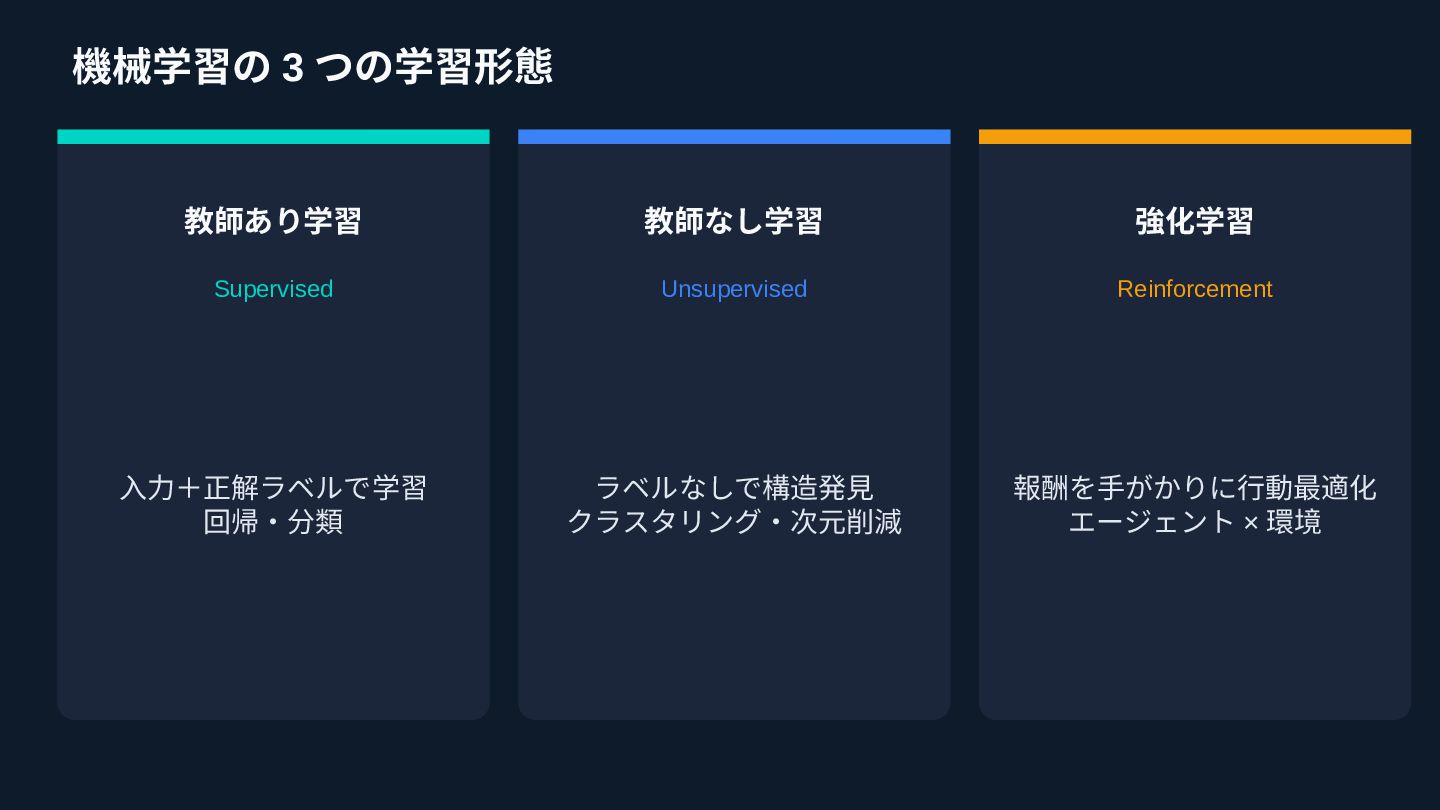
機械学習の 3 つの学習形態 教師あり学習 教師なし学習 強化学習 Supervised Unsupervised Reinforcement 入力+正解ラベルで学習
回帰・分類 ラベルなしで構造発見 クラスタリング・次元削減 報酬を手がかりに行動最適化 エージェント × 環境
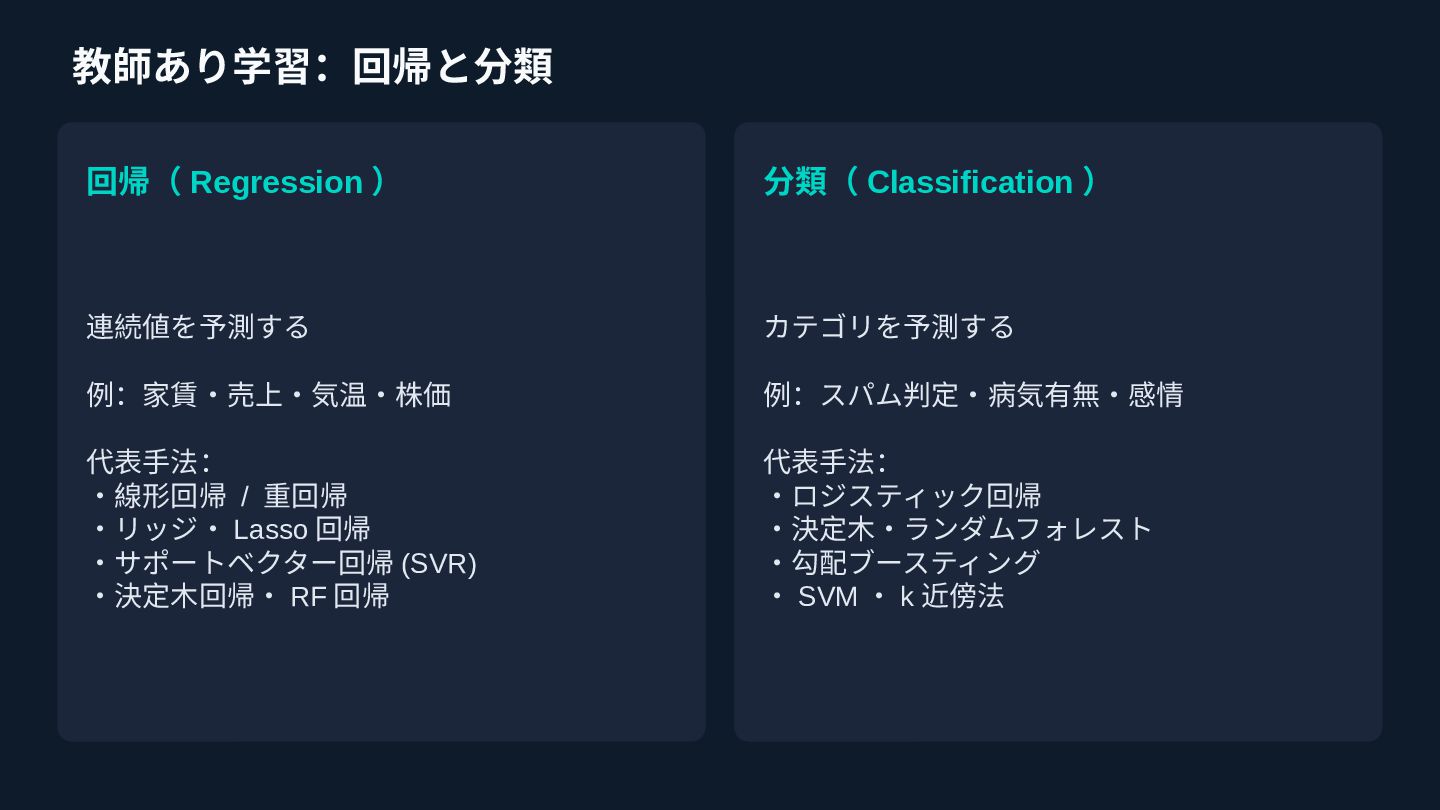
教師あり学習:回帰と分類 回帰( Regression ) 分類( Classification ) 連続値を予測する カテゴリを予測する 例:家賃・売上・気温・株価
例:スパム判定・病気有無・感情 代表手法: ・線形回帰 / 重回帰 ・リッジ・ Lasso 回帰 ・サポートベクター回帰 (SVR) ・決定木回帰・ RF 回帰 代表手法: ・ロジスティック回帰 ・決定木・ランダムフォレスト ・勾配ブースティング ・ SVM ・ k 近傍法
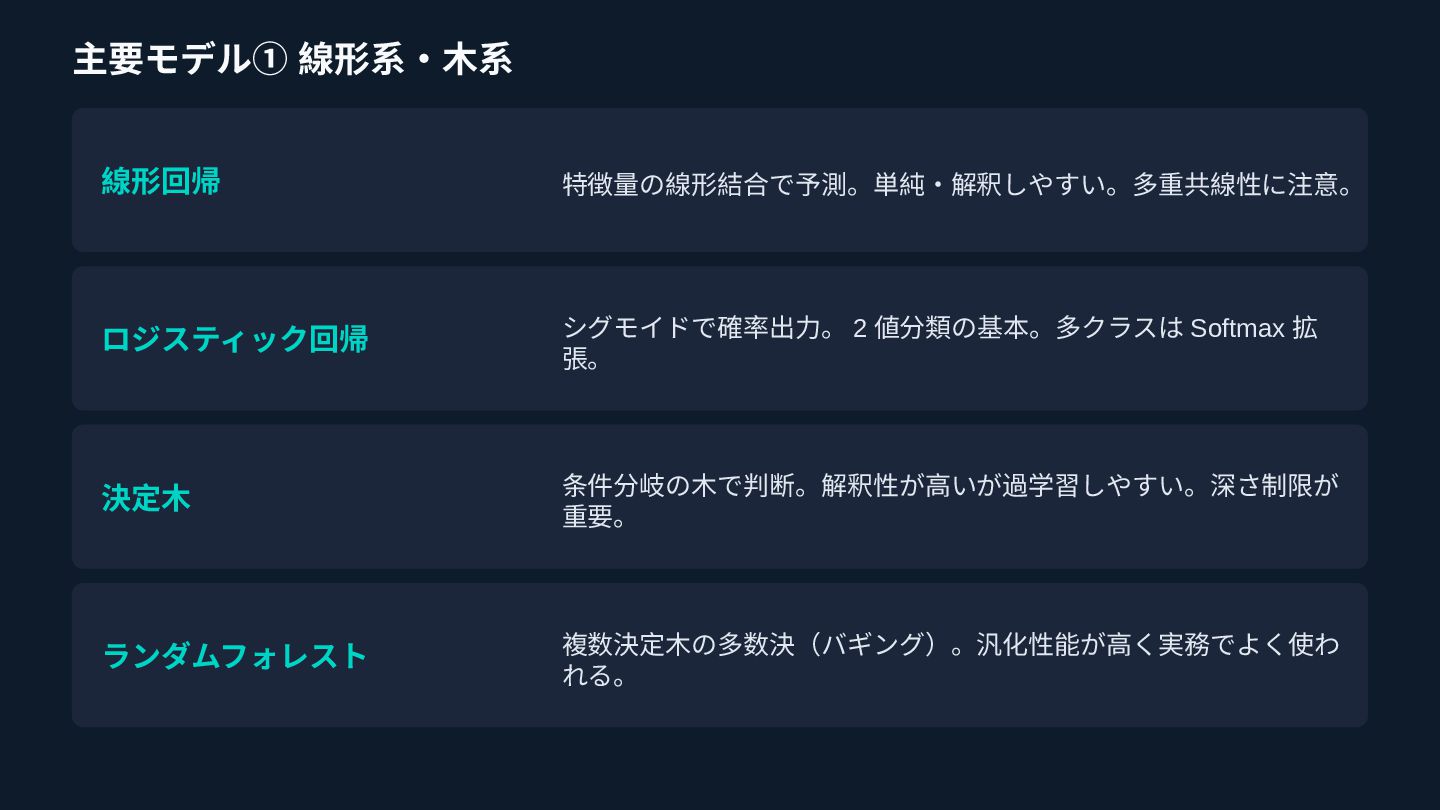
主要モデル① 線形系・木系 線形回帰 特徴量の線形結合で予測。単純・解釈しやすい。多重共線性に注意。 ロジスティック回帰 シグモイドで確率出力。 2 値分類の基本。多クラスは Softmax 拡
張。 決定木 条件分岐の木で判断。解釈性が高いが過学習しやすい。深さ制限が 重要。 ランダムフォレスト 複数決定木の多数決(バギング)。汎化性能が高く実務でよく使わ れる。
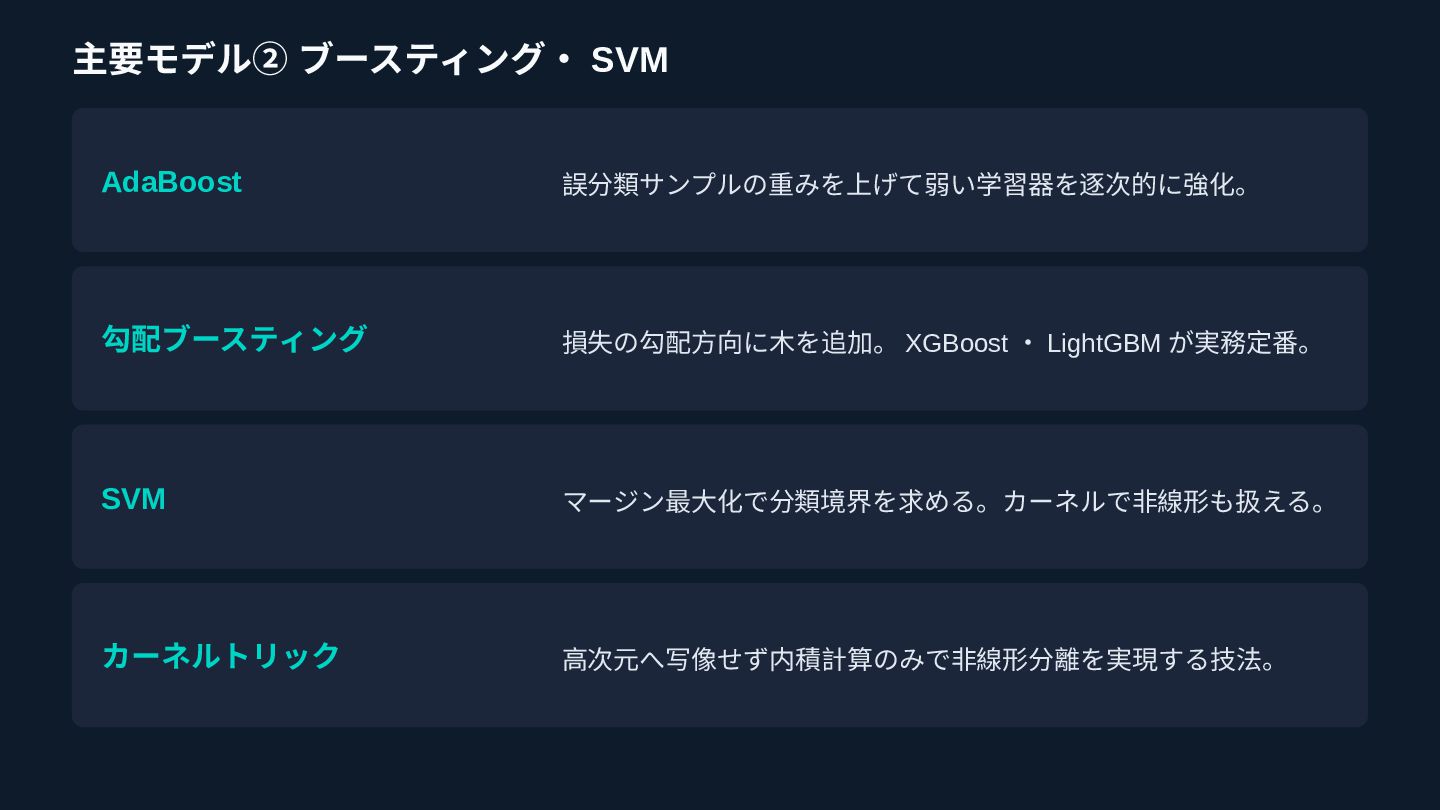
主要モデル② ブースティング・ SVM AdaBoost 誤分類サンプルの重みを上げて弱い学習器を逐次的に強化。 勾配ブースティング 損失の勾配方向に木を追加。 XGBoost ・ LightGBM
が実務定番。 SVM マージン最大化で分類境界を求める。カーネルで非線形も扱える。 カーネルトリック 高次元へ写像せず内積計算のみで非線形分離を実現する技法。
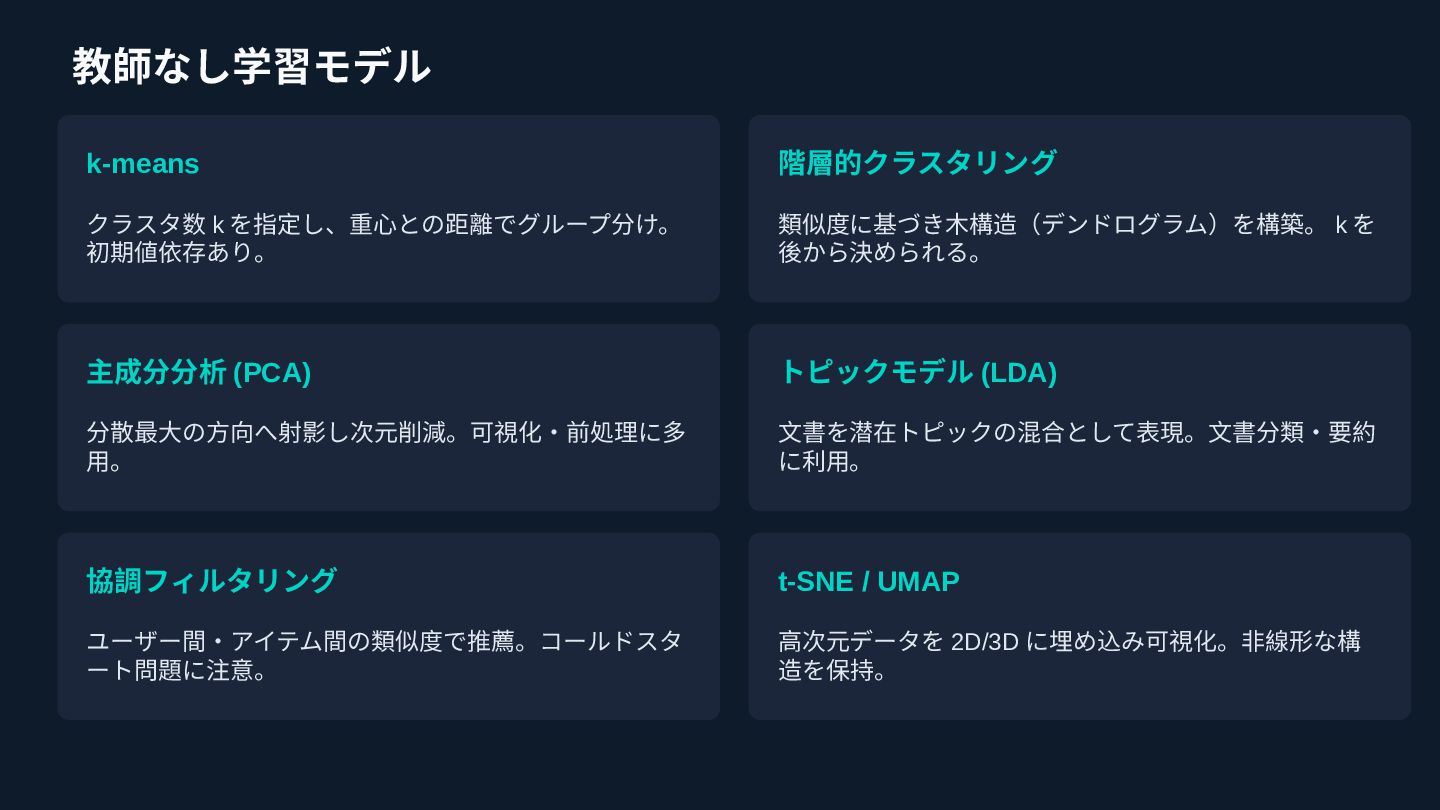
教師なし学習モデル k-means 階層的クラスタリング クラスタ数 k を指定し、重心との距離でグループ分け。 初期値依存あり。 類似度に基づき木構造(デンドログラム)を構築。 k を
後から決められる。 主成分分析 (PCA) トピックモデル (LDA) 分散最大の方向へ射影し次元削減。可視化・前処理に多 用。 文書を潜在トピックの混合として表現。文書分類・要約 に利用。 協調フィルタリング t-SNE / UMAP ユーザー間・アイテム間の類似度で推薦。コールドスタ ート問題に注意。 高次元データを 2D/3D に埋め込み可視化。非線形な構 造を保持。
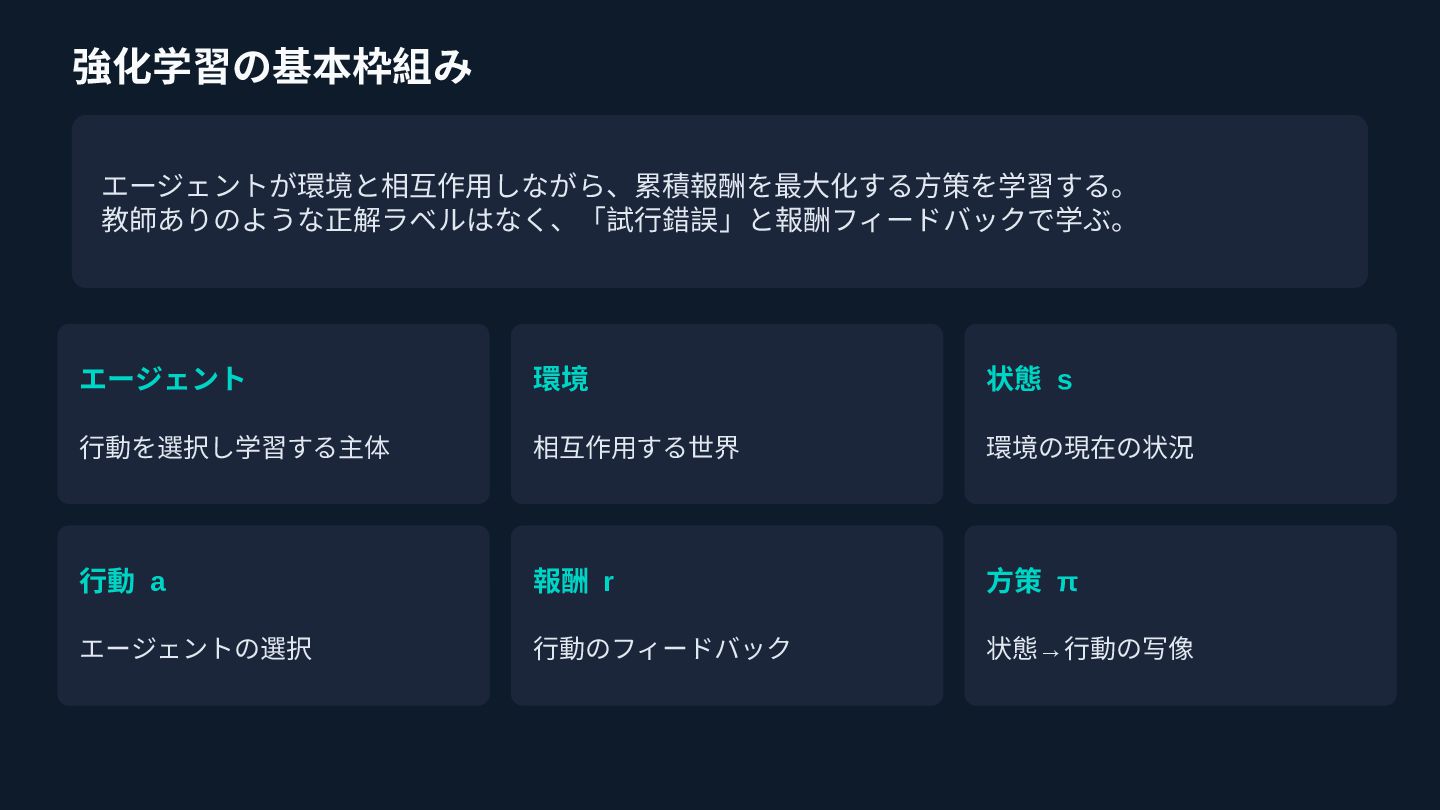
強化学習の基本枠組み エージェントが環境と相互作用しながら、累積報酬を最大化する方策を学習する。 教師ありのような正解ラベルはなく、「試行錯誤」と報酬フィードバックで学ぶ。 エージェント 環境 状態 s 行動を選択し学習する主体 相互作用する世界 環境の現在の状況
行動 a 報酬 r 方策 π エージェントの選択 行動のフィードバック 状態→行動の写像
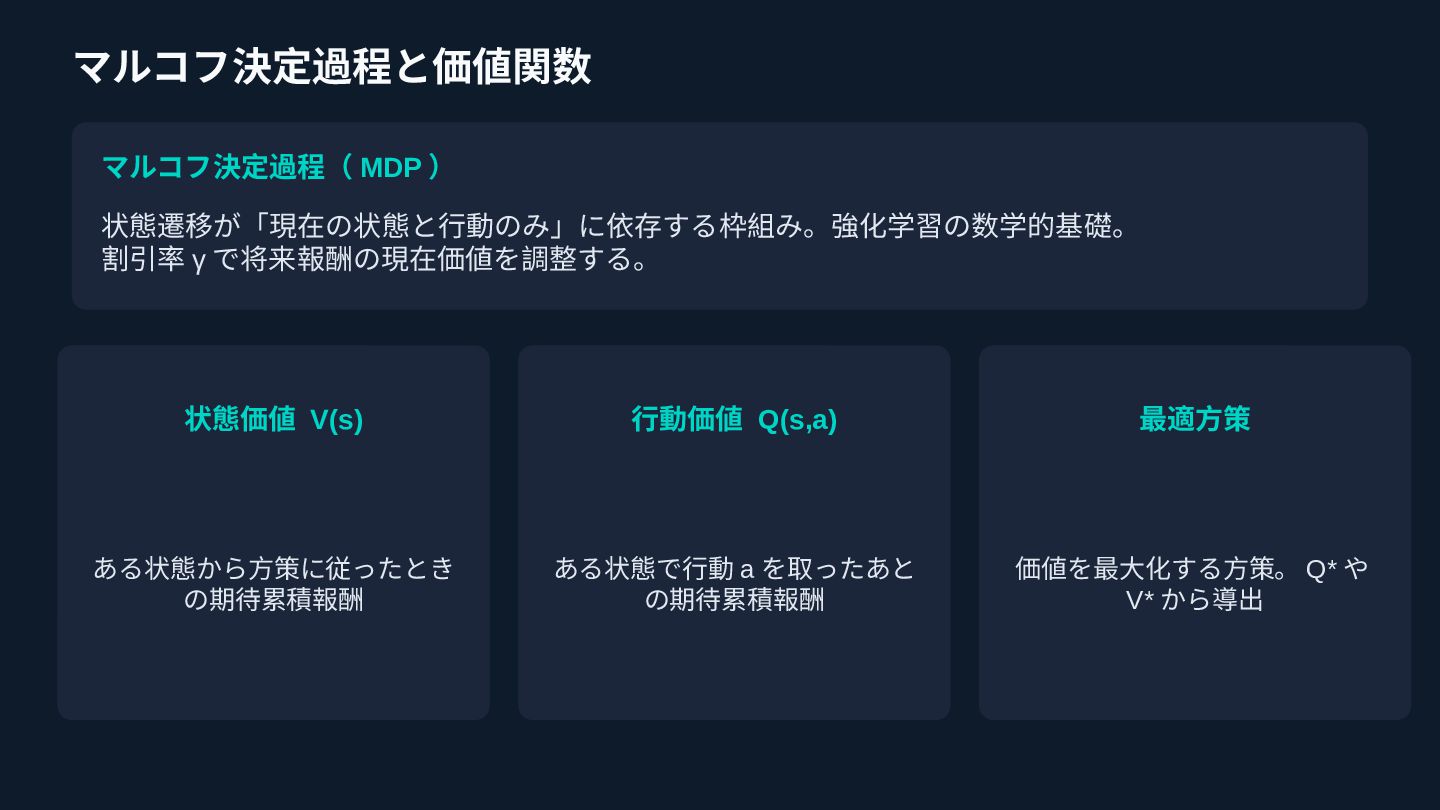
マルコフ決定過程と価値関数 マルコフ決定過程( MDP ) 状態遷移が「現在の状態と行動のみ」に依存する枠組み。強化学習の数学的基礎。 割引率 γ で将来報酬の現在価値を調整する。 状態価値 V(s)
行動価値 Q(s,a) 最適方策 ある状態から方策に従ったとき の期待累積報酬 ある状態で行動 a を取ったあと の期待累積報酬 価値を最大化する方策。 Q* や V* から導出
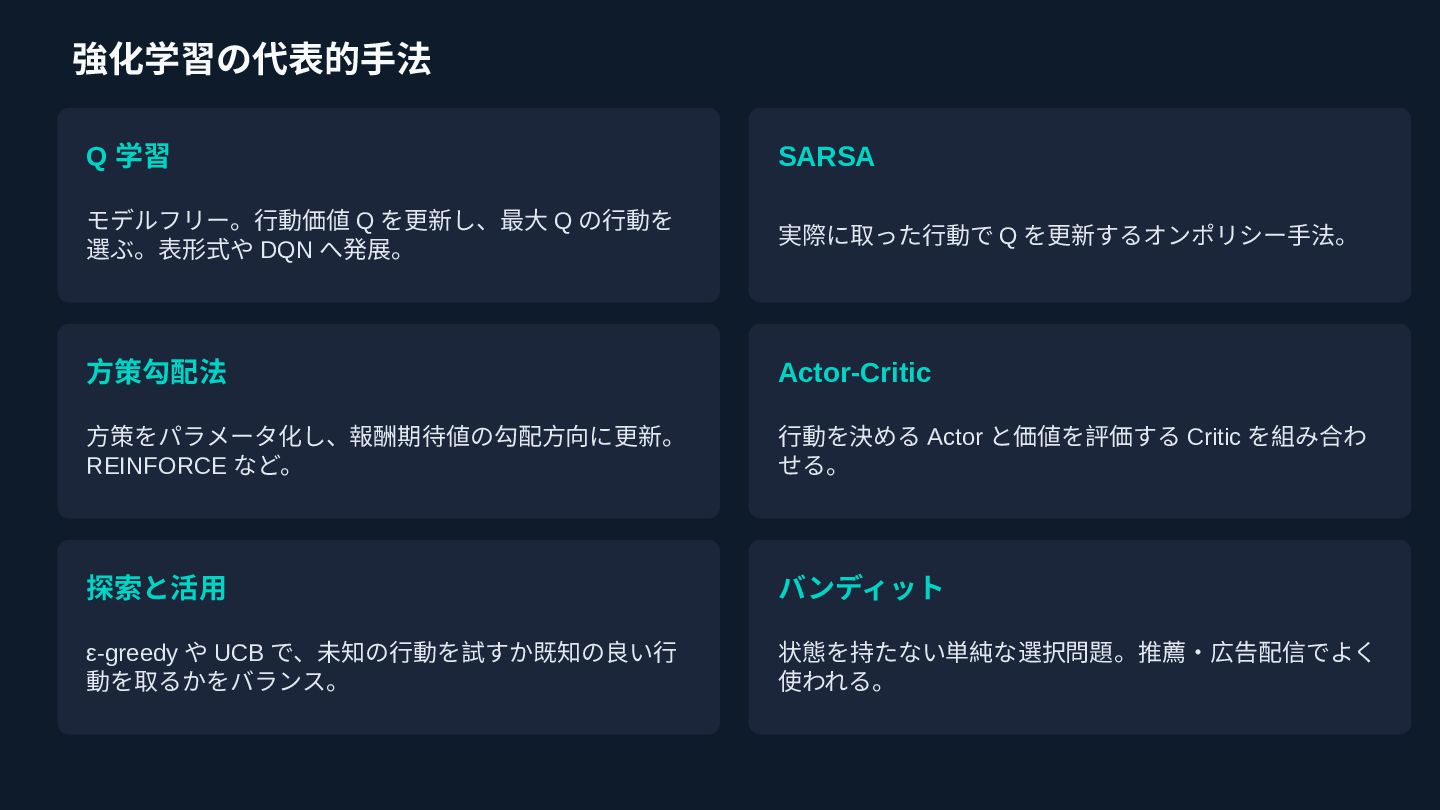
強化学習の代表的手法 Q 学習 SARSA モデルフリー。行動価値 Q を更新し、最大 Q の行動を 選ぶ。表形式や
DQN へ発展。 実際に取った行動で Q を更新するオンポリシー手法。 方策勾配法 Actor-Critic 方策をパラメータ化し、報酬期待値の勾配方向に更新。 REINFORCE など。 行動を決める Actor と価値を評価する Critic を組み合わ せる。 探索と活用 バンディット ε-greedy や UCB で、未知の行動を試すか既知の良い行 動を取るかをバランス。 状態を持たない単純な選択問題。推薦・広告配信でよく 使われる。
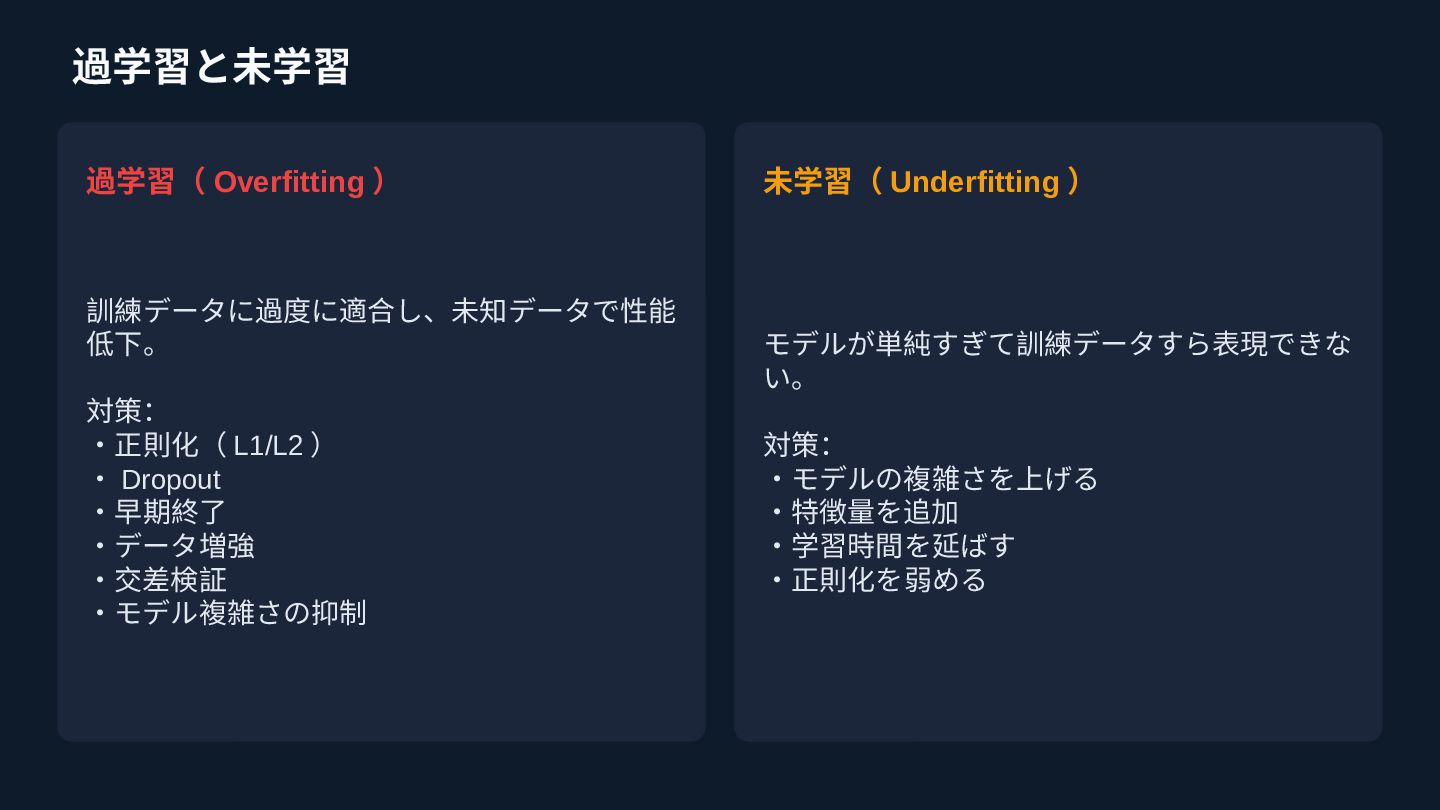
過学習と未学習 過学習( Overfitting ) 訓練データに過度に適合し、未知データで性能 低下。 対策: ・正則化( L1/L2 )
・ Dropout ・早期終了 ・データ増強 ・交差検証 ・モデル複雑さの抑制 未学習( Underfitting ) モデルが単純すぎて訓練データすら表現できな い。 対策: ・モデルの複雑さを上げる ・特徴量を追加 ・学習時間を延ばす ・正則化を弱める
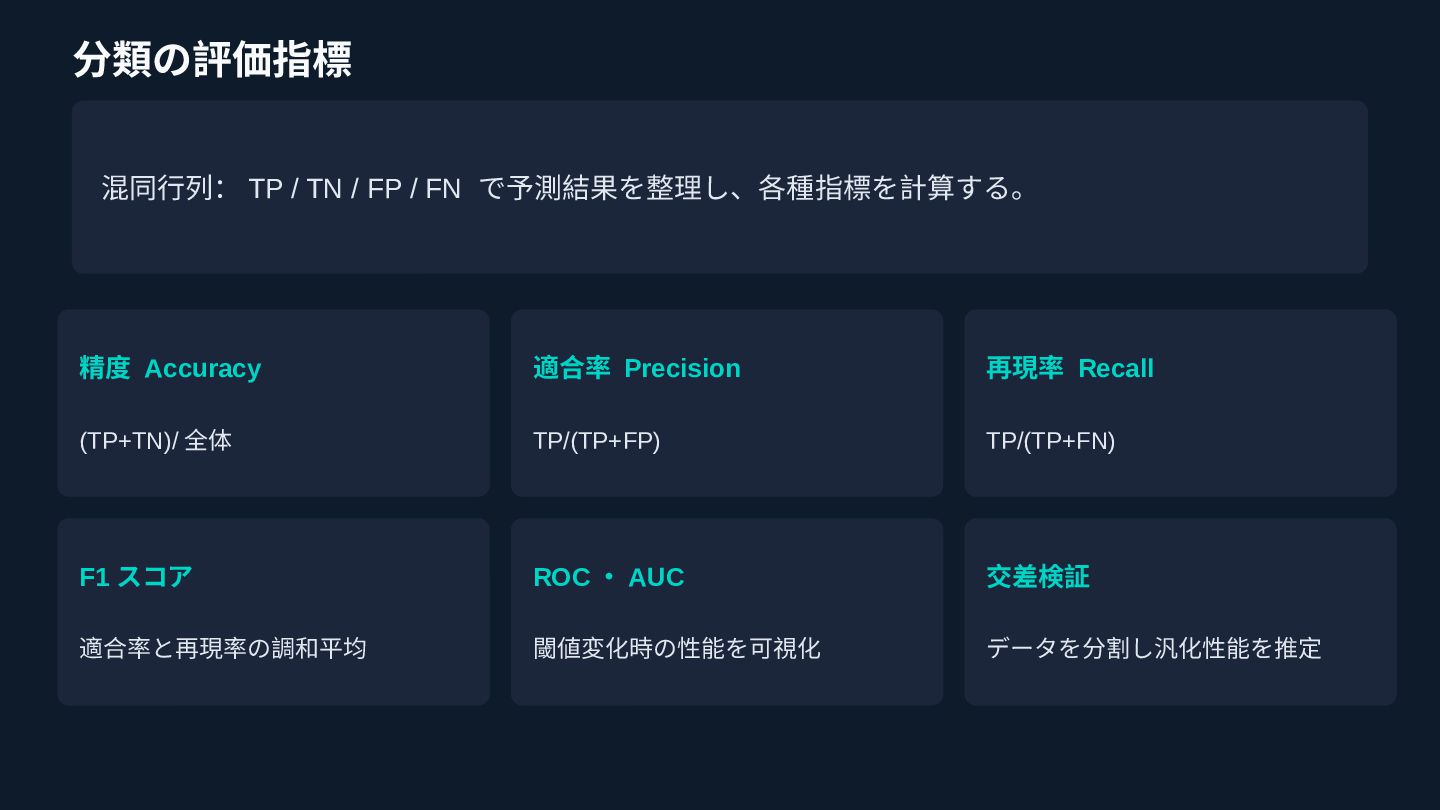
分類の評価指標 混同行列: TP / TN / FP / FN で予測結果を整理し、各種指標を計算する。
精度 Accuracy 適合率 Precision 再現率 Recall (TP+TN)/ 全体 TP/(TP+FP) TP/(TP+FN) F1 スコア ROC ・ AUC 交差検証 適合率と再現率の調和平均 閾値変化時の性能を可視化 データを分割し汎化性能を推定
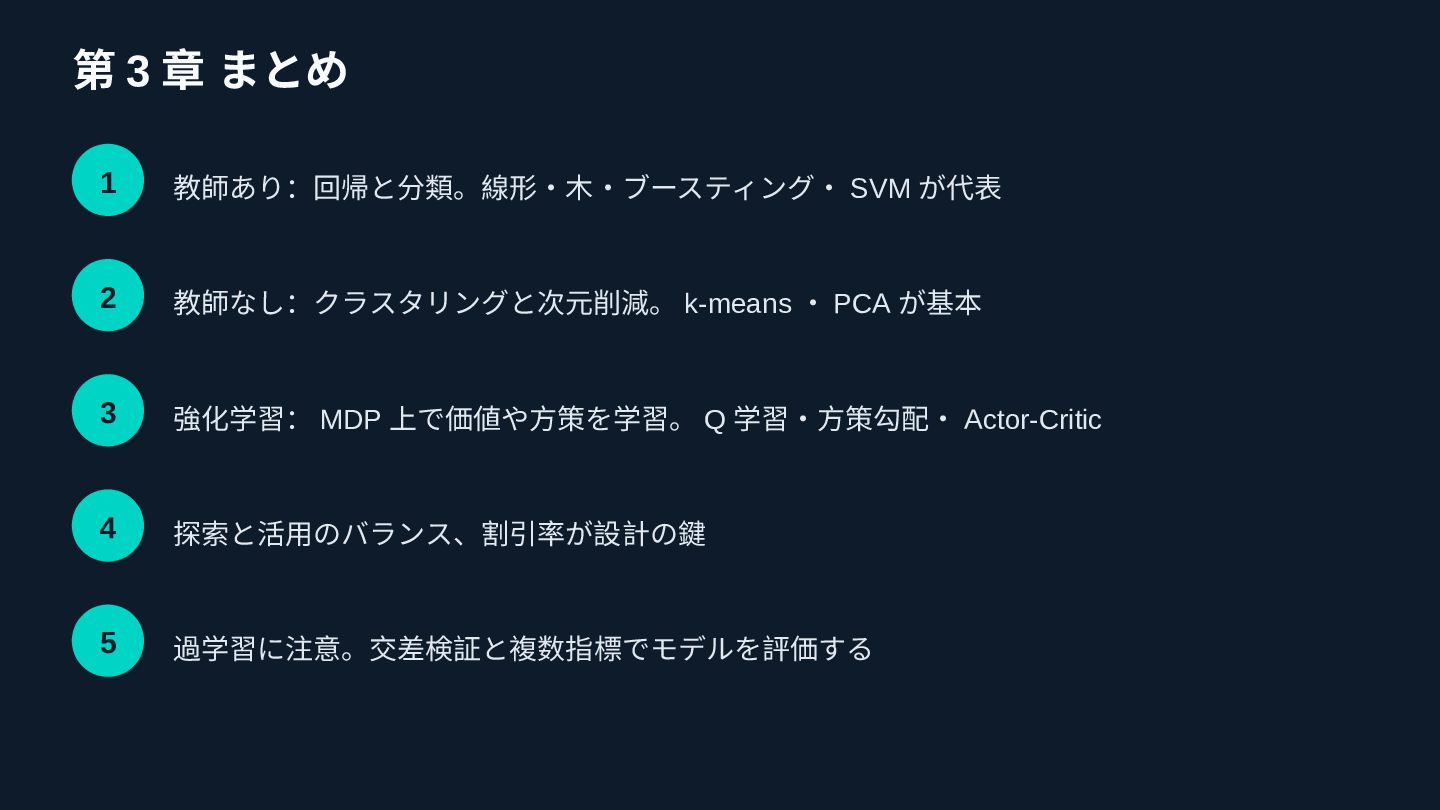
第 3 章 まとめ 1 教師あり:回帰と分類。線形・木・ブースティング・ SVM が代表 2 教師なし:クラスタリングと次元削減。
k-means ・ PCA が基本 3 強化学習: MDP 上で価値や方策を学習。 Q 学習・方策勾配・ Actor-Critic 4 探索と活用のバランス、割引率が設計の鍵 5 過学習に注意。交差検証と複数指標でモデルを評価する
G 検定対策講座 #6 機械学習の基礎 聞き流しで学ぶ G 検定対策講座 データから規則性を学ぶ技術の全体像
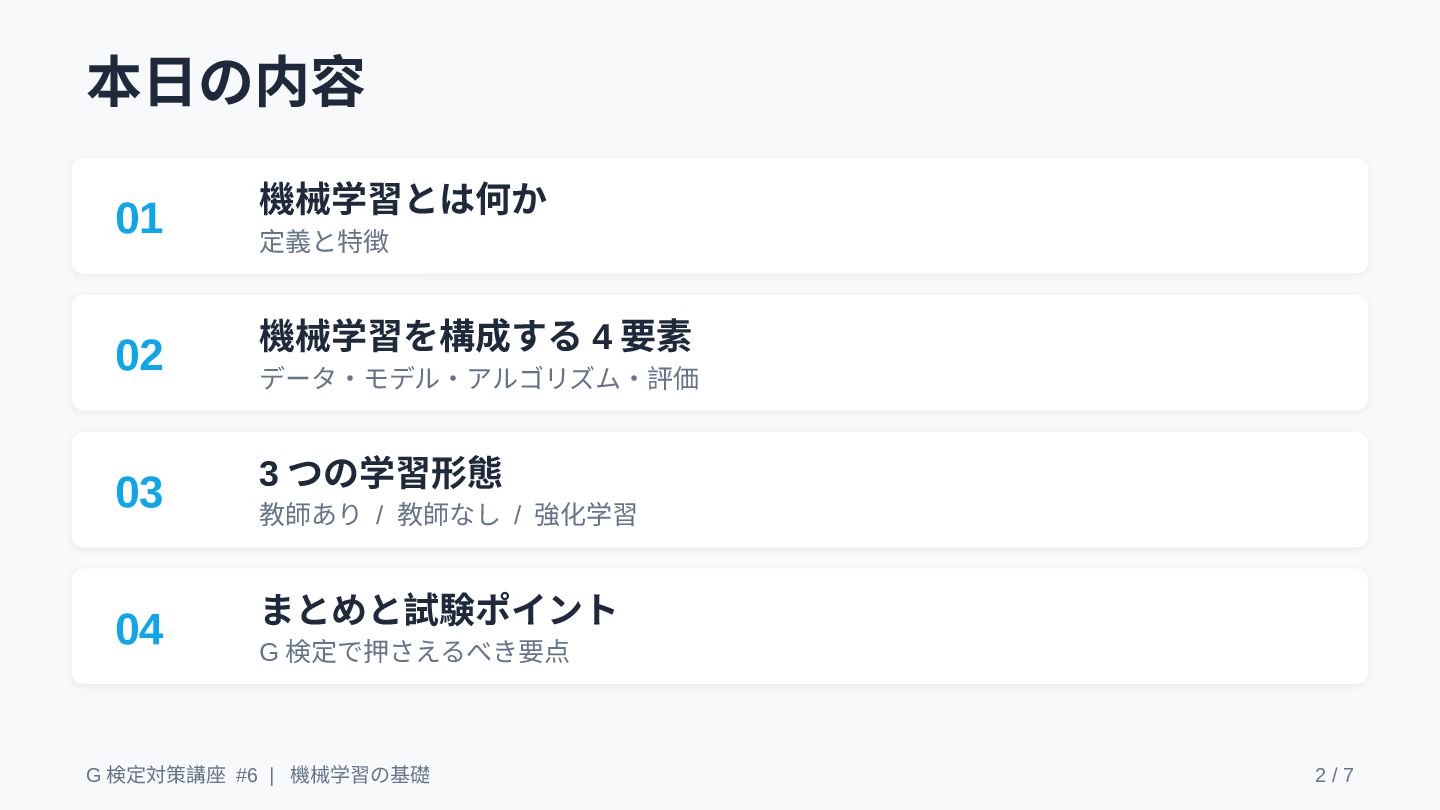
本日の内容 01 02 03 04 機械学習とは何か 定義と特徴 機械学習を構成する 4 要素
データ・モデル・アルゴリズム・評価 3 つの学習形態 教師あり / 教師なし / 強化学習 まとめと試験ポイント G 検定で押さえるべき要点 G 検定対策講座 #6 | 機械学習の基礎 2/7
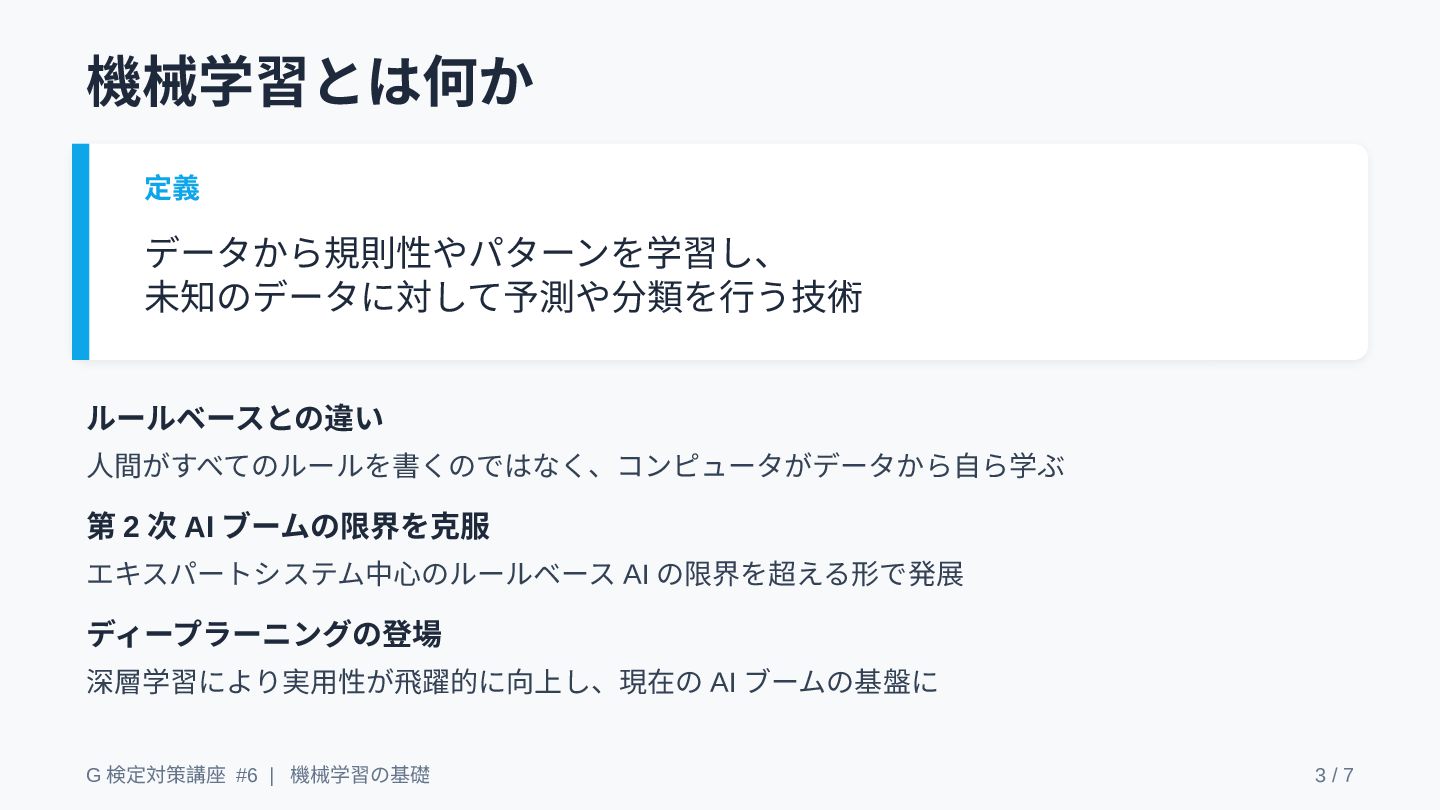
機械学習とは何か 定義 データから規則性やパターンを学習し、 未知のデータに対して予測や分類を行う技術 ルールベースとの違い 人間がすべてのルールを書くのではなく、コンピュータがデータから自ら学ぶ 第 2 次 AI
ブームの限界を克服 エキスパートシステム中心のルールベース AI の限界を超える形で発展 ディープラーニングの登場 深層学習により実用性が飛躍的に向上し、現在の AI ブームの基盤に G 検定対策講座 #6 | 機械学習の基礎 3/7
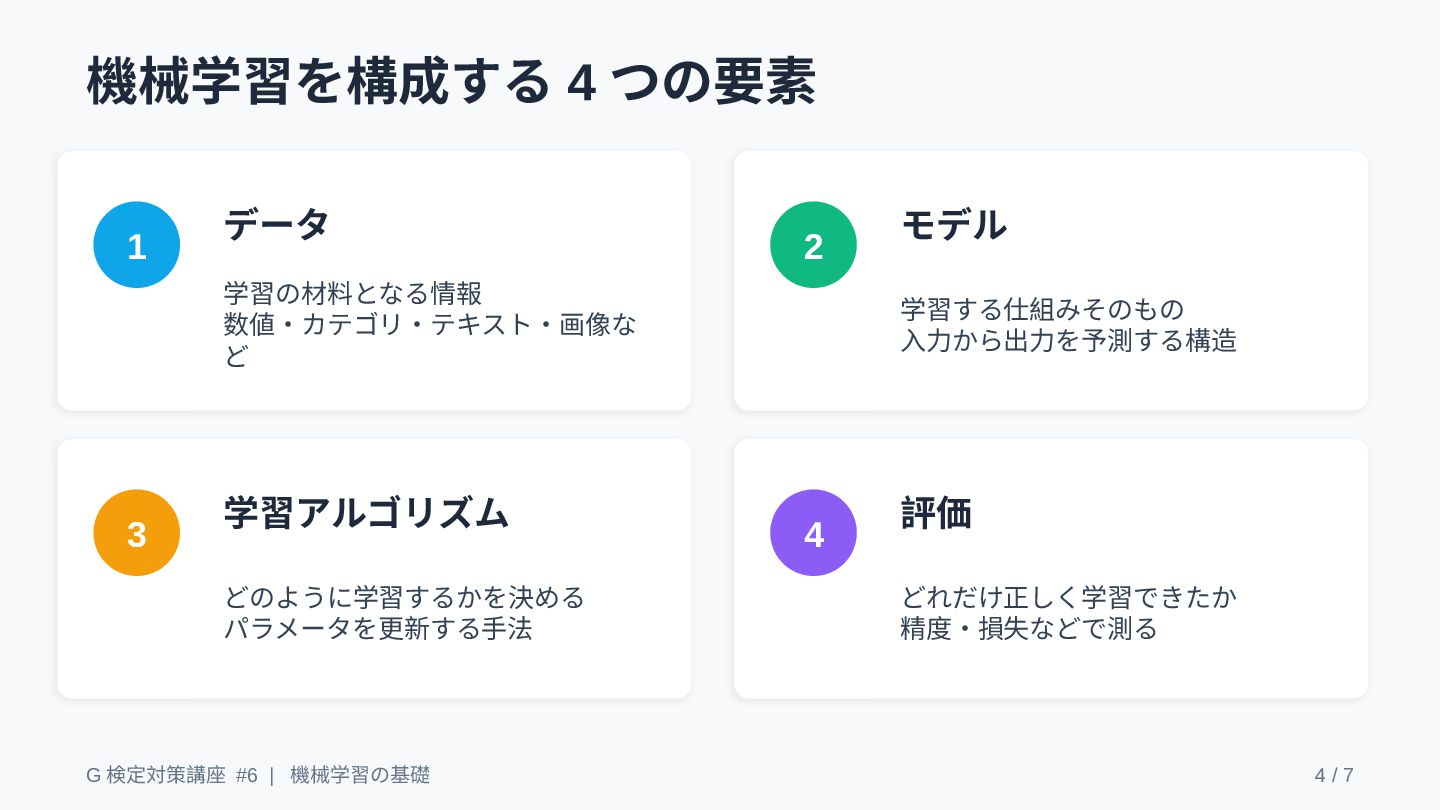
機械学習を構成する 4 つの要素 1 データ 2 学習の材料となる情報 数値・カテゴリ・テキスト・画像な ど 3
学習アルゴリズム どのように学習するかを決める パラメータを更新する手法 G 検定対策講座 #6 | 機械学習の基礎 モデル 学習する仕組みそのもの 入力から出力を予測する構造 4 評価 どれだけ正しく学習できたか 精度・損失などで測る 4/7
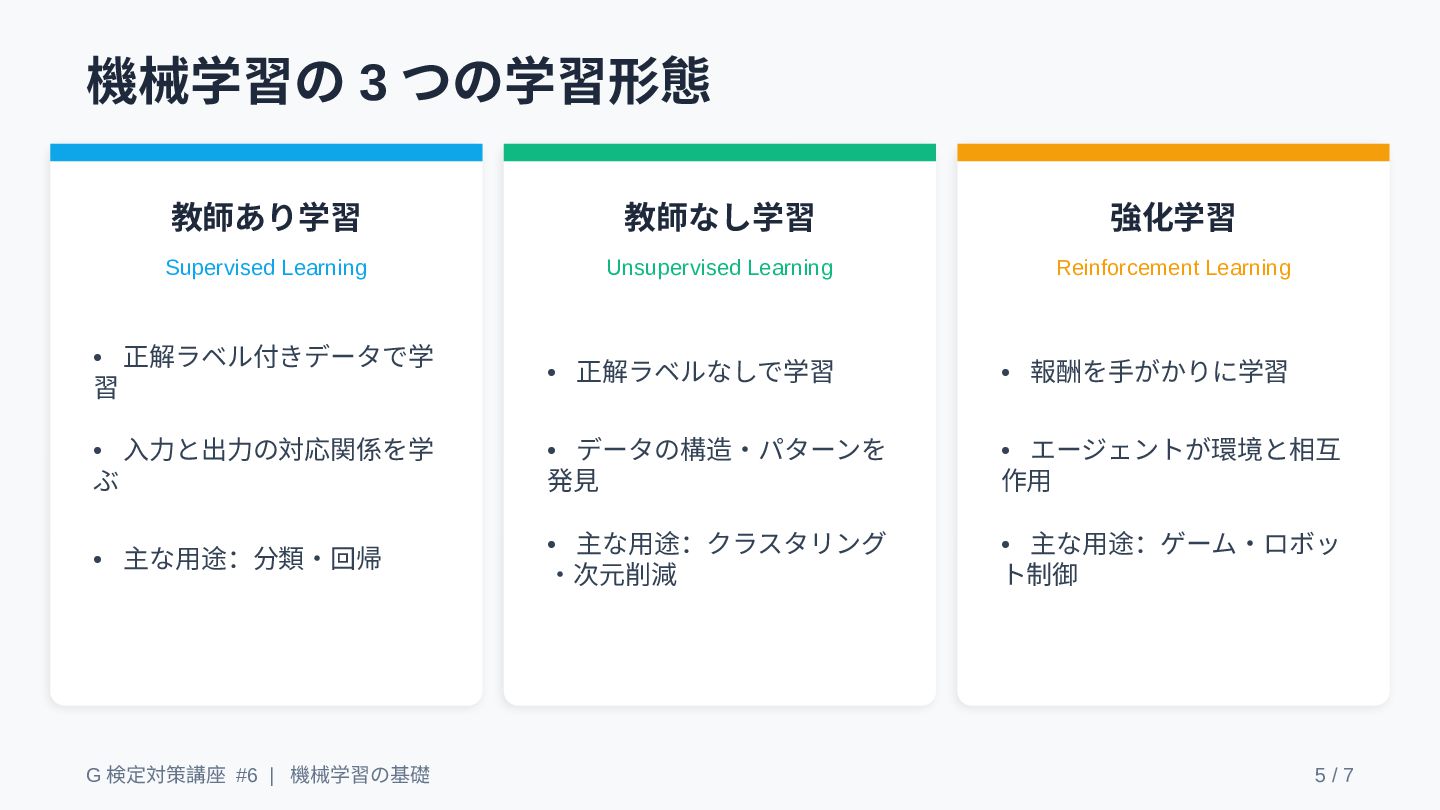
機械学習の 3 つの学習形態 教師あり学習 教師なし学習 強化学習 Supervised Learning Unsupervised Learning
Reinforcement Learning • 正解ラベル付きデータで学 習 • 正解ラベルなしで学習 • 報酬を手がかりに学習 • 入力と出力の対応関係を学 ぶ • データの構造・パターンを 発見 • エージェントが環境と相互 作用 • 主な用途:分類・回帰 • 主な用途:クラスタリング ・次元削減 • 主な用途:ゲーム・ロボッ ト制御 G 検定対策講座 #6 | 機械学習の基礎 5/7
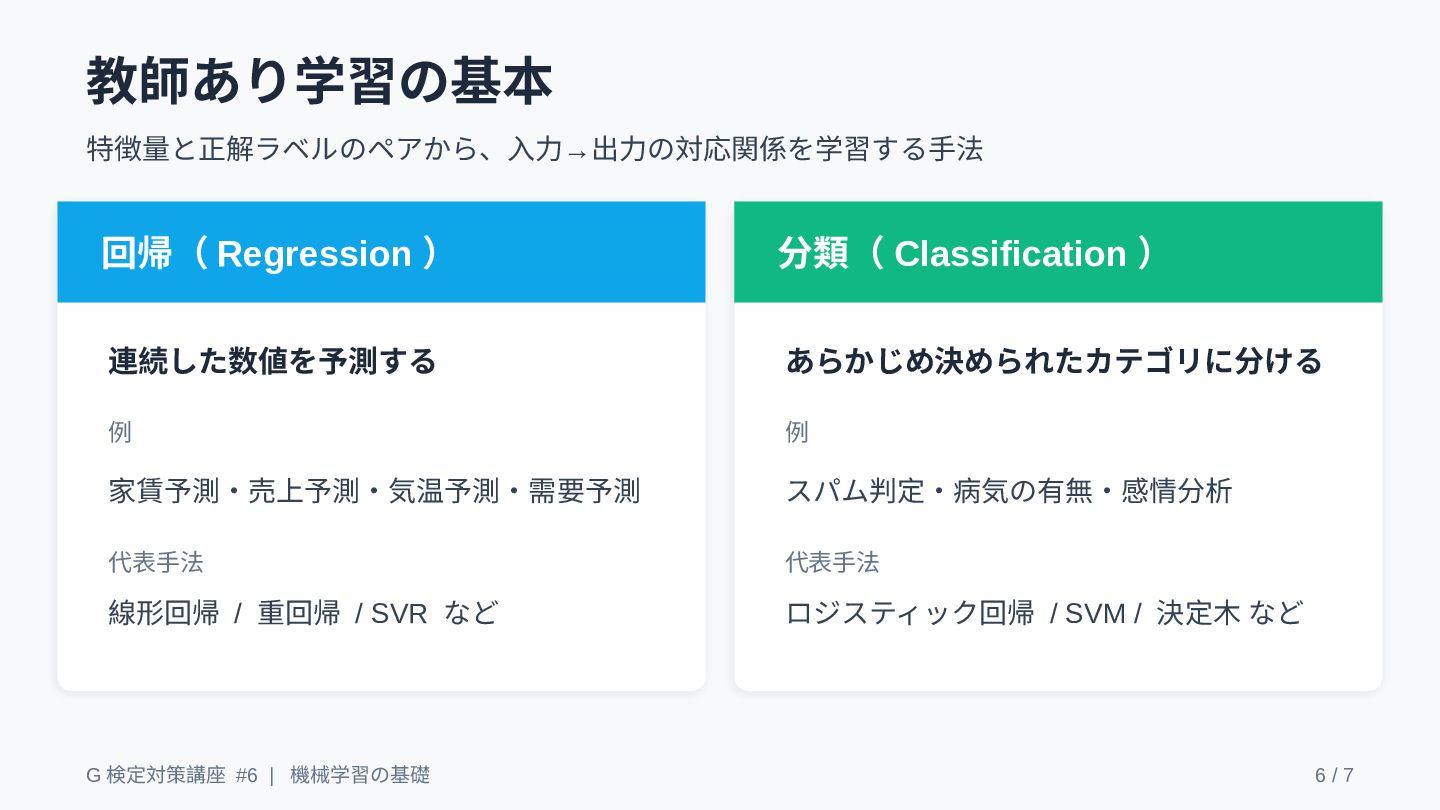
教師あり学習の基本 特徴量と正解ラベルのペアから、入力→出力の対応関係を学習する手法 回帰( Regression ) 分類( Classification ) 連続した数値を予測する あらかじめ決められたカテゴリに分ける
例 例 家賃予測・売上予測・気温予測・需要予測 スパム判定・病気の有無・感情分析 代表手法 代表手法 線形回帰 / 重回帰 / SVR など ロジスティック回帰 / SVM / 決定木 など G 検定対策講座 #6 | 機械学習の基礎 6/7
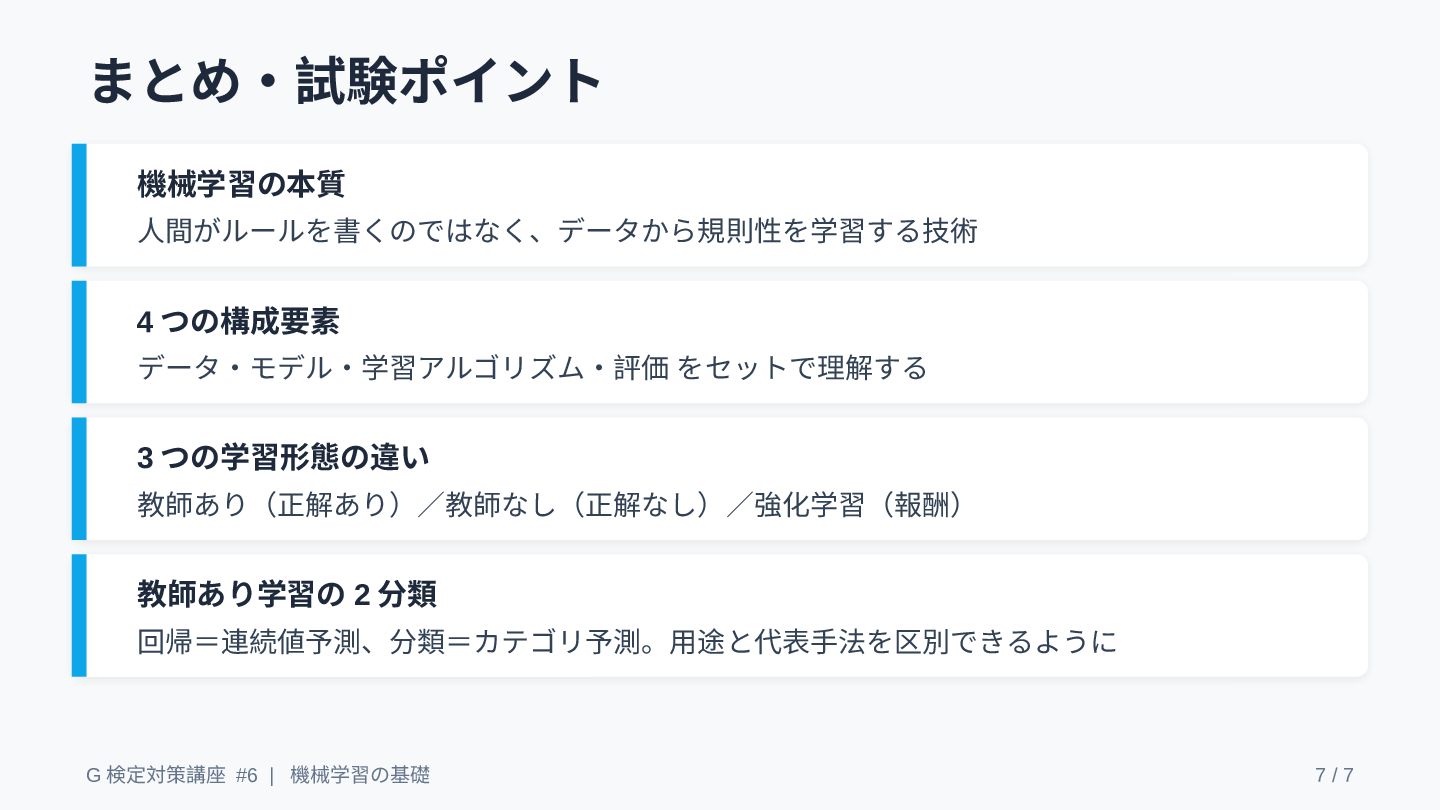
まとめ・試験ポイント 機械学習の本質 人間がルールを書くのではなく、データから規則性を学習する技術 4 つの構成要素 データ・モデル・学習アルゴリズム・評価 をセットで理解する 3 つの学習形態の違い 教師あり(正解あり)/教師なし(正解なし)/強化学習(報酬)
教師あり学習の 2 分類 回帰=連続値予測、分類=カテゴリ予測。用途と代表手法を区別できるように G 検定対策講座 #6 | 機械学習の基礎 7/7
G 検定対策講座 #7 教師あり学習の 代表的な機械学習手法 線形回帰・ロジスティック回帰を中心に徹底解説
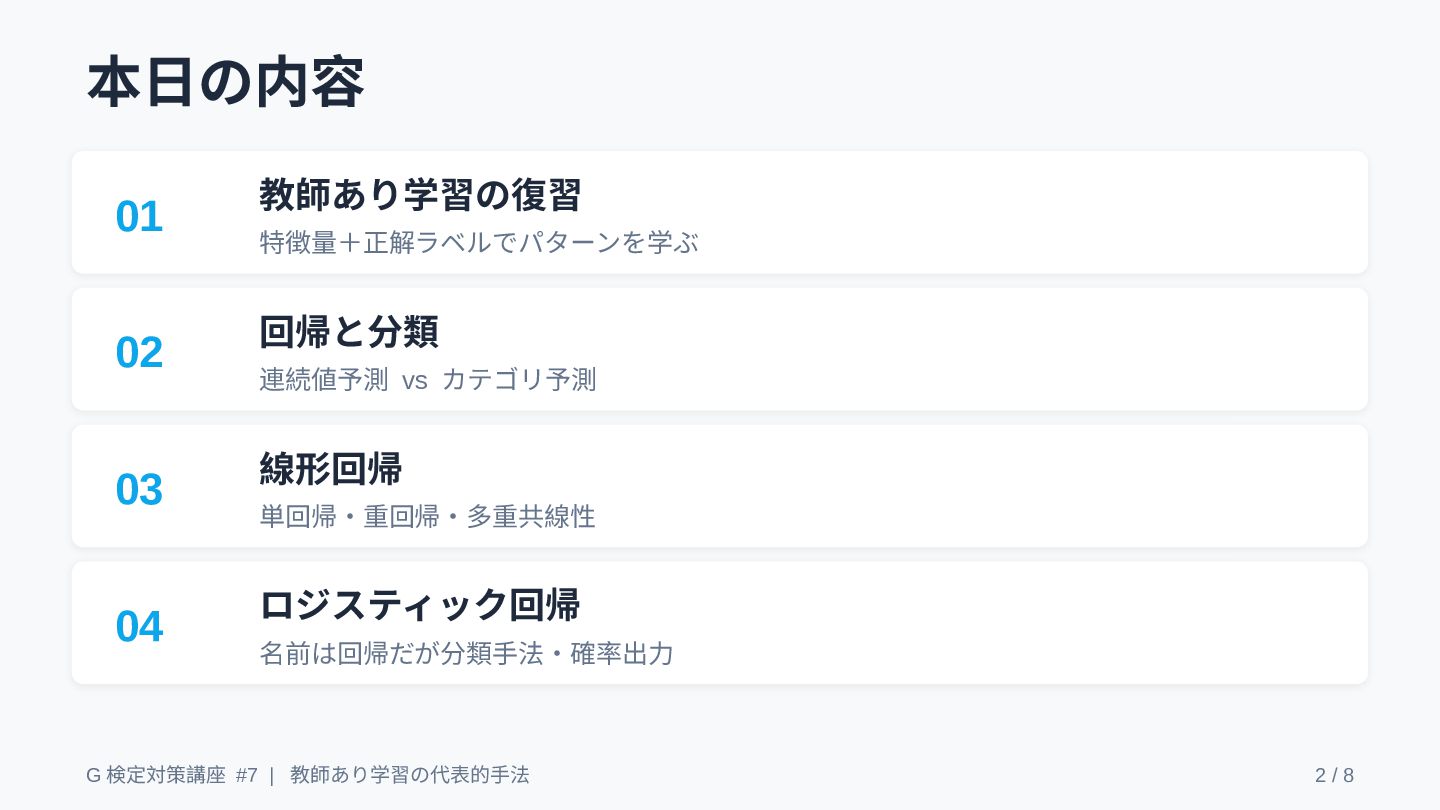
本日の内容 01 02 03 04 教師あり学習の復習 特徴量+正解ラベルでパターンを学ぶ 回帰と分類 連続値予測 vs
カテゴリ予測 線形回帰 単回帰・重回帰・多重共線性 ロジスティック回帰 名前は回帰だが分類手法・確率出力 G 検定対策講座 #7 | 教師あり学習の代表的手法 2/8
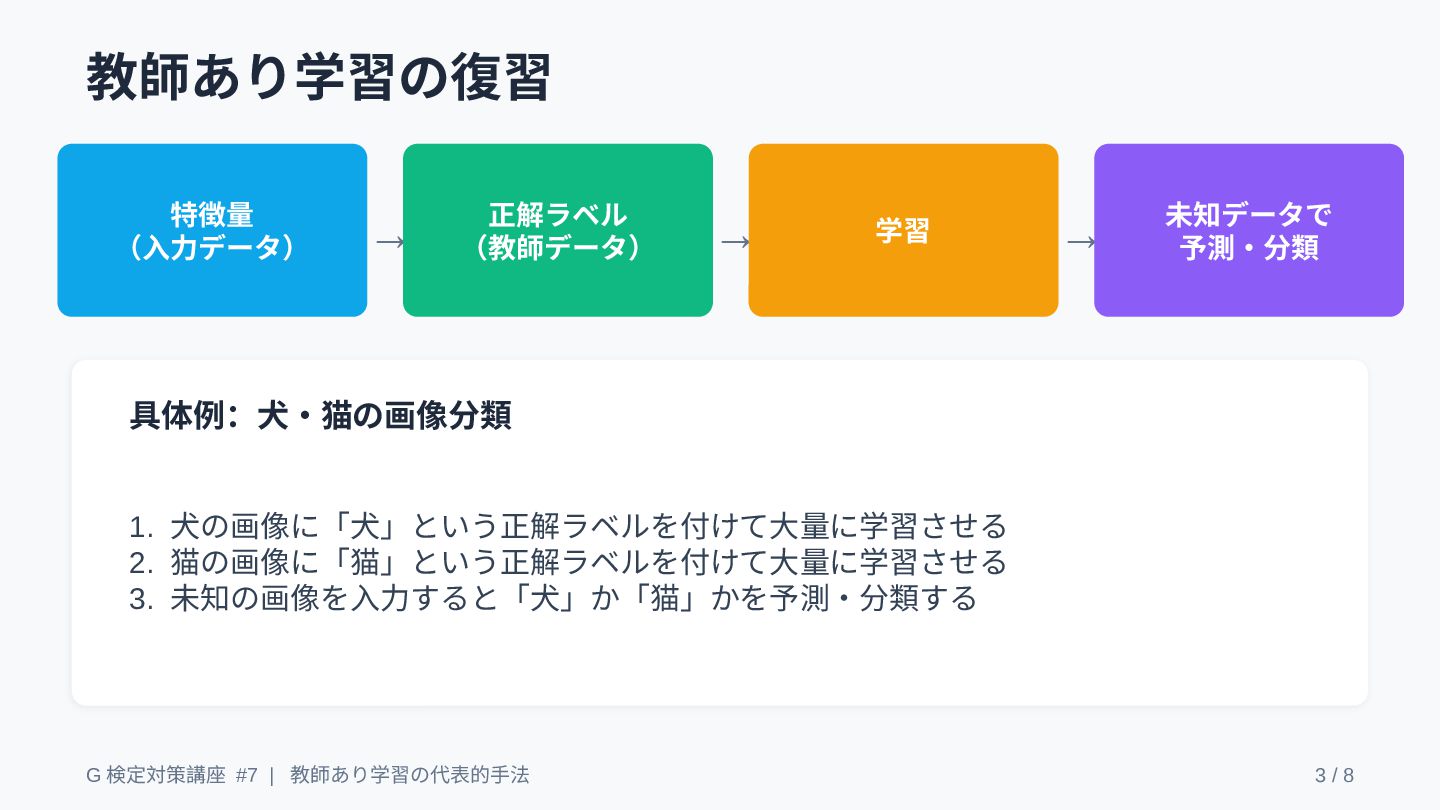
教師あり学習の復習 特徴量 (入力データ) → 正解ラベル (教師データ) → 学習 → 未知データで
予測・分類 具体例:犬・猫の画像分類 1. 犬の画像に「犬」という正解ラベルを付けて大量に学習させる 2. 猫の画像に「猫」という正解ラベルを付けて大量に学習させる 3. 未知の画像を入力すると「犬」か「猫」かを予測・分類する G 検定対策講座 #7 | 教師あり学習の代表的手法 3/8
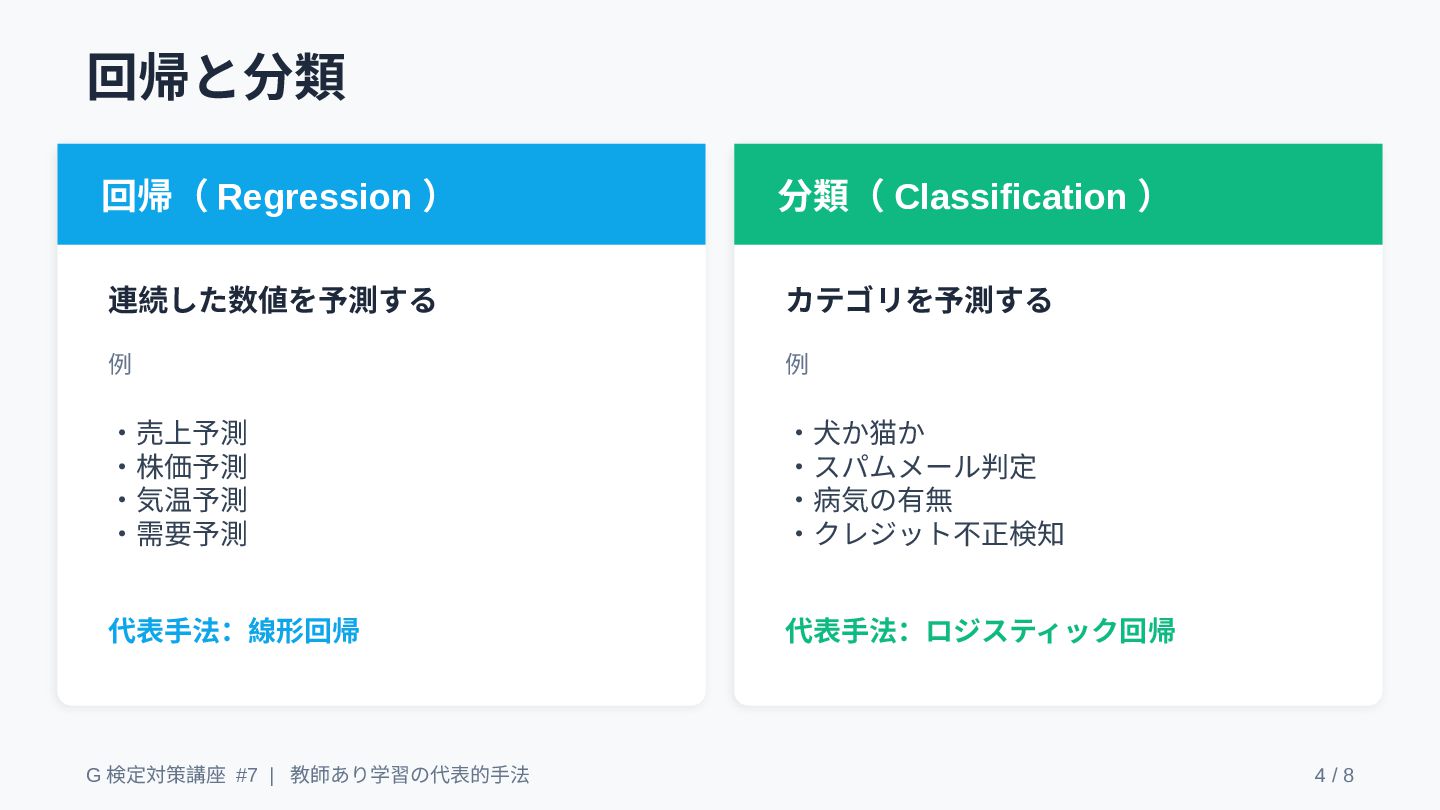
回帰と分類 回帰( Regression ) 分類( Classification ) 連続した数値を予測する カテゴリを予測する 例
例 ・売上予測 ・株価予測 ・気温予測 ・需要予測 ・犬か猫か ・スパムメール判定 ・病気の有無 ・クレジット不正検知 代表手法:線形回帰 代表手法:ロジスティック回帰 G 検定対策講座 #7 | 教師あり学習の代表的手法 4/8
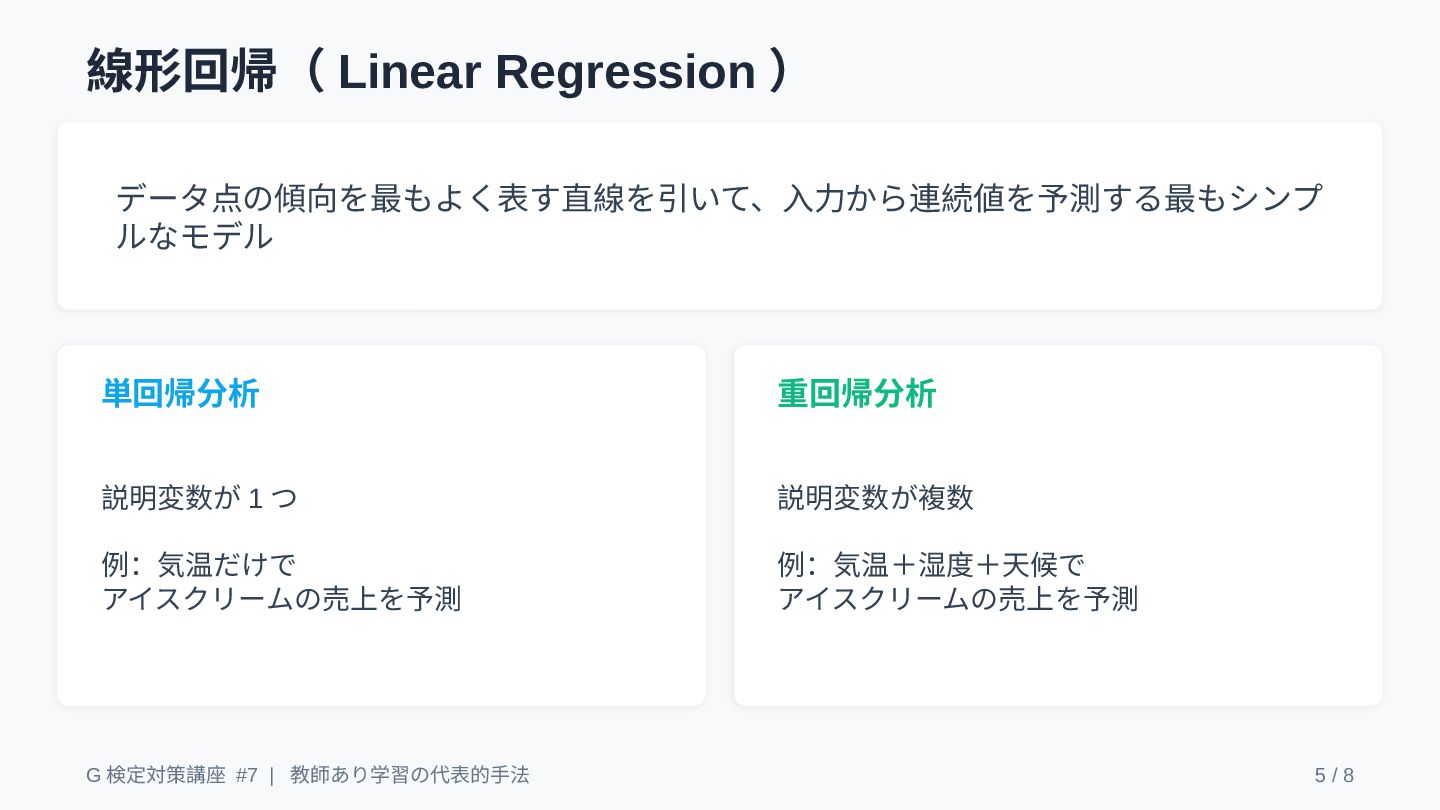
線形回帰( Linear Regression ) データ点の傾向を最もよく表す直線を引いて、入力から連続値を予測する最もシンプ ルなモデル 単回帰分析 重回帰分析 説明変数が 1
つ 説明変数が複数 例:気温だけで アイスクリームの売上を予測 例:気温+湿度+天候で アイスクリームの売上を予測 G 検定対策講座 #7 | 教師あり学習の代表的手法 5/8
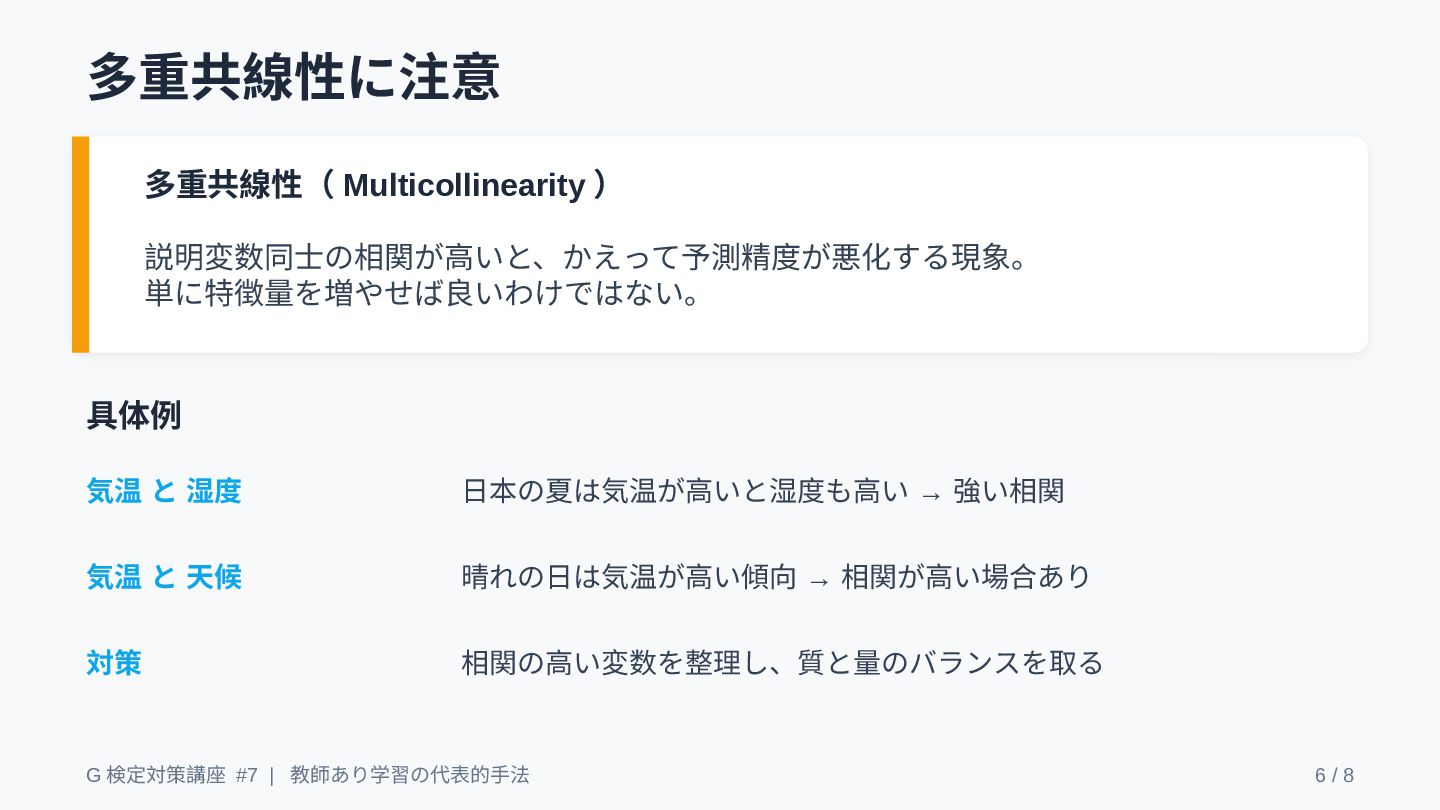
多重共線性に注意 多重共線性( Multicollinearity ) 説明変数同士の相関が高いと、かえって予測精度が悪化する現象。 単に特徴量を増やせば良いわけではない。 具体例 気温 と 湿度
日本の夏は気温が高いと湿度も高い → 強い相関 気温 と 天候 晴れの日は気温が高い傾向 → 相関が高い場合あり 対策 相関の高い変数を整理し、質と量のバランスを取る G 検定対策講座 #7 | 教師あり学習の代表的手法 6/8
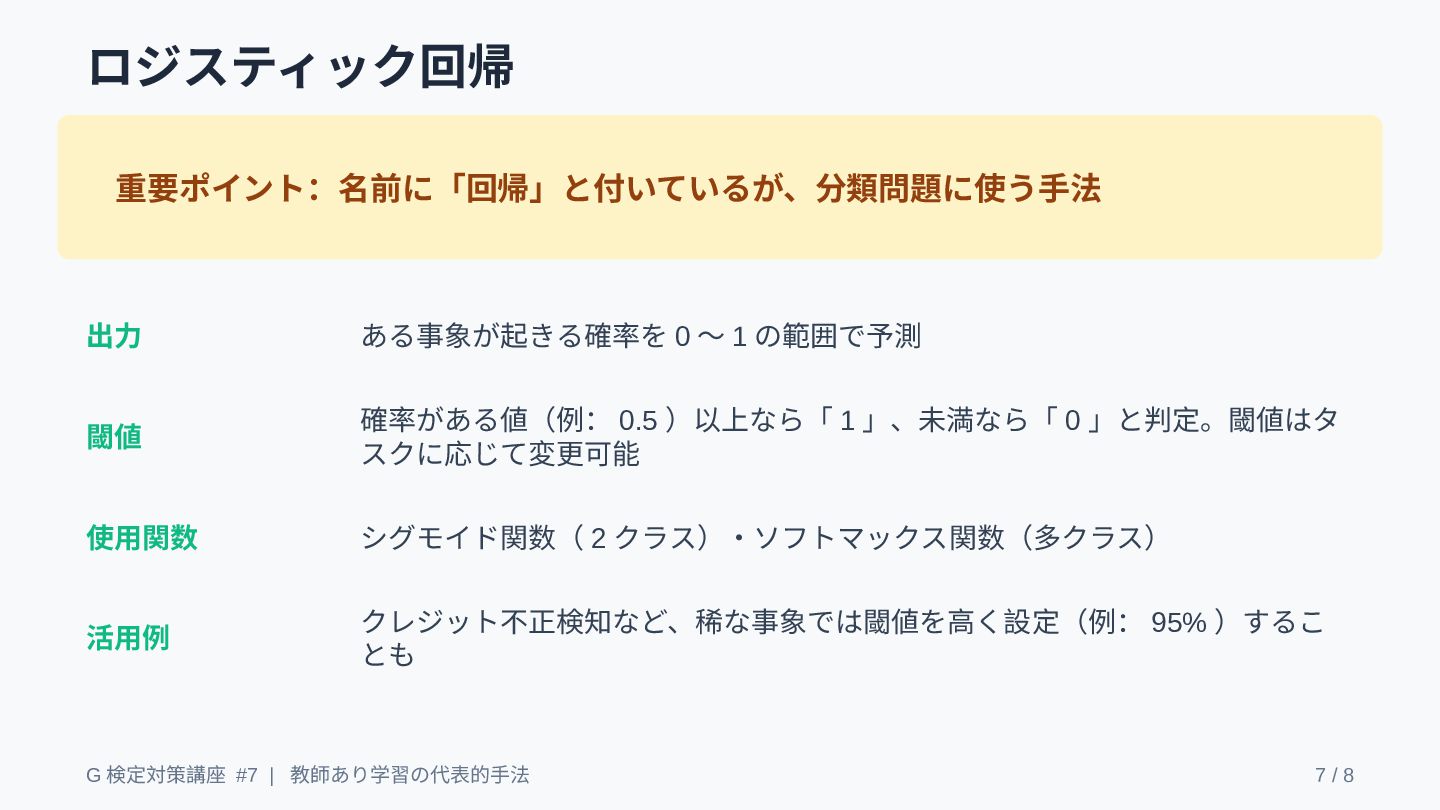
ロジスティック回帰 重要ポイント:名前に「回帰」と付いているが、分類問題に使う手法 出力 ある事象が起きる確率を 0 〜 1 の範囲で予測 閾値 確率がある値(例:
0.5 )以上なら「 1 」、未満なら「 0 」と判定。閾値はタ スクに応じて変更可能 使用関数 シグモイド関数( 2 クラス)・ソフトマックス関数(多クラス) 活用例 クレジット不正検知など、稀な事象では閾値を高く設定(例: 95% )するこ とも G 検定対策講座 #7 | 教師あり学習の代表的手法 7/8
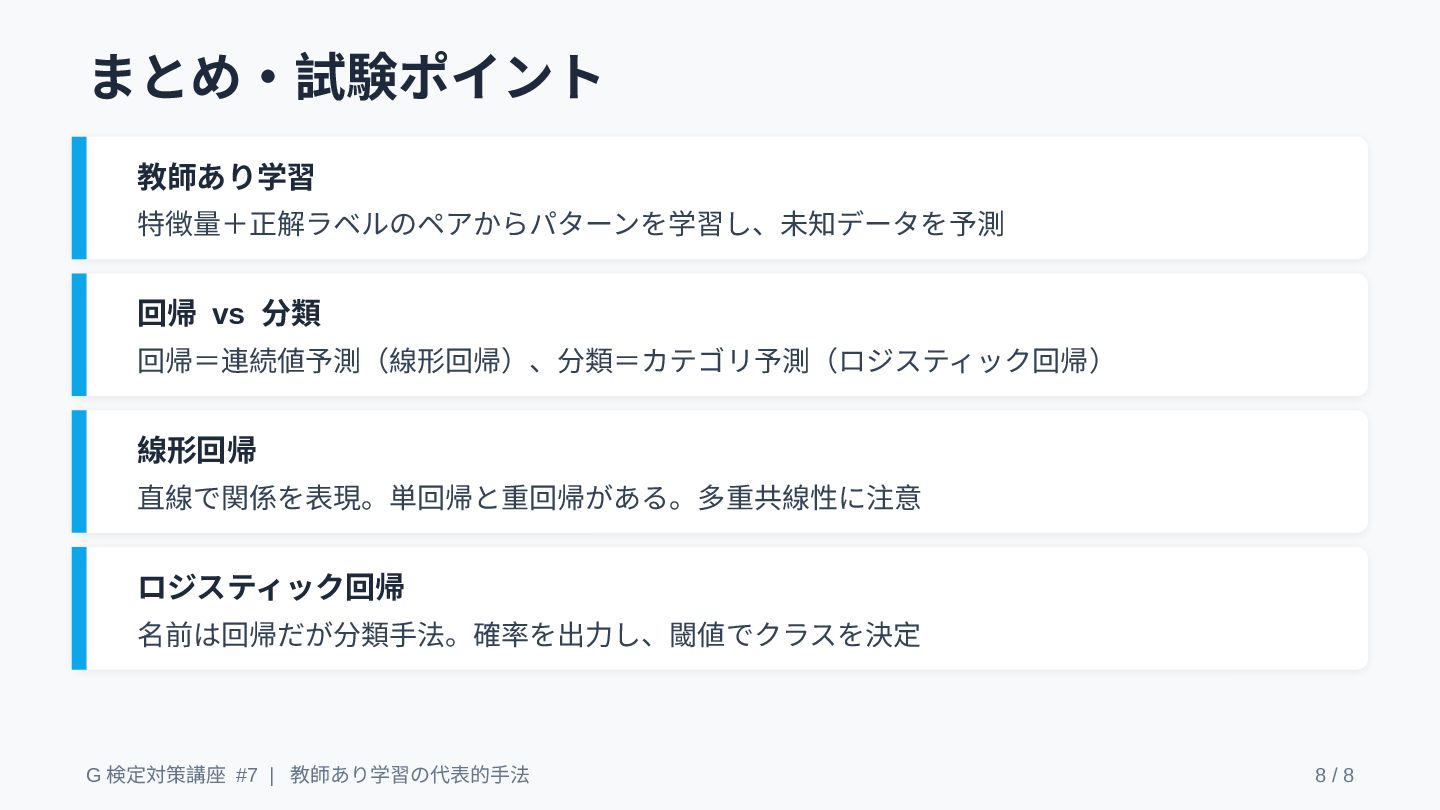
まとめ・試験ポイント 教師あり学習 特徴量+正解ラベルのペアからパターンを学習し、未知データを予測 回帰 vs 分類 回帰=連続値予測(線形回帰)、分類=カテゴリ予測(ロジスティック回帰) 線形回帰 直線で関係を表現。単回帰と重回帰がある。多重共線性に注意 ロジスティック回帰
名前は回帰だが分類手法。確率を出力し、閾値でクラスを決定 G 検定対策講座 #7 | 教師あり学習の代表的手法 8/8
G 検定 学習スライド 第4章 ディープラーニングの概要 学習の仕組み・損失関数・最適化・活性化関数(深掘り版)
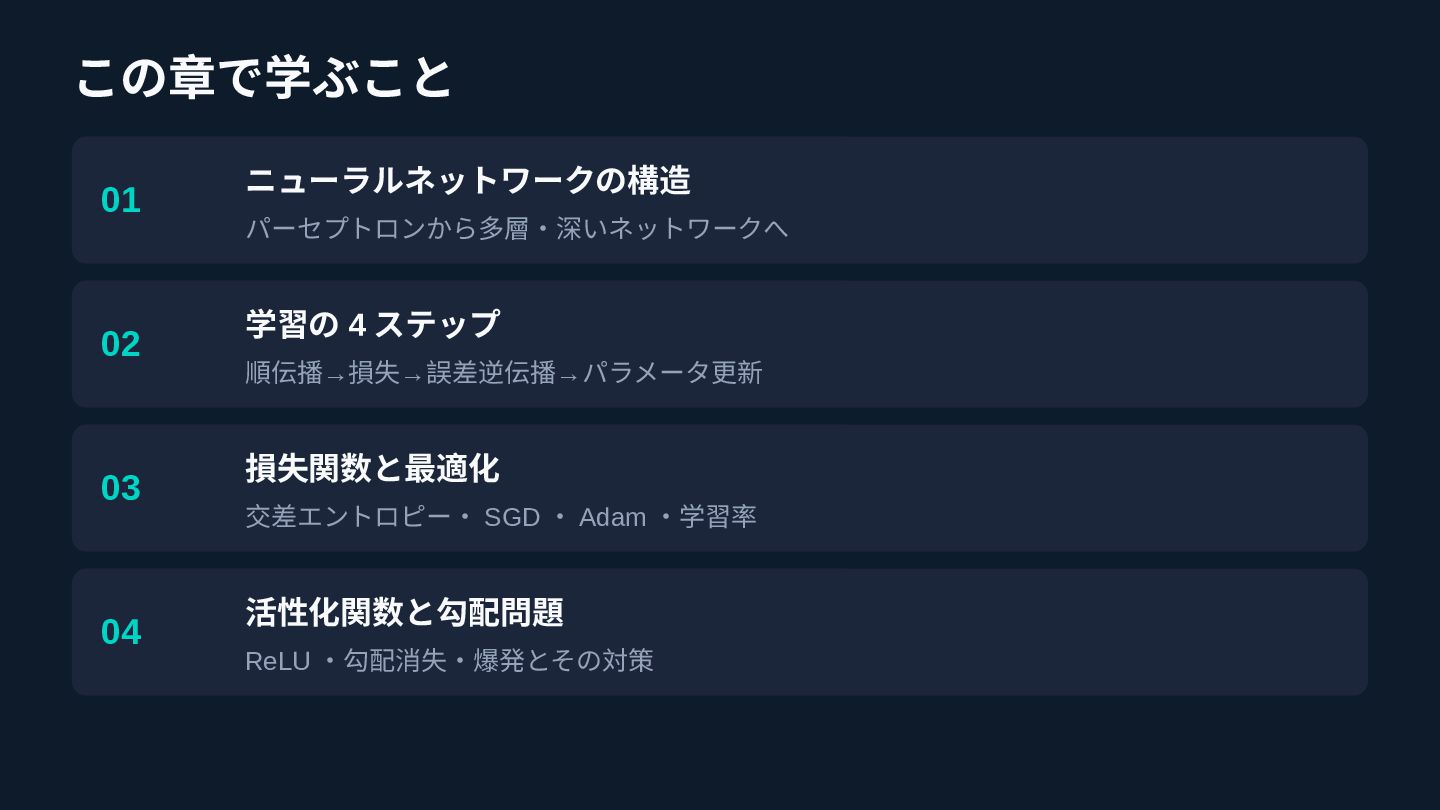
この章で学ぶこと 01 02 03 04 ニューラルネットワークの構造 パーセプトロンから多層・深いネットワークへ 学習の 4 ステップ
順伝播→損失→誤差逆伝播→パラメータ更新 損失関数と最適化 交差エントロピー・ SGD ・ Adam ・学習率 活性化関数と勾配問題 ReLU ・勾配消失・爆発とその対策
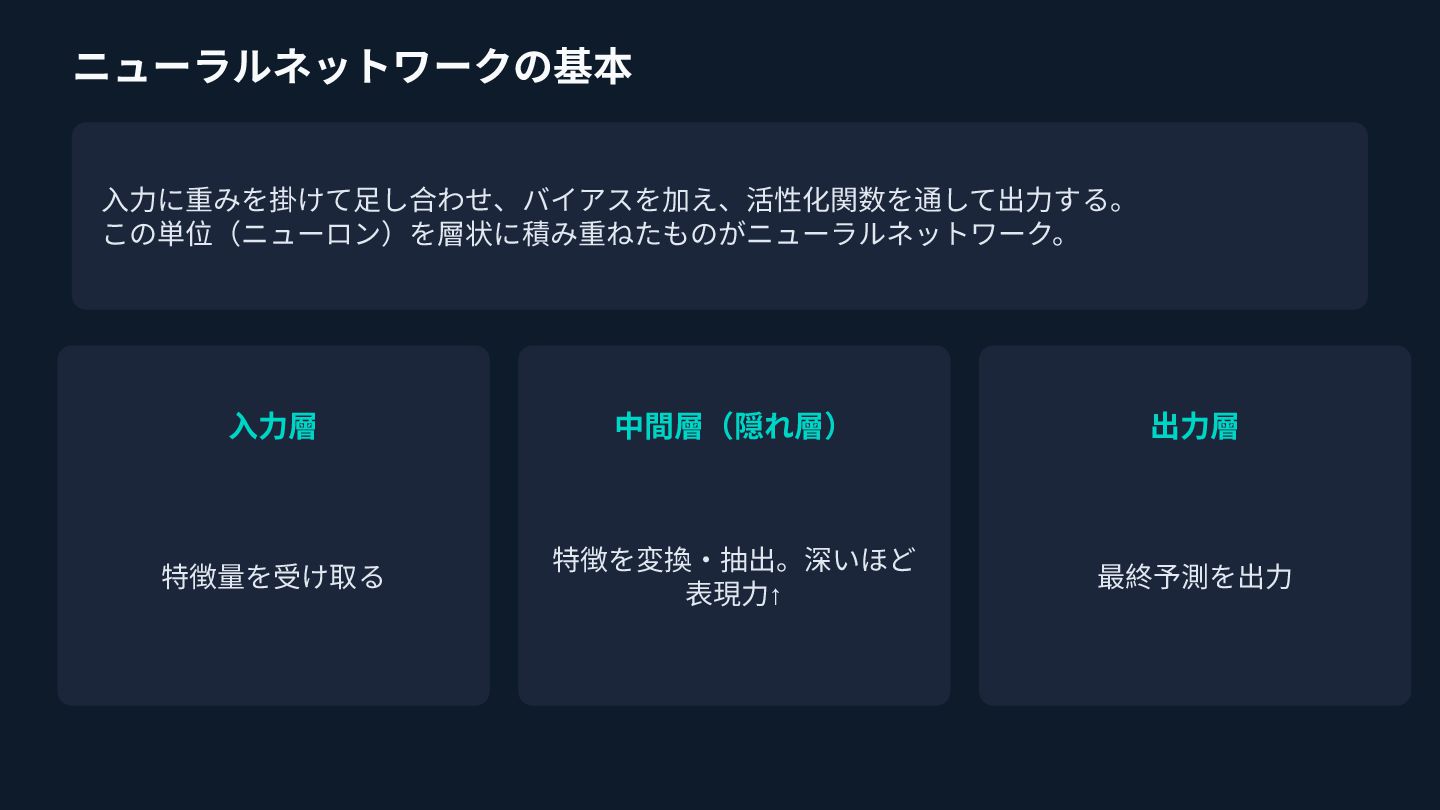
ニューラルネットワークの基本 入力に重みを掛けて足し合わせ、バイアスを加え、活性化関数を通して出力する。 この単位(ニューロン)を層状に積み重ねたものがニューラルネットワーク。 入力層 中間層(隠れ層) 出力層 特徴量を受け取る 特徴を変換・抽出。深いほど 表現力↑ 最終予測を出力
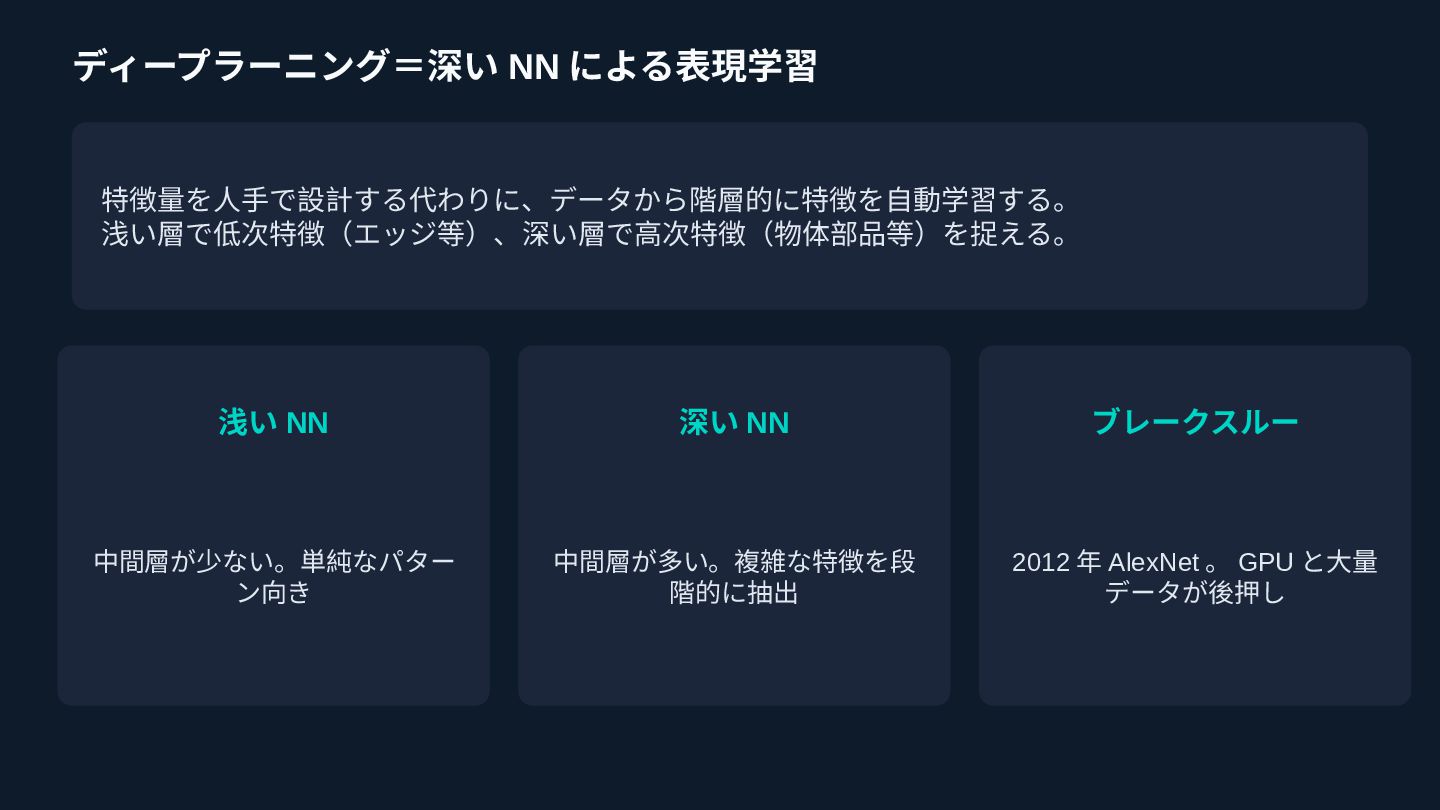
ディープラーニング=深い NN による表現学習 特徴量を人手で設計する代わりに、データから階層的に特徴を自動学習する。 浅い層で低次特徴(エッジ等)、深い層で高次特徴(物体部品等)を捉える。 浅い NN 深い NN ブレークスルー
中間層が少ない。単純なパター ン向き 中間層が多い。複雑な特徴を段 階的に抽出 2012 年 AlexNet 。 GPU と大量 データが後押し
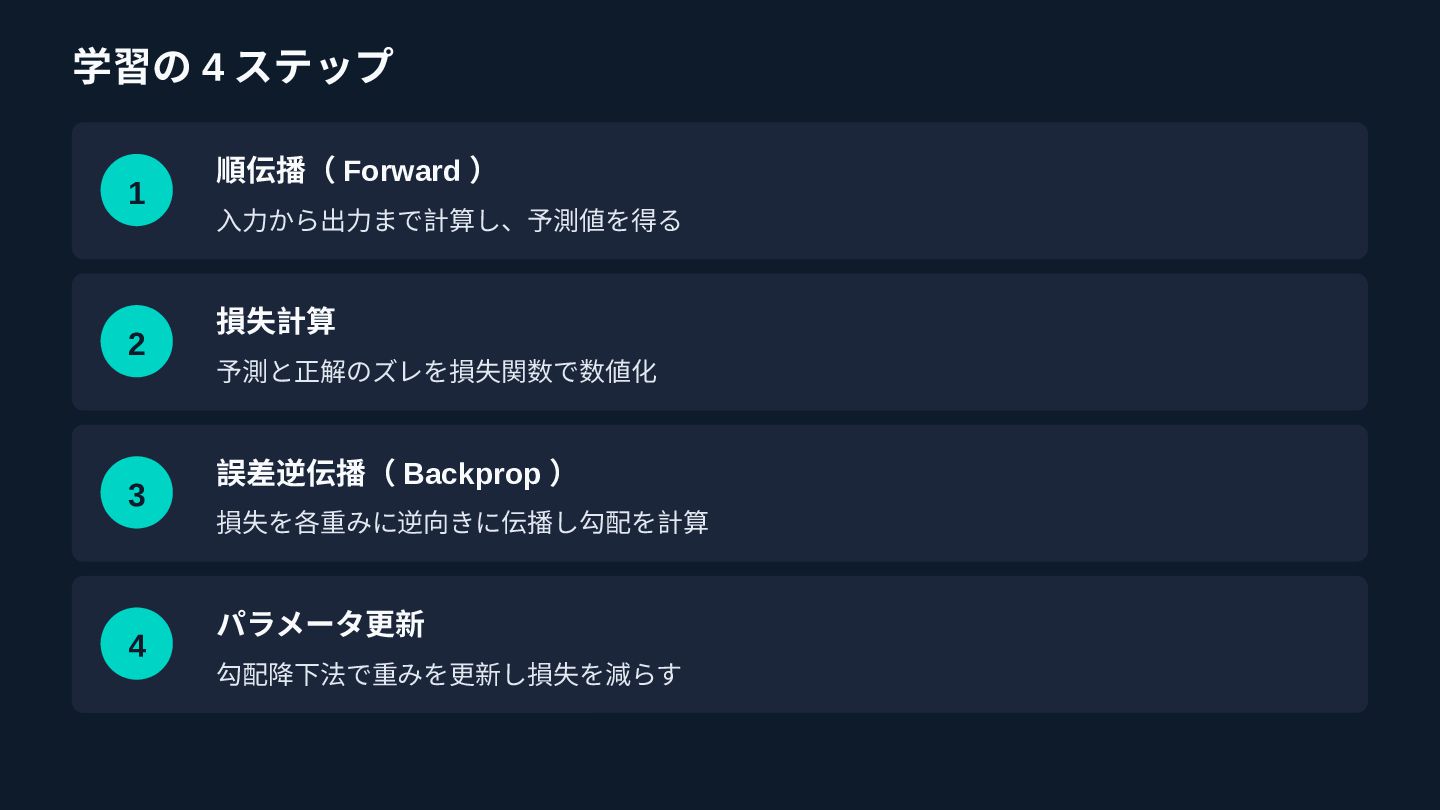
学習の 4 ステップ 1 2 3 4 順伝播( Forward )
入力から出力まで計算し、予測値を得る 損失計算 予測と正解のズレを損失関数で数値化 誤差逆伝播( Backprop ) 損失を各重みに逆向きに伝播し勾配を計算 パラメータ更新 勾配降下法で重みを更新し損失を減らす
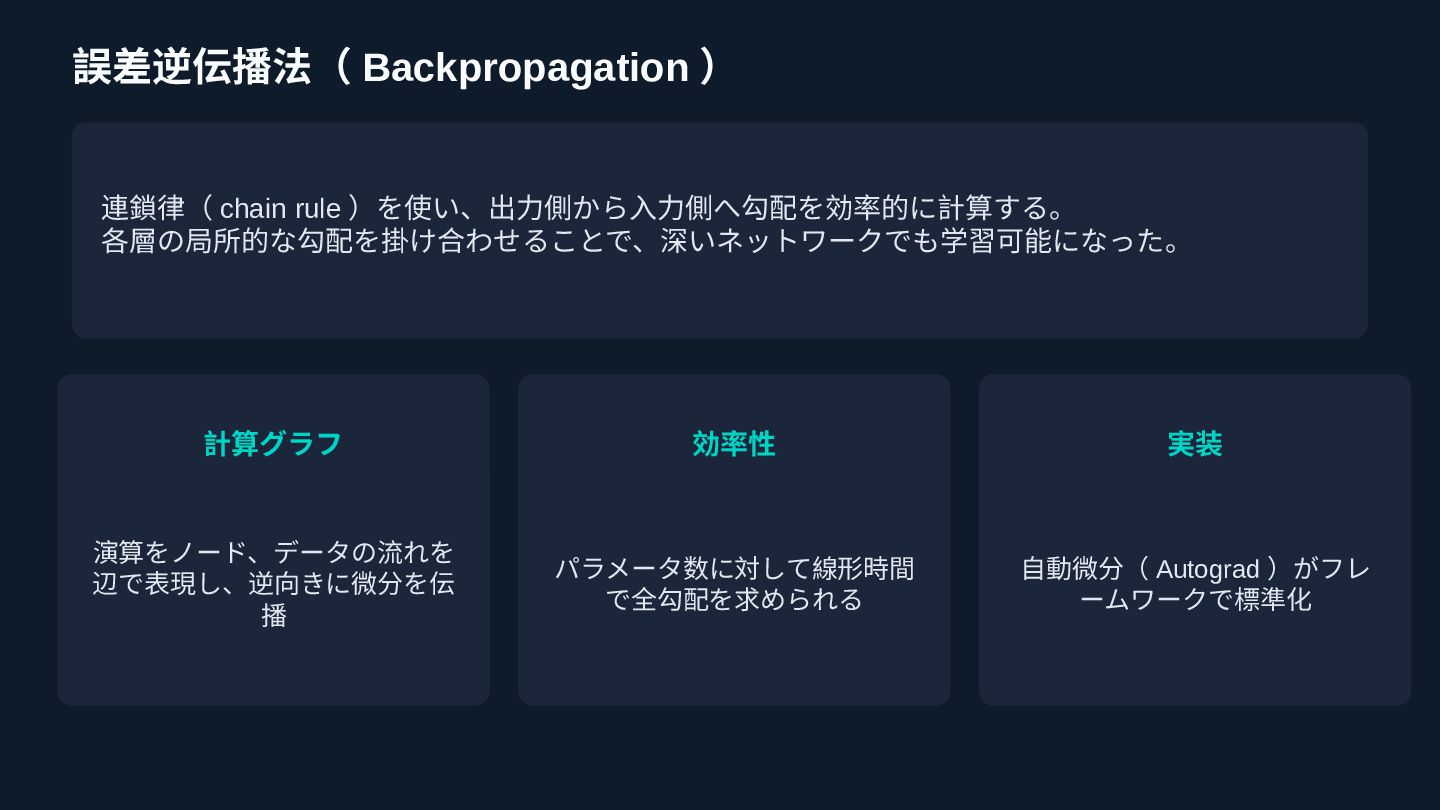
誤差逆伝播法( Backpropagation ) 連鎖律( chain rule )を使い、出力側から入力側へ勾配を効率的に計算する。 各層の局所的な勾配を掛け合わせることで、深いネットワークでも学習可能になった。 計算グラフ 効率性
実装 演算をノード、データの流れを 辺で表現し、逆向きに微分を伝 播 パラメータ数に対して線形時間 で全勾配を求められる 自動微分( Autograd )がフレ ームワークで標準化
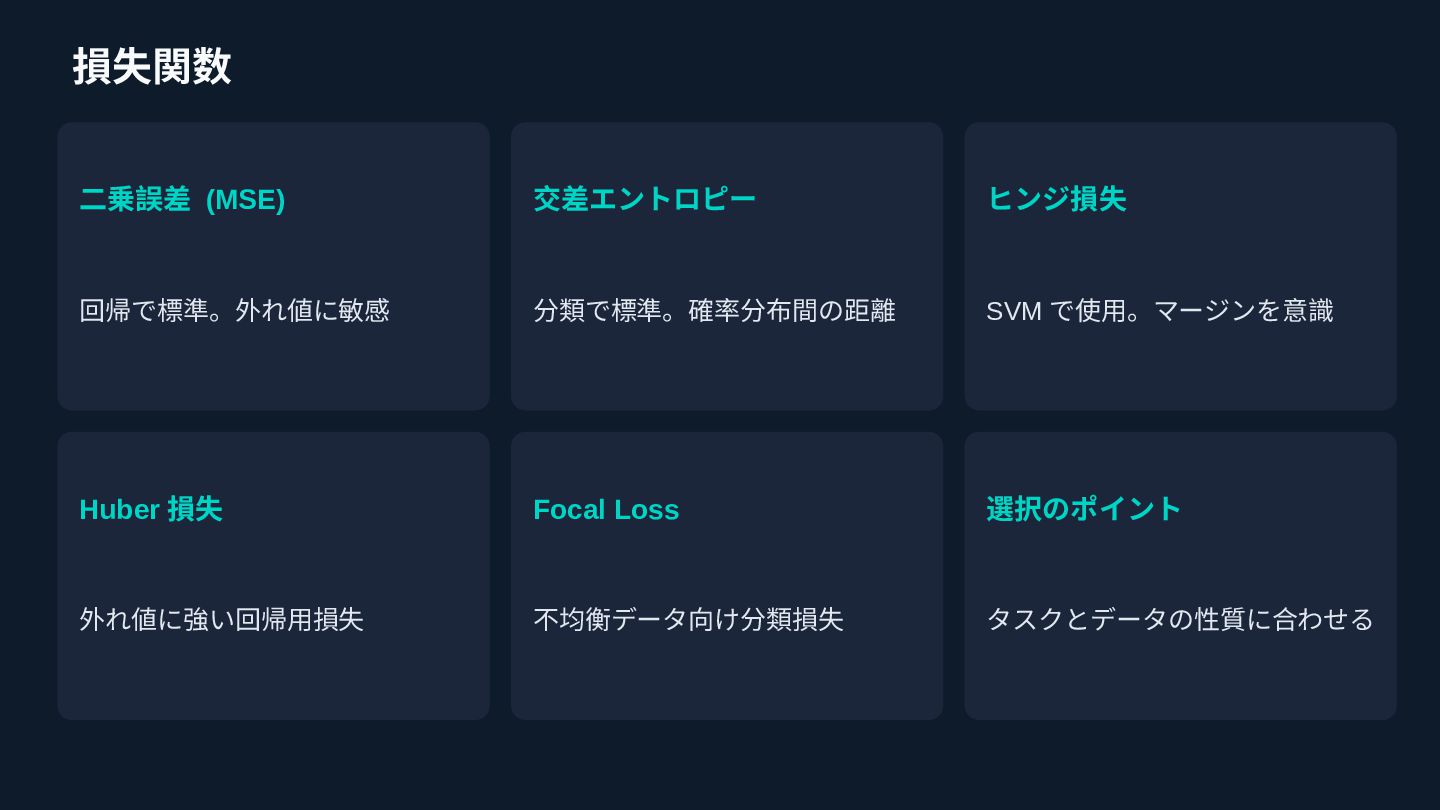
損失関数 二乗誤差 (MSE) 交差エントロピー ヒンジ損失 回帰で標準。外れ値に敏感 分類で標準。確率分布間の距離 SVM で使用。マージンを意識 Huber
損失 Focal Loss 選択のポイント 外れ値に強い回帰用損失 不均衡データ向け分類損失 タスクとデータの性質に合わせる
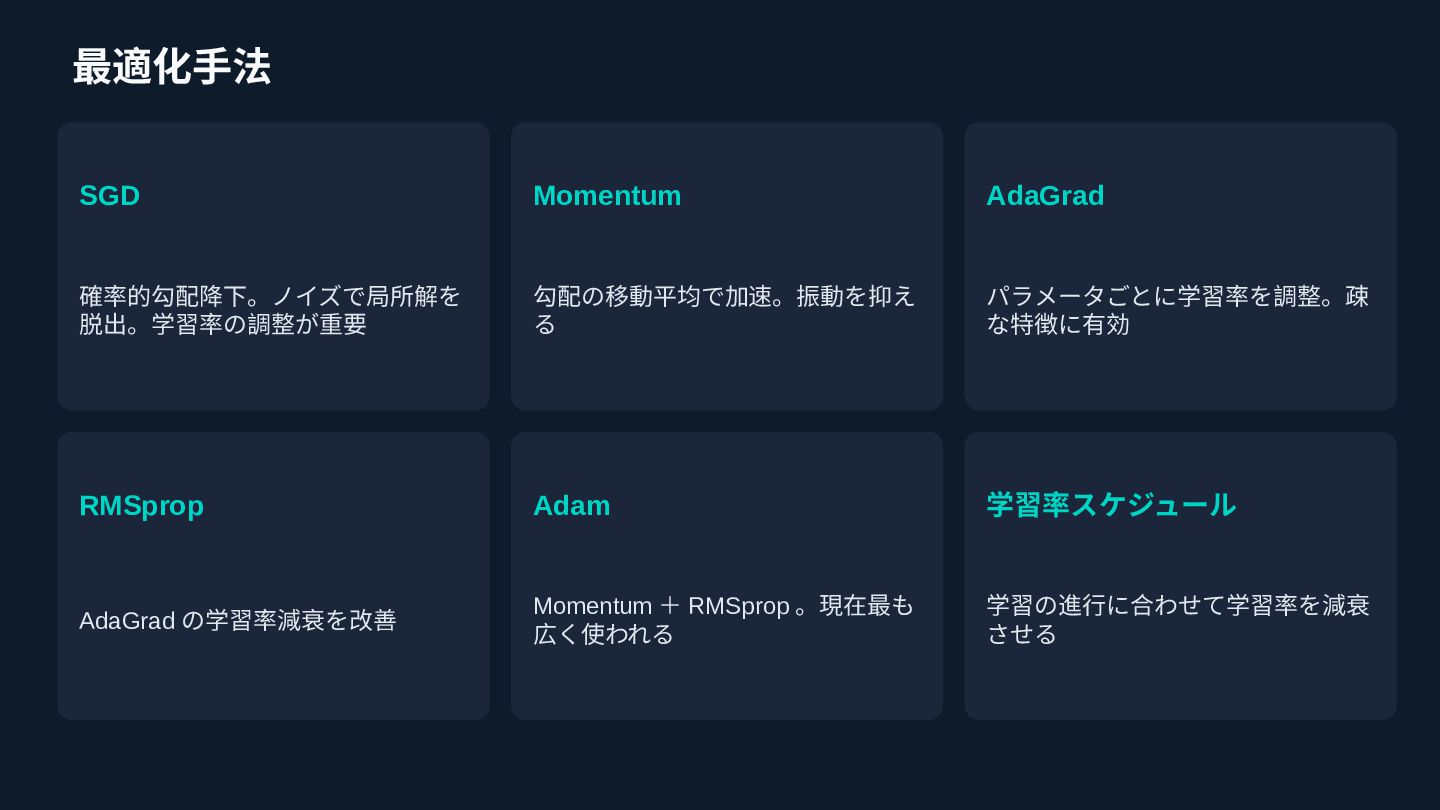
最適化手法 SGD Momentum AdaGrad 確率的勾配降下。ノイズで局所解を 脱出。学習率の調整が重要 勾配の移動平均で加速。振動を抑え る パラメータごとに学習率を調整。疎 な特徴に有効
RMSprop Adam 学習率スケジュール AdaGrad の学習率減衰を改善 Momentum + RMSprop 。現在最も 広く使われる 学習の進行に合わせて学習率を減衰 させる
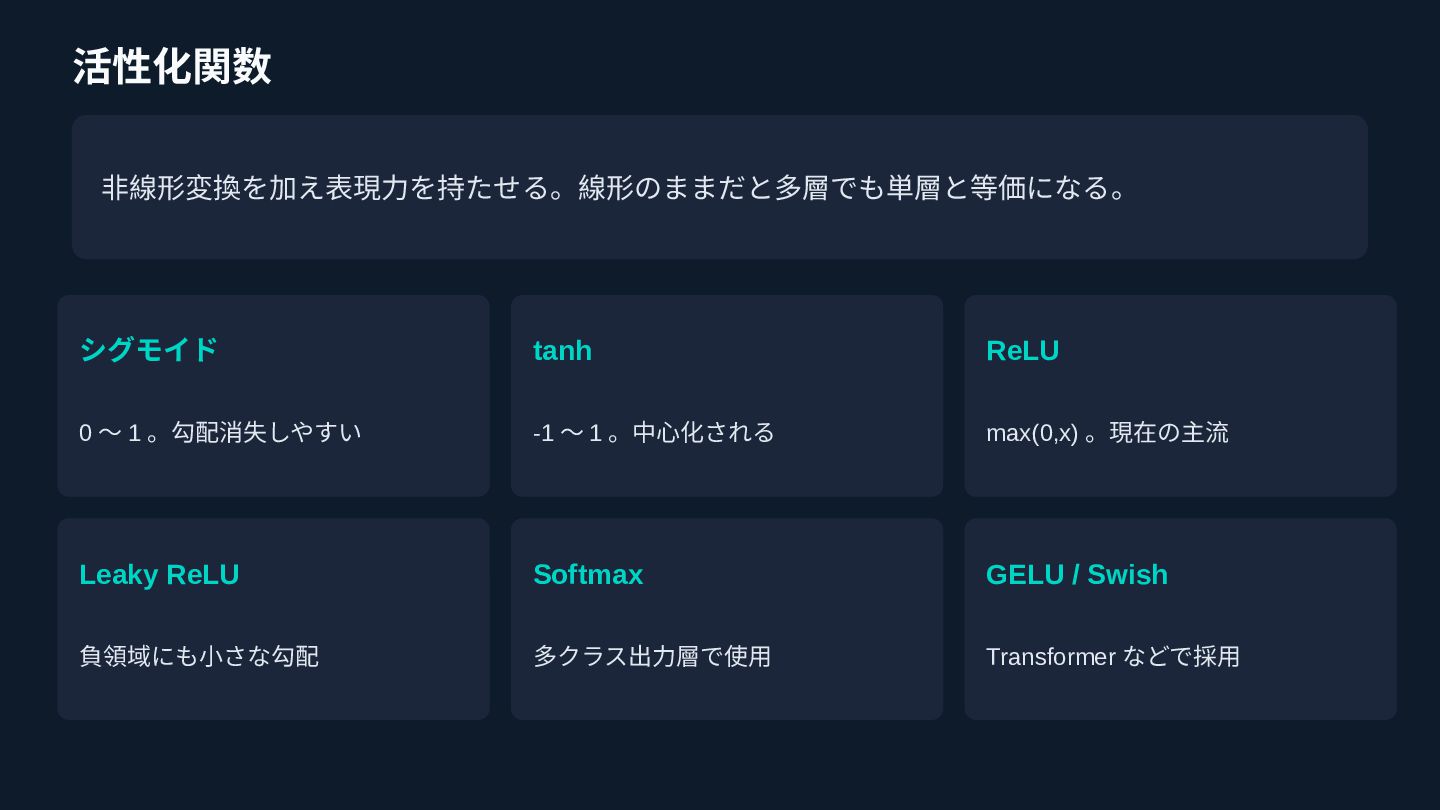
活性化関数 非線形変換を加え表現力を持たせる。線形のままだと多層でも単層と等価になる。 シグモイド tanh ReLU 0 〜 1 。勾配消失しやすい -1
〜 1 。中心化される max(0,x) 。現在の主流 Leaky ReLU Softmax GELU / Swish 負領域にも小さな勾配 多クラス出力層で使用 Transformer などで採用
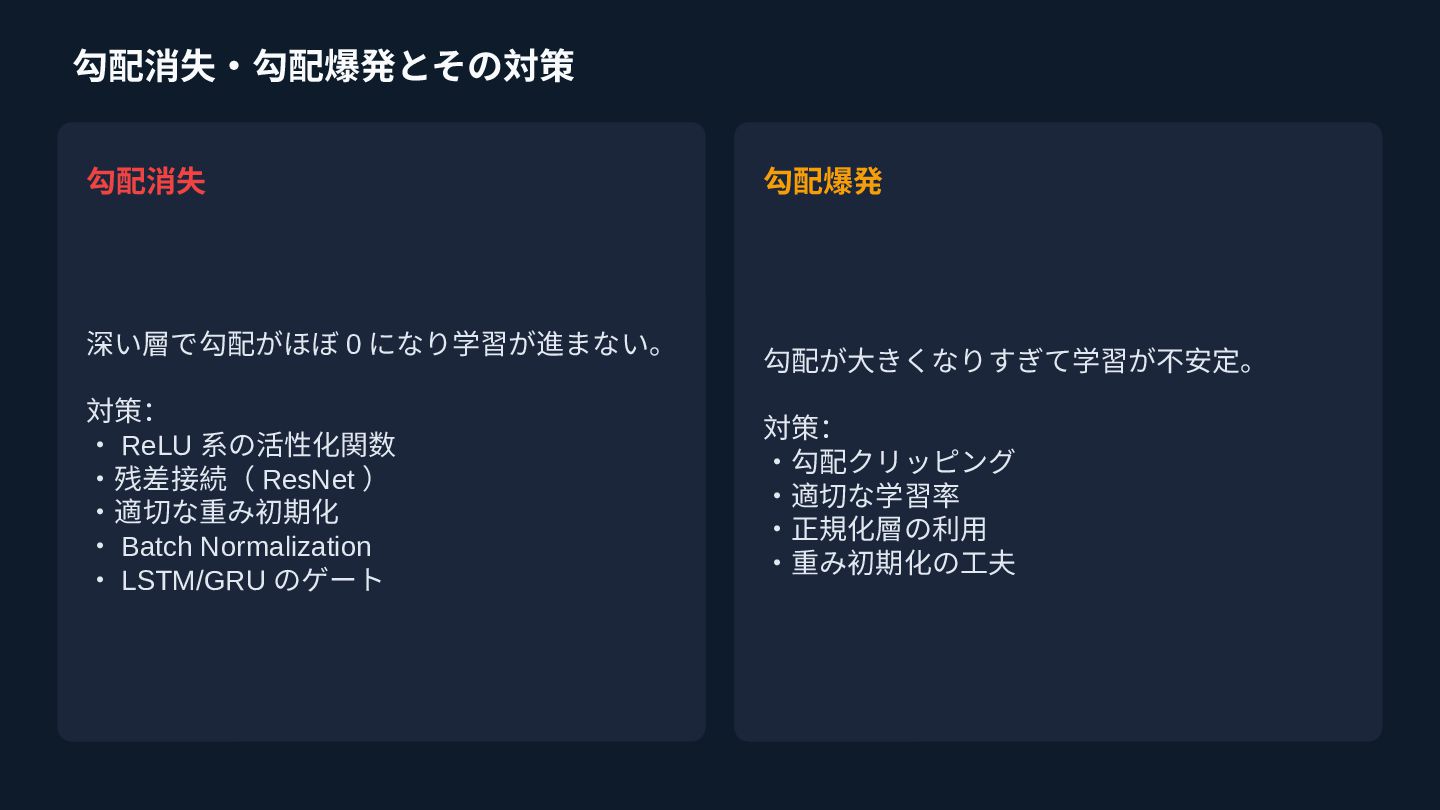
勾配消失・勾配爆発とその対策 勾配消失 深い層で勾配がほぼ 0 になり学習が進まない。 対策: ・ ReLU 系の活性化関数 ・残差接続(
ResNet ) ・適切な重み初期化 ・ Batch Normalization ・ LSTM/GRU のゲート 勾配爆発 勾配が大きくなりすぎて学習が不安定。 対策: ・勾配クリッピング ・適切な学習率 ・正規化層の利用 ・重み初期化の工夫
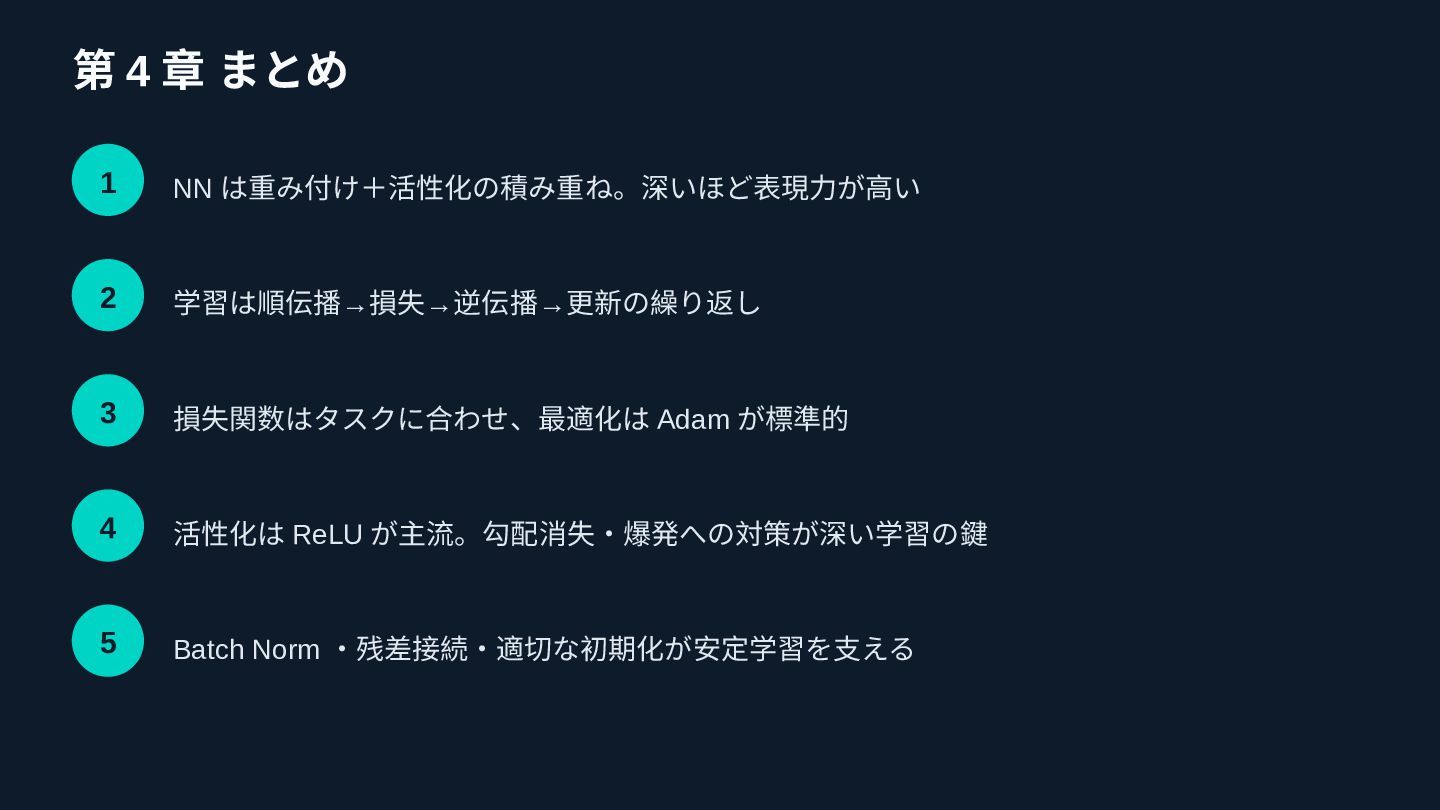
第 4 章 まとめ 1 NN は重み付け+活性化の積み重ね。深いほど表現力が高い 2 学習は順伝播→損失→逆伝播→更新の繰り返し 3
損失関数はタスクに合わせ、最適化は Adam が標準的 4 活性化は ReLU が主流。勾配消失・爆発への対策が深い学習の鍵 5 Batch Norm ・残差接続・適切な初期化が安定学習を支える
G 検定 学習スライド 第5章 ディープラーニングの要素技術 CNN / Transformer / 正規化・正則化
/ 転移学習(深掘り版)
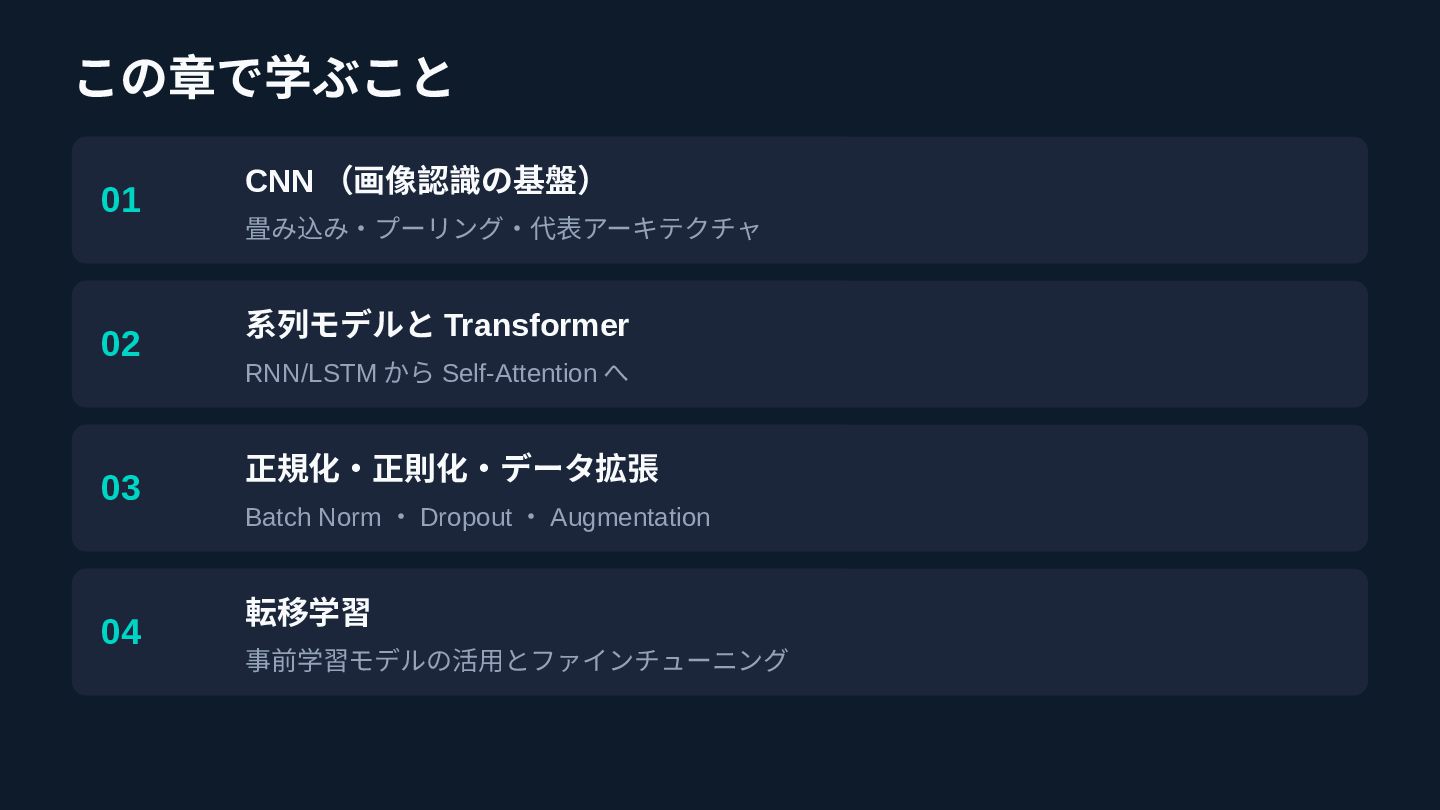
この章で学ぶこと 01 02 03 04 CNN (画像認識の基盤) 畳み込み・プーリング・代表アーキテクチャ 系列モデルと Transformer
RNN/LSTM から Self-Attention へ 正規化・正則化・データ拡張 Batch Norm ・ Dropout ・ Augmentation 転移学習 事前学習モデルの活用とファインチューニング
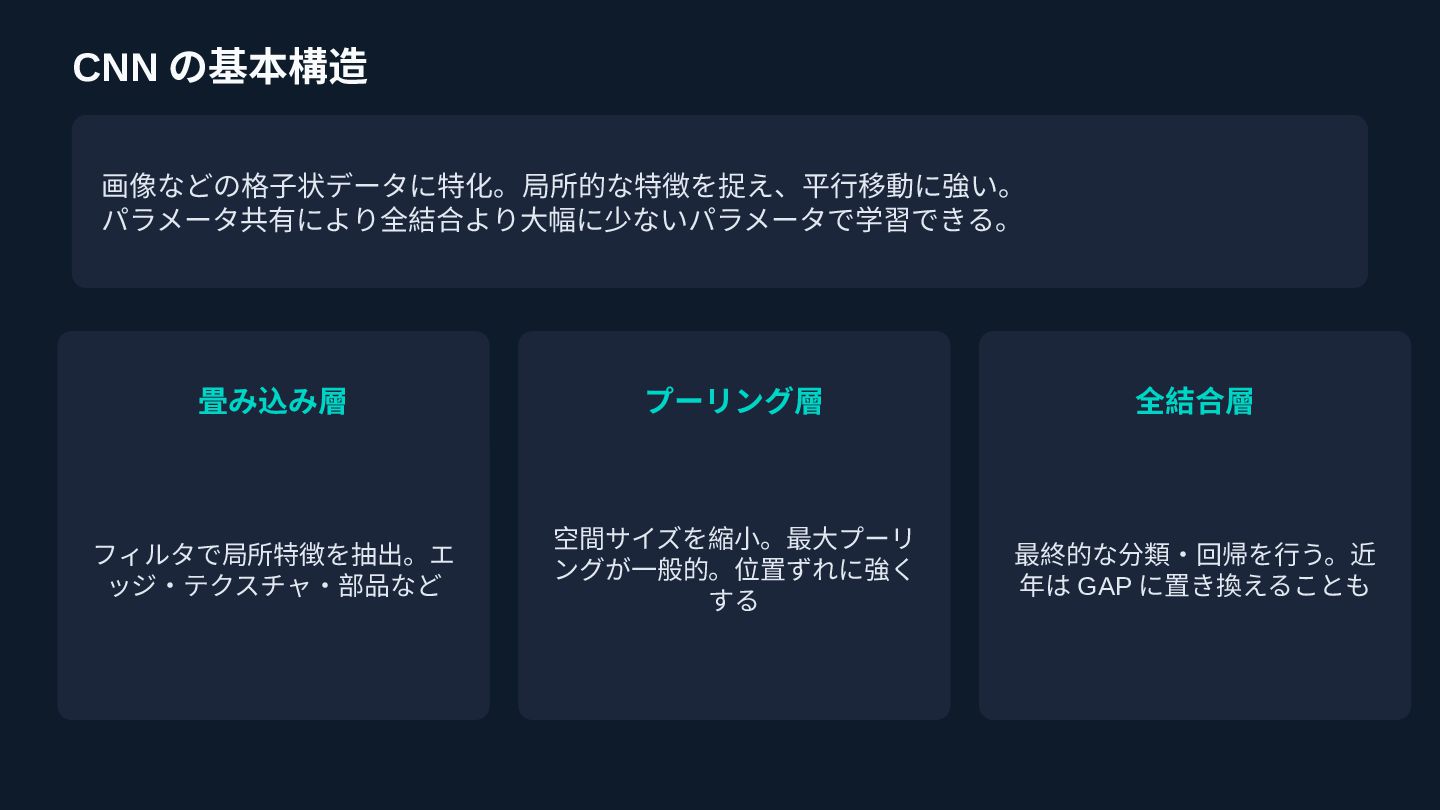
CNN の基本構造 画像などの格子状データに特化。局所的な特徴を捉え、平行移動に強い。 パラメータ共有により全結合より大幅に少ないパラメータで学習できる。 畳み込み層 プーリング層 全結合層 フィルタで局所特徴を抽出。エ ッジ・テクスチャ・部品など 空間サイズを縮小。最大プーリ
ングが一般的。位置ずれに強く する 最終的な分類・回帰を行う。近 年は GAP に置き換えることも
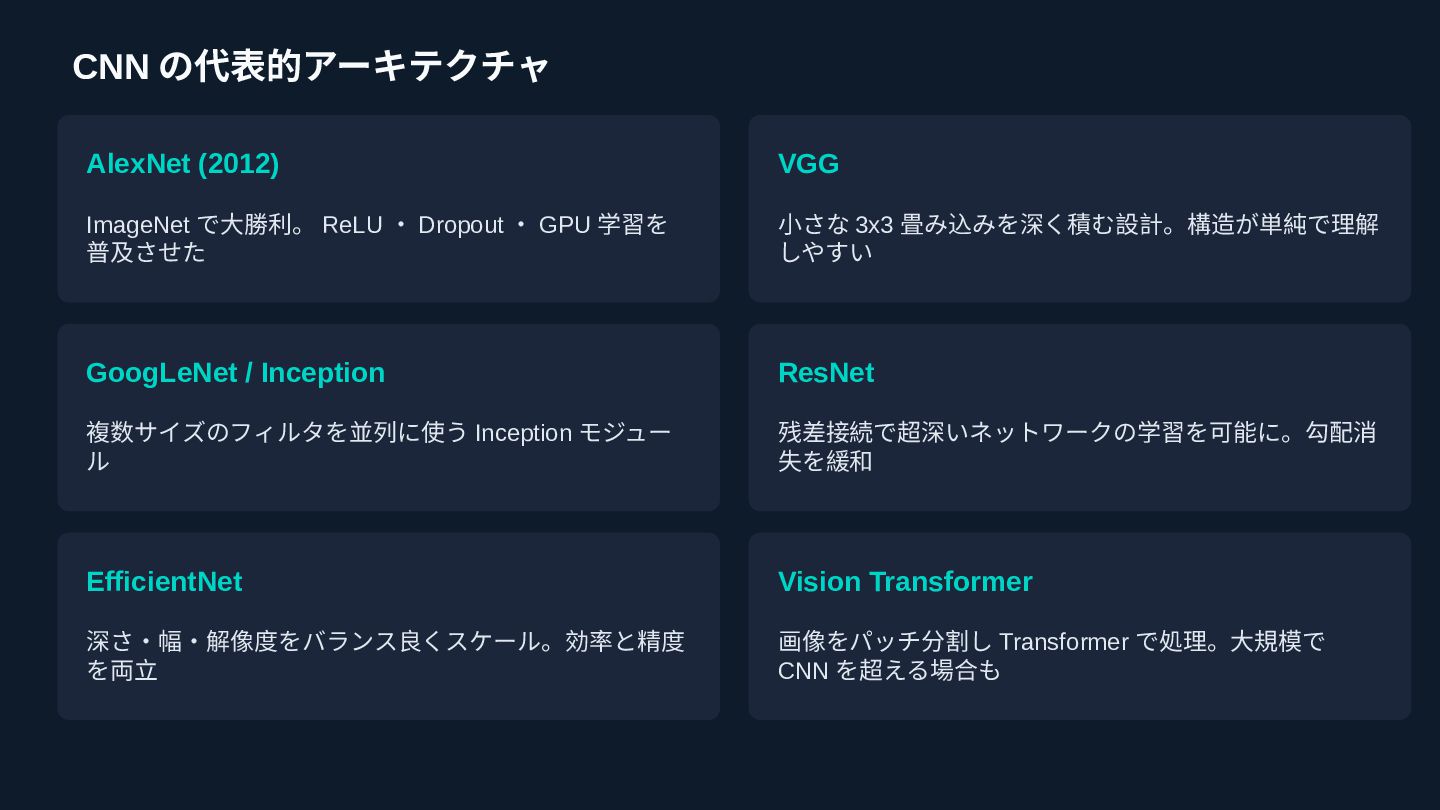
CNN の代表的アーキテクチャ AlexNet (2012) VGG ImageNet で大勝利。 ReLU ・ Dropout
・ GPU 学習を 普及させた 小さな 3x3 畳み込みを深く積む設計。構造が単純で理解 しやすい GoogLeNet / Inception ResNet 複数サイズのフィルタを並列に使う Inception モジュー ル 残差接続で超深いネットワークの学習を可能に。勾配消 失を緩和 EfficientNet Vision Transformer 深さ・幅・解像度をバランス良くスケール。効率と精度 を両立 画像をパッチ分割し Transformer で処理。大規模で CNN を超える場合も
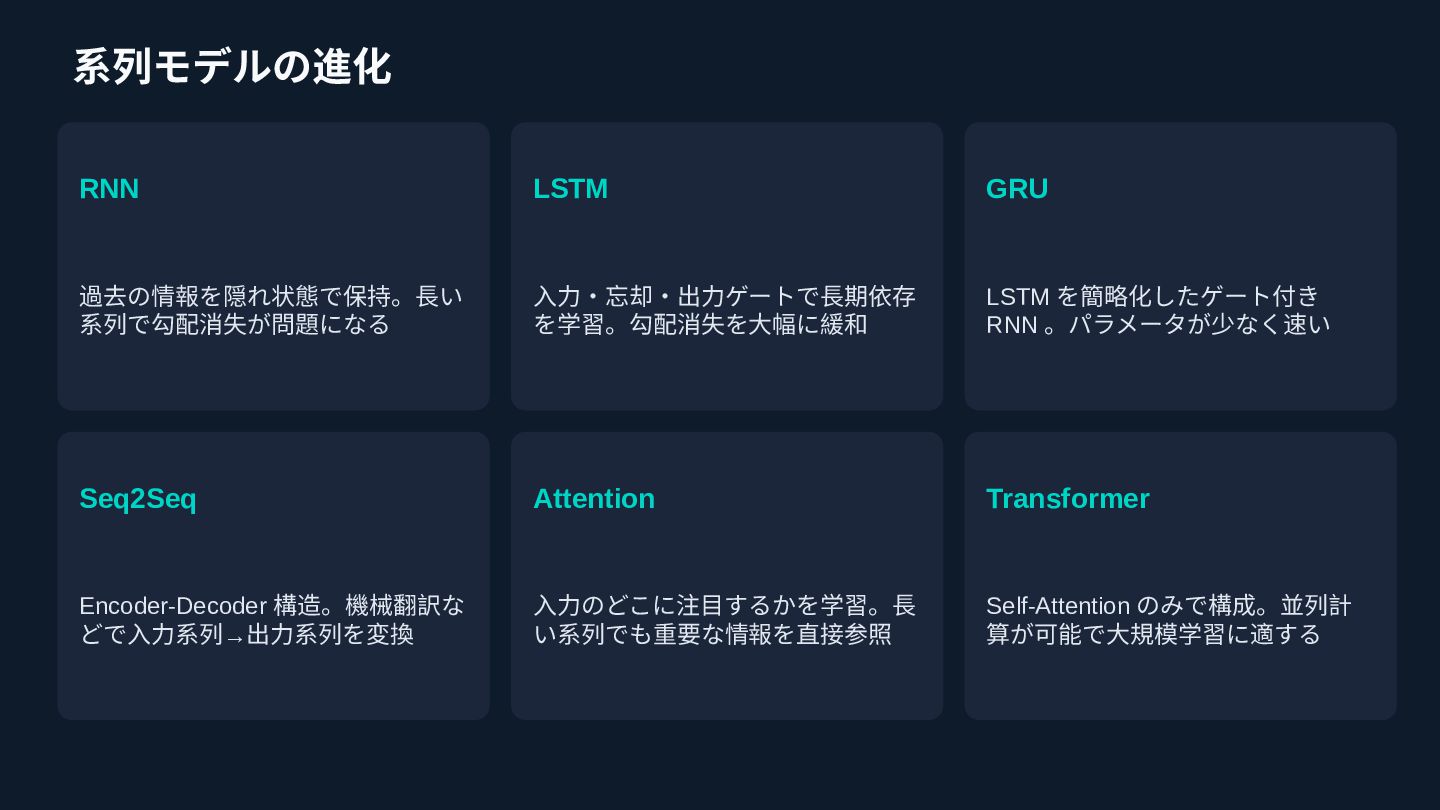
系列モデルの進化 RNN LSTM GRU 過去の情報を隠れ状態で保持。長い 系列で勾配消失が問題になる 入力・忘却・出力ゲートで長期依存 を学習。勾配消失を大幅に緩和 LSTM を簡略化したゲート付き
RNN 。パラメータが少なく速い Seq2Seq Attention Transformer Encoder-Decoder 構造。機械翻訳な どで入力系列→出力系列を変換 入力のどこに注目するかを学習。長 い系列でも重要な情報を直接参照 Self-Attention のみで構成。並列計 算が可能で大規模学習に適する
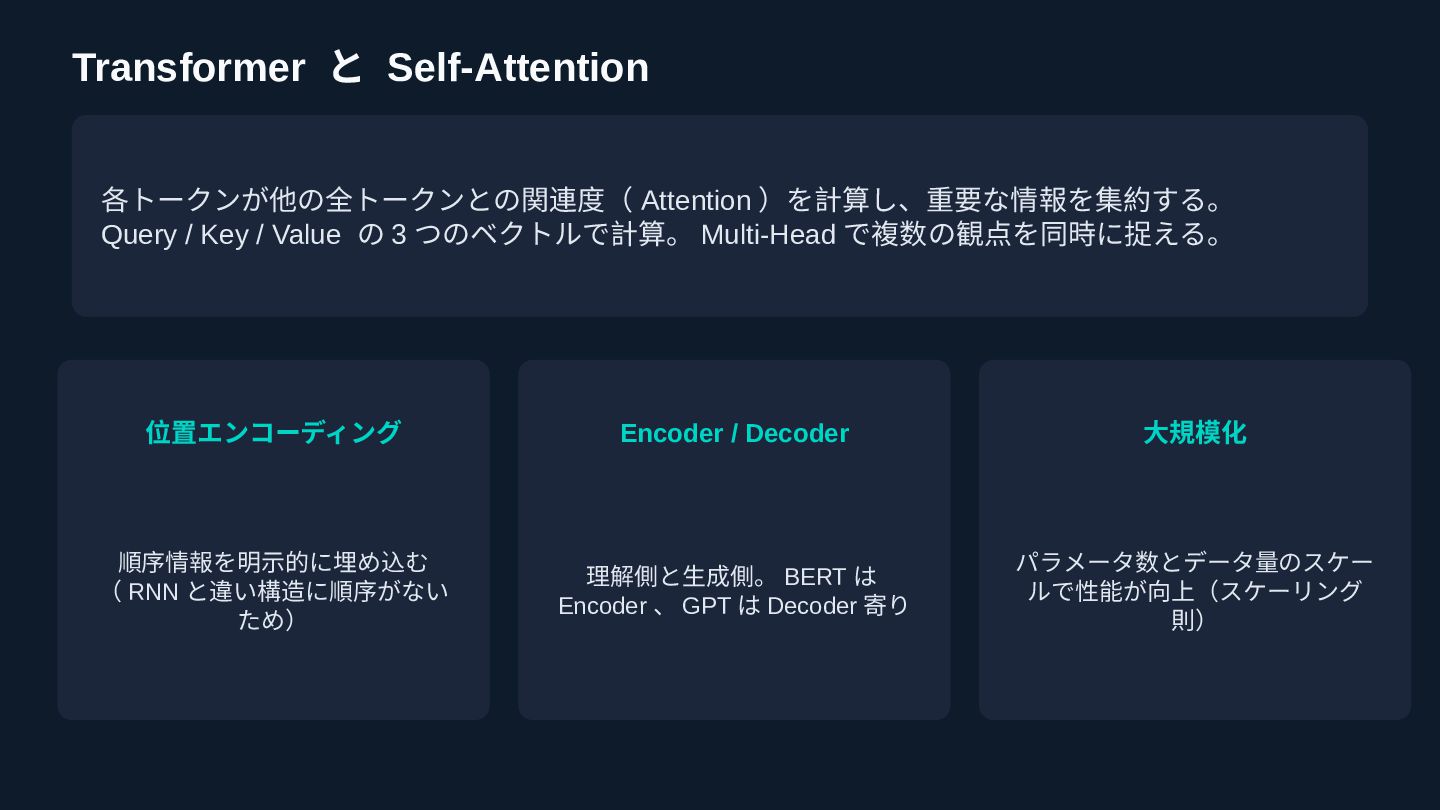
Transformer と Self-Attention 各トークンが他の全トークンとの関連度( Attention )を計算し、重要な情報を集約する。 Query / Key /
Value の 3 つのベクトルで計算。 Multi-Head で複数の観点を同時に捉える。 位置エンコーディング Encoder / Decoder 大規模化 順序情報を明示的に埋め込む ( RNN と違い構造に順序がない ため) 理解側と生成側。 BERT は Encoder 、 GPT は Decoder 寄り パラメータ数とデータ量のスケー ルで性能が向上(スケーリング 則)
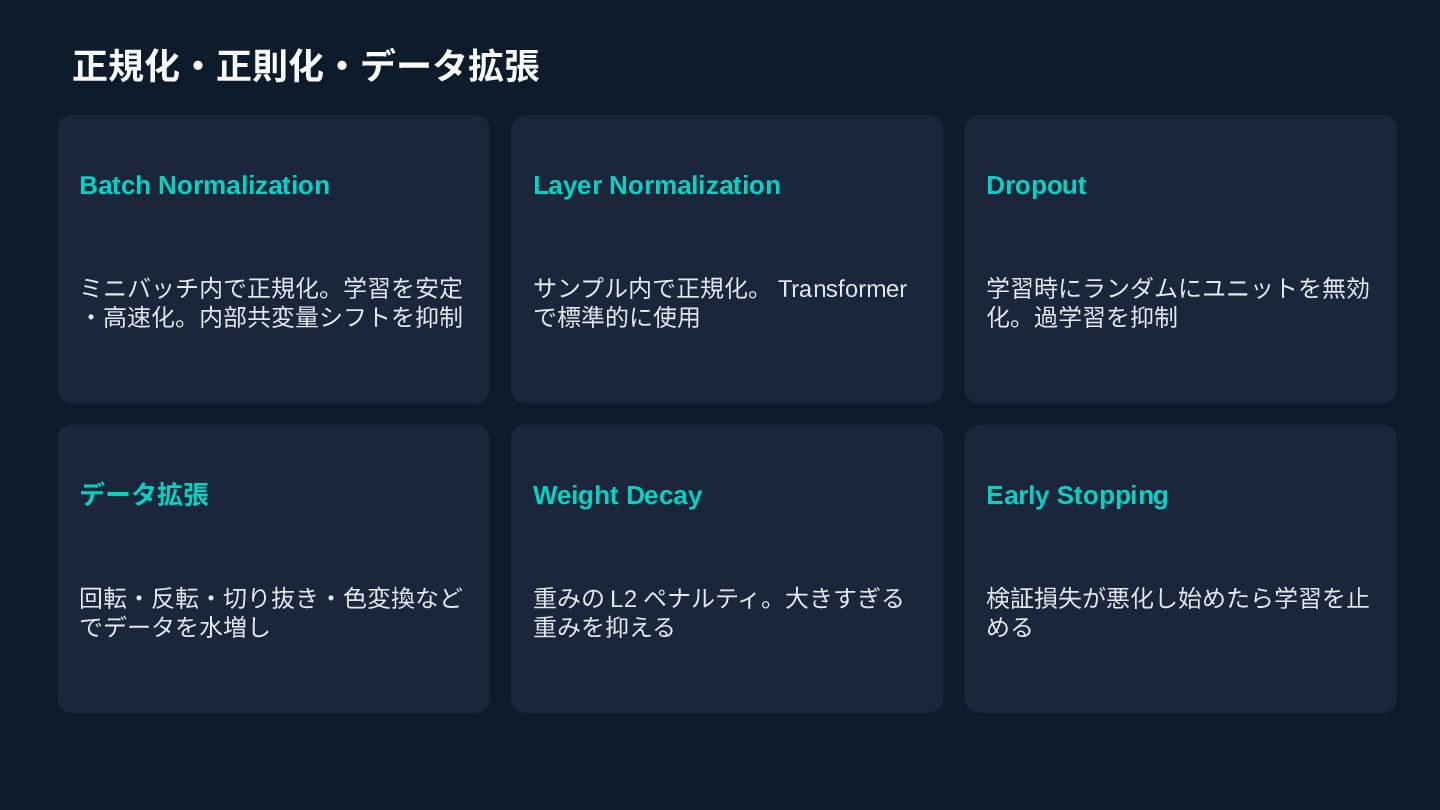
正規化・正則化・データ拡張 Batch Normalization Layer Normalization Dropout ミニバッチ内で正規化。学習を安定 ・高速化。内部共変量シフトを抑制 サンプル内で正規化。 Transformer
で標準的に使用 学習時にランダムにユニットを無効 化。過学習を抑制 データ拡張 Weight Decay Early Stopping 回転・反転・切り抜き・色変換など でデータを水増し 重みの L2 ペナルティ。大きすぎる 重みを抑える 検証損失が悪化し始めたら学習を止 める
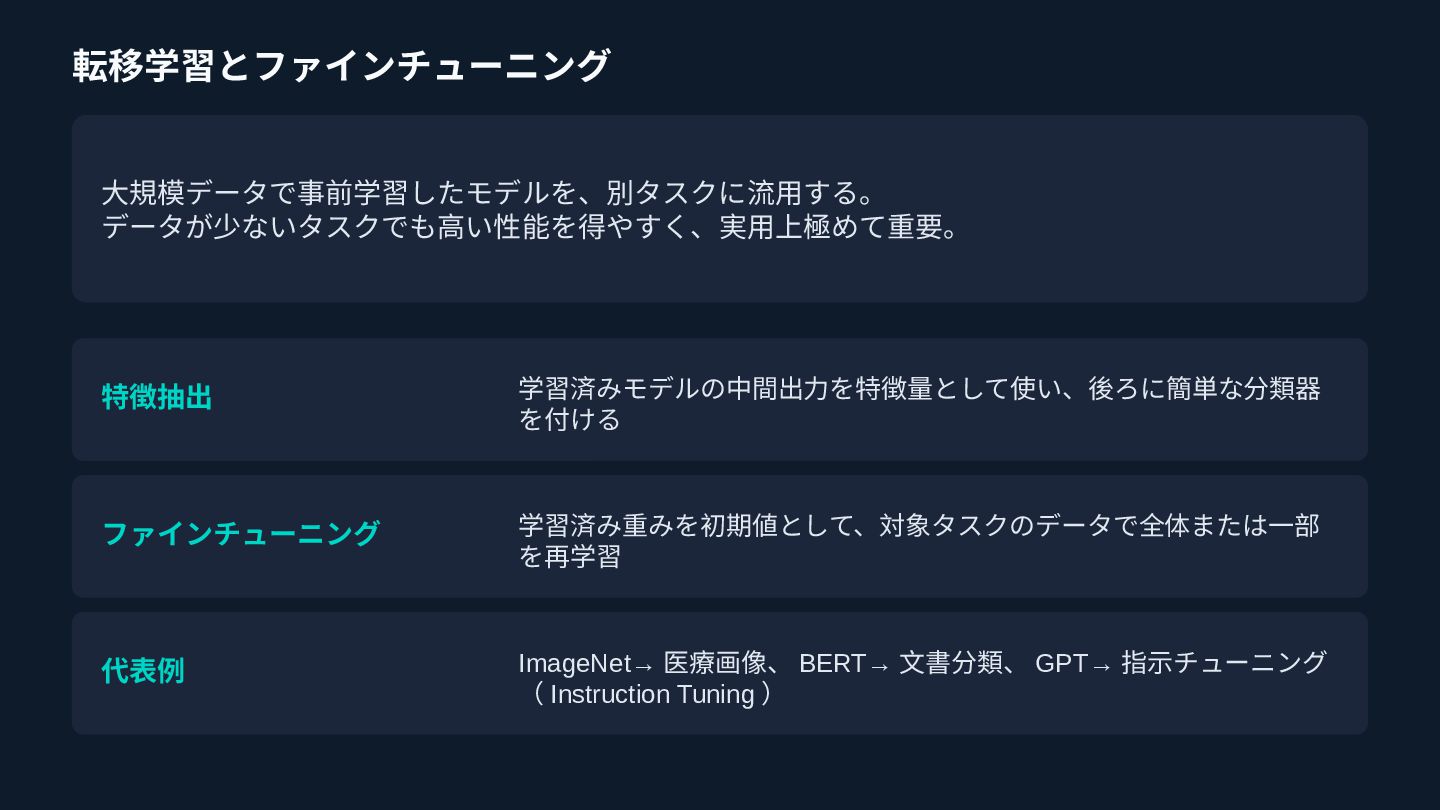
転移学習とファインチューニング 大規模データで事前学習したモデルを、別タスクに流用する。 データが少ないタスクでも高い性能を得やすく、実用上極めて重要。 特徴抽出 学習済みモデルの中間出力を特徴量として使い、後ろに簡単な分類器 を付ける ファインチューニング 学習済み重みを初期値として、対象タスクのデータで全体または一部 を再学習 代表例
ImageNet→ 医療画像、 BERT→ 文書分類、 GPT→ 指示チューニング ( Instruction Tuning )
第 5 章 まとめ 1 CNN は畳み込みとプーリングで画像の局所特徴を効率的に学習する 2 ResNet の残差接続が深いネットワークの学習を可能にした
3 系列は RNN/LSTM から、現在は Transformer ( Self-Attention )が主流 4 Batch Norm ・ Dropout ・データ拡張で学習を安定・汎化させる 5 転移学習により、少量データでも高性能なモデルを構築できる
G 検定 学習スライド 第6章 ディープラーニングの応用例 画像認識 / NLP / 生成モデル
/ 深層強化学習(深掘り版)
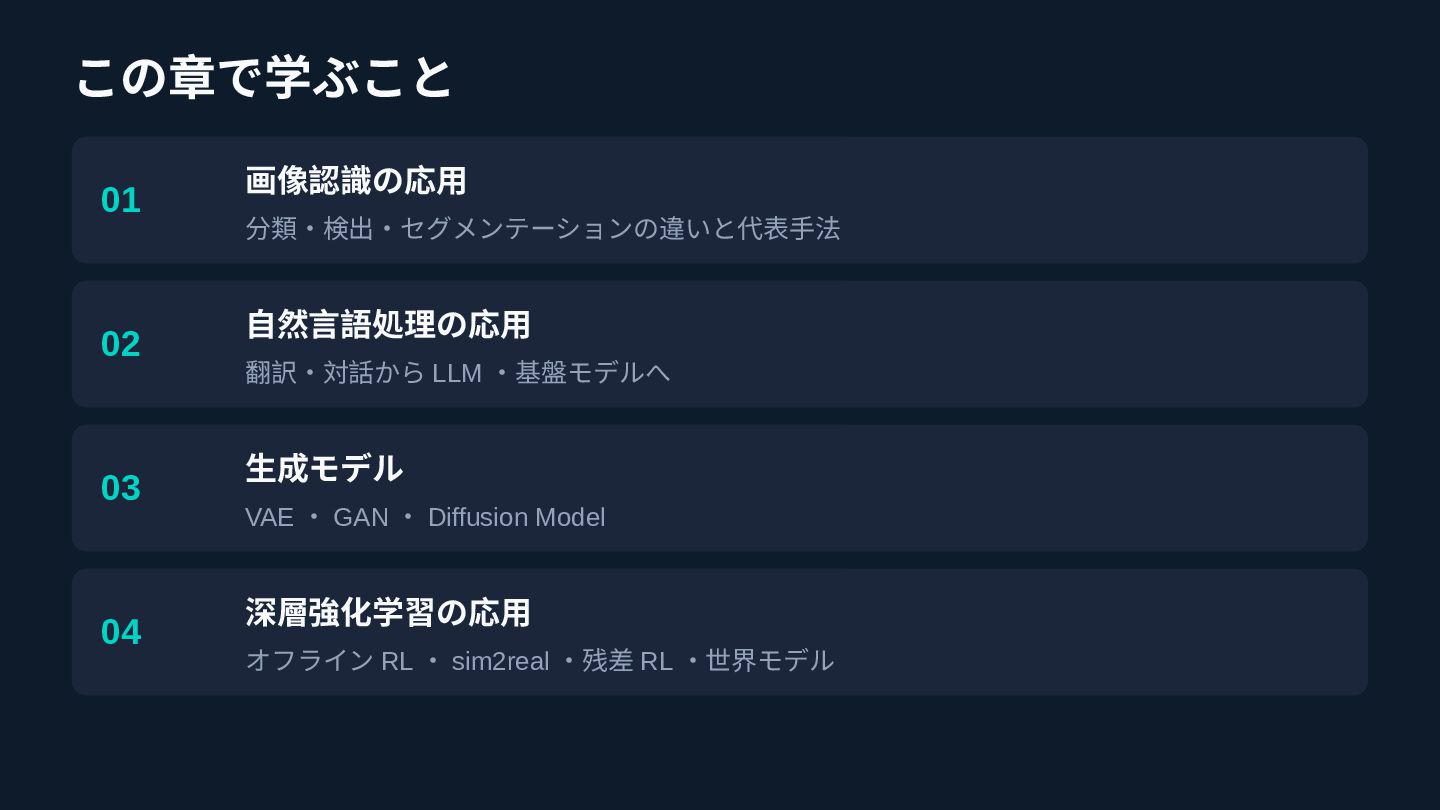
この章で学ぶこと 01 02 03 04 画像認識の応用 分類・検出・セグメンテーションの違いと代表手法 自然言語処理の応用 翻訳・対話から LLM
・基盤モデルへ 生成モデル VAE ・ GAN ・ Diffusion Model 深層強化学習の応用 オフライン RL ・ sim2real ・残差 RL ・世界モデル
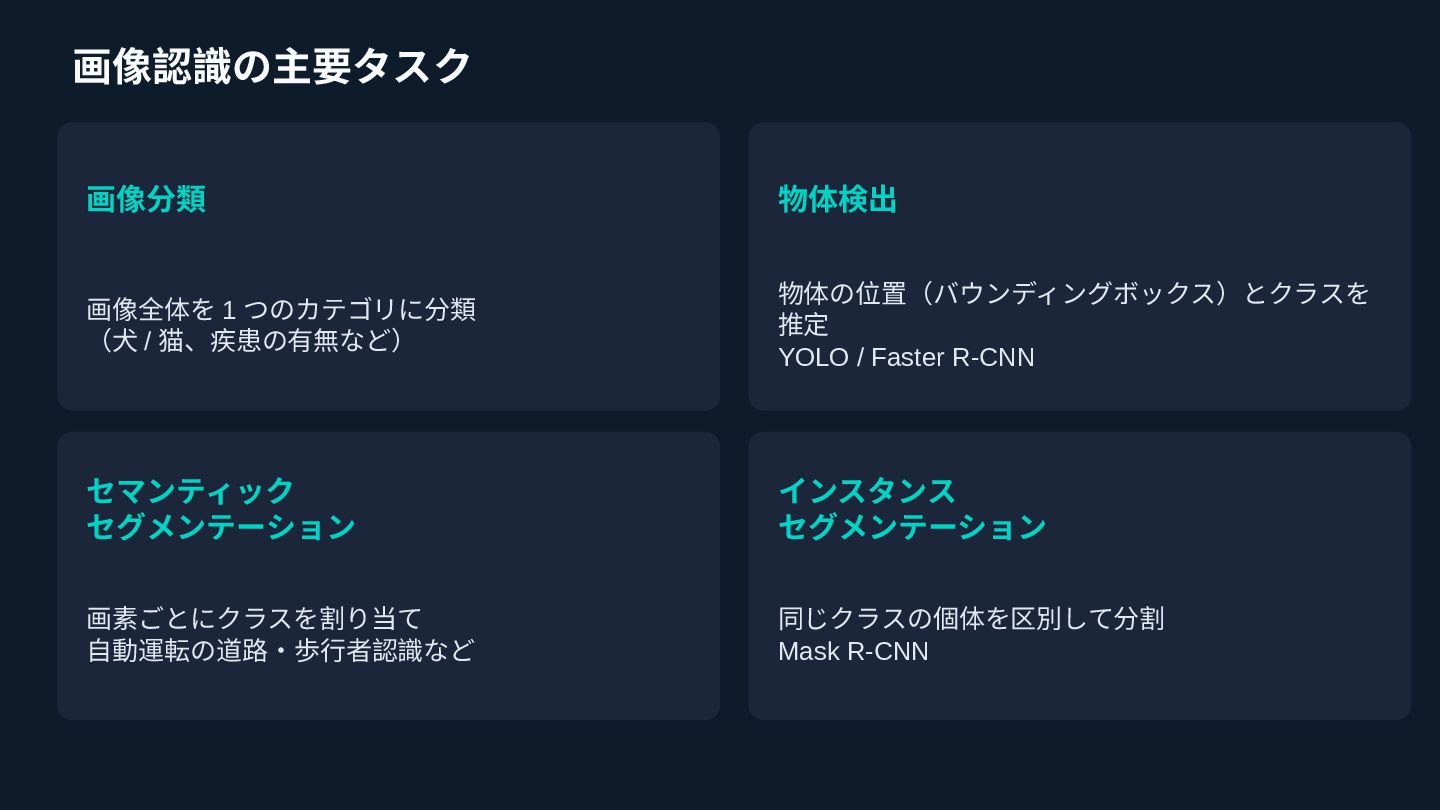
画像認識の主要タスク 画像分類 物体検出 画像全体を 1 つのカテゴリに分類 (犬 / 猫、疾患の有無など) 物体の位置(バウンディングボックス)とクラスを
推定 YOLO / Faster R-CNN セマンティック セグメンテーション インスタンス セグメンテーション 画素ごとにクラスを割り当て 自動運転の道路・歩行者認識など 同じクラスの個体を区別して分割 Mask R-CNN
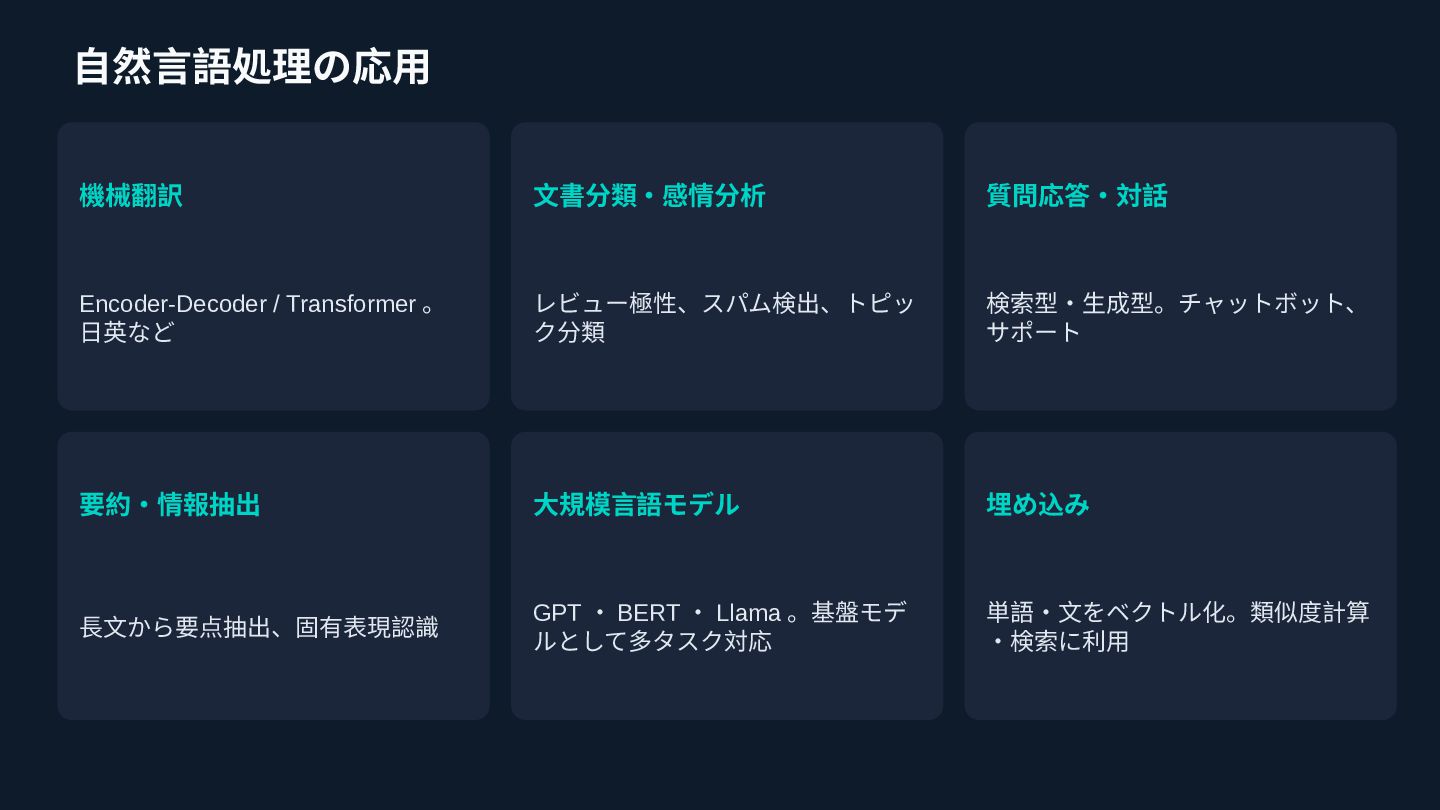
自然言語処理の応用 機械翻訳 文書分類・感情分析 質問応答・対話 Encoder-Decoder / Transformer 。 日英など レビュー極性、スパム検出、トピッ
ク分類 検索型・生成型。チャットボット、 サポート 要約・情報抽出 大規模言語モデル 埋め込み 長文から要点抽出、固有表現認識 GPT ・ BERT ・ Llama 。基盤モデ ルとして多タスク対応 単語・文をベクトル化。類似度計算 ・検索に利用
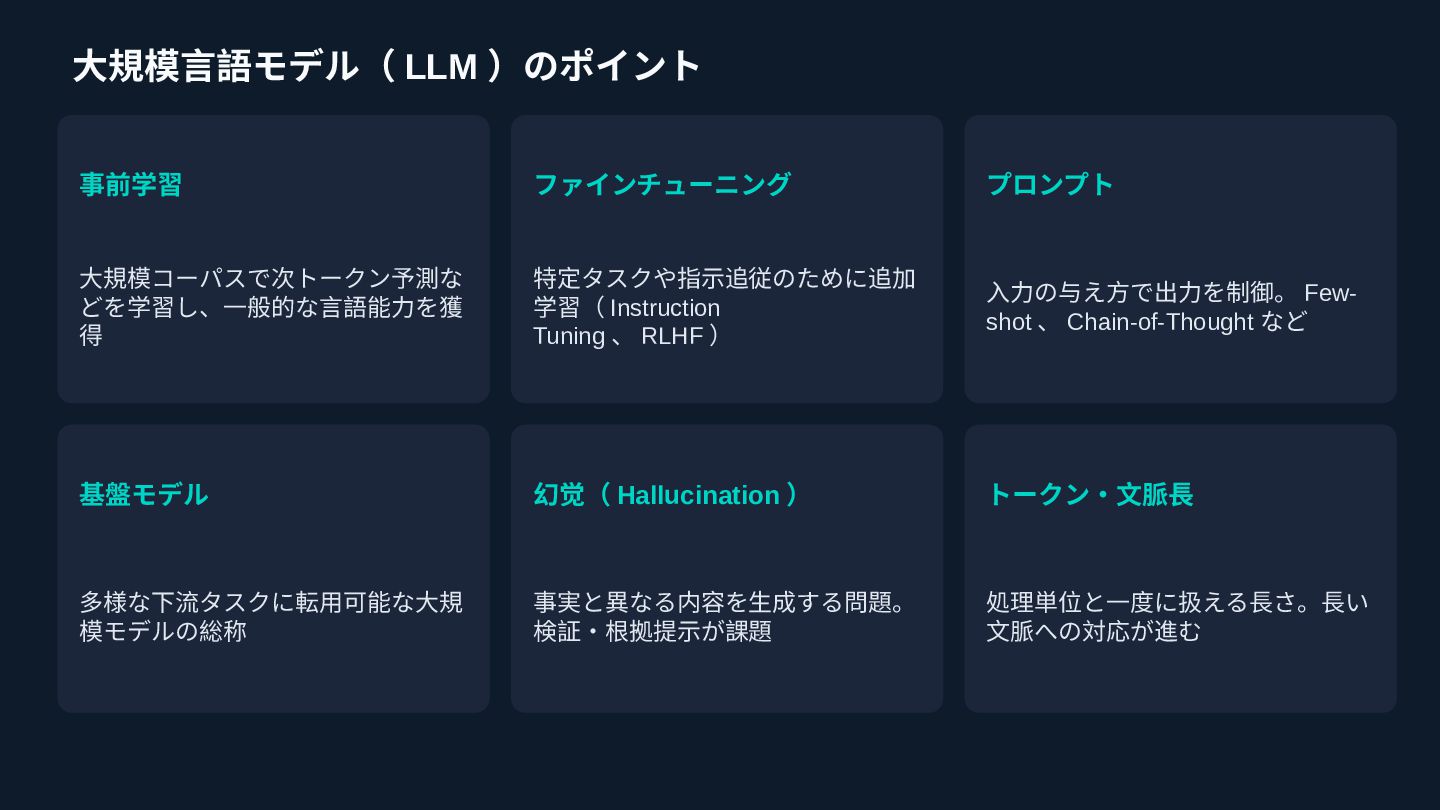
大規模言語モデル( LLM )のポイント 事前学習 ファインチューニング プロンプト 大規模コーパスで次トークン予測な どを学習し、一般的な言語能力を獲 得 特定タスクや指示追従のために追加
学習( Instruction Tuning 、 RLHF ) 入力の与え方で出力を制御。 Fewshot 、 Chain-of-Thought など 基盤モデル 幻觉( Hallucination ) トークン・文脈長 多様な下流タスクに転用可能な大規 模モデルの総称 事実と異なる内容を生成する問題。 検証・根拠提示が課題 処理単位と一度に扱える長さ。長い 文脈への対応が進む
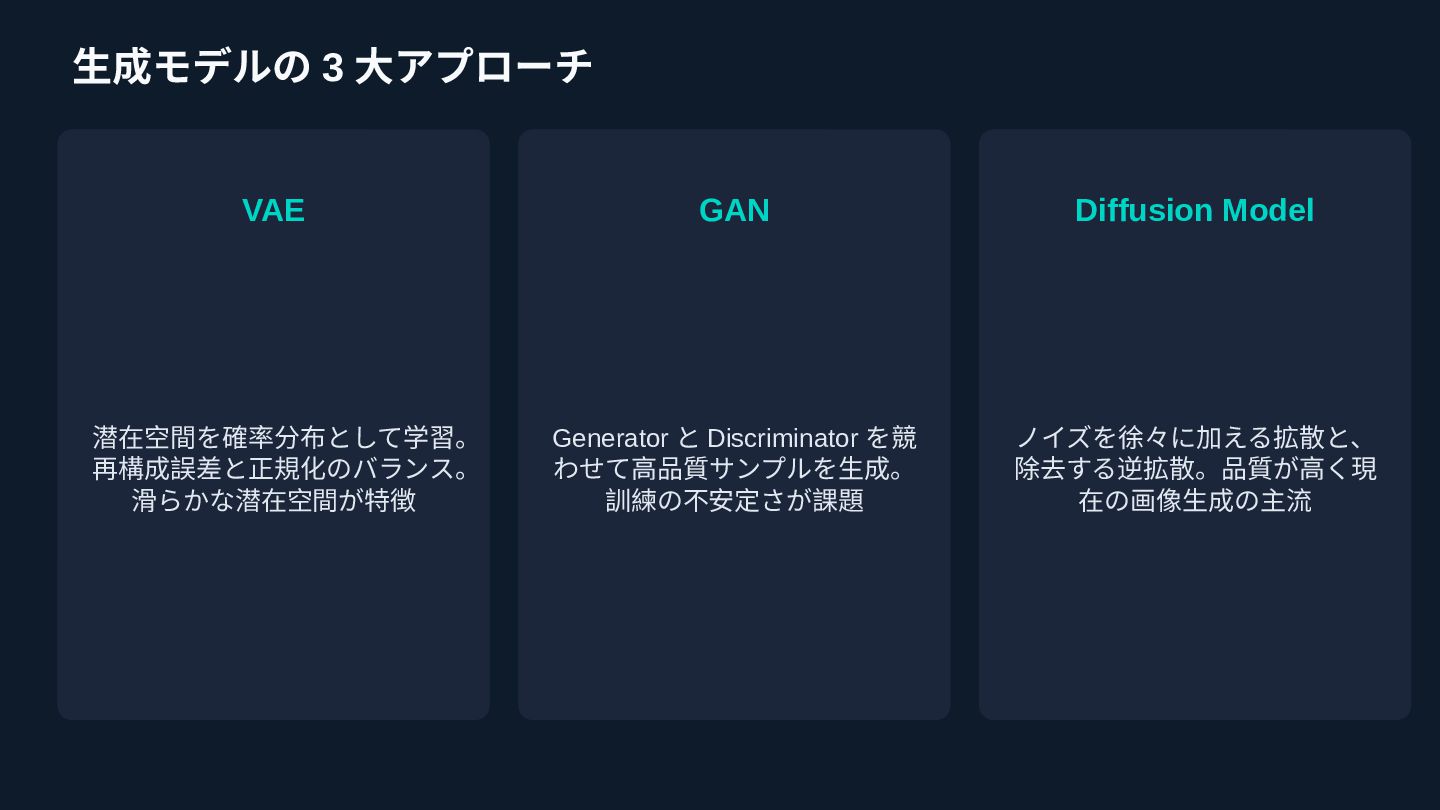
生成モデルの 3 大アプローチ VAE GAN Diffusion Model 潜在空間を確率分布として学習。 再構成誤差と正規化のバランス。 滑らかな潜在空間が特徴
Generator と Discriminator を競 わせて高品質サンプルを生成。 訓練の不安定さが課題 ノイズを徐々に加える拡散と、 除去する逆拡散。品質が高く現 在の画像生成の主流
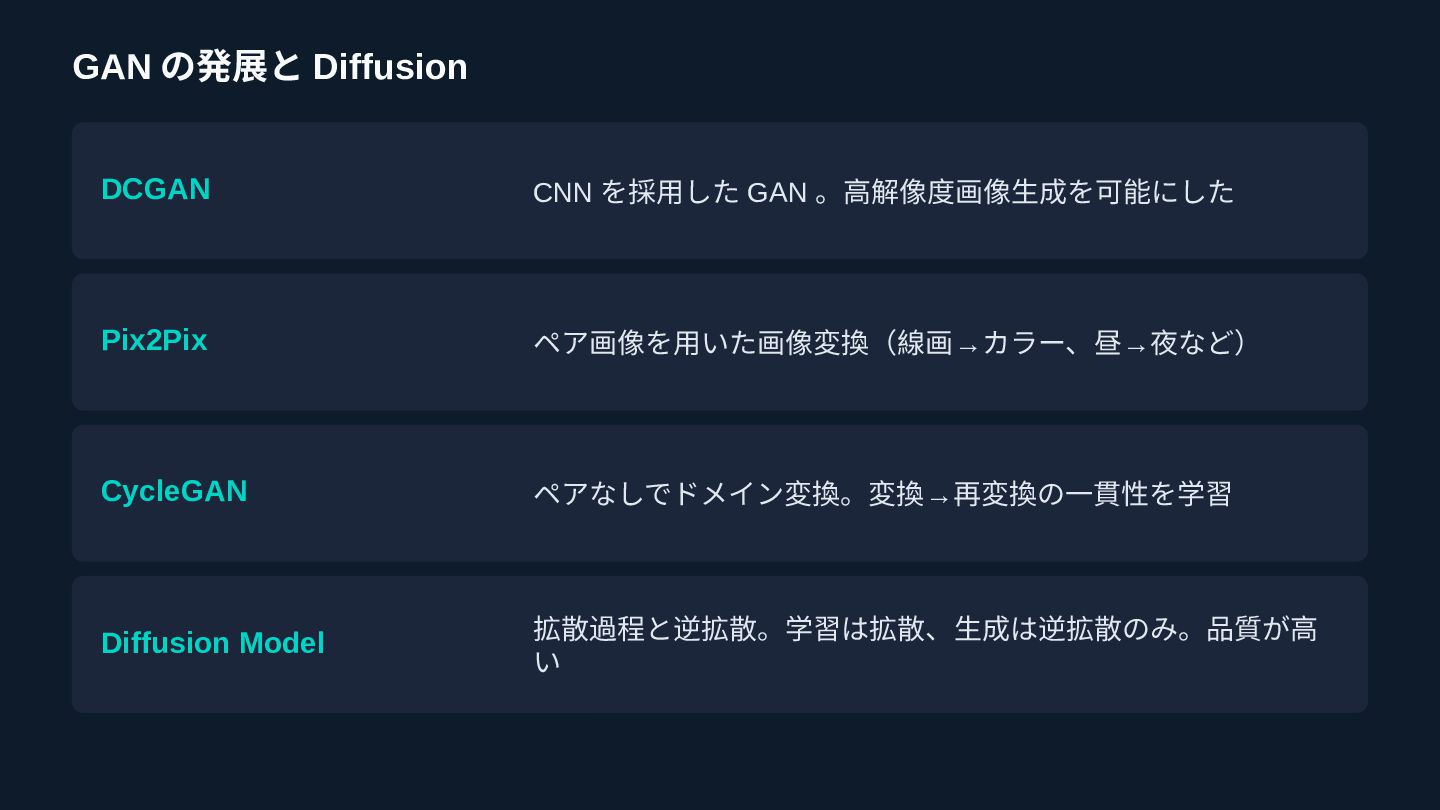
GAN の発展と Diffusion DCGAN CNN を採用した GAN 。高解像度画像生成を可能にした Pix2Pix ペア画像を用いた画像変換(線画→カラー、昼→夜など)
CycleGAN ペアなしでドメイン変換。変換→再変換の一貫性を学習 Diffusion Model 拡散過程と逆拡散。学習は拡散、生成は逆拡散のみ。品質が高 い
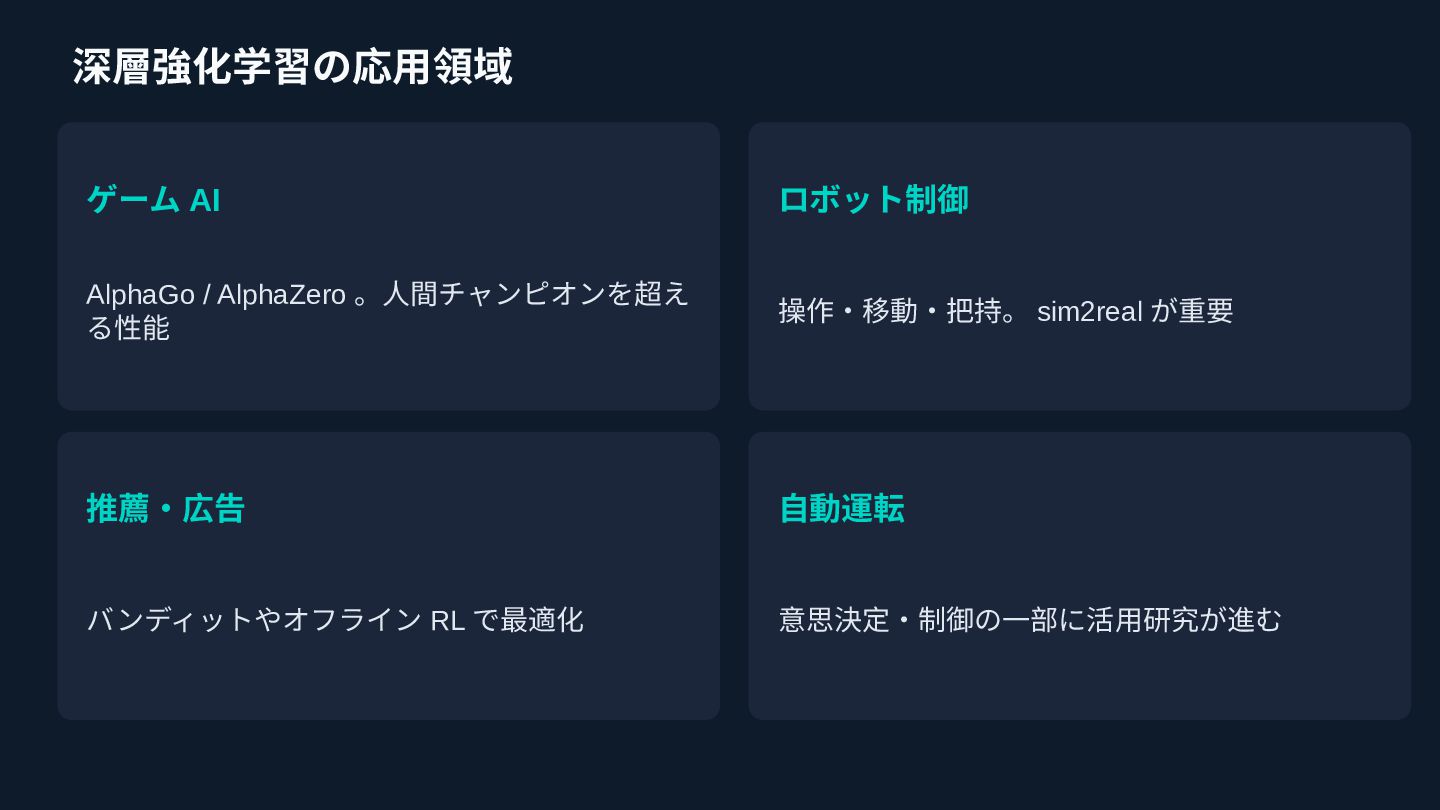
深層強化学習の応用領域 ゲーム AI ロボット制御 AlphaGo / AlphaZero 。人間チャンピオンを超え る性能 操作・移動・把持。
sim2real が重要 推薦・広告 自動運転 バンディットやオフライン RL で最適化 意思決定・制御の一部に活用研究が進む
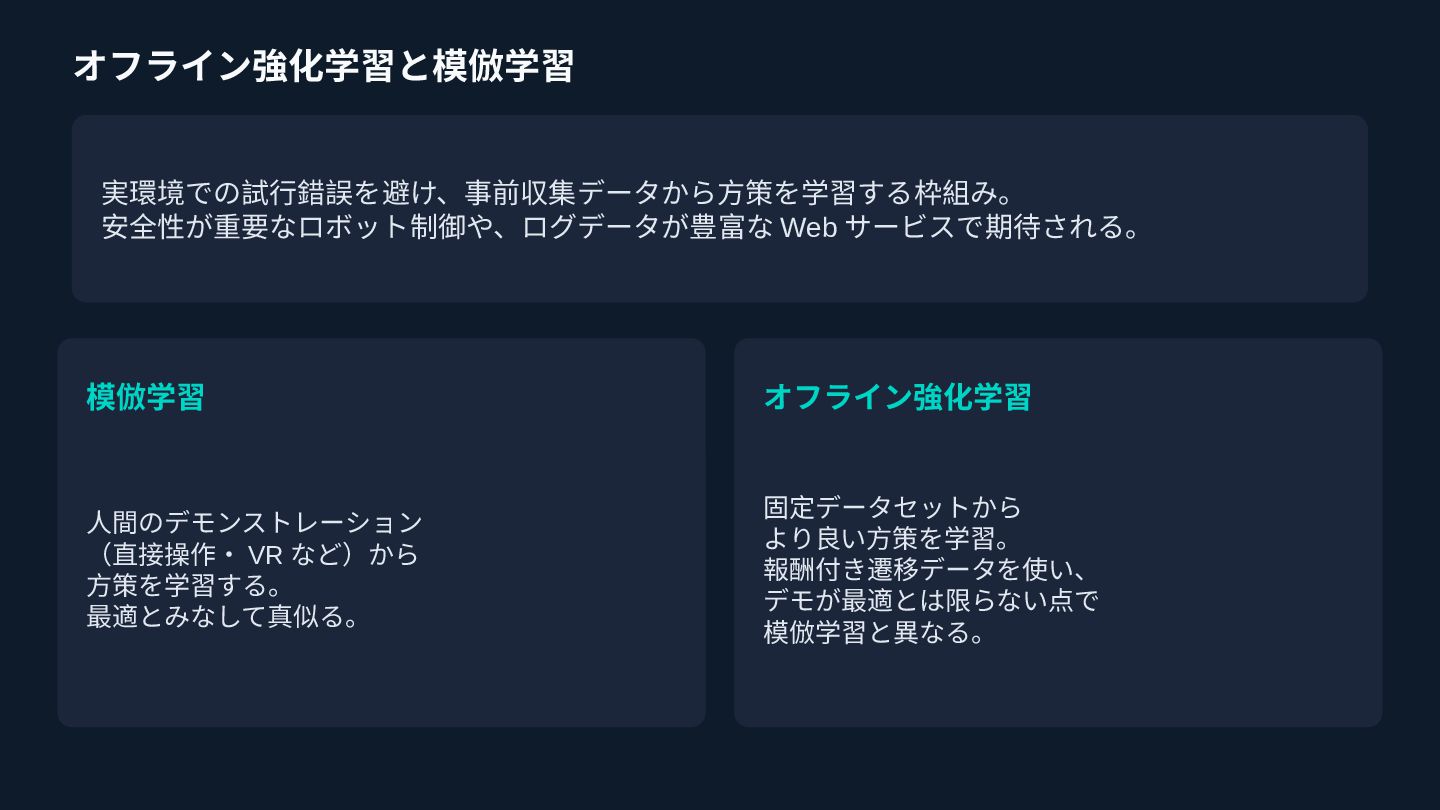
オフライン強化学習と模倣学習 実環境での試行錯誤を避け、事前収集データから方策を学習する枠組み。 安全性が重要なロボット制御や、ログデータが豊富な Web サービスで期待される。 模倣学習 オフライン強化学習 人間のデモンストレーション (直接操作・ VR
など)から 方策を学習する。 最適とみなして真似る。 固定データセットから より良い方策を学習。 報酬付き遷移データを使い、 デモが最適とは限らない点で 模倣学習と異なる。
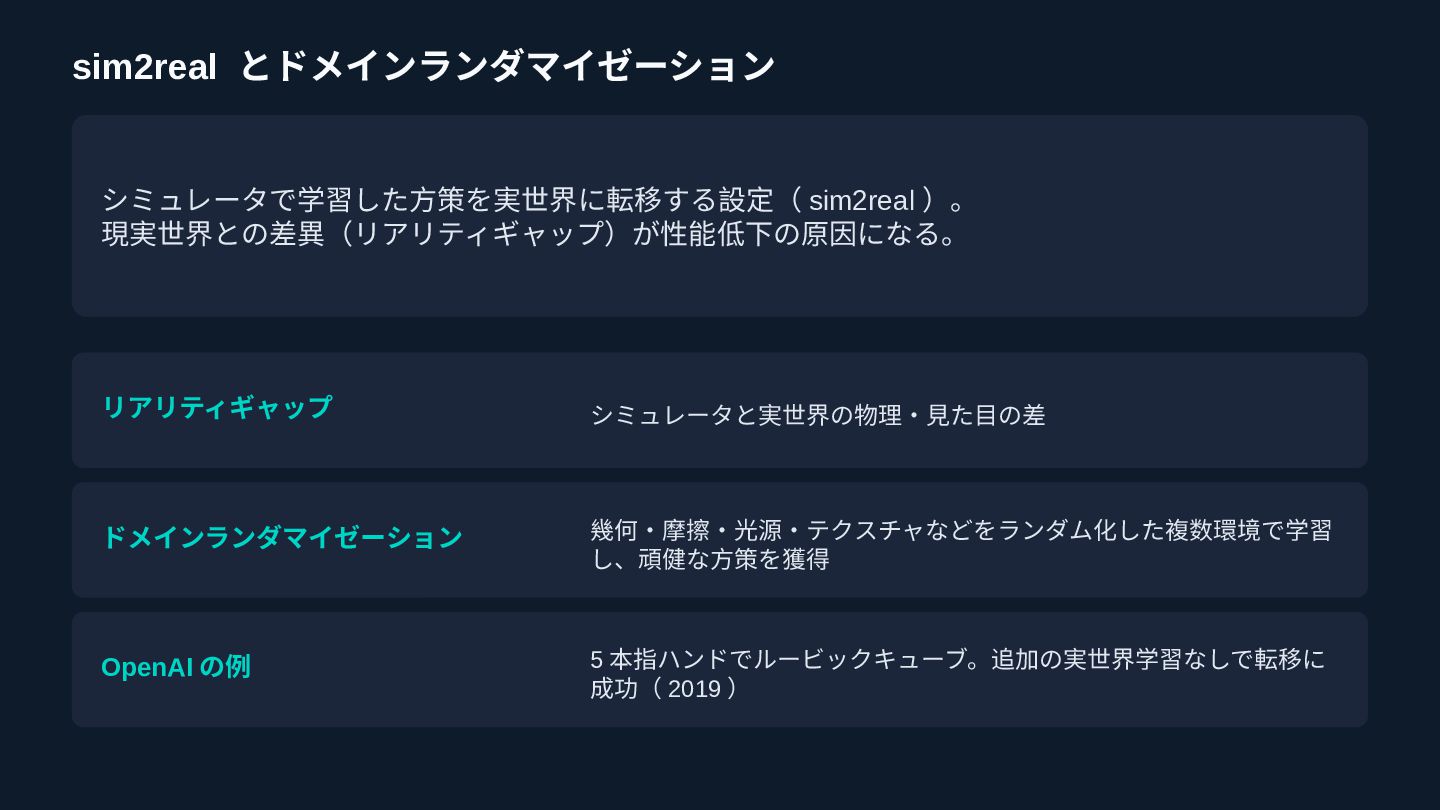
sim2real とドメインランダマイゼーション シミュレータで学習した方策を実世界に転移する設定( sim2real )。 現実世界との差異(リアリティギャップ)が性能低下の原因になる。 リアリティギャップ シミュレータと実世界の物理・見た目の差 ドメインランダマイゼーション 幾何・摩擦・光源・テクスチャなどをランダム化した複数環境で学習
し、頑健な方策を獲得 OpenAI の例 5 本指ハンドでルービックキューブ。追加の実世界学習なしで転移に 成功( 2019 )
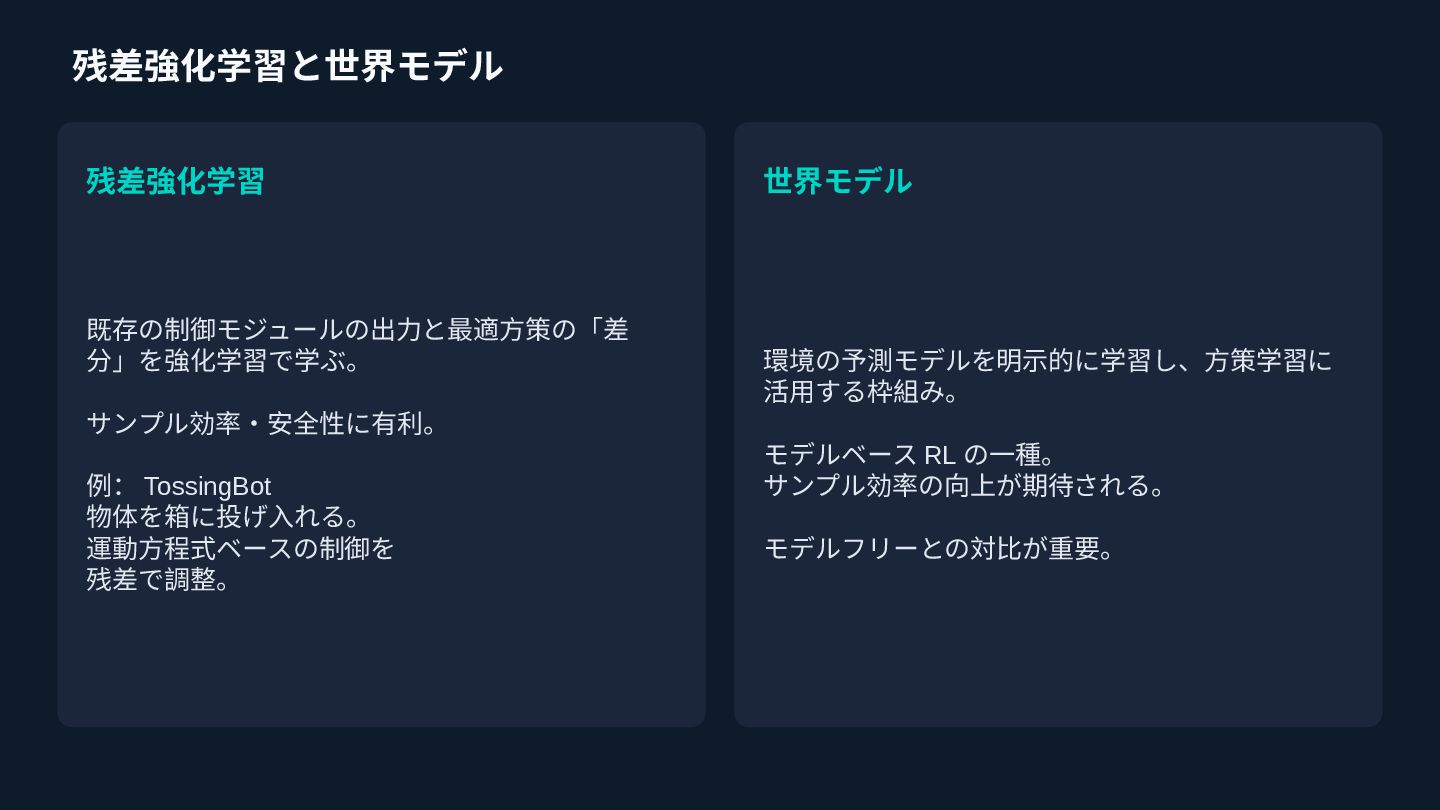
残差強化学習と世界モデル 残差強化学習 既存の制御モジュールの出力と最適方策の「差 分」を強化学習で学ぶ。 サンプル効率・安全性に有利。 例: TossingBot 物体を箱に投げ入れる。 運動方程式ベースの制御を 残差で調整。
世界モデル 環境の予測モデルを明示的に学習し、方策学習に 活用する枠組み。 モデルベース RL の一種。 サンプル効率の向上が期待される。 モデルフリーとの対比が重要。
第 6 章 まとめ 1 画像:分類・検出・セグメンテーション。用途に応じてタスクを選ぶ 2 NLP :翻訳・対話から LLM
・基盤モデルへ。プロンプトとチューニングが重要 3 生成: VAE / GAN / Diffusion 。 Diffusion が現在の画像生成の主流 4 深層 RL :オフライン RL ・ sim2real ・残差 RL ・世界モデルが実用の鍵 5 応用は要素技術の組み合わせで実現される
G 検定 学習スライド 第7章 AI の社会実装に向けて プロジェクト計画から運用・評価までの実践的視点
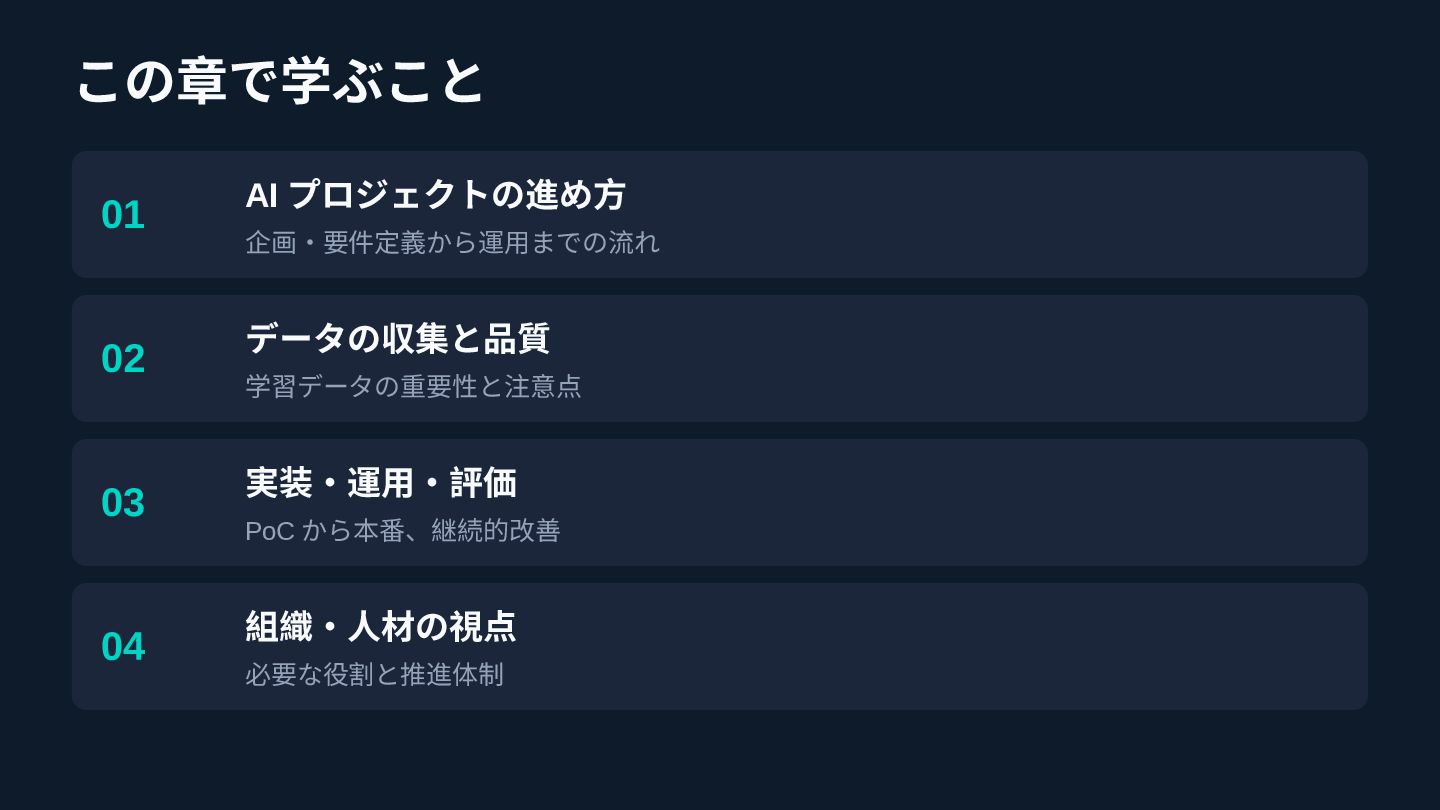
この章で学ぶこと 01 02 03 04 AI プロジェクトの進め方 企画・要件定義から運用までの流れ データの収集と品質 学習データの重要性と注意点
実装・運用・評価 PoC から本番、継続的改善 組織・人材の視点 必要な役割と推進体制
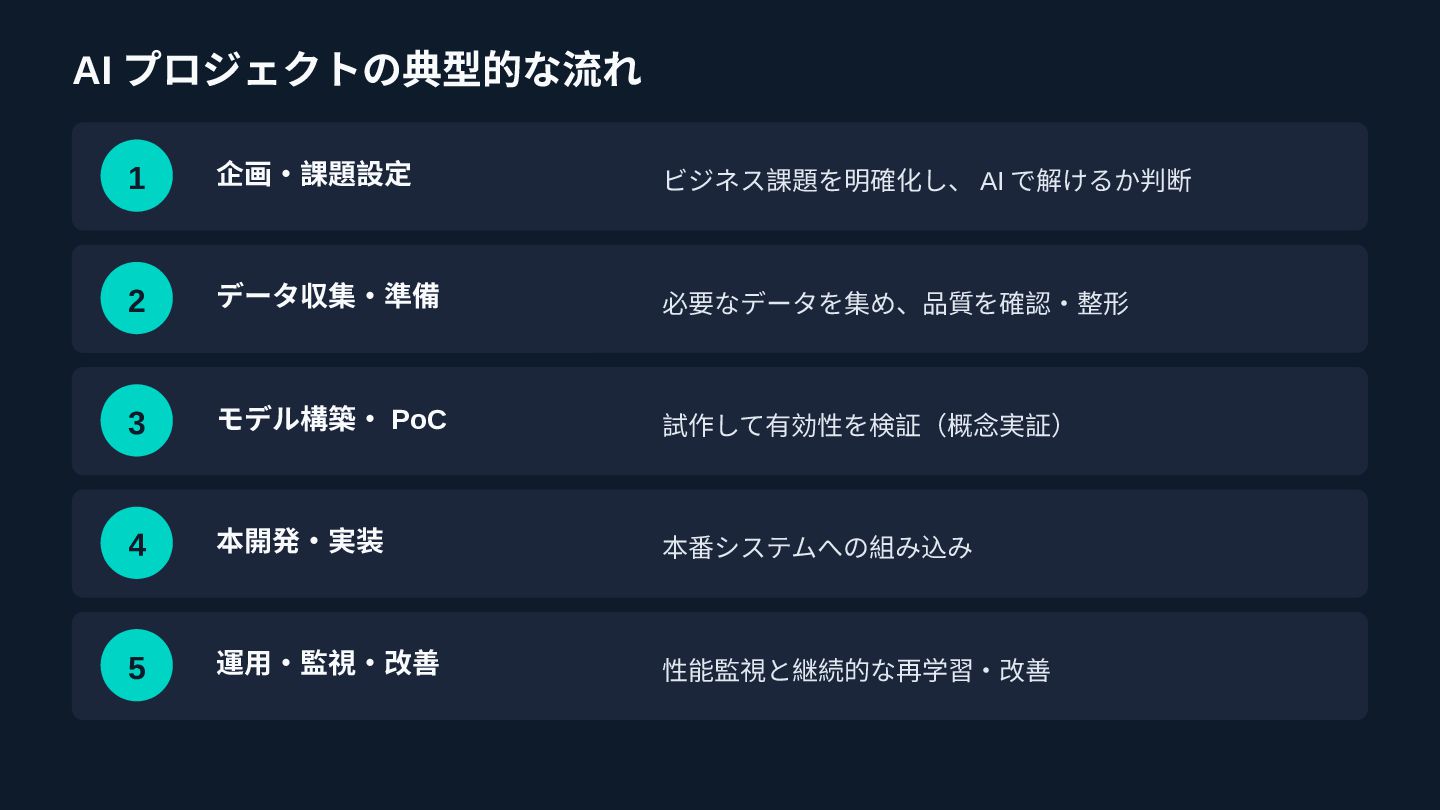
AI プロジェクトの典型的な流れ 1 企画・課題設定 ビジネス課題を明確化し、 AI で解けるか判断 2 データ収集・準備 必要なデータを集め、品質を確認・整形
3 モデル構築・ PoC 試作して有効性を検証(概念実証) 4 本開発・実装 本番システムへの組み込み 5 運用・監視・改善 性能監視と継続的な再学習・改善
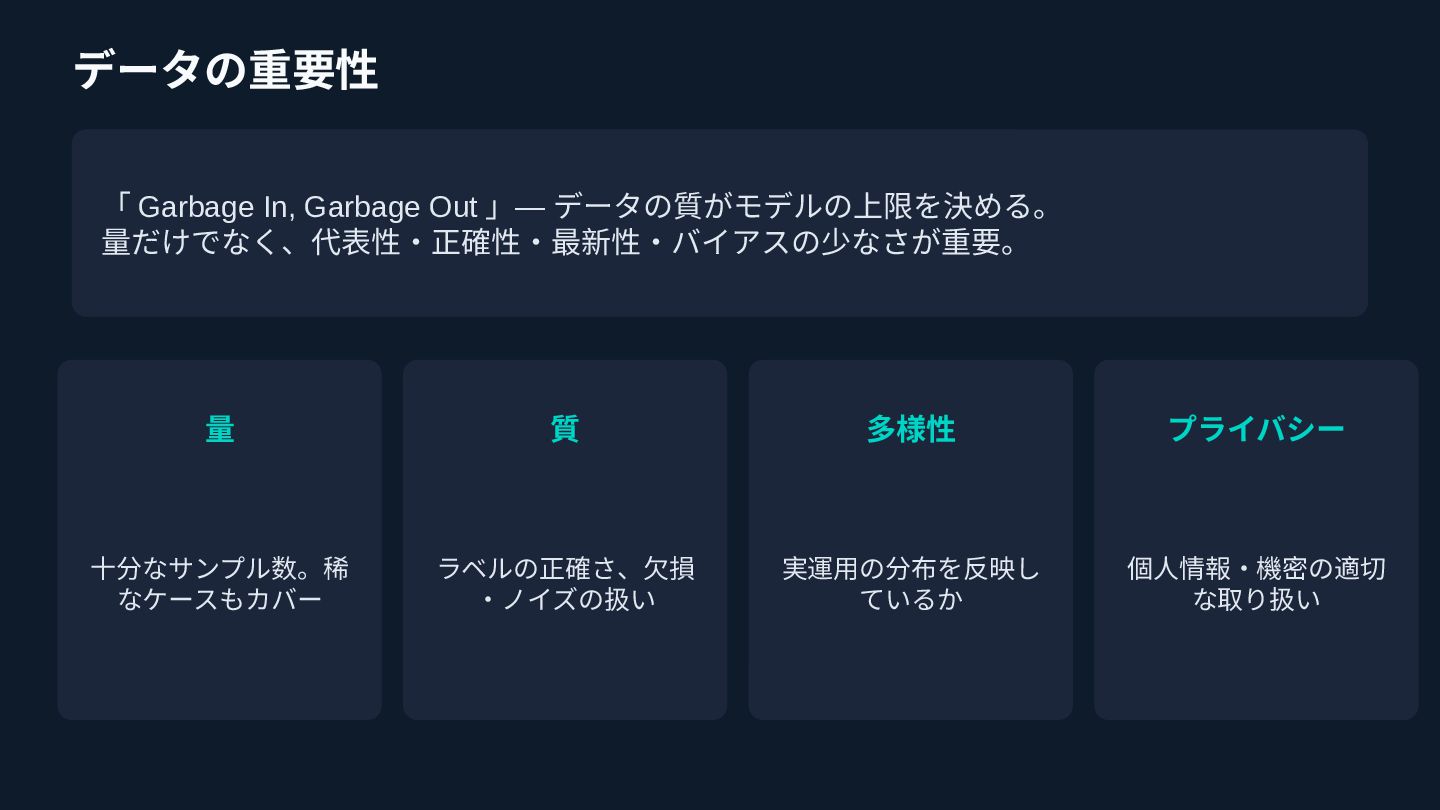
データの重要性 「 Garbage In, Garbage Out 」— データの質がモデルの上限を決める。 量だけでなく、代表性・正確性・最新性・バイアスの少なさが重要。 量
質 多様性 プライバシー 十分なサンプル数。稀 なケースもカバー ラベルの正確さ、欠損 ・ノイズの扱い 実運用の分布を反映し ているか 個人情報・機密の適切 な取り扱い
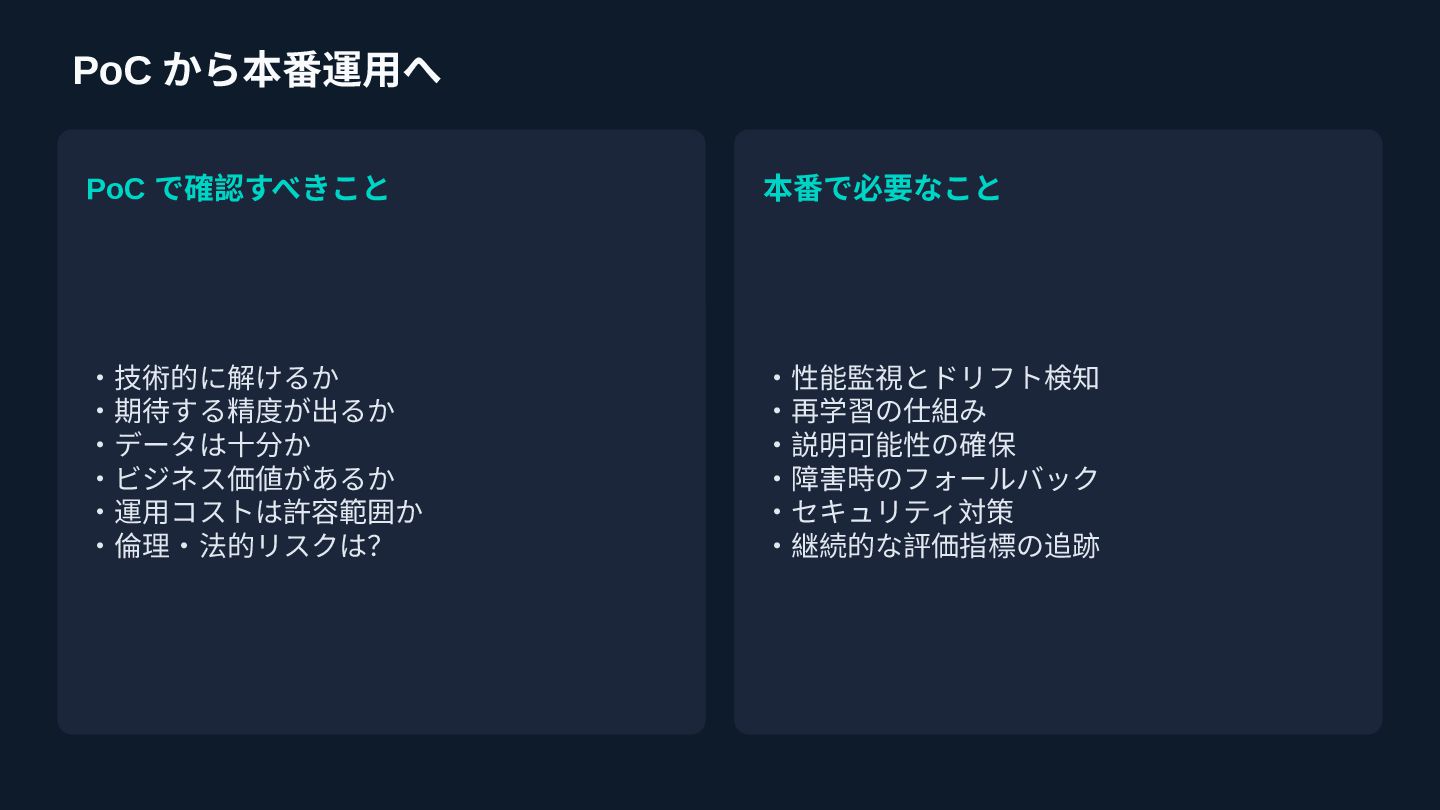
PoC から本番運用へ PoC で確認すべきこと 本番で必要なこと ・技術的に解けるか ・期待する精度が出るか ・データは十分か ・ビジネス価値があるか ・運用コストは許容範囲か
・倫理・法的リスクは? ・性能監視とドリフト検知 ・再学習の仕組み ・説明可能性の確保 ・障害時のフォールバック ・セキュリティ対策 ・継続的な評価指標の追跡
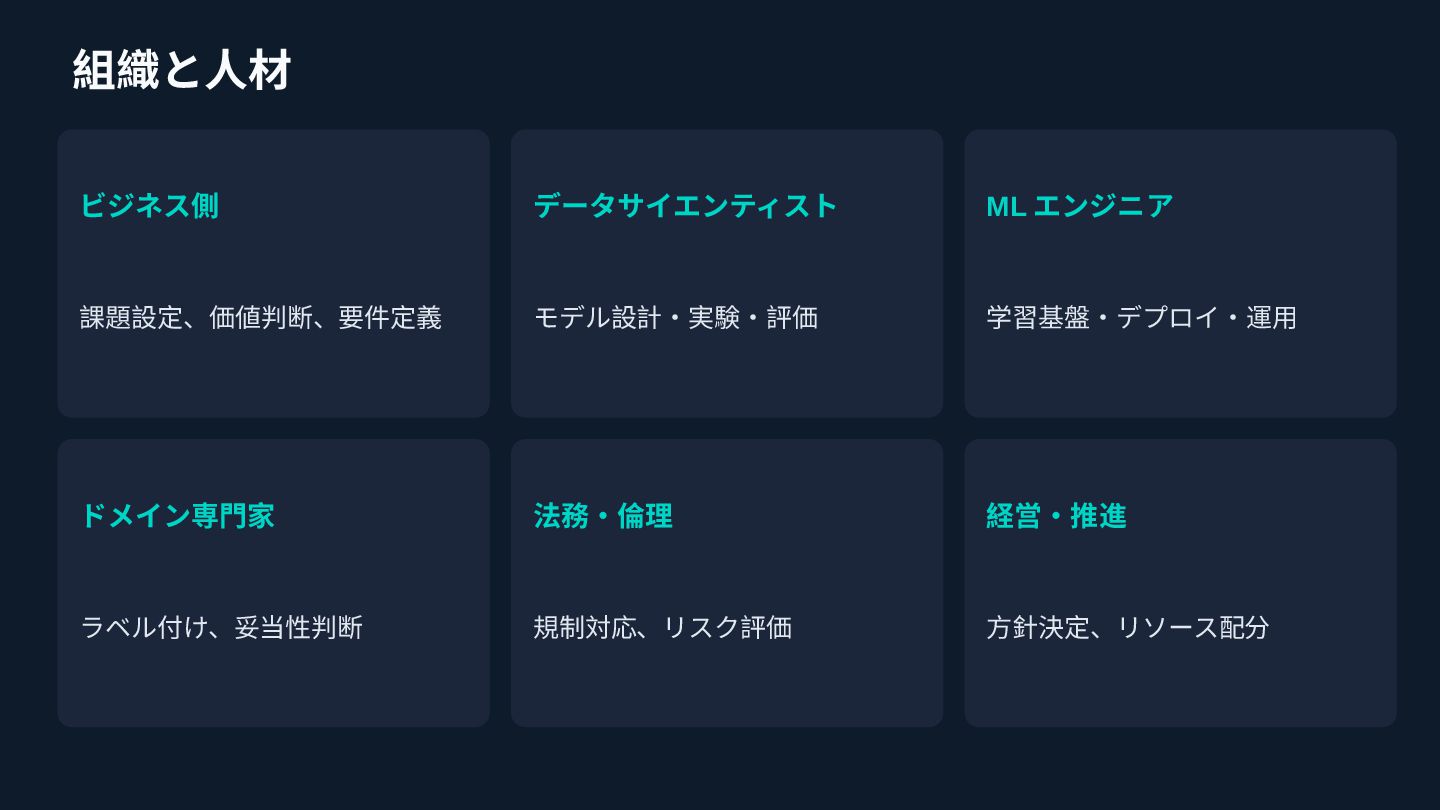
組織と人材 ビジネス側 データサイエンティスト ML エンジニア 課題設定、価値判断、要件定義 モデル設計・実験・評価 学習基盤・デプロイ・運用 ドメイン専門家 法務・倫理
経営・推進 ラベル付け、妥当性判断 規制対応、リスク評価 方針決定、リソース配分
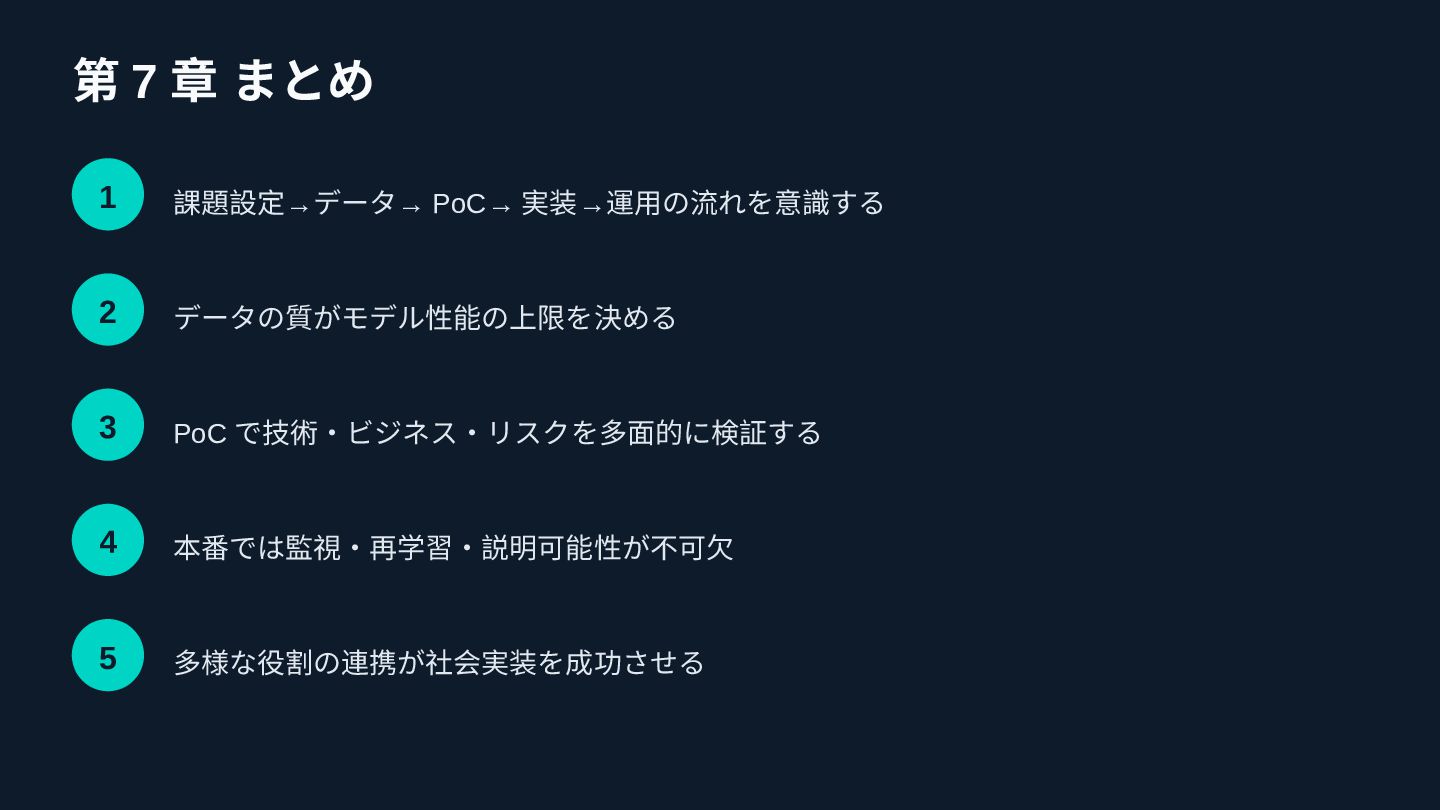
第 7 章 まとめ 1 課題設定→データ→ PoC→ 実装→運用の流れを意識する 2 データの質がモデル性能の上限を決める
3 PoC で技術・ビジネス・リスクを多面的に検証する 4 本番では監視・再学習・説明可能性が不可欠 5 多様な役割の連携が社会実装を成功させる
次の章へ 第8章 AI の法律と倫理 プライバシー・公平性・説明責任など、責任ある AI の視点を学びます
G 検定 学習スライド 第8章 AI の法律と倫理 プライバシー・公平性・説明責任・規制のポイント
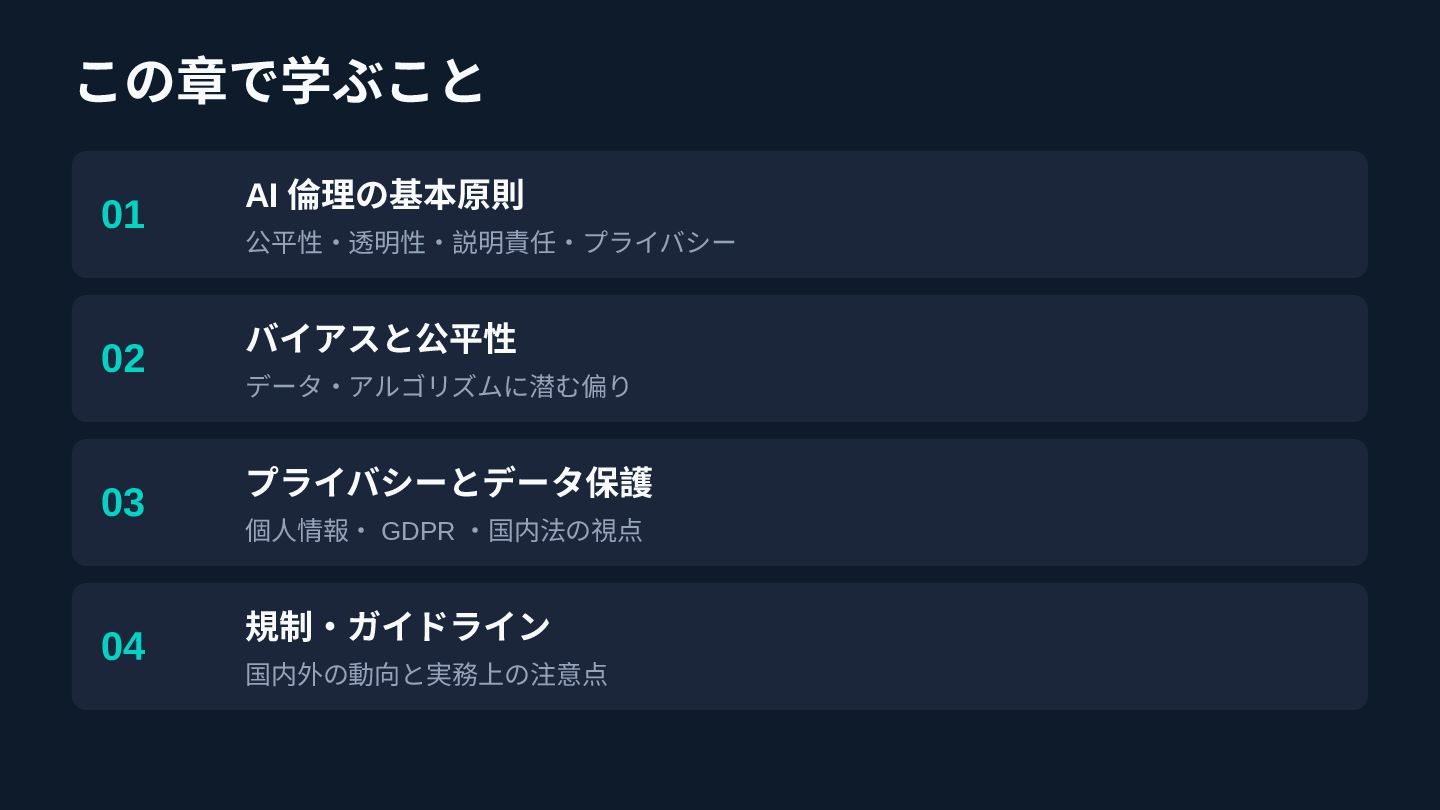
この章で学ぶこと 01 02 03 04 AI 倫理の基本原則 公平性・透明性・説明責任・プライバシー バイアスと公平性 データ・アルゴリズムに潜む偏り
プライバシーとデータ保護 個人情報・ GDPR ・国内法の視点 規制・ガイドライン 国内外の動向と実務上の注意点
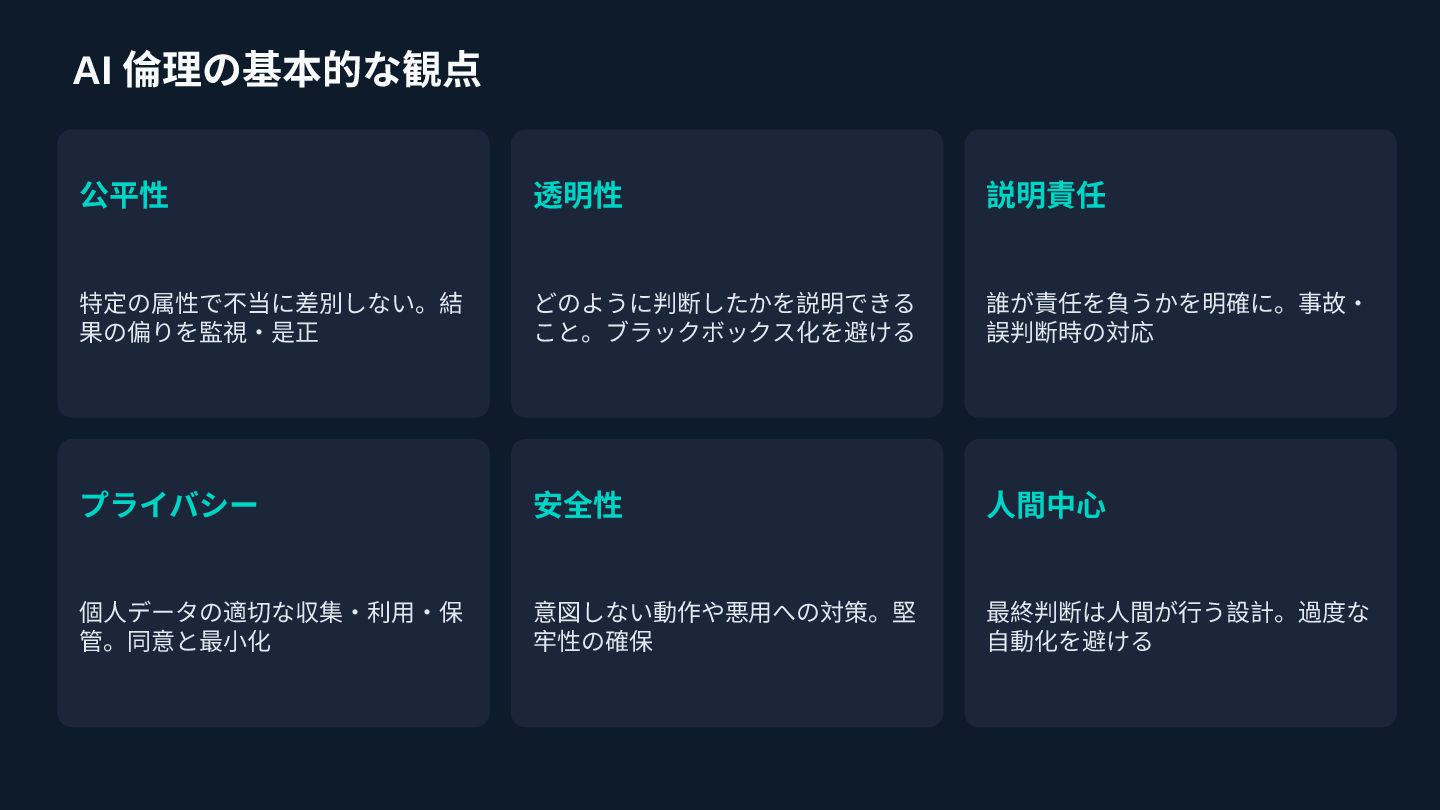
AI 倫理の基本的な観点 公平性 透明性 説明責任 特定の属性で不当に差別しない。結 果の偏りを監視・是正 どのように判断したかを説明できる こと。ブラックボックス化を避ける 誰が責任を負うかを明確に。事故・
誤判断時の対応 プライバシー 安全性 人間中心 個人データの適切な収集・利用・保 管。同意と最小化 意図しない動作や悪用への対策。堅 牢性の確保 最終判断は人間が行う設計。過度な 自動化を避ける
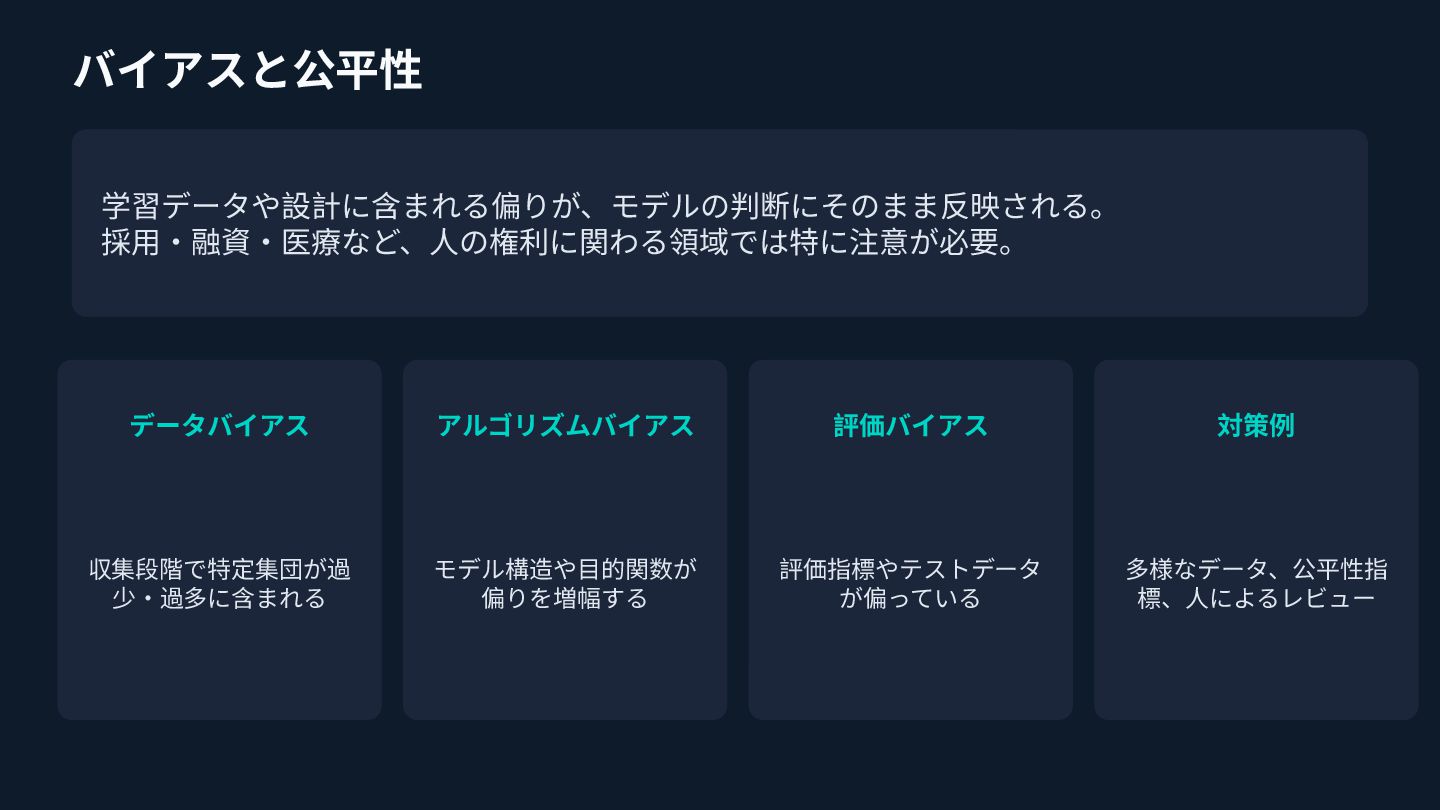
バイアスと公平性 学習データや設計に含まれる偏りが、モデルの判断にそのまま反映される。 採用・融資・医療など、人の権利に関わる領域では特に注意が必要。 データバイアス アルゴリズムバイアス 評価バイアス 対策例 収集段階で特定集団が過 少・過多に含まれる モデル構造や目的関数が
偏りを増幅する 評価指標やテストデータ が偏っている 多様なデータ、公平性指 標、人によるレビュー
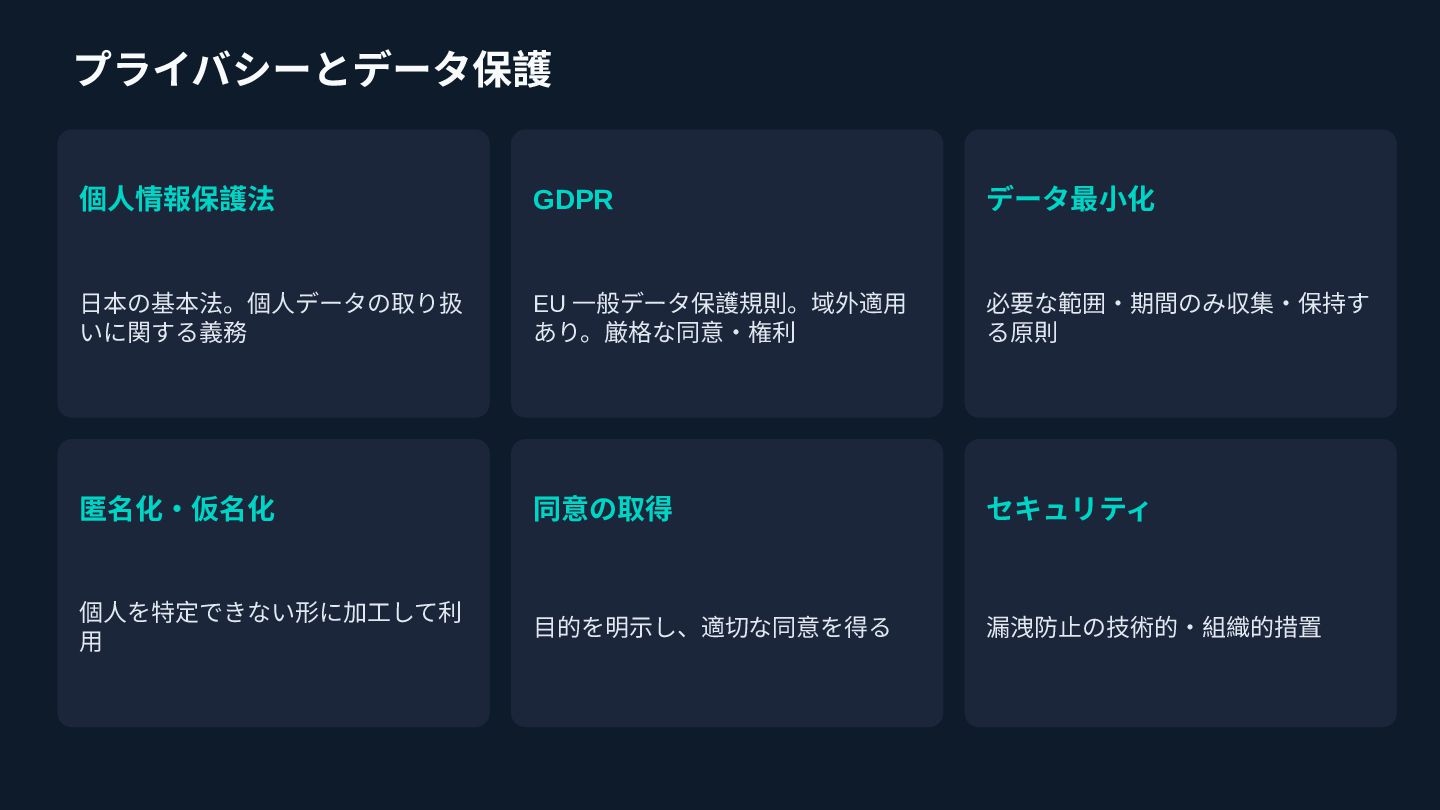
プライバシーとデータ保護 個人情報保護法 GDPR データ最小化 日本の基本法。個人データの取り扱 いに関する義務 EU 一般データ保護規則。域外適用 あり。厳格な同意・権利 必要な範囲・期間のみ収集・保持す
る原則 匿名化・仮名化 同意の取得 セキュリティ 個人を特定できない形に加工して利 用 目的を明示し、適切な同意を得る 漏洩防止の技術的・組織的措置
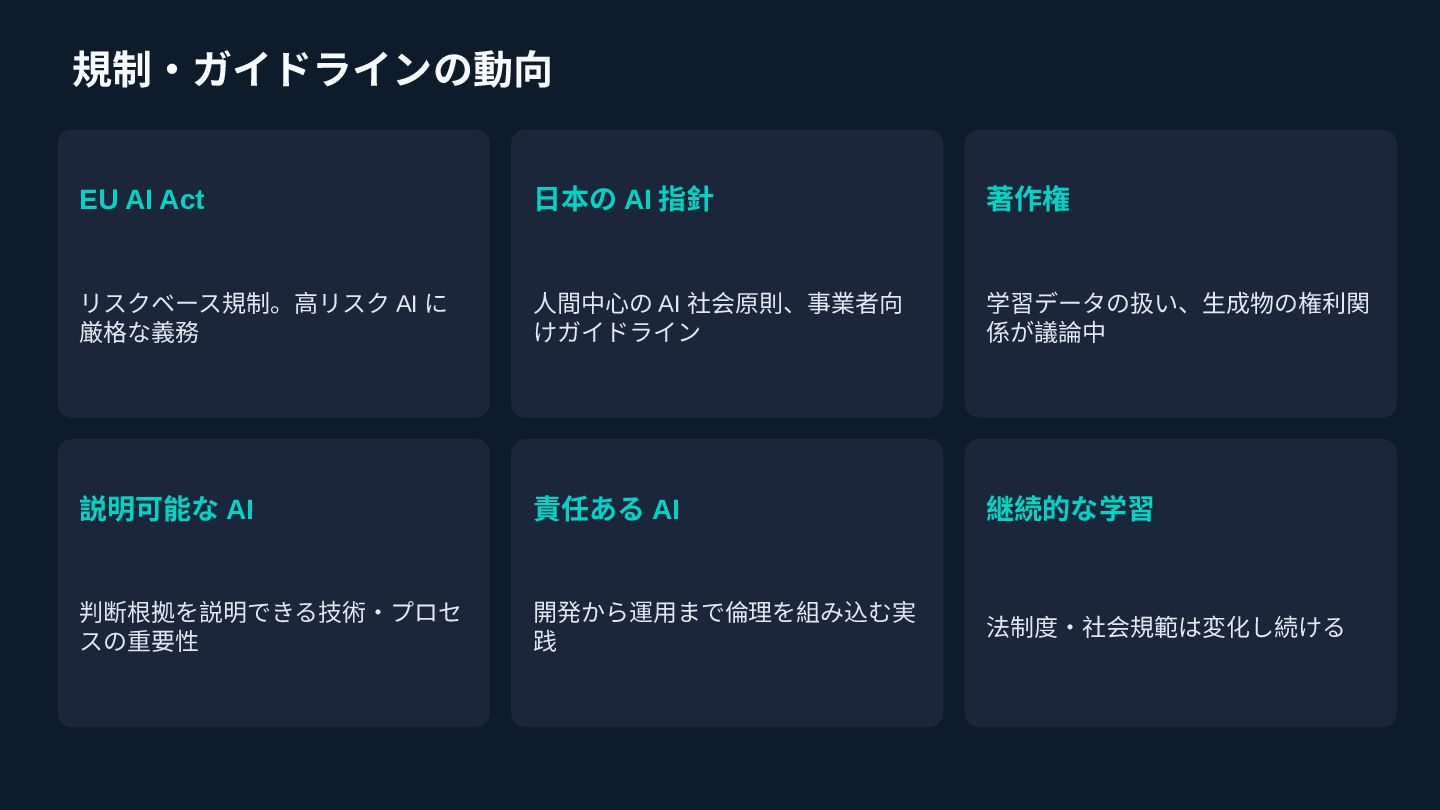
規制・ガイドラインの動向 EU AI Act 日本の AI 指針 著作権 リスクベース規制。高リスク AI
に 厳格な義務 人間中心の AI 社会原則、事業者向 けガイドライン 学習データの扱い、生成物の権利関 係が議論中 説明可能な AI 責任ある AI 継続的な学習 判断根拠を説明できる技術・プロセ スの重要性 開発から運用まで倫理を組み込む実 践 法制度・社会規範は変化し続ける
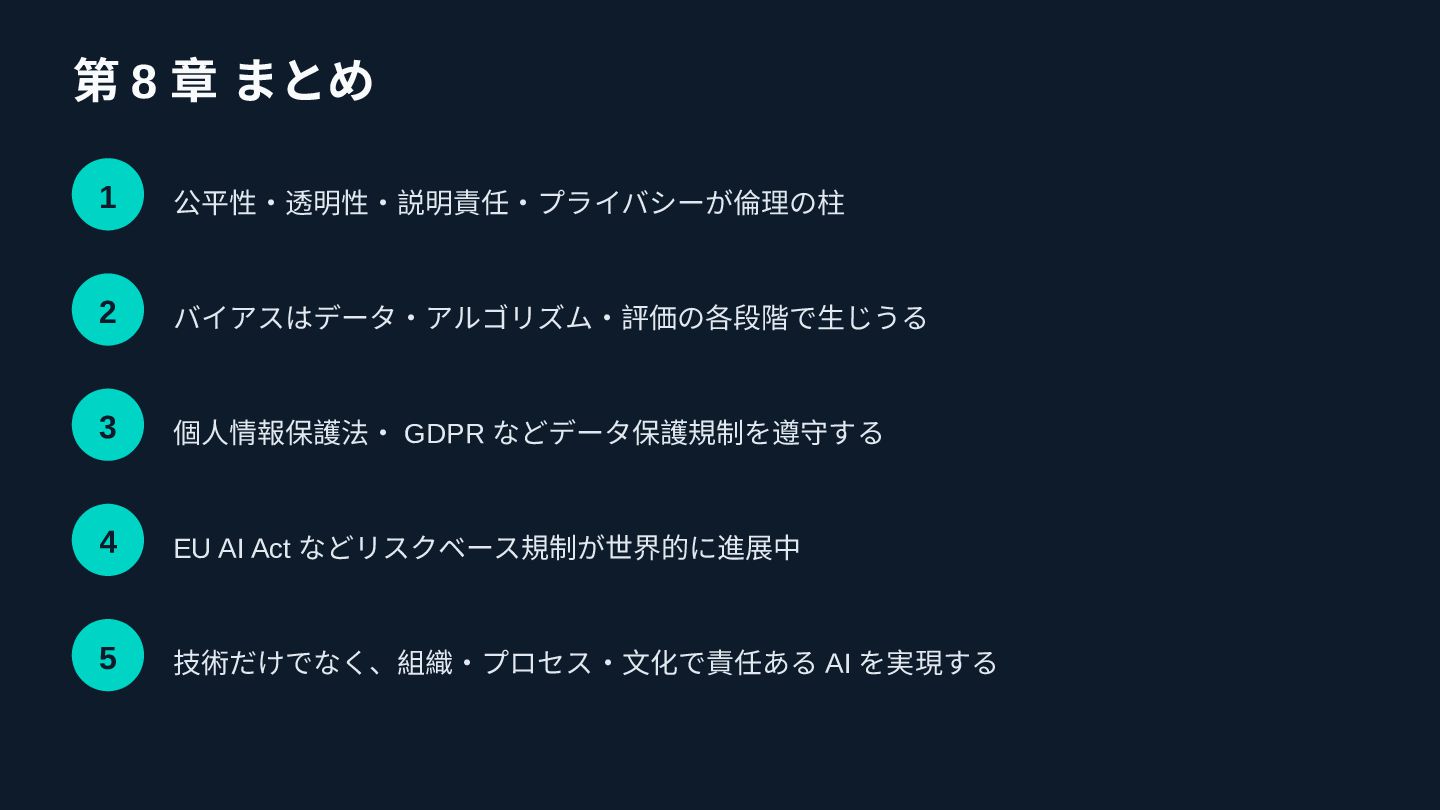
第 8 章 まとめ 1 公平性・透明性・説明責任・プライバシーが倫理の柱 2 バイアスはデータ・アルゴリズム・評価の各段階で生じうる 3 個人情報保護法・
GDPR などデータ保護規制を遵守する 4 EU AI Act などリスクベース規制が世界的に進展中 5 技術だけでなく、組織・プロセス・文化で責任ある AI を実現する
全章完了 G 検定 学習スライド 第 1 章〜第 8 章 引き続き練習問題や過去問で知識を定着させていきましょう


 sugarenia
 cromwellryan
 helenjbeal
 mfonobong
 matthewcrist
 lfama
 pedronauck
 irinanazarova
 tammyeverts
 lindahogenes
 garrettdimon
 baasie