Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Sprint16論文紹介

Avatar for kazukim10 kazukim10
December 18, 2020

 Sprint16論文紹介

Avatar for kazukim10

kazukim10

December 18, 2020

More Decks by kazukim10

Other Decks in Programming

Transcript

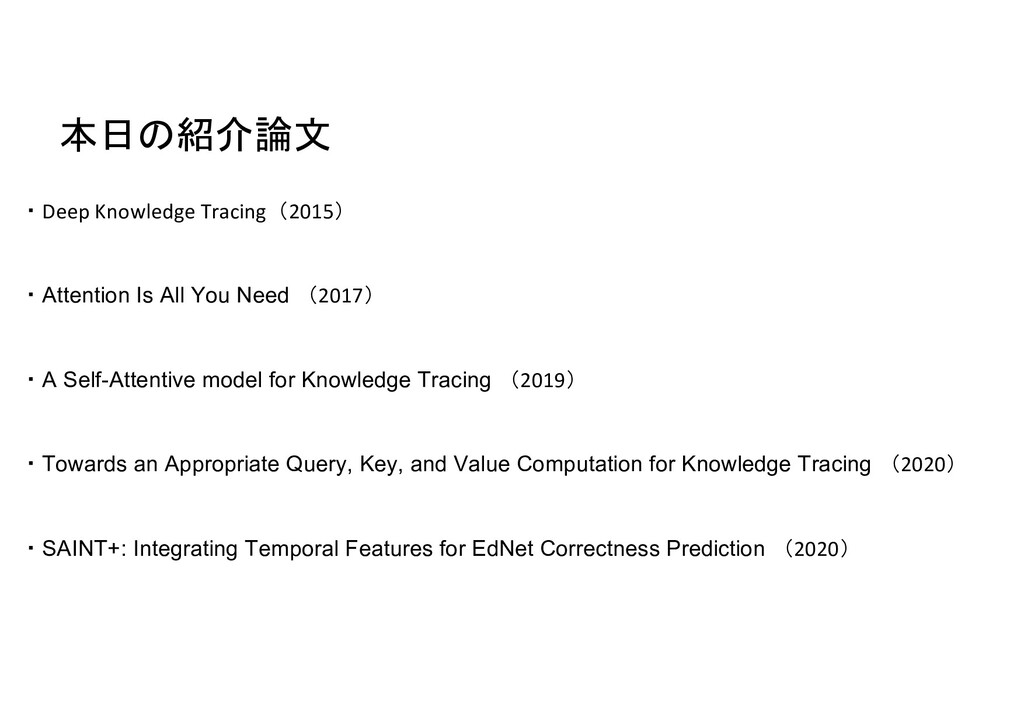
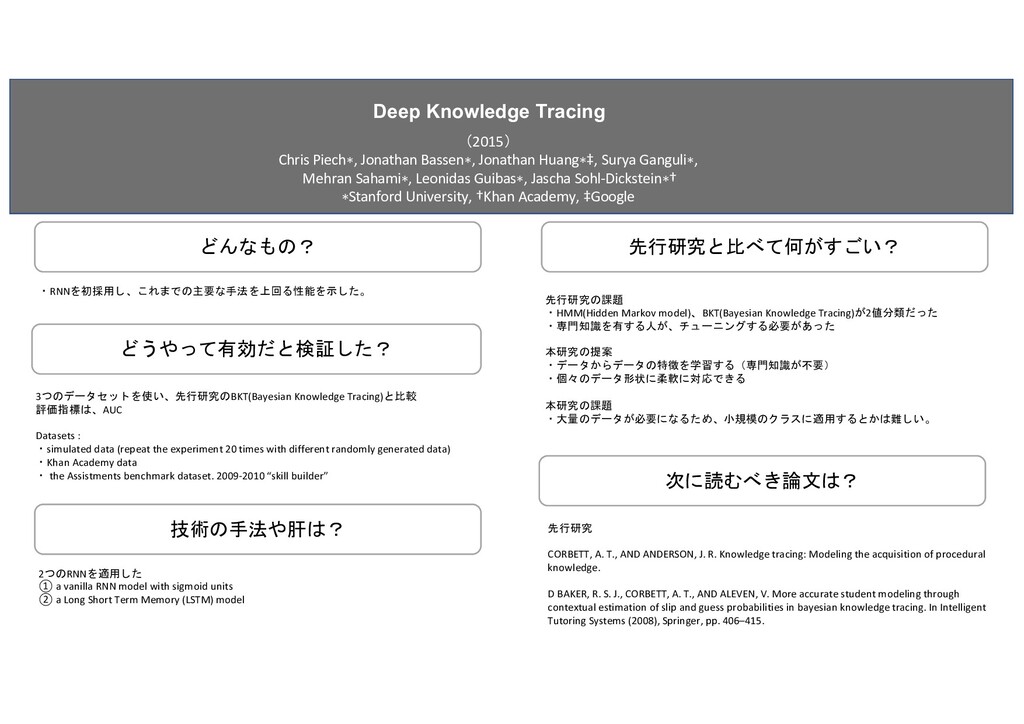
  1. 本日の紹介論文 ・Deep Knowledge Tracing(2015) ・Attention Is All You Need (2017)

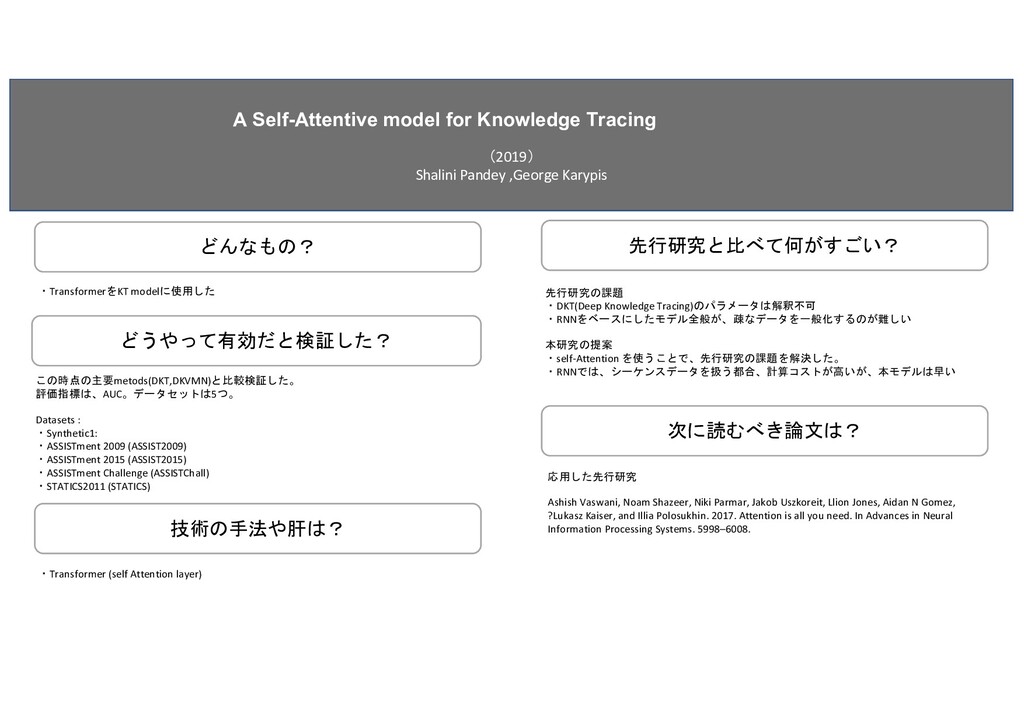
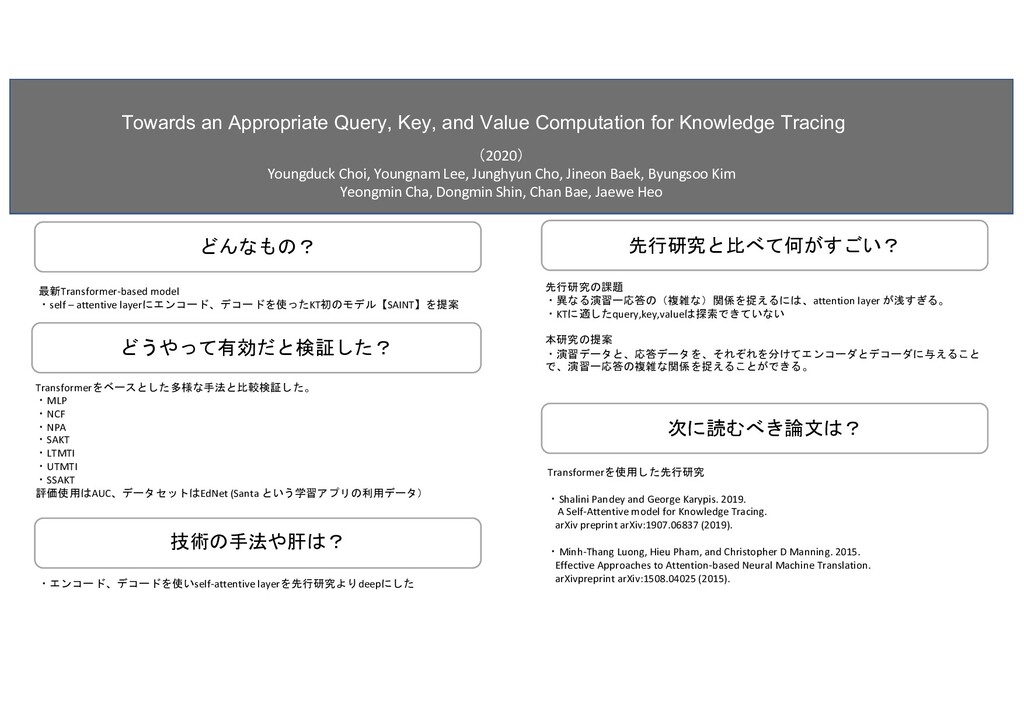
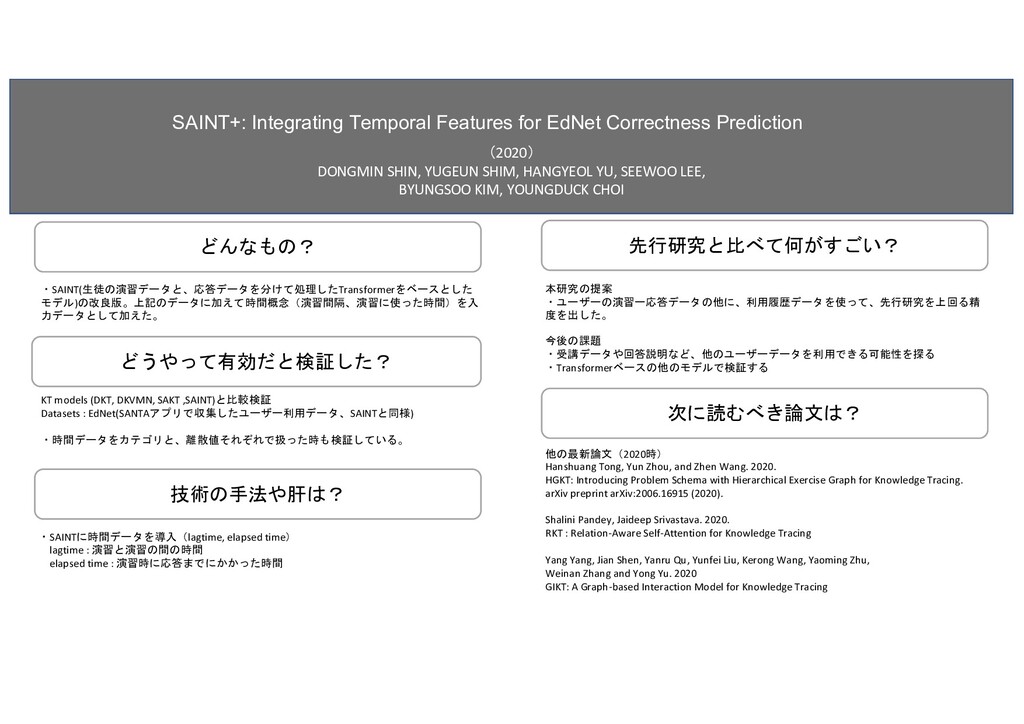
    ・A Self-Attentive model for Knowledge Tracing (2019) ・Towards an Appropriate Query, Key, and Value Computation for Knowledge Tracing (2020) ・SAINT+: Integrating Temporal Features for EdNet Correctness Prediction (2020)
  2. どんなもの? 先行研究と比べて何がすごい? 技術の手法や肝は? どうやって有効だと検証した? 次に読むべき論文は? 3つのデータセットを使い、先行研究のBKT(Bayesian Knowledge Tracing)と比較 評価指標は、AUC Datasets

    : ・simulated data (repeat the experiment 20 times with different randomly generated data) ・Khan Academy data ・ the Assistments benchmark dataset. 2009-2010 “skill builder” 2つのRNNを適用した ① a vanilla RNN model with sigmoid units ② a Long Short Term Memory (LSTM) model 先行研究の課題 ・HMM(Hidden Markov model)、BKT(Bayesian Knowledge Tracing)が2値分類だった ・専門知識を有する人が、チューニングする必要があった 本研究の提案 ・データからデータの特徴を学習する(専門知識が不要) ・個々のデータ形状に柔軟に対応できる 本研究の課題 ・大量のデータが必要になるため、小規模のクラスに適用するとかは難しい。 ・RNNを初採用し、これまでの主要な手法を上回る性能を示した。 Deep Knowledge Tracing (2015) Chris Piech∗, Jonathan Bassen∗, Jonathan Huang∗‡, Surya Ganguli∗, Mehran Sahami∗, Leonidas Guibas∗, Jascha Sohl-Dickstein∗† ∗Stanford University, †Khan Academy, ‡Google 先行研究 CORBETT, A. T., AND ANDERSON, J. R. Knowledge tracing: Modeling the acquisition of procedural knowledge. D BAKER, R. S. J., CORBETT, A. T., AND ALEVEN, V. More accurate student modeling through contextual estimation of slip and guess probabilities in bayesian knowledge tracing. In Intelligent Tutoring Systems (2008), Springer, pp. 406–415.
  3. どんなもの? 先行研究と比べて何がすごい? 技術の手法や肝は? どうやって有効だと検証した? 次に読むべき論文は? この時点の主要metods(DKT,DKVMN)と比較検証した。 評価指標は、AUC。データセットは5つ。 Datasets : ・Synthetic1:

    ・ASSISTment 2009 (ASSIST2009) ・ASSISTment 2015 (ASSIST2015) ・ASSISTment Challenge (ASSISTChall) ・STATICS2011 (STATICS) ・Transformer (self Attention layer) ・TransformerをKT modelに使用した A Self-Attentive model for Knowledge Tracing (2019) Shalini Pandey ,George Karypis 先行研究の課題 ・DKT(Deep Knowledge Tracing)のパラメータは解釈不可 ・RNNをベースにしたモデル全般が、疎なデータを一般化するのが難しい 本研究の提案 ・self-Attention を使うことで、先行研究の課題を解決した。 ・RNNでは、シーケンスデータを扱う都合、計算コストが高いが、本モデルは早い 応用した先行研究 Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, ?Lukasz Kaiser, and Illia Polosukhin. 2017. Attention is all you need. In Advances in Neural Information Processing Systems. 5998–6008.
  4. どんなもの? 先行研究と比べて何がすごい? 技術の手法や肝は? どうやって有効だと検証した? 次に読むべき論文は? Transformerをベースとした多様な手法と比較検証した。 ・MLP ・NCF ・NPA ・SAKT

    ・LTMTI ・UTMTI ・SSAKT 評価使用はAUC、データセットはEdNet (Santa という学習アプリの利用データ) ・エンコード、デコードを使いself-attentive layerを先行研究よりdeepにした 先行研究の課題 ・異なる演習ー応答の(複雑な)関係を捉えるには、attention layer が浅すぎる。 ・KTに適したquery,key,valueは探索できていない 本研究の提案 ・演習データと、応答データを、それぞれを分けてエンコーダとデコーダに与えること で、演習ー応答の複雑な関係を捉えることができる。 最新Transformer-based model ・self – attentive layerにエンコード、デコードを使ったKT初のモデル【SAINT】を提案 Towards an Appropriate Query, Key, and Value Computation for Knowledge Tracing (2020) Youngduck Choi, Youngnam Lee, Junghyun Cho, Jineon Baek, Byungsoo Kim Yeongmin Cha, Dongmin Shin, Chan Bae, Jaewe Heo Transformerを使用した先行研究 ・Shalini Pandey and George Karypis. 2019. A Self-Attentive model for Knowledge Tracing. arXiv preprint arXiv:1907.06837 (2019). ・Minh-Thang Luong, Hieu Pham, and Christopher D Manning. 2015. Effective Approaches to Attention-based Neural Machine Translation. arXivpreprint arXiv:1508.04025 (2015).
  5. どんなもの? 先行研究と比べて何がすごい? 技術の手法や肝は? どうやって有効だと検証した? 次に読むべき論文は? KT models (DKT, DKVMN, SAKT

    ,SAINT)と比較検証 Datasets : EdNet(SANTAアプリで収集したユーザー利用データ、SAINTと同様) ・時間データをカテゴリと、離散値それぞれで扱った時も検証している。 ・SAINTに時間データを導入(lagtime, elapsed time) lagtime : 演習と演習の間の時間 elapsed time : 演習時に応答までにかかった時間 本研究の提案 ・ユーザーの演習ー応答データの他に、利用履歴データを使って、先行研究を上回る精 度を出した。 今後の課題 ・受講データや回答説明など、他のユーザーデータを利用できる可能性を探る ・Transformerベースの他のモデルで検証する ・SAINT(生徒の演習データと、応答データを分けて処理したTransformerをベースとした モデル)の改良版。上記のデータに加えて時間概念(演習間隔、演習に使った時間)を入 力データとして加えた。 SAINT+: Integrating Temporal Features for EdNet Correctness Prediction (2020) DONGMIN SHIN, YUGEUN SHIM, HANGYEOL YU, SEEWOO LEE, BYUNGSOO KIM, YOUNGDUCK CHOI 他の最新論文(2020時) Hanshuang Tong, Yun Zhou, and Zhen Wang. 2020. HGKT: Introducing Problem Schema with Hierarchical Exercise Graph for Knowledge Tracing. arXiv preprint arXiv:2006.16915 (2020). Shalini Pandey, Jaideep Srivastava. 2020. RKT : Relation-Aware Self-Attention for Knowledge Tracing Yang Yang, Jian Shen, Yanru Qu, Yunfei Liu, Kerong Wang, Yaoming Zhu, Weinan Zhang and Yong Yu. 2020 GIKT: A Graph-based Interaction Model for Knowledge Tracing
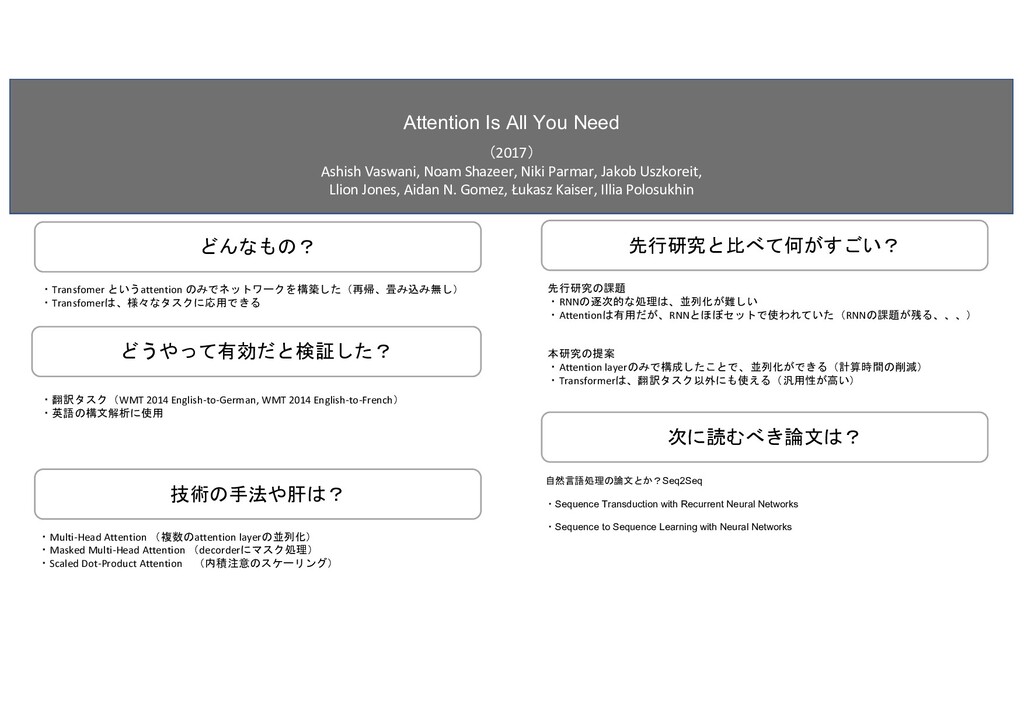
  6. どんなもの? 先行研究と比べて何がすごい? 技術の手法や肝は? どうやって有効だと検証した? 次に読むべき論文は? ・翻訳タスク(WMT 2014 English-to-German, WMT 2014

    English-to-French) ・英語の構文解析に使用 ・Multi-Head Attention (複数のattention layerの並列化) ・Masked Multi-Head Attention (decorderにマスク処理) ・Scaled Dot-Product Attention (内積注意のスケーリング) ・Transfomer というattention のみでネットワークを構築した(再帰、畳み込み無し) ・Transfomerは、様々なタスクに応用できる Attention Is All You Need (2017) Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, Illia Polosukhin 自然言語処理の論文とか?Seq2Seq ・Sequence Transduction with Recurrent Neural Networks ・Sequence to Sequence Learning with Neural Networks 先行研究の課題 ・RNNの逐次的な処理は、並列化が難しい ・Attentionは有用だが、RNNとほぼセットで使われていた(RNNの課題が残る、、、) 本研究の提案 ・Attention layerのみで構成したことで、並列化ができる(計算時間の削減) ・Transformerは、翻訳タスク以外にも使える(汎用性が高い)