Share
Embed
[JSAI23] A Transfer Learning Method for the Multimodal Language Understanding Based on Dual ProtoNCE
Semantic Machine Intelligence Lab., Keio Univ. PRO
June 05, 2023
Transcript
36 slides
-
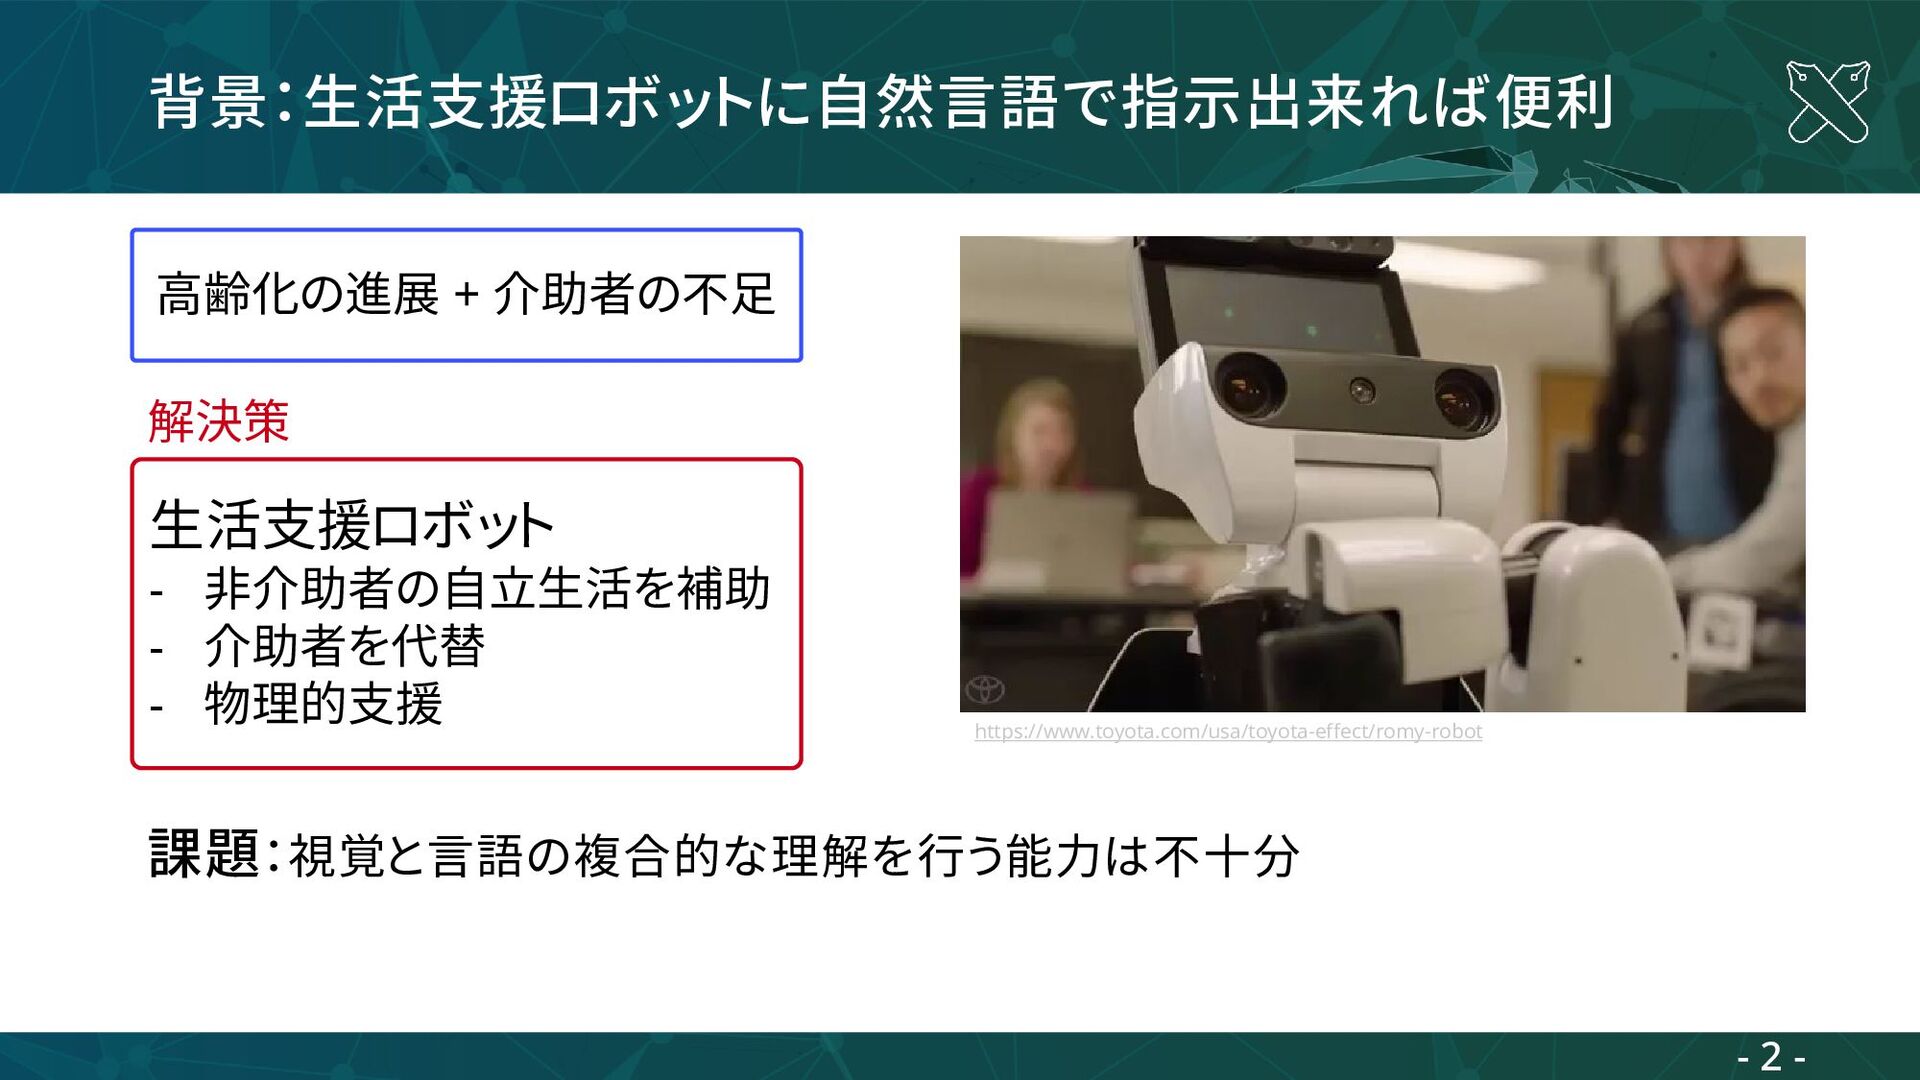
背景:生活支援ロボットに自然言語で指示出来れば便利 https://www.toyota.com/usa/toyota-effect/romy-robot 生活支援ロボット - 非介助者の自立生活を補助 - 介助者を代替 - 物理的支援 高齢化の進展
+ 介助者の不足 解決策 課題:視覚と言語の複合的な理解を行う能力は不十分 - 2 - -
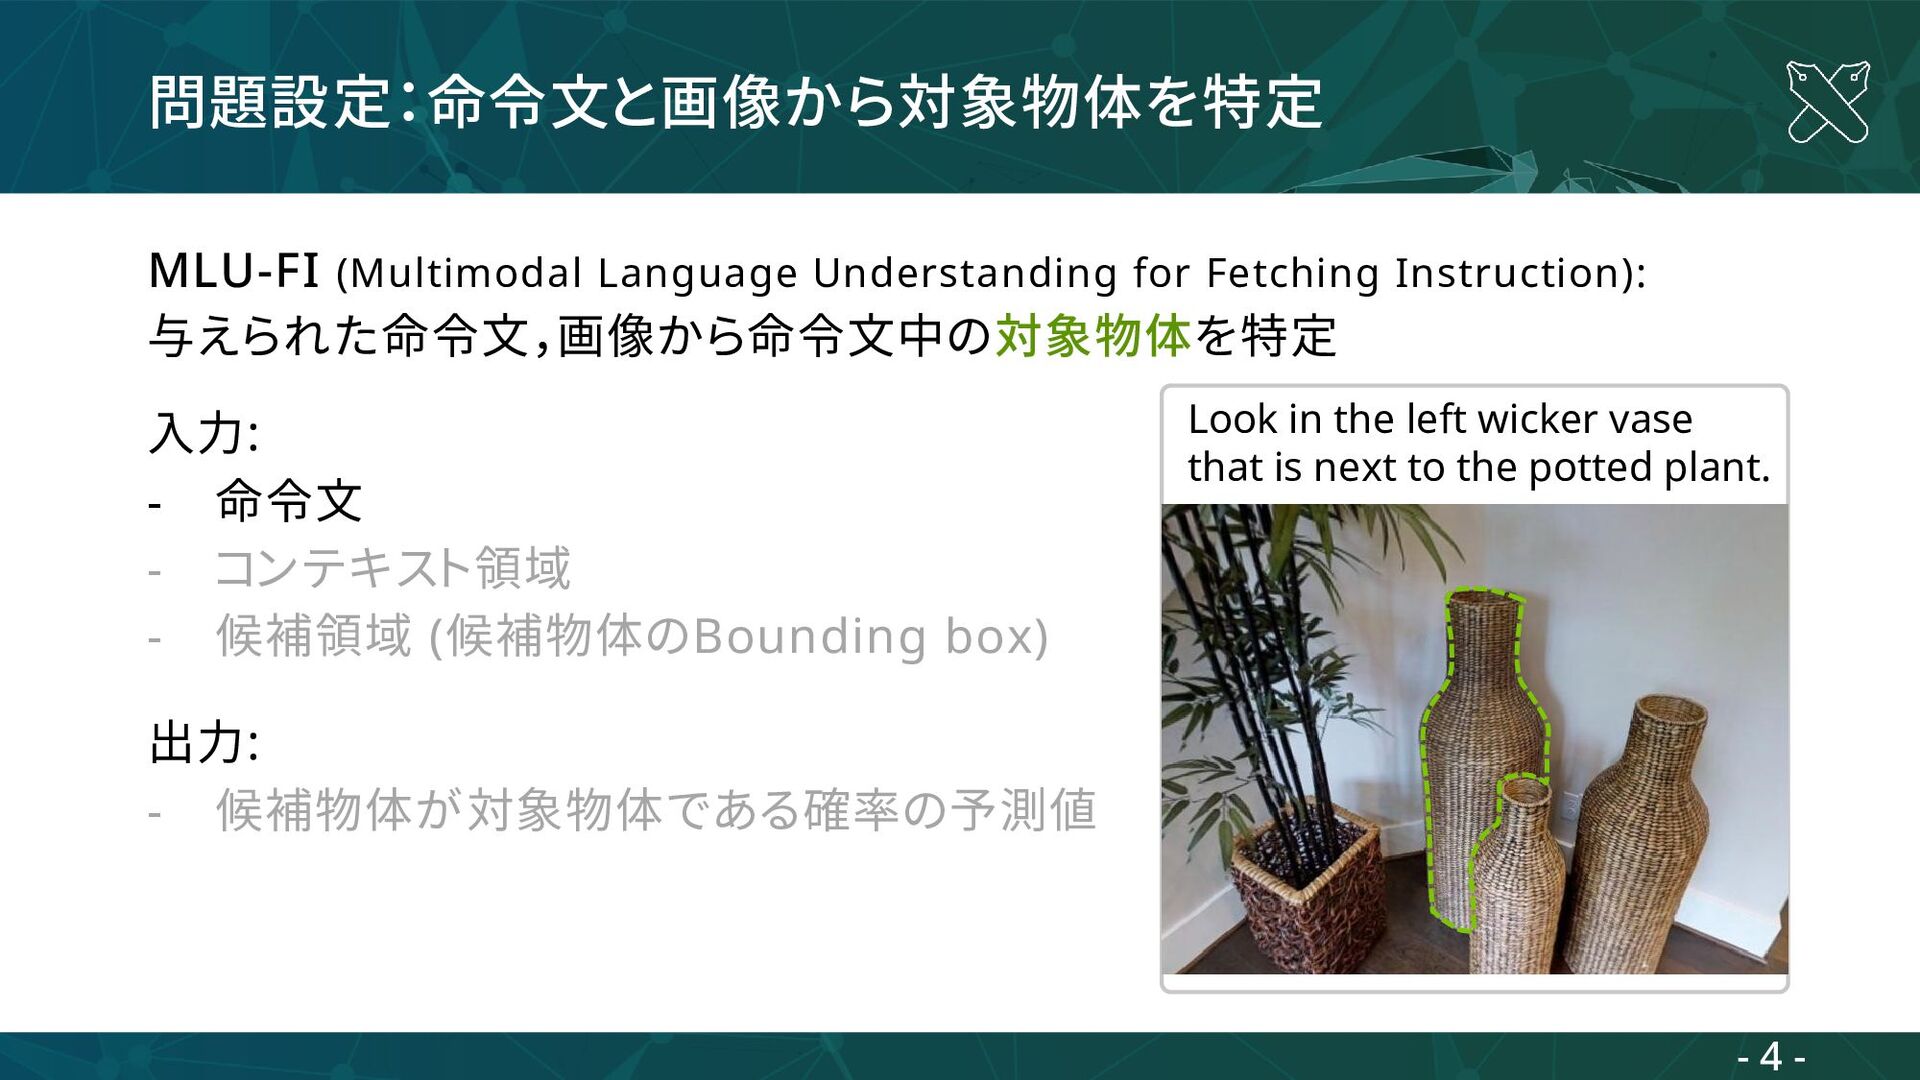
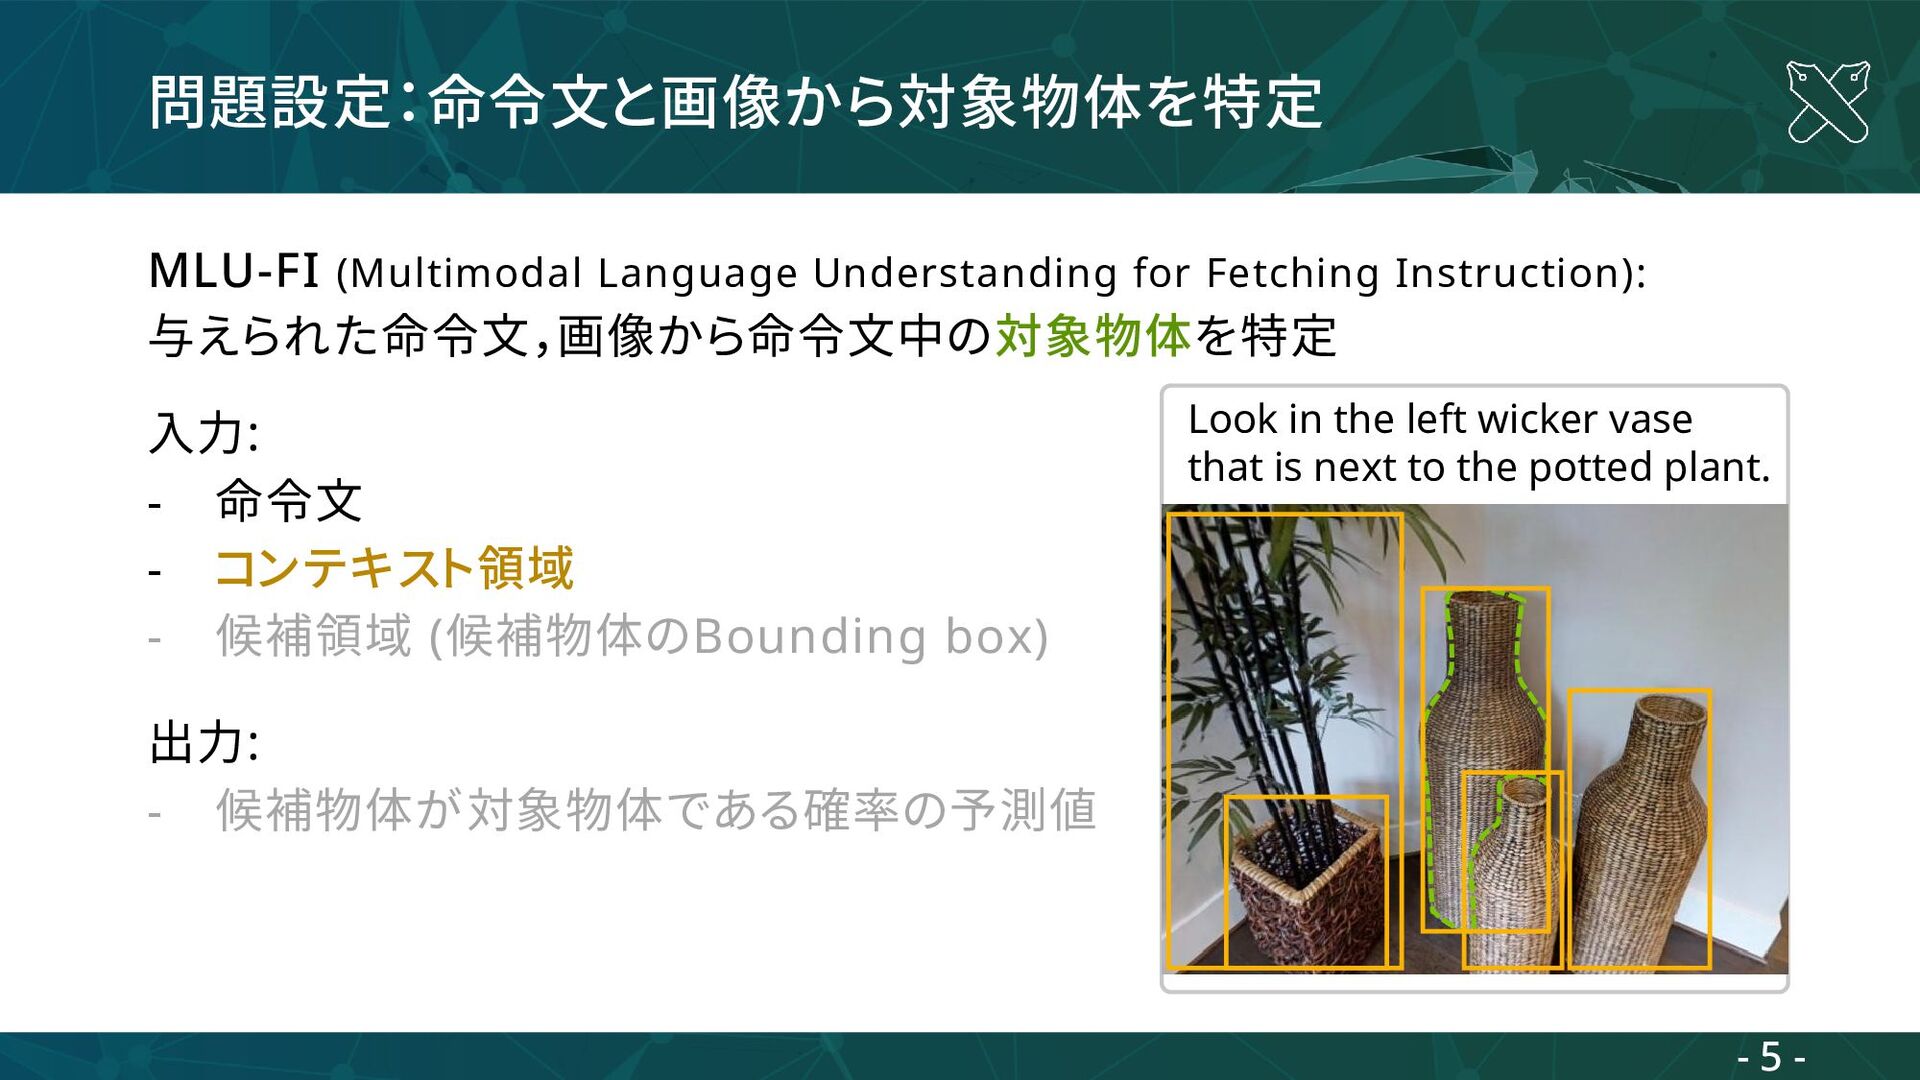
問題設定:命令文と画像から対象物体を特定 MLU-FI (Multimodal Language Understanding for Fetching Instruction): 与えられた命令文,画像から命令文中の対象物体を特定 入力:
- 命令文 - コンテキスト領域 - 候補領域 (候補物体のBounding box) 出力: - 候補物体が対象物体である確率の予測値 Look in the left wicker vase that is next to the potted plant. - 4 - -
問題設定:命令文と画像から対象物体を特定 MLU-FI (Multimodal Language Understanding for Fetching Instruction): 与えられた命令文,画像から命令文中の対象物体を特定 入力:
- 命令文 - コンテキスト領域 - 候補領域 (候補物体のBounding box) 出力: - 候補物体が対象物体である確率の予測値 Look in the left wicker vase that is next to the potted plant. - 5 - -
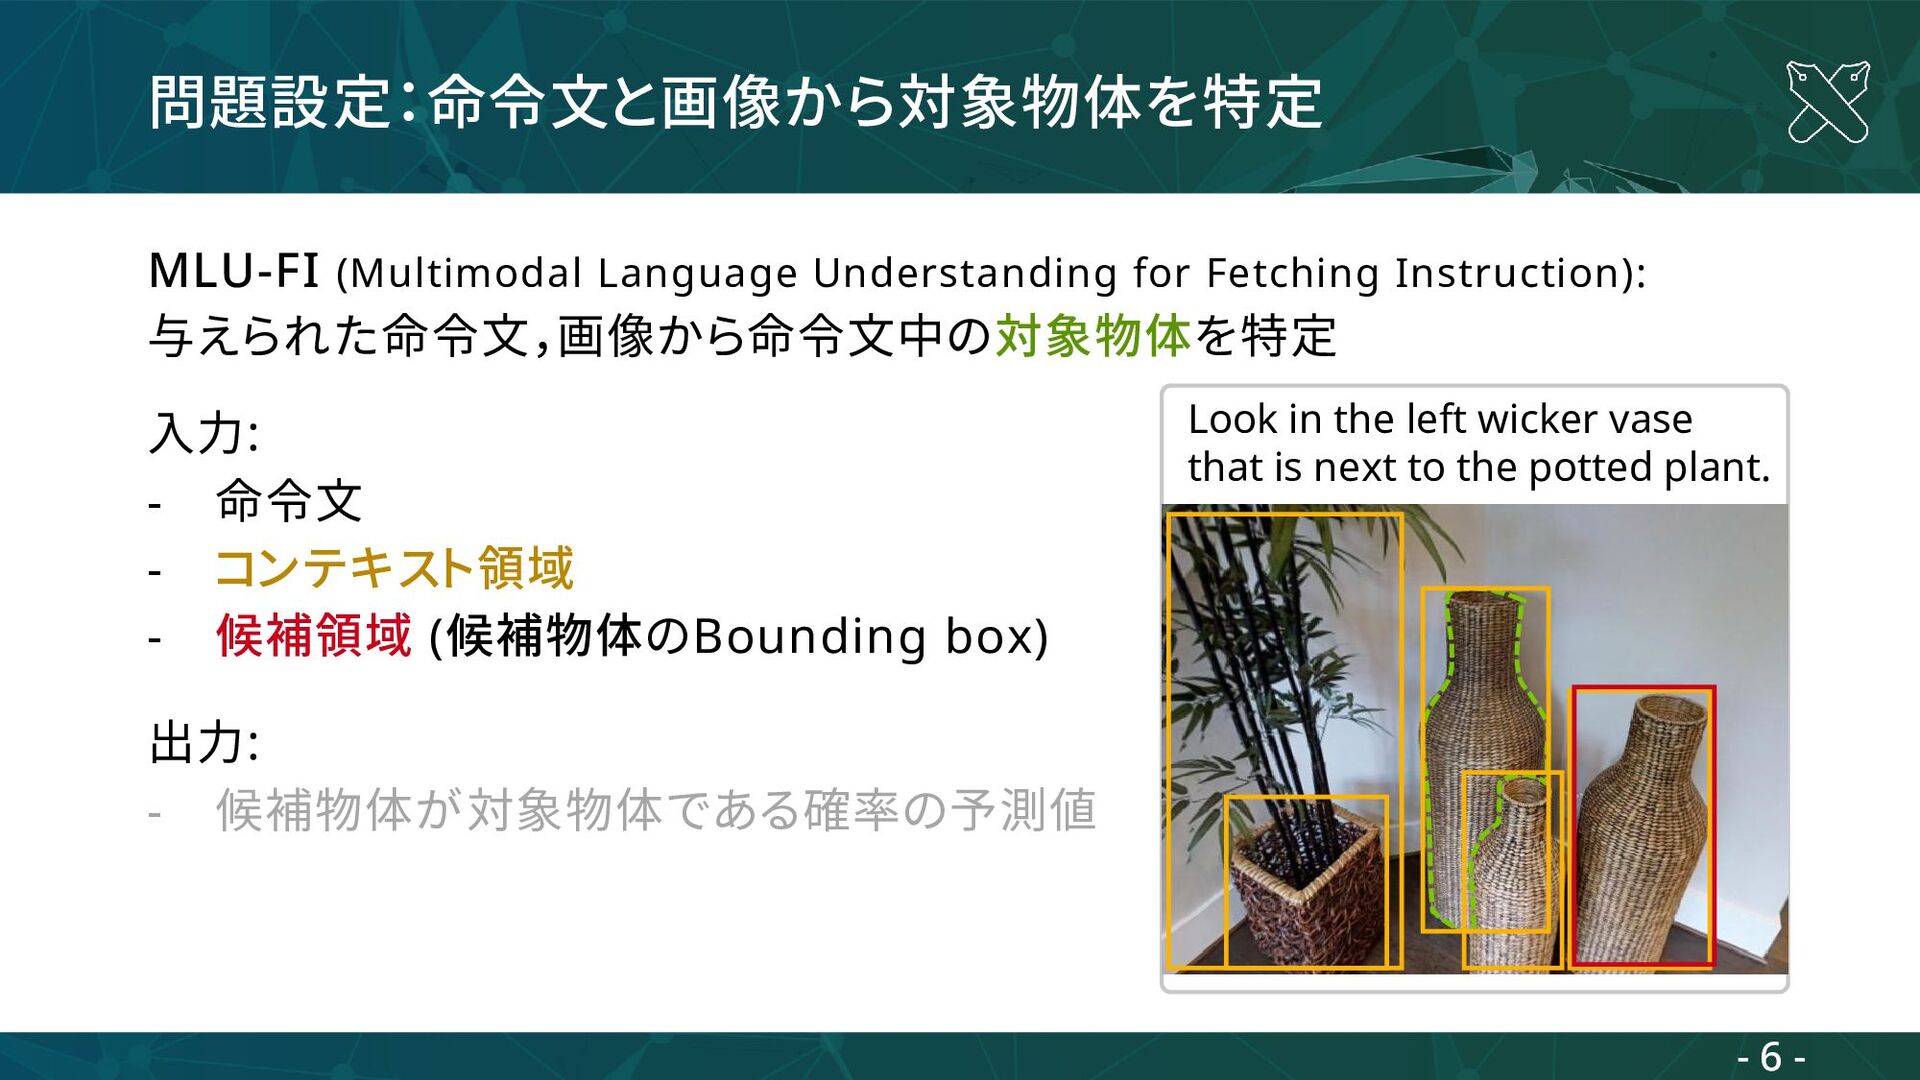
問題設定:命令文と画像から対象物体を特定 MLU-FI (Multimodal Language Understanding for Fetching Instruction): 与えられた命令文,画像から命令文中の対象物体を特定 入力:
- 命令文 - コンテキスト領域 - 候補領域 (候補物体のBounding box) 出力: - 候補物体が対象物体である確率の予測値 Look in the left wicker vase that is next to the potted plant. - 6 - -
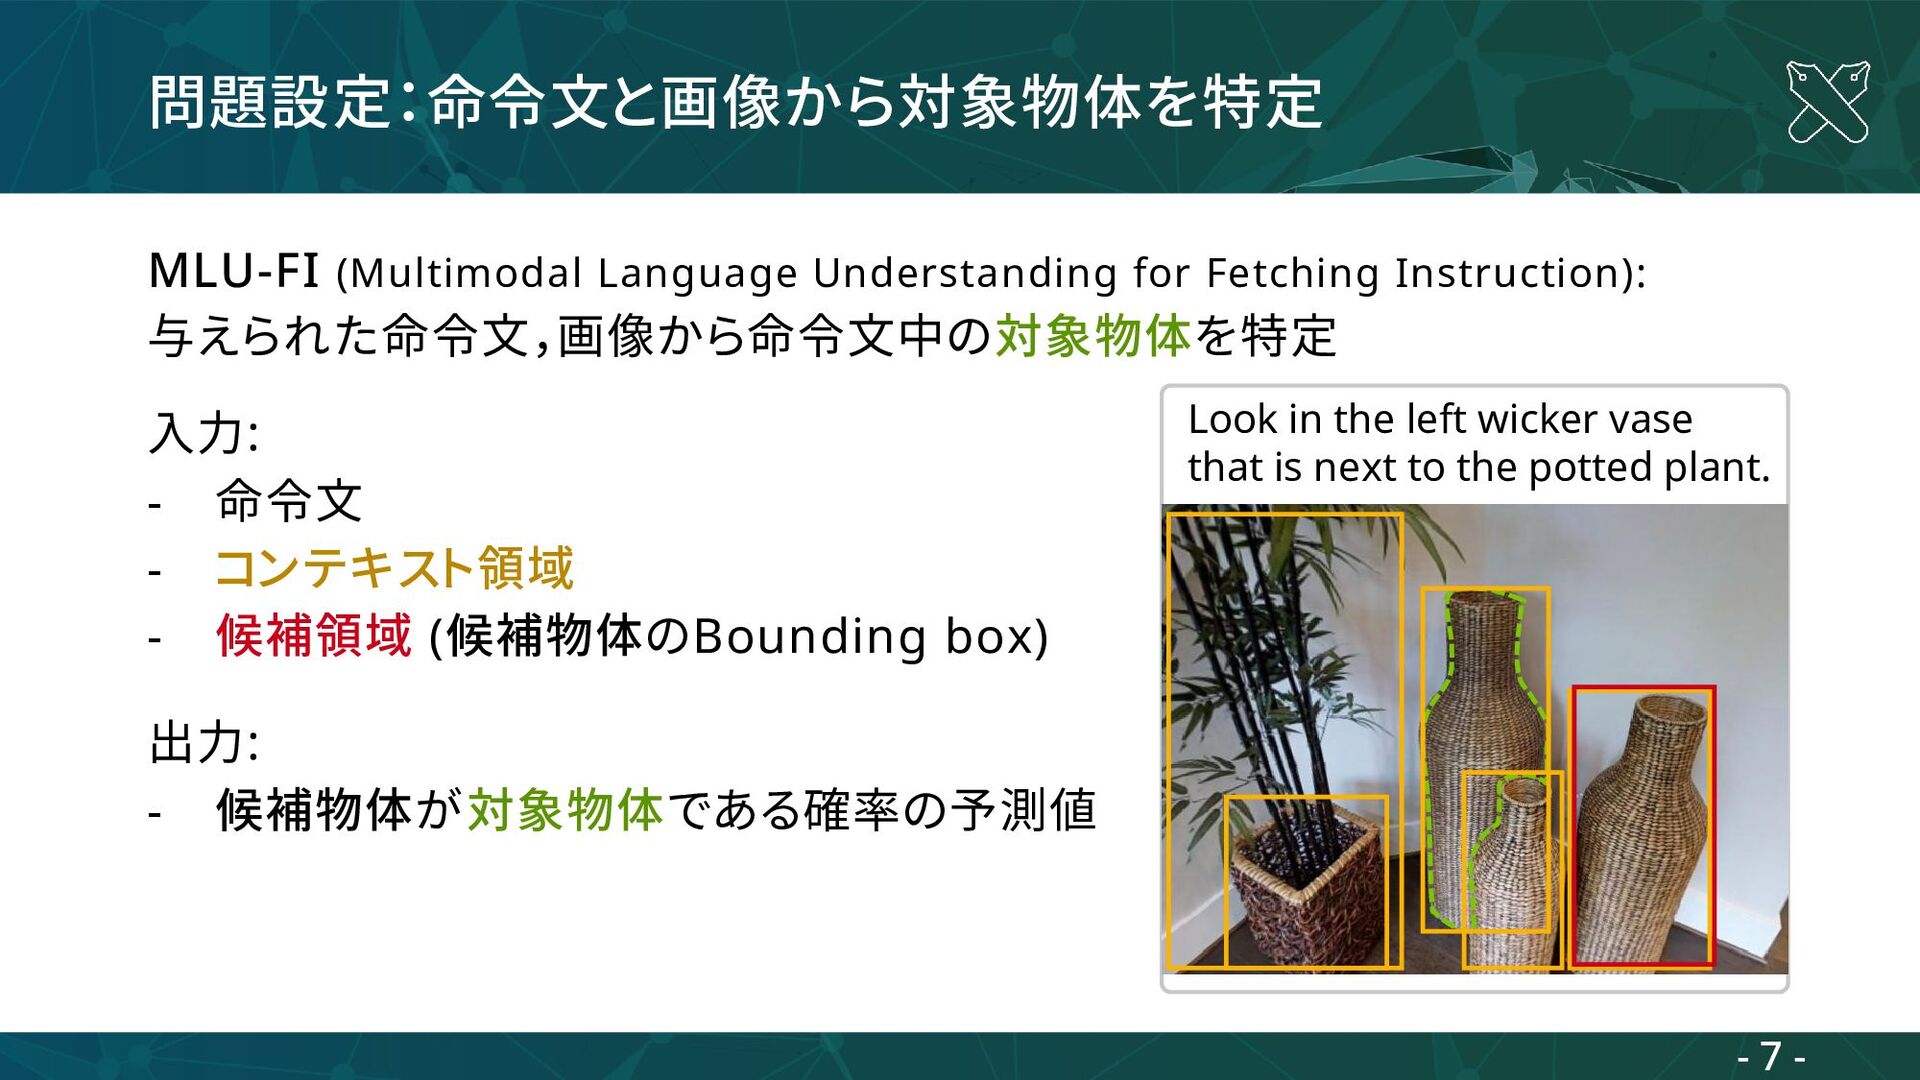
問題設定:命令文と画像から対象物体を特定 MLU-FI (Multimodal Language Understanding for Fetching Instruction): 与えられた命令文,画像から命令文中の対象物体を特定 入力:
- 命令文 - コンテキスト領域 - 候補領域 (候補物体のBounding box) 出力: - 候補物体が対象物体である確率の予測値 Look in the left wicker vase that is next to the potted plant. - 7 - -
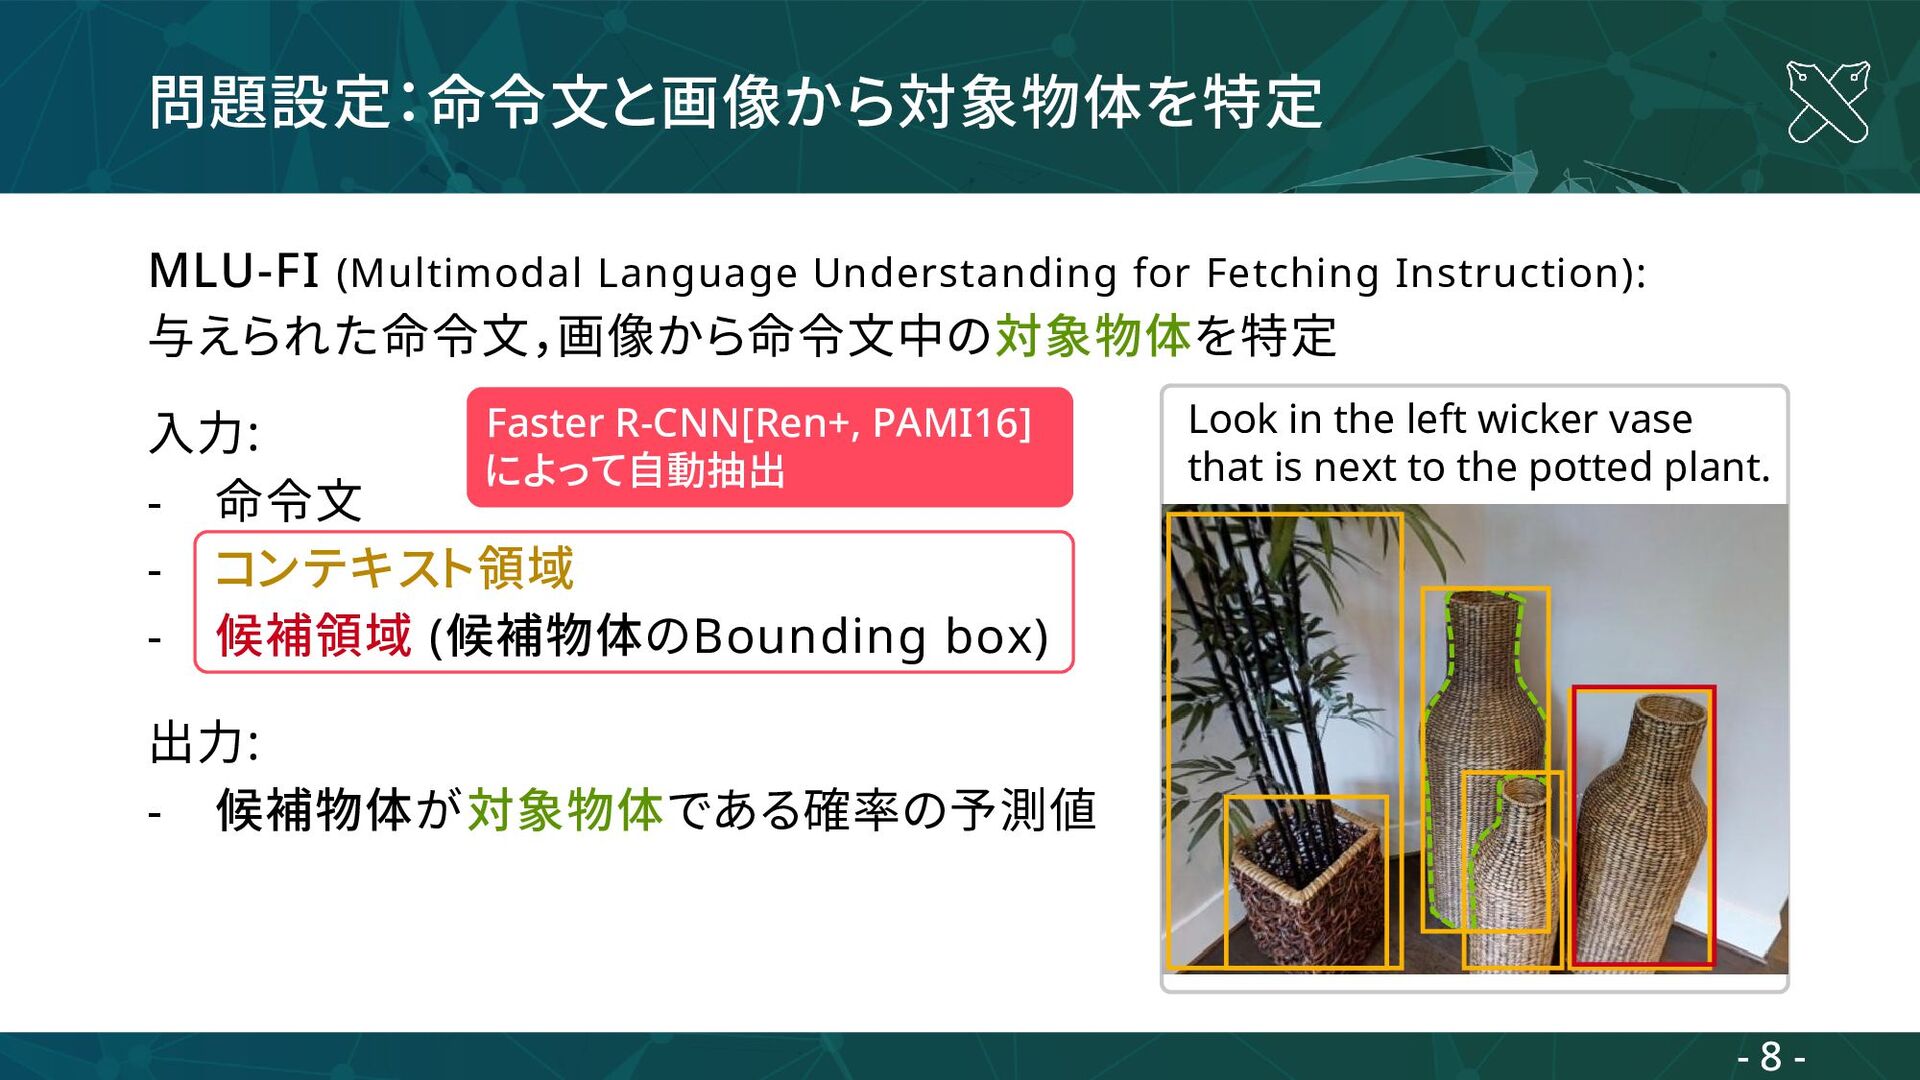
問題設定:命令文と画像から対象物体を特定 MLU-FI (Multimodal Language Understanding for Fetching Instruction): 与えられた命令文,画像から命令文中の対象物体を特定 入力:
- 命令文 - コンテキスト領域 - 候補領域 (候補物体のBounding box) 出力: - 候補物体が対象物体である確率の予測値 Look in the left wicker vase that is next to the potted plant. Faster R-CNN[Ren+, PAMI16] によって自動抽出 - 8 - -
既存研究は高コストな実世界データのみを用いて学習 →データの大規模化が大変 PFN-PIC [Hatori+, ICRA18] 4つの箱に分け入れられた約20種類の日用品を 対象に,対象物体および目標位置の特定 MTCM [Magassouba+, RA-L19]
自然言語による命令文と視覚的情報から 対象物体を特定, LSTMおよびVGGを利用 Target-Dependent UNITER [Ishikawa+, RA-L21] UNITER [Chen+, ECCV20] に対して候補領域を扱う 構造を追加. MLU-FIに適用 Target-Dependent UNITER [Ishikawa+, RA-L21] PFN-PIC [Hatori+, ICRA18] - 9 - -
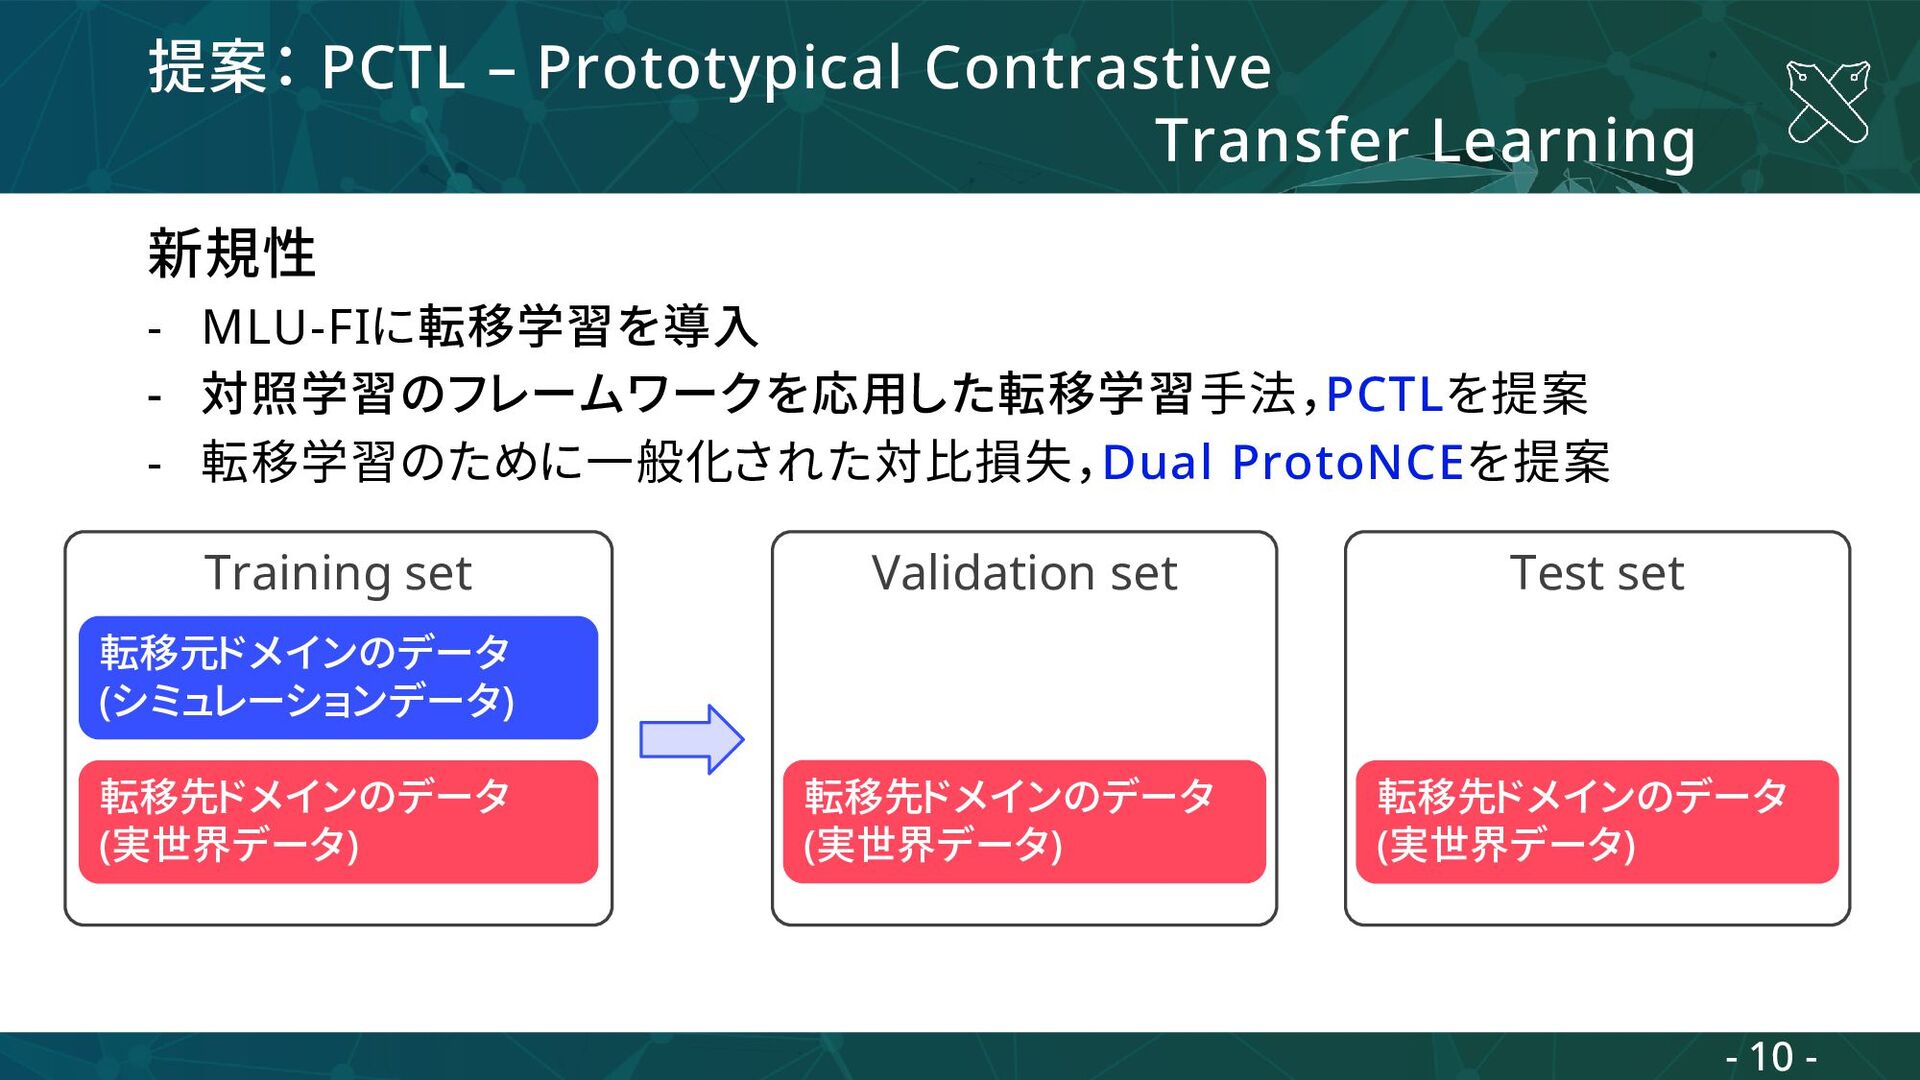
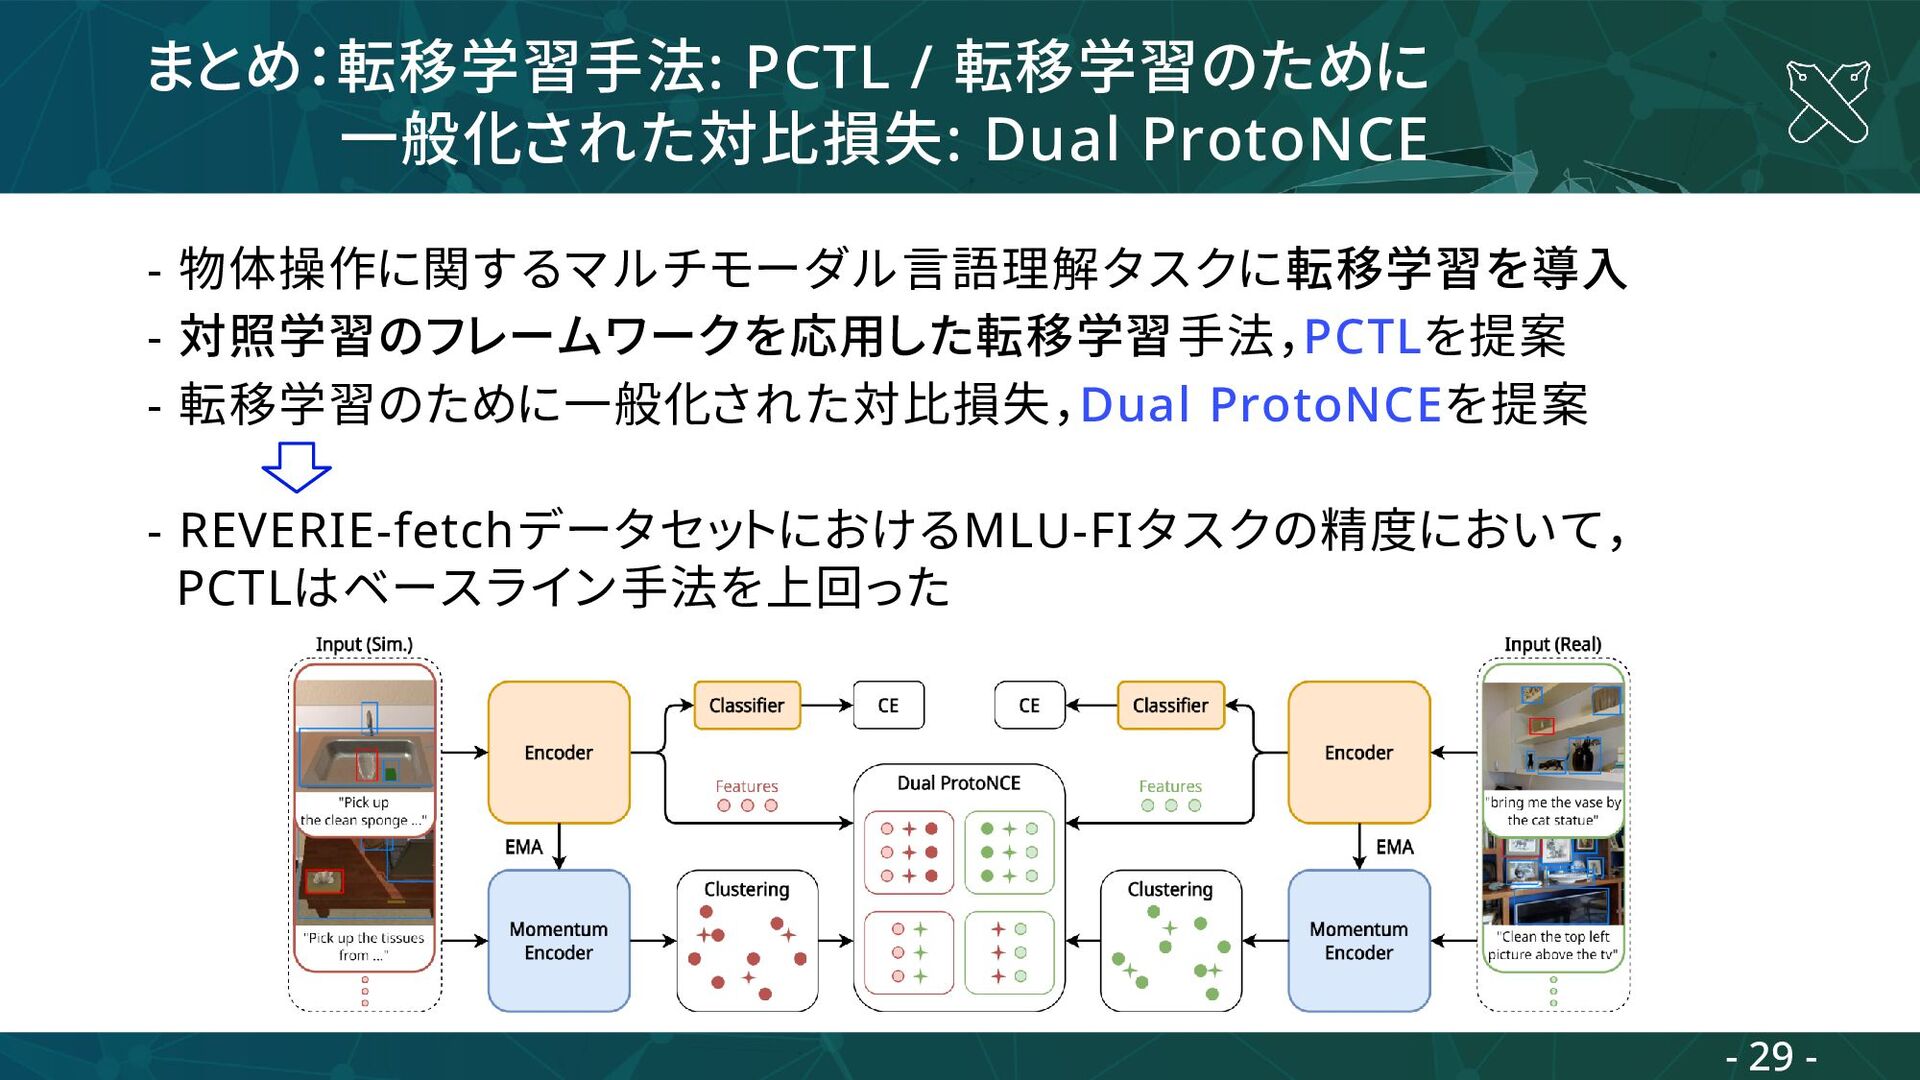
提案: PCTL – Prototypical Contrastive Transfer Learning 新規性 - MLU-FIに転移学習を導入
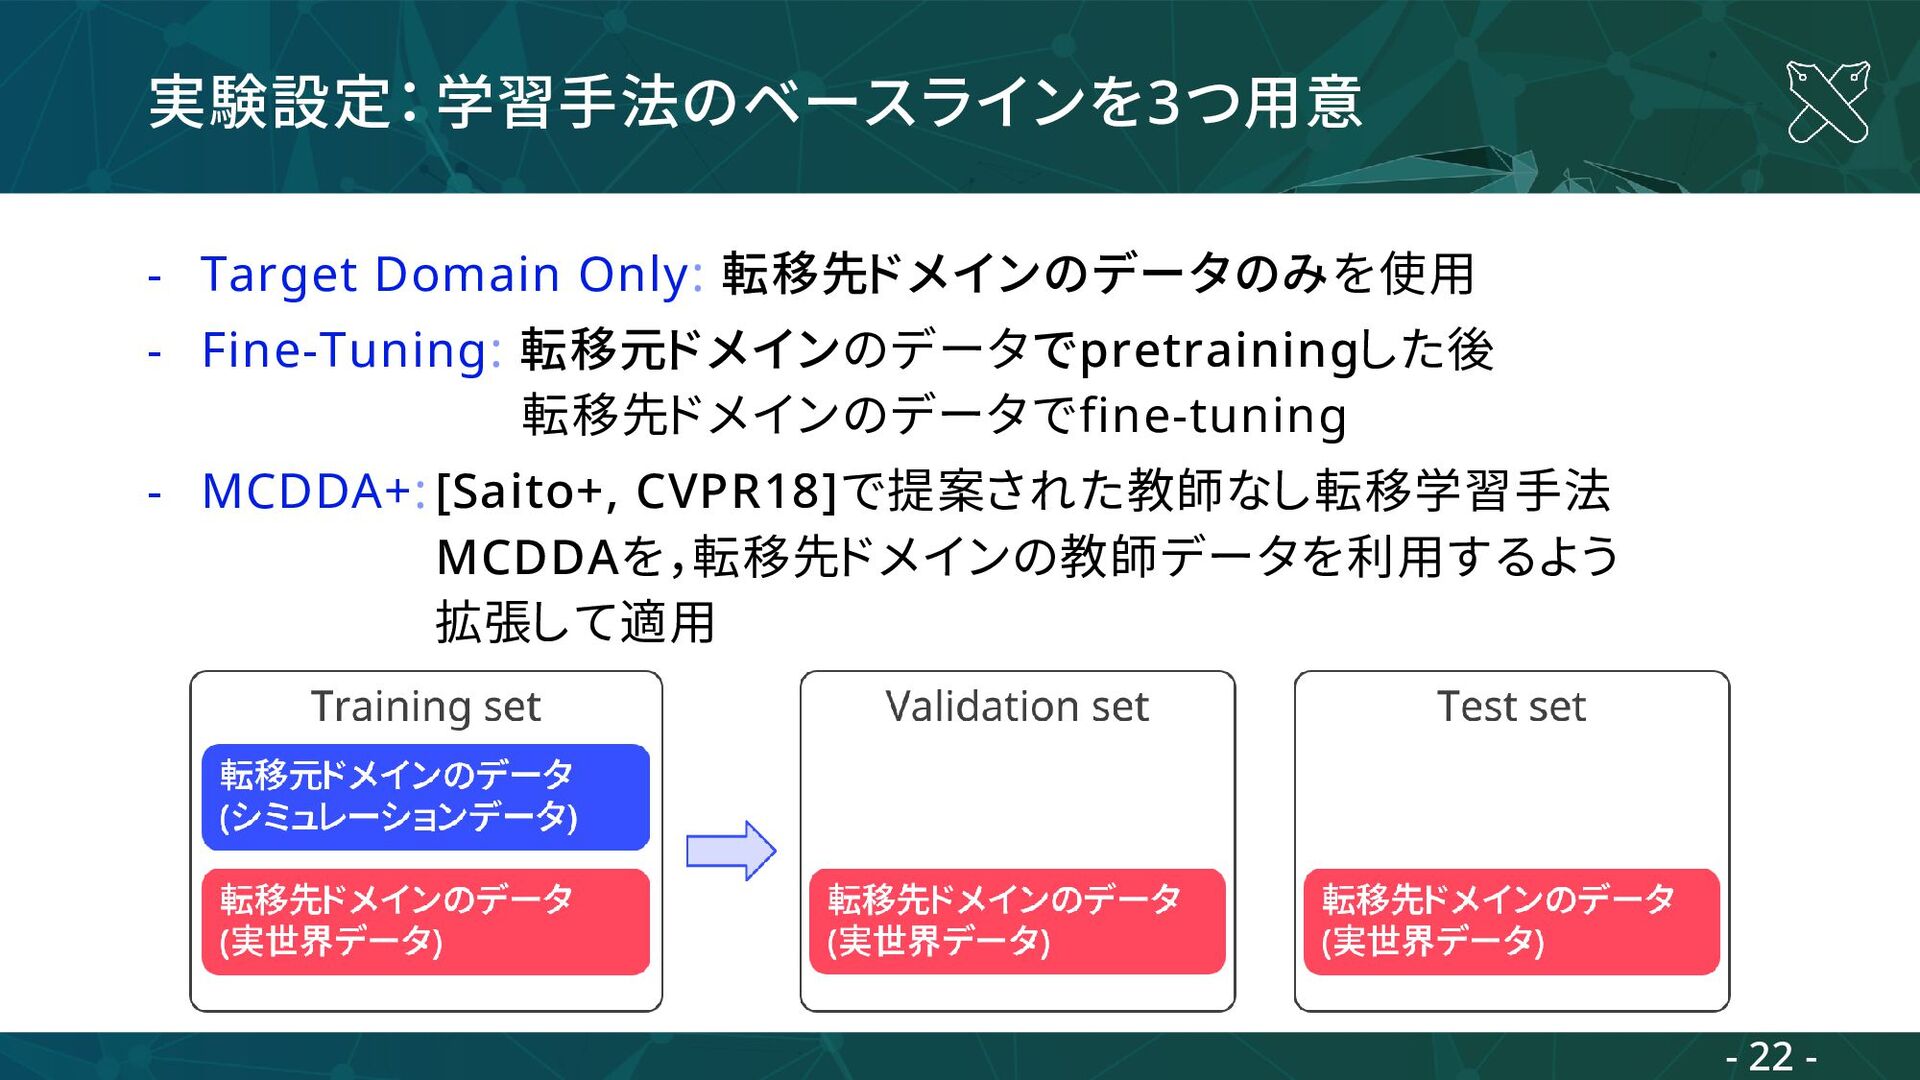
- 対照学習のフレームワークを応用した転移学習手法,PCTLを提案 - 転移学習のために一般化された対比損失,Dual ProtoNCEを提案 転移元ドメインのデータ (シミュレーションデータ) 転移先ドメインのデータ (実世界データ) Training set Validation set 転移先ドメインのデータ (実世界データ) Test set 転移先ドメインのデータ (実世界データ) - 10 - -
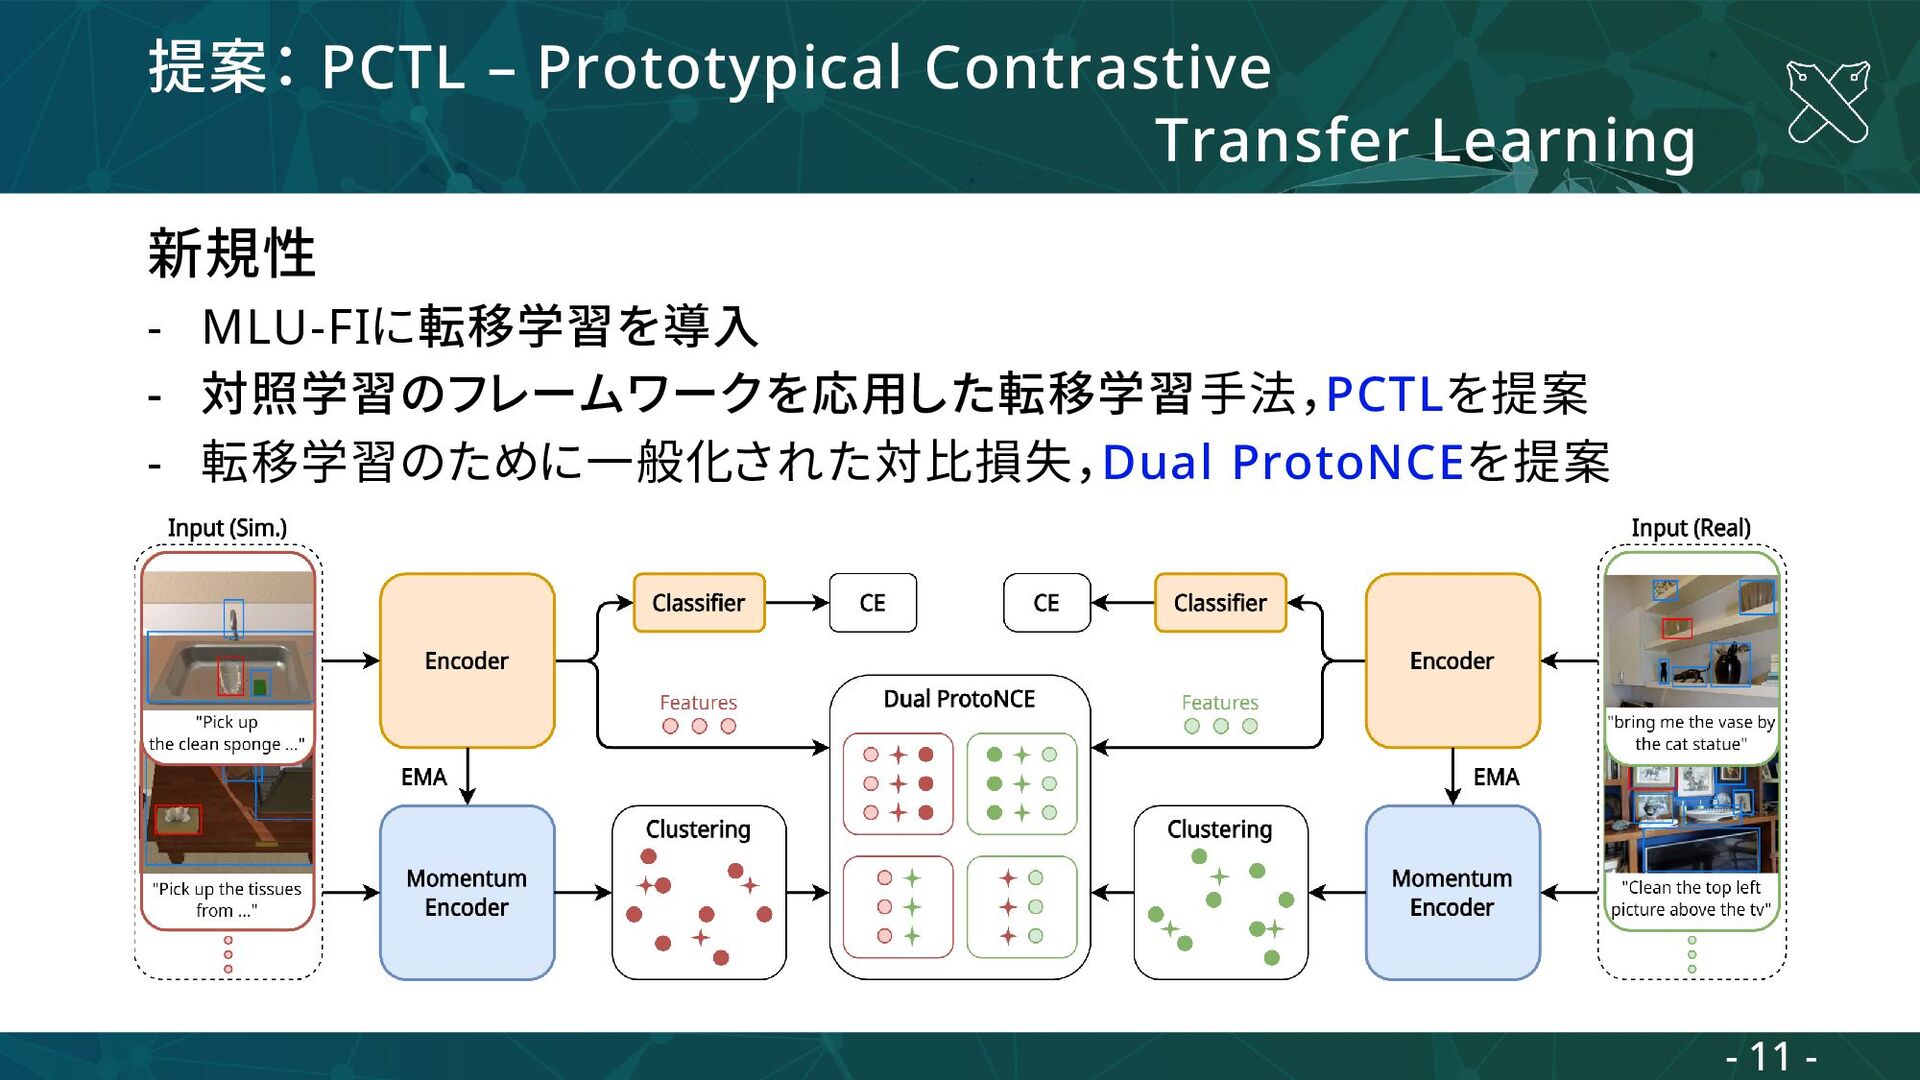
提案: PCTL – Prototypical Contrastive Transfer Learning 新規性 - MLU-FIに転移学習を導入
- 対照学習のフレームワークを応用した転移学習手法,PCTLを提案 - 転移学習のために一般化された対比損失,Dual ProtoNCEを提案 - 11 - -
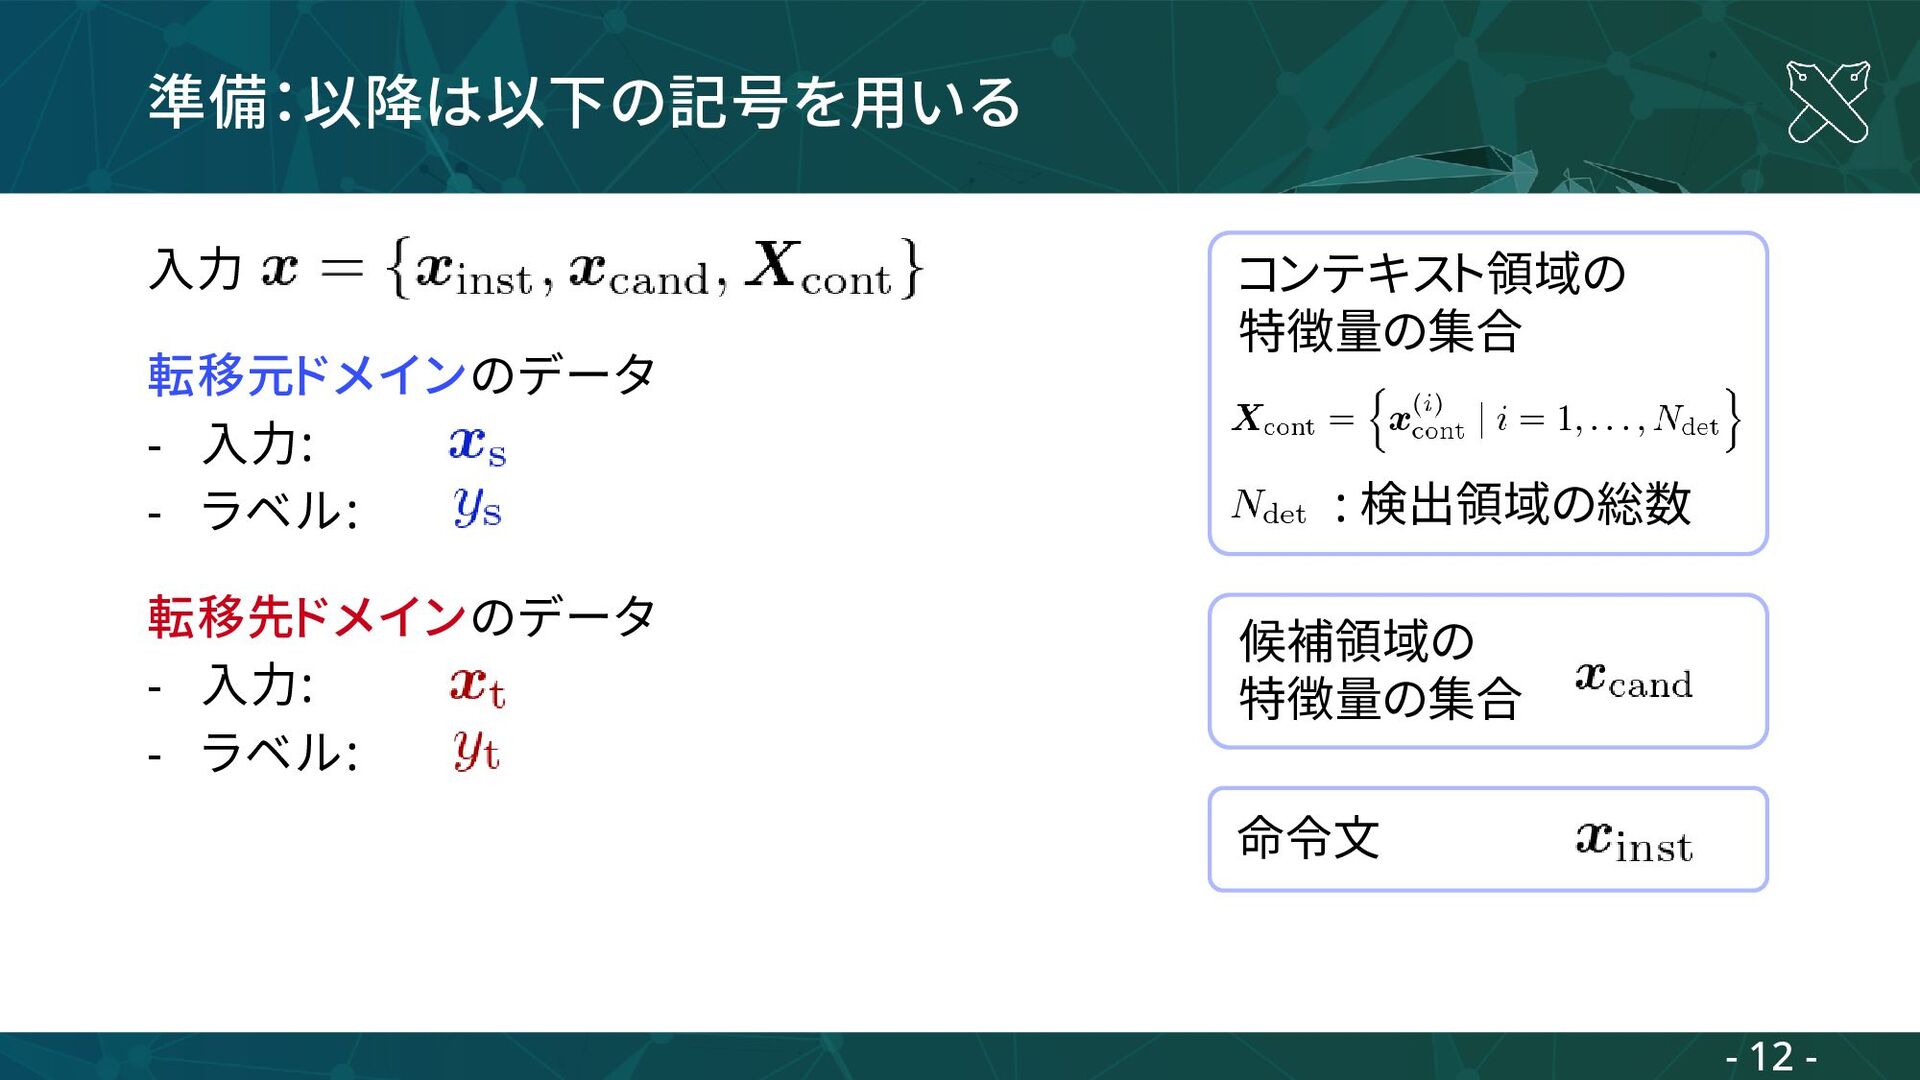
入力 転移元ドメインのデータ - 入力: - ラベル: 転移先ドメインのデータ - 入力: -
ラベル: 準備:以降は以下の記号を用いる 命令文 候補領域の 特徴量の集合 コンテキスト領域の 特徴量の集合 : 検出領域の総数 - 12 - -
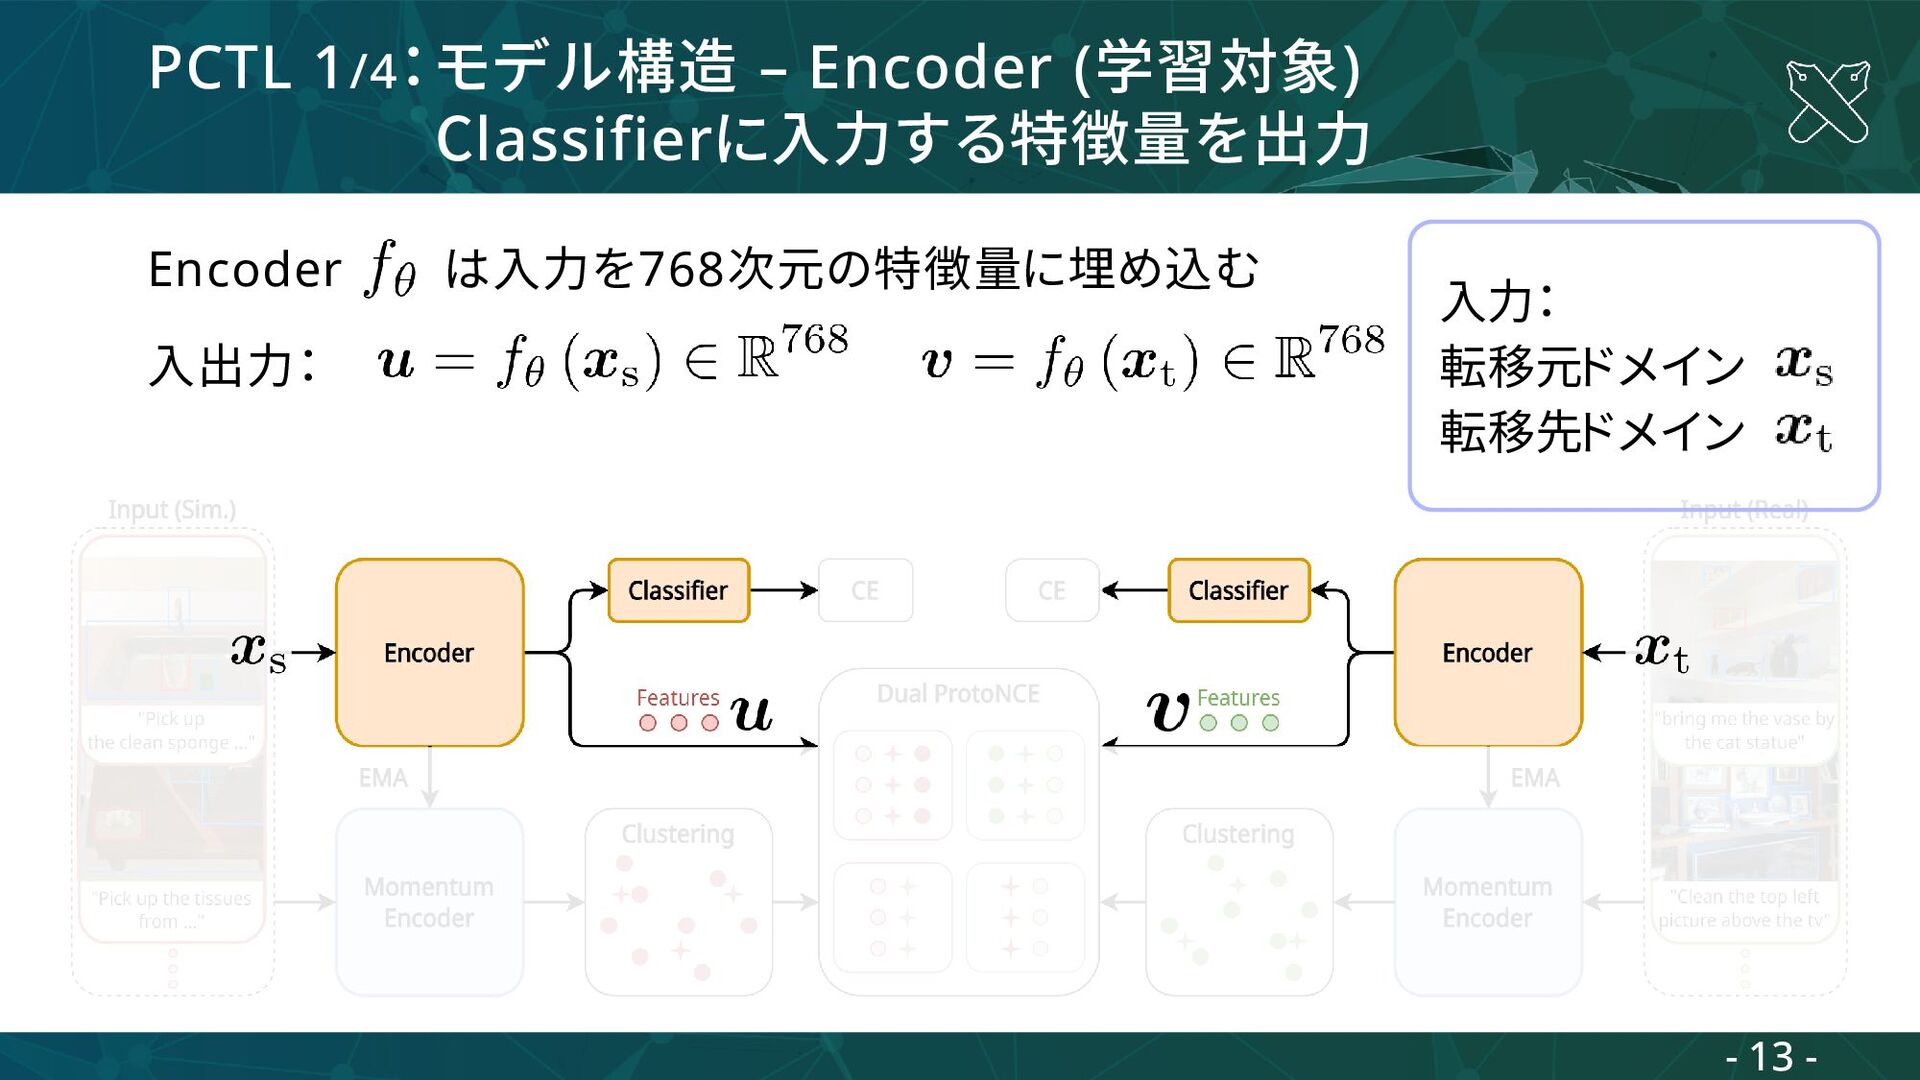
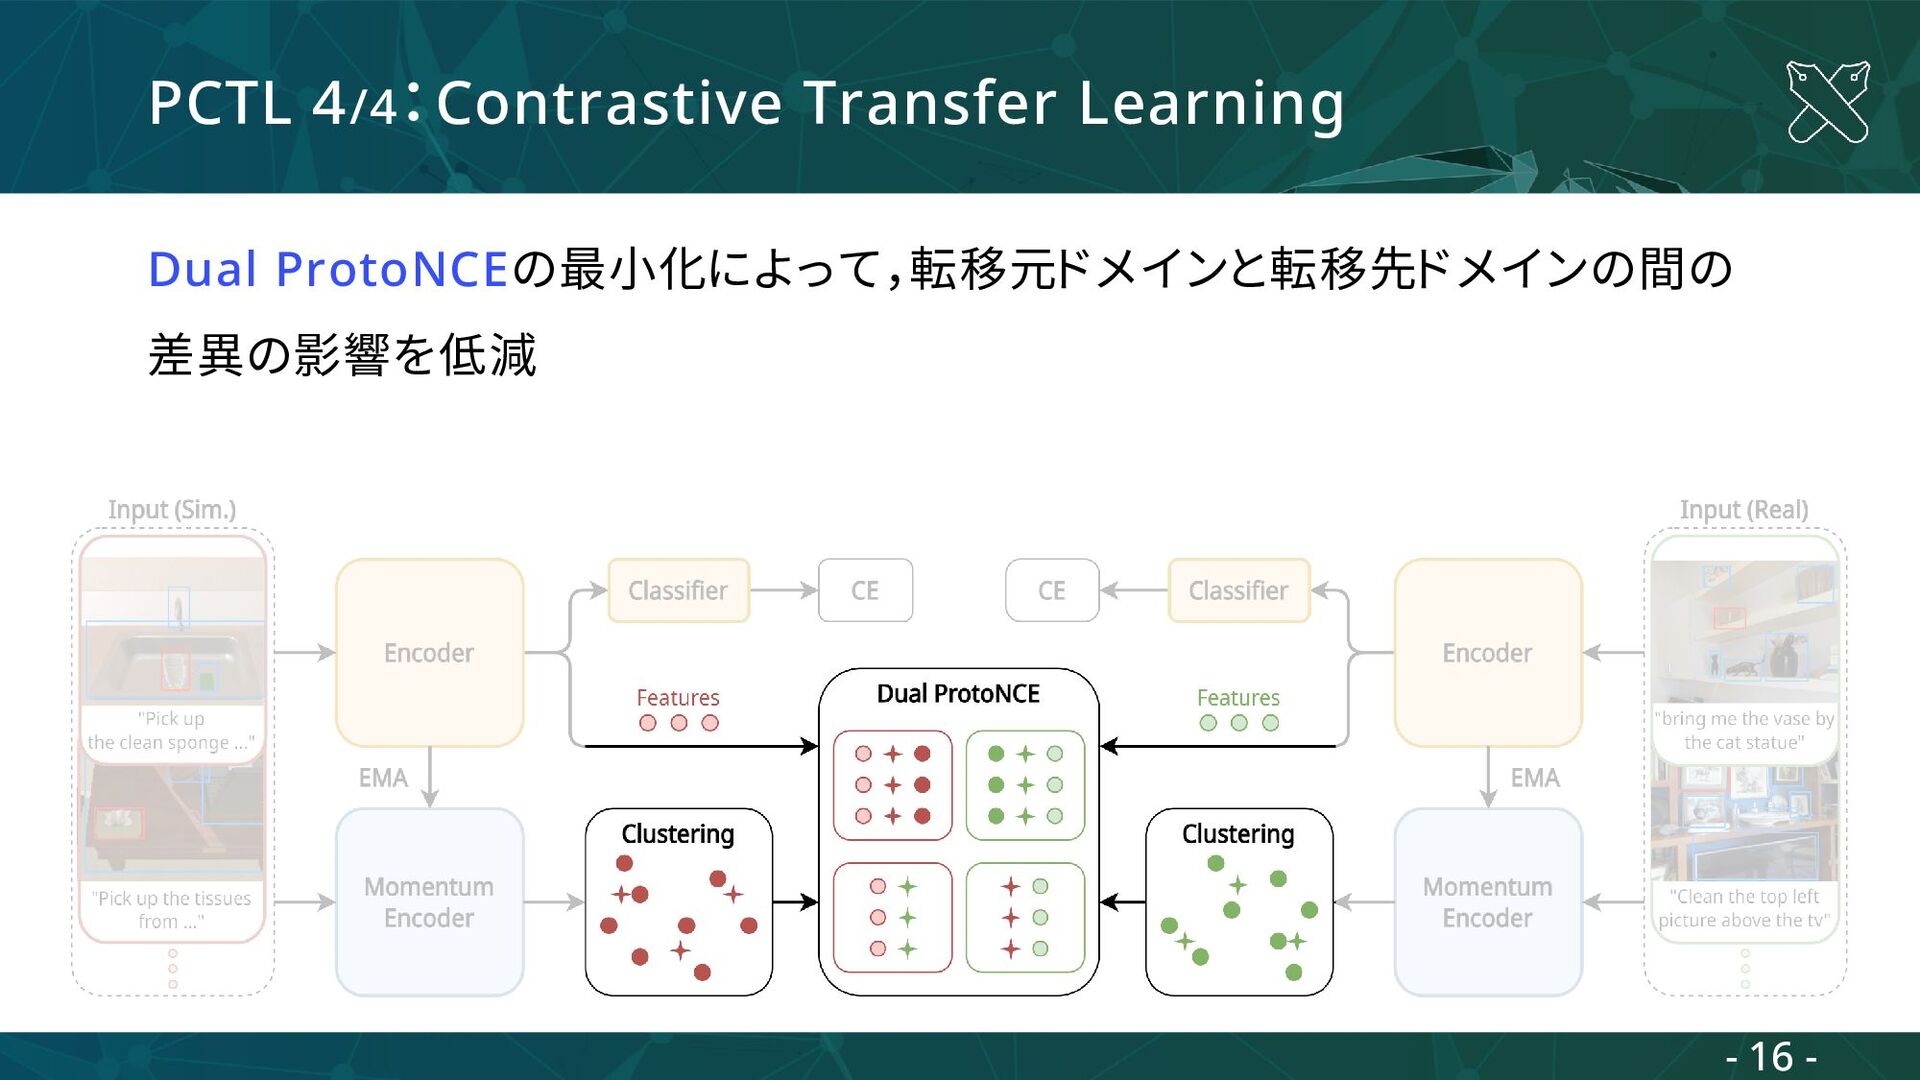
Encoder は入力を768次元の特徴量に埋め込む 入出力: PCTL 1/4:モデル構造 – Encoder (学習対象) Classifierに入力する特徴量を出力 入力:
転移元ドメイン 転移先ドメイン - 13 - -
構造はEncoder と同等, 入出力: パラメータ は のパラメータ の指数移動平均 PCTL 2/4:モデル構造 –
Momentum Encoder Dual ProtoNCEの正例,負例となる特徴量を出力 入力: 転移元ドメイン 転移先ドメイン - 14 - -
PCTL 3/4:Clustering Module Dual ProtoNCEが利用するプロトタイプを出力 各エポックの初めに , に対してk近傍法によるクラスタリングを クラスタ数を変えて 回行う
クラスタの重心を プロトタイプと呼称 - 15 - 回目の , に対するクラスタリングにおける クラスタ数: その 番目のクラスタの重心: , -
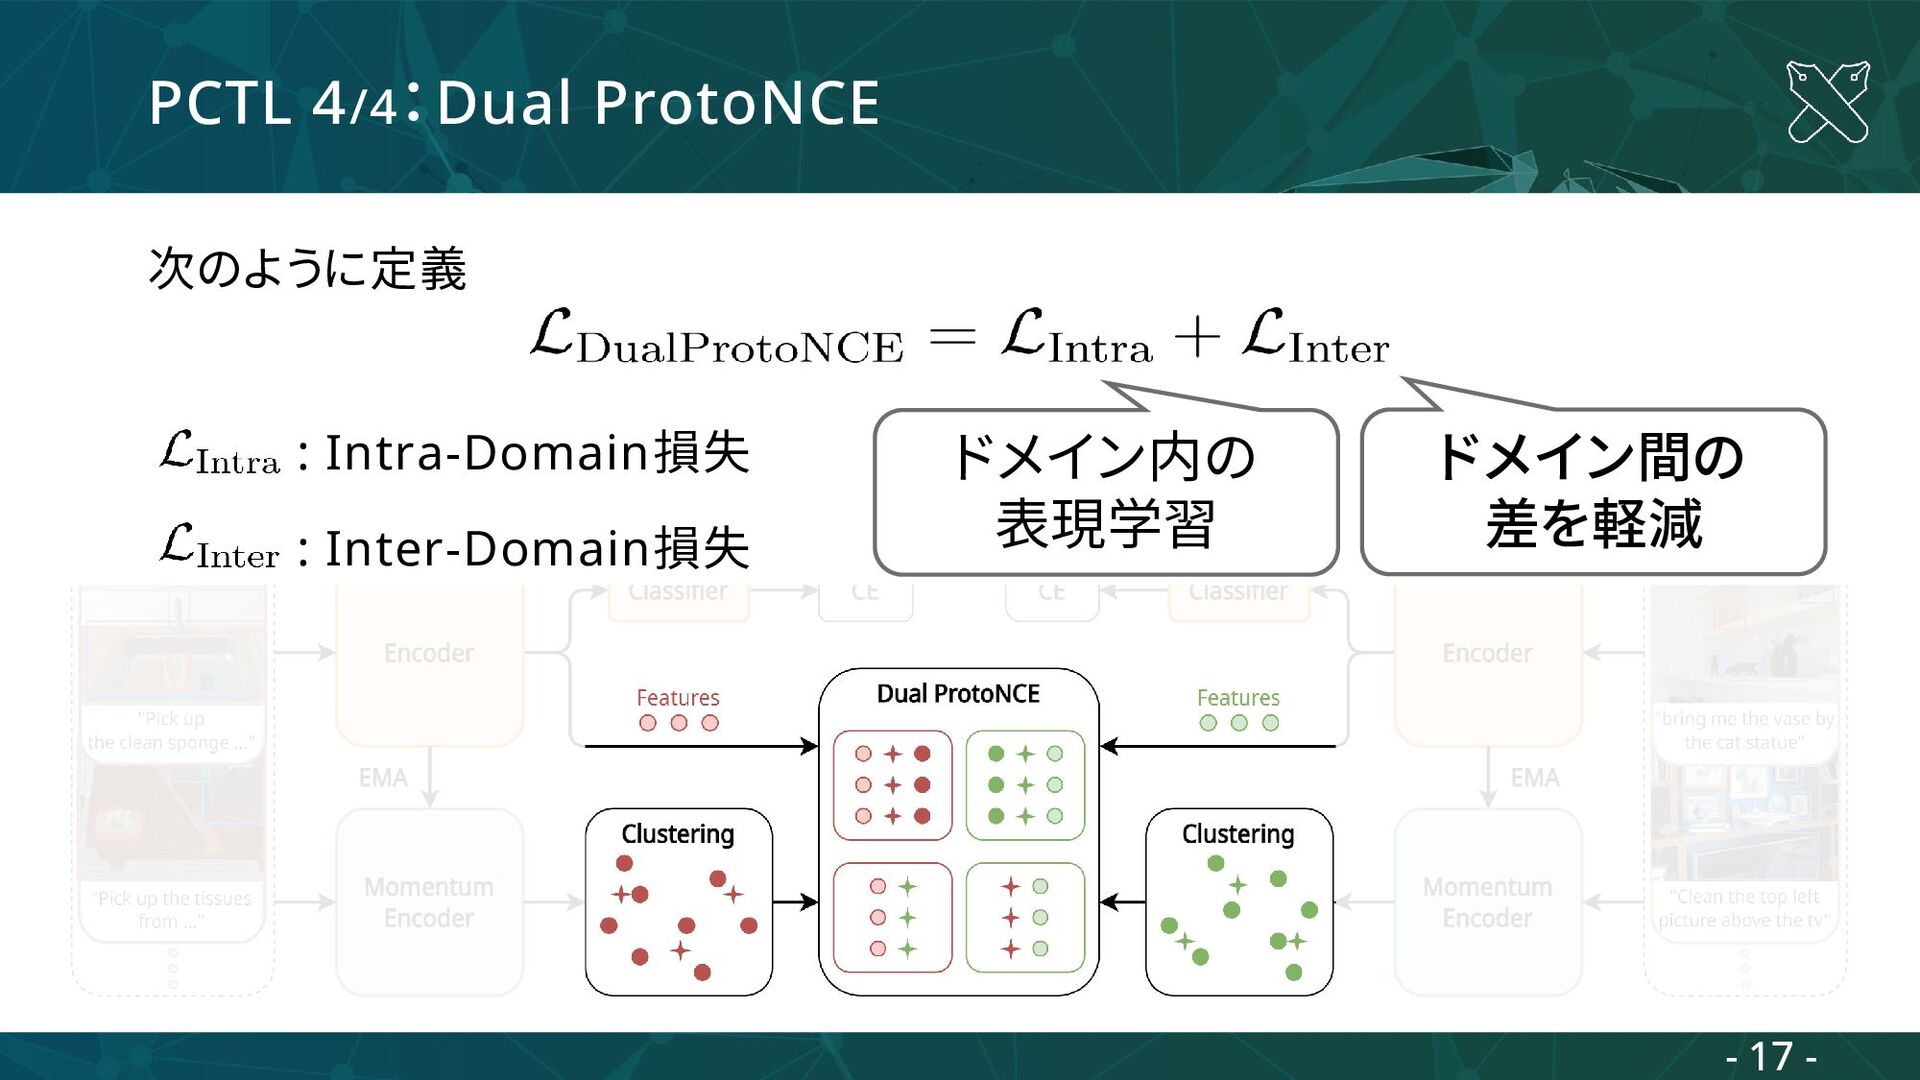
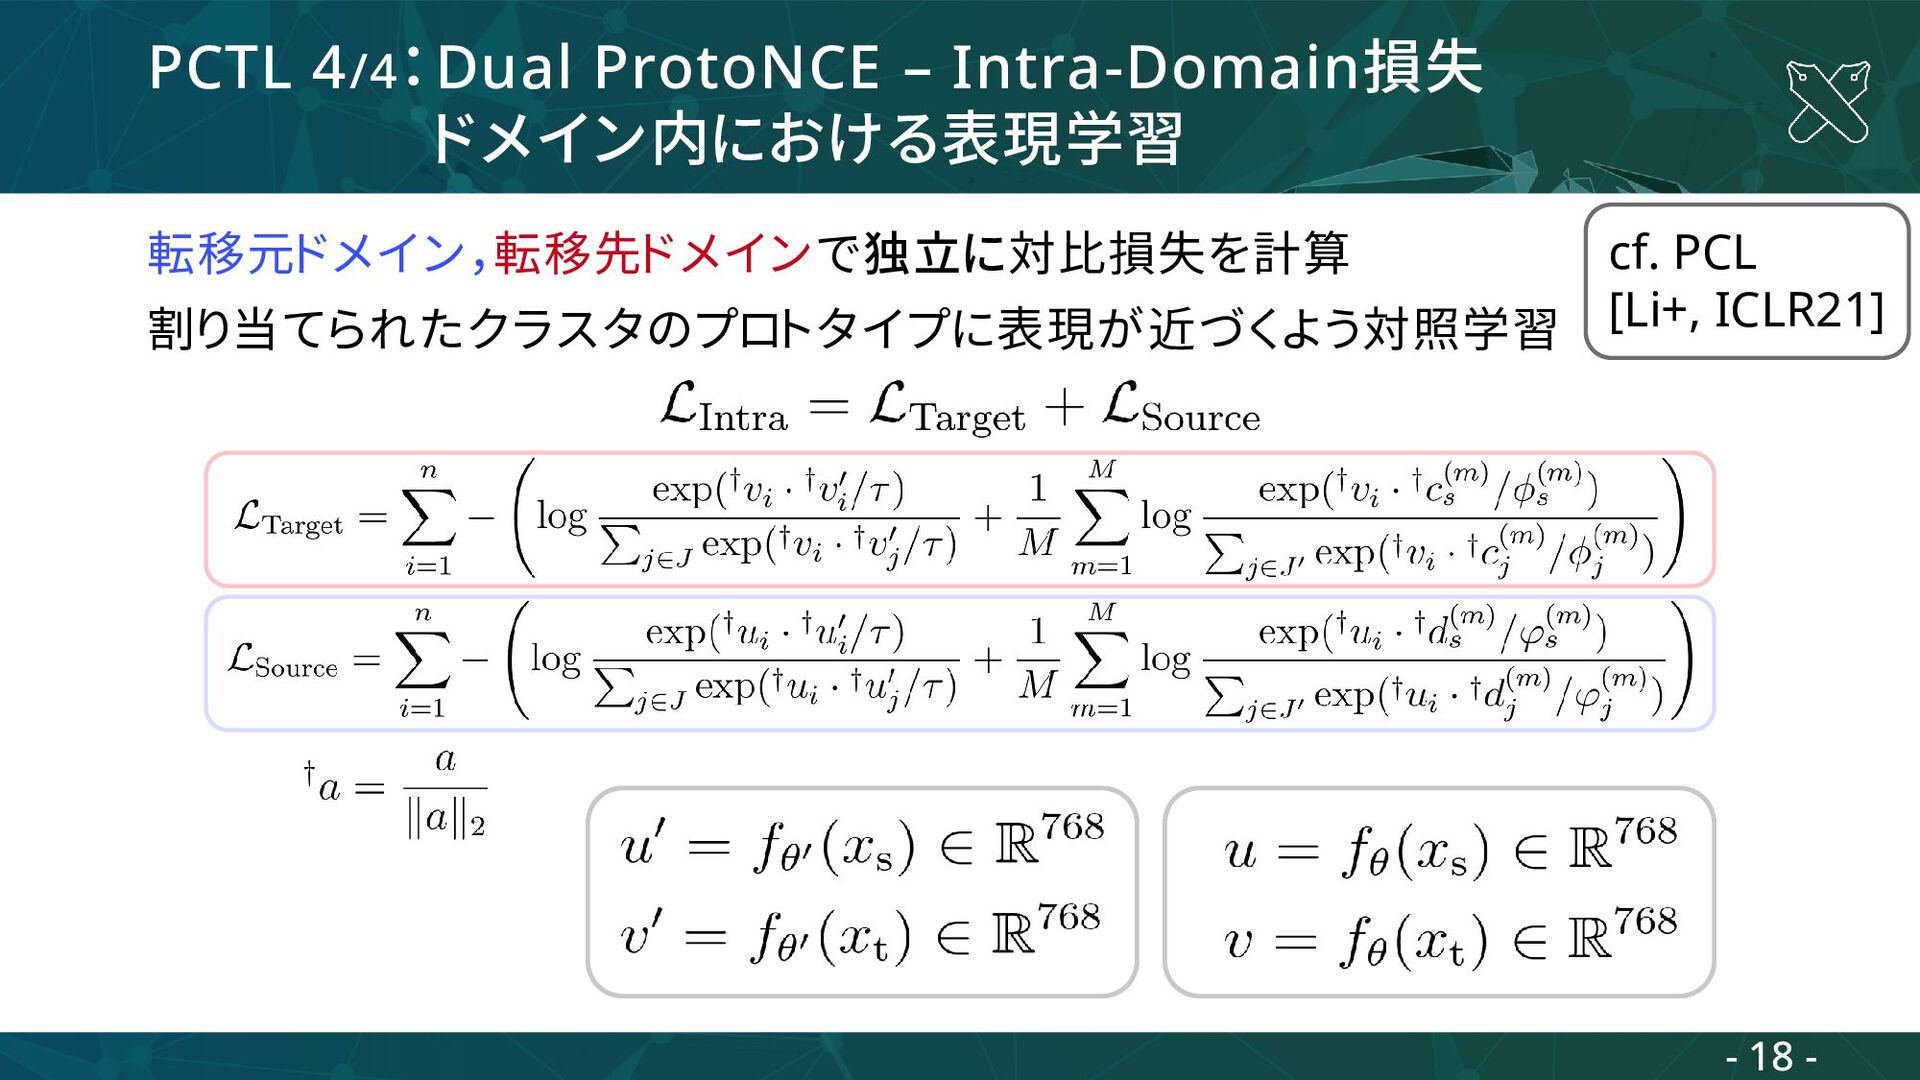
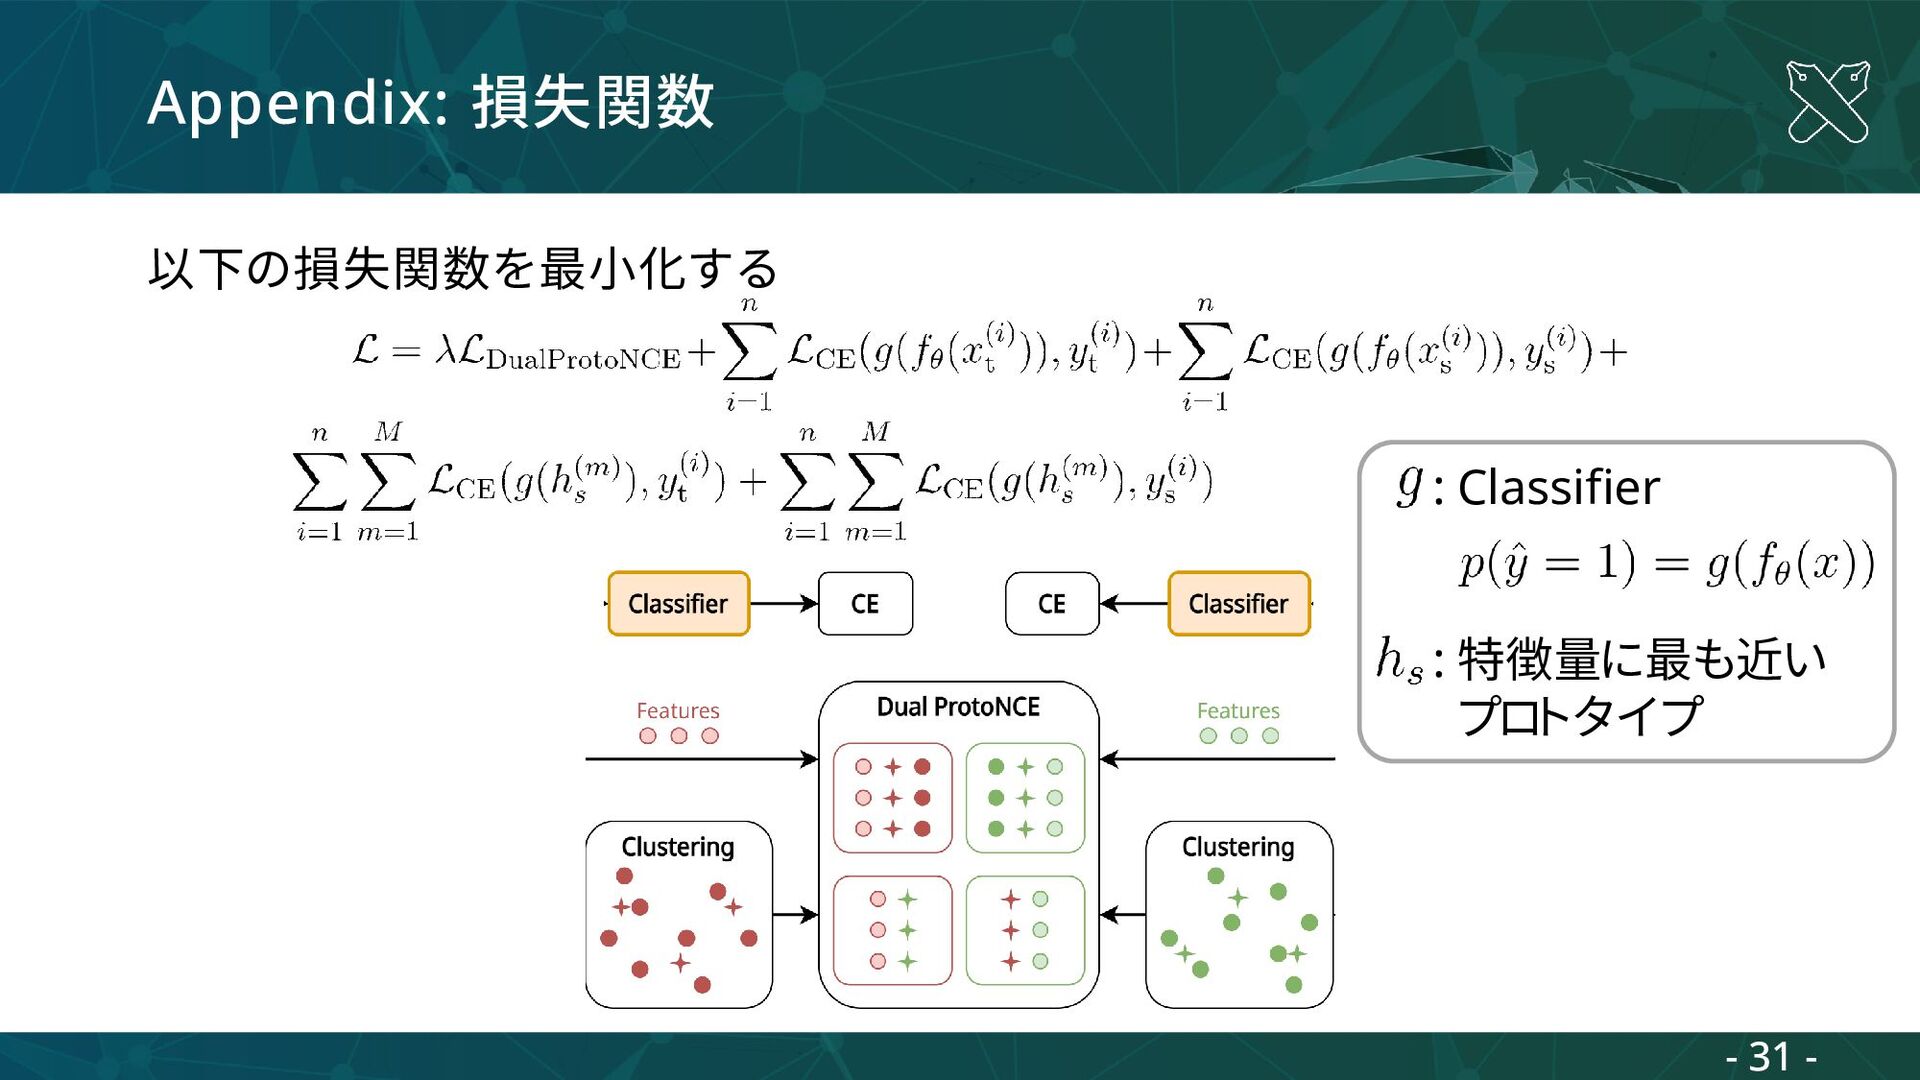
PCTL 4/4:Dual ProtoNCE 次のように定義 : Intra-Domain損失 : Inter-Domain損失 - 17
- ドメイン内の 表現学習 ドメイン間の 差を軽減 -
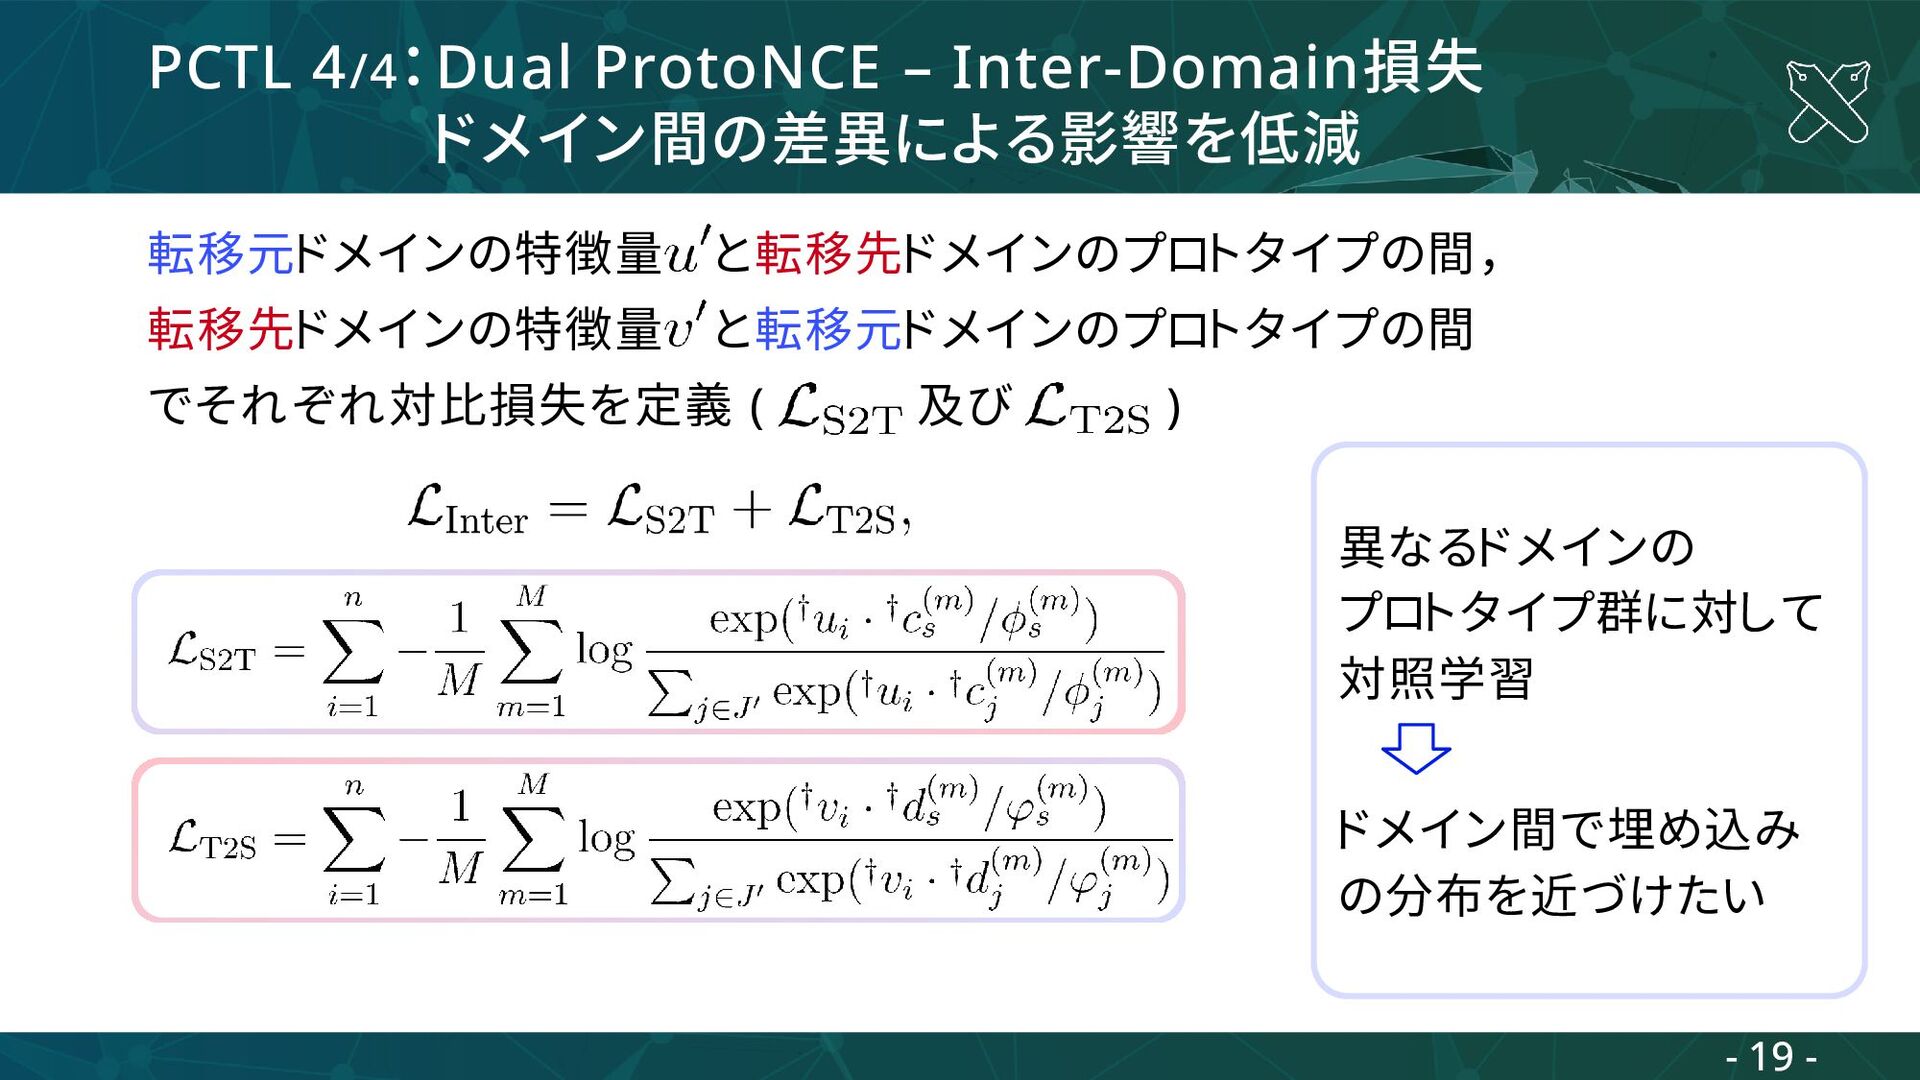
PCTL 4/4:Dual ProtoNCE – Inter-Domain損失 ドメイン間の差異による影響を低減 転移元ドメインの特徴量 と転移先ドメインのプロトタイプの間, 転移先ドメインの特徴量 と転移元ドメインのプロトタイプの間
でそれぞれ対比損失を定義 ( 及び ) - 19 - 異なるドメインの プロトタイプ群に対して 対照学習 ドメイン間で埋め込み の分布を近づけたい -
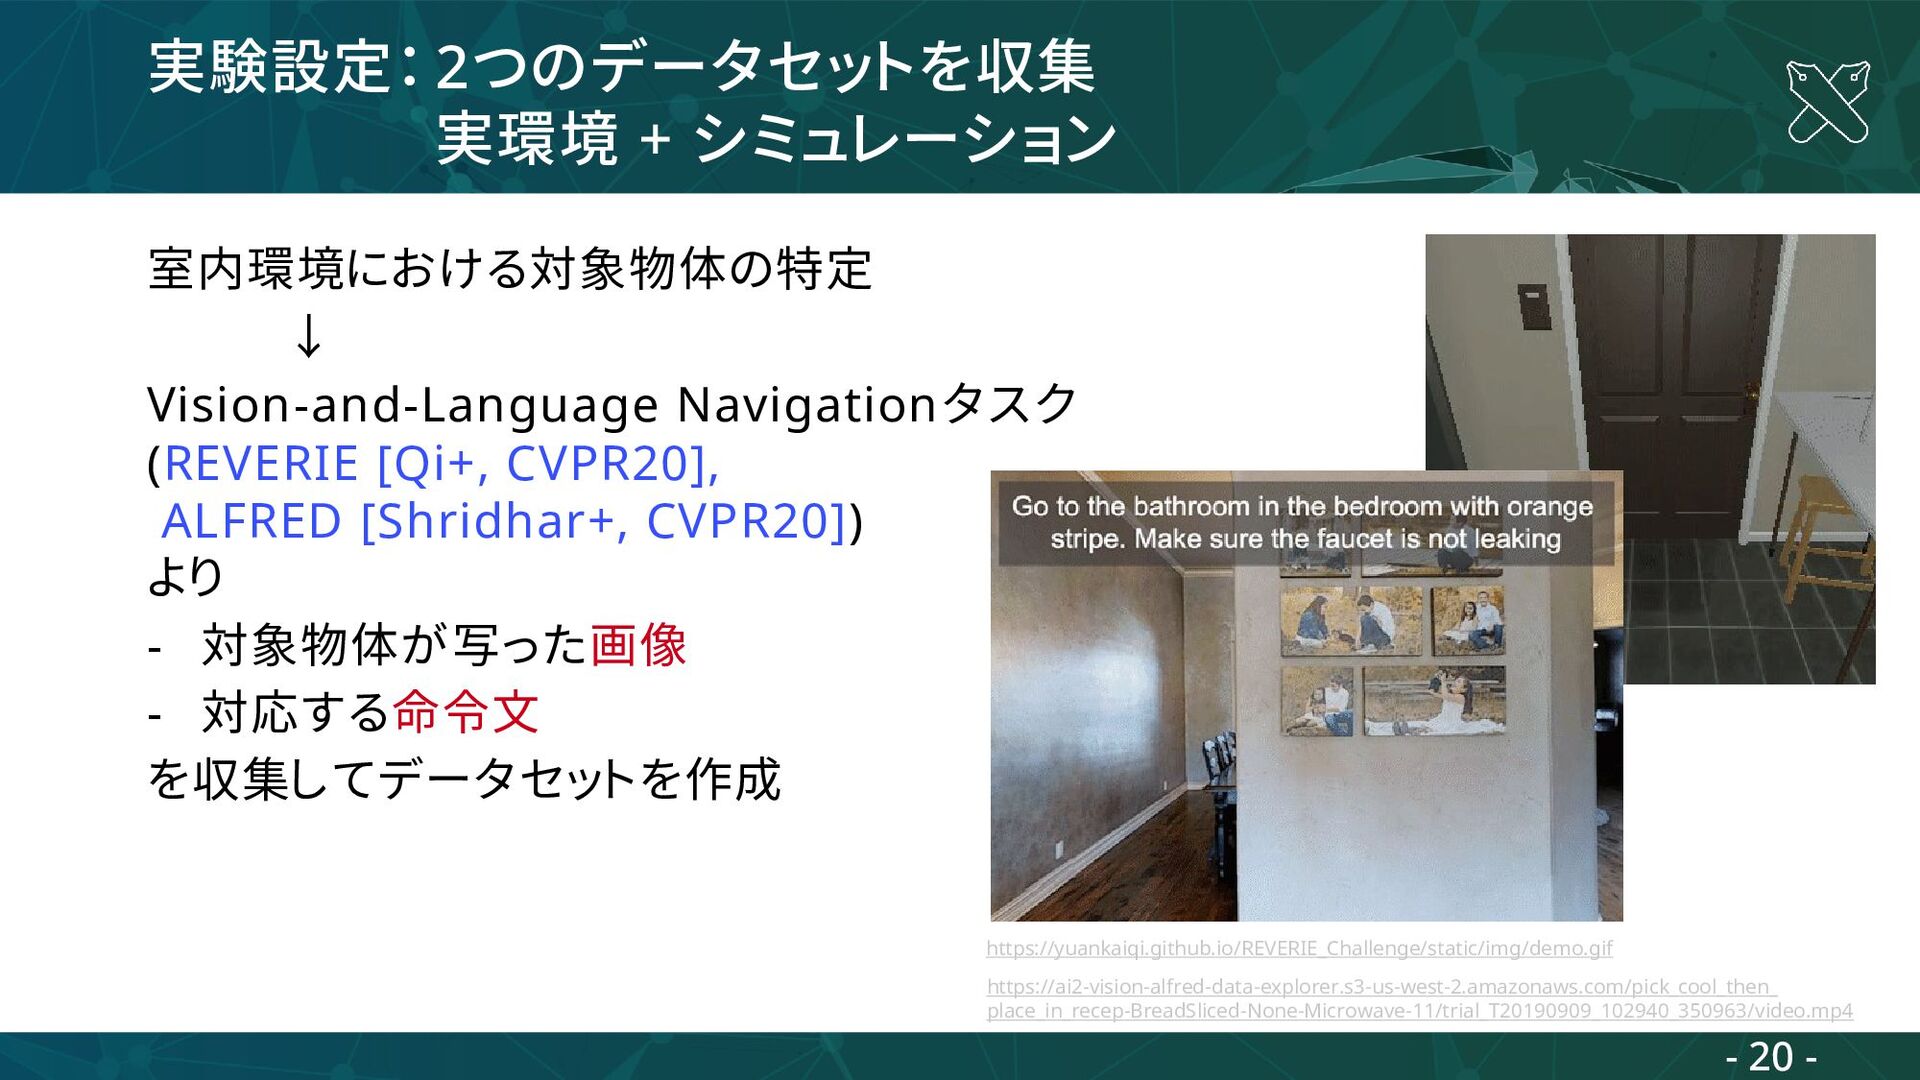
実験設定: 2つのデータセットを収集 実環境 + シミュレーション 室内環境における対象物体の特定 ↓ Vision-and-Language Navigationタスク (REVERIE
[Qi+, CVPR20], ALFRED [Shridhar+, CVPR20]) より - 対象物体が写った画像 - 対応する命令文 を収集してデータセットを作成 https://yuankaiqi.github.io/REVERIE_Challenge/static/img/demo.gif https://ai2-vision-alfred-data-explorer.s3-us-west-2.amazonaws.com/pick_cool_then_ place_in_recep-BreadSliced-None-Microwave-11/trial_T20190909_102940_350963/video.mp4 - 20 - -
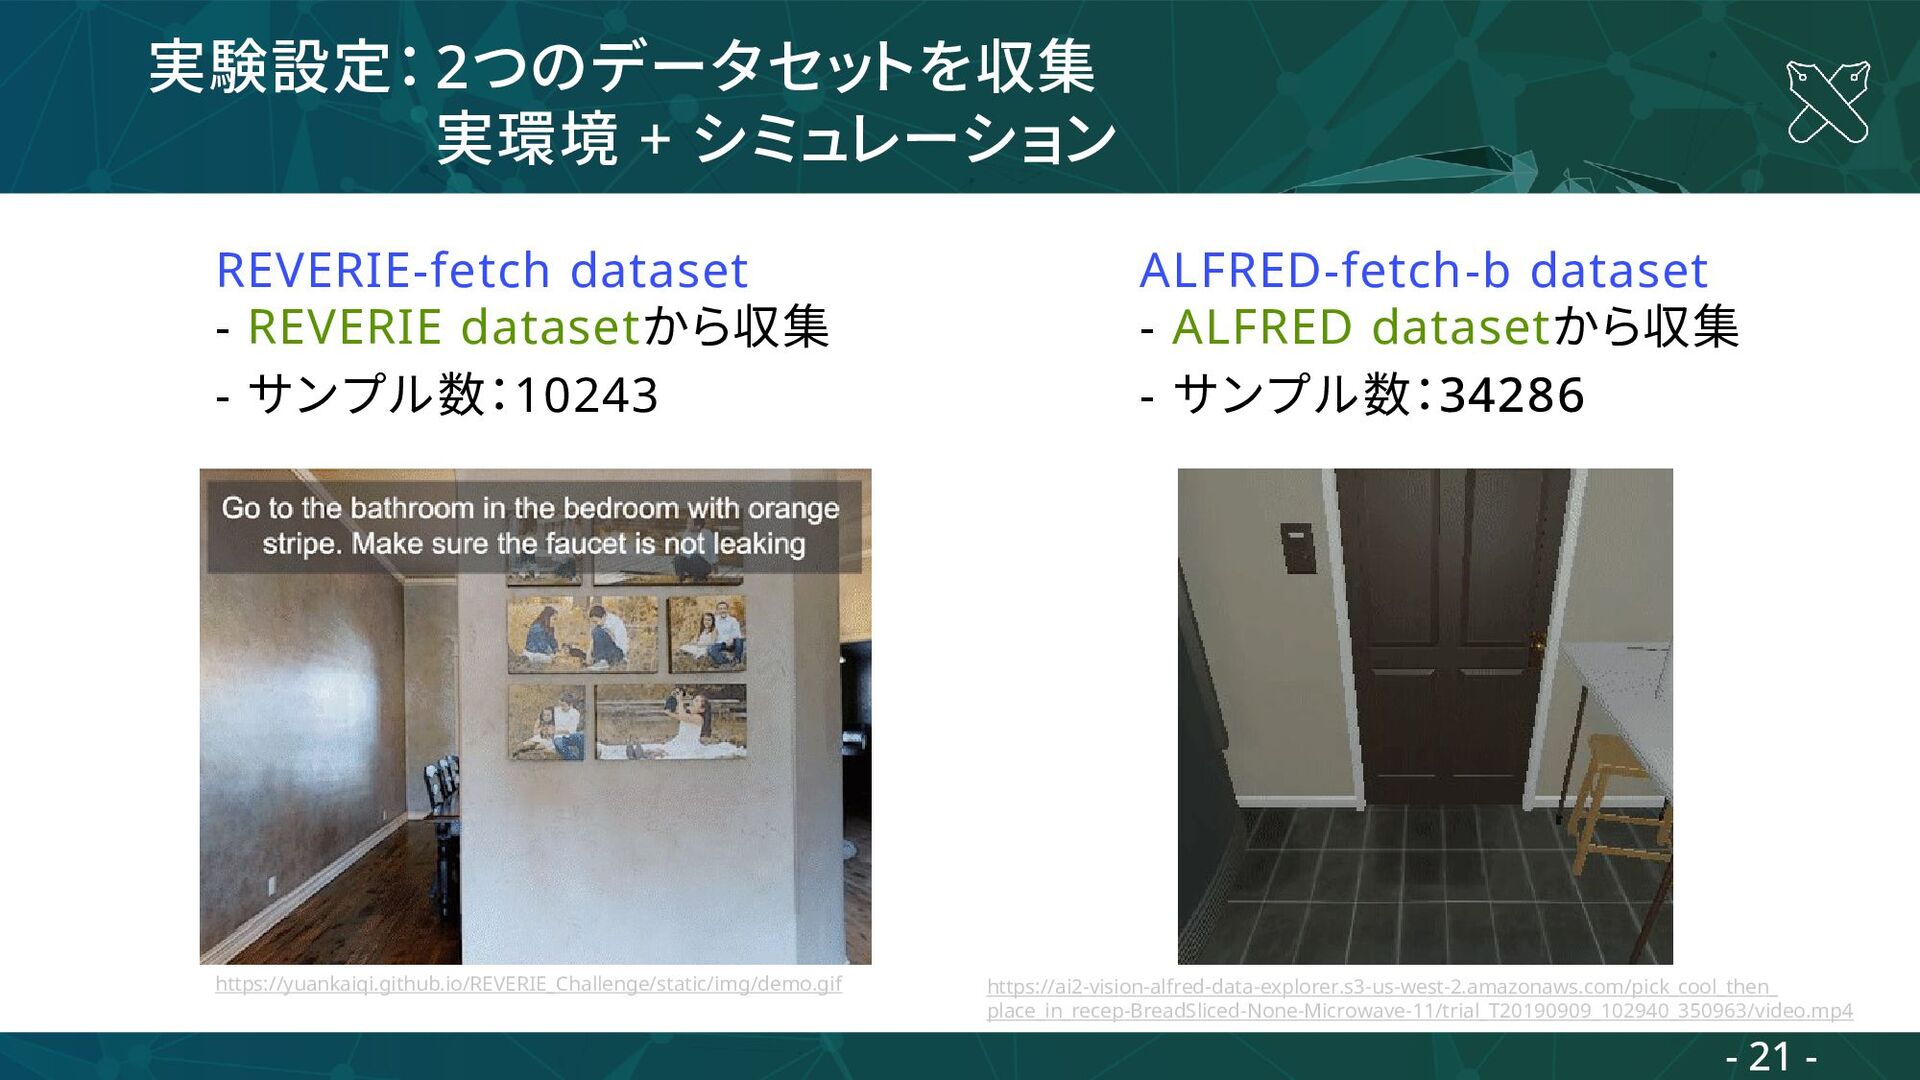
実験設定: 2つのデータセットを収集 実環境 + シミュレーション REVERIE-fetch dataset - REVERIE datasetから収集
- サンプル数:10243 ALFRED-fetch-b dataset - ALFRED datasetから収集 - サンプル数:34286 https://yuankaiqi.github.io/REVERIE_Challenge/static/img/demo.gif https://ai2-vision-alfred-data-explorer.s3-us-west-2.amazonaws.com/pick_cool_then_ place_in_recep-BreadSliced-None-Microwave-11/trial_T20190909_102940_350963/video.mp4 - 21 - -
実験設定: 学習手法のベースラインを3つ用意 - Target Domain Only: 転移先ドメインのデータのみを使用 - Fine-Tuning: 転移元ドメインのデータでpretrainingした後
転移先ドメインのデータでfine-tuning - MCDDA+: [Saito+, CVPR18]で提案された教師なし転移学習手法 MCDDAを,転移先ドメインの教師データを利用するよう 拡張して適用 - 22 - -
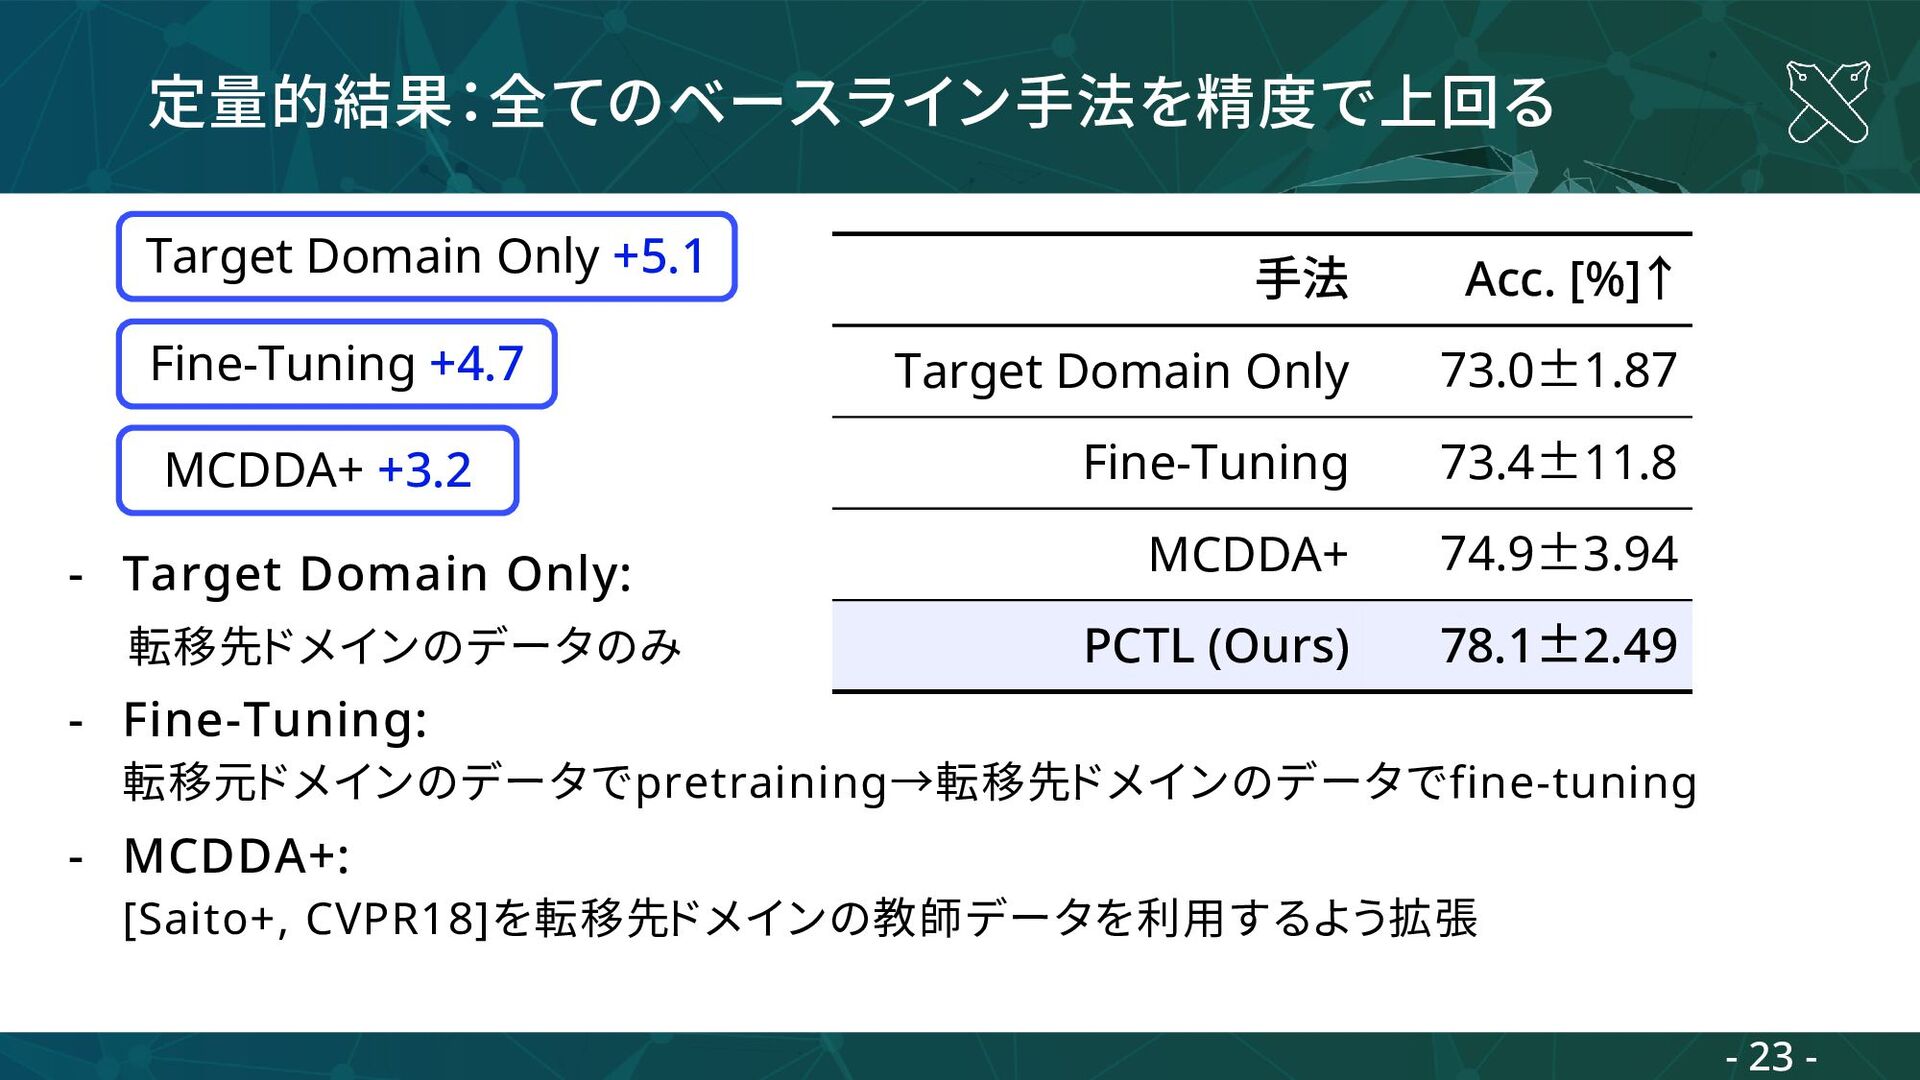
定量的結果:全てのベースライン手法を精度で上回る - Target Domain Only: 転移先ドメインのデータのみ - Fine-Tuning: 転移元ドメインのデータでpretraining→転移先ドメインのデータでfine-tuning -
MCDDA+: [Saito+, CVPR18]を転移先ドメインの教師データを利用するよう拡張 手法 Acc. [%]↑ Target Domain Only 73.0±1.87 Fine-Tuning 73.4±11.8 MCDDA+ 74.9±3.94 PCTL (Ours) 78.1±2.49 Target Domain Only +5.1 MCDDA+ +3.2 Fine-Tuning +4.7 - 23 - -
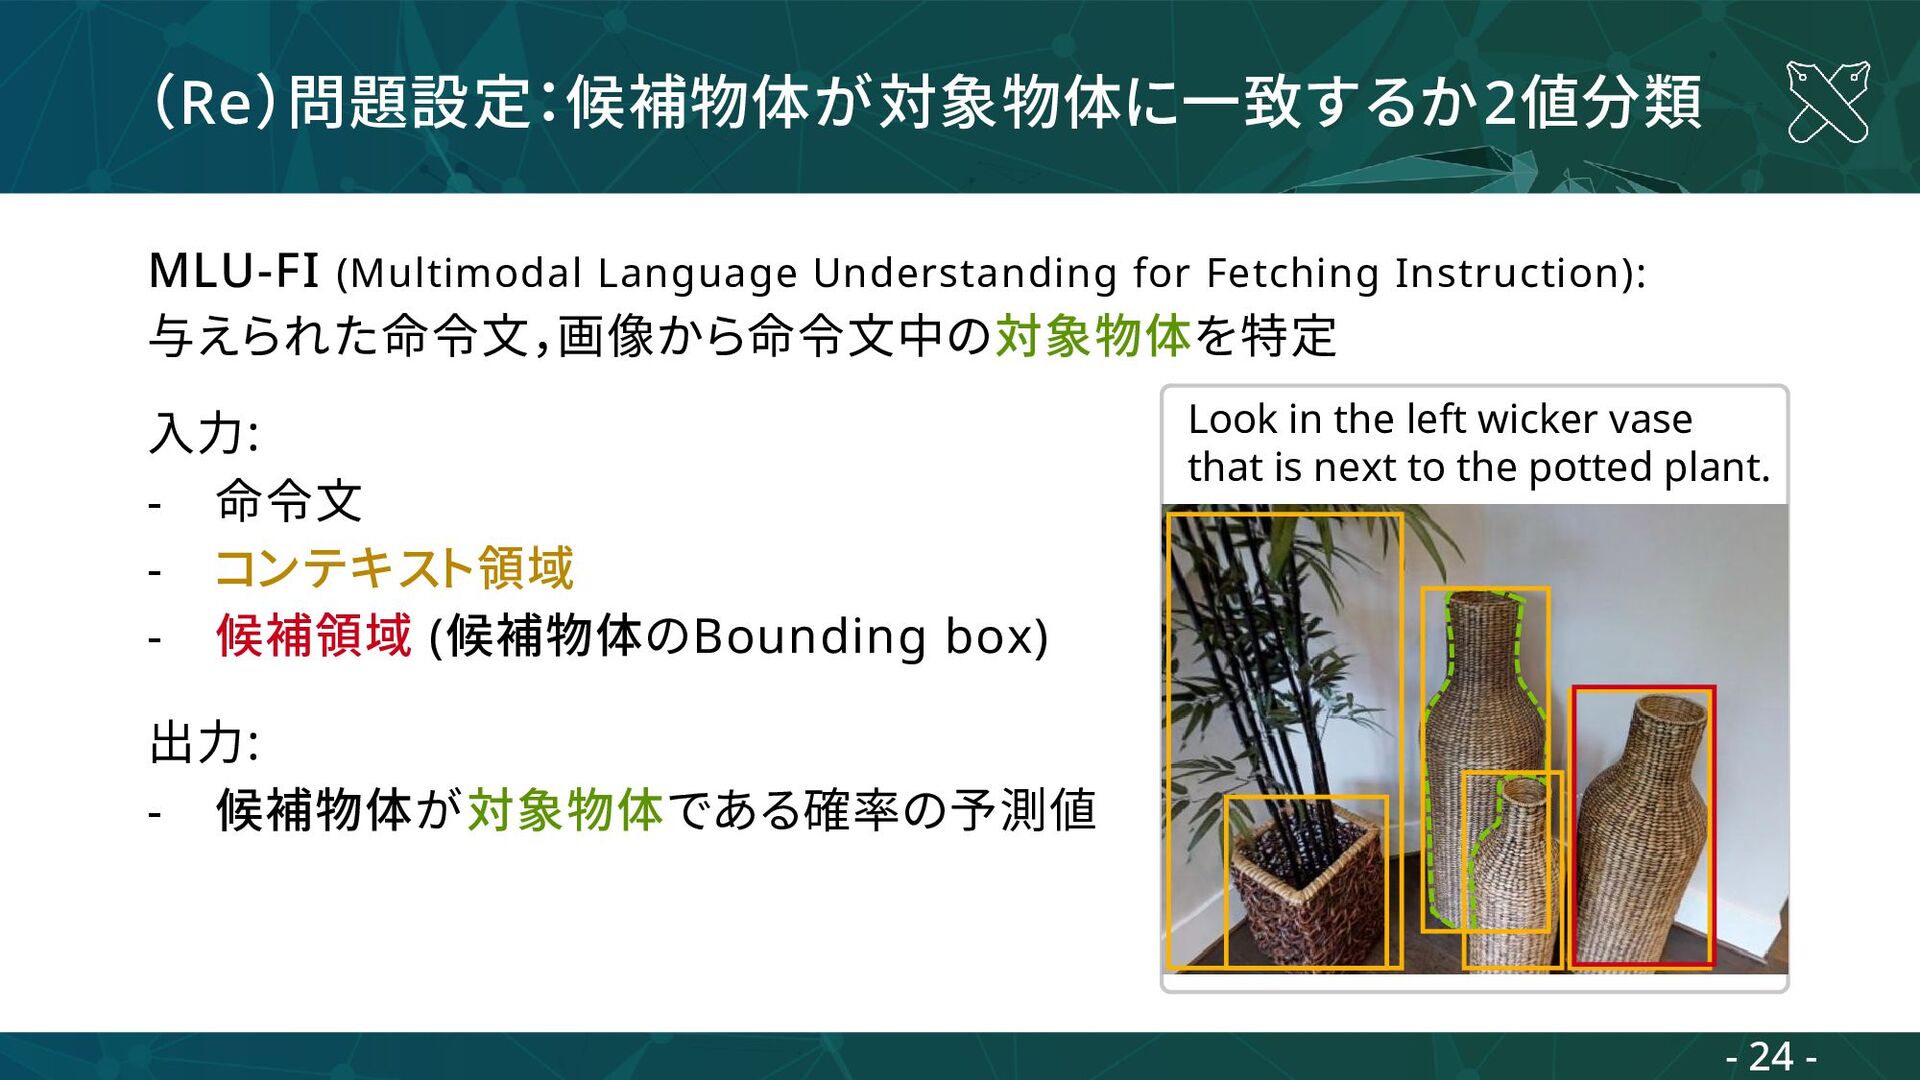
(Re)問題設定:候補物体が対象物体に一致するか2値分類 MLU-FI (Multimodal Language Understanding for Fetching Instruction): 与えられた命令文,画像から命令文中の対象物体を特定 入力:
- 命令文 - コンテキスト領域 - 候補領域 (候補物体のBounding box) 出力: - 候補物体が対象物体である確率の予測値 Look in the left wicker vase that is next to the potted plant. - 24 - -
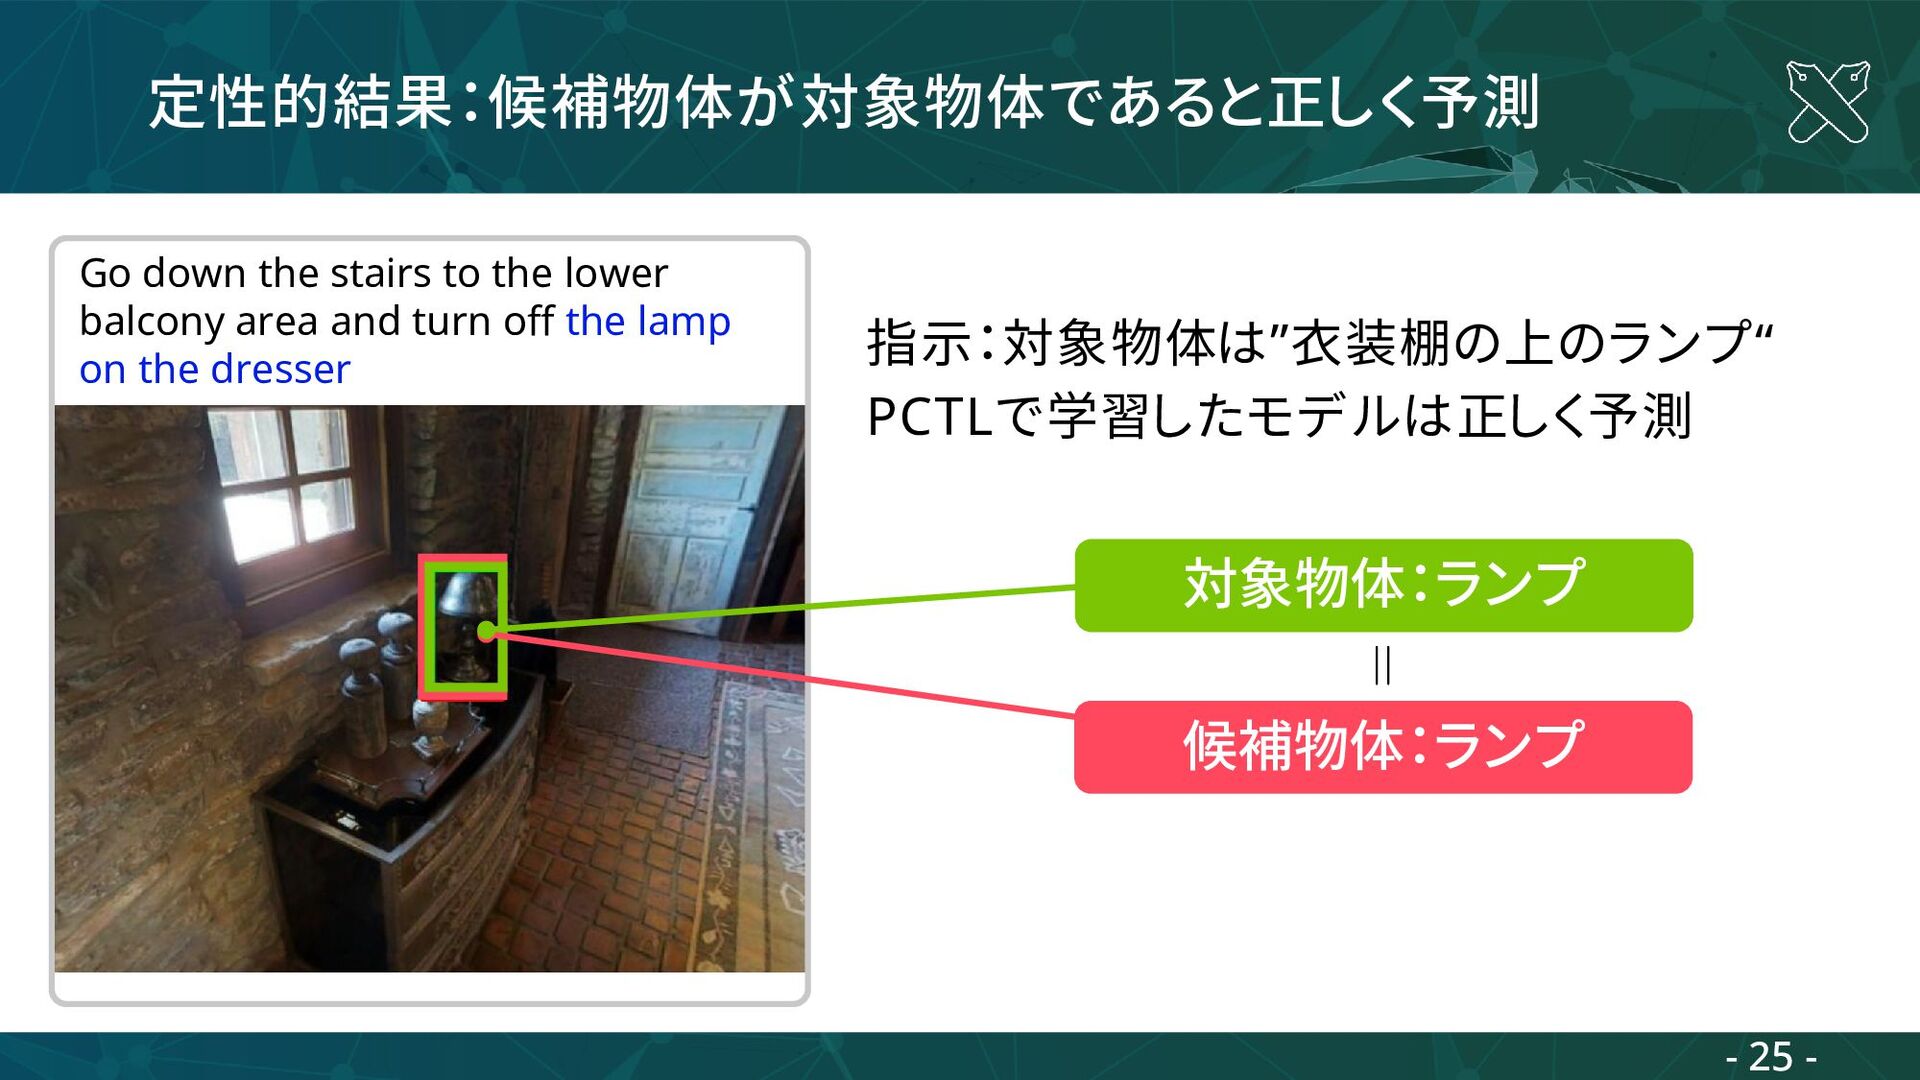
定性的結果:候補物体が対象物体であると正しく予測 Go down the stairs to the lower balcony area
and turn off the lamp on the dresser 指示:対象物体は”衣装棚の上のランプ“ PCTLで学習したモデルは正しく予測 - 25 - 候補物体:ランプ 対象物体:ランプ -
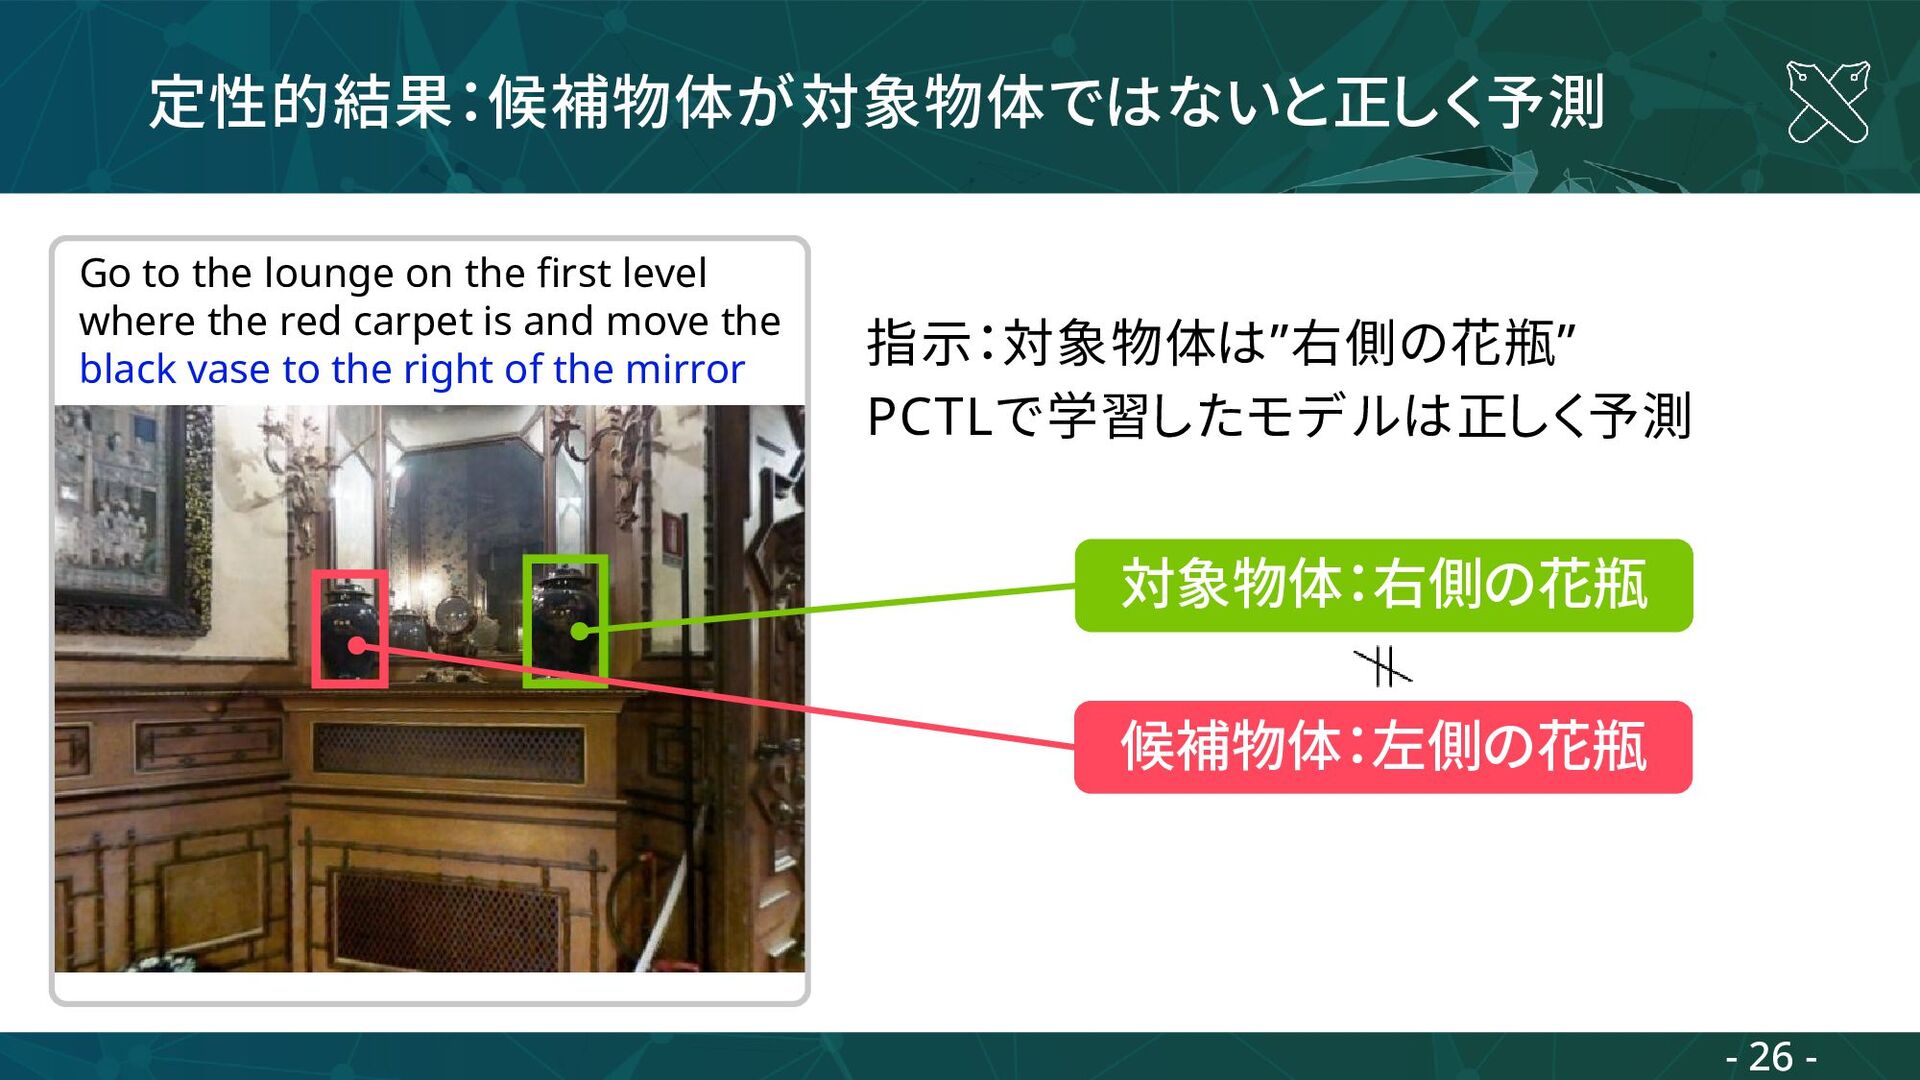
定性的結果:候補物体が対象物体ではないと正しく予測 Go to the lounge on the first level where
the red carpet is and move the black vase to the right of the mirror 候補物体:左側の花瓶 対象物体:右側の花瓶 指示:対象物体は”右側の花瓶” PCTLで学習したモデルは正しく予測 - 26 - -
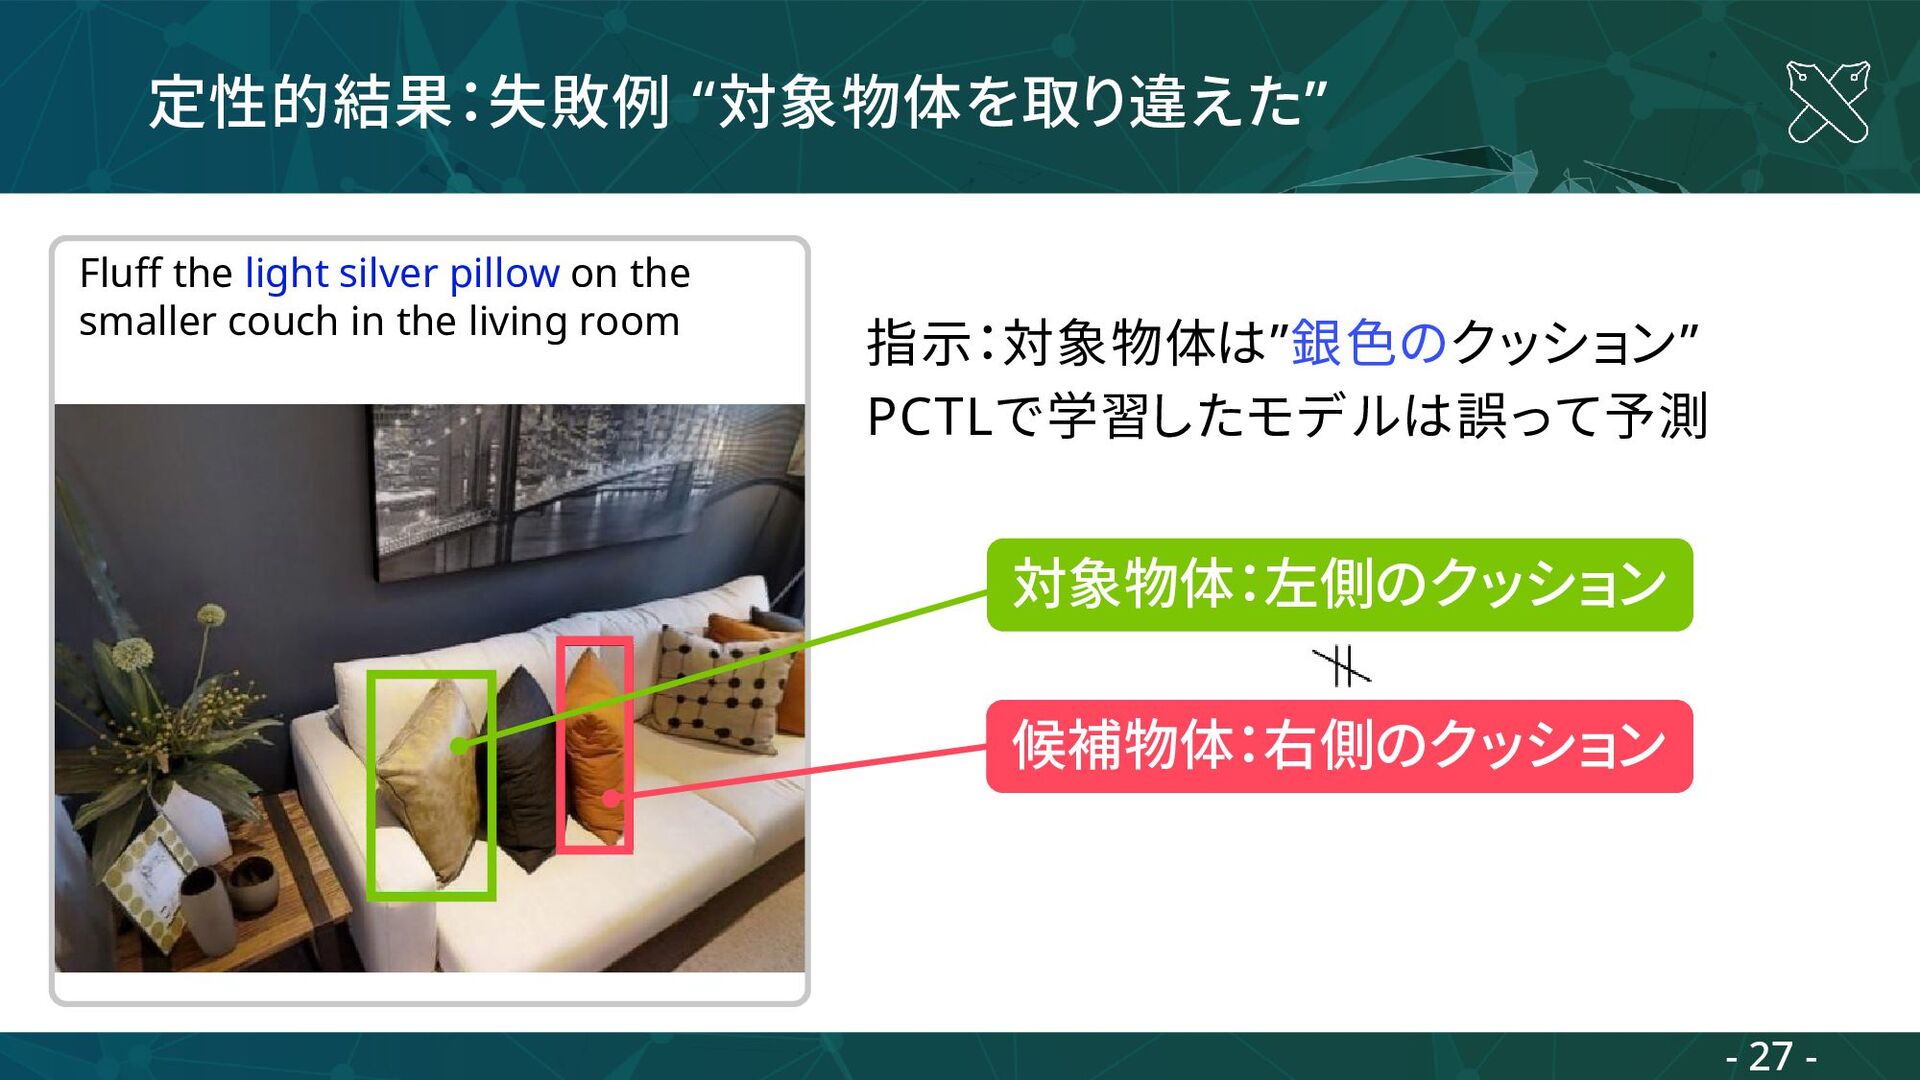
定性的結果:失敗例 “対象物体を取り違えた” Fluff the light silver pillow on the smaller
couch in the living room 指示:対象物体は”銀色のクッション” PCTLで学習したモデルは誤って予測 候補物体:右側のクッション 対象物体:左側のクッション - 27 - -
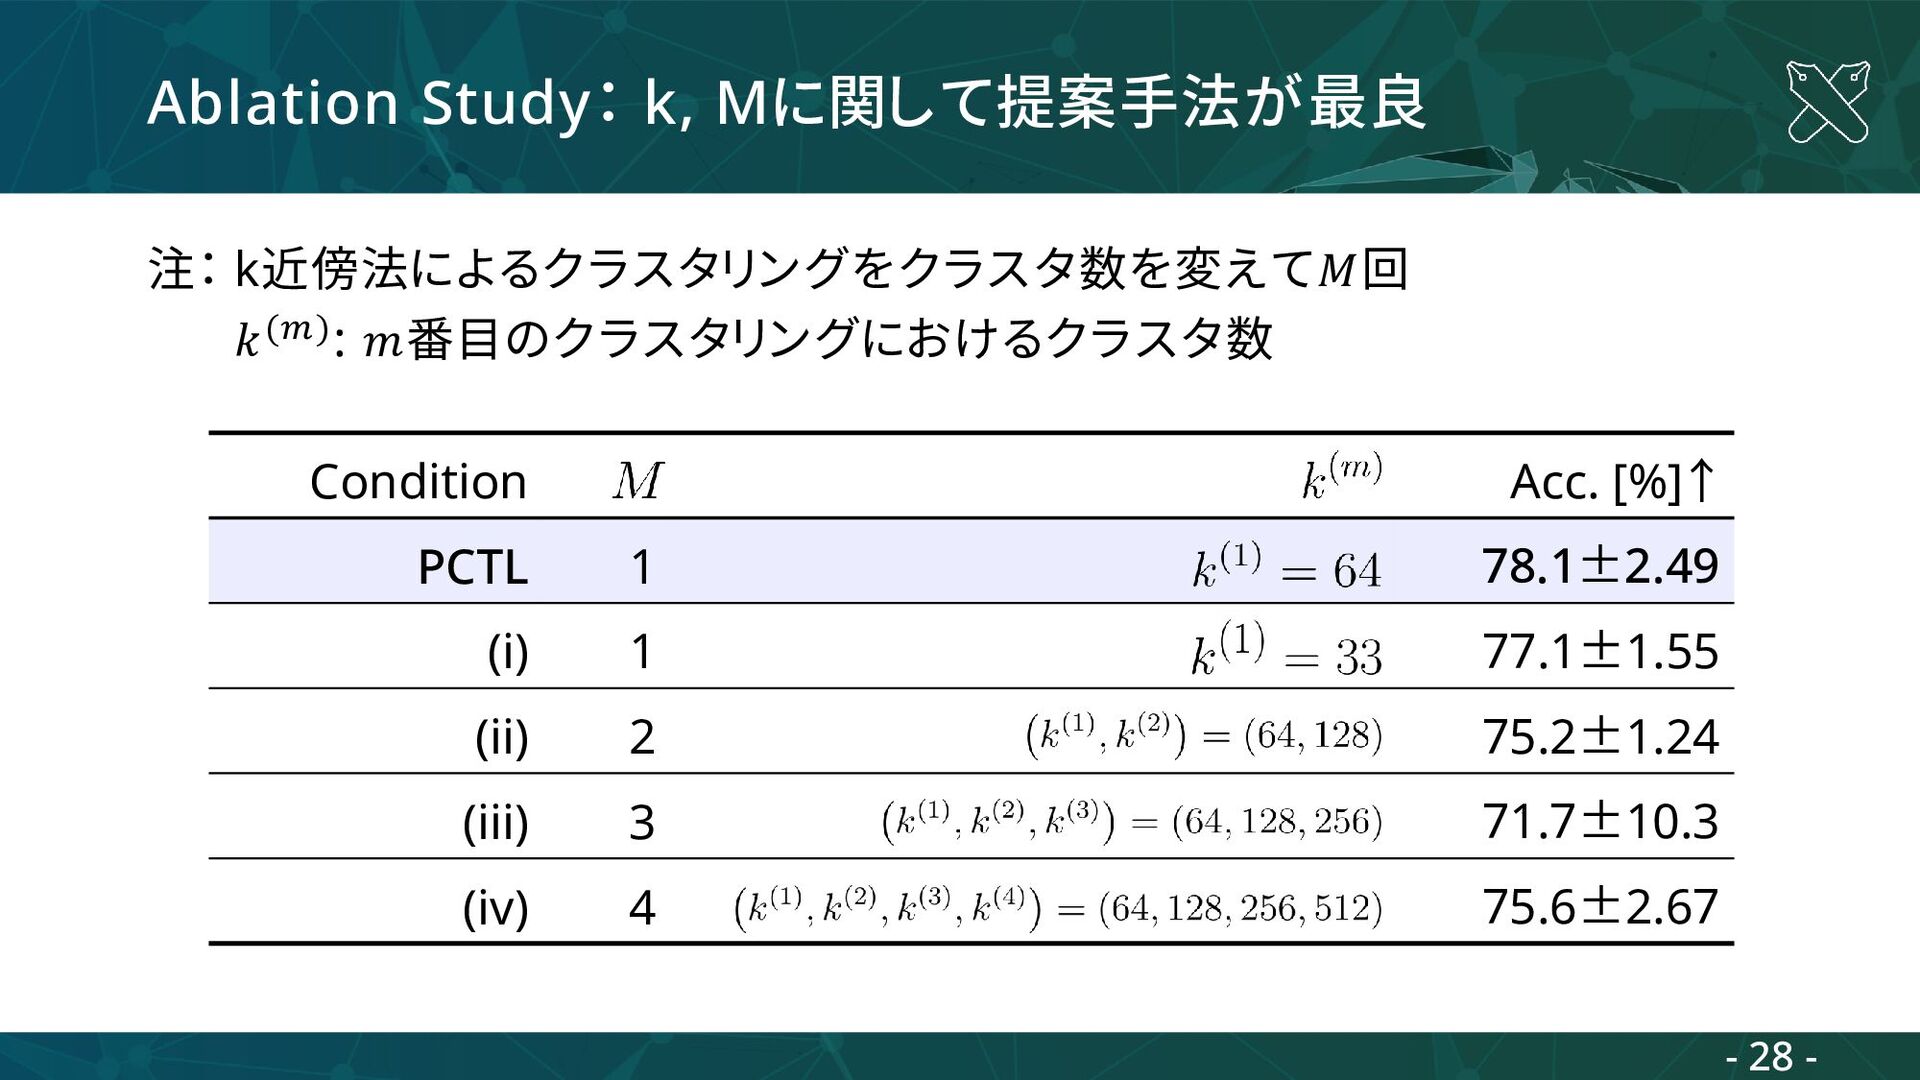
Ablation Study: k, Mに関して提案手法が最良 注: k近傍法によるクラスタリングをクラスタ数を変えて𝑀回 𝑘(𝑚): 𝑚番目のクラスタリングにおけるクラスタ数 - 28
- Condition Acc. [%]↑ PCTL 1 78.1±2.49 (i) 1 77.1±1.55 (ii) 2 75.2±1.24 (iii) 3 71.7±10.3 (iv) 4 75.6±2.67 -
まとめ:転移学習手法: PCTL / 転移学習のために 一般化された対比損失: Dual ProtoNCE - 物体操作に関するマルチモーダル言語理解タスクに転移学習を導入 -
対照学習のフレームワークを応用した転移学習手法,PCTLを提案 - 転移学習のために一般化された対比損失,Dual ProtoNCEを提案 - REVERIE-fetchデータセットにおけるMLU-FIタスクの精度において, PCTLはベースライン手法を上回った - 29 - -
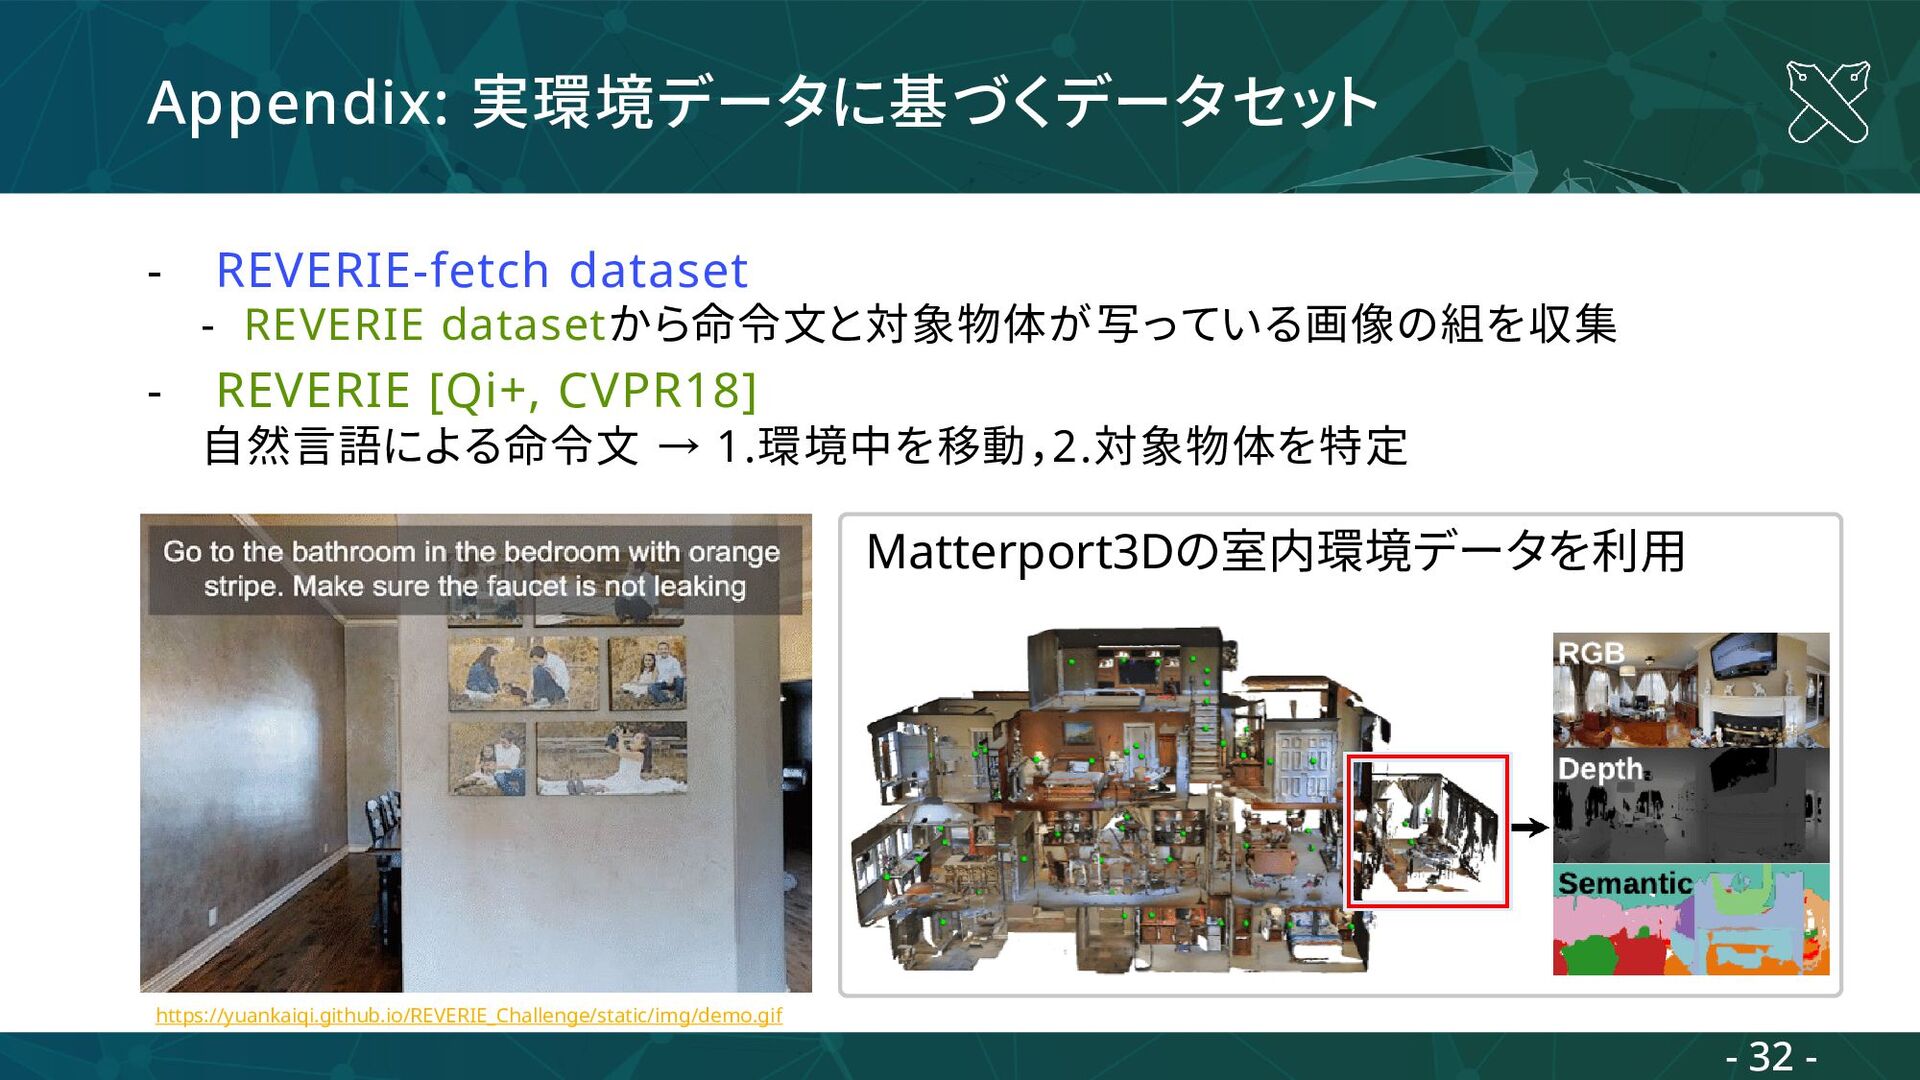
Appendix: 実環境データに基づくデータセット - REVERIE-fetch dataset - REVERIE datasetから命令文と対象物体が写っている画像の組を収集 - REVERIE
[Qi+, CVPR18] 自然言語による命令文 → 1.環境中を移動,2.対象物体を特定 Matterport3Dの室内環境データを利用 https://yuankaiqi.github.io/REVERIE_Challenge/static/img/demo.gif - 32 - -
Appendix: シミュレーションに基づくデータセット - ALFRED-fetch-b dataset - ALFRED datasetから命令文と対象物体が写っている画像の組を収集 - ALFRED
[Shridhar+, CVPR18] 自然言語による命令文 → 室内環境における複数ステップの行動選択タスク https://ai2-vision-alfred-data-explorer.s3-us-west- 2.amazonaws.com/pick_cool_then_place_in_recep-BreadSliced-None- Microwave-11/trial_T20190909_102940_350963/video.mp4 - 33 - -
Appendix: データセットの統計情報 REVERIE-fetch: 実環境データに基づく (転移先ドメイン) ALFRED-fetch-b: シミュレーションに基づく (転移元ドメイン) REVERIE-fetch ALFRED-fetch-b
Vocabulary size 1958 1558 Average sentence length 18.4 11.7 #Sample 10243 34286 #Sample in Training set 8302 27492 #Sample in Validation set 994 3470 #Sample in Test set 947 3324 - 34 - -
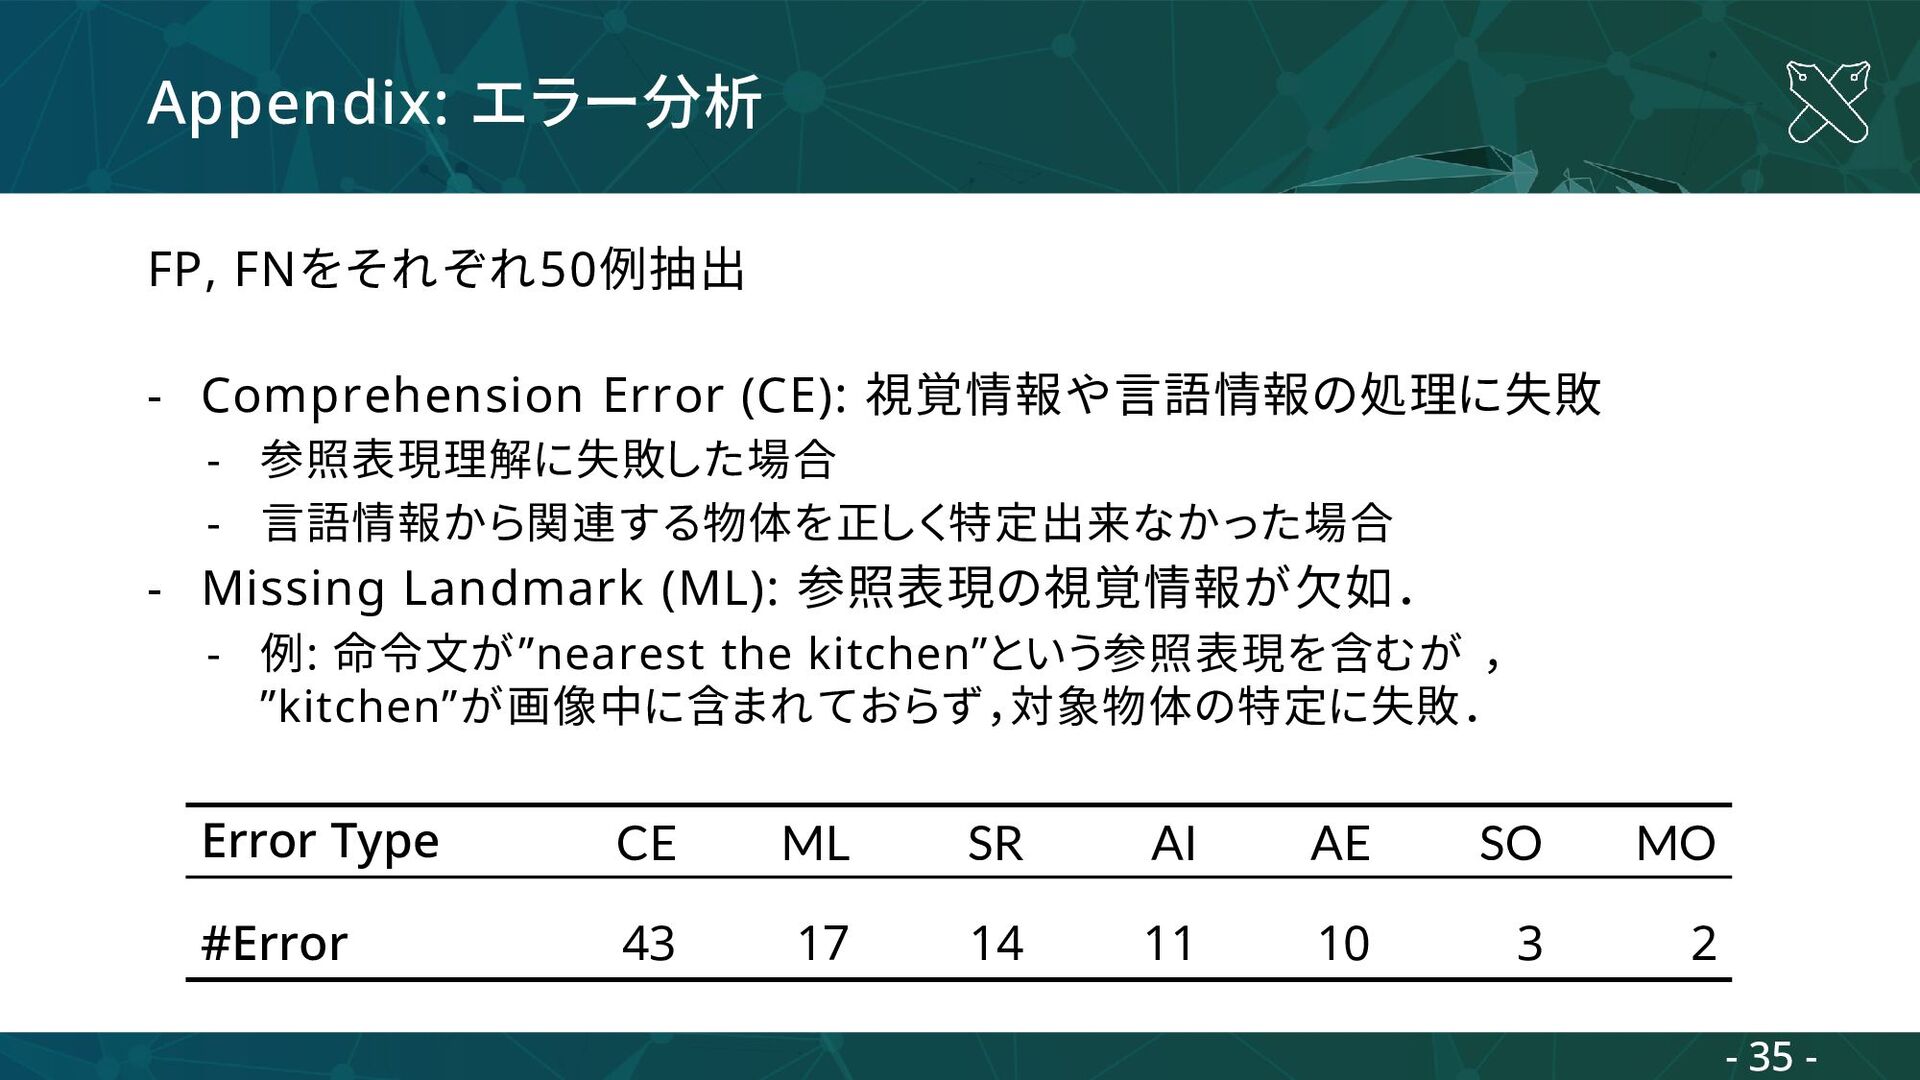
Appendix: エラー分析 FP, FNをそれぞれ50例抽出 - Comprehension Error (CE): 視覚情報や言語情報の処理に失敗 -
参照表現理解に失敗した場合 - 言語情報から関連する物体を正しく特定出来なかった場合 - Missing Landmark (ML): 参照表現の視覚情報が欠如. - 例: 命令文が”nearest the kitchen”という参照表現を含むが , ”kitchen”が画像中に含まれておらず,対象物体の特定に失敗. Error Type CE ML SR AI AE SO MO #Error 43 17 14 11 10 3 2 - 35 - -
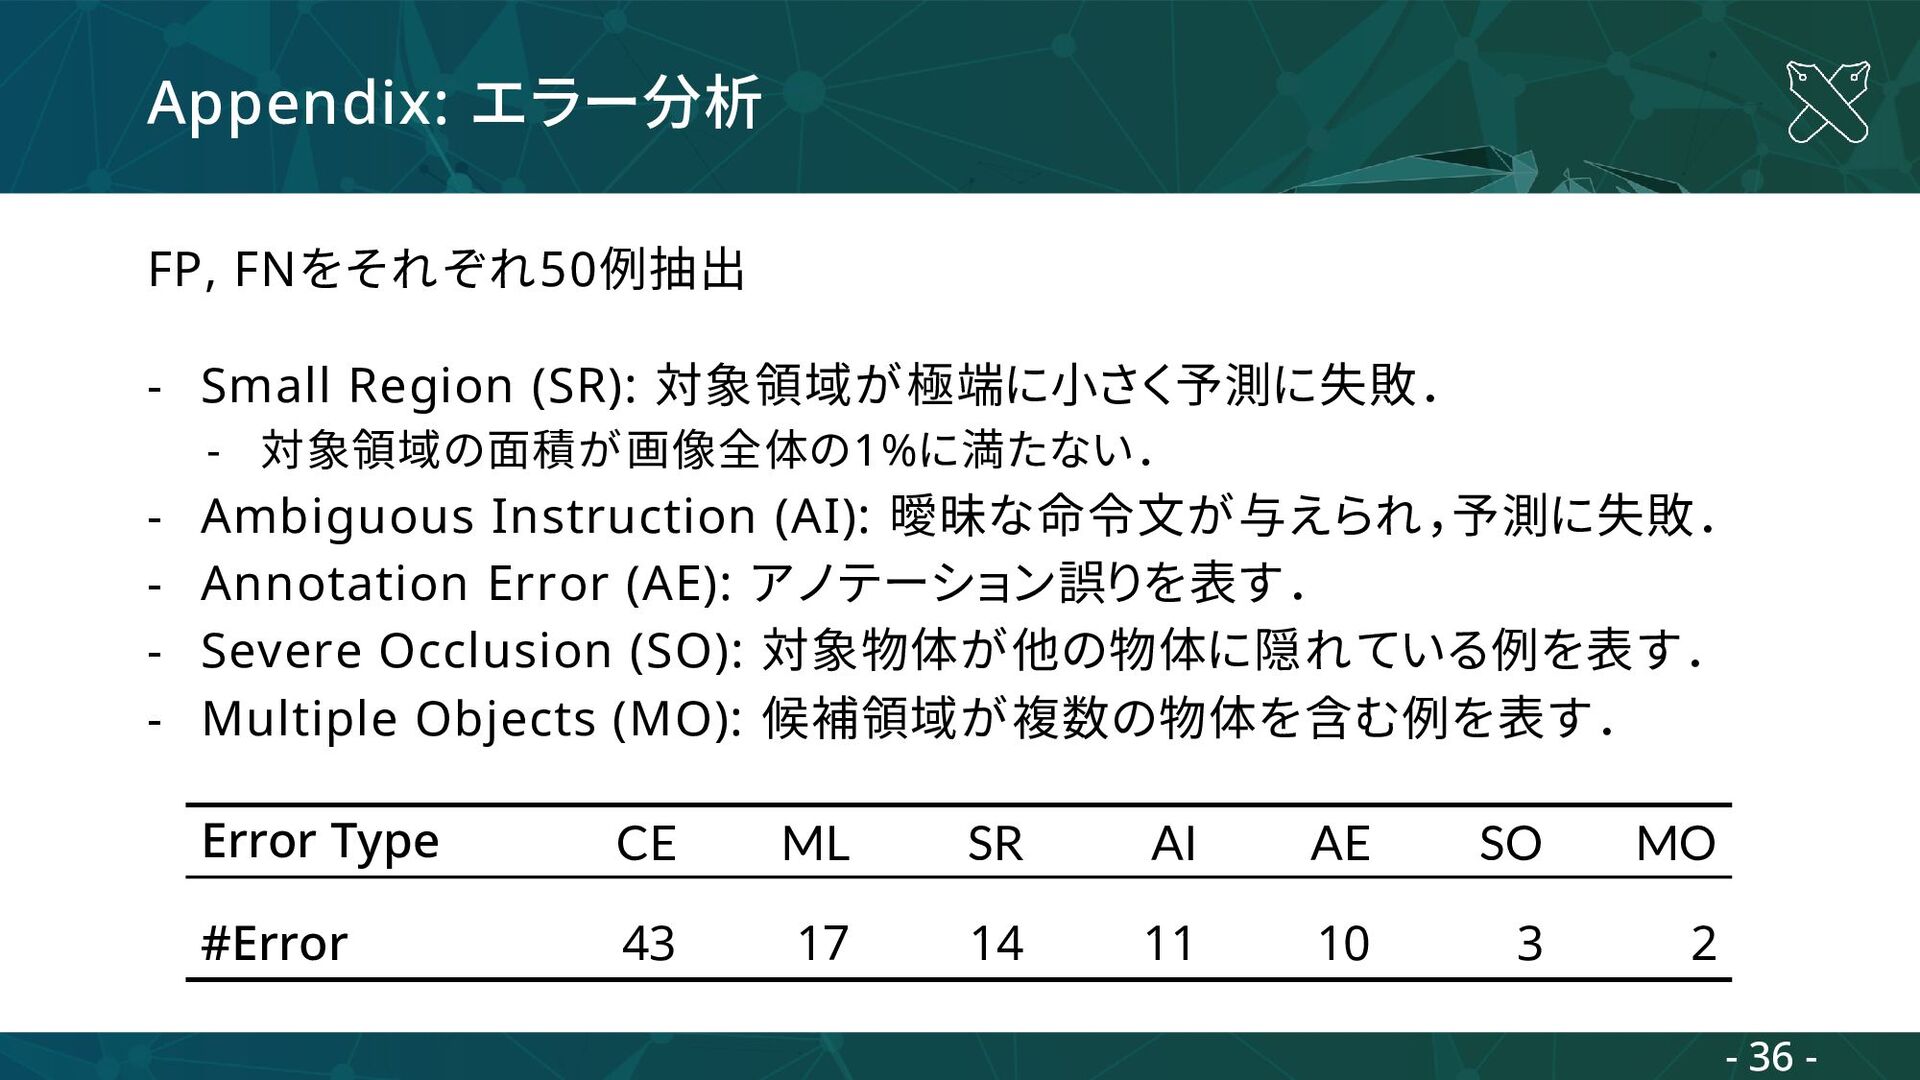
Appendix: エラー分析 FP, FNをそれぞれ50例抽出 - Small Region (SR): 対象領域が極端に小さく予測に失敗. -
対象領域の面積が画像全体の1%に満たない. - Ambiguous Instruction (AI): 曖昧な命令文が与えられ,予測に失敗. - Annotation Error (AE): アノテーション誤りを表す. - Severe Occlusion (SO): 対象物体が他の物体に隠れている例を表す. - Multiple Objects (MO): 候補領域が複数の物体を含む例を表す. Error Type CE ML SR AI AE SO MO #Error 43 17 14 11 10 3 2 - 36 -