Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
AWS Data Pipelineについての調査
Search
Koshi.Funamizu
August 17, 2018
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
AWS Data Pipelineについての調査
Koshi.Funamizu
August 17, 2018
More Decks by Koshi.Funamizu
See All by Koshi.Funamizu
AWS Glueについての調査
koshi
0
260
Featured
See All Featured
How to train your dragon (web standard)
notwaldorf
96
6.9k
B2B Lead Gen: Tactics, Traps & Triumph
marketingsoph
1
280
Joys of Absence: A Defence of Solitary Play
codingconduct
1
550
The Curse of the Amulet
leimatthew05
3
16k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
530
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.7k
Unsuck your backbone
ammeep
672
58k
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
How to Create Impact in a Changing Tech Landscape [PerfNow 2023]
tammyeverts
56
3.5k
The Pragmatic Product Professional
lauravandoore
37
7.5k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
Why Mistakes Are the Best Teachers: Turning Failure into a Pathway for Growth
auna
0
320
Transcript
AWS Data Pipeline 調査 Koshi Funamizu
AWS Data Pipelineとは AWS サービス間のデータ統合・処理をスケジュールベースで自動化してくれるサービス ポイント AWSのマネージドサービスである
サービスをまたいでのデータ移行やETL処理を実行することができる 一般的なスケジューラの機能を持っている(時間指定やサイクリック、依存関係設定、エラー処理など) オンプレの処理にも使える
主な機能 耐障害性があり、繰り返し可能で、高可用性を備えた、複雑なデータ処理ワークフローを作成・管理 依存関係の解決を提供 スケジュールすることが可能 頻度と数を含む再試行の制御を実現可能
S3、DynamoDB、RDS、EMR、EC2、および Redshift とのネイティブ統合 AWS ベースおよび外部オンプレミスリソースの両方のサポート
リージョン サポートされているリージョンを下記に示す。 (2018/08 時点) • バージニア北部 • オレゴン •
シドニー • 東京 • アイルランド
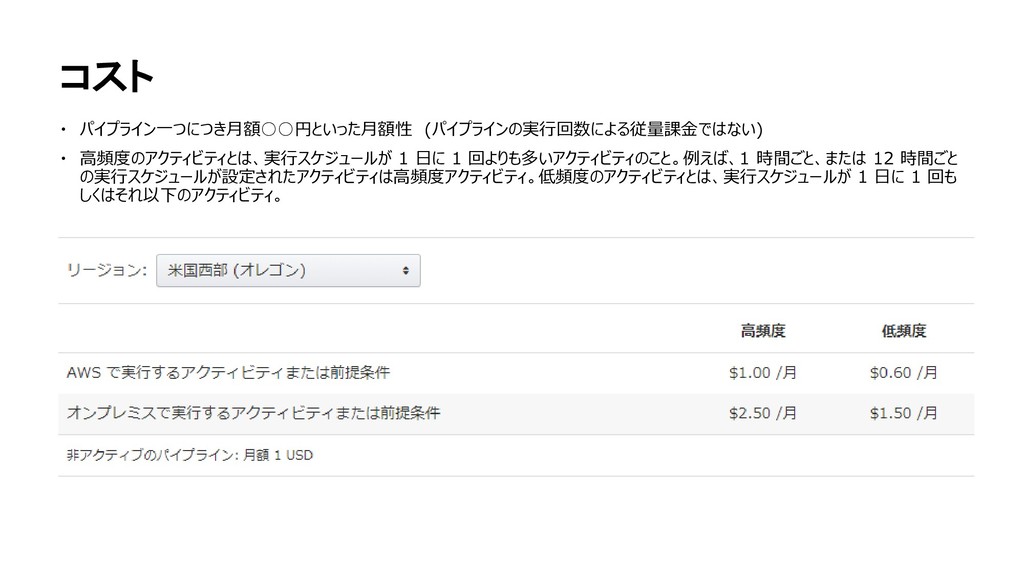
コスト パイプライン一つにつき月額◦◦円といった月額性 (パイプラインの実行回数による従量課金ではない) 高頻度のアクティビティとは、実行スケジュールが 1 日に 1 回よりも多いアクティビティのこと。例えば、1
時間ごと、または 12 時間ごと の実行スケジュールが設定されたアクティビティは高頻度アクティビティ。低頻度のアクティビティとは、実行スケジュールが 1 日に 1 回も しくはそれ以下のアクティビティ。
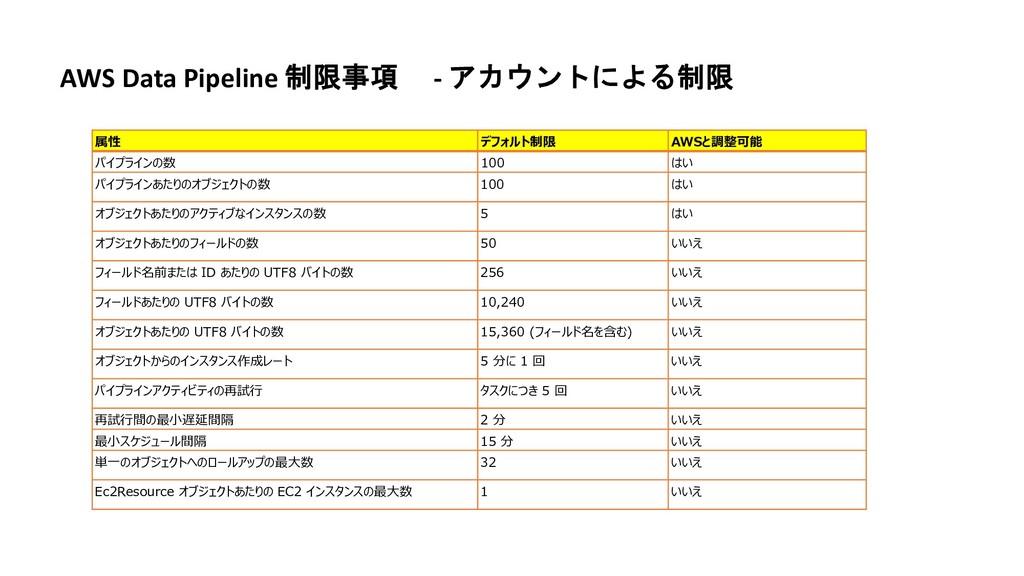
AWS Data Pipeline 制限事項 - アカウントによる制限 属性 デフォルト制限 AWSと調整可能 パイプラインの数
100 はい パイプラインあたりのオブジェクトの数 100 はい オブジェクトあたりのアクティブなインスタンスの数 5 はい オブジェクトあたりのフィールドの数 50 いいえ フィールド名前または ID あたりの UTF8 バイトの数 256 いいえ フィールドあたりの UTF8 バイトの数 10,240 いいえ オブジェクトあたりの UTF8 バイトの数 15,360 (フィールド名を含む) いいえ オブジェクトからのインスタンス作成レート 5 分に 1 回 いいえ パイプラインアクティビティの再試行 タスクにつき 5 回 いいえ 再試行間の最小遅延間隔 2 分 いいえ 最小スケジュール間隔 15 分 いいえ 単一のオブジェクトへのロールアップの最大数 32 いいえ Ec2Resource オブジェクトあたりの EC2 インスタンスの最大数 1 いいえ
AWS Data Pipeline 制限事項 - スケーリングの制限 AWS アカウントの EC2
インスタンス数の制限対象
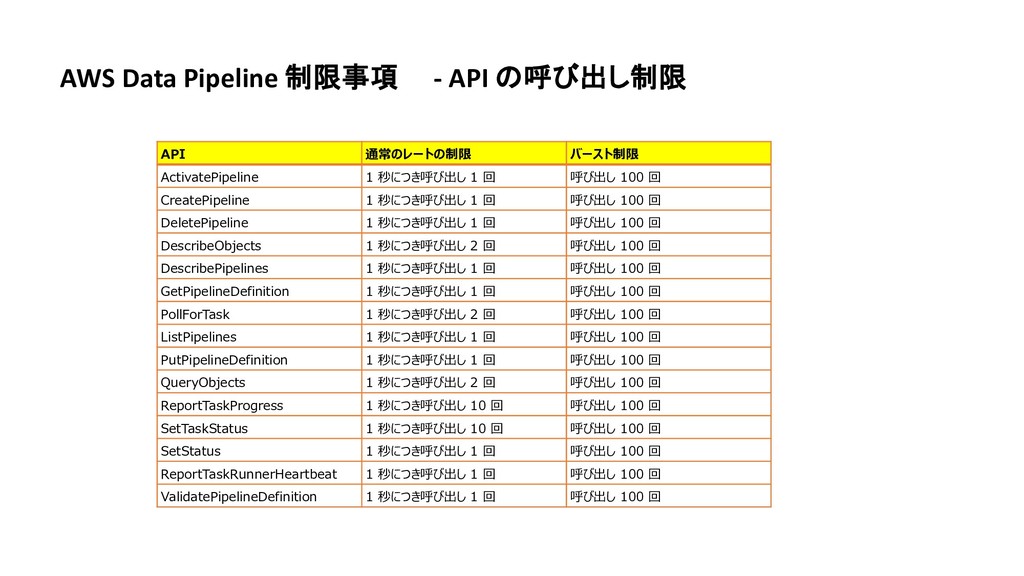
AWS Data Pipeline 制限事項 - API の呼び出し制限 API 通常のレートの制限 バースト制限
ActivatePipeline 1 秒につき呼び出し 1 回 呼び出し 100 回 CreatePipeline 1 秒につき呼び出し 1 回 呼び出し 100 回 DeletePipeline 1 秒につき呼び出し 1 回 呼び出し 100 回 DescribeObjects 1 秒につき呼び出し 2 回 呼び出し 100 回 DescribePipelines 1 秒につき呼び出し 1 回 呼び出し 100 回 GetPipelineDefinition 1 秒につき呼び出し 1 回 呼び出し 100 回 PollForTask 1 秒につき呼び出し 2 回 呼び出し 100 回 ListPipelines 1 秒につき呼び出し 1 回 呼び出し 100 回 PutPipelineDefinition 1 秒につき呼び出し 1 回 呼び出し 100 回 QueryObjects 1 秒につき呼び出し 2 回 呼び出し 100 回 ReportTaskProgress 1 秒につき呼び出し 10 回 呼び出し 100 回 SetTaskStatus 1 秒につき呼び出し 10 回 呼び出し 100 回 SetStatus 1 秒につき呼び出し 1 回 呼び出し 100 回 ReportTaskRunnerHeartbeat 1 秒につき呼び出し 1 回 呼び出し 100 回 ValidatePipelineDefinition 1 秒につき呼び出し 1 回 呼び出し 100 回
LambadaとData Pipelineの違い • Data Pipelineはスケジュールドリブンの処理を便利に実装・管理するためのサービス - バッチ処理の組み合わせに適している • Lambada はイベントドリブンの処理を実装するためのサービス
- リアルタイム処理に適している
Data PipelineでできるがCronでできないこと ログの記録、ローテーション(パイプラインのログの表示) 失敗時のリトライ、リトライしてもダメだった場合の後続処理キャンセル(カスケードの失敗と再実行) 入力ファイルが配置されるまで処理を待機(前提条件) 正常終了・失敗の通知(アクション)
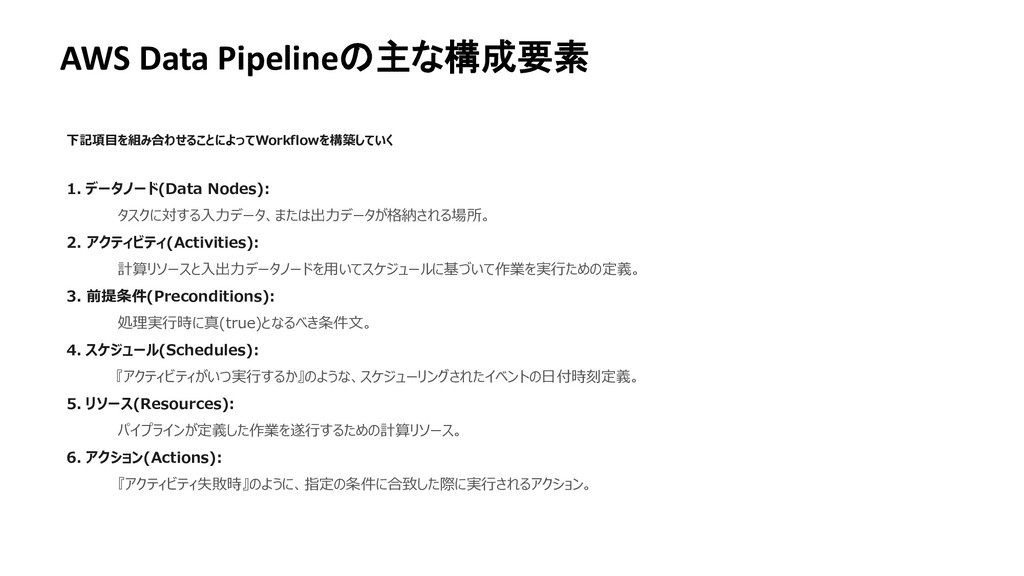
AWS Data Pipelineの主な構成要素 下記項目を組み合わせることによってWorkflowを構築していく 1. データノード(Data Nodes): タスクに対する入力データ、または出力データが格納される場所。 2. アクティビティ(Activities):
計算リソースと入出力データノードを用いてスケジュールに基づいて作業を実行ための定義。 3. 前提条件(Preconditions): 処理実行時に真(true)となるべき条件文。 4. スケジュール(Schedules): 『アクティビティがいつ実行するか』のような、スケジューリングされたイベントの日付時刻定義。 5. リソース(Resources): パイプラインが定義した作業を遂行するための計算リソース。 6. アクション(Actions): 『アクティビティ失敗時』のように、指定の条件に合致した際に実行されるアクション。
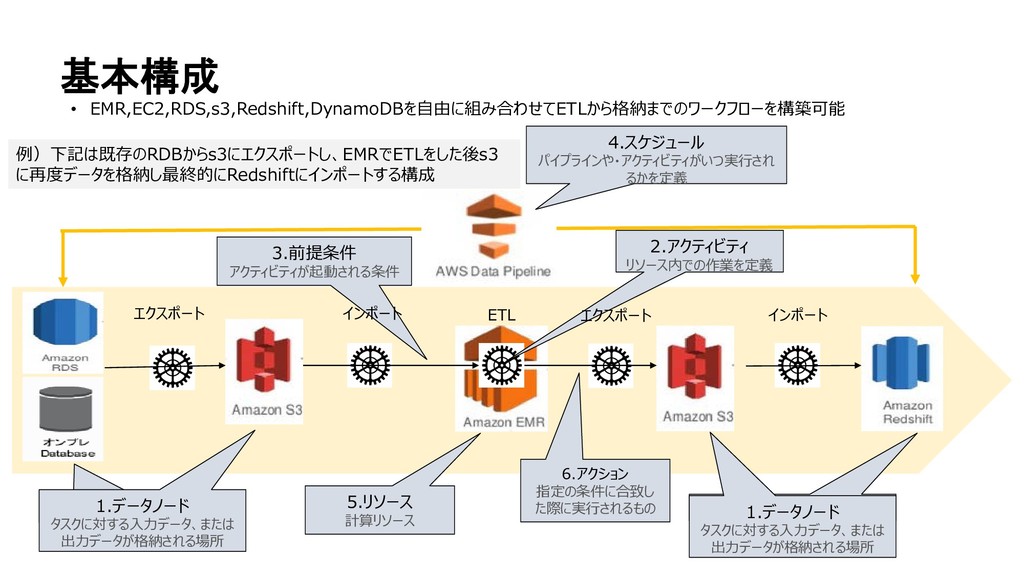
基本構成 ETL エクスポート インポート 5.リソース 計算リソース • EMR,EC2,RDS,s3,Redshift,DynamoDBを自由に組み合わせてETLから格納までのワークフローを構築可能 1.データノード タスクに対する入力データ、または
出力データが格納される場所 1.データノード タスクに対する入力データ、または 出力データが格納される場所 4.スケジュール パイプラインや・アクティビティがいつ実行され るかを定義 2.アクティビティ リソース内での作業を定義 3.前提条件 アクティビティが起動される条件 インポート 例)下記は既存のRDBからs3にエクスポートし、EMRでETLをした後s3 に再度データを格納し最終的にRedshiftにインポートする構成 6.アクション 指定の条件に合致し た際に実行されるもの エクスポート
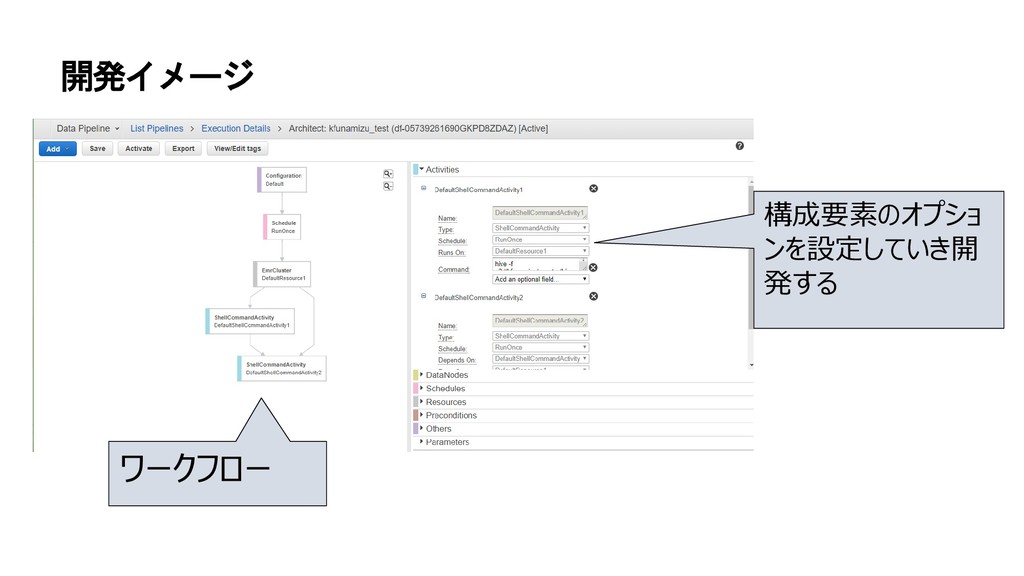
開発イメージ ワークフロー 構成要素のオプショ ンを設定していき開 発する
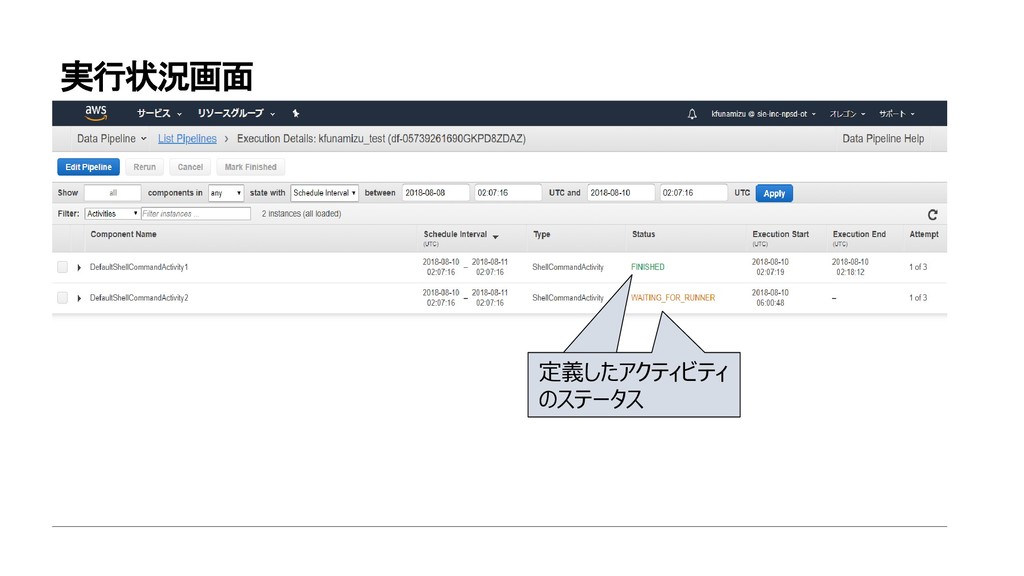
ワークフロー 実行状況画面 定義したアクティビティ のステータス
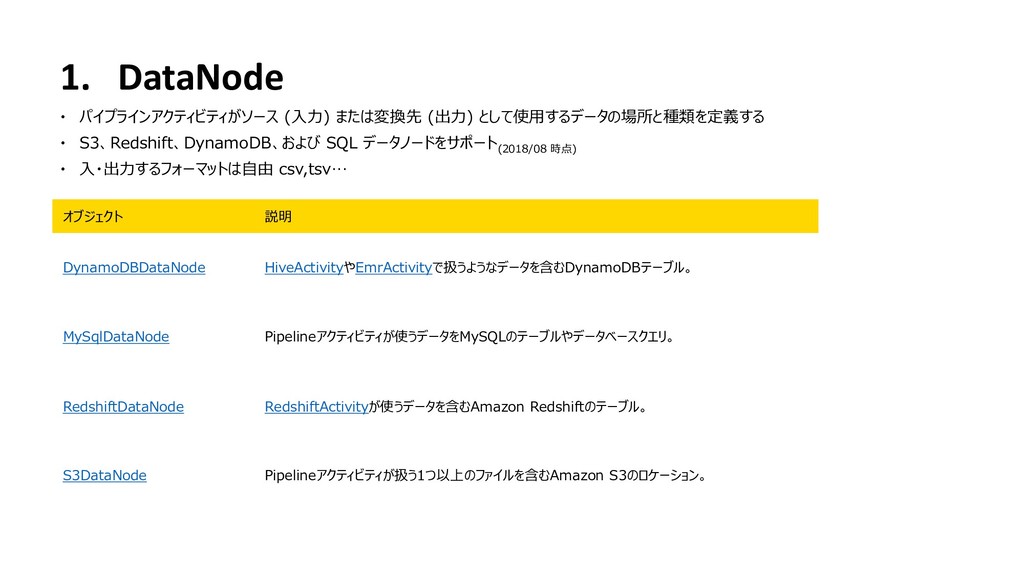
1. DataNode パイプラインアクティビティがソース (入力) または変換先 (出力) として使用するデータの場所と種類を定義する S3、Redshift、DynamoDB、および
SQL データノードをサポート(2018/08 時点) 入・出力するフォーマットは自由 csv,tsv… オブジェクト 説明 DynamoDBDataNode HiveActivityやEmrActivityで扱うようなデータを含むDynamoDBテーブル。 MySqlDataNode Pipelineアクティビティが使うデータをMySQLのテーブルやデータベースクエリ。 RedshiftDataNode RedshiftActivityが使うデータを含むAmazon Redshiftのテーブル。 S3DataNode Pipelineアクティビティが扱う1つ以上のファイルを含むAmazon S3のロケーション。
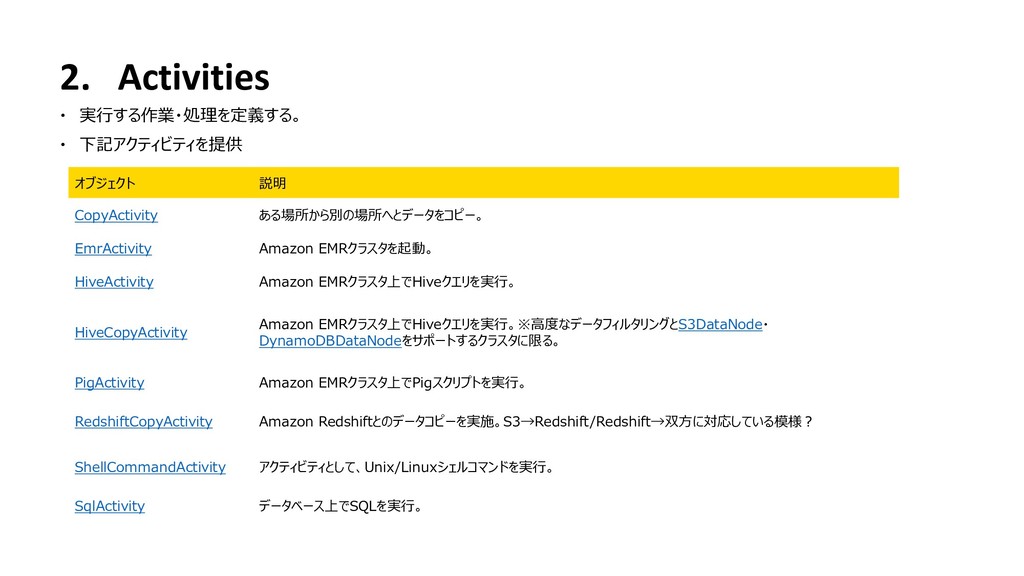
2. Activities 実行する作業・処理を定義する。 下記アクティビティを提供 オブジェクト 説明 CopyActivity ある場所から別の場所へとデータをコピー。
EmrActivity Amazon EMRクラスタを起動。 HiveActivity Amazon EMRクラスタ上でHiveクエリを実行。 HiveCopyActivity Amazon EMRクラスタ上でHiveクエリを実行。※高度なデータフィルタリングとS3DataNode・ DynamoDBDataNodeをサポートするクラスタに限る。 PigActivity Amazon EMRクラスタ上でPigスクリプトを実行。 RedshiftCopyActivity Amazon Redshiftとのデータコピーを実施。S3→Redshift/Redshift→双方に対応している模様? ShellCommandActivity アクティビティとして、Unix/Linuxシェルコマンドを実行。 SqlActivity データベース上でSQLを実行。
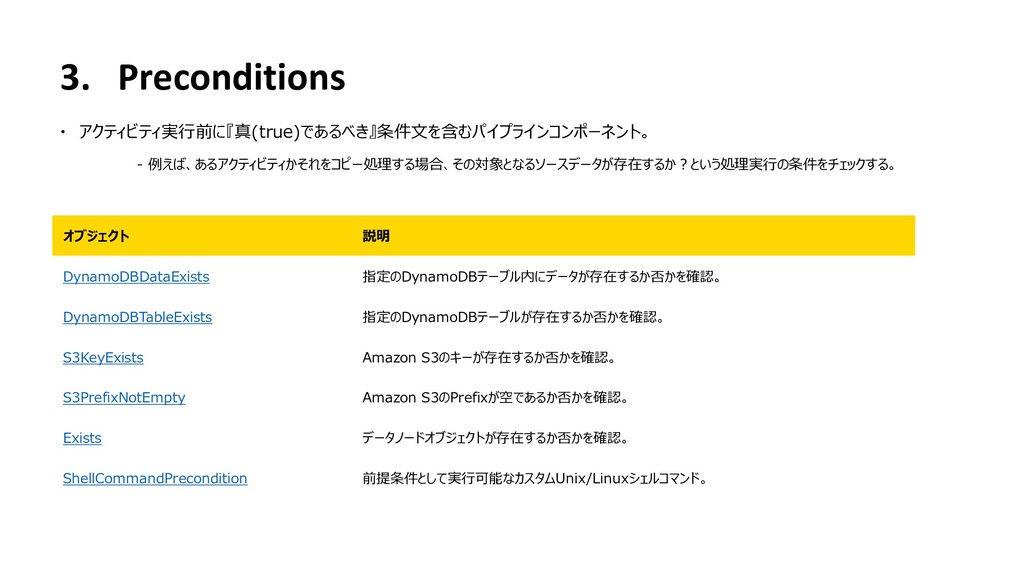
3. Preconditions アクティビティ実行前に『真(true)であるべき』条件文を含むパイプラインコンポーネント。 - 例えば、あるアクティビティかそれをコピー処理する場合、その対象となるソースデータが存在するか?という処理実行の条件をチェックする。 オブジェクト 説明 DynamoDBDataExists 指定のDynamoDBテーブル内にデータが存在するか否かを確認。
DynamoDBTableExists 指定のDynamoDBテーブルが存在するか否かを確認。 S3KeyExists Amazon S3のキーが存在するか否かを確認。 S3PrefixNotEmpty Amazon S3のPrefixが空であるか否かを確認。 Exists データノードオブジェクトが存在するか否かを確認。 ShellCommandPrecondition 前提条件として実行可能なカスタムUnix/Linuxシェルコマンド。
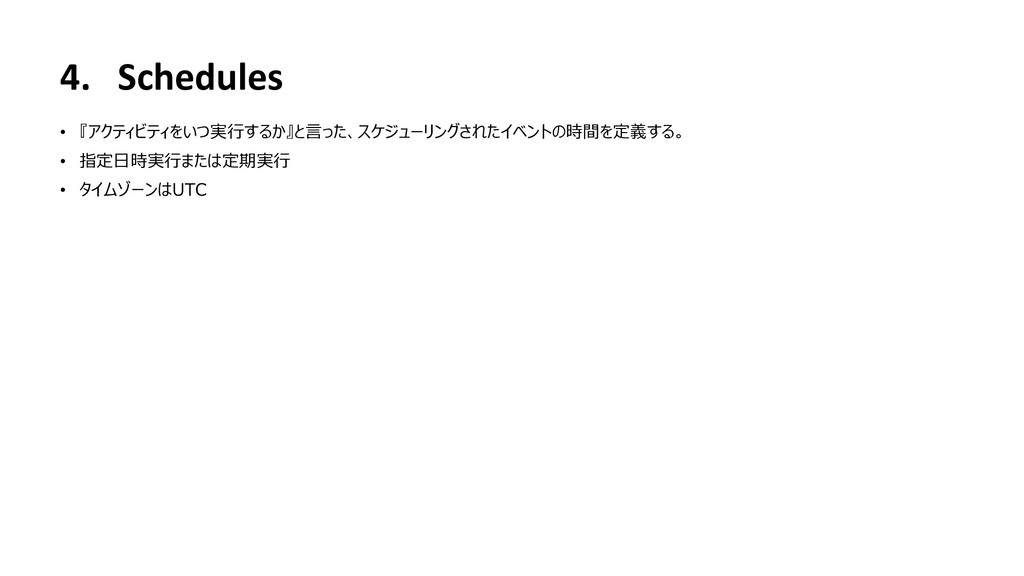
4. Schedules • 『アクティビティをいつ実行するか』と言った、スケジューリングされたイベントの時間を定義する。 • 指定日時実行または定期実行 • タイムゾーンはUTC
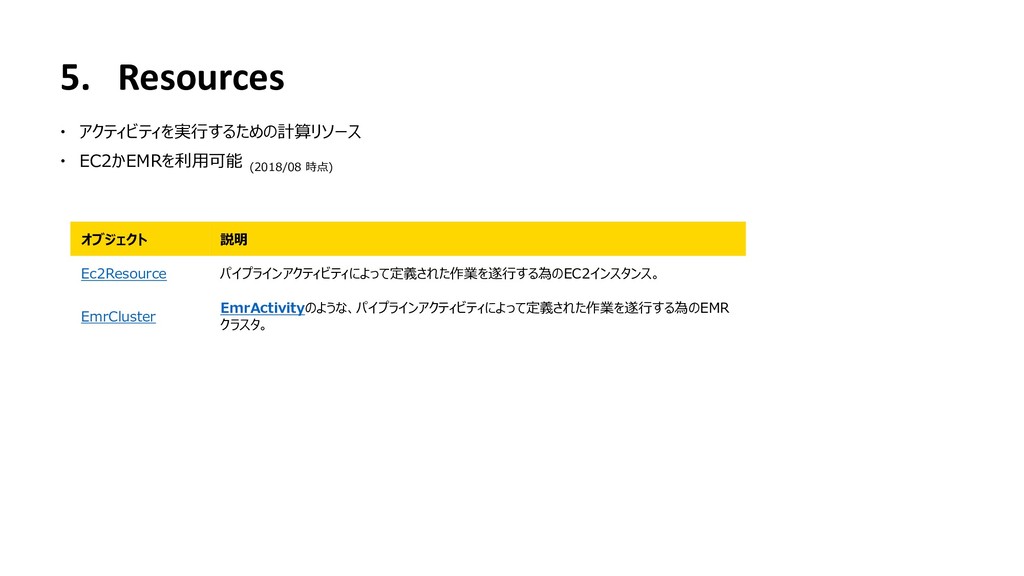
5. Resources アクティビティを実行するための計算リソース EC2かEMRを利用可能 (2018/08 時点) オブジェクト 説明
Ec2Resource パイプラインアクティビティによって定義された作業を遂行する為のEC2インスタンス。 EmrCluster EmrActivityのような、パイプラインアクティビティによって定義された作業を遂行する為のEMR クラスタ。
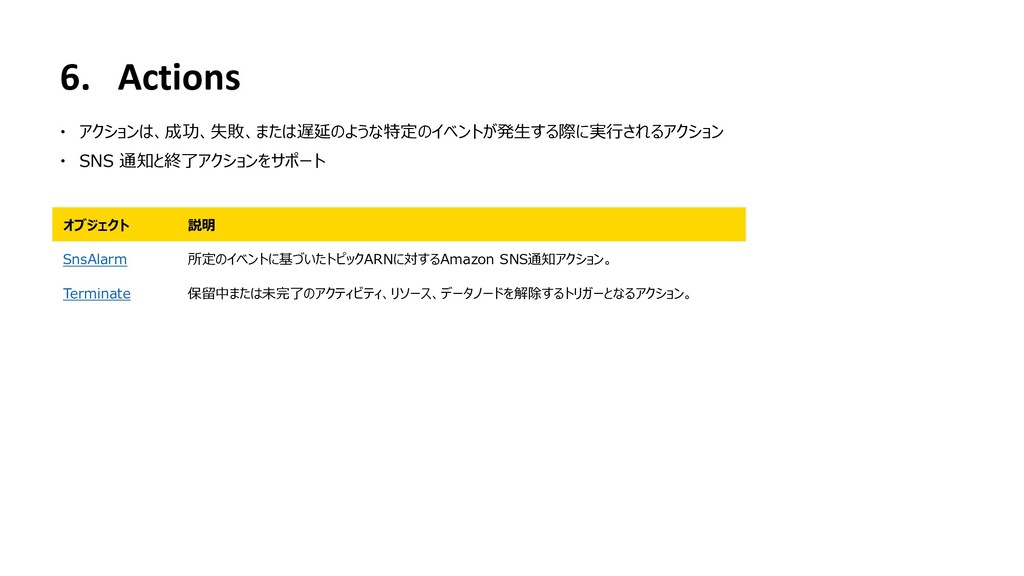
6. Actions アクションは、成功、失敗、または遅延のような特定のイベントが発生する際に実行されるアクション SNS 通知と終了アクションをサポート オブジェクト 説明 SnsAlarm
所定のイベントに基づいたトピックARNに対するAmazon SNS通知アクション。 Terminate 保留中または未完了のアクティビティ、リソース、データノードを解除するトリガーとなるアクション。
気になったところ フィールドがドロップダウンで選択できないものが多いため何を入力すればいいかわからないことがあった • Spark Activity はネイティブにサポートされていない • AWSコンソールではData Pipelineの全機能は使えずJSONで定義ファイルを作って読み込ませる必要あり
• VPCで立ち上げるとインスタンスタイプはHVMのインスタンスストアでないといけない • 一度パイプラインをアクティブ化した後、パイプラインの編集に一部制限がかかってしまう – オブジェクトの削除 – 既存のオブジェクトのスケジュール期間 – 既存のオブジェクトの参照フィールドの追加、削除、変更 – 新しいオブジェクトの出力フィールドで既存のオブジェクト参照 – オブジェクトの予定された開始日の変更
所感 DataPipeline内の用語の癖がすごい 一度パイプラインをアクティブ化した後、パイプラインの編集に一部制限がかかってしまうため、開発しづらい 一般的なスケジューラの機能は持っているため単純なジョブスケジュールは組める Data Pipeline上では条件分岐のようなフロー制御はできないので、複雑な処理には不向き
AWSサービスのジョブスケジュールをできるのは嬉しい 設定項目が多かったり、ドキュメントが少なかったりするので学習コストは高い 処理が失敗した場合や思い通りにならなかった場合、パイプラインの状態がどうなっているのかわからなくなってしまうことがある (バックグラウンドでいろいろな処理が走っているため) 多数のまったく異なるジョブを管理するというよりは、データを一気通貫してETLするサービス向き 一度ワークフローを作ってしまえばジョブ管理は楽になりそうだが、編集したり作り変えるのにはそれなりの工数が必要 • 個人的には使いづらいサービスであった
参考資料 AWS再入門 AWS Data Pipeline編 https://dev.classmethod.jp/cloud/aws/cm-advent-calendar-2015-getting-started-again-datapipeline/ AWS DataPipelineって何ができるの?
https://qiita.com/uzresk/items/213a34481a3522ce0317 【新機能】AWS Data PipelineですべてのAmazon RDSを簡単に指定できるようになりました https://dev.classmethod.jp/cloud/aws/datapipeline-for-rds/


 koshi
 notwaldorf
 marketingsoph
 codingconduct
 leimatthew05
 jct
 eileencodes
 ammeep
 sugarenia
 tammyeverts
 lauravandoore
 jeffersonlam
 auna