Share
Embed
AI の判定を ワークフローに組み込んでみよう
DevelopersIO 2026 Osaka Day2 セッションの登壇資料です。
https://classmethod.connpass.com/event/401017/
桑野翔
September 28, 2026
Transcript
41 slides
-
⾃⼰紹介 名前 桑野 翔 所属 クラウド事業統括本部 コンサルティング1部 クラメソ歴 1年(2025年9⽉ジョイン) 認定
Japan All AWS Certifications Engineers 2026 7⽉に結婚式を挙げました! ←⾃分とは思えない写真でビックリです! 2 -
⾃⼰紹介 名前 桑野 翔 所属 クラウド事業統括本部 コンサルティング1部 クラメソ歴 1年(2025年9⽉ジョイン) 認定
Japan All AWS Certifications Engineers 2026 披露宴で爆⾷いをするぐらい遠慮がないです しっかりと全部⾷べ切りました! 3 -
想定する対象と⽬的 ワークフローに AI を取り⼊れることに関⼼があるが、設計や実装、 それらの判断をどうすればいいか迷っている⽅を想定しています。 対象 ⽬的 • AI を業務に取り⼊れたいと考えている⼈
• Bedrock の実践的な活⽤例を探している⼈ • AI × ワークフローの設計判断を持ち帰ってもらう • 「⾃分もやってみよう!」と思ってもらう 4 -
アジェンダ 本セッションのアジェンダと登場⼈物を紹介します! 1 AI 推論をワークフローに組み込むとは 2 ユースケースの紹介とその構成 3 フォールバックによるバッチ推論の拡張 4
まとめ やあ!僕は棒⼈間の「ぼーくん」 このセッションのところどころで桑野の気持ちを代弁するよ! 5 -
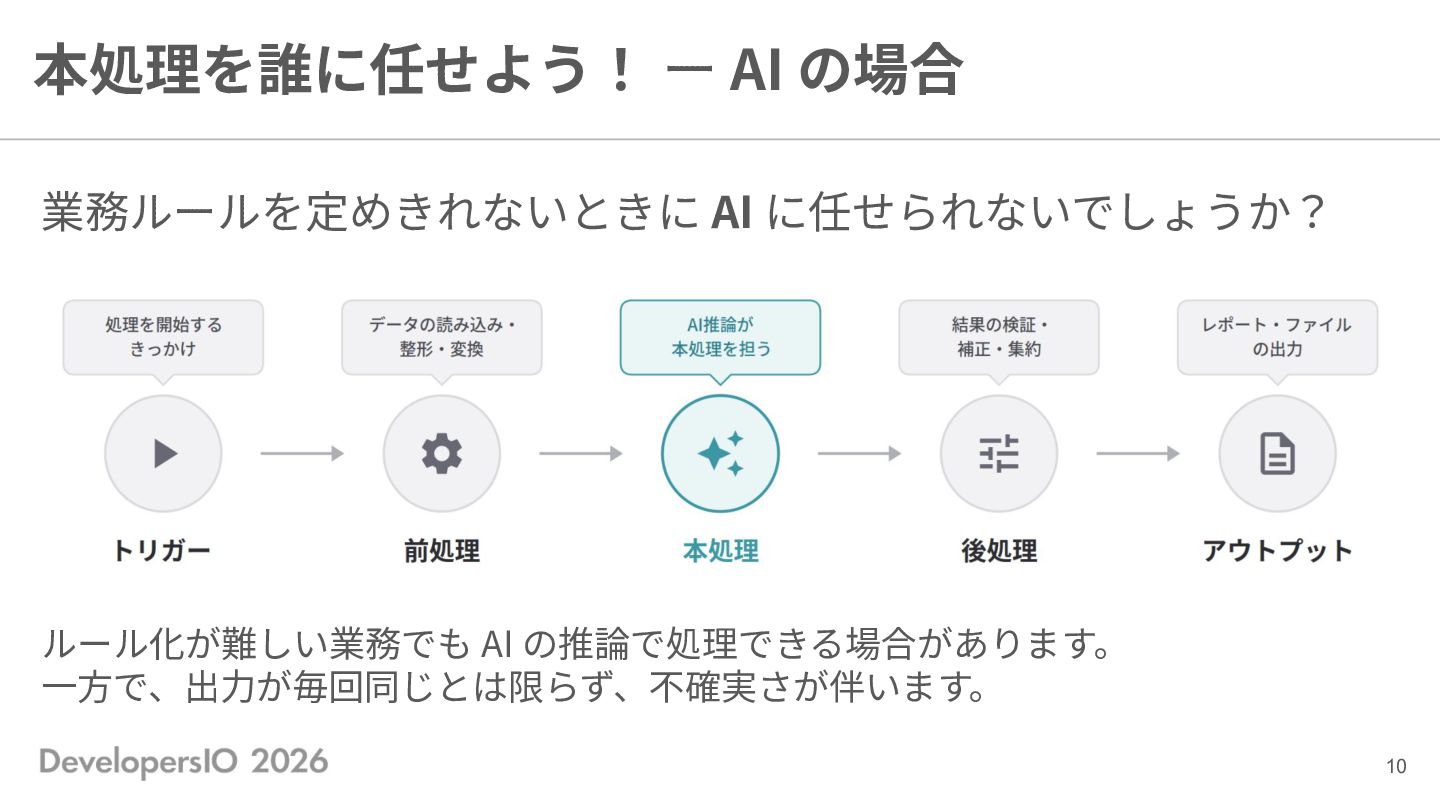
本処理を誰に任せよう! ー AI の場合 業務ルールを定めきれないときに AI に任せられないでしょうか? ルール化が難しい業務でも AI の推論で処理できる場合があります。
⼀⽅で、出⼒が毎回同じとは限らず、不確実さが伴います。 10 -
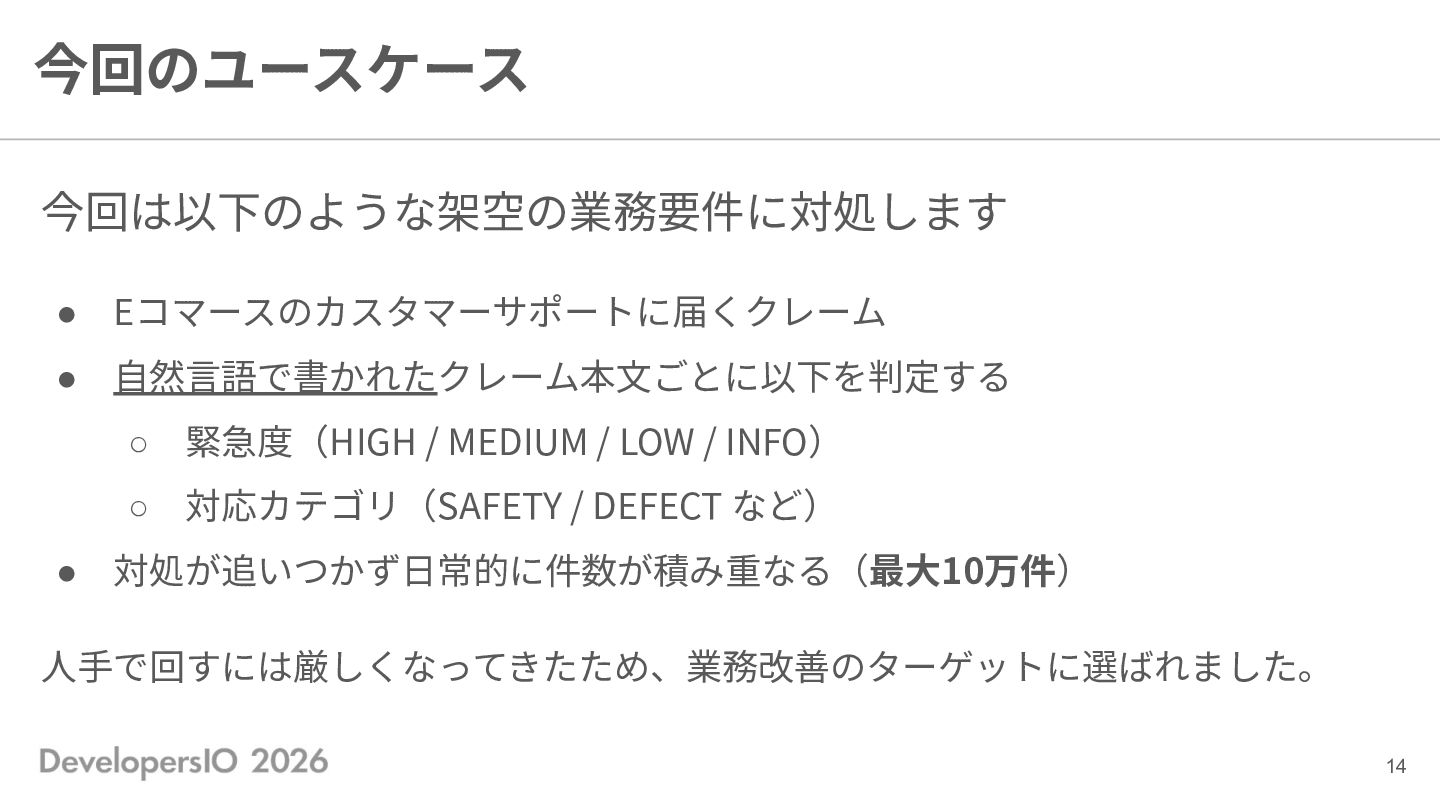
今回のユースケース 今回は以下のような架空の業務要件に対処します • Eコマースのカスタマーサポートに届くクレーム • ⾃然⾔語で書かれたクレーム本⽂ごとに以下を判定する • ◦ 緊急度(HIGH /
MEDIUM / LOW / INFO) ◦ 対応カテゴリ(SAFETY / DEFECT など) 対処が追いつかず⽇常的に件数が積み重なる(最⼤10万件) ⼈⼿で回すには厳しくなってきたため、業務改善のターゲットに選ばれました。 14 -
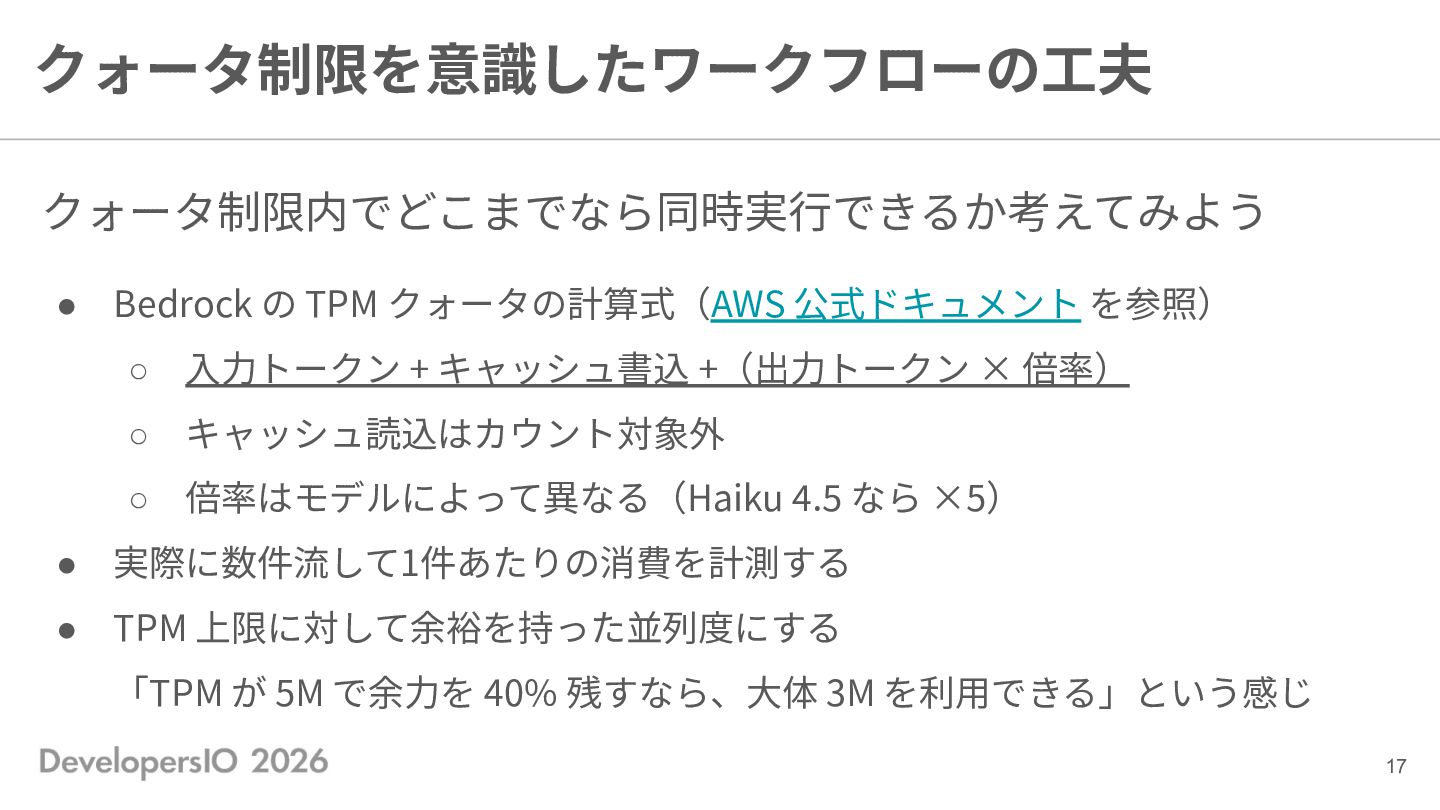
クォータ制限を意識したワークフローの⼯夫 クォータ制限内でどこまでなら同時実⾏できるか考えてみよう • Bedrock の TPM クォータの計算式(AWS 公式ドキュメント を参照) ◦
⼊⼒トークン + キャッシュ書込 +(出⼒トークン × 倍率) ◦ キャッシュ読込はカウント対象外 ◦ 倍率はモデルによって異なる(Haiku 4.5 なら ×5) • 実際に数件流して1件あたりの消費を計測する • TPM 上限に対して余裕を持った並列度にする 「TPM が 5M で余⼒を 40% 残すなら、⼤体 3M を利⽤できる」という感じ 17 -
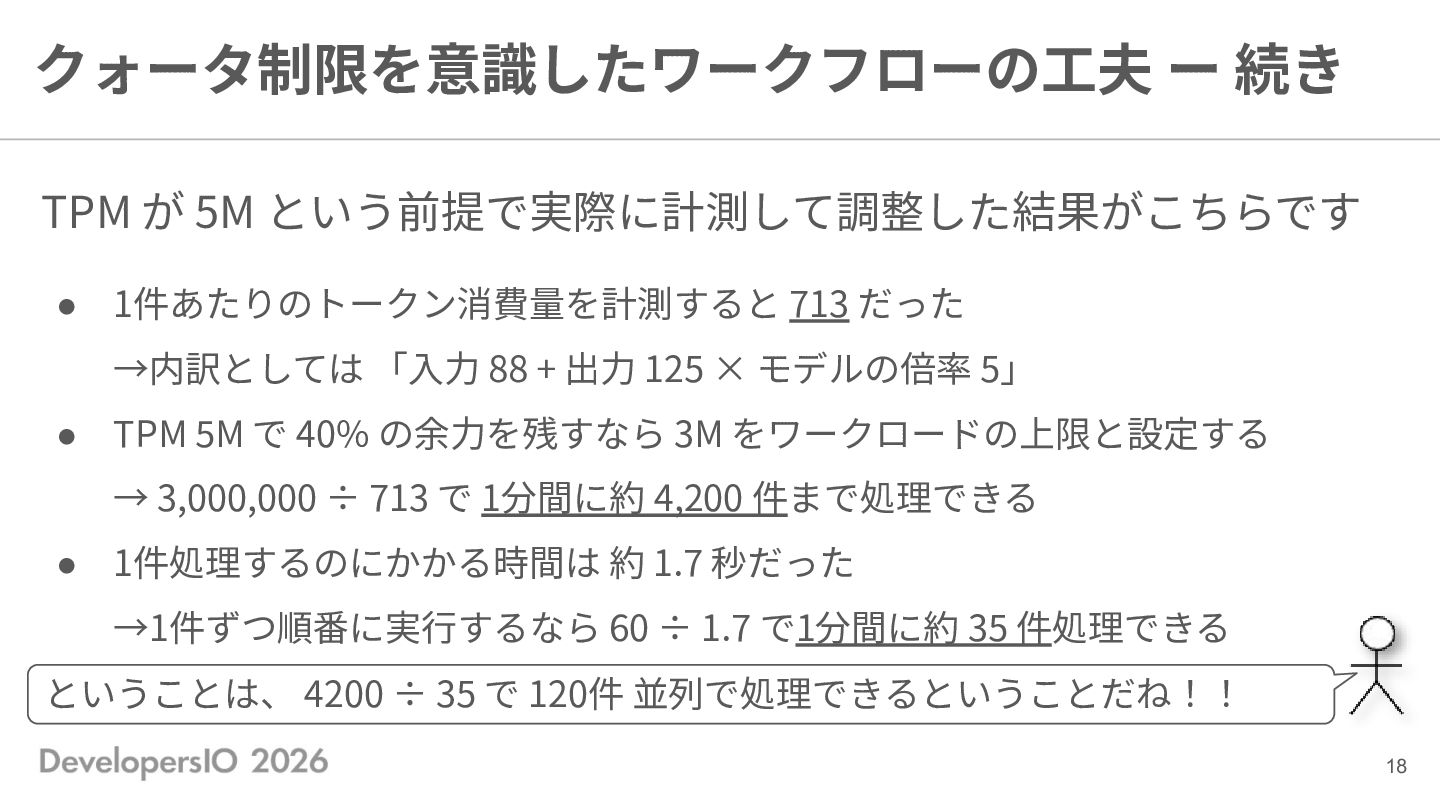
クォータ制限を意識したワークフローの⼯夫 ー 続き TPM が 5M という前提で実際に計測して調整した結果がこちらです • 1件あたりのトークン消費量を計測すると 713
だった →内訳としては 「⼊⼒ 88 + 出⼒ 125 × モデルの倍率 5」 • TPM 5M で 40% の余⼒を残すなら 3M をワークロードの上限と設定する → 3,000,000 ÷ 713 で 1分間に約 4,200 件まで処理できる • 1件処理するのにかかる時間は 約 1.7 秒だった →1件ずつ順番に実⾏するなら 60 ÷ 1.7 で1分間に約 35 件処理できる ということは、 4200 ÷ 35 で 120件 並列で処理できるということだね!! 18 -
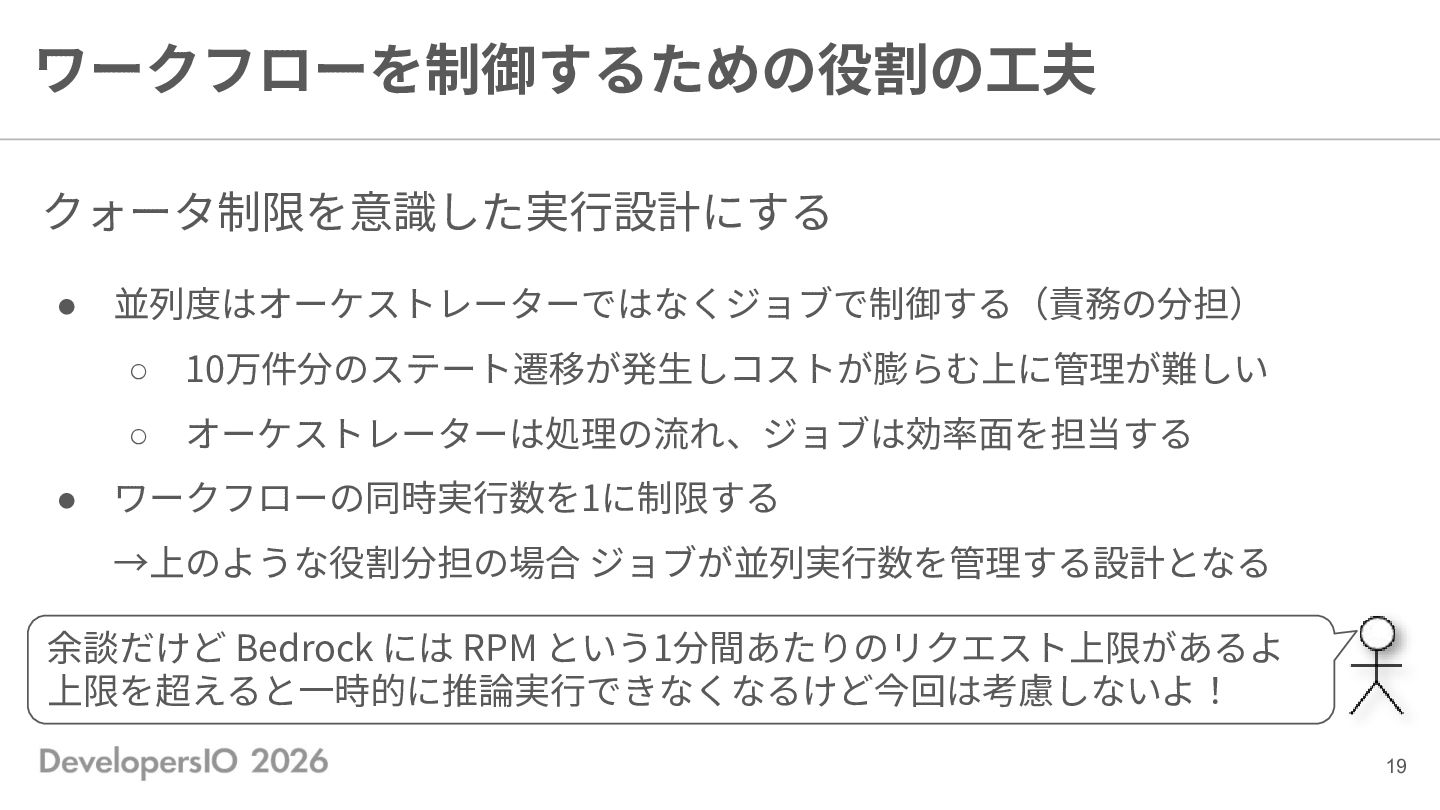
ワークフローを制御するための役割の⼯夫 クォータ制限を意識した実⾏設計にする • • 並列度はオーケストレーターではなくジョブで制御する(責務の分担) ◦ 10万件分のステート遷移が発⽣しコストが膨らむ上に管理が難しい ◦ オーケストレーターは処理の流れ、ジョブは効率⾯を担当する ワークフローの同時実⾏数を1に制限する
→上のような役割分担の場合 ジョブが並列実⾏数を管理する設計となる 余談だけど Bedrock には RPM という1分間あたりのリクエスト上限があるよ 上限を超えると⼀時的に推論実⾏できなくなるけど今回は考慮しないよ! 19 -
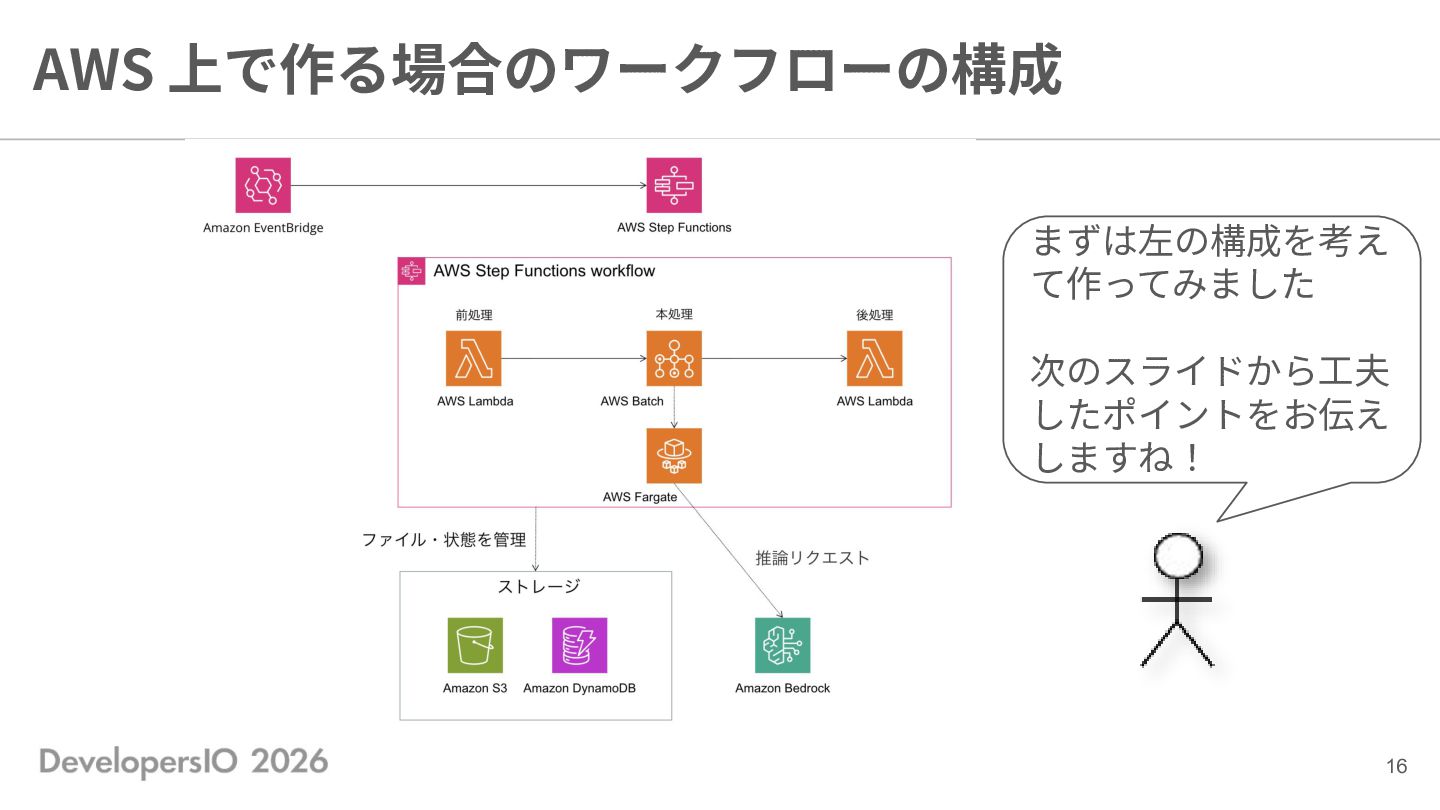
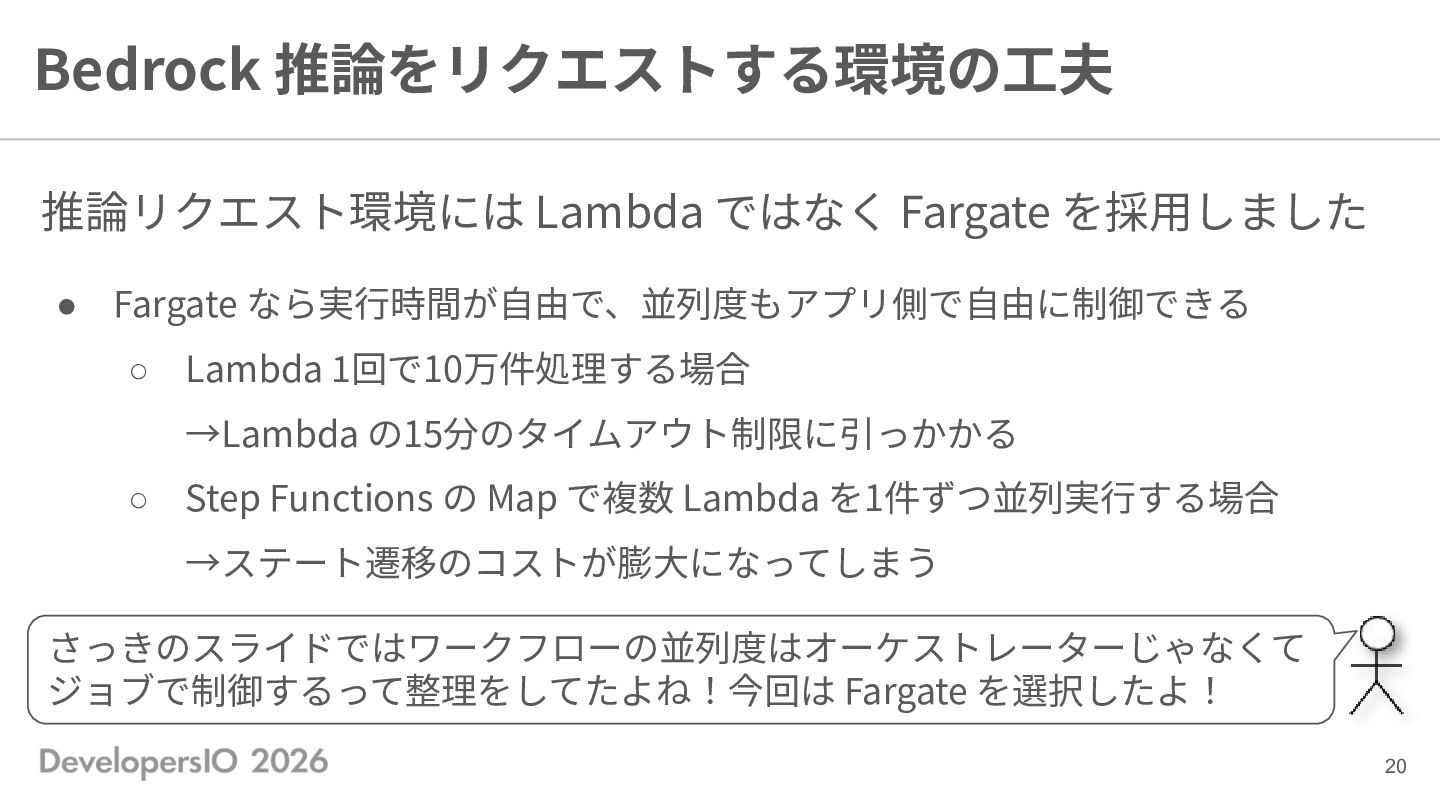
Bedrock 推論をリクエストする環境の⼯夫 推論リクエスト環境には Lambda ではなく Fargate を採⽤しました • Fargate なら実⾏時間が⾃由で、並列度もアプリ側で⾃由に制御できる
◦ Lambda 1回で10万件処理する場合 →Lambda の15分のタイムアウト制限に引っかかる ◦ Step Functions の Map で複数 Lambda を1件ずつ並列実⾏する場合 →ステート遷移のコストが膨⼤になってしまう さっきのスライドではワークフローの並列度はオーケストレーターじゃなくて ジョブで制御するって整理をしてたよね!今回は Fargate を選択したよ! 20 -
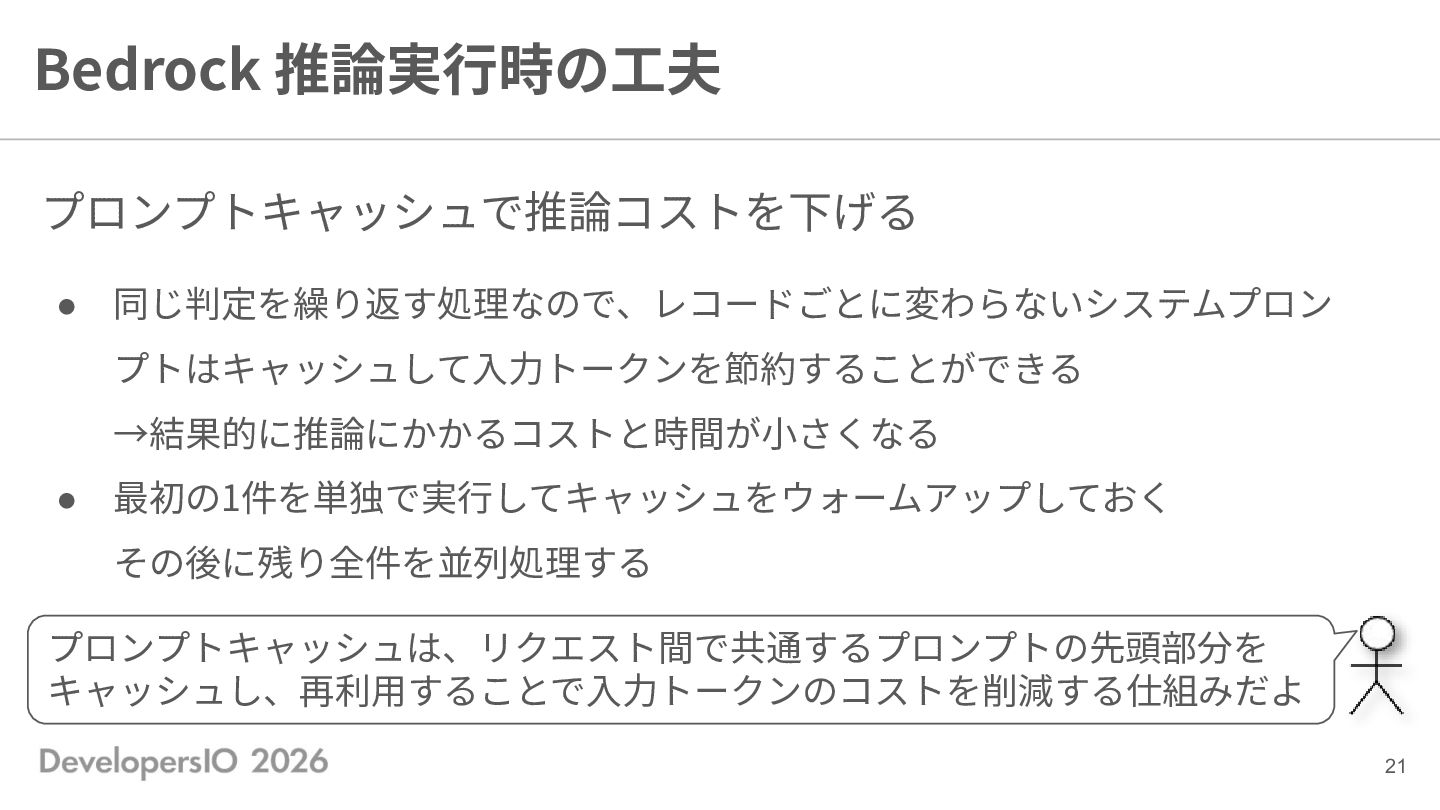
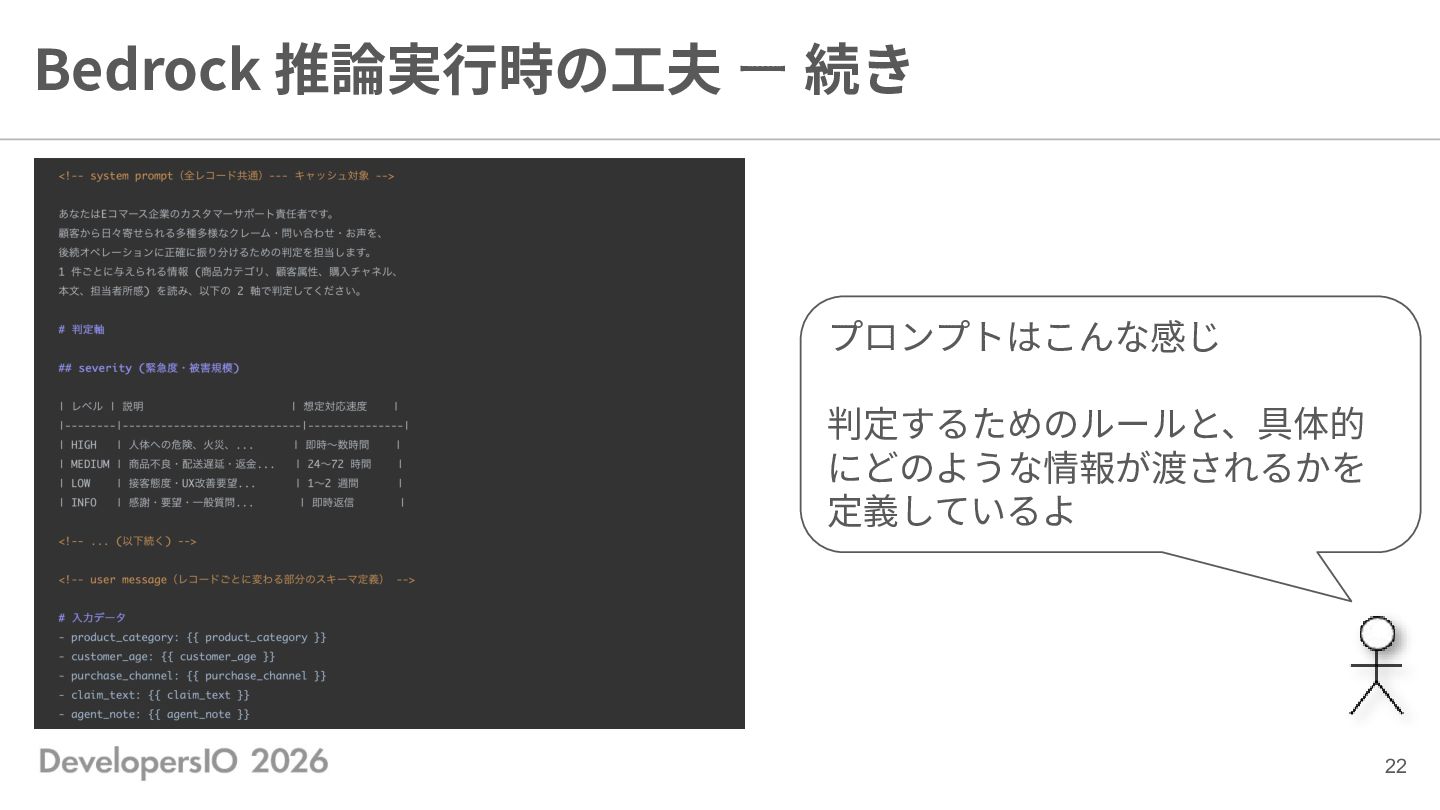
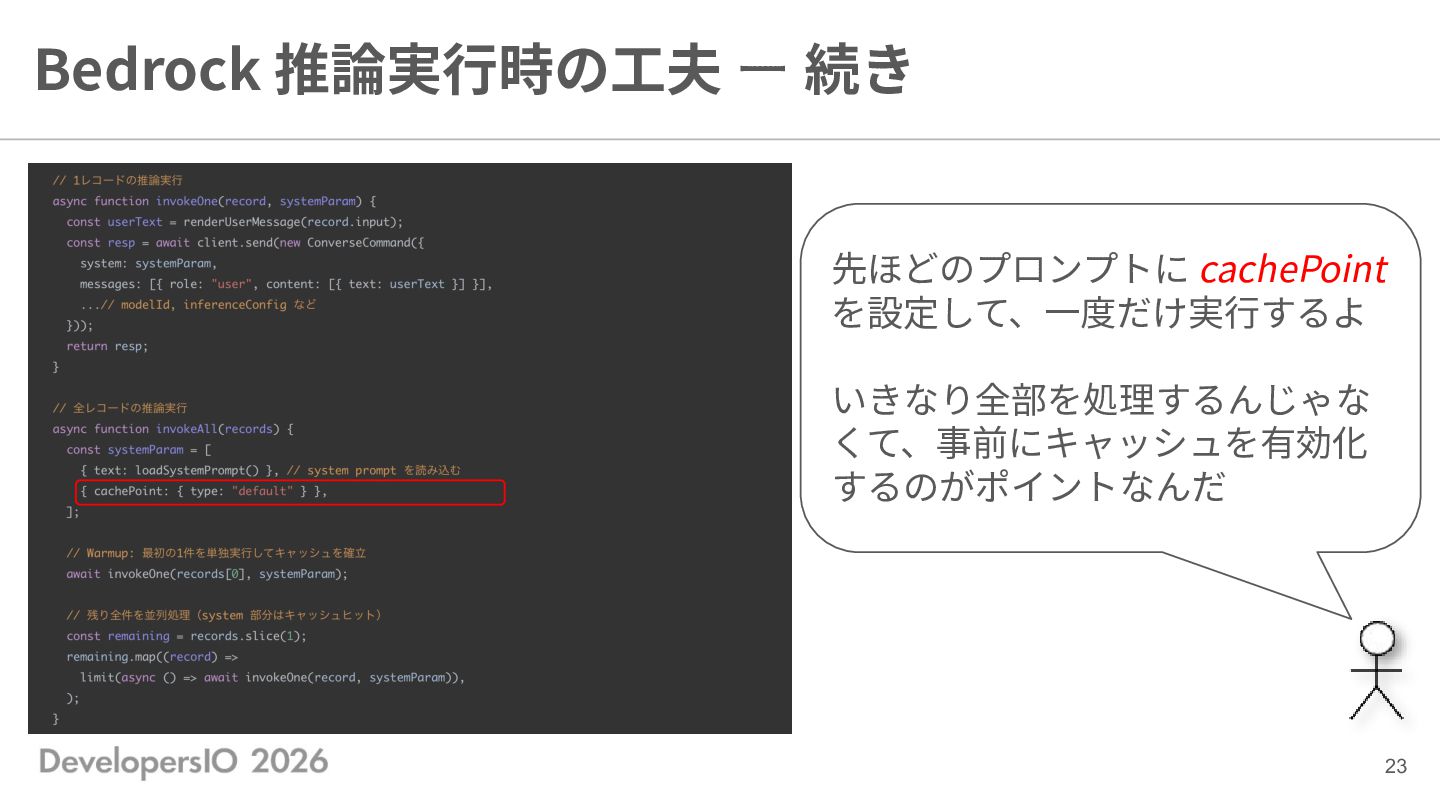
Bedrock 推論実⾏時の⼯夫 プロンプトキャッシュで推論コストを下げる • 同じ判定を繰り返す処理なので、レコードごとに変わらないシステムプロン プトはキャッシュして⼊⼒トークンを節約することができる →結果的に推論にかかるコストと時間が⼩さくなる • 最初の1件を単独で実⾏してキャッシュをウォームアップしておく その後に残り全件を並列処理する
プロンプトキャッシュは、リクエスト間で共通するプロンプトの先頭部分を キャッシュし、再利⽤することで⼊⼒トークンのコストを削減する仕組みだよ 21 -
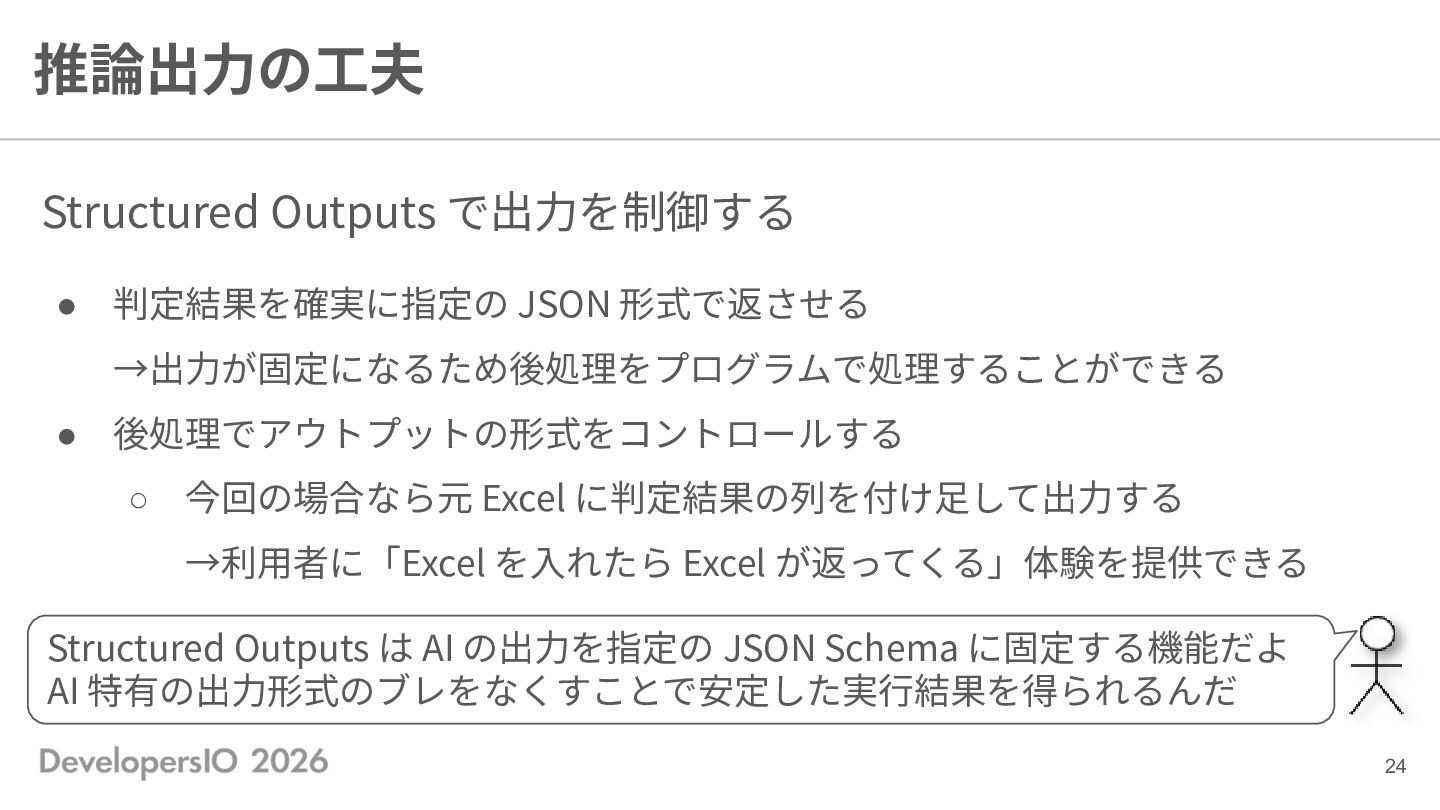
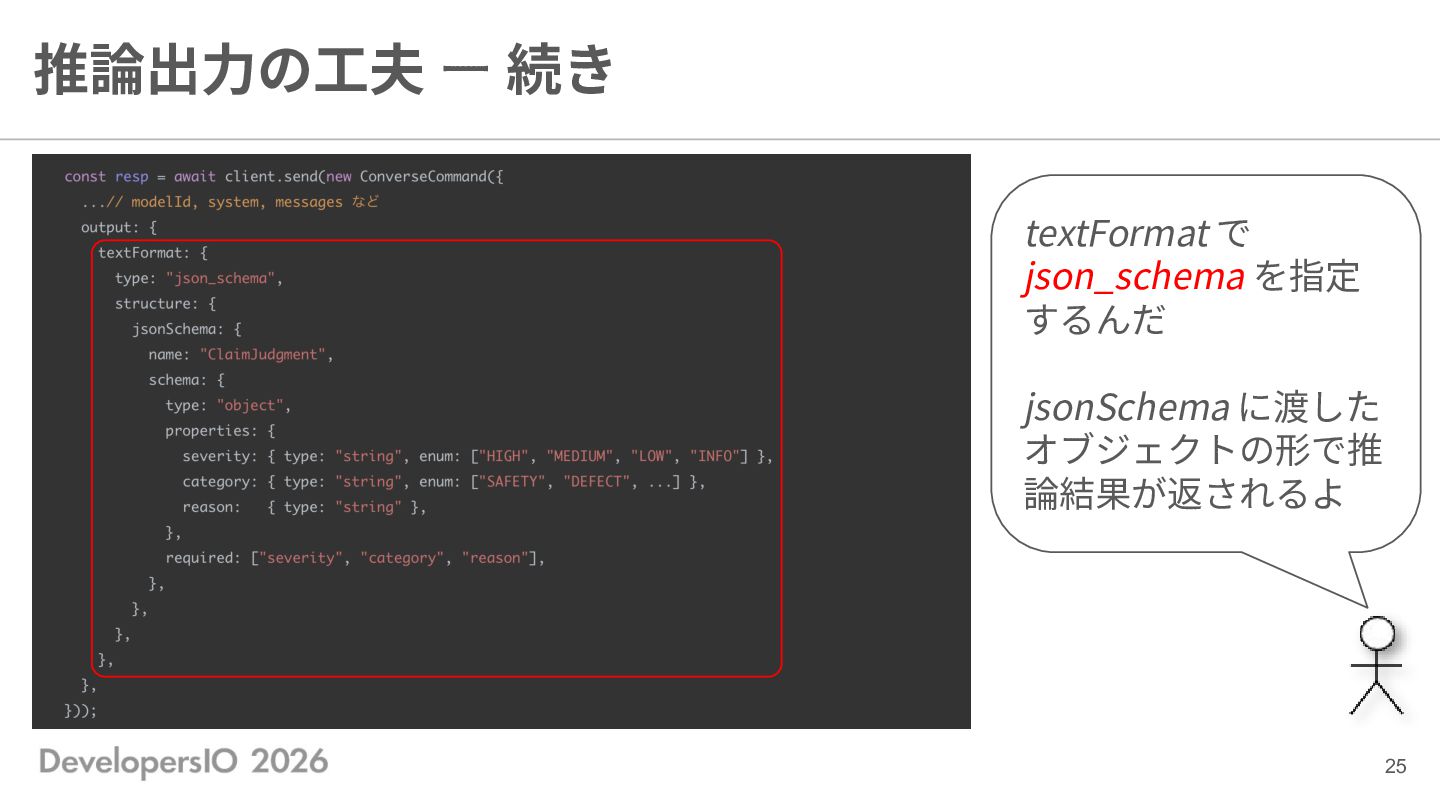
推論出⼒の⼯夫 Structured Outputs で出⼒を制御する • 判定結果を確実に指定の JSON 形式で返させる →出⼒が固定になるため後処理をプログラムで処理することができる •
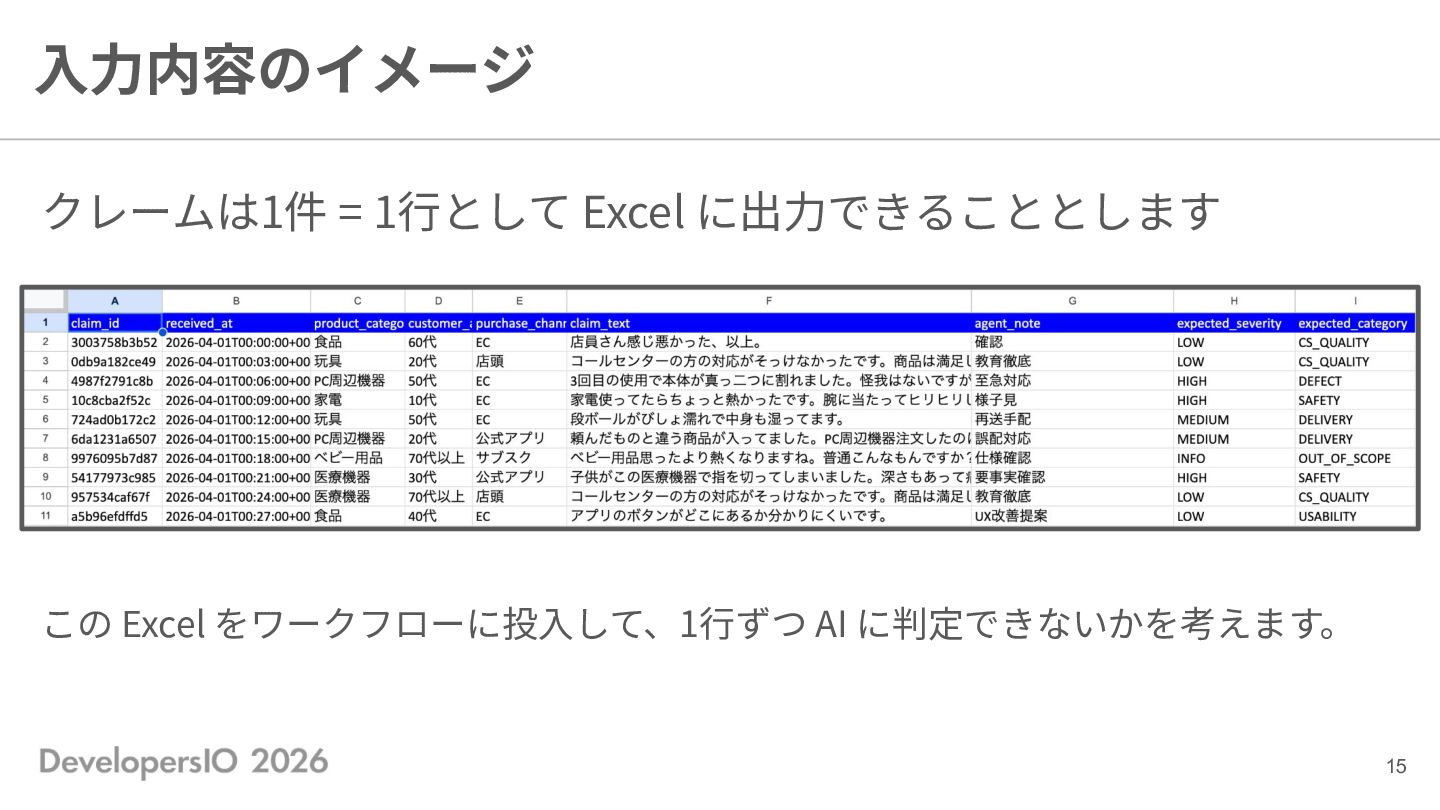
後処理でアウトプットの形式をコントロールする ◦ 今回の場合なら元 Excel に判定結果の列を付け⾜して出⼒する →利⽤者に「Excel を⼊れたら Excel が返ってくる」体験を提供できる Structured Outputs は AI の出⼒を指定の JSON Schema に固定する機能だよ AI 特有の出⼒形式のブレをなくすことで安定した実⾏結果を得られるんだ 24 -
推論出⼒の⼯夫 ー 続き textFormat で json_schema を指定 するんだ jsonSchema に渡した
オブジェクトの形で推 論結果が返されるよ 25 -
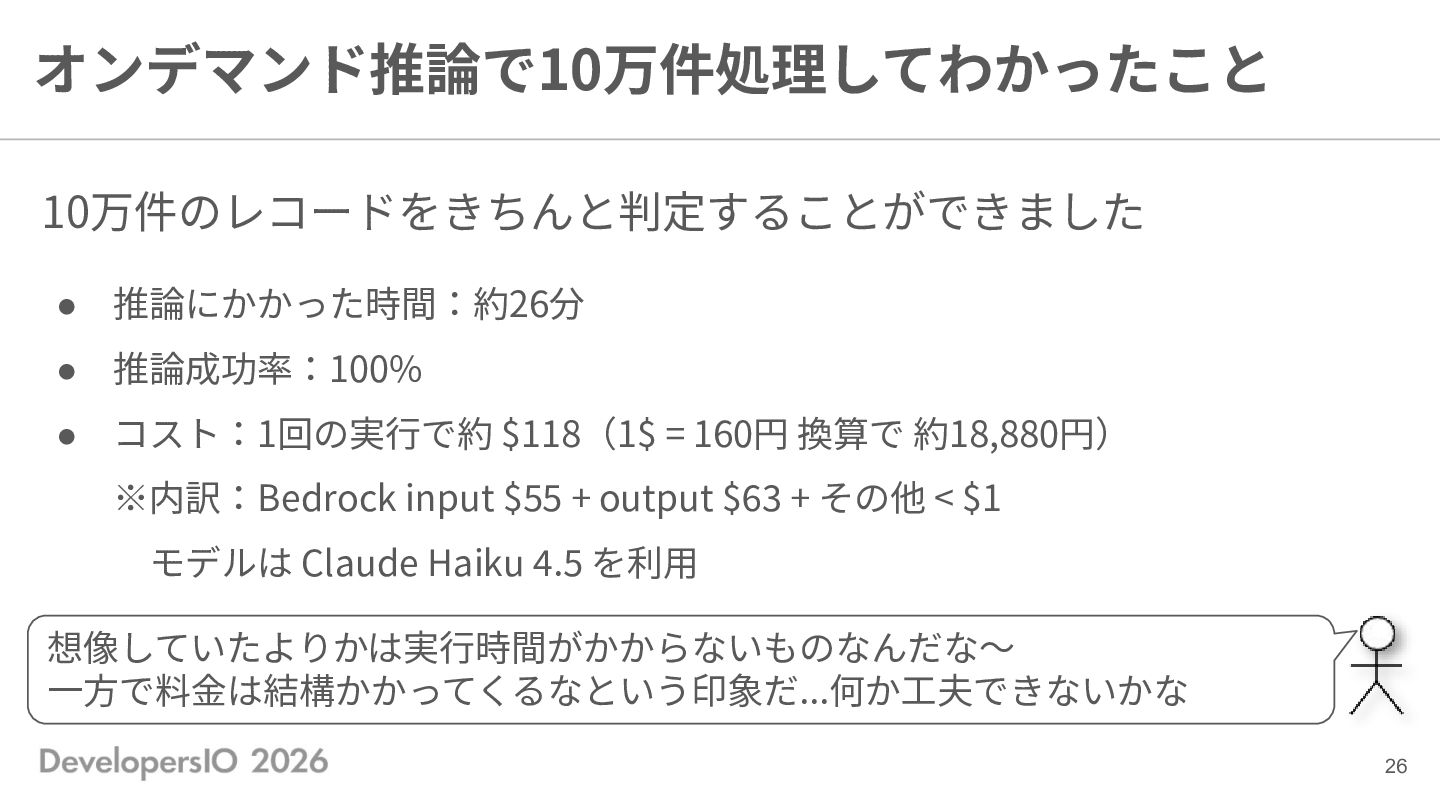
オンデマンド推論で10万件処理してわかったこと 10万件のレコードをきちんと判定することができました • 推論にかかった時間:約26分 • 推論成功率:100% • コスト:1回の実⾏で約 $118(1$ =
160円 換算で 約18,880円) ※内訳:Bedrock input $55 + output $63 + その他 < $1 モデルは Claude Haiku 4.5 を利⽤ 想像していたよりかは実⾏時間がかからないものなんだな〜 ⼀⽅で料⾦は結構かかってくるなという印象だ...何か⼯夫できないかな 26 -
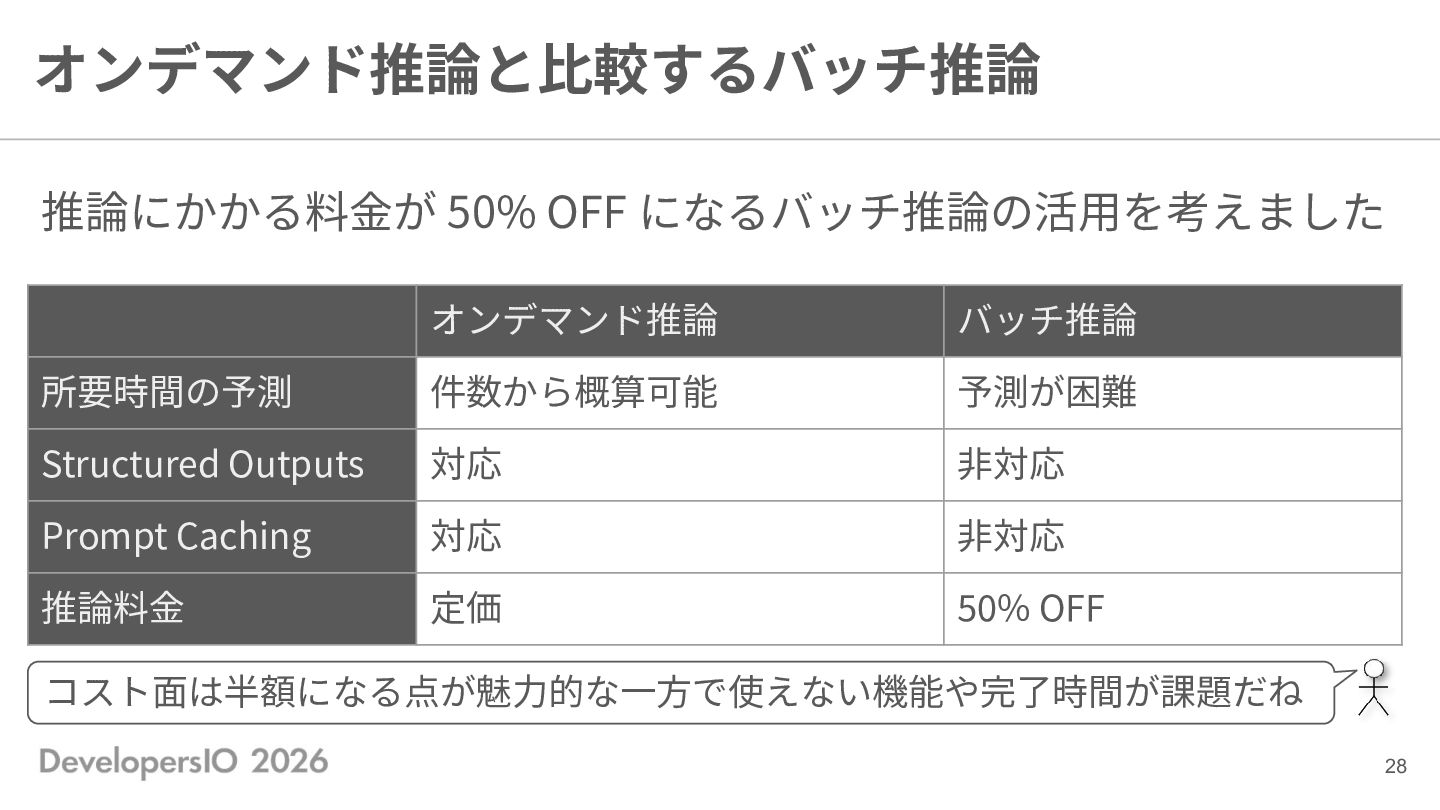
オンデマンド推論と⽐較するバッチ推論 推論にかかる料⾦が 50% OFF になるバッチ推論の活⽤を考えました オンデマンド推論 バッチ推論 所要時間の予測 件数から概算可能 予測が困難
Structured Outputs 対応 ⾮対応 Prompt Caching 対応 ⾮対応 推論料⾦ 定価 50% OFF コスト⾯は半額になる点が魅⼒的な⼀⽅で使えない機能や完了時間が課題だね 28 -
ハイブリッド構成の可能性 バッチ推論の課題を解決できそうな⽅法を考えてみました • 完了時間が読めない ◦ 結果を届けるまでに猶予があればその間にバッチ推論を⾛らせられる →制限時間を設け、もし間に合わなければオンデマンド推論に縮退する • Structured Outputs
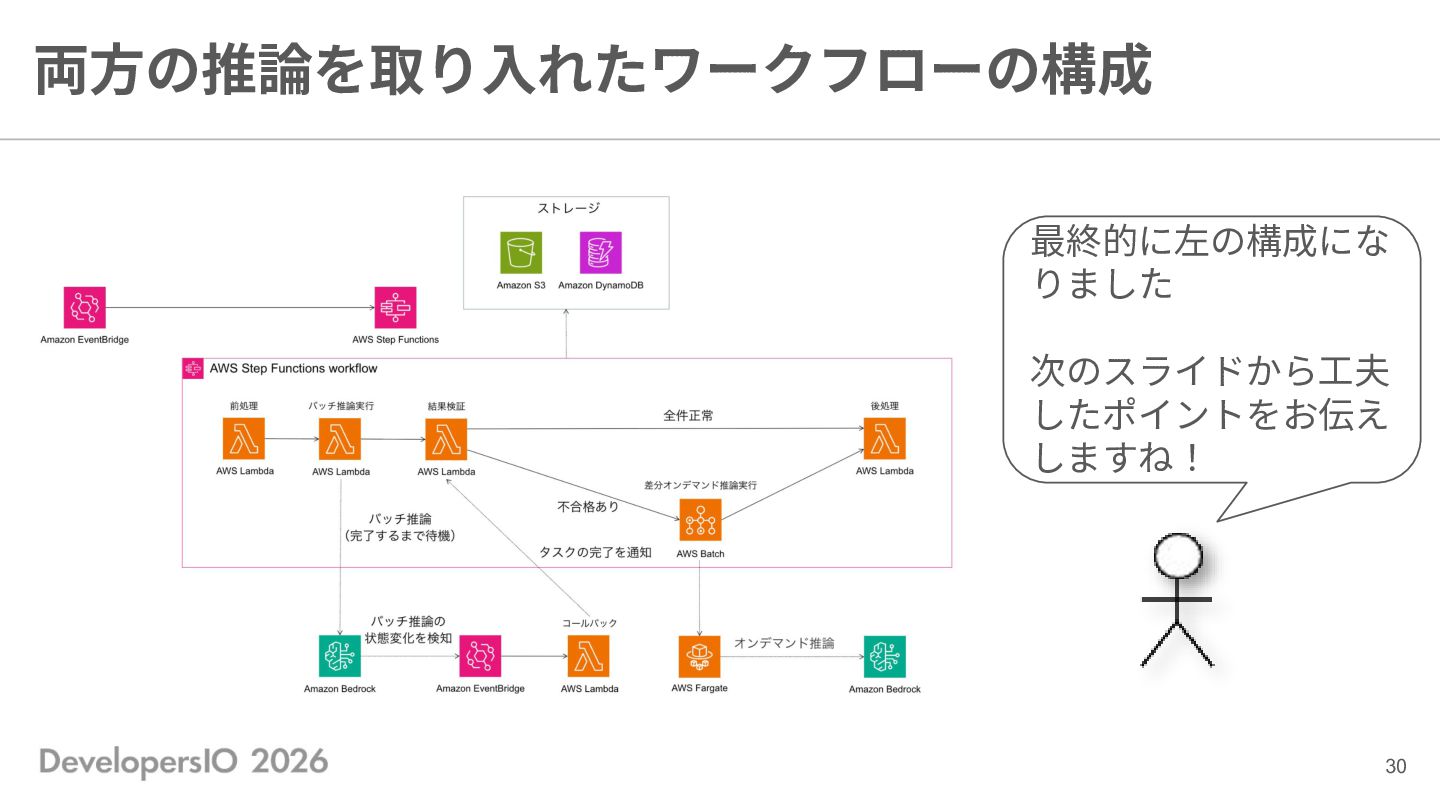
⾮対応による実⾏結果の不安定さ →事後バリデーションで検証し、不合格分だけオンデマンドで再処理する コストメリットのあるバッチ推論をワークフローの主軸にしつつ 完了時間と推論結果の不安定さはオンデマンド推論でカバーするってことだね 29 -
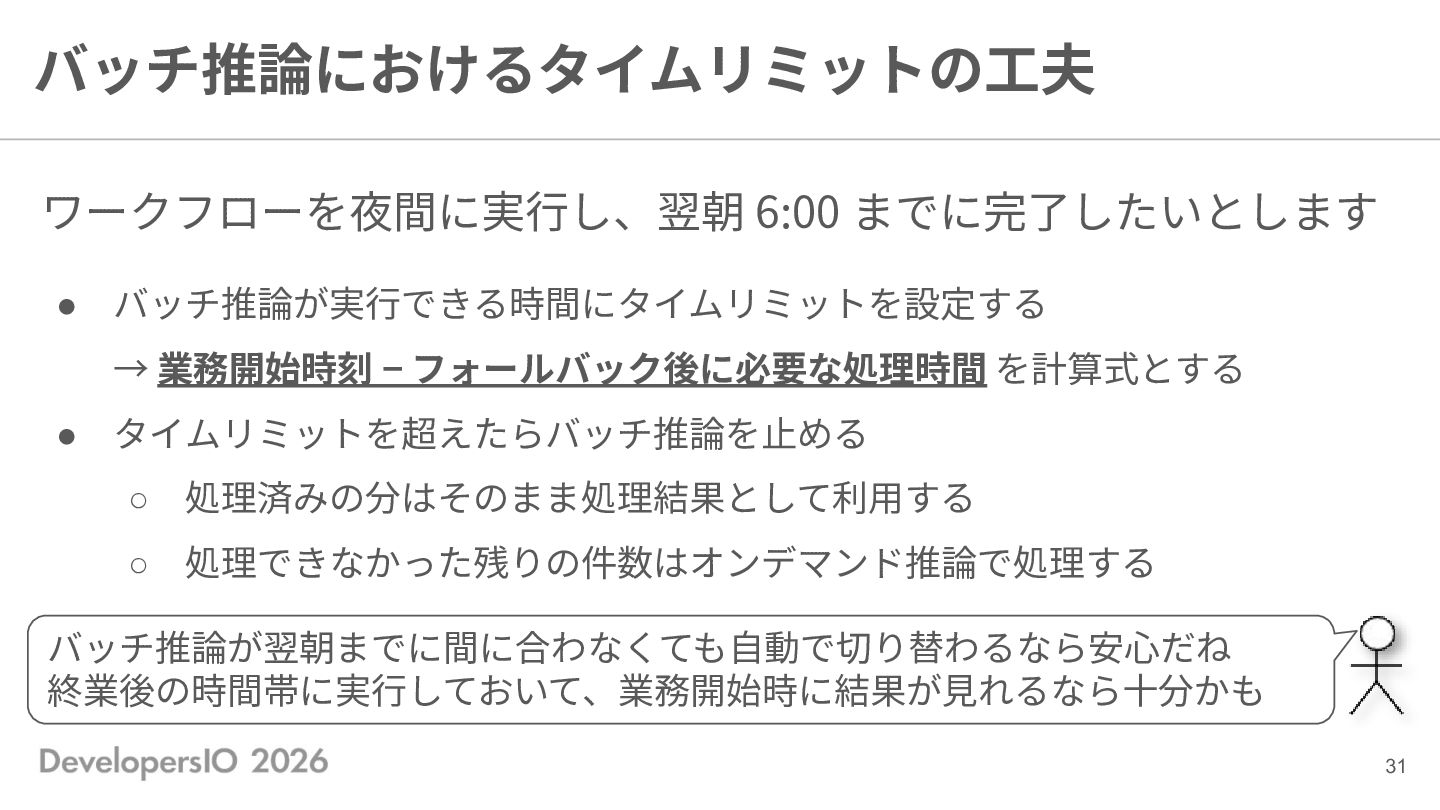
バッチ推論におけるタイムリミットの⼯夫 ワークフローを夜間に実⾏し、翌朝 6:00 までに完了したいとします • バッチ推論が実⾏できる時間にタイムリミットを設定する → 業務開始時刻 − フォールバック後に必要な処理時間
を計算式とする • タイムリミットを超えたらバッチ推論を⽌める ◦ 処理済みの分はそのまま処理結果として利⽤する ◦ 処理できなかった残りの件数はオンデマンド推論で処理する バッチ推論が翌朝までに間に合わなくても⾃動で切り替わるなら安⼼だね 終業後の時間帯に実⾏しておいて、業務開始時に結果が⾒れるなら⼗分かも 31 -
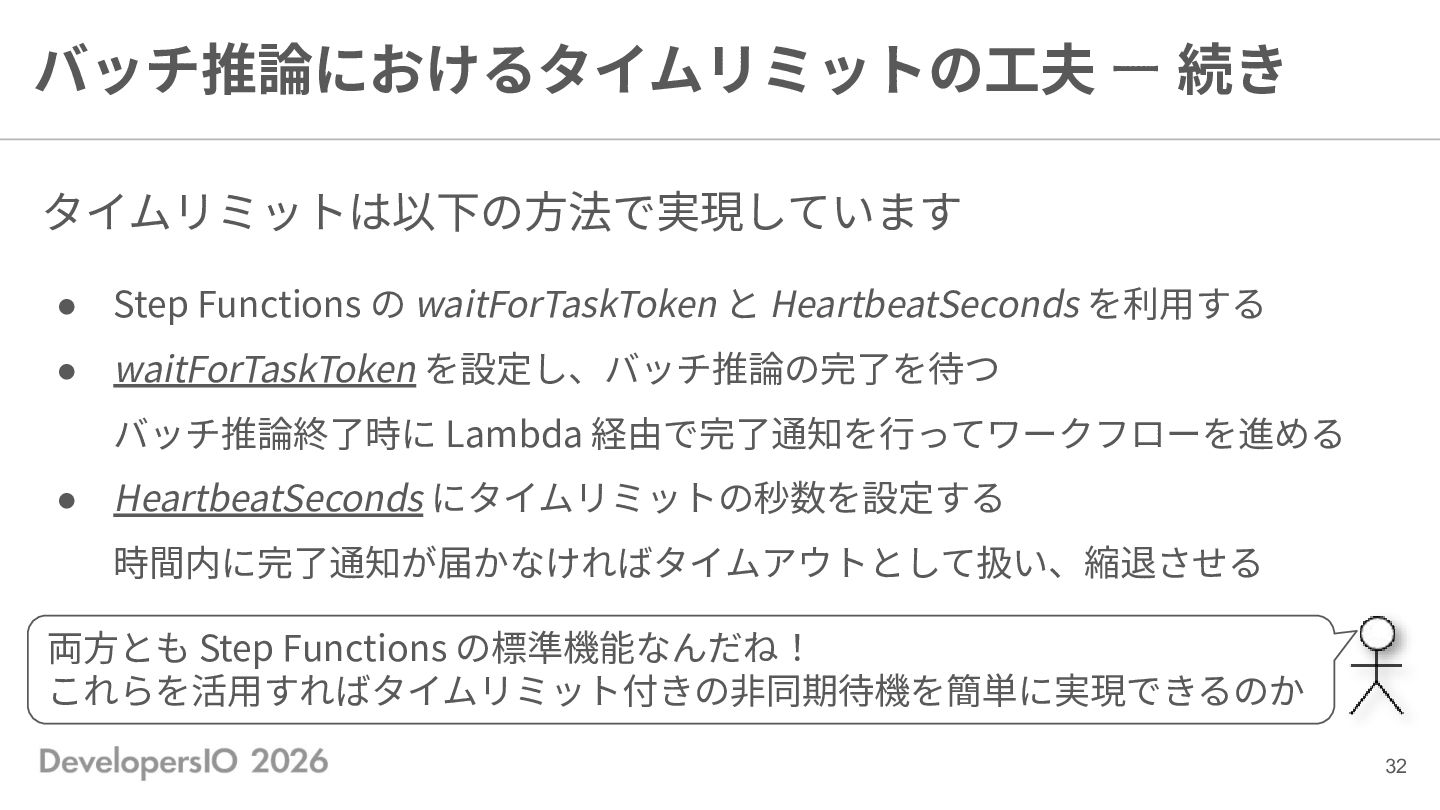
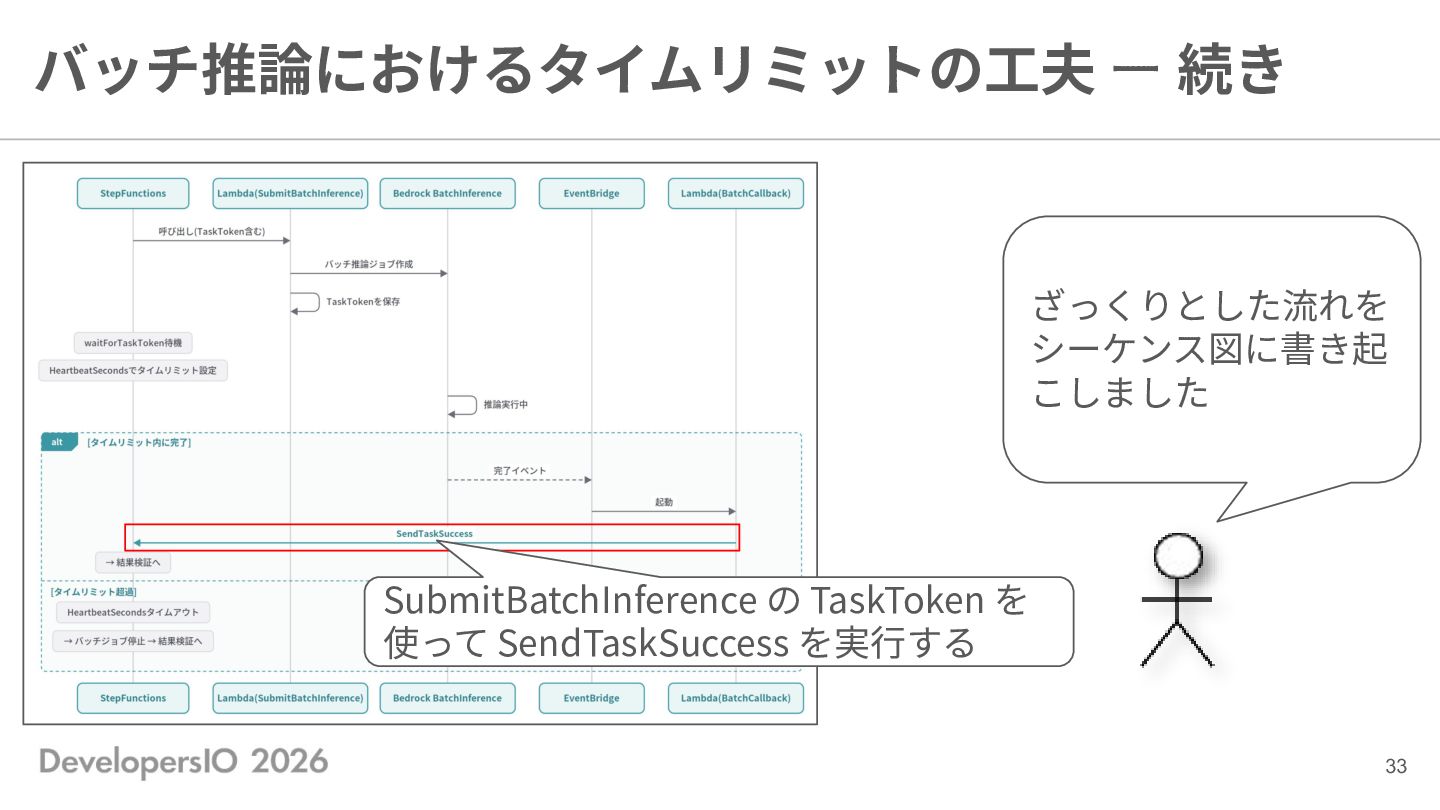
バッチ推論におけるタイムリミットの⼯夫 ー 続き タイムリミットは以下の⽅法で実現しています • Step Functions の waitForTaskToken と
HeartbeatSeconds を利⽤する • waitForTaskToken を設定し、バッチ推論の完了を待つ バッチ推論終了時に Lambda 経由で完了通知を⾏ってワークフローを進める • HeartbeatSeconds にタイムリミットの秒数を設定する 時間内に完了通知が届かなければタイムアウトとして扱い、縮退させる 両⽅とも Step Functions の標準機能なんだね! これらを活⽤すればタイムリミット付きの⾮同期待機を簡単に実現できるのか 32 -
バッチ推論におけるタイムリミットの⼯夫 ー 続き ざっくりとした流れを シーケンス図に書き起 こしました SubmitBatchInference の TaskToken を
使って SendTaskSuccess を実⾏する 33 -
バッチ推論における出⼒品質の⼯夫 出⼒形式の品質は事後バリデーションで担保します • バッチ推論は Structured Outputs に該当する仕組みがない 現状はシステムプロンプトで JSON 出⼒を指⽰するぐらいが限界
→出⼒形式が期待と異なることを考慮した作りにしないといけない • 推論結果が期待する形式かをチェックすれば良い ◦ 不合格となったレコードだけをオンデマンド推論で再処理する 出⼒形式をチェックするようにしておけばオンデマンド推論で吸収できるね 34 -
バッチ推論における出⼒品質の⼯夫 ー 続き バリデーションは以下の流れで実装を⾏いました • JSON パースを⾏う プレーンテキストからコードフェンスを除去 → JSON
として解析する • JSON Schema でバリデーションを⾏う フィールド‧型‧ enum の検証を実施する • NG だった場合は失敗レコードとして保持し、オンデマンド推論でリトライ バリデーションはお使いの⾔語に合わせて実装をする形になるね ここではあくまでもどのような検査をすればいいかだけを説明したよ 35 -
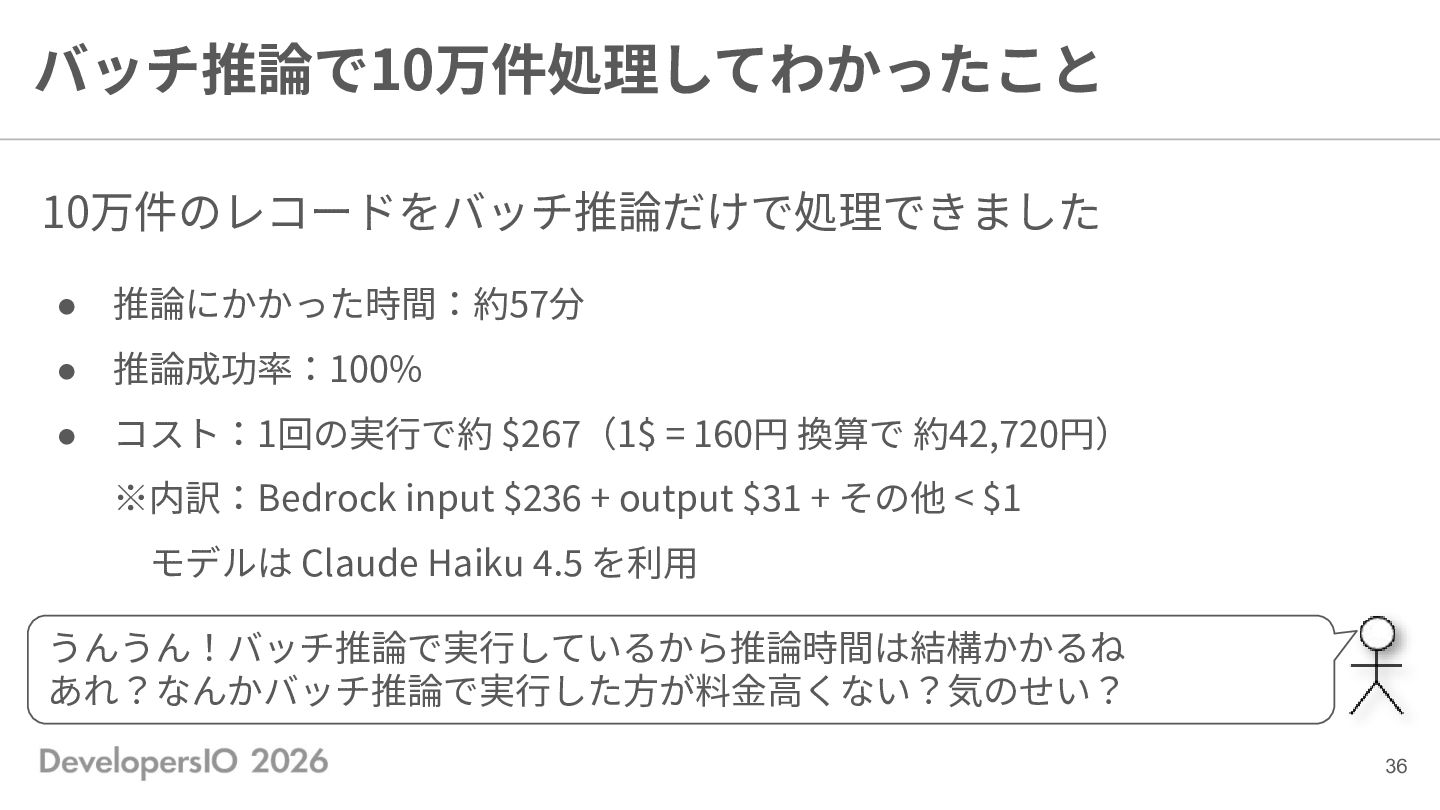
バッチ推論で10万件処理してわかったこと 10万件のレコードをバッチ推論だけで処理できました • 推論にかかった時間:約57分 • 推論成功率:100% • コスト:1回の実⾏で約 $267(1$ =
160円 換算で 約42,720円) ※内訳:Bedrock input $236 + output $31 + その他 < $1 モデルは Claude Haiku 4.5 を利⽤ うんうん!バッチ推論で実⾏しているから推論時間は結構かかるね あれ?なんかバッチ推論で実⾏した⽅が料⾦⾼くない?気のせい? 36 -
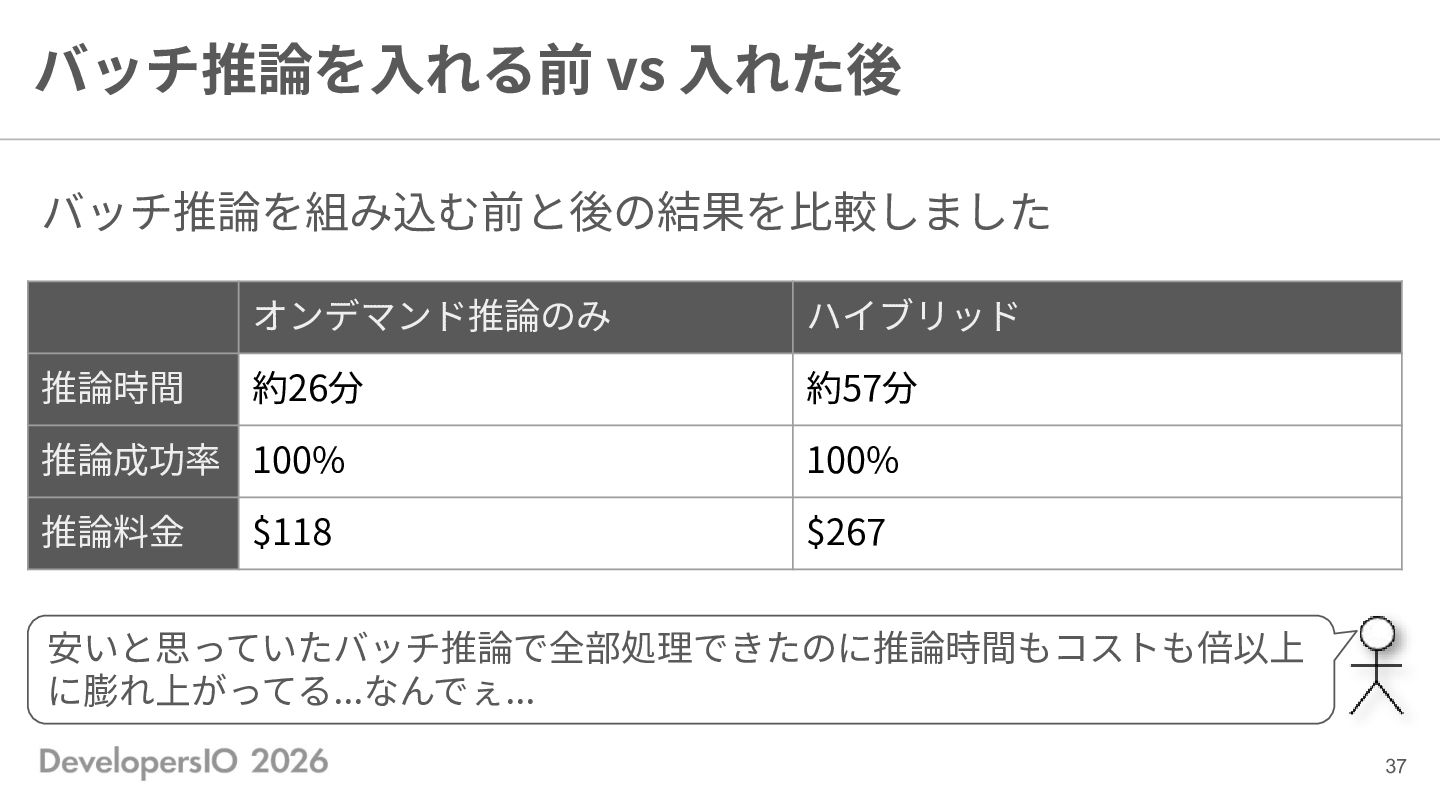
バッチ推論を⼊れる前 vs ⼊れた後 バッチ推論を組み込む前と後の結果を⽐較しました オンデマンド推論のみ ハイブリッド 約26分 約57分 推論成功率 100%
100% 推論料⾦ $267 推論時間 $118 安いと思っていたバッチ推論で全部処理できたのに推論時間もコストも倍以上 に膨れ上がってる...なんでぇ... 37 -
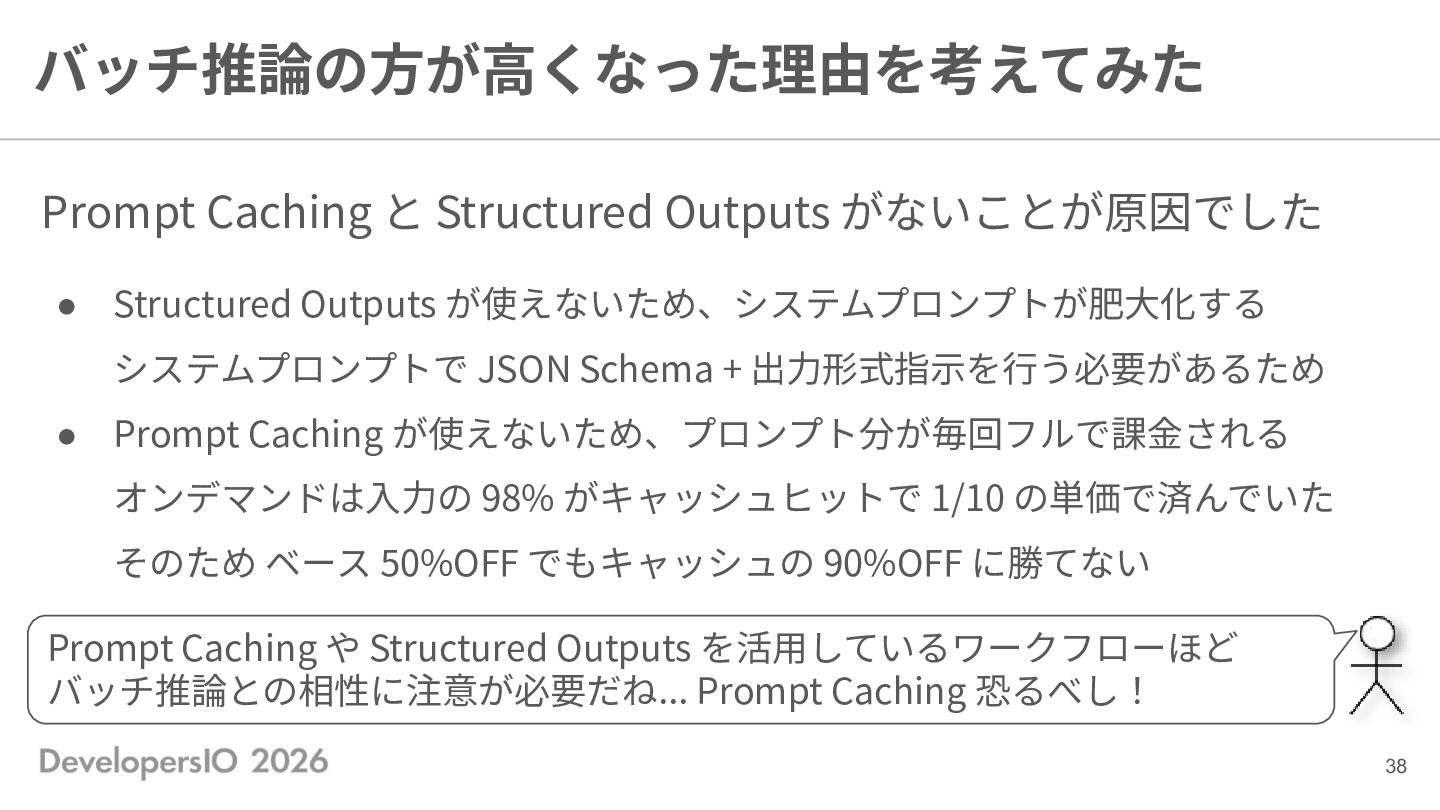
バッチ推論の⽅が⾼くなった理由を考えてみた Prompt Caching と Structured Outputs がないことが原因でした • Structured Outputs
が使えないため、システムプロンプトが肥⼤化する システムプロンプトで JSON Schema + 出⼒形式指⽰を⾏う必要があるため • Prompt Caching が使えないため、プロンプト分が毎回フルで課⾦される オンデマンドは⼊⼒の 98% がキャッシュヒットで 1/10 の単価で済んでいた そのため ベース 50%OFF でもキャッシュの 90%OFF に勝てない Prompt Caching や Structured Outputs を活⽤しているワークフローほど バッチ推論との相性に注意が必要だね... Prompt Caching 恐るべし! 38 -
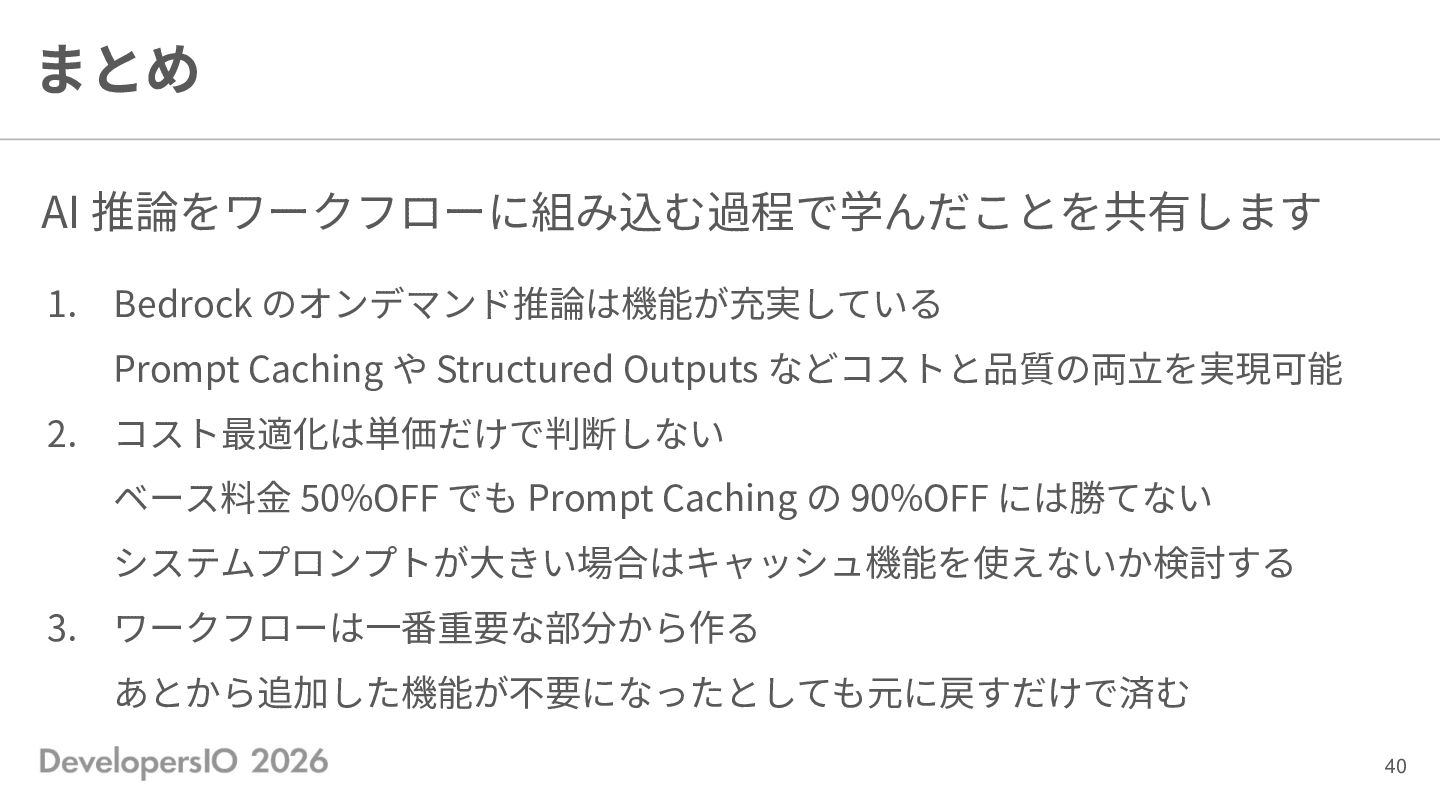
まとめ AI 推論をワークフローに組み込む過程で学んだことを共有します 1. Bedrock のオンデマンド推論は機能が充実している Prompt Caching や Structured
Outputs などコストと品質の両⽴を実現可能 2. コスト最適化は単価だけで判断しない ベース料⾦ 50%OFF でも Prompt Caching の 90%OFF には勝てない システムプロンプトが⼤きい場合はキャッシュ機能を使えないか検討する 3. ワークフローは⼀番重要な部分から作る あとから追加した機能が不要になったとしても元に戻すだけで済む 40