Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
AIに作業を任せるためのシステムづくり
Search
LEF
September 09, 2026
Programming
86
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
AIに作業を任せるためのシステムづくり
開発プロセスとプロダクト設計に関する20のTips
LEF
September 09, 2026
More Decks by LEF
See All by LEF
人生で初めてRubyGemをリリースした話
lef237
1
170
shadcn/uiを使ってReactでの開発を加速させよう!
lef237
1
130k
Web 開発における Deno Fresh の活用例:ペアプロタイマー timer.team の開発
lef237
1
2k
Rails 7でReactとHotwireを同時に使って個人開発して得た知見
lef237
2
4.1k
引用から学ぶプログラミングエッセンス
lef237
0
350
ピアノと囲碁とプログラミング
lef237
0
510
Other Decks in Programming
See All in Programming
更なる可用性を求めて、5年間運用したKotlinのアプリケーションをGoでリプレイスする話
ken_tunc
0
380
JPUG勉強会 OSSデータベースの内部構造を理解しよう(第2回)
oga5
0
270
C#の現在地 進化の歴史と、AI時代の.NET Everywhere
neuecc
5
4.1k
速習iPhone Duo対応
yuukiw00w
2
840
Are APIs Still Relevant in the AI Era?
soyuka
0
330
AI活用は、個人から組織へ|マルチプレイヤーエージェントハーネス「QM」の社内活用事例 / AI use is moving from individuals to orgs
rkaga
1
270
TiDB Cloudのカスタムコントローラーによるオートスケール対応
takaidohigasi
0
140
フロントエンドUIフレームワークのこれまでとこれから
ssssota
5
3k
SREの越境 / SRE Collaboration
y0hgi
2
290
新卒PdEのリアル
ryu1013
1
520
AI Agent時代のリアーキテクチャ戦略と実践
hokaccha
9
5.1k
すこし踏み込む CancellationToken
htkym
2
1.3k
Featured
See All Featured
Agile that works and the tools we love
rasmusluckow
331
22k
Jamie Indigo - Trashchat’s Guide to Black Boxes: Technical SEO Tactics for LLMs
techseoconnect
PRO
0
680
Navigating the moral maze — ethical principles for Al-driven product design
skipperchong
2
580
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
1
540
DBのスキルで生き残る技術 - AI時代におけるテーブル設計の勘所
soudai
PRO
68
58k
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
1
3.1k
Why You Should Never Use an ORM
jnunemaker
PRO
61
10k
Have SEOs Ruined the Internet? - User Awareness of SEO in 2025
akashhashmi
0
500
ピンチをチャンスに:未来をつくるプロダクトロードマップ #pmconf2020
aki_iinuma
128
56k
Testing 201, or: Great Expectations
jmmastey
46
8.3k
How To Stay Up To Date on Web Technology
chriscoyier
790
250k
Sam Torres - BigQuery for SEOs
techseoconnect
PRO
0
550
Transcript
AIに作業を任せるためのシステムづくり 開発プロセスとプロダクト設計に関するTips集 LEF(@lef237) 2026-09-09
自己紹介 LEFと書いて「レフ」と読みます 好きな食べ物:アイスクリーム、角煮まんじゅう 好きなお寿司:サーモン、いくら 最近はエアロバイクに乗るのが日課です。 2
3 AIを使って開発をしたり、プロダクトに組み込んだ際に調べたことを もとにして、スライドにまとめたTips集です。 grill-meのような具体的なスキルの話ではなく、全体の設計についてのお話がメインです。
構成 第1部:AIエージェントで開発プロセスを加速させる 第2部:AIエージェントをプロダクトに組み込む 4
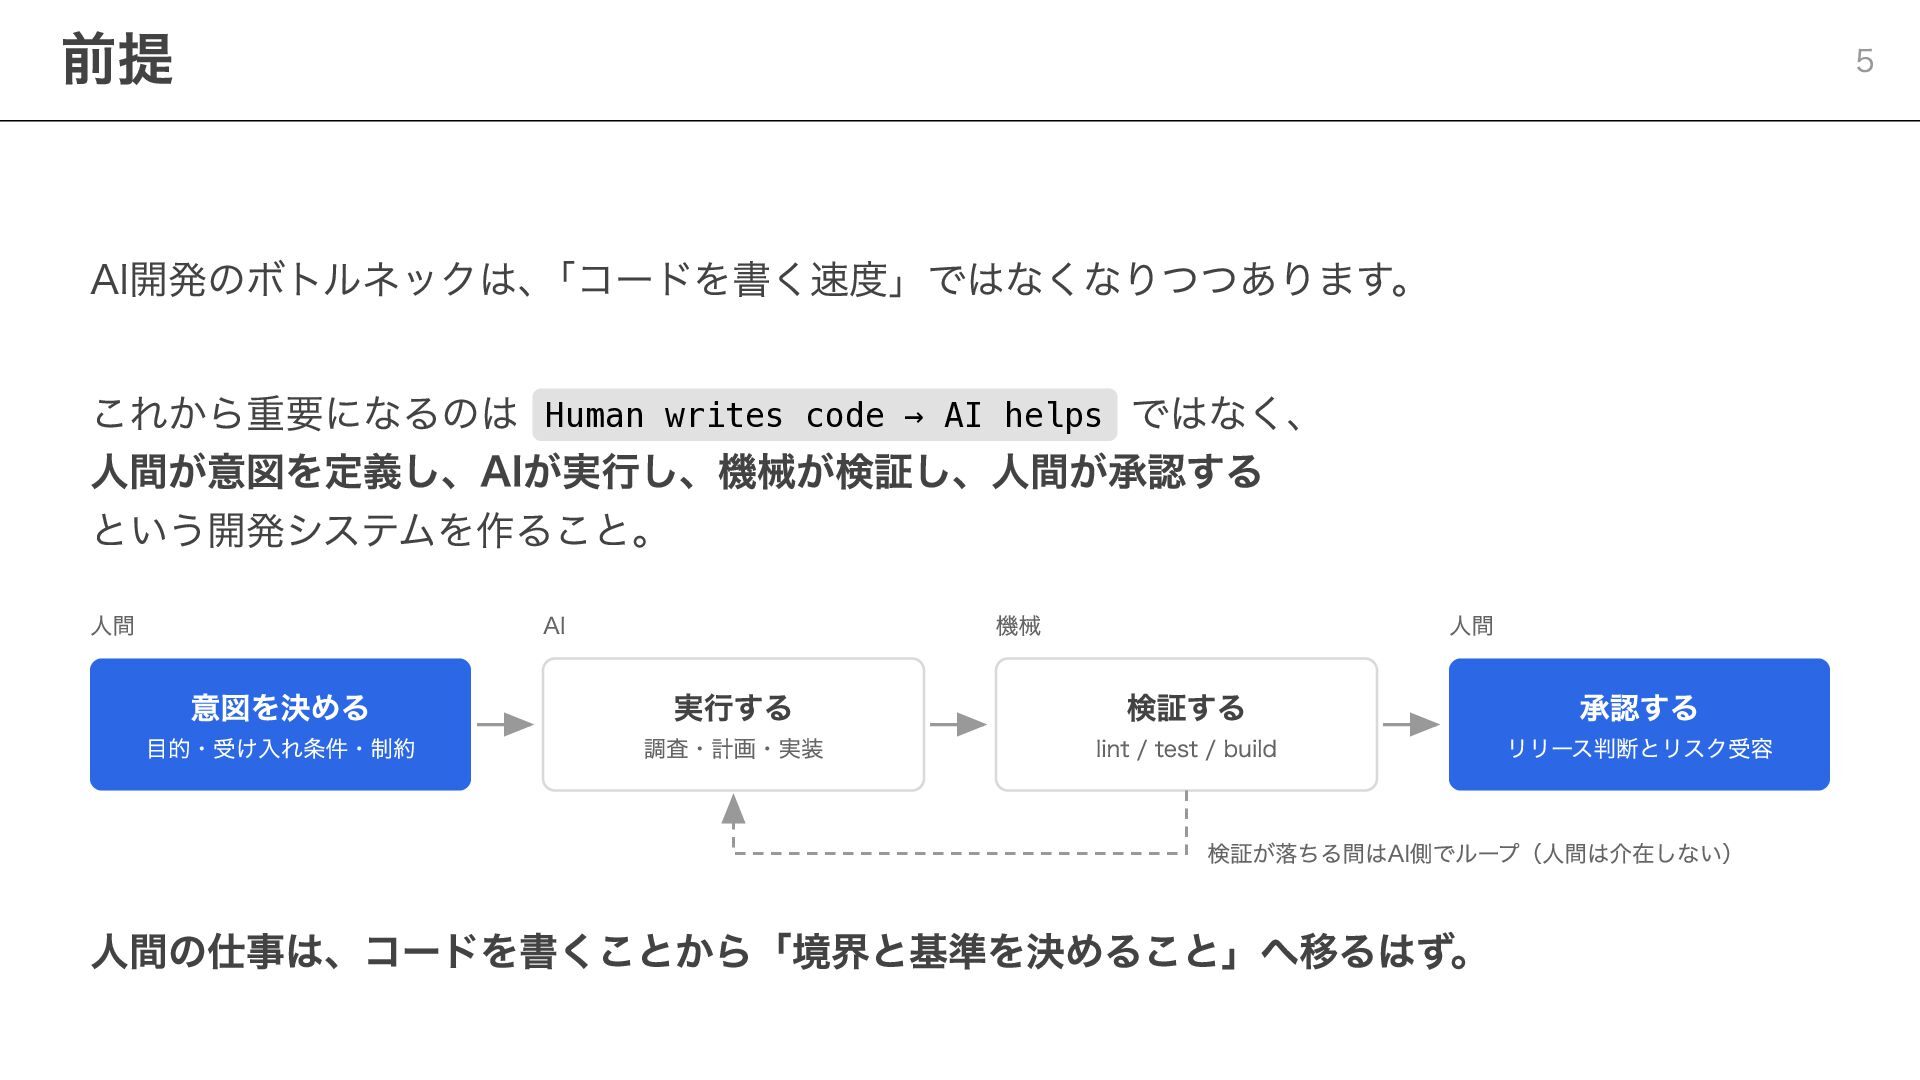
前提 5 AI開発のボトルネックは、「コードを書く速度」ではなくなりつつあります。 これから重要になるのは Human writes code → AI helps
ではなく、 人間が意図を定義し、AIが実行し、機械が検証し、人間が承認する という開発システムを作ること。 人間 AI 意図を決める 目的・受け入れ条件・制約 機械 実行する 調査・計画・実装 人間 検証する lint / test / build 承認する リリース判断とリスク受容 検証が落ちる間はAI側でループ(人間は介在しない) 人間の仕事は、コードを書くことから「境界と基準を決めること」へ移るはず。
第1部:AIエージェントで開発プロセスを加速させる 指示するAIから、自走するAIへ
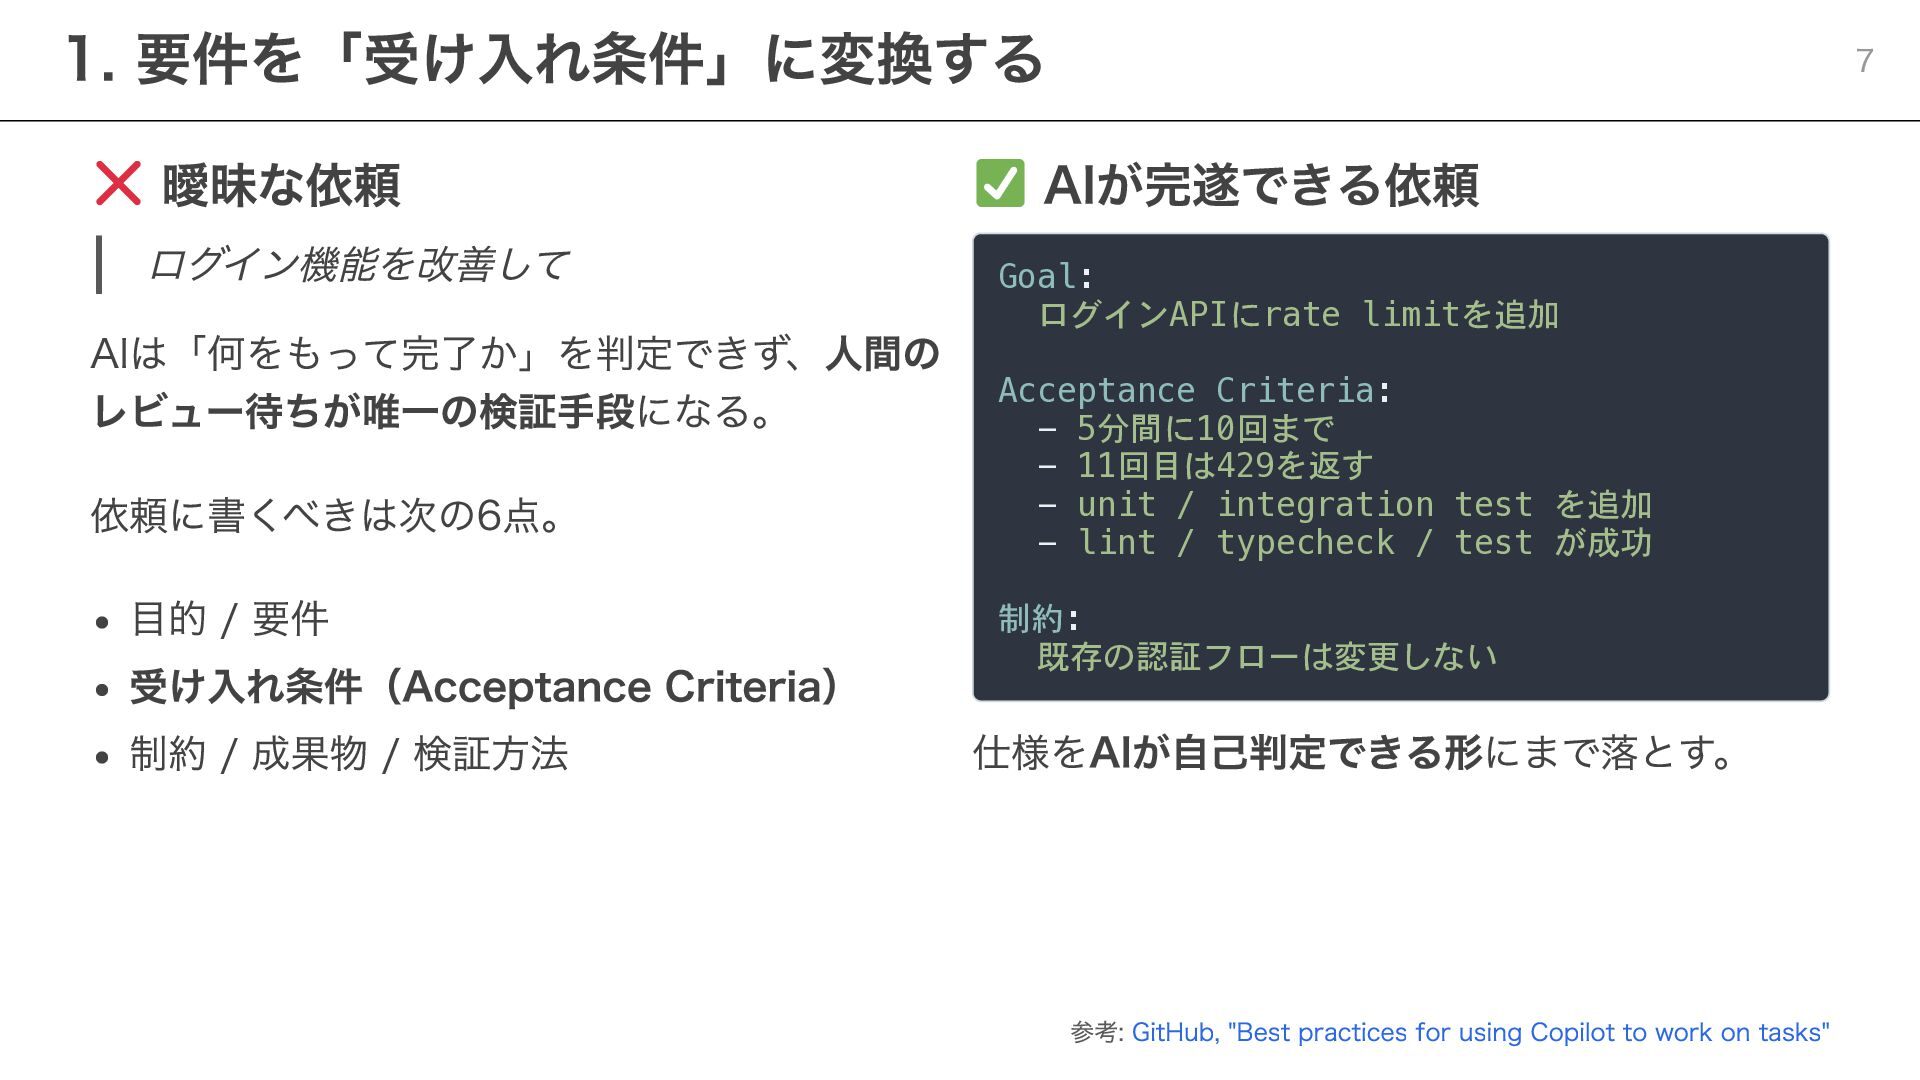
1. 要件を「受け入れ条件」に変換する 曖昧な依頼 7 AIが完遂できる依頼 ログイン機能を改善して Goal: ログインAPIにrate limitを追加 AIは「何をもって完了か」を判定できず、人間の
Acceptance Criteria: レビュー待ちが唯一の検証手段になる。 - 5分間に10回まで - 11回目は429を返す - unit / integration test を追加 依頼に書くべきは次の6点。 - lint / typecheck / test が成功 制約: 目的 / 要件 既存の認証フローは変更しない 受け入れ条件(Acceptance Criteria) 仕様をAIが自己判定できる形にまで落とす。 制約 / 成果物 / 検証方法 参考: GitHub, "Best practices for using Copilot to work on tasks"
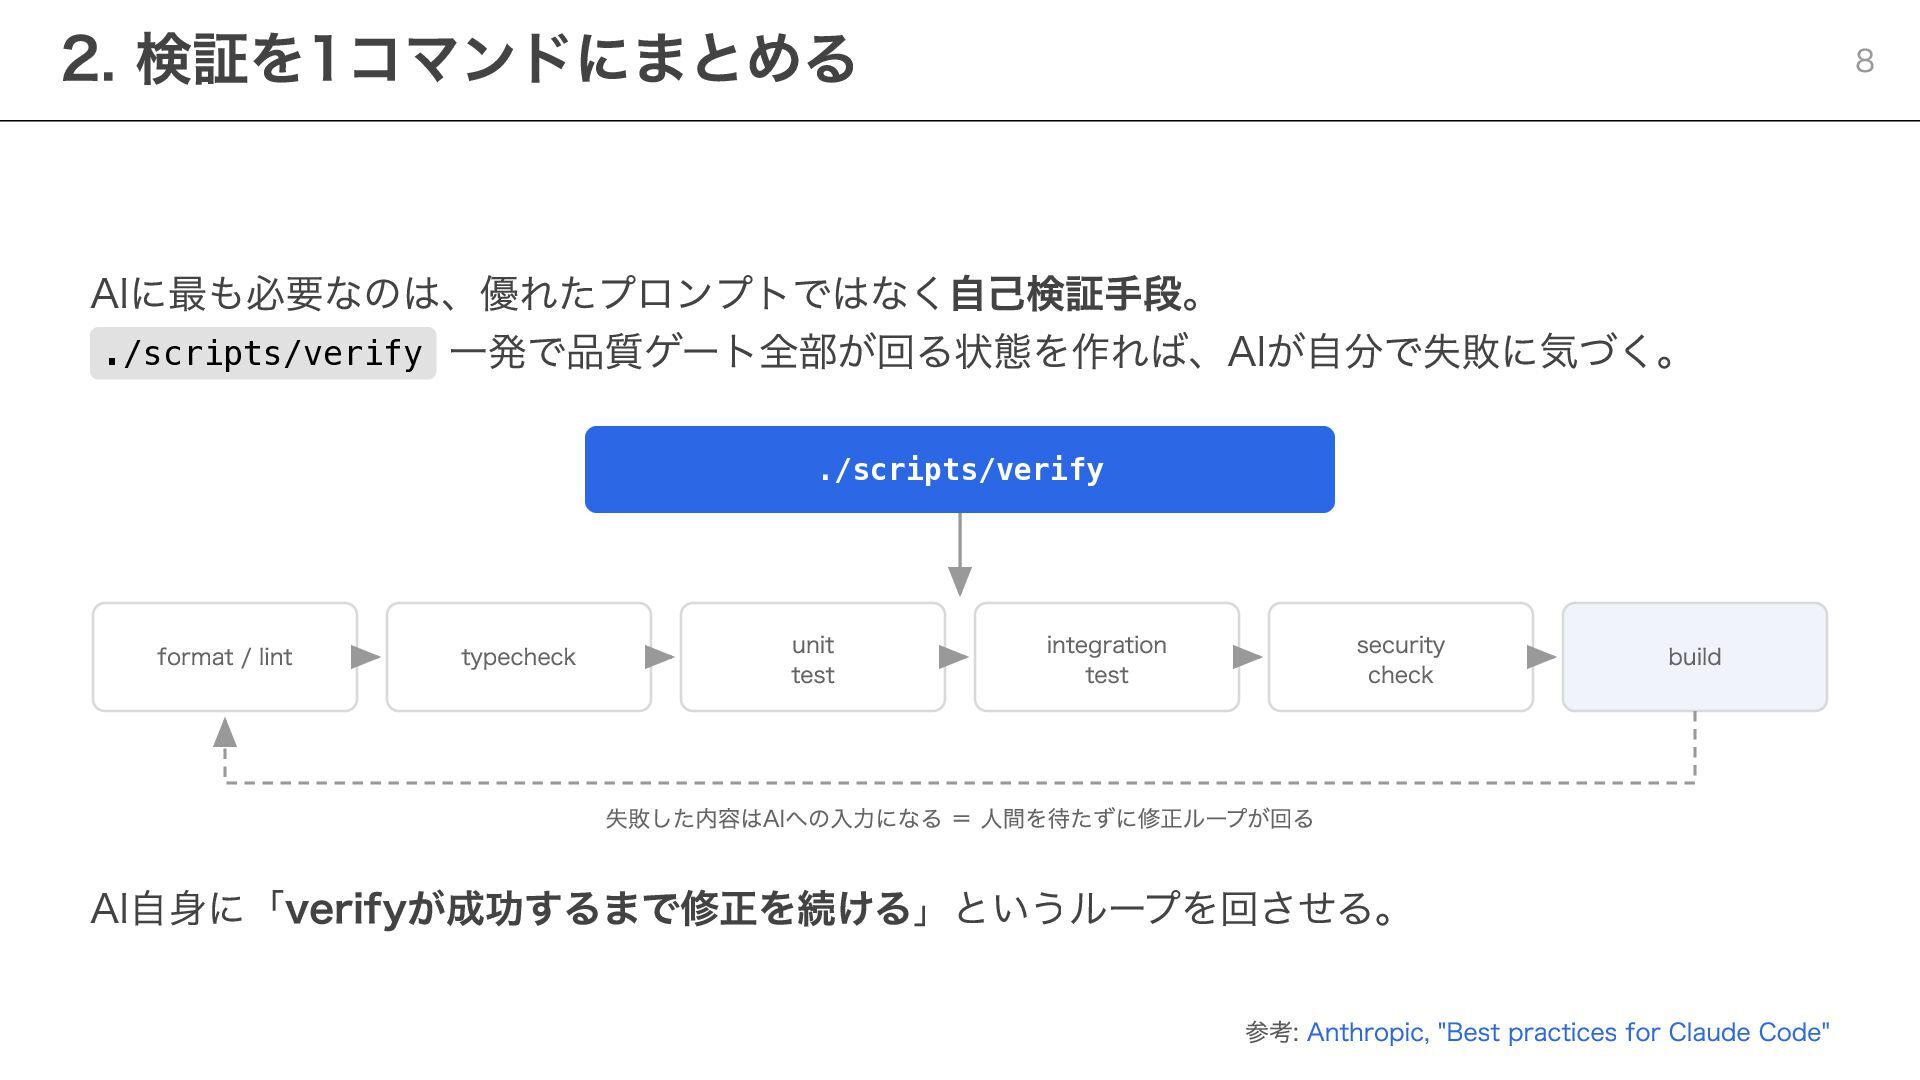
2. 検証を1コマンドにまとめる 8 AIに最も必要なのは、優れたプロンプトではなく自己検証手段。 ./scripts/verify 一発で品質ゲート全部が回る状態を作れば、AIが自分で失敗に気づく。 ./scripts/verify format / lint
typecheck unit test integration test security check build 失敗した内容はAIへの入力になる = 人間を待たずに修正ループが回る AI自身に「verifyが成功するまで修正を続ける」というループを回させる。 参考: Anthropic, "Best practices for Claude Code"
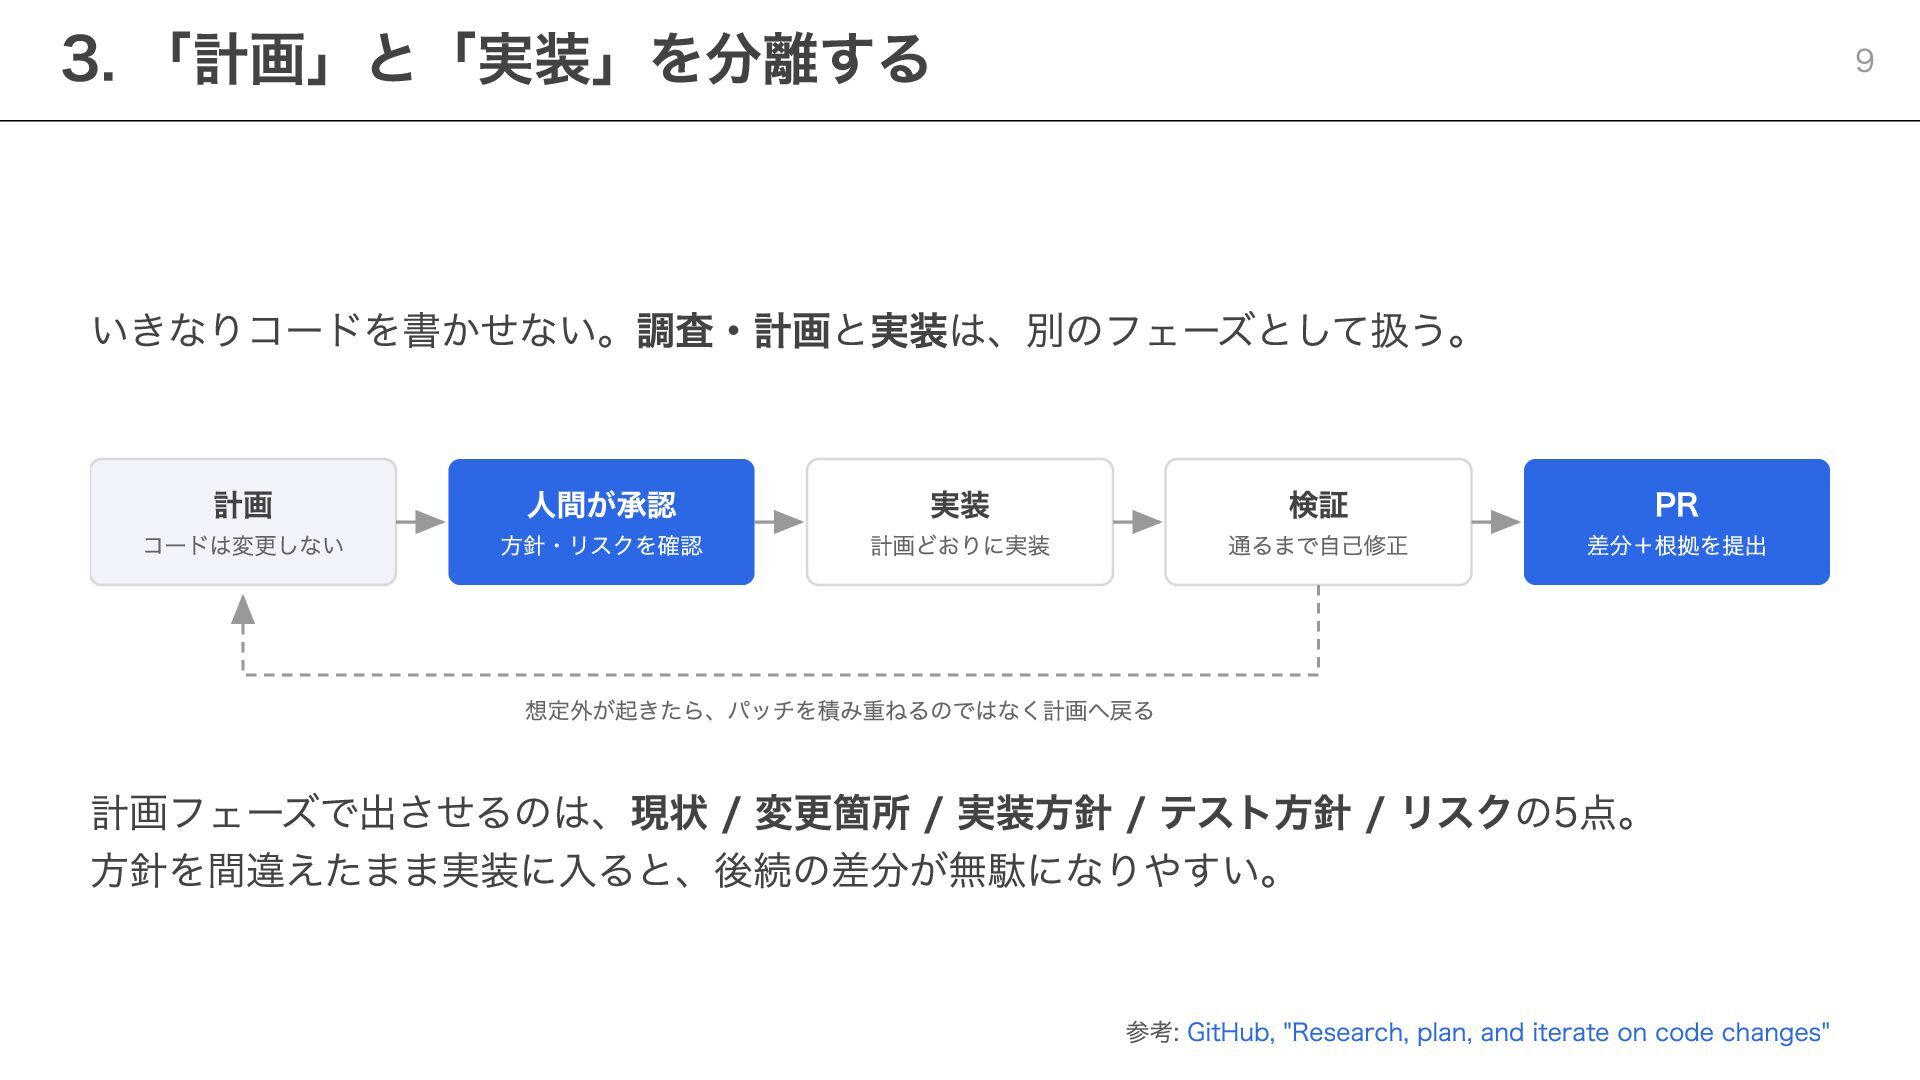
3. 「計画」と「実装」を分離する 9 いきなりコードを書かせない。調査・計画と実装は、別のフェーズとして扱う。 計画 コードは変更しない 人間が承認 方針・リスクを確認 実装 検証
計画どおりに実装 通るまで自己修正 PR 差分+根拠を提出 想定外が起きたら、パッチを積み重ねるのではなく計画へ戻る 計画フェーズで出させるのは、現状 / 変更箇所 / 実装方針 / テスト方針 / リスクの5点。 方針を間違えたまま実装に入ると、後続の差分が無駄になりやすい。 参考: GitHub, "Research, plan, and iterate on code changes"
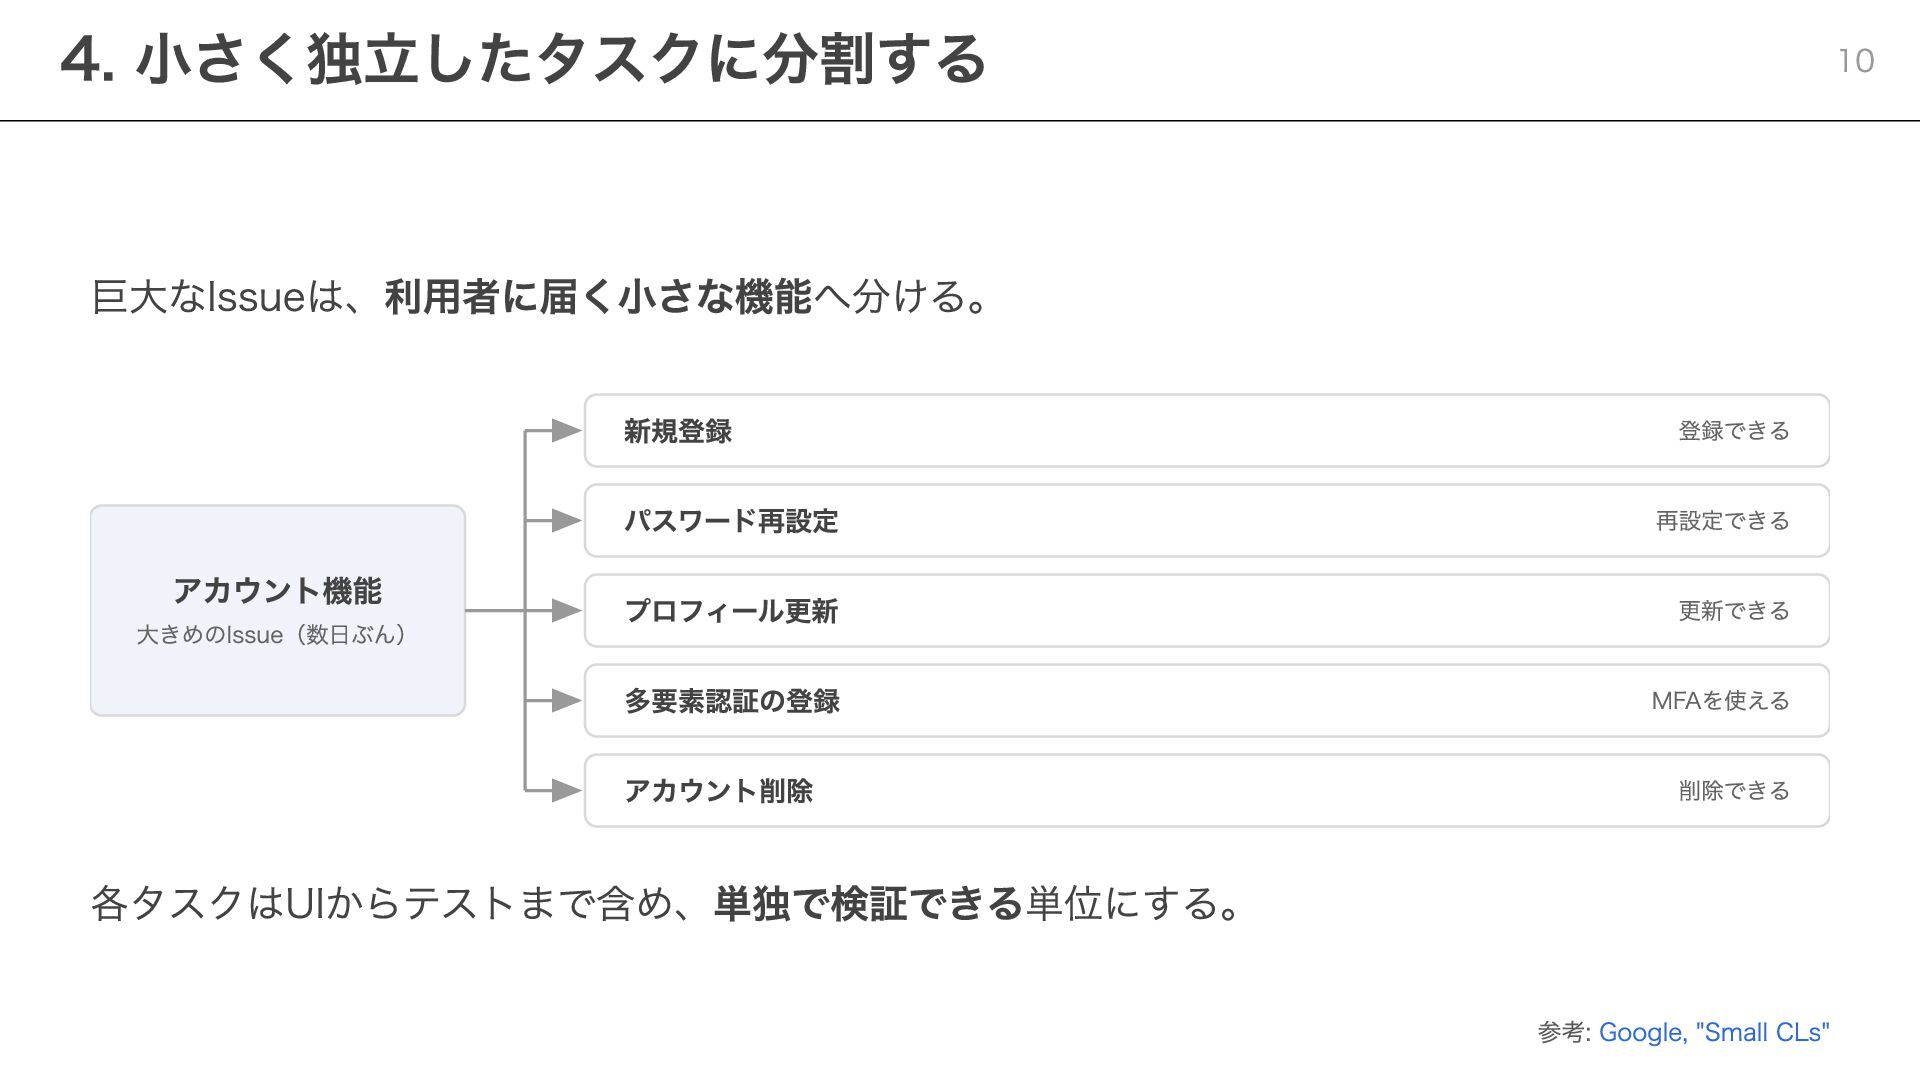
4. 小さく独立したタスクに分割する 10 巨大なIssueは、利用者に届く小さな機能へ分ける。 アカウント機能 大きめのIssue(数日ぶん) 新規登録 登録できる パスワード再設定 再設定できる
プロフィール更新 更新できる 多要素認証の登録 MFAを使える アカウント削除 削除できる 各タスクはUIからテストまで含め、単独で検証できる単位にする。 参考: Google, "Small CLs"
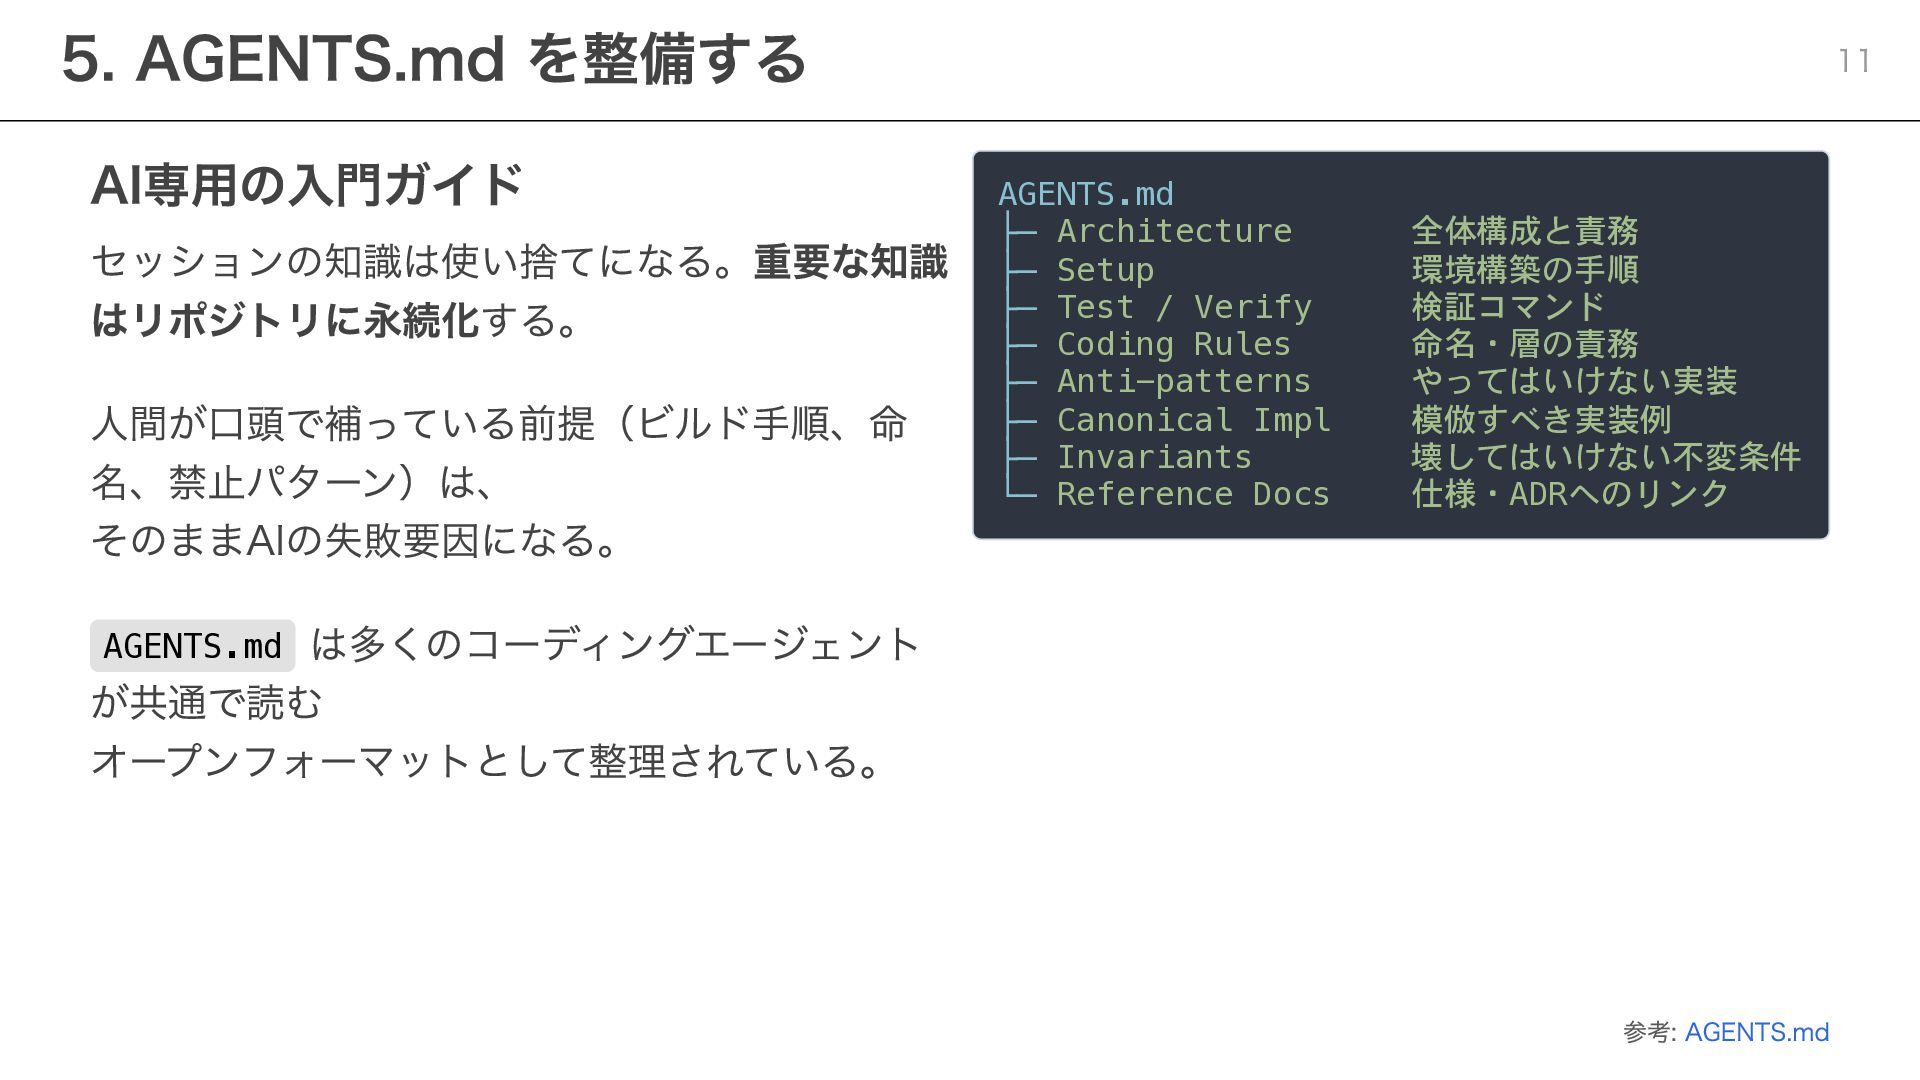
5. AGENTS.md を整備する AI専用の入門ガイド セッションの知識は使い捨てになる。重要な知識 はリポジトリに永続化する。 人間が口頭で補っている前提(ビルド手順、命 名、禁止パターン)は、 そのままAIの失敗要因になる。 AGENTS.md
は多くのコーディングエージェント が共通で読む オープンフォーマットとして整理されている。 11 AGENTS.md ├─ Architecture ├─ Setup ├─ Test / Verify ├─ Coding Rules ├─ Anti-patterns ├─ Canonical Impl ├─ Invariants └─ Reference Docs 全体構成と責務 環境構築の手順 検証コマンド 命名・層の責務 やってはいけない実装 模倣すべき実装例 壊してはいけない不変条件 仕様・ADRへのリンク 参考: AGENTS.md
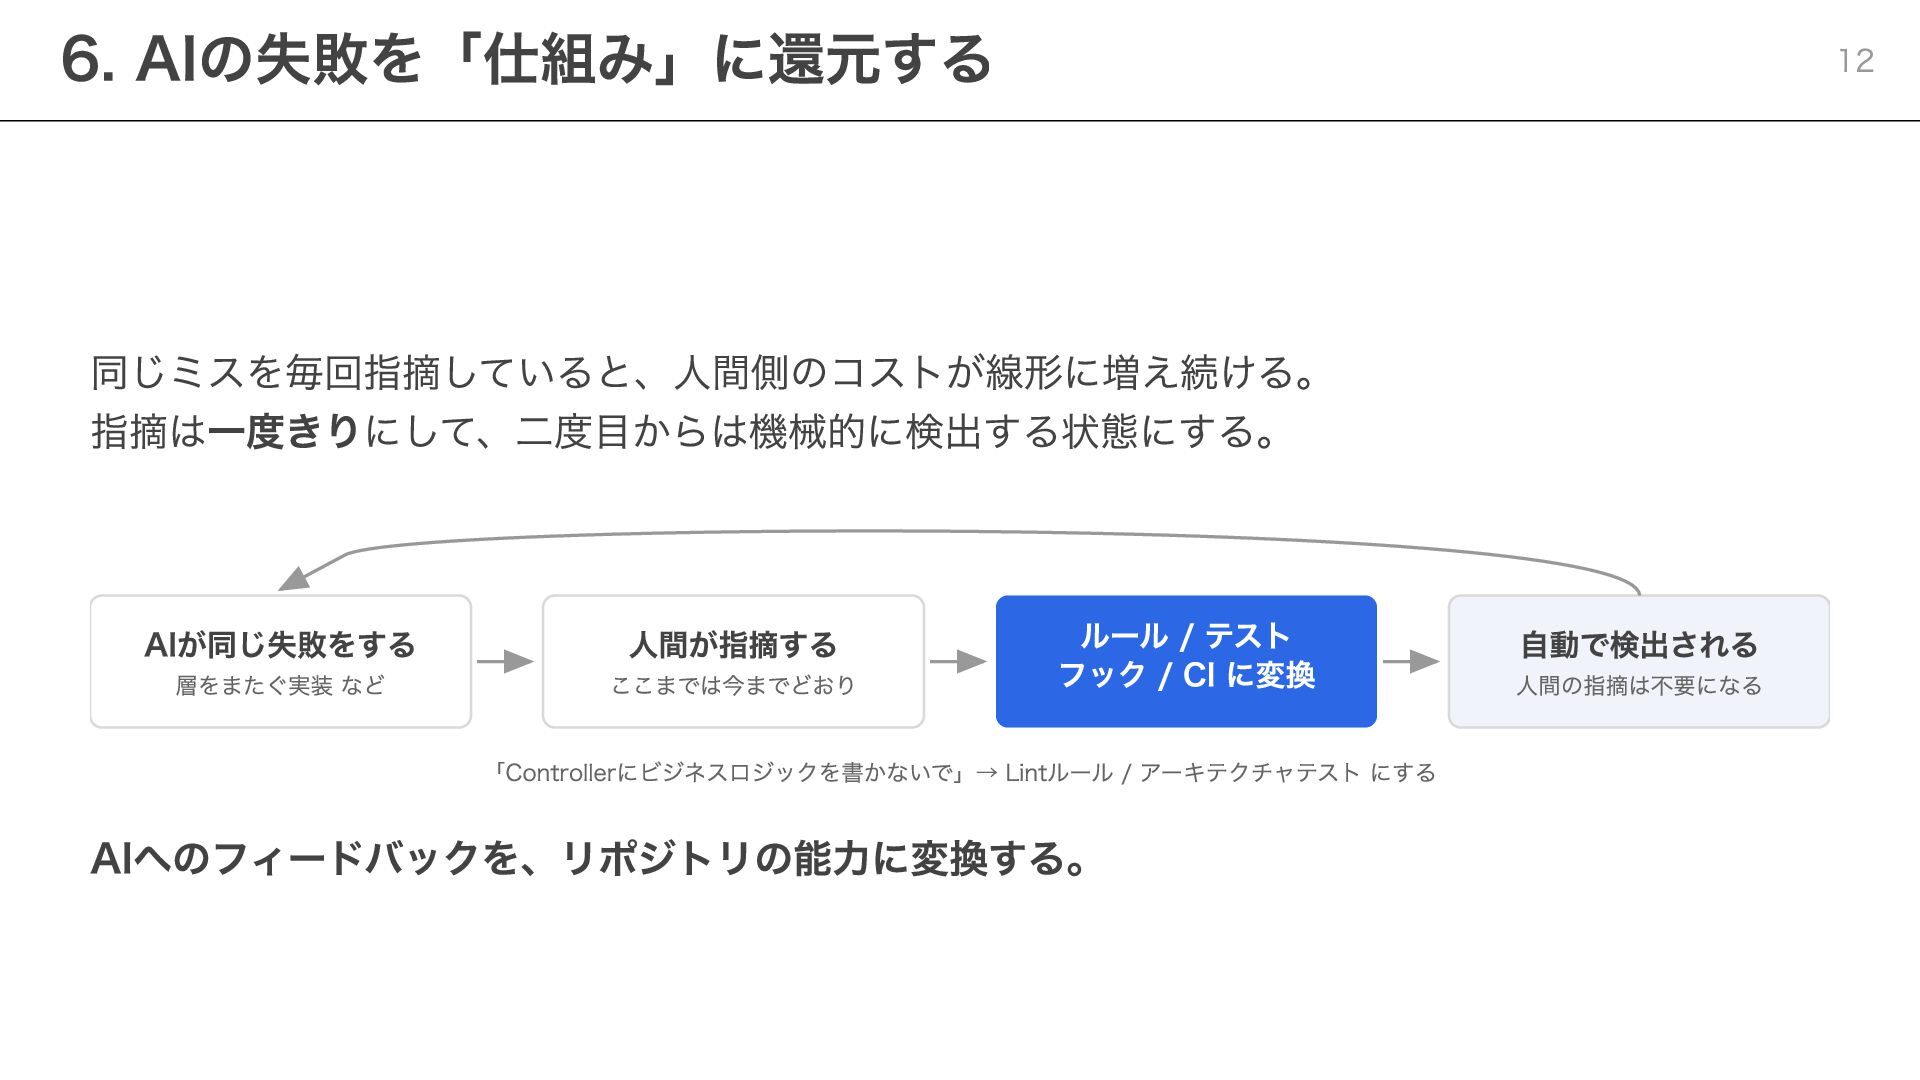
6. AIの失敗を「仕組み」に還元する 12 同じミスを毎回指摘していると、人間側のコストが線形に増え続ける。 指摘は一度きりにして、二度目からは機械的に検出する状態にする。 AIが同じ失敗をする 層をまたぐ実装 など 人間が指摘する ここまでは今までどおり
ルール / テスト フック / CI に変換 「Controllerにビジネスロジックを書かないで」→ Lintルール / アーキテクチャテスト にする AIへのフィードバックを、リポジトリの能力に変換する。 自動で検出される 人間の指摘は不要になる
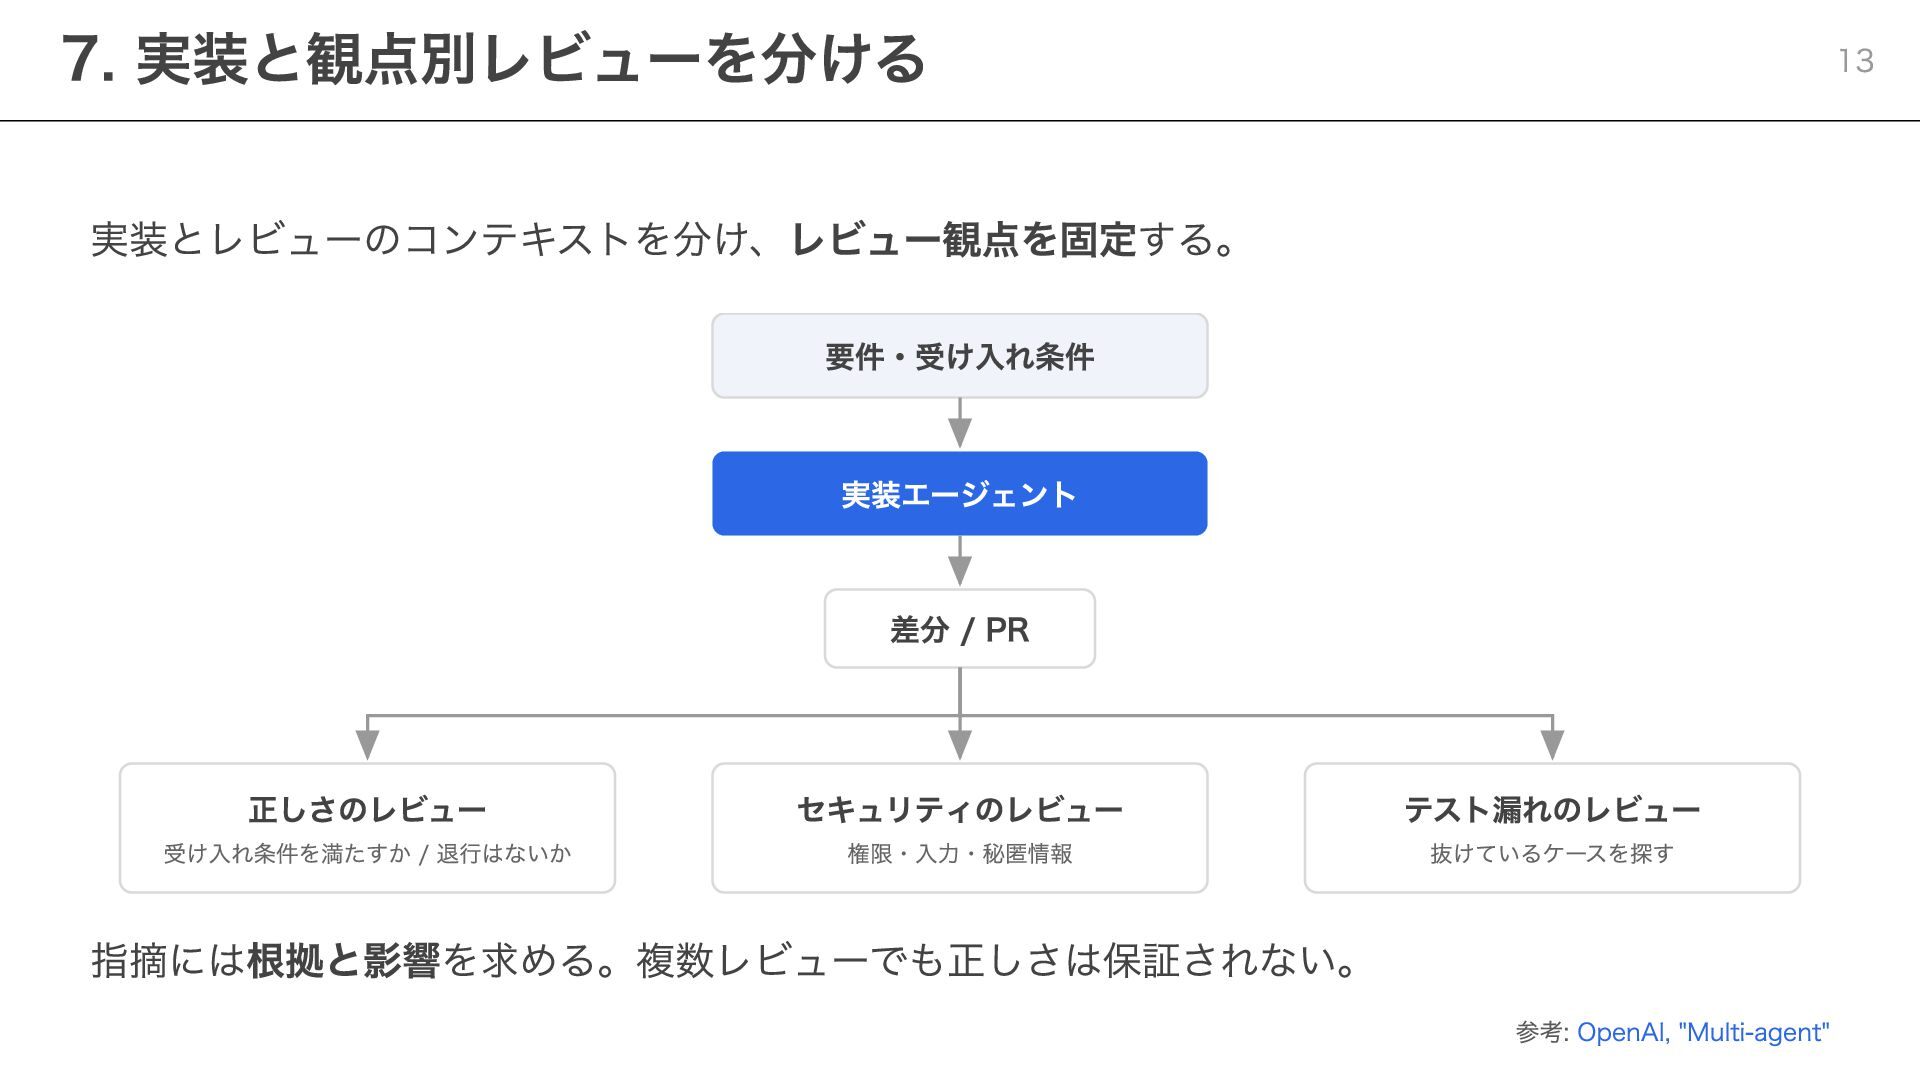
7. 実装と観点別レビューを分ける 13 実装とレビューのコンテキストを分け、レビュー観点を固定する。 要件・受け入れ条件 実装エージェント 差分 / PR 正しさのレビュー
受け入れ条件を満たすか / 退行はないか セキュリティのレビュー 権限・入力・秘匿情報 指摘には根拠と影響を求める。複数レビューでも正しさは保証されない。 テスト漏れのレビュー 抜けているケースを探す 参考: OpenAI, "Multi-agent"
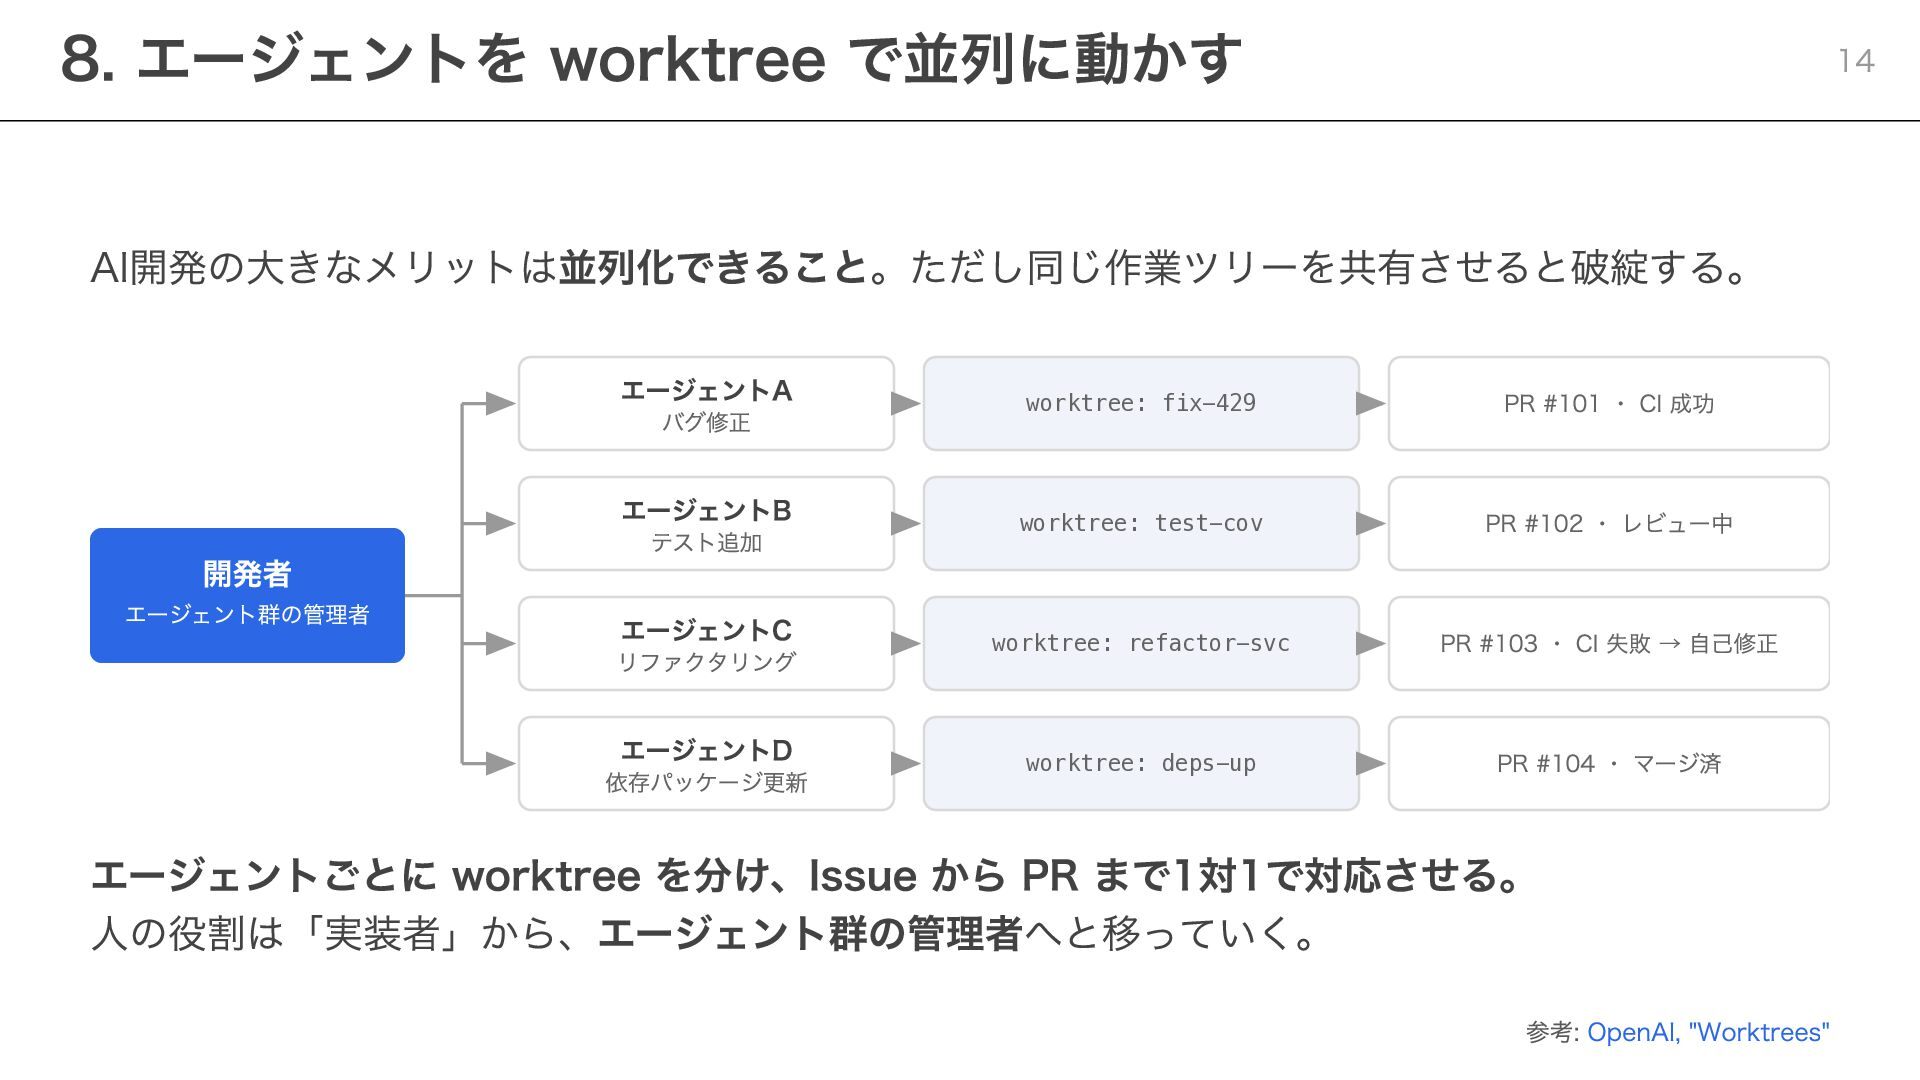
8. エージェントを worktree で並列に動かす 14 AI開発の大きなメリットは並列化できること。ただし同じ作業ツリーを共有させると破綻する。 エージェントA worktree: fix-429 PR
#101 ・ CI 成功 エージェントB worktree: test-cov PR #102 ・ レビュー中 エージェントC worktree: refactor-svc PR #103 ・ CI 失敗 → 自己修正 エージェントD worktree: deps-up PR #104 ・ マージ済 バグ修正 開発者 エージェント群の管理者 テスト追加 リファクタリング 依存パッケージ更新 エージェントごとに worktree を分け、Issue から PR まで1対1で対応させる。 人の役割は「実装者」から、エージェント群の管理者へと移っていく。 参考: OpenAI, "Worktrees"
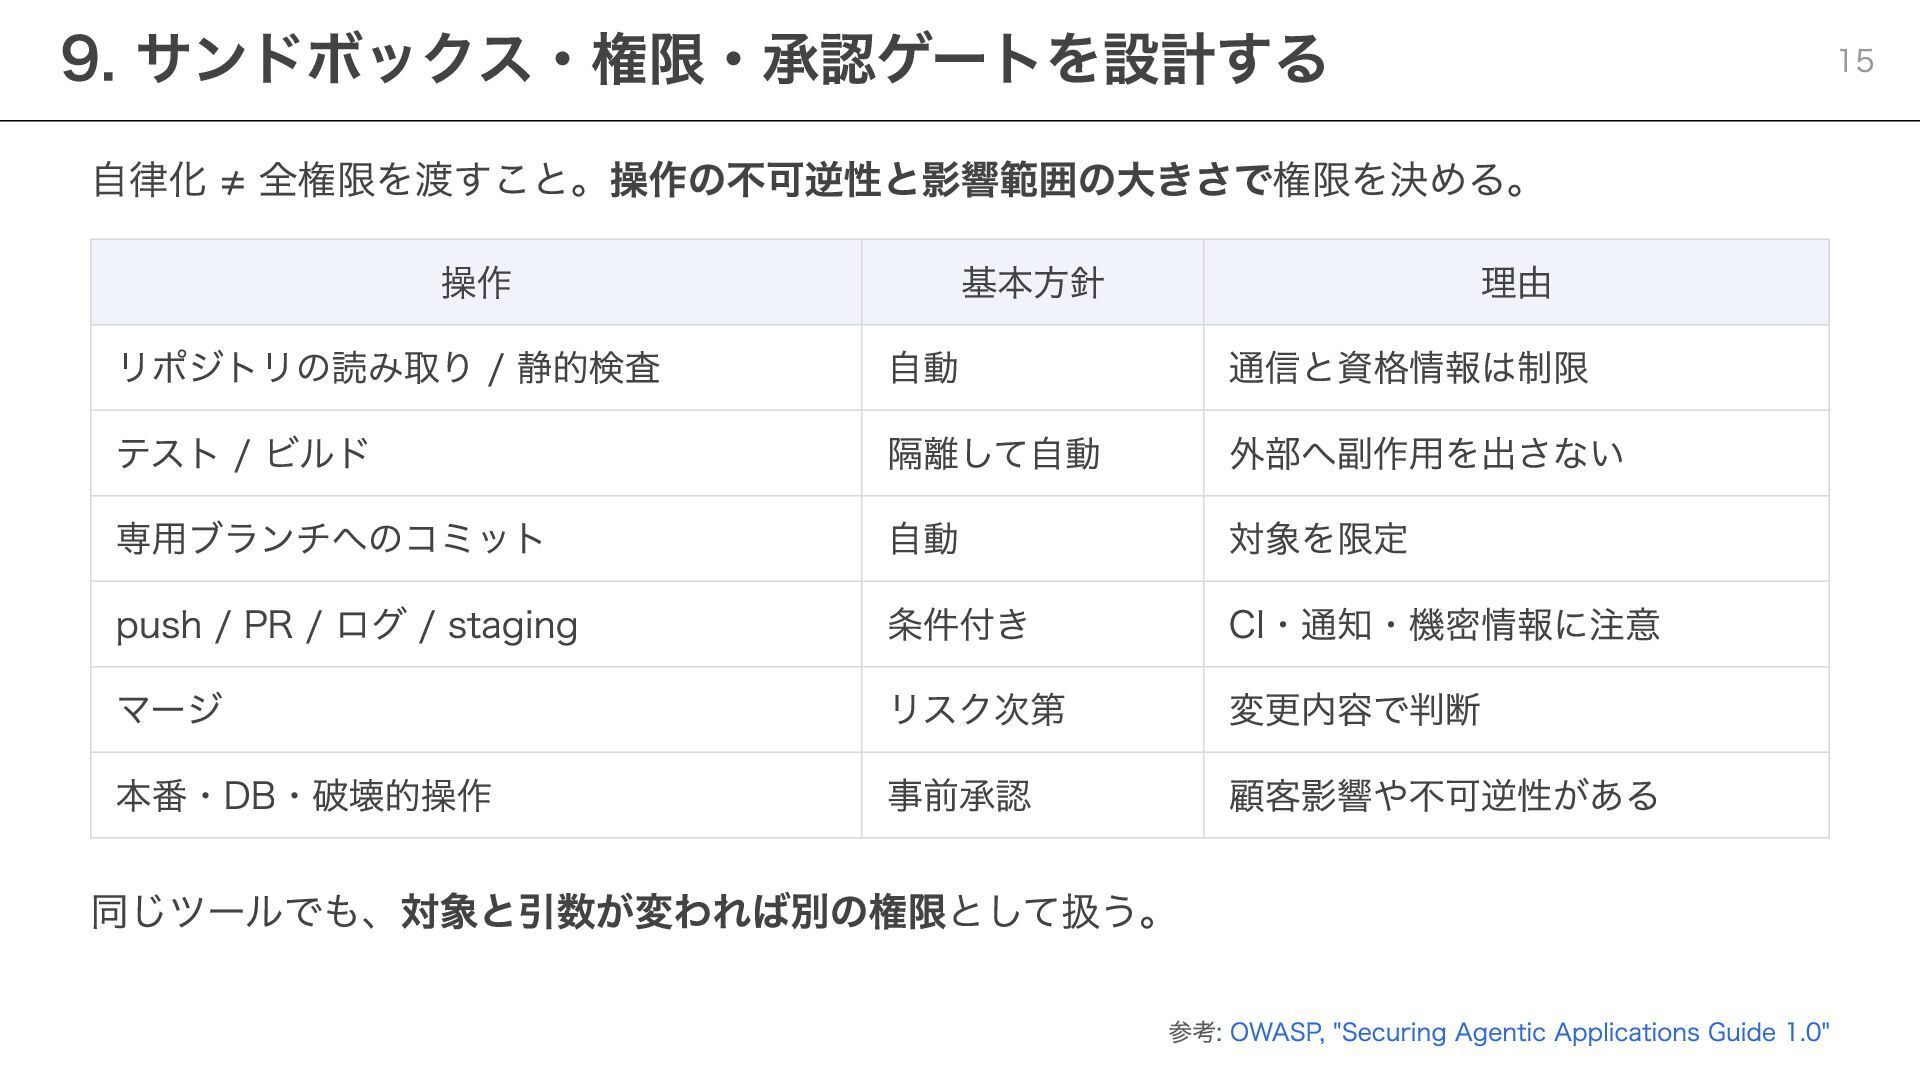
9. サンドボックス・権限・承認ゲートを設計する 自律化 ≠ 全権限を渡すこと。操作の不可逆性と影響範囲の大きさで権限を決める。 操作 リポジトリの読み取り / 静的検査 テスト
/ ビルド 専用ブランチへのコミット push / PR / ログ / staging マージ 本番・DB・破壊的操作 基本方針 理由 通信と資格情報は制限 外部へ副作用を出さない 対象を限定 CI・通知・機密情報に注意 変更内容で判断 顧客影響や不可逆性がある 自動 隔離して自動 自動 条件付き リスク次第 事前承認 同じツールでも、対象と引数が変われば別の権限として扱う。 参考: OWASP, "Securing Agentic Applications Guide 1.0" 15
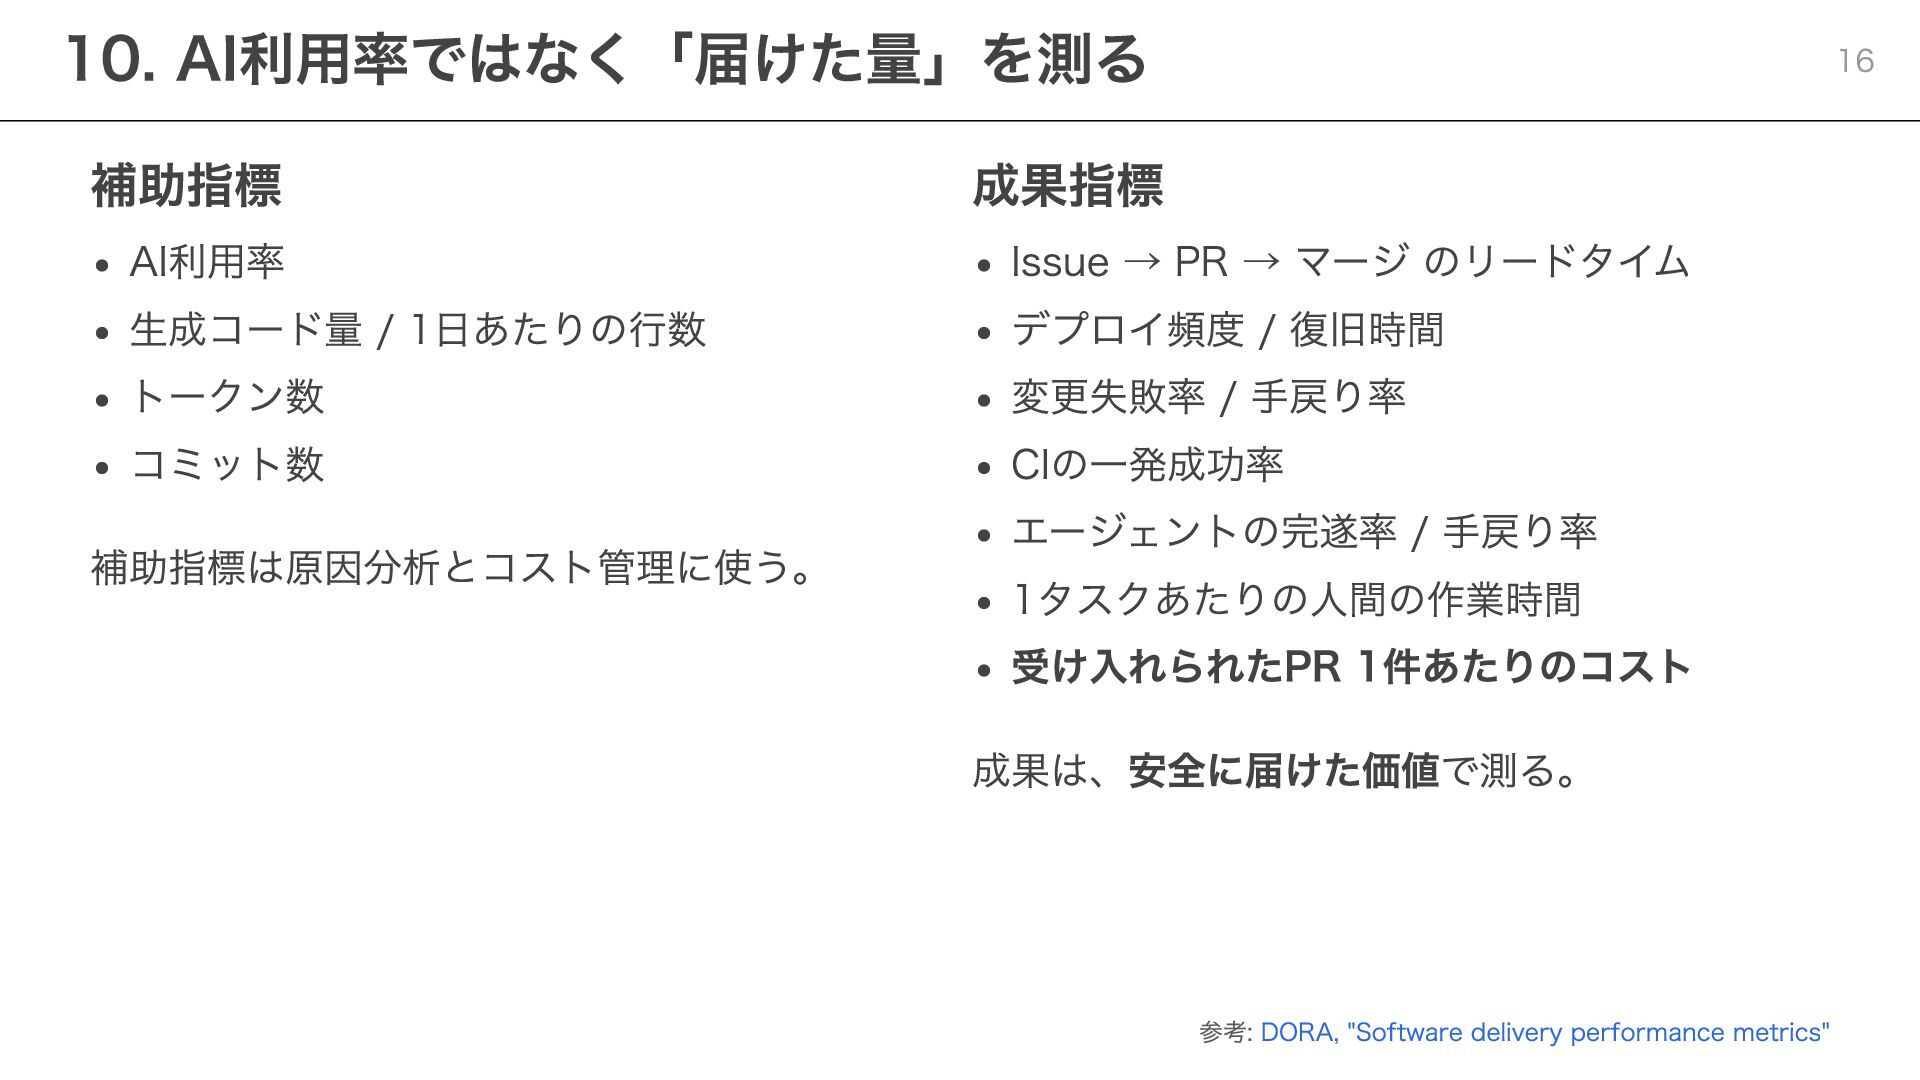
10. AI利用率ではなく「届けた量」を測る 補助指標 AI利用率 生成コード量 / 1日あたりの行数 トークン数 コミット数 補助指標は原因分析とコスト管理に使う。
16 成果指標 Issue → PR → マージ のリードタイム デプロイ頻度 / 復旧時間 変更失敗率 / 手戻り率 CIの一発成功率 エージェントの完遂率 / 手戻り率 1タスクあたりの人間の作業時間 受け入れられたPR 1件あたりのコスト 成果は、安全に届けた価値で測る。 参考: DORA, "Software delivery performance metrics"
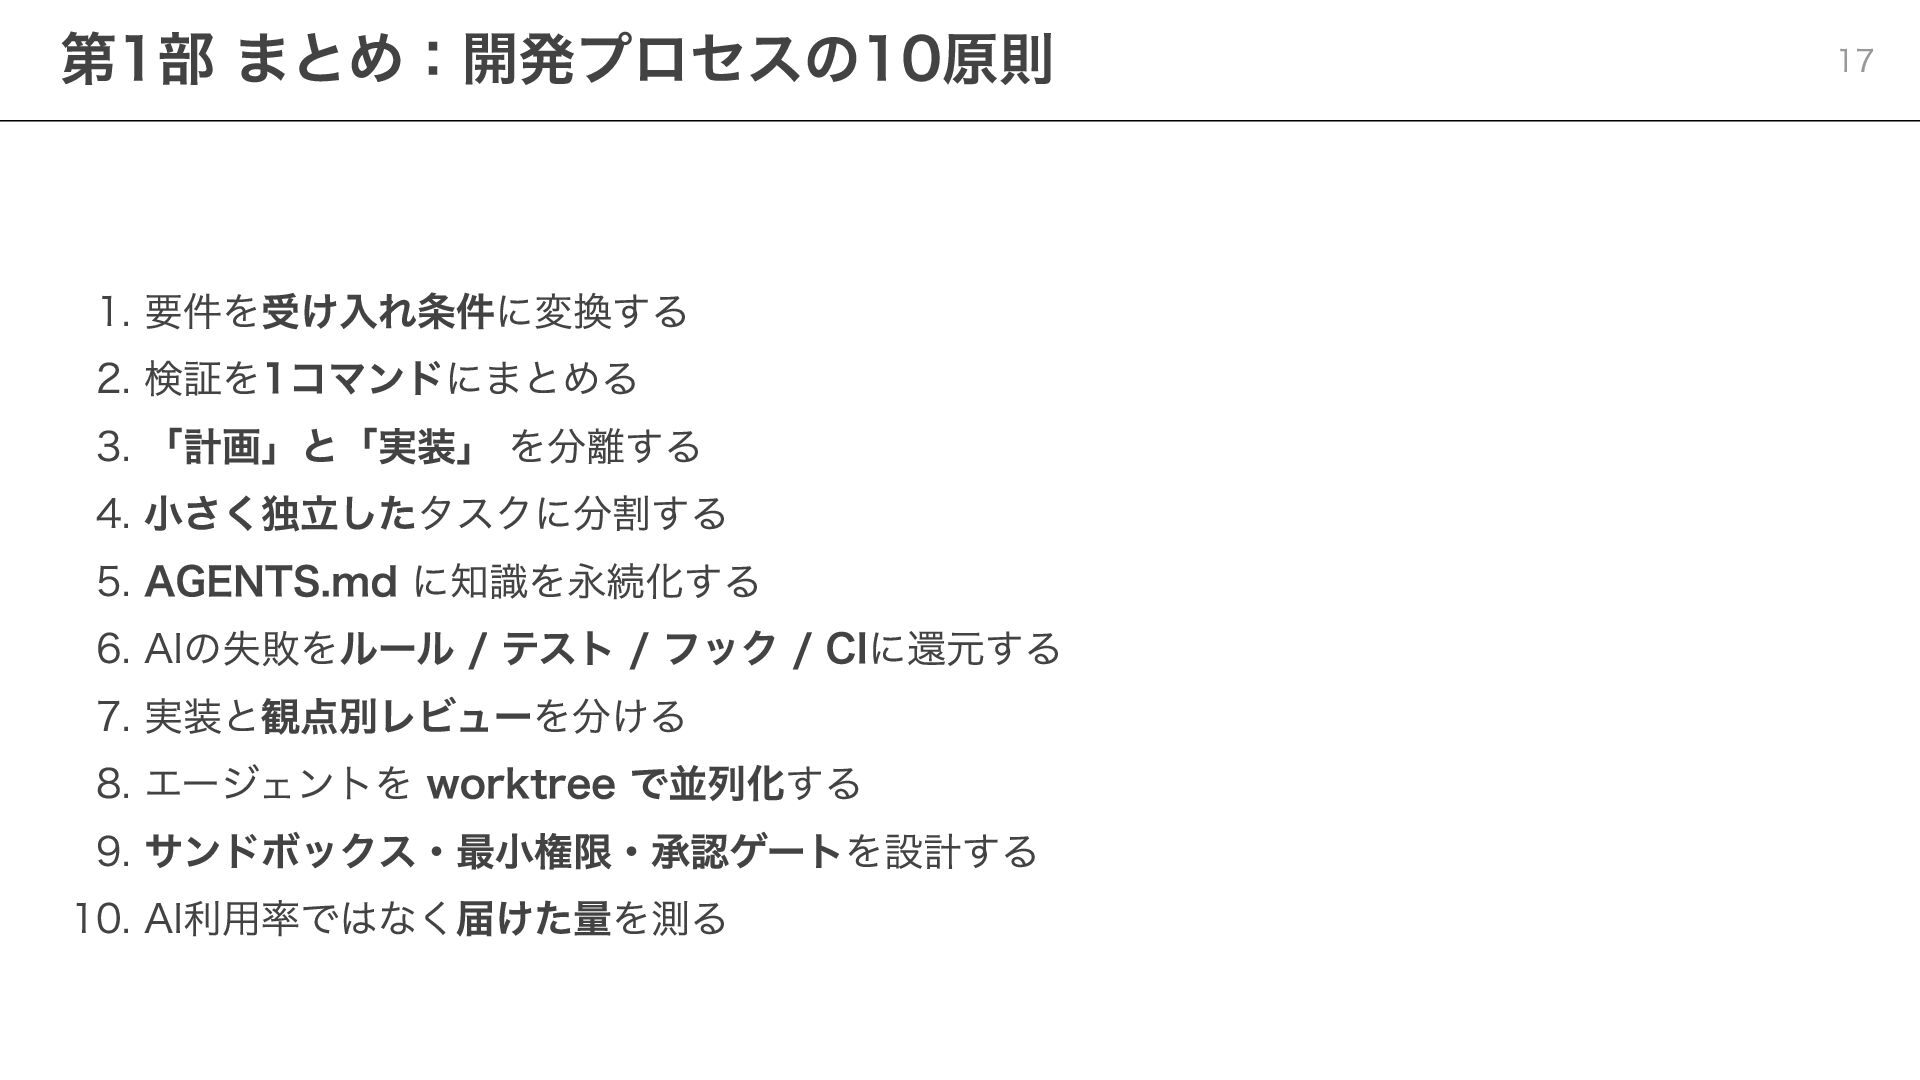
第1部 まとめ:開発プロセスの10原則 1. 要件を受け入れ条件に変換する 2. 検証を1コマンドにまとめる 3. 「計画」と「実装」 を分離する 4.
小さく独立したタスクに分割する 5. AGENTS.md に知識を永続化する 6. AIの失敗をルール / テスト / フック / CIに還元する 7. 実装と観点別レビューを分ける 8. エージェントを worktree で並列化する 9. サンドボックス・最小権限・承認ゲートを設計する 10. AI利用率ではなく届けた量を測る 17
第2部:AIエージェントをプロダクトに組み込む 賢いLLMから、制御された実行系へ
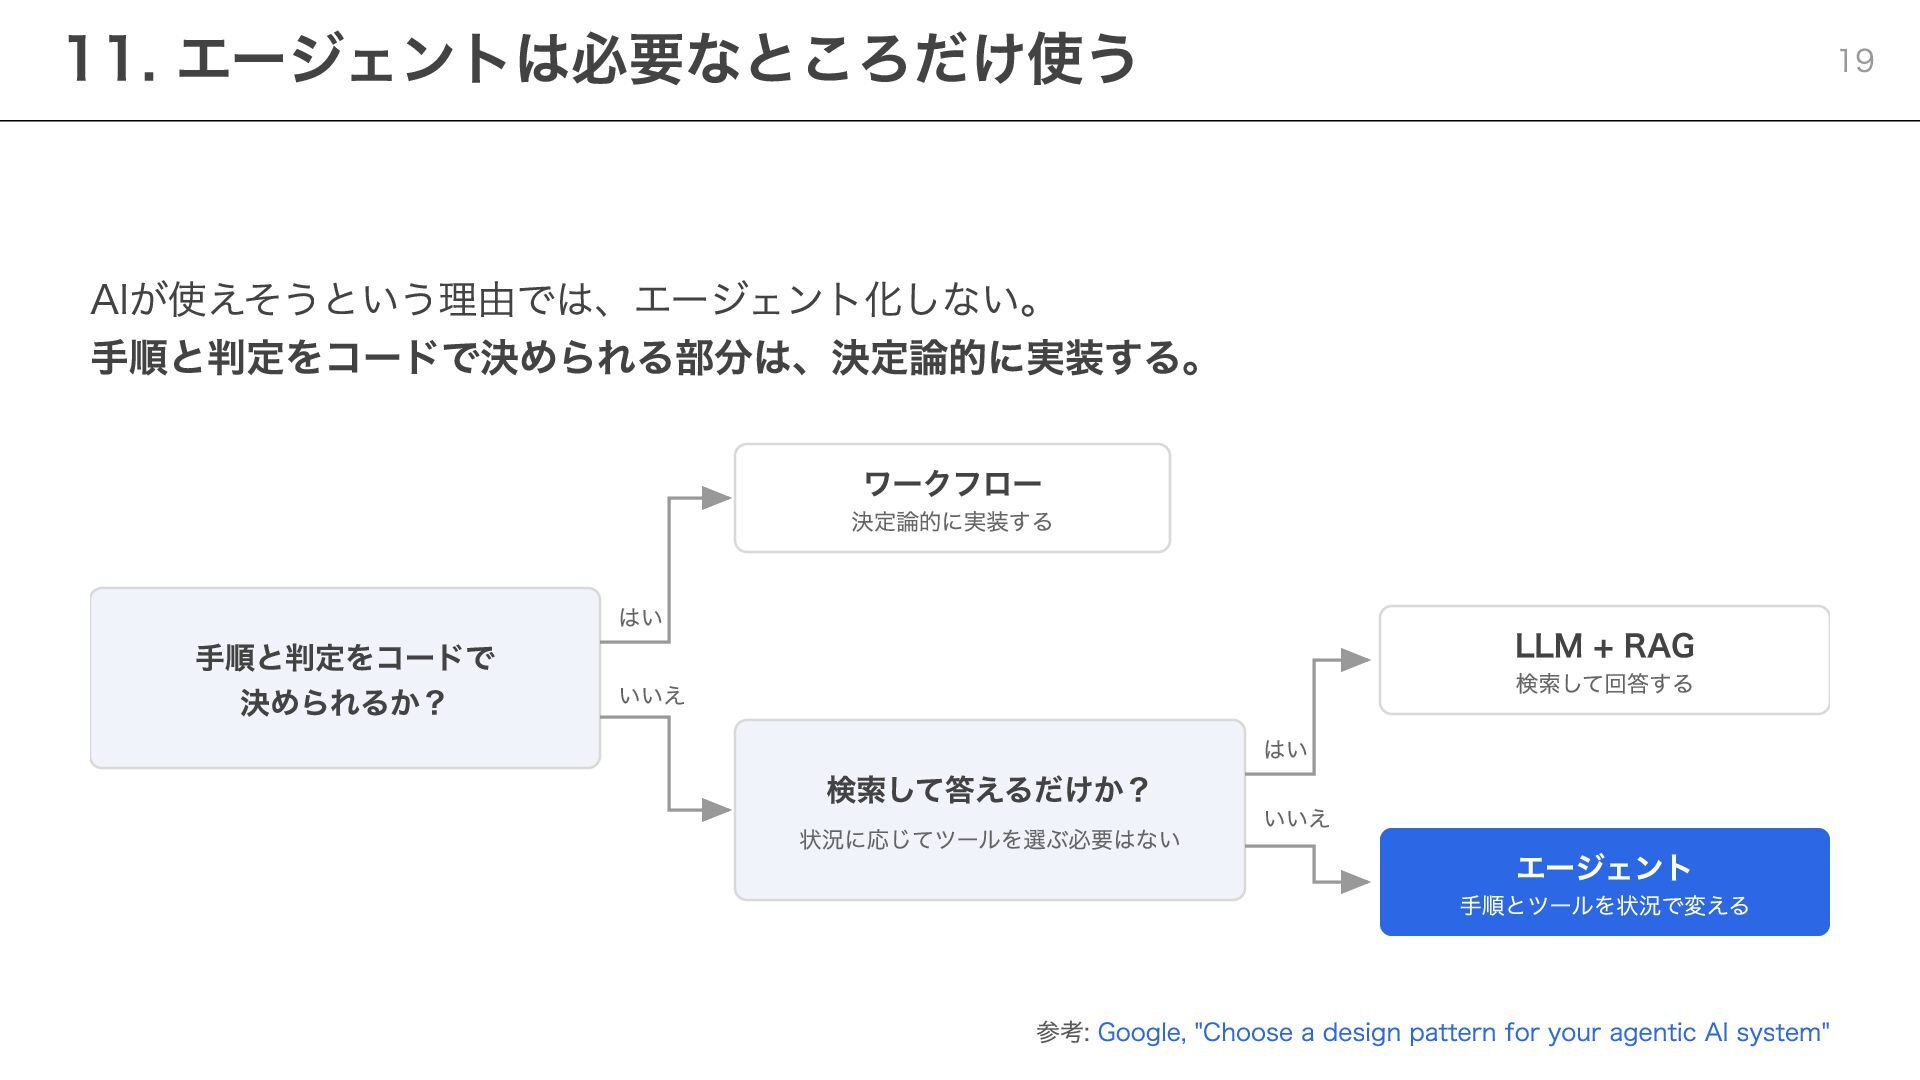
11. エージェントは必要なところだけ使う 19 AIが使えそうという理由では、エージェント化しない。 手順と判定をコードで決められる部分は、決定論的に実装する。 ワークフロー 決定論的に実装する 手順と判定をコードで 決められるか? はい
LLM + RAG 検索して回答する いいえ 検索して答えるだけか? 状況に応じてツールを選ぶ必要はない はい いいえ エージェント 手順とツールを状況で変える 参考: Google, "Choose a design pattern for your agentic AI system"
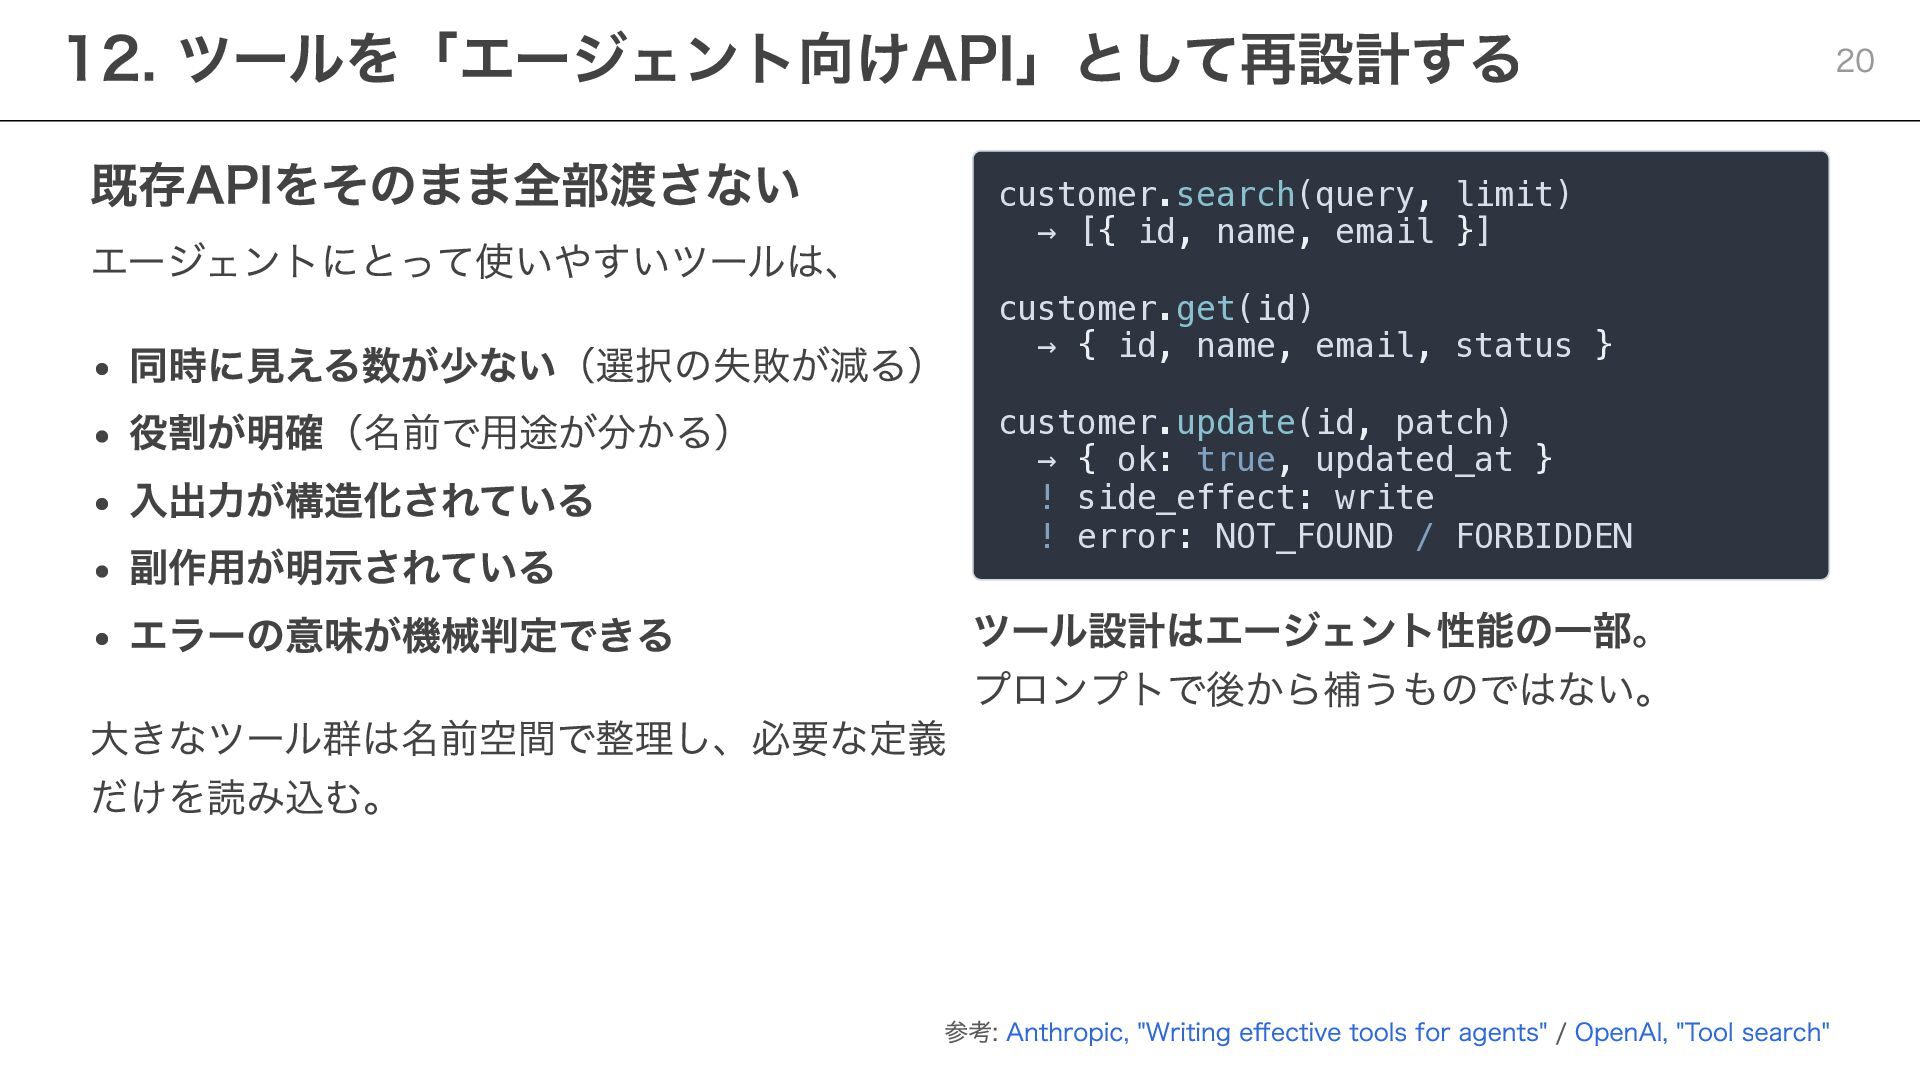
12. ツールを「エージェント向けAPI」として再設計する 既存APIをそのまま全部渡さない customer.search(query, limit) → [{ id, name, email
}] エージェントにとって使いやすいツールは、 customer.get(id) 同時に見える数が少ない(選択の失敗が減る) → { id, name, email, status } customer.update(id, patch) 役割が明確(名前で用途が分かる) → { ok: true, updated_at } ! side_effect: write 入出力が構造化されている ! error: NOT_FOUND / FORBIDDEN 副作用が明示されている ツール設計はエージェント性能の一部。 エラーの意味が機械判定できる プロンプトで後から補うものではない。 大きなツール群は名前空間で整理し、必要な定義 だけを読み込む。 参考: Anthropic, "Writing effective tools for agents" / OpenAI, "Tool search" 20
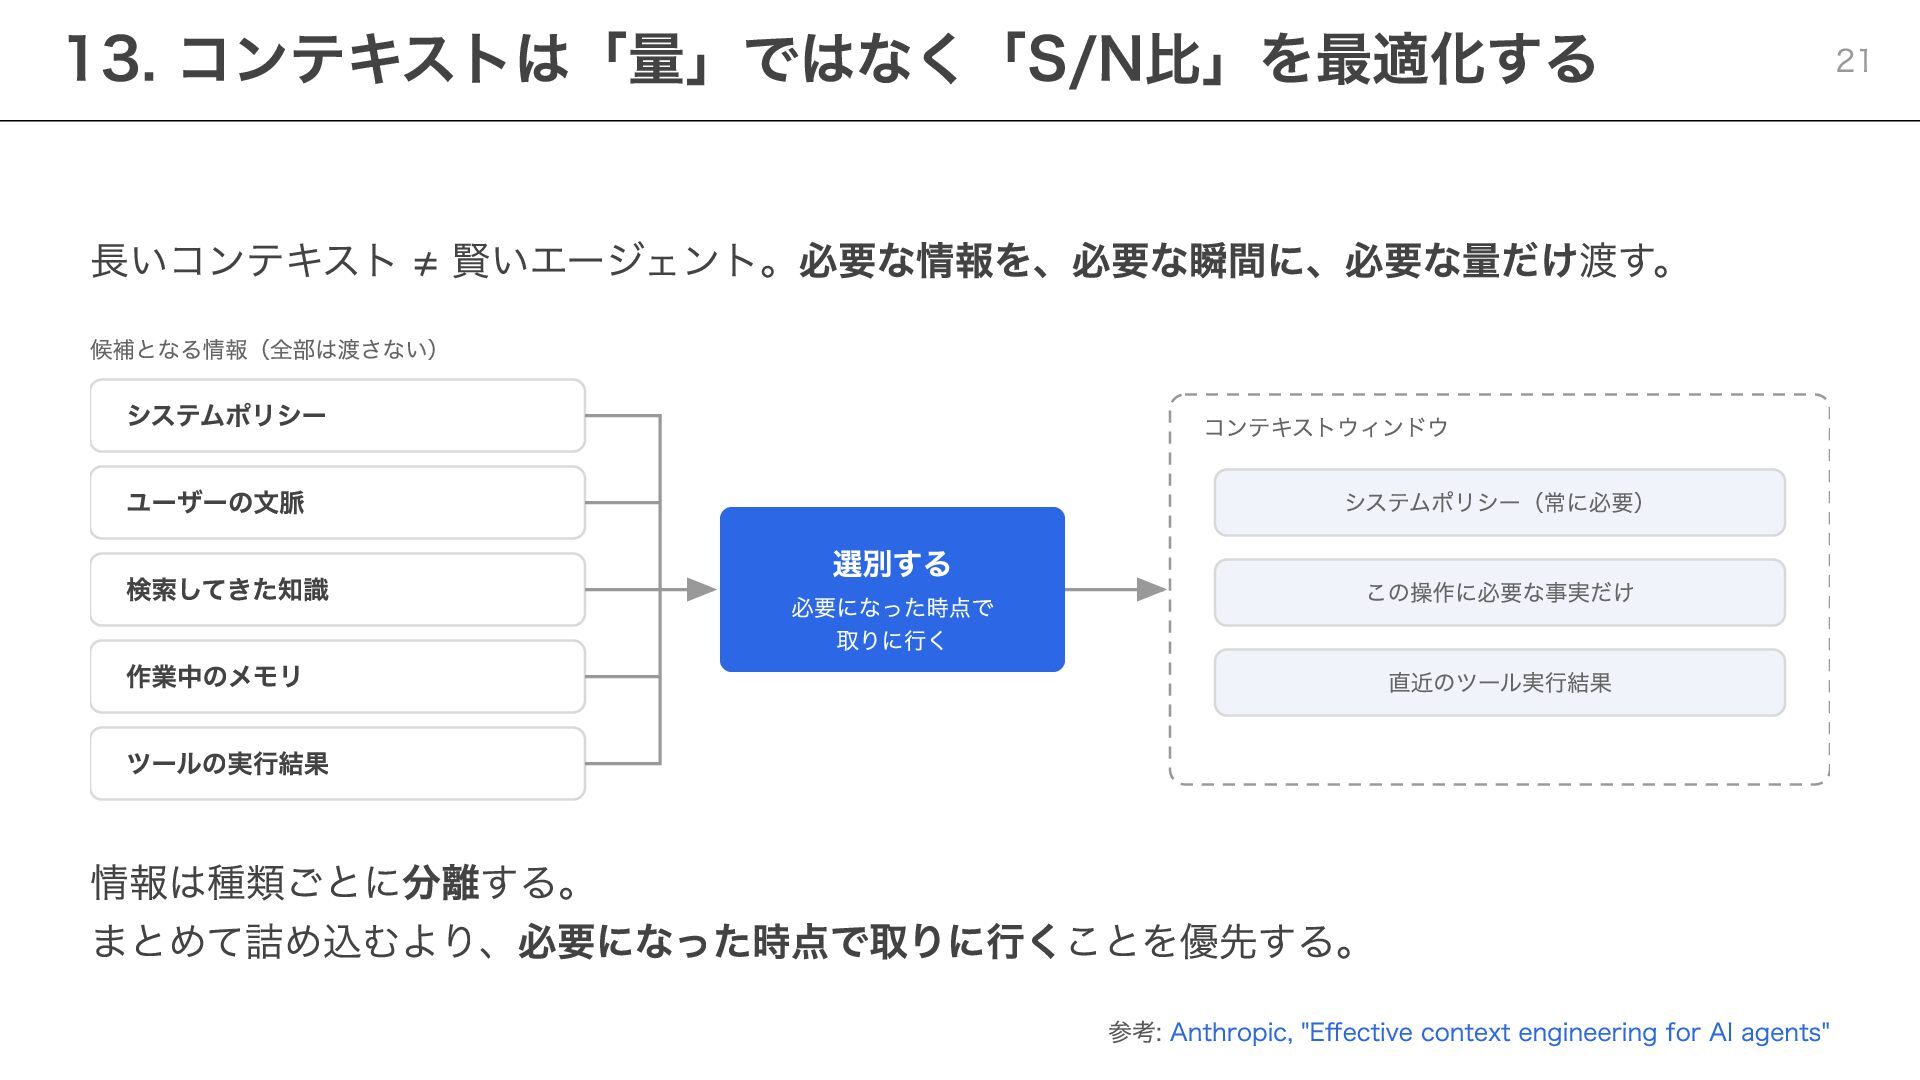
13. コンテキストは「量」ではなく「S/N比」を最適化する 長いコンテキスト ≠ 賢いエージェント。必要な情報を、必要な瞬間に、必要な量だけ渡す。 候補となる情報(全部は渡さない) システムポリシー ユーザーの文脈 検索してきた知識 作業中のメモリ
コンテキストウィンドウ 選別する 必要になった時点で 取りに行く システムポリシー(常に必要) この操作に必要な事実だけ 直近のツール実行結果 ツールの実行結果 情報は種類ごとに分離する。 まとめて詰め込むより、必要になった時点で取りに行くことを優先する。 参考: Anthropic, "Effective context engineering for AI agents" 21
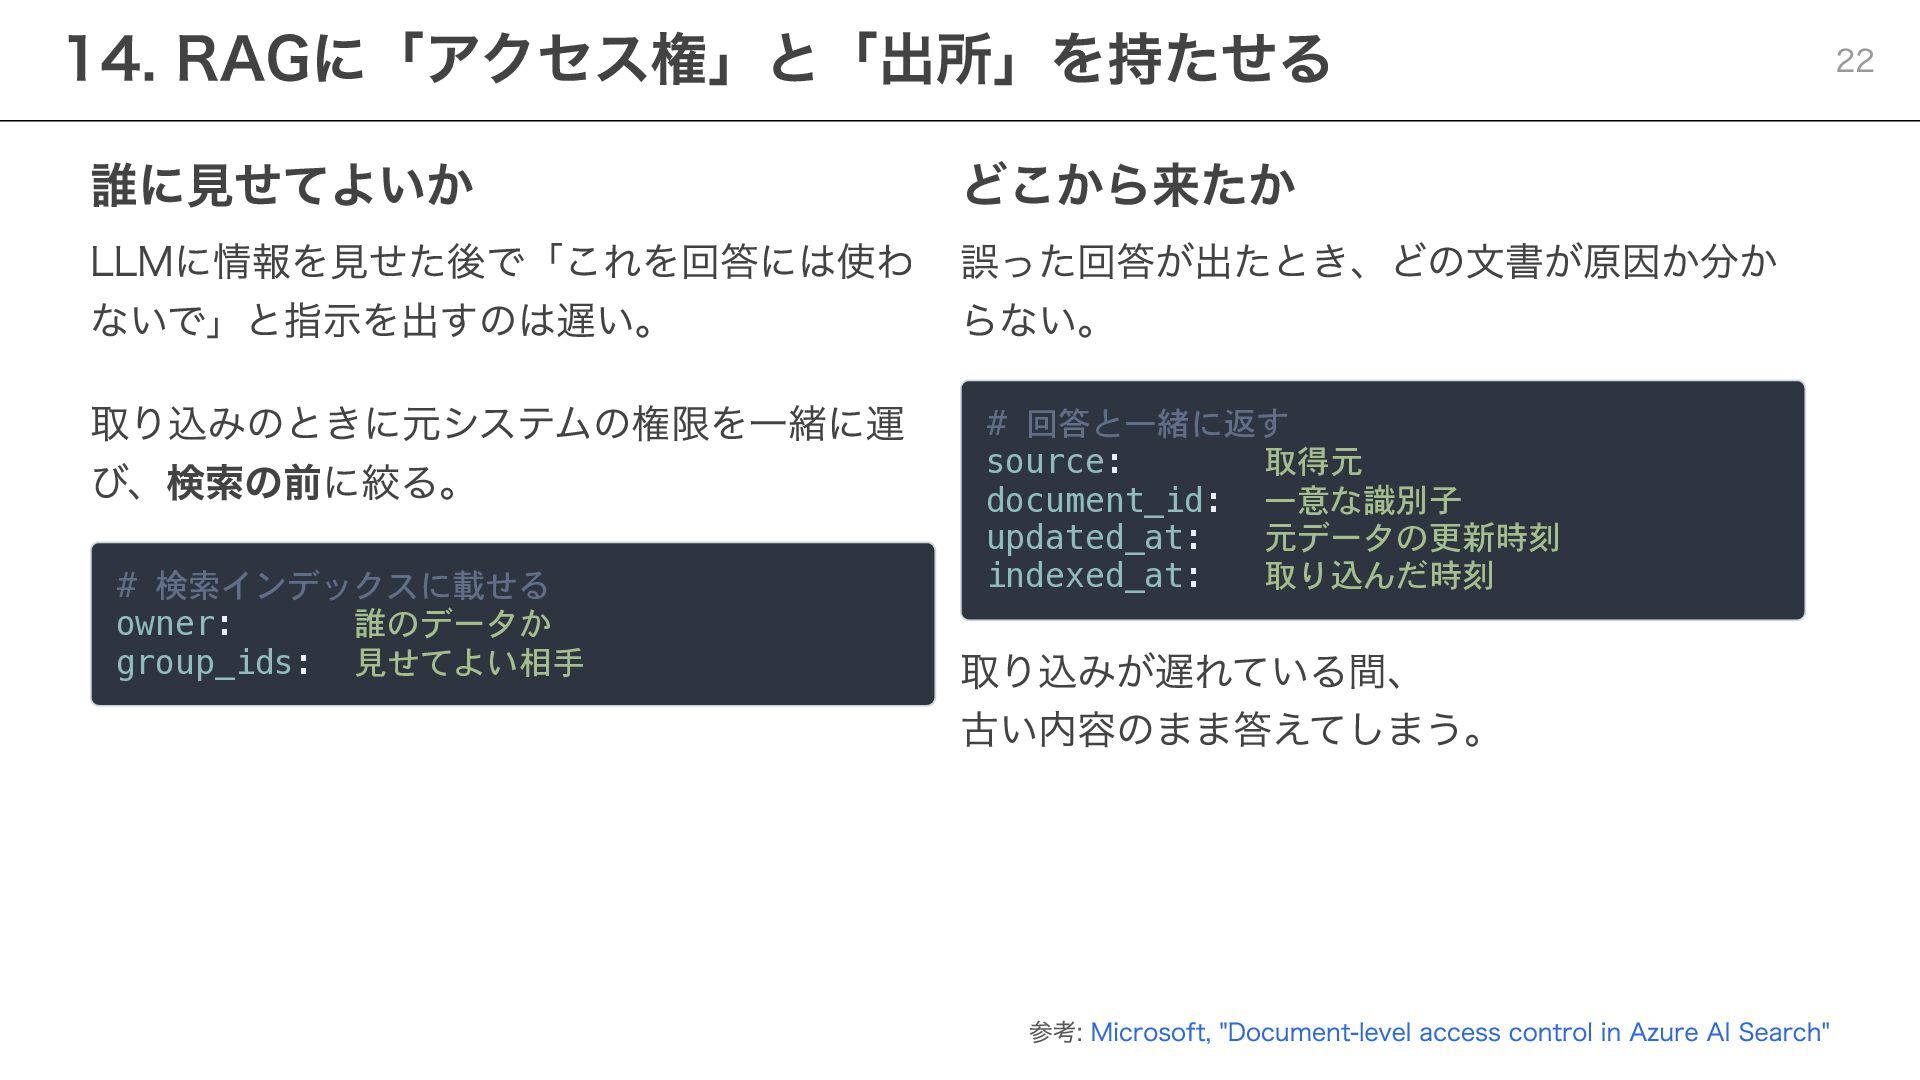
14. RAGに「アクセス権」と「出所」を持たせる 誰に見せてよいか どこから来たか LLMに情報を見せた後で「これを回答には使わ 誤った回答が出たとき、どの文書が原因か分か ないで」と指示を出すのは遅い。 らない。 回答と一緒に返す 取り込みのときに元システムの権限を一緒に運
#source: 取得元 び、検索の前に絞る。 document_id: 一意な識別子 # 検索インデックスに載せる owner: 誰のデータか group_ids: 見せてよい相手 updated_at: indexed_at: 元データの更新時刻 取り込んだ時刻 取り込みが遅れている間、 古い内容のまま答えてしまう。 参考: Microsoft, "Document-level access control in Azure AI Search" 22
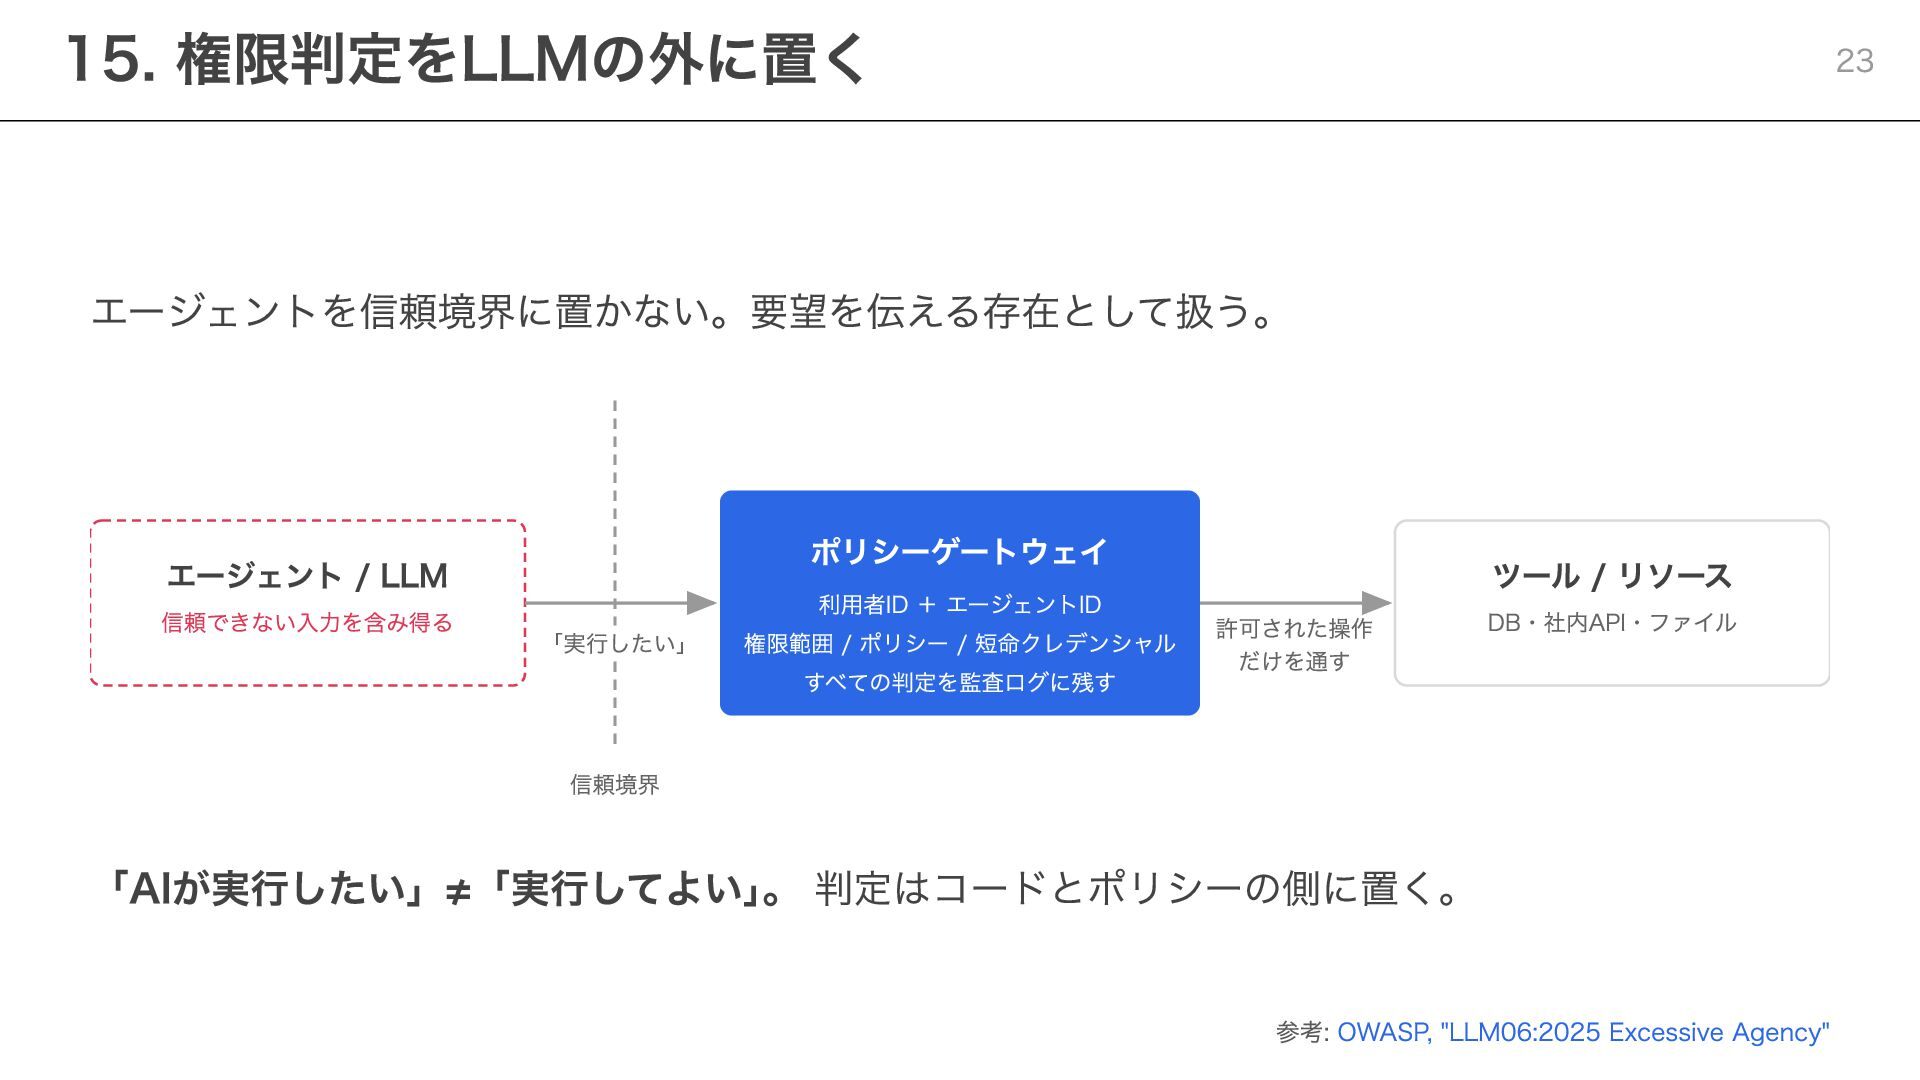
15. 権限判定をLLMの外に置く 23 エージェントを信頼境界に置かない。要望を伝える存在として扱う。 ポリシーゲートウェイ エージェント / LLM 信頼できない入力を含み得る 「実行したい」
利用者ID + エージェントID 権限範囲 / ポリシー / 短命クレデンシャル 許可された操作 だけを通す すべての判定を監査ログに残す ツール / リソース DB・社内API・ファイル 信頼境界 「AIが実行したい」≠「実行してよい」。 判定はコードとポリシーの側に置く。 参考: OWASP, "LLM06:2025 Excessive Agency"
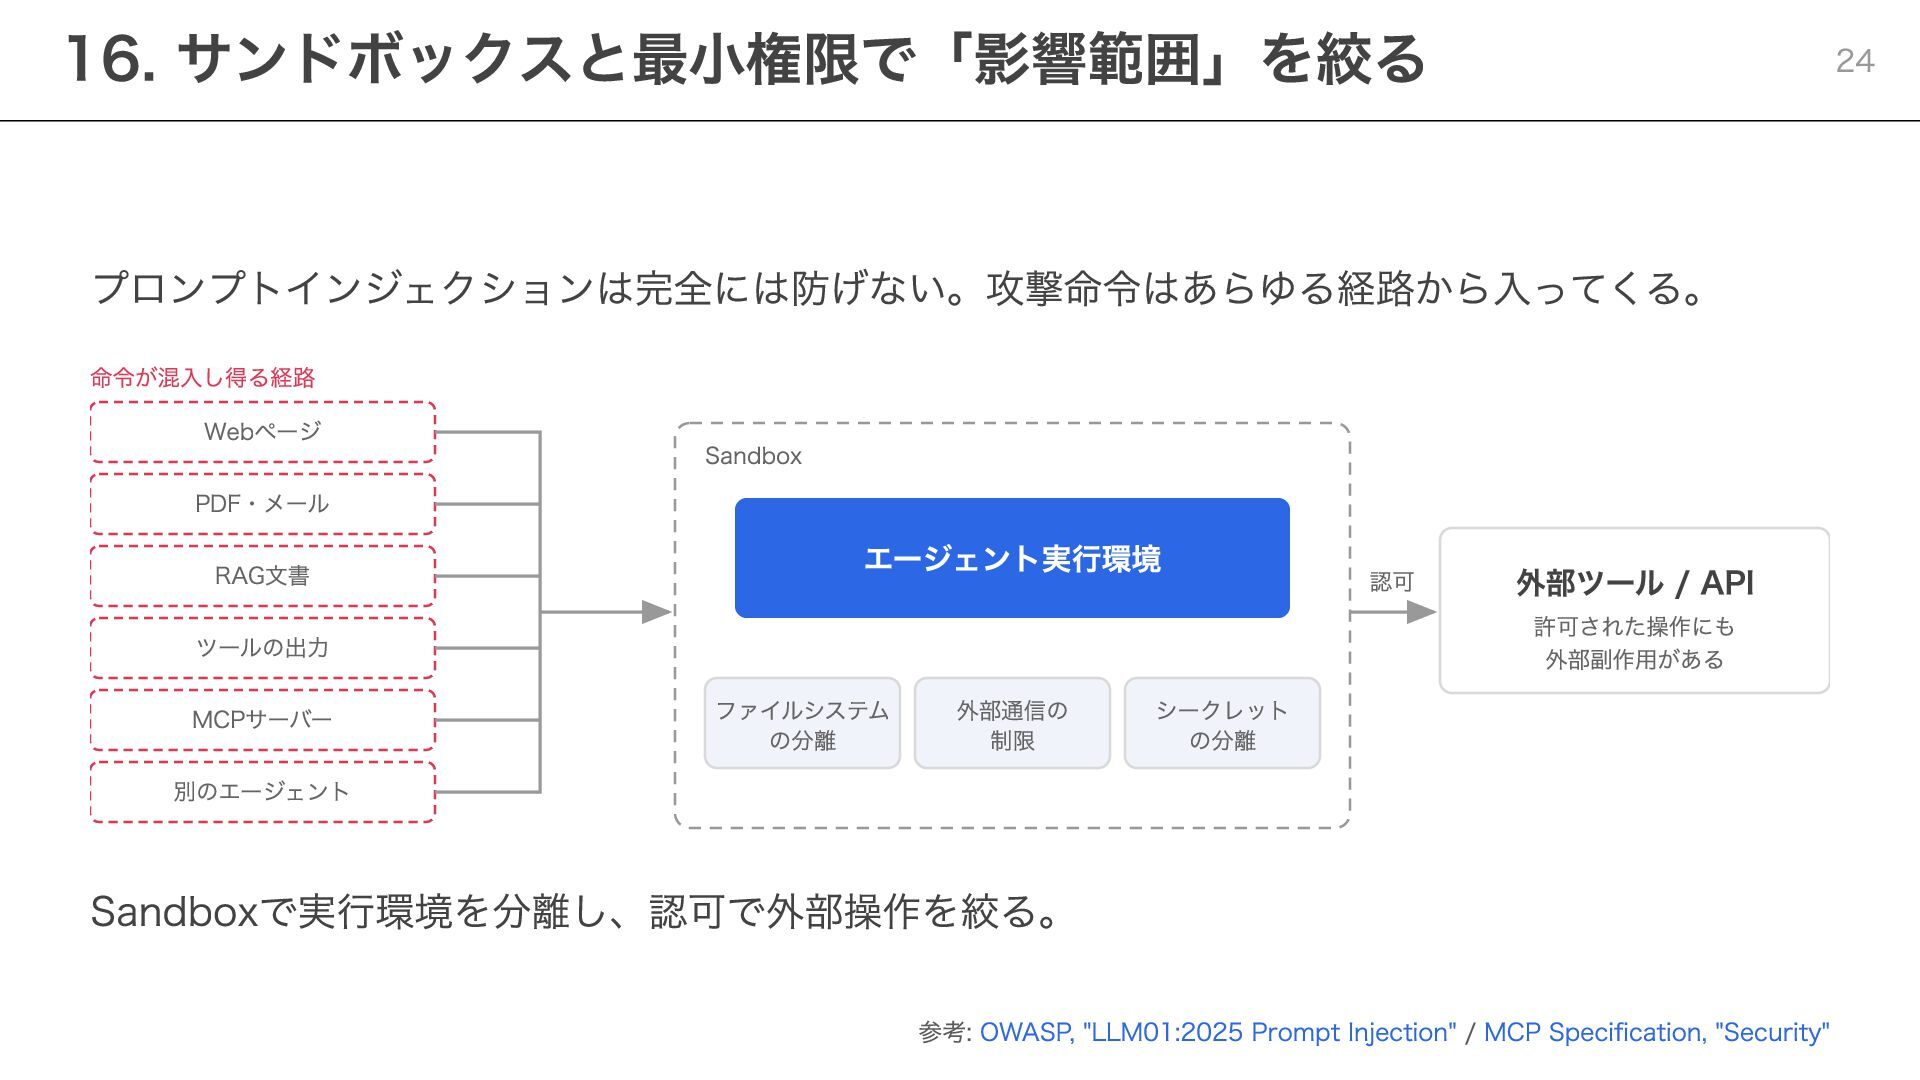
16. サンドボックスと最小権限で「影響範囲」を絞る 24 プロンプトインジェクションは完全には防げない。攻撃命令はあらゆる経路から入ってくる。 命令が混入し得る経路 Webページ PDF・メール RAG文書 Sandbox エージェント実行環境
ツールの出力 MCPサーバー 別のエージェント ファイルシステム の分離 外部通信の 制限 シークレット の分離 認可 外部ツール / API 許可された操作にも 外部副作用がある Sandboxで実行環境を分離し、認可で外部操作を絞る。 参考: OWASP, "LLM01:2025 Prompt Injection" / MCP Specification, "Security"
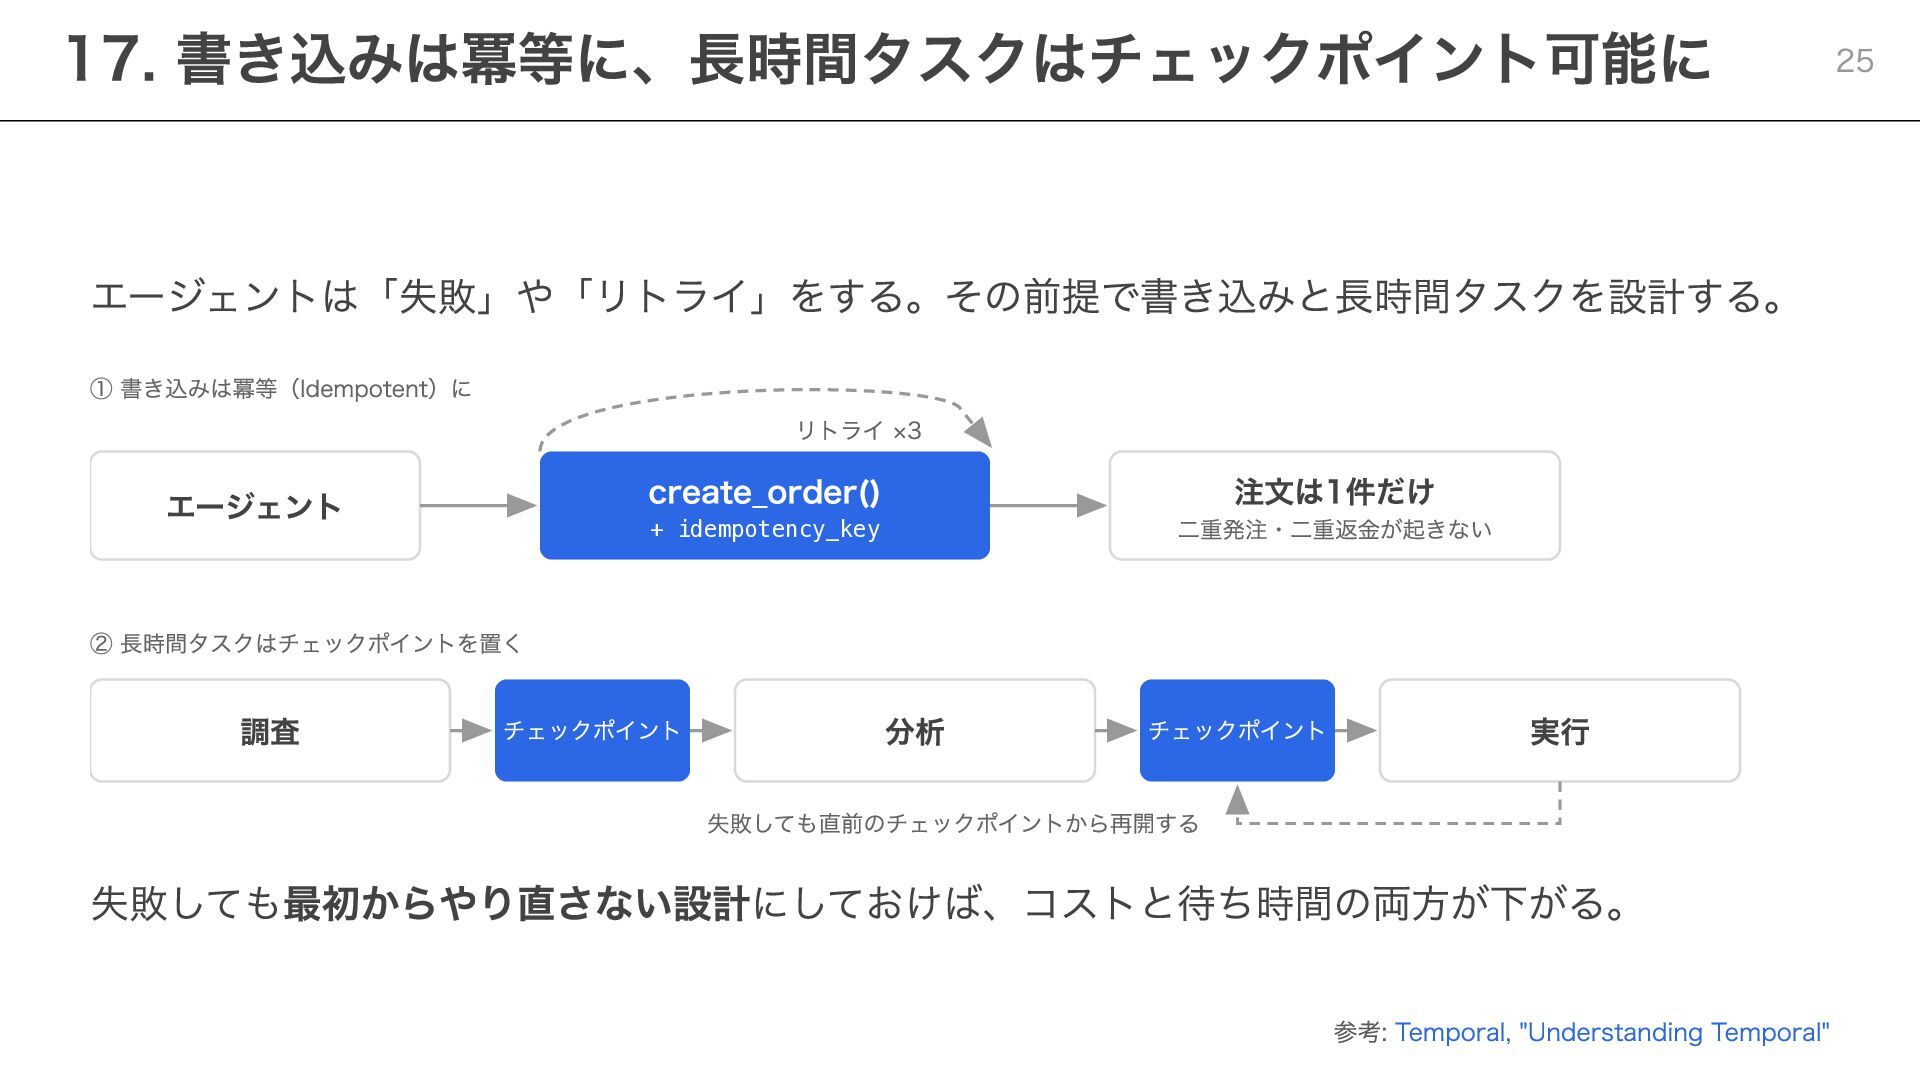
17. 書き込みは冪等に、長時間タスクはチェックポイント可能に エージェントは「失敗」や「リトライ」をする。その前提で書き込みと長時間タスクを設計する。 ① 書き込みは冪等(Idempotent)に リトライ ×3 create_order() エージェント 注文は1件だけ
二重発注・二重返金が起きない + idempotency_key ② 長時間タスクはチェックポイントを置く 調査 チェックポイント 分析 チェックポイント 実行 失敗しても直前のチェックポイントから再開する 失敗しても最初からやり直さない設計にしておけば、コストと待ち時間の両方が下がる。 参考: Temporal, "Understanding Temporal" 25
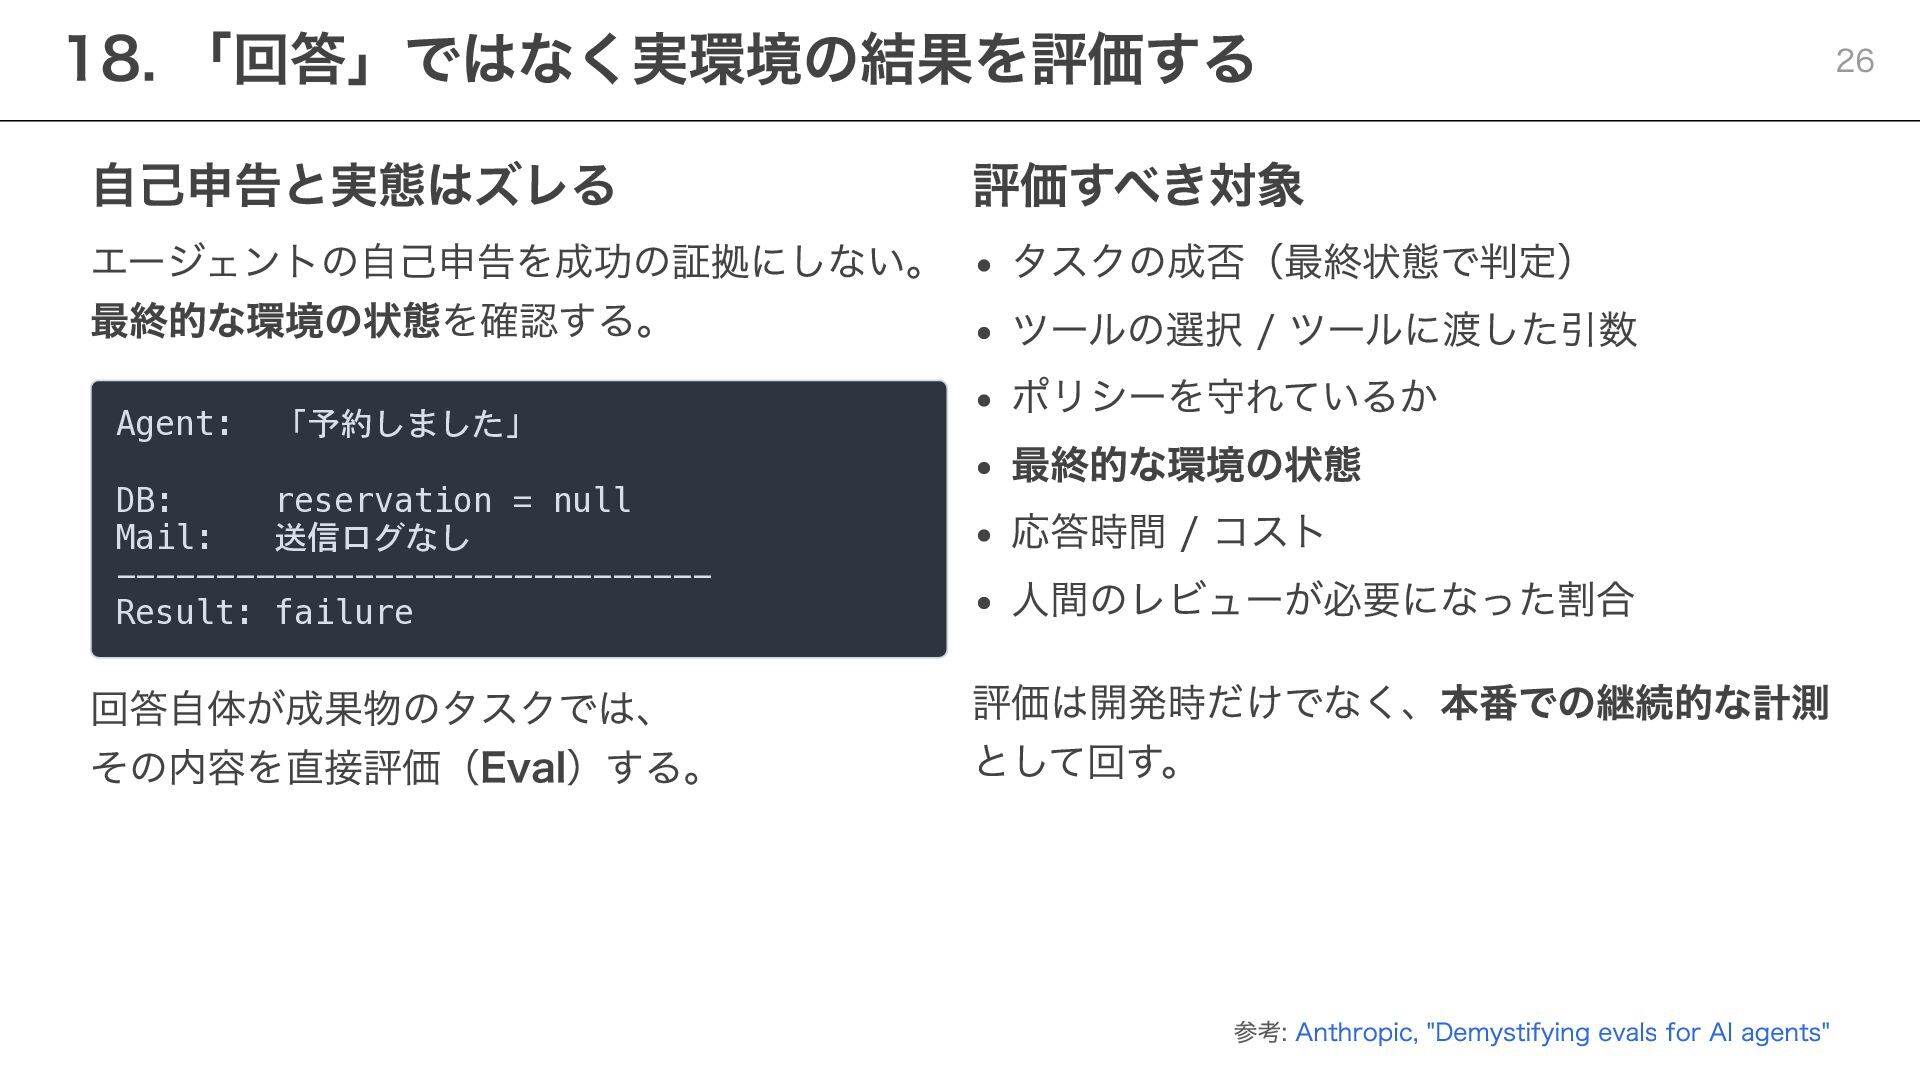
18. 「回答」ではなく実環境の結果を評価する 自己申告と実態はズレる 評価すべき対象 エージェントの自己申告を成功の証拠にしない。 タスクの成否(最終状態で判定) 最終的な環境の状態を確認する。 ツールの選択 / ツールに渡した引数
ポリシーを守れているか Agent: 「予約しました」 最終的な環境の状態 DB: reservation = null 応答時間 / コスト Mail: 送信ログなし -----------------------------人間のレビューが必要になった割合 Result: failure 評価は開発時だけでなく、本番での継続的な計測 回答自体が成果物のタスクでは、 として回す。 その内容を直接評価(Eval)する。 参考: Anthropic, "Demystifying evals for AI agents" 26
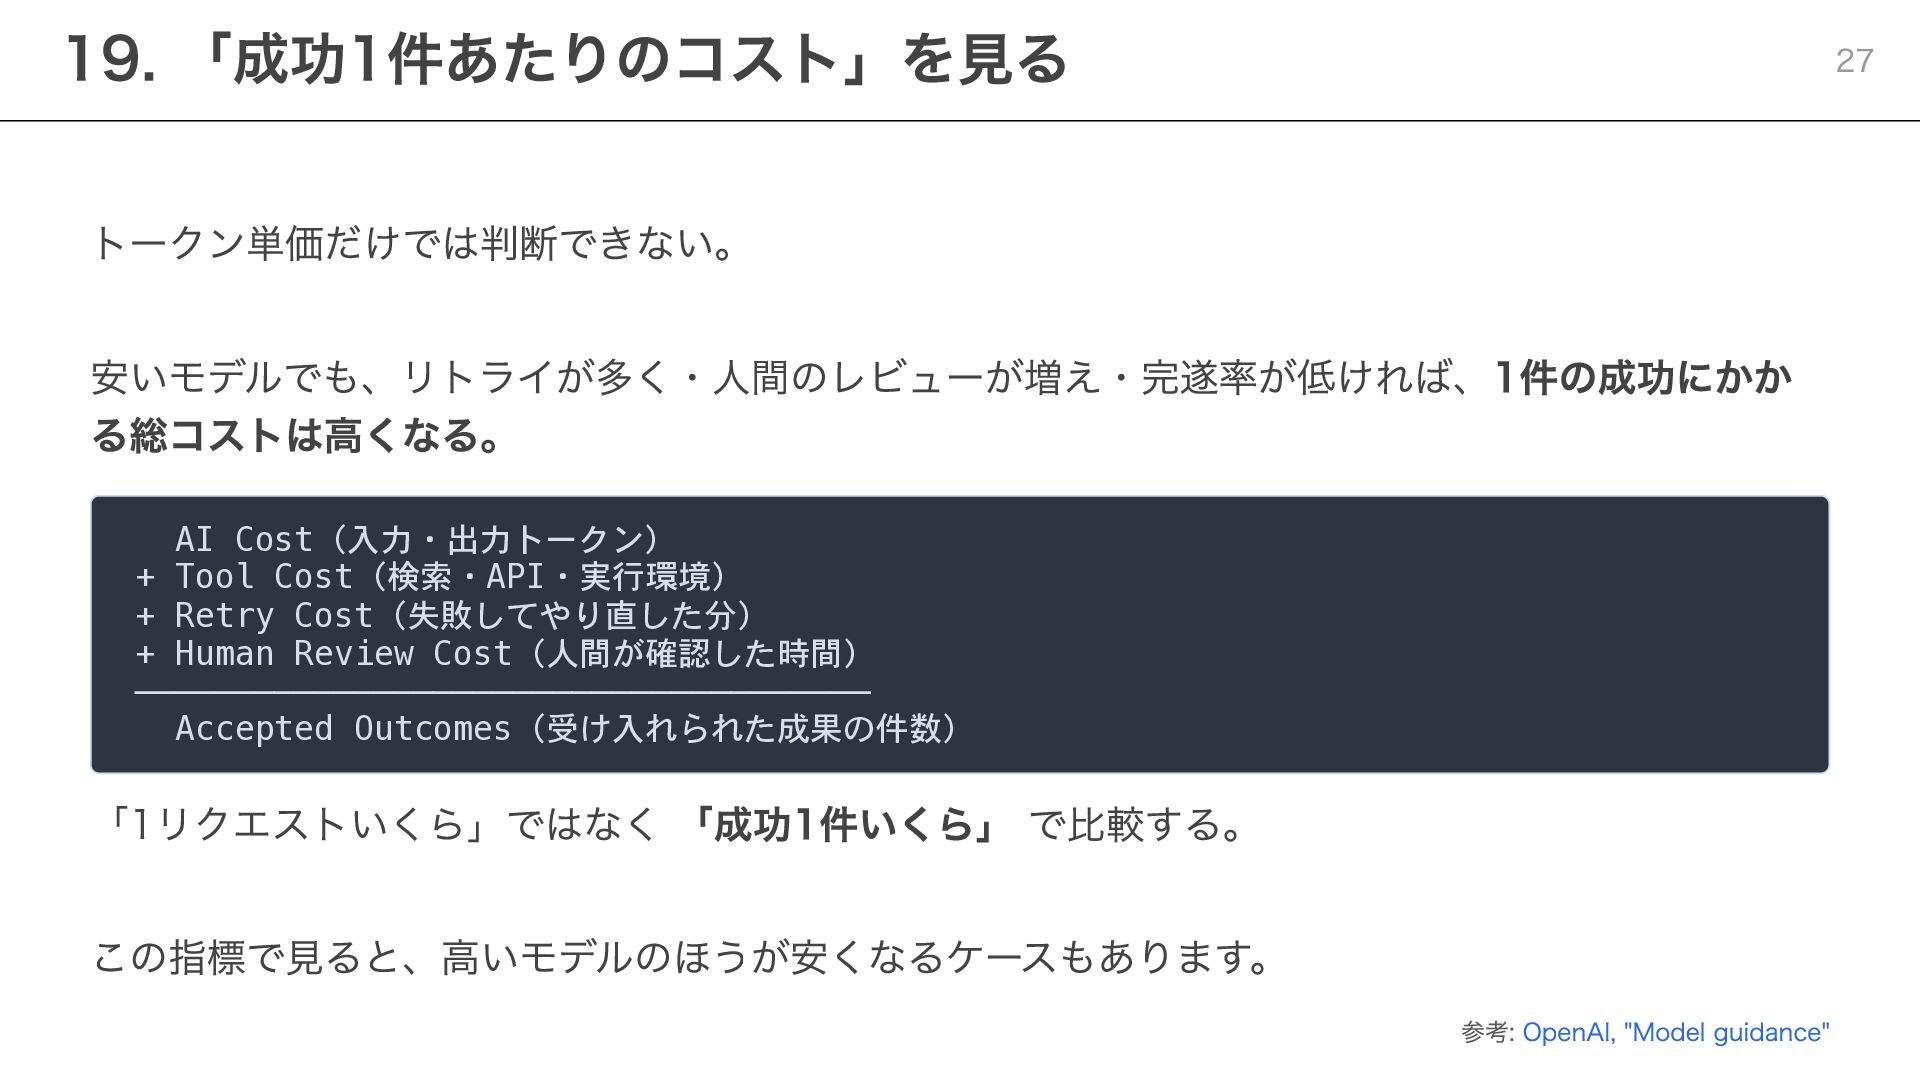
19. 「成功1件あたりのコスト」を見る 27 トークン単価だけでは判断できない。 安いモデルでも、リトライが多く・人間のレビューが増え・完遂率が低ければ、1件の成功にかか る総コストは高くなる。 AI Cost(入力・出力トークン) + Tool
Cost(検索・API・実行環境) + Retry Cost(失敗してやり直した分) + Human Review Cost(人間が確認した時間) ───────────────────────────────────── Accepted Outcomes(受け入れられた成果の件数) 「1リクエストいくら」ではなく 「成功1件いくら」 で比較する。 この指標で見ると、高いモデルのほうが安くなるケースもあります。 参考: OpenAI, "Model guidance"
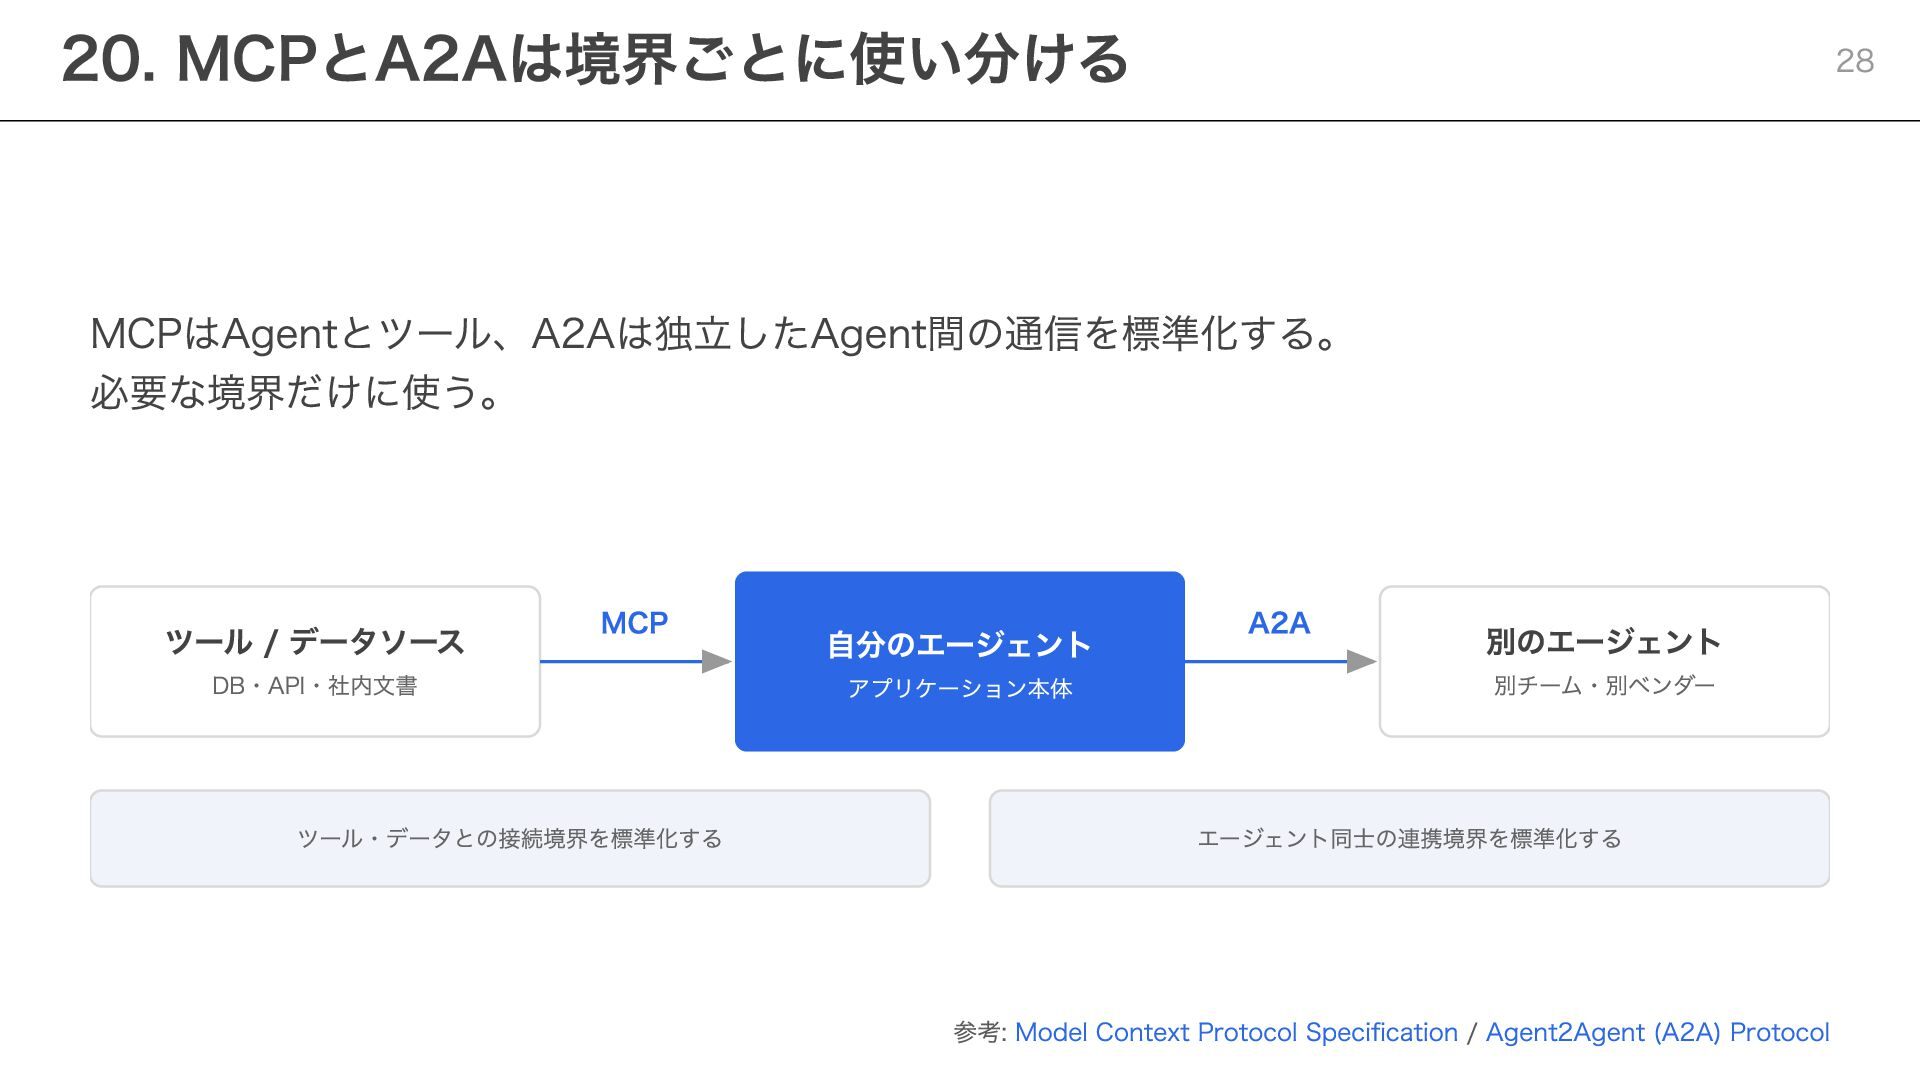
20. MCPとA2Aは境界ごとに使い分ける 28 MCPはAgentとツール、A2Aは独立したAgent間の通信を標準化する。 必要な境界だけに使う。 ツール / データソース DB・API・社内文書 MCP
ツール・データとの接続境界を標準化する 自分のエージェント アプリケーション本体 A2A 別のエージェント 別チーム・別ベンダー エージェント同士の連携境界を標準化する 参考: Model Context Protocol Specification / Agent2Agent (A2A) Protocol
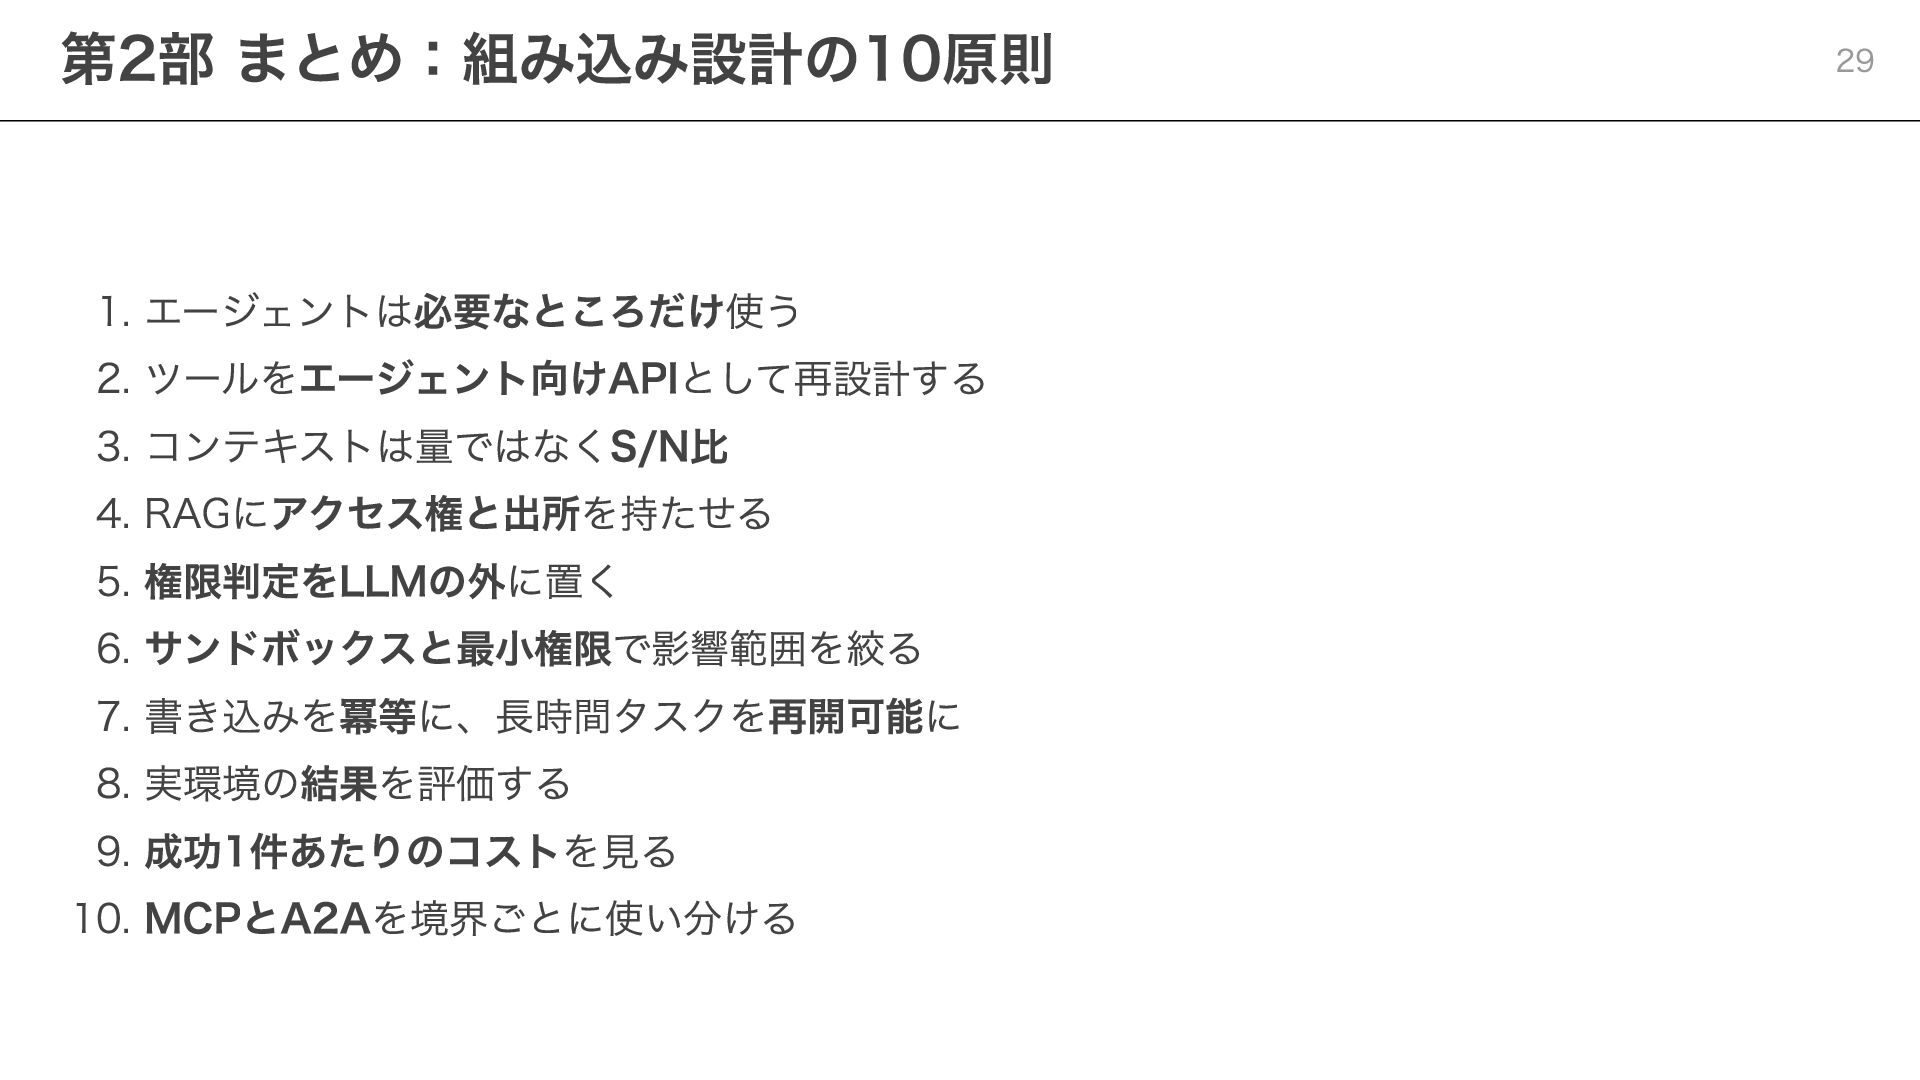
第2部 まとめ:組み込み設計の10原則 1. エージェントは必要なところだけ使う 2. ツールをエージェント向けAPIとして再設計する 3. コンテキストは量ではなくS/N比 4. RAGにアクセス権と出所を持たせる
5. 権限判定をLLMの外に置く 6. サンドボックスと最小権限で影響範囲を絞る 7. 書き込みを冪等に、長時間タスクを再開可能に 8. 実環境の結果を評価する 9. 成功1件あたりのコストを見る 10. MCPとA2Aを境界ごとに使い分ける 29
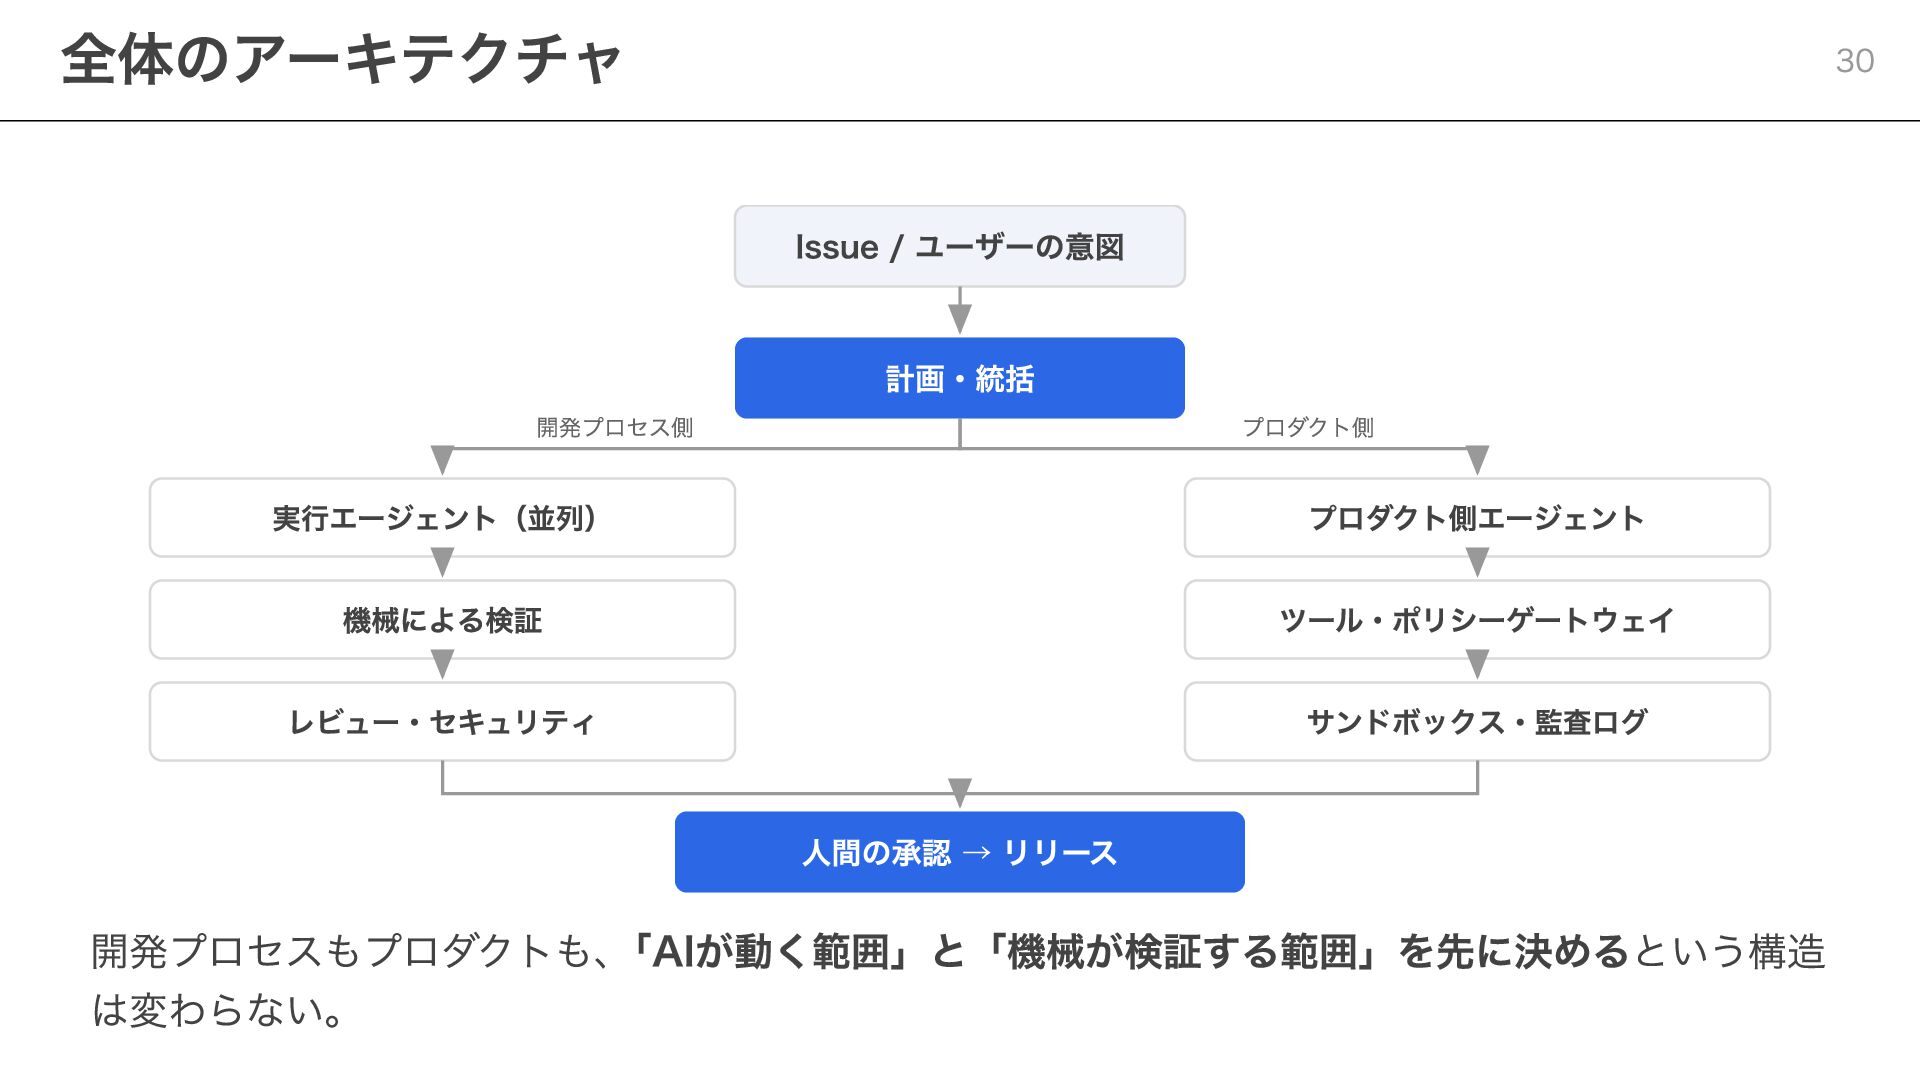
全体のアーキテクチャ 30 Issue / ユーザーの意図 開発プロセス側 計画・統括 プロダクト側 実行エージェント(並列) プロダクト側エージェント
機械による検証 ツール・ポリシーゲートウェイ レビュー・セキュリティ サンドボックス・監査ログ 人間の承認 → リリース 開発プロセスもプロダクトも、「AIが動く範囲」と「機械が検証する範囲」を先に決めるという構造 は変わらない。
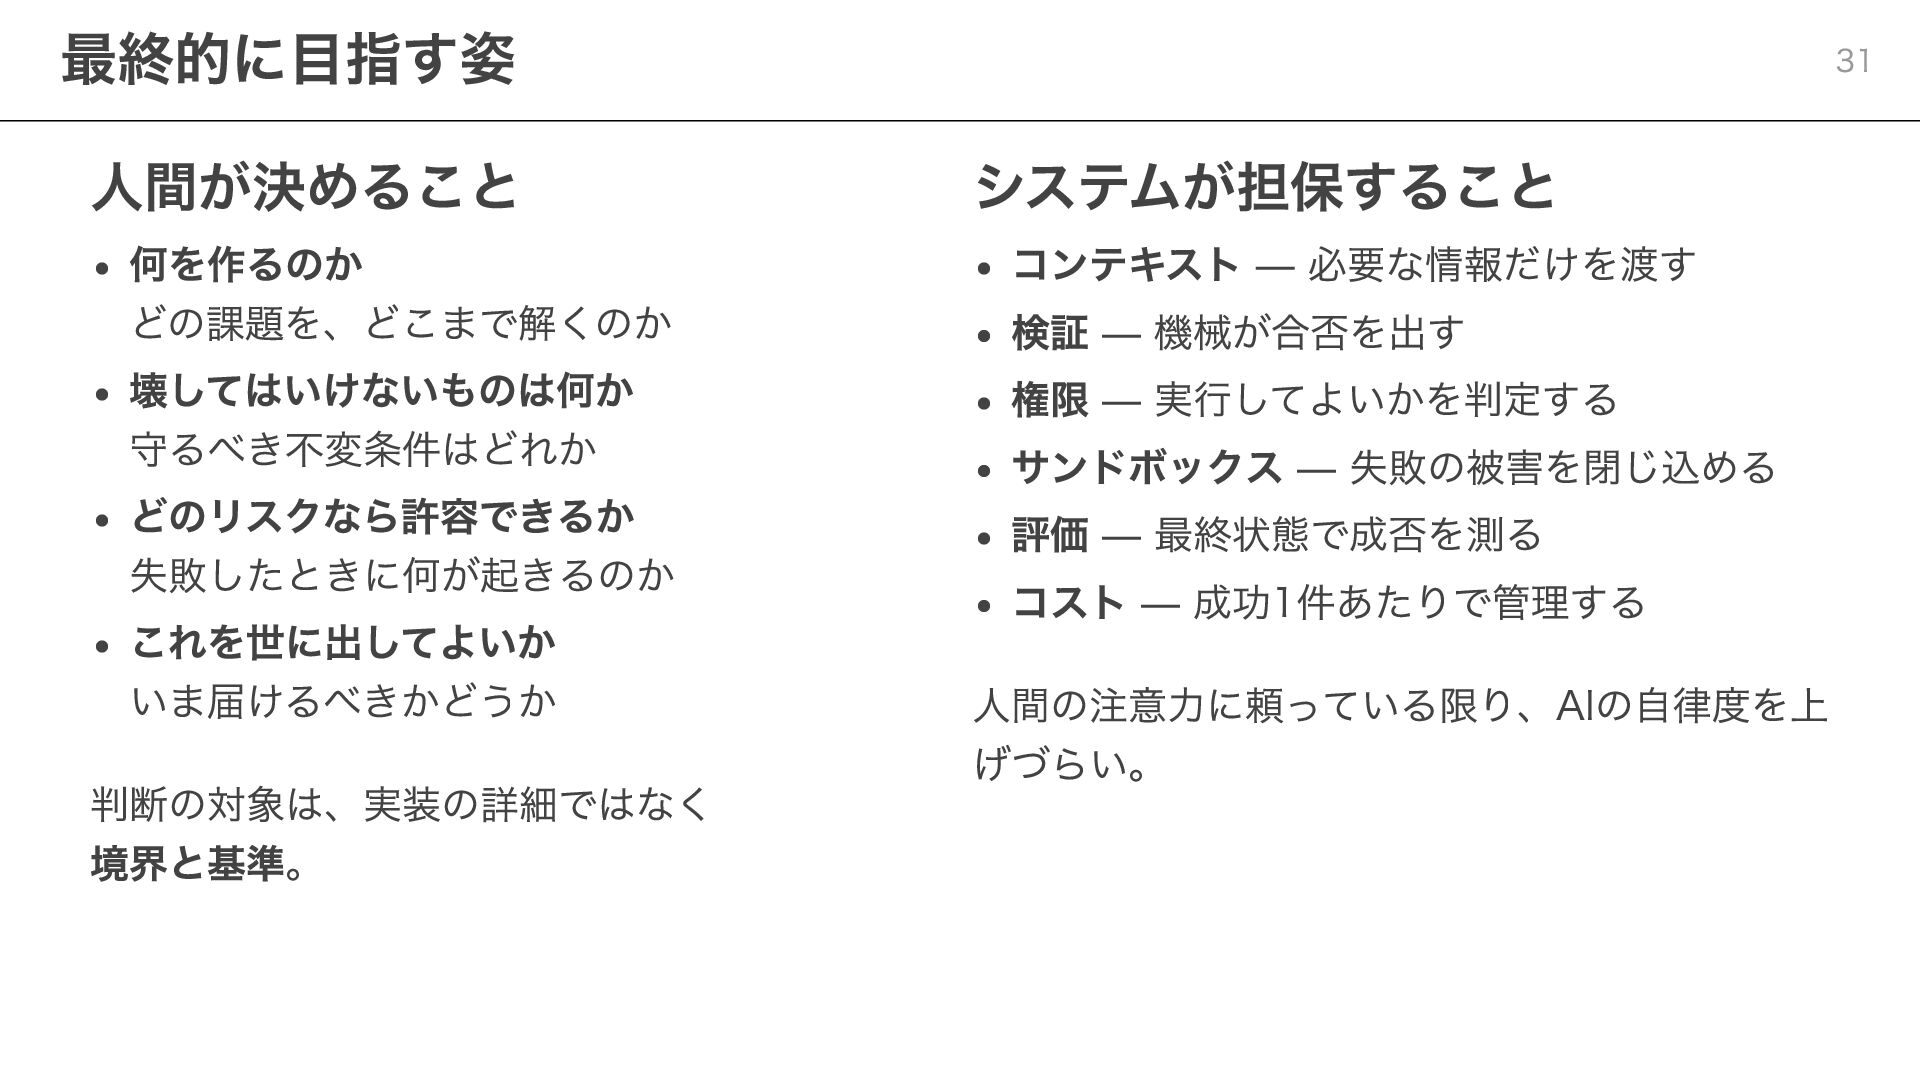
最終的に目指す姿 人間が決めること 何を作るのか どの課題を、どこまで解くのか 壊してはいけないものは何か 守るべき不変条件はどれか どのリスクなら許容できるか 失敗したときに何が起きるのか これを世に出してよいか いま届けるべきかどうか
判断の対象は、実装の詳細ではなく 境界と基準。 31 システムが担保すること コンテキスト — 必要な情報だけを渡す 検証 — 機械が合否を出す 権限 — 実行してよいかを判定する サンドボックス — 失敗の被害を閉じ込める 評価 — 最終状態で成否を測る コスト — 成功1件あたりで管理する 人間の注意力に頼っている限り、AIの自律度を上 げづらい。
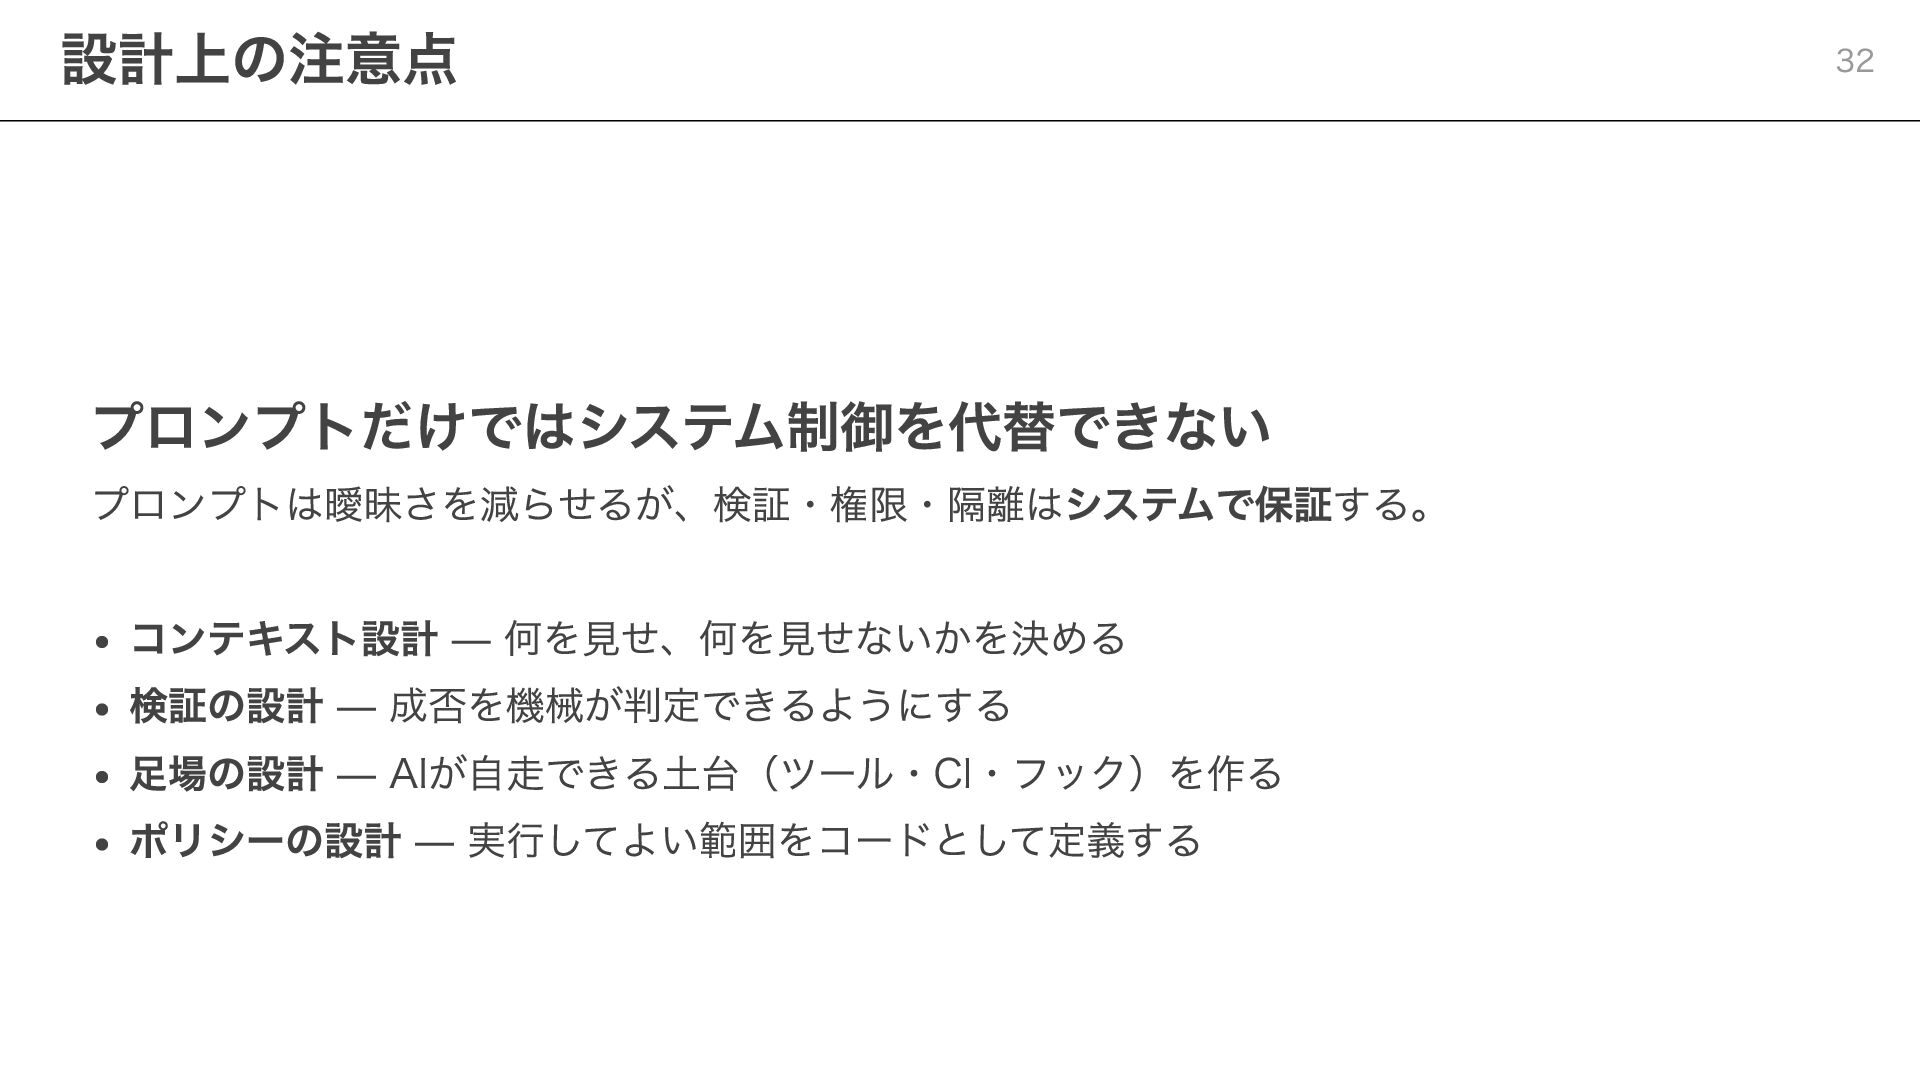
設計上の注意点 プロンプトだけではシステム制御を代替できない プロンプトは曖昧さを減らせるが、検証・権限・隔離はシステムで保証する。 コンテキスト設計 — 何を見せ、何を見せないかを決める 検証の設計 — 成否を機械が判定できるようにする 足場の設計
— AIが自走できる土台(ツール・CI・フック)を作る ポリシーの設計 — 実行してよい範囲をコードとして定義する 32
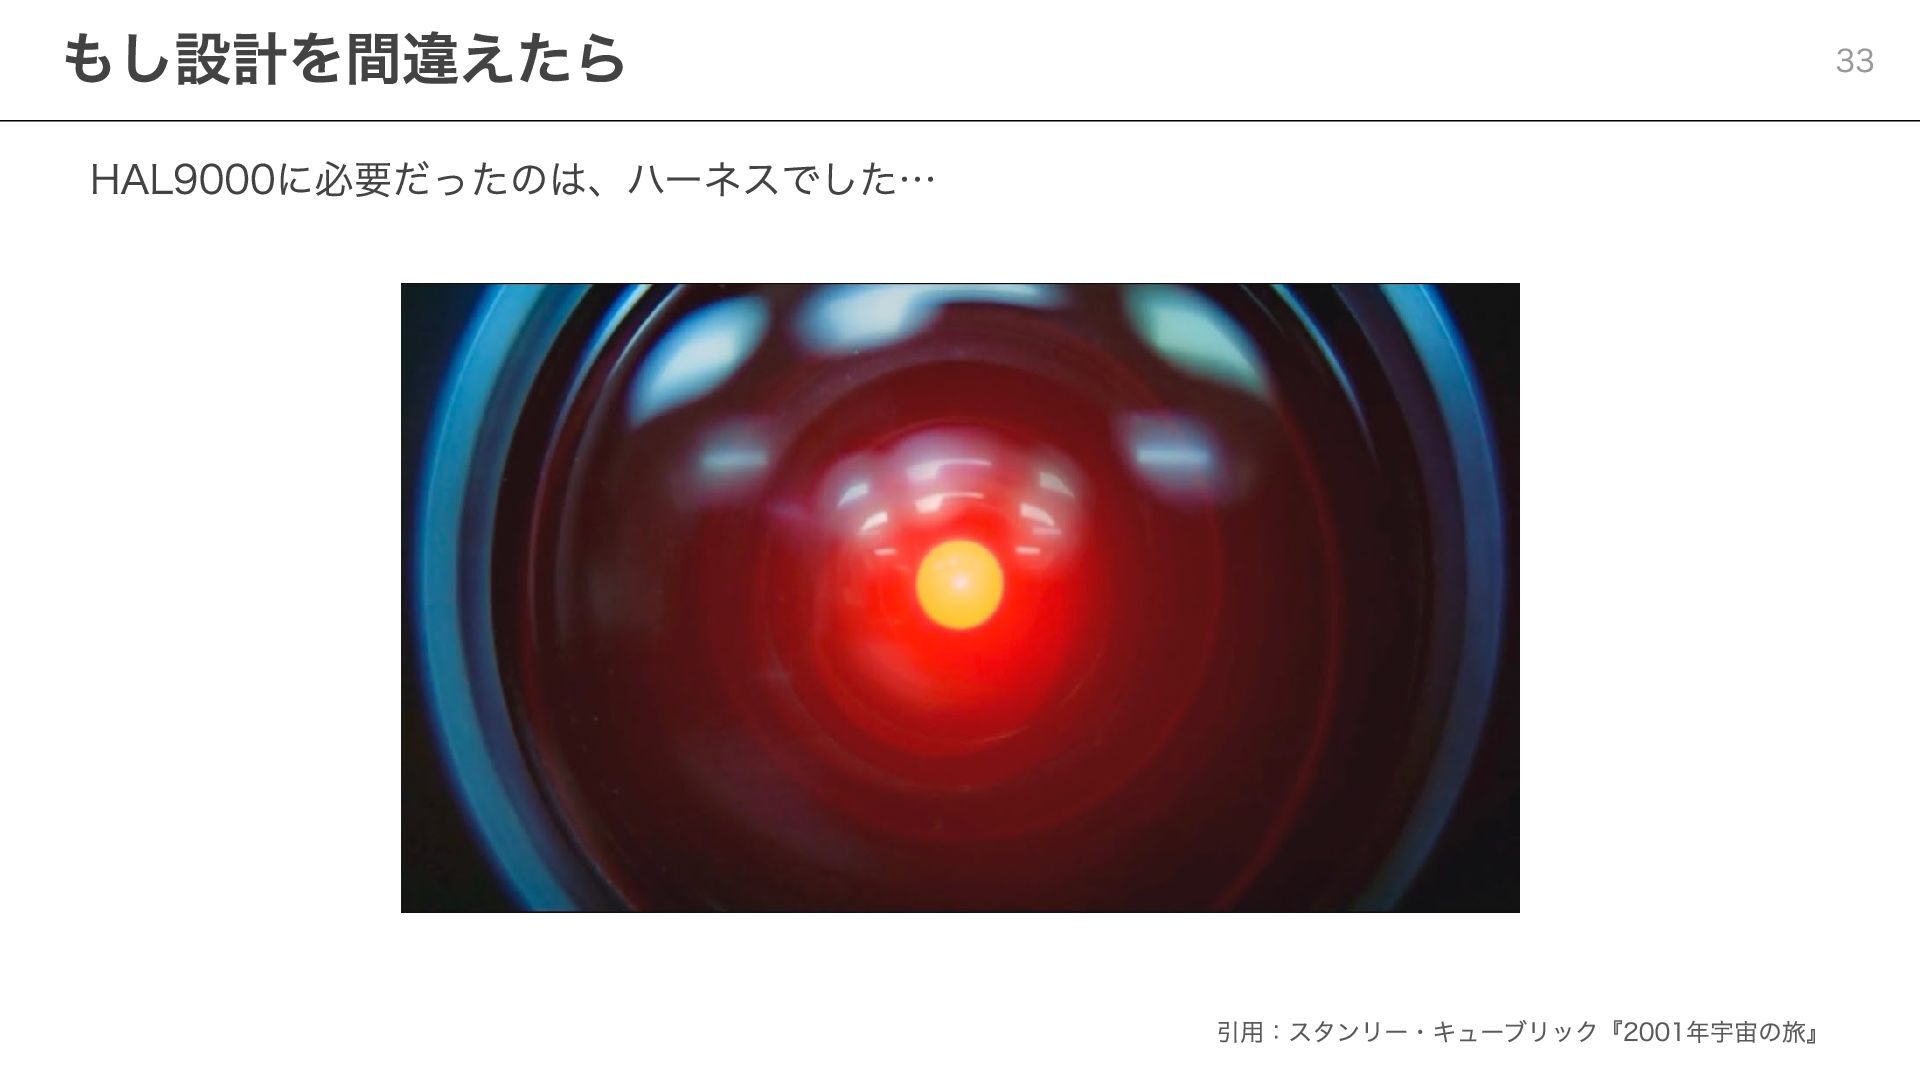
もし設計を間違えたら 33 HAL9000に必要だったのは、ハーネスでした… 引用:スタンリー・キューブリック『2001年宇宙の旅』
AIにコードを書かせるだけでなく、 AIが安全に完遂できるシステムを作る。
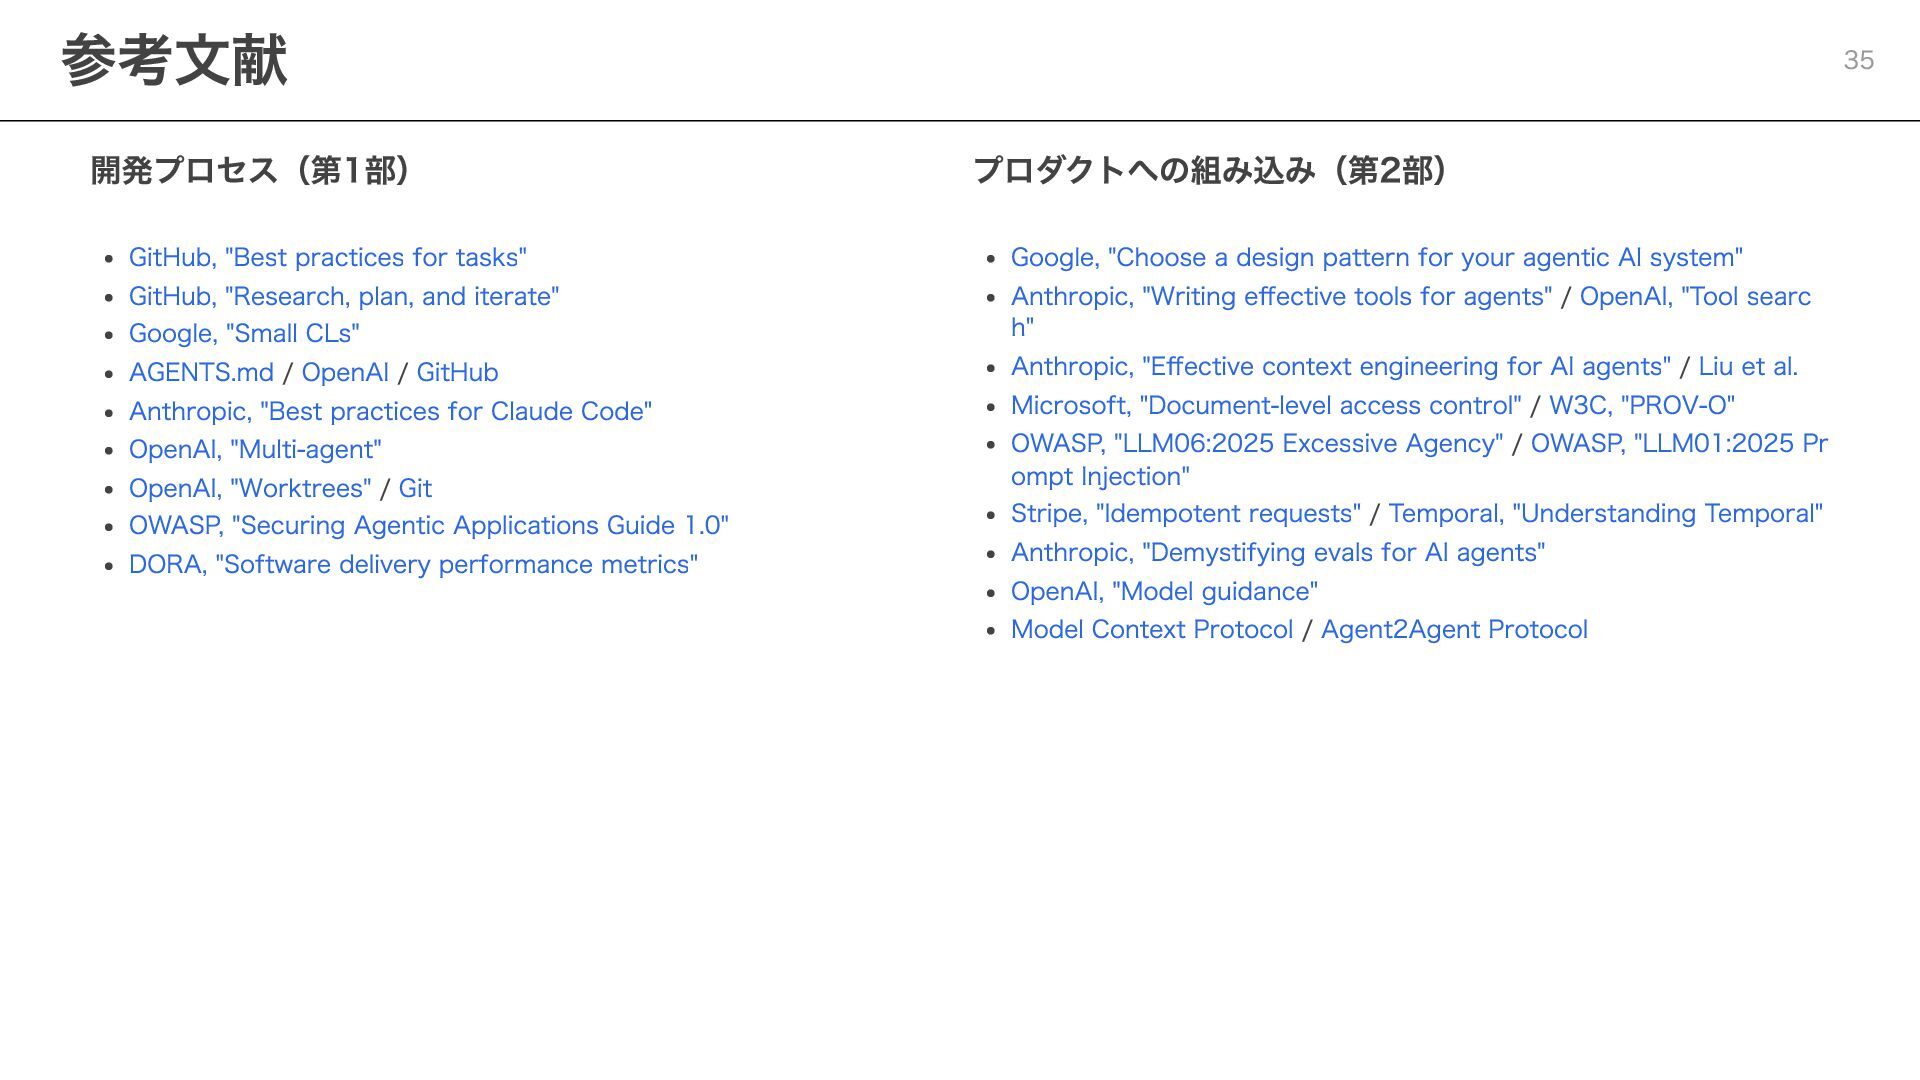
参考文献 開発プロセス(第1部) GitHub, "Best practices for tasks" GitHub, "Research, plan,
and iterate" Google, "Small CLs" AGENTS.md / OpenAI / GitHub Anthropic, "Best practices for Claude Code" OpenAI, "Multi-agent" OpenAI, "Worktrees" / Git OWASP, "Securing Agentic Applications Guide 1.0" DORA, "Software delivery performance metrics" 35 プロダクトへの組み込み(第2部) Google, "Choose a design pattern for your agentic AI system" Anthropic, "Writing effective tools for agents" / OpenAI, "Tool searc h" Anthropic, "Effective context engineering for AI agents" / Liu et al. Microsoft, "Document-level access control" / W3C, "PROV-O" OWASP, "LLM06:2025 Excessive Agency" / OWASP, "LLM01:2025 Pr ompt Injection" Stripe, "Idempotent requests" / Temporal, "Understanding Temporal" Anthropic, "Demystifying evals for AI agents" OpenAI, "Model guidance" Model Context Protocol / Agent2Agent Protocol


 lef237
 ken_tunc
 oga5
 neuecc
 yuukiw00w
 soyuka
 rkaga
 takaidohigasi
 ssssota
 y0hgi
 ryu1013
 hokaccha
 htkym
 rasmusluckow
 techseoconnect
 skipperchong
 baasie
 soudai
 uxyall
 jnunemaker
 akashhashmi
 aki_iinuma
 jmmastey
 chriscoyier