Share
Embed
Transcript
84 slides
-
1. UXメトリクスについての10の誤解 2. ユーザビリティ調査の設計 3. ユーザビリティ調査の計画 4. パフォーマンスメトリクス 5. 問題点に基づいたメトリクス
6. ⾃⼰申告メトリクス 7. ⾏動・⽣理メトリクス 8. 統合・⽐較メトリクス 9. 特別なトピック 10. ケーススタディ 11. 更に前進するために 2 もくじ -
1.UXメトリクスについての10の誤解 1. メトリクスを収集するには時間がかかる 2. UXメトリクスはお⾦がかかる 3. UXメトリクスは⼩規模の改良には役⽴たない 4. UXメトリクスは原因の理解につながらない 5.
UXデータはノイズが多すぎる 6. 「勘」を信じるに越したことはない 7. メトリクスは新製品には適⽤できない 8. ⾃分の取り組んでいる問題点に関係したメトリクスは存在しない 9. 経営陣がメトリクスを理解していない、その価値を⾒出していない 10. サンプルサイズが⼩さいと信頼性の⾼いデータを収集できない 3 -
タイプ分けの⼿法 7 どのように参加者を選定するか n ⾃⼰申告に基づく、その領域の専⾨知識レベル n 初⼼者、中級者、熟練者 n 使⽤頻度 n
1ヶ⽉あたりの使⽤回数やインタラクション回数など n 関連領域での経験 n ⽇数、⽉数、年数 n ⼈⼝統計 n 性別、年齢、居住地 n 活動 n 特定の機能の使⽤など -
参加者のサンプリング 8 どのように参加者を選定するか n 無作為抽出 n ランダムで抽出するもの n 系統的抽出 n
10⼈おきに選ぶなど⼀定の決まりをもって選ぶ n 層化抽出 n ⼤きな⺟集団を反映した、⼩さな⺟集団を作成する n たとえば、男⼥⽐1:1、65歳以上の⼈は20%など、各々のプロダクトのユーザ層に 合わせたり。 n 便宜的抽出 n 募集に対して来たユーザを対象とする⽅法。 n バイアスがかかる可能性を把握しておくことが重要 -
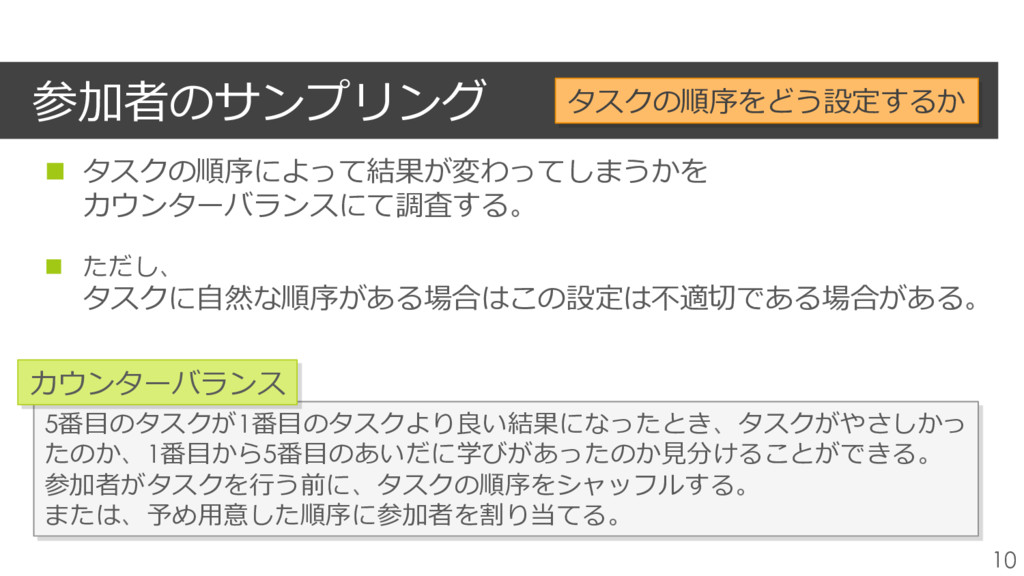
参加者のサンプリング 10 タスクの順序をどう設定するか n タスクの順序によって結果が変わってしまうかを カウンターバランスにて調査する。 n ただし、 タスクに⾃然な順序がある場合はこの設定は不適切である場合がある。 5番⽬のタスクが1番⽬のタスクより良い結果になったとき、タスクがやさしかっ
たのか、1番⽬から5番⽬のあいだに学びがあったのか⾒分けることができる。 参加者がタスクを⾏う前に、タスクの順序をシャッフルする。 または、予め⽤意した順序に参加者を割り当てる。 カウンターバランス -
参加者のサンプリング 12 何⼈の参加者が必要か n 反復的なユーザテストで、主だったユーザビリティの問題を⾒つけたい n 4, 5⼈程度で⼗分(すべての問題を発⾒することは難しく、それが⽬的でない) n あらゆる側⾯から評価したい
n 5⼈以上必要 デザインの初期段階では反復的な少⼈数のユーザテストを繰り返し、 完成に近づくほどより多くの参加者を募り、残りの問題を⾒つける (サンプルサイズを決めるための単純な統計は後述) -
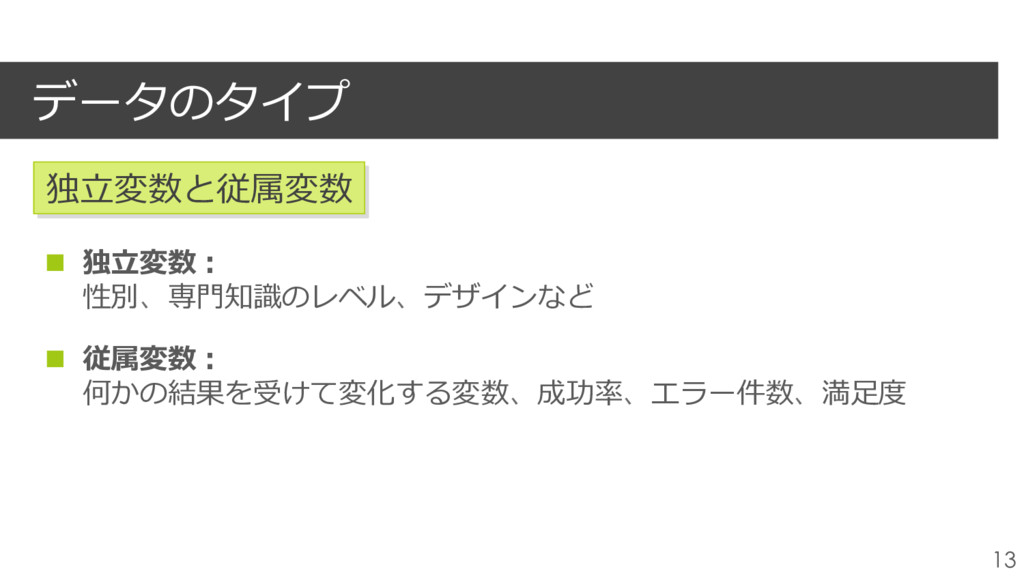
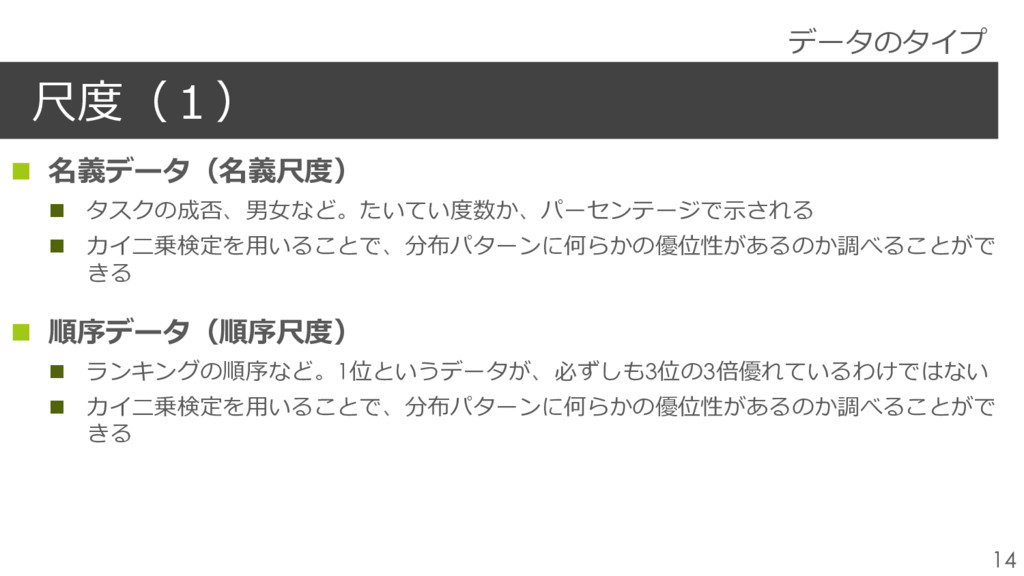
尺度(1) 14 n 名義データ(名義尺度) n タスクの成否、男⼥など。たいてい度数か、パーセンテージで⽰される n カイ⼆乗検定を⽤いることで、分布パターンに何らかの優位性があるのか調べることがで きる n
順序データ(順序尺度) n ランキングの順序など。1位というデータが、必ずしも3位の3倍優れているわけではない n カイ⼆乗検定を⽤いることで、分布パターンに何らかの優位性があるのか調べることがで きる データのタイプ -
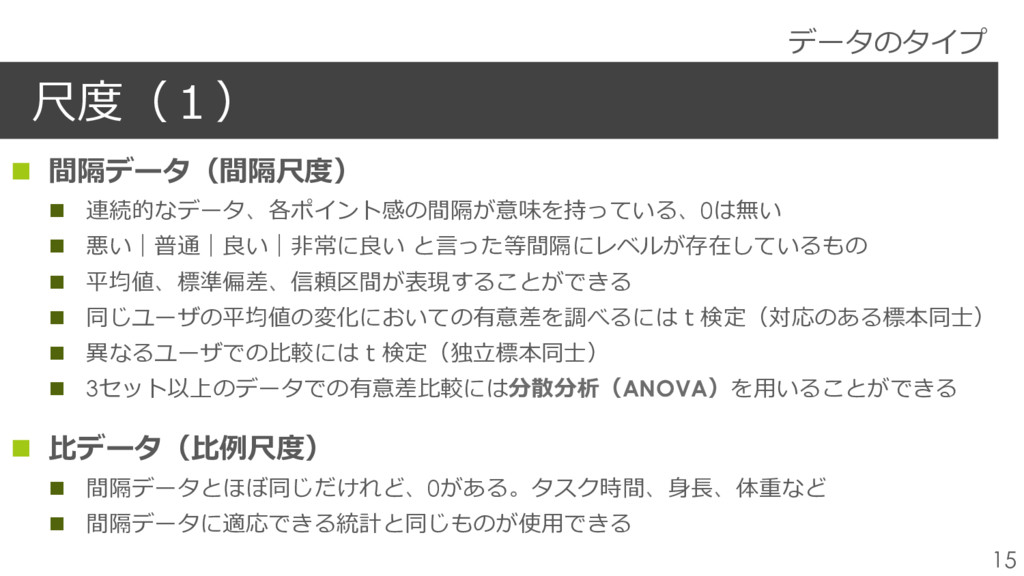
尺度(1) 15 n 間隔データ(間隔尺度) n 連続的なデータ、各ポイント感の間隔が意味を持っている、0は無い n 悪い|普通|良い|⾮常に良い と⾔った等間隔にレベルが存在しているもの n
平均値、標準偏差、信頼区間が表現することができる n 同じユーザの平均値の変化においての有意差を調べるにはt検定(対応のある標本同⼠) n 異なるユーザでの⽐較にはt検定(独⽴標本同⼠) n 3セット以上のデータでの有意差⽐較には分散分析(ANOVA)を⽤いることができる n ⽐データ(⽐例尺度) n 間隔データとほぼ同じだけれど、0がある。タスク時間、⾝⻑、体重など n 間隔データに適応できる統計と同じものが使⽤できる データのタイプ -
変数間の関係 16 n 異なる変数同⼠が関係あるもの(または無いもの)なのかを調べる (⾝⻑、体重、タスク時間など) n 相関係数 n -1 ~
1 の間を取る n ⾝⻑が上がると体重も増える、といったデータの場合相関係数は 1 に近い(⽐例している 状態) http://www.cuc.ac.jp/~nagaoka/2011/ouyou/10/expr/index.html -
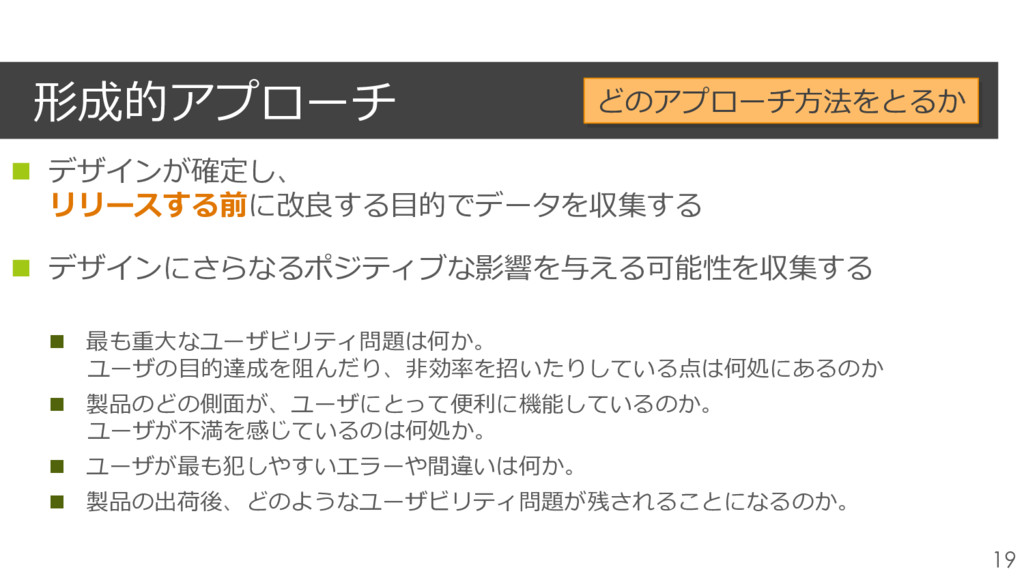
形成的アプローチ 19 どのアプローチ⽅法をとるか n デザインが確定し、 リリースする前に改良する⽬的でデータを収集する n デザインにさらなるポジティブな影響を与える可能性を収集する n 最も重⼤なユーザビリティ問題は何か。
ユーザの⽬的達成を阻んだり、⾮効率を招いたりしている点は何処にあるのか n 製品のどの側⾯が、ユーザにとって便利に機能しているのか。 ユーザが不満を感じているのは何処か。 n ユーザが最も犯しやすいエラーや間違いは何か。 n 製品の出荷後、どのようなユーザビリティ問題が残されることになるのか。 -
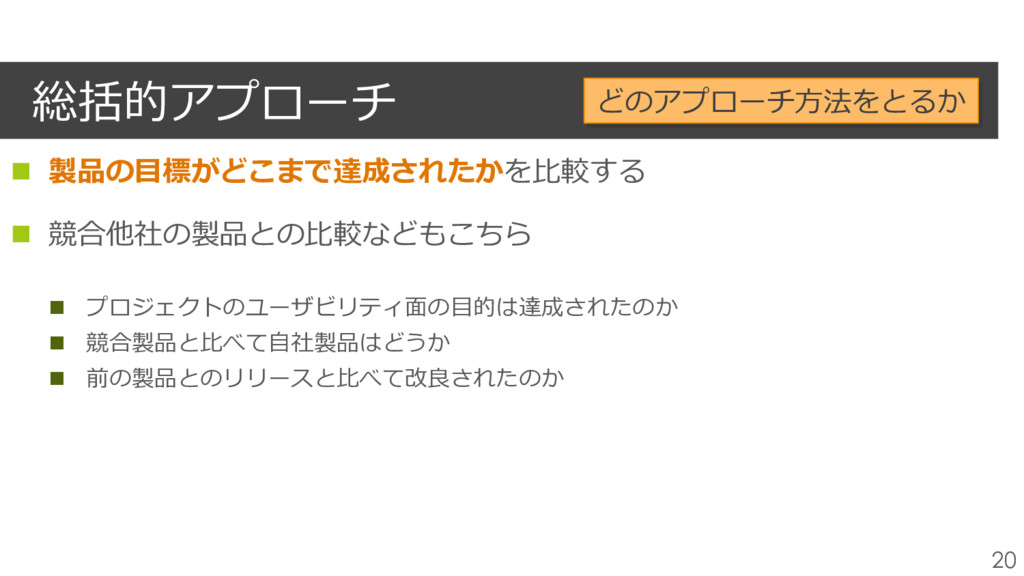
総括的アプローチ 20 どのアプローチ⽅法をとるか n 製品の⽬標がどこまで達成されたかを⽐較する n 競合他社の製品との⽐較などもこちら n プロジェクトのユーザビリティ⾯の⽬的は達成されたのか n
競合製品と⽐べて⾃社製品はどうか n 前の製品とのリリースと⽐べて改良されたのか -
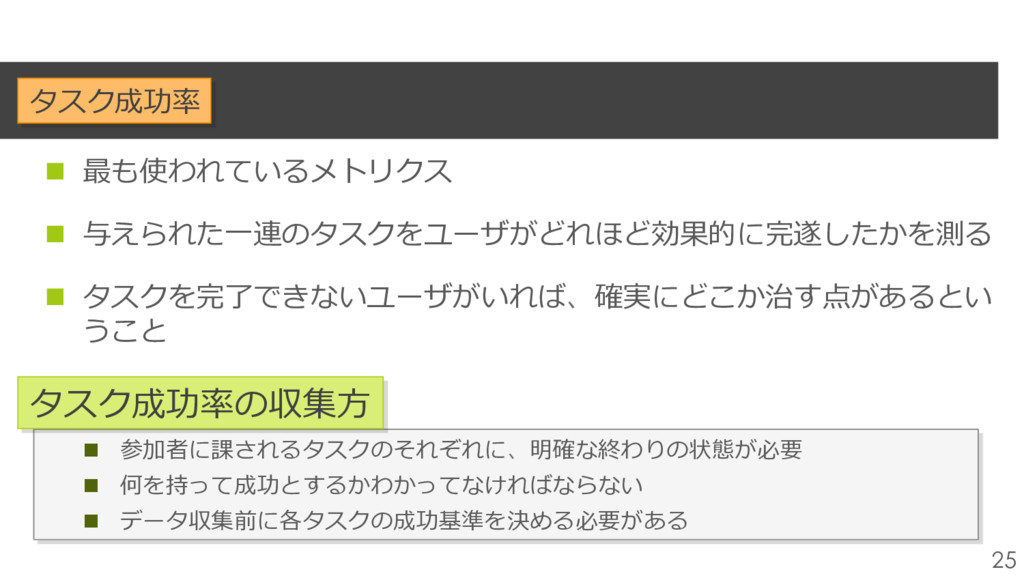
n 最も使われているメトリクス n 与えられた⼀連のタスクをユーザがどれほど効果的に完遂したかを測る n タスクを完了できないユーザがいれば、確実にどこか治す点があるとい うこと n 参加者に課されるタスクのそれぞれに、明確な終わりの状態が必要 n
何を持って成功とするかわかってなければならない n データ収集前に各タスクの成功基準を決める必要がある 25 タスク成功率 タスク成功率の収集⽅ -
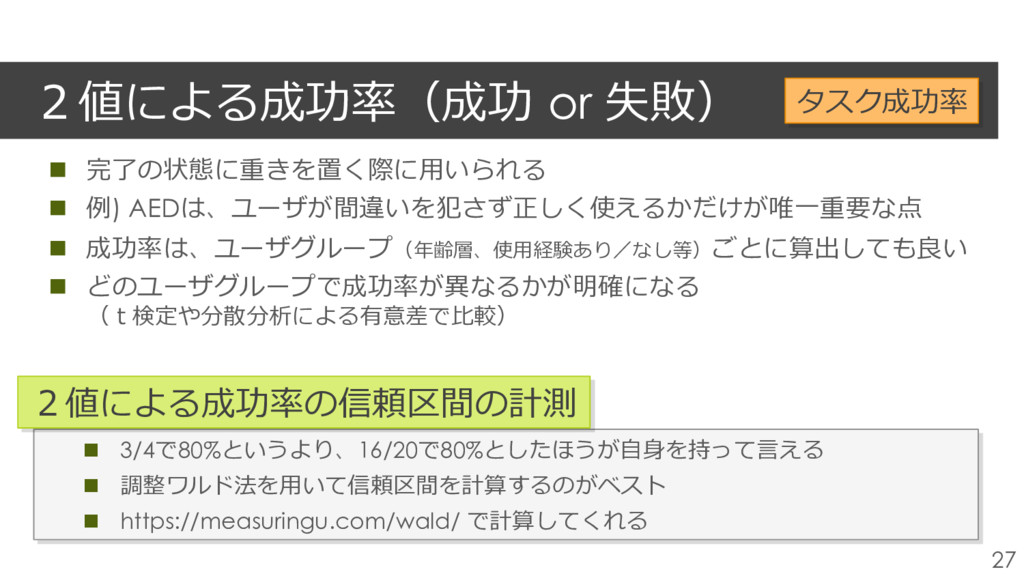
n 完了の状態に重きを置く際に⽤いられる n 例) AEDは、ユーザが間違いを犯さず正しく使えるかだけが唯⼀重要な点 n 成功率は、ユーザグループ(年齢層、使⽤経験あり/なし等)ごとに算出しても良い n どのユーザグループで成功率が異なるかが明確になる (t検定や分散分析による有意差で⽐較)
2値による成功率(成功 or 失敗) 27 タスク成功率 n 3/4で80%というより、16/20で80%としたほうが⾃⾝を持って⾔える n 調整ワルド法を⽤いて信頼区間を計算するのがベスト n https://measuringu.com/wald/ で計算してくれる 2値による成功率の信頼区間の計測 -
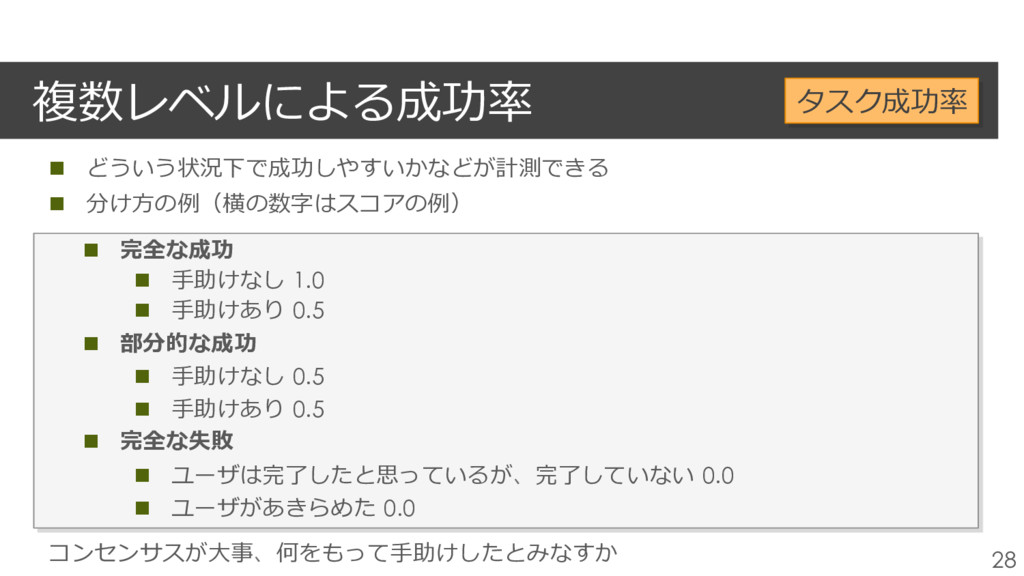
n どういう状況下で成功しやすいかなどが計測できる n 分け⽅の例(横の数字はスコアの例) コンセンサスが⼤事、何をもって⼿助けしたとみなすか 複数レベルによる成功率 28 タスク成功率 n 完全な成功
n ⼿助けなし 1.0 n ⼿助けあり 0.5 n 部分的な成功 n ⼿助けなし 0.5 n ⼿助けあり 0.5 n 完全な失敗 n ユーザは完了したと思っているが、完了していない 0.0 n ユーザがあきらめた 0.0 -
n タスク完了までの時間を計測(とても⼀般的なメトリクス) n セッションすべてを録画することで、タイムスタンプから逆算もできる n タスク時間が短ければいいというものでないものも存在する (ゲーム/勉強などの体験が⼤事なもの) n 発話思考法と組み合わせることで、詰まっている原因がわかる n
時間を図っていることをユーザに説明するかはメリットデメリットある n メリット: Webでのタスクで、タスク外の興味に惹かれ別⾏動を挟んでしまうことを防ぐ n デメリット: 緊張してしまう、無駄なミスが増える 30 タスク時間 -
n ユーザがタスクを⾏う中で犯す間違いを計測 n UIのなかでどこが混乱を招くのか、 誤解されやすいかを絞り込むのにつかえる n エラーを測定するべきとき n タスクを失敗させる可能性があるあるアクションを明確にしたいとき n
例)株を買い増すつもりが、売ってしまう。 医療機器の間違ったボタンを押したことで誤った投薬がされてしまう等 n エラーによって、効率が著しく損なわれるとき n エラーによって、タスク完了が⼤幅に遅れるとき n エラーによって、タスクが失敗するとき 32 エラー -
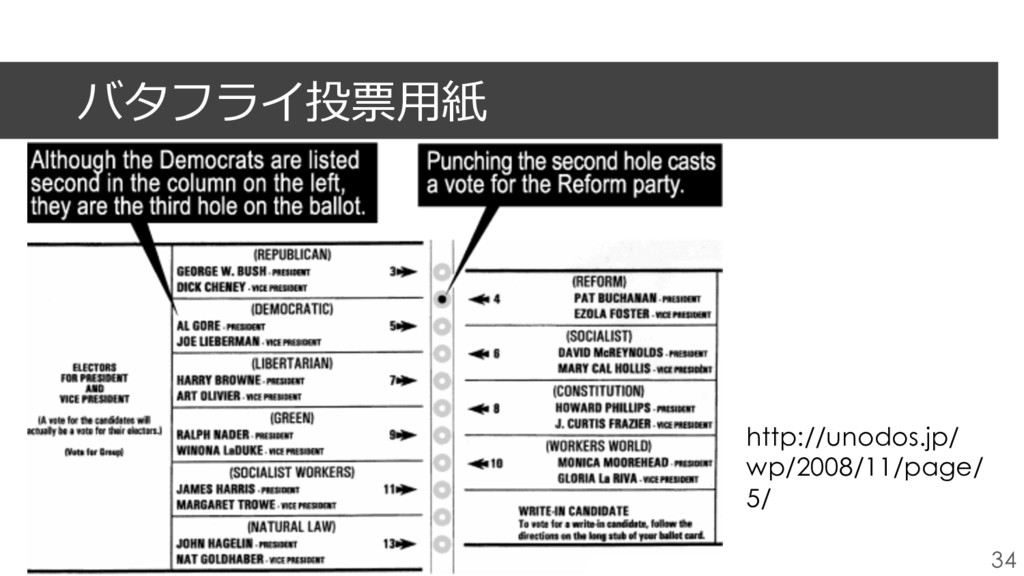
n エラーとみなす条件 n 広く認知された定義はない n ログイン失敗、メニューから間違ったものを選択する 間違った順序アクションをとる 等 n 例)
バタフライ投票⽤紙 n エラーデータの収集 n 正しいアクションは何かを明確にしておくと良い n エラーの数を単純に記録する、0=エラーなし、1=エラー1回 n エラーの頻度をタスクごとに求めると、どのタスクがエラーを起こしやすいかわかる n エラーは重複にカウントできないようする(⾃動で取得する際に注意) 33 エラー -
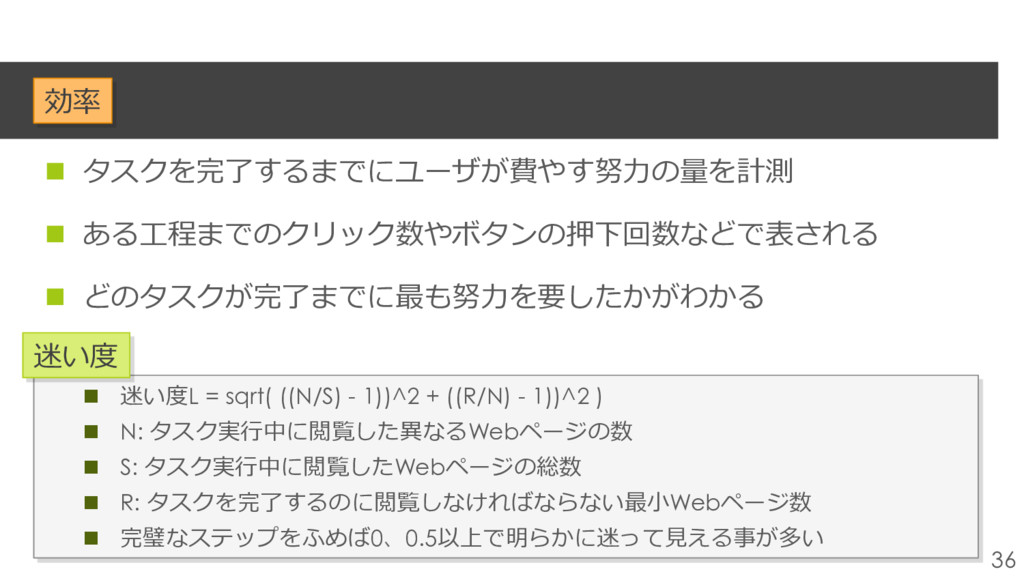
n タスクを完了するまでにユーザが費やす努⼒の量を計測 n ある⼯程までのクリック数やボタンの押下回数などで表される n どのタスクが完了までに最も努⼒を要したかがわかる 36 効率 n
迷い度L = sqrt( ((N/S) - 1))^2 + ((R/N) - 1))^2 ) n N: タスク実⾏中に閲覧した異なるWebページの数 n S: タスク実⾏中に閲覧したWebページの総数 n R: タスクを完了するのに閲覧しなければならない最⼩Webページ数 n 完璧なステップをふめば0、0.5以上で明らかに迷って⾒える事が多い 迷い度 -
n 完成までに3年かかると⾔われたら開発者もスポンサーもいい顔はしない n 現実的なアプローチは、同じ参加者に短い間隔でタスクをしてもらう n 同⼀セッション内の複数試⾏ n 休憩を⼊れずに1つまたは1連のタスクを繰り返す n ⼈は忘れるということを考慮しない⽅法でもある
n 同⼀セッション内の複数試⾏で休憩を挟む n タスクから注意を⼀旦そらす n 忘れることを促す 現実的な学習可⽤性の取得 39 学習可⽤性 -
5.問題点に基づいたメトリクス 40 n 問題点を明確にするために計測を⾏うための⽅法 n タスク完了を妨げるもの n ユーザの⾏動を「脇道にそらせる」もの n 何らかの混乱や困惑を起こすもの
n エラーを招くもの n 気づくべきことに気付かない状況 n 正しくないことを正しいと思いこんでる状況 n タスクが完了していないのに完了したと思いこんでいる状況 n 正しくないアクションを取ってしまう状況 n コンテンツのどこかを誤解してしまう状況 n ナビゲーションが理解できない状況 ユーザビリティの問題とは何か -
真の問題と偽りの問題 41 n 何が特殊な事例で、何が⼀般的な問題なのかわかりづらい n 10⼈中1⼈だけが間違ったとき、 この問題が多くの⺟集団で繰り返されるかを⾒極めなければならない n 間違いを犯したユーザの⾏動や思考のプロセス、認識、 意思決定が理論的かを問いかけると良い
n ユーザの思考順序に⼀貫性があれば真の問題であり、 説明できなければ特殊ケースの可能性が⾼い -
問題の深刻度 42 n 特定できた問題点を全て治すのは難しいし、時間がかかる n 問題の深刻度を以下のように⾼・中・低とわけて順序⽴てると良い n 低:参加者を悩ませたり、苛⽴たせたりするが、タスクの失敗には関係がない問題。こ の問題のせいでユーザーが本来の経路から外れる恐れはあるが、回復してタスクを終え ることができる。影響があるとしても、効率や満⾜度を僅かに下げる程度に限られる。
n 中:タスクの失敗に寄与するが、直接的な原因とはならない問題。ユーザーは迂回策を みつけて⽬標に到達できることが多い。このタイプの問題は、有効性に影響し、効率を 下げる可能性がある。 n ⾼:タスクの失敗を直接的に起こす問題。この問題に直⾯しながら、主なタスクを完了 する⽅法は、基本的に存在しない。このタイプの問題は、有効性、効率、満⾜度に⼤き な影響を及ぼす。 n 深刻度についての定義に誰もが賛同しているものはまだ無い。 -
参加者の数 43 n ユーザビリティ専⾨者の数だけ意⾒があると⾔っても過⾔ではない n 5⼈で⼗分と考えられる根拠 n ⼤事なのはユーザー1⼈から問題が検出される確率 n Nielsenらの研究ではユーザー1⼈につき
31% の問題が観測されると発表 n 10つ問題があったとき、1⼈30%の発⾒率だと、 5⼈で 10(1-((1-0.3)^5)) = 8.3193つの問題が発⾒できる(83%) n ⼀概に上記のとおりではないと⾔われている研究もある n 本書では ユーザグループ(年齢層、男⼥等)ごとに5⼈程度が良いといっている -
⾃⼰申告データの収集 45 n リッカート尺度 n 質問⽂を提⽰し、それに対してどれだけ同意できるかを答えてもらう n 質問⽂に対して、同意の程度を表現できること、選択肢を奇数にして中⽴を表現することの2つが⼤ 事 n
全く同意できない|同意できない|どちらとも⾔えない|同意できる|⾮常に同意できる n ⼤抵は5つ、7つを好む⼈もいる -
⾃⼰申告データの収集 46 n SD法 n 尺度の両端に対⽴する概念の修飾後をおく n 弱い ◯◯◯◯◯ 強い|美しい ◯◯◯◯◯ 醜い
など n 選択できる程度は奇数であるべき n ⾔葉の⾔外のニュアンスを知っておかなければならない n 親切 ⇔ 不親切は「親切」と「親切でない」の対とは多少違ったニュアンスになる -
⾃⼰申告データの収集タイミング 47 n 各タスク終わりと、セッション全体の終わりの2箇所がある n 各タスク終わり: 特に問題のあるインターフェースがわかる可能性がある n セッション全体の終わり: 製品に対して全体評価を効果的に引き出せる可能性がある
n ⾃⼰申告データを収集する際の偏向 n 対⾯または電話調査で直接聞かれたほうが ポジティブなフィードバックを下しやすくなる。 n ユーザが退出するまでモデレータが回答を⾒ないような仕組みが必要となる -
タスク終了後の評価(1) 48 n 参加者の期待の測定 n 最も重要なのはユーザが事前に考えていたことに⽐較して、 タスクがいかにやさしかったか、または難しかったか n Albertらはユーザがタスクを⾏う前に、 そのタスクがどれだけ難しいものになると予想していたかを聞いた
n 1=⾮常に難しい、7=⾮常にやさしいとして評価をつける n タスク取り組み前とタスク取り組み後を⽐較して図を作る -
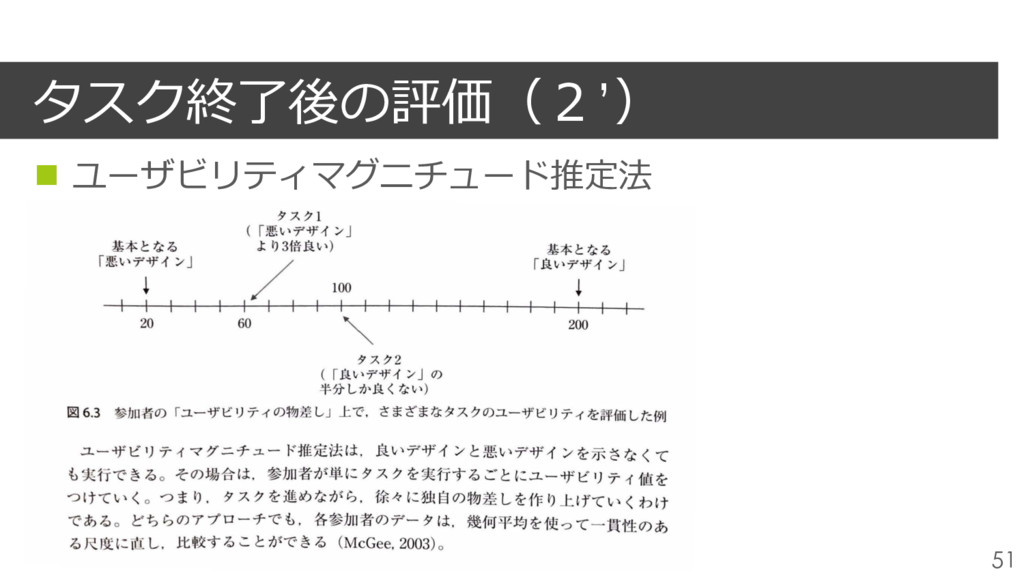
タスク終了後の評価(2) 50 n ユーザビリティマグニチュード推定法 n McGee, 2004 n 元々は、精神物理学の伝統⼿法のマグニチュードから n
光源をみせて、明るさといった属性に値をつける、 次に新しい光源をみせて最初に⾒た光源との⽐較で値をつけてもらう n 重要なのは、度合いを数値の⽐率でつけるということ n McGeeは良いWebサイトと悪いWebサイトを⾒せて値をつけ、 テストしているWebサイトがどの程度か値をつけてもらう n 実際は良い例/悪い例がなくてもいい、 ユーザがタスクを進めながらユーザ⾃⾝の物差しを作っていければよい -
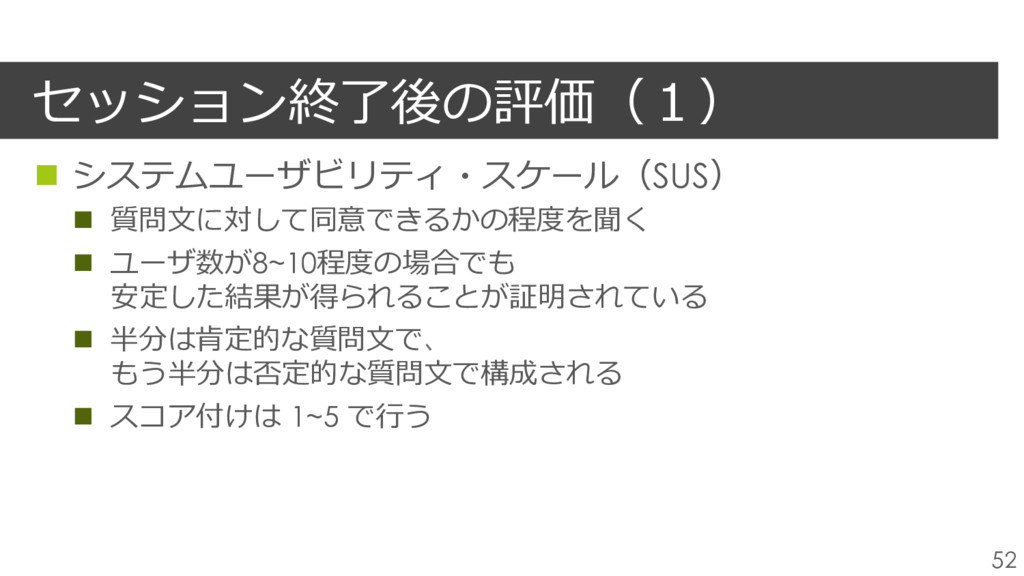
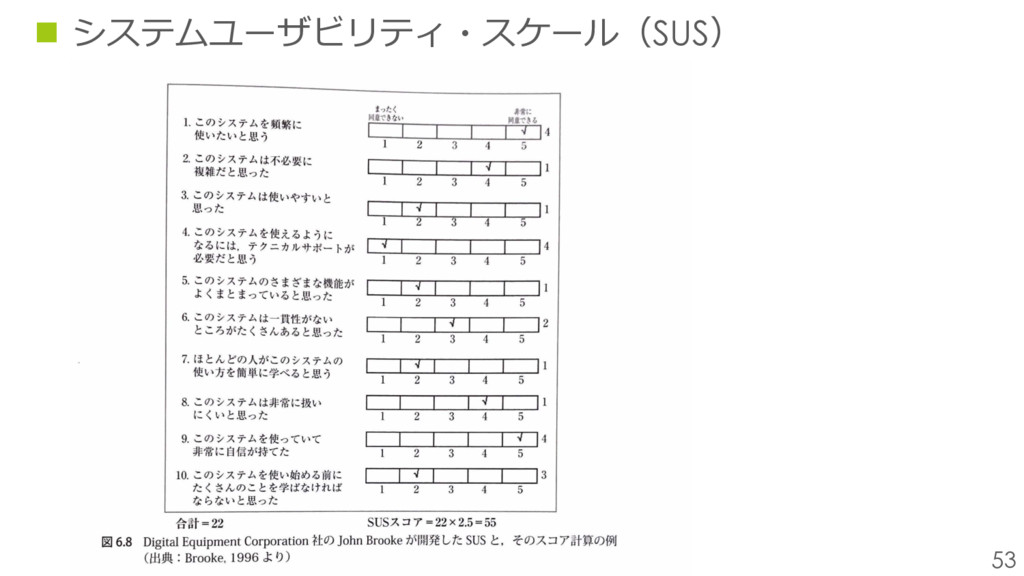
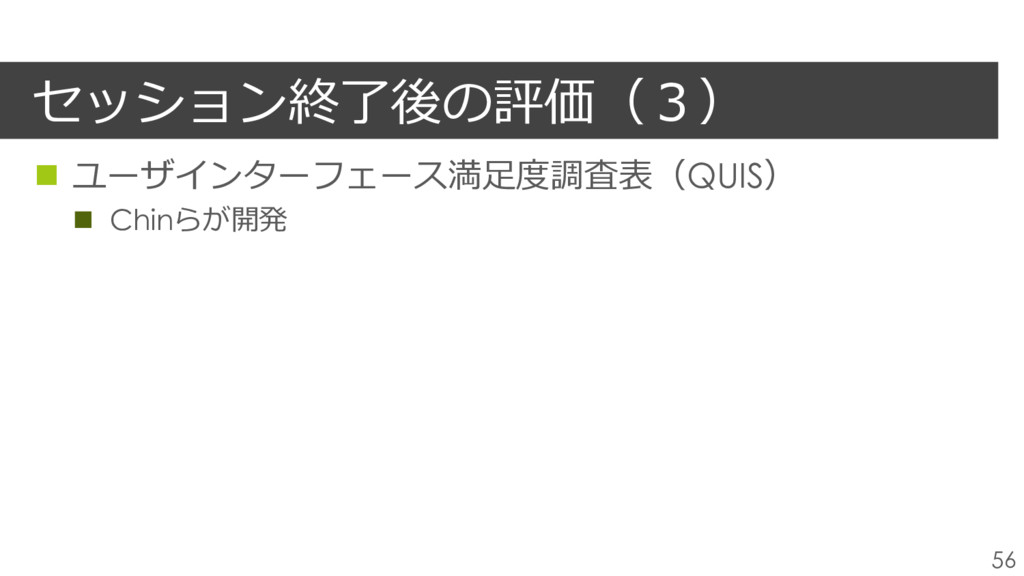
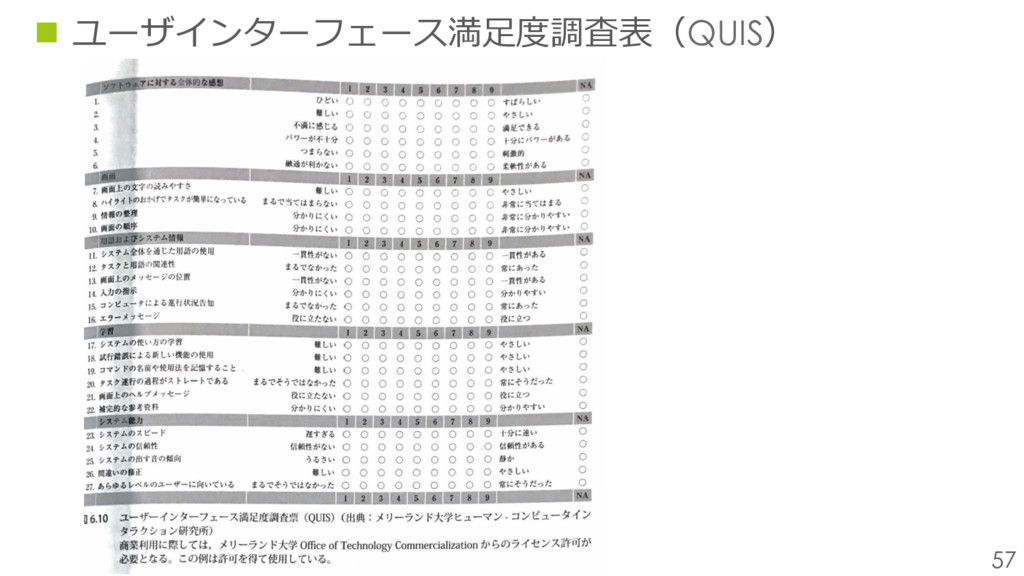
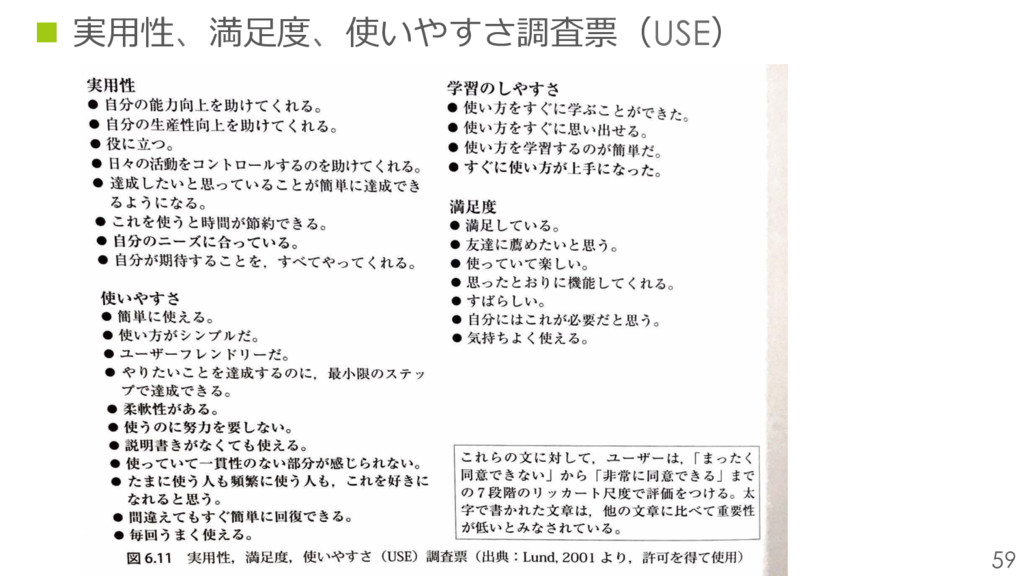
セッション終了後の評価(1) 52 n システムユーザビリティ・スケール(SUS) n 質問⽂に対して同意できるかの程度を聞く n ユーザ数が8~10程度の場合でも 安定した結果が得られることが証明されている n
半分は肯定的な質問⽂で、 もう半分は否定的な質問⽂で構成される n スコア付けは 1~5 で⾏う -
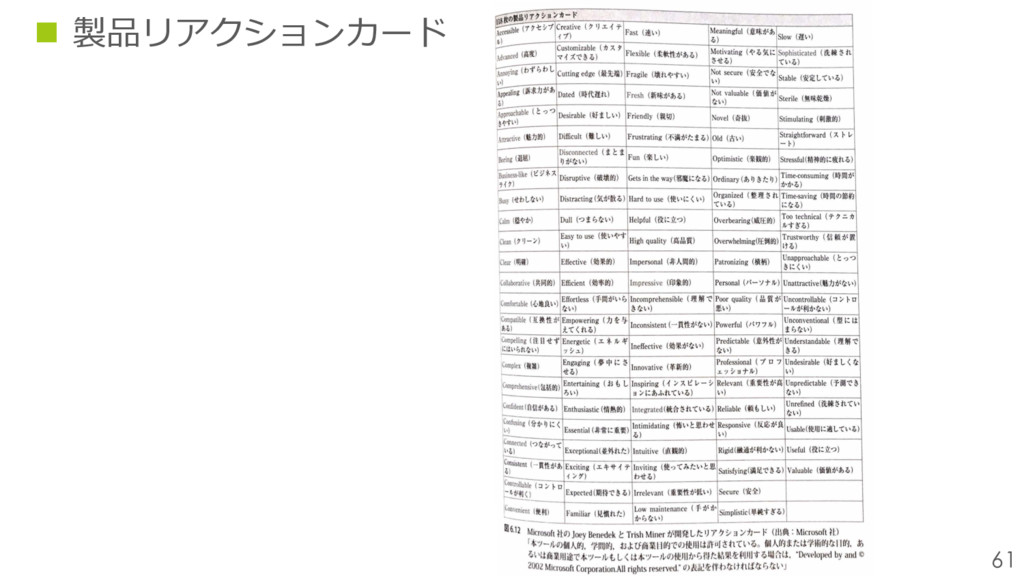
セッション終了後の評価(5) 60 n 製品リアクションカード n Microsoftが開発 n 製品を修飾する⾔葉をたくさん並べ、ユーザにそれを選んでもらう n カードには肯定的なものと否定的なものがある
n 肯定的なカードの数と、否定的なカードの数を数える。 -
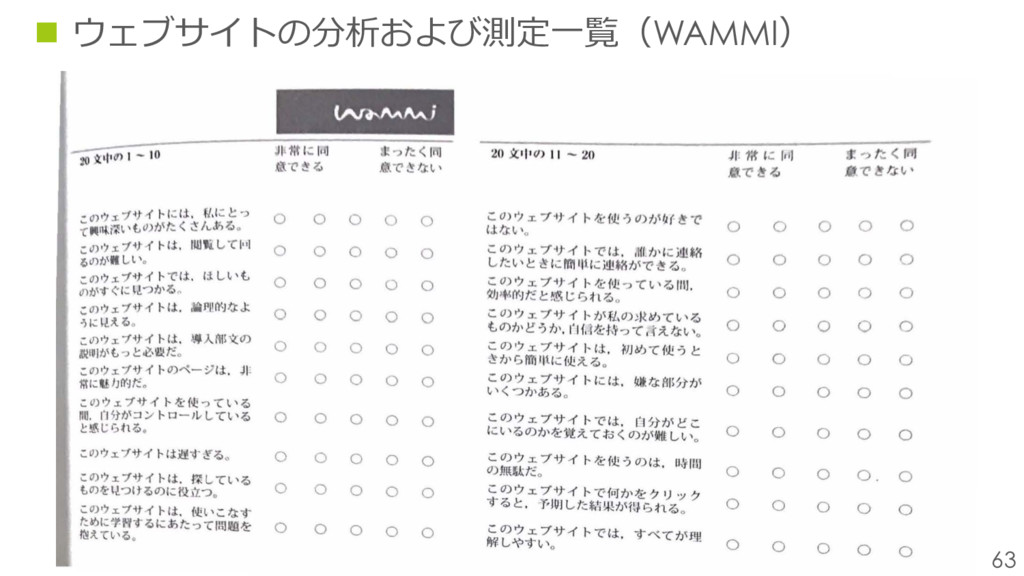
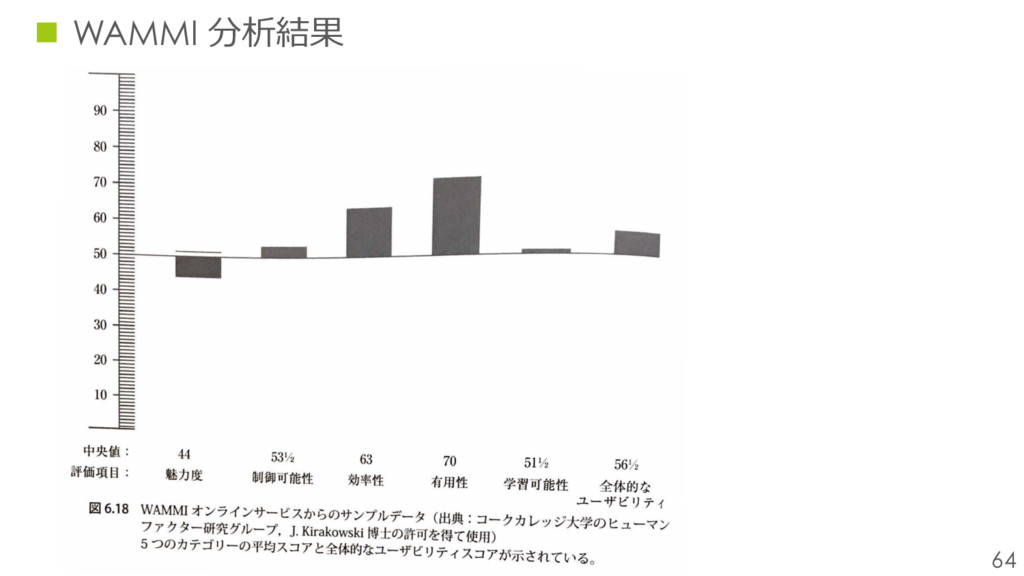
オンラインサービス 62 n ウェブサイトの分析および測定⼀覧(WAMMI) n コークカレッジ⼤学が開発 n ウェブサイトの評価が⽬的として作られている n 20の質問とリッカート尺度から構成される
n その他のWebサイトとWAMMIを⽐較することもできる -
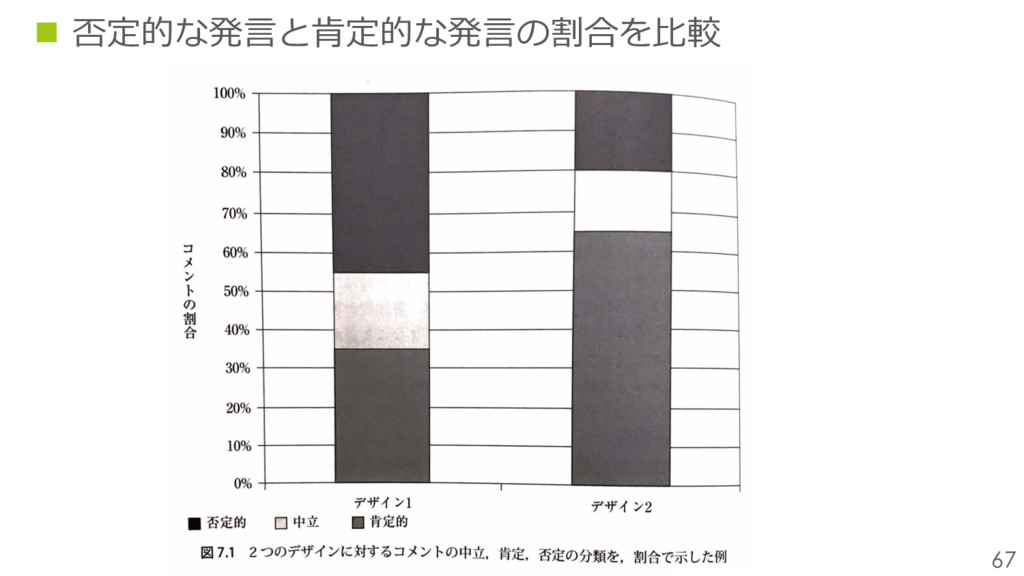
⾔語⾏動 66 n ⾮常に肯定的なコメント「すばらしい!」 n その他の肯定的なコメント「なかなか良かった」 n ⾮常に否定的なコメント「このサイトはひどい!」 n その他の否定的なコメント「機能があまり良いとは思えない」
n 改善の提案「こうしたらもっと良くなるのに」 n 質問「どう機能するんですか」 n 期待との差「思っていたのと違う結果になった」 n ⼾惑いや理解の⽋如「このページの⾔っていることが理解できない」 n 苛⽴ち「もう電源を切ってしまいたいぐらいだ」 -
観察するために機器が必要な⾏動 68 n 実際のユーザビリティテストでは参加者の邪魔にならないようなデバイス でなければ、基本的には採⽤しない。 n 顔の表情 n ビデオを付けて常に顔を計測する n
筋電図センサーにて、頬の筋⾁を計測する(笑うなど) -
瞳孔の反応 70 n 瞳孔の⼤きさはアイトラッキングをするために必要なので、 機器におまけ的についてる。 n 瞳孔は周囲の明るさのレベルに応じて開いたり閉じたりする n 感情的な反応に対しても変化がある n
瞳孔が開く: 頭を使っている n 瞳孔が収縮する: 記憶⼒を使いすぎる -
8.統合・⽐較メトリクス 72 n ⽬標値に基づくメトリクスの統合 n 複数メトリクスを簡単に統合するならこれ n タスク成功率75%以上、タスク時間70秒以内 と⾔った組み合わせの割合を求める n
割合に基づくメトリクスの統合 n タスク時間なら、最短時間を100%ととして割合を表⽰ n あとは⽬標値に基づくメトリクスの統合と同じ -
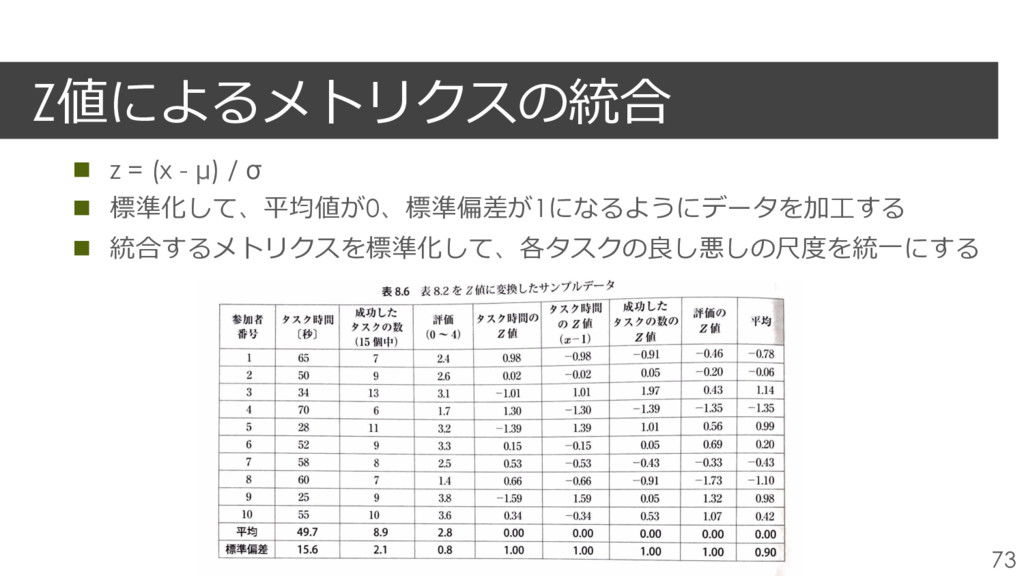
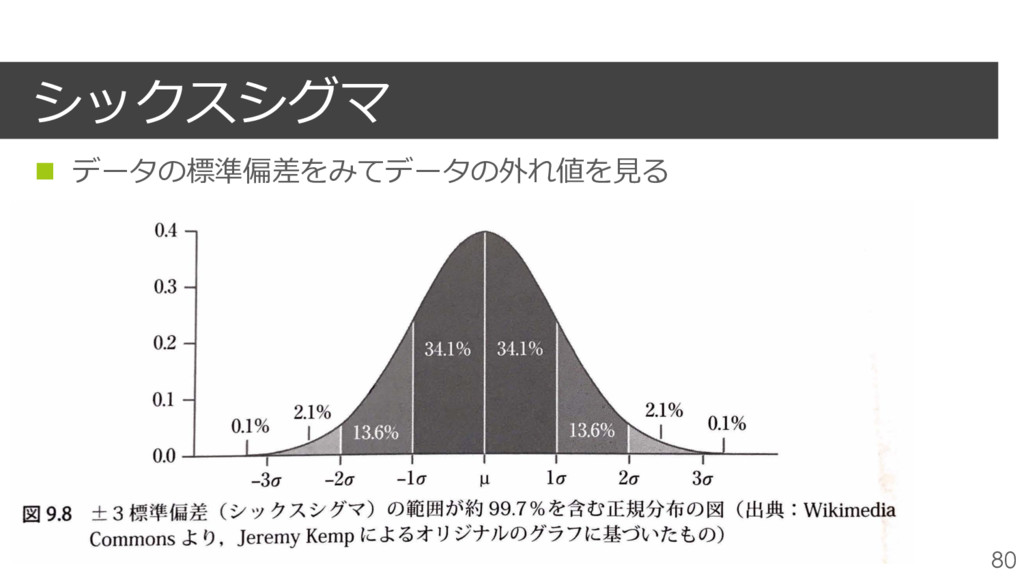
Z値によるメトリクスの統合 73 n z = (x - μ) / σ
n 標準化して、平均値が0、標準偏差が1になるようにデータを加⼯する n 統合するメトリクスを標準化して、各タスクの良し悪しの尺度を統⼀にする -
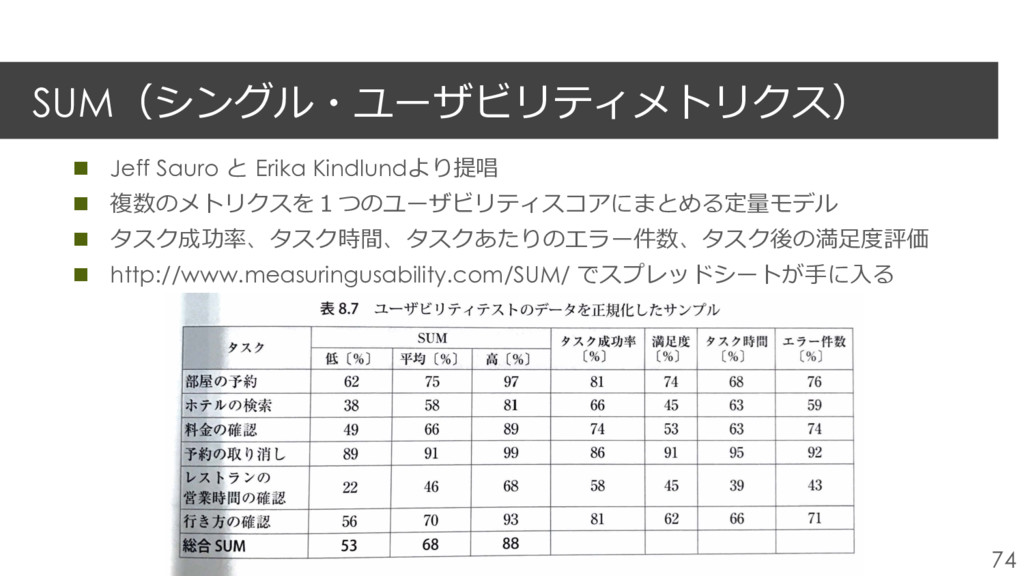
SUM(シングル・ユーザビリティメトリクス) 74 n Jeff Sauro と Erika Kindlundより提唱 n 複数のメトリクスを1つのユーザビリティスコアにまとめる定量モデル
n タスク成功率、タスク時間、タスクあたりのエラー件数、タスク後の満⾜度評価 n http://www.measuringusability.com/SUM/ でスプレッドシートが⼿に⼊る -
9.特別なトピック 76 n 稼働中のウェブサイトデータ n 稼働中のウェブサイトは宝の⼭、ユーザがどのようにページを閲覧しているかを取れる n サーバのログからわかるデータ n ページビュー
n ページビジット n クリックスルー率 n 離脱率 n A/Bテスト -
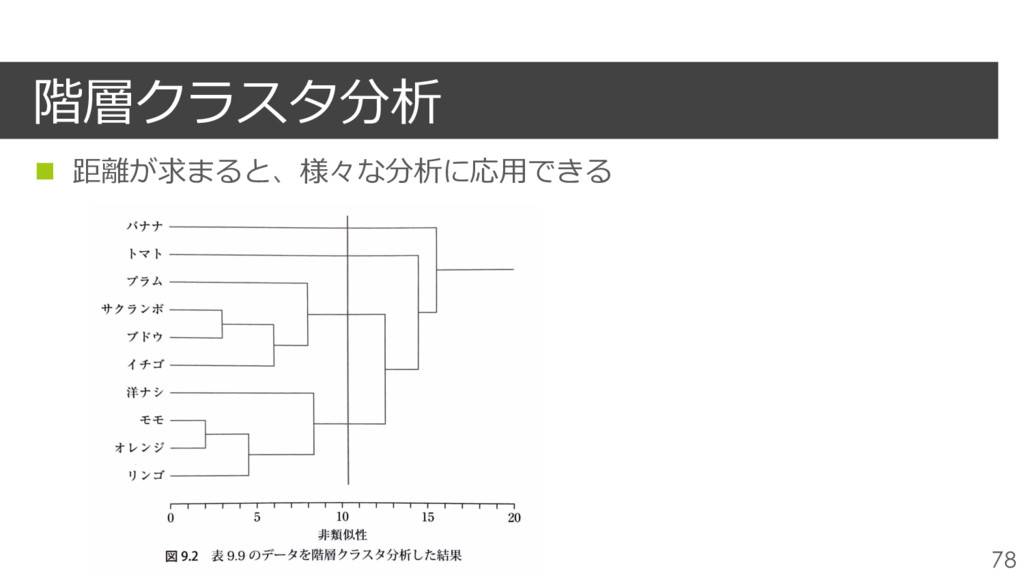
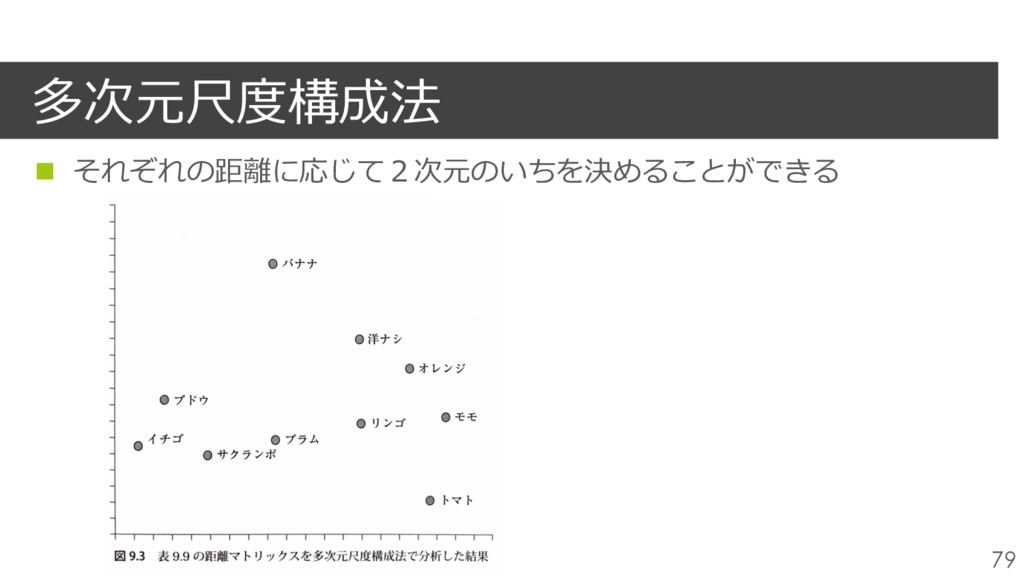
カードソートのデータ 77 n 情報の整理に使われる n たとえば果物を提⽰して、何処に当てはまるかを答えてもらう n ⼤きくて丸いもの、⼩さいもの、変わった形のもの n 参加者が同じグループに果物を⼊れると距離0、異なったグループだと距離1
n クローズドカードソートは予め決まったクラスタに分けてもらう n オープンカードソートはクラスタを⾃由に決めてよい -
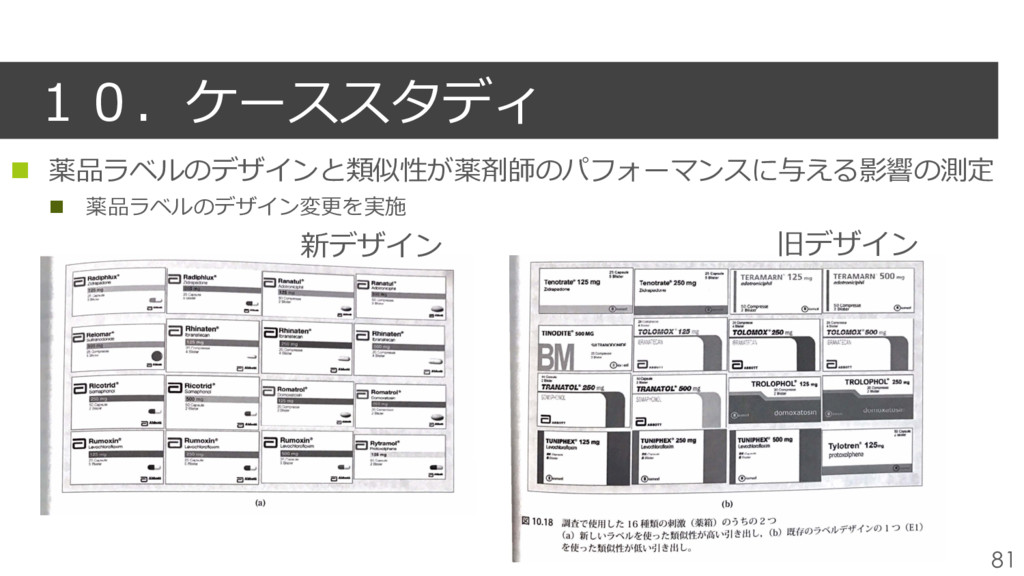
薬品ラベルのデザインと類似性が薬剤師の パフォーマンスに与える影響の測定 82 n 参加者 n 26〜45の薬剤師20名 n ⼥性14, 男性6
n 謝礼は専⾨誌の購読1年分 n 装置 n PCと 1024 x 768のモニター n アイトラッカー Tobii1750 n 刺激 n 薬のパッケージ画像を4 x 4に配置 n ⼿順 n キーボードにて指定された薬品パッケージを選択する n マウスでは視線にノイズが⼊ることを考慮して使⽤しなかった -
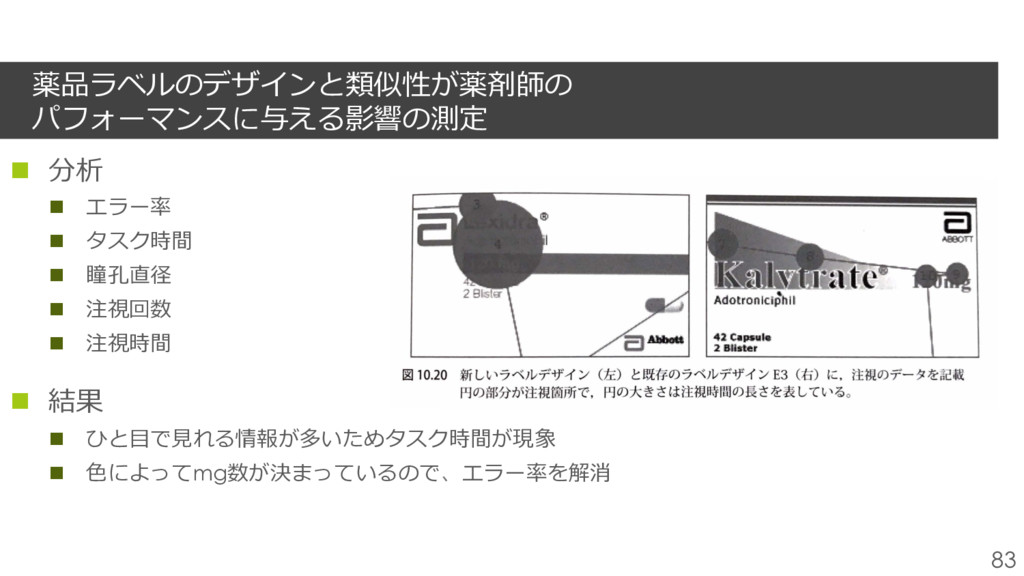
薬品ラベルのデザインと類似性が薬剤師の パフォーマンスに与える影響の測定 83 n 分析 n エラー率 n タスク時間 n
瞳孔直径 n 注視回数 n 注視時間 n 結果 n ひと⽬で⾒れる情報が多いためタスク時間が現象 n ⾊によってmg数が決まっているので、エラー率を解消 -
11.更に前進するために 84 n UXとメトリクスのパワーを売り込む n ⼩さく産んで⼤きく育てる n 時間と費⽤を確保する n 早めに何度も計画を⽴てる
n 製品のベンチマークを確⽴する n データを吟味する n ビジネスの視点を持つ n ⾃⾝を⾒せる n メトリクスを誤⽤しない n プレゼンテーションをシンプルにする