Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Was kostet AI Coding wirklich?

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for Alex T Alex T
October 22, 2026
19

Was kostet AI Coding wirklich?

AI Coding ist gerade absurd günstig – zumindest auf den ersten Blick. Für rund 40 Euro im Monat bekommt man die stärksten Modelle von OpenAI und Anthropic, und agentische Tools wie Codex, Claude Code oder Cursor erledigen damit einen erstaunlichen Teil der täglichen Arbeit. Und ja, Spoiler: Diese subventionierten Subscriptions sind mit Abstand der beste Deal, den man aktuell bekommen kann. Aber sie erzählen nicht die ganze Geschichte. Über die API kostet ein einziger komplexer Agent-Task schnell mal mehr als einen Euro, und im Enterprise-Umfeld gelten ohnehin ganz andere Spielregeln.

In diesem Vortrag rechnen wir ehrlich nach: keine Benchmarks, kein Marketing, sondern echte Zahlen und Erfahrungen aus dem Projektalltag. Was kosten Abos, APIs und Team-Pläne wirklich? Was treibt den Token-Verbrauch in agentischen Workflows – und wie bekommt man ihn mit Reasoning-Levels, Kontext-Management und klaren Guidelines in den Griff? Ein Gedanke zieht sich dabei durch den ganzen Vortrag: Am Ende zählt nicht der Preis pro Token, sondern die Kosten pro akzeptiertem, gereviewtem und gemergtem Change.

Avatar for Alex T

Alex T

October 22, 2026

Transcript

  1. LXT.dev • Textmasterformat bearbeiten • Zweite Ebene Was kostet AI

    wirklich? https://LXT.dev Alexander Thalhammer Kosten von Agentic Coding · was ein gemergter PR / ein Feature wirklich kostet Alexander Thalhammer · LXT.dev · x.com/LX_T
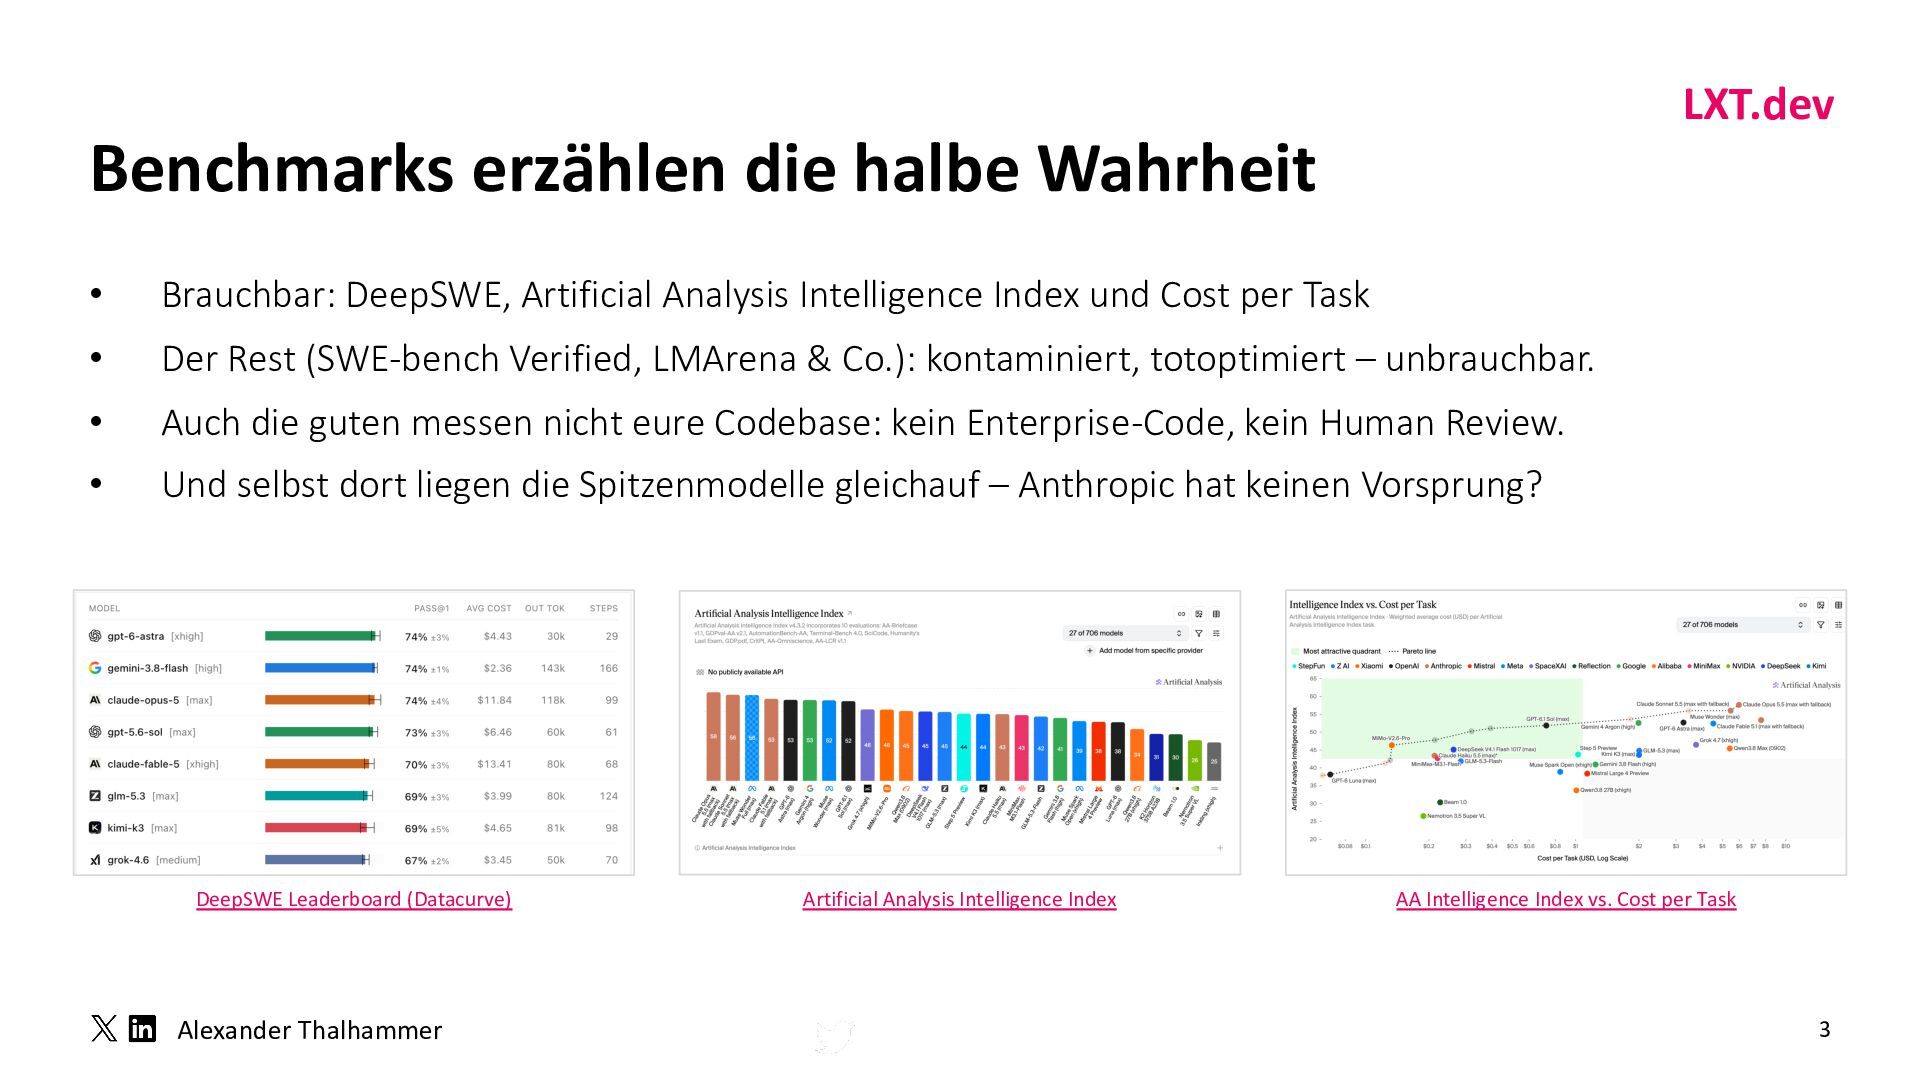
  2. LXT.dev Benchmarks erzählen die halbe Wahrheit • Brauchbar: DeepSWE, Artificial

    Analysis Intelligence Index und Cost per Task •• Textmasterformat Der Rest (SWE-bench Verified, LMArena & Co.): kontaminiert, totoptimiert – unbrauchbar. bearbeiten Zweite • •Auch dieEbene guten messen nicht eure Codebase: kein Enterprise-Code, kein Human Review. • Und selbst dort liegen die Spitzenmodelle gleichauf – Anthropic hat keinen Vorsprung? DeepSWE Leaderboard (Datacurve) Alexander Thalhammer Artificial Analysis Intelligence Index AA Intelligence Index vs. Cost per Task 3
  3. LXT.dev Also, meinen eigenen gebaut: Human benchom.at Setup 1. Run

    Beginn 10 '26: 8 Modelle, dieselben 20 Feature-Tickets einer AngularComponent-Library, derselbe Start-Commit, derselbe Prompt. • Textmasterformat bearbeiten • • • Zweite Ebene Bewertung: 4 menschliche Reviewer, blind, je 4 Achsen • Ticket-Intent • Functional Testing • Merge Readiness & • Code Quality • Gemessen: Score vs Kosten pro Ticket, zusätzlich die Zeit • Report-Post auf angulararchitects.io: coming soon 😏 Alexander Thalhammer 4
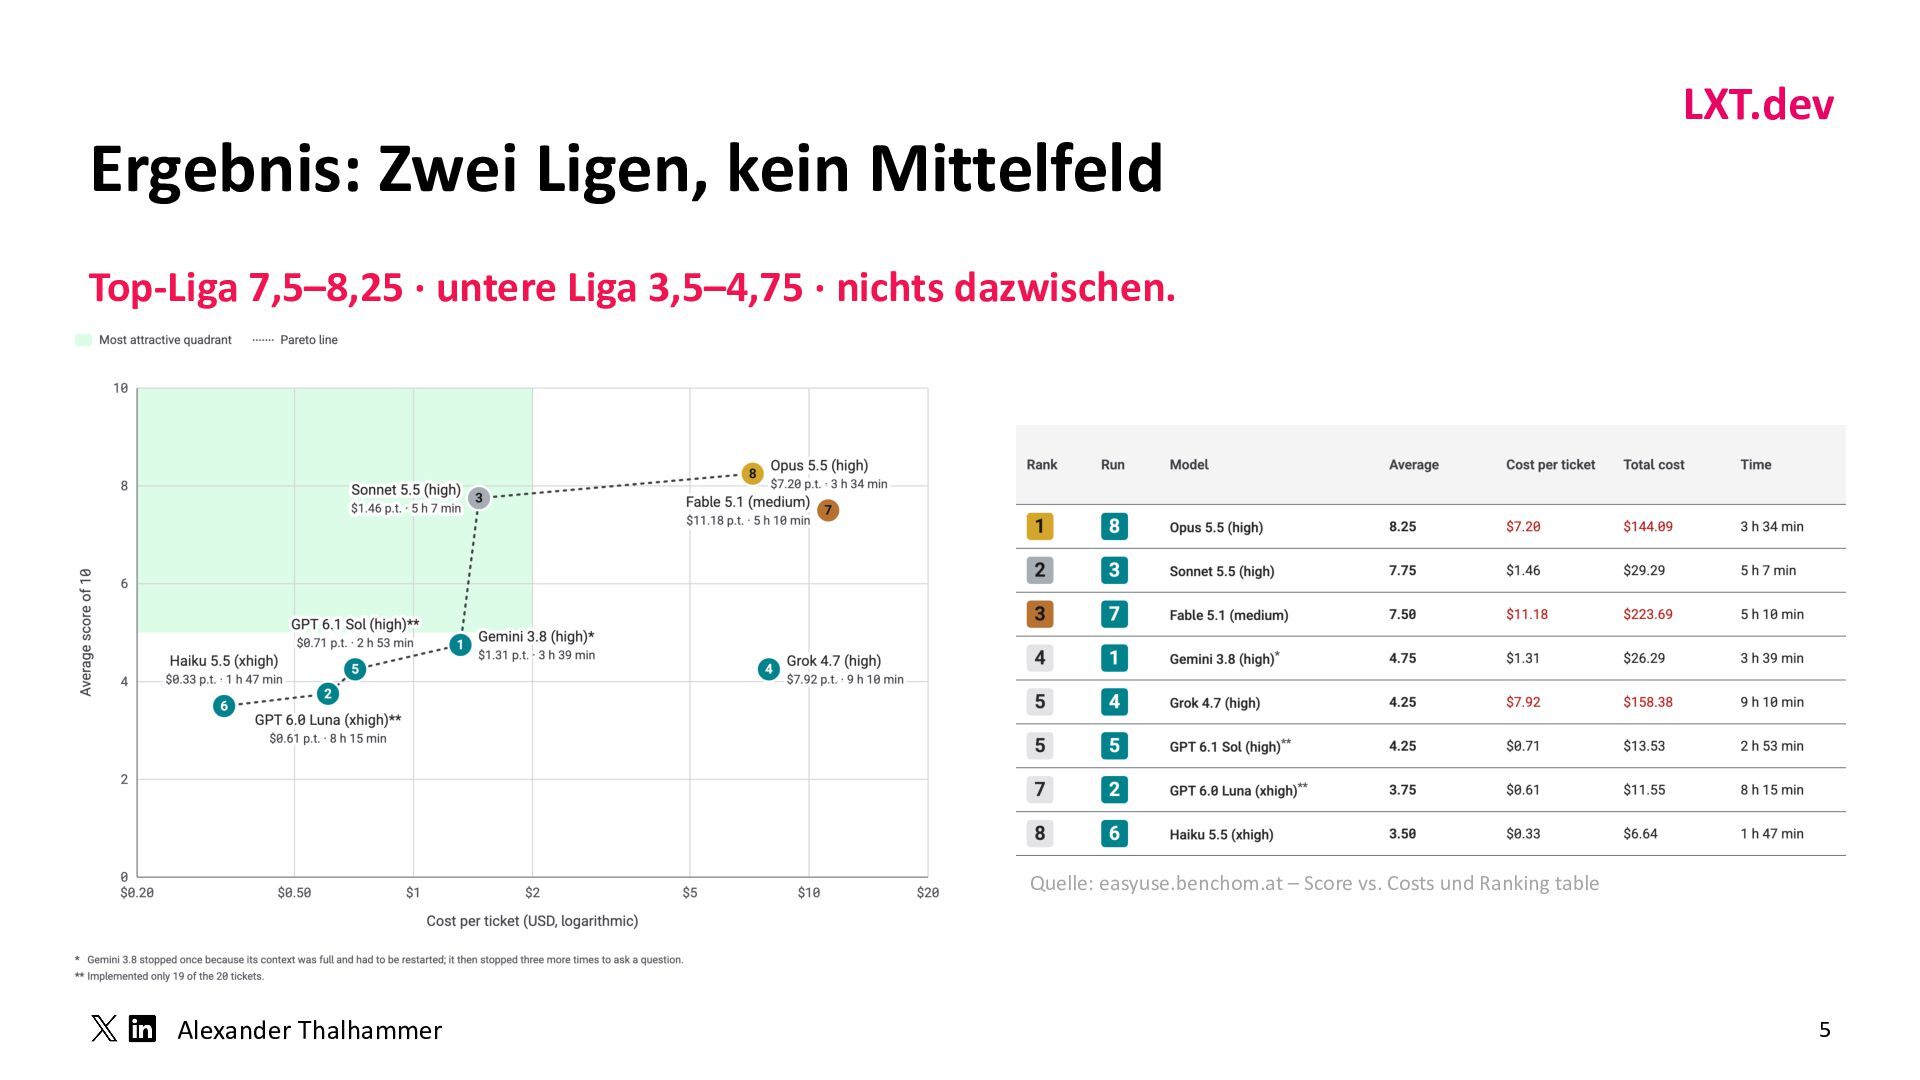
  4. Ergebnis: Zwei Ligen, kein Mittelfeld LXT.dev Top-Liga 7,5–8,25 · untere

    Liga 3,5–4,75 · nichts dazwischen. • Textmasterformat bearbeiten • Zweite Ebene Quelle: easyuse.benchom.at – Score vs. Costs und Ranking table Alexander Thalhammer 5
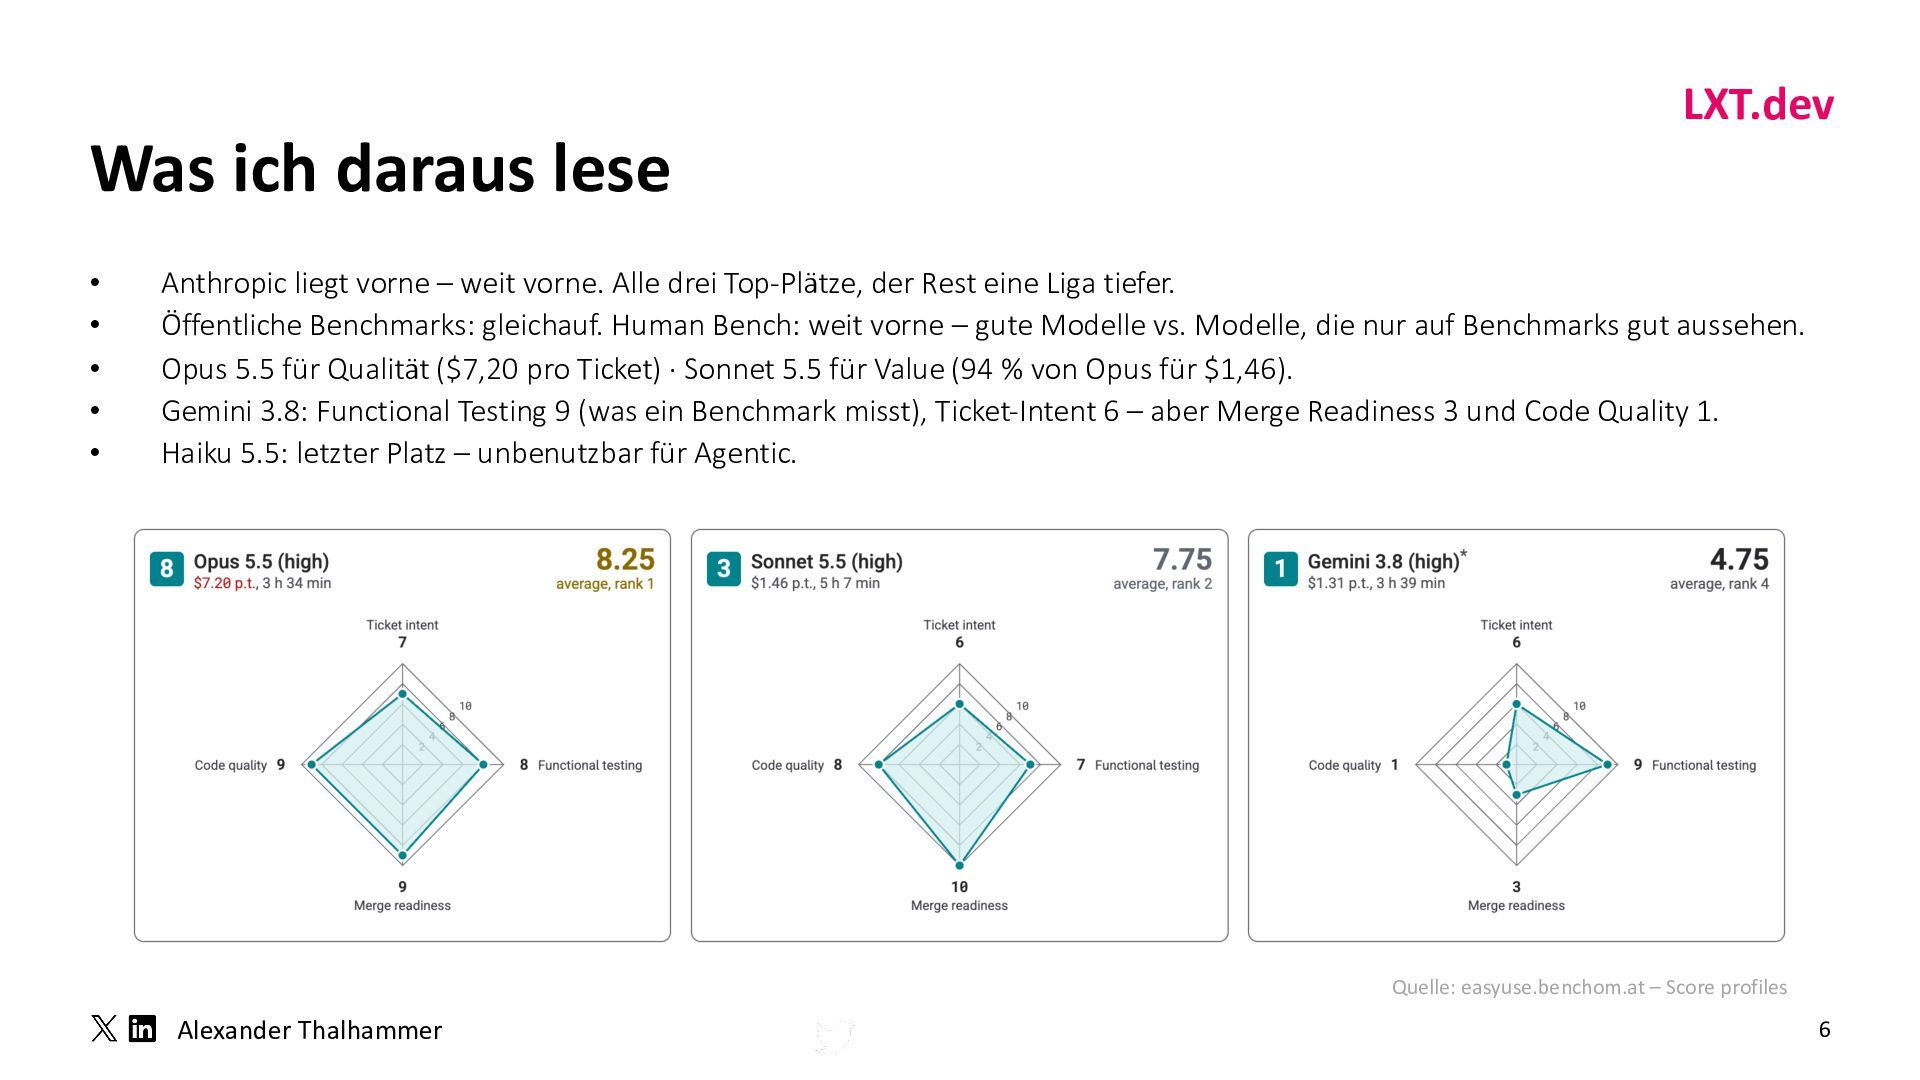
  5. Was ich daraus lese LXT.dev • Anthropic liegt vorne –

    weit vorne. Alle drei Top-Plätze, der Rest eine Liga tiefer. • Öffentliche Benchmarks: gleichauf. Human Bench: weit vorne – gute Modelle vs. Modelle, die nur auf Benchmarks gut aussehen. • Textmasterformat Opus 5.5 für Qualitätbearbeiten ($7,20 pro Ticket) · Sonnet 5.5 für Value (94 % von Opus für $1,46). • Gemini 3.8: Functional Testing 9 (was ein Benchmark misst), Ticket-Intent 6 – aber Merge Readiness 3 und Code Quality 1. • Zweite Ebene • Haiku 5.5: letzter Platz – unbenutzbar für Agentic. Quelle: easyuse.benchom.at – Score profiles Alexander Thalhammer 6
  6. LXT.dev Hi, it's me à @LX_T •• Textmasterformat Alexander Thalhammer

    bearbeiten aus Graz • • • Zweite Ebene Agentic-Trainer & Consultant Lieblingsthemen: • Agentic Engineering • Refactoring • Performance Alexander Thalhammer https://LXT.dev 7
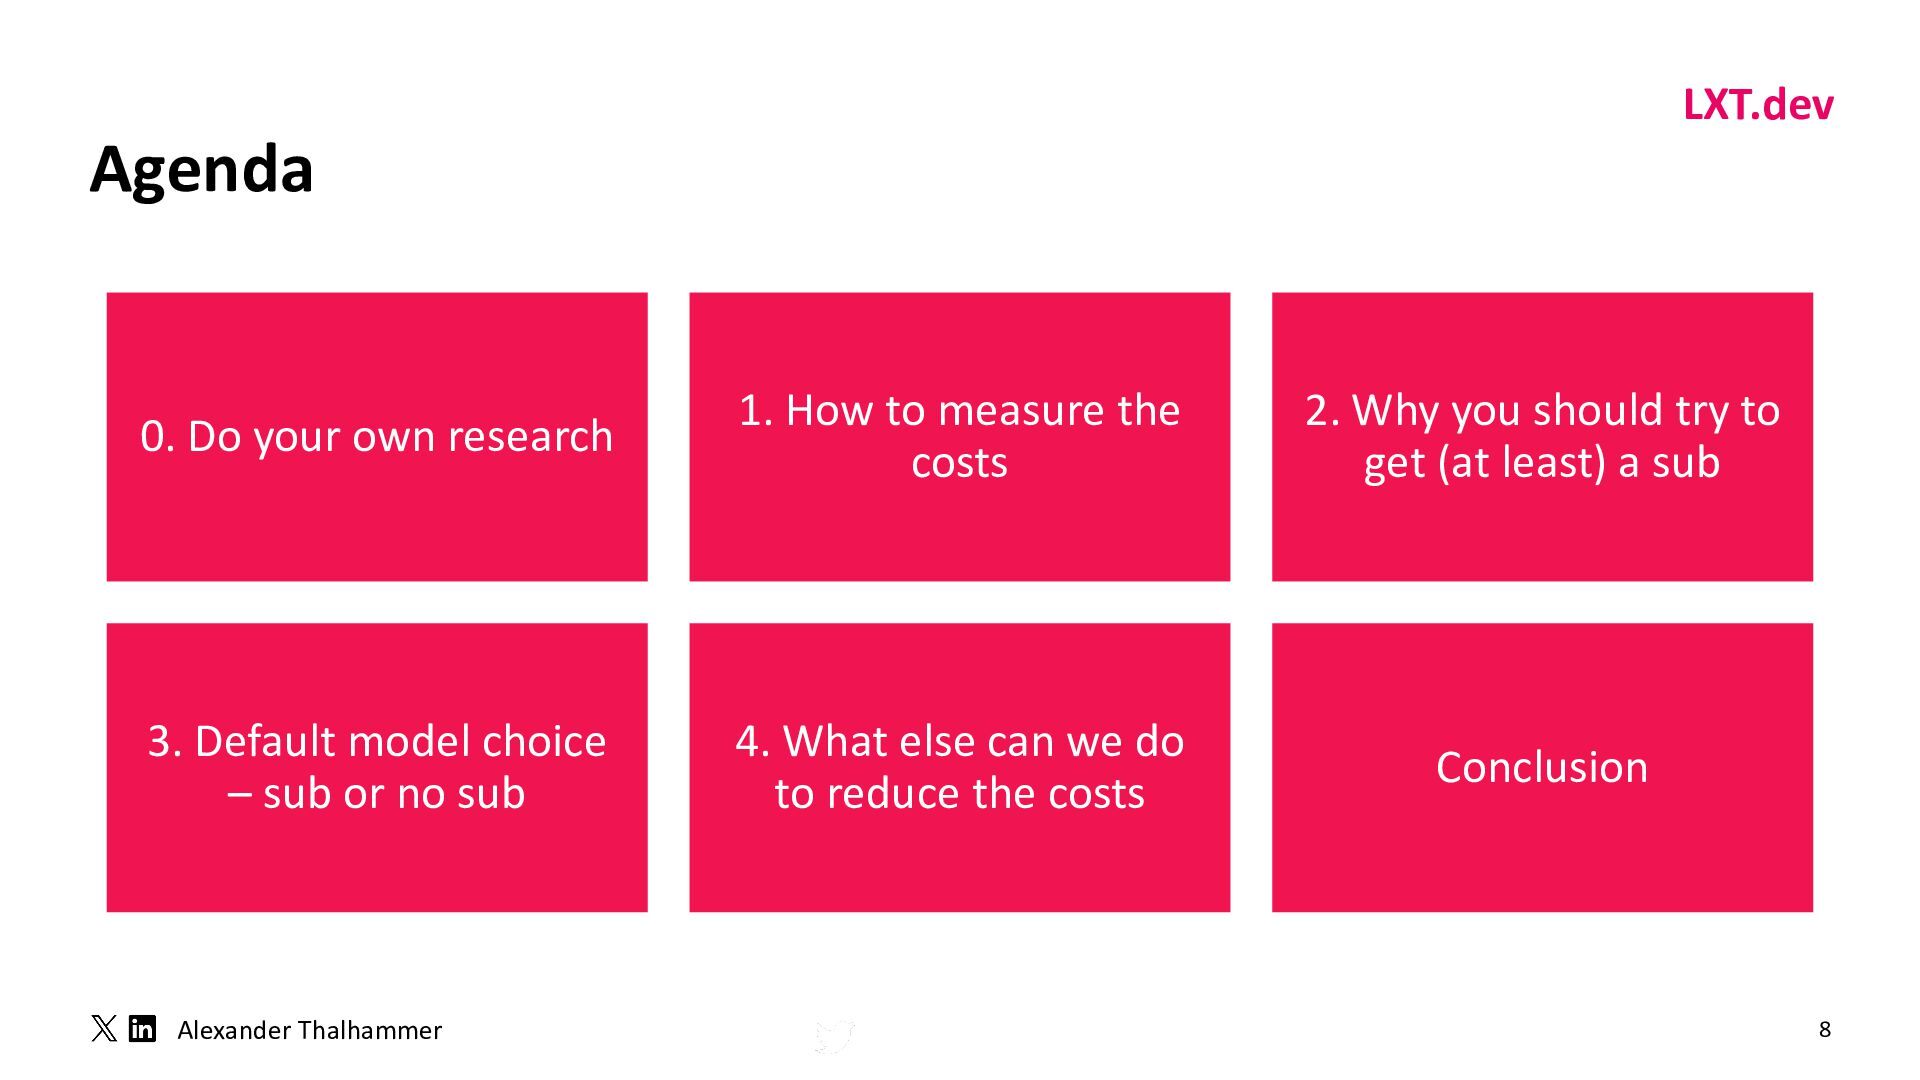
  7. LXT.dev Agenda • Textmasterformat bearbeiten Zweite Ebene 0.• Do your

    own research 1. How to measure the costs 2. Why you should try to get (at least) a sub 3. Default model choice – sub or no sub 4. What else can we do to reduce the costs Conclusion Alexander Thalhammer 8
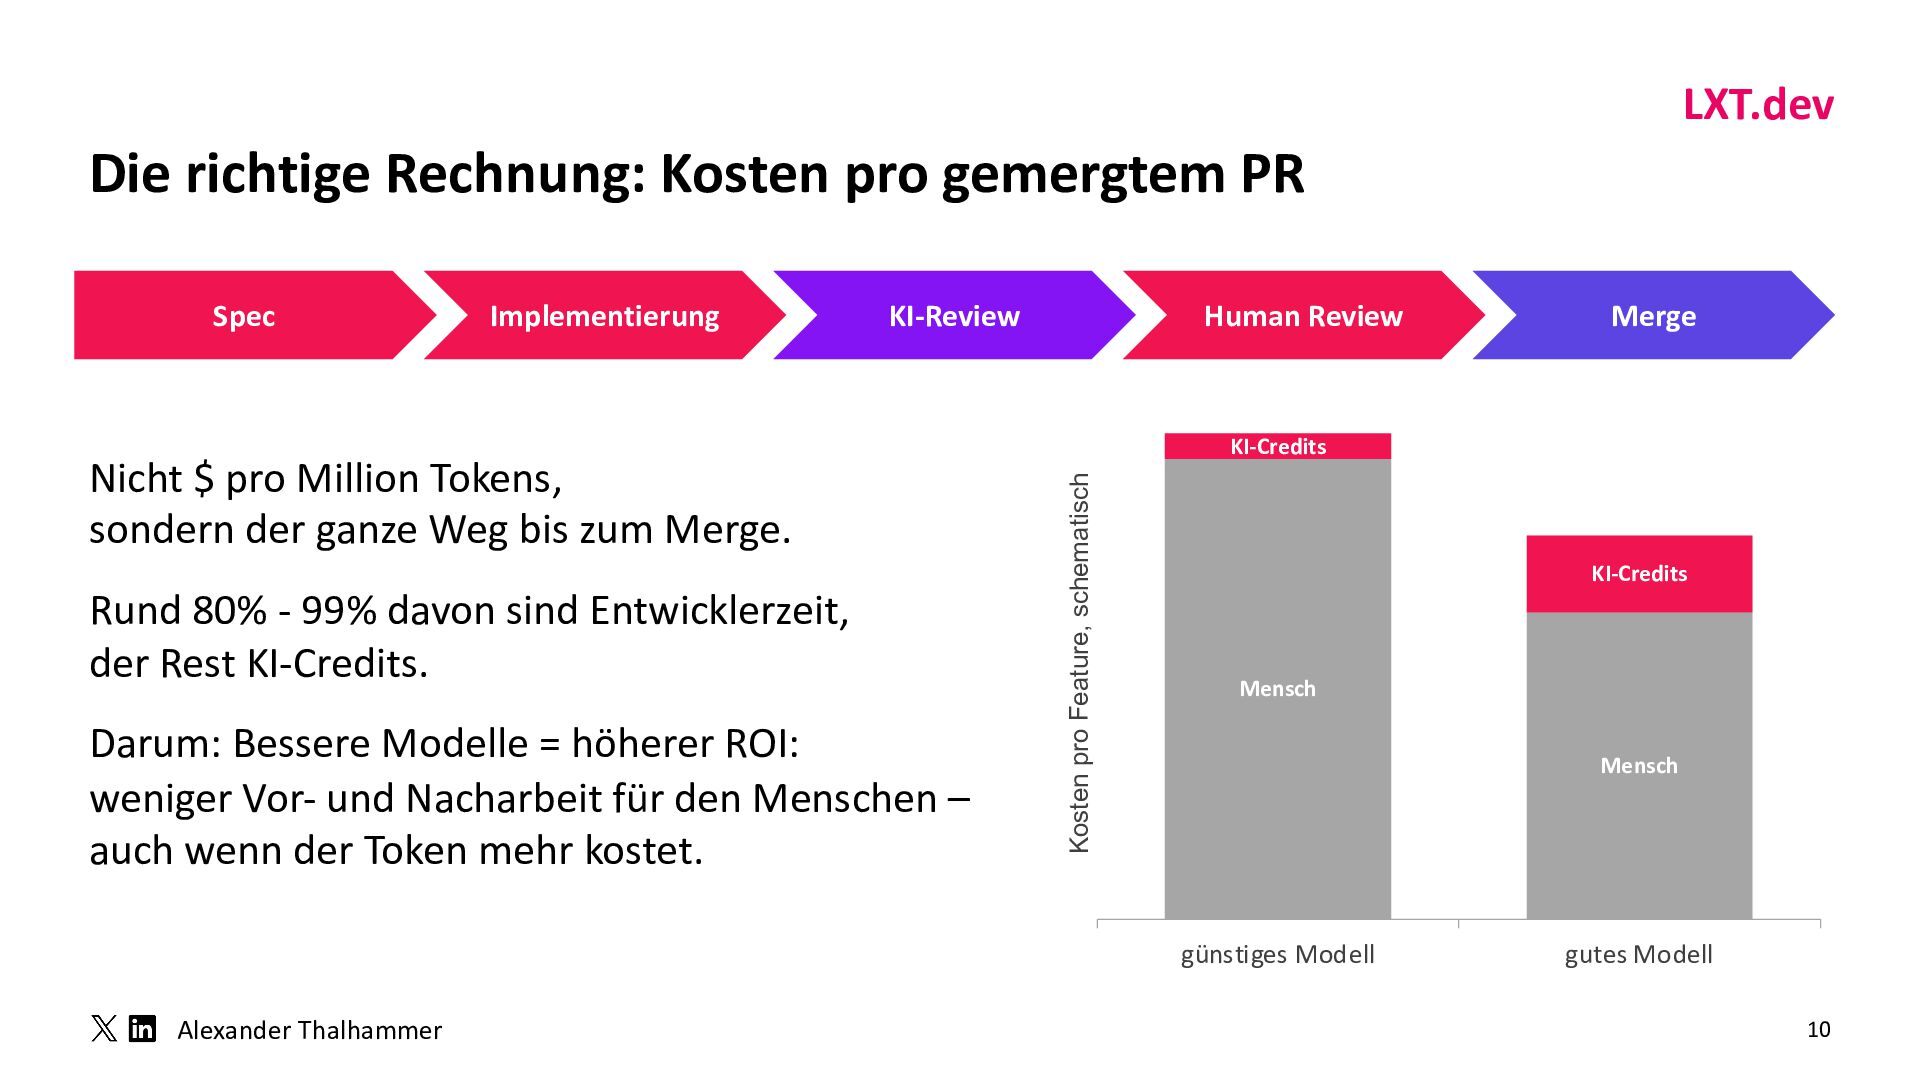
  8. LXT.dev Die richtige Rechnung: Kosten pro gemergtem PR Spec Implementierung

    KI-Review Human Review Merge • Textmasterformat bearbeiten • Zweite Ebene Rund 80% - 99% davon sind Entwicklerzeit, der Rest KI-Credits. Darum: Bessere Modelle = höherer ROI: weniger Vor- und Nacharbeit für den Menschen – auch wenn der Token mehr kostet. Kosten pro Feature, schematisch Nicht $ pro Million Tokens, sondern der ganze Weg bis zum Merge. KI-Credits KI-Credits Mensch Mensch günstiges Modell Alexander Thalhammer gutes Modell 10
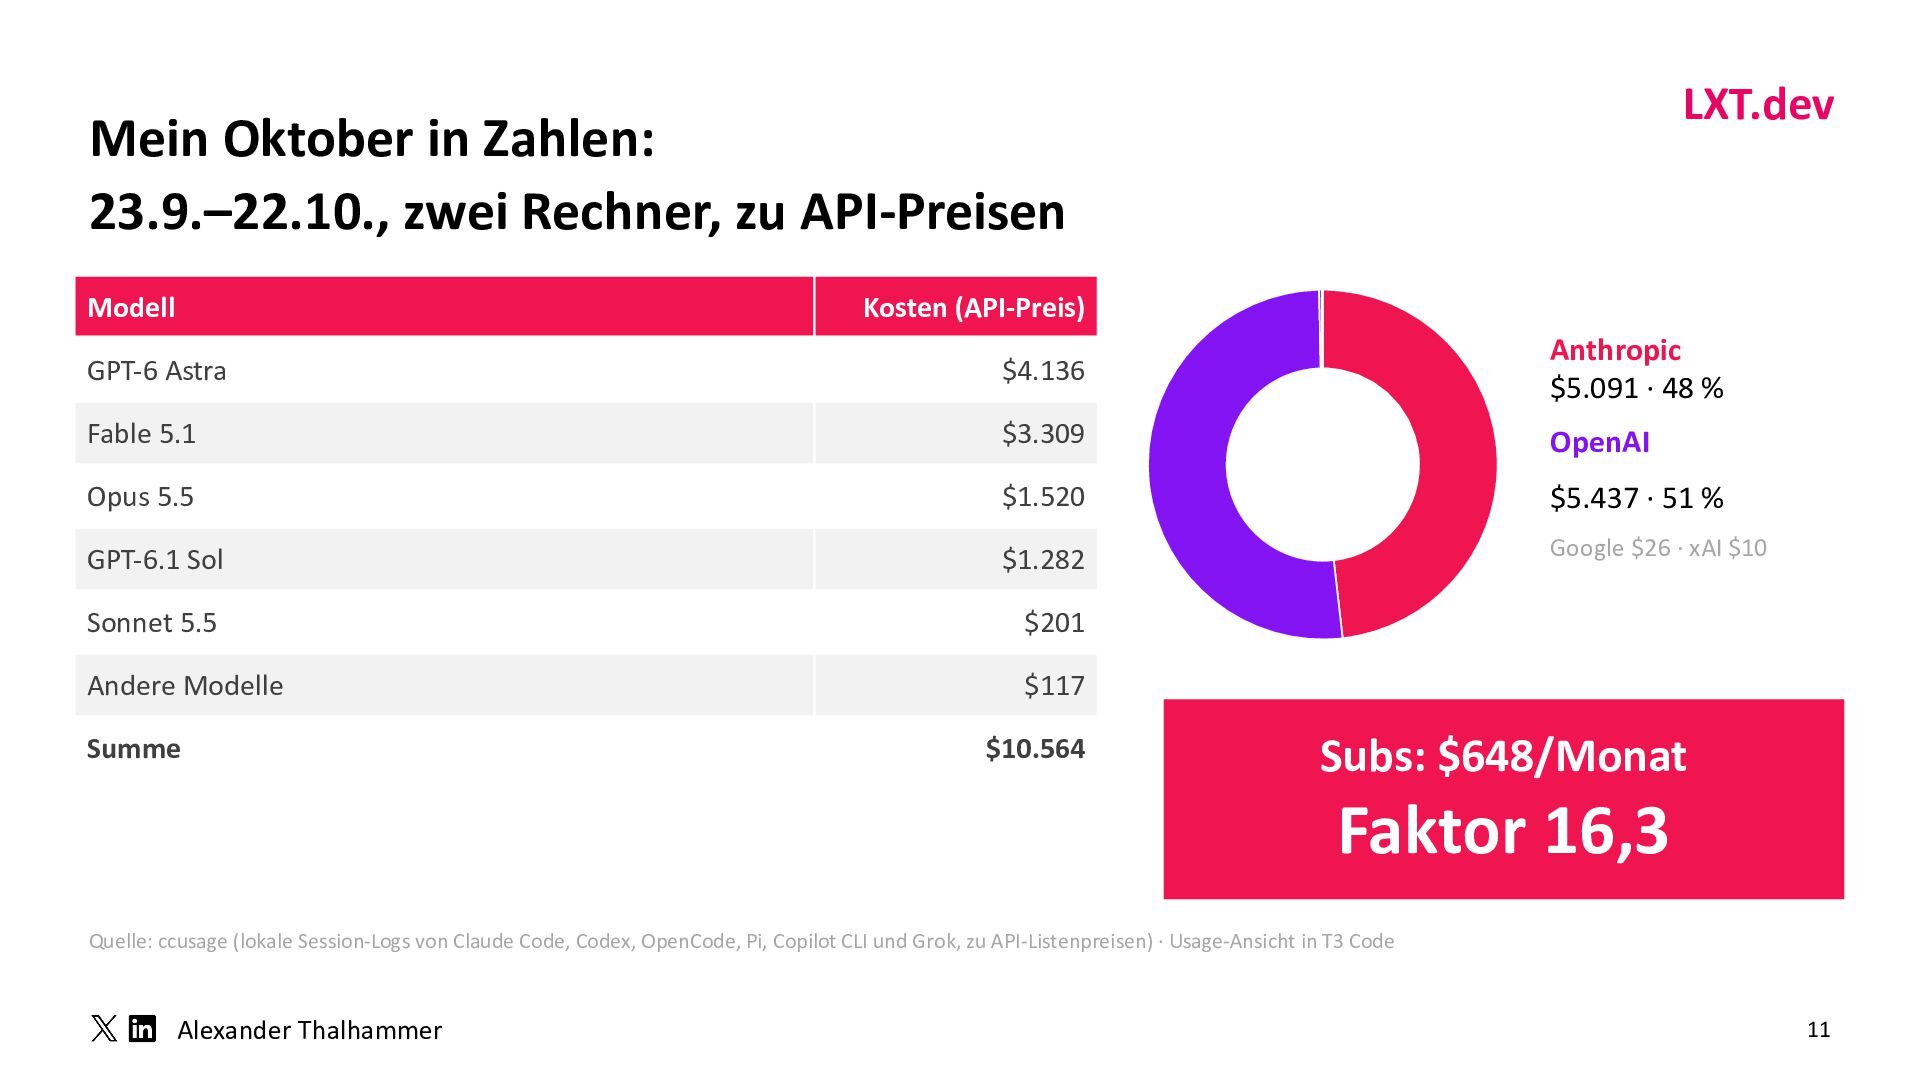
  9. LXT.dev Mein Oktober in Zahlen: 23.9.–22.10., zwei Rechner, zu API-Preisen

    Modell Kosten (API-Preis) GPT-6 Astra • Textmasterformat bearbeiten $4.136 • Zweite Ebene Fable 5.1 Anthropic $5.091 · 48 % $3.309 OpenAI Opus 5.5 $1.520 $5.437 · 51 % GPT-6.1 Sol $1.282 Google $26 · xAI $10 Sonnet 5.5 $201 Andere Modelle $117 Summe $10.564 Subs: $648/Monat Faktor 16,3 Quelle: ccusage (lokale Session-Logs von Claude Code, Codex, OpenCode, Pi, Copilot CLI und Grok, zu API-Listenpreisen) · Usage-Ansicht in T3 Code Alexander Thalhammer 11
  10. LXT.dev • Textmasterformat bearbeiten • Zweite Ebene 2. Why you

    should try to get (at least) a sub Alexander Thalhammer 12
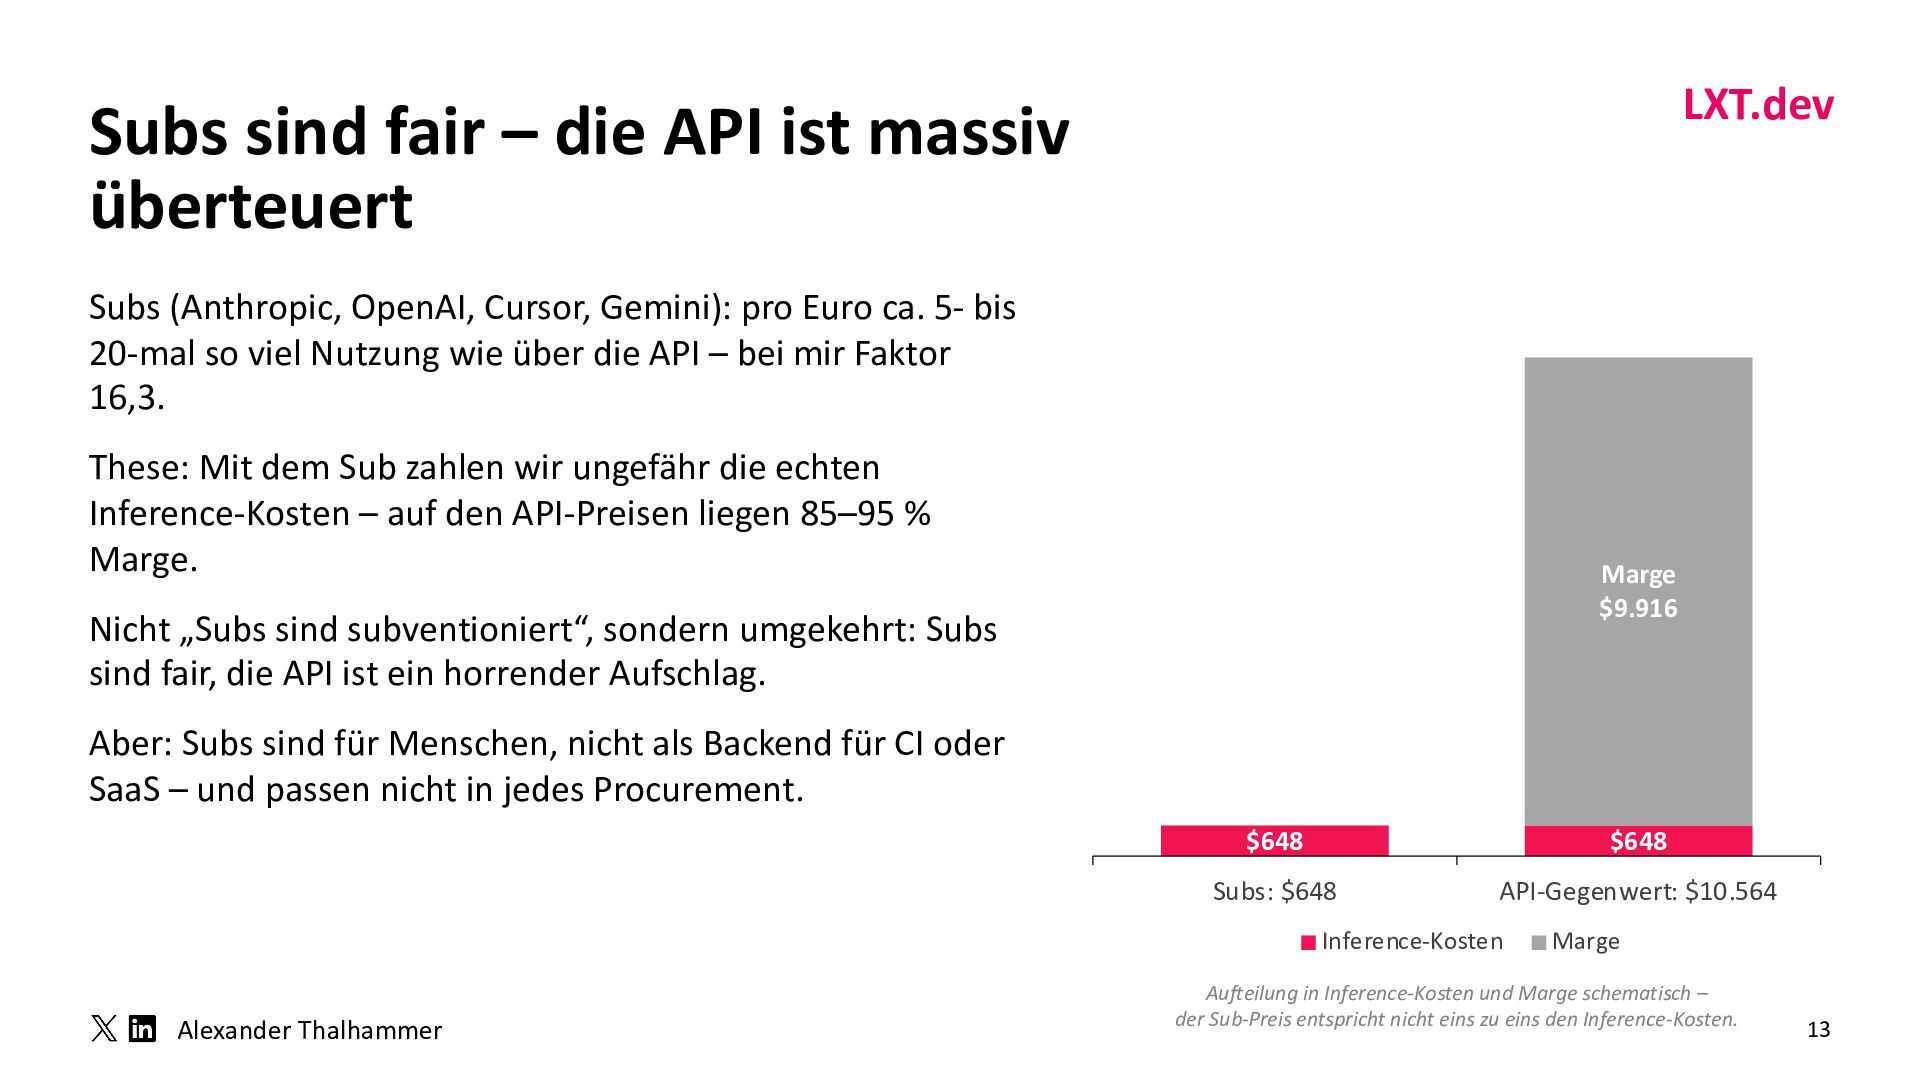
  11. LXT.dev Subs sind fair – die API ist massiv überteuert

    Subs (Anthropic, OpenAI, Cursor, Gemini): pro Euro ca. 5- bis 20-mal so viel Nutzung wie über die API – bei mir Faktor • Textmasterformat bearbeiten 16,3. • Zweite Ebene These: Mit dem Sub zahlen wir ungefähr die echten Inference-Kosten – auf den API-Preisen liegen 85–95 % Marge. Marge $9.916 Nicht „Subs sind subventioniert“, sondern umgekehrt: Subs sind fair, die API ist ein horrender Aufschlag. Aber: Subs sind für Menschen, nicht als Backend für CI oder SaaS – und passen nicht in jedes Procurement. $648 $648 Subs: $648 API-Gegenwert: $10.564 Inference-Kosten Alexander Thalhammer Marge Aufteilung in Inference-Kosten und Marge schematisch – der Sub-Preis entspricht nicht eins zu eins den Inference-Kosten. 13
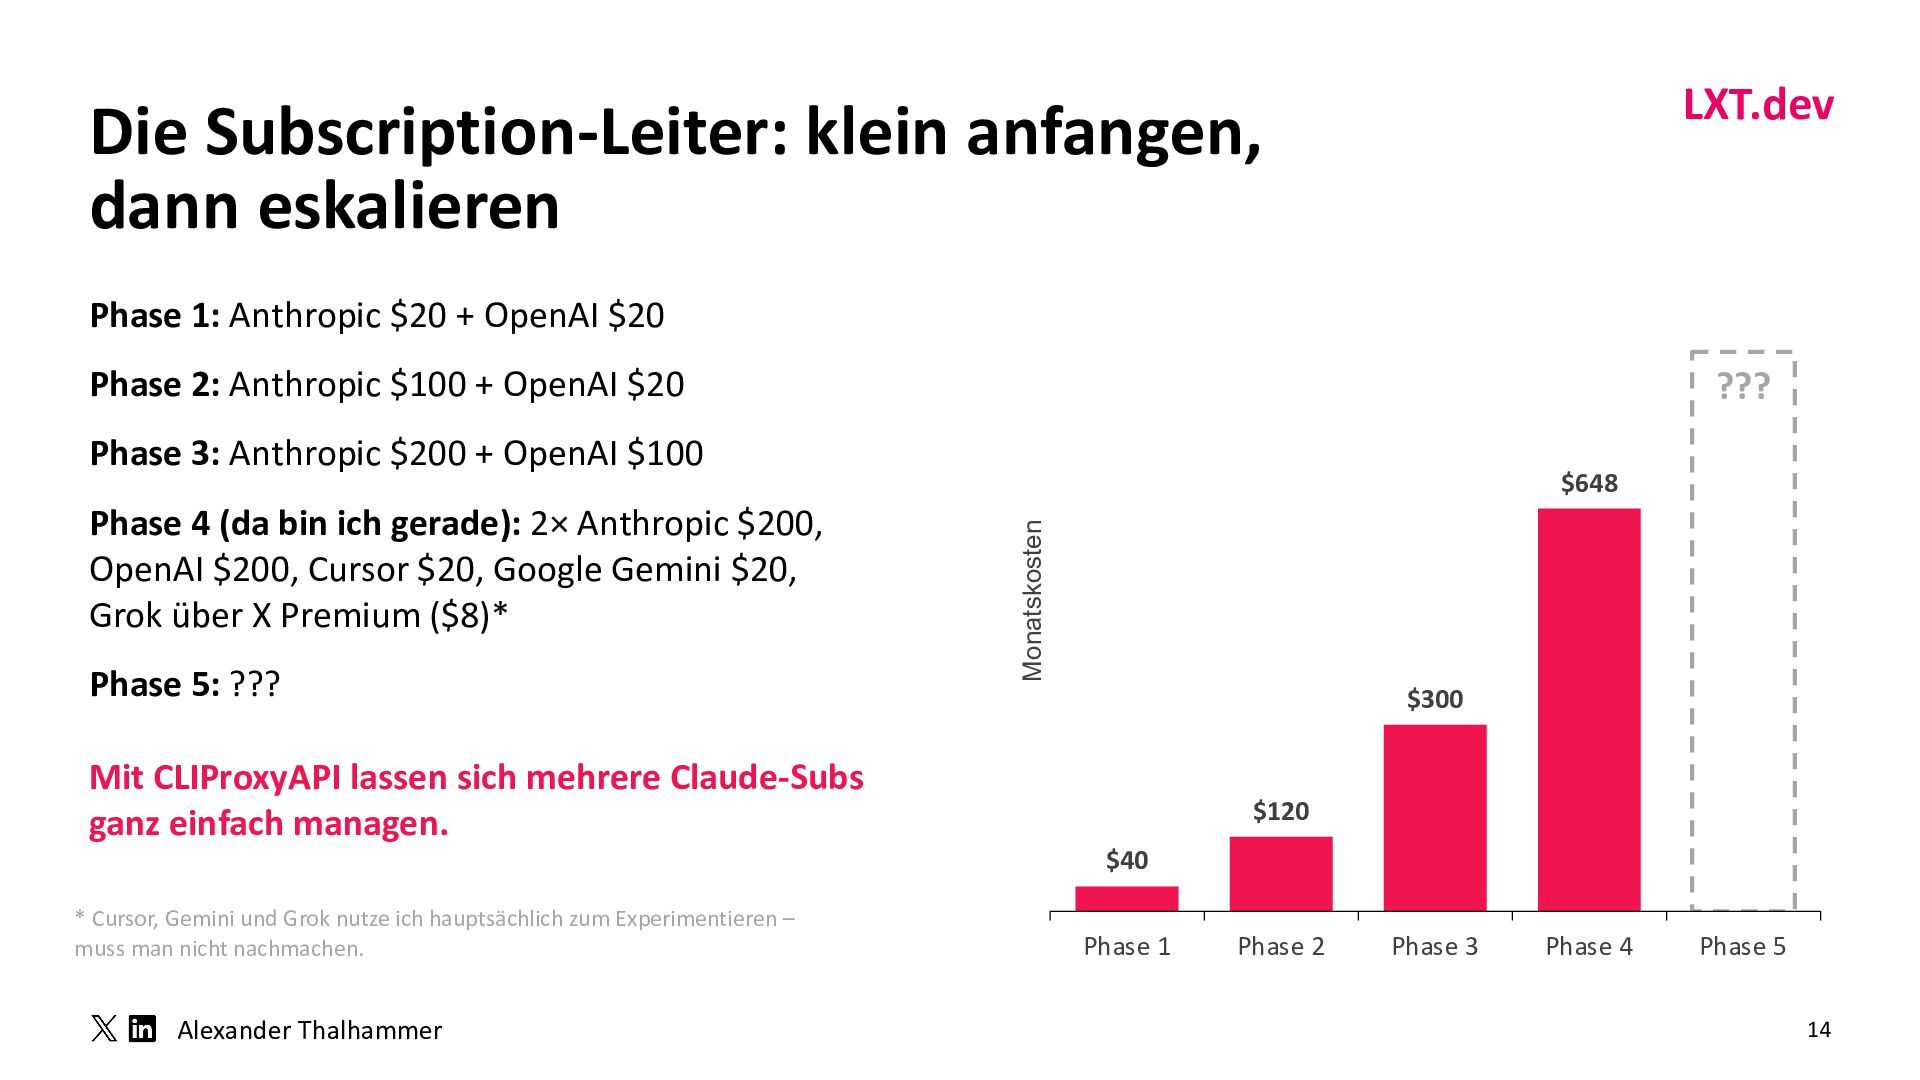
  12. LXT.dev Die Subscription-Leiter: klein anfangen, dann eskalieren Phase 1: Anthropic

    $20 + OpenAI $20 •Phase Textmasterformat bearbeiten 2: Anthropic $100 + OpenAI $20 ??? • Zweite Ebene Phase 3: Anthropic $200 + OpenAI $100 Phase 5: ??? Mit CLIProxyAPI lassen sich mehrere Claude-Subs ganz einfach managen. * Cursor, Gemini und Grok nutze ich hauptsächlich zum Experimentieren – muss man nicht nachmachen. Alexander Thalhammer Monatskosten Phase 4 (da bin ich gerade): 2× Anthropic $200, OpenAI $200, Cursor $20, Google Gemini $20, Grok über X Premium ($8)* $648 $300 $120 $40 Phase 1 Phase 2 Phase 3 Phase 4 Phase 5 14
  13. LXT.dev • Textmasterformat bearbeiten • Zweite Ebene 3. Default model

    choice – sub or no sub Alexander Thalhammer 15
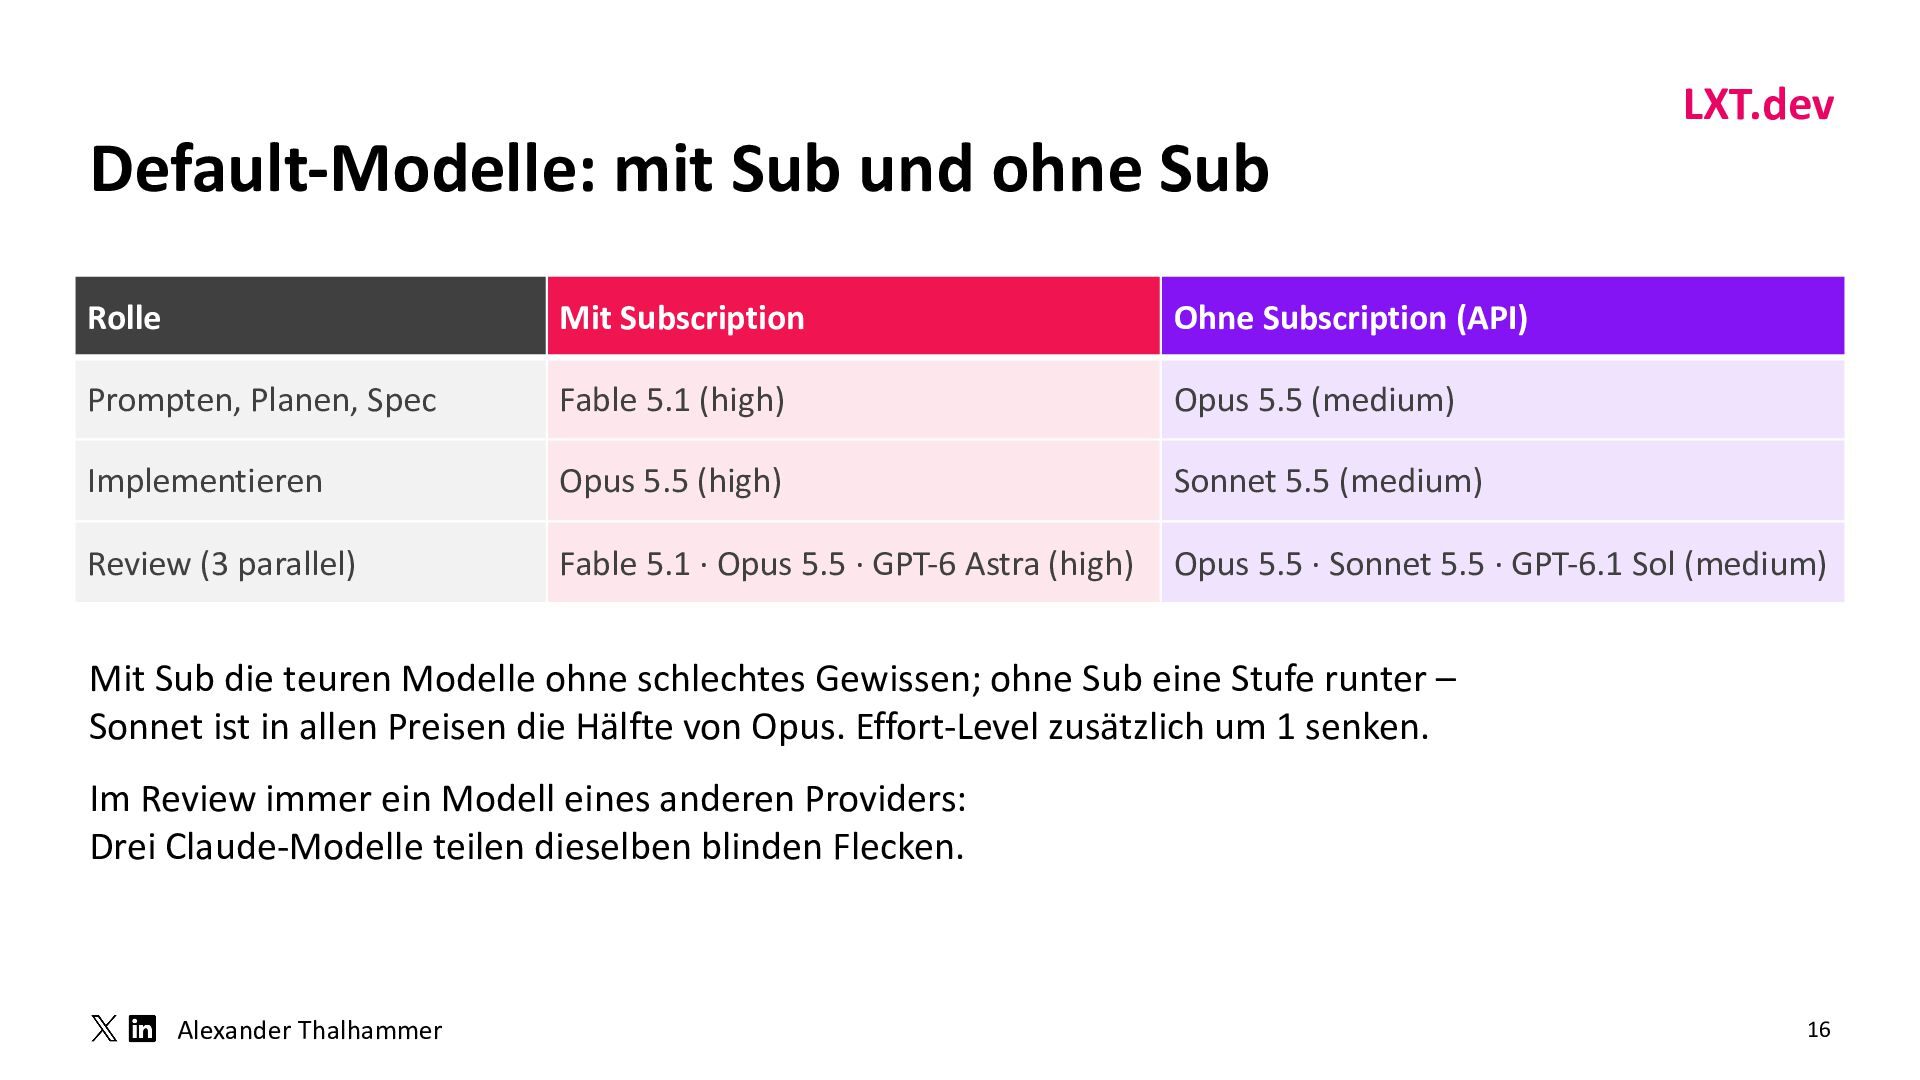
  14. Default-Modelle: mit Sub und ohne Sub Rolle Mit Subscription •

    Textmasterformat bearbeiten LXT.dev Ohne Subscription (API) Prompten, Planen, Spec Fable 5.1 (high) Opus 5.5 (medium) Implementieren Opus 5.5 (high) Sonnet 5.5 (medium) Review (3 parallel) Fable 5.1 · Opus 5.5 · GPT-6 Astra (high) Opus 5.5 · Sonnet 5.5 · GPT-6.1 Sol (medium) • Zweite Ebene Mit Sub die teuren Modelle ohne schlechtes Gewissen; ohne Sub eine Stufe runter – Sonnet ist in allen Preisen die Hälfte von Opus. Effort-Level zusätzlich um 1 senken. Im Review immer ein Modell eines anderen Providers: Drei Claude-Modelle teilen dieselben blinden Flecken. Alexander Thalhammer 16
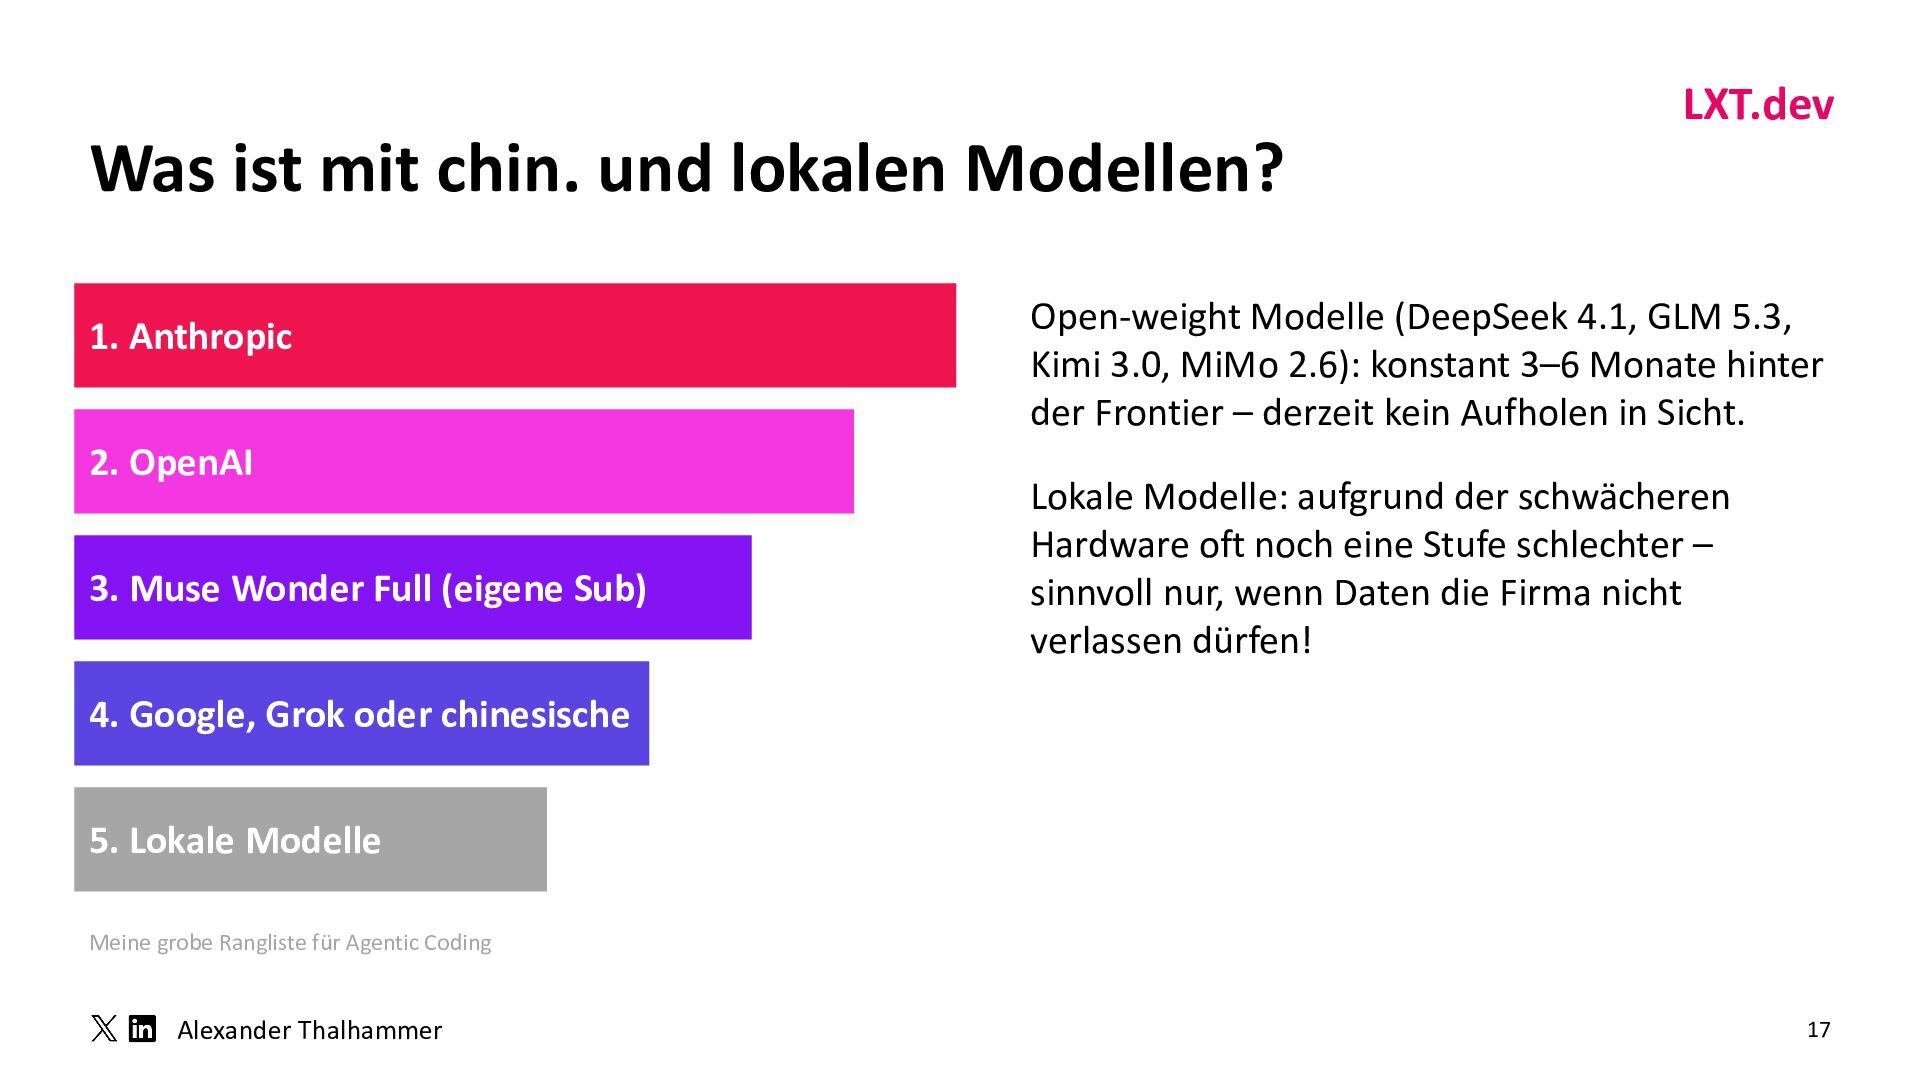
  15. Was ist mit chin. und lokalen Modellen? 1. Anthropic •

    Textmasterformat bearbeiten • Zweite Ebene 2. OpenAI 3. Muse Wonder Full (eigene Sub) LXT.dev Open-weight Modelle (DeepSeek 4.1, GLM 5.3, Kimi 3.0, MiMo 2.6): konstant 3–6 Monate hinter der Frontier – derzeit kein Aufholen in Sicht. Lokale Modelle: aufgrund der schwächeren Hardware oft noch eine Stufe schlechter – sinnvoll nur, wenn Daten die Firma nicht verlassen dürfen! 4. Google, Grok oder chinesische 5. Lokale Modelle Meine grobe Rangliste für Agentic Coding Alexander Thalhammer 17
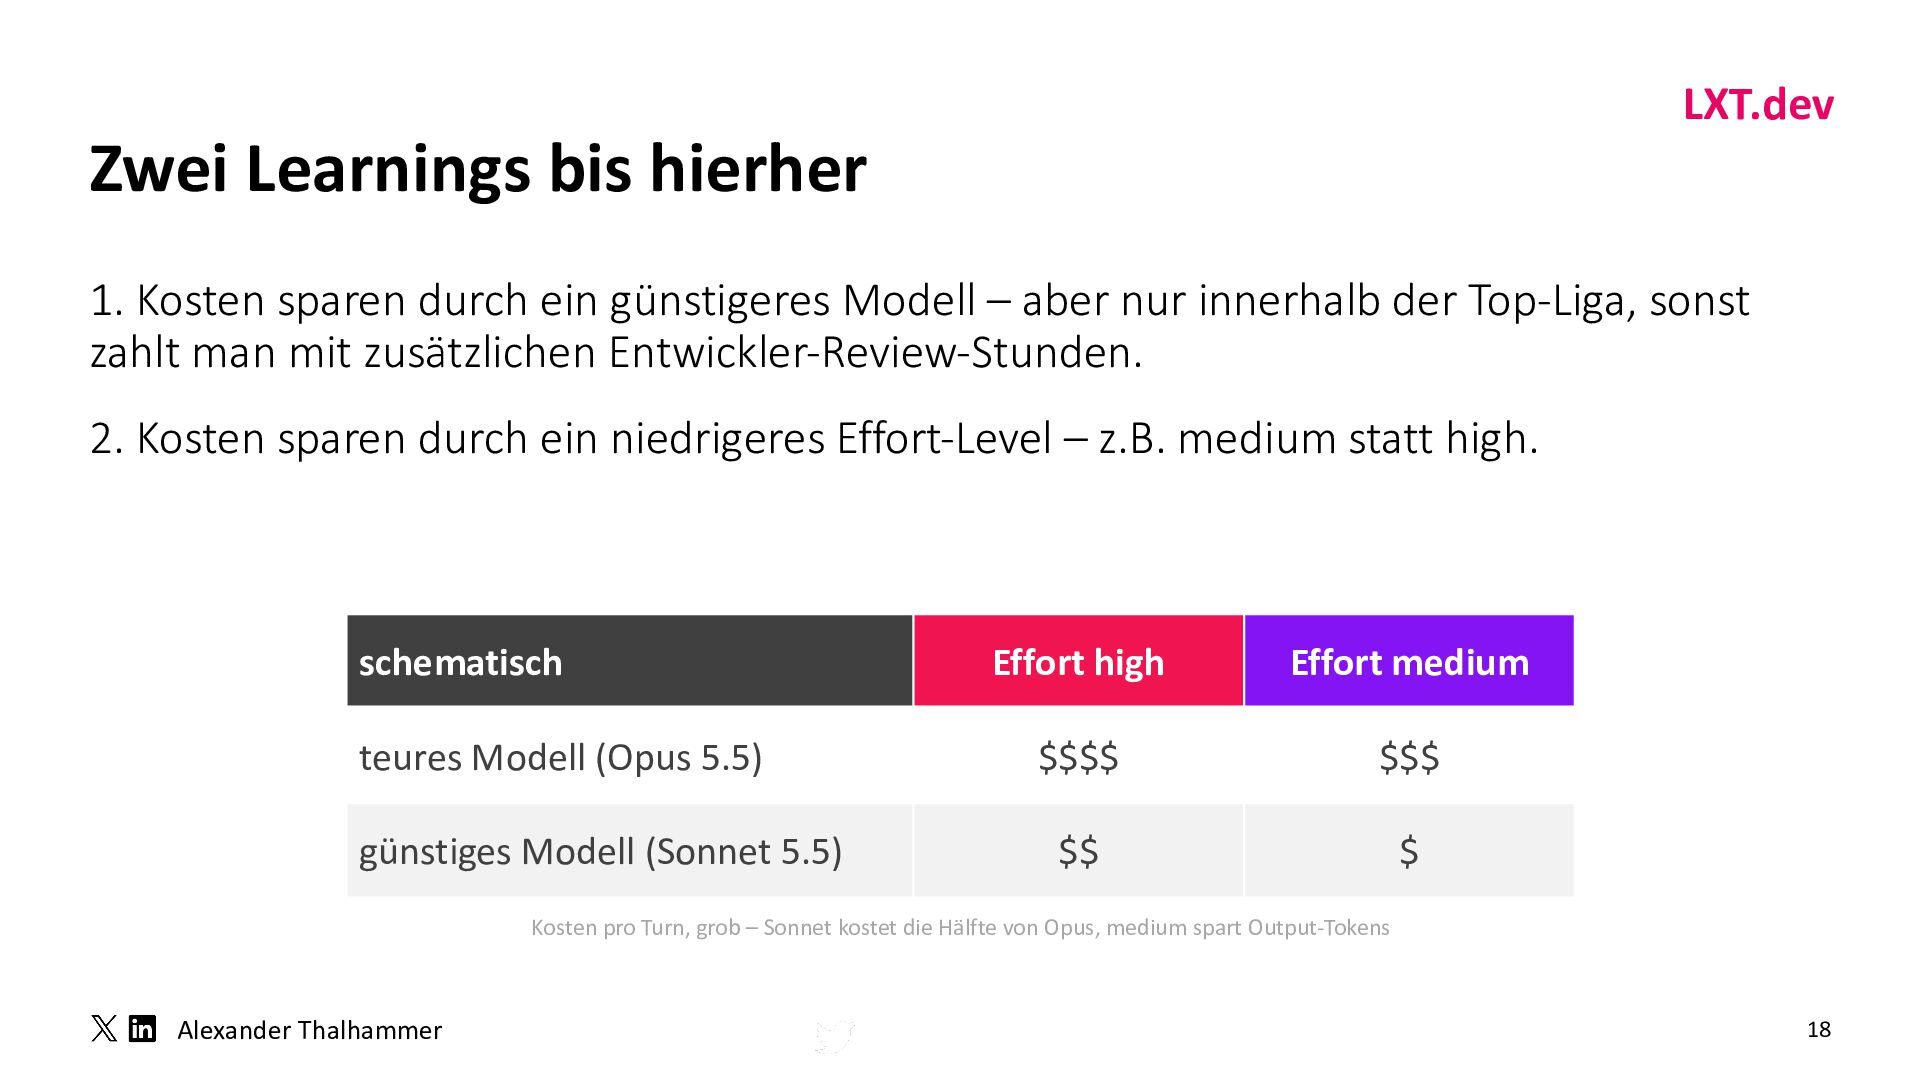
  16. LXT.dev Zwei Learnings bis hierher 1. Kosten sparen durch ein

    günstigeres Modell – aber nur innerhalb der Top-Liga, sonst zahlt man mit zusätzlichen • Textmasterformat bearbeiten Entwickler-Review-Stunden. • Zweite Ebene 2. Kosten sparen durch ein niedrigeres Effort-Level – z.B. medium statt high. schematisch Effort high Effort medium teures Modell (Opus 5.5) $$$$ $$$ günstiges Modell (Sonnet 5.5) $$ $ Kosten pro Turn, grob – Sonnet kostet die Hälfte von Opus, medium spart Output-Tokens Alexander Thalhammer 18
  17. LXT.dev • Textmasterformat bearbeiten • Zweite Ebene 4. What else

    can we do to reduce the costs Alexander Thalhammer 19
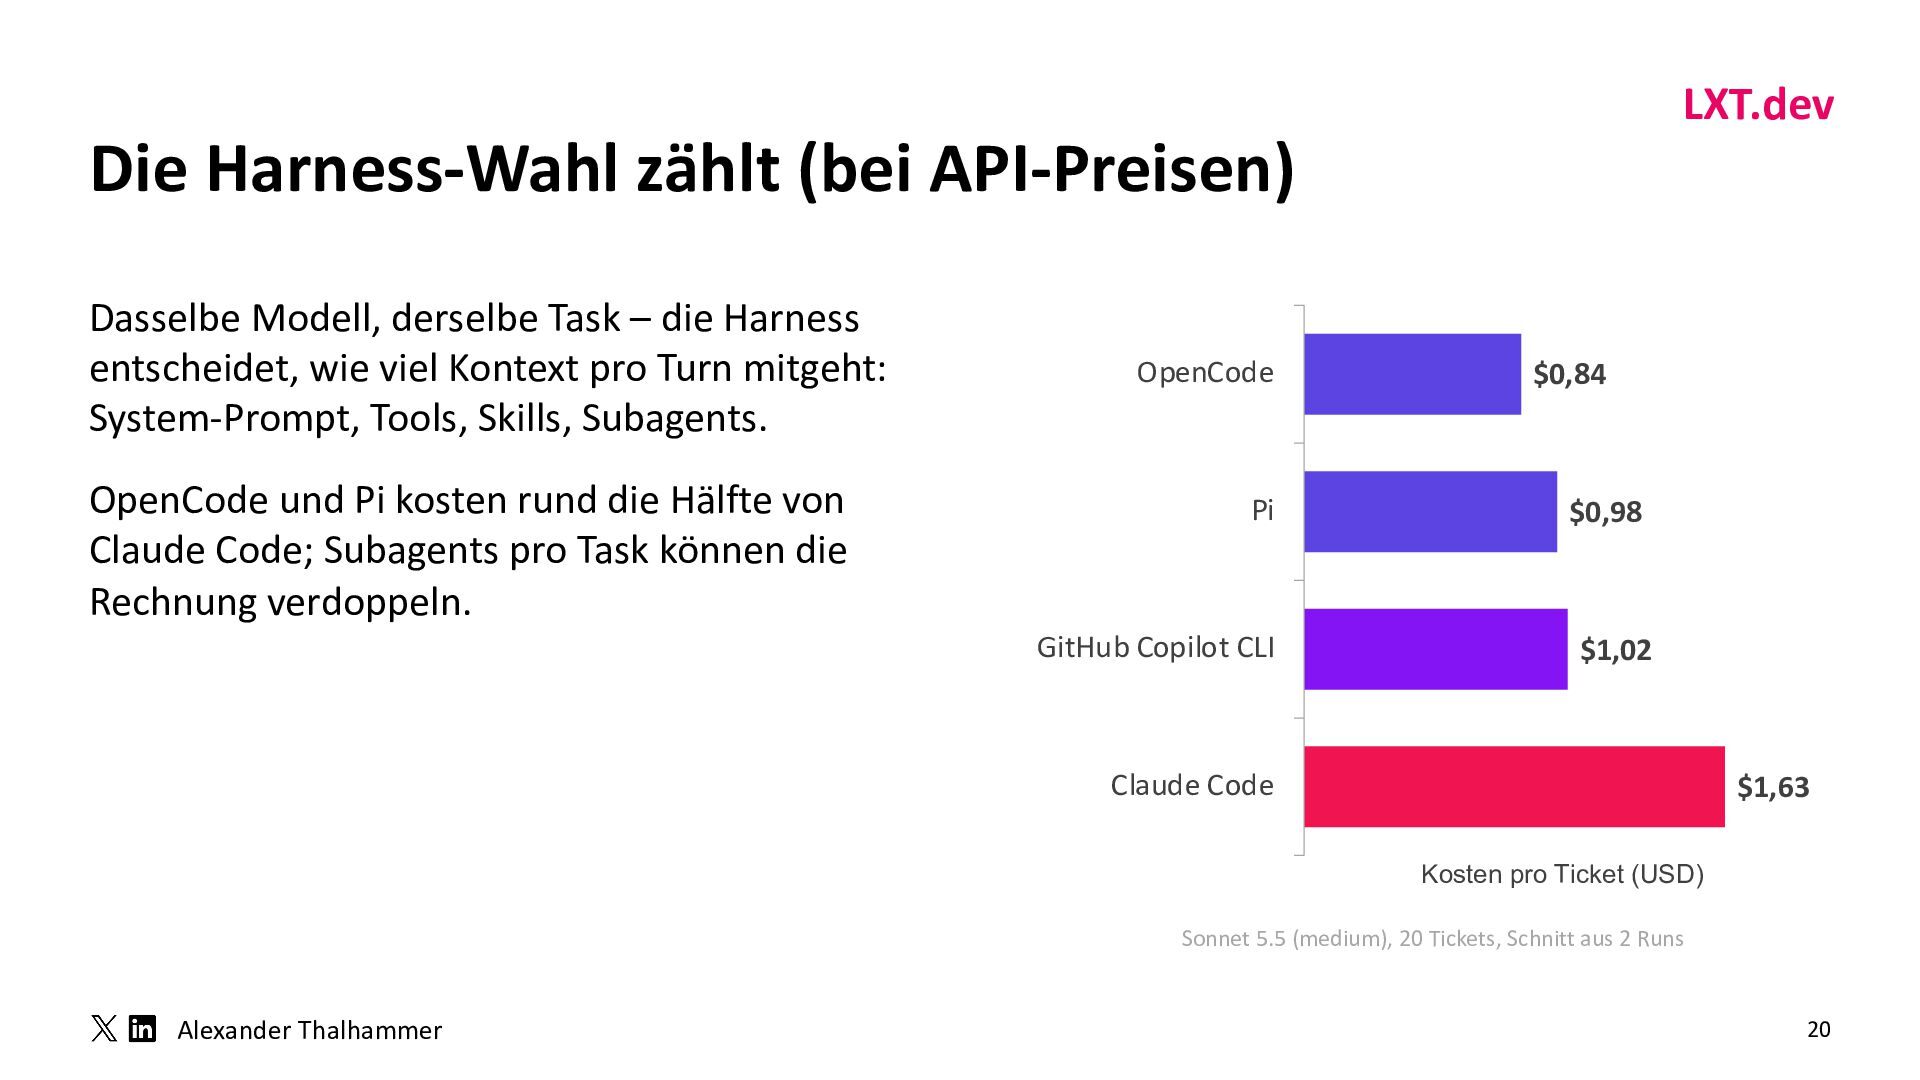
  18. LXT.dev Die Harness-Wahl zählt (bei API-Preisen) Dasselbe Modell, derselbe Task

    – die Harness entscheidet, wie vielbearbeiten Kontext pro Turn mitgeht: • Textmasterformat System-Prompt, • Zweite EbeneTools, Skills, Subagents. OpenCode und Pi kosten rund die Hälfte von Claude Code; Subagents pro Task können die Rechnung verdoppeln. OpenCode $0,84 Pi $0,98 GitHub Copilot CLI $1,02 Claude Code $1,63 Kosten pro Ticket (USD) Sonnet 5.5 (medium), 20 Tickets, Schnitt aus 2 Runs Alexander Thalhammer 20
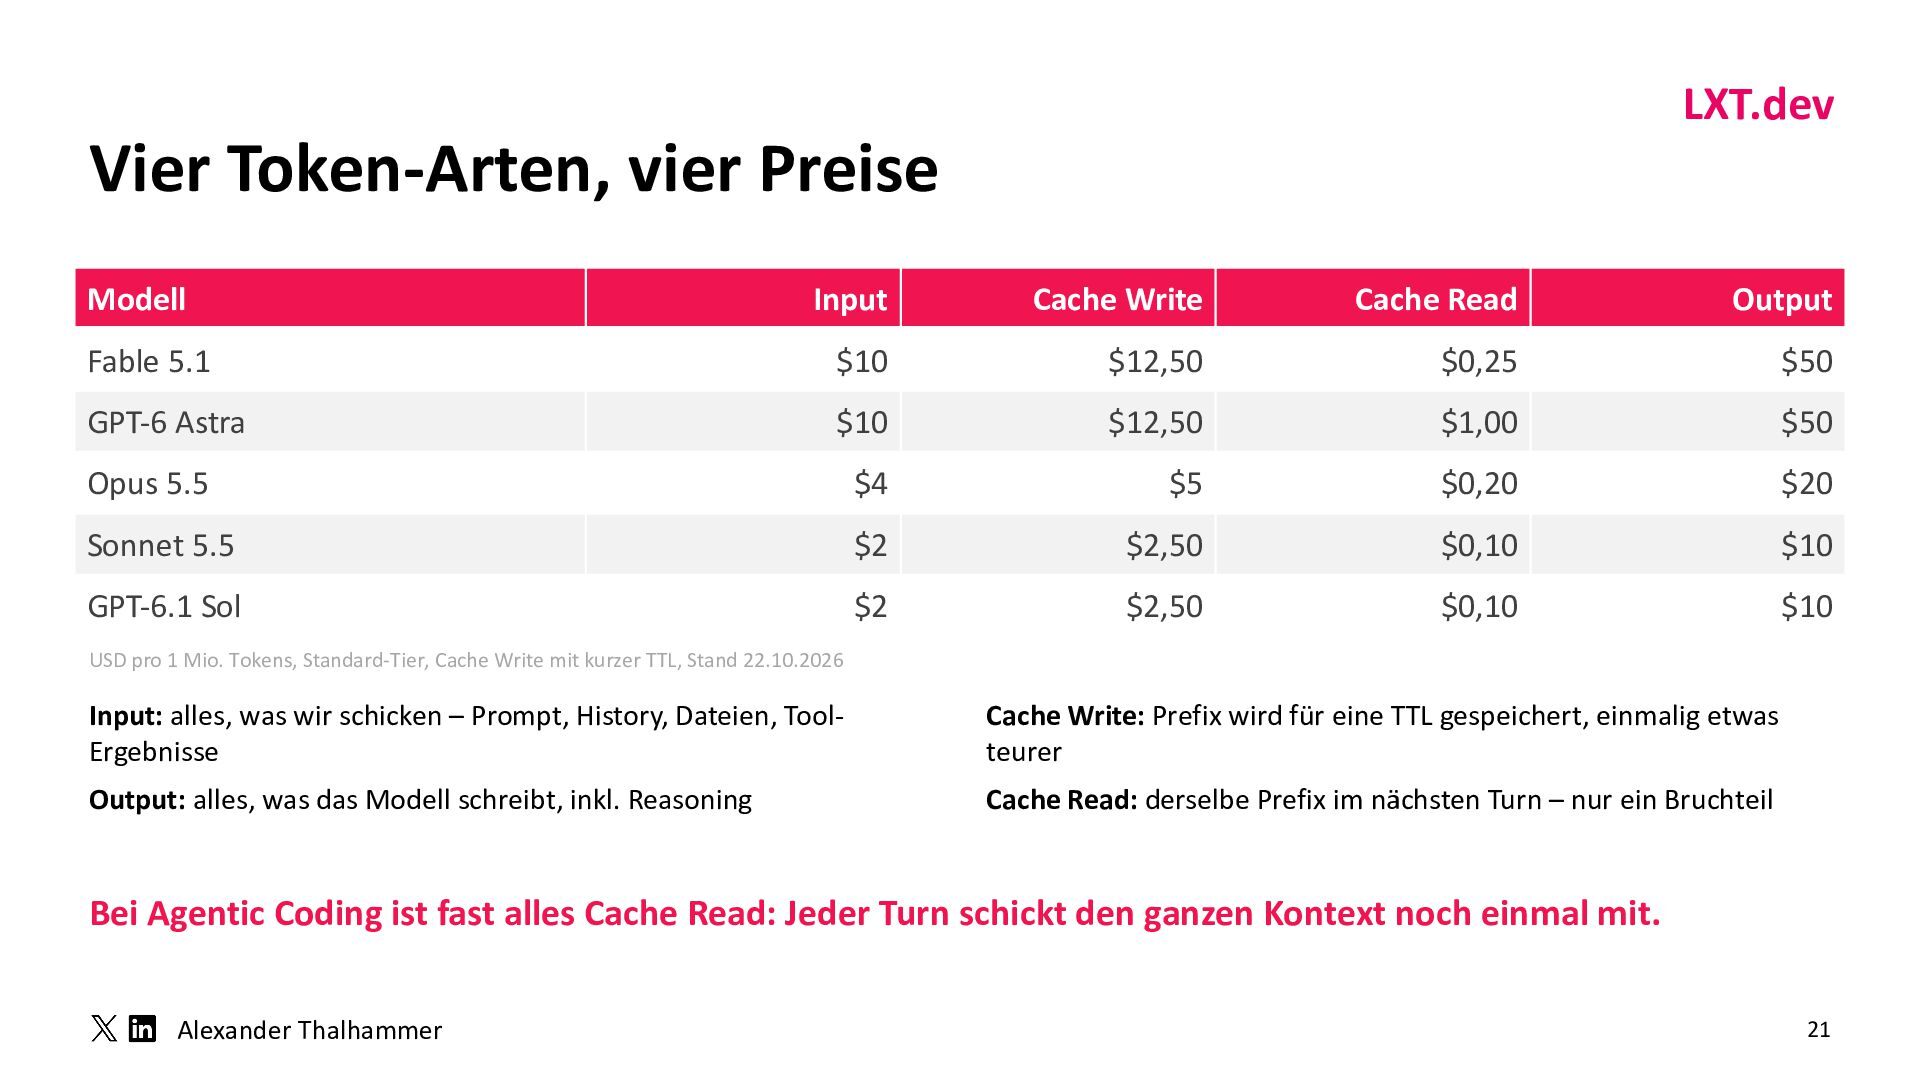
  19. LXT.dev Vier Token-Arten, vier Preise Modell Input Cache Write Cache

    Read Output Fable 5.1 • Textmasterformat bearbeiten $10 $12,50 $0,25 $50 Zweite Ebene GPT-6• Astra $10 $12,50 $1,00 $50 Opus 5.5 $4 $5 $0,20 $20 Sonnet 5.5 $2 $2,50 $0,10 $10 GPT-6.1 Sol $2 $2,50 $0,10 $10 USD pro 1 Mio. Tokens, Standard-Tier, Cache Write mit kurzer TTL, Stand 22.10.2026 Input: alles, was wir schicken – Prompt, History, Dateien, ToolErgebnisse Cache Write: Prefix wird für eine TTL gespeichert, einmalig etwas teurer Output: alles, was das Modell schreibt, inkl. Reasoning Cache Read: derselbe Prefix im nächsten Turn – nur ein Bruchteil Bei Agentic Coding ist fast alles Cache Read: Jeder Turn schickt den ganzen Kontext noch einmal mit. Alexander Thalhammer 21
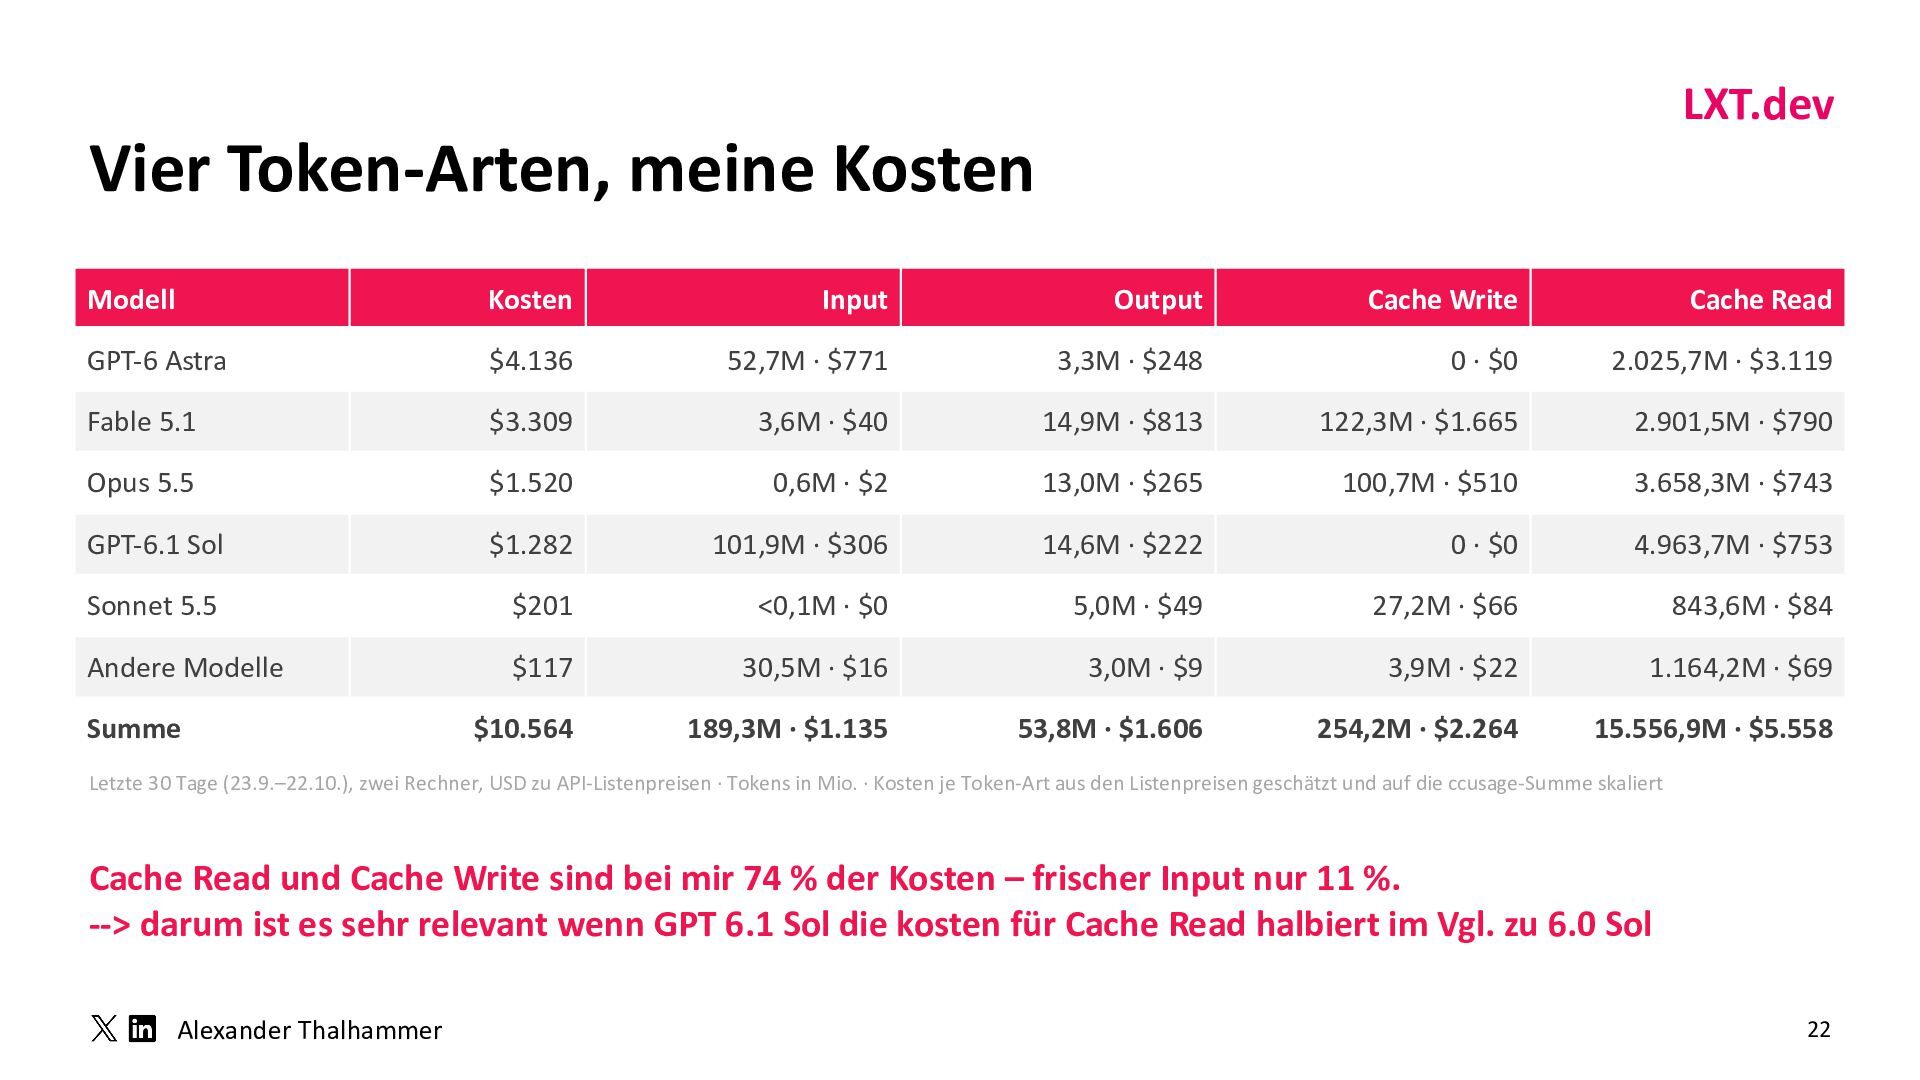
  20. LXT.dev Vier Token-Arten, meine Kosten Modell Kosten GPT-6 Astra $4.136

    • Textmasterformat bearbeiten Input Output Cache Write Cache Read 52,7M · $771 3,3M · $248 0 · $0 2.025,7M · $3.119 • Zweite Ebene Fable 5.1 $3.309 3,6M · $40 14,9M · $813 122,3M · $1.665 2.901,5M · $790 Opus 5.5 $1.520 0,6M · $2 13,0M · $265 100,7M · $510 3.658,3M · $743 GPT-6.1 Sol $1.282 101,9M · $306 14,6M · $222 0 · $0 4.963,7M · $753 Sonnet 5.5 $201 <0,1M · $0 5,0M · $49 27,2M · $66 843,6M · $84 Andere Modelle $117 30,5M · $16 3,0M · $9 3,9M · $22 1.164,2M · $69 $10.564 189,3M · $1.135 53,8M · $1.606 254,2M · $2.264 15.556,9M · $5.558 Summe Letzte 30 Tage (23.9.–22.10.), zwei Rechner, USD zu API-Listenpreisen · Tokens in Mio. · Kosten je Token-Art aus den Listenpreisen geschätzt und auf die ccusage-Summe skaliert Cache Read und Cache Write sind bei mir 74 % der Kosten – frischer Input nur 11 %. --> darum ist es sehr relevant wenn GPT 6.1 Sol die kosten für Cache Read halbiert im Vgl. zu 6.0 Sol Alexander Thalhammer 22
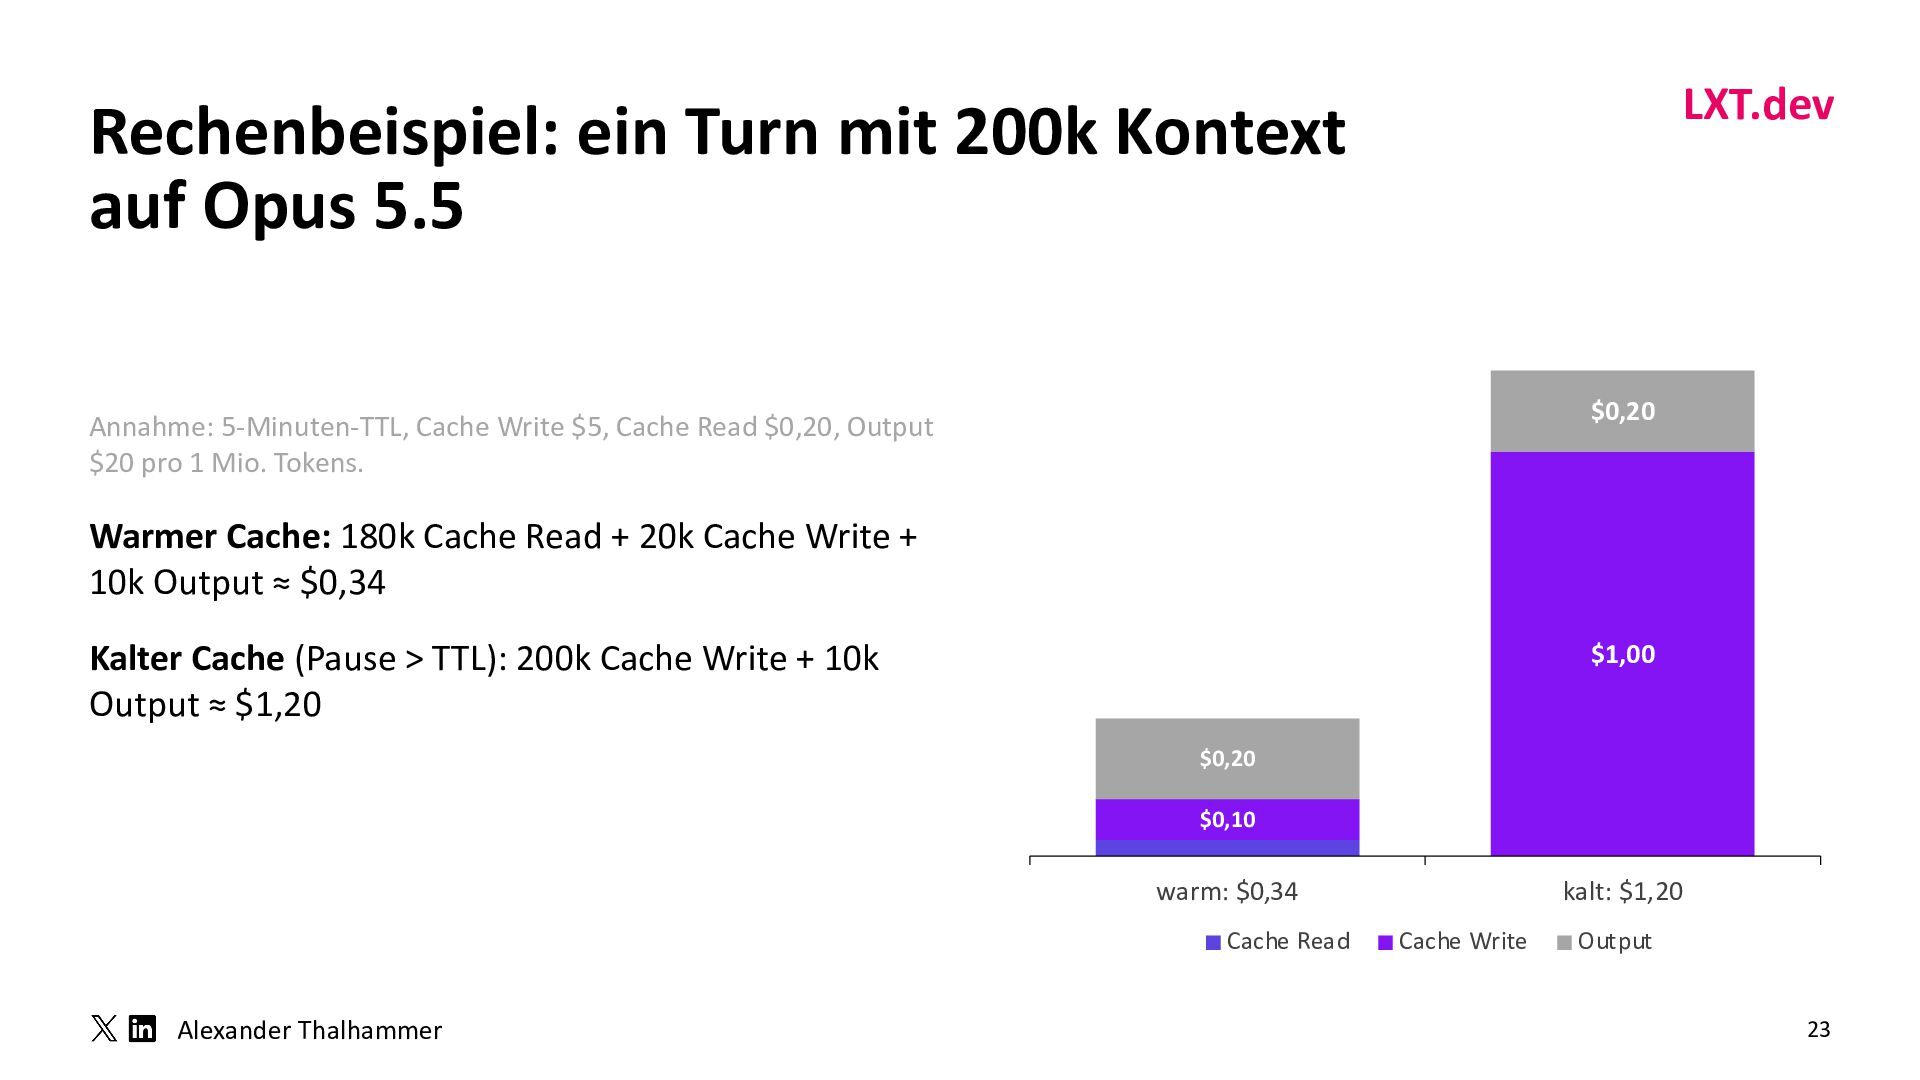
  21. LXT.dev Rechenbeispiel: ein Turn mit 200k Kontext auf Opus 5.5

    • Textmasterformat bearbeiten $0,20 • Zweite Ebene Cache Write $5, Cache Read $0,20, Output Annahme: 5-Minuten-TTL, $20 pro 1 Mio. Tokens. Warmer Cache: 180k Cache Read + 20k Cache Write + 10k Output ≈ $0,34 Kalter Cache (Pause > TTL): 200k Cache Write + 10k Output ≈ $1,20 $1,00 $0,20 $0,10 warm: $0,34 Cache Read Alexander Thalhammer kalt: $1,20 Cache Write Output 23
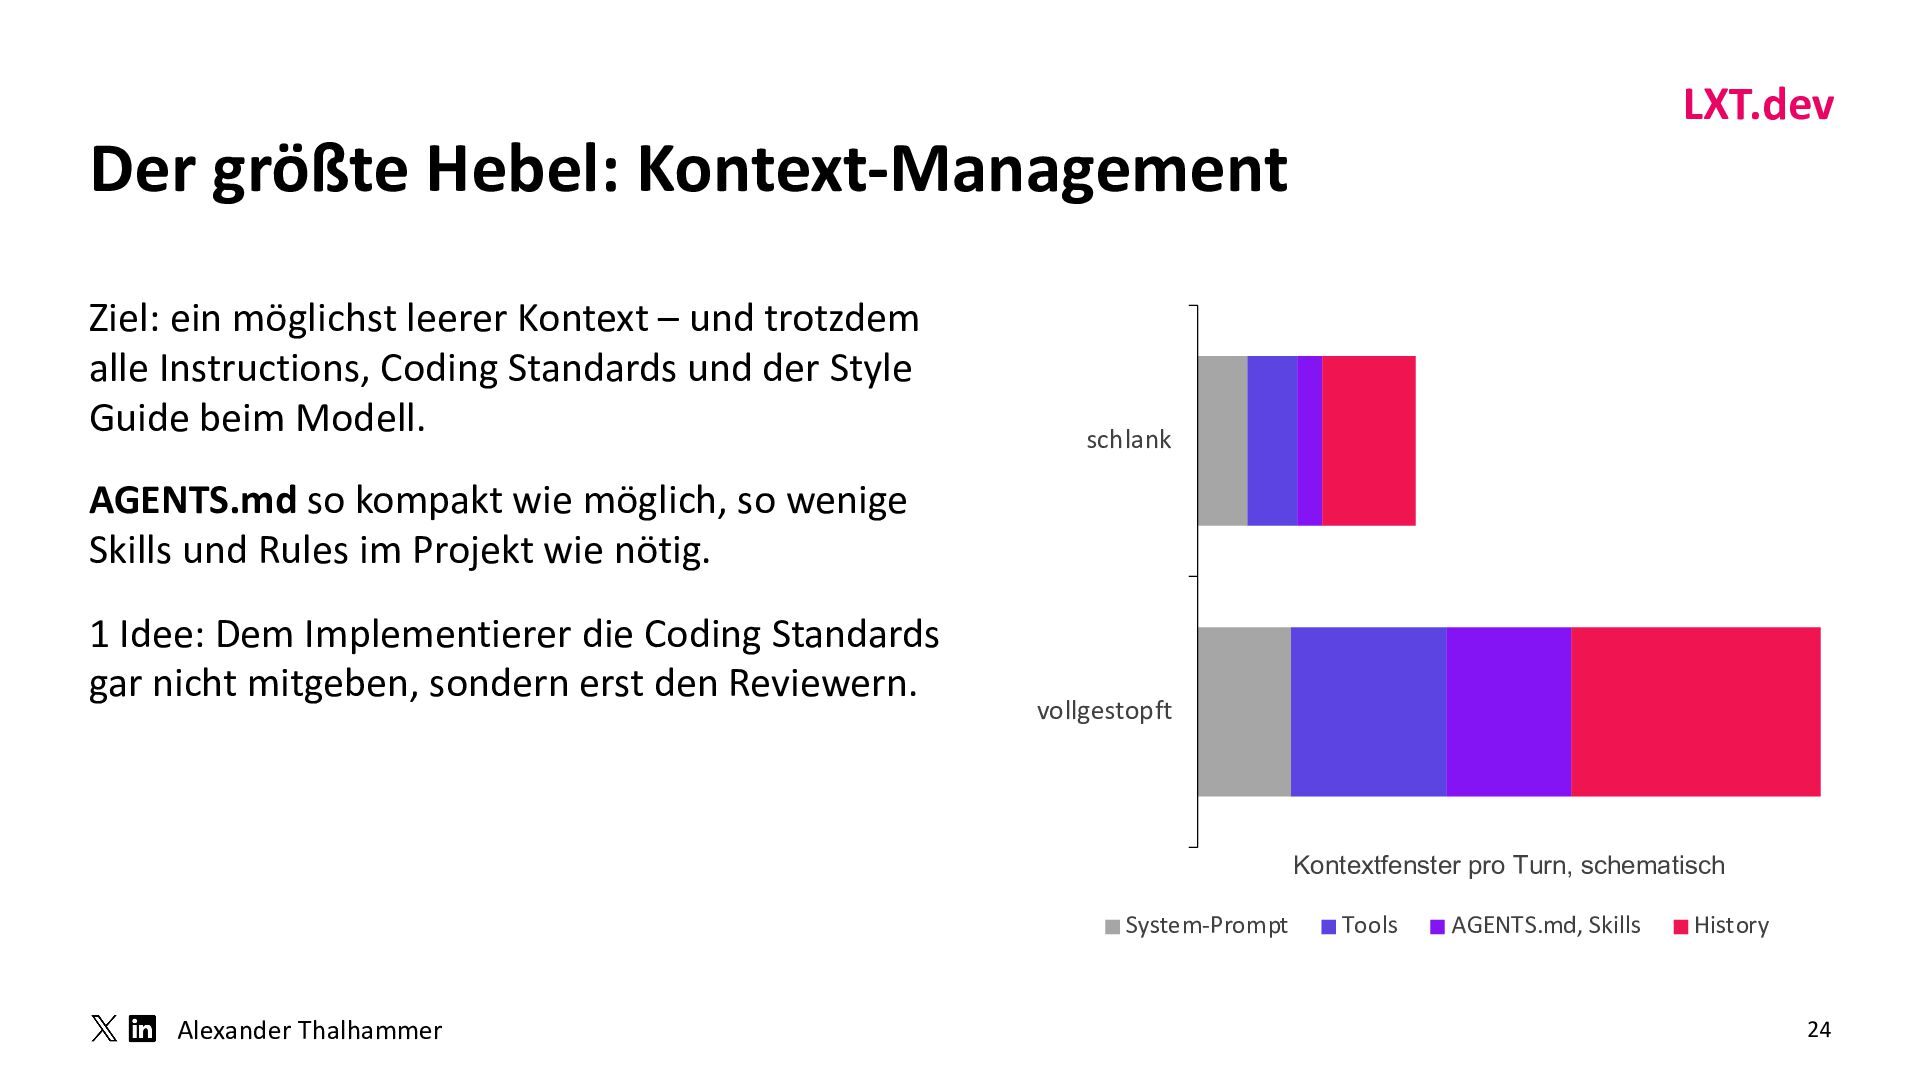
  22. LXT.dev Der größte Hebel: Kontext-Management Ziel: ein möglichst leerer Kontext

    – und trotzdem alle Instructions, Coding Standards und der Style • Textmasterformat bearbeiten Guide • Zweite beim Ebene Modell. schlank AGENTS.md so kompakt wie möglich, so wenige Skills und Rules im Projekt wie nötig. 1 Idee: Dem Implementierer die Coding Standards gar nicht mitgeben, sondern erst den Reviewern. vollgestopft Kontextfenster pro Turn, schematisch System-Prompt Alexander Thalhammer Tools AGENTS.md, Skills History 24
  23. LXT.dev Sessions und Compact gezielt einsetzen • Neuer Task =

    neue Session, damit die alte History nicht bei jedem Turn mitbezahlt wird. •• Textmasterformat bearbeiten Compact statt History-Übergabe: wenn ein Modell an ein anderes übergibt (Fable plant → •Opus Zweite Ebene implementiert). • Compact nach einer Pause: Ist die TTL abgelaufen (Anthropic 5 min / 1 h, OpenAI 30 min / 12 h), kostet der volle Kontext wieder Cache Write. • T3 Code macht das automatisch: Auto-Compaction nach mehr als einer Stunde Pause – passend zur 1-Stunden-TTL. Alexander Thalhammer 25
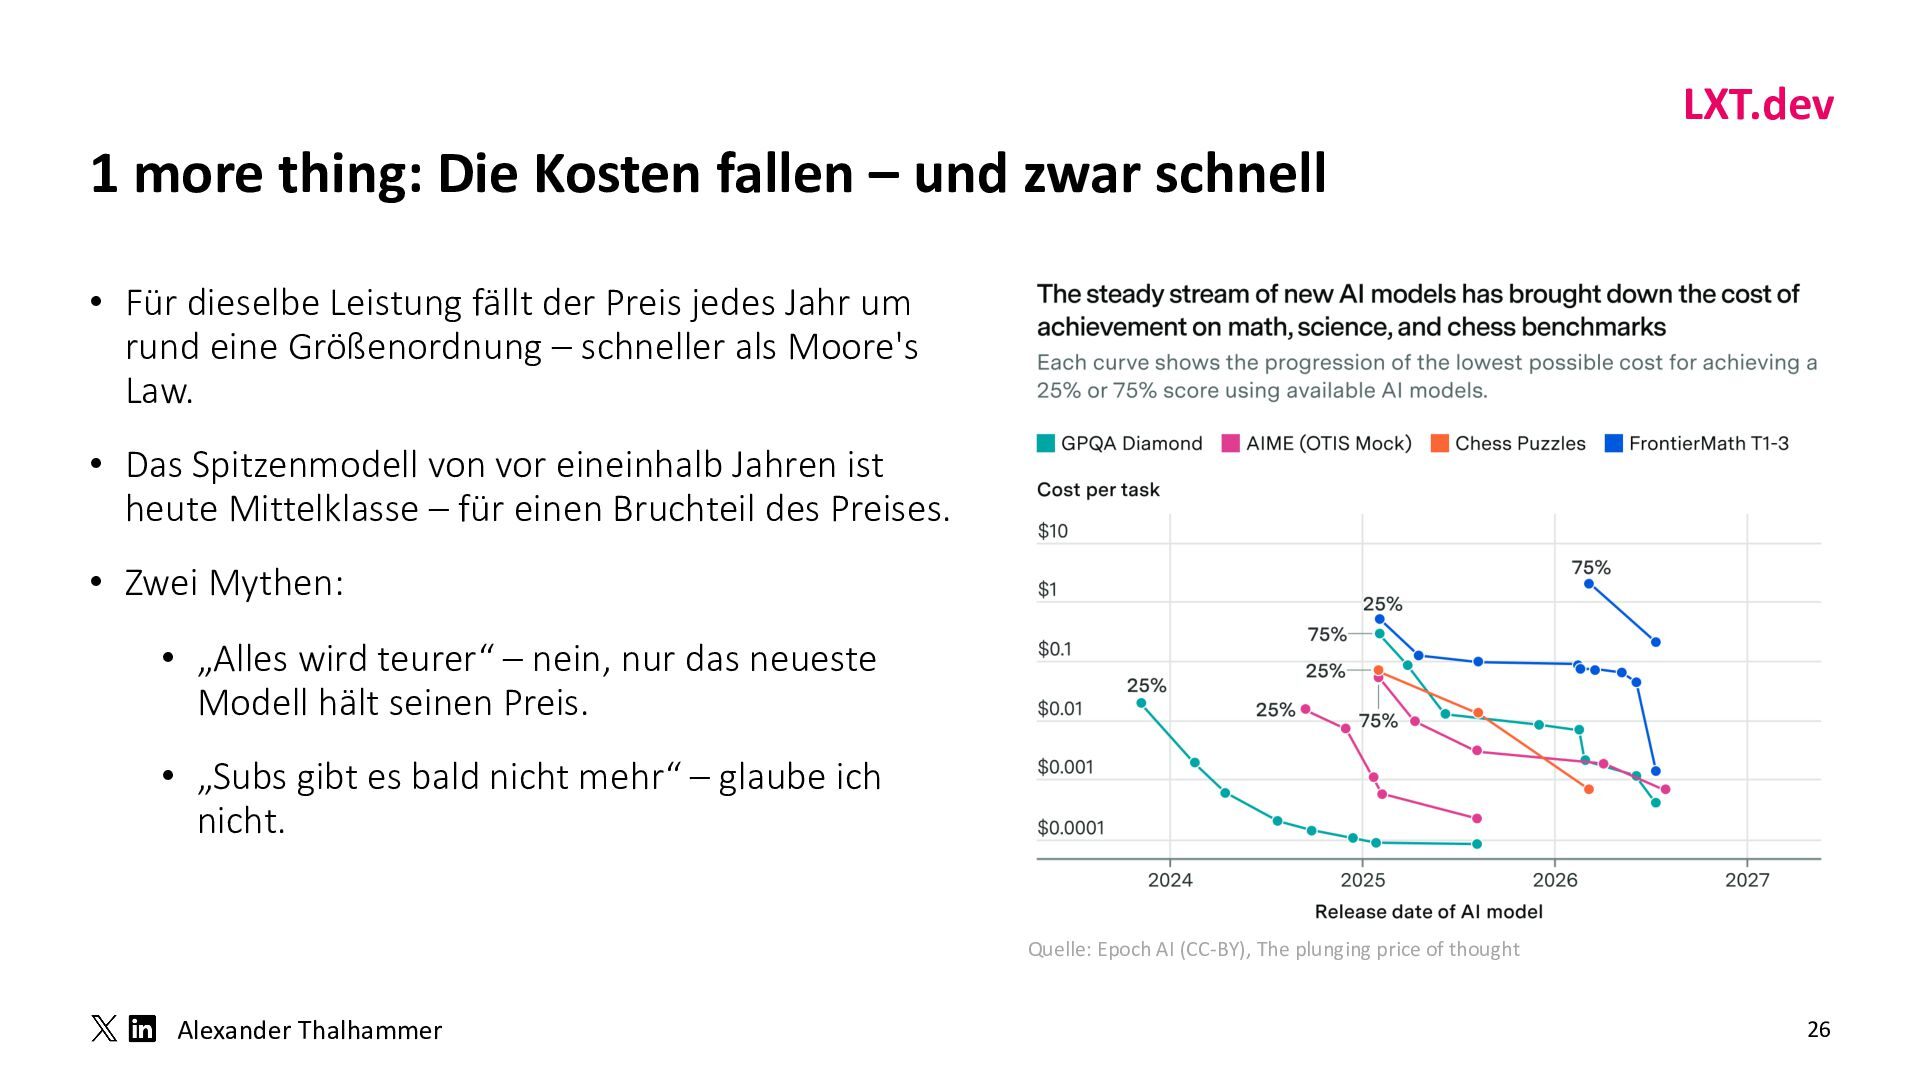
  24. LXT.dev 1 more thing: Die Kosten fallen – und zwar

    schnell • Für dieselbe Leistung fällt der Preis jedes Jahr um rund eine Größenordnung – schneller als Moore's • Textmasterformat bearbeiten Law. • Zweite Ebene • Das Spitzenmodell von vor eineinhalb Jahren ist heute Mittelklasse – für einen Bruchteil des Preises. • Zwei Mythen: • „Alles wird teurer“ – nein, nur das neueste Modell hält seinen Preis. • „Subs gibt es bald nicht mehr“ – glaube ich nicht. Quelle: Epoch AI (CC-BY), The plunging price of thought Alexander Thalhammer 26
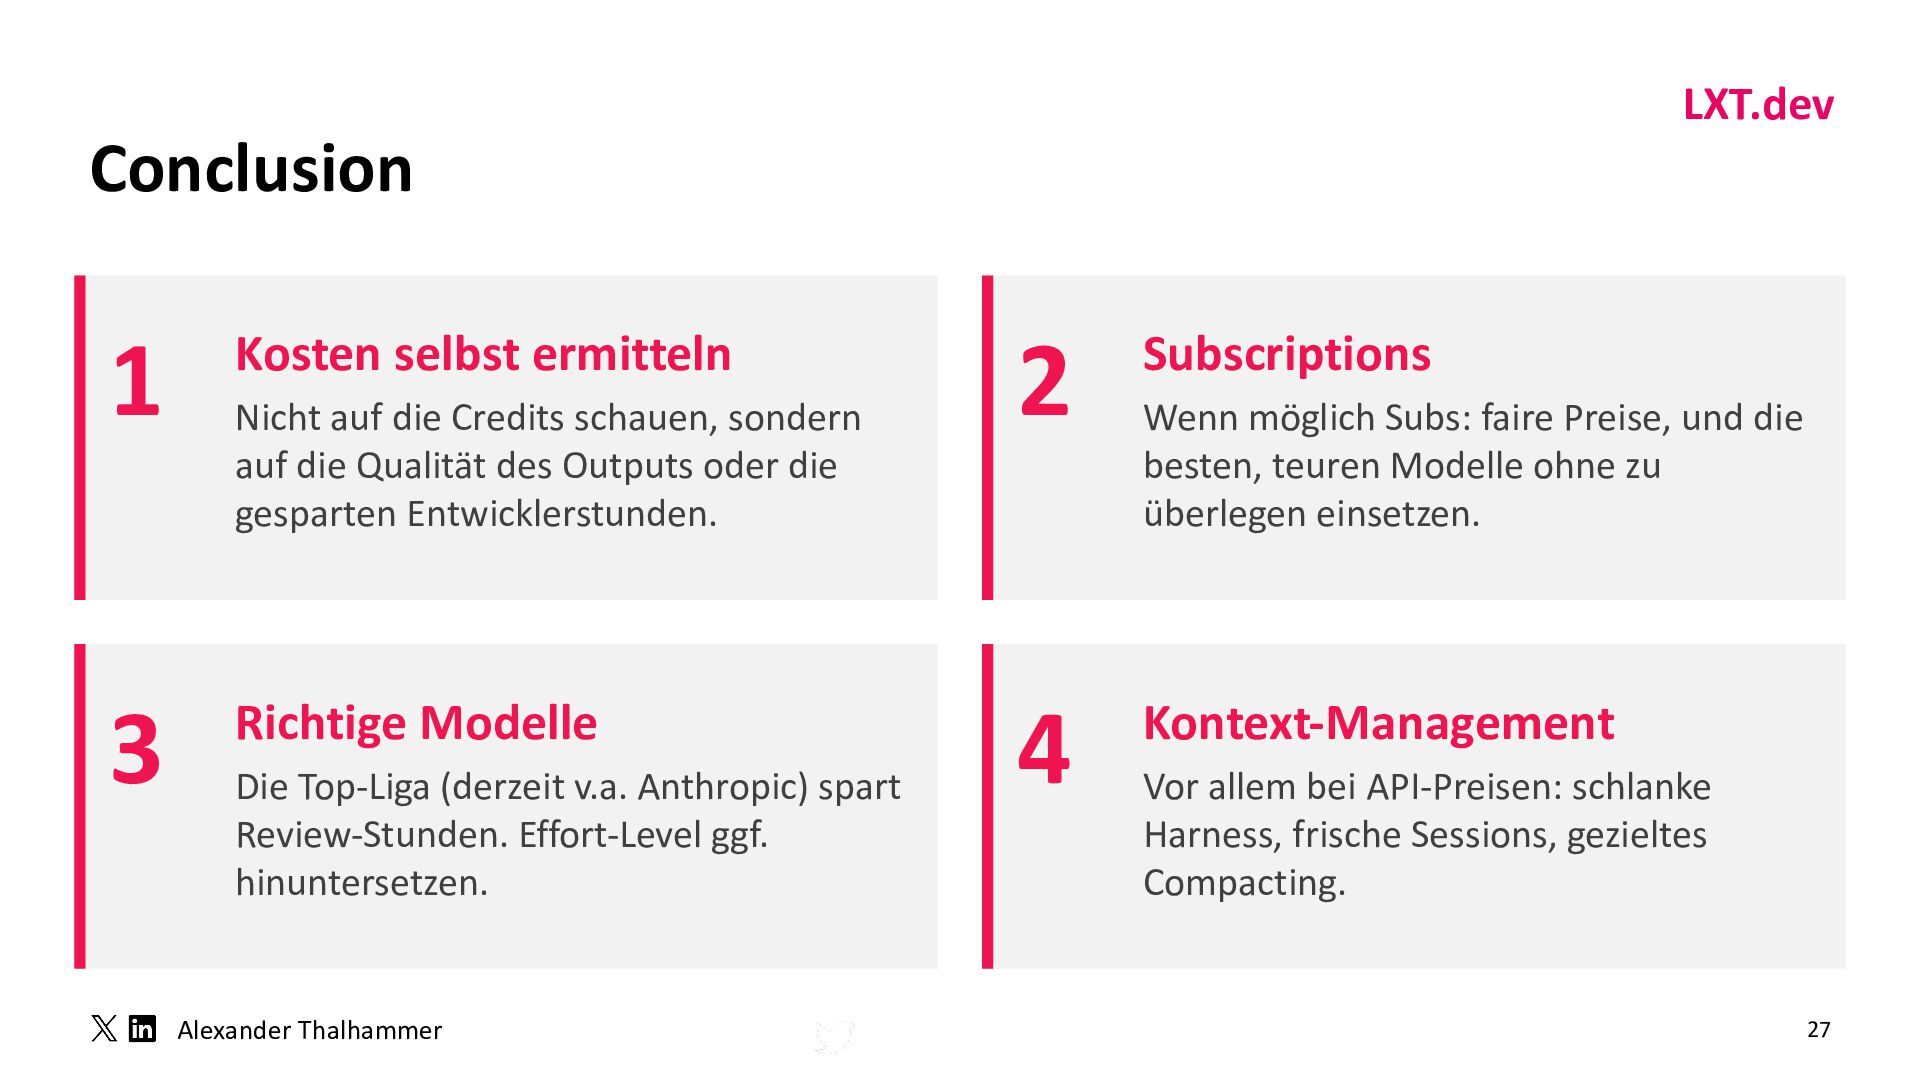
  25. LXT.dev Conclusion Kosten selbst ermitteln • Textmasterformat bearbeiten Nicht auf

    die Credits schauen, sondern • Zweite Ebene auf die Qualität des Outputs oder die gesparten Entwicklerstunden. 2 Subscriptions 1 3 4 Kontext-Management Richtige Modelle Die Top-Liga (derzeit v.a. Anthropic) spart Review-Stunden. Effort-Level ggf. hinuntersetzen. Alexander Thalhammer Wenn möglich Subs: faire Preise, und die besten, teuren Modelle ohne zu überlegen einsetzen. Vor allem bei API-Preisen: schlanke Harness, frische Sessions, gezieltes Compacting. 27
  26. LXT.dev • Textmasterformat bearbeiten • Zweite Ebene Questions & Feedback

    Slides & Blogposts: https://LXT.dev Alexander Thalhammer 28
  27. LXT.dev Thank you for the attention • Textmasterformat bearbeiten Zweite

    Ebene [X] •@LX_T [web] https://LXT.dev Workshops and Consulting https://angulararchitects.io Alexander Thalhammer 29