Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Durch digitale Gezeiten: Mit KI den Kurs der Zu...

Durch digitale Gezeiten: Mit KI den Kurs der Zukunft bestimmen

Diese Präsentation gibt einen praxisnahen Einblick in den strukturierten Einsatz von Künstlicher Intelligenz (KI) und Predictive Analytics im Mittelstand. Anhand eines fiktiven Use Cases aus der Getränkeindustrie wird gezeigt, wie Unternehmen mit modernen Datenanalysemethoden wie dem CRISP-DM-Prozess Vorhersagen treffen, Prozesse optimieren und datengetriebene Entscheidungen treffen können.

Du erfährst:

Wie ein typisches KI-Projekt im Unternehmen abläuft – von Business Understanding bis Deployment

Welche Daten (Formate, Spalten, Qualitätsaspekte) für Prognosen erforderlich sind

Wie Machine Learning-Modelle wie lineare Regression, ARIMA, Neuronale Netze und Facebook Prophet zum Einsatz kommen

Welche Tools (z. B. Python, Power BI) und Methoden zur Visualisierung, Modellierung und Bewertung verwendet werden

Wie die Ergebnisse für Entscheider aufbereitet und in Geschäftsprozesse integriert werden

Ziel ist es, das Potenzial von KI verständlich und anwendungsnah aufzuzeigen – als Entscheidungsbasis für die digitale Zukunft.

Avatar for Markus Begerow

Markus Begerow

January 22, 2025

More Decks by Markus Begerow

Other Decks in Technology

Transcript

  1. About me – Markus Begerow - Data & AI Expert

    | Speaker | Mentor | Author #gerneperDu
  2. Wir arbeiten für einen (fiktiven) europäischen Getränkeproduzenten durchgeführt. Der Fokus

    liegt auf der Planung der Absatzmenge des laufenden und folgenden Jahres. Rahmendaten Das Unternehmen beliefert 2 Segmente:  On-trade: Restaurants, Bars, Cafés  Off-trade: Großhandel und Einzelhandel Das Unternehmen führt 2 Kategorien mit jeweiligen Produktgruppen:  Beer – alkoholische Getränke  Nonalcoholic Das Unternehmen hat diverse Absatzmärkte  5 Regionen, denen jeweils die Länder zugeordnet sind. Fiktiver Anwendungsfall in einem mittelständischen Unternehmen
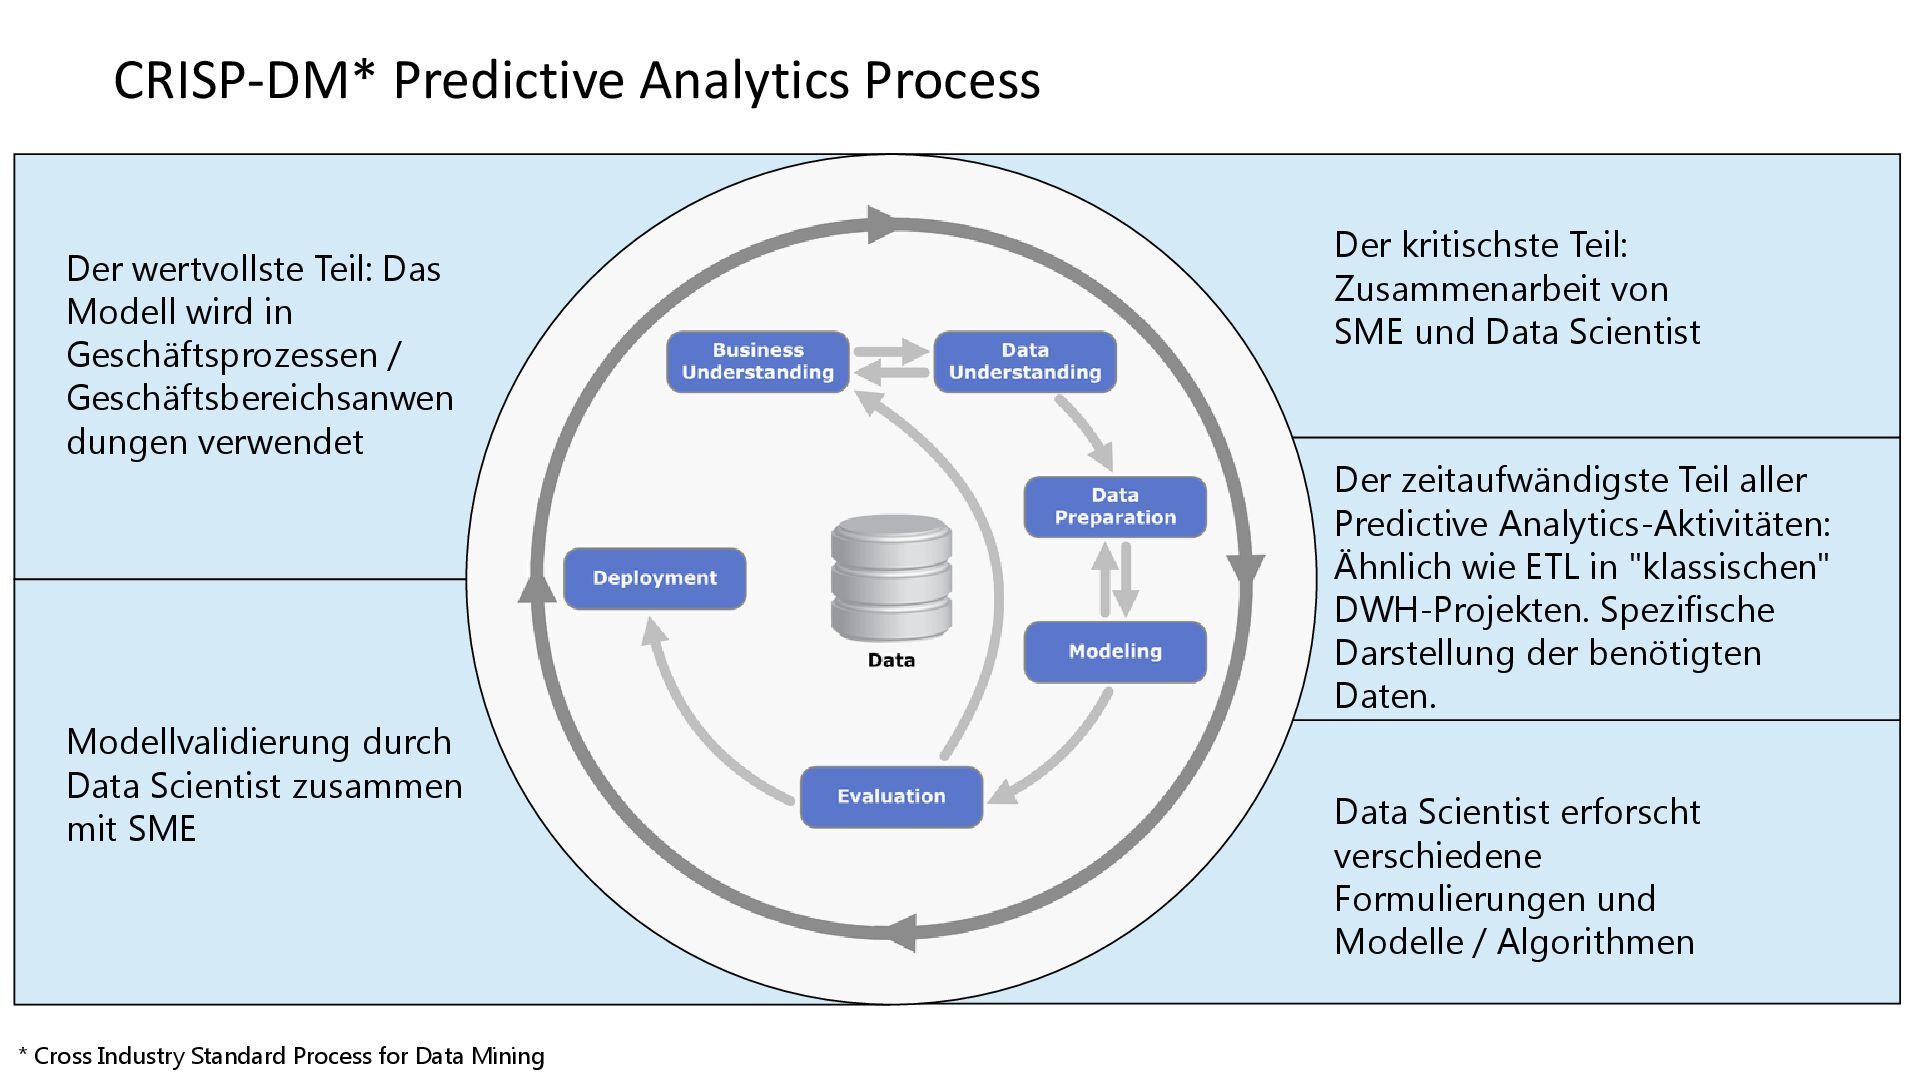
  3. CRISP-DM* Predictive Analytics Process Der kritischste Teil: Zusammenarbeit von SME

    und Data Scientist Der zeitaufwändigste Teil aller Predictive Analytics-Aktivitäten: Ähnlich wie ETL in "klassischen" DWH-Projekten. Spezifische Darstellung der benötigten Daten. Data Scientist erforscht verschiedene Formulierungen und Modelle / Algorithmen Der wertvollste Teil: Das Modell wird in Geschäftsprozessen / Geschäftsbereichsanwen dungen verwendet Modellvalidierung durch Data Scientist zusammen mit SME * Cross Industry Standard Process for Data Mining
  4.  Was ist das Ziel des Projektes?  Welche Fragen

    sollen beantwortet werden?  Anforderungen aus der Geschäftsperspektive  Umwandeln in Machine Learning Problem  Vorläufiger Plan  Evaluationskriterien bestimmen und definieren  Mathematische Definition des Ziel-Erreichungs-Kriteriums, z.B.  Abweichung von einem Zielwert  Anzahl der fehlerhaft Klassifizierten Datenpunkte Business Understanding
  5.  Chefetage: Wir wollen den Umsatz von dem Produkt Coke

    für den deutschen Markt für unser On-trade-Geschäft (Restaurants, Bars, Cafés) besser voraussagen…  Chef: Irgendwelche Vorschläge? Marketing, Sales?  Sales: Wir machen eine Rabattaktion!  Marketing: Wir machen eine knallige Werbung!!  Controlling: Wir sollten auf unser Bauchgefühl hören!?!!!  Neue Kollegin seit Juni dabei: Wir sollten eine datengetriebene Entscheidung treffen?!?  Chef: Das ist mir neu? Fahren Sie fort… Business Understanding
  6.  Erste Datenerfassung  Datenquellen identifizieren  „Kennenlernen“ der Daten:

    erster Überblick  Erste Erkenntnisse aus den Daten ziehen  Domänenexperten identifizieren / einbinden  Vorstudien und Ergebnisse aggregieren, z.B.  Daten analysieren  Zusammenfassende Statistiken  Datenqualität  Korrelationen  Visualisierung Data Understanding
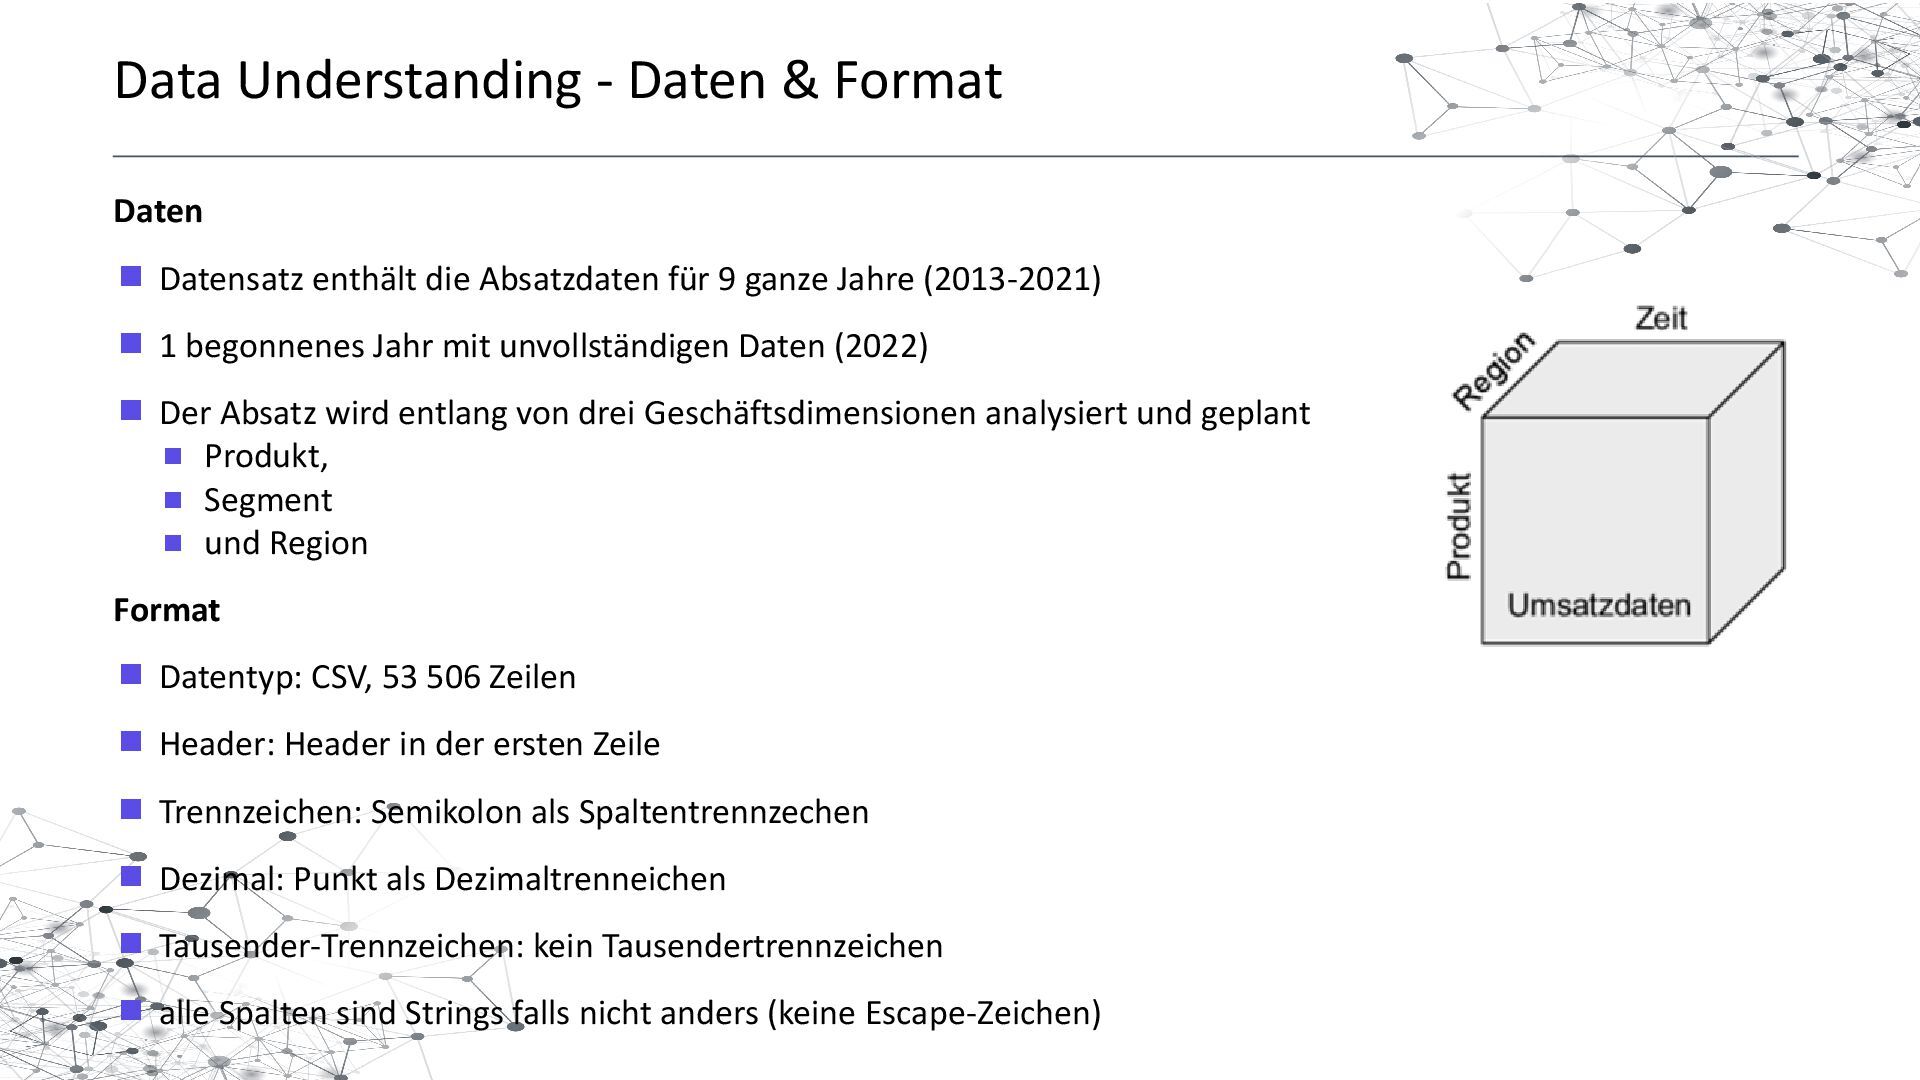
  7. Daten  Datensatz enthält die Absatzdaten für 9 ganze Jahre

    (2013-2021)  1 begonnenes Jahr mit unvollständigen Daten (2022)  Der Absatz wird entlang von drei Geschäftsdimensionen analysiert und geplant  Produkt,  Segment  und Region Format  Datentyp: CSV, 53 506 Zeilen  Header: Header in der ersten Zeile  Trennzeichen: Semikolon als Spaltentrennzechen  Dezimal: Punkt als Dezimaltrenneichen  Tausender-Trennzeichen: kein Tausendertrennzeichen  alle Spalten sind Strings falls nicht anders (keine Escape-Zeichen) Data Understanding - Daten & Format
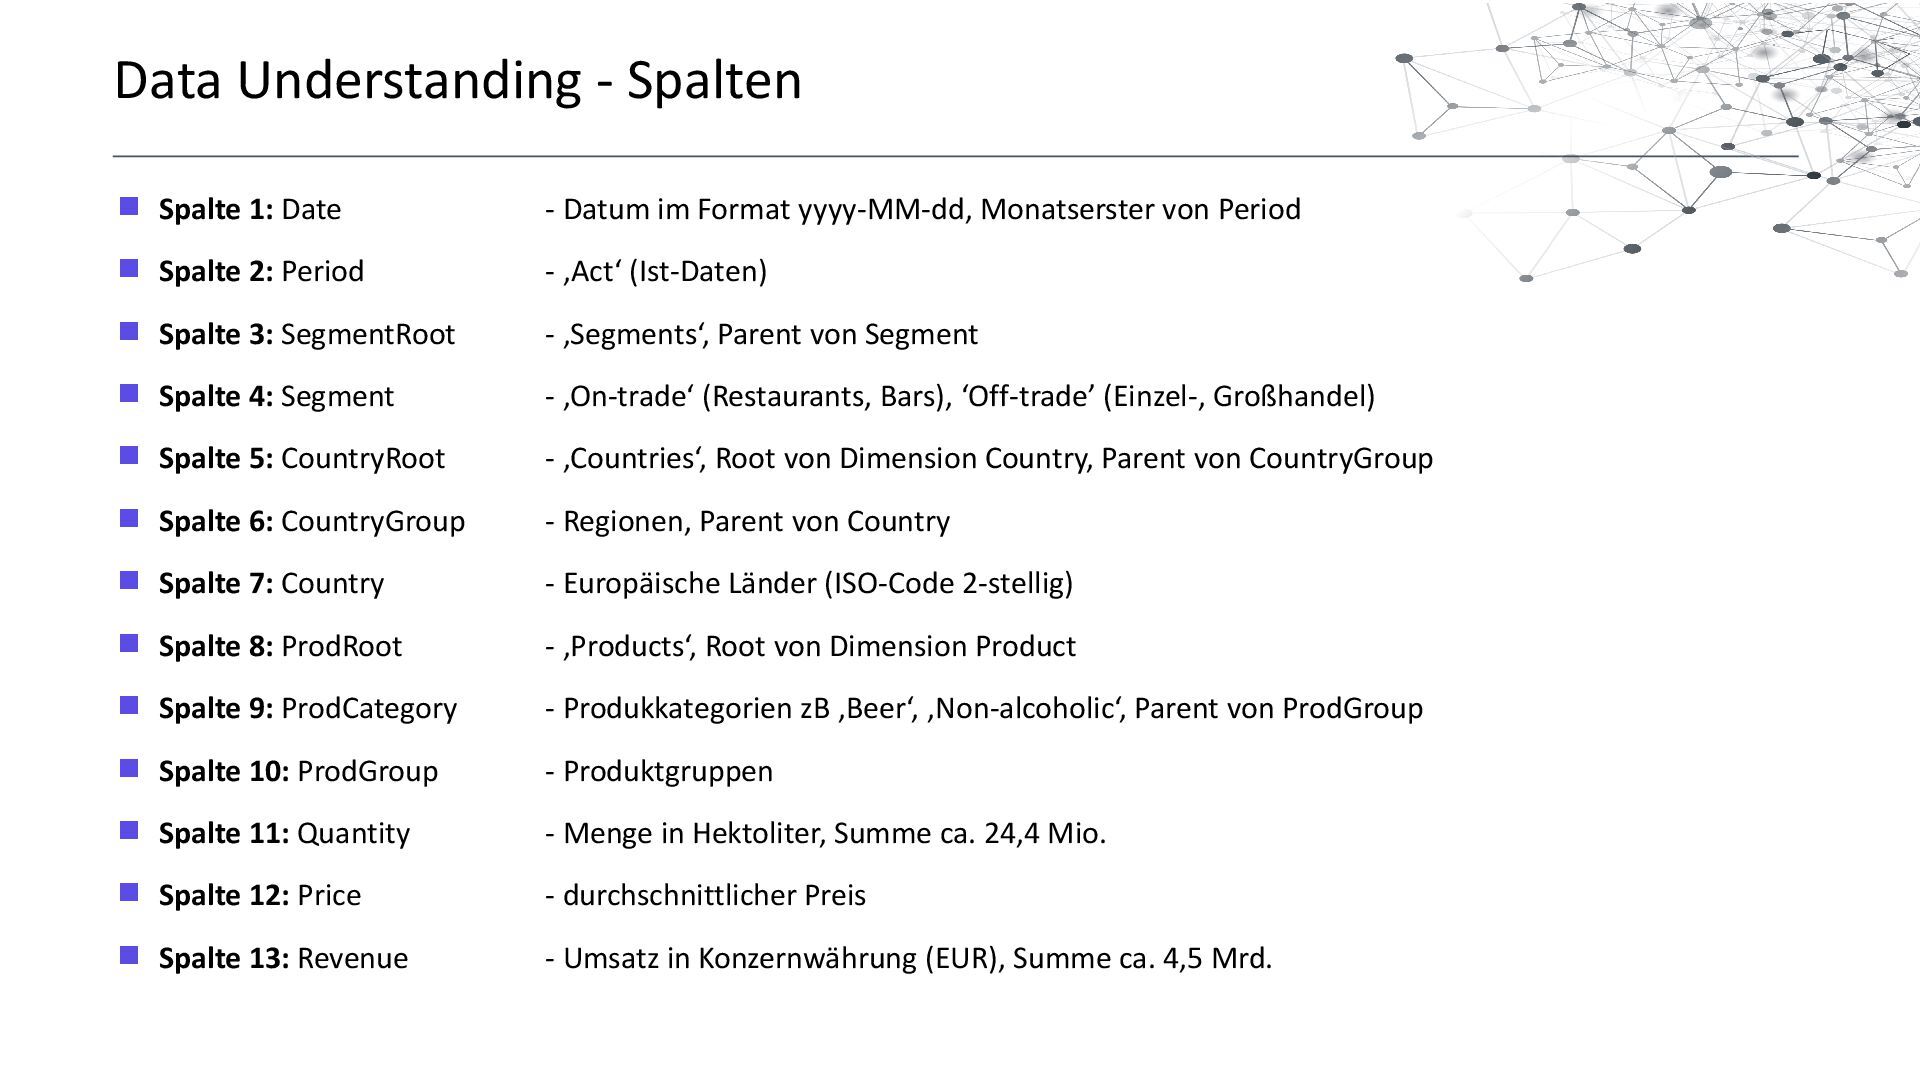
  8.  Spalte 1: Date - Datum im Format yyyy-MM-dd, Monatserster

    von Period  Spalte 2: Period - ‚Act‘ (Ist-Daten)  Spalte 3: SegmentRoot - ‚Segments‘, Parent von Segment  Spalte 4: Segment - ‚On-trade‘ (Restaurants, Bars), ‘Off-trade’ (Einzel-, Großhandel)  Spalte 5: CountryRoot - ‚Countries‘, Root von Dimension Country, Parent von CountryGroup  Spalte 6: CountryGroup - Regionen, Parent von Country  Spalte 7: Country - Europäische Länder (ISO-Code 2-stellig)  Spalte 8: ProdRoot - ‚Products‘, Root von Dimension Product  Spalte 9: ProdCategory - Produkkategorien zB ‚Beer‘, ‚Non-alcoholic‘, Parent von ProdGroup  Spalte 10: ProdGroup - Produktgruppen  Spalte 11: Quantity - Menge in Hektoliter, Summe ca. 24,4 Mio.  Spalte 12: Price - durchschnittlicher Preis  Spalte 13: Revenue - Umsatz in Konzernwährung (EUR), Summe ca. 4,5 Mrd. Data Understanding - Spalten
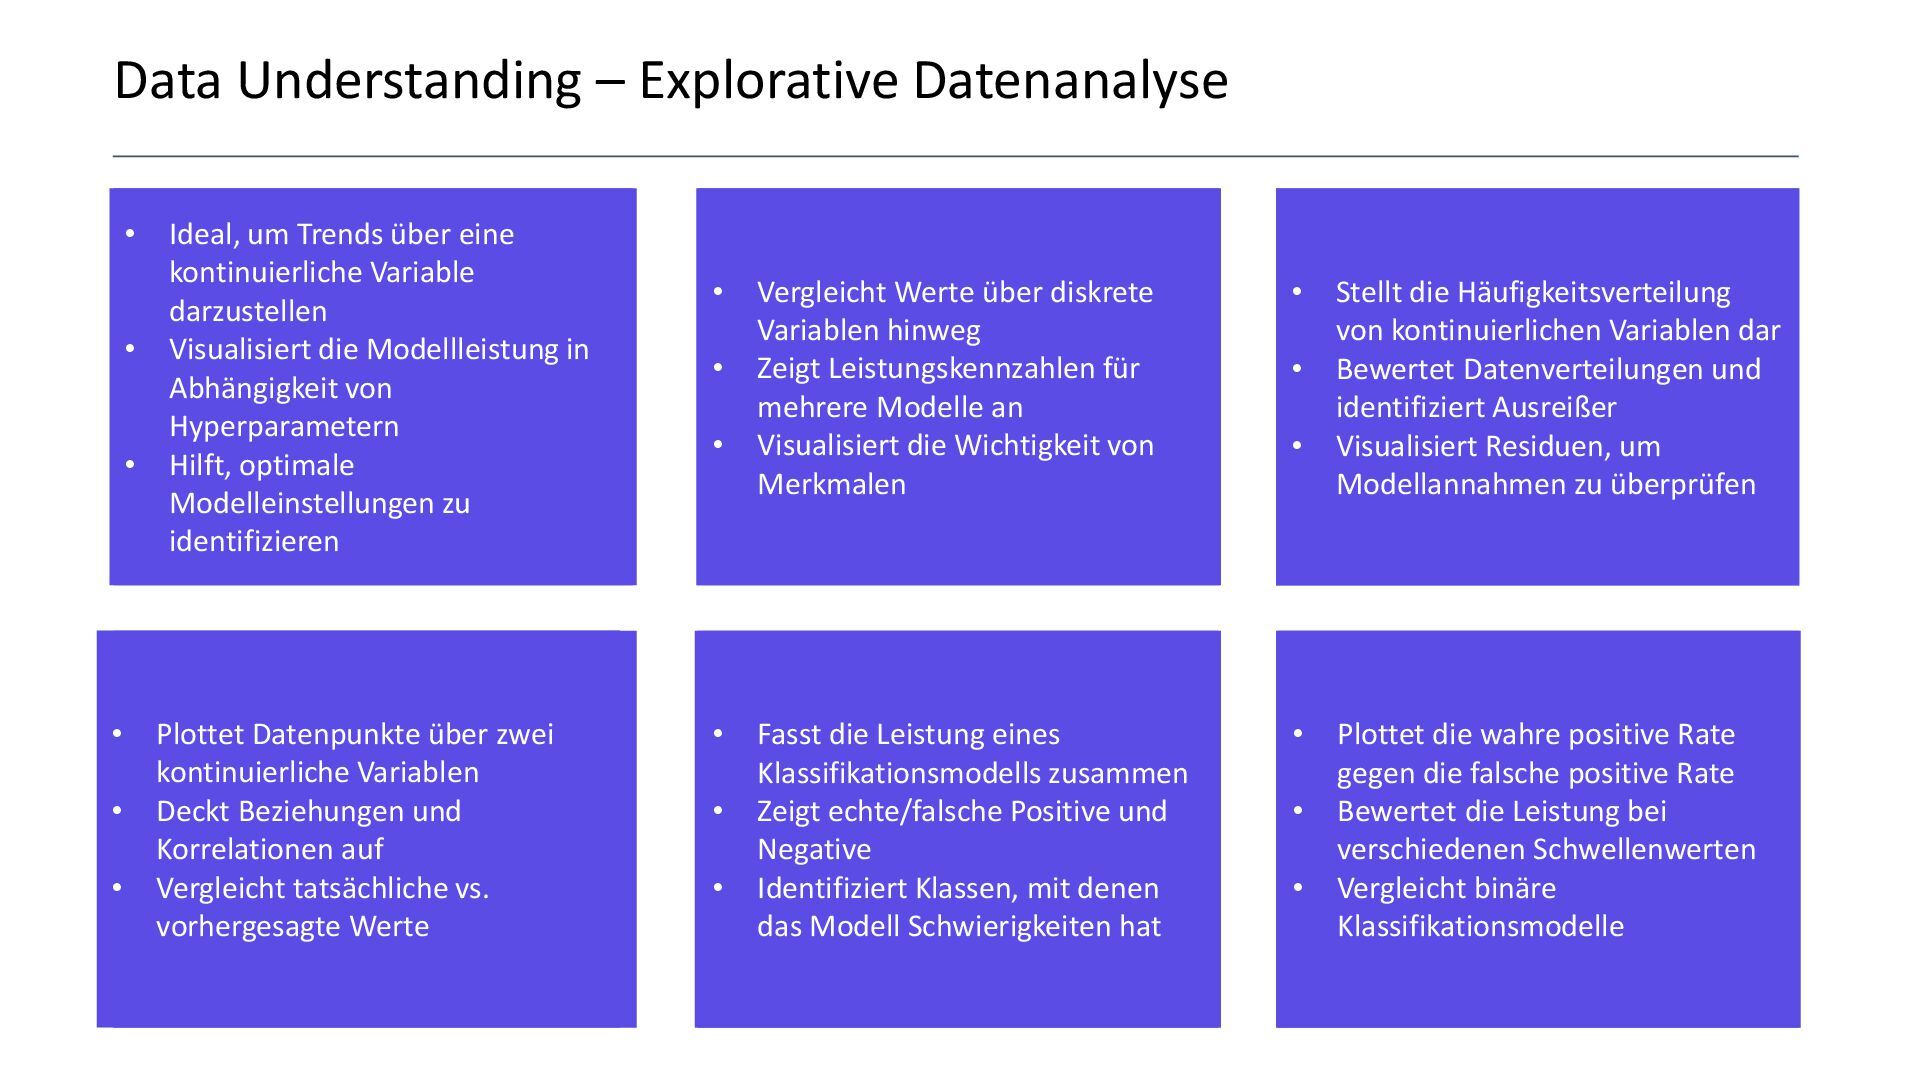
  9. Data Understanding – Explorative Datenanalyse Scatter Plot Conusion Matrix ROC

    Curve Icon/Bild Icon/Bild Icon/Bild Line Plot Bar Chart Histogram Icon/Bild Icon/Bild Icon/Bild • Ideal, um Trends über eine kontinuierliche Variable darzustellen • Visualisiert die Modellleistung in Abhängigkeit von Hyperparametern • Hilft, optimale Modelleinstellungen zu identifizieren • Vergleicht Werte über diskrete Variablen hinweg • Zeigt Leistungskennzahlen für mehrere Modelle an • Visualisiert die Wichtigkeit von Merkmalen • Stellt die Häufigkeitsverteilung von kontinuierlichen Variablen dar • Bewertet Datenverteilungen und identifiziert Ausreißer • Visualisiert Residuen, um Modellannahmen zu überprüfen • Plottet Datenpunkte über zwei kontinuierliche Variablen • Deckt Beziehungen und Korrelationen auf • Vergleicht tatsächliche vs. vorhergesagte Werte • Fasst die Leistung eines Klassifikationsmodells zusammen • Zeigt echte/falsche Positive und Negative • Identifiziert Klassen, mit denen das Modell Schwierigkeiten hat • Plottet die wahre positive Rate gegen die falsche positive Rate • Bewertet die Leistung bei verschiedenen Schwellenwerten • Vergleicht binäre Klassifikationsmodelle
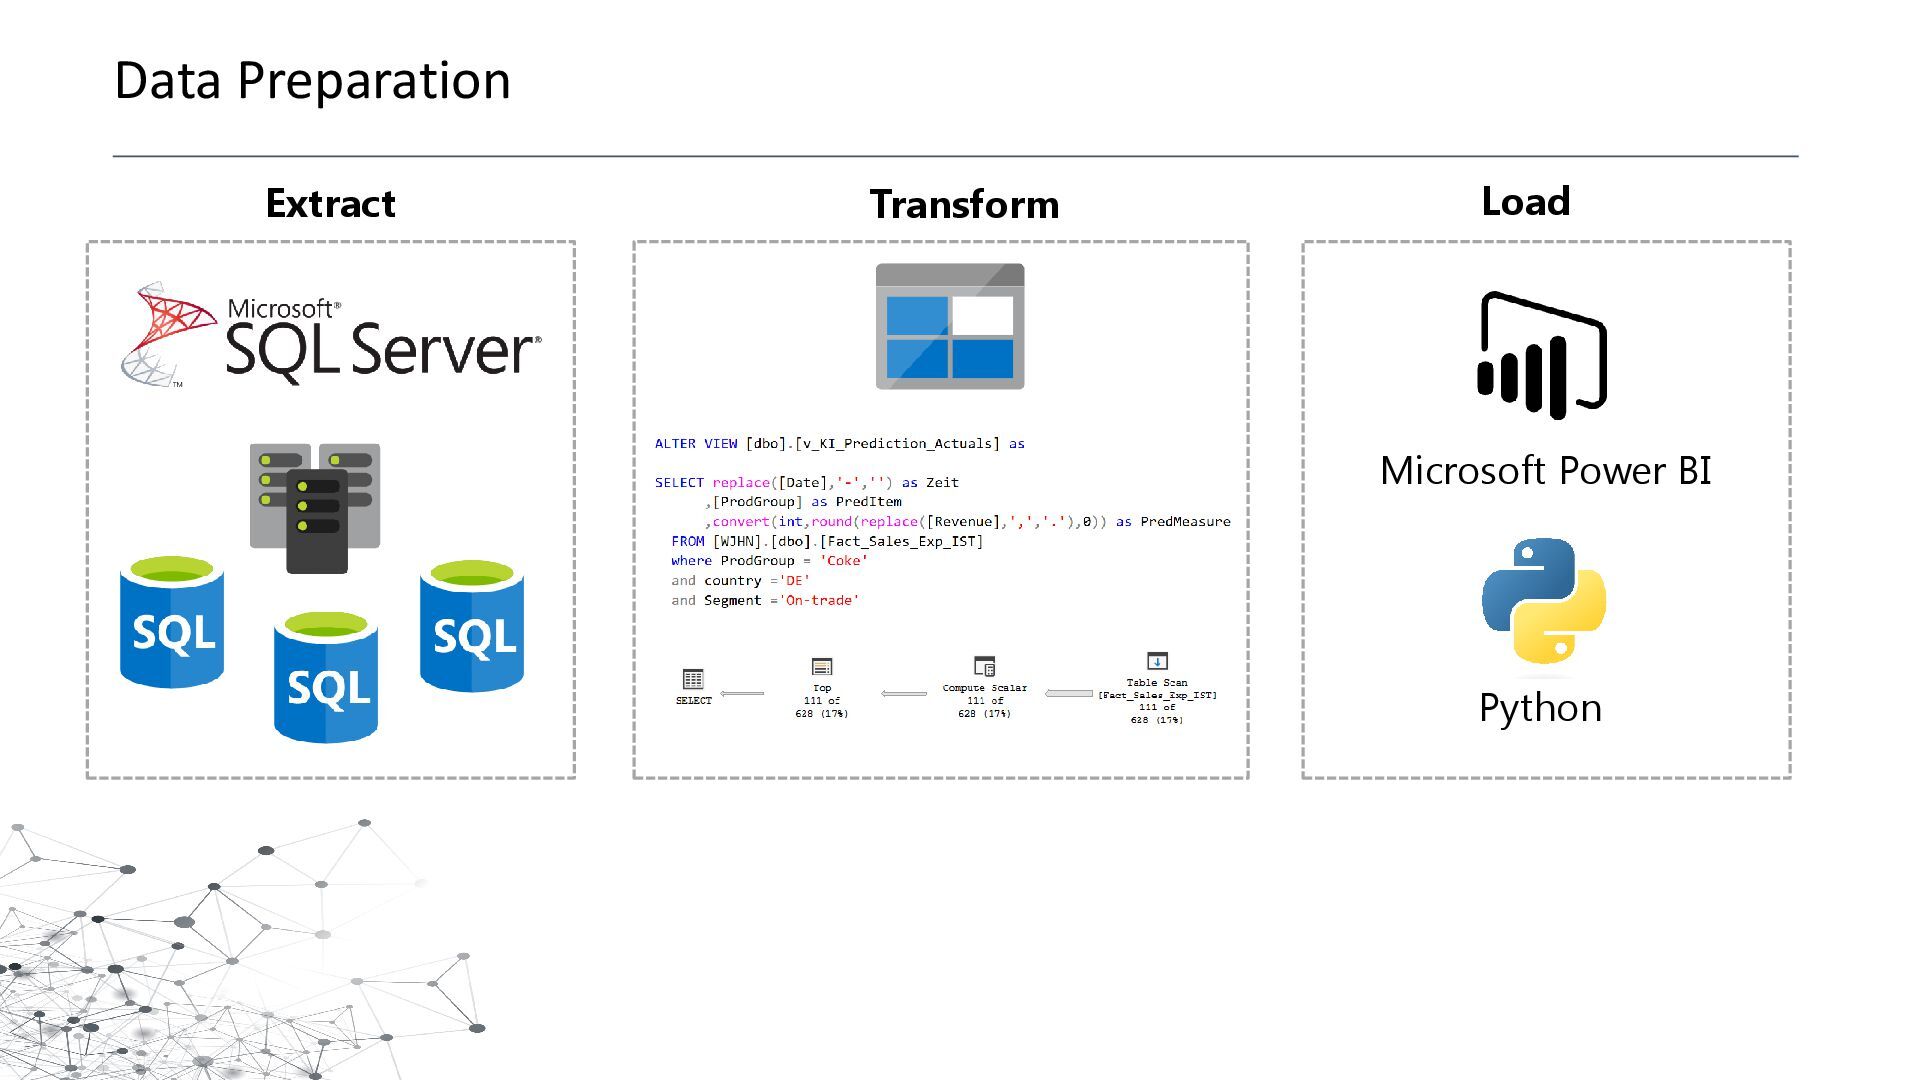
  10.  Datenset aus Rohdaten erzeugen  Auswahl der  Tabelle(n)

     Datensätze  Bestimmung der Attribute  Transformationen  Datenqualität bewerten  Bereinigung der Daten  Oftmals mehrfach wiederholt Data Preparation
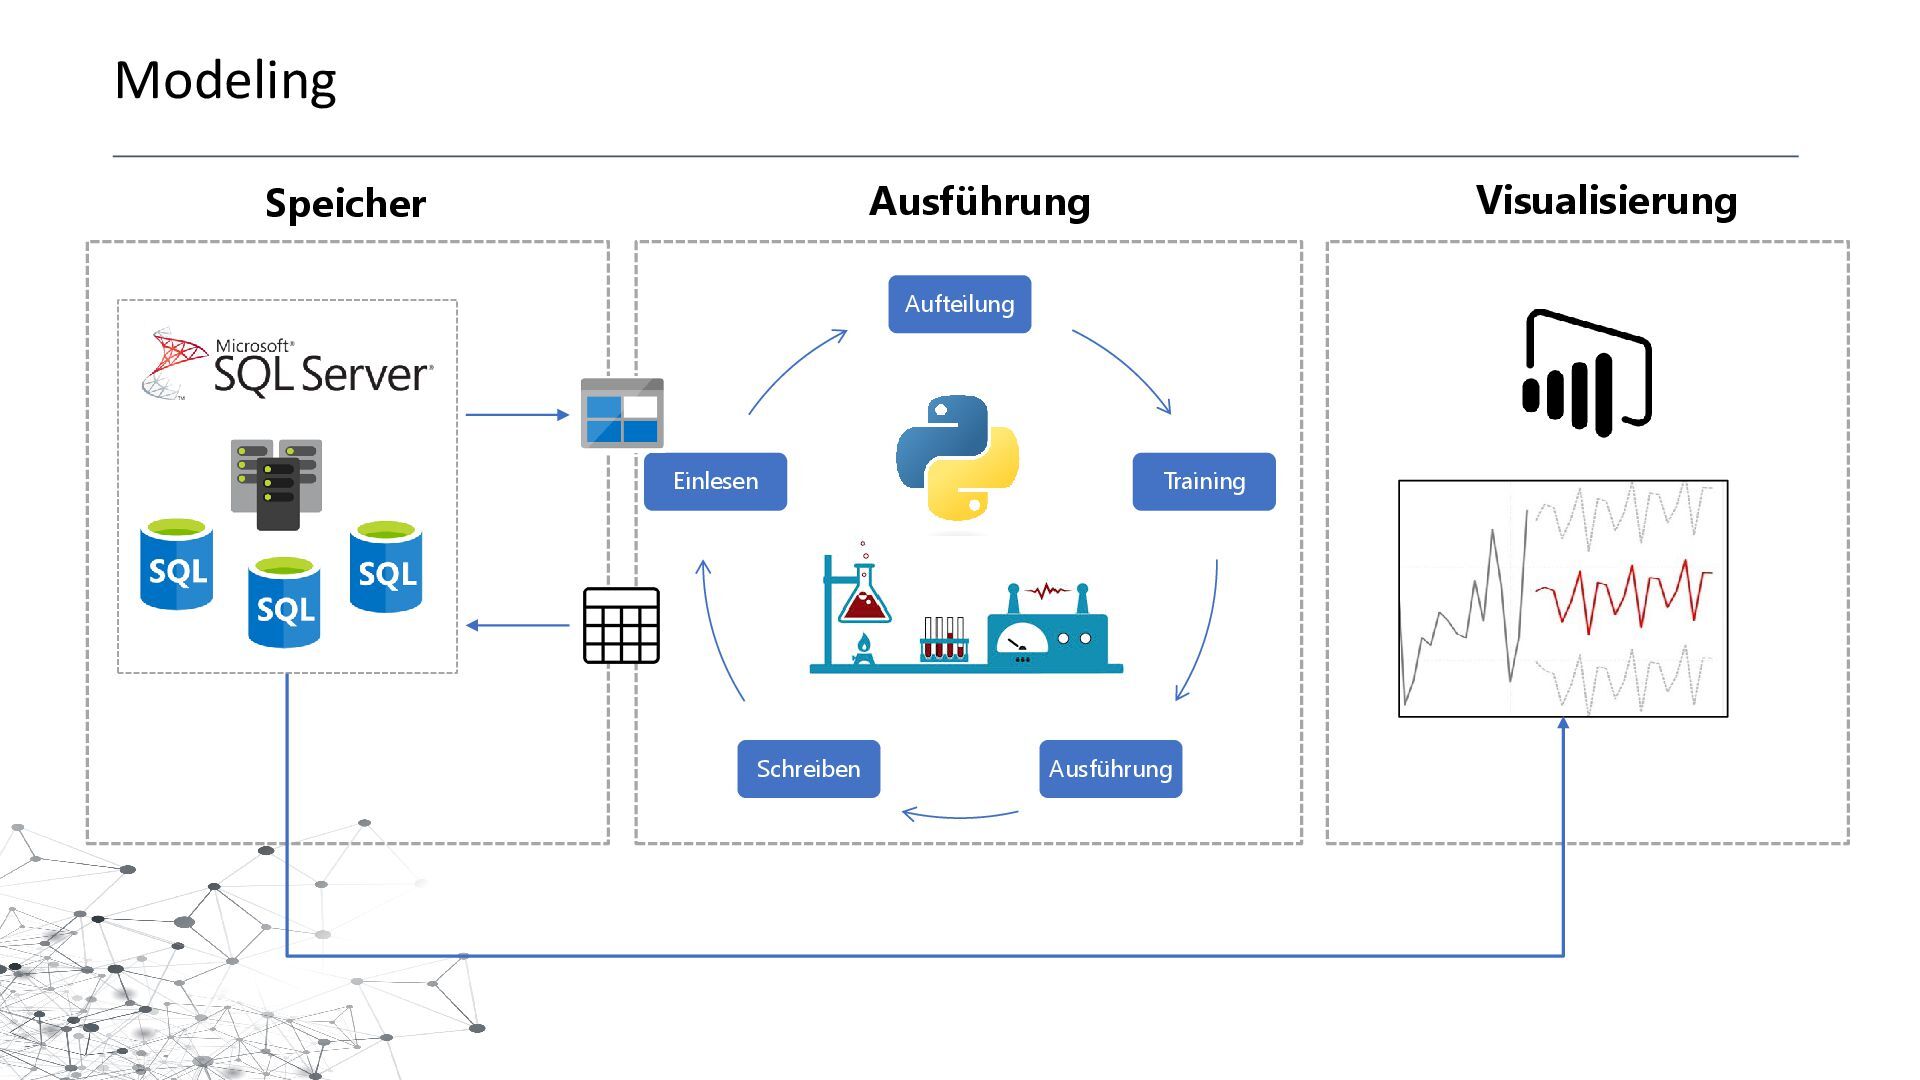
  11.  Baselines definieren und implementieren  Modellierungsansätze auswählen, anwenden und

    vergleichen  Anpassung der Parameter des Verfahrens  Beste Einstellungen für die betrachteten Daten  Oftmals “trial-and-error”  Entscheidung für ein Verfahren  Erkennen von Anforderungen an die Daten  U.U. Rückkehr zur Datenvorverarbeitung Modeling
  12.  Evaluation des Modells  Sicherstellen, dass das Modell die

    Anforderungen erfüllt  Schrittweise Fortschritt bestimmen und zusammen mit den jeweils benutzten Methoden reporten  Reproduzierbarkeit sicherstellen  Übersichtlichkeit sicherstellen  Das beste Modell wurde ausgewählt  Wie gut ist es in Wirklichkeit? Evaluation
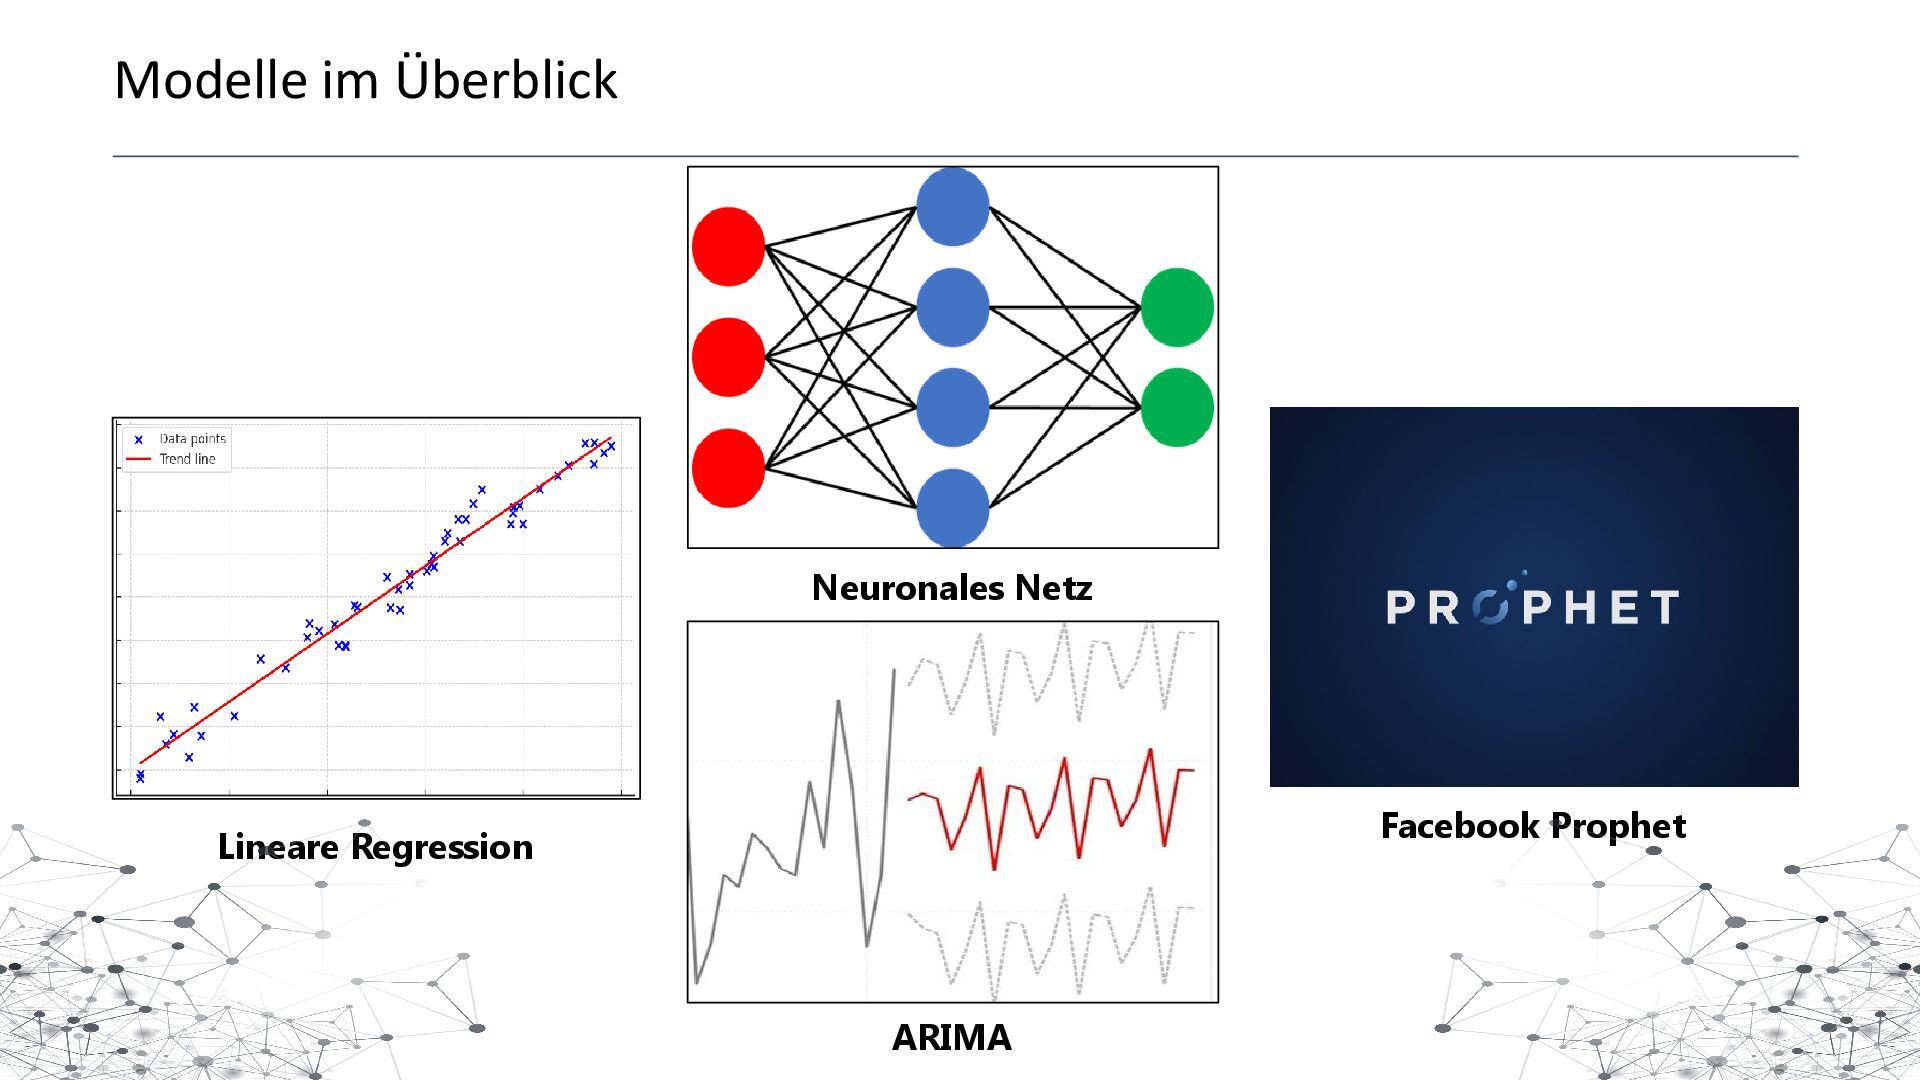
  13. Die Wahl des Modells hängt letztendlich von der Art der

    Daten, den Modellierungsanforderungen und den verfügbaren Ressourcen ab:  Lineare Regression eignet sich für einfache Modelle mit linearen Beziehungen und geringem Rechenaufwand  Neuronale Netze sind ideal für komplexe, nichtlineare Beziehungen, erfordern jedoch mehr Ressourcen und sind schwerer zu interpretieren  ARIMA-Modelle sind gut für Zeitreihenanalysen, wenn ein Gleichgewicht zwischen Modellkomplexität und Interpretierbarkeit angestrebt wird  Facebook Prophet ist optimal für Zeitreihenanalysen, bietet Automatisierung und Anpassungsfähigkeit, aber weniger Kontrolle und Flexibilität in anderen Kontexten Zusammenfassung
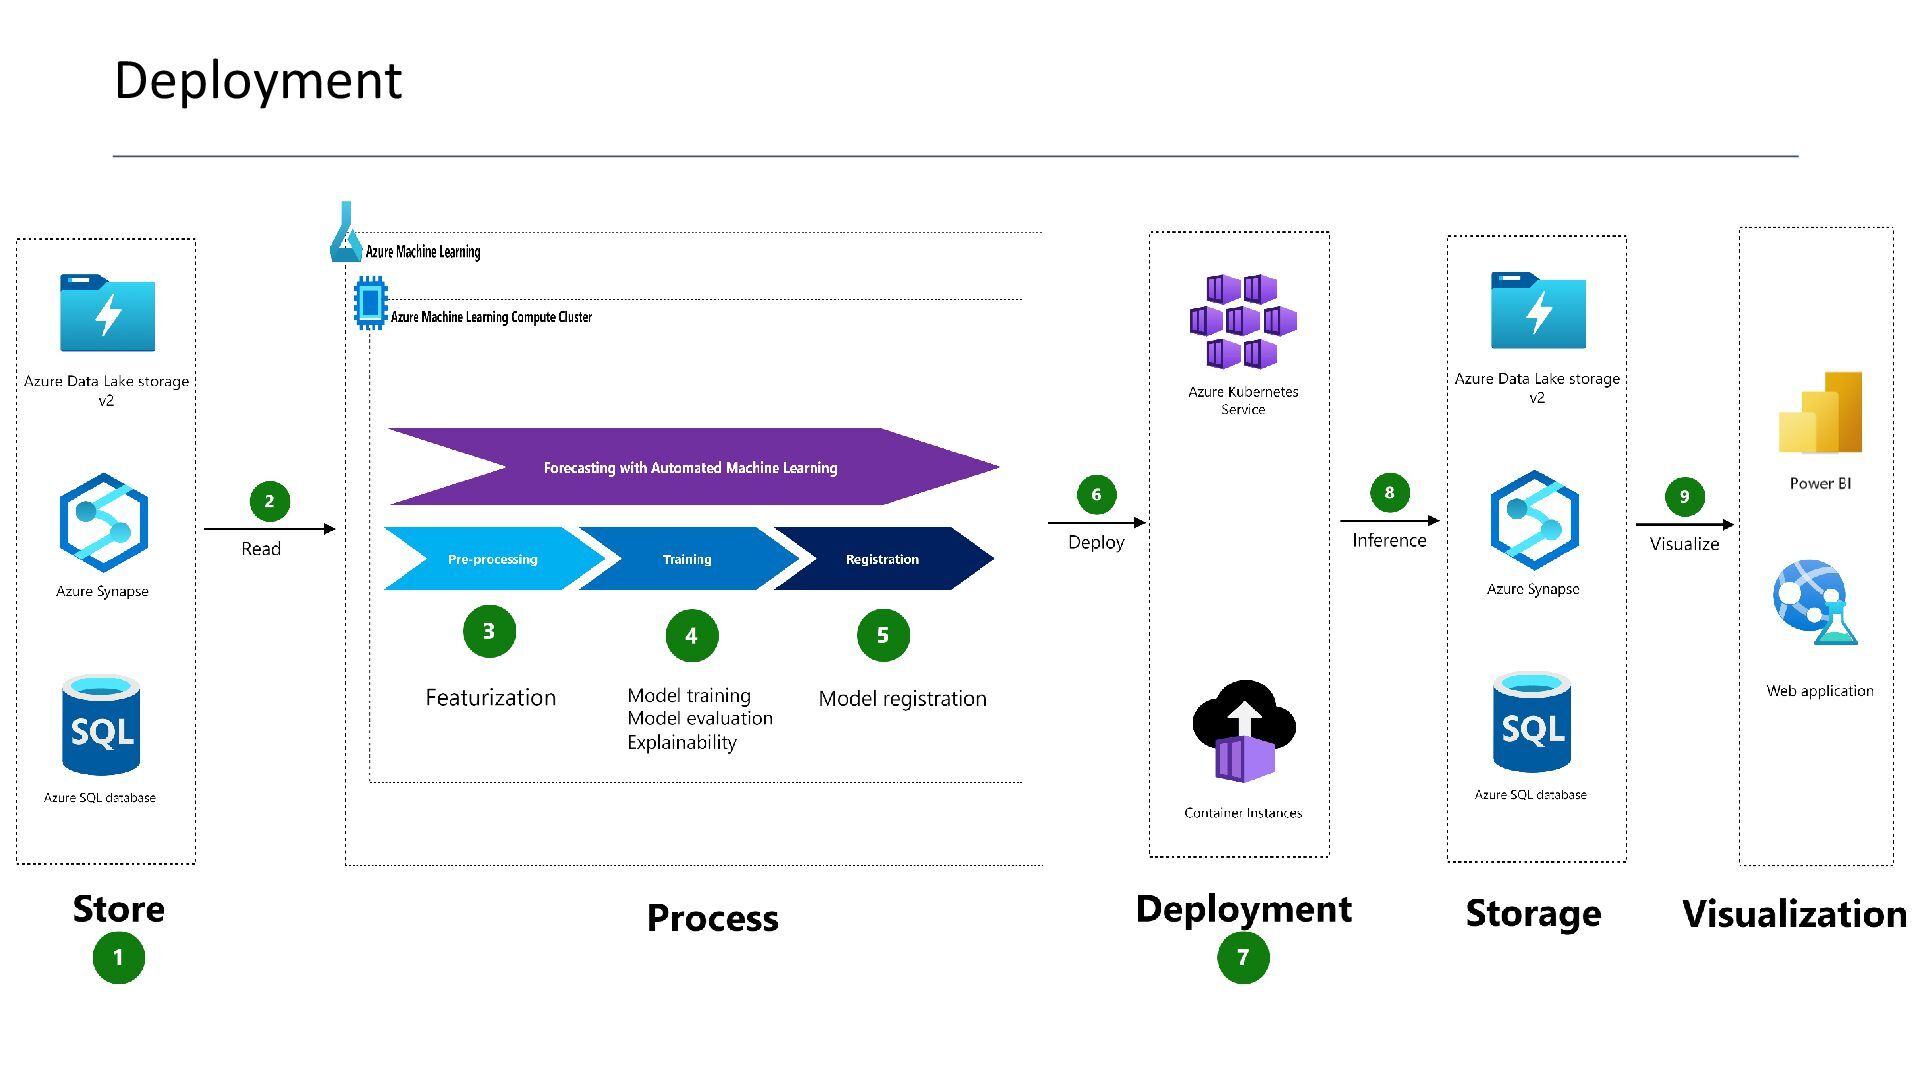
  14.  Nutzung des besten Modells  Einhaltung der definierten Nebenbedingungen

    (Laufzeit, Speicherplatzbedarf, …)  Nutzung, bis ein besserer Kandidat in der Auswertungsphase ermittelt wurde  Aufbereiten der Ergebnisse / des Modells  So, dass der Kunde es wie gewünscht nutzen kann  Möglichkeiten der Auslieferung  Visualisierung der Ergebnisse (z.B. mit Reporting Tool)  Implementierung einer Nutzeroberfläche  API Deployment