Share
Embed
Transcript
34 slides
-
普段の登壇では… • 2025/09 • Platform Engineering Kaigi • 2025/11 •
Observability Conference Tokyo • 2026/01 • SRE Kaigi 考えてること(原液) →自分のチームで試行錯誤 → 後から振り返って整理する << ここを普段は話す -
普段の登壇では… • 2025/09 • Platform Engineering Kaigi • 2025/11 •
Observability Conference Tokyo • 2026/01 • SRE Kaigi 考えてること(原液) << 今日はここを話す! →自分のチームで試行錯誤 → 後から振り返って整理する << ここを普段は話す -
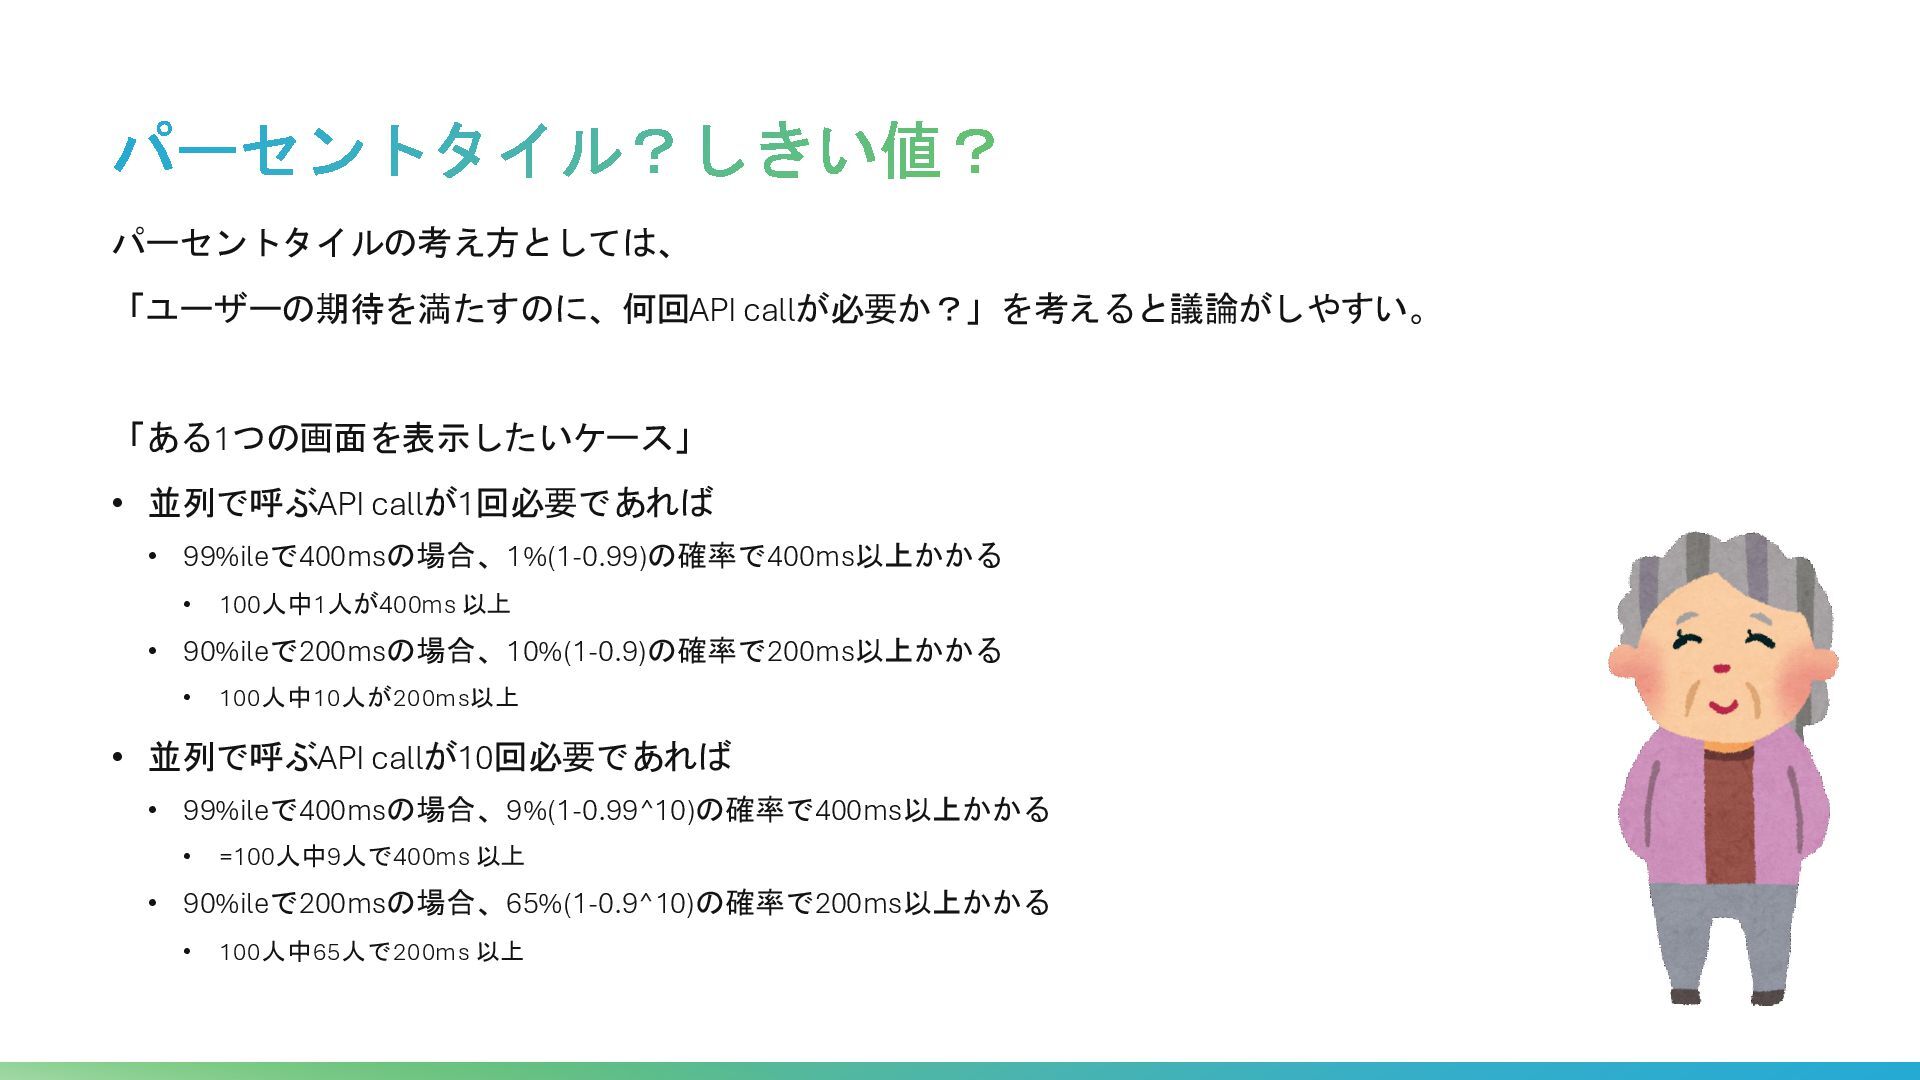
パーセントタイル?しきい値? パーセントタイルの考え方としては、 「ユーザーの期待を満たすのに、何回API callが必要か?」を考えると議論がしやすい。 「ある1つの画面を表示したいケース」 • 並列で呼ぶAPI callが1回必要であれば • 99%ileで400msの場合、1%(1-0.99)の確率で400ms以上かかる
• 100人中1人が400ms 以上 • 90%ileで200msの場合、10%(1-0.9)の確率で200ms以上かかる • 100人中10人が200ms以上 • 並列で呼ぶAPI callが10回必要であれば • 99%ileで400msの場合、9%(1-0.99^10)の確率で400ms以上かかる • =100人中9人で400ms 以上 • 90%ileで200msの場合、65%(1-0.9^10)の確率で200ms以上かかる • 100人中65人で200ms 以上 -
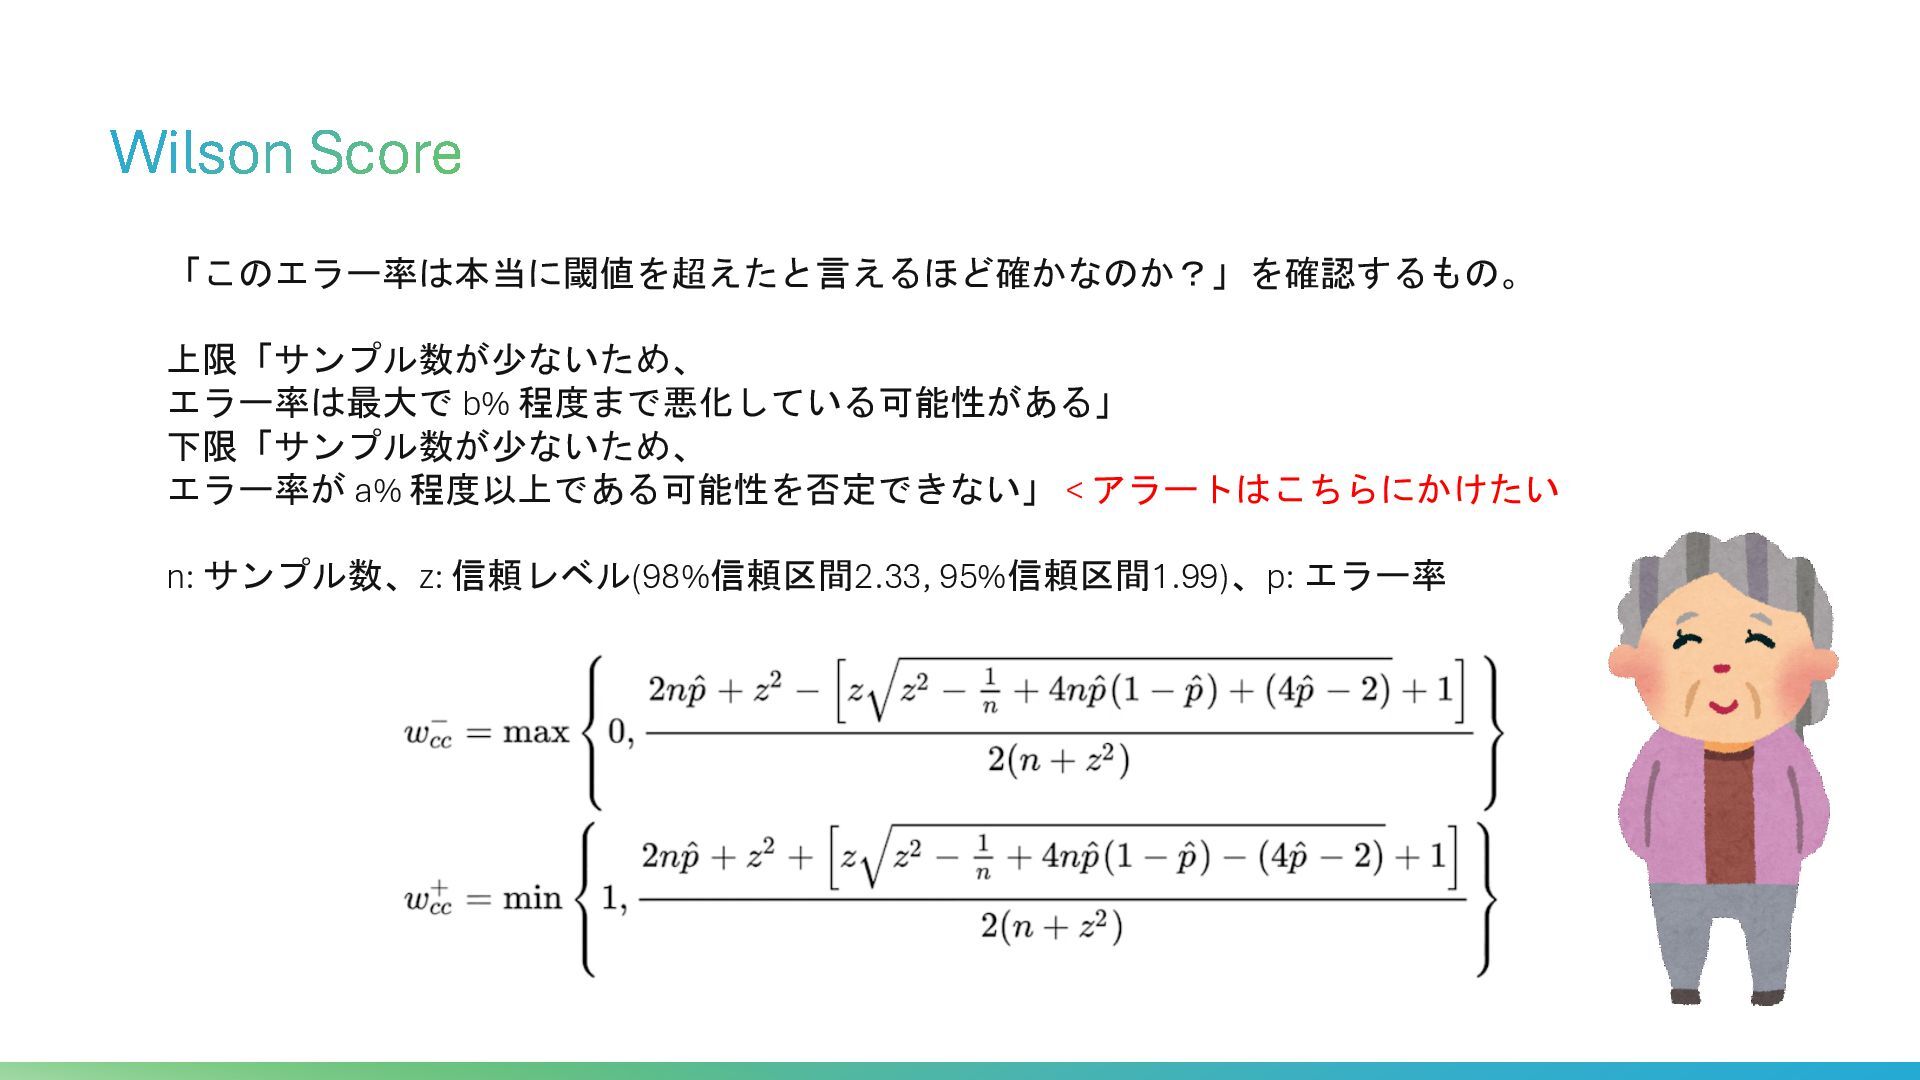
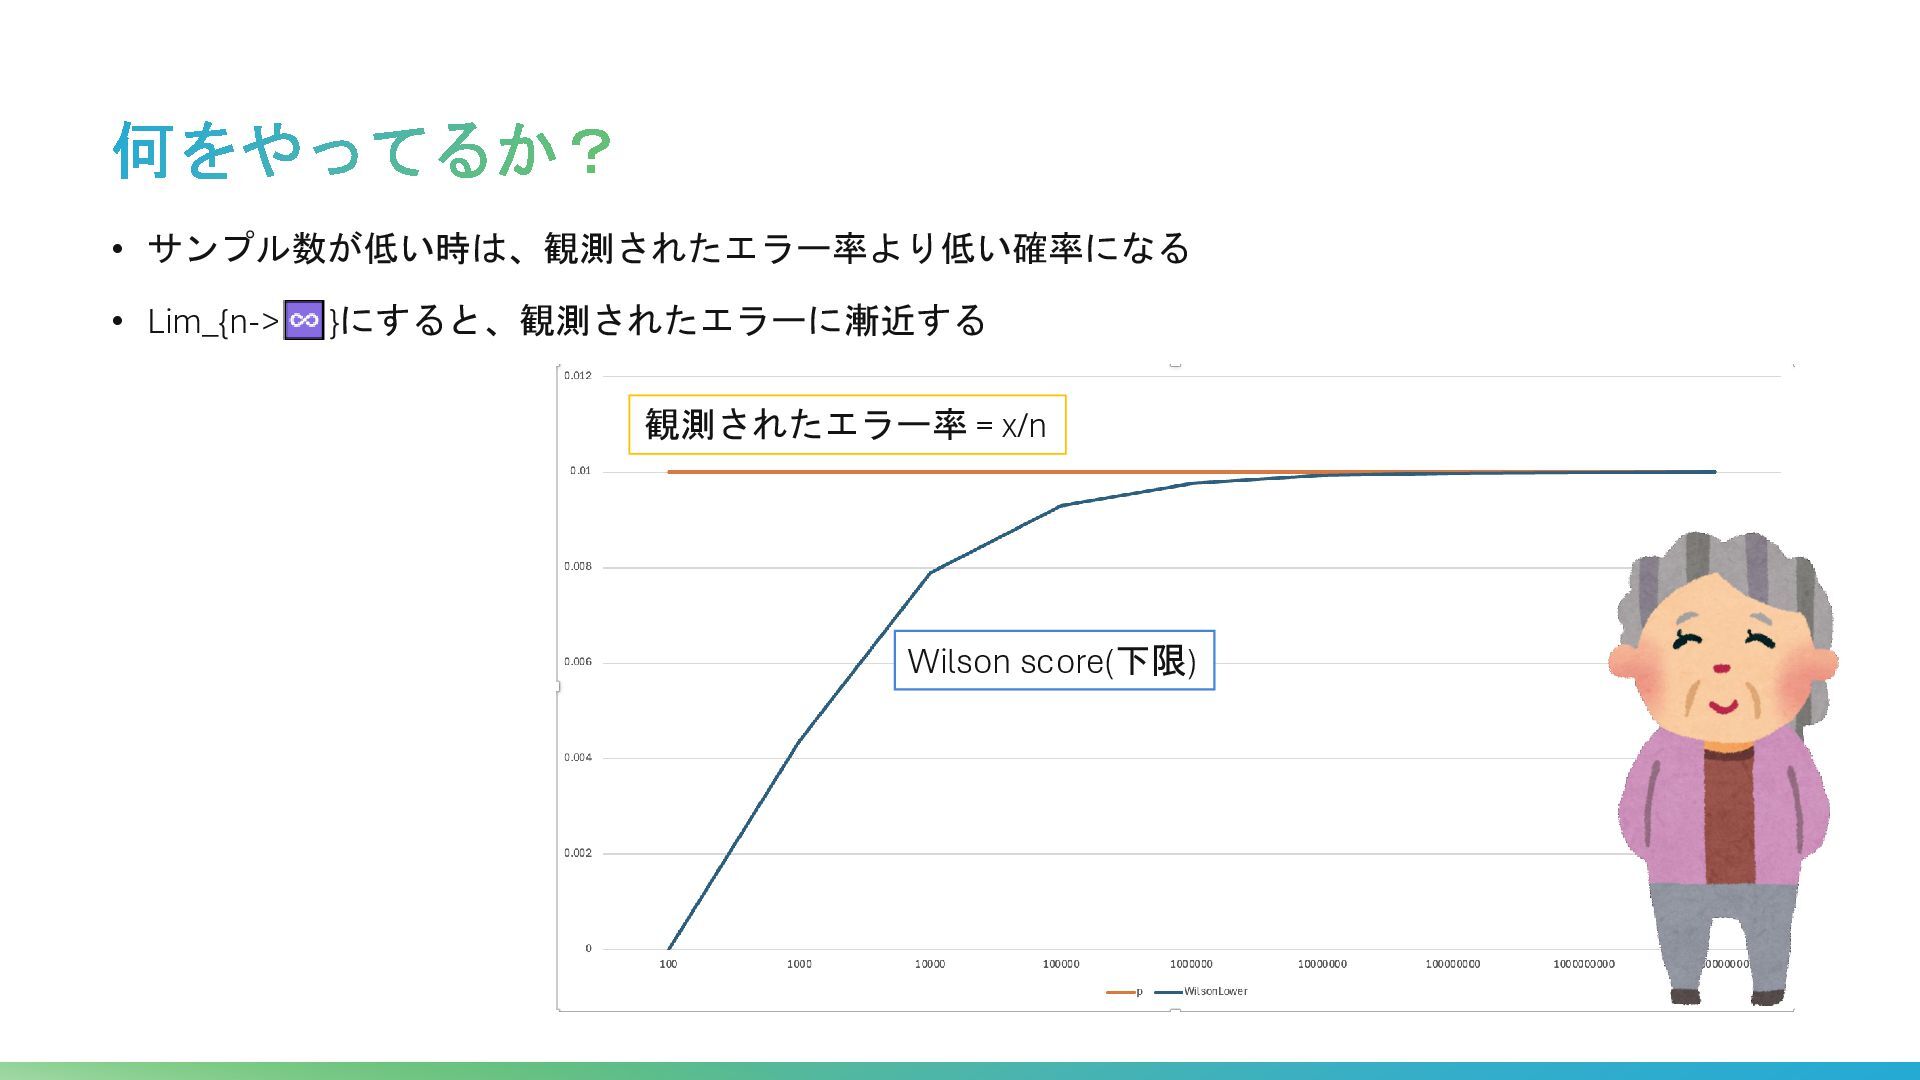
Wilson Score 「このエラー率は本当に閾値を超えたと言えるほど確かなのか?」を確認するもの。 上限「サンプル数が少ないため、 エラー率は最大で b% 程度まで悪化している可能性がある」 下限「サンプル数が少ないため、 エラー率が a%
程度以上である可能性を否定できない」 < アラートはこちらにかけたい n: サンプル数、z: 信頼レベル(98%信頼区間2.33, 95%信頼区間1.99)、p: エラー率 -
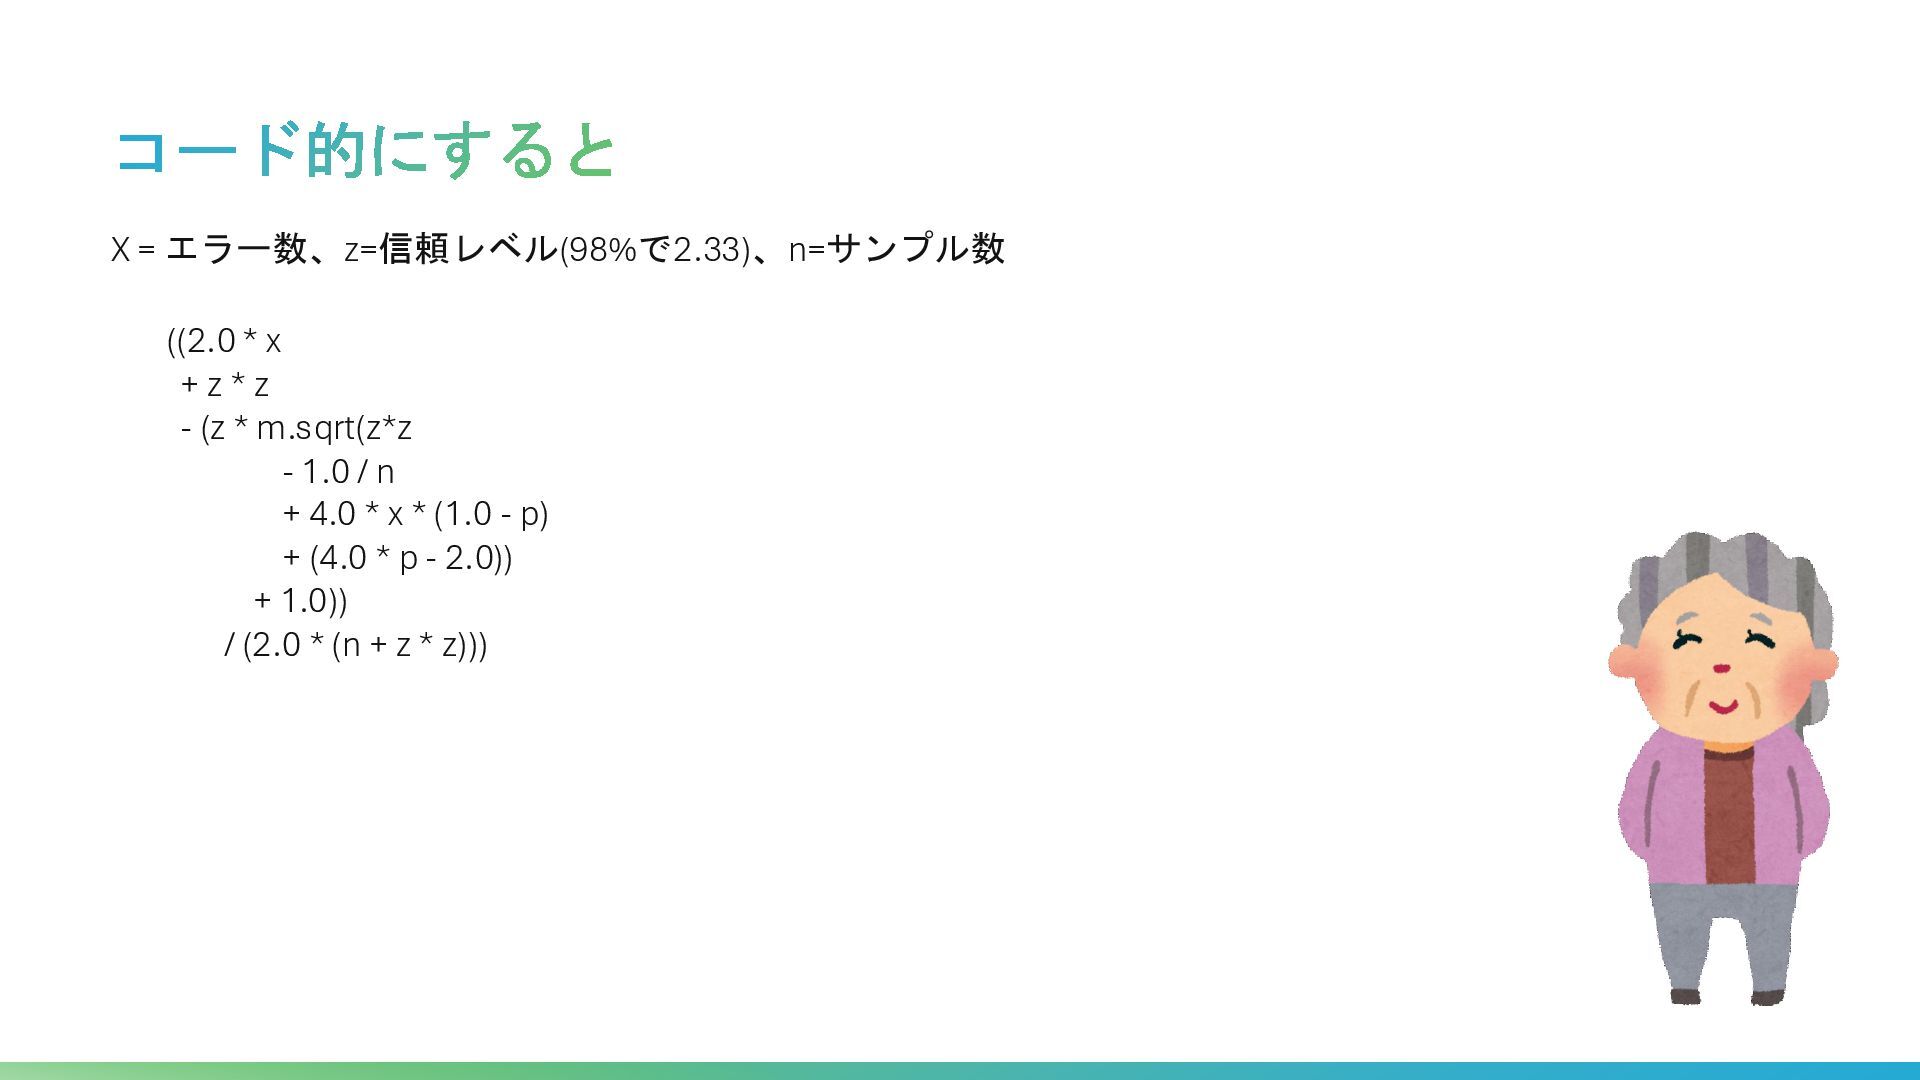
コード的にすると X = エラー数、z=信頼レベル(98%で2.33)、n=サンプル数 ((2.0 * x + z *
z - (z * m.sqrt(z*z - 1.0 / n + 4.0 * x * (1.0 - p) + (4.0 * p - 2.0)) + 1.0)) / (2.0 * (n + z * z))) -
PromQLクエリにすると ((2.0 * sum(increase(requests_total{status="500"}[1m])) + 2.33 * 2.33 - (2.33
* sqrt(2.33*2.33 - 1.0 / sum(increase(requests_total[1m])) + 4.0 * sum(increase(requests_total{status="500"}[1m])) * (1.0 - (sum(increase(requests_total{status="500"}[1m])) / sum(increase(requests_total[1m])))) + (4.0 * (sum(increase(requests_total{status="500"}[1m])) / sum(increase(requests_total[1m]))) - 2.0)) + 1.0)) / (2.0 * (sum(increase(requests_total[1m])) + 2.33 * 2.33))) * on (_your_label_) sum(increase(requests_total{status="500"}[1m])) > bool 0 -
それぞれの区間で平均と分散を集計するんじゃ • 発生からシステムの検知(Detection)まで • Time to Detect(TTD) • 発生から人間の認知(Acknowledge)まで •
Time to Ack • 発生から原因判明(Identify)まで • Time to Identify • 発生からサービス復旧(Service Recovery)まで • Time to (Service) Recovery • 発生から次の障害発生(Between failure)まで • Time between Failures -
それぞれの区間で平均と分散を集計するんじゃ • 発生からシステムの検知(Detection)まで • Time to Detect(TTD) • ➔ TTDの分散が大きければ、アラートやメトリクスを改善する。その成果は分散の変化で計測できる。
• 発生から人間の認知(Acknowledge)まで • Time to Ack • ➔TTAの分散が大きければ、オンコール体制の整備が効果的。 • 発生から原因判明(Identify)まで • Time to Identify • 発生からサービス復旧(Service Recovery)まで • Time to (Service) Recovery • 発生から次の障害発生(Between failure)まで • Time between Failures -
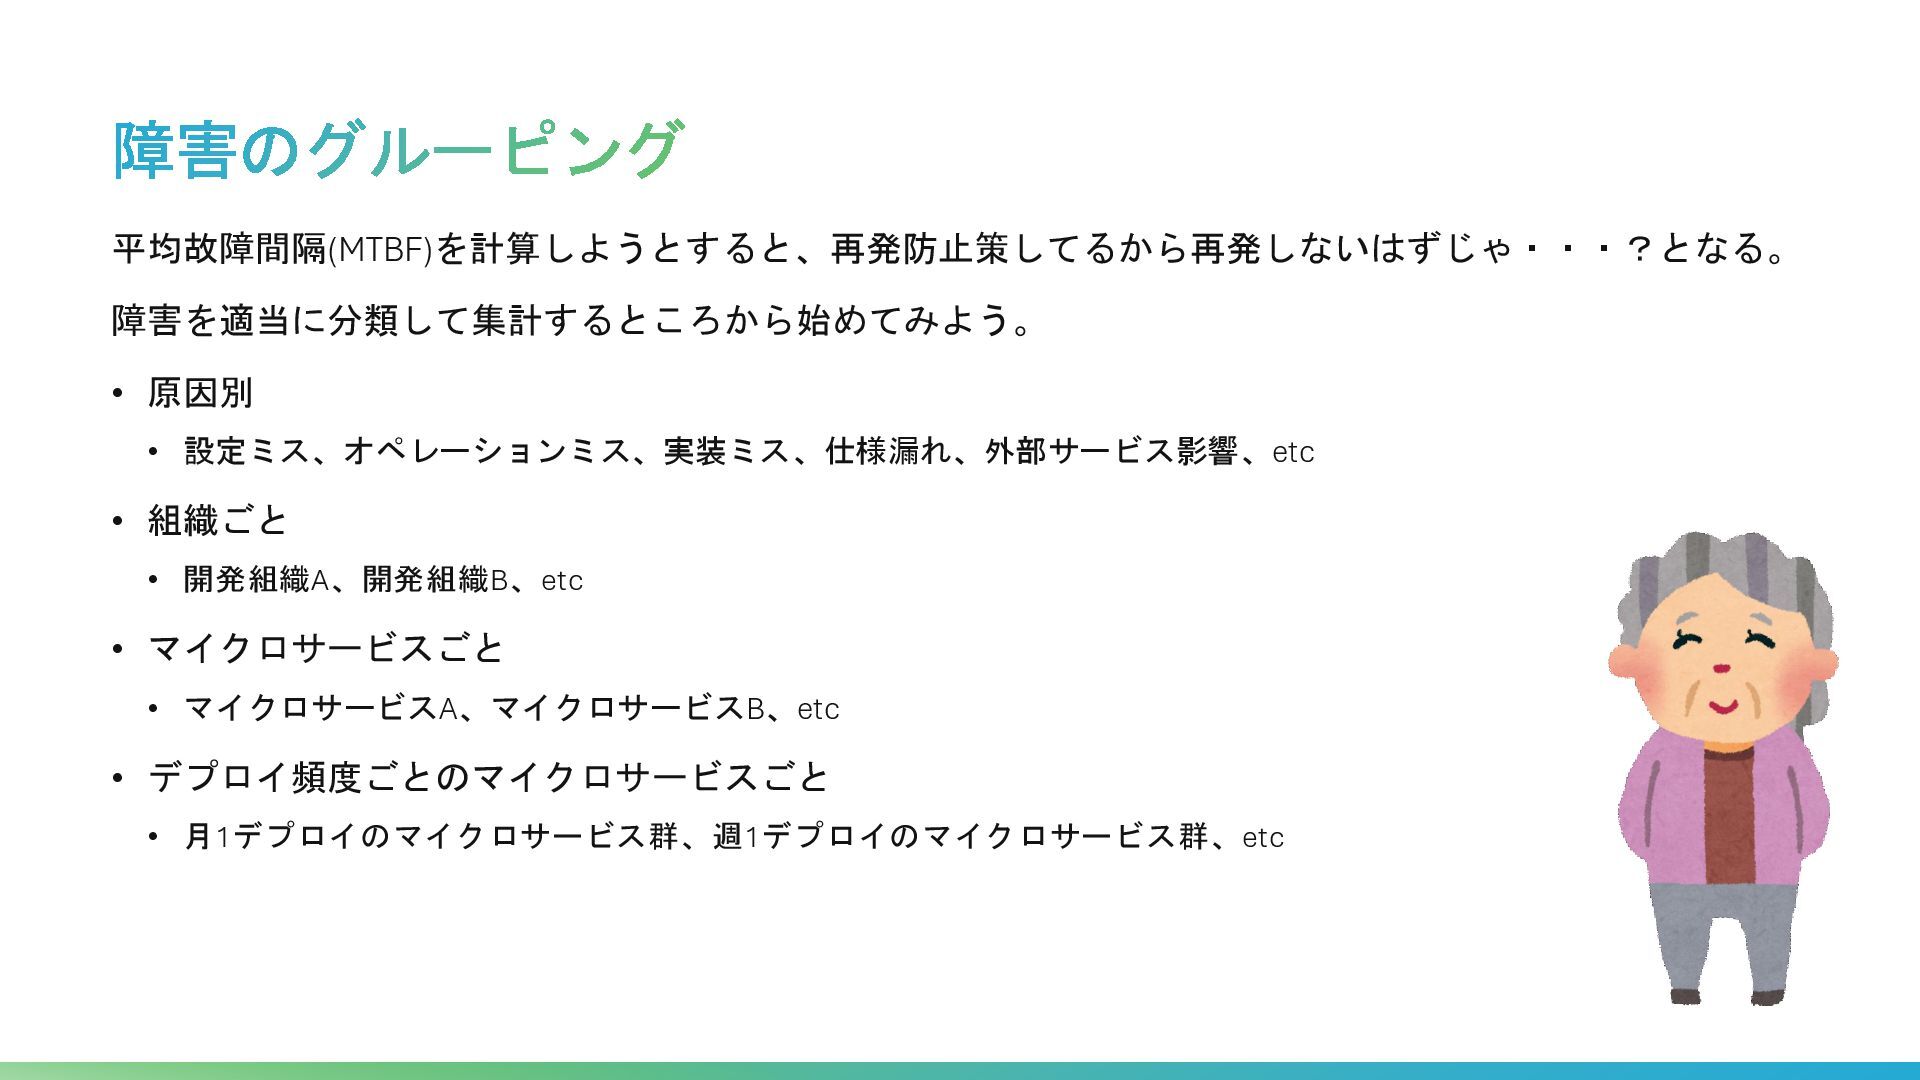
障害のグルーピング 平均故障間隔(MTBF)を計算しようとすると、再発防止策してるから再発しないはずじゃ・・・?となる。 障害を適当に分類して集計するところから始めてみよう。 • 原因別 • 設定ミス、オペレーションミス、実装ミス、仕様漏れ、外部サービス影響、etc • 組織ごと •
開発組織A、開発組織B、etc • マイクロサービスごと • マイクロサービスA、マイクロサービスB、etc • デプロイ頻度ごとのマイクロサービスごと • 月1デプロイのマイクロサービス群、週1デプロイのマイクロサービス群、etc