Share
Embed
農夫は秘伝のタレを知らない - NOBODY KNOWS THE HIDDEN SOURCE - Kaggriculture 3rd Place Solution
Kaggriculture 3rd Place Solution
- 登壇資料; 関西Kaggler会 交流会 in Osaka 2026#2
- Kaggle Writeup Link: https://www.kaggle.com/competitions/kaggriculture/writeups/kaggriculture-3rd-place-dsm-solution
- X: https://x.com/masspeakss

masspeaks
November 13, 2026
Transcript
52 slides
-
農家は秘伝のタレを知らない N O B O D Y K N O
W S T H E H I D D E N Kaggriculture 3rd Place Solution masspeaks(まっすー)|Team DSM|関西Kaggler会 交流会 in Osaka 2026#2 S O U R C E -
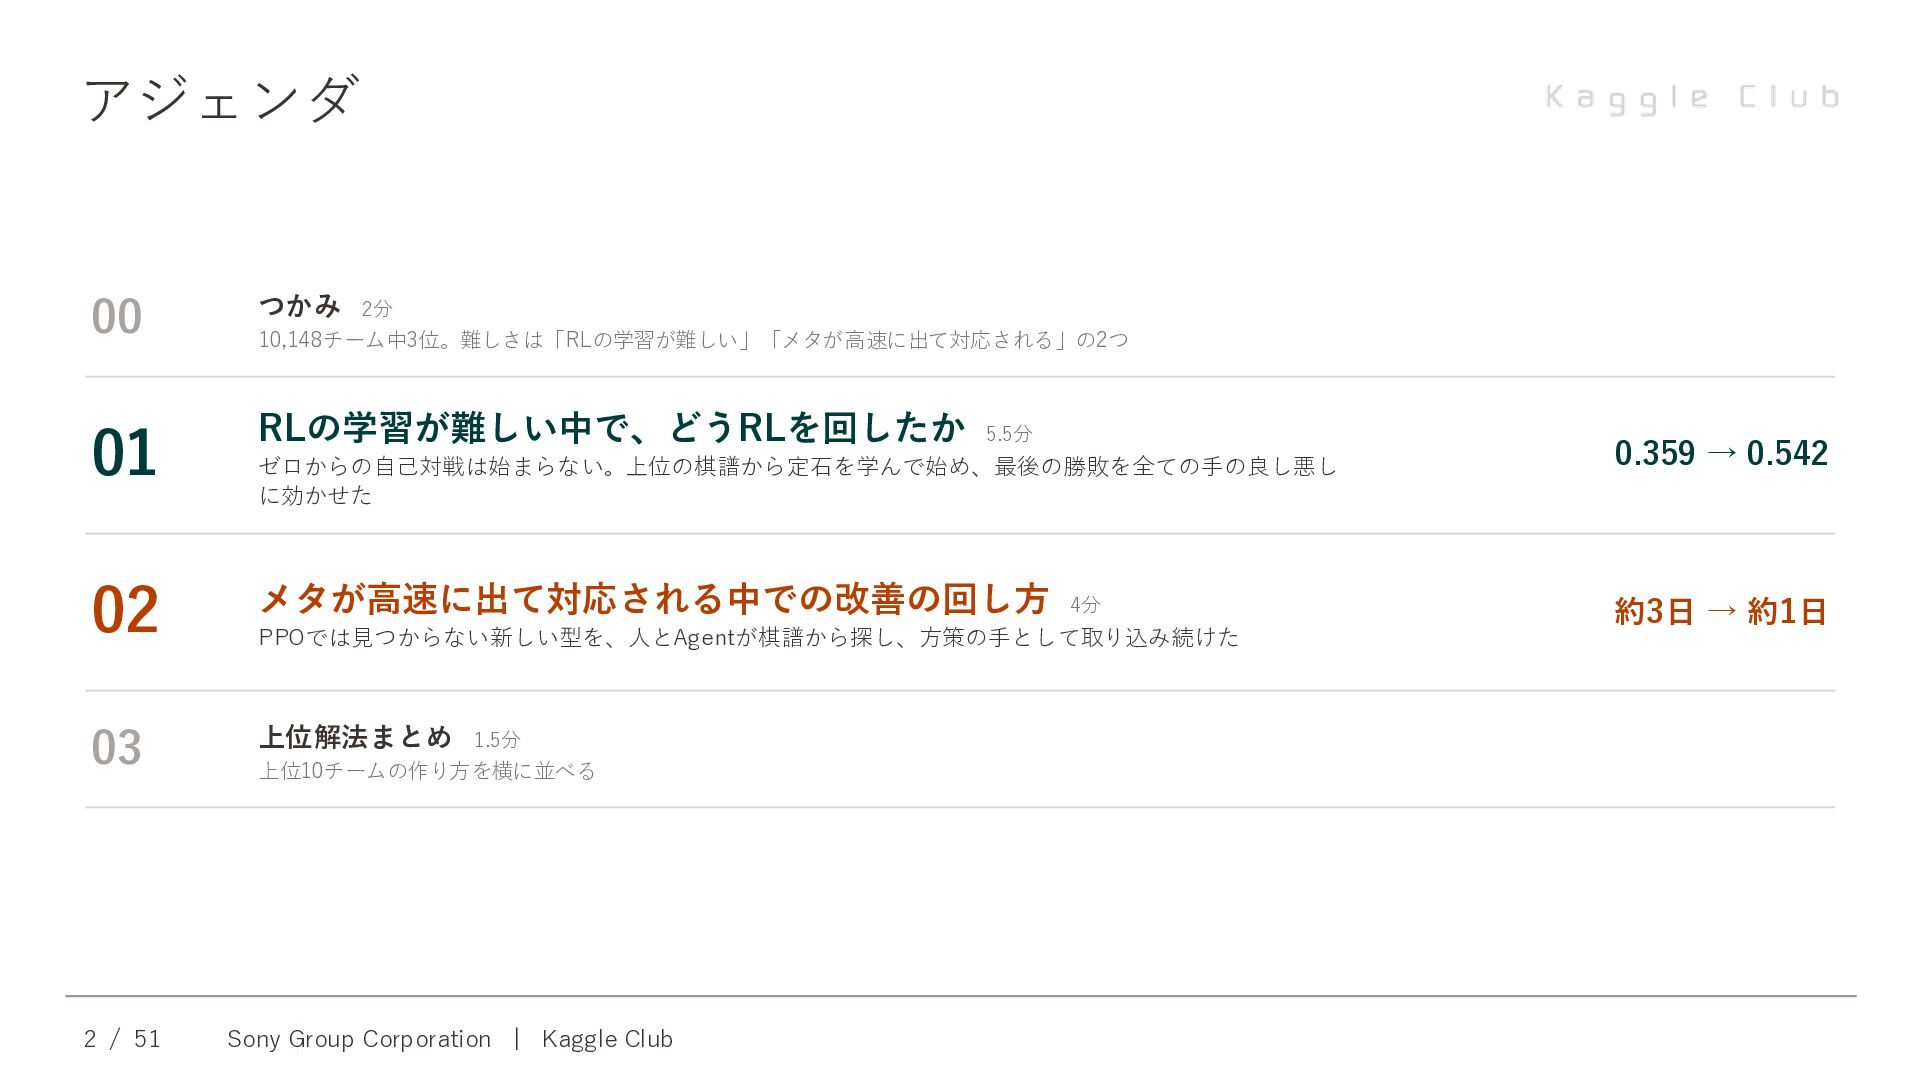
アジェンダ 00 つかみ 01 RLの学習が難しい中で、どうRLを回したか 5.5分 02 メタが高速に出て対応される中での改善の回し方 4分 03
上位解法まとめ 2 / 51 2分 10,148チーム中3位。難しさは「RLの学習が難しい」「メタが高速に出て対応される」の2つ ゼロからの自己対戦は始まらない。上位の棋譜から定石を学んで始め、最後の勝敗を全ての手の良し悪し に効かせた PPOでは見つからない新しい型を、人とAgentが棋譜から探し、方策の手として取り込み続けた 1.5分 上位10チームの作り方を横に並べる Sony Group Corporation | Kaggle Club 0.359 → 0.542 約3日 → 約1日 -
自己紹介とチーム Team DSM(3人) denden12 チームリーダー masspeaks(まっすー) 推論時の後処理、公式と完全一致するRustエンジン、評価ツール 増山 京太 「まっすー」と気軽に呼んでください
• ソニーグループ データサイエンティスト • 今回の担当:BC・非同期PPOの学習基盤、リーグ とゲート、リプレイ分析、学習時の介入 shimishige 最終提出モデルの学習(21→70世代目、H200×4) • 前回のポケカコンペは銀メダル止まり → 今回リベ ンジ masspeaks(まっすー) 発表者 BC+PPOの学習基盤、リーグ、リプレイ分析、学習時の介入 denden12さんのXの投稿「完全Copyではない戦略で勝つ」に共鳴して結成 3 / 51 Sony Group Corporation | Kaggle Club アイコン:各メンバーのKaggleプロフィール画像 -
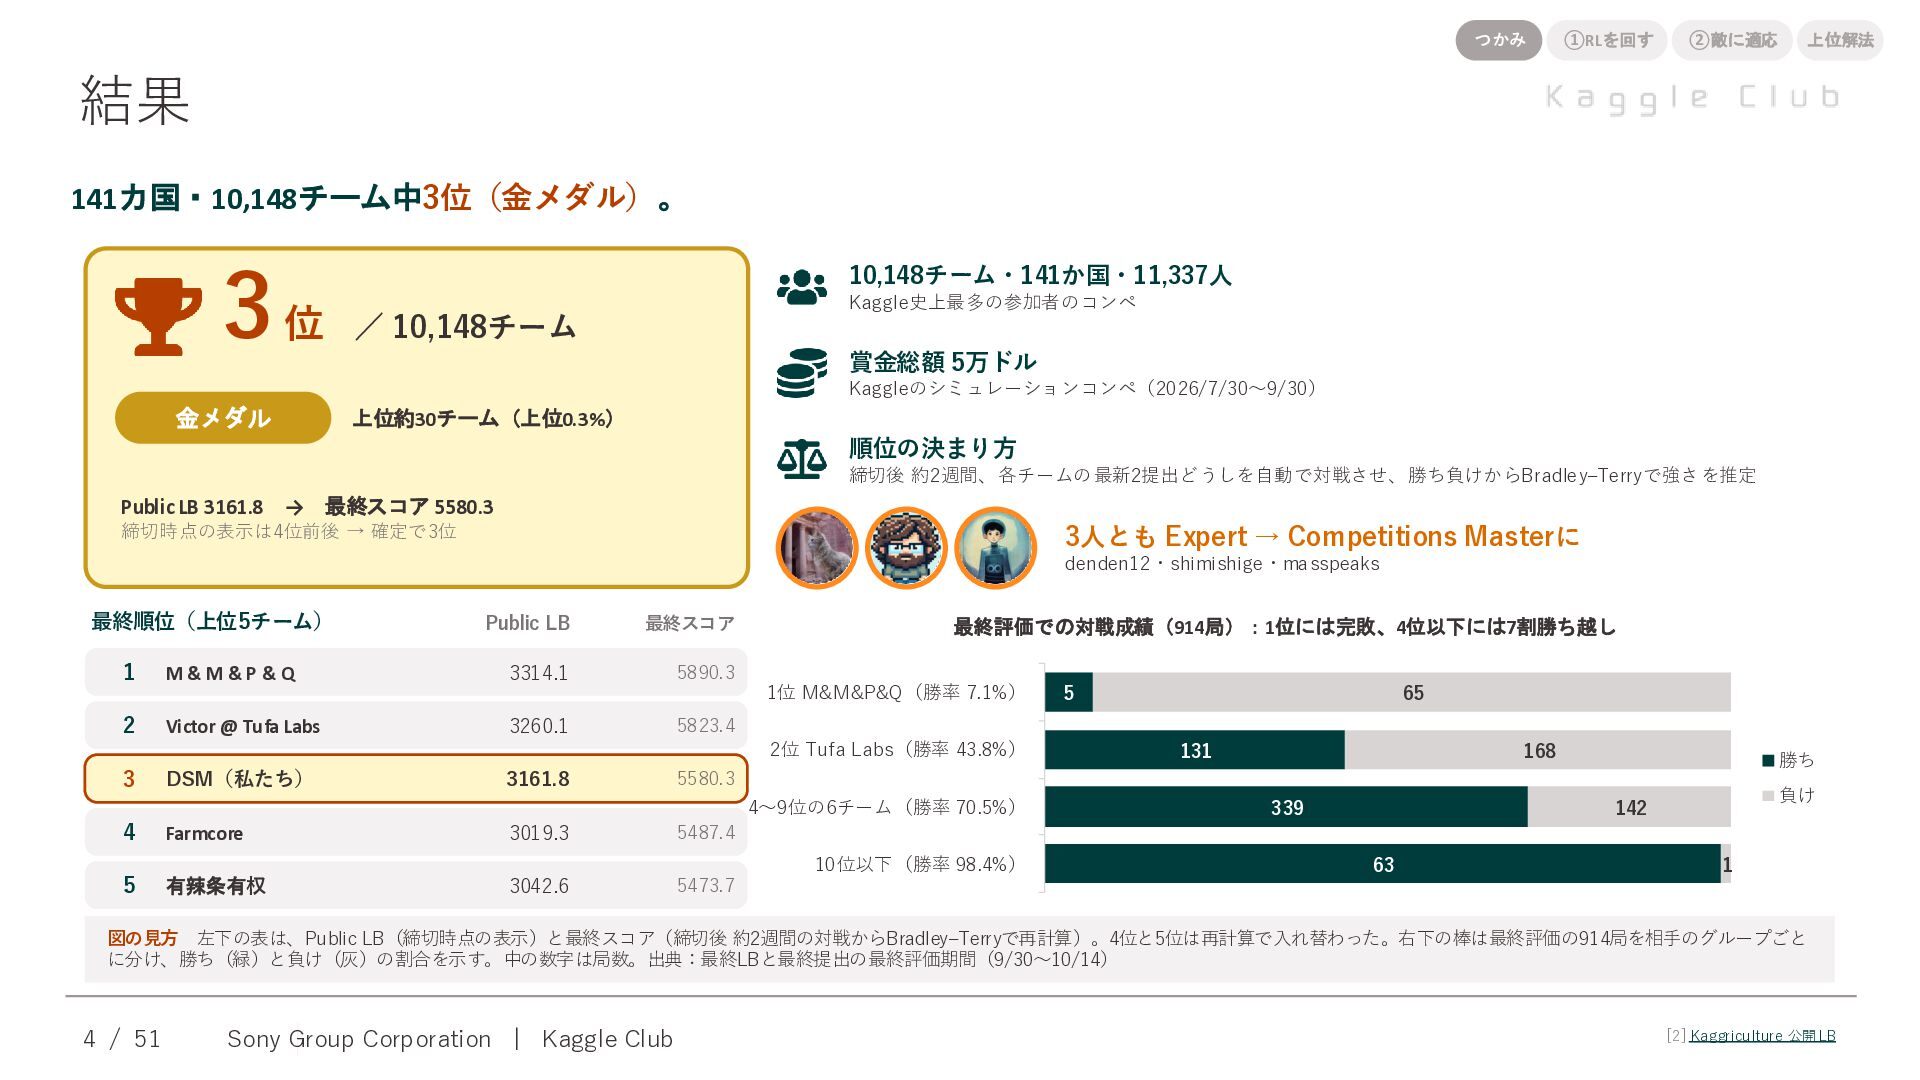
つかみ ①RLを回す ②敵に適応 上位解法 結果 141カ国・10,148チーム中3位(金メダル)。 3位 10,148チーム・141か国・11,337人 Kaggle史上最多の参加者のコンペ /
10,148チーム 賞金総額 5万ドル Kaggleのシミュレーションコンペ(2026/7/30〜9/30) 金メダル 上位約30チーム(上位0.3%) 順位の決まり方 締切後 約2週間、各チームの最新2提出どうしを自動で対戦させ、勝ち負けからBradley–Terryで強さを推定 Public LB 3161.8 → 最終スコア 5580.3 締切時点の表示は4位前後 → 確定で3位 3人とも Expert → Competitions Masterに denden12・shimishige・masspeaks 最終順位(上位5チーム) 1 2 Public LB 最終スコア M&M&P&Q 3314.1 5890.3 Victor @ Tufa Labs 3260.1 最終評価での対戦成績(914局):1位には完敗、4位以下には7割勝ち越し 1位 M&M&P&Q(勝率 7.1%) DSM(私たち) 3161.8 65 5823.4 2位 Tufa Labs(勝率 43.8%) 3 5 131 168 勝ち 5580.3 4〜9位の6チーム(勝率 70.5%) 4 Farmcore 3019.3 5487.4 5 有辣条有权 3042.6 5473.7 10位以下(勝率 98.4%) 339 負け 142 63 1 図の見方 左下の表は、Public LB(締切時点の表示)と最終スコア(締切後 約2週間の対戦からBradley–Terryで再計算)。4位と5位は再計算で入れ替わった。右下の棒は最終評価の914局を相手のグループごと に分け、勝ち(緑)と負け(灰)の割合を示す。中の数字は局数。出典:最終LBと最終提出の最終評価期間(9/30〜10/14) 4 / 51 Sony Group Corporation | Kaggle Club [2] Kaggricu lture 公開LB -
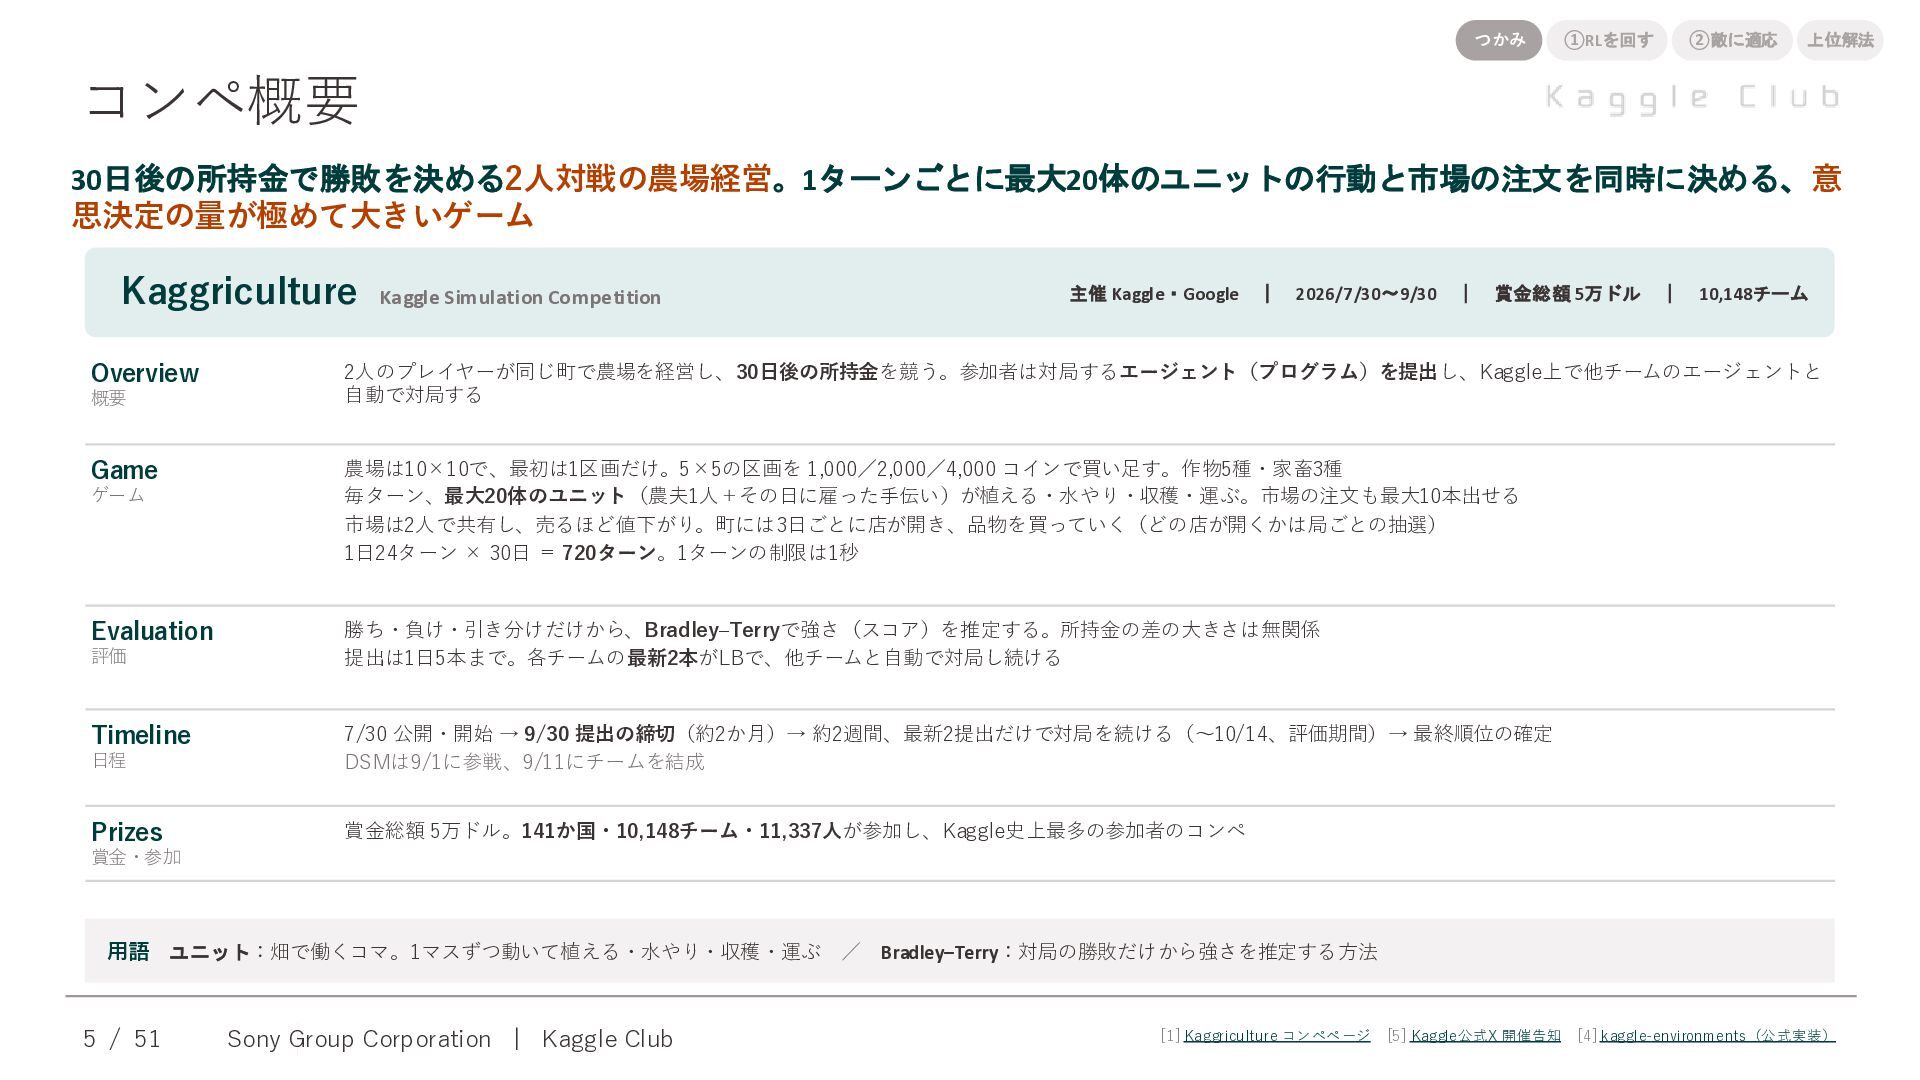
つかみ ①RLを回す ②敵に適応 上位解法 コンペ概要 30日後の所持金で勝敗を決める2人対戦の農場経営。1ターンごとに最大20体のユニットの行動と市場の注文を同時に決める、意 思決定の量が極めて大きいゲーム Kaggriculture Kaggle Simulation
Competition Overview 概要 Game ゲーム Evaluation 評価 Timeline 主催 Kaggle・Google | 2026/7/30〜9/30 | 賞金総額 5万ドル | 10,148チーム 2人のプレイヤーが同じ町で農場を経営し、30日後の所持金を競う。参加者は対局するエージェント(プログラム)を提出し、Kaggle上で他チームのエージェントと 自動で対局する 農場は10×10で、最初は1区画だけ。5×5の区画を 1,000/2,000/4,000 コインで買い足す。作物5種・家畜3種 毎ターン、最大20体のユニット(農夫1人+その日に雇った手伝い)が植える・水やり・収穫・運ぶ。市場の注文も最大10本出せる 市場は2人で共有し、売るほど値下がり。町には3日ごとに店が開き、品物を買っていく(どの店が開くかは局ごとの抽選) 1日24ターン × 30日 = 720ターン。1ターンの制限は1秒 勝ち・負け・引き分けだけから、Bradley–Terryで強さ(スコア)を推定する。所持金の差の大きさは無関係 提出は1日5本まで。各チームの最新2本がLBで、他チームと自動で対局し続ける 日程 7/30 公開・開始 → 9/30 提出の締切(約2か月)→ 約2週間、最新2提出だけで対局を続ける(〜10/14、評価期間)→ 最終順位の確定 DSMは9/1に参戦、9/11にチームを結成 Prizes 賞金総額 5万ドル。141か国・10,148チーム・11,337人が参加し、Kaggle史上最多の参加者のコンペ 賞金・参加 用語 ユニット:畑で働くコマ。1マスずつ動いて植える・水やり・収穫・運ぶ / Bradley–Terry:対局の勝敗だけから強さを推定する方法 5 / 51 Sony Group Corporation | Kaggle Club [1] Kaggricu lture コンペページ [5] Kaggle公式X 開催告知 [4] kaggle-environments(公 式実 装) -
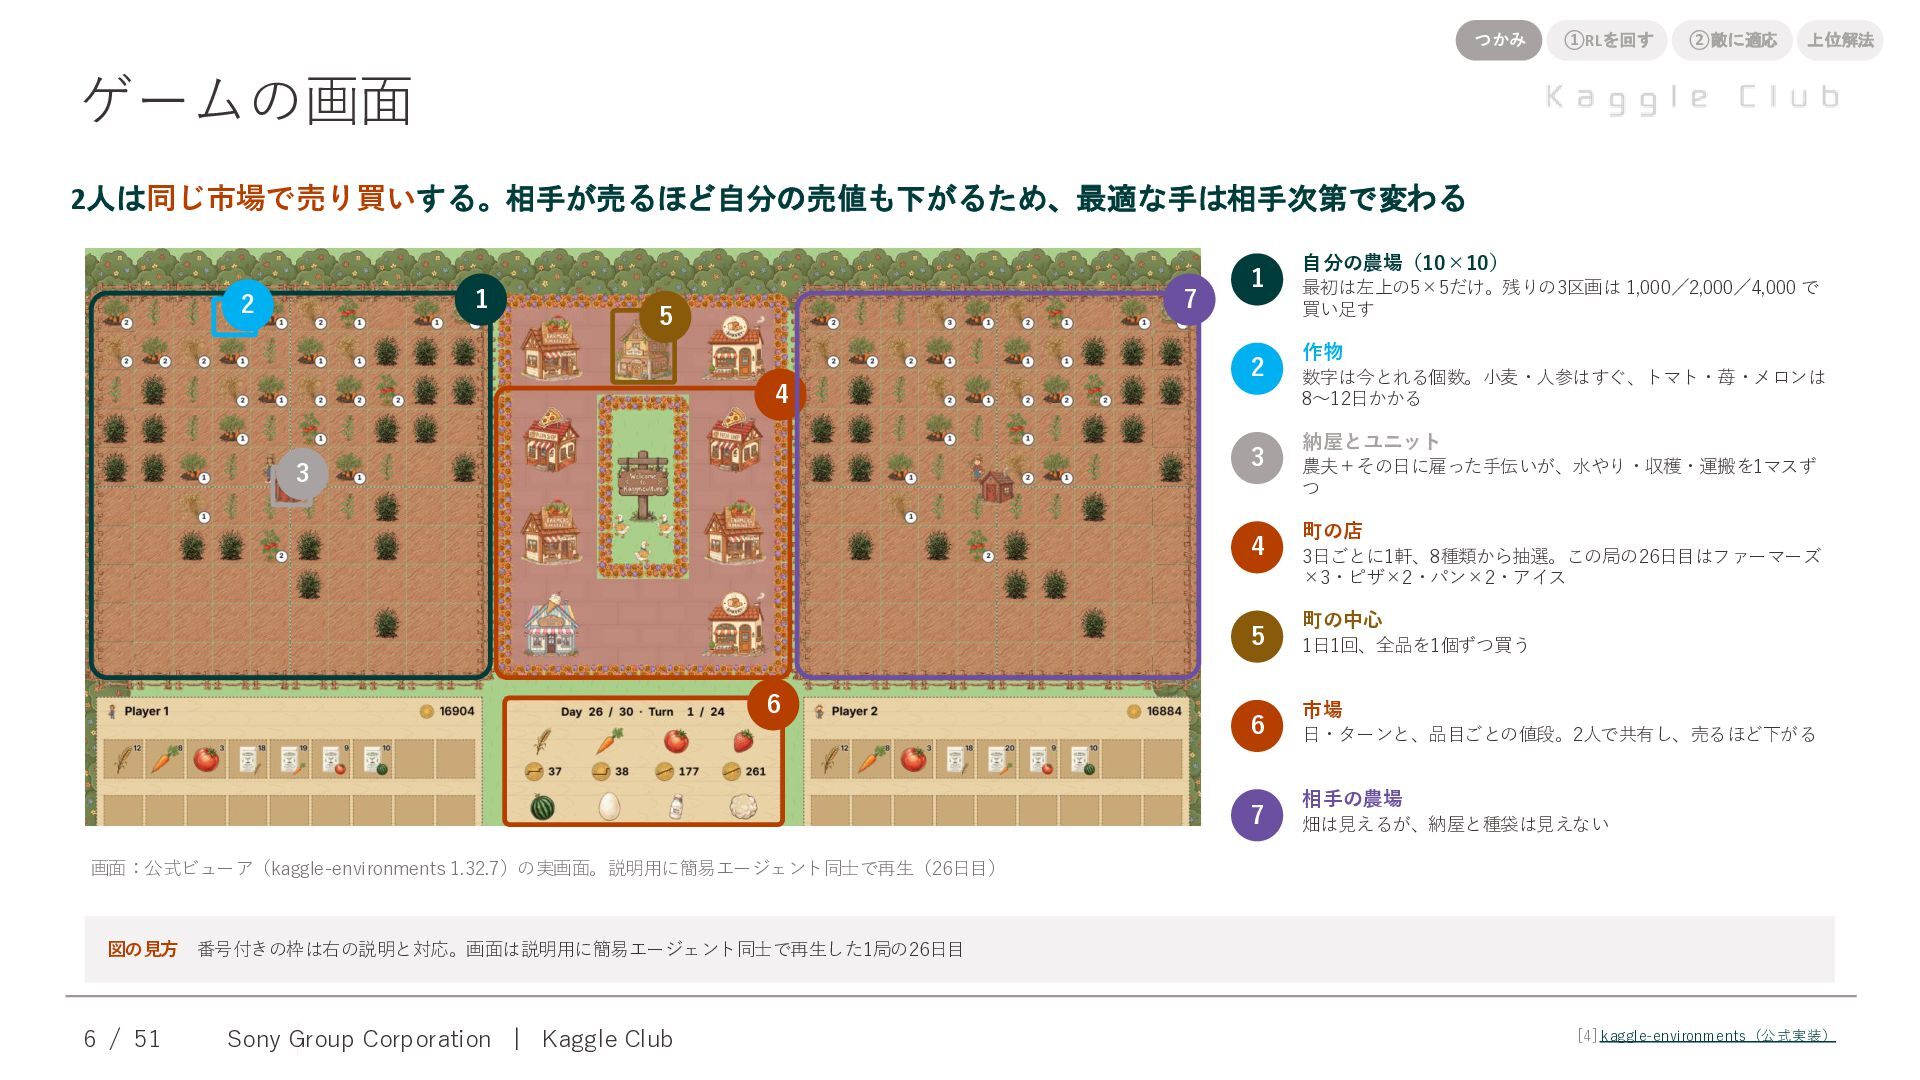
つかみ ①RLを回す ②敵に適応 上位解法 ゲームの画面 2人は同じ市場で売り買いする。相手が売るほど自分の売値も下がるため、最適な手は相手次第で変わる 1 2 7 5
1 2 4 3 3 4 5 6 6 7 自分の農場(10×10) 最初は左上の5×5だけ。残りの3区画は 1,000/2,000/4,000 で 買い足す 作物 数字は今とれる個数。小麦・人参はすぐ、トマト・苺・メロンは 8〜12日かかる 納屋とユニット 農夫+その日に雇った手伝いが、水やり・収穫・運搬を1マスず つ 町の店 3日ごとに1軒、8種類から抽選。この局の26日目はファーマーズ ×3・ピザ×2・パン×2・アイス 町の中心 1日1回、全品を1個ずつ買う 市場 日・ターンと、品目ごとの値段。2人で共有し、売るほど下がる 相手の農場 畑は見えるが、納屋と種袋は見えない 画面:公式ビューア(kaggle-environments 1.32.7)の実画面。説明用に簡易エージェント同士で再生(26日目) 図の見方 番号付きの枠は右の説明と対応。画面は説明用に簡易エージェント同士で再生した1局の26日目 6 / 51 Sony Group Corporation | Kaggle Club [4] kaggle-environments(公 式実 装) -
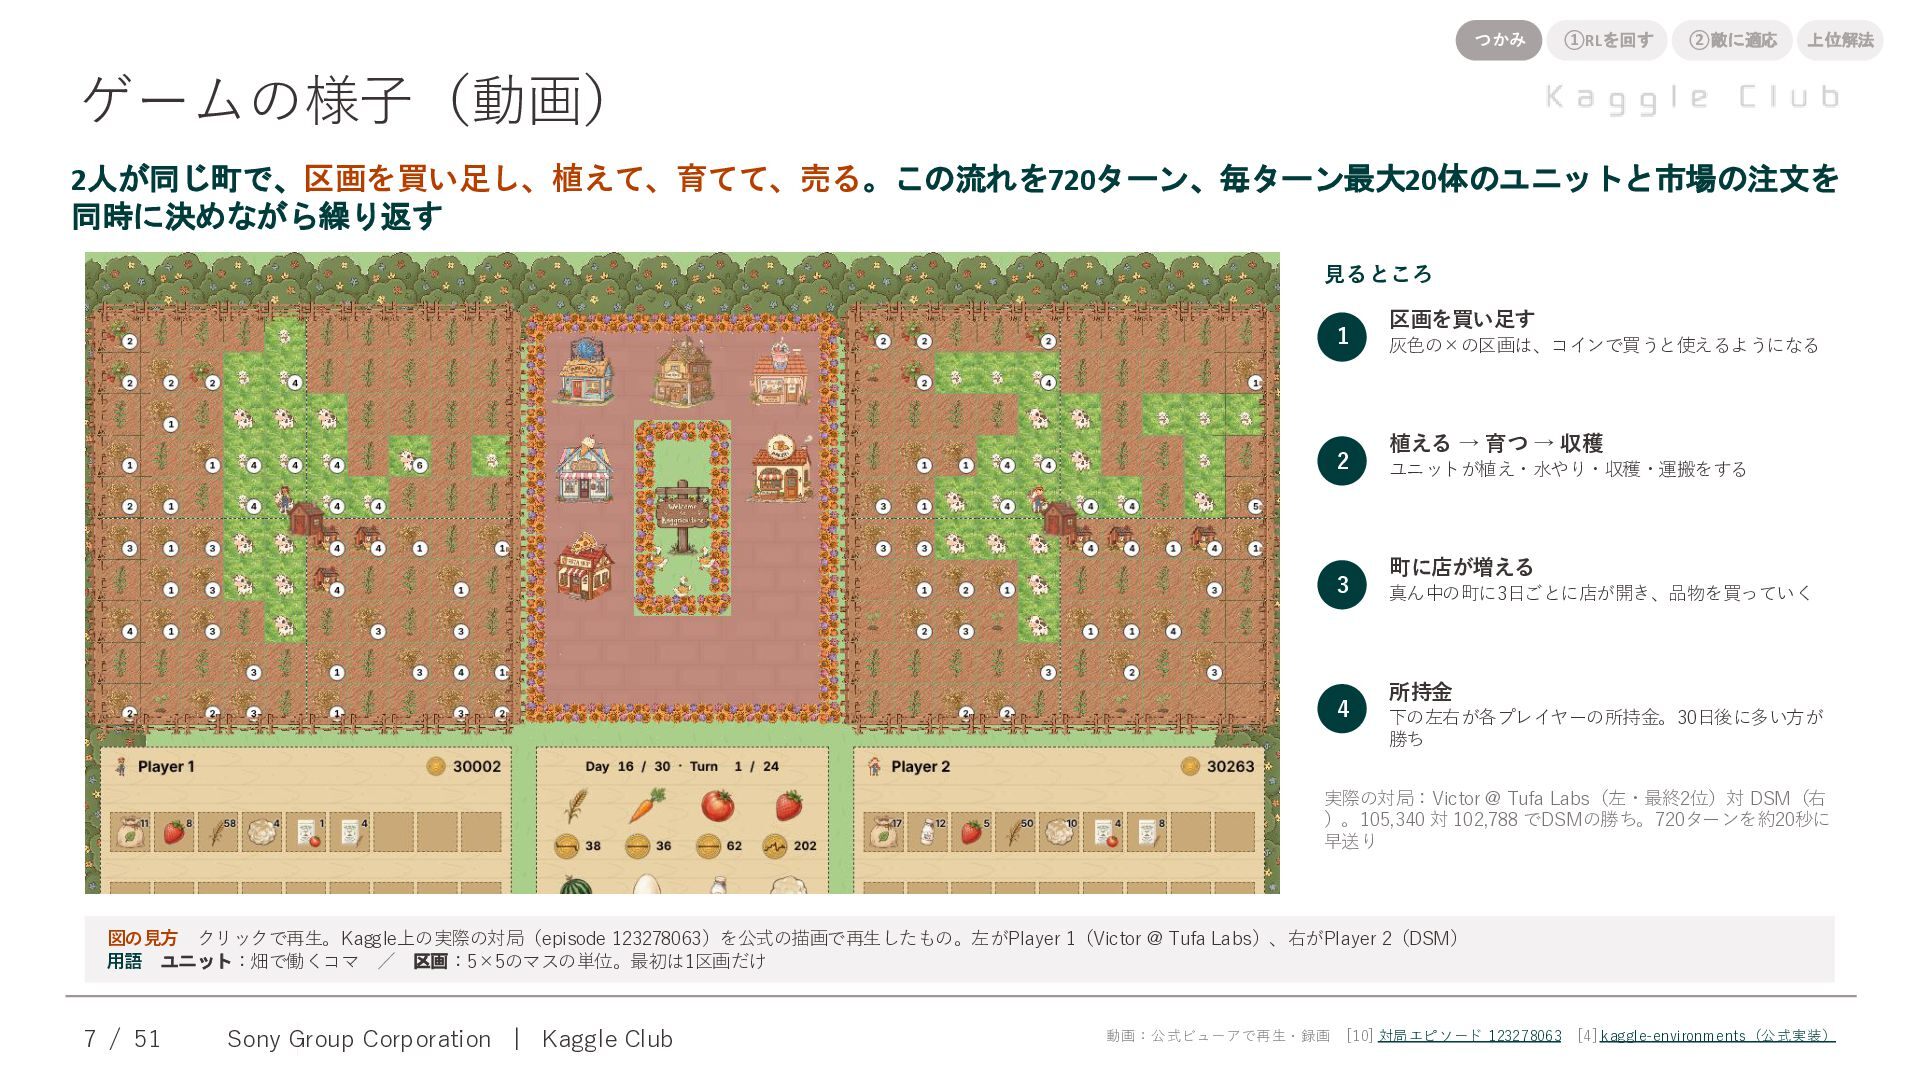
つかみ ①RLを回す ②敵に適応 上位解法 ゲームの様子(動画) 2人が同じ町で、区画を買い足し、植えて、育てて、売る。この流れを720ターン、毎ターン最大20体のユニットと市場の注文を 同時に決めながら繰り返す 見るところ 1 2
3 4 区画を買い足す 灰色の×の区画は、コインで買うと使えるようになる 植える → 育つ → 収穫 ユニットが植え・水やり・収穫・運搬をする 町に店が増える 真ん中の町に3日ごとに店が開き、品物を買っていく 所持金 下の左右が各プレイヤーの所持金。30日後に多い方が 勝ち 実際の対局:Victor @ Tufa Labs(左・最終2位)対 DSM(右 )。105,340 対 102,788 でDSMの勝ち。720ターンを約20秒に 早送り 図の見方 クリックで再生。Kaggle上の実際の対局(episode 123278063)を公式の描画で再生したもの。左がPlayer 1(Victor @ Tufa Labs)、右がPlayer 2(DSM) 用語 ユニット:畑で働くコマ / 区画:5×5のマスの単位。最初は1区画だけ 7 / 51 Sony Group Corporation | Kaggle Club 動画:公式ビューアで再生・録画 [10] 対局 エピ ソード 123278063 [4] kaggle-environments(公 式実 装) -
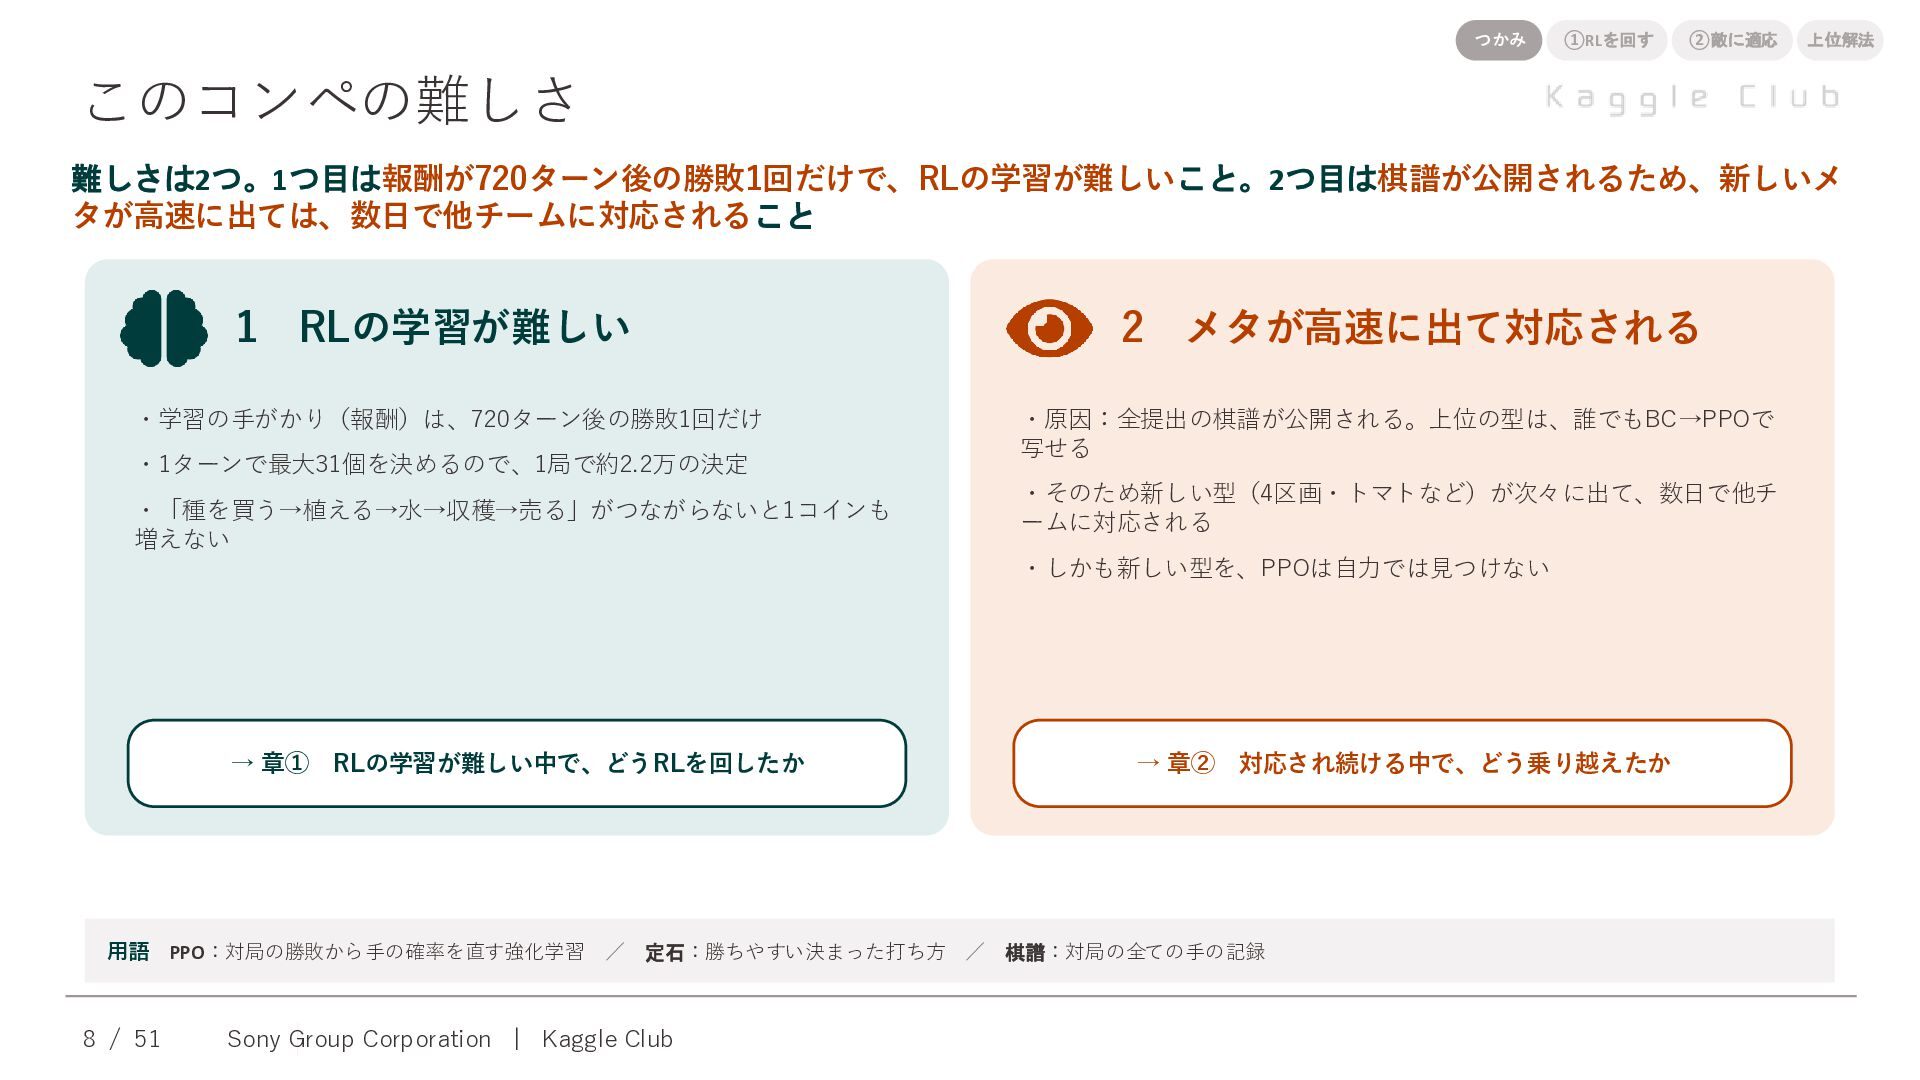
つかみ ①RLを回す ②敵に適応 上位解法 このコンペの難しさ 難しさは2つ。1つ目は報酬が720ターン後の勝敗1回だけで、RLの学習が難しいこと。2つ目は棋譜が公開されるため、新しいメ タが高速に出ては、数日で他チームに対応されること 1 RLの学習が難しい 2
メタが高速に出て対応される ・学習の手がかり(報酬)は、720ターン後の勝敗1回だけ ・原因:全提出の棋譜が公開される。上位の型は、誰でもBC→PPOで 写せる ・1ターンで最大31個を決めるので、1局で約2.2万の決定 ・「種を買う→植える→水→収穫→売る」がつながらないと1コインも 増えない ・そのため新しい型(4区画・トマトなど)が次々に出て、数日で他チ ームに対応される ・しかも新しい型を、PPOは自力では見つけない → 章① RLの学習が難しい中で、どうRLを回したか → 章② 対応され続ける中で、どう乗り越えたか 用語 PPO:対局の勝敗から手の確率を直す強化学習 / 定石:勝ちやすい決まった打ち方 / 棋譜:対局の全ての手の記録 8 / 51 Sony Group Corporation | Kaggle Club -
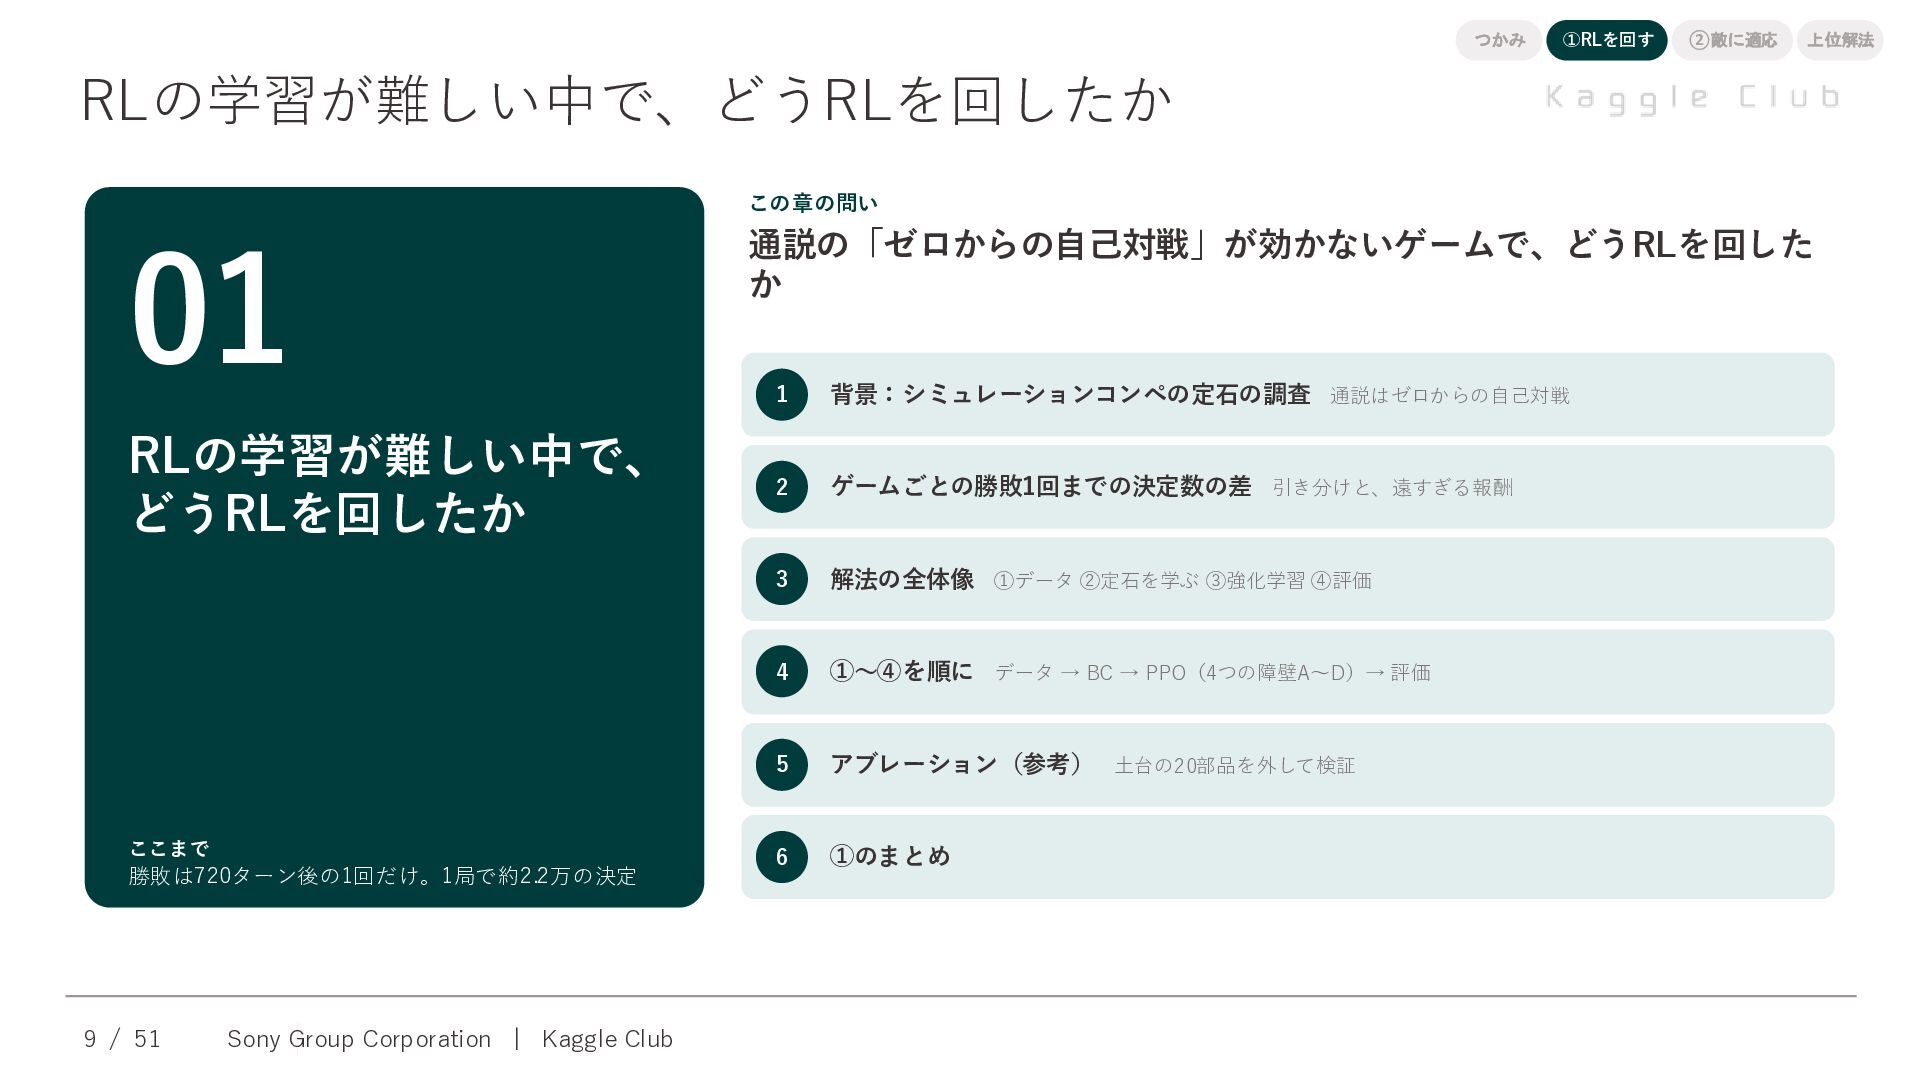
つかみ ①RLを回す ②敵に適応 上位解法 RLの学習が難しい中で、どうRLを回したか この章の問い 01 RLの学習が難しい中で、 どうRLを回したか ここまで
勝敗は720ターン後の1回だけ。1局で約2.2万の決定 9 / 51 Sony Group Corporation | Kaggle Club 通説の「ゼロからの自己対戦」が効かないゲームで、どうRLを回した か 1 背景:シミュレーションコンペの定石の調査 通説はゼロからの自己対戦 2 ゲームごとの勝敗1回までの決定数の差 引き分けと、遠すぎる報酬 3 解法の全体像 ①データ ②定石を学ぶ ③強化学習 ④評価 4 ①〜④を順に データ → BC → PPO(4つの障壁A〜D)→ 評価 5 アブレーション(参考) 土台の20部品を外して検証 6 ①のまとめ -
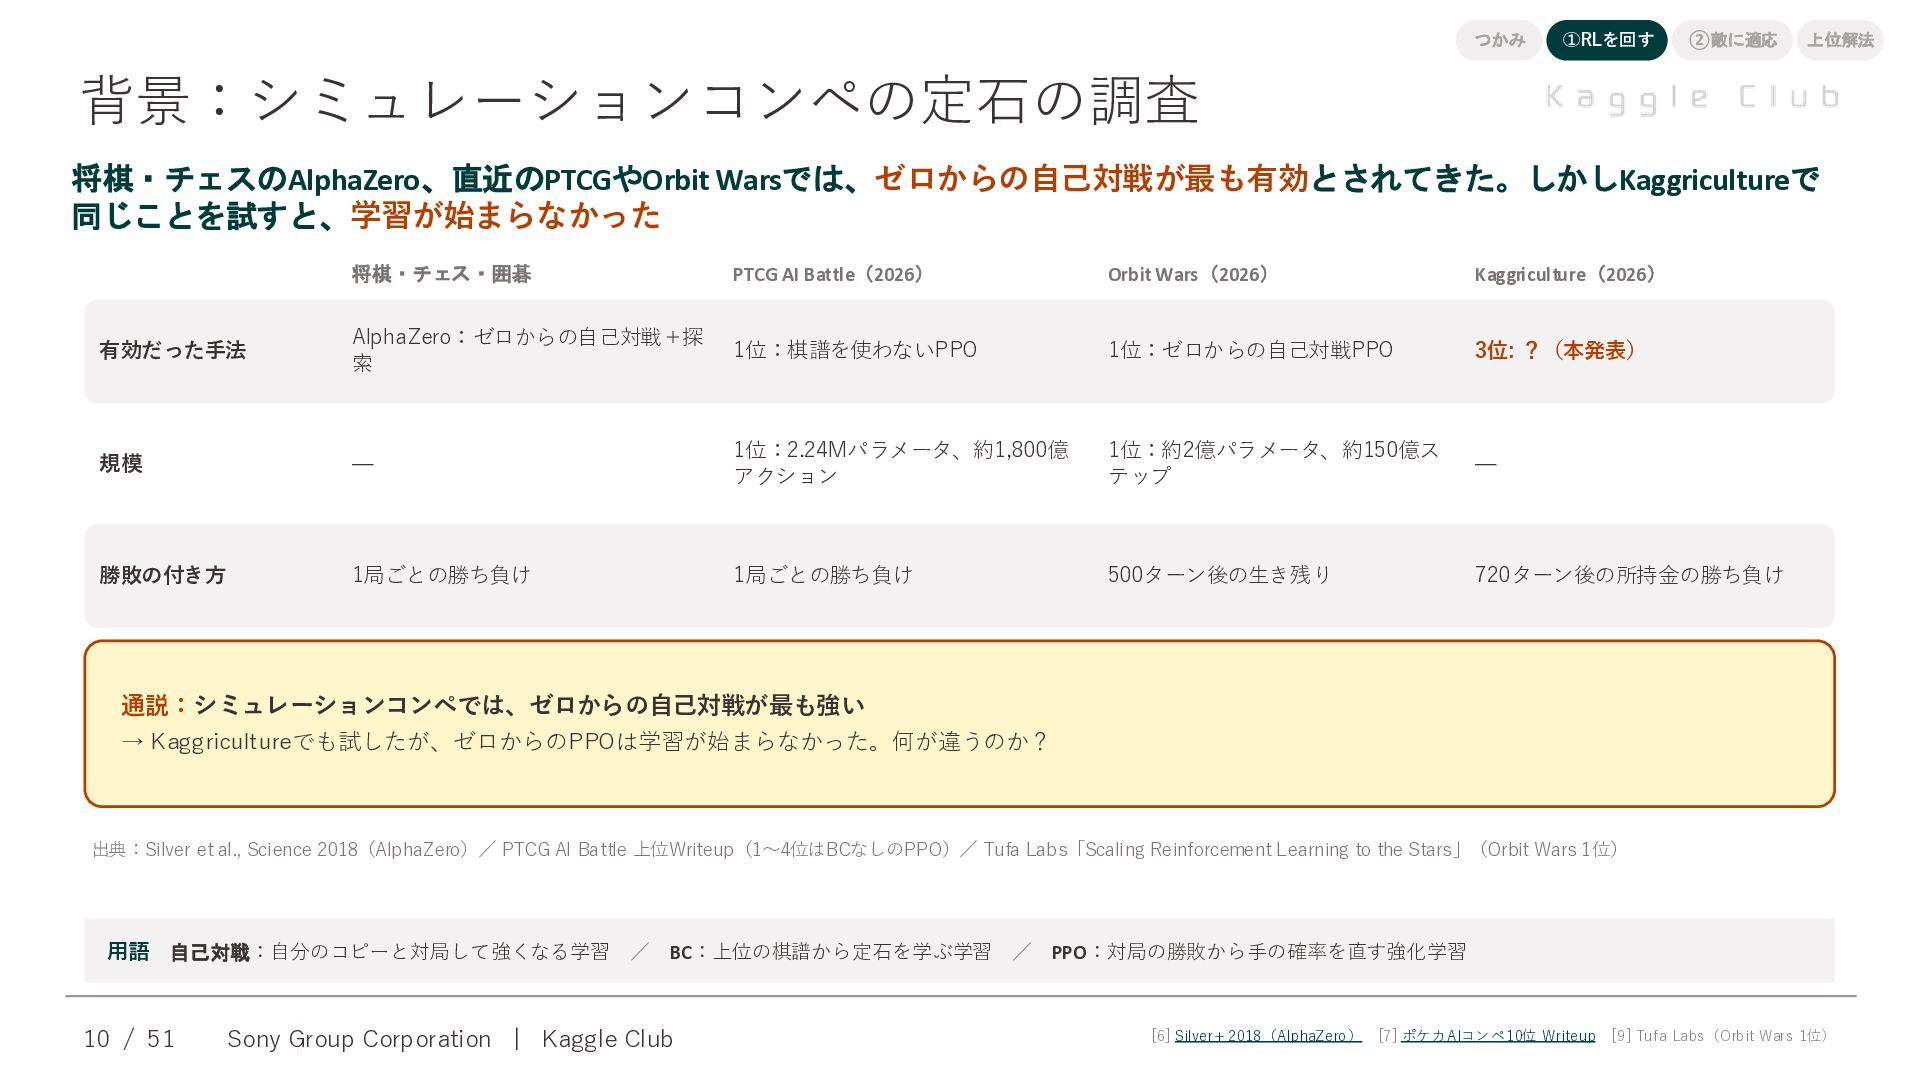
つかみ ①RLを回す ②敵に適応 上位解法 背景:シミュレーションコンペの定石の調査 将棋・チェスのAlphaZero、直近のPTCGやOrbit Warsでは、ゼロからの自己対戦が最も有効とされてきた。しかしKaggricultureで 同じことを試すと、学習が始まらなかった 将棋・チェス・囲碁 PTCG
AI Battle(2026) Orbit Wars(2026) Kaggriculture(2026) 有効だった手法 AlphaZero:ゼロからの自己対戦+探 索 1位:棋譜を使わないPPO 1位:ゼロからの自己対戦PPO 3位: ?(本発表) 規模 — 1位:2.24Mパラメータ、約1,800億 アクション 1位:約2億パラメータ、約150億ス テップ — 勝敗の付き方 1局ごとの勝ち負け 1局ごとの勝ち負け 500ターン後の生き残り 720ターン後の所持金の勝ち負け 通説:シミュレーションコンペでは、ゼロからの自己対戦が最も強い → Kaggricultureでも試したが、ゼロからのPPOは学習が始まらなかった。何が違うのか? 出典:Silver et al., Science 2018(AlphaZero)/ PTCG AI Battle 上位Writeup(1〜4位はBCなしのPPO)/ Tufa Labs「Scaling Reinforcement Learning to the Stars」(Orbit Wars 1位) 用語 自己対戦:自分のコピーと対局して強くなる学習 / BC:上位の棋譜から定石を学ぶ学習 / PPO:対局の勝敗から手の確率を直す強化学習 10 / 51 Sony Group Corporation | Kaggle Club [6] Silver+ 2018(AlphaZero) [7] ポケカAIコンペ10位 Writeup [9] Tufa Labs(Orb it Wars 1位) -
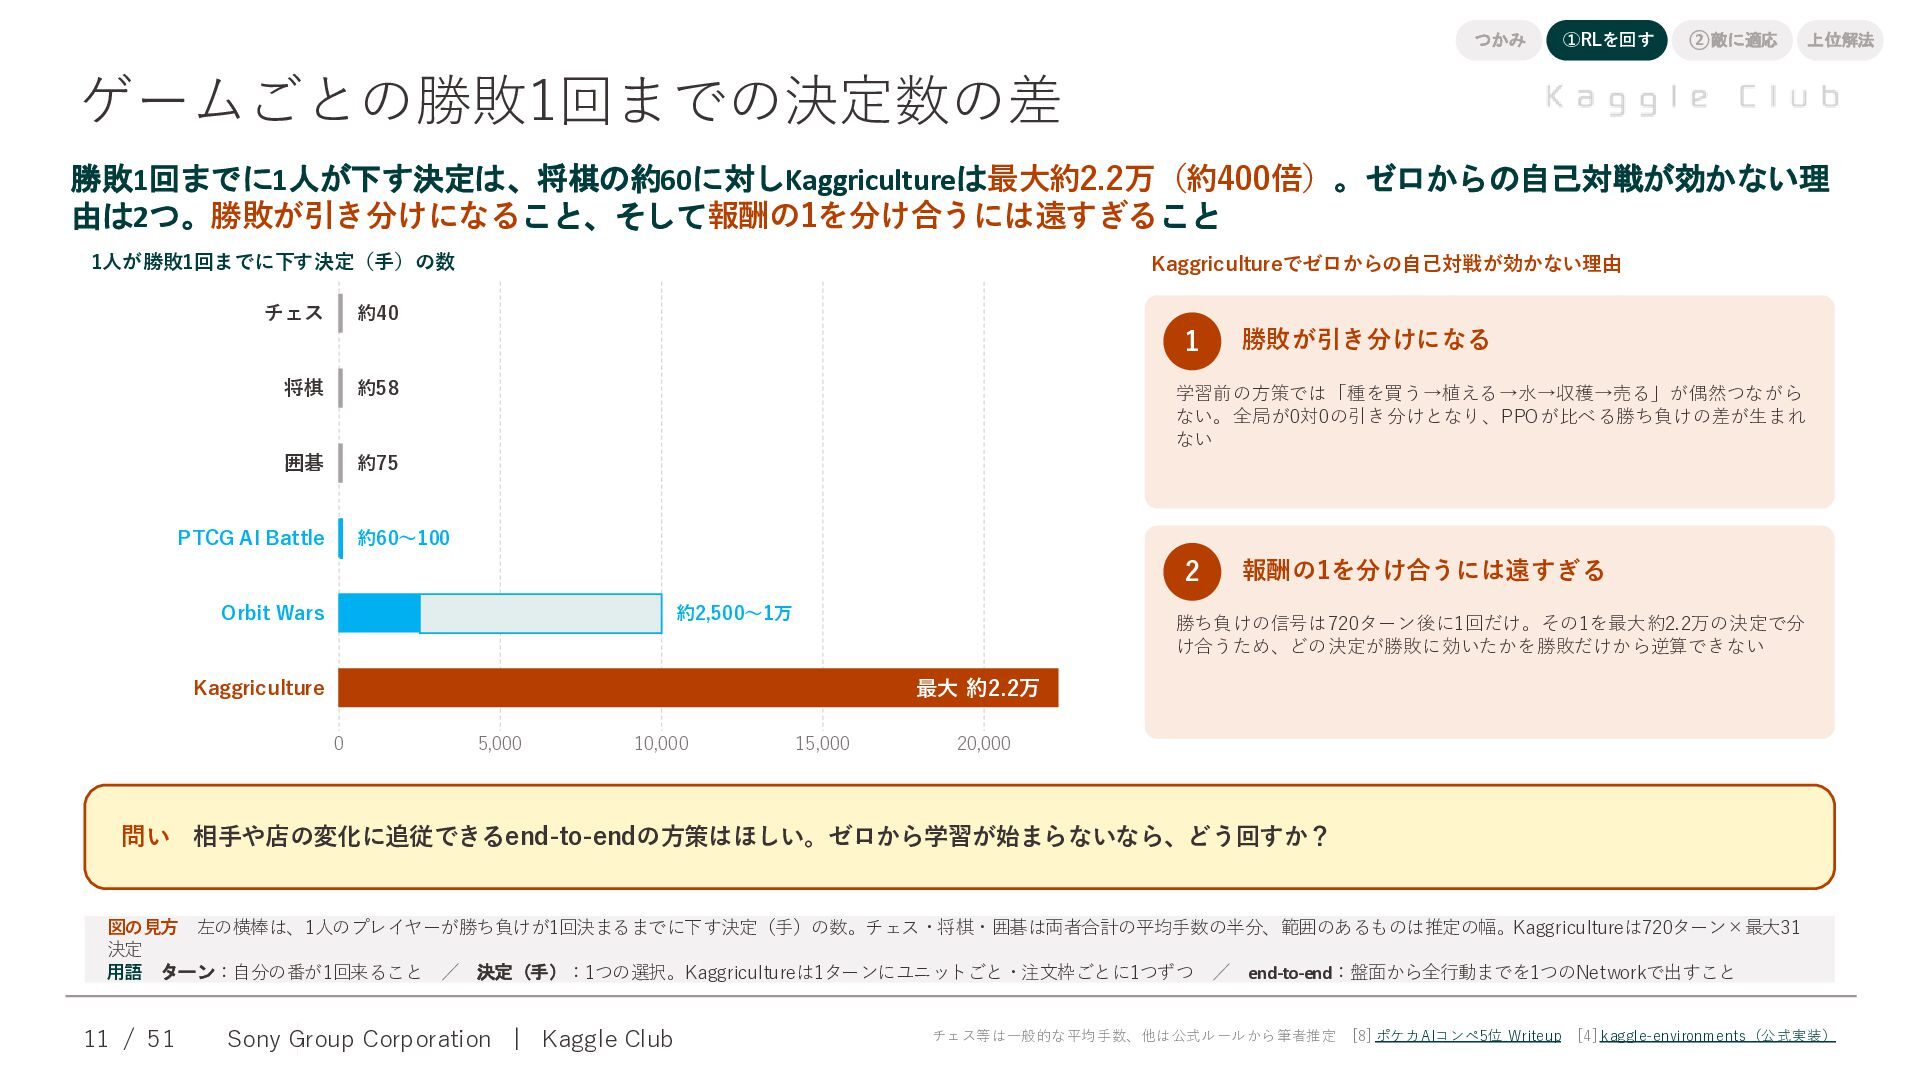
つかみ ①RLを回す ②敵に適応 上位解法 ゲームごとの勝敗1回までの決定数の差 勝敗1回までに1人が下す決定は、将棋の約60に対しKaggricultureは最大約2.2万(約400倍)。ゼロからの自己対戦が効かない理 由は2つ。勝敗が引き分けになること、そして報酬の1を分け合うには遠すぎること 1人が勝敗1回までに下す決定(手)の数 チェス Kaggricultureでゼロからの自己対戦が効かない理由
約40 1 将棋 約58 囲碁 約75 PTCG AI Battle 勝敗が引き分けになる 学習前の方策では「種を買う→植える→水→収穫→売る」が偶然つながら ない。全局が0対0の引き分けとなり、PPOが比べる勝ち負けの差が生まれ ない 約60〜100 2 Orbit Wars 約2,500〜1万 報酬の1を分け合うには遠すぎる 勝ち負けの信号は720ターン後に1回だけ。その1を最大約2.2万の決定で分 け合うため、どの決定が勝敗に効いたかを勝敗だけから逆算できない 最大 約2.2万 Kaggriculture 0 5,000 10,000 15,000 20,000 問い 相手や店の変化に追従できるend-to-endの方策はほしい。ゼロから学習が始まらないなら、どう回すか? 図の見方 左の横棒は、1人のプレイヤーが勝ち負けが1回決まるまでに下す決定(手)の数。チェス・将棋・囲碁は両者合計の平均手数の半分、範囲のあるものは推定の幅。Kaggricultureは720ターン×最大31 決定 用語 ターン:自分の番が1回来ること / 決定(手):1つの選択。Kaggricultureは1ターンにユニットごと・注文枠ごとに1つずつ / end-to-end:盤面から全行動までを1つのNetworkで出すこと 11 / 51 Sony Group Corporation | Kaggle Club チェス等は一般的な平均手数、他は公式ルールから筆者推定 [8] ポケカAIコンペ5位 Writeup [4] kaggle-environments(公 式実 装) -
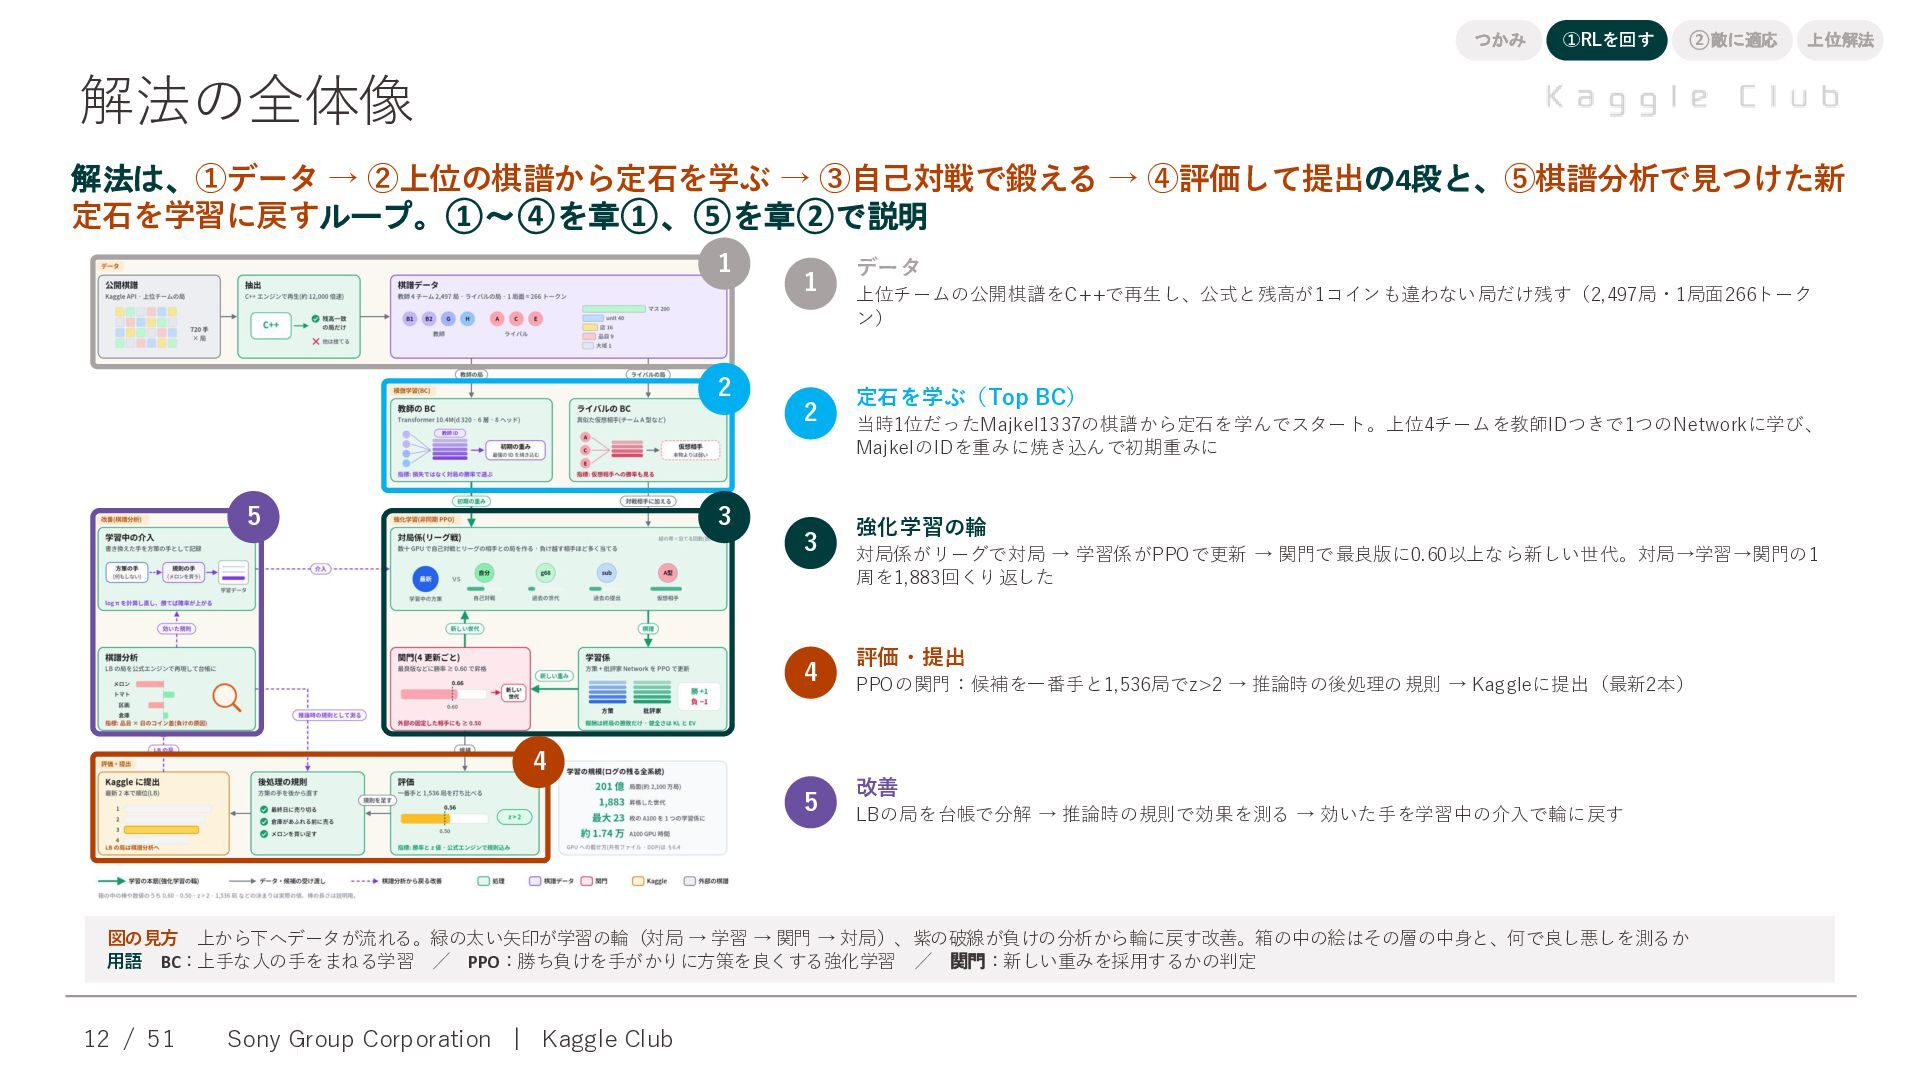
つかみ ①RLを回す ②敵に適応 上位解法 解法の全体像 解法は、①データ → ②上位の棋譜から定石を学ぶ → ③自己対戦で鍛える
→ ④評価して提出の4段と、⑤棋譜分析で見つけた新 定石を学習に戻すループ。①〜④を章①、⑤を章②で説明 1 1 2 2 5 3 3 4 データ 上位チームの公開棋譜をC++で再生し、公式と残高が1コインも違わない局だけ残す(2,497局・1局面266トーク ン) 定石を学ぶ(Top BC) 当時1位だったMajkel1337の棋譜から定石を学んでスタート。上位4チームを教師IDつきで1つのNetworkに学び、 MajkelのIDを重みに焼き込んで初期重みに 強化学習の輪 対局係がリーグで対局 → 学習係がPPOで更新 → 関門で最良版に0.60以上なら新しい世代。対局→学習→関門の1 周を1,883回くり返した 評価・提出 PPOの関門:候補を一番手と1,536局でz>2 → 推論時の後処理の規則 → Kaggleに提出(最新2本) 4 5 改善 LBの局を台帳で分解 → 推論時の規則で効果を測る → 効いた手を学習中の介入で輪に戻す 図の見方 上から下へデータが流れる。緑の太い矢印が学習の輪(対局 → 学習 → 関門 → 対局)、紫の破線が負けの分析から輪に戻す改善。箱の中の絵はその層の中身と、何で良し悪しを測るか 用語 BC:上手な人の手をまねる学習 / PPO:勝ち負けを手がかりに方策を良くする強化学習 / 関門:新しい重みを採用するかの判定 12 / 51 Sony Group Corporation | Kaggle Club -
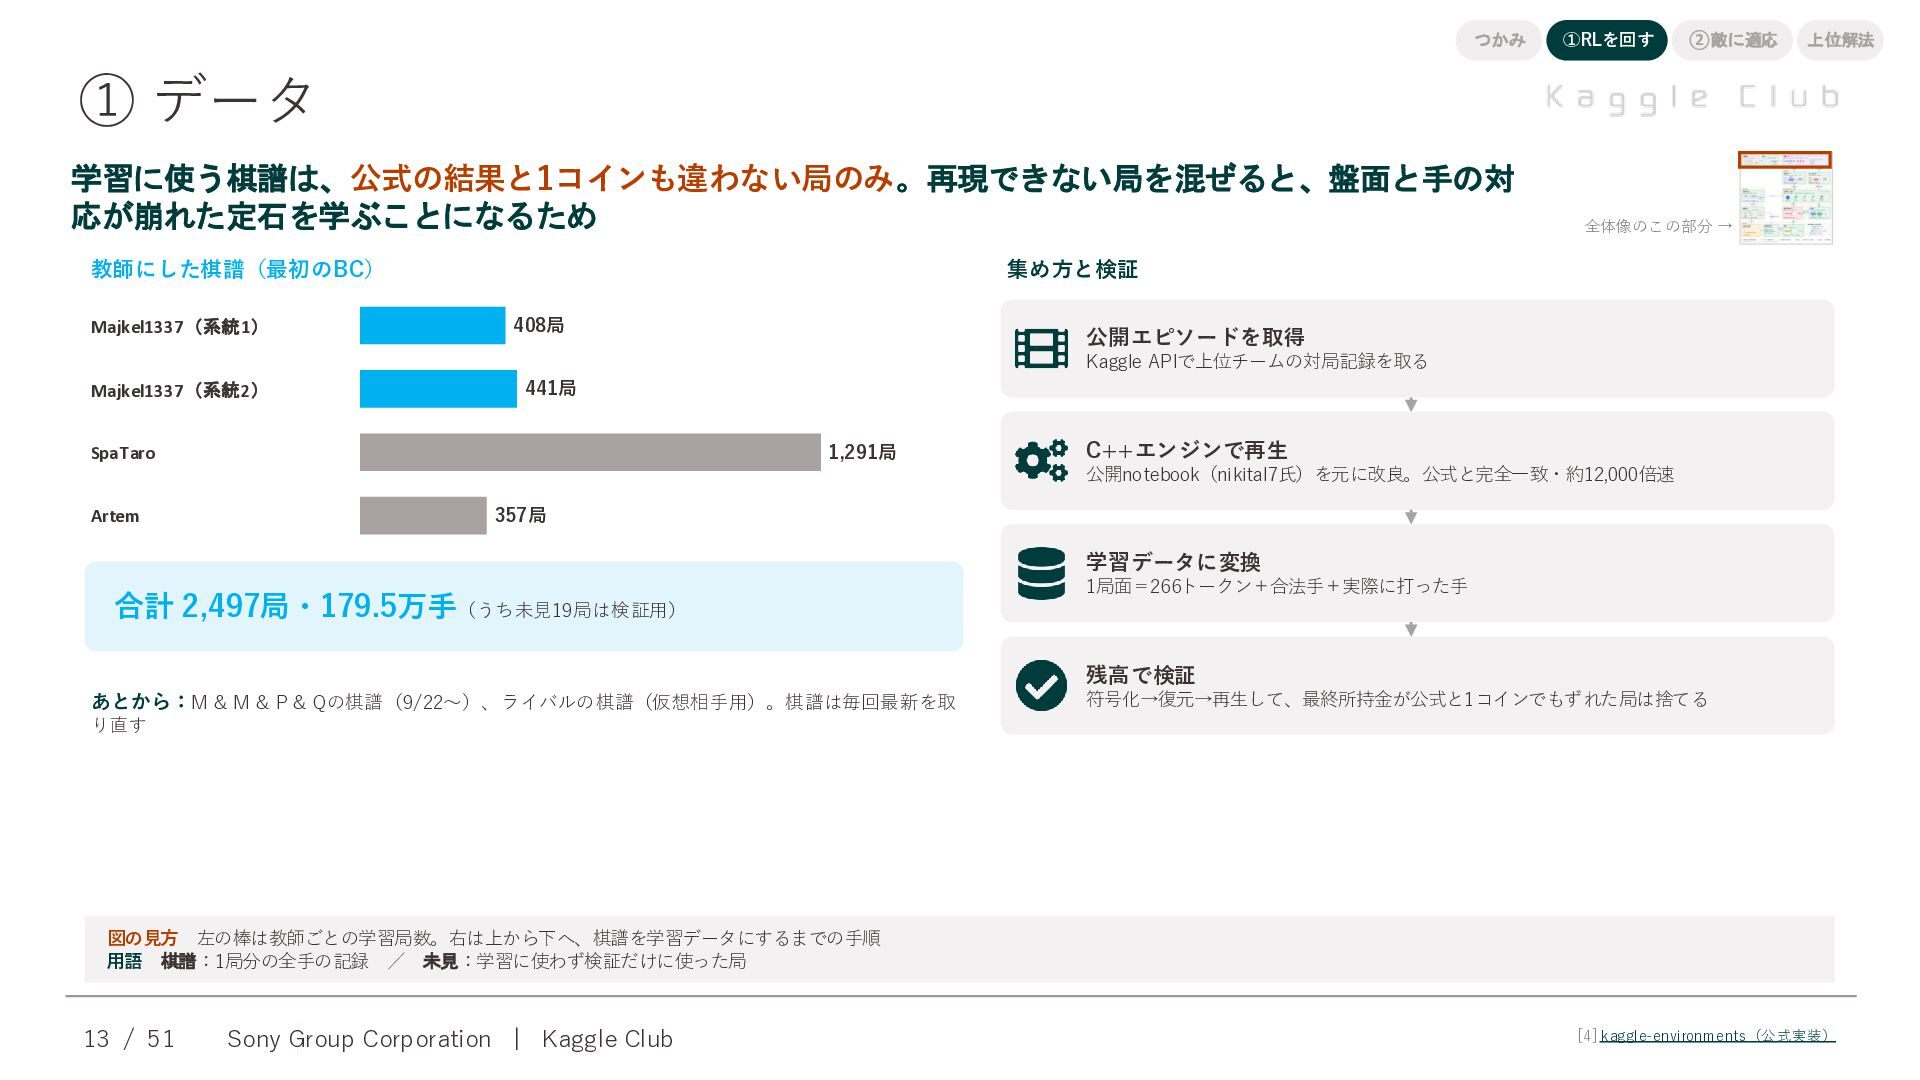
つかみ ①RLを回す ②敵に適応 上位解法 ① データ 学習に使う棋譜は、公式の結果と1コインも違わない局のみ。再現できない局を混ぜると、盤面と手の対 応が崩れた定石を学ぶことになるため 教師にした棋譜(最初のBC) 全体像のこの部分
→ 集め方と検証 Majkel1337(系統1) 408局 Majkel1337(系統2) 441局 公開エピソードを取得 Kaggle APIで上位チームの対局記録を取る 1,291局 SpaTaro C++エンジンで再生 公開notebook(nikital7氏)を元に改良。公式と完全一致・約12,000倍速 Artem 357局 学習データに変換 合計 2,497局・179.5万手(うち未見19局は検証用) 1局面=266トークン+合法手+実際に打った手 残高で検証 あとから:M & M & P & Qの棋譜(9/22〜)、ライバルの棋譜(仮想相手用)。棋譜は毎回最新を取 符号化→復元→再生して、最終所持金が公式と1コインでもずれた局は捨てる り直す 図の見方 左の棒は教師ごとの学習局数。右は上から下へ、棋譜を学習データにするまでの手順 用語 棋譜:1局分の全手の記録 / 未見:学習に使わず検証だけに使った局 13 / 51 Sony Group Corporation | Kaggle Club [4] kaggle-environments(公 式実 装) -
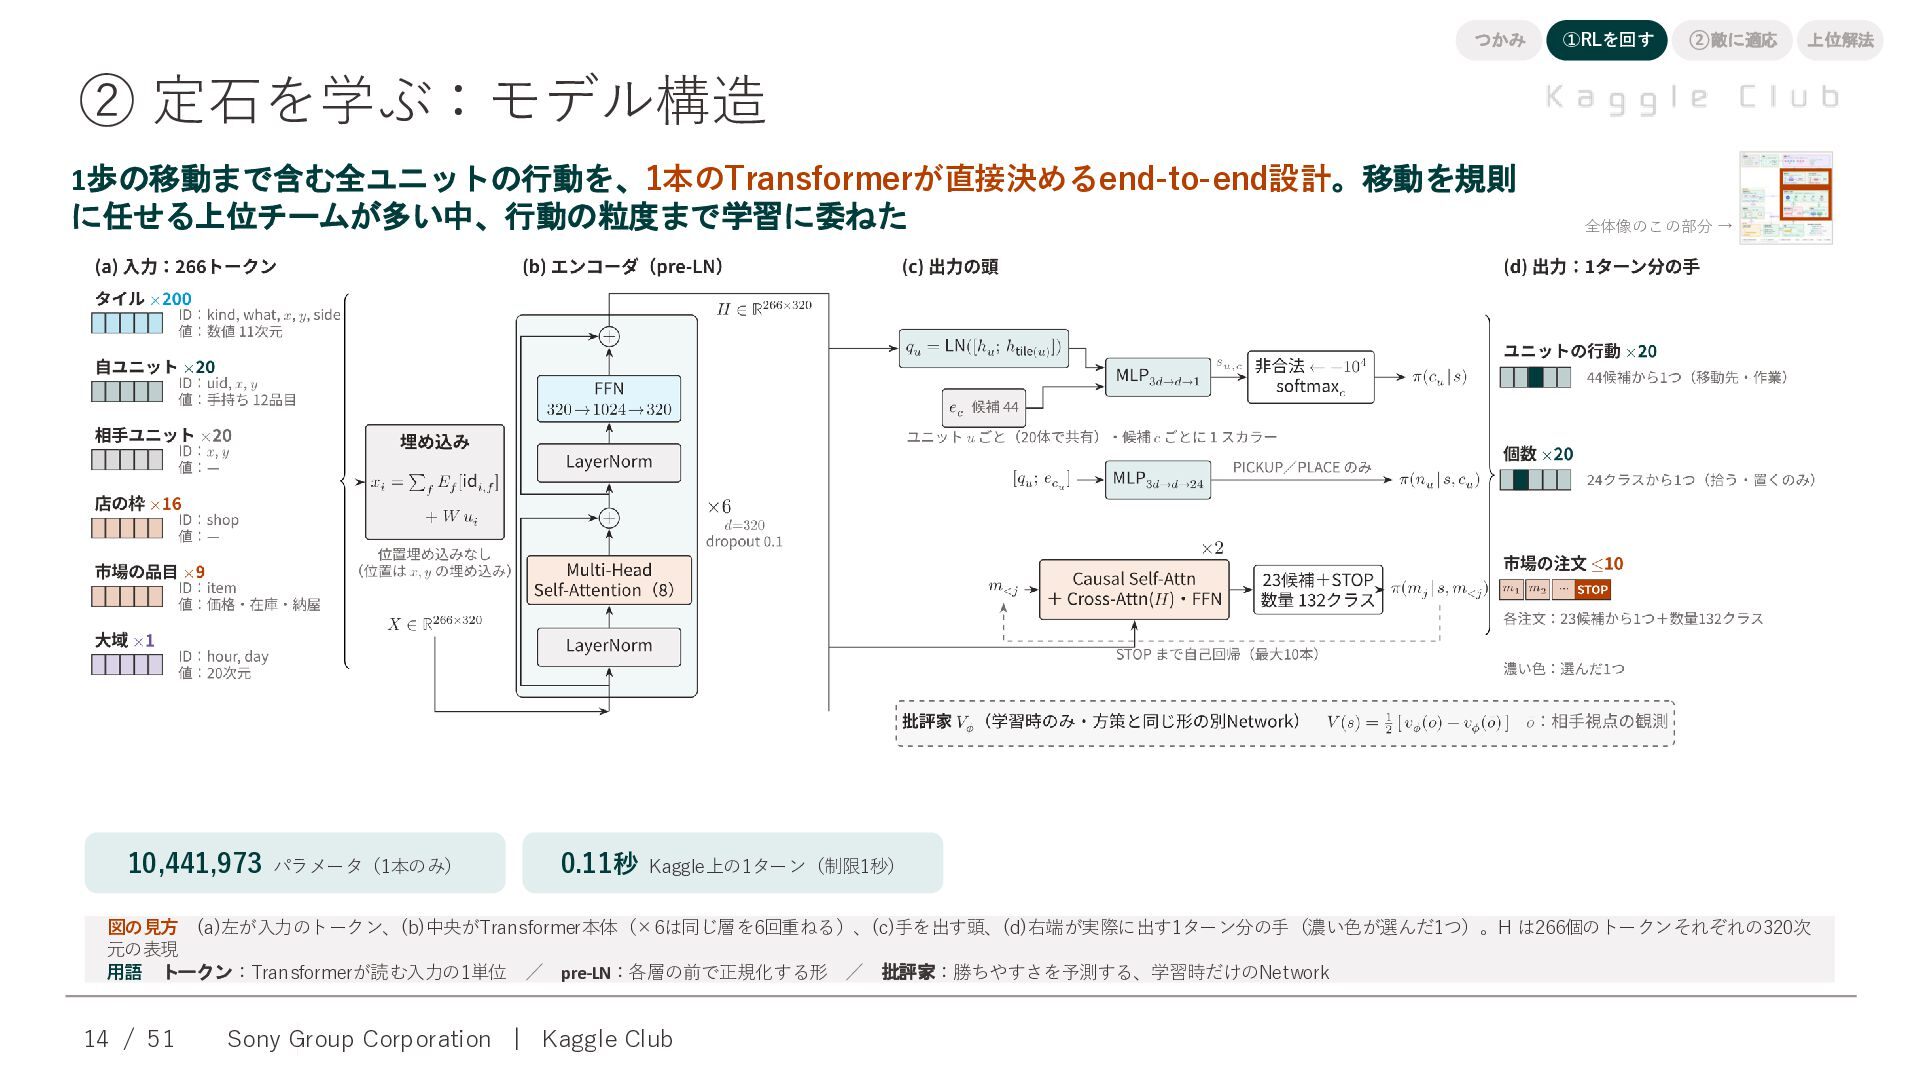
つかみ ①RLを回す ②敵に適応 上位解法 ② 定石を学ぶ:モデル構造 1歩の移動まで含む全ユニットの行動を、1本のTransformerが直接決めるend-to-end設計。移動を規則 に任せる上位チームが多い中、行動の粒度まで学習に委ねた 10,441,973 パラメータ(1本のみ)
全体像のこの部分 → 0.11秒 Kaggle上の1ターン(制限1秒) 図の見方 (a)左が入力のトークン、(b)中央がTransformer本体(×6は同じ層を6回重ねる)、(c)手を出す頭、(d)右端が実際に出す1ターン分の手(濃い色が選んだ1つ)。H は266個のトークンそれぞれの320次 元の表現 用語 トークン:Transformerが読む入力の1単位 / pre-LN:各層の前で正規化する形 / 批評家:勝ちやすさを予測する、学習時だけのNetwork 14 / 51 Sony Group Corporation | Kaggle Club -
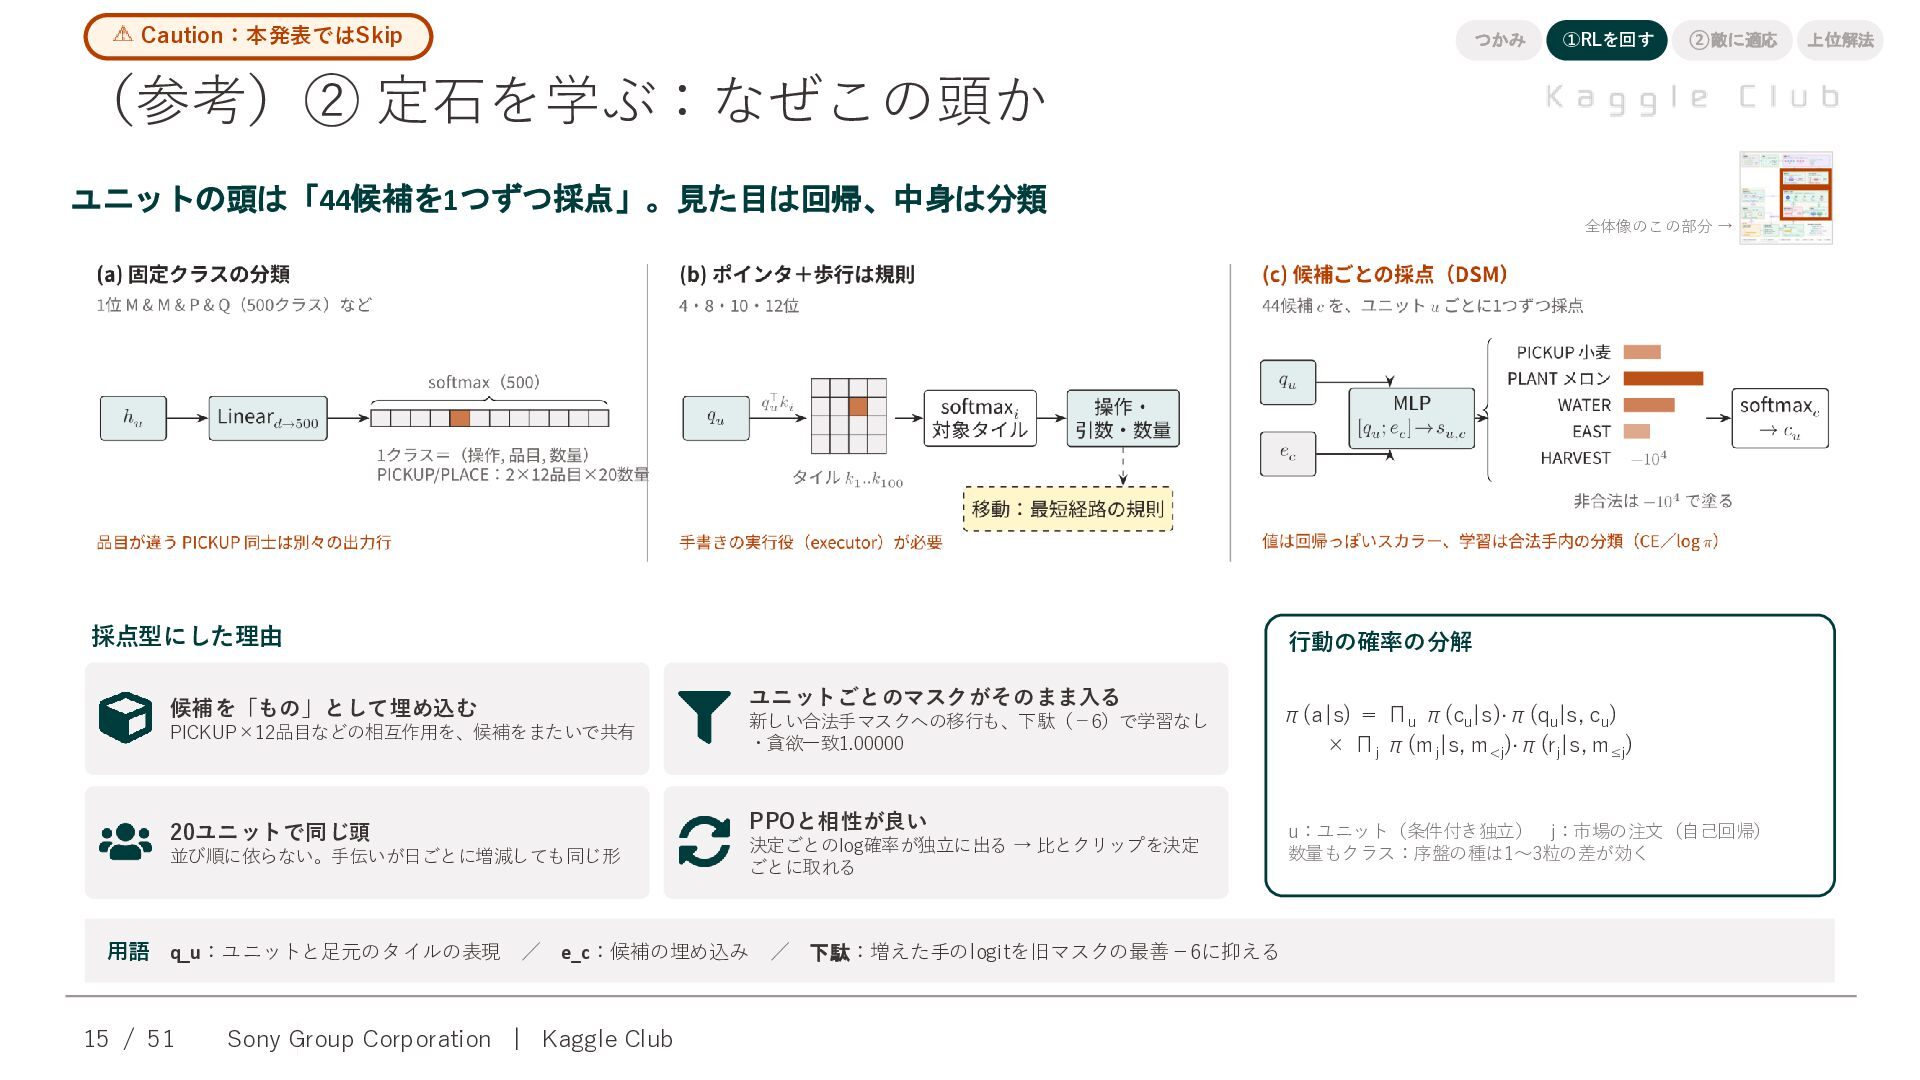
Caution:本発表ではSkip つかみ ①RLを回す ②敵に適応 (参考)② 定石を学ぶ:なぜこの頭か ユニットの頭は「44候補を1つずつ採点」。見た目は回帰、中身は分類 全体像のこの部分 → 採点型にした理由
候補を「もの」として埋め込む PICKUP×12品目などの相互作用を、候補をまたいで共有 20ユニットで同じ頭 並び順に依らない。手伝いが日ごとに増減しても同じ形 行動の確率の分解 ユニットごとのマスクがそのまま入る 新しい合法手マスクへの移行も、下駄(−6)で学習なし ・貪欲一致1.00000 π(a|s) = Πu π(cu|s)·π(qu|s, cu) × Πj π(mj|s, m<j)·π(rj|s, m≤j) PPOと相性が良い 決定ごとのlog確率が独立に出る → 比とクリップを決定 ごとに取れる 用語 q_u:ユニットと足元のタイルの表現 / e_c:候補の埋め込み / 下駄:増えた手のlogitを旧マスクの最善−6に抑える 15 / 51 Sony Group Corporation | Kaggle Club u:ユニット(条件付き独立) j:市場の注文(自己回帰) 数量もクラス:序盤の種は1〜3粒の差が効く 上位解法 -
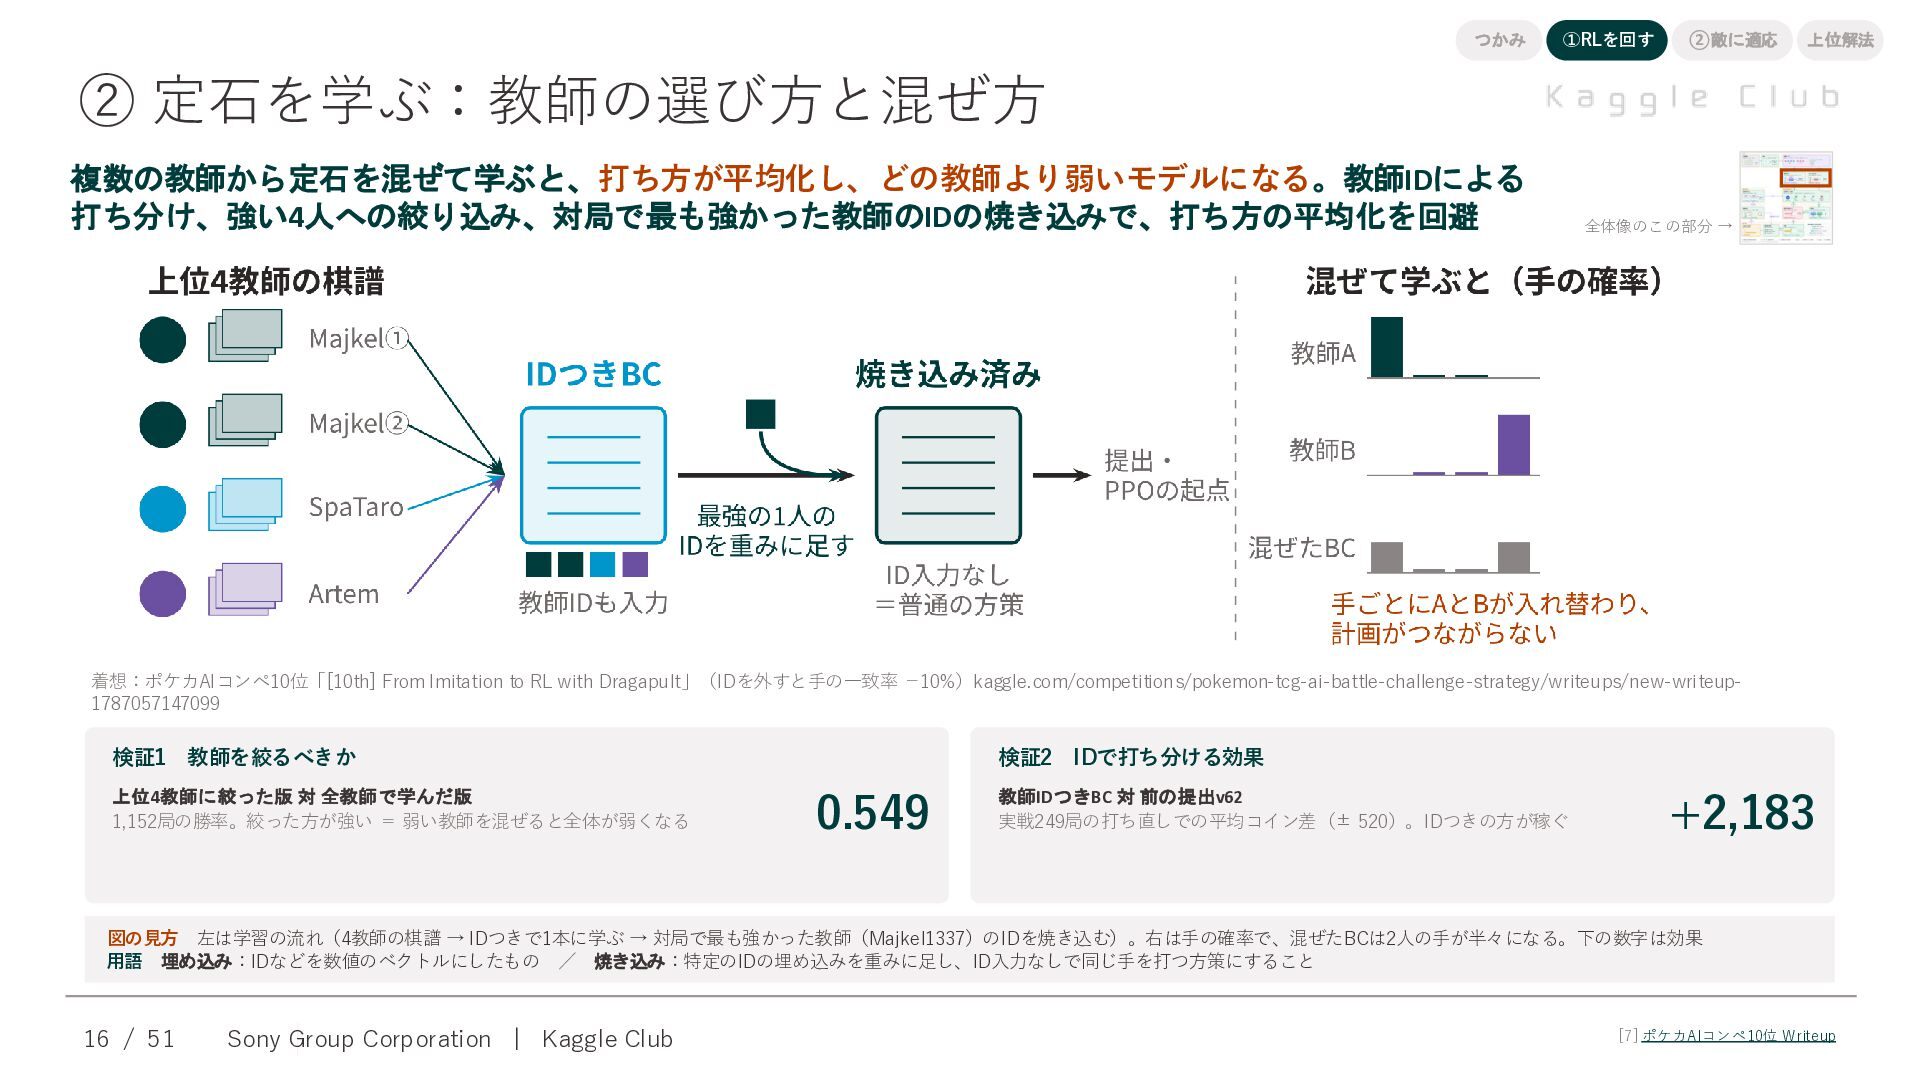
つかみ ①RLを回す ②敵に適応 上位解法 ② 定石を学ぶ:教師の選び方と混ぜ方 複数の教師から定石を混ぜて学ぶと、打ち方が平均化し、どの教師より弱いモデルになる。教師IDによる 打ち分け、強い4人への絞り込み、対局で最も強かった教師のIDの焼き込みで、打ち方の平均化を回避 全体像のこの部分 →
着想:ポケカAIコンペ10位「[10th] From Imitation to RL with Dragapult」(IDを外すと手の一致率 −10%)kaggle.com/competitions/pokemon-tcg-ai-battle-challenge-strategy/writeups/new-writeup1787057147099 検証1 教師を絞るべきか 上位4教師に絞った版 対 全教師で学んだ版 1,152局の勝率。絞った方が強い = 弱い教師を混ぜると全体が弱くなる 検証2 IDで打ち分ける効果 0.549 教師IDつきBC 対 前の提出v62 実戦249局の打ち直しでの平均コイン差(± 520)。IDつきの方が稼ぐ +2,183 図の見方 左は学習の流れ(4教師の棋譜 → IDつきで1本に学ぶ → 対局で最も強かった教師(Majkel1337)のIDを焼き込む)。右は手の確率で、混ぜたBCは2人の手が半々になる。下の数字は効果 用語 埋め込み:IDなどを数値のベクトルにしたもの / 焼き込み:特定のIDの埋め込みを重みに足し、ID入力なしで同じ手を打つ方策にすること 16 / 51 Sony Group Corporation | Kaggle Club [7] ポケカAIコンペ10位 Writeup -
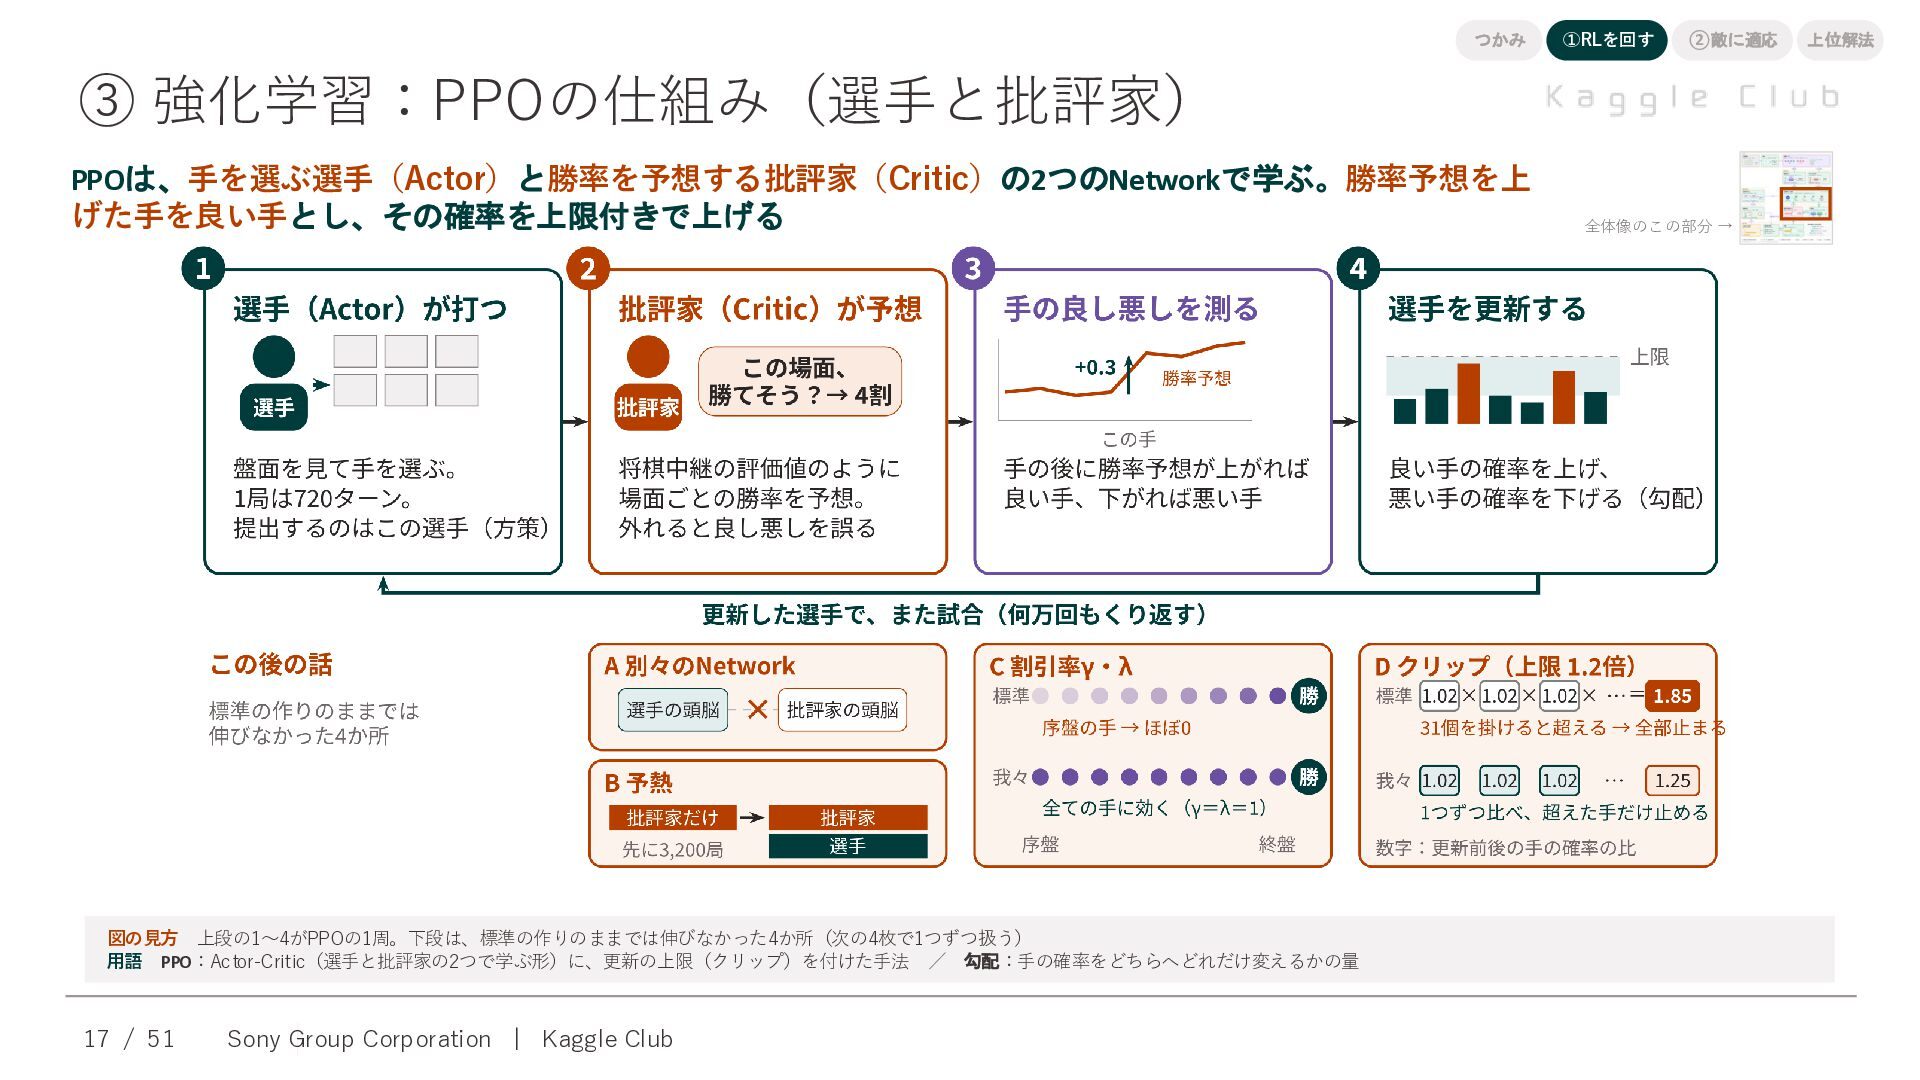
つかみ ①RLを回す ②敵に適応 ③ 強化学習:PPOの仕組み(選手と批評家) PPOは、手を選ぶ選手(Actor)と勝率を予想する批評家(Critic)の2つのNetworkで学ぶ。勝率予想を上 げた手を良い手とし、その確率を上限付きで上げる 図の見方 上段の1〜4がPPOの1周。下段は、標準の作りのままでは伸びなかった4か所(次の4枚で1つずつ扱う) 用語
PPO:Actor-Critic(選手と批評家の2つで学ぶ形)に、更新の上限(クリップ)を付けた手法 / 勾配:手の確率をどちらへどれだけ変えるかの量 17 / 51 Sony Group Corporation | Kaggle Club 全体像のこの部分 → 上位解法 -
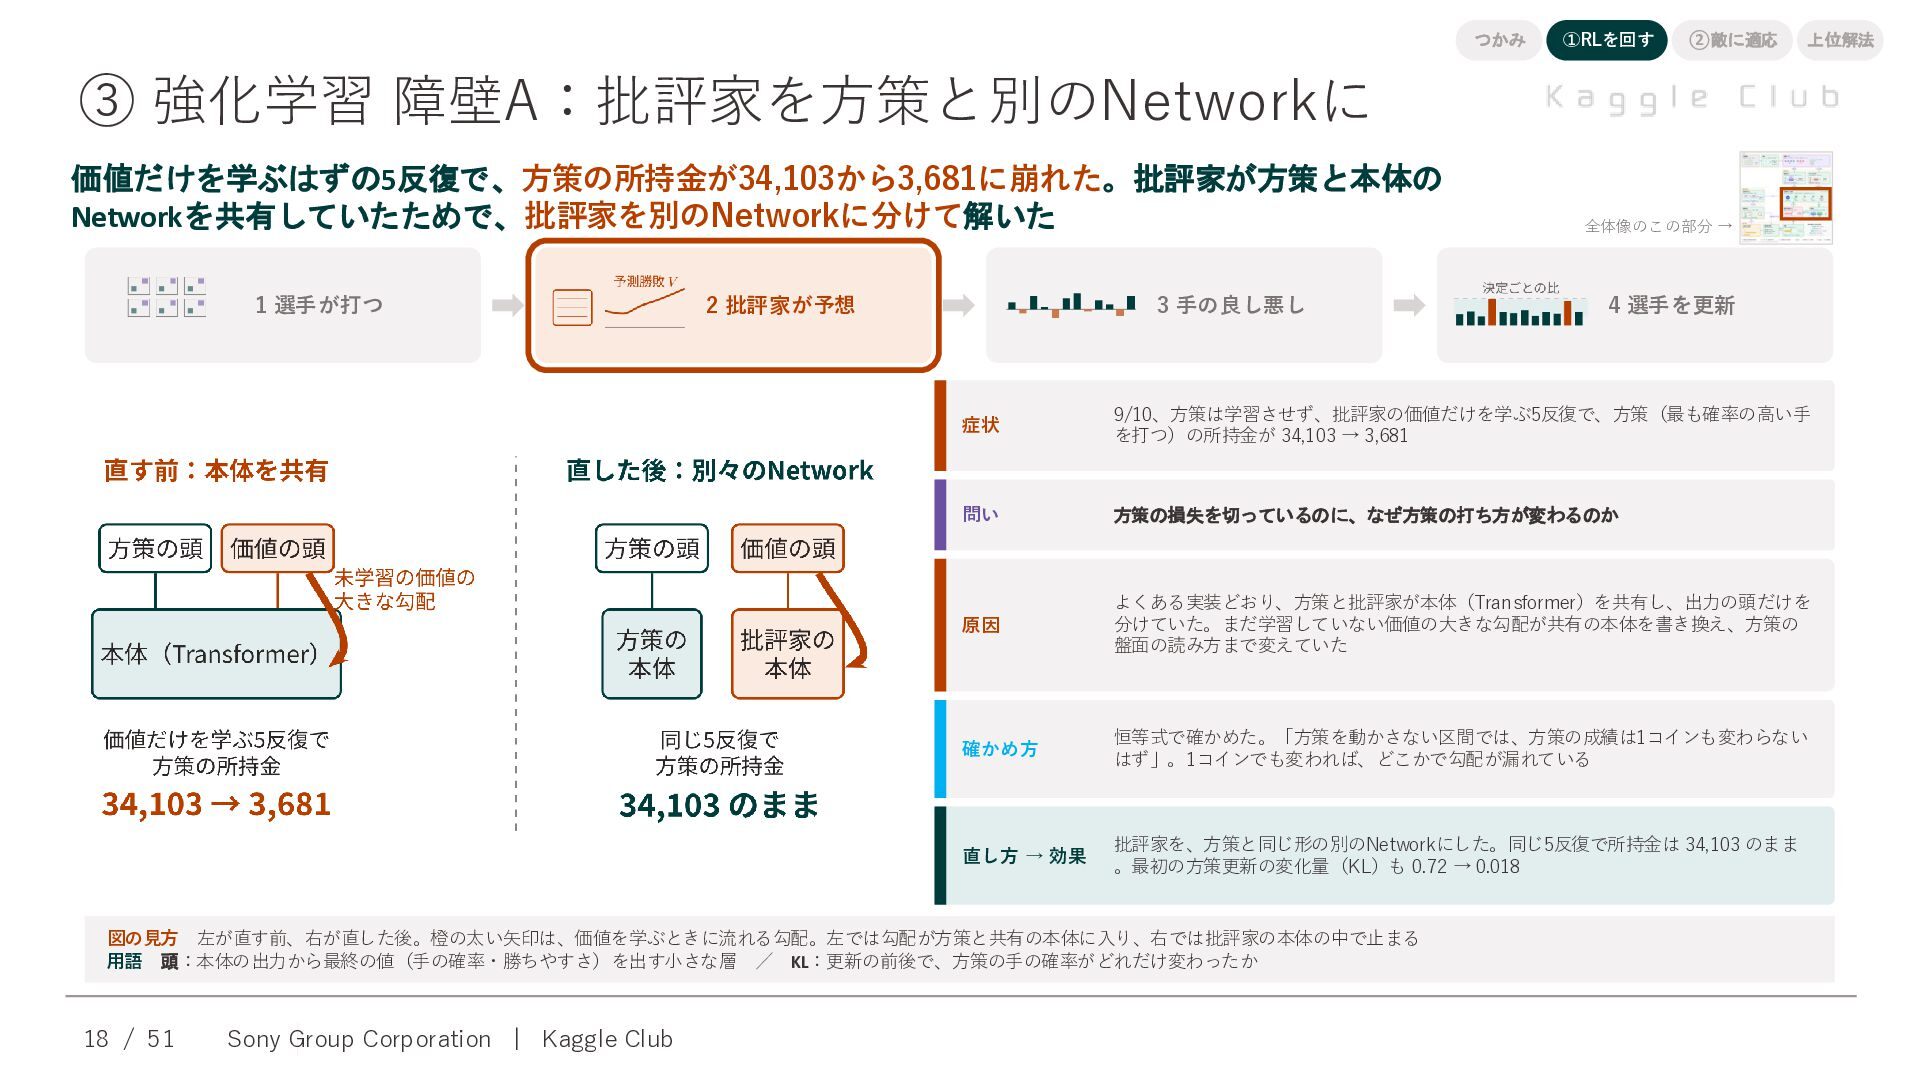
つかみ ①RLを回す ②敵に適応 上位解法 ③ 強化学習 障壁A:批評家を方策と別のNetworkに 価値だけを学ぶはずの5反復で、方策の所持金が34,103から3,681に崩れた。批評家が方策と本体の Networkを共有していたためで、批評家を別のNetworkに分けて解いた 1
選手が打つ 2 批評家が予想 3 手の良し悪し Sony Group Corporation | Kaggle Club 4 選手を更新 症状 9/10、方策は学習させず、批評家の価値だけを学ぶ5反復で、方策(最も確率の高い手 を打つ)の所持金が 34,103 → 3,681 問い 方策の損失を切っているのに、なぜ方策の打ち方が変わるのか 原因 よくある実装どおり、方策と批評家が本体(Transformer)を共有し、出力の頭だけを 分けていた。まだ学習していない価値の大きな勾配が共有の本体を書き換え、方策の 盤面の読み方まで変えていた 確かめ方 恒等式で確かめた。「方策を動かさない区間では、方策の成績は1コインも変わらない はず」。1コインでも変われば、どこかで勾配が漏れている 直し方 → 効果 批評家を、方策と同じ形の別のNetworkにした。同じ5反復で所持金は 34,103 のまま 。最初の方策更新の変化量(KL)も 0.72 → 0.018 図の見方 左が直す前、右が直した後。橙の太い矢印は、価値を学ぶときに流れる勾配。左では勾配が方策と共有の本体に入り、右では批評家の本体の中で止まる 用語 頭:本体の出力から最終の値(手の確率・勝ちやすさ)を出す小さな層 / KL:更新の前後で、方策の手の確率がどれだけ変わったか 18 / 51 全体像のこの部分 → -
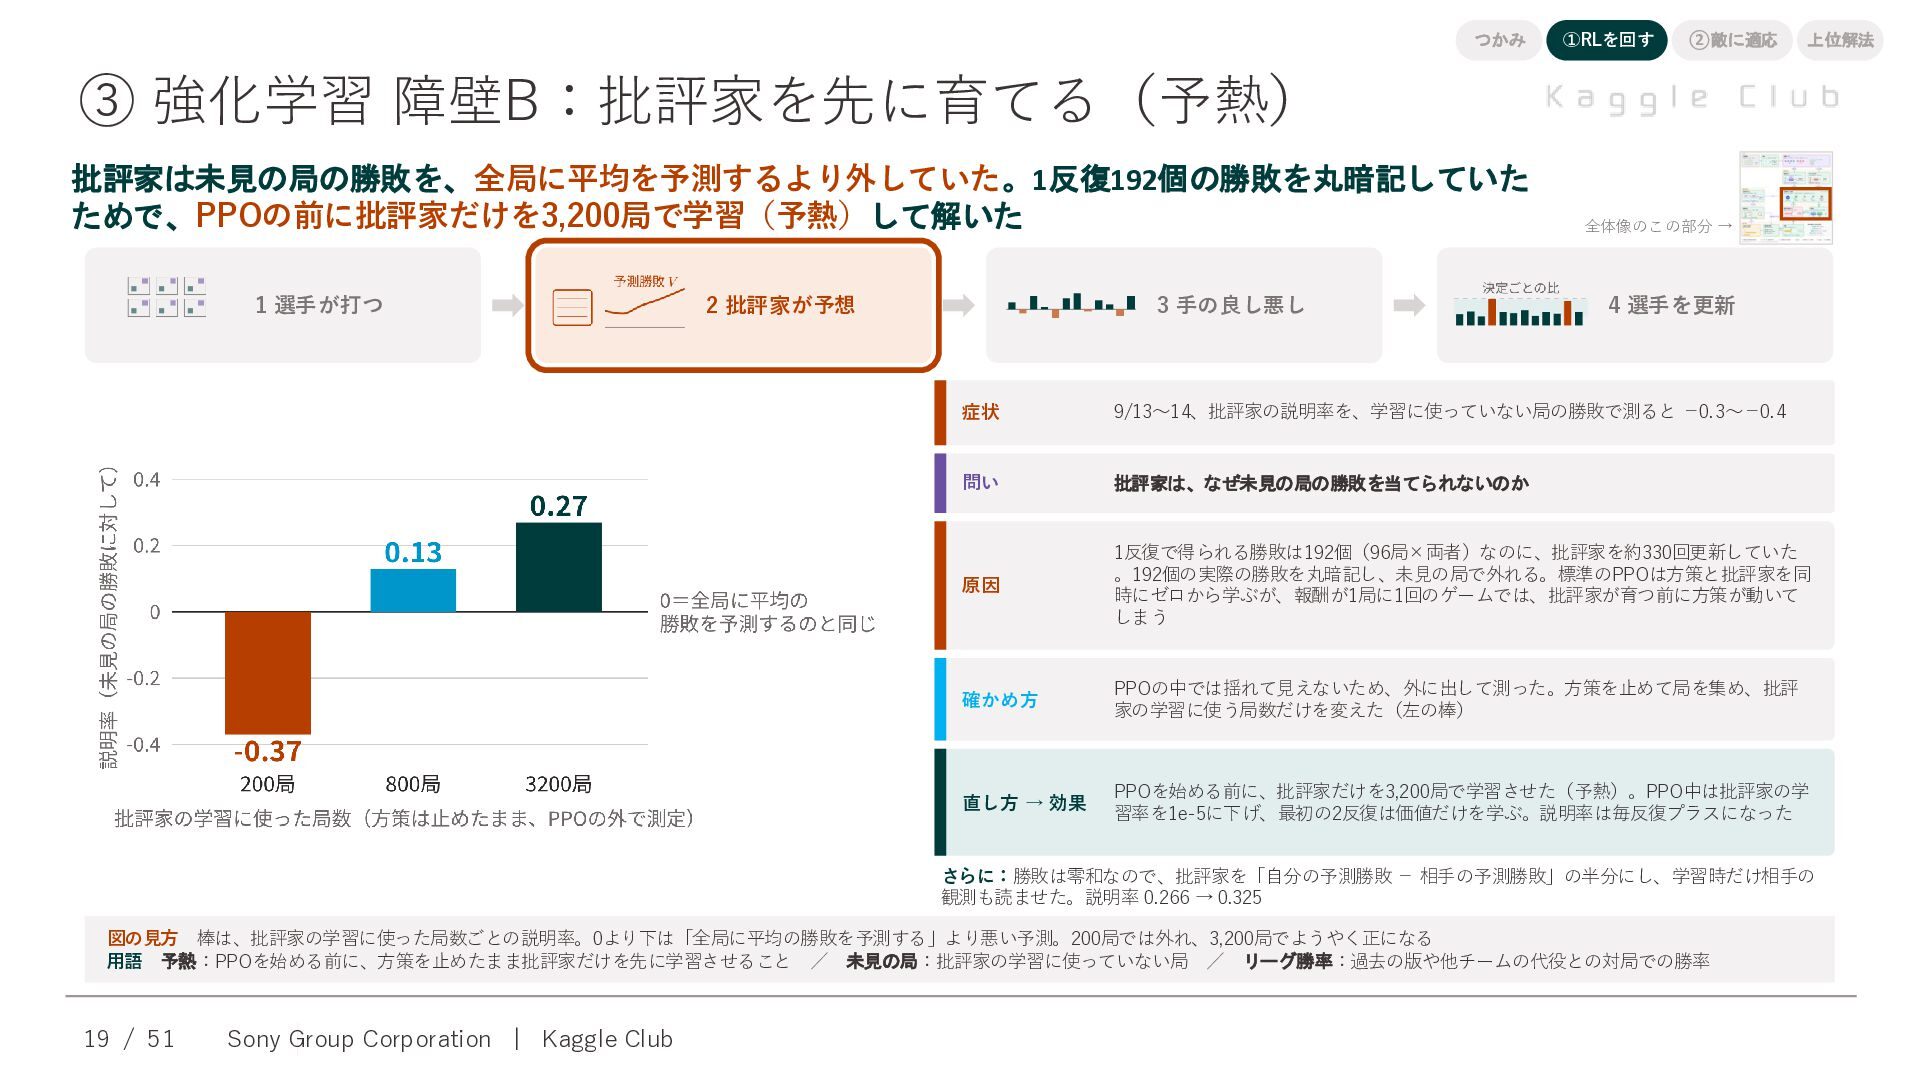
つかみ ①RLを回す ②敵に適応 上位解法 ③ 強化学習 障壁B:批評家を先に育てる(予熱) 批評家は未見の局の勝敗を、全局に平均を予測するより外していた。1反復192個の勝敗を丸暗記していた ためで、PPOの前に批評家だけを3,200局で学習(予熱)して解いた 1
選手が打つ 2 批評家が予想 3 手の良し悪し 全体像のこの部分 → 4 選手を更新 症状 9/13〜14、批評家の説明率を、学習に使っていない局の勝敗で測ると −0.3〜−0.4 問い 批評家は、なぜ未見の局の勝敗を当てられないのか 原因 1反復で得られる勝敗は192個(96局×両者)なのに、批評家を約330回更新していた 。192個の実際の勝敗を丸暗記し、未見の局で外れる。標準のPPOは方策と批評家を同 時にゼロから学ぶが、報酬が1局に1回のゲームでは、批評家が育つ前に方策が動いて しまう 確かめ方 PPOの中では揺れて見えないため、外に出して測った。方策を止めて局を集め、批評 家の学習に使う局数だけを変えた(左の棒) 直し方 → 効果 PPOを始める前に、批評家だけを3,200局で学習させた(予熱)。PPO中は批評家の学 習率を1e-5に下げ、最初の2反復は価値だけを学ぶ。説明率は毎反復プラスになった さらに:勝敗は零和なので、批評家を「自分の予測勝敗 − 相手の予測勝敗」の半分にし、学習時だけ相手の 観測も読ませた。説明率 0.266 → 0.325 図の見方 棒は、批評家の学習に使った局数ごとの説明率。0より下は「全局に平均の勝敗を予測する」より悪い予測。200局では外れ、3,200局でようやく正になる 用語 予熱:PPOを始める前に、方策を止めたまま批評家だけを先に学習させること / 未見の局:批評家の学習に使っていない局 / リーグ勝率:過去の版や他チームの代役との対局での勝率 19 / 51 Sony Group Corporation | Kaggle Club -
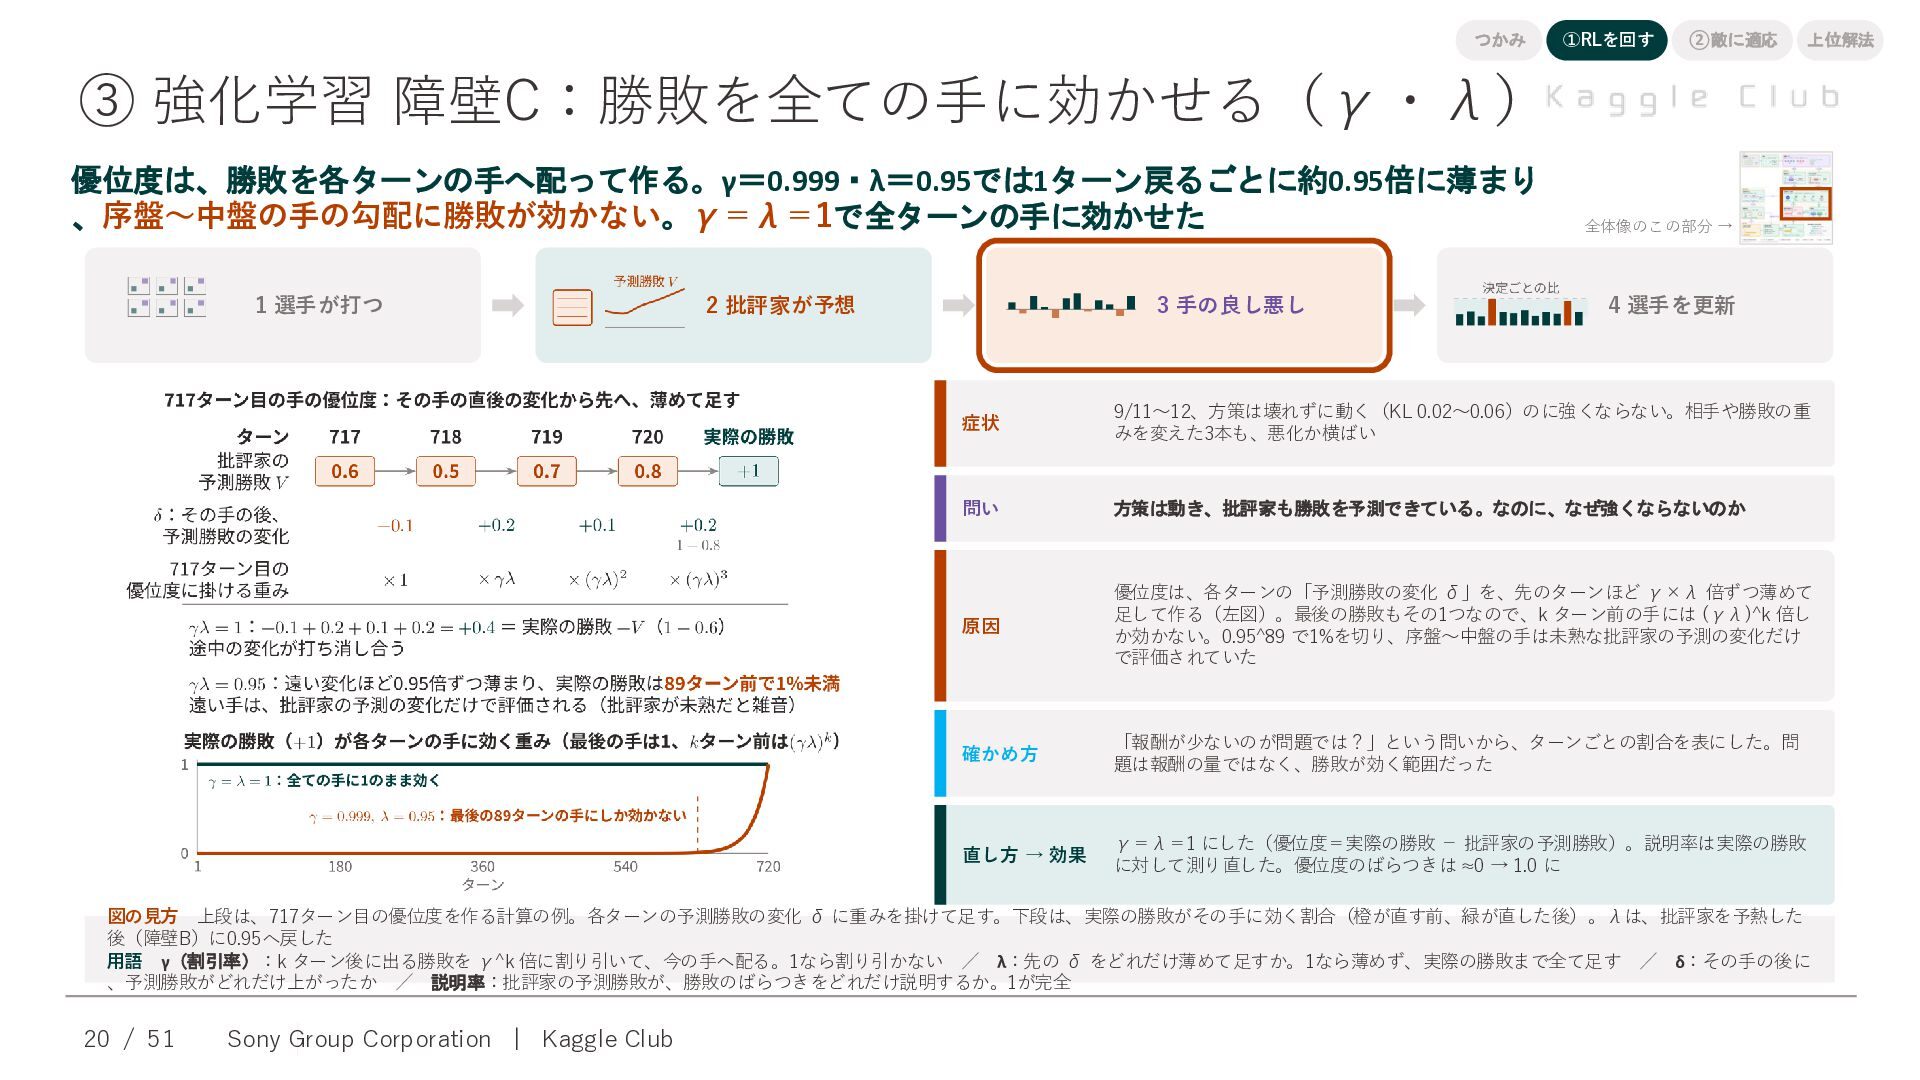
つかみ ①RLを回す ②敵に適応 上位解法 ③ 強化学習 障壁C:勝敗を全ての手に効かせる(γ・λ) 優位度は、勝敗を各ターンの手へ配って作る。γ=0.999・λ=0.95では1ターン戻るごとに約0.95倍に薄まり 、序盤〜中盤の手の勾配に勝敗が効かない。γ=λ=1で全ターンの手に効かせた 1
選手が打つ 2 批評家が予想 3 手の良し悪し 全体像のこの部分 → 4 選手を更新 症状 9/11〜12、方策は壊れずに動く(KL 0.02〜0.06)のに強くならない。相手や勝敗の重 みを変えた3本も、悪化か横ばい 問い 方策は動き、批評家も勝敗を予測できている。なのに、なぜ強くならないのか 原因 優位度は、各ターンの「予測勝敗の変化 δ」を、先のターンほど γ×λ 倍ずつ薄めて 足して作る(左図)。最後の勝敗もその1つなので、k ターン前の手には (γλ)^k 倍し か効かない。0.95^89 で1%を切り、序盤〜中盤の手は未熟な批評家の予測の変化だけ で評価されていた 確かめ方 「報酬が少ないのが問題では?」という問いから、ターンごとの割合を表にした。問 題は報酬の量ではなく、勝敗が効く範囲だった 直し方 → 効果 γ=λ=1 にした(優位度=実際の勝敗 − 批評家の予測勝敗)。説明率は実際の勝敗 に対して測り直した。優位度のばらつきは ≈0 → 1.0 に 図の見方 上段は、717ターン目の優位度を作る計算の例。各ターンの予測勝敗の変化 δ に重みを掛けて足す。下段は、実際の勝敗がその手に効く割合(橙が直す前、緑が直した後)。λは、批評家を予熱した 後(障壁B)に0.95へ戻した 用語 γ(割引率):k ターン後に出る勝敗を γ^k 倍に割り引いて、今の手へ配る。1なら割り引かない / λ:先の δ をどれだけ薄めて足すか。1なら薄めず、実際の勝敗まで全て足す / δ:その手の後に 、予測勝敗がどれだけ上がったか / 説明率:批評家の予測勝敗が、勝敗のばらつきをどれだけ説明するか。1が完全 20 / 51 Sony Group Corporation | Kaggle Club -
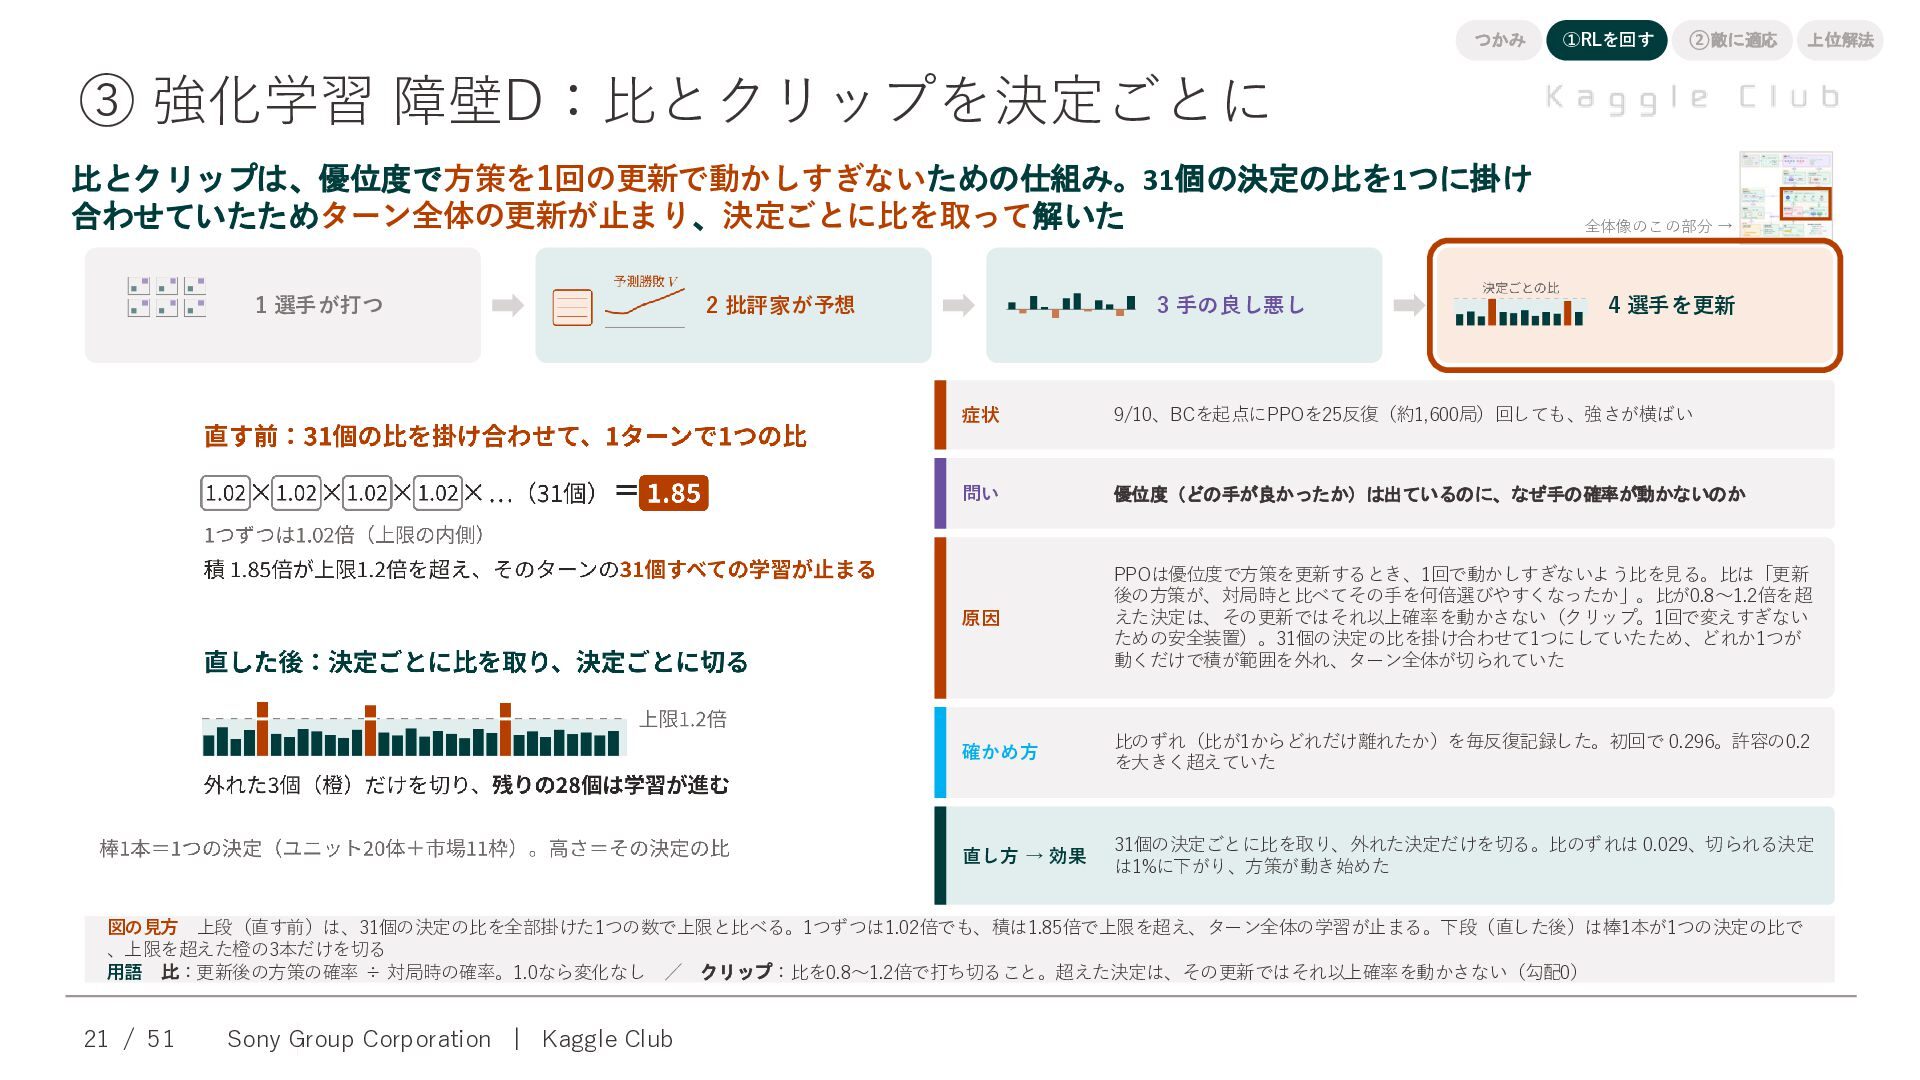
つかみ ①RLを回す ②敵に適応 上位解法 ③ 強化学習 障壁D:比とクリップを決定ごとに 比とクリップは、優位度で方策を1回の更新で動かしすぎないための仕組み。31個の決定の比を1つに掛け 合わせていたためターン全体の更新が止まり、決定ごとに比を取って解いた 1
選手が打つ 2 批評家が予想 3 手の良し悪し 全体像のこの部分 → 4 選手を更新 症状 9/10、BCを起点にPPOを25反復(約1,600局)回しても、強さが横ばい 問い 優位度(どの手が良かったか)は出ているのに、なぜ手の確率が動かないのか 原因 PPOは優位度で方策を更新するとき、1回で動かしすぎないよう比を見る。比は「更新 後の方策が、対局時と比べてその手を何倍選びやすくなったか」。比が0.8〜1.2倍を超 えた決定は、その更新ではそれ以上確率を動かさない(クリップ。1回で変えすぎない ための安全装置)。31個の決定の比を掛け合わせて1つにしていたため、どれか1つが 動くだけで積が範囲を外れ、ターン全体が切られていた 確かめ方 比のずれ(比が1からどれだけ離れたか)を毎反復記録した。初回で 0.296。許容の0.2 を大きく超えていた 直し方 → 効果 31個の決定ごとに比を取り、外れた決定だけを切る。比のずれは 0.029、切られる決定 は1%に下がり、方策が動き始めた 図の見方 上段(直す前)は、31個の決定の比を全部掛けた1つの数で上限と比べる。1つずつは1.02倍でも、積は1.85倍で上限を超え、ターン全体の学習が止まる。下段(直した後)は棒1本が1つの決定の比で 、上限を超えた橙の3本だけを切る 用語 比:更新後の方策の確率 ÷ 対局時の確率。1.0なら変化なし / クリップ:比を0.8〜1.2倍で打ち切ること。超えた決定は、その更新ではそれ以上確率を動かさない(勾配0) 21 / 51 Sony Group Corporation | Kaggle Club -
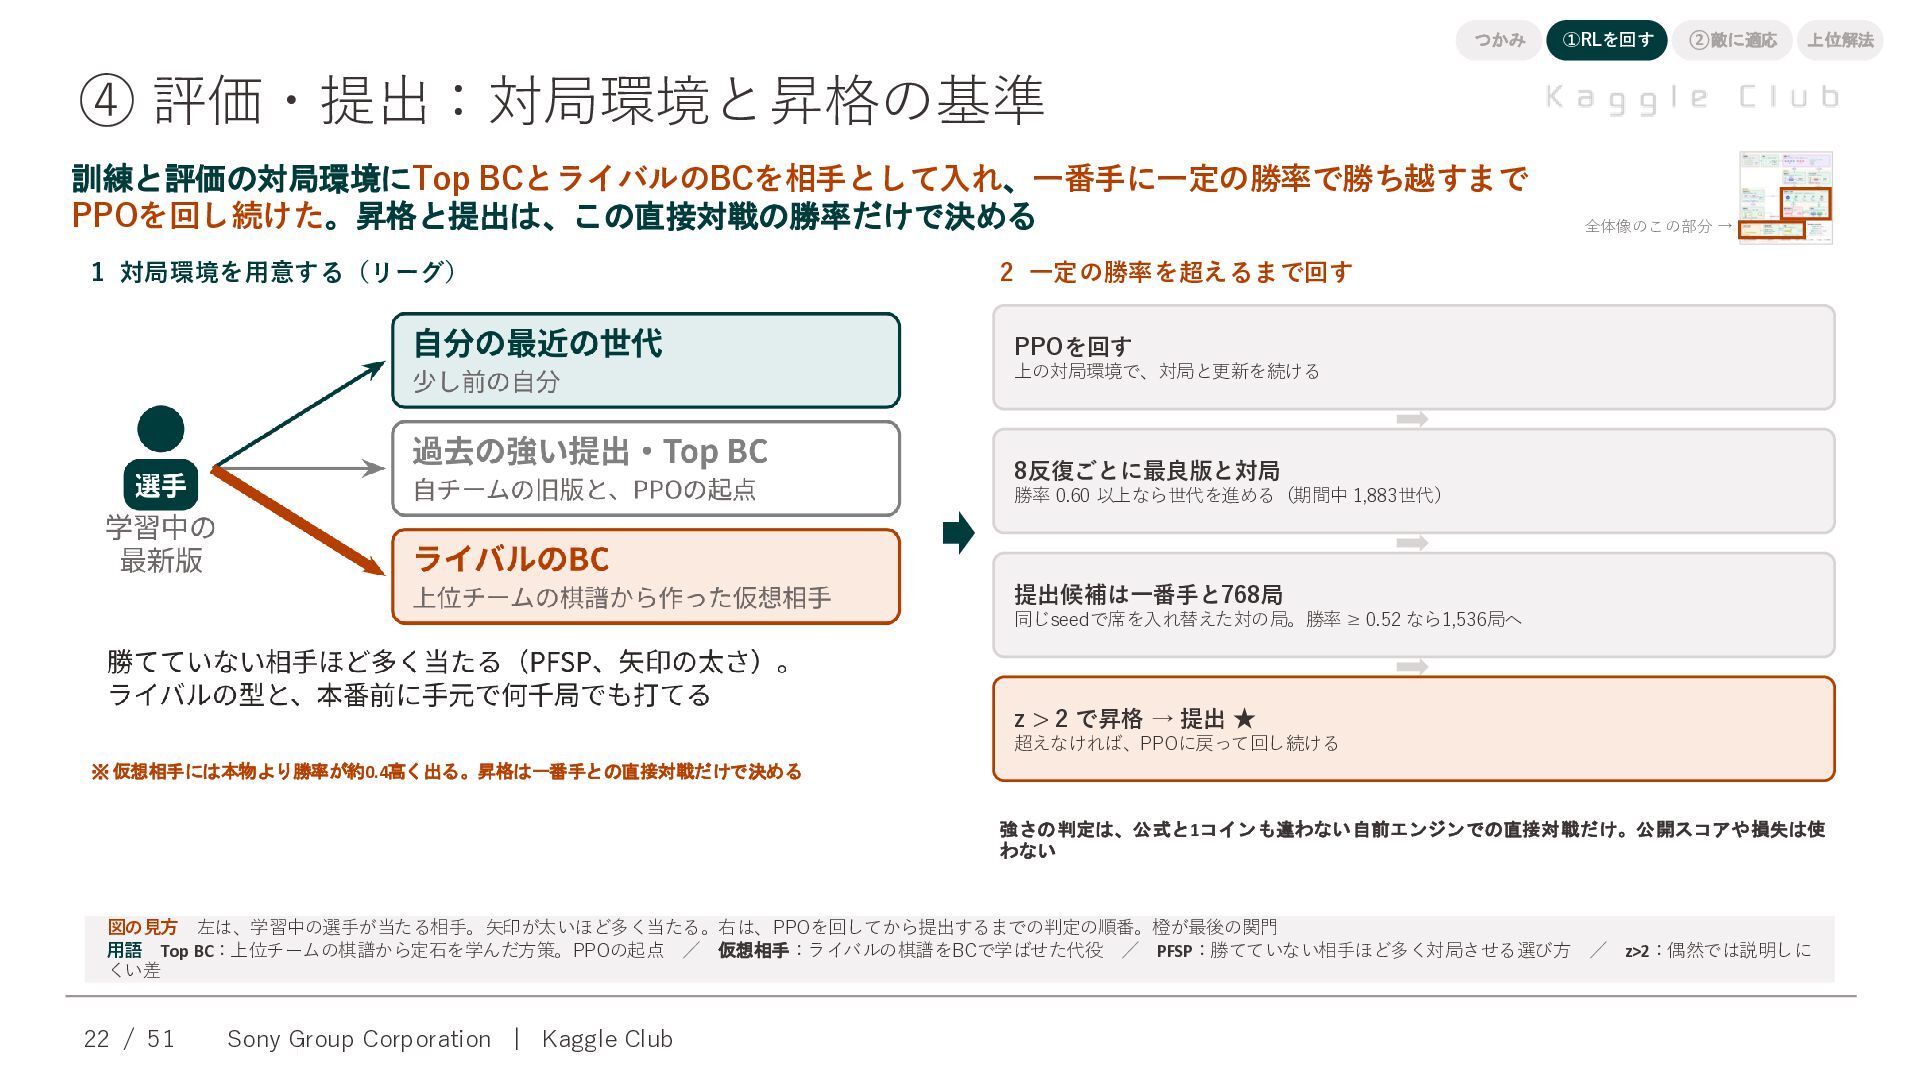
つかみ ①RLを回す ②敵に適応 上位解法 ④ 評価・提出:対局環境と昇格の基準 訓練と評価の対局環境にTop BCとライバルのBCを相手として入れ、一番手に一定の勝率で勝ち越すまで PPOを回し続けた。昇格と提出は、この直接対戦の勝率だけで決める 1
対局環境を用意する(リーグ) 全体像のこの部分 → 2 一定の勝率を超えるまで回す PPOを回す 上の対局環境で、対局と更新を続ける 8反復ごとに最良版と対局 勝率 0.60 以上なら世代を進める(期間中 1,883世代) 提出候補は一番手と768局 同じseedで席を入れ替えた対の局。勝率 ≥ 0.52 なら1,536局へ z > 2 で昇格 → 提出 ★ 超えなければ、PPOに戻って回し続ける ※ 仮想相手には本物より勝率が約0.4高く出る。昇格は一番手との直接対戦だけで決める 強さの判定は、公式と1コインも違わない自前エンジンでの直接対戦だけ。公開スコアや損失は使 わない 図の見方 左は、学習中の選手が当たる相手。矢印が太いほど多く当たる。右は、PPOを回してから提出するまでの判定の順番。橙が最後の関門 用語 Top BC:上位チームの棋譜から定石を学んだ方策。PPOの起点 / 仮想相手:ライバルの棋譜をBCで学ばせた代役 / PFSP:勝てていない相手ほど多く対局させる選び方 / z>2:偶然では説明しに くい差 22 / 51 Sony Group Corporation | Kaggle Club -
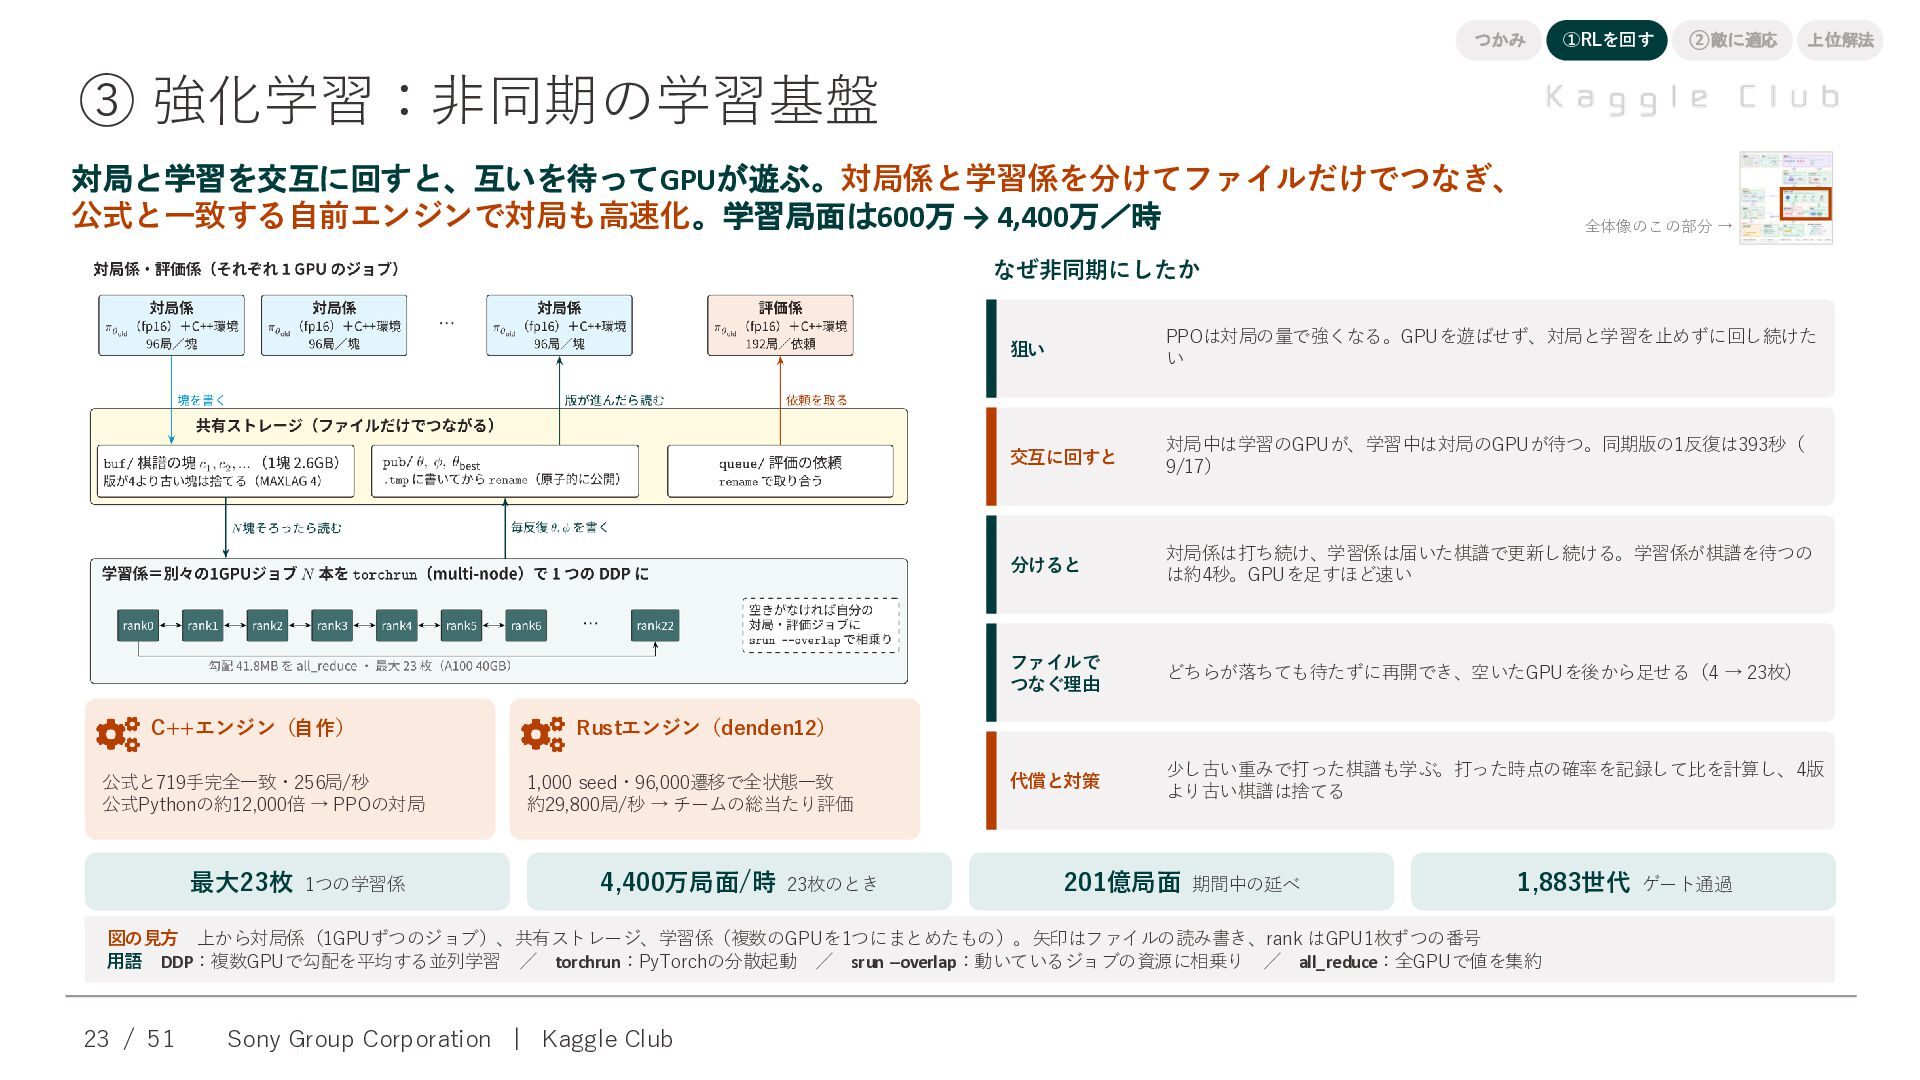
つかみ ①RLを回す ②敵に適応 上位解法 ③ 強化学習:非同期の学習基盤 対局と学習を交互に回すと、互いを待ってGPUが遊ぶ。対局係と学習係を分けてファイルだけでつなぎ、 公式と一致する自前エンジンで対局も高速化。学習局面は600万 → 4,400万/時
全体像のこの部分 → なぜ非同期にしたか C++エンジン(自作) 公式と719手完全一致・256局/秒 公式Pythonの約12,000倍 → PPOの対局 最大23枚 1つの学習係 狙い PPOは対局の量で強くなる。GPUを遊ばせず、対局と学習を止めずに回し続けた い 交互に回すと 対局中は学習のGPUが、学習中は対局のGPUが待つ。同期版の1反復は393秒( 9/17) 分けると 対局係は打ち続け、学習係は届いた棋譜で更新し続ける。学習係が棋譜を待つの は約4秒。GPUを足すほど速い ファイルで つなぐ理由 どちらが落ちても待たずに再開でき、空いたGPUを後から足せる(4 → 23枚) 代償と対策 少し古い重みで打った棋譜も学ぶ。打った時点の確率を記録して比を計算し、4版 より古い棋譜は捨てる Rustエンジン(denden12) 1,000 seed・96,000遷移で全状態一致 約29,800局/秒 → チームの総当たり評価 4,400万局面/時 23枚のとき 201億局面 期間中の延べ 1,883世代 ゲート通過 図の見方 上から対局係(1GPUずつのジョブ)、共有ストレージ、学習係(複数のGPUを1つにまとめたもの)。矢印はファイルの読み書き、rank はGPU1枚ずつの番号 用語 DDP:複数GPUで勾配を平均する並列学習 / torchrun:PyTorchの分散起動 / srun --overlap:動いているジョブの資源に相乗り / all_reduce:全GPUで値を集約 23 / 51 Sony Group Corporation | Kaggle Club -
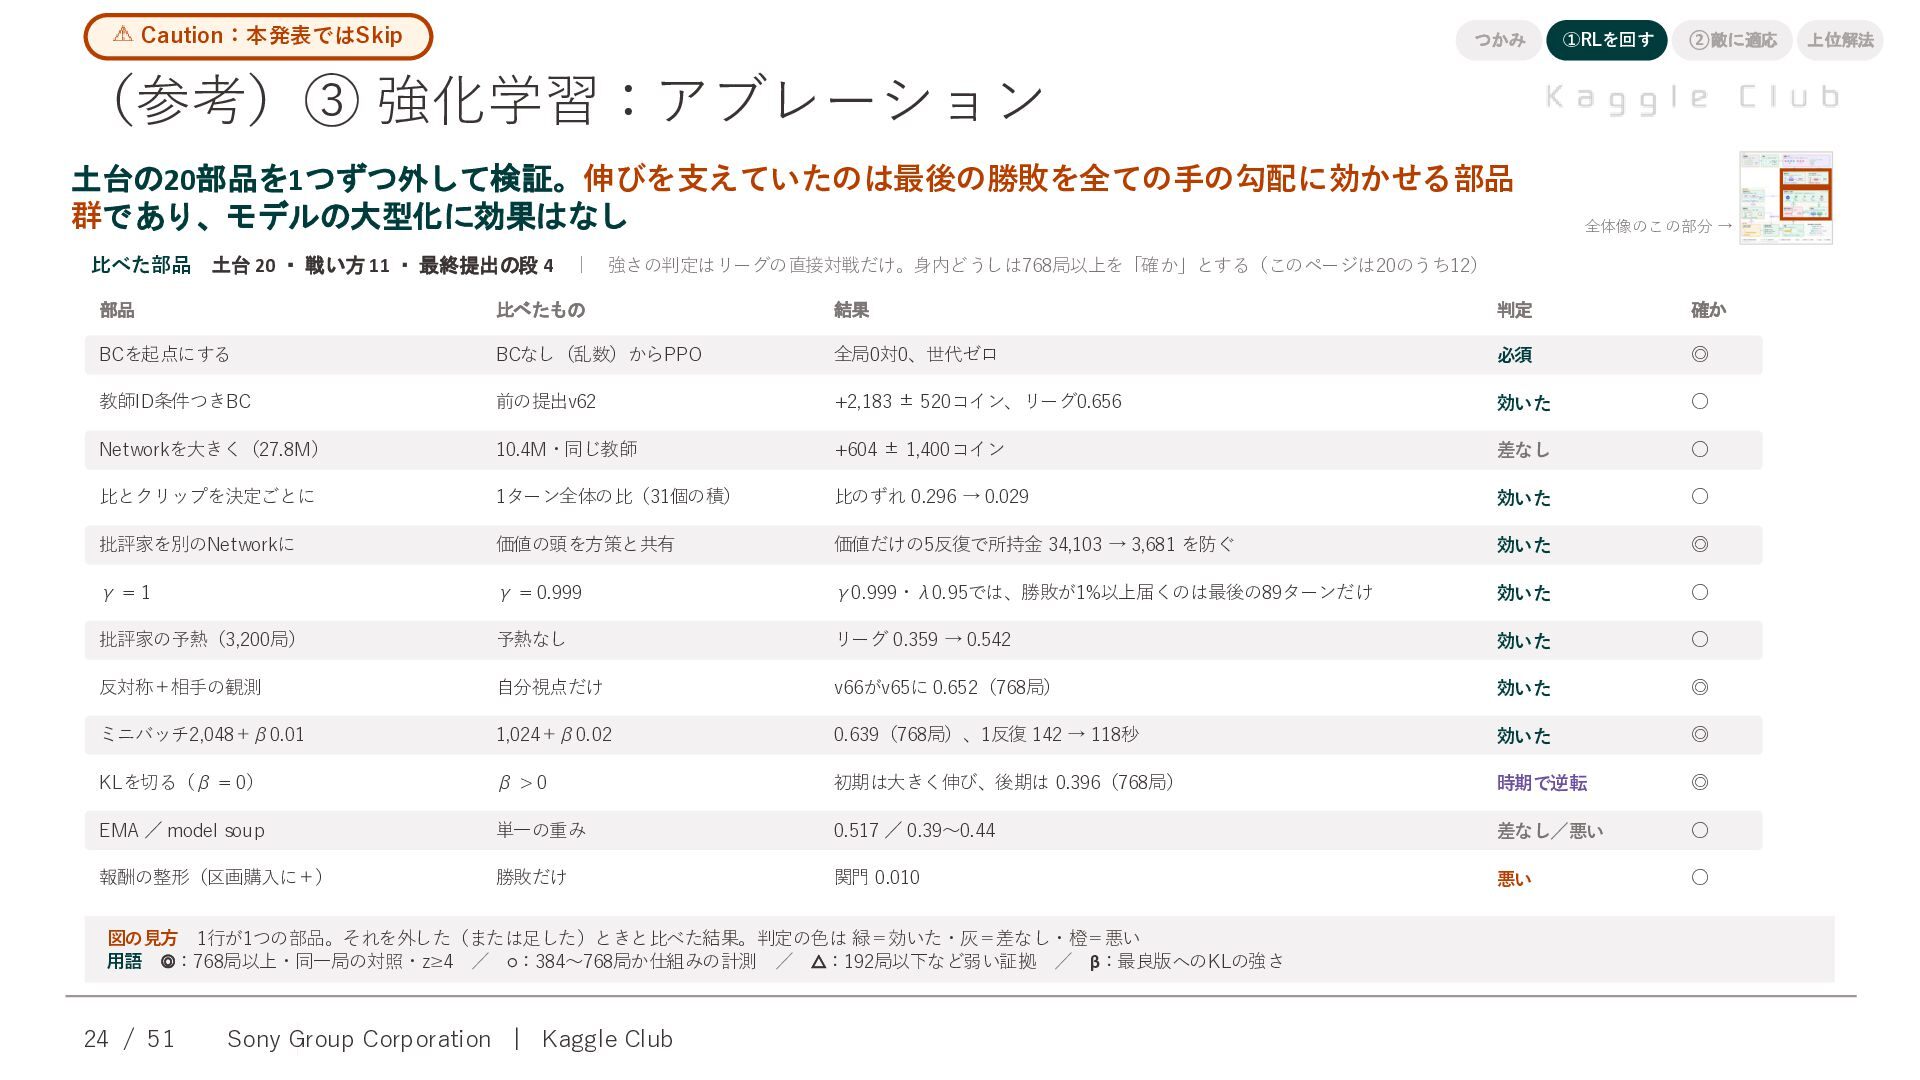
Caution:本発表ではSkip つかみ ①RLを回す ②敵に適応 (参考)③ 強化学習:アブレーション 土台の20部品を1つずつ外して検証。伸びを支えていたのは最後の勝敗を全ての手の勾配に効かせる部品 群であり、モデルの大型化に効果はなし 全体像のこの部分 →
比べた部品 土台 20 ・ 戦い方 11 ・ 最終提出の段 4 | 強さの判定はリーグの直接対戦だけ。身内どうしは768局以上を「確か」とする(このページは20のうち12) 部品 比べたもの 結果 判定 確か BCを起点にする BCなし(乱数)からPPO 全局0対0、世代ゼロ 必須 ◎ 教師ID条件つきBC 前の提出v62 +2,183 ± 520コイン、リーグ0.656 効いた ◦ Networkを大きく(27.8M) 10.4M・同じ教師 +604 ± 1,400コイン 差なし ◦ 比とクリップを決定ごとに 1ターン全体の比(31個の積) 比のずれ 0.296 → 0.029 効いた ◦ 批評家を別のNetworkに 価値の頭を方策と共有 価値だけの5反復で所持金 34,103 → 3,681 を防ぐ 効いた ◎ γ=1 γ = 0.999 γ0.999・λ0.95では、勝敗が1%以上届くのは最後の89ターンだけ 効いた ◦ 批評家の予熱(3,200局) 予熱なし リーグ 0.359 → 0.542 効いた ◦ 反対称+相手の観測 自分視点だけ v66がv65に 0.652(768局) 効いた ◎ ミニバッチ2,048+β0.01 1,024+β0.02 0.639(768局)、1反復 142 → 118秒 効いた ◎ KLを切る(β = 0) β>0 初期は大きく伸び、後期は 0.396(768局) 時期で逆転 ◎ EMA / model soup 単一の重み 0.517 / 0.39〜0.44 差なし/悪い ◦ 報酬の整形(区画購入に+) 勝敗だけ 関門 0.010 悪い ◦ 図の見方 1行が1つの部品。それを外した(または足した)ときと比べた結果。判定の色は 緑=効いた・灰=差なし・橙=悪い 用語 ◎:768局以上・同一局の対照・z≥4 / ◦:384〜768局か仕組みの計測 / △:192局以下など弱い証拠 / β:最良版へのKLの強さ 24 / 51 Sony Group Corporation | Kaggle Club 上位解法 -
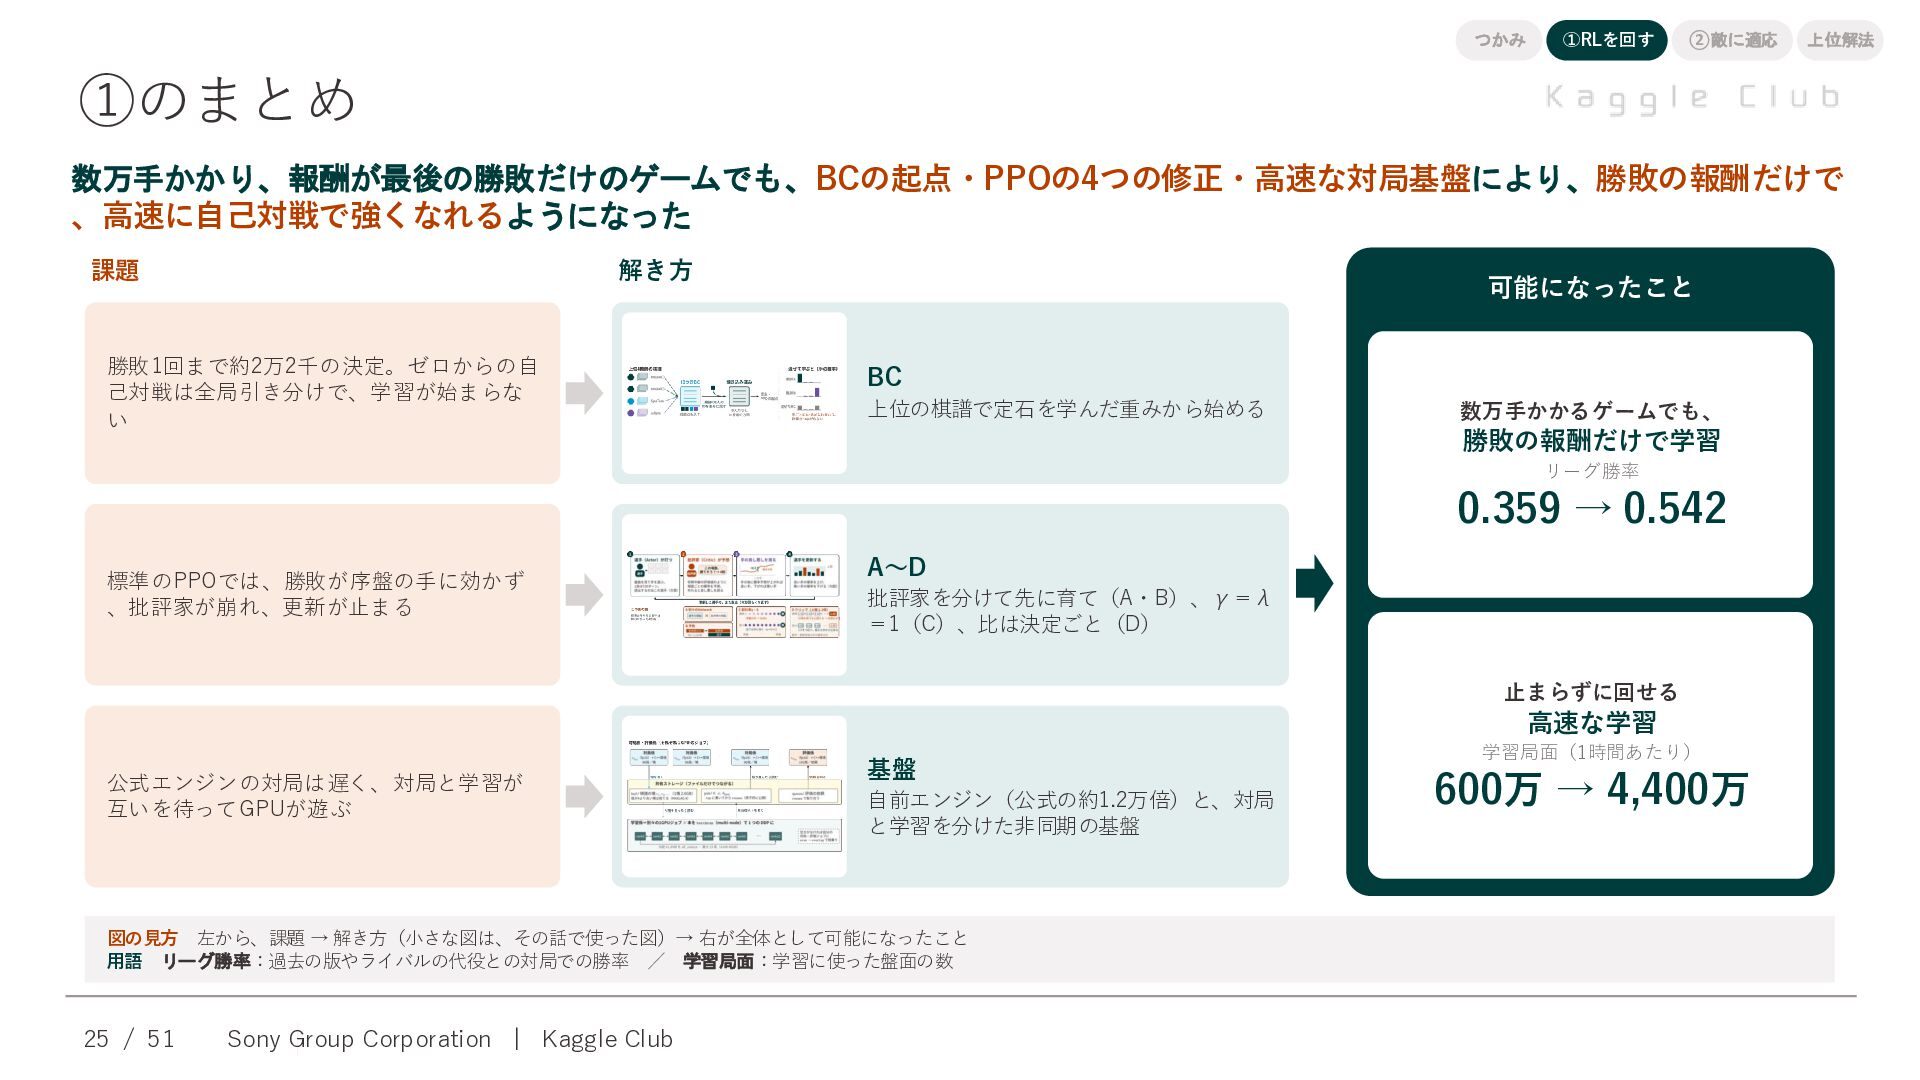
つかみ ①RLを回す ②敵に適応 上位解法 ①のまとめ 数万手かかり、報酬が最後の勝敗だけのゲームでも、BCの起点・PPOの4つの修正・高速な対局基盤により、勝敗の報酬だけで 、高速に自己対戦で強くなれるようになった 課題 解き方 勝敗1回まで約2万2千の決定。ゼロからの自
己対戦は全局引き分けで、学習が始まらな い 可能になったこと BC 上位の棋譜で定石を学んだ重みから始める 数万手かかるゲームでも、 勝敗の報酬だけで学習 リーグ勝率 0.359 → 0.542 標準のPPOでは、勝敗が序盤の手に効かず 、批評家が崩れ、更新が止まる A〜D 批評家を分けて先に育て(A・B)、γ=λ =1(C)、比は決定ごと(D) 止まらずに回せる 高速な学習 公式エンジンの対局は遅く、対局と学習が 互いを待ってGPUが遊ぶ 基盤 自前エンジン(公式の約1.2万倍)と、対局 と学習を分けた非同期の基盤 図の見方 左から、課題 → 解き方(小さな図は、その話で使った図)→ 右が全体として可能になったこと 用語 リーグ勝率:過去の版やライバルの代役との対局での勝率 / 学習局面:学習に使った盤面の数 25 / 51 Sony Group Corporation | Kaggle Club 学習局面(1時間あたり) 600万 → 4,400万 -
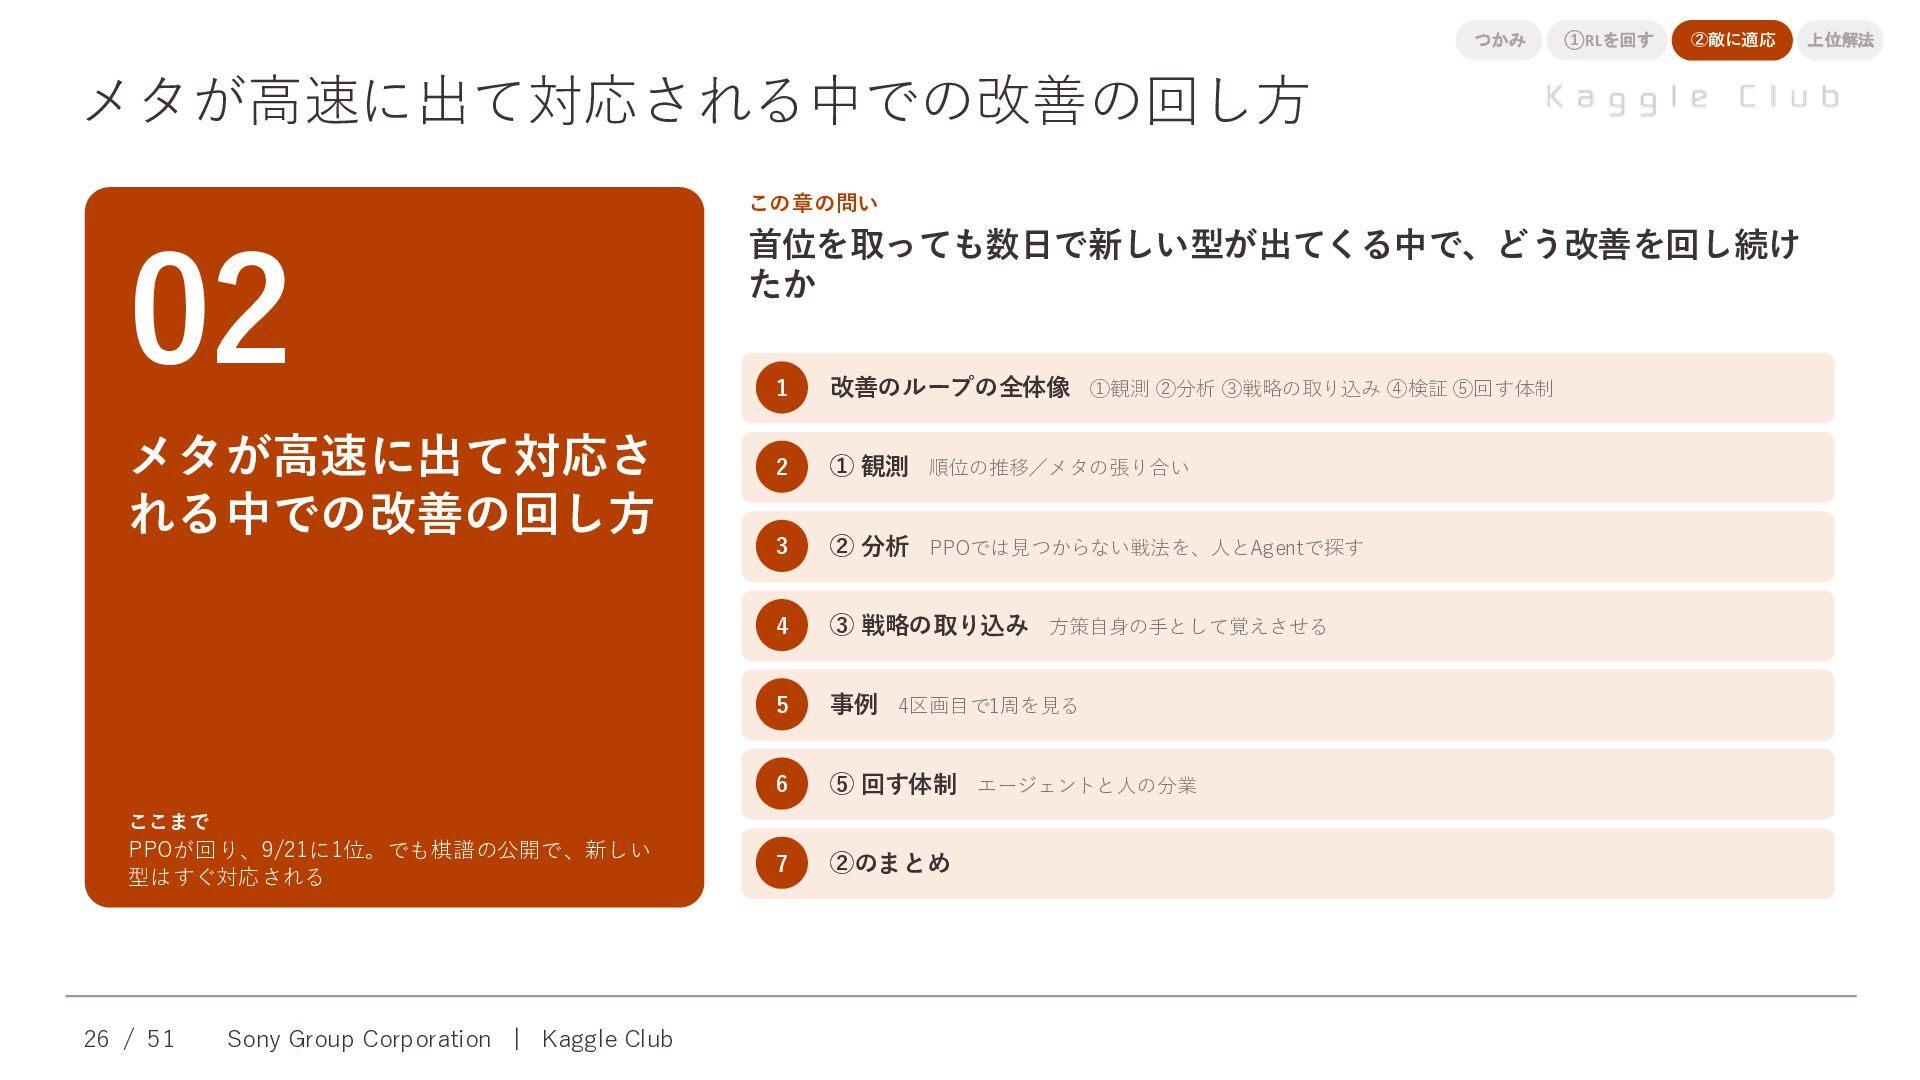
つかみ ①RLを回す ②敵に適応 メタが高速に出て対応される中での改善の回し方 この章の問い 02 メタが高速に出て対応さ れる中での改善の回し方 首位を取っても数日で新しい型が出てくる中で、どう改善を回し続け たか
1 改善のループの全体像 ①観測 ②分析 ③戦略の取り込み ④検証 ⑤回す体制 2 ① 観測 順位の推移/メタの張り合い 3 ② 分析 PPOでは見つからない戦法を、人とAgentで探す 4 ③ 戦略の取り込み 方策自身の手として覚えさせる 5 事例 4区画目で1周を見る 6 ⑤ 回す体制 エージェントと人の分業 7 ②のまとめ ここまで PPOが回り、9/21に1位。でも棋譜の公開で、新しい 型はすぐ対応される 26 / 51 Sony Group Corporation | Kaggle Club 上位解法 -
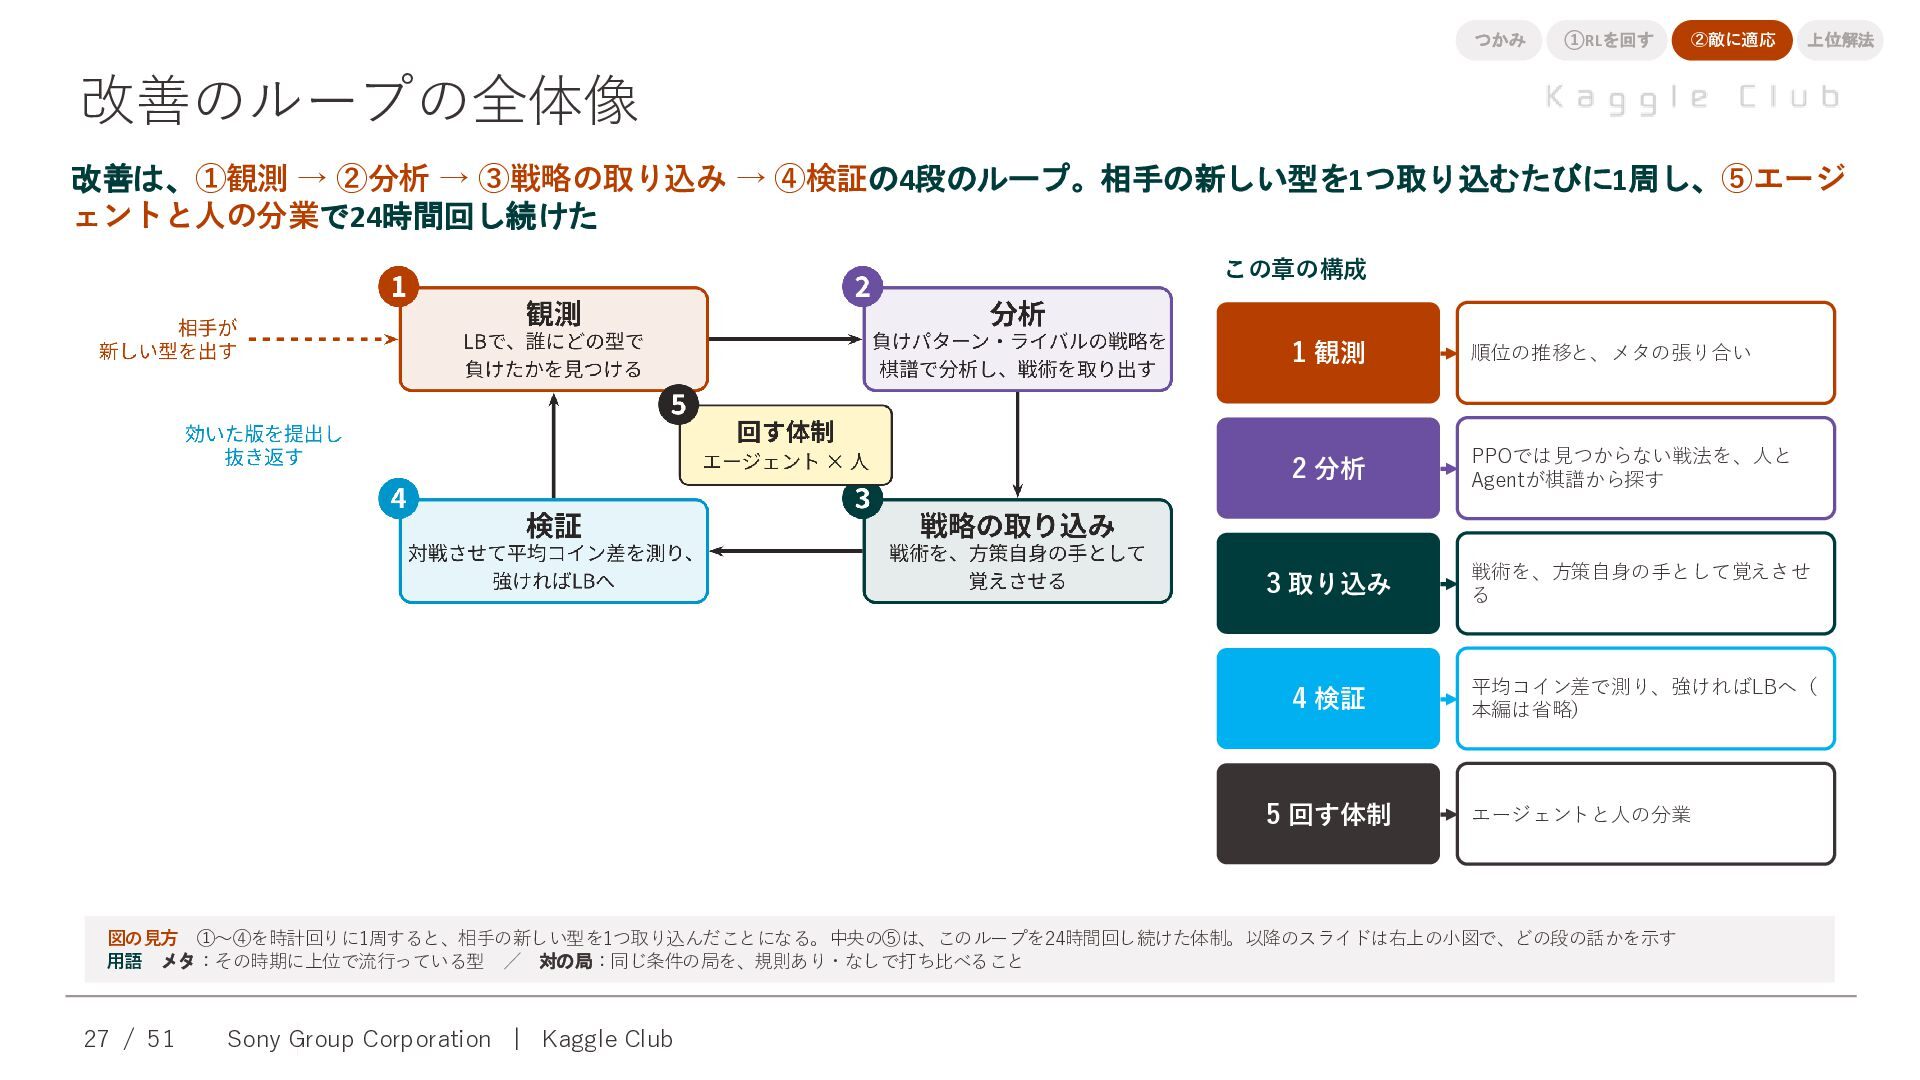
つかみ ①RLを回す ②敵に適応 上位解法 改善のループの全体像 改善は、①観測 → ②分析 → ③戦略の取り込み
→ ④検証の4段のループ。相手の新しい型を1つ取り込むたびに1周し、⑤エージ ェントと人の分業で24時間回し続けた この章の構成 1 観測 順位の推移と、メタの張り合い 2 分析 PPOでは見つからない戦法を、人と Agentが棋譜から探す 3 取り込み 戦術を、方策自身の手として覚えさせ る 4 検証 平均コイン差で測り、強ければLBへ( 本編は省略) 5 回す体制 エージェントと人の分業 図の見方 ①〜④を時計回りに1周すると、相手の新しい型を1つ取り込んだことになる。中央の⑤は、このループを24時間回し続けた体制。以降のスライドは右上の小図で、どの段の話かを示す 用語 メタ:その時期に上位で流行っている型 / 対の局:同じ条件の局を、規則あり・なしで打ち比べること 27 / 51 Sony Group Corporation | Kaggle Club -
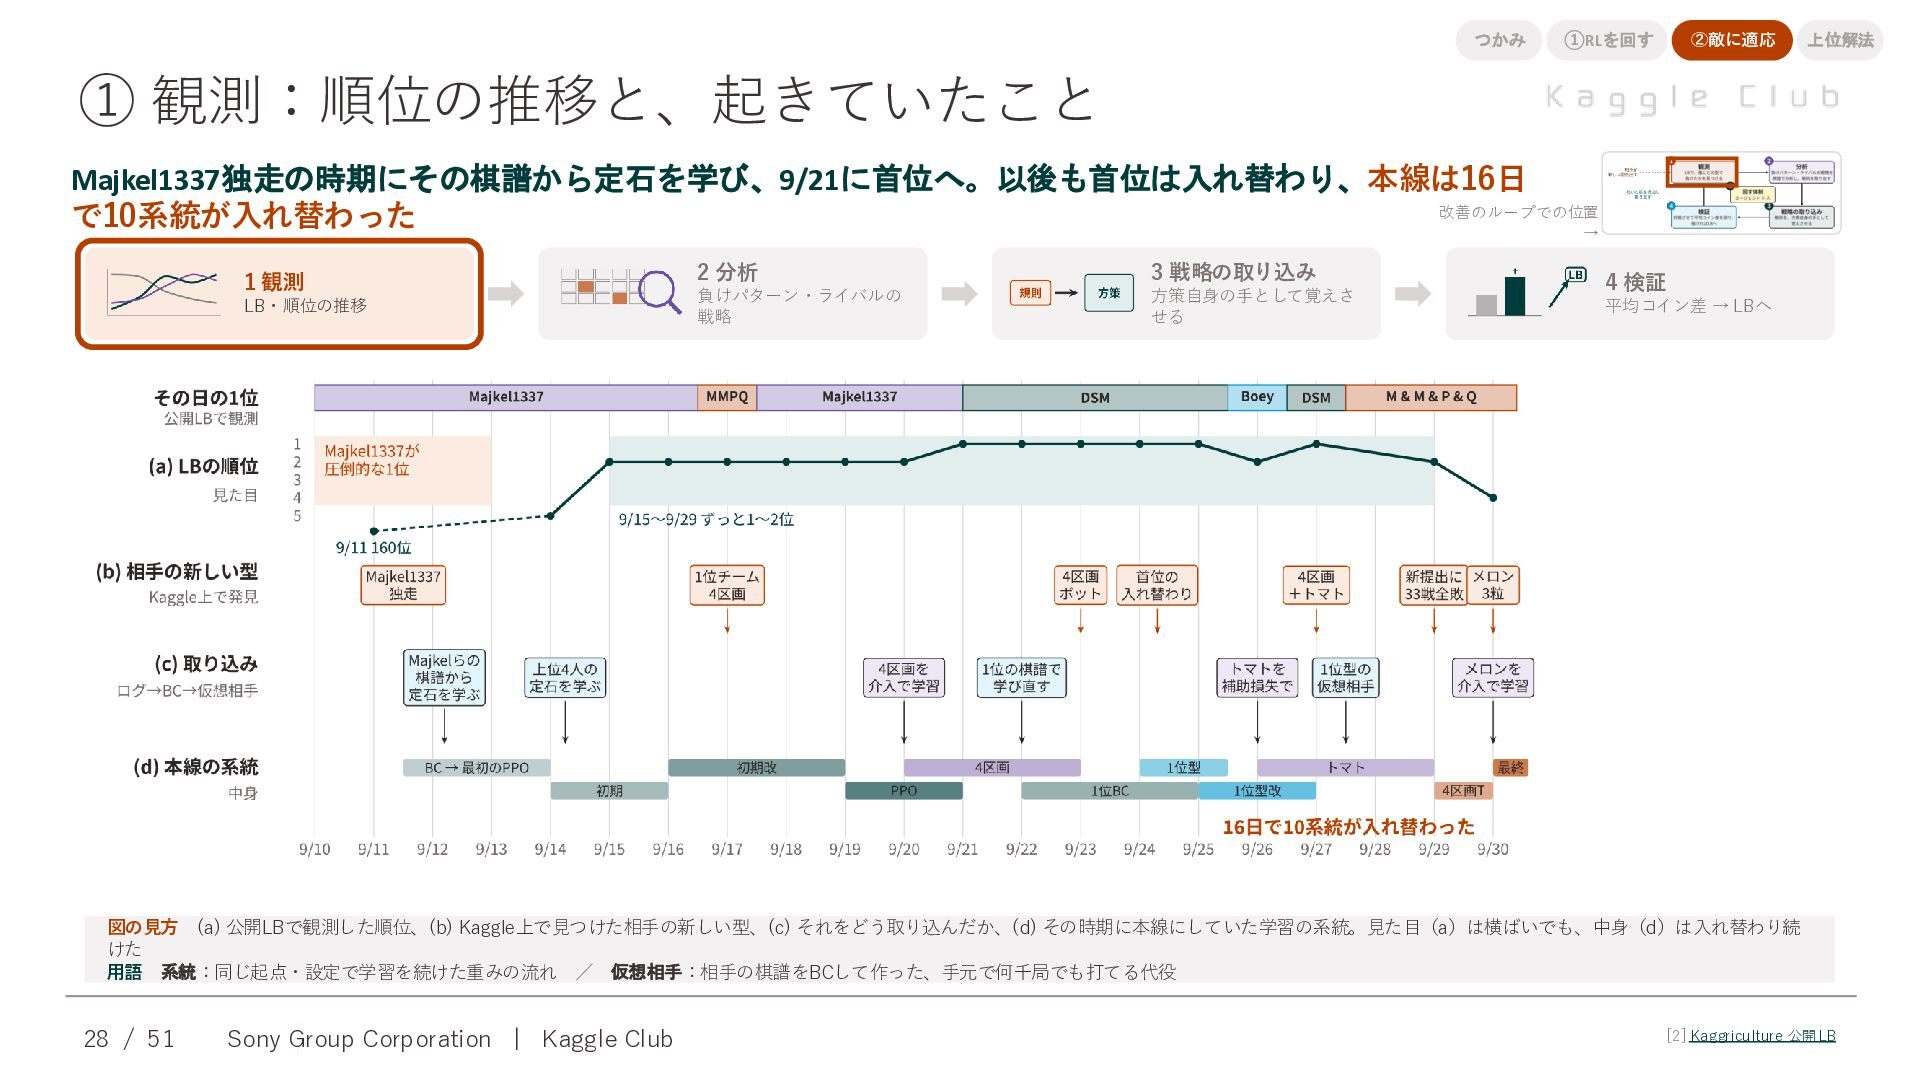
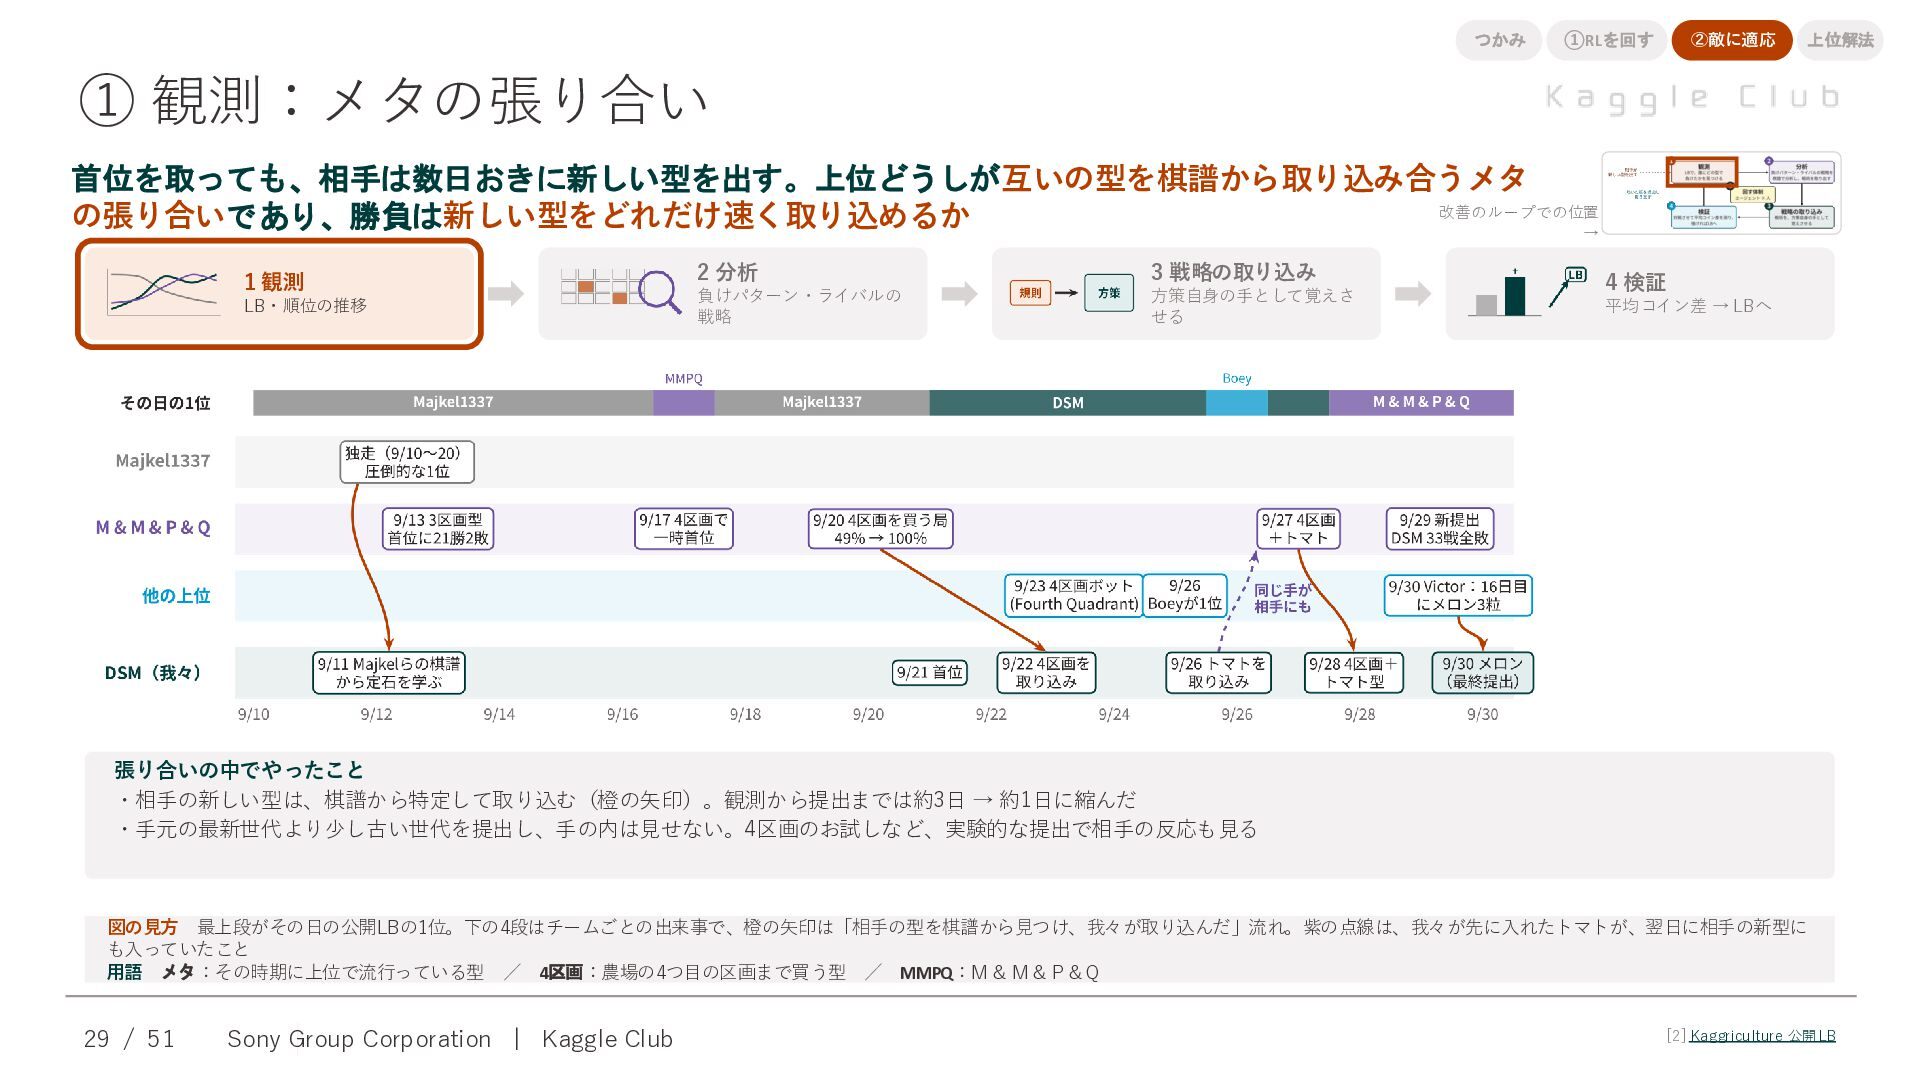
つかみ ①RLを回す ②敵に適応 上位解法 ① 観測:順位の推移と、起きていたこと Majkel1337独走の時期にその棋譜から定石を学び、9/21に首位へ。以後も首位は入れ替わり、本線は16日 改善のループでの位置 で10系統が入れ替わった →
1 観測 LB・順位の推移 2 分析 3 戦略の取り込み 負けパターン・ライバルの 戦略 方策自身の手として覚えさ せる 4 検証 平均コイン差 → LBへ 図の見方 (a) 公開LBで観測した順位、(b) Kaggle上で見つけた相手の新しい型、(c) それをどう取り込んだか、(d) その時期に本線にしていた学習の系統。見た目(a)は横ばいでも、中身(d)は入れ替わり続 けた 用語 系統:同じ起点・設定で学習を続けた重みの流れ / 仮想相手:相手の棋譜をBCして作った、手元で何千局でも打てる代役 28 / 51 Sony Group Corporation | Kaggle Club [2] Kaggricu lture 公開LB -
つかみ ①RLを回す ②敵に適応 上位解法 ① 観測:メタの張り合い 首位を取っても、相手は数日おきに新しい型を出す。上位どうしが互いの型を棋譜から取り込み合うメタ 改善のループでの位置 の張り合いであり、勝負は新しい型をどれだけ速く取り込めるか →
1 観測 LB・順位の推移 2 分析 3 戦略の取り込み 負けパターン・ライバルの 戦略 方策自身の手として覚えさ せる 4 検証 平均コイン差 → LBへ 張り合いの中でやったこと ・相手の新しい型は、棋譜から特定して取り込む(橙の矢印)。観測から提出までは約3日 → 約1日に縮んだ ・手元の最新世代より少し古い世代を提出し、手の内は見せない。4区画のお試しなど、実験的な提出で相手の反応も見る 図の見方 最上段がその日の公開LBの1位。下の4段はチームごとの出来事で、橙の矢印は「相手の型を棋譜から見つけ、我々が取り込んだ」流れ。紫の点線は、我々が先に入れたトマトが、翌日に相手の新型に も入っていたこと 用語 メタ:その時期に上位で流行っている型 / 4区画:農場の4つ目の区画まで買う型 / MMPQ:M & M & P & Q 29 / 51 Sony Group Corporation | Kaggle Club [2] Kaggricu lture 公開LB -
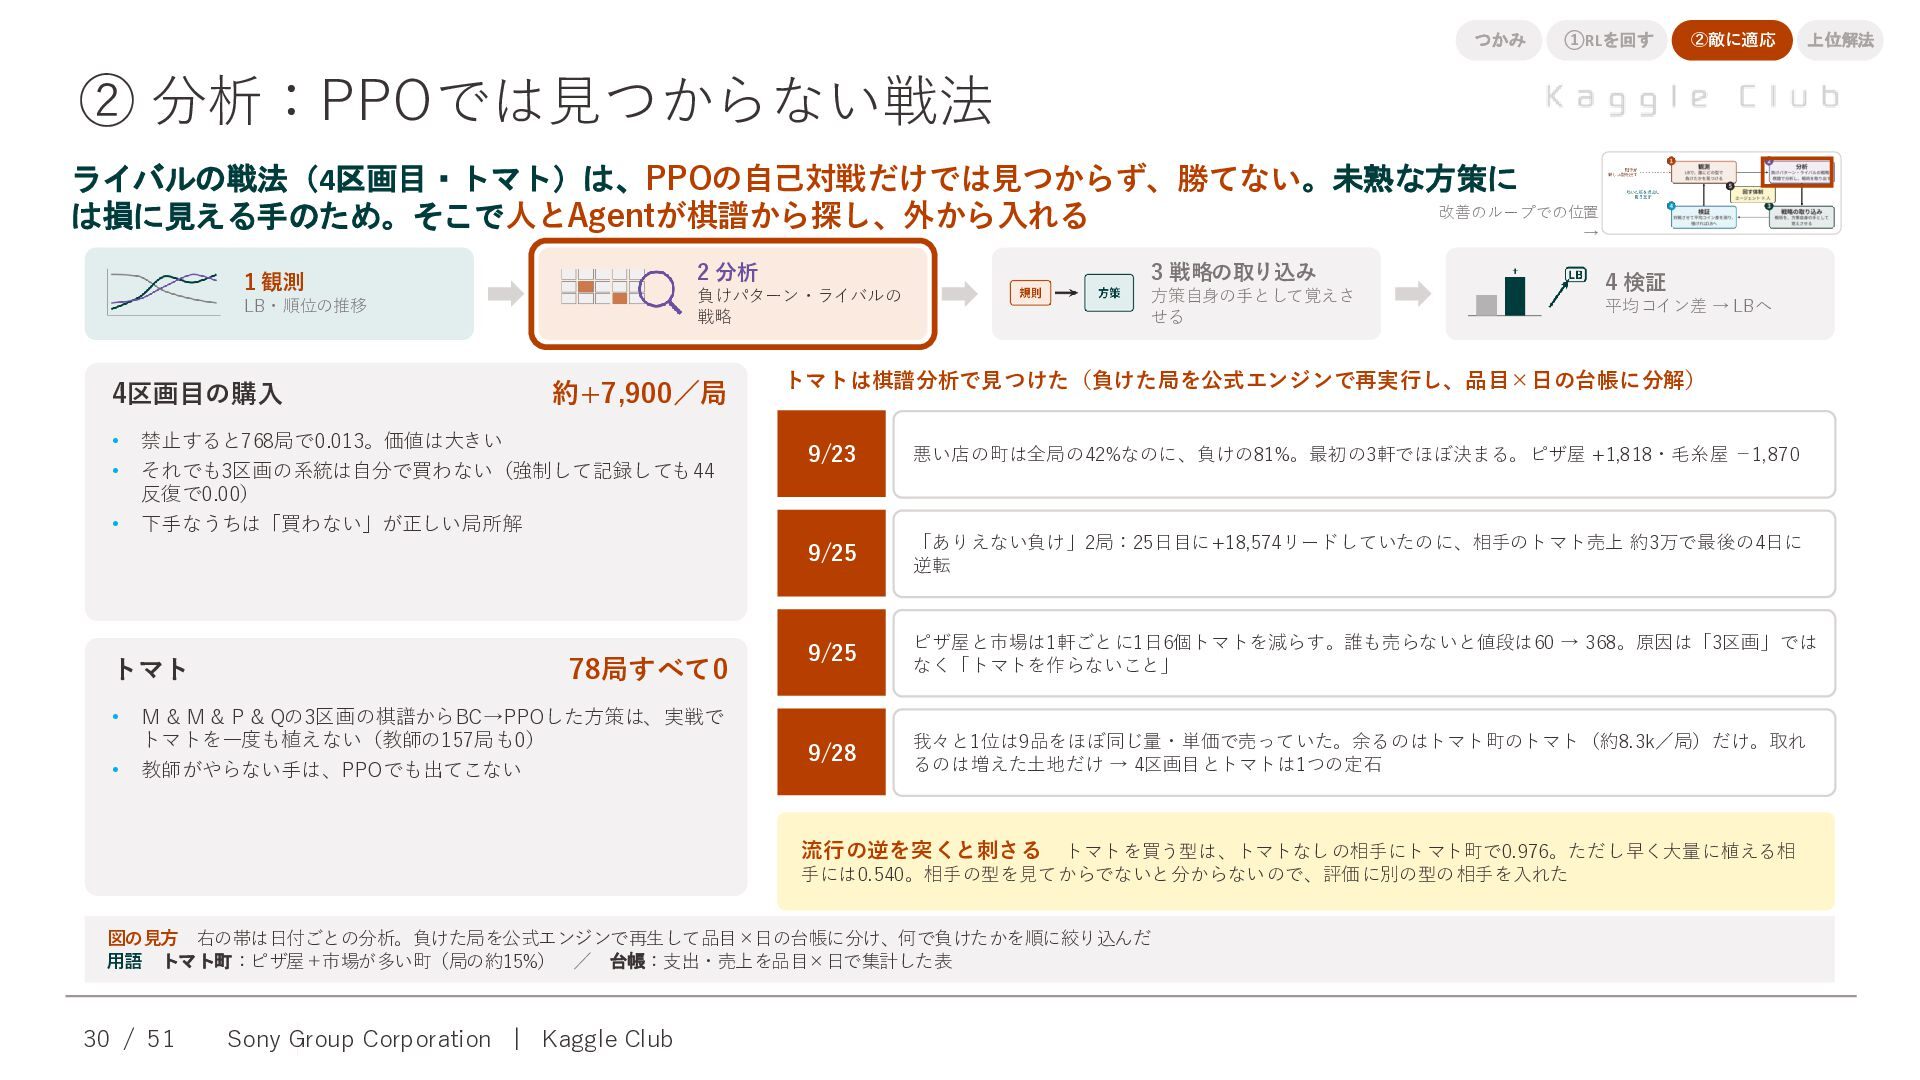
つかみ ①RLを回す ②敵に適応 上位解法 ② 分析:PPOでは見つからない戦法 ライバルの戦法(4区画目・トマト)は、PPOの自己対戦だけでは見つからず、勝てない。未熟な方策に 改善のループでの位置 は損に見える手のため。そこで人とAgentが棋譜から探し、外から入れる →
1 観測 LB・順位の推移 4区画目の購入 • • • • 3 戦略の取り込み 負けパターン・ライバルの 戦略 方策自身の手として覚えさ せる 約+7,900/局 禁止すると768局で0.013。価値は大きい それでも3区画の系統は自分で買わない(強制して記録しても44 反復で0.00) 下手なうちは「買わない」が正しい局所解 78局すべて0 トマト • 2 分析 M & M & P & Qの3区画の棋譜からBC→PPOした方策は、実戦で トマトを一度も植えない(教師の157局も0) 教師がやらない手は、PPOでも出てこない 4 検証 平均コイン差 → LBへ トマトは棋譜分析で見つけた(負けた局を公式エンジンで再実行し、品目×日の台帳に分解) 9/23 悪い店の町は全局の42%なのに、負けの81%。最初の3軒でほぼ決まる。ピザ屋 +1,818・毛糸屋 −1,870 9/25 「ありえない負け」2局:25日目に+18,574リードしていたのに、相手のトマト売上 約3万で最後の4日に 逆転 9/25 ピザ屋と市場は1軒ごとに1日6個トマトを減らす。誰も売らないと値段は60 → 368。原因は「3区画」では なく「トマトを作らないこと」 9/28 我々と1位は9品をほぼ同じ量・単価で売っていた。余るのはトマト町のトマト(約8.3k/局)だけ。取れ るのは増えた土地だけ → 4区画目とトマトは1つの定石 流行の逆を突くと刺さる トマトを買う型は、トマトなしの相手にトマト町で0.976。ただし早く大量に植える相 手には0.540。相手の型を見てからでないと分からないので、評価に別の型の相手を入れた 図の見方 右の帯は日付ごとの分析。負けた局を公式エンジンで再生して品目×日の台帳に分け、何で負けたかを順に絞り込んだ 用語 トマト町:ピザ屋+市場が多い町(局の約15%) / 台帳:支出・売上を品目×日で集計した表 30 / 51 Sony Group Corporation | Kaggle Club -
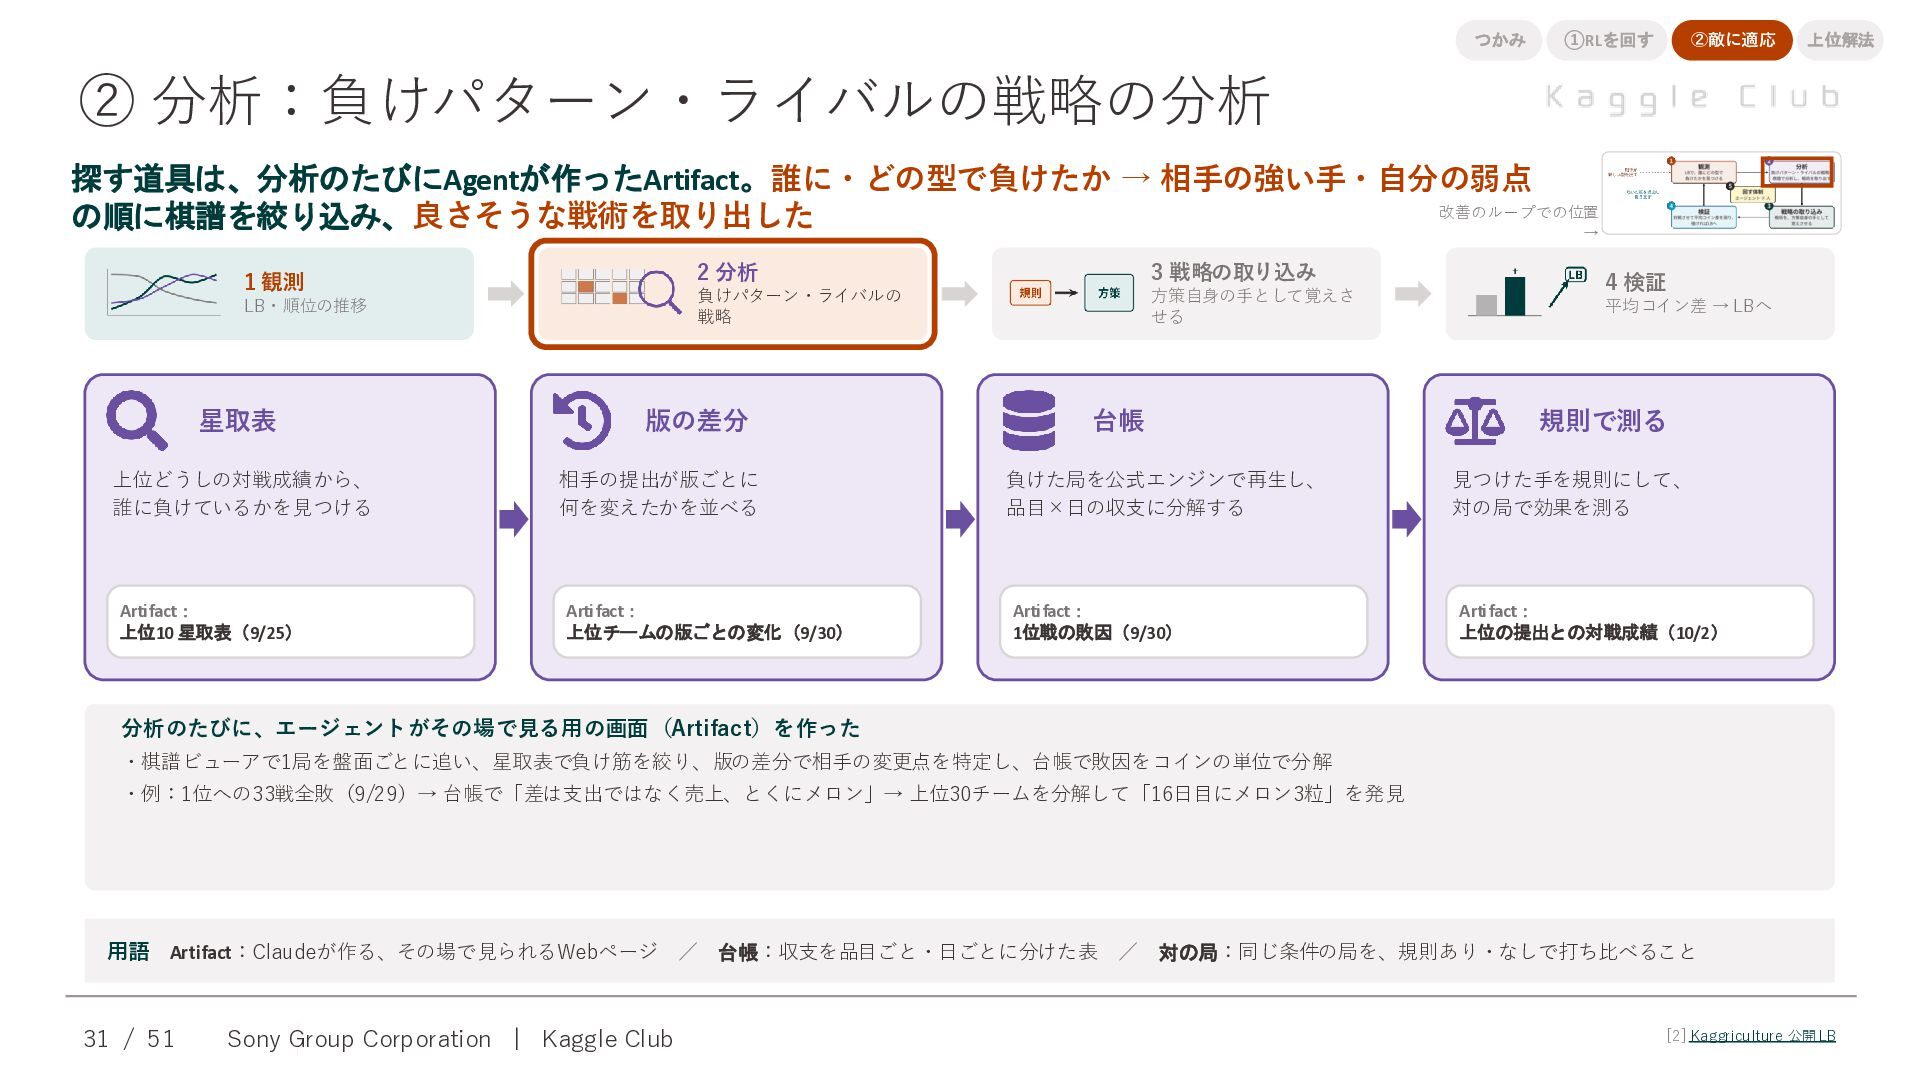
つかみ ②敵に適応 ①RLを回す 上位解法 ② 分析:負けパターン・ライバルの戦略の分析 探す道具は、分析のたびにAgentが作ったArtifact。誰に・どの型で負けたか → 相手の強い手・自分の弱点 改善のループでの位置
の順に棋譜を絞り込み、良さそうな戦術を取り出した → 1 観測 LB・順位の推移 星取表 2 分析 3 戦略の取り込み 負けパターン・ライバルの 戦略 方策自身の手として覚えさ せる 版の差分 台帳 4 検証 平均コイン差 → LBへ 規則で測る 上位どうしの対戦成績から、 誰に負けているかを見つける 相手の提出が版ごとに 何を変えたかを並べる 負けた局を公式エンジンで再生し、 品目×日の収支に分解する 見つけた手を規則にして、 対の局で効果を測る Artifact: 上位10 星取表(9/25) Artifact: 上位チームの版ごとの変化(9/30) Artifact: 1位戦の敗因(9/30) Artifact: 上位の提出との対戦成績(10/2) 分析のたびに、エージェントがその場で見る用の画面(Artifact)を作った ・棋譜ビューアで1局を盤面ごとに追い、星取表で負け筋を絞り、版の差分で相手の変更点を特定し、台帳で敗因をコインの単位で分解 ・例:1位への33戦全敗(9/29)→ 台帳で「差は支出ではなく売上、とくにメロン」→ 上位30チームを分解して「16日目にメロン3粒」を発見 用語 Artifact:Claudeが作る、その場で見られるWebページ / 台帳:収支を品目ごと・日ごとに分けた表 / 対の局:同じ条件の局を、規則あり・なしで打ち比べること 31 / 51 Sony Group Corporation | Kaggle Club [2] Kaggricu lture 公開LB -
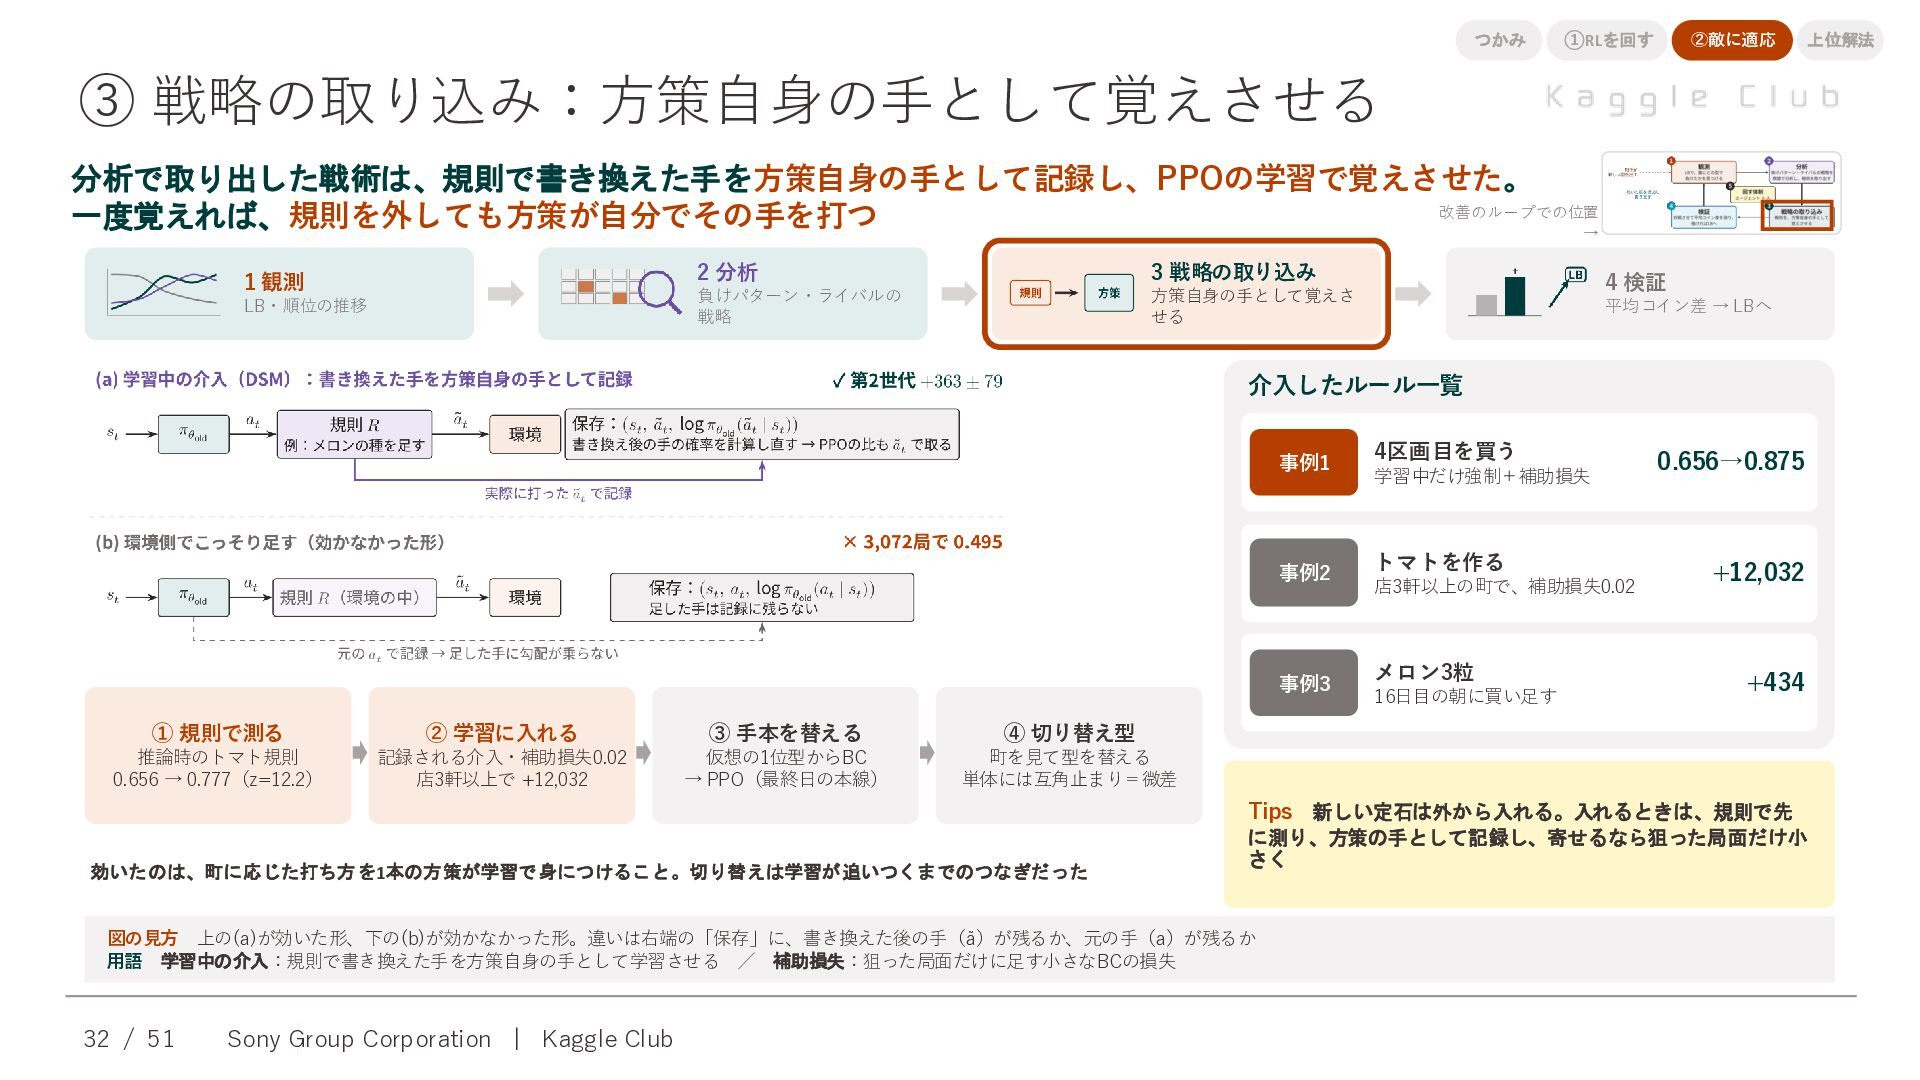
つかみ ②敵に適応 ①RLを回す 上位解法 ③ 戦略の取り込み:方策自身の手として覚えさせる 分析で取り出した戦術は、規則で書き換えた手を方策自身の手として記録し、PPOの学習で覚えさせた。 改善のループでの位置 一度覚えれば、規則を外しても方策が自分でその手を打つ →
1 観測 LB・順位の推移 2 分析 3 戦略の取り込み 負けパターン・ライバルの 戦略 方策自身の手として覚えさ せる 4 検証 平均コイン差 → LBへ 介入したルール一覧 事例1 事例2 事例3 ① 規則で測る ② 学習に入れる ③ 手本を替える ④ 切り替え型 推論時のトマト規則 0.656 → 0.777(z=12.2) 記録される介入・補助損失0.02 店3軒以上で +12,032 仮想の1位型からBC → PPO(最終日の本線) 町を見て型を替える 単体には互角止まり=微差 4区画目を買う 学習中だけ強制+補助損失 トマトを作る 店3軒以上の町で、補助損失0.02 メロン3粒 16日目の朝に買い足す 0.656→0.875 +12,032 +434 Tips 新しい定石は外から入れる。入れるときは、規則で先 効いたのは、町に応じた打ち方を1本の方策が学習で身につけること。切り替えは学習が追いつくまでのつなぎだった に測り、方策の手として記録し、寄せるなら狙った局面だけ小 さく 図の見方 上の(a)が効いた形、下の(b)が効かなかった形。違いは右端の「保存」に、書き換えた後の手(ã)が残るか、元の手(a)が残るか 用語 学習中の介入:規則で書き換えた手を方策自身の手として学習させる / 補助損失:狙った局面だけに足す小さなBCの損失 32 / 51 Sony Group Corporation | Kaggle Club -
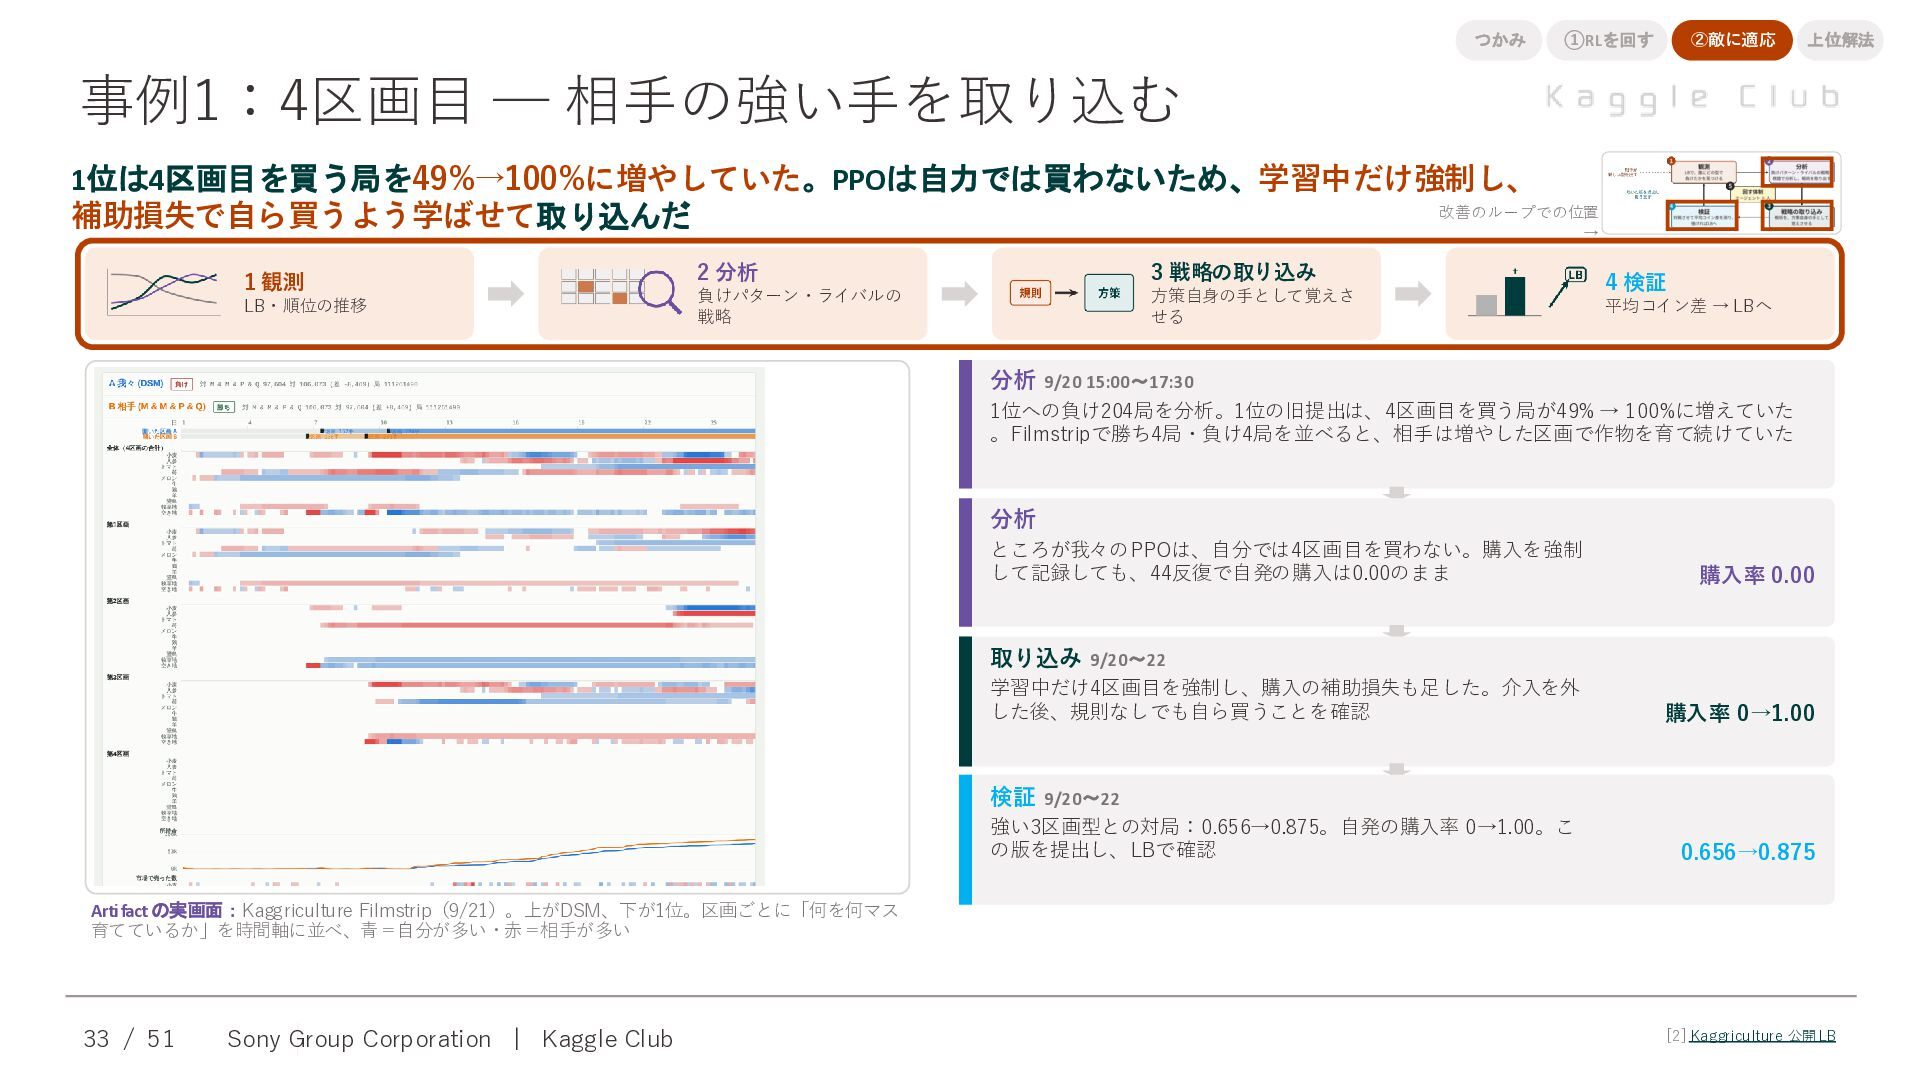
つかみ ②敵に適応 ①RLを回す 上位解法 事例1:4区画目 ─ 相手の強い手を取り込む 1位は4区画目を買う局を49%→100%に増やしていた。PPOは自力では買わないため、学習中だけ強制し、 改善のループでの位置 補助損失で自ら買うよう学ばせて取り込んだ
→ 1 観測 LB・順位の推移 2 分析 3 戦略の取り込み 負けパターン・ライバルの 戦略 方策自身の手として覚えさ せる 4 検証 平均コイン差 → LBへ 分析 9/20 15:00〜17:30 1位への負け204局を分析。1位の旧提出は、4区画目を買う局が49% → 100%に増えていた 。Filmstripで勝ち4局・負け4局を並べると、相手は増やした区画で作物を育て続けていた 分析 ところが我々のPPOは、自分では4区画目を買わない。購入を強制 して記録しても、44反復で自発の購入は0.00のまま 購入率 0.00 取り込み 9/20〜22 学習中だけ4区画目を強制し、購入の補助損失も足した。介入を外 した後、規則なしでも自ら買うことを確認 購入率 0→1.00 検証 9/20〜22 強い3区画型との対局:0.656→0.875。自発の購入率 0→1.00。こ の版を提出し、LBで確認 0.656→0.875 Artifact の実画面:Kaggriculture Filmstrip(9/21)。上がDSM、下が1位。区画ごとに「何を何マス 育てているか」を時間軸に並べ、青=自分が多い・赤=相手が多い 33 / 51 Sony Group Corporation | Kaggle Club [2] Kaggricu lture 公開LB -
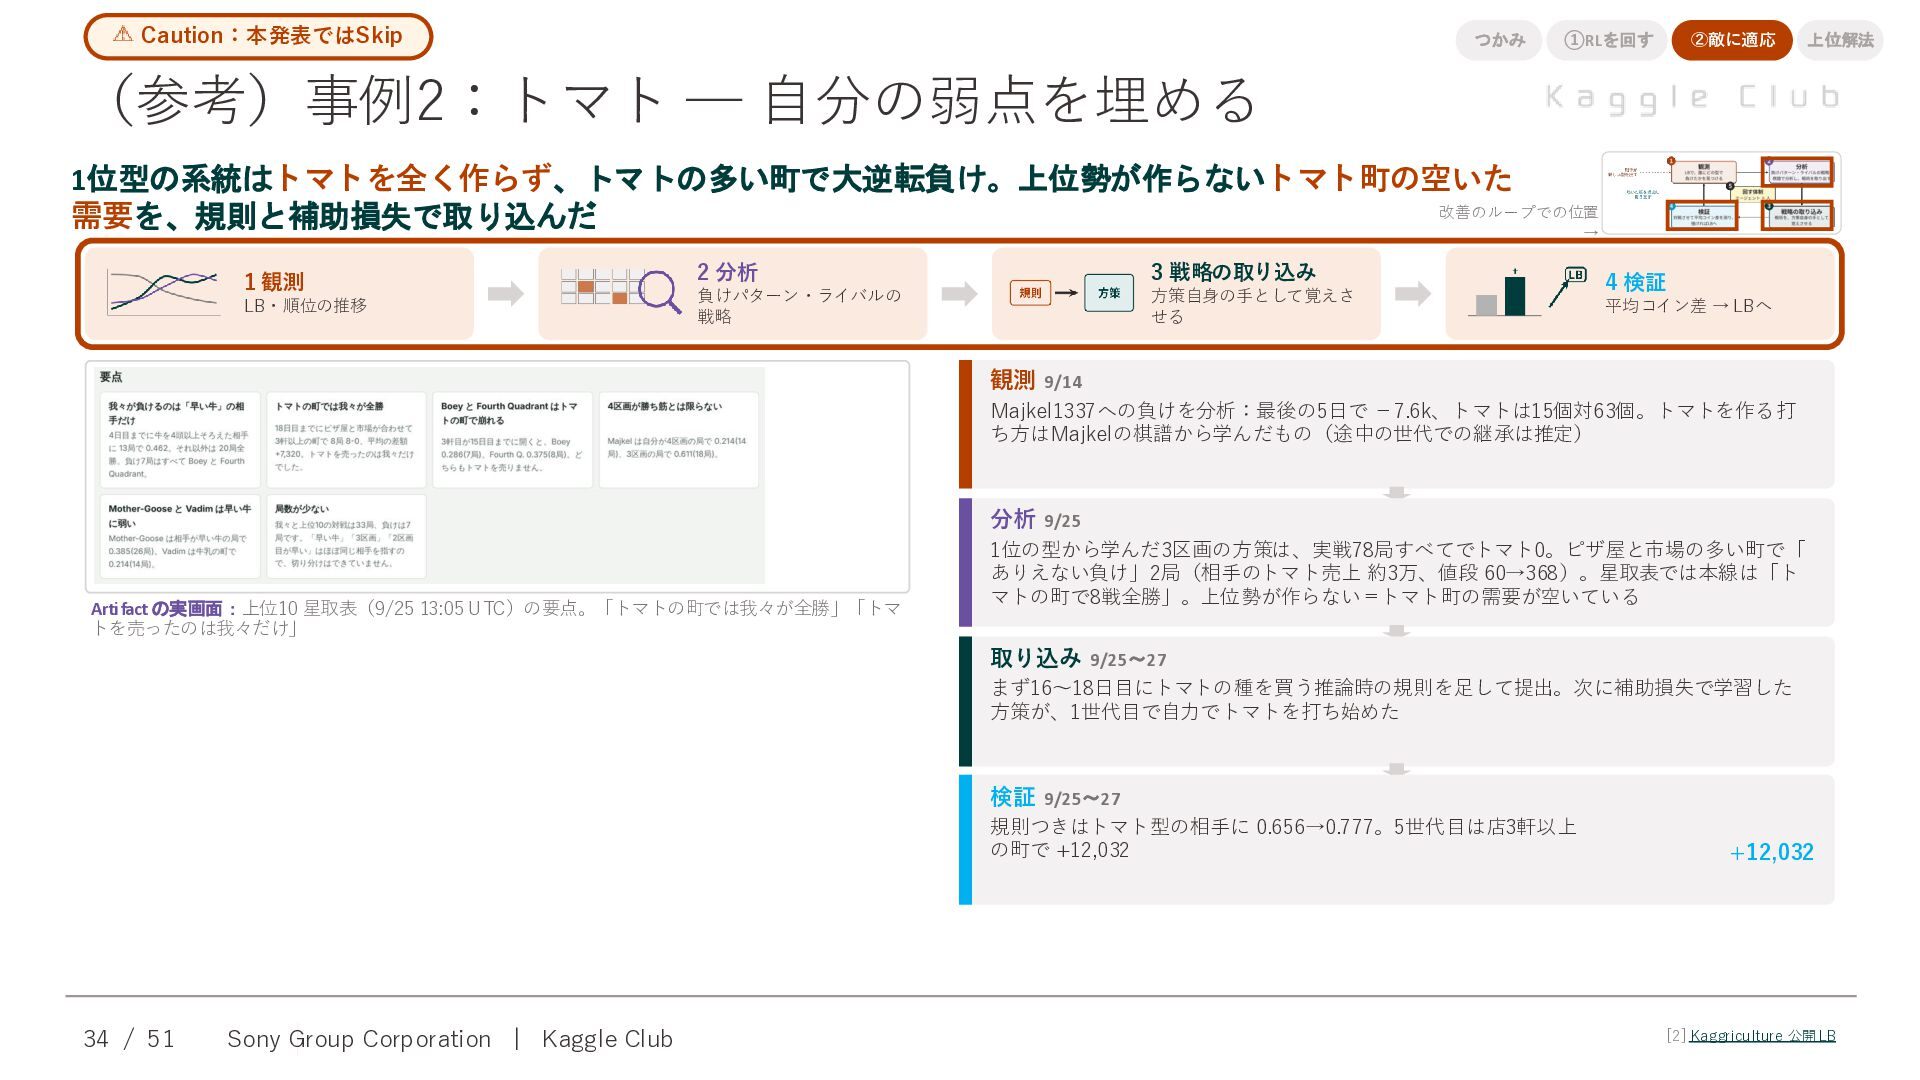
Caution:本発表ではSkip つかみ ①RLを回す ②敵に適応 上位解法 (参考)事例2:トマト ─ 自分の弱点を埋める 1位型の系統はトマトを全く作らず、トマトの多い町で大逆転負け。上位勢が作らないトマト町の空いた 改善のループでの位置
需要を、規則と補助損失で取り込んだ → 1 観測 LB・順位の推移 2 分析 3 戦略の取り込み 負けパターン・ライバルの 戦略 方策自身の手として覚えさ せる 4 検証 平均コイン差 → LBへ 観測 9/14 Majkel1337への負けを分析:最後の5日で −7.6k、トマトは15個対63個。トマトを作る打 ち方はMajkelの棋譜から学んだもの(途中の世代での継承は推定) 分析 9/25 Artifact の実画面:上位10 星取表(9/25 13:05 UTC)の要点。「トマトの町では我々が全勝」「トマ トを売ったのは我々だけ」 1位の型から学んだ3区画の方策は、実戦78局すべてでトマト0。ピザ屋と市場の多い町で「 ありえない負け」2局(相手のトマト売上 約3万、値段 60→368)。星取表では本線は「ト マトの町で8戦全勝」。上位勢が作らない=トマト町の需要が空いている 取り込み 9/25〜27 まず16〜18日目にトマトの種を買う推論時の規則を足して提出。次に補助損失で学習した 方策が、1世代目で自力でトマトを打ち始めた 検証 9/25〜27 規則つきはトマト型の相手に 0.656→0.777。5世代目は店3軒以上 の町で +12,032 34 / 51 Sony Group Corporation | Kaggle Club +12,032 [2] Kaggricu lture 公開LB -
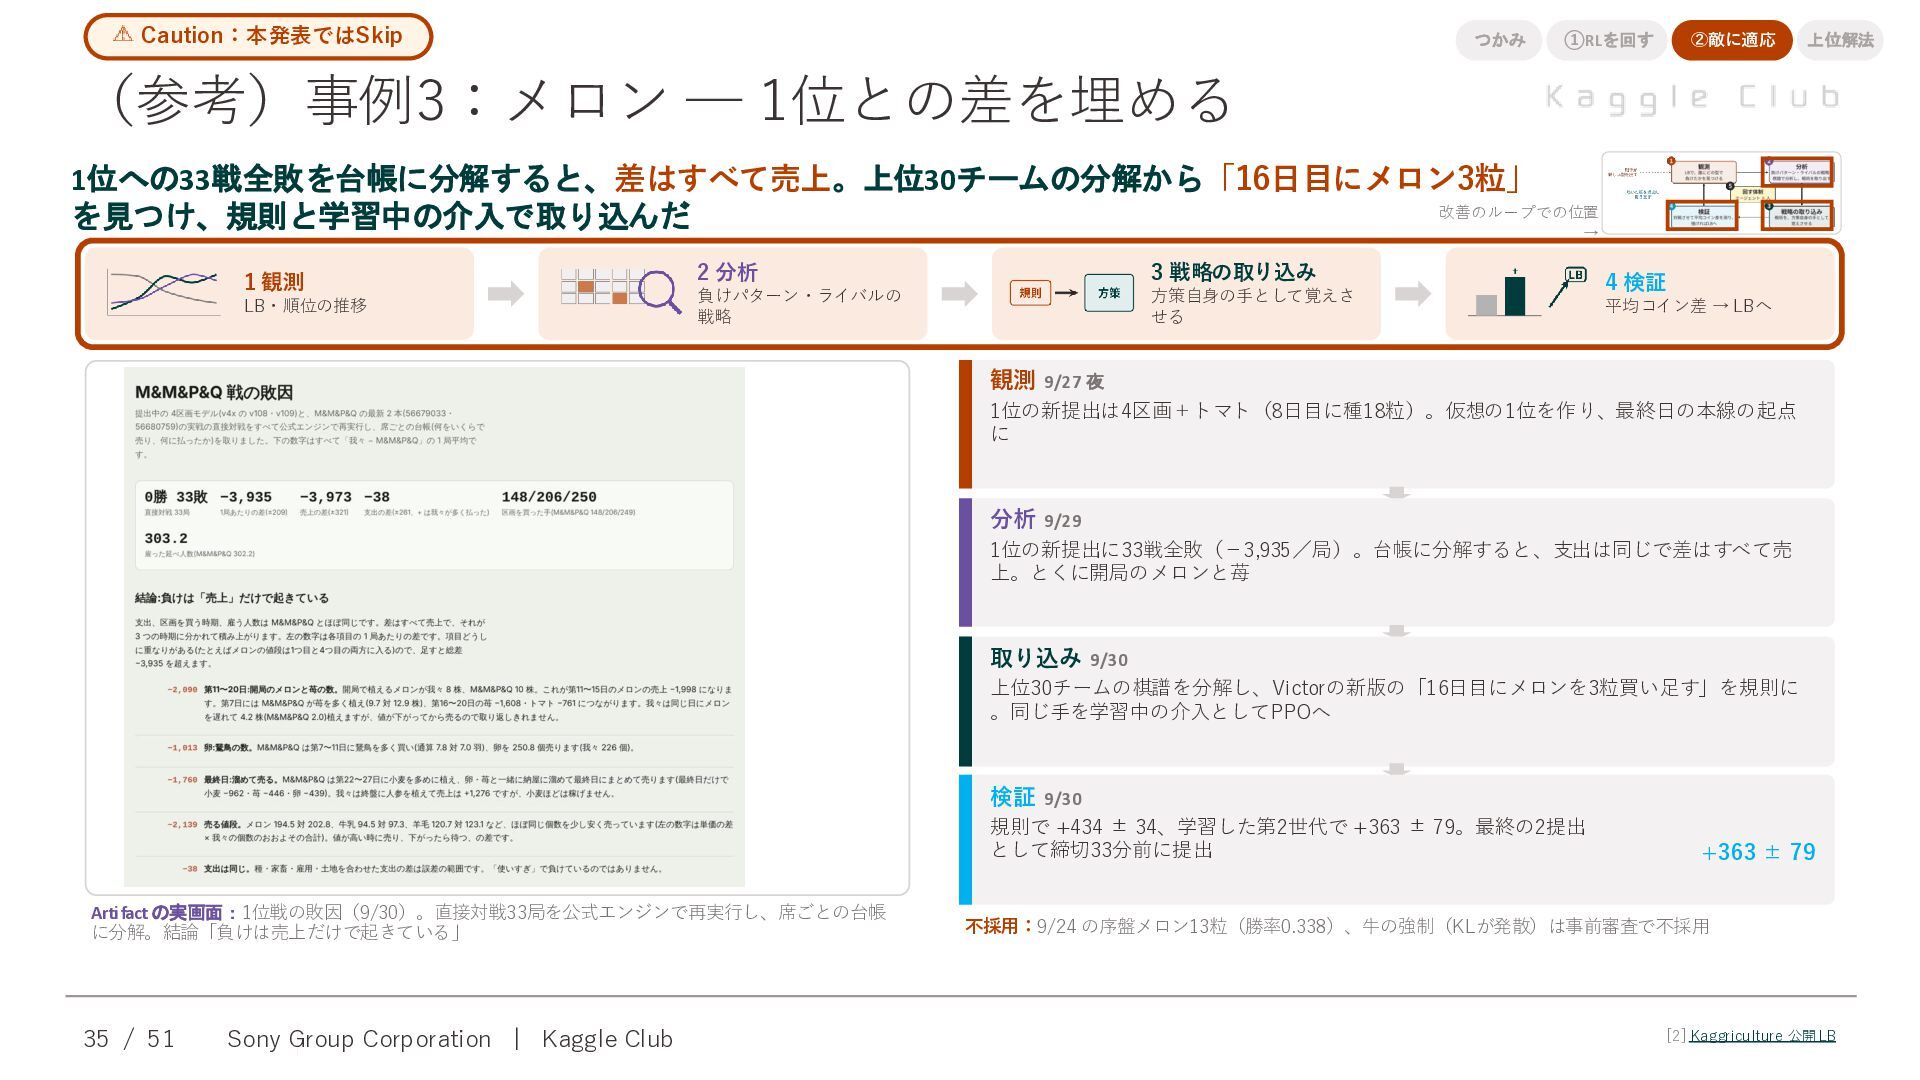
Caution:本発表ではSkip つかみ ①RLを回す ②敵に適応 上位解法 (参考)事例3:メロン ─ 1位との差を埋める 1位への33戦全敗を台帳に分解すると、差はすべて売上。上位30チームの分解から「16日目にメロン3粒」 改善のループでの位置
を見つけ、規則と学習中の介入で取り込んだ → 1 観測 LB・順位の推移 2 分析 3 戦略の取り込み 負けパターン・ライバルの 戦略 方策自身の手として覚えさ せる 4 検証 平均コイン差 → LBへ 観測 9/27 夜 1位の新提出は4区画+トマト(8日目に種18粒)。仮想の1位を作り、最終日の本線の起点 に 分析 9/29 1位の新提出に33戦全敗(−3,935/局)。台帳に分解すると、支出は同じで差はすべて売 上。とくに開局のメロンと苺 取り込み 9/30 上位30チームの棋譜を分解し、Victorの新版の「16日目にメロンを3粒買い足す」を規則に 。同じ手を学習中の介入としてPPOへ 検証 9/30 規則で +434 ± 34、学習した第2世代で +363 ± 79。最終の2提出 として締切33分前に提出 Artifact の実画面:1位戦の敗因(9/30)。直接対戦33局を公式エンジンで再実行し、席ごとの台帳 に分解。結論「負けは売上だけで起きている」 35 / 51 Sony Group Corporation | Kaggle Club +363 ± 79 不採用:9/24 の序盤メロン13粒(勝率0.338)、牛の強制(KLが発散)は事前審査で不採用 [2] Kaggricu lture 公開LB -
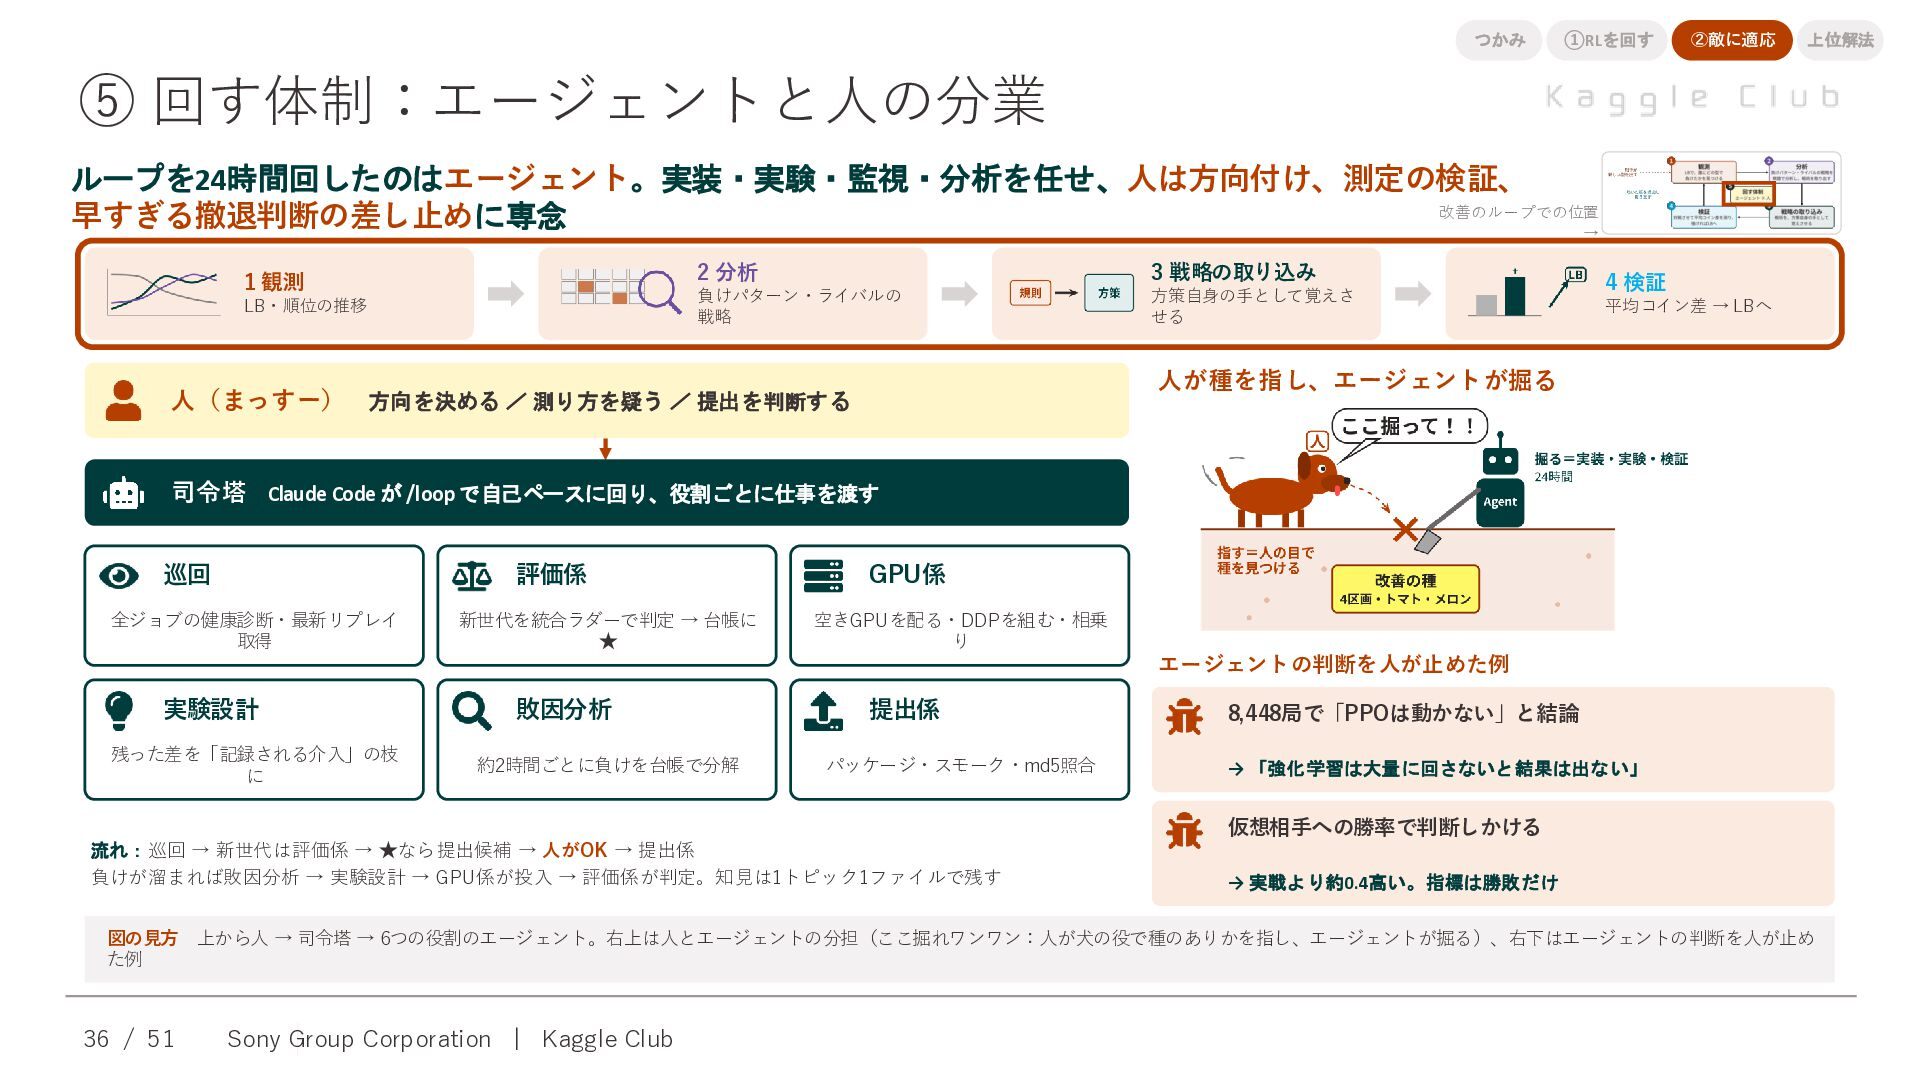
つかみ ①RLを回す ②敵に適応 上位解法 ⑤ 回す体制:エージェントと人の分業 ループを24時間回したのはエージェント。実装・実験・監視・分析を任せ、人は方向付け、測定の検証、 改善のループでの位置 早すぎる撤退判断の差し止めに専念 →
1 観測 LB・順位の推移 2 分析 3 戦略の取り込み 負けパターン・ライバルの 戦略 方策自身の手として覚えさ せる 4 検証 平均コイン差 → LBへ 人が種を指し、エージェントが掘る 人(まっすー) 方向を決める / 測り方を疑う / 提出を判断する 司令塔 Claude Code が /loop で自己ペースに回り、役割ごとに仕事を渡す 巡回 評価係 全ジョブの健康診断・最新リプレイ 取得 新世代を統合ラダーで判定 → 台帳に ★ GPU係 空きGPUを配る・DDPを組む・相乗 り エージェントの判断を人が止めた例 実験設計 残った差を「記録される介入」の枝 に 敗因分析 約2時間ごとに負けを台帳で分解 提出係 パッケージ・スモーク・md5照合 8,448局で「PPOは動かない」と結論 → 「強化学習は大量に回さないと結果は出ない」 仮想相手への勝率で判断しかける 流れ:巡回 → 新世代は評価係 → ★なら提出候補 → 人がOK → 提出係 負けが溜まれば敗因分析 → 実験設計 → GPU係が投入 → 評価係が判定。知見は1トピック1ファイルで残す → 実戦より約0.4高い。指標は勝敗だけ 図の見方 上から人 → 司令塔 → 6つの役割のエージェント。右上は人とエージェントの分担(ここ掘れワンワン:人が犬の役で種のありかを指し、エージェントが掘る)、右下はエージェントの判断を人が止め た例 36 / 51 Sony Group Corporation | Kaggle Club -
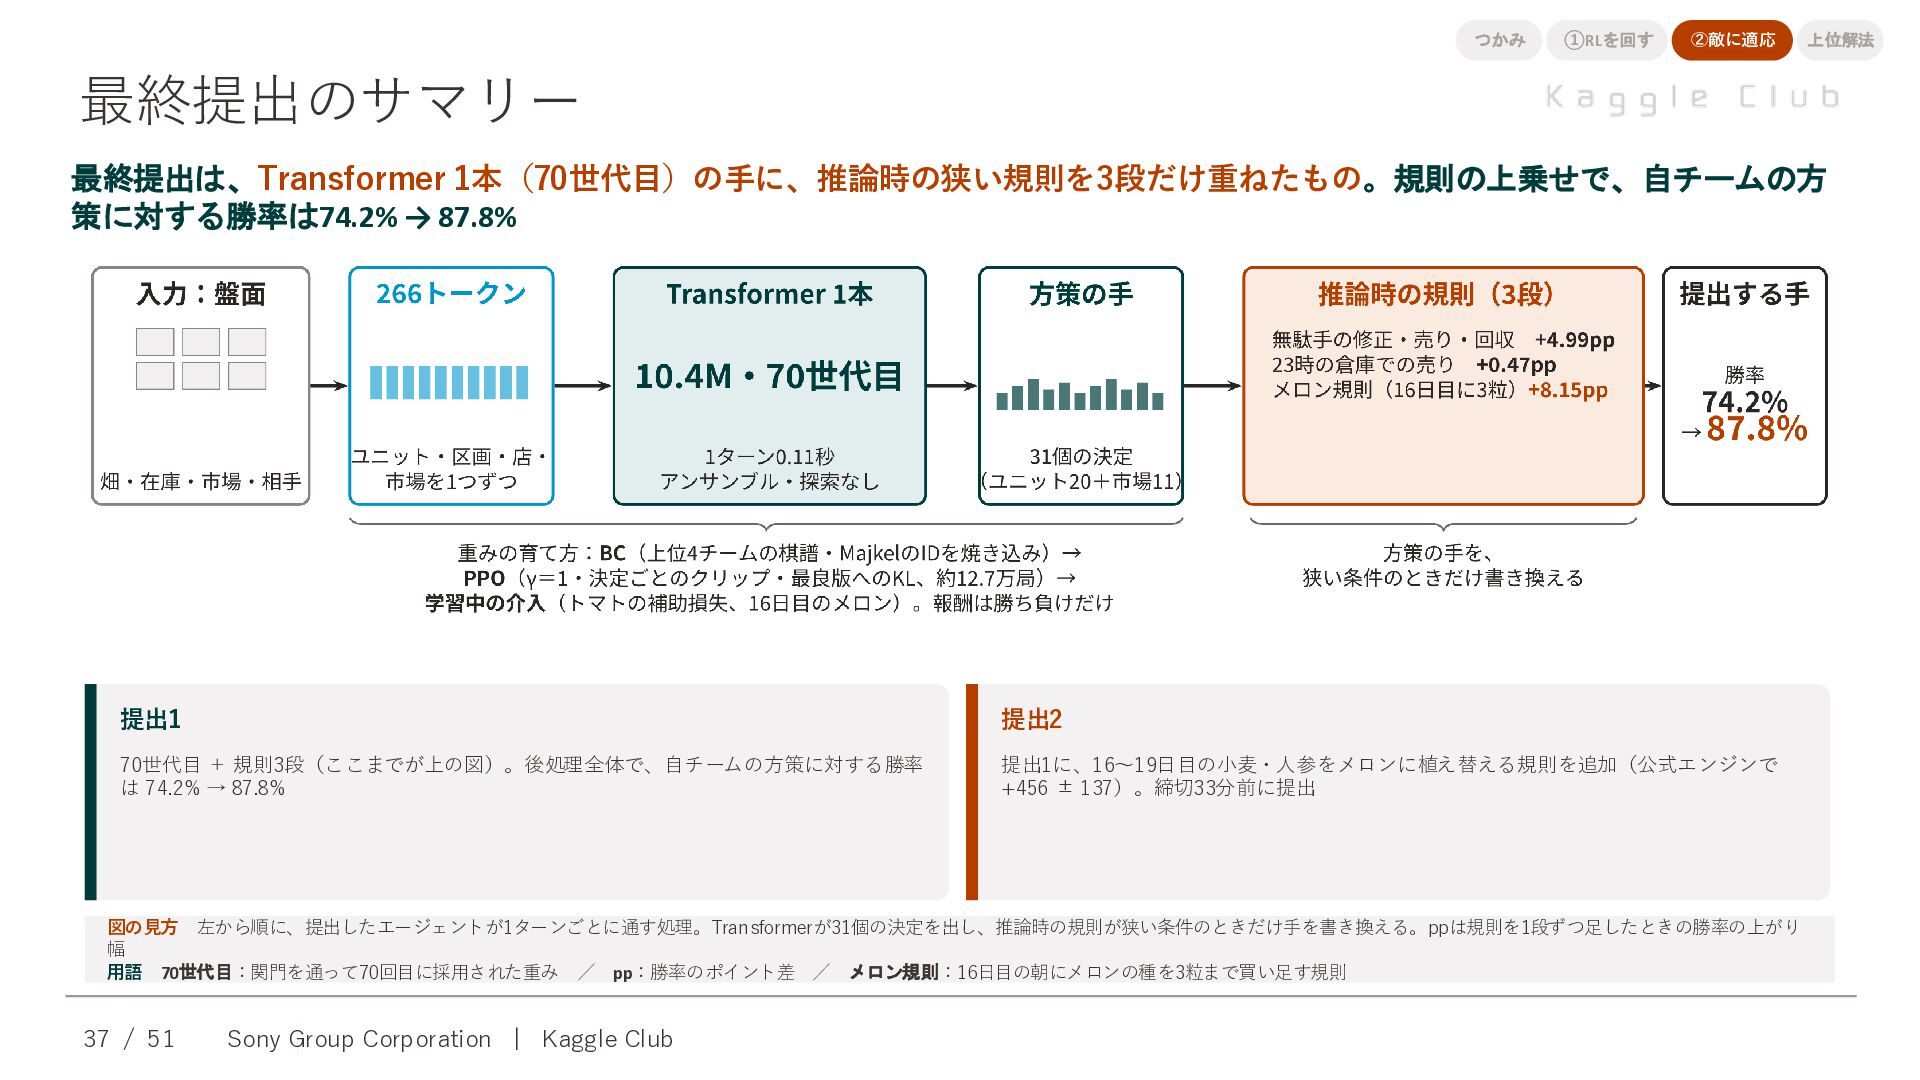
つかみ ①RLを回す ②敵に適応 上位解法 最終提出のサマリー 最終提出は、Transformer 1本(70世代目)の手に、推論時の狭い規則を3段だけ重ねたもの。規則の上乗せで、自チームの方 策に対する勝率は74.2% → 87.8%
提出1 提出2 70世代目 + 規則3段(ここまでが上の図)。後処理全体で、自チームの方策に対する勝率 は 74.2% → 87.8% 提出1に、16〜19日目の小麦・人参をメロンに植え替える規則を追加(公式エンジンで +456 ± 137)。締切33分前に提出 図の見方 左から順に、提出したエージェントが1ターンごとに通す処理。Transformerが31個の決定を出し、推論時の規則が狭い条件のときだけ手を書き換える。ppは規則を1段ずつ足したときの勝率の上がり 幅 用語 70世代目:関門を通って70回目に採用された重み / pp:勝率のポイント差 / メロン規則:16日目の朝にメロンの種を3粒まで買い足す規則 37 / 51 Sony Group Corporation | Kaggle Club -
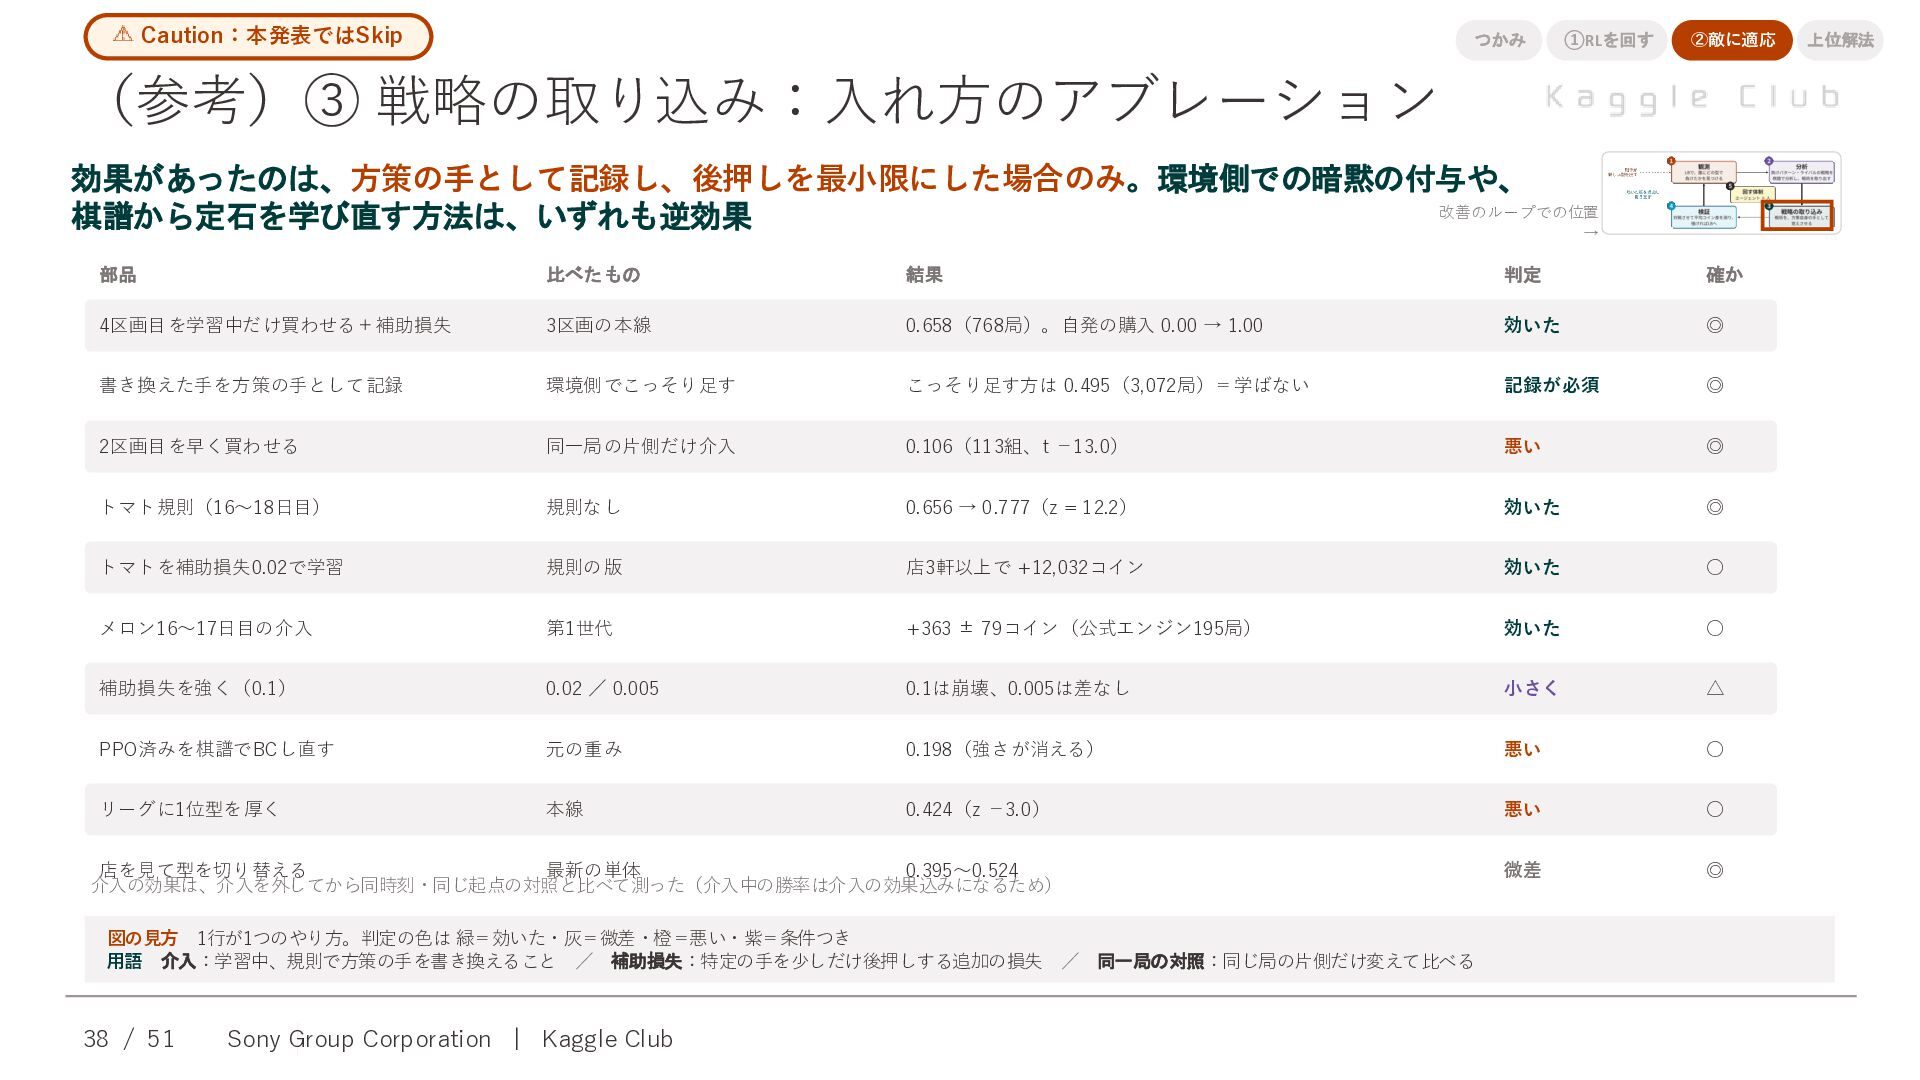
Caution:本発表ではSkip つかみ ①RLを回す ②敵に適応 (参考)③ 戦略の取り込み:入れ方のアブレーション 効果があったのは、方策の手として記録し、後押しを最小限にした場合のみ。環境側での暗黙の付与や、 改善のループでの位置 棋譜から定石を学び直す方法は、いずれも逆効果 →
部品 比べたもの 結果 判定 確か 4区画目を学習中だけ買わせる+補助損失 3区画の本線 0.658(768局)。自発の購入 0.00 → 1.00 効いた ◎ 書き換えた手を方策の手として記録 環境側でこっそり足す こっそり足す方は 0.495(3,072局)=学ばない 記録が必須 ◎ 2区画目を早く買わせる 同一局の片側だけ介入 0.106(113組、t −13.0) 悪い ◎ トマト規則(16〜18日目) 規則なし 0.656 → 0.777(z = 12.2) 効いた ◎ トマトを補助損失0.02で学習 規則の版 店3軒以上で +12,032コイン 効いた ◦ メロン16〜17日目の介入 第1世代 +363 ± 79コイン(公式エンジン195局) 効いた ◦ 補助損失を強く(0.1) 0.02 / 0.005 0.1は崩壊、0.005は差なし 小さく △ PPO済みを棋譜でBCし直す 元の重み 0.198(強さが消える) 悪い ◦ リーグに1位型を厚く 本線 0.424(z −3.0) 悪い ◦ 店を見て型を切り替える 最新の単体 0.395〜0.524 介入の効果は、介入を外してから同時刻・同じ起点の対照と比べて測った(介入中の勝率は介入の効果込みになるため) 微差 ◎ 図の見方 1行が1つのやり方。判定の色は 緑=効いた・灰=微差・橙=悪い・紫=条件つき 用語 介入:学習中、規則で方策の手を書き換えること / 補助損失:特定の手を少しだけ後押しする追加の損失 / 同一局の対照:同じ局の片側だけ変えて比べる 38 / 51 Sony Group Corporation | Kaggle Club 上位解法 -
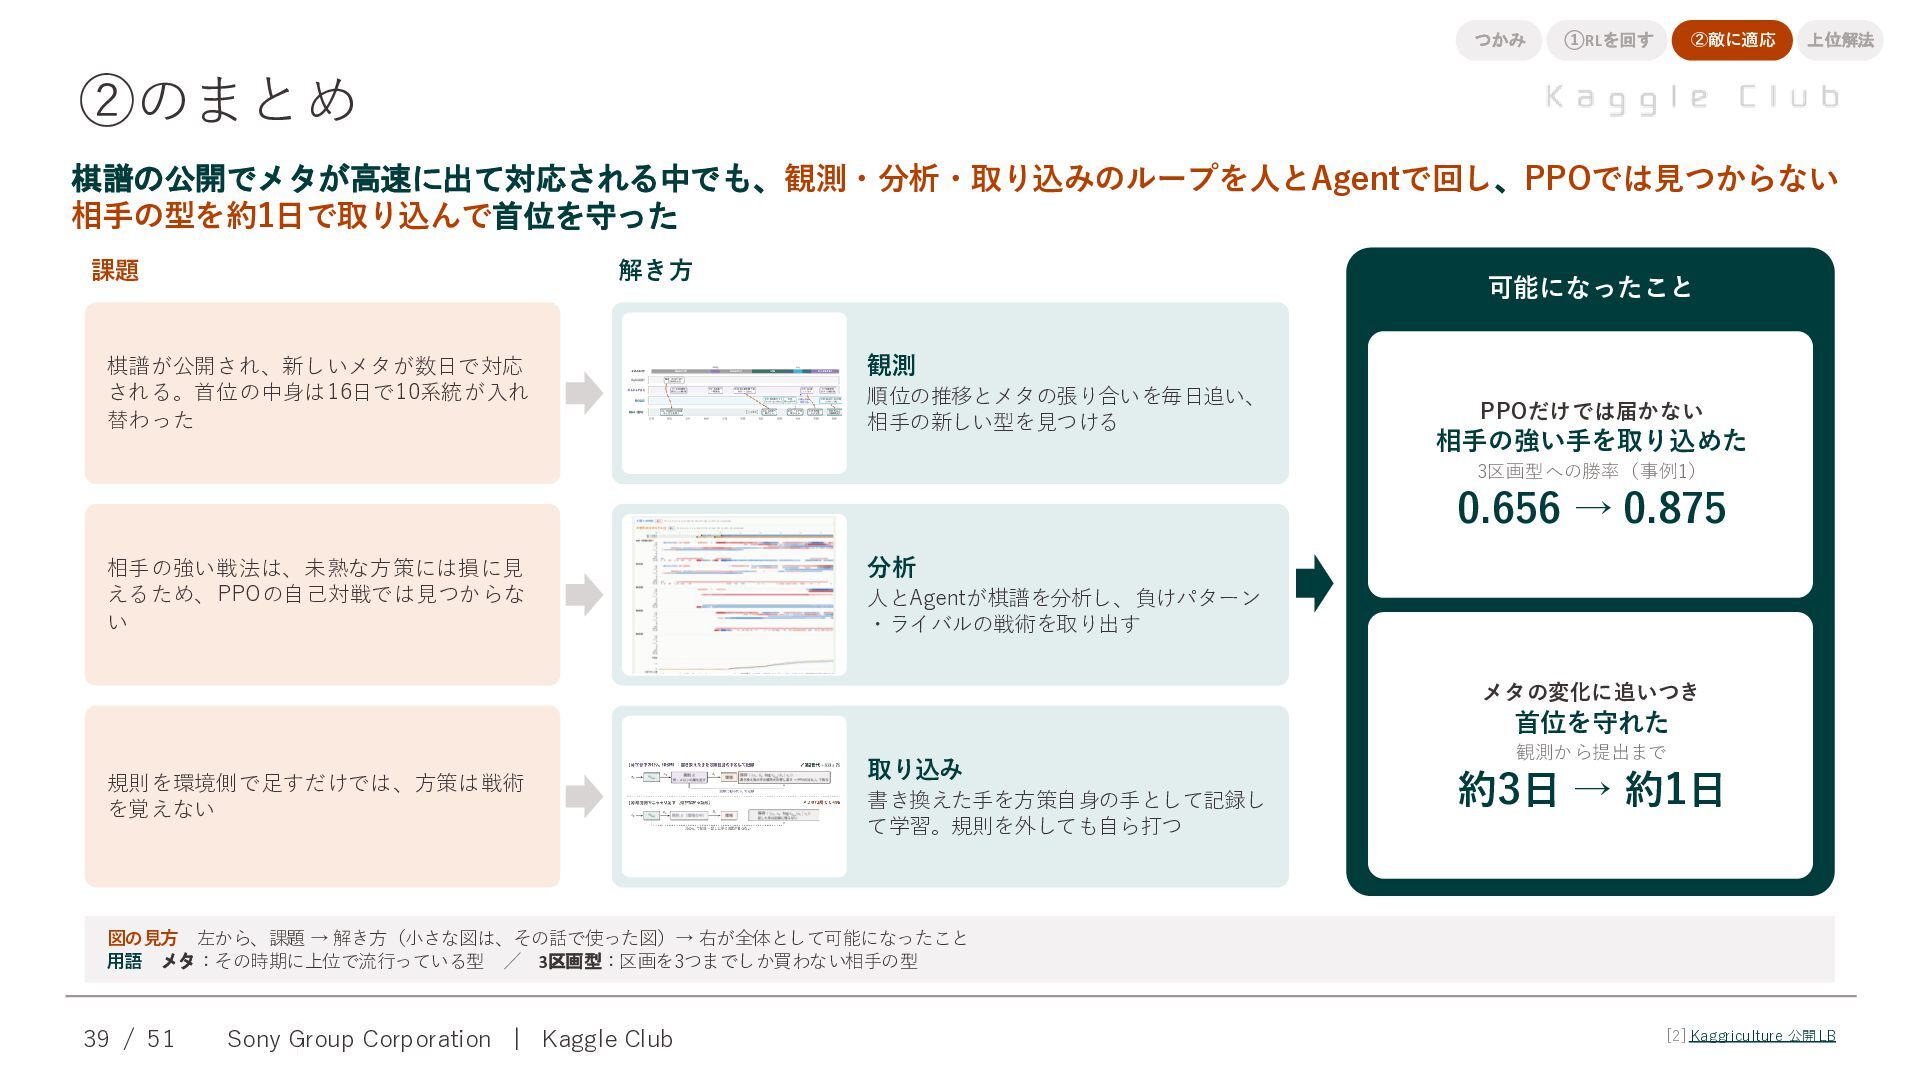
つかみ ②敵に適応 ①RLを回す 上位解法 ②のまとめ 棋譜の公開でメタが高速に出て対応される中でも、観測・分析・取り込みのループを人とAgentで回し、PPOでは見つからない 相手の型を約1日で取り込んで首位を守った 課題 解き方 棋譜が公開され、新しいメタが数日で対応
される。首位の中身は16日で10系統が入れ 替わった 可能になったこと 観測 順位の推移とメタの張り合いを毎日追い、 相手の新しい型を見つける PPOだけでは届かない 相手の強い手を取り込めた 3区画型への勝率(事例1) 0.656 → 0.875 相手の強い戦法は、未熟な方策には損に見 えるため、PPOの自己対戦では見つからな い 分析 人とAgentが棋譜を分析し、負けパターン ・ライバルの戦術を取り出す メタの変化に追いつき 首位を守れた 規則を環境側で足すだけでは、方策は戦術 を覚えない 取り込み 書き換えた手を方策自身の手として記録し て学習。規則を外しても自ら打つ 観測から提出まで 約3日 → 約1日 図の見方 左から、課題 → 解き方(小さな図は、その話で使った図)→ 右が全体として可能になったこと 用語 メタ:その時期に上位で流行っている型 / 3区画型:区画を3つまでしか買わない相手の型 39 / 51 Sony Group Corporation | Kaggle Club [2] Kaggricu lture 公開LB -
つかみ ①RLを回す ②敵に適応 上位解法 上位解法まとめ この章の問い 03 最終順位と、各チームの作り方・学習した棋譜・自己対戦の有無 1 上位解法まとめ
1位〜10位の作り方の横比較 上位解法まとめ ここまで 上位10チームは、どう作っていたか 40 / 51 Sony Group Corporation | Kaggle Club [3] Kaggricu lture 上位Writeup -
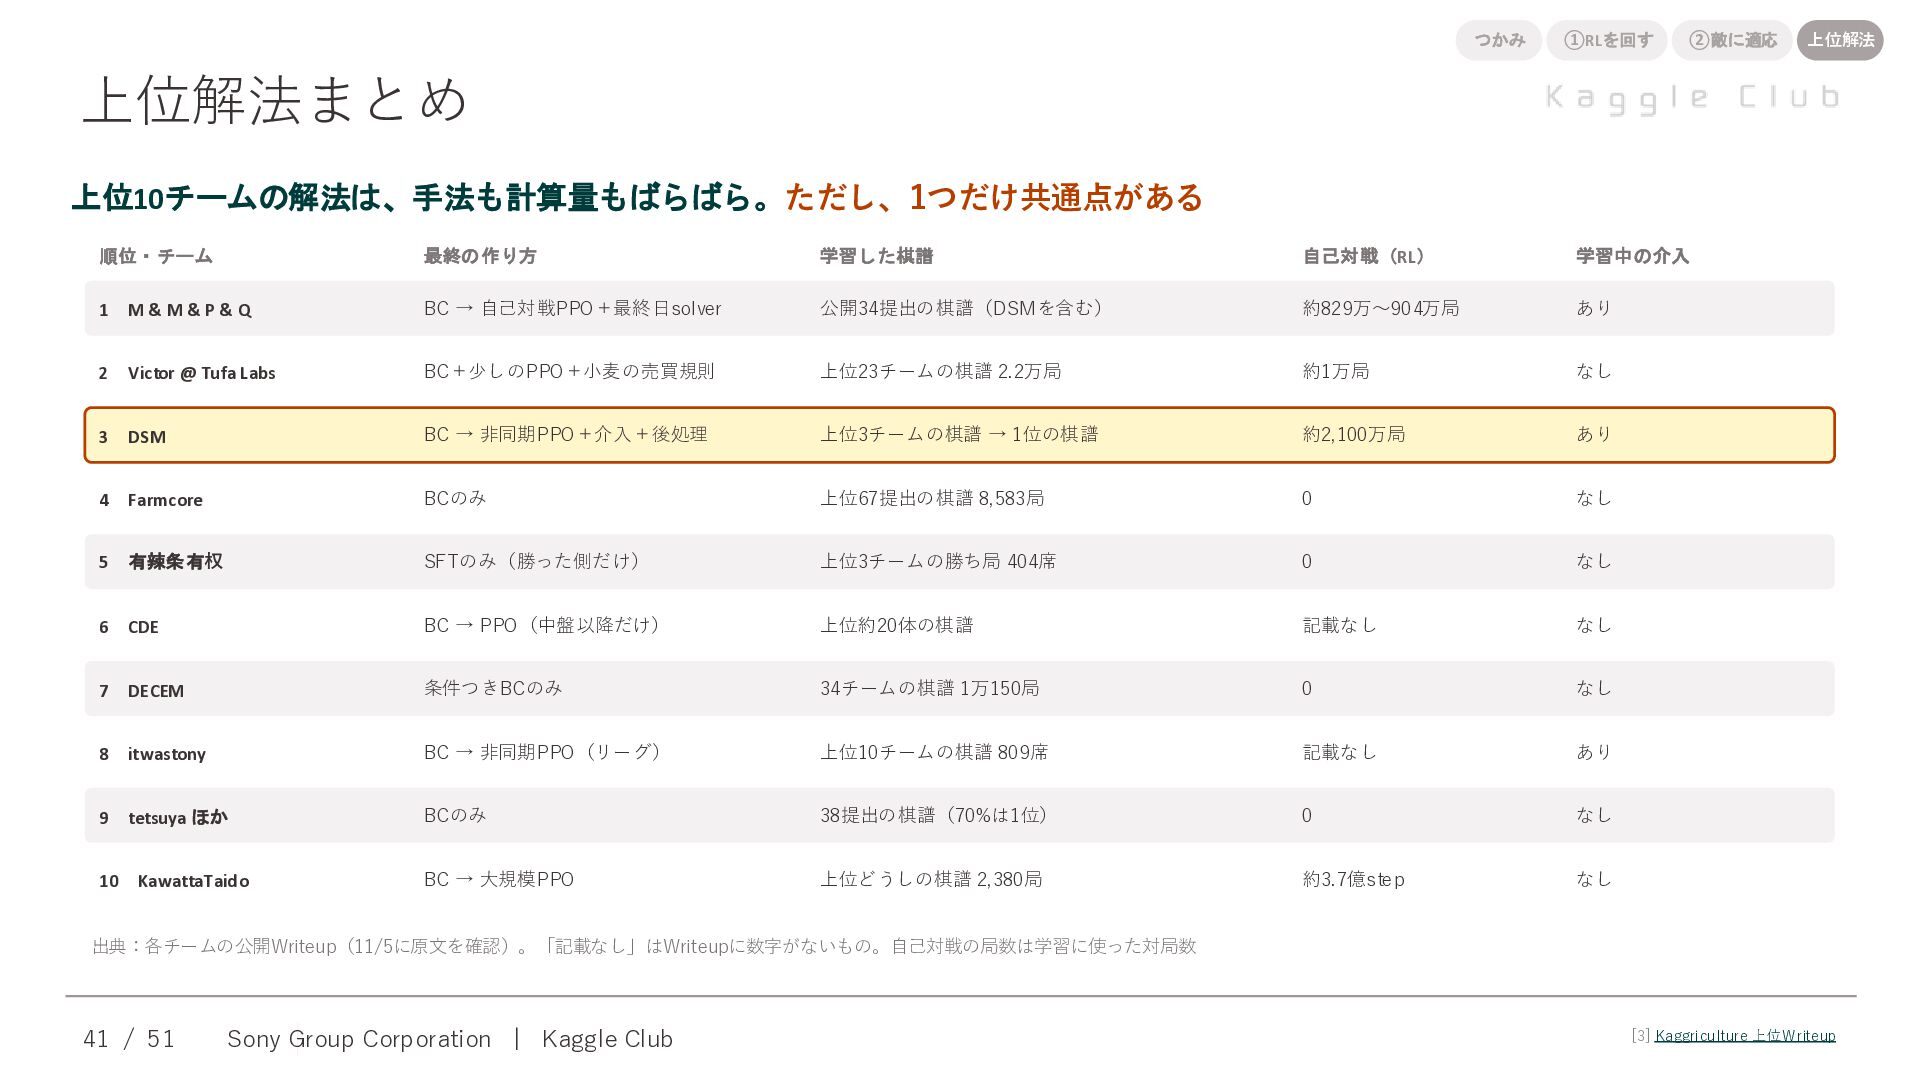
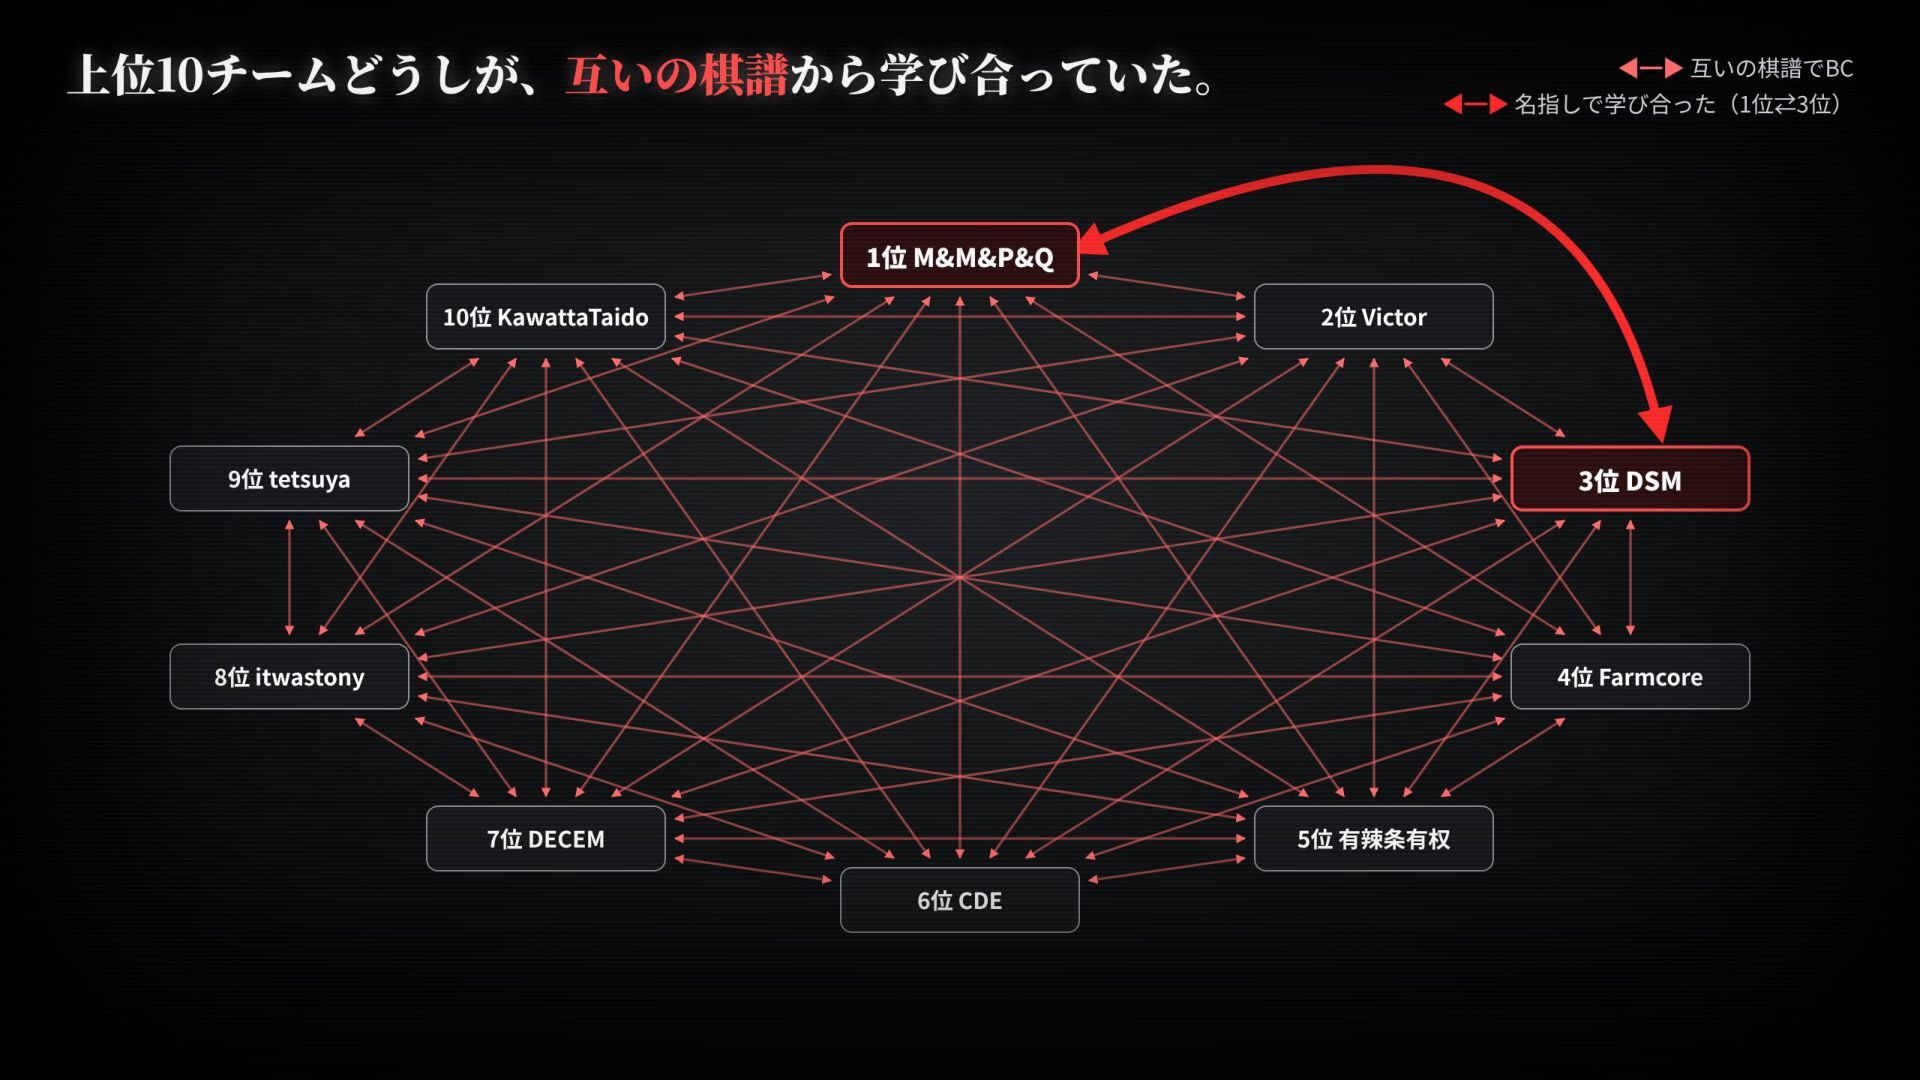
つかみ ①RLを回す ②敵に適応 上位解法 上位解法まとめ 上位10チームの解法は、手法も計算量もばらばら。ただし、1つだけ共通点がある 順位・チーム 最終の作り方 学習した棋譜 自己対戦(RL)
学習中の介入 1 M& M&P& Q BC → 自己対戦PPO+最終日solver 公開34提出の棋譜(DSMを含む) 約829万〜904万局 あり 2 Victor @ Tufa Labs BC+少しのPPO+小麦の売買規則 上位23チームの棋譜 2.2万局 約1万局 なし 3 DSM BC → 非同期PPO+介入+後処理 上位3チームの棋譜 → 1位の棋譜 約2,100万局 あり 4 Farmcore BCのみ 上位67提出の棋譜 8,583局 0 なし 5 有辣条有权 SFTのみ(勝った側だけ) 上位3チームの勝ち局 404席 0 なし 6 CDE BC → PPO(中盤以降だけ) 上位約20体の棋譜 記載なし なし 7 DECEM 条件つきBCのみ 34チームの棋譜 1万150局 0 なし 8 itwastony BC → 非同期PPO(リーグ) 上位10チームの棋譜 809席 記載なし あり 9 tetsuya ほか BCのみ 38提出の棋譜(70%は1位) 0 なし 10 KawattaTaido BC → 大規模PPO 上位どうしの棋譜 2,380局 約3.7億step なし 出典:各チームの公開Writeup(11/5に原文を確認)。「記載なし」はWriteupに数字がないもの。自己対戦の局数は学習に使った対局数 41 / 51 Sony Group Corporation | Kaggle Club [3] Kaggricu lture 上位Writeup -
つかみ 上位10チームの共通点 x 42 / 51 Sony Group Corporation |
Kaggle Club ①RLを回す ②敵に適応 上位解法 -
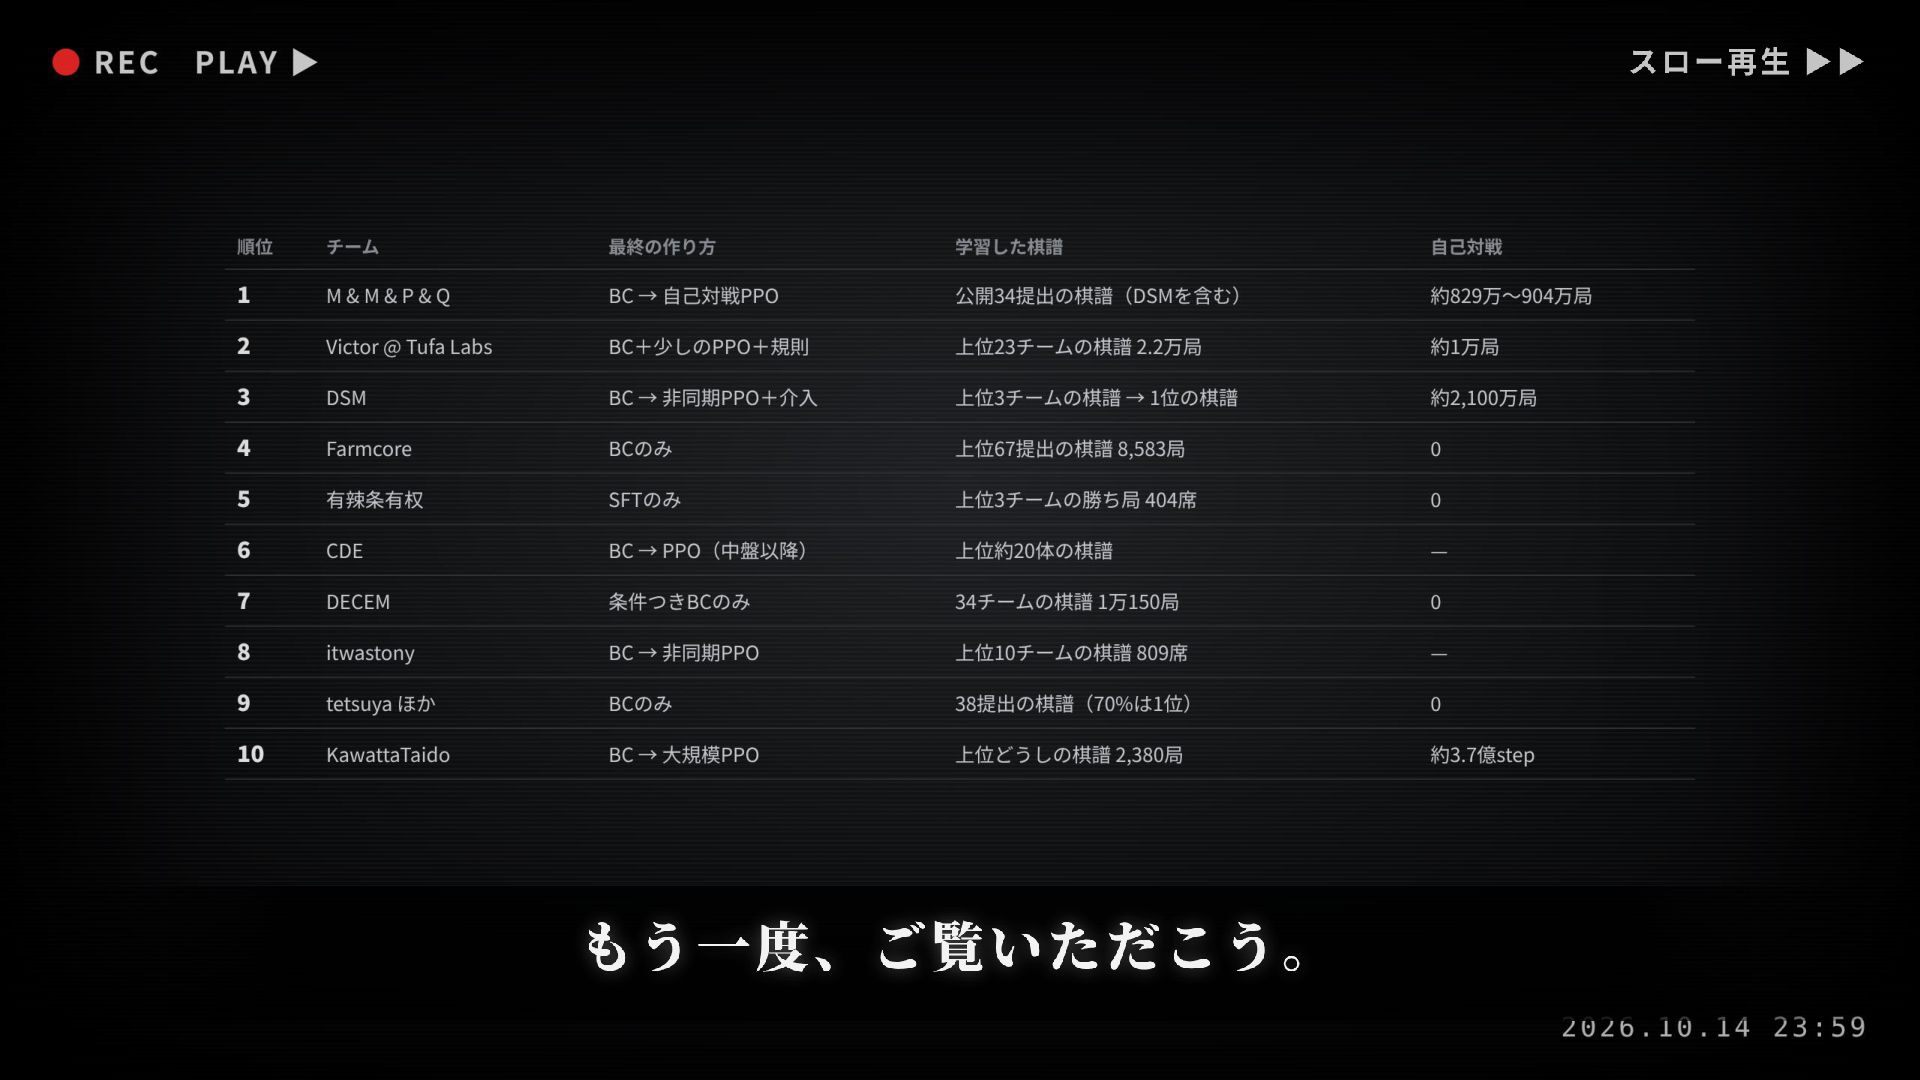
つかみ 上位10チームの共通点(再生) x 43 / 51 Sony Group Corporation |
Kaggle Club ①RLを回す ②敵に適応 上位解法 -
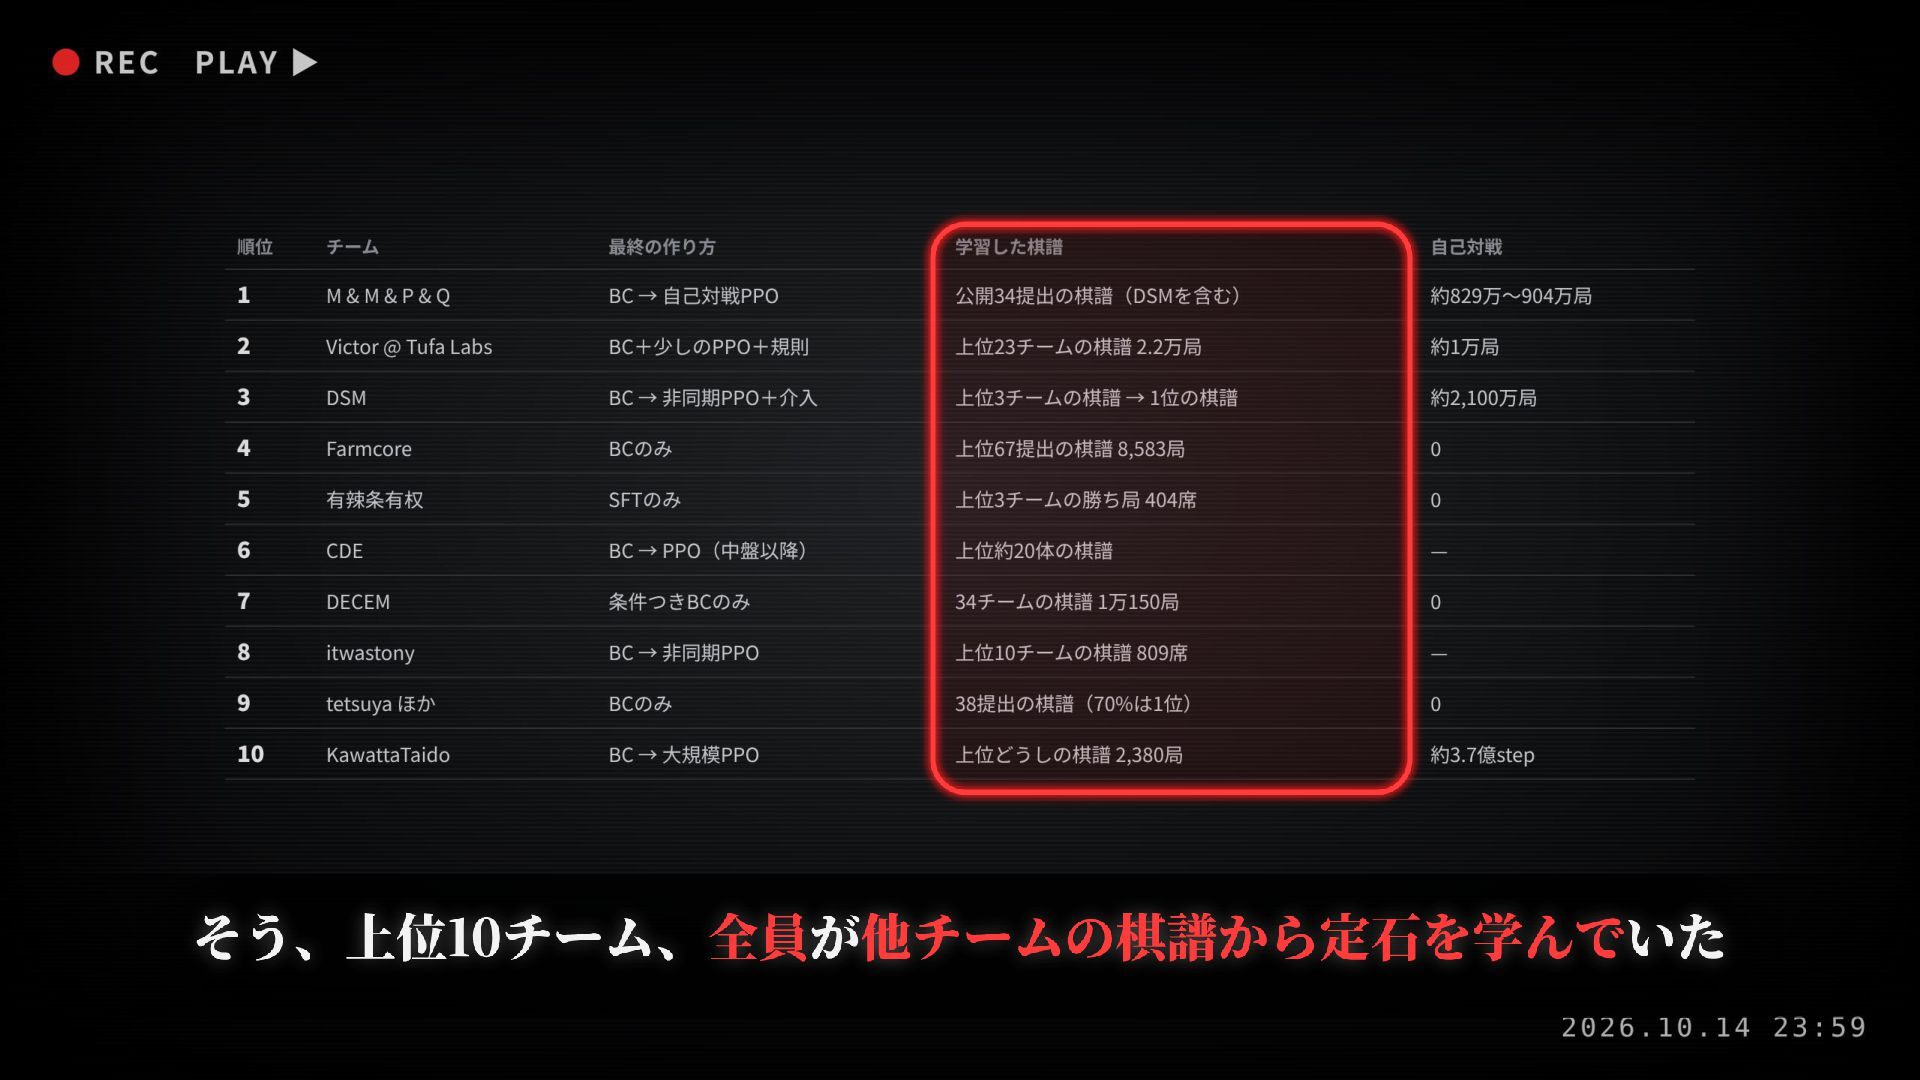
つかみ 上位10チームの共通点(注目) x 44 / 51 Sony Group Corporation |
Kaggle Club ①RLを回す ②敵に適応 上位解法 -
つかみ 誰の棋譜が誰に渡ったか x 45 / 51 Sony Group Corporation |
Kaggle Club ①RLを回す ②敵に適応 上位解法 -
つかみ 誰の棋譜が誰に渡ったか x 45 / 51 Sony Group Corporation |
Kaggle Club ①RLを回す ②敵に適応 上位解法 -
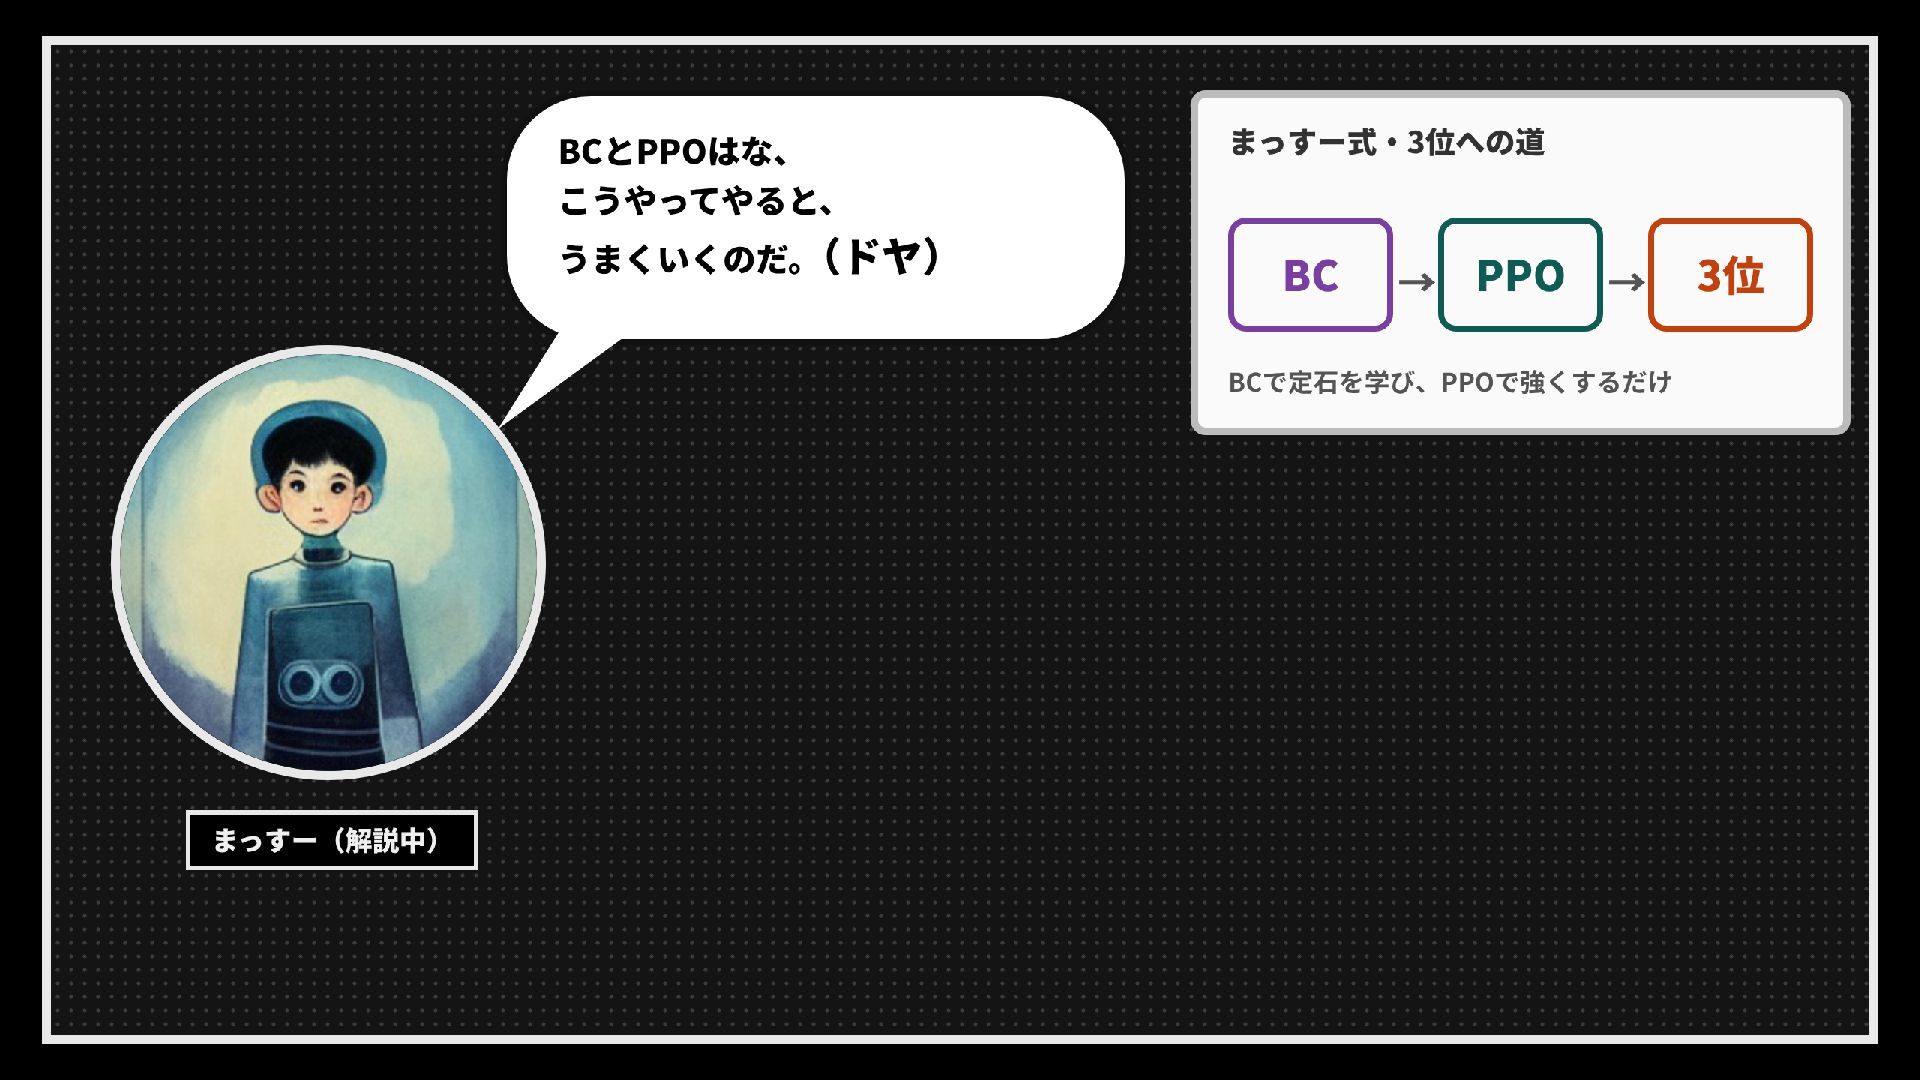
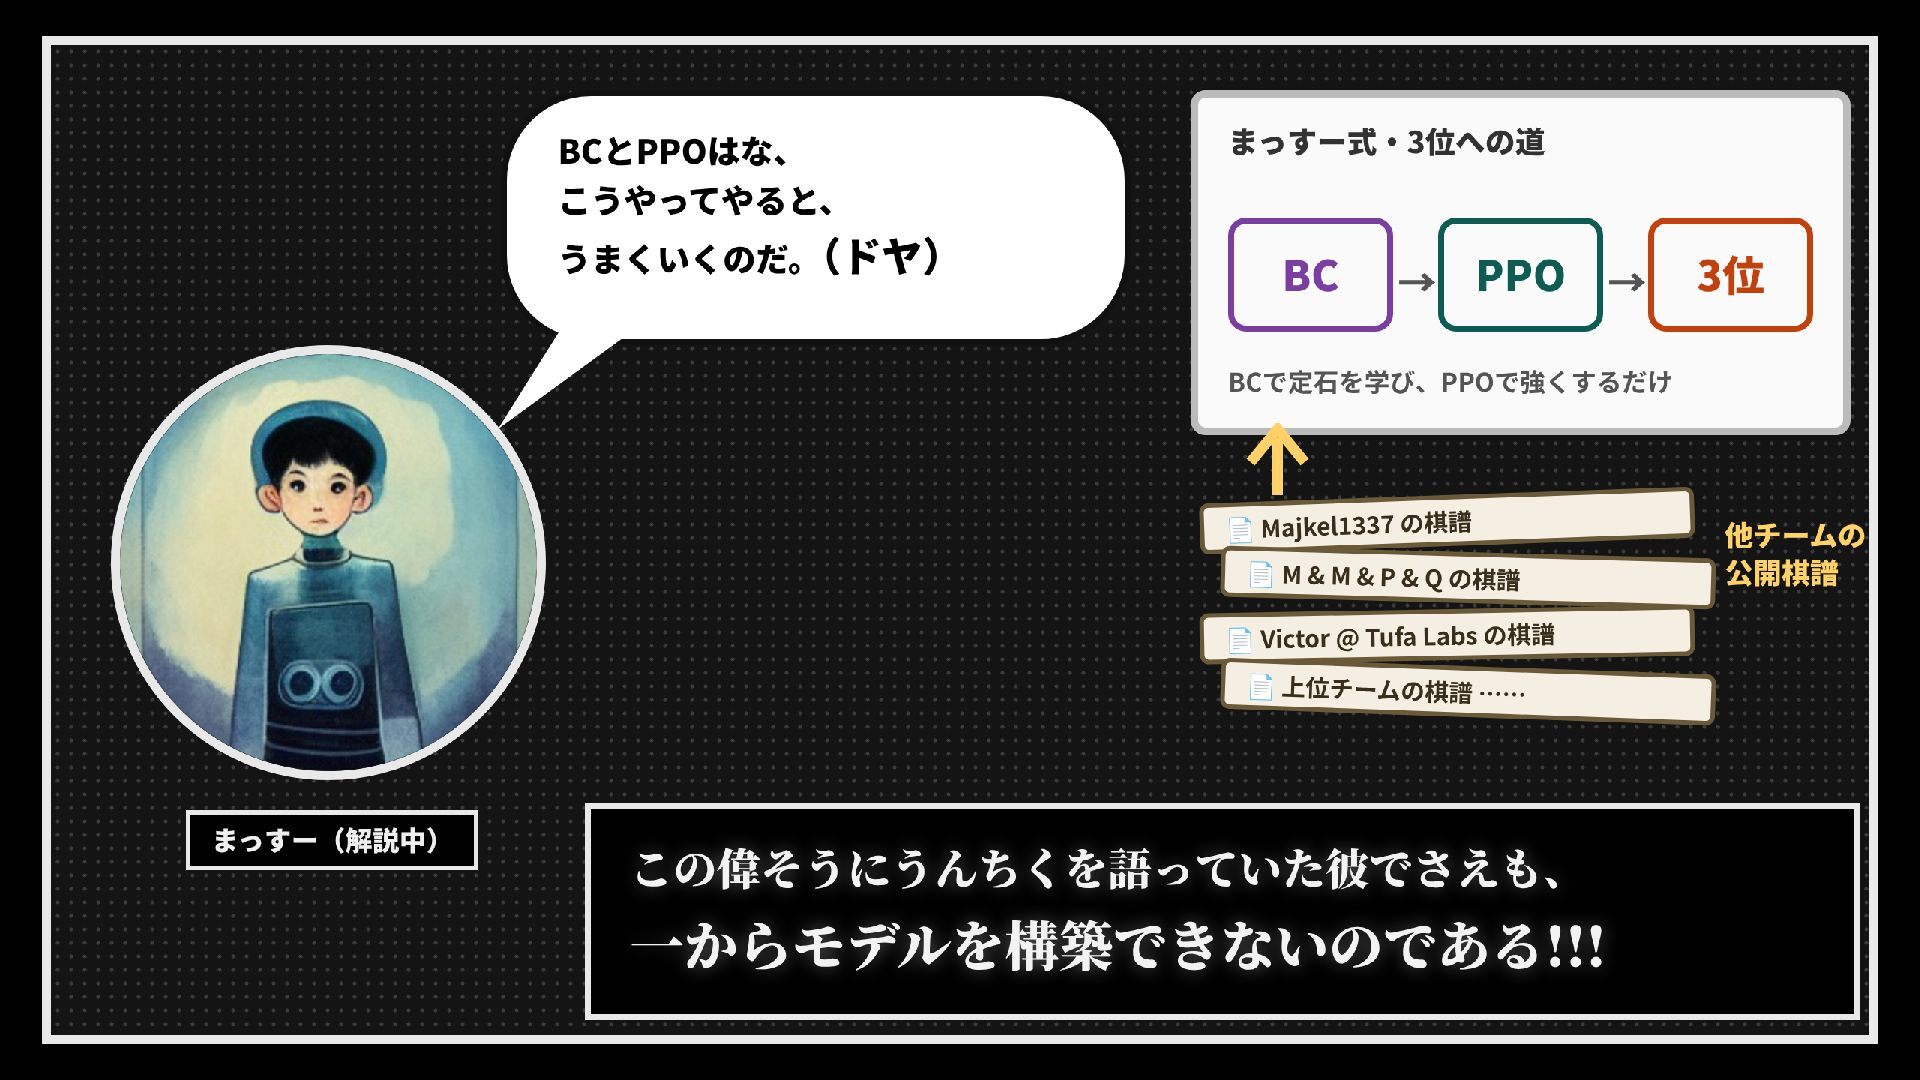
つかみ オチ(前振り) x 46 / 51 Sony Group Corporation |
Kaggle Club ①RLを回す ②敵に適応 上位解法 -
つかみ オチ x 47 / 51 Sony Group Corporation |
Kaggle Club ①RLを回す ②敵に適応 上位解法 -
つかみ 謝辞 x 48 / 51 Sony Group Corporation |
Kaggle Club ①RLを回す ②敵に適応 上位解法 -
つかみ タイトル回収 x 49 / 51 Sony Group Corporation |
Kaggle Club ①RLを回す ②敵に適応 上位解法 -
つかみ Happy Kaggle Life x 音声:AivisSpeech:阿井田 茂 / VOICEVOX:ずんだもん 50
/ 51 Sony Group Corporation | Kaggle Club ①RLを回す ②敵に適応 上位解法
 masspeaks
 torounit
 kentapapa
 okiyuki99
 inariku
 techniczna
 nagisa53
 littlehands
 oracle4engineer
 falken
 bulbulpaul
 pospome
 palkan
 gr2m
 rocio
 marketingsoph
 holman
 soudai
 shlominoach
 danielanewman
 techseoconnect
 jct
 szymonslowik
 ianozsvald