Upgrade to Pro — share decks privately, control downloads, hide ads and more …

AIエージェントの精度検証の模索とインサイト

 AIエージェントの精度検証の模索とインサイト

こちらのLT会での資料になります。
https://meetsmore.connpass.com/event/381519/

Avatar for 増田宙斗

増田宙斗

March 18, 2026

Other Decks in Technology

Transcript

  1. ©ミツモア 2 / 20 自己紹介 プロワンのAIエージェント開発・精度検証を担当しています 増田 宙斗(ますだ ひろと) Meetsmore,

    Inc. — ソフトウェアエンジニア プロワン AIエージェント開発 現場仕事向けSaaS「プロワン」に 組み込むAIエージェントの開発を担当 趣味 散歩 土日は意味もなく最寄り駅ととなり駅の間 を往復している
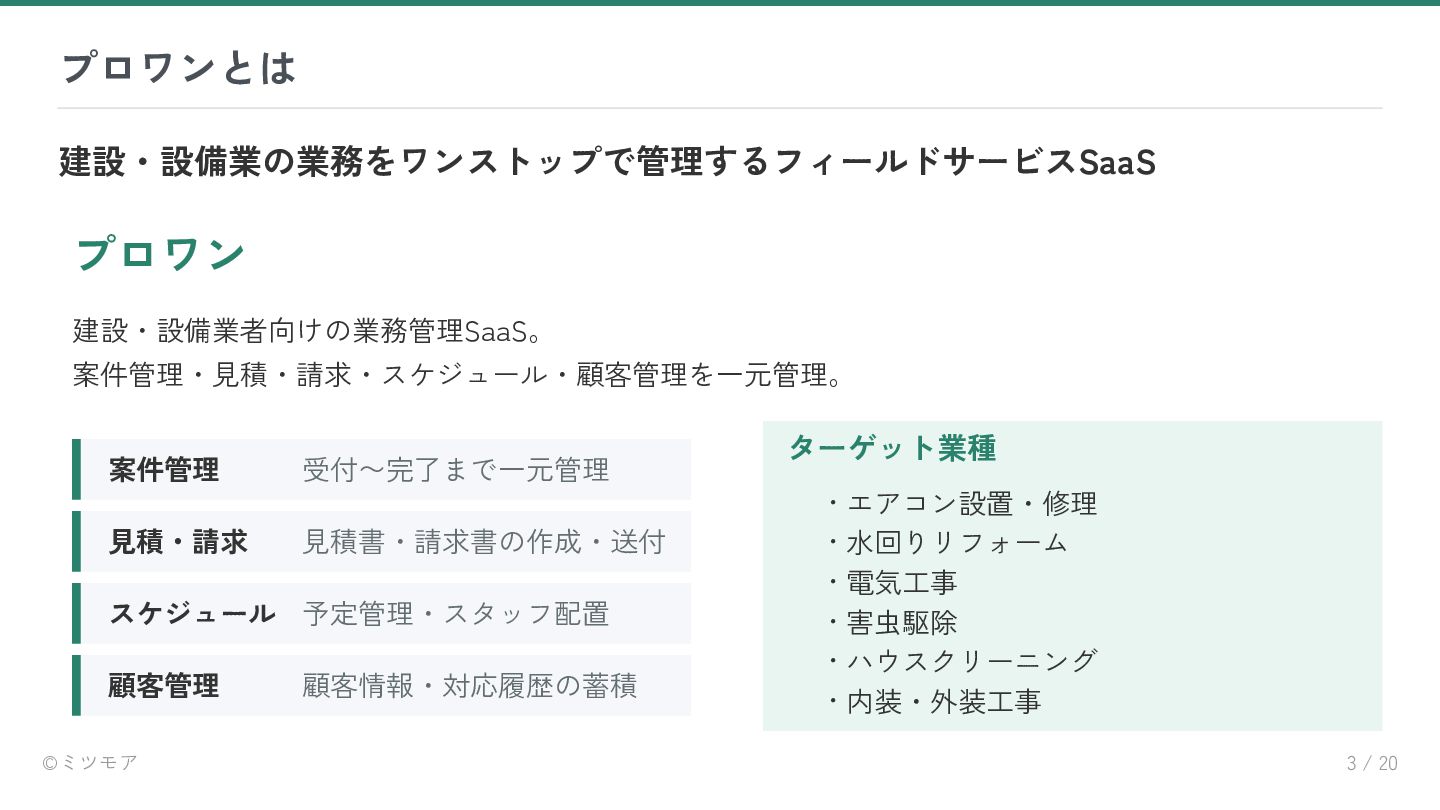
  2. ©ミツモア 3 / 20 プロワンとは 建設・設備業の業務をワンストップで管理するフィールドサービスSaaS プロワン 建設・設備業者向けの業務管理SaaS。 案件管理・見積・請求・スケジュール・顧客管理を一元管理。 案件管理

    受付〜完了まで一元管理 見積・請求 見積書・請求書の作成・送付 スケジュール 予定管理・スタッフ配置 顧客管理 顧客情報・対応履歴の蓄積 ターゲット業種 • エアコン設置・修理 • 水回りリフォーム • 電気工事 • 害虫駆除 • ハウスクリーニング • 内装・外装工事
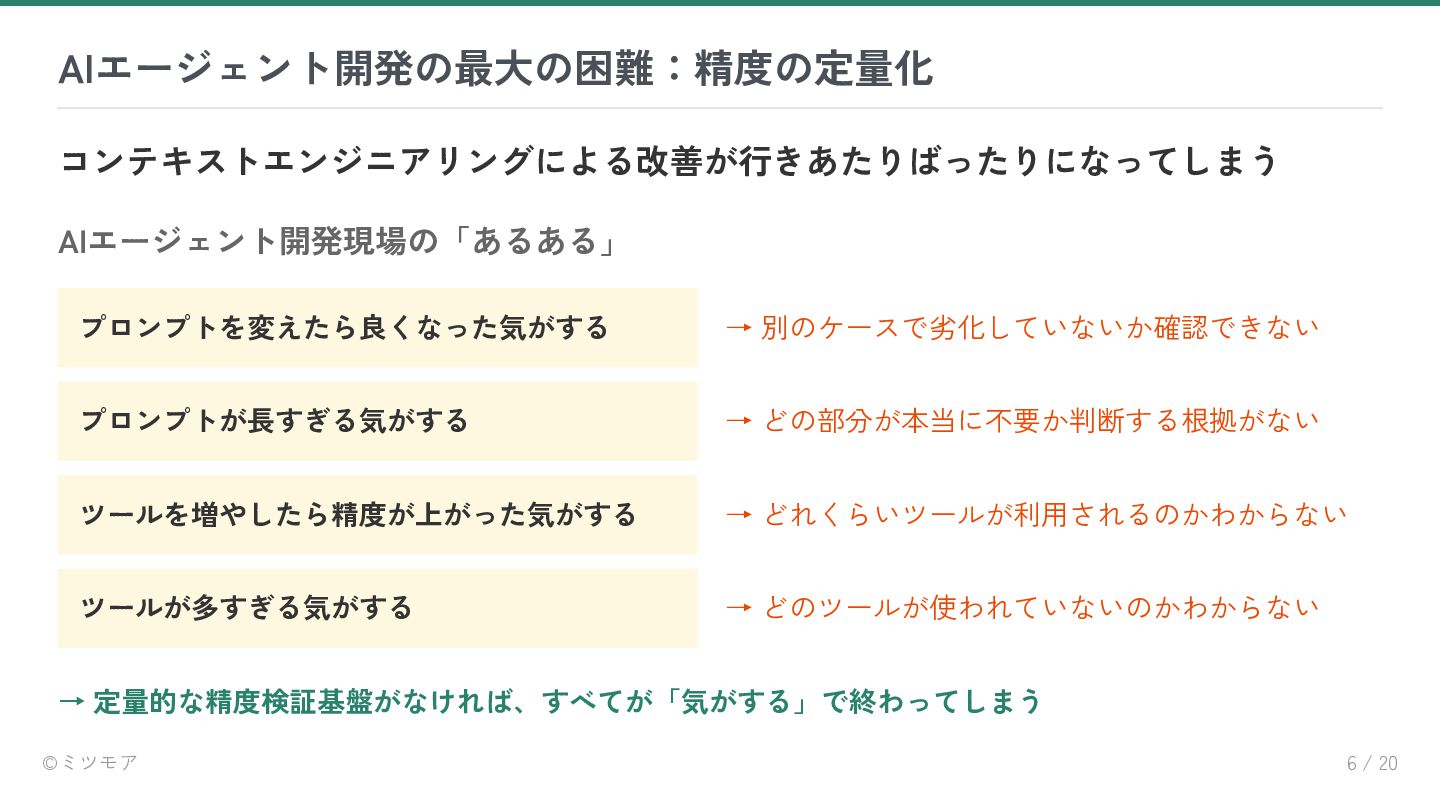
  3. ©ミツモア 6 / 20 AIエージェント開発の最大の困難:精度の定量化 コンテキストエンジニアリングによる改善が行きあたりばったりになってしまう AIエージェント開発現場の「あるある」 プロンプトを変えたら良くなった気がする → 別のケースで劣化していないか確認できない

    プロンプトが長すぎる気がする → どの部分が本当に不要か判断する根拠がない ツールを増やしたら精度が上がった気がする → どれくらいツールが利用されるのかわからない ツールが多すぎる気がする → どのツールが使われていないのかわからない → 定量的な精度検証基盤がなければ、すべてが「気がする」で終わってしまう
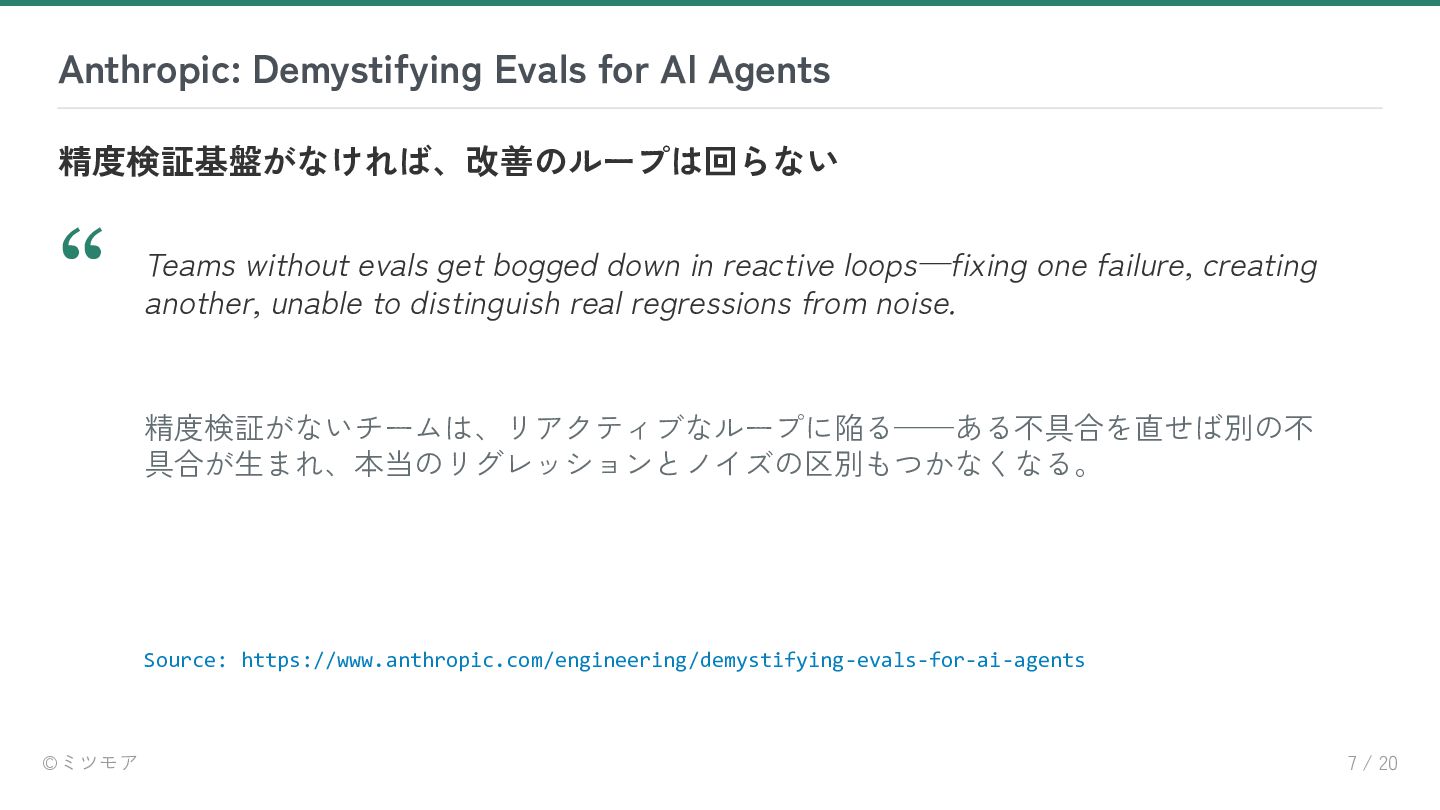
  4. ©ミツモア 7 / 20 Anthropic: Demystifying Evals for AI Agents

    精度検証基盤がなければ、改善のループは回らない “ Teams without evals get bogged down in reactive loops—fixing one failure, creating another, unable to distinguish real regressions from noise. 精度検証がないチームは、リアクティブなループに陥る——ある不具合を直せば別の不 具合が生まれ、本当のリグレッションとノイズの区別もつかなくなる。 Source: https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
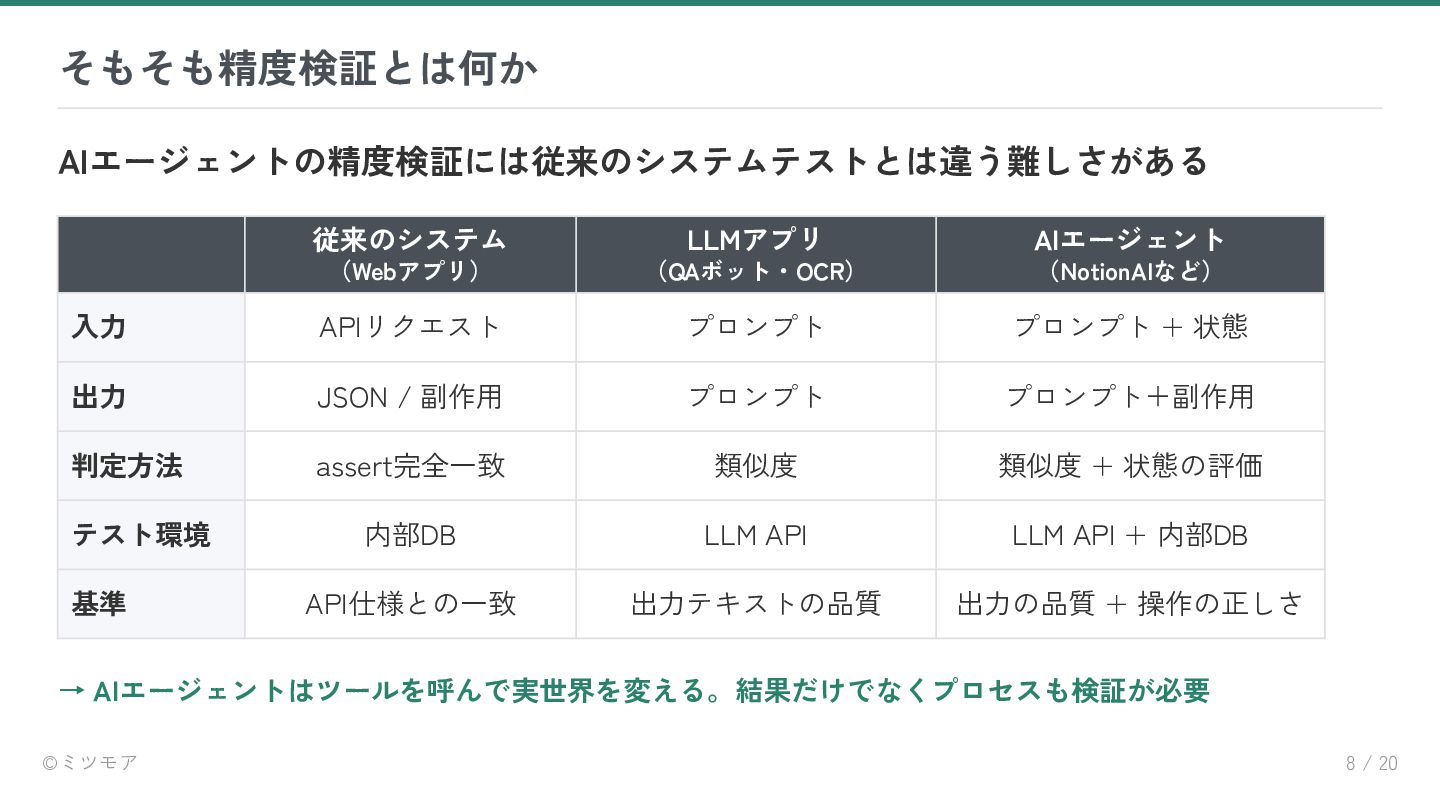
  5. ©ミツモア 8 / 20 そもそも精度検証とは何か AIエージェントの精度検証には従来のシステムテストとは違う難しさがある 従来のシステム (Webアプリ) LLMアプリ (QAボット・OCR)

    AIエージェント (NotionAIなど) 入力 APIリクエスト プロンプト プロンプト + 状態 出力 JSON / 副作用 プロンプト プロンプト+副作用 判定方法 assert完全一致 類似度 類似度 + 状態の評価 テスト環境 内部DB LLM API LLM API + 内部DB 基準 API仕様との一致 出力テキストの品質 出力の品質 + 操作の正しさ → AIエージェントはツールを呼んで実世界を変える。結果だけでなくプロセスも検証が必要
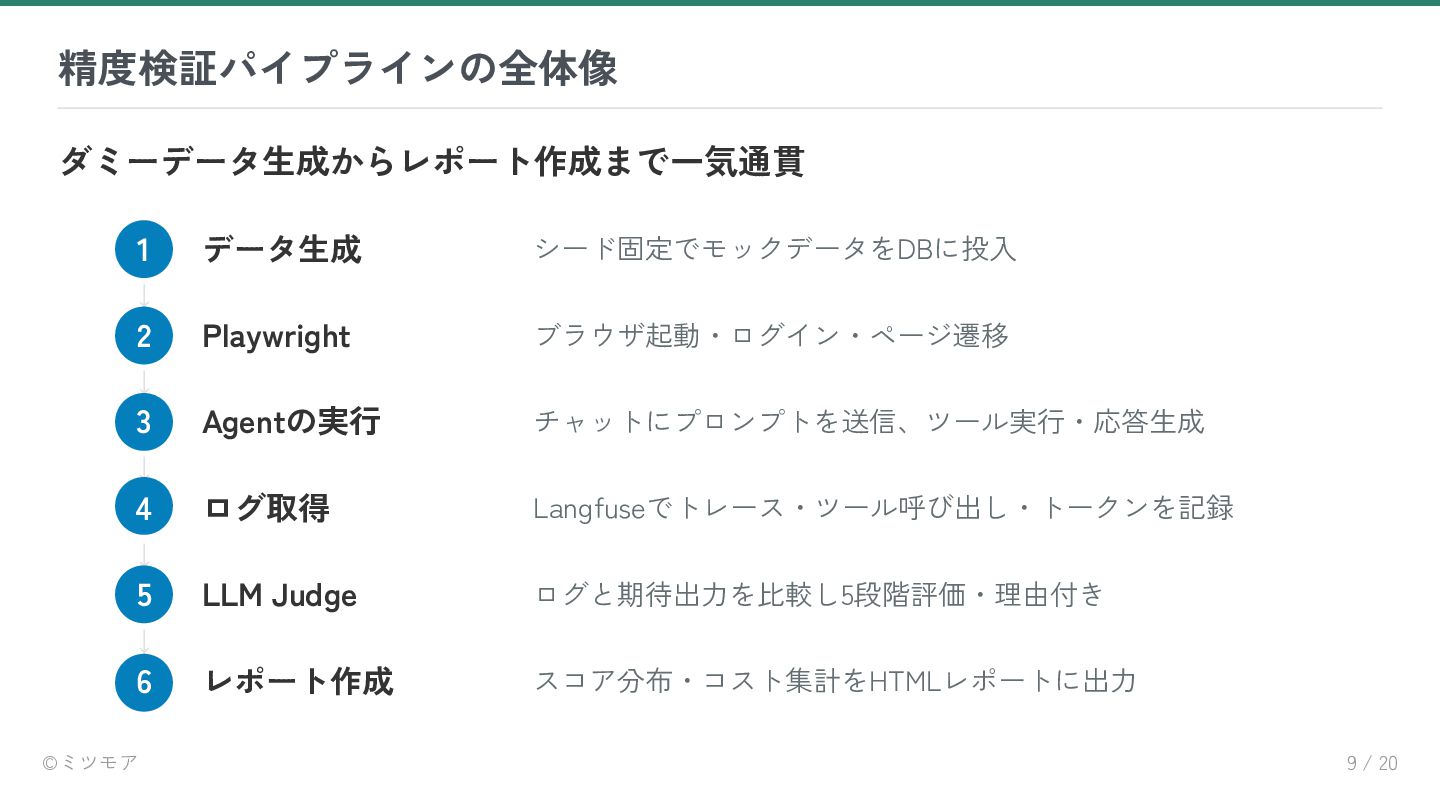
  6. ©ミツモア 9 / 20 精度検証パイプラインの全体像 ダミーデータ生成からレポート作成まで一気通貫 1 データ生成 シード固定でモックデータをDBに投入 ↓

    2 Playwright ブラウザ起動・ログイン・ページ遷移 ↓ 3 Agentの実行 チャットにプロンプトを送信、ツール実行・応答生成 ↓ ログ取得 Langfuseでトレース・ツール呼び出し・トークンを記録 ↓ LLM Judge ログと期待出力を比較し5段階評価・理由付き ↓ レポート作成 スコア分布・コスト集計をHTMLレポートに出力 4 5 6
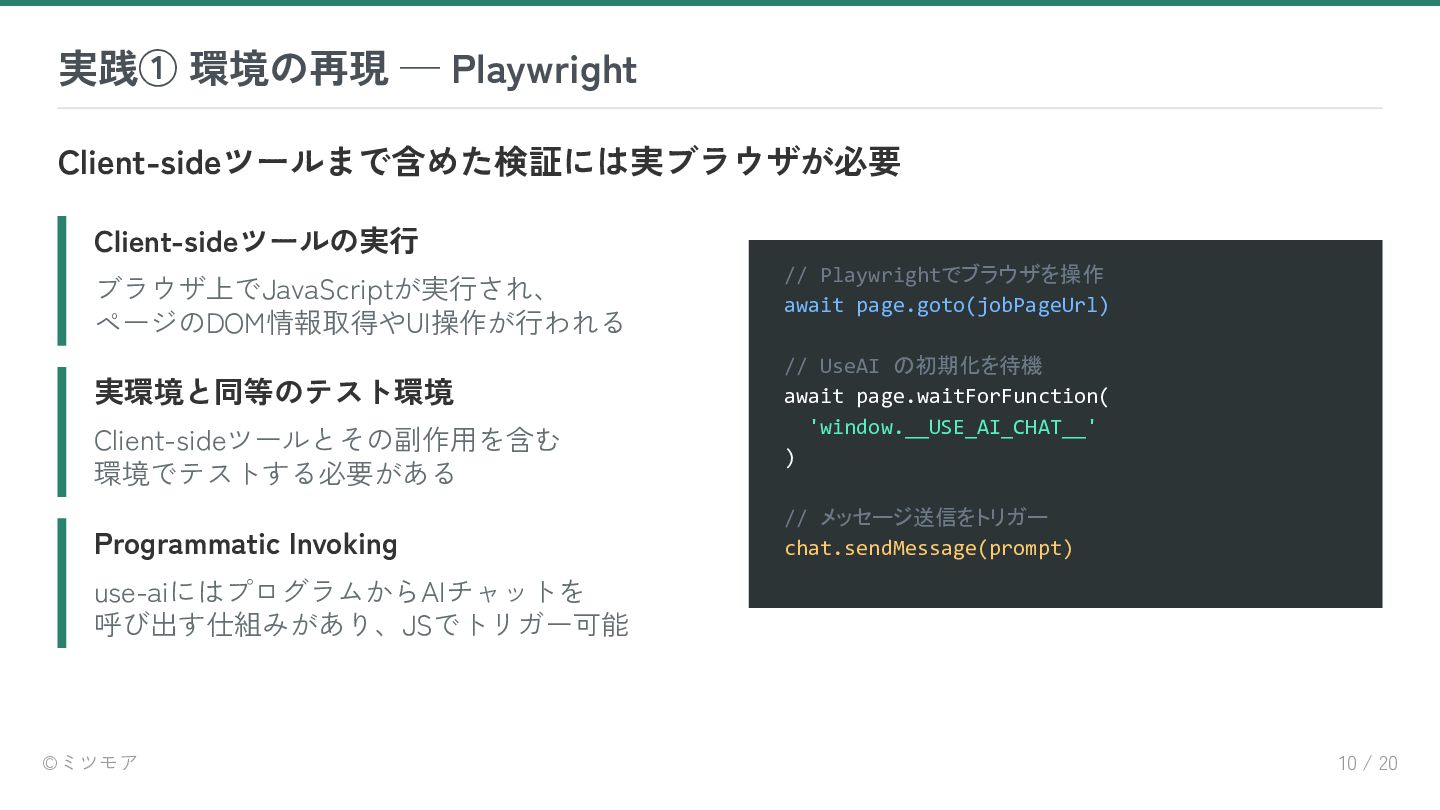
  7. ©ミツモア 10 / 20 実践① 環境の再現 — Playwright Client-sideツールまで含めた検証には実ブラウザが必要 Client-sideツールの実行

    ブラウザ上でJavaScriptが実行され、 ページのDOM情報取得やUI操作が行われる 実環境と同等のテスト環境 Client-sideツールとその副作用を含む 環境でテストする必要がある Programmatic Invoking use-aiにはプログラムからAIチャットを 呼び出す仕組みがあり、JSでトリガー可能 // Playwrightでブラウザを操作 await page.goto(jobPageUrl) // UseAI の初期化を待機 await page.waitForFunction( 'window.__USE_AI_CHAT__' ) // メッセージ送信をトリガー chat.sendMessage(prompt)
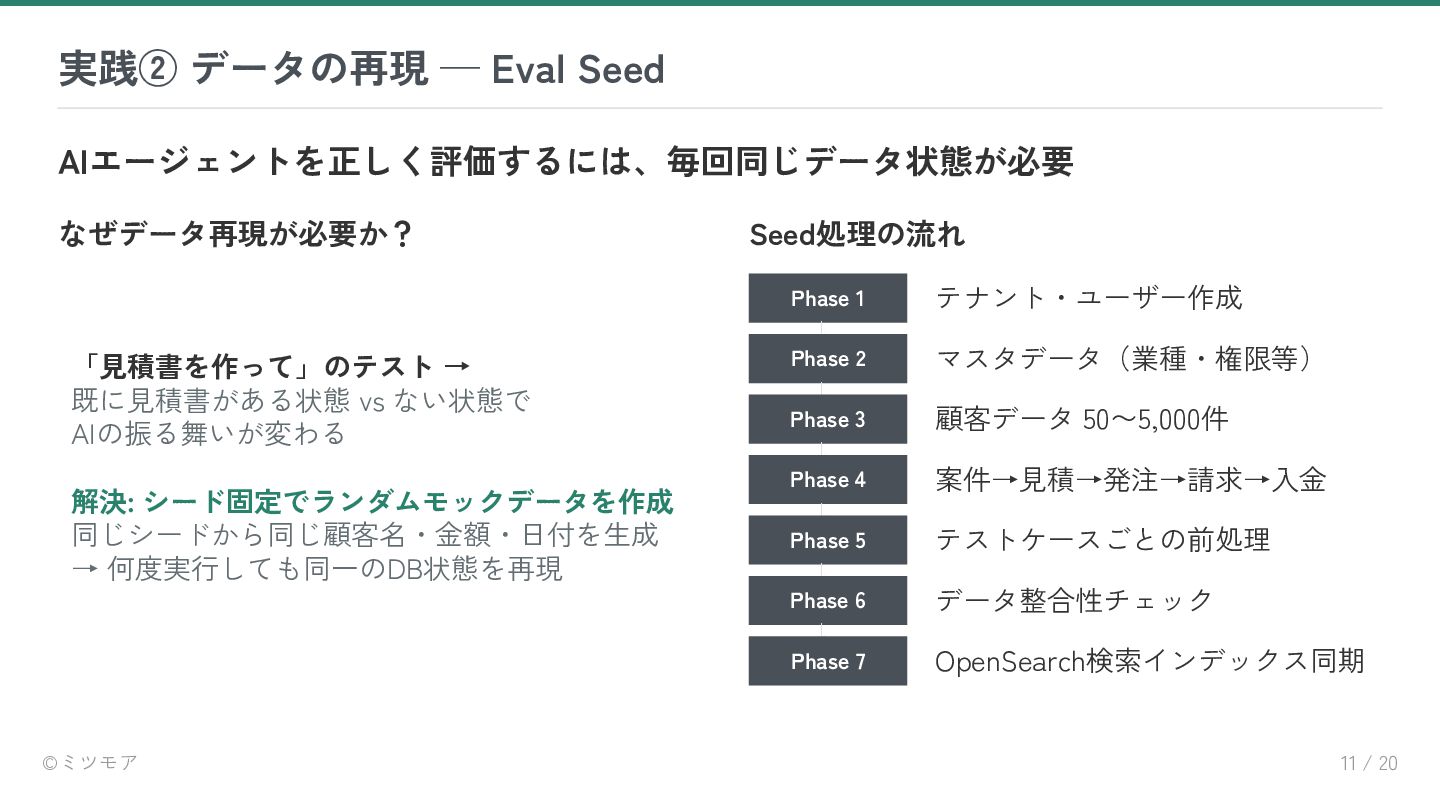
  8. ©ミツモア 11 / 20 実践② データの再現 — Eval Seed AIエージェントを正しく評価するには、毎回同じデータ状態が必要

    なぜデータ再現が必要か? 「見積書を作って」のテスト → 既に見積書がある状態 vs ない状態で AIの振る舞いが変わる 解決: シード固定でランダムモックデータを作成 同じシードから同じ顧客名・金額・日付を生成 → 何度実行しても同一のDB状態を再現 Seed処理の流れ Phase 1 テナント・ユーザー作成 ↓ Phase 2 マスタデータ(業種・権限等) ↓ Phase 3 顧客データ 50〜5,000件 ↓ Phase 4 案件→見積→発注→請求→入金 ↓ Phase 5 テストケースごとの前処理 ↓ Phase 6 データ整合性チェック ↓ Phase 7 OpenSearch検索インデックス同期
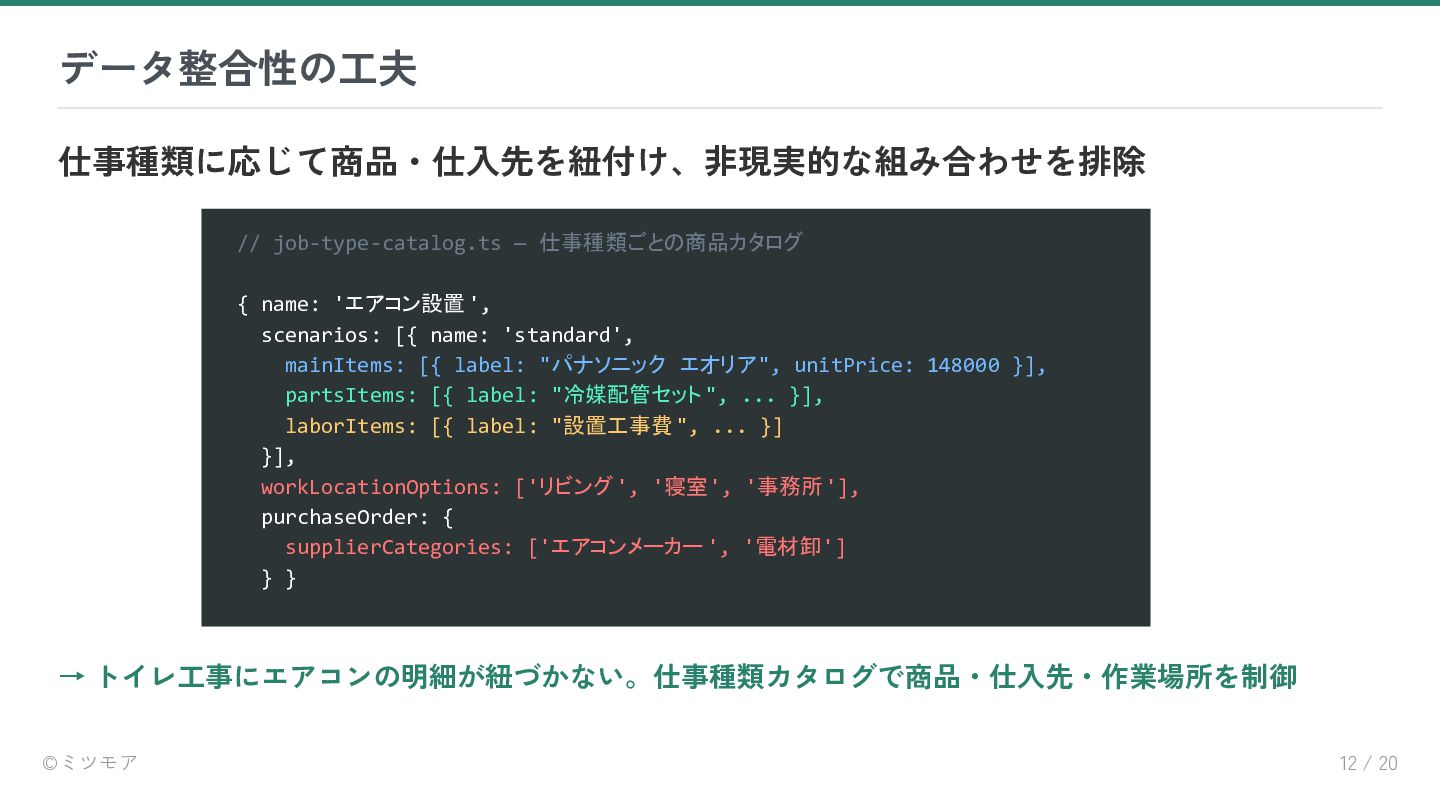
  9. ©ミツモア 12 / 20 データ整合性の工夫 仕事種類に応じて商品・仕入先を紐付け、非現実的な組み合わせを排除 // job-type-catalog.ts — 仕事種類ごとの商品カタログ

    { name: 'エアコン設置', scenarios: [{ name: 'standard', mainItems: [{ label: "パナソニック エオリア", unitPrice: 148000 }], partsItems: [{ label: "冷媒配管セット", ... }], laborItems: [{ label: "設置工事費", ... }] }], workLocationOptions: ['リビング', '寝室', '事務所'], purchaseOrder: { supplierCategories: ['エアコンメーカー ', '電材卸'] } } → トイレ工事にエアコンの明細が紐づかない。仕事種類カタログで商品・仕入先・作業場所を制御
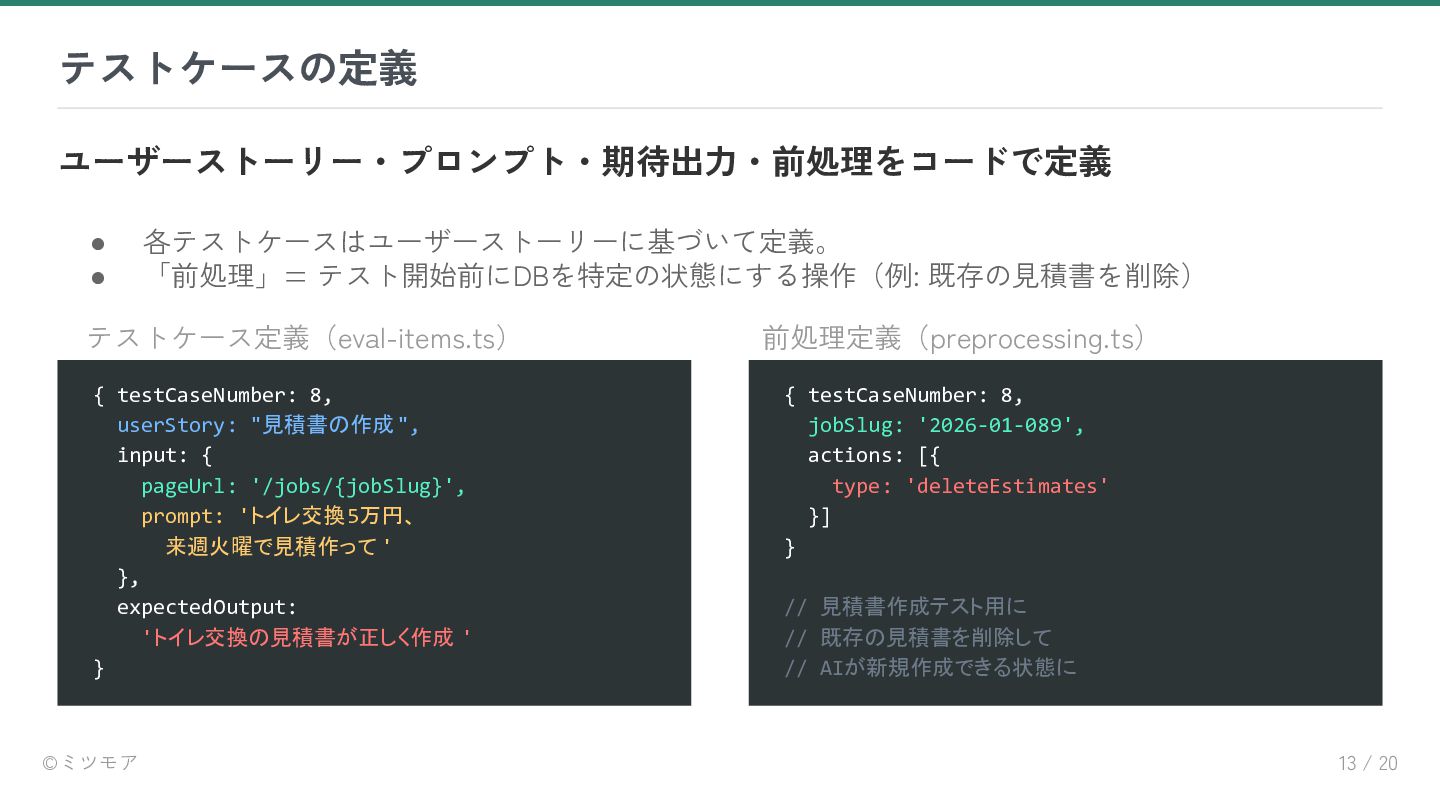
  10. ©ミツモア 13 / 20 テストケースの定義 ユーザーストーリー・プロンプト・期待出力・前処理をコードで定義 • 各テストケースはユーザーストーリーに基づいて定義。 • 「前処理」=

    テスト開始前にDBを特定の状態にする操作(例: 既存の見積書を削除) テストケース定義(eval-items.ts) { testCaseNumber: 8, userStory: "見積書の作成", input: { pageUrl: '/jobs/{jobSlug}', prompt: 'トイレ交換5万円、 来週火曜で見積作って ' }, expectedOutput: 'トイレ交換の見積書が正しく作成 ' } 前処理定義(preprocessing.ts) { testCaseNumber: 8, jobSlug: '2026-01-089', actions: [{ type: 'deleteEstimates' }] } // 見積書作成テスト用に // 既存の見積書を削除して // AIが新規作成できる状態に
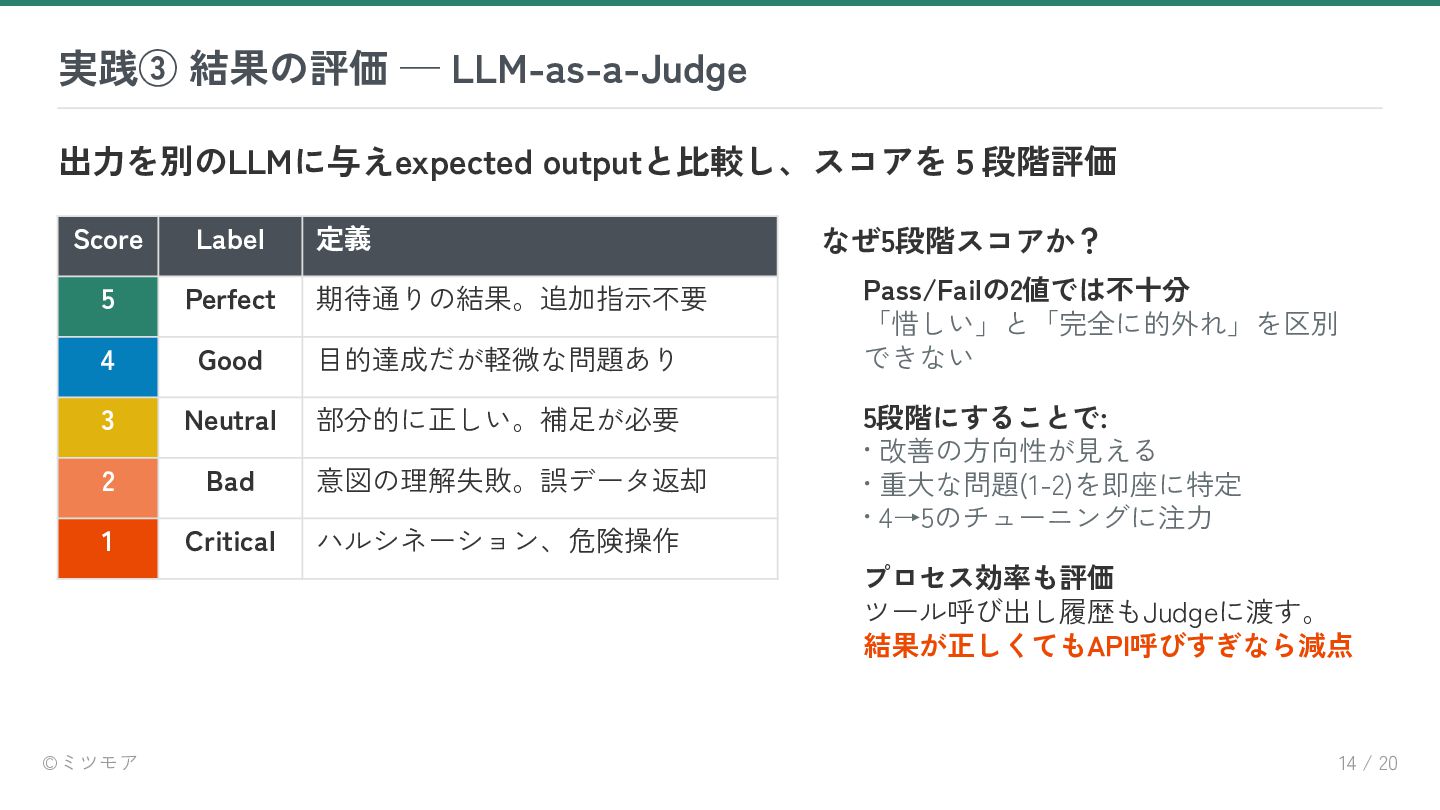
  11. ©ミツモア 14 / 20 実践③ 結果の評価 — LLM-as-a-Judge 出力を別のLLMに与えexpected outputと比較し、スコアを5段階評価

    Score Label 定義 5 Perfect 期待通りの結果。追加指示不要 4 Good 目的達成だが軽微な問題あり 3 Neutral 部分的に正しい。補足が必要 2 Bad 意図の理解失敗。誤データ返却 1 Critical ハルシネーション、危険操作 なぜ5段階スコアか? Pass/Failの2値では不十分 「惜しい」と「完全に的外れ」を区別 できない 5段階にすることで: • 改善の方向性が見える • 重大な問題(1-2)を即座に特定 • 4→5のチューニングに注力 プロセス効率も評価 ツール呼び出し履歴もJudgeに渡す。 結果が正しくてもAPI呼びすぎなら減点
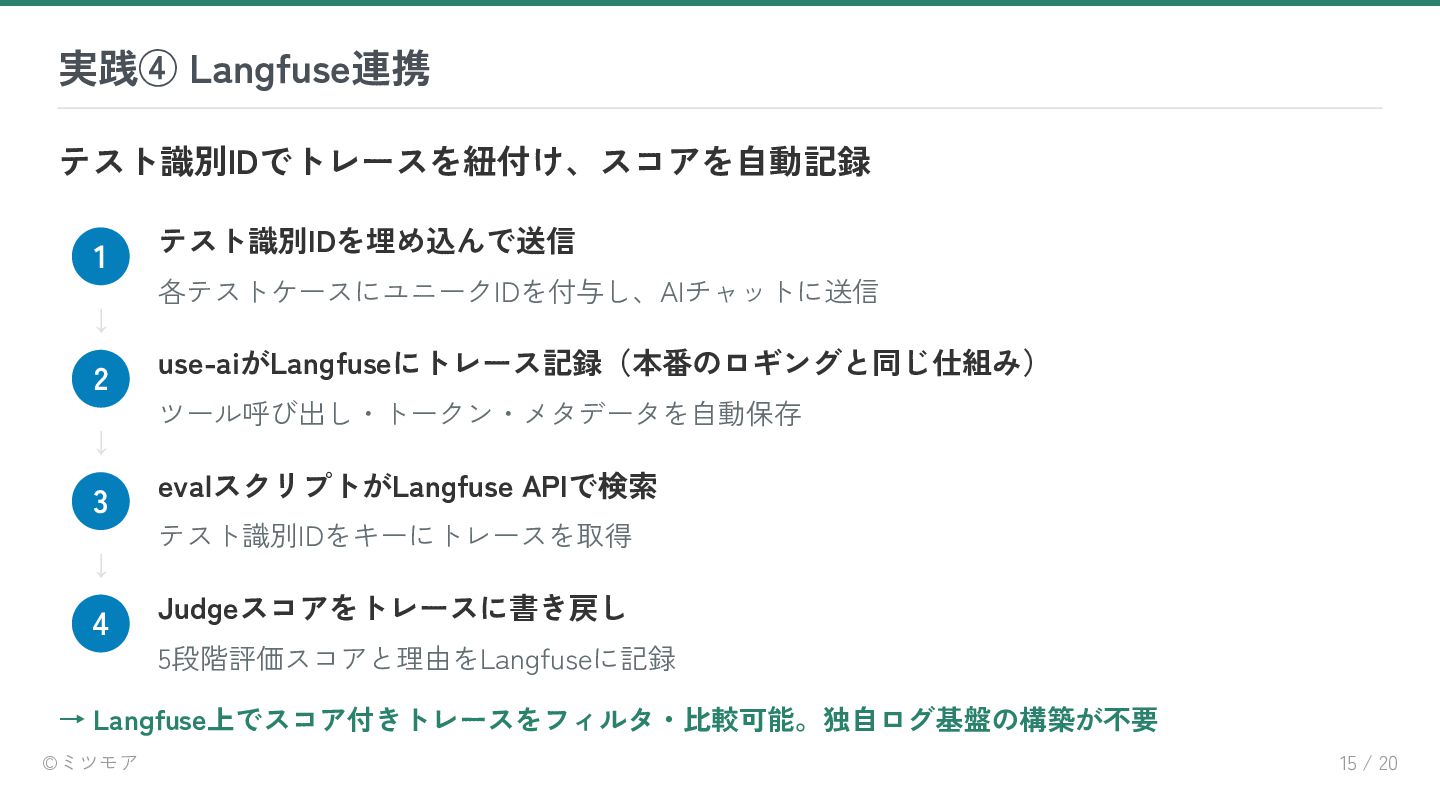
  12. ©ミツモア 15 / 20 実践④ Langfuse連携 テスト識別IDでトレースを紐付け、スコアを自動記録 1 テスト識別IDを埋め込んで送信 各テストケースにユニークIDを付与し、AIチャットに送信

    ↓ 2 use-aiがLangfuseにトレース記録(本番のロギングと同じ仕組み) ツール呼び出し・トークン・メタデータを自動保存 ↓ 3 evalスクリプトがLangfuse APIで検索 テスト識別IDをキーにトレースを取得 ↓ 4 Judgeスコアをトレースに書き戻し 5段階評価スコアと理由をLangfuseに記録 → Langfuse上でスコア付きトレースをフィルタ・比較可能。独自ログ基盤の構築が不要
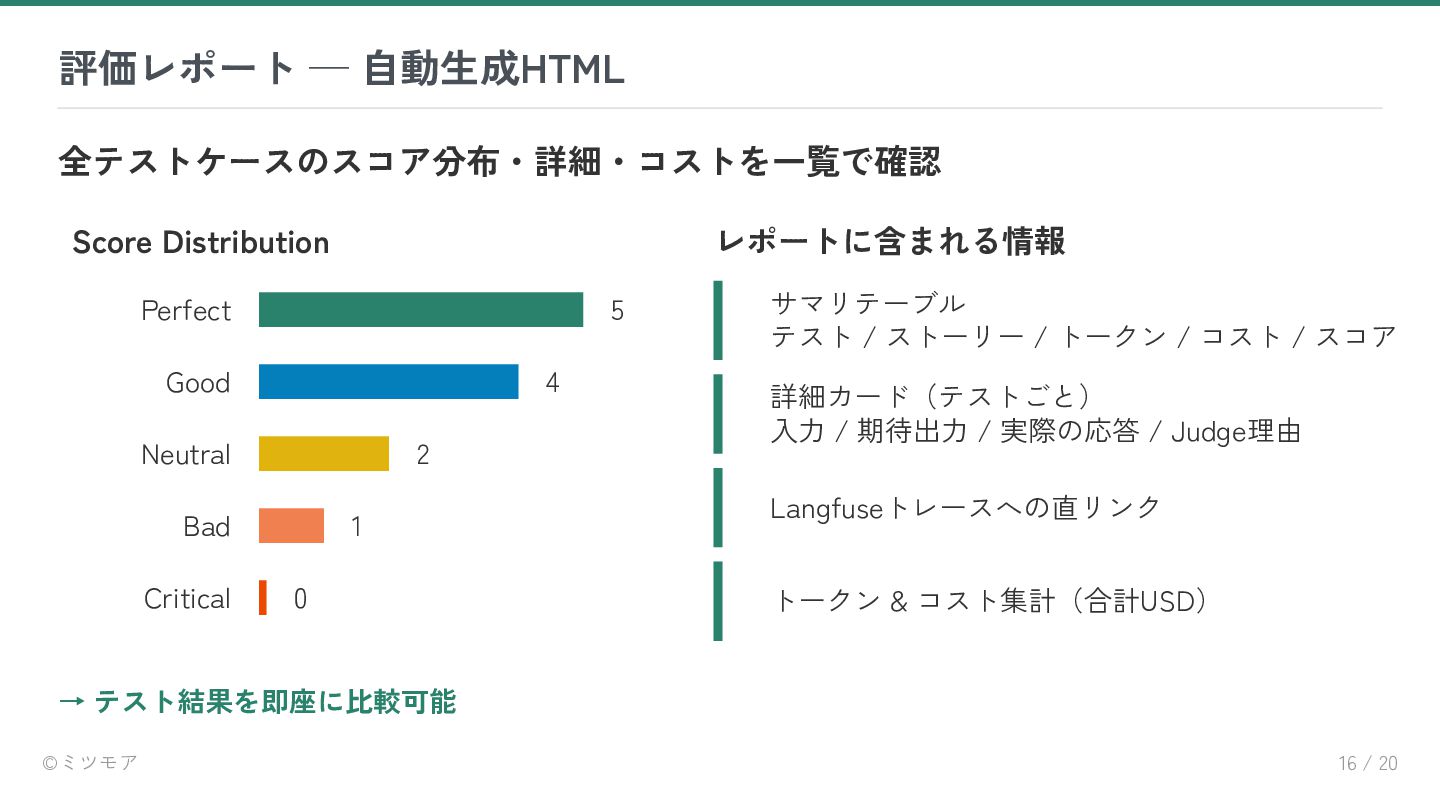
  13. ©ミツモア 16 / 20 評価レポート — 自動生成HTML 全テストケースのスコア分布・詳細・コストを一覧で確認 Score Distribution

    Perfect 5 Good 4 Neutral 2 Bad 1 Critical 0 レポートに含まれる情報 サマリテーブル テスト / ストーリー / トークン / コスト / スコア 詳細カード(テストごと) 入力 / 期待出力 / 実際の応答 / Judge理由 Langfuseトレースへの直リンク トークン & コスト集計(合計USD) → テスト結果を即座に比較可能
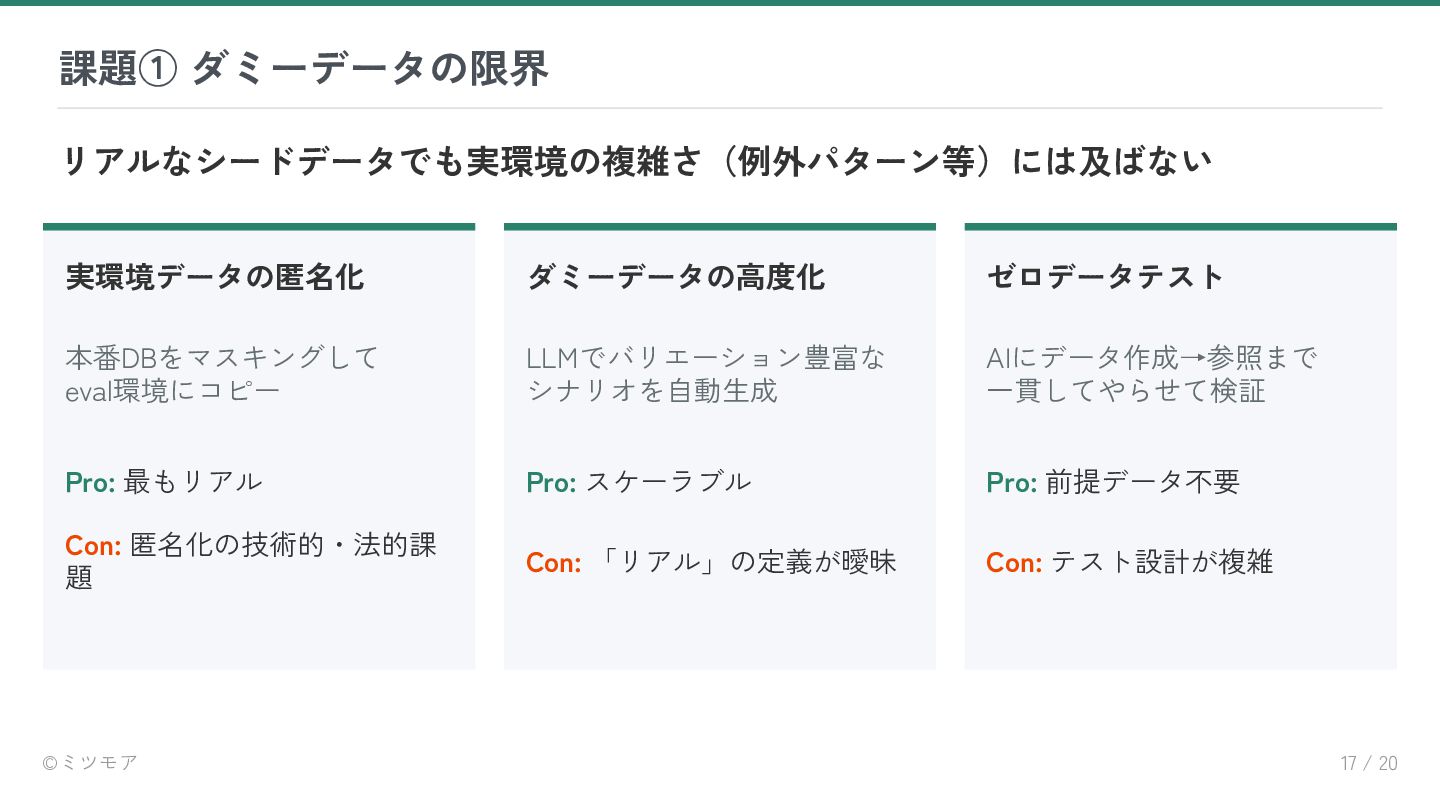
  14. ©ミツモア 17 / 20 課題① ダミーデータの限界 リアルなシードデータでも実環境の複雑さ(例外パターン等)には及ばない 実環境データの匿名化 本番DBをマスキングして eval環境にコピー

    Pro: 最もリアル Con: 匿名化の技術的・法的課 題 ダミーデータの高度化 LLMでバリエーション豊富な シナリオを自動生成 Pro: スケーラブル Con: 「リアル」の定義が曖昧 ゼロデータテスト AIにデータ作成→参照まで 一貫してやらせて検証 Pro: 前提データ不要 Con: テスト設計が複雑
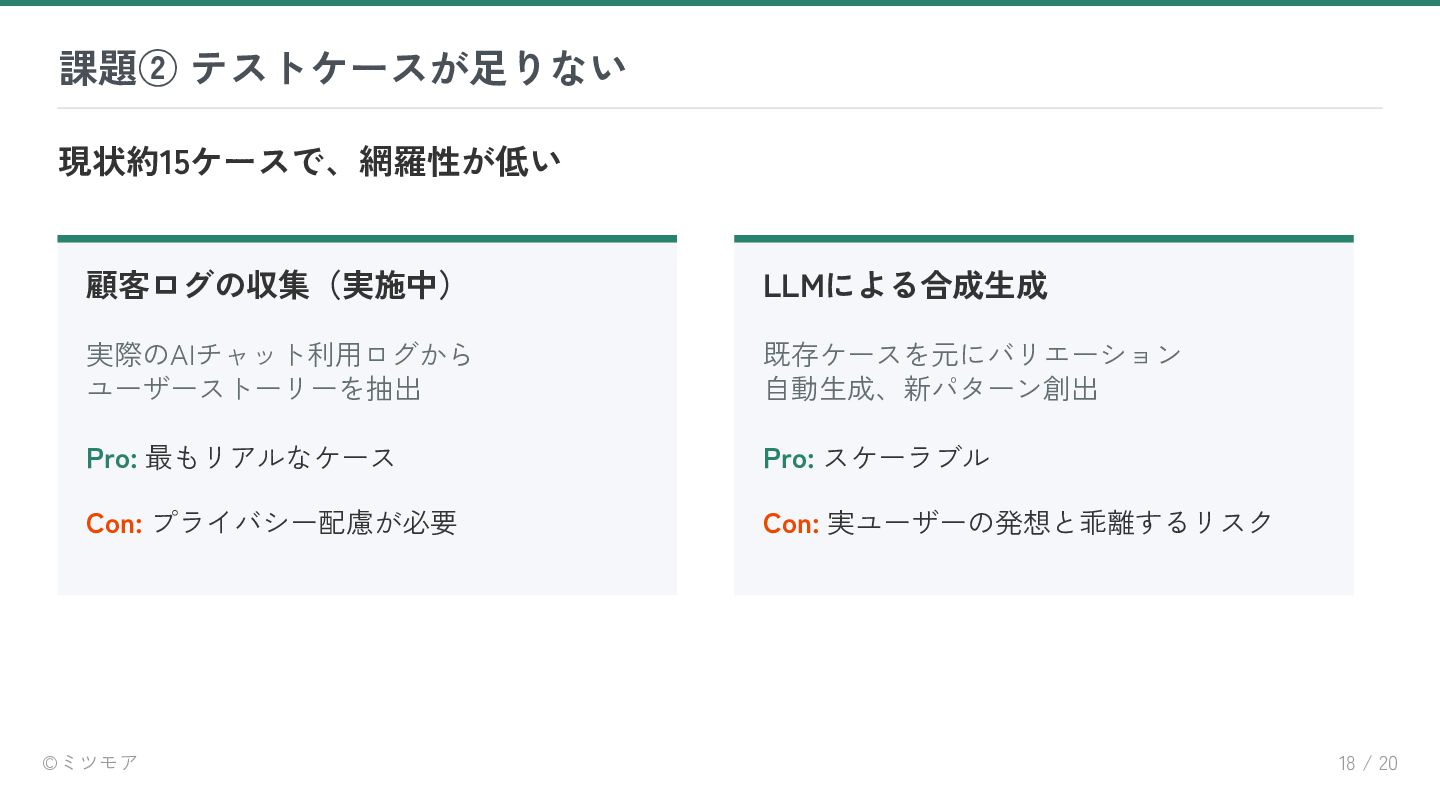
  15. ©ミツモア 18 / 20 課題② テストケースが足りない 現状約15ケースで、網羅性が低い 顧客ログの収集(実施中) 実際のAIチャット利用ログから ユーザーストーリーを抽出

    Pro: 最もリアルなケース Con: プライバシー配慮が必要 LLMによる合成生成 既存ケースを元にバリエーション 自動生成、新パターン創出 Pro: スケーラブル Con: 実ユーザーの発想と乖離するリスク
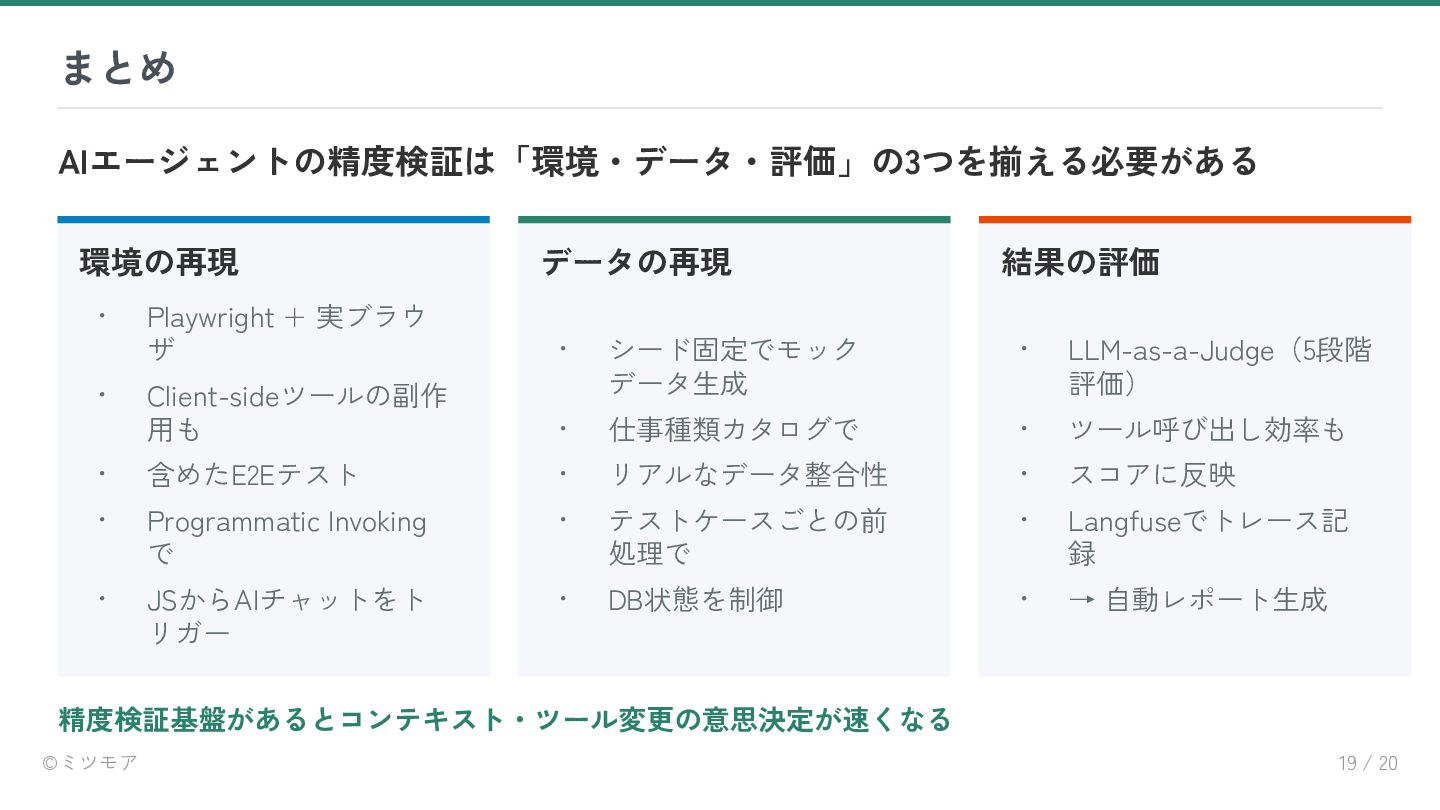
  16. ©ミツモア 19 / 20 まとめ AIエージェントの精度検証は「環境・データ・評価」の3つを揃える必要がある 環境の再現 • Playwright +

    実ブラウ ザ • Client-sideツールの副作 用も • 含めたE2Eテスト • Programmatic Invoking で • JSからAIチャットをト リガー データの再現 • シード固定でモック データ生成 • 仕事種類カタログで • リアルなデータ整合性 • テストケースごとの前 処理で • DB状態を制御 結果の評価 • LLM-as-a-Judge(5段階 評価) • ツール呼び出し効率も • スコアに反映 • Langfuseでトレース記 録 • → 自動レポート生成 精度検証基盤があるとコンテキスト・ツール変更の意思決定が速くなる