Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
第2回B3ゼミ
Search
miyanishi
January 16, 2013
260
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
第2回B3ゼミ
言語処理における識別モデルの発展
-HMMからCRFまで
miyanishi
January 16, 2013
More Decks by miyanishi
See All by miyanishi
平成27年度最終ゼミ
miyanishi
0
100
文献紹介1月
miyanishi
0
200
文献紹介12月
miyanishi
0
260
文献紹介11月
miyanishi
0
270
文献紹介10月
miyanishi
0
210
文献紹介(2015/09)
miyanishi
0
230
文献紹介8月(PPDB)
miyanishi
0
350
文献紹介15年08月
miyanishi
0
250
15年7月文献紹介
miyanishi
0
270
Featured
See All Featured
Hiding What from Whom? A Critical Review of the History of Programming languages for Music
tomoyanonymous
3
1.3k
Music & Morning Musume
bryan
48
7.4k
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
Practical Orchestrator
shlominoach
192
12k
Jamie Indigo - Trashchat’s Guide to Black Boxes: Technical SEO Tactics for LLMs
techseoconnect
PRO
0
700
Designing for Timeless Needs
cassininazir
1
520
HDC tutorial
michielstock
2
950
State of Search Keynote: SEO is Dead Long Live SEO
ryanjones
0
320
Become a Pro
speakerdeck
PRO
31
6.3k
Stop Working from a Prison Cell
hatefulcrawdad
274
21k
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
930
How to train your dragon (web standard)
notwaldorf
96
6.9k
Transcript
第2回 B3ゼミ 言語処理における識別モデルの発展 ーHMMからCRFまで 宮西 由貴
はじめに(背景) • 配列・木・グラフなど=構造データという • 自然言語処理は構造データをよく使う o 構造データ間のマッピングが必要 o (例)文中の人名などにラベルを付与(固有表現抽出) o
(例)構文解析 • 今回扱う問題について o ラベル付け問題
はじめに(問題の定式化) • 入力:x o 単語列 o 全てのxの集合=X • 出力:y o
ラベル o 全てのyの集合=Y • xを入力して対応するyを出力 o 対応関係をルールとして書き出す o 過去の事例(学習データ)と統計的な推論を使う 限られた学習データから求めることが必要 未知の部分は確率的なもの
はじめに(数式で表現) • 条件付き確率分布:Pr(y|x)を使う o xが分かった時にyが出る確率 • 予測: を求める o =max(∈)Pr(y|x)
Yの中で最も大きなPr(y|x)を実現するy∈Y
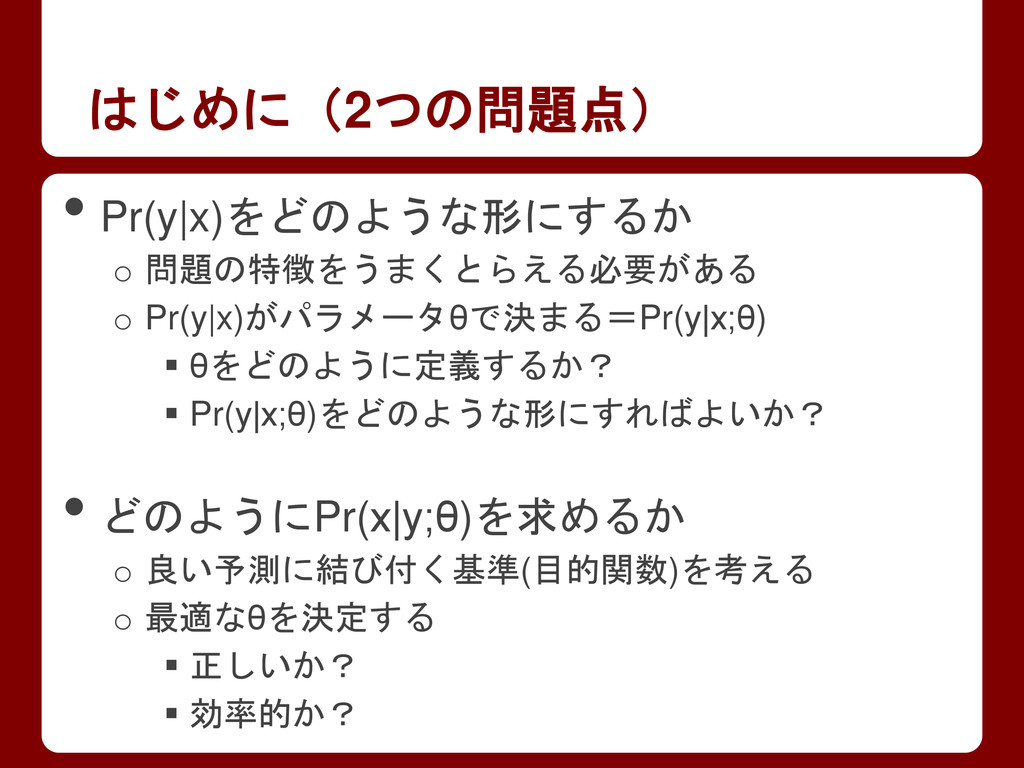
はじめに(2つの問題点) • Pr(y|x)をどのような形にするか o 問題の特徴をうまくとらえる必要がある o Pr(y|x)がパラメータθで決まる=Pr(y|x;θ) θをどのように定義するか?
Pr(y|x;θ)をどのような形にすればよいか? • どのようにPr(x|y;θ)を求めるか o 良い予測に結び付く基準(目的関数)を考える o 最適なθを決定する 正しいか? 効率的か?
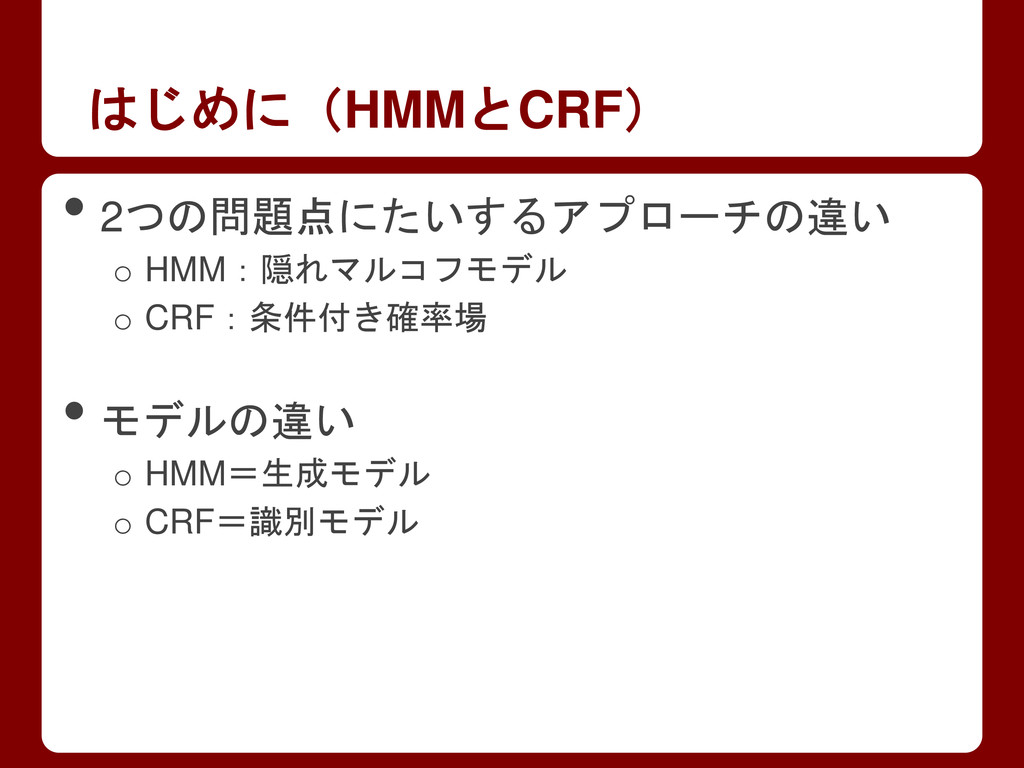
はじめに(HMMとCRF) • 2つの問題点にたいするアプローチの違い o HMM:隠れマルコフモデル o CRF:条件付き確率場 • モデルの違い o
HMM=生成モデル o CRF=識別モデル
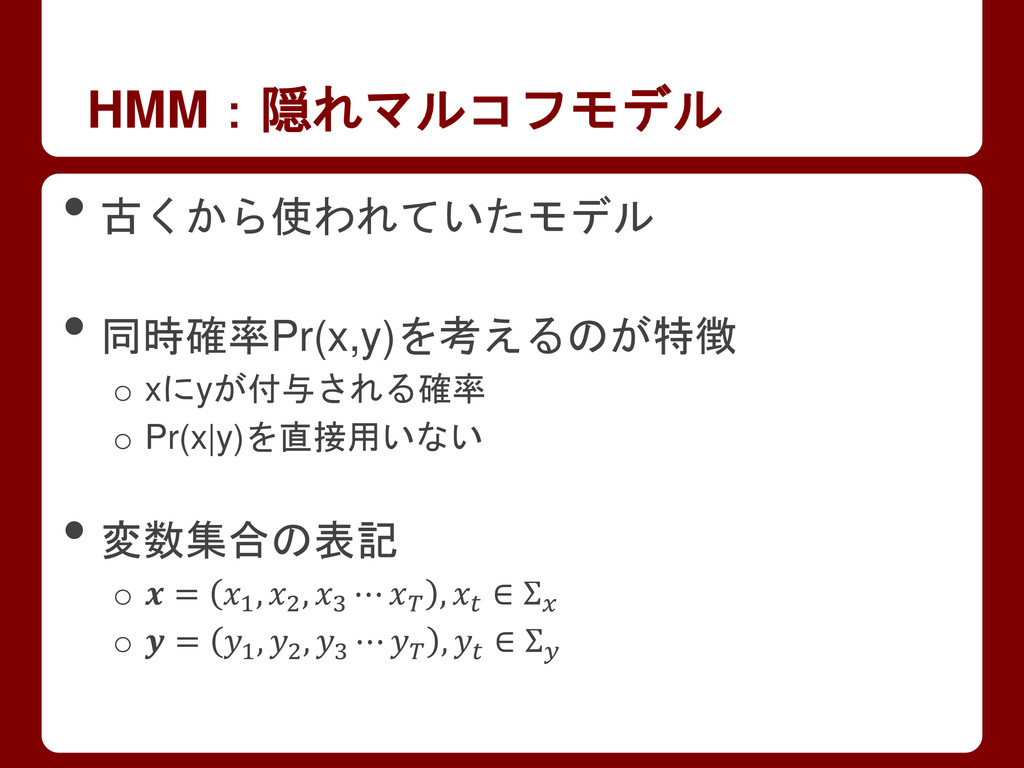
HMM:隠れマルコフモデル • 古くから使われていたモデル • 同時確率Pr(x,y)を考えるのが特徴 o xにyが付与される確率 o Pr(x|y)を直接用いない •
変数集合の表記 o = 1 , 2 , 3 ⋯ , ∈ Σ o = 1 , 2 , 3 ⋯ , ∈ Σ
HMM:隠れマルコフモデル • Pr(y|x)=0,1 1,1 1,2 2,2 ⋯ , ,+1 o
,+1 = Pr +1 o , = Pr • は直前の−1 に, は にのみ依存する • HMMには“制約”がある o ,′ = 1 ′∈Σ および , = 1 ∈Σ 確率を用いたモデルになっていることを保証する
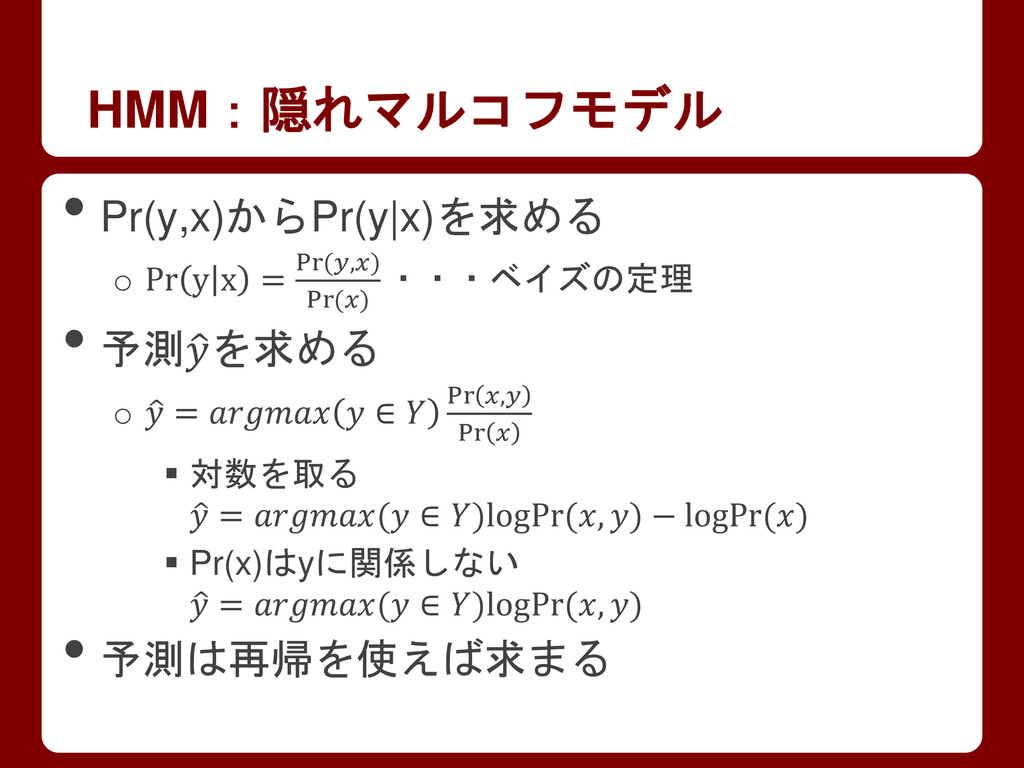
HMM:隠れマルコフモデル • Pr(y,x)からPr(y|x)を求める o Pr y x = Pr (,)
Pr () ・・・ベイズの定理 • 予測 を求める o = ∈ Pr , Pr 対数を取る = ( ∈ )logPr (, ) − logPr () Pr(x)はyに関係しない = ( ∈ )logPr (, ) • 予測は再帰を使えば求まる
HMM:隠れマルコフモデル • N個の学習データが与えられるとする o パラメータ,′ , , の推定 • 学習データの表記について
o i番目の学習データ((), ) i=1・・・N • HMMにおいてのパラメータ推定について o 学習データを最もよく再現するパラメータ o 学習データを生成する率が最も高いパラメータ
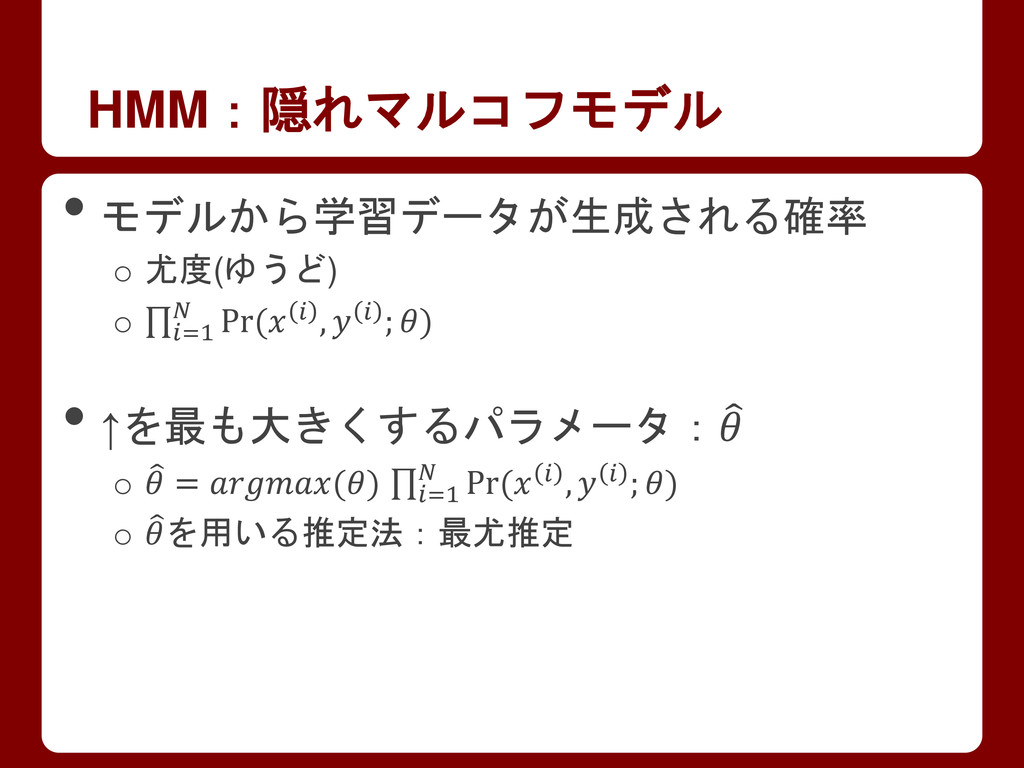
HMM:隠れマルコフモデル • モデルから学習データが生成される確率 o 尤度(ゆうど) o Pr ( , ;
) =1 • ↑を最も大きくするパラメータ: o = () Pr ( , ; ) =1 o を用いる推定法:最尤推定
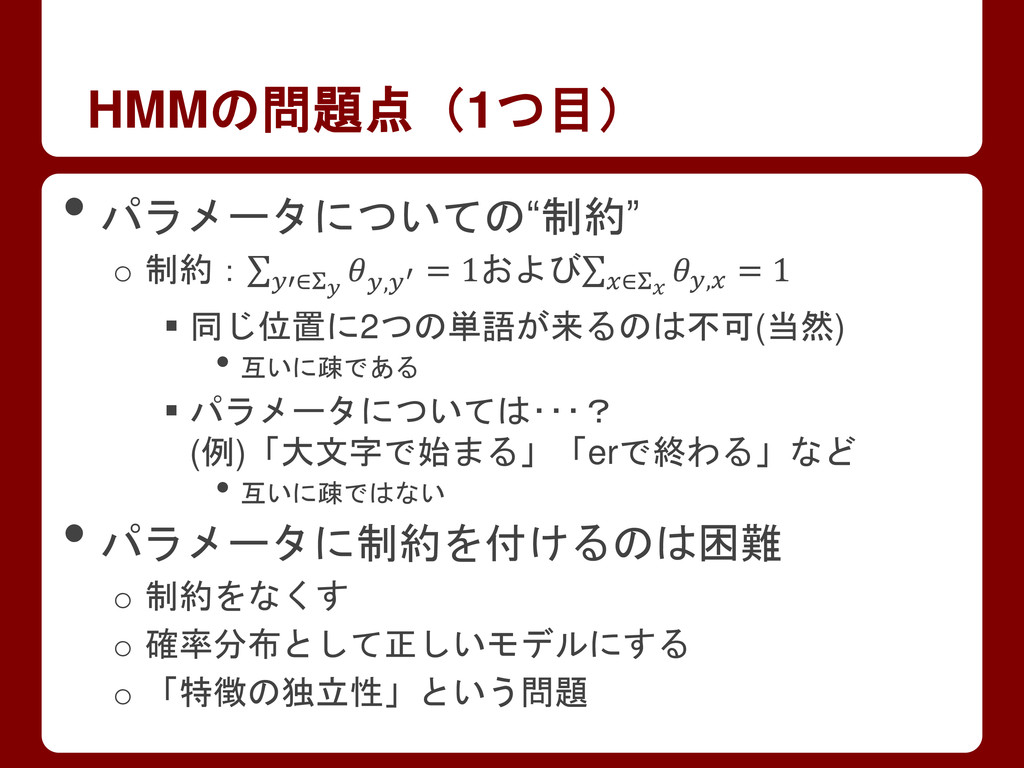
HMMの問題点(1つ目) • パラメータについての“制約” o 制約: ,′ = 1 ′∈Σ および
, = 1 ∈Σ 同じ位置に2つの単語が来るのは不可(当然) • 互いに疎である パラメータについては・・・? (例)「大文字で始まる」「erで終わる」など • 互いに疎ではない • パラメータに制約を付けるのは困難 o 制約をなくす o 確率分布として正しいモデルにする o 「特徴の独立性」という問題
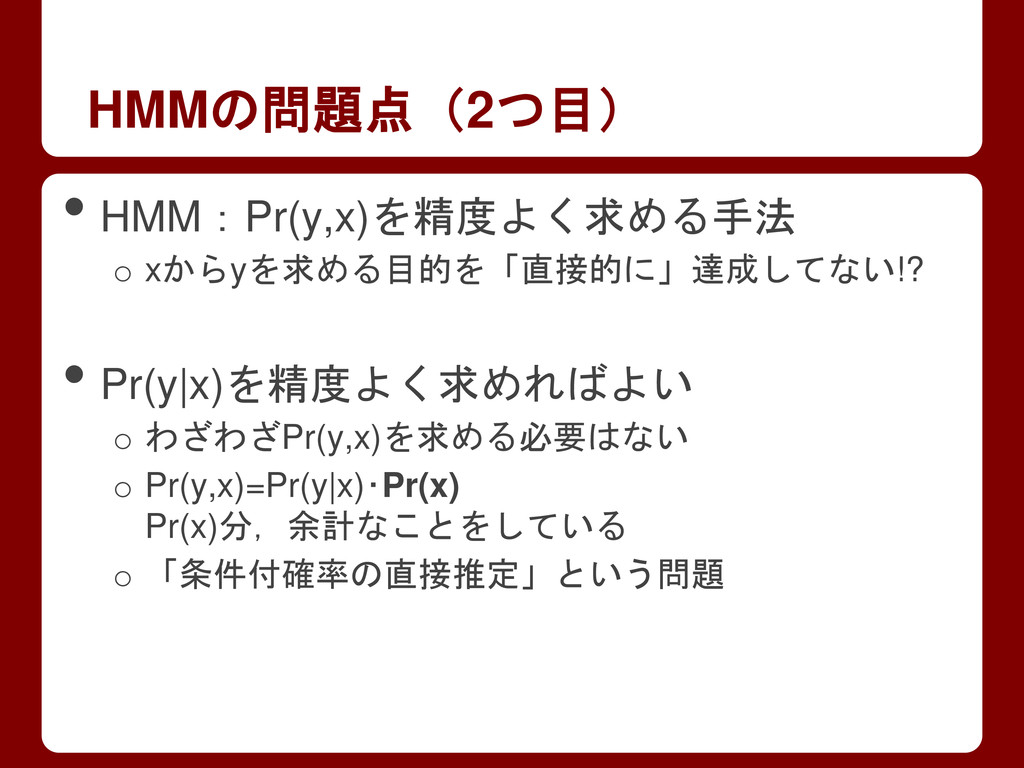
HMMの問題点(2つ目) • HMM:Pr(y,x)を精度よく求める手法 o xからyを求める目的を「直接的に」達成してない!? • Pr(y|x)を精度よく求めればよい o わざわざPr(y,x)を求める必要はない o
Pr(y,x)=Pr(y|x)・Pr(x) Pr(x)分,余計なことをしている o 「条件付確率の直接推定」という問題
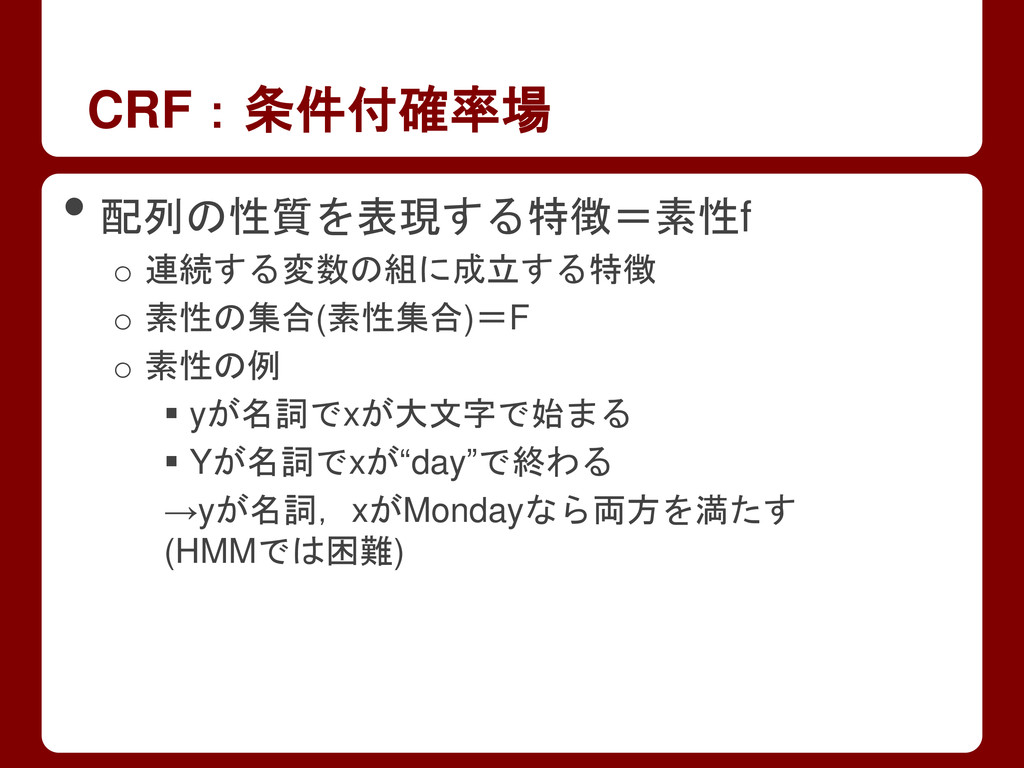
CRF:条件付確率場 • 配列の性質を表現する特徴=素性f o 連続する変数の組に成立する特徴 o 素性の集合(素性集合)=F o 素性の例
yが名詞でxが大文字で始まる Yが名詞でxが“day”で終わる →yが名詞,xがMondayなら両方を満たす (HMMでは困難)
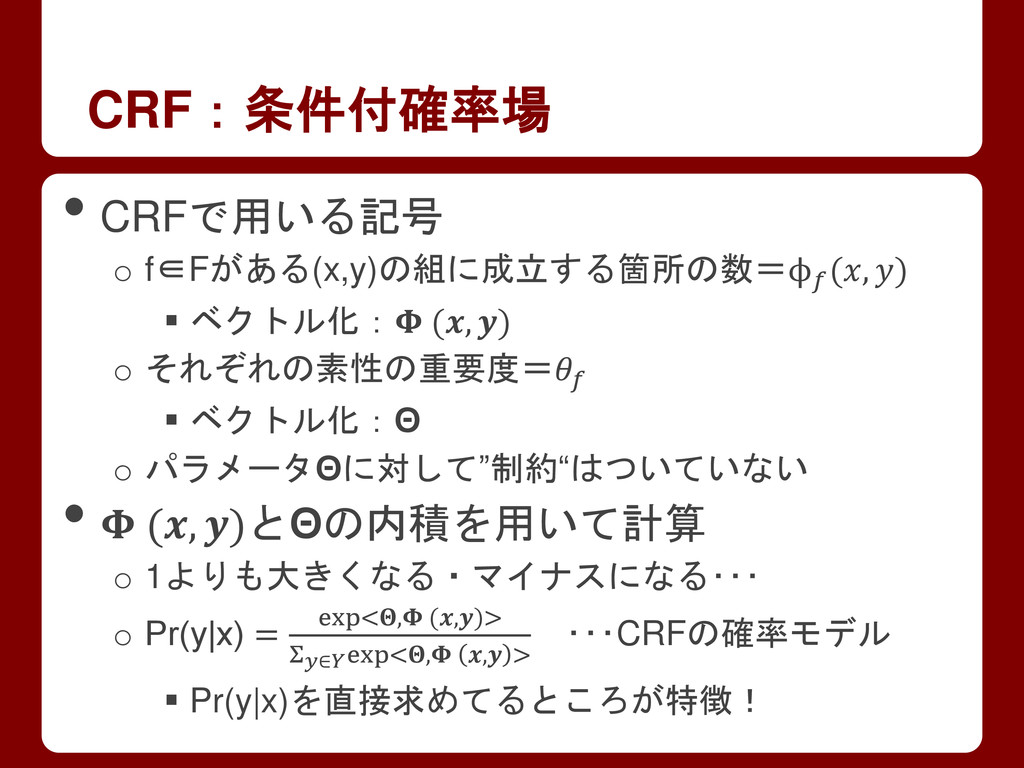
CRF:条件付確率場 • CRFで用いる記号 o f∈Fがある(x,y)の組に成立する箇所の数=ϕ (, ) ベクトル化: (,
) o それぞれの素性の重要度= ベクトル化:Θ o パラメータΘに対して”制約“はついていない • (, )とΘの内積を用いて計算 o 1よりも大きくなる・マイナスになる・・・ o Pr(y|x) = exp<, (,)> Σ∈exp<, , > ・・・CRFの確率モデル Pr(y|x)を直接求めてるところが特徴!
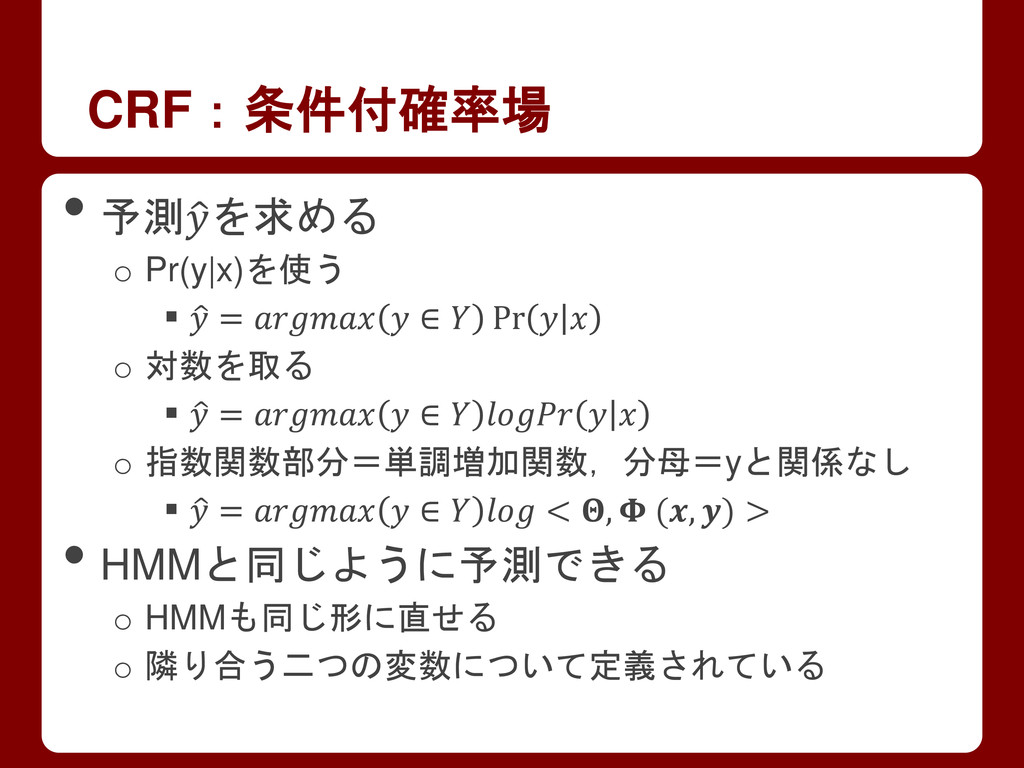
CRF:条件付確率場 • 予測 を求める o Pr(y|x)を使う = ∈ Pr
o 対数を取る = ∈ o 指数関数部分=単調増加関数,分母=yと関係なし = ∈ < , (, ) > • HMMと同じように予測できる o HMMも同じ形に直せる o 隣り合う二つの変数について定義されている
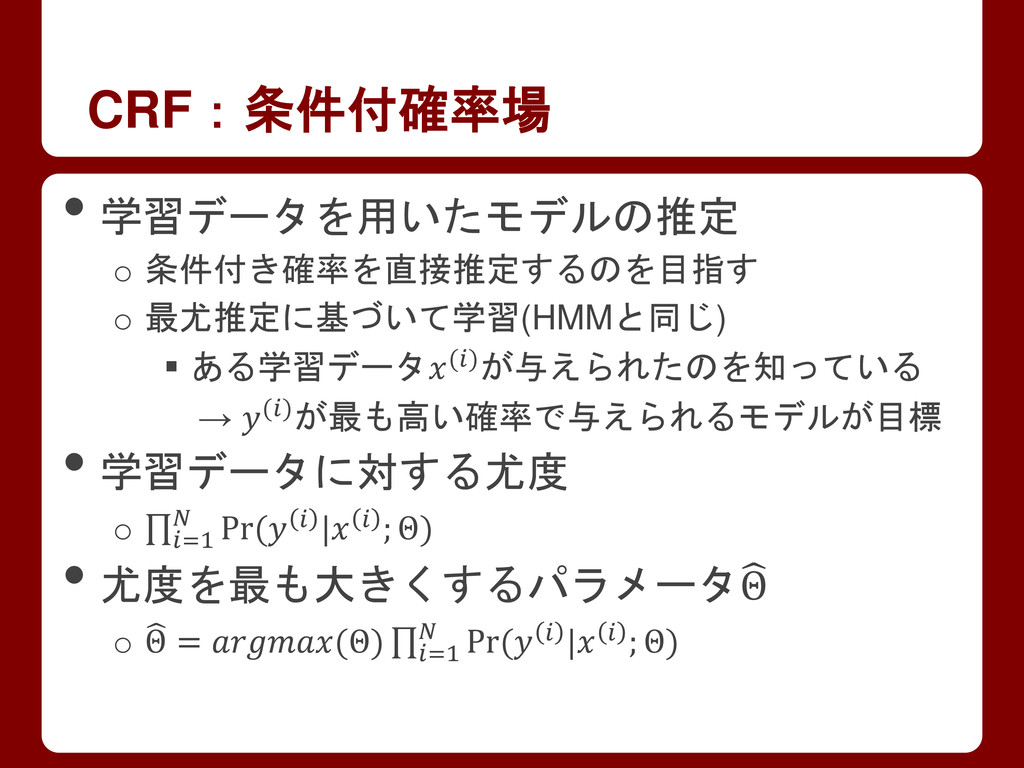
CRF:条件付確率場 • 学習データを用いたモデルの推定 o 条件付き確率を直接推定するのを目指す o 最尤推定に基づいて学習(HMMと同じ) ある学習データ()が与えられたのを知っている →
()が最も高い確率で与えられるモデルが目標 • 学習データに対する尤度 o Pr ( | ; Θ) =1 • 尤度を最も大きくするパラメータΘ o Θ = (Θ) Pr ( | ; Θ) =1
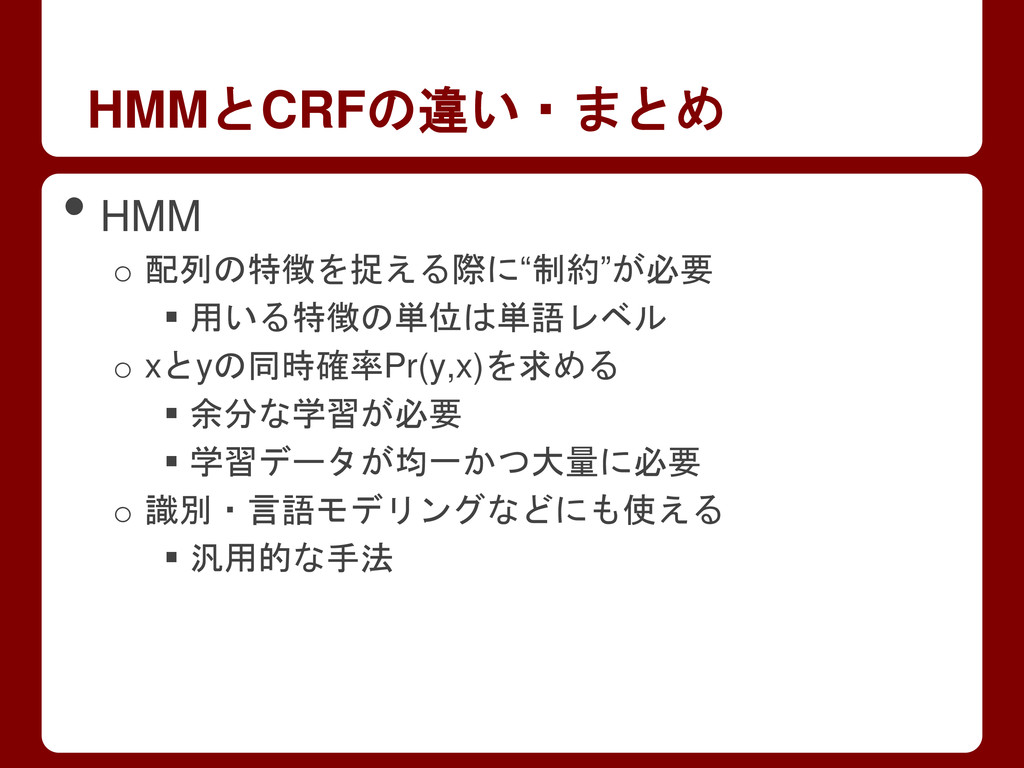
HMMとCRFの違い・まとめ • HMM o 配列の特徴を捉える際に“制約”が必要 用いる特徴の単位は単語レベル o xとyの同時確率Pr(y,x)を求める
余分な学習が必要 学習データが均一かつ大量に必要 o 識別・言語モデリングなどにも使える 汎用的な手法
HMMとCRFの違い・まとめ • CRF o “制約”がない 単語より細かいレベルで特徴設計できる o Pr(x|y)を求める
正規化が必要 余分な学習が不必要 o 識別にしか使えない 汎用性が低い


 miyanishi
 tomoyanonymous
 bryan
 aarron
 shlominoach
 techseoconnect
 cassininazir
 michielstock
 ryanjones
 speakerdeck
 hatefulcrawdad
 katarinadahlin
 notwaldorf