Share
Embed
Context-Sensitive Fencing
Context-Sensitive Fencing: Securing Speculative Execution via Microcode Customization (https://dl.acm.org/citation.cfm?id=3304060) のサーベイ

srup
July 08, 2019
Transcript
114 slides
-
はじめに 文献[1]をサーベイした 背景知識の補充などに他の参考文献も利用しています. 文献[2, 3, 4] が基礎となっている Spectre[2] に対して, DIFT[3]
とCSD[4] を用いた対策を実装している. 2 -
参考文献 [1] Context-Sensitive Fencing: Securing Speculative Execution via Microcode Customization
[ASPLOS '19] [2] Spectre Attacks: Exploiting Speculative Execution [arXiv Jan 2018] [3] Secure program execution via dynamic information flow tracking [ASPLOS ‘04] [4] Mobilizing the Micro-Ops: Exploiting Context Sensitive Decoding for Security and Energy Efficiency [ISCA ‘18] 3 -
参考文献 [5] FLUSH+RELOAD: A High Resolution, Low Noise, L3 Cache
Side-Channel Attack [USENIX Security Symposium ‘14] [6] A Systematic Evaluation of Transient Execution Attacks and Defenses [arXiv May 2019] [7] SafeSpec: Banishing the Spectre of a Meltdown with Leakage-Free Speculation [arXiv Jun 2018] [8] Data Oblivious ISA Extensions for Side Channel-Resistant and High Performance Computing [NDSS ‘19] 4 -
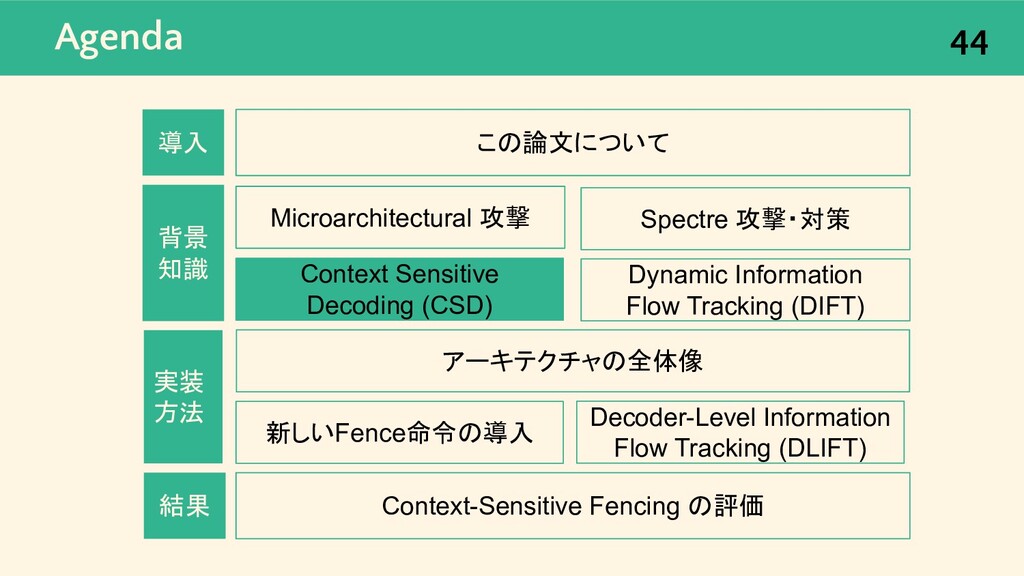
Agenda 導入 5 導入 背景 知識 実装 方法 この論文について Microarchitectural
Attacks Spectre 攻撃・対策 Context Sensitive Decoding (CSD) Dynamic Information Flow Tracking (DIFT) アーキテクチャの全体像 新しいFence命令の導入 Decoder-Level Information Flow Tracking (DLIFT) 結果 Context-Sensitive Fencing の評価 -
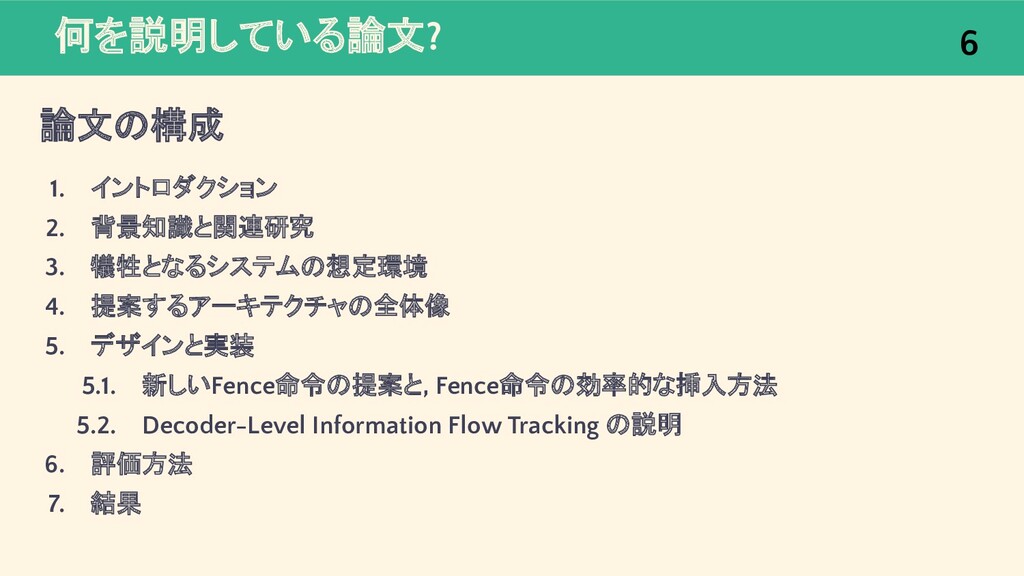
何を説明している論文? 論文の構成 1. イントロダクション 2. 背景知識と関連研究 3. 犠牲となるシステムの想定環境 4. 提案するアーキテクチャの全体像
5. デザインと実装 5.1. 新しいFence命令の提案と, Fence命令の効率的な挿入方法 5.2. Decoder-Level Information Flow Tracking の説明 6. 評価方法 7. 結果 6 -
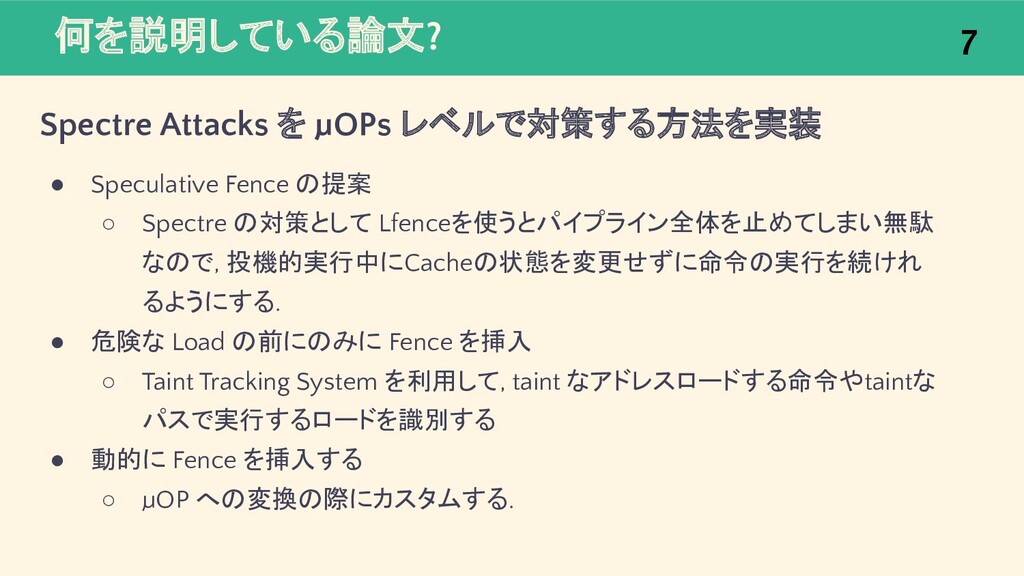
何を説明している論文? Spectre Attacks を μOPs レベルで対策する方法を実装 • Speculative Fence の提案
◦ Spectre の対策として Lfenceを使うとパイプライン全体を止めてしまい無駄 なので, 投機的実行中にCacheの状態を変更せずに命令の実行を続けれ るようにする. • 危険な Load の前にのみに Fence を挿入 ◦ Taint Tracking System を利用して, taint なアドレスロードする命令やtaintな パスで実行するロードを識別する • 動的に Fence を挿入する ◦ μOP への変換の際にカスタムする. 7 -
Agenda 導入 8 導入 背景 知識 実装 方法 この論文について Microarchitectural
攻撃 Spectre 攻撃・対策 Context Sensitive Decoding (CSD) Dynamic Information Flow Tracking (DIFT) アーキテクチャの全体像 新しいFence命令の導入 Decoder-Level Information Flow Tracking (DLIFT) 結果 Context-Sensitive Fencing の評価 -
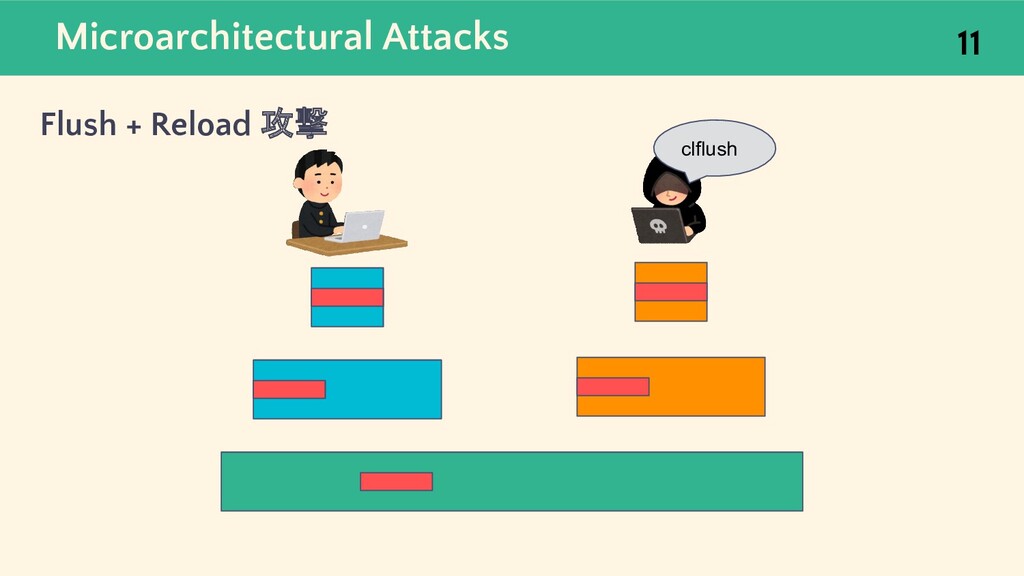
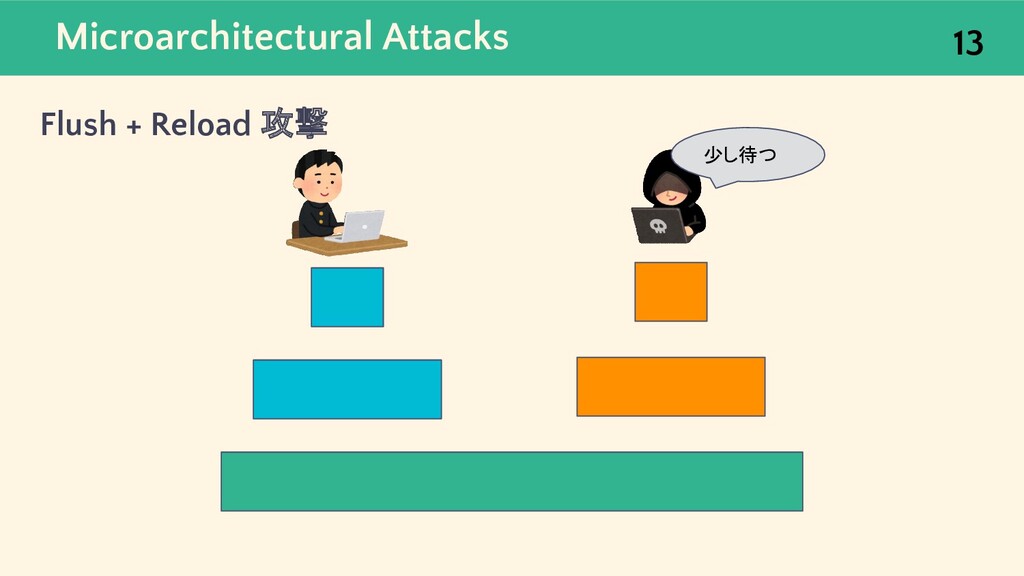
Microarchitectural Attacks 9 Flush + Reload 攻撃 [5] キャッシュに対するマイクロアーキテクチャ攻撃のひとつで, メモリアクセスのレイテンシの差から
攻撃者は被害者がどのようなメモリにアクセスしたかを推測できる. 条件: • キャッシュライン単位の粒度でしかわからない • 攻撃者 と 被害者 が物理メモリを共有している必要がある -
Microarchitectural Attacks Flush + Reload 攻撃 [5] 10 L1 Cache
L2 Cache L3 Cacche -
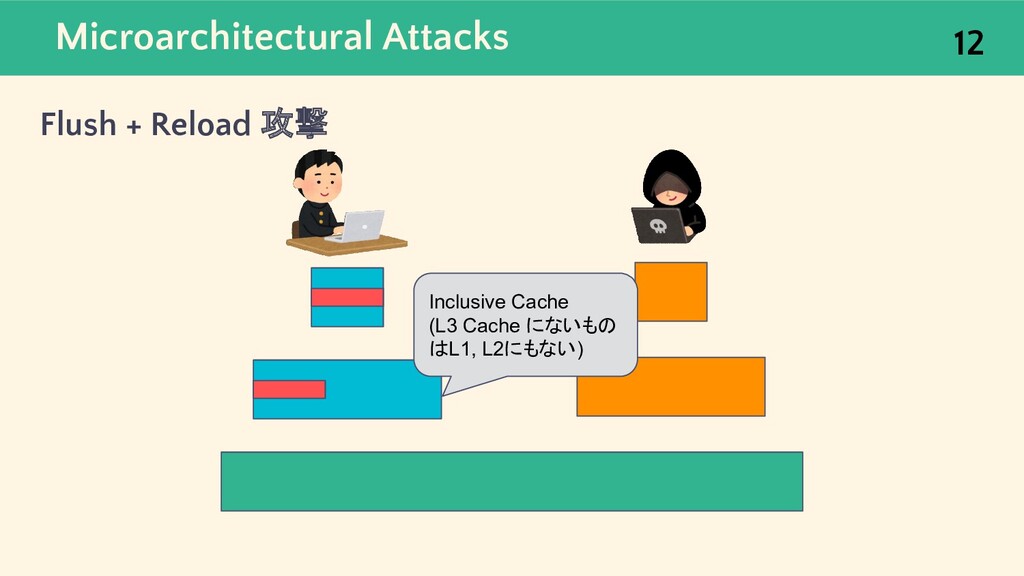
Microarchitectural Attacks Flush + Reload 攻撃 12 Inclusive Cache (L3
Cache にないもの はL1, L2にもない) -
Microarchitectural Attacks Flush + Reload 攻撃 17 a = data[0xf000]
はやい!! メモリアクセスのレイテンシの差から 攻撃者は被害者がどのようなメモリにアクセスし たかを推測できた !! -
Agenda 導入 18 導入 背景 知識 実装 方法 この論文について Microarchitectural
攻撃 Spectre 攻撃・対策 Context Sensitive Decoding (CSD) Dynamic Information Flow Tracking (DIFT) アーキテクチャの全体像 新しいFence命令の導入 Decoder-Level Information Flow Tracking (DLIFT) 結果 Context-Sensitive Fencing の評価 -
Speculative Execution CPUの性能最適化技術の一つ • 実際に命令を実行する必要があるか決定する前に命令を実行することで, 命令 の実行のスループットを上げている. • 実行フローの中には分岐が多く, 分岐先がわかる前に分岐先を予測して実行を
進めててしまう. ◦ 予測が正しかった場合 ▪ スループット上がるし, 問題もない. ◦ 予測が正しくなかった場合 ▪ パイプラインをフラッシュして実行をやり直すので, オーバーヘッドがか かるが問題ない. 19 -
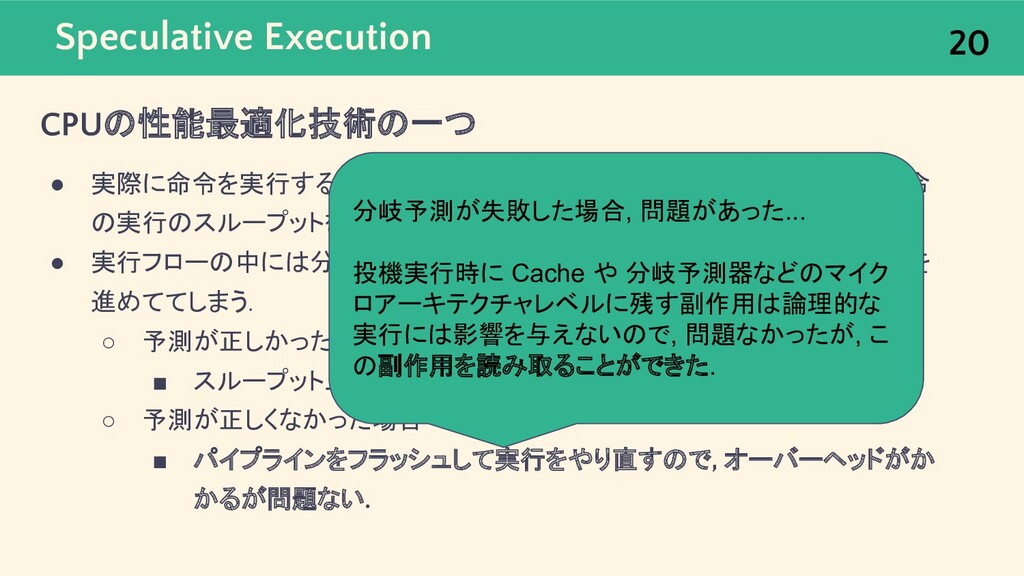
Speculative Execution CPUの性能最適化技術の一つ • 実際に命令を実行する必要があるか決定する前に命令を実行することで, 命令 の実行のスループットを上げている. • 実行フローの中には分岐が多く, 分岐先がわかる前に分岐先を予測して実行を
進めててしまう. ◦ 予測が正しかった場合 ▪ スループット上がるし, 問題もない. ◦ 予測が正しくなかった場合 ▪ パイプラインをフラッシュして実行をやり直すので, オーバーヘッドがか かるが問題ない. 20 分岐予測が失敗した場合, 問題があった... 投機実行時に Cache や 分岐予測器などのマイク ロアーキテクチャレベルに残す副作用は論理的な 実行には影響を与えないので, 問題なかったが, こ の副作用を読み取ることができた. -
Transient Execution Attacks [6] 攻撃の手順 1. 攻撃者がマイクロアーキテクチャの状態を望む状態にする • 攻撃者が分岐予測器を誤学習させる •
攻撃者が Cache をフラッシュする 2. 投機的実行がミスするような命令を実行する • 攻撃者が分岐予測が失敗するような入力をいれる 3. 被害者のプロセスがCovert Channel の送信側となる命令を実行する • Cache にメモリをロードする 4. CPUがアーキテクチャレベルの影響を修正 • パイプラインフラッシュなど • Cacheや分岐予測器への副作用は残っている 5. Covert Channel の受信側の操作を行う • Flush + Reload 21 -
Spectre Attacks (variant-1) Spectre gadget 22 uint8_t array1[array1_size]; uint8_t array2[];
// prob if (x < array1_size) y = array2[array1[x] * 4096]; # r1 = x cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: -
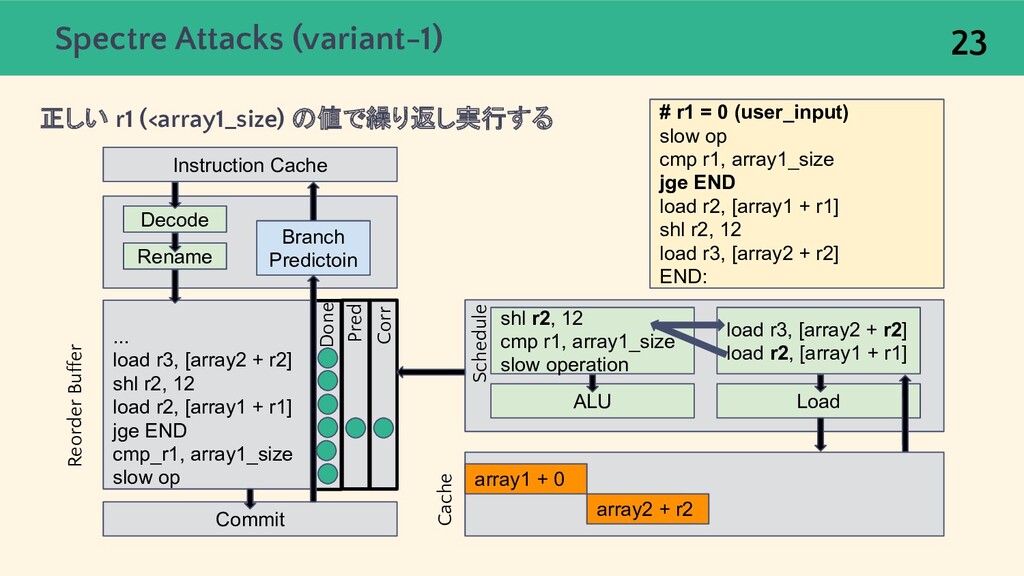
Spectre Attacks (variant-1) 正しい r1 (<array1_size) の値で繰り返し実行する 23 Instruction Cache
... load r3, [array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END cmp_r1, array1_size slow op Commit # r1 = 0 (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr array1 + 0 array2 + r2 -
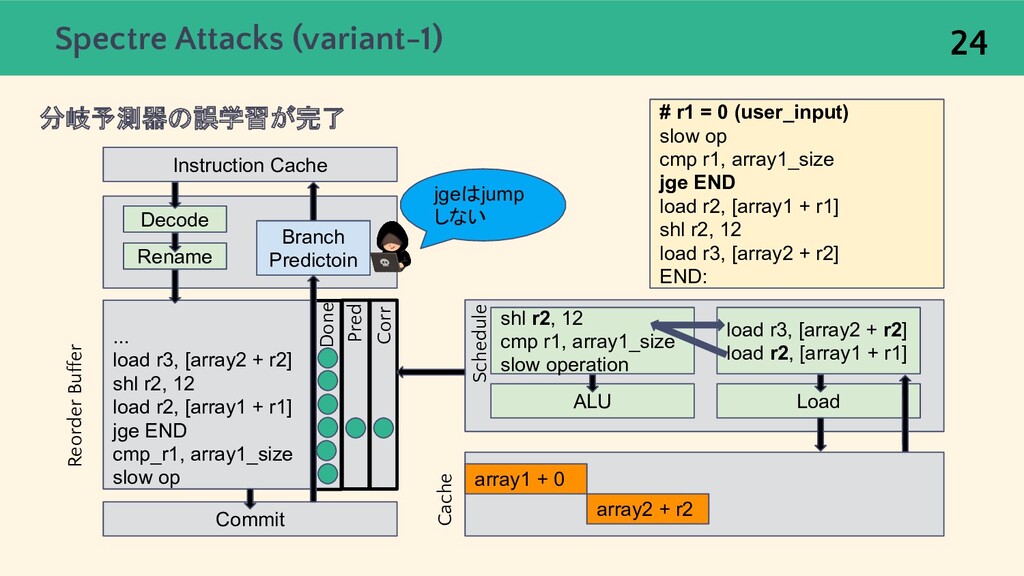
Spectre Attacks (variant-1) 分岐予測器の誤学習が完了 24 Instruction Cache ... load r3,
[array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END cmp_r1, array1_size slow op Commit # r1 = 0 (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr array1 + 0 array2 + r2 jgeはjump しない -
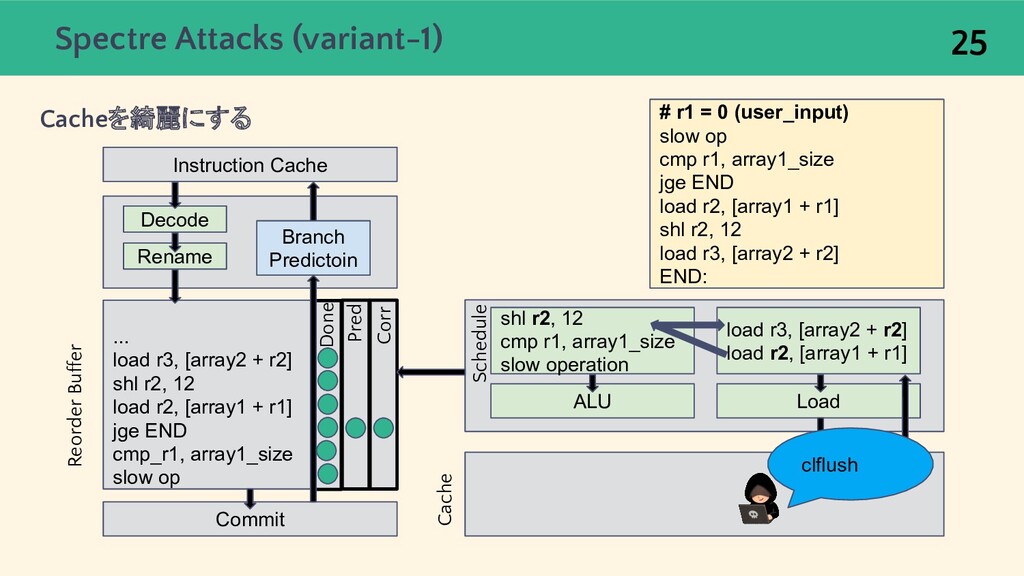
Spectre Attacks (variant-1) Cacheを綺麗にする 25 Instruction Cache ... load r3,
[array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END cmp_r1, array1_size slow op Commit # r1 = 0 (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr clflush -
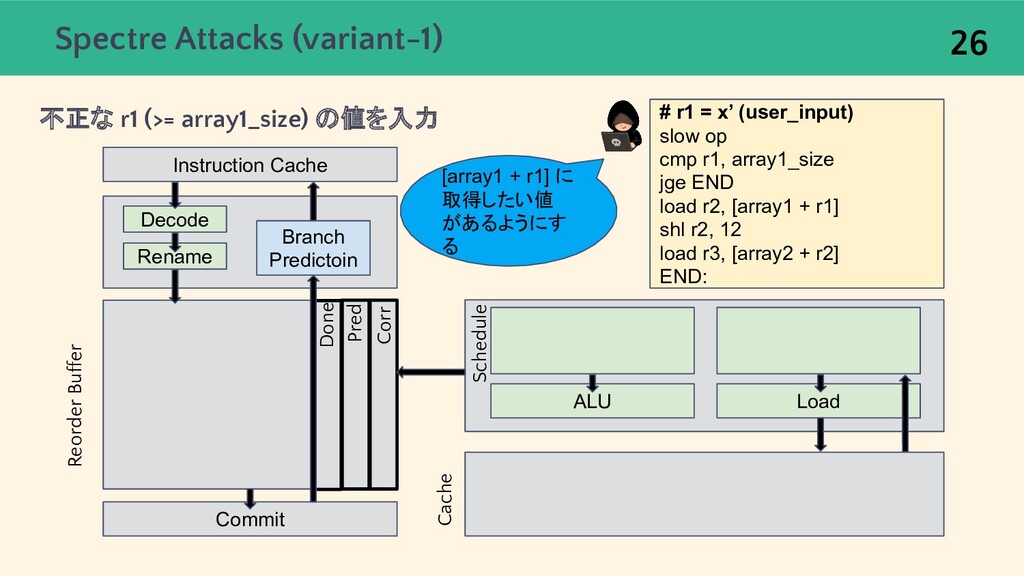
Spectre Attacks (variant-1) 不正な r1 (>= array1_size) の値を入力 26 Instruction
Cache Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load Schedule Cache Done Pred Corr [array1 + r1] に 取得したい値 があるようにす る -
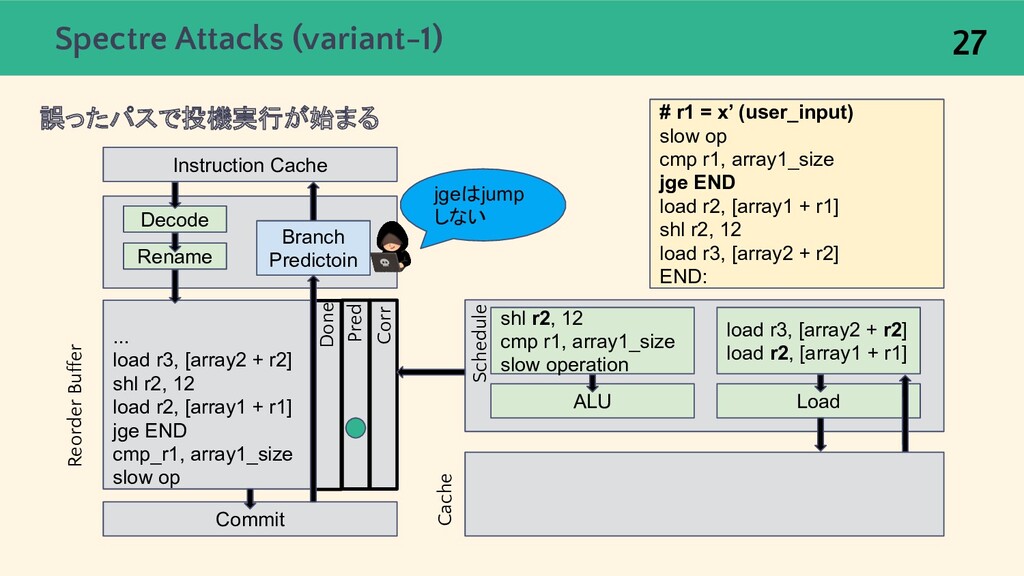
Spectre Attacks (variant-1) 誤ったパスで投機実行が始まる 27 Instruction Cache ... load r3,
[array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END cmp_r1, array1_size slow op Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr jgeはjump しない -
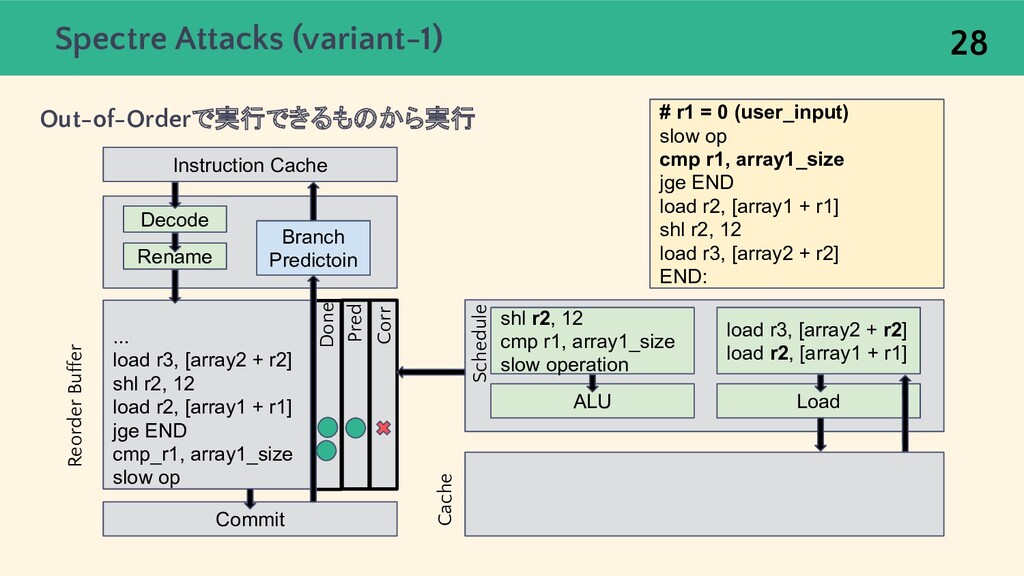
Spectre Attacks (variant-1) Out-of-Orderで実行できるものから実行 28 Instruction Cache ... load r3,
[array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END cmp_r1, array1_size slow op Commit # r1 = 0 (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr -
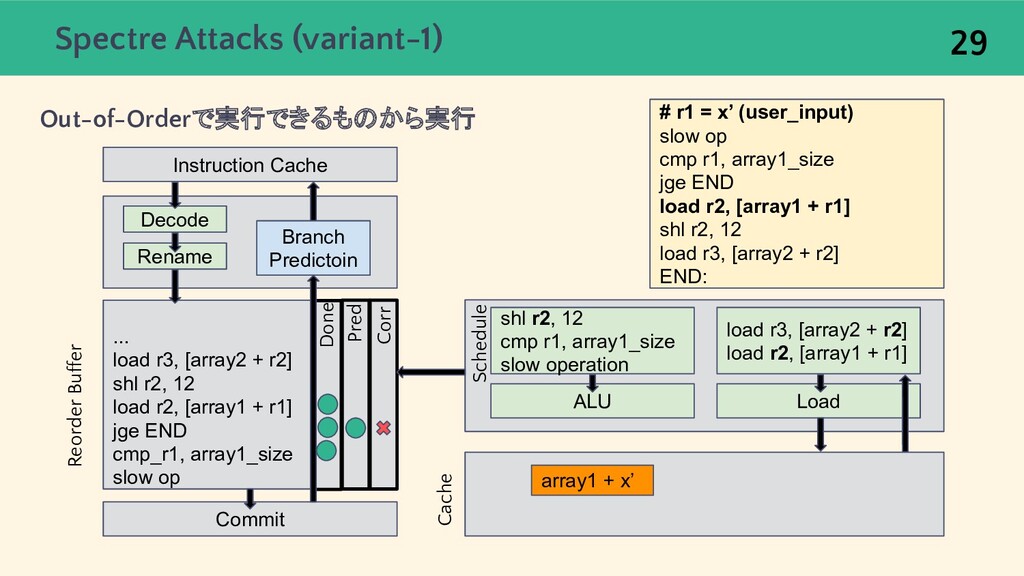
Spectre Attacks (variant-1) Out-of-Orderで実行できるものから実行 29 Instruction Cache ... load r3,
[array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END cmp_r1, array1_size slow op Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr array1 + x’ -
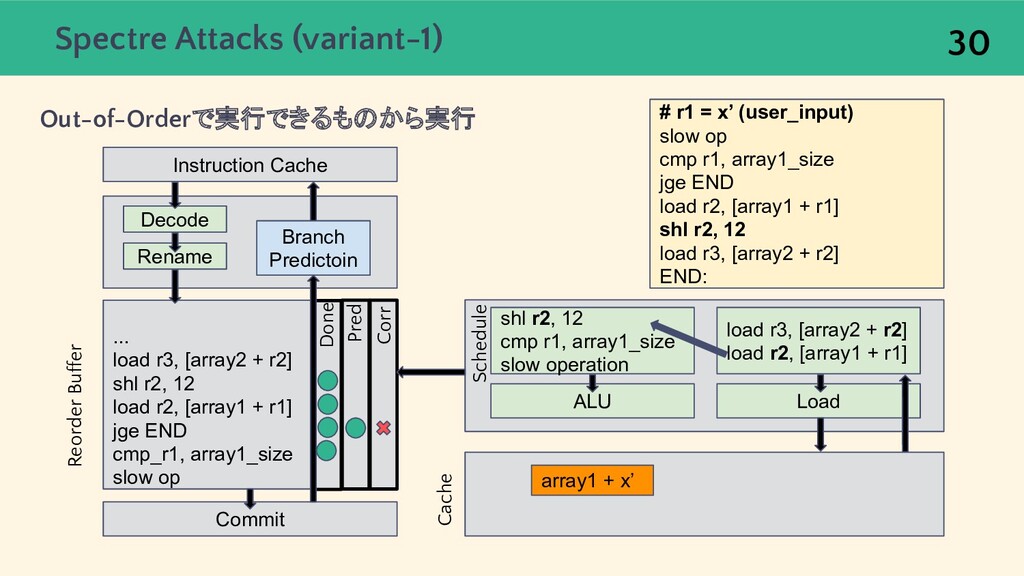
Spectre Attacks (variant-1) Out-of-Orderで実行できるものから実行 30 Instruction Cache ... load r3,
[array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END cmp_r1, array1_size slow op Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr array1 + x’ -
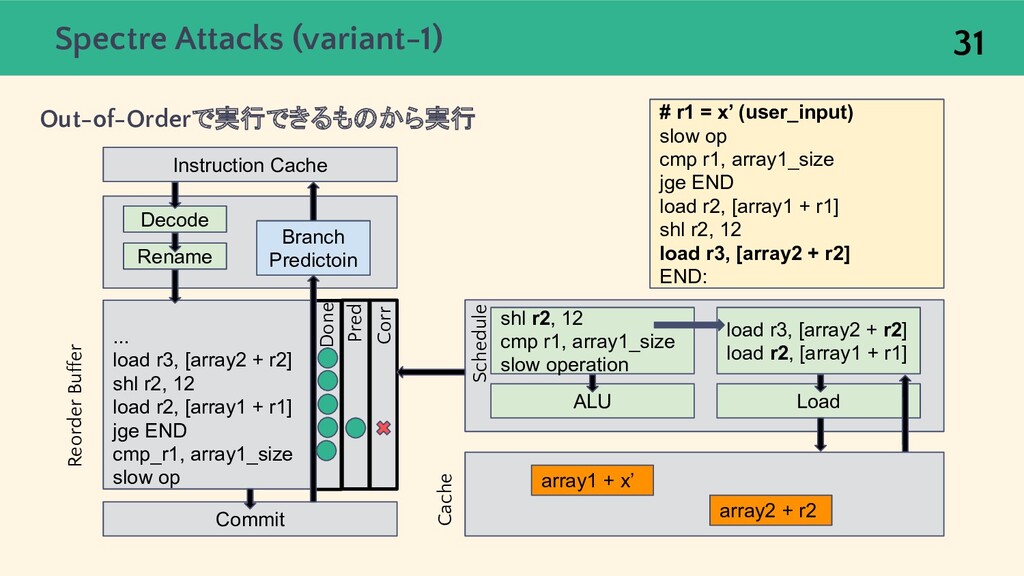
Spectre Attacks (variant-1) Out-of-Orderで実行できるものから実行 31 Instruction Cache ... load r3,
[array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END cmp_r1, array1_size slow op Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr array1 + x’ array2 + r2 -
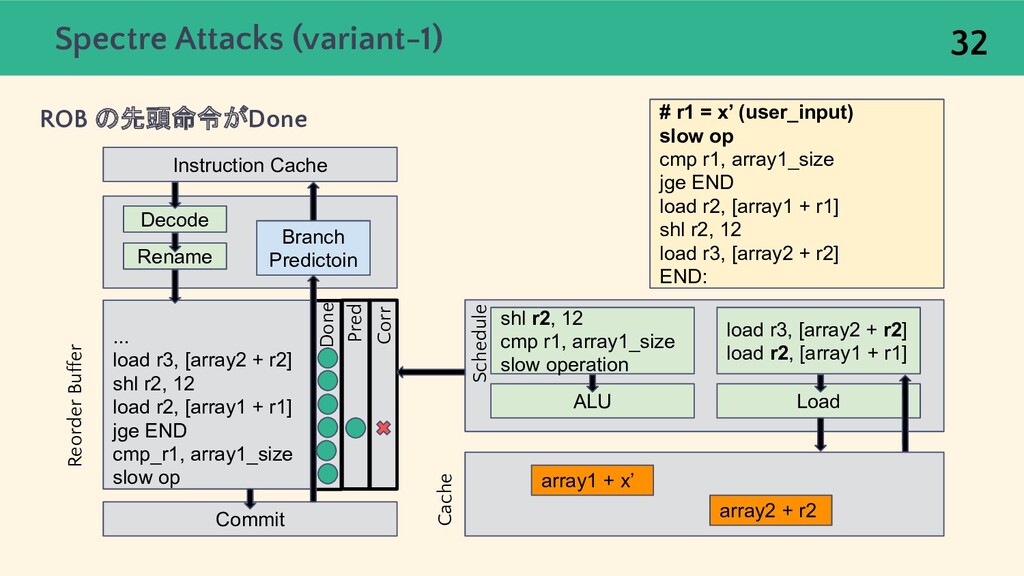
Spectre Attacks (variant-1) ROB の先頭命令がDone 32 Instruction Cache ... load
r3, [array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END cmp_r1, array1_size slow op Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr array1 + x’ array2 + r2 -
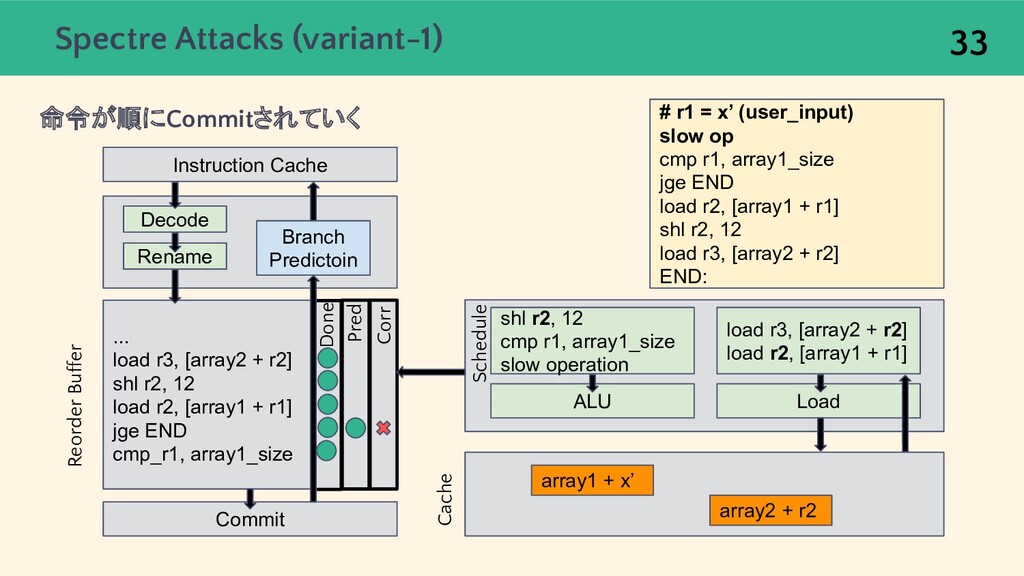
Spectre Attacks (variant-1) 命令が順にCommitされていく 33 Instruction Cache ... load r3,
[array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END cmp_r1, array1_size Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr array1 + x’ array2 + r2 -
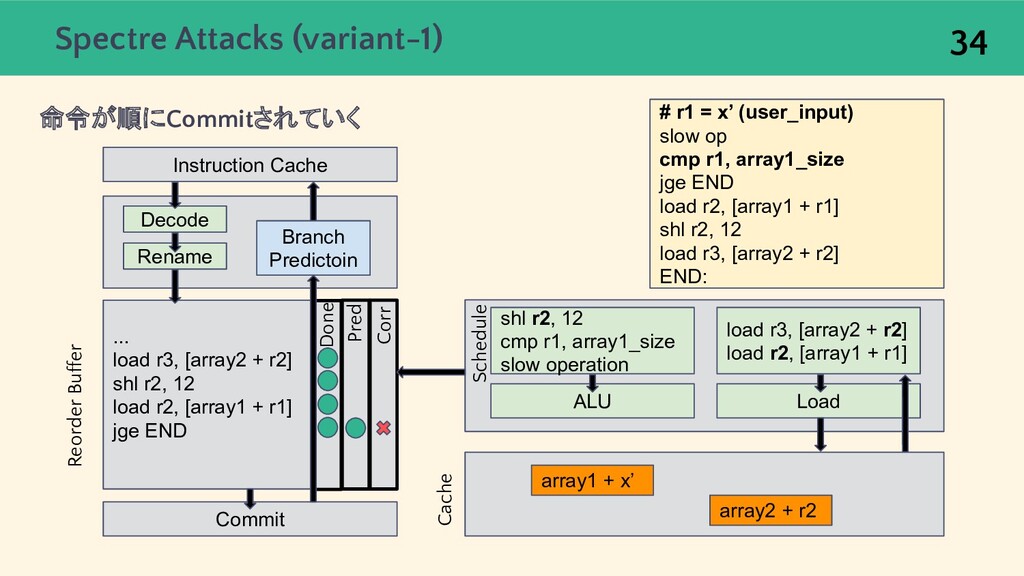
Spectre Attacks (variant-1) 命令が順にCommitされていく 34 Instruction Cache ... load r3,
[array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr array1 + x’ array2 + r2 -
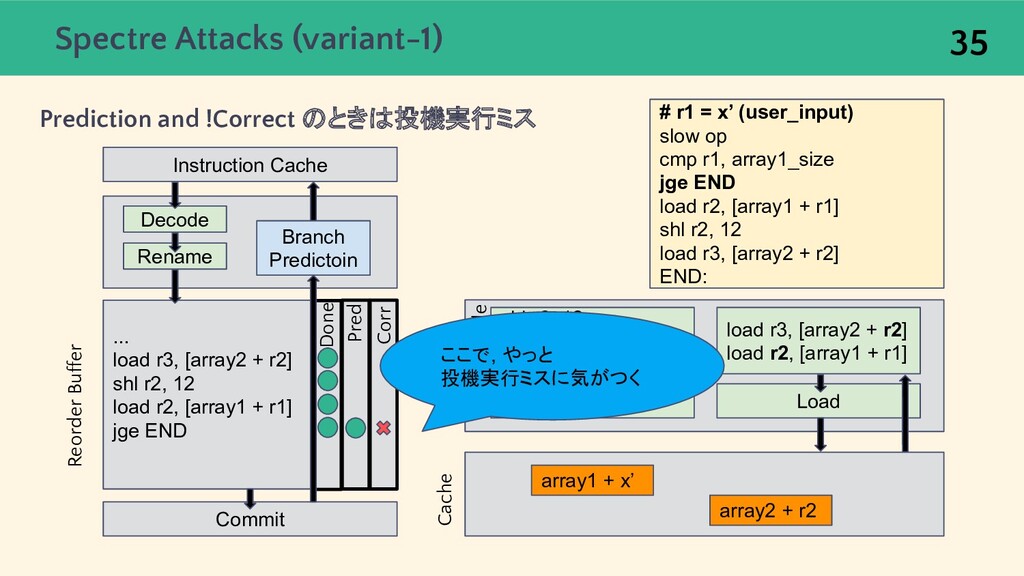
Spectre Attacks (variant-1) Prediction and !Correct のときは投機実行ミス 35 Instruction Cache
... load r3, [array2 + r2] shl r2, 12 load r2, [array1 + r1] jge END Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr ここで, やっと 投機実行ミスに気がつく array1 + x’ array2 + r2 -
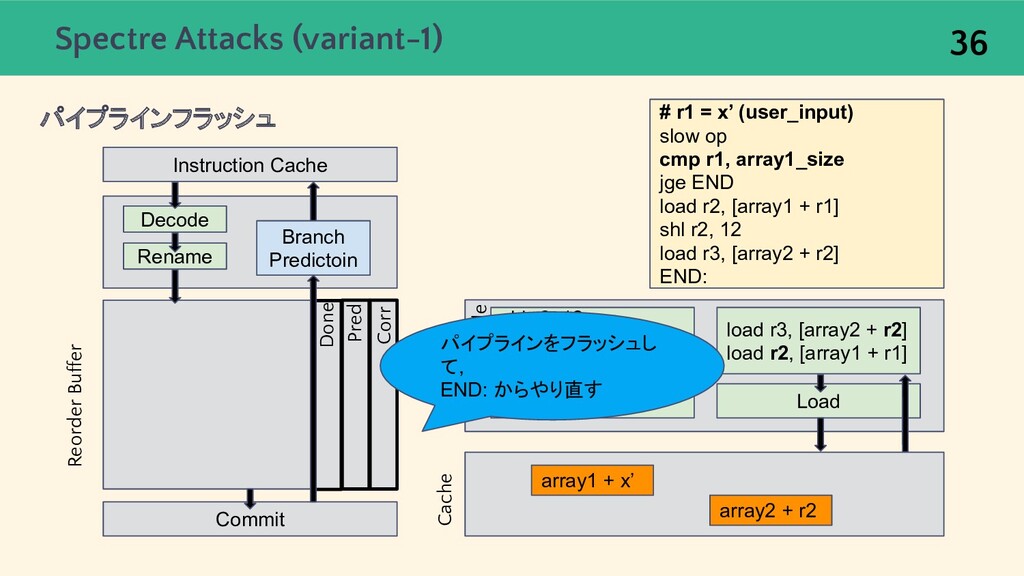
Spectre Attacks (variant-1) パイプラインフラッシュ 36 Instruction Cache Commit # r1
= x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr パイプラインをフラッシュし て, END: からやり直す array1 + x’ array2 + r2 -
Spectre Attacks (variant-1) Flush + Reload で [array1 + r1]
(=r2) の値を復元 37 Instruction Cache Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr array2 + 0, 1, 2, …, 0xff と順にアクセスすることで , r2 の値を復元できる array1 + x’ array2 + r2 -
Spectre Attacks (variant-1) Flush + Reload で [array1 + r1]
(=r2) の値を復元 38 Instruction Cache Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr [array2 + 0] にアクセス! 遅い... array1 + x’ array2 + r2 array2 + 0 -
Spectre Attacks (variant-1) Flush + Reload で [array1 + r1]
(=r2) の値を復元 39 Instruction Cache Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr [array2 + 1] にアクセス! 遅い... array1 + x’ array2 + r2 array2 + 1 array2 + 0 -
Spectre Attacks (variant-1) Flush + Reload で [array1 + r1]
(=r2) の値を復元 40 Instruction Cache Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr [array2 + 2] にアクセス! 速い!! r2の値は 0x2 だ!! [array1+r2] = 0x2 !! array1 + x’ array2 + 2 array2 + 1 array2 + 0 -
Spectre Attacks (variant-1) Flush + Reload で [array1 + r1]
(=r2) の値を復元 41 Instruction Cache Commit # r1 = x’ (user_input) slow op cmp r1, array1_size jge END load r2, [array1 + r1] shl r2, 12 load r3, [array2 + r2] END: Reorder Buffer Decode Rename Branch Predictoin ALU Load shl r2, 12 cmp r1, array1_size slow operation load r3, [array2 + r2] load r2, [array1 + r1] Schedule Cache Done Pred Corr [array2 + 2] にアクセス! 速い!! r2の値は 0x2 だ!! [array1+r2] = 0x2 !! array1 + x’ array2 + 2 array2 + 1 array2 + 0 array2 + 0 論理的に読めるはずのない array1[x’] (x’ >= array1_size) の値を読むことができた. array1[x’] に 入っている secret key を 読み出すことができる. -
Spectre Mitigation ソフトウェアによる対策 • Load の前に Fence 命令を入れる ◦ Fence
の前の命令は Fence 命令自体がCommitされるまでデコードされな い ◦ パフォーマンスオーバーヘッドが10倍 42 -
Spectre Mitigation ハードウェアによる対策 • マイクロアーキテクチャ状態も復元する ◦ SafeSpec [7] ▪ Cache
や TLB を複数用意して, 投機実行のときはそれを利用する ▪ ハードウェアが複雑になる • ISA 自体に手を加える ◦ Data Oblivious ISA extension [8] 43 -
Agenda 導入 44 導入 背景 知識 実装 方法 この論文について Microarchitectural
攻撃 Spectre 攻撃・対策 Context Sensitive Decoding (CSD) Dynamic Information Flow Tracking (DIFT) アーキテクチャの全体像 新しいFence命令の導入 Decoder-Level Information Flow Tracking (DLIFT) 結果 Context-Sensitive Fencing の評価 -
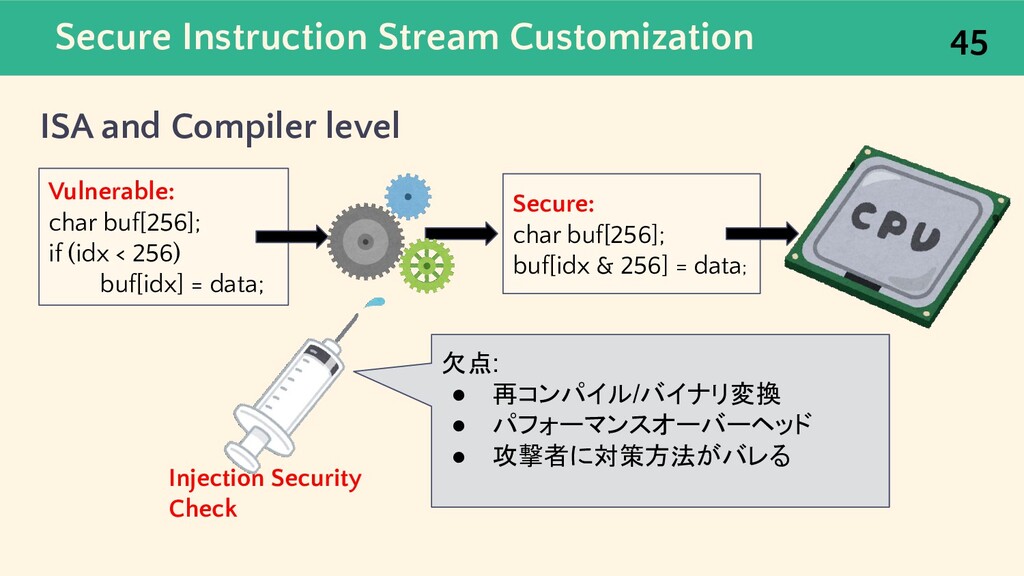
Secure Instruction Stream Customization ISA and Compiler level 45 Vulnerable:
char buf[256]; if (idx < 256) buf[idx] = data; Secure: char buf[256]; buf[idx & 256] = data; 欠点: • 再コンパイル/バイナリ変換 • パフォーマンスオーバーヘッド • 攻撃者に対策方法がバレる Injection Security Check -
Secure Instruction Stream Customization microcode level 46 Vulnerable: char buf[256];
if (idx < 256) buf[idx] = data; 長所: • 動的 • 攻撃者に対策方法が見えない Injection Security Check -
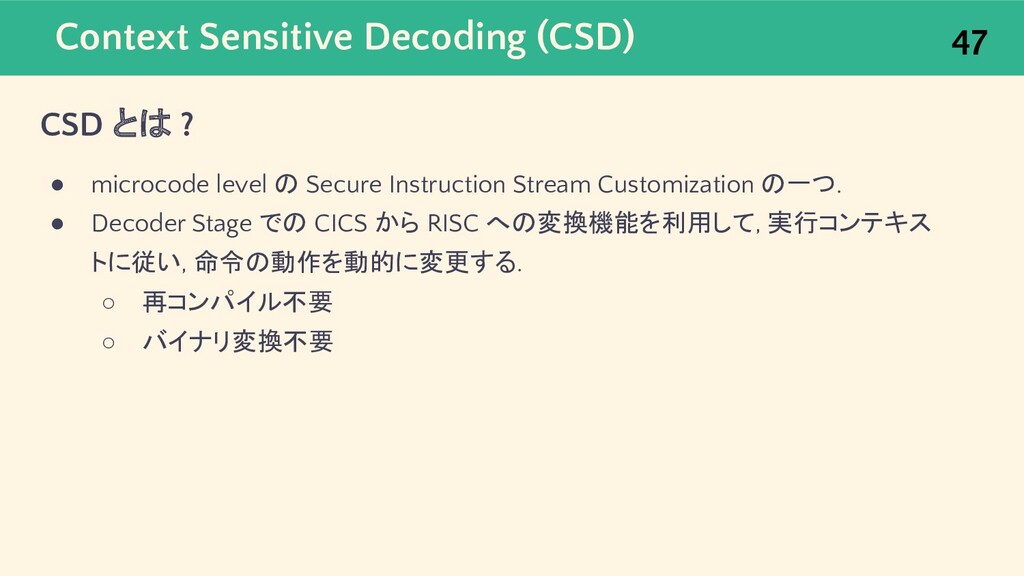
Context Sensitive Decoding (CSD) CSD とは ? • microcode level
の Secure Instruction Stream Customization の一つ. • Decoder Stage での CICS から RISC への変換機能を利用して, 実行コンテキス トに従い, 命令の動作を動的に変更する. ◦ 再コンパイル不要 ◦ バイナリ変換不要 47 -
Context Sensitive Decoding (CSD) micro-ops への変換方法 (inc [0xbeef] が Fetch
されたとき) 48 Fetch Decoder Execute Write Back add t0, t0, 1 ld t0, [0xbeef] st [0xbeef], t0 パフォーマンス -
Context Sensitive Decoding (CSD) micro-ops への変換方法 (inc [0xbeef] が Fetch
されたとき) 49 Fetch Decoder Execute Write Back add t0, t0, 1 ld t0, [0xbeef] st [0xbeef], t0 security check1 security check2 セキュリティ -
Agenda 導入 50 導入 背景 知識 実装 方法 この論文について Microarchitectural
攻撃 Spectre 攻撃・対策 Context Sensitive Decoding (CSD) Dynamic Information Flow Tracking (DIFT) アーキテクチャの全体像 新しいFence命令の導入 Decoder-Level Information Flow Tracking (DLIFT) 結果 Context-Sensitive Fencing の評価 -
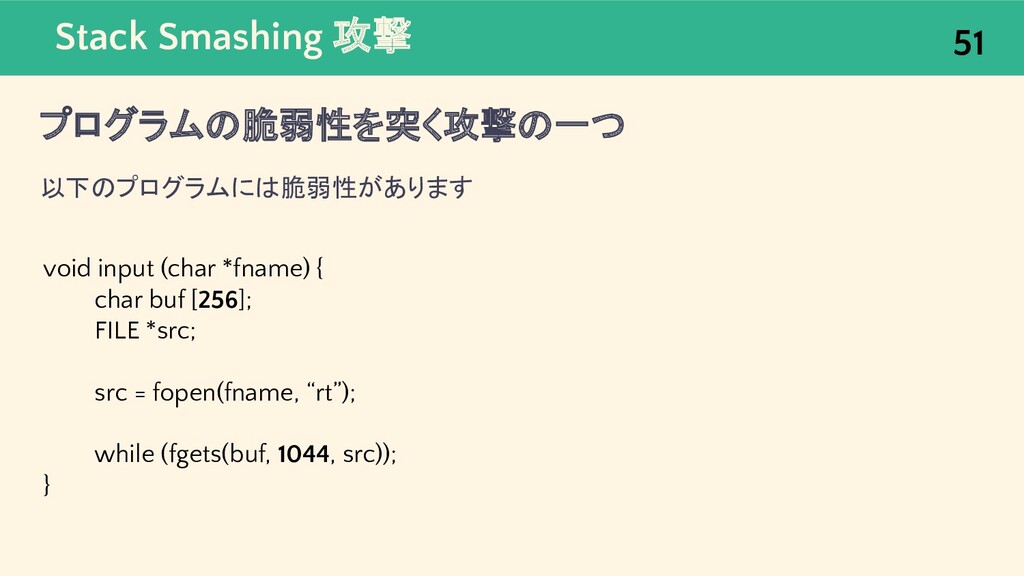
Stack Smashing 攻撃 プログラムの脆弱性を突く攻撃の一つ 以下のプログラムには脆弱性があります 51 void input (char *fname)
{ char buf [256]; FILE *src; src = fopen(fname, “rt”); while (fgets(buf, 1044, src)); } -
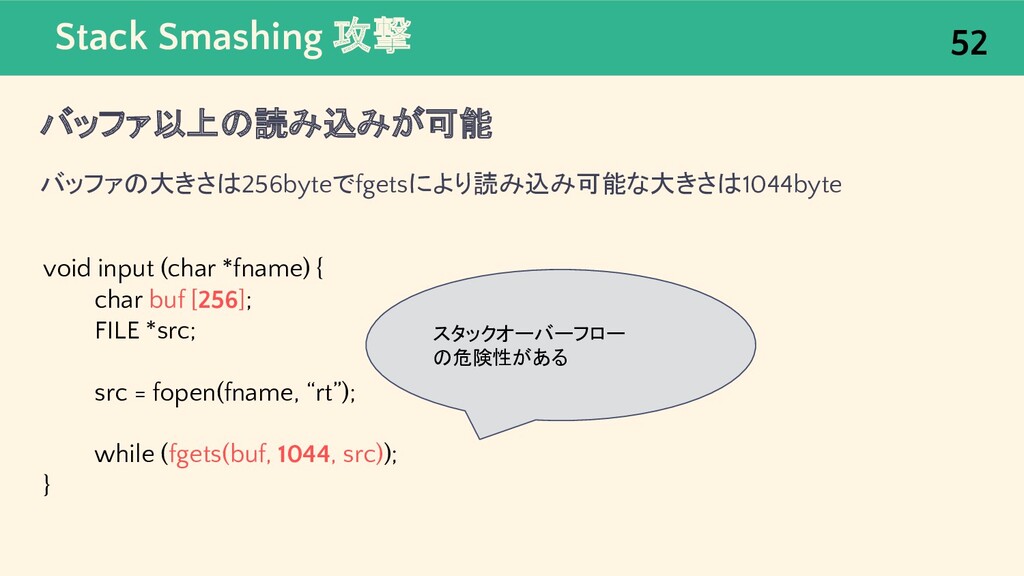
Stack Smashing 攻撃 バッファ以上の読み込みが可能 バッファの大きさは256byteでfgetsにより読み込み可能な大きさは1044byte 52 void input (char *fname)
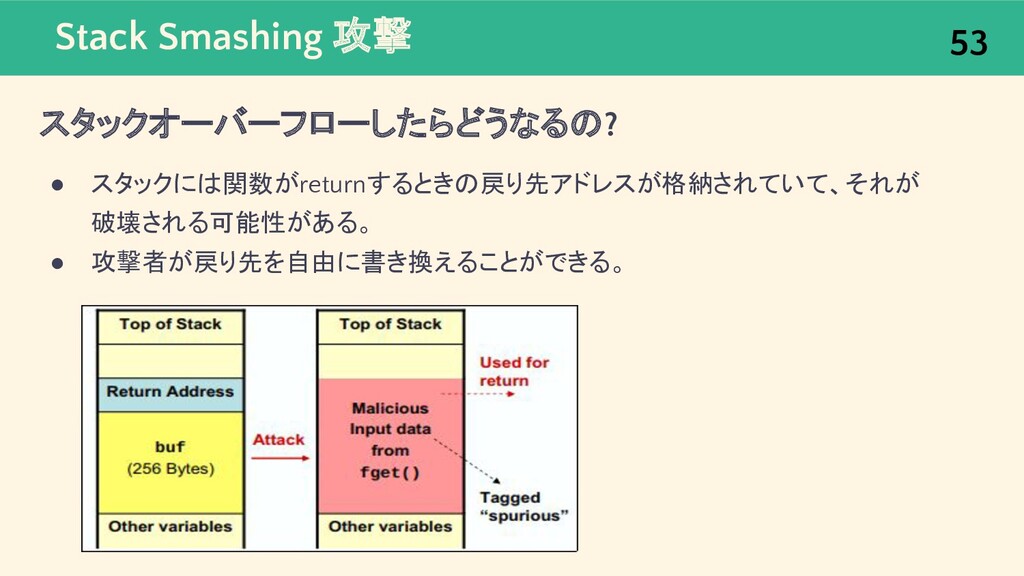
{ char buf [256]; FILE *src; src = fopen(fname, “rt”); while (fgets(buf, 1044, src)); } スタックオーバーフロー の危険性がある -
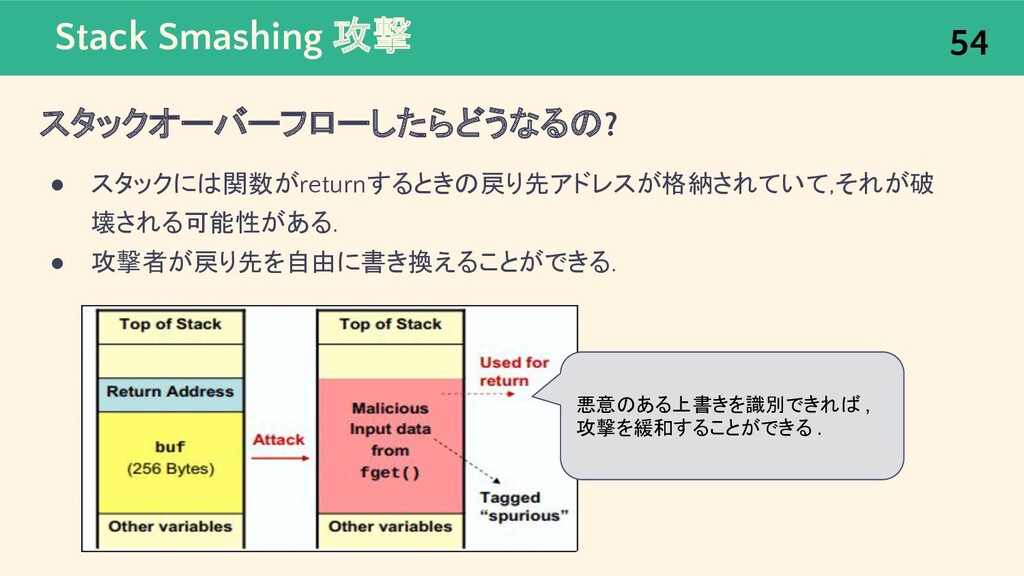
Stack Smashing 攻撃 スタックオーバーフローしたらどうなるの? • スタックには関数がreturnするときの戻り先アドレスが格納されていて,それが破 壊される可能性がある. • 攻撃者が戻り先を自由に書き換えることができる. 54
悪意のある上書きを識別できれば , 攻撃を緩和することができる . -
Dynamic Informatin Flow Tracking (DIFT) ソフトウェア脆弱性を突く攻撃に対する対策法 アイデア: 信用できないI/Oからシステムに入ってきたデータを動的に追跡して, そのデータを利用した実行が行われるときに安全化どうかを確認する. 実装方法:
OSは悪意のある入力チャンネルを識別し, プロセッサがそのチャンネルから入力されたデータのフローを追跡する. 55 -
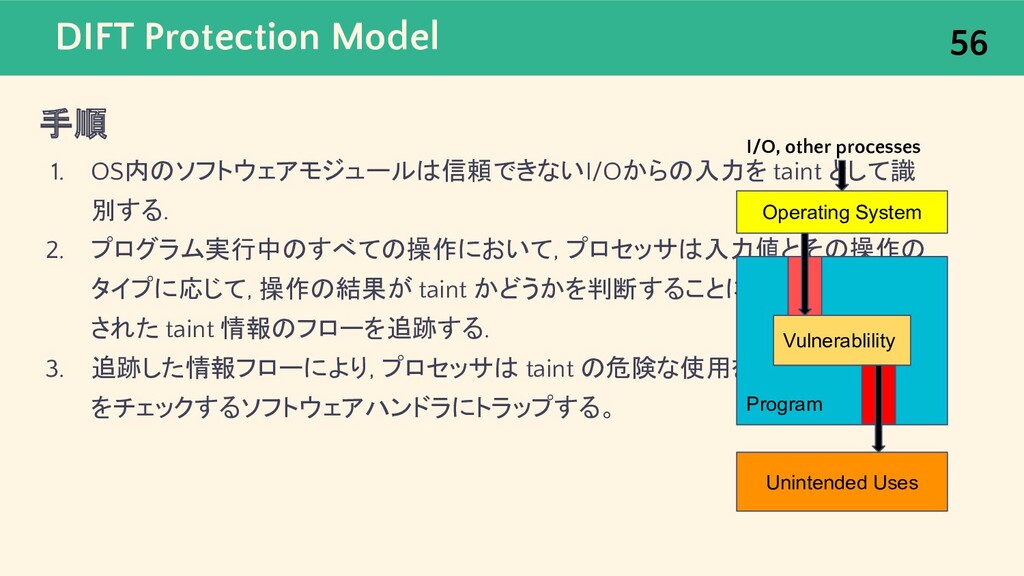
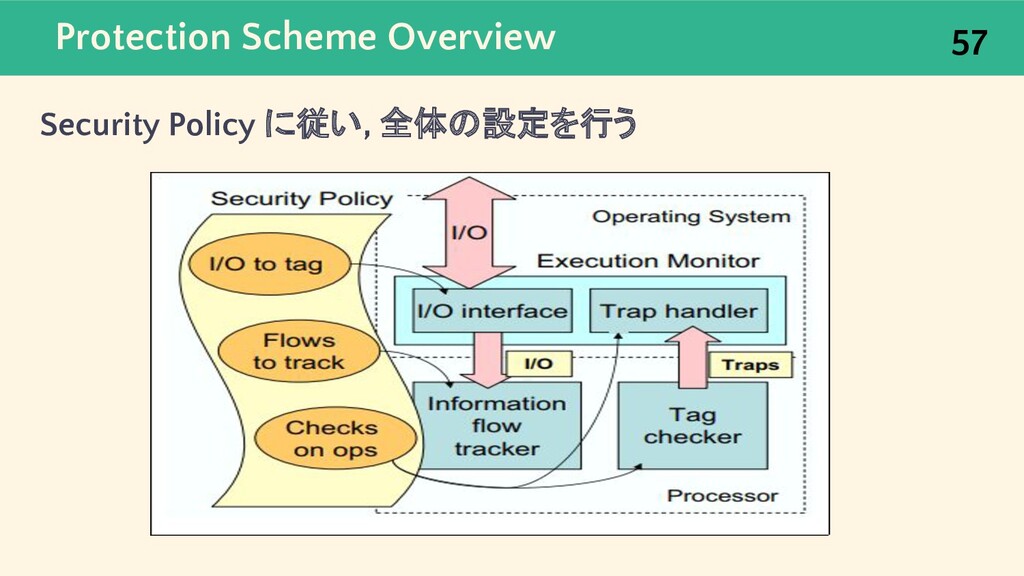
DIFT Protection Model 手順 1. OS内のソフトウェアモジュールは信頼できないI/Oからの入力を taint として識 別する. 2.
プログラム実行中のすべての操作において, プロセッサは入力値とその操作の タイプに応じて, 操作の結果が taint かどうかを判断することにより, 生成・コピー された taint 情報のフローを追跡する. 3. 追跡した情報フローにより, プロセッサは taint の危険な使用を検出し, その使用 をチェックするソフトウェアハンドラにトラップする。 56 Operating System Program Vulnerablility Unintended Uses I/O, other processes -
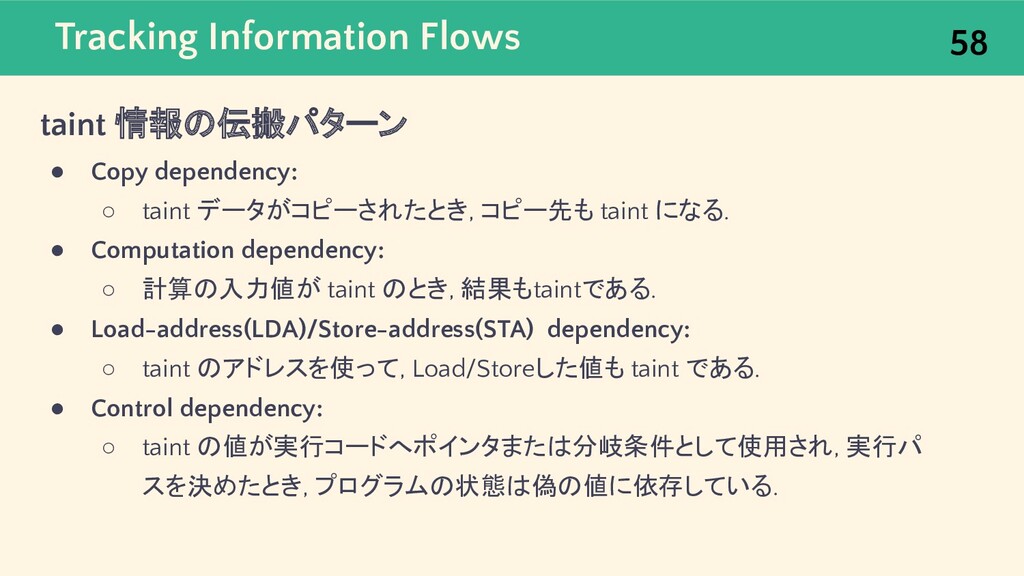
Tracking Information Flows taint 情報の伝搬パターン • Copy dependency: ◦ taint
データがコピーされたとき, コピー先も taint になる. • Computation dependency: ◦ 計算の入力値が taint のとき, 結果もtaintである. • Load-address(LDA)/Store-address(STA) dependency: ◦ taint のアドレスを使って, Load/Storeした値も taint である. • Control dependency: ◦ taint の値が実行コードへポインタまたは分岐条件として使用され, 実行パ スを決めたとき, プログラムの状態は偽の値に依存している. 58 -
Agenda 導入 59 導入 背景 知識 実装 方法 この論文について Microarchitectural
攻撃 Spectre 攻撃・対策 Context Sensitive Decoding (CSD) Dynamic Information Flow Tracking (DIFT) アーキテクチャの全体像 新しいFence命令の導入 Decoder-Level Information Flow Tracking (DLIFT) 結果 Context-Sensitive Fencing の評価 -
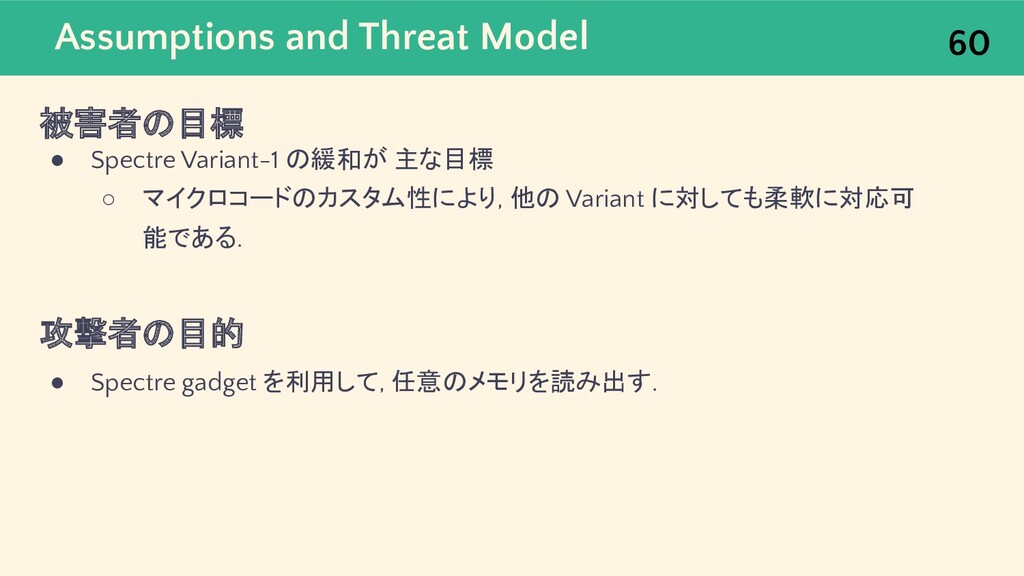
Assumptions and Threat Model 被害者の目標 • Spectre Variant-1 の緩和が 主な目標
◦ マイクロコードのカスタム性により, 他の Variant に対しても柔軟に対応可 能である. 攻撃者の目的 • Spectre gadget を利用して, 任意のメモリを読み出す. 60 -
Assumptions and Threat Model 攻撃者の条件 • Covert Channelを通して情報を抜き取ることができる ◦ Probe,
Flush, Evict でマイクロアーキテクチャ状態を操作できる ◦ rdtscで正確な時間が測定できる • 攻撃者と被害者はマイクロアーキテクチャ状態を共有している ◦ L3 Cache ◦ 分岐予測器 • ユーザ権限で動いている ◦ システムコール呼び出しができる ◦ キーボードやネットワークにアクセスできる 61 -
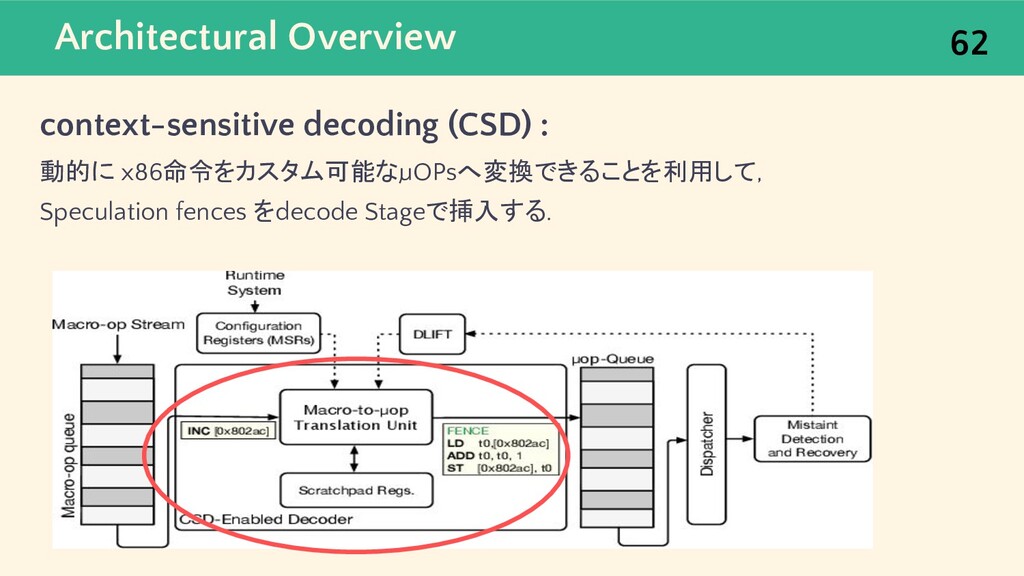
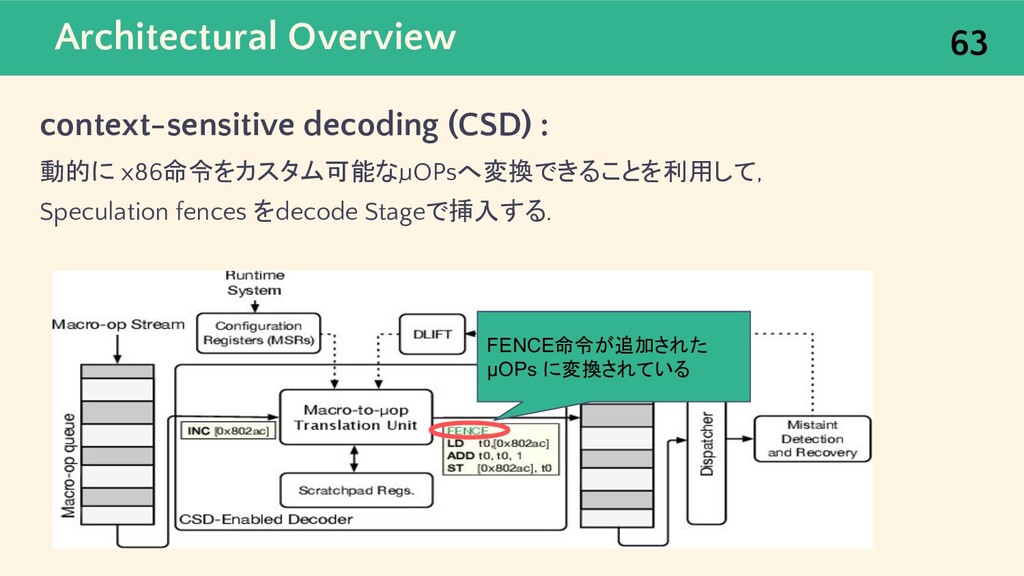
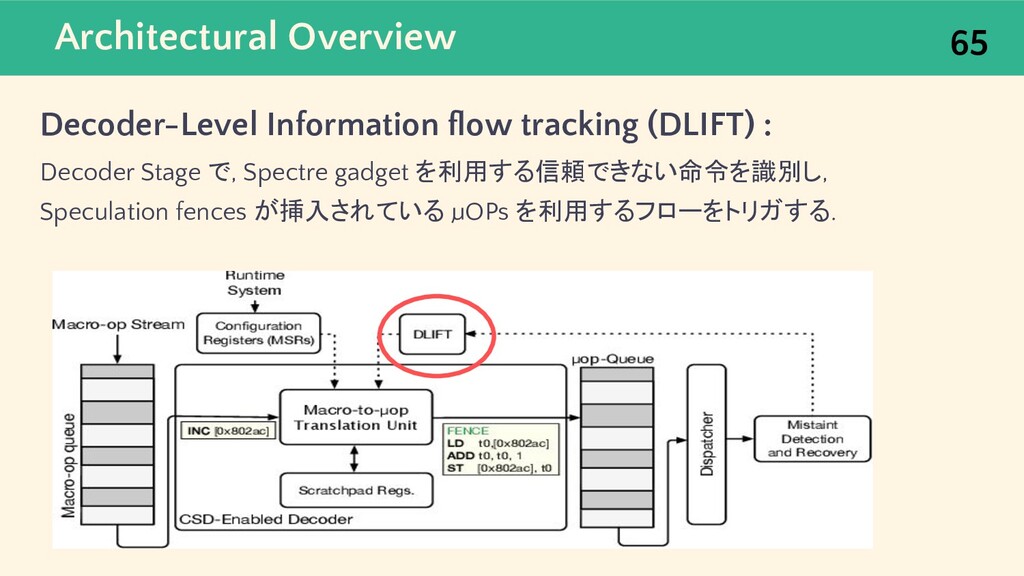
Architectural Overview context-sensitive decoding (CSD) : 動的に x86命令をカスタム可能なμOPsへ変換できることを利用して, Speculation fences
をdecode Stageで挿入する. 63 FENCE命令が追加された μOPs に変換されている -
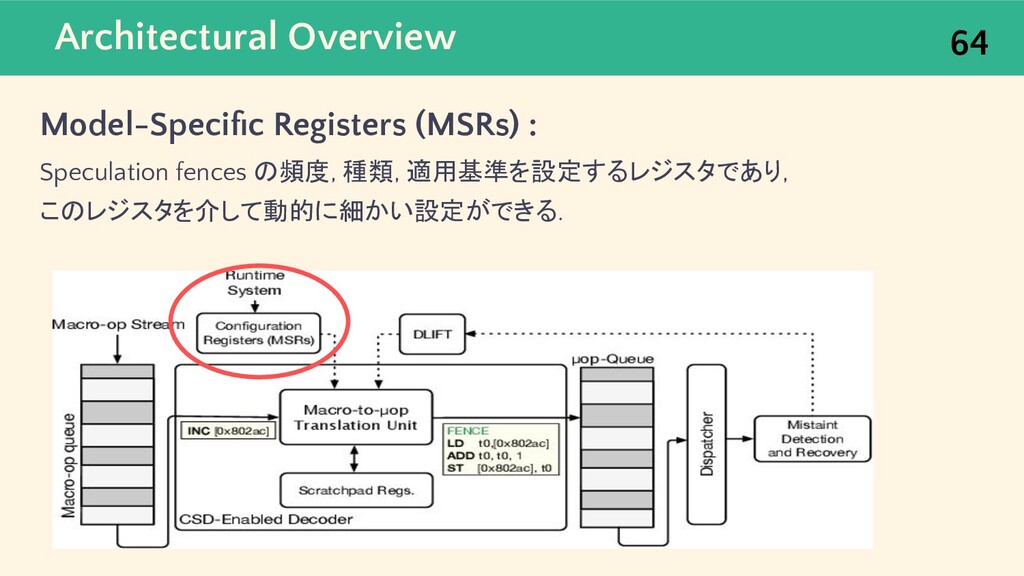
Architectural Overview Model-Specific Registers (MSRs) : Speculation fences の頻度, 種類,
適用基準を設定するレジスタであり, このレジスタを介して動的に細かい設定ができる. 64 -
Architectural Overview Decoder-Level Information flow tracking (DLIFT) : Decoder Stage
で, Spectre gadget を利用する信頼できない命令を識別し, Speculation fences が挿入されている μOPs を利用するフローをトリガする. 65 -
Agenda 導入 66 導入 背景 知識 実装 方法 この論文について Microarchitectural
攻撃 Spectre 攻撃・対策 Context Sensitive Decoding (CSD) Dynamic Information Flow Tracking (DIFT) アーキテクチャの全体像 新しいFence命令の導入 Decoder-Level Information Flow Tracking (DLIFT) 結果 Context-Sensitive Fencing の評価 -
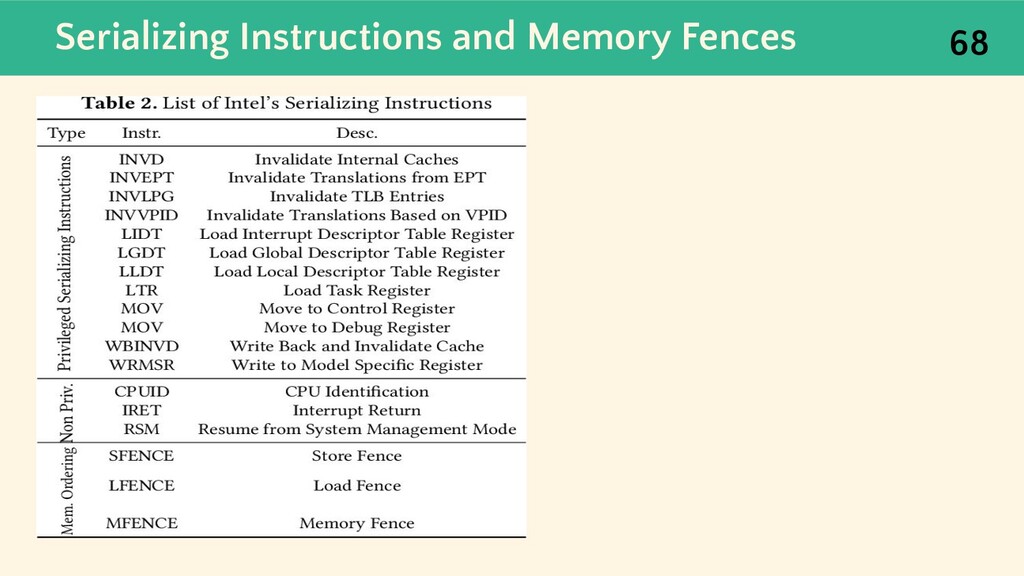
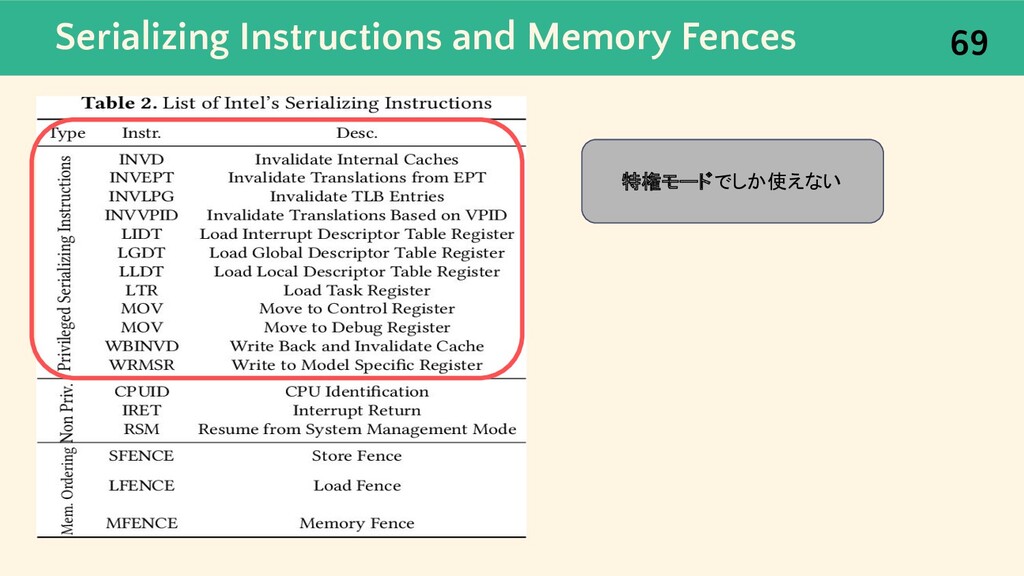
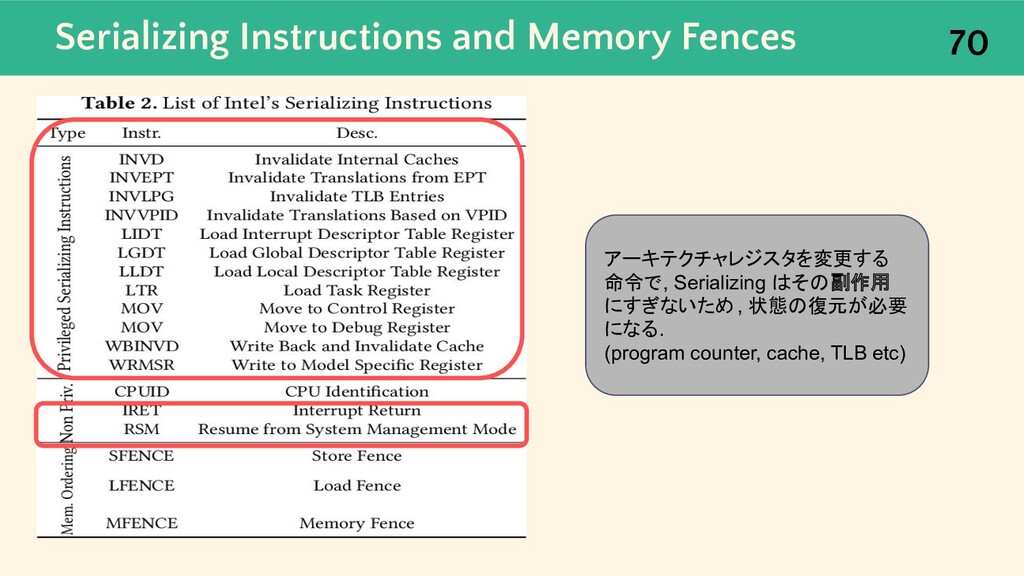
Serializing Instructions and Memory Fences Serializing Instructions: Serializing Instruction がデコードされると,
その Seriazling Instruction より前方の命令がすべて retire されるまで, プロセッサはストールする. Memory Fences: Fence命令より前に存在するメモリ要求をすべて完了するまで, Fence命令の後に現れるメモリ操作命令は, すべてストールする. 67 -
Serializing Instructions and Memory Fences 70 アーキテクチャレジスタを変更する 命令で, Serializing はその副作用
にすぎないため, 状態の復元が必要 になる. (program counter, cache, TLB etc) -
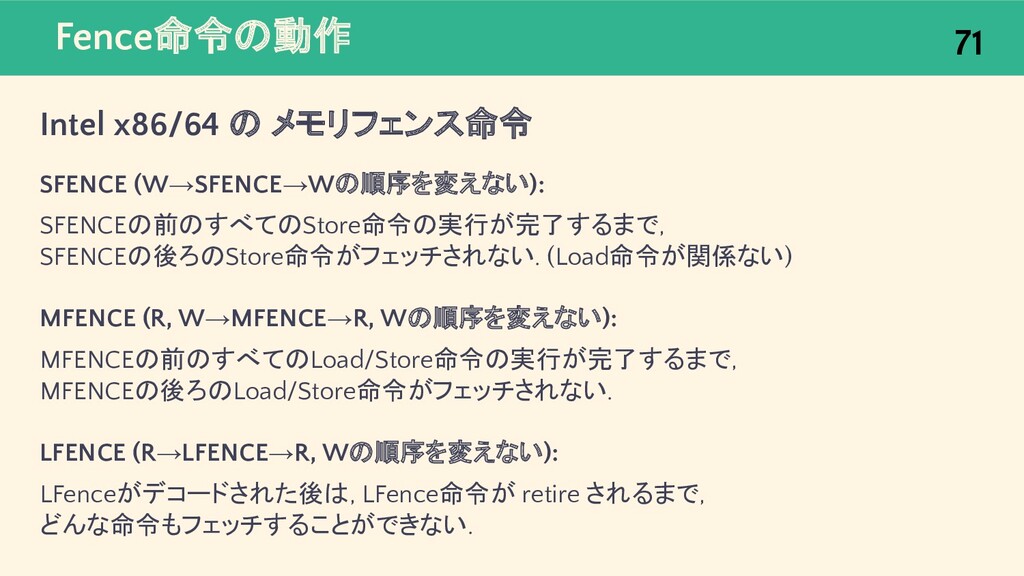
Fence命令の動作 Intel x86/64 の メモリフェンス命令 SFENCE (W→SFENCE→Wの順序を変えない): SFENCEの前のすべてのStore命令の実行が完了するまで, SFENCEの後ろのStore命令がフェッチされない. (Load命令が関係ない)
MFENCE (R, W→MFENCE→R, Wの順序を変えない): MFENCEの前のすべてのLoad/Store命令の実行が完了するまで, MFENCEの後ろのLoad/Store命令がフェッチされない. LFENCE (R→LFENCE→R, Wの順序を変えない): LFenceがデコードされた後は, LFence命令が retire されるまで, どんな命令もフェッチすることができない. 71 -
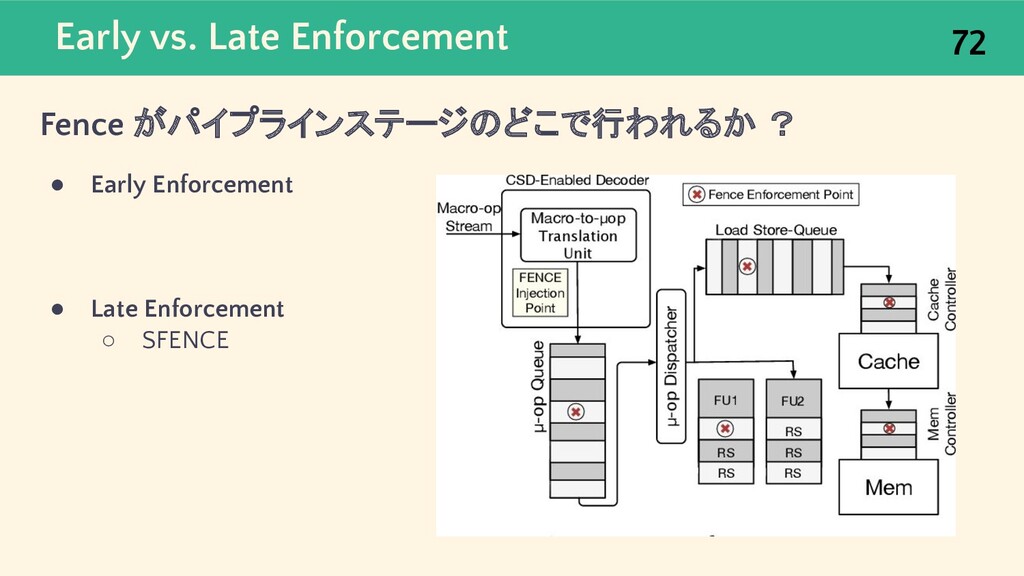
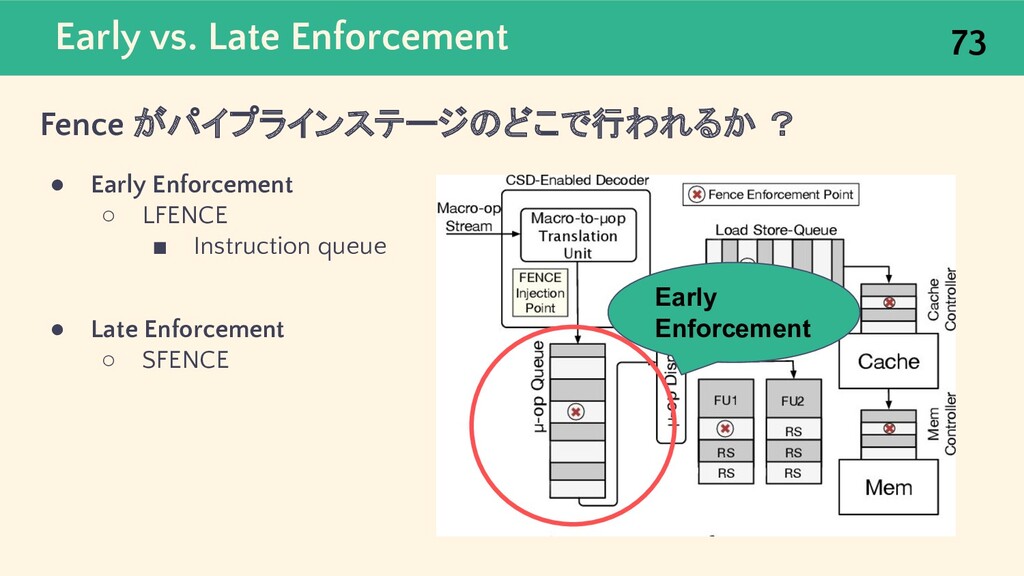
Early vs. Late Enforcement Fence がパイプラインステージのどこで行われるか ? • Early Enforcement
• Late Enforcement ◦ SFENCE 72 -
Early vs. Late Enforcement Fence がパイプラインステージのどこで行われるか ? • Early Enforcement
◦ LFENCE ▪ Instruction queue • Late Enforcement ◦ SFENCE 73 Early Enforcement -
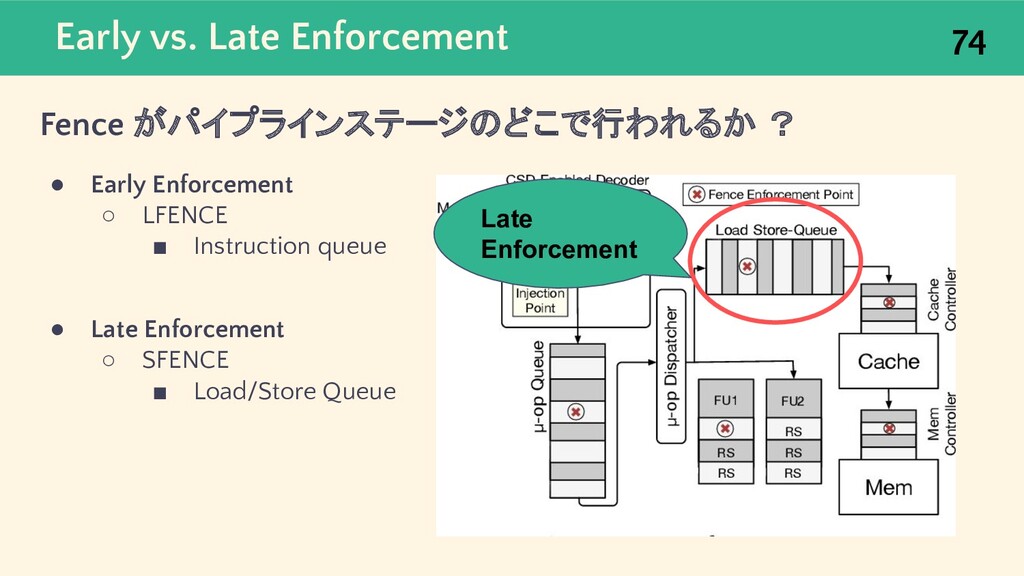
Early vs. Late Enforcement Fence がパイプラインステージのどこで行われるか ? • Early Enforcement
◦ LFENCE ▪ Instruction queue • Late Enforcement ◦ SFENCE ▪ Load/Store Queue 74 Late Enforcement -
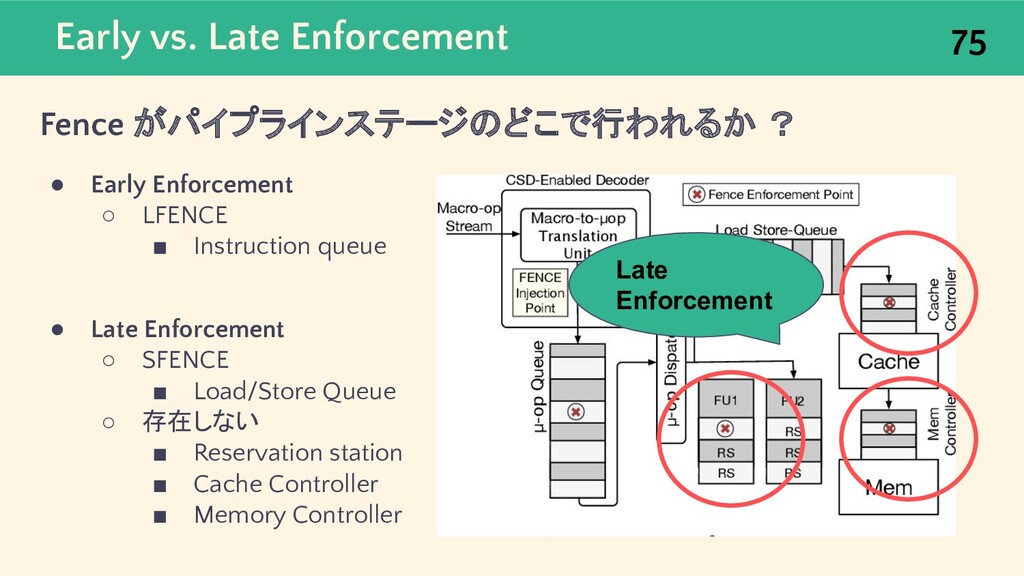
Early vs. Late Enforcement Fence がパイプラインステージのどこで行われるか ? • Early Enforcement
◦ LFENCE ▪ Instruction queue • Late Enforcement ◦ SFENCE ▪ Load/Store Queue ◦ 存在しない ▪ Reservation station ▪ Cache Controller ▪ Memory Controller 75 Late Enforcement -
Early vs. Late Enforcement Late Enforcement の長所と短所 長所: • Early
Enforcement に比べて, パイプラインを止める位置が後段になるので, パ フォーマンス低下が少ない. • より粒度の細かい Fence が可能になる. 短所: • Early Fence に比べて, 防げるサイドチャネル攻撃が減る. ◦ Cache Controller で行う場合, Instruction Queue に対する攻撃は防げな い. 76 -
Strict vs. Relaxed Enforcement Fence 後のどんな種類の命令の実行を許可するか? • Strict Enforcement ◦
Fence 命令がリタイアするまでどんな命令の実行も許可しない ▪ LFENCE • どんな種類の命令の実行も許可しない • Relaxed Enforcement ◦ 特定の種類の命令を実行できる ▪ SFENCE • Store 命令以外の実行を許可する 77 -
Early vs. Late Commit いつまで命令を Fence するか ? 改善点: device
synchronization または memory ordering enforcement のために, 先行する store が write back されるまで fence 命令はCommitされないが, store 命令が retire するまで(storeの投機的実行が正しいとわかるまで), write buffer は Cache にコミットされないので, Speculation Fence は 前方の Store 命令が retireするまで待つは必要ない. 解決策: 先行する store が Cache に write back されるのを待たずに, Fence 命令を早く Commit できるようにして, 後続の命令の実行をより早く再開できるようにする. 78 -
Early vs. Late Commit いつまで命令を Fence するか ? 改善点: device
synchronization または memory ordering enforcement のために, 先行する store が write back されるまで fence 命令はCommitされないが, store 命令が retire するまで(storeの投機的実行が正しいとわかるまで), write buffer は Cache にコミットされないので, Speculation Fence は 前方の Store 命令が retireするまで待つは必要ない. 解決策: 先行する store が Cache に write back されるのを待たずに, Fence 命令を早く Commit できるようにして, 後続の命令の実行をより早く再開できるようにする. 79 注意: synchronization のために これを利用してはだめ ! -
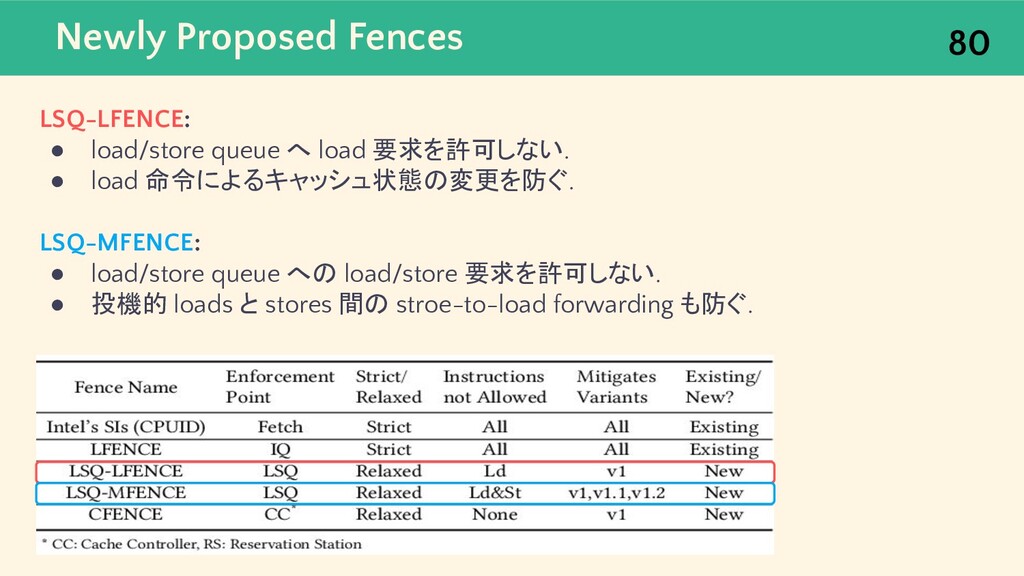
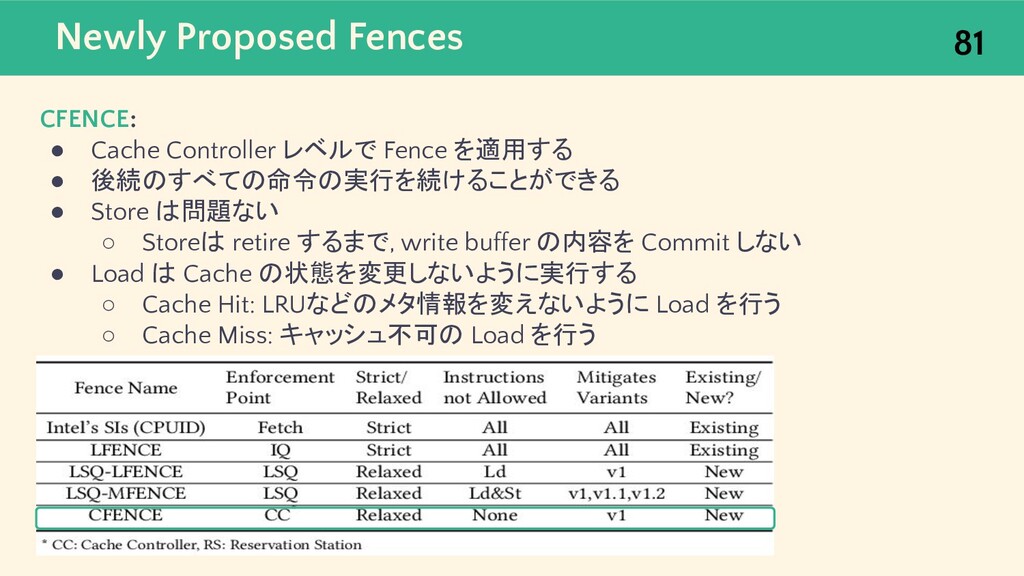
Newly Proposed Fences LSQ-LFENCE: • load/store queue へ load 要求を許可しない.
• load 命令によるキャッシュ状態の変更を防ぐ. LSQ-MFENCE: • load/store queue への load/store 要求を許可しない. • 投機的 loads と stores 間の stroe-to-load forwarding も防ぐ. 80 -
Newly Proposed Fences CFENCE: • Cache Controller レベルで Fence を適用する
• 後続のすべての命令の実行を続けることができる • Store は問題ない ◦ Storeは retire するまで, write buffer の内容を Commit しない • Load は Cache の状態を変更しないように実行する ◦ Cache Hit: LRUなどのメタ情報を変えないように Load を行う ◦ Cache Miss: キャッシュ不可の Load を行う 81 -
Agenda 導入 82 導入 背景 知識 実装 方法 この論文について Microarchitectural
攻撃 Spectre 攻撃・対策 Context Sensitive Decoding (CSD) Dynamic Information Flow Tracking (DIFT) アーキテクチャの全体像 新しいFence命令の導入 Decoder-Level Information Flow Tracking (DLIFT) 結果 Context-Sensitive Fencing の評価 -
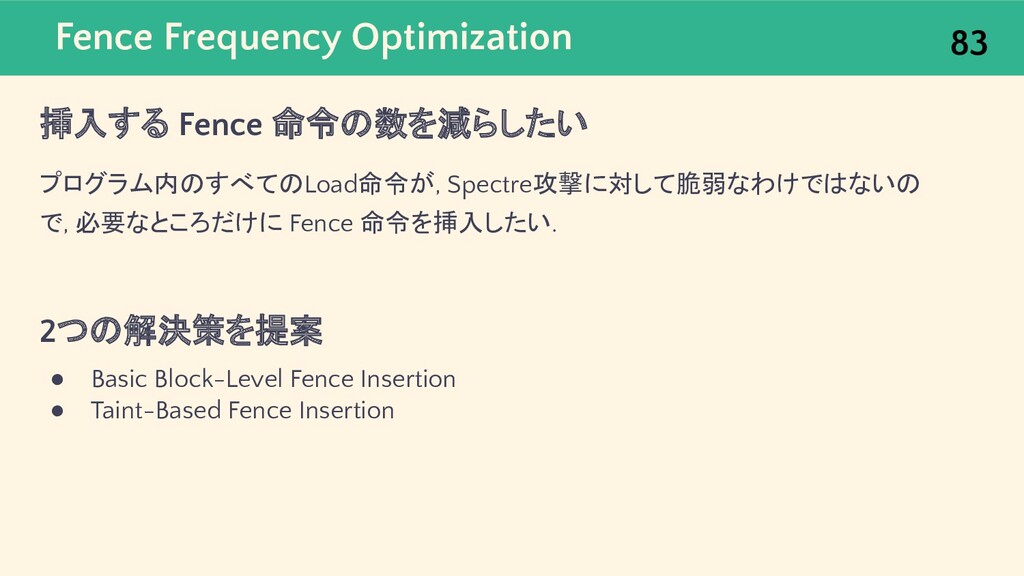
Fence Frequency Optimization 挿入する Fence 命令の数を減らしたい プログラム内のすべてのLoad命令が, Spectre攻撃に対して脆弱なわけではないの で, 必要なところだけに
Fence 命令を挿入したい. 2つの解決策を提案 • Basic Block-Level Fence Insertion • Taint-Based Fence Insertion 83 -
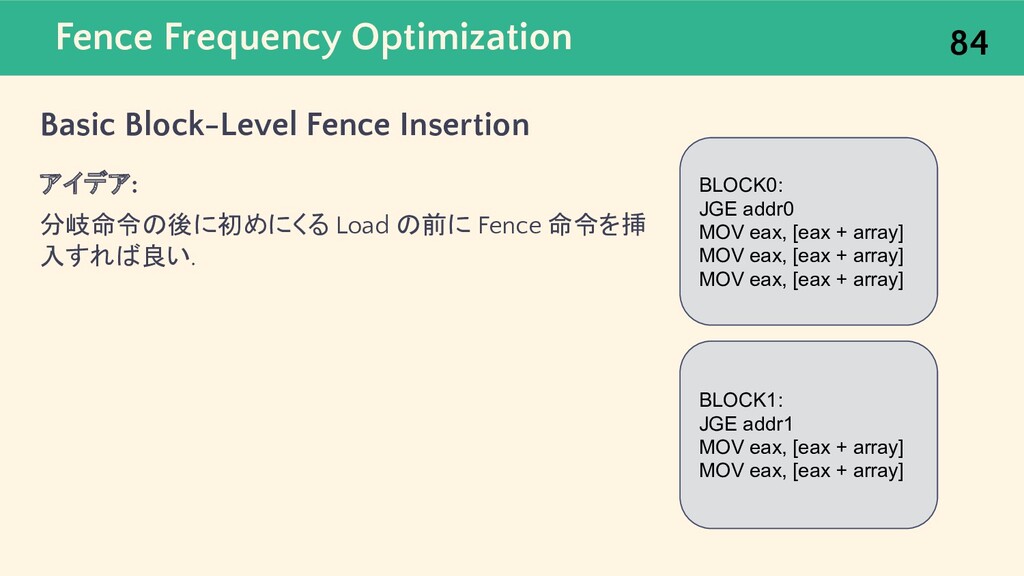
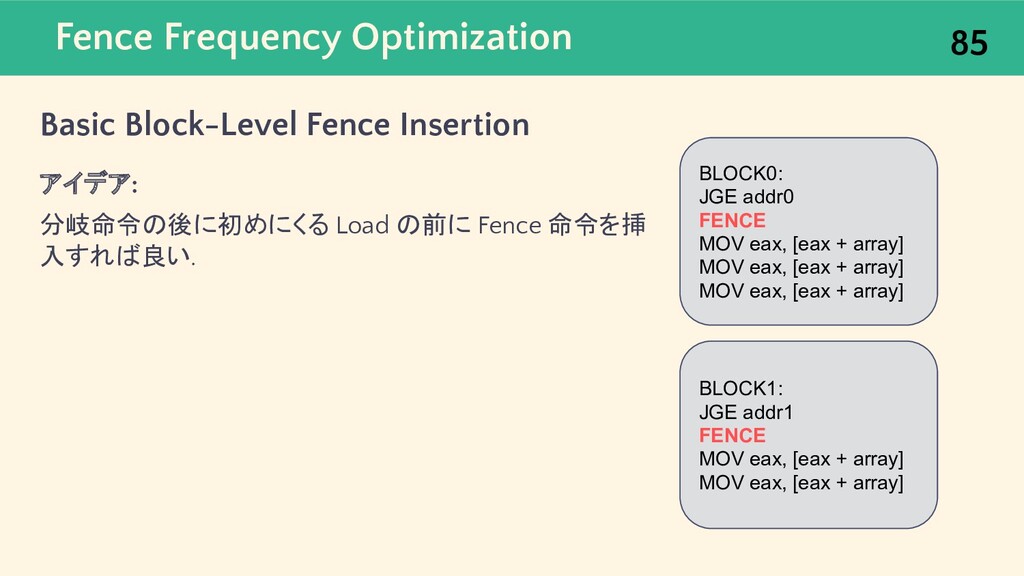
Fence Frequency Optimization Basic Block-Level Fence Insertion アイデア: 分岐命令の後に初めにくる Load
の前に Fence 命令を挿 入すれば良い. 84 BLOCK0: JGE addr0 MOV eax, [eax + array] MOV eax, [eax + array] MOV eax, [eax + array] BLOCK1: JGE addr1 MOV eax, [eax + array] MOV eax, [eax + array] -
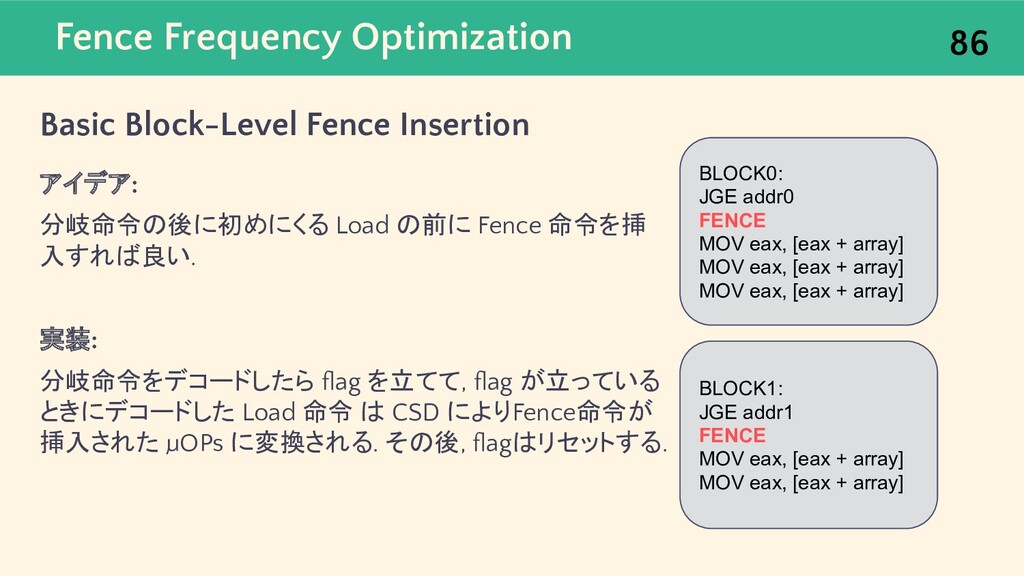
Fence Frequency Optimization Basic Block-Level Fence Insertion アイデア: 分岐命令の後に初めにくる Load
の前に Fence 命令を挿 入すれば良い. 85 BLOCK0: JGE addr0 FENCE MOV eax, [eax + array] MOV eax, [eax + array] MOV eax, [eax + array] BLOCK1: JGE addr1 FENCE MOV eax, [eax + array] MOV eax, [eax + array] -
Fence Frequency Optimization Basic Block-Level Fence Insertion アイデア: 分岐命令の後に初めにくる Load
の前に Fence 命令を挿 入すれば良い. 実装: 分岐命令をデコードしたら flag を立てて, flag が立っている ときにデコードした Load 命令 は CSD によりFence命令が 挿入された μOPs に変換される. その後, flagはリセットする. 86 BLOCK0: JGE addr0 FENCE MOV eax, [eax + array] MOV eax, [eax + array] MOV eax, [eax + array] BLOCK1: JGE addr1 FENCE MOV eax, [eax + array] MOV eax, [eax + array] -
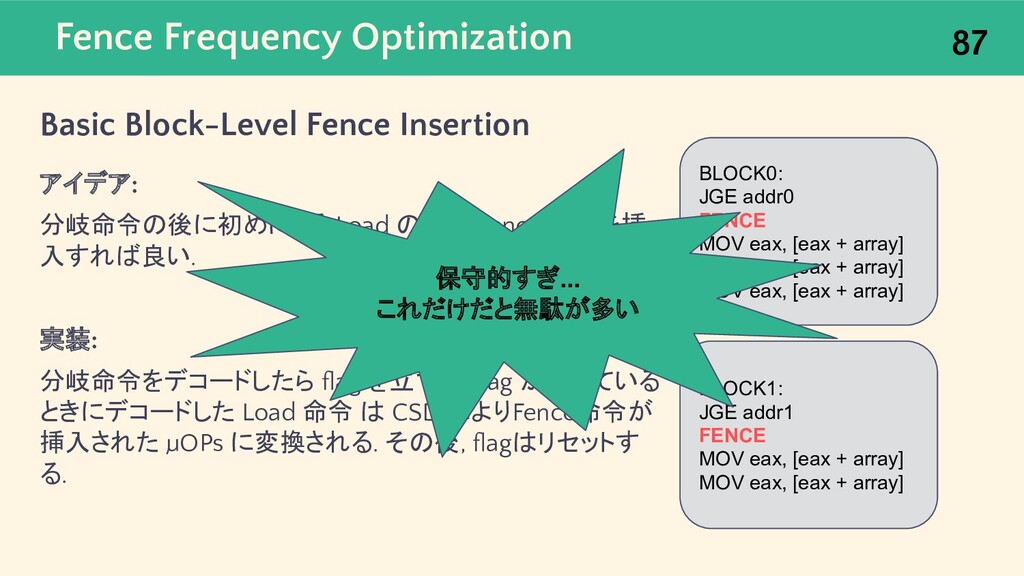
Fence Frequency Optimization Basic Block-Level Fence Insertion アイデア: 分岐命令の後に初めにくる Load
の前に Fence 命令を挿 入すれば良い. 実装: 分岐命令をデコードしたら flag を立てて, flag が立っている ときにデコードした Load 命令 は CSD によりFence命令が 挿入された μOPs に変換される. その後, flagはリセットす る. 87 BLOCK0: JGE addr0 FENCE MOV eax, [eax + array] MOV eax, [eax + array] MOV eax, [eax + array] BLOCK1: JGE addr1 FENCE MOV eax, [eax + array] MOV eax, [eax + array] 保守的すぎ... これだけだと無駄が多い -
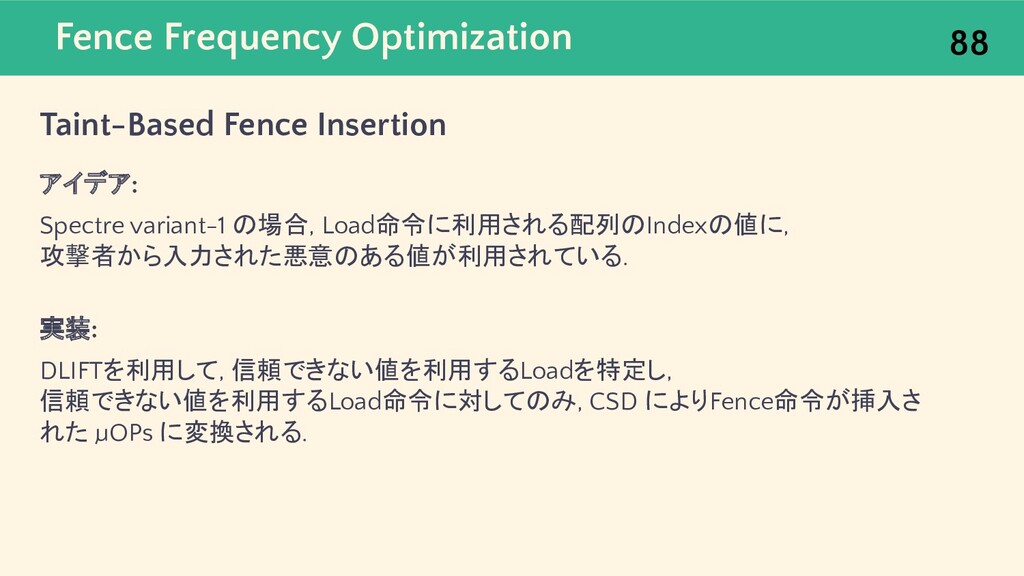
Fence Frequency Optimization Taint-Based Fence Insertion アイデア: Spectre variant-1 の場合,
Load命令に利用される配列のIndexの値に, 攻撃者から入力された悪意のある値が利用されている. 実装: DLIFTを利用して, 信頼できない値を利用するLoadを特定し, 信頼できない値を利用するLoad命令に対してのみ, CSD によりFence命令が挿入さ れた μOPs に変換される. 88 -
Decoder-Level Information Flow Tracking (DLIFT) DLIFTとは? これまでの taint tracking systems
とは異なり, Commit Stage ではなく, Decoder Stage で taint 情報を提供する. なぜ Decoder Stage? Commit Stage で taint を検出したときには, すでにマイクロアーキテクチャに 副作用が及んでいて, 遅すぎる. だから Decoder Stage で行う必要がある. 89 -
Decoder-Level Information Flow Tracking (DLIFT) Decoder Stage での taint 検出は難しい
! Commit の時にしか, 本当に taint 情報が正しいかどうかはわからない. なぜ ? Decoder Stage と Commit Stage は離れており, Decoder Stage で register files から得た traint 情報は, 実際に命令を実行するときの taint 情報とか異なっている場合があるため. 90 -
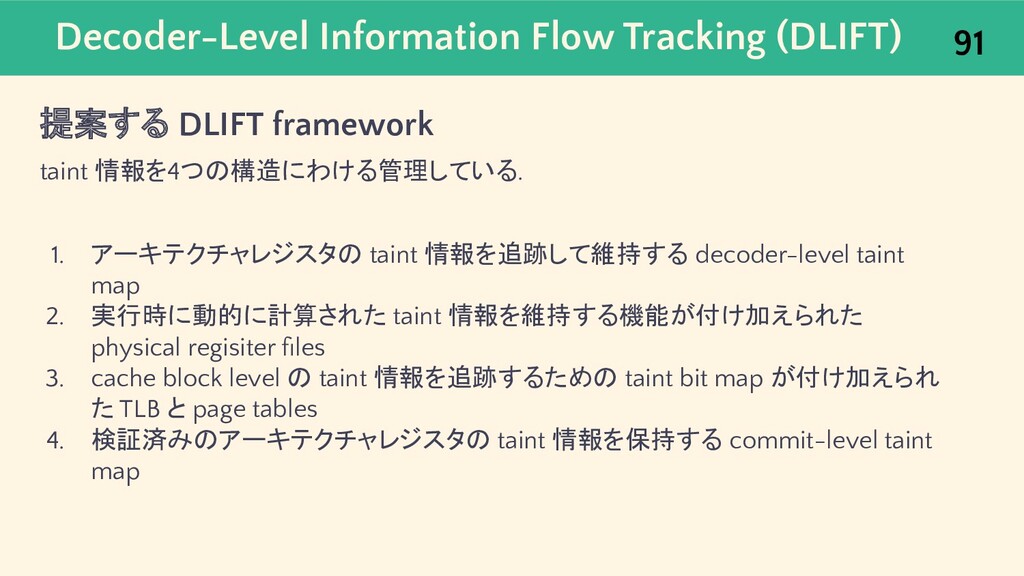
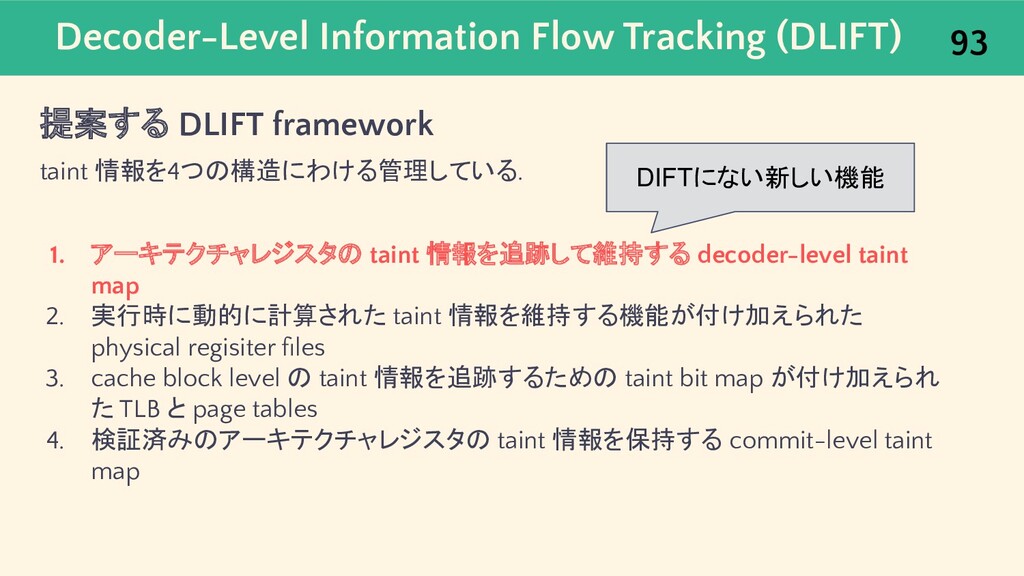
Decoder-Level Information Flow Tracking (DLIFT) 提案する DLIFT framework taint 情報を4つの構造にわける管理している.
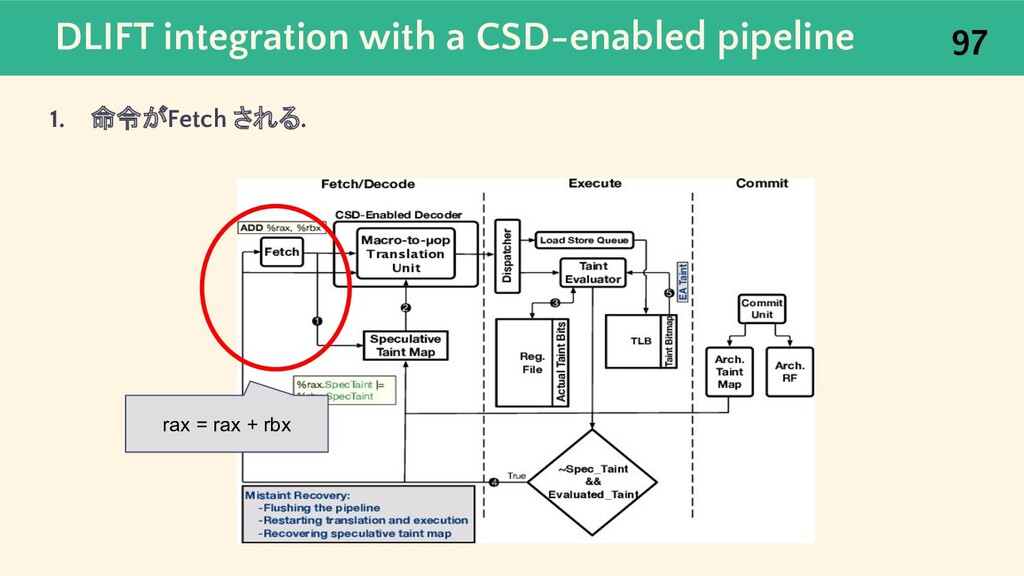
1. アーキテクチャレジスタの taint 情報を追跡して維持する decoder-level taint map 2. 実行時に動的に計算された taint 情報を維持する機能が付け加えられた physical regisiter files 3. cache block level の taint 情報を追跡するための taint bit map が付け加えられ た TLB と page tables 4. 検証済みのアーキテクチャレジスタの taint 情報を保持する commit-level taint map 91 -
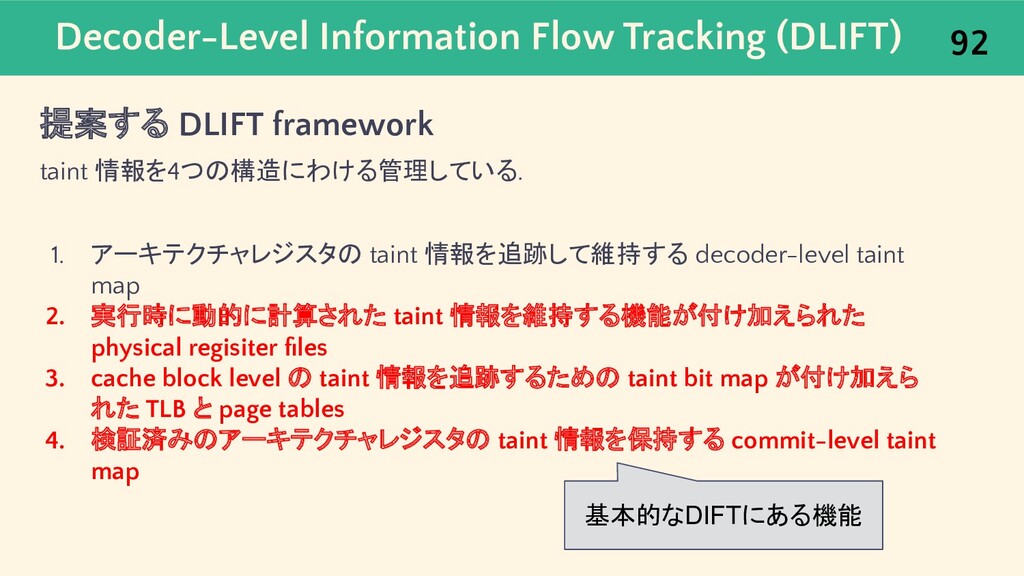
Decoder-Level Information Flow Tracking (DLIFT) 提案する DLIFT framework taint 情報を4つの構造にわける管理している.
1. アーキテクチャレジスタの taint 情報を追跡して維持する decoder-level taint map 2. 実行時に動的に計算された taint 情報を維持する機能が付け加えられた physical regisiter files 3. cache block level の taint 情報を追跡するための taint bit map が付け加えら れた TLB と page tables 4. 検証済みのアーキテクチャレジスタの taint 情報を保持する commit-level taint map 92 基本的なDIFTにある機能 -
Decoder-Level Information Flow Tracking (DLIFT) 提案する DLIFT framework taint 情報を4つの構造にわける管理している.
1. アーキテクチャレジスタの taint 情報を追跡して維持する decoder-level taint map 2. 実行時に動的に計算された taint 情報を維持する機能が付け加えられた physical regisiter files 3. cache block level の taint 情報を追跡するための taint bit map が付け加えられ た TLB と page tables 4. 検証済みのアーキテクチャレジスタの taint 情報を保持する commit-level taint map 93 DIFTにない新しい機能 -
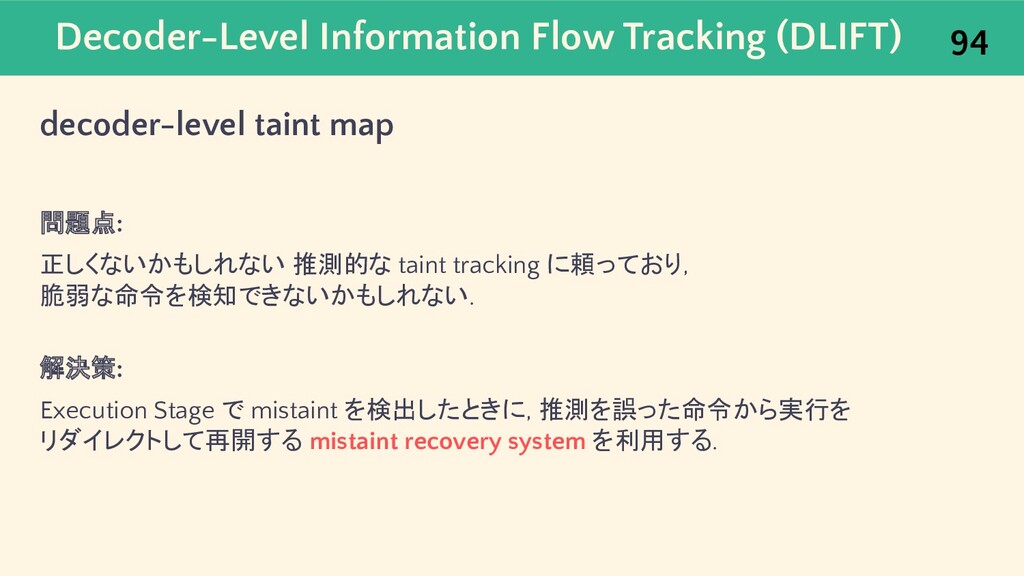
Decoder-Level Information Flow Tracking (DLIFT) decoder-level taint map 問題点: 正しくないかもしれない
推測的な taint tracking に頼っており, 脆弱な命令を検知できないかもしれない. 解決策: Execution Stage で mistaint を検出したときに, 推測を誤った命令から実行を リダイレクトして再開する mistaint recovery system を利用する. 94 -
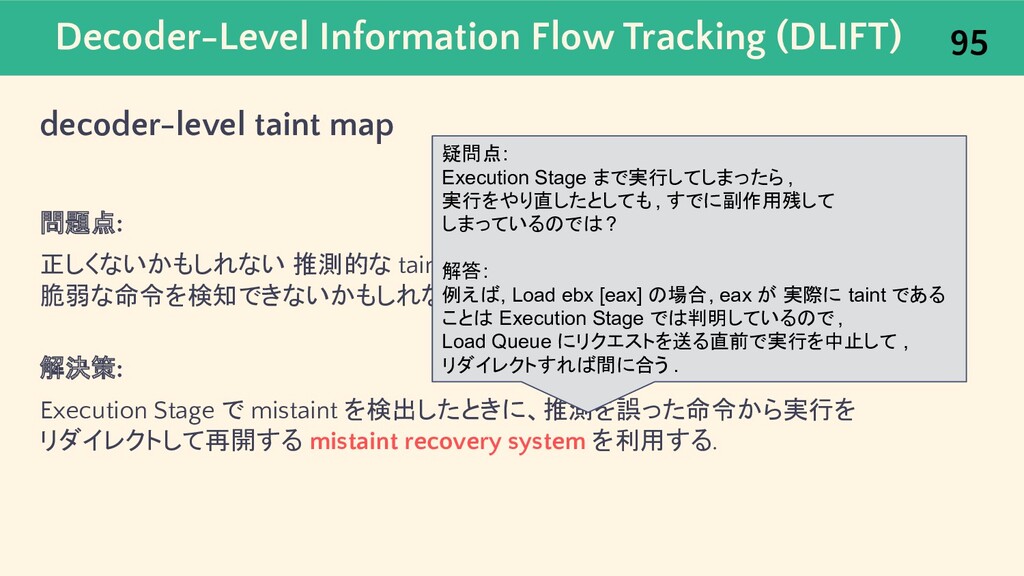
Decoder-Level Information Flow Tracking (DLIFT) decoder-level taint map 問題点: 正しくないかもしれない
推測的な taint tracking に頼っており, 脆弱な命令を検知できないかもしれない. 解決策: Execution Stage で mistaint を検出したときに、推測を誤った命令から実行を リダイレクトして再開する mistaint recovery system を利用する. 95 疑問点: Execution Stage まで実行してしまったら , 実行をやり直したとしても , すでに副作用残して しまっているのでは? 解答: 例えば, Load ebx [eax] の場合, eax が 実際に taint である ことは Execution Stage では判明しているので , Load Queue にリクエストを送る直前で実行を中止して , リダイレクトすれば間に合う . -
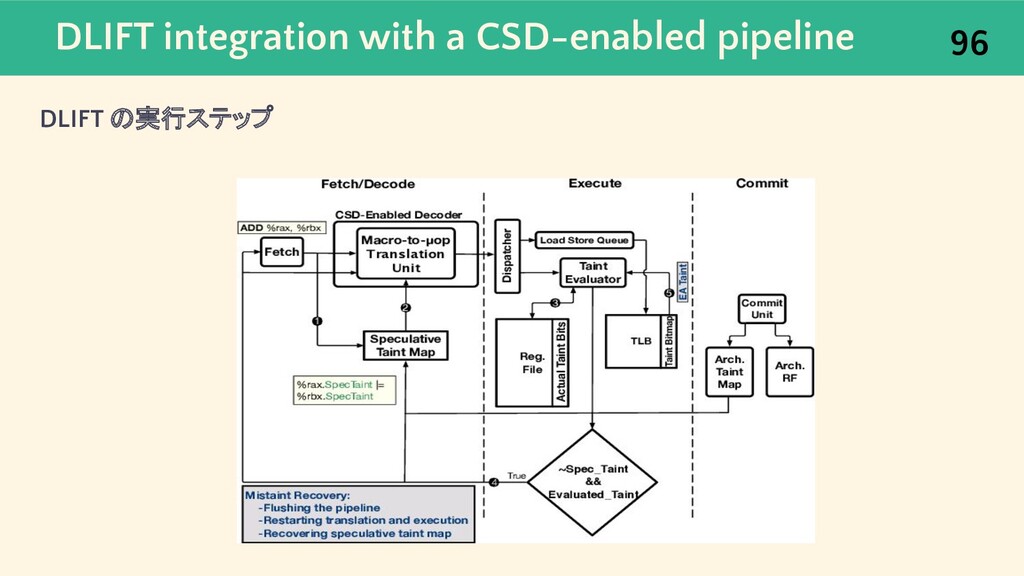
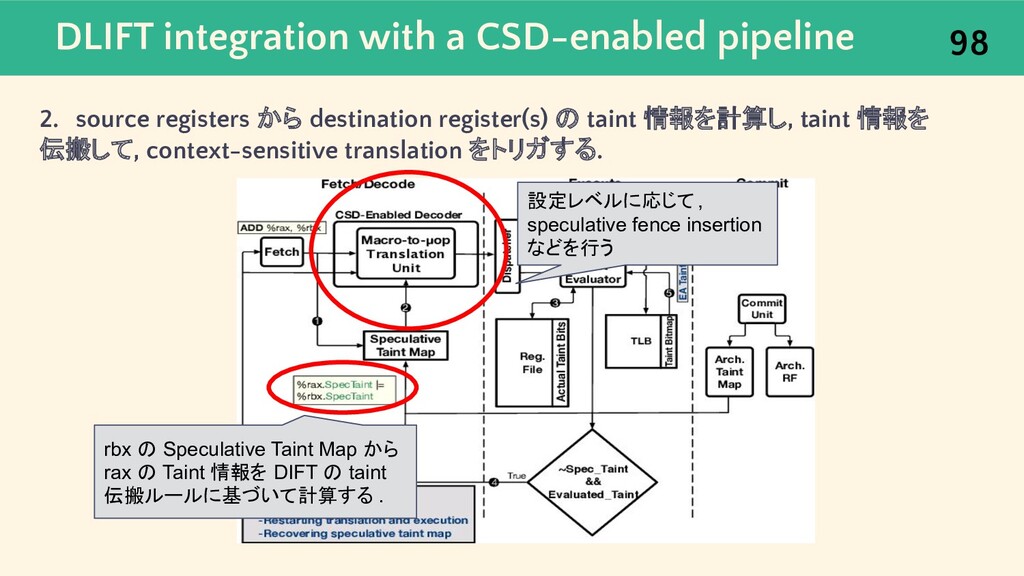
DLIFT integration with a CSD-enabled pipeline 2. source registers から destination
register(s) の taint 情報を計算し, taint 情報を 伝搬して, context-sensitive translation をトリガする. 98 rbx の Speculative Taint Map から rax の Taint 情報を DIFT の taint 伝搬ルールに基づいて計算する . 設定レベルに応じて , speculative fence insertion などを行う -
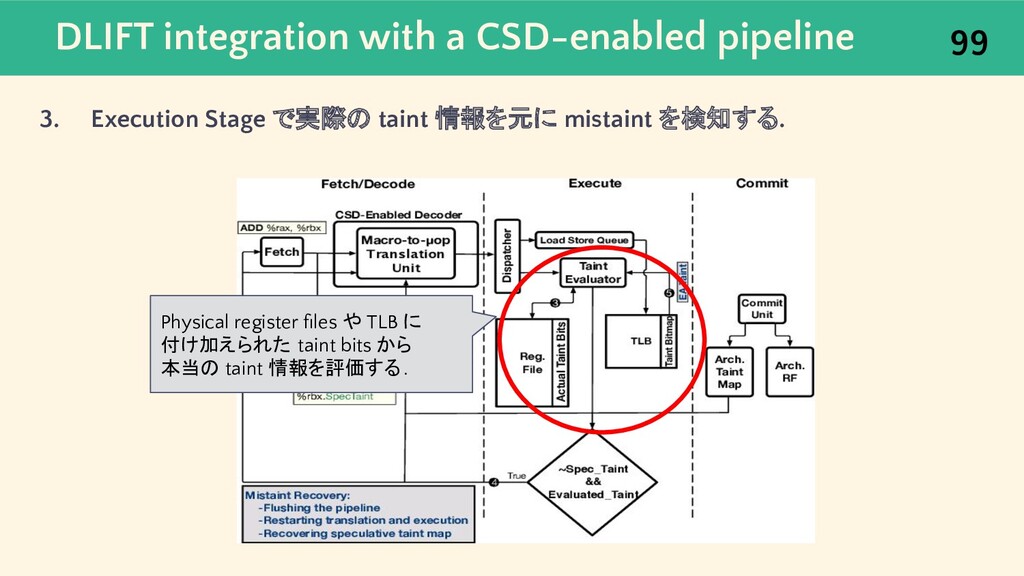
DLIFT integration with a CSD-enabled pipeline 3. Execution Stage で実際の
taint 情報を元に mistaint を検知する. 99 Physical register files や TLB に 付け加えられた taint bits から 本当の taint 情報を評価する. -
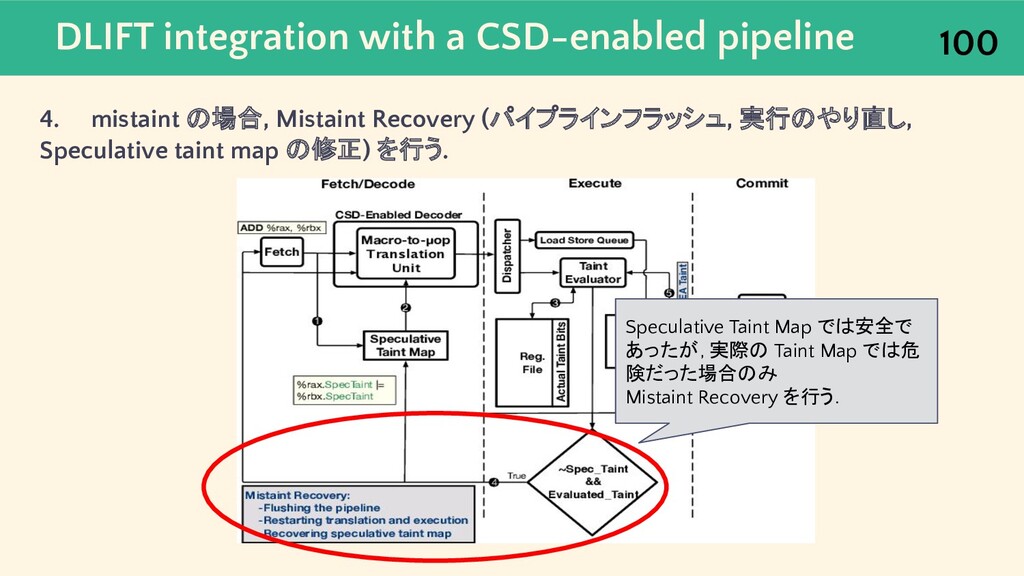
DLIFT integration with a CSD-enabled pipeline 4. mistaint の場合, Mistaint
Recovery (パイプラインフラッシュ, 実行のやり直し, Speculative taint map の修正) を行う. 100 Speculative Taint Map では安全で あったが, 実際の Taint Map では危 険だった場合のみ Mistaint Recovery を行う. -
Agenda 導入 101 導入 背景 知識 実装 方法 この論文について Microarchitectural
攻撃 Spectre 攻撃・対策 Context Sensitive Decoding (CSD) Dynamic Information Flow Tracking (DIFT) アーキテクチャの全体像 新しいFence命令の導入 Decoder-Level Information Flow Tracking (DLIFT) 結果 Context-Sensitive Fencing の評価 -
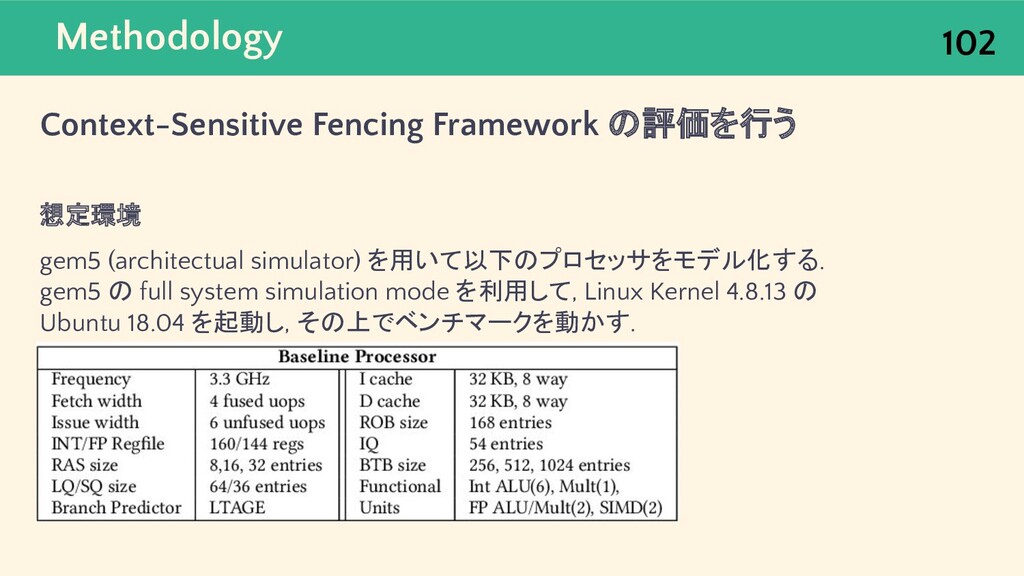
Methodology Context-Sensitive Fencing Framework の評価を行う 想定環境 gem5 (architectual simulator) を用いて以下のプロセッサをモデル化する.
gem5 の full system simulation mode を利用して, Linux Kernel 4.8.13 の Ubuntu 18.04 を起動し, その上でベンチマークを動かす. 102 -
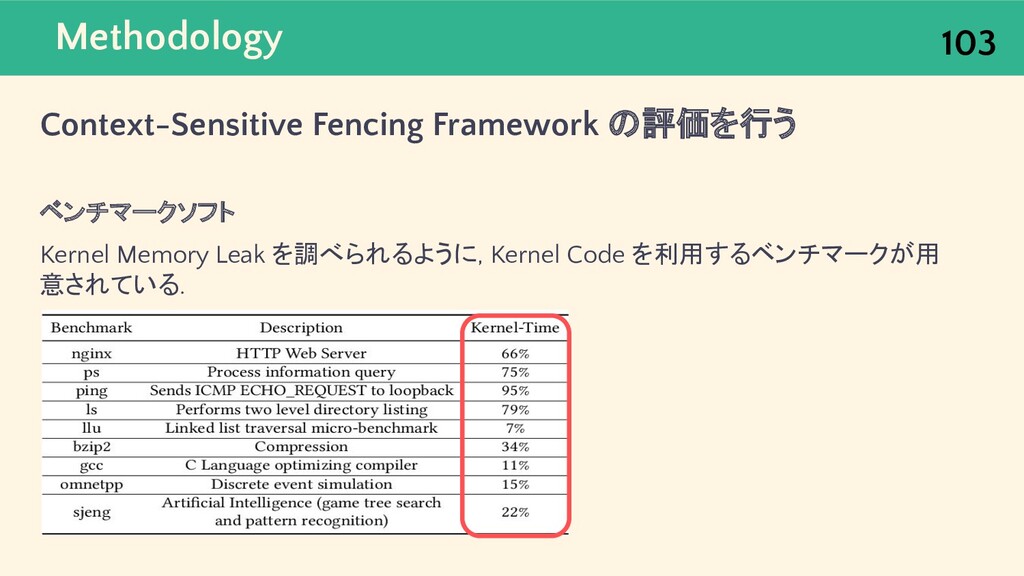
Methodology Context-Sensitive Fencing Framework の評価を行う ベンチマークソフト Kernel Memory Leak を調べられるように,
Kernel Code を利用するベンチマークが用 意されている. 103 -
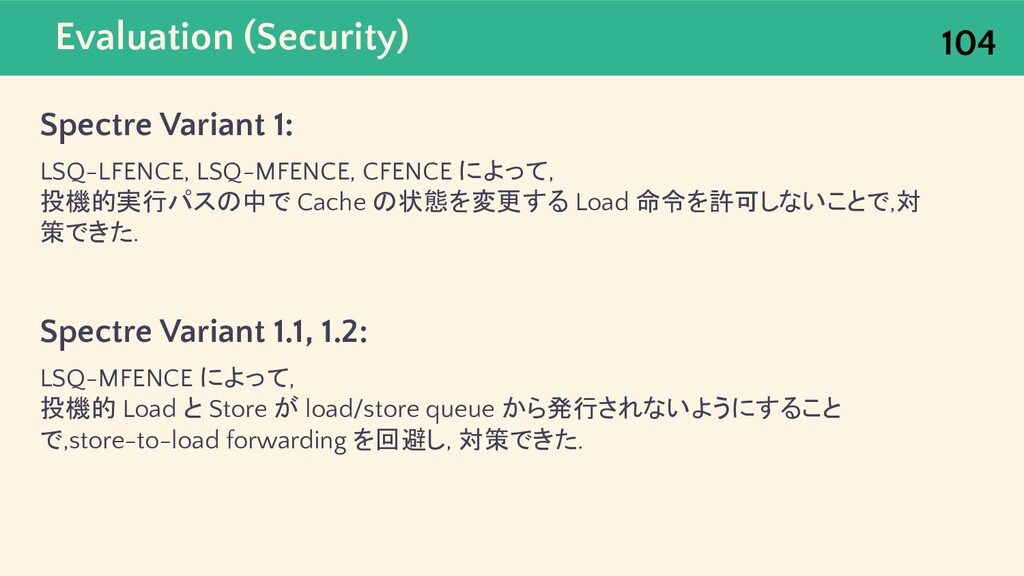
Evaluation (Security) Spectre Variant 1: LSQ-LFENCE, LSQ-MFENCE, CFENCE によって, 投機的実行パスの中で
Cache の状態を変更する Load 命令を許可しないことで,対 策できた. Spectre Variant 1.1, 1.2: LSQ-MFENCE によって, 投機的 Load と Store が load/store queue から発行されないようにすること で,store-to-load forwarding を回避し, 対策できた. 104 -
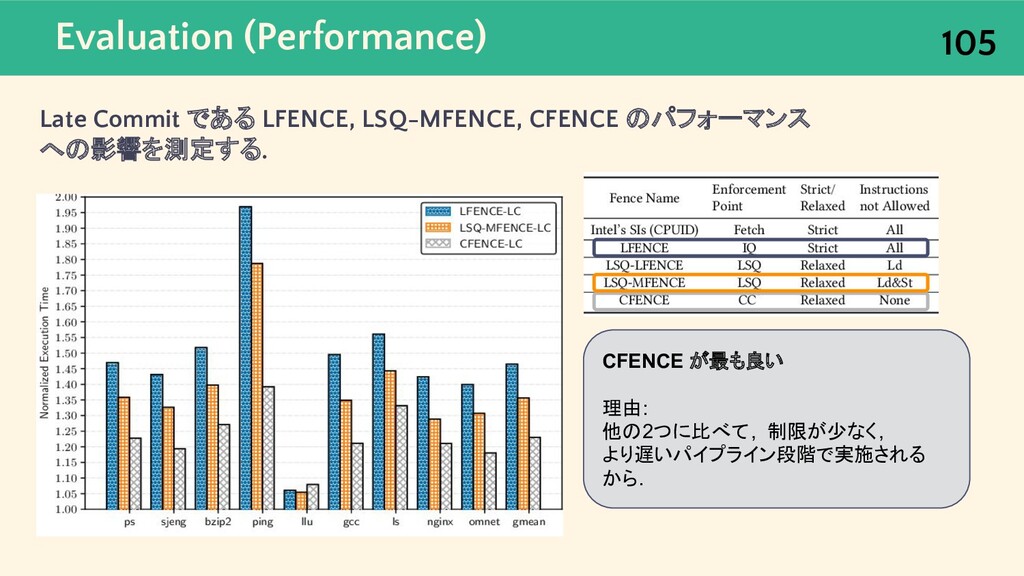
Evaluation (Performance) Late Commit である LFENCE, LSQ-MFENCE, CFENCE のパフォーマンス への影響を測定する.
105 CFENCE が最も良い 理由: 他の2つに比べて, 制限が少なく, より遅いパイプライン段階で実施される から. -
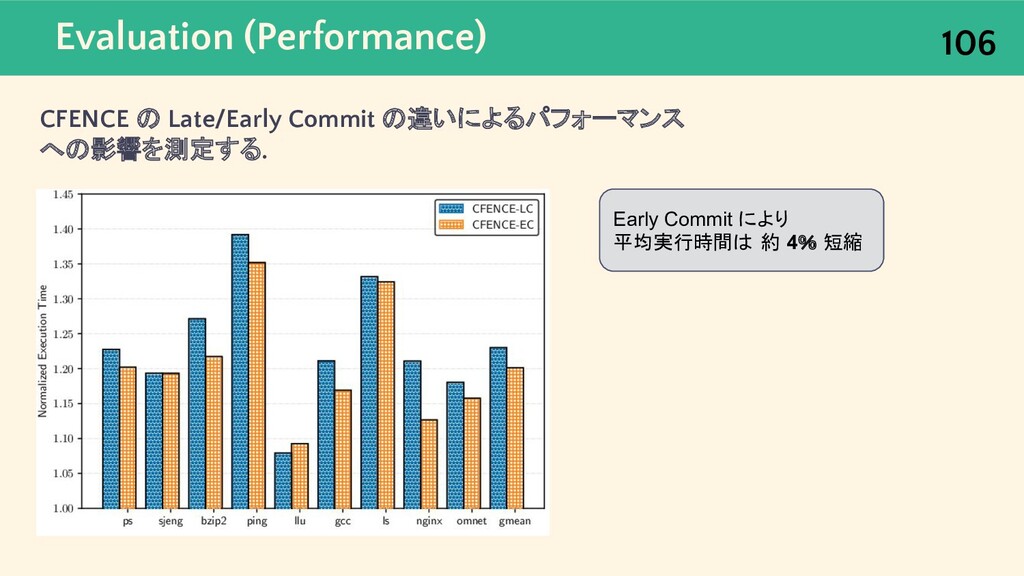
Evaluation (Performance) CFENCE の Late/Early Commit の違いによるパフォーマンス への影響を測定する. 106 Early
Commit により 平均実行時間は 約 4% 短縮 -
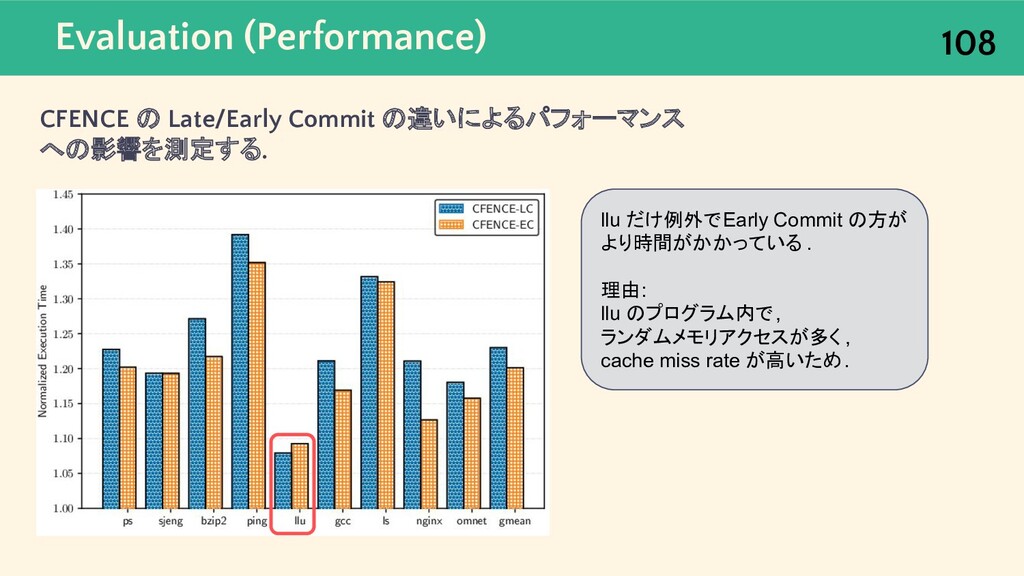
Evaluation (Performance) CFENCE の Late/Early Commit の違いによるパフォーマンス への影響を測定する. 108 llu
だけ例外でEarly Commit の方が より時間がかかっている . 理由: llu のプログラム内で, ランダムメモリアクセスが多く , cache miss rate が高いため. -
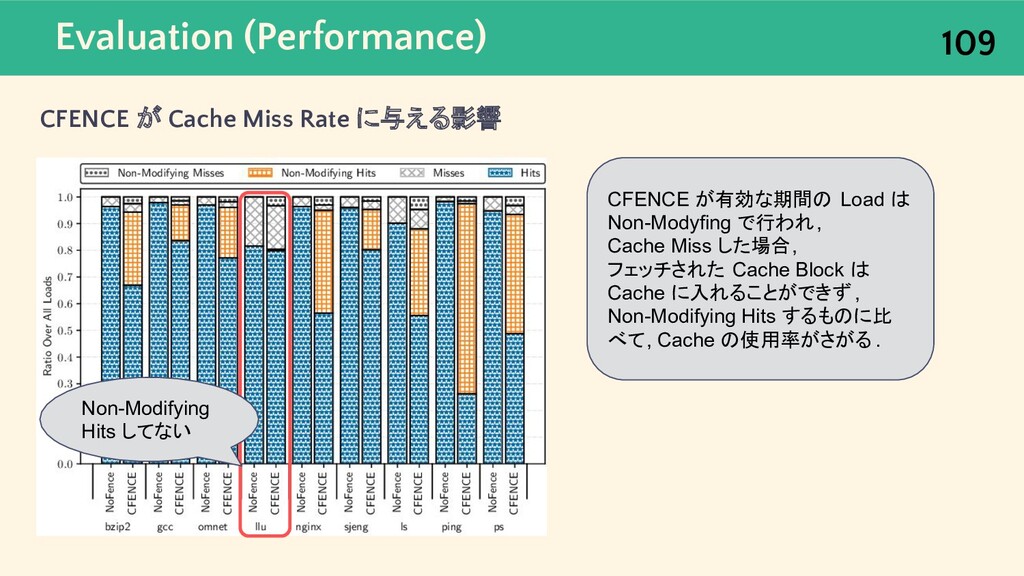
Evaluation (Performance) CFENCE が Cache Miss Rate に与える影響 109 CFENCE
が有効な期間の Load は Non-Modyfing で行われ, Cache Miss した場合, フェッチされた Cache Block は Cache に入れることができず , Non-Modifying Hits するものに比 べて, Cache の使用率がさがる. Non-Modifying Hits してない -
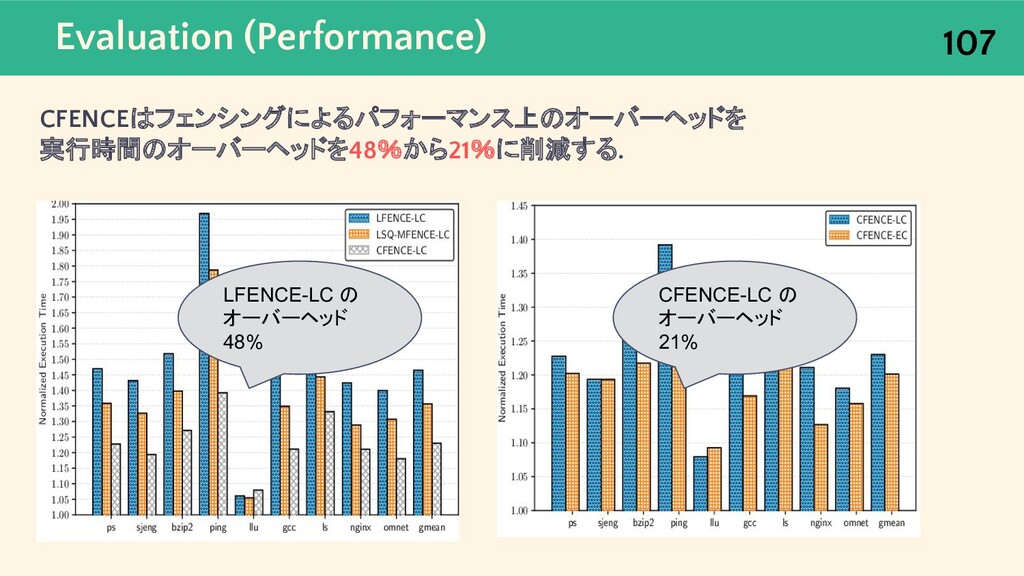
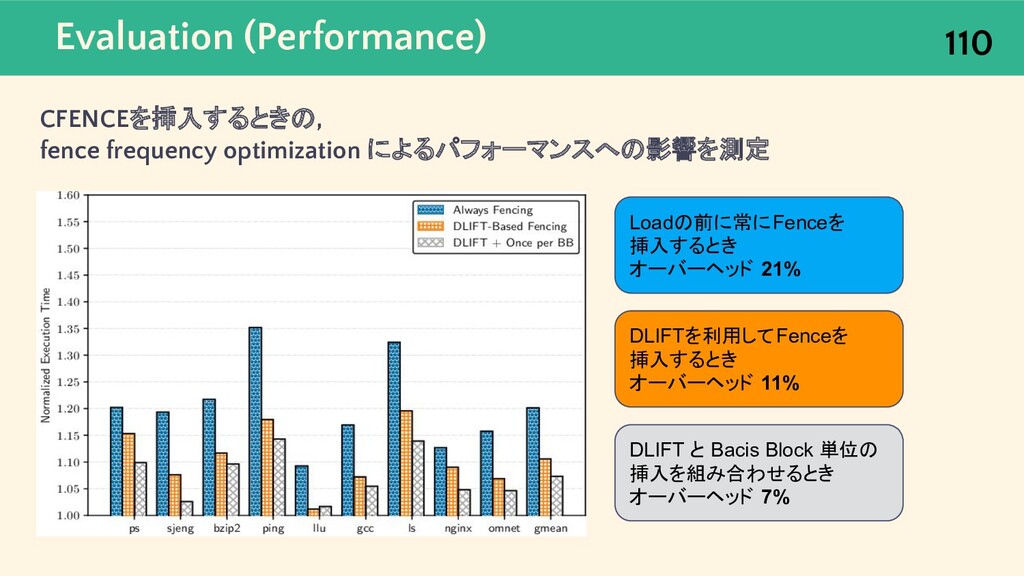
Evaluation (Performance) CFENCEを挿入するときの, fence frequency optimization によるパフォーマンスへの影響を測定 Always Fenceing: Loadの前に常にFence命令を挿入する
オーバーヘッド 48% 110 Loadの前に常にFenceを 挿入するとき オーバーヘッド 21% DLIFTを利用してFenceを 挿入するとき オーバーヘッド 11% DLIFT と Bacis Block 単位の 挿入を組み合わせるとき オーバーヘッド 7% -
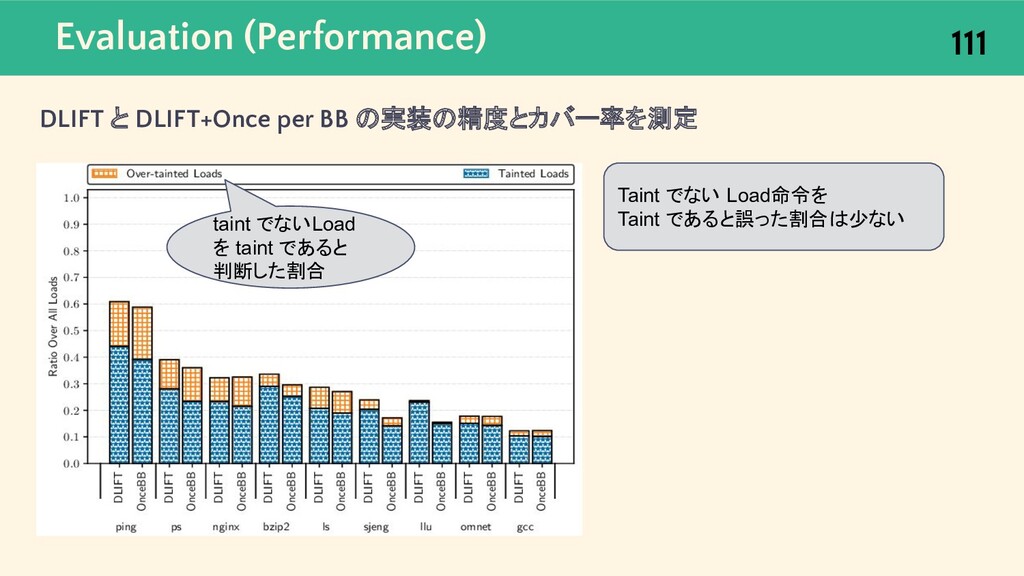
Evaluation (Performance) DLIFT と DLIFT+Once per BB の実装の精度とカバー率を測定 111 Taint
でない Load命令を Taint であると誤った割合は少ない taint でないLoad を taint であると 判断した割合 -
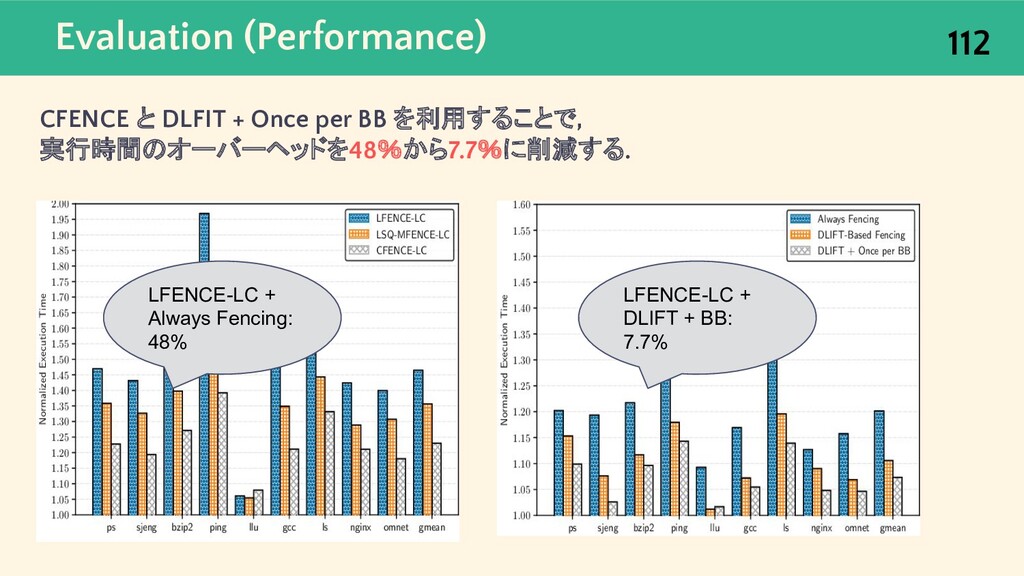
Evaluation (Performance) CFENCE と DLFIT + Once per BB を利用することで,
実行時間のオーバーヘッドを48%から7.7%に削減する. 112 LFENCE-LC + Always Fencing: 48% LFENCE-LC + DLIFT + BB: 7.7% -
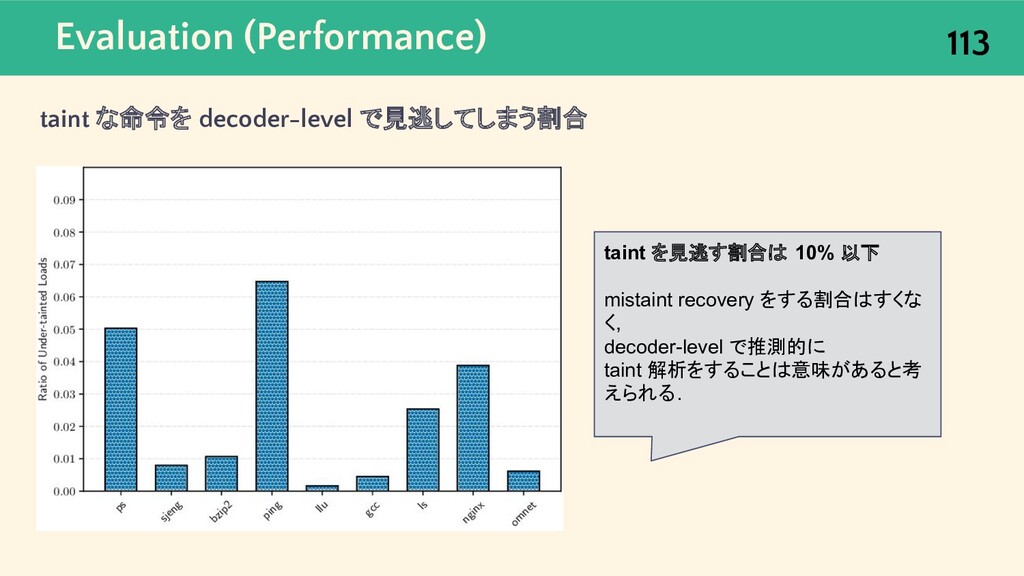
Evaluation (Performance) taint な命令を decoder-level で見逃してしまう割合 113 taint を見逃す割合は 10%
以下 mistaint recovery をする割合はすくな く, decoder-level で推測的に taint 解析をすることは意味があると考 えられる. -
Conclusion • Spectre-Style attacks に対する 対策法である CSF を提案 ◦ fencing
によるオーバーヘッド を ⅙ • CSF の特徴 ◦ プロセッサ内の Decoder Stage で動的に fence命令を挿入 ▪ 再コンパイル不要 ▪ バイナリ変換不要 ◦ taint 情報を利用して, 必要なときにのみ fence命令を挿入 ▪ パフォーマンスオーバーヘッドが小さい ◦ 新たな Fence 命令を提案 ▪ CFENCE • Cache Controller で, 副作用を残さないように調整 114
 mmxsrup
 torounit
 jackojacko_
 puku0x
 xkxaxkx
 kamadamakoto
 everpeace
 a_suenami
 fj_yoshimura_kosuke
 grimoh
 yuutosi
 hagino3000
 imuta
 lauravandoore
 reverentgeek
 irinanazarova
 samanthasiow
 lfama
 tamaranovitovic
 rmw
 sergeychernyshev
 moore
 seathinner
 samlambert
 dougneiner