Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Student Cup 2020 反省会 21th solution LT
Search
K Hashimoto
August 30, 2020
Technology
490
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Student Cup 2020 反省会 21th solution LT
Student Cup 2020 反省会 で使用した解法LTスライドです。
K Hashimoto
August 30, 2020
Other Decks in Technology
See All in Technology
AIにシークレットを見せない、WSL2で安全な開発環境
yazm
0
310
実践!Cloud Run ハンズオン!! / Cloud Run handson
y0hgi
2
290
Rust で関数型ドメインモデリング
takonda
0
160
ストレスなくAIと付き合いたい!こんなときどうしてる?
namiki64
3
590
Claude の新機能を、 出た日に触って社内に届けるまで
rfdnxbro
1
190
Kiro Crewをはじめよう
kizawa2020
1
160
初海外で注意すべきこと12選!!!安全快適なre:invent生活にするために
yuuuuuuu168
1
180
パスキーの自動テストはどこまでいけるのか
teamlab
PRO
0
270
DBについての基礎説明(MySQL編) - コロプラ 2026年度 新卒研修
colopl
0
110
夫婦で子育てするための育児標準化
codmoninc
PRO
0
420
二歩目のフロントエンド・ウェブアクセシビリティ
camiha
2
650
WasmをRustにする
sansantech
PRO
0
260
Featured
See All Featured
Prompt Engineering for Job Search
mfonobong
0
520
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
370
How to Grow Your eCommerce with AI & Automation
katarinadahlin
PRO
2
330
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
Building Applications with DynamoDB
mza
96
7.2k
YesSQL, Process and Tooling at Scale
rocio
174
15k
Dealing with People You Can't Stand - Big Design 2015
cassininazir
367
27k
ピンチをチャンスに:未来をつくるプロダクトロードマップ #pmconf2020
aki_iinuma
128
56k
A better future with KSS
kneath
240
18k
Thoughts on Productivity
jonyablonski
76
5.4k
Marketing Yourself as an Engineer | Alaka | Gurzu
gurzu
0
330
16th Malabo Montpellier Forum Presentation
akademiya2063
PRO
0
410
Transcript
戦略の話 SIGNATE Student Cup 2020 反省会 Solution LT (21th) mosamosa
(twitter:@dear_morality)
/ ⾃⼰紹介 名前 : 橋本 翔 所属 : 東京⼤学⼤学院 機械⼯学専攻
twitter:@dear_morality(mosamosa) アイコン画像はそのうち変わるかも 普段は機械学習とか全く関係ないことしていて,趣味で競プロとかコンペに出ています. Kaggleのコンペに出る時間と計算リソースが欲しい今⽇このごろです.
/ ⽬次 • ⾃⼰紹介 • モデル概要 • なぜ保守的戦略をとったのか • 保守的戦略とは
• おまけ 1. モデル検討の諸々 • おまけ 2. モデルのスコアとSub選択 • おまけ 3. 効かなかった⼿法とか
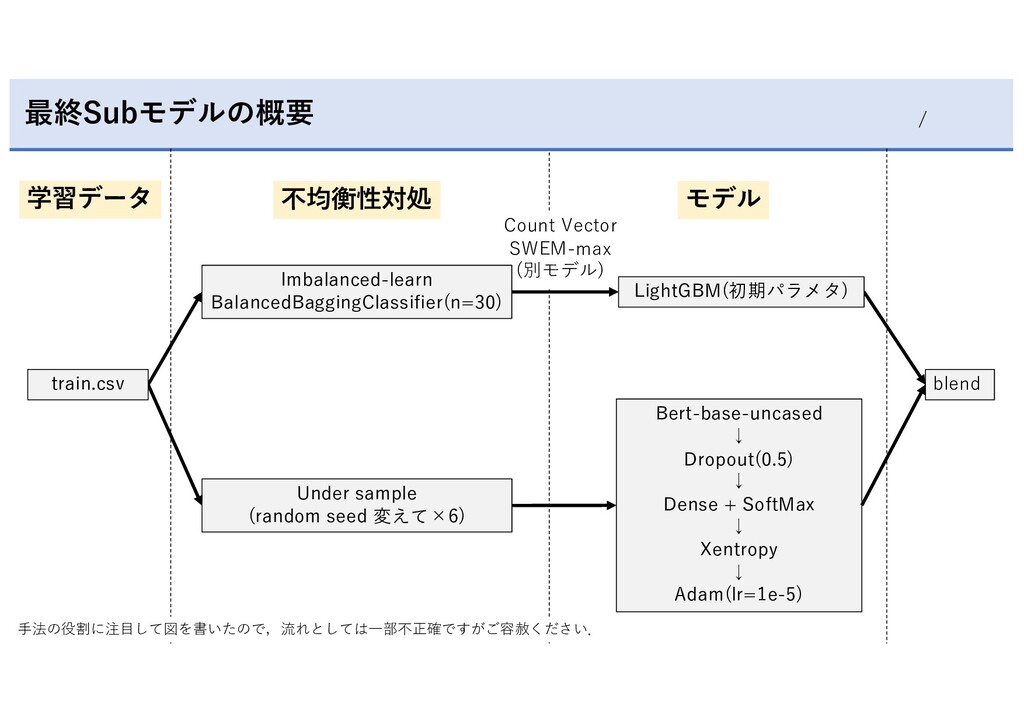
/ 最終Subモデルの概要 Under sample (random seed 変えて×6) 学習データ 不均衡性対処 モデル
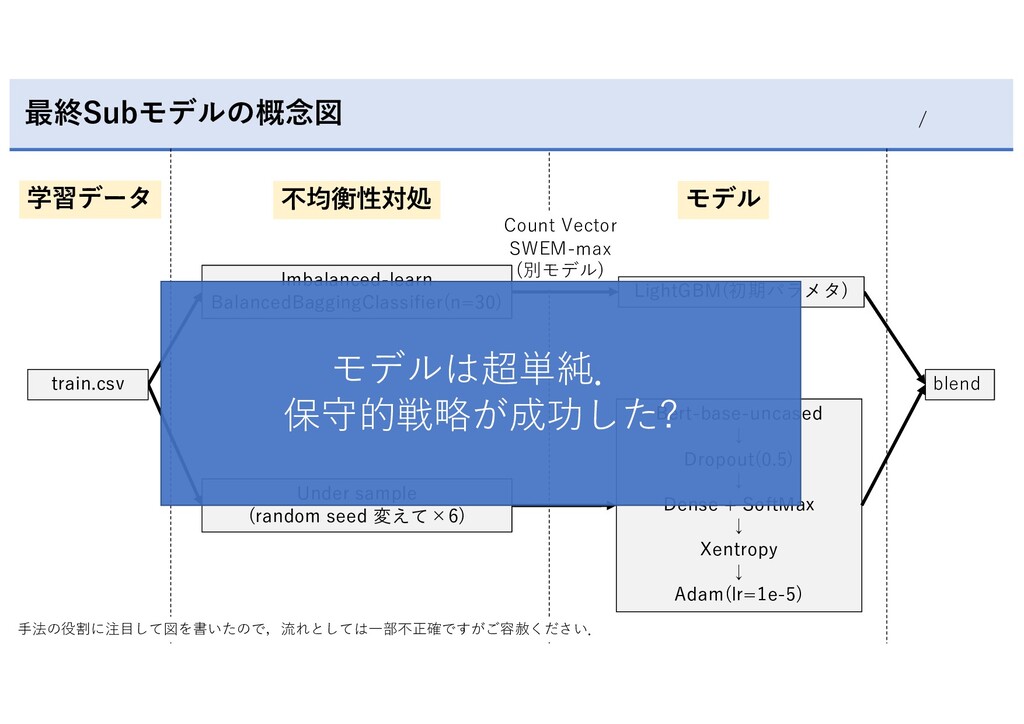
blend Bert-base-uncased ↓ Dropout(0.5) ↓ Dense + SoftMax ↓ Xentropy ↓ Adam(lr=1e-5) ⼿法の役割に注⽬して図を書いたので,流れとしては⼀部不正確ですがご容赦ください. Count Vector SWEM-max (別モデル) train.csv Imbalanced-learn BalancedBaggingClassifier(n=30) LightGBM(初期パラメタ)
/ 最終Subモデルの概念図 Under sample (random seed 変えて×6) 学習データ 不均衡性対処 モデル
blend Bert-base-uncased ↓ Dropout(0.5) ↓ Dense + SoftMax ↓ Xentropy ↓ Adam(lr=1e-5) ⼿法の役割に注⽬して図を書いたので,流れとしては⼀部不正確ですがご容赦ください. Count Vector SWEM-max (別モデル) train.csv Imbalanced-learn BalancedBaggingClassifier(n=30) LightGBM(初期パラメタ) モデルは超単純. 保守的戦略が成功した?
/ ⽬次 • ⾃⼰紹介 • モデル概要 • 保守的戦略をとった理由 • 保守的戦略とは
• おまけ 1. モデル検討の諸々 • おまけ 2. モデルのスコアとSub選択 • おまけ 3. 効かなかった⼿法とか
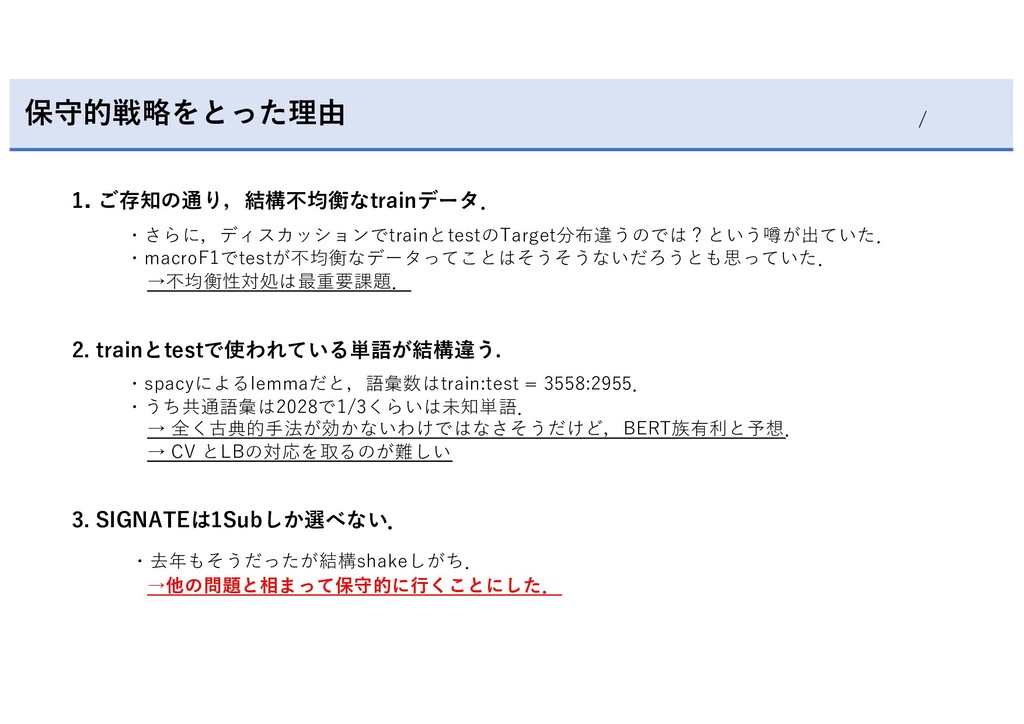
/ 保守的戦略をとった理由 1. ご存知の通り,結構不均衡なtrainデータ. ・さらに,ディスカッションでtrainとtestのTarget分布違うのでは?という噂が出ていた. ・macroF1でtestが不均衡なデータってことはそうそうないだろうとも思っていた. →不均衡性対処は最重要課題. 2. trainとtestで使われている単語が結構違う. ・spacyによるlemmaだと,語彙数はtrain:test
= 3558:2955. ・うち共通語彙は2028で1/3くらいは未知単語. → 全く古典的⼿法が効かないわけではなさそうだけど,BERT族有利と予想. → CV とLBの対応を取るのが難しい 3. SIGNATEは1Subしか選べない. ・去年もそうだったが結構shakeしがち. →他の問題と相まって保守的に⾏くことにした.
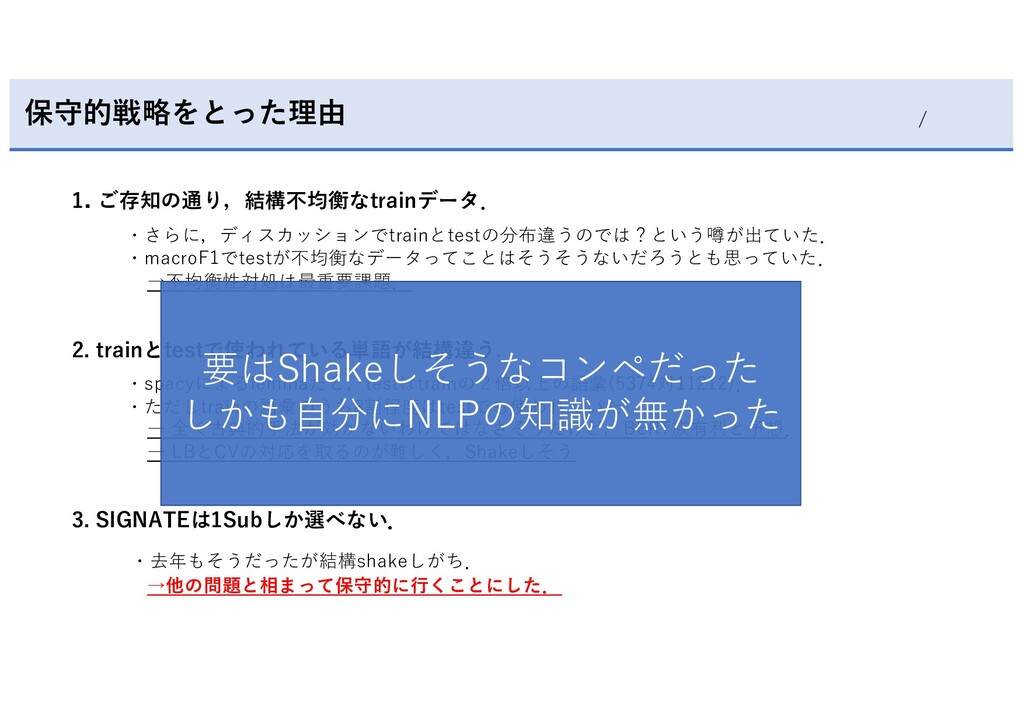
/ 保守的戦略をとった理由 1. ご存知の通り,結構不均衡なtrainデータ. ・さらに,ディスカッションでtrainとtestの分布違うのでは?という噂が出ていた. ・macroF1でtestが不均衡なデータってことはそうそうないだろうとも思っていた. →不均衡性対処は最重要課題. 2. trainとtestで使われている単語が結構違う. ・spacyによるlemmaだと,testはtrainの2倍以上の語彙(5374対11212).
・ただしtrainの語彙のうち8割程度はtestでも使われていた. → 全く古典的⼿法が効かないわけではなさそうだけど,BERT族有利と予想. → LBとCVの対応を取るのが難しく,Shakeしそう 3. SIGNATEは1Subしか選べない. ・去年もそうだったが結構shakeしがち. →他の問題と相まって保守的に⾏くことにした. 要はShakeしそうなコンペだった しかも⾃分にNLPの知識が無かった
/ ⽬次 • ⾃⼰紹介 • モデル概要 • なぜ保守的戦略をとったのか • 保守的戦略とは
• おまけ 1. モデル検討の諸々 • おまけ 2. モデルのスコアとSub選択 • おまけ 3. 効かなかった⼿法とか
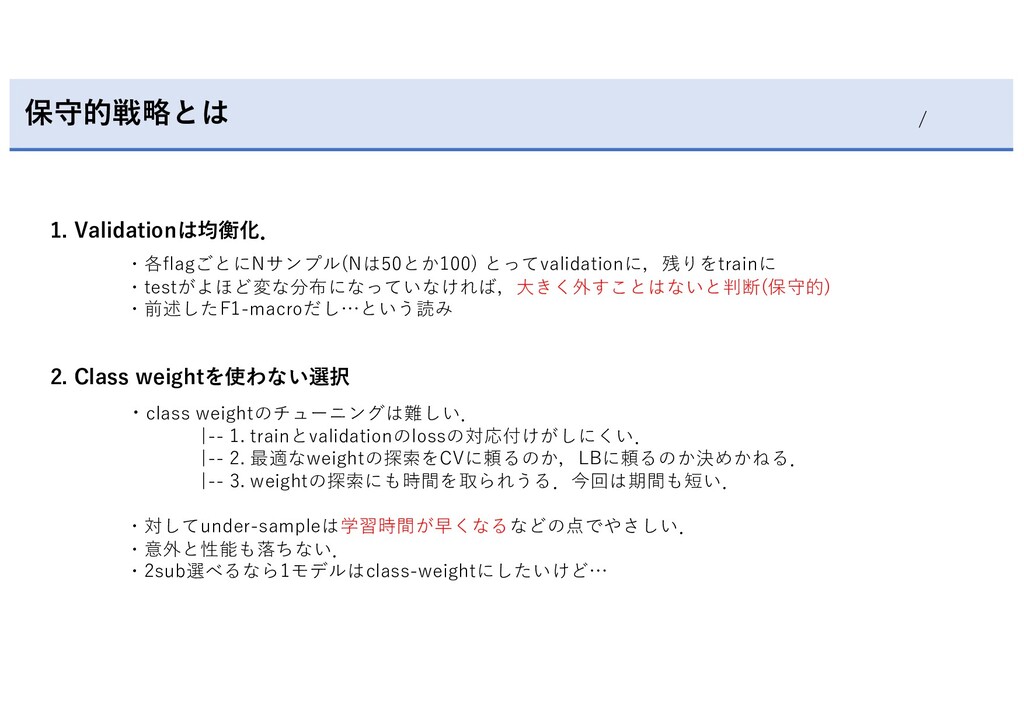
/ 保守的戦略とは 2. Class weightを使わない選択 ・class weightのチューニングは難しい. |-- 1. trainとvalidationのlossの対応付けがしにくい.
|-- 2. 最適なweightの探索をCVに頼るのか,LBに頼るのか決めかねる. |-- 3. weightの探索にも時間を取られうる.今回は期間も短い. ・対してunder-sampleは学習時間が早くなるなどの点でやさしい. ・意外と性能も落ちない. ・2sub選べるなら1モデルはclass-weightにしたいけど… 1. Validationは均衡化. ・各flagごとにNサンプル(Nは50とか100) とってvalidationに,残りをtrainに ・testがよほど変な分布になっていなければ,⼤きく外すことはないと判断(保守的) ・前述したF1-macroだし…という読み
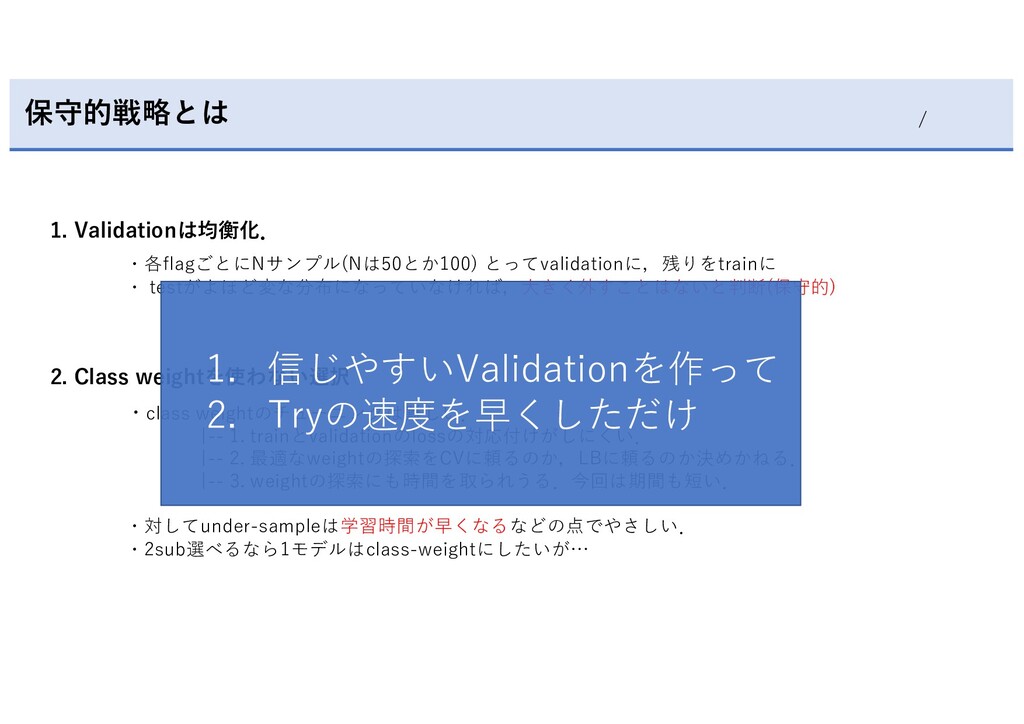
/ 保守的戦略とは 2. Class weightを使わない選択 ・class weightのチューニングは難しい. |-- 1. trainとvalidationのlossの対応付けがしにくい.
|-- 2. 最適なweightの探索をCVに頼るのか,LBに頼るのか決めかねる. |-- 3. weightの探索にも時間を取られうる.今回は期間も短い. ・対してunder-sampleは学習時間が早くなるなどの点でやさしい. ・2sub選べるなら1モデルはclass-weightにしたいが… 1. Validationは均衡化. ・各flagごとにNサンプル(Nは50とか100) とってvalidationに,残りをtrainに ・ testがよほど変な分布になっていなければ,⼤きく外すことはないと判断(保守的) 1. 信じやすいValidationを作って 2. Tryの速度を早くしただけ
/ 今回のコンペ,Shake downした⽅も多いと思ったのでこの点についてまとめました. Shakeしそう,期間が短い,計算リソースが⾟い,(個⼈的に時間がない) あたりの要素が多めのときはこんな感じの戦略で⾏くのがいいのかなぁと思います. (1位は取れないかもしれないけど,そこそこの上位は安定しやすい.)
/ 以降おまけです
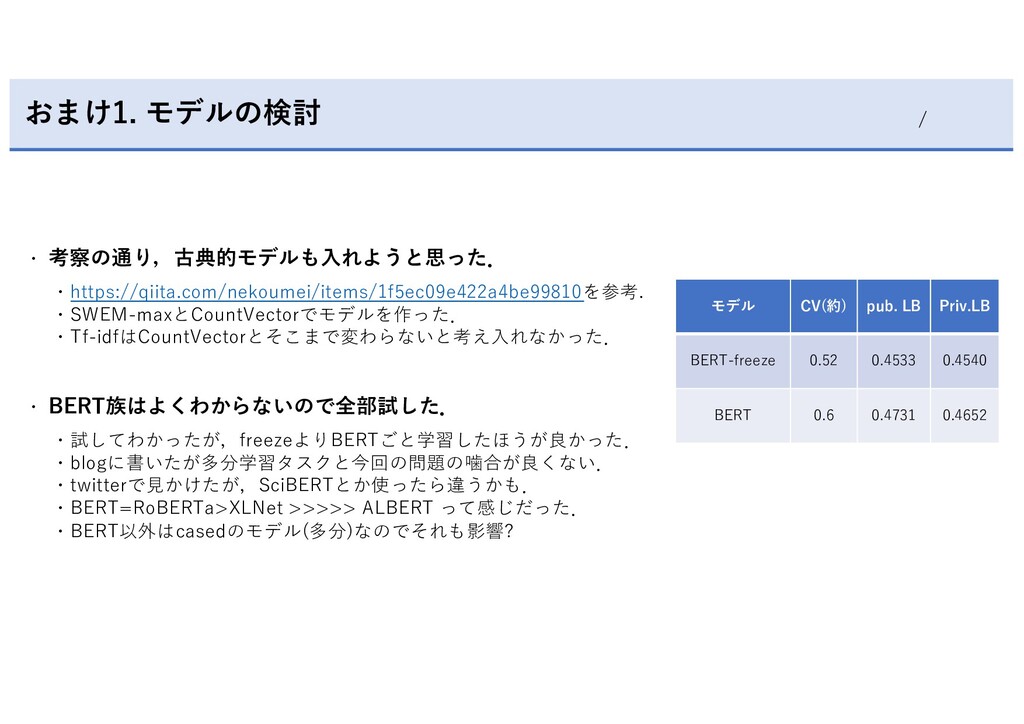
/ おまけ1. モデルの検討 ・ 考察の通り,古典的モデルも⼊れようと思った. ・https://qiita.com/nekoumei/items/1f5ec09e422a4be99810を参考. ・SWEM-maxとCountVectorでモデルを作った. ・Tf-idfはCountVectorとそこまで変わらないと考え⼊れなかった. ・ BERT族はよくわからないので全部試した.
・試してわかったが,freezeよりBERTごと学習したほうが良かった. ・blogに書いたが多分学習タスクと今回の問題の噛合が良くない. ・twitterで⾒かけたが,SciBERTとか使ったら違うかも. ・BERT=RoBERTa>XLNet >>>>> ALBERT って感じだった. ・BERT以外はcasedのモデル(多分)なのでそれも影響? モデル CV(約) pub. LB Priv.LB BERT-freeze 0.52 0.4533 0.4540 BERT 0.6 0.4731 0.4652
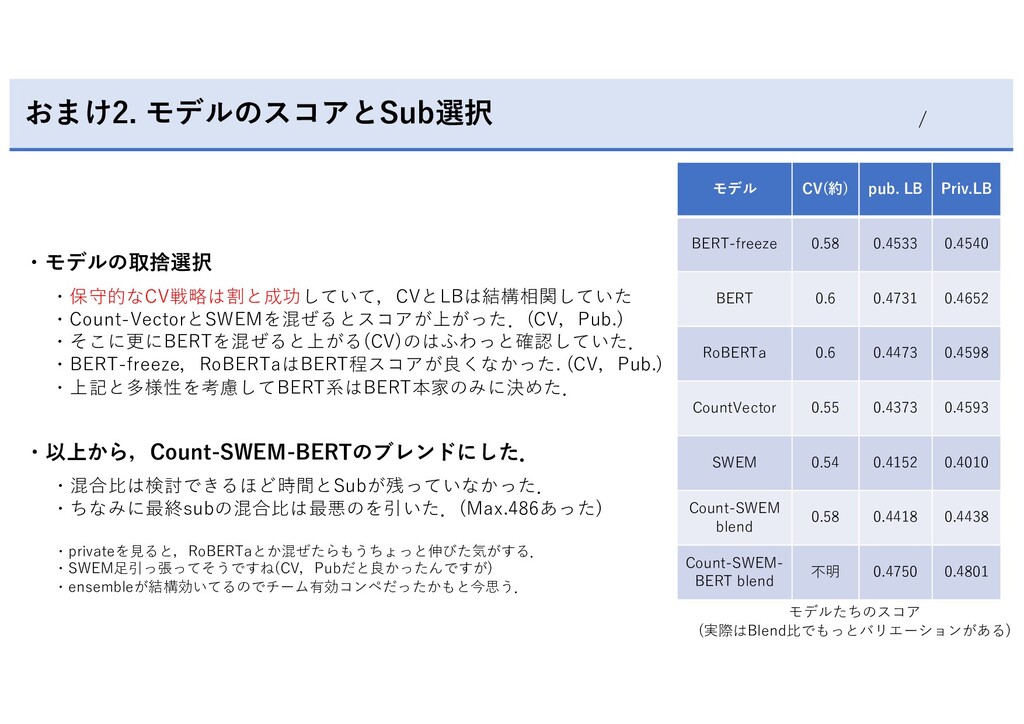
/ おまけ2. モデルのスコアとSub選択 モデル CV(約) pub. LB Priv.LB BERT-freeze 0.58
0.4533 0.4540 BERT 0.6 0.4731 0.4652 RoBERTa 0.6 0.4473 0.4598 CountVector 0.55 0.4373 0.4593 SWEM 0.54 0.4152 0.4010 Count-SWEM blend 0.58 0.4418 0.4438 Count-SWEM- BERT blend 不明 0.4750 0.4801 モデルたちのスコア (実際はBlend⽐でもっとバリエーションがある) ・モデルの取捨選択 ・保守的なCV戦略は割と成功していて,CVとLBは結構相関していた ・Count-VectorとSWEMを混ぜるとスコアが上がった.(CV,Pub.) ・そこに更にBERTを混ぜると上がる(CV)のはふわっと確認していた. ・BERT-freeze,RoBERTaはBERT程スコアが良くなかった. (CV,Pub.) ・上記と多様性を考慮してBERT系はBERT本家のみに決めた. ・以上から,Count-SWEM-BERTのブレンドにした. ・混合⽐は検討できるほど時間とSubが残っていなかった. ・ちなみに最終subの混合⽐は最悪のを引いた.(Max.486あった) ・privateを⾒ると,RoBERTaとか混ぜたらもうちょっと伸びた気がする. ・SWEM⾜引っ張ってそうですね(CV,Pubだと良かったんですが) ・ensembleが結構効いてるのでチーム有効コンペだったかもと今思う.
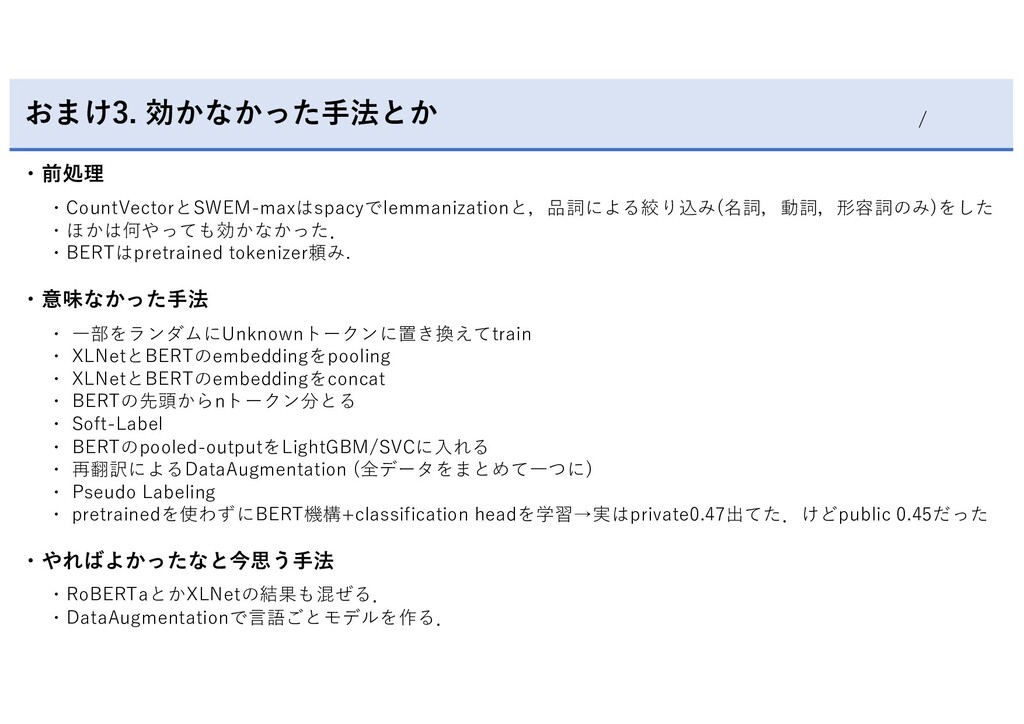
/ おまけ3. 効かなかった⼿法とか ・前処理 ・CountVectorとSWEM-maxはspacyでlemmanizationと,品詞による絞り込み(名詞,動詞,形容詞のみ)をした ・ほかは何やっても効かなかった. ・BERTはpretrained tokenizer頼み. ・意味なかった⼿法 ・
⼀部をランダムにUnknownトークンに置き換えてtrain ・ XLNetとBERTのembeddingをpooling ・ XLNetとBERTのembeddingをconcat ・ BERTの先頭からnトークン分とる ・ Soft-Label ・ BERTのpooled-outputをLightGBM/SVCに⼊れる ・ 再翻訳によるDataAugmentation (全データをまとめて⼀つに) ・ Pseudo Labeling ・ pretrainedを使わずにBERT機構+classification headを学習→実はprivate0.47出てた.けどpublic 0.45だった ・やればよかったなと今思う⼿法 ・RoBERTaとかXLNetの結果も混ぜる. ・DataAugmentationで⾔語ごとモデルを作る.


 yazm
 y0hgi
 takonda
 namiki64
 rfdnxbro
 kizawa2020
 yuuuuuuu168
 teamlab
 colopl
 codmoninc
 camiha
 sansantech
 mfonobong
 greggifford
 katarinadahlin
 inesmontani
 mza
 rocio
 cassininazir
 aki_iinuma
 kneath
 jonyablonski
 gurzu
 akademiya2063