Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Agentic TaskにおけるOn-Policy Distillation入門.pdf
Search
mujirushi
October 03, 2026
270
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Agentic TaskにおけるOn-Policy Distillation入門.pdf
mujirushi
October 03, 2026
Transcript
21 slides
Agentic Taskにおける On-Policy Distillation入門 第2回 沖縄Kaggler会 2026.10.03
自己紹介 • 氏名:鈴木 明作(スズキ メイサク) • 所属:松尾研究所 • Kaggle Competitions
Master
On-Policy Distillation(OPD)とは • Studentによる途中生成をTeacherへの入力とした時の、Teacherの出力分布を Studentが学ぶ手法 ◦ off policy training :
外部からの正解データ分布を使って学習 ◦ on policy training : Student自身が生成したデータ分布を使って学習 https://thinkingmachines.ai/blog/on-policy-distillation/#on-policy-distillation--best-of-both-worlds
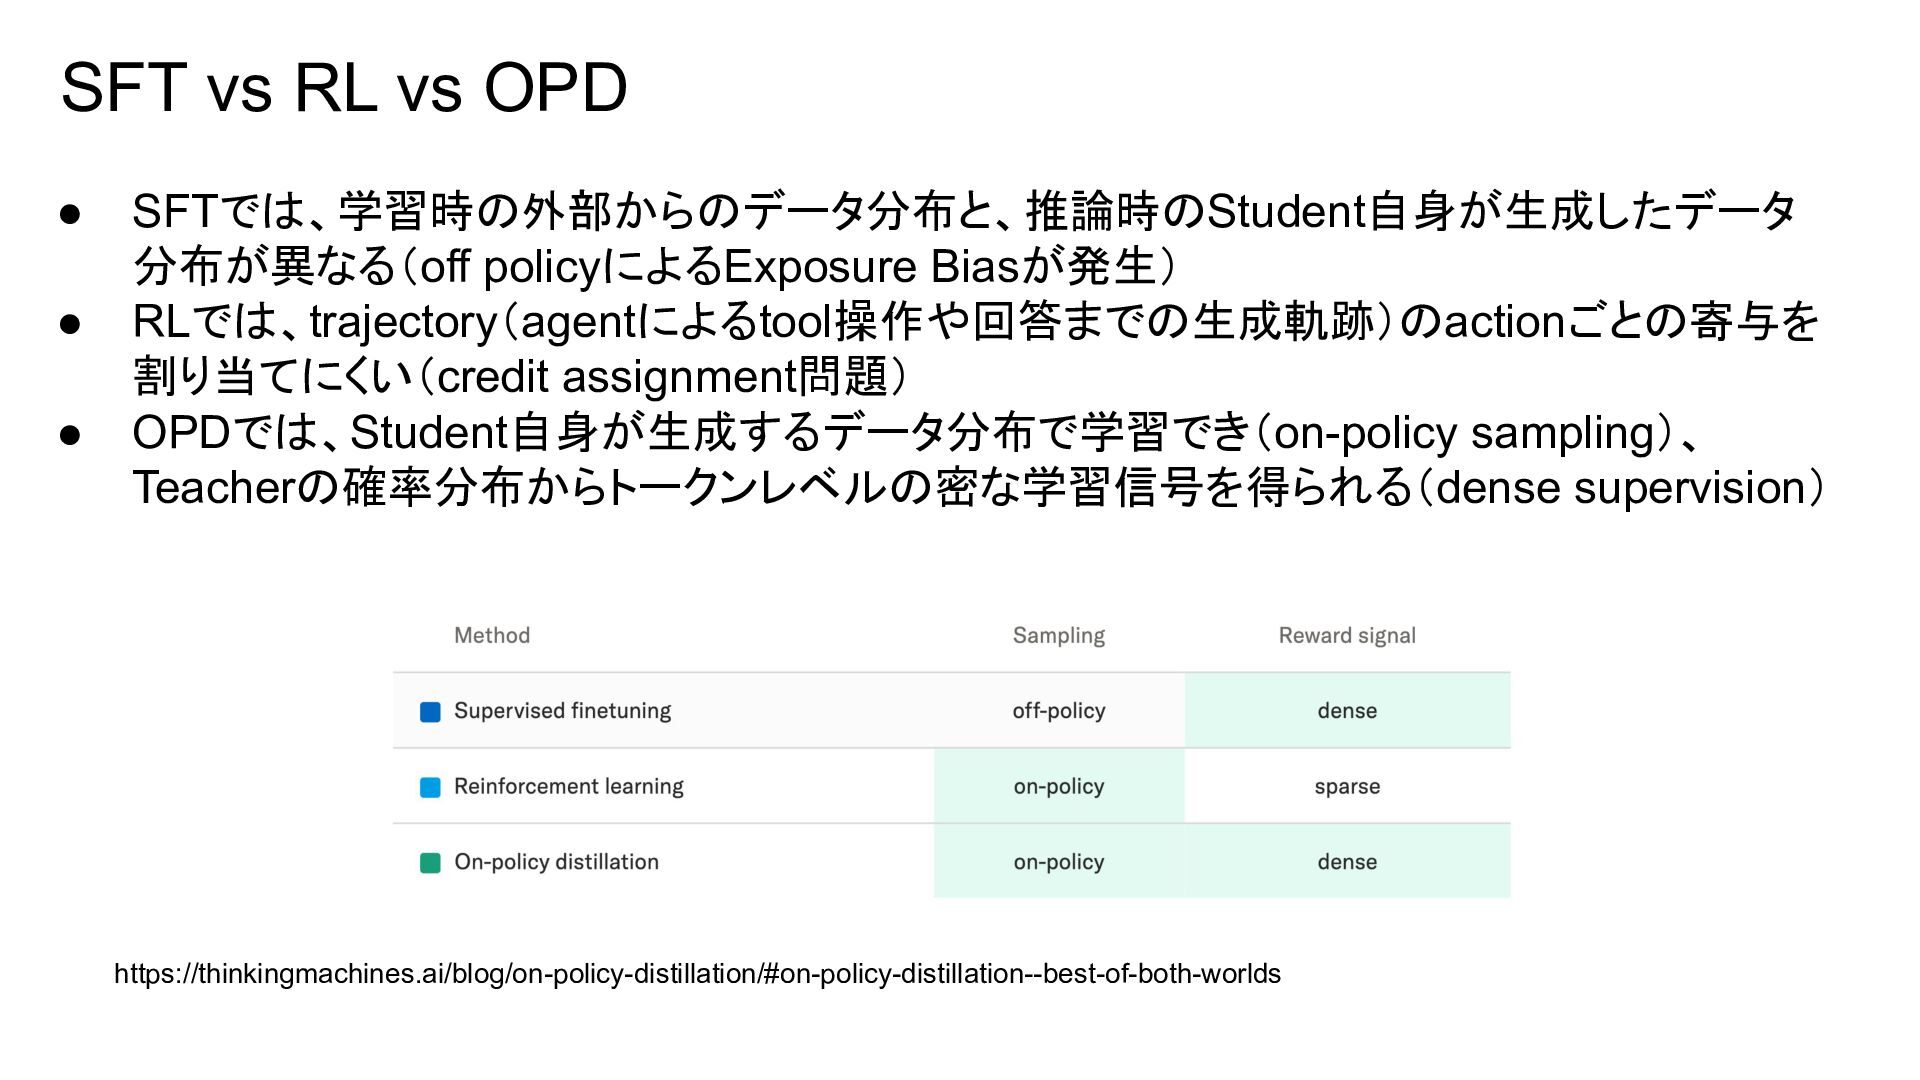
SFT vs RL vs OPD • • • SFTでは、学習時の外部からのデータ分布と、推論時のStudent自身が生成したデータ 分布が異なる(off
policyによるExposure Biasが発生) RLでは、trajectory(agentによるtool操作や回答までの生成軌跡)のactionごとの寄与を 割り当てにくい(credit assignment問題) OPDでは、Student自身が生成するデータ分布で学習でき(on-policy sampling)、 Teacherの確率分布からトークンレベルの密な学習信号を得られる(dense supervision) https://thinkingmachines.ai/blog/on-policy-distillation/#on-policy-distillation--best-of-both-worlds
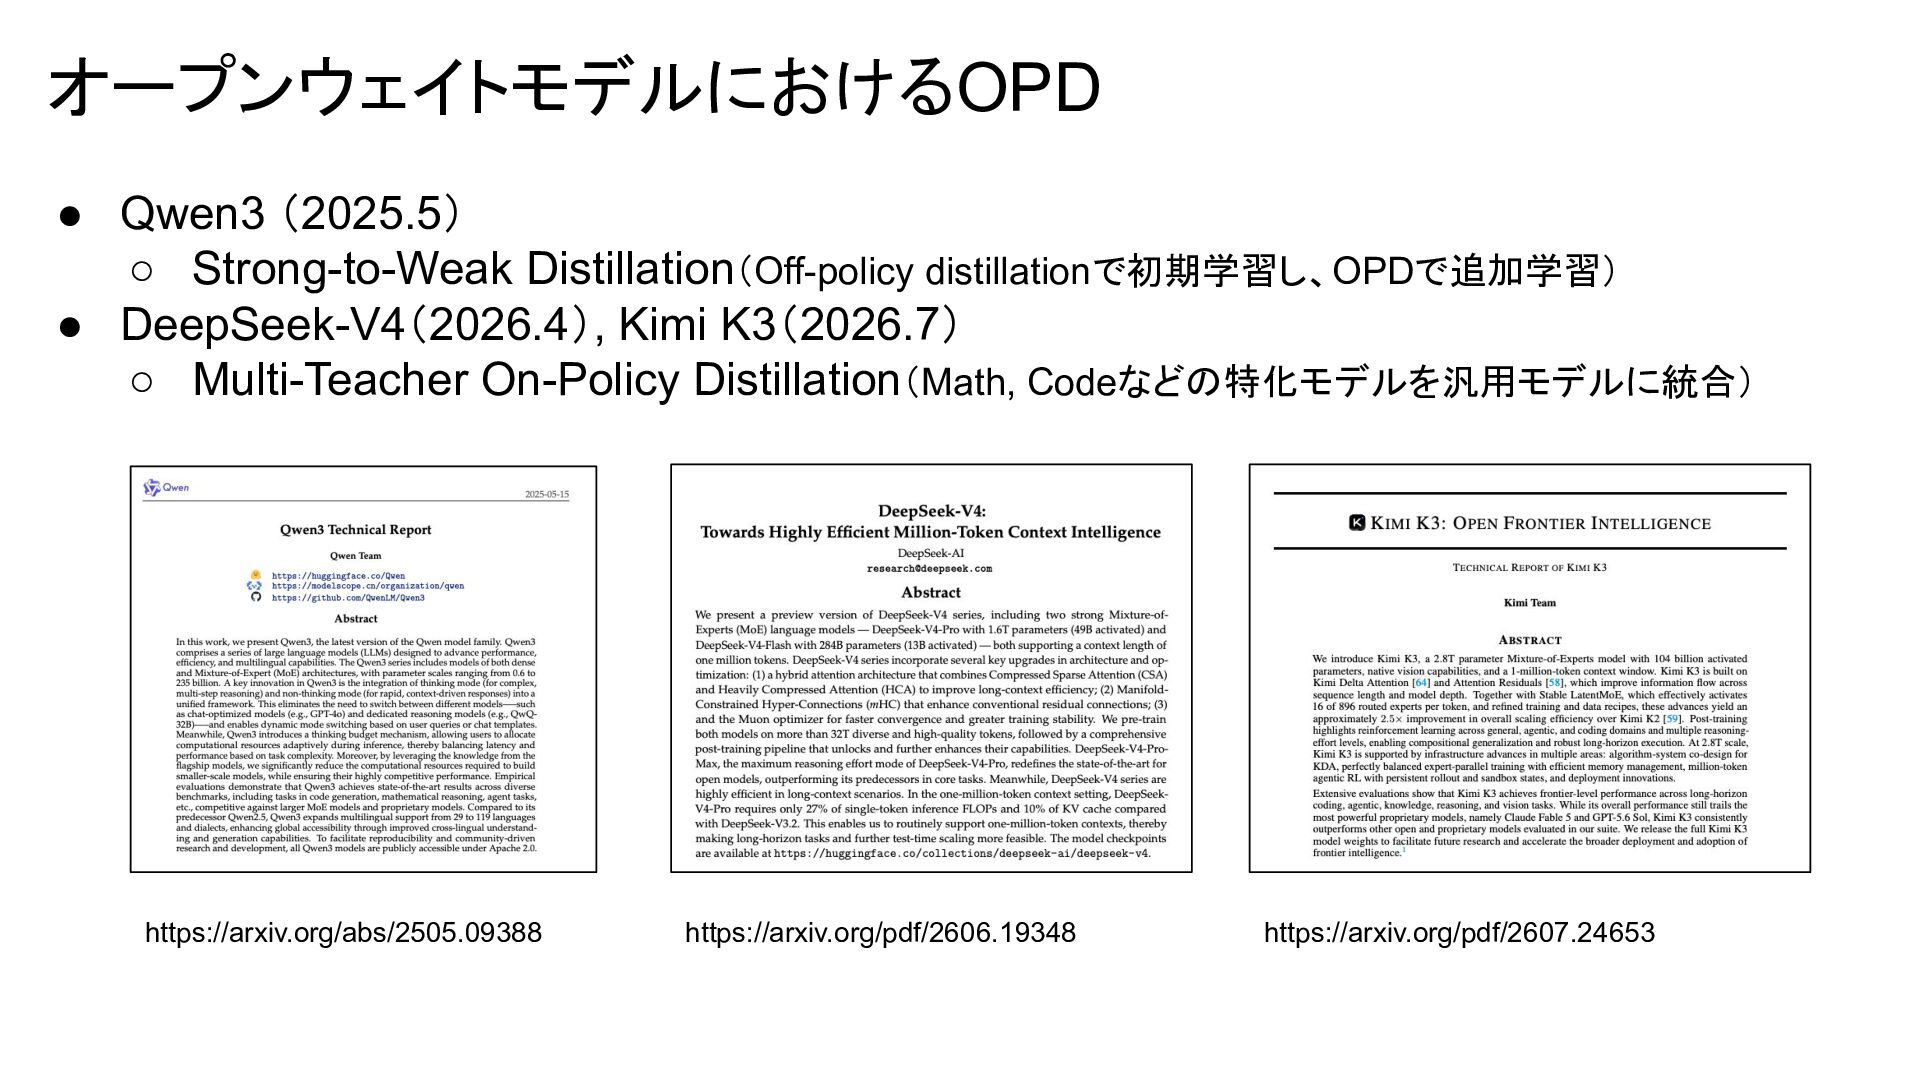
オープンウェイトモデルにおけるOPD • Qwen3 (2025.5) ◦ Strong-to-Weak Distillation(Off-policy distillationで初期学習し、OPDで追加学習) • DeepSeek-V4(2026.4),
Kimi K3(2026.7) ◦ Multi-Teacher On-Policy Distillation(Math, Codeなどの特化モデルを汎用モデルに統合) https://arxiv.org/abs/2505.09388 https://arxiv.org/pdf/2606.19348 https://arxiv.org/pdf/2607.24653
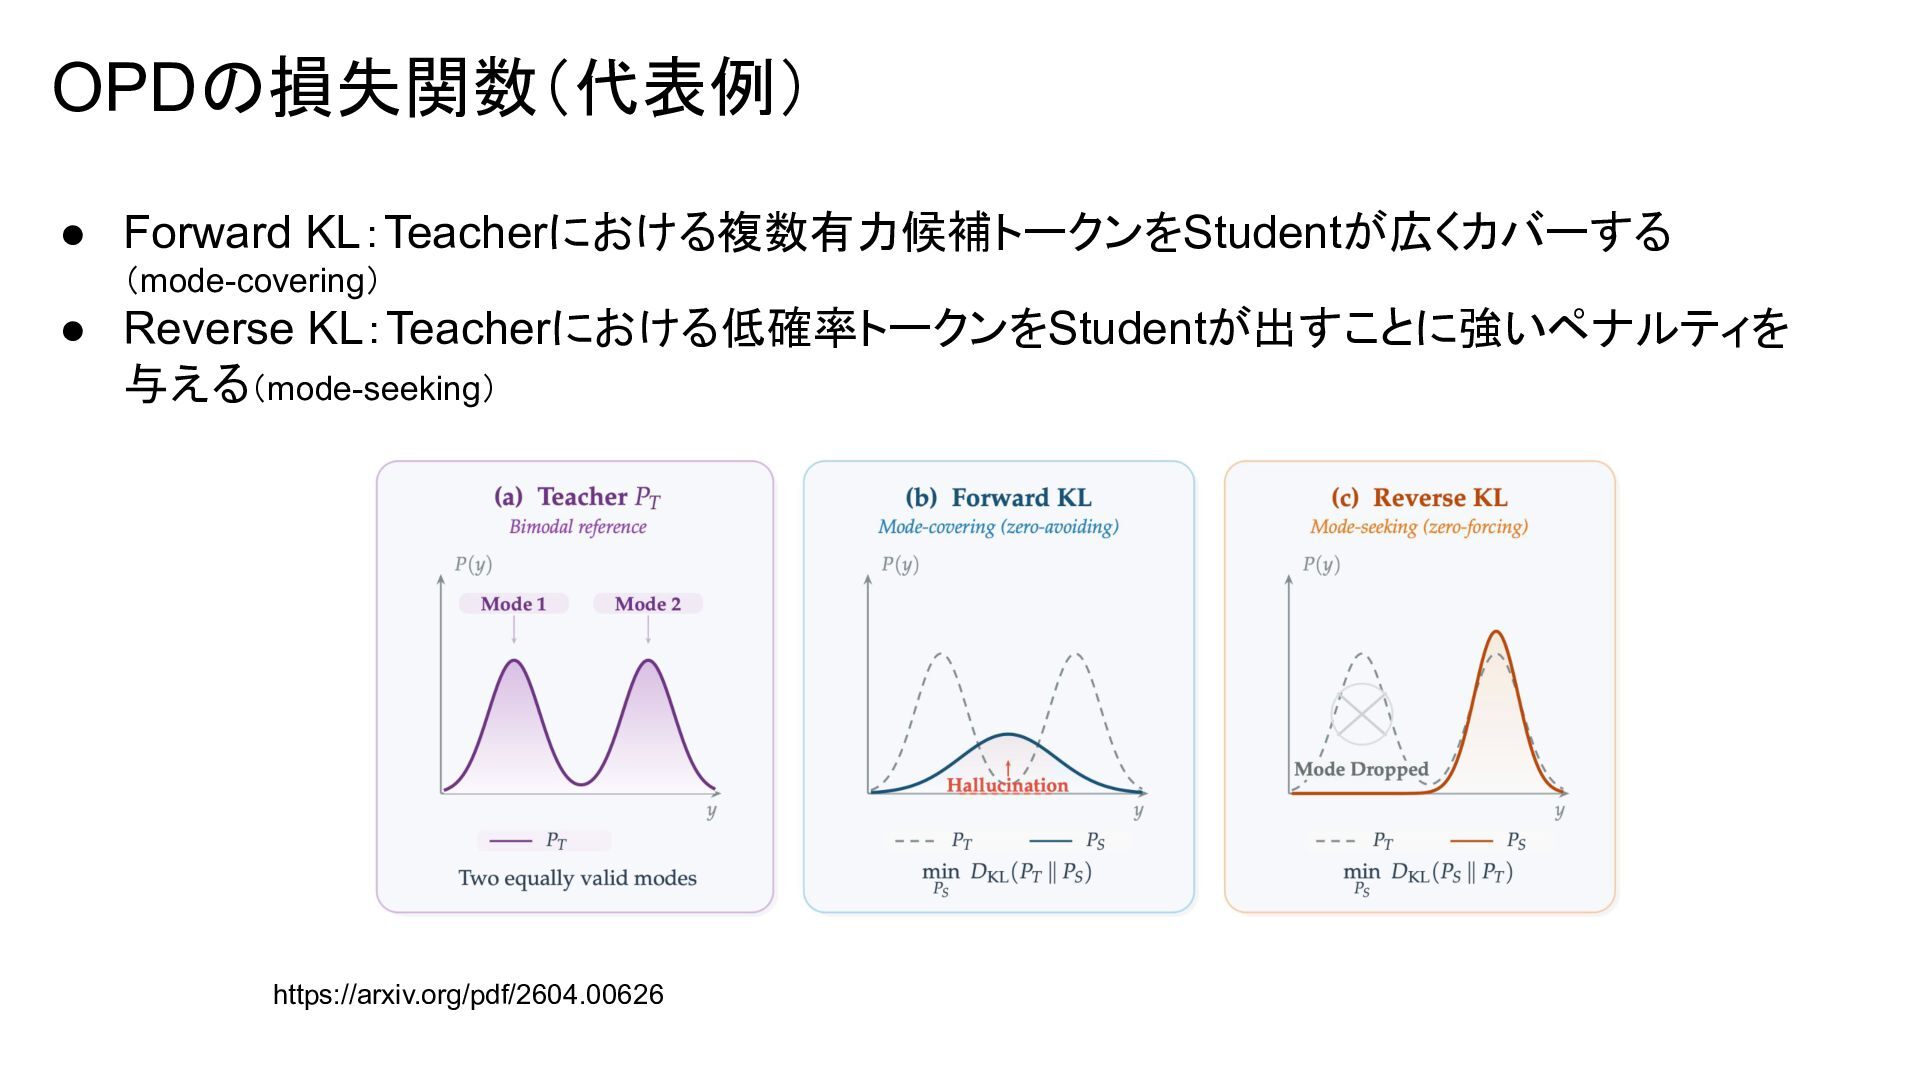
OPDの損失関数(代表例) • Forward KL:Teacherにおける複数有力候補トークンをStudentが広くカバーする (mode-covering) • Reverse KL:Teacherにおける低確率トークンをStudentが出すことに強いペナルティを 与える(mode-seeking) https://arxiv.org/pdf/2604.00626
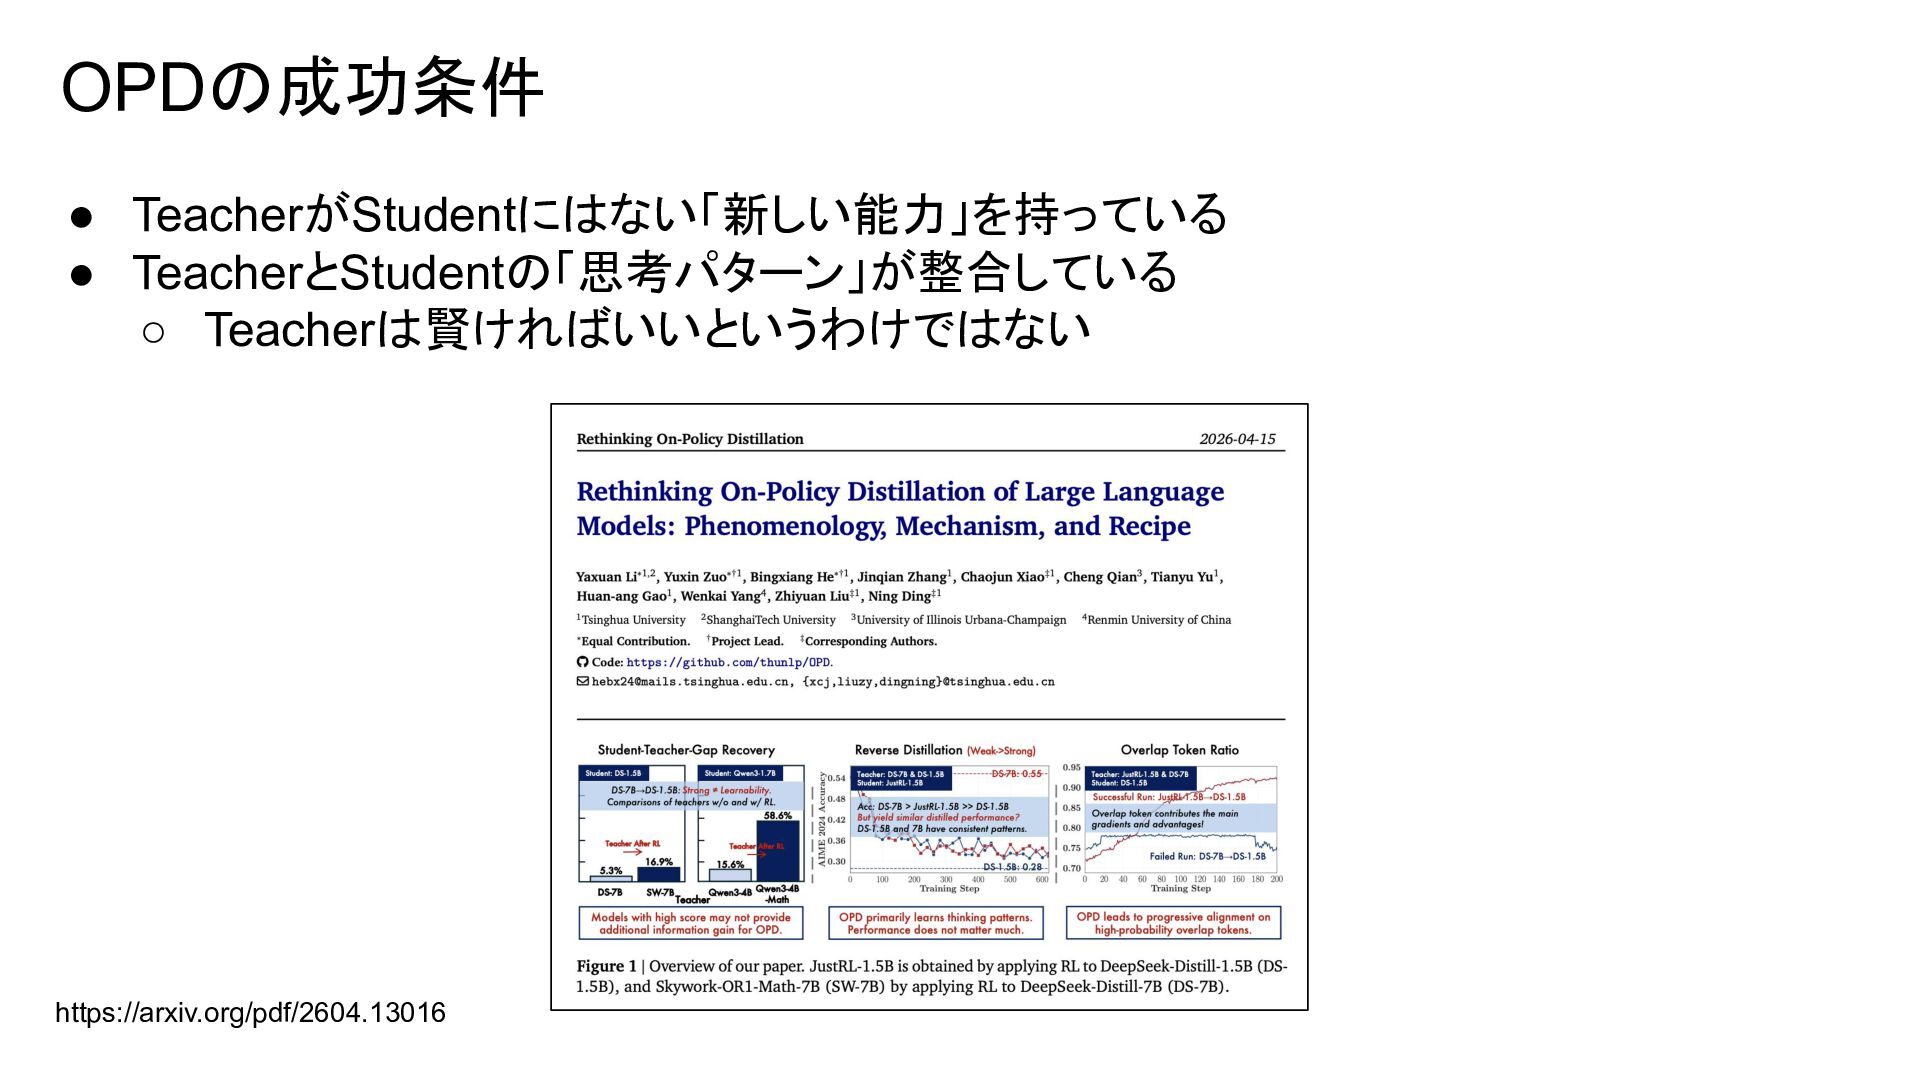
OPDの成功条件 • TeacherがStudentにはない「新しい能力」を持っている • TeacherとStudentの「思考パターン」が整合している ◦ Teacherは賢ければいいというわけではない https://arxiv.org/pdf/2604.13016
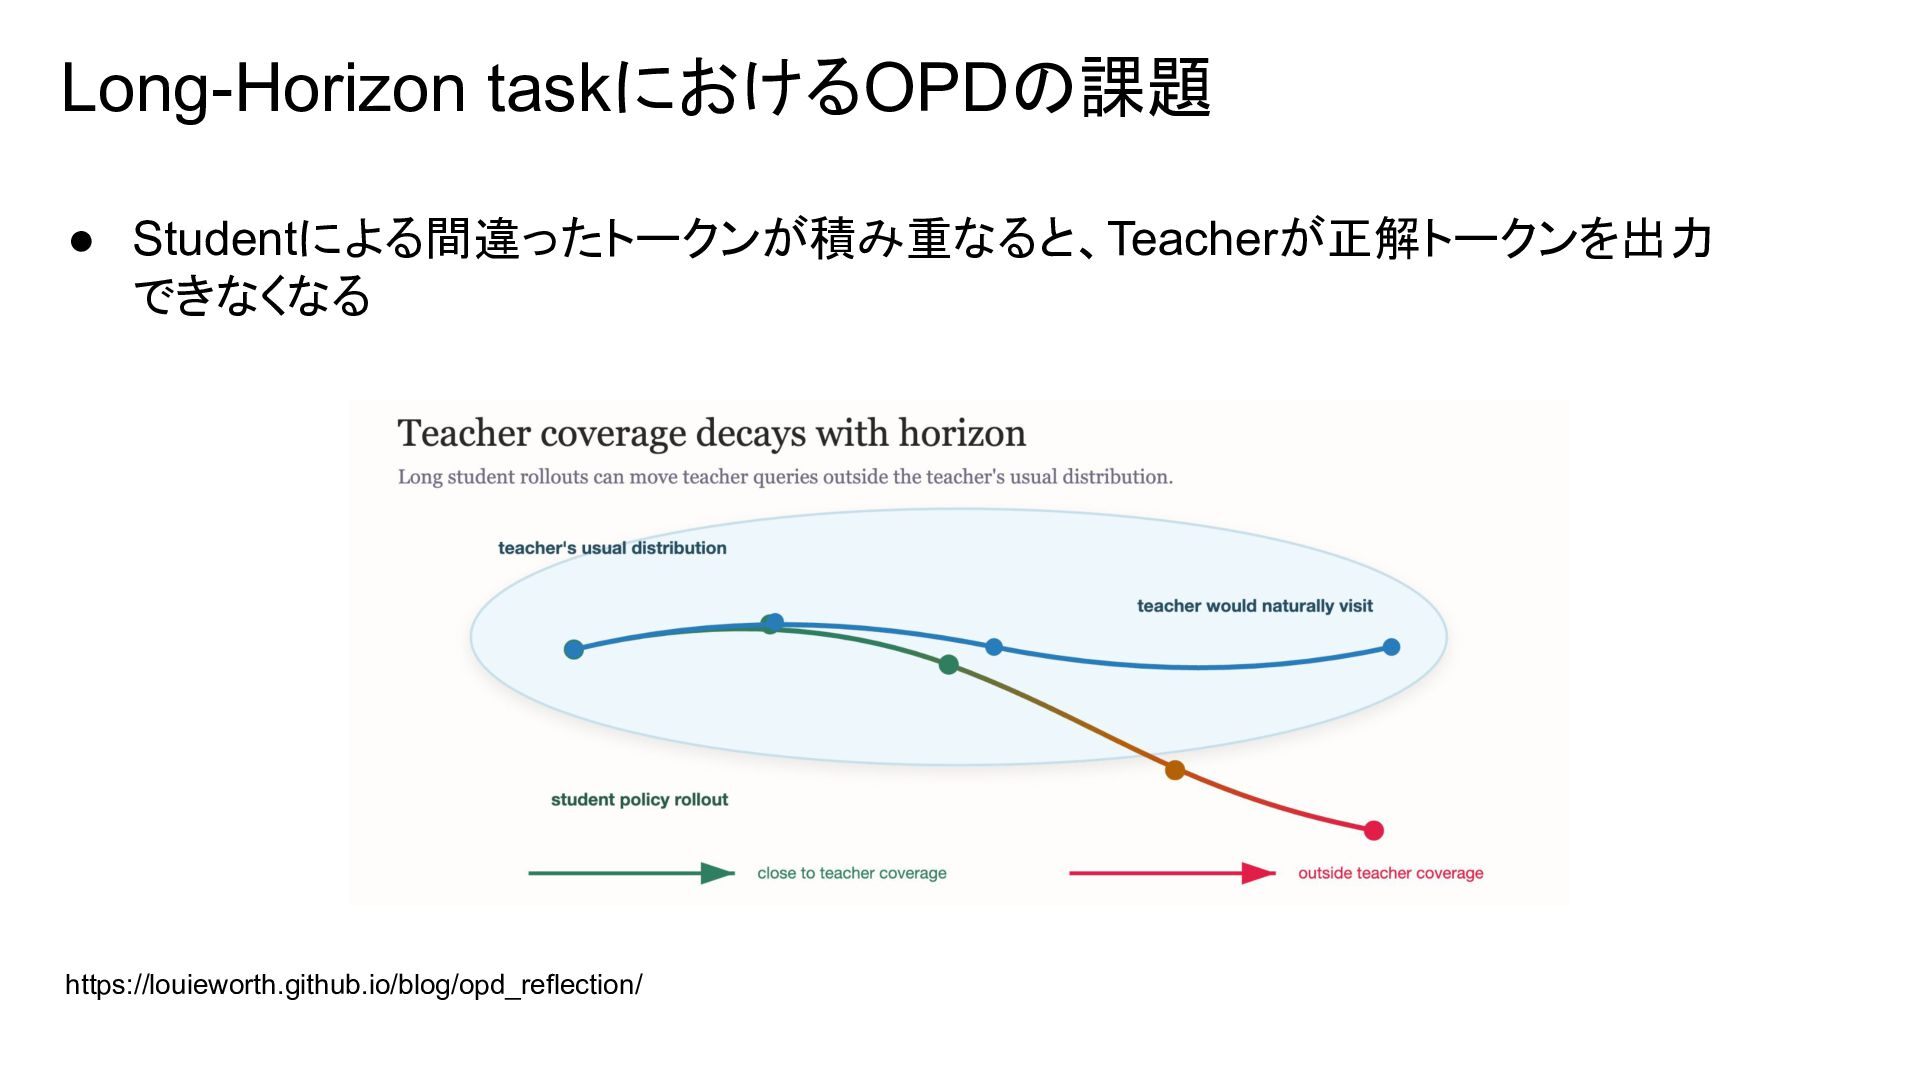
Long-Horizon taskにおけるOPDの課題 • Studentによる間違ったトークンが積み重なると、Teacherが正解トークンを出力 できなくなる https://louieworth.github.io/blog/opd_reflection/
Agentic Task OPDの舞台 • エンロンは米国のエネルギー企業。 • 粉飾決算をめぐる訴訟の過程で約50万通の社内メールが公開され、現在は研究用データ セットとしても利用されている。 https://www.amazon.co.jp/-/en/%E5%85%83%E3%82%A8%E3%83%B3% E3%83%AD%E3%83%B3%E7%A4%BE%E5%93%A1-%E3%82%B1%E3
%83%B3%E3%83%BB%E3%83%AC%E3%82%A4-%E5%85%83CEO-% E3%82%B8%E3%82%A7%E3%83%95%E3%83%BB%E3%82%B9%E3% 82%AD%E3%83%AA%E3%83%B3%E3%82%B0-%E3%82%A2%E3%83 %B3%E3%83%87%E3%82%A3%E3%83%BB%E3%83%95%E3%82%A1 %E3%82%B9%E3%83%88%E3%82%A6/dp/B000O1OBLE
参考)Enron メールの例 ◦ Question: When will the new Weekly Report
be delivered each week?(新し い週次レポートは毎週いつ届きますか?) ◦ Mail: for delivery 8am Monday mornings(毎週月曜の午前8時に配信予定) ◦ Answer: 8am Monday mornings.(毎週月曜の午前8時)
Agentic Task OPDの概要 • • • • Task:メール検索 Dataset:Enron Mail
Pipeline:ReAct(4つのTool: メール検索, メールベクトル検索, メール読み込み, 最終回答) Training:On-Policy Distillation(LoRA) ◦ Student Model:Qwen3 4B ◦ Teacher Model:Qwen3 14B
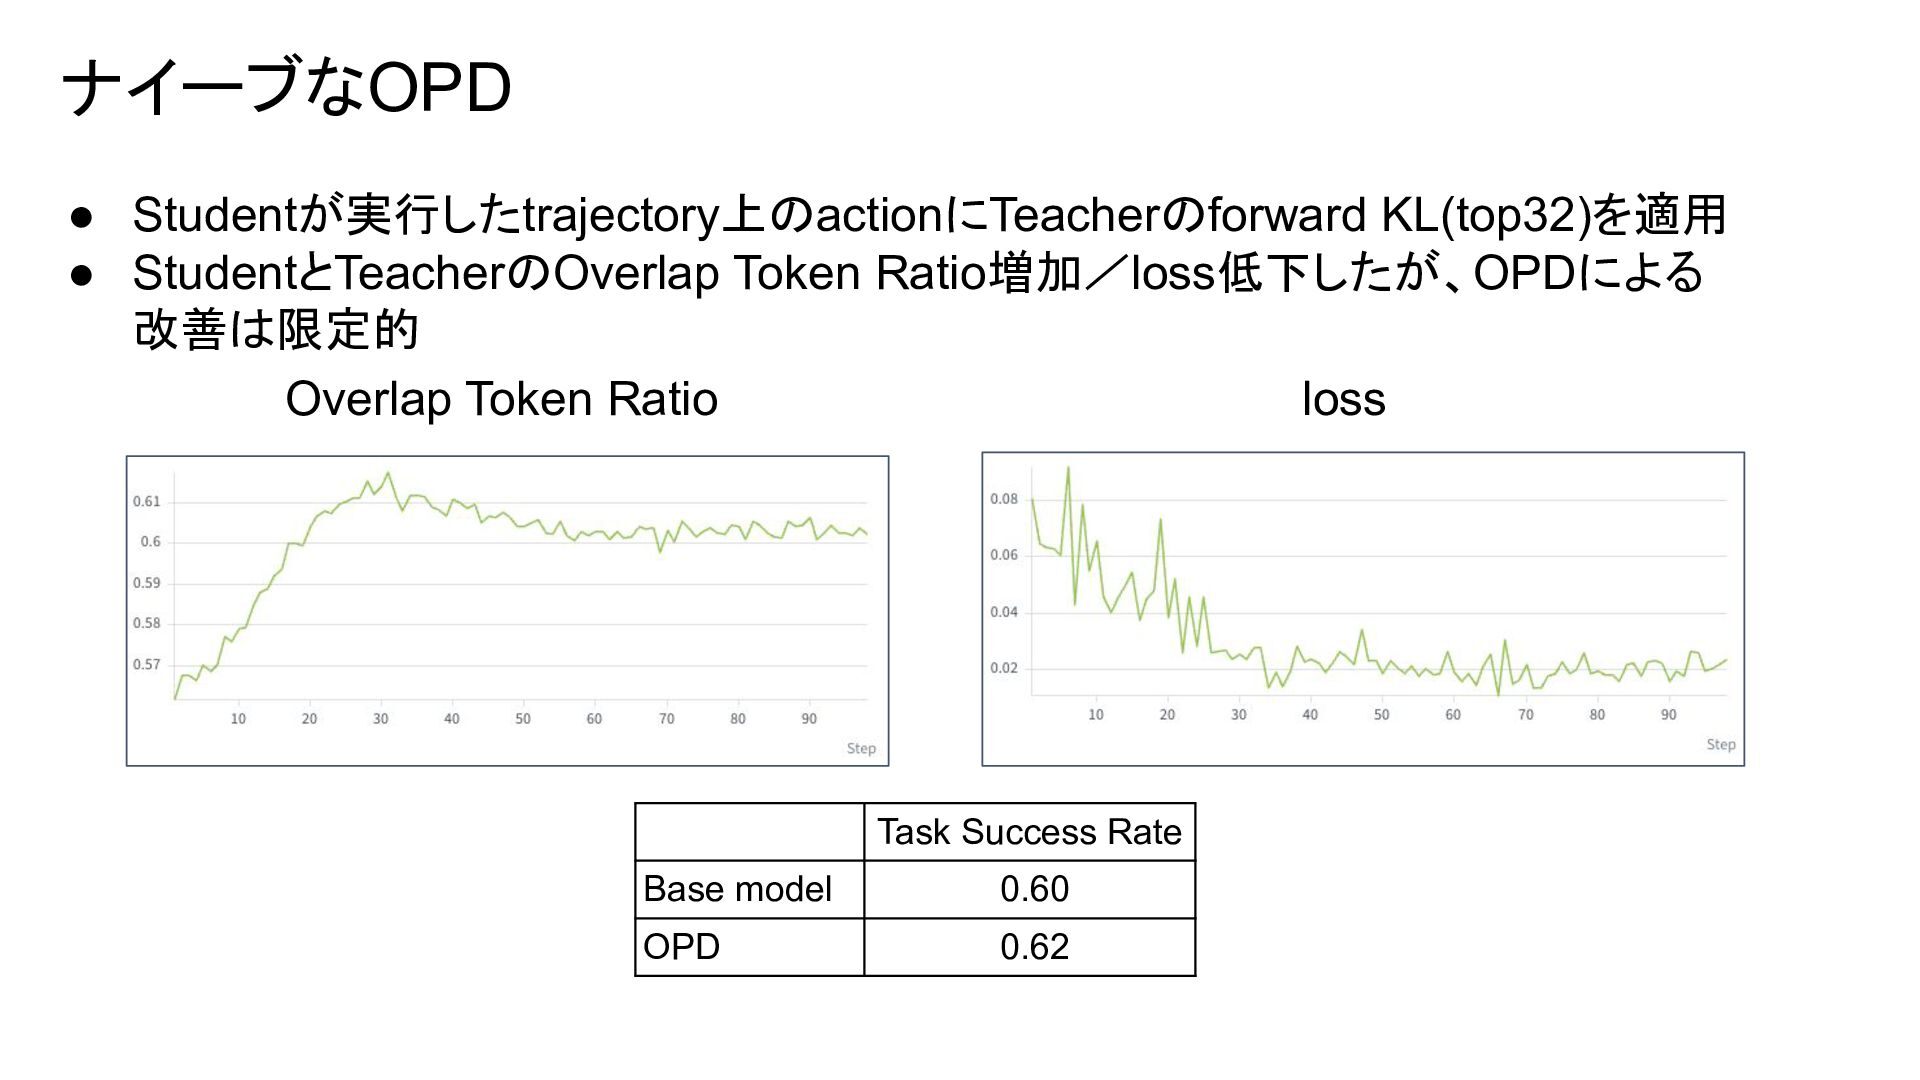
ナイーブなOPD • Studentが実行したtrajectory上のactionにTeacherのforward KL(top32)を適用 • StudentとTeacherのOverlap Token Ratio増加/loss低下したが、OPDによる 改善は限定的 loss
Overlap Token Ratio Task Success Rate Base model 0.60 OPD 0.62
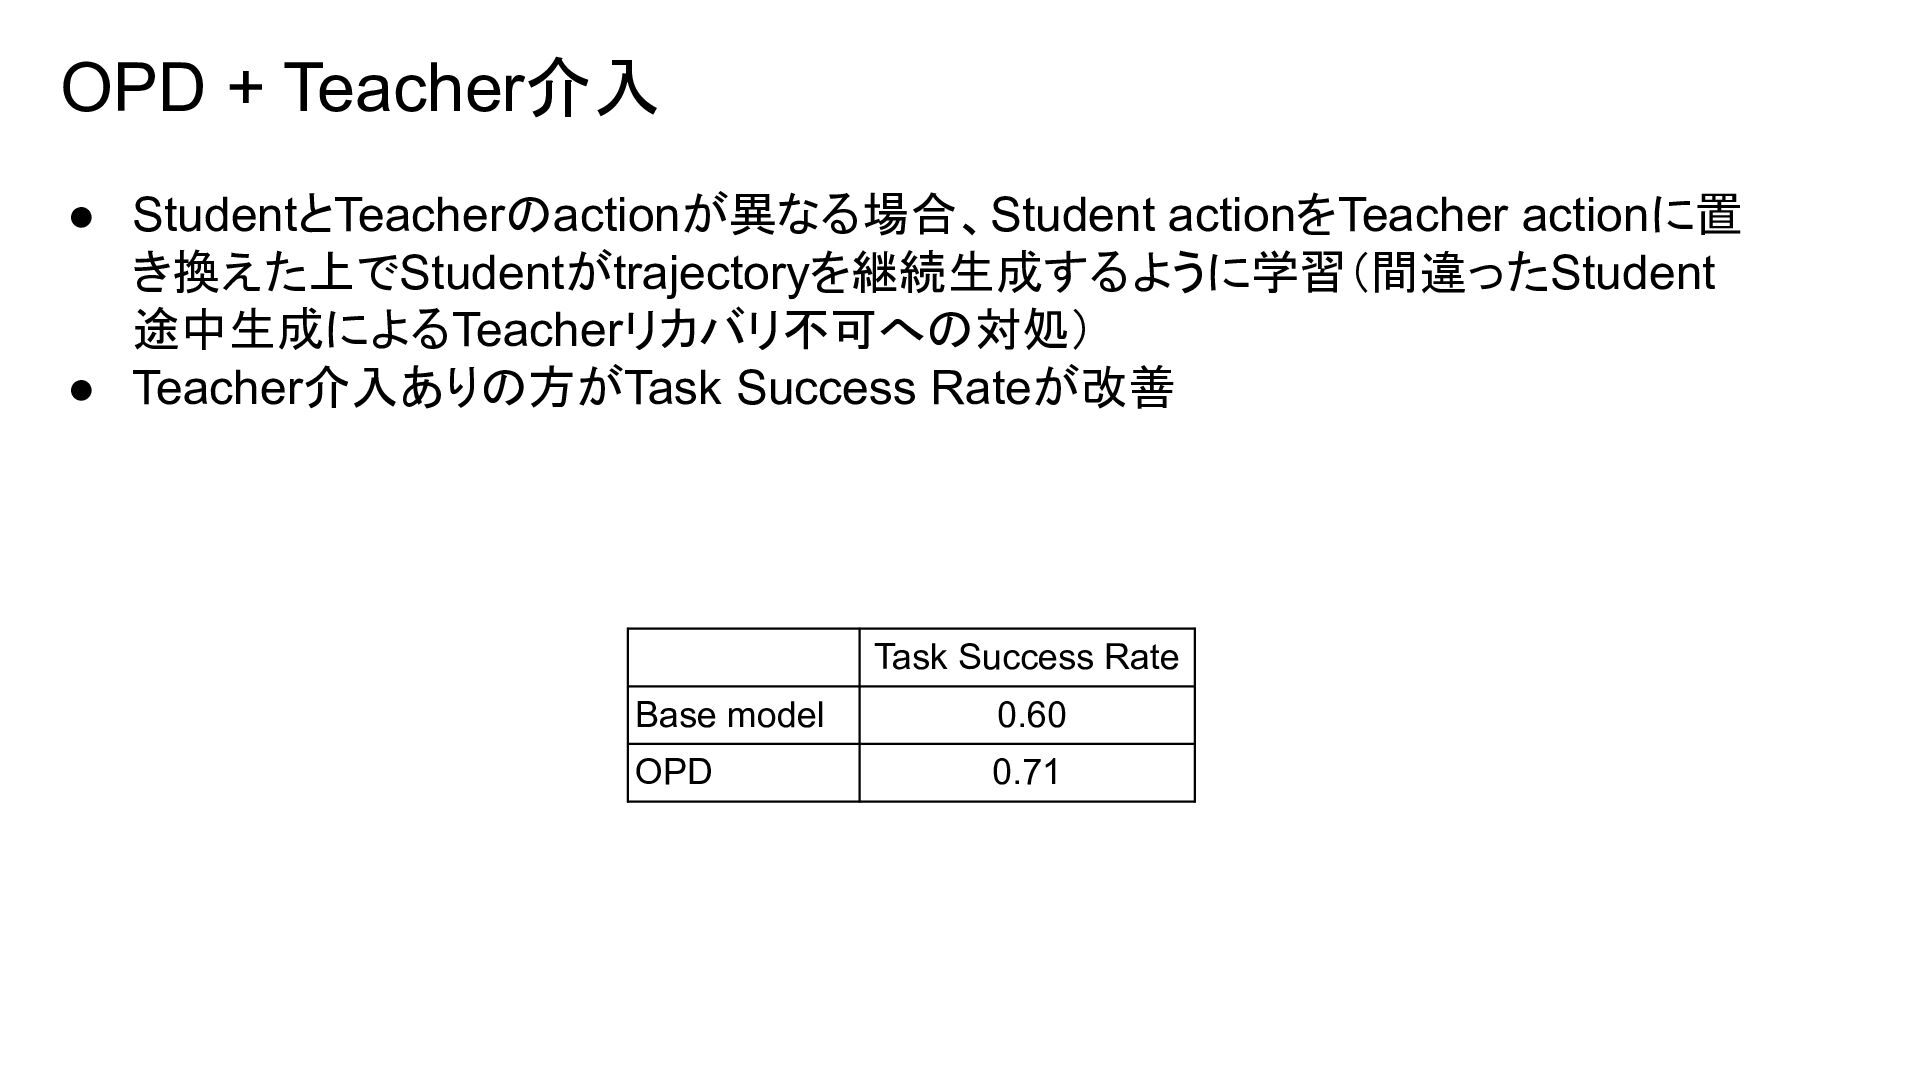
OPD + Teacher介入 • StudentとTeacherのactionが異なる場合、Student actionをTeacher actionに置 き換えた上でStudentがtrajectoryを継続生成するように学習(間違ったStudent 途中生成によるTeacherリカバリ不可への対処) •
Teacher介入ありの方がTask Success Rateが改善 Task Success Rate Base model 0.60 OPD 0.71
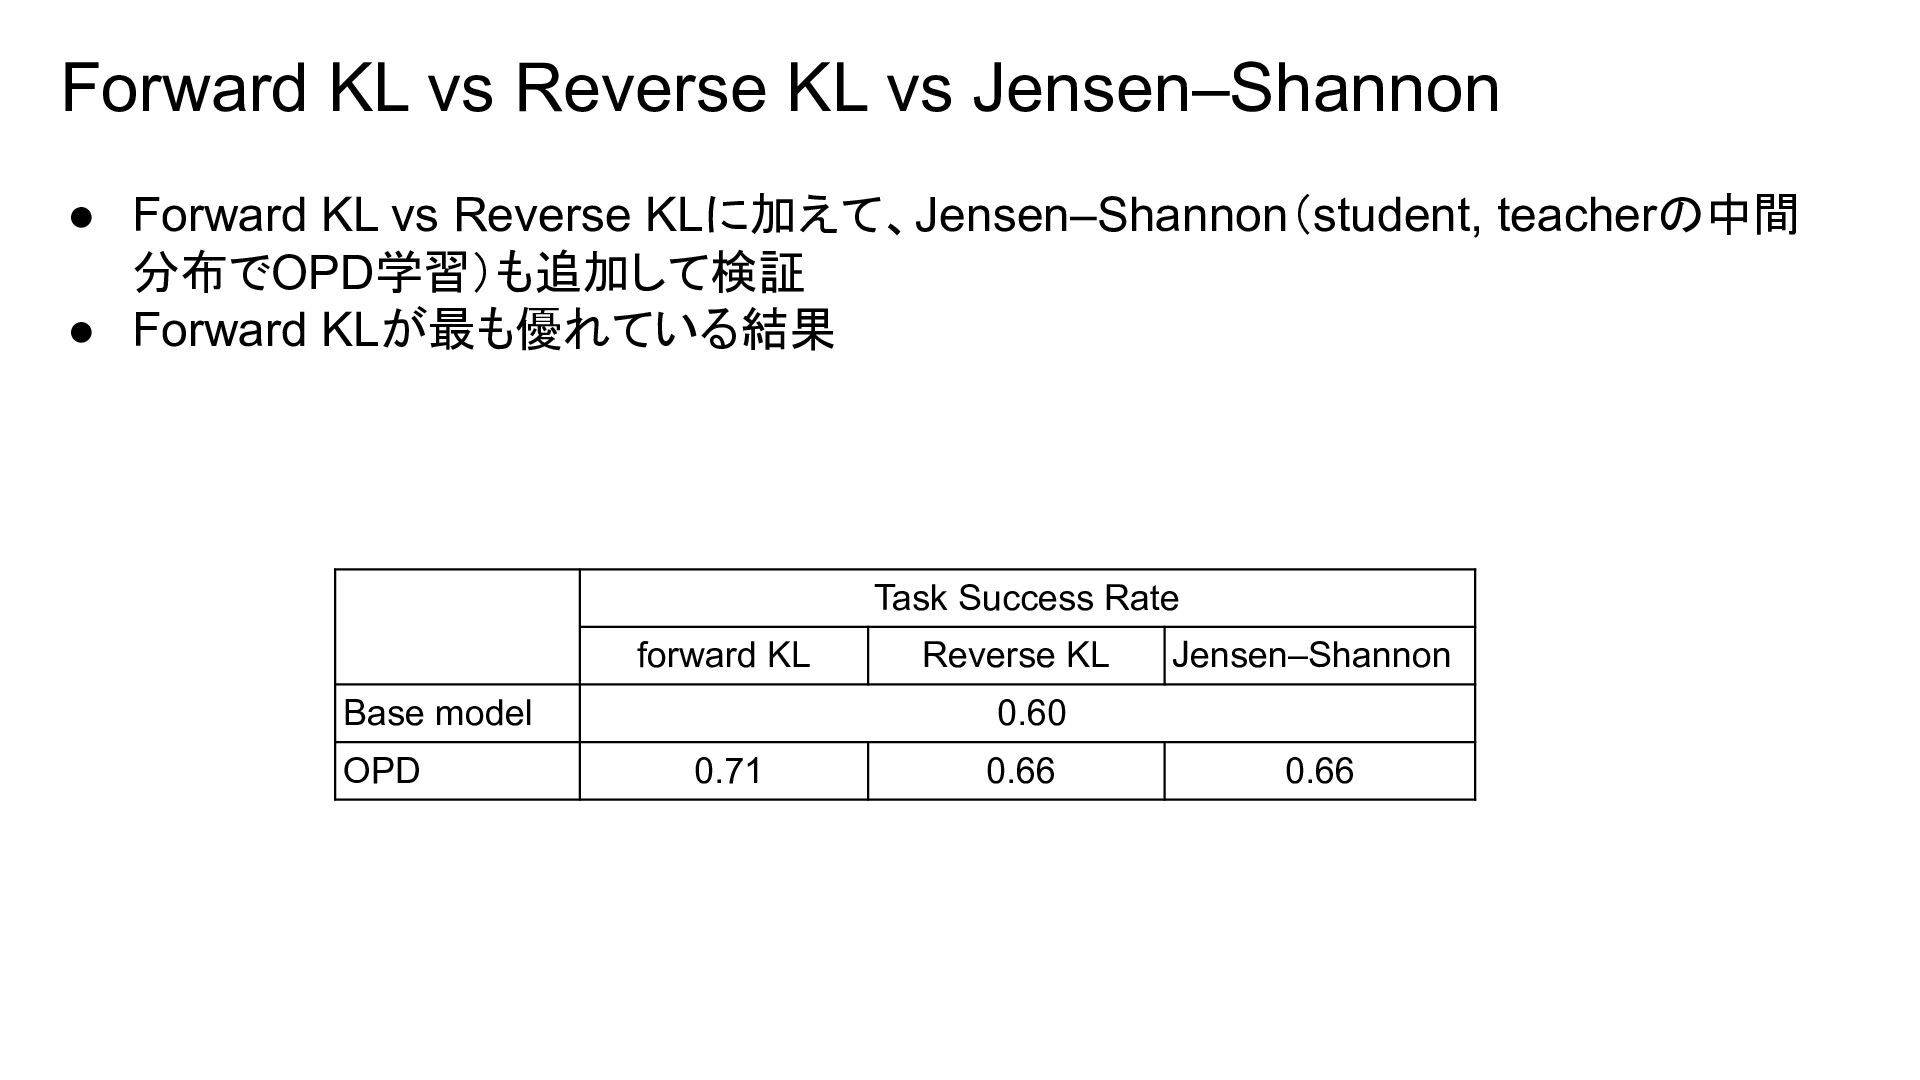
Forward KL vs Reverse KL vs Jensen–Shannon • Forward KL
vs Reverse KLに加えて、Jensen–Shannon(student, teacherの中間 分布でOPD学習)も追加して検証 • Forward KLが最も優れている結果 Task Success Rate forward KL Base model OPD Reverse KL Jensen–Shannon 0.60 0.71 0.66 0.66
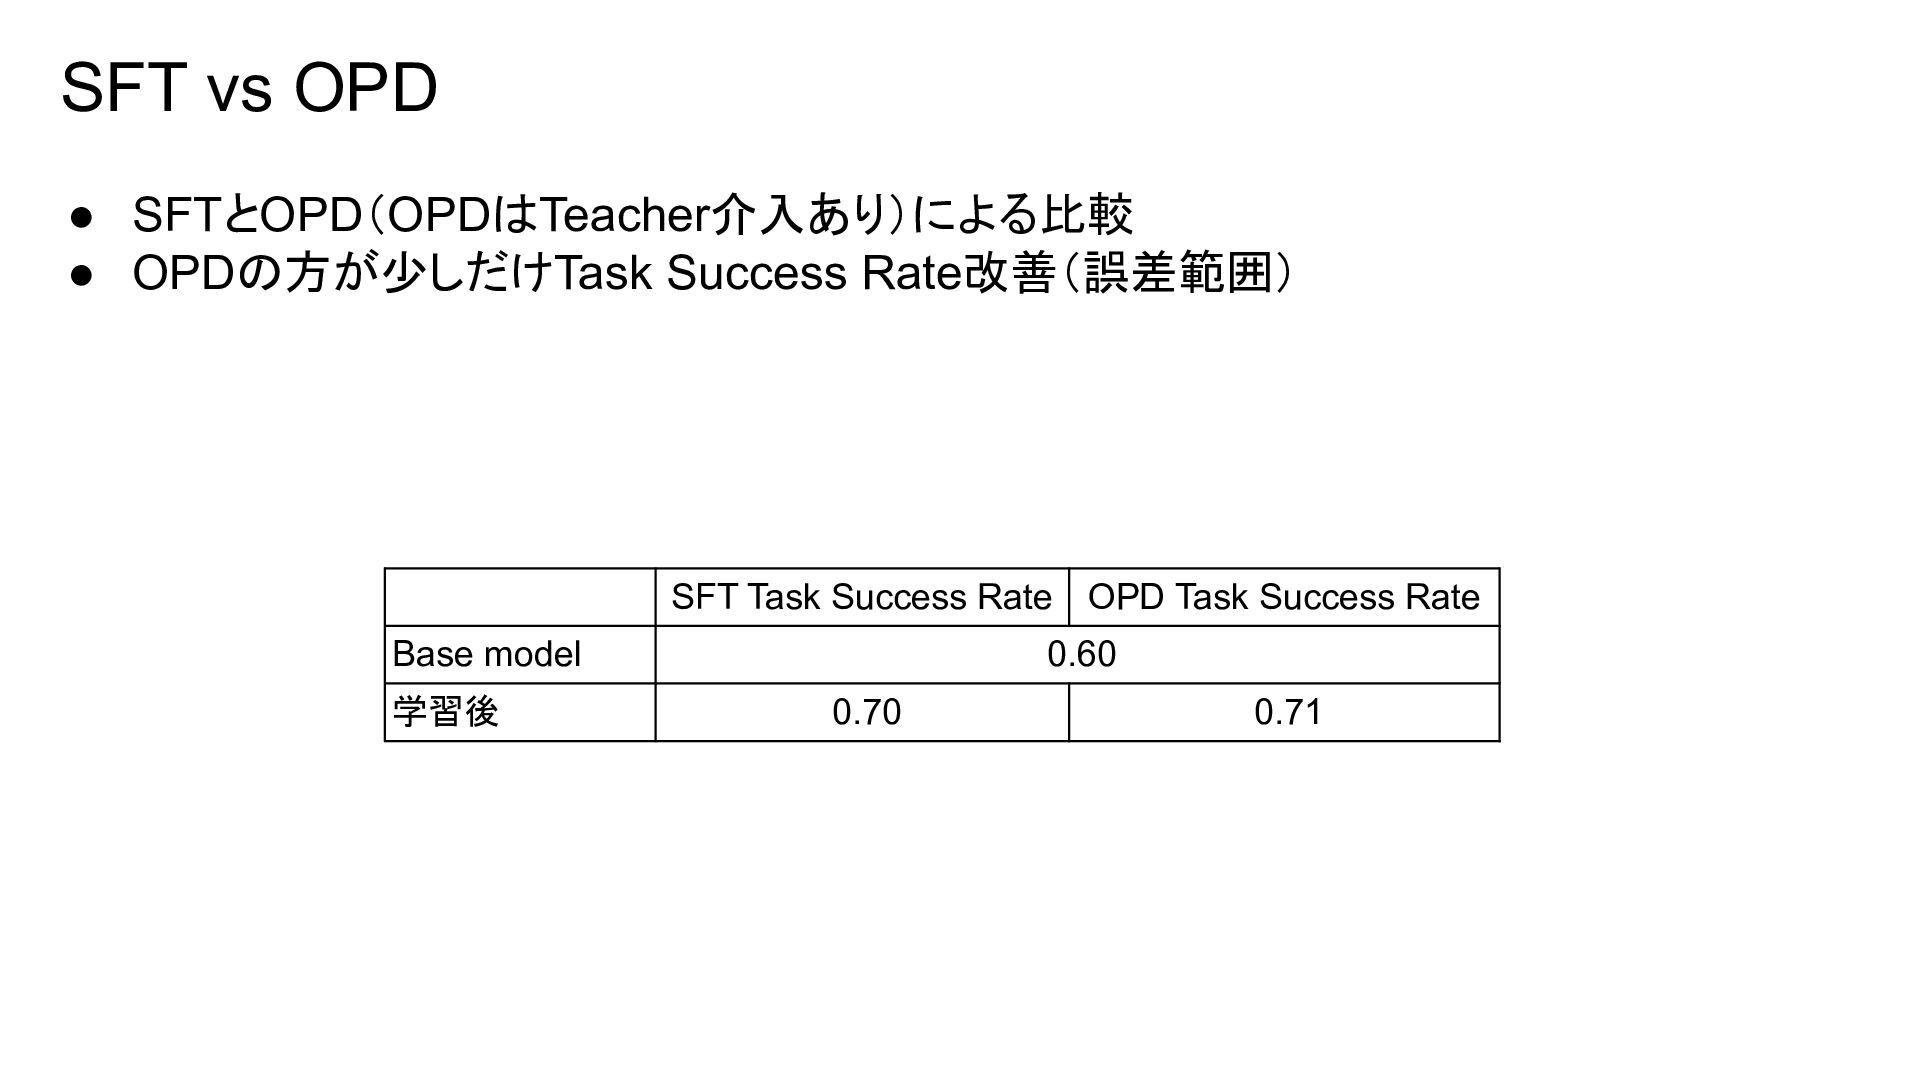
SFT vs OPD • SFTとOPD(OPDはTeacher介入あり)による比較 • OPDの方が少しだけTask Success Rate改善(誤差範囲) SFT
Task Success Rate OPD Task Success Rate Base model 学習後 0.60 0.70 0.71
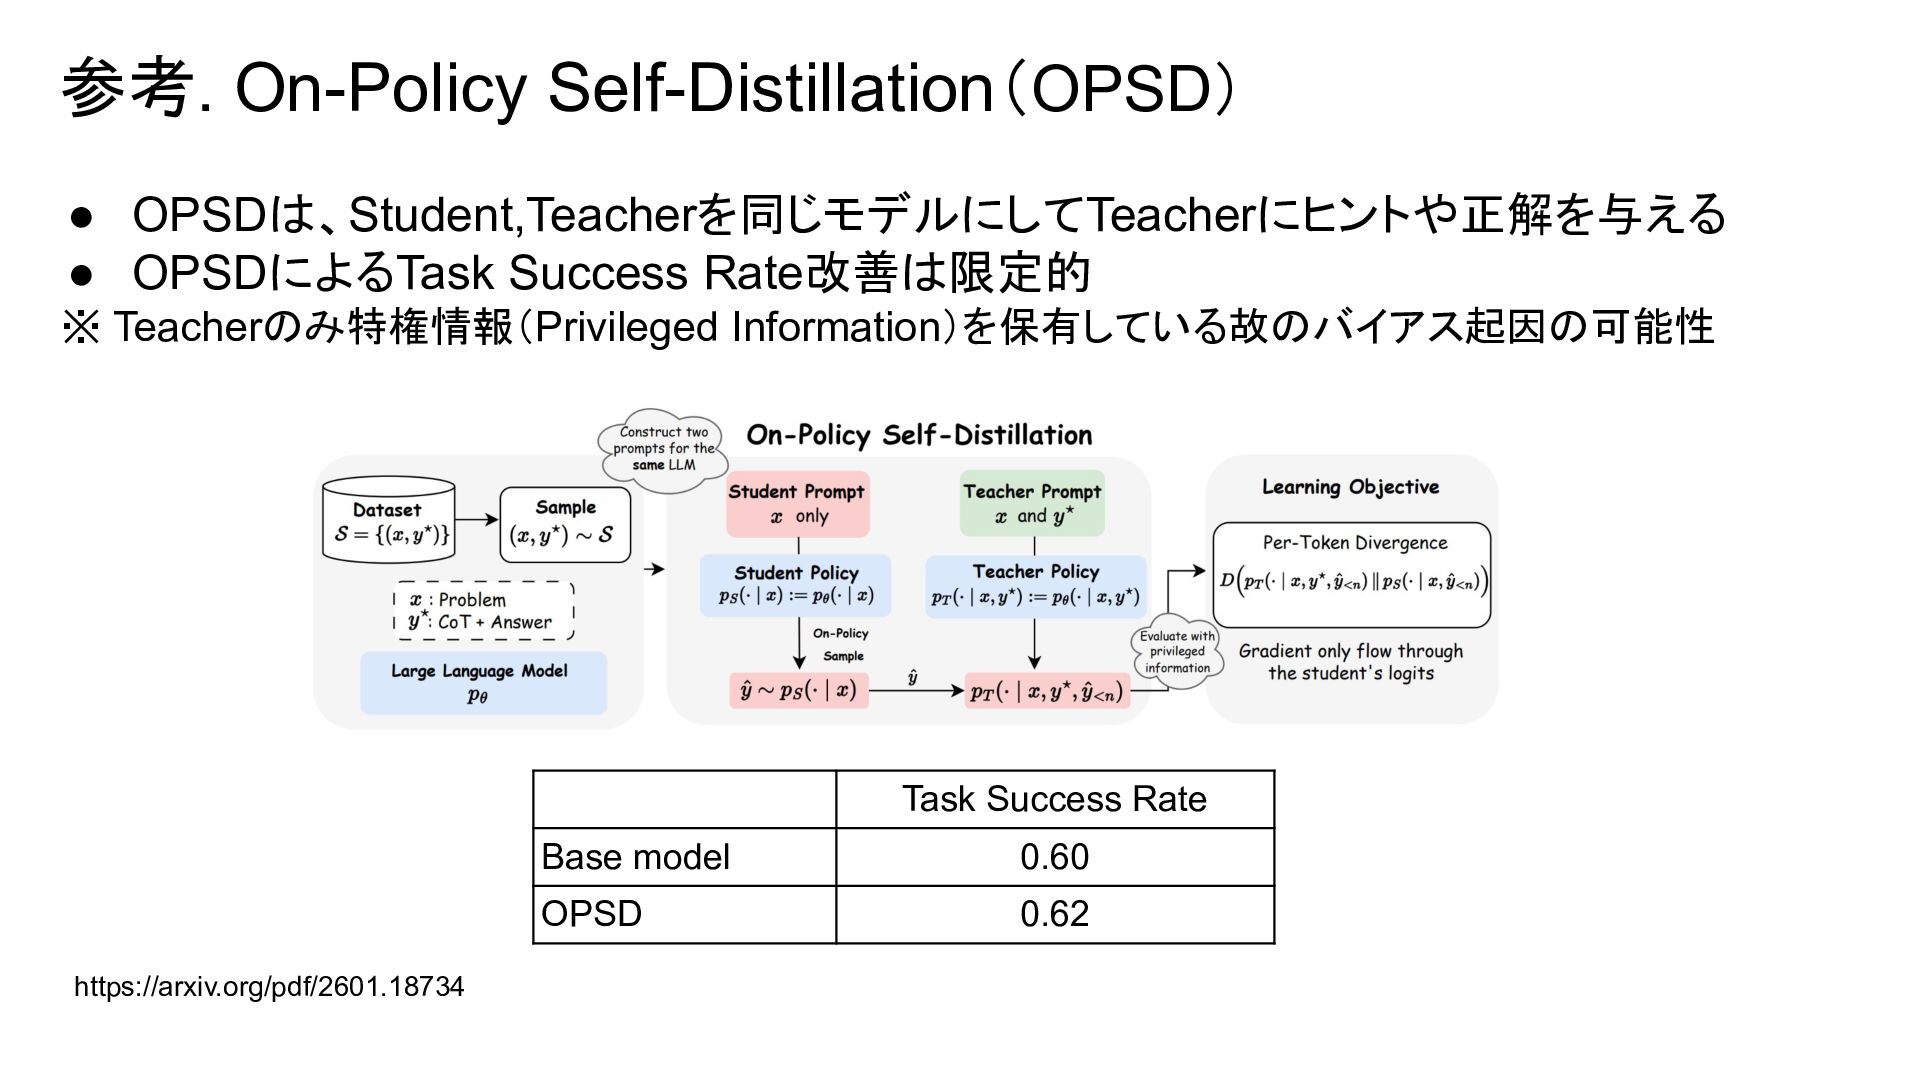
参考. On-Policy Self-Distillation(OPSD) • OPSDは、Student,Teacherを同じモデルにしてTeacherにヒントや正解を与える • OPSDによるTask Success Rate改善は限定的 ※
Teacherのみ特権情報(Privileged Information)を保有している故のバイアス起因の可能性 Task Success Rate https://arxiv.org/pdf/2601.18734 Base model 0.60 OPSD 0.62
Takeaway • OPD = On-policy × Dense teacher signal ◦
オープンウェイトのフロンティアモデルでOPDが採用されている • OPDはLLM事後学習の選択肢になりうる ◦ 今後のKaggleで活躍する可能性がある
None
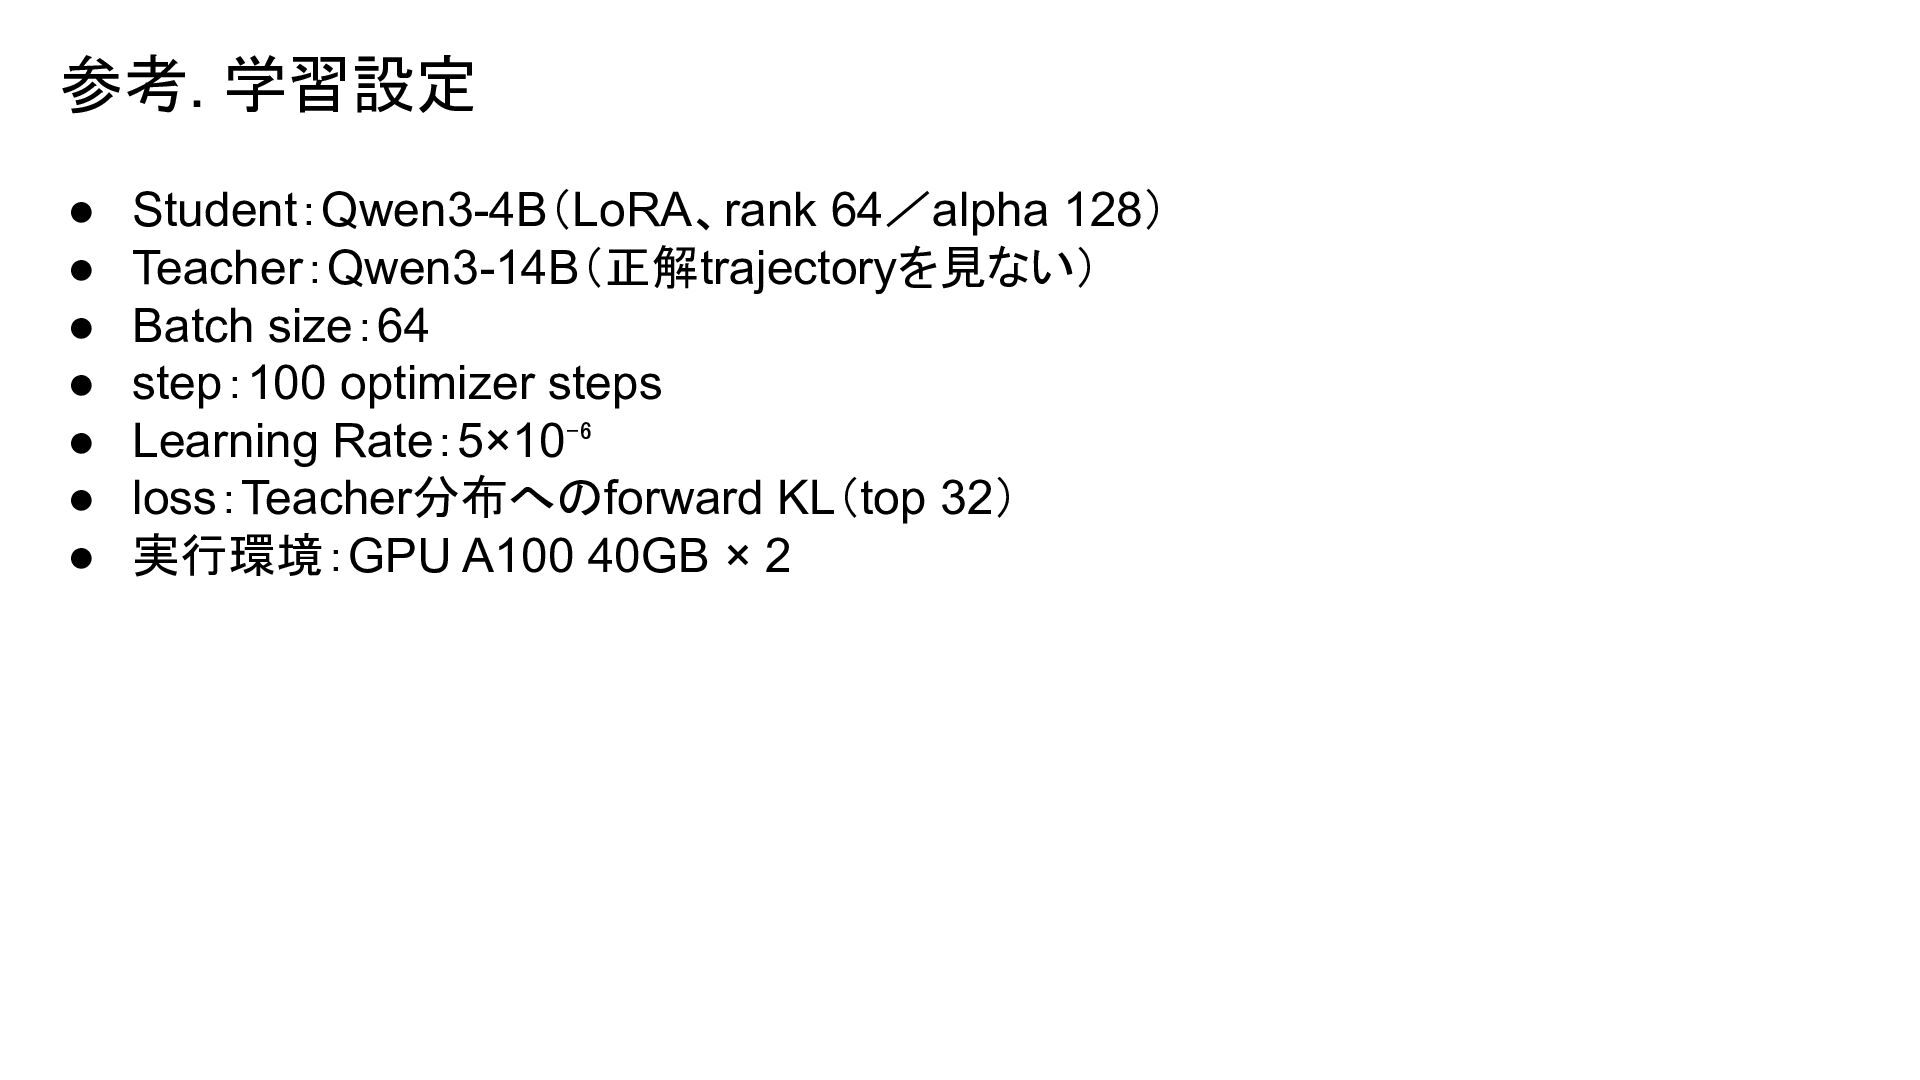
参考. 学習設定 • • • • • • • Student:Qwen3-4B(LoRA、rank
64/alpha 128) Teacher:Qwen3-14B(正解trajectoryを見ない) Batch size:64 step:100 optimizer steps Learning Rate:5×10⁻⁶ loss:Teacher分布へのforward KL(top 32) 実行環境:GPU A100 40GB × 2
参考. verl(Volcano Engine Reinforcement Learning for LLMs) • ByteDance Seed発の、LLMの強化学習・事後学習を支えるOSS
• メール検索エージェントをverlにてOPD学習 https://github.com/verl-project/verl
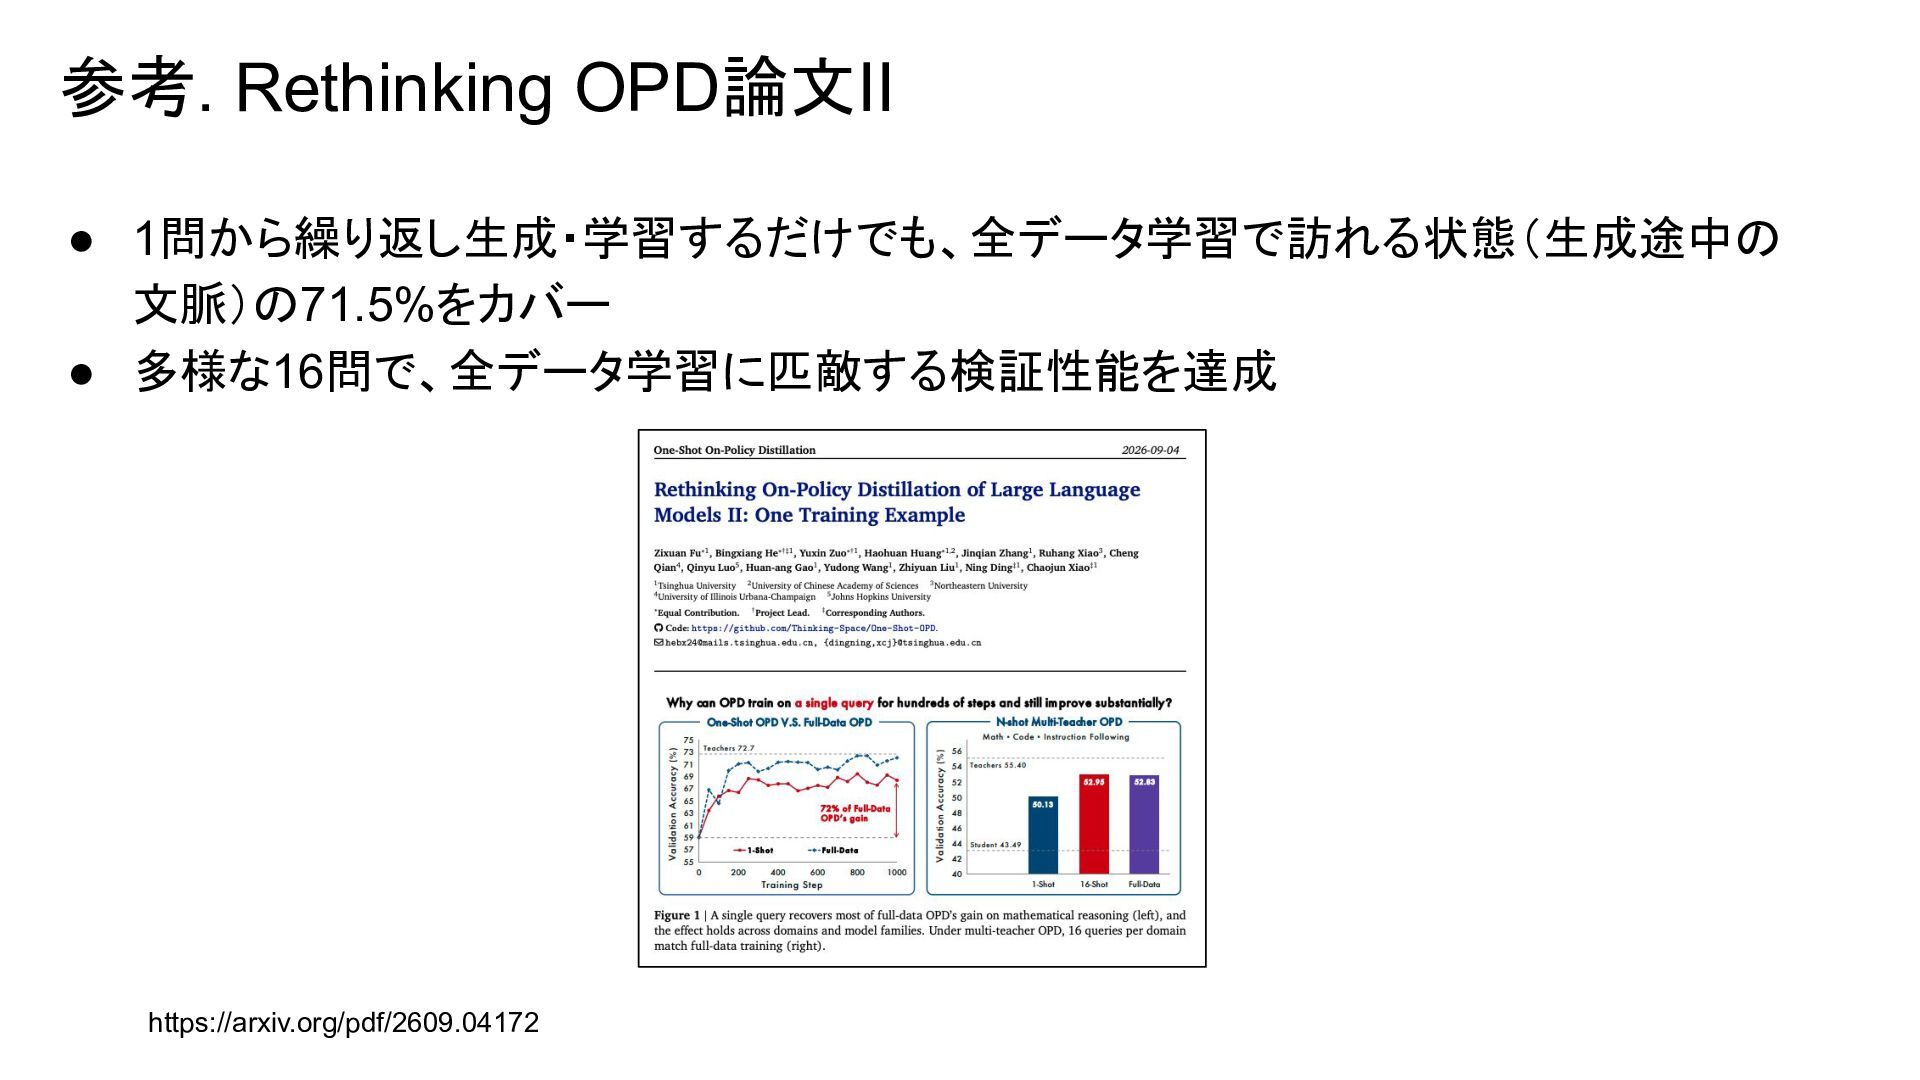
参考. Rethinking OPD論文II • 1問から繰り返し生成・学習するだけでも、全データ学習で訪れる状態(生成途中の 文脈)の71.5%をカバー • 多様な16問で、全データ学習に匹敵する検証性能を達成 https://arxiv.org/pdf/2609.04172
More Decks by mujirushi
See All by mujirushi
Eval-centric_Agentic__RL.pdf
mujirushi
0
140
都市における人間移動予測の最前線___SIGSPATIAL_Cup_2025_上位解法の紹介_.pdf
mujirushi
1
570
KDDCup2025_CRAG-MM_Challenge上位解法の紹介.pdf
mujirushi
0
140
関西kaggler会_2025_1_Mujirushi.pdf
mujirushi
2
1.7k
Kagglerが学会コンペに参加したら無双できる説
mujirushi
2
3k
Featured
See All Featured
Agile that works and the tools we love
rasmusluckow
331
22k
Building the Perfect Custom Keyboard
takai
2
960
Technical Leadership for Architectural Decision Making
baasie
4
650
From π to Pie charts
rasagy
1
450
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
3k
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
43k
RailsConf 2023
tenderlove
30
1.6k
How People are Using Generative and Agentic AI to Supercharge Their Products, Projects, Services and Value Streams Today
helenjbeal
2
400
Designing Experiences People Love
moore
143
24k
Designing for humans not robots
tammielis
254
26k
Mozcon NYC 2025: Stop Losing SEO Traffic
samtorres
1
610
Into the Great Unknown - MozCon
thekraken
41
2.8k


 mujirushi
 rasmusluckow
 takai
 baasie
 rasagy
 lindahogenes
 akihiro_kokubo
 tenderlove
 helenjbeal
 moore
 tammielis
 samtorres
 thekraken