Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
DynamoDB vs Timestream for InfluxDB 3.0 IoTデータを...
Search
村上優稀
November 14, 2026
Technology
39
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
DynamoDB vs Timestream for InfluxDB 3.0 IoTデータをリアルタイムに分析するなら
村上優稀
November 14, 2026
Transcript
21 slides
DynamoDB vs Timestream for InfluxDB 3 IoTデータをリアルタイムに分析するなら 2026 / 11
/ 15 村上優稀
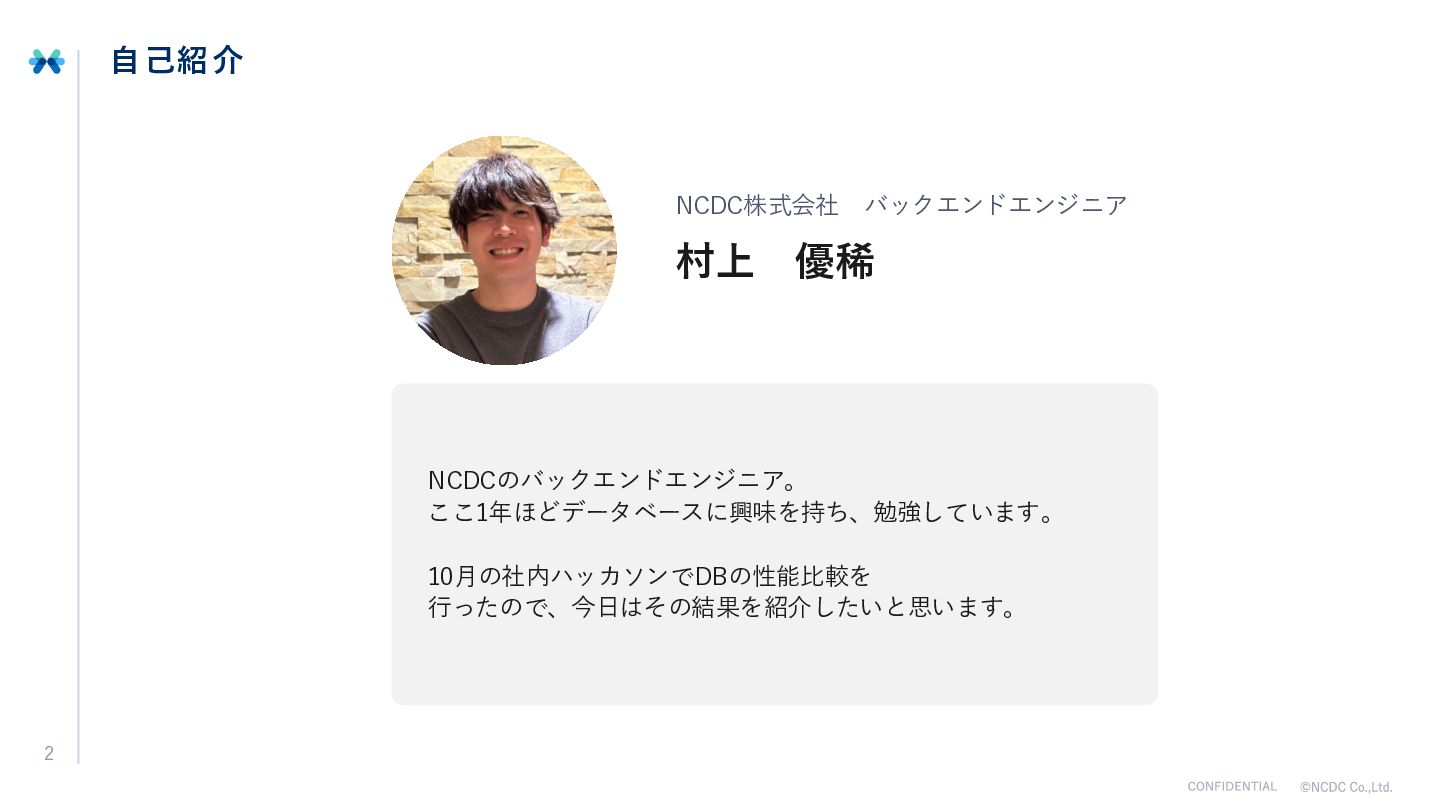
自己紹介 NCDC株式会社 バックエンドエンジニア 村上 優稀 NCDCのバックエンドエンジニア。 ここ1年ほどデータベースに興味を持ち、勉強しています。 10月の社内ハッカソンでDBの性能比較を 行ったので、今日はその結果を紹介したいと思います。 2
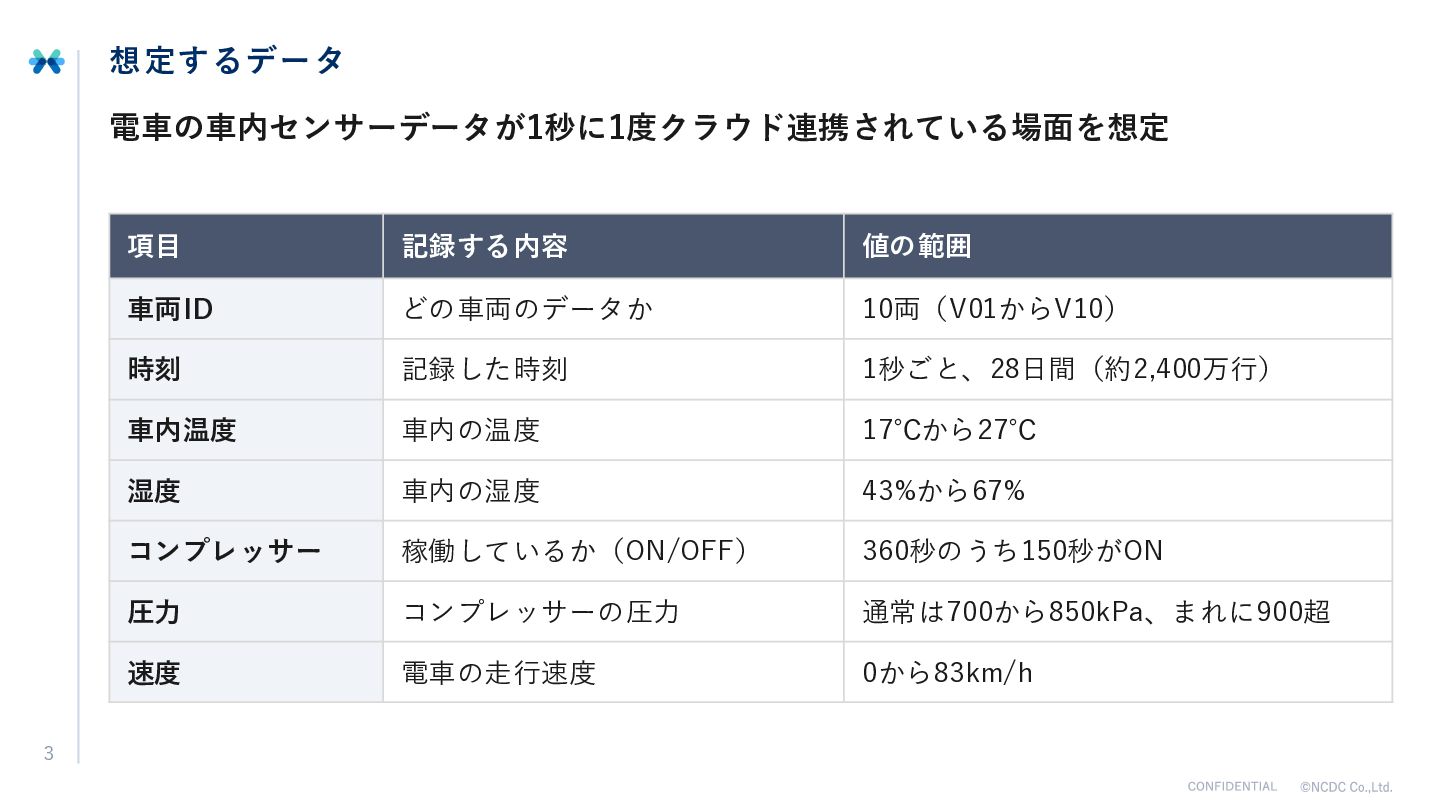
想定するデータ 電車の車内センサーデータが1秒に1度クラウド連携されている場面を想定 3 項目 記録する内容 値の範囲 車両ID どの車両のデータか 10両(V01からV10) 時刻
記録した時刻 1秒ごと、28日間(約2,400万行) 車内温度 車内の温度 17℃から27℃ 湿度 車内の湿度 43%から67% コンプレッサー 稼働しているか(ON/OFF) 360秒のうち150秒がON 圧力 コンプレッサーの圧力 通常は700から850kPa、まれに900超 速度 電車の走行速度 0から83km/h
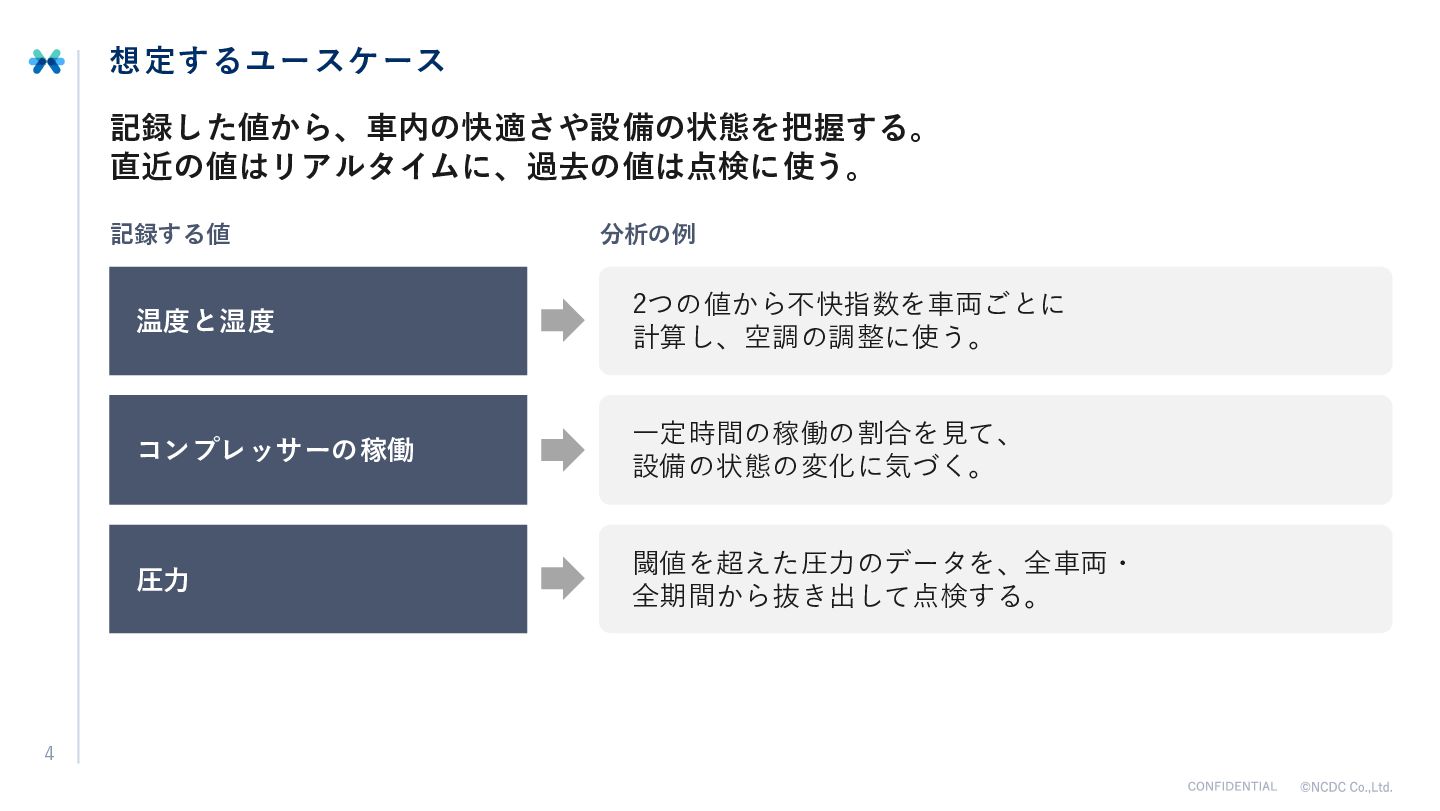
想定するユースケース 記録した値から、車内の快適さや設備の状態を把握する。 直近の値はリアルタイムに、過去の値は点検に使う。 記録する値 4 分析の例 温度と湿度 2つの値から不快指数を車両ごとに 計算し、空調の調整に使う。 コンプレッサーの稼働
一定時間の稼働の割合を見て、 設備の状態の変化に気づく。 圧力 閾値を超えた圧力のデータを、全車両・ 全期間から抜き出して点検する。
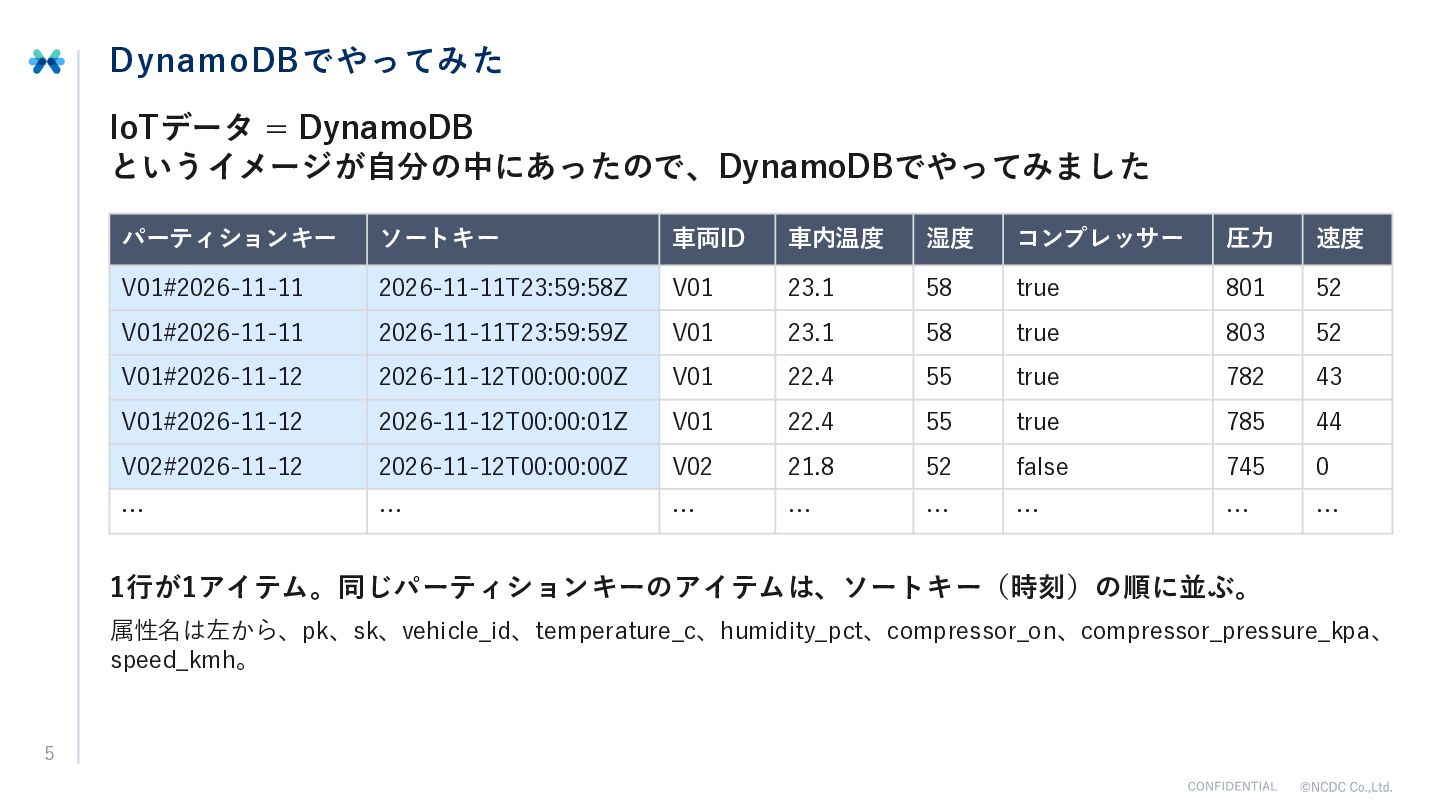
DynamoDBでやってみた IoTデータ = DynamoDB というイメージが自分の中にあったので、DynamoDBでやってみました パーティションキー ソートキー 車両ID 車内温度 湿度
コンプレッサー 圧力 速度 V01#2026-11-11 2026-11-11T23:59:58Z V01 23.1 58 true 801 52 V01#2026-11-11 2026-11-11T23:59:59Z V01 23.1 58 true 803 52 V01#2026-11-12 2026-11-12T00:00:00Z V01 22.4 55 true 782 43 V01#2026-11-12 2026-11-12T00:00:01Z V01 22.4 55 true 785 44 V02#2026-11-12 2026-11-12T00:00:00Z V02 21.8 52 false 745 0 … … … … … … … … 1行が1アイテム。同じパーティションキーのアイテムは、ソートキー(時刻)の順に並ぶ。 属性名は左から、pk、sk、vehicle_id、temperature_c、humidity_pct、compressor_on、compressor_pressure_kpa、 speed_kmh。 5
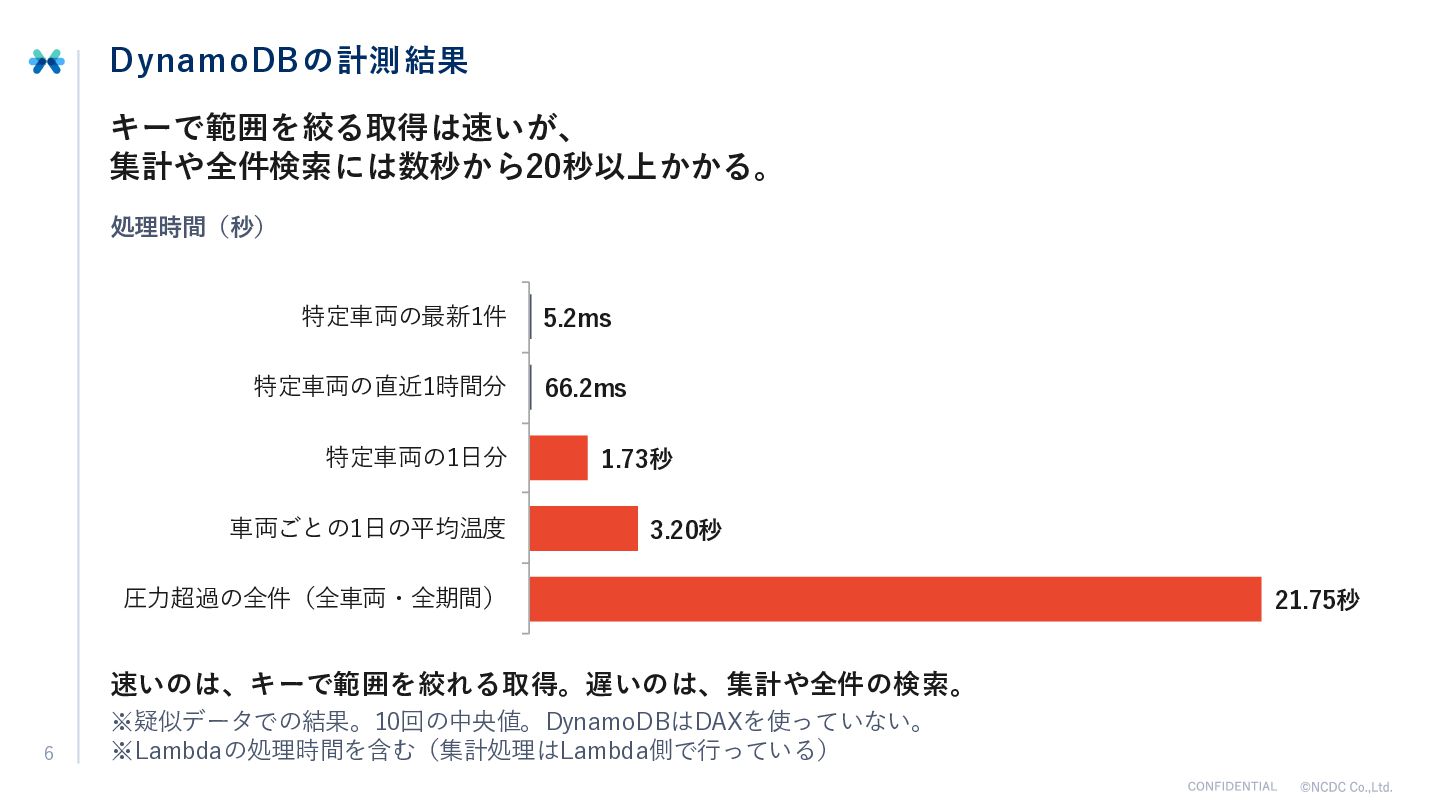
DynamoDBの計測結果 キーで範囲を絞る取得は速いが、 集計や全件検索には数秒から20秒以上かかる。 処理時間(秒) 特定車両の最新1件 5.2ms 特定車両の直近1時間分 66.2ms 特定車両の1日分 車両ごとの1日の平均温度
1.73秒 3.20秒 圧力超過の全件(全車両・全期間) 速いのは、キーで範囲を絞れる取得。遅いのは、集計や全件の検索。 6 ※疑似データでの結果。10回の中央値。DynamoDBはDAXを使っていない。 ※Lambdaの処理時間を含む(集計処理はLambda側で行っている) 21.75秒
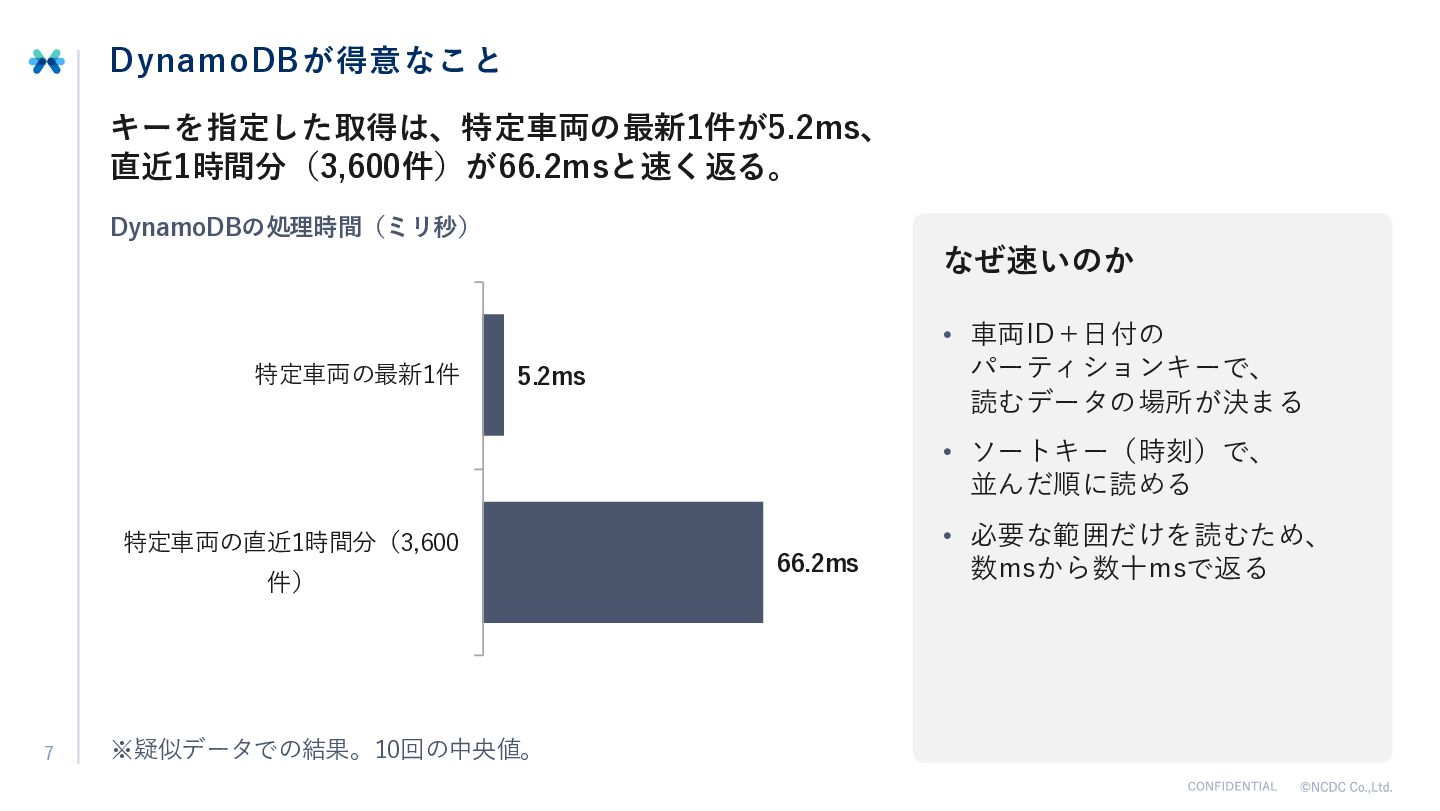
DynamoDBが得意なこと キーを指定した取得は、特定車両の最新1件が5.2ms、 直近1時間分(3,600件)が66.2msと速く返る。 DynamoDBの処理時間(ミリ秒) なぜ速いのか 特定車両の最新1件 • 車両ID+日付の パーティションキーで、 読むデータの場所が決まる
5.2ms • ソートキー(時刻)で、 並んだ順に読める 特定車両の直近1時間分(3,600 件) 7 ※疑似データでの結果。10回の中央値。 66.2ms • 必要な範囲だけを読むため、 数msから数十msで返る
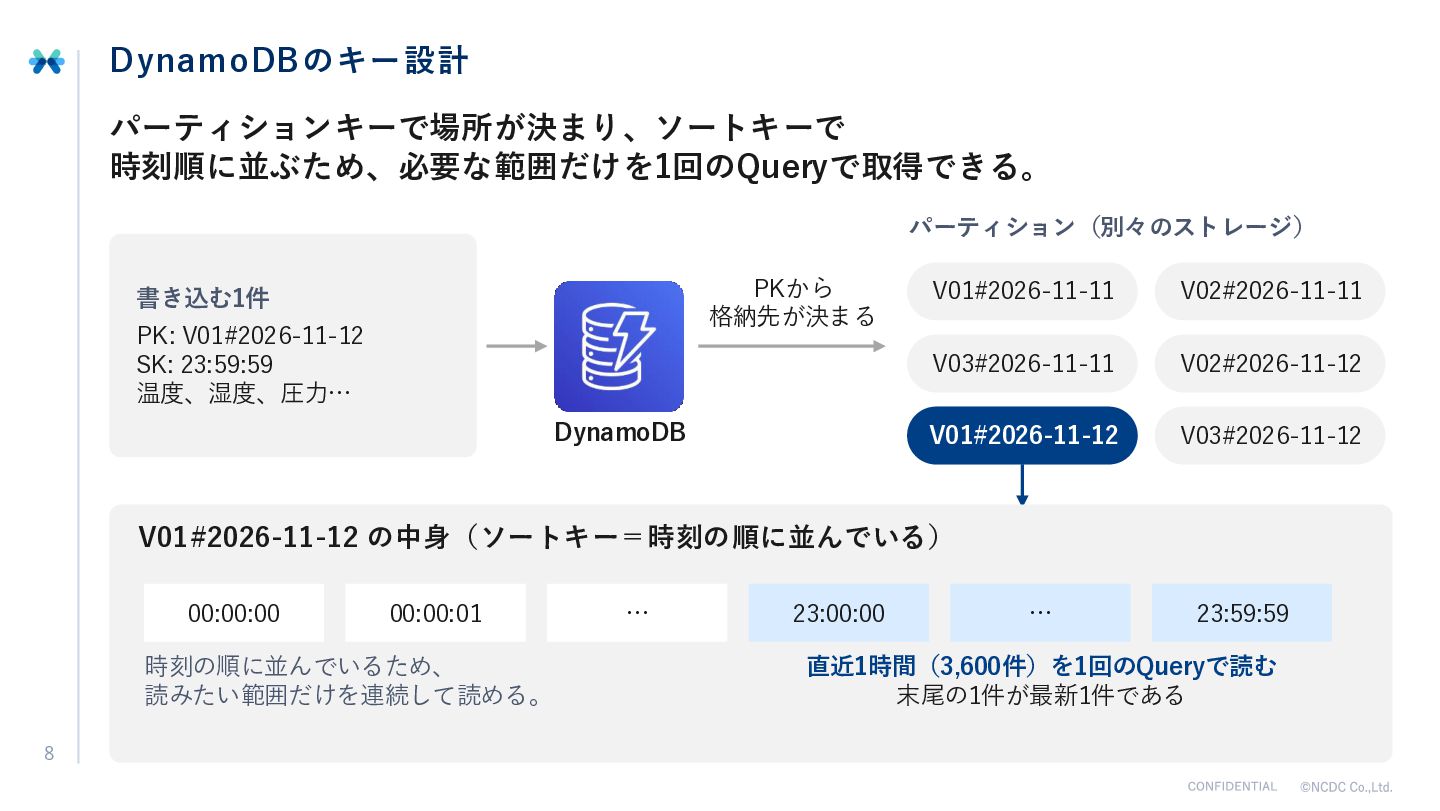
DynamoDBのキー設計 パーティションキーで場所が決まり、ソートキーで 時刻順に並ぶため、必要な範囲だけを1回のQueryで取得できる。 パーティション(別々のストレージ) PKから 格納先が決まる 書き込む1件 PK: V01#2026-11-12 SK:
23:59:59 温度、湿度、圧力… DynamoDB V01#2026-11-11 V02#2026-11-11 V03#2026-11-11 V02#2026-11-12 V01#2026-11-12 V03#2026-11-12 V01#2026-11-12 の中身(ソートキー=時刻の順に並んでいる) 00:00:00 00:00:01 時刻の順に並んでいるため、 読みたい範囲だけを連続して読める。 8 … 23:00:00 … 23:59:59 直近1時間(3,600件)を1回のQueryで読む 末尾の1件が最新1件である
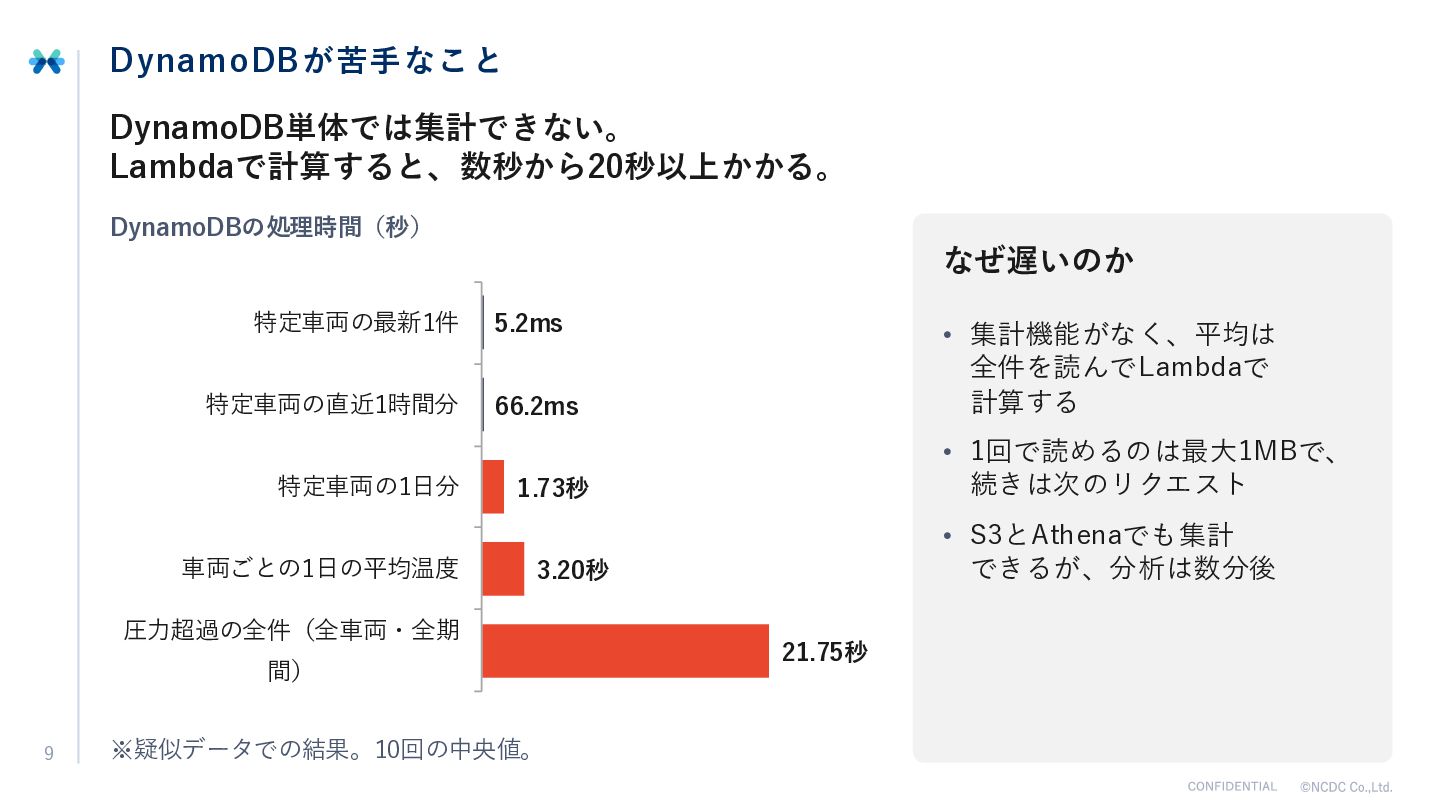
DynamoDBが苦手なこと DynamoDB単体では集計できない。 Lambdaで計算すると、数秒から20秒以上かかる。 DynamoDBの処理時間(秒) なぜ遅いのか 特定車両の最新1件 5.2ms 特定車両の直近1時間分 66.2ms 特定車両の1日分
車両ごとの1日の平均温度 • 1回で読めるのは最大1MBで、 続きは次のリクエスト 1.73秒 • S3とAthenaでも集計 できるが、分析は数分後 3.20秒 圧力超過の全件(全車両・全期 間) 9 • 集計機能がなく、平均は 全件を読んでLambdaで 計算する ※疑似データでの結果。10回の中央値。 21.75秒
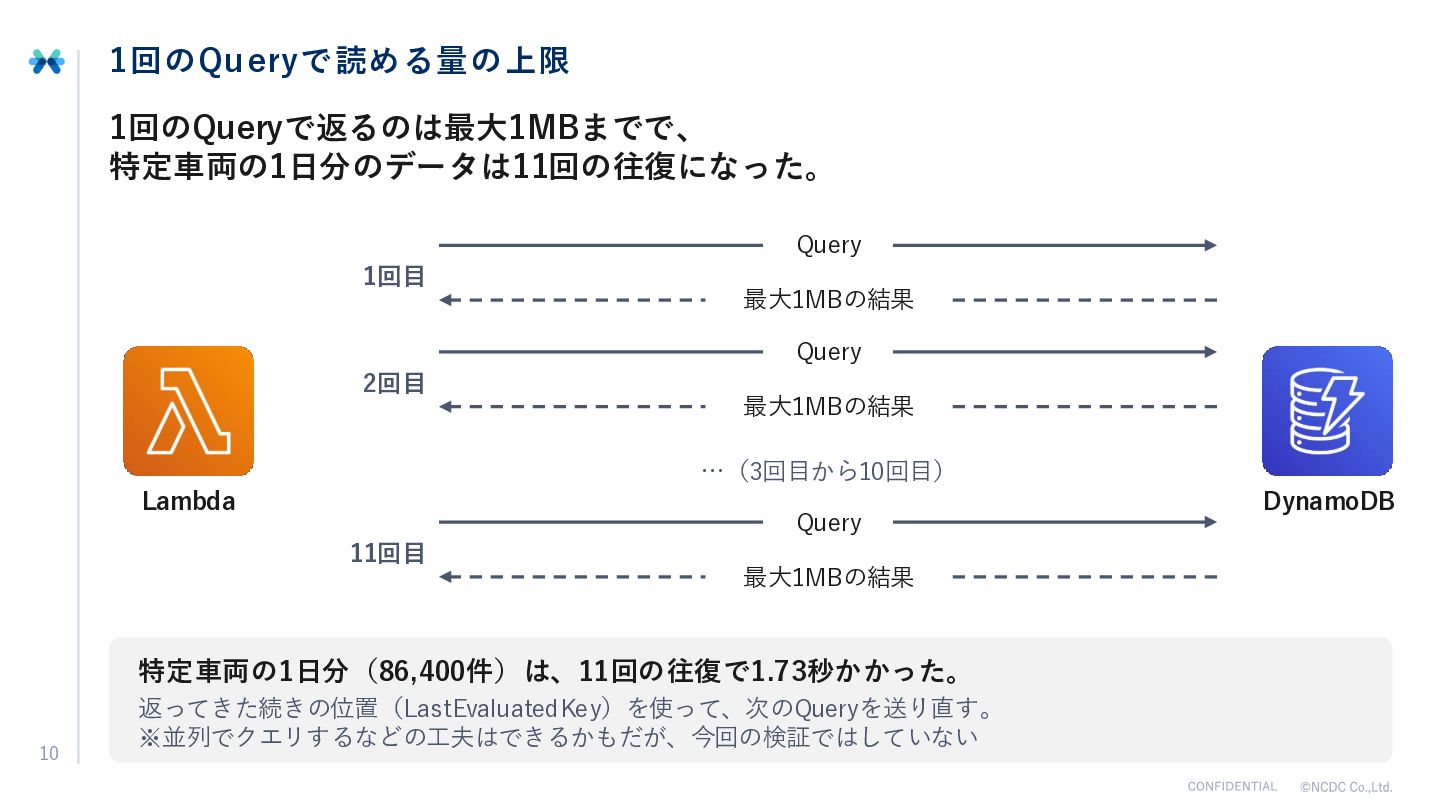
1回のQu eryで読める量の上限 1回のQueryで返るのは最大1MBまでで、 特定車両の1日分のデータは11回の往復になった。 Query 1回目 最大1MBの結果 Query 2回目 最大1MBの結果
…(3回目から10回目) Lambda Query 11回目 最大1MBの結果 特定車両の1日分(86,400件)は、11回の往復で1.73秒かかった。 10 返ってきた続きの位置(LastEvaluatedKey)を使って、次のQueryを送り直す。 ※並列でクエリするなどの工夫はできるかもだが、今回の検証ではしていない DynamoDB
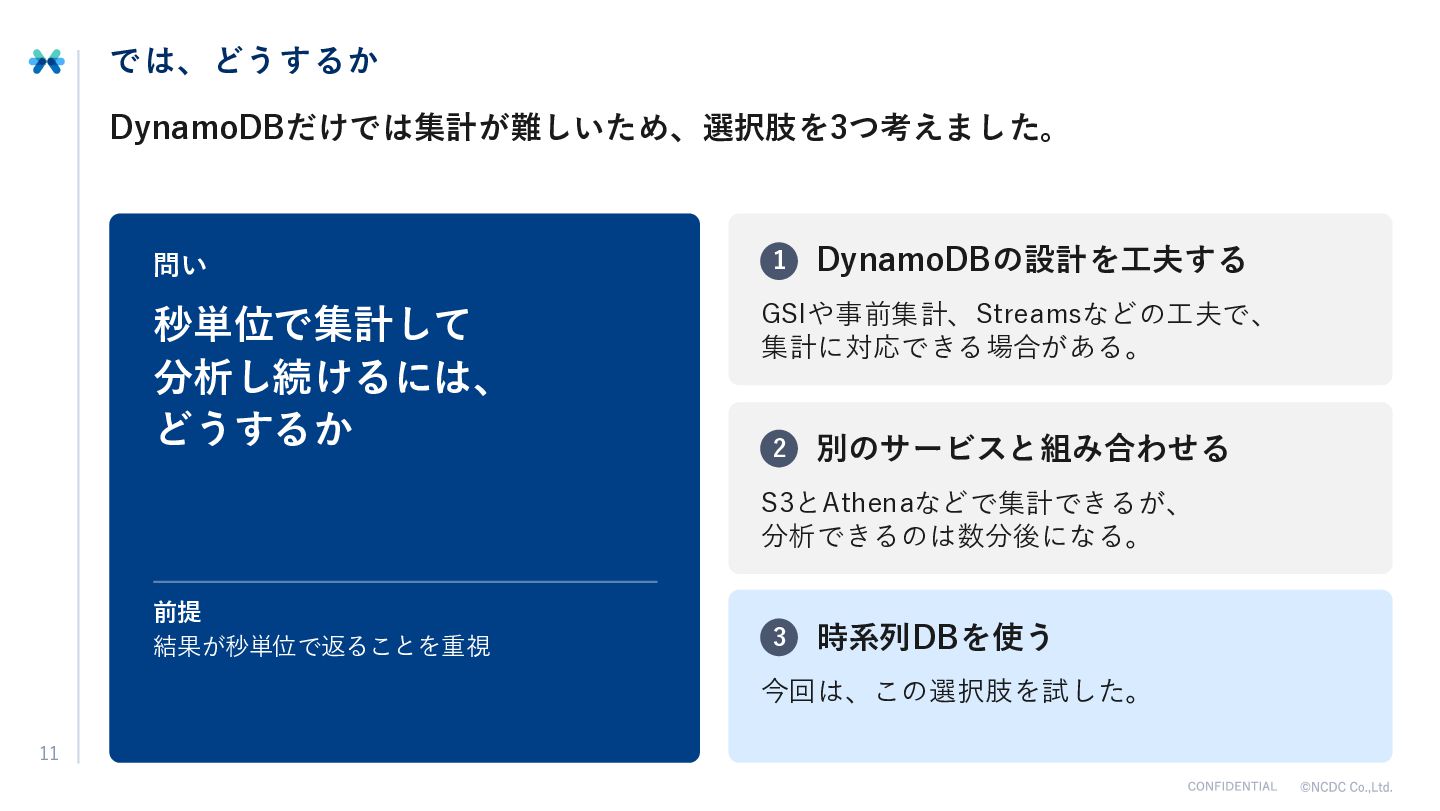
では、どうするか DynamoDBだけでは集計が難しいため、選択肢を3つ考えました。 DynamoDBの設計を工夫する 問い 1 秒単位で集計して 分析し続けるには、 どうするか GSIや事前集計、Streamsなどの工夫で、 集計に対応できる場合がある。
2 別のサービスと組み合わせる S3とAthenaなどで集計できるが、 分析できるのは数分後になる。 前提 結果が秒単位で返ることを重視 3 時系列DBを使う 今回は、この選択肢を試した。 11
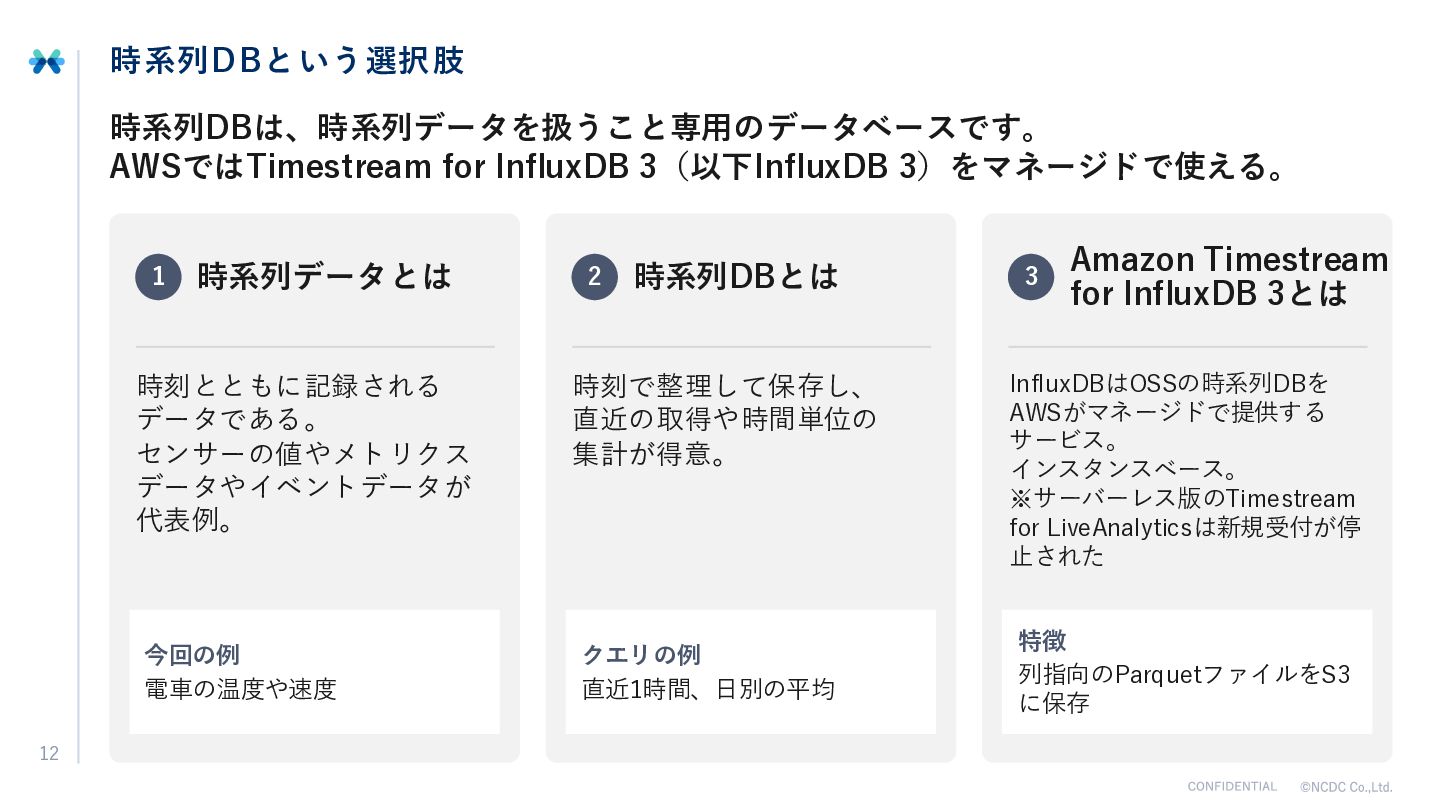
時系列DBという選択肢 時系列DBは、時系列データを扱うこと専用のデータベースです。 AWSではTimestream for InfluxDB 3(以下InfluxDB 3)をマネージドで使える。 1 12 時系列データとは
2 時系列DBとは 時刻とともに記録される データである。 センサーの値やメトリクス データやイベントデータが 代表例。 時刻で整理して保存し、 直近の取得や時間単位の 集計が得意。 今回の例 電車の温度や速度 クエリの例 直近1時間、日別の平均 3 Amazon Timestream for InfluxDB 3とは InfluxDBはOSSの時系列DBを AWSがマネージドで提供する サービス。 インスタンスベース。 ※サーバーレス版のTimestream for LiveAnalyticsは新規受付が停 止された 特徴 列指向のParquetファイルをS3 に保存
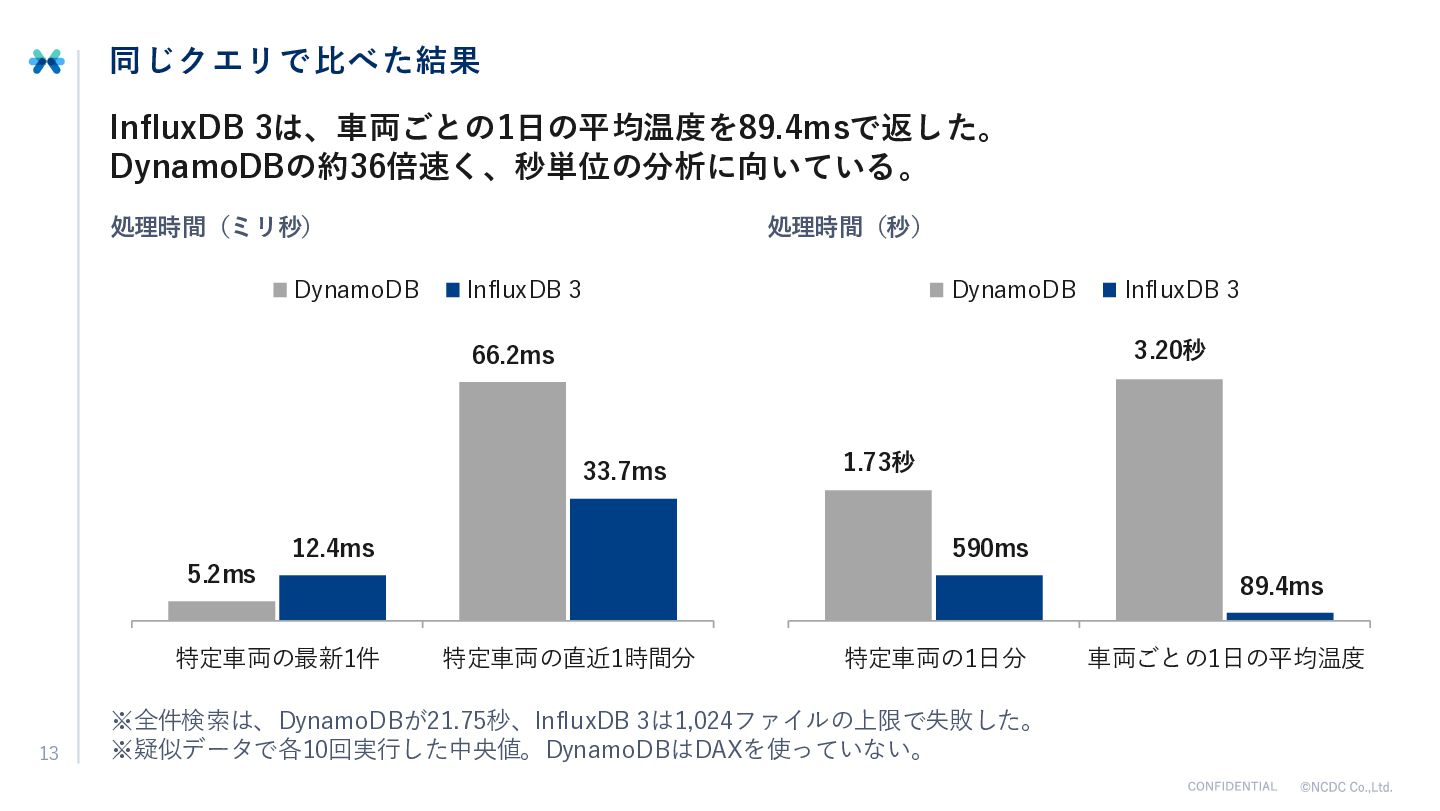
同じクエリで比べた結果 InfluxDB 3は、車両ごとの1日の平均温度を89.4msで返した。 DynamoDBの約36倍速く、秒単位の分析に向いていそう。 処理時間(ミリ秒) DynamoDB 処理時間(秒) InfluxDB 3 DynamoDB
3.20秒 66.2ms 33.7ms 1.73秒 590ms 12.4ms 5.2ms 特定車両の最新1件 13 InfluxDB 3 89.4ms 特定車両の直近1時間分 特定車両の1日分 ※全件検索は、DynamoDBが21.75秒、InfluxDB 3は1,024ファイルの上限で失敗した。 ※疑似データで各10回実行した中央値。DynamoDBはDAXを使っていない。 車両ごとの1日の平均温度
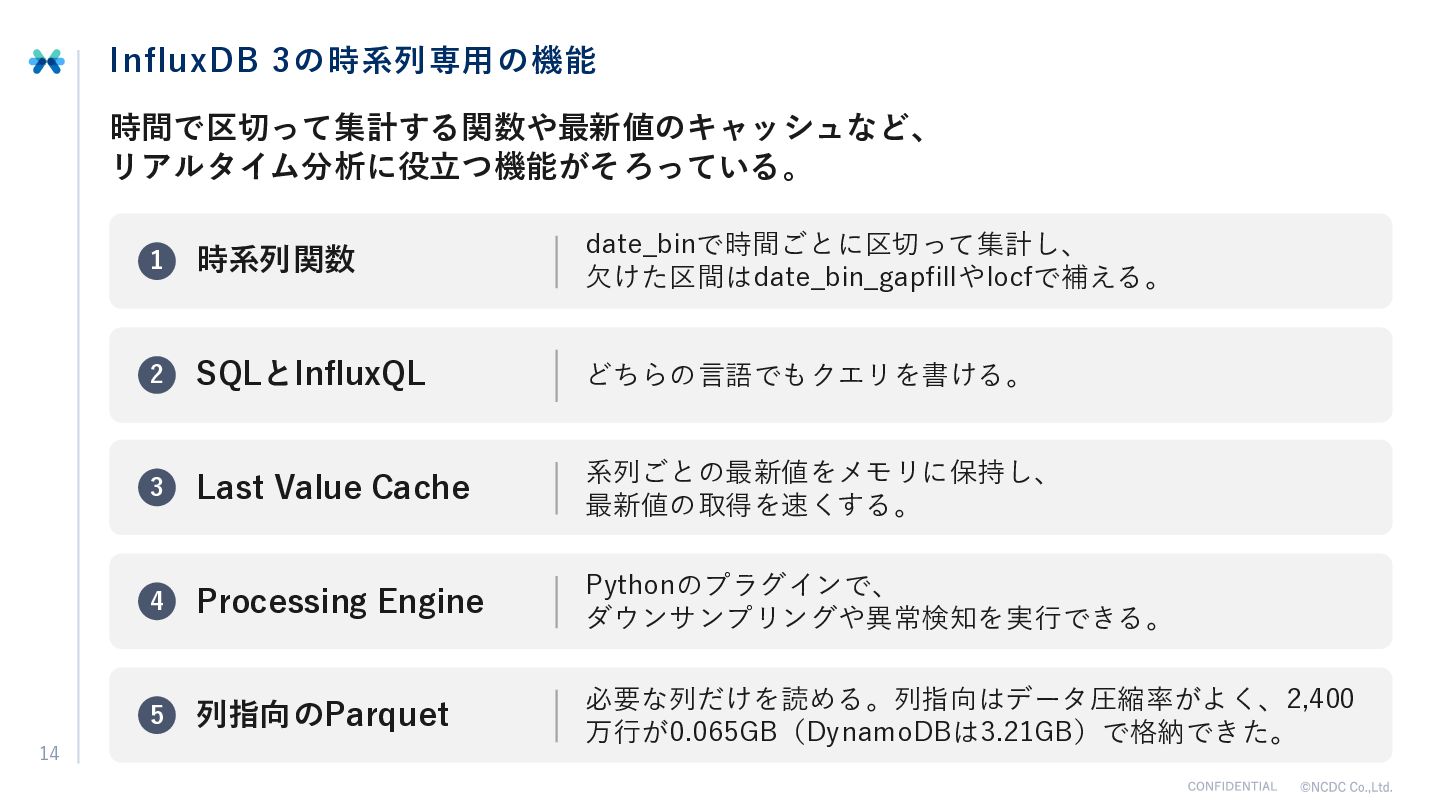
InfluxDB 3の時系列専用の機能 時間で区切って集計する関数や最新値のキャッシュなど、 リアルタイム分析に役立つ機能がそろっている。 14 1 時系列関数 date_binで時間ごとに区切って集計し、 欠けた区間はdate_bin_gapfillやlocfで補える。 2
SQLとInfluxQL どちらの言語でもクエリを書ける。 3 Last Value Cache 系列ごとの最新値をメモリに保持し、 最新値の取得を速くする。 4 Processing Engine Pythonのプラグインで、 ダウンサンプリングや異常検知を実行できる。 5 列指向のParquet 必要な列だけを読める。列指向はデータ圧縮率がよく、2,400 万行が0.065GB(DynamoDBは3.21GB)で格納できた。
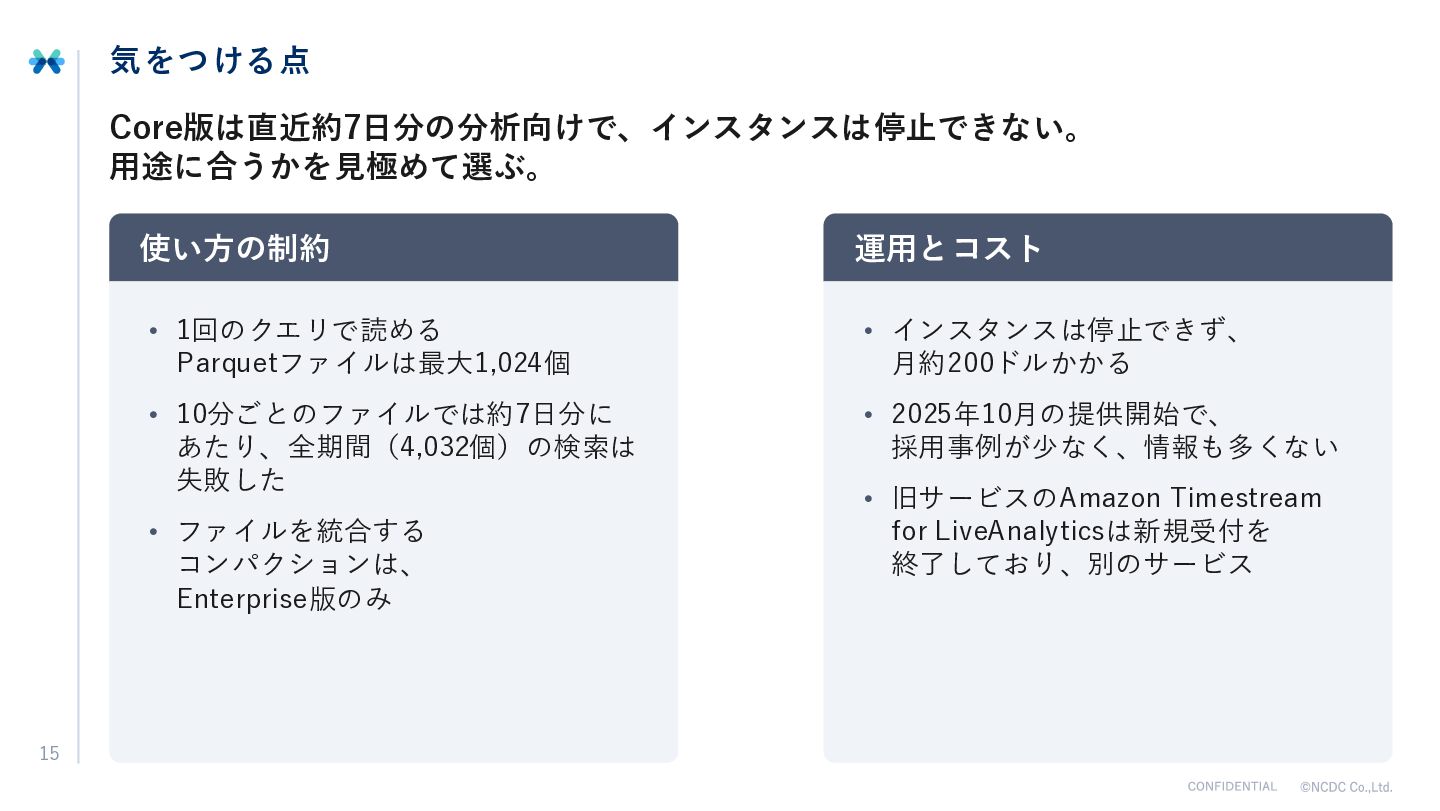
気をつける点 Core版は直近約7日分の分析向けで、インスタンスは停止できない。 用途に合うかを見極めて選ぶ。 使い方の制約 運用とコスト • 1回のクエリで読める Parquetファイルは最大1,024個 • インスタンスは停止できず、
月約200ドルかかる • 10分ごとのファイルでは約7日分に あたり、全期間(4,032個)の検索は 失敗した • 2025年10月の提供開始で、 採用事例が少なく、情報も多くない • ファイルを統合する コンパクションは、 Enterprise版のみ 15 • 旧サービスのAmazon Timestream for LiveAnalyticsは新規受付を 終了しており、別のサービス
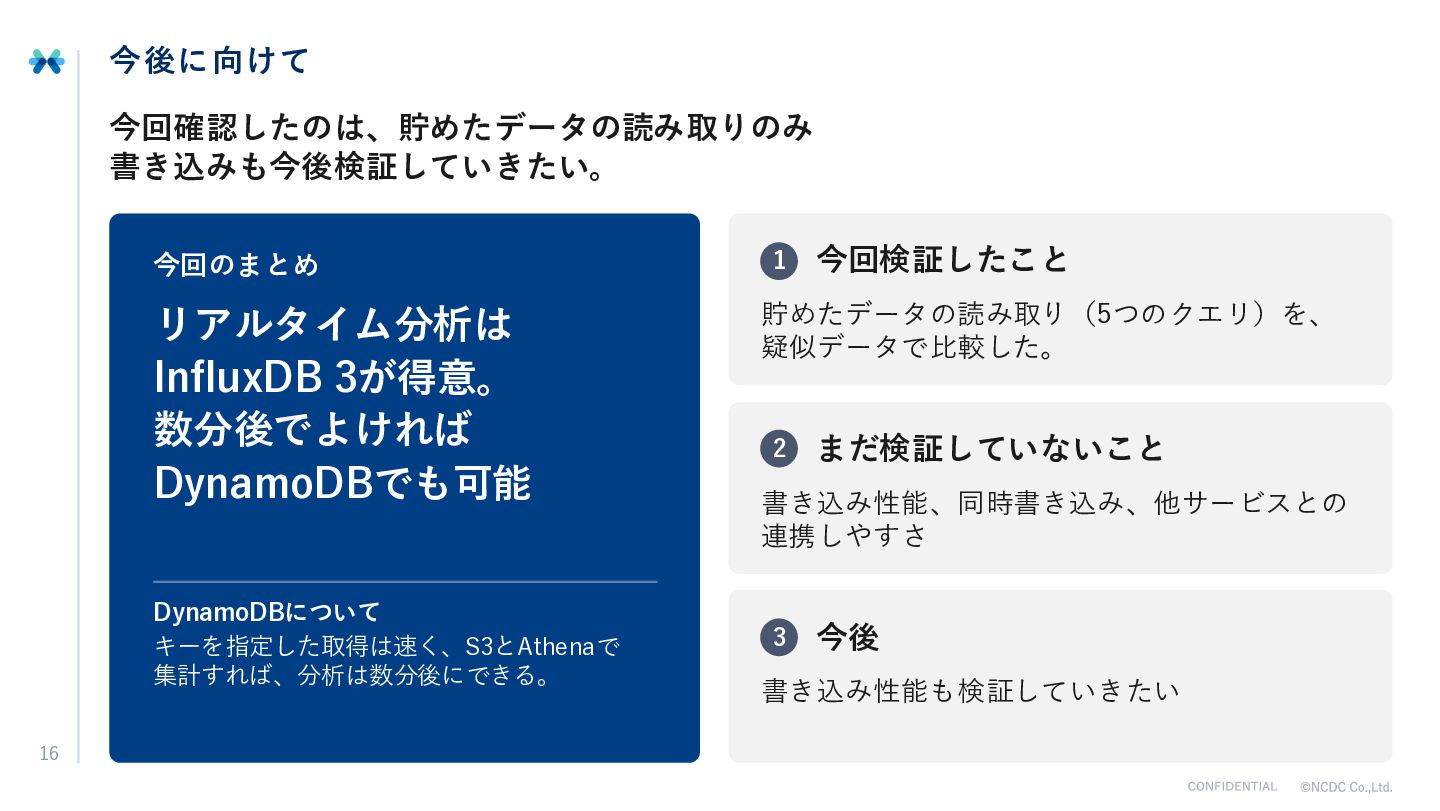
今後に向けて 今回確認したのは、貯めたデータの読み取りのみ 書き込みも今後検証していきたい。 1 リアルタイム分析は InfluxDB 3が得意。 数分後でよければ DynamoDBでも可能 貯めたデータの読み取り(5つのクエリ)を、
疑似データで比較した。 DynamoDBについて キーを指定した取得は速く、S3とAthenaで 集計すれば、分析は数分後にできる。 16 今回検証したこと 今回のまとめ 2 まだ検証していないこと 書き込み性能、同時書き込み、他サービスとの 連携しやすさ 3 今後 書き込み性能も検証していきたい
ありがとうございました! 17
Appendix 18
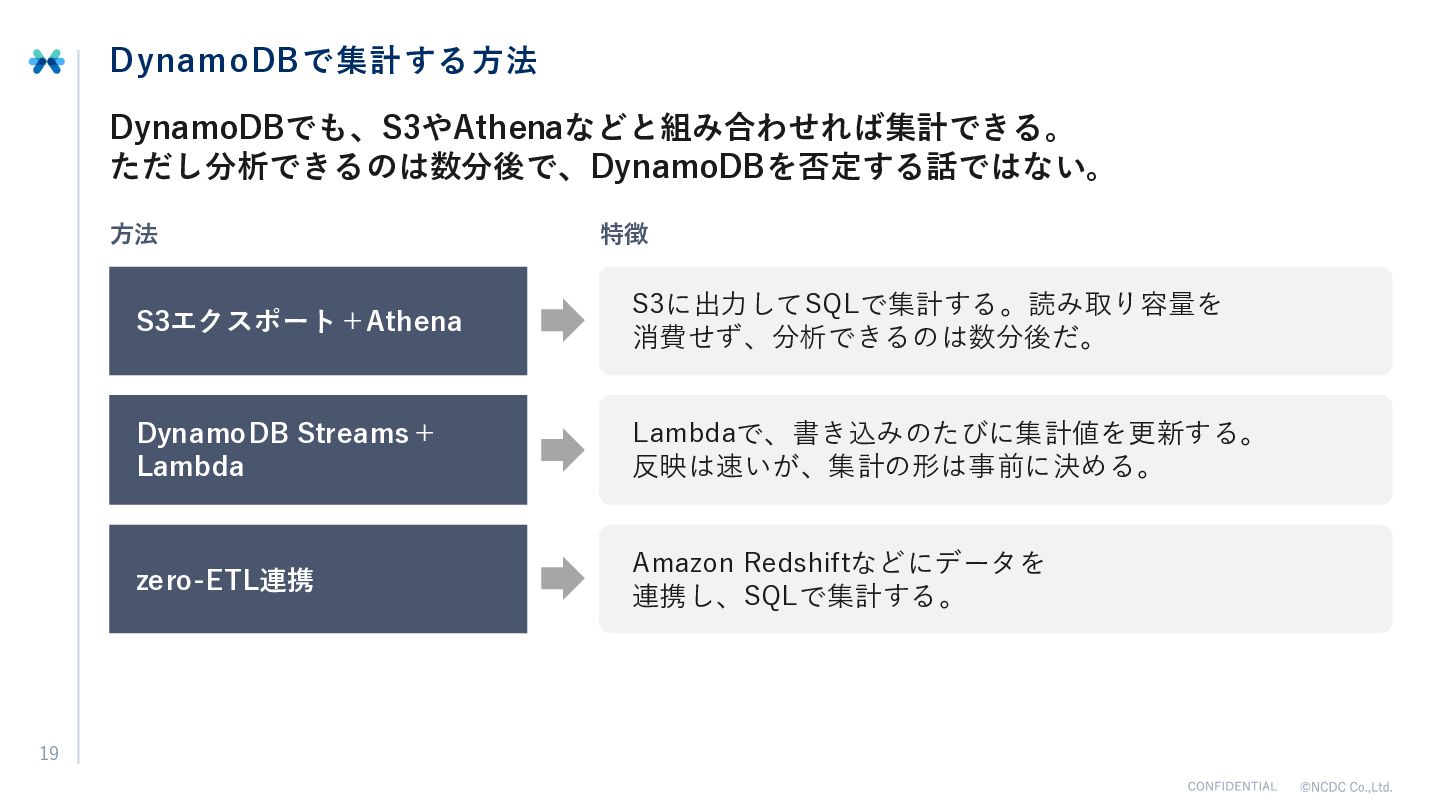
DynamoDBで集計する方法 DynamoDBでも、S3やAthenaなどと組み合わせれば集計できる。 ただし分析できるのは数分後で、DynamoDBを否定する話ではない。 方法 19 特徴 S3エクスポート+Athena S3に出力してSQLで集計する。読み取り容量を 消費せず、分析できるのは数分後だ。 DynamoDB
Streams+ Lambda Lambdaで、書き込みのたびに集計値を更新する。 反映は速いが、集計の形は事前に決める。 zero-ETL連携 Amazon Redshiftなどにデータを 連携し、SQLで集計する。
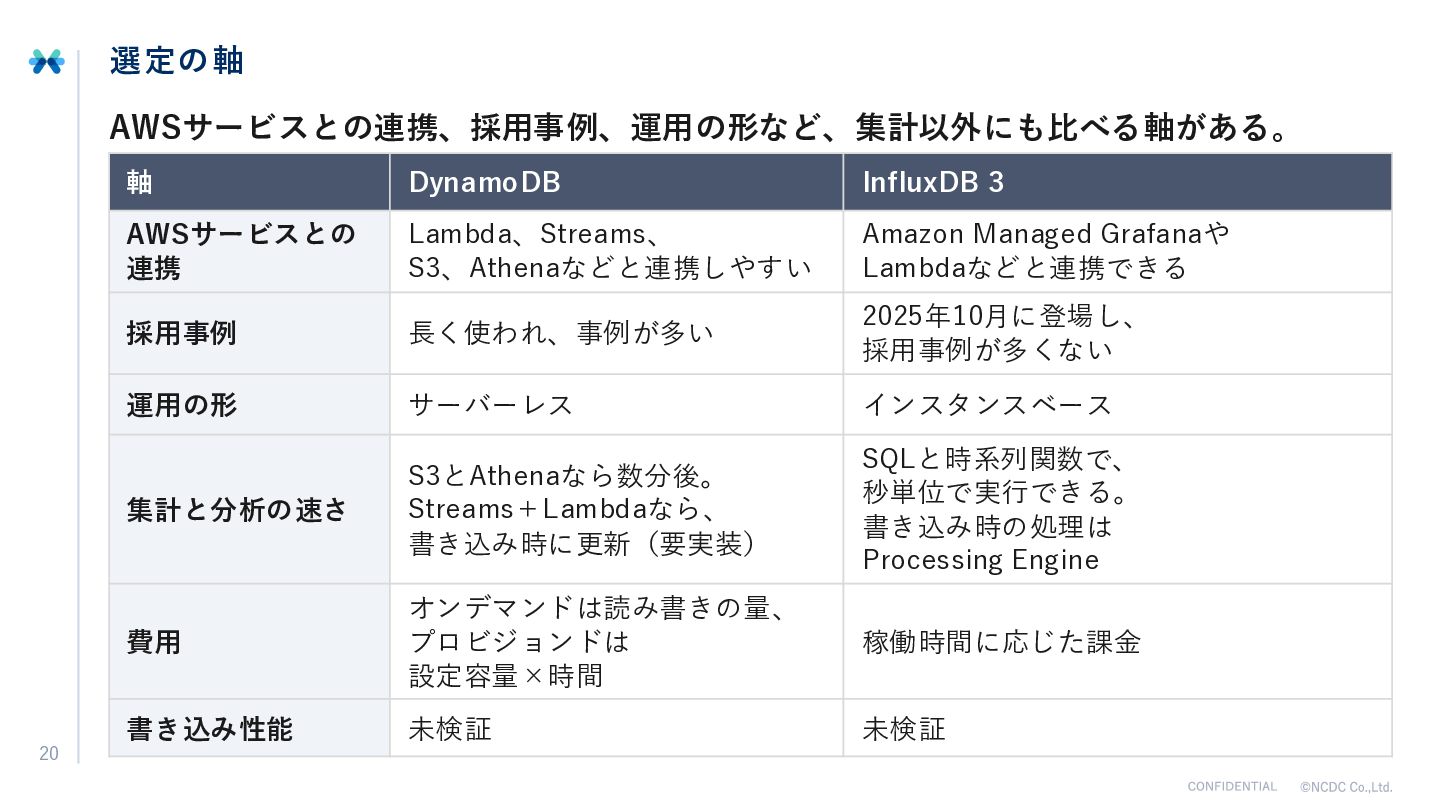
選定の軸 AWSサービスとの連携、採用事例、運用の形など、集計以外にも比べる軸がある。 20 軸 DynamoDB InfluxDB 3 AWSサービスとの 連携 Lambda、Streams、
S3、Athenaなどと連携しやすい Amazon Managed Grafanaや Lambdaなどと連携できる 採用事例 長く使われ、事例が多い 2025年10月に登場し、 採用事例が多くない 運用の形 サーバーレス インスタンスベース 集計と分析の速さ S3とAthenaなら数分後。 Streams+Lambdaなら、 書き込み時に更新(要実装) SQLと時系列関数で、 秒単位で実行できる。 書き込み時の処理は Processing Engine 費用 オンデマンドは読み書きの量、 プロビジョンドは 設定容量×時間 稼働時間に応じた課金 書き込み性能 未検証 未検証
None
More Decks by 村上優稀
See All by 村上優稀
DynamoDBの基礎を振り返りながらベクトル検索機能を理解する
musan
3
310
Amplify gen2 を使うと何が嬉しいか?
musan
0
35
DynamoDBには集計系のクエリがないけどなんとかしたい
musan
1
280
DI(依存性注入)
musan
0
97
FastAPIでAOP的ロギングはありなのか?
musan
1
120
Other Decks in Technology
See All in Technology
これからのデータエンジニアの役割について考える / Rethinking the Role of Data Engineers in the AI Era
okiyuki99
1
530
Context != Context: One window, many lifecycles (AI Native DevCon, Nov 2026)
birgitta410
0
160
おうち環境でも「なるべく止めたくない!」 ― おうち環境の機器冗長化の理想と現実
yuutosi
1
580
Datadog の権限統制 〜Org 統合に向けて調べた注意点 / JDDUG-Meetup_24
visional_engineering_and_design
1
180
AI時代における医療情報システムのセキュリティ / Security of Healthcare IT Systems in the AI Era
henryofficial
0
190
あの日、見つかっていなかったらどうなっていたか
kazzpapa3
2
240
[関西Kaggler会 20261113] 続・コミュニティコンペのススメ
nejumi
0
140
RAGの改善を速く回すための評価基盤
yosukeyoshida
6
2.8k
Claude Securityを使ってみた / claude-security-claude-code-meetup-nagoya
tnir
0
140
速くなった開発の効果をどう推し量るのか
bulbulpaul
0
130
IP重複は"ランディングVPC"で受け止める ― PrivateLink と Transit Gatewayによるマルチテナント接続基盤の設計
hatahata021
3
240
こんなに変わった! AWSネットワークの常識
shotashiratori
16
9.8k
Featured
See All Featured
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
Agile that works and the tools we love
rasmusluckow
331
22k
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.3k
The Director’s Chair: Orchestrating AI for Truly Effective Learning
tmiket
1
350
What does AI have to do with Human Rights?
axbom
PRO
1
2.5k
Imperfection Machines: The Place of Print at Facebook
scottboms
270
14k
Product Roadmaps are Hard
iamctodd
55
13k
The Invisible Side of Design
smashingmag
301
52k
Become a Pro
speakerdeck
PRO
31
6.4k
コードの90%をAIが書く世界で何が待っているのか / What awaits us in a world where 90% of the code is written by AI
rkaga
63
48k
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
570


 musan
 okiyuki99
 birgitta410
 yuutosi
 visional_engineering_and_design
 henryofficial
 kazzpapa3
 nejumi
 yosukeyoshida
 tnir
 bulbulpaul
 hatahata021
 shotashiratori
 chrisshort
 rasmusluckow
 aleyda
 tmiket
 axbom
 scottboms
 iamctodd
 smashingmag
 speakerdeck
 rkaga
 jct