*本スライドは、dbt World Tour Tokyo 2026 (https://www.getdbt.com/events/roadshow/dbt-world-tour-tokyo-agenda) で発表したものです。
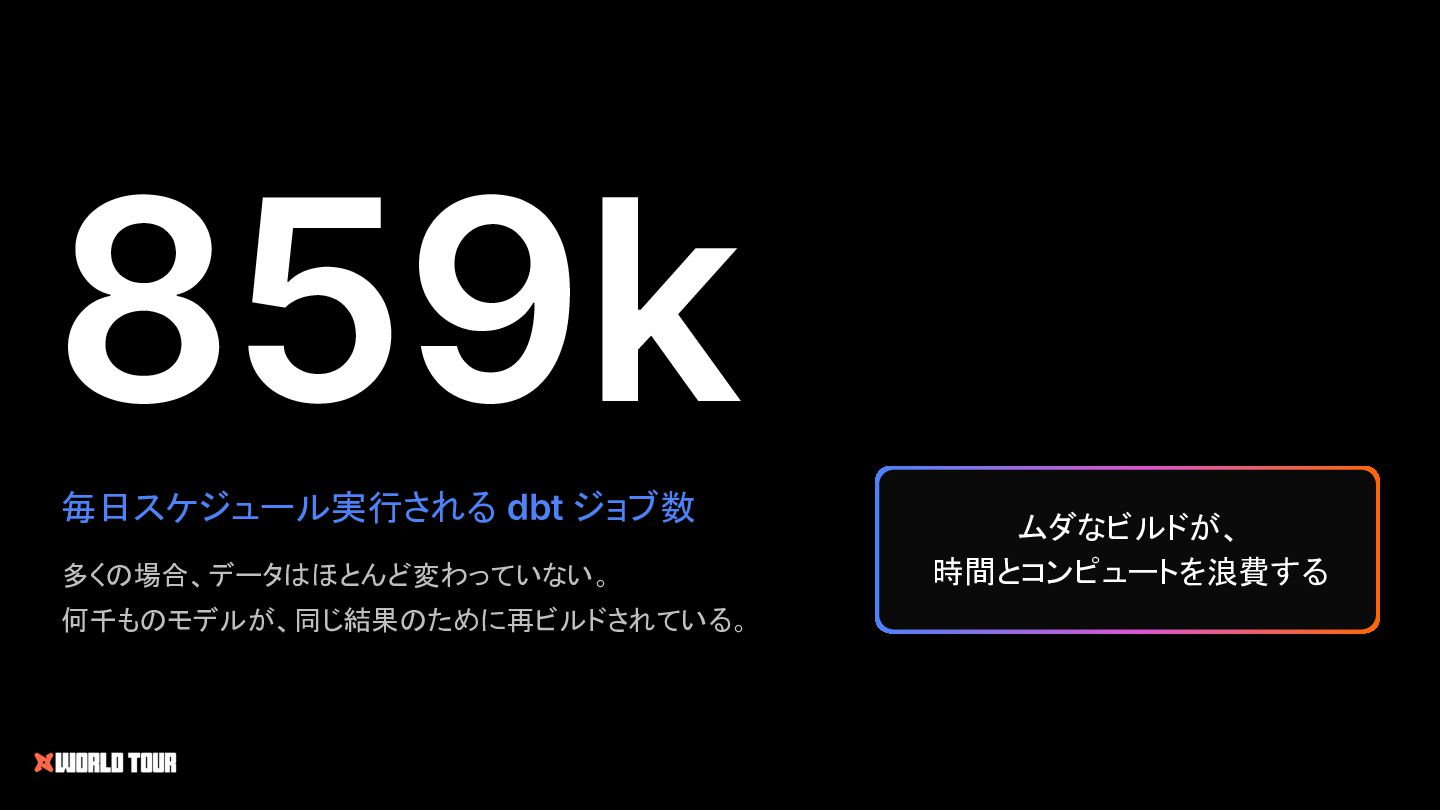
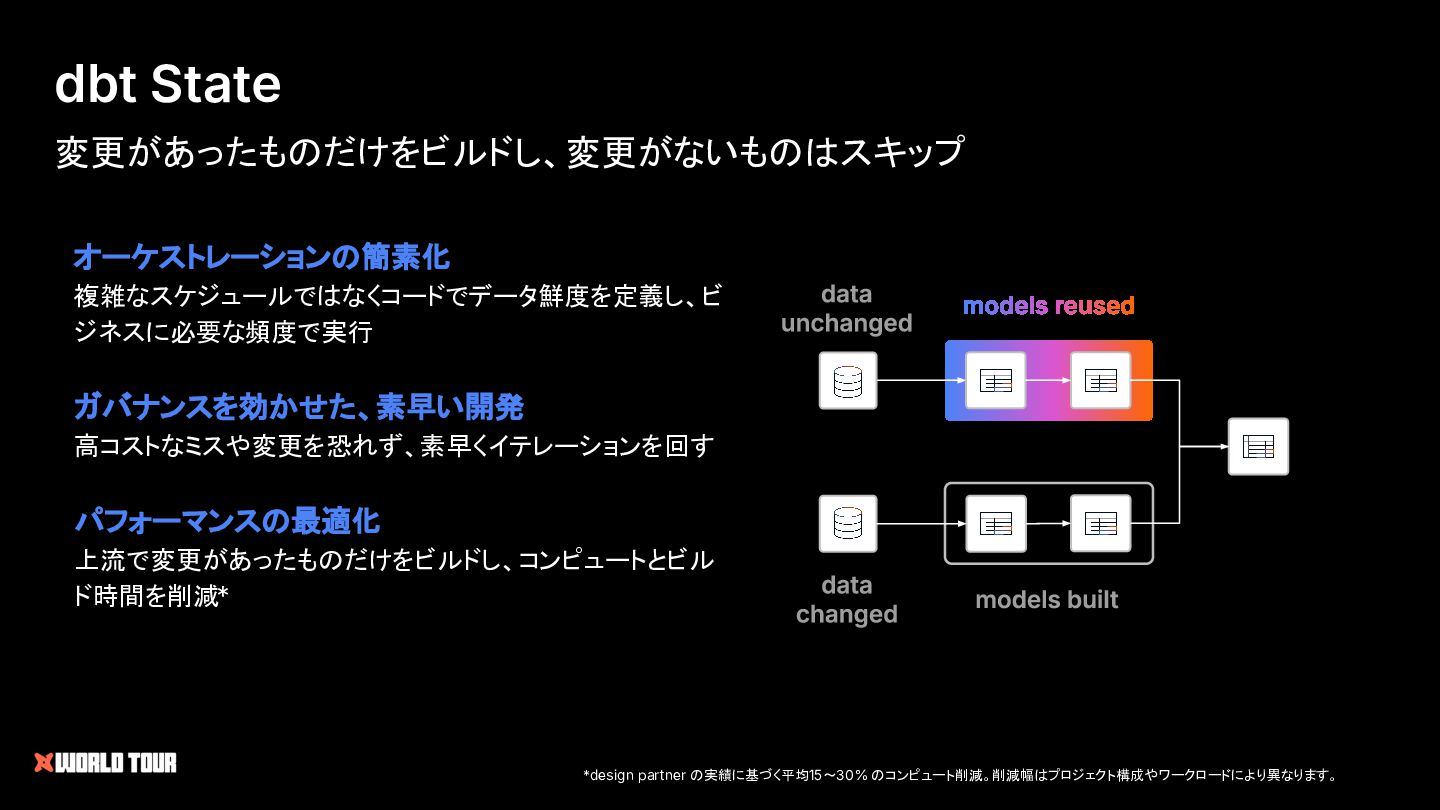
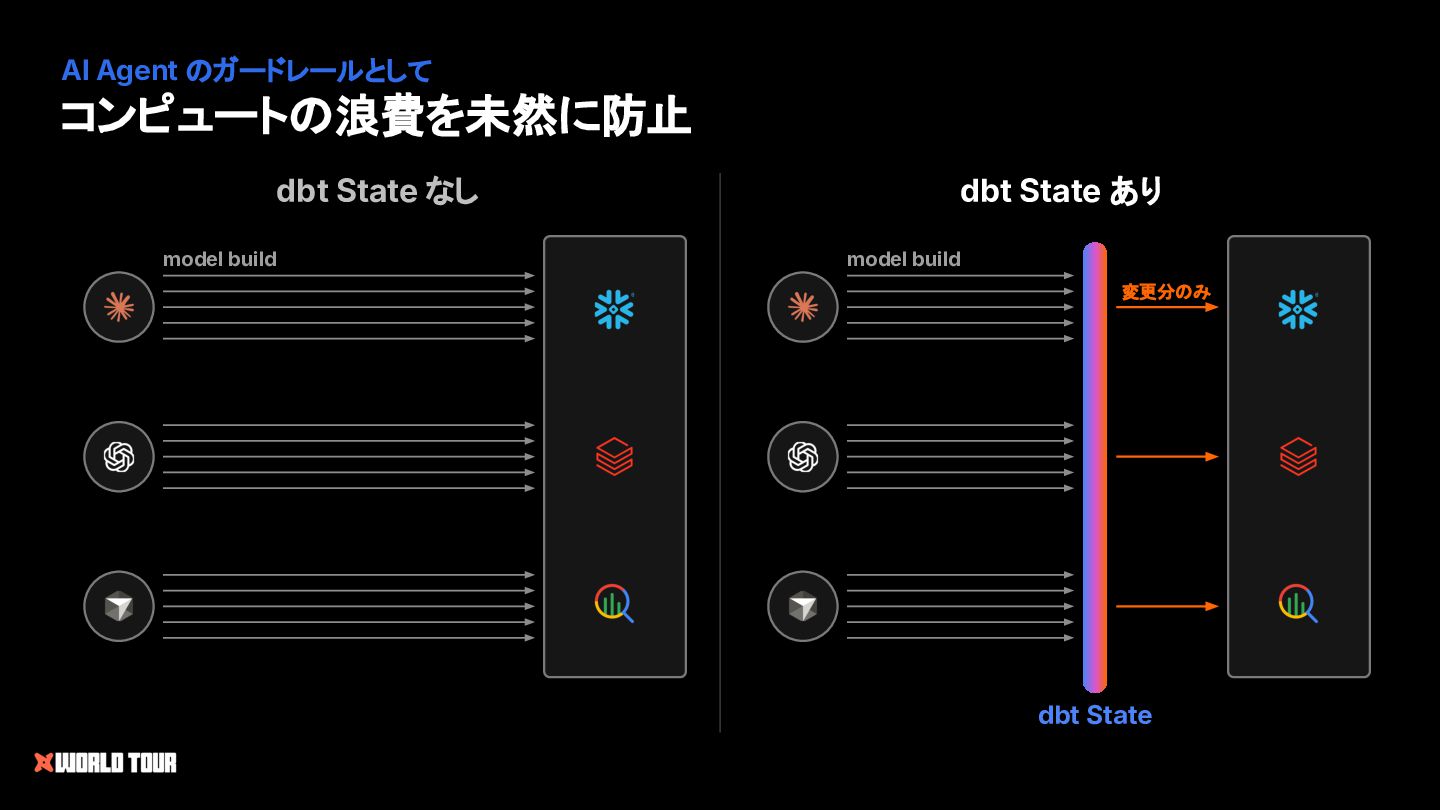
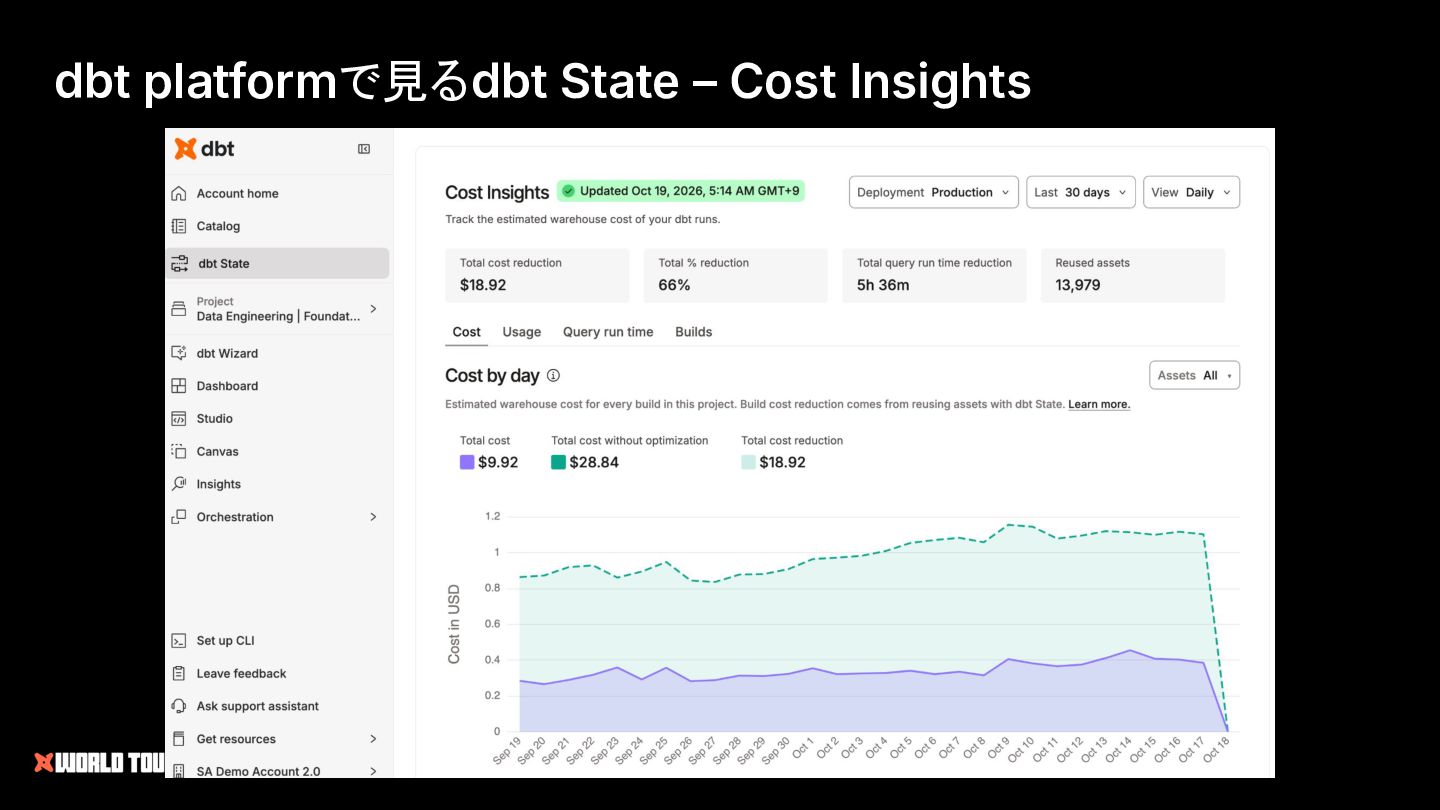
ほとんどの dbt プロジェクトは、変更の有無にかかわらず、runごとに同じモデルを再構築しています。dbt State はそれを変えます。
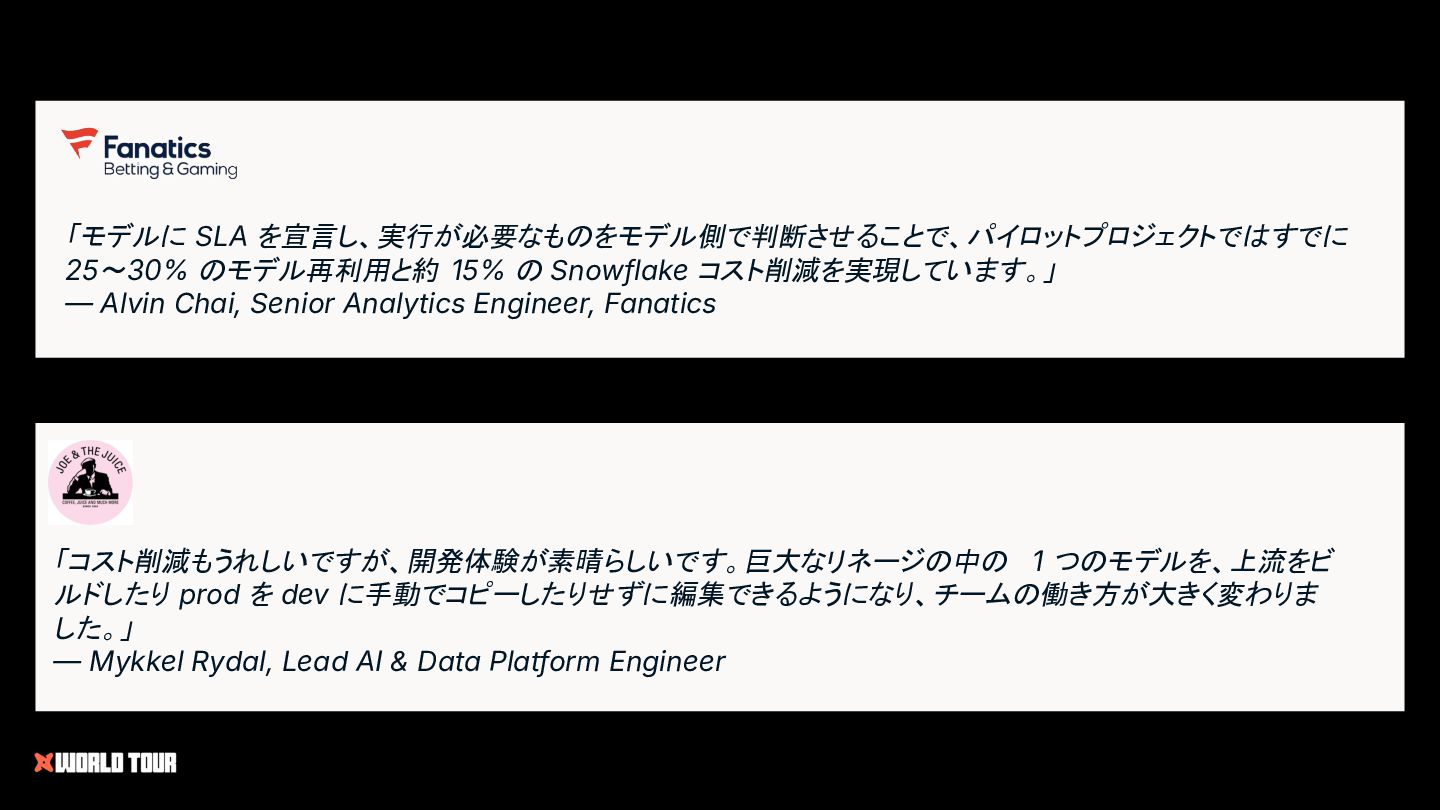
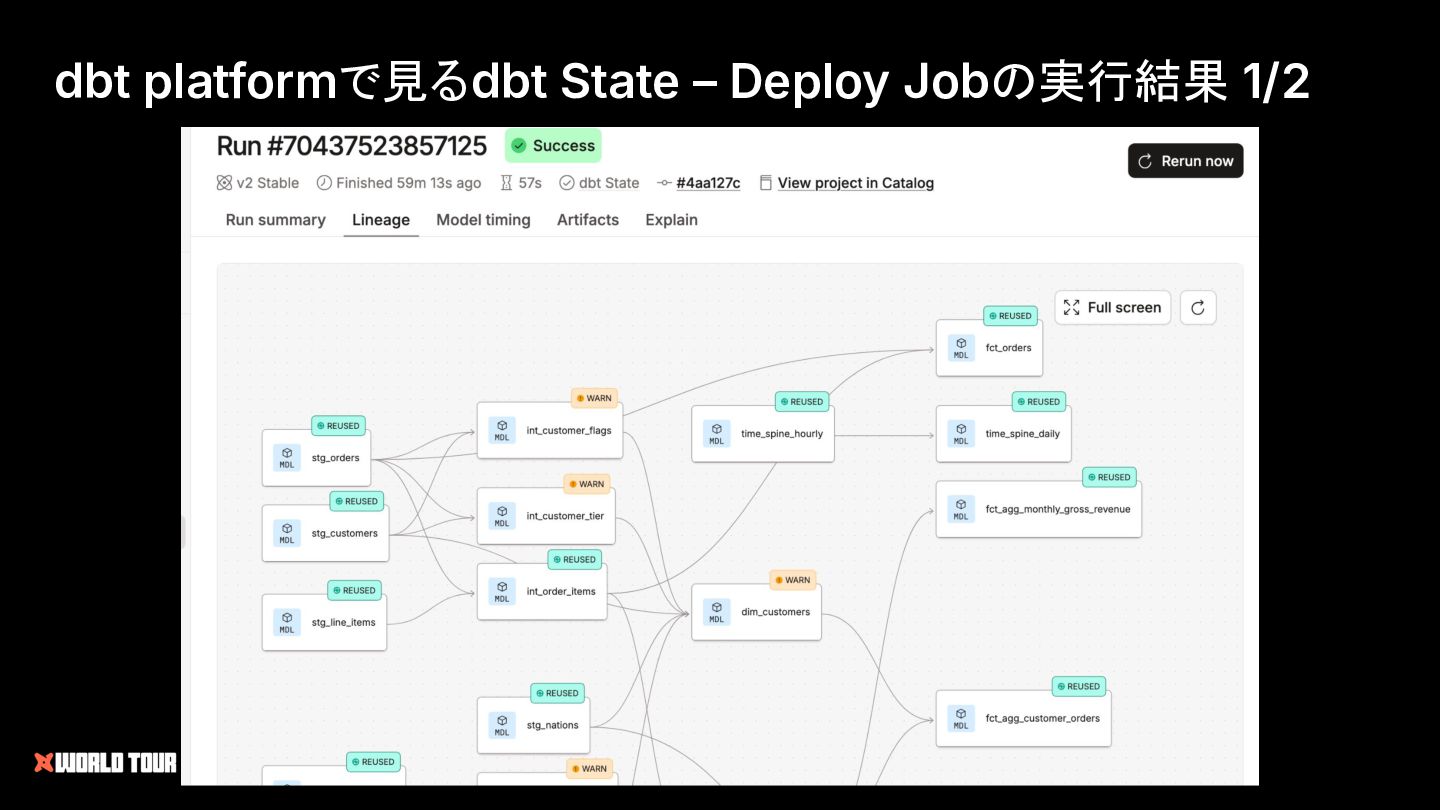
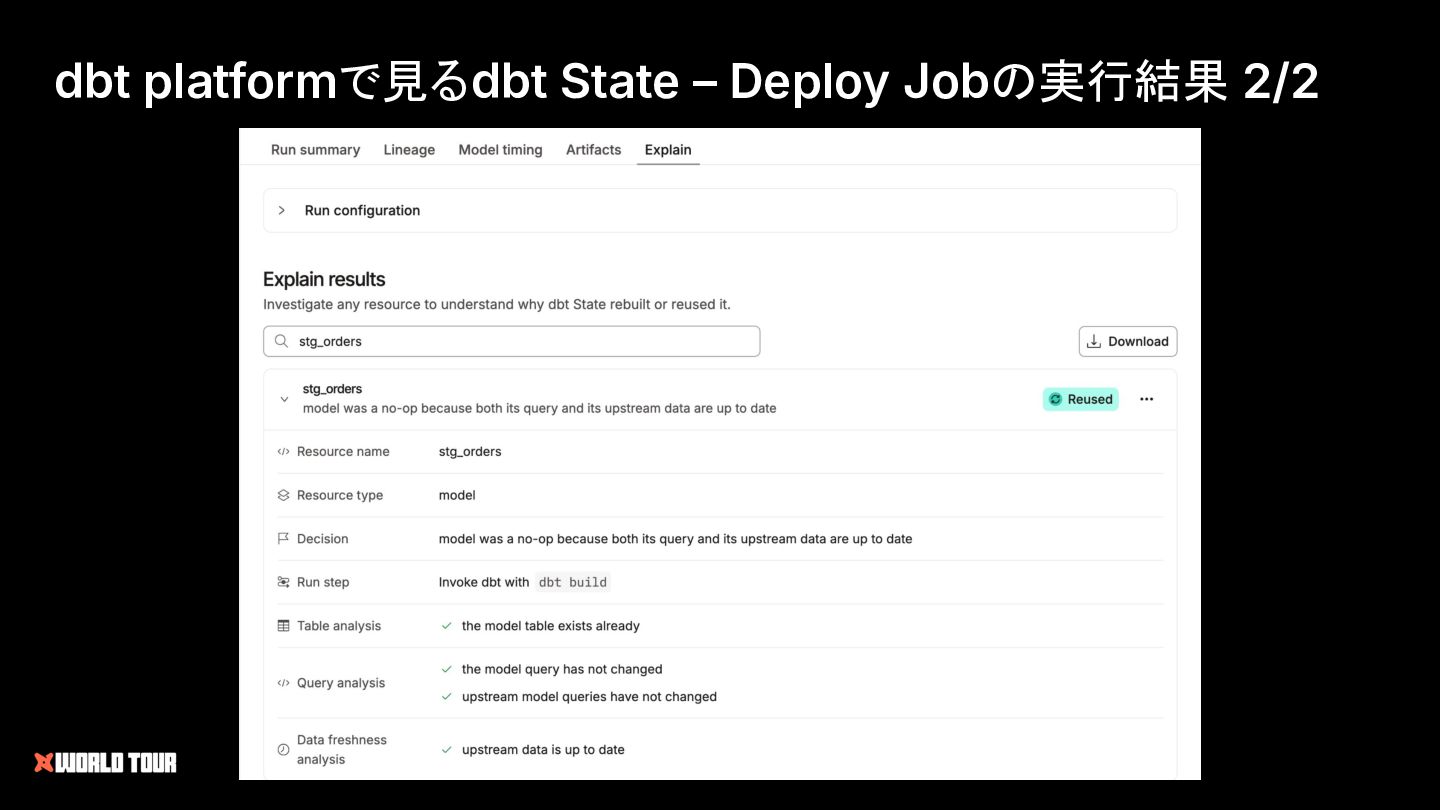
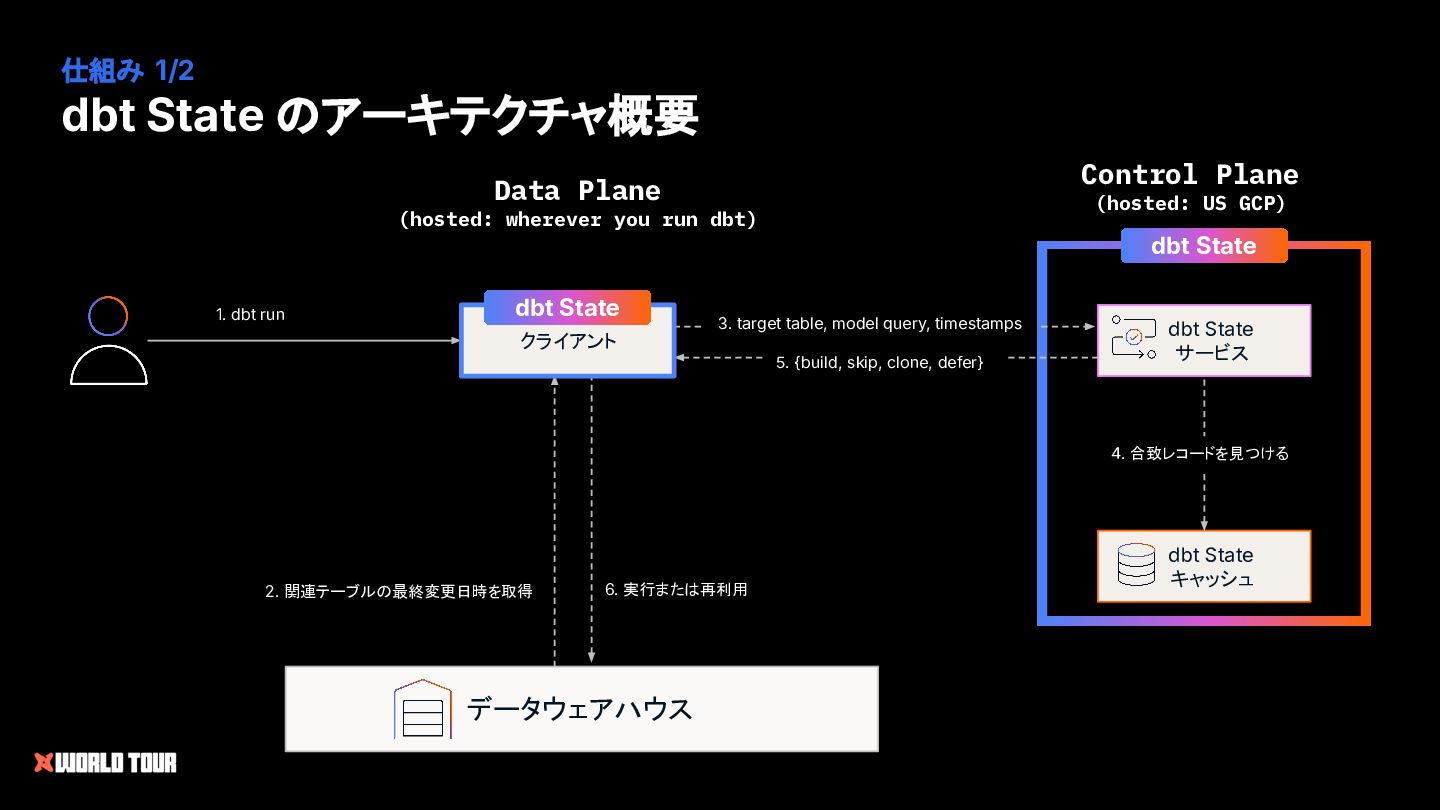
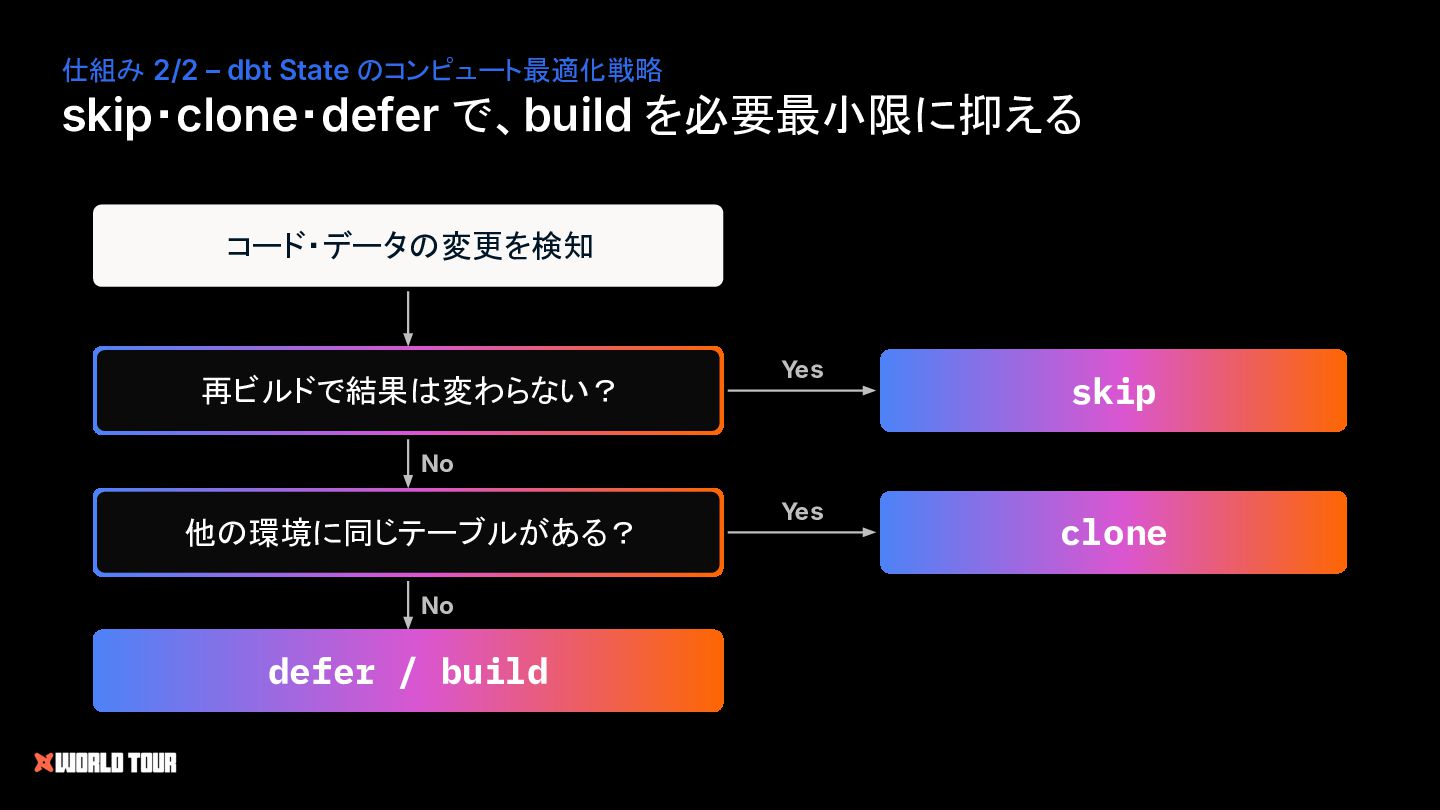
Run のたびに、dbt State はウェアハウスのメタデータとモデルの SQL をチェックし、結果が変わるかどうかを意味的に判断した上で、build、skip、clone、または本番環境への auto-defer のいずれかを決定します。その結果、平均30%のコンピュート削減、無駄な再構築のないより新鮮なデータ、そして scheduler の速度ではなく、あなたの思考の速度で進む dev cycles を実現します。
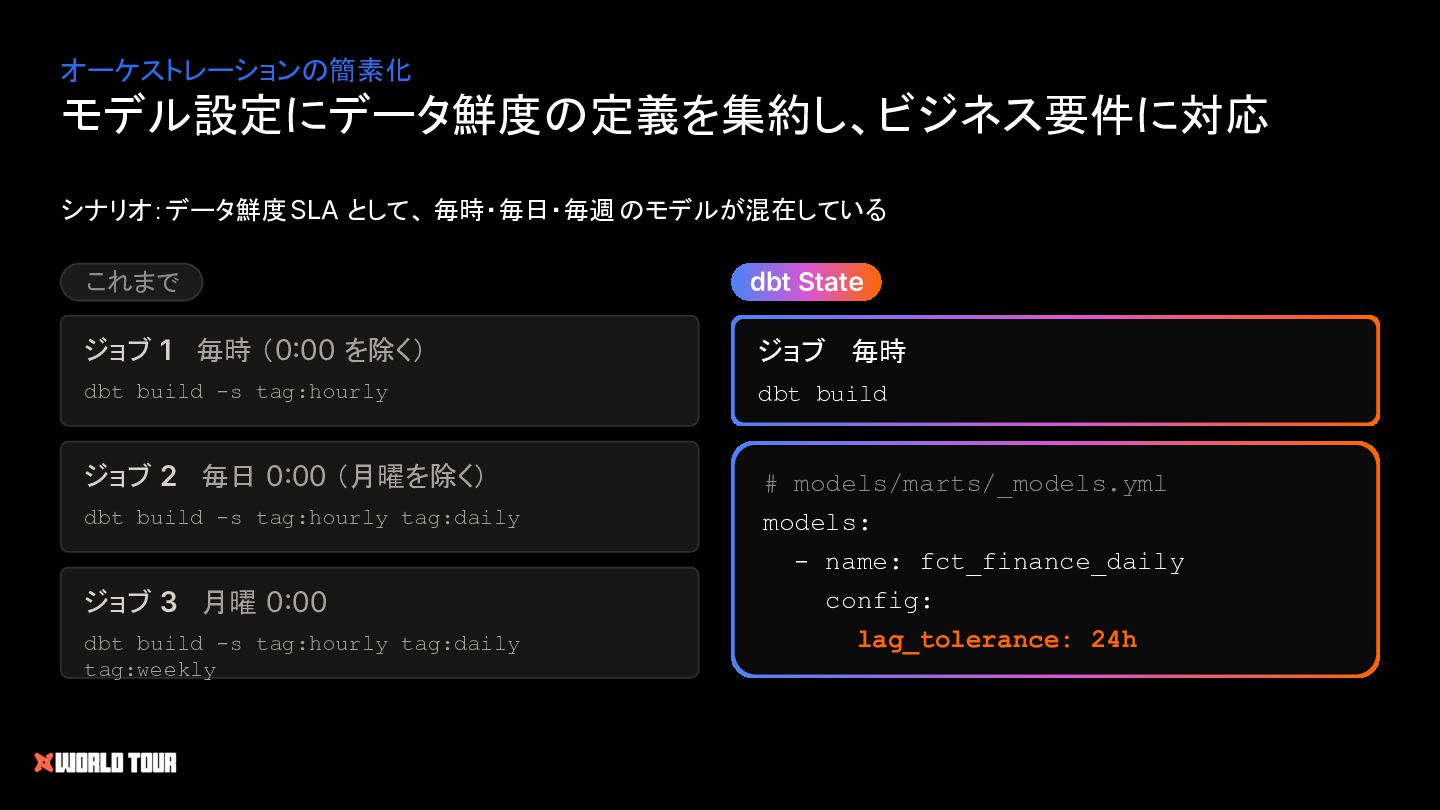
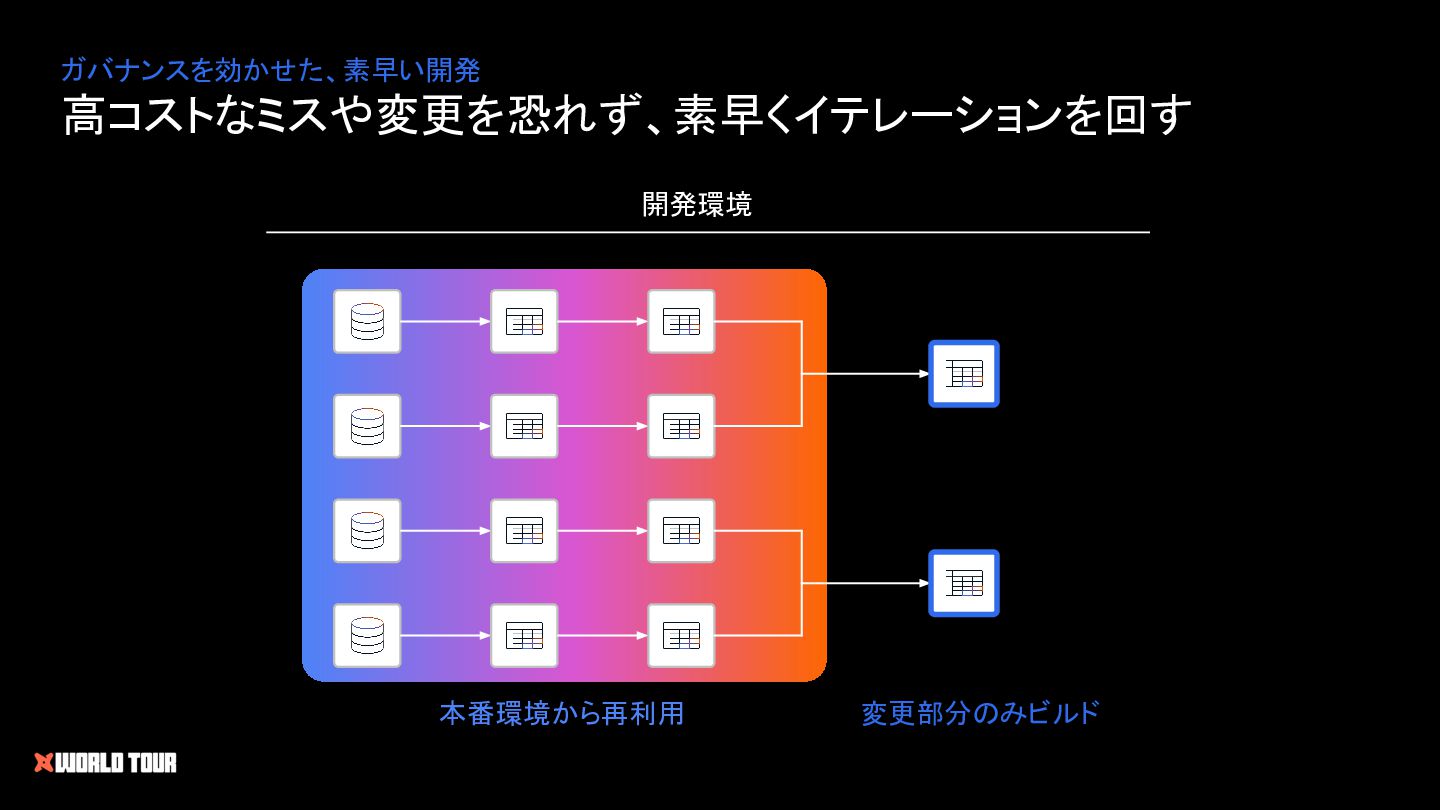
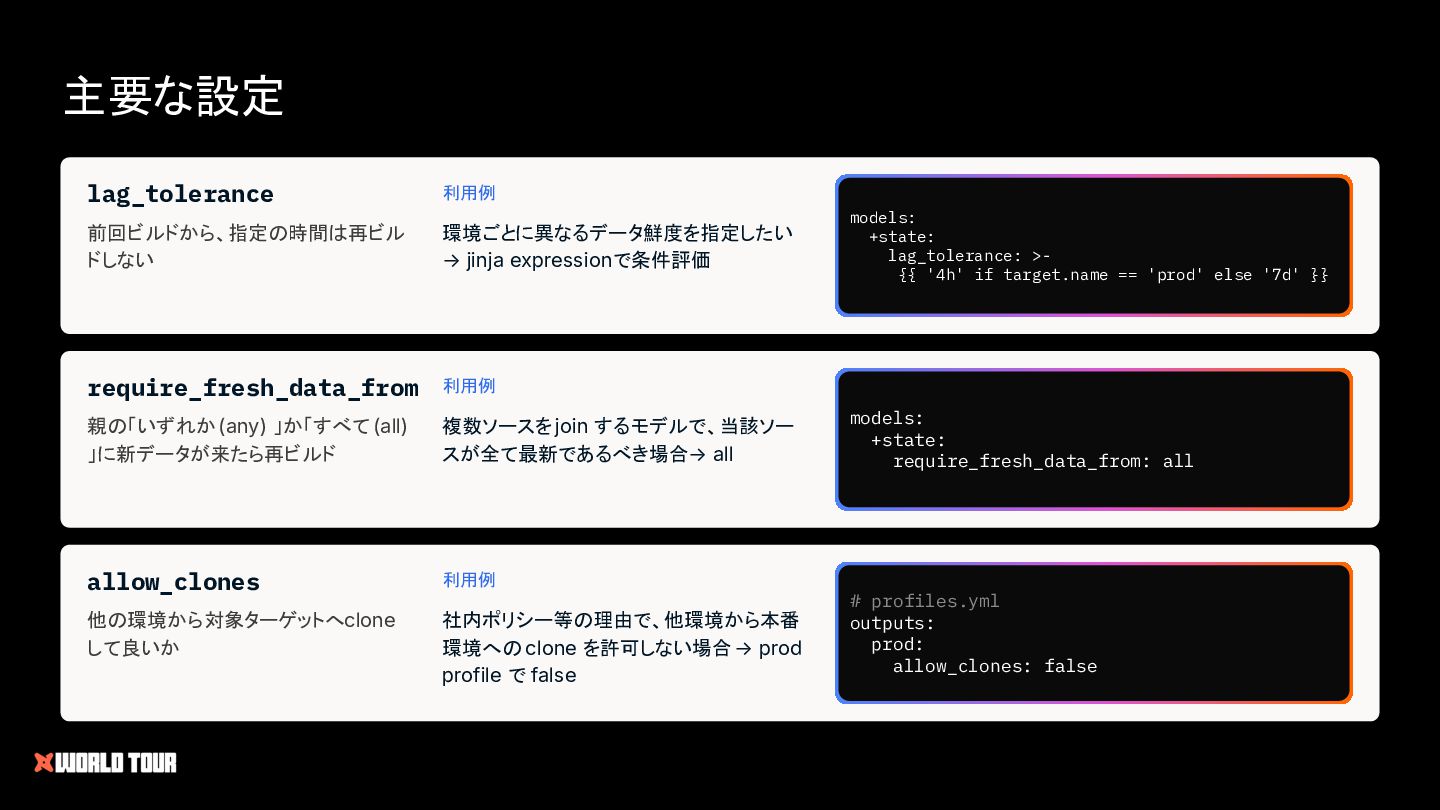
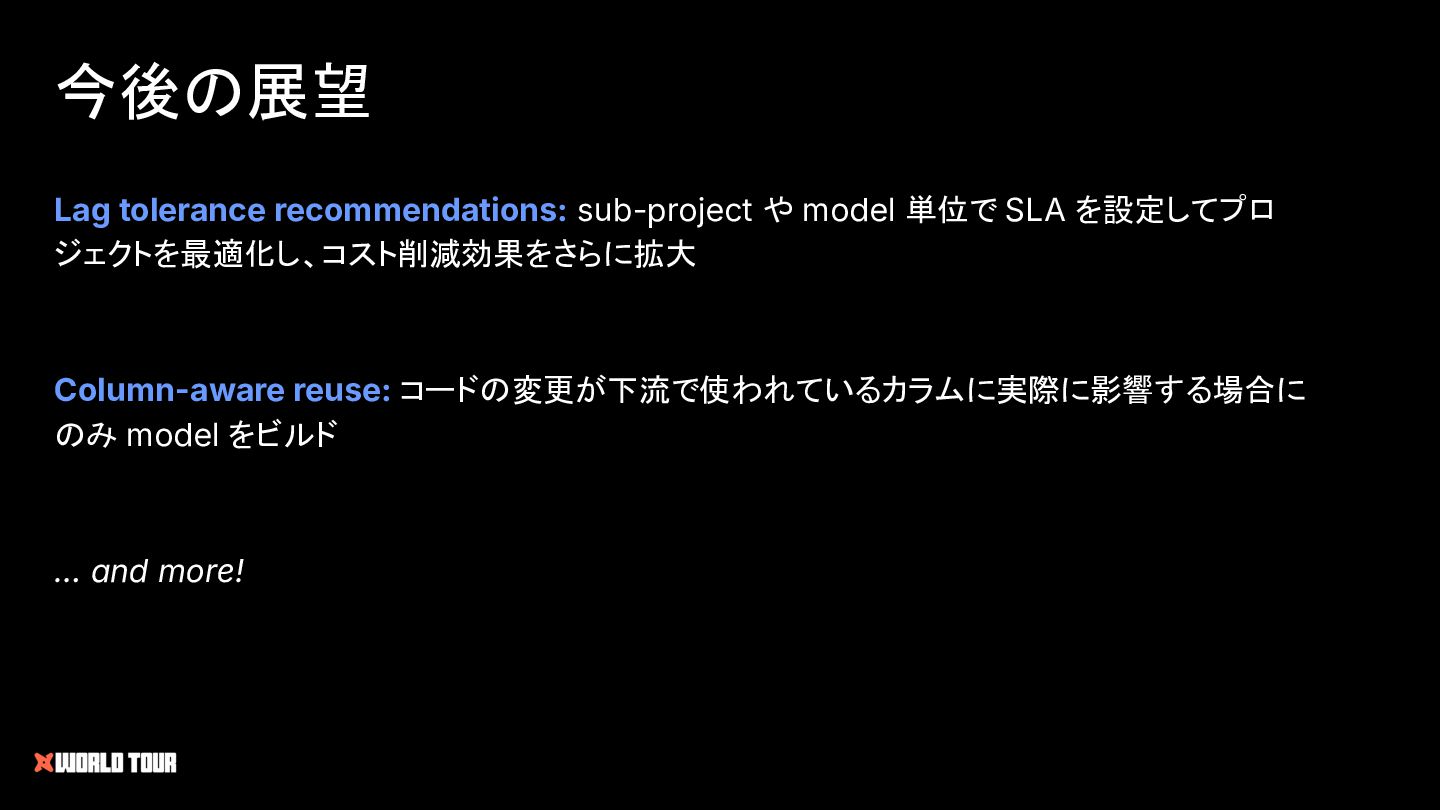
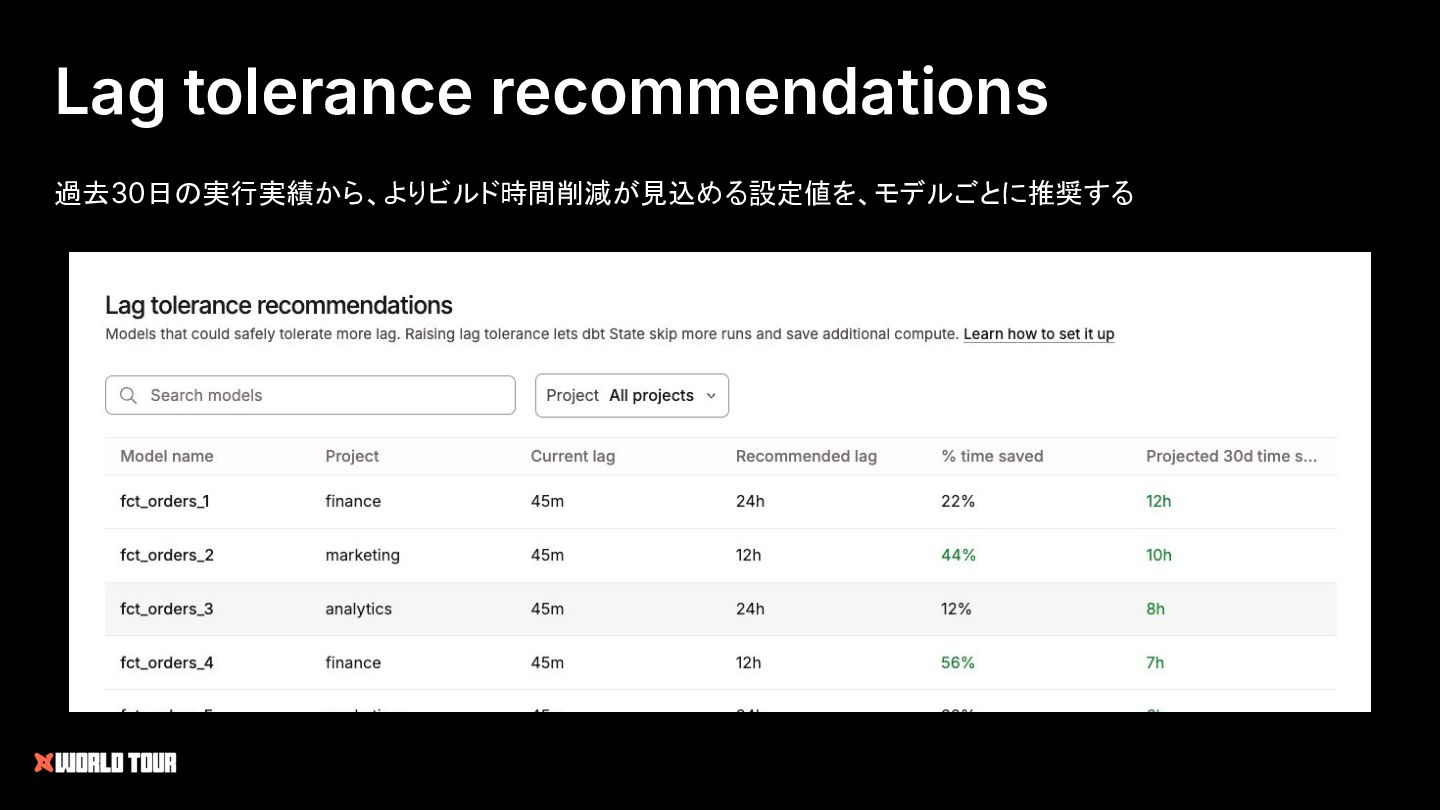
このセッションでは、dbt State の仕組み、upstream の変更をどう解決するか、freshness SLA によってスケジュールではなくビジネスの都合に合わせた再構築がどう可能になるか、そして本番環境からの auto-cloning がコストをかけずにローカルでの iteration をどう加速するかをご紹介します。


 myshmeh_
 mclloyd
 akademiya2063
 tammyeverts
 katarinadahlin
 sabderemane
 reverentgeek
 trallard
 cassininazir
 kimpetersen
 szymonslowik
 chriscoyier
 nmsamuel