Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
強化学習アルゴリズムPPOの改善案を考えてみた
Search
NearMeの技術発表資料です
PRO
August 22, 2025
320
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
強化学習アルゴリズムPPOの改善案を考えてみた
NearMeの技術発表資料です
PRO
August 22, 2025
More Decks by NearMeの技術発表資料です
See All by NearMeの技術発表資料です
AIエージェントのための 隔離された安全なインフラ設計
nearme_tech
PRO
0
23
Claude Code × git worktree で並列開発 (続き) -差分のサービスだけを併設する-
nearme_tech
PRO
1
69
Claude Code × git worktree で並列開発 — サブモジュール構成のリポジトリで成立させる —
nearme_tech
PRO
0
79
LLM + 強化学習
nearme_tech
PRO
0
37
PosthogのA/Bテスト機能の紹介
nearme_tech
PRO
1
110
AIフレンドリーなプロダクトに向けて
nearme_tech
PRO
2
71
初めてのLean言語
nearme_tech
PRO
0
110
Apache Airflow Workflow orchestration without turning cron into spaghetti
nearme_tech
PRO
2
50
実務で役立つ幾何学 ボロノイ図の基礎から グラフ・ネットワーク応用まで
nearme_tech
PRO
1
93
Featured
See All Featured
Introduction to Domain-Driven Design and Collaborative software design
baasie
1
1k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
950
Building AI with AI
inesmontani
PRO
1
1.3k
Fantastic passwords and where to find them - at NoRuKo
philnash
53
4k
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
270
Visualization
eitanlees
153
17k
Designing Experiences People Love
moore
143
24k
Winning Ecommerce Organic Search in an AI Era - #searchnstuff2025
aleyda
2
2.2k
brightonSEO & MeasureFest 2025 - Winning Strategies for Black Friday CRO & PPC - Christian Goodrich
cargoodrich
3
870
SEO in 2025: How to Prepare for the Future of Search
ipullrank
3
3.9k
Kristin Tynski - Automating Marketing Tasks With AI
techseoconnect
PRO
0
550
Highjacked: Video Game Concept Design
rkendrick25
PRO
1
480
Transcript
0 強化学習アルゴリズムPPOの改善案を考えてみた 2025-08-22 第128回NearMe技術勉強会 Takuma KAKINOUE
1 概要 • 強化学習の従来のオンポリシーアルゴリズムの⽋点 ◦ 良い⾏動軌跡を⾒つけて⼀度学習しても、探索するうちに忘れてしまう • 提案⼿法 ◦ 報酬が⾼かったエピソードの各ステップの⾏動確率分布を記録する
◦ “記録した分布”と”現在の⽅策が出⼒した分布”のKLダイバージェンスを計算 ◦ 算出したKLダイバージェンスを最⼩化する項を⽬的関数に加える
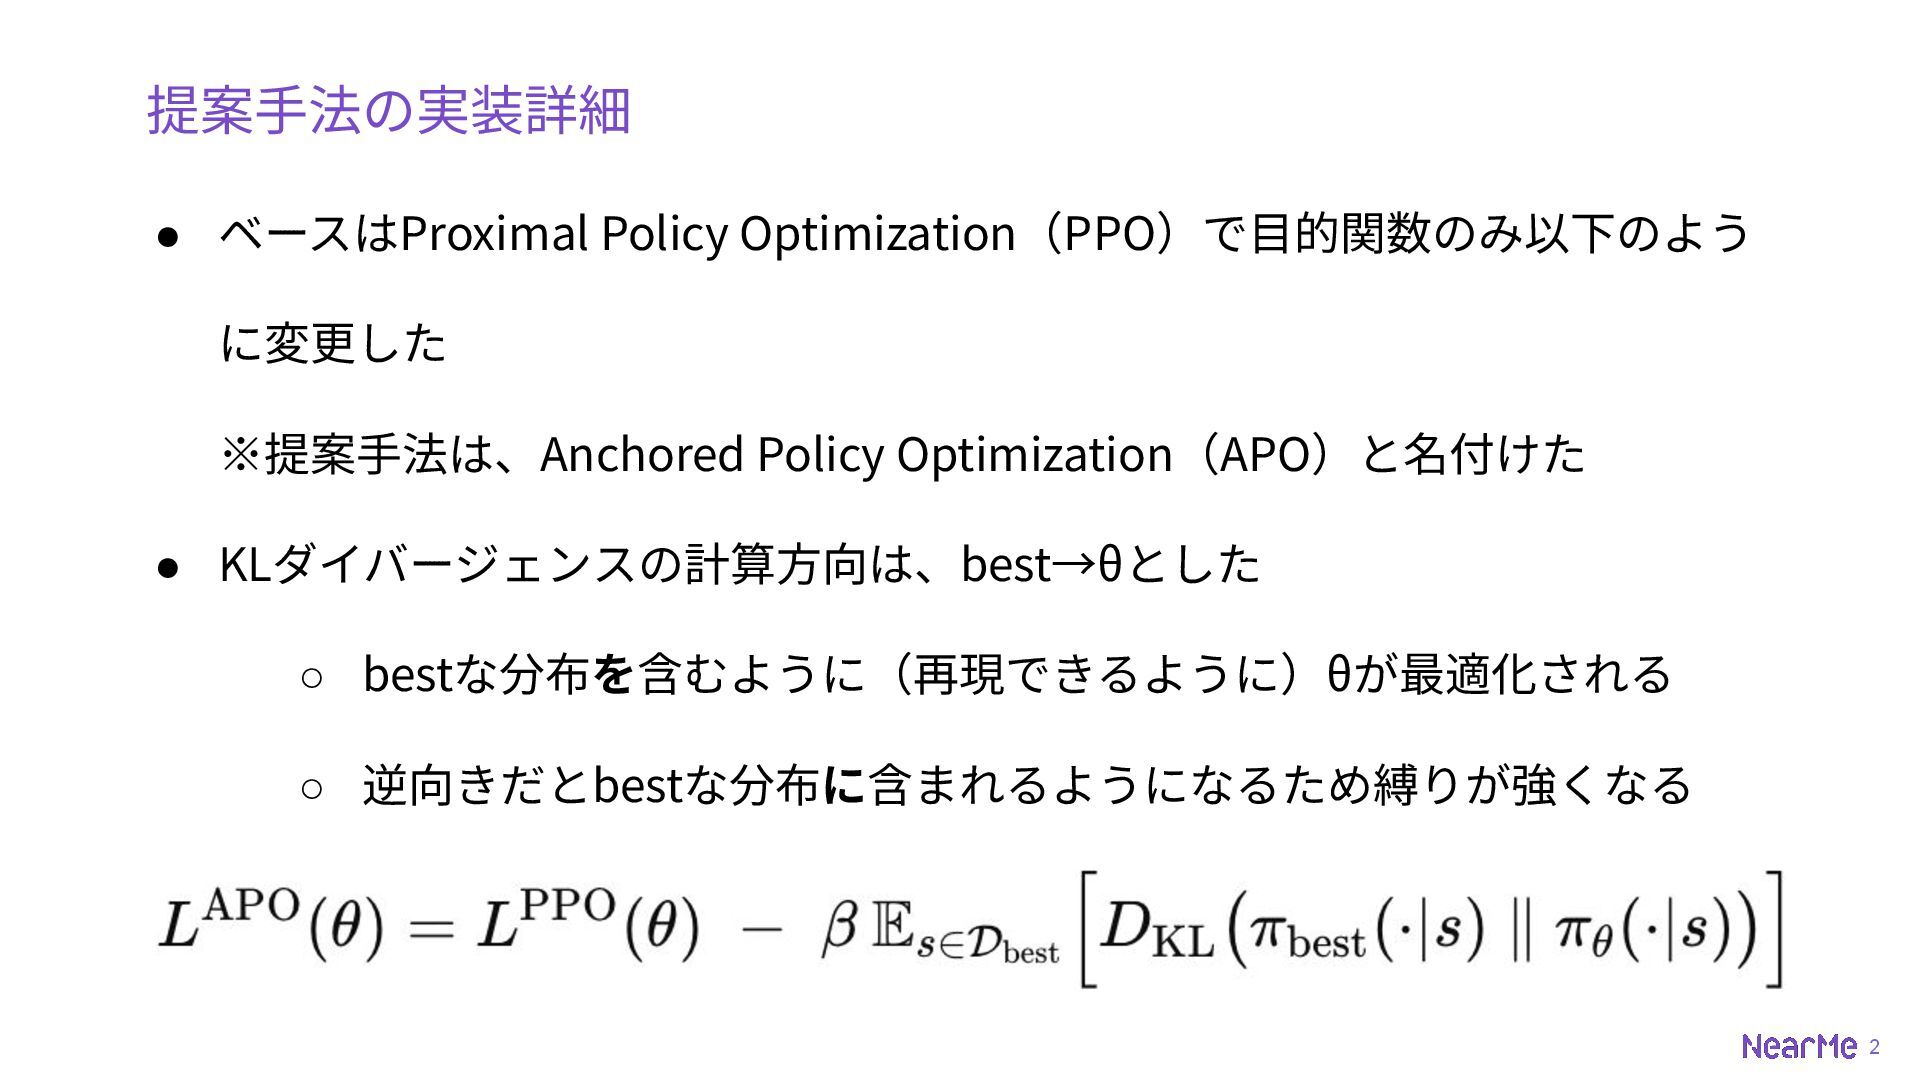
2 提案⼿法の実装詳細 • ベースはProximal Policy Optimization(PPO)で⽬的関数のみ以下のよう に変更した ※提案⼿法は、Anchored Policy Optimization(APO)と名付けた
• KLダイバージェンスの計算⽅向は、best→θとした ◦ bestな分布を含むように(再現できるように)θが最適化される ◦ 逆向きだとbestな分布に含まれるようになるため縛りが強くなる
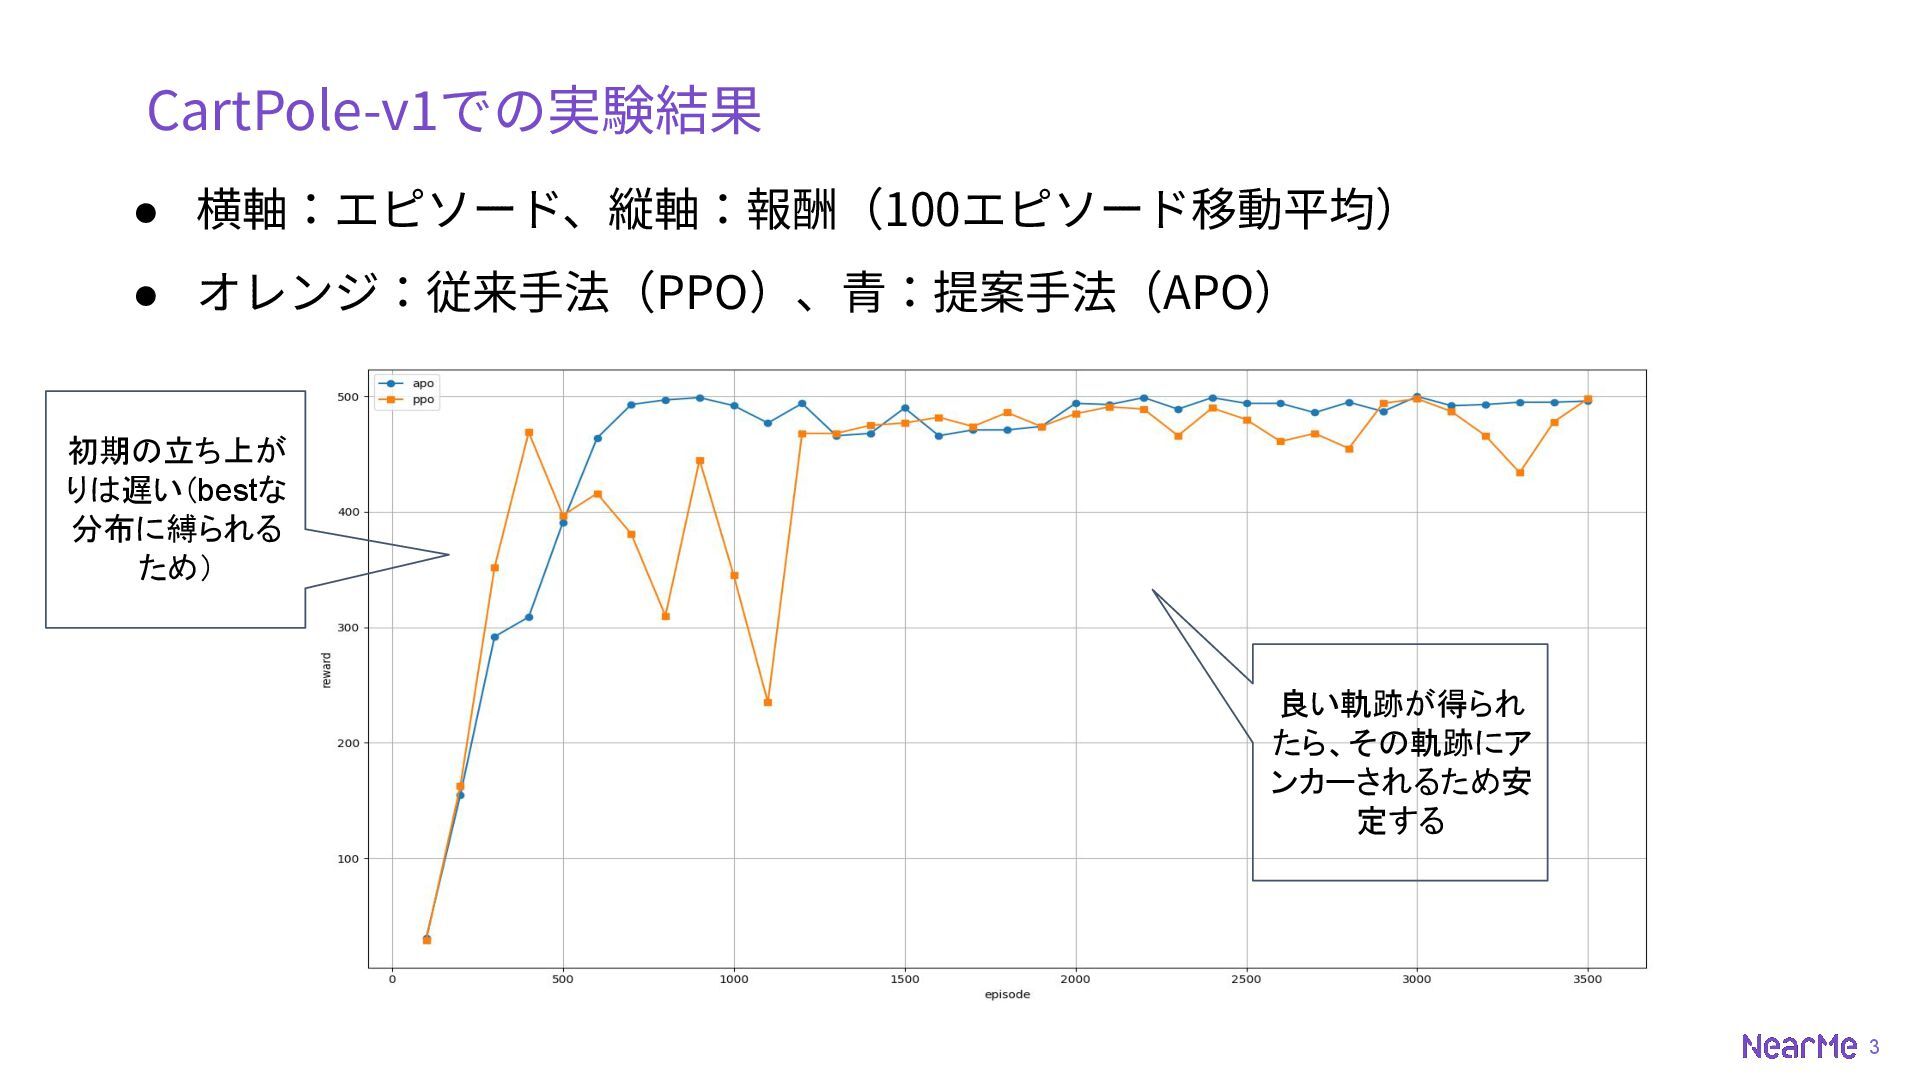
3 CartPole-v1での実験結果 • 横軸:エピソード、縦軸:報酬(100エピソード移動平均) • オレンジ:従来⼿法(PPO)、⻘:提案⼿法(APO) 初期の立ち上が りは遅い(bestな 分布に縛られる ため)
良い軌跡が得られ たら、その軌跡にア ンカーされるため安 定する
4 今後の展望 • 複数エージェントで並列化訓練させる仕組みと組み合わせてみる ◦ どれか1つのエージェントが良い⾏動軌跡を発⾒したら、他のエージェントに も共有して、良い⾏動軌跡にアンカーすることで学習の安定性と効率を向上 させる狙い • スーパーマリオなどの滅多にゴールに辿り着けない環境で真価を発揮するのでは
ないかと考えているので実験してみる
5 Thank you


 nearme_tech
 baasie
 nmsamuel
 inesmontani
 philnash
 tmiket
 eitanlees
 moore
 aleyda
 cargoodrich
 ipullrank
 techseoconnect
 rkendrick25