Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
exists?で起きるN+1問題にSetで対処する
Search
patorash
July 21, 2021
Technology
870
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
exists?で起きるN+1問題にSetで対処する
Ruby on Railsでよく発生するN+1問題の解決方法として、exists?の場合は標準ライブラリのSetを使うといいかもしれない、という話です。
patorash
July 21, 2021
More Decks by patorash
See All by patorash
中間管理職はそこそこ楽しい
patorash
0
59
情報共有戦略と戦術
patorash
1
1.4k
DBのメタデータを管理する文化を作る
patorash
0
720
Stimulusのススメ
patorash
0
100
ActiveRecordの速度改善Tips2020冬
patorash
0
95
わかった気になる!OpenID Connect
patorash
2
2.2k
Indexの種類
patorash
1
850
Start-SQLの紹介
patorash
0
790
RailsアプリにGraphQLを導入してみた話
patorash
1
710
Other Decks in Technology
See All in Technology
なぜ「決定性」が 決定的に重要なのか? Durable Execution 基盤の数理的理解 #serverlessjp / ServerlessDays Tokyo 2026
ytaka23
3
1.2k
あけおめLINE 傾向とその対策
nasa9084
0
320
バイブコーディング時代のWebアプリ開発入門~Cloud Runで学ぶセキュアなビルドとデプロイ
waiwai2111
1
150
beyond jj: config & tools ecosystem
indirect
0
6k
認知負荷を吸収し、プロダクトをまたぐPR Preview基盤の設計事例
taiki45
2
160
開発投資の期待値を上げるプロダクトロードマップづくり ~プロダクトエンジニアが越境して事業を伸ばす~
kekekenta
1
250
登壇の自信を奪う3匹のオバケ / 3 Ghosts That Rob You of Your Confidence in Public Speaking
pauli
9
1.1k
Oracle Base Database Service 技術詳細
oracle4engineer
PRO
16
120k
AIは推し活である。
kurazuuuuuu
1
960
その Lambda、8分で 管理者権限まで奪われます
k1nakayama
7
3.7k
AI Agent入門〜今更聞けないAgentの話〜
hiromimaganuma
0
110
時うどん〜Socket.getifaddrsで学ぶネットワーク編 / Tokiudon: The Socket.getifaddrs Edition
coe401_
4
260
Featured
See All Featured
Stop Working from a Prison Cell
hatefulcrawdad
274
21k
More Than Pixels: Becoming A User Experience Designer
marktimemedia
3
530
Code Review Best Practice
trishagee
74
20k
Leo the Paperboy
mayatellez
10
2.3k
Side Projects
sachag
456
43k
職位にかかわらず全員がリーダーシップを発揮するチーム作り / Building a team where everyone can demonstrate leadership regardless of position
madoxten
69
66k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
21k
Understanding Cognitive Biases in Performance Measurement
bluesmoon
32
3k
The Spectacular Lies of Maps
axbom
PRO
1
1k
Tell your own story through comics
letsgokoyo
1
1.1k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
1
2k
Transcript
exists?で起きるN+1問 題にSetで対処する 2021-07-21 株式会社リゾーム 社内勉強会 @patorash
稀によくあるコード # CSVファイルの行数だけUser.exists?が実行されるやーつ csv.foreach do |row| name = row['名前'] age
= row['年齢'] hobby = row['趣味'] # User.find_or_create_by!とか言わないで… unless User.exists?(name: name, age: age, hobby: hobby) User.create!(name: name, age: age, hobby: hobby) end end
何が問題か? • CSVファイルの⾏数だけexists?が実⾏される • exists?の1回の実⾏時間が仮に1msだったとしても、CSVが1,000⾏あれば1秒か かる。1万⾏あれば10秒、10万⾏あれば100秒…と増えていく • usersテーブルにデータがたくさんあると、exists?の時間は更にかかる • 1msではなく5msなら?
• 1,000⾏なら5秒、1万⾏なら50秒、10万⾏なら500秒
どうしてこんなことに… • 重複データを検知したいから
どうすれば… • とはいえ、重複しているかどうかは DBに問い合わせしなければわからな いじゃないか! • N回のクエリが発⽣するのも⽌むを 得ない!
そう考えていた頃が私にもありました
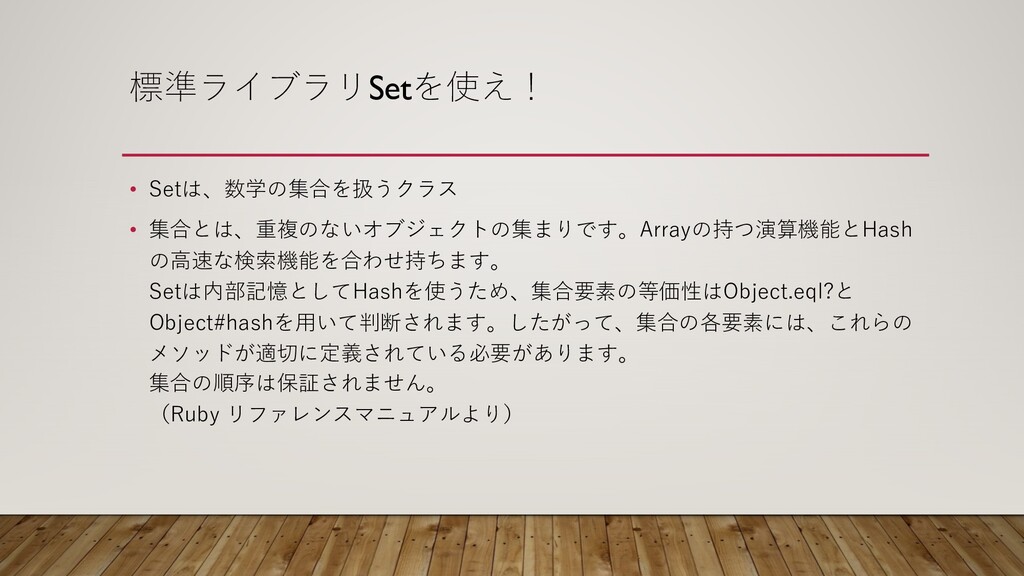
標準ライブラリSetを使え! • Setは、数学の集合を扱うクラス • 集合とは、重複のないオブジェクトの集まりです。Arrayの持つ演算機能とHash の⾼速な検索機能を合わせ持ちます。 Setは内部記憶としてHashを使うため、集合要素の等価性はObject.eql?と Object#hashを⽤いて判断されます。したがって、集合の各要素には、これらの メソッドが適切に定義されている必要があります。 集合の順序は保証されません。
(Ruby リファレンスマニュアルより)
どういうこと? • Setを使うと、配列の要素毎にhash関数が呼ばれて、それがkeyに設定された Hashを持つことになる。(内部的に) # これはつまり… set = Set.new(["a", "b"])
# 内部としてはこういう感じになっている hash = ["a", "b"].each_with_object({}) {|v, o| o[v.hash] = v } # => {690777552598146486=>"a", -2489798041940868951=>"b"} # これはつまり… set.include?("a") # => true # こういうこと。総当りせず、hash値がキーとヒットするかを調べるので速い hash.keys.include?("a".hash) # => true
つまり… • usersテーブルの内容を全て持ってきてSetに⼊れてしまえばN回発⾏される クエリは必要ない!(富豪的発想) • なぜ富豪的? • メモリにusersテーブルの全データを載せるから
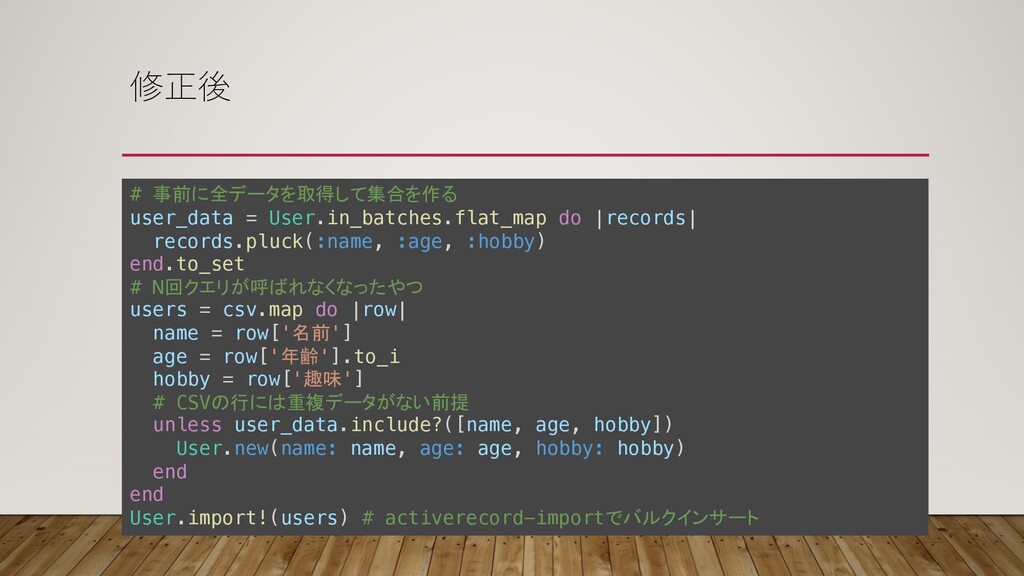
修正後 # 事前に全データを取得して集合を作る user_data = User.in_batches.flat_map do |records| records.pluck(:name, :age,
:hobby) end.to_set # N回クエリが呼ばれなくなったやつ users = csv.map do |row| name = row['名前'] age = row['年齢'].to_i hobby = row['趣味'] # CSVの行には重複データがない前提 unless user_data.include?([name, age, hobby]) User.new(name: name, age: age, hobby: hobby) end end User.import!(users) # activerecord-importでバルクインサート
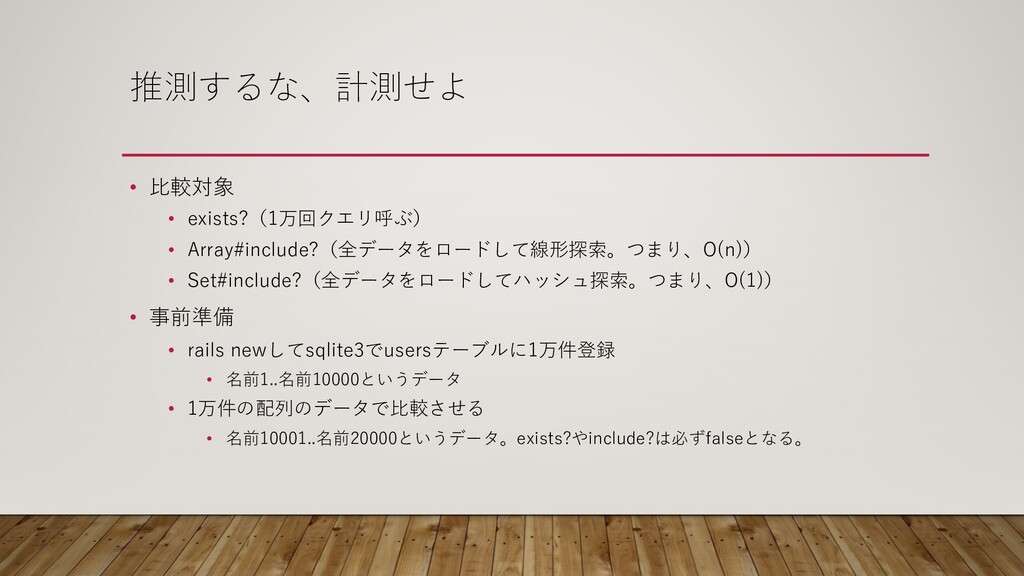
推測するな、計測せよ • ⽐較対象 • exists?(1万回クエリ呼ぶ) • Array#include?(全データをロードして線形探索。つまり、O(n)) • Set#include?(全データをロードしてハッシュ探索。つまり、O(1)) •
事前準備 • rails newしてsqlite3でusersテーブルに1万件登録 • 名前1..名前10000というデータ • 1万件の配列のデータで⽐較させる • 名前10001..名前20000というデータ。exists?やinclude?は必ずfalseとなる。
推測するな、計測せよ(結果) bin/rails runner script/benchmark.rb Warming up -------------------------------------- exists? 1.000 i/100ms
Array#include? 1.000 i/100ms Set#include? 1.000 i/100ms Calculating ------------------------------------- exists? 0.085 (± 0.0%) i/s - 1.000 in 11.734614s Array#include? 0.059 (± 0.0%) i/s - 1.000 in 17.012424s Set#include? 8.503 (± 0.0%) i/s - 43.000 in 5.064850s Comparison: Set#include?: 8.5 i/s exists?: 0.1 i/s - 99.78x (± 0.00) slower Array#include?: 0.1 i/s - 144.66x (± 0.00) slower
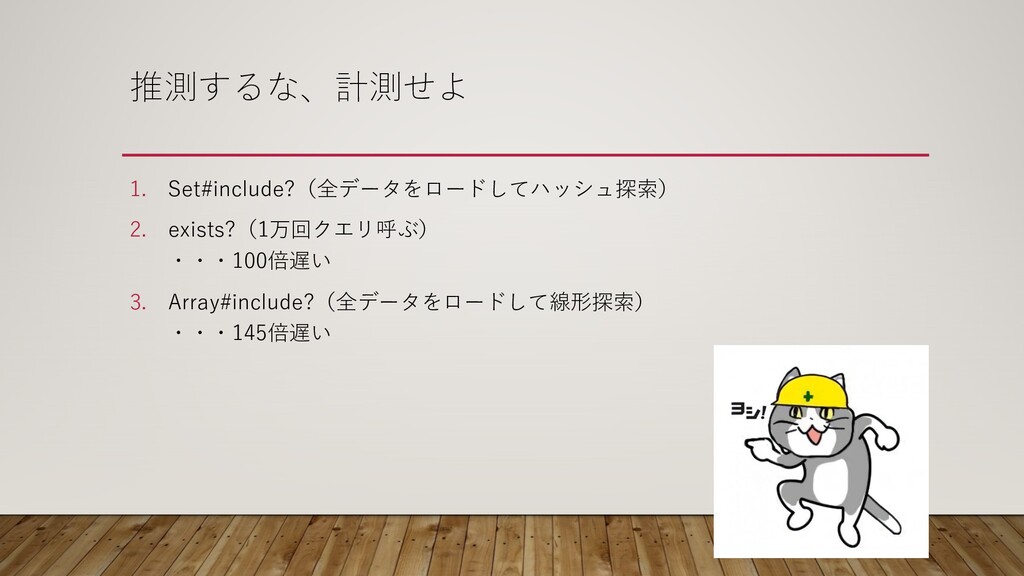
推測するな、計測せよ 1. Set#include?(全データをロードしてハッシュ探索) 2. exists?(1万回クエリ呼ぶ) ・・・100倍遅い 3. Array#include?(全データをロードして線形探索) ・・・145倍遅い
ご清聴ありがとうございました


 patorash
 ytaka23
 nasa9084
 waiwai2111
 indirect
 taiki45
 kekekenta
 pauli
 oracle4engineer
 kurazuuuuuu
 k1nakayama
 hiromimaganuma
 coe401_
 hatefulcrawdad
 marktimemedia
 trishagee
 mayatellez
 sachag
 madoxten
 jeffersonlam
 bluesmoon
 axbom
 letsgokoyo
 codingconduct
 joshbly