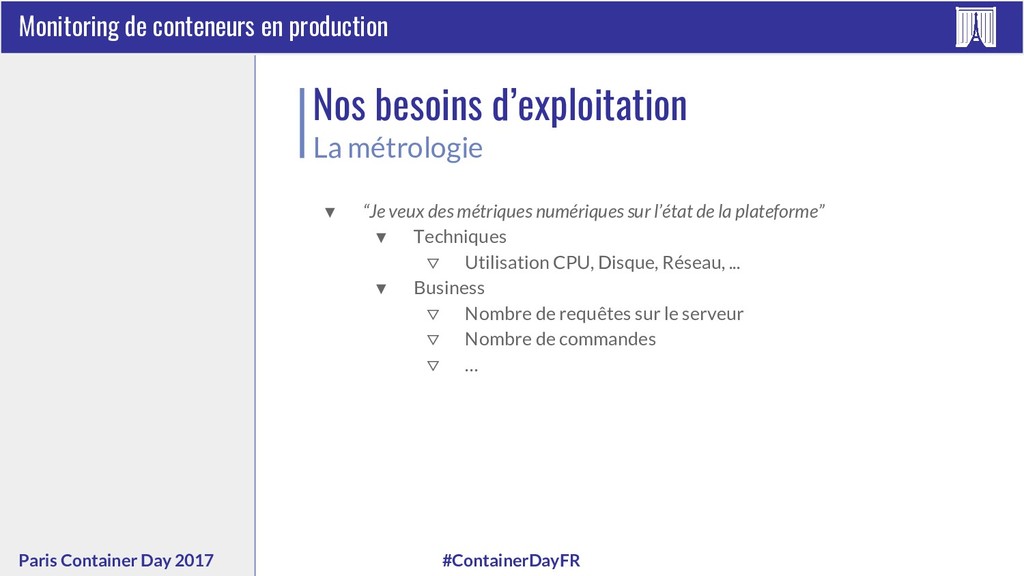
Nos besoins d’exploitation La métrologie ▼ “Je veux des métriques numériques sur l’état de la plateforme” ▼ Techniques ▽ Utilisation CPU, Disque, Réseau, ... ▼ Business ▽ Nombre de requêtes sur le serveur ▽ Nombre de commandes ▽ …
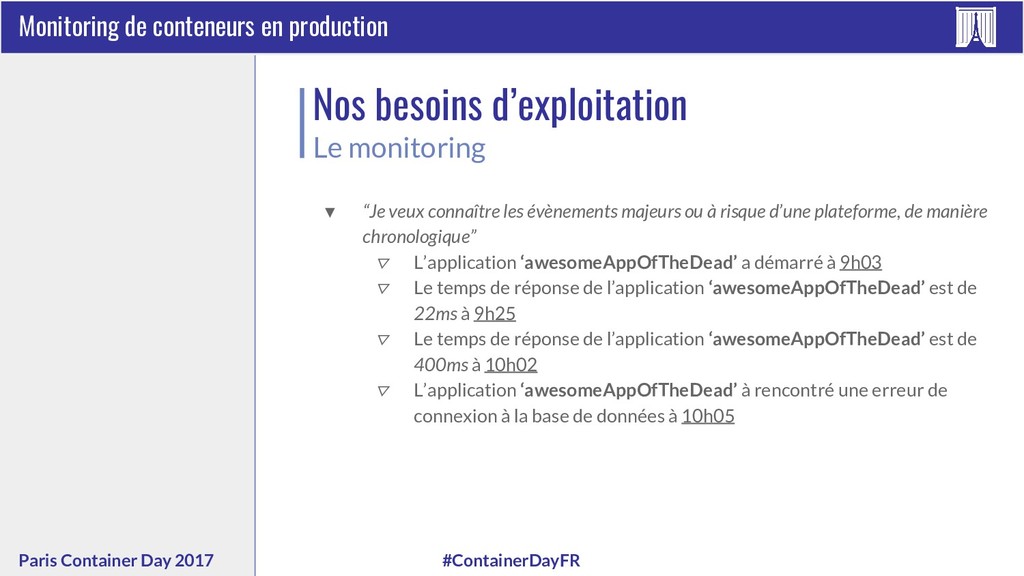
Nos besoins d’exploitation Le monitoring ▼ “Je veux connaître les évènements majeurs ou à risque d’une plateforme, de manière chronologique” ▽ L’application ‘awesomeAppOfTheDead’ a démarré à 9h03 ▽ Le temps de réponse de l’application ‘awesomeAppOfTheDead’ est de 22ms à 9h25 ▽ Le temps de réponse de l’application ‘awesomeAppOfTheDead’ est de 400ms à 10h02 ▽ L’application ‘awesomeAppOfTheDead’ à rencontré une erreur de connexion à la base de données à 10h05
Nos besoins d’exploitation L’alerting ▼ “Je veux être alerté des états anormaux et critiques de la plateforme, que ce soit à partir des métriques ou des données de monitoring” ▽ Il reste moins de 5% d’espace disque sur une machine. ▽ Il n’y a plus de commande depuis plus de 20 mins (alors qu’il y a toujours de l’activité normalement)
Avant la mise en boîte Le monitoring ▼ Agents de supervision contrôlés par un serveur ▽ Nouveau serveur -> opération sur le serveur de supervision ▼ Équilibre entre : ▽ Granularité des checks contre généricité ▪ Vérification d’un point de montage inexistant ? ▪ Seuils d’occupation RAM inadaptés pour un SGBD ? ▽ Complexité de maintenance ▪ Cas spécifiques à maintenir
Avant la mise en boîte Le monitoring ▼ Monitoring des serveurs d’applications (Tomcat, Websphere, …) ▽ Déport des métriques de l’application vers le middleware ▽ Métriques pas toujours adaptées ▼ Centralisation de logs peu répandue ▽ Comment trouver mon erreur métier parmi les 40 serveurs de l’application ?
Avant la mise en boîte La métrologie ▼ Un serveur est lié à une application de manière “permanente” ▽ “Le serveur slvfrcrm01 héberge le CRM de la société” ▽ On “sait” que les logs de ce serveur sont liés au CRM ▼ Le monitoring et la métrologie sont souvent liés ▽ Utilisation d’outils “tout-en-un”: Zabbix, HPOV
qui change ▼ Un conteneur contient une version allégée de l’OS ▽ Pas de noyau, de système de démarrage, … ▽ “J’installe comment mon agent Zabbix ?” ▽ “Il est où init.d ? bash?” ▽ “Comment j’audite ce que les utilisateurs font dans le conteneur ?” ▼ Une machine peut héberger plusieurs conteneurs d’applications différentes ▽ “Que fait le conteneur d91457f5-89d8-45da-a307-276792240224 ?” ▽ “A quelle application correspondent ces logs ?”
qui change ▼ Les architectures microservices profitent de ce mouvement ▽ Myriade de conteneurs possédant chacun une fonction métier ▽ Chaque log possède à lui seul peu de valeur ▽ Nécessité de centraliser les logs et métriques pour une vision d’ensemble ▽ Les conteneurs démarrent, s’arrêtent, sont remplacés, se déplacent de serveur en serveur
fait que changer ! Un changement de paradigme ▼ La disparition et l’apparition de conteneurs est un phénomène normal ▽ La notion de “pet versus cattle” est en partie vraie ici ▽ Les conteneurs font partie du troupeau ▪ Ils peuvent être remplacés à tout moment ! ▪ La mise à jour d’un conteneur passe par son remplacement ▼ Un hôte héberge maintenant plusieurs apps, dont les logs n’ont rien à voir ▽ Nécessité d’identification de chaque ligne de log
fait que changer ! Un changement de paradigme ▼ Mais comment je déclare tout cela dans mon monitoring/alerting ?! ▽ Un service va changer régulièrement d’adresse IP et de serveur ▽ Certaines vérifications n’ont plus de sens ▪ Espace disque dans un conteneur ? ▪ Mises à jour de sécurité dans un conteneur ? ▽ Qu’est-ce que je dois encore vérifier sur un conteneur ? ▽ Quid d’un modèle où les conteneurs se déclarent eux même ?
fait que changer ! Un changement de paradigme ▼ “Comment j’installe mon agent de collecte de métriques dans vos conteneurs ?” ▽ Est-ce réellement nécessaire qu’il soit dans le conteneur ? ▽ Et si l’on tentait de collecter ces infos depuis l’hôte ?
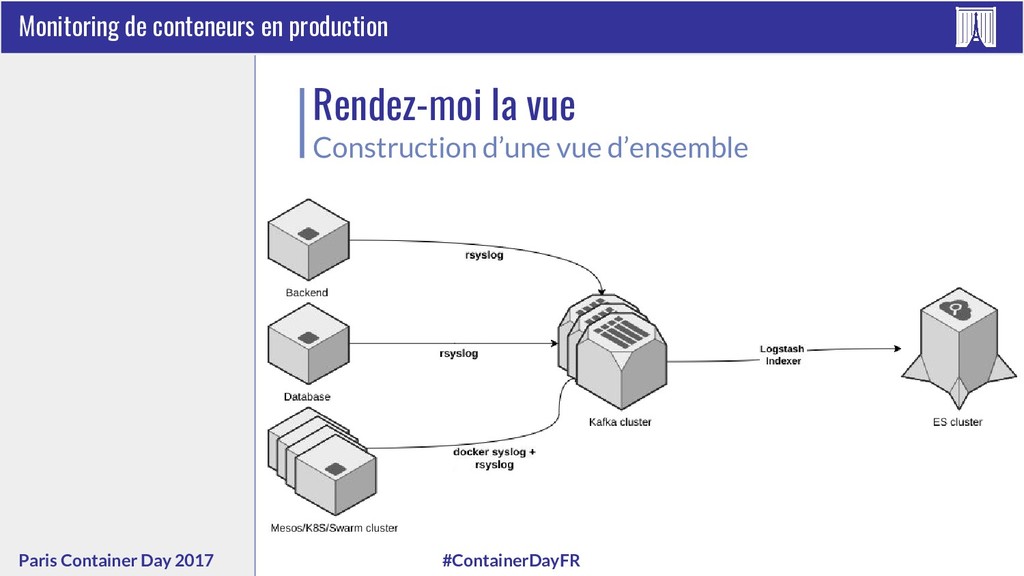
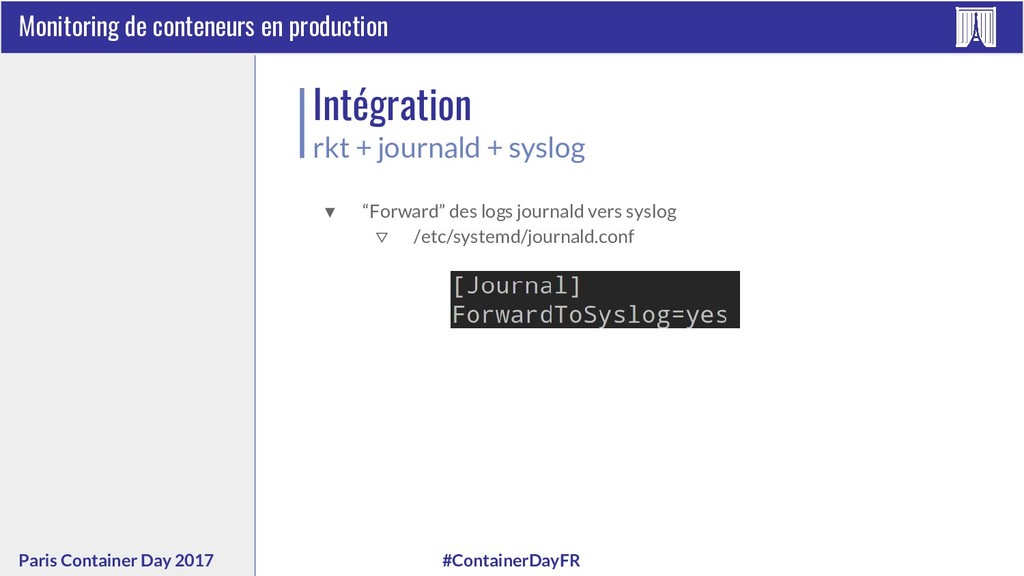
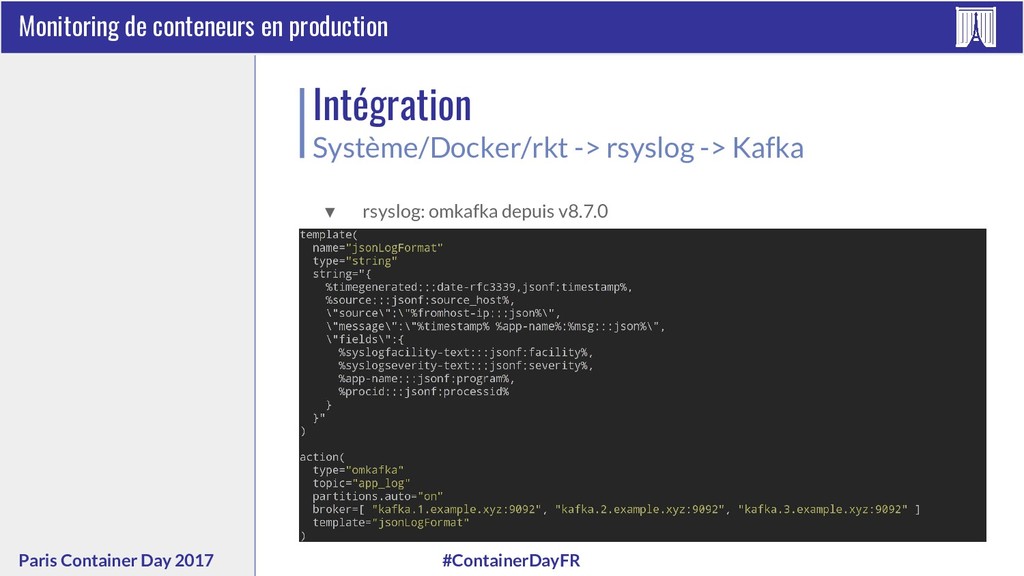
Rendez-moi la vue Construction d’une vue d’ensemble ▼ L'agrégation de l’ensemble des logs va nous permettre d’avoir une vision d’ensemble ▼ Plusieurs outils sont disponibles pour l’acheminement de ces logs ▽ Events système: syslog/rsyslog ▽ Events conteneurs: ▪ rkt: intégration avec journald + syslog ▪ docker: plugin syslog ▪ chacun fournit des capacités de tags sur les logs générés
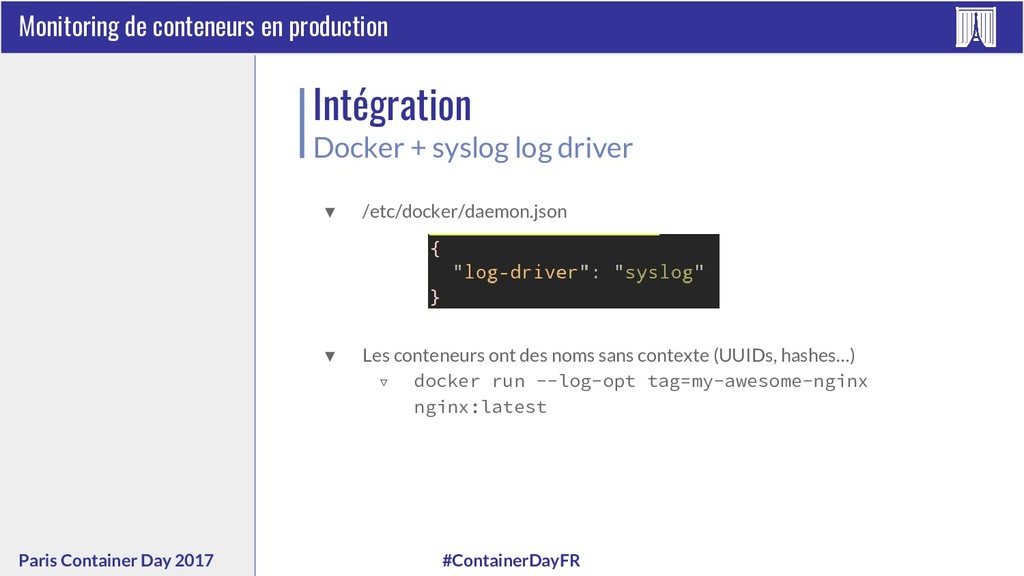
Intégration Docker + syslog log driver ▼ /etc/docker/daemon.json ▼ Les conteneurs ont des noms sans contexte (UUIDs, hashes…) ▽ docker run --log-opt tag=my-awesome-nginx nginx:latest
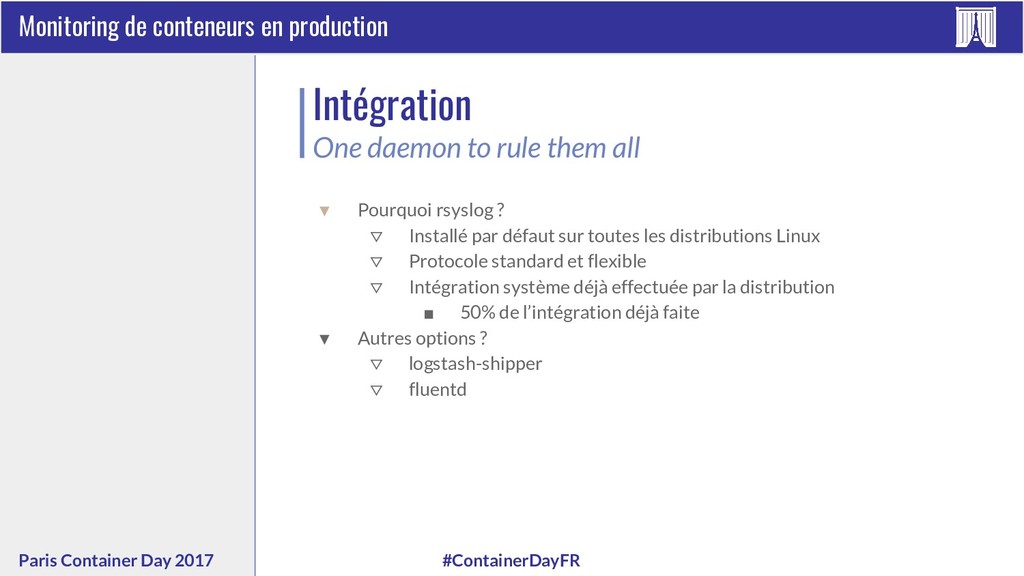
Intégration One daemon to rule them all ▼ Pourquoi rsyslog ? ▽ Installé par défaut sur toutes les distributions Linux ▽ Protocole standard et flexible ▽ Intégration système déjà effectuée par la distribution ▪ 50% de l’intégration déjà faite ▼ Autres options ? ▽ logstash-shipper ▽ fluentd
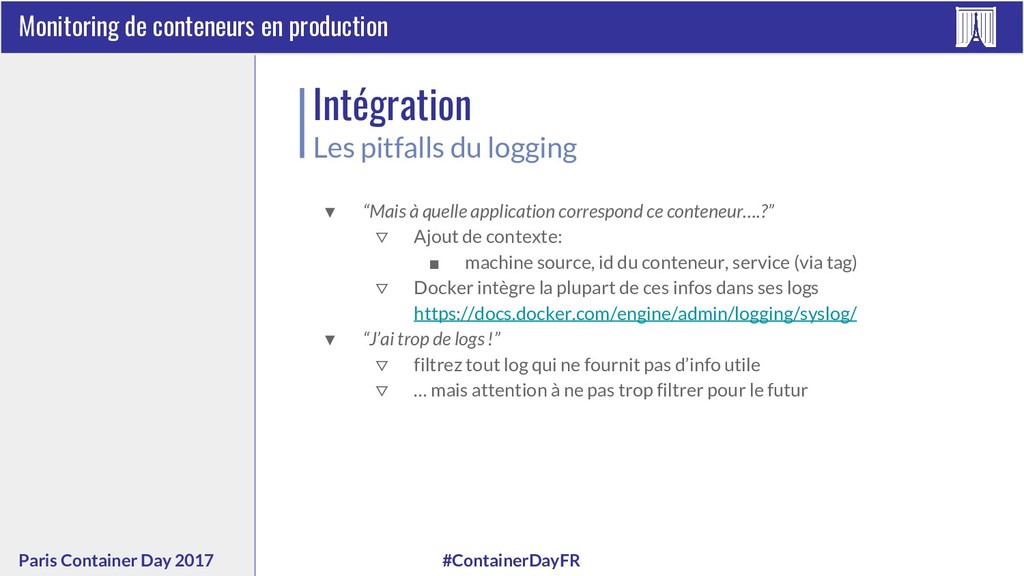
Intégration Les pitfalls du logging ▼ “Mais à quelle application correspond ce conteneur….?” ▽ Ajout de contexte: ▪ machine source, id du conteneur, service (via tag) ▽ Docker intègre la plupart de ces infos dans ses logs https://docs.docker.com/engine/admin/logging/syslog/ ▼ “J’ai trop de logs !” ▽ filtrez tout log qui ne fournit pas d’info utile ▽ … mais attention à ne pas trop filtrer pour le futur
Mais je veux des chiffres ! Agrégation de métriques ▼ Les logs nous permet de voir les évènements de manière chronologique ▽ Quid des métriques système, business ? ▼ “Mais tu nous dis qu’on ne peut pas mettre d’agents dans les conteneurs…” ▽ Docker/rkt fournissent des APIs pour les métriques système
Mais je veux des chiffres ! Agrégation de métriques ▼ “Et mon agent d’APM/NewRelic/AppDynamics ?” ▽ Certains éditeurs fournissent des agents spécifiques à Docker ▽ La plupart des frameworks de métriques fournissent des méthodes d’export vers statsd ▪ metrics, kamon, datadog, node-statsd, … ▽ Il devient aussi à la charge de l’application de remonter les métriques ▪ Contrôle plus fin sur les métriques que l’on veut voir !
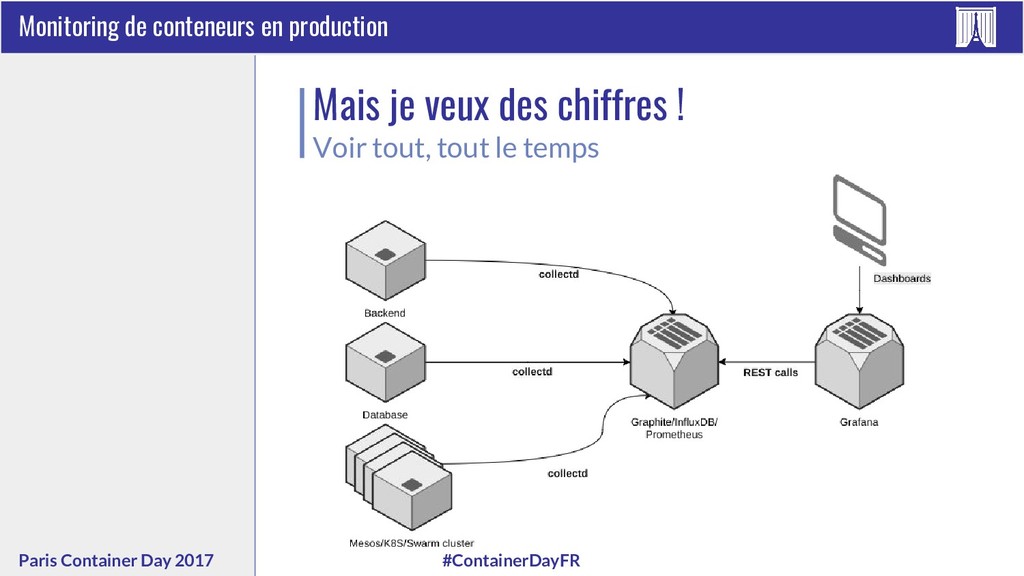
Mais je veux des chiffres ! Agrégation de métriques ▼ Comment récupérer et centraliser ces métriques ? ▽ collectd/telegraf/prometheus pour la récupération ▪ listener statsd, collecte directe, ... ▽ InfluxDB/Prometheus/Carbon pour le stockage de métriques ▽ Prometheus/Grafana/Chronograf pour la visualisation ▽ possible de “mix’n’match” ▽ chacun fournit des capacités de tags sur les métriques collectées !
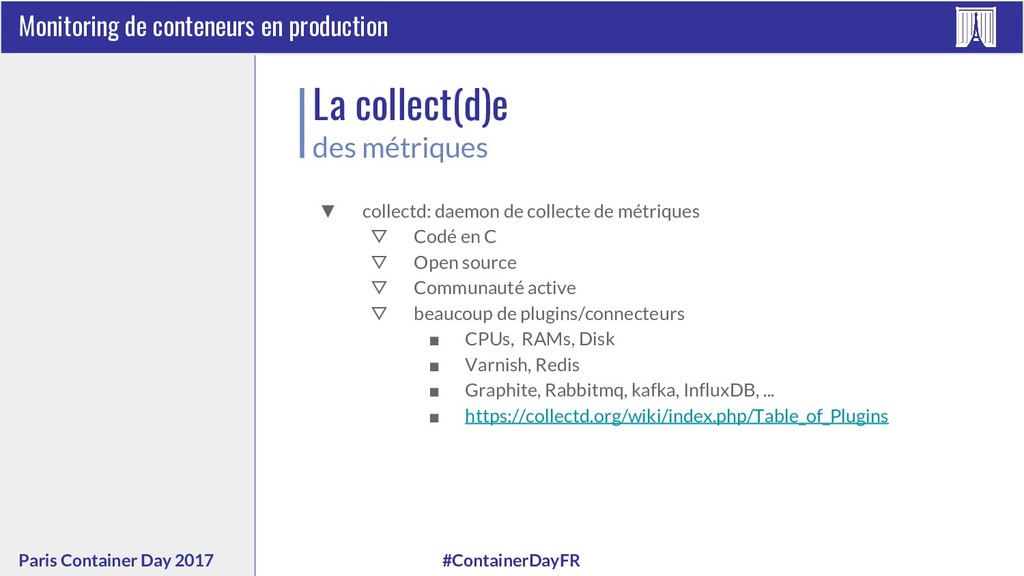
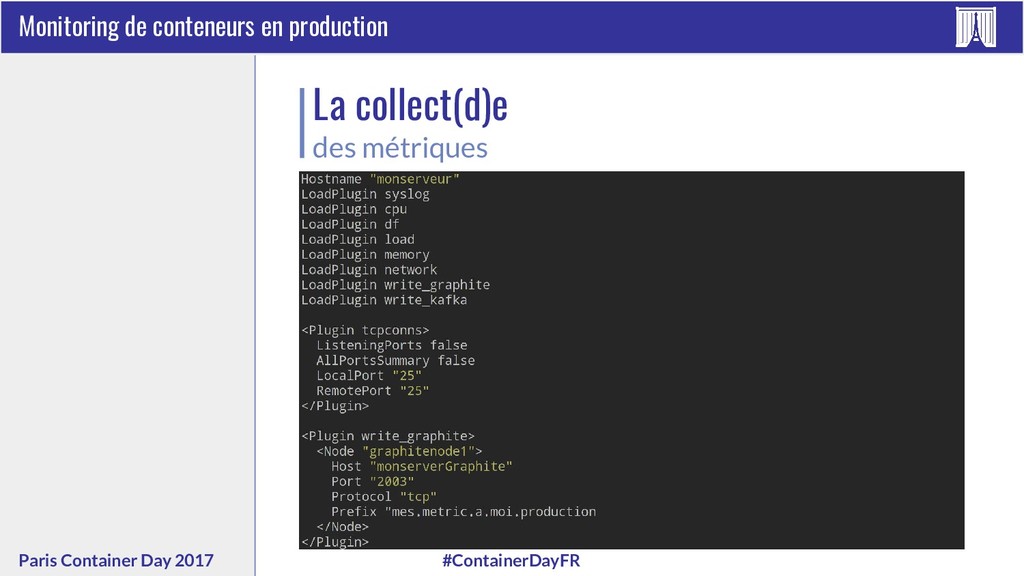
La collect(d)e ▼ collectd: daemon de collecte de métriques ▽ Codé en C ▽ Open source ▽ Communauté active ▽ beaucoup de plugins/connecteurs ▪ CPUs, RAMs, Disk ▪ Varnish, Redis ▪ Graphite, Rabbitmq, kafka, InfluxDB, ... ▪ https://collectd.org/wiki/index.php/Table_of_Plugins des métriques
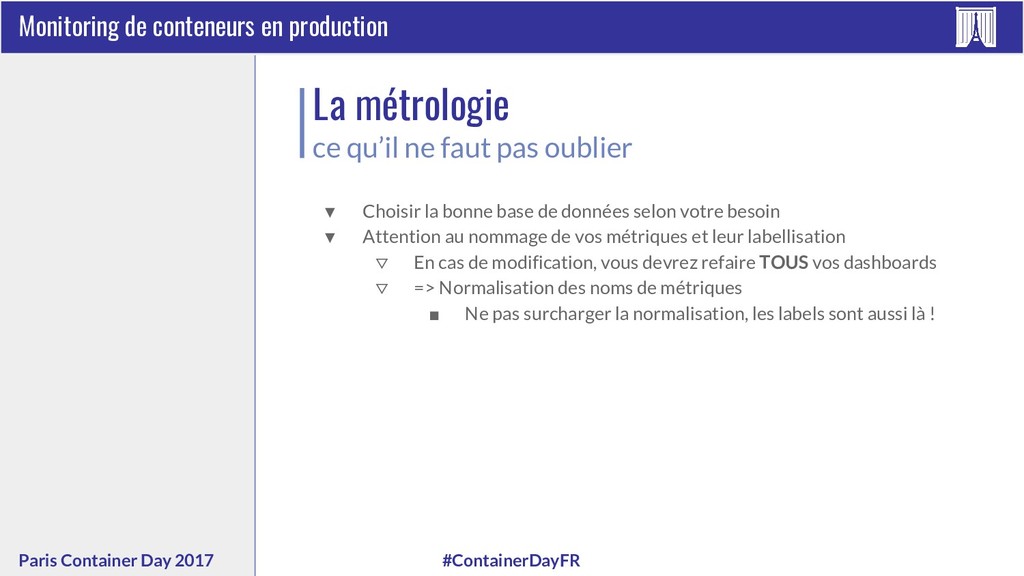
La métrologie ce qu’il ne faut pas oublier ▼ Choisir la bonne base de données selon votre besoin ▼ Attention au nommage de vos métriques et leur labellisation ▽ En cas de modification, vous devrez refaire TOUS vos dashboards ▽ => Normalisation des noms de métriques ▪ Ne pas surcharger la normalisation, les labels sont aussi là !
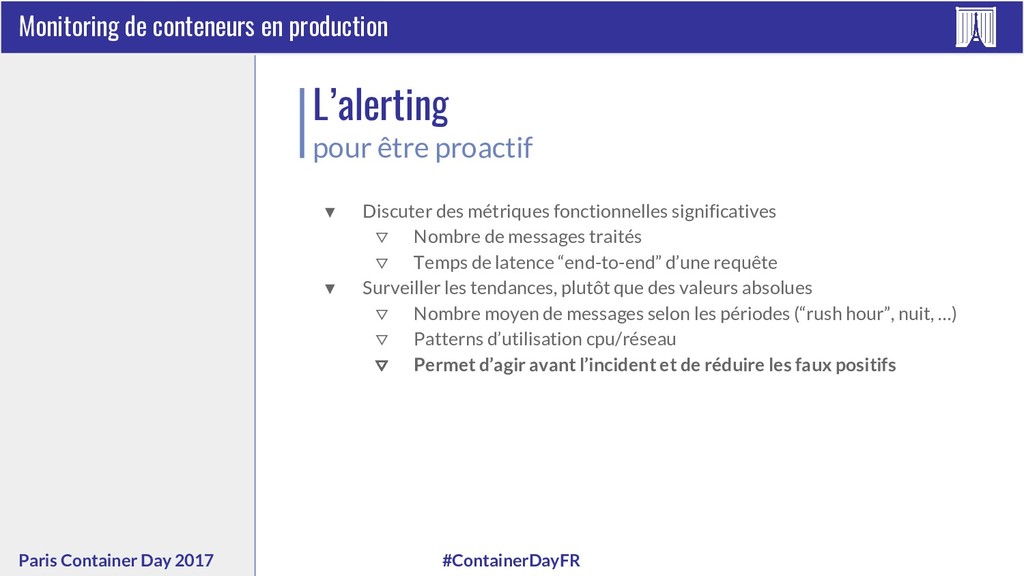
L’alerting pour être proactif ▼ Discuter des métriques fonctionnelles significatives ▽ Nombre de messages traités ▽ Temps de latence “end-to-end” d’une requête ▼ Surveiller les tendances, plutôt que des valeurs absolues ▽ Nombre moyen de messages selon les périodes (“rush hour”, nuit, …) ▽ Patterns d’utilisation cpu/réseau ▽ Permet d’agir avant l’incident et de réduire les faux positifs
L’alerting de manière intelligente ▼ Effectuer les checks sur des points névralgiques de la plateforme ▽ Accès aux endpoints critiques (sur HAProxy, Traefik, …) ▽ Vérification de la présence d’une balise validant le fonctionnement “end-to-end” ▽ Santé de vos systèmes de cluster (Mesos, K8S, Swarm, …)
Attention vous pourriez vous faire mal ▼ Attention de ne pas tomber dans l’extrême de l’alerting ▽ ne pas faire de checks détaillés par conteneur ▪ trop d’informations tue l’information ▪ privilégier les visions d’ensemble, concises et simplifiées ▽ Healthchecks déjà effectués par vos orchestrateurs !
Attention vous pourriez vous faire mal ▼ Ne multipliez pas les outils ▼ Automatiser votre infrastructure avec de l’Infra As Code ▽ Terraform/CloudFormation/Google Deploy Manager ▽ Ansible/Puppet/Salt Stack/Chef ▼ Faites usage au maximum de templating lorsque c’est possible ▽ Kibana + paramètres ▽ http://docs.grafana.org/reference/templating/
Attention vous pourriez vous faire mal ▼ Ne sous-estimez pas la volumétrie des données que vous allez devoir gérer : ▽ Multitude de source de données (nombre de serveurs, d’applications) ▪ Une charge à un instant t importante ▽ La durée de la rétention des données (logs et métriques)


 pcd
 riyaamemiya
 techtekt
 koukihosaka
 sansantech
 occhi
 shuta13
 namiki64
 finengine
 masakiokuda
 ykanoh
 yazm
 jacobian
 aarron
 philnash
 smashingmag
 eileencodes
 inesmontani
 quramy
 dougneiner
 joshbly
 thoeni
 deanohume