Upgrade to Pro — share decks privately, control downloads, hide ads and more …

MN-Core™ について語りたい - 第59回 情報科学若手の会

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
Avatar for Preferred Networks Preferred Networks PRO
September 14, 2026
7

MN-Core™ について語りたい - 第59回 情報科学若手の会

2026年9月5–7日に開催された「第59回 情報科学若手の会」での発表資料です。

Avatar for Preferred Networks

Preferred Networks PRO

September 14, 2026

More Decks by Preferred Networks

Transcript

  1. 自己紹介 氏名: 山縣 龍人 (やまがた たつひと) 所属: 株式会社 Preferred Networks

    AI コンピューティング事業本部 ソフトウェア開発部 経歴: 2024/03: 東京工業大学 数理・計算科学系 卒業 2026/03: 同大学院 数理・計算科学コース 修了 X: @tatyam_prime その他: 競技プログラマ ICPC World Finals (2021, 2023) AtCoder 銀冠 (トップ 30) Universal Cup Finals (2026) 写真
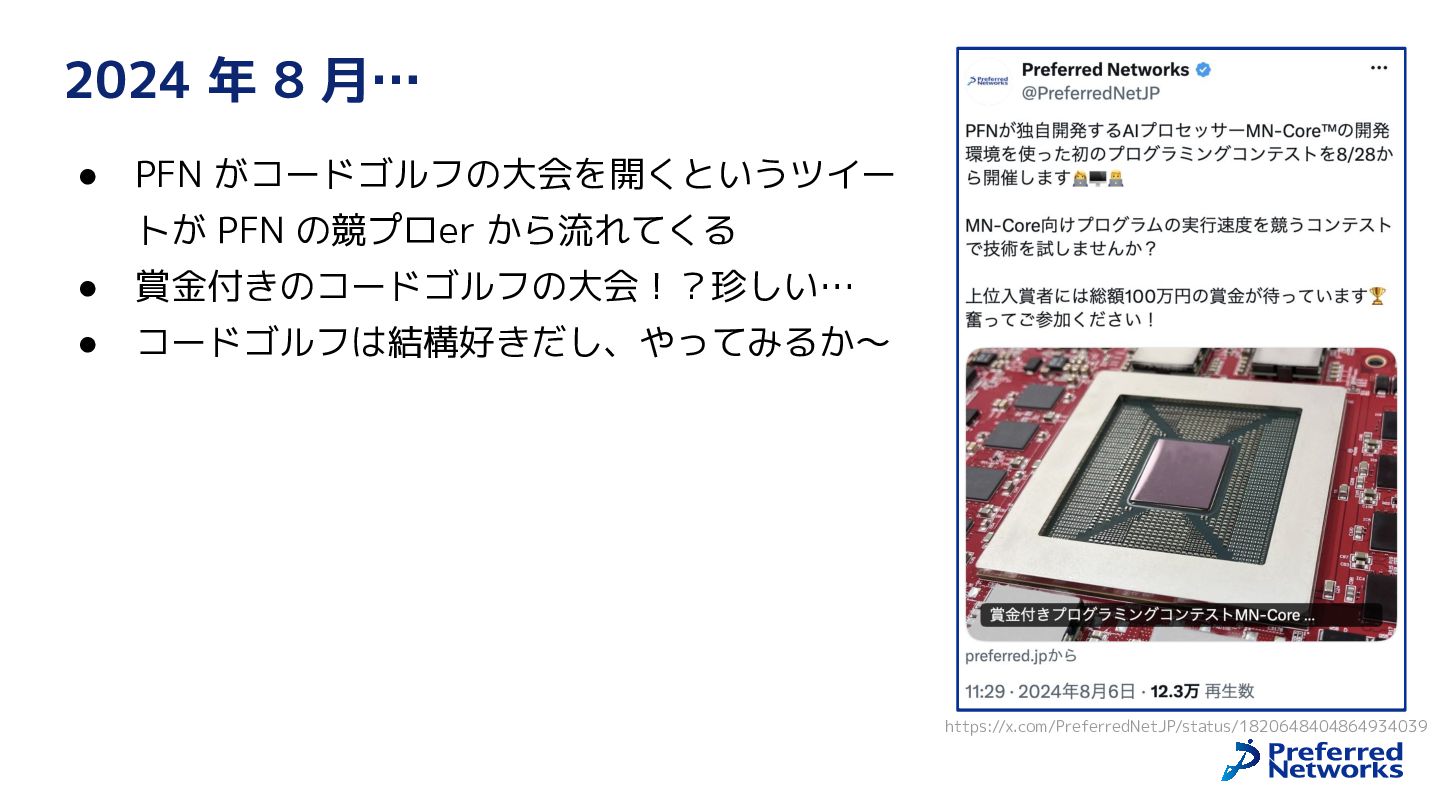
  2. 2024 年 8 月… • PFN がコードゴルフの大会を開くというツイー トが PFN の競プロer

    から流れてくる • 賞金付きのコードゴルフの大会!?珍しい… • コードゴルフは結構好きだし、やってみるか〜 https://x.com/PreferredNetJP/status/1820648404864934039
  3. MN-Core の特徴 • “fully-deterministic architecture” だから、コードの行数がそのまま プログラムの実行時間になるらしい ◦ • コードゴルフに重要な意味があって、うれしい

    巨大な SIMD 計算機で、1 サイクルにつき 262144 bit を計算できるらしい ◦ 普段 AVX-512 を使って定数倍高速化をしている競プロer としては、ワクワクする
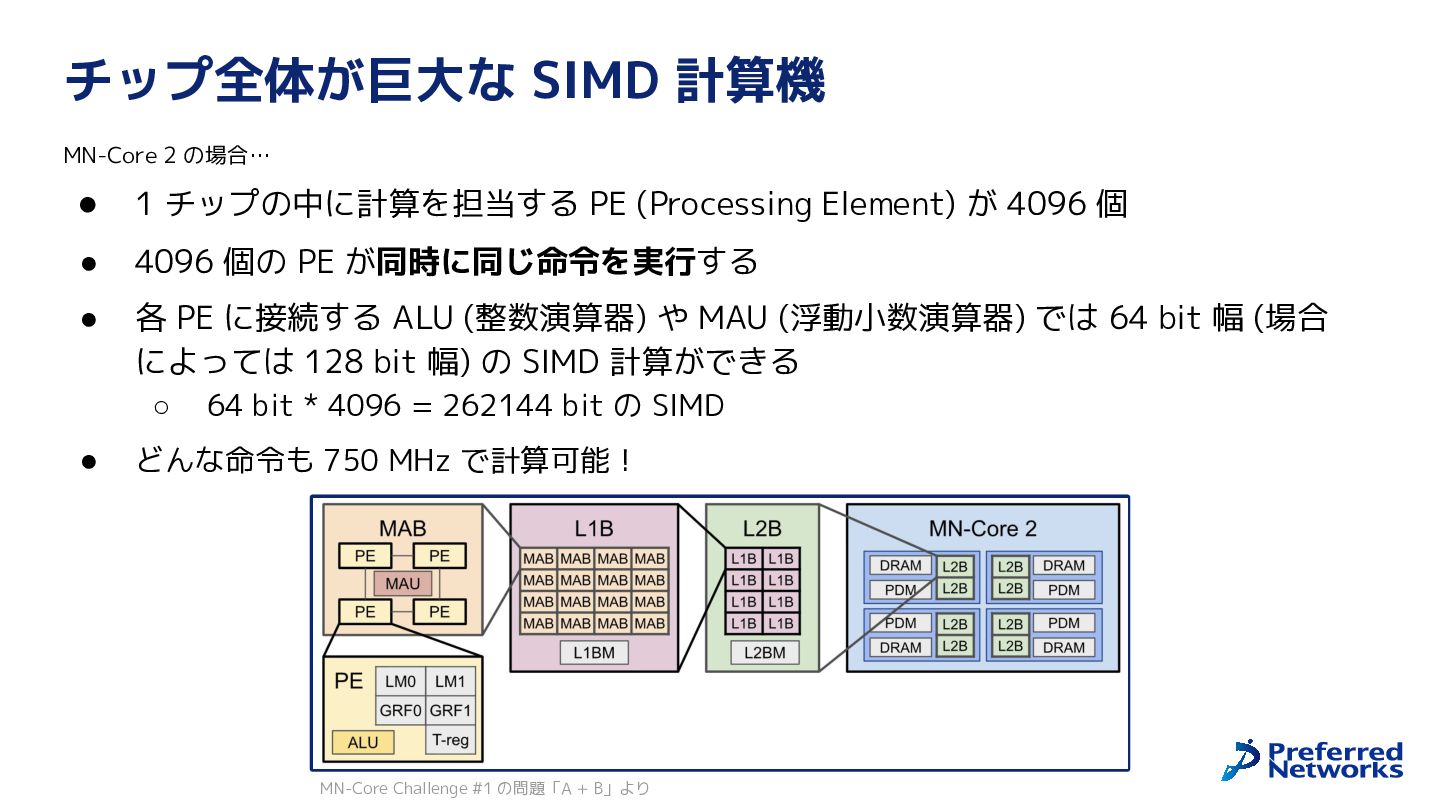
  4. チップ全体が巨大な SIMD 計算機 MN-Core 2 の場合… • 1 チップの中に計算を担当する PE

    (Processing Element) が 4096 個 • 4096 個の PE が同時に同じ命令を実行する • 各 PE に接続する ALU (整数演算器) や MAU (浮動小数演算器) では 64 bit 幅 (場合 によっては 128 bit 幅) の SIMD 計算ができる ◦ • 64 bit * 4096 = 262144 bit の SIMD どんな命令も 750 MHz で計算可能! MN-Core Challenge #1 の問題「A + B」より
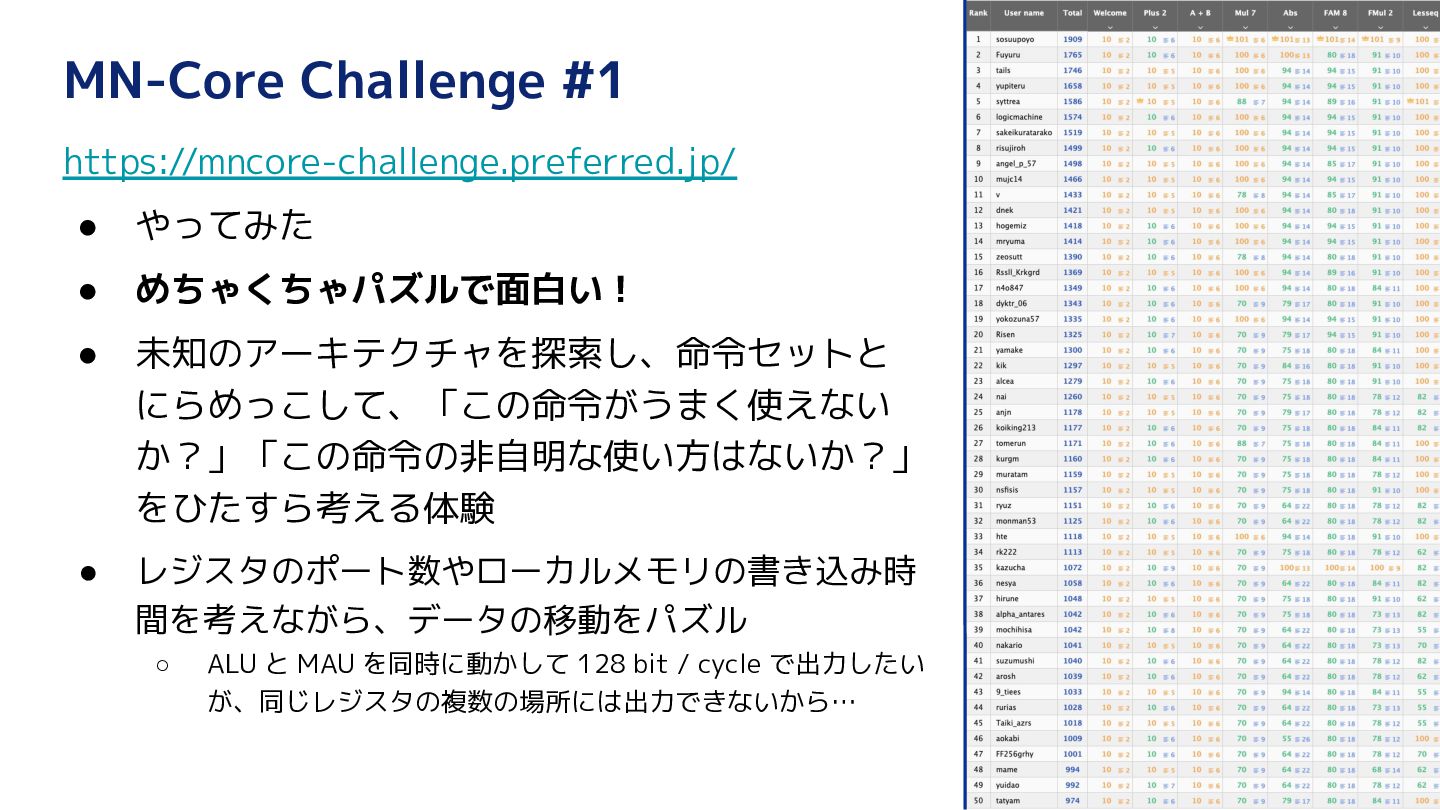
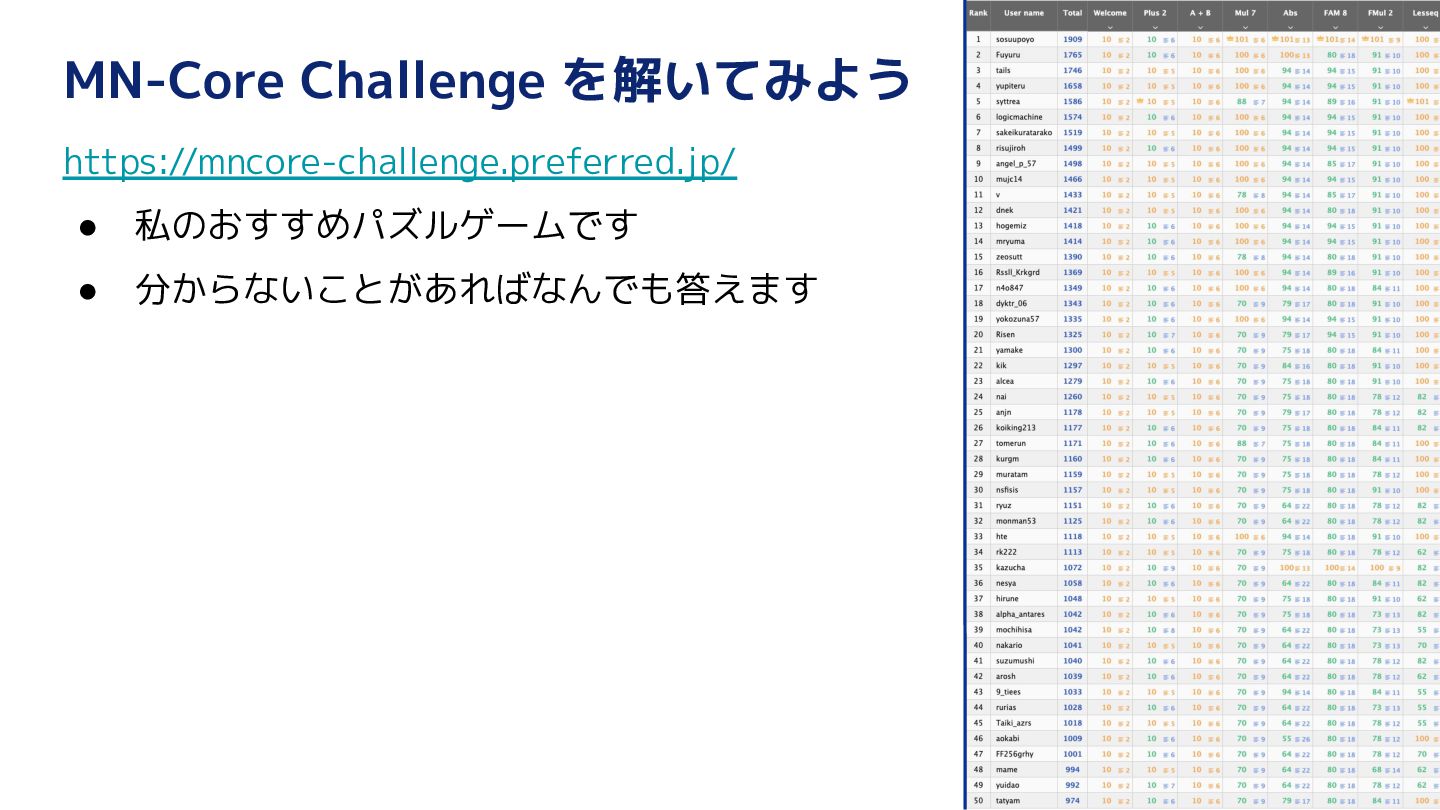
  5. MN-Core Challenge #1 https://mncore-challenge.preferred.jp/ • やってみた • めちゃくちゃパズルで面白い! • 未知のアーキテクチャを探索し、命令セットと

    にらめっこして、「この命令がうまく使えない か?」「この命令の非自明な使い方はないか?」 をひたすら考える体験 • レジスタのポート数やローカルメモリの書き込み時 間を考えながら、データの移動をパズル ◦ ALU と MAU を同時に動かして 128 bit / cycle で出力したい が、同じレジスタの複数の場所には出力できないから…
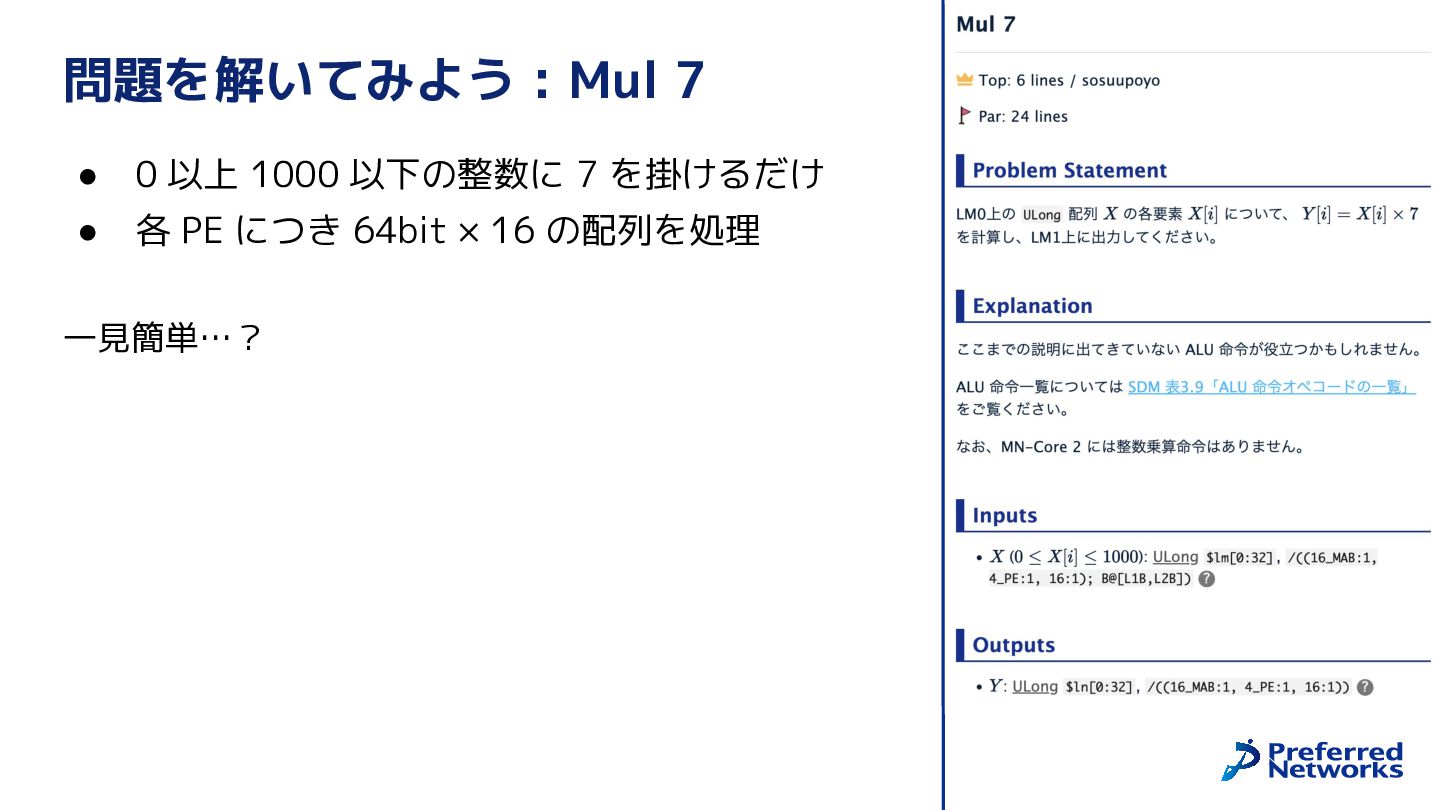
  6. 問題を解いてみよう : Mul 7 • 0 以上 1000 以下の整数に 7

    を掛けるだけ • 各 PE につき 64bit × 16 の配列を処理 一見簡単…?
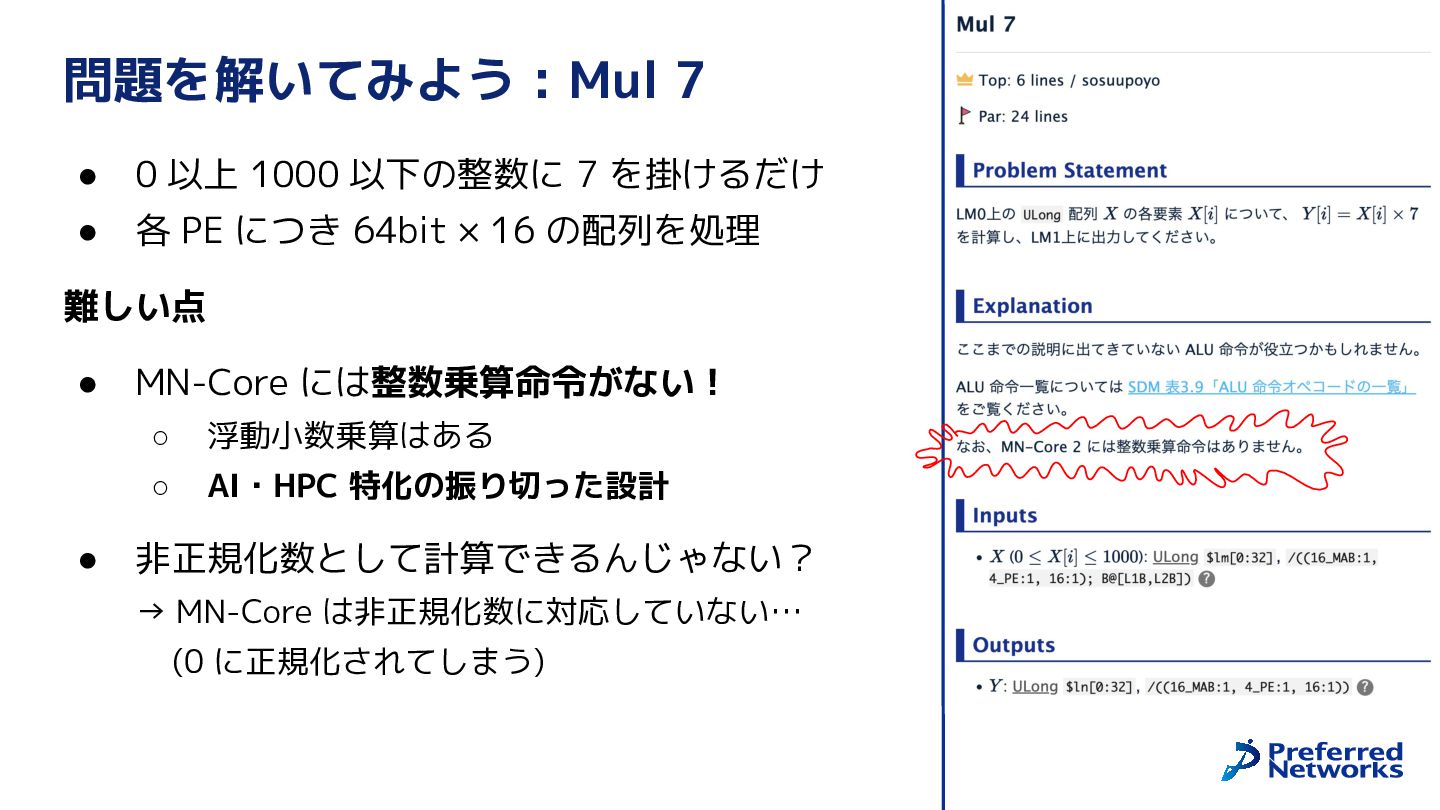
  7. 問題を解いてみよう : Mul 7 • 0 以上 1000 以下の整数に 7

    を掛けるだけ • 各 PE につき 64bit × 16 の配列を処理 難しい点 • • MN-Core には整数乗算命令がない! ◦ 浮動小数乗算はある ◦ AI・HPC 特化の振り切った設計 非正規化数として計算できるんじゃない? → MN-Core は非正規化数に対応していない… (0 に正規化されてしまう)
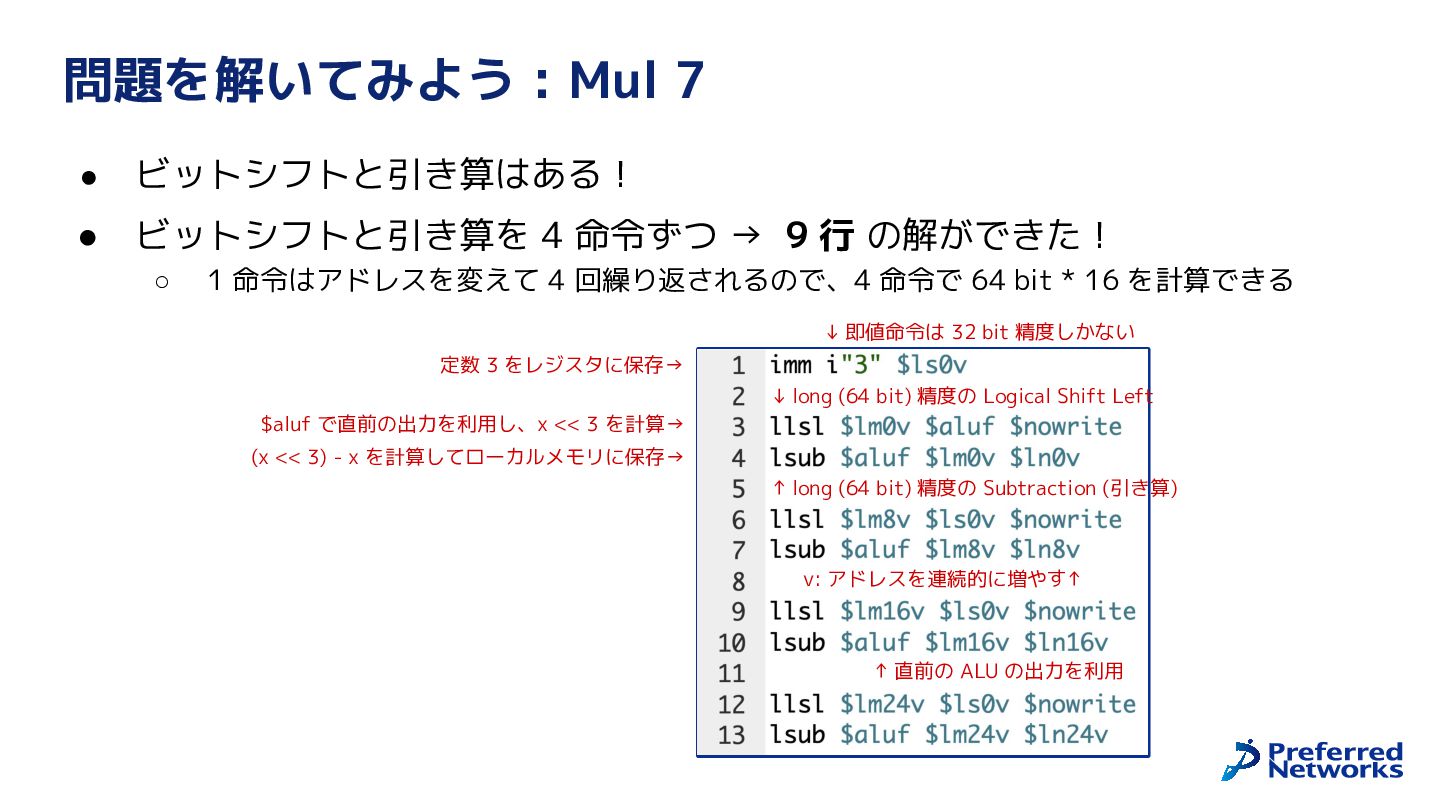
  8. 問題を解いてみよう : Mul 7 • ビットシフトと引き算はある! • ビットシフトと引き算を 4 命令ずつ

    → 9 行 の解ができた! ◦ 1 命令はアドレスを変えて 4 回繰り返されるので、4 命令で 64 bit * 16 を計算できる ↓ 即値命令は 32 bit 精度しかない 定数 3 をレジスタに保存→ ↓ long (64 bit) 精度の Logical Shift Left $aluf で直前の出力を利用し、x << 3 を計算→ (x << 3) - x を計算してローカルメモリに保存→ ↑ long (64 bit) 精度の Subtraction (引き算) v: アドレスを連続的に増やす↑ ↑ 直前の ALU の出力を利用
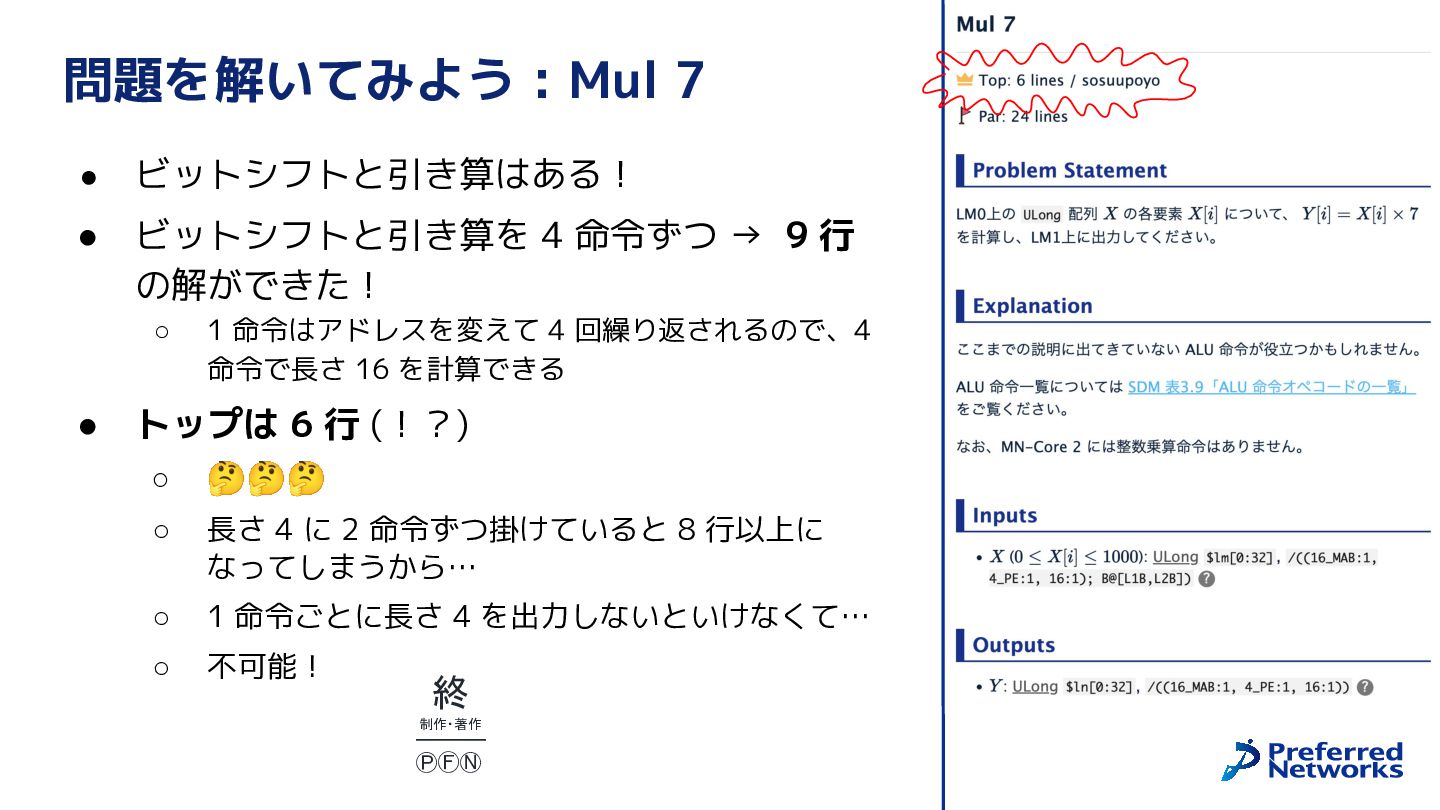
  9. 問題を解いてみよう : Mul 7 • ビットシフトと引き算はある! • ビットシフトと引き算を 4 命令ずつ

    → 9 行 の解ができた! ◦ • 1 命令はアドレスを変えて 4 回繰り返されるので、4 命令で長さ 16 を計算できる トップは 6 行 (!?) ◦ 🤔🤔🤔 ◦ 長さ 4 に 2 命令ずつ掛けていると 8 行以上に なってしまうから… ◦ 1 命令ごとに長さ 4 を出力しないといけなくて… ◦ 不可能! 終 制作・著作 ━━━━━ ⓅⒻⓃ
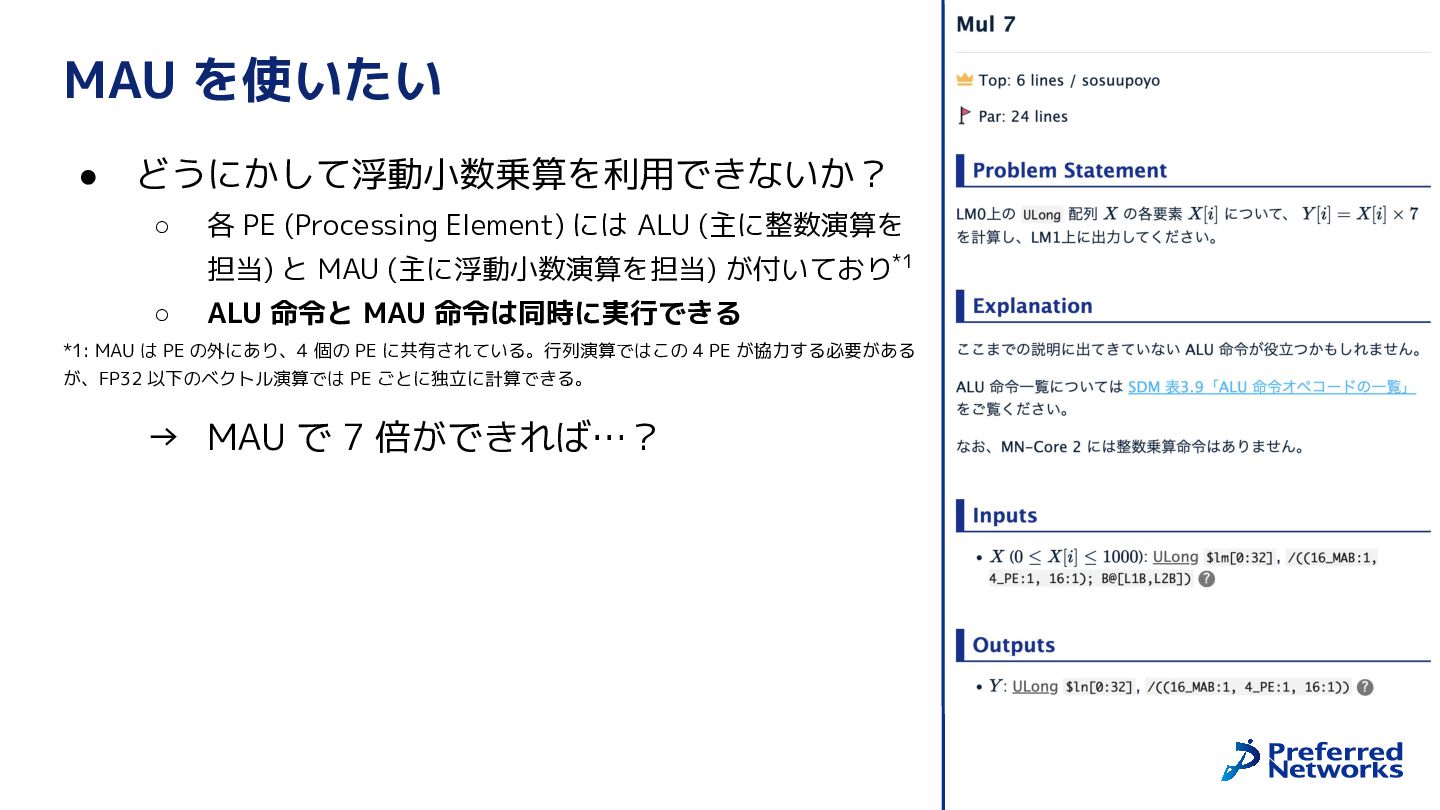
  10. MAU を使いたい • どうにかして浮動小数乗算を利用できないか? ◦ 各 PE (Processing Element) には

    ALU (主に整数演算を 担当) と MAU (主に浮動小数演算を担当) が付いており*1 ◦ ALU 命令と MAU 命令は同時に実行できる *1: MAU は PE の外にあり、4 個の PE に共有されている。行列演算ではこの 4 PE が協力する必要がある が、FP32 以下のベクトル演算では PE ごとに独立に計算できる。 → MAU で 7 倍ができれば…?
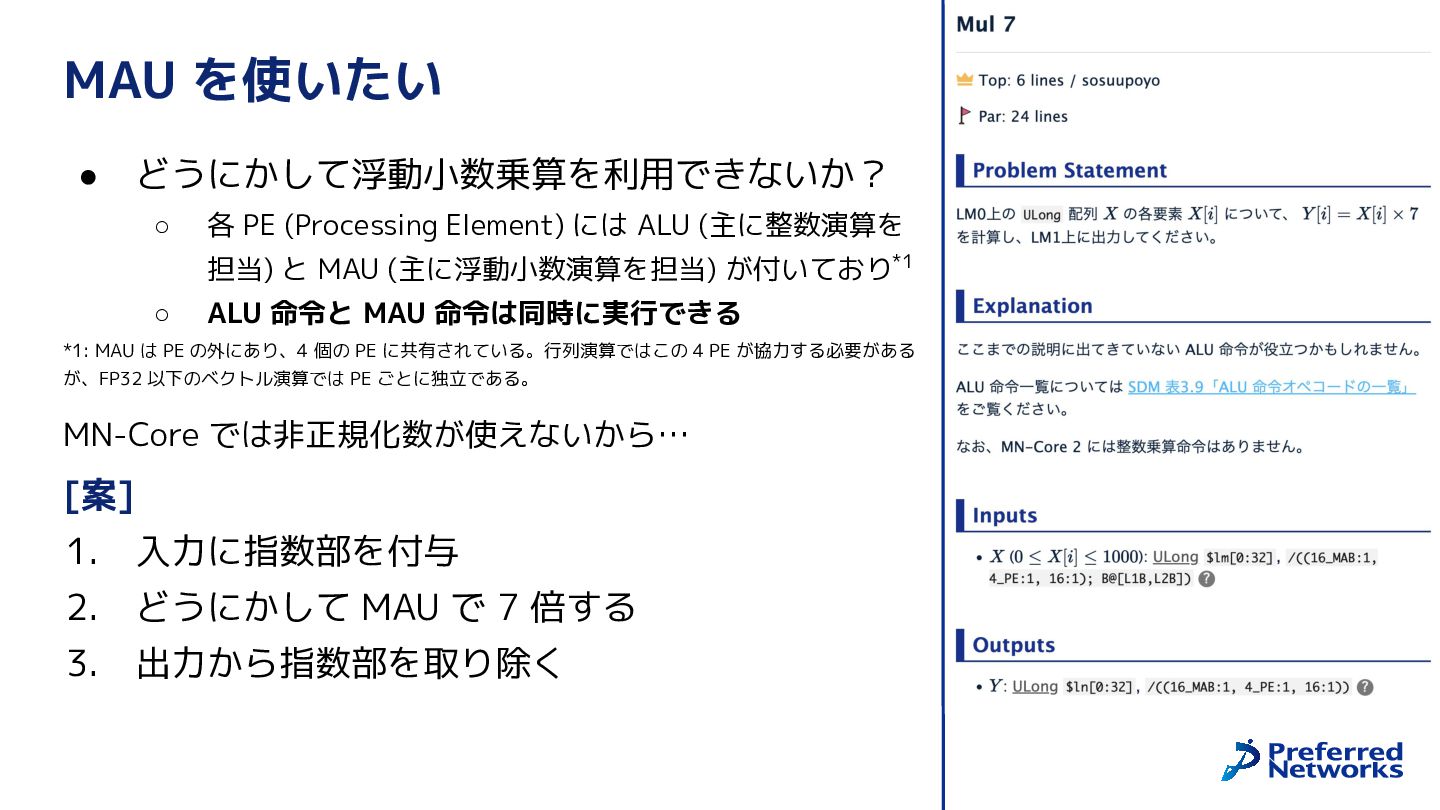
  11. MAU を使いたい • どうにかして浮動小数乗算を利用できないか? ◦ 各 PE (Processing Element) には

    ALU (主に整数演算を 担当) と MAU (主に浮動小数演算を担当) が付いており*1 ◦ ALU 命令と MAU 命令は同時に実行できる *1: MAU は PE の外にあり、4 個の PE に共有されている。行列演算ではこの 4 PE が協力する必要がある が、FP32 以下のベクトル演算では PE ごとに独立である。 MN-Core では非正規化数が使えないから… [案] 1. 入力に指数部を付与 2. どうにかして MAU で 7 倍する 3. 出力から指数部を取り除く
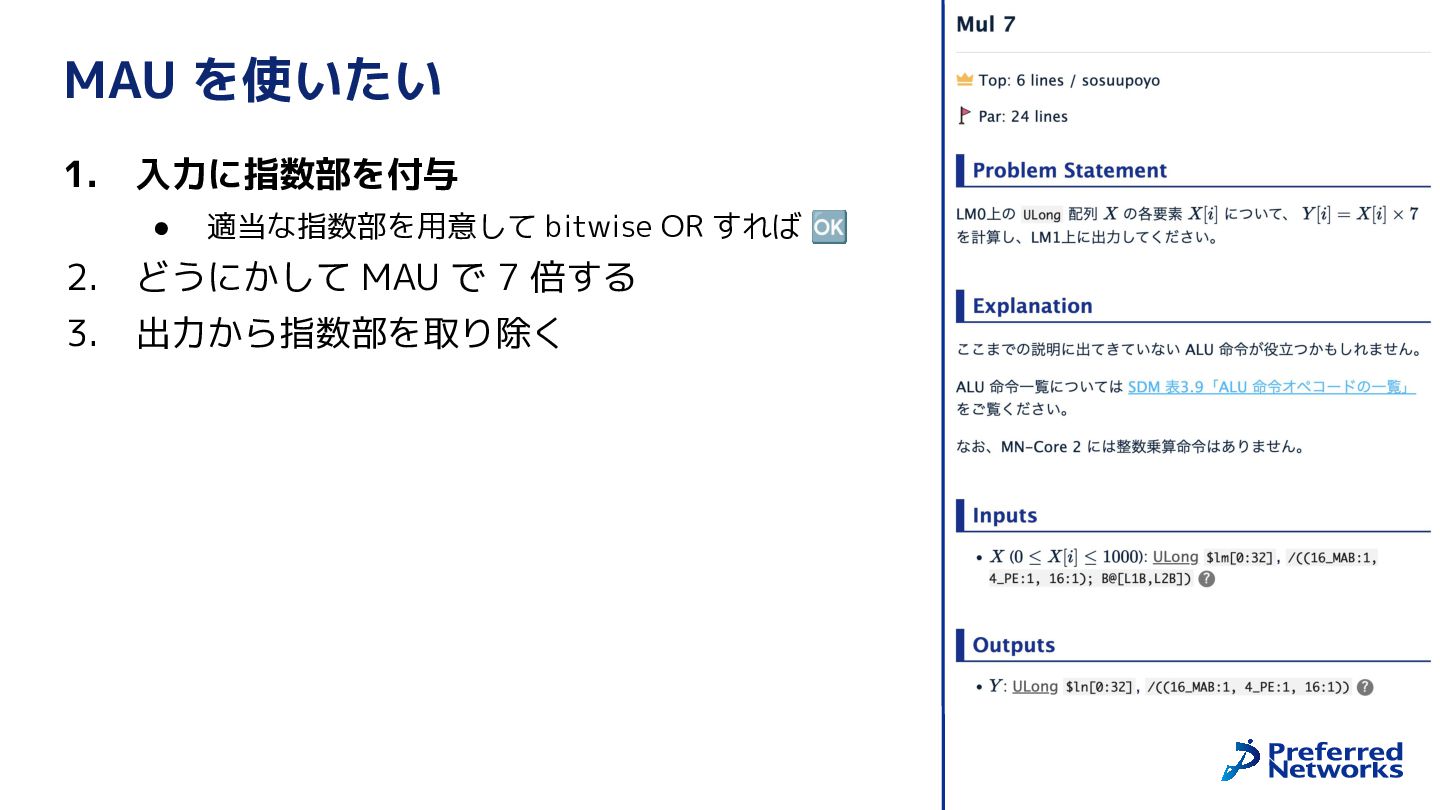
  12. MAU を使いたい 1. 入力に指数部を付与 • 適当な指数部を用意して bitwise OR すれば 🆗

    2. どうにかして MAU で 7 倍する 3. 出力から指数部を取り除く
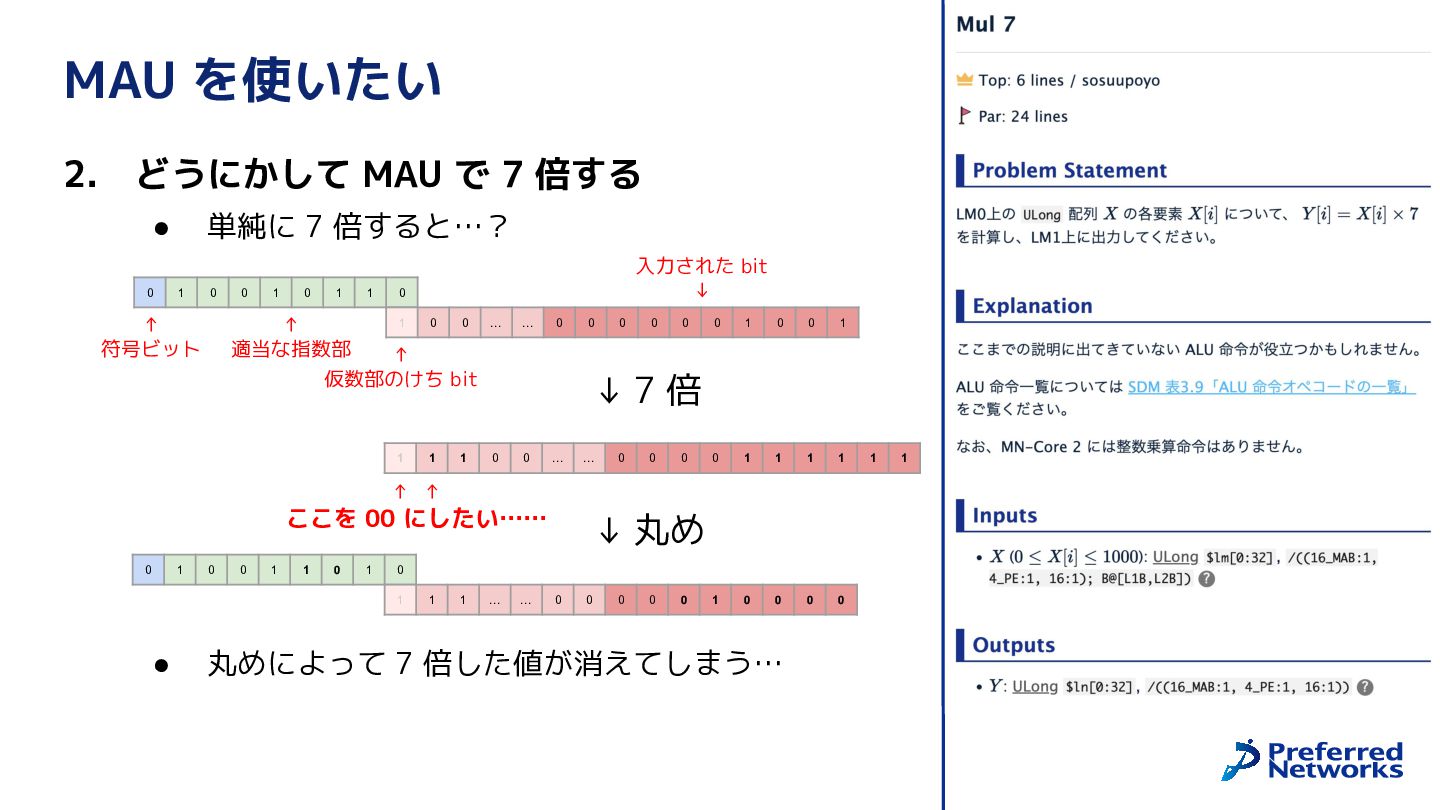
  13. MAU を使いたい 2. どうにかして MAU で 7 倍する 単純に 7

    倍すると…? • 0 1 0 ↑ 符号ビット 0 1 0 1 1 ↑ 適当な指数部 入力された bit ↓ 0 1 0 0 … … 0 0 ↑ 仮数部のけち bit 1 1 1 0 0 0 0 1 0 0 1 0 1 1 1 1 1 0 0 0 0 ↓7倍 0 0 … … 0 0 0 ↑ ↑ ここを 00 にしたい…… 0 1 0 0 1 1 0 1 0 1 • ↓ 丸め 1 1 … … 0 0 0 0 0 丸めによって 7 倍した値が消えてしまう… 1 1
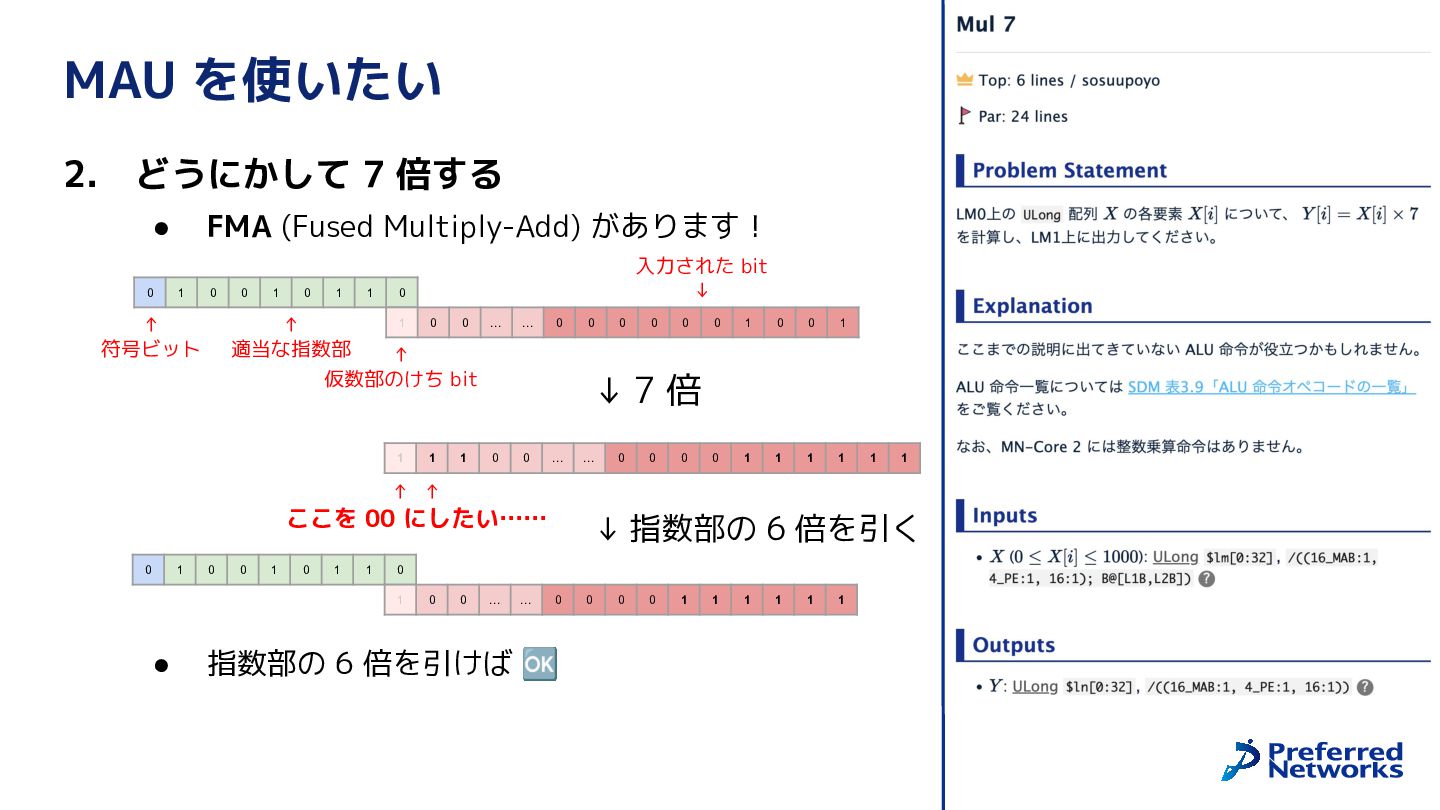
  14. MAU を使いたい 2. どうにかして 7 倍する FMA (Fused Multiply-Add) があります!

    • 0 1 0 ↑ 符号ビット 0 1 0 1 1 ↑ 適当な指数部 入力された bit ↓ 0 1 0 0 … … 0 0 ↑ 仮数部のけち bit 1 1 1 0 0 0 0 1 0 0 1 0 1 1 1 1 ↓7倍 0 0 … … 0 0 0 1 1 ↑ ↑ ここを 00 にしたい…… 0 1 0 0 1 0 1 1 0 1 • ↓ 指数部の 6 倍を引く 0 0 … … 0 指数部の 6 倍を引けば 🆗 0 0 0 1 1 1 1 1 1
  15. MAU を使いたい 1. 入力に指数部を付与 2. 7 倍して、指数部の 6 倍を引く 3.

    出力から指数部を取り除く • 今度は逆に bitwise AND…? • ALU 命令が 2 回あると 8 行以上になってしまう 😫
  16. MAU を使いたい 1. 入力に指数部を付与 2. 7 倍して、指数部の 6 倍を引く 3.

    出力から指数部を取り除く Q. ALU を使わずに指数部を取り除くには? マスクレジスタと書き込みマスクがあります! 本来、比較を行って要素ごとに書き込むかどうかを選ぶものですが…?
  17. MAU を使いたい 1. 入力に指数部を付与 2. 7 倍して、指数部の 6 倍を引く 3.

    出力から指数部を取り除く Q. ALU を使わずに指数部を取り除くには? マスクレジスタと書き込みマスクがあります! 本来、比較を行って要素ごとに書き込むかどうかを選ぶものですが…? 16 bit 精度の演算で作ったマスクを 64 bit 精度の計 算に適用できて、(!?) 16 bit ごとに書き込むかどうかを選べる 🫨 ←普通にマニュアルを読んだだけでは 気づけない、あまりに非自明な使い方 確かに仕様を読むとそのように書かれ ているし、回路の自然な実装を考えれ ばそうなるが…
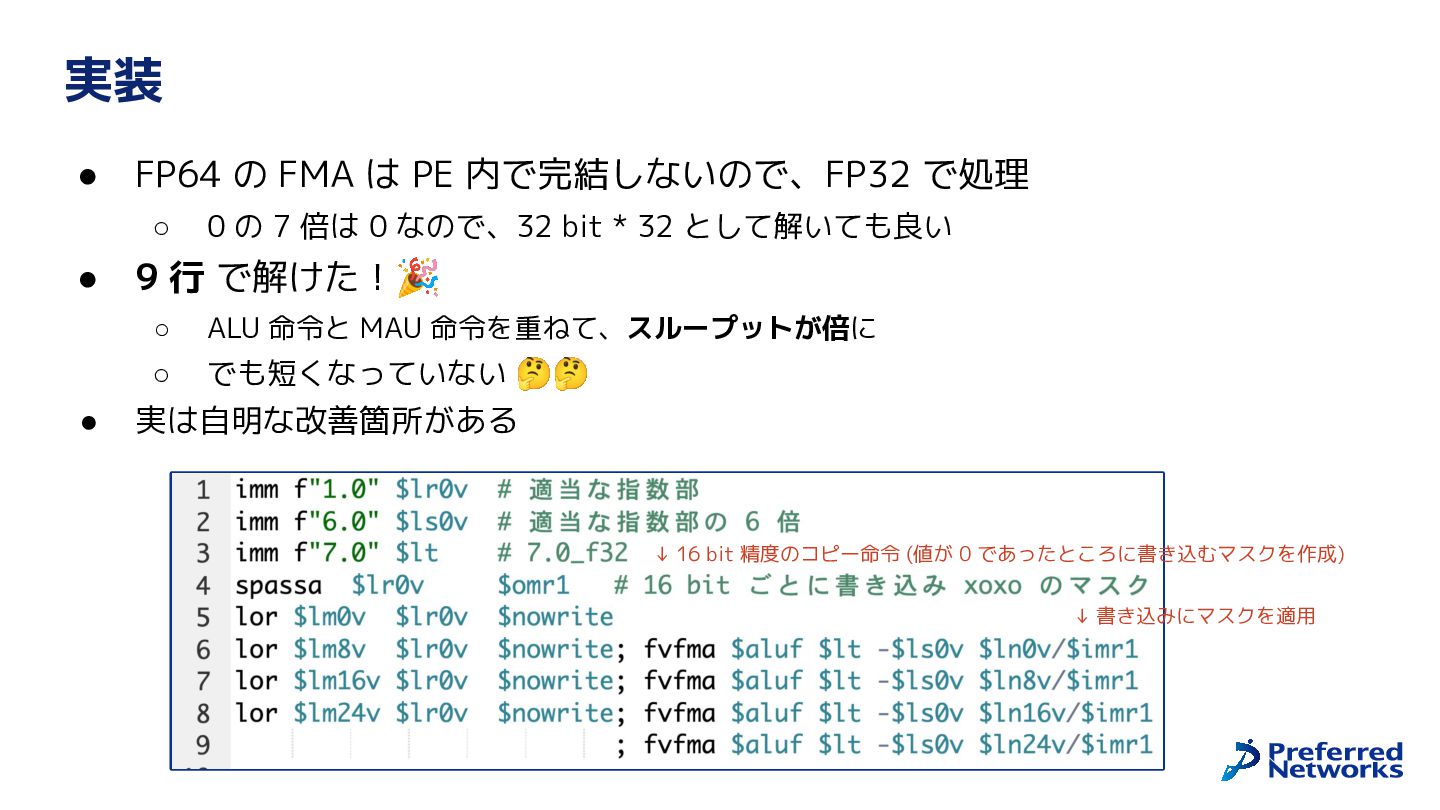
  18. 実装 • FP64 の FMA は PE 内で完結しないので、FP32 で処理 ◦

    • • 0 の 7 倍は 0 なので、32 bit * 32 として解いても良い 9 行 で解けた!🎉 ◦ ALU 命令と MAU 命令を重ねて、スループットが倍に ◦ でも短くなっていない 🤔🤔 実は自明な改善箇所がある ↓ 16 bit 精度のコピー命令 (値が 0 であったところに書き込むマスクを作成) ↓ 書き込みにマスクを適用
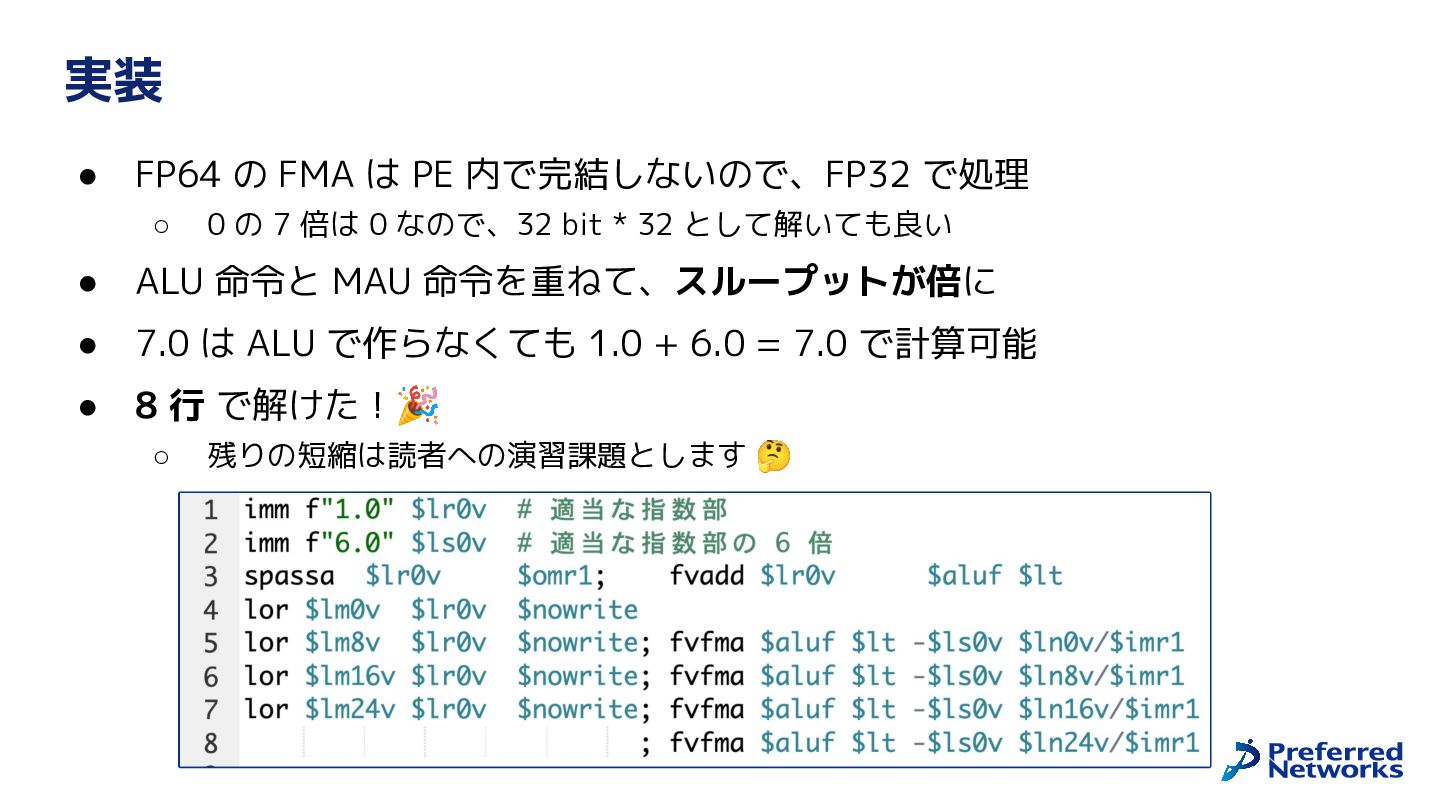
  19. 実装 • FP64 の FMA は PE 内で完結しないので、FP32 で処理 ◦

    0 の 7 倍は 0 なので、32 bit * 32 として解いても良い • ALU 命令と MAU 命令を重ねて、スループットが倍に • 7.0 は ALU で作らなくても 1.0 + 6.0 = 7.0 で計算可能 • 8 行 で解けた!🎉 ◦ 残りの短縮は読者への演習課題とします 🤔
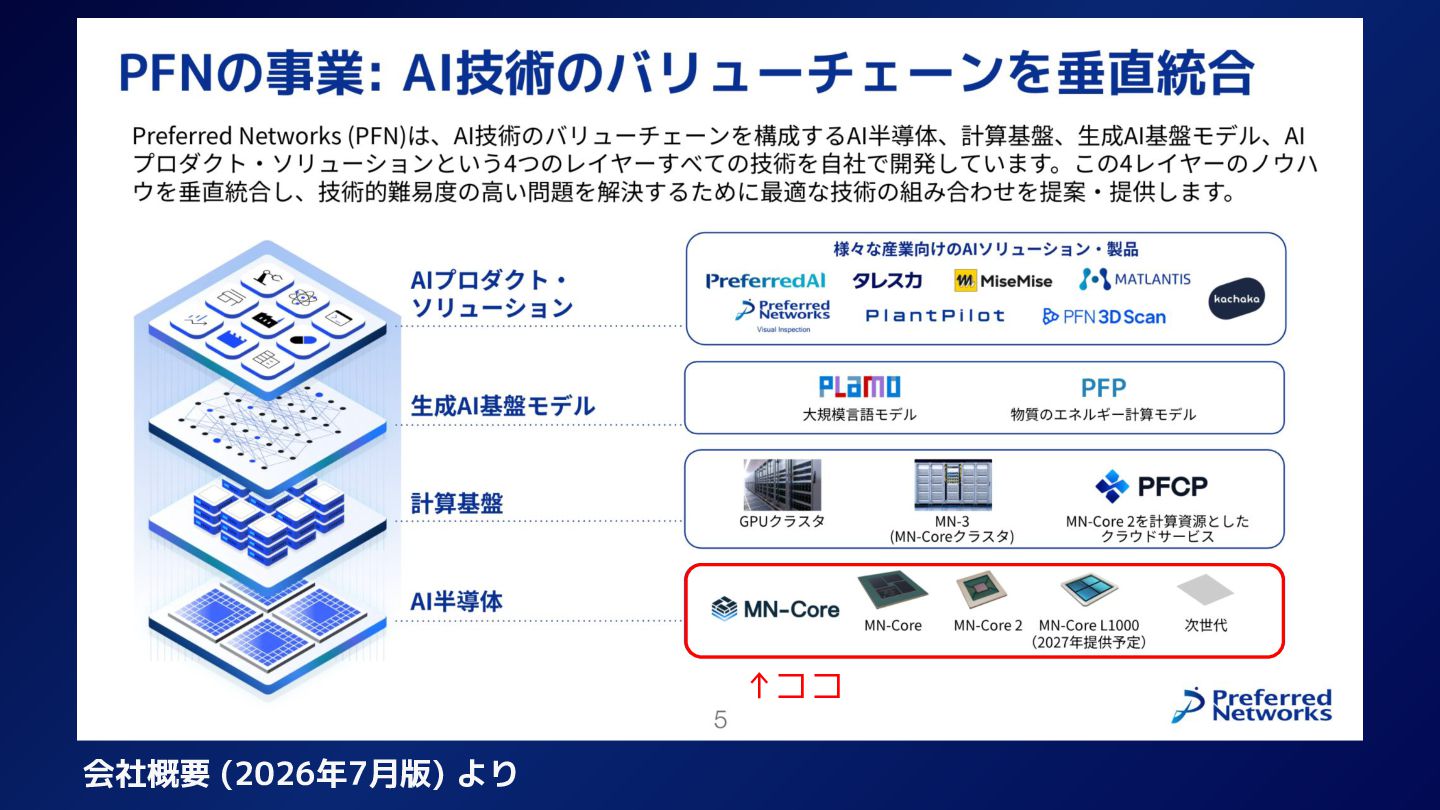
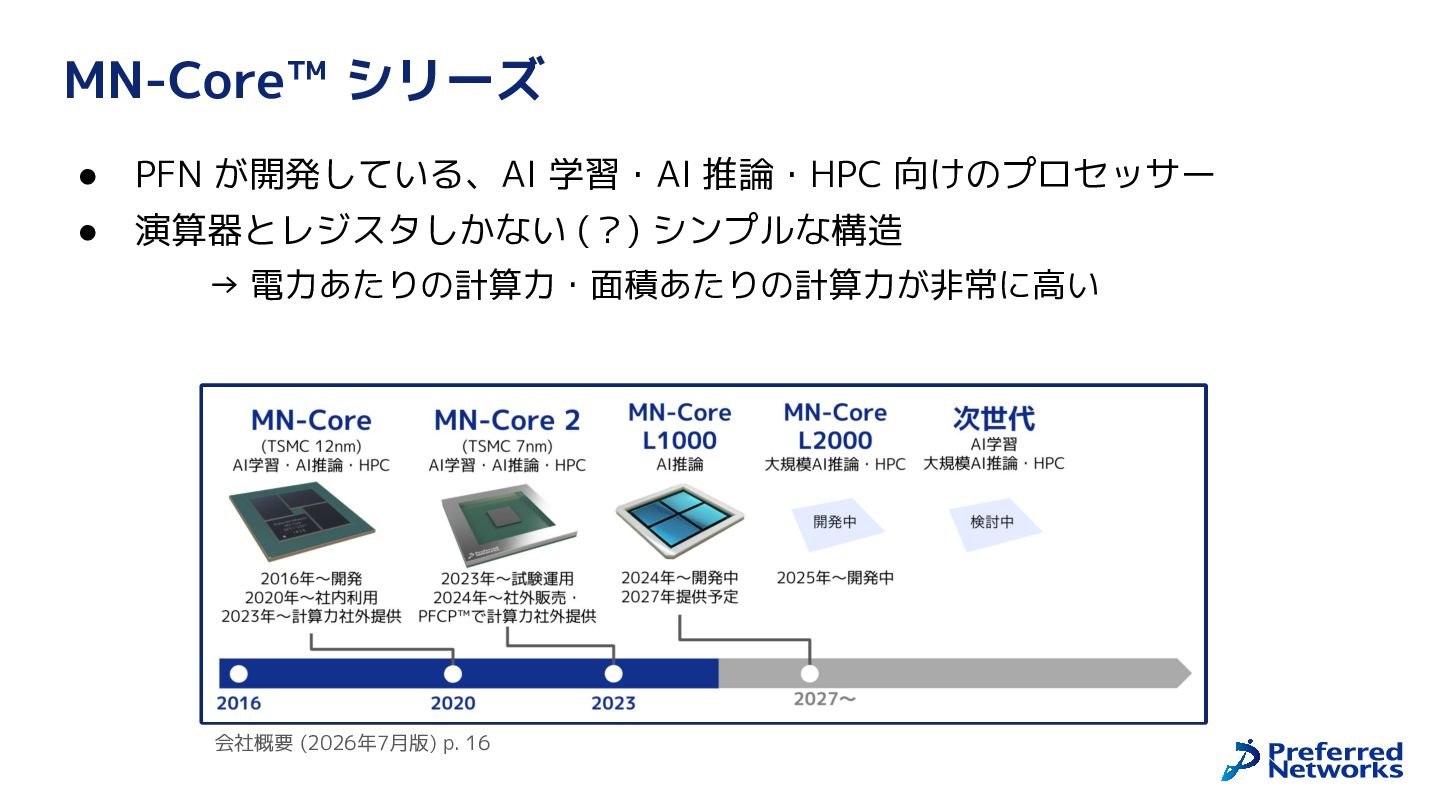
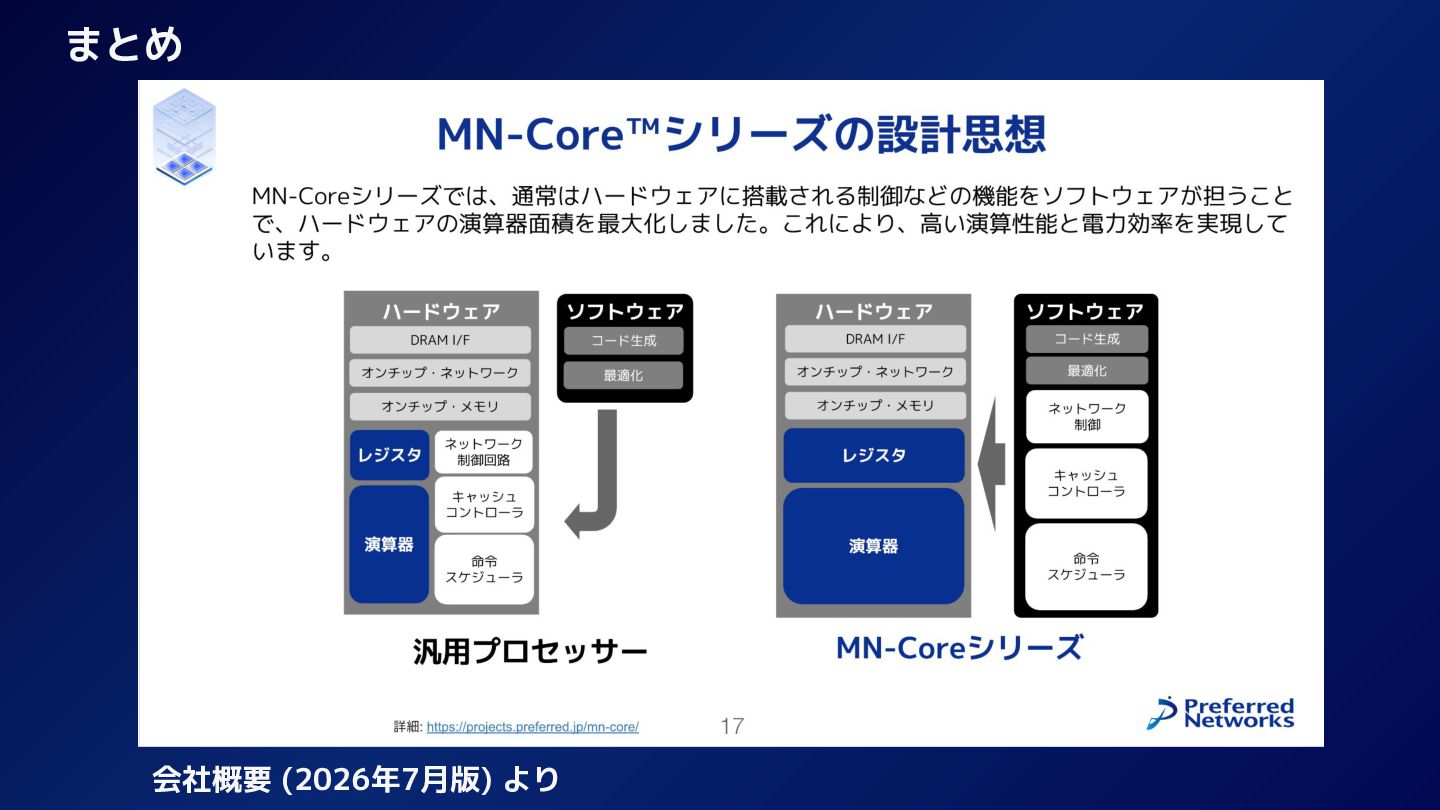
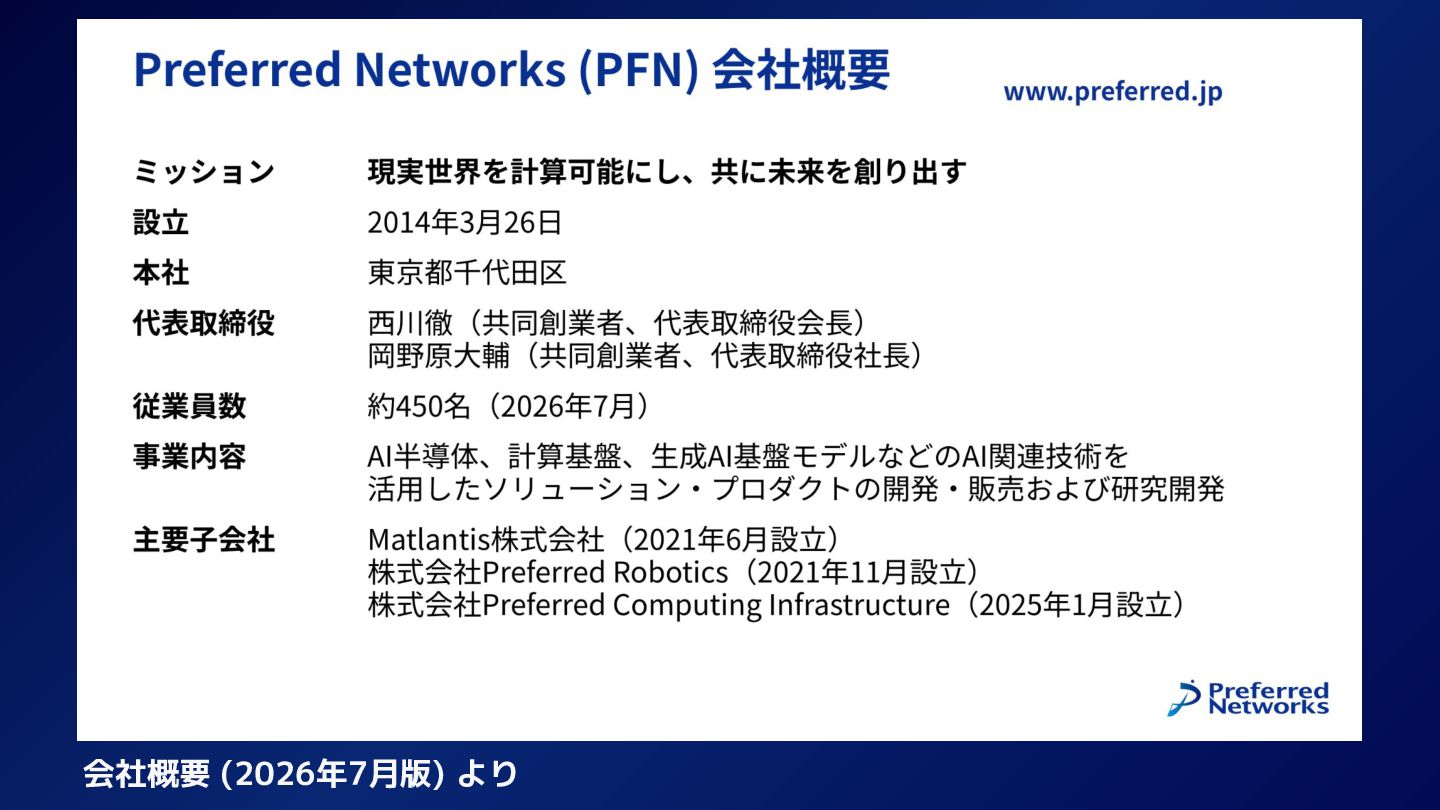
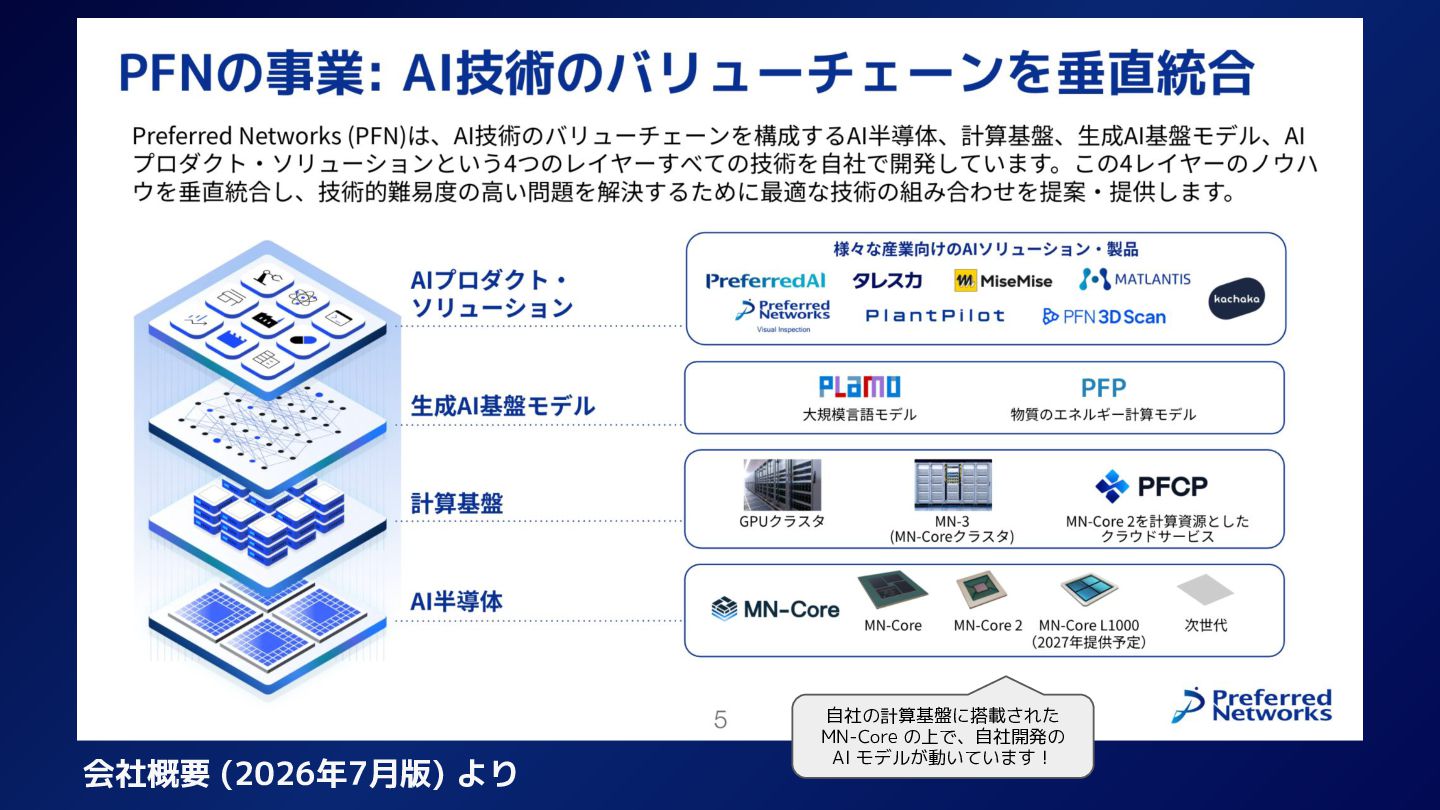
  20. MN-Core™ シリーズ • PFN が開発している、AI 学習・AI 推論・HPC 向けのプロセッサー • 演算器とレジスタしかない

    (?) シンプルな構造 → 電力あたりの計算力・面積あたりの計算力が非常に高い 会社概要 (2026年7月版) p. 16
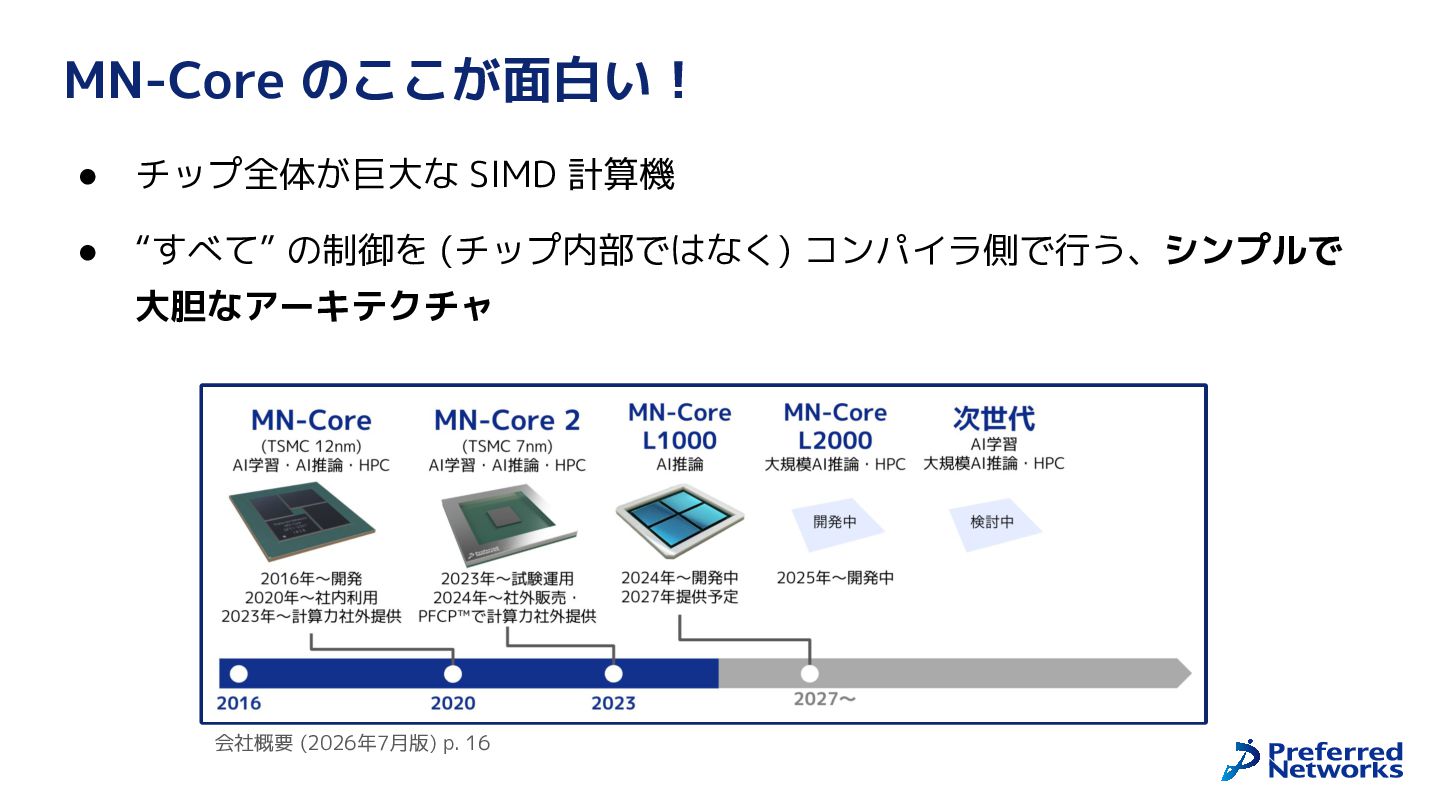
  21. MN-Core のここが面白い! • チップ全体が巨大な SIMD 計算機 • “すべて” の制御を (チップ内部ではなく)

    コンパイラ側で行う、シンプルで 大胆なアーキテクチャ 会社概要 (2026年7月版) p. 16
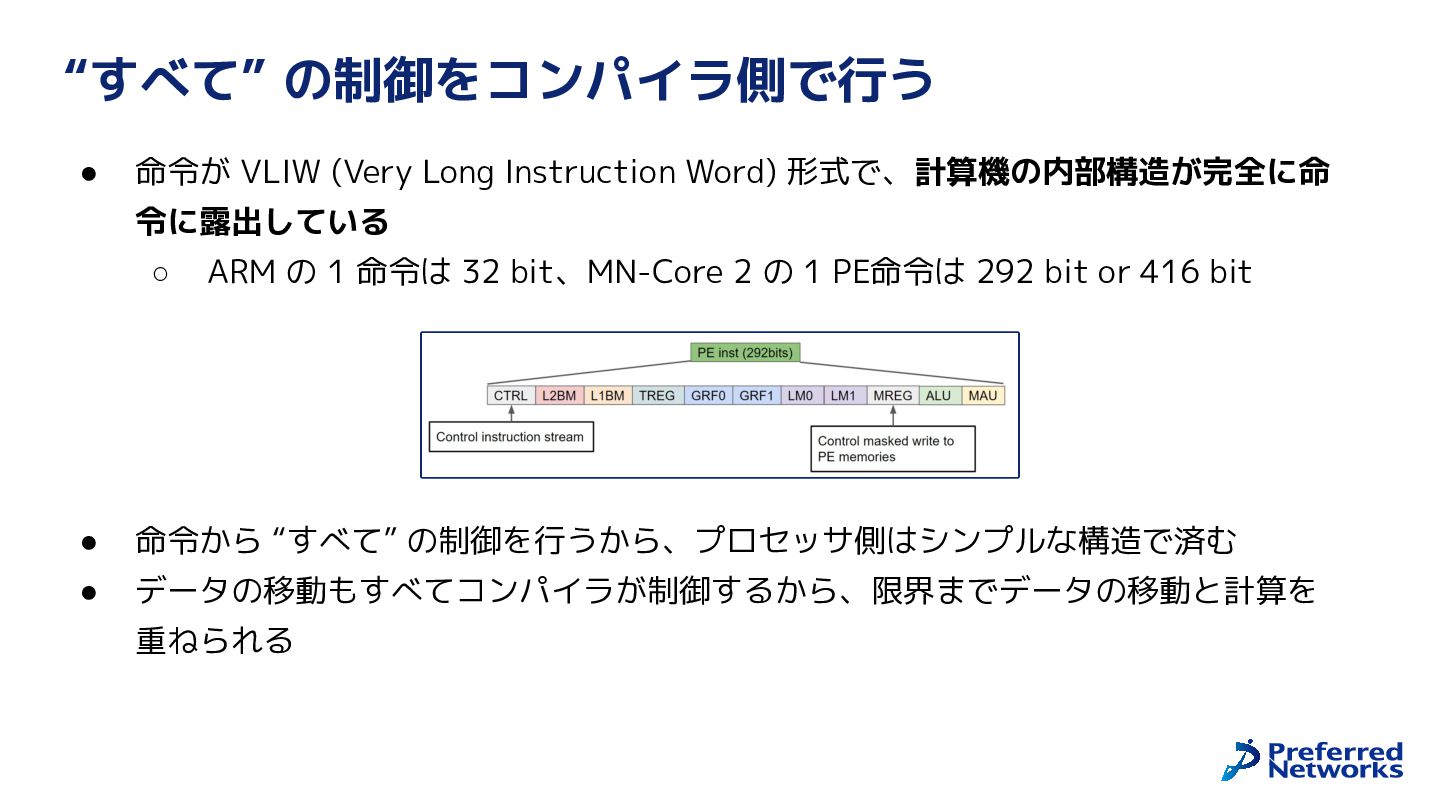
  22. “すべて” の制御をコンパイラ側で行う • 命令が VLIW (Very Long Instruction Word) 形式で、計算機の内部構造が完全に命

    令に露出している ◦ ARM の 1 命令は 32 bit、MN-Core 2 の 1 PE命令は 292 bit or 416 bit • 命令から “すべて” の制御を行うから、プロセッサ側はシンプルな構造で済む • データの移動もすべてコンパイラが制御するから、限界までデータの移動と計算を 重ねられる
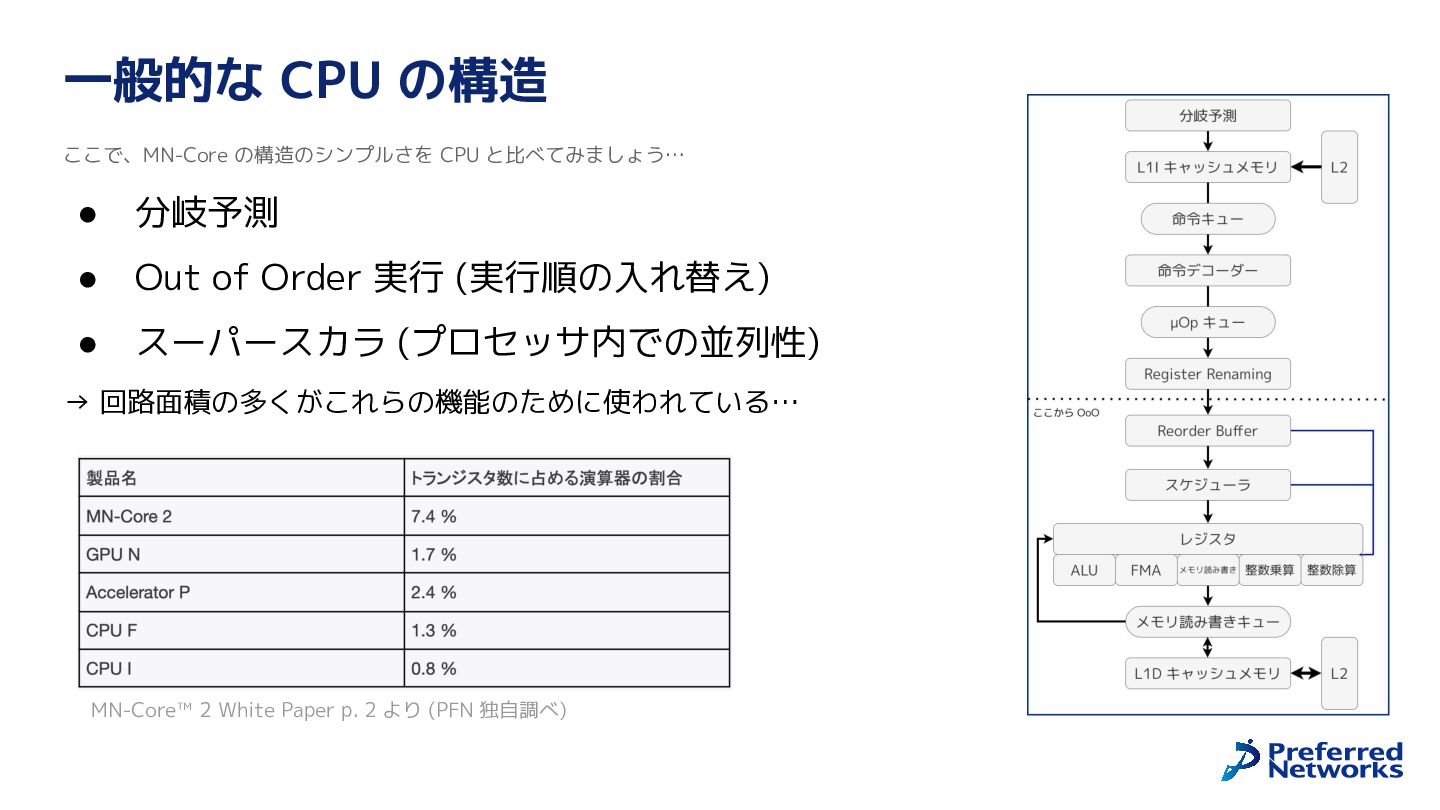
  23. 一般的な CPU の構造 ここで、MN-Core の構造のシンプルさを CPU と比べてみましょう… • 分岐予測 •

    Out of Order 実行 (実行順の入れ替え) • スーパースカラ (プロセッサ内での並列性) → 回路面積の多くがこれらの機能のために使われている… MN-Core™ 2 White Paper p. 2 より (PFN 独自調べ)
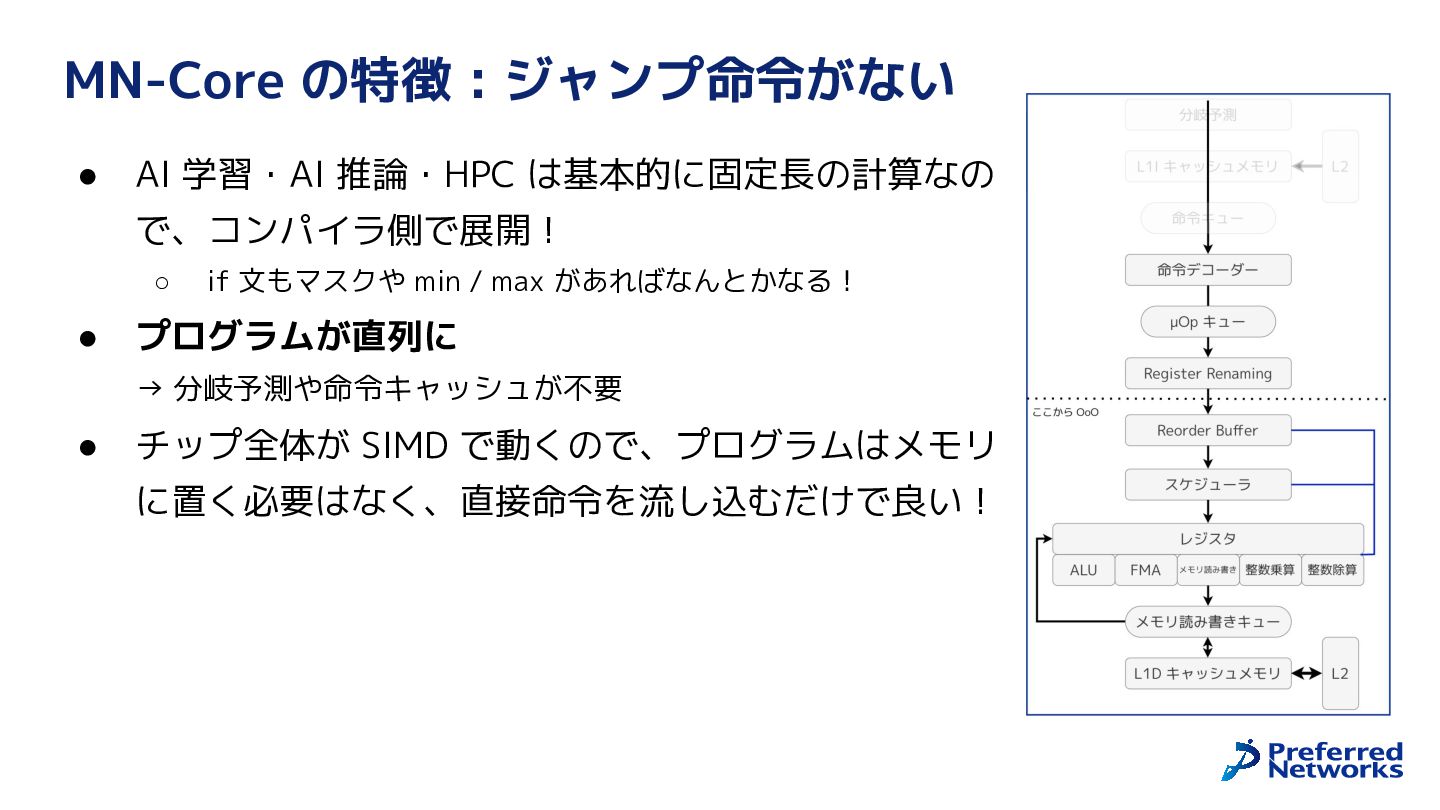
  24. MN-Core の特徴 : ジャンプ命令がない • AI 学習・AI 推論・HPC は基本的に固定長の計算なの で、コンパイラ側で展開!

    ◦ • if 文もマスクや min / max があればなんとかなる! プログラムが直列に → 分岐予測や命令キャッシュが不要 • チップ全体が SIMD で動くので、プログラムはメモリ に置く必要はなく、直接命令を流し込むだけで良い!
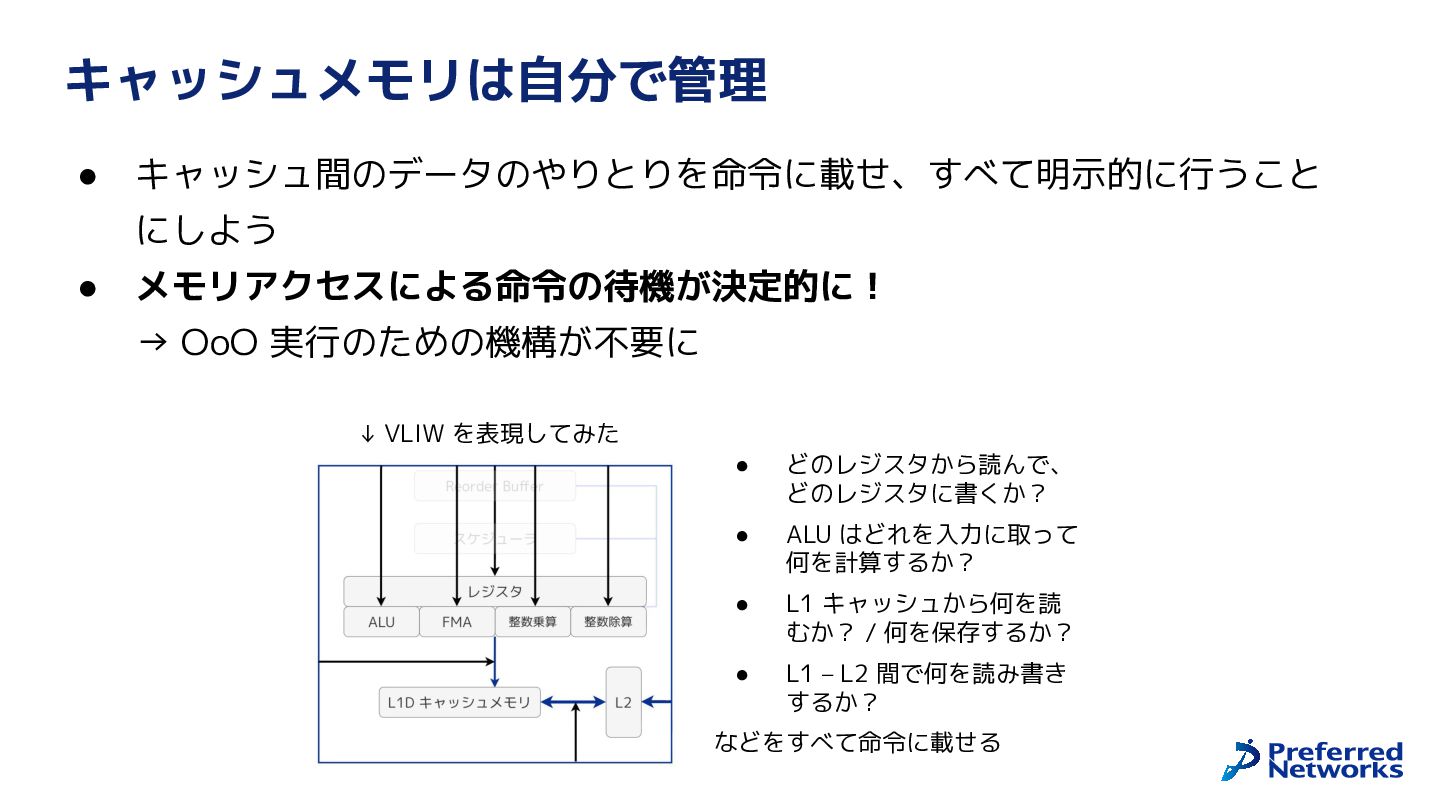
  25. キャッシュメモリは自分で管理 • キャッシュ間のデータのやりとりを命令に載せ、すべて明示的に行うこと にしよう • メモリアクセスによる命令の待機が決定的に! → OoO 実行のための機構が不要に ↓

    VLIW を表現してみた • どのレジスタから読んで、 どのレジスタに書くか? • ALU はどれを入力に取って 何を計算するか? • L1 キャッシュから何を読 むか? / 何を保存するか? • L1 – L2 間で何を読み書き するか? などをすべて命令に載せる
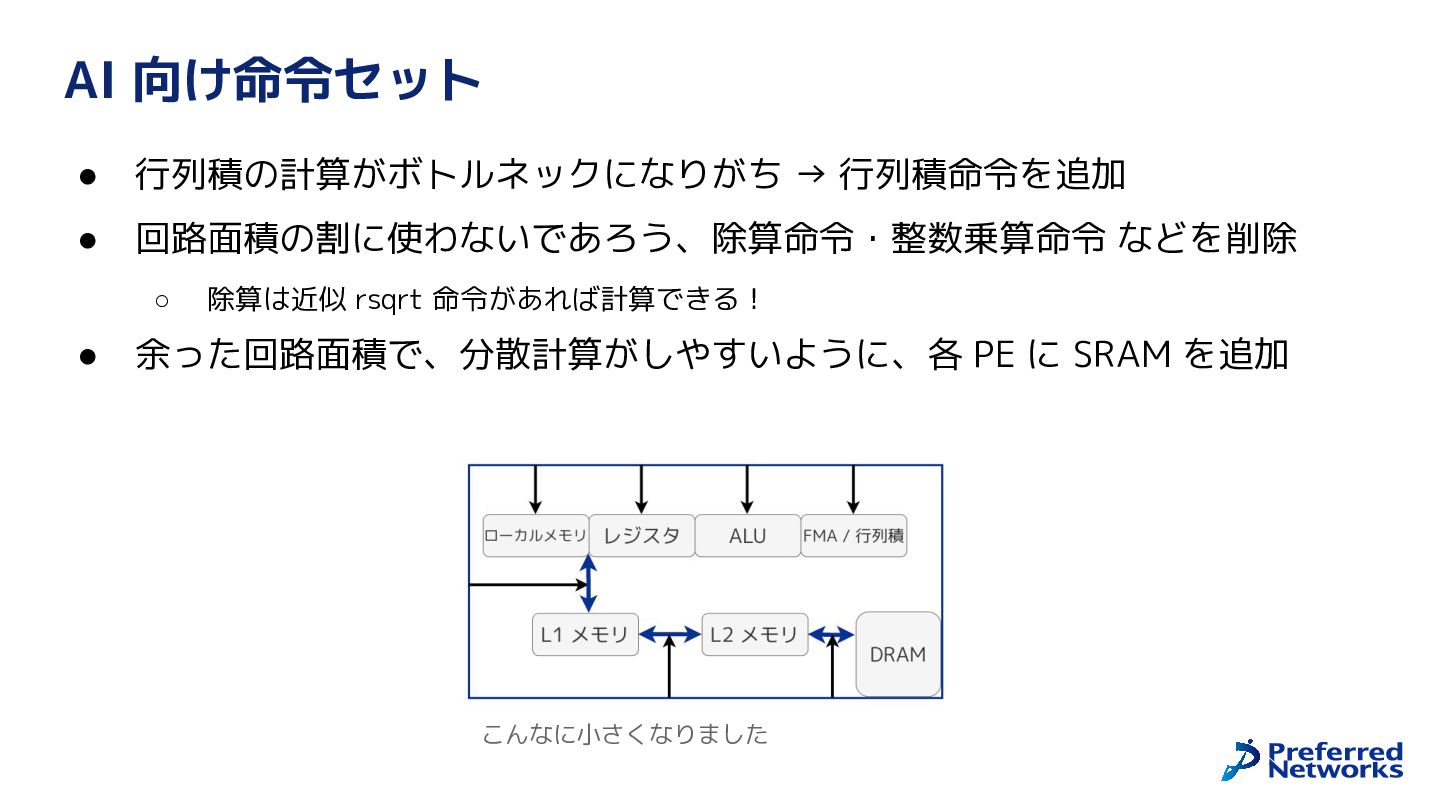
  26. AI 向け命令セット • 行列積の計算がボトルネックになりがち → 行列積命令を追加 • 回路面積の割に使わないであろう、除算命令・整数乗算命令 などを削除 ◦

    • 除算は近似 rsqrt 命令があれば計算できる! 余った回路面積で、分散計算がしやすいように、各 PE に SRAM を追加 こんなに小さくなりました
  27. MN-Core で自分のプログラムを動かしたい! • CUDA みたいに動かす環境がないと使えないよね • VLIW ですべてを制御できる ⇔ すべてを制御しなければならない!😱

    ◦ 💪 ソフトウェア開発パワー 💪 ◦ 我々ソフトウェア開発部が頑張って開発しているコンパイラが、良い感じに制御 と最適化を行います ◦ コンパイラチームを中心に、競技プログラマが多く所属しています
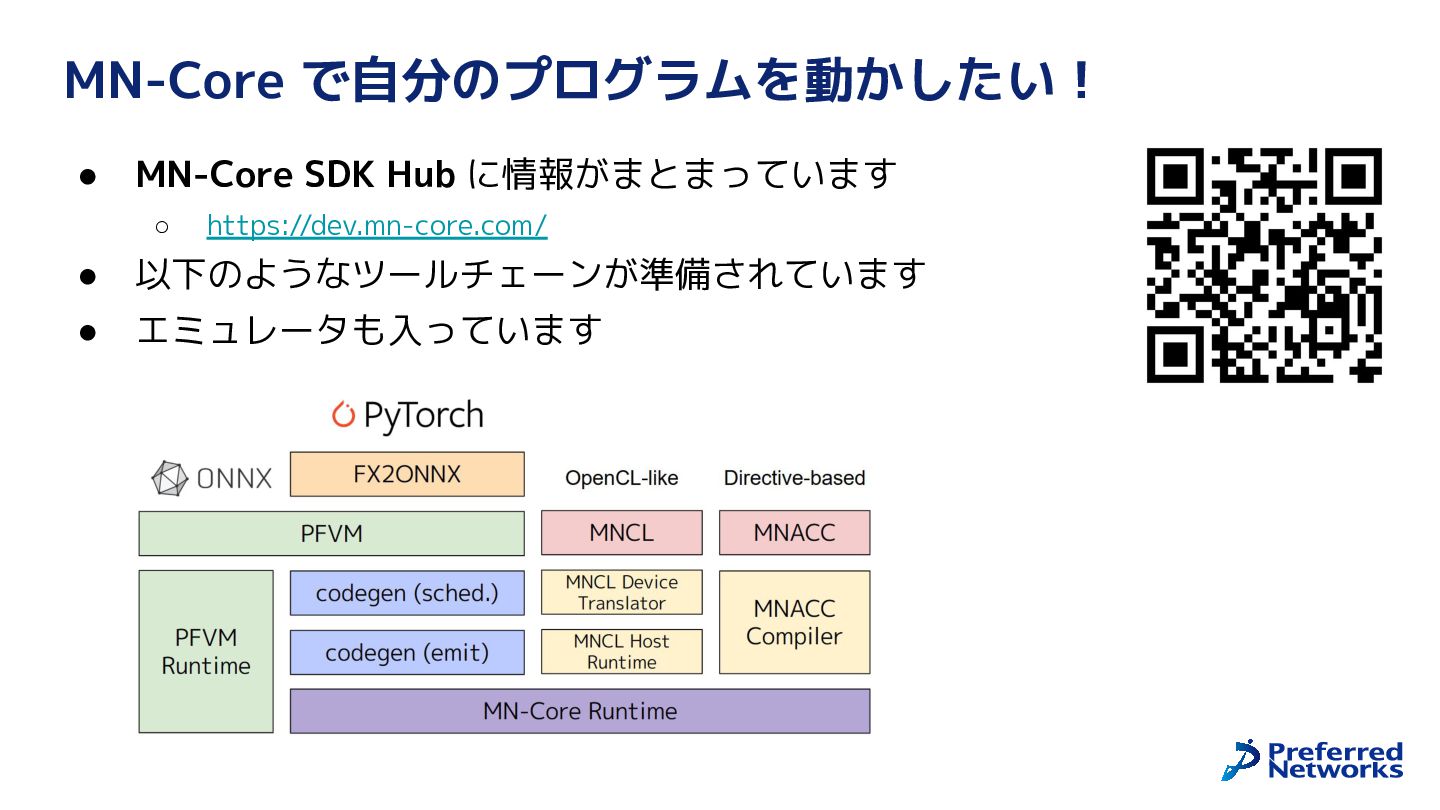
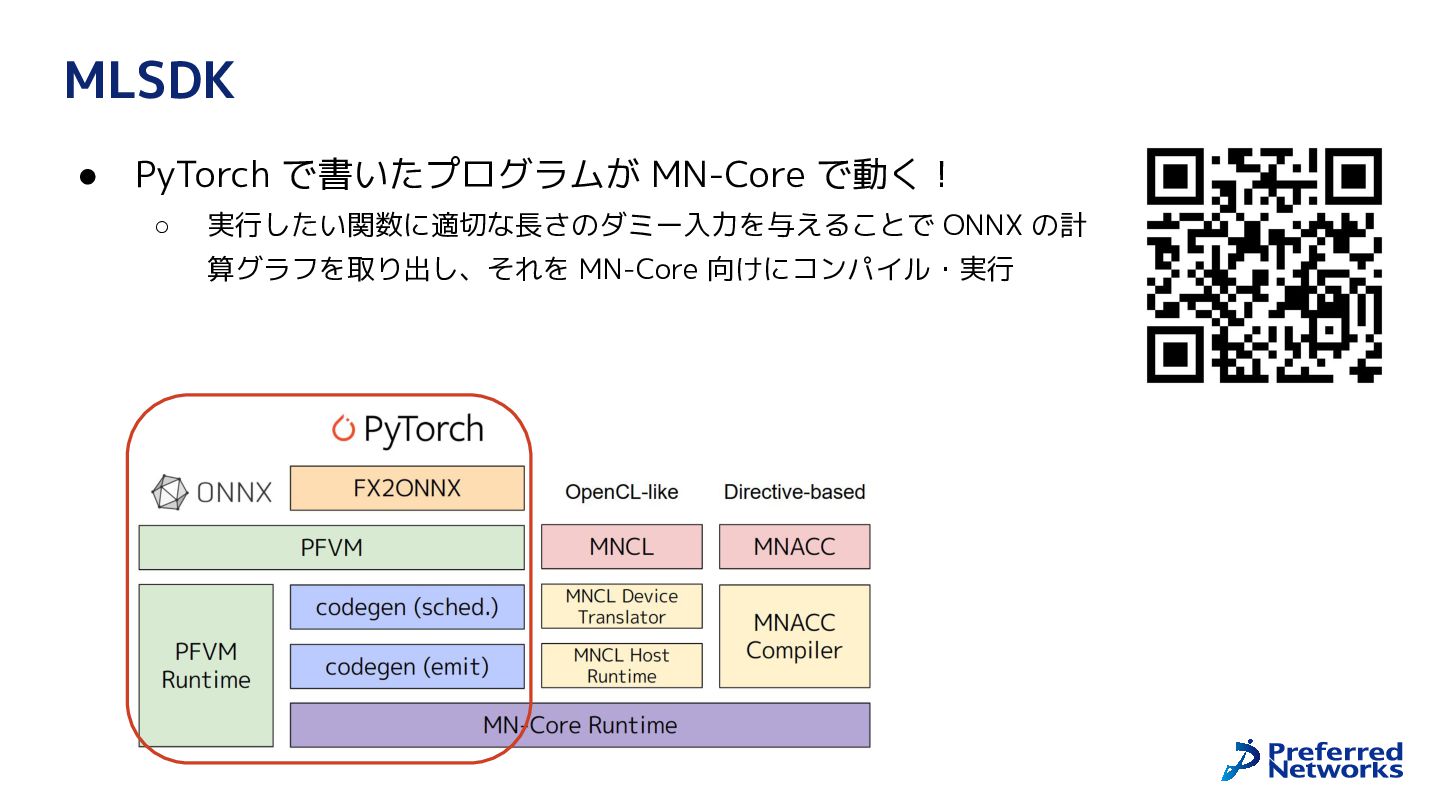
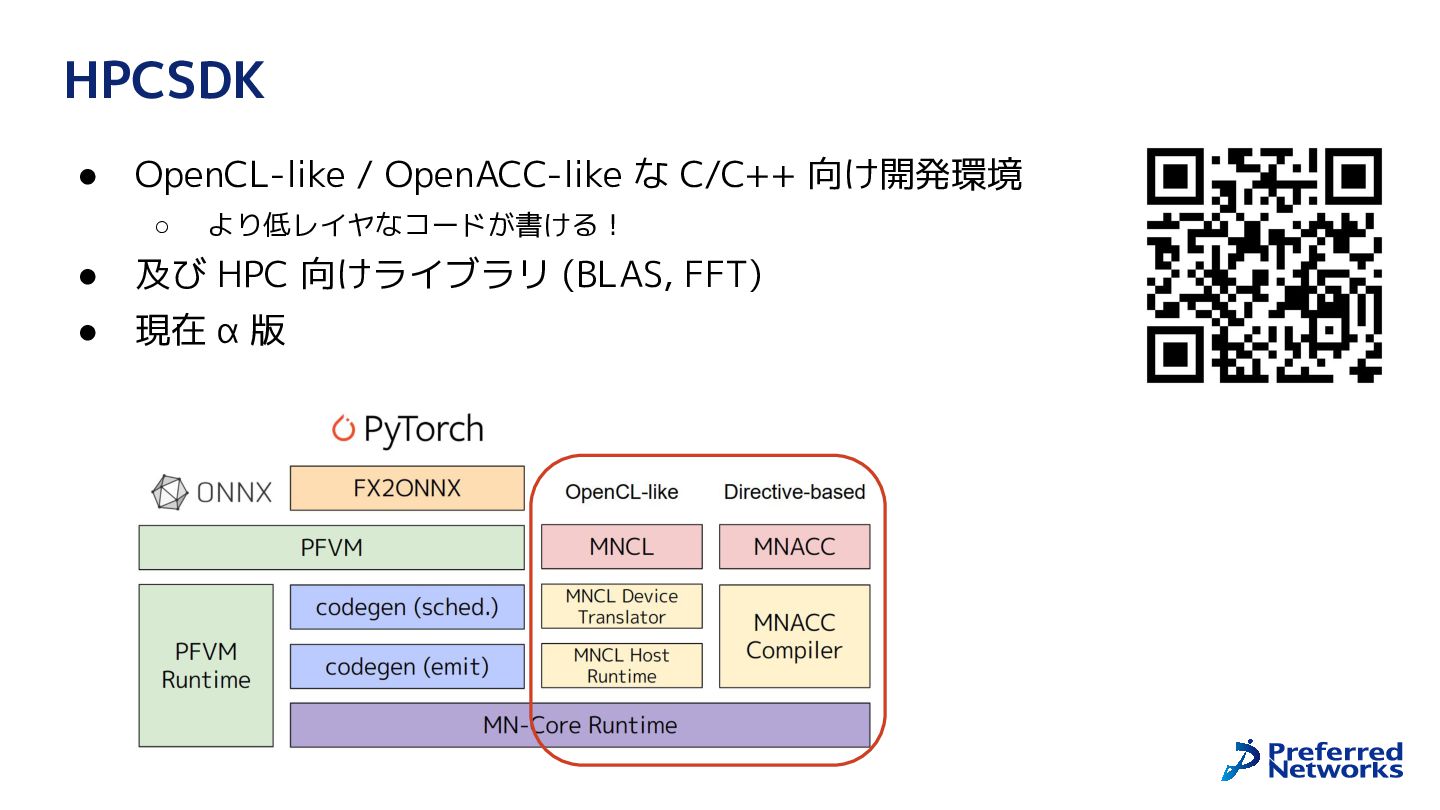
  28. MN-Core で自分のプログラムを動かしたい! • MN-Core SDK Hub に情報がまとまっています ◦ https://dev.mn-core.com/ •

    以下のようなツールチェーンが準備されています • エミュレータも入っています
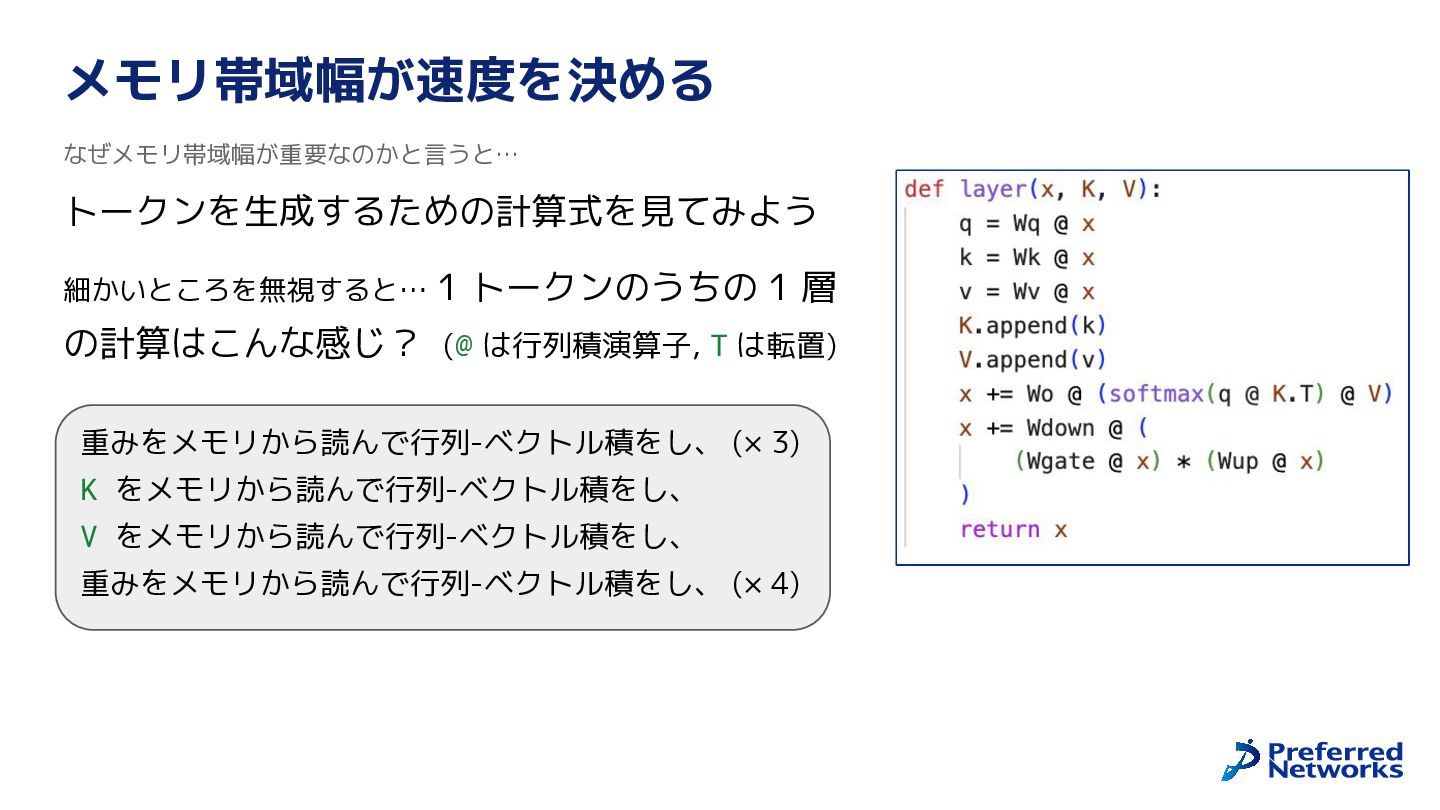
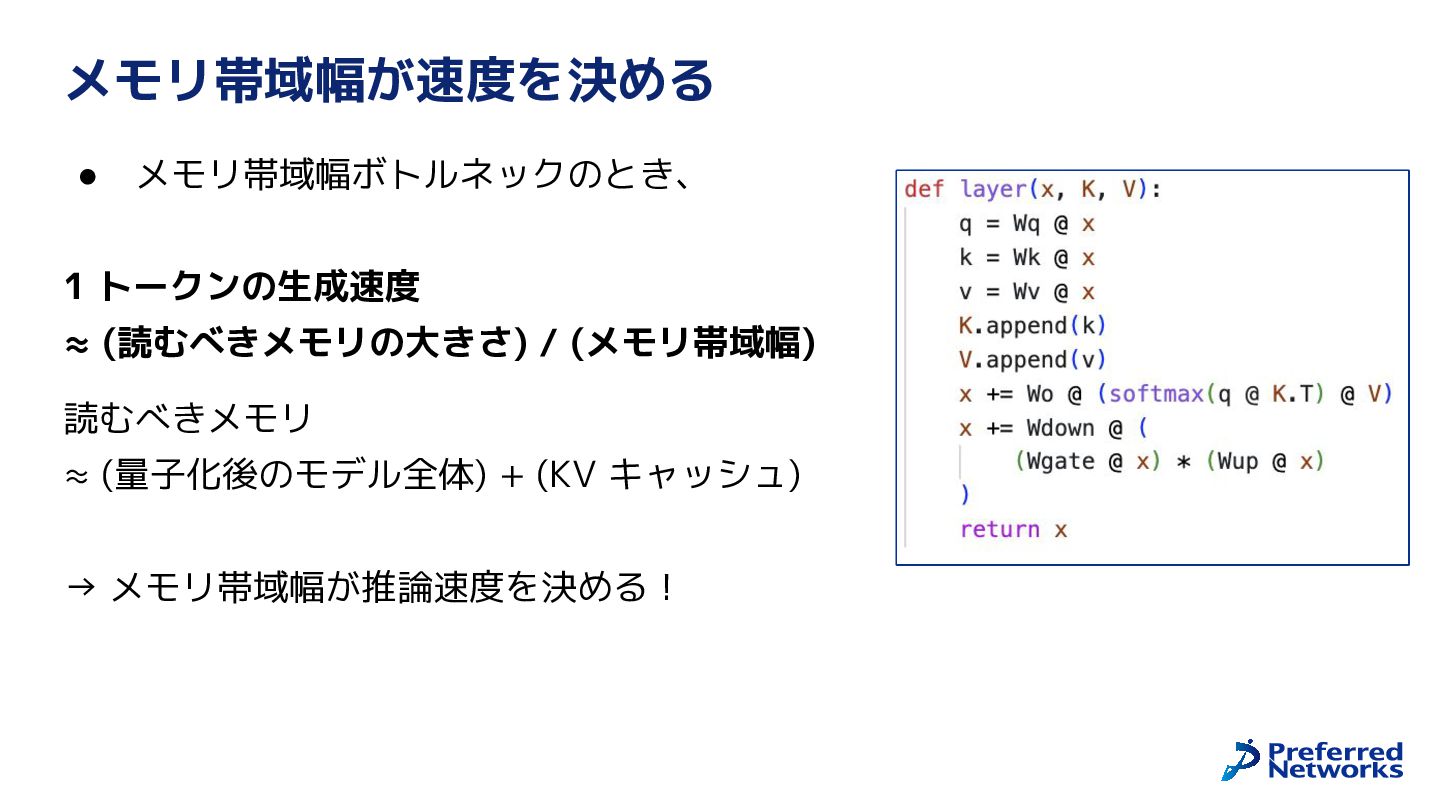
  29. メモリ帯域幅が速度を決める なぜメモリ帯域幅が重要なのかと言うと… トークンを生成するための計算式を見てみよう 細かいところを無視すると… 1 トークンのうちの 1 層 の計算はこんな感じ? (@

    は行列積演算子, T は転置) 重みをメモリから読んで行列-ベクトル積をし、 (× 3) K をメモリから読んで行列-ベクトル積をし、 V をメモリから読んで行列-ベクトル積をし、 重みをメモリから読んで行列-ベクトル積をし、 (× 4)
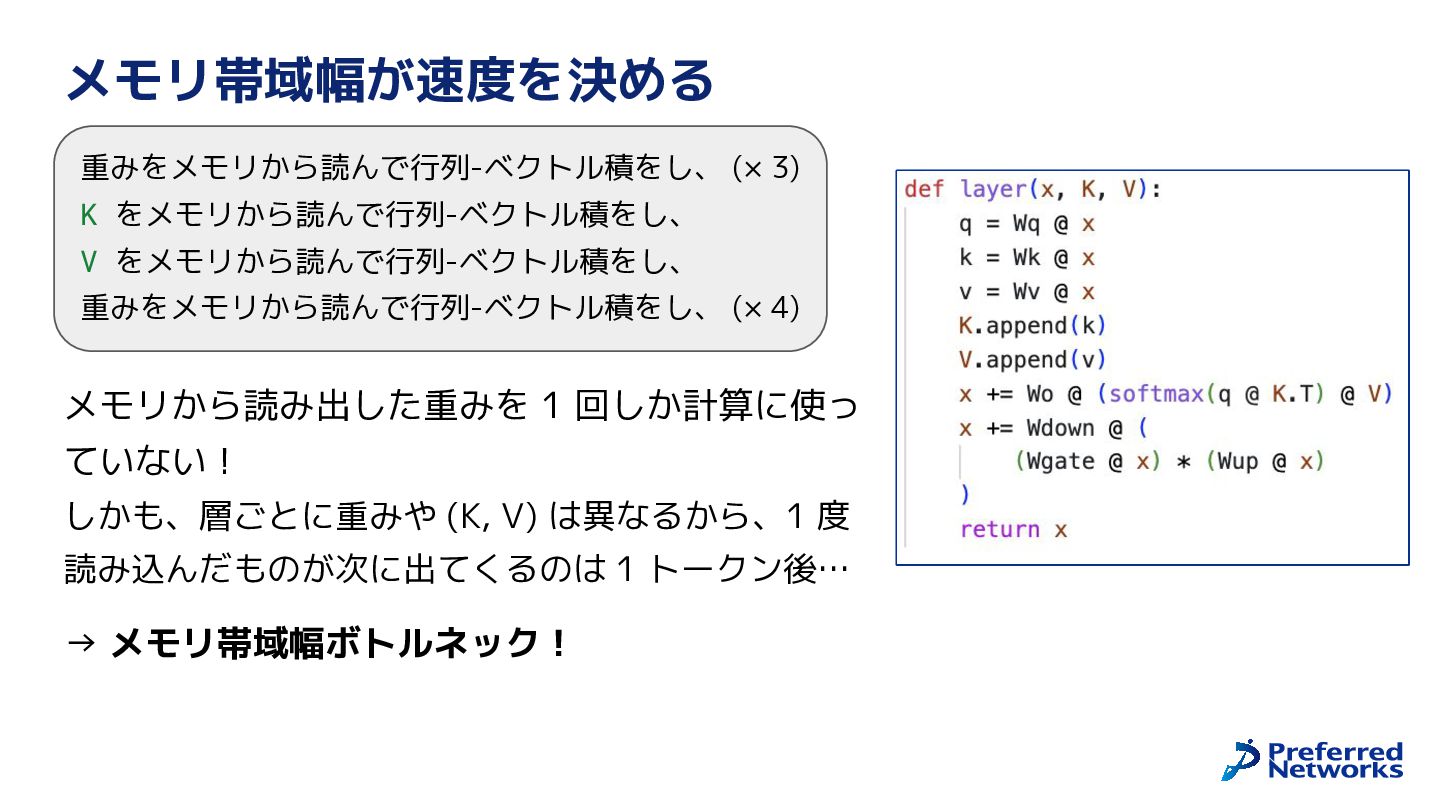
  30. メモリ帯域幅が速度を決める 重みをメモリから読んで行列-ベクトル積をし、 (× 3) K をメモリから読んで行列-ベクトル積をし、 V をメモリから読んで行列-ベクトル積をし、 重みをメモリから読んで行列-ベクトル積をし、 (×

    4) メモリから読み出した重みを 1 回しか計算に使っ ていない! しかも、層ごとに重みや (K, V) は異なるから、1 度 読み込んだものが次に出てくるのは 1 トークン後… → メモリ帯域幅ボトルネック!
  31. 余っている計算力を使う工夫 • 並列数を増やす ◦ 複数人分の推論を同時に処理すれば、ロードした重みを複数回の行列積に使える! ◦ それだけのユーザ数がいれば良いけど… ◦ KV-キャッシュは独立なので、context (入力長)

    が長いと並列数を増やしても解決 しない 😢 • 投機的デコード ◦ 小さなモデルで先に数トークン推論させた後、実際に予測されたトークンが 出てくるかを並列で検証 ◦ 予測が当たらないと無駄に計算しただけ → 電力効率は下がる
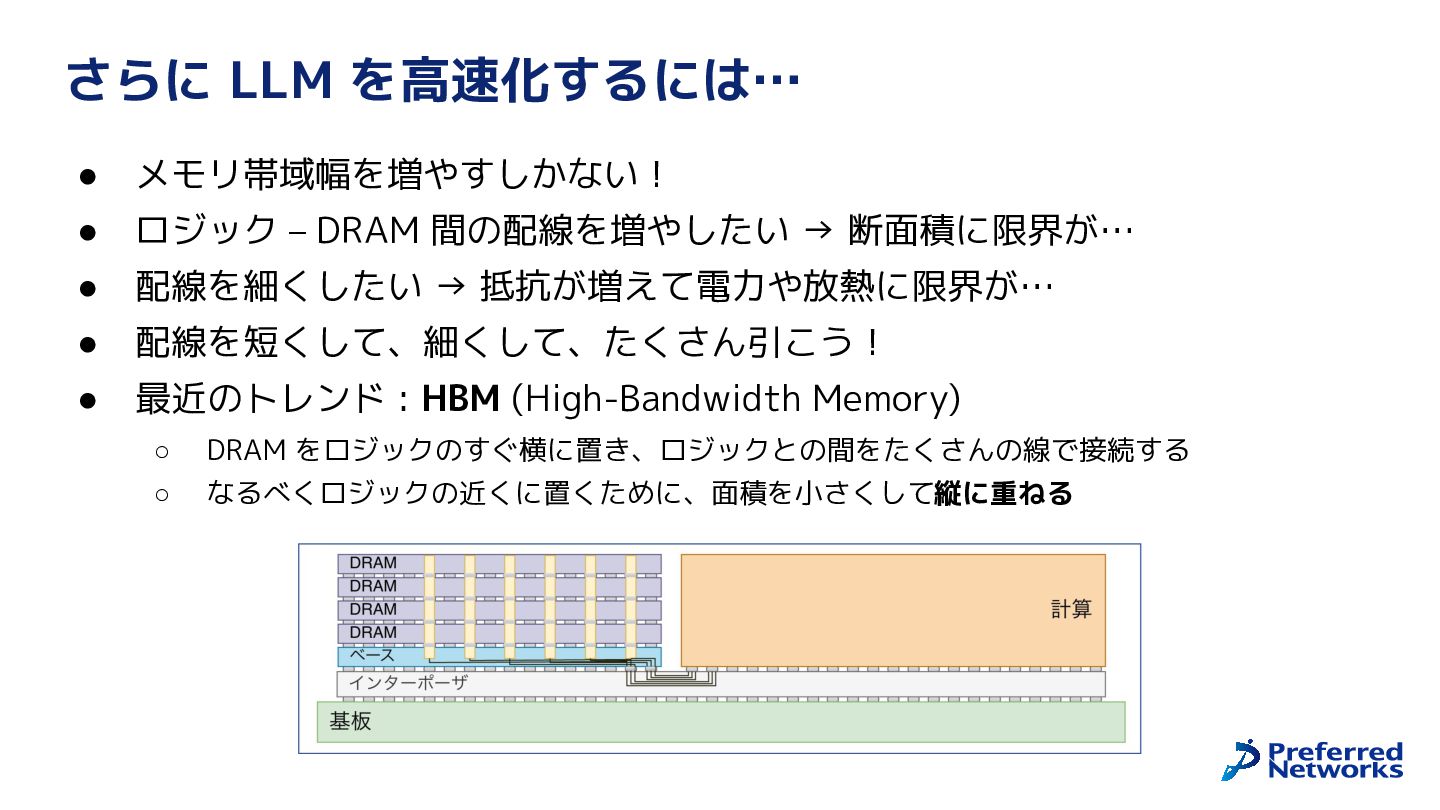
  32. さらに LLM を高速化するには… • メモリ帯域幅を増やすしかない! • ロジック – DRAM 間の配線を増やしたい

    → 断面積に限界が… • 配線を細くしたい → 抵抗が増えて電力や放熱に限界が… • 配線を短くして、細くして、たくさん引こう! • 最近のトレンド : HBM (High-Bandwidth Memory) ◦ DRAM をロジックのすぐ横に置き、ロジックとの間をたくさんの線で接続する ◦ なるべくロジックの近くに置くために、面積を小さくして縦に重ねる [HBM の図を書く]
  33. LLM 推論の電力事情 • HBM を使った近年のプロセッサでも、LLM 推論 (decode) では、メモリから のデータ転送に多くの電力を使っているらしい ◦

    NVIDIA GTC 2026 の Bill Dally の講演では、消費電力のうち、重みの転送が 73%、KV キャッシュの転送が 18%、計算が 9% と説明されている • HBM でもまだ DRAM が遠い! • もっとメモリ帯域を広げるには…?
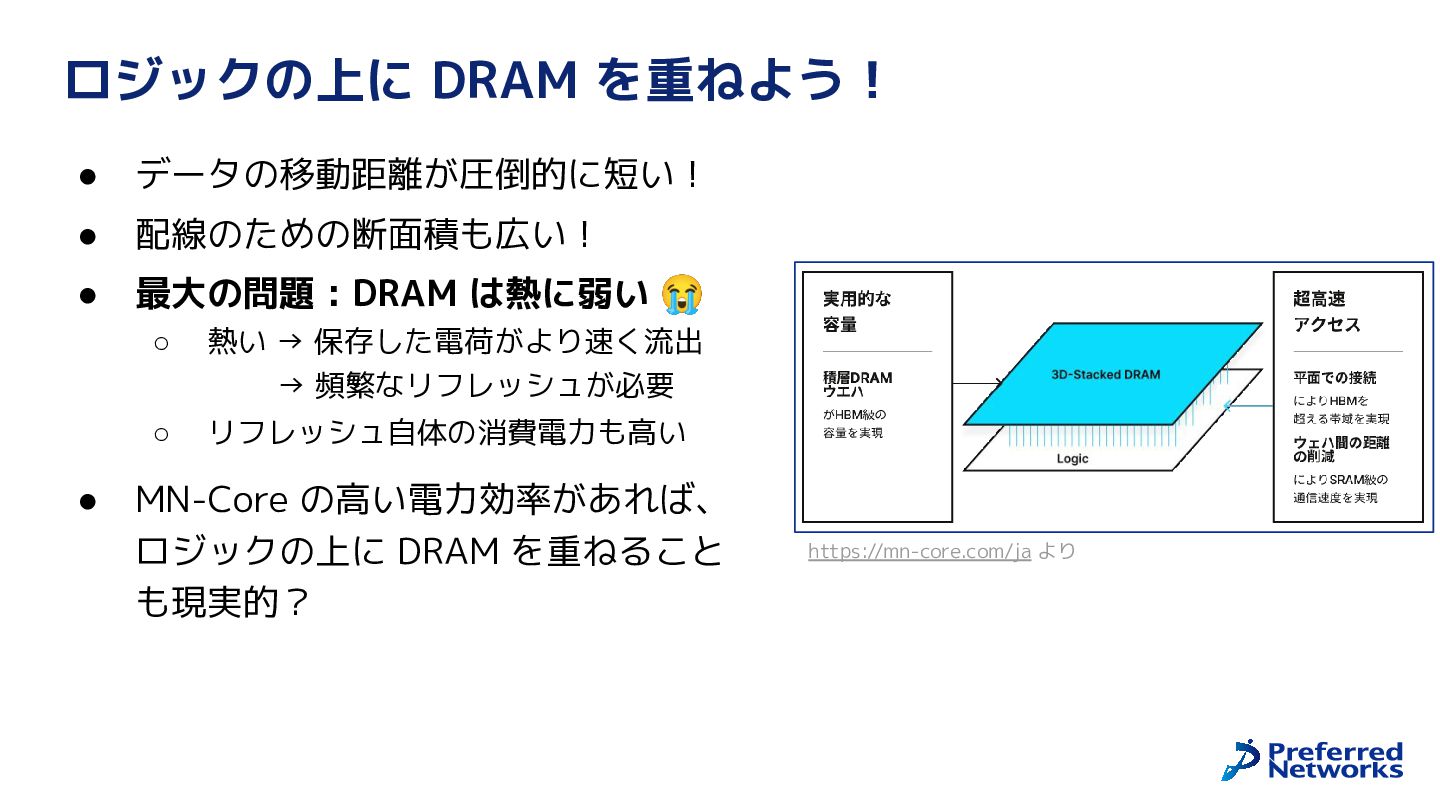
  34. ロジックの上に DRAM を重ねよう! • データの移動距離が圧倒的に短い! • 配線のための断面積も広い! • 最大の問題 :

    DRAM は熱に弱い 😭 • ◦ 熱い → 保存した電荷がより速く流出 → 頻繁なリフレッシュが必要 ◦ リフレッシュ自体の消費電力も高い MN-Core の高い電力効率があれば、 ロジックの上に DRAM を重ねること も現実的? https://mn-core.com/ja より
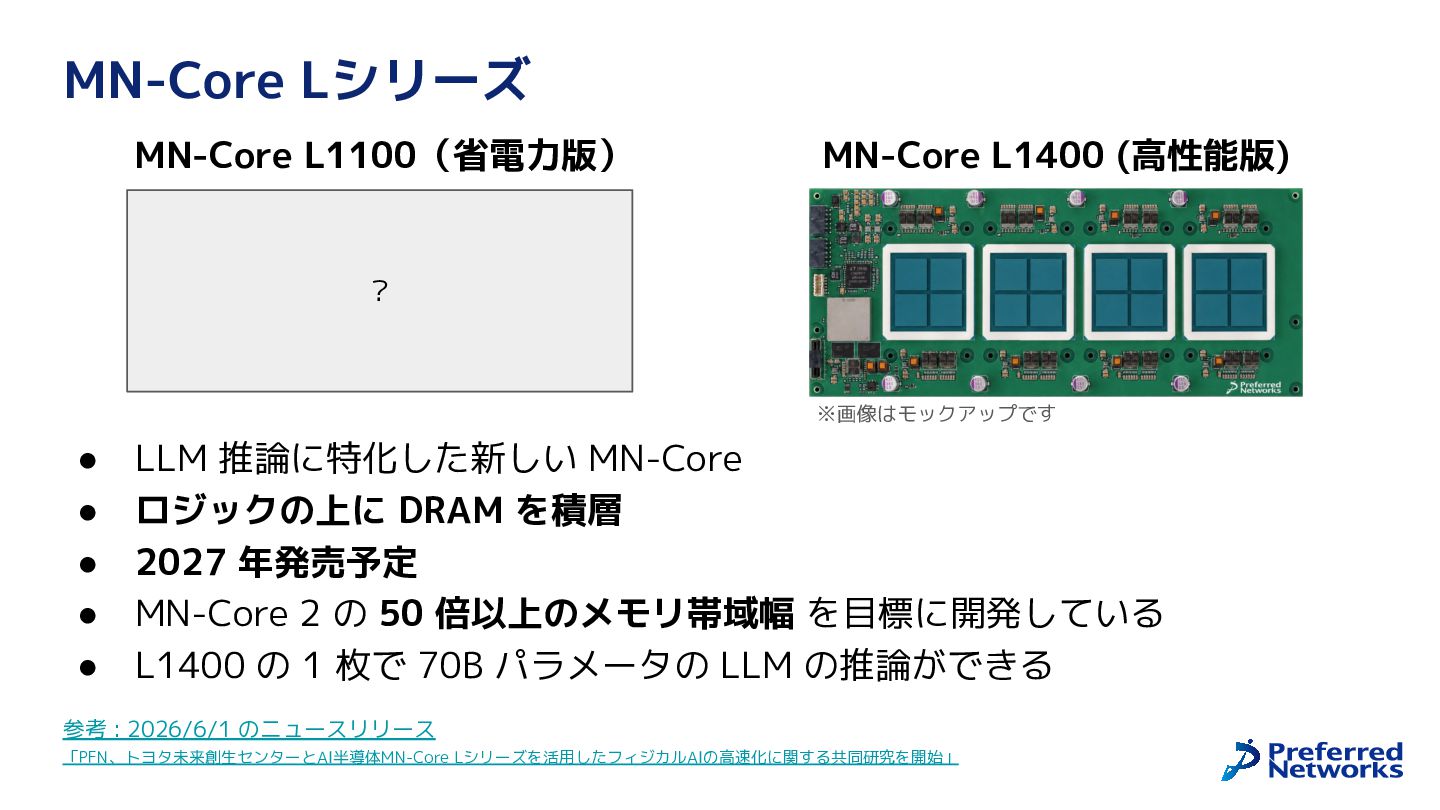
  35. MN-Core Lシリーズ MN-Core L1100(省電力版) MN-Core L1400 (高性能版) ? ※画像はモックアップです •

    • • • • LLM 推論に特化した新しい MN-Core ロジックの上に DRAM を積層 2027 年発売予定 MN-Core 2 の 50 倍以上のメモリ帯域幅 を目標に開発している L1400 の 1 枚で 70B パラメータの LLM の推論ができる 参考 : 2026/6/1 のニュースリリース 「PFN、トヨタ未来創生センターとAI半導体MN-Core Lシリーズを活用したフィジカルAIの高速化に関する共同研究を開始」
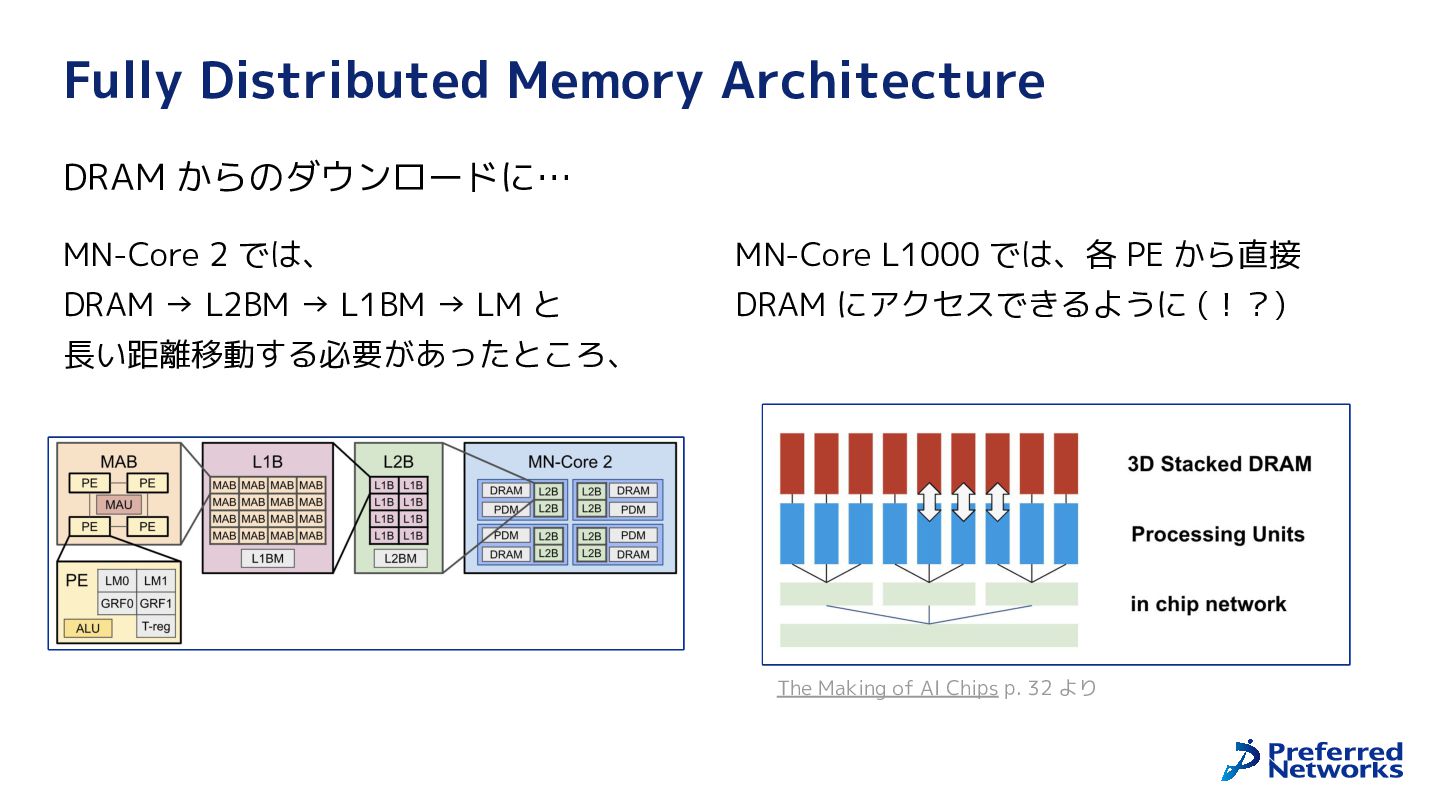
  36. Fully Distributed Memory Architecture DRAM からのダウンロードに… MN-Core 2 では、 MN-Core

    L1000 では、各 PE から直接 DRAM → L2BM → L1BM → LM と DRAM にアクセスできるように (!?) 長い距離移動する必要があったところ、 The Making of AI Chips p. 32 より
  37. We’re Hiring! AI コンピューティング事業本部では、一緒に MN-Core をつくる人を募集してい ます! • https://open.talentio.com/r/1/c/preferred/homes/4618 •

    競プロ勢とか低レイヤ勢とかローカル LLM 勢とか、色んな人が求められています • ソフトウェア開発部のアルバイトも募集しています 全社的な情報 • https://www.preferred.jp/ja/careers • 28卒 新卒採用 (11 月募集開始) ◦ • プレエントリーが始まりました インターン : 毎年夏にやっています! (4 月募集締切)