Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
PLaMo 3.0 Primeの事後学習
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
Preferred Networks
PRO
July 30, 2026
Technology
430
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
PLaMo 3.0 Primeの事後学習
2026年7月30日に開催された「PFN LLMオープンハウス」での講演資料です。
Preferred Networks
PRO
July 30, 2026
More Decks by Preferred Networks
See All by Preferred Networks
Rustuna: Rustによる高速なOptuna実装
pfn
PRO
0
190
Optunaの最新リリースv5.0について
pfn
PRO
0
120
OptunaHub: ブラックボックス最適化のためのプラットフォーム
pfn
PRO
0
140
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
130
AI を支えるクラウドネイティブエコシステム
pfn
PRO
0
51
MN-Core™ について語りたい - 第59回 情報科学若手の会
pfn
PRO
1
890
User Namespaces in Production: Enabling Root in Containers with RWX
pfn
PRO
0
120
世界最先端の研究を製品へ~PFNでのプロダクトマネジメントの難しさとその醍醐味~
pfn
PRO
0
81
PLaMo 3.0 Primeの構造化出力サポート
pfn
PRO
0
290
Other Decks in Technology
See All in Technology
UniFi(ユニファイ)AIカメラの現場活用
ludicmind
1
440
go-sqletch
moznion
0
140
大型犬好きによるPugの紹介
yamanoku
1
160
Active Record Connection Adaptersにおける長年の課題に再び取り組む
yahonda
0
140
ソフトウェア ファクトリー - 再現性のあるソフトウェアの工場づくり / Software factory
iktakahiro
6
4.9k
ストレスなくAIと付き合いたい!こんなときどうしてる?
namiki64
3
480
PagerDuty Tech Hub-鳴らすけれど、人は動かない
ezaki
0
170
AI時代のPRレビューにどう向き合うか?
kairim0
1
240
日本語に強いオープンな大規模言語モデル「LLM-jp」
odashi
4
1.1k
エンタメ企業のM&Aを支えるデータ基盤 ― 統合から店舗のリアルタイム分析まで / Data Engineering Summit 2026
genda
0
170
10年後、Engineering 行為を剥奪されるとして、わたしたちは、どう、何を創ればいいだろうか。 / If Engineering Is Taken Away in 10 Years, How and What Should We Create?
bitkey
PRO
1
190
サブエージェントと Claude Mods で作る独自 Advisor ツールの話
kenichiodo
2
160
Featured
See All Featured
How to train your dragon (web standard)
notwaldorf
96
6.9k
SEO for Brand Visibility & Recognition
aleyda
0
4.8k
The SEO Collaboration Effect
kristinabergwall1
1
590
Code Reviewing Like a Champion
maltzj
529
40k
What Being in a Rock Band Can Teach Us About Real World SEO
427marketing
0
1.1k
VelocityConf: Rendering Performance Case Studies
addyosmani
331
25k
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8.1k
Git: the NoSQL Database
bkeepers
PRO
433
67k
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
270
Building the Perfect Custom Keyboard
takai
2
910
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
Utilizing Notion as your number one productivity tool
mfonobong
4
620
Transcript
PLaMo 3.0 Primeの事後学習 LLM開発事業部 PLaMo Post-training team 野沢 健人
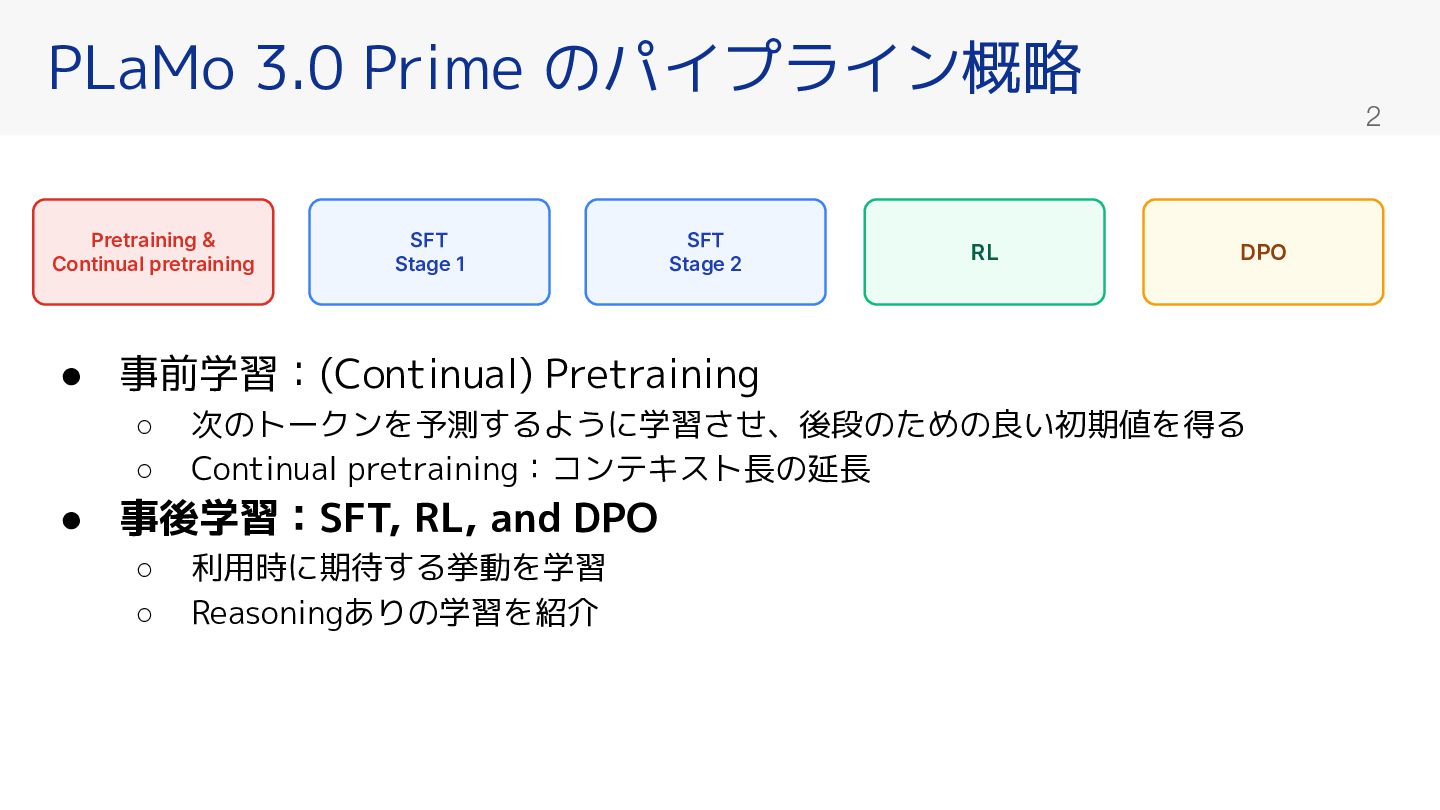
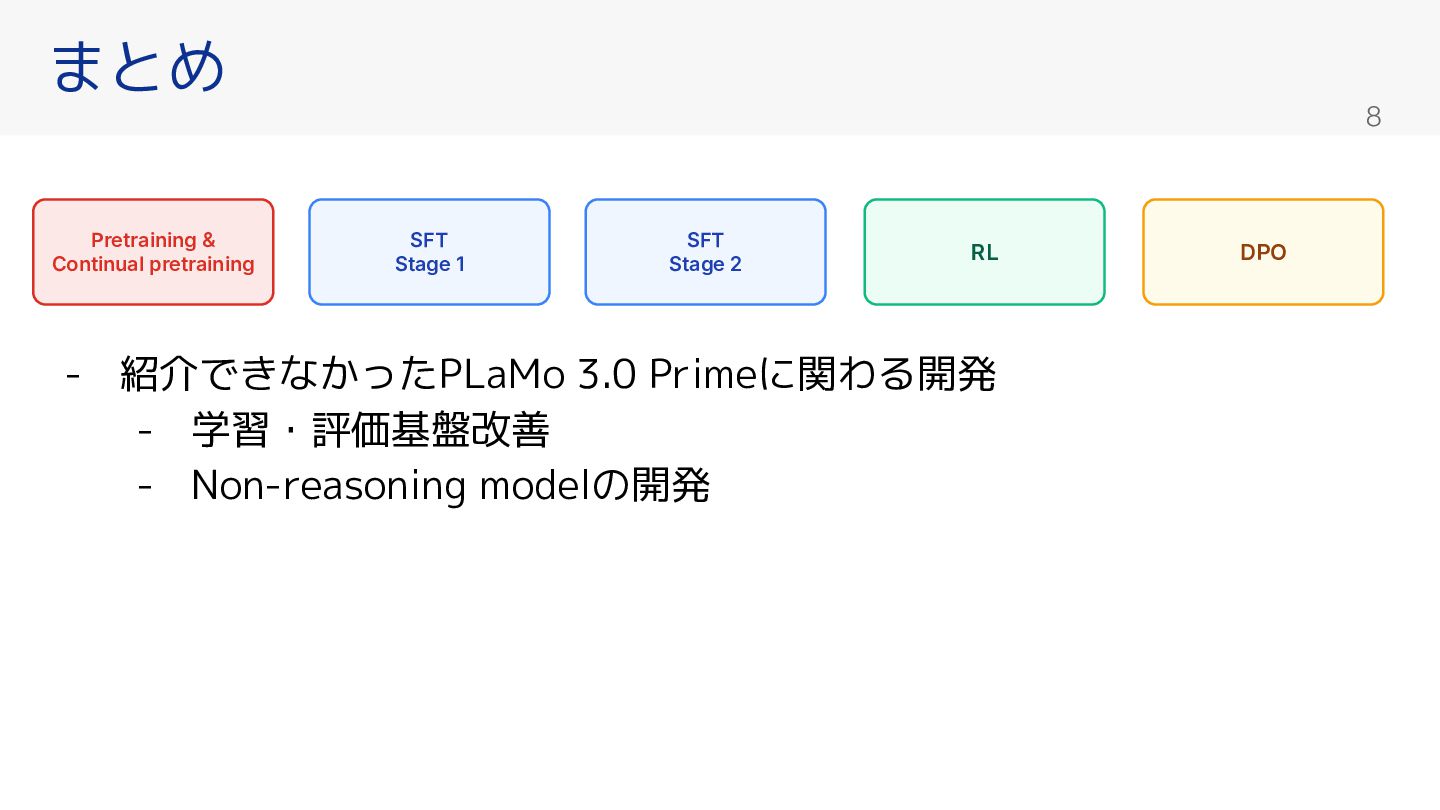
PLaMo 3.0 Prime のパイプライン概略 2 Pretraining & Continual pretraining SFT
Stage 1 SFT Stage 2 RL DPO • 事前学習:(Continual) Pretraining ◦ ◦ 次のトークンを予測するように学習させ、後段のための良い初期値を得る Continual pretraining:コンテキスト長の延長 • 事後学習:SFT, RL, and DPO ◦ ◦ 利用時に期待する挙動を学習 Reasoningありの学習を紹介
SFT (Supervised fine-tuning) 3 - プロンプトと期待される応答のペアを用意し、期待する形式の応答がで きるように学習 - プロンプト:自己紹介よろ -
応答:株式会社PFNで開発されたAI PLaMoです!😀 - 応答のトークンの予測誤差を使って学習 - PLaMo 3.0 Prime では2段から構成
SFT Stage 1 4 - 大規模にReasoningを伴う応答ができるように学習 - プロンプト:1+1 - Reasoning:ユーザーが1+1…田ではなく2と回答しよう。
- 最終的な応答:2です! - データのドメインは、STEMやCodingが支配的
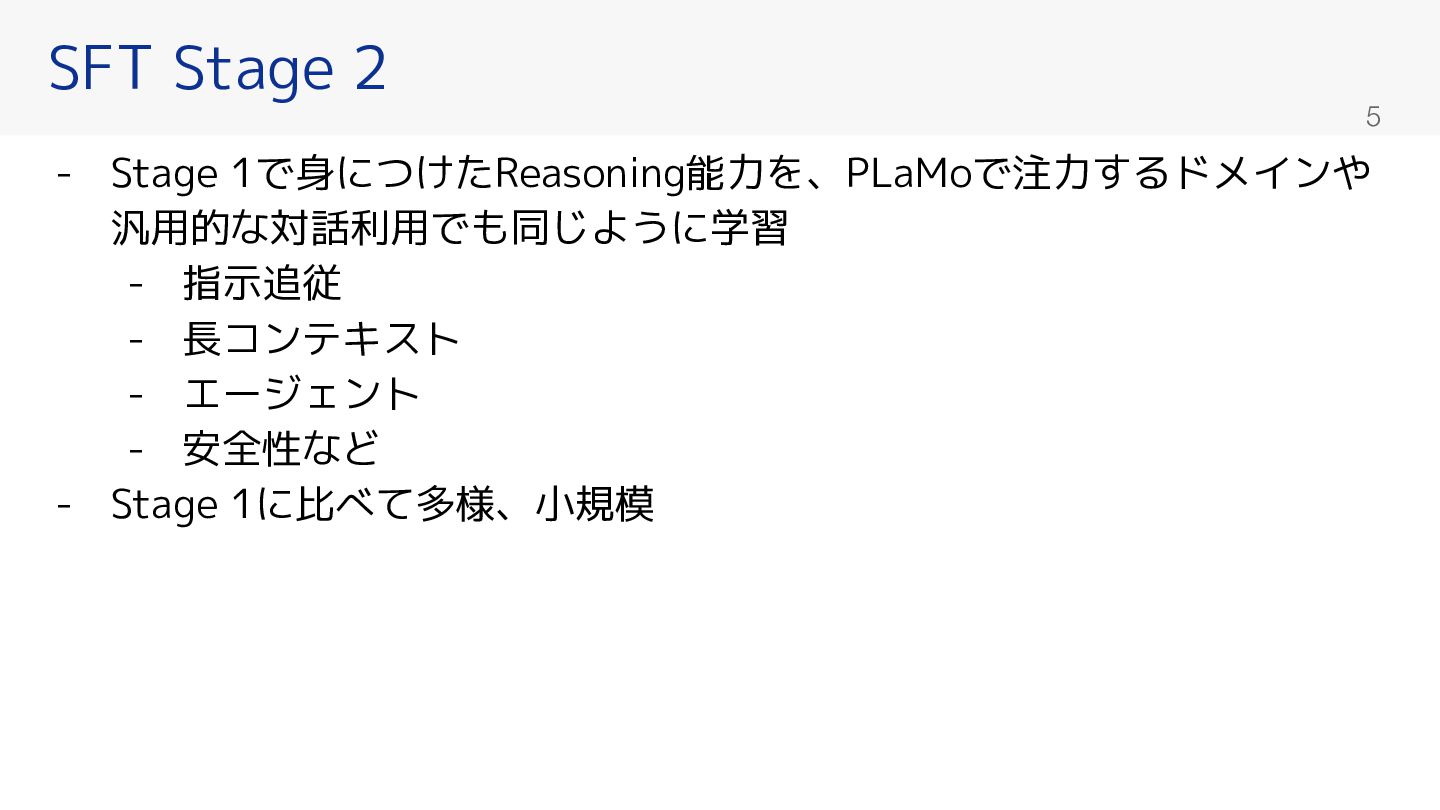
SFT Stage 2 5 - Stage 1で身につけたReasoning能力を、PLaMoで注力するドメインや 汎用的な対話利用でも同じように学習 - 指示追従
- 長コンテキスト - エージェント - 安全性など - Stage 1に比べて多様、小規模
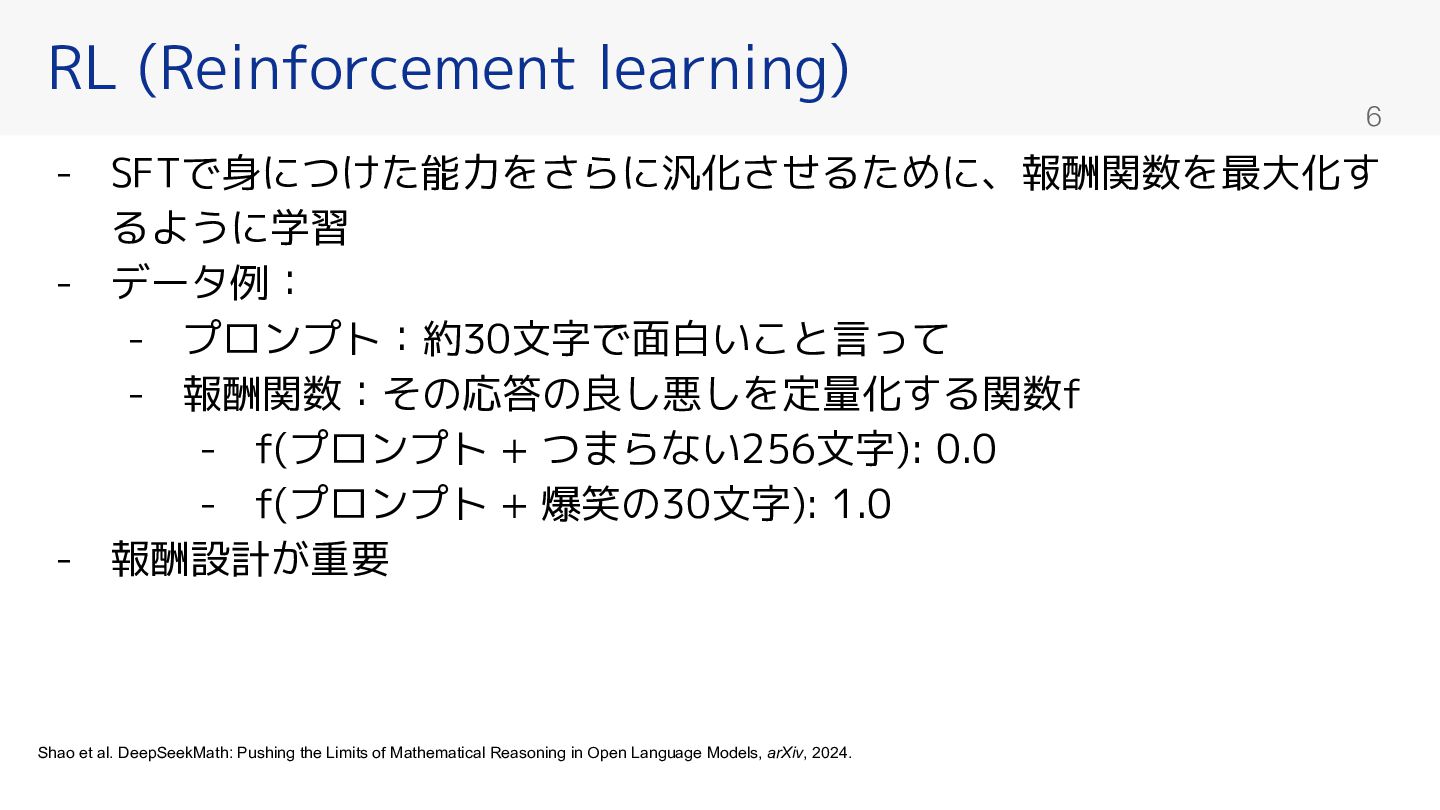
RL (Reinforcement learning) 6 - SFTで身につけた能力をさらに汎化させるために、報酬関数を最大化す るように学習 - データ例: -
プロンプト:約30文字で面白いこと言って - 報酬関数:その応答の良し悪しを定量化する関数f - f(プロンプト + つまらない256文字): 0.0 - f(プロンプト + 爆笑の30文字): 1.0 - 報酬設計が重要 Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, arXiv, 2024.
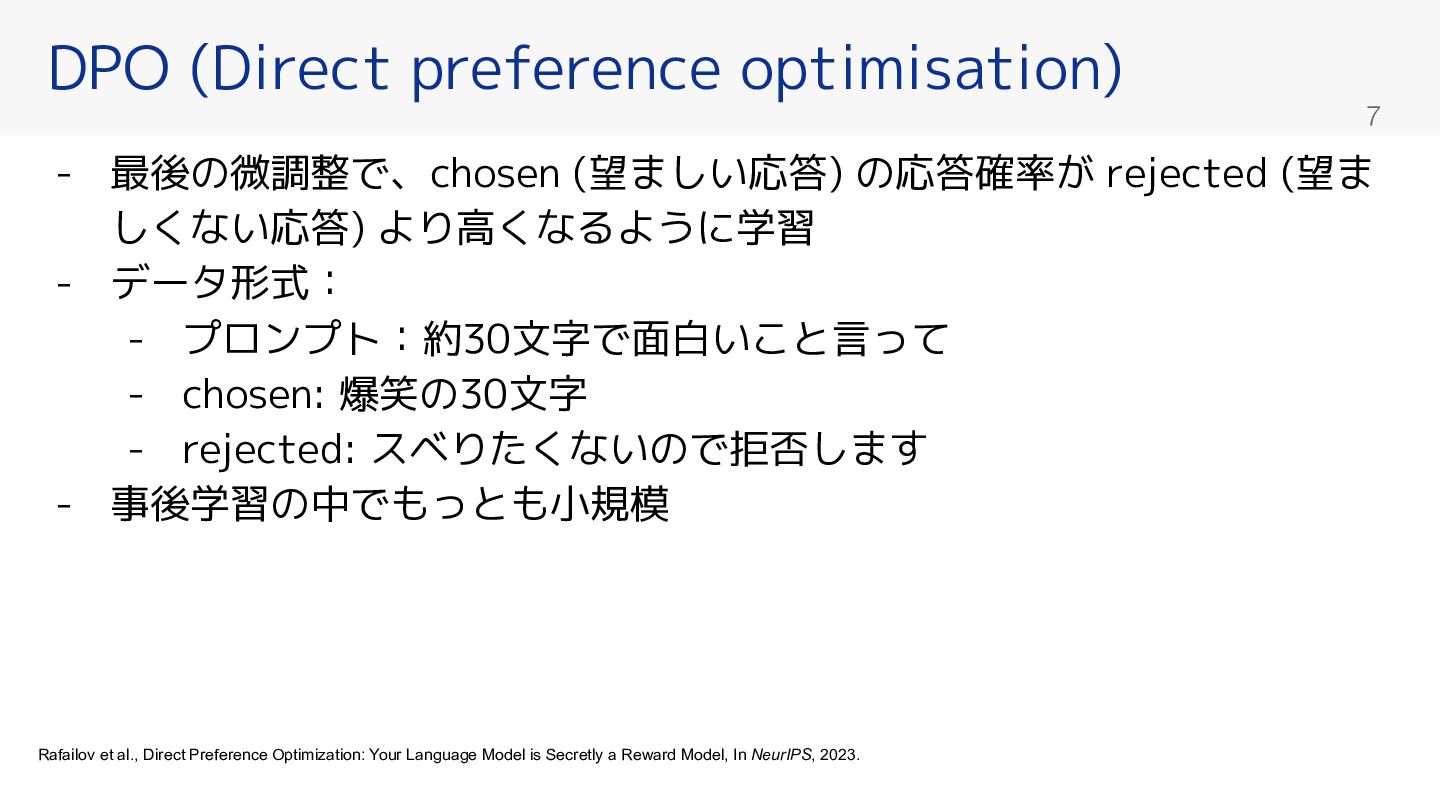
DPO (Direct preference optimisation) 7 - 最後の微調整で、chosen (望ましい応答) の応答確率が rejected
(望ま しくない応答) より高くなるように学習 - データ形式: - プロンプト:約30文字で面白いこと言って - chosen: 爆笑の30文字 - rejected: スベりたくないので拒否します - 事後学習の中でもっとも小規模 Rafailov et al., Direct Preference Optimization: Your Language Model is Secretly a Reward Model, In NeurIPS, 2023.
まとめ 8 Pretraining & Continual pretraining SFT Stage 1 SFT
Stage 2 RL - 紹介できなかったPLaMo 3.0 Primeに関わる開発 - 学習・評価基盤改善 - Non-reasoning modelの開発 DPO
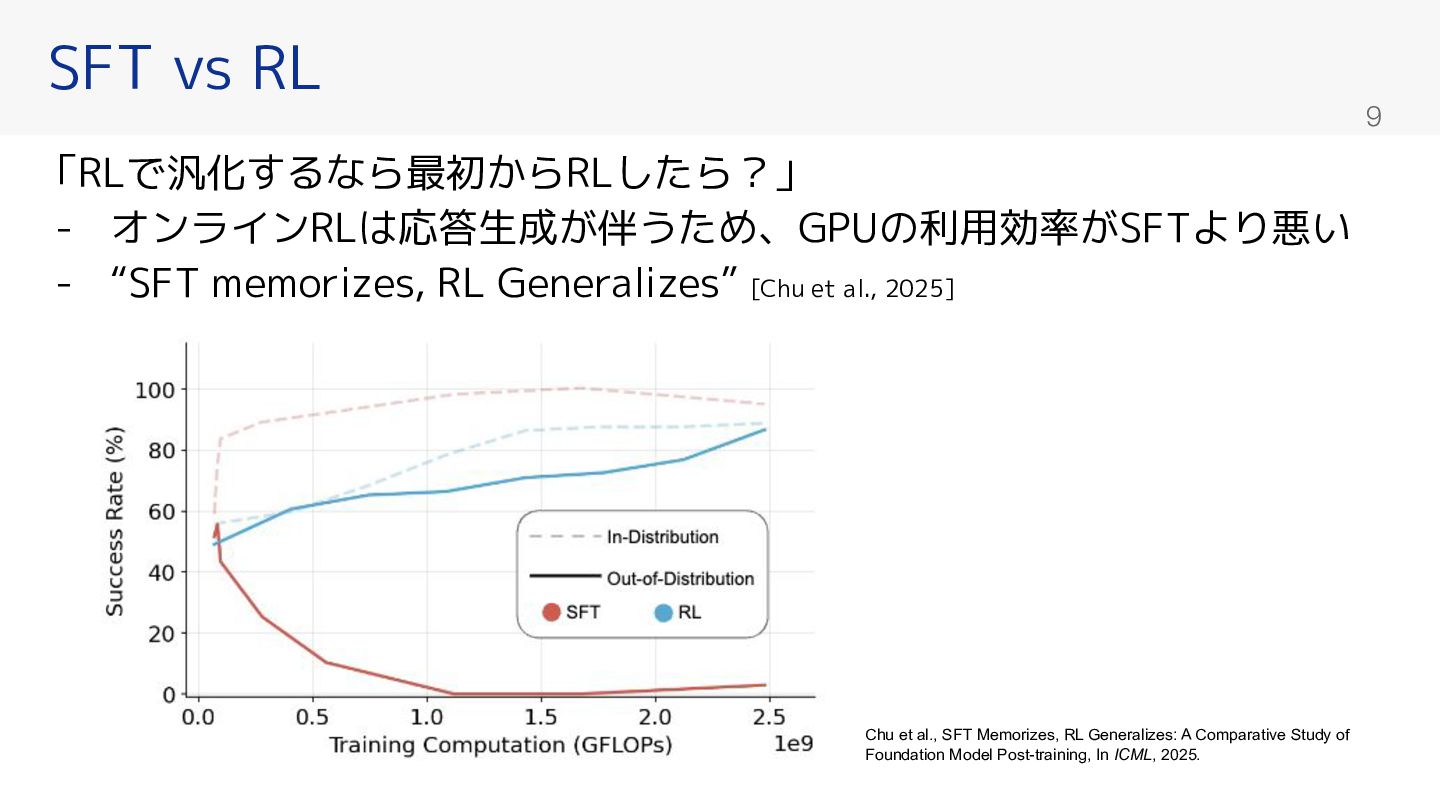
SFT vs RL 9 「RLで汎化するなら最初からRLしたら?」 - オンラインRLは応答生成が伴うため、GPUの利用効率がSFTより悪い - “SFT memorizes,
RL Generalizes” [Chu et al., 2025] Chu et al., SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training, In ICML, 2025.

 SiteGround - Reliable hosting with speed, security, and support you can count on.


 pfn
 ludicmind
 moznion
 yamanoku
 yahonda
 iktakahiro
 namiki64
 ezaki
 kairim0
 odashi
 genda
 bitkey
 kenichiodo
 notwaldorf
 aleyda
 kristinabergwall1
 maltzj
 427marketing
 addyosmani
 bkeepers
 stuffmc
 takai
 destraynor
 mfonobong