Share
Embed
国産生成AI PLaMoを支える事後学習と推論最適化
国産生成AI PLaMoの開発になぜ我々Preferred Networksが取り組むのか、また先日公開したPLaMo 3.0 Prime Betaの開発に向けた事後学習・推論最適化の取り組みについて技術詳細をご紹介します。

Preferred Networks PRO
April 05, 2026
Transcript
73 slides
-
国産生成AI PLaMoを支える 事後学習と推論最適化 Hideaki Imamura@PLaMo Post-training Team, LLM Dev Department,
Preferred Networks, Inc Shinichi Hemmi@InferenceOpt Team, LLM Dev Department, Preferred Networks, Inc -
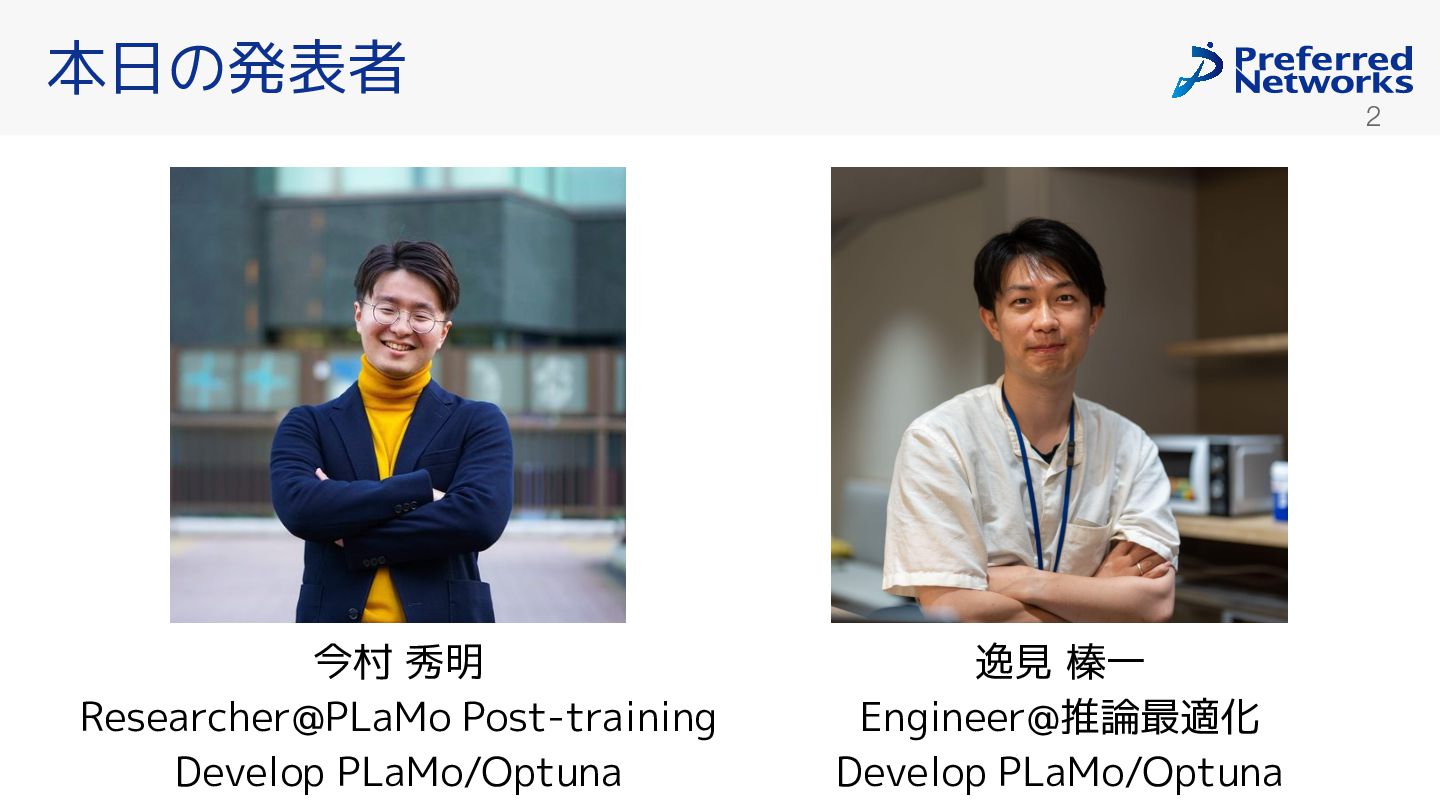
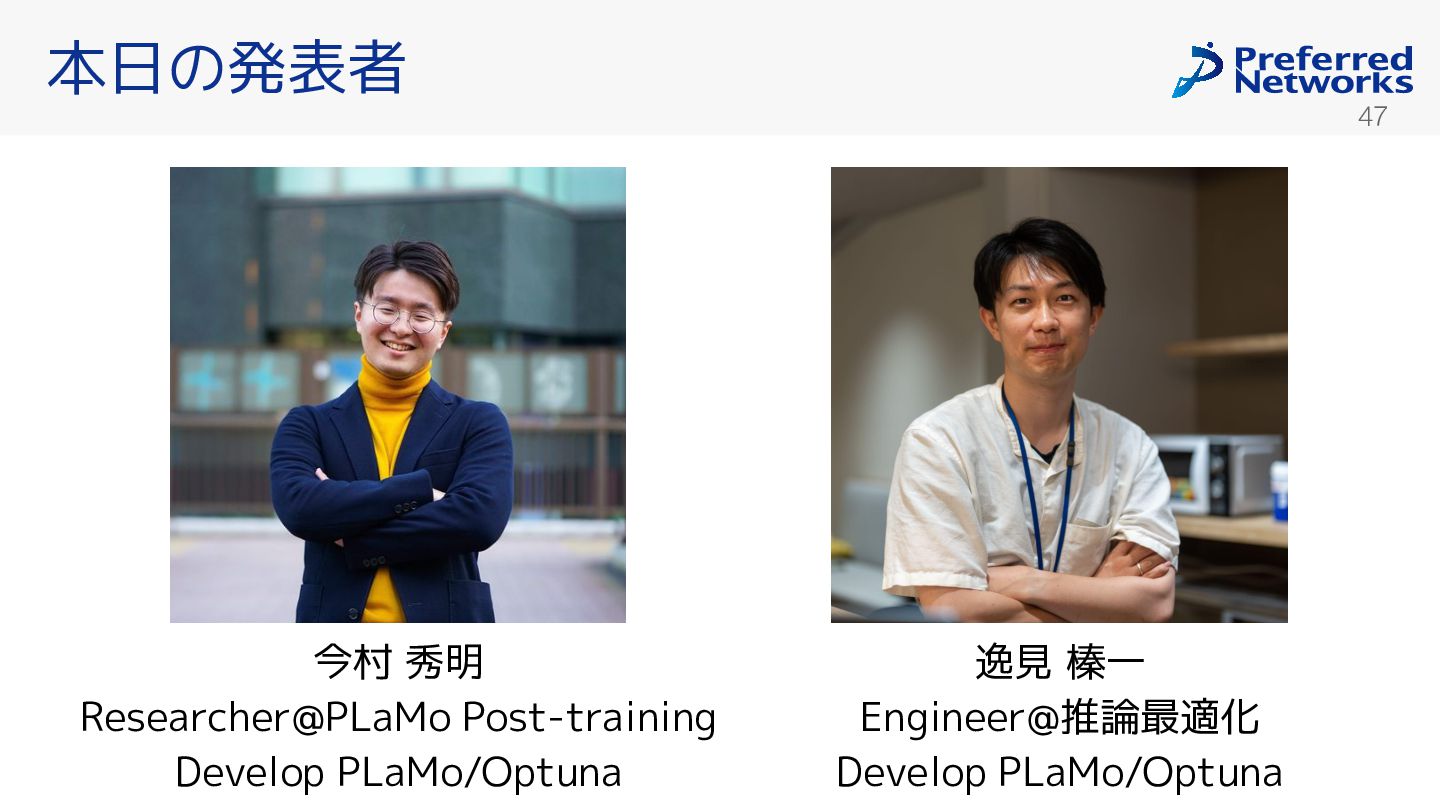
2 今村 秀明 Researcher@PLaMo Post-training Develop PLaMo/Optuna 本日の発表者 逸見 榛一
Engineer@推論最適化 Develop PLaMo/Optuna -
3 • 国産生成AI PLaMoとは • PLaMo 3.0 Prime Betaの事後学習 •
PLaMo 3.0 Prime Betaの推論最適化 • QAセッション アジェンダ -
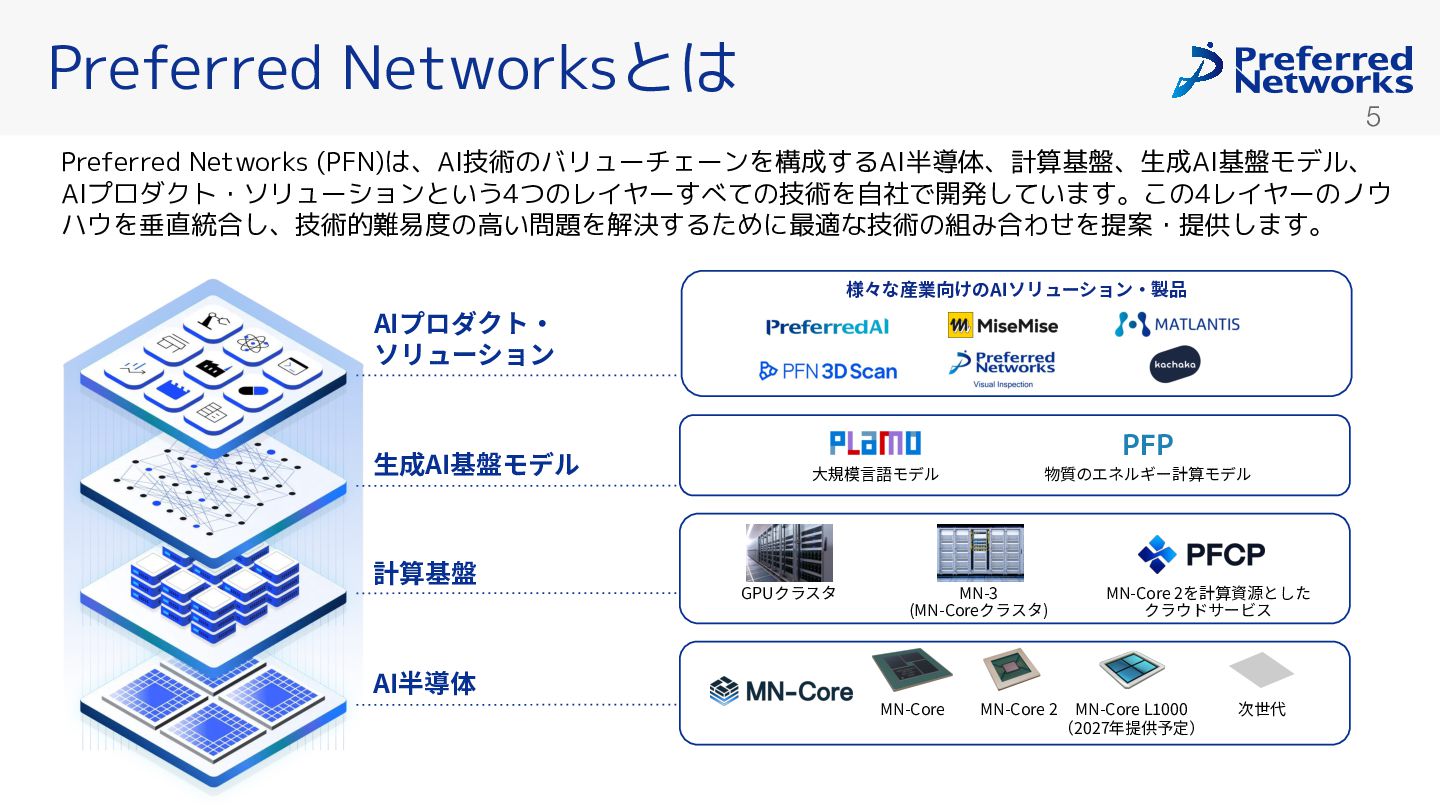
5 Preferred Networksとは AIプロダクト‧ ソリューション 計算基盤 AI半導体 ⽣成AI基盤モデル MN-Core MN-Core
2 GPUクラスタ MN-3 (MN-Coreクラスタ) ⼤規模⾔語モデル 次世代 MN-Core 2を計算資源とした クラウドサービス 物質のエネルギー計算モデル PFP MN-Core L1000 (2027年提供予定) Preferred Networks (PFN)は、AI技術のバリューチェーンを構成するAI半導体、計算基盤、生成AI基盤モデル、 AIプロダクト・ソリューションという4つのレイヤーすべての技術を自社で開発しています。 の4レイヤーのノウ ハウを垂直統合し、技術的難易度の高い問題を解決するために最適な技術の組み合わせを提案・提供します。 様々な産業向けのAIソリューション‧製品 -
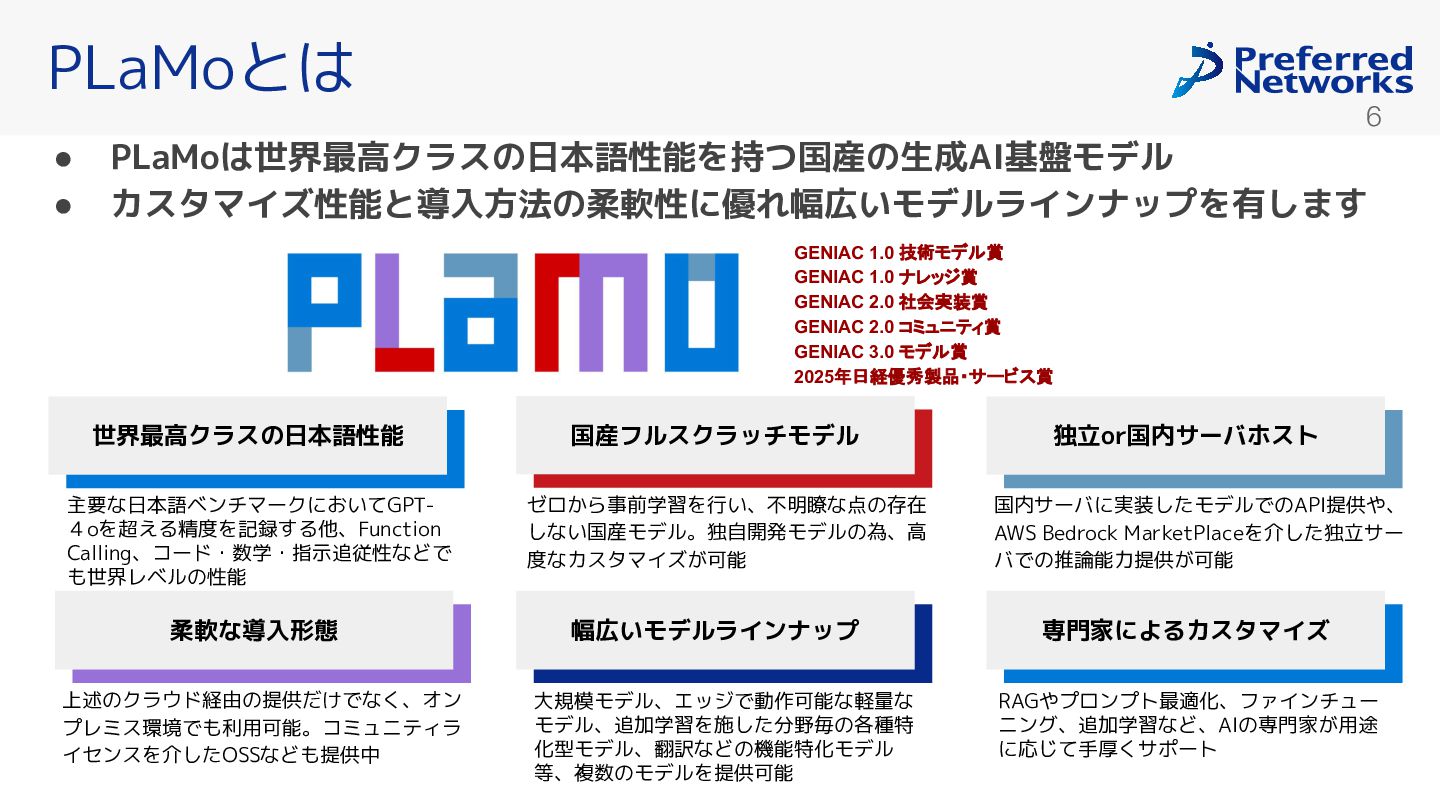
6 PLaMoとは 独立or国内サーバホスト 世界最高クラスの日本語性能 柔軟な導入形態 国内サーバに実装したモデルでのAPI提供や、 AWS Bedrock MarketPlaceを介した独立サー バでの推論能力提供
可能 主要な日本語ベンチマークに いてGPT- 4oを超える精度を記録する他、Function Calling、コード・数学・指示追従性などで も世界レベルの性能 上述のクラウド経由の提供だ でな 、オン プレミス環境でも利用可能。コミュニティラ イセンスを介したOSSなども提供中 専門家によるカスタマイズ RAGやプロンプト最適化、ファインチュー ニング、追加学習など、AIの専門家 用途 に応じて手厚 サポート 幅広いモデルラインナップ 大規模モデル、エッジで動作可能な軽量な モデル、追加学習を施した分野毎の各種特 化型モデル、翻訳などの機能特化モデル 等、複数のモデルを提供可能 • PLaMoは世界最高クラスの日本語性能を持つ国産の生成AI基盤モデル • カスタマイズ性能と導入方法の柔軟性に優れ幅広いモデルラインナップを有します 国産フルスクラッチモデル ゼロ ら事前学習を行い、不明瞭な点の存在 しない国産モデル。独自開発モデルの為、高 度なカスタマイズ 可能 GENIAC 1.0 技術モデル賞 GENIAC 1.0 ナレッジ賞 GENIAC 2.0 社会実装賞 GENIAC 2.0 コミュニティ賞 GENIAC 3.0 モデル賞 2025年日経優秀製品・サービス賞 -
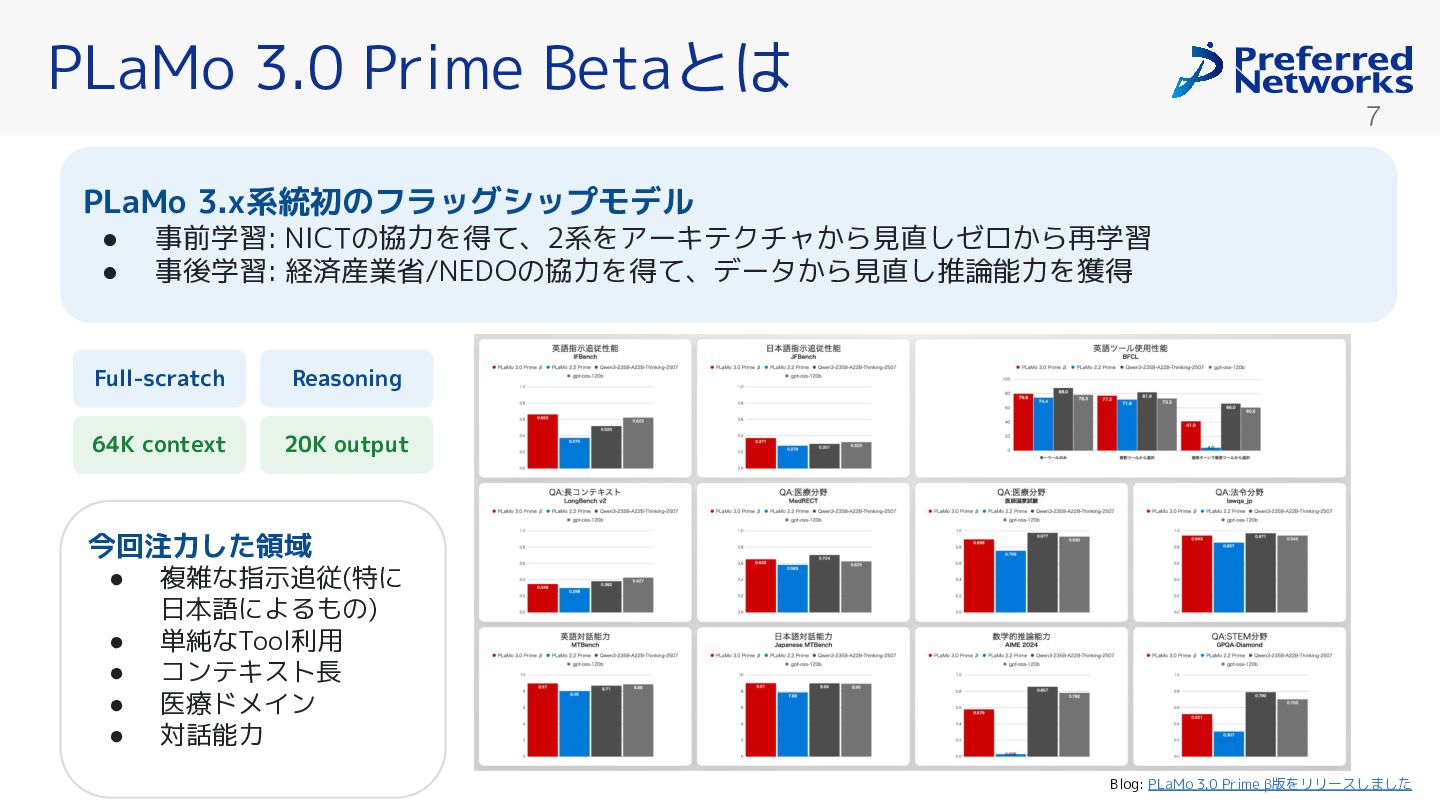
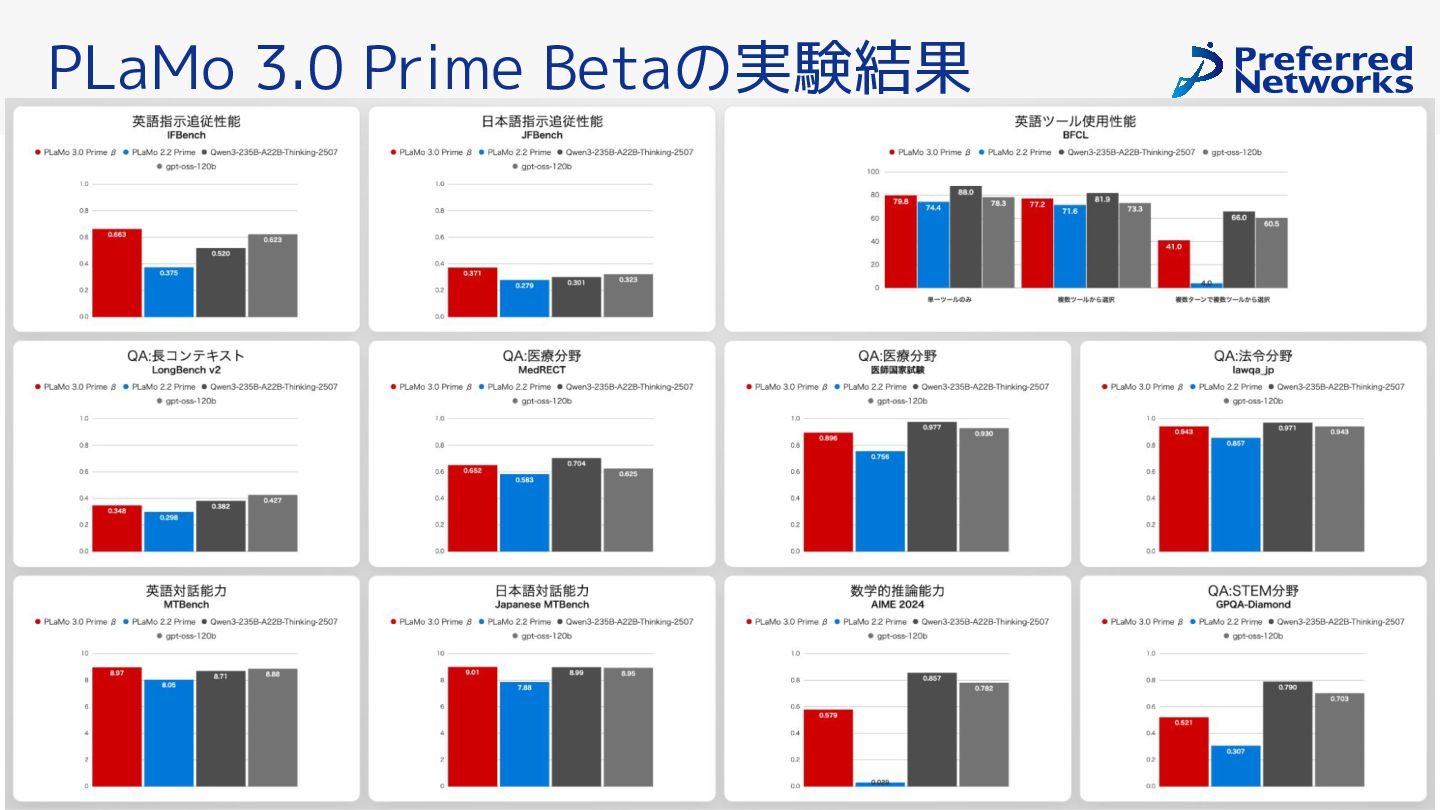
7 PLaMo 3.0 Prime Betaとは PLaMo 3.x系統初のフラッグシップモデル • 事前学習: NICTの協力を得て、2系をアーキテクチャ
ら見直しゼロ ら再学習 • 事後学習: 経済産業省/NEDOの協力を得て、データ ら見直し推論能力を獲得 Full-scratch Reasoning 64K context 20K output 今回注力した領域 • 複雑な指示追従(特に 日本語によるもの) • 単純なTool利用 • コンテキスト長 • 医療ドメイン • 対話能力 Blog: PLaMo 3.0 Prime β版をリリースしました -
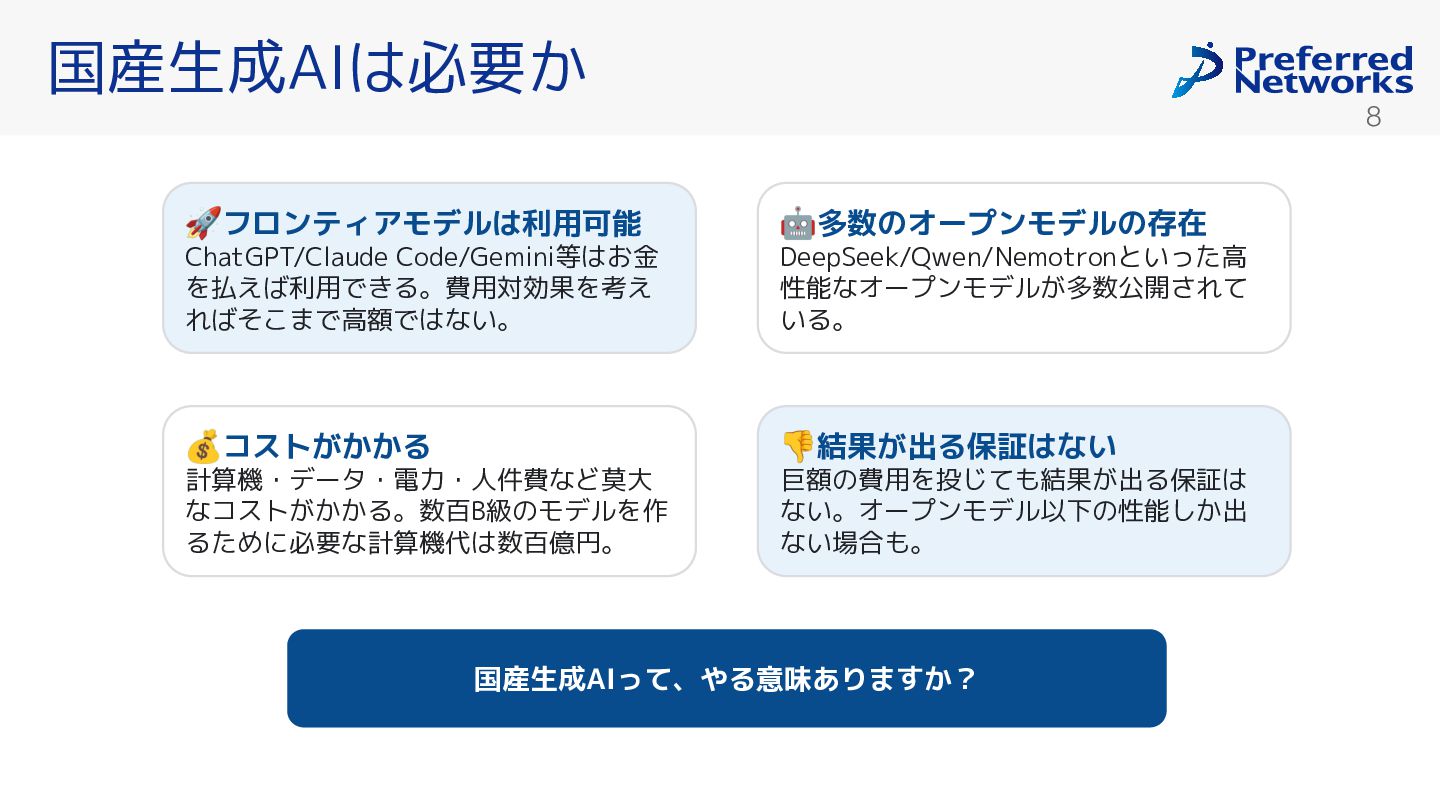
8 国産生成AIは必要 🚀フロンティアモデルは利用可能 ChatGPT/Claude Code/Gemini等は 金 を払えば利用で る。費用対効果を考え ればそ まで高額ではない。
🤖多数のオープンモデルの存在 DeepSeek/Qwen/Nemotronといった高 性能なオープンモデル 多数公開 れて いる。 💰コストがかかる 計算機・データ・電力・人件費など莫大 なコスト る。数百B級のモデルを作 るために必要な計算機代は数百億円。 👎結果が出る保証はない 巨額の費用を投じても結果 出る保証は ない。オープンモデル以下の性能し 出 ない場合も。 国産生成AIって、やる意味ありますか? -
9 我々はど にいる その他 韓国, UAE, フランス, 日本, ... 中国
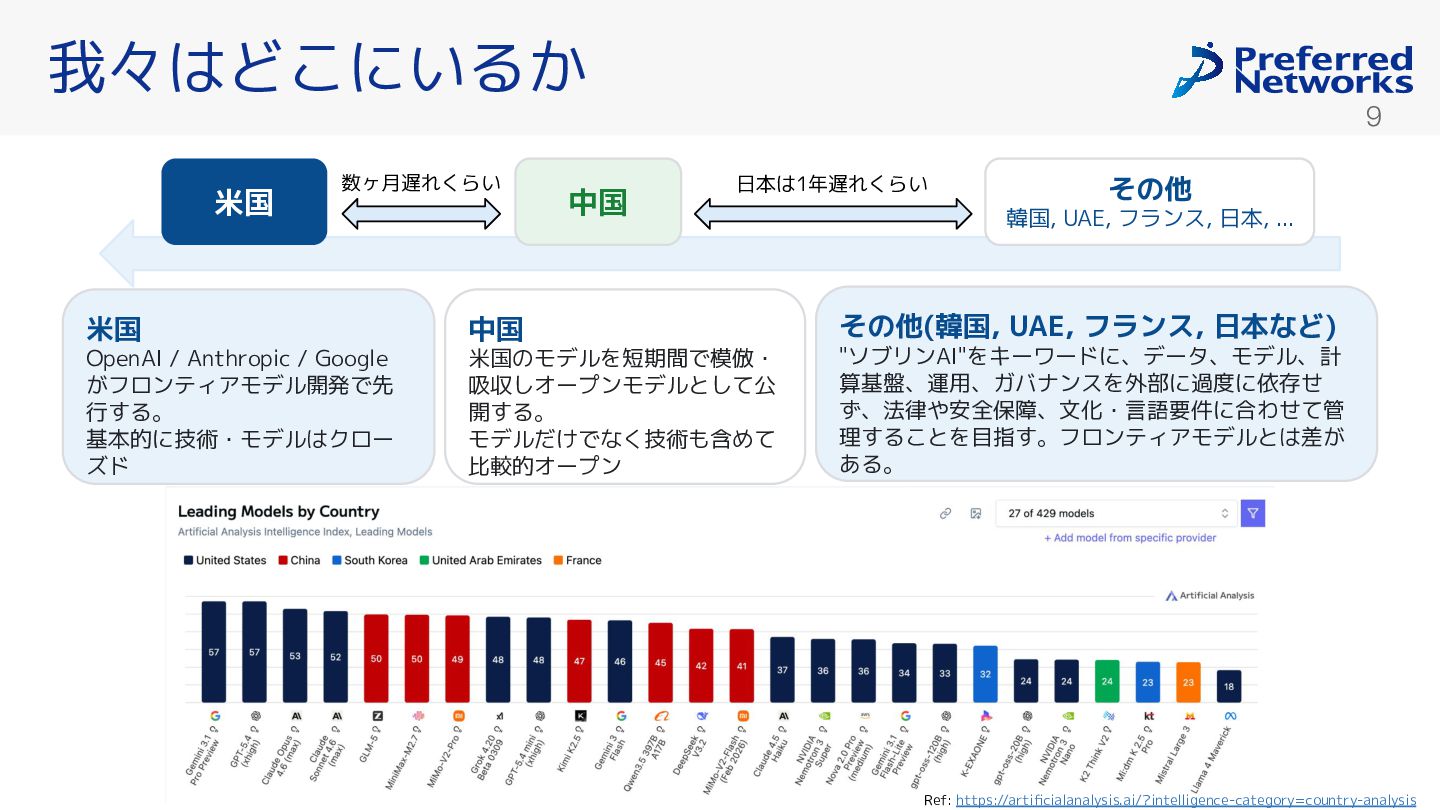
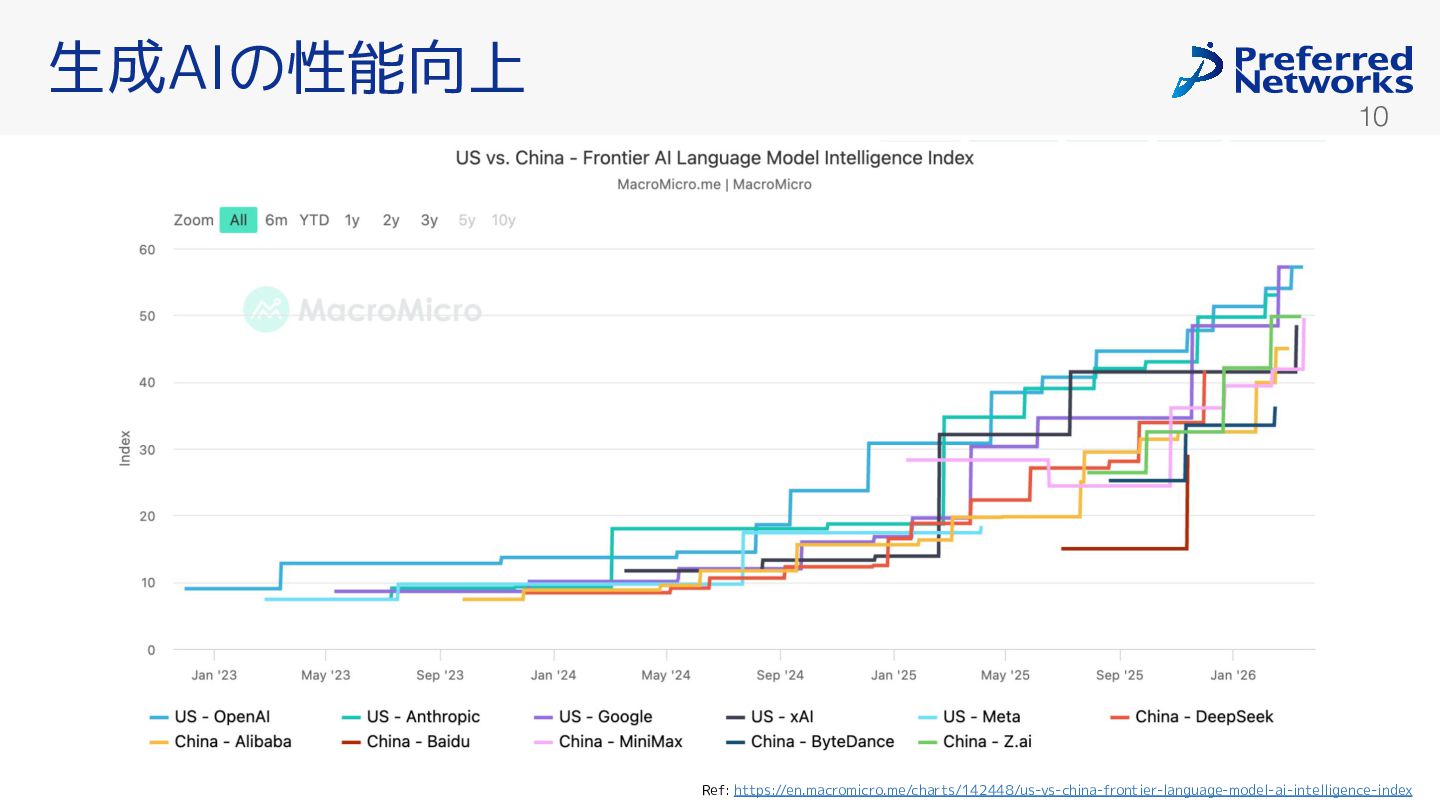
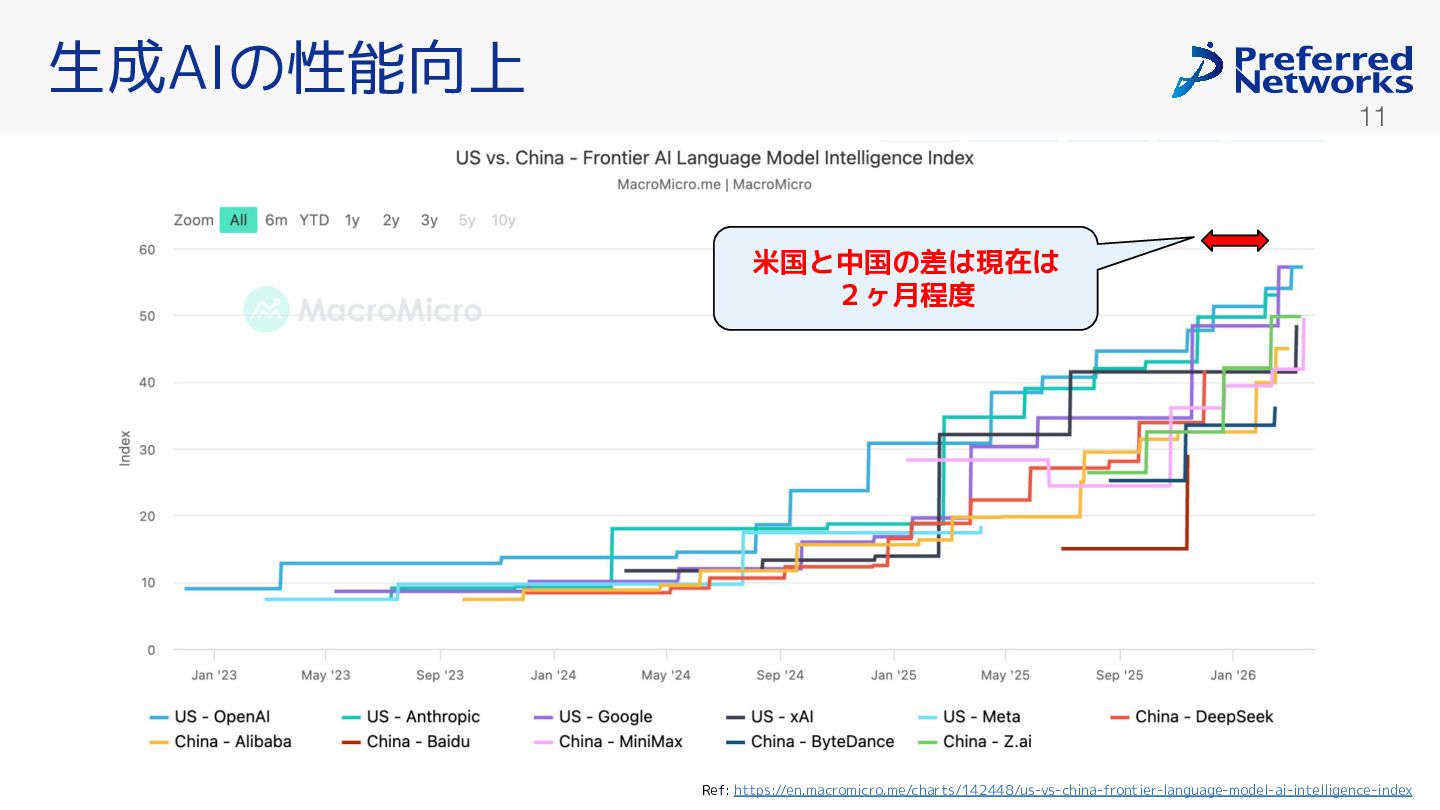
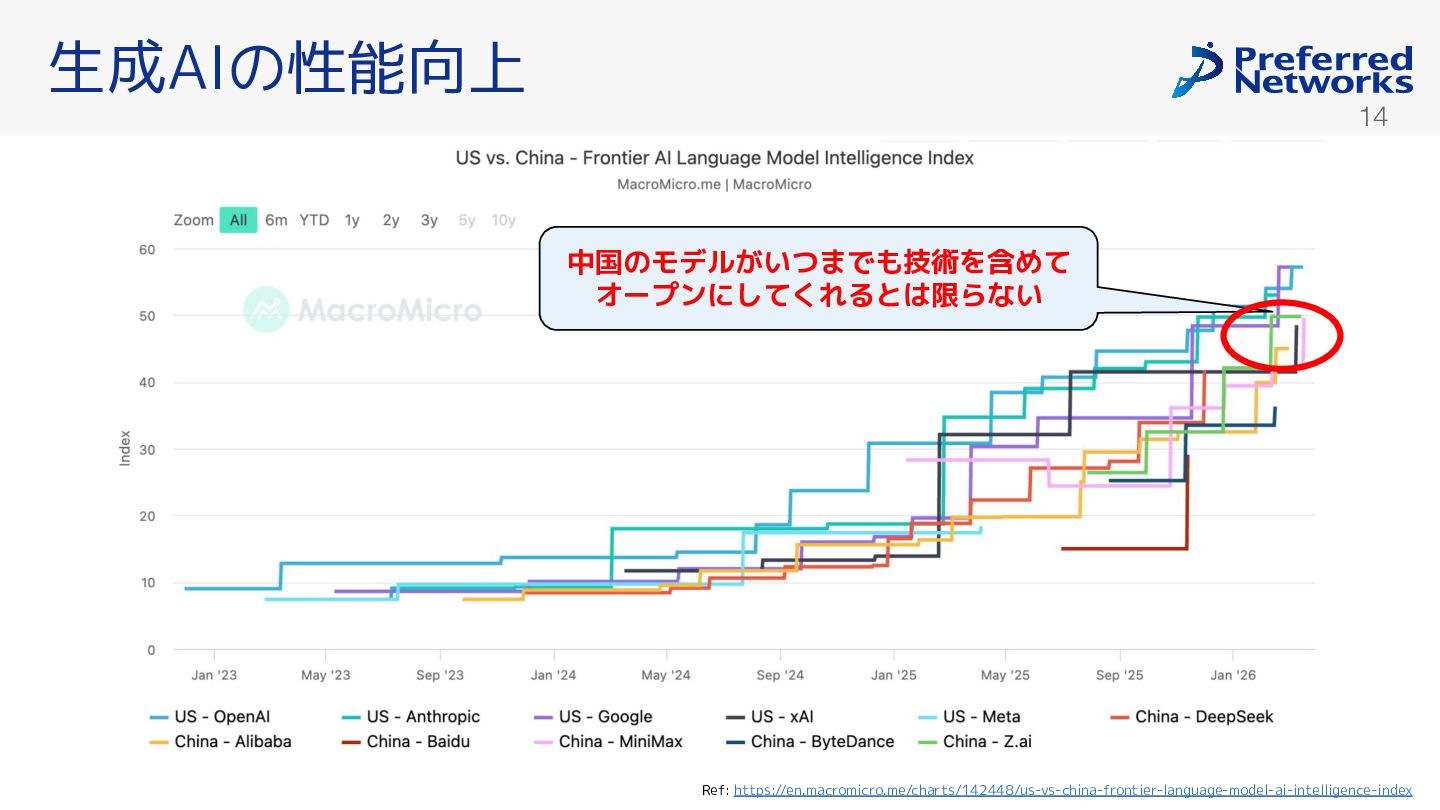
米国 その他(韓国, UAE, フランス, 日本など) "ソブリンAI"をキーワードに、データ、モデル、計 算基盤、運用、ガバナンスを外部に過度に依存せ ず、法律や安全保障、文化・言語要件に合わせて管 理する とを目指す。フロンティアモデルとは差 ある。 中国 米国のモデルを短期間で模倣・ 吸収しオープンモデルとして公 開する。 モデルだ でな 技術も含めて 比較的オープン 米国 OpenAI / Anthropic / Google フロンティアモデル開発で先 行する。 基本的に技術・モデルはクロー ズド 日本は1年遅れ らい 数ヶ月遅れ らい Ref: https://artificialanalysis.ai/?intelligence-category=country-analysis -
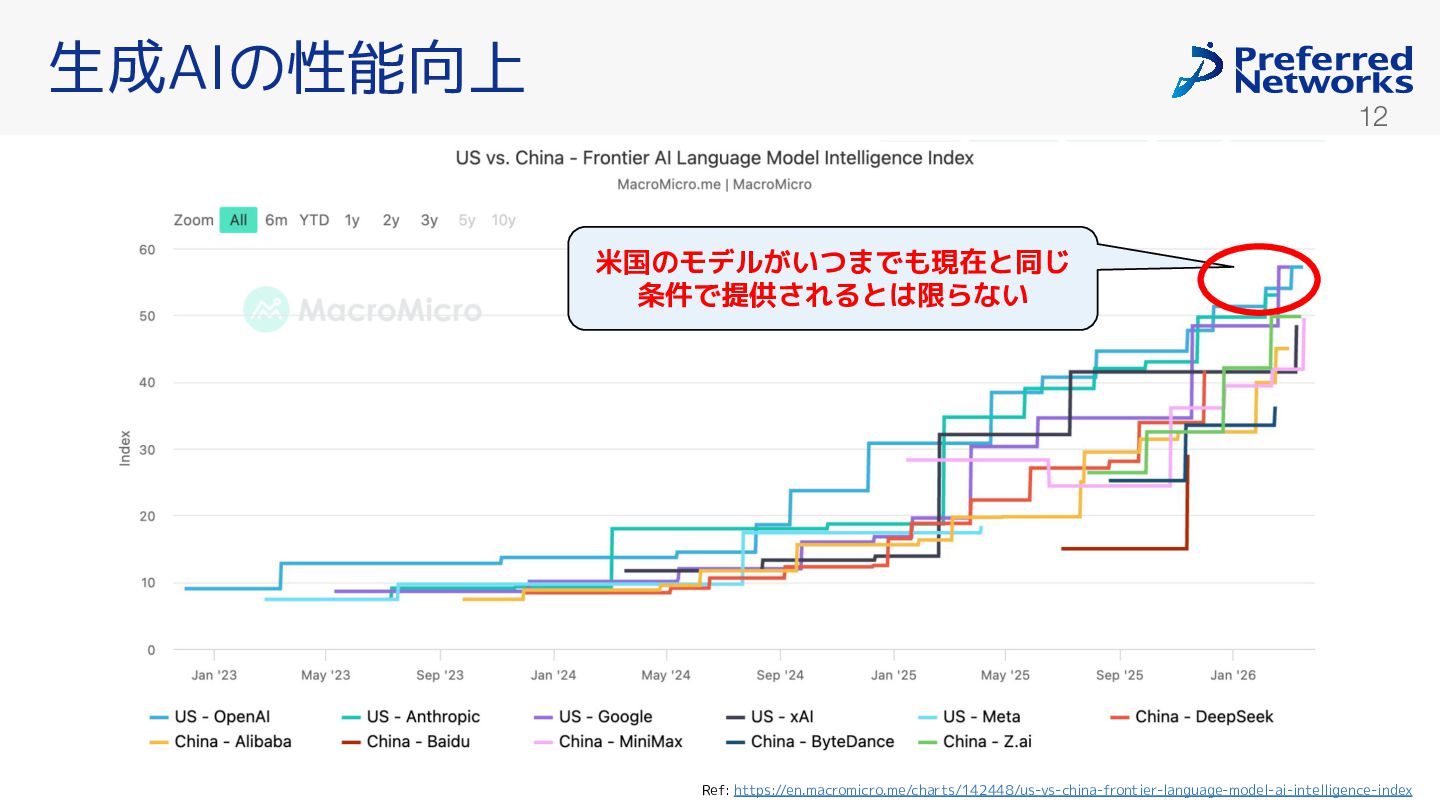
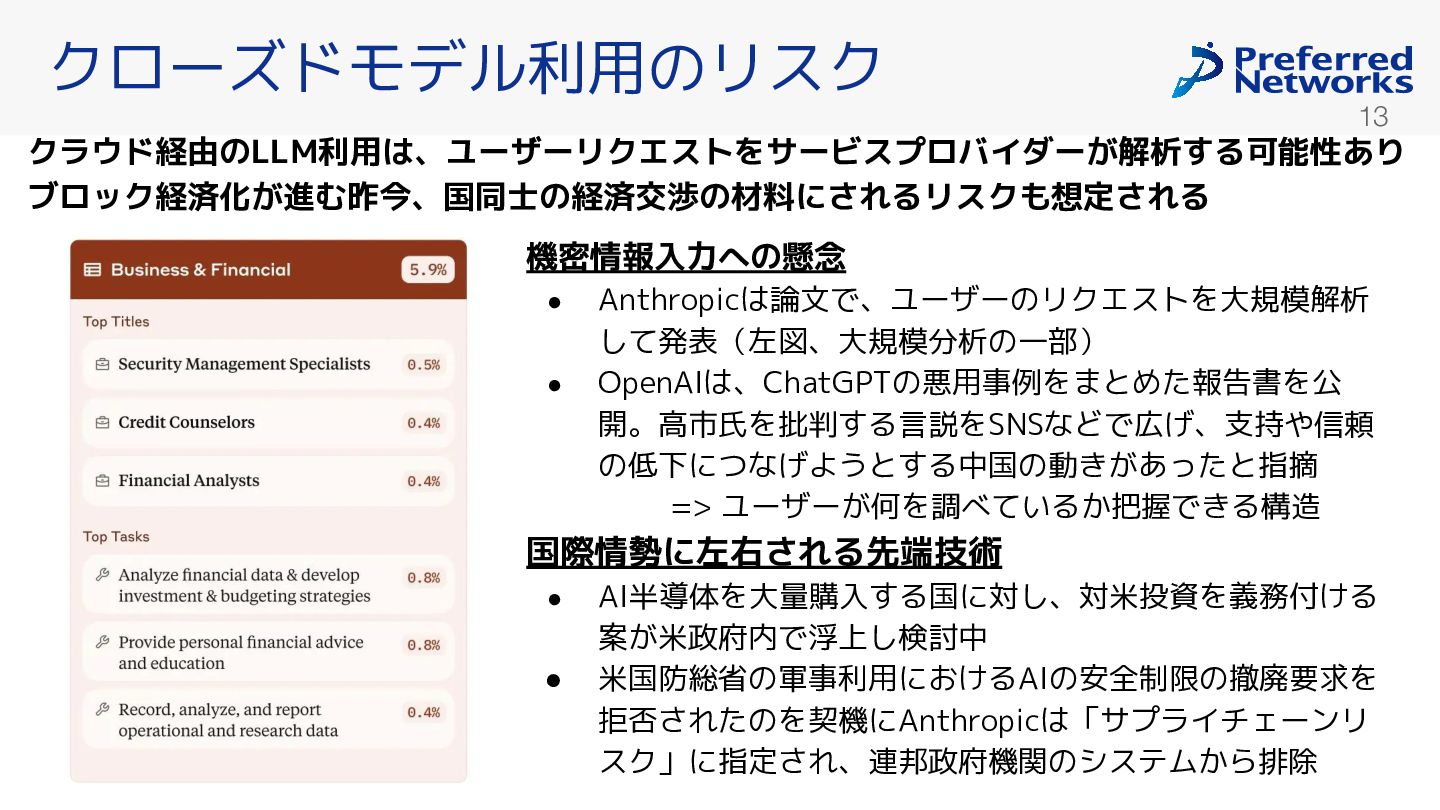
13 クローズドモデル利用のリスク クラウド経由のLLM利用は、ユーザーリクエストをサービスプロバイダーが解析する可能性あり ブロック経済化が進む昨今、国同士の経済交渉の材料にされるリスクも想定される 機密情報入力への懸念 • Anthropicは論文で、ユーザーのリクエストを大規模解析 して発表(左図、大規模分析の一部) • OpenAIは、ChatGPTの悪用事例をまとめた報告書を公
開。高市氏を批判する言説をSNSなどで広 、支持や信頼 の低下につな ようとする中国の動 あったと指摘 => ユーザー 何を調べている 把握で る構造 国際情勢に左右される先端技術 • AI半導体を大量購入する国に対し、対米投資を義務付 る 案 米政府内で浮上し検討中 • 米国防総省の軍事利用に るAIの安全制限の撤廃要求を 拒否 れたのを契機にAnthropicは「サプライチェーンリ スク」に指定 れ、連邦政府機関のシステム ら排除 -
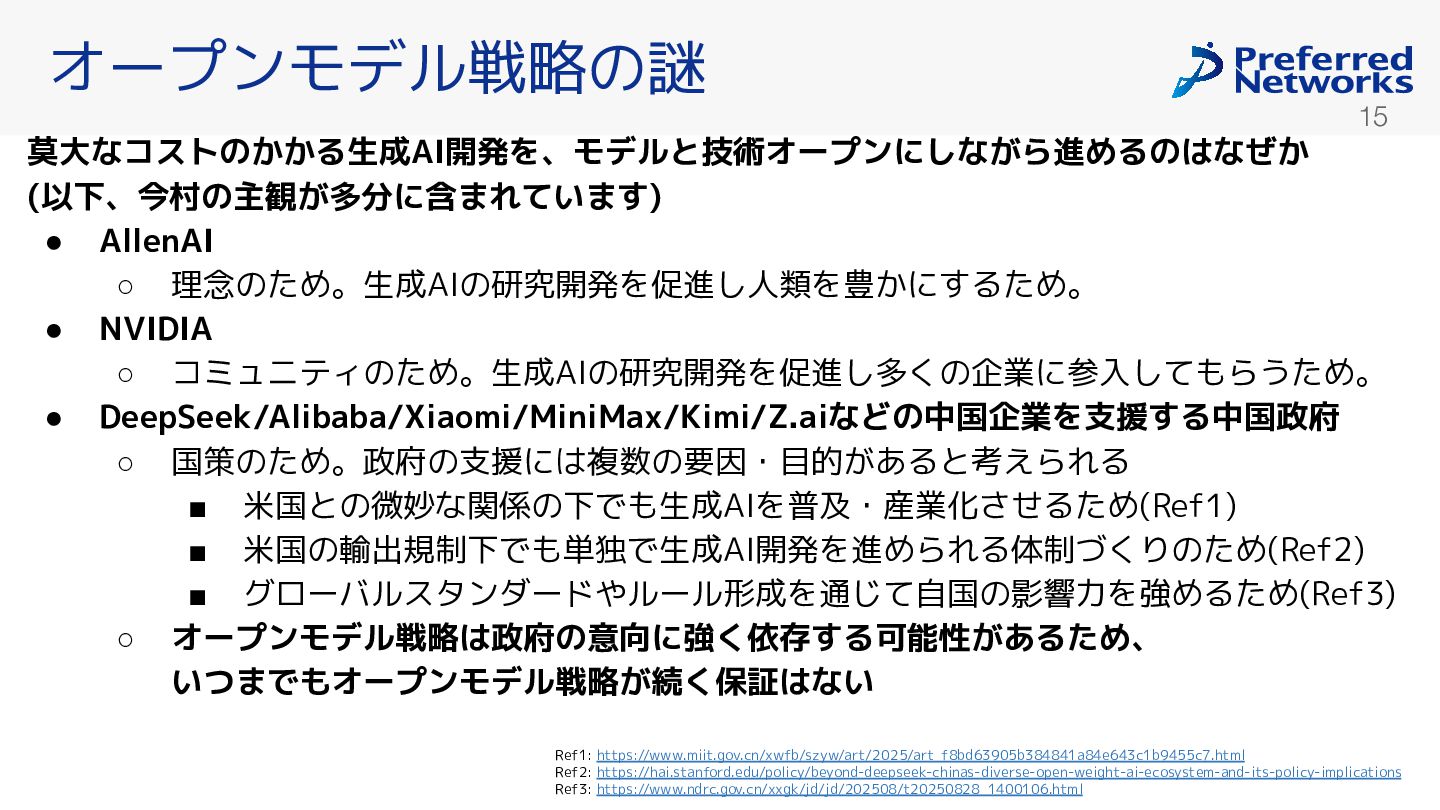
15 オープンモデル戦略の謎 莫大なコストのかかる生成AI開発を、モデルと技術オープンにしながら進めるのはなぜか (以下、今村の主観が多分に含まれています) • AllenAI ◦ 理念のため。生成AIの研究開発を促進し人類を豊 にするため。 •
NVIDIA ◦ コミュニティのため。生成AIの研究開発を促進し多 の企業に参入してもらうため。 • DeepSeek/Alibaba/Xiaomi/MiniMax/Kimi/Z.aiなどの中国企業を支援する中国政府 ◦ 国策のため。政府の支援には複数の要因・目的 あると考えられる ▪ 米国との微妙な関係の下でも生成AIを普及・産業化 せるため(Ref1) ▪ 米国の輸出規制下でも単独で生成AI開発を進められる体制づ りのため(Ref2) ▪ グローバルスタンダードやルール形成を通じて自国の影響力を強めるため(Ref3) ◦ オープンモデル戦略は政府の意向に強く依存する可能性があるため、 いつまでもオープンモデル戦略が続く保証はない Ref1: https://www.miit.gov.cn/xwfb/szyw/art/2025/art_f8bd63905b384841a84e643c1b9455c7.html Ref2: https://hai.stanford.edu/policy/beyond-deepseek-chinas-diverse-open-weight-ai-ecosystem-and-its-policy-implications Ref3: https://www.ndrc.gov.cn/xxgk/jd/jd/202508/t20250828_1400106.html -
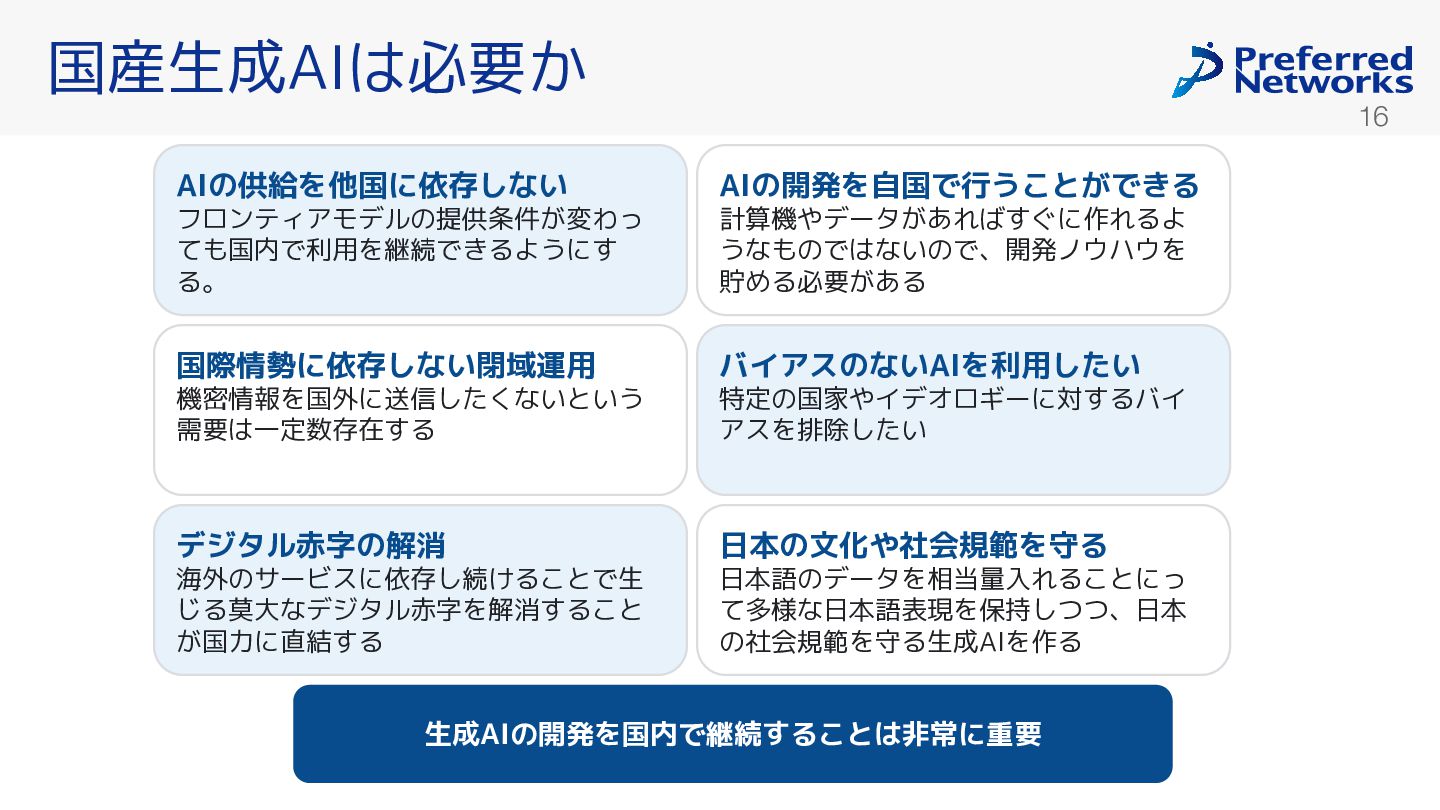
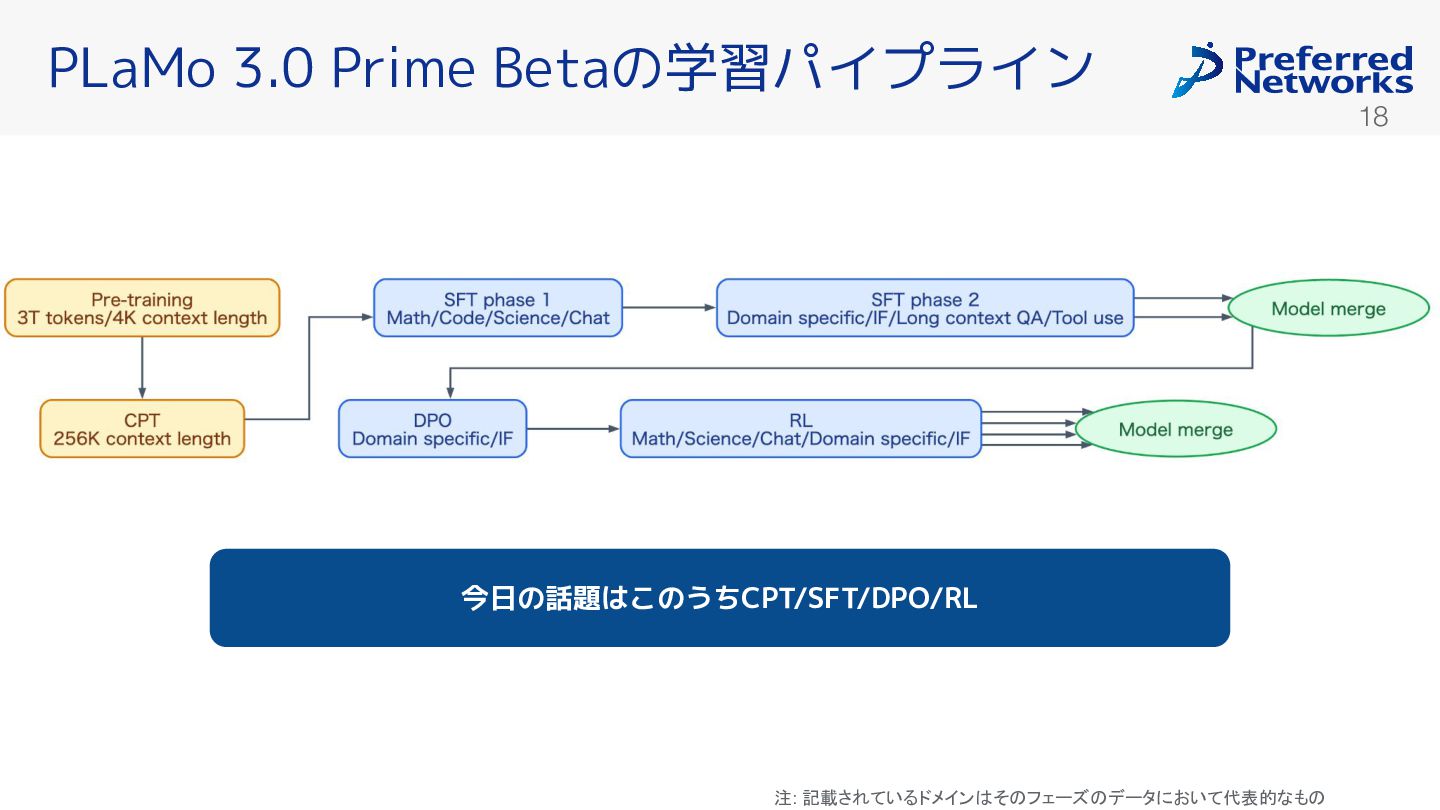
16 国産生成AIは必要 AIの供給を他国に依存しない フロンティアモデルの提供条件 変わっ ても国内で利用を継続で るようにす る。 AIの開発を自国で行うことができる 計算機やデータ
あればす に作れるよ うなものではないので、開発ノウハウを 貯める必要 ある 国際情勢に依存しない閉域運用 機密情報を国外に送信した ないという 需要は一定数存在する バイアスのないAIを利用したい 特定の国家やイデオロギーに対するバイ アスを排除したい 生成AIの開発を国内で継続することは非常に重要 デジタル赤字の解消 海外のサービスに依存し続 る とで生 じる莫大なデジタル赤字を解消する と 国力に直結する 日本の文化や社会規範を守る 日本語のデータを相当量入れる とにっ て多様な日本語表現を保持しつつ、日本 の社会規範を守る生成AIを作る -
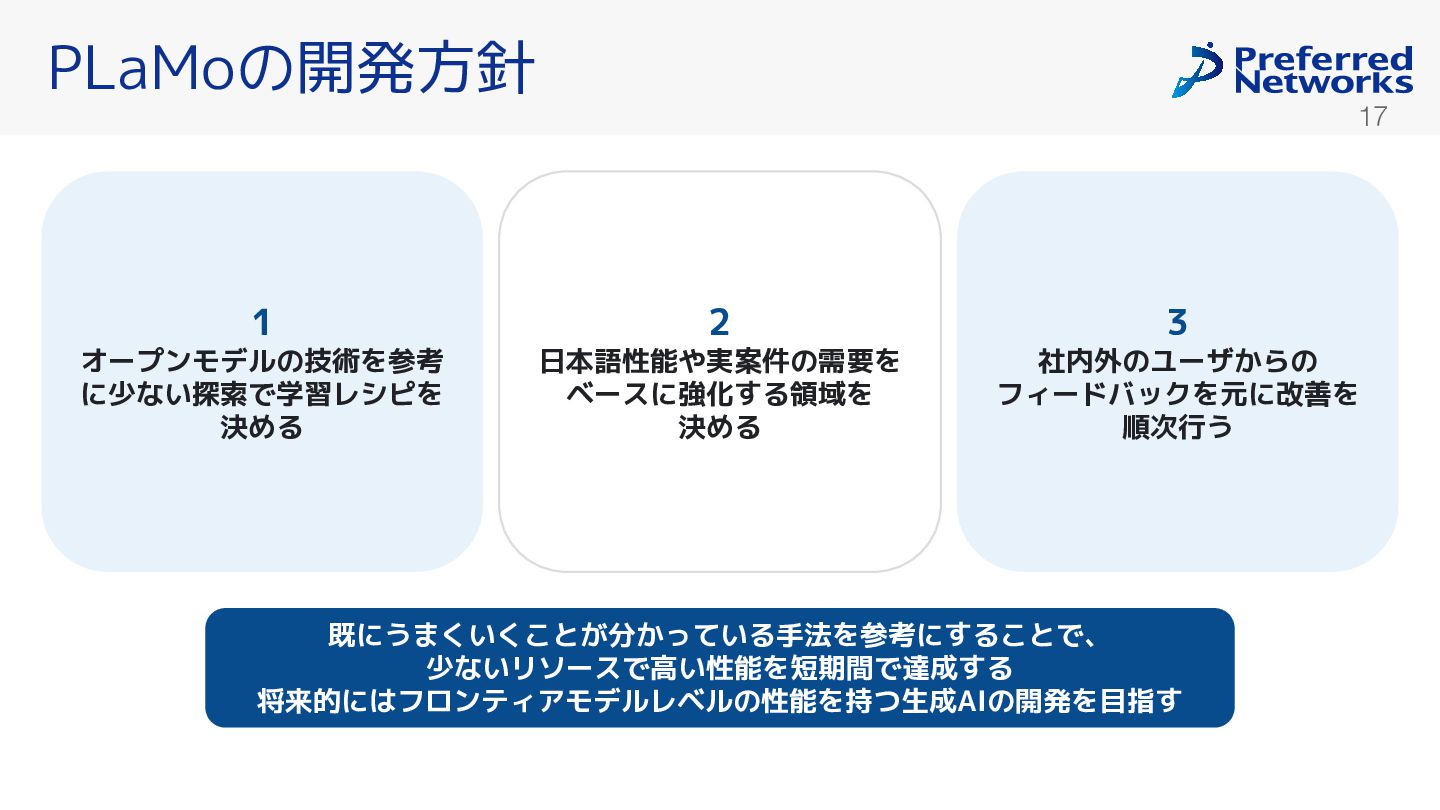
17 PLaMoの開発方針 1 オープンモデルの技術を参考 に少ない探索で学習レシピを 決める 2 日本語性能や実案件の需要を ベースに強化する領域を 決める
3 社内外のユーザからの フィードバックを元に改善を 順次行う 既にうまくいくことが分かっている手法を参考にすることで、 少ないリソースで高い性能を短期間で達成する 将来的にはフロンティアモデルレベルの性能を持つ生成AIの開発を目指す -
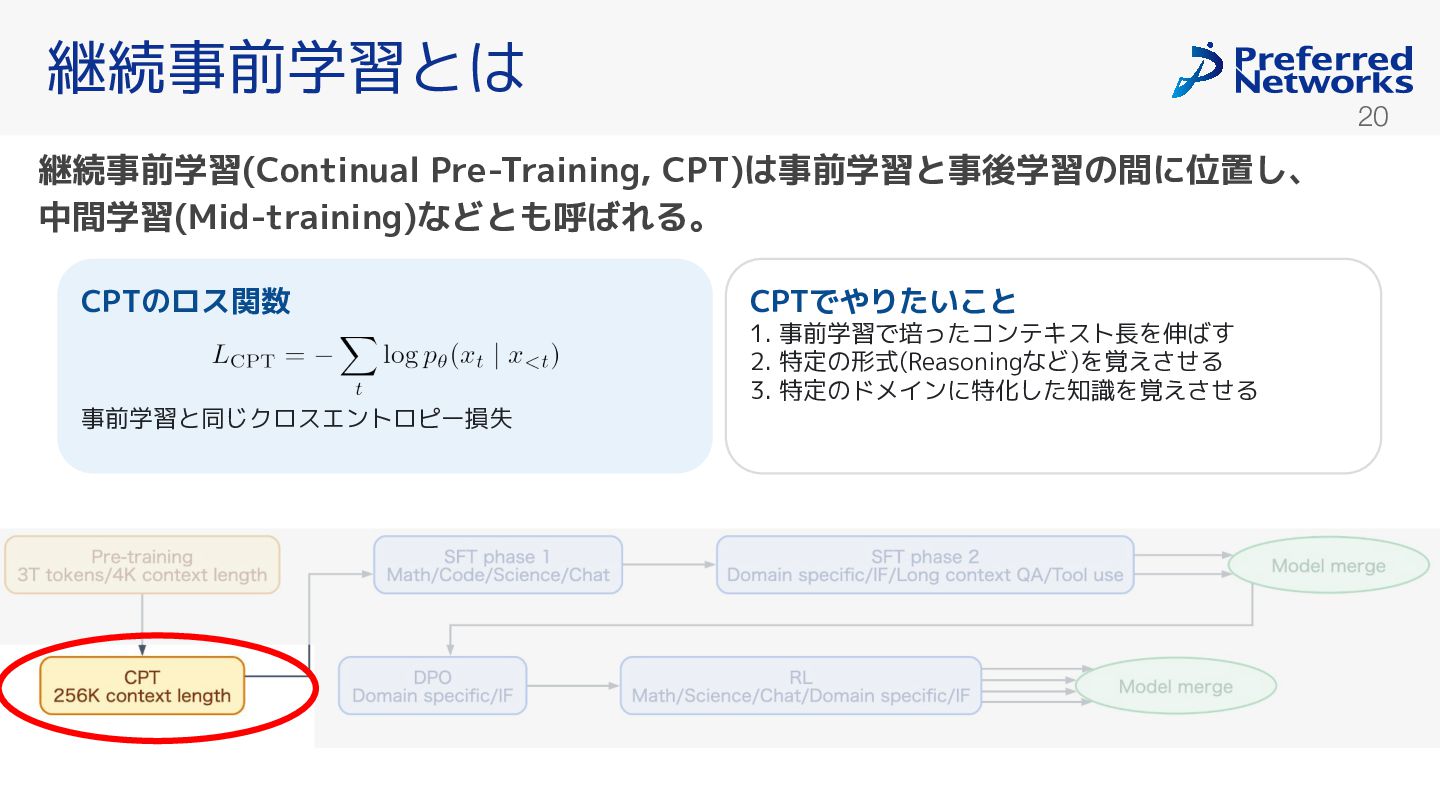
20 継続事前学習とは CPTのロス関数 事前学習と同じクロスエントロピー損失 CPTでやりたいこと 1. 事前学習で培ったコンテキスト長を伸ばす 2. 特定の形式(Reasoningなど)を覚え せる
3. 特定のドメインに特化した知識を覚え せる 継続事前学習(Continual Pre-Training, CPT)は事前学習と事後学習の間に位置し、 中間学習(Mid-training)などとも呼ばれる。 -
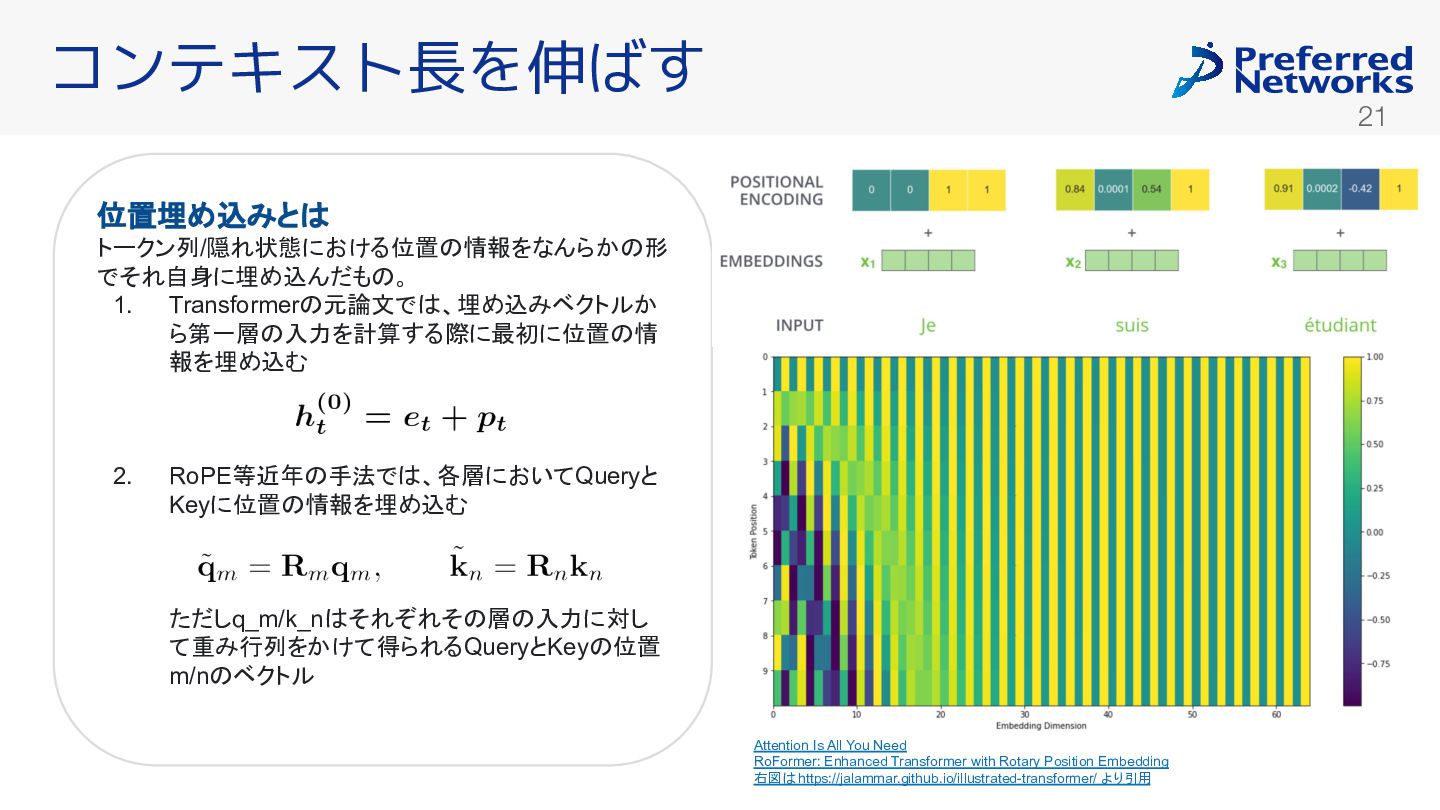
21 コンテキスト長を伸ばす Attention Is All You Need RoFormer: Enhanced Transformer
with Rotary Position Embedding 右図 https://jalammar.github.io/illustrated-transformer/ より引用 位置埋め込みと トークン列/隠れ状態における位置 情報をなんらか 形 でそれ自身に埋め込んだも 。 1. Transformer 元論文で 、埋め込みベクトルか ら第一層 入力を計算する際に最初に位置 情 報を埋め込む 2. RoPE等近年 手法で 、各層においてQueryと Keyに位置 情報を埋め込む ただしq_m/k_n それぞれそ 層 入力に対し て重み行列をかけて得られるQueryとKey 位置 m/n ベクトル -
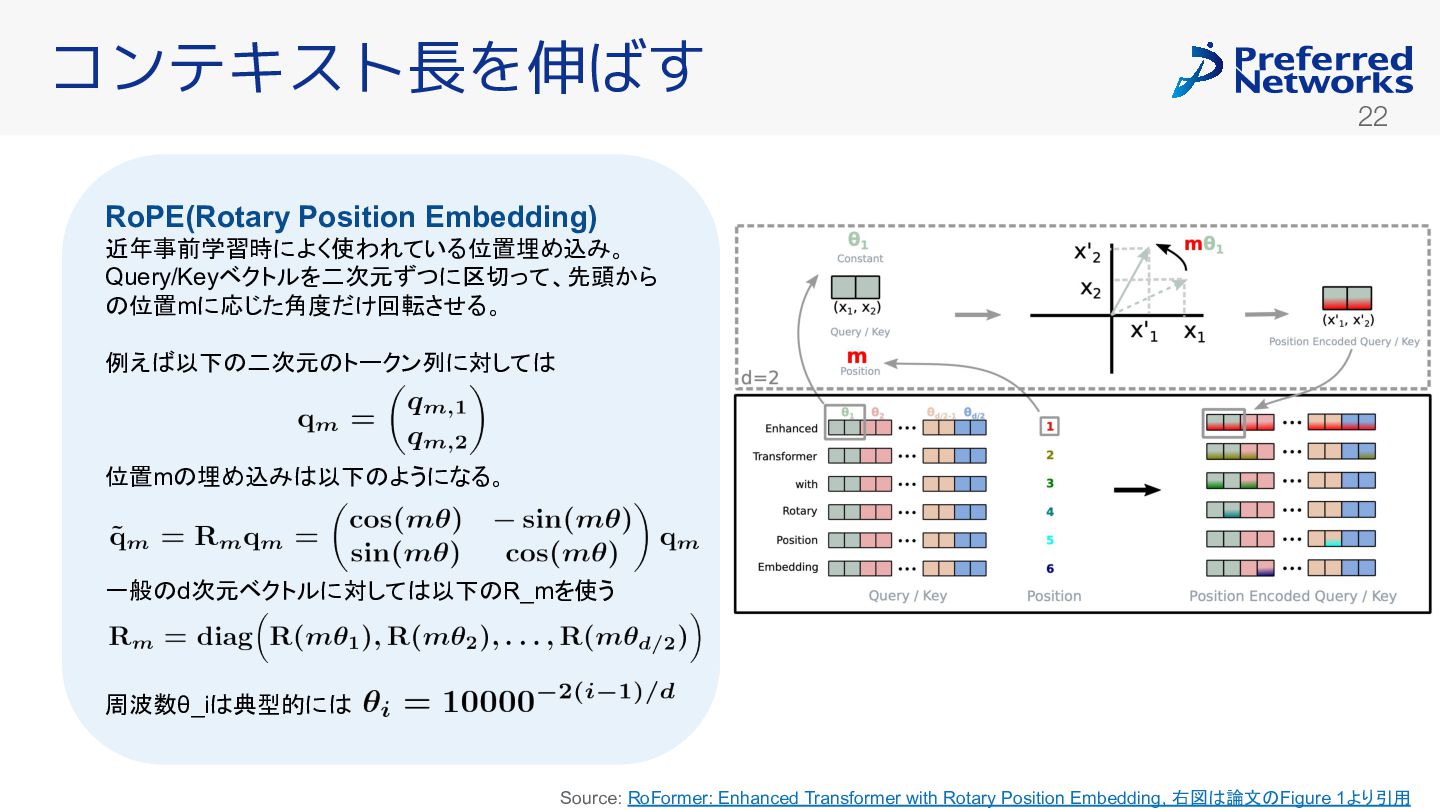
22 コンテキスト長を伸ばす Source: RoFormer: Enhanced Transformer with Rotary Position Embedding,
右図 論文 Figure 1より引用 RoPE(Rotary Position Embedding) 近年事前学習時によく使われている位置埋め込み。 Query/Keyベクトルを二次元ずつに区切って、先頭から 位置mに応じた角度だけ回転させる。 例え 以下 二次元 トークン列に対して 位置m 埋め込み 以下 ようになる。 一般 d次元ベクトルに対して 以下 R_mを使う 周波数θ_i 典型的に -
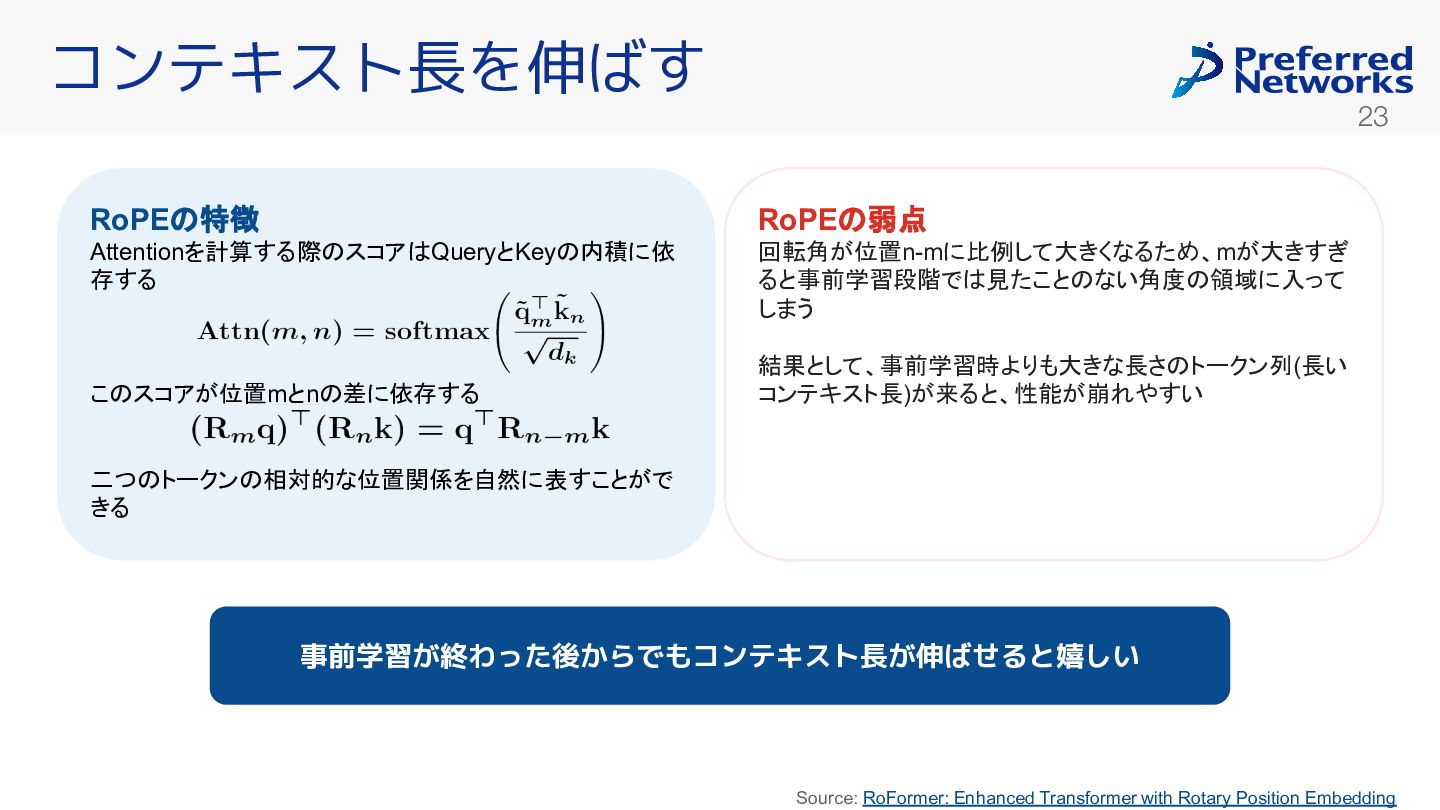
23 コンテキスト長を伸ばす RoPE 特徴 Attentionを計算する際 スコア QueryとKey 内積に依 存する こ
スコアが位置mとn 差に依存する 二つ トークン 相対的な位置関係を自然に表すことがで きる RoPE 弱点 回転角が位置n-mに比例して大きくなるため、mが大きすぎ ると事前学習段階で 見たこと ない角度 領域に入って しまう 結果として、事前学習時よりも大きな長さ トークン列(長い コンテキスト長)が来ると、性能が崩れやすい Source: RoFormer: Enhanced Transformer with Rotary Position Embedding 事前学習が終わった後からでもコンテキスト長が伸ばせると嬉しい -
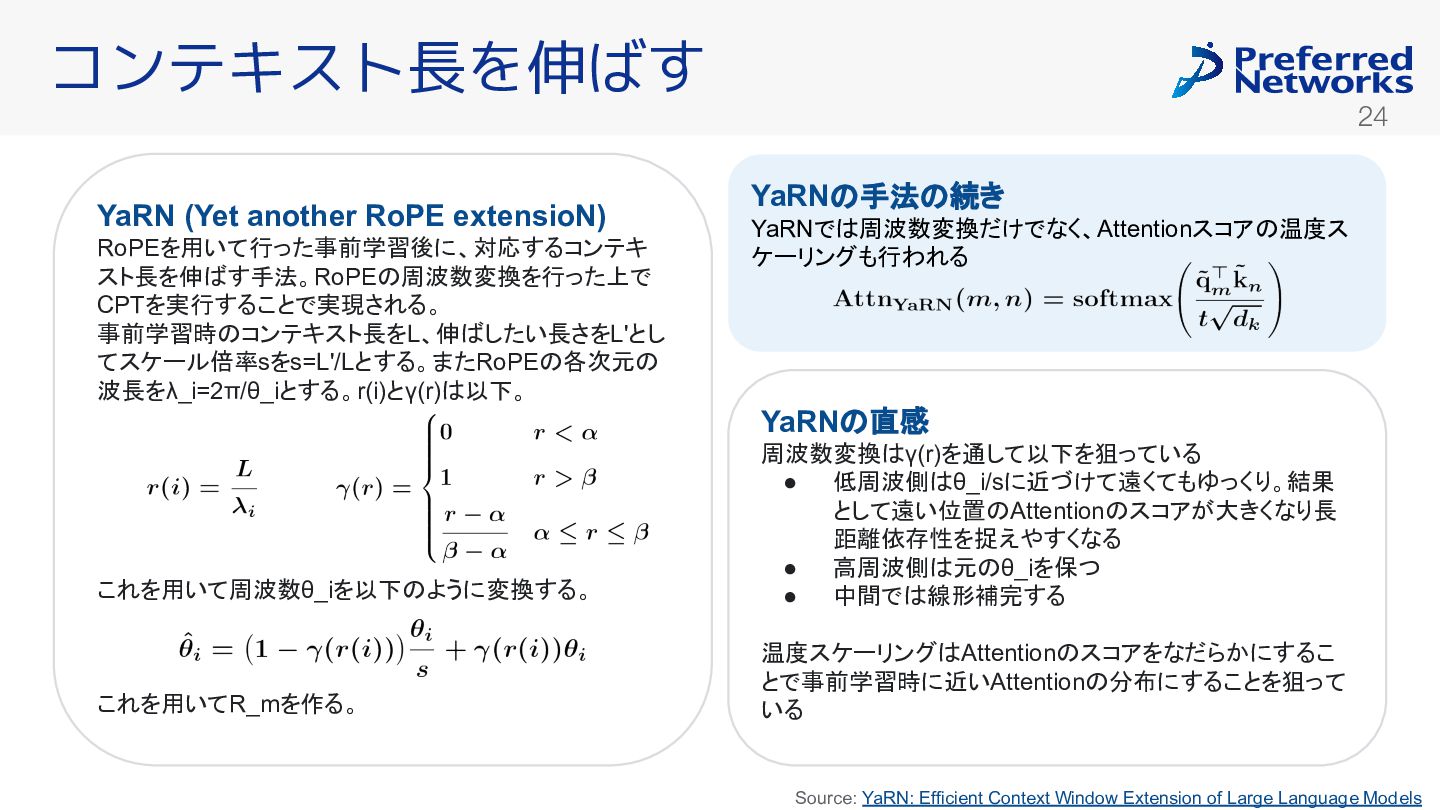
24 コンテキスト長を伸ばす YaRN (Yet another RoPE extensioN) RoPEを用いて行った事前学習後に、対応するコンテキ スト長を伸 す手法。RoPE
周波数変換を行った上で CPTを実行することで実現される。 事前学習時 コンテキスト長をL、伸 したい長さをL'とし てスケール倍率sをs=L'/Lとする。またRoPE 各次元 波長をλ_i=2π/θ_iとする。r(i)とγ(r) 以下。 これを用いて周波数θ_iを以下 ように変換する。 これを用いてR_mを作る。 YaRN 手法 続き YaRNで 周波数変換だけでなく、Attentionスコア 温度ス ケーリングも行われる Source: YaRN: Efficient Context Window Extension of Large Language Models YaRN 直感 周波数変換 γ(r)を通して以下を狙っている • 低周波側 θ_i/sに近づけて遠くてもゆっくり。結果 として遠い位置 Attention スコアが大きくなり長 距離依存性を捉えやすくなる • 高周波側 元 θ_iを保つ • 中間で 線形補完する 温度スケーリング Attention スコアをなだらかにするこ とで事前学習時に近いAttention 分布にすることを狙って いる -
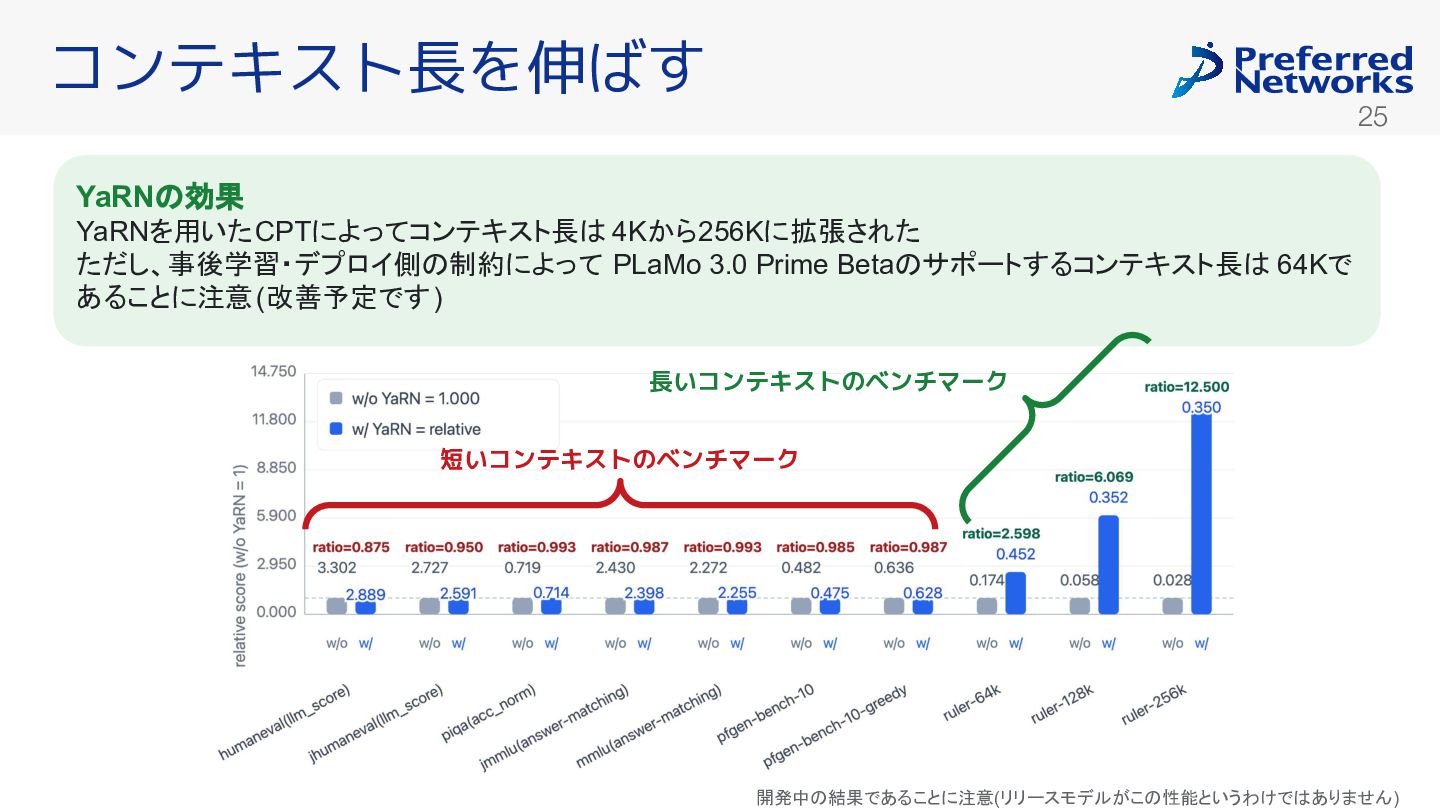
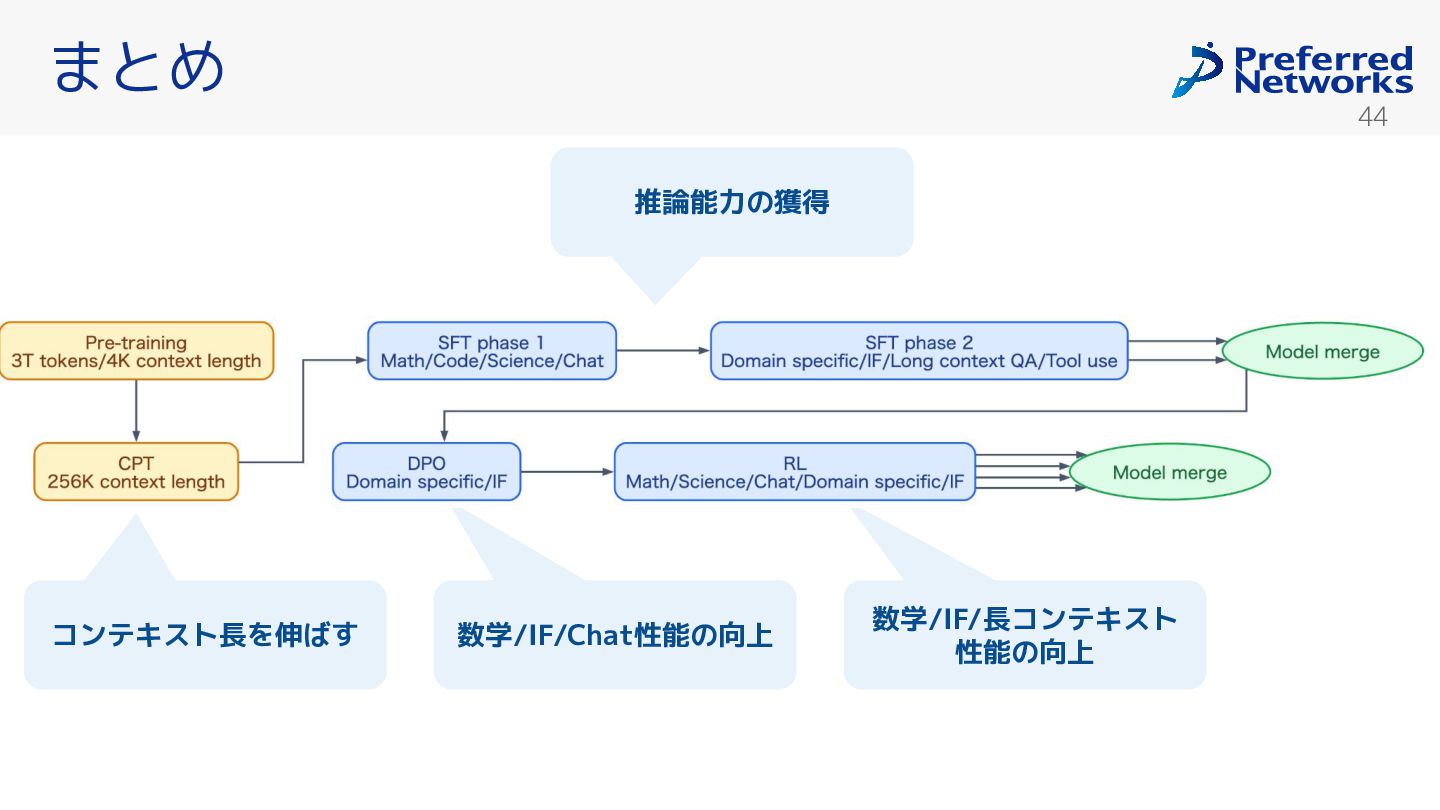
25 コンテキスト長を伸ばす YaRN 効果 YaRNを用いたCPTによってコンテキスト長 4Kから256Kに拡張された ただし、事後学習・デプロイ側 制約によって PLaMo 3.0
Prime Beta サポートするコンテキスト長 64Kで あることに注意(改善予定です) 短いコンテキストのベンチマーク 長いコンテキストのベンチマーク 開発中 結果であることに注意(リリースモデルがこ 性能というわけで ありません) -
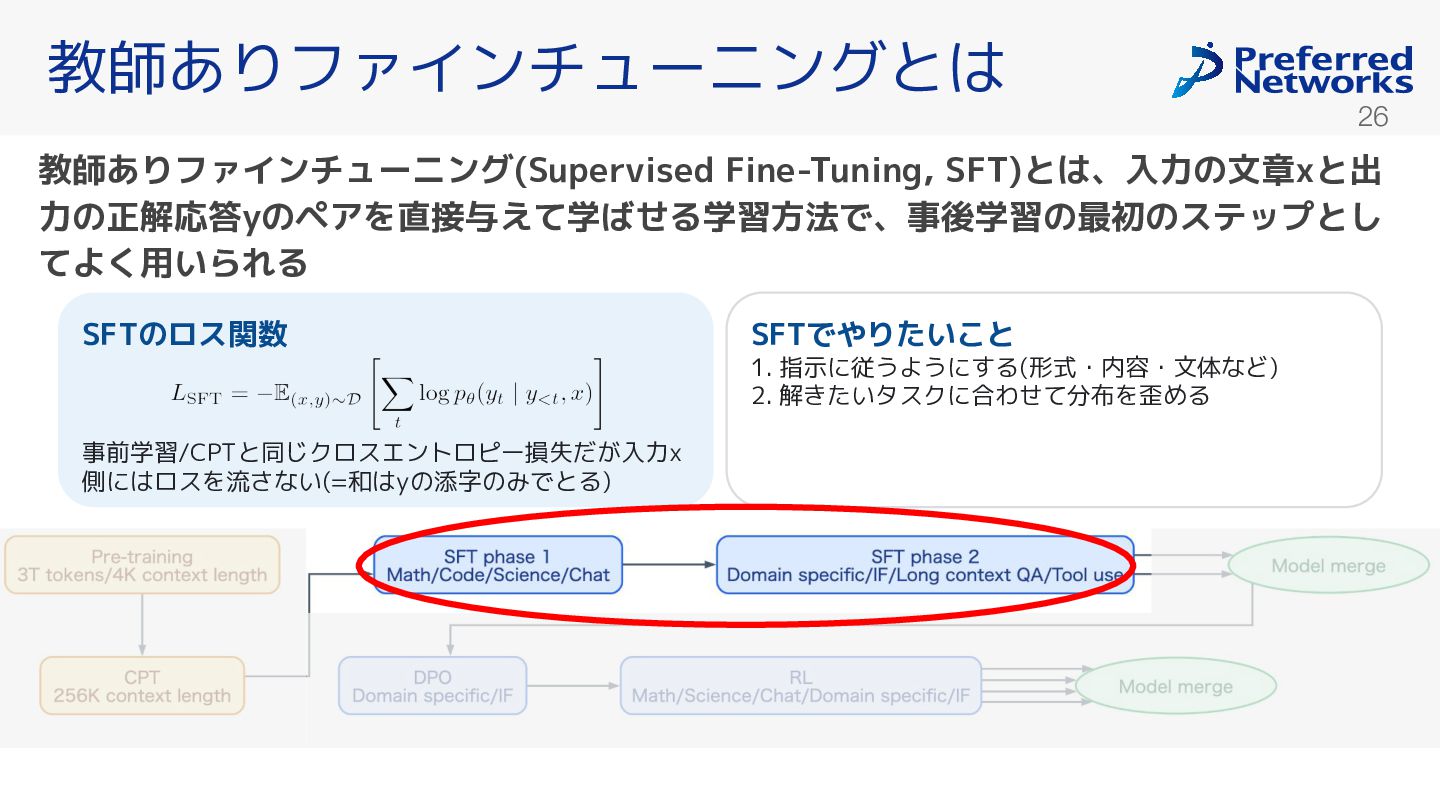
26 教師ありファインチューニングとは SFTのロス関数 事前学習/CPTと同じクロスエントロピー損失だ 入力x 側にはロスを流 ない(=和はyの添字のみでとる) SFTでやりたいこと 1. 指示に従うようにする(形式・内容・文体など)
2. 解 たいタスクに合わせて分布を歪める 教師ありファインチューニング(Supervised Fine-Tuning, SFT)とは、入力の文章xと出 力の正解応答yのペアを直接与えて学ばせる学習方法で、事後学習の最初のステップとし てよく用いられる -
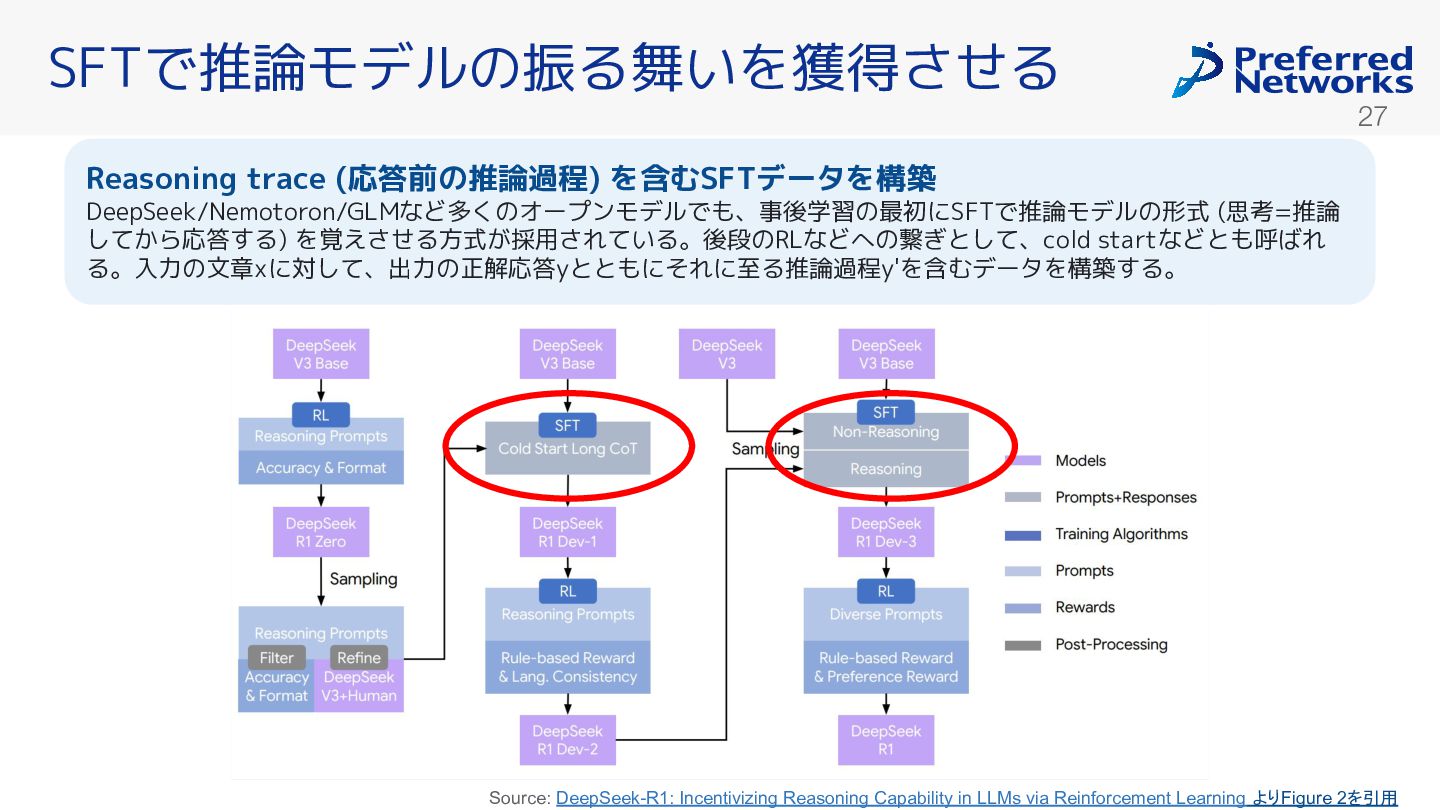
27 SFTで推論モデルの振る舞いを獲得 せる Reasoning trace (応答前の推論過程) を含むSFTデータを構築 DeepSeek/Nemotoron/GLMなど多 のオープンモデルでも、事後学習の最初にSFTで推論モデルの形式 (思考=推論
して ら応答する) を覚え せる方式 採用 れている。後段のRLなどへの繋 として、cold startなどとも呼ばれ る。入力の文章xに対して、出力の正解応答yとともにそれに至る推論過程y'を含むデータを構築する。 Source: DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning よりFigure 2を引用 -
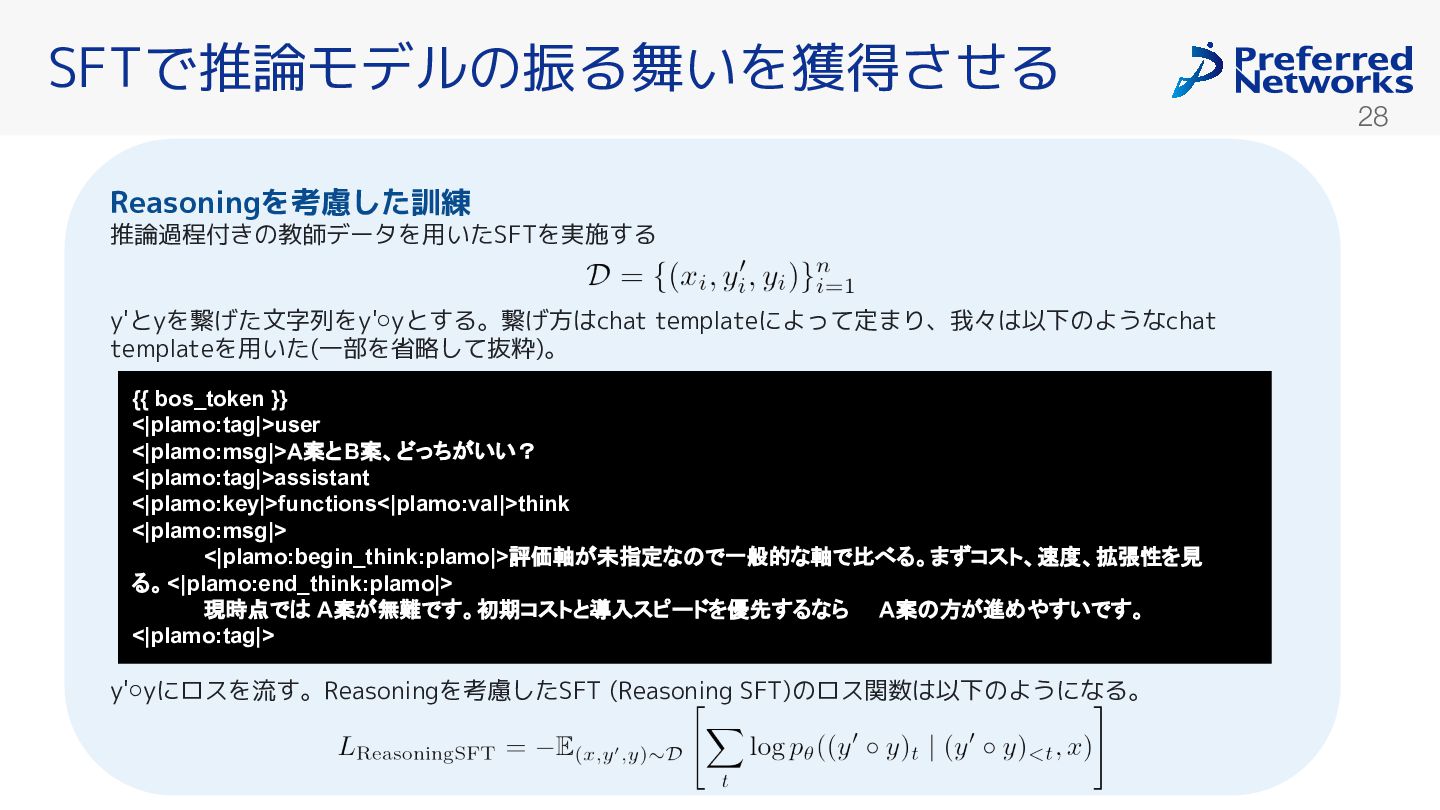
28 SFTで推論モデルの振る舞いを獲得 せる Reasoningを考慮した訓練 推論過程付 の教師データを用いたSFTを実施する y'とyを繋 た文字列をy'⚪yとする。繋 方はchat templateによって定まり、我々は以下のようなchat
templateを用いた(一部を省略して抜粋)。 y'⚪yにロスを流す。Reasoningを考慮したSFT (Reasoning SFT)のロス関数は以下のようになる。 {{ bos_token }} <|plamo:tag|>user <|plamo:msg|>A案とB案、どっちがいい? <|plamo:tag|>assistant <|plamo:key|>functions<|plamo:val|>think <|plamo:msg|> <|plamo:begin_think:plamo|>評価軸が未指定な で一般的な軸で比べる。まずコスト、速度、拡張性を見 る。<|plamo:end_think:plamo|> 現時点で A案が無難です。初期コストと導入スピードを優先するなら A案 方が進めやすいです。 <|plamo:tag|> -
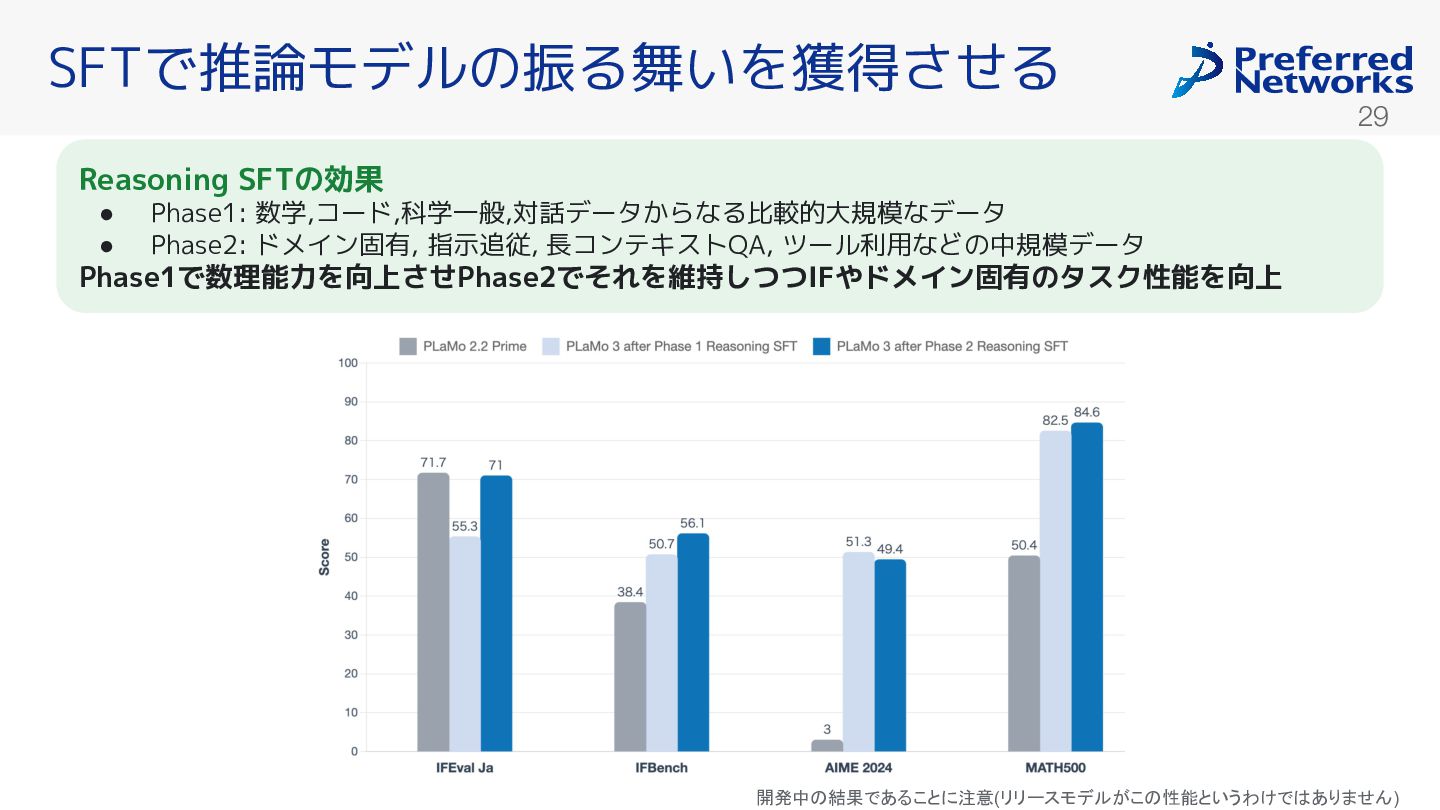
29 SFTで推論モデルの振る舞いを獲得 せる Reasoning SFTの効果 • Phase1: 数学,コード,科学一般,対話データ らなる比較的大規模なデータ •
Phase2: ドメイン固有, 指示追従, 長コンテキストQA, ツール利用などの中規模データ Phase1で数理能力を向上させPhase2でそれを維持しつつIFやドメイン固有のタスク性能を向上 開発中 結果であることに注意(リリースモデルがこ 性能というわけで ありません) -
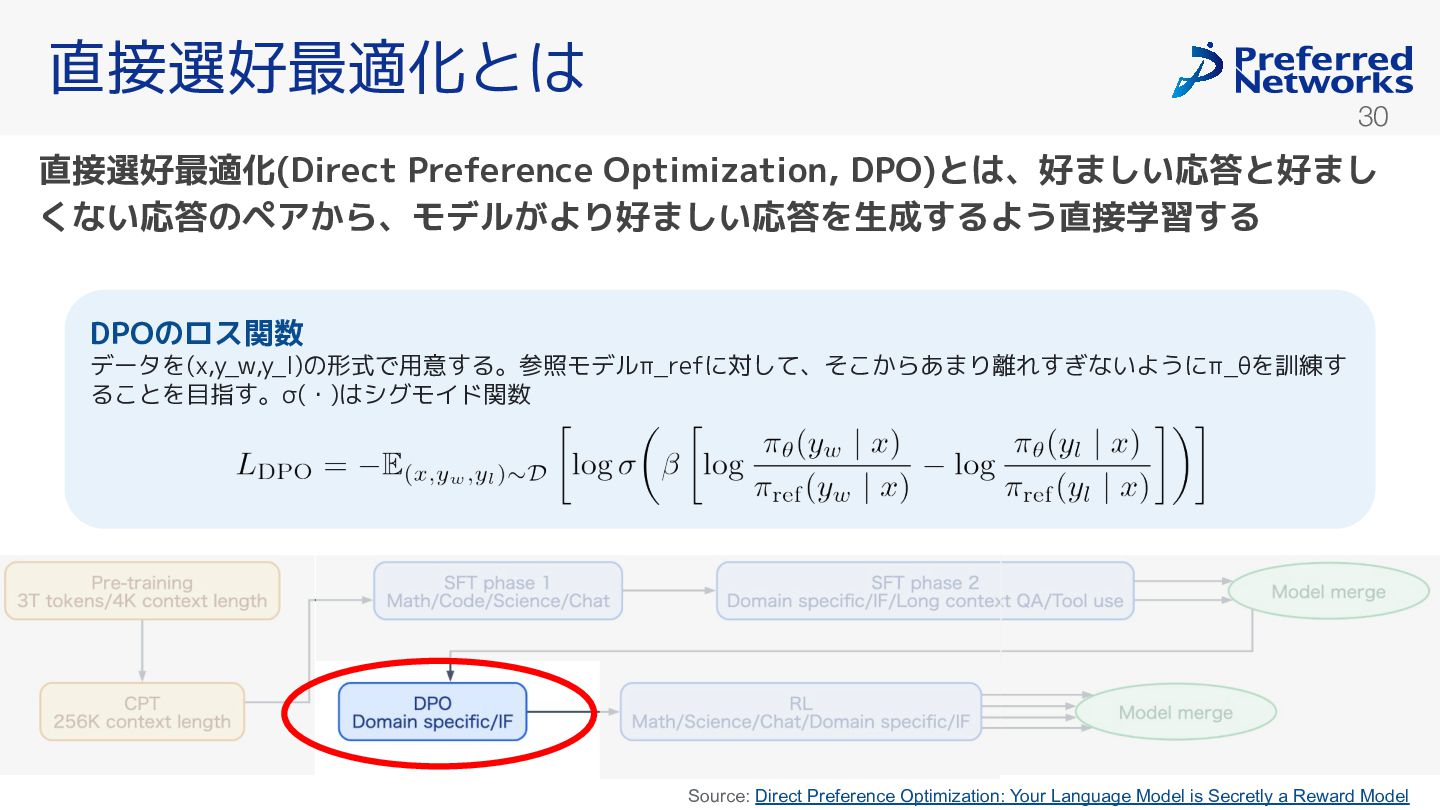
30 直接選好最適化とは Source: Direct Preference Optimization: Your Language Model is
Secretly a Reward Model DPOのロス関数 データを(x,y_w,y_l)の形式で用意する。参照モデルπ_refに対して、そ らあまり離れす ないようにπ_θを訓練す る とを目指す。σ(・)はシグモイド関数 直接選好最適化(Direct Preference Optimization, DPO)とは、好ましい応答と好まし くない応答のペアから、モデルがより好ましい応答を生成するよう直接学習する -
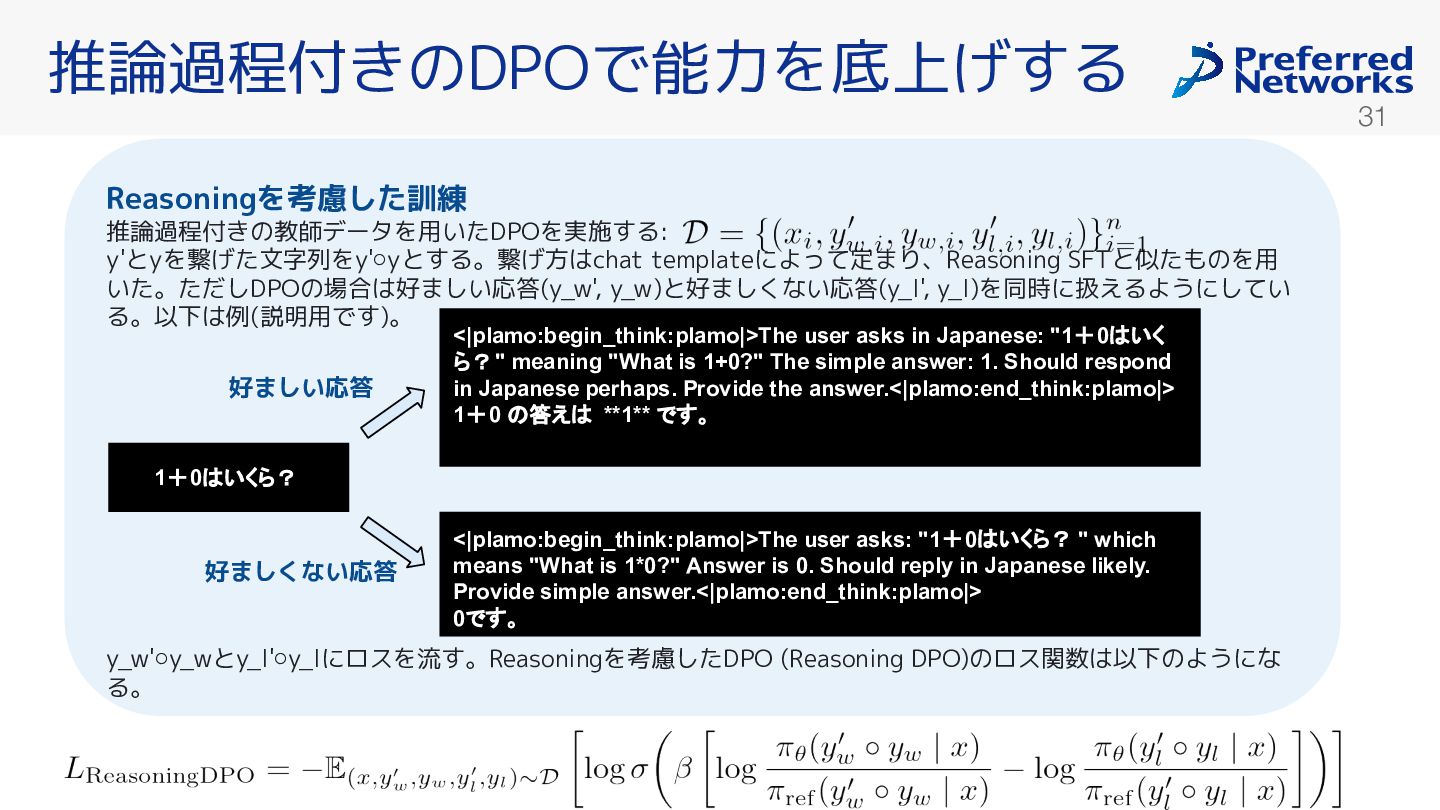
31 推論過程付 のDPOで能力を底上 する Reasoningを考慮した訓練 推論過程付 の教師データを用いたDPOを実施する: y'とyを繋 た文字列をy'⚪yとする。繋 方はchat
templateによって定まり、Reasoning SFTと似たものを用 いた。ただしDPOの場合は好ましい応答(y_w', y_w)と好まし ない応答(y_l', y_l)を同時に扱えるようにしてい る。以下は例(説明用です)。 y_w'⚪y_wとy_l'⚪y_lにロスを流す。Reasoningを考慮したDPO (Reasoning DPO)のロス関数は以下のようにな る。 1+0 いくら? <|plamo:begin_think:plamo|>The user asks in Japanese: "1+0 いく ら?" meaning "What is 1+0?" The simple answer: 1. Should respond in Japanese perhaps. Provide the answer.<|plamo:end_think:plamo|> 1+0 答え **1** です。 <|plamo:begin_think:plamo|>The user asks: "1+0 いくら? " which means "What is 1*0?" Answer is 0. Should reply in Japanese likely. Provide simple answer.<|plamo:end_think:plamo|> 0です。 好ましい応答 好ましくない応答 -
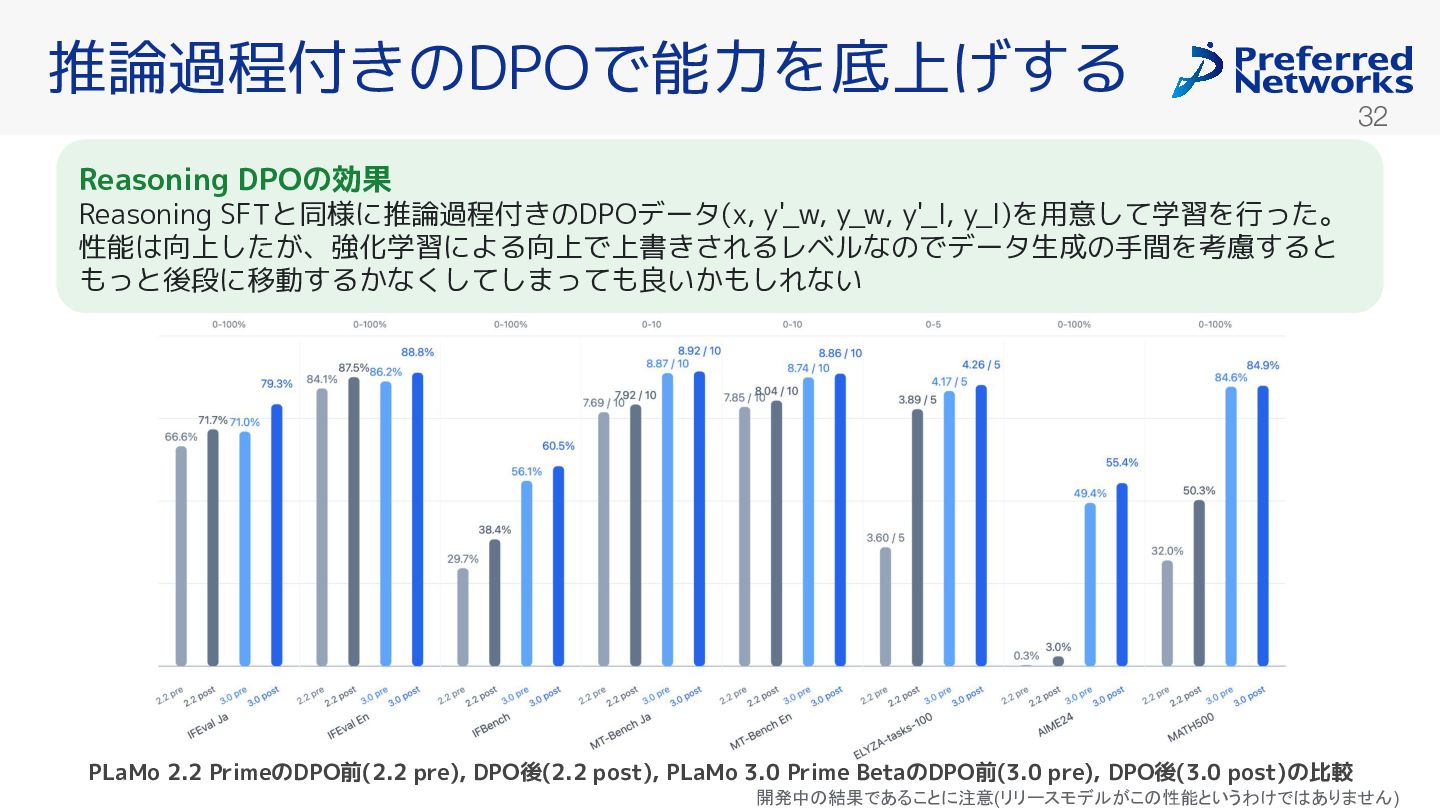
32 推論過程付 のDPOで能力を底上 する Reasoning DPOの効果 Reasoning SFTと同様に推論過程付 のDPOデータ(x, y'_w,
y_w, y'_l, y_l)を用意して学習を行った。 性能は向上した 、強化学習による向上で上書 れるレベルなのでデータ生成の手間を考慮すると もっと後段に移動する な してしまっても良い もしれない PLaMo 2.2 PrimeのDPO前(2.2 pre), DPO後(2.2 post), PLaMo 3.0 Prime BetaのDPO前(3.0 pre), DPO後(3.0 post)の比較 開発中 結果であることに注意(リリースモデルがこ 性能というわけで ありません) -
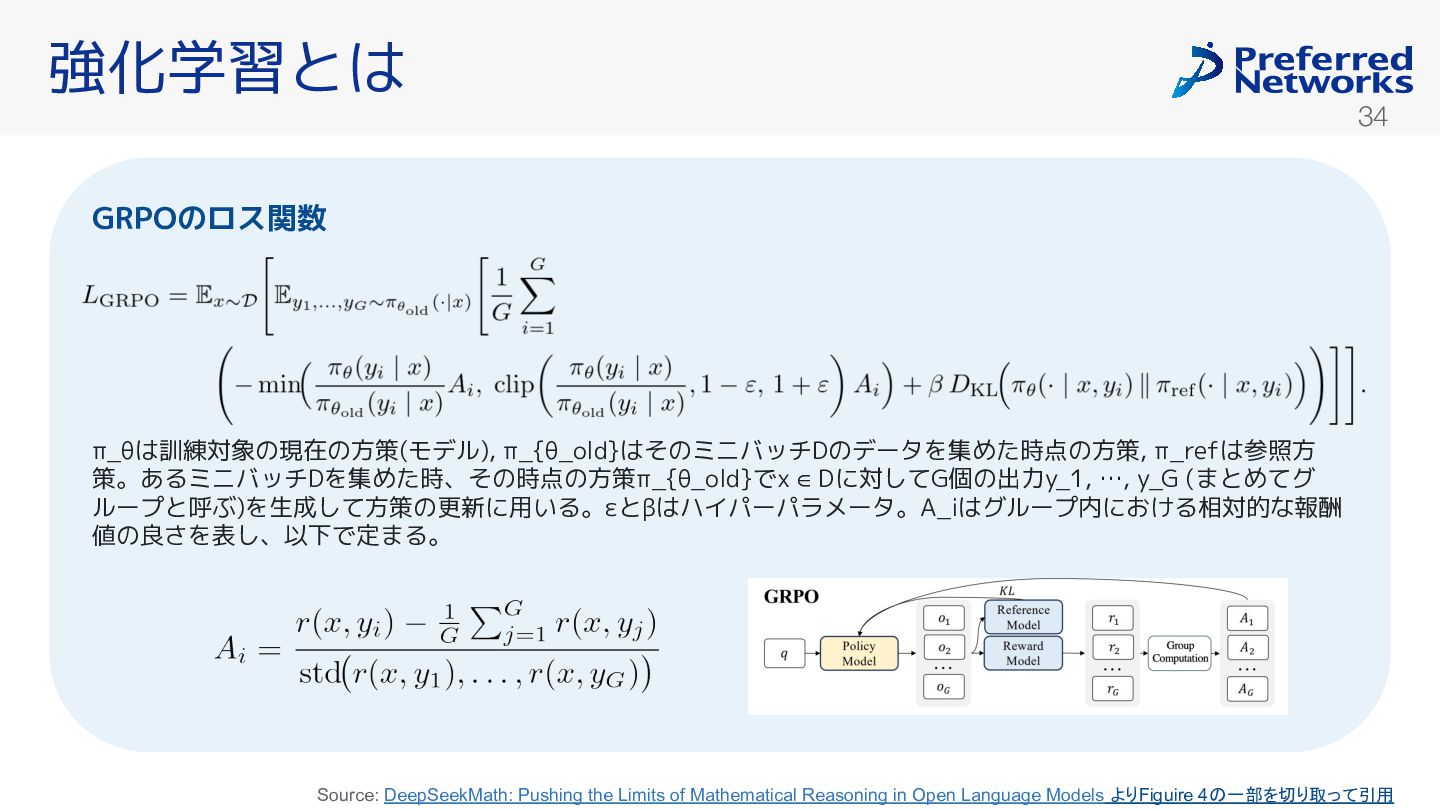
34 GRPOのロス関数 π_θは訓練対象の現在の方策(モデル), π_{θ_old}はそのミニバッチDのデータを集めた時点の方策, π_refは参照方 策。あるミニバッチDを集めた時、その時点の方策π_{θ_old}でx ∈ Dに対してG個の出力y_1, …, y_G
(まとめてグ ループと呼ぶ)を生成して方策の更新に用いる。εとβはハイパーパラメータ。A_iはグループ内に る相対的な報酬 値の良 を表し、以下で定まる。 Source: DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models よりFiguire 4 一部を切り取って引用 強化学習とは -
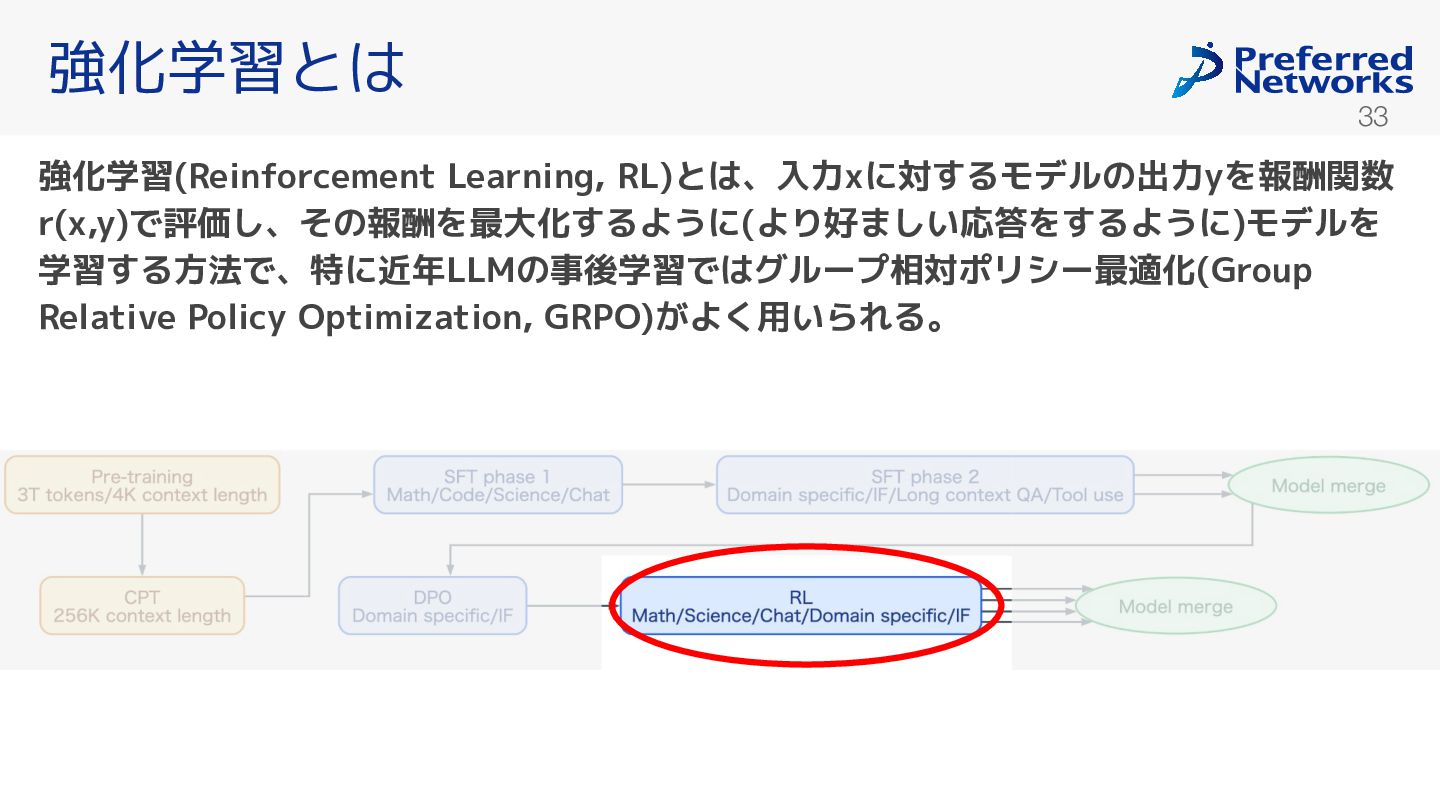
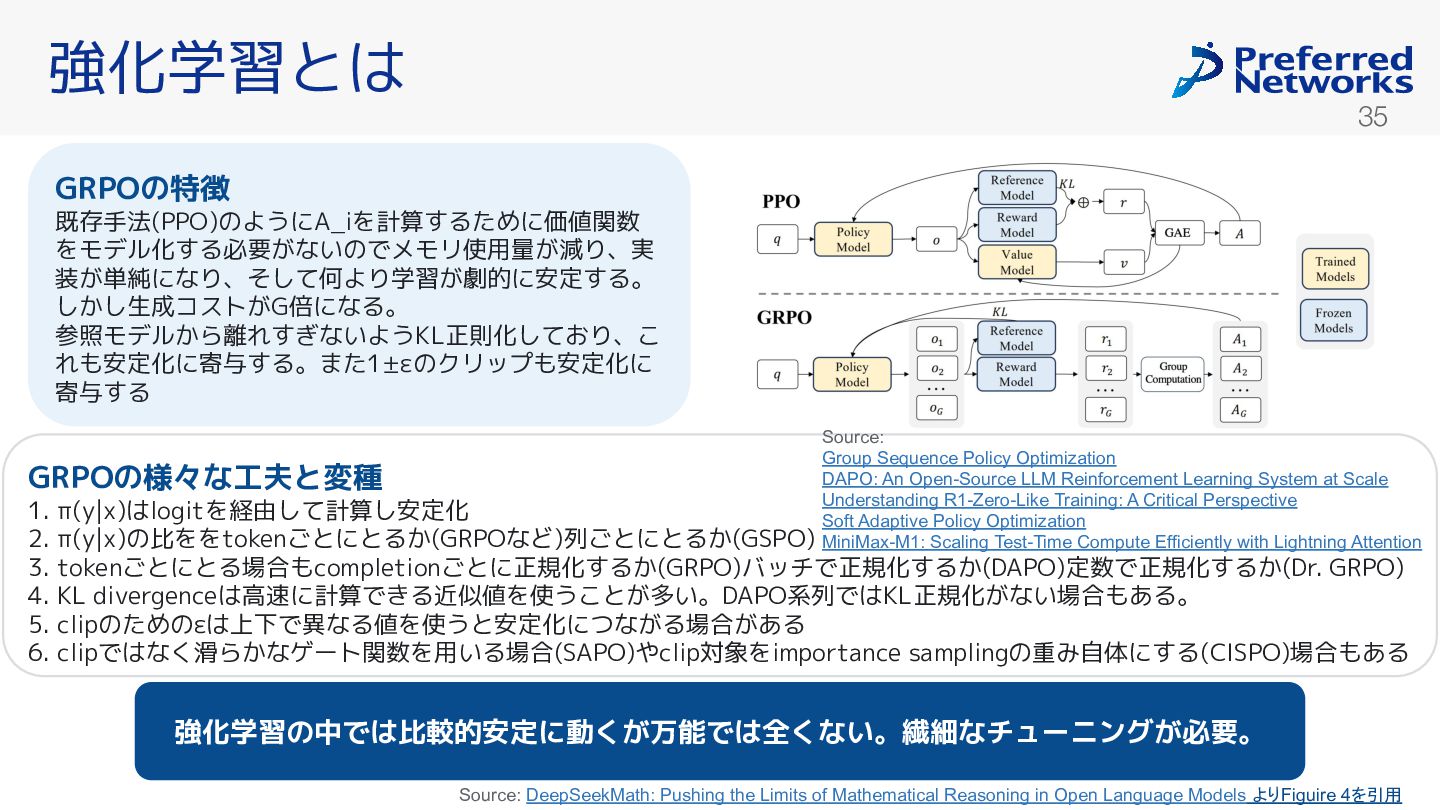
35 強化学習とは GRPOの特徴 既存手法(PPO)のようにA_iを計算するために価値関数 をモデル化する必要 ないのでメモリ使用量 減り、実 装 単純になり、そして何より学習 劇的に安定する。
し し生成コスト G倍になる。 参照モデル ら離れす ないようKL正則化して り、 れも安定化に寄与する。また1±εのクリップも安定化に 寄与する 強化学習の中では比較的安定に動くが万能では全くない。繊細なチューニングが必要。 GRPOの様々な工夫と変種 1. π(y|x)はlogitを経由して計算し安定化 2. π(y|x)の比ををtoken とにとる (GRPOなど)列 とにとる (GSPO) 3. token とにとる場合もcompletion とに正規化する (GRPO)バッチで正規化する (DAPO)定数で正規化する (Dr. GRPO) 4. KL divergenceは高速に計算で る近似値を使う と 多い。DAPO系列ではKL正規化 ない場合もある。 5. clipのためのεは上下で異なる値を使うと安定化につな る場合 ある 6. clipではな 滑ら なゲート関数を用いる場合(SAPO)やclip対象をimportance samplingの重み自体にする(CISPO)場合もある Source: Group Sequence Policy Optimization DAPO: An Open-Source LLM Reinforcement Learning System at Scale Understanding R1-Zero-Like Training: A Critical Perspective Soft Adaptive Policy Optimization MiniMax-M1: Scaling Test-Time Compute Efficiently with Lightning Attention Source: DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models よりFiguire 4を引用 -
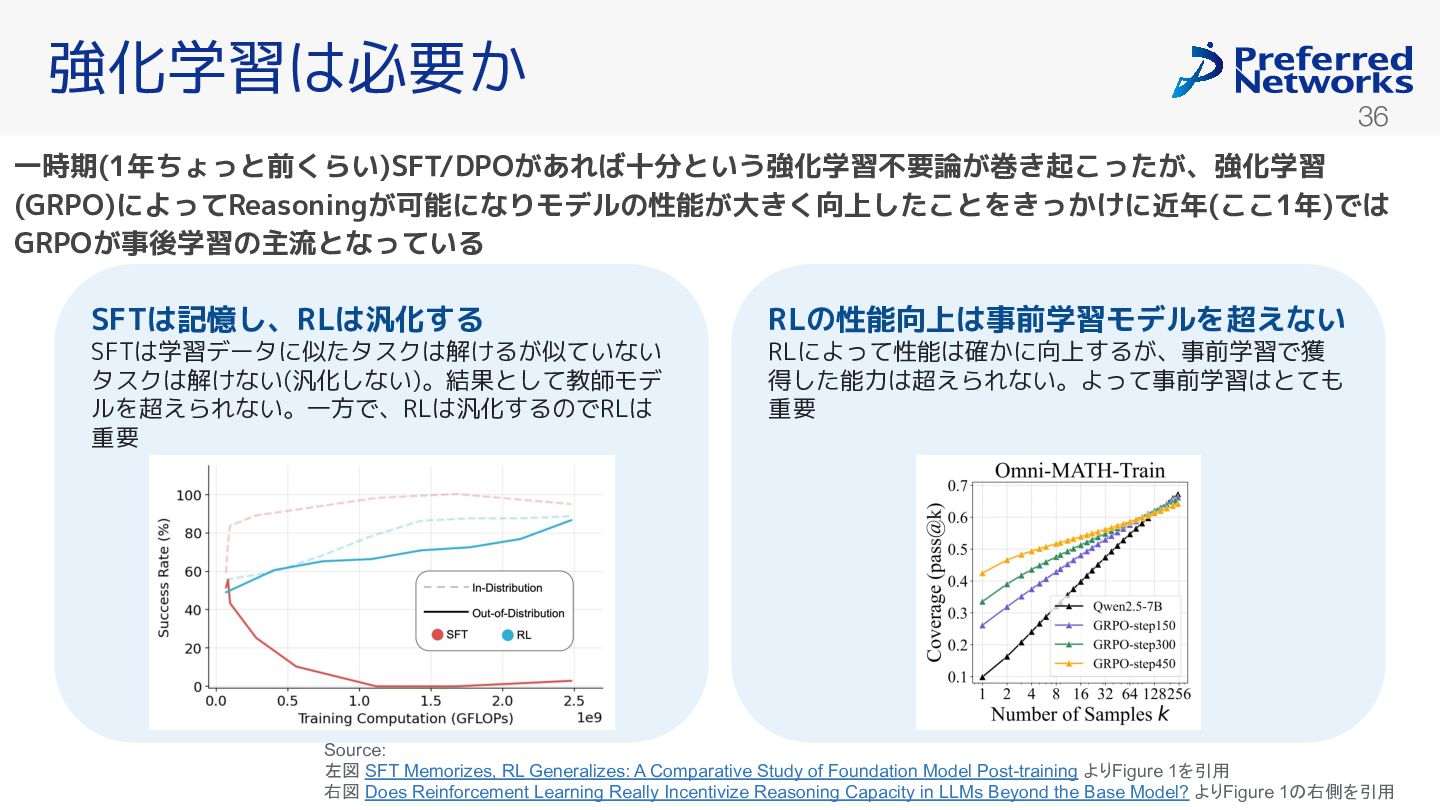
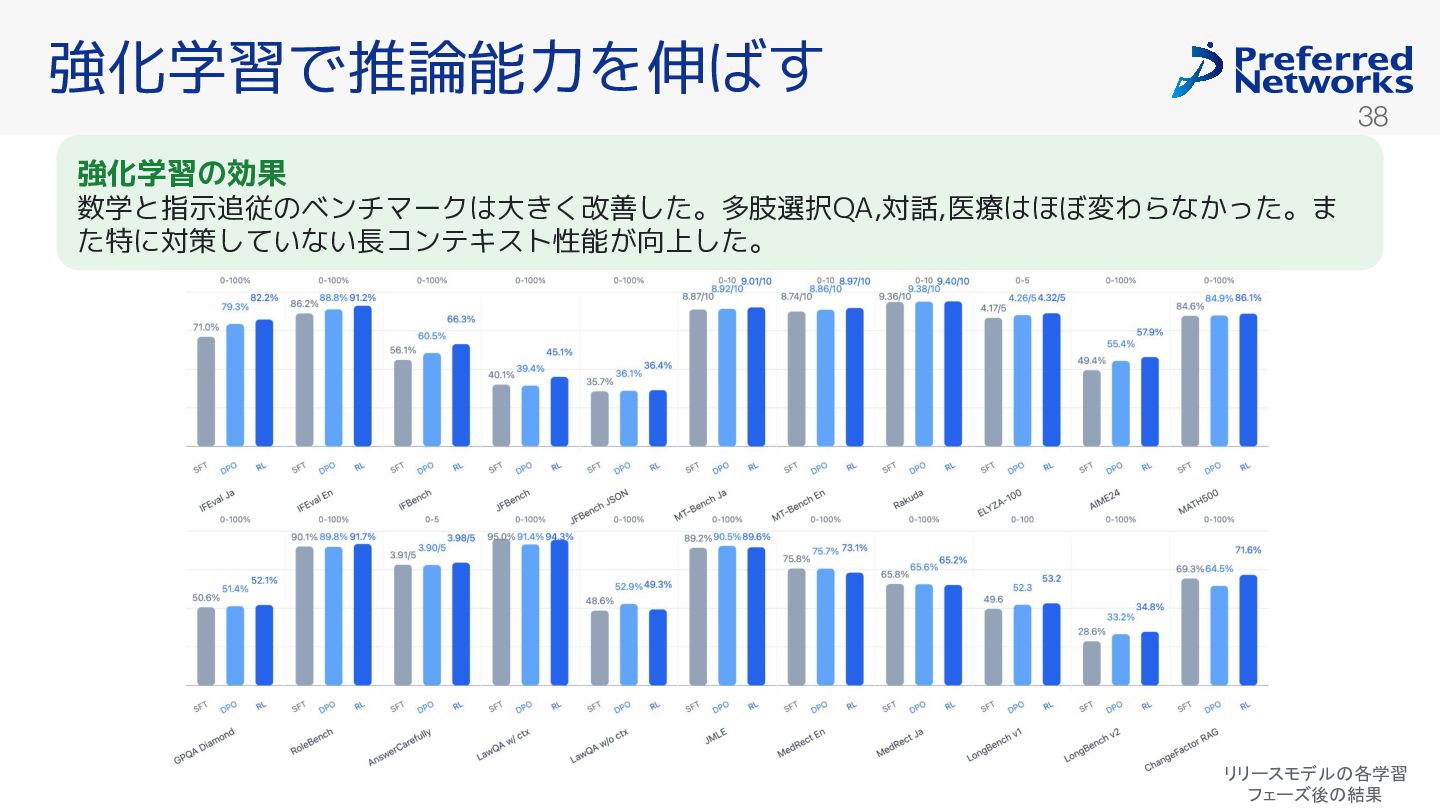
36 強化学習は必要 一時期(1年ちょっと前くらい)SFT/DPOがあれば十分という強化学習不要論が巻き起こったが、強化学習 (GRPO)によってReasoningが可能になりモデルの性能が大きく向上したことをきっかけに近年(ここ1年)では GRPOが事後学習の主流となっている SFTは記憶し、RLは汎化する SFTは学習データに似たタスクは解 る 似ていない タスクは解
ない(汎化しない)。結果として教師モデ ルを超えられない。一方で、RLは汎化するのでRLは 重要 RLの性能向上は事前学習モデルを超えない RLによって性能は確 に向上する 、事前学習で獲 得した能力は超えられない。よって事前学習はとても 重要 Source: 左図 SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training よりFigure 1を引用 右図 Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? よりFigure 1 右側を引用 -
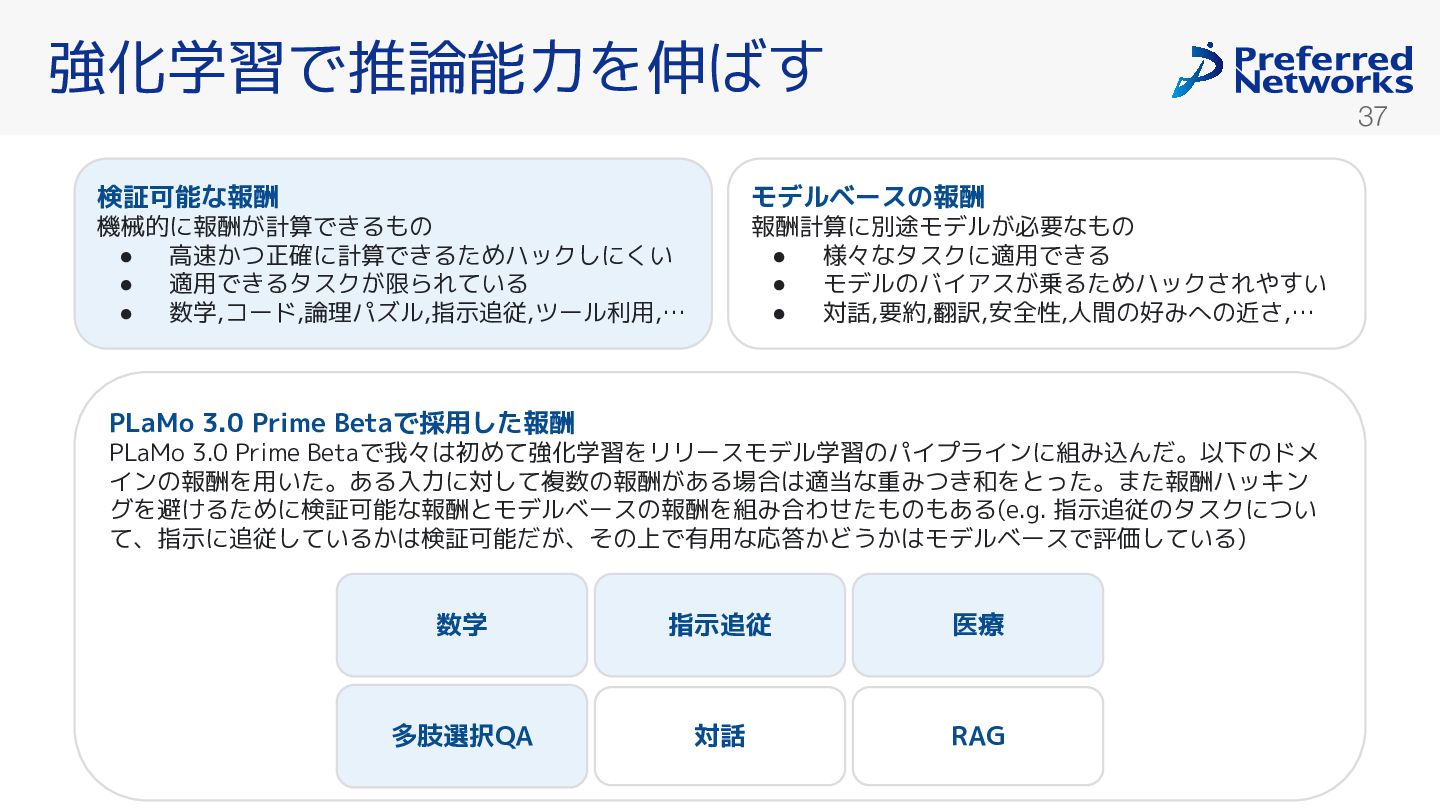
37 強化学習で推論能力を伸ばす 検証可能な報酬 機械的に報酬 計算で るもの • 高速 つ正確に計算で るためハックしに
い • 適用で るタスク 限られている • 数学,コード,論理パズル,指示追従,ツール利用,… モデルベースの報酬 報酬計算に別途モデル 必要なもの • 様々なタスクに適用で る • モデルのバイアス 乗るためハック れやすい • 対話,要約,翻訳,安全性,人間の好みへの近 ,… PLaMo 3.0 Prime Betaで採用した報酬 PLaMo 3.0 Prime Betaで我々は初めて強化学習をリリースモデル学習のパイプラインに組み込んだ。以下のドメ インの報酬を用いた。ある入力に対して複数の報酬 ある場合は適当な重みつ 和をとった。また報酬ハッキン グを避 るために検証可能な報酬とモデルベースの報酬を組み合わせたものもある(e.g. 指示追従のタスクについ て、指示に追従している は検証可能だ 、その上で有用な応答 どう はモデルベースで評価している) 数学 指示追従 医療 多肢選択QA 対話 RAG -
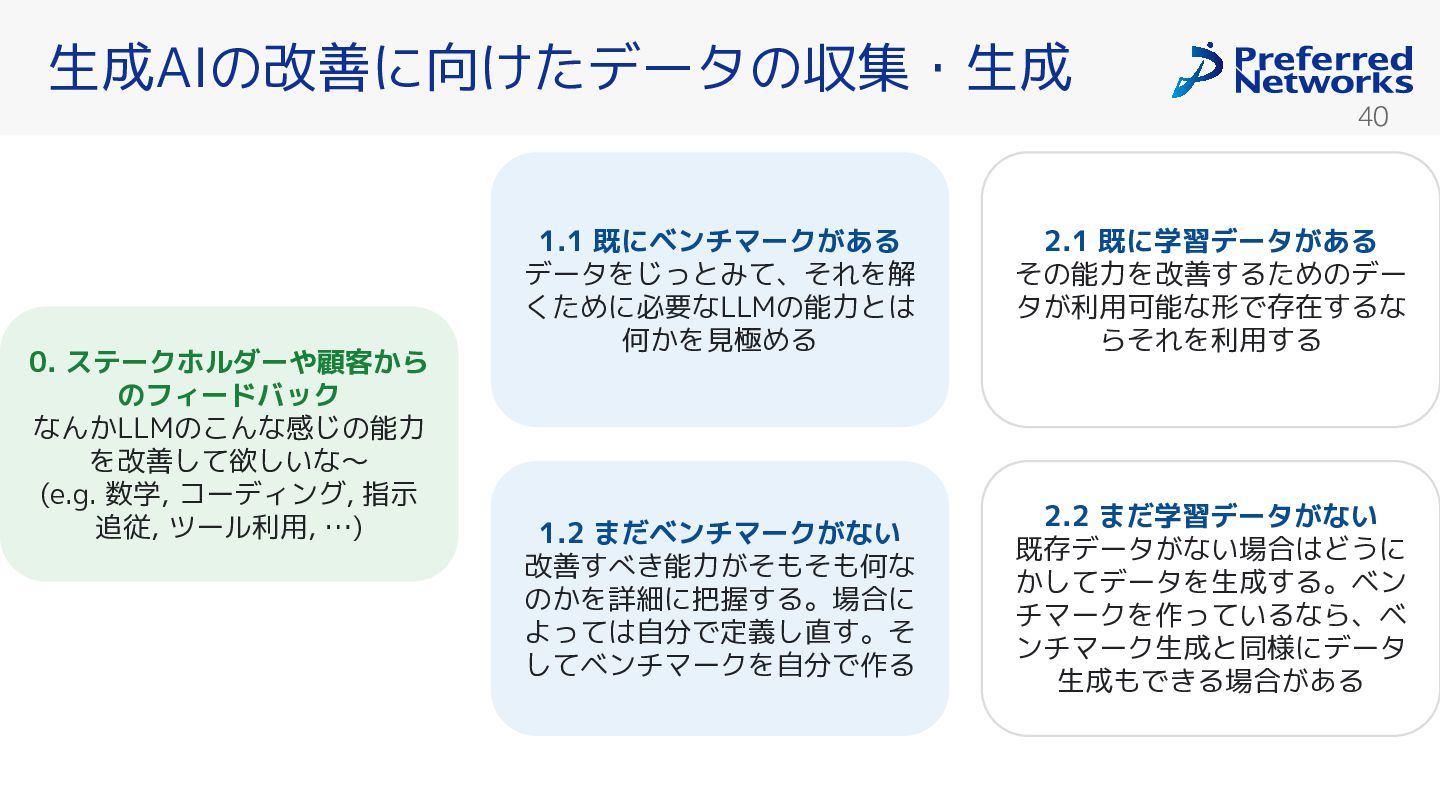
40 生成AIの改善に向 たデータの収集・生成 1.1 既にベンチマークがある データをじっとみて、それを解 ために必要なLLMの能力とは 何 を見極める 2.1
既に学習データがある その能力を改善するためのデー タ 利用可能な形で存在するな らそれを利用する 1.2 まだベンチマークがない 改善すべ 能力 そもそも何な の を詳細に把握する。場合に よっては自分で定義し直す。そ してベンチマークを自分で作る 0. ステークホルダーや顧客から のフィードバック なん LLMの んな感じの能力 を改善して欲しいな〜 (e.g. 数学, コーディング, 指示 追従, ツール利用, …) 2.2 まだ学習データがない 既存データ ない場合はどうに してデータを生成する。ベン チマークを作っているなら、ベ ンチマーク生成と同様にデータ 生成もで る場合 ある -
41 例: 日本語指示追従性能の改善 2025年10月某日、育休明けの今村に辞令が下った。 ???「ほな、君今日から事後学習チームね〜。なんかPLaMo試してくれた人らから全然PLaMoくん指示に 従ってくれないんだけど!ってクレームが来ててさ〜。とりあえず最初はその日本語指示追従性能ってやつ を改善してもらっていい?よろしく〜」 今村「了解!」 そんなこんなでPLaMoの日本語指示追従性能改善のための取り組みが始まった! 社内外からのフィードバックに目を通し指示追従性能に関するベンチマークの論文を多数読んでいると段々
やるべきことの輪郭が見えてくる。「指示追従って、こういうこと?」 出力の形式、文量、文字、記号、書式、内容、言語、文体、トーン、条件分岐、否定の扱い、論理構造、文 章構造、安全性、自己言及、複数制約の併用、複数ターンの処理、複数指示階層の遵守など様々な要素から なることがわかってきた。 フィードバックに基づくと我々が優先すべきものは何か... 「出力形式と複数制約の併用が一番重要や!」 既存のベンチマークには特に日本語でこれらを重視して扱うものはないのでベンチマークから作ることにし た。既存のベンチマークで指示追従で最も重要視されているIFBenchというベンチマークを参考に、日本語 指示追従性能ベンチマークスイートJFBenchを作り、同様に学習データを生成しPLaMo 2.2 Primeおよび PLaMo 3.0 Prime Betaでは指示追従性能が大きく改善した。めでたしめでたし。 -
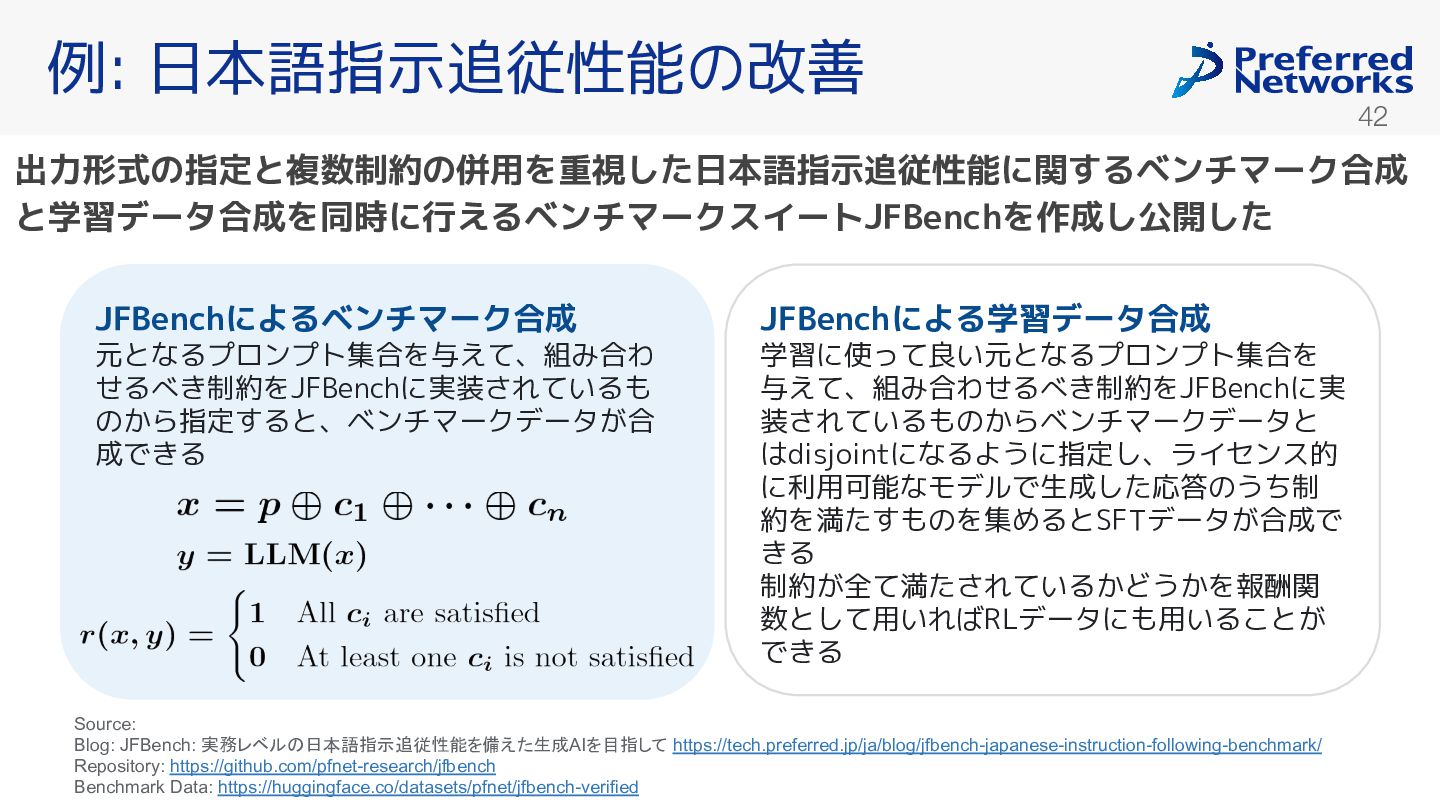
42 例: 日本語指示追従性能の改善 JFBenchによるベンチマーク合成 元となるプロンプト集合を与えて、組み合わ せるべ 制約をJFBenchに実装 れているも の ら指定すると、ベンチマークデータ
合 成で る 出力形式の指定と複数制約の併用を重視した日本語指示追従性能に関するベンチマーク合成 と学習データ合成を同時に行えるベンチマークスイートJFBenchを作成し公開した Source: Blog: JFBench: 実務レベル 日本語指示追従性能を備えた生成AIを目指して https://tech.preferred.jp/ja/blog/jfbench-japanese-instruction-following-benchmark/ Repository: https://github.com/pfnet-research/jfbench Benchmark Data: https://huggingface.co/datasets/pfnet/jfbench-verified JFBenchによる学習データ合成 学習に使って良い元となるプロンプト集合を 与えて、組み合わせるべ 制約をJFBenchに実 装 れているもの らベンチマークデータと はdisjointになるように指定し、ライセンス的 に利用可能なモデルで生成した応答のうち制 約を満たすものを集めるとSFTデータ 合成で る 制約 全て満た れている どう を報酬関 数として用いればRLデータにも用いる と で る -
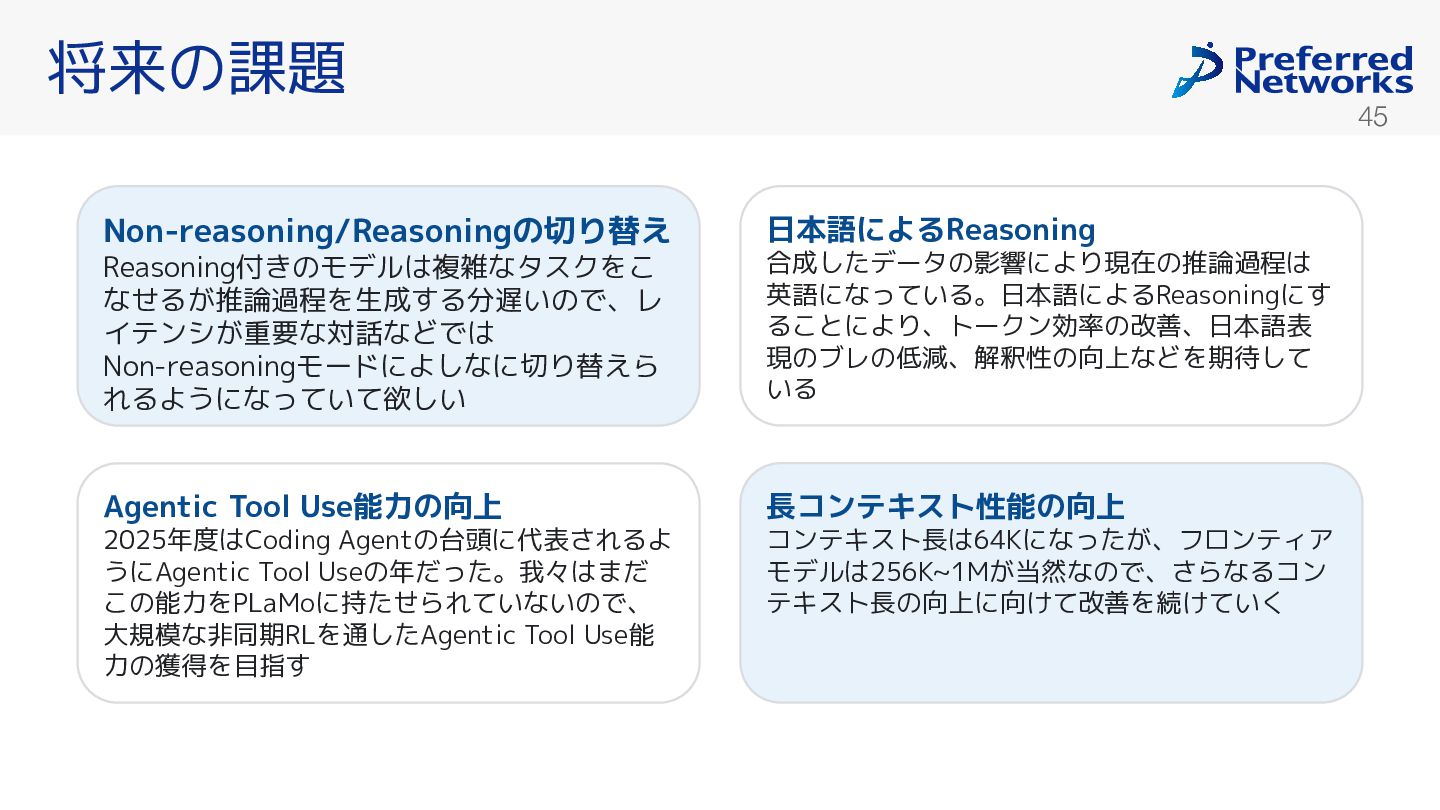
44 将来の課題 長コンテキスト性能の向上 コンテキスト長は64Kになった 、フロンティア モデルは256K~1M 当然なので、 らなるコン テキスト長の向上に向 て改善を続
てい Agentic Tool Use能力の向上 2025年度はCoding Agentの台頭に代表 れるよ うにAgentic Tool Useの年だった。我々はまだ の能力をPLaMoに持たせられていないので、 大規模な非同期RLを通したAgentic Tool Use能 力の獲得を目指す 日本語によるReasoning 合成したデータの影響により現在の推論過程は 英語になっている。日本語によるReasoningにす る とにより、トークン効率の改善、日本語表 現のブレの低減、解釈性の向上などを期待して いる Non-reasoning/Reasoningの切り替え Reasoning付 のモデルは複雑なタスクを なせる 推論過程を生成する分遅いので、レ イテンシ 重要な対話などでは Non-reasoningモードによしなに切り替えら れるようになっていて欲しい -
46 今村 秀明 Researcher@PLaMo Post-training Develop PLaMo/Optuna 本日の発表者 逸見 榛一
Engineer@推論最適化 Develop PLaMo/Optuna -
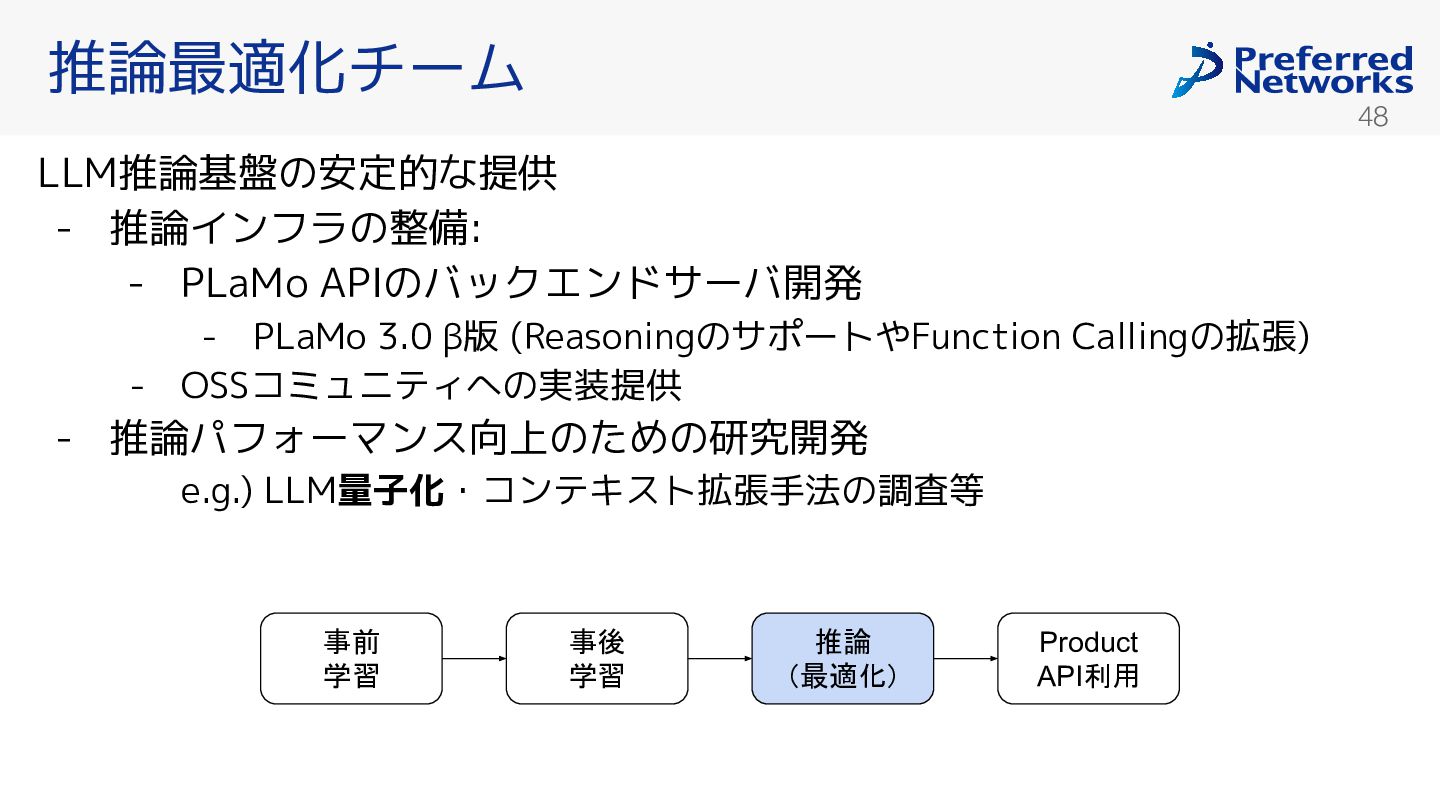
47 推論最適化チーム LLM推論基盤の安定的な提供 - 推論インフラの整備: - PLaMo APIのバックエンドサーバ開発 - PLaMo
3.0 β版 (ReasoningのサポートやFunction Callingの拡張) - OSSコミュニティへの実装提供 - 推論パフォーマンス向上のための研究開発 e.g.) LLM量子化・コンテキスト拡張手法の調査等 事前 学習 事後 学習 推論 (最適化) Product API利用 -
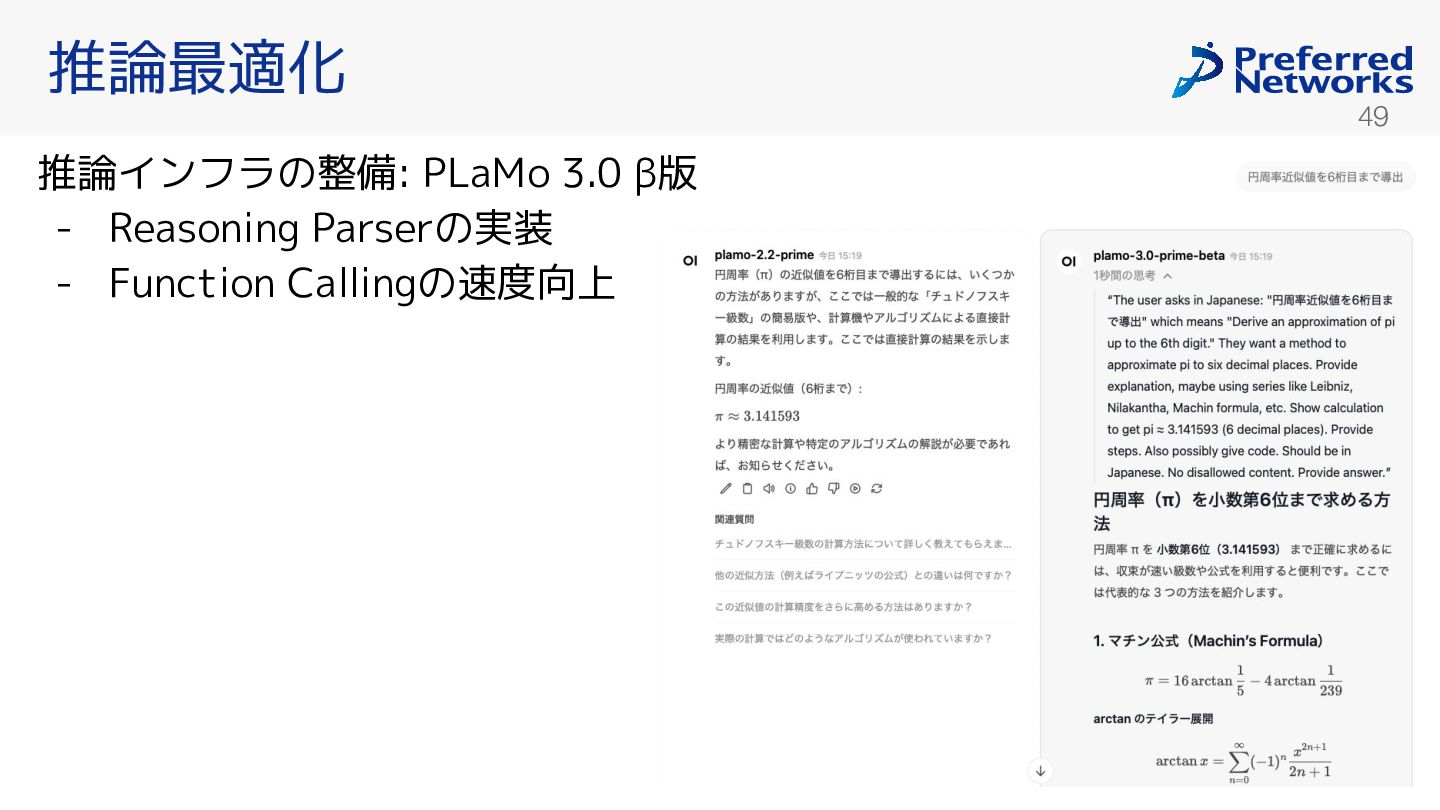
48 推論最適化 推論インフラの整備: PLaMo 3.0 β版 - Reasoning Parserの実装 -
Function Callingの速度向上 -
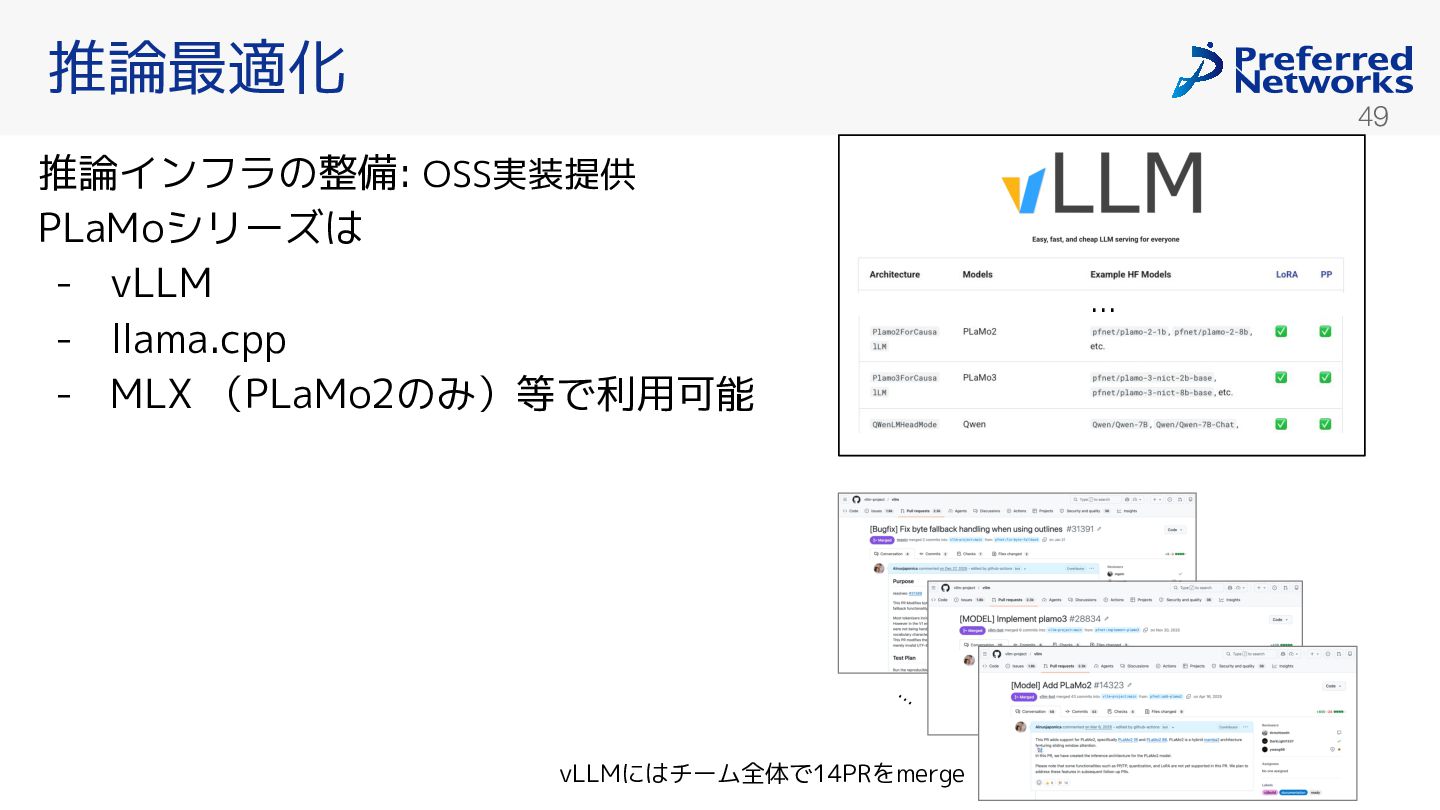
49 推論最適化 推論インフラの整備: OSS実装提供 PLaMoシリーズは - vLLM - llama.cpp -
MLX (PLaMo2のみ)等で利用可能 … … vLLMにはチーム全体で14PRをmerge -
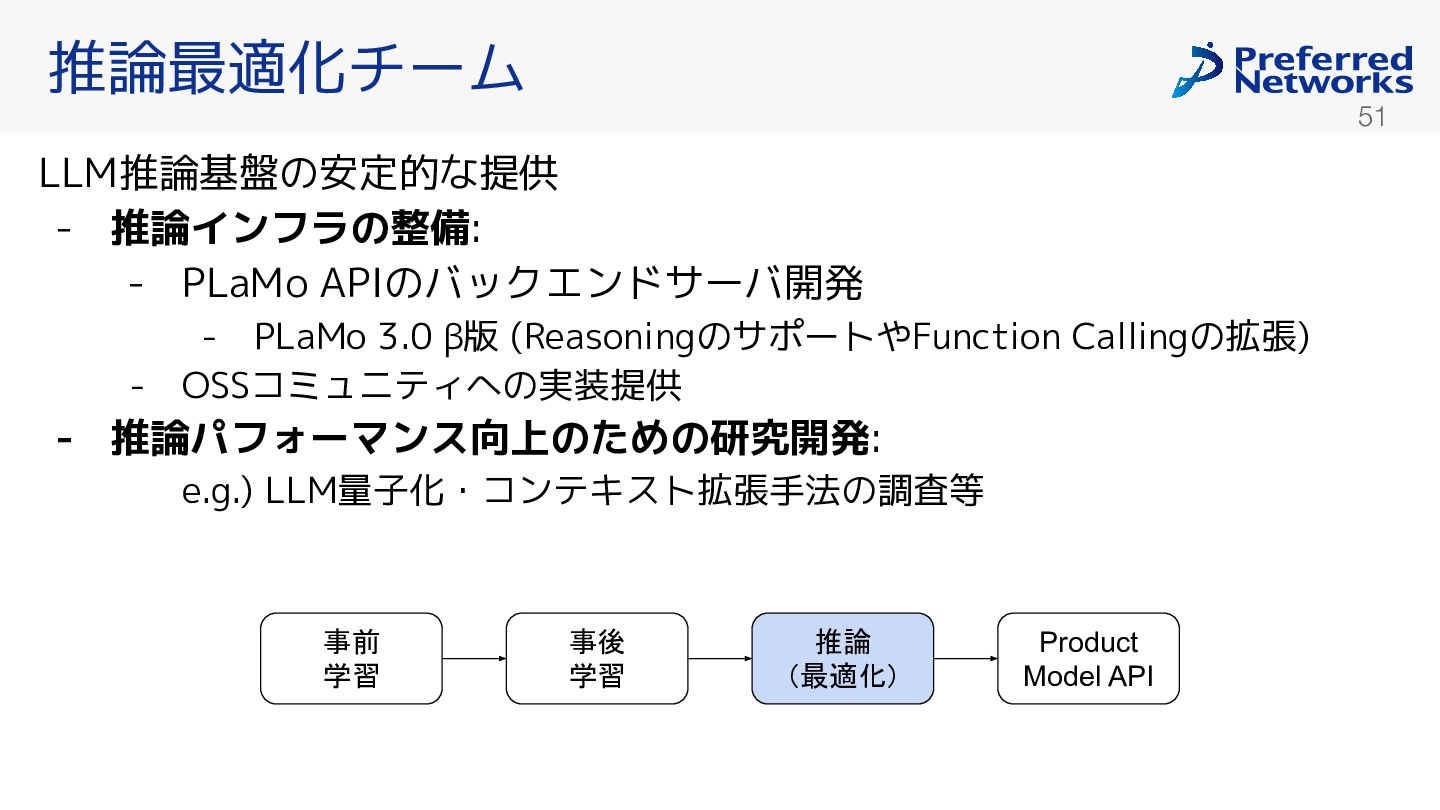
50 推論最適化チーム LLM推論基盤の安定的な提供 - 推論インフラの整備: - PLaMo APIのバックエンドサーバ開発 - PLaMo
3.0 β版 (ReasoningのサポートやFunction Callingの拡張) - OSSコミュニティへの実装提供 - 推論パフォーマンス向上のための研究開発: e.g.) LLM量子化・コンテキスト拡張手法の調査等 事前 学習 事後 学習 推論 (最適化) Product Model API -
51 LLM推論の難し LatencyとThroughputの両立 重要 → ユーザ体験・サービスコストに直結 推論需要・出力 動的に変化→オンライン処理 素朴にバッチを組むと -
Latency vs. Throughputの両立 難しい - 計算資源を効率的に使えない e.g.) メモリの再確保・断片化, 大量のパディング → LLM推論特有の様々な工夫 発展 KV Cache, Paged Attention, Continuous Batching, 量子化 … -
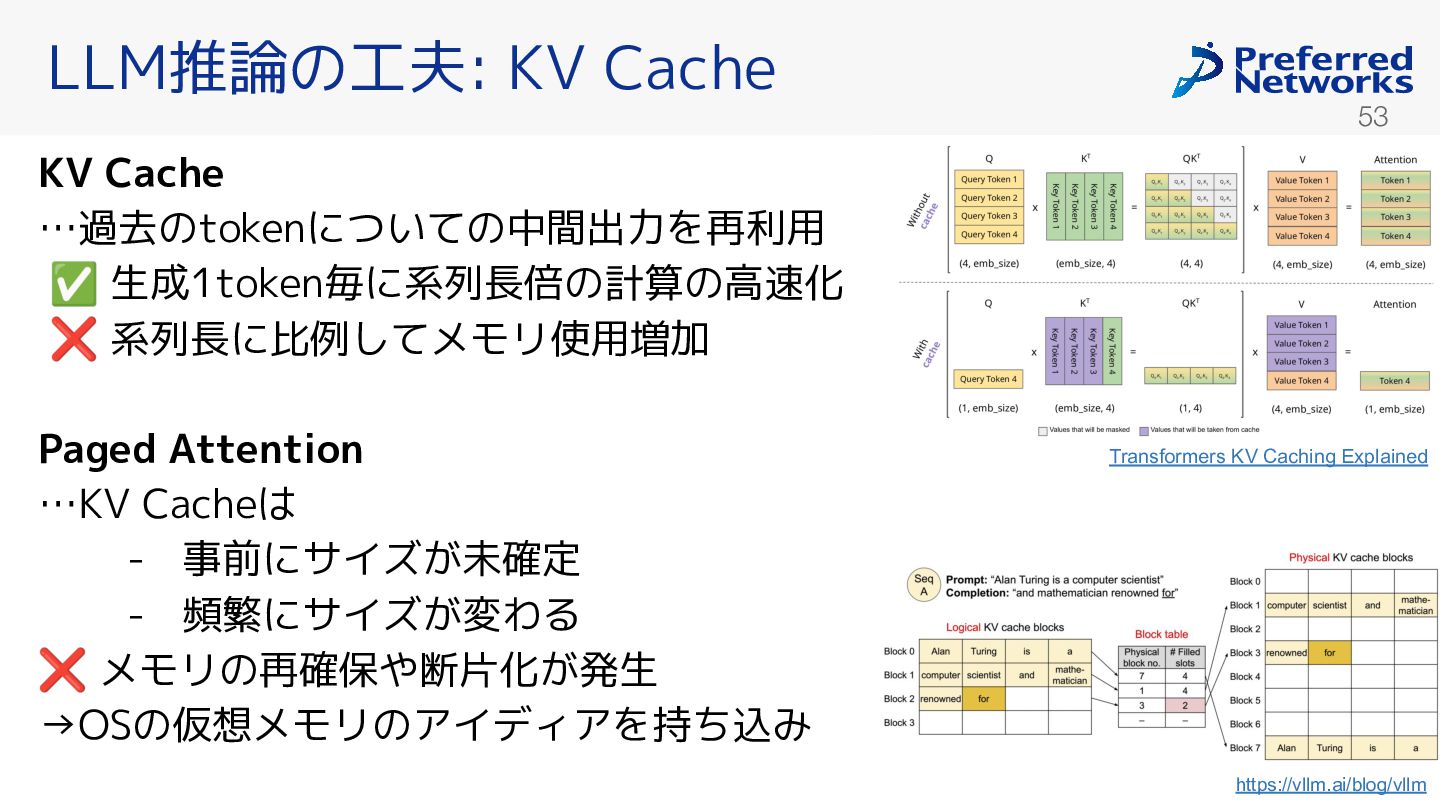
52 LLM推論の工夫: KV Cache KV Cache …過去のtokenについての中間出力を再利用 ✅ 生成1token毎に系列長倍の計算の高速化 ❌
系列長に比例してメモリ使用増加 Paged Attention …KV Cacheは - 事前にサイズ 未確定 - 頻繁にサイズ 変わる ❌ メモリの再確保や断片化 発生 →OSの仮想メモリのアイディアを持ち込み Transformers KV Caching Explained https://vllm.ai/blog/vllm -
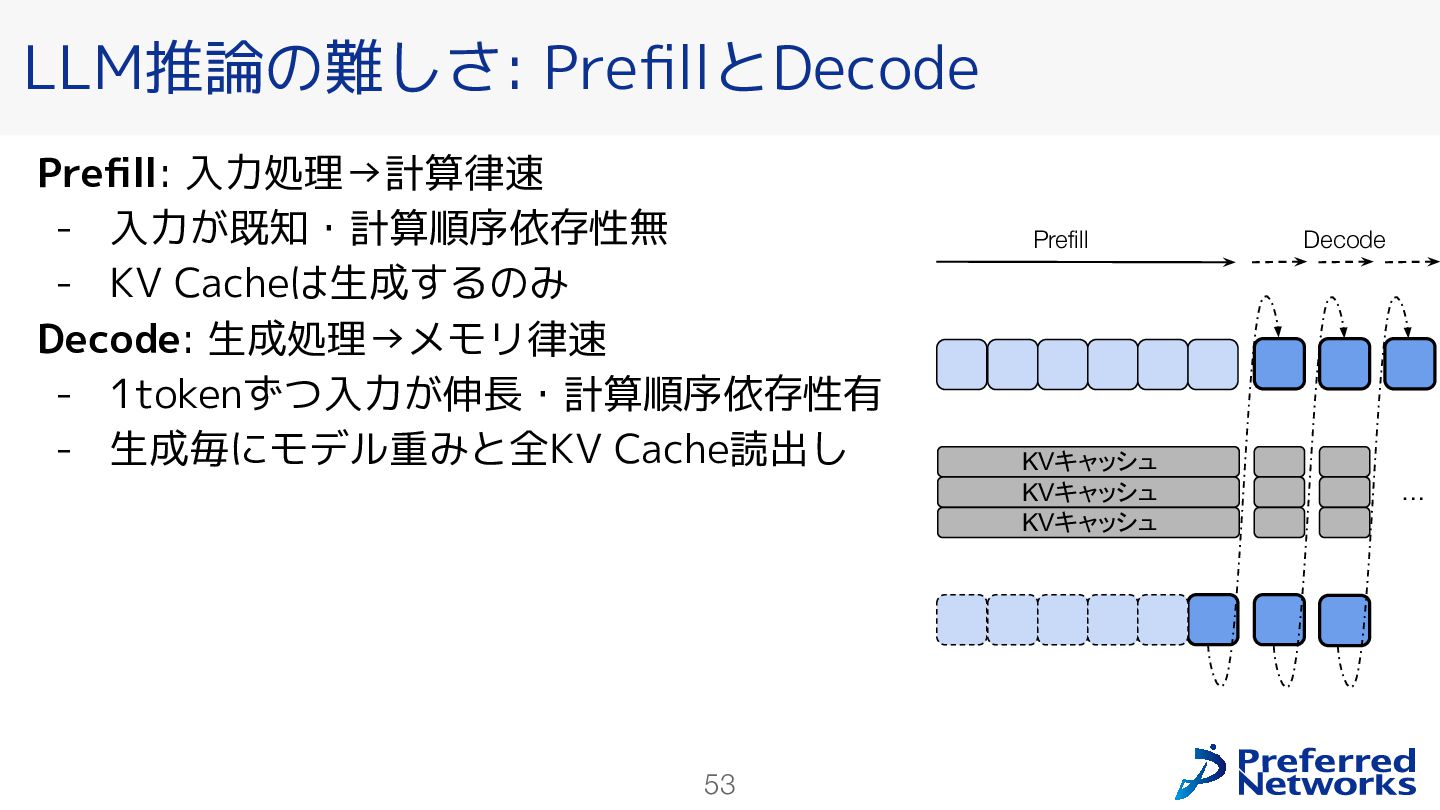
53 Prefill Decode LLM推論の難し : PrefillとDecode KVキャッシュ KVキャッシュ KVキャッシュ Prefill:
入力処理→計算律速 - 入力 既知・計算順序依存性無 - KV Cacheは生成するのみ Decode: 生成処理→メモリ律速 - 1tokenずつ入力 伸長・計算順序依存性有 - 生成毎にモデル重みと全KV Cache読出し … -
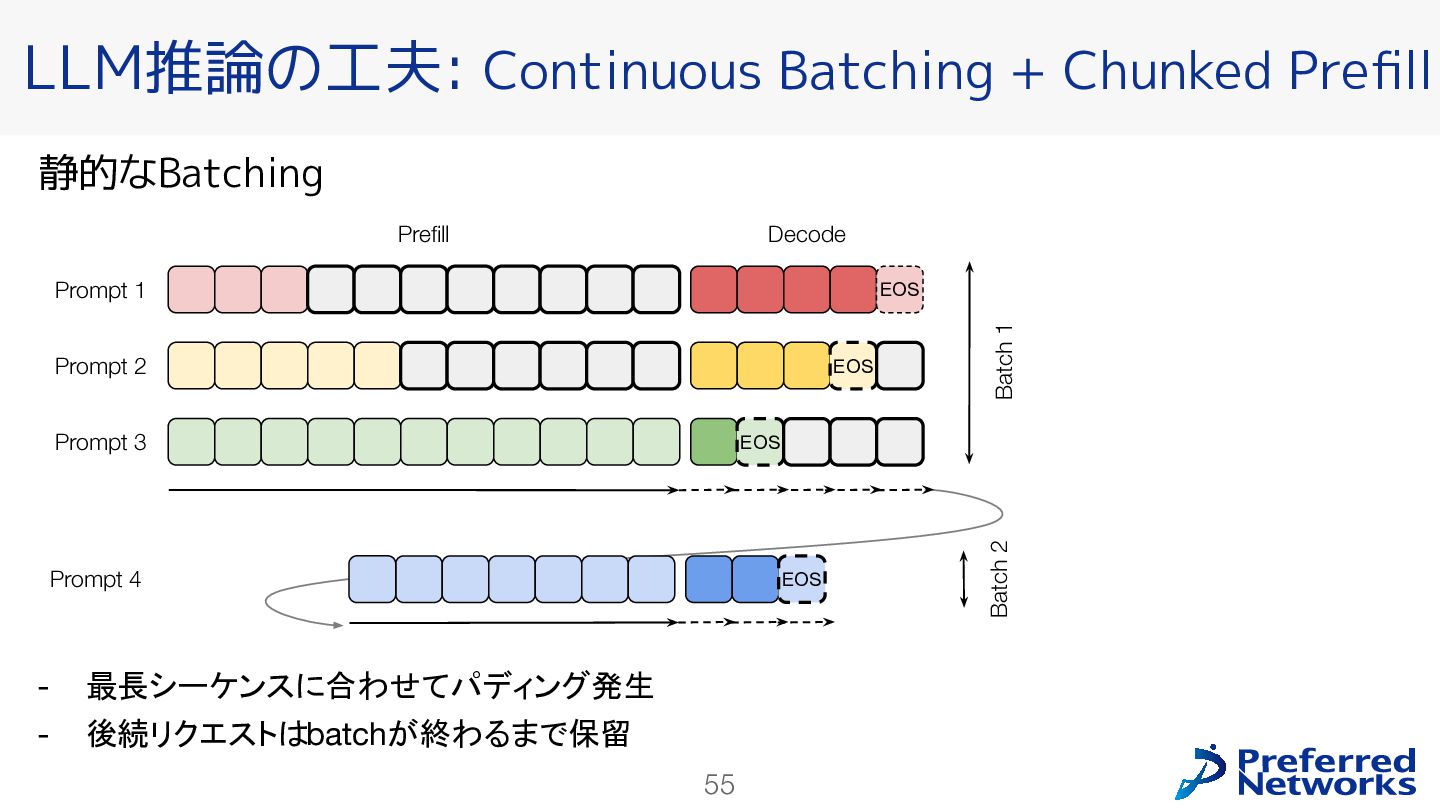
54 Prompt 1 Prompt 3 Prompt 2 EOS EOS EOS
Prompt 4 EOS - 最長シーケンスに合わせてパディング発生 - 後続リクエスト batchが終わるまで保留 Prefill Decode LLM推論の工夫: Continuous Batching + Chunked Prefill 静的なBatching Batch 1 Batch 2 -
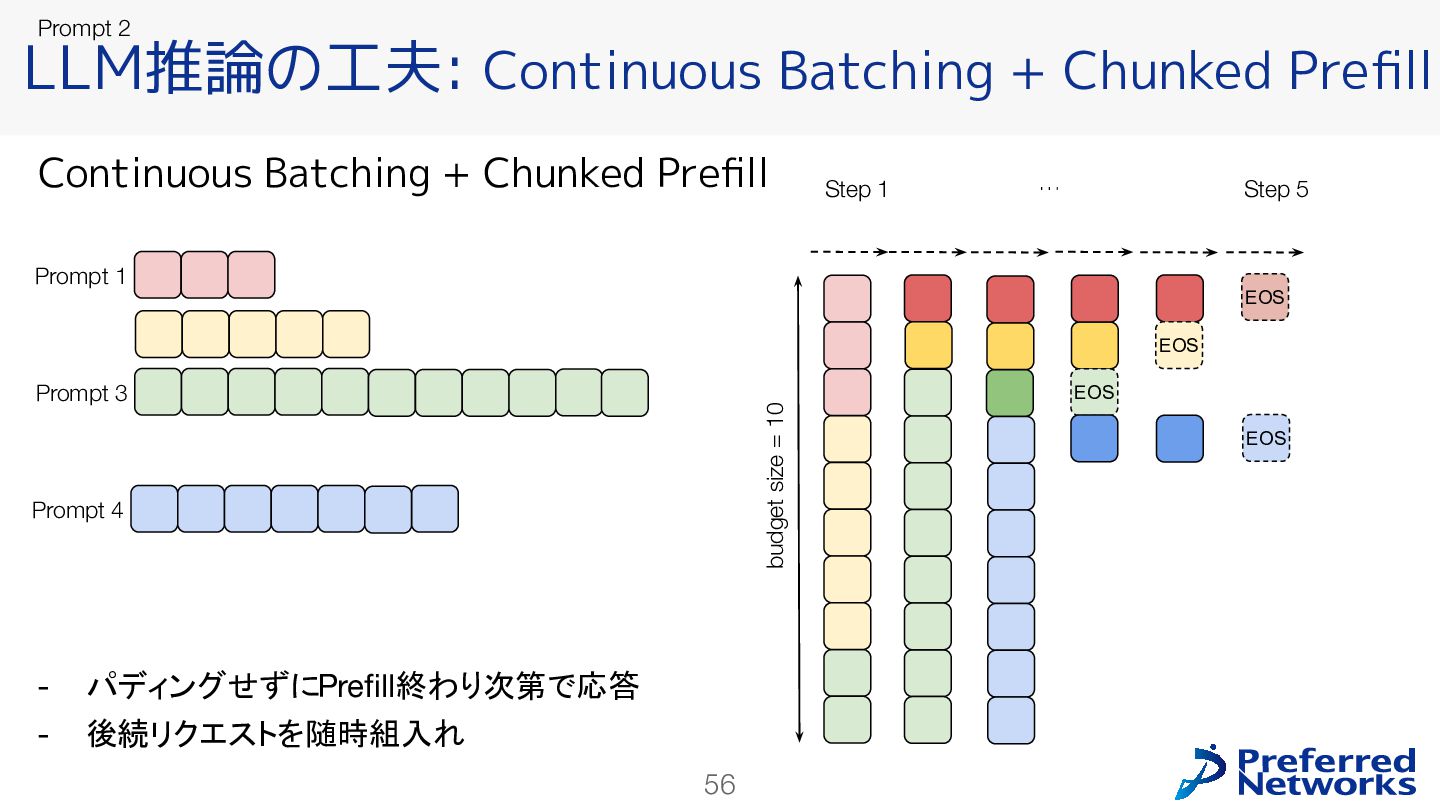
55 Step 1 … Step 5 EOS EOS EOS budget
size = 10 EOS Prompt 1 Prompt 3 Prompt 2 Prompt 4 LLM推論の工夫: Continuous Batching + Chunked Prefill Continuous Batching + Chunked Prefill - パディングせずにPrefill終わり次第で応答 - 後続リクエストを随時組入れ -
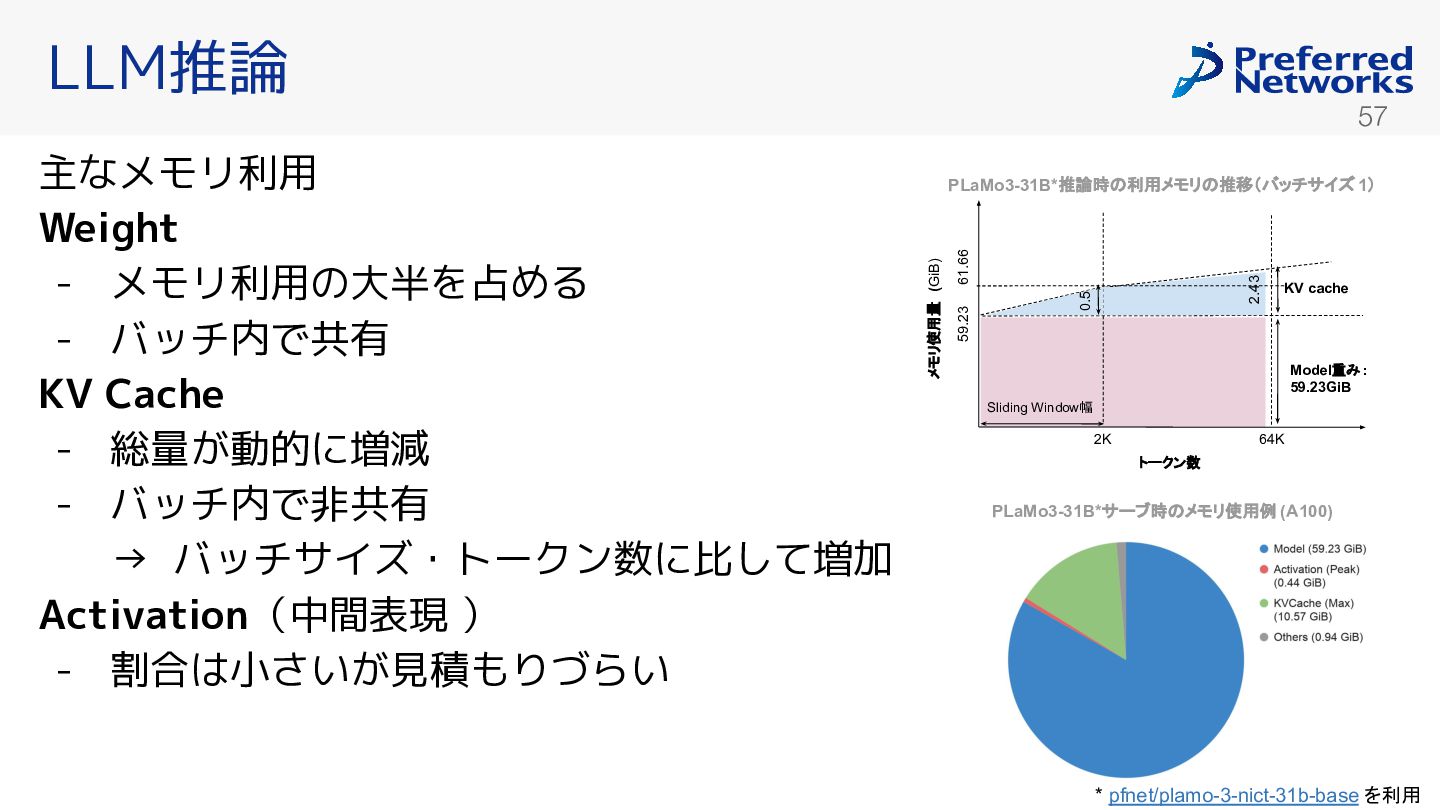
56 主なメモリ利用 Weight - メモリ利用の大半を占める - バッチ内で共有 KV Cache -
総量 動的に増減 - バッチ内で非共有 → バッチサイズ・トークン数に比して増加 Activation(中間表現 ) - 割合は小 い 見積もりづらい LLM推論 トークン数 メモリ使用量 (GiB) 59.23 KV cache Sliding Window幅 2K Model重み: 59.23GiB 64K 0.5 2.43 PLaMo3-31B*推論時 利用メモリ 推移(バッチサイズ 1) 61.66 PLaMo3-31B*サーブ時 メモリ使用例 (A100) * pfnet/plamo-3-nict-31b-base を利用 -
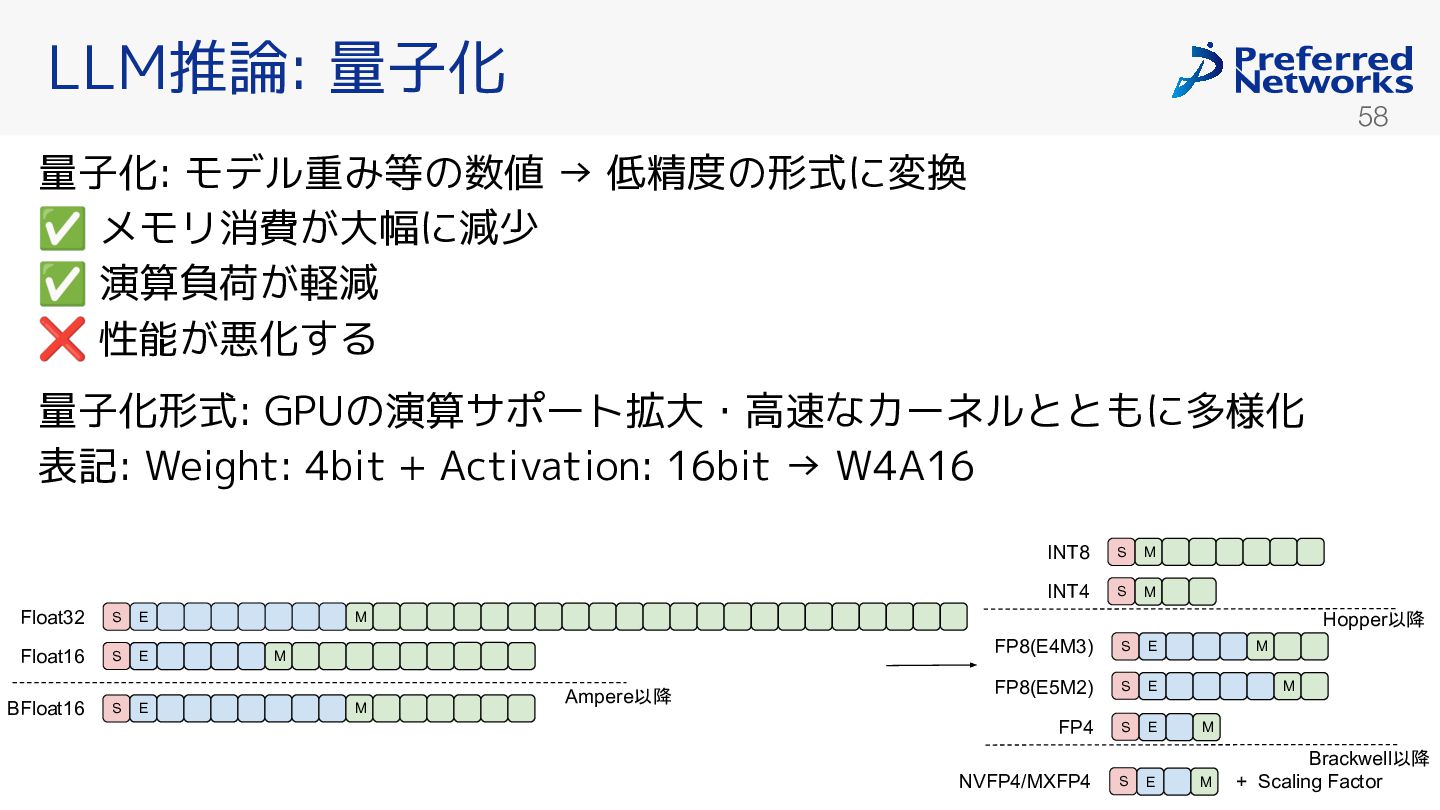
57 LLM推論: 量子化 量子化: モデル重み等の数値 → 低精度の形式に変換 ✅ メモリ消費 大幅に減少
✅ 演算負荷 軽減 ❌ 性能 悪化する 量子化形式: GPUの演算サポート拡大・高速なカーネルとともに多様化 表記: Weight: 4bit + Activation: 16bit → W4A16 S E S E S E M M M Float32 Float16 BFloat16 S S M M INT8 INT4 S E M NVFP4/MXFP4 + Scaling Factor S S E E M FP8(E4M3) FP4 M FP8(E5M2) S E M Ampere以降 Hopper以降 Brackwell以降 -
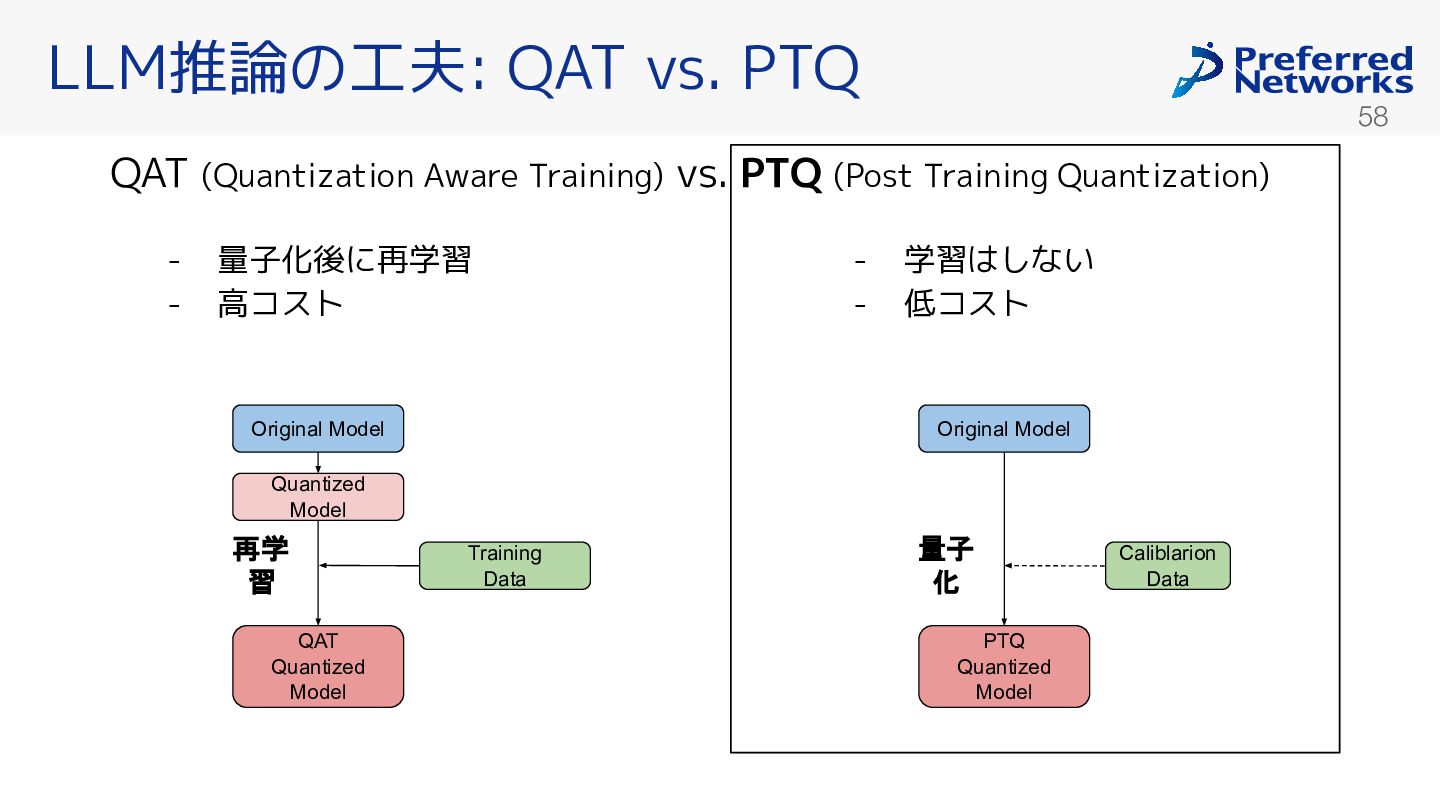
58 QAT (Quantization Aware Training) vs. PTQ (Post Training Quantization)
LLM推論の工夫: QAT vs. PTQ Original Model Quantized Model Training Data PTQ Quantized Model Caliblarion Data QAT Quantized Model Original Model - 量子化後に再学習 - 高コスト - 学習はしない - 低コスト 再学 習 量子 化 -
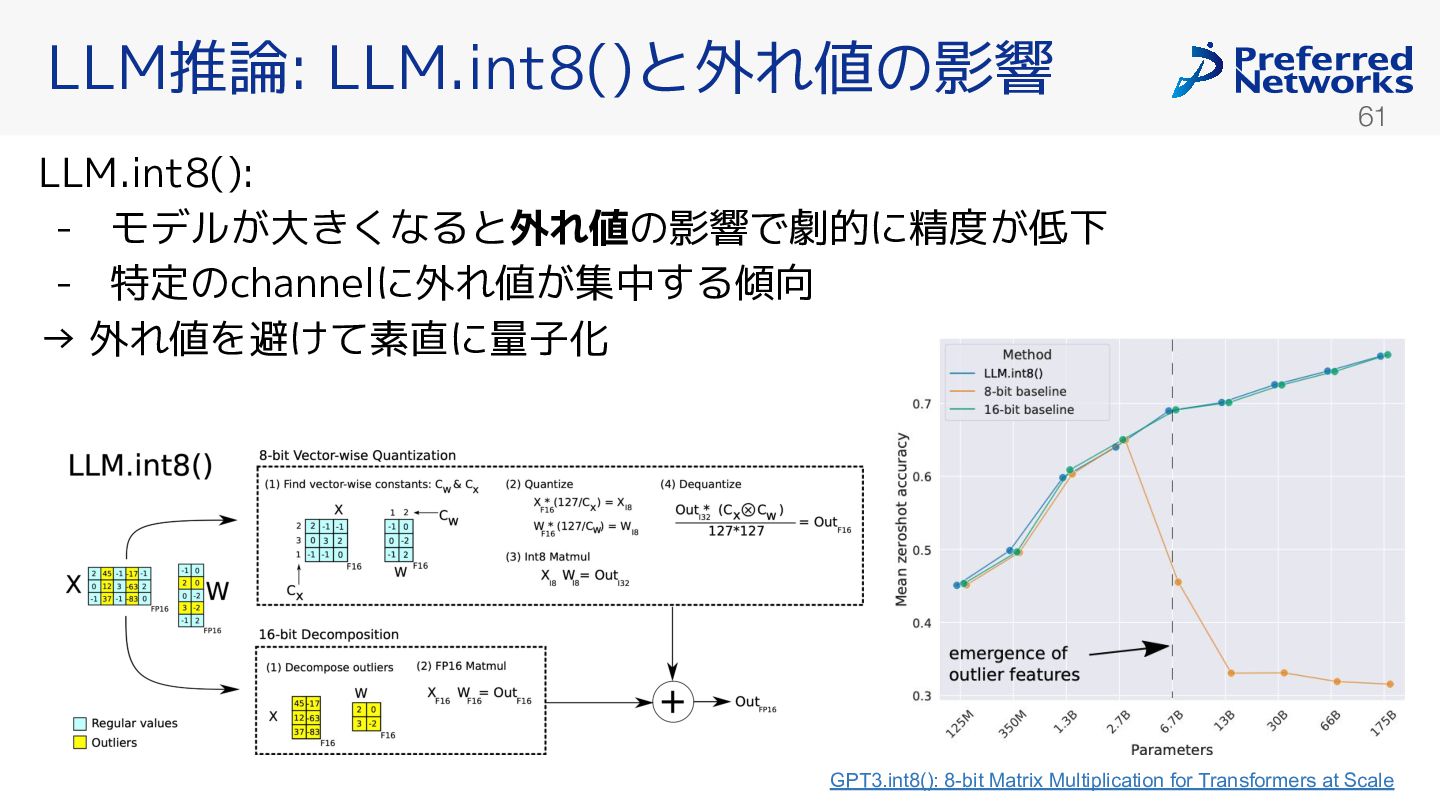
60 LLM推論: LLM.int8()と外れ値の影響 LLM.int8(): - モデル 大 なると外れ値の影響で劇的に精度 低下 -
特定のchannelに外れ値 集中する傾向 → 外れ値を避 て素直に量子化 GPT3.int8(): 8-bit Matrix Multiplication for Transformers at Scale -
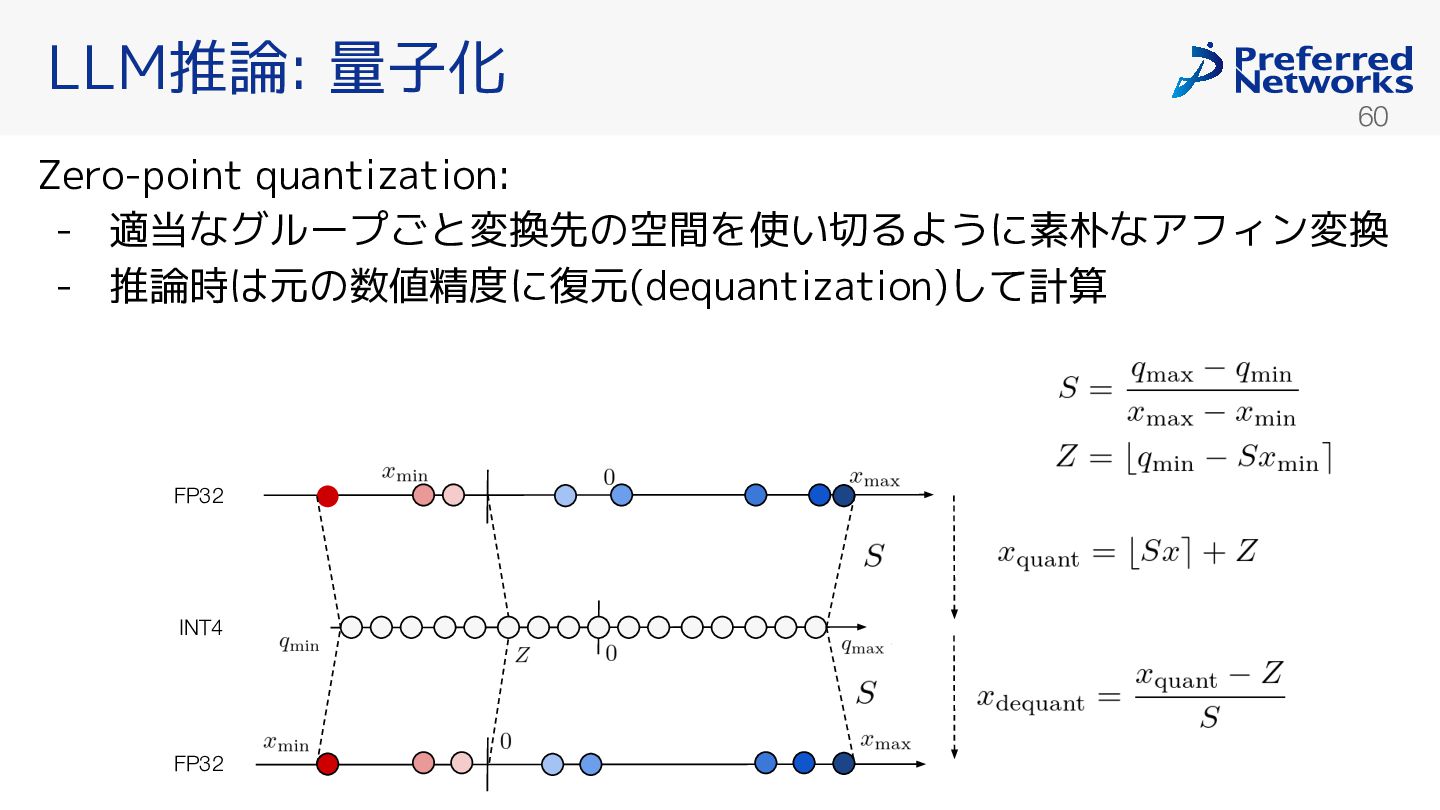
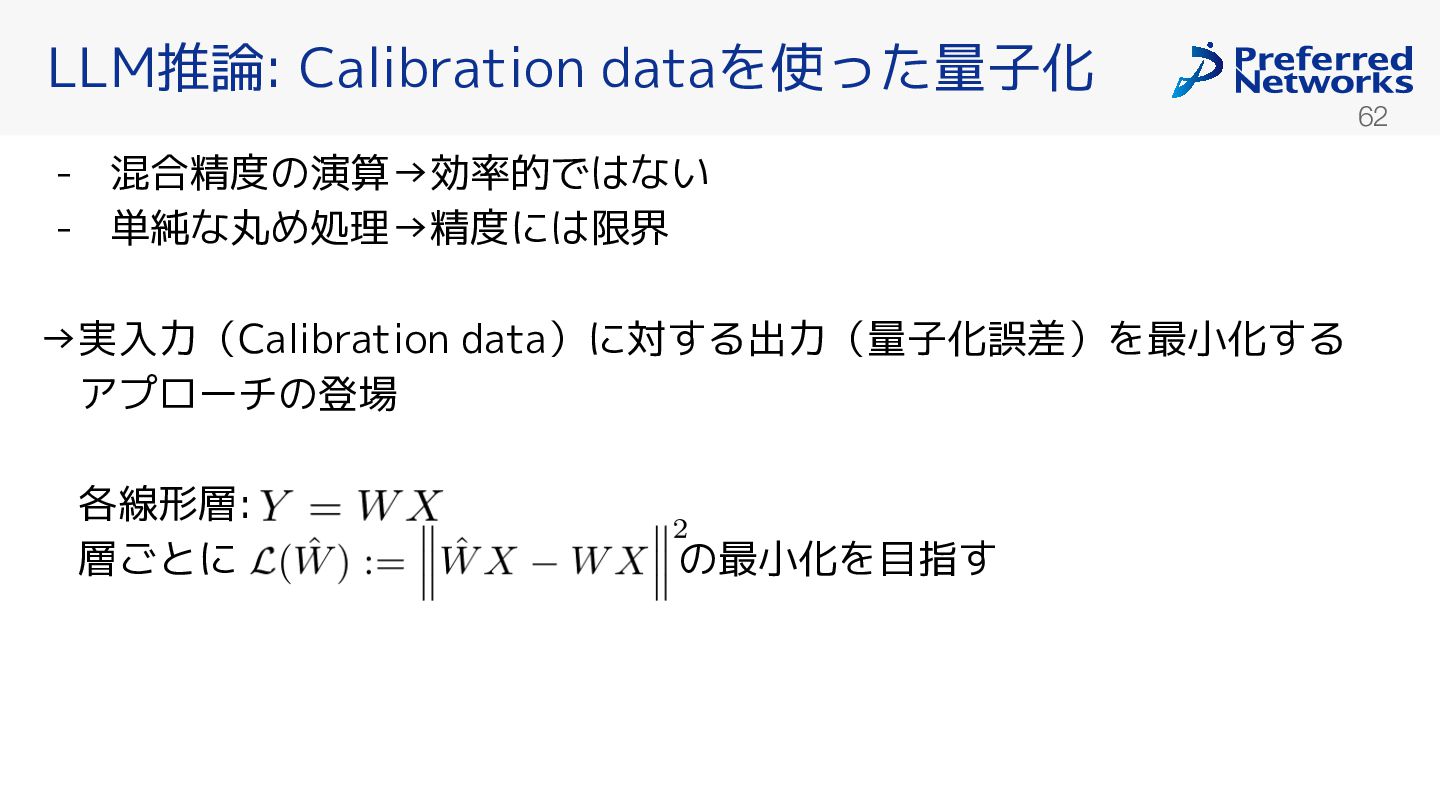
61 - 混合精度の演算→効率的ではない - 単純な丸め処理→精度には限界 →実入力(Calibration data)に対する出力(量子化誤差)を最小化する アプローチの登場 各線形層: 層
とに の最小化を目指す LLM推論: Calibration dataを使った量子化 -
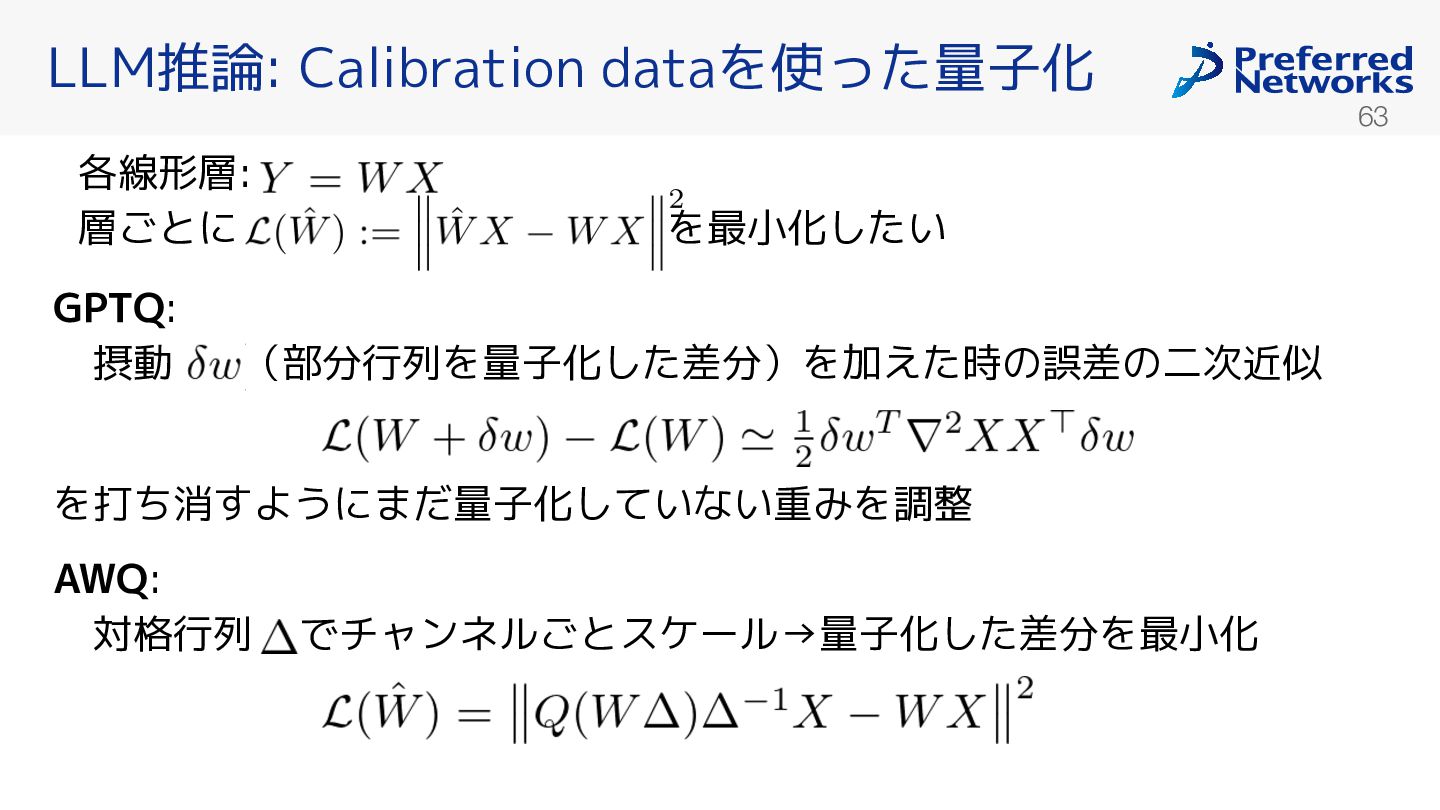
62 GPTQ: 摂動 (部分行列を量子化した差分)を加えた時の誤差の二次近似 を打ち消すようにまだ量子化していない重みを調整 AWQ: 対格行列 でチャンネル とスケール→量子化した差分を最小化 各線形層:
層 とに を最小化したい LLM推論: Calibration dataを使った量子化 -
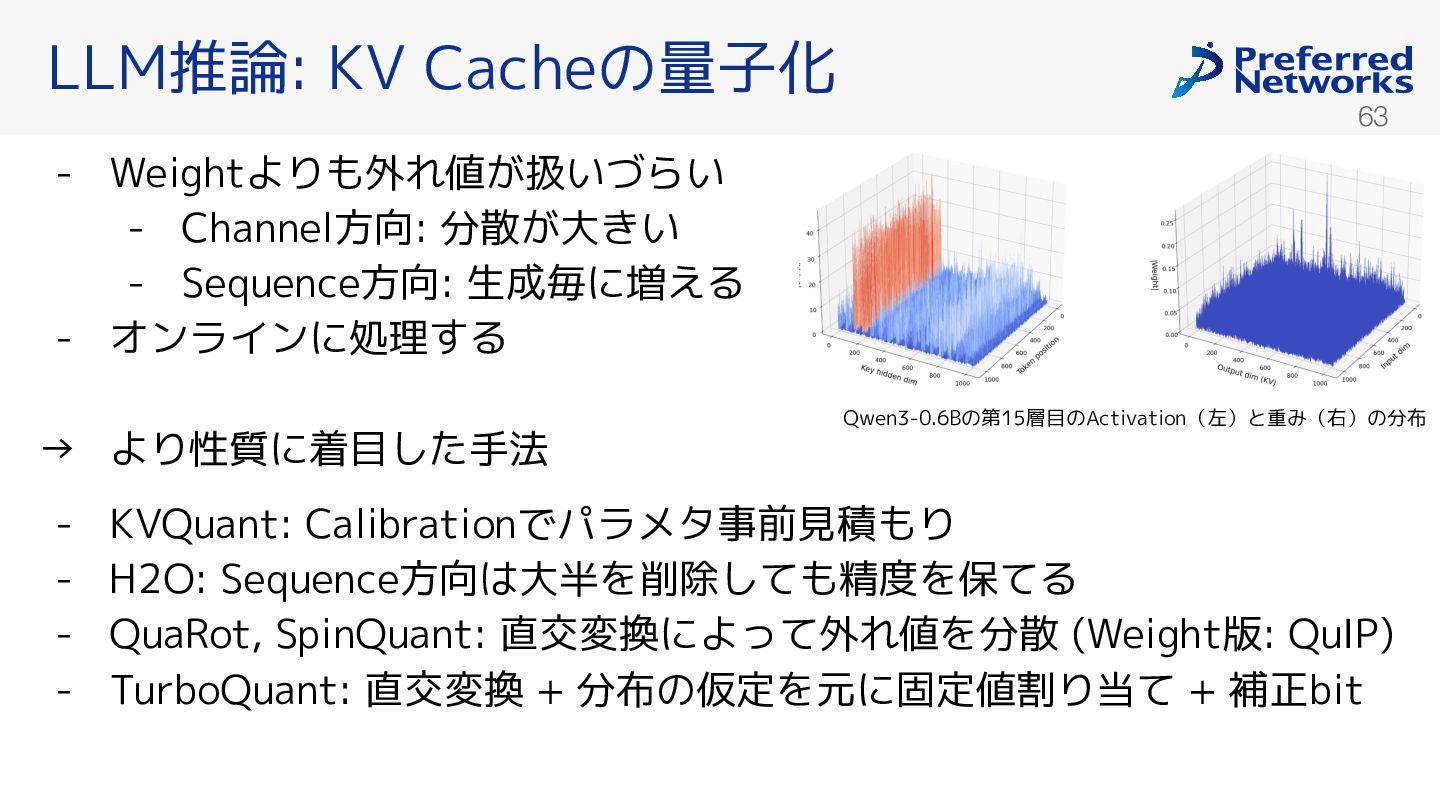
63 - Weightよりも外れ値 扱いづらい - Channel方向: 分散 大 い -
Sequence方向: 生成毎に増える - オンラインに処理する → より性質に着目した手法 - KVQuant: Calibrationでパラメタ事前見積もり - H2O: Sequence方向は大半を削除しても精度を保てる - QuaRot, SpinQuant: 直交変換によって外れ値を分散 (Weight版: QuIP) - TurboQuant: 直交変換 + 分布の仮定を元に固定値割り当て + 補正bit LLM推論: KV Cacheの量子化 Qwen3-0.6Bの第15層目のActivation(左)と重み(右)の分布 -
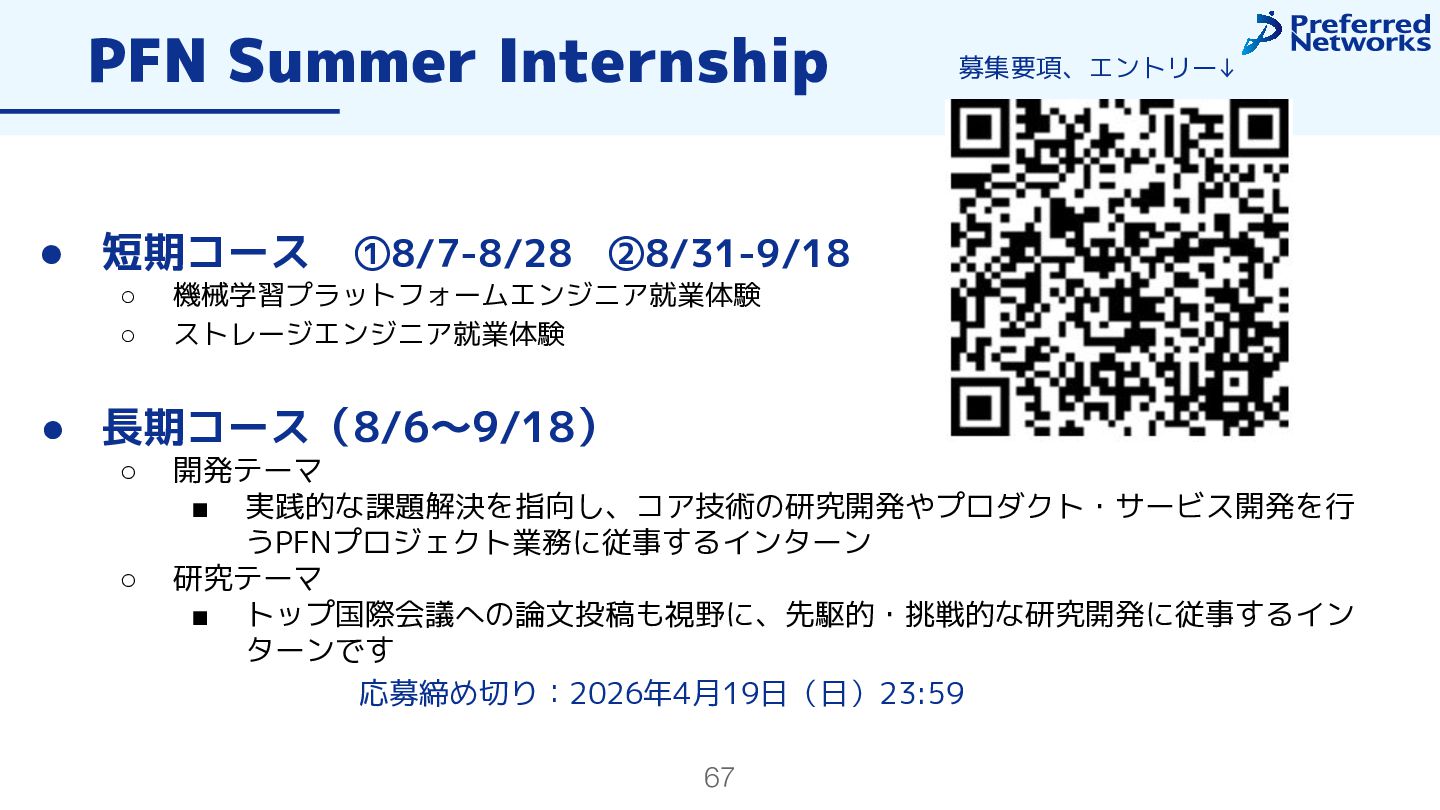
65 PFN Summer Internship 勤務体系 福利厚生 • 短期コース ①8/7-8/28 ②8/31-9/18 ◦
機械学習プラットフォームエンジニア就業体験 ◦ ストレージエンジニア就業体験 • 長期コース(8/6~9/18) ◦ 開発テーマ ▪ 実践的な課題解決を指向し、コア技術の研究開発やプロダクト・サービス開発を行 うPFNプロジェクト業務に従事するインターン ◦ 研究テーマ ▪ トップ国際会議への論文投稿も視野に、先駆的・挑戦的な研究開発に従事するイン ターンです 応募締め切り:2026年4月19日(日)23:59 募集要項、エントリー↓ -
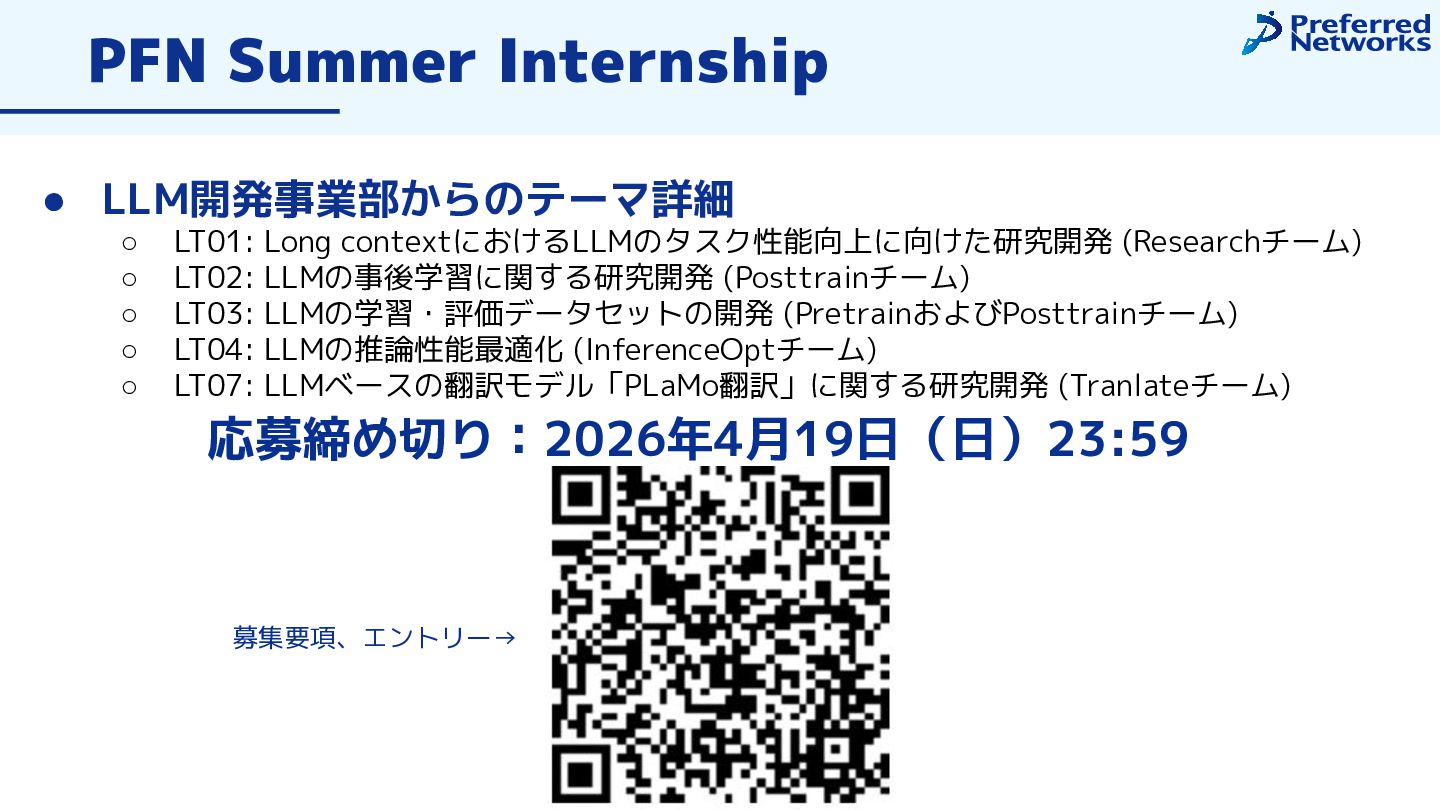
66 PFN Summer Internship 勤務体系 • LLM開発事業部からのテーマ詳細 ◦ LT01: Long
contextに るLLMのタスク性能向上に向 た研究開発 (Researchチーム) ◦ LT02: LLMの事後学習に関する研究開発 (Posttrainチーム) ◦ LT03: LLMの学習・評価データセットの開発 (Pretrain よびPosttrainチーム) ◦ LT04: LLMの推論性能最適化 (InferenceOptチーム) ◦ LT07: LLMベースの翻訳モデル「PLaMo翻訳」に関する研究開発 (Tranlateチーム) 応募締め切り:2026年4月19日(日)23:59 募集要項、エントリー→ -
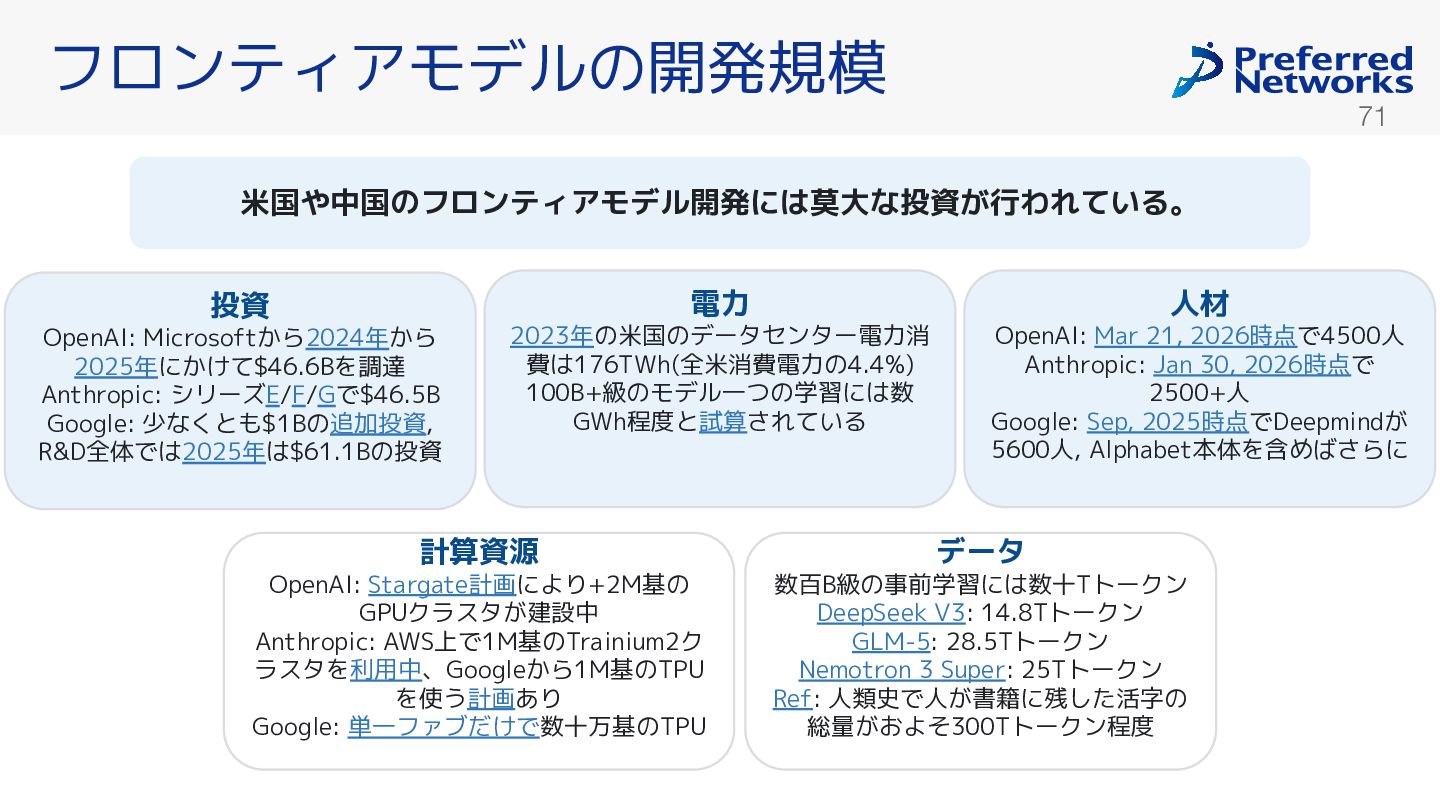
69 フロンティアモデルの開発規模 米国や中国のフロンティアモデル開発には莫大な投資が行われている。 投資 OpenAI: Microsoft ら2024年 ら 2025年に て$46.6Bを調達
Anthropic: シリーズE/F/Gで$46.5B Google: 少な とも$1Bの追加投資, R&D全体では2025年は$61.1Bの投資 計算資源 OpenAI: Stargate計画により+2M基の GPUクラスタ 建設中 Anthropic: AWS上で1M基のTrainium2ク ラスタを利用中、Google ら1M基のTPU を使う計画あり Google: 単一ファブだ で数十万基のTPU 電力 2023年の米国のデータセンター電力消 費は176TWh(全米消費電力の4.4%) 100B+級のモデル一つの学習には数 GWh程度と試算 れている データ 数百B級の事前学習には数十Tトークン DeepSeek V3: 14.8Tトークン GLM-5: 28.5Tトークン Nemotron 3 Super: 25Tトークン Ref: 人類史で人 書籍に残した活字の 総量 よそ300Tトークン程度 人材 OpenAI: Mar 21, 2026時点で4500人 Anthropic: Jan 30, 2026時点で 2500+人 Google: Sep, 2025時点でDeepmind 5600人, Alphabet本体を含めば らに -
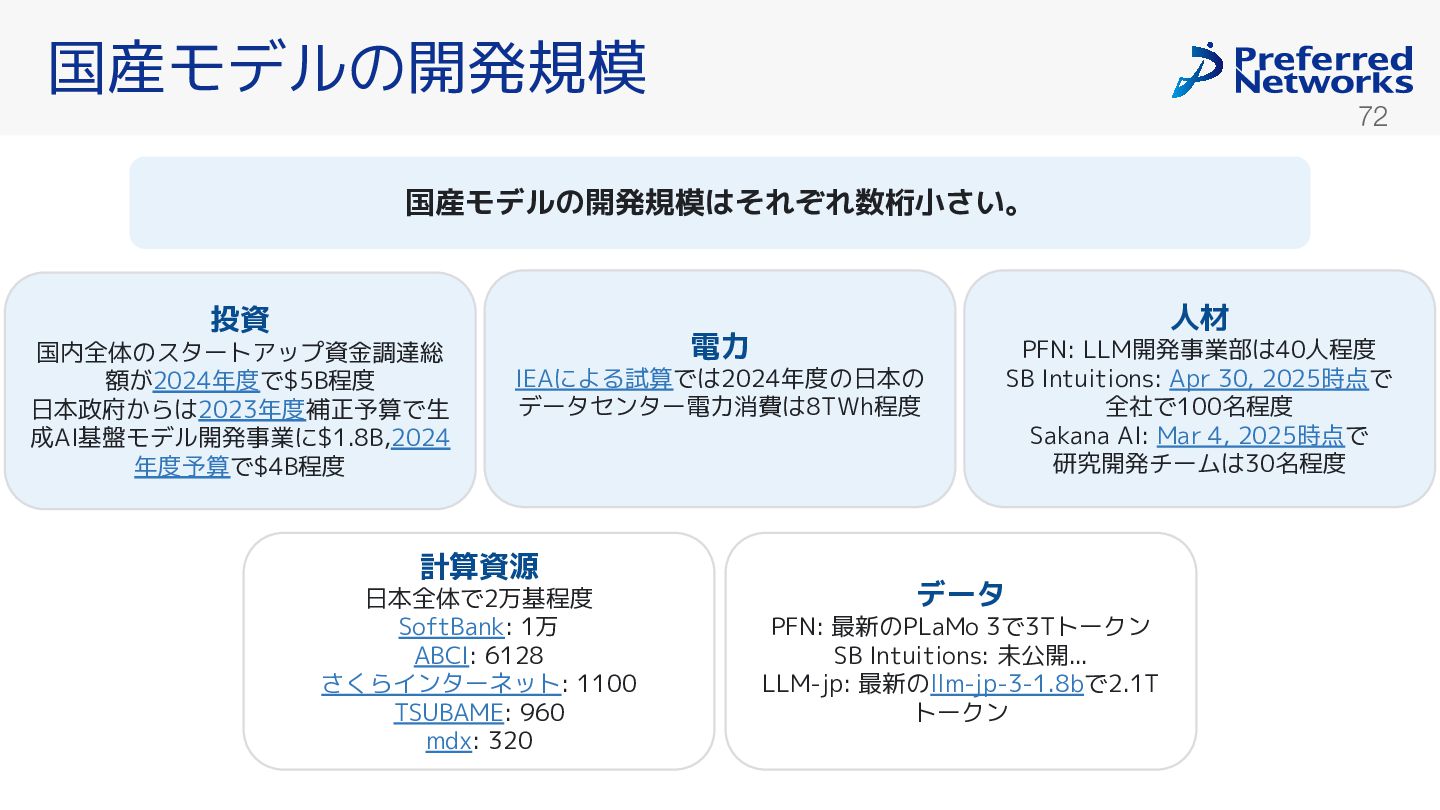
70 国産モデルの開発規模 国産モデルの開発規模はそれぞれ数桁小さい。 投資 国内全体のスタートアップ資金調達総 額 2024年度で$5B程度 日本政府 らは2023年度補正予算で生 成AI基盤モデル開発事業に$1.8B,2024
年度予算で$4B程度 計算資源 日本全体で2万基程度 SoftBank: 1万 ABCI: 6128 らインターネット: 1100 TSUBAME: 960 mdx: 320 電力 IEAによる試算では2024年度の日本の データセンター電力消費は8TWh程度 データ PFN: 最新のPLaMo 3で3Tトークン SB Intuitions: 未公開... LLM-jp: 最新のllm-jp-3-1.8bで2.1T トークン 人材 PFN: LLM開発事業部は40人程度 SB Intuitions: Apr 30, 2025時点で 全社で100名程度 Sakana AI: Mar 4, 2025時点で 研究開発チームは30名程度 -
71 クローズドモデル ナーフ れま って、オープンモデルもオープンに開発 れな なって、それでもフロンティアモデルを開発し続 たいとして、公 開 れた最後のオープンモデルの事後学習だ
で追いつ ます ? 追いつ るとは、限らないと思います。 事前学習は必要 -
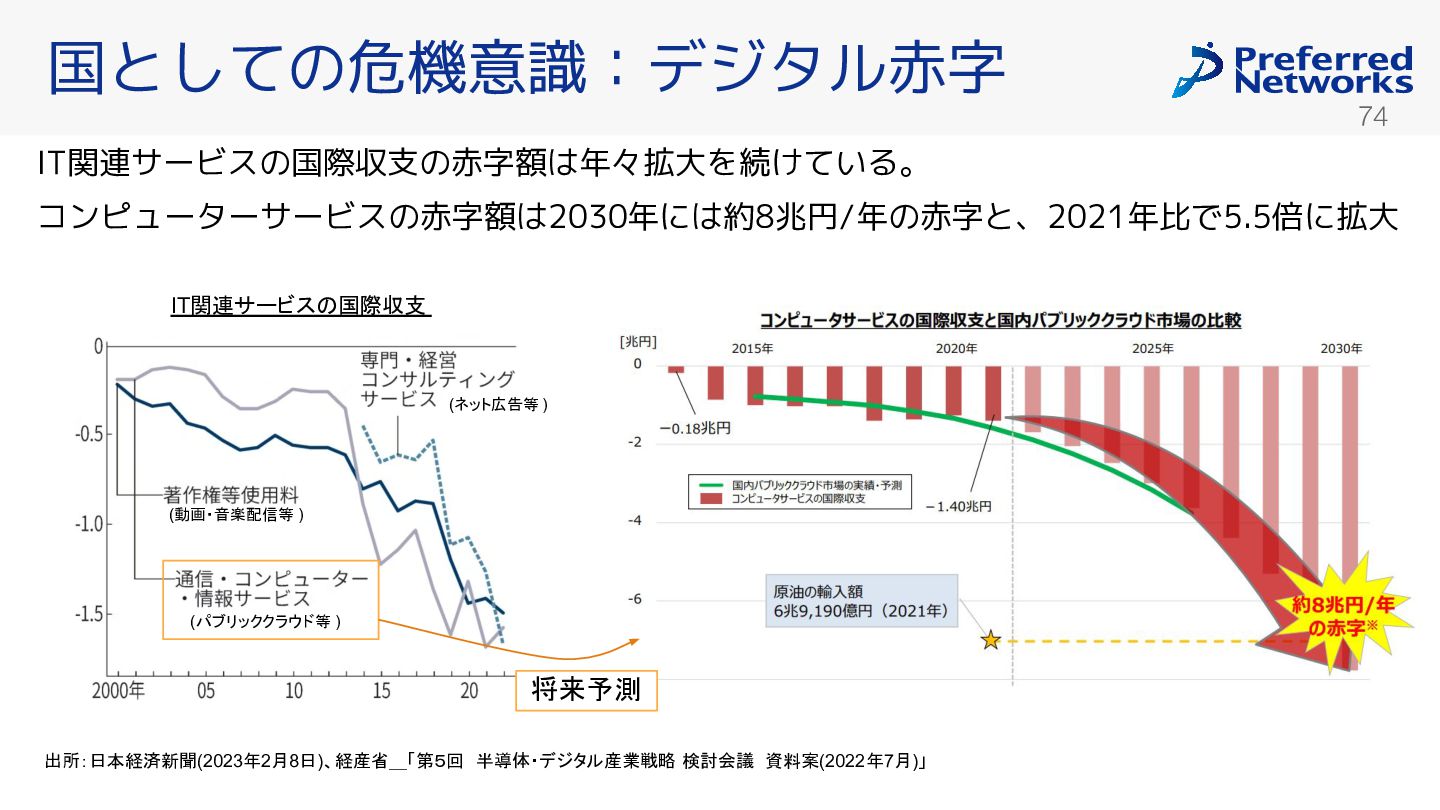
72 国としての危機意識:デジタル赤字 出所:日本経済新聞(2023年2月8日)、経産省_「第5回 半導体・デジタル産業戦略 検討会議 資料案(2022年7月)」 将来予測 IT関連サービス 国際収支 (動画・音楽配信等 ) (ネット広告等
) (パブリッククラウド等 ) IT関連サービスの国際収支の赤字額は年々拡大を続 ている。 コンピューターサービスの赤字額は2030年には約8兆円/年の赤字と、2021年比で5.5倍に拡大 -
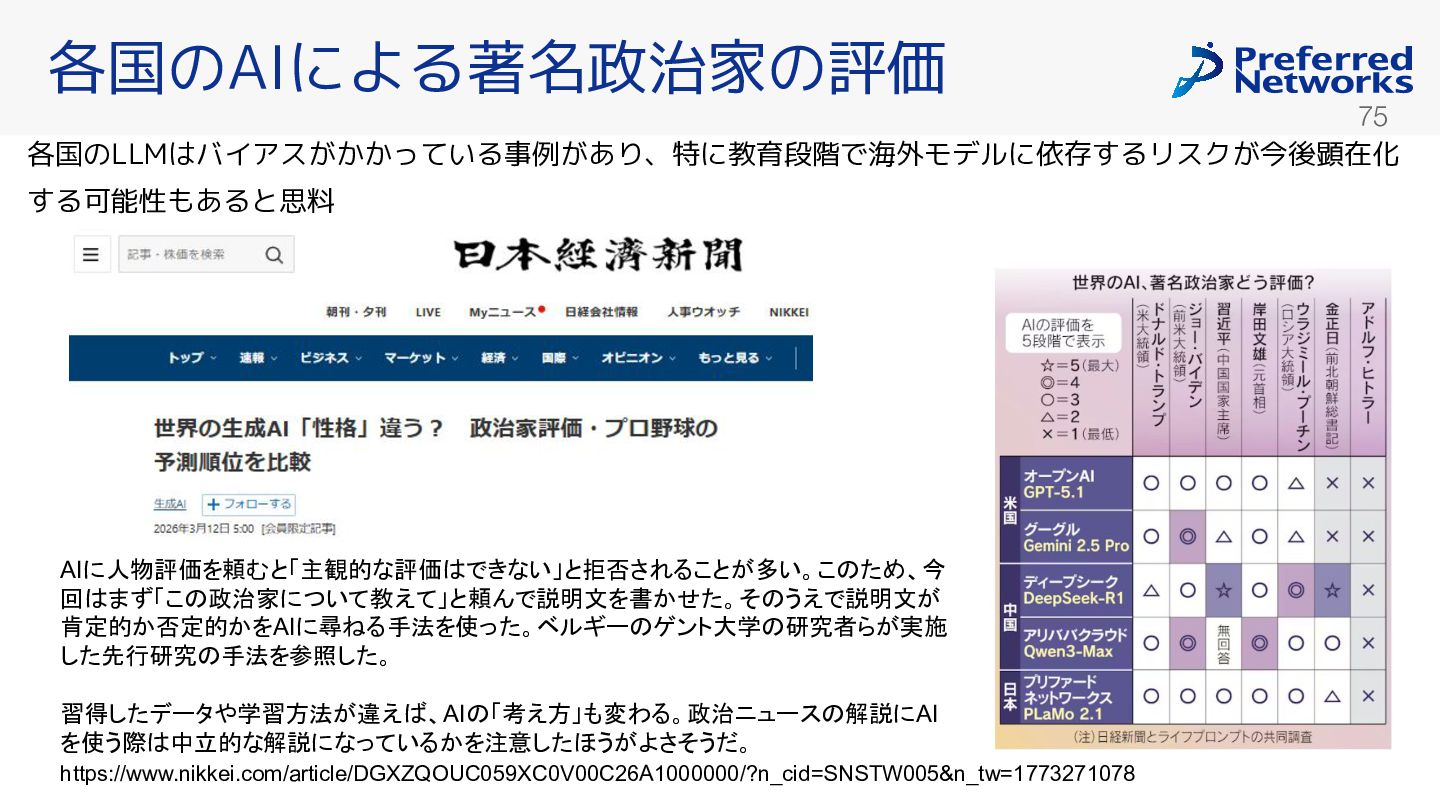
73 各国のAIによる著名政治家の評価 各国のLLMはバイアス っている事例 あり、特に教育段階で海外モデルに依存するリスク 今後顕在化 する可能性もあると思料 https://www.nikkei.com/article/DGXZQOUC059XC0V00C26A1000000/?n_cid=SNSTW005&n_tw=1773271078 AIに人物評価を頼むと「主観的な評価 できない」と拒否されることが多い。こ
ため、今 回 まず「こ 政治家について教えて」と頼んで説明文を書かせた。そ うえで説明文が 肯定的か否定的かをAIに尋 る手法を使った。ベルギー ゲント大学 研究者らが実施 した先行研究 手法を参照した。 習得したデータや学習方法が違え 、AI 「考え方」も変わる。政治ニュース 解説にAI を使う際 中立的な解説になっているかを注意したほうがよさそうだ。
 pfn
 aemeredith
 tapps
 jonoalderson
 rasmusluckow
 jonrohan
 mkilby
 baasie
 malarkey
 stuffmc
 bluesmoon
 keathley
 marktimemedia