Here are the concise descriptions for each subsystem in English:
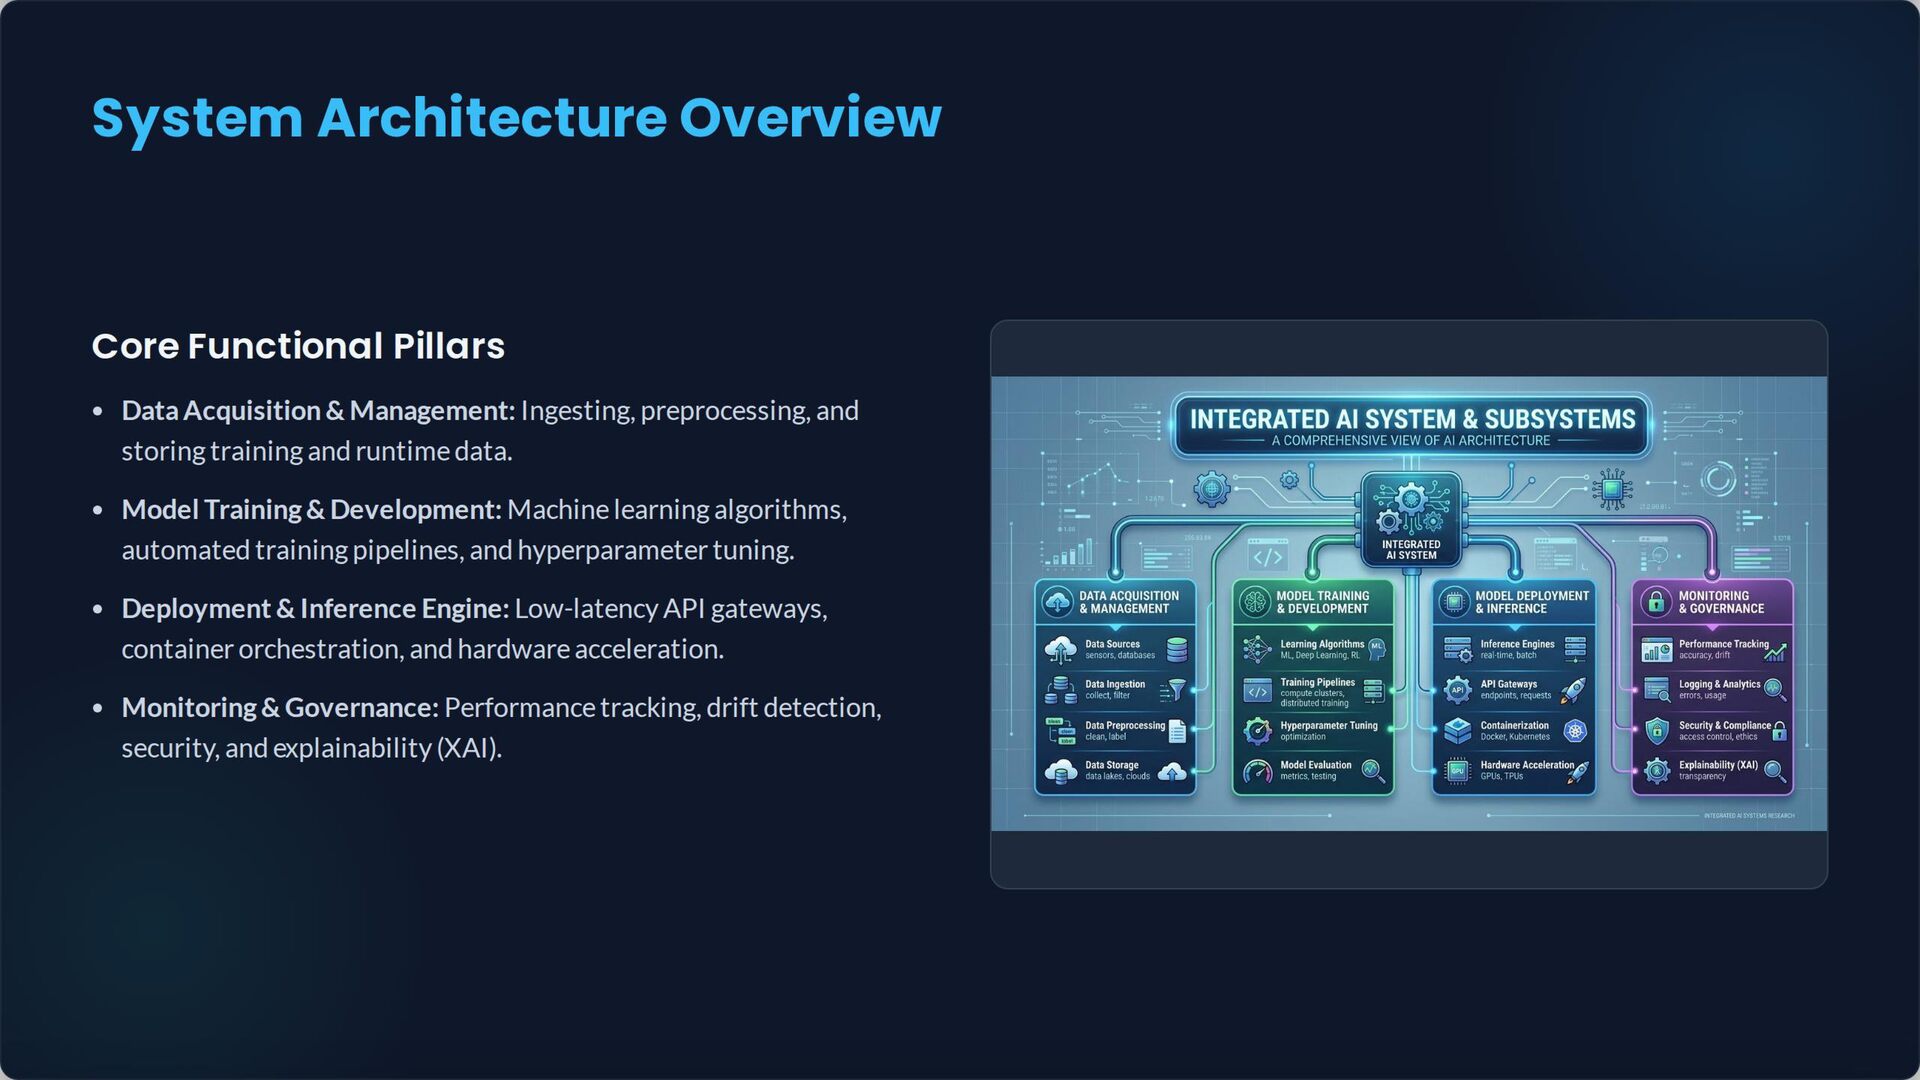
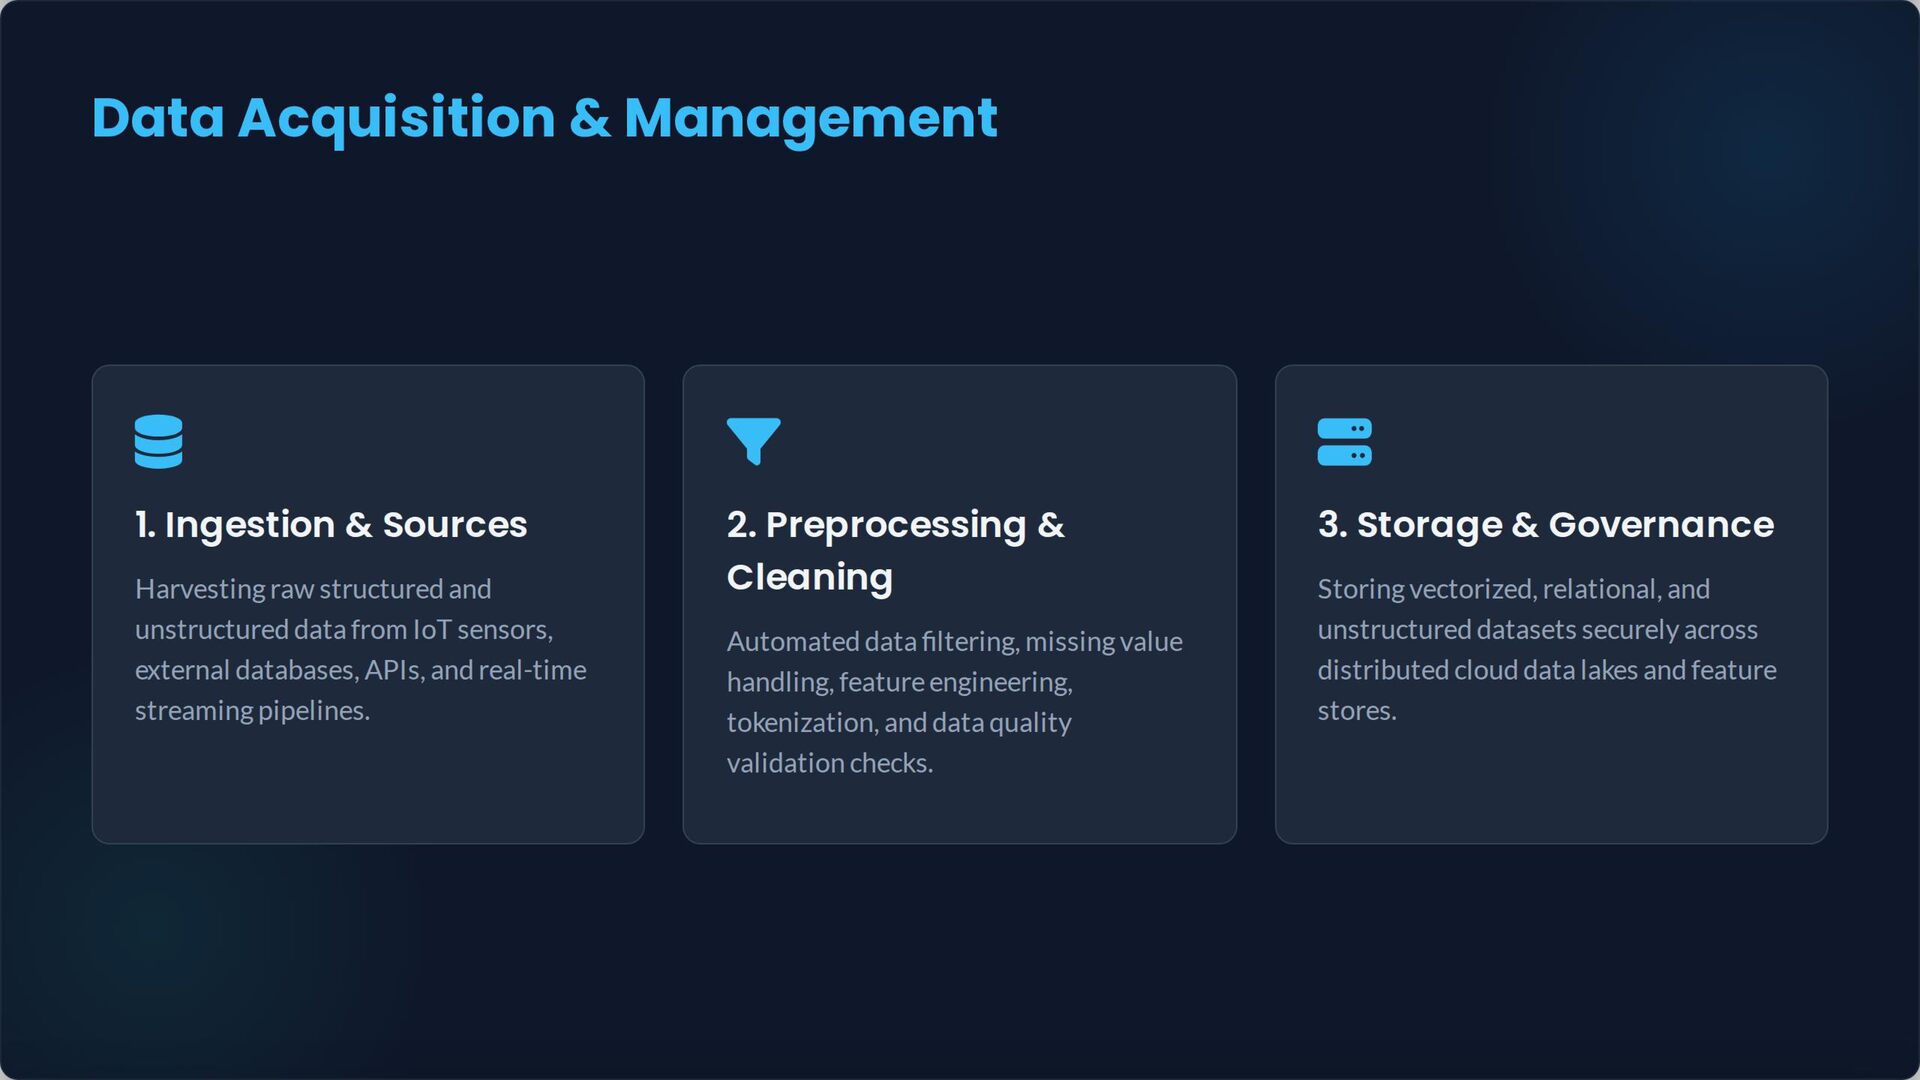
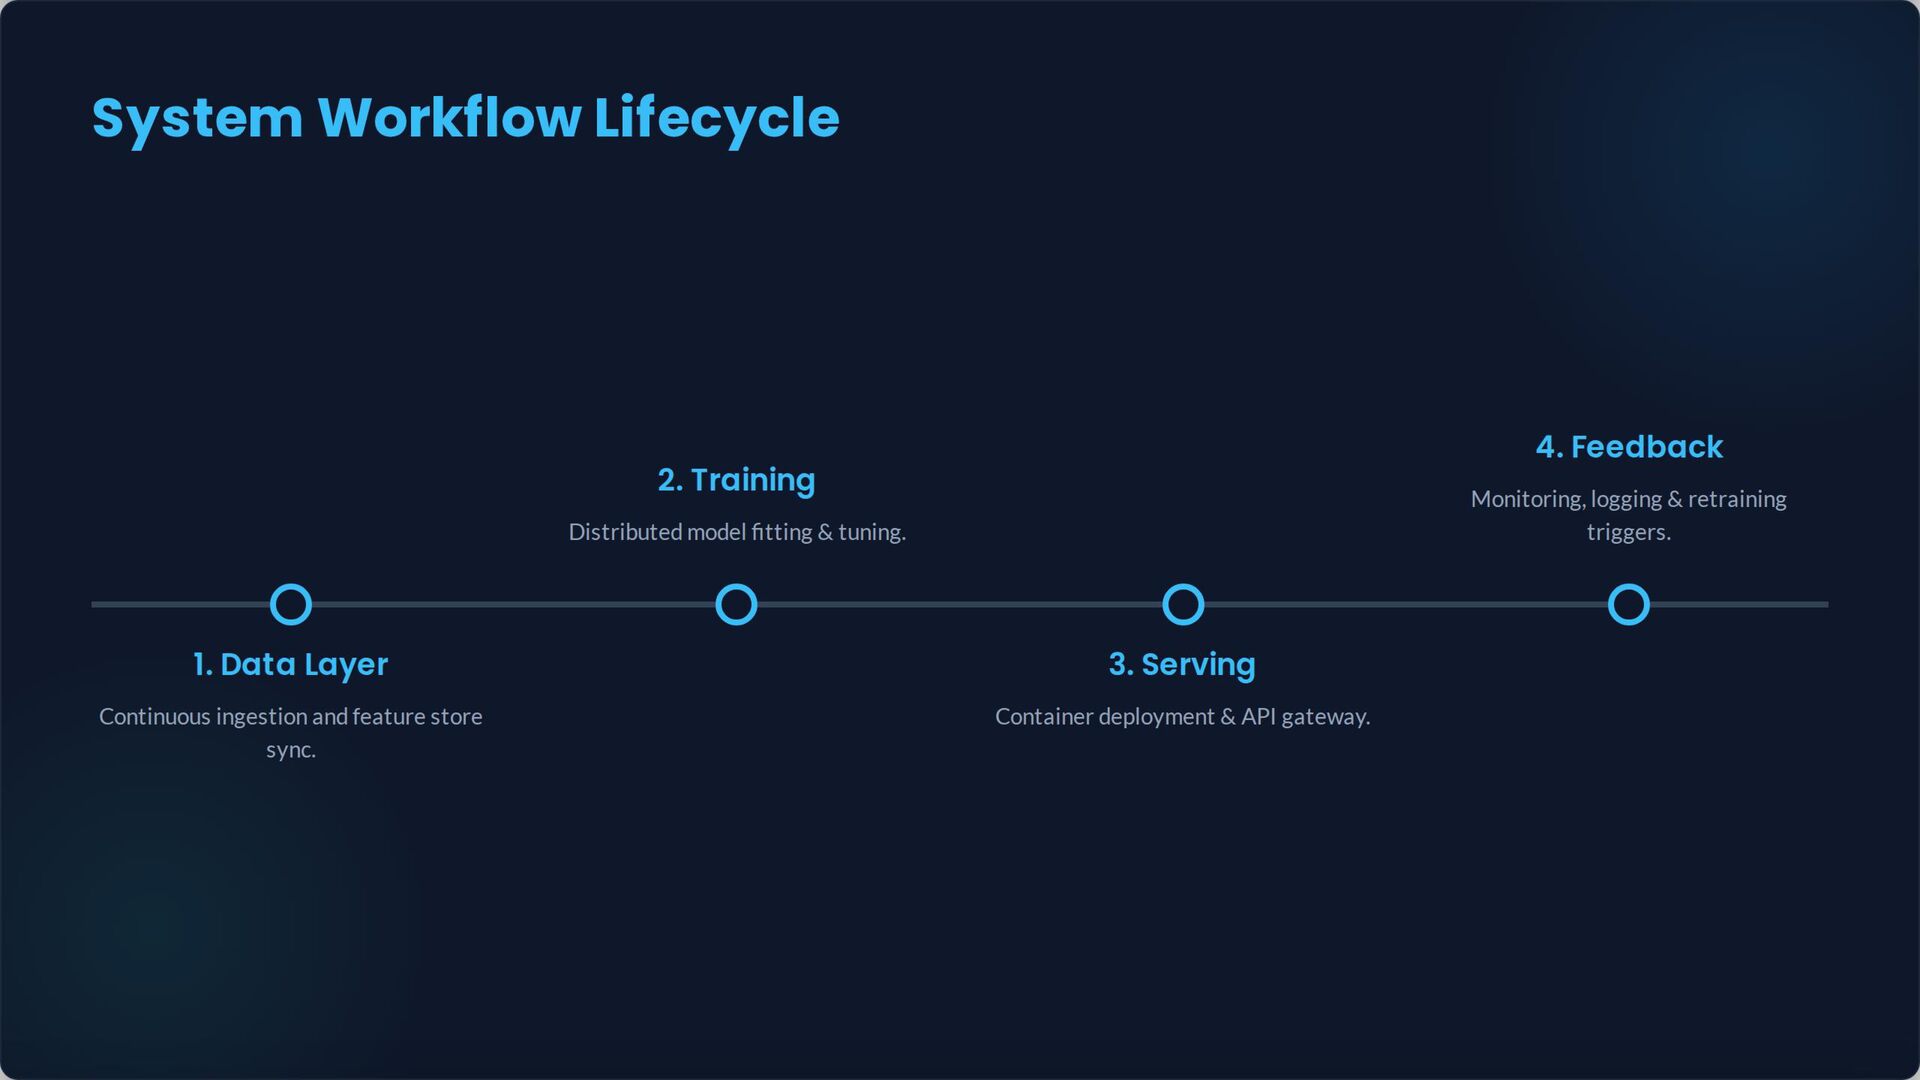
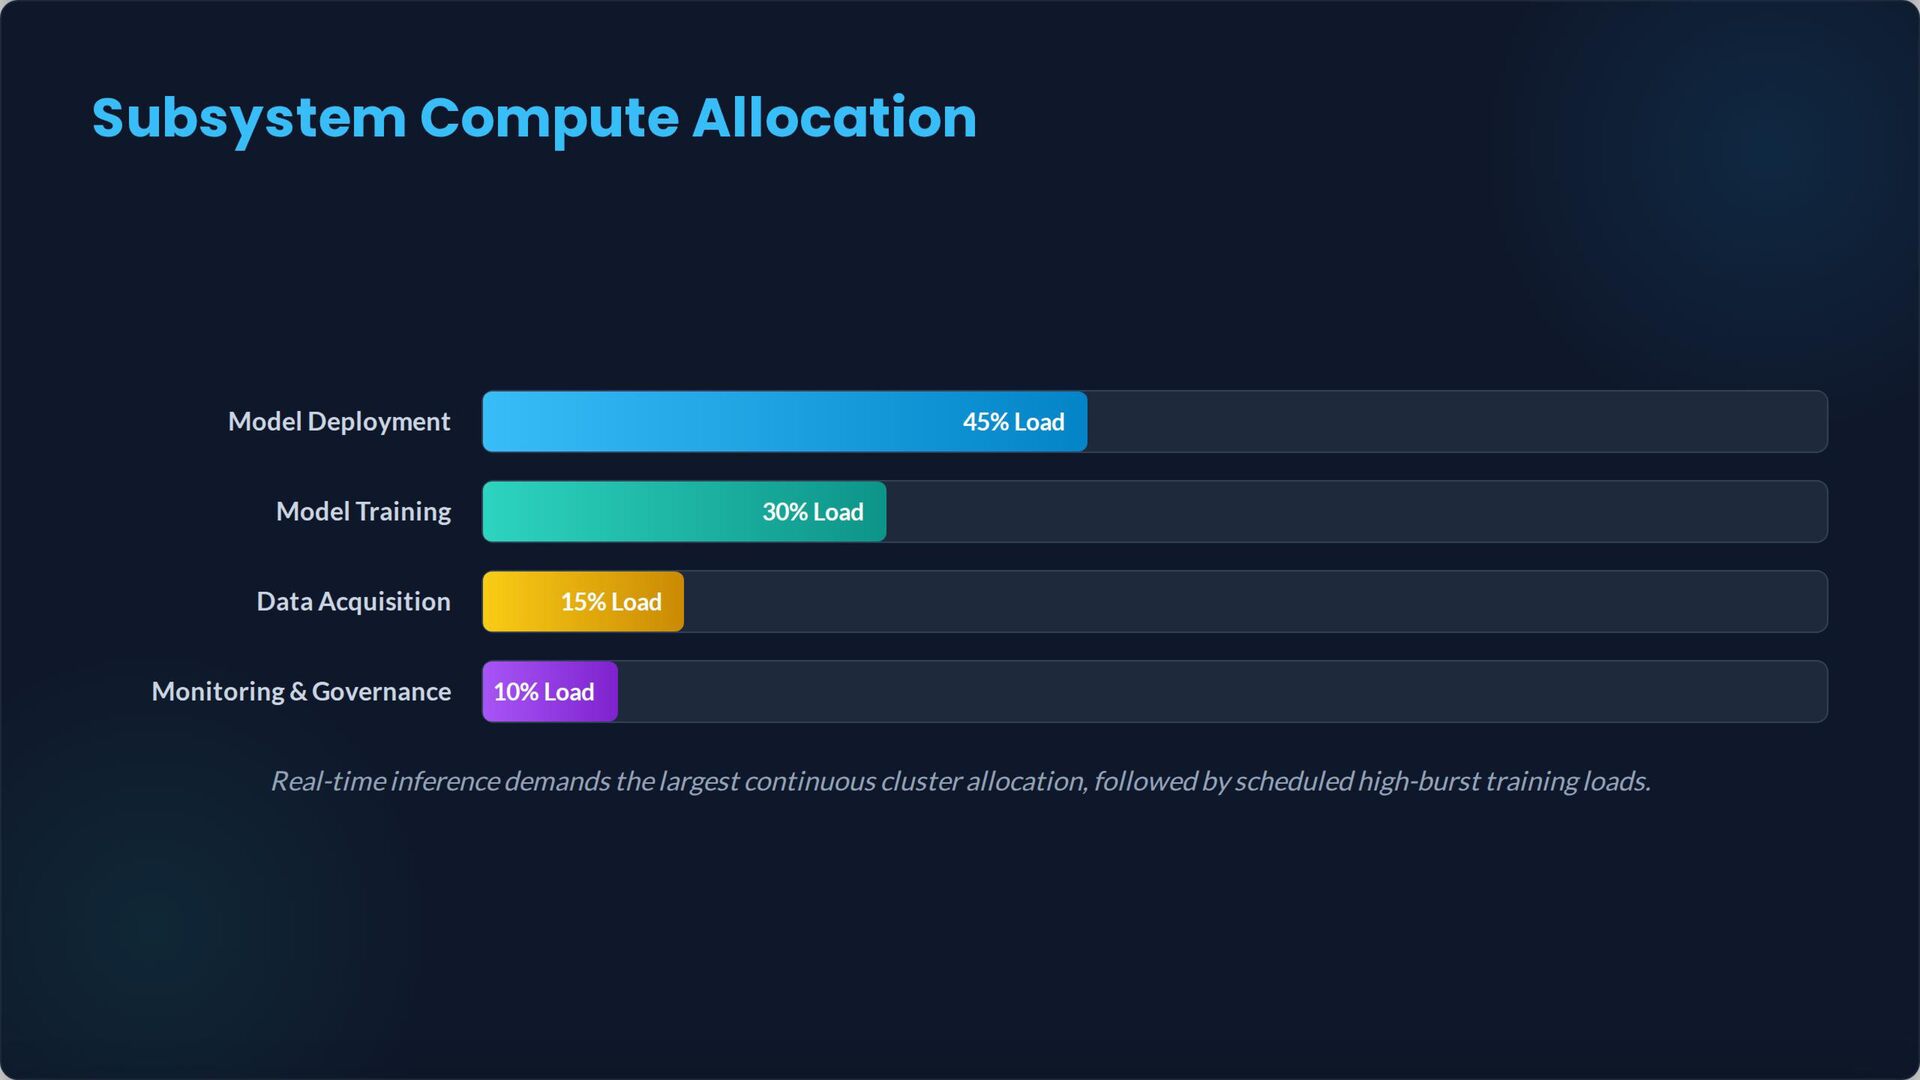
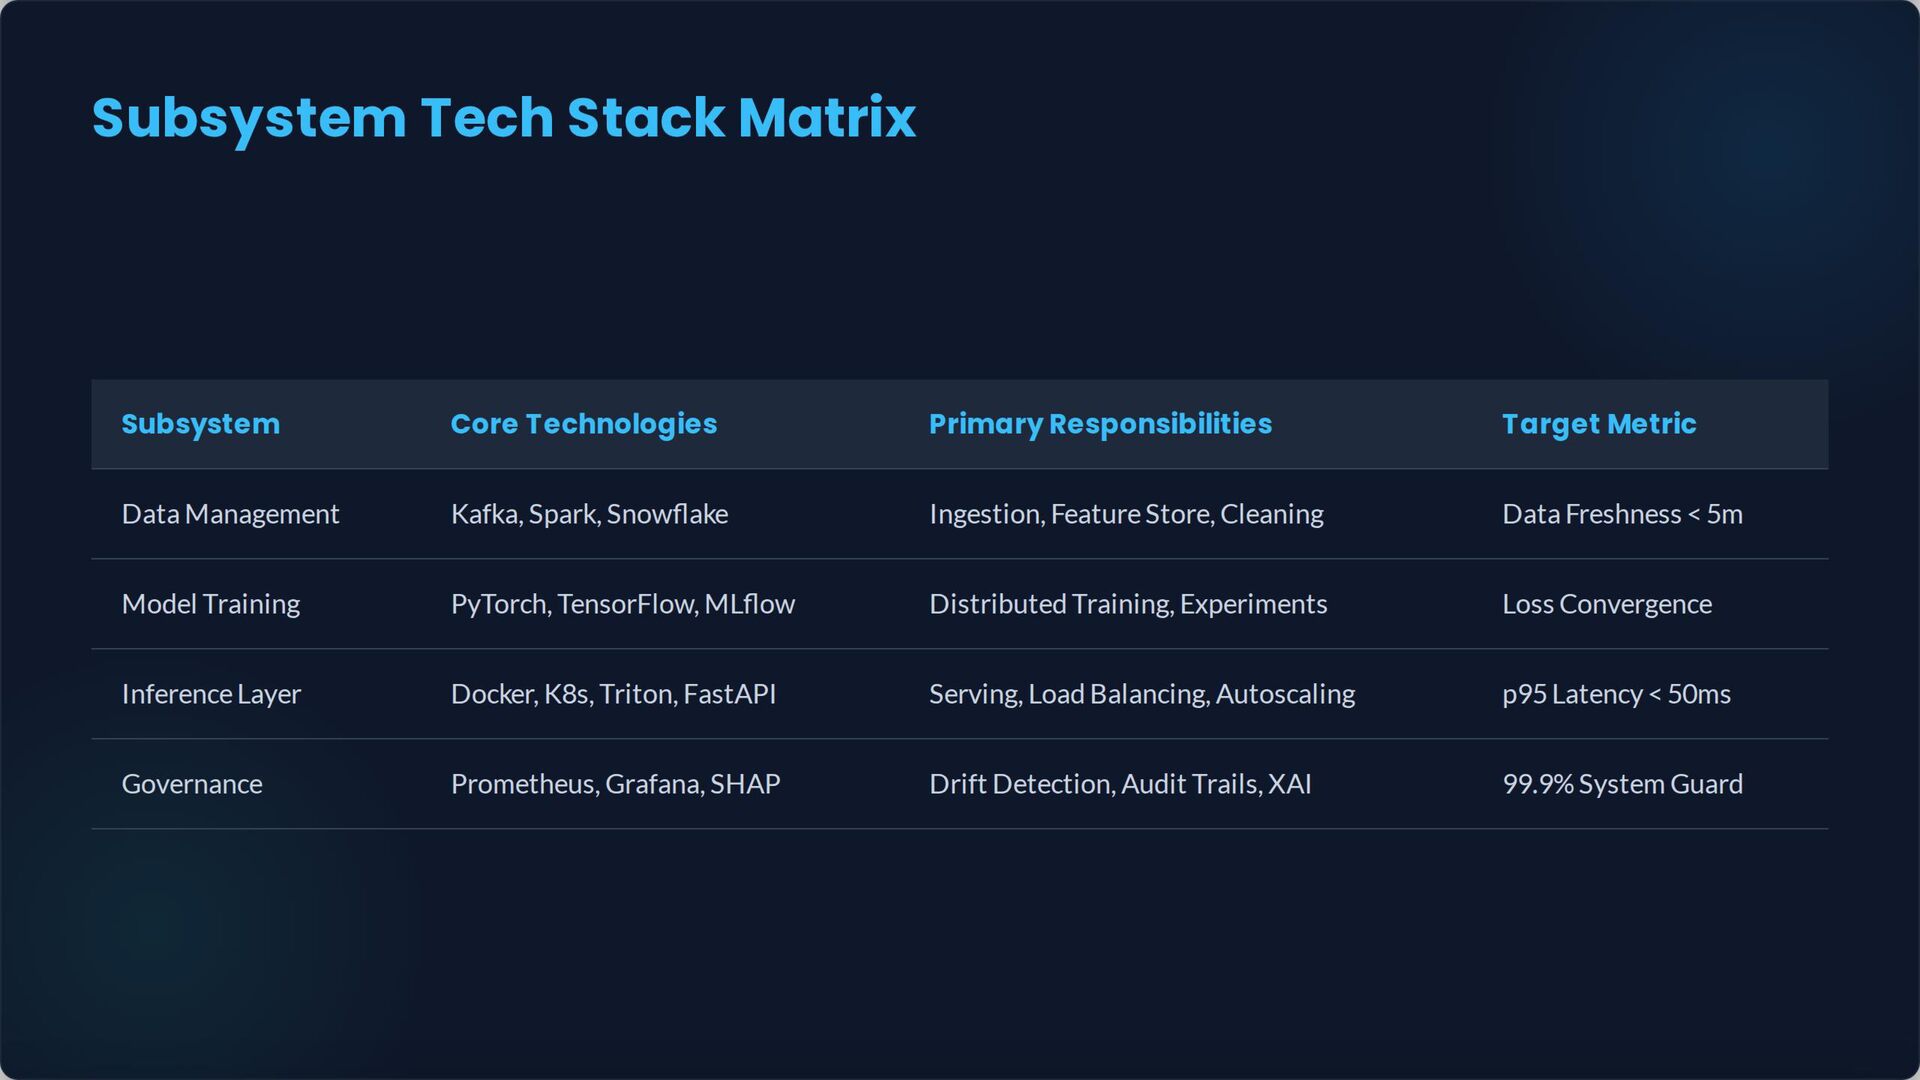
* Data Acquisition & Management: Responsible for harvesting raw data from diverse sources, preprocessing and cleaning it via feature engineering, and securely storing it across cloud data lakes and feature stores.
* Model Training & Development: Handles algorithm selection (ML/DL/RL), orchestrates distributed parallel training pipelines, optimizes hyperparameters, and validates models against benchmark metrics.
* Model Deployment & Inference: Containerizes trained models using Docker and Kubernetes, exposes low-latency endpoints via FastAPI/gRPC, and leverages GPU/TPU acceleration for real-time predictions.
* Monitoring & Governance: Continuously tracks runtime performance (latency, accuracy), detects data/concept drift and security threats, and provides model explainability (XAI) using SHAP and LIME values.
____Verified by Physics Teacher Telman Askeraliyev , Fizika Muellimi, Azerbaijan ,Baku HikmetMemmedov


 tenderlove
 konakalab
 signer
 reverentgeek
 addyosmani
 keithpitt
 soudai
 uxyall
 nonsquared
 palkan
 ipullrank
 akademiya2063