Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
論文紹介: Real-Time Execution of Action Chunking Fl...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
sakami
October 07, 2026
2
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
論文紹介: Real-Time Execution of Action Chunking Flow Policies
sakami
October 07, 2026
More Decks by sakami
See All by sakami
Rayで分散処理
sakami
0
16
Optunaアルゴリズムの紹介
sakami
0
370
Featured
See All Featured
WCS-LA-2024
lcolladotor
0
850
New Earth Scene 8
popppiees
4
2.6k
Imperfection Machines: The Place of Print at Facebook
scottboms
270
14k
Navigating Weather and Climate Data
rabernat
0
550
Claude Code のすすめ
schroneko
67
230k
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
740
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.7k
Rebuilding a faster, lazier Slack
samanthasiow
85
9.7k
A Soul's Torment
seathinner
8
3.7k
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
1.9k
Done Done
chrislema
187
17k
Ethics towards AI in product and experience design
skipperchong
2
410
Transcript
論文紹介: Real-Time Execution of Action Chunking Flow Policies 2026.08.13 Kosuke
Sakami 株式会社ディー・エヌ・エー AI Community
01|Diffusion Policy 項目 02|Real-Time Chunking 03|後続研究 2
01 Diffusion Policy 3
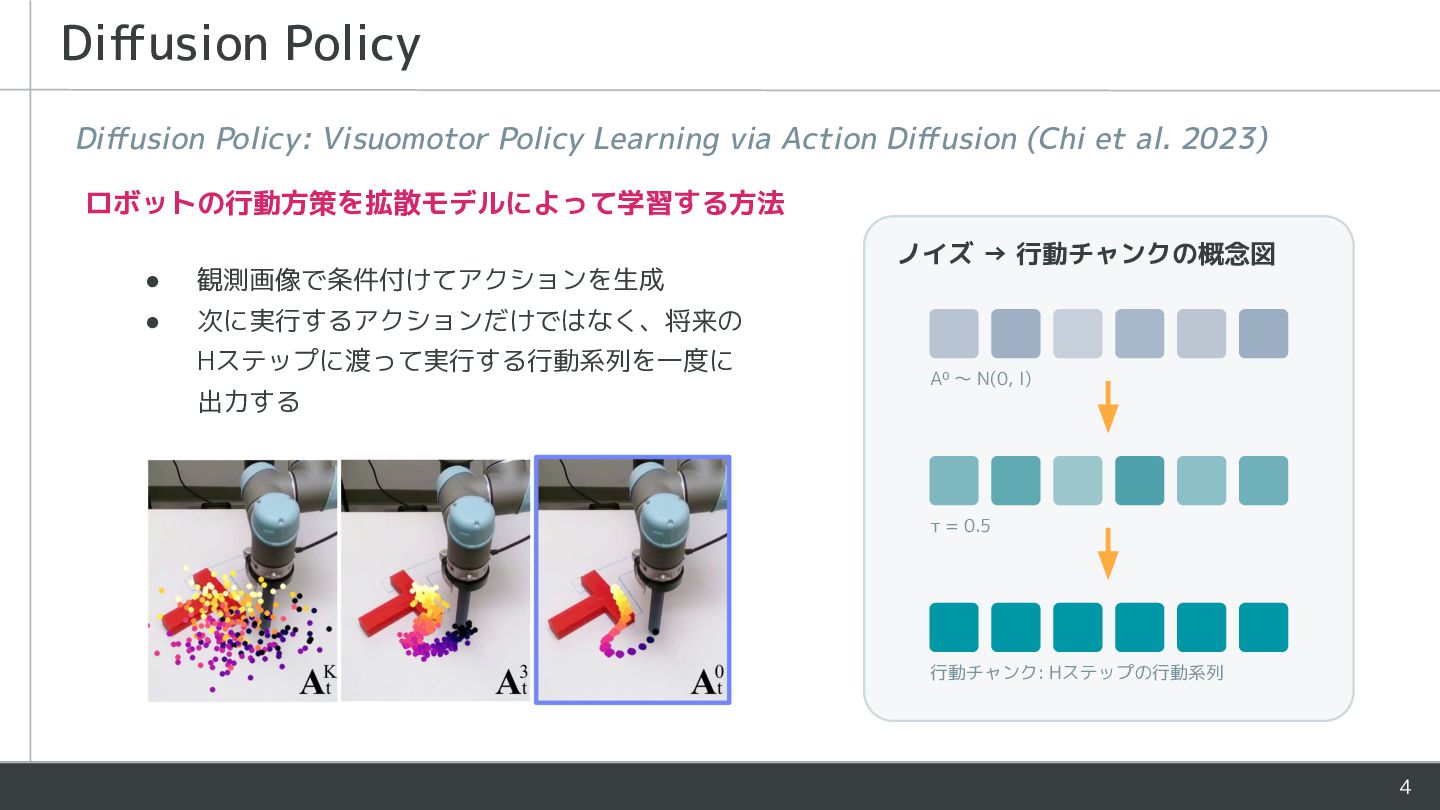
Diffusion Policy Diffusion Policy: Visuomotor Policy Learning via Action Diffusion
(Chi et al. 2023) ロボットの行動方策を拡散モデルによって学習する方法 ノイズ → 行動チャンクの概念図 • 観測画像で条件付けてアクションを生成 • 次に実行するアクションだけではなく、将来の Hステップに渡って実行する行動系列を一度に A⁰ ~ N(0, I) 出力する τ = 0.5 行動チャンク: Hステップの行動系列 4
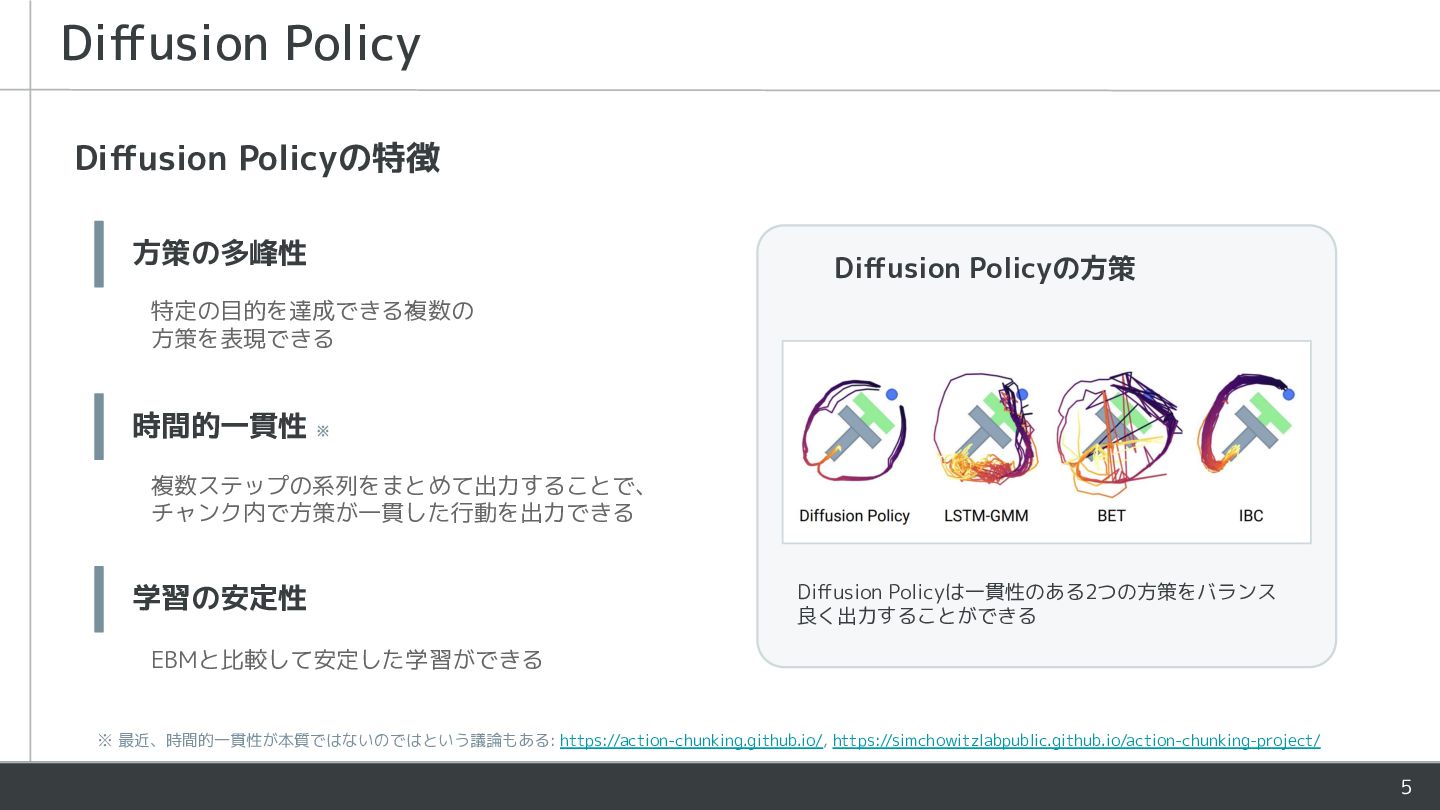
Diffusion Policy Diffusion Policyの特徴 方策の多峰性 Diffusion Policyの方策 特定の目的を達成できる複数の 方策を表現できる 時間的一貫性
※ 複数ステップの系列をまとめて出力することで、 チャンク内で方策が一貫した行動を出力できる 学習の安定性 Diffusion Policyは一貫性のある2つの方策をバランス 良く出力することができる EBMと比較して安定した学習ができる ※ 最近、時間的一貫性が本質ではないのではという議論もある: https://action-chunking.github.io/, https://simchowitzlabpublic.github.io/action-chunking-project/ 5
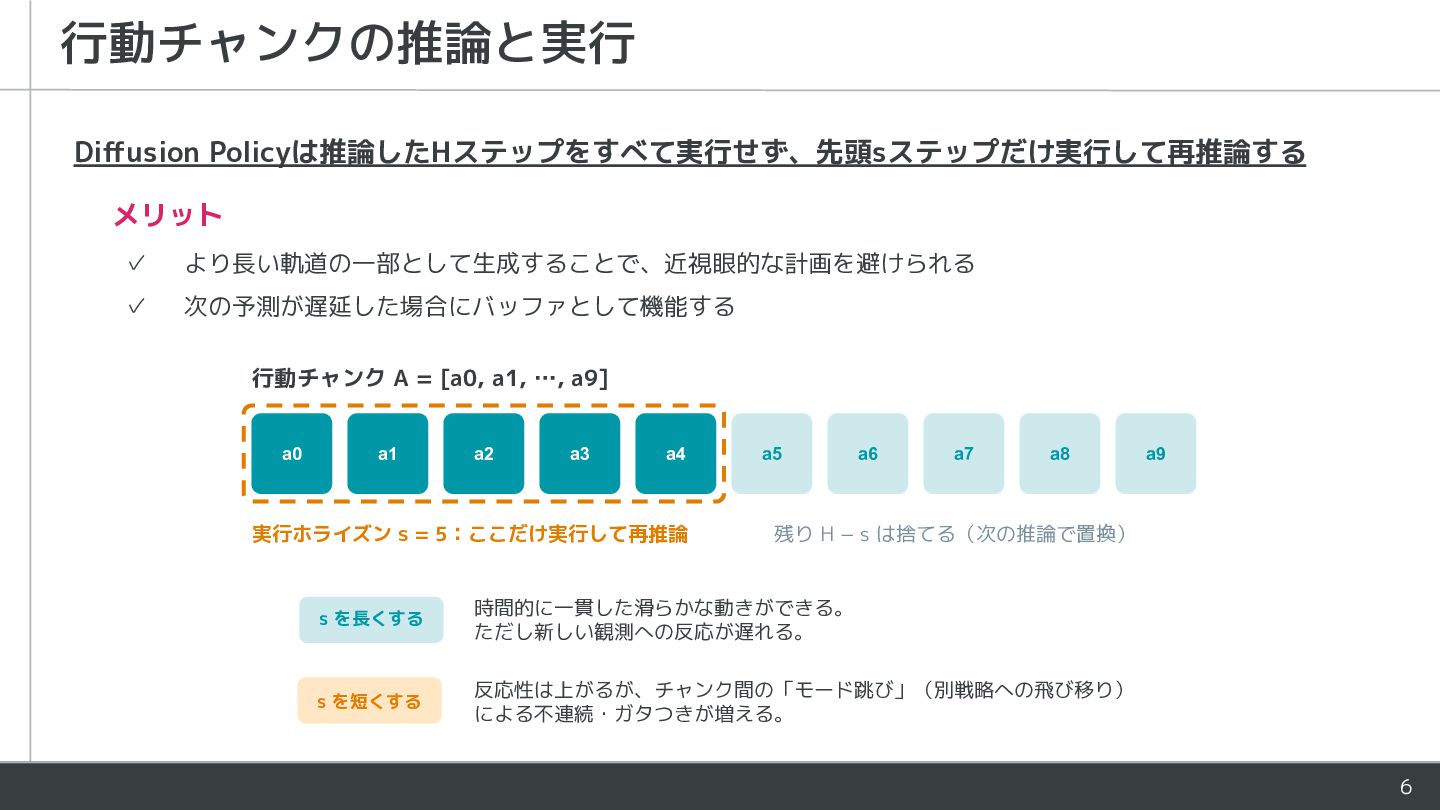
行動チャンクの推論と実行 Diffusion Policyは推論したHステップをすべて実行せず、先頭sステップだけ実行して再推論する メリット ✓ より長い軌道の一部として生成することで、近視眼的な計画を避けられる ✓ 次の予測が遅延した場合にバッファとして機能する 行動チャンク A
= [a0, a1, …, a9] a0 a1 a2 a3 a4 実行ホライズン s = 5:ここだけ実行して再推論 a5 a6 a7 a8 a9 残り H − s は捨てる(次の推論で置換) s を長くする 時間的に一貫した滑らかな動きができる。 ただし新しい観測への反応が遅れる。 s を短くする 反応性は上がるが、チャンク間の「モード跳び」(別戦略への飛び移り) による不連続・ガタつきが増える。 6
02 Real-Time Chunking (RTC) 7
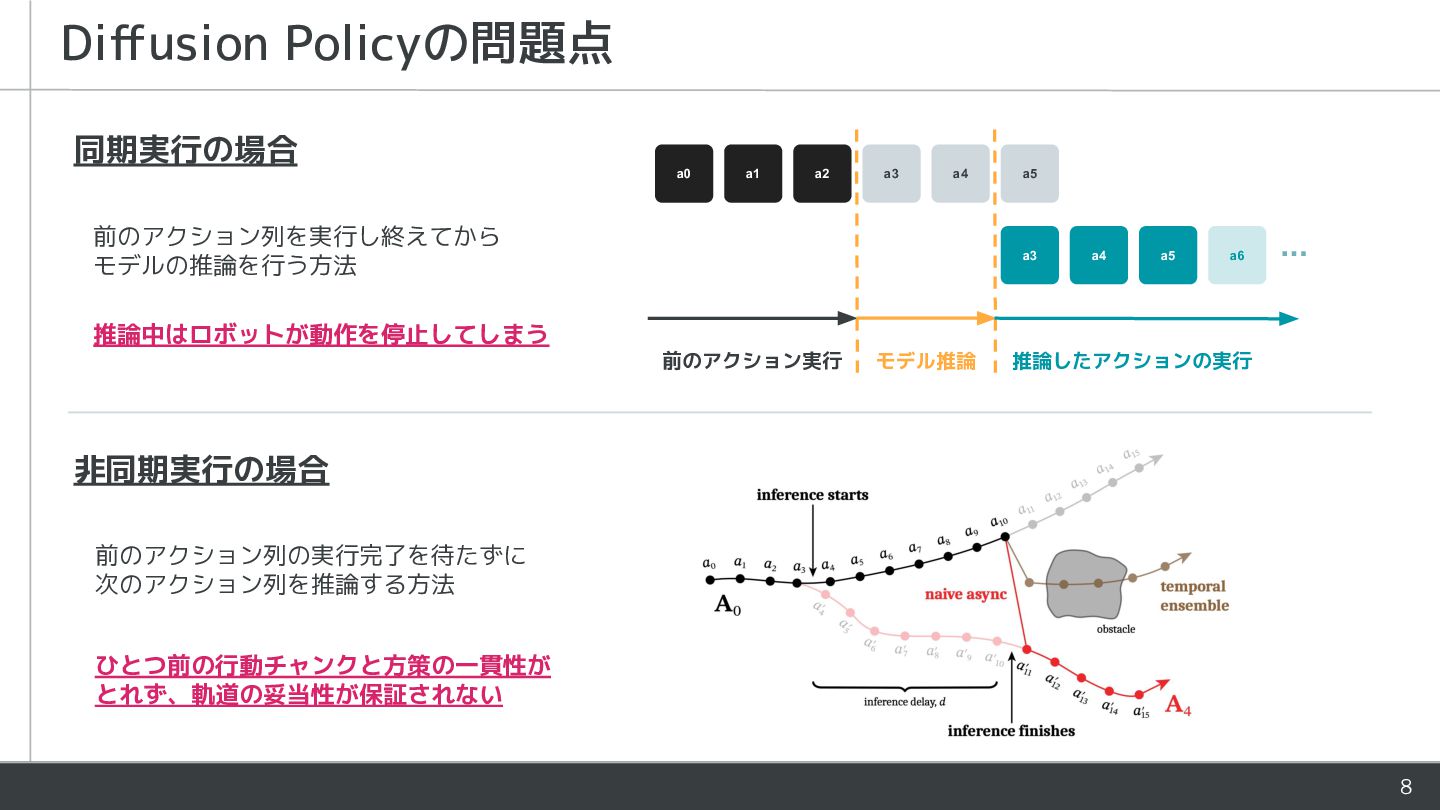
Diffusion Policyの問題点 同期実行の場合 a0 a1 a2 a3 a4 前のアクション列を実行し終えてから モデルの推論を行う方法
a5 a3 a4 a5 a6 … 推論中はロボットが動作を停止してしまう 前のアクション実行 モデル推論 推論したアクションの実行 非同期実行の場合 前のアクション列の実行完了を待たずに 次のアクション列を推論する方法 ひとつ前の行動チャンクと方策の一貫性が とれず、軌道の妥当性が保証されない 8
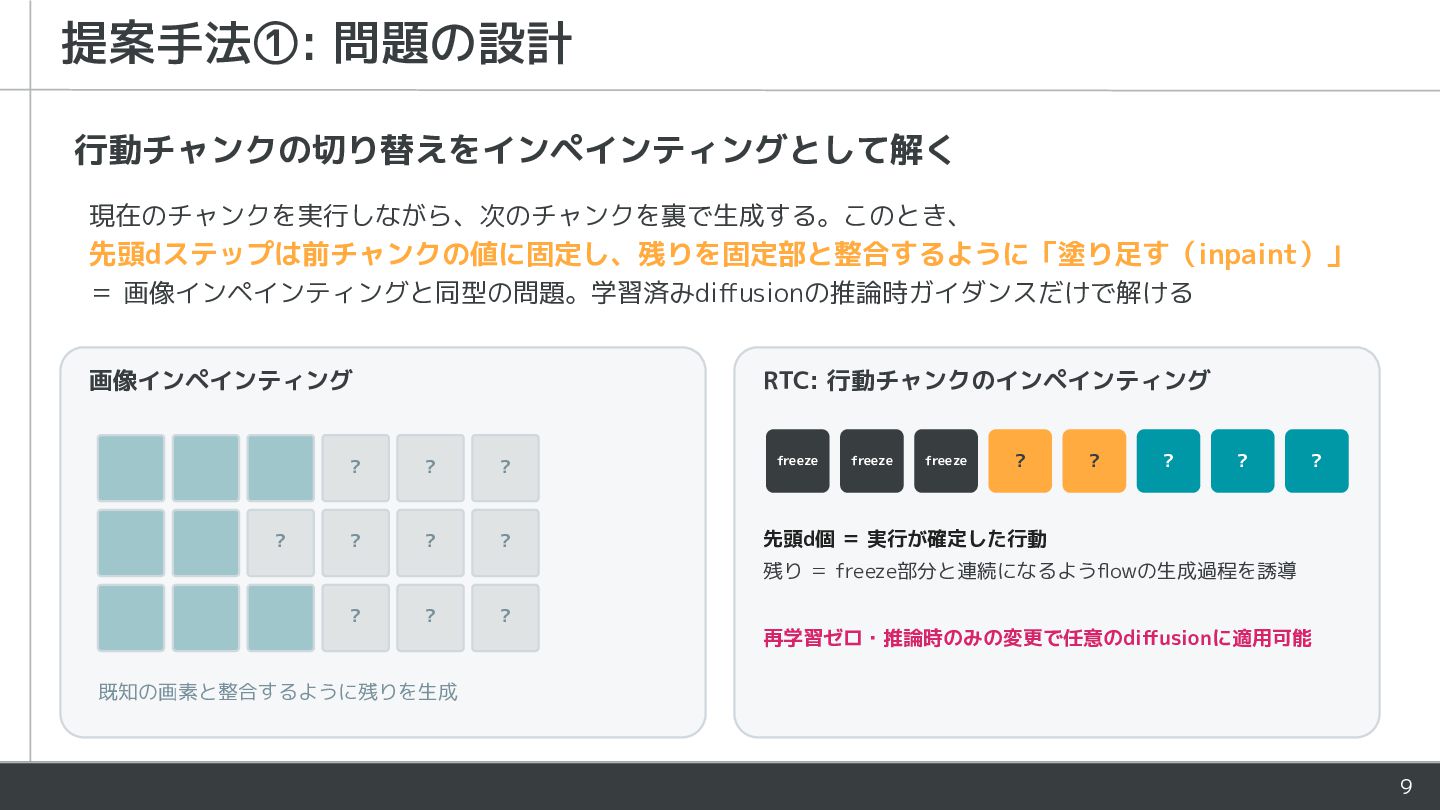
提案手法①: 問題の設計 行動チャンクの切り替えをインペインティングとして解く 現在のチャンクを実行しながら、次のチャンクを裏で生成する。このとき、 先頭dステップは前チャンクの値に固定し、残りを固定部と整合するように「塗り足す(inpaint)」 = 画像インペインティングと同型の問題。学習済みdiffusionの推論時ガイダンスだけで解ける 画像インペインティング ? RTC:
行動チャンクのインペインティング ? ? ? ? ? ? freeze freeze freeze ? ? ? ? ? 先頭d個 = 実行が確定した行動 残り = freeze部分と連続になるようflowの生成過程を誘導 ? ? ? 再学習ゼロ・推論時のみの変更で任意のdiffusionに適用可能 既知の画素と整合するように残りを生成 9
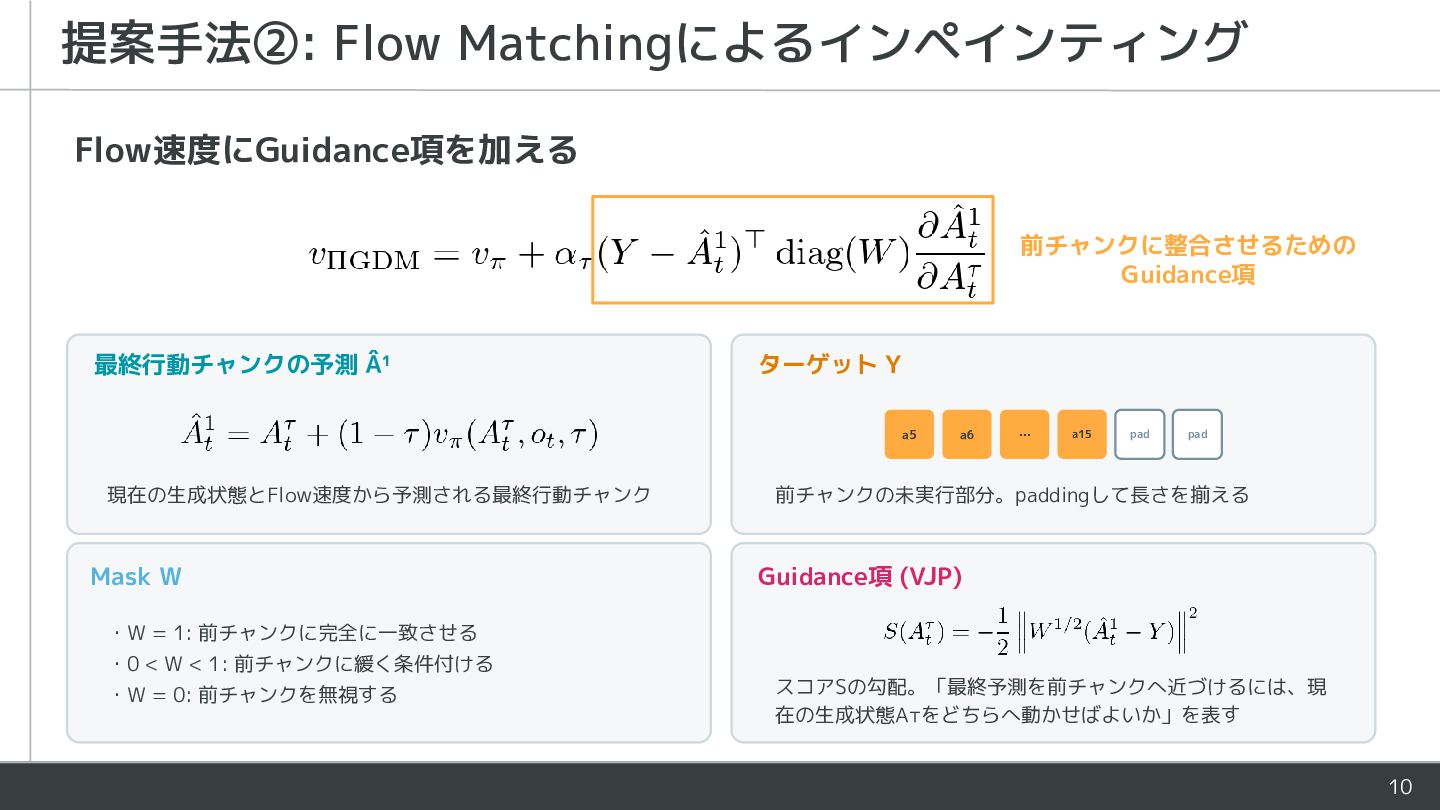
提案手法②: Flow Matchingによるインペインティング Flow速度にGuidance項を加える 前チャンクに整合させるための Guidance項 最終行動チャンクの予測 ¹ ターゲット Y
a5 現在の生成状態とFlow速度から予測される最終行動チャンク Mask W a6 … a15 pad pad 前チャンクの未実行部分。paddingして長さを揃える Guidance項 (VJP) ・W = 1: 前チャンクに完全に一致させる ・0 < W < 1: 前チャンクに緩く条件付ける ・W = 0: 前チャンクを無視する スコアSの勾配。「最終予測を前チャンクへ近づけるには、現 在の生成状態Aτをどちらへ動かせばよいか」を表す 10
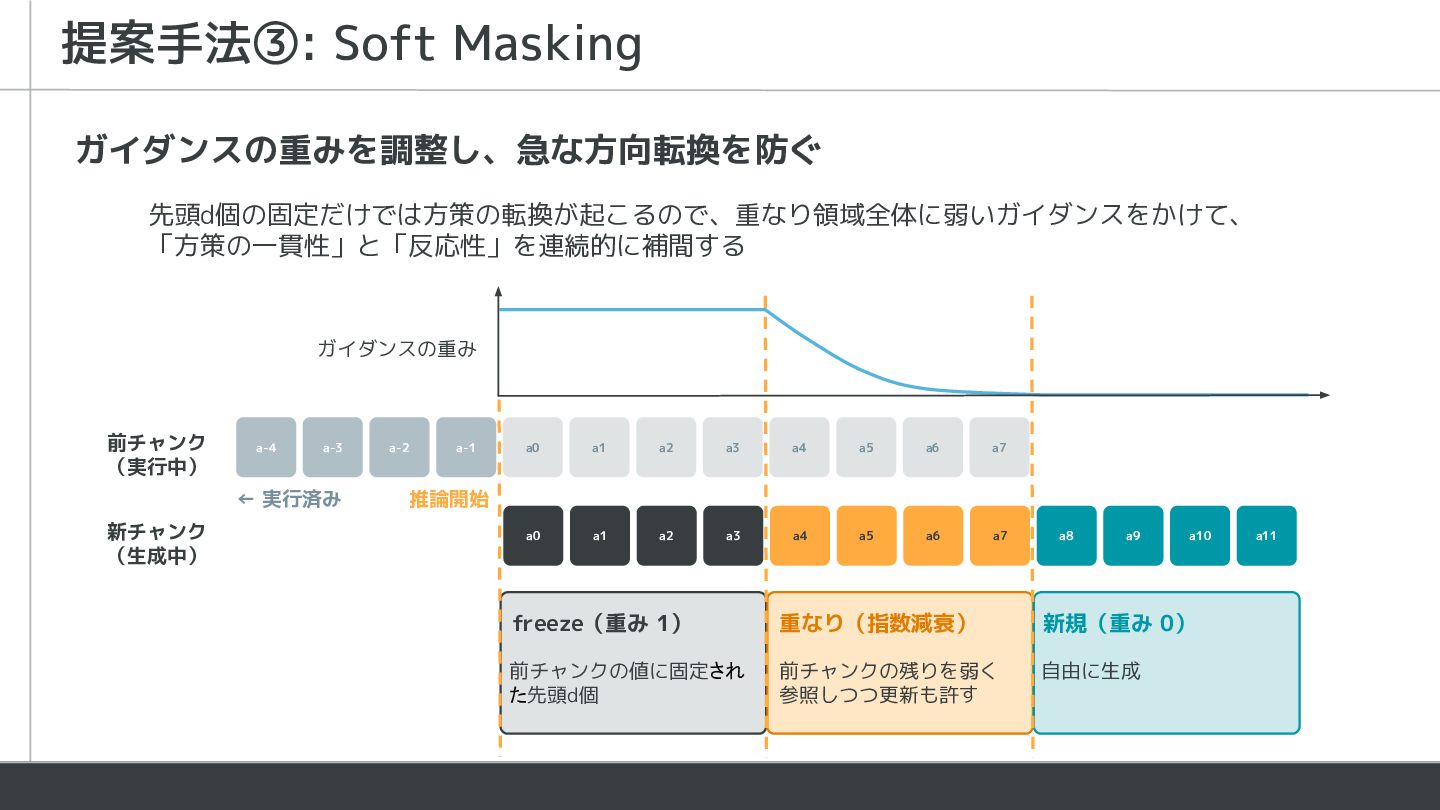
提案手法③: Soft Masking ガイダンスの重みを調整し、急な方向転換を防ぐ 先頭d個の固定だけでは方策の転換が起こるので、重なり領域全体に弱いガイダンスをかけて、 「方策の一貫性」と「反応性」を連続的に補間する ガイダンスの重み 前チャンク (実行中) a-4
a-3 ← 実行済み 新チャンク (生成中) a-2 a-1 a0 a1 a2 a3 a4 a5 a6 a7 a0 a1 a2 a3 a4 a5 a6 a7 推論開始 a8 a9 a10 freeze(重み 1) 重なり(指数減衰) 新規(重み 0) 前チャンクの値に固定され た先頭d個 前チャンクの残りを弱く 参照しつつ更新も許す 自由に生成 a11 11
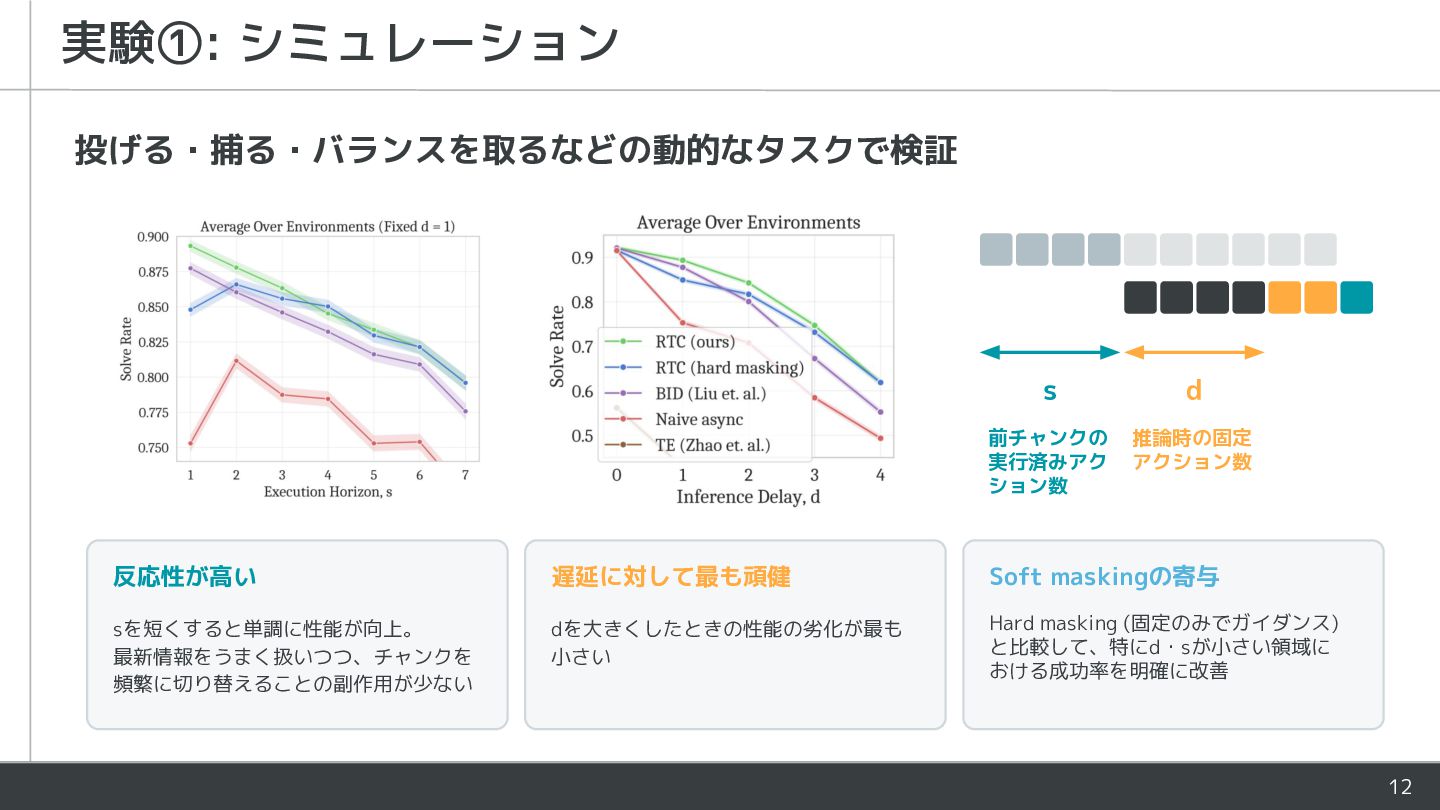
実験①: シミュレーション 投げる・捕る・バランスを取るなどの動的なタスクで検証 s d 前チャンクの 実行済みアク ション数 推論時の固定 アクション数
反応性が高い 遅延に対して最も頑健 Soft maskingの寄与 sを短くすると単調に性能が向上。 最新情報をうまく扱いつつ、チャンクを 頻繁に切り替えることの副作用が少ない dを大きくしたときの性能の劣化が最も 小さい Hard masking (固定のみでガイダンス) と比較して、特にd・sが小さい領域に おける成功率を明確に改善 12
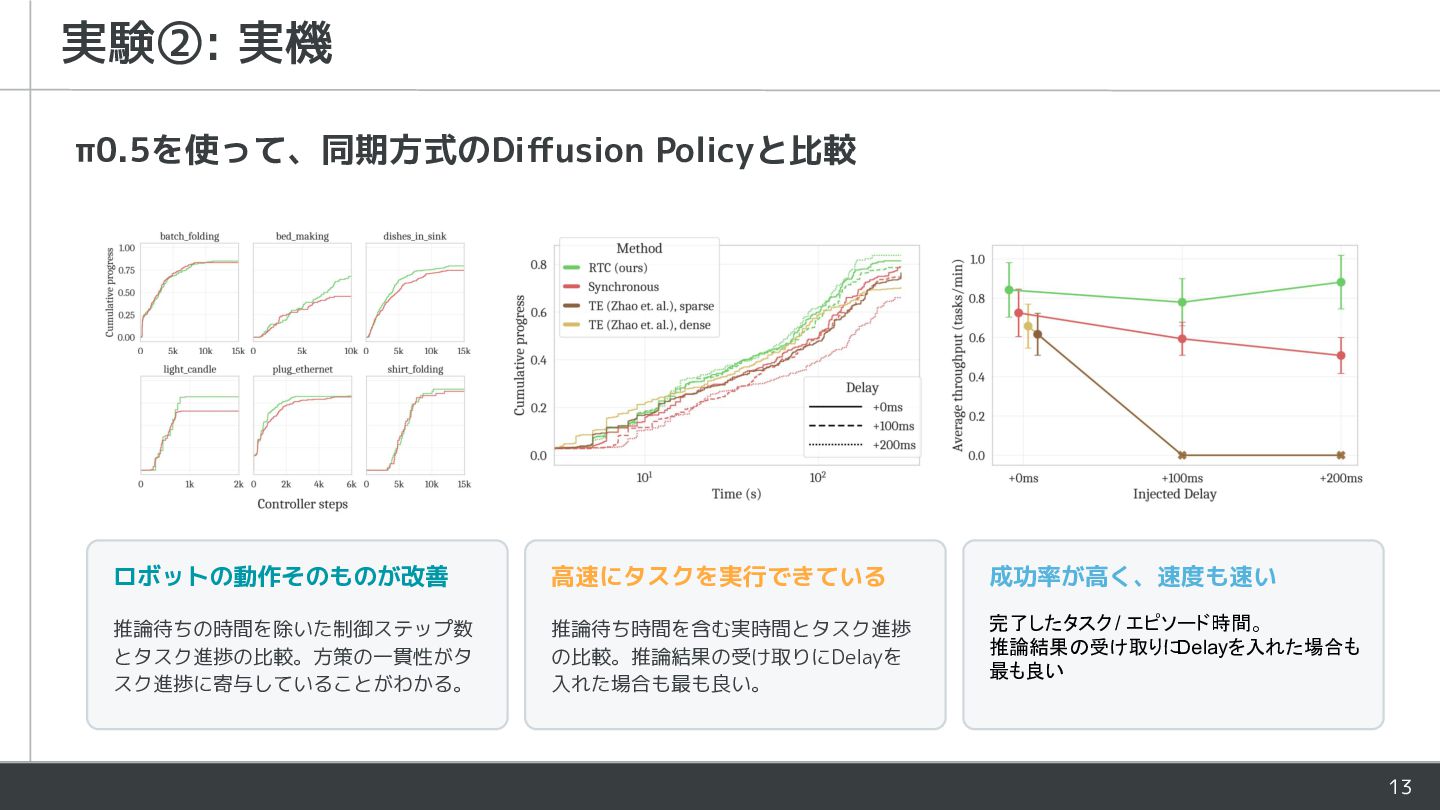
実験②: 実機 π0.5を使って、同期方式のDiffusion Policyと比較 ロボットの動作そのものが改善 高速にタスクを実行できている 成功率が高く、速度も速い 推論待ちの時間を除いた制御ステップ数 とタスク進捗の比較。方策の一貫性がタ スク進捗に寄与していることがわかる。
推論待ち時間を含む実時間とタスク進捗 の比較。推論結果の受け取りにDelayを 入れた場合も最も良い。 完了したタスク / エピソード時間。 推論結果の受け取りにDelayを入れた場合も 最も良い 13
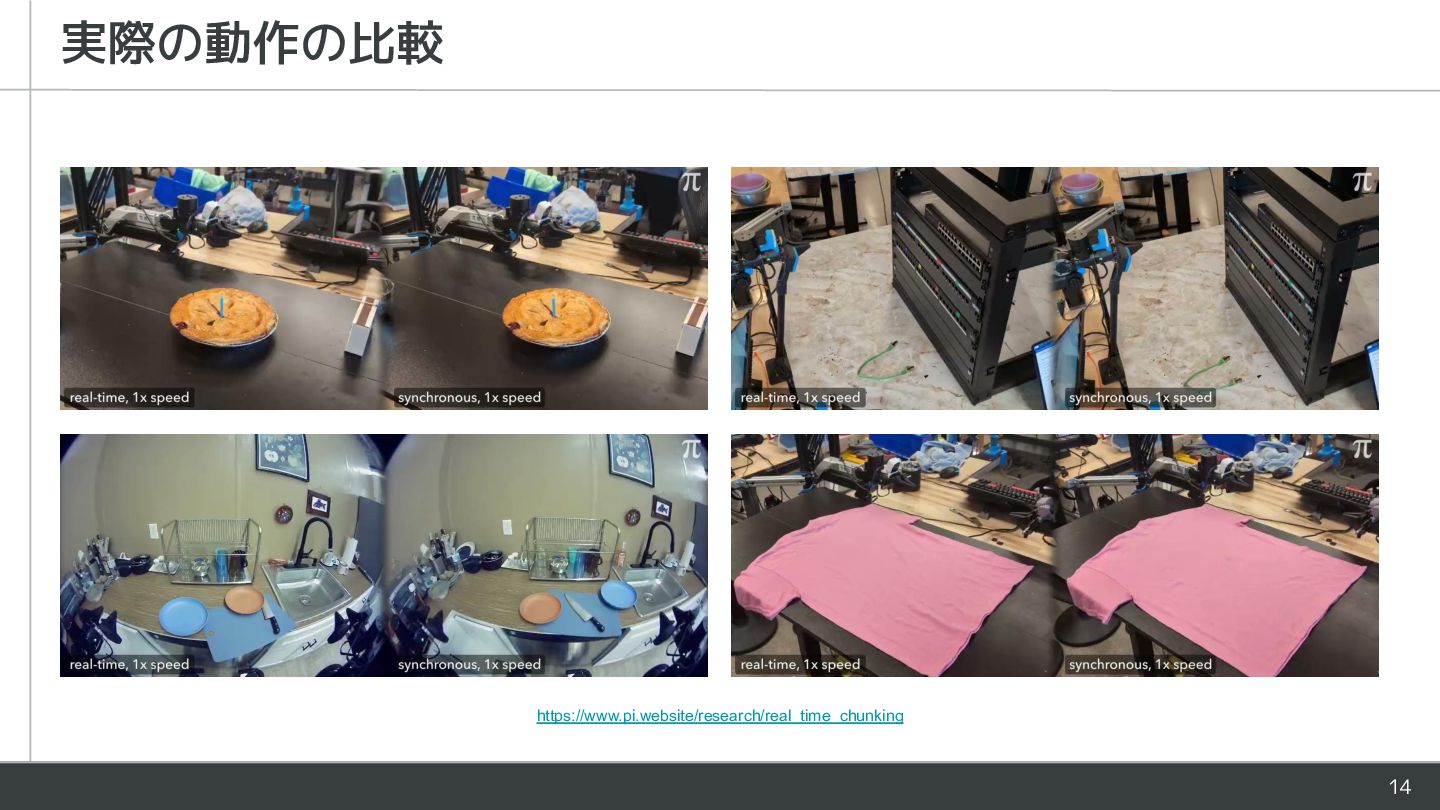
実際の動作の比較 https://www.pi.website/research/real_time_chunking 14
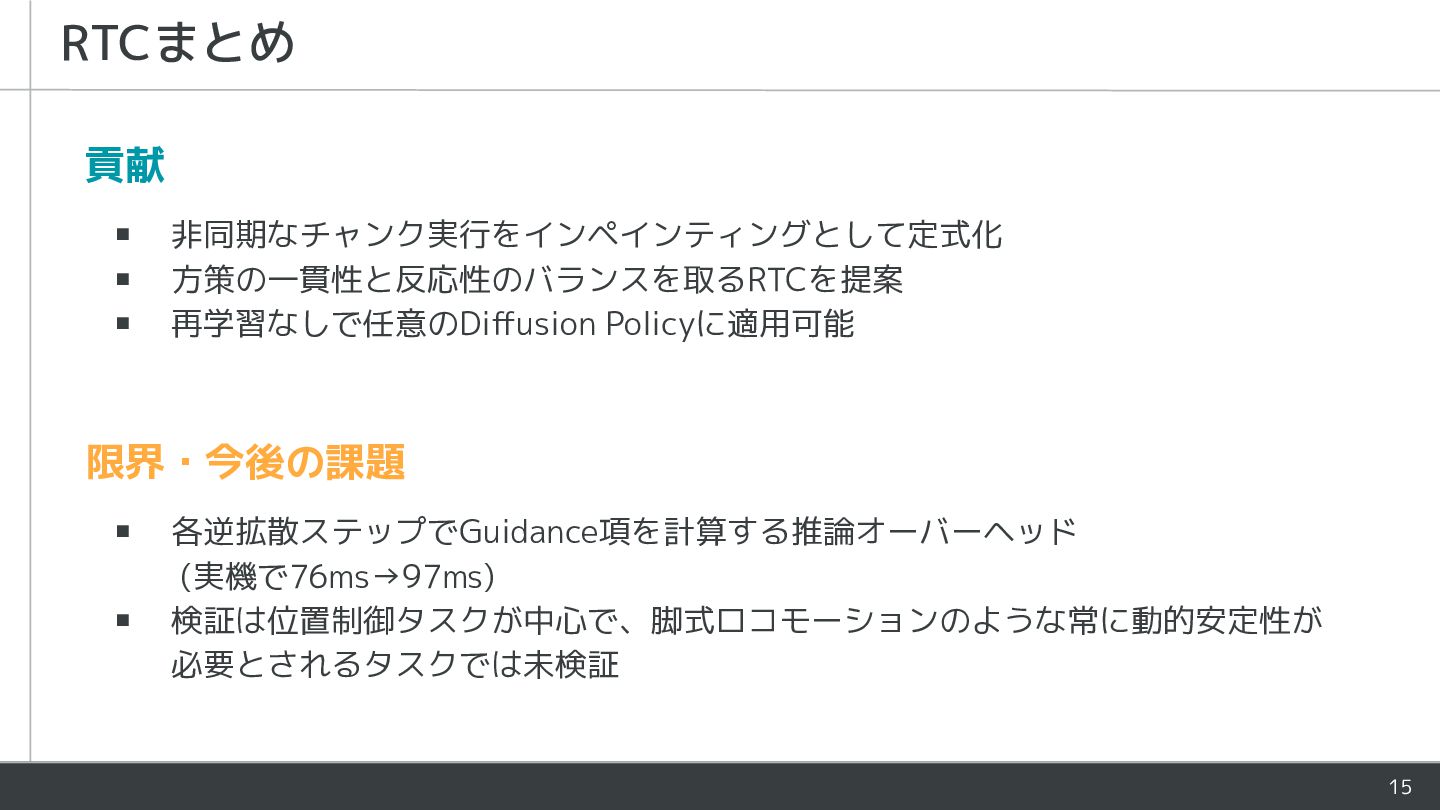
RTCまとめ 貢献 ▪ ▪ ▪ 非同期なチャンク実行をインペインティングとして定式化 方策の一貫性と反応性のバランスを取るRTCを提案 再学習なしで任意のDiffusion Policyに適用可能 限界・今後の課題
▪ ▪ 各逆拡散ステップでGuidance項を計算する推論オーバーヘッド (実機で76ms→97ms) 検証は位置制御タスクが中心で、脚式ロコモーションのような常に動的安定性が 必要とされるタスクでは未検証 15
03 後続研究 16
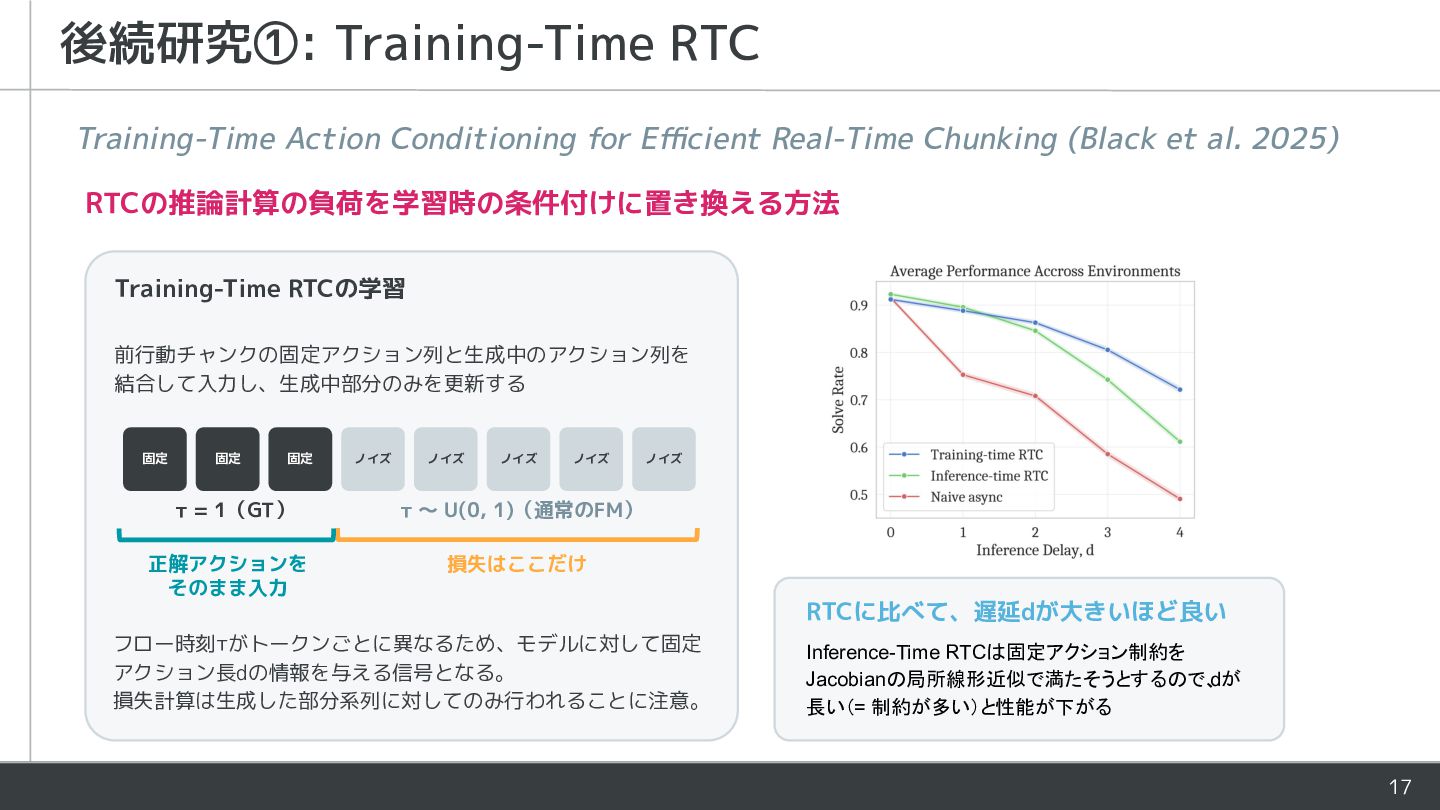
後続研究①: Training-Time RTC Training-Time Action Conditioning for Efficient Real-Time Chunking
(Black et al. 2025) RTCの推論計算の負荷を学習時の条件付けに置き換える方法 Training-Time RTCの学習 前行動チャンクの固定アクション列と生成中のアクション列を 結合して入力し、生成中部分のみを更新する 固定 固定 固定 ノイズ ノイズ ノイズ ノイズ τ = 1(GT) τ ~ U(0, 1)(通常のFM) 正解アクションを そのまま入力 損失はここだけ ノイズ RTCに比べて、遅延dが大きいほど良い フロー時刻τがトークンごとに異なるため、モデルに対して固定 アクション長dの情報を与える信号となる。 損失計算は生成した部分系列に対してのみ行われることに注意。 Inference-Time RTCは固定アクション制約を Jacobianの局所線形近似で満たそうとするので、dが 長い(= 制約が多い)と性能が下がる 17
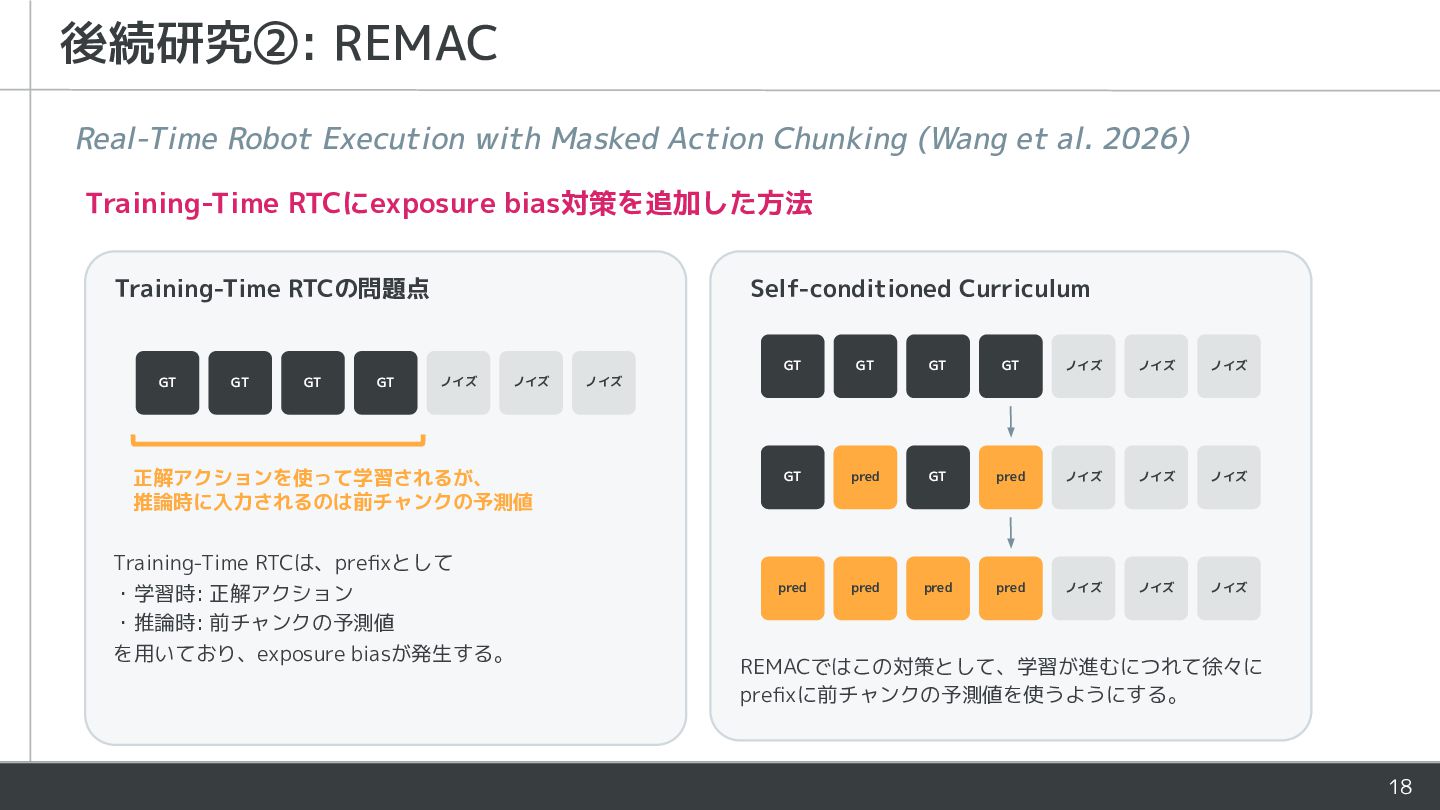
後続研究②: REMAC Real-Time Robot Execution with Masked Action Chunking (Wang
et al. 2026) Training-Time RTCにexposure bias対策を追加した方法 Training-Time RTCの問題点 GT GT GT GT Self-conditioned Curriculum ノイズ ノイズ 正解アクションを使って学習されるが、 推論時に入力されるのは前チャンクの予測値 GT GT GT GT ノイズ ノイズ ノイズ GT pred GT pred ノイズ ノイズ ノイズ pred pred pred pred ノイズ ノイズ ノイズ ノイズ Training-Time RTCは、prefixとして ・学習時: 正解アクション ・推論時: 前チャンクの予測値 を用いており、exposure biasが発生する。 REMACではこの対策として、学習が進むにつれて徐々に prefixに前チャンクの予測値を使うようにする。 18
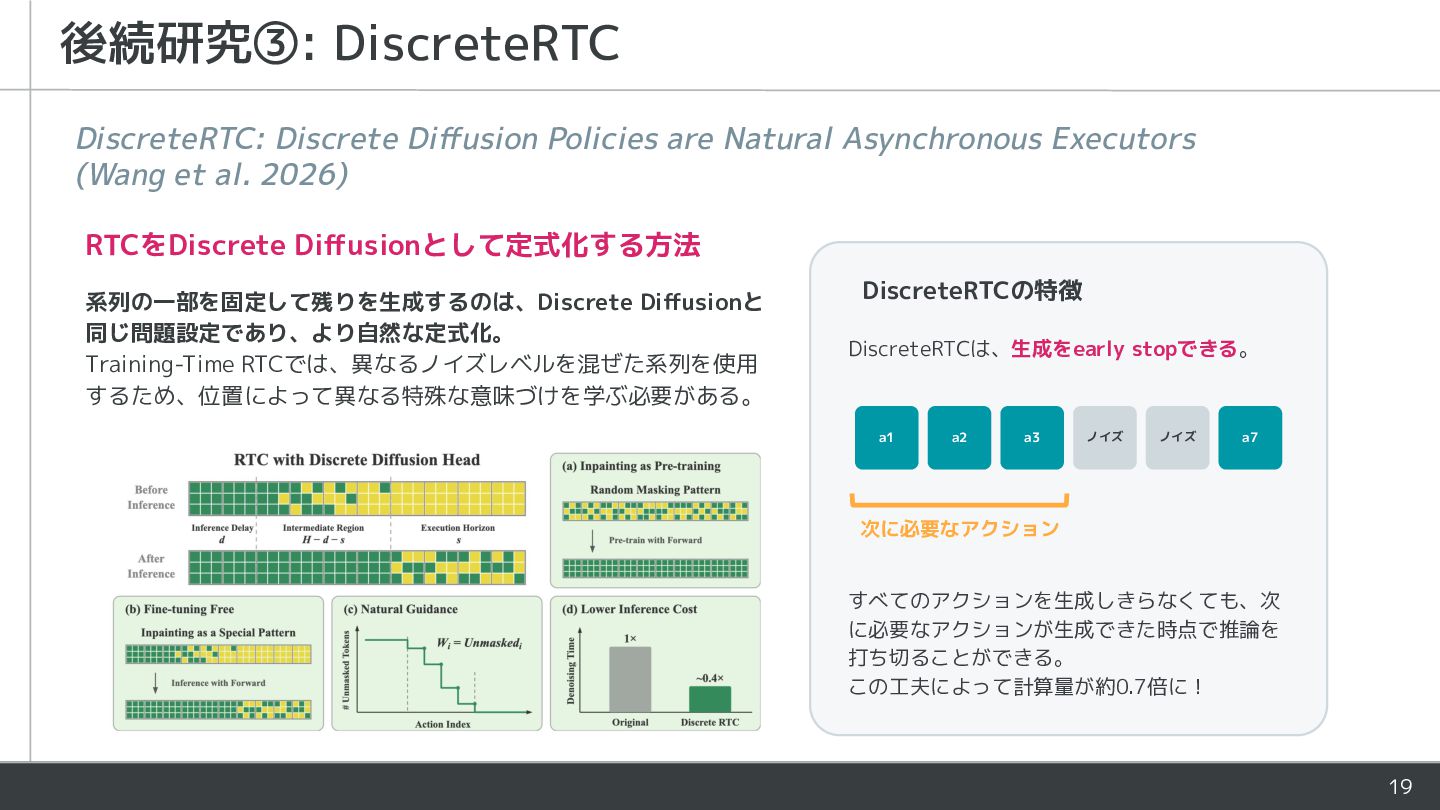
後続研究③: DiscreteRTC DiscreteRTC: Discrete Diffusion Policies are Natural Asynchronous Executors
(Wang et al. 2026) RTCをDiscrete Diffusionとして定式化する方法 系列の一部を固定して残りを生成するのは、Discrete Diffusionと 同じ問題設定であり、より自然な定式化。 Training-Time RTCでは、異なるノイズレベルを混ぜた系列を使用 するため、位置によって異なる特殊な意味づけを学ぶ必要がある。 DiscreteRTCの特徴 DiscreteRTCは、生成をearly stopできる。 a1 a2 a3 ノイズ ノイズ a7 次に必要なアクション すべてのアクションを生成しきらなくても、次 に必要なアクションが生成できた時点で推論を 打ち切ることができる。 この工夫によって計算量が約0.7倍に! 19
AI 20

 Your Podcast. Everywhere. Effortlessly.


 sakami
 lcolladotor
 popppiees
 scottboms
 rabernat
 schroneko
 inesmontani
 eileencodes
 samanthasiow
 seathinner
 tammyeverts
 chrislema
 skipperchong