Upgrade to Pro — share decks privately, control downloads, hide ads and more …

(Preprint) Diffusion Transformers with Represen...

Shumpei Takezaki
November 05, 2025
1.3k

(Preprint) Diffusion Transformers with Representation Autoencoders

Shumpei Takezaki

November 05, 2025

Transcript

30 slides
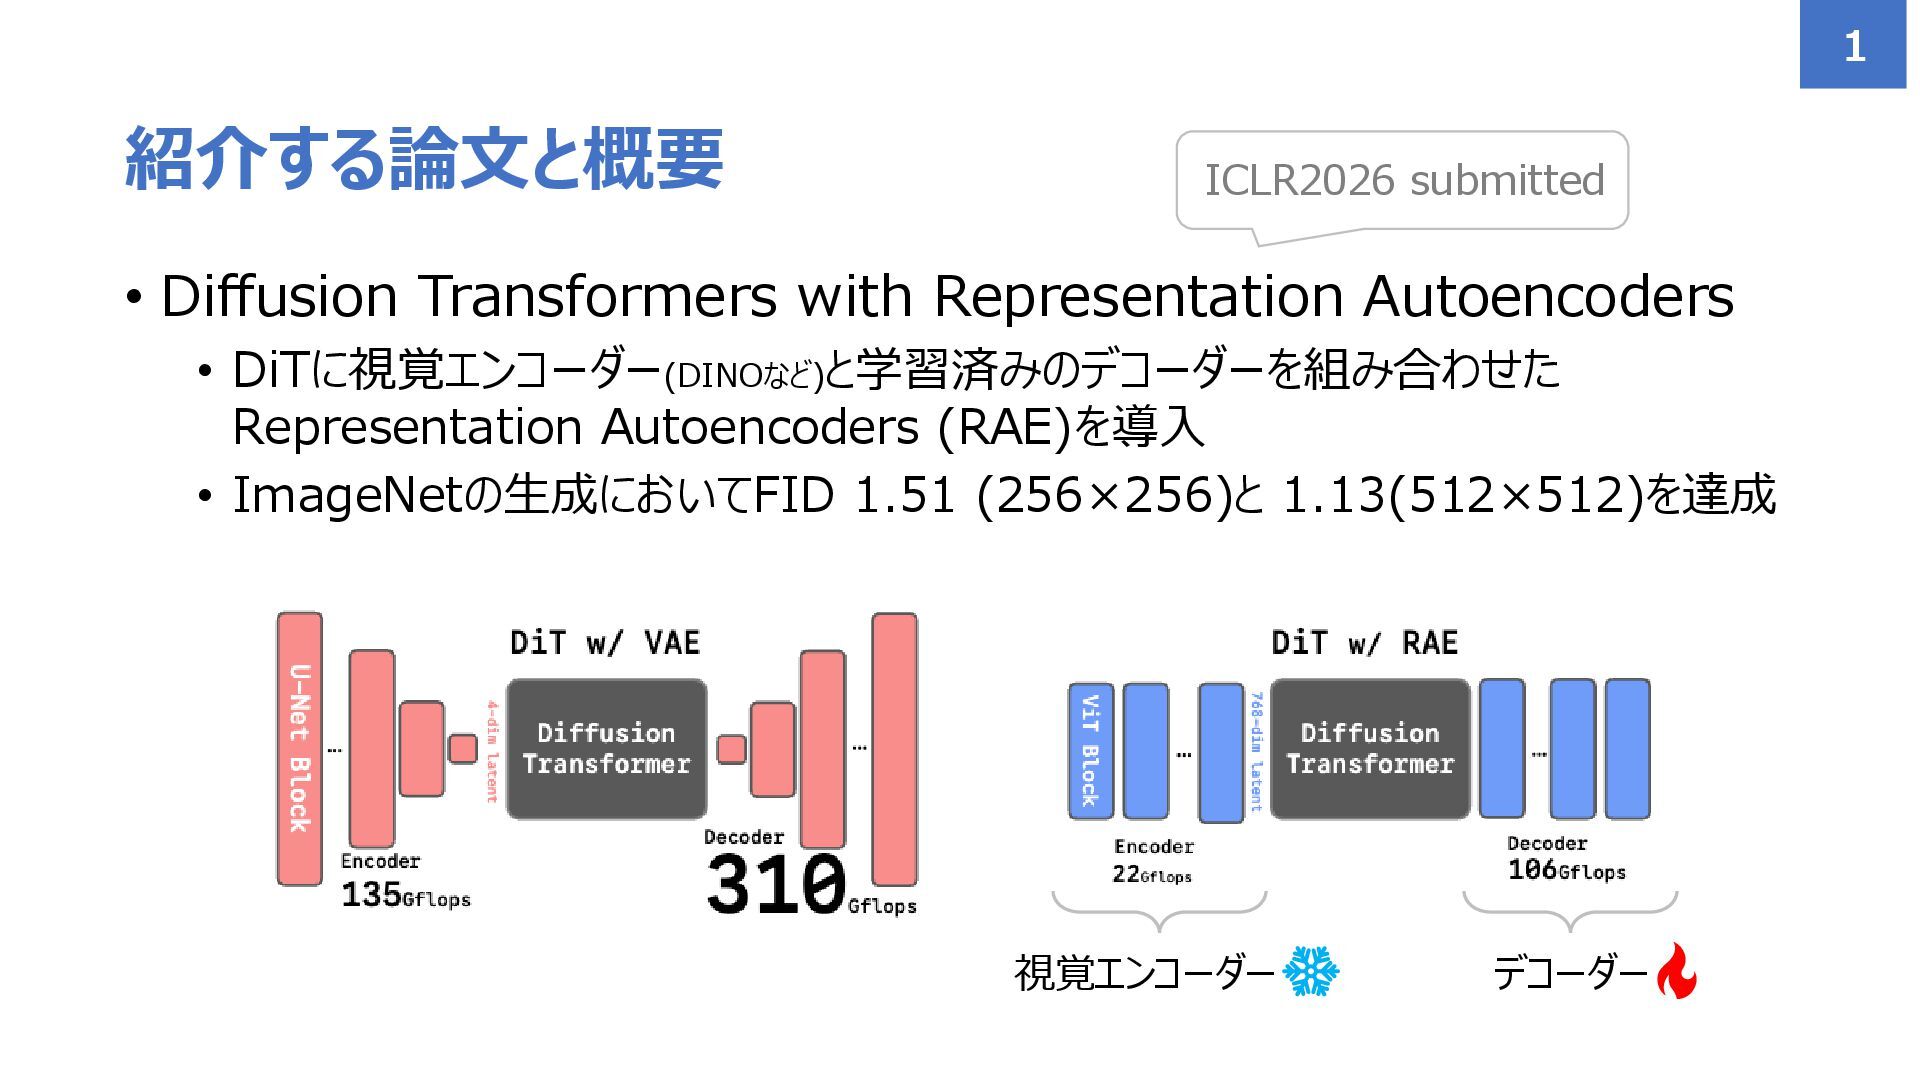
  1. • Diffusion Transformers with Representation Autoencoders • DiTに視覚エンコーダー(DINOなど)と学習済みのデコーダーを組み合わせた Representation Autoencoders

    (RAE)を導入 • ImageNetの生成においてFID 1.51 (256×256)と 1.13(512×512)を達成 紹介する論文と概要 1 視覚エンコーダー デコーダー ICLR2026 submitted
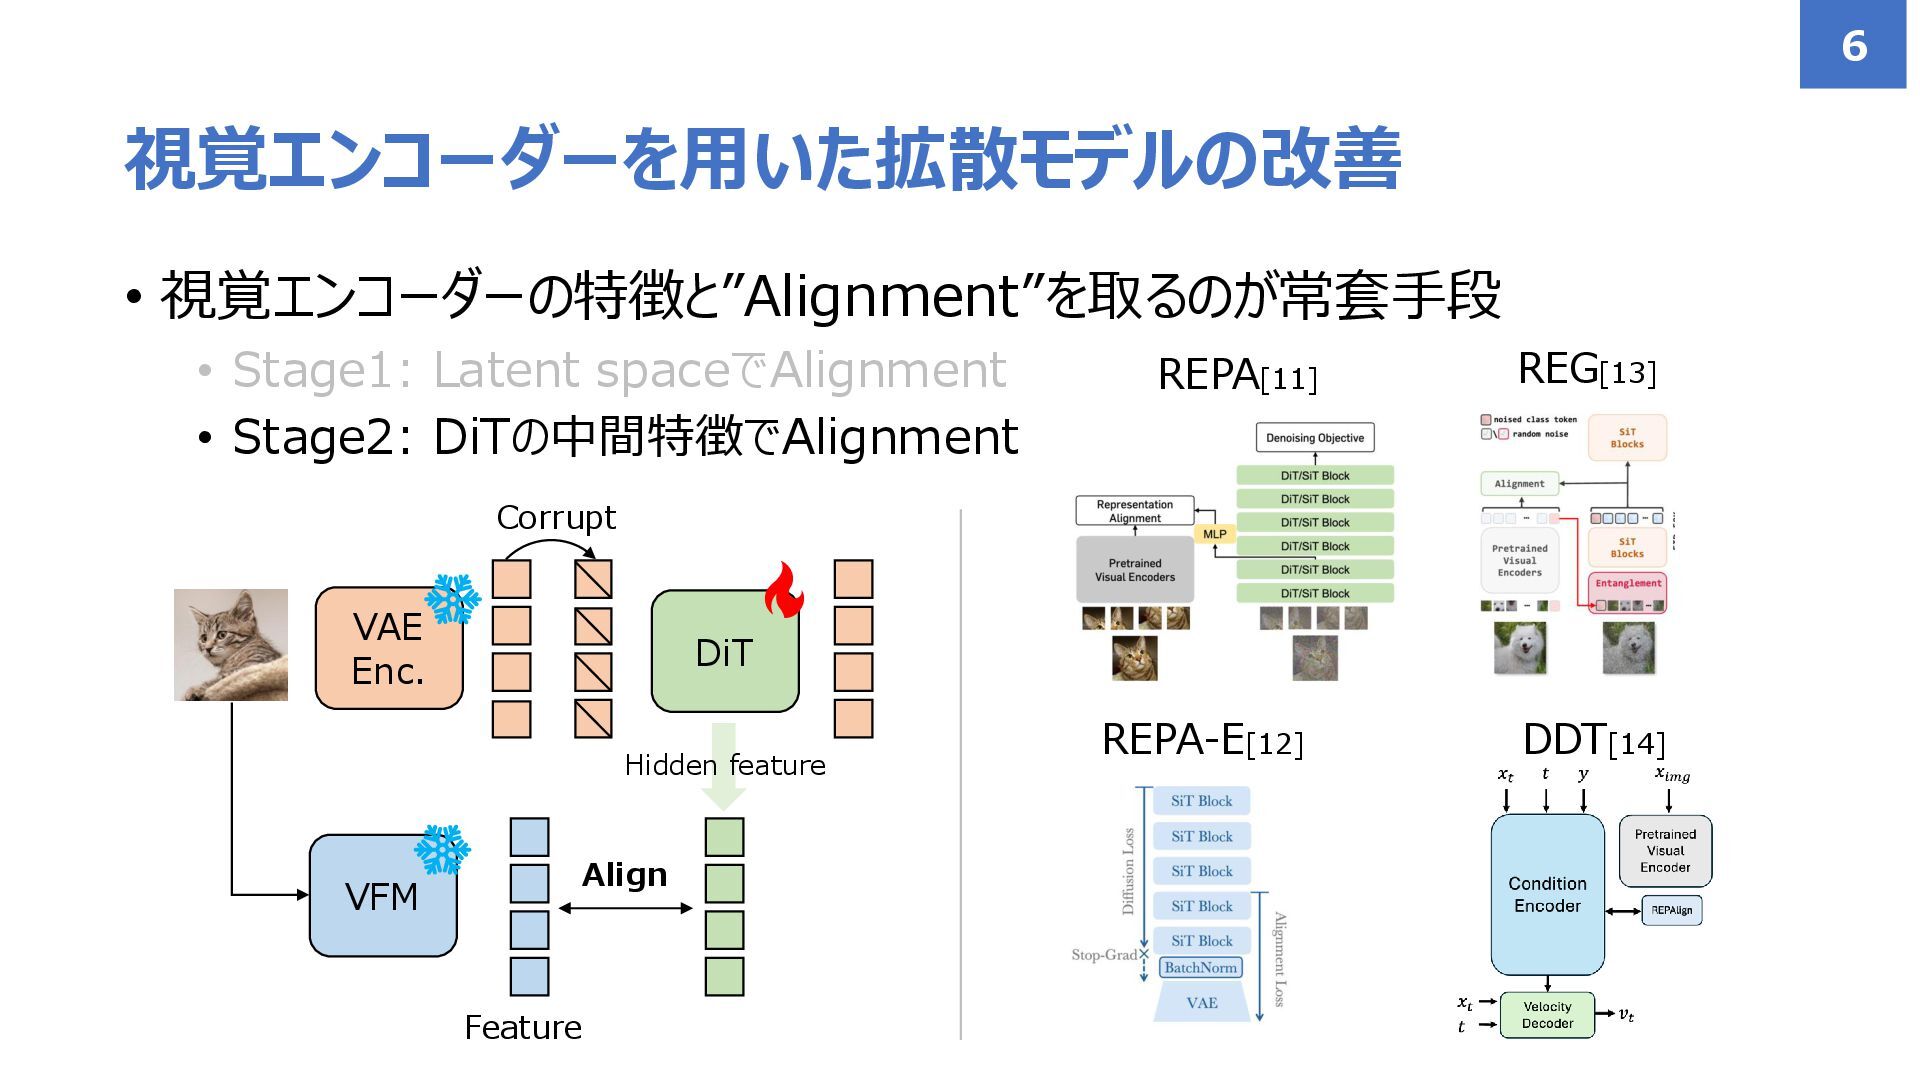
  2. • Latent Diffusion Models (LDM)やDiffusion Transformer (DiT) が高い生成精度と処理効率を実現 • ほとんどの大規模な拡散モデル[1,2,3]はLatent

    spaceで動いているといっていい 拡散モデルはLatent spaceで動いている 2 Stage1: Autoencoder for Latent Space Stage 2: Diffusion Model in Latent space VAE Enc. VAE Dec. Reconstruction Latent VAE Enc. DiT Corrupt Denoising 今日はDiTメイン SD-VAE
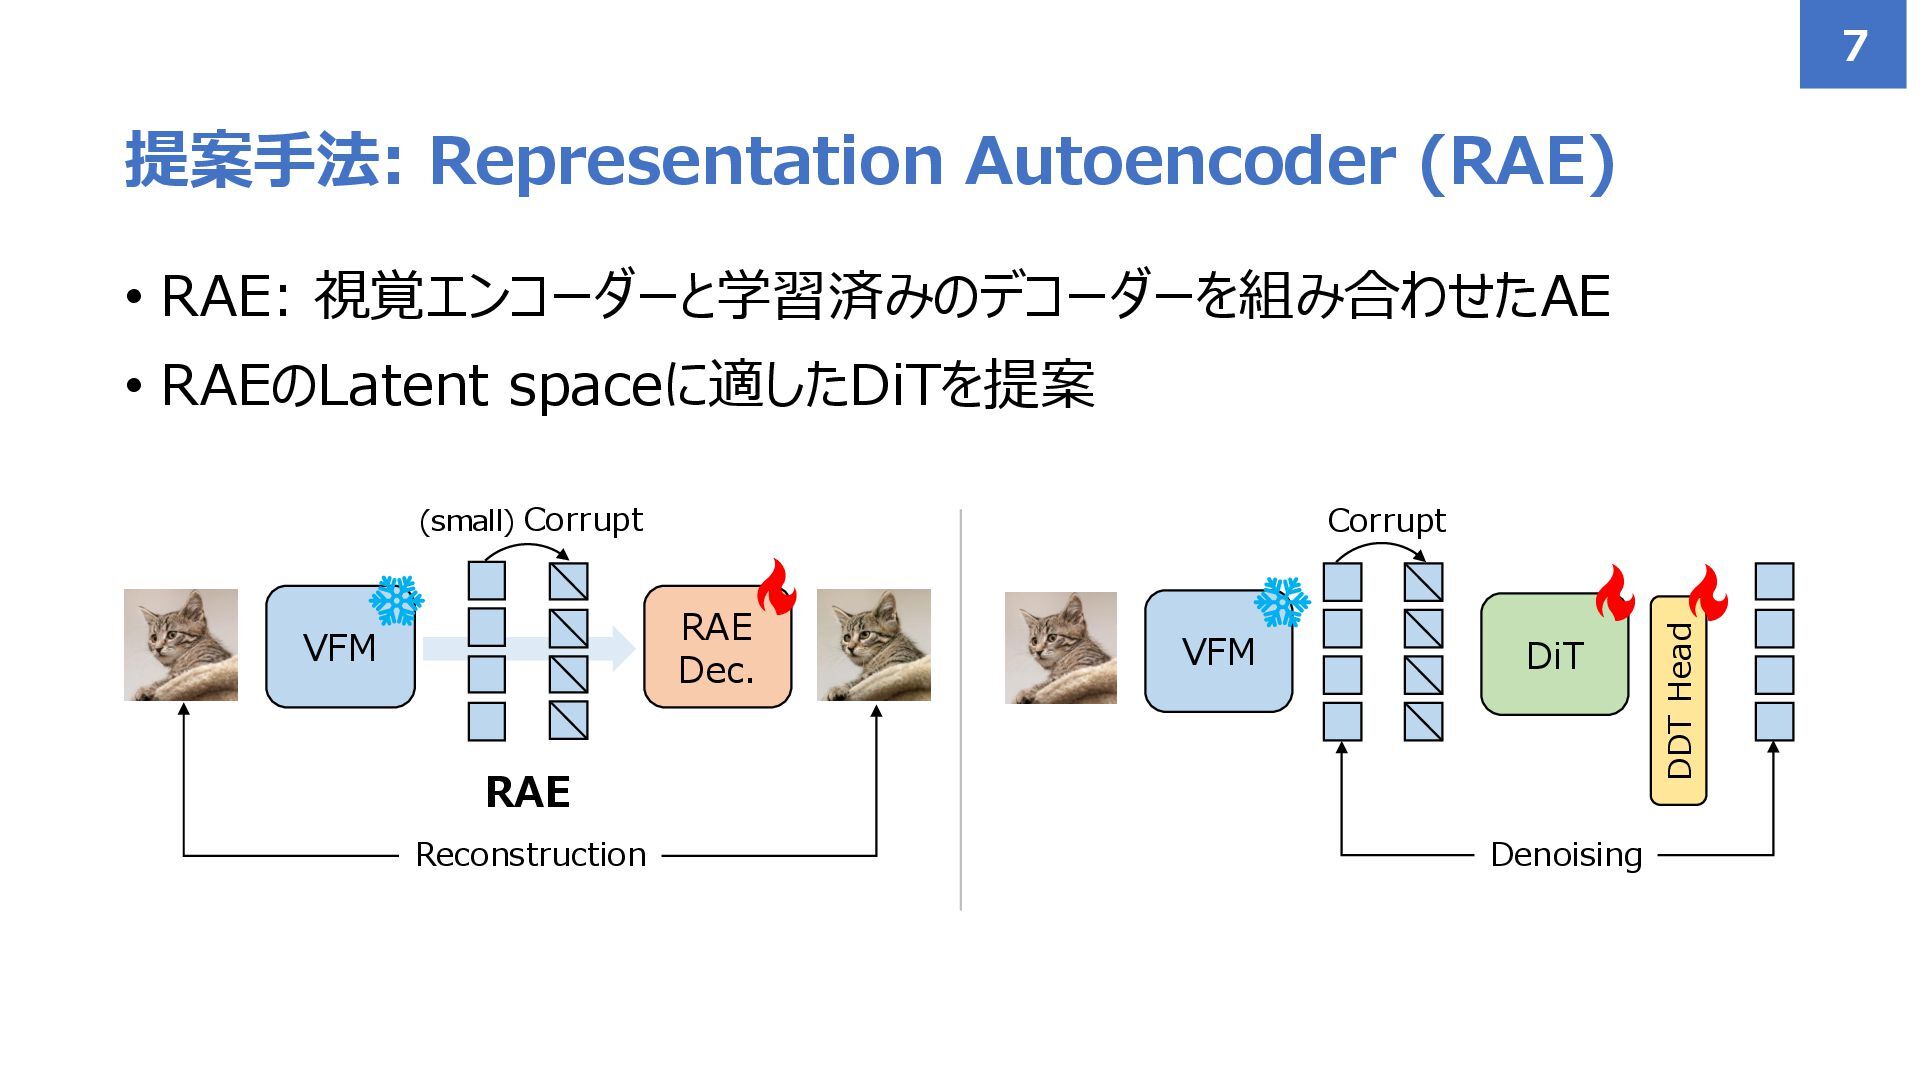
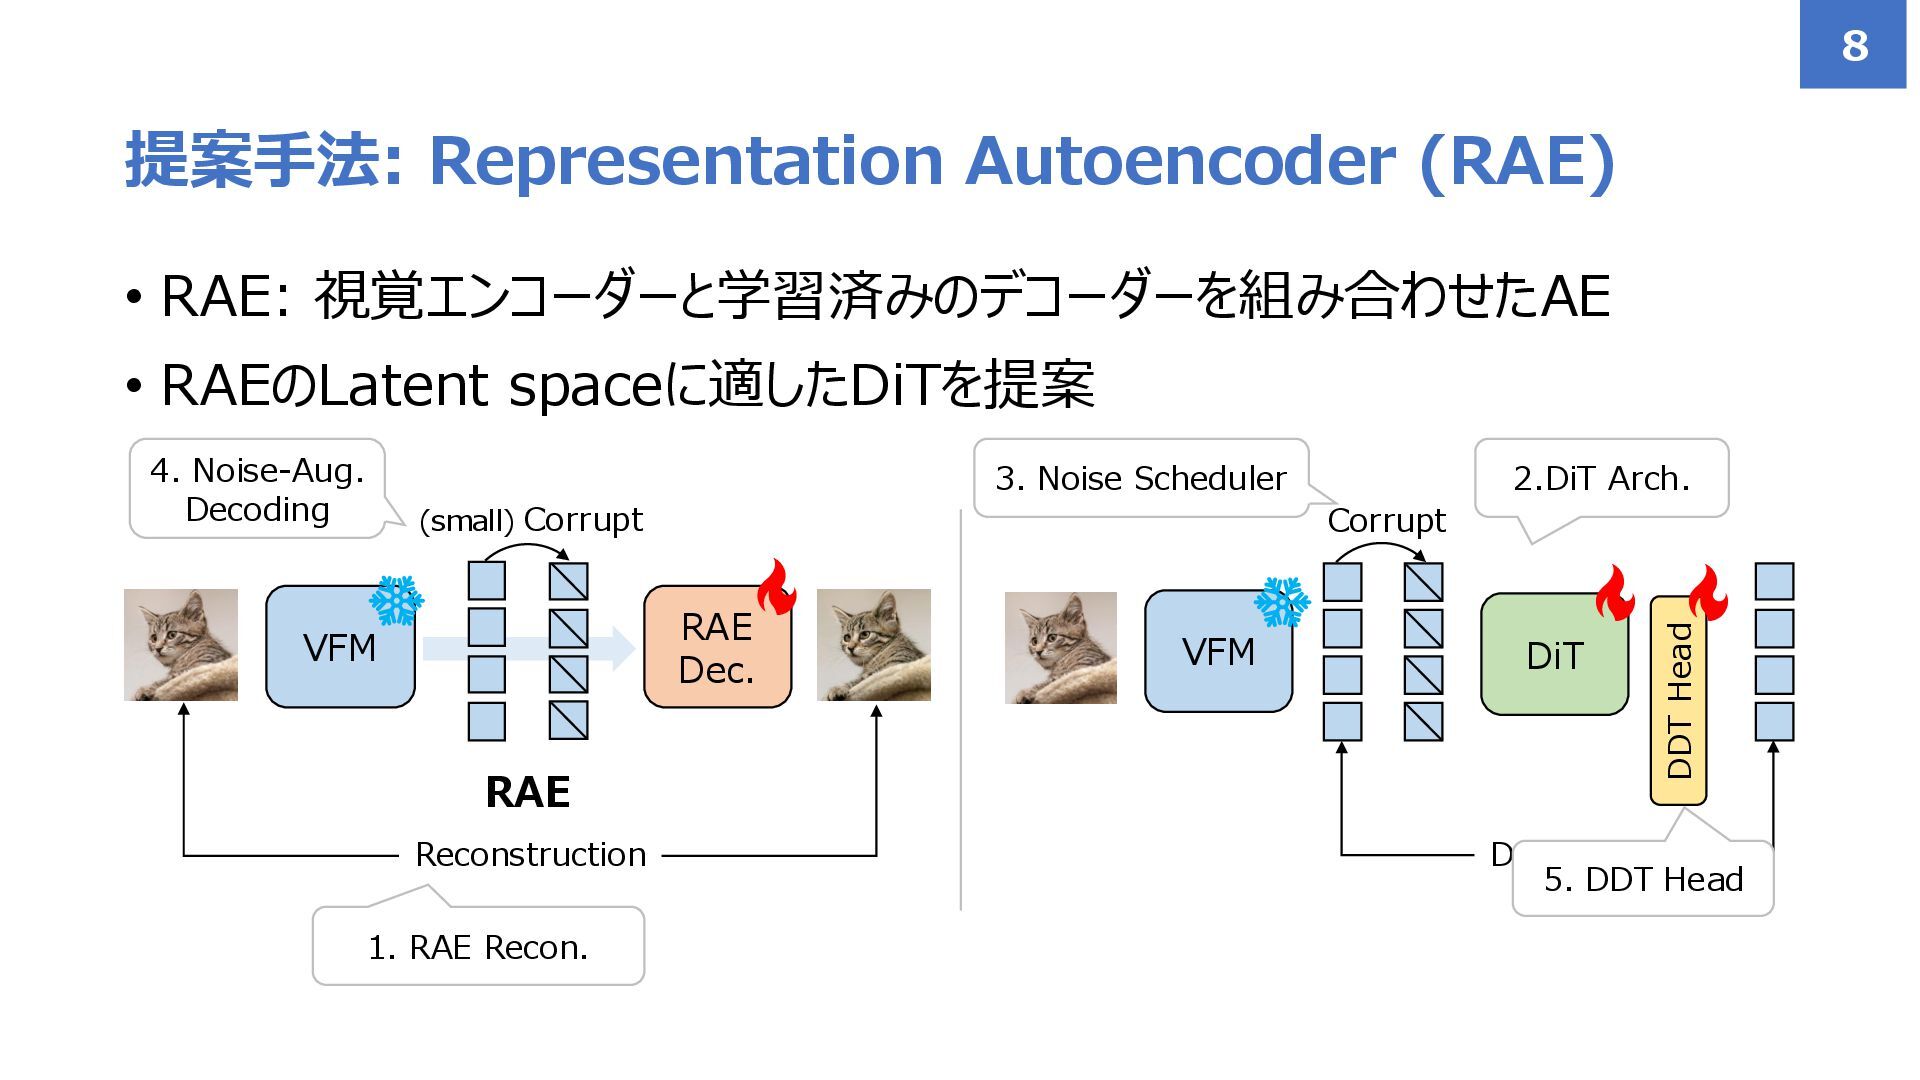
  3. • RAE: 視覚エンコーダーと学習済みのデコーダーを組み合わせたAE • RAEのLatent spaceに適したDiTを提案 提案手法: Representation Autoencoder (RAE)

    8 VFM DiT Corrupt DDT Head 1. RAE Recon. 2.DiT Arch. Denoising 5. DDT Head 3. Noise Scheduler 4. Noise-Aug. Decoding RAE Dec. VFM Reconstruction (small) Corrupt RAE
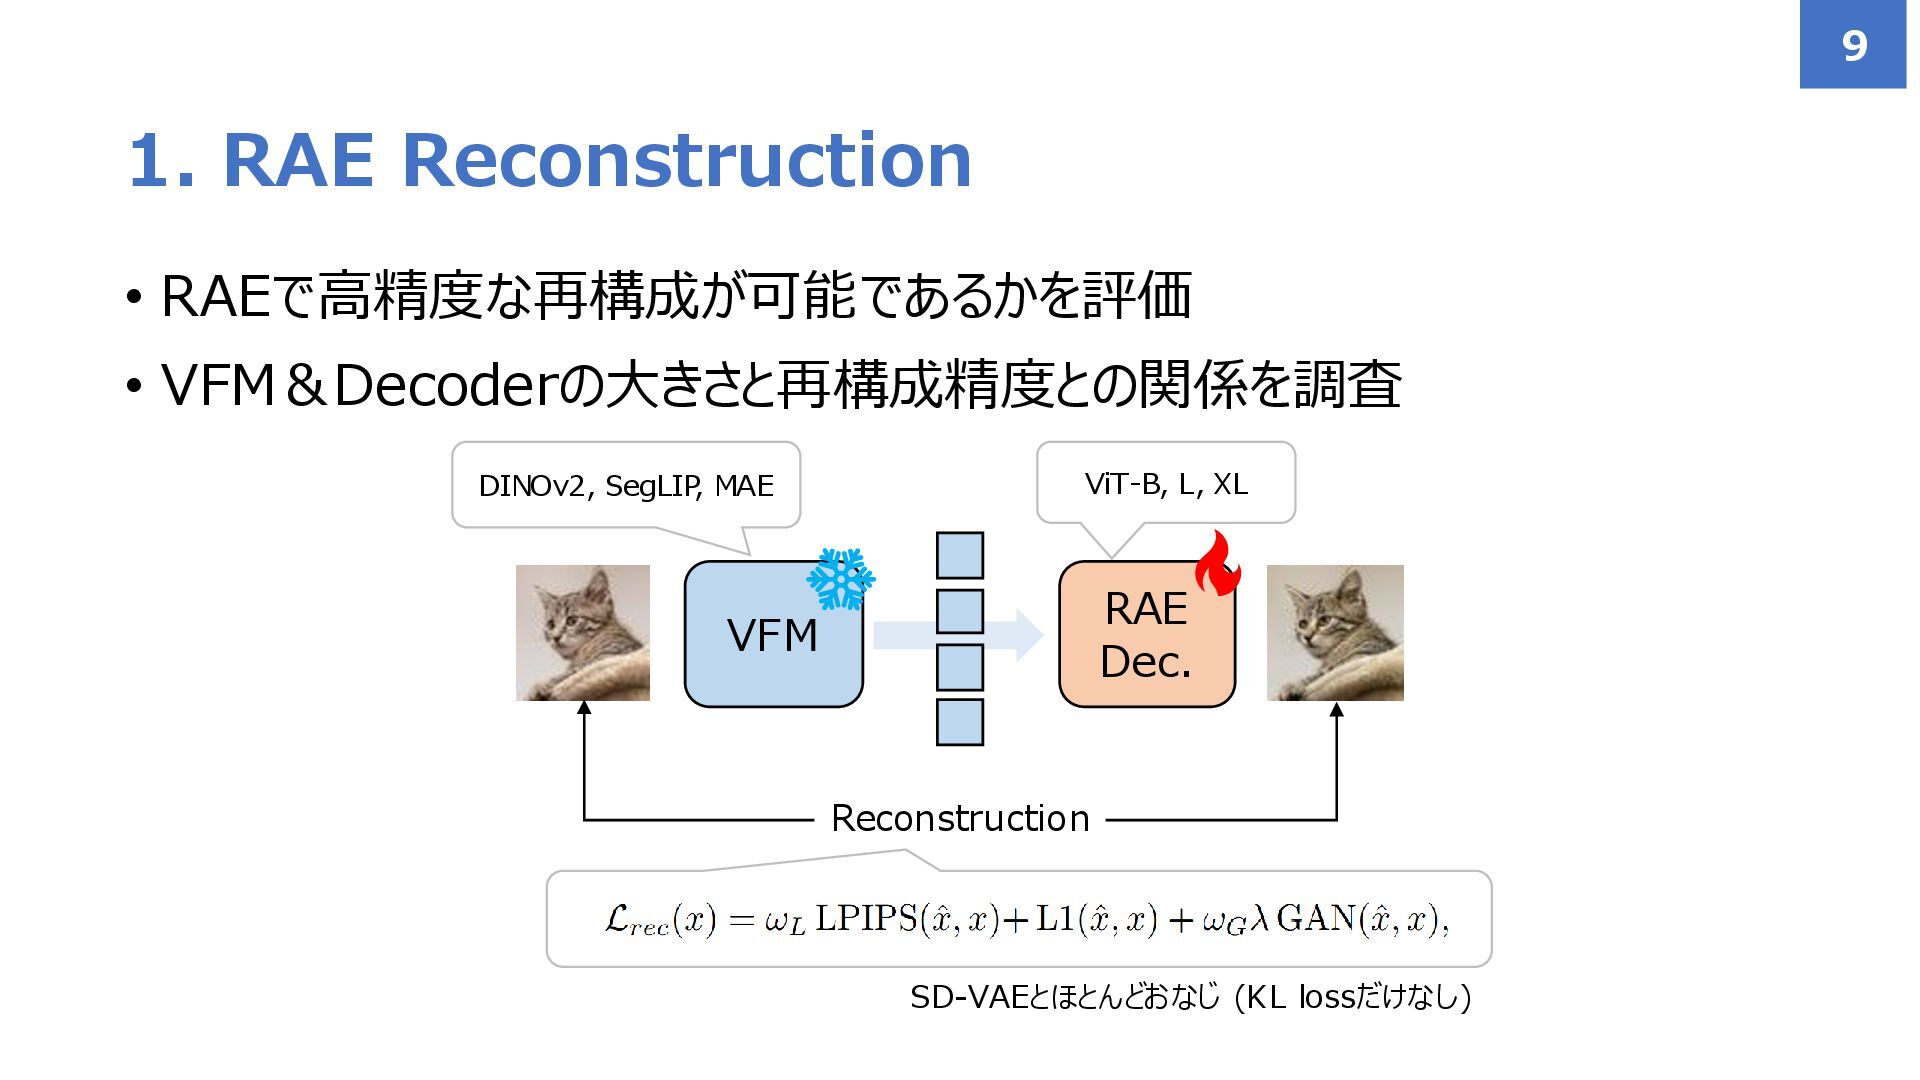
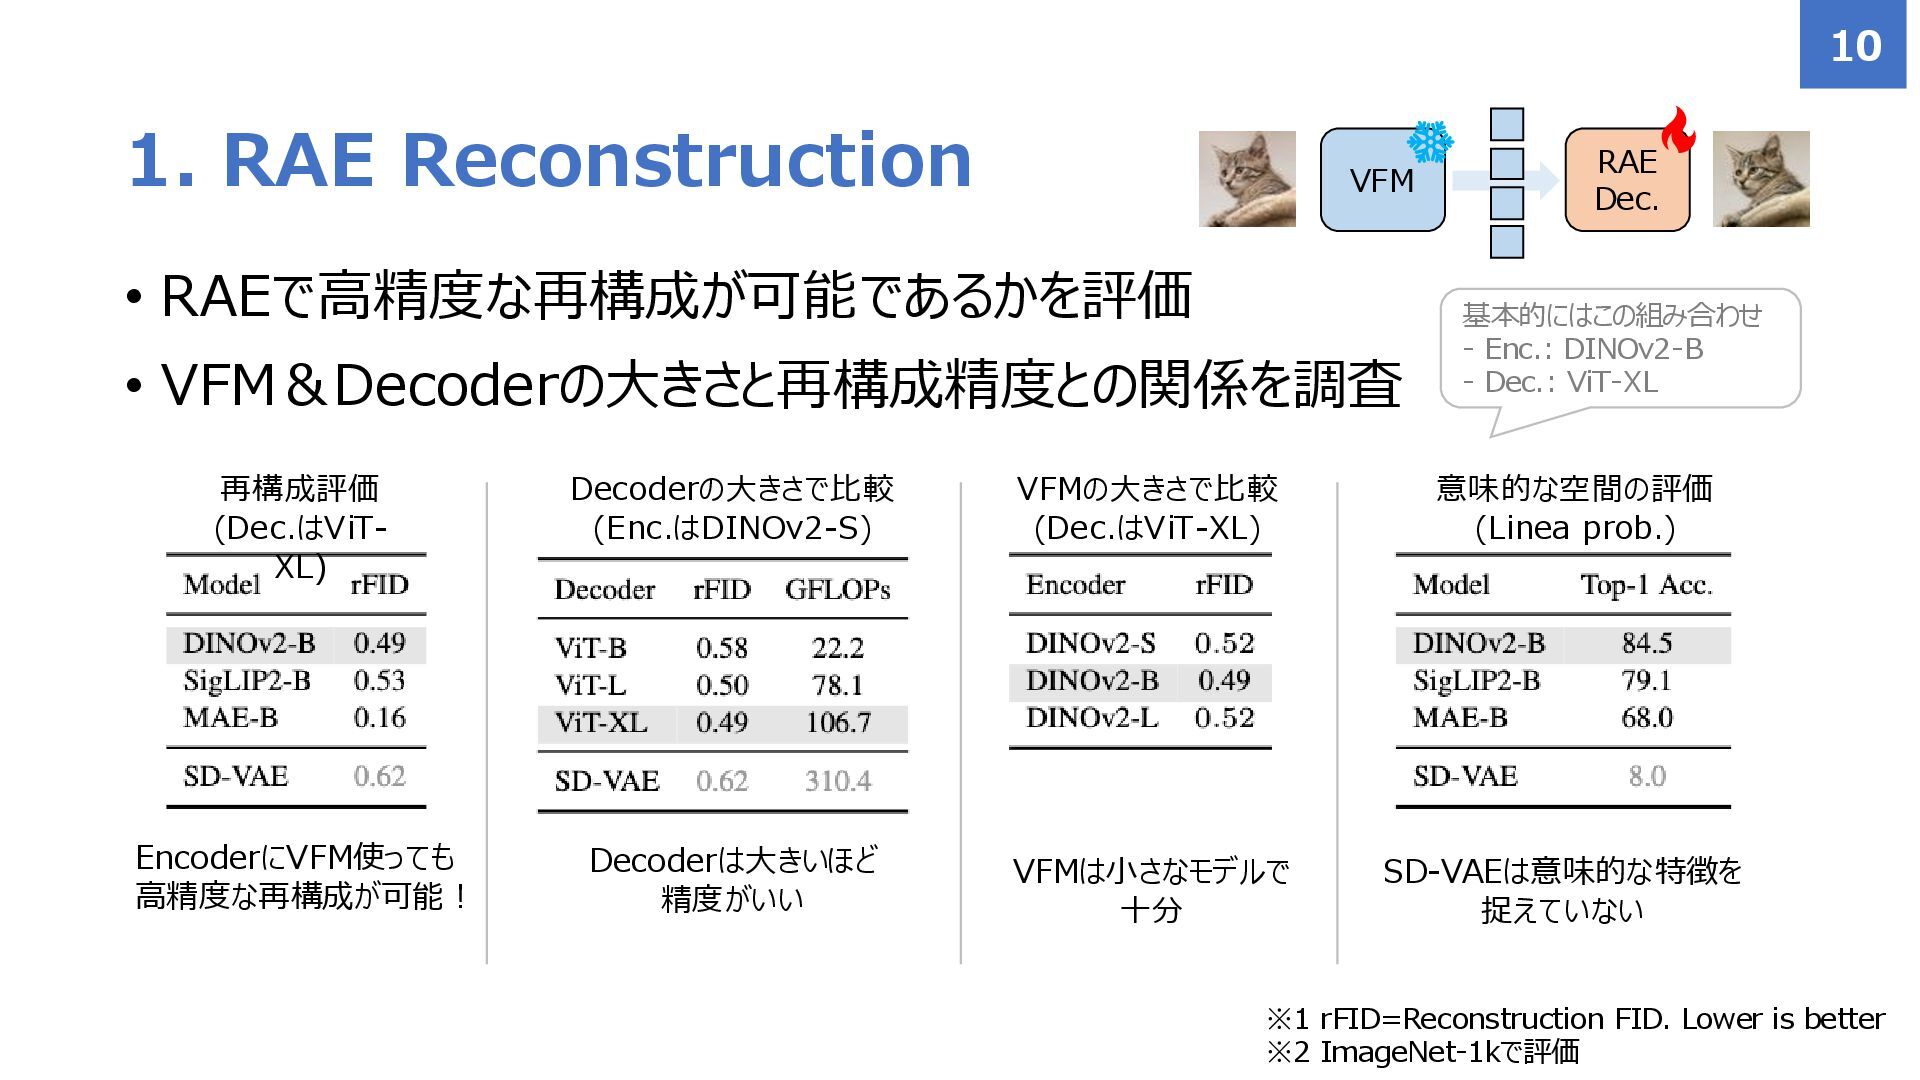
  4. • RAEで高精度な再構成が可能であるかを評価 • VFM&Decoderの大きさと再構成精度との関係を調査 1. RAE Reconstruction 10 再構成評価 (Dec.はViT-

    XL) ※1 rFID=Reconstruction FID. Lower is better ※2 ImageNet-1kで評価 Decoderの大きさで比較 (Enc.はDINOv2-S) VFMの大きさで比較 (Dec.はViT-XL) 意味的な空間の評価 (Linea prob.) EncoderにVFM使っても 高精度な再構成が可能! Decoderは大きいほど 精度がいい VFMは小さなモデルで 十分 SD-VAEは意味的な特徴を 捉えていない A e 基本的にはこの組み合わせ - Enc.: DINOv2-B - Dec.: ViT-XL
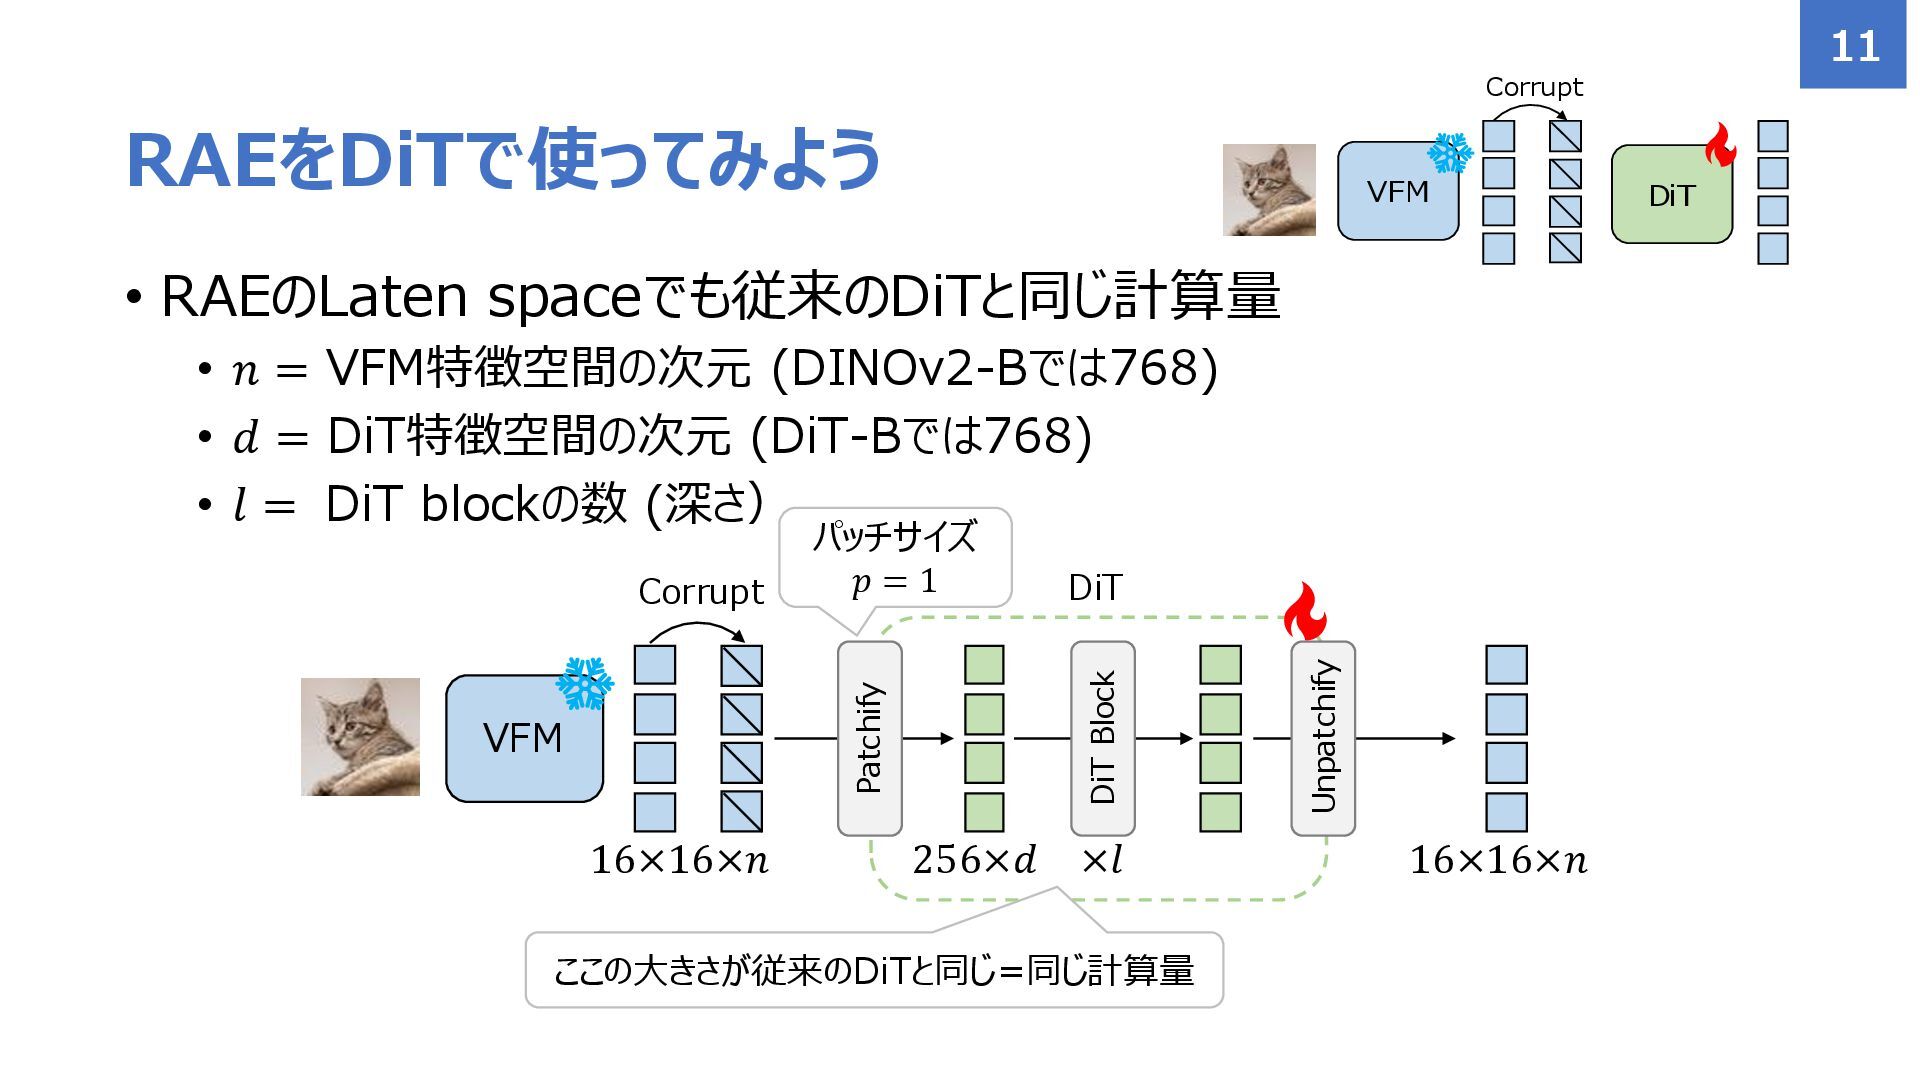
  5. t at i i i l n at i •

    RAEのLaten spaceでも従来のDiTと同じ計算量 • 𝑛 = VFM特徴空間の次元 (DINOv2-Bでは768) • 𝑑 = DiT特徴空間の次元 (DiT-Bでは768) • 𝑙 = DiT blockの数 (深さ) RAEをDiTで使ってみよう 11 i t パッチサイズ 𝑝 = ここの大きさが従来のDiTと同じ=同じ計算量
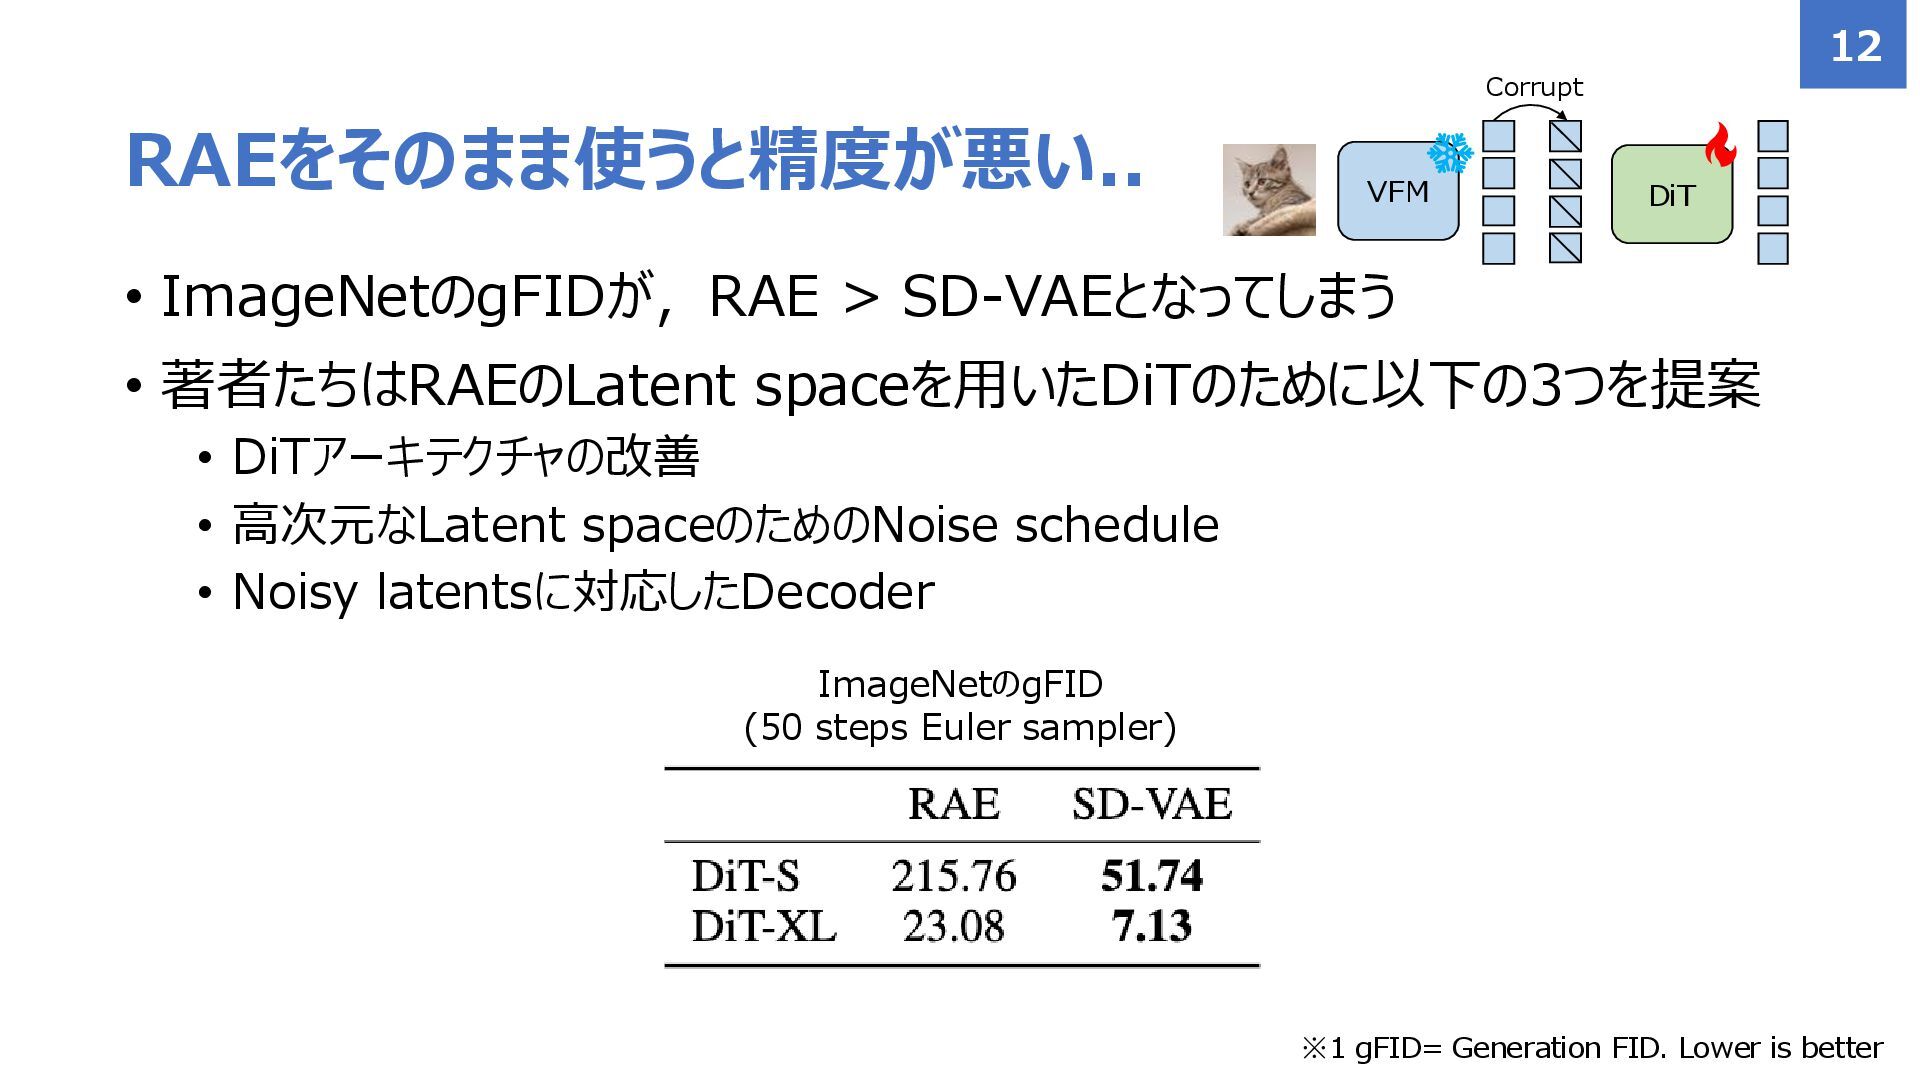
  6. • ImageNetのgFIDが,RAE > SD-VAEとなってしまう • 著者たちはRAEのLatent spaceを用いたDiTのために以下の3つを提案 • DiTアーキテクチャの改善 •

    高次元なLatent spaceのためのNoise schedule • Noisy latentsに対応したDecoder RAEをそのまま使うと精度が悪い.. 12 ImageNetのgFID (50 steps Euler sampler) ※1 gFID= Generation FID. Lower is better i t
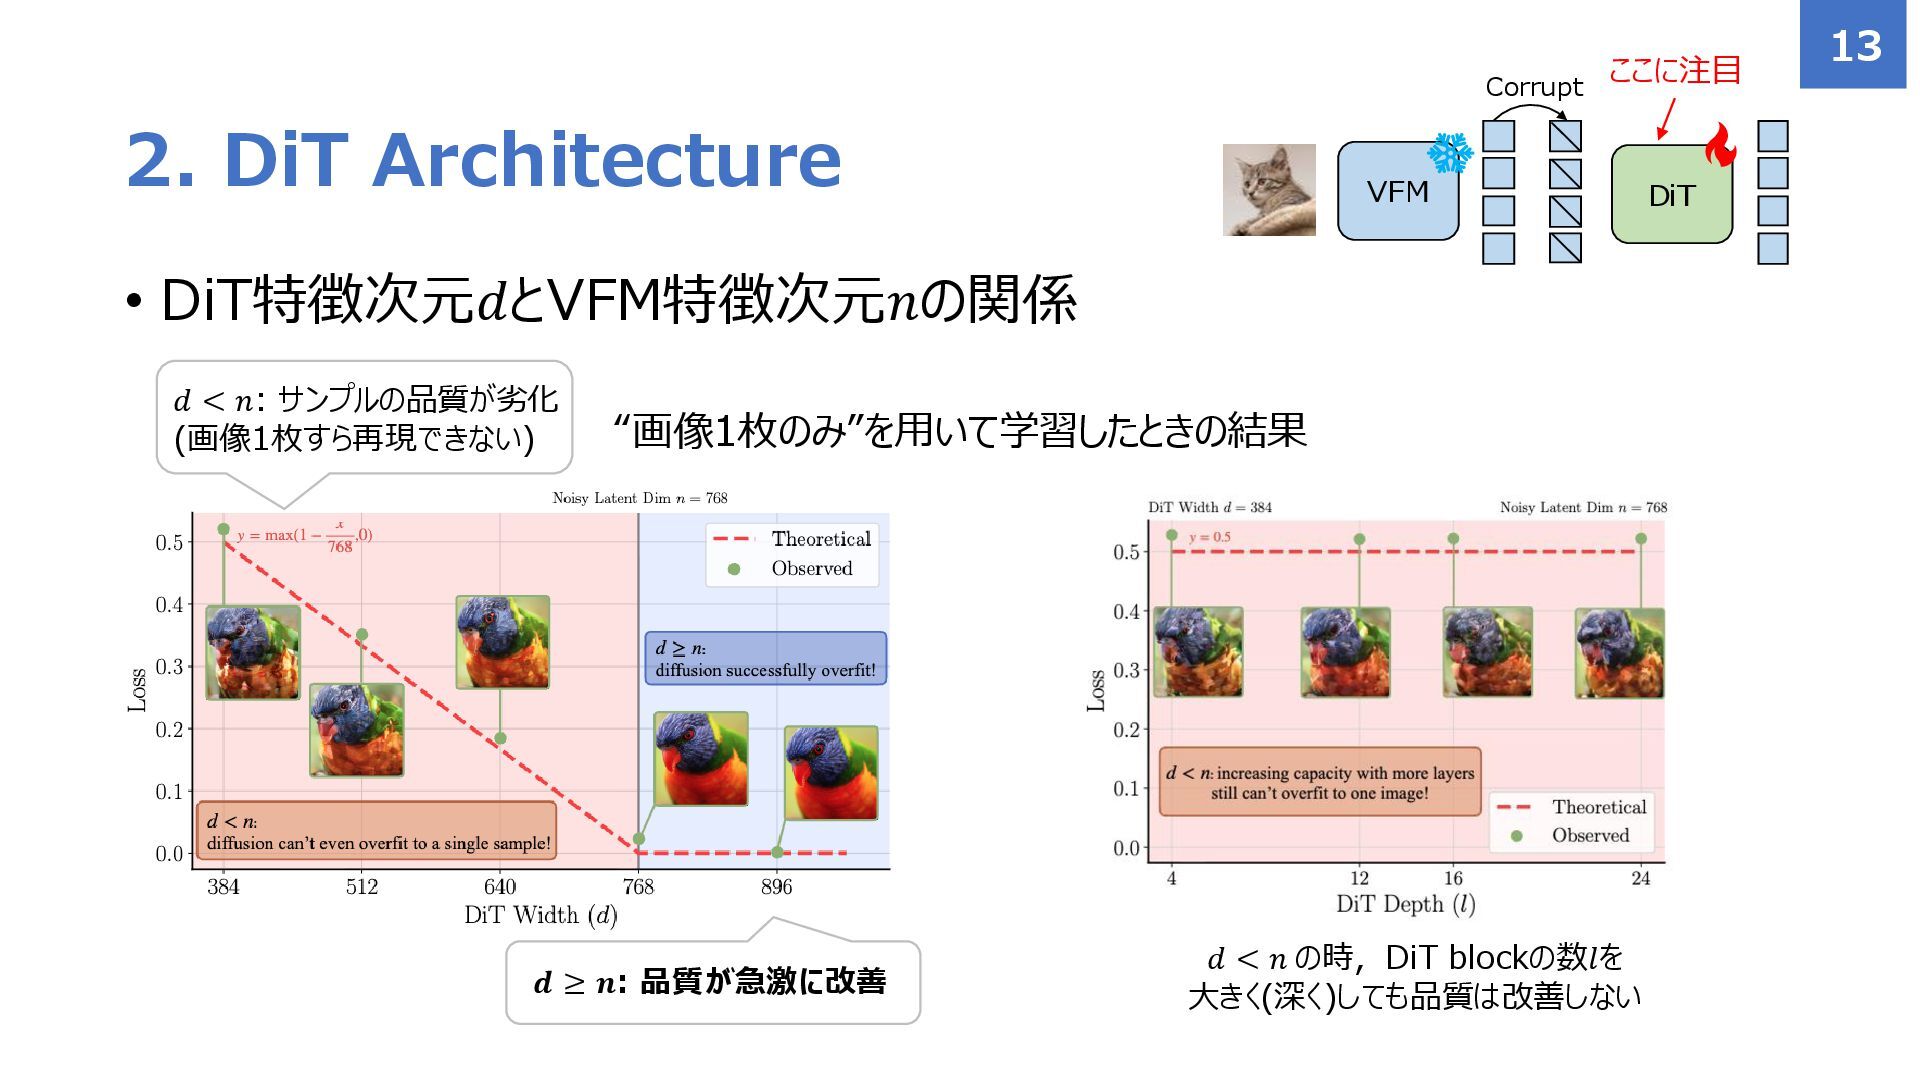
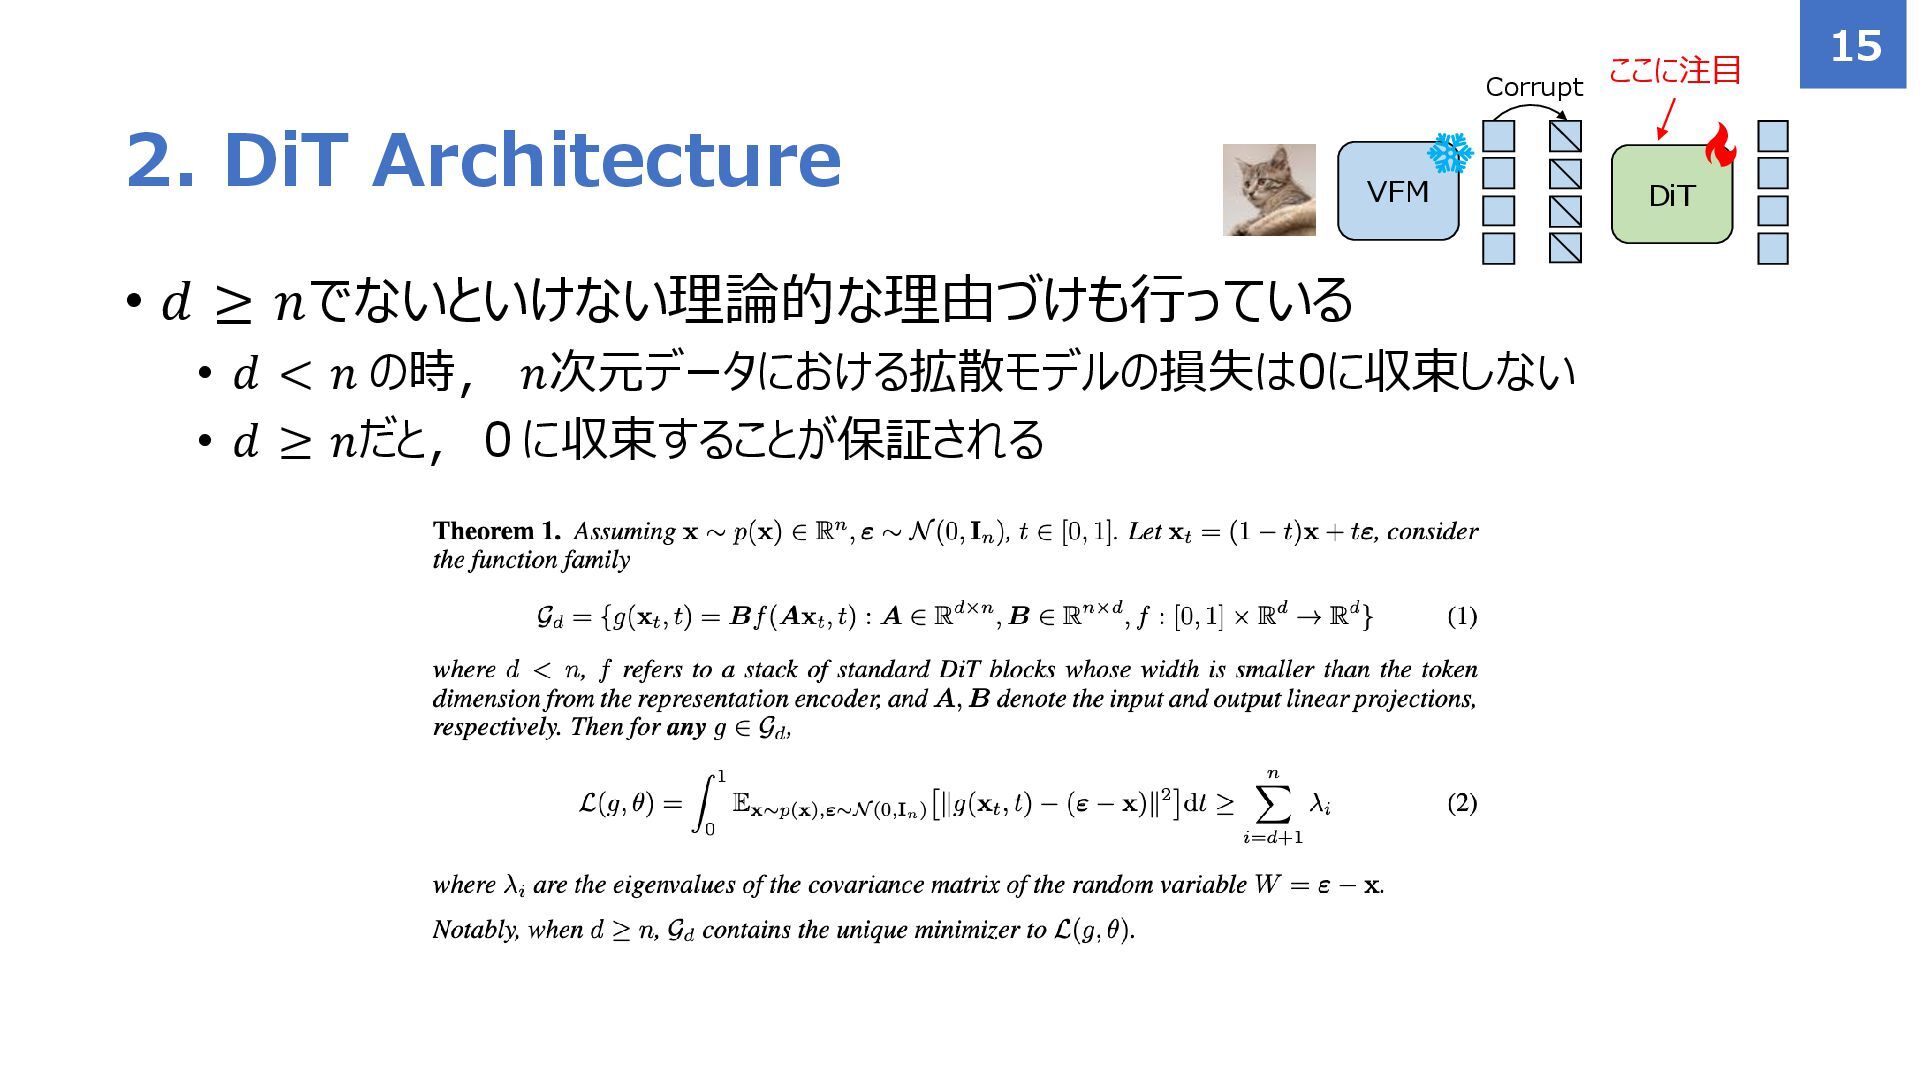
  7. • DiT特徴次元𝑑とVFM特徴次元𝑛の関係 2. DiT Architecture 13 i t “画像1枚のみ”を用いて学習したときの結果 )

    𝑑 < 𝑛: サンプルの品質が劣化 (画像1枚すら再現できない) ) 𝒅 ≥ 𝒏: 品質が急激に改善 𝑑 < 𝑛 の時,DiT blockの数𝑙を 大きく(深く)しても品質は改善しない ここに注目
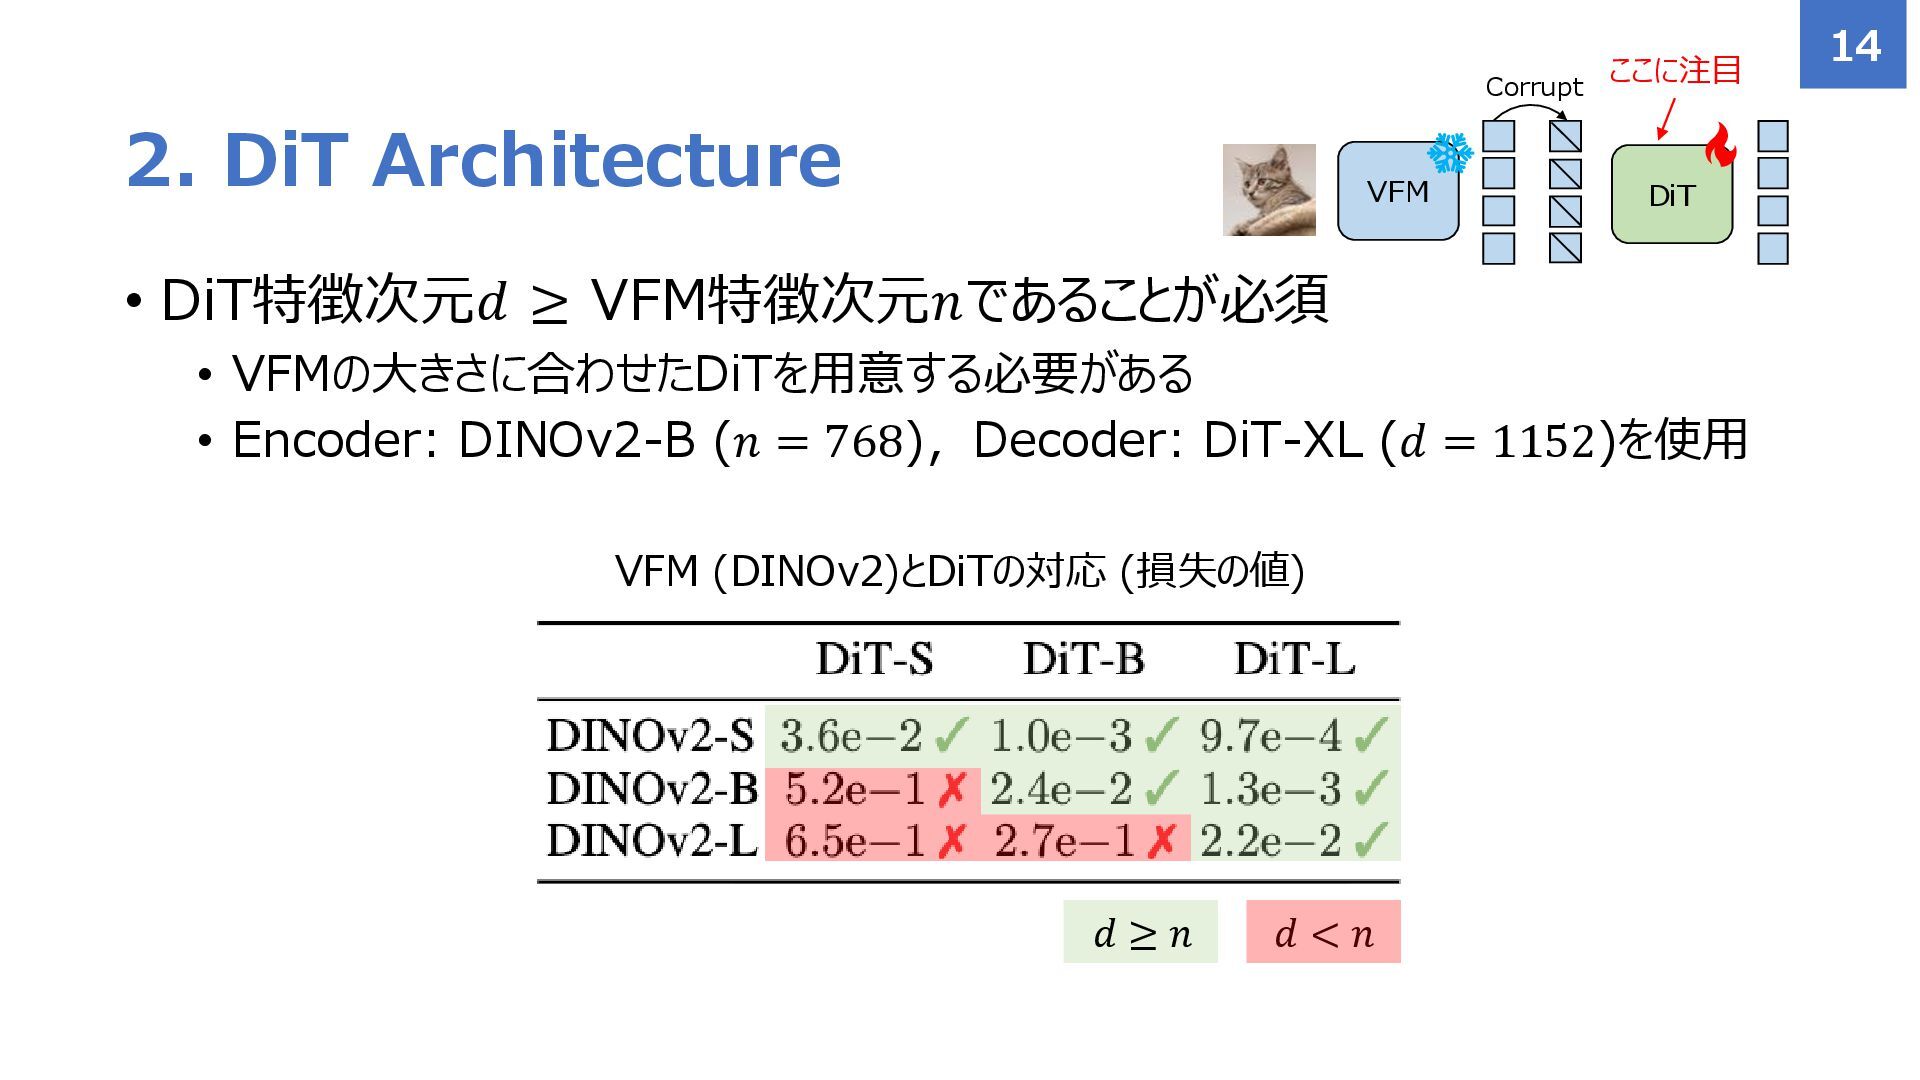
  8. • DiT特徴次元𝑑 ≥ VFM特徴次元𝑛であることが必須 • VFMの大きさに合わせたDiTを用意する必要がある • Encoder: DINOv2-B (𝑛

    = 7 8),Decoder: DiT-XL (𝑑 = )を使用 2. DiT Architecture 14 i t VFM (DINOv2)とDiTの対応 (損失の値) 𝑑 ≥ 𝑛 𝑑 < 𝑛 ここに注目
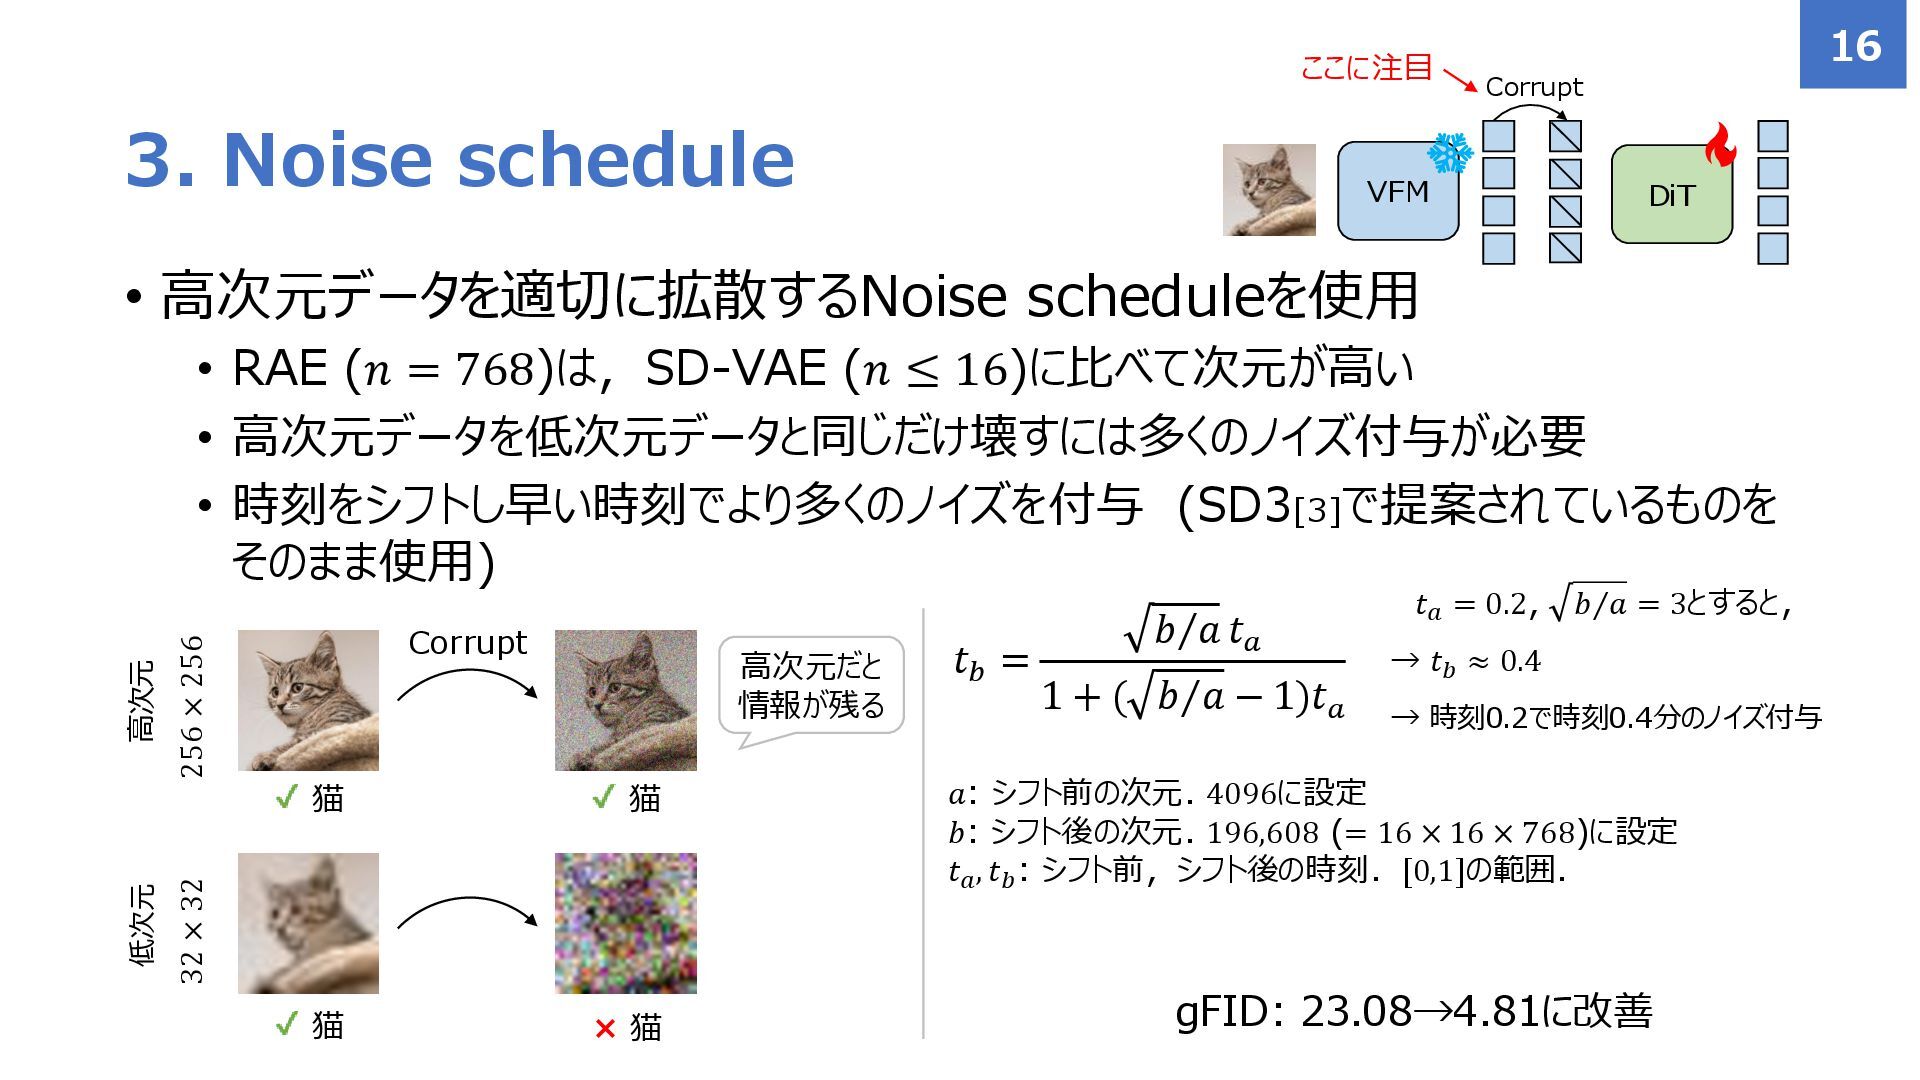
  9. • 高次元データを適切に拡散するNoise scheduleを使用 • RAE (𝑛 = 7 8)は,SD-VAE (𝑛

    ≤ )に比べて次元が高い • 高次元データを低次元データと同じだけ壊すには多くのノイズ付与が必要 • 時刻をシフトし早い時刻でより多くのノイズを付与 (SD3[3]で提案されているものを そのまま使用) 3. Noise schedule 16 i t ここに注目 𝑎: シフト前の次元. 409 に設定 𝑏: シフト後の次元. 9 , 08 (= 7 8)に設定 𝑡𝑎 , 𝑡𝑏 : シフト前,シフト後の時刻.[0, ]の範囲. 𝑡𝑏 = Τ 𝑏 𝑎 𝑡𝑎 + ( Τ 𝑏 𝑎 − )𝑡𝑎 3 3 Corrupt 猫 猫 猫 × 猫 高次元 低次元 高次元だと 情報が残る 𝑡𝑎 = 0. , Τ 𝑏 𝑎 = 3とすると, → 𝑡𝑏 ≈ 0.4 → 時刻0 2で時刻0 4分のノイズ付与 g I : 23 08→4 81に改善
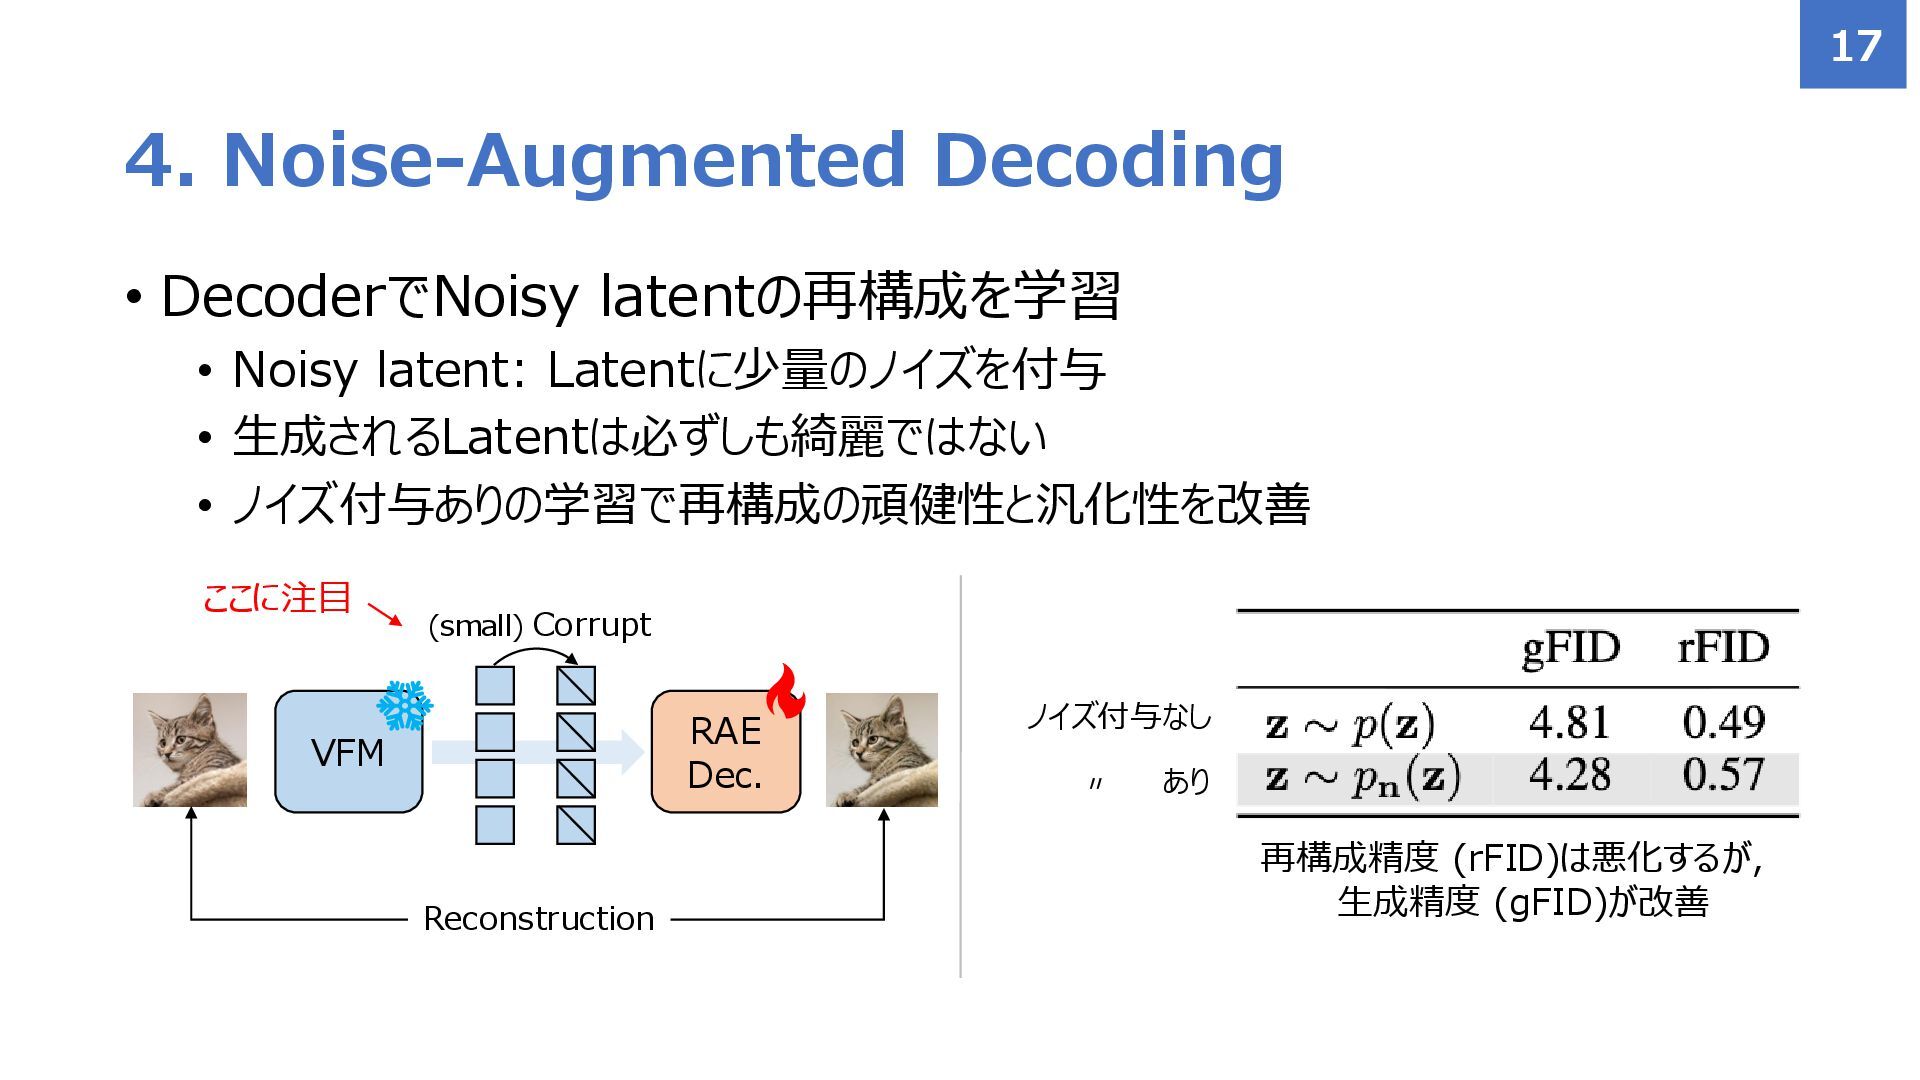
  10. • DecoderでNoisy latentの再構成を学習 • Noisy latent: Latentに少量のノイズを付与 • 生成されるLatentは必ずしも綺麗ではない •

    ノイズ付与ありの学習で再構成の頑健性と汎化性を改善 4. Noise-Augmented Decoding 17 ここに注目 ノイズ付与なし あり 〃 再構成精度 ( I )は悪化するが, 生成精度 (g I )が改善 RAE Dec. VFM Reconstruction (small) Corrupt
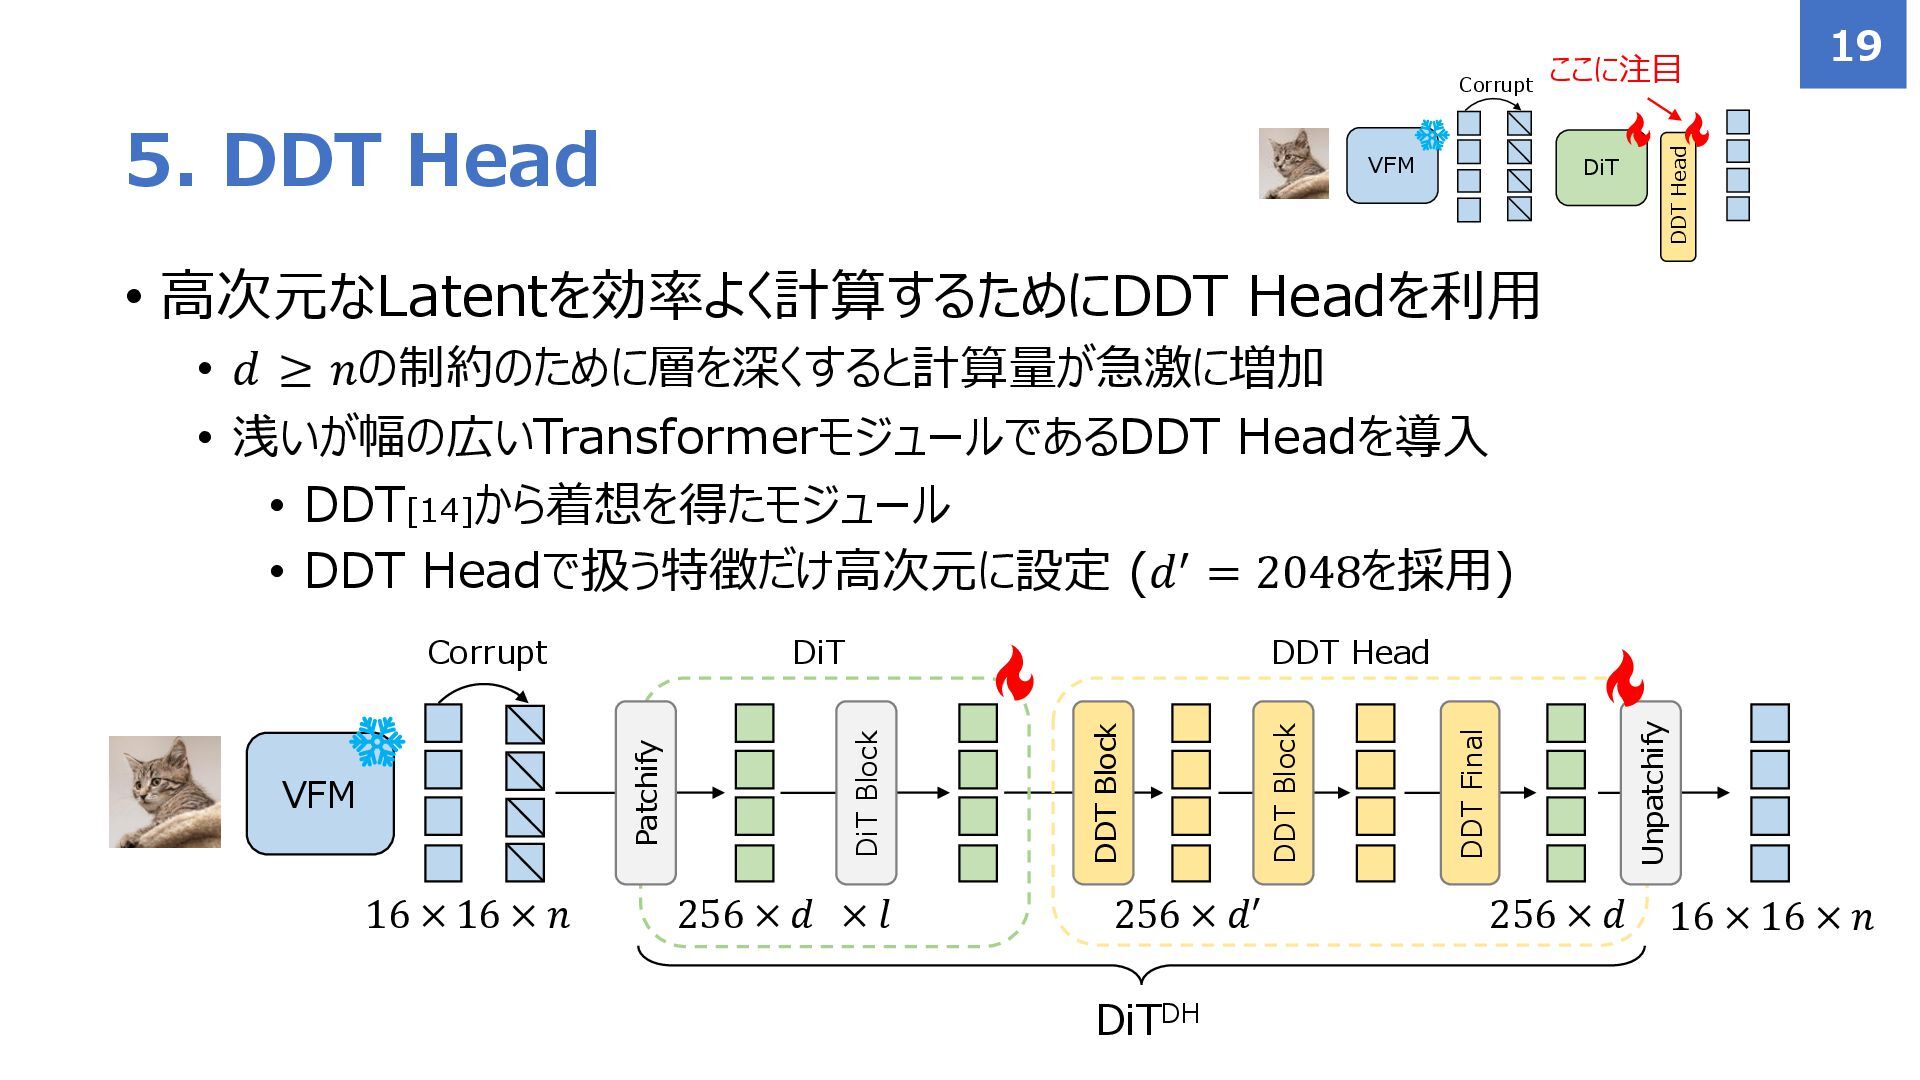
  11. • 高次元なLatentを効率よく計算するためにDDT Headを利用 • 𝑑 ≥ 𝑛の制約のために層を深くすると計算量が急激に増加 • 浅いが幅の広いTransformerモジュールであるDDT Headを導入

    • DDT[14]から着想を得たモジュール • DDT Headで扱う特徴だけ高次元に設定 (𝑑′ = 048を採用) 5. DDT Head 19 ここに注目 t i DiT Block 𝑛 𝑑 𝑛 𝑙 i t ea i l ea DDT Block 𝑑′ DDT Final 𝑑 Unpatchify at i
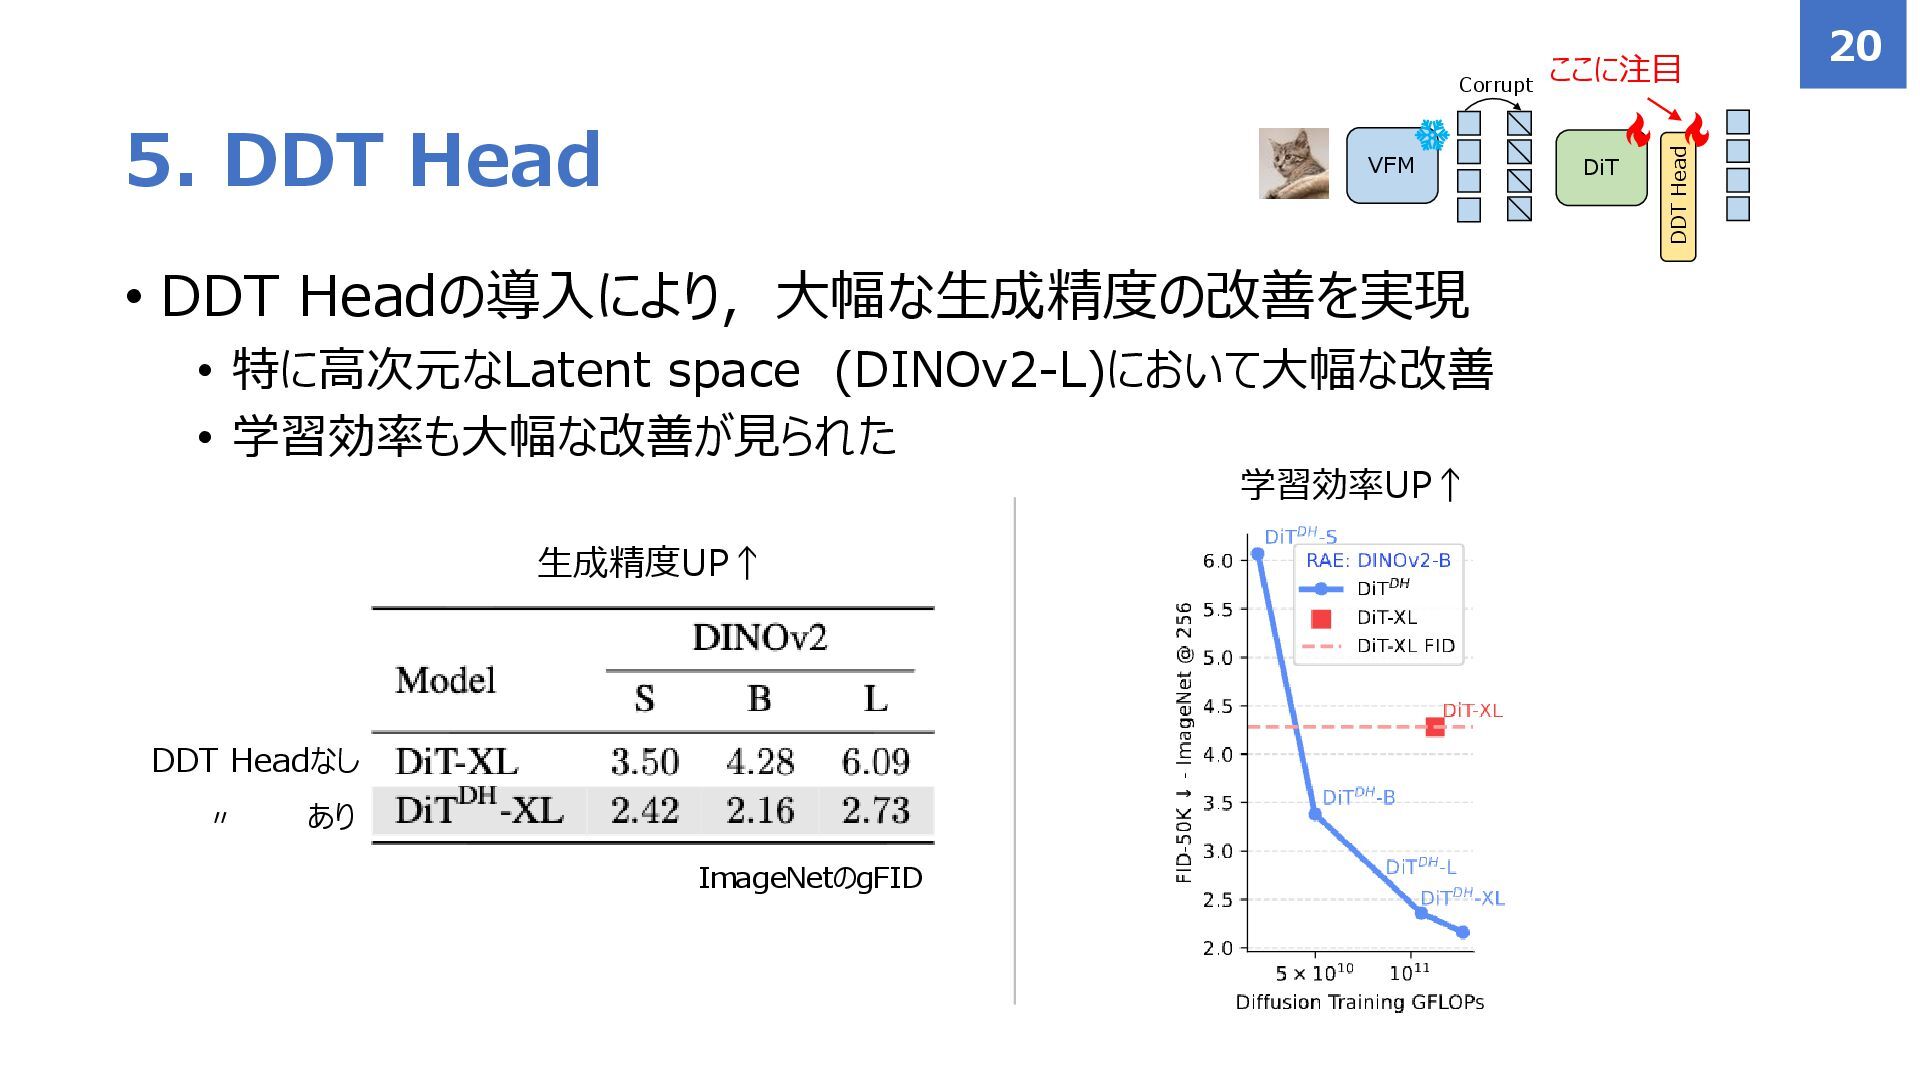
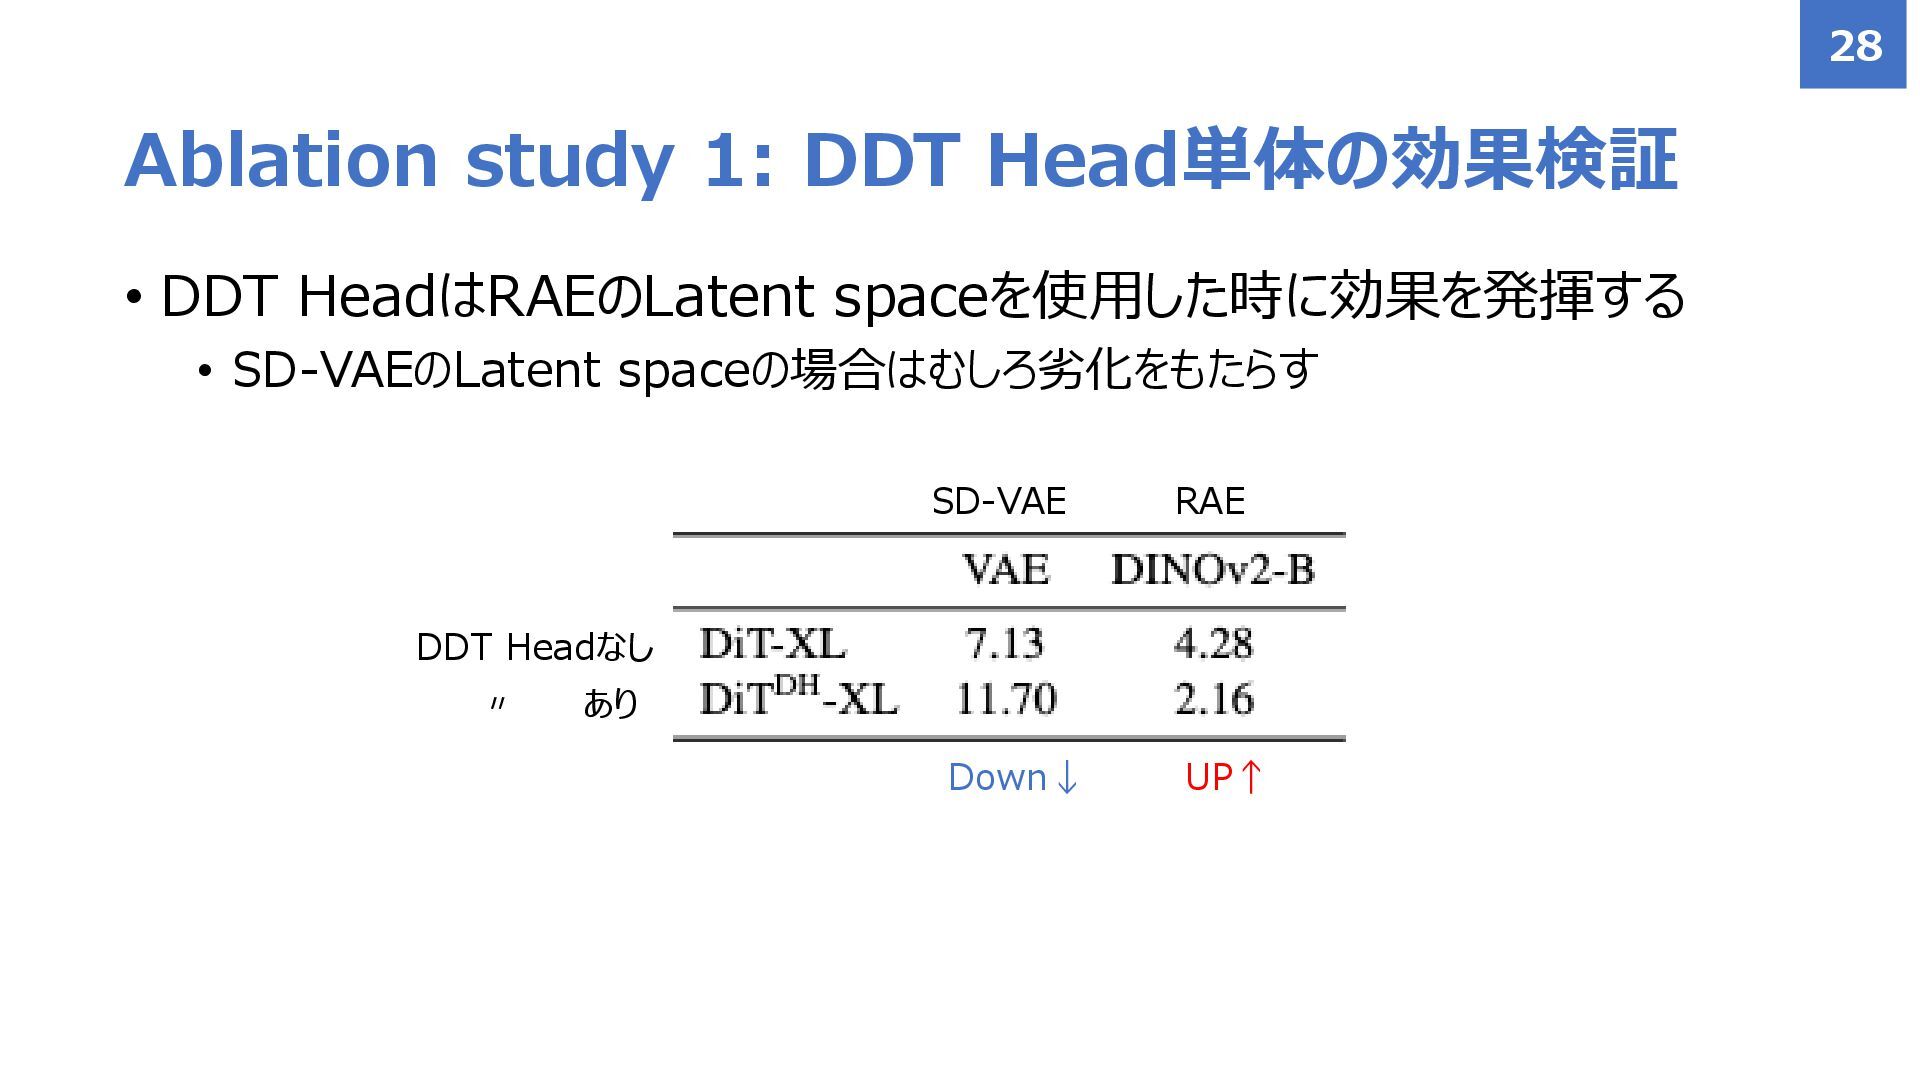
  12. • ea の導入により,大幅な生成精度の改善を実現 • 特に高次元なLatent s a e ( INOv2-L)において大幅な改善

    • 学習効率も大幅な改善が見られた 5. DDT Head 20 ここに注目 i t ea DDT Headなし あり 〃 ImageNetのg I 学習効率 ↑ 生成精度 ↑
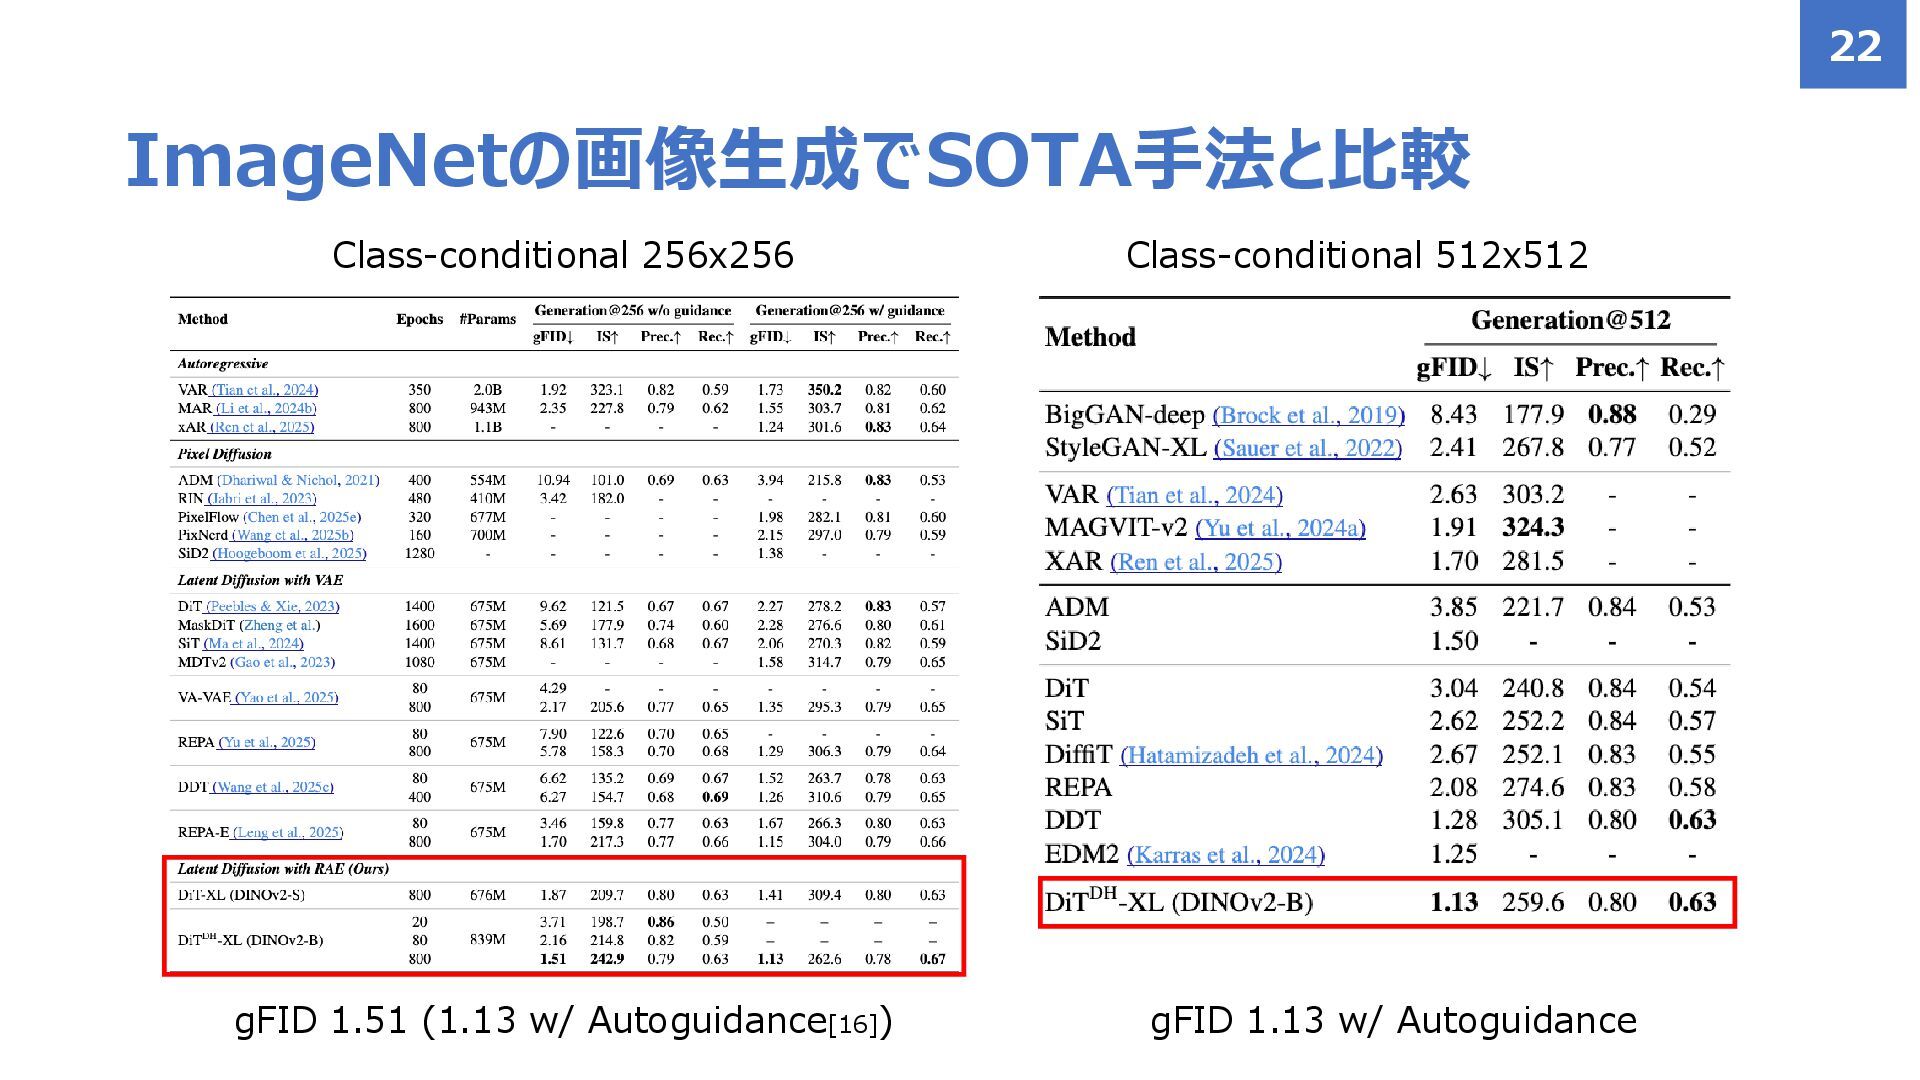
  13. ImageNetの画像生成でSOTA手法と比較 22 lass- n iti nal 256x256 gFID 1.51 (1.13

    w/ Autoguidance[16]) Class-conditional 512x512 gFID 1.13 w/ Autoguidance
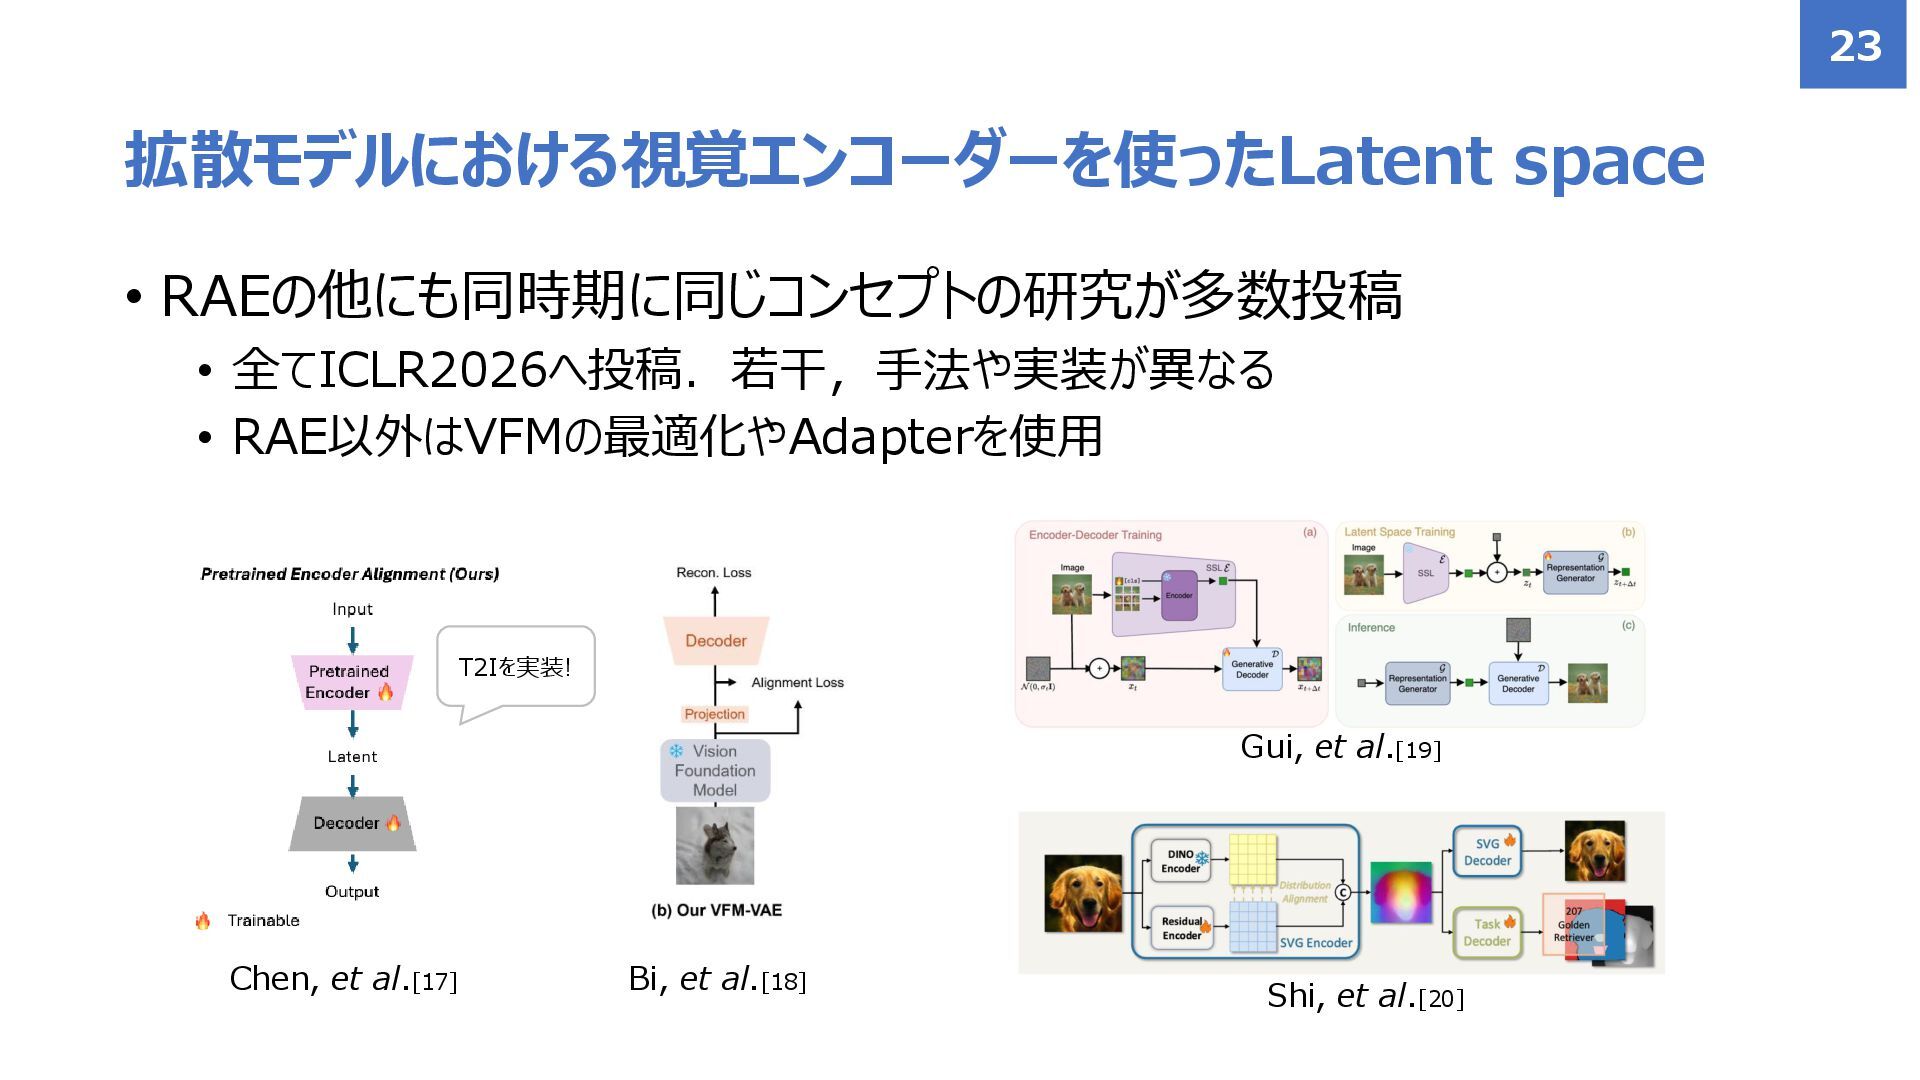
  14. • まとめ • DiTのLatent spaceとしてVFMの特徴空間をそのまま使用 • VFMの特徴空間は,再構成精度 (rFID),生成精度 (gFID)ともに改善 •

    同じようなモチベーションの研究が複数報告されている (T2Iも可能) • 感想 • VFMとDiTを“直接つなげた”初めての研究で興味深かった • これからのスタンダードな拡散モデルとなり得るので今後の発展に期待 • AEも含めてすべてがTransformerで成立しているところも大きい まとめ 24
  15. [1] bin mba , et al , “ ig -

    es l ti n Image S nt esis wit Latent i si n els”, 2022 [2] la est Labs, L X, 2024, tt s://git b m/bla - est-labs/ l x [3] at i sse , et al , “S aling e ti ie l w ans me s ig - es l ti n Image S nt esis”, I L2024 [4] at il e a n, et al , “ me ging e ties in Sel -S e vise isi n ans me s,” I 2021 [5] axime Oq ab, et al , “ INOv2: Lea ning b st is al eat es wit t S e visi n,” L , 2024 [6] Kaiming e, et al , “ as e A t en e s A e S alable isi n Lea ne s,” 2022 [7] Ale a , et al , “Lea ning ans e able is al els m Nat al Lang age S e visi n,” I L2021 [8] Xia a Z ai, et al , “Sigm i L ss Lang age Image e- aining,” I 2023 [9] Jing eng Ya , et al , “ e nst ti n vs Gene ati n: aming O timizati n ilemma in Latent i si n els,” 2025 [10] e s K zelis, et al , “ sting Gene ative Image eling via J int Image- eat e S nt esis,” Ne I S2025 [11] Si n Y , et al , “ e esentati n Alignment Gene ati n: aining i si n ans me s Is asie an Y in ”, I L 2025 [12] Xingjian Leng, et al , “ A- : nl ing A n -t - n ning wit Latent i si n ans me s”, I 2025 [13] Ge W , et al , “ e esentati n ntanglement Gene ati n: aining i si n ans me s Is asie an Y in ,” a xiv e int, 2025 [14] S ai Wang et al , “ : e le i si n ans me ,” a xiv e int, 2025 [15] Nan e a, et al , “Si : x l ing l w an i si n-base Gene ative els wit S alable Inte lant ans me s,” 2024 [16] e Ka as, et al , “G i ing a i si n el wit a a e si n Itsel ,” Ne I S2024 [17] wei en, et al , “Aligning is al n ati n n e s t enize s i si n els,” a xiv e int, 2025 [18] ian i i, et al , “ isi n n ati n els an e G enize s Latent i si n els”, a xiv e int, 2025 [19] ing G i, et al , “A a ting Sel -S e vise e esentati ns as a Latent S a e i ient Gene ati n,” a xiv e int, 2025 [20] inglei S i, et al , “Latent i si n el wit t a iati nal A t en e ”, a xiv e int, 2025 参考文献 25
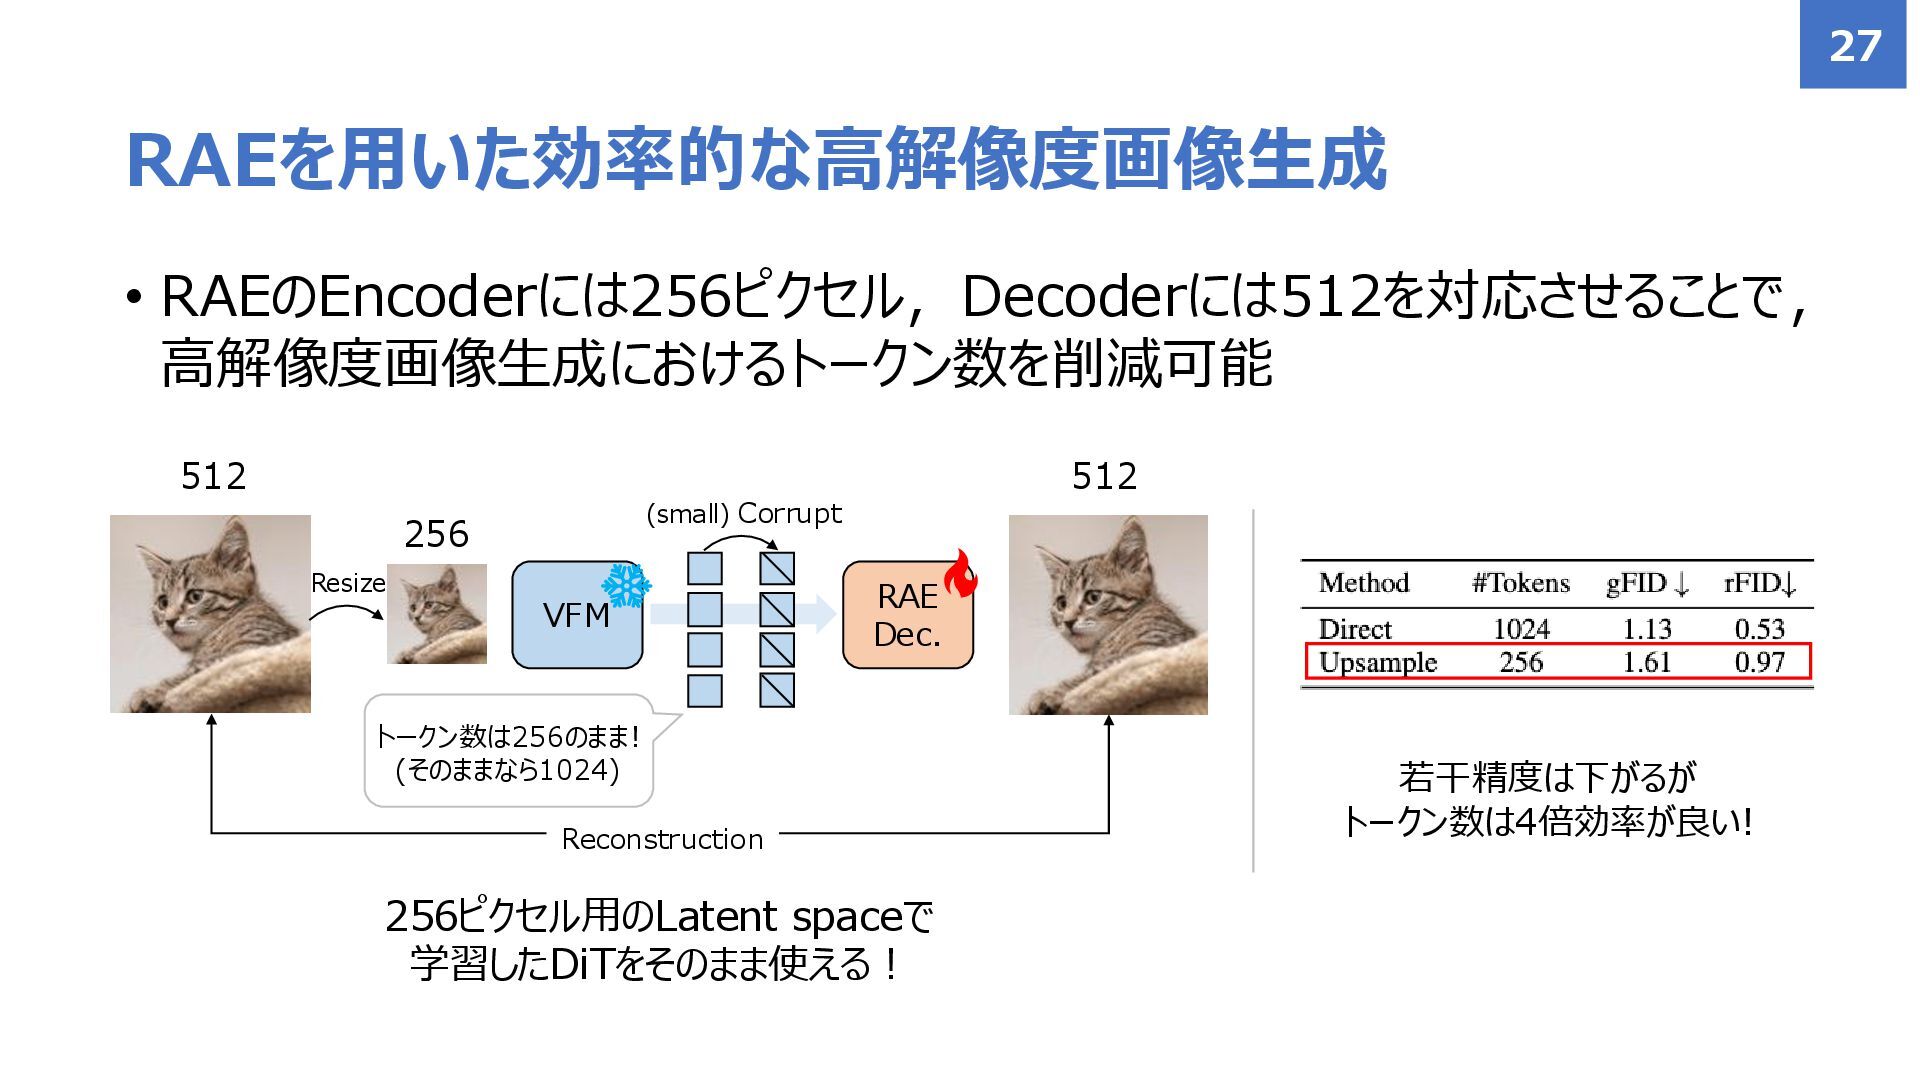
  16. • RAEのEncoderには256ピクセル,Decoderには512を対応させることで, 高解像度画像生成におけるトークン数を削減可能 RAEを用いた効率的な高解像度画像生成 27 A e (small) t esize

    e nst ti n トークン数は256のまま (そのままなら1024) 256ピクセル用のLatent s a eで 学習した i をそのまま使える! 若干精度は下がるが トークン数は4倍効率が良い 512 256 512
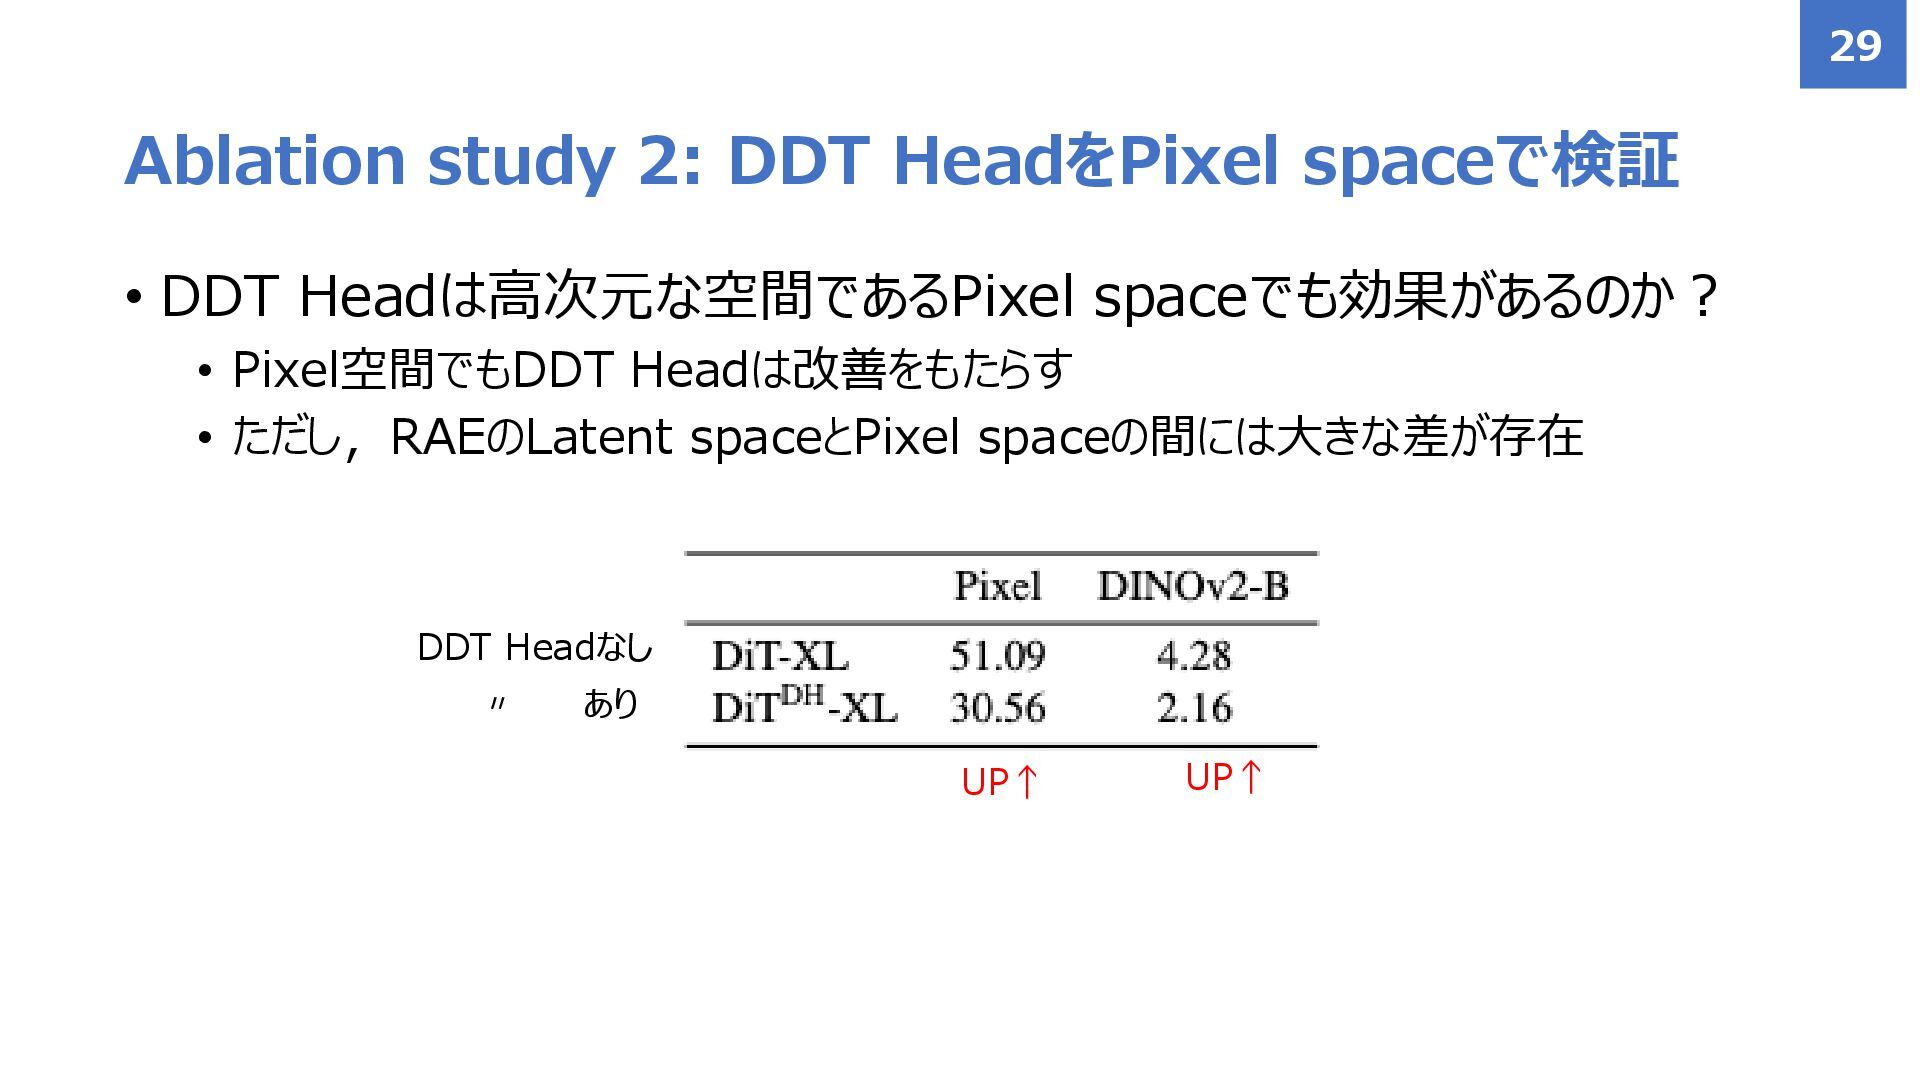
  17. • ea は高次元な空間である ixel s a eでも効果があるのか? • ixel空間でも ea

    は改善をもたらす • ただし, A のLatent s a eと ixel s a eの間には大きな差が存在 Ablation study 2: DDT HeadをPixel spaceで検証 29 DDT Headなし あり 〃 UP↑ UP↑

More Decks by Shumpei Takezaki