Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
0.8BのVLMで始めるリアルタイム動画解析VLM
Search
Yusuke
August 29, 2026
210
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
0.8BのVLMで始めるリアルタイム動画解析VLM
https://machine-learning15minutes.connpass.com/event/401182/
Yusuke
August 29, 2026
More Decks by Yusuke
See All by Yusuke
教師あり学習を用いたSkillsの最適化
shuredev
2
1.6k
Featured
See All Featured
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.6k
Chasing Engaging Ingredients in Design
codingconduct
0
340
Google's AI Overviews - The New Search
badams
0
1.6k
The Limits of Empathy - UXLibs8
cassininazir
1
690
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3k
Game over? The fight for quality and originality in the time of robots
wayneb77
1
290
Making the Leap to Tech Lead
cromwellryan
135
10k
エンジニアに許された特別な時間の終わり
watany
109
250k
Code Review Best Practice
trishagee
74
20k
Highjacked: Video Game Concept Design
rkendrick25
PRO
1
460
Amusing Abliteration
ianozsvald
1
320
Transcript
0.8BのVLMで始める リアルタイム動画解析VLM 2026/08/29
自己紹介
自己紹介 Yusuke X: @yusuke_post
自己紹介 修士までAIの研究してた AIエンジニア スタートアップ属性
個人ミッション
個人ミッション 建設・製造・ インフラ・物流・農業 日本産業の現場を マルチモーダルAIでDXする テキスト・音声・ 動画・画像 効率化・安全・教育 ・技能継承
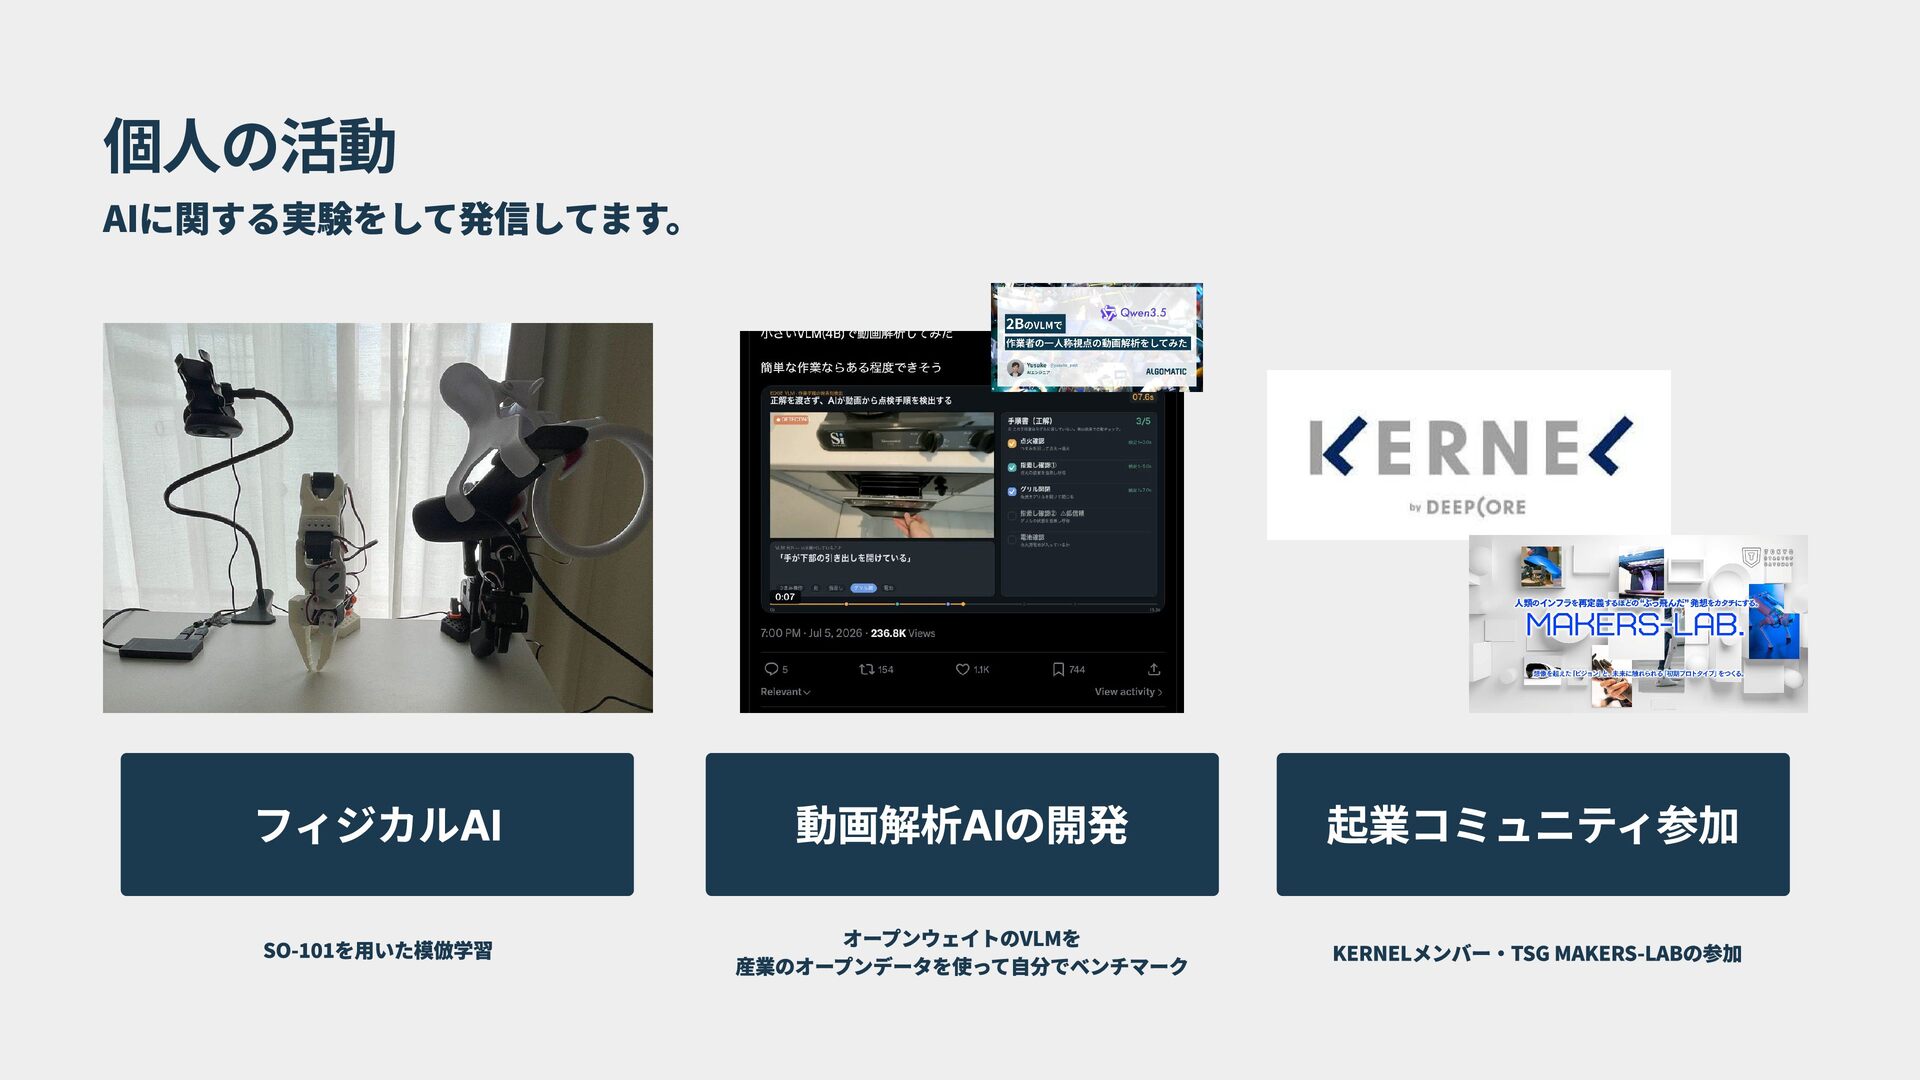
個人の活動 AIに関する実験をして発信してます。 フィジカルAI 動画解析AIの開発 起業コミュニティ参加 SO-101を用いた模倣学習 オープンウェイトのVLMを 産業のオープンデータを使って自分でベンチマーク KERNELメンバー・TSG MAKERS-LABの参加
研究してました 修士では研究してたりしました。 VIMA: General Robot Manipulation with Multimodal Prompts こちらのベンチマークを用いて研究してたりしました。(これは自分の研究ではないです。)
WHY
今回は、個人でやってる工作を 紹介するだけの回です。
暖かく見守っていただけると 助かります。
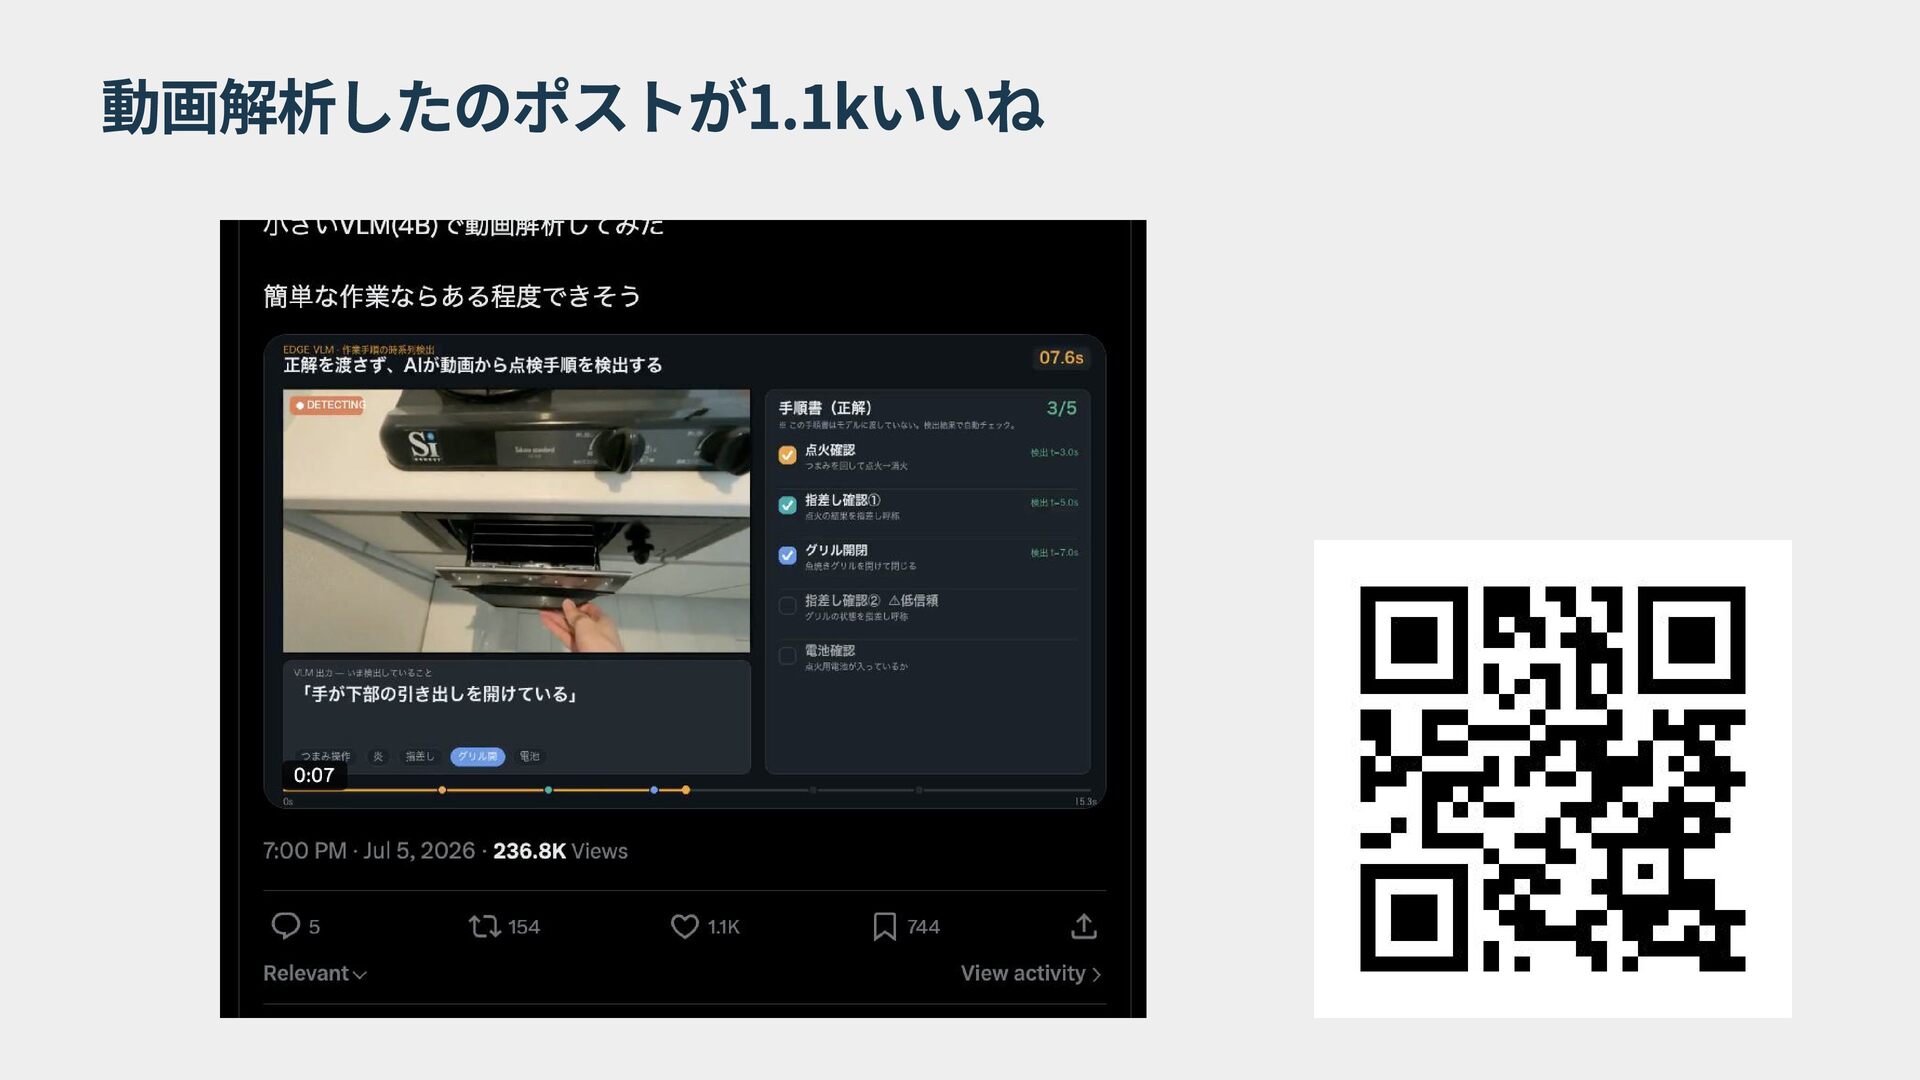
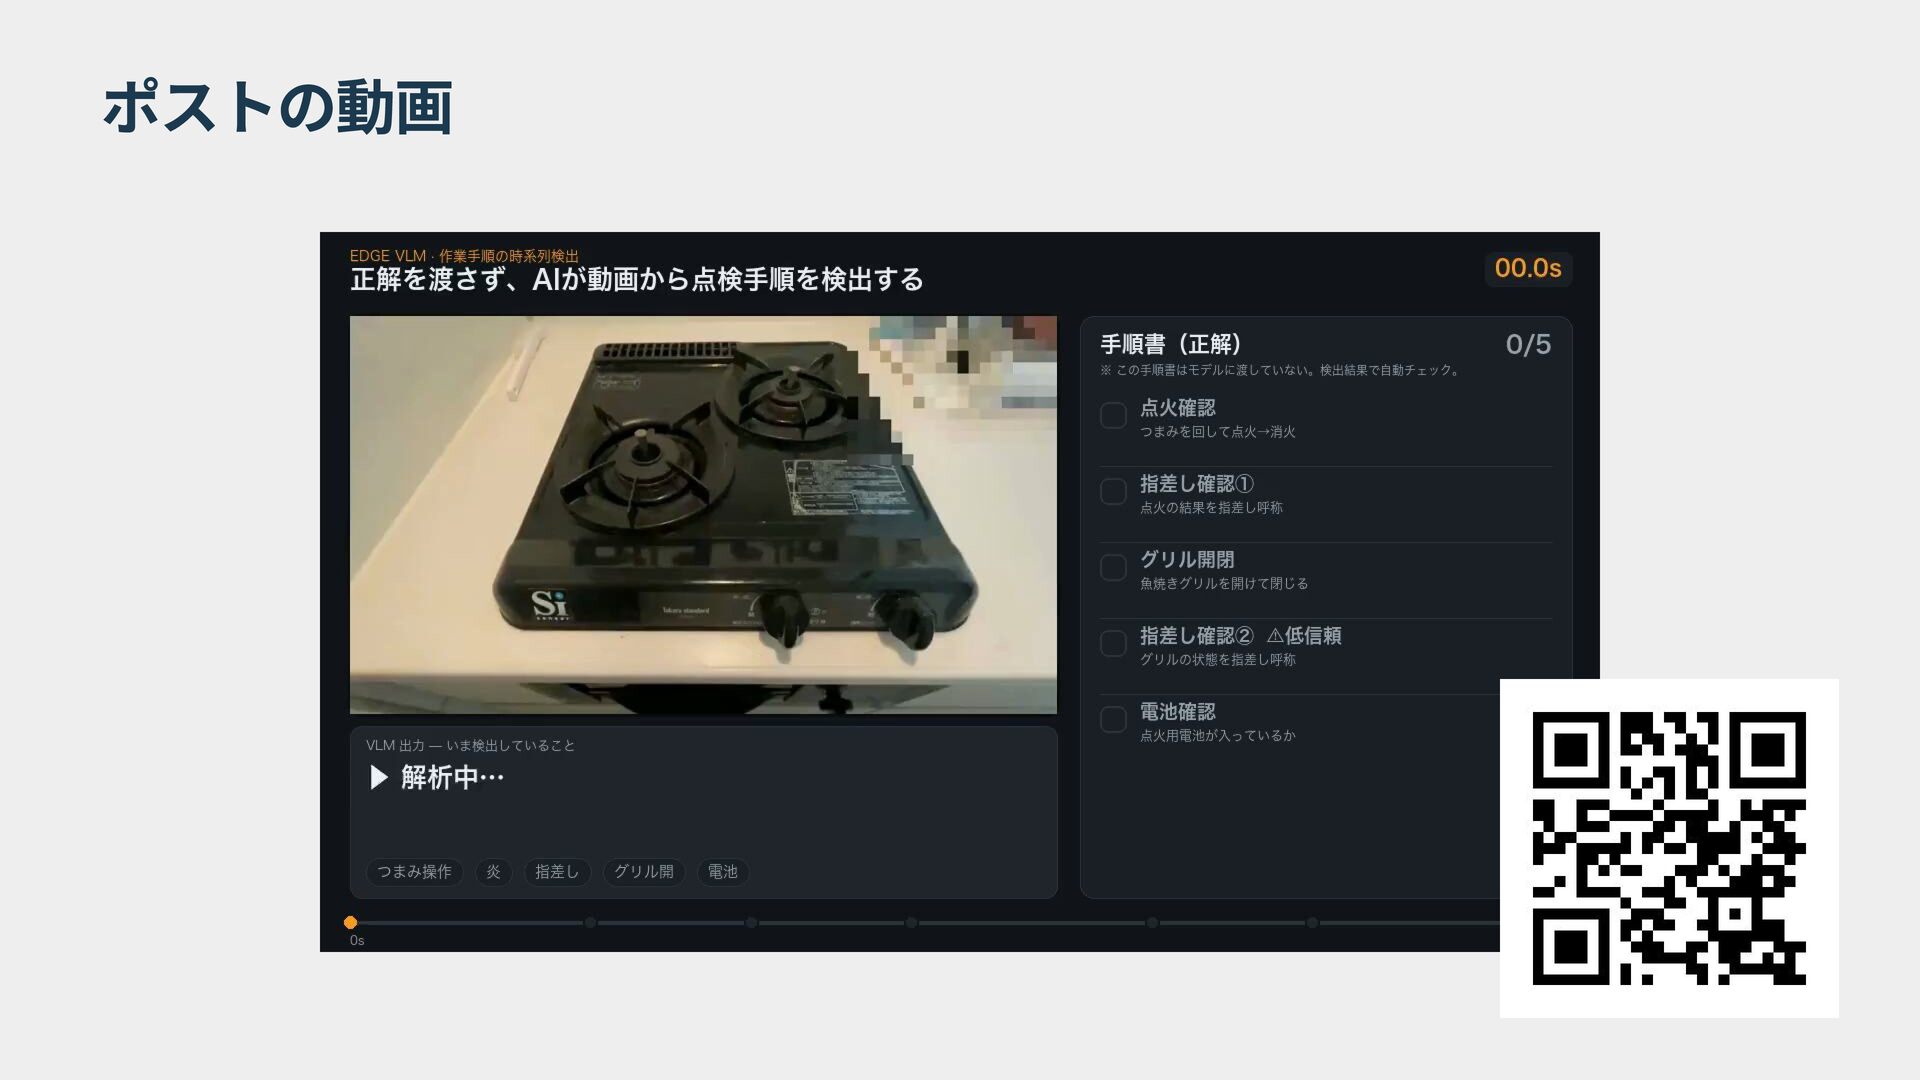
動画解析したのポストが1.1kいいね
ポストの動画
やること
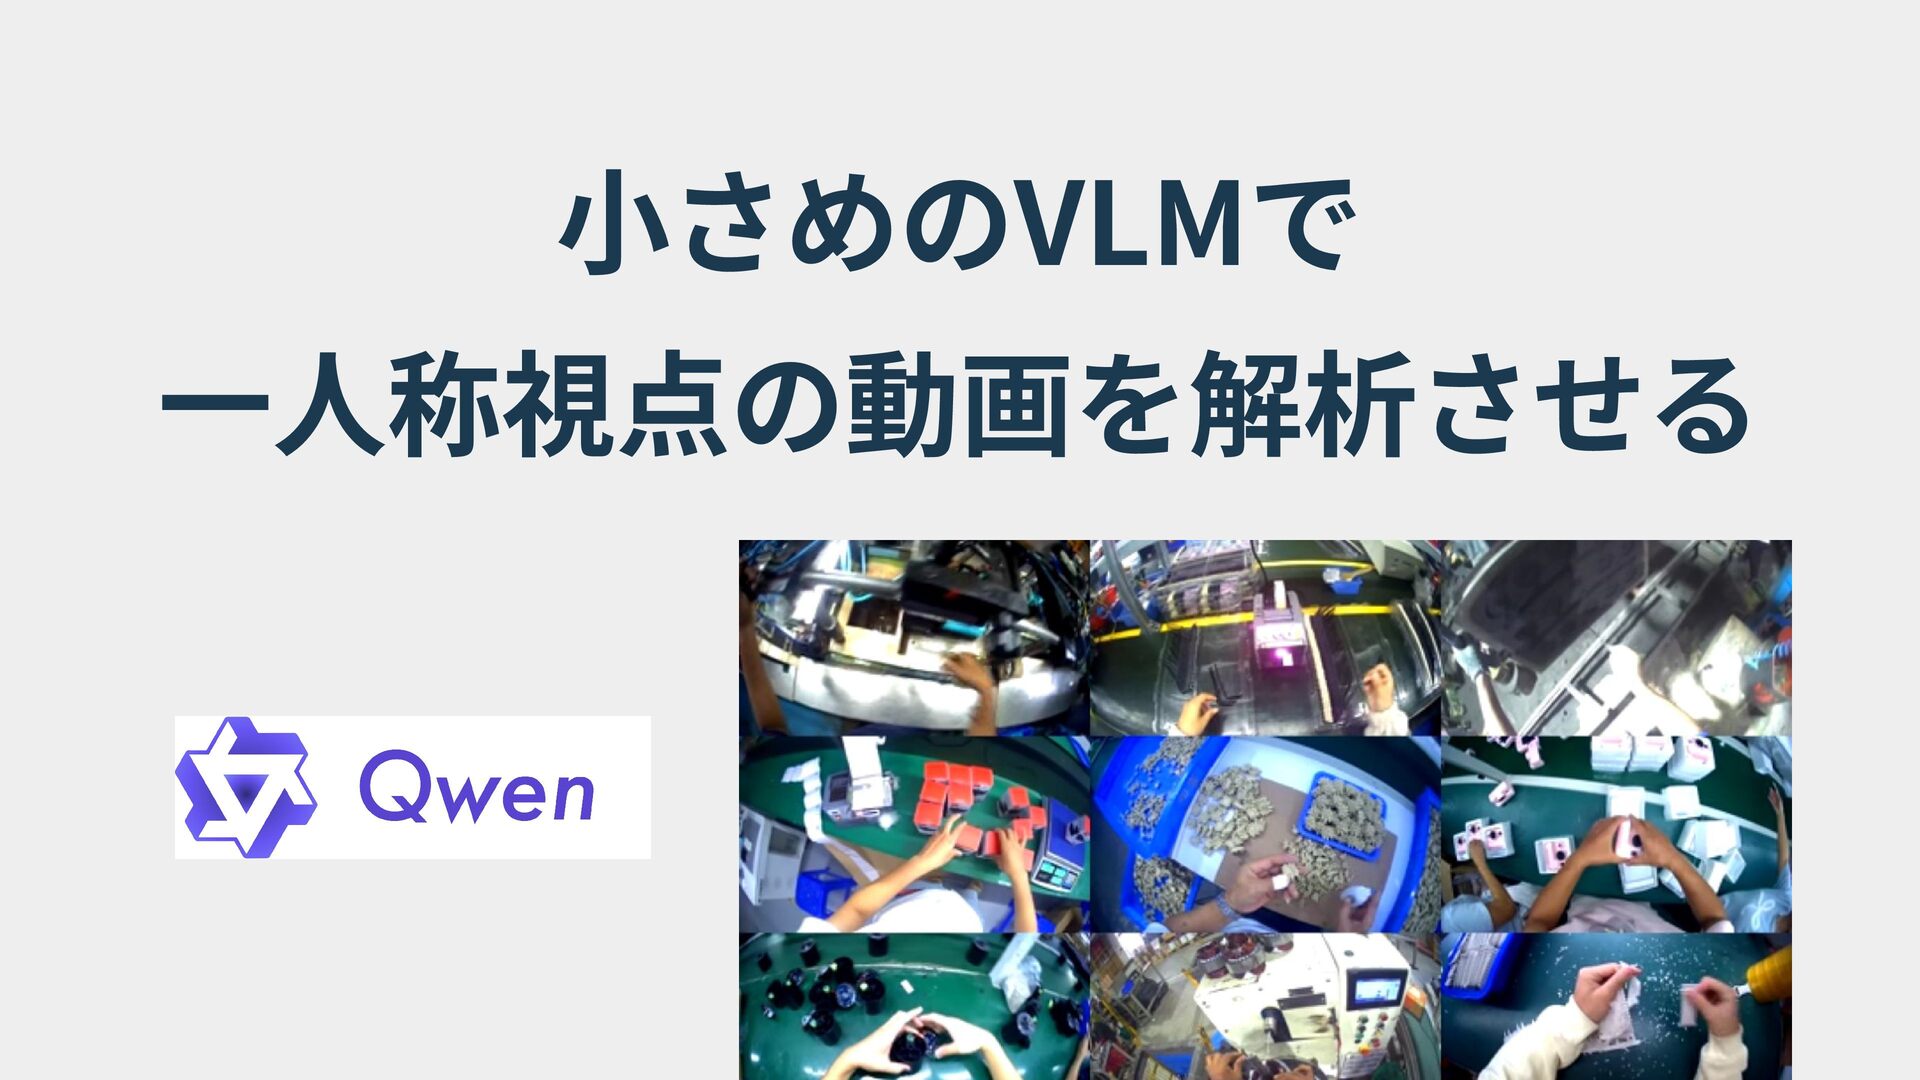
小さめのVLMで 一人称視点の動画を解析させる
なんで?
なんでやるの? 暇だから? 面白そうだから?
なんでやるの? ちょっと違います
なんでやるの? 社会的な意義
なんでやるの? 手順の抜け・順序違い・危険な工具操作 → 人身事故/品質不良/ライン停止
なんでやるの? エッジAI・ ローカルVLM
なんでエッジAI? 現場映像はクラウドに出せない(機密・個人情報) 記録を後で見るのでは損失は防げない。作業中の本人・ 監督者に即通知したい → オフライン前提 → 2Bクラス、できればもっと小さく
エッジVLMで、 一人称視点の外の環境を リアルタイムで 分析し続けたい
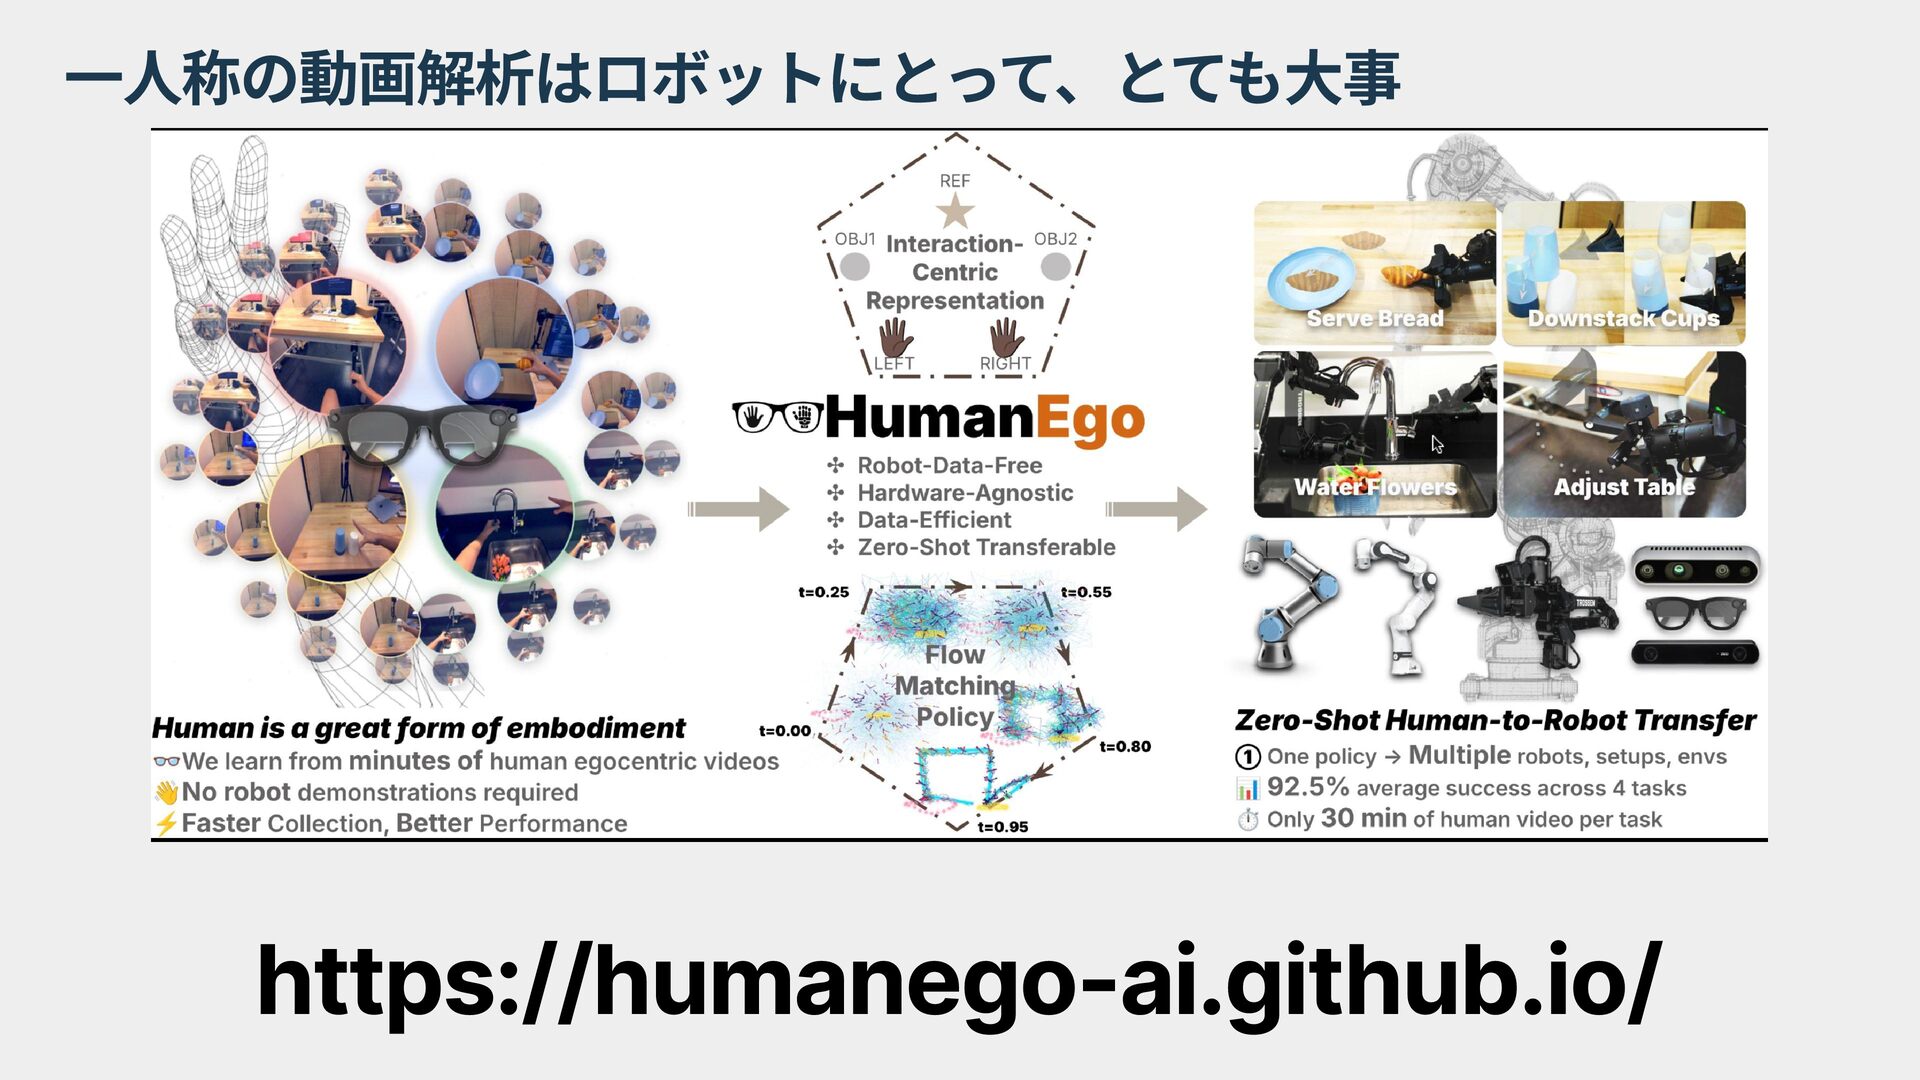
※重要 フィジカルAIにつながるから
一人称の動画解析はロボットにとって、とても大事 https://humanego-ai.github.io/
WHAT
動画解析って何?
わからないです。
画像フレームではなく 動画として理解し、 タイムスタンプを入力or出力する
? ? 画像フレームではなく 動画として理解し、 タイムスタンプを入力or出力する
本LTにおける”動画解析”の定義 画像フレームの連続性を VLMが理解しないと 動画解析とは言えないよね
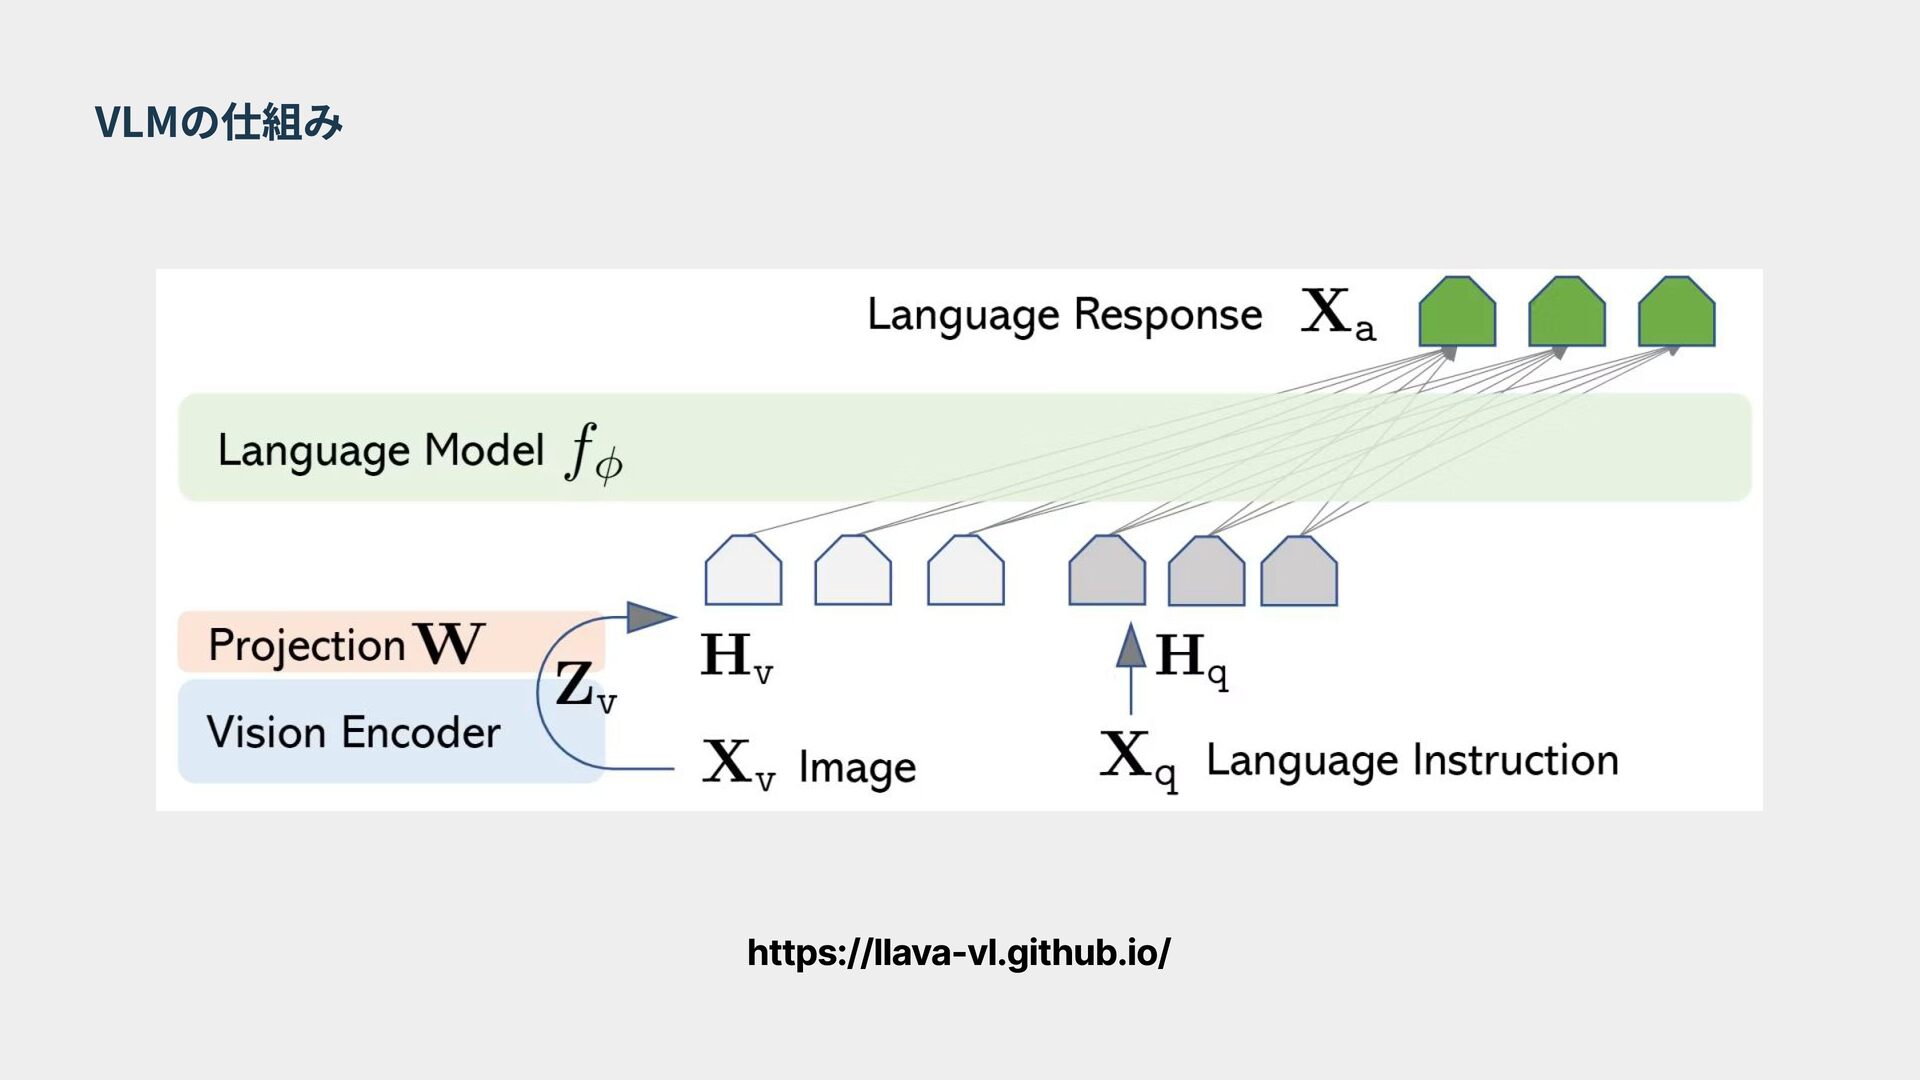
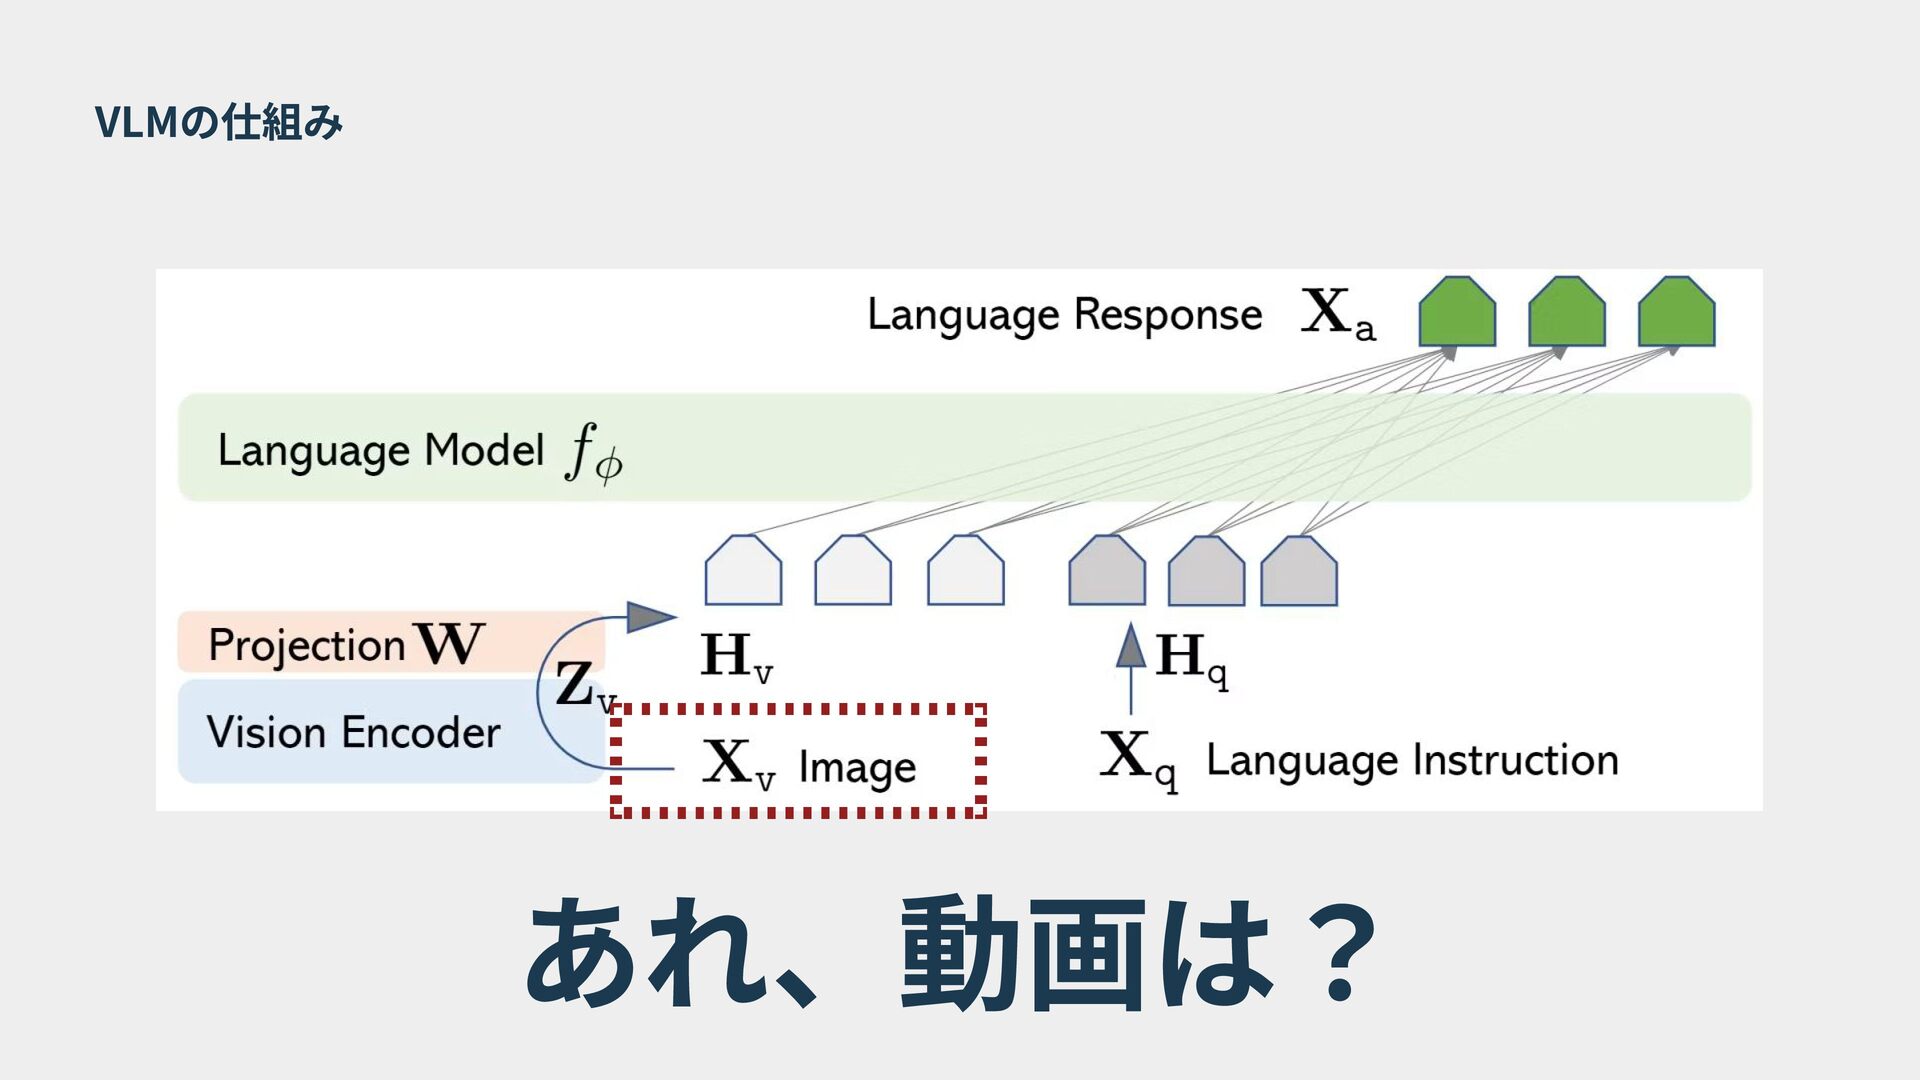
VLMの仕組み https://llava-vl.github.io/
VLMの仕組み あれ、動画は?
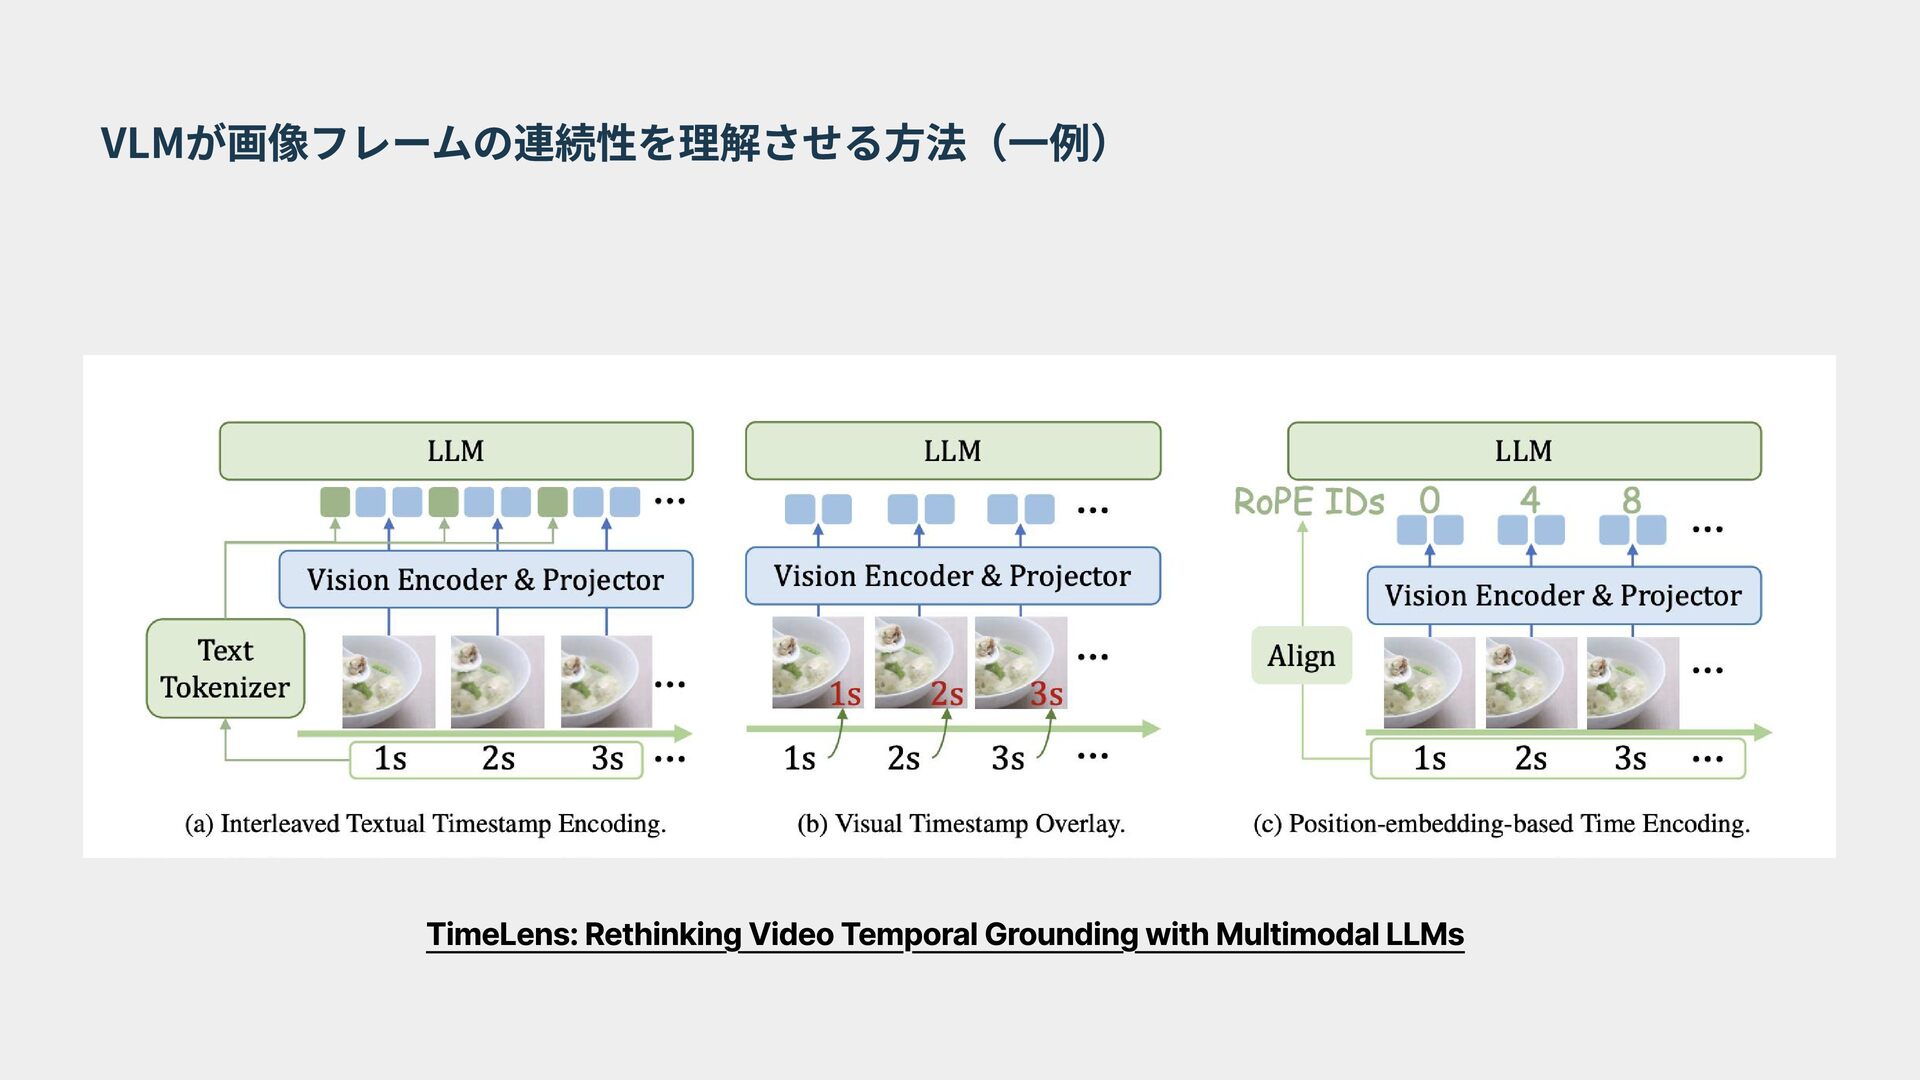
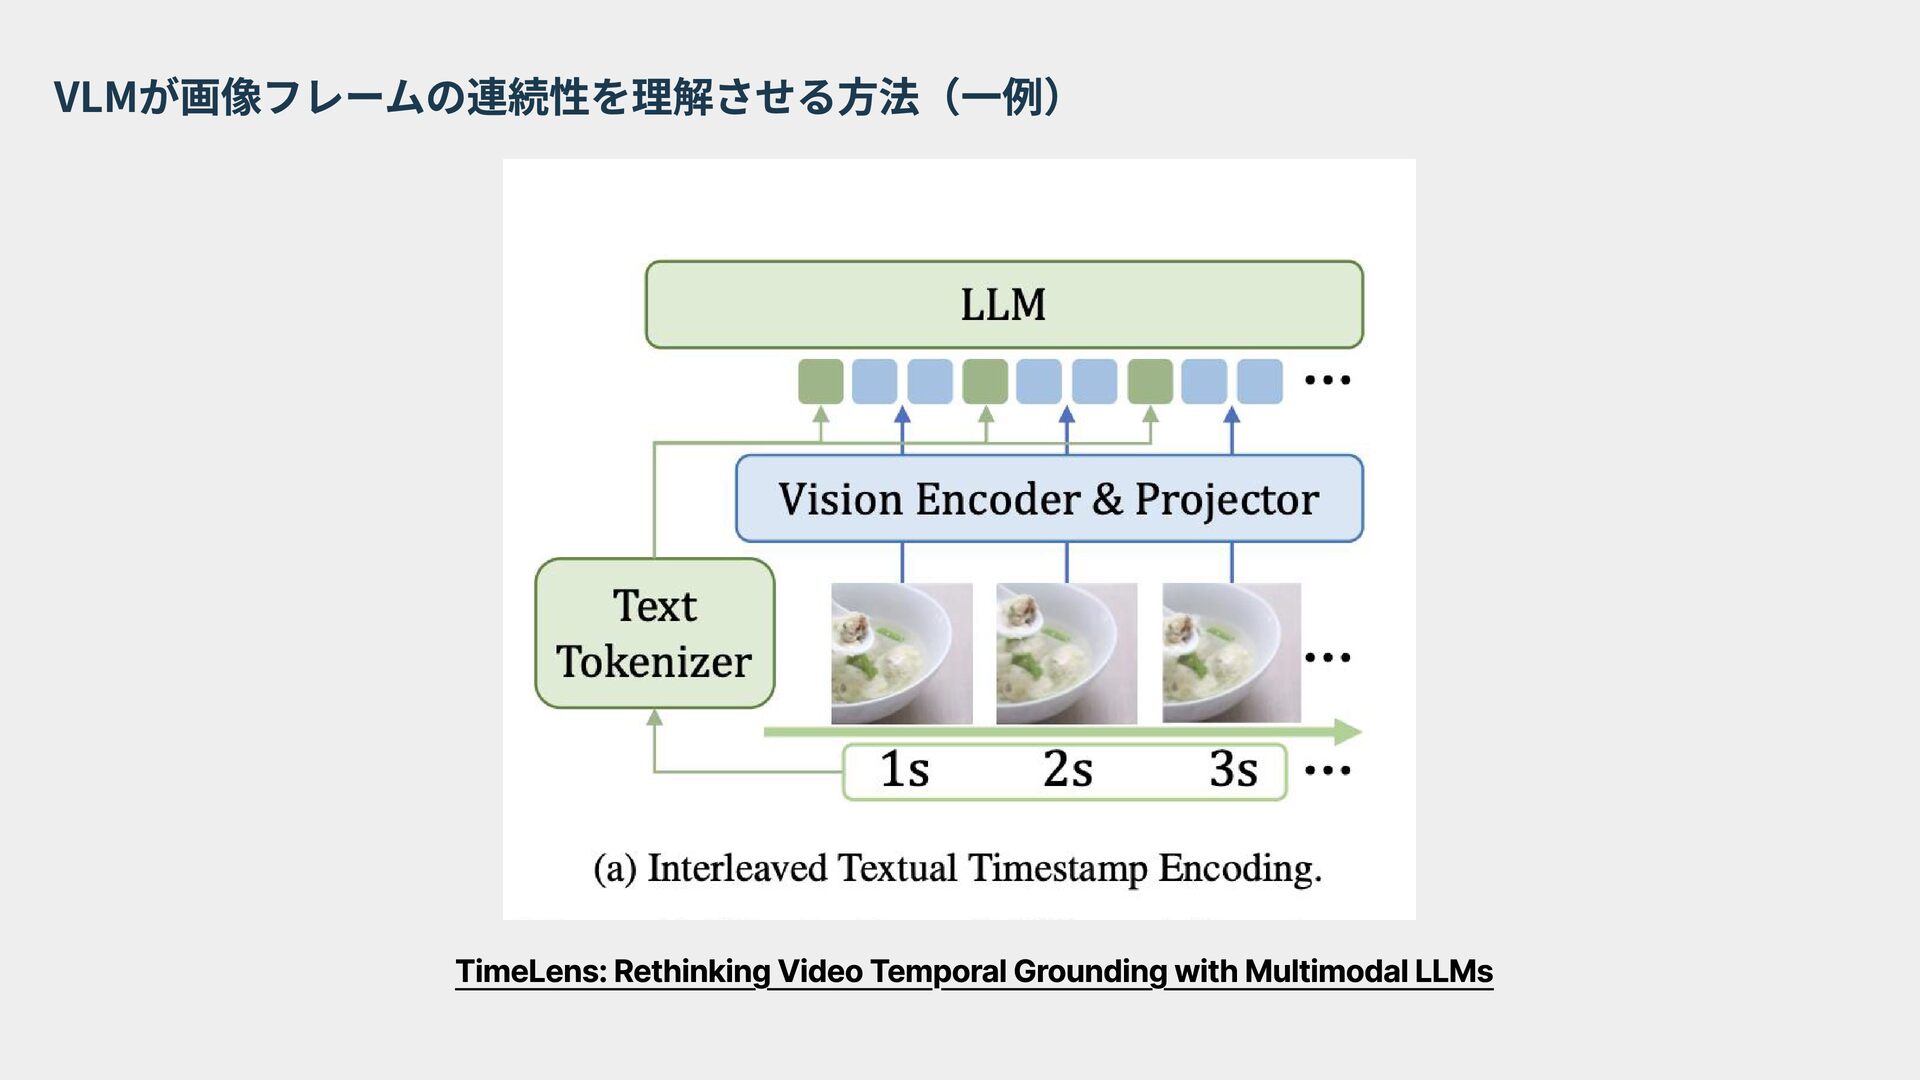
VLMが画像フレームの連続性を理解させる方法(一例) TimeLens: Rethinking Video Temporal Grounding with Multimodal LLMs
VLMが画像フレームの連続性を理解させる方法(一例) TimeLens: Rethinking Video Temporal Grounding with Multimodal LLMs
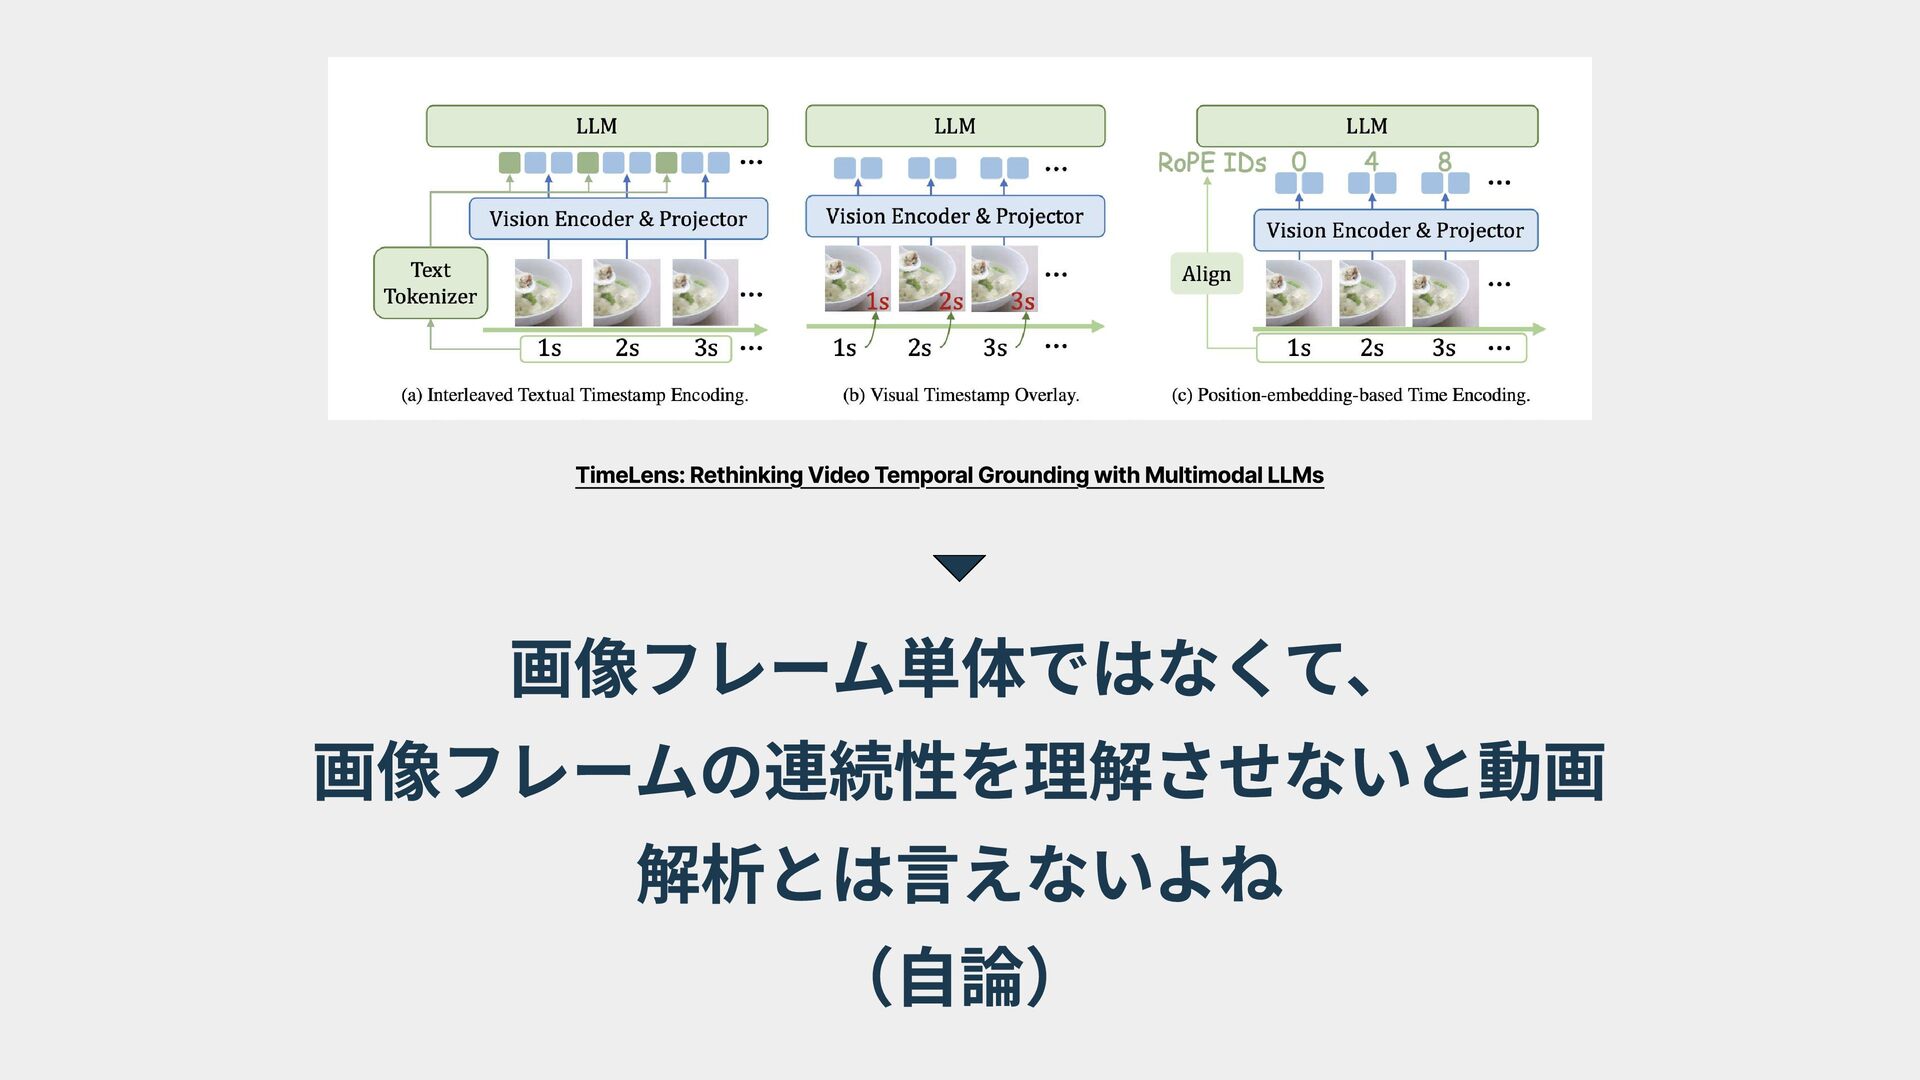
TimeLens: Rethinking Video Temporal Grounding with Multimodal LLMs 画像フレーム単体ではなくて、 画像フレームの連続性を理解させないと動画
解析とは言えないよね (自論)
なんのタスク? 入出力は?
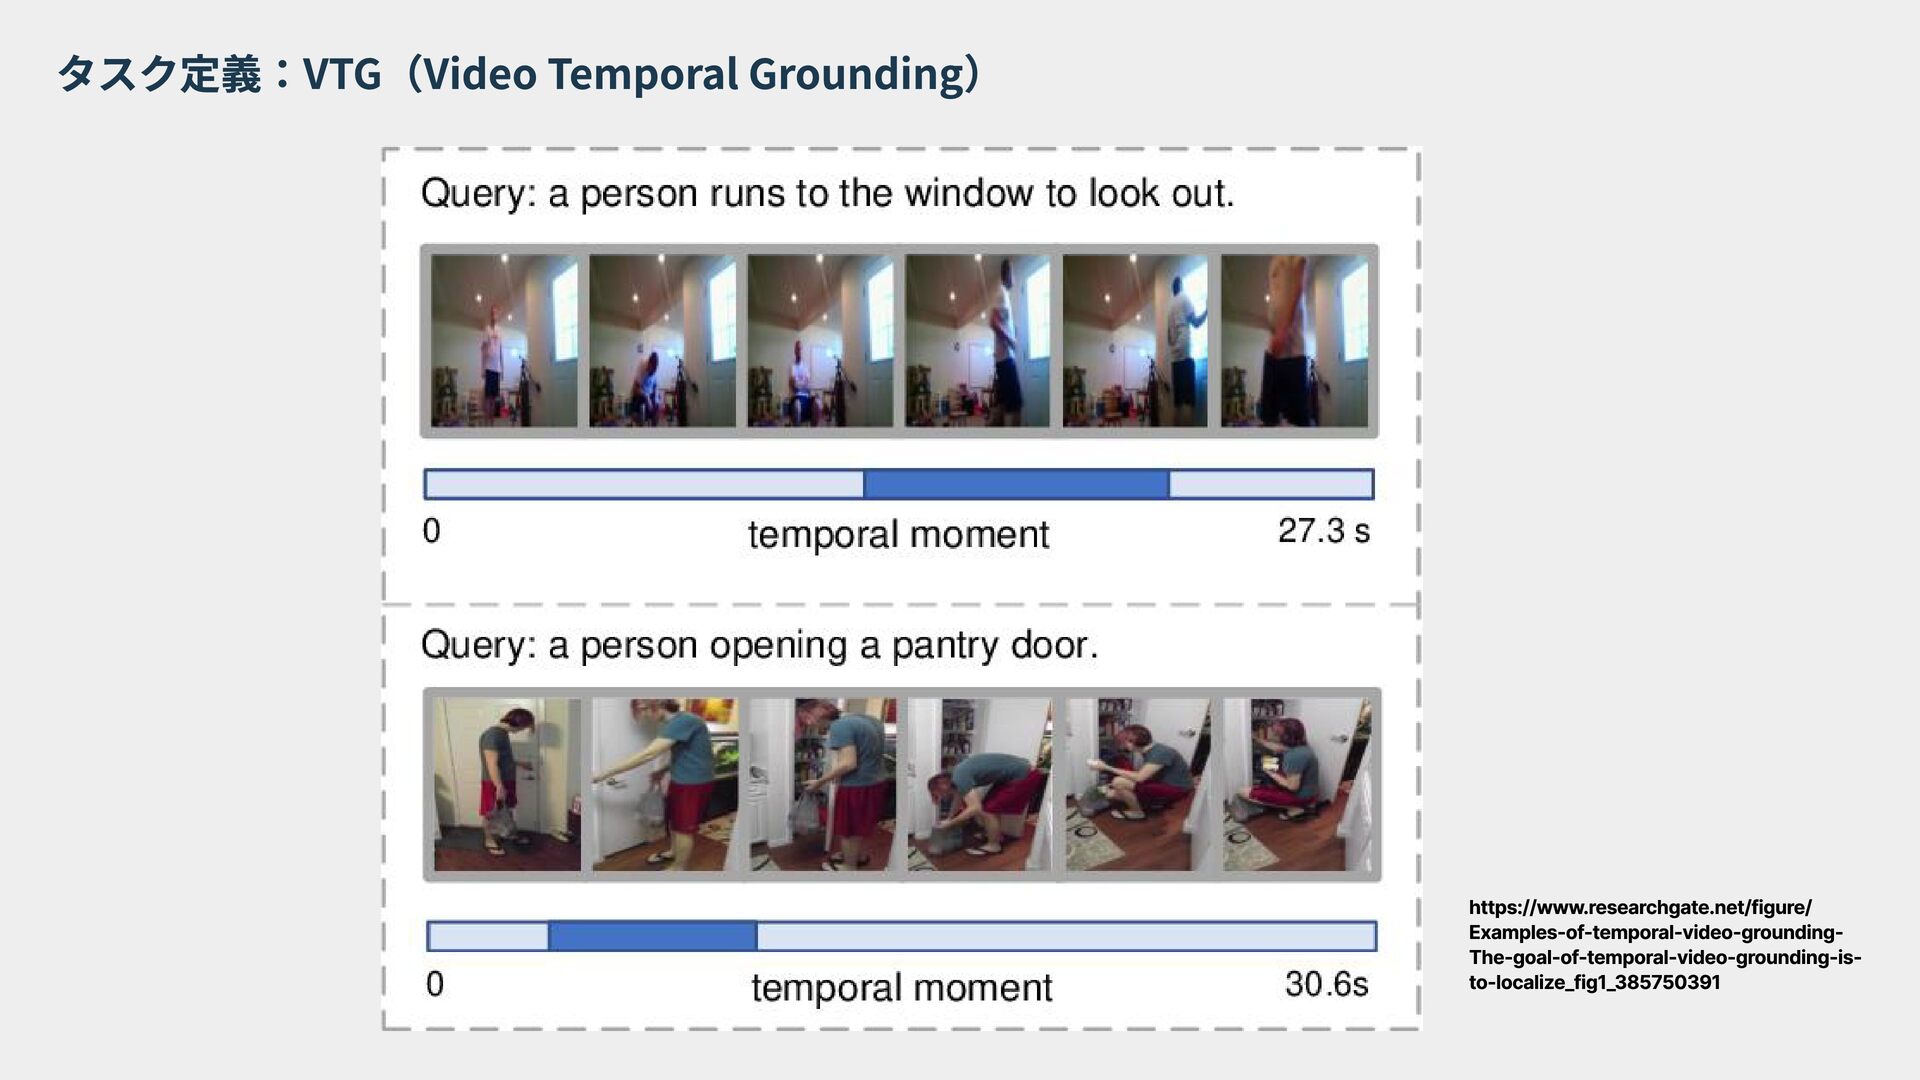
タスク定義:VTG(Video Temporal Grounding) https://www.researchgate.net/figure/ Examples-of-temporal-video-groundingThe-goal-of-temporal-video-grounding-isto-localize_fig1_385750391
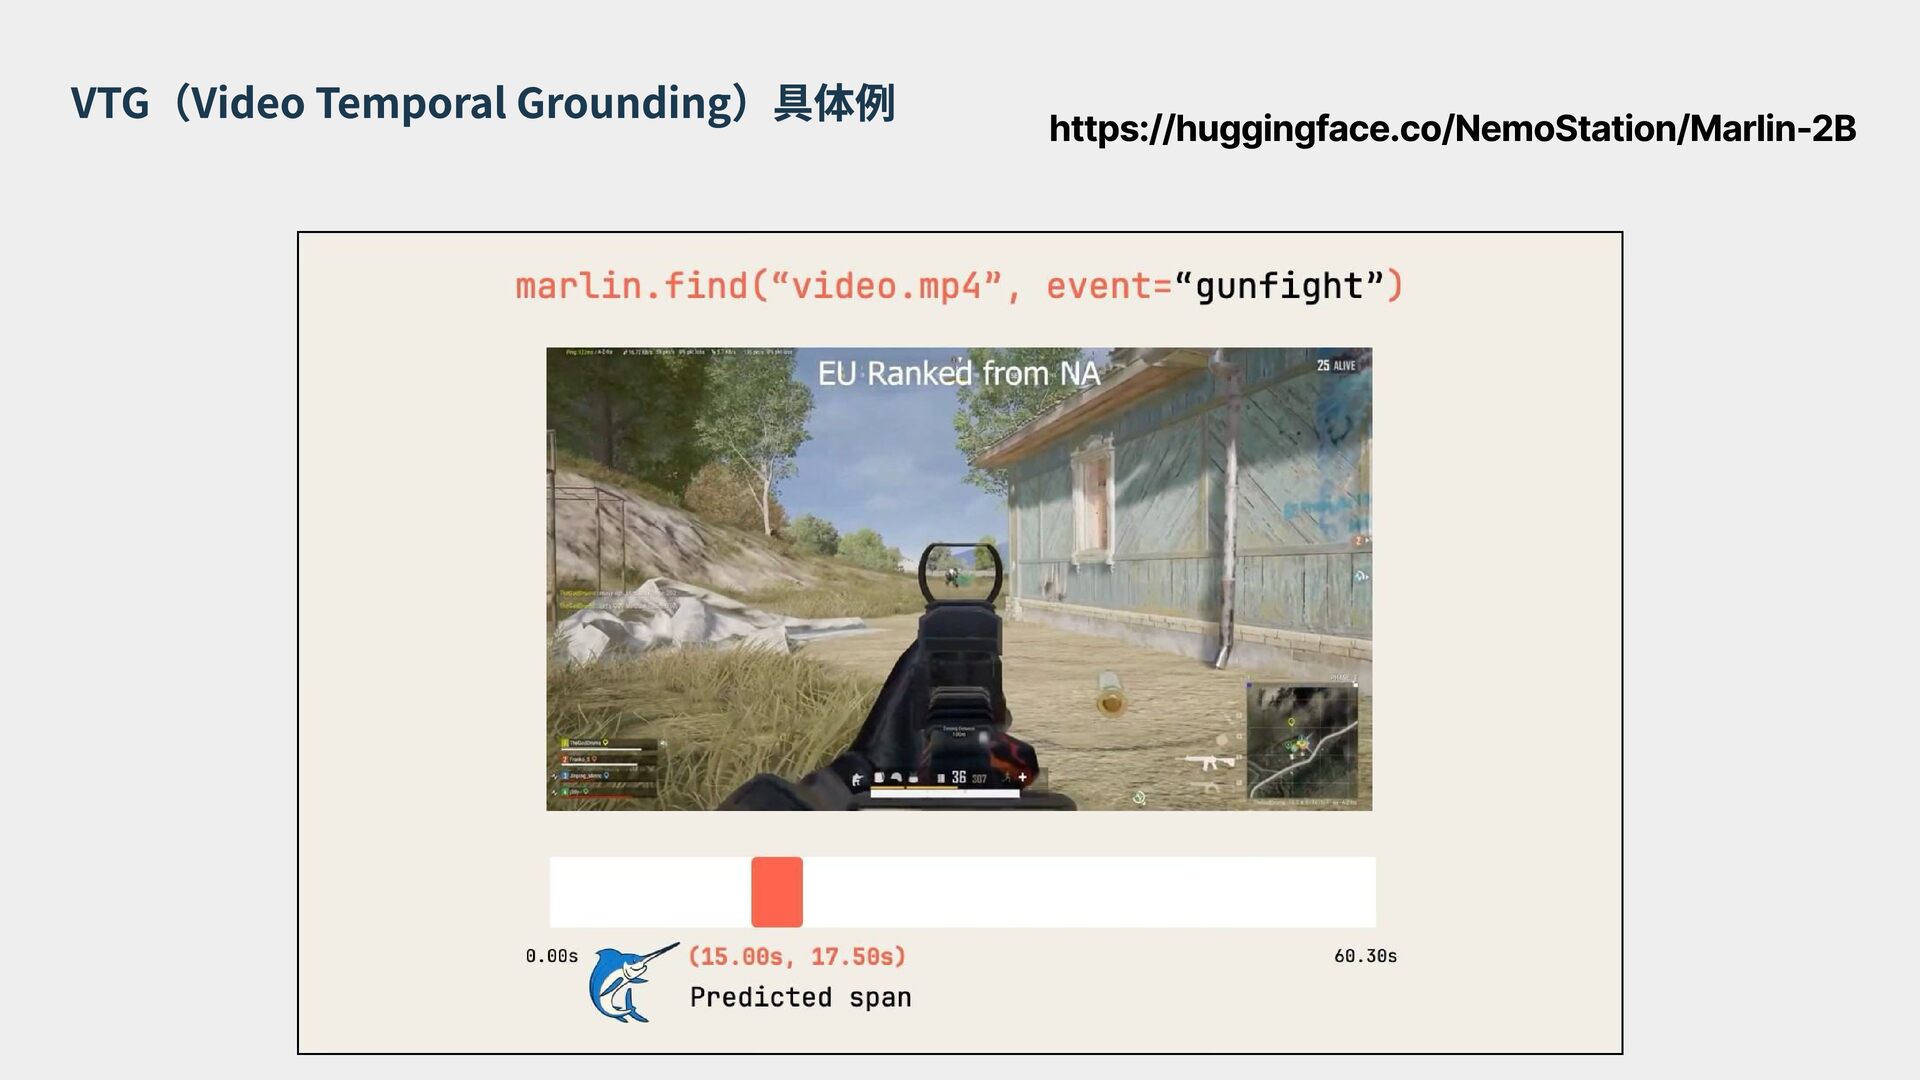
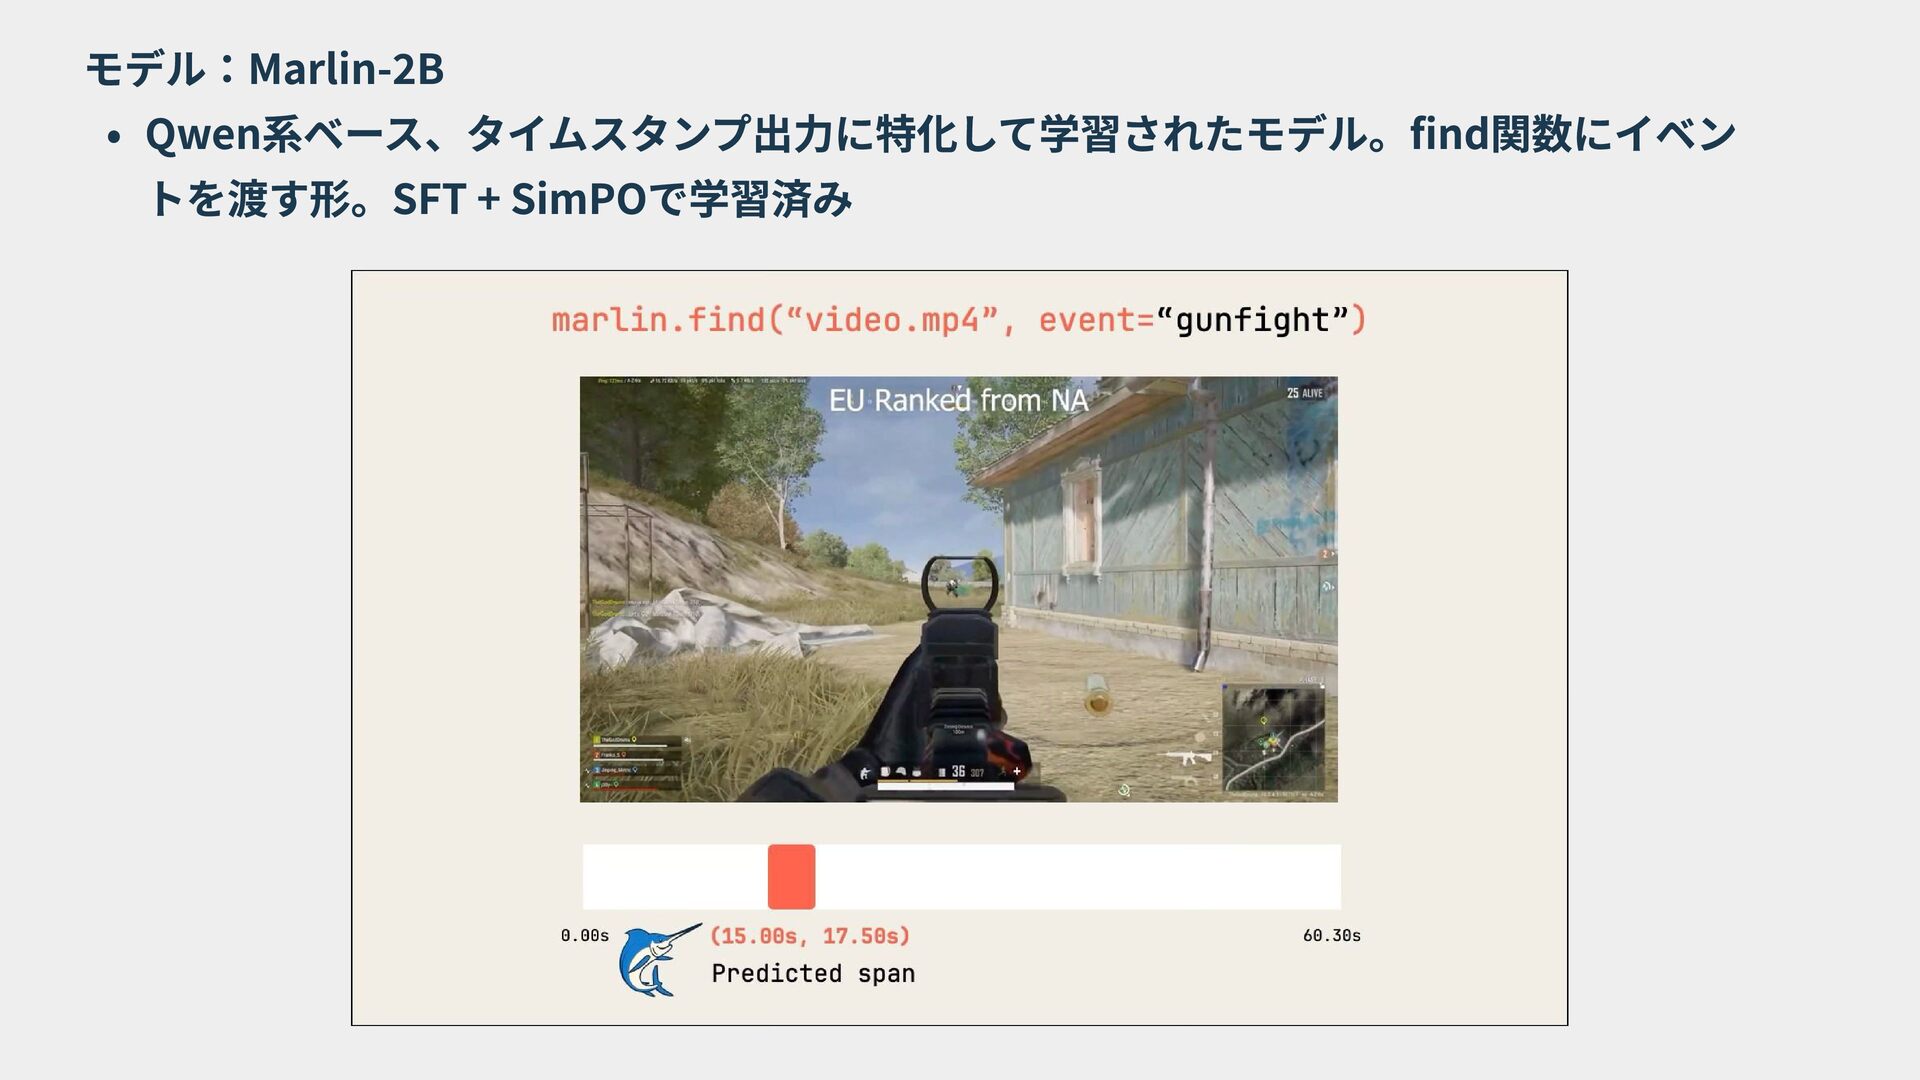
VTG(Video Temporal Grounding)具体例 https://huggingface.co/NemoStation/Marlin-2B
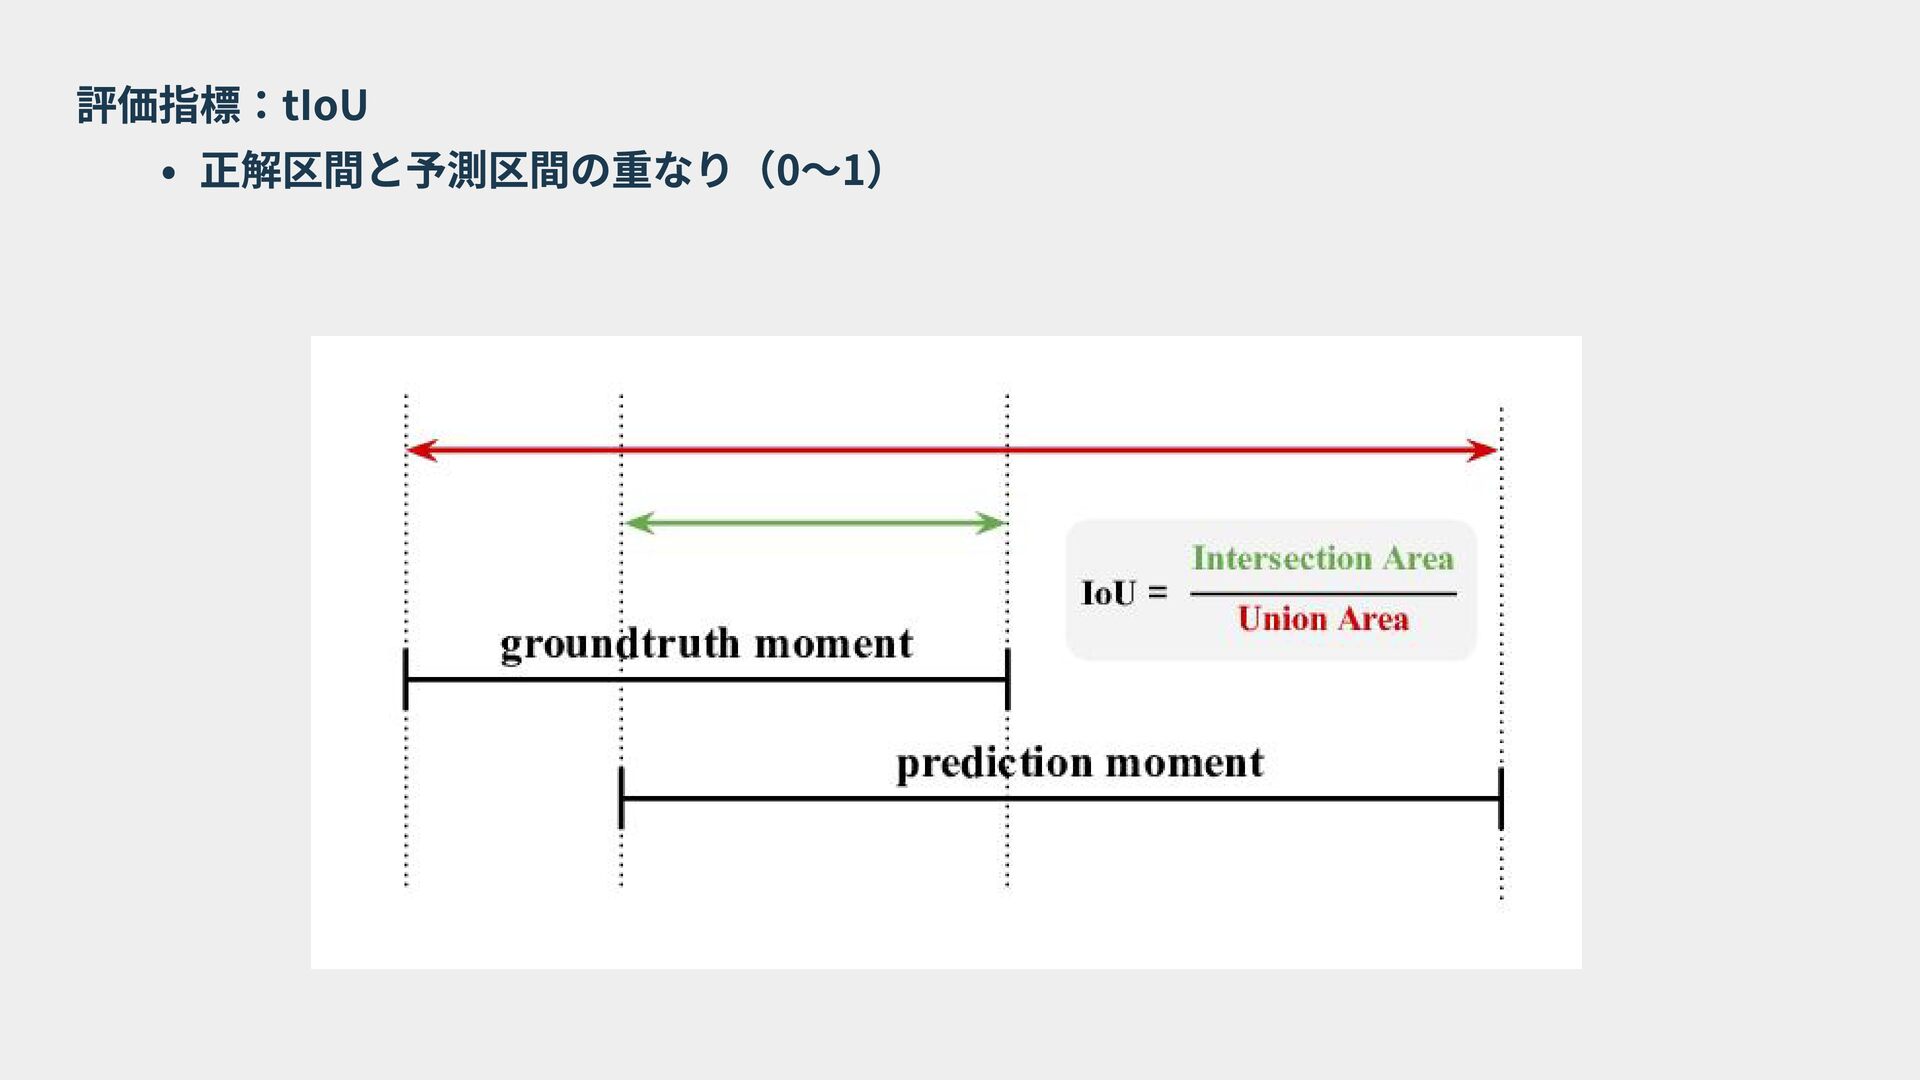
評価指標:tIoU 正解区間と予測区間の重なり(0〜1)
やったこと 2つ
①ベンチマーク ②VLMのFT
①ベンチマーク
モデル:Marlin-2B Qwen系ベース、タイムスタンプ出力に特化して学習されたモデル。find関数にイベン トを渡す形。SFT + SimPOで学習済み
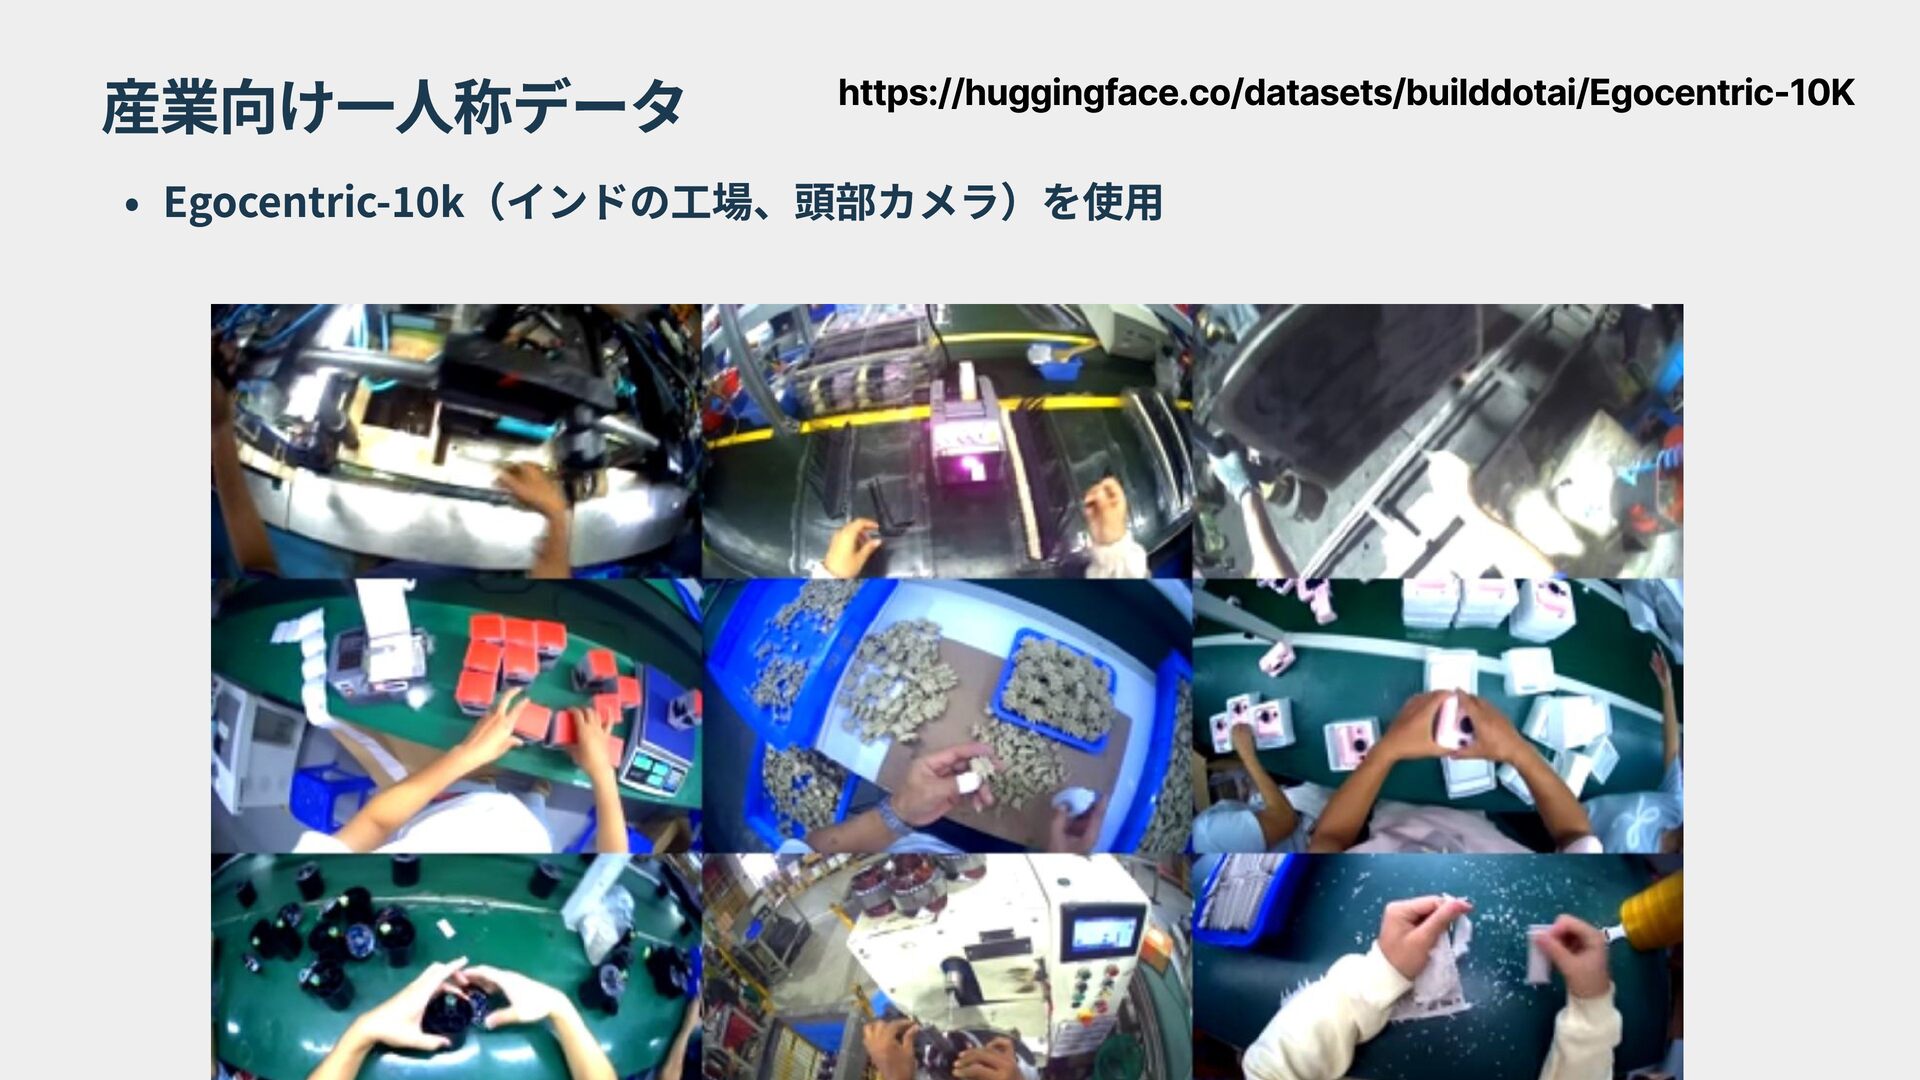
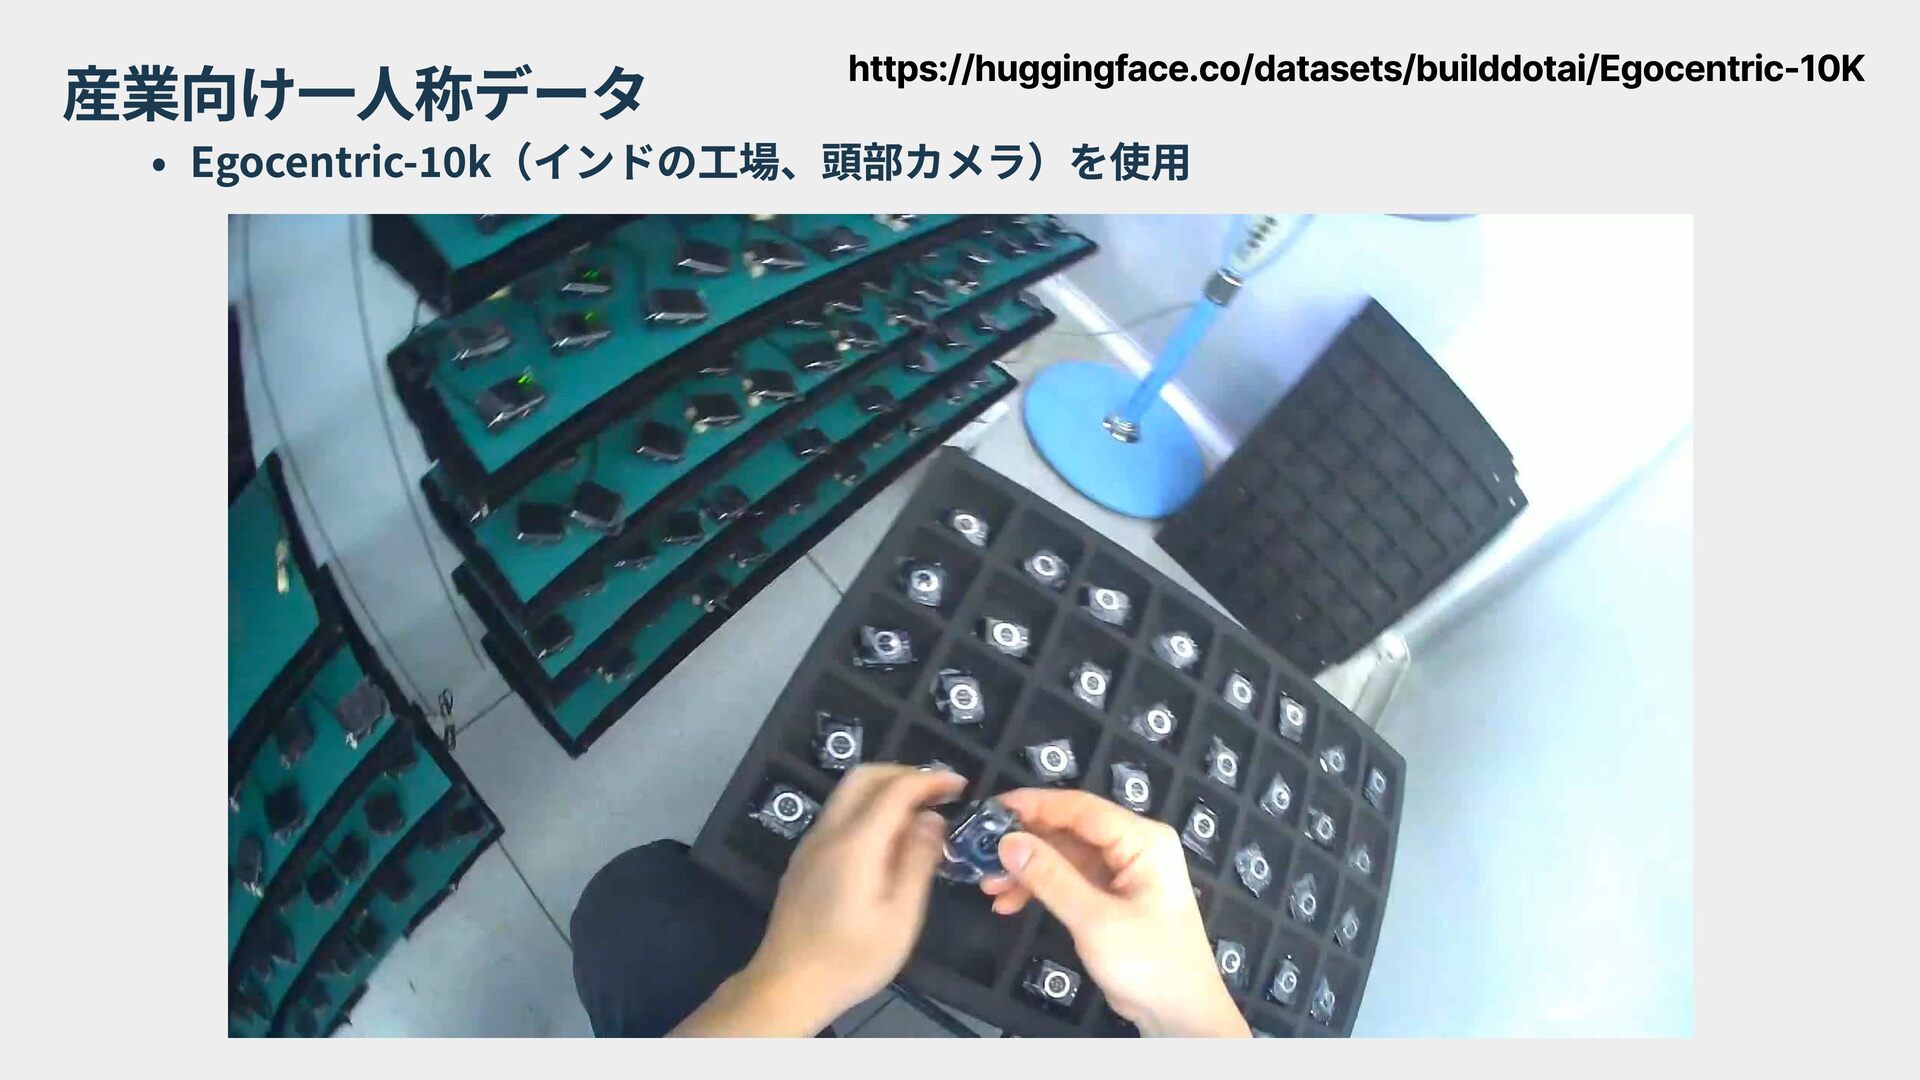
産業向け一人称データ https://huggingface.co/datasets/builddotai/Egocentric-10K Egocentric-10k(インドの工場、頭部カメラ)を使用
産業向け一人称データ https://huggingface.co/datasets/builddotai/Egocentric-10K Egocentric-10k(インドの工場、頭部カメラ)を使用
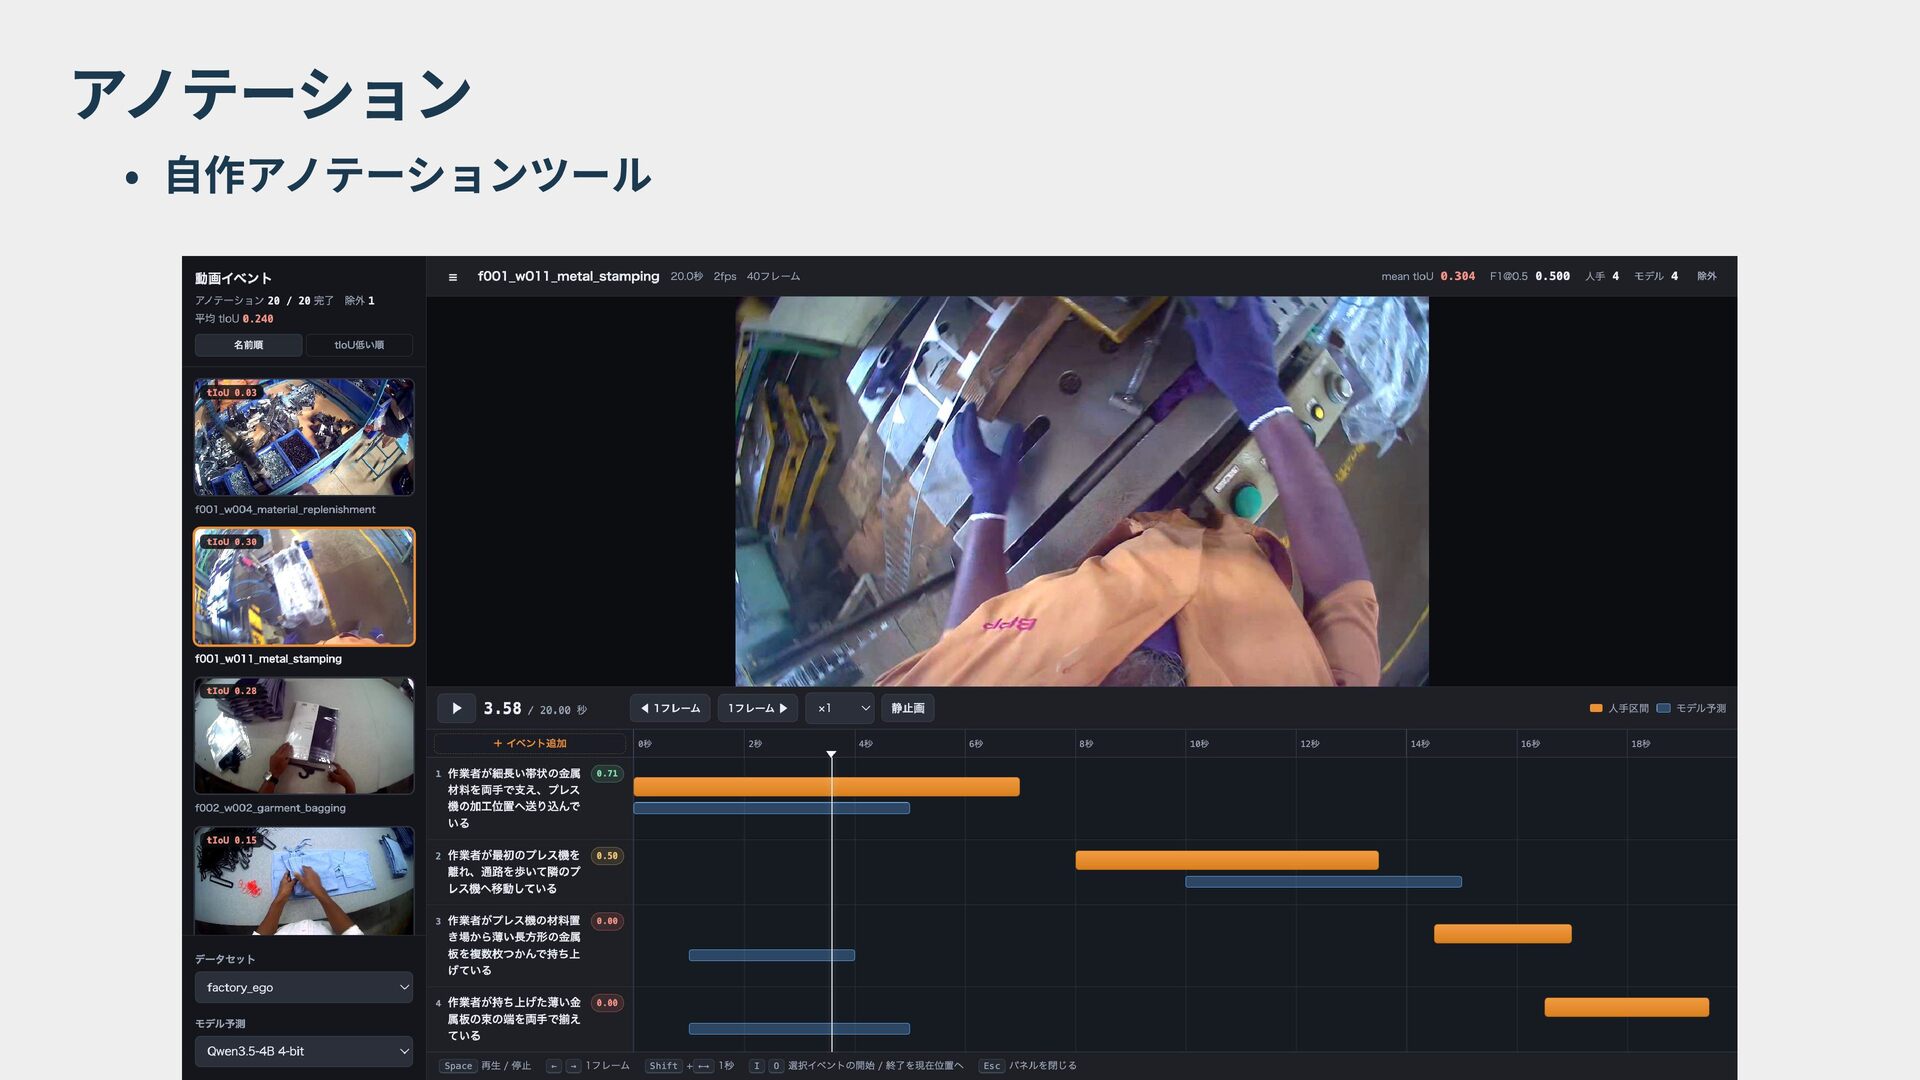
アノテーション 自作アノテーションツール
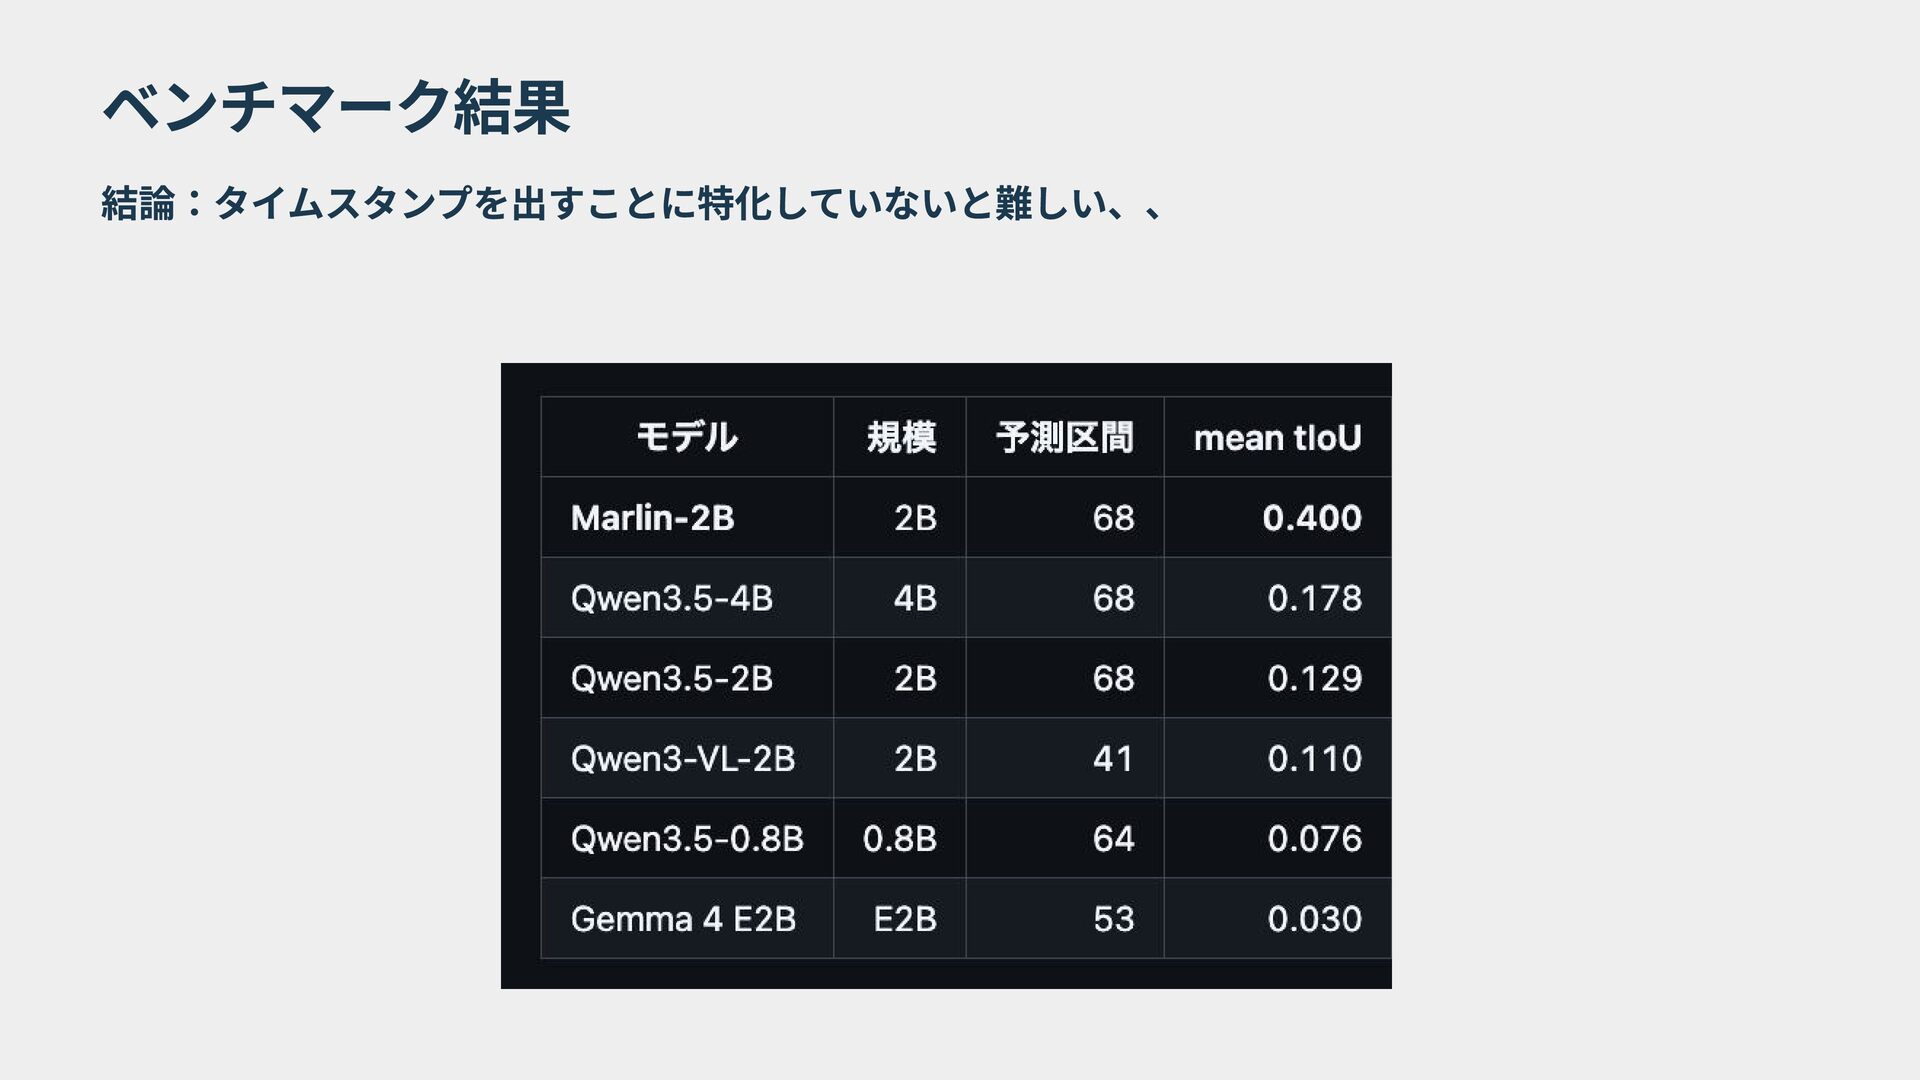
ベンチマーク結果 結論:タイムスタンプを出すことに特化していないと難しい、、
②VLMのFT
次の課題 ①区間を2つ以上出したい ②いろんなデータに対応したい ③そもそもリアルタイムで動かしたい
自分で学習させるしかないね、 アーキテクチャも考えたいね
解析し続けたい、、、 小さいモデルで、エッジデバイスで、 数分間の動画を入れて、数秒以内に答えるのっ て、難しいのでは?
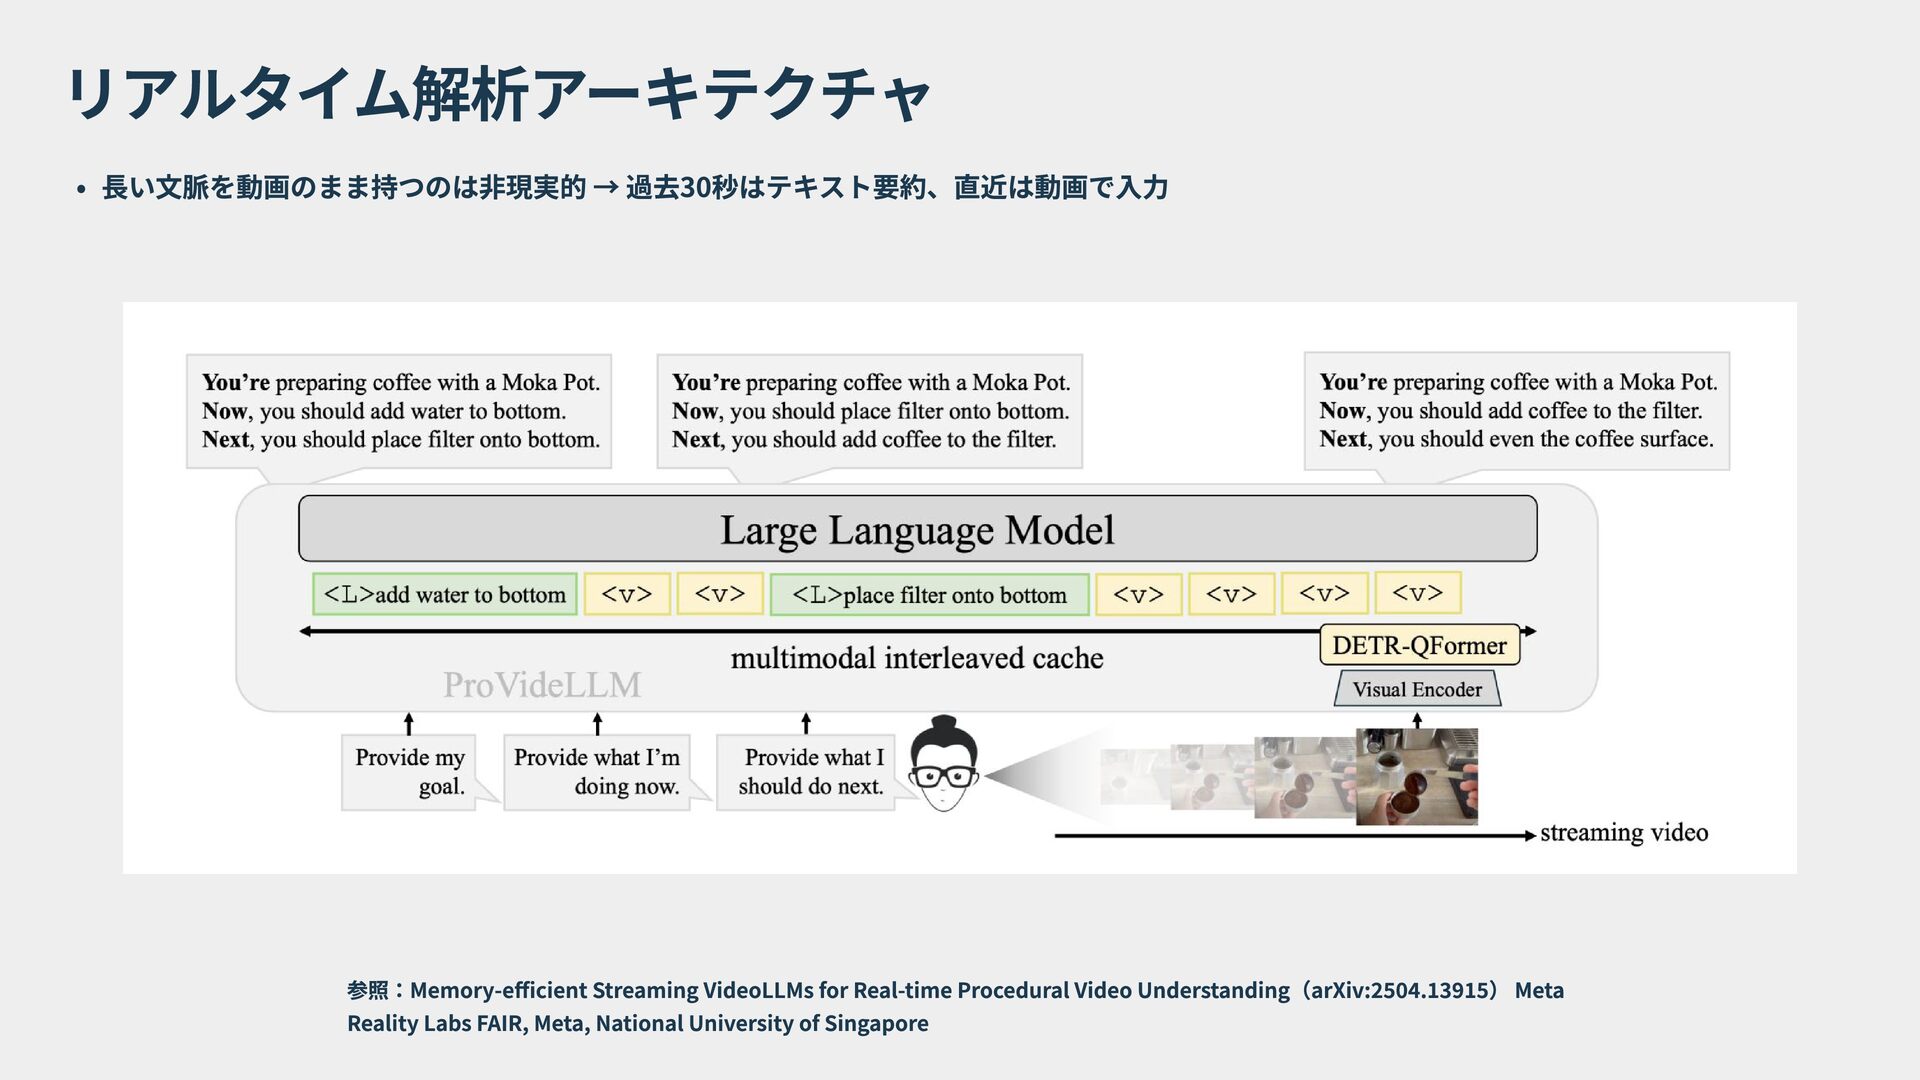
リアルタイム解析アーキテクチャ 長い文脈を動画のまま持つのは非現実的 → 過去30秒はテキスト要約、直近は動画で入力 参照:Memory-efficient Streaming VideoLLMs for Real-time Procedural
Video Understanding(arXiv:2504.13915) Meta Reality Labs FAIR, Meta, National University of Singapore
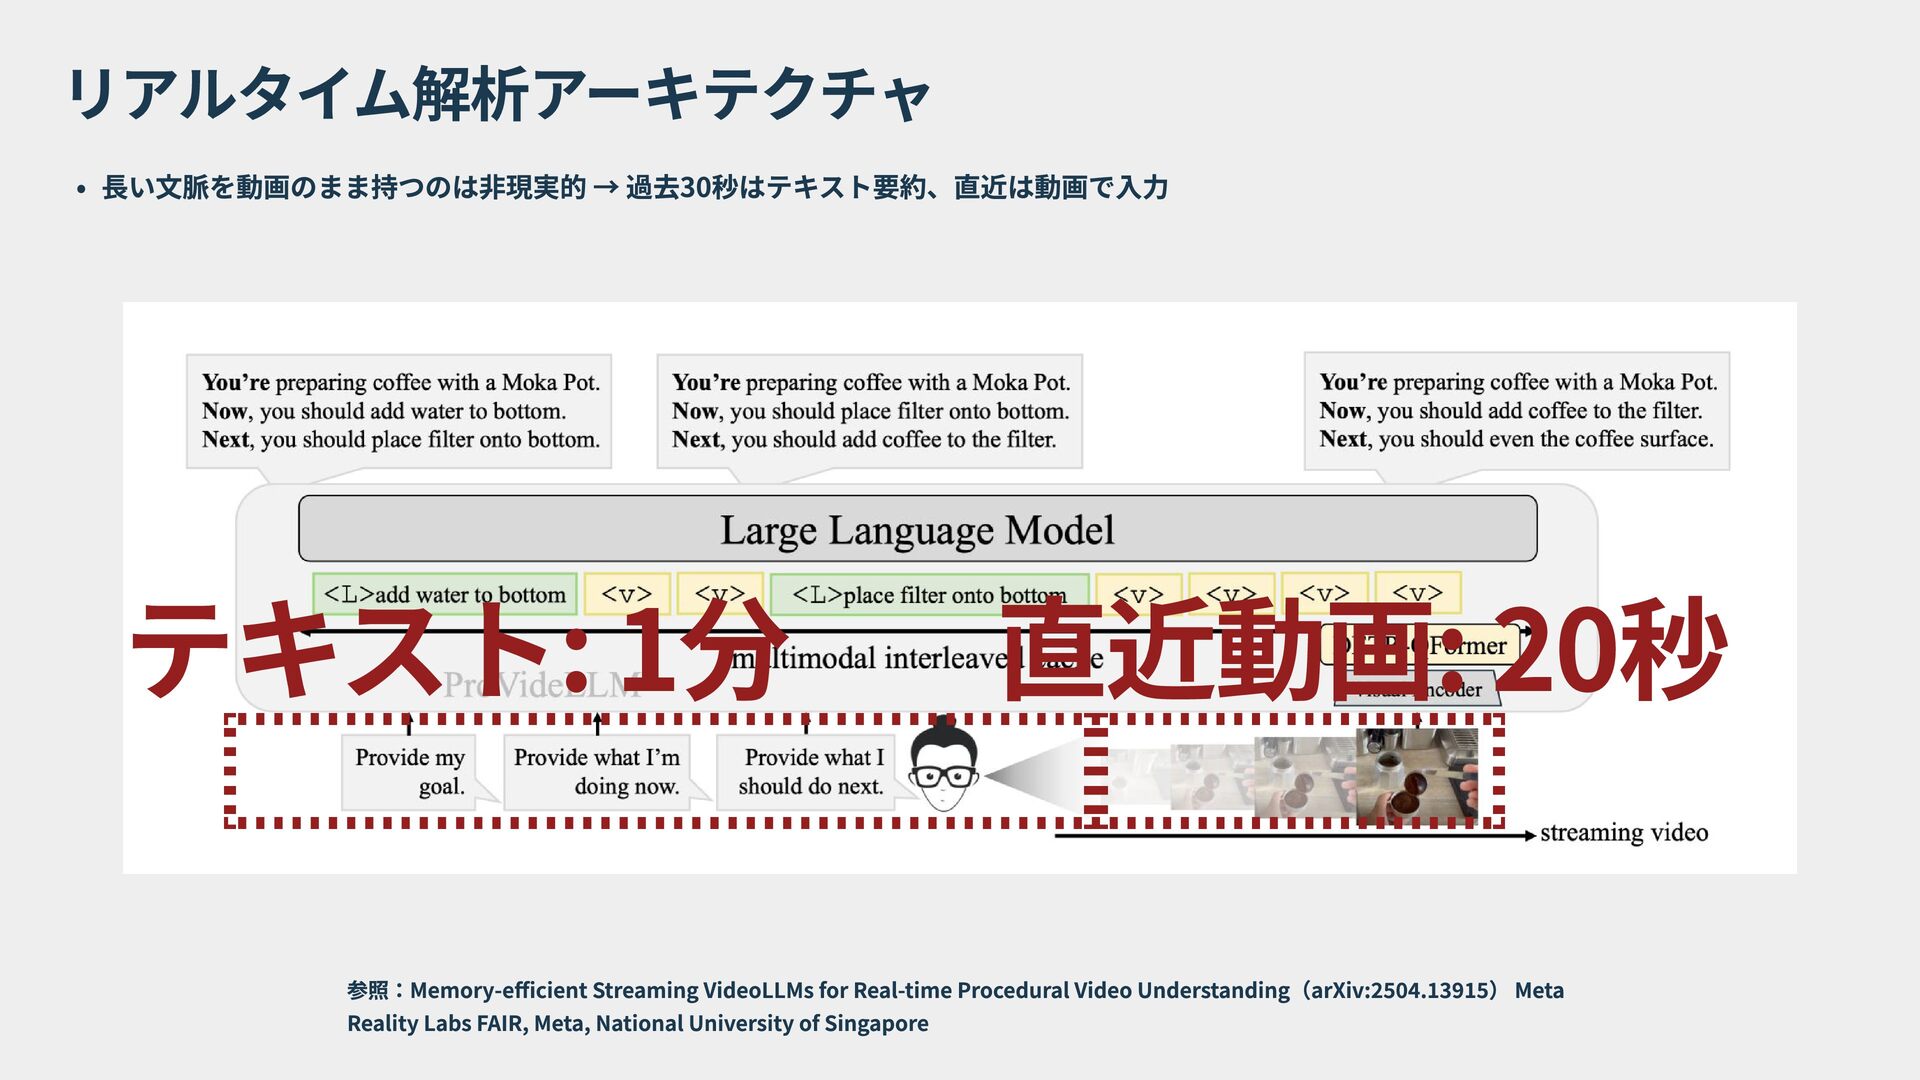
リアルタイム解析アーキテクチャ 長い文脈を動画のまま持つのは非現実的 → 過去30秒はテキスト要約、直近は動画で入力 テキスト: 1分 直近動画: 20秒 参照:Memory-efficient Streaming
VideoLLMs for Real-time Procedural Video Understanding(arXiv:2504.13915) Meta Reality Labs FAIR, Meta, National University of Singapore
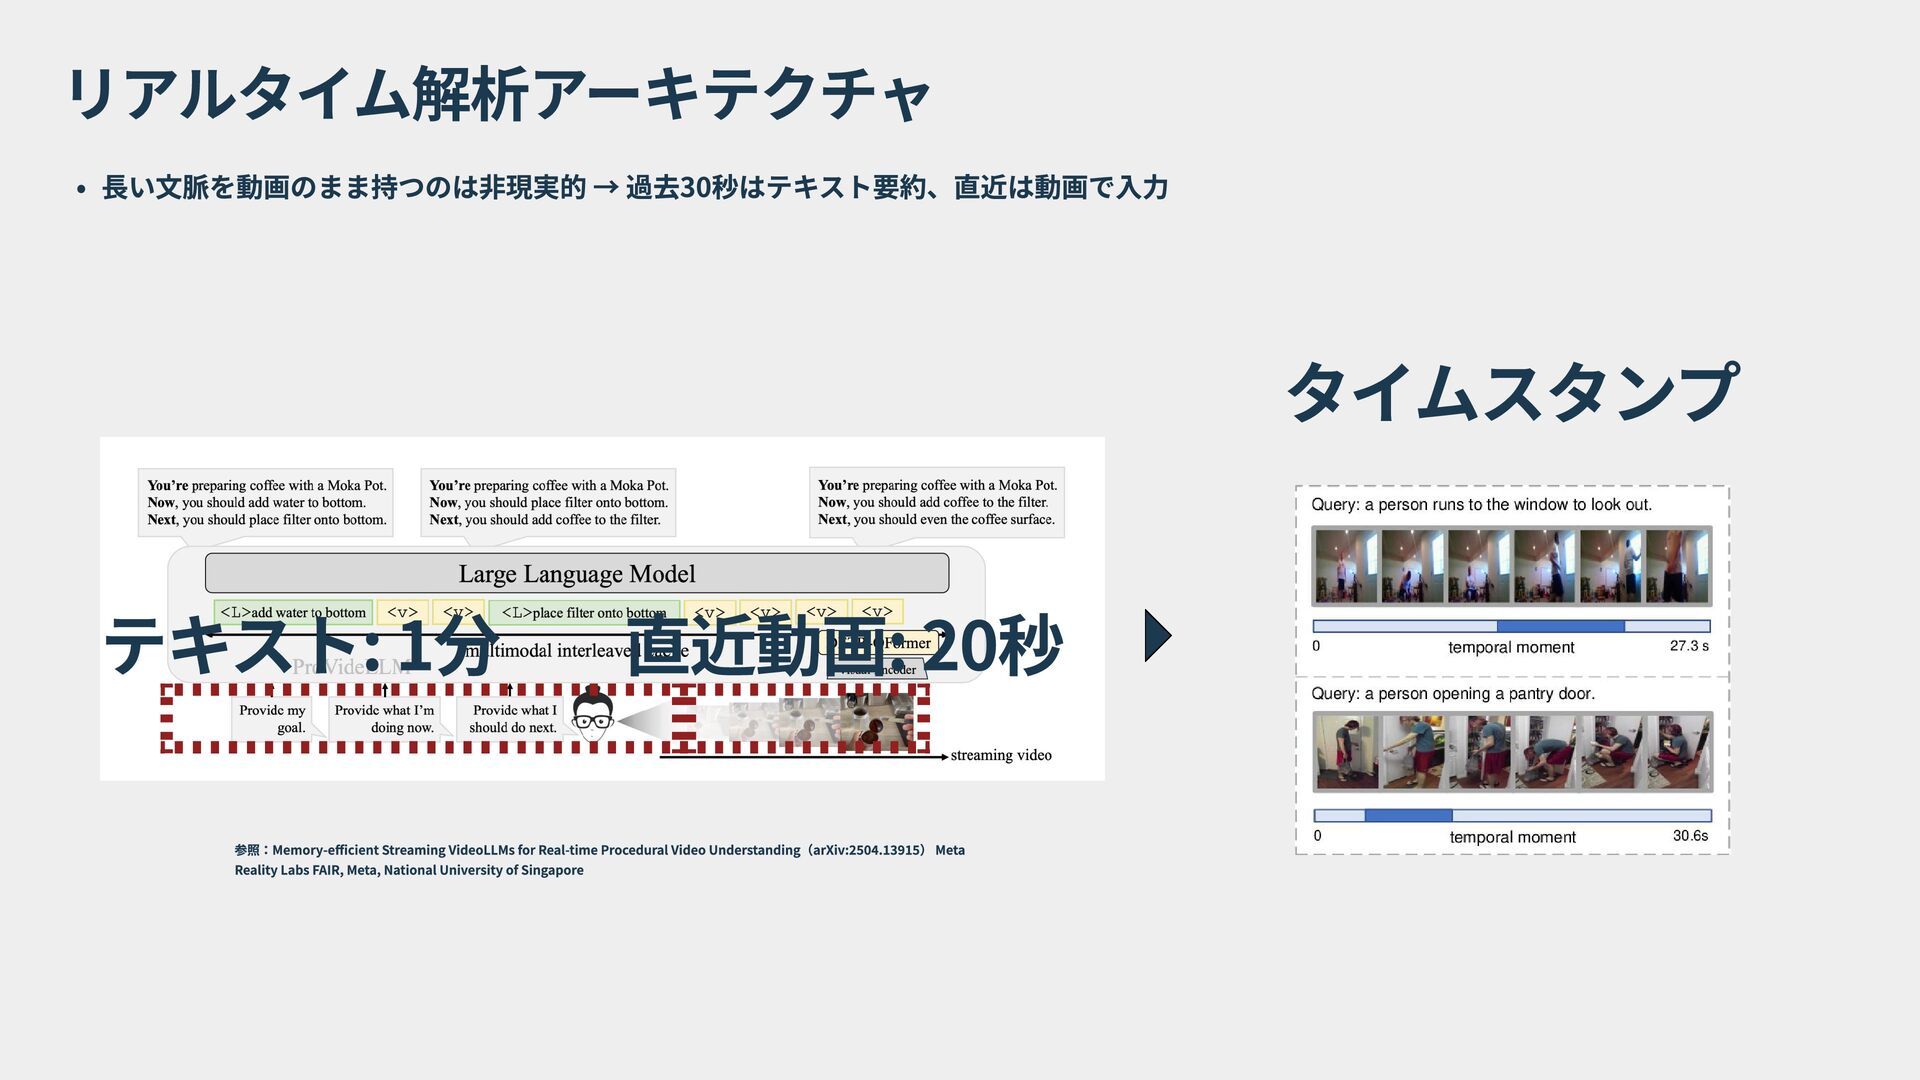
リアルタイム解析アーキテクチャ 長い文脈を動画のまま持つのは非現実的 → 過去30秒はテキスト要約、直近は動画で入力 タイムスタンプ テキスト: 1分 直近動画: 20秒 参照:Memory-efficient
Streaming VideoLLMs for Real-time Procedural Video Understanding(arXiv:2504.13915) Meta Reality Labs FAIR, Meta, National University of Singapore
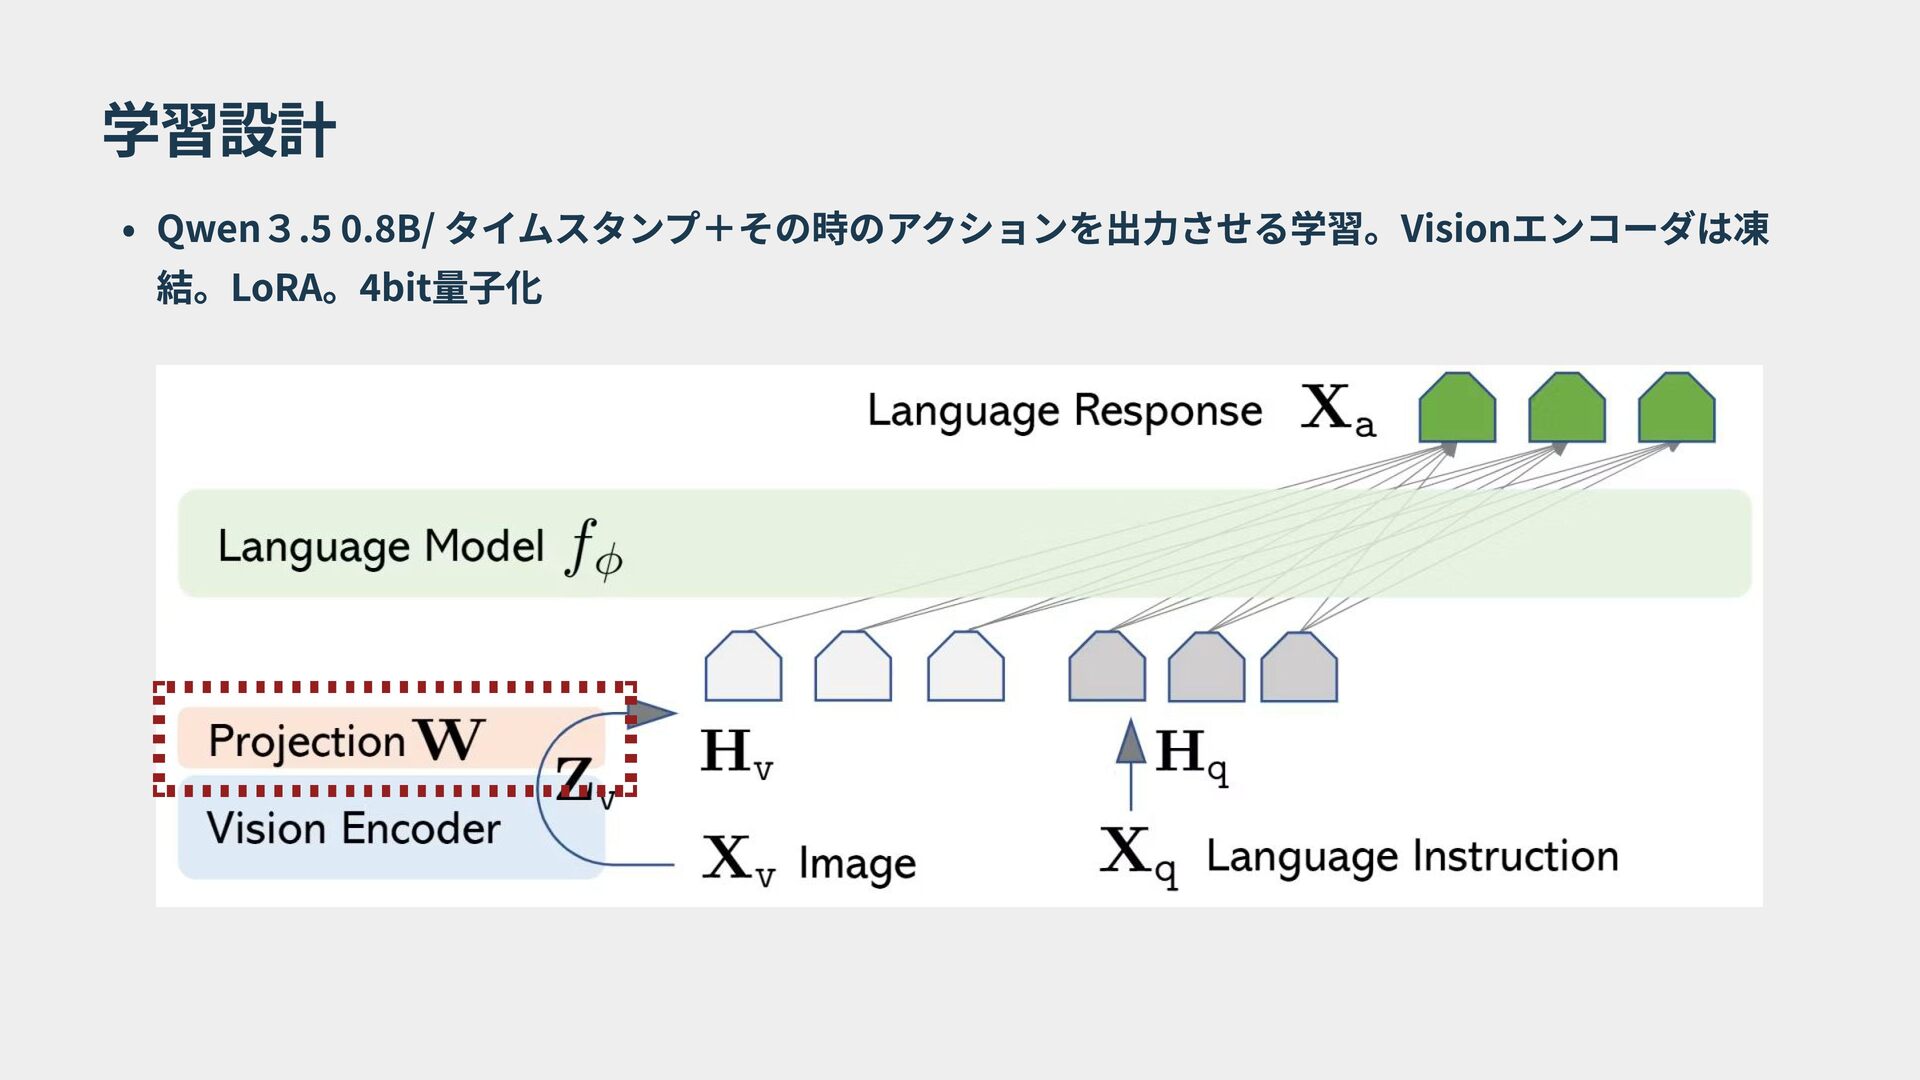
学習設計 Qwen3.5 0.8B/ タイムスタンプ+その時のアクションを出力させる学習。Visionエンコーダは凍 結。LoRA。4bit量子化
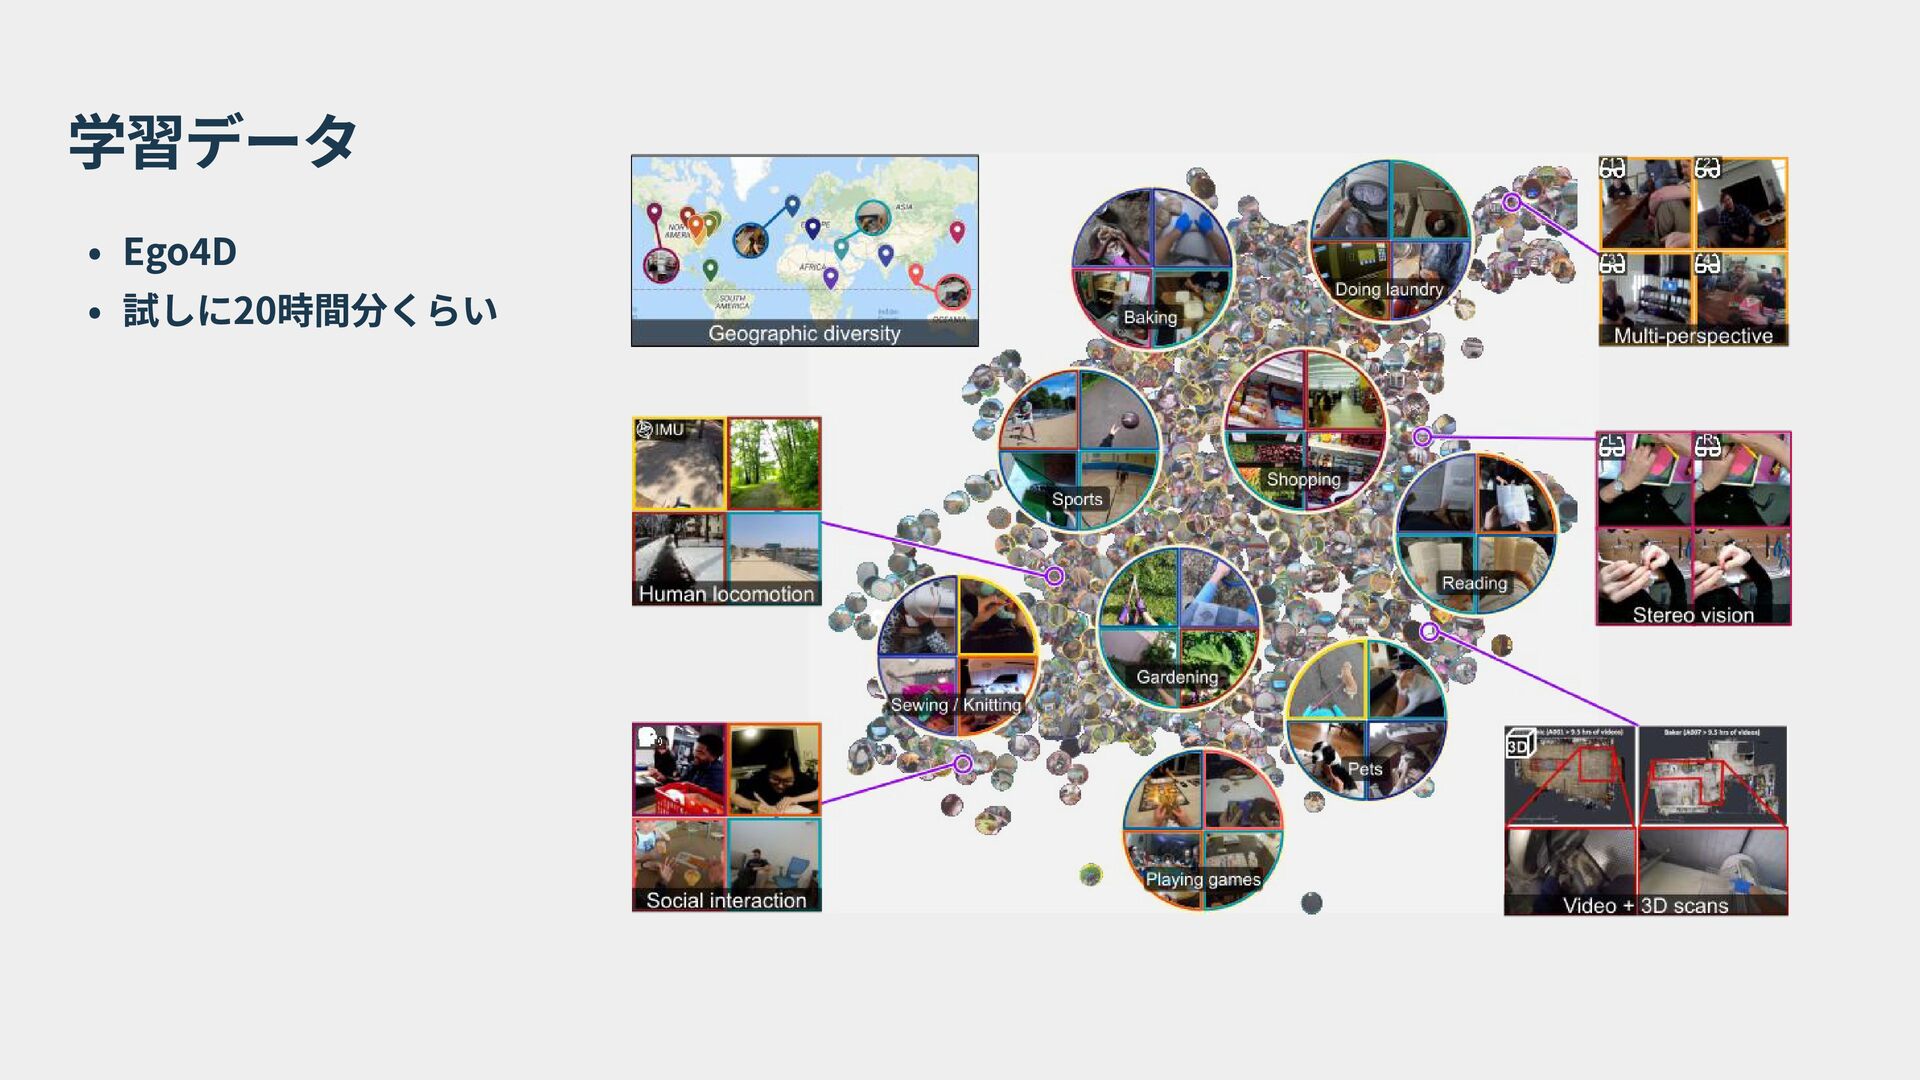
学習データ Ego4D 試しに20時間分くらい
結果
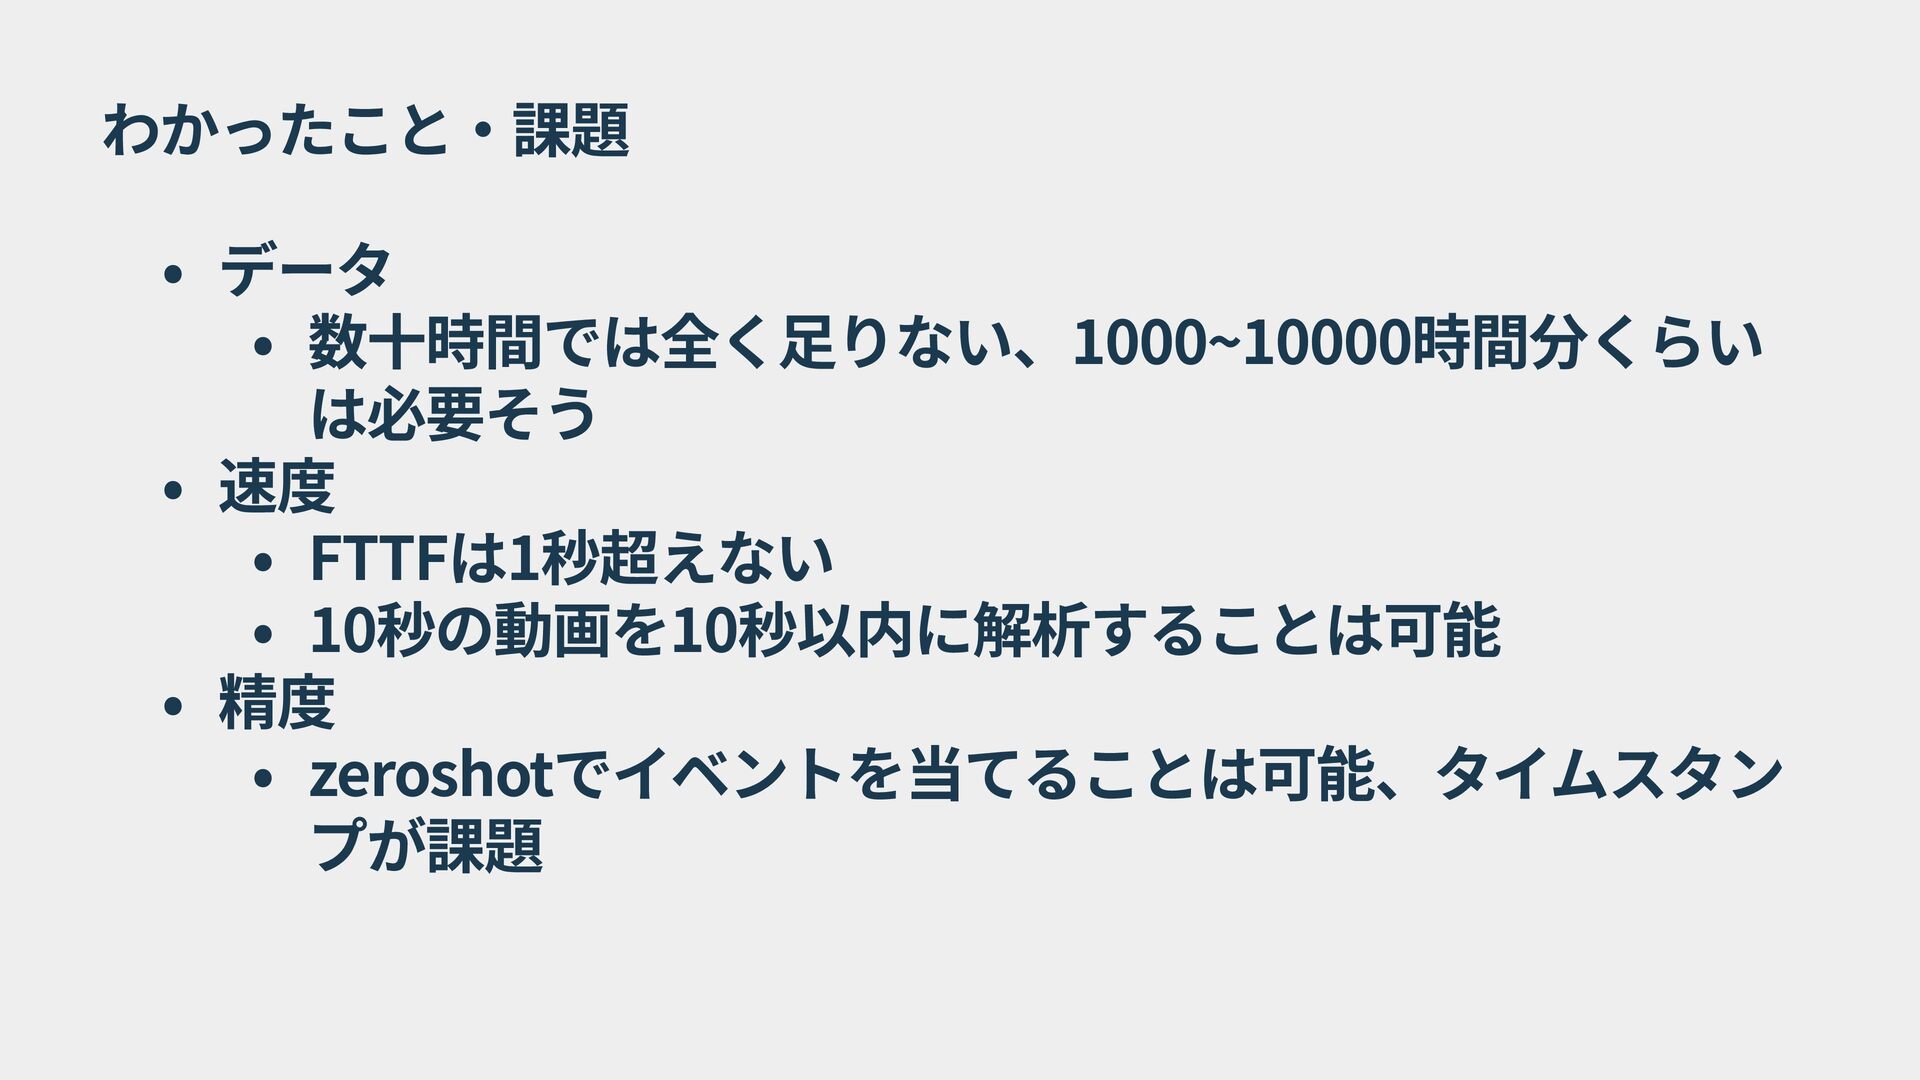
わかったこと・課題 データ 数十時間では全く足りない、1000~10000時間分くらい は必要そう 速度 FTTFは1秒超えない 10秒の動画を10秒以内に解析することは可能 精度 zeroshotでイベントを当てることは可能、タイムスタン プが課題
クロージング
振り返り・反省
GPU 時間 がない。 学習データ
解決策 GPU: SaaS使う 時間: 仕事してる時も学習・改善 させる
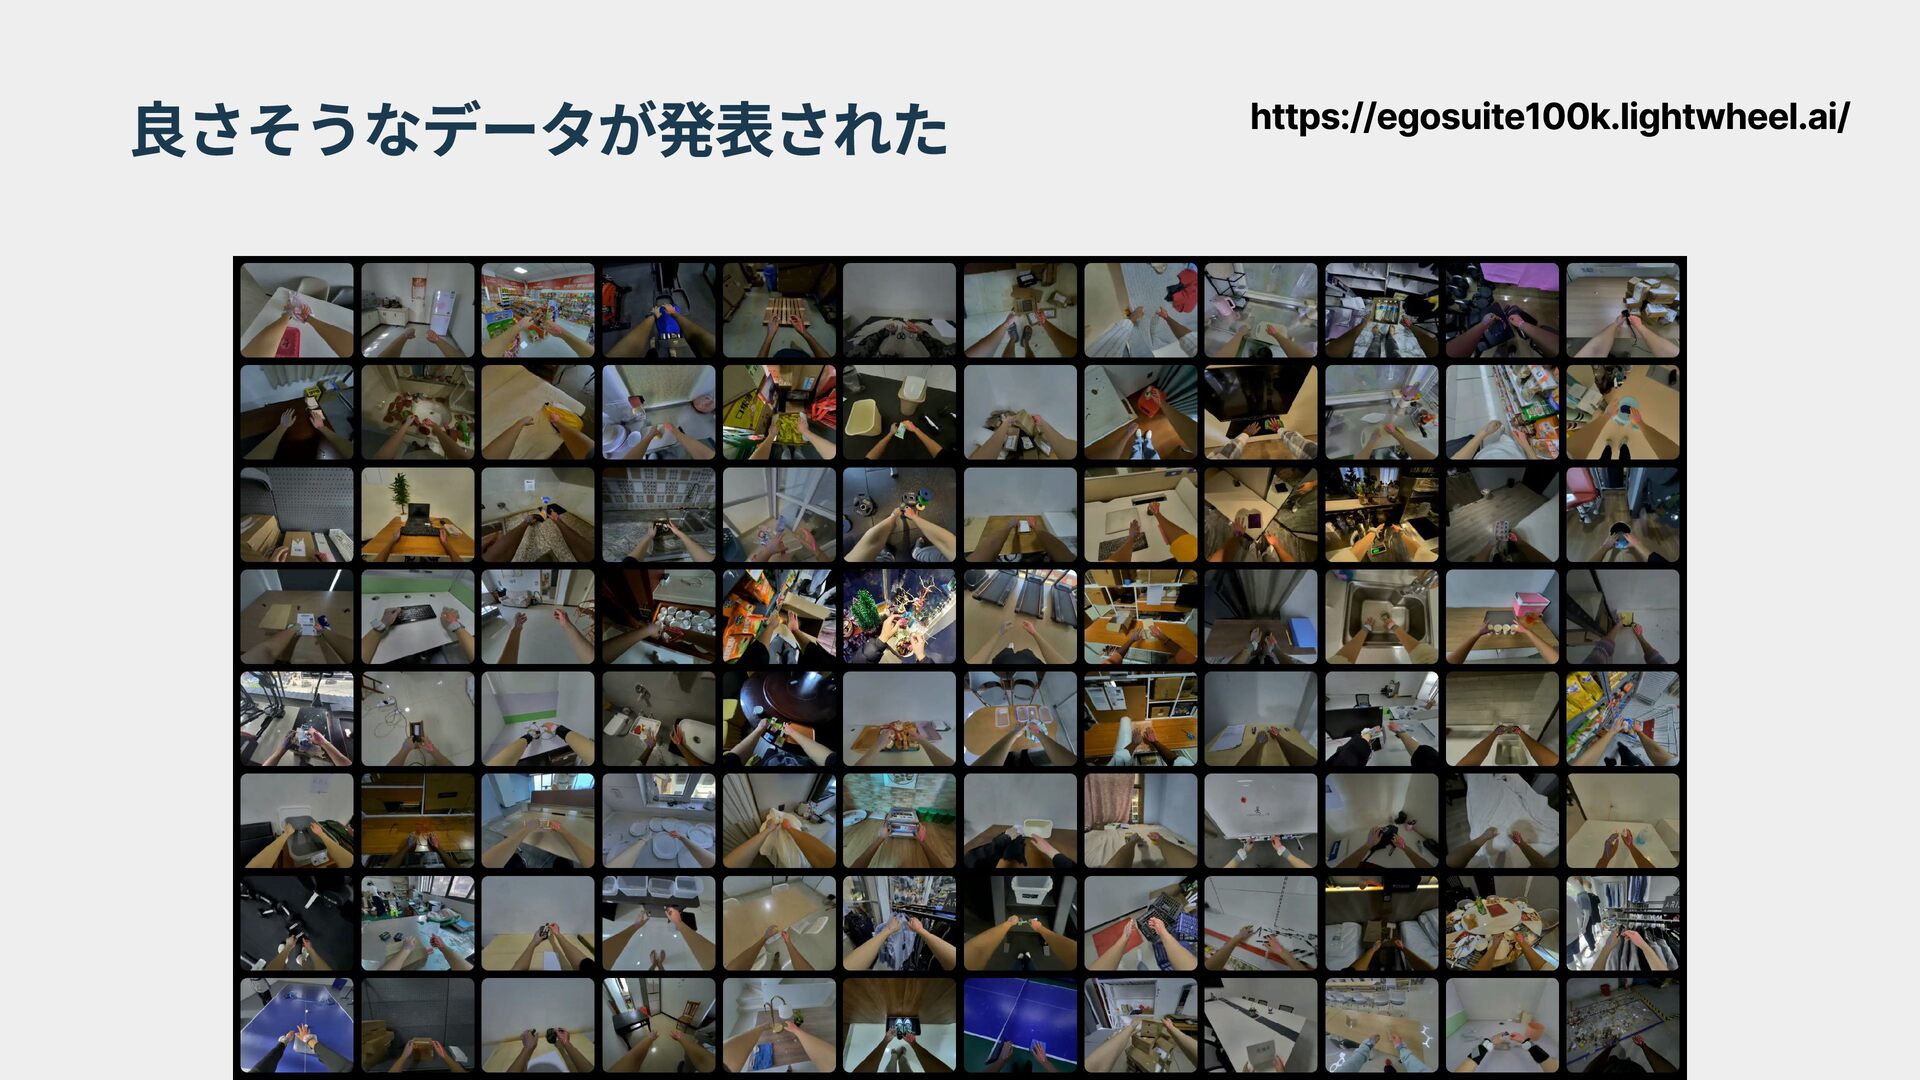
これから データは?
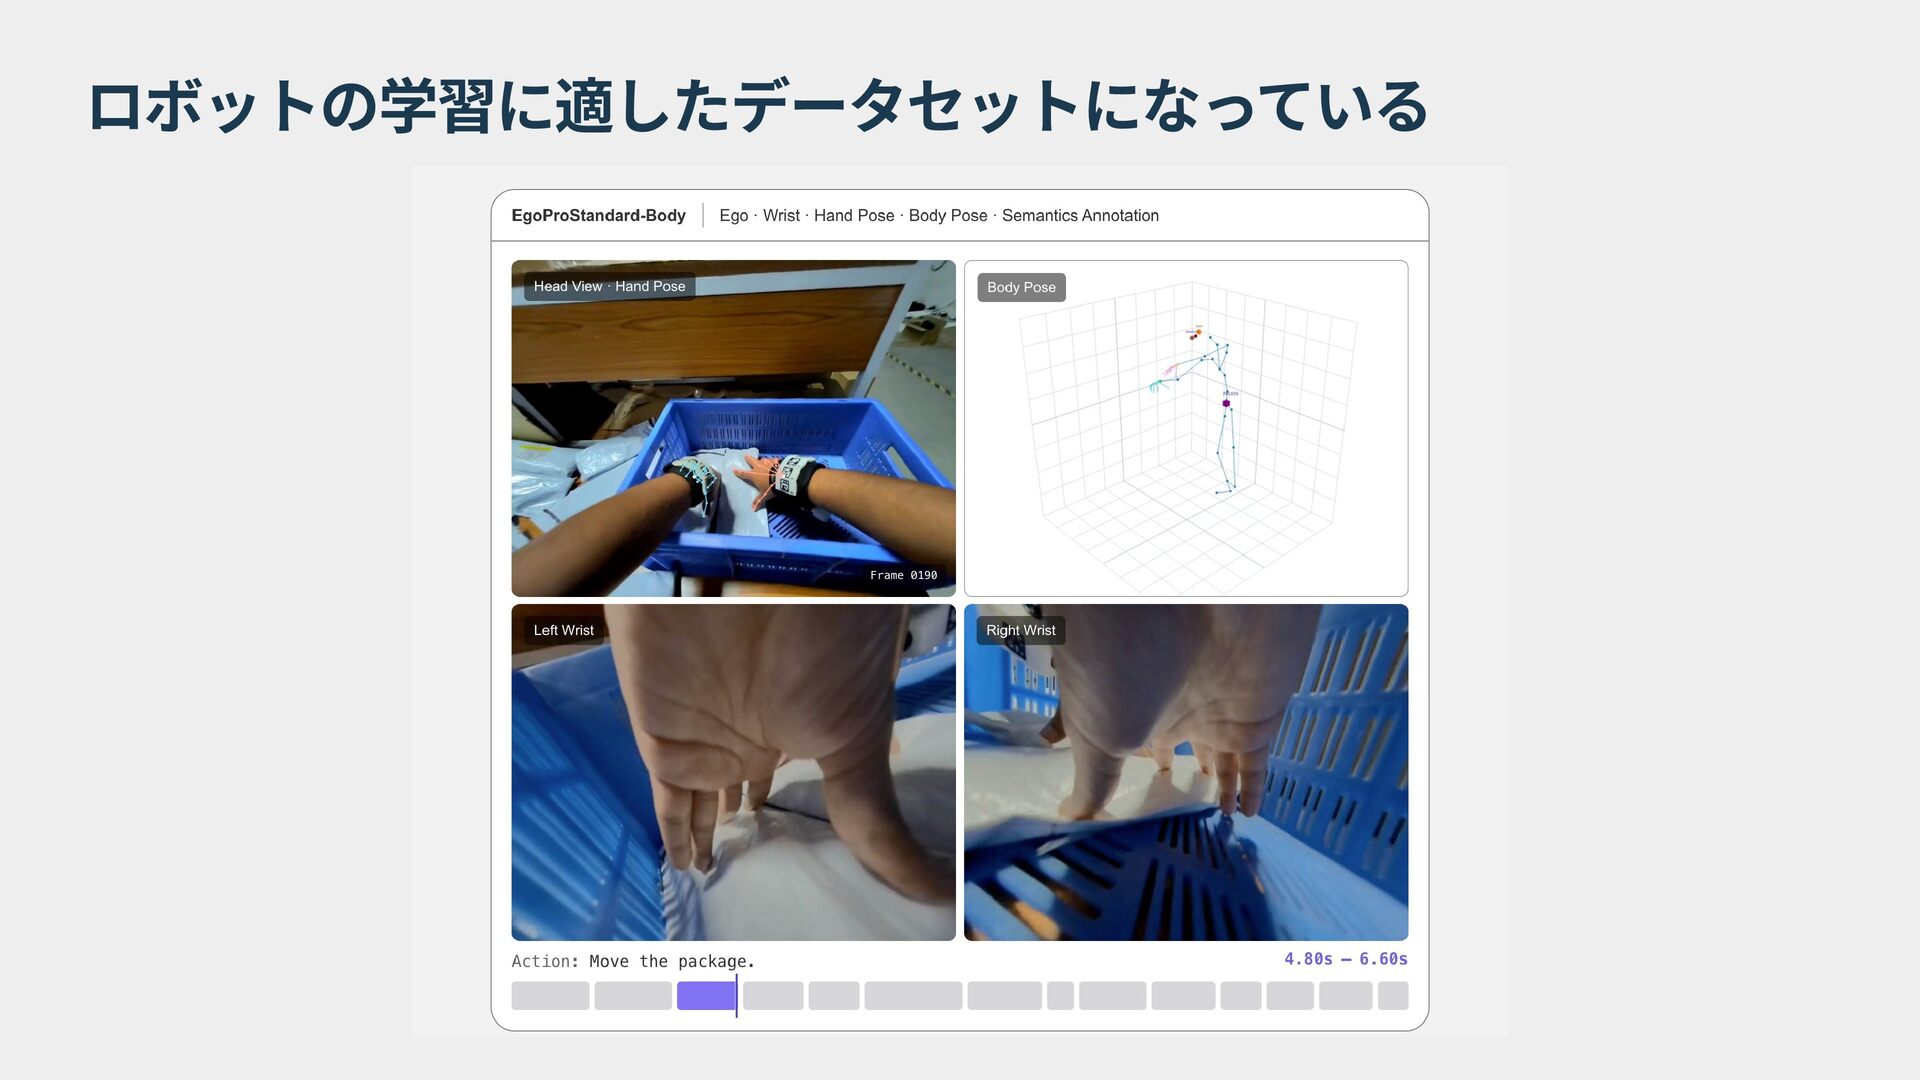
良さそうなデータが発表された https://egosuite100k.lightwheel.ai/
ロボットの学習に適したデータセットになっている
学習・改善はClaude Codeに 手伝ってもらった →Opus5は微妙、Fableは良さそう
GPU 時間 解決 学習データ
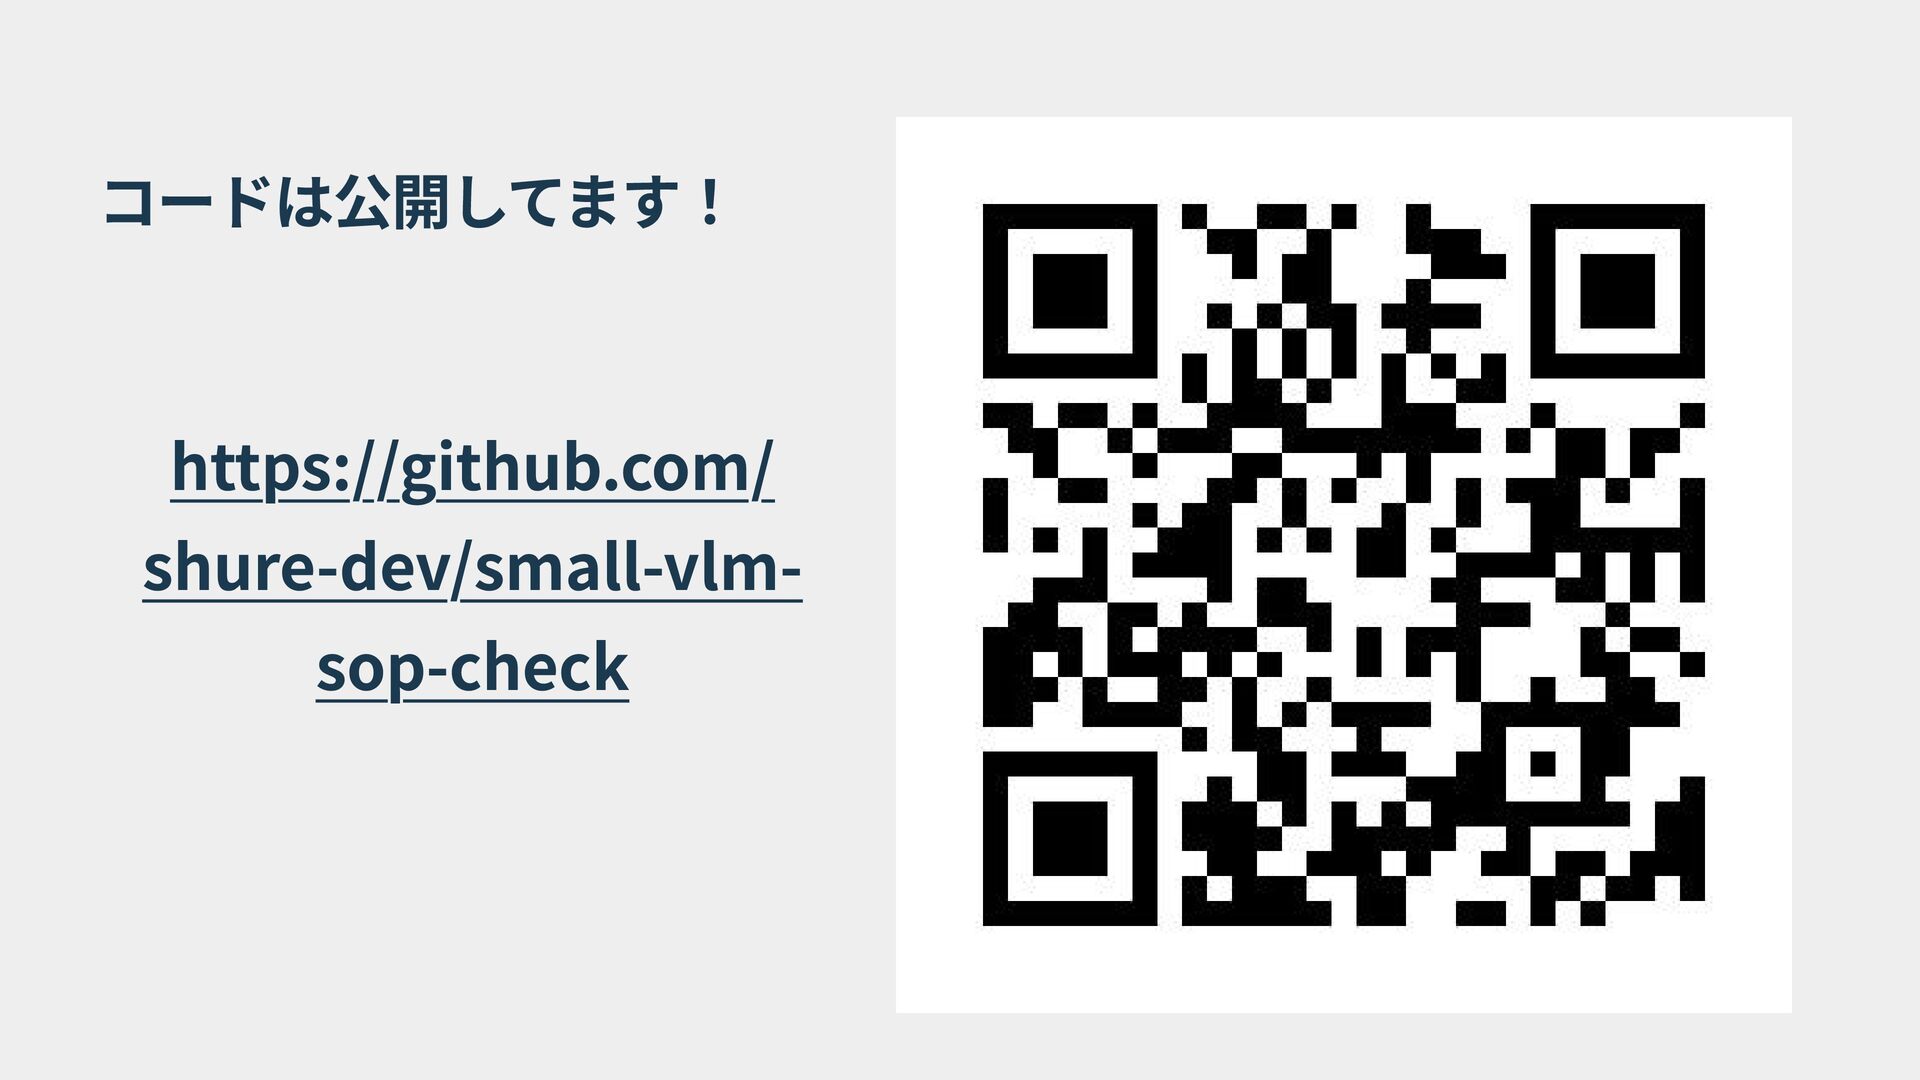
コードは公開してます! https://github.com/ shure-dev/small-vlmsop-check


 shuredev
 reverentgeek
 eileencodes
 codingconduct
 badams
 cassininazir
 wayneb77
 cromwellryan
 watany
 trishagee
 rkendrick25
 ianozsvald