Share
Embed
Machine Learning — Was ist das eigentlich, und was haben GPUs damit zu tun?
Die Präsentation ist zur Vertriebsunterstützung eines Systemhauses, um Kunden eine kurze, grundlegende Übersicht zu Machine Learning und Deep Learning zu geben, sowie aktuelle NVIDIA Tesla GPUs zu positionieren.
Wolfgang Stief
December 02, 2016
Transcript
28 slides
-
Boston Webinar Machine Learning — Welche Rolle spielen GPUs? Welche
Anwendungsfälle gibt es? Wolfgang Stief Senior Consultant -
§ Gegründet 1992 – 24 Jahre Innovation § Supermicros ältester
& größter globaler Partner — seit über 20 Jahren § Lösungshersteller mit Fokus auf Technologie (First-to-Market Strategie) § London HQ, Niederlassungen in London City, München, Mumbai, Bangalore, New York. Weitere Expansion geplant. § Experten im Lösungs- und HPC-System-Design unter Verwendung von Premium-Komponenten von Supermicro und ausgewählten Partnern § Supermicros Fastest Growing Partner Über uns -
§ Was ist eigentlich Machine Learning? Grundprinzipien, neuronale Netze, Algorithmen,
Deep Learning, Historie § Anwendungsbeispiele für Machine Learning Wo wird Machine Learning schon heute genutzt? Was bringt die Zukunft? § Hardware- und Software-Ökosystem NVIDIA Tesla und Pascal, Supermicro ANNA, NVIDIA CUDA, Anwendungskatalog Agenda -
§ Nimm ein bisschen (gleichartige) Daten. § Trainiere ein (geeignetes
mathematisches) Modell mit den Daten. § Benutze das trainierte Modell, um Vorhersagen auf neue Daten zu machen. Der Trainingsprozess ist (normalerweise) iterativ über viele Schleifen mit Fehlerrückkopplung. Was ist eigentlich Machine Learning? -
§ Forschung zu AI/KI ab 1965 § Convolutional Networks ab
1979 § Fehlerrückkopplung seit 1960 als Prinzip, aber kaum genutzt § MNIST (1989) >> Handschriftenerkennung mit Fehlerrückkopplung kommerzielle Nutzung: automatisiertes Lesen handgeschriebener Schecks (USA) § erst mit schnellen CPUs und ersten GPUs stellen kommen Erfolge § ImageNet (2012) — automatische Klassifizierung von Bildern ab jetzt feature learning/deep learning anstatt feature engineering § ab 2012: Microsoft, Google, Facebook investiert (Startups, Research) § 2015/2016: NVIDIA bringt Pascal/Tesla und Deep Learning Libraries Geschichtliches -
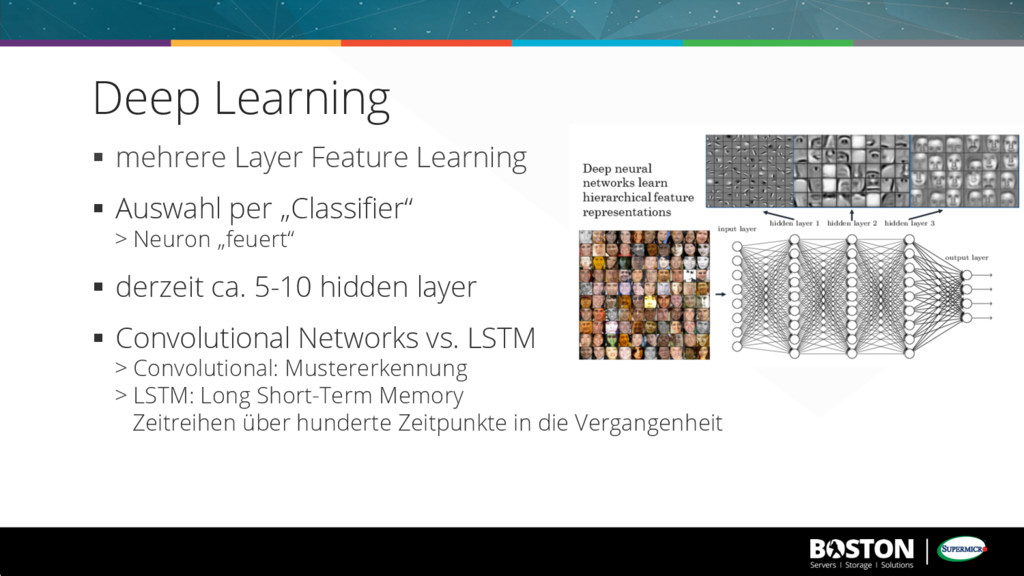
§ mehrere Layer Feature Learning § Auswahl per „Classifier“ >
Neuron „feuert“ § derzeit ca. 5-10 hidden layer § Convolutional Networks vs. LSTM > Convolutional: Mustererkennung > LSTM: Long Short-Term Memory Zeitreihen über hunderte Zeitpunkte in die Vergangenheit Deep Learning -
§ so, wie auch Kinder lernen / das Gehirn lernt
deshalb auch „neuronales Netz“ § mehrere (viele) Bilder/Muster einer einzelnen Sache § Fehlerrückkopplung Einordnung über Wahrscheinlichkeiten >> Entscheidung ja/nein >> Schleifenparameter justieren >> erneute Einordnung (Schleife) Anlernen -
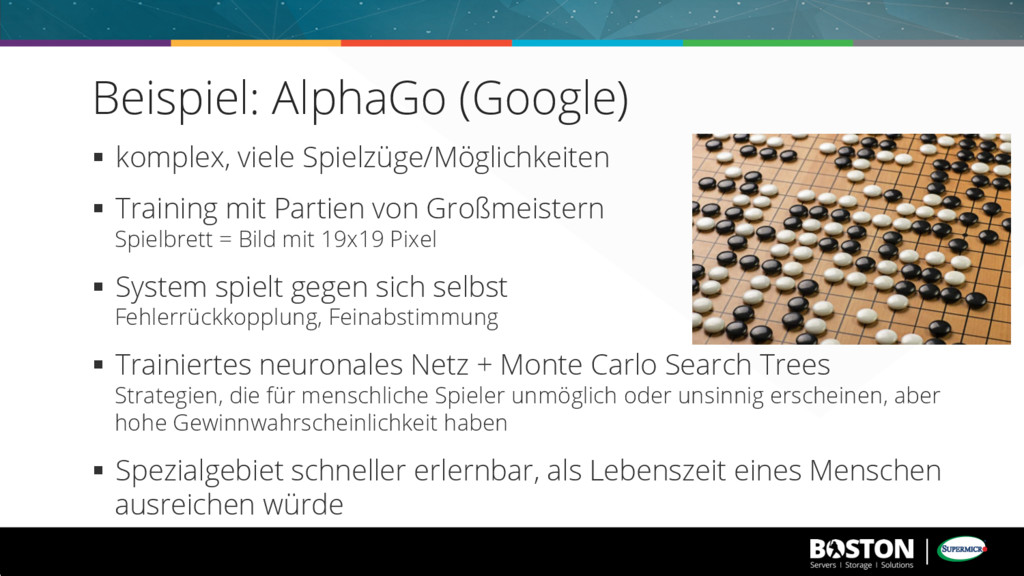
§ komplex, viele Spielzüge/Möglichkeiten § Training mit Partien von Großmeistern
Spielbrett = Bild mit 19x19 Pixel § System spielt gegen sich selbst Fehlerrückkopplung, Feinabstimmung § Trainiertes neuronales Netz + Monte Carlo Search Trees Strategien, die für menschliche Spieler unmöglich oder unsinnig erscheinen, aber hohe Gewinnwahrscheinlichkeit haben § Spezialgebiet schneller erlernbar, als Lebenszeit eines Menschen ausreichen würde Beispiel: AlphaGo (Google) -
§ Vorlesung Deep Learning, Oxford University (Anfang 2015) 16x 50min
https://www.youtube.com/playlist?list=PLE6Wd9FR--EfW8dtjAuPoTuPcqmOV53Fu § Deep Learning in a Nutshell 4-teilge Artikel-Serie im NVIDIA Developer Blog https://devblogs.nvidia.com/parallelforall/deep-learning-nutshell-core-concepts/ Wer Deep Learning genauer wissen will -
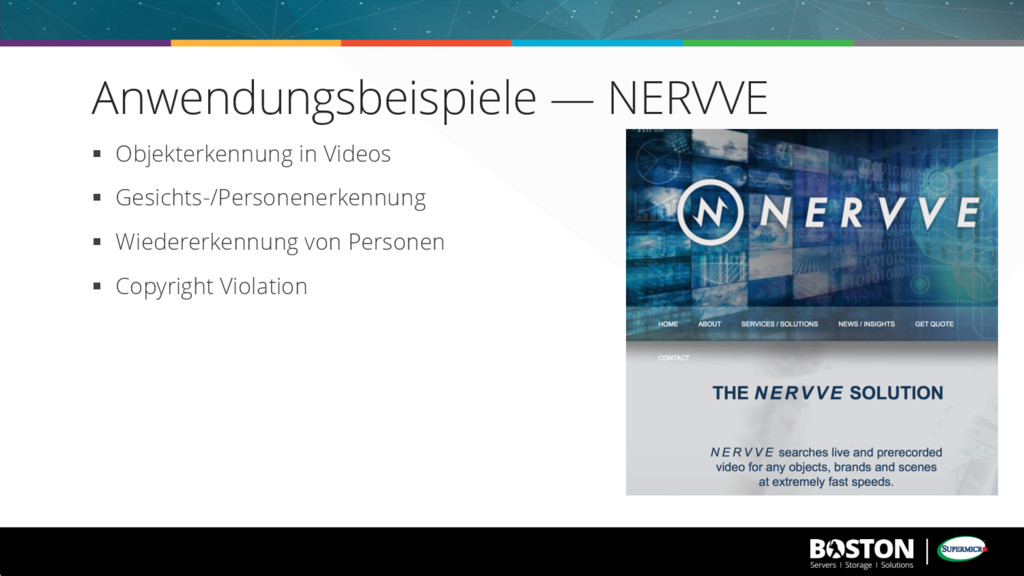
§ Objekterkennung in Videos § Gesichts-/Personenerkennung § Wiedererkennung von Personen
§ Copyright Violation Anwendungsbeispiele — NERVVE -
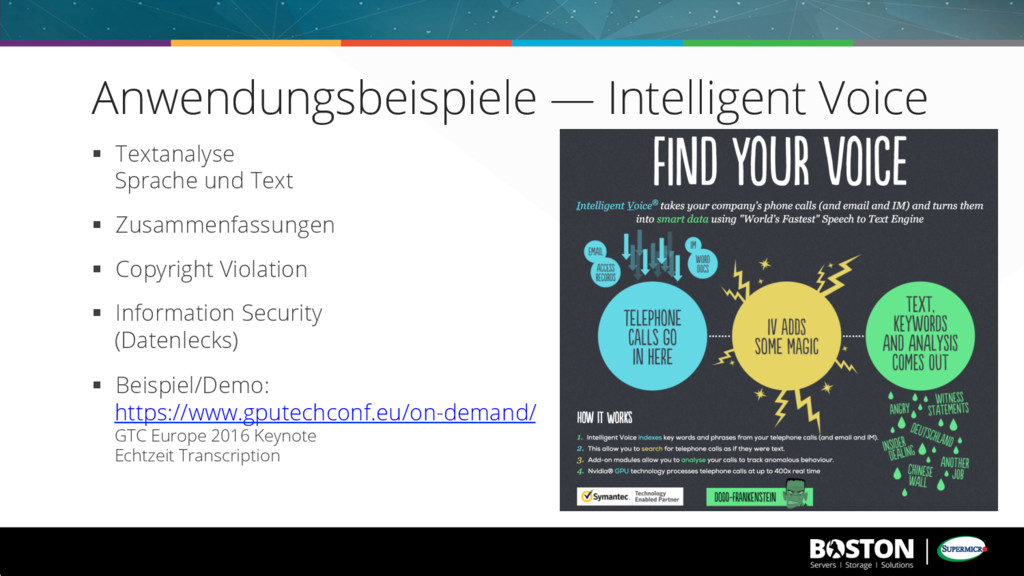
§ Textanalyse Sprache und Text § Zusammenfassungen § Copyright Violation
§ Information Security (Datenlecks) § Beispiel/Demo: https://www.gputechconf.eu/on-demand/ GTC Europe 2016 Keynote Echtzeit Transcription Anwendungsbeispiele — Intelligent Voice -
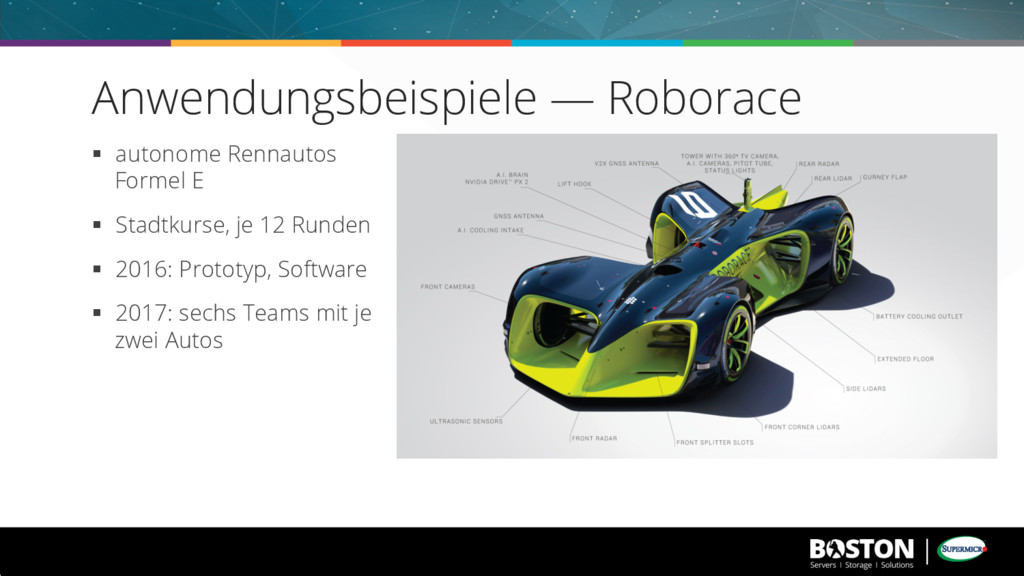
§ autonome Rennautos Formel E § Stadtkurse, je 12 Runden
§ 2016: Prototyp, Software § 2017: sechs Teams mit je zwei Autos Anwendungsbeispiele — Roborace -
Anwendungsbeispiele — Google Translate “This inspired us to ask the
following question: Can we translate between a language pair which the system has never seen before? An example of this would be translations between Korean and Japanese where Korean ⇄ Japanese examples were not shown to the system. Impressively, the answer is yes — it can generate reasonable Korean ⇄ Japanese translations, even though it has never been taught to do so.” https://research.googleblog.com/2016/11/zero-shot-translation-with-googles.html -
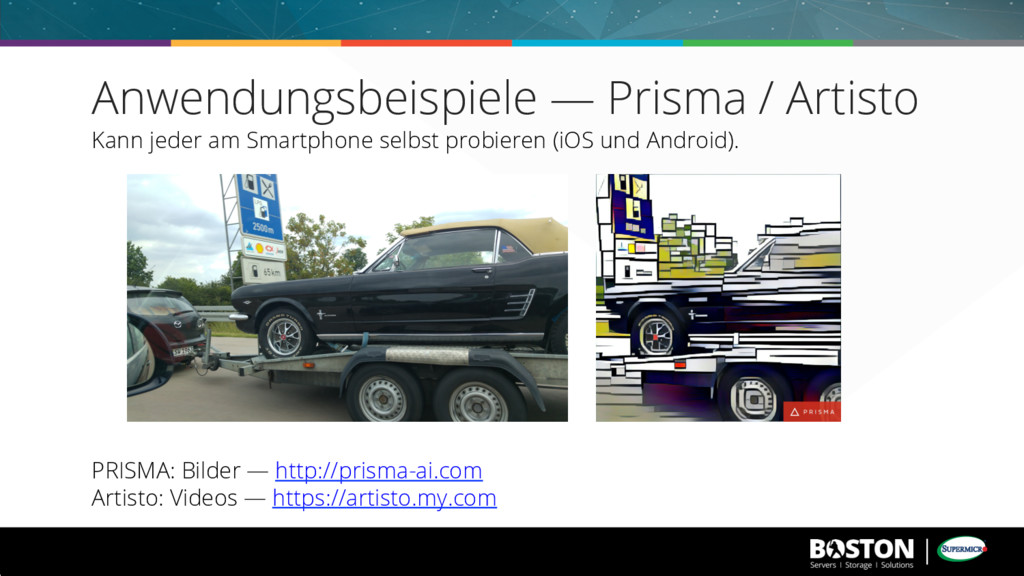
Anwendungsbeispiele — Prisma / Artisto PRISMA: Bilder — http://prisma-ai.com Artisto:
Videos — https://artisto.my.com Kann jeder am Smartphone selbst probieren (iOS und Android). -
§ autonomes Fahren Lkw, Landmaschinen, Taxi, Pkw § Videoüberwachung §
Data Leak Prevention § Deep Learning mit IoT Killerapplikation? Und in Zukunft? -
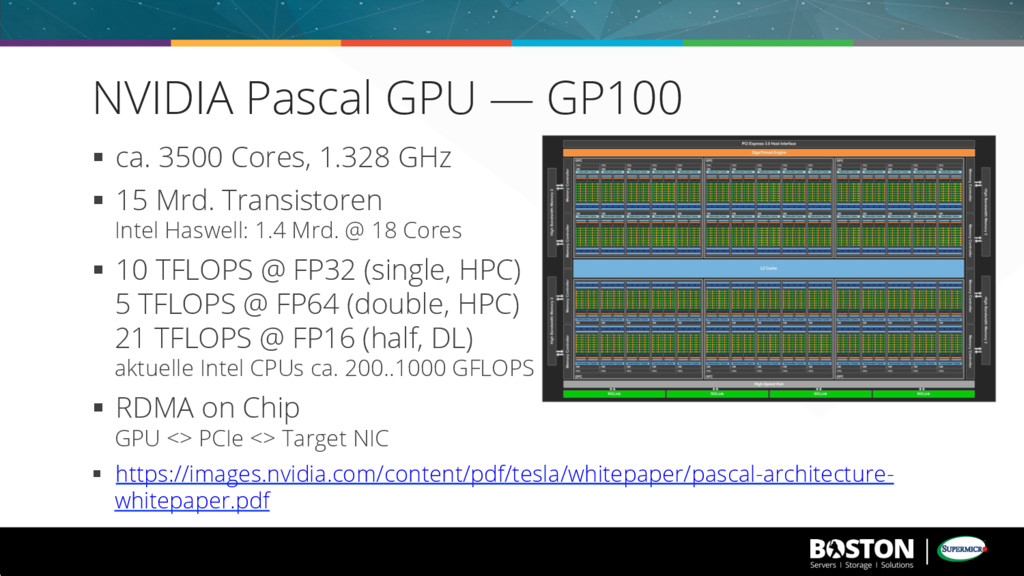
§ ca. 3500 Cores, 1.328 GHz § 15 Mrd. Transistoren
Intel Haswell: 1.4 Mrd. @ 18 Cores § 10 TFLOPS @ FP32 (single, HPC) 5 TFLOPS @ FP64 (double, HPC) 21 TFLOPS @ FP16 (half, DL) aktuelle Intel CPUs ca. 200..1000 GFLOPS § RDMA on Chip GPU <> PCIe <> Target NIC § https://images.nvidia.com/content/pdf/tesla/whitepaper/pascal-architecture- whitepaper.pdf NVIDIA Pascal GPU — GP100 -
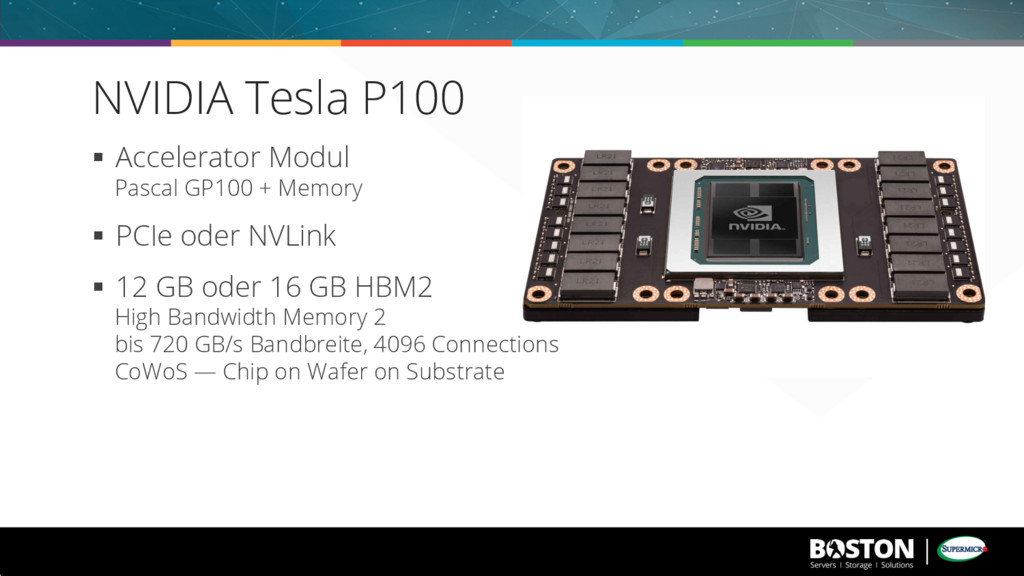
§ Accelerator Modul Pascal GP100 + Memory § PCIe oder
NVLink § 12 GB oder 16 GB HBM2 High Bandwidth Memory 2 bis 720 GB/s Bandbreite, 4096 Connections CoWoS — Chip on Wafer on Substrate NVIDIA Tesla P100 -
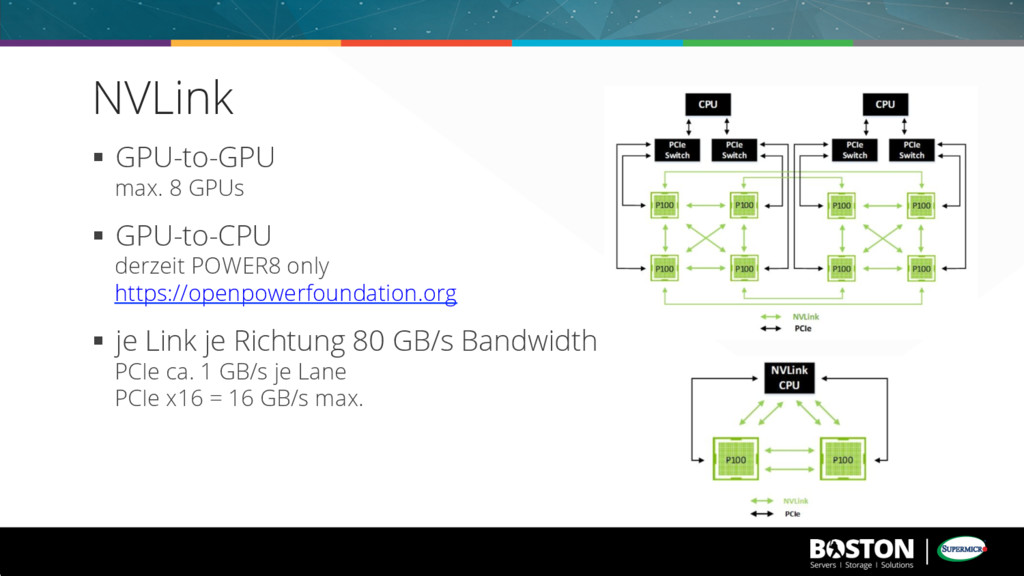
§ GPU-to-GPU max. 8 GPUs § GPU-to-CPU derzeit POWER8 only
https://openpowerfoundation.org § je Link je Richtung 80 GB/s Bandwidth PCIe ca. 1 GB/s je Lane PCIe x16 = 16 GB/s max. NVLink -
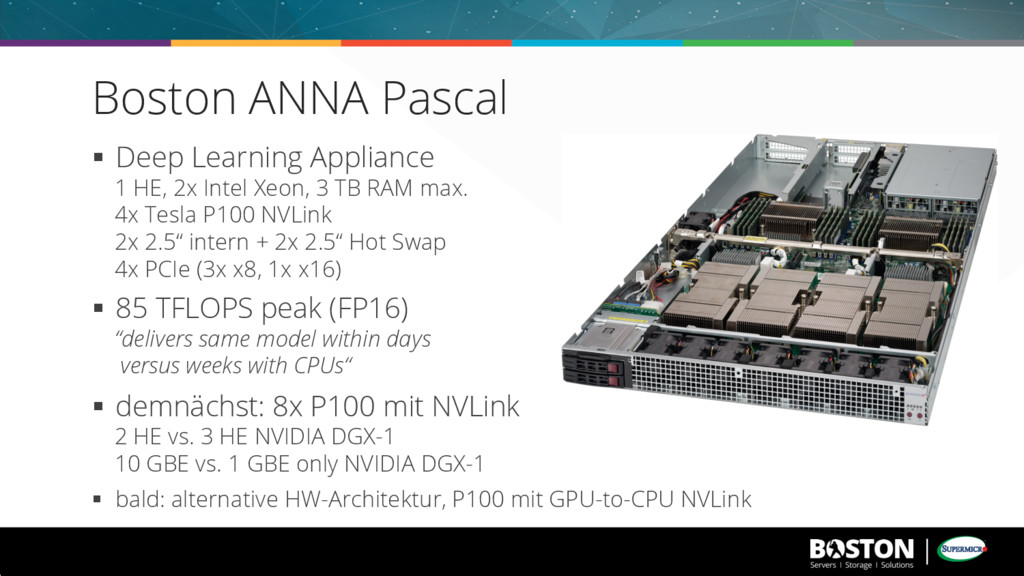
§ Deep Learning Appliance 1 HE, 2x Intel Xeon, 3
TB RAM max. 4x Tesla P100 NVLink 2x 2.5“ intern + 2x 2.5“ Hot Swap 4x PCIe (3x x8, 1x x16) § 85 TFLOPS peak (FP16) “delivers same model within days versus weeks with CPUs“ § demnächst: 8x P100 mit NVLink 2 HE vs. 3 HE NVIDIA DGX-1 10 GBE vs. 1 GBE only NVIDIA DGX-1 § bald: alternative HW-Architektur, P100 mit GPU-to-CPU NVLink Boston ANNA Pascal -
§ verschiedene Boards und Chassis Tesla P100 auch als PCIe-Variante
verfügbar bis max. acht P100 GPUs (PCIe based, 4 HE) Supermicro Server >> beim zuständigen Kollegen im Vertrieb nachfragen -
§ NVIDIA CUDA 8 Development, Libraries § NVIDIA Deep Learning
SDK unterstützt alle üblichen Deep Learning Frameworks - cuDNN — Deep Learning Primitives - TensorRT — Deep Learning Inference Engine - DeepStream SDK — Deep Learning for Video Analytics - cuBLAS — Linear Algebra - cuSPARSE — Sparse Matrix Operations - NCCL — Multi-GPU Communication § https://developer.nvidia.com/deep-learning-software https://www.nvidia.com/content/gpu-applications/PDF/gpu-applications-catalog.pdf Software für P100 und Deep Learning -
GPU zum Ausprobieren > Fragen Sie ihren Ansprechpartner bei Boston
[email protected] > vScaler GPU Cloud