Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Data Parallel C++ とOpenVINOでiGPU, NPU の計算速度とエネル...

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for Muneyoshi Suzuki Muneyoshi Suzuki
April 25, 2025
1

Data Parallel C++ とOpenVINOでiGPU, NPU の計算速度とエネルギー効率をを測ってみた

C++ MIX #14

Avatar for Muneyoshi Suzuki

Muneyoshi Suzuki

April 25, 2025

Transcript

  1. Data Parallel C++ と OpenVINO で iGPU, NPU の計算速度とエネルギー 効率をを測ってみた

    C++ MIX #14 @suzumushi0 2025/4/25 @suzumushi0.bsky.social 鈴木 宗良
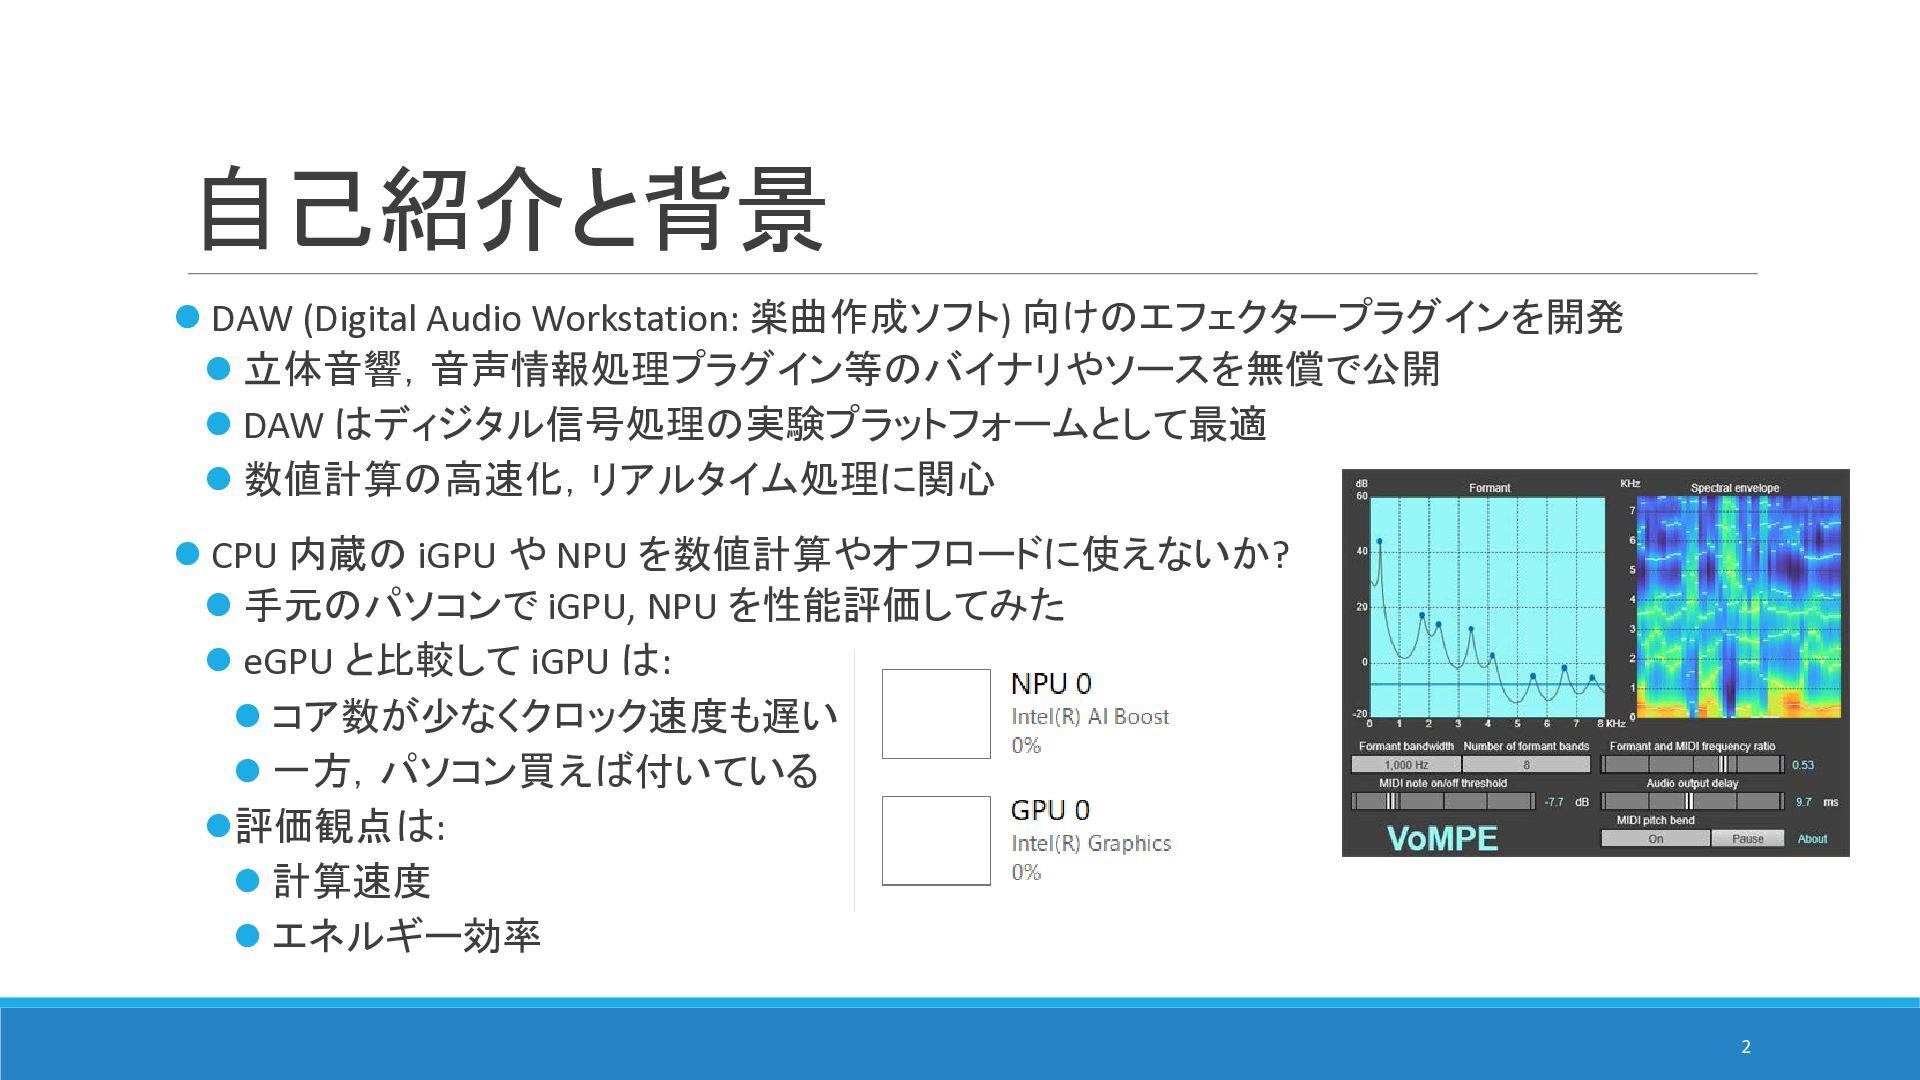
  2. 自己紹介と背景  DAW (Digital Audio Workstation: 楽曲作成ソフト) 向けのエフェクタープラグインを開発  立体音響,音声情報処理プラグイン等のバイナリやソースを無償で公開

     DAW はディジタル信号処理の実験プラットフォームとして最適  数値計算の高速化,リアルタイム処理に関心  CPU 内蔵の iGPU や NPU を数値計算やオフロードに使えないか?  手元のパソコンで iGPU, NPU を性能評価してみた  eGPU と比較して iGPU は:  コア数が少なくクロック速度も遅い  一方,パソコン買えば付いている 評価観点は:  計算速度  エネルギー効率 2
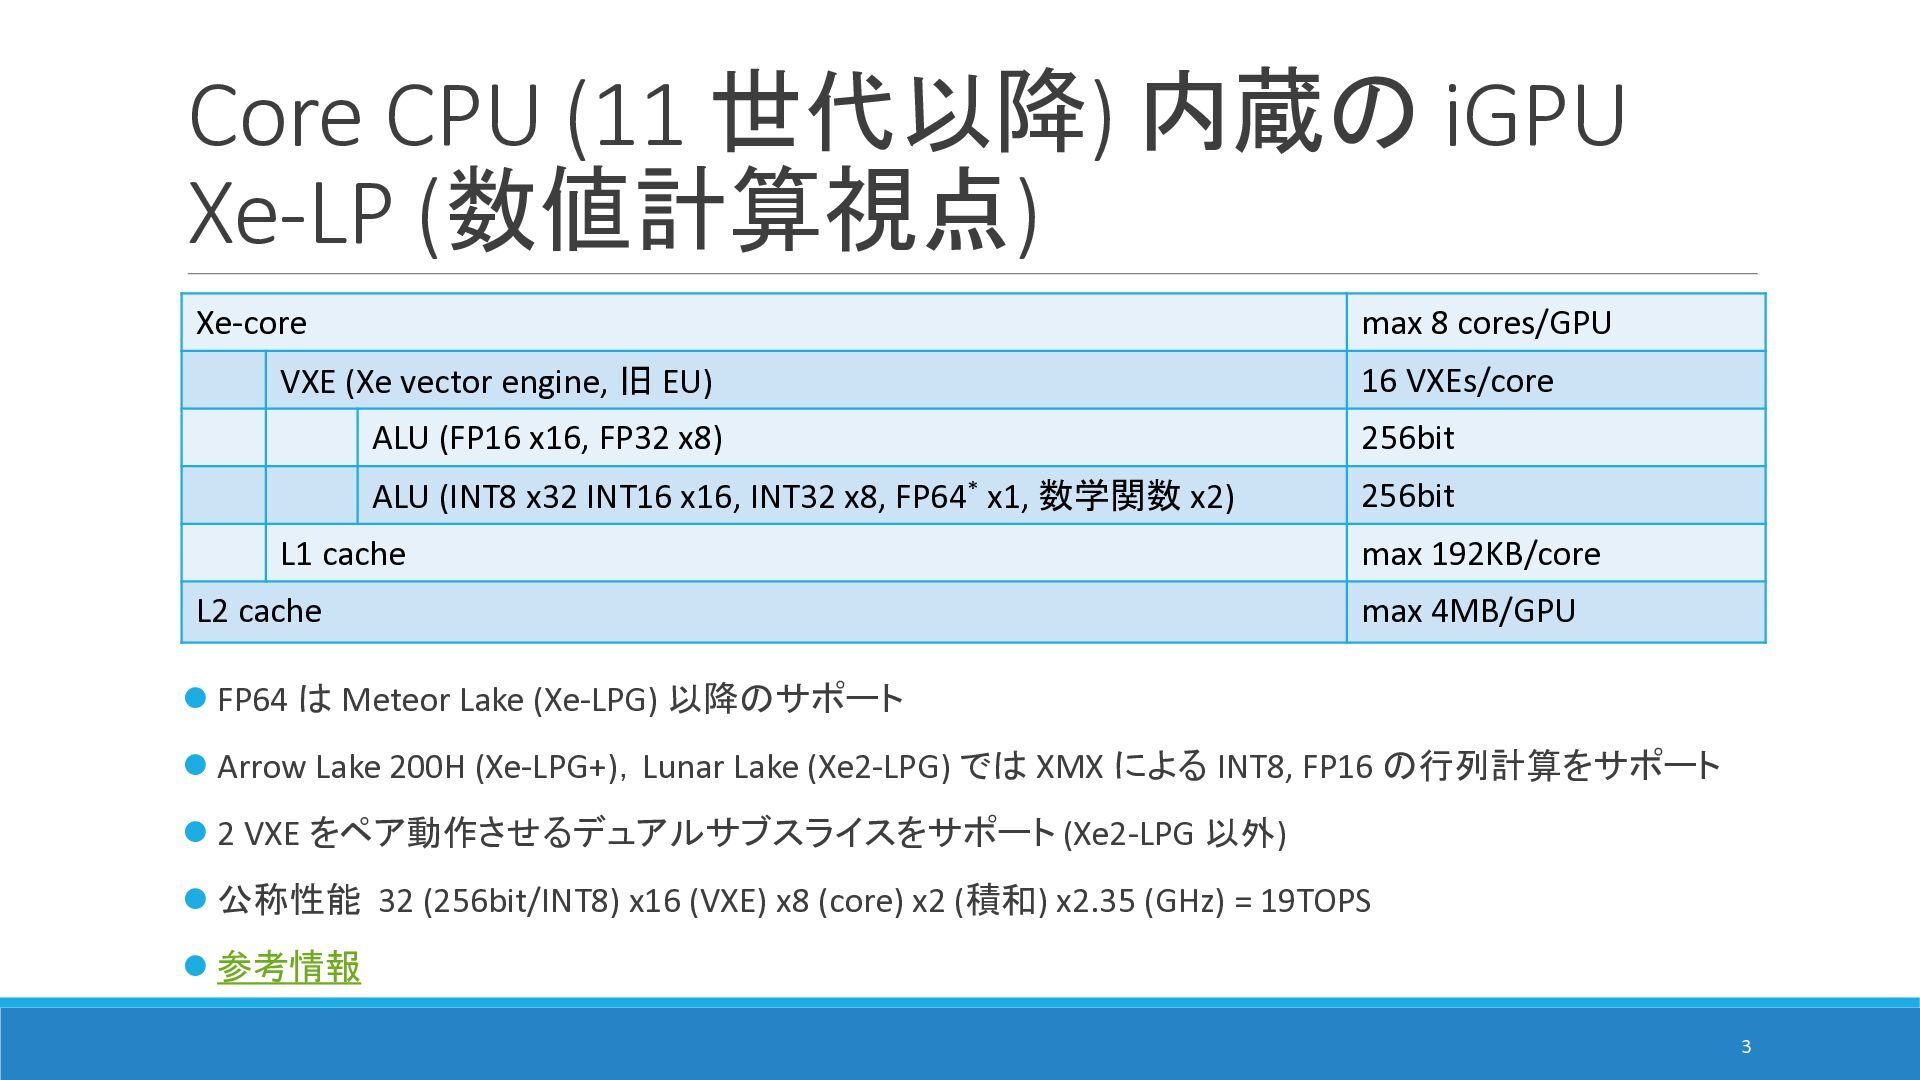
  3. Core CPU (11 世代以降) 内蔵の iGPU Xe-LP (数値計算視点) Xe-core max

    8 cores/GPU VXE (Xe vector engine, 旧 EU) 16 VXEs/core ALU (FP16 x16, FP32 x8) 256bit ALU (INT8 x32 INT16 x16, INT32 x8, FP64* x1, 数学関数 x2) 256bit L1 cache L2 cache max 192KB/core max 4MB/GPU  FP64 は Meteor Lake (Xe-LPG) 以降のサポート  Arrow Lake 200H (Xe-LPG+),Lunar Lake (Xe2-LPG) では XMX による INT8, FP16 の行列計算をサポート  2 VXE をペア動作させるデュアルサブスライスをサポート (Xe2-LPG 以外)  公称性能 32 (256bit/INT8) x16 (VXE) x8 (core) x2 (積和) x2.35 (GHz) = 19TOPS  参考情報 3
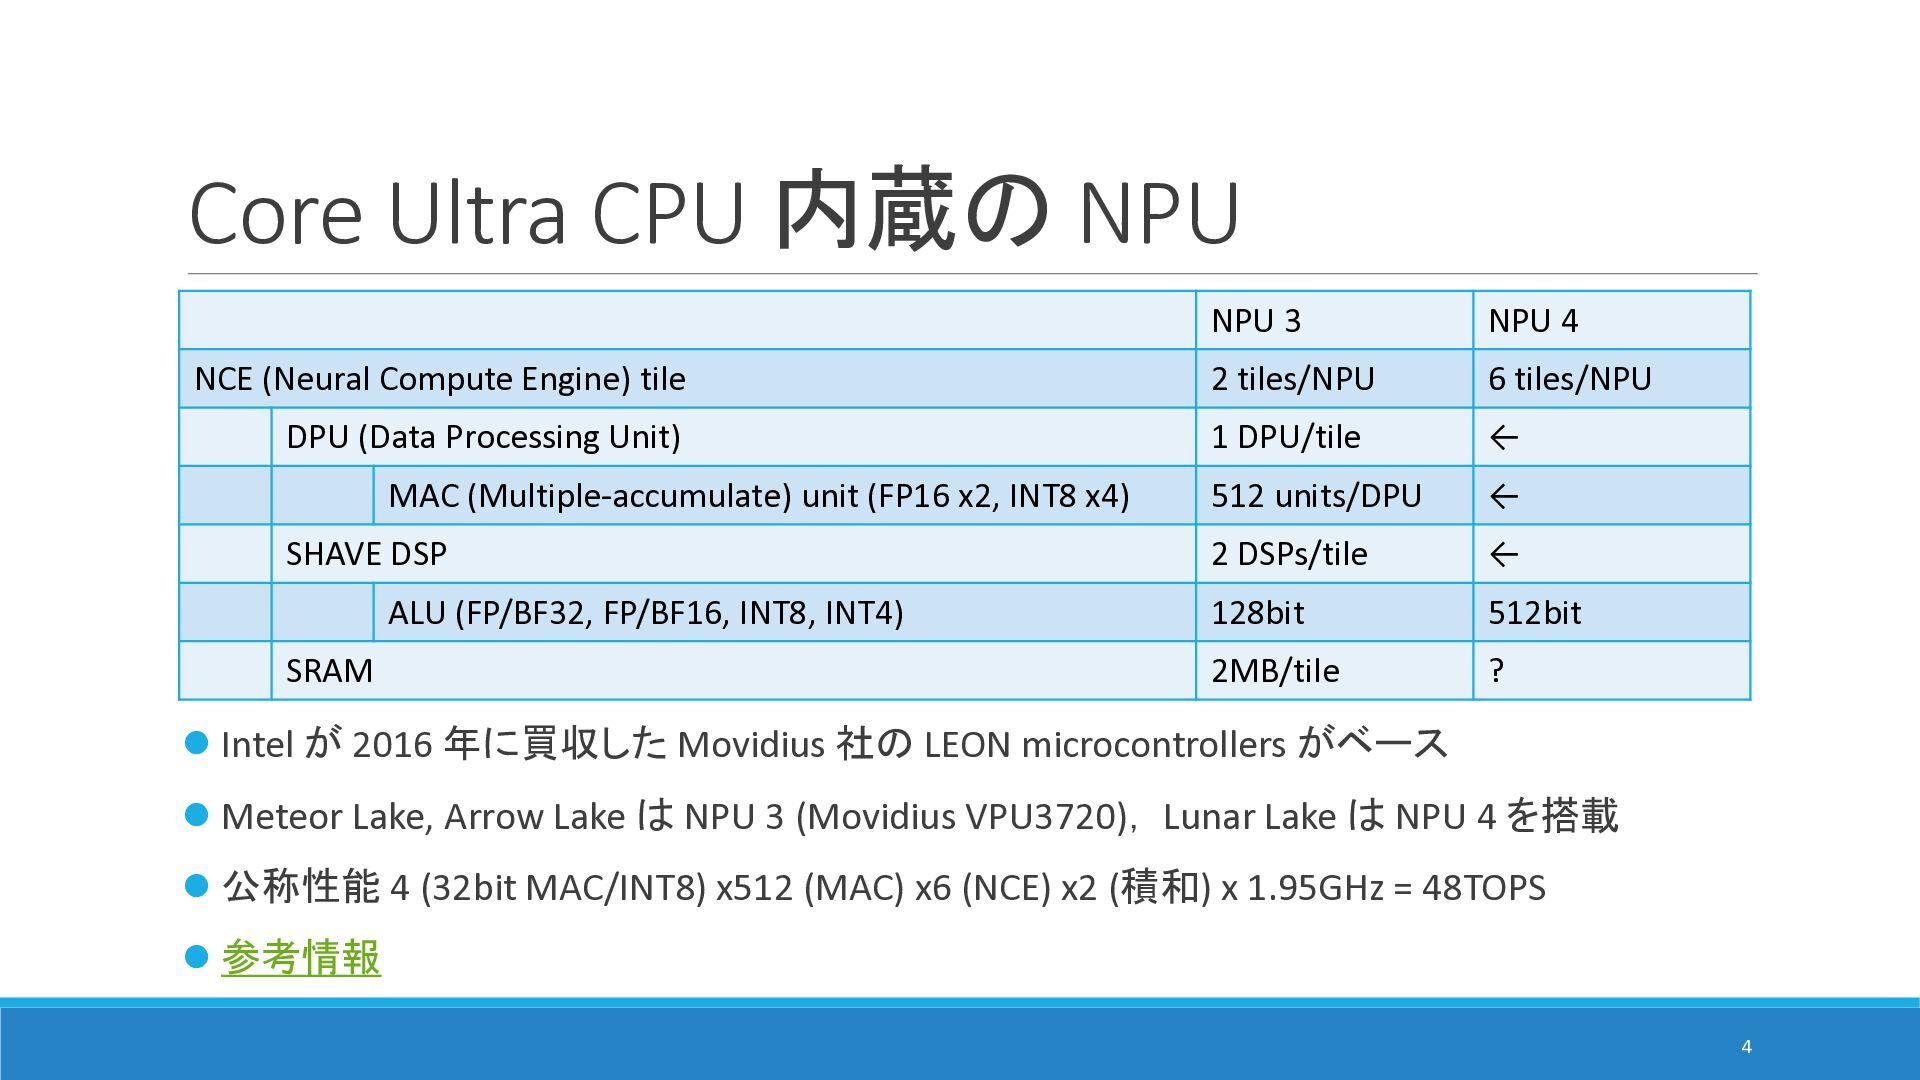
  4. Core Ultra CPU 内蔵の NPU NPU 3 NPU 4 NCE

    (Neural Compute Engine) tile 2 tiles/NPU 6 tiles/NPU DPU (Data Processing Unit) 1 DPU/tile ← 512 units/DPU ← 2 DSPs/tile ← 128bit 512bit 2MB/tile ? MAC (Multiple-accumulate) unit (FP16 x2, INT8 x4) SHAVE DSP ALU (FP/BF32, FP/BF16, INT8, INT4) SRAM  Intel が 2016 年に買収した Movidius 社の LEON microcontrollers がベース  Meteor Lake, Arrow Lake は NPU 3 (Movidius VPU3720), Lunar Lake は NPU 4 を搭載  公称性能 4 (32bit MAC/INT8) x512 (MAC) x6 (NCE) x2 (積和) x 1.95GHz = 48TOPS  参考情報 4
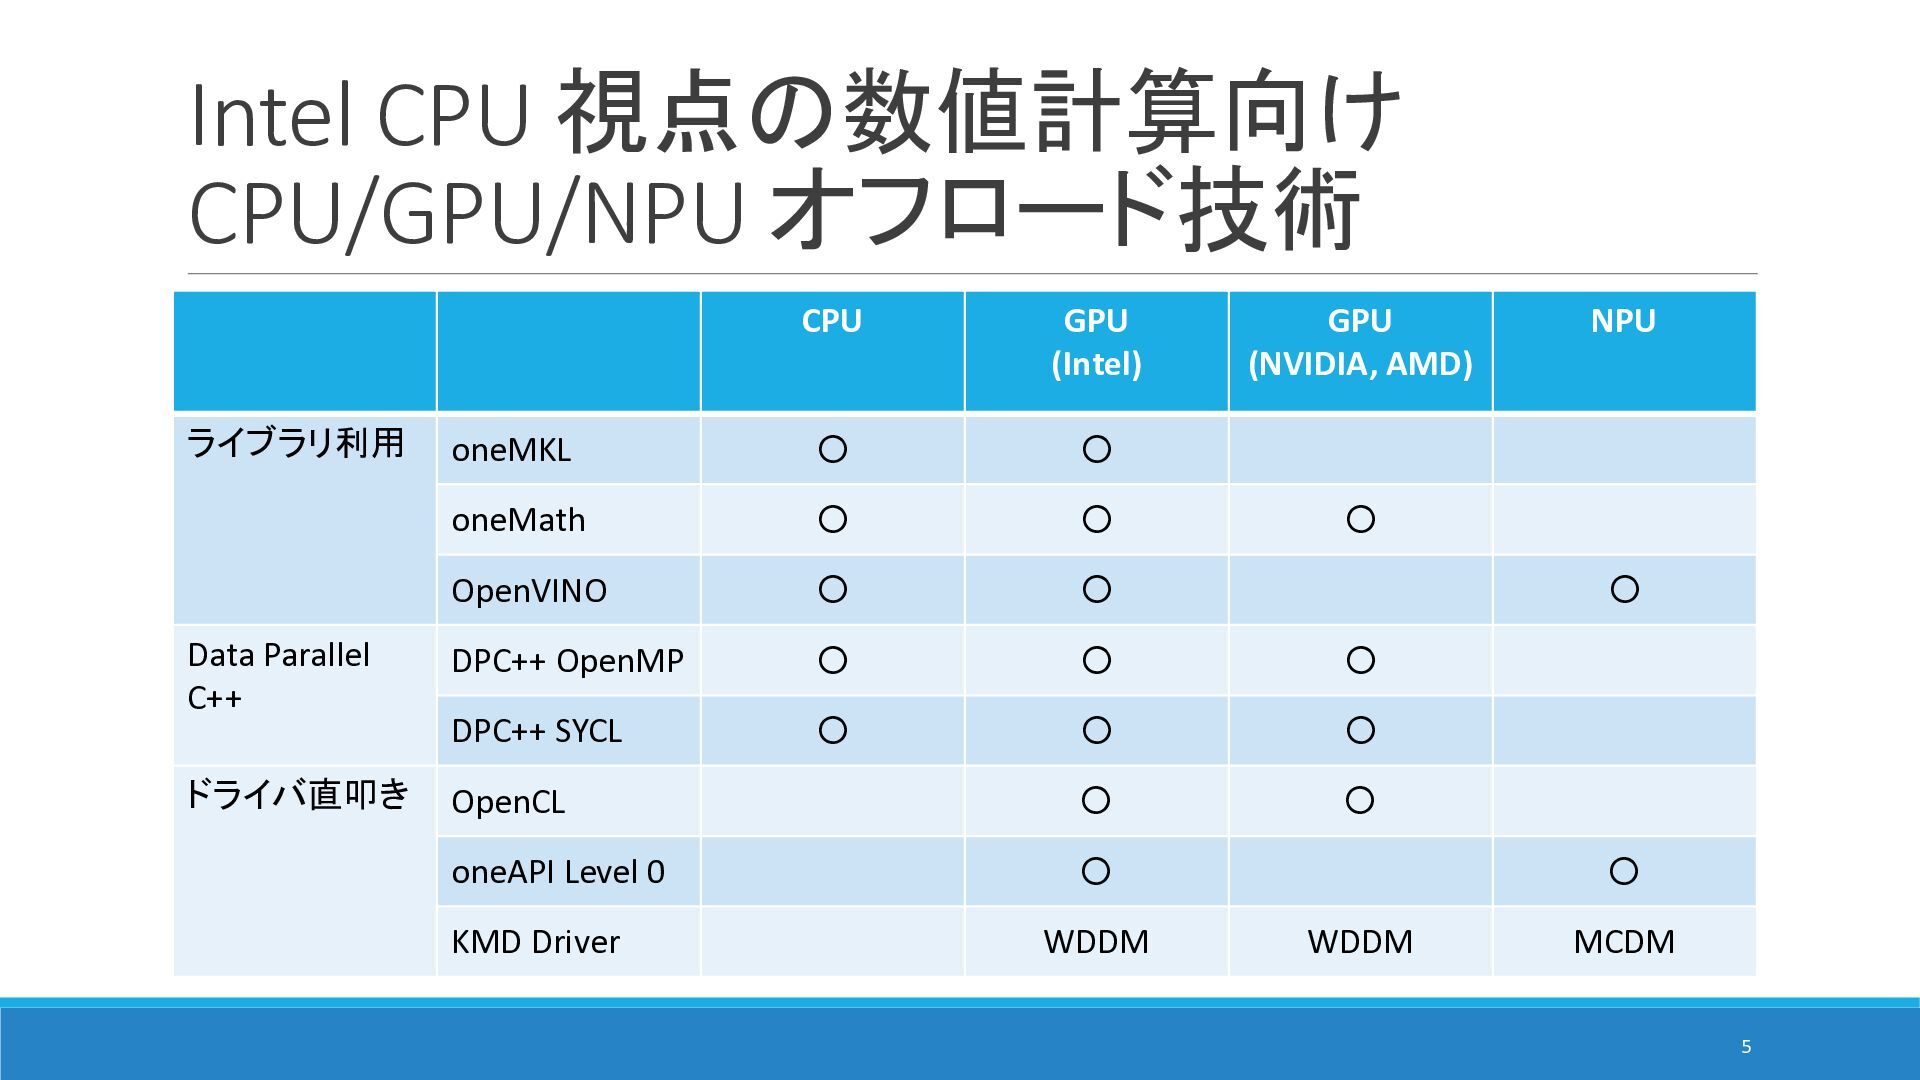
  5. Intel CPU 視点の数値計算向け CPU/GPU/NPU オフロード技術 ライブラリ利用 Data Parallel C++ ドライバ直叩き

    CPU GPU (Intel) GPU (NVIDIA, AMD) oneMKL 〇 〇 oneMath 〇 〇 OpenVINO 〇 〇 DPC++ OpenMP 〇 〇 〇 DPC++ SYCL 〇 〇 〇 OpenCL 〇 〇 oneAPI Level 0 〇 KMD Driver WDDM NPU 〇 〇 〇 WDDM MCDM 5
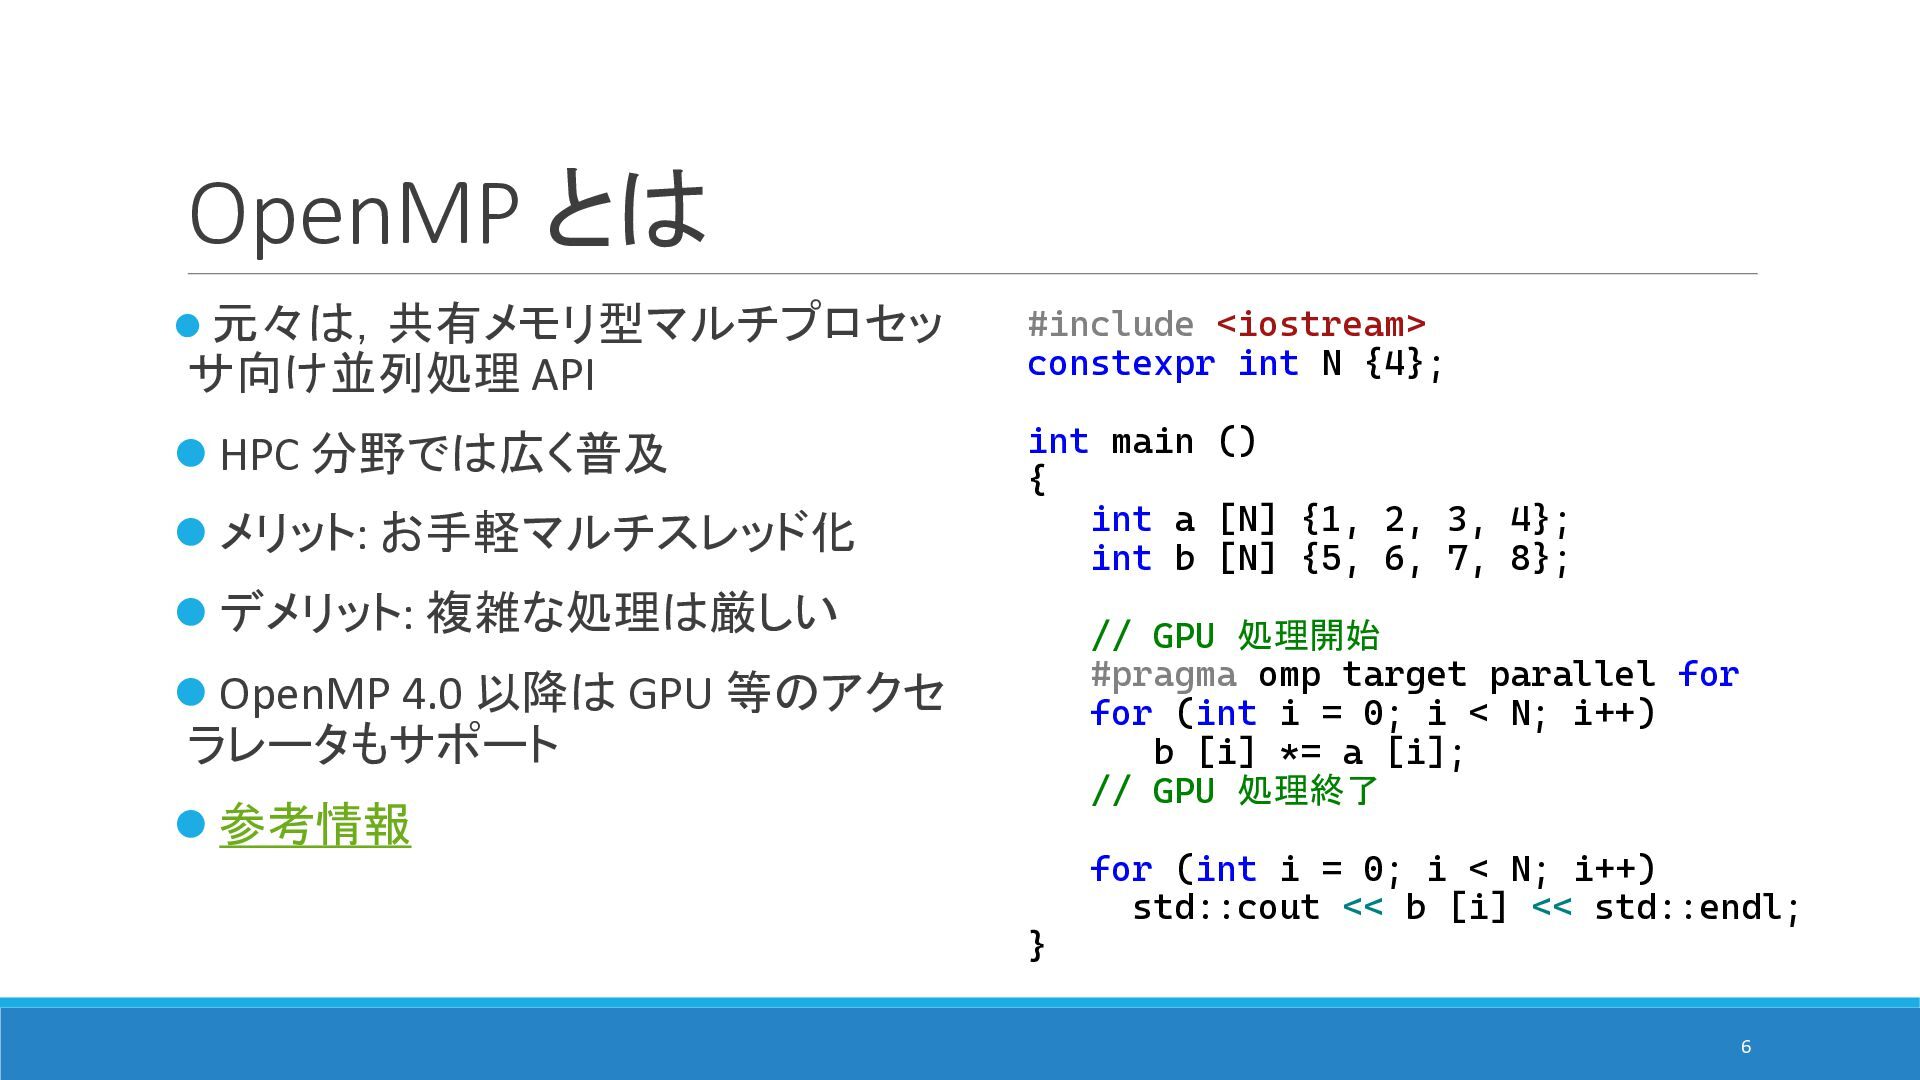
  6. OpenMP とは  元々は,共有メモリ型マルチプロセッ #include <iostream> constexpr int N {4};

     HPC 分野では広く普及 int main () { int a [N] {1, 2, 3, 4}; int b [N] {5, 6, 7, 8}; サ向け並列処理 API  メリット: お手軽マルチスレッド化  デメリット: 複雑な処理は厳しい // GPU 処理開始 #pragma omp target parallel for for (int i = 0; i < N; i++) b [i] *= a [i]; // GPU 処理終了  OpenMP 4.0 以降は GPU 等のアクセ ラレータもサポート  参考情報 } for (int i = 0; i < N; i++) std::cout << b [i] << std::endl; 6
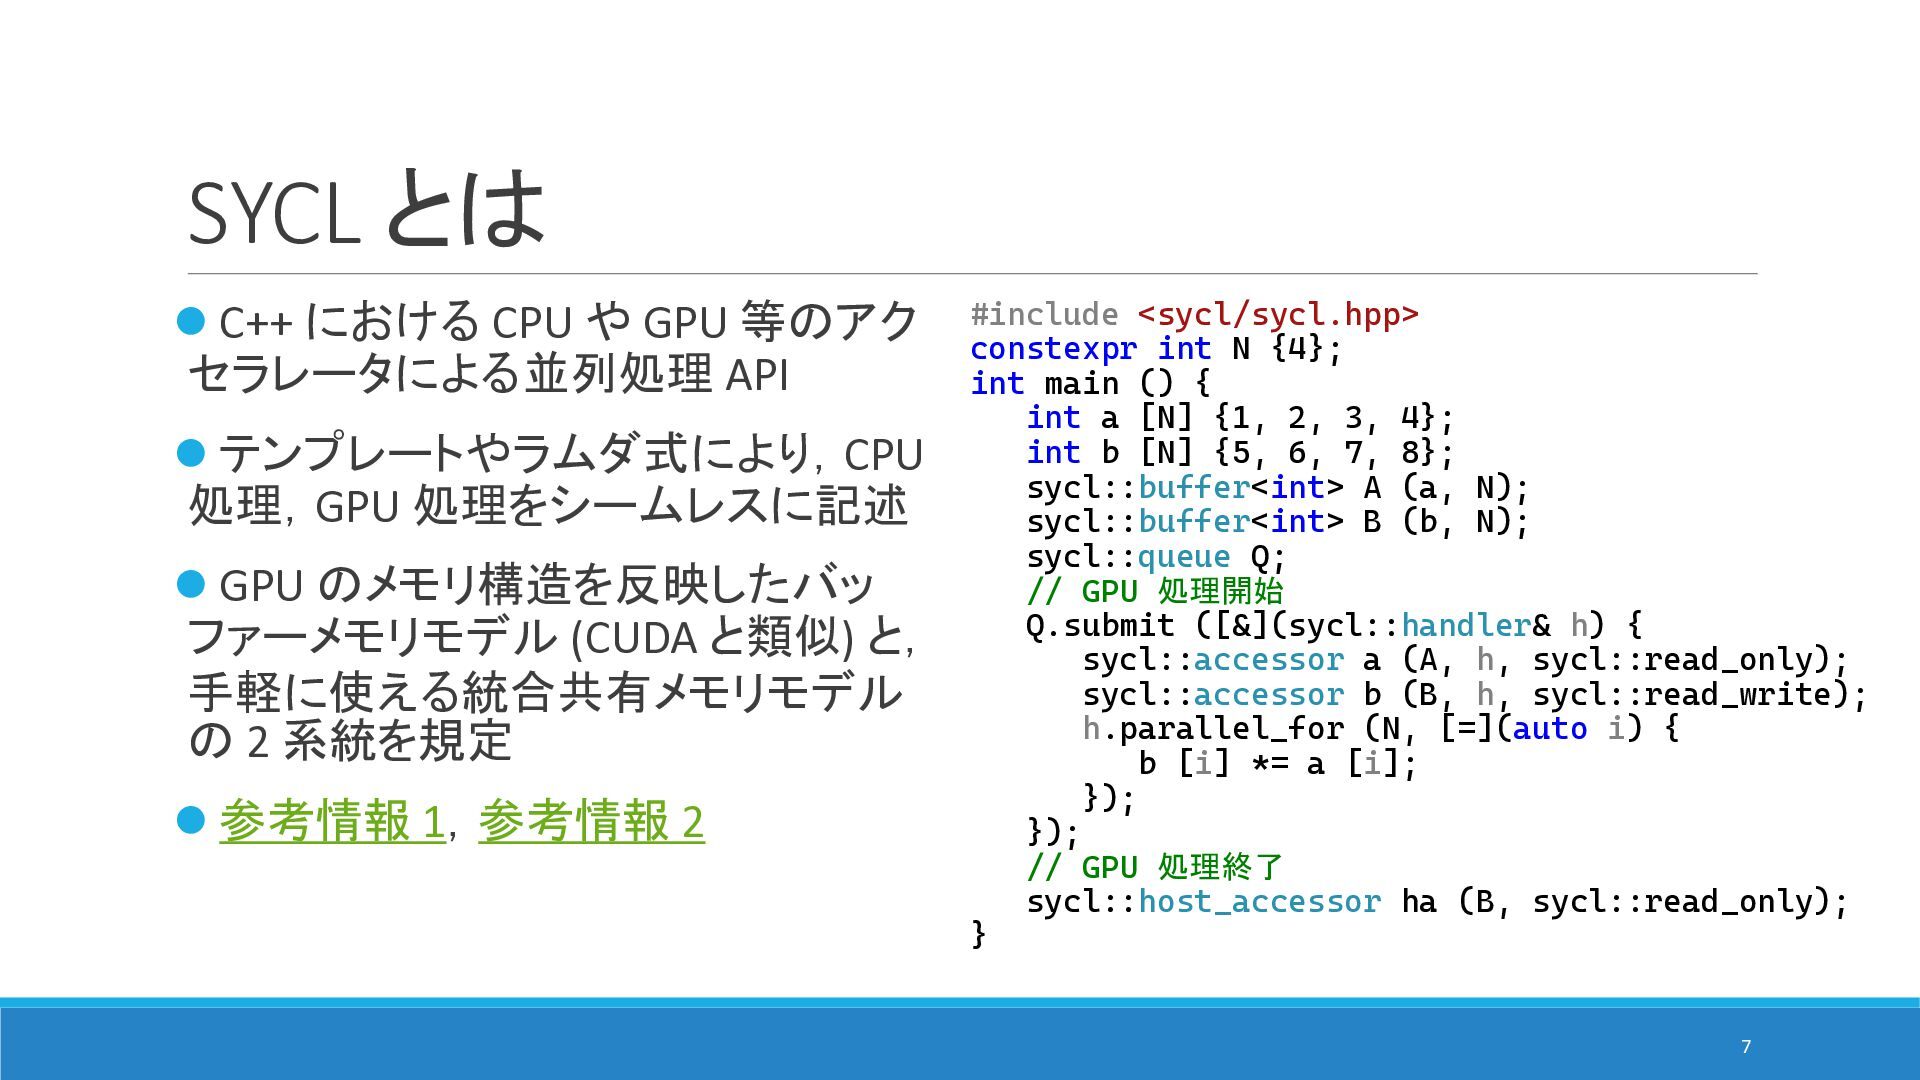
  7. SYCL とは  C++ における CPU や GPU 等のアク セラレータによる並列処理

    API  テンプレートやラムダ式により,CPU 処理,GPU 処理をシームレスに記述  GPU のメモリ構造を反映したバッ ファーメモリモデル (CUDA と類似) と, 手軽に使える統合共有メモリモデル の 2 系統を規定  参考情報 1,参考情報 2 #include <sycl/sycl.hpp> constexpr int N {4}; int main () { int a [N] {1, 2, 3, 4}; int b [N] {5, 6, 7, 8}; sycl::buffer<int> A (a, N); sycl::buffer<int> B (b, N); sycl::queue Q; // GPU 処理開始 Q.submit ([&](sycl::handler& h) { sycl::accessor a (A, h, sycl::read_only); sycl::accessor b (B, h, sycl::read_write); h.parallel_for (N, [=](auto i) { b [i] *= a [i]; }); }); // GPU 処理終了 sycl::host_accessor ha (B, sycl::read_only); } 7
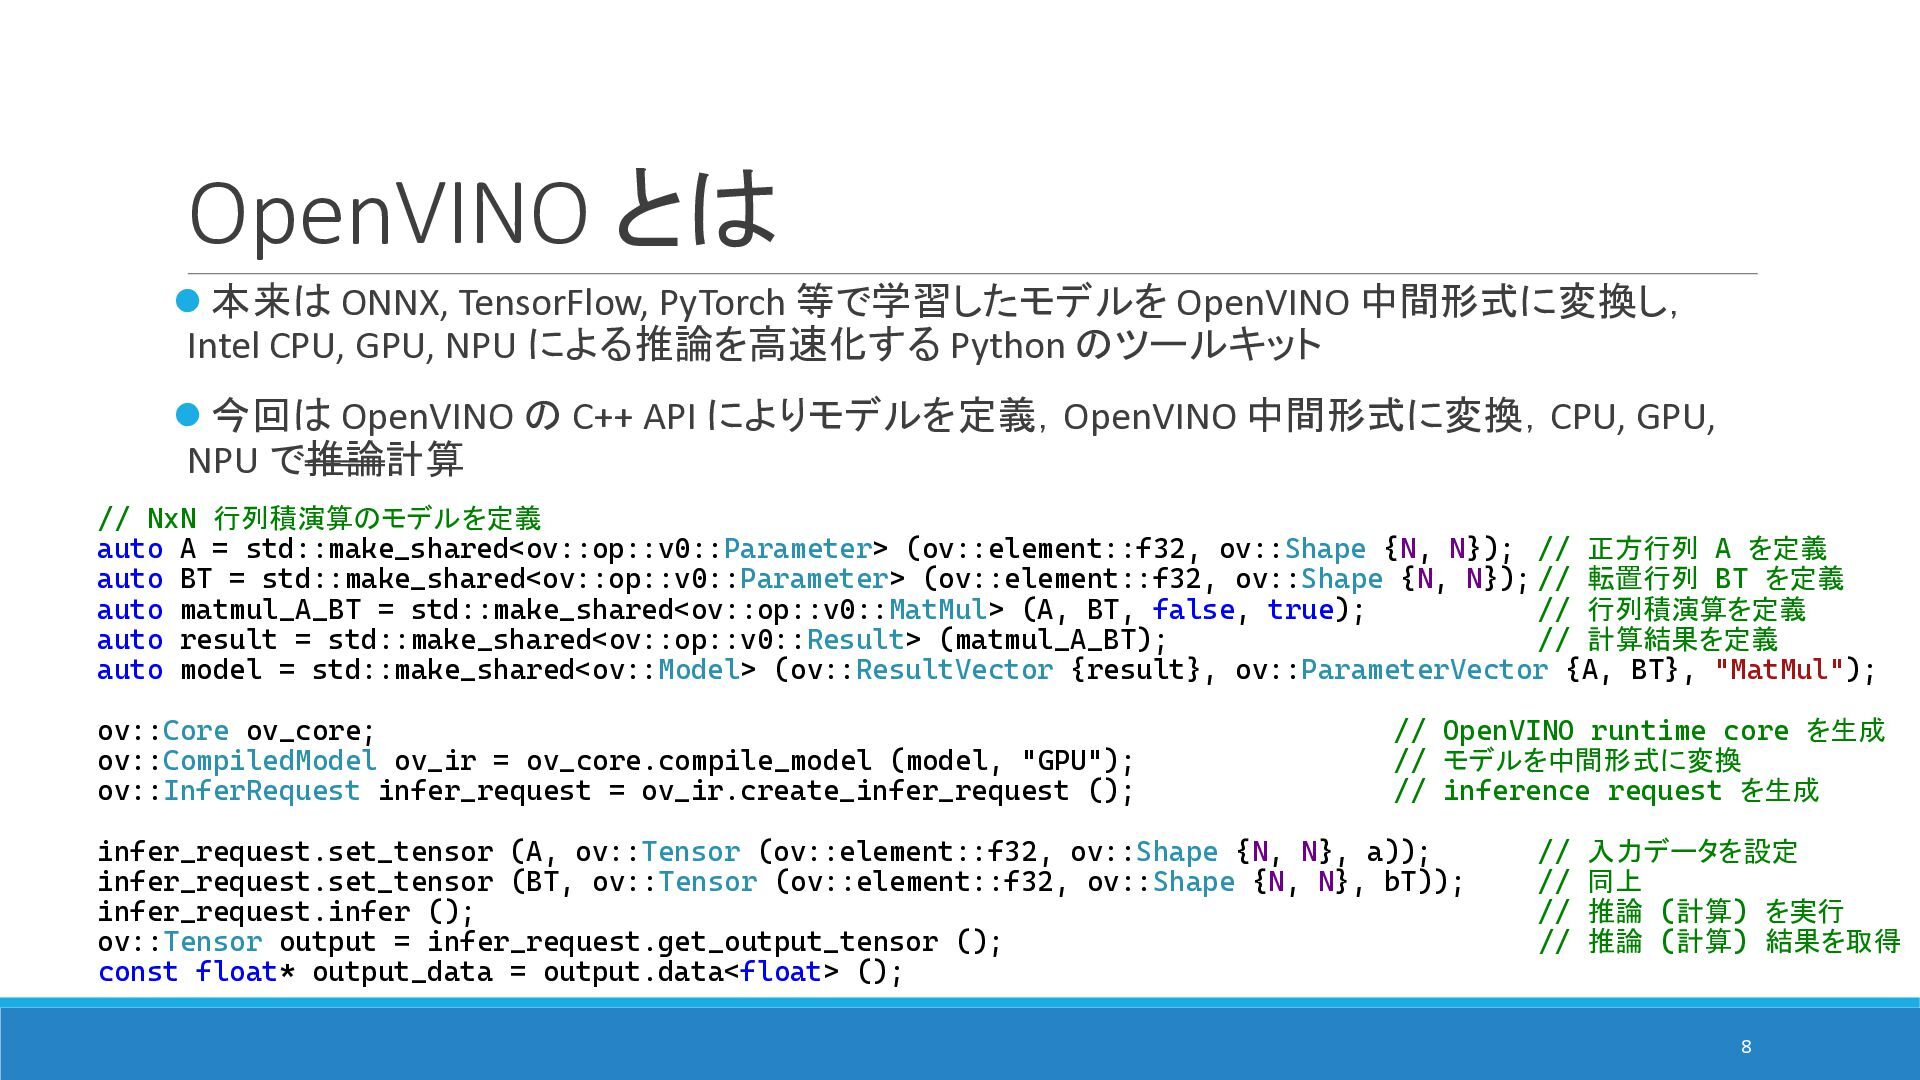
  8. OpenVINO とは  本来は ONNX, TensorFlow, PyTorch 等で学習したモデルを OpenVINO 中間形式に変換し,

    Intel CPU, GPU, NPU による推論を高速化する Python のツールキット  今回は OpenVINO の C++ API によりモデルを定義,OpenVINO 中間形式に変換,CPU, GPU, NPU で推論計算 // NxN 行列積演算のモデルを定義 auto A = std::make_shared<ov::op::v0::Parameter> (ov::element::f32, ov::Shape {N, N}); // 正方行列 A を定義 auto BT = std::make_shared<ov::op::v0::Parameter> (ov::element::f32, ov::Shape {N, N}); // 転置行列 BT を定義 auto matmul_A_BT = std::make_shared<ov::op::v0::MatMul> (A, BT, false, true); // 行列積演算を定義 auto result = std::make_shared<ov::op::v0::Result> (matmul_A_BT); // 計算結果を定義 auto model = std::make_shared<ov::Model> (ov::ResultVector {result}, ov::ParameterVector {A, BT}, "MatMul"); ov::Core ov_core; ov::CompiledModel ov_ir = ov_core.compile_model (model, "GPU"); ov::InferRequest infer_request = ov_ir.create_infer_request (); // OpenVINO runtime core を生成 // モデルを中間形式に変換 // inference request を生成 infer_request.set_tensor (A, ov::Tensor (ov::element::f32, ov::Shape {N, N}, a)); infer_request.set_tensor (BT, ov::Tensor (ov::element::f32, ov::Shape {N, N}, bT)); infer_request.infer (); ov::Tensor output = infer_request.get_output_tensor (); const float* output_data = output.data<float> (); // 入力データを設定 // 同上 // 推論 (計算) を実行 // 推論 (計算) 結果を取得 8
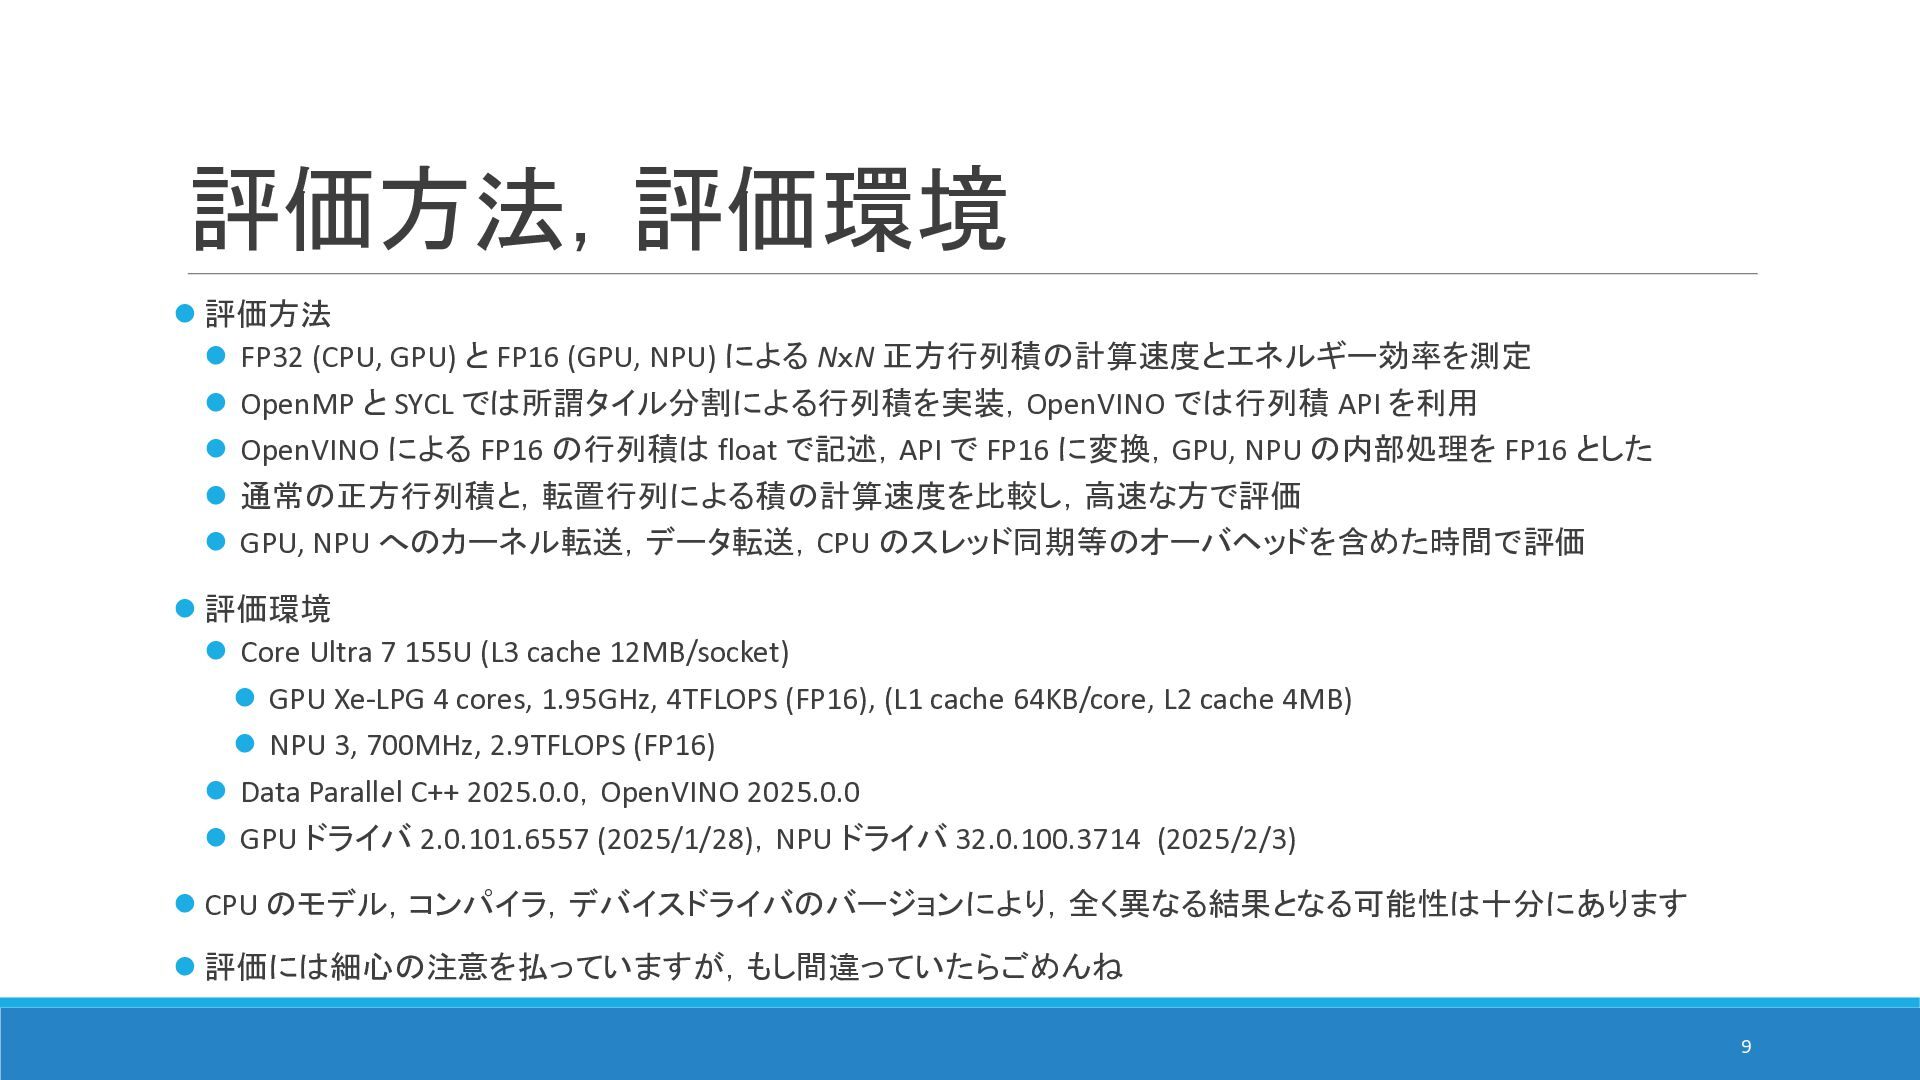
  9. 評価方法,評価環境  評価方法  FP32 (CPU, GPU) と FP16 (GPU,

    NPU) による NxN 正方行列積の計算速度とエネルギー効率を測定  OpenMP と SYCL では所謂タイル分割による行列積を実装,OpenVINO では行列積 API を利用  OpenVINO による FP16 の行列積は float で記述,API で FP16 に変換,GPU, NPU の内部処理を FP16 とした  通常の正方行列積と,転置行列による積の計算速度を比較し,高速な方で評価  GPU, NPU へのカーネル転送,データ転送,CPU のスレッド同期等のオーバヘッドを含めた時間で評価  評価環境  Core Ultra 7 155U (L3 cache 12MB/socket)  GPU Xe-LPG 4 cores, 1.95GHz, 4TFLOPS (FP16), (L1 cache 64KB/core, L2 cache 4MB)  NPU 3, 700MHz, 2.9TFLOPS (FP16)  Data Parallel C++ 2025.0.0,OpenVINO 2025.0.0  GPU ドライバ 2.0.101.6557 (2025/1/28),NPU ドライバ 32.0.100.3714 (2025/2/3)  CPU のモデル,コンパイラ,デバイスドライバのバージョンにより,全く異なる結果となる可能性は十分にあります  評価には細心の注意を払っていますが,もし間違っていたらごめんね 9
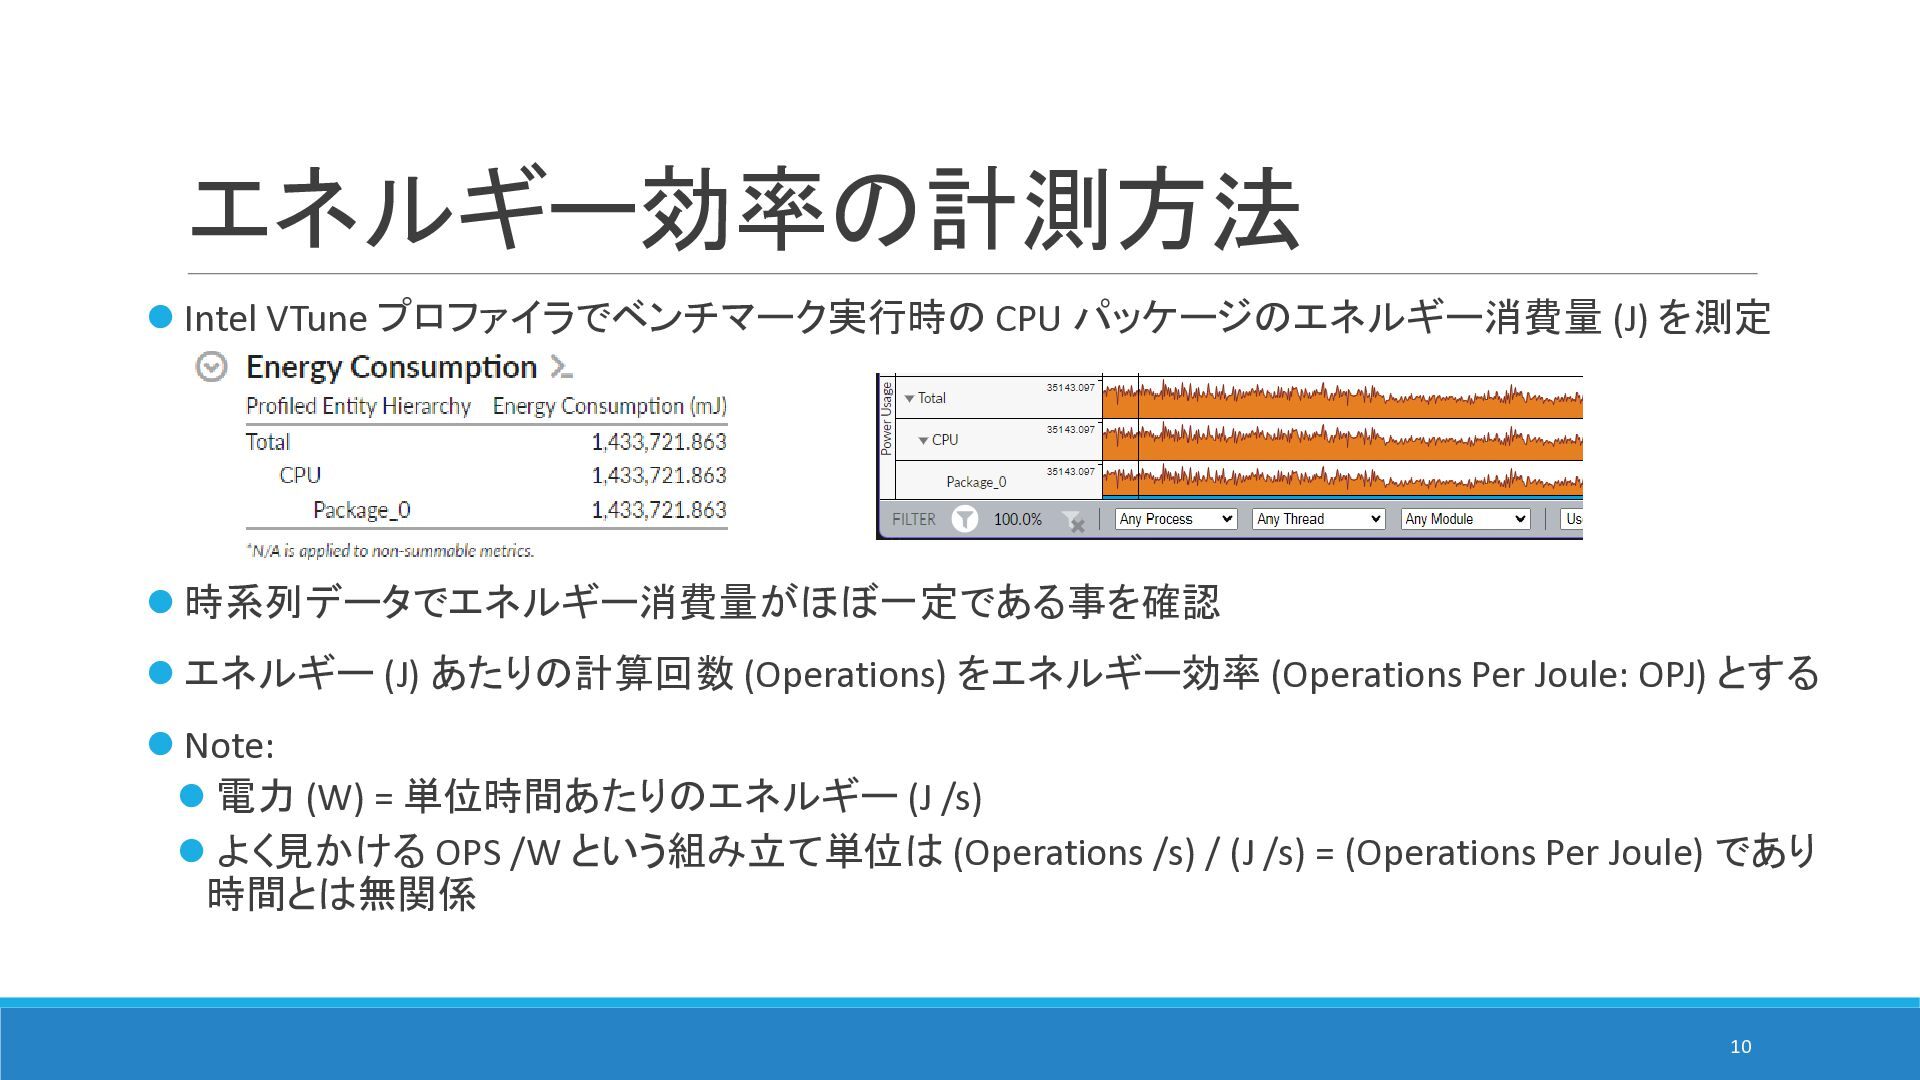
  10. エネルギー効率の計測方法  Intel VTune プロファイラでベンチマーク実行時の CPU パッケージのエネルギー消費量 (J) を測定 

    時系列データでエネルギー消費量がほぼ一定である事を確認  エネルギー (J) あたりの計算回数 (Operations) をエネルギー効率 (Operations Per Joule: OPJ) とする  Note:  電力 (W) = 単位時間あたりのエネルギー (J /s)  よく見かける OPS /W という組み立て単位は (Operations /s) / (J /s) = (Operations Per Joule) であり 時間とは無関係 10
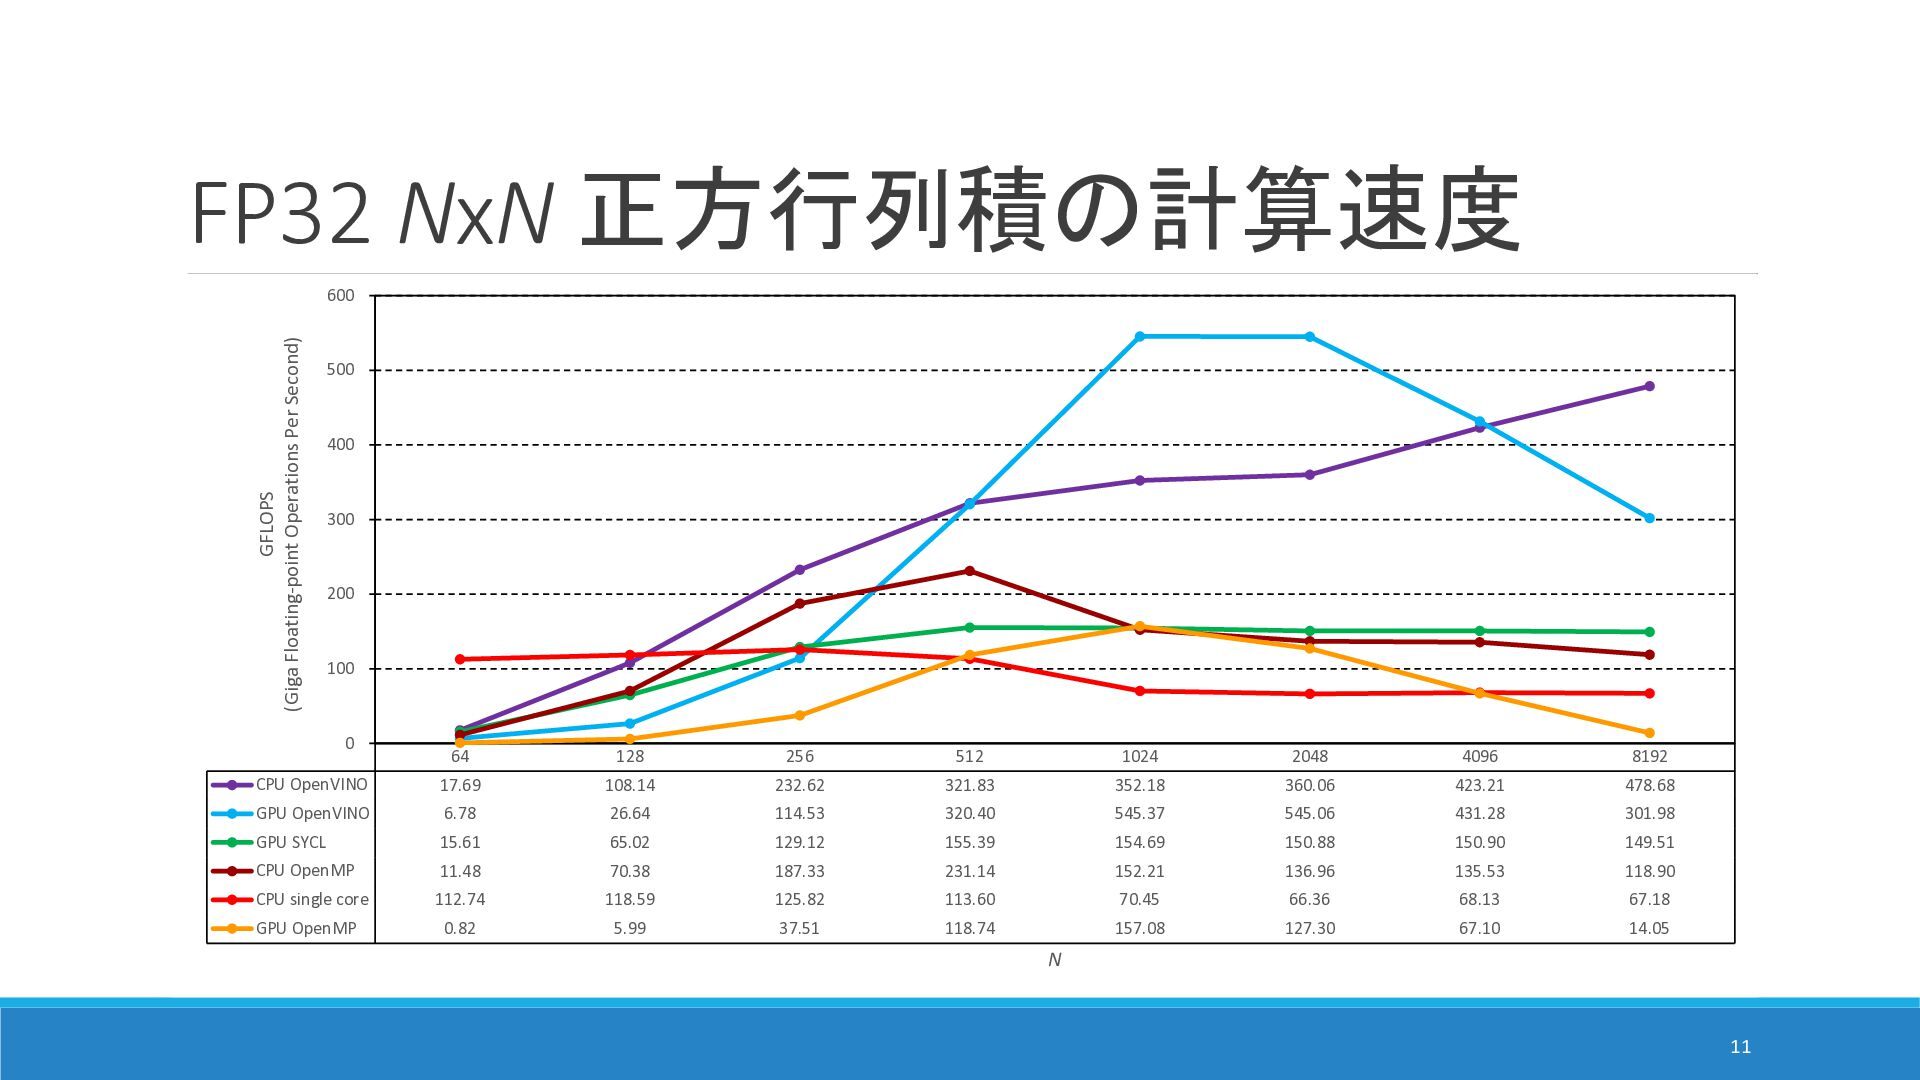
  11. FP32 NxN 正方行列積の計算速度 GFLOPS (Giga Floating-point Operations Per Second) 600

    500 400 300 200 100 0 64 128 256 512 1024 2048 4096 8192 CPU OpenVINO 17.69 108.14 232.62 321.83 352.18 360.06 423.21 478.68 GPU OpenVINO 6.78 26.64 114.53 320.40 545.37 545.06 431.28 301.98 GPU SYCL 15.61 65.02 129.12 155.39 154.69 150.88 150.90 149.51 CPU OpenMP 11.48 70.38 187.33 231.14 152.21 136.96 135.53 118.90 CPU single core 112.74 118.59 125.82 113.60 70.45 66.36 68.13 67.18 GPU OpenMP 0.82 5.99 37.51 118.74 157.08 127.30 67.10 14.05 N 11
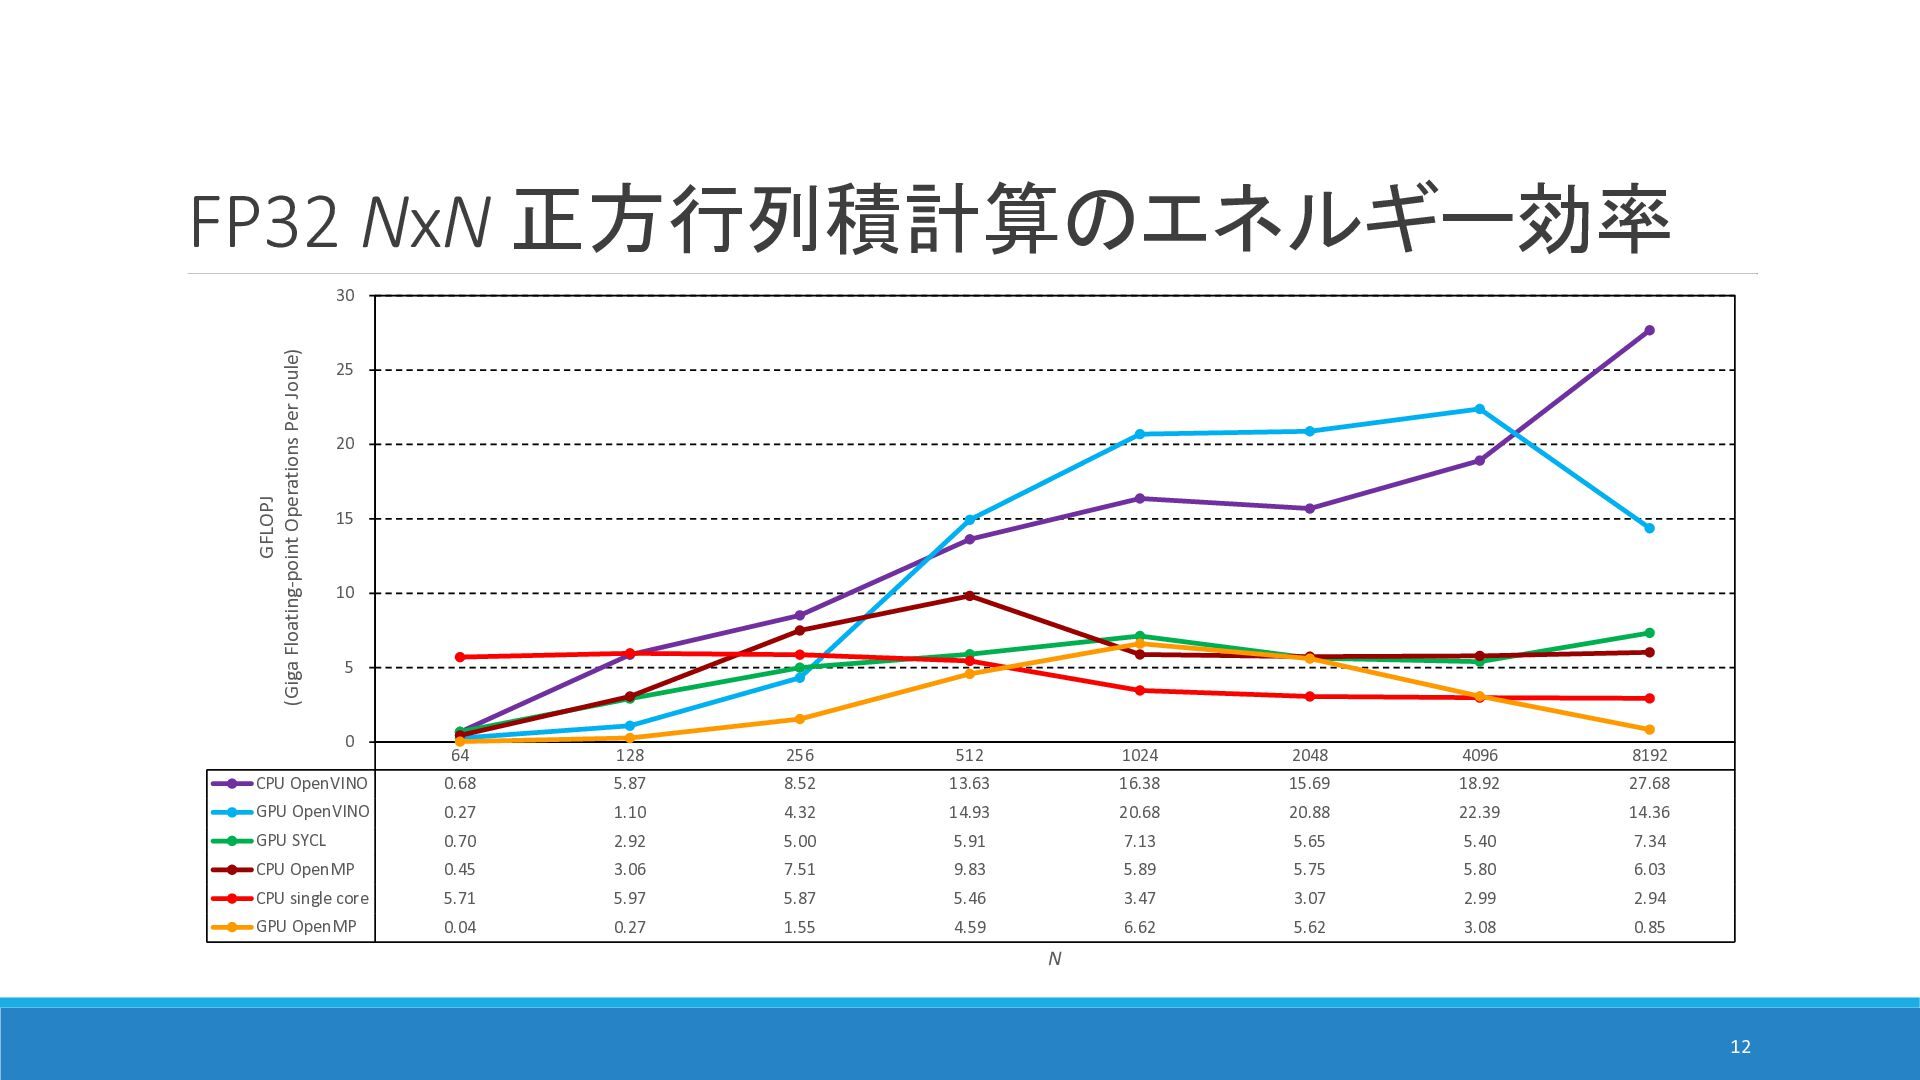
  12. FP32 NxN 正方行列積計算のエネルギー効率 GFLOPJ (Giga Floating-point Operations Per Joule) 30

    25 20 15 10 5 0 64 128 256 512 1024 2048 4096 8192 CPU OpenVINO 0.68 5.87 8.52 13.63 16.38 15.69 18.92 27.68 GPU OpenVINO 0.27 1.10 4.32 14.93 20.68 20.88 22.39 14.36 GPU SYCL 0.70 2.92 5.00 5.91 7.13 5.65 5.40 7.34 CPU OpenMP 0.45 3.06 7.51 9.83 5.89 5.75 5.80 6.03 CPU single core 5.71 5.97 5.87 5.46 3.47 3.07 2.99 2.94 GPU OpenMP 0.04 0.27 1.55 4.59 6.62 5.62 3.08 0.85 N 12
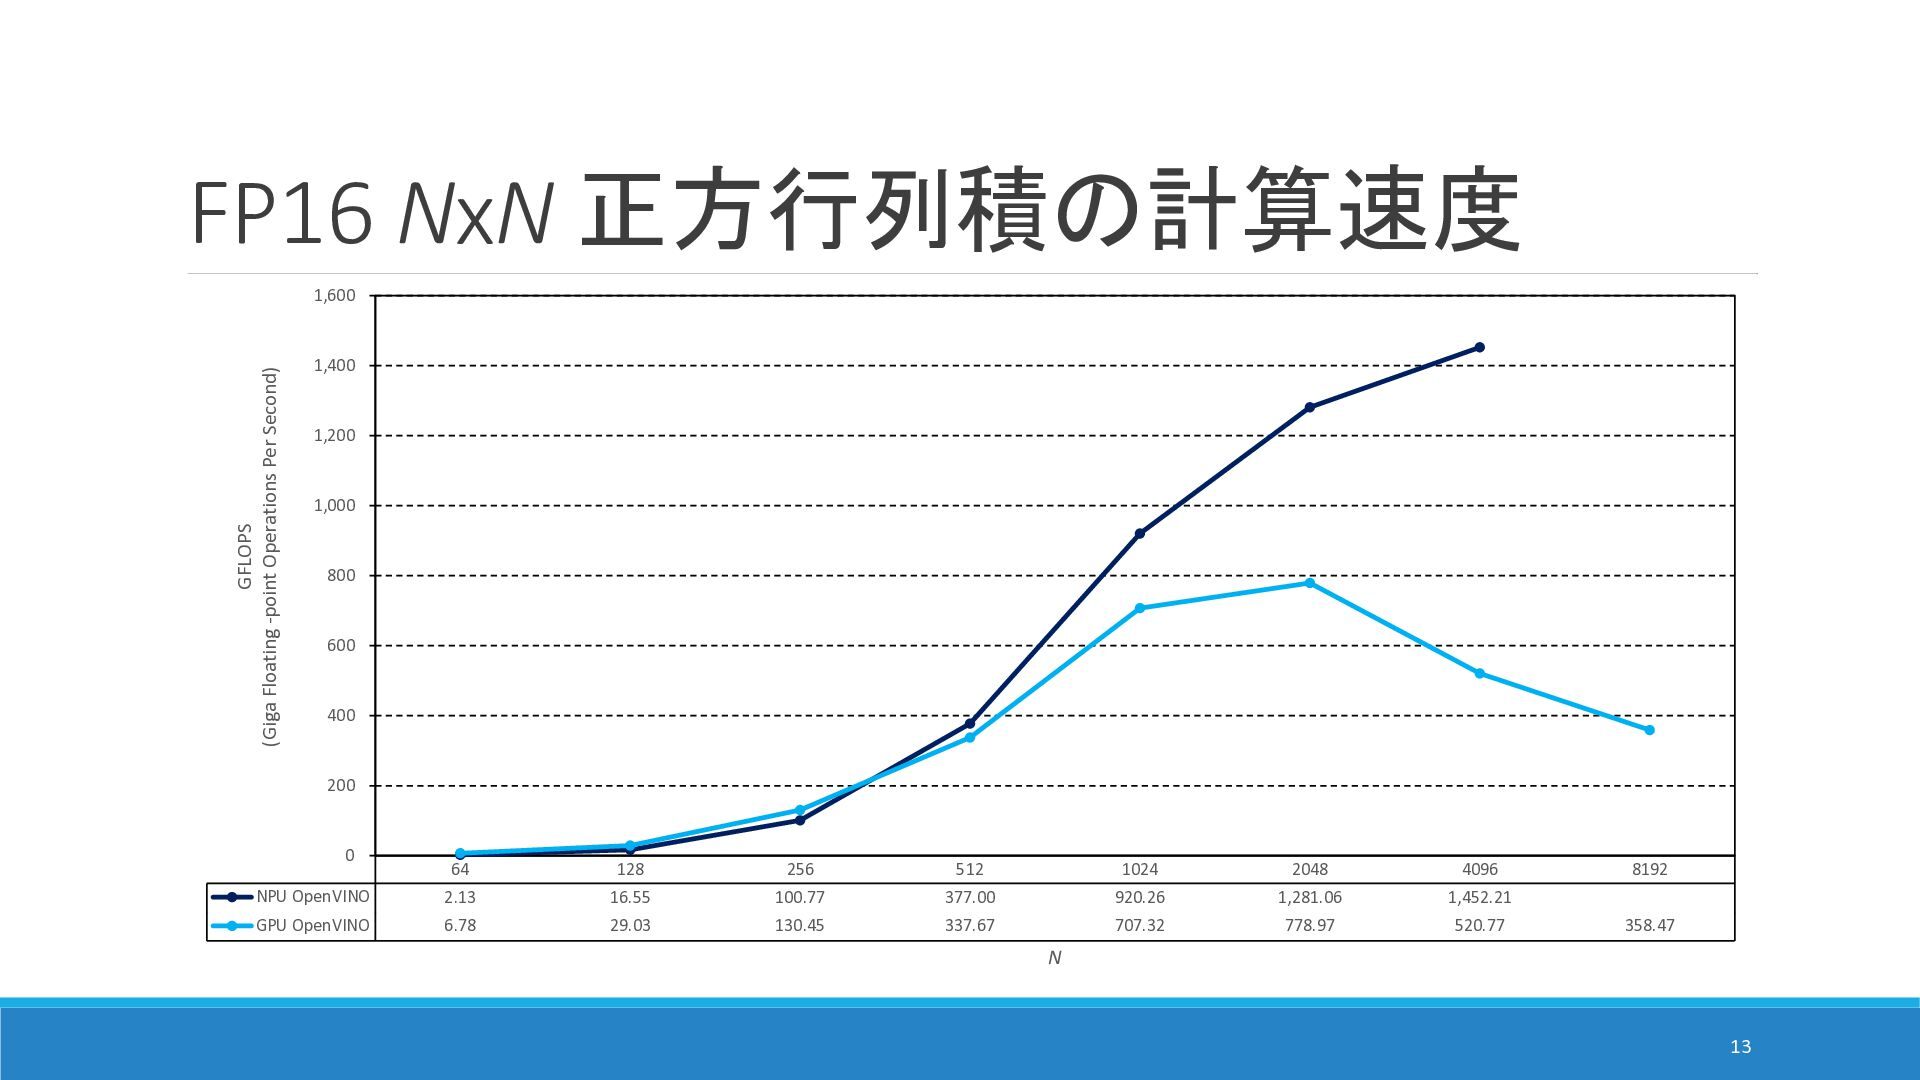
  13. FP16 NxN 正方行列積の計算速度 GFLOPS (Giga Floating -point Operations Per Second)

    1,600 1,400 1,200 1,000 800 600 400 200 0 64 128 256 512 1024 2048 4096 NPU OpenVINO 2.13 16.55 100.77 377.00 920.26 1,281.06 1,452.21 GPU OpenVINO 6.78 29.03 130.45 337.67 707.32 778.97 520.77 8192 358.47 N 13
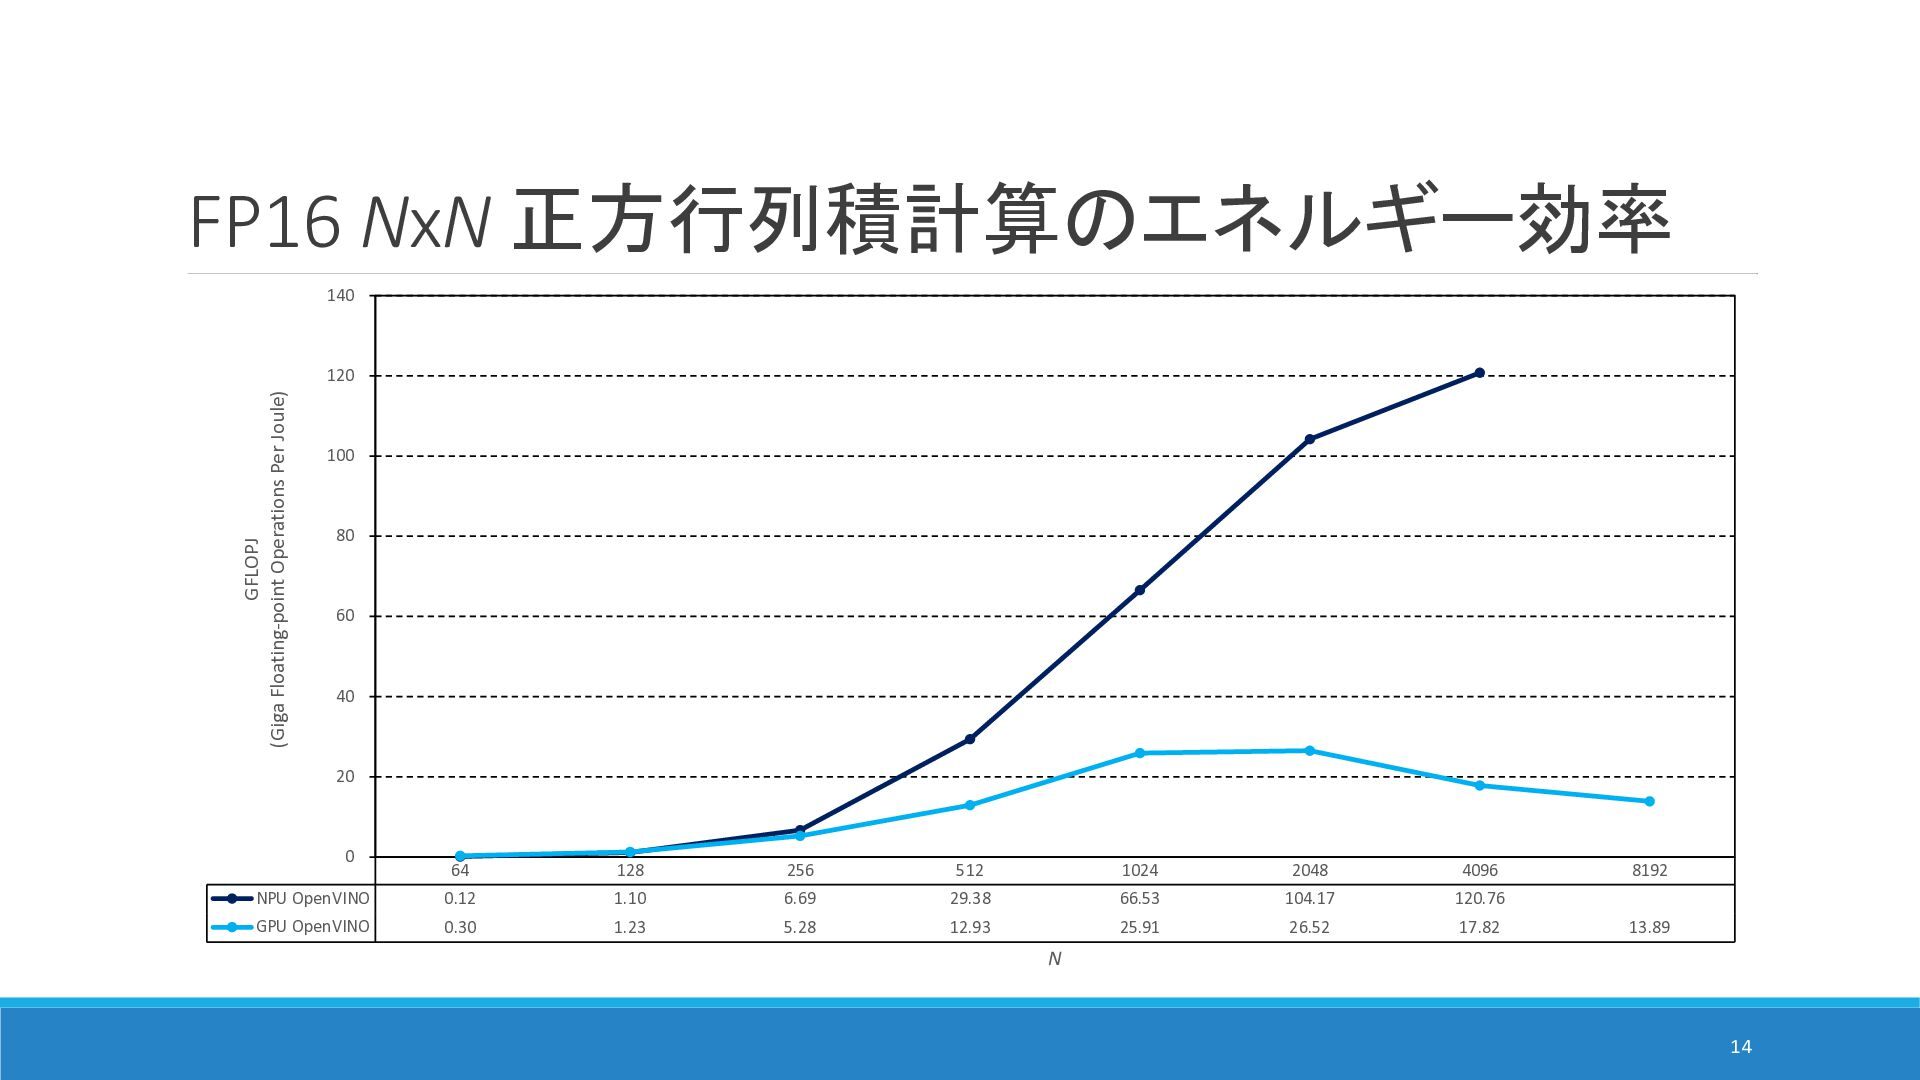
  14. FP16 NxN 正方行列積計算のエネルギー効率 140 GFLOPJ (Giga Floating-point Operations Per Joule)

    120 100 80 60 40 20 0 64 128 256 512 1024 2048 4096 NPU OpenVINO 0.12 1.10 6.69 29.38 66.53 104.17 120.76 GPU OpenVINO 0.30 1.23 5.28 12.93 25.91 26.52 17.82 8192 13.89 N 14
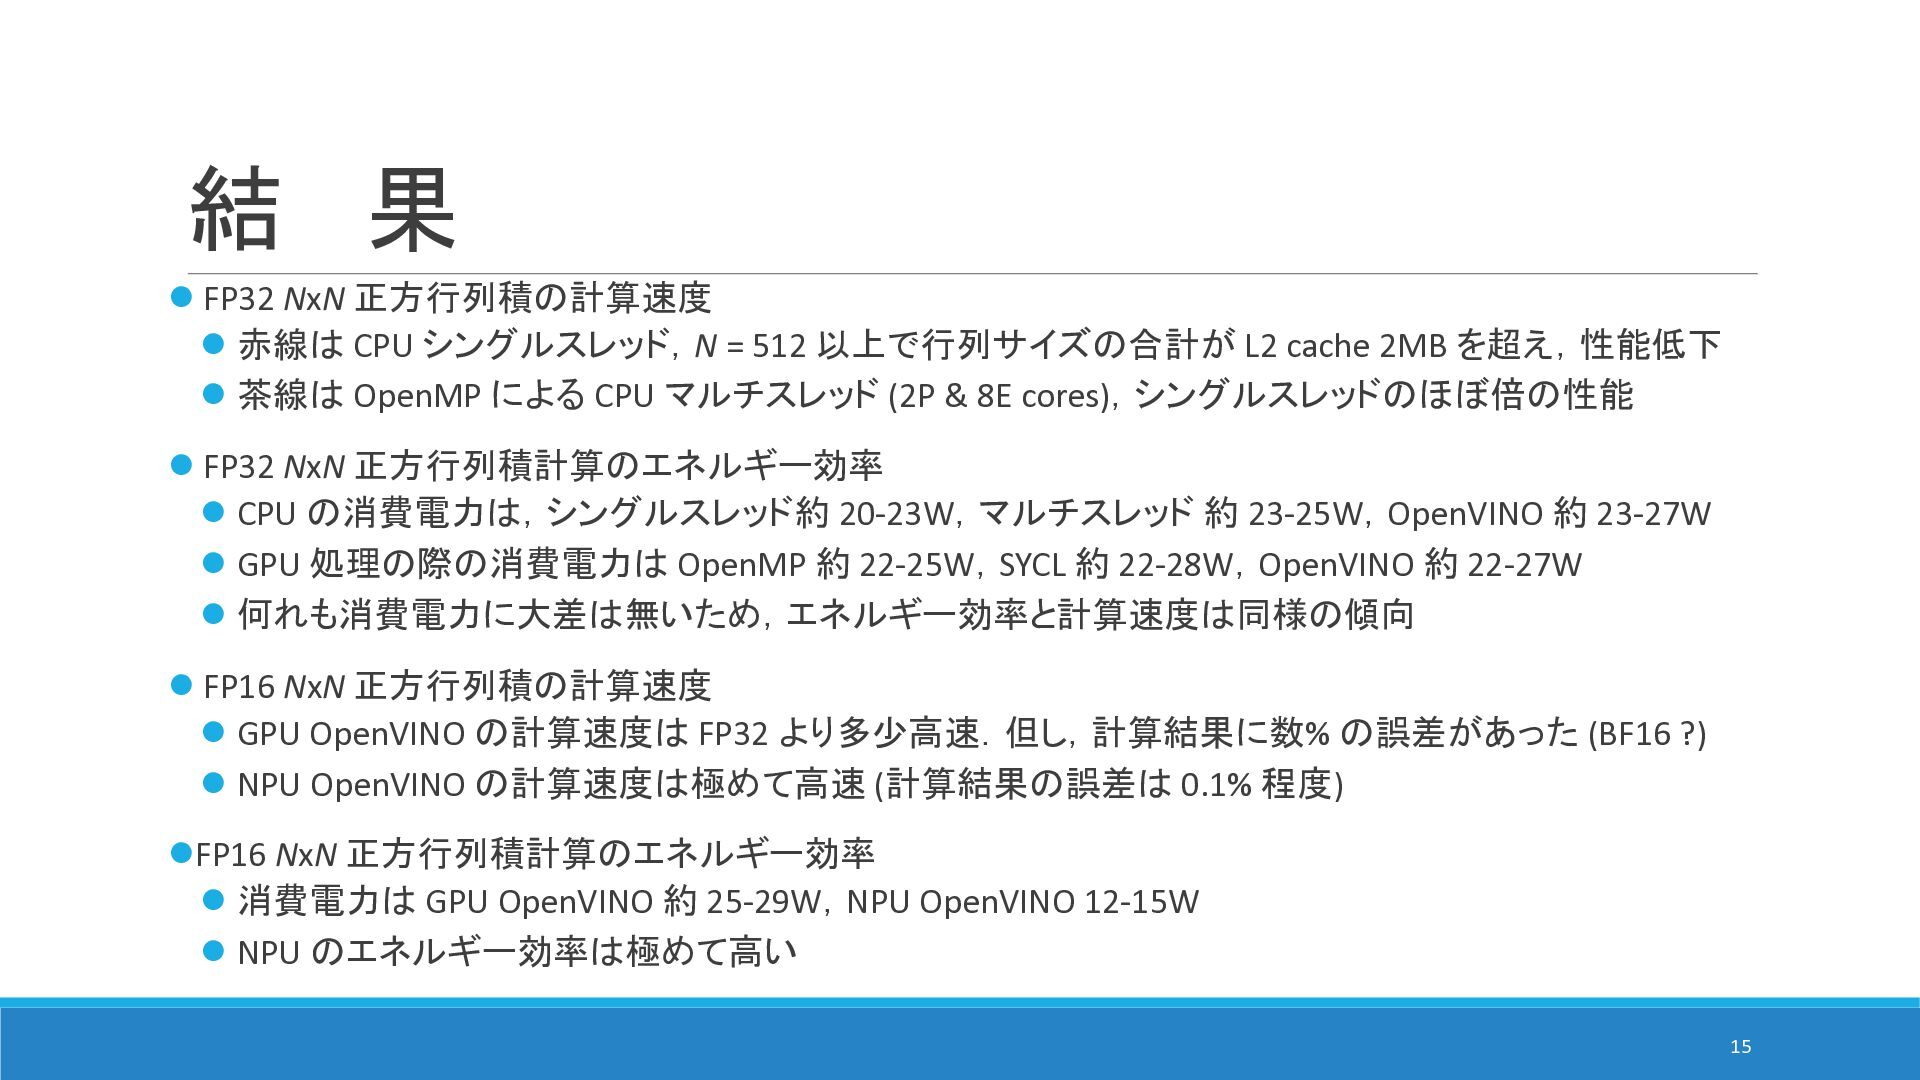
  15. 結 果  FP32 NxN 正方行列積の計算速度  赤線は CPU シングルスレッド,N

    = 512 以上で行列サイズの合計が L2 cache 2MB を超え,性能低下  茶線は OpenMP による CPU マルチスレッド (2P & 8E cores),シングルスレッドのほぼ倍の性能  FP32 NxN 正方行列積計算のエネルギー効率  CPU の消費電力は,シングルスレッド約 20-23W,マルチスレッド 約 23-25W,OpenVINO 約 23-27W  GPU 処理の際の消費電力は OpenMP 約 22-25W,SYCL 約 22-28W,OpenVINO 約 22-27W  何れも消費電力に大差は無いため,エネルギー効率と計算速度は同様の傾向  FP16 NxN 正方行列積の計算速度  GPU OpenVINO の計算速度は FP32 より多少高速.但し,計算結果に数% の誤差があった (BF16 ?)  NPU OpenVINO の計算速度は極めて高速 (計算結果の誤差は 0.1% 程度) FP16 NxN 正方行列積計算のエネルギー効率  消費電力は GPU OpenVINO 約 25-29W,NPU OpenVINO 12-15W  NPU のエネルギー効率は極めて高い 15
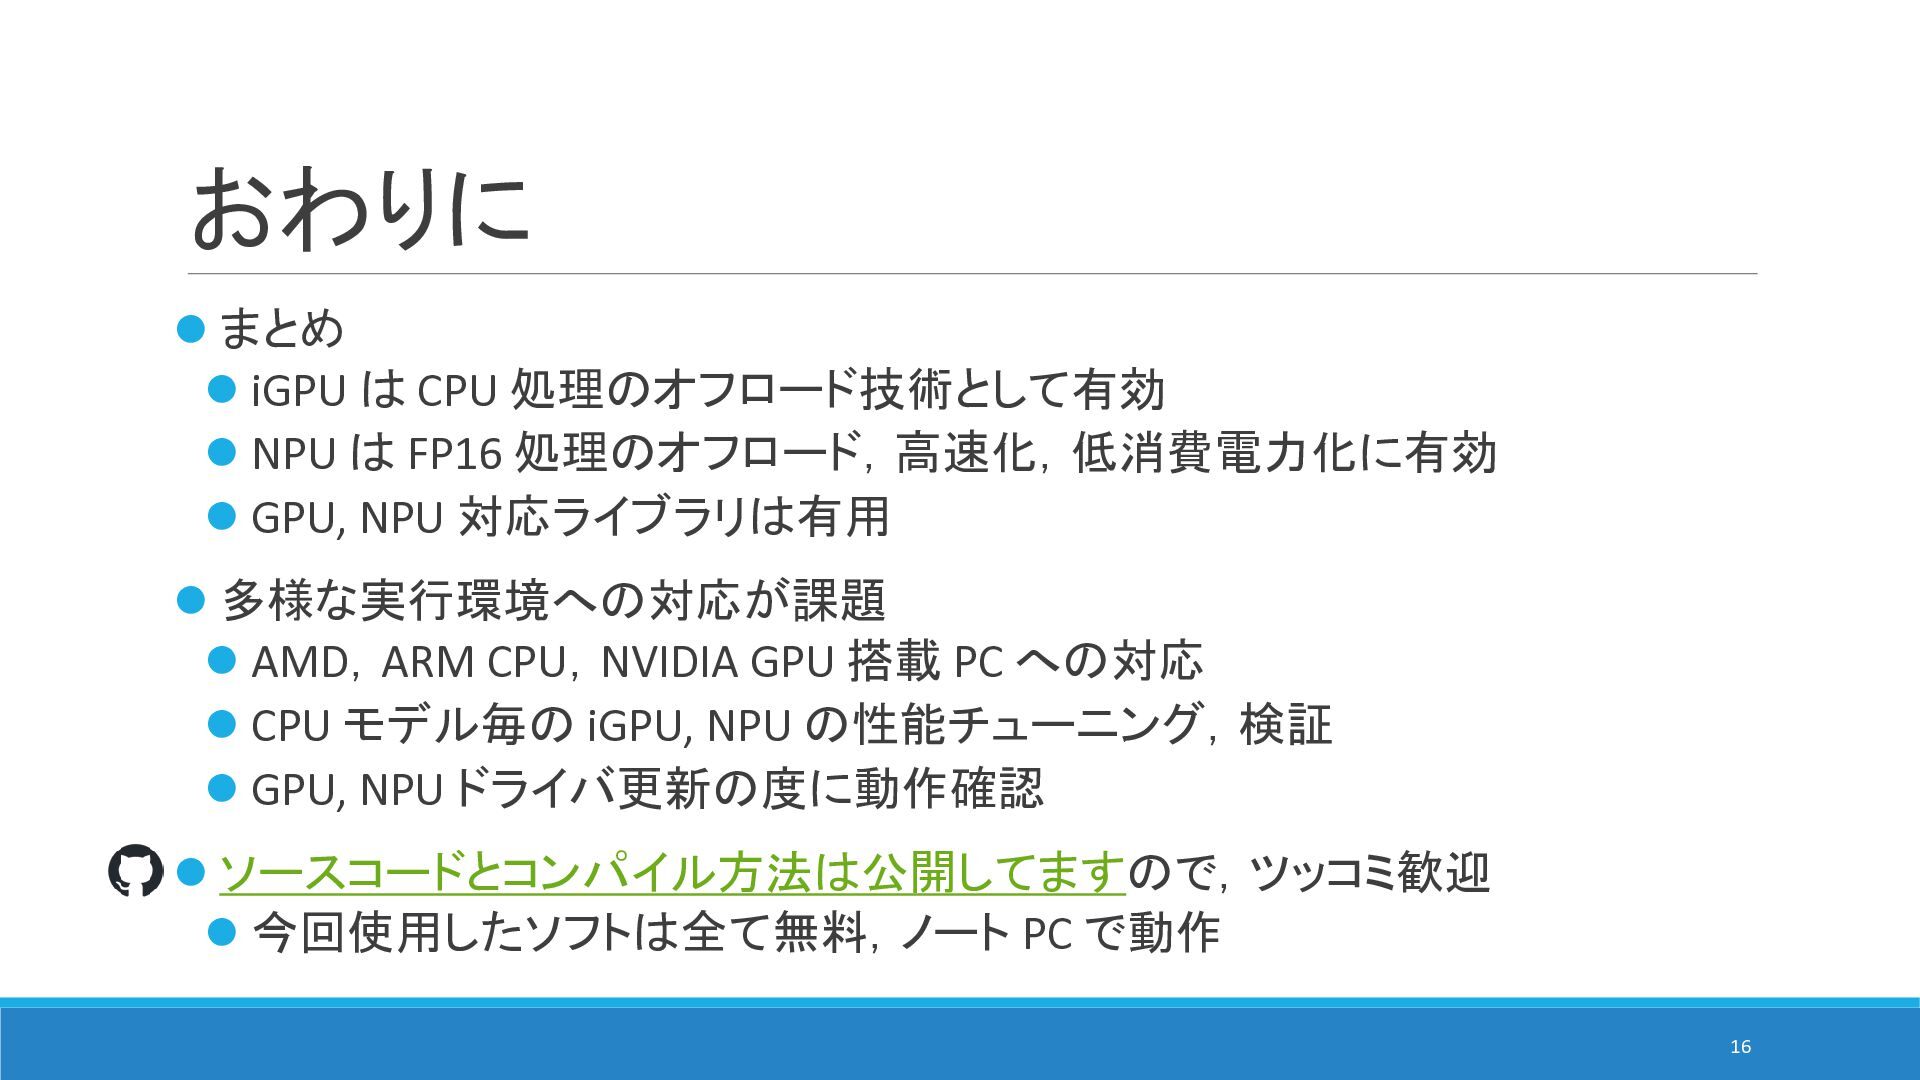
  16. おわりに  まとめ  iGPU は CPU 処理のオフロード技術として有効  NPU

    は FP16 処理のオフロード,高速化,低消費電力化に有効  GPU, NPU 対応ライブラリは有用  多様な実行環境への対応が課題  AMD,ARM CPU,NVIDIA GPU 搭載 PC への対応  CPU モデル毎の iGPU, NPU の性能チューニング,検証  GPU, NPU ドライバ更新の度に動作確認  ソースコードとコンパイル方法は公開してますので,ツッコミ歓迎  今回使用したソフトは全て無料,ノート PC で動作 16
  17. 参考資料  Intel Data Parallel C++  Get Started Guide

     Intel® oneAPI Programming Guide  oneAPI DPC++ Compiler and Runtime architecture design  Developer Guide and Reference  Intel OpenVINO  OpenVINO Runtime API Tutorial  Running and Integrating Inference Pipeline  Model Representation in OpenVINO Runtime  Interactive Tutorials (Python) 17
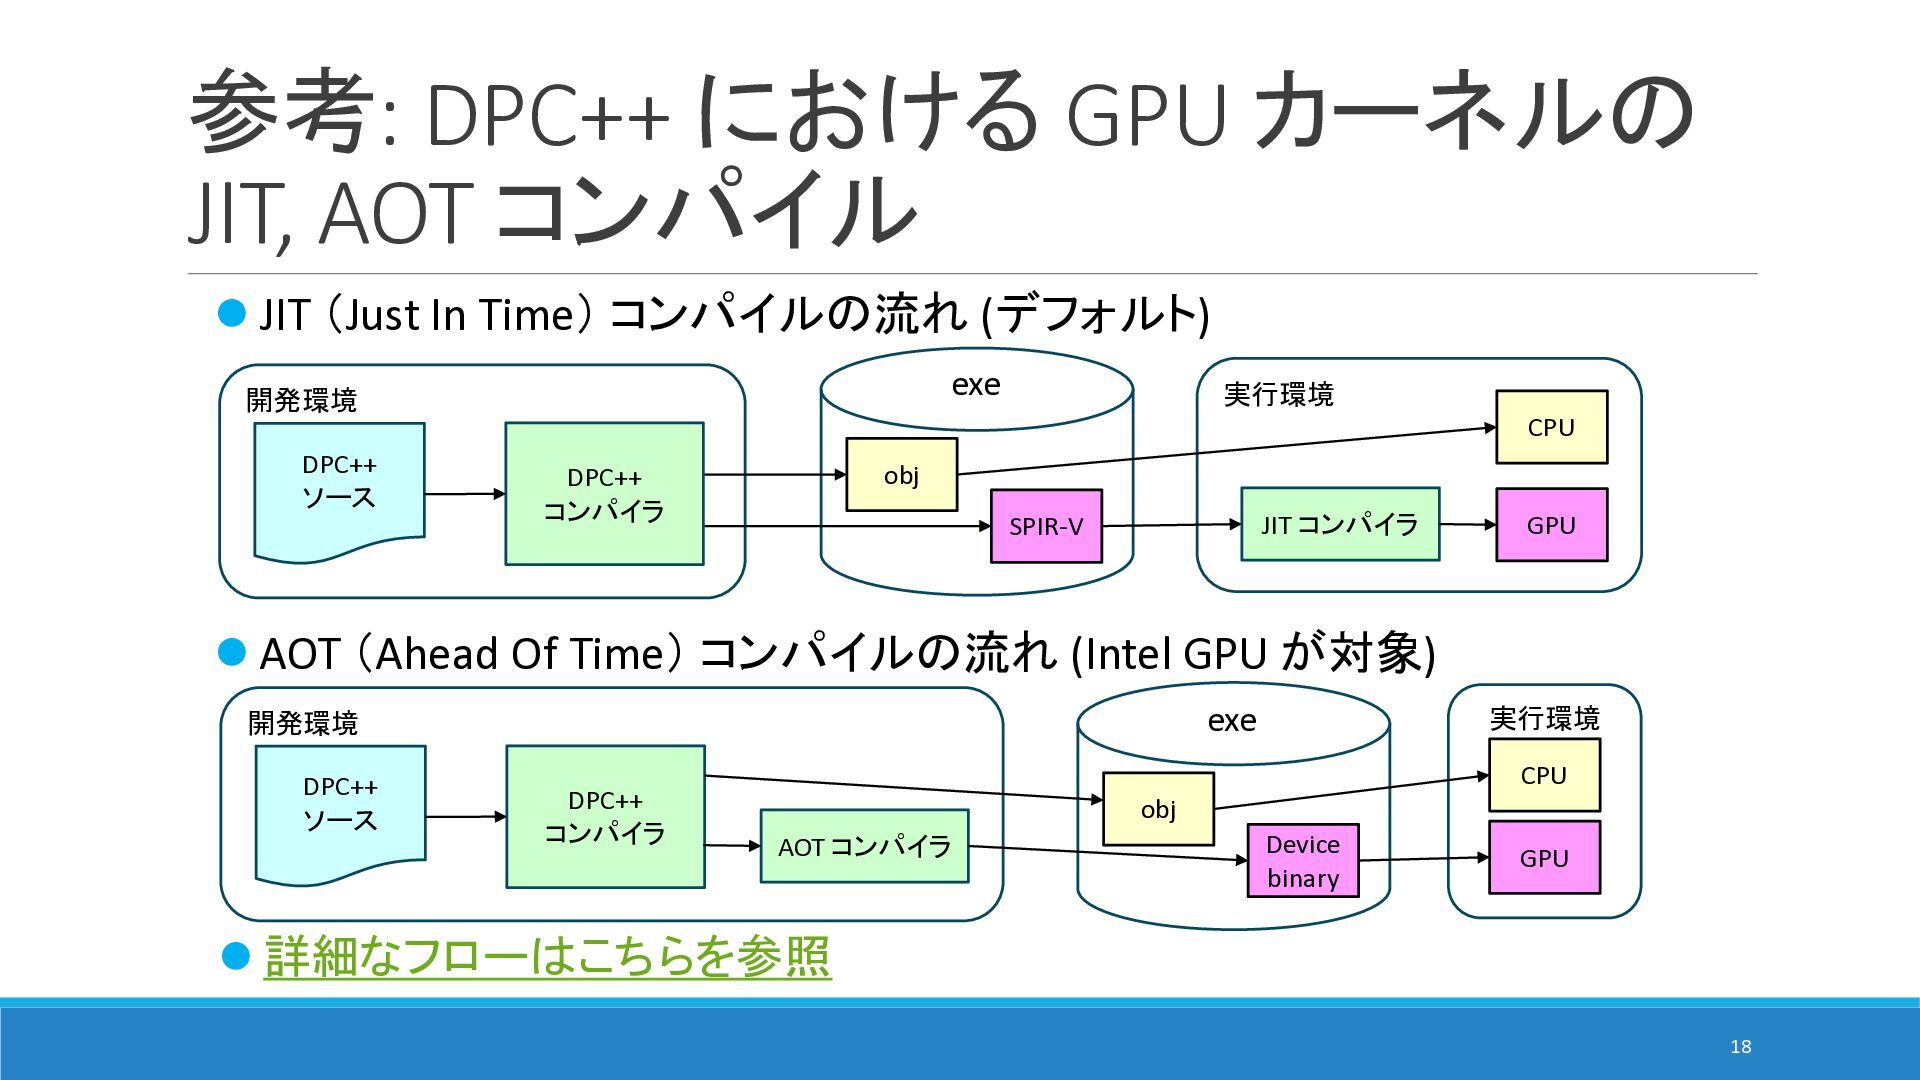
  18. 参考: DPC++ における GPU カーネルの JIT, AOT コンパイル  JIT

    (Just In Time) コンパイルの流れ (デフォルト) exe 開発環境 DPC++ ソース 実行環境 CPU obj DPC++ コンパイラ JIT コンパイラ SPIR-V GPU  AOT (Ahead Of Time) コンパイルの流れ (Intel GPU が対象) exe 開発環境 DPC++ ソース DPC++ コンパイラ AOT コンパイラ obj 実行環境 CPU Device binary GPU  詳細なフローはこちらを参照 18